Модуль 15. Модели рассуждения и вычисления во время инференса (test-time compute)
О чём этот модуль. До сих пор мы в основном улучшали модель до того, как пользователь отправит запрос: выбирали архитектуру, обучали базовую модель, проводили SFT и настраивали её по обратной связи. Теперь появляется другой способ управления. Уже обученной модели можно дать больше вычислений во время инференса: позволить ей построить более длинную траекторию, сгенерировать несколько независимых решений, проверить их или распределить бюджет между задачами разной сложности.
Эти способы часто объединяют выражением test-time compute, но они не эквивалентны. Длинная последовательная траектория увеличивает глубину одного поиска. Параллельная выборка увеличивает ширину и помогает, когда модель иногда попадает в правильный путь. Верификатор превращает набор кандидатов в процедуру отбора. Адаптивная политика решает, какой из этих ресурсов вообще стоит тратить на конкретный запрос.
В модуле мы разберём не только выигрыш в качестве, но и его физическую цену: секунды декодирования, FLOP, KV-память и падение параллелизма сервиса. Все численные оценки сервинга являются прозрачными учебными сценариями, а не универсальными характеристиками конкретного API.
Связь с другими курсами серии. Модуль самодостаточен. Более глубокий разбор обучения моделей рассуждению через RLVR, GRPO и проверяемые среды дан в курсе RL for LLM, прежде всего в модулях 9–10. Информационно-теоретический взгляд на ансамбли, неопределённость и ценность дополнительного наблюдения развивается в Information Theory for ML.
Как читать модуль
Первый проход. Прочитайте §§1–5, в §§6–7 проследите различие между наличием правильного ответа и его выбором, затем переходите к §§8–12 и §§15–17. В таблицах пока достаточно увидеть направление изменений. Завершите вопросами §18: вы должны уметь объяснить, кто генерирует кандидата, кто его проверяет и кто оплачивает дополнительную работу.
Второй проход. Выведите вероятности в §§6–7, пересчитайте время и память в §§10–12, выполните код §13 и ноутбук §14. Затем решите упражнения §19. Здесь важны уже точные правила ничьей, допущение независимости и разница между заданным лимитом и фактически выполненной работой.
Справочный проход. Для выбора API вернитесь к §§4 и 17; для выбора проверяющего сигнала — к §15. Эти разделы содержат датированный снимок интерфейсов, а не вечный рейтинг моделей.
Понадобятся условная вероятность, смысл KV-кэша из модуля 10 и различие SFT и обучения с подкреплением из модулей 13–14. RLVR — обучение с подкреплением на проверяемой награде: например, за правильный численный ответ или прохождение теста. В этом модуле проверяющий сигнал используется ещё и при инференсе, когда веса уже зафиксированы.
1. Мотивация: вторая ось масштабирования
Сначала договоримся о словах. Траектория — одна последовательность промежуточных действий и итогового ответа. Кандидат — результат одной попытки, который можно сравнить с другими. Верификатор проверяет кандидата или присваивает ему оценку; селектор по этим оценкам выбирает ответ. В процедуре best-of-N генерируют кандидатов и возвращают лучший по заранее заданному правилу. Правило может ошибаться, поэтому «лучший» здесь означает лучший по оценке, а не обязательно правильный.
Представим две модели. Первая заметно крупнее, но располагает только одной попыткой решения. Вторая меньше, зато получает право сделать несколько попыток, перепроверить промежуточные шаги и вызвать точный инструмент. Какая из них решит задачу лучше?
Ответ зависит от задачи, модели и способа потратить бюджет. Именно поэтому вычисления во время инференса полезно считать второй осью масштабирования, а не бесплатной надстройкой над размером модели. Первая ось — сколько вычислений мы вложили в обучение и насколько сильной стала сама политика. Вторая — сколько работы мы разрешаем ей выполнить для одного запроса после обучения.
У этой оси есть три базовых направления.
- Последовательная глубина. Модель продолжает одну траекторию: уточняет план, возвращается к ошибочному шагу, проводит дополнительные вычисления. Это тот случай, который обычно ассоциируют с «длинным рассуждением».
- Параллельная ширина. Мы генерируем несколько кандидатов — иногда одной моделью, иногда несколькими агентами — и затем объединяем или отбираем результаты.
- Адаптивное распределение. Лёгкий запрос получает короткий маршрут, а сложный — большой бюджет, дополнительные попытки или инструменты.
К этим трём направлениям добавляется сквозная проблема: кто решает, что результат хорош? Без правила отбора параллельная выборка даёт только множество текстов. Без критерия остановки последовательная траектория может стать длиннее, но не лучше.
Работа Snell и соавторов показала важный принцип: лучший способ потратить фиксированный бюджет зависит от трудности запроса. В их экспериментальных условиях адаптивное распределение вычислений было более чем в четыре раза эффективнее простого best-of-N, а меньшая модель на части задач превосходила по качеству модель в 14 раз крупнее при сопоставимом числе FLOP. Это не универсальный коэффициент, а демонстрация того, что политика распределения вычислений сама становится частью алгоритма. Snell et al., 2024
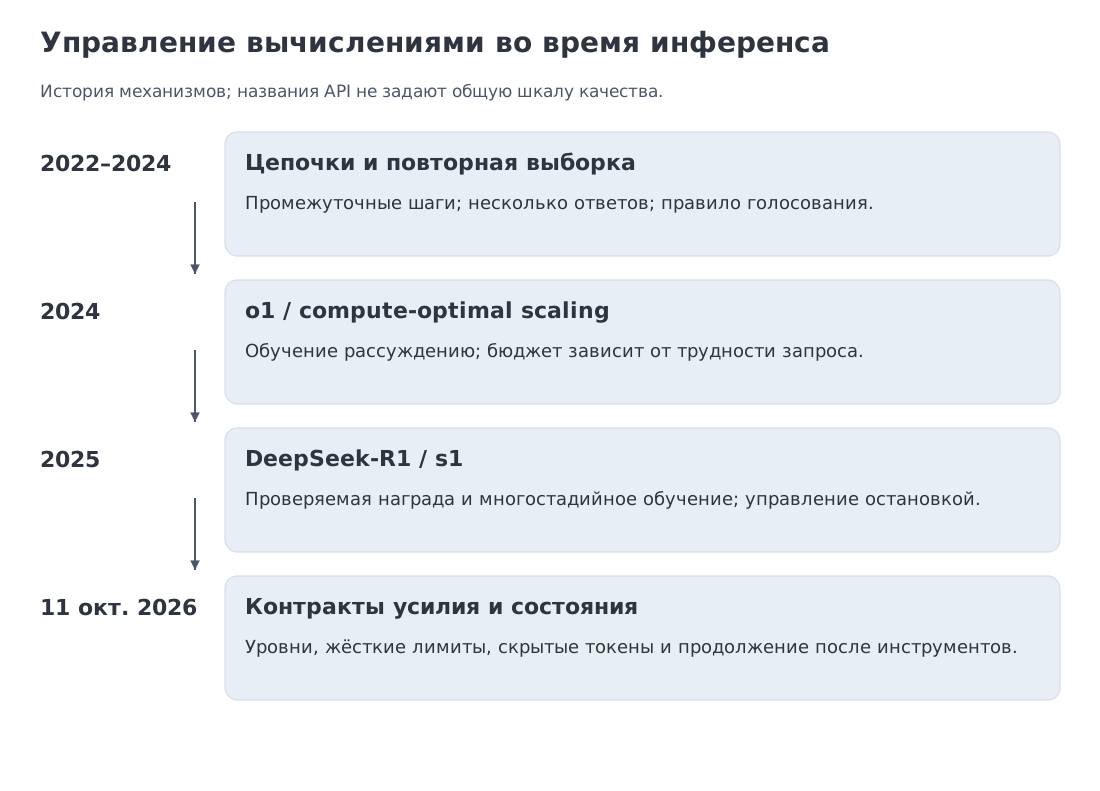 От появления публичных моделей рассуждения к управляемым и адаптивным режимам: o1, DeepSeek-R1, исследования test-time scaling и контракты API 2026 года.
2. Историческая дуга: от длинной цепочки к управлению бюджетом
Цепочки рассуждений существовали задолго до современных моделей рассуждения. Модель можно было попросить «думать пошагово», применить self-consistency или перебрать несколько решений. Новизна 2024–2026 годов состояла не в самом факте промежуточного текста, а в том, что обучение и интерфейс модели стали целенаправленно поддерживать масштабирование вычислений при инференсе.
В сентябре 2024 года OpenAI представила o1 и сообщила, что качество растёт как с увеличением RL-вычислений при обучении, так и с увеличением времени, потраченного на решение во время инференса. Публичный материал не раскрывал полный рецепт, но чётко сформулировал новую ось масштабирования. OpenAI, 2024
В январе 2025 года технический отчёт DeepSeek-R1 сделал механизм значительно прозрачнее. R1-Zero обучалась крупномасштабным RL на проверяемом сигнале без предварительного SFT и обнаружила поведения, похожие на самопроверку, возврат к предыдущим шагам и увеличение длины решения. Полная R1 добавила холодный старт и многостадийный рецепт, чтобы улучшить читаемость, устойчивость формата и общие способности. DeepSeek-R1, 2025
Следующий шаг — превратить «модель иногда думает дольше» в явный контракт. По состоянию на 11 октября 2026 года разные системы предлагают разные способы управления:
- GPT-6.1 Sol принимает уровни
low,medium(по умолчанию),high,xhighиmax. Значенияnoneиminimalэта модель не поддерживает. - Claude Opus 5.5 использует адаптивное рассуждение. Для этой модели нет ручного
budget_tokensи отключения рассуждения; уровень усилия и видимость промежуточного текста — отдельные настройки. - Gemini 3.8 Flash в Interactions API принимает
generation_config.thinking_levelсо значениямиlow,mediumиhigh; значение по умолчанию —medium. Название поля относится именно к этому API. - Kimi K3 всегда рассуждает;
reasoning_effortпринимаетlow,highиmax, по умолчаниюmax. - Inkling, по описанию разработчика, обучена управляемому уровню усилия. Это характеристика модели из сообщения о выпуске, а не общий контракт остальных API.
Эти интерфейсы нельзя сводить к общей шкале. high у двух поставщиков не означает одинаковое число токенов, время или алгоритм. Интерфейс сообщает, какой параметр управления доступен, но не раскрывает внутреннюю траекторию целиком. OpenAI API · Anthropic · Gemini API · Kimi K3 · Inkling
Главный исторический сдвиг поэтому можно сформулировать так: длина рассуждения перестала быть только свойством текста и стала управляемым ресурсом системы.
3. Мостик к классике: три знакомых предка
Современная терминология иногда создаёт впечатление, будто test-time compute возник вместе с моделями рассуждения. На самом деле его основные идеи хорошо знакомы из классического ИИ и статистики.
3.1. Алгоритмы с прерыванием (anytime algorithms)
Алгоритм с прерыванием (anytime algorithm) умеет выдать допустимый результат быстро, а затем улучшать его, пока есть время. Поиск в дереве, оптимизация маршрута, приближённое доказательство — естественные примеры. Модель рассуждения с регулируемым бюджетом стремится к тому же свойству: короткий режим должен дать приемлемый ответ, длинный — использовать дополнительное время продуктивно.
Наличие лимита токенов ещё не делает алгоритм пригодным для прерывания. Жёсткий обрыв может оставить незавершённое рассуждение или вообще не дать финального ответа. Для устойчивой процедуры полезно хранить лучший уже проверенный кандидат и возвращать его при исчерпании бюджета; очередная незавершённая попытка тогда не уничтожает предыдущий результат.
3.2. Ансамбли и повторная выборка
Если отдельная попытка имеет ненулевую вероятность успеха, несколько независимых попыток увеличивают вероятность, что правильный ответ появится в наборе. Это близко к ансамблям, bagging и повторным запускам стохастического поиска. Но появление правильного кандидата ещё не означает, что система сумеет его распознать.
3.3. Генерация с проверкой (generate-and-test)
Классическая схема «сгенерируй — проверь» разделяет поиск и проверку. Для кода проверкой могут служить тесты, для формального доказательства — ядро системы формальной проверки, для арифметики — точный вычислитель. Когда проверка надёжна и дёшева, масштабирование выборки особенно естественно: можно генерировать много решений и принимать только те, которые проходят внешний контракт.
Эти три предка подсказывают полезную карту:
- длинная траектория — это последовательный поиск;
- несколько кандидатов — стохастический ансамбль;
- верификатор — функция отбора или остановки;
- адаптивный бюджет — метаполитика, которая решает, какой поиск запускать.
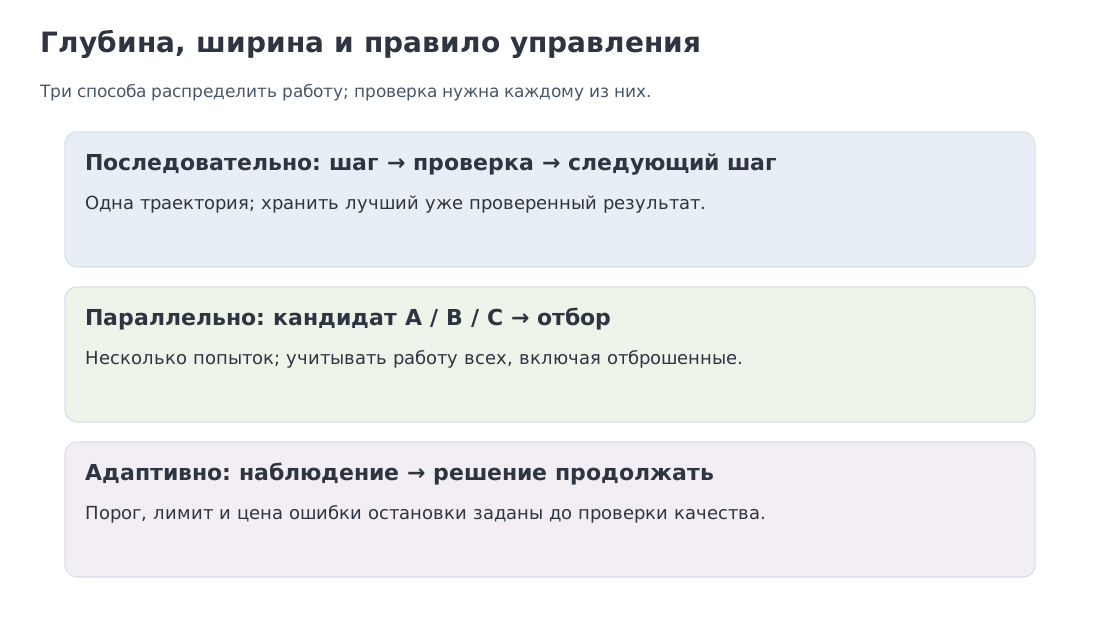 Три способа потратить вычисления: углубить одну траекторию, расширить набор кандидатов или адаптивно выбрать стратегию.
4. Анатомия модели рассуждения и карта режимов
Термин «модель рассуждения» удобен, но опасно буквальный. Генерируемая последовательность может помогать решению, однако она не обязана быть полным и верным отчётом о внутренних вычислениях модели. В этом модуле мы используем операционное определение:
Модель рассуждения — это модель, обученная и/или развёрнутая так, чтобы продуктивно использовать дополнительный вычислительный бюджет до финального ответа.
У такого решения есть несколько независимых слоёв.
Формат. Рассуждение может быть видимым, скрытым, кратко суммированным или представлено служебными блоками. Наличие <think> в шаблоне ещё не доказывает качество рассуждения; отсутствие видимого текста не означает отсутствия дополнительных вычислений.
Управление. Система может принимать фиксированный бюджет, категориальный уровень усилия, динамический режим или вообще не давать пользователю явного управления.
Планирование. Увеличить усилие одной модели и запустить несколько исполнителей — разные решения. Уровень max сам по себе не задаёт число параллельных кандидатов. Разработчик Muse Spark 1.1 описывает поддержку планирования и делегирования в агентных средах. Если выбранная среда запускает нескольких исполнителей, при оценке нужно учитывать их суммарную работу; из самого названия модели такая организация не следует. Muse Spark 1.1
Учёт токенов. Скрытые токены рассуждения могут учитываться в лимите и тарификации, хотя пользователь видит лишь итог или краткую сводку. В Gemini, например, полное число токенов рассуждения отражается в метаданных использования и участвует в цене ответа. Gemini API
Продолжение между ходами. Некоторые API возвращают подписи или служебные элементы, которые нужно передавать в следующем запросе. Это часть вычислительного состояния, а не декоративная метаинформация.
Поэтому сравнение моделей только по полю reasoning_effort почти бессодержательно. Нужны как минимум четыре координаты: глубина одной траектории, число параллельных траекторий, правило отбора и видимость/тарификация промежуточной работы.
5. Рецепт DeepSeek-R1 и феномен R1-Zero
DeepSeek-R1 важна не только результатами, но и тем, что её отчёт позволяет разложить «обучение рассуждению» на несколько различимых механизмов.
R1-Zero: что может возникнуть из RL
Точка старта — предварительно обученная DeepSeek-V3-Base. «Без предварительного SFT» относится к этапу обучения рассуждению: языковые знания и представления уже получены на предобучении. Поэтому эксперимент не следует читать как обучение языковой модели с нуля одной лишь наградой.
R1-Zero начинала без предварительного SFT, специально обучающего формат длинных решений. Политика получала проверяемую награду за корректность и соблюдение формата. В ходе RL увеличивалась средняя длина ответов и появлялись приёмы самопроверки, пересмотра и поиска альтернативного пути.
Сильный вывод здесь не в том, что модель «обрела человеческое мышление». Эксперимент показывает более узкое и более интересное: при подходящем пространстве задач и проверяемой награде политика может сама обнаружить полезные вычислительные стратегии, выраженные в последовательности токенов.
Цена чистого эксперимента была заметна: смешение языков, неудобный формат и плохая читаемость. Эти дефекты важны, потому что дообучение оптимизирует не только вероятность правильного ответа, но и интерфейс модели для человека.
Полная R1: многостадийный рецепт
Полная DeepSeek-R1 добавляет:
- небольшой холодный SFT-старт с читаемыми примерами рассуждений;
- RL на задачах рассуждения;
- сбор успешных траекторий из RL-модели; новое SFT-обучение DeepSeek-V3-Base на этих траекториях и общих данных;
- дополнительный RL для полезности, безопасности и следования инструкциям.
Такой рецепт показывает, почему противопоставление «SFT или RL» часто ошибочно. SFT задаёт язык и форму поведения, RL исследует пространство решений под наградой, повторный отбор превращает найденные траектории в данные, а общий этап возвращает модели широкий контракт диалогового поведения.
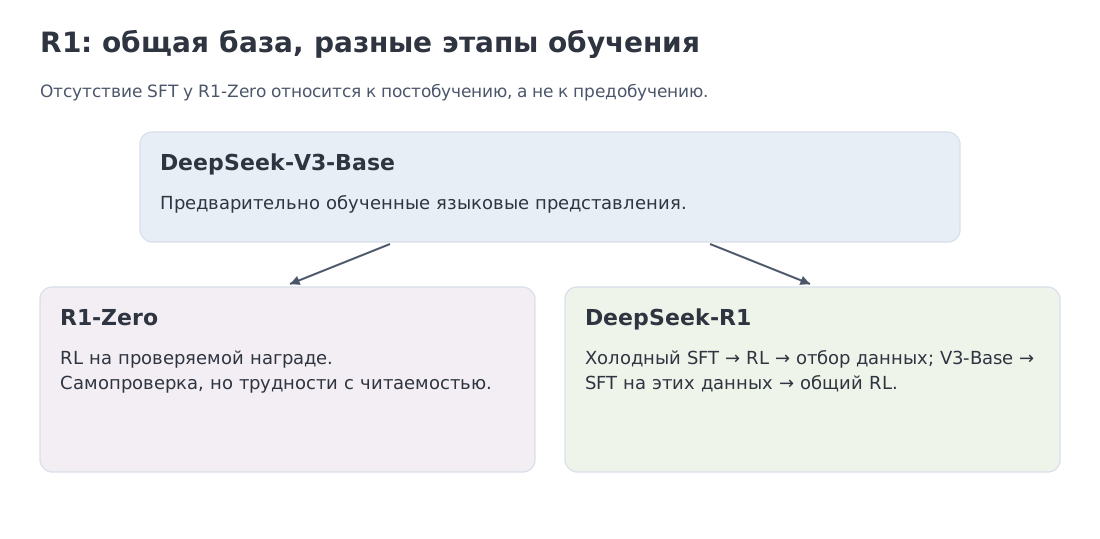 R1-Zero как чистый RL-эксперимент и полный многостадийный рецепт DeepSeek-R1.
6. Параллельное масштабирование: решённый пример A — сюрприз голосования
Начнём с простой модели. Одна попытка правильна с вероятностью
Если ответ неверен, он равновероятно попадает в один из шести разных дистракторов. Мы генерируем независимых кандидатов и выбираем самый частый нормализованный ответ.
На первый взгляд кажется, что больше попыток обязаны помочь. Но алгоритм ещё не определён полностью: что делать при ничьей? В учебном контракте рассматриваются две политики.
- Ничья считается провалом. Успех возможен только тогда, когда правильный ответ образует уникальную моду.
- Случайный выбор среди мод. Если несколько ответов делят первое место, выбираем одну моду равновероятно.
Здесь дистрактор — один из неверных вариантов ответа, а мода — наиболее частый вариант. Это голосование по относительному большинству (plurality): победителю не обязательно набрать больше половины голосов. Введём , число появлений варианта . Индекс обозначает правильный ответ; , а . Для независимых попыток вероятность одного набора счётчиков равна
Множитель с факториалами считает, сколько порядков появления ответов дают те же счётчики. Для строгой политики суммируем эту вероятность по наборам, где . Для случайного разрешения ничьей добавляем наборы, где правильный ответ делит первое место, с весом : — число вариантов на первом месте.
При правильный ответ является единственной модой ровно тогда, когда он появился два или три раза. Поэтому результат можно проверить без перебора: . Это отдельный случай, в котором относительное и абсолютное большинство совпадают; при большем такое совпадение уже не гарантировано.
Точный перебор мультиномиальных исходов даёт:
| уникальная мода | случайное разрешение ничьей | |
|---|---|---|
| 1 | 0.400 | 0.400 |
| 3 | 0.352 | 0.472 |
| 5 | 0.509 | 0.596 |
| 9 | 0.671 | 0.737 |
| 17 | 0.857 | 0.889 |
При вероятность ничьей на первом месте равна 0.48. Поэтому строгая политика «ничья = провал» делает три попытки хуже одной. Причина снижения — выбранное правило: оно отвергает все ничьи, в том числе наборы, где правильный ответ присутствует среди мод.
Этот пример важен далеко за пределами игрушечной модели. Для self-consistency нужно явно фиксировать:
- как нормализуются числовые и текстовые ответы;
- считаются ли эквивалентными
1/2,0.5и50%; - что происходит при ничьей;
- насколько независимы выборки;
- применяется ли вес по уверенности или качеству траектории.
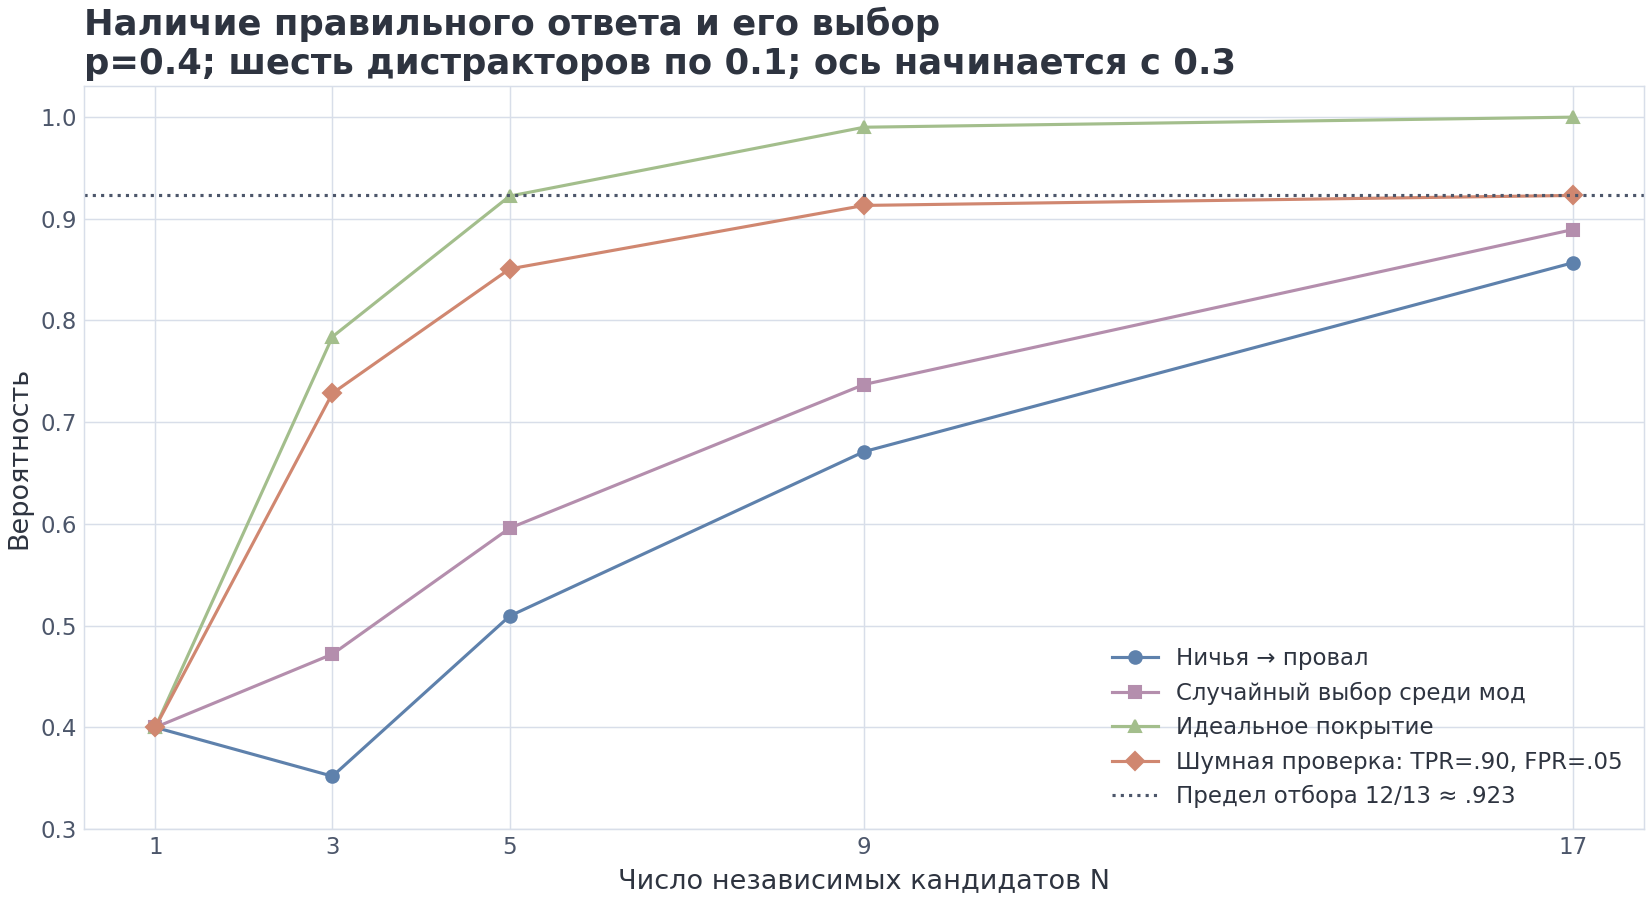 Точная вероятность успеха голосования при разных правилах ничьей, покрытие правильного ответа и отбор шумным верификатором.
Работа Large Language Monkeys показывает, что повторная выборка действительно увеличивает покрытие на много порядков числа попыток. Но в задачах без автоматической проверки большинство и модели награды могут выходить на плато: генерация нашла больше решений, а отбор не научился надёжно распознавать лучшие. Brown et al., 2024
7. Решённый пример B: верификатор вместо голосования
Голосование использует только частоту. Если правильные решения разнообразны, а одна типичная ошибка повторяется почти дословно, большинство легко выберет ошибку. Верификатор пытается оценивать кандидатов по содержанию.
Сначала отделим покрытие от точности отбора. Если каждая независимая попытка правильна с вероятностью , вероятность того, что среди кандидатов есть хотя бы один правильный, равна
Для :
| покрытие правильного ответа | |
|---|---|
| 1 | 0.400 |
| 3 | 0.784 |
| 5 | 0.922 |
| 9 | 0.990 |
| 17 | 0.9998 |
Это верхняя граница процедуры отбора. Идеальный проверяющий модуль сможет найти правильный ответ, если тот присутствует. Реальный верификатор ошибается.
В учебном сценарии вероятность принятия правильного кандидата — TPR (true-positive rate) — равна 0.90. Вероятность принятия неверного — FPR (false-positive rate) — равна 0.05. Проверки независимы между кандидатами при заданной корректности. Среди принятых выбирается случайный кандидат; если не принят никто, система случайно выбирает из всего исходного набора. Для этого конкретного правила получаем:
| шумный верификатор | |
|---|---|
| 1 | 0.400 |
| 3 | 0.728 |
| 5 | 0.851 |
| 9 | 0.913 |
| 17 | 0.923 |
Почему предел близок к 0.923, а не к 0.90? Обозначим вероятность принятия произвольного кандидата через , а долю правильных среди принятых — через :
Для точность описанного правила отбора имеет замкнутую форму
Чтобы прочитать её, заметим: при наличии принятых кандидатов случайный выбранный имеет вероятность корректности . Если все отклонены, вероятность корректности случайного отклонённого кандидата равна . Взвешивание этих двух случаев даёт формулу выше; граничные случаи читаются непосредственно, а при проверка никого не принимает и .
В нашем примере и . При получаем , при большом — . TPR отвечает на вопрос «как часто принимают правильное», а — «как часто принятое правильно». Это разные условные вероятности.
При заданных постоянных TPR и FPR и TPR > FPR эта кривая монотонно растёт. Ухудшение отбора при расширении поиска требует другого механизма: например, ранжирования по экстремальной шумной оценке или поиска решений, специально эксплуатирующих слабость проверяющего модуля. Последний случай родственен оптимизации ошибочной награды из модуля 14.
Независимость тоже содержательное допущение. При полностью совпадающих ошибках повторение не повышает покрытие вообще. Даже независимость внутри одной задачи не разрешает подставлять среднюю по задачам вероятность в . Если половина задач имеет , а половина — , средняя , но покрытие при трёх попытках равно , а не . Сложность задачи остаётся общей причиной успеха всех попыток.
Практический порядок выбора проверяющего сигнала таков:
- точная программа или формальный проверяющий модуль;
- детерминированные тесты и ограничения;
- специализированная модель процесса или результата;
- общая модель-судья с явной рубрикой;
- голосование, когда более сильного сигнала нет.
Нельзя просить LLM-судью «заменить» компилятор или формальный проверяющий модуль там, где точная проверка уже доступна.
8. Последовательное масштабирование и budget forcing
Параллельная выборка запускает несколько траекторий. Последовательное масштабирование пытается улучшить одну: продолжить вычисление, заставить модель перепроверить себя или остановить слишком длинный поиск.
Работа s1: Simple Test-Time Scaling дала особенно ясный эксперимент. Авторы отобрали всего 1000 сложных, разнообразных и качественных примеров рассуждений, дообучили Qwen2.5-32B-Instruct и применили принудительное управление бюджетом (budget forcing):
- чтобы удлинить траекторию, при попытке закончить рассуждение добавляли слово
Waitи разрешали продолжить; - чтобы сократить траекторию, принудительно переходили к финальному ответу.
На AIME 2024 увеличение бюджета этим способом подняло сообщённый авторами результат s1-32B с 50% до 57%. Это результат конкретной модели и протокола, а не обещание монотонного улучшения для любой задачи. Muennighoff et al., 2025
Механизм интересен тем, что не требует нового обновления весов во время запроса. Мы меняем траекторию декодирования. Но отсюда не следует, что вставка Wait создаёт новые знания. Она полезна, если модель уже располагает подходящими операциями и ей не хватило времени применить их.
Последовательный бюджет можно тратить по-разному:
- продолжать одну цепочку;
- периодически просить модель сформулировать проверку;
- возвращаться к последней сомнительной развилке;
- чередовать планирование и исполнение;
- завершать раньше, когда получен достаточный сигнал уверенности.
Последний пункт особенно важен: масштабирование должно уметь не только добавлять вычисления, но и не тратить их без нужды.
9. Когда думать дольше — хуже
Интуитивная история «больше вычислений → выше качество» неполна. Увеличение бюджета создаёт по меньшей мере четыре риска.
9.1. Уход с правильного пути
Модель может быстро найти корректный ответ, затем начать сомневаться и заменить его ошибочным. В литературе это называют overthinking. Эффект не означает, что длинные траектории всегда вредны; он означает, что зависимость качества от длины может быть немонотонной и различаться по трудности задачи. Hassid et al., 2025; v2 2026
Здесь важно различать наблюдение и причинный эффект. Длинные ответы могут чаще ошибаться потому, что сами задачи труднее. Даже сравнение разных траекторий одного запроса ещё не равно случайному назначению бюджета: длину выбирает и сама модель. Для проверки пользы дополнительных вычислений задайте несколько бюджетов на одних и тех же запросах, повторите выборку и сравните качество при фиксированном протоколе отбора.
9.2. Повторение без нового состояния
Дополнительные токены могут лишь перефразировать ту же гипотезу. Вычисления потрачены, но пространство поиска не расширилось.
9.3. Накопление локальной ошибки
Ошибочный промежуточный факт попадает в контекст и становится предпосылкой для следующих шагов. Длинная связная цепочка может выглядеть убедительнее короткой, хотя основана на ранней ошибке.
9.4. Эксплуатация проверяющего сигнала
Если модель знает типичные слабости верификатора, дополнительный поиск может улучшать оценку, а не истинность. Внешняя проверка полезна только в той мере, в какой её сигнал соответствует задаче.
Учебная иллюстрация в Jupyter-ноутбуке показывает немонотонность: на синтетическом наборе сложные задачи улучшаются с бюджетом, а простые после некоторого уровня начинают ухудшаться. Это модель механизма, не эмпирический результат измерения.
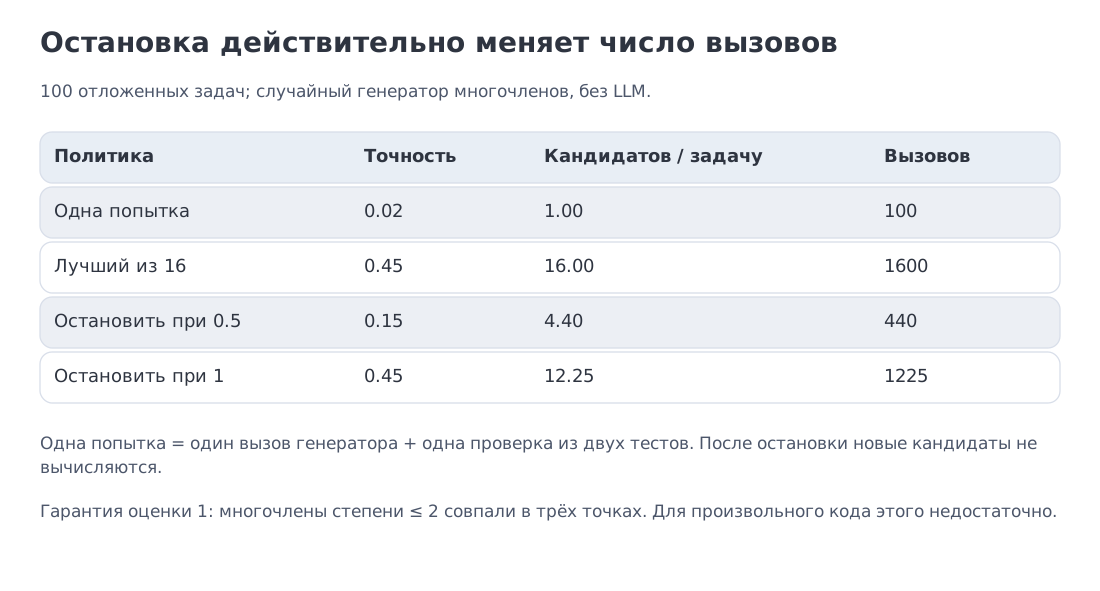 Случайный поиск исполняемых многочленов: фактические вызовы и цена двух правил остановки; подробности в §14.
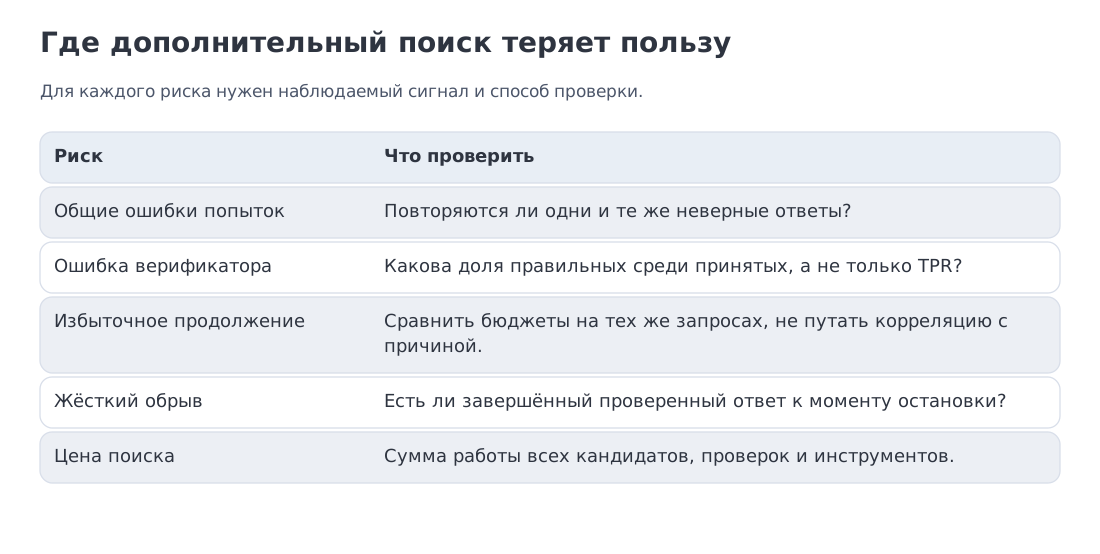 Наблюдаемые причины неудачи поиска: общие ошибки, слабая проверка, лишнее продолжение, обрыв ответа и стоимость.
10. Решённый пример C: учебная лестница бюджета в секундах и FLOP
Теперь переведём абстрактный «уровень усилия» в физические величины. Важно: следующая лестница не повторяет квоты какого-либо поставщика. Это учебный сценарий, который помогает увидеть порядок затрат.
Примем:
- плотная модель с параметров;
- скорость последовательного декодирования 209.4 токена/с — фиксированное допущение курса;
- обычный короткий ответ с рассуждением — 512 токенов;
- четыре условных бюджета: 1K, 4K, 16K и 64K токенов.
Приближённая работа матричных умножений с весами плотной модели:
где — число сгенерированных токенов. Латентность без пакетной обработки:
| учебный уровень | токены | время | FLOP в умножениях с весами | относительно 512 токенов |
|---|---|---|---|---|
| короткий базовый | 512 | 2.45 с | 1× | |
| малый | 1 000 | 4.78 с | 1.95× | |
| средний | 4 000 | 19.10 с | 7.81× | |
| большой | 16 000 | 76.41 с | 31.25× | |
| очень большой | 64 000 | 305.64 с | 125× |
Коэффициент 2 считает умножение и сложение как две операции. Приближение удобно, когда в работе преобладают матричные умножения с весами. Оно не включает полную обработку запроса, произведения attention по растущему контексту, обращения к инструментам и проверку кандидатов. Даже число задействованных параметров зависит от архитектуры; для MoE нельзя механически подставлять все хранимые параметры.
Линейное время в таблице следует из принятой постоянной скорости 209.4 токена/с. В реальном сервисе скорость зависит от длины контекста, размера пакета и нагрузки, а к декодированию добавляются очередь и обработка входа. При нескольких кандидатах нужно учитывать работу всех попыток, включая отброшенные. Таблица позволяет понять масштаб расходов: пять секунд ещё могут быть интерактивными, пять минут требуют другого сценария использования.
Если принудительное управление бюджетом увеличивает траекторию с 2K до 8K токенов, дополнительные 6K при принятой скорости дают
Формула не говорит, оправдан ли этот расход. Это должен решить прирост качества на целевом распределении задач.
11. Решённый пример D: KV-цена мысли
Длинное рассуждение стоит не только матричных операций. Рассмотрим декодер с полным вниманием и сохранением всей истории: в этой модели каждый новый токен добавляет ключи и значения во всех слоях внимания.
В учебном сценарии:
- 32 слоя;
- ширина KV на слой ;
- bf16, то есть 2 байта на элемент;
- отдельно хранятся K и V.
Тогда KV-память на токен:
Отсюда:
| токены рассуждения | KV на запрос |
|---|---|
| 512 | 0.0625 GiB |
| 1K | 0.122 GiB |
| 4K | 0.488 GiB |
| 16K | 1.953 GiB |
| 64K | 7.8125 GiB |
Таблица считает только KV новых токенов при полном сохранении истории во всех 32 слоях. Если запрос содержит токенов, полный объём равен KiB. Например, и дают GiB вместо GiB для одного продолжения. В оконных и гибридных архитектурах формулу нужно составлять по слоям; при совместном использовании префикса несколькими кандидатами часть памяти может быть общей.
Следующие границы используют нулевой входной префикс и учебное устройство с доступной ёмкостью 80 GiB. Это явно заданная ёмкость, а не перевод любой маркетинговой маркировки «80 GB».
Для модели 8.03B в bf16 веса занимают примерно 14.96 GiB. Если взять карту 80 GiB и наивно отдать всё остальное только под KV, получим верхнюю границу числа одновременных запросов:
| токены | верхняя граница только по KV-памяти |
|---|---|
| 512 | 1040 |
| 1K | 532 |
| 4K | 133 |
| 16K | 33 |
| 64K | 8 |
Это не прогноз реальной пропускной способности. Оценка не учитывает активации, служебную память, фрагментацию, планировщик, размер пакета и резерв исполнения. Если оставить 8 GiB резерва, границы снижаются до 467, 116, 29 и 7 для четырёх уровней 1K–64K.
Но порядок величины показывает главное: 64K токенов рассуждения уменьшают KV-ограниченный параллелизм примерно в 130 раз относительно 512 токенов. Поэтому PagedAttention, выгрузка KV, квантизация и многоуровневое хранение из модуля 10 особенно важны именно для нагрузок с длинным рассуждением.
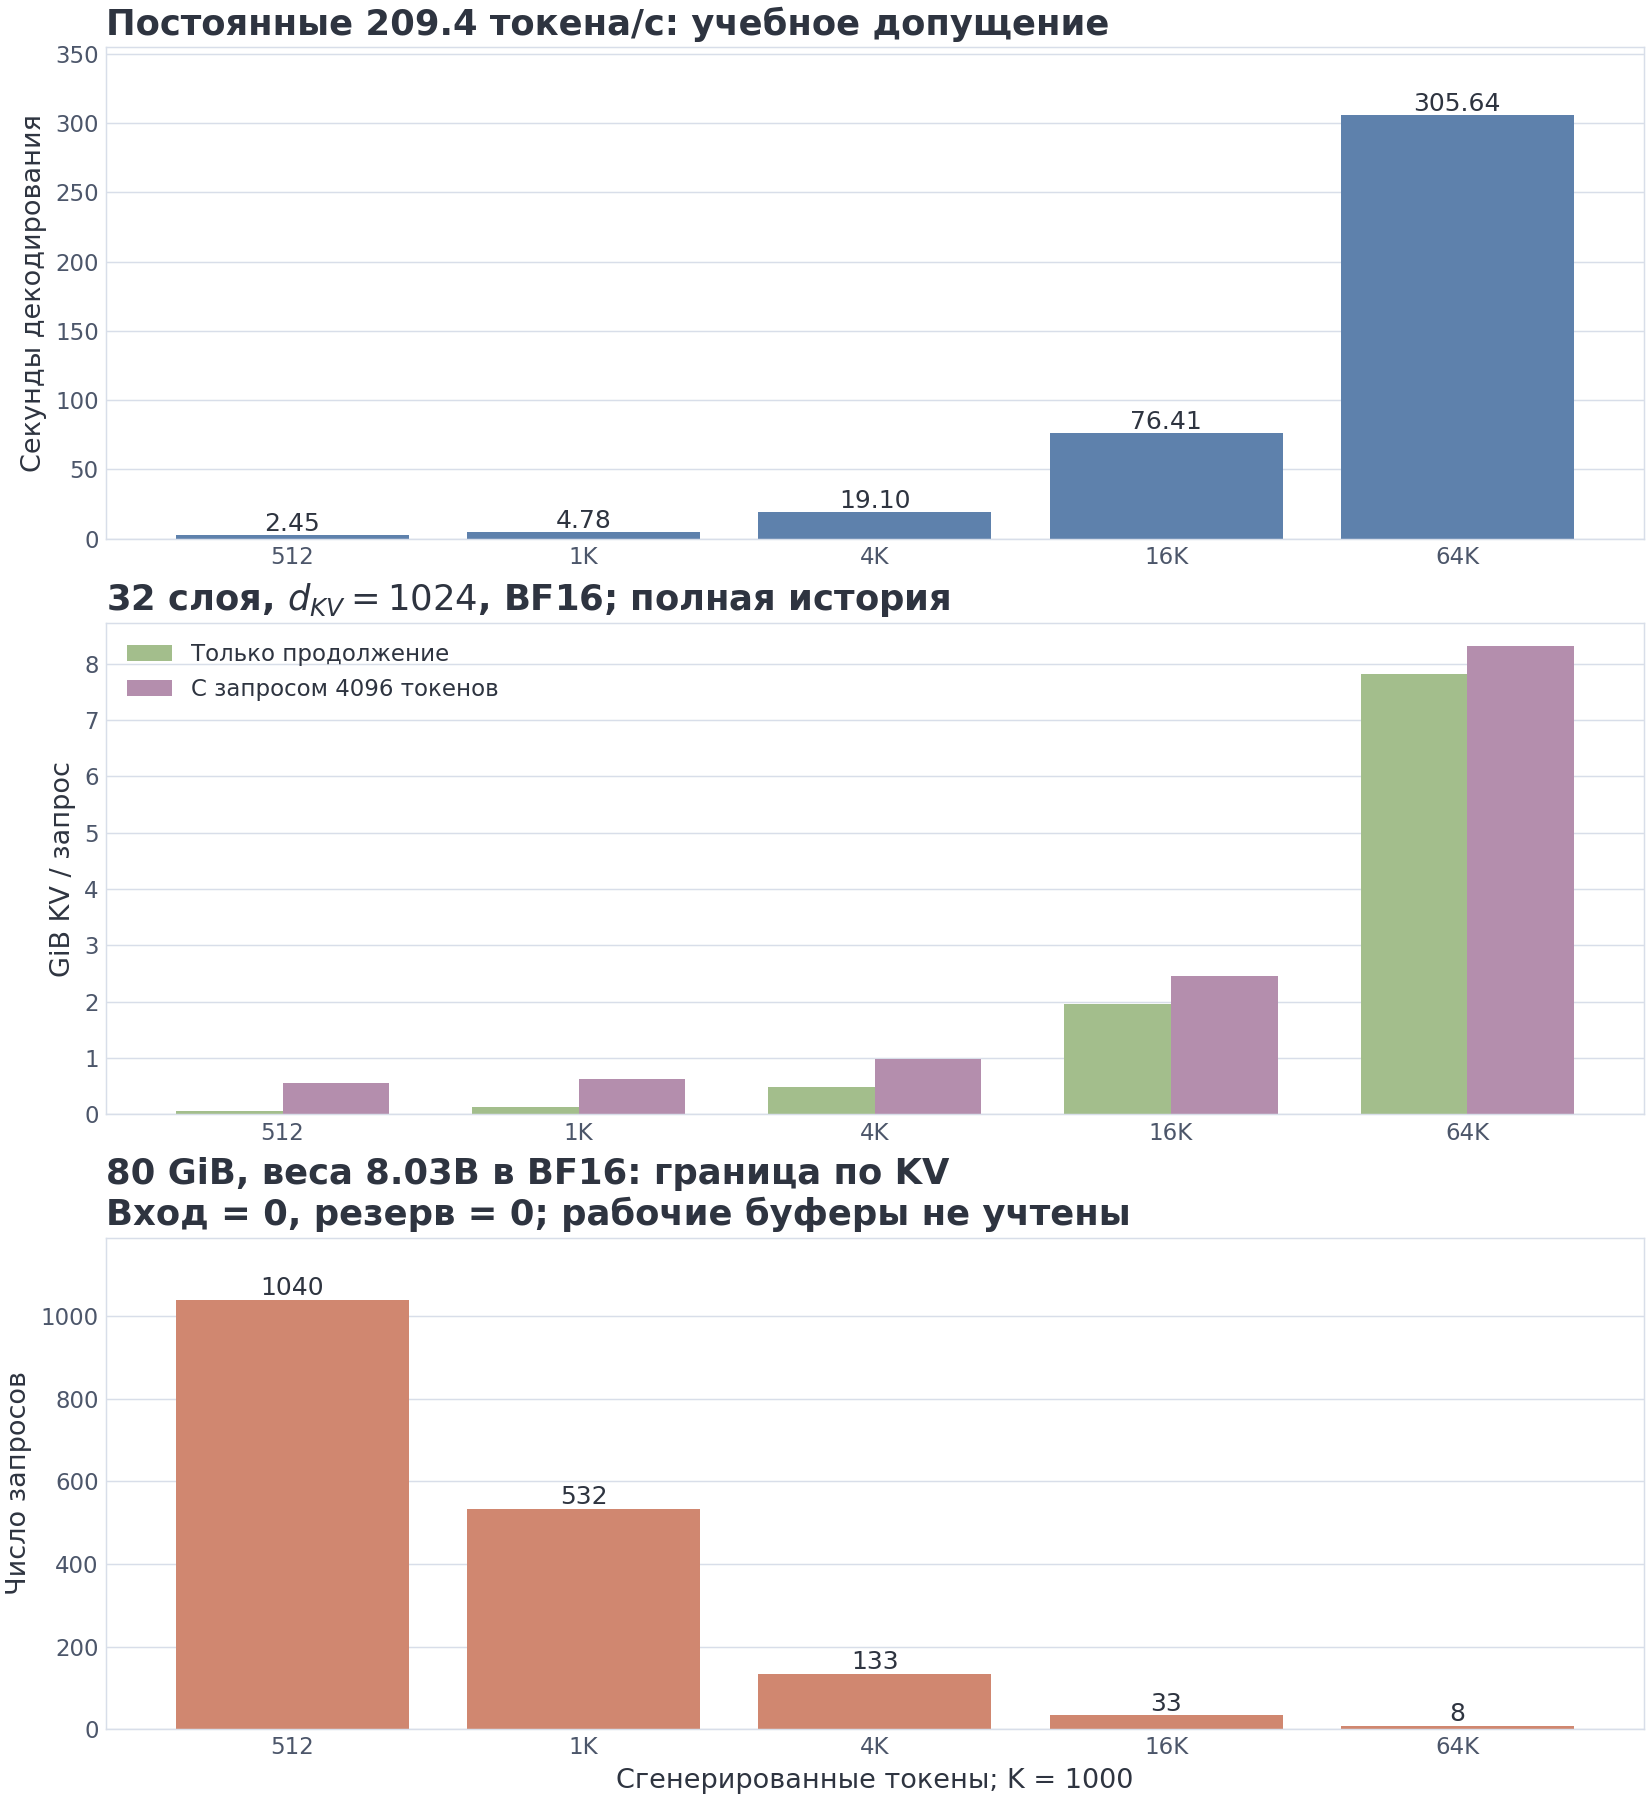 Учебная модель времени декодирования, KV с входным запросом и без него, а также граница числа запросов только по KV.
12. Решённый пример E: зачем нужен адаптивный бюджет
Предположим, поток запросов состоит из трёх классов:
- 70% простых задач, которым достаточно 500 токенов;
- 20% средних, которым требуется 4000;
- 10% сложных, которым нужен бюджет 32000.
Предположим, что каждый назначенный бюджет расходуется целиком, а политика безошибочно распознаёт класс задачи. Тогда единый бюджет даёт средний расход 32000 токенов, а адаптивное распределение —
Экономия относительно единого максимального бюджета:
Это арифметика смеси при двух сильных допущениях: маршрутизатор безошибочно знает класс запроса, а назначенный бюджет расходуется целиком. Верхний лимит сам по себе не равен потреблению: модель может закончить раньше и при лимите 32000. Для реального выигрыша сравнивают фактически потраченные токены и качество, включая цену определения класса.
Как определить класс задачи? Есть несколько вариантов.
- дешёвый классификатор сложности до генерации;
- начальный короткий ответ и оценка уверенности;
- последовательная генерация кандидатов до пересечения порога верификатора;
- согласие нескольких независимых попыток;
- сигналы среды: прошли ли тесты, завершилось ли доказательство, достигнута ли цель.
В первой симуляции ноутбука все кандидаты и оценки сначала вычислены в массиве. Затем мы моделируем, сколько из них просмотрела бы политика: остановка при оценке не ниже 0.82 или после 16 попыток. На фиксированной смеси получаются 4.02 просмотренного кандидата и точность 0.886 против 0.632 у одной попытки. Отбор лучшего из всех 16 даёт 0.940. Это сравнение правил на общих данных; сама векторизованная симуляция не сэкономила вызовы генератора.
Поэтому далее идёт отдельный исполняемый поиск программ: генератор вызывается внутри цикла и после остановки действительно больше не работает. Его устройство описано в §14. Порог или бюджет следует выбирать на отдельной калибровочной выборке, а качество готовой политики оценивать на отложенных задачах. Подбор порога по итоговым правильным ответам сделал бы сравнение оптимистичным.
Адаптивность — не магическая способность модели «знать, сколько думать». Это политика принятия решения под шумным сигналом. Её нужно оценивать вместе с ошибками маршрутизации: простая задача может быть ошибочно отправлена в дорогой режим, а трудная — остановлена слишком рано.
13. Код, уровень 1: точный контракт отбора и цена токенов
Первый фрагмент отделяет покрытие от качества выбора.
"""Coverage, noisy selection and scoped inference accounting."""
import math
from dataclasses import dataclass

def positive_count(value, name):
    if isinstance(value, bool) or not isinstance(value, int) or value <= 0:
        raise ValueError(name + " must be a positive integer")

def probability(value, name):
    if not math.isfinite(value) or not 0 <= value <= 1:
        raise ValueError(name + " must be finite and lie in [0, 1]")

def oracle_coverage(p_correct, n):
    """At least one success in n independent, identically distributed attempts."""
    positive_count(n, "n")
    probability(p_correct, "p_correct")
    if p_correct == 1:
        return 1.0
    return -math.expm1(n * math.log1p(-p_correct))

def noisy_selection(p, n, tpr, fpr):
    """Uniform accepted candidate; uniform pool fallback if none are accepted."""
    positive_count(n, "n")
    for name, value in (("p", p), ("tpr", tpr), ("fpr", fpr)):
        probability(value, name)
    acceptance = p*tpr + (1-p)*fpr
    if acceptance == 0 or n == 1:
        return p
    precision = p*tpr/acceptance
    if acceptance == 1:
        return precision
    log_survival = (n-1)*math.log1p(-acceptance)
    # A non-negative mixture avoids cancellation for tiny probabilities.
    return p*math.exp(log_survival) + precision*(-math.expm1(log_survival))

@dataclass(frozen=True)
class ReasoningCost:
    parameters: float = 8.03e9
    tokens_per_second: float = 209.4
    layers: int = 32
    kv_width: int = 1024
    bytes_per_element: int = 2

    def __post_init__(self):
        for name in ("parameters", "tokens_per_second"):
            value = getattr(self, name)
            if not math.isfinite(value) or value <= 0:
                raise ValueError(name + " must be finite and positive")
        for name in ("layers", "kv_width", "bytes_per_element"):
            positive_count(getattr(self, name), name)

    @property
    def kv_bytes_per_token(self):
        return 2*self.layers*self.kv_width*self.bytes_per_element

    def estimate(self, tokens, prompt_tokens=0):
        positive_count(tokens, "tokens")
        if isinstance(prompt_tokens, bool) or not isinstance(prompt_tokens, int) or prompt_tokens < 0:
            raise ValueError("prompt_tokens must be a non-negative integer")
        return dict(decode_seconds=tokens/self.tokens_per_second,
                    parameter_matmul_flops=2*self.parameters*tokens,
                    generated_kv_gib=self.kv_bytes_per_token*tokens/2**30,
                    total_kv_gib=self.kv_bytes_per_token*(tokens+prompt_tokens)/2**30)

scenario = ReasoningCost()
assert abs(noisy_selection(.4, 17, .9, .05)-.923)<.001
assert oracle_coverage(1e-18, 1) > 0  # direct 1-(1-p)**n loses this value
assert noisy_selection(1e-18, 1, 1, 0) == 1e-18
assert math.isclose(noisy_selection(1e-18, 2, 1, 0), 2e-18, rel_tol=1e-15)
Логарифмическая запись покрытия сохраняет точность даже при очень малом . Например, прямое 1-(1-p)**n в стандартной арифметике может дать ноль для и , хотя вероятность положительна. Функция отбора реализует ту же замкнутую формулу, что и §7. Число попыток и размеры должны быть целыми: значение True не считается допустимым бюджетом.
В модели стоимости разделены KV новых токенов и полный KV с учётом запроса. Поле parameter_matmul_flops считает приближённую работу матричных умножений с весами; decode_seconds использует заданную постоянную скорость. Эти поля не являются измерением полного запуска.
15. Кто проверяет решение: от точного правила до верификатора рассуждений
Верификаторы удобно рассматривать не как линейную лестницу «старое → новое», а как семейства с разными контрактами.
15.1. Точные проверяющие модули
Компилятор, модульные тесты, символьная алгебра, формальный проверяющий модуль и симулятор среды дают наиболее сильный сигнал, когда задача действительно формализуема. Они могут быть неполными — тесты не покрывают все случаи, — но их семантика обычно прозрачнее, чем у модели-судьи.
15.2. Модель вознаграждения за итог (Outcome Reward Model, ORM)
Модель результата оценивает решение целиком. Разметка сравнительно дешева, но сигнал трудно локализовать: низкая оценка не говорит, на каком шаге возникла ошибка.
15.3. Модель вознаграждения за процесс (Process Reward Model, PRM)
PRM оценивает промежуточные шаги. В Let's Verify Step by Step был опубликован PRM800K — набор из 800 тысяч пошаговых человеческих меток; в условиях работы надзор за процессом (process supervision) превосходил надзор только за итогом (outcome supervision) на исследованном математическом наборе. Пошаговый сигнал помогает вести поиск и раньше отсекать ошибочные ветви. В этом исследовании его получение требовало человеческой разметки математических решений. Lightman et al., 2023
Однако ручная разметка не входит в определение PRM. Например, Math-Shepherd строит пошаговые обучающие метки автоматически. Меняется источник сигнала, но остаётся необходимость проверить, насколько метки отражают корректность шагов и переносятся на новые задачи. Wang et al., 2024
15.4. Генеративный верификатор (Generative Verifier)
GenRM формулирует проверку как предсказание следующего токена (next-token prediction): модель может написать разбор, а вероятность токена Yes/No становится численным сигналом. Это позволяет использовать цепочку рассуждения и повторную выборку уже внутри проверяющей модели. В опубликованных экспериментах подход улучшал Best-of-N относительно ряда дискриминативных базовых линий; вывод относится к протоколам работы, а не ко всем задачам. Zhang et al., 2024
15.5. Модель вознаграждения с рассуждением (Reasoning Reward Model)
RM-R1 рассматривает оценивание как самостоятельную задачу рассуждения. Модель строит рубрику или разбор, а затем выдаёт вердикт; рецепт включает дистилляцию качественных цепочек рассуждения и RLVR. Это исследовательское семейство, а не обязательный стандарт архитектуры верификатора. Chen et al., 2025
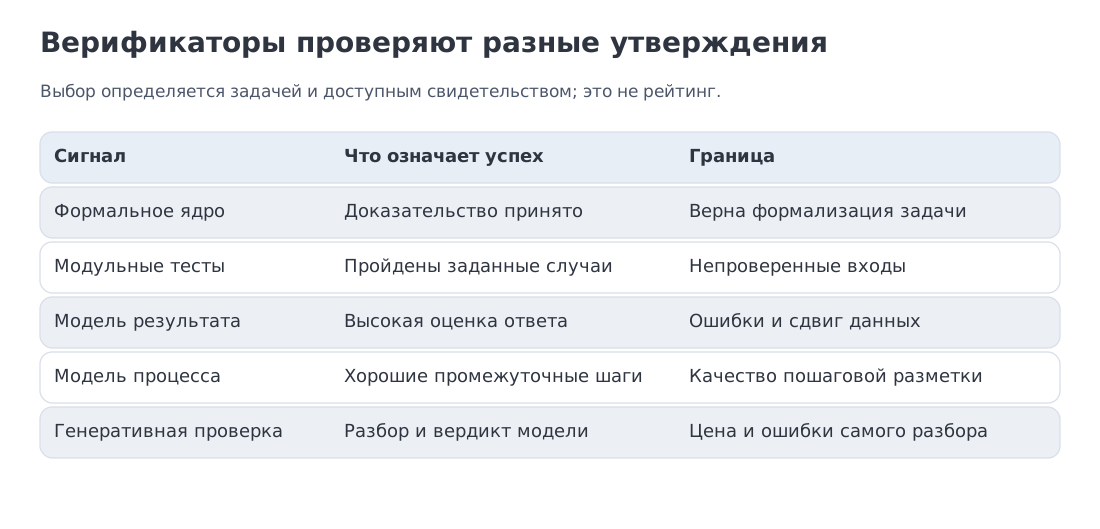 Семейства проверяющего сигнала: точные правила, модели результата и процесса, генеративные и верификаторы с рассуждением.
Для проверяемых задач RL для моделей рассуждения получает особенно чистый сигнал. Для творческого текста или субъективного совета единственного правильного ответа нет; там верификатор кодирует предпочтение, рубрику и риск, а не математическую истину.
16. Дистилляция рассуждений: что переносится, а что нет
DeepSeek опубликовала шесть плотных моделей R1-Distill размером от 1.5B до 70B, обученных на данных, сгенерированных R1. Этот результат сделал видимой важную практическую возможность: длинные успешные траектории рассуждения сильной модели можно превратить в SFT-данные для меньшей модели. DeepSeek-R1, 2025
Что получает ученик?
- формат разложения задачи;
- типичные промежуточные операции;
- приёмы проверки и исправления;
- распределение длины и стиля решения;
- часть доменных эвристик, присутствующих в трассах.
Дистилляция обновляет веса ученика: данные могут научить его новым знаниям, представлениям и процедурам. Поэтому исходная базовая модель не задаёт неизменный потолок после обучения. При этом наблюдаемые траектории не копируют параметры учителя и не гарантируют перенос всей его способности. Результат зависит от ёмкости ученика, качества и разнообразия данных, цели обучения и распределения проверки.
Полезно сравнить это с §8. Удлинение генерации при фиксированных весах меняет работу на одном запросе. Дистилляция меняет саму функцию, которую модель применяет к будущим запросам. Обоим механизмам нужны проверяемые результаты, но они используют вычисления на разных этапах.
Полезно различать три уровня переноса:
- формат — модель научилась выдавать структурированную цепочку;
- алгоритмические шаблоны — научилась применять типичные процедуры;
- обобщение за пределы данных — проверяется на новых семействах задач; зависит от ёмкости модели, данных и цели обучения.
Поэтому «дистиллированная модель рассуждения» не означает «маленькая копия учителя на всех распределениях». Её нужно оценивать по качеству, длине, стоимости и устойчивости отдельно.
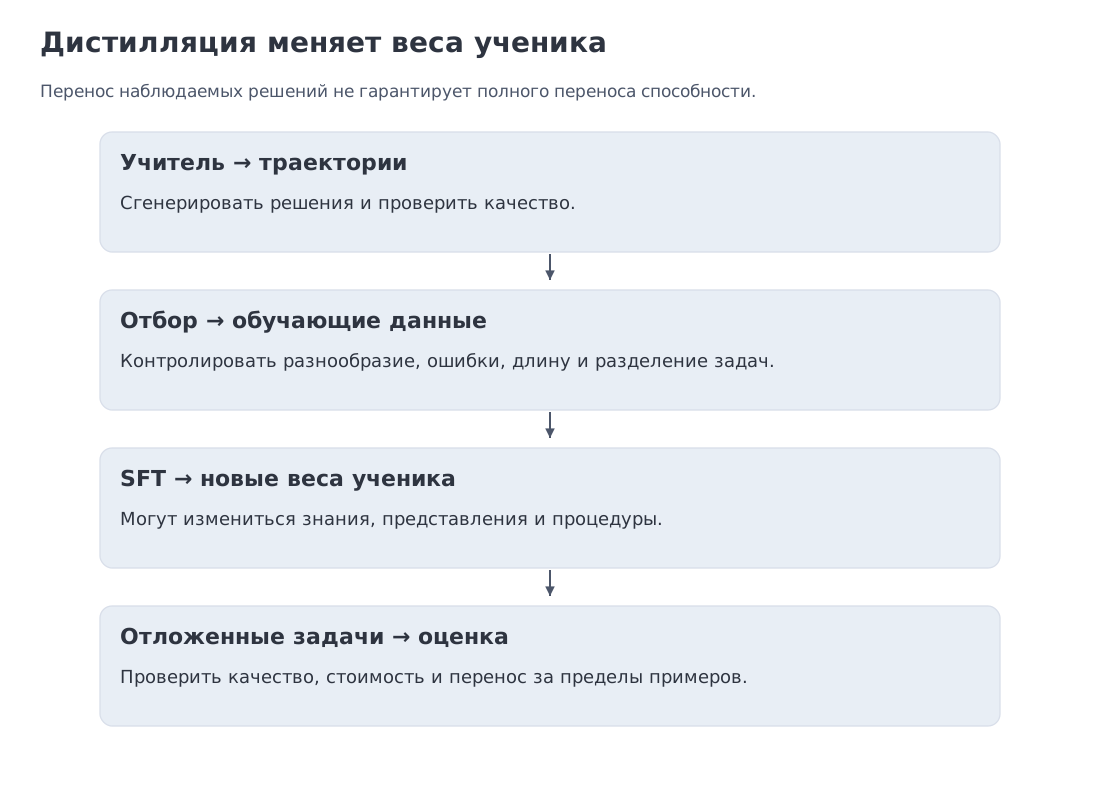 Дистилляция траекторий рассуждения: сильный учитель создаёт данные, обучение меняет веса ученика; перенос проверяется на отдельных задачах.
17. Как читать «паспорт рассуждения» модели
По состоянию на 11 октября 2026 года одной строки «поддерживает рассуждение» недостаточно. Для инженерного выбора нужен паспорт минимум из семи пунктов.
1. Как включается режим
Автоматически, отдельным флагом, уровнем усилия или точным бюджетом? Можно ли отключить? Значения полей нужно читать в документации конкретной модели, а не переносить между поставщиками.
2. Что масштабируется
Удлиняется одна траектория, увеличивается число попыток, запускаются субагенты или комбинируются все механизмы? max и многоагентная оркестрация — разные виды вычислений.
3. Что видит пользователь
Полный текст рассуждения, сводку, отдельное поле, зашифрованную подпись или только финальный ответ? Видимый текст нельзя автоматически считать полным внутренним процессом.
4. Что оплачивается
Учитываются ли токены рассуждения как выходные токены? Входят ли они в max_tokens? Возвращается ли их число в метаданных использования?
5. Как режим взаимодействует с инструментами
Сохраняется ли состояние рассуждения после вызова инструмента? Нужно ли вернуть служебную подпись или полное сообщение ассистента? Поддерживается ли принудительный выбор инструмента?
6. Какие ограничения по латентности и параллелизму
Среднее и хвостовое время, длина траекторий рассуждения, KV-память и число одновременных запросов должны измеряться на вашей нагрузке.
7. Как проводилась оценка
Сравнивались ли режимы при равной цене, равном времени или равном числе выходных токенов? Использовались ли внешние инструменты и несколько агентов? Без протокола сопоставимого бюджета слово «лучше» трудно интерпретировать.
На практике этот паспорт важнее маркетингового названия режима. Он позволяет отделить способность модели от политики сервинга и понять, за что именно платит система.
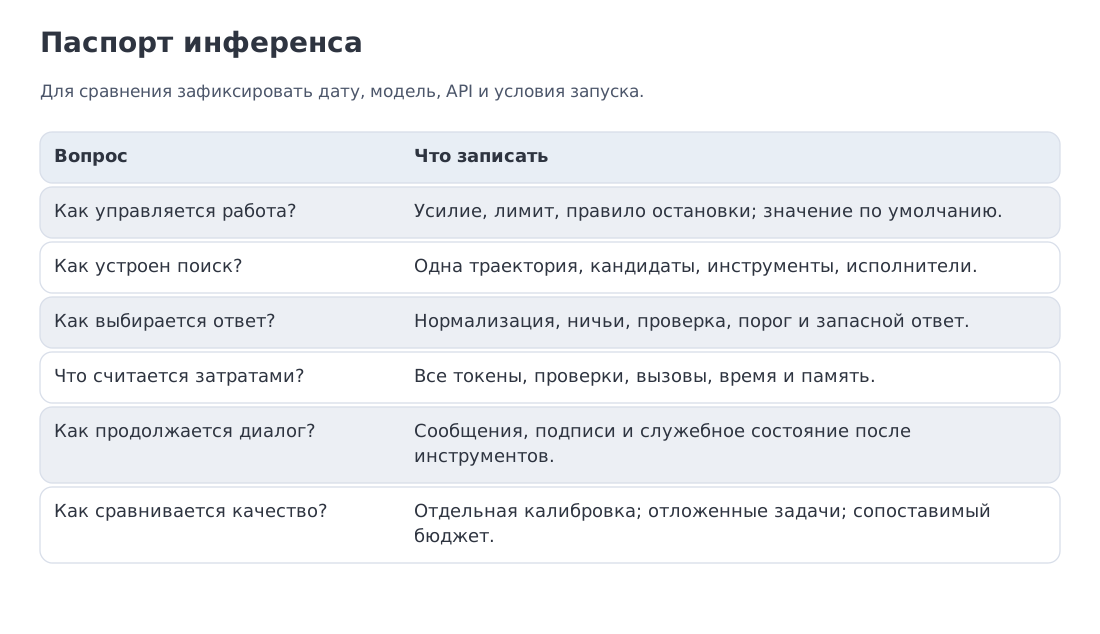 Каждая строка фиксирует часть воспроизводимого протокола; название модели не заменяет эти сведения.
20. Ключевые выводы модуля, Jupyter- и источники
- Вычисления во время инференса — самостоятельная ось масштабирования, но не бесплатная замена сильной базовой модели.
- Последовательная глубина, параллельная ширина и адаптивное распределение решают разные задачи.
- Повторная выборка увеличивает покрытие; качество системы определяется ещё и правилом отбора.
- Правило разрешения ничьих, нормализация ответов и независимость выборок являются частью алгоритма self-consistency.
- Верификатор задаёт верхний предел практической пользы большого числа кандидатов и сам может быть объектом эксплуатации.
- В сценарии с постоянной скоростью и полным KV-кэшем время декодирования и KV-память растут линейно по числу токенов; влияние на продукт и параллелизм может быть существенным.
- Адаптивный бюджет нужен потому, что запросы неоднородны, а зависимость качества от длины не обязана быть монотонной.
- Дистилляция переносит наблюдаемые траектории и процедуры, но не превращает ученика в полную копию учителя.
- Для сравнения систем рассуждения нужен паспорт: контроль, глубина/ширина, видимость, тарификация, инструменты, системная цена и протокол оценки.
Основные источники:
- OpenAI — Learning to reason with LLMs
- DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning
- Scaling LLM Test-Time Compute Optimally
- Large Language Monkeys: Scaling Inference Compute with Repeated Sampling
- s1: Simple Test-Time Scaling
- Let's Verify Step by Step
- Generative Verifiers
- RM-R1: Reward Modeling as Reasoning
- OpenAI API — current model guidance
- Anthropic — thinking modes
- Gemini API — thinking
- Kimi K3 — quickstart
- Thinking Machines — Inkling
- Meta — Muse Spark 1.1
Снимок текущих сведений об API: 11 октября 2026 года.
Ландшафт сверен: 11 октября 2026 года. Текущие режимы API проверены по официальной документации; результаты исследований — по первичным публикациям. Учебные оценки времени, памяти и стоимости воспроизводятся локальными расчётами и действуют только при указанных допущениях.