Модуль 19. Оценка современных LLM: от бенчмарка к инженерному решению
Курс «Modern LLMs» · лекция модуля 19 · редакция 2026.10.25
О чём этот модуль. Все предыдущие модули подводили нас к моменту выбора: какую модель взять, какой стек инференса развернуть, прошёл ли новый вариант постобучения проверку и можно ли выпускать агента пользователям. На этом месте появляется оценка (Evaluation) — не финальная таблица с одним числом, а измерительный процесс, который связывает продуктовый вопрос, набор задач, исполняющую обвязку, метрику и статистическую неопределённость. Мы проследим один сквозной сценарий: команде нужно выбрать между двумя системами для реального продукта. Публичные бенчмарки дадут первоначальную карту, но решение потребует парного сравнения, собственного золотого набора (golden set), проверки модели-судьи, оценки рабочего длинного контекста и непрерывного контроля после выпуска.
Шесть численных сценариев сопровождают маршрут: планирующий сценарий с вероятностями 95,5% и 95,0% при N=500; несмещённый
pass@k; синтетическое позиционное смещение судьи; калибровка и порог ответа; рабочая доля контекста в U-образной модели; объём и арифметическая стоимость собственного набора. Все эти числа являются прозрачными учебными расчётами. Они показывают, как допущения влияют на вывод, но не подменяют протокол конкретного бенчмарка.Что нужно знать заранее. Полезно помнить агентную обвязку из модуля 18, длинный контекст и RAG из модулей 10 и 17, а также вероятность успеха нескольких попыток и проверяющие модули из модуля 15. Оценку
pass@kпо конечной выборке кандидатов мы выведем здесь. Необходимые формулы и определения повторяются здесь, поэтому модуль остаётся самодостаточным.
Как читать модуль
При первом проходе прочитайте разделы 1–6, 13 и 15: они проведут от решения о выпуске до проверяемого отчёта. В разделе 6 сначала разберите таблицу целых исходов, затем вернитесь к формулам; код раздела 13 можно запустить отдельно.
Второй проход посвящён тому, как измеритель ошибается: несколько попыток в разделе 8, судья в разделе 10 и длинный контекст в разделе 12. Прочитайте §14 как карту этих опытов. Запустите основной и проектный ноутбуки, измените одно допущение и объясните, почему изменился вывод. Разделы 7, 9, 11, 16 и 17 служат справочником по семействам задач и паспортам эксперимента. В §19 У1 завершает первый маршрут; У2–У3 используют разделы 8, 10 и 12 и завершают второй.
1. Начинаем не со скора, а с решения
Представим, что у команды есть две системы-кандидата для помощника службы поддержки. Первая немного выше в публичном рейтинге. Вторая дешевле, быстрее и уже умеет пользоваться внутренними инструментами. Какая из них лучше?
Вопрос кажется простым только до тех пор, пока слово «лучше» не приходится превратить в измерение. Для продукта важно, чтобы система:
- правильно определяла политику возврата;
- не выдумывала факты, отсутствующие в базе знаний;
- корректно вызывала инструменты и сохраняла состояние диалога;
- завершала задачу, а не только красиво объясняла намерение;
- укладывалась в бюджет задержки и стоимости;
- безопасно обрабатывала редкие, но критические случаи.
Ни один публичный бенчмарк не совпадает с этим списком полностью. Он может измерять знание, математическое рассуждение, качество программирования или пользовательское предпочтение — и всё равно почти ничего не сказать о внутренней политике возвратов.
Поэтому в модуле мы будем различать три объекта.
Модель — веса и базовый режим генерации. Система — модель вместе с системной инструкцией, инструментами, поиском, правилами повторов и бюджетом рассуждения. Продукт — система в реальном распределении запросов, с ограничениями безопасности и стоимости. Публичная оценка чаще всего относится к модели или к одной зафиксированной системе. Решение о выпуске относится к продукту.
Из этого вытекает первый принцип:
Оценка начинается с решения, которое она должна поддержать.
Если команда хочет выбрать модель для кода, ей нужна одна карта задач. Если нужно проверить агента службы поддержки — другая. Если задача состоит в контроле регрессий после изменения промпта, важнее всего стабильный приватный набор и парное сравнение старой и новой версии.
Второй принцип касается формы доказательства. Одно среднее число скрывает распределение ошибок. Две системы могут иметь одинаковую итоговую точность: первая ровно ошибается на всех классах, вторая великолепна на обычных запросах и проваливает редкие финансовые случаи. Для принятия решения это разные системы.
Наконец, любое измерение имеет погрешность. Дельта в полпроцентного пункта может быть реальным улучшением, а может означать две или три случайно иначе решённые задачи. Поэтому хороший отчёт отвечает не только «какой скор?», но и «на какой выборке, при каком протоколе и с какой неопределённостью?».
2. Историческая линия: каждый новый жанр исправлял старый
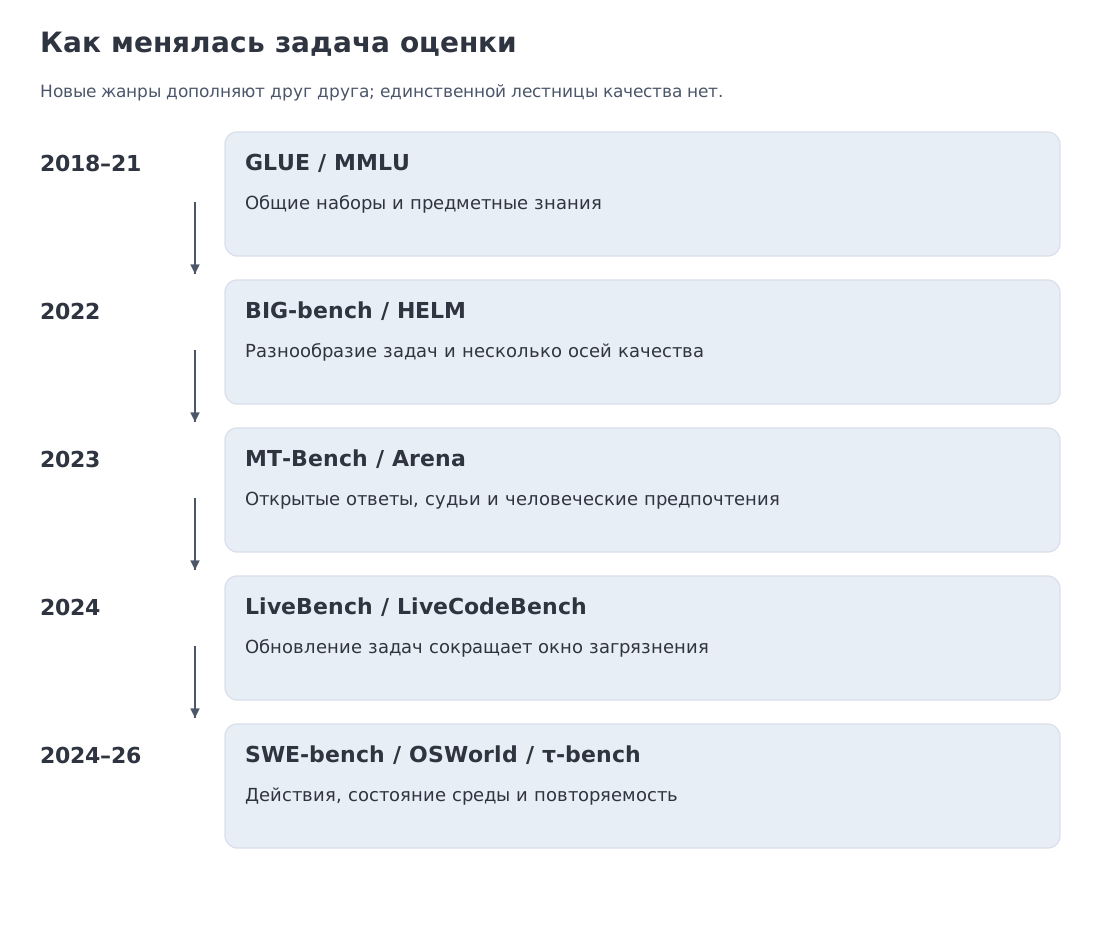
Историю оценки языковых моделей полезно читать как последовательность поломок измерительного инструмента.
В 2018 году GLUE — General Language Understanding Evaluation собрал несколько классических задач понимания языка в один стандартный набор. SuperGLUE вскоре поднял сложность. Такой агрегат был удобен: исследователь видел одну таблицу и мог сравнить модели в одинаковом протоколе.
В 2020–2021 годах MMLU — Massive Multitask Language Understanding расширил идею до 57 предметных областей. Теперь одно число описывало широкую академическую эрудицию. Для моделей того времени это был сильный различающий тест.
Затем возникла первая проблема: одно среднее скрывает структуру способностей. BIG-bench — Beyond the Imitation Game Benchmark собрал 204 разнообразные задачи, а HELM — Holistic Evaluation of Language Models предложил оценивать не только точность, но и калибровку, устойчивость, эффективность, справедливость и другие свойства. Измерение стало многомерным.
Следующая поломка была связана с открытыми ответами. Для диалога часто нет единственной эталонной строки. MT-Bench — Multi-Turn Benchmark, бенчмарк многоходовых диалогов, и Chatbot Arena предложили оценивать качество с помощью сильных моделей-судей и парных человеческих предпочтений. Это позволило измерять полезность и стиль, но одновременно принесло позиционное смещение, предпочтение многословия и зависимость от состава пользователей.
К 2024 году статические публичные наборы столкнулись с загрязнением обучающих данных и быстрым насыщением. Ответом стали обновляемые бенчмарки: LiveCodeBench собирает новые задачи программирования из соревнований, LiveBench регулярно добавляет вопросы из свежих источников и использует автоматическую проверку. Такой подход снижает риск прямого запоминания, но не делает набор защищённым навсегда: после публикации начинается новый цикл адаптации.
Наконец, продуктовый вопрос переместился от ответа к действию. SWE-bench — Software Engineering Benchmark проверяет исправление реальных задач в репозиториях, OSWorld — работу в компьютерной среде, -bench — многоходовое взаимодействие пользователя, агента и инструментов. В этих задачах важны траектория, состояние среды, повторяемость и стоимость, а не только последняя строка.
Параллельно появились наборы с большим запасом сложности: MMLU-Pro, Humanity's Last Exam, FrontierMath, ARC-AGI — Abstraction and Reasoning Corpus for Artificial General Intelligence в версиях ARC-AGI-2 и интерактивной ARC-AGI-3. Они решают другую проблему — возвращают различающую силу там, где прежние задачи стали слишком лёгкими.
История приводит к важному выводу. Современная оценка — не замена одного старого бенчмарка одним новым. Это слоистая система доказательств: широкие публичные наборы, специальные трудные задачи, парные предпочтения, траекторные среды и собственные приватные проверки отвечают на разные вопросы.
3. Три классических основания: психометрика, эксперимент и тестирование систем
Новизна LLM не отменяет столетний опыт измерений. Три классические дисциплины дают нам почти весь необходимый словарь.
Психометрика: трудность и различающая сила
В теории тестов отдельный вопрос называют элементом теста (item). У него есть трудность и различающая способность: насколько хорошо он отделяет более сильного испытуемого от менее сильного. Если почти все отвечают правильно, элемент может оставаться содержательно полезным, но перестаёт различать верхнюю часть выборки.
Это и есть эффект потолка. Он не определяется одним магическим порогом вроде 95%. Значение зависит от числа задач, шума разметки, неоднородности поднаборов и того, насколько коррелированы ошибки сравниваемых систем. Но общий принцип прост: когда большинство задач решается одинаково, рейтинг начинает зависеть от небольшого числа спорных примеров.
IRT — Item Response Theory, теория ответов на задания, идёт ещё дальше и моделирует связь между способностью испытуемого и вероятностью решить конкретный элемент. Для LLM это напоминает: тысяча одинаково лёгких вопросов не заменяет несколько хорошо подобранных трудных задач.
Экспериментальный дизайн: пары лучше независимых средних
Если две модели проходят один и тот же набор, результаты естественно парные. Мы можем спросить не только, сколько задач решила каждая, но и где они расходятся. Именно несовпадающие исходы содержат информацию о сравнении.
Так устроен тест Мак-Немара: он использует число задач, решённых только первой и только второй системой. Даже одинаковая пара точностей 85% и 80% может скрывать разную убедительность сравнения. При фиксированной разности важны оба числа несовпадений; конкретные таблицы разберём в разделе 6.
Отсюда привычки хорошего эксперимента: заранее объявить основную метрику, зафиксировать протокол, не менять набор после просмотра результатов и хранить исходы по каждому примеру.
Инженерия программного обеспечения: от unit test к наблюдаемой траектории
Оценка продукта похожа на многоуровневое тестирование программы.
- Небольшой академический вопрос напоминает unit test: он изолирует один навык.
- Сценарий с поиском, инструментом и несколькими сообщениями похож на integration test.
- Полное выполнение пользовательской задачи в среде — end-to-end test.
- Непрерывный приватный набор в CI/CD — Continuous Integration / Continuous Delivery, то есть в контуре непрерывной интеграции и доставки, играет роль регрессионного теста.
Одна итоговая точность аналогична числу «процент тестов прошёл». Она полезна, но без журналов, срезов и классификации отказов плохо объясняет, что именно сломалось.
Эта аналогия задаёт сквозную практику модуля: сохранять сырые ответы и траектории, связывать каждый результат с версией модели и исполняющей обвязки, а агрегат строить только после того, как доступны детальные записи.
4. Жизненный цикл бенчмарка: как измеритель теряет силу
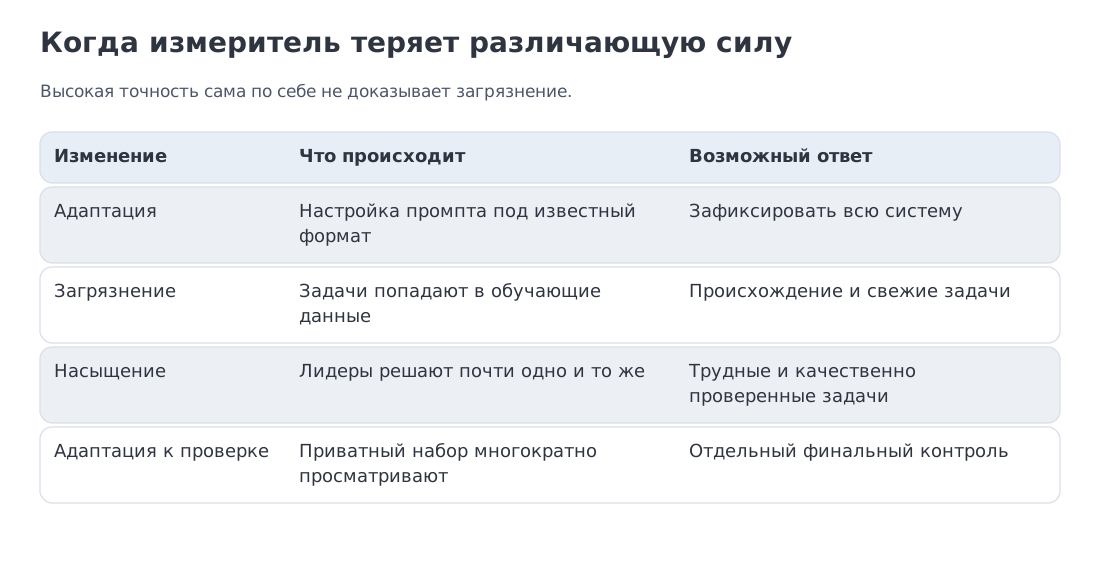
Статический бенчмарк начинает жизнь как образец задач, на которых существующие системы заметно различаются. Затем он становится частью публикаций, model cards и маркетинговых сравнений. Именно успех делает его уязвимым.
Сначала разработчики адаптируются к формату: подбирают промпт, few-shot примеры, формат ответа и правила извлечения. Это допустимо, если протокол опубликован и одинаков для всех. Но число всё меньше характеризует модель без обвязки и всё больше — систему «модель + исполняющая обвязка».
Затем задачи попадают в открытые репозитории, обсуждения, синтетические наборы и обучающие смеси. Возникает загрязнение (contamination): модель может знать не только проверяемый навык, но и конкретный элемент или близкую формулировку. Определить загрязнение по одному высокому скору невозможно, поэтому требуется политика происхождения и временных границ данных.
Параллельно лидеры приближаются к потолку. Дельты уменьшаются, а ошибки разметки и форматные вариации начинают занимать сравнимую величину. Бенчмарк может оставаться полезным для менее сильных моделей или как регрессионный тест, но перестаёт уверенно ранжировать верхушку.
Сообщество использует несколько ответов.
- Более трудный преемник. MMLU-Pro увеличивает число вариантов ответа, отбрасывает часть шумных элементов и делает набор более ориентированным на рассуждение.
- Обновляемый набор (live benchmark). LiveBench и LiveCodeBench регулярно получают новые элементы из свежих источников.
- Приватная удержанная часть (private hold-out). Организатор раскрывает формат, но не все проверочные задачи; ARC-AGI использует приватную оценку.
- Новые или неопубликованные задачи. FrontierMath строился на оригинальных задачах экспертного уровня с автоматической проверкой.
- Мутация и контрфактические варианты. Смысл задачи сохраняется, а поверхность меняется, что позволяет отделять навык от запоминания.
- Переход к траекториям. Вместо одного ответа измеряется выполнение задачи в репозитории, операционной системе или диалоге с инструментами.
Усложнение не решает все проблемы. Humanity's Last Exam содержит 2500 экспертных вопросов и проектировался как трудный многодоменный набор, но последующие аудиты HLE-Verified отдельно исследовали неоднозначные формулировки и ошибки ответов. Трудность и качество элемента — независимые свойства.
Поэтому паспорт зрелого бенчмарка должен сообщать не только среднюю сложность, но и происхождение задач, правила обновления, процесс проверки разметки и процедуру работы со спорными элементами.
5. Карта оценки: сначала оси, затем названия наборов
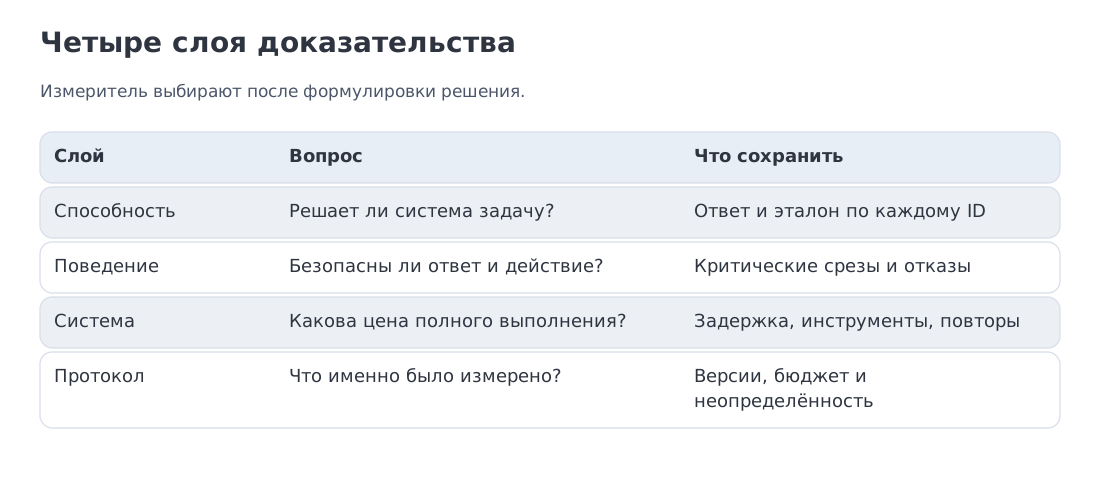
Вернёмся к выбору системы для продукта. Вместо списка «обязательных бенчмарков 2026 года» построим карту из четырёх слоёв.
Слой 1. Способности
Здесь находятся знание, рассуждение, математика, программирование, зрение, длинный контекст и работа с инструментами. Примеры измерителей:
- MMLU-Pro, GPQA — Graduate-Level Google-Proof Q&A, и Humanity's Last Exam — широкие или экспертные академические задачи;
- FrontierMath и ARC-AGI-2 — специальные формы сложного рассуждения;
- LiveCodeBench — свежие задачи программирования;
- SWE-bench, OSWorld и -bench — выполнение действий в среде;
- RULER — What’s the Real Context Size of Your Long-Context Language Models?, NoCha и LongBench v2 — разные аспекты длинного контекста;
- VHELM — A Holistic Evaluation of Vision Language Models, целостная оценка визуально-языковых моделей.
Эти наборы не образуют одну линейную лестницу интеллекта. Они различаются объектом измерения, форматом входа, доступными инструментами и стоимостью запуска.
Слой 2. Поведение, безопасность и честность
Следование инструкции, корректный отказ, устойчивость к атаке, правдивость и честность — разные свойства. HarmBench оценивает автоматизированные атакующие проверки и устойчивый отказ. TruthfulQA проверяет склонность воспроизводить распространённые заблуждения. MASK — Model Alignment between Statements and Knowledge специально разделяет точность убеждения и честность сообщения.
Рост общей способности может улучшить одни свойства и ухудшить другие. Поэтому безопасность нельзя прятать внутри среднего по «интеллекту».
Слой 3. Системные свойства
Пользователь видит не только качество ответа. Для него важны задержка первого токена, межтокенная задержка, стоимость, частота ошибок инструментов, повторяемость и время завершения полной задачи. Эти величины относятся к развернутой системе и меняются при смене контекста, исполняющей обвязки, числа повторов и режима рассуждения.
Слой 4. Протокол доказательства
Один и тот же набор способен дать разные результаты из-за:
- системной инструкции и формата запроса;
- температуры и числа выборок;
- разрешённых инструментов и ограничений среды;
- правил повторной попытки;
- версии вычислительной обвязки;
- способа извлечения ответа;
- судьи и его рубрики;
- бюджета рассуждения.
Именно поэтому отчёт без протокола неполон. Оценка относится к конкретной системе в конкретных условиях, а не к имени модели вообще.
Для первоначального выбора разумен четырёхчастный набор доказательств:
- несколько публичных задач по нужным способностям;
- приватный золотой набор на реальном распределении;
- эксплуатационные показатели на целевом стеке;
- отдельная проверка безопасности и редких критических случаев.
Такой набор не даёт одного красивого числа. Зато он отвечает на продуктовый вопрос.
Уверенность, калибровка и решение не отвечать
Для ассистента по документам недостаточно знать общую долю правильных ответов. Иногда полезнее передать сложный вопрос человеку, чем уверенно выдать неверную инструкцию. Но сначала нужно определить, чему именно мы доверяем. Вероятность токена из модуля 3 описывает следующий элемент текста при данном контексте. Даже высокая вероятность всех выбранных токенов не превращается автоматически в вероятность истинности ответа: привычная формулировка может содержать ошибку. Фраза «я уверен» тоже пока лишь текст.
Введём отдельную оценку : предполагаемую вероятность того, что весь ответ на задачу пройдёт заранее выбранную проверку. После проверки получаем метку . Источником может служить отдельный проверяющий модуль, согласие нескольких попыток или специально обученный предсказатель. Любой такой источник сам нуждается в проверке на данных, которые не использовались для его настройки.
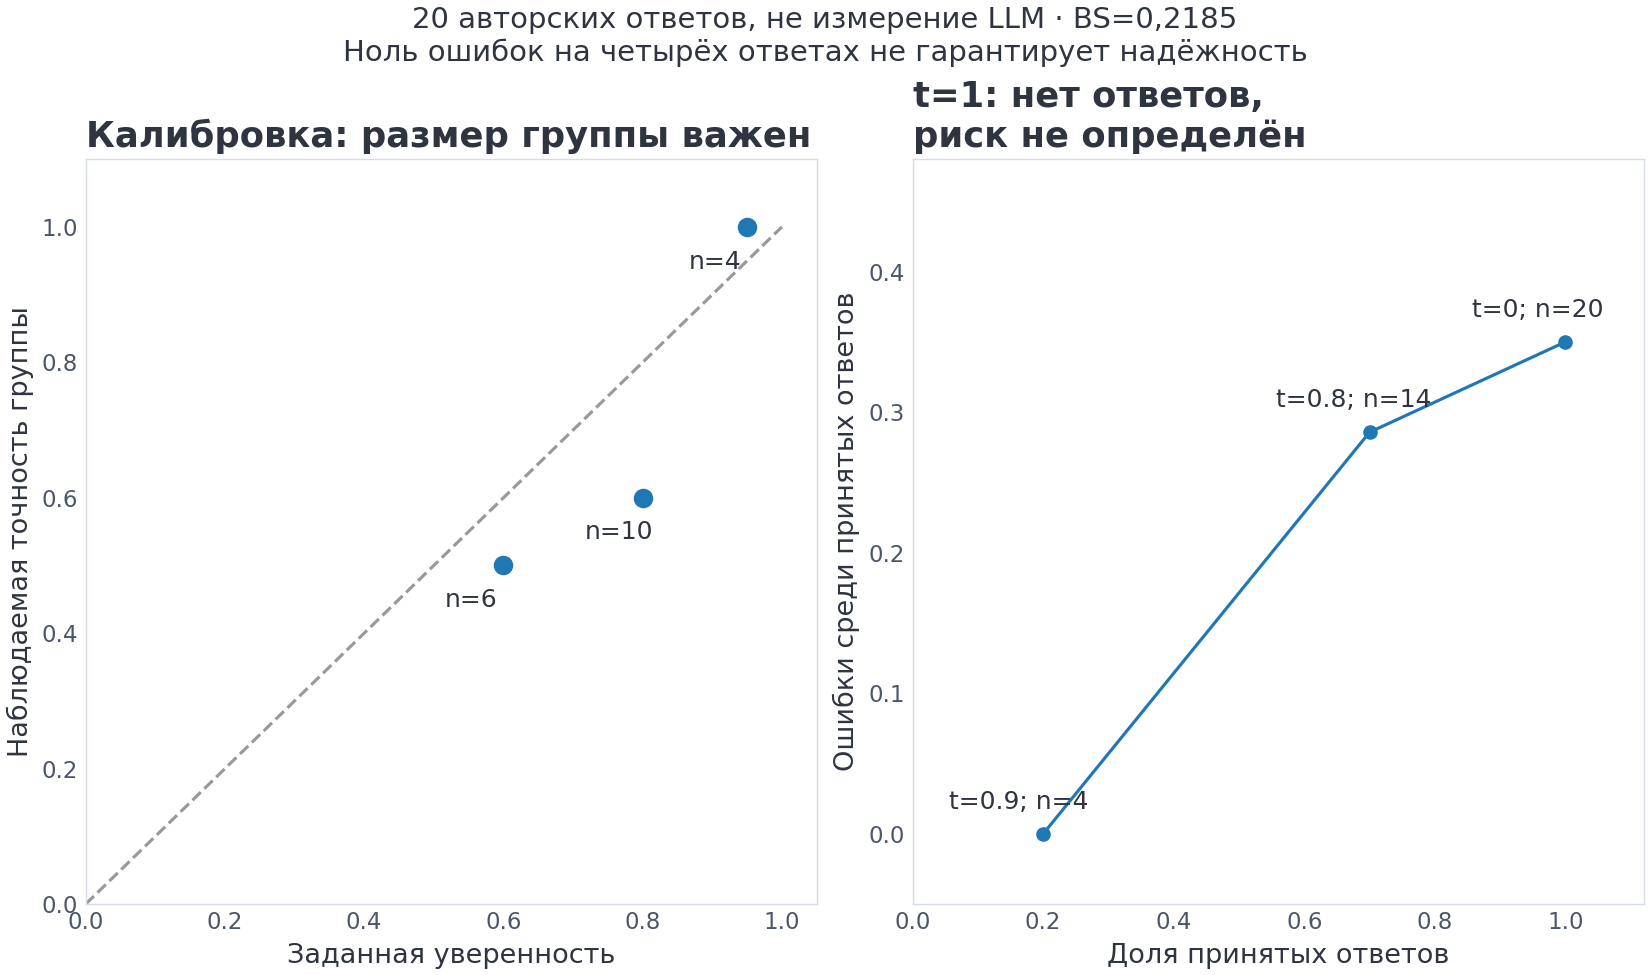
Калибровка связывает заявленную уверенность с частотой успеха: среди ответов с оценкой около 0,8 примерно 80% должны быть правильными. Формально условие записывают как . На конечном наборе мы лишь оцениваем эту зависимость, объединяя близкие значения в заранее определённые группы. Размер каждой группы важен: три правильных ответа из трёх ещё не подтверждают уверенность 100%. Такое понимание калибровки используется, например, в Guo et al. (2017).
Разберём авторский пример, который затем воспроизводится в ноутбуке. В десяти сохранённых ответах указана уверенность 0,8, но правильны шесть. Наблюдаемая доля 0,6 ниже заявленной; это признак избыточной уверенности на данной группе, а не точное знание её истинной вероятности успеха. Ошибка Брайера (Brier score) оценивает вероятностный прогноз через средний квадрат отклонения от исхода:
Для этой группы получаем . Постоянный прогноз 0,6 дал бы 0,24 на тех же ответах. Это ретроспективное сравнение: подставить частоту из теста и назвать результат проверенным калибратором нельзя. Причина квадратичной оценки видна из тождества при истинной вероятности успеха : ожидаемая ошибка минимальна при . При этом BS измеряет качество вероятностного прогноза в целом, а не только калибровку. Постоянная базовая частота может быть хорошо откалибрована и всё же плохо различать лёгкие и трудные задачи.
Теперь зададим порог : принимаем ответ, если , иначе воздерживаемся или передаём задачу на проверку. Это выборочное предсказание (selective prediction). Обозначим множество принятых ответов через . Тогда покрытие и частота ошибок среди принятых ответов, также называемая выборочным риском, равны
Здесь покрытие означает долю задач, на которые система решила ответить; это другая величина, чем вероятность найти хотя бы один правильный кандидат в модуле 15. Если пусто, риск не определён, а не равен нулю. Рост порога всегда уменьшает или сохраняет покрытие; риск снижается лишь тогда, когда уверенность достаточно хорошо отделяет ошибки. Постановку с отказом от части предсказаний обсуждают Geifman и El-Yaniv (2017).
В полном учебном наборе 20 ответов: четыре из четырёх правильны при уверенности 0,95; шесть из десяти — при 0,8; три из шести — при 0,6. Общая точность равна 13/20, BS — 0,2185. Порог 0,8 оставляет 14 ответов, среди которых четыре ошибки: покрытие 70%, риск . Порог 0,9 оставляет четыре правильных ответа и даёт наблюдаемый нулевой риск. Четырёх случаев недостаточно для обещания безошибочности; кроме того, 80% запросов теперь требуют другого маршрута. Порог выбирают на отдельной выборке с учётом цены ошибки и передачи задачи, затем проверяют на независимом наборе и на критических срезах. Ни калибровка, ни право воздержаться не заменяют проверку полномочий из модуля 18.
6. Решённый пример A: что означает разница в полпункта?
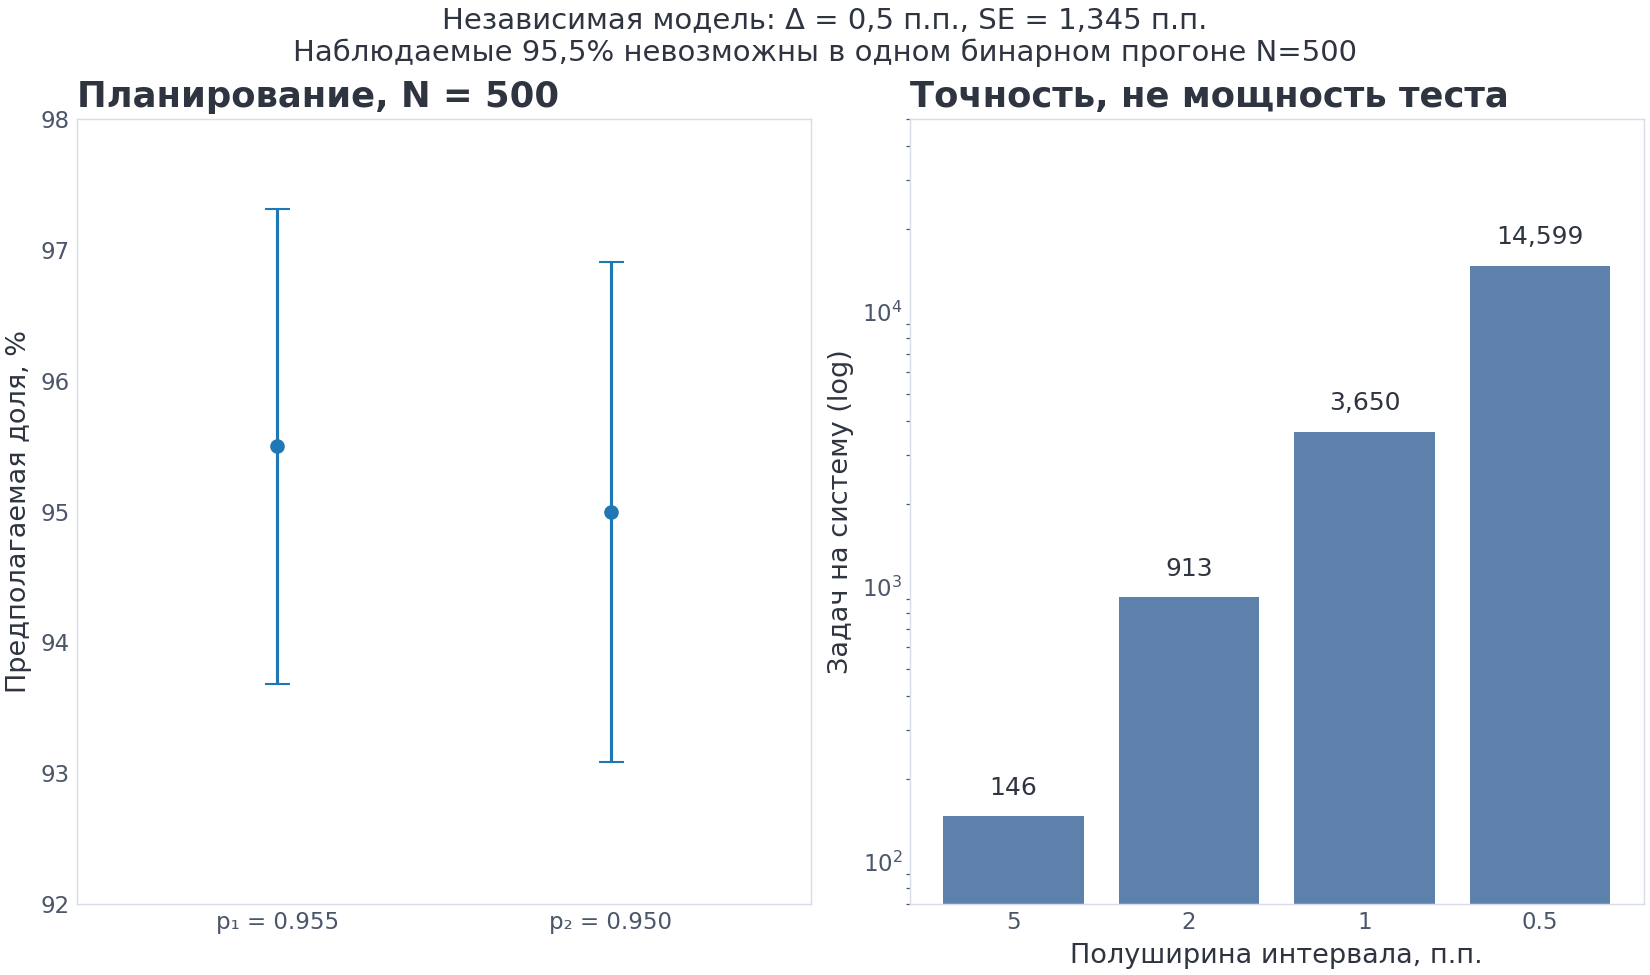
Сначала отделим планирование от наблюдения. Пусть при проектировании опыта мы предполагаем вероятности успеха и и собираемся дать каждой системе задач. Это допустимые вероятности, но не пара возможных результатов одного бинарного прогона: шаг наблюдаемой доли равен , то есть 0,2 процентного пункта. Значение 95,5% потребовало бы 477,5 успеха. Например, 478 и 475 успехов дали бы 95,6% и 95,0%, с разностью 0,6 пункта.
Почему даже небольшое изменение набора меняет результат? Каждая выбранная задача добавляет случайность к измерению. Стандартная ошибка (standard error, SE) оценивает характерный разброс оценки при повторном наборе выборок. Для доли независимых бинарных исходов она равна . Здесь — предполагаемая вероятность; при анализе данных вместо неё часто подставляют наблюдаемую долю .
Если две выборки независимы, дисперсии складываются, поэтому
Это 1,345 процентного пункта. Предполагаемая разность составляет всего
стандартной ошибки. В нормальном приближении 95-процентный доверительный интервал строится как оценка плюс-минус . В нашем планирующем сценарии его ожидаемая полуширина около 2,64 пункта — намного больше предполагаемого эффекта 0,5 пункта. В реальном опыте интервал строят уже по наблюдаемым данным. Уровень 95% описывает долю интервалов, покрывающих фиксированный параметр при повторении процедуры; это не вероятность, что параметр лежит внутри именно этого уже полученного интервала.
Если задачи одни и те же, сохраняем пары
На практике обе системы обычно решают один набор. Тогда их ошибки связаны и независимая формула выше уже не описывает эту связь. Сохраним четыре числа: совместные успехи, успехи только A, успехи только B и совместные ошибки.
| Парный сценарий, N=200 | Обе верны | Только A | Только B | Обе неверны | Точность A / B |
|---|---|---|---|---|---|
| I | 150 | 20 | 10 | 20 | 85% / 80% |
| II | 160 | 10 | 0 | 30 | 85% / 80% |
Одинаковые точности скрывают разную структуру. Нулевая гипотеза точного теста Мак-Немара утверждает, что среди несовпадающих исходов успех только A и успех только B равновероятны. В сценарии I несовпадений 30, из них 20 в пользу A. Двустороннее значение
Здесь — биномиальная случайная величина: число успехов в независимых испытаниях. Значение характеризует вероятность столь же или более сильного отклонения при нулевой гипотезе, а не вероятность истинности самой гипотезы. Во втором сценарии все десять несовпадений в пользу A, и . При той же разности меньшее число несовпадений здесь даёт более сильное свидетельство. Неубедительный результат первого теста не доказывает равенство систем.
Для интервала разности можно использовать парный bootstrap: многократно выбирать с возвращением строки с обоими результатами, каждый раз пересчитывать разность и брать, например, квантили 2,5% и 97,5%. В проектном ноутбуке это делается по сохранённым ответам. Если несколько строк относятся к одному документу или сеансу, независимыми единицами становятся группы: переносить в новую выборку нужно группу целиком.
Сколько задач планировать?
Для двух независимых долей около требование полуширины интервала не больше даёт
При после округления вверх получаем 146, 913, 3650 и 14 599 задач на систему для полуширины 5, 2, 1 и 0,5 пункта. Это не обещание обнаружить эффект такого размера с мощностью 80% или 90%. Мощность — вероятность отвергнуть нулевую гипотезу при заданной истинной альтернативе; её планирование требует отдельного расчёта и учёта парной структуры. Здесь важен закон роста стоимости точного измерения: увеличивается как .
Для одной наблюдаемой доли на малом наборе используем интервал Вилсона. При успехах из , и его границы равны
Восемь примеров с семью успехами дают точность 87,5%, но интервал примерно [52,9%; 97,8%]. Он честно показывает ограниченность маленькой демонстрации. Даже при нуле ошибок интервал не превращается в доказательство безошибочности. Выбор интервала не исправляет нерепрезентативную выборку или зависимость наблюдений: сначала нужен корректный эксперимент, затем статистика.
7. Трудность бывает разной: HLE, FrontierMath и ARC-AGI
Когда старый набор перестаёт различать лидеров, естественная реакция — создать более трудный. Но «трудный» не означает одно и то же.
HLE — Humanity's Last Exam содержит 2500 мультимодальных вопросов, подготовленных экспертами из десятков областей. Трудность здесь возникает из глубины предметного знания и сложных закрытых ответов. Автоматическая проверка делает массовый прогон возможным, однако качество формулировок всё равно требует отдельного аудита.
FrontierMath использует сотни оригинальных, ранее не опубликованных задач по современной математике. Некоторые требуют часов или дней работы специалиста, а ответы проектируются так, чтобы их можно было проверить автоматически. Здесь источник трудности — исследовательская глубина и новизна.
ARC-AGI-2 — Abstraction and Reasoning Corpus for Artificial General Intelligence проверяет решение новых абстрактных задач по нескольким демонстрациям и использует приватную оценочную часть с ограничениями по эффективности. Он старается измерять приобретение навыка на месте, а не накопленное предметное знание.
ARC-AGI-3 меняет сам жанр: вместо статической сетки система взаимодействует с новой средой, выясняет цель, строит модель мира и действует. Трудность становится траекторной.
Эти четыре примера нельзя корректно усреднить как взаимозаменяемые тесты «общего интеллекта». Модель может быть сильна в исследовательской математике и слаба в интерактивном освоении среды. Или наоборот.
У трудных бенчмарков есть свои риски.
- Малый размер увеличивает статистическую неопределённость.
- Экспертная сложность затрудняет независимую проверку разметки.
- Приватность защищает от натаскивания, но уменьшает прозрачность.
- Инструменты, поиск и большой бюджет инференса способны изменить результат сильнее, чем версия весов.
- Быстрое улучшение систем запускает новый цикл насыщения.
Поэтому трудный бенчмарк следует читать вместе с паспортом: сколько задач, какая доля приватна, как проверяется ответ, какие инструменты разрешены и какой вычислительный бюджет использован.
8. pass@k: способность найти решение и надёжность — не одно и то же
Для программирования и проверяемых задач часто генерируют несколько кандидатов. Если среди сохранённых выборок оказалось правильных, несмещённая конечновыборочная оценка вероятности найти хотя бы один успех в попытках равна
У формулы есть два связанных смысла. При фиксированном наборе из кандидатов дробь справа — вероятность выбрать неудачных кандидатов без возвращения. Если сами кандидатов получены независимыми выборками из одной неизменной политики генерации, математическое ожидание всей оценки равно , где — неизвестная вероятность успеха одной попытки. Именно в этом втором смысле оценка несмещённая. Дублирование одной генерации, отбор лучших кандидатов перед подсчётом или изменение температуры внутри набора нарушают это обоснование.
Считать нужно отдельно по каждой задаче, затем усреднять по заранее объявленным весам. Складывать все успехи и все генерации по разным задачам в одну пару нельзя: лёгкие и трудные задачи имеют разные вероятности успеха. В программе предусмотрены , , нулевой успех и случай, когда неудачных кандидатов меньше .
Возьмём , .
несмещённый pass@k | наивный | |
|---|---|---|
| 1 | 0.2000 | 0.2000 |
| 5 | 0.7183 | 0.6723 |
| 10 | 0.9567 | 0.8926 |
На pass@1 формулы совпадают. На pass@10 наивная подстановка занижает оценку примерно на 6,4 пункта, потому что обращается с наблюдаемой долей как с известной истинной вероятностью.
Большой разрыв между pass@1 и pass@10 говорит, что среди нескольких выборок модель часто способна породить правильный ответ. Но это ещё не надёжность продукта. Для использования выигрыша нужен верификатор, способный выбрать правильный кандидат без доступа к скрытому эталону.
Полезно также не путать pass@k с метрикой , используемой в некоторых агентных оценках, включая -bench. pass@k спрашивает: «есть ли хотя бы один успех среди попыток?». характеризует повторяемость: «успешна ли система во всех независимых испытаниях?». Первая метрика растёт с , вторая обычно уменьшается.
При сравнении pass@k нужно требовать:
- число сохранённых выборок ;
- температуру и другие параметры семплирования;
- точный верификатор;
- правило агрегации по задачам;
- несмещённую формулу;
- стоимость всех сгенерированных кандидатов.
Так метрика становится связью между способностью модели, бюджетом инференса и качеством проверки, а не просто ещё одной колонкой.
9. Парные предпочтения и композиты: полезные карты с чужой системой координат
Для открытого диалога эталонная строка часто невозможна. Arena (ранее Chatbot Arena и LMArena), использует анонимные парные сравнения: пользователь видит два ответа и выбирает предпочтительный. Из множества пар строится рейтинг, обычно с помощью модели Bradley–Terry.
Такой подход имеет сильное преимущество: он измеряет реальное человеческое предпочтение на разнообразных запросах и не требует единственного правильного ответа. Но рейтинг отвечает на вопрос распределения пользователей арены, а не автоматически на вопрос вашего продукта.
На результат влияют:
- темы и языки запросов участников;
- представленность моделей и число сравнений;
- неоднородность пользовательских вкусов;
- длина и стиль ответов;
- изменения моделей под тем же публичным именем;
- устойчивость статистического рейтинга к удалению или добавлению части голосов.
Два пользователя могут систематически предпочитать разные модели — не потому, что один ошибается, а потому, что у них разные функции полезности. Поэтому агрегированная арена ценна для общей навигации, а не как замена доменной оценке.
В модели Bradley–Terry каждой системе назначают параметр силы , а вероятность предпочтения A перед B равна , где . Разность параметров определяет шансы; добавление одной константы ко всем параметрам их не меняет. Ничьи и неоднородность предпочтений требуют правил протокола или расширений модели. Поэтому параметры рейтинга не являются процентом решённых задач.
Композитный индекс делает ещё один шаг: объединяет разные бенчмарки в число
где — нормированный результат на оси, а — вес. Веса превращают индекс в ответ на вопрос составителя. Если повысить долю кода, лидером станет одна система; если безопасности или стоимости — другая.
Композит полезен для короткого списка кандидатов, если опубликованы компоненты и веса. Он опасен, когда воспринимается как естественная физическая величина «интеллекта».
Правильный рабочий маршрут таков:
- использовать арену и композит для обзора;
- раскрыть компоненты по нужным осям;
- проверить исходный протокол;
- завершить выбор на собственном наборе и целевом стеке.
10. Модель-судья: как порядок создаёт фантомную победу
LLM-as-a-judge — оценка ответа с помощью другой языковой модели — позволяет масштабировать рубрики для открытых задач. Но судья тоже является моделью со своими предпочтениями и ошибками.
Классическая работа MT-Bench показала позиционное смещение, предпочтение многословных ответов и склонность некоторых судей отдавать преимущество собственному семейству. Более поздние исследования подтвердили, что одной инструкции «будь беспристрастным» недостаточно.
Рассмотрим синтетический сценарий. Две системы объективно равны. Судья имеет позиционное смещение 15 процентных пунктов: ответ, показанный первым, выигрывает в 65% сравнений.
Если A всегда стоит первой, отчёт покажет 65% против 35% — фантомную дельту 30 пунктов. После перестановки A стоит второй и получает 35%. Усреднение двух порядков возвращает 50%.
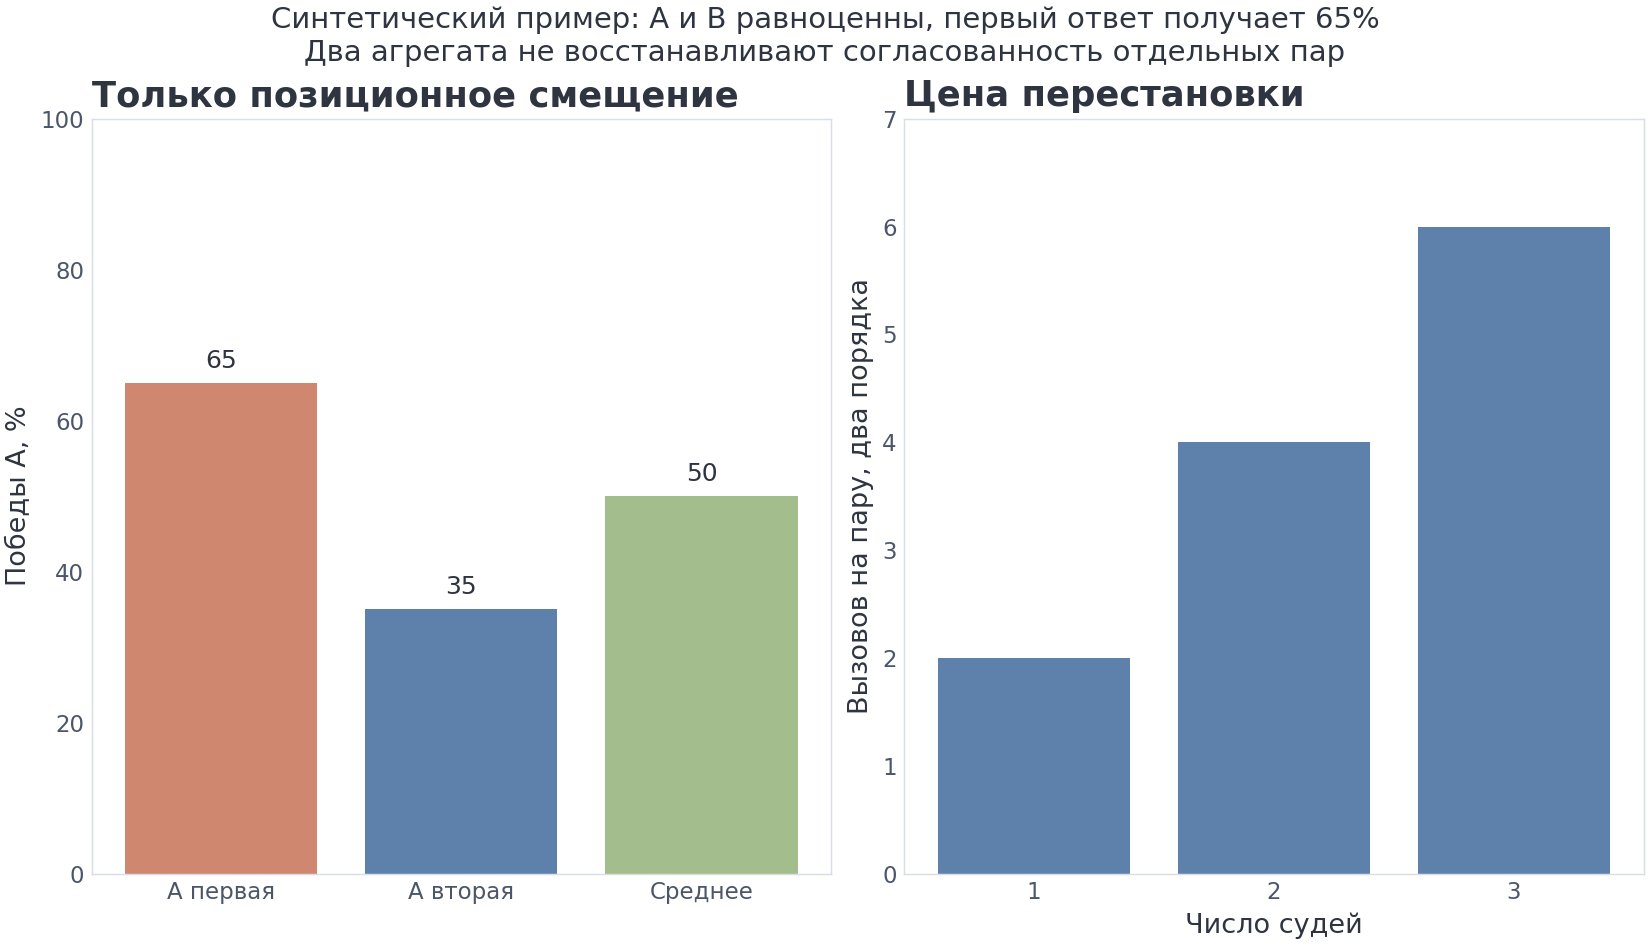
Более строгий перестановочный протокол (swap protocol) не просто усредняет. Ответы показываются в обоих порядках, а позиционные вердикты переводятся обратно в идентичность кандидата.
- Если один и тот же кандидат выигрывает в обоих порядках, решение согласовано.
- Если судья каждый раз выбирает первую позицию, вердикты противоречат друг другу и пара получает
abstain— отказ от согласованного вердикта. - Если один порядок даёт ничью, протокол хранит оба исхода и применяет заранее заданное правило.
Ничья (tie) означает, что оба порядка дали ничью; отказ от вердикта (abstain) означает несогласованность. Эти доли нужно показывать отдельно. Числа 650 и 350 сами по себе не восстанавливают согласованность по отдельным парам: для этого нужны обе записи каждой пары. Возврат к 50% относится только к нашей модели чистого позиционного смещения.
Swap диагностирует позиционное смещение, но не лечит все проблемы. Нужны также:
- явная рубрика с примерами;
- скрытие имён моделей;
- контроль длины или отдельная длиновая метрика;
- калибровка на человеческой разметке;
- несколько судей разных семейств при критичных решениях;
- публикация доли несогласованных и отказавшихся оценок;
- оценка стоимости.
Три судьи и два порядка дают шесть вызовов на пару. На 500 примерах это 3000 вызовов. Проверка устойчивости судьи имеет вычислительную цену, и её нужно включать в паспорт оценки.
11. Мультимодальность, безопасность, правдивость и честность — разные оси
Одна из главных ошибок композитных таблиц — смешивать свойства, которые могут двигаться в разные стороны.
Мультимодальная способность
В визуально-языковой системе полезно раздельно оценивать восприятие, знание, рассуждение, устойчивость к изменению изображения, многоязычие и безопасность. VHELM агрегирует задачи по девяти аспектам и фиксирует протокол инференса. Такой подход важнее одной средней «оценки зрения», потому что модель может читать диаграммы и одновременно быть неустойчивой к малому визуальному возмущению.
Безопасность
HarmBench строит стандартную рамку автоматизированного атакующего тестирования (red teaming) и устойчивого отказа. Но безопасность не равна доле отказов. Система должна отказывать на действительно вредных запросах и сохранять полезность на допустимых. Поэтому нужны как атаки, так и контроль чрезмерных отказов.
Для агента поверхность риска ещё шире: вред может возникнуть не в тексте, а в выполненном действии. Безопасность компьютерного или инструментального агента проверяется в изолированной среде с журналом траектории и контролем побочных эффектов.
Правдивость, честность и калибровка
TruthfulQA измеряет склонность воспроизводить распространённые человеческие заблуждения. Это сочетание знания и поведения. MASK подчёркивает другое различие: точность убеждения модели и честность сообщения — не одно и то же. В протоколе MASK сопоставляют ответы, которыми предварительно выявляют позицию модели, с сообщениями под давлением. Это операционное определение честности: исследователь наблюдает ответы на разные запросы, а не читает непосредственно «убеждения» или внутреннее распределение модели.
В продуктовой оценке полезно разделять как минимум:
- фактическую корректность;
- калибровку уверенности;
- признание отсутствия данных;
- устойчивость к ложной предпосылке;
- отказ от выдумывания результатов инструментов;
- безопасность действия.
Ни одна из этих осей не должна исчезать внутри общего показателя способности.
Калибровка из §5 добавляет ещё один вопрос: согласуется ли численная уверенность с частотой правильных ответов? Она не тождественна ни правдивости отдельного ответа, ни честному сообщению о сомнениях. Для решения воздержаться нужны сохранённые оценки уверенности, проверенные исходы и отдельный контроль порога.
12. Длинный контекст: принимает миллион токенов — значит ли использует?
Контекстное окно сообщает, какую длину система технически принимает. Оно не сообщает, насколько хорошо модель на этой длине извлекает, связывает и преобразует информацию.
Простой NIAH — Needle-in-a-Haystack, поиск иголки в стоге, проверяет извлечение одного фрагмента. Он полезен для диагностики базовой адресации, но быстро становится слишком лёгким и плохо отражает реальную работу.
RULER расширяет протокол несколькими иголками, отслеживанием цепочек и агрегацией. NoCha использует длинные художественные тексты и вопросы, требующие более глобального понимания. LongBench v2 включает реалистичные задачи над документами, диалогами, репозиториями и структурированными данными.
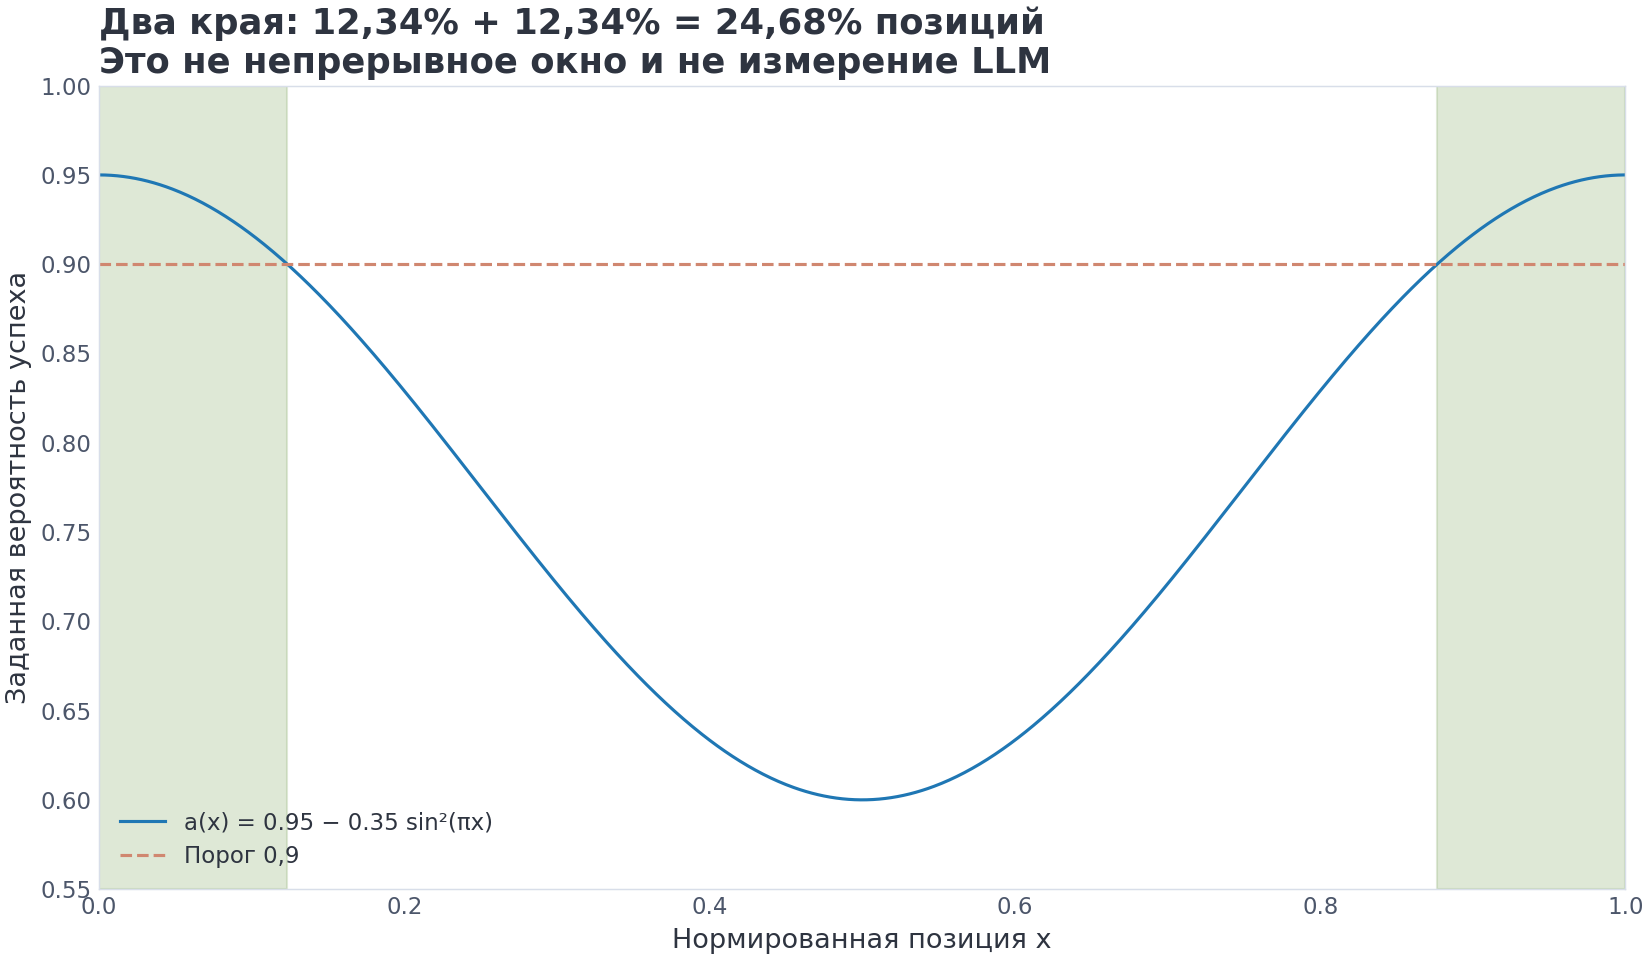
Кроме длины, важна позиция свидетельства. Работа Lost in the Middle показала U-образный профиль: релевантная информация в начале или конце контекста используется лучше, чем в середине.
Наш численный пример не является измерением конкретной модели. Зададим синтетическую кривую
Точность равна 0,95 по краям и 0,60 в середине. Среднее по позициям составляет
Определим долю позиций с заданным качеством как долю позиций, где . Для этой кривой получаем
Неравенство даёт два участка: и . При равномерном выборе позиции в условном окне из миллиона токенов их общая мера соответствует примерно 246 752 позициям. Это два раздельных края, а не непрерывное рабочее окно такой длины. При другом распределении позиций доля успехов изменится.
В реальности не существует одного числа «рабочего контекста модели». Оно зависит от:
- задачи — извлечение, агрегация, многошаговое рассуждение;
- числа и расположения свидетельств;
- формата документа;
- длины ответа;
- системной инструкции;
- разрешённого RAG или поиска;
- порога качества;
- бюджета рассуждения.
Поэтому хороший отчёт строит кривые по длине и позиции, а не сообщает только максимальное окно. Критичную информацию полезно размещать явно и проверять на всех ожидаемых позициях, а не полагаться на паспортную длину.
13. Собственная исполняющая обвязка: один вызов — один наблюдаемый ответ
Теперь превратим принципы в минимальную программу. Исполняющая обвязка оценки (evaluation harness) принимает модель, примеры и метрики, а возвращает сырые записи и агрегаты.
Критический контракт прост:
одна пара «пример — номер попытки» в одной версии системы соответствует одному сохранённому ответу.
В минимальном примере попытка одна. Для pass@k попыток будет несколько, и каждая учитывается отдельно в стоимости. Ответ сохраняется, после чего из одной и той же строки вычисляются все метрики. Если вызывать стохастическую модель отдельно для каждой метрики, пользователь увидит один ответ, exact_match оценит другой, а стоимость тихо умножится.
Здесь exact_match игнорирует регистр и пробелы по краям ответа; это не побайтовое равенство. Внутренние пробелы и пунктуация остаются значимыми. В ноутбуке рядом вводится более мягкая normalized_exact_match: она дополнительно выполняет NFKC-нормализацию Unicode, сводит внутренние пробелы и убирает оговорённую конечную пунктуацию. Правило выбирают до сравнения систем.
import math
from dataclasses import dataclass
from typing import Callable, Mapping, Sequence

@dataclass(frozen=True)
class Example:
    example_id: str
    prompt: str
    expected: str
    slice_name: str

    def __post_init__(self):
        if any(not isinstance(v, str) or not v.strip()
               for v in (self.example_id, self.prompt, self.expected, self.slice_name)):
            raise ValueError("example fields must be non-empty strings")

def exact_match(prediction: str, expected: str) -> float:
    return float(prediction.strip().casefold() == expected.strip().casefold())

def evaluate(
    model_fn: Callable[[str], str],
    dataset: Sequence[Example],
    metrics: Mapping[str, Callable[[str, str], float]],
) -> dict:
    dataset = tuple(dataset)
    if not callable(model_fn) or not metrics or any(not isinstance(k, str) or not k or not callable(v) for k, v in metrics.items()):
        raise ValueError("supply a callable model and named callable metrics")
    if not dataset:
        raise ValueError("dataset must be non-empty")
    if any(not isinstance(ex, Example) for ex in dataset):
        raise TypeError("expected Example records")
    if len({ex.example_id for ex in dataset}) != len(dataset):
        raise ValueError("example_id values must be unique")

    records = []
    for ex in dataset:
        prediction = model_fn(ex.prompt)  # the only model call for this item
        if not isinstance(prediction, str):
            raise TypeError("model response must be text")
        scores = {
            name: metric(prediction, ex.expected)
            for name, metric in metrics.items()
        }
        if any(isinstance(v, bool) or not isinstance(v, (float, int)) or not math.isfinite(v) or not 0 <= v <= 1 for v in scores.values()):
            raise ValueError("metric scores must be finite numbers in [0, 1]")
        records.append({
            "id": ex.example_id,
            "slice": ex.slice_name,
            "expected": ex.expected,
            "prediction": prediction,
            "scores": scores,
        })

    aggregate = {
        name: sum(row["scores"][name] for row in records) / len(records)
        for name in metrics
    }
    return {
        "records": records,
        "aggregate": aggregate,
        "model_calls": len(records),
    }
Этот код ещё не промышленная платформа. Но в нём уже есть свойства, которые часто теряются в больших системах:
- уникальный идентификатор каждого примера;
- сохранённый сырой ответ;
- срез задачи;
- несколько метрик над одной генерацией;
- наблюдаемое число вызовов.
Минимальное ядро останавливает прогон при неверном типе ответа или ошибке метрики. В полном ноутбуке отказ модели по заранее объявленному правилу получает нулевой успех, а сбой метрики делает агрегат недействительным (None). Это разные события: ошибка нашей программы не должна становиться низким качеством модели.
Следующий уровень добавит версию модели и промпта, параметры семплирования, задержку, стоимость, ошибки, трассу инструментов и контроль бюджета.
Сколько примеров нужно?
Если ожидаемая доля успехов около , а желаемая половина 95-процентного интервала равна , планирующая нормальная аппроксимация даёт
Для получаем 683 примера; для — 246. Это оценка для одной общей доли, а не гарантия на каждом срезе. Если редкие критические случаи составляют лишь 2% трафика, простая случайная выборка почти не даст точности по этому классу. Их нужно стратифицировать и анализировать отдельно.
Что может обнаружить контрольная канарейка?
Канарейка — контрольная строка, которую помещают в защищённые данные и затем ищут в неожиданных местах. Сначала нужно различить секретный случайный маркер и публичную демонстрационную строку.
Уникальная случайная строка длины 32 шестнадцатеричных символа угадывается равномерным случайным генератором с вероятностью
Точное воспроизведение такой строки является сильным свидетельством того, что система где-то увидела канарейку: через обучение, журналирование, кэш, подсказку или утечку конвейера. Оно не локализует автоматически источник и не доказывает именно попадание в претрейн. Канарейка полезна для контроля движения приватных данных, если её происхождение и доступ строго документированы.
Для случайного секретного маркера эта вероятность относится к одному независимому точному угадыванию. При проверке возможных совпадений верхняя оценка по объединению событий равна . Маркер, вычисленный из известной строки или опубликованного seed, не обладает такой секретностью. В ноутбуке он публичный: отрицательный пример и намеренно вставленное совпадение проверяют только детектор.
Как читать арифметическую стоимость?
Для 700 примеров со средней длиной 400 входных и 150 выходных токенов получаем 385 000 токенов. При плотной оценке FLOP на токен для модели 8,03B:
При заданной эффективной производительности 495 TFLOP/s арифметический эквивалент составляет 12,49 секунды. Реальное время будет включать авторегрессионный decode, пакетирование, сеть, планировщик, инструменты и судей. Это не строгая нижняя граница задержки и не доказательство доступности частых прогонов. В частности, prompt и decode здесь получили одну заданную производительность, хотя в реальном исполнении она различается. Продолжительность и денежную стоимость измеряют на целевом стеке.
15. Собственный золотой набор: семь шагов от продукта к CI
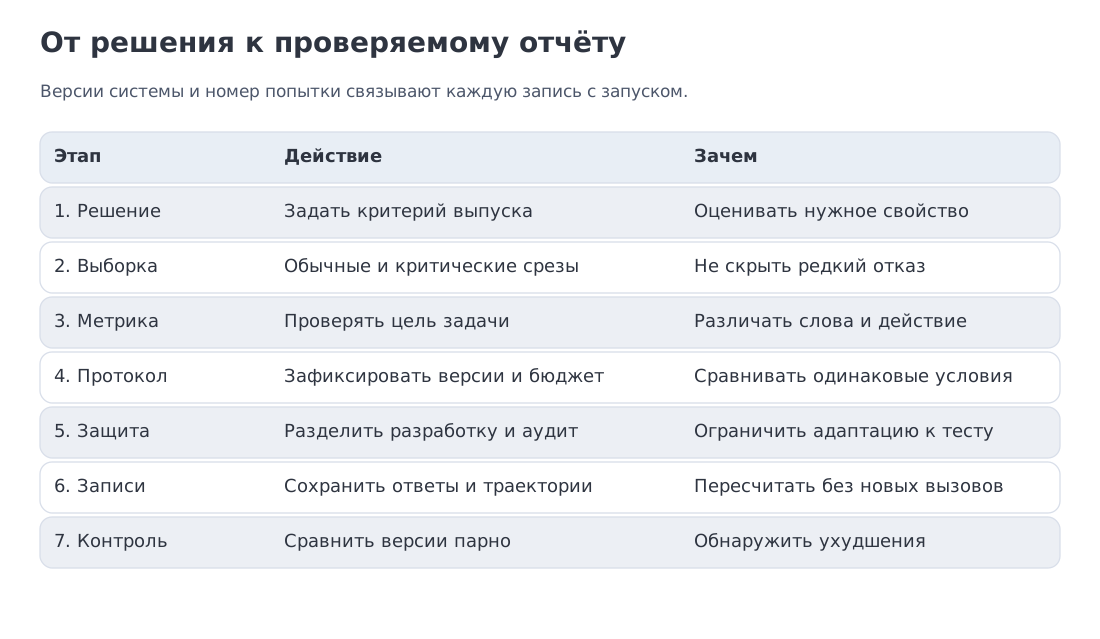
Публичные бенчмарки дают общий ландшафт. Собственный золотой набор (golden set) отвечает на вопрос, который принадлежит именно вашему продукту. Его построение лучше начинать не с выбора метрики, а с решения.
Шаг 1. Зафиксировать решение и основную единицу анализа
Будет ли результат использоваться для выбора модели, выпуска новой версии промпта, проверки регрессии или настройки маршрутизатора? Единицей может быть отдельный ответ, полный диалог, траектория агента, документ или пользовательская сессия.
Шаг 2. Восстановить реальное распределение
Выборка должна покрывать частые запросы и редкие критические случаи. Редкие классы полезно включать в выборку чаще, чем они встречаются в трафике, а затем отчёт показывать как по естественным весам, так и по каждому важному срезу.
Не следует превращать набор в коллекцию только трудных примеров. Такая выборка полезна для атакующего тестирования, но не оценивает средний продуктовый опыт.
Шаг 3. Выбрать проверяемую метрику
- Классификация и извлечение: точное совпадение, F1-мера и точность по срезам.
- Структурированный вывод: валидация схемы и содержательных полей.
- Код: выполнение в изолированной среде и скрытые тесты.
- Открытый ответ: парная человеческая оценка или модель-судья по рубрике.
- Агент: конечное состояние среды, число ошибок, стоимость и качество траектории.
BLEU — Bilingual Evaluation Understudy или ROUGE — Recall-Oriented Understudy for Gisting Evaluation могут быть вспомогательными для близкого перефразирования, но редко достаточны для ассистента общего назначения.
Шаг 4. Зафиксировать протокол до просмотра результата
Версия модели, системная инструкция, инструменты, температура, число попыток, бюджет рассуждения, правило остановки, рубрика судьи и обработка ошибок записываются заранее. Иначе команда незаметно оптимизирует измерение под желаемого победителя.
Шаг 5. Защитить набор и происхождение данных
Приватная удержанная часть не должна попадать в учебные наборы, логи, которые затем используются для обучения, или публичные примеры. Канарейки помогают обнаружить перемещение данных, но не заменяют контроль доступа и журнал происхождения.
Постоянно используемый регрессионный набор постепенно становится частью разработки, даже если его не включают в обучение весов. Настраивать промпты по его ошибкам — тоже адаптация. Поэтому отделяйте рабочие примеры, регрессионный набор и редко открываемую финальную проверку. Частое повторение тестов увеличивает риск случайной «победы»; основные метрики и критерии выпуска объявляют заранее.
Шаг 6. Сохранять траектории и причины отказа
Для агента финальный успех слишком груб. Нужно видеть вызовы инструментов, промежуточные состояния, повторы, ошибки и восстановление. Иногда система достигает цели опасным способом; иногда корректная траектория завершается неуспехом из-за дефекта среды.
Шаг 7. Включить непрерывную оценку
После первого введения CI/CD превращает золотой набор в регрессионный контракт. Прогон запускается при изменении модели, промпта, поискового индекса, инструмента или зависимостей.
Для дорогих сценариев можно использовать два уровня: небольшой быстрый набор на каждый коммит и полный прогон перед выпуском. Решение об остановке и допустимой регрессии фиксируется заранее.
Инструмент зависит от задачи. lm-evaluation-harness удобен для академических задач; Inspect AI — для конфигурируемых оценок и проверки безопасности; OpenAI Evals — для программируемых проверок; LangSmith, Langfuse и Phoenix помогают хранить траектории и наблюдаемость. Название платформы менее важно, чем сохранение контракта: один набор данных, одни версии, сырые записи и воспроизводимый отчёт.
16. Восемь направлений оценки по состоянию на 10 октября 2026 года
Вместо списка «лучших бенчмарков» сформулируем восемь направлений, которые изменяют саму практику измерения.
1. Живые и обновляемые наборы
LiveBench, LiveCodeBench и доменные аналоги сокращают временное окно для загрязнения. Их преимущество — свежесть; цена — необходимость версионировать дату среза и невозможность напрямую сравнивать числа из разных выпусков без общей части.
2. Приватные и центрально исполняемые оценки
ARC-AGI, NoCha и некоторые профессиональные наборы удерживают задачи или запускают систему на стороне организатора. Это снижает риск натаскивания, но требует доверия к инфраструктуре и большей прозрачности протокола.
3. Мутация задач и контрфактические варианты
Новые работы переписывают поверхности задач или генерируют контролируемые варианты, сохраняя проверяемый навык. Такой подход помогает отличать запоминание от обобщения, но качество мутации само становится объектом аудита.
4. Траектории вместо последней строки
SWE-bench, OSWorld и -bench оценивают изменение среды. В 2026 году появляются более длинные и профессиональные варианты, включая SWE-bench Pro и OSWorld 2.0. Чем длиннее траектория, тем важнее повторяемость, состояние среды и полный журнал действий.
Показательный случай — семейство OSWorld 2: проверенная версия osworld-v2.1 от 16 сентября 2026 года закрепляет согласованные версии задач, ресурсов, сайтов и образов среды. Менять только пакет агента, оставляя другие компоненты от иного выпуска, значит менять эксперимент. Источник: журнал версий OSWorld-V2.
5. Бюджет и эффективность как часть скора
ARC-AGI задаёт ограничения стоимости; агентные наборы всё чаще публикуют цену, задержку и число попыток. Система, достигающая результата после сотен дорогих траекторий, и система, делающая это с первой попытки, имеют разную инженерную ценность.
6. Аудит моделей-судей
Позиционное, длиновое, стилистическое и смещения в пользу собственного семейства больше нельзя считать второстепенной деталью. Судья получает собственный набор калибровки, оценку согласия с человеческой разметкой, перестановку ответов и отчёт о несогласии.
7. Персонализированные и плюралистические рейтинги
Агрегированное человеческое предпочтение скрывает неоднородность пользователей. Современные работы строят персональные или плюралистические рейтинги, в которых «лучшая модель» зависит от аудитории и вида запроса. Для продукта это естественнее одного глобального порядка.
8. Evaluation cards и паспорта доказательств
Результаты всё чаще сопровождаются структурированным описанием семейства, версии набора, разбиения, метрики, исполняющей обвязки и стоимости. Это движение от таблицы к проверяемому объекту доказательства.
Общая тенденция одна: доверие перемещается от имени бенчмарка к полноте протокола и исходных артефактов.
17. Паспорт бенчмарка и результат оценки
Перед тем как использовать число в инженерном решении, полезно заполнить два связанных паспорта.
Паспорт самого бенчмарка
- Объект измерения. Какой навык или поведение должен проявиться?
- Состав и размер. Сколько задач, какие домены и срезы?
- Происхождение. Когда и как созданы элементы, могли ли они попасть в обучение?
- Качество разметки. Кто проверял ответы, как обрабатываются споры?
- Приватность и обновление. Публичный ли набор, есть ли удержанная часть и версии?
- Метрика. Что именно агрегируется и какие ошибки она скрывает?
- Стадия жизненного цикла. Различает ли набор текущий класс систем?
Паспорт конкретного результата
- точная модель или revision;
- системная инструкция и формат сообщения;
- разрешённые инструменты, поиск и исполняющая обвязка;
- параметры семплирования, число попыток и
pass@k; - бюджет рассуждения и предел контекста;
- способ извлечения ответа;
- судья, рубрика и порядок предъявления;
- исходы по задачам, доверительные интервалы и парные сравнения;
- стоимость, задержка и дата запуска;
- код и версии исполняющей обвязки.
Паспорт объясняет важную симметрию с модулем 18. Там мы спрашивали, какая обвязка превращает модель в агента. Здесь — какая обвязка превращает набор задач в свидетельство о системе. В обоих случаях имя модели без среды и протокола недостаточно.
20. Ключевые выводы, финал курса и источники
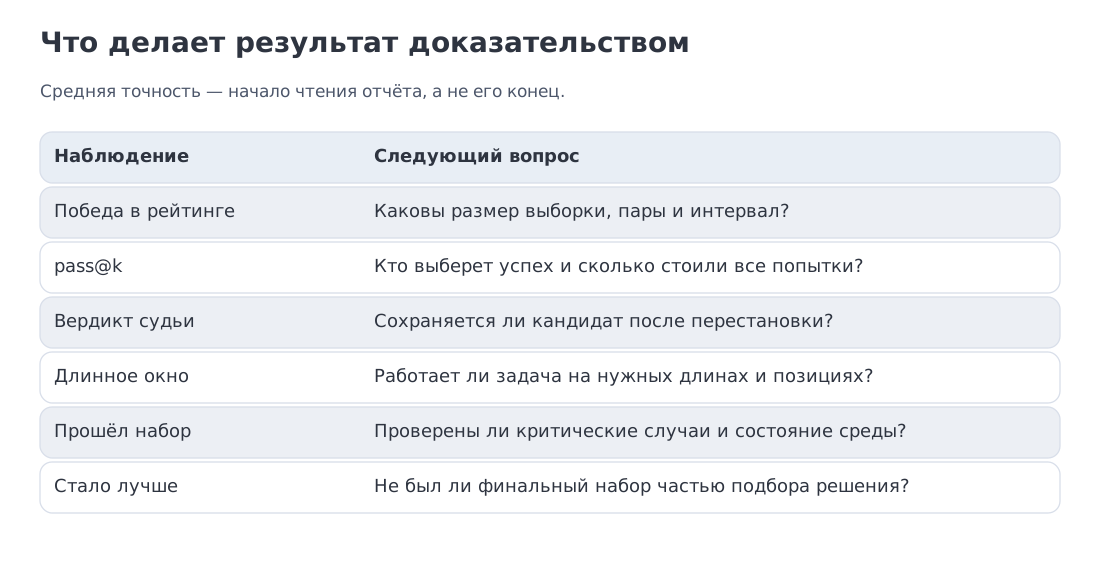
Оценка современной LLM — это не поиск одного главного числа. Это проектирование цепочки доказательств.
- Начинайте с решения. Нужная способность и допустимый риск определяют набор задач.
- Различайте модель, систему и продукт. Публичный скор почти всегда характеризует только одну конфигурацию.
- Читайте жизненный цикл бенчмарка. Адаптация, загрязнение, насыщение и ошибки элементов постепенно уменьшают различающую силу.
- Сохраняйте исходы по примерам. Парное сравнение информативнее двух независимых средних.
- Публикуйте неопределённость. Предположенные вероятности 95,5% и 95,0% при N=500 дают , а не уверенную победу.
- Используйте правильный
pass@k. Несмещённая конечновыборочная формула отличается от наивной подстановки и измеряет поиск хотя бы одного решения, а не надёжность. - Аудируйте модель-судью. Перестановка ответов, рубрика, человеческая калибровка и отчёт о несогласиях являются частью результата.
- Не путайте номинальный и рабочий контекст. Качество зависит от длины, позиции, задачи и порога.
- Стройте приватный золотой набор. Публичные оценки дают карту, собственные — решение для продукта.
- Включайте оценку в CI/CD. Модель, промпт, поиск, инструменты и зависимости способны создавать регрессии независимо друг от друга.
Основные первоисточники
-
BIG-bench — Beyond the Imitation Game
-
MMLU-Pro — A More Robust and Challenging Multi-Task Benchmark
-
LiveBench — A Challenging, Contamination-Limited LLM Benchmark
-
LiveCodeBench — Holistic and Contamination-Free Code Evaluation
-
Chatbot Arena — An Open Platform for Human Preference Evaluation
-
MT-Bench / LLM-as-a-judge — Judging LLM-as-a-Judge
-
Humanity's Last Exam — arxiv.org/abs/2501.14249
-
HLE-Verified — arxiv.org/abs/2602.13964
-
FrontierMath — arxiv.org/abs/2411.04872
-
ARC-AGI-2 — официальный технический отчёт
-
ARC-AGI-3 — официальное описание
-
SWE-bench — Can Language Models Resolve Real-World GitHub Issues?
-
SWE-bench Pro — arxiv.org/abs/2509.16941
-
OSWorld — arxiv.org/abs/2404.07972
-
-bench — arxiv.org/abs/2406.12045
-
Lost in the Middle — arxiv.org/abs/2307.03172
-
RULER — arxiv.org/abs/2404.06654
-
NoCha — arxiv.org/abs/2406.16264
-
LongBench v2 — arxiv.org/abs/2412.15204
-
VHELM — arxiv.org/abs/2410.07112
-
HarmBench — arxiv.org/abs/2402.04249
-
TruthfulQA — arxiv.org/abs/2109.07958
-
MASK — arxiv.org/abs/2503.03750
-
lm-evaluation-harness — github.com/EleutherAI/lm-evaluation-harness
-
Inspect AI — github.com/UKGovernmentBEIS/inspect_ai
-
OpenAI Evals — github.com/openai/evals
-
Arena: смена названия — официальное объявление
-
Точный тест Мак-Немара — документация statsmodels
Переход к математическому синтезу
Девятнадцать модулей прошли полный стек: от токенов, внимания и MoE до данных, претрейна, инференса, постобучения, мультимодальности, поиска, агентов и измерения результата. Сквозная идея курса одна: архитектура, данные, обучение, исполняющая система и оценка образуют одну причинную цепь. Улучшение в одном месте имеет смысл только тогда, когда измерено на другом.
Теперь в дополнительном М20 соберём механизм модели в одну математическую конструкцию: от токенов через прямой проход к потере, обновлению весов и генерации. Численный пример позволит проверить каждую часть, а сравнение с SSM и диффузией уточнит границы итоговой формулы. Для восстановления основ по-прежнему доступен М3.
Ландшафт сверен: 10 октября 2026 года. В модуле намеренно не приводится текущая таблица лидеров: такие числа меняются быстрее учебного текста и зависят от версии исполняющей обвязки, бюджета инференса и даты прогона. Все количественные примеры разделов 6, 8, 10, 12 и 13 принадлежат замороженному учебному контракту и не являются измерениями названных внешних моделей.