Модуль 17. Эмбеддинги, поиск и RAG
Курс «Modern LLMs» · лекция модуля 17 · редакция 2026.10.25
О чём этот модуль. Представим корпоративного ассистента, которому задают один вопрос: «Почему сборка 4.7.3 падает с ошибкой TS-999 и какое исправление уже одобрено?» Ответ может находиться в документации, журнале инцидента, обсуждении запроса на слияние (pull request) и новой внутренней инструкции, появившейся после претрейна модели. Поместить весь корпус в веса дорого и медленно; посылать его целиком в каждый промпт — дорого на инференсе. Третий путь — поиск (retrieval): заранее подготовить корпус и для каждого запроса выбрать небольшой набор свидетельств. Когда найденные фрагменты передаются генератору, получается RAG (Retrieval-Augmented Generation).
Мы будем следить не за каталогом библиотек, а за путешествием одного запроса через каскад. На каждом этапе система необратимо что-то отбрасывает: документ режется на фрагменты, фрагмент сжимается в представление, индекс просматривает лишь часть кандидатов, реранкер оставляет несколько результатов, а сборщик контекста укладывает их в токенный бюджет. Поэтому главный вопрос модуля звучит так: какую информацию теряет каждая стадия и как доказать, что ответ всё ещё можно найти? Сквозные численные сценарии отвечают на пять инженерных вопросов: сколько памяти занимают векторы; когда точный поиск перестаёт быть разумным; как разбиение корпуса меняет число индексируемых объектов; где в запросе действительно расходуется время; и во сколько раз полный документ отличается от компактного RAG-контекста по входу, prefill и KV-состоянию.
Что нужно знать заранее. Полезны контрастивная функция потерь из модуля 16, арифметика prefill и KV-кэша из модуля 10, а также токенизация и эмбеддинги из модуля 2. Все необходимые определения повторяются здесь, поэтому модуль остаётся самодостаточным.
Как читать модуль
Первый проход: разделы 1, 4–5, 7, 10–12, 15–17 и выводы. Держите в уме один вопрос: на каком переходе нужное свидетельство может исчезнуть? В разделе 10 перед таблицей введены все три метрики; к устройству индексов можно вернуться позже.
Второй проход: исторический маршрут 2–3, расчёты 6 и 8, индексы 9, код 13–14 и задачи 18–19. Запустите тетрадь, проследите один запрос по сохранённым спискам и уменьшите бюджет контекста. Сравнивайте результат со своими ожиданиями до запуска.
Справочный проход: таблицы памяти и каскада, паспорт эмбеддера в разделе 17, формулы метрик и первоисточники. Числа времени относятся к заданному сценарию; при выборе системы подставляются собственные измерения.
1. Мотивация: один вопрос и четыре потери информации
Начнём с задачи, а не с векторной базы. У нас есть большой изменяемый корпус, права доступа зависят от пользователя, а ответ должен ссылаться на источник. Системе нужно превратить миллионы возможных фрагментов в несколько тысяч входных токенов для генератора.
Есть три способа дать модели знания.
Дообучение помещает их в параметры. Оно полезно, когда нужно изменить устойчивое поведение или освоить повторяющийся узкий навык, но плохо подходит для ежедневных обновлений, точного удаления сведений и разграничения доступа по пользователям.
Длинный контекст помещает знания непосредственно в запрос. Этот путь сохраняет документ целиком и удобен для разового анализа одного файла, однако каждый новый длинный префикс требует обработки и хранения состояния. В §16 мы увидим учебный сценарий, где 200 тысяч входных токенов отличаются от RAG-контекста на 3712 токенов в 53.88 раза.
Поиск отделяет память от генератора. Корпус индексируется заранее, а при запросе выбираются только кандидаты, способные содержать ответ. Свежесть обеспечивается обновлением индекса, права — фильтрами, а происхождение ответа — сохранёнными идентификаторами и цитатами.
Однако слово «поиск» скрывает четыре последовательные потери.
- Разбиение: документ превращается в фрагменты; связь через границу может исчезнуть.
- Представление: фрагмент сжимается в термы, один вектор или набор векторов; часть структуры теряется.
- Отбор: точный или приближённый индекс оставляет небольшой список кандидатов; релевантный фрагмент может не попасть в него.
- Сборка контекста: даже среди найденного не всё помещается в бюджет; порядок и дубликаты начинают влиять на генерацию.
RAG поэтому лучше понимать не как «LLM плюс векторная база», а как управляемый каскад сжатия информации. Качество определяется не одной моделью эмбеддингов, а тем, насколько хорошо контролируется потеря на каждом переходе.
2. Историческая прогрессия: каждый новый метод возвращал потерянный сигнал
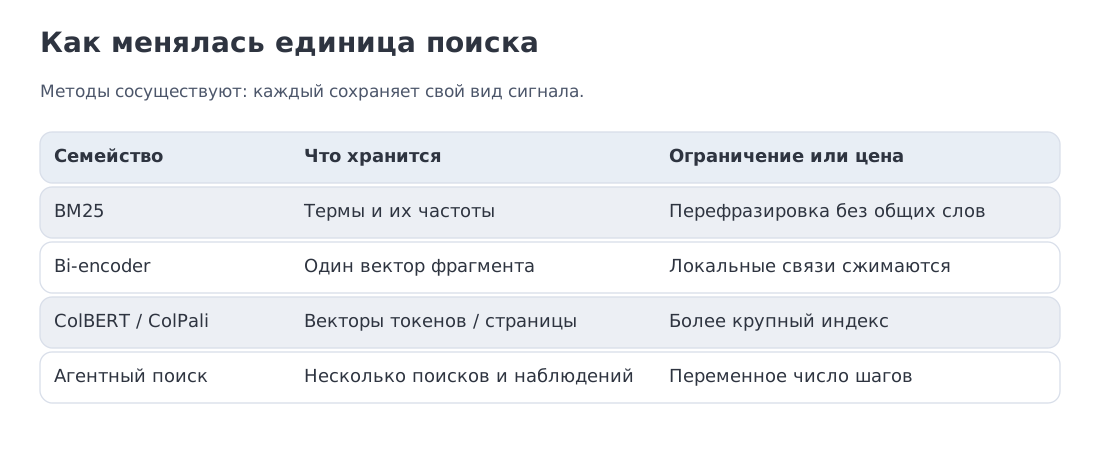 История поиска как последовательность нерешённых проблем: точное совпадение → словарный разрыв → семантическое сжатие → масштаб индекса → связь с генератором → адаптивный поиск.
Классический информационный поиск начинался с инвертированного индекса: для каждого терма хранится список документов, где он встречается. TF-IDF (Term Frequency–Inverse Document Frequency, частота терма — обратная частота документа) и BM25 (Best Matching 25, историческое название функции ранжирования) научились учитывать редкость слова, насыщение частоты и длину документа. Такая система прекрасно находит TS-999, имя функции или номер детали, но не понимает, что «перестал отвечать» и «завис» могут описывать одно событие.
Сиамские энкодеры вернули семантику. Sentence-BERT показал, что предложения можно заранее кодировать в векторы, а DPR (Dense Passage Retrieval, плотный поиск фрагментов) продемонстрировал сильный поиск для открытого ответа на вопросы — open-domain QA (Question Answering). Теперь запрос и документ могли не разделять ни одного слова, но оставаться соседями в пространстве представлений. Цена такого удобства — весь документ сжимается до одного вектора до встречи с конкретным запросом.
ColBERT (Contextualized Late Interaction over BERT) предложил промежуточное решение: кодировать запрос и документ независимо, но сохранять несколько токенных векторов и выполнять позднее взаимодействие. Так система возвращает часть тонкой структуры, не платя стоимостью полного cross-encoder по всему корпусу.
Когда число векторов выросло до миллионов и миллиардов, новым ограничением стал сам поиск ближайших соседей. Методы ANN (Approximate Nearest Neighbor, приближённый поиск ближайших соседей) — HNSW (Hierarchical Navigable Small World, иерархический навигационный граф малого мира), PQ (Product Quantization, квантование по подвекторам) и DiskANN (дисковый ANN-индекс) — решают не задачу семантики, а задачу какую долю пространства вообще просмотреть при заданных памяти, задержке и полноте.
RAG связал поиск с вероятностью ответа. В исходной работе Lewis et al. найденный документ был скрытой переменной: вероятности генерации при разных документах складывались с весами поиска. В RAG-Sequence вклад каждого документа рассчитывался для всей последовательности, а в RAG-Token — отдельно для каждой позиции. В распространённом прикладном варианте найденные фрагменты вместо этого объединяют в один контекст генератора; именно этот каскад мы разбираем ниже. Более сложные схемы переписывают запрос, оценивают найденное, ищут повторно и выбирают между RAG и длинным контекстом. Поиск превратился из одной функции в действие внутри более длинного цикла.
История модуля поэтому имеет один рисунок: каждый новый метод возвращает часть информации, потерянной предыдущим упрощением, и за это создаёт новую стоимость.
3. Мостик к классике: три старых задачи внутри RAG
Современный стек выглядит новым только из-за масштаба и терминологии. Его основание составляют три давно изучаемые задачи.
Информационный поиск: релевантность не равна совпадению слов
Инвертированный индекс отвечает на вопрос «где встречается терм?», а функция ранжирования — «насколько это совпадение важно?». BM25 наследует вероятностную традицию IR (Information Retrieval, информационного поиска) и до сих пор остаётся сильной базовой линией. Его особенно трудно заменить там, где значимы редкие строки: коды ошибок, идентификаторы, номера версий, фамилии и буквальные цитаты.
Метрическое обучение: полезное соседство нужно выучить
В kNN объект считается похожим, если находится рядом по выбранной метрике. Но для текста сама метрика не дана природой. Bi-encoder обучается так, чтобы релевантная пара была ближе нерелевантных. Здесь поиск наследует сиамские сети, контрастивное и метрическое обучение: модель не предсказывает ответ, а формирует пространство, где геометрия помогает отбору.
Каскадное ранжирование: сначала полнота, затем точность
Поисковые системы задолго до LLM использовали несколько стадий. Первая дешёвая стадия должна не потерять хорошие документы, вторая — точнее переупорядочить ограниченный список. В современных RAG-системах эти стадии называют отбором кандидатов, слиянием списков и реранкингом. Принцип остаётся прежним: невозможно одновременно применить самый дорогой скорер ко всему корпусу и сохранить низкую задержку.
Эти три задачи дают нам полезное разделение ответственности. BM25 защищает буквальный сигнал, эмбеддинг — семантическое соседство, реранкер — тонкое соответствие конкретной пары, а индекс — масштаб. Ни один слой не заменяет все остальные автоматически.
4. BM25 и обучаемые разреженные представления: ветка точных термов
Рассмотрим запрос ошибка TS-999 после обновления 4.7.3. Редкий код почти однозначно указывает на нужный документ. Семантическая модель может счесть похожими общие тексты об ошибках обновления, а лексическая ветвь проверяет совпадение выделенных термов. Инвертированный индекс хранит для каждого терма список документов, в которых он встречается, и необходимые сведения о вхождениях. Система обращается к этим спискам, чтобы найти кандидатов, а BM25 оценивает силу совпадения.
BM25 оценивает документ так:
Здесь — запрос, — документ, — терм после токенизации, — число таких термов, а — средняя длина в коллекции. В учебном коде используется положительный вариант
где — число документов, а — сколько документов содержат терм. При , множитель равен ; при он равен . Редкое совпадение получает больший вес. Повтор слова в запросе здесь повторяет его вклад; реализации с другой обработкой частоты запроса могут дать иной результат.
Токенизация тоже является частью метода. Учебное регулярное выражение разделит TS-999 на ts и 999, а 4.7.3 на три числа. Поэтому сохранность идентификатора проверяют на выходе анализатора: само название BM25 не гарантирует поиск целого кода. В прикладном индексе для таких полей часто сохраняют и исходную строку.
Формулу полезно прочитать словами.
- усиливает редкие термы и ослабляет слова, встречающиеся почти везде.
- учитывает частоту терма, но вклад насыщается: десятое повторение не должно быть в десять раз важнее первого.
- отношение не позволяет длинным документам выигрывать только потому, что в них больше слов.
Параметр управляет насыщением частоты, а — силой нормировки длины. Часто встречаются значения порядка и , но это отправные точки, а не универсальные константы для любого языка и корпуса.
Слабое место BM25 — словарный разрыв. Документ может описывать «аварийное завершение процесса», а запрос — «приложение падает». Термы различаются, хотя смысл близок.
SPLADE (Sparse Lexical and Expansion Model) и другие обучаемые разреженные модели пытаются вернуть семантику, сохранив совместимость с инвертированным индексом. Модель присваивает веса термам словаря, включая слова, которых буквально нет в исходном тексте, и одновременно штрафует слишком плотные представления. Получается промежуточный объект: не один непрозрачный плотный вектор, но и не обычный мешок встреченных слов.
Практическая роль лексической ветки ясна. Она не обязана быть единственным поиском, но часто служит страховкой от потери точных строк. В гибридном каскаде её ценность измеряют не отдельно от потока запросов, а по тем классам ошибок, которые плотная ветка пропускает.
5. Плотные bi-encoder-модели: как учат семантическое пространство
Теперь возьмём запрос «как не потерять ссылку на объект после разбиения текста». Релевантный документ может говорить об анафоре и местоимениях, не повторяя формулировку пользователя. Здесь буквального совпадения недостаточно.
В М2 эмбеддинг был строкой таблицы, выбранной по ID одного токена. Здесь нужен вектор целого запроса или фрагмента документа. В Transformer-энкодере сначала учитывается контекст токенов, а затем их представления собираются в один вектор — например, усредняются или читаются из выделенной позиции. Способ такого объединения должен совпадать с тем, на котором модель обучали. Поэтому брать произвольную строку входной таблицы LLM вместо поискового представления нельзя.
Двухбашенная модель (bi-encoder) кодирует запрос и документ независимо:
а релевантность оценивает косинусом или скалярным произведением. Независимость — главный системный выигрыш: документы кодируются один раз офлайн, а во время запроса остаются один проход для запроса и поиск по уже готовым векторам.
Чтобы геометрия стала полезной, модель обучают контрастивно. Для положительного документа и набора отрицательных одна из распространённых целей имеет вид
Температура управляет резкостью различий: меньшая температура сильнее выделяет максимальные сходства. Она не исправляет ошибочно размеченную пару. Но качество обучения чаще определяется не красивой формулой, а отрицательными примерами.
Негативы из пакета (in-batch negatives) почти бесплатны: положительные документы других запросов становятся отрицательными для текущего. При размере пакета каждая пара получает до кандидатов. Риск — ложные негативы: другой документ может тоже отвечать на запрос, и модель будет наказана за правильное соседство.
Трудные негативы (hard negatives) выбираются среди документов, которые текущая система считает похожими, но разметка не считает релевантными. Их часто добывают BM25, предыдущей версией эмбеддера или более дорогим реранкером. Такие примеры заставляют модель различать близкие темы, а не отделять очевидно несвязанные тексты.
E5 показала сильный двухстадийный рецепт: большой слабонаблюдаемый набор текстовых пар, затем дообучение на качественных данных. Современные эмбеддеры также могут принимать инструкцию задачи или разные префиксы для запроса и документа. Например, Qwen3-Embedding опубликована в размерах 0.6B, 4B и 8B и использует базовую языковую модель для эмбеддингов и реранкинга. Это расширяет качество и контекст, но увеличивает стоимость кодирования по сравнению с компактными энкодерами.
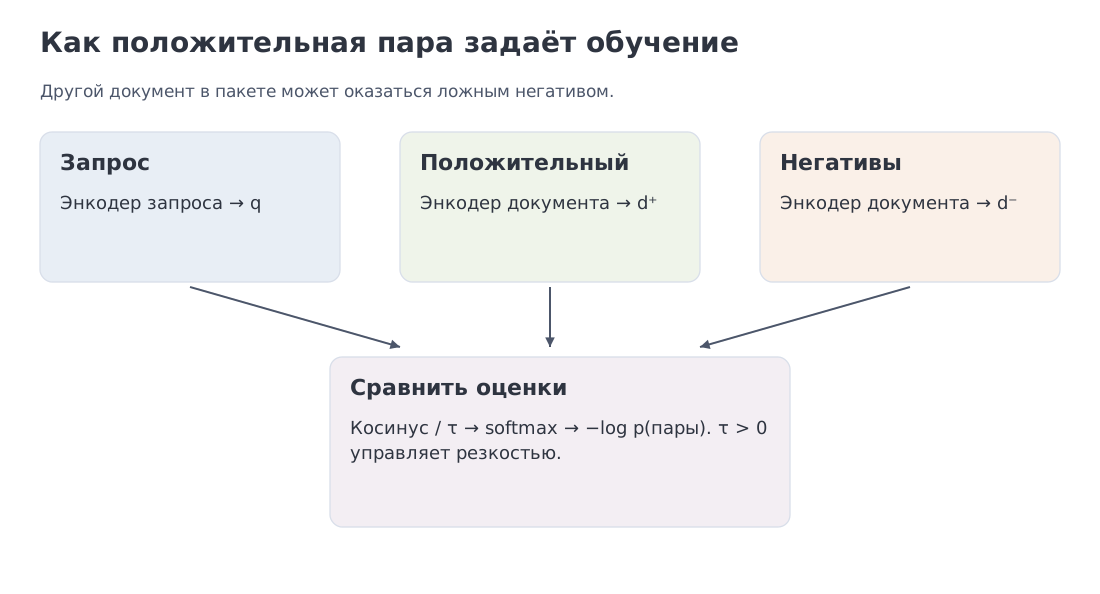 Обучение плотного эмбеддера: положительная пара, негативы из пакета, трудные негативы и переход от широкого предварительного обучения к целевой настройке.
Углубление. InfoNCE, температура и связь контрастивного обучения с оценкой взаимной информации подробнее разбираются в Information Theory for ML. Для текущего модуля достаточно понимать цель как обучение относительному порядку: релевантная пара должна получить больший скор, чем негативы.
6. MRL (Matryoshka Representation Learning), квантизация и решённый пример A: сколько стоит хранить смысл
После обучения возникает новый вопрос. Вектор удобен для поиска, но десять миллионов векторов размерности 1024 — уже отдельный набор данных. Его нужно хранить, загружать, реплицировать и сравнивать.
Matryoshka Representation Learning (MRL) обучает одно представление так, чтобы его префиксы разной длины оставались полезными. Функция потерь применяется не только к полному вектору, но и к усечениям . Это свойство возникает у обученных на таких срезах моделей; произвольный эмбеддинг не обязан его иметь. После обучения система может выбирать размерность под ресурсный бюджет без отдельной проекционной модели; срез обычно заново нормируется перед косинусным сравнением.
Квантизация решает соседнюю задачу: уменьшает число битов на координату. Короткая размерность и низкая точность воздействуют на разные оси, поэтому их можно сочетать. Часто грубый поиск выполняется по короткому или бинарному представлению, а ограниченный набор кандидатов пересчитывается полным вектором.
Для 10 млн векторов размерности 1024 получаем:
| Представление | байт на вектор | Десятичный объём | Двоичный объём | Отношение к fp32 |
|---|---|---|---|---|
| fp32 | 4096 | 40.96 GB | 38.15 GiB | 1× |
| fp16 | 2048 | 20.48 GB | 19.07 GiB | 2× меньше |
| int8 | 1024 | 10.24 GB | 9.54 GiB | 4× меньше |
| binary | 128 | 1.28 GB | 1.19 GiB | 32× меньше |
| MRL-256 + int8 | 256 | 2.56 GB | 2.38 GiB | 16× меньше |
Таблица считает только полезную нагрузку векторов. HNSW добавит рёбра графа, IVF-PQ (Inverted File + Product Quantization, инвертированный файл с квантованием по подвекторам) — центроиды и кодовые книги, сервис — идентификаторы, метаданные, фильтры, репликацию и служебные структуры. Поэтому число 1.19 GiB нельзя читать как размер готовой базы.
Смысл примера не в выборе победившего формата. Он показывает, что качество эмбеддера и экономика индекса связаны: размерность, точность и возможность повторного ранжирования должны проектироваться вместе.
7. Один вектор, одна пара или матрица: где происходит взаимодействие
Плотный bi-encoder получает масштаб ценой сильного сжатия: документ превращается в один вектор до того, как увидел запрос. Это хорошо для первого отбора, но может скрыть тонкое совпадение отдельной фразы.
На другом конце находится кросс-энкодер (cross-encoder). Запрос и документ подаются в один Transformer, и все их токены взаимодействуют внутри внимания. Такой скорер знает, какой именно аспект документа важен запросу, но его оценку нельзя заранее вычислить для корпуса. Если кандидатов , нужно совместно обработать пар. Их можно объединить в пакеты: число пар определяет объём работы, а число последовательных вызовов зависит от размера пакета и исполнения.
Между ними располагается позднее взаимодействие (late interaction). ColBERT кодирует запрос и документ независимо, но сохраняет вектор для каждого токена. Один из вариантов оценки — MaxSim:
Каждый токен запроса выбирает наиболее похожий токен документа, а результаты суммируются. Документный индекс можно построить заранее, но он значительно больше одновекторного индекса.
Эти три архитектуры образуют не рейтинг, а шкалу компромисса.
- Bi-encoder: дешёвый широкий отбор, сильное сжатие взаимодействия.
- Cross-encoder: самое полное взаимодействие, но только для небольшого числа пар.
- Late interaction: токенная детализация с предвычислимым документным представлением, но большой многовекторный индекс.
ColPali переносит позднее взаимодействие на изображения страниц: вместо хрупкой цепочки OCR → парсинг → текстовые фрагменты модель непосредственно кодирует страницу в набор визуальных векторов. В работе авторов этот подход оценивался на ViDoRe и показал преимущества на визуально богатых документах. Для продукта это не означает, что OCR больше не нужен: текстовая индексация остаётся полезной для точных строк, копирования, фильтров и доступности. Мультимодальная ветка добавляет ещё один источник кандидатов.
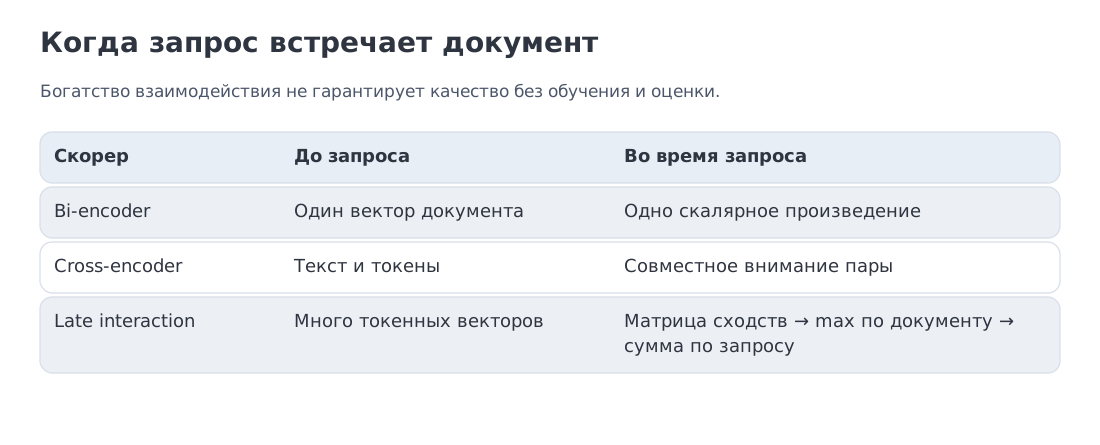 Шкала взаимодействия: один вектор для широкого отбора, полная пара для точного реранкинга и токенная матрица для позднего взаимодействия.
8. Решённый пример B: точный поиск и арифметика ANN (Approximate Nearest Neighbor)
Предположим, что все 10 млн векторов хранятся в памяти и запрос нужно сравнить с каждым. Для скалярного произведения размерности грубая оценка числа операций равна
При условной производительности 10 GFLOP/s оценка только числа операций составляет 2.048 секунды.
Теперь зададим учебный ANN-сценарий: после навигации индекс выполняет 2000 полных сравнений. Только эти расстояния требуют
или 0.4096 мс при тех же 10 GFLOP/s. Отношение арифметических работ равно 5000.
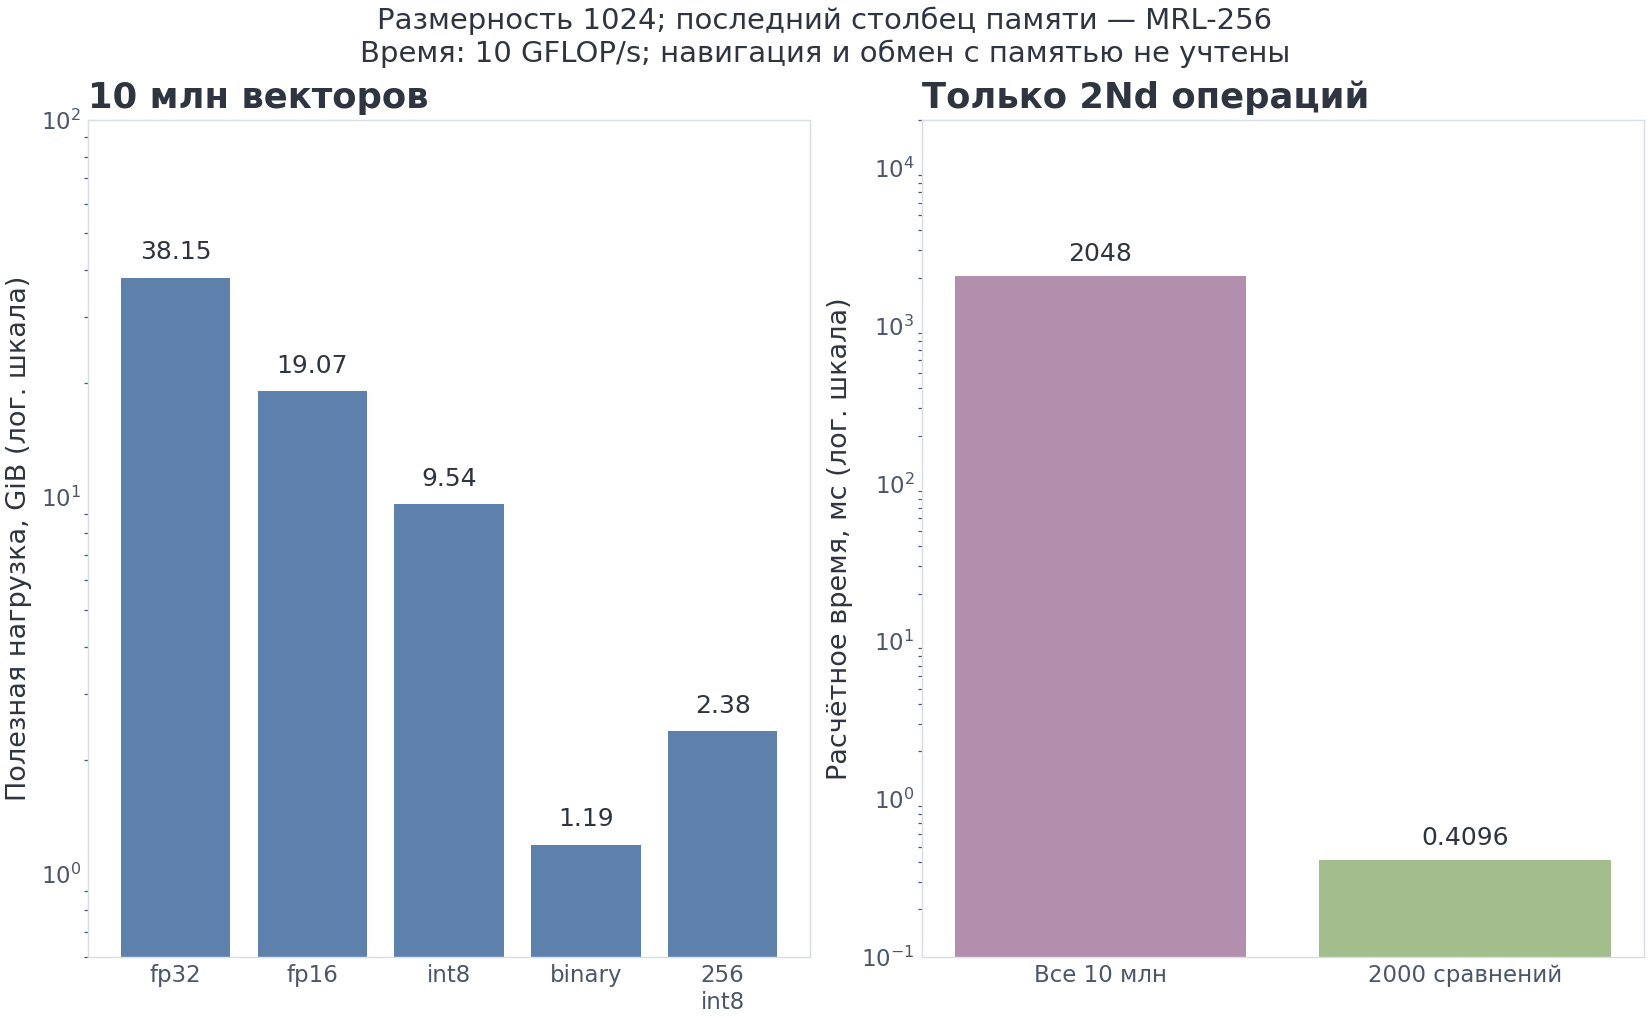 Слева — полезная нагрузка векторов; справа — арифметика полного сканирования и сценария с 2000 полными расстояниями.
Это не измерение HNSW и не обещание задержки 0.41 мс. ANN-индекс тратит время на обход структуры, нерегулярные обращения к памяти, декодирование сжатых представлений, фильтры и иногда повторное ранжирование. Кроме того, приближённость создаёт новую метрику — recall индекса относительно точного поиска.
Именно здесь полезно различить две задачи. Модель эмбеддингов определяет, какие соседи считаются хорошими. ANN определяет, какую долю пространства мы успеем исследовать. Улучшение одного слоя не компенсирует автоматически ошибку другого.
9. ANN под капотом: три индекса для трёх ограничений
Все ANN-методы сокращают объём поиска, но делают это по-разному. Выбор определяется не только числом векторов, а тем, что именно является дефицитом: оперативная память, время обновления, задержка или место на диске.
HNSW (Hierarchical Navigable Small World): память в обмен на навигацию
HNSW строит многослойный граф близости. Разреженные верхние слои позволяют делать дальние переходы, нижний слой уточняет локальную окрестность. Параметр M влияет на число рёбер и память, efConstruction — на качество и стоимость построения, efSearch — на компромисс полноты и задержки во время запроса.
HNSW удобен, когда индекс и граф помещаются в RAM и нужны хорошие задержки с динамическими вставками. Его слабая сторона — память под рёбра и необходимость измерять поведение фильтров: выборка по правам доступа или метаданным может изменить эффективную связанность графа.
IVF-PQ (Inverted File + Product Quantization): сначала кластер, затем короткий код
IVF (Inverted File, инвертированный файл) делит пространство на крупные области и проверяет только несколько ближайших списков. Product Quantization дополнительно разбивает вектор на подвекторы и заменяет каждый индексом ближайшего центроида. Параметр nprobe увеличивает число просматриваемых списков, а длина PQ-кода управляет памятью и ошибкой расстояния.
Такой индекс полезен, когда главная проблема — объём векторов. Цена — калибровка кластера, ошибка квантования и более сложный путь обновления.
DiskANN: часть пространства остаётся на SSD
DiskANN проектирует графовый поиск так, чтобы большой набор векторов мог жить на NVMe, а оперативная память использовалась для навигации и кэшей. В исходной работе показан миллиардный поиск на одном узле с 64 GB RAM и SSD. Это не означает, что любой SSD-индекс автоматически быстрее HNSW в оперативной памяти; выигрыш появляется, когда задача иначе не помещается в доступную память.
Индекс — не обязательно отдельная база
Алгоритм ANN и способ эксплуатации — разные решения. Индекс может находиться внутри библиотеки, расширения реляционной БД, поискового движка или специализированного сервиса. Если данные уже живут в PostgreSQL и критичны транзакции, метаданные и списки управления доступом — ACL (Access Control Lists), расширение вроде pgvector может уменьшить операционную сложность. Если требуются независимое масштабирование, множество коллекций и специализированное управление индексами, отдельный сервис может быть оправдан.
Не существует надёжного универсального порога «после 50 тысяч нужна векторная база». Точный поиск иногда остаётся лучшим решением и на больших наборах, если векторы короткие, запросы пакетируются и ускоритель уже доступен. Решение принимается по кривой полнота–задержка–память–стоимость обновления на собственном распределении запросов.
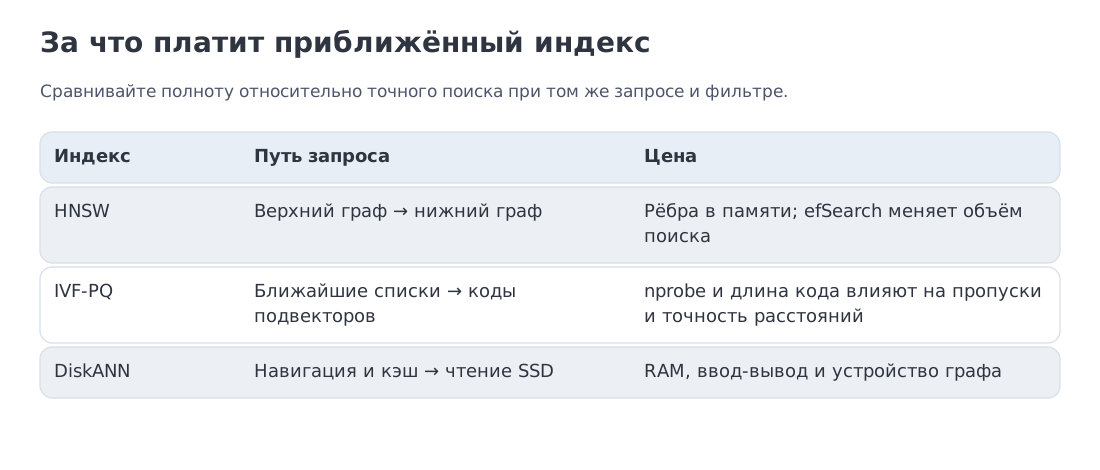 HNSW, IVF-PQ и DiskANN как ответы на разные дефициты: память графа, сжатие векторов и вынос большого индекса на SSD.
10. Гибридный поиск, RRF (Reciprocal Rank Fusion) и решённый пример F
Теперь у нас есть две первые стадии. BM25 хорошо защищает точные термы; плотный поиск возвращает семантические перефразировки. Их оценки несопоставимы: BM25 и косинус живут в разных шкалах и меняются от запроса к запросу.
Reciprocal Rank Fusion (RRF) обходит проблему калибровки, используя только позиции:
где — ранг документа в ветке , начиная с единицы. Если документа нет в списке ветки, вклад равен нулю. Константа уменьшает разницу между соседними позициями вверху списка; веса позволяют менять относительный вклад ветвей.
Чтобы прочитать результат, сначала определим метрики. Пусть — множество релевантных документов для запроса, — первые позиций списка, а — позиция первого релевантного документа. Recall@k равен : найден один из двух нужных документов — полнота , даже если он стоит первым. MRR усредняет по запросам; при отсутствии ответа вклад нулевой. nDCG@k сравнивает ценность полученного порядка с идеальным, учитывая степени релевантности. Подробная формула будет в разделе 17; значение 1 означает идеальный порядок при принятой разметке.
Но RRF не создаёт новую информацию. Он лишь объединяет списки. Для автономной практики плотная ветвь использует латентный семантический анализ (LSA). Сначала составляется матрица TF-IDF «документы × термы»: частоты слов умножаются на их редкость. Сингулярное разложение (SVD) приближает её произведением , сохраняя направлений с наибольшими сингулярными значениями. Они описывают наиболее сильные совместные изменения термов в этой матрице; это не заранее заданные смысловые темы. Документ и запрос проектируются как и нормируются перед косинусным сравнением. Это обученная по совместной встречаемости слов линейная геометрия; она не наследует знания большой языковой модели и не гарантирует понимания перефразировок.
На замороженном наборе из 13 документов и семи запросов получены такие результаты:
| Метод | MRR (Mean Reciprocal Rank) | Recall@5 | nDCG@5 (Normalized Discounted Cumulative Gain) |
|---|---|---|---|
| BM25 | 0.929 | 0.786 | 0.872 |
| плотная ветка LSA (Latent Semantic Analysis, латентный семантический анализ) | 0.762 | 0.857 | 0.755 |
| RRF, | 0.929 | 0.786 | 0.866 |
| взаимодействующий реранкер | 1.000 | 0.857 | 0.928 |
Плотная ветка находит больше релевантных документов в top-5, но располагает их хуже. RRF в этой маленькой выборке не улучшает nDCG относительно BM25. Реранкер получает объединённый список и восстанавливает более точный порядок.
Это авторский диагностический набор, замороженный независимо от лекции. Семь запросов используются для разработки, а не как отложенный тест. LSA строится по всему индексируемому корпусу без меток запросов. Реранкер не обучается: он усредняет наибольшее сходство по символьным триграммам для каждого слова запроса. Это лексический учебный механизм, а не нейросетевой ColBERT. RU и EN используют разные формулировки, поэтому различие их чисел не измеряет качество поиска на языках.
Этот отрицательный результат педагогически важен. Слияние списков расширяет или стабилизирует пул кандидатов; реранкинг заново оценивает конкретные пары. Считать их одной операцией нельзя. Гибридная система считается лучше только после измерения на распределении запросов, где ветви действительно покрывают разные ошибки.
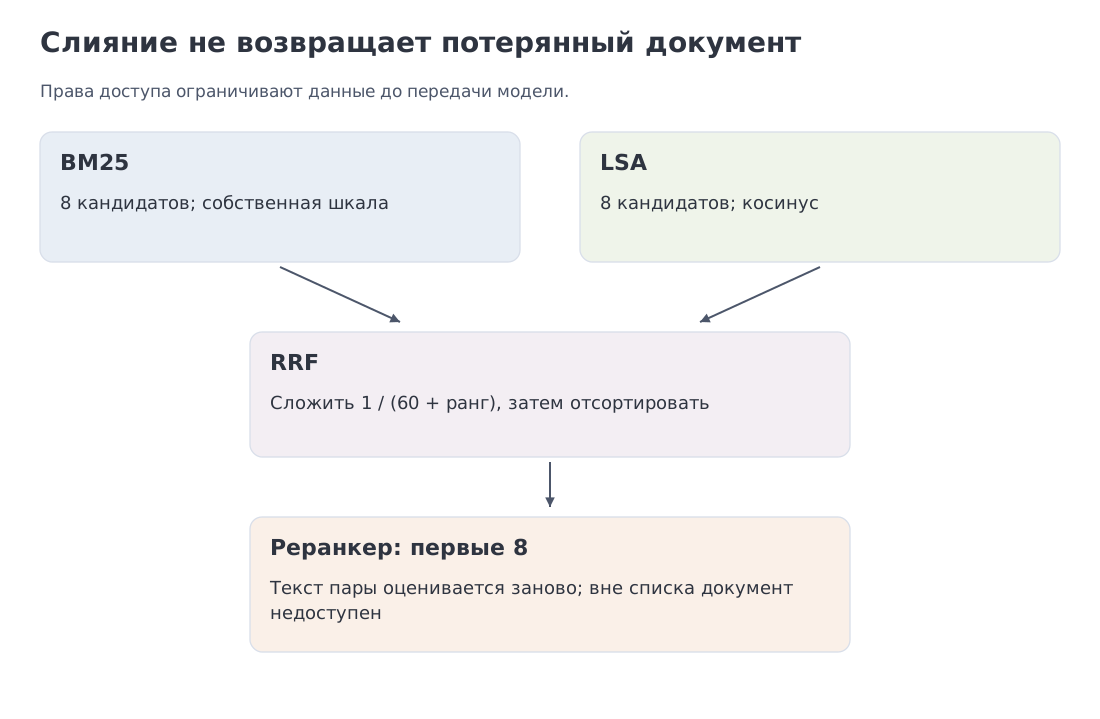 Две ветви создают кандидатов, RRF объединяет ранги, а взаимодействующий реранкер меняет порядок ограниченного списка. На каждом отсечении нужно проверять, какие релевантные кандидаты ещё доступны.
11. Разбиение на фрагменты: что именно становится объектом поиска
До сих пор мы говорили «документ», словно он имеет естественную длину для эмбеддера. На практике руководство на 200 страниц и короткая запись журнала не могут быть одной единицей индекса. Нужно решить, какой фрагмент система будет возвращать генератору.
Слишком длинный фрагмент смешивает несколько тем в одном векторе и расходует токенный бюджет. Слишком короткий теряет определения, местоимения и причинные связи. Разбиение поэтому является частью модели релевантности, а не предварительной технической уборкой.
Простое перекрывающееся окно
Фиксированное окно в несколько сотен токенов с перекрытием — сильная исходная точка. Оно детерминировано, дёшево и легко оценивается. Перекрытие защищает локальные связи у границы, но создаёт дубликаты и увеличивает индекс.
Структурное разбиение
Заголовки, абзацы, таблицы, блоки кода и страницы часто дают более естественные границы. Структурный метод сохраняет смысловые единицы, но зависит от качества парсинга и может породить очень неравномерные длины.
Позднее разбиение (Late Chunking)
Позднее разбиение сначала проводит длинный документ через длинноконтекстный энкодер, а затем усредняет уже контекстуализированные токенные представления внутри границ фрагментов. Поэтому местоимение внутри короткого фрагмента всё ещё несёт информацию о предыдущем тексте. Цена — более дорогая индексация и ограничение максимальной длиной энкодера. Описанный метод предполагает доступ к токенным состояниям и усреднение внутри фрагмента; эмбеддер, возвращающий только последний токен, нельзя подставить без изменения этого контракта. Для более длинных документов авторы отдельно рассматривают окна с перекрытием. Позднее разбиение не гарантирует преимущество для любого размера фрагмента и корпуса.
Contextual Retrieval
В подходе Anthropic перед индексацией к каждому фрагменту добавляется короткое объяснение его места в документе. В опубликованных экспериментах компании контекстуализированные эмбеддинги уменьшили долю неудачного поиска в top-20 на 35%, сочетание с контекстуализированным BM25 — на 49%, а добавление реранкера — на 67%. Это результаты конкретного набора доменов, моделей и протокола, а не универсальные множители.
Теперь посчитаем масштаб. Корпус содержит 20 млн токенов, размер фрагмента — 400, перекрытие — 64, поэтому шаг равен 336. Число фрагментов:
Формула считает весь корпус одним непрерывным документом. При независимых документах число окон суммируется по каждому: применять формулу к суммарной длине уже нельзя. Для оценки вычислений все окна, включая последнее, дополняются до 400 токенов. Поэтому обрабатывается позиций с учётом перекрытий и дополнения.
В замороженном вычислительном сценарии кодирование 0.6B-энкодером оценивается в FLOP. При 990 TFLOP/s и MFU 0.5 оценка равна 57.7 секунды. Это не время полной индексации: вне модели остаются чтение, токенизация, упаковка, запись, повторные попытки и служебные этапы.
Сырые векторы этих фрагментов занимают 232.52 MiB в fp32, 58.13 MiB в int8 и 7.27 MiB в бинарном представлении. Малый размер подчёркивает важный вывод: в таком корпусе сложность системы может определяться не векторами, а метаданными, правами, обновлениями и качеством фрагментации.
12. Полный каскад и решённый пример D: где живёт задержка
Списки управления доступом (ACL) ограничивают видимые данные ещё до передачи текста реранкеру или генератору. Если индекс фильтруется после поиска, число кандидатов и полноту измеряют после этого фильтра; метаданные запрещённых документов также не должны попадать в ответ.
Соберём стадии в один запрос.
- Запрос нормализуется или раскладывается на подзапросы.
- Лексическая и плотная ветви возвращают кандидатов.
- RRF или другой способ слияния объединяет списки.
- Реранкер оценивает ограниченный набор пар.
- Сборщик удаляет дубликаты разрешённых фрагментов, сохраняет цитаты и укладывает фрагменты в бюджет.
- Генератор выполняет prefill и создаёт ответ.
- При недостатке свидетельств агент может переформулировать запрос и повторить поиск.
Между сборкой и генерацией проходит ещё одна граница: найденный текст служит данными для ответа, а его команды не получают полномочий пользовательского запроса. Документ может описывать одобренное исправление и одновременно содержать чужую инструкцию «выполнить действие». Ни высокий ранг, ни правильная цитата не дают системе разрешения её выполнить. В модуле 18 разберём эту границу на агенте с инструментами.
Для учебного сценария зададим 8B-генератор, восемь фрагментов по 400 токенов, 100 кандидатов для 0.6B-реранкера и ответ длиной 300 токенов.
Покажем, откуда берутся времена. Для энкодера и реранкера используем приближение операций прямого прохода: — число параметров, — число обработанных токенов. Заданы пиковые 990 TFLOP/s и условный MFU 0.5, то есть расчётная скорость FLOP/s. Запрос содержит 32 токена; пара для реранкера — . Отсюда мс; сто пар длины 432 дают 104.7 мс.
Генератор в расчёте имеет ровно параметров. Вход — токенов: 512 отведены инструкции и запросу. Линейная оценка prefill равна 120.4 мс. Для decode отдельно предполагается скорость 209.4 токена/с, поэтому 300 токенов требуют с. Это не результат измерения и не вывод из .
Сумма предполагает последовательное выполнение и не учитывает очереди, сеть, чтение индекса и упаковку. MFU может различаться между коротким запросом и большим пакетом пар; квадратичная составляющая внимания опущена. Таблица поэтому является условным бюджетом сценария, а не строгой нижней границей времени запроса.
| Стадия | Условная оценка времени | Доля общей оценки |
|---|---|---|
| кодирование запроса | 0.0776 мс | <0.1% |
| 2000 точных расстояний после ANN-навигации | 0.4096 мс | <0.1% |
| реранкинг 100 кандидатов | 104.7 мс | 6.3% |
| prefill 3712 токенов | 120.4 мс | 7.3% |
| decode 300 токенов | 1432.7 мс | 86.4% |
| итого | 1.658 с | 100% |
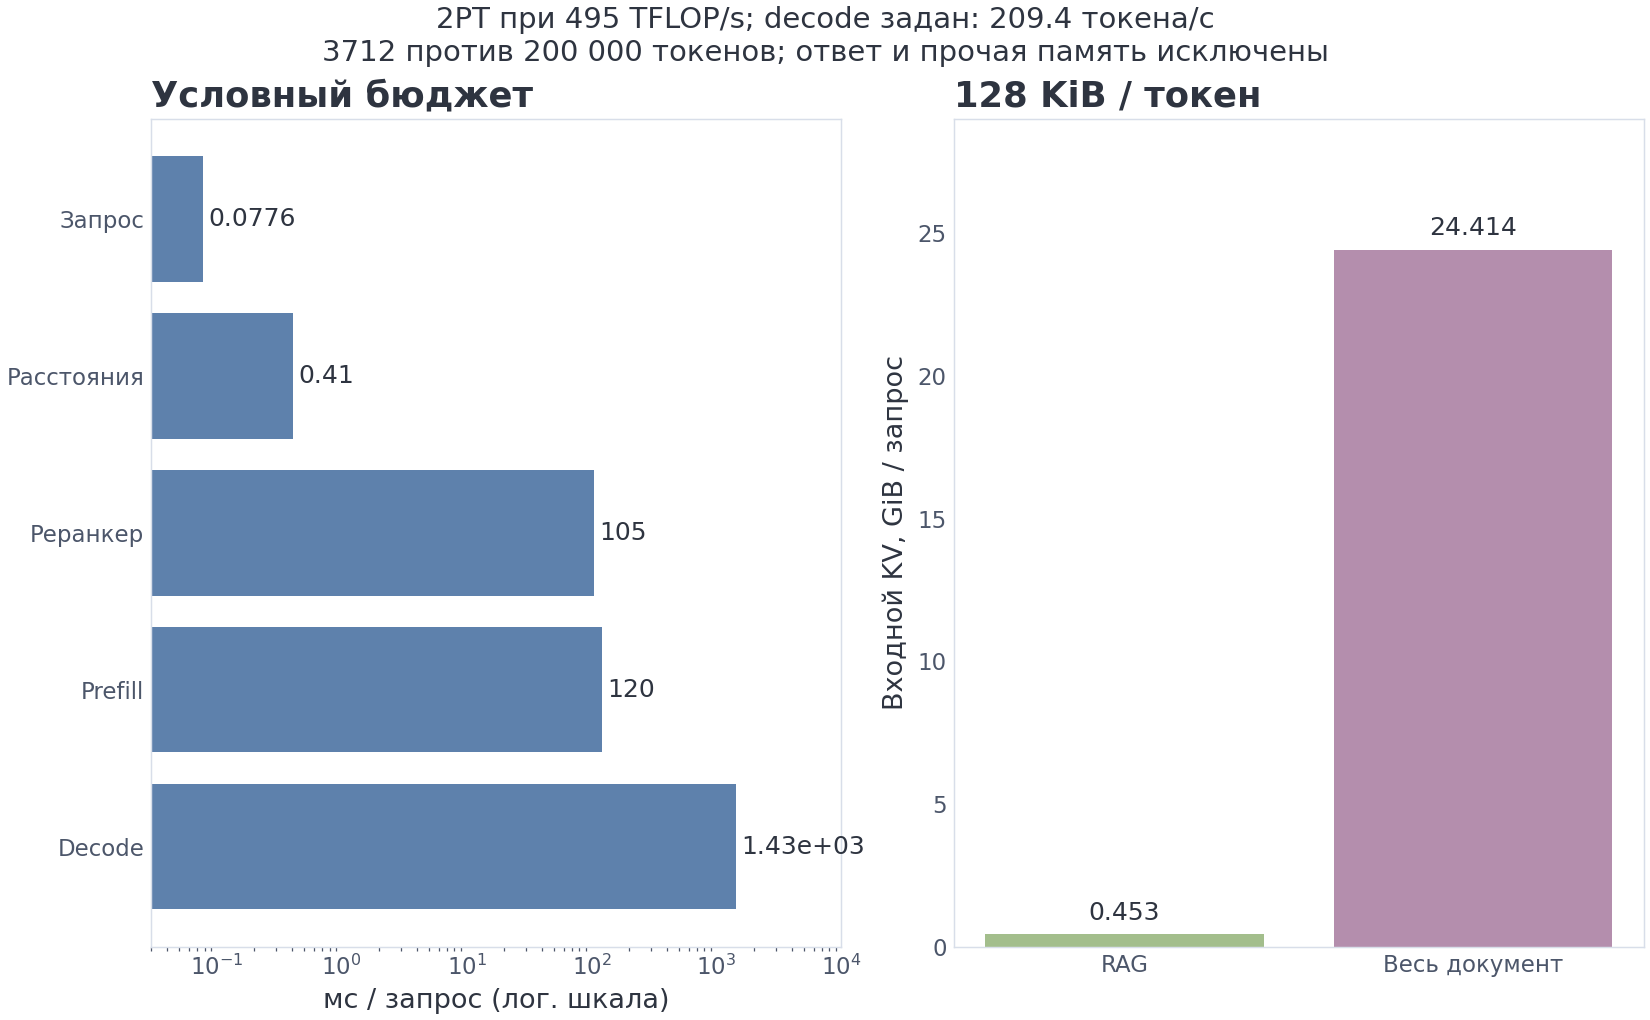 Слева — параметризованный бюджет каскада; справа — одинаковый коэффициент входа, prefill и KV в учебном сравнении RAG с полным документом.
Эта таблица не доказывает, что реранкинг «почти бесплатен» вообще. Она показывает, что в одном интерактивном сценарии длинный decode доминирует над выбранным реранкером. При коротком ответе, большом числе кандидатов, удалённом API или насыщенной пакетной генерации соотношение изменится.
Следовательно, оптимизация должна идти по измеренному профилю. Иногда стоит ускорять генератор, иногда — уменьшать число реранжируемых пар, иногда — заранее кэшировать запросные векторы. Главное — не переносить долю 6.3% из учебного сценария в чужую систему.
13. Код первого уровня: гибридный поиск с явными контрактами
Минимальный код выделяет два разных механизма. RRF складывает вклады позиций, не читая текст. MaxSim строит матрицу косинусных сходств токенов и для каждого токена запроса выбирает лучший столбец. Входы MaxSim уже нормированы; здесь не обучается энкодер.
"""RRF and exact late interaction: executable, model-independent mechanisms."""
import numpy as np

def rrf(rankings, k=60):
    """Accumulate one-based reciprocal ranks, then sort U unique candidates."""
    if not np.isfinite(k) or k <= 0:
        raise ValueError("k must be positive and finite")
    scores = {}
    for ranking in rankings:
        if any(not isinstance(doc, str) or not doc for doc in ranking):
            raise ValueError("IDs must be nonempty strings")
        if len(ranking) != len(set(ranking)):
            raise ValueError("duplicate document in a branch")
        for rank, doc in enumerate(ranking, 1):
            scores[doc] = scores.get(doc, 0.0) + 1.0 / (k + rank)
    return sorted(scores, key=lambda doc: (-scores[doc], doc)), scores

def maxsim(query, document):
    """Q:[nq,d], D:[nd,d]; sum the best document match for each query row."""
    q, d = np.asarray(query, float), np.asarray(document, float)
    if q.ndim != 2 or d.ndim != 2 or q.shape[1] != d.shape[1]:
        raise ValueError("expected two matrices with one shared feature dimension")
    if not all(q.shape) or not all(d.shape):
        raise ValueError("empty token matrices")
    if not np.isfinite(q).all() or not np.isfinite(d).all():
        raise ValueError("non-finite vectors")
    if not (np.allclose(np.linalg.norm(q, axis=1), 1)
            and np.allclose(np.linalg.norm(d, axis=1), 1)):
        raise ValueError("normalize token vectors before cosine MaxSim")
    similarities = q @ d.T
    return float(similarities.max(axis=1).sum()), similarities

order, scores = rrf([["a", "b"], ["b", "c"]])
assert order == ["b", "a", "c"]
assert np.isclose(scores["b"], 1 / 62 + 1 / 61)
score, matrix = maxsim(np.eye(2), np.array([[1.0, 0.0]]))
assert score == 1.0 and matrix.shape == (2, 1)
В примере документ b получает два вклада и оказывается первым. В матрице MaxSim первый вектор запроса полностью совпадает с единственным вектором документа, а второй ортогонален ему: сумма равна 1. Повторное использование одного токена документа разрешено — MaxSim не является взаимно однозначным сопоставлением.
Накопление RRF требует времени, линейного по длине входных списков, но итоговая сортировка уникальных кандидатов стоит . В тетради к этим механизмам добавлены индексирование, ограничения и проверка результата.
15. Эволюция RAG: каждый «продвинутый» метод исправляет конкретный сбой
Список названий RAG-методов мало полезен без вопроса, какую потерю они пытаются исправить.
Запрос плохо похож на нужный документ
HyDE (Hypothetical Document Embeddings, эмбеддинги гипотетического документа) просит LLM написать гипотетический документ-ответ и ищет по его эмбеддингу. Генерация может содержать ошибочные детали, но используется не как источник фактов, а как мост к нужной области пространства документов.
Поиск выполняется всегда, даже когда он не нужен
Self-RAG обучает модель принимать решение о поиске и оценивать найденное с помощью специальных токенов рефлексии. Идея состоит не в одном новом индексе, а в том, что поиск становится условным действием.
Найденные документы могут быть плохими
CRAG (Corrective Retrieval-Augmented Generation, корректирующая генерация с дополнением поиском) добавляет оценку качества поиска и выбирает корректирующее действие, включая дополнительный веб-поиск и фильтрацию найденного текста.
Локальные фрагменты не отвечают на глобальный вопрос
RAPTOR (Recursive Abstractive Processing for Tree-Organized Retrieval) строит дерево фрагментов и рекурсивных суммаризаций, позволяя искать на нескольких уровнях абстракции. GraphRAG строит граф сущностей и резюме сообществ для вопросов вида «какие главные темы проходят через весь корпус?». Такие индексы дороже строить и обновлять; их ценность появляется только на соответствующих классах вопросов.
Одного запроса недостаточно
В агентном поиске модель формулирует подзапросы, читает результаты, замечает пробелы, уточняет формулировки и останавливается по критерию достаточности. Здесь поиск становится инструментом, а не фиксированной стадией. Цена — переменное число обращений, менее предсказуемая задержка и необходимость оценивать весь маршрут, а не только первый top-k.
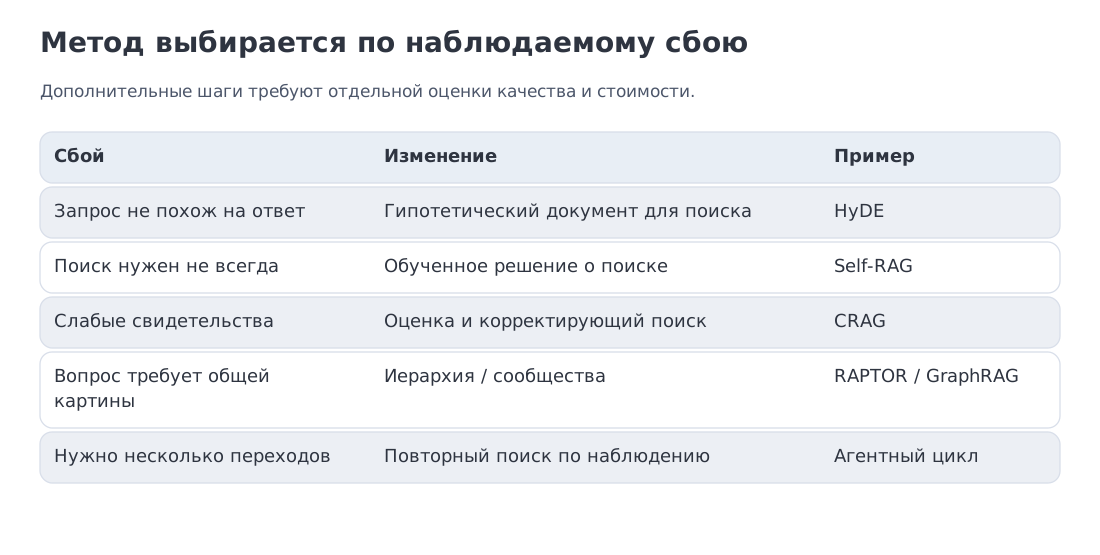 Пять типовых сбоев однопроходного RAG и методы, которые меняют запрос, момент поиска, проверку, уровень абстракции или число итераций.
Общий вывод важнее названий. «Продвинутый RAG» — не обязательный набор из HyDE, графа и агента. Это минимальное изменение, устраняющее измеренный тип ошибки. Если обычный BM25 плюс реранкер уже решает задачу, дополнительная автономность только увеличит стоимость и пространство отказов.
16. Решённый пример E: RAG или длинный контекст
Вернёмся к исходному выбору. Пусть полный документ содержит 200 тысяч токенов, а после поиска и сборки контекста генератор получает 3712 токенов. Отношение длин равно
При одной и той же линейной модели prefill и одинаковой цене KV на токен получаем:
| Ресурс | Полный документ | RAG-контекст | Отношение |
|---|---|---|---|
| вход | 200 000 токенов | 3712 токенов | 53.88× |
| условная линейная оценка prefill | 6.489 с | 0.120 с | 53.88× |
| KV при 128 KiB/токен | 24.414 GiB | 0.453 GiB | 53.88× |
Совпадение отношений опирается на линейное приближение. При 200 тысячах токенов квадратичная работа внимания может быть существенной; одинаковое число байтов KV на позицию предполагает одну архитектуру и точность. Учтён только входной KV, без будущего ответа и прочей памяти исполнения.
Это ресурсное сравнение, а не доказательство качества. RAG может не найти важный фрагмент, потерять связь между частями документа или принести противоречивые источники. Длинный контекст сохраняет весь документ, но модель всё равно может хуже использовать информацию в середине, а цена нового префикса остаётся высокой.
Исследование Self-Route сравнивало RAG и LLM с длинным контекстом на нескольких наборах и обнаружило характерную развилку: при достаточных ресурсах длинный контекст часто давал более высокое среднее качество, а RAG сохранял ценовое преимущество; маршрутизация между ними позволяла приблизиться к качеству длинного контекста при меньших затратах. Это результат конкретного протокола, но сам принцип устойчив: выбирать ветку следует по типу запроса.
- Большой изменяемый корпус, ACL, свежесть и цитаты благоприятствуют RAG.
- Целостное сравнение всего документа, проверка распределённых по тексту тем и разовая работа с одним файлом благоприятствуют длинному контексту.
- Смешанный поток запросов благоприятствует маршрутизатору или гибриду: поиск выбирает область, а ёмкий контекст сохраняет достаточно широкое окружение.
17. Оценка и паспорт эмбеддера
Когда итоговый ответ неверен, нужно определить, где именно возникла потеря.
Recall@k измеряет долю всех размеченных релевантных объектов, попавших в первые позиций. Низкая полнота указывает на риск потери нужного свидетельства. Но иногда одного из нескольких релевантных документов достаточно для ответа: поэтому отдельно проверяют достаточность выбранного контекста.
Зафиксируем формулу nDCG. Если документ на позиции имеет целочисленную степень релевантности , то
IDCG вычисляется по всем известным оценкам запроса, отсортированным по убыванию, и затем обрезанным до . При оценках 3 и 1 идеальная ценность равна . Если порядок перевёрнут, получаем . Полнота двух результатов при этом остаётся единицей, а MRR тоже равен единице: первый документ всё ещё релевантен.
В тетради запрос без положительной разметки считается ошибкой набора, а не нулевым качеством. В реальном потоке такие запросы нужны для оценки отказа от ответа, но требуют отдельного протокола. Одинаковый ID не может занимать две позиции: иначе nDCG может искусственно превысить 1. Результаты усредняются по запросам, а не по числу найденных документов.
MRR смотрит только на позицию первого релевантного результата. Метрика полезна, когда пользователю достаточно одного правильного документа.
nDCG@k поддерживает градуированную релевантность и штрафует хорошие документы, оказавшиеся слишком низко. Она лучше отражает задачи, где несколько источников имеют разную ценность.
Для генерации нужны отдельные измерения: соответствие ответа найденному контексту, корректность цитат, полнота и качество финального текста. RAGAS (Retrieval-Augmented Generation Assessment) предлагает автоматизированные оценки на основе LLM нескольких таких измерений, но модель-судья сама является источником ошибки. Поэтому золотой набор реальных запросов и ручная проверка остаются обязательными.
BEIR (Benchmarking IR, сравнительный стенд информационного поиска) показывает, что сильный метод на одном домене не обязан хорошо переноситься на другие. MTEB (Massive Text Embedding Benchmark) расширяет оценку эмбеддингов на разные задачи, а MMTEB (Massive Multilingual Text Embedding Benchmark) содержит более 500 контролируемых задач на 250+ языках. Эти стенды полезны для короткого списка кандидатов, но не заменяют собственный корпус, запросы, ACL и распределение длин.
Паспорт эмбеддера
Перед выбором модели нужно зафиксировать:
- архитектуру: базовый энкодер или декодер;
- размерность полного вектора и поддерживаемые обученные префиксы вектора — MRL-срезы из §6;
- способ агрегации токенных представлений (pooling);
- необходимость инструкций и различие кодирования запроса и документа;
- максимальную длину входа и правила усечения;
- нормировку и функцию сходства;
- язык, домен и типы задач обучения;
- лицензию, доступность весов и стоимость исполнения;
- поддержку int8/binary и способ повторного ранжирования;
- версию токенизатора и контрольную точку.
Например, Qwen3-Embedding предоставляет 0.6B/4B/8B модели под Apache 2.0; это делает локальное развёртывание возможным, но не доказывает превосходство на вашем домене. ColPali имеет многовекторное визуальное представление и поэтому требует другой оценки памяти, чем одновекторный текстовый эмбеддер.
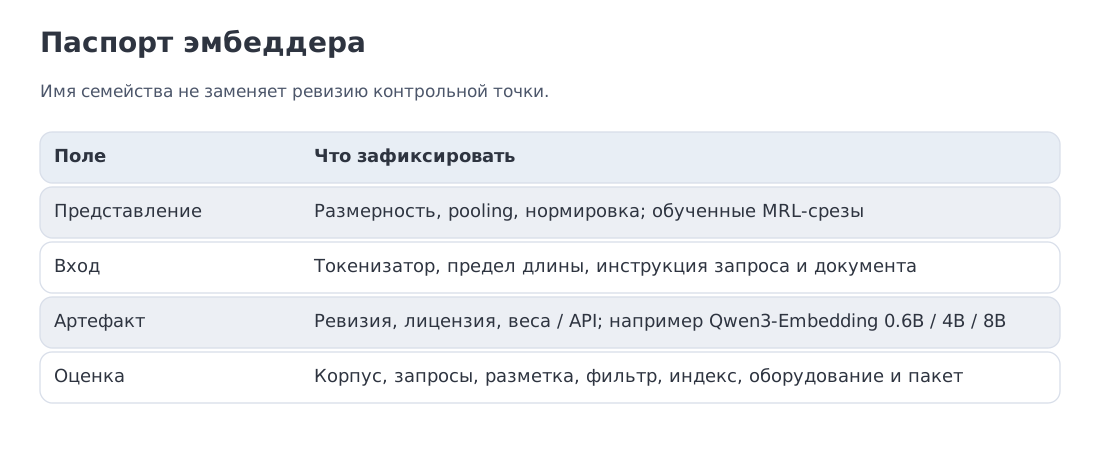 Паспорт эмбеддера: представление, инструкции, длина, размерность, точность, лицензия и протокол собственной оценки.
Главный диагностический принцип модуля: поиск и генерация оцениваются раздельно. Высокая полнота поиска при необоснованном ответе означает проблему генерации или сборки контекста. Низкая полнота при убедительном ответе требует проверки его опоры на выбранные фрагменты. Ответ может быть подтверждён оставшимся документом; сама полнота этого не устанавливает.
20. Ключевые выводы и источники
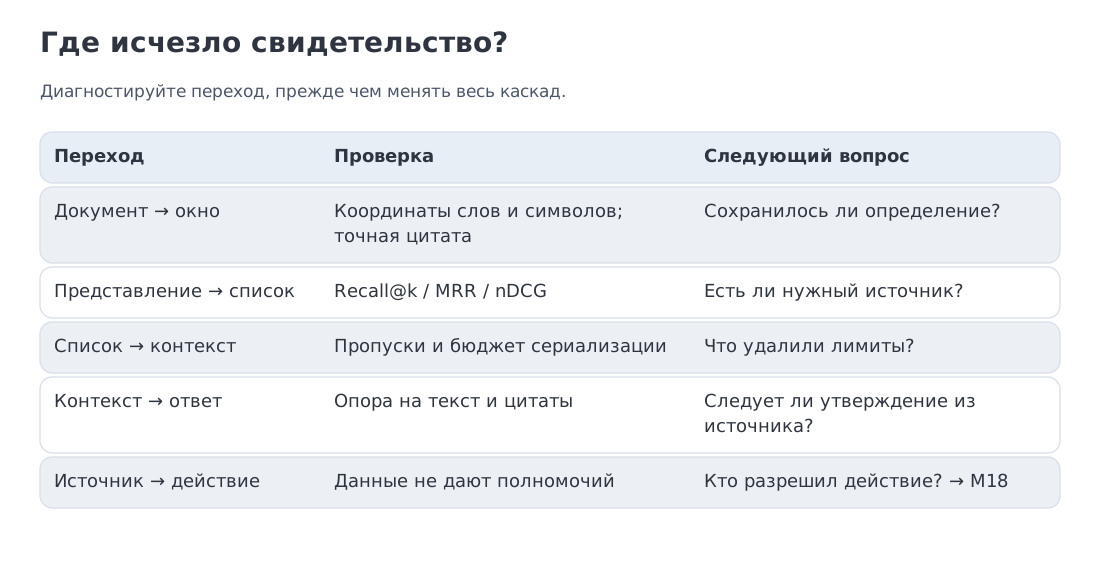 Шпаргалка: четыре потери информации, три семейства скоринга, ANN, слияние списков и реранкинг, разбиение, сборка контекста и раздельная оценка поиска и генерации.
Один запрос проходит через каскад, где каждая стадия уменьшает объём данных и может потерять ответ.
Лексический поиск сохраняет буквальный сигнал редких термов при подходящем анализаторе. BM25 учитывает редкость терма, насыщение частоты и длину документа. Обучаемые разреженные модели добавляют расширение словаря, сохраняя инвертированный индекс.
Плотный поиск представляет текст векторами. Качество зависит от отрицательных примеров, инструкций, домена и способа агрегации токенных представлений. Один вектор масштабируется хорошо, но теряет токенную структуру.
Кросс-энкодеры и late interaction возвращают более тонкое взаимодействие. Первый подходит для небольшого списка пар; второй хранит многовекторное представление и платит размером индекса.
MRL и квантизация управляют стоимостью хранения. MRL обучает полезные префиксы одного вектора (§6), а квантизация сокращает число битов на координату. Для 10 млн векторов 1024d полезная нагрузка меняется от 38.15 GiB в fp32 до 1.19 GiB в бинарном представлении; реальные индексы содержат дополнительные структуры.
ANN уменьшает объём просмотренного пространства, но добавляет собственную вероятность пропуска. HNSW, IVF-PQ и DiskANN отвечают на разные ограничения памяти и размещения.
Слияние списков и реранкинг выполняют разные роли. RRF объединяет ранги без калибровки оценок; реранкер заново сравнивает запрос с ограниченным набором документов. На замороженном наборе слияние списков не превосходит BM25 по nDCG, а реранкер улучшает итоговый порядок.
Разбиение определяет единицу памяти. Перекрывающиеся окна — сильная базовая линия; позднее разбиение и контекстуализированный поиск возвращают контекст, но увеличивают стоимость индексации или подготовки данных.
RAG и длинный контекст не являются взаимоисключающими идеологиями. RAG экономит вход и поддерживает свежесть, ACL и цитаты; длинный контекст сохраняет целостность одного документа. Маршрутизация выбирает ветку по запросу.
Оценка должна быть разложена по стадиям. Recall/MRR/nDCG измеряют поиск; обоснованность, цитаты и качество текста — генерацию. Лидерборд эмбеддингов формирует короткий список, но решение принимает собственный набор запросов.
Основные первоисточники
- Gao et al., HyDE — arxiv.org/abs/2212.10496
- Yan et al., CRAG — arxiv.org/abs/2401.15884
- Lewis et al., RAG — arxiv.org/abs/2005.11401
- Karpukhin et al., DPR — arxiv.org/abs/2004.04906
- Khattab & Zaharia, ColBERT — arxiv.org/abs/2004.12832
- Formal et al., SPLADE — arxiv.org/abs/2107.05720
- Wang et al., E5 — arxiv.org/abs/2212.03533
- Kusupati et al., MRL — arxiv.org/abs/2205.13147
- Malkov & Yashunin, HNSW — arxiv.org/abs/1603.09320
- Subramanya et al., DiskANN — proceedings.neurips.cc
- Faysse et al., ColPali — arxiv.org/abs/2407.01449
- Zhang et al., Qwen3 Embedding — arxiv.org/abs/2506.05176
- Günther et al., Late Chunking v3 — arxiv.org/abs/2409.04701v3
- Anthropic, Contextual Retrieval — anthropic.com/engineering/contextual-retrieval
- Asai et al., Self-RAG — arxiv.org/abs/2310.11511
- Sarthi et al., RAPTOR — arxiv.org/abs/2401.18059
- Edge et al., GraphRAG — arxiv.org/abs/2404.16130
- Li et al., RAG vs long context / Self-Route — arxiv.org/abs/2407.16833
- Thakur et al., BEIR — arxiv.org/abs/2104.08663
- Muennighoff et al., MTEB — arxiv.org/abs/2210.07316
- Enevoldsen et al., MMTEB — arxiv.org/abs/2502.13595
- Es et al., RAGAS — arxiv.org/abs/2309.15217
Дальше: модуль 18 разбирает агента, который использует поиск как один из инструментов: планирует действие, вызывает среду, читает наблюдение и решает, продолжать ли цикл.
Ландшафт сверен: 11 октября 2026 года. Числа памяти и времени являются воспроизводимыми сценариями модуля, а не измерениями конкретного векторного движка или производственного сервиса.