Модуль 6. Нормализация, активации и анатомия блока
Курс «Modern LLMs» · редакция 11 октября 2026 года
В М5 мы разобрали, как внимание передаёт информацию между позициями. Теперь посмотрим на весь блок: как он сохраняет уже найденные признаки, добавляет новые и удерживает вычисления в подходящем численном диапазоне. По ходу соберём полный блок и рассчитаем его параметры.
Предпосылки. Нужны матричные проекции и остаточная связь из М3, а также головы внимания и GQA из М5. Формулы ниже используют векторы-столбцы; NumPy хранит токены строками и поэтому умножает их на матрицы справа.
Маршруты чтения
- Первый проход: §1 → §§4–10, пропуская раскрываемые реализации → §§14–15 → §20. Проверьте себя по В1–В6 в §18 и У1–У3 в §19; В7 и У7 используют mHC из §12 и относятся к следующему проходу. В §10 проследите путь от формы каждой матрицы до общего числа параметров. Этого достаточно, чтобы перейти к М7.
- Второй проход: вернитесь к B07/B08 в §§5/9, коду §13 и ноутбуку. Проверьте малые и большие входы, ось нормализации и совпадение градиентов; выполните упражнения 1–3 и 6–7.
- Справочный проход: §§2–3 связывают материал с историей и классикой; §§11–12 разбирают DyT, DyISRU и несколько остаточных потоков; §§16–17 помогают читать конфигурации реальных моделей. Проекты 4–5 расширяют практику.
1. Что делает блок помимо внимания
У каждого токена есть вектор состояния . Его координаты — признаки, а — ширина модели. Остаточный поток (residual stream) — это состояние, которое проходит через слои и получает добавки от подслоёв. Остаточная связь имеет вид : функция вычисляет поправку той же формы, что и вход.
Внимание смешивает информацию разных позиций. Полносвязный подслой FFN (feed-forward network) затем преобразует каждую позицию отдельно, используя одни и те же веса для всех токенов. Нормализация управляет масштабом признаков на входе или выходе этих операций. Сам токен при этом остаётся на своей позиции.
Масштаб удобно измерять среднеквадратичным значением:
В отличие от среднего, RMS не обнуляется при взаимном сокращении положительных и отрицательных координат. Например, у среднее равно нулю, а RMS — единице.
Дальше мы ответим на три вопроса. Как именно нормализация меняет вектор? Где её поставить относительно остаточного сложения? Сколько параметров добавляет FFN, когда одна проекция управляет другой? Для проверки используем численный пример нормы, цепочку из 36 линейных шагов и точный бюджет Llama-3.1-8B.
2. Как менялась конструкция блока
Этот раздел можно оставить на справочный проход. Названия ниже обозначают разные изменения блока; их формулы появятся в §§5–12.
LayerNorm (2016) нормирует признаки одного примера без статистики мини-пакета. В исходном Transformer она стояла после остаточного сложения — Post-LN. В Pre-LN норма перенесена на вход подслоя. Анализ Xiong et al. связал различия начальных градиентов с необходимостью прогрева скорости обучения в исследованной постановке; это не универсальный запрет на Post-LN без прогрева. Статья.
RMSNorm (2019) убрала вычитание среднего. Авторы получили сопоставимое качество и сокращение времени на 7–64% в своих экспериментальных системах. Переносить этот диапазон на современный блок без измерения нельзя: результат зависит от доли нормализации в вычислениях и её реализации. RMSNorm.
Параллельно развивались гейтованные FFN: две проекции перемножаются, и одна регулирует вклад другой (§8). DeepNorm меняет масштаб остаточной связи и инициализацию для очень глубоких сетей. Peri-LN нормирует вход и выход подслоя, а OLMo2 — выход подслоя перед сложением (§6). DyT и DyISRU исследуют поэлементные замены нормы (§11); mHC меняет способ соединения нескольких потоков (§12). Эти решения затрагивают разные части вычисления и могут сочетаться.
3. Мостик к классике: стандартизация, численное интегрирование и гейты
Три классических аналогии помогают читать блок, если не превращать их в буквальные тождества.
Нормализация и стандартизация. LayerNorm вычитает среднее и делит на стандартное отклонение по признакам одного токена. RMSNorm делит только на корень среднего квадрата. Ни одна из них не является декорреляцией (whitening): ковариационная матрица не диагонализируется и пространство признаков не поворачивается. Полезнее думать о норме как о локальном контроле масштаба и частичном предобусловливании (preconditioning): последующие матрицы получают входы в более предсказуемом диапазоне.
Остаточная связь и шаг Эйлера. Формула
похожа на дискретизацию дифференциального уравнения. Глубина играет роль времени, а подслой добавляет приращение. Аналогия объясняет интерес к размеру шага и устойчивости, но реальный Transformer не является одной системой дифференциальных уравнений с неизменной правой частью: функции различаются, а шаг не обязан быть малым.
Гейтованный FFN и мультипликативные взаимодействия. В SwiGLU две обученные проекции взаимодействуют поэлементно. Одна ветвь создаёт содержимое, другая регулирует его пропускание. Без нелинейности произведение двух линейных функций было бы квадратичным; с SiLU получается более общий входозависимый мультипликативный механизм. Это роднит GLU с вентилями рекуррентных сетей, но не делает их одинаковыми архитектурами.
4. Остаточный поток: два последовательных приращения
Рассмотрим Pre-LN: нормализация стоит перед каждым подслоем. Для слоя обозначим два его нормализатора через и . Тогда
FFN читает уже обновлённое состояние . Складываются только векторы одинаковой ширины ; внутренние проекции внимания и FFN могут иметь другие размеры. Для последовательности обе строки применяются к матрице состояний всех токенов, причём внимание использует маску из М5.
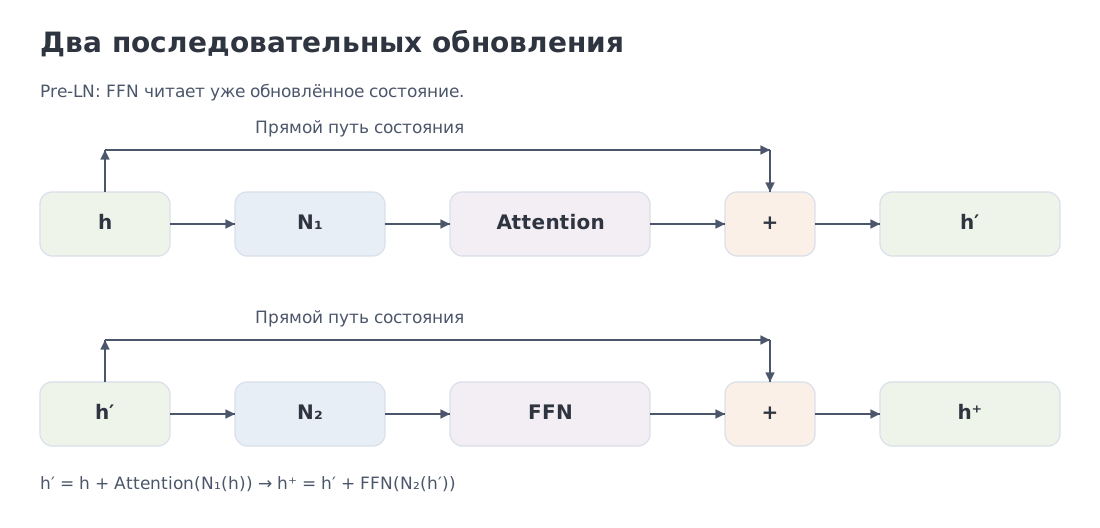 Внимание обновляет состояние первым; FFN читает результат этого сложения.
Для одного шага матрица производных, или якобиан, равна
Здесь — единичная матрица. Она представляет прямой путь через сложение, однако итоговый градиент зависит от всей суммы. Например, при получается . Поэтому наличие обходного пути помогает проектировать глубокие сети, но само по себе не гарантирует ненулевой градиент или возможность удалить обученный слой. Эта граница будет полезна при сравнении размещений нормы.
5. LayerNorm и RMSNorm: две операции над одним вектором
Нормализация действует по признакам одного токена, а не по последовательности или пакету. Сведение набора координат к одной статистике — например, среднему — называется редукцией. Для определим среднее и дисперсию . Делитель здесь , а не : нам нужна статистика данного вектора, а не несмещённая оценка дисперсии популяции.
LayerNorm сначала центрирует вектор, затем меняет масштаб:
Векторы — обучаемые масштабы и сдвиги, а защищает знаменатель около нуля. RMSNorm использует средний квадрат без центрирования:
В этой распространённой форме у RMSNorm нет обучаемого сдвига. Для , , и получаем , , :
У первого результата среднее нулевое. Второй до умножения на сохраняет нули, знаки и отношения ненулевых координат. Обучаемая шкала меняет отношения координат, а при отрицательных значениях — и знаки; нули сохраняются. Постоянный ненулевой вектор LayerNorm без сдвига превратит в нулевой, а RMSNorm сохранит ненулевым — простой способ увидеть, что операции не эквивалентны.
Малый сигнал, epsilon и точность
Без обучаемой шкалы множитель RMSNorm не превосходит . При RMS входа он равен примерно 707.1 для и 301.5 для . Это предел множителя до , а не универсальный предел всего выхода.
Инвариантность к положительному масштабированию тоже имеет условие. При и ненулевом нормированные и совпадают для . При фиксированном :
Для приближённой инвариантности нужны оба условия: и . Очень маленький положительный может нарушить второе условие даже при большом исходном сигнале. Когда энергия сигнала сравнима с , разница заметна. В ноутбуке есть и обычный вход, и контрпример около нуля. Нулевой вектор при положительном обрабатывается без деления на ноль.
FP16 — 16-битный формат, FP32 — 32-битный. В FP16 квадрат большого конечного числа может переполниться, а малого — округлиться до нуля. Поэтому повышать точность нужно до возведения в квадрат, а не только при суммировании. Такой порядок показан ниже; выбор и формата накопления остаётся частью контракта конкретной реализации.
Второй проход: RMSNorm в NumPy, PyTorch и библиотечном API
NumPy → PyTorch · B07 — RMSNorm: редукция, dtype и autograd
Сравниваем конечный вещественный вход [..., D], D>0, и необязательный вес [D] при конечном eps>0. Для сопоставления с API вход и вес имеют общий плавающий тип и устройство. Предполагаем, что квадраты, сумма и результат помещаются в рабочий формат: сам по себе конечный FP64-вход этого не гарантирует. NumPy раскрывает редукцию, PyTorch добавляет автоматическое дифференцирование.
import numpy as np
import torch
import torch.nn.functional as F
1. Явная NumPy-реализация
def numpy_rms_norm(x: np.ndarray, weight: np.ndarray | None = None, *, eps: float = 1e-6) -> np.ndarray:
    x = np.asarray(x)
    if x.ndim == 0 or x.shape[-1] == 0 or not np.isfinite(x).all() or not np.isfinite(eps) or eps <= 0:
        raise ValueError("x must be finite and eps positive")
    work = x.astype(np.float64, copy=False)
    y = work / np.sqrt(np.mean(work * work, axis=-1, keepdims=True) + eps)
    if weight is not None:
        w = np.asarray(weight, dtype=np.float64)
        if w.shape != (x.shape[-1],) or not np.isfinite(w).all():
            raise ValueError("weight must be finite with shape [D]")
        y = y * w
    return y.astype(x.dtype, copy=False) if np.issubdtype(x.dtype, np.floating) else y
NumPy-эталон показывает средний квадрат по последней размерности, добавление , обратный корень и покоординатный обучаемый масштаб.
2. Та же математика явными операциями PyTorch
def torch_rms_norm_explicit(
    x: torch.Tensor,
    weight: torch.Tensor | None = None,
    *,
    eps: float = 1e-6,
) -> torch.Tensor:
    if not x.is_floating_point() or x.ndim == 0 or x.shape[-1] == 0:
        raise ValueError("x must be floating with a nonempty last axis")
    if not np.isfinite(eps) or eps <= 0:
        raise ValueError("eps must be finite and positive")
    work = x.to(torch.float32) if x.dtype in (torch.float16, torch.bfloat16) else x
    rms_inv = torch.rsqrt(work.square().mean(dim=-1, keepdim=True) + eps)
    y = work * rms_inv
    if weight is not None:
        if weight.shape != (x.shape[-1],):
            raise ValueError("weight must have shape [D]")
        y = y * weight.to(work.dtype)
    return y.to(x.dtype)
Явная PyTorch-реализация переводит FP16/BF16 в FP32 до возведения в квадрат. После умножения на вес она возвращает формат входа; FP64 сохраняется для проверки производных.
3. Оптимизированный или библиотечный PyTorch API
def torch_rms_norm(x: torch.Tensor, weight: torch.Tensor | None = None, *, eps: float = 1e-6) -> torch.Tensor:
    return F.rms_norm(x, [x.shape[-1]], weight=weight, eps=eps)
F.rms_norm скрывает редукцию внутри библиотечного оператора и может использовать оптимизированную реализацию.
| Аспект | NumPy | PyTorch |
|---|---|---|
| Редукция | np.mean(..., axis=-1) | mean(dim=-1) |
| Обратный корень | 1 / np.sqrt | torch.rsqrt |
| Вес | broadcast массива [D] | parameter [D] с градиентом |
| Накопление | float64 в эталоне | явный путь: минимум FP32; API проверяется отдельно |
| Градиент | нет | проверяется gradcheck |
Исполняемая проверка эквивалентности и граничных случаев
rng = np.random.default_rng(7)
x_np = rng.standard_normal((3, 5)); w_np = rng.standard_normal(5)
np_out = numpy_rms_norm(x_np, w_np, eps=1e-6)
x = torch.tensor(x_np, dtype=torch.float64, requires_grad=True)
w = torch.tensor(w_np, dtype=torch.float64, requires_grad=True)
explicit = torch_rms_norm_explicit(x, w, eps=1e-6)
api = torch_rms_norm(x, w, eps=1e-6)
np.testing.assert_allclose(np_out, explicit.detach().numpy(), rtol=1e-10, atol=1e-10)
torch.testing.assert_close(api, explicit, rtol=1e-10, atol=1e-10)
assert torch.autograd.gradcheck(lambda a, b: torch_rms_norm_explicit(a, b, eps=1e-6), (x, w))
for a, b in zip(torch.autograd.grad(explicit.square().sum(), (x, w)),
                torch.autograd.grad(api.square().sum(), (x, w))):
    torch.testing.assert_close(a, b, rtol=1e-9, atol=1e-10)
for dtype in (torch.float16, torch.bfloat16):
    large = torch.full((2, 8), 1000.0, dtype=dtype)
    torch.testing.assert_close(torch_rms_norm_explicit(large), torch.ones_like(large))
print("B07 explicit NumPy / PyTorch / F.rms_norm: PASS")
Полный исполняемый файл: m06_block_bridges.py
Официальный API: PyTorch rms_norm.
6. Где поставить норму
Обозначим преобразование подслоя через , нормализатор через , вход через , выход через . Названия Pre-LN и Post-LN описывают размещение: вместо LayerNorm в этих же схемах может стоять RMSNorm.
| Схема | Один шаг | Что получает нормированный масштаб |
|---|---|---|
| Post-LN | результат сложения | |
| Pre-LN | вход подслоя | |
| Peri-LN | вход подслоя и его добавка | |
| Схема OLMo2 | добавка подслоя |
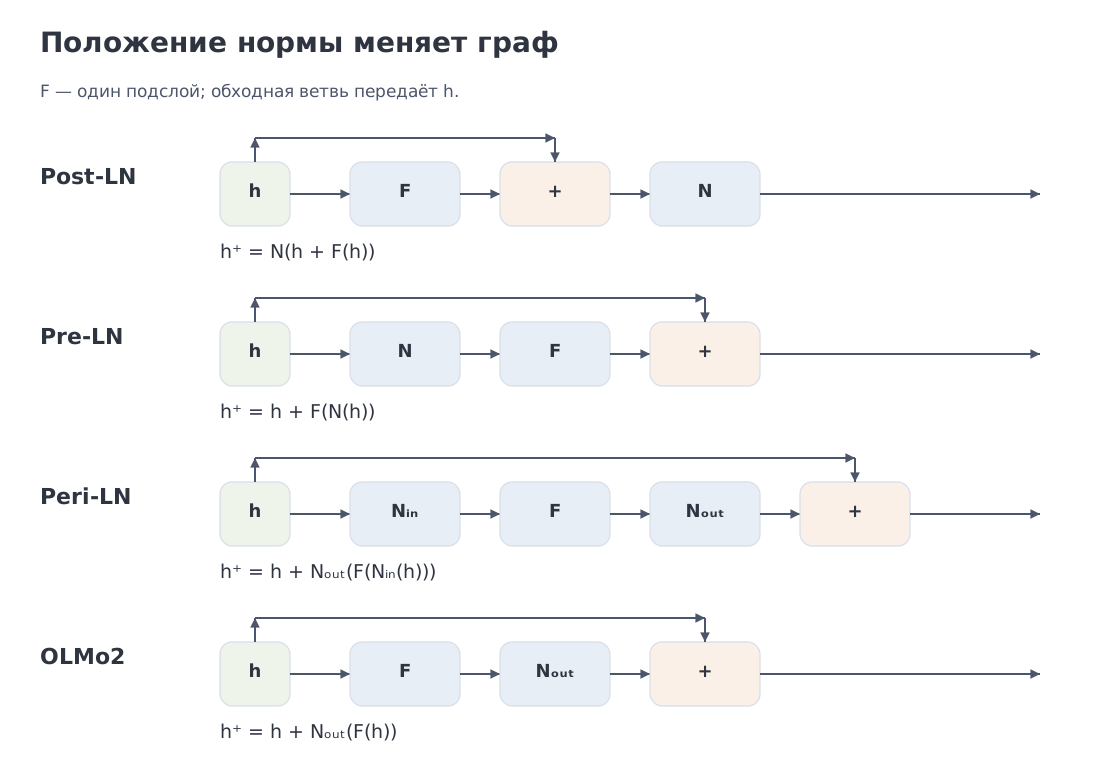 Положение нормы относительно подслоя и сложения задаёт разные вычислительные графы.
В Post-LN нормализация лежит на сквозном пути. Для одного шага якобиан содержит произведение . В Pre-LN он имеет вид : прямой единичный член сохранён. Это структурное различие, а качество обучения зависит также от инициализации, масштаба весов и оптимизатора.
В Peri-LN вторая норма управляет размером добавки перед сложением. Авторы исследовали такой подход на моделях до 3.2B параметров. В OLMo2 нет соответствующей нормы на входе подслоя; отдельная нормализация Q/K внутри внимания выполняет другую работу. Peri-LN, OLMo2.
Опыт с общими входом и весами
Возьмём один вектор из стандартного нормального распределения ширины 256 и 36 независимых матриц с элементами из . Для сравнения определим и запустим три цепочки на одних и тех же данных:
Это соответственно режимы без нормы, с нормой перед подслоем и после сложения. При seed 5 RMS на шаге 36 равен примерно 412 442, 6.42 и 1.
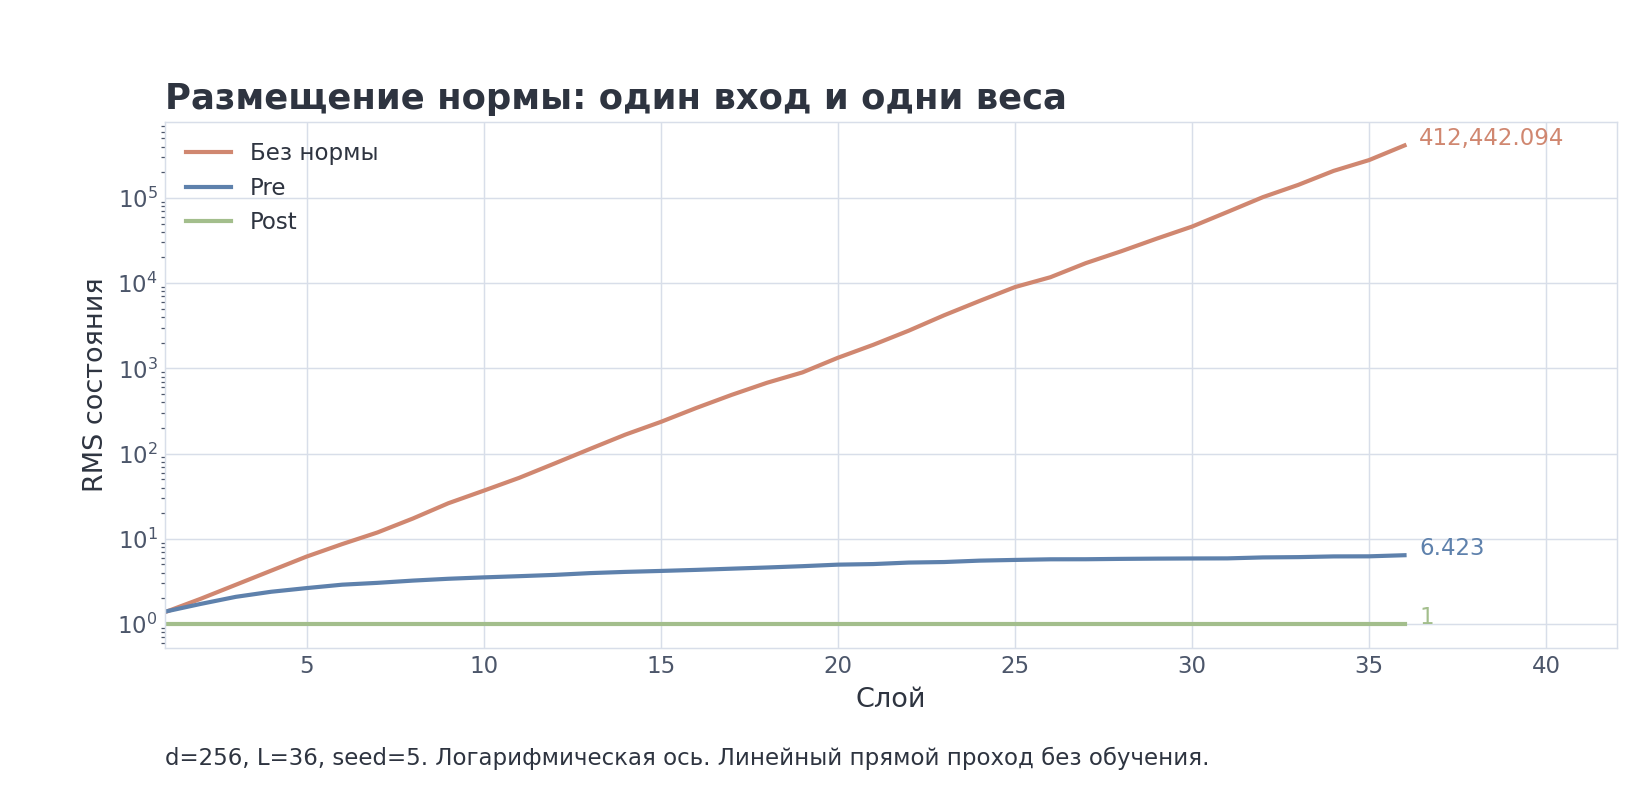 Ось RMS логарифмическая. Веса различаются между слоями, но повторно используются во всех трёх режимах.
Единичный результат третьей цепочки задан операцией ; это не измерение качества. Опыт показывает динамику прямого прохода без обучения, нелинейностей и обучаемой . В реальной RMSNorm с даже до обучаемого масштаба RMS лишь близок к единице. Далее ноутбук сравнивает Pre-LN и Peri-LN уже на малом стеке с вниманием и FFN.
7. Нормализация Q/K: важна и формула, и ось
Логит внимания, то есть число перед softmax, равен . Фиксированный делитель компенсирует рост дисперсии при увеличении ширины головы , но не мешает обучаемым проекциям увеличивать длину запросов и ключей. Если оба вектора умножить на , логит вырастет в раз.
Исходная Query-Key Normalization (QKNorm) использует единичные по L2 векторы:
Здесь — обучаемый масштаб вместо фиксированного . Нулевую длину на практике защищают стабилизатором. Авторы сообщили среднее улучшение 0.928 BLEU на пяти низкоресурсных парах перевода в своём протоколе. BLEU — метрика качества перевода, основанная на совпадении фрагментов с эталонными переводами; приведённый прирост относится именно к этой оценке. QKNorm.
RMSNorm для Q/K — другая операция. Без и обучаемых весов она даёт . Поэтому после обычного деления на логит равен , а не просто . Подмена L2-нормы RMS-нормой меняет масштаб softmax.
Важна и ось редукции. В проверенном коде Qwen3 нормируется каждая голова отдельно по признакам. OLMo2 нормирует весь вектор Q ширины и весь K ширины ещё до разбиения на головы. Если увеличить только одну голову, при общей норме изменятся и остальные. Ноутбук показывает это на двух головах по два признака.
Ещё один механизм — мягкое ограничение логитов (soft-capping): , где задаёт предел. Оно действует на готовые логиты, тогда как Q/K-норма — на векторы. Такие ограничения и методы управления оптимизатором следует проверять отдельно. Примеры реальных реализаций собраны в §16.
8. FFN: расширить признаки, преобразовать, вернуть ширину
Для каждой позиции обычный FFN без смещений вычисляет
Промежуточная ширина обычно больше ; в исходном Transformer использовалась . Функция действует поэлементно. Без неё две матрицы можно было бы заменить одной, и дополнительная глубина не дала бы нелинейного преобразования.
Три распространённых варианта:
Здесь — функция распределения стандартной нормальной величины, а — сигмоида. SiLU также называют Swish при коэффициенте 1. GELU и SiLU меняются плавно, но сами по себе не гарантируют ненулевого градиента во всех точках.
В гейтованном FFN два набора признаков вычисляются параллельно:
Символ означает поэлементное произведение. Ветвь управляет вкладом ветви для данного входа. Однако при гейт не является вероятностью: его значения не ограничены интервалом . В семейство входят ReGLU, GEGLU и SwiGLU; эксперимент Shazeer сравнивал их при согласованном бюджете. GLU Variants.
Связь между двумя активациями можно проверить численно:
На сетке из 4001 точки в максимальная абсолютная ошибка равна примерно 0.020335. Это ошибка на заданной сетке; множитель 1.702 не превращает сигмоидную формулу в точную GELU.
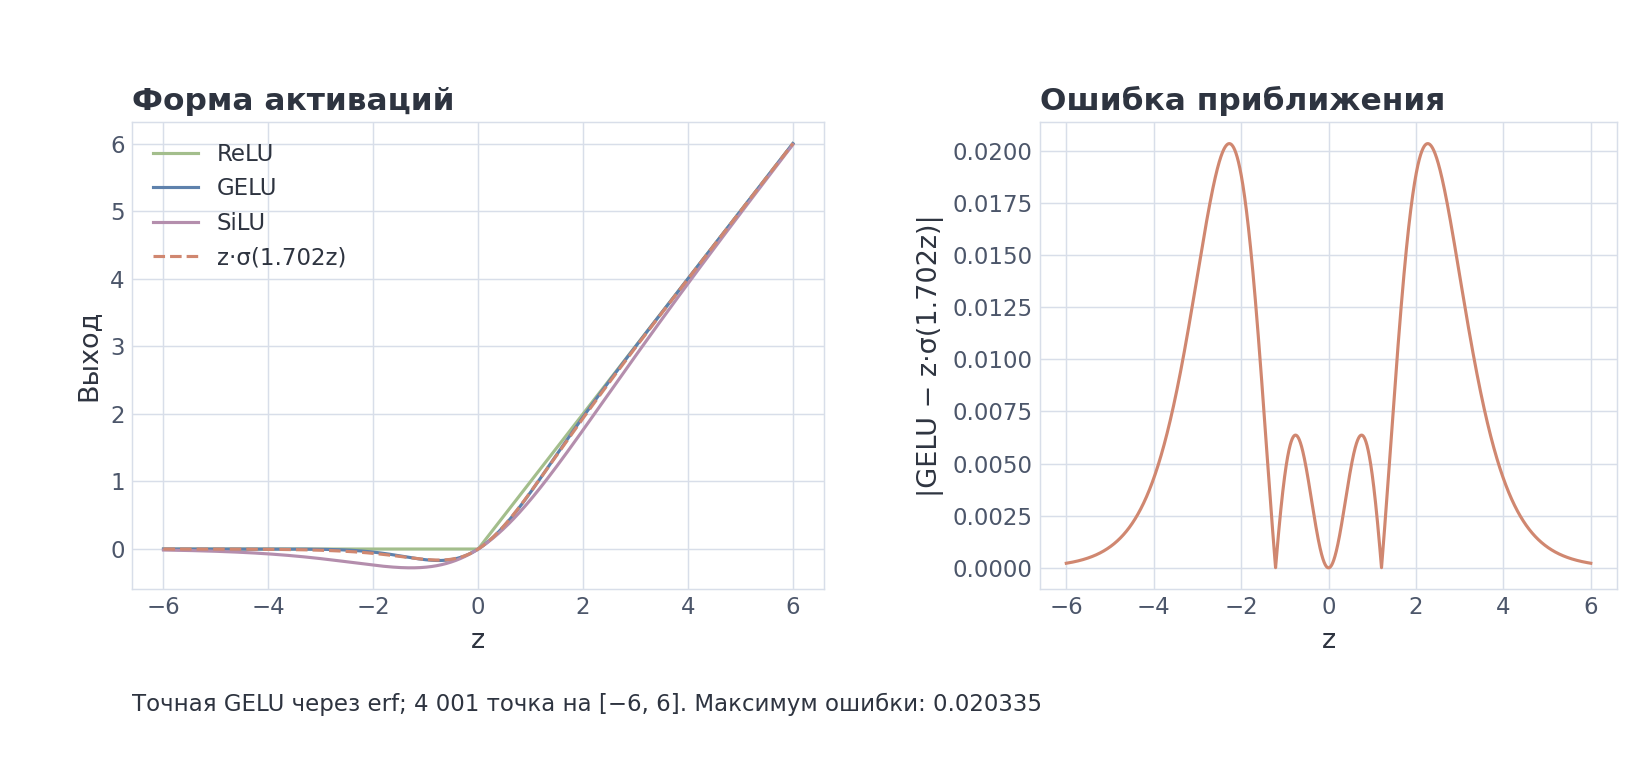 Слева — функции, справа — ошибка приближения GELU на той же сетке, что используется в ноутбуке.
9. SwiGLU: бюджет трёх матриц и вариант gpt-oss
У SwiGLU нелинейность гейта — SiLU:
Матрицы gate и up имеют форму , down — . Без смещений это параметров. У обычного FFN ширины их . Для одинакового матричного бюджета:
Это точка равенства бюджетов, а не обязательная ширина. В следующем примере Llama использует .
Что вычисляет gpt-oss
В зафиксированном эталонном коде gpt-oss две ветви ограничены по-разному:
Это выход активации до down-проекции. При :
| −9 | 0.000012019 |
| −2 | 0.064341377 |
| 0 | 0 |
| 2 | 5.806975869 |
| 7 | 55.999625026 |
| 9 | 55.999625026 |
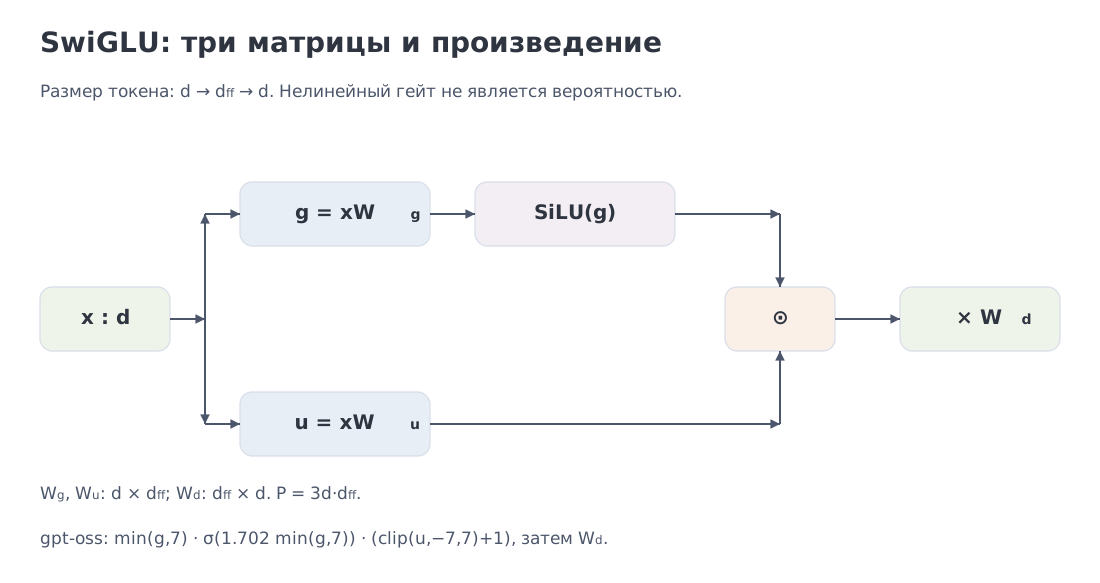 Гейт проходит через SiLU, умножается на ветвь up, затем результат поступает в down-проекцию.
При изменение gate-входа уже не меняет результат: производная по нему равна нулю. В отрицательную сторону gate не обрезается, но подавляется сигмоидой. Ветвь up имеет свой двусторонний предел. На диагонали и обе используемые ветви совпадают, поэтому получается одно плато около 56.
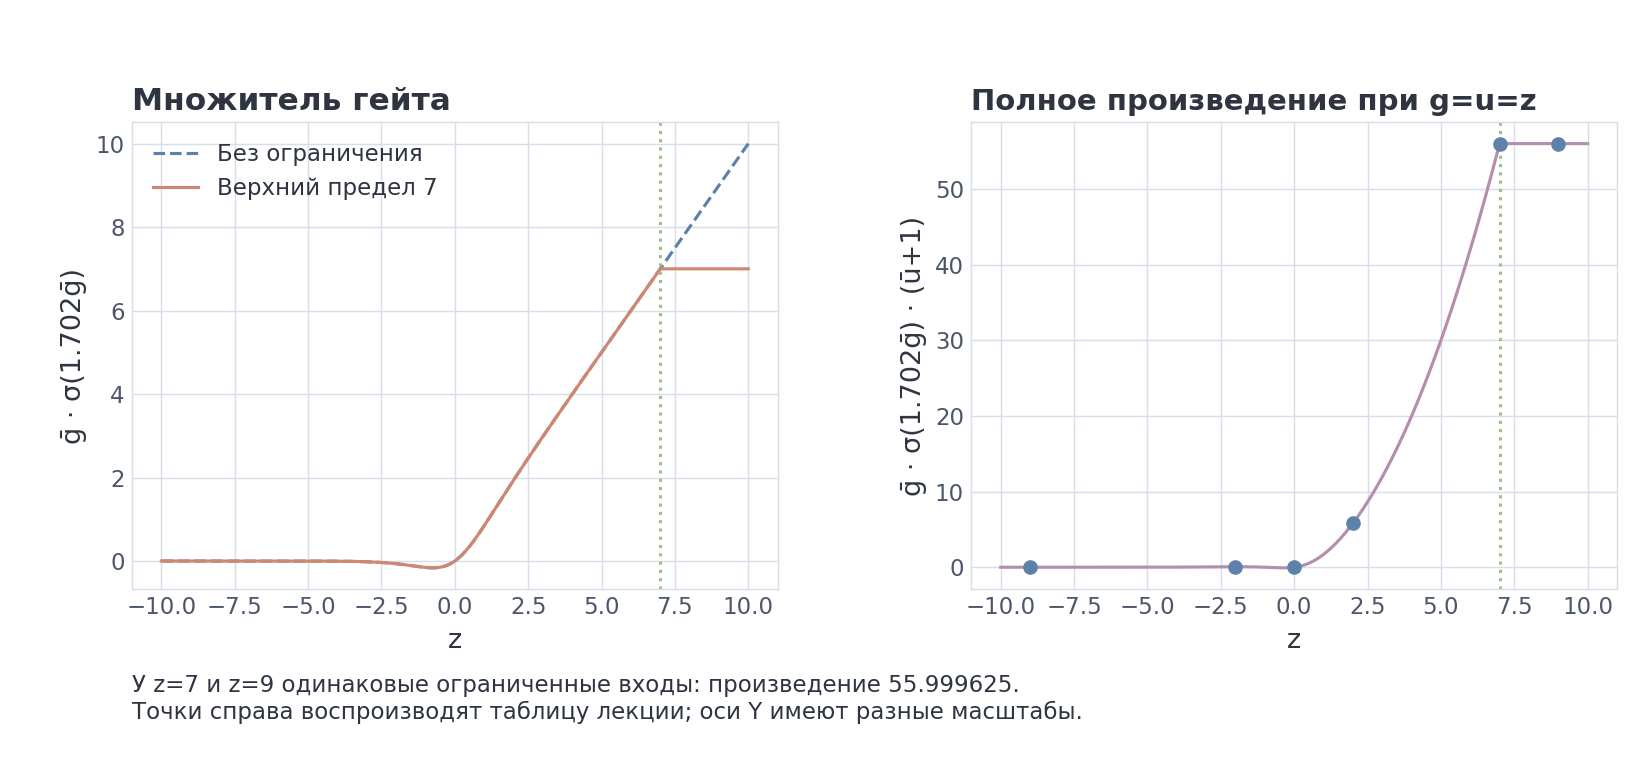 Выход одного гейта около 7 и выход произведения около 56 — разные величины. Точки справа соответствуют таблице.
Сдвиг оставляет множитель равным единице при . Ограничения меняют обученный граф; их нельзя произвольно убрать при загрузке весов. Сокращение выбросов полезно для низкоточных вычислений, но код сам по себе не устанавливает единственную причину выбора этой формулы. Источник и размещение упакованных ветвей разобраны в §15.
Второй проход: устойчивые реализации SwiGLU и проверка производных
NumPy → PyTorch · B08 — SwiGLU и ограниченный вариант
Обе реализации разделяют gate- и up-ветви. Параметры alpha, ограничение диапазона и сдвиг up-ветви задаются явно.
import numpy as np
import torch
1. Явная NumPy-реализация
def numpy_swiglu(
    gate: np.ndarray,
    up: np.ndarray,
    *,
    alpha: float = 1.0,
    gate_limit: float | None = None,
    up_limit: float | None = None,
    shift_up: float = 0.0,
) -> np.ndarray:
    gate, up = np.asarray(gate), np.asarray(up)
    if gate.shape != up.shape or not np.isfinite(gate).all() or not np.isfinite(up).all():
        raise ValueError("gate and up must be finite arrays of the same shape")
    if not np.isfinite(alpha) or not np.isfinite(shift_up):
        raise ValueError("alpha and shift_up must be finite")
    if any(v is not None and (not np.isfinite(v) or v <= 0) for v in (gate_limit, up_limit)):
        raise ValueError("limits must be finite and positive")
    g = gate.astype(np.float64, copy=False)
    u = up.astype(np.float64, copy=False)
    if gate_limit is not None:
        g = np.minimum(g, gate_limit)
    if up_limit is not None:
        u = np.clip(u, -up_limit, up_limit)
    sigmoid = np.exp(-np.logaddexp(0.0, -alpha * g))
    y = g * sigmoid * (u + shift_up)
    dtype = np.result_type(gate.dtype, up.dtype)
    return y.astype(dtype, copy=False) if np.issubdtype(dtype, np.floating) else y
Обе ветви видны явно: gate проходит через SiLU-подобную нелинейность и затем умножается на up-ветвь. Параметры alpha, ограничения и сдвиг не прячутся в имени функции.
2. Та же математика явными операциями PyTorch
def torch_swiglu(
    gate: torch.Tensor,
    up: torch.Tensor,
    *,
    alpha: float = 1.0,
    gate_limit: float | None = None,
    up_limit: float | None = None,
    shift_up: float = 0.0,
) -> torch.Tensor:
    if gate.shape != up.shape:
        raise ValueError("gate and up must have the same shape")
    if gate.dtype != up.dtype or not gate.is_floating_point() or gate.device != up.device:
        raise ValueError("gate and up must share a floating dtype and device")
    if not np.isfinite(alpha) or not np.isfinite(shift_up):
        raise ValueError("alpha and shift_up must be finite")
    if any(v is not None and (not np.isfinite(v) or v <= 0) for v in (gate_limit, up_limit)):
        raise ValueError("limits must be finite and positive")
    dtype = torch.float32 if gate.dtype in (torch.float16, torch.bfloat16) else gate.dtype
    g, u = gate.to(dtype), up.to(dtype)
    if gate_limit is not None:
        g = g.clamp(max=gate_limit)
    if up_limit is not None:
        u = u.clamp(min=-up_limit, max=up_limit)
    return (g * torch.sigmoid(alpha * g) * (u + shift_up)).to(gate.dtype)
NumPy вычисляет сигмоиду через logaddexp, PyTorch — через torch.sigmoid. PyTorch сохраняет граф производных и повышает точность промежуточных вычислений FP16/BF16. В точках излома clamp обычная производная не определена; численная проверка проходит по обе стороны границ.
| Аспект | NumPy | PyTorch |
|---|---|---|
| Нелинейность | явная сигмоида | torch.sigmoid |
| Ограничение gate | np.minimum | Tensor.clamp(max=...) |
| Ограничение up | np.clip | Tensor.clamp(min=..., max=...) |
| Обычная SwiGLU | без limits, shift_up=0 | тот же контракт |
| Градиенты | нет | autograd; точки clamp проверяются отдельно |
Исполняемая проверка эквивалентности и граничных случаев
rng = np.random.default_rng(8)
g_np = rng.uniform(-4, 4, (3, 5)); u_np = rng.uniform(-4, 4, (3, 5))
kwargs = dict(alpha=1.702, gate_limit=7.0, up_limit=7.0, shift_up=1.0)
np_out = numpy_swiglu(g_np, u_np, **kwargs)
g = torch.tensor(g_np, dtype=torch.float64, requires_grad=True); u = torch.tensor(u_np, dtype=torch.float64, requires_grad=True)
t_out = torch_swiglu(g, u, **kwargs)
np.testing.assert_allclose(np_out, t_out.detach().numpy(), rtol=1e-10, atol=1e-10)
assert torch.autograd.gradcheck(lambda a, b: torch_swiglu(a, b, **kwargs), (g, u))
extreme = np.array([-1000., -9., 0., 9., 1000.])
with np.errstate(over='raise', invalid='raise'):
    stable = numpy_swiglu(extreme, np.ones_like(extreme), **kwargs)
np.testing.assert_allclose(stable, torch_swiglu(torch.tensor(extreme), torch.ones(5, dtype=torch.float64), **kwargs))
outside = torch.tensor([-9., 9.], dtype=torch.float64, requires_grad=True)
assert torch.autograd.gradcheck(lambda a: torch_swiglu(a, a, **kwargs), (outside,))
print("B08 forward + gradient: PASS")
Полный исполняемый файл: m06_block_bridges.py
10. Решённый пример: Llama-3.1-8B до последнего параметра
Считаем веса плотного декодера Llama-3.1-8B при явно заданной геометрии:
Здесь — число строк словаря, — число блоков, и — количества голов запросов и K/V, — ширина головы. Предполагаем отсутствие смещений и отдельные входную таблицу эмбеддингов и выходную матрицу логитов. Базовые размеры опубликованы в таблице 3 отчёта Llama 3; для точного счёта используем , включая специальные токены, а не округлённые «128K».
У Q ширина выхода , у K/V — . Выходная проекция O возвращает конкатенацию голов к . Для произвольных размеров без смещений:
Теперь можно подставить размеры.
Attention. Q и O стоят по , K и V вместе — :
FFN. Три матрицы SwiGLU:
Нормы. Две RMSNorm добавляют
Следовательно, матричная часть блока равна
а полный блок:
Полная модель:
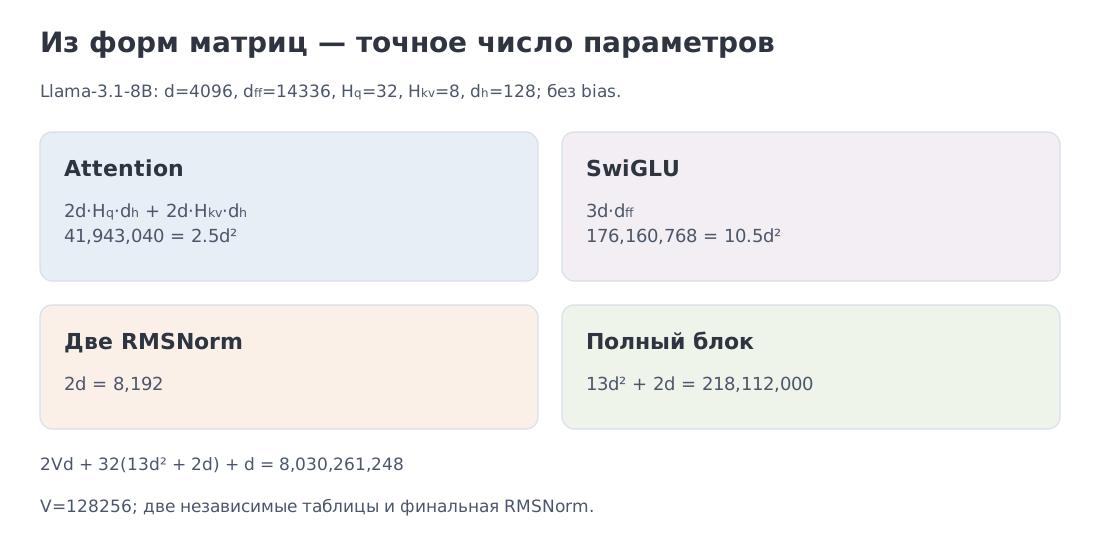 Разделены матричная часть и полный блок . В итоге получается точное число параметров Llama-3.1-8B.
FFN занимает около 80.8% полного блока, внимание — около 19.2%, нормы — менее 0.004%. Последнее слагаемое в формуле модели — финальная RMSNorm. Это число обучаемых параметров; буферы RoPE, активации и состояние оптимизатора в него не входят. Ноутбук сверяет формулу с суммой размеров реально созданных тензоров малого блока, а валидатор — с полной геометрией на устройстве meta, без выделения памяти под 8B весов.
11. DyT и DyISRU: преобразования без общей статистики
Чтобы вычислить RMSNorm, нужно собрать средний квадрат по признакам — выполнить редукцию. Можно ли заменить её функцией, которая работает с каждой координатой независимо? Dynamic Tanh (DyT) предлагает
Здесь — обучаемый скаляр, и — покоординатные параметры. Авторы показали сопоставимые или лучшие результаты в рассмотренных задачах зрения и языка. Это экспериментальное основание для изучения замены, а не равенство DyT и RMSNorm. DyT.
Структурное различие видно на и : RMSNorm изменит первую координату по-разному, поскольку изменился общий знаменатель. Любая фиксированная поэлементная функция даст на первой координате один и тот же ответ.
Откуда берётся DyISRU
В RMSNorm без обучаемой шкалы и при выделим одну координату:
Если заменить сумму квадратов остальных координат положительным параметром , связь между координатами исчезнет. Получится семейство DyISRU. Поглотив в обучаемый масштаб, будем записывать его так:
При наклон в нуле равен . Чтобы сравнить его с DyT при , зададим : начальные наклоны совпадут. Это конкретная параметризация из математической работы о DyISRU, где также обсуждается положительная параметризация через softplus. Для неё обучают свободный скаляр и задают . В точной арифметике результат положителен при любом конечном . В ноутбуке используется устойчивая библиотечная функция с небольшой положительной добавкой для конечной точности. Точность вывода относится к операции после замены суммы параметром; обычная RMSNorm от этой замены меняется.
В ноутбуке сохранён отдельный опыт курса: для 200 000 чисел подбирается по 171 точке сетки от 0.3 до 2.0 при seed 5, чтобы приблизила . Получаются и MSE около 0.161704. RMS здесь вычислен по всей синтетической выборке. Это скалярная аппроксимация с фиксированными , а не обучение нормализатора Transformer и не подбор параметра DyISRU.
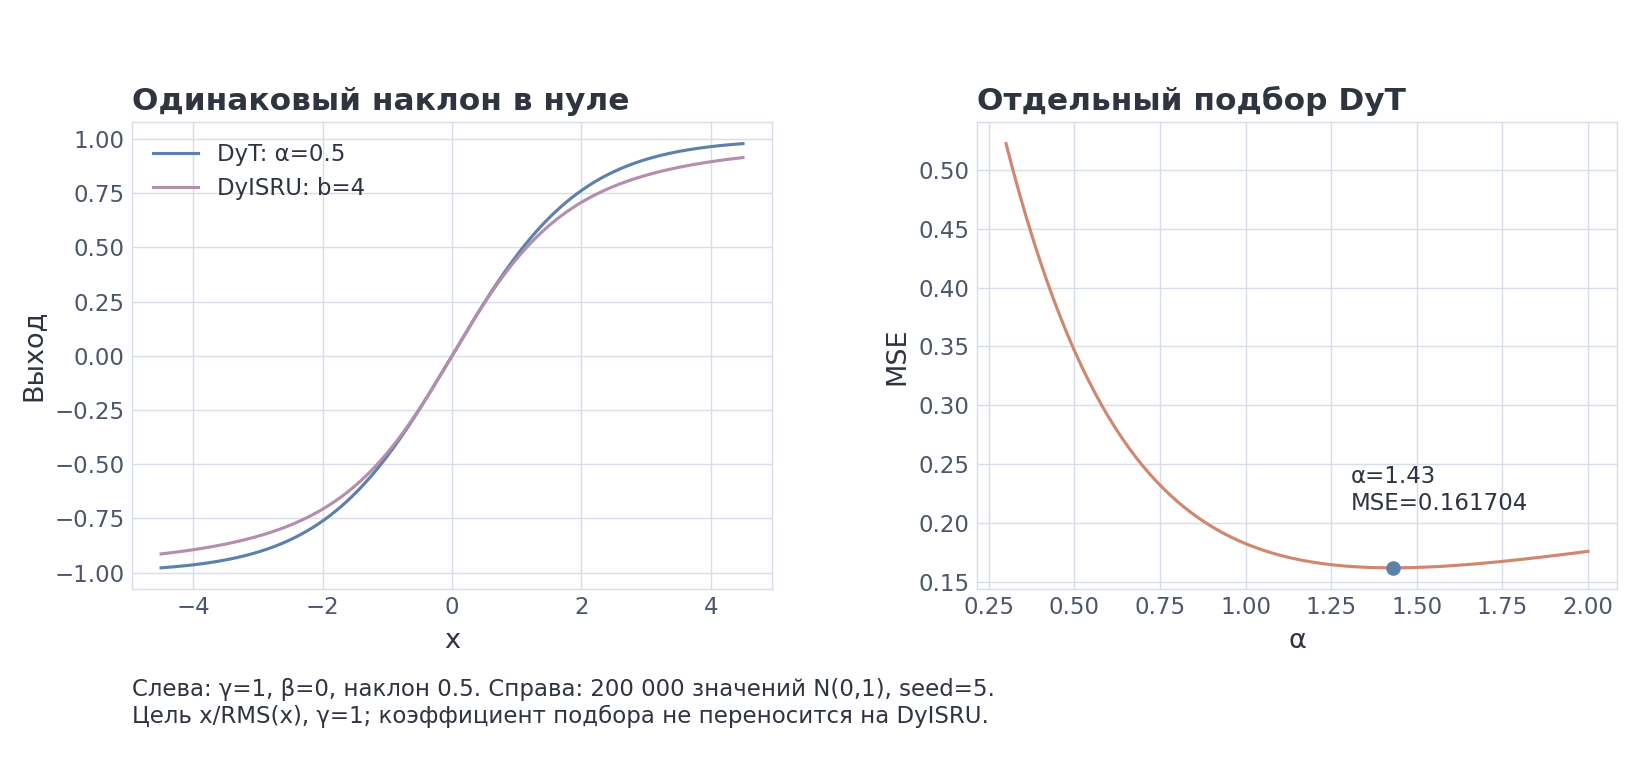 Слева DyT и DyISRU имеют одинаковый наклон в нуле. Справа показана ошибка самостоятельного подбора DyT по сетке.
Исследовательские результаты зависят от оптимизатора и масштаба. В работе 2026 года на 1B параметров и 1000 шагах обнаружено отрицательное взаимодействие Dynamic Erf с Muon; контрольный DyT не показал того же штрафа. Это основание совместно проверять нормализатор и оптимизатор, но не общий вывод против DyT. Протокол и результаты авторов. Оптимизаторы подробно рассматриваются в М9.
12. mHC: несколько остаточных потоков
До сих пор у токена был один вектор . Hyper-Connections хранят несколько таких потоков и обучают их смешивание вокруг подслоя. Соберём потоков строками матрицы . Вход подслоя может быть их взвешенной суммой; его результат распределяется обратно по потокам.
Если матрица переноса произвольна, уже преобразование может сильно увеличить масштаб. В Manifold-Constrained Hyper-Connections (mHC) остаточное смешивание ограничивается дважды стохастической матрицей:
«Дважды» означает нормированные суммы и по строкам, и по столбцам. Каждая выходная координата — выпуклая комбинация соответствующих координат входных потоков. Например,
Смешивание удержало значения внутри исходного диапазона, но не сохранило каждый поток без изменений: дважды стохастическая матрица не обязана быть единичной.
Для получения такой матрицы используется Sinkhorn–Knopp: положительные элементы попеременно нормируются по строкам и столбцам. Конечное число итераций даёт приближение, поэтому нужно проверять обе невязки сумм. В исходной работе применялись 20 итераций. Наш небольшой опыт сравнивает 1, 20 и 100 итераций; он не воспроизводит всю модель. mHC, §§4.2/5.3.
Ограничение относится к остаточной матрице; коэффициенты чтения и записи ветви задаются отдельно. Кроме того, в реальном mHC коэффициенты зависят от , а подслой добавляет своё преобразование. Поэтому свойство фиксированного не доказывает ограниченности полного якобиана сети. Множество допустимых матриц называют многогранником Биркгофа; «manifold» в названии работы относится к связям, а не к предположению о низкой размерности скрытых состояний.
DeepSeek-V4 использует mHC вместе с нормализацией внутри подслоёв: это сочетание разных механизмов. Карточка авторов. Развиваются и последующие варианты ограничений и реализации проекции; сравнивать их нужно по точности, затратам и протоколу обучения. Контекст обучения — в М9.
13. Код первого уровня: собрать две остаточные ветви
Здесь вход — матрица токенов x[T, d]. Матрицы gate/up имеют форму [d, d_ff], down — [d_ff, d]. Они записаны в соглашении NumPy с умножением справа; это транспонированное хранение матриц из формул §9.
RMSNorm вычисляет статистику минимум в FP32, а сигмоида использует устойчивую форму. Две функции FFN различаются только активацией. В PreNormStep внимание передаётся явно и должно вернуть массив той же формы; полный GQA-блок находится в ноутбуке.
Второй проход: полный минимальный листинг
import math
import numpy as np

def _floating_array(x: np.ndarray) -> np.ndarray:
    """Validate and return a floating NumPy array without changing its shape."""

    array = np.asarray(x)
    if not np.issubdtype(array.dtype, np.floating):
        raise TypeError("normalization expects a floating-point array")
    if array.ndim == 0 or array.shape[-1] == 0:
        raise ValueError("the normalized last axis must be non-empty")
    if not np.isfinite(array).all():
        raise ValueError("inputs must be finite")
    return array

def _statistics_dtype(dtype: np.dtype) -> np.dtype:
    """Use at least float32 for reductions while preserving float64 inputs."""

    return np.dtype(np.float32) if np.dtype(dtype).itemsize < 4 else np.dtype(dtype)

def rms_norm(
    x: np.ndarray,
    gamma: np.ndarray | float = 1.0,
    eps: float = 1e-6,
) -> np.ndarray:
    """RMS-normalize `[..., d_model]` over the last axis and preserve dtype."""

    if eps <= 0 or not math.isfinite(eps):
        raise ValueError("eps must be finite and positive")
    array = _floating_array(x)
    work_dtype = _statistics_dtype(array.dtype)
    work = array.astype(work_dtype, copy=False)
    mean_square = np.mean(work * work, axis=-1, keepdims=True)
    result = work / np.sqrt(mean_square + eps)
    if np.shape(gamma) not in ((), (array.shape[-1],)) or not np.isfinite(gamma).all():
        raise ValueError("gamma must be a finite scalar or [D] vector")
    result = result * np.asarray(gamma, dtype=work_dtype)
    return result.astype(array.dtype, copy=False)

def stable_sigmoid(x: np.ndarray | float) -> np.ndarray:
    """Compute sigmoid without `exp` overflow on large negative inputs."""

    z = np.asarray(x, dtype=np.float64)
    return np.exp(-np.logaddexp(0.0, -z))

def silu(x: np.ndarray | float) -> np.ndarray:
    """Return SiLU/Swish: x * sigmoid(x)."""

    z = np.asarray(x, dtype=np.float64)
    return z * stable_sigmoid(z)

def gpt_oss_swiglu(
    gate: np.ndarray | float,
    up: np.ndarray | float,
    *,
    alpha: float = 1.702,
    limit: float = 7.0,
) -> np.ndarray:
    """Apply the public gpt-oss gate clamp, up clamp, and `(up + 1)` shift."""

    if limit <= 0 or not math.isfinite(limit):
        raise ValueError("limit must be finite and positive")
    if not math.isfinite(alpha):
        raise ValueError("alpha must be finite")
    g = np.minimum(np.asarray(gate, dtype=np.float64), limit)
    u = np.clip(np.asarray(up, dtype=np.float64), -limit, limit)
    return g * stable_sigmoid(alpha * g) * (u + 1.0)

def swiglu_mlp(x, w_gate, w_up, w_down):
    """Row-vector SwiGLU: two projections, product, then output projection."""
    return (silu(x @ w_gate) * (x @ w_up)) @ w_down

def swiglu_oss_mlp(x, w_gate, w_up, w_down, alpha=1.702, limit=7.0):
    """Apply the gpt-oss activation before the down projection."""
    return gpt_oss_swiglu(x @ w_gate, x @ w_up, alpha=alpha, limit=limit) @ w_down

class PreNormStep:
    """Inspect two sequential residual updates; attention accepts a mask."""
    def __init__(self, norm1, norm2, attention, ffn):
        self.norm1, self.norm2 = norm1, norm2
        self.attention, self.ffn = attention, ffn

    def __call__(self, x, mask):
        h = x + self.attention(self.norm1(x), mask)
        return h + self.ffn(self.norm2(h))
Проследите два инварианта: FFN получает состояние после добавки внимания, а down-проекция выполняется после произведения gate/up. Граничные входы и отключение ветвей проверяются отдельно. Нулевая добавка даёт тождественный шаг, но это проверка формулы, а не вывод о безвредности удаления обученного слоя.
15. Сопоставляем учебный блок с кодом gpt-oss
Для чтения реализации зафиксирована ревизия 7b583341fe16… файла gpt_oss/torch/model.py. Ревизия и SHA-256 записаны в манифесте источников. Это эталонный PyTorch-путь; оптимизированные ядра проверяются отдельно.
Проследите три участка. RMSNorm переводит вход в FP32 до среднего квадрата, умножает на обучаемый вектор scale и возвращает исходный формат; значение по умолчанию равно . SwiGLU выделяет gate/up как чередующиеся координаты x[..., ::2] и x[..., 1::2], затем применяет формулу §9. Разделить тензор на две сплошные половины здесь означало бы другое размещение весов. Порядок блока — Pre-LN перед вниманием и экспертным MLP.
Конфигурация gpt-oss-120b содержит, в частности:
{"hidden_size": 2880, "intermediate_size": 2880,
 "num_experts": 128, "experts_per_token": 4, "swiglu_limit": 7.0}
В исходном ModelConfig нет поля hidden_act: функцию задаёт код. Другие библиотеки могут представлять ту же архитектуру своей схемой конфигурации.
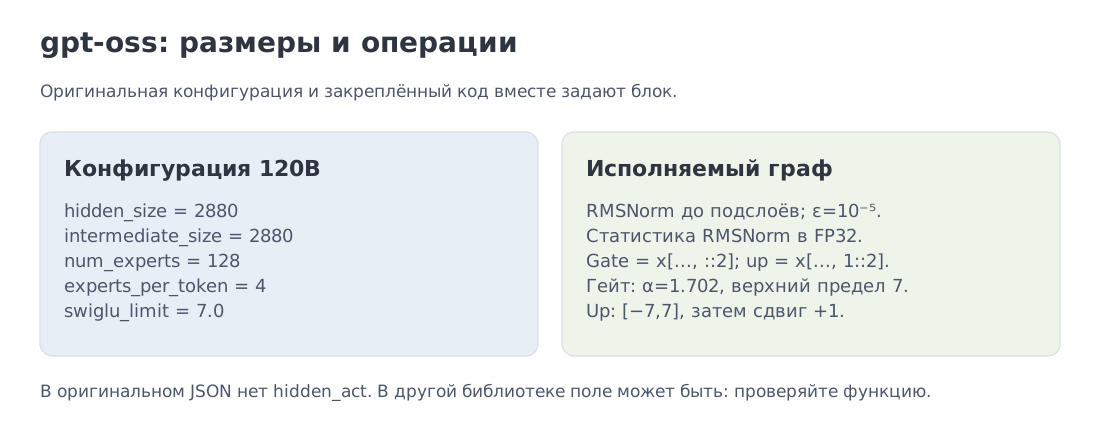 Размеры и число экспертов читаются из конфигурации; точная активация, порядок операций и упаковка ветвей — из кода.
Валидатор сопоставляет учебные RMSNorm и SwiGLU с этими конкретными функциями на малых входах. Он не запускает всю модель. intermediate_size=2880 относится к одному эксперту — отдельному FFN. Механизм выбора четырёх экспертов из 128 и его полный бюджет разберём в М7.
16. Какие детали искать в современных блоках
Срез на 10 октября 2026 года. Таблица — справочник к уже разобранным механизмам. MoE означает набор экспертных FFN с выбором части из них для токена; его устройство — тема М7.
| Семейство | Нормализация и размещение | FFN | Обработка Q/K или логитов |
|---|---|---|---|
| Llama 3.1 | RMSNorm, Pre-LN | SwiGLU | отдельной Q/K-нормы в проверенном пути нет |
| Llama 4 | RMSNorm, Pre-LN | гейтованные MLP/MoE | L2 по голове на RoPE-слоях при включённом use_qk_norm |
| Gemma 2 | RMSNorm до и после подслоёв | гейтованный GELU-tanh MLP | мягкое ограничение логитов |
| Gemma 3 | RMSNorm до и после подслоёв | гейтованный GELU-tanh MLP | RMSNorm по голове для Q/K; soft-cap зависит от конфигурации |
| Gemma 4, текстовая часть | входные и выходные RMSNorm; дополнительные ветви зависят от размера модели | плотные и, в отдельных вариантах, экспертные ветви | RMSNorm Q/K; при повторном использовании K/V учитывается источник состояний |
| OLMo2 | RMSNorm выхода подслоя перед сложением | SiLU-гейтованный MLP | RMSNorm по всей проекции Q/K до разделения на головы |
| gpt-oss | RMSNorm, Pre-LN | ограниченный SwiGLU с | обучаемый дополнительный логит sink из М5 |
| DeepSeek-V4 | RMSNorm внутри подслоёв и mHC между потоками | эксперты с ограниченным SwiGLU | детали зависят от вида внимания |
| Qwen3 | RMSNorm, Pre-LN | SiLU-гейтованный MLP | RMSNorm по размерности каждой головы Q/K |
Основание — конкретные классы DecoderLayer, Attention, RMSNorm и MLP в зафиксированном коде Transformers и эталонный код gpt-oss из §15. Файлы, контрольные суммы и дополнительные источники перечислены в манифесте.
При переносе весов проверяйте не только имя нормы, но и её ось, , обучаемую шкалу, порядок приведения типов и место относительно сложения. Настройки отдельной версии модели не являются свойством всех поколений семейства. Для закрытых моделей отсутствующая архитектурная информация остаётся нераскрытой.
17. Текстовые и визуальные блоки
Vision Transformer (ViT) превращает участки изображения в последовательность векторов и использует знакомые нормализацию, внимание, FFN и остаточные связи. Подсчёт параметров переносится на него после подстановки размеров и правил смещений. Однако маска внимания в визуальном кодировщике обычно отличается от каузальной маски декодера.
Нормализация Q/K имеет примеры и в языке, и в зрении. QKNorm была опубликована в 2020 году для перевода, а ViT-22B позднее продемонстрировала её родственный механизм в крупной визуальной модели. QKNorm, ViT-22B.
В мультимодальной конфигурации отдельно читайте текстовую и визуальную части: ширина, активация, и размещение норм могут различаться. Это тот же навык восстановления вычислительного графа, который мы применили к gpt-oss.
20. Как прочитать незнакомый блок
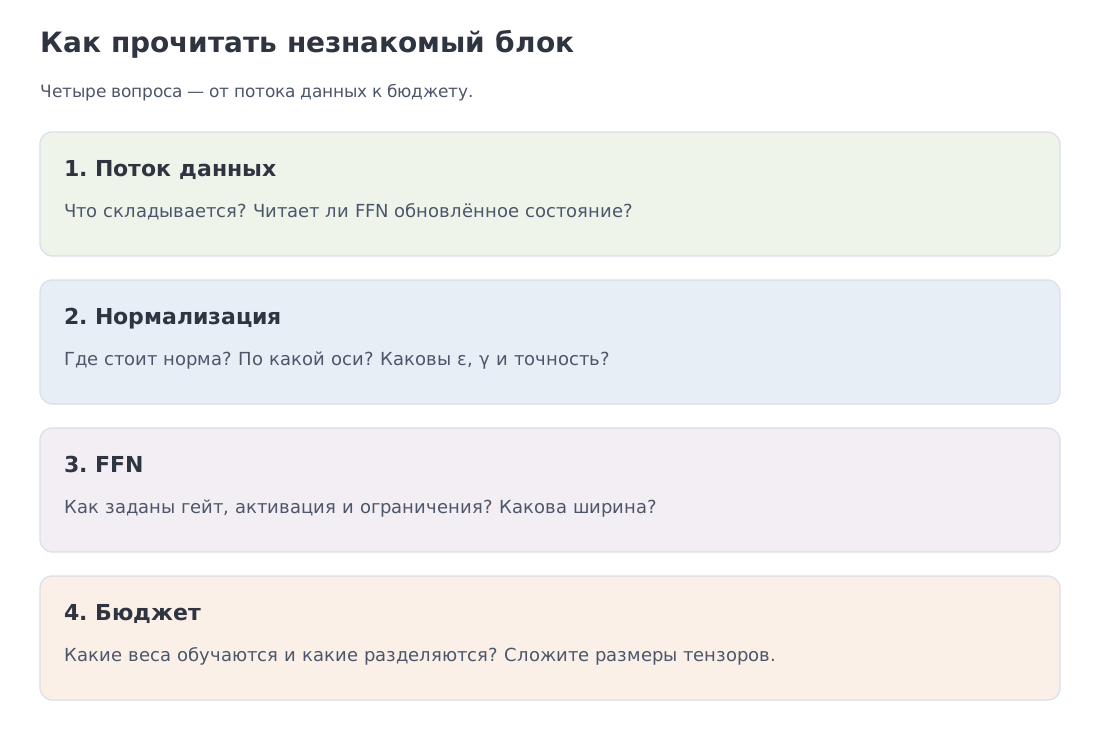 Сначала восстановите поток данных, затем нормализацию, FFN и точный бюджет.
Начните с остаточного сложения: какие тензоры в него входят и совпадают ли их формы? Затем найдите каждую норму, её ось, параметры и точность. После этого проследите обе ветви гейта и выходную проекцию. Последний шаг — сумма размеров всех обучаемых тензоров.
Такой порядок разделяет четыре вопроса: куда идёт информация, как меняется её масштаб, какое преобразование обучается и сколько оно стоит. Для Llama-3.1-8B получается матричных параметров и ещё параметров норм на блок. Для экспертной модели этот же подсчёт нужно дополнить выбором FFN — к этому переходим в М7.
На справочном проходе добавьте два различия: DyT/DyISRU устраняют общую статистику признаков, а mHC меняет связи между несколькими остаточными потоками. Их следует оценивать на своём вычислительном и экспериментальном уровне.
21. первоисточники
Основные первоисточники:
- Ba, Kiros, Hinton. Layer Normalization
- Zhang, Sennrich. Root Mean Square Layer Normalization
- Xiong et al. On Layer Normalization in the Transformer Architecture
- Wang et al. DeepNet: Scaling Transformers to 1,000 Layers
- Kim et al. Peri-LN
- Henry et al. Query-Key Normalization for Transformers
- Shazeer. GLU Variants Improve Transformer
- Zhu et al. Transformers without Normalization
- Stollenwerk. On the Mathematical Relationship Between Layer Normalization and Dynamic Activation Functions
- Xie et al. Manifold-Constrained Hyper-Connections
- OpenAI. gpt-oss reference implementation
- Документация моделей Hugging Face: OLMo2, Llama 4, Gemma 2, Gemma 3, Qwen3 и DeepSeek-V4
- Официальный код Transformers для OLMo2, Llama 4, Gemma 3 и Qwen3
Дальше: модуль 7 рассматривает смесь экспертов (Mixture of Experts). На примере 128 экспертов gpt-oss и выбора четырёх из них разберём общее число параметров и число параметров, участвующих в обработке одного токена.
Источники проверены: 10 октября 2026 года. Численные примеры воспроизводятся локальным контрактом; эмпирические результаты сохраняют условия первоисточников; архитектурные свойства привязаны к официальным конфигурациям, коду или техническим отчётам.