Модуль 4. Позиционные представления: от синусоид к нескольким осям
Курс «Modern LLMs» · лекция модуля 4 · редакция 2026.10.6 · 10 октября 2026 года
В М3 мы собирали внимание из запросов, ключей и значений. Теперь оставим содержимое запроса и ключа неизменным и спросим: как изменится их взаимодействие, если переставить токены или увеличить расстояние между ними? Этот вопрос приведёт нас от синусоидального вектора к вращению RoPE, а затем — к расширению контекста и координатам изображения, видео и аудио.
Понадобятся скалярное произведение и механизм внимания из М3. Синус, косинус и матрицу поворота разберём на одной паре координат; комплексные числа останутся дополнительным способом записать то же вычисление.
Как читать модуль
- Первый проход — понять геометрию. Прочитайте §§1–10 по порядку. В §2 достаточно карты методов; подробности истории и код в §4 раскрываются отдельно. В §7 следите за тем, какие частоты меняются и почему; вывод границ можно разобрать позже. Затем прочитайте §§13 и 17 и ответьте на вопросы §15.
- Второй проход — посчитать и реализовать. Воспроизведите пример §5, рампу §7 и код §§4 и 11. Пройдите ноутбук (§12), особенно проверку кэша и точности позиций, затем упражнения §16.
- Справочный проход. Формы и спаривание координат — §4; спектр — §6; PI/NTK/YaRN — §7; конфигурация — §10; несколько осей — §13; карта проверенных реализаций — §14. Следующий модуль, М5, посвящён устройству и исполнению внимания.
1. Мотивация: от содержания к порядку
Возьмём последовательность скрытых состояний и обычный двунаправленный self-attention без позиционного сигнала и ограничивающей маски, с отключённым dropout. Если переставить строки одной и той же матрицей перестановки , то запросы, ключи и значения переставятся так же, а выход удовлетворит
Это свойство называется перестановочной эквивариантностью (permutation equivariance). Оно не означает, что выход полностью инвариантен к перестановке: строки результата тоже переставляются. Но содержательная операция не различает две последовательности, если отличается только порядок их элементов.
Каузальная маска уже задаёт порядок доступа: позиция видит только разрешённый префикс. Такой декодер не сохраняет симметрию относительно произвольной перестановки. Через маску и слои модель может научиться различать позиции и без отдельного кодирования — к этому мы вернёмся в §9. Явная позиционная схема даёт более прямой способ задать расстояние и направление между двумя токенами.
Позиционная схема решает именно эту задачу. Она должна сообщить модели как минимум три вида информации:
- порядок — что было раньше, а что позже;
- расстояние — насколько далеко расположены элементы;
- структуру координат — для изображения и видео одной линейной оси уже недостаточно.
При этом желательно не превращать максимальную длину последовательности в жёсткий размер таблицы параметров. Отсюда и исторический переход от обучаемых абсолютных векторов к формулам, относительным смещениям и вращениям.
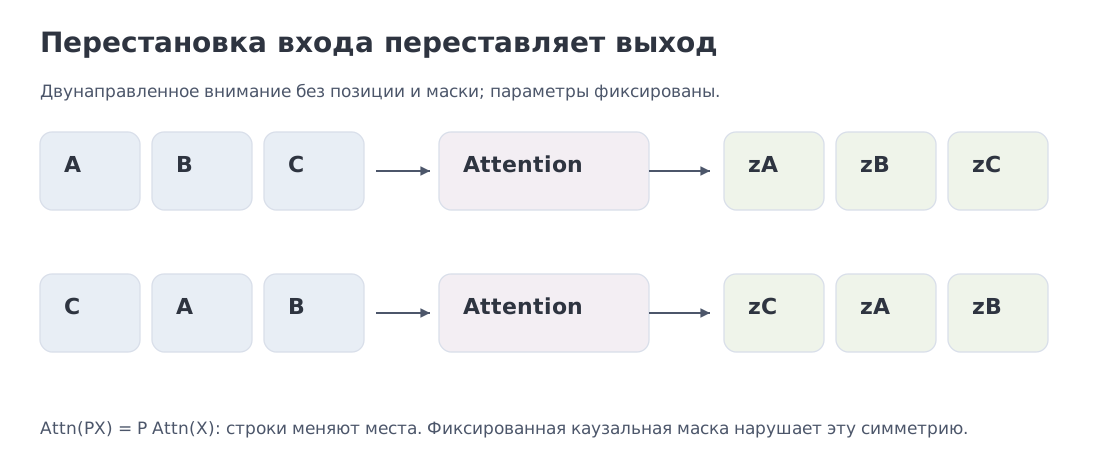 Без позиционного сигнала двунаправленный self-attention перестановочно-эквивариантен. Каузальная маска нарушает полную симметрию, но не заменяет богатую позиционную геометрию.
2. Карта методов: где появляется позиция
Позиционное кодирование (Positional Encoding, PE) — способ внести координаты токена в вычисление. Один из вариантов — RoPE (Rotary Position Embedding), вращение пар координат.
Позицию можно добавить к входному вектору, учесть при вычислении запроса и ключа или внести как отдельное смещение логита. Логит здесь — число до softmax, определяющее вес связи между позициями. Это три разных места вмешательства в уже знакомое вычисление из М3.
| Где появляется сигнал | Что меняется | Пример и продолжение |
|---|---|---|
| Во входном векторе | к эмбеддингу прибавляется вектор позиции | синусоидальное PE, §§3–4 |
| В запросе и ключе после проекции | пары координат поворачиваются на угол, зависящий от позиции | RoPE, §§4–7 |
| В логите перед softmax | добавляется слагаемое, зависящее от расстояния | ALiBi, §8 |
| Отдельного сигнала нет | порядок может усваиваться через каузальную маску и слои | NoPE, §9 |
Имена PI, NTK-aware и YaRN обозначают способы изменения частот RoPE (§7). M-RoPE распределяет пары координат между несколькими осями (§13). Пока достаточно знать, к какому вопросу относится каждое имя; определения появятся перед формулами.
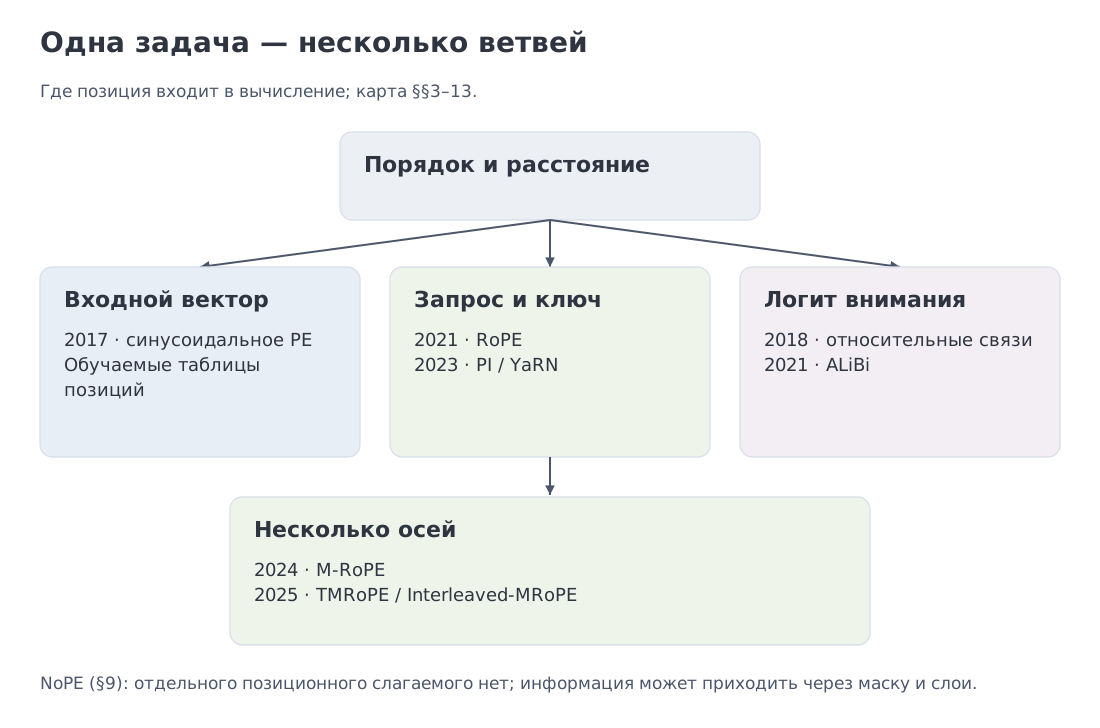 Методы разветвляются по месту и способу внесения позиции. Более поздняя ветвь не отменяет предыдущие.
Исторические связи — дополнительное чтение
Оригинальный Transformer использовал детерминированное синусоидальное позиционное кодирование (Positional Encoding, PE). Для каждой позиции вычислялась лестница синусов и косинусов с геометрически распределёнными частотами. Таблица не обучалась и могла быть вычислена для позиции за пределами исходного контекста.
Параллельно распространились обучаемые абсолютные эмбеддинги. Они просты: позиция индексирует строку матрицы. Но таблица имеет конечную длину, а значение позиции за пределами обученного диапазона не определено без отдельного расширения.
Следующий шаг — относительные представления. Shaw et al. добавили обучаемые представления относительного смещения непосредственно в механизм внимания. Transformer-XL использовал относительную формулировку, чтобы согласовать повторно используемую память сегментов. ALiBi — Attention with Linear Biases пошла ещё проще: вместо вращения или таблицы к логиту добавляется линейный штраф за расстояние.
RoPE — Rotary Position Embedding кодирует абсолютную позицию как вращение, но в скалярном произведении запроса и ключа оставляет только их относительную фазу. Этот механизм оказался особенно удобным для языковых моделей с декодерной архитектурой: он не добавляет обучаемых позиционных параметров и совместим с кэшем ключей и значений (KV-cache).
Когда контекст начал расти с тысяч до сотен тысяч токенов, возникла отдельная линия расширения RoPE:
- PI — Position Interpolation сжимает новые позиции в прежний диапазон;
- статическое и динамическое NTK-aware масштабирование меняют спектр частот более неравномерно;
- YaRN — Yet another RoPE extensioN соединяет интерполяцию и сохранение части исходных частот;
- LongRoPE и родственные методы ищут коэффициенты по отдельным размерностям или стадиям длины;
- Llama3-style scaling, partial RoPE, interleaved RoPE/NoPE, локальное внимание и настройка температуры образуют другие ветви.
Мультимодальные модели добавили ещё одно измерение проблемы. Для изображения важны высота и ширина, для видео — ещё и время, а потоковые аудио-видео системы должны синхронизировать разные временные сетки. Так появились M-RoPE и TMRoPE.
3. Мостик к классике: Фурье, комплексные числа и относительная фаза
Пусть — целочисленная позиция, отсчитываемая с нуля, а — угловая частота пары координат: число радиан на один шаг позиции. Произведение — фаза, то есть угол на этой позиции. При увеличении позиции на один частота задаёт величину поворота.
Синусоидальное кодирование часто сравнивают с Fourier features. Аналогия полезна: положение отображается в набор периодических координат
Для одной пары координат скалярное произведение точно, а не приблизительно, зависит от разности позиций:
Но в классическом аддитивном PE позиционный вектор складывается с содержательным эмбеддингом до обучаемых проекций. Появляются перекрёстные слагаемые «содержание–позиция», и итоговый логит внимания уже не обязан быть чистой функцией .
RoPE помещает фазу в другое место: после проекции скрытого состояния в запрос и ключ. Пару координат можно воспринимать как стрелку на плоскости. Поворот обеих стрелок на одинаковый угол сохраняет угол между ними и их скалярное произведение.
Дополнительная запись через комплексные числа. Если записать пару как , где здесь — мнимая единица, поворот задаётся умножением на
Обозначим через поворот на позицию m для всех пар координат. В произведении повёрнутых запроса и ключа общий сдвиг фазы сокращается:
Именно поэтому относительное смещение входит в логит напрямую. RoPE не требует, чтобы произвольный линейный слой коммутировал с вращением. Реальная последовательность операций другая: скрытое состояние сначала проецируется в и , а затем уже полученные координатные пары поворачиваются.
Случайные Fourier features обычно выбирают частоты как стохастическую аппроксимацию заданного ядра. В Transformer частоты детерминированы геометрической прогрессией. Поэтому связь с ядрами — объясняющая аналогия, а не утверждение, что RoPE является конкретной случайной аппроксимацией ядра.
4. Формализм: от синусоид к вращению запроса и ключа
В формулах ниже — чётное число вращаемых координат, а не ширина всей модели . Для обычной RoPE на всей голове . В аддитивном PE тот же вид формулы применяется к ширине входного вектора. Частоту в коде часто называют inv_freq: она обратна масштабу, стоящему в знаменателе фазы. База base>1 задаёт, как быстро уменьшаются частоты от пары к паре.
Для размерности определим обратных частот
Соответствующая длина волны, измеряемая в позициях, равна
В синусоидальном PE позиция получает координаты
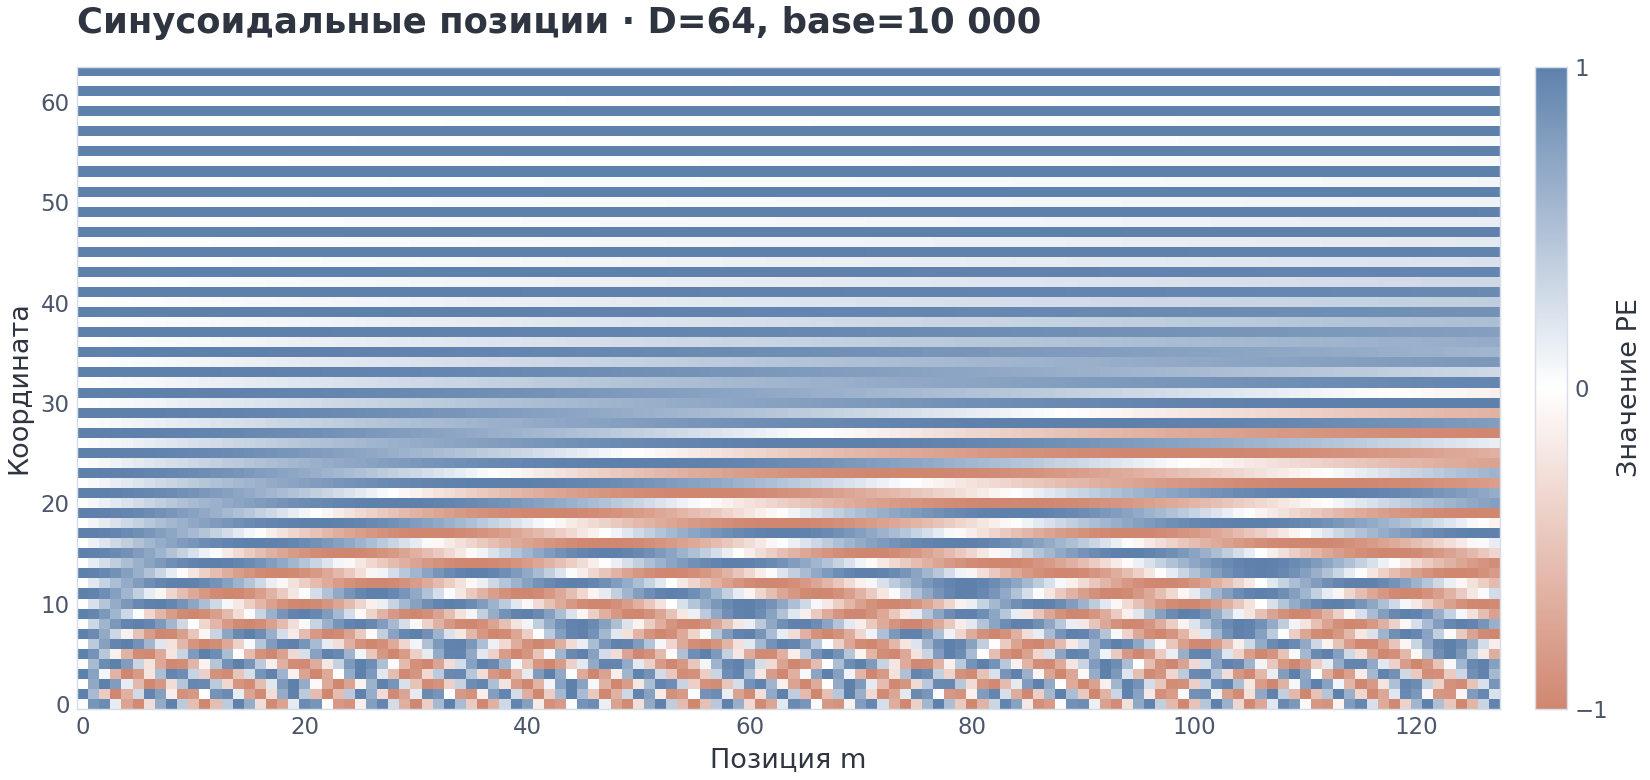 Каждая строка — одна координата позиционного вектора. Соседние строки образуют синусно-косинусную пару; высокие индексы меняются медленнее.
В RoPE та же фаза используется как матрица вращения пары:
Запрос и ключ поворачиваются независимо:
Поскольку ,
Абсолютные позиции нужны, чтобы вычислить повороты, но при фиксированных содержательных и позиционная часть билинейного скалярного произведения входит через относительное смещение . Полный логит зависит и от содержания запроса и ключа.
Две конвенции спаривания
Формулы часто записывают через соседние пары . Реализации Llama/Hugging Face обычно используют rotate_half, где первая половина вектора спаривается со второй: . Обе схемы математически эквивалентны после фиксированной перестановки координат, но веса одной модели нельзя интерпретировать другой схемой без этой перестановки.
RoPE сохраняет норму каждой пары и не увеличивает размер тензора. Но это не означает, что он «бесплатен»: нужно вычислить или получить sin/cos, применить их в нужной точности и правильно согласовать позиции с KV-cache.
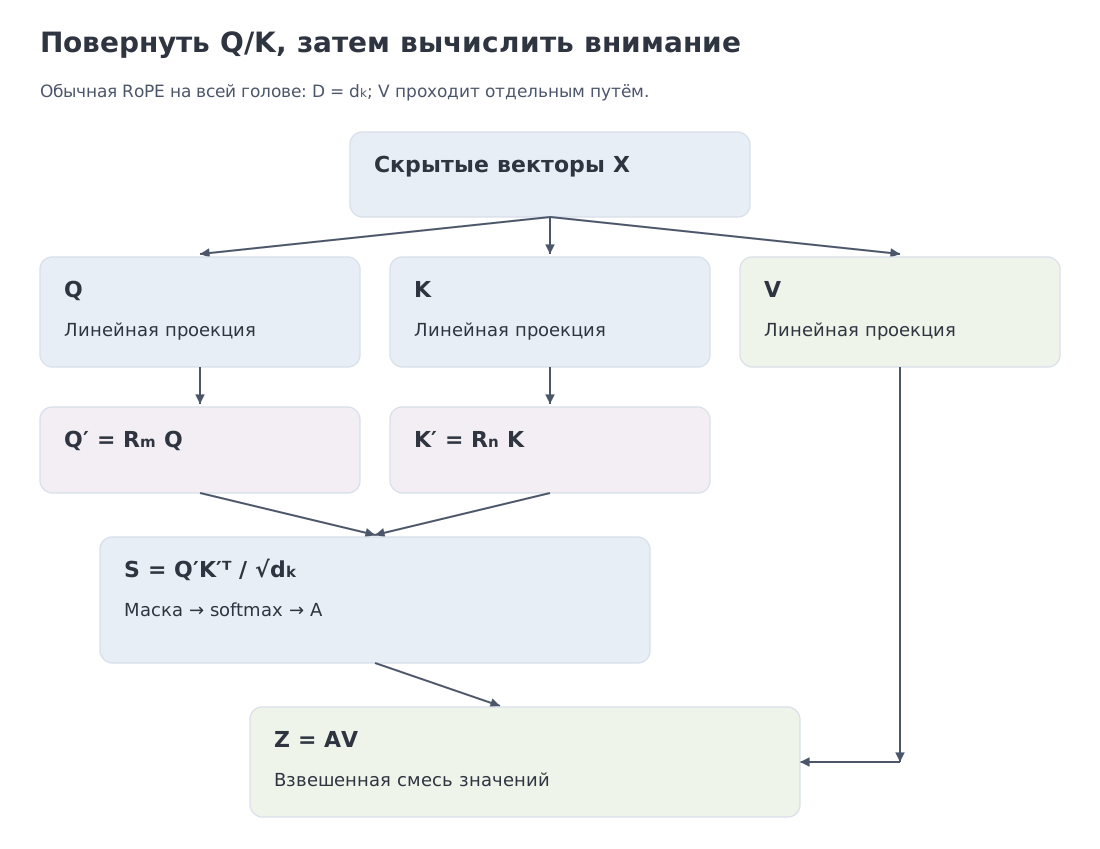 Сначала получаем Q/K/V линейными проекциями. Затем вращаем Q и K, вычисляем масштабированные логиты и смешиваем V. В показанном варианте V не вращается.
Частичная RoPE. Иногда вращается только часть головы: , а остальные координаты проходят без изменения. В формуле частот используется вращаемая ширина D; при нормировке логитов внимания — полная ширина ключа . Если дополнительный множитель применяется только к вращаемой части, он не масштабирует весь логит одинаково.
Реализация на NumPy и PyTorch — второй проход
NumPy → PyTorch · B02 — RoPE: вращение пар координат
Код для второго прохода. Здесь вход x[..., T, D] уже проверен: непустой вещественный тензор, чётная ширина D, целочисленные неотрицательные позиции [T], конечная база больше 1. Соседние координаты образуют пары. Полные проверки входа находятся в ноутбуке (§12).
import numpy as np
import torch
1. Явная NumPy-реализация
def numpy_rope_explicit(
    x: np.ndarray,
    position_ids: np.ndarray,
    *,
    base: float = 10_000.0,
) -> np.ndarray:
    dim = x.shape[-1]
    inv_freq = base ** (-np.arange(0, dim, 2) / dim)
    angles = position_ids[:, None] * inv_freq[None, :]
    shape = (1,) * (x.ndim - 2) + angles.shape
    cos, sin = np.cos(angles).reshape(shape), np.sin(angles).reshape(shape)
    even, odd = x[..., 0::2], x[..., 1::2]
    out = np.empty_like(x, dtype=np.result_type(x.dtype, np.float64))
    out[..., 0::2] = even * cos - odd * sin
    out[..., 1::2] = even * sin + odd * cos
    return out
NumPy явно строит обратные частоты, углы для абсолютных позиций и две координаты каждого двумерного вращения. Благодаря этому видно, где именно позиция входит в оператор.
2. Та же математика явными операциями PyTorch
def torch_rope_explicit(
    x: torch.Tensor,
    position_ids: torch.Tensor,
    *,
    base: float = 10_000.0,
) -> torch.Tensor:
    dim = x.shape[-1]
    work_dtype = torch.float64 if x.dtype == torch.float64 else torch.float32
    inv_freq = base ** (-torch.arange(0, dim, 2, device=x.device, dtype=work_dtype) / dim)
    angles = position_ids.to(device=x.device, dtype=work_dtype)[:, None] * inv_freq[None, :]
    shape = (1,) * (x.ndim - 2) + tuple(angles.shape)
    cos, sin = angles.cos().reshape(shape), angles.sin().reshape(shape)
    even, odd = x[..., 0::2].to(work_dtype), x[..., 1::2].to(work_dtype)
    out = torch.stack((even * cos - odd * sin, even * sin + odd * cos), dim=-1).flatten(-2)
    return out.to(x.dtype)
PyTorch вычисляет фазы и вращения как минимум в float32, затем возвращает тип входа. Это предотвращает раннее округление позиций в FP16/BF16. Для больших индексов и точного эталона используется float64; целочисленное хранение само по себе не устраняет погрешность последующего преобразования. Градиенты проходят по входным векторам.
| Аспект | NumPy | PyTorch |
|---|---|---|
| Частоты | np.arange + обычный массив | torch.arange(..., device=x.device) |
| Тригонометрия | np.cos, np.sin | Tensor.cos, Tensor.sin |
| Устройство | CPU | CPU/CUDA/MPS |
| Градиенты | нет | autograd по входу |
| Точность | вычисления и выход float64 | фазы float32/64; выход как у входа |
| Абсолютная позиция | явный position_ids | согласована с позициями ключей в кэше |
Исполняемая проверка эквивалентности и граничных случаев
rng = np.random.default_rng(2)
x_np = rng.standard_normal((2, 5, 8))
pos_np = np.arange(5, dtype=np.int64) + 11
np_out = numpy_rope_explicit(x_np, pos_np)
x = torch.tensor(x_np, dtype=torch.float64, requires_grad=True)
t_out = torch_rope_explicit(x, torch.tensor(pos_np))
np.testing.assert_allclose(np_out, t_out.detach().numpy(), rtol=1e-12, atol=1e-12)
t_out.square().sum().backward()
# A rotation is orthogonal: d ||R x||^2 / dx = 2 x.
torch.testing.assert_close(x.grad, 2 * x.detach(), rtol=1e-12, atol=1e-12)
# Half-precision IDs would merge 2048 and 2049 before the rotation.
long_ids = torch.tensor([2048, 2049], dtype=torch.int64)
half_x = torch.ones((2, 8), dtype=torch.float16)
half_out = torch_rope_explicit(half_x, long_ids)
expected = numpy_rope_explicit(half_x.numpy(), long_ids.numpy())
np.testing.assert_allclose(half_out.numpy(), expected, rtol=1e-3, atol=1e-3)
assert not torch.equal(half_out[0], half_out[1])
assert long_ids.to(torch.float16)[0] == long_ids.to(torch.float16)[1]
print("B02 outputs, analytic gradient, and float16 positions: PASS")
Полный исполняемый файл: m04_rope_bridges.py
5. Решённый пример: один и тот же относительный сдвиг
Возьмём
и base = 10000. Обратные частоты:
Поместим запрос на позицию 3, а ключ — на позицию 1. Используем соседние пары координат. После двух независимых вращений получаем скалярное произведение до масштабирования логита внимания:
Теперь одновременно сдвинем обе позиции: . Разность остаётся равной 2, и численный результат не меняется. То же происходит для пары .
| Позиция запроса | Позиция ключа | Скалярное произведение | |
|---|---|---|---|
| 3 | 1 | 2 | 1.144248 |
| 7 | 5 | 2 | 1.144248 |
| 2 | 0 | 2 | 1.144248 |
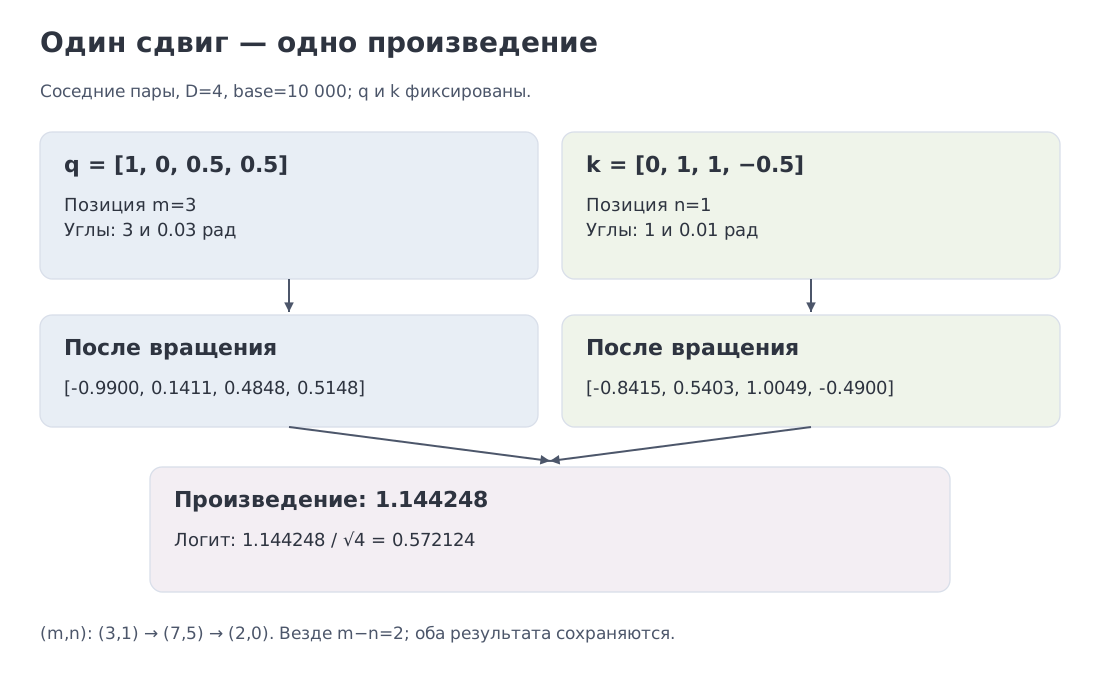 Ручная трассировка двух координатных пар: абсолютные углы различаются, а общий относительный сдвиг даёт одинаковое скалярное произведение.
Для обычного внимания из М3 нужно ещё разделить результат на : логит равен примерно 0.572124. Маску и softmax применяют после этого. При сравнении общего сдвига постоянный множитель ничего не меняет.
Этот пример показывает точную алгебру относительности. Он не утверждает, что внимание всегда является функцией только расстояния: и зависят от содержания токенов, слоя, головы и контекста.
6. Спектр частот: что действительно выбирает rope_theta
Параметр rope_theta, или base, определяет геометрическую лестницу частот. Самая быстрая пара при имеет
для любой базы. Увеличение base не удаляет эту локальную частоту. Оно сильнее замедляет пары с большими индексами и тем самым перераспределяет спектральный бюджет в сторону длинных волн.
В таблице — число оборотов на интервале длины L. Это соглашение формулы YaRN. У последовательности из L токенов с индексами расстояние между крайними индексами равно L−1; не смешивайте эти две величины. Здесь длины волн измеряются в шагах позиции.
Для получаем:
| base | минимальная длина волны | максимальная длина волны | пар с ≥1 оборотом при L=4096 |
|---|---|---|---|
| 10 000 | 6.28 | 47 117 | 23 из 32 |
| 150 000 | 6.28 | 649 409 | 18 из 32 |
| 500 000 | 6.28 | 2 084 765 | 16 из 32 |
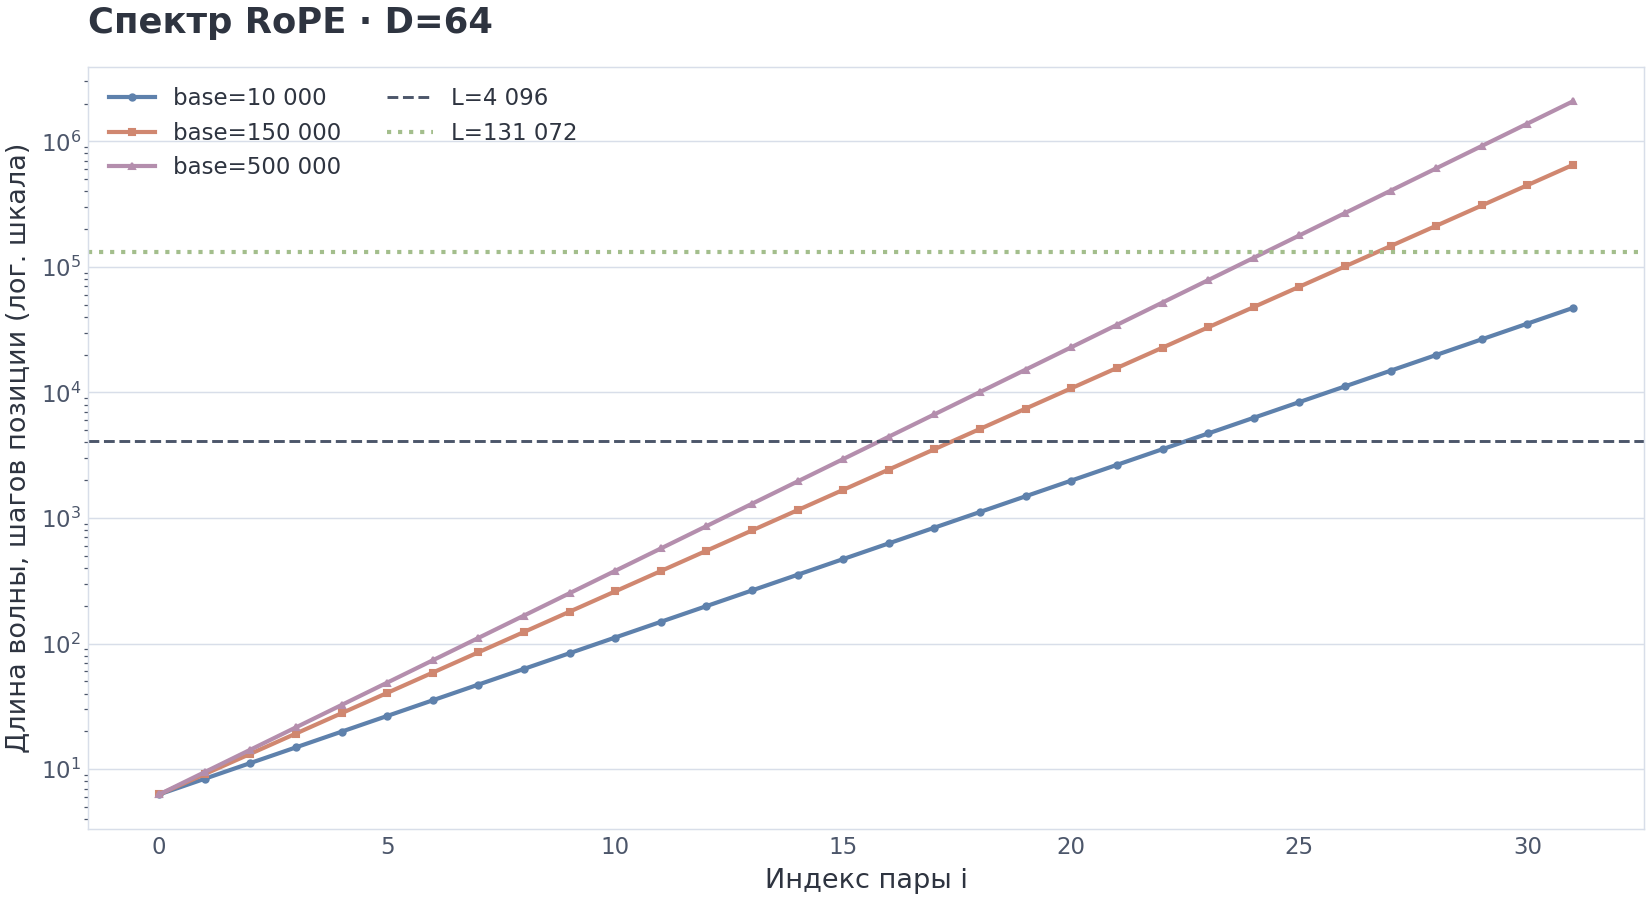 Лестница длин волн для трёх баз. Горизонтали контекста помогают диагностировать, какие пары успели пройти значительную часть цикла, но не задают жёсткую границу различимости всей позиции.
Здесь особенно важна осторожная интерпретация. Каждая отдельная пара периодична. Но полный RoPE-вектор содержит много частот с разными периодами. Возврат одной пары в похожую фазу не означает, что весь позиционный код повторился. Поэтому максимальная длина волны одной координатной пары не является физическим пределом контекста, а число полных оборотов — не теорема о том, какие позиции модель способна различить.
Эти величины всё же полезны как диагностика. Пары, которые многократно вращались в обучающем диапазоне, хорошо покрыли свою фазу. Медленные пары видели лишь небольшой участок окружности; при экстраполяции они попадают в новую геометрию. Качество зависит от всего спектра, обучения, схемы внимания и задачи.
7. Расширение контекста: PI, NTK-aware scaling, YaRN и другие ветви
Обозначим через исходную длину, относительно которой настроены частоты, и захотим обрабатывать токенов, где — коэффициент расширения. В исследованиях это часто обучающая длина; в конфигурации модели смысл поля нужно проверять отдельно (§10).
Position Interpolation
PI заменяет позицию на . Эквивалентно можно разделить все обратные частоты на :
Новые позиции попадают в диапазон углов, знакомый модели. Цена — сжатие и локальных фаз: соседние позиции становятся ближе по всем вращаемым координатам. Поэтому исходная работа использует дообучение, чтобы модель адаптировалась к новой геометрии.
Static NTK-aware scaling
Популярная статическая эвристика меняет базу:
Быстрые частоты меняются слабее, медленные — сильнее. Название связано с NTK-мотивацией, но формула не является универсальной теоремой о безопасном расширении. Результат без дополнительного обучения зависит от модели и длины; его нужно измерять.
Здесь , . При подстановке новой базы отношение частот равно : пара i=0 не меняется, а последняя пара замедляется ровно в s раз. При D=2 эта формула не определена. NTK — Neural Tangent Kernel, теоретическая модель поведения широких сетей; для нашего расчёта нужен только приведённый закон изменения базы.
YaRN
YaRN строит две версии спектра:
- исходную — для экстраполяции;
- интерполированную — .
Затем по числу оборотов на исходном интервале вычисляется плавная рампа между ними. Пусть — число оборотов на исходном интервале. Параметры задают границы по оборотам: быстрые пары сохраняют исходную частоту, медленные получают интерполяцию. Решая , находим дробный индекс пары:
Рампа — линейный переход, обрезанный до диапазона от 0 до 1:
При частота исходная, при — полностью интерполированная. Промежуточные пары смешивают два значения. Далее рассматриваем невырожденные границы внутри спектра; код отклоняет схлопнувшийся диапазон.
Для учебного сценария
head_dim = 64
base = 150000
original_context = 4096
factor = 32
beta_fast = 32
beta_slow = 1
оригинальная реализация gpt-oss использует непрерывные границы
По целочисленным индексам это всё равно даёт три группы:
- 9 пар остаются без изменения;
- 9 находятся на переходной рампе;
- 14 полностью интерполируются.
Универсальная реализация YaRN в Hugging Face также поддерживает режим truncate=True, который округляет эти границы до low=8, high=18. Для GptOssConfig по умолчанию задано truncate=False, поэтому при разборе именно gpt-oss корректнее сохранять непрерывные значения.
В данном сценарии полностью интерполированная зона совпадает с парами, не совершившими полного оборота на 4096. Это следствие выбранной формулы границ и параметров, а не общий закон «полный оборот разрешает экстраполяцию».
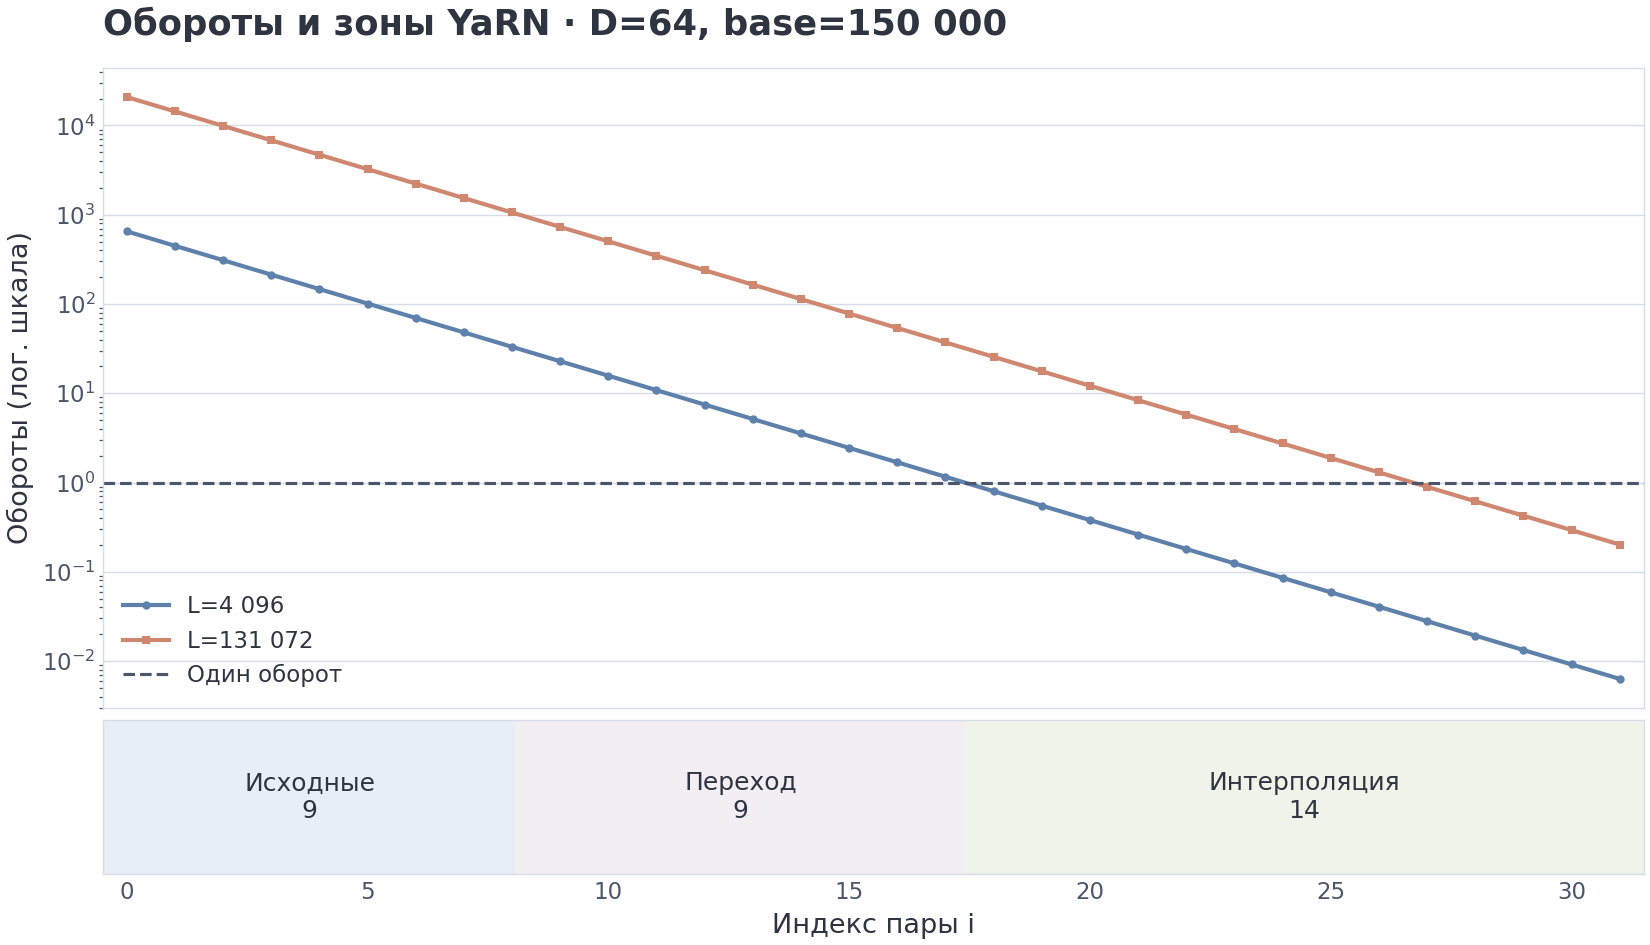 Число оборотов используется как диагностический параметр YaRN-рампы: исходная зона, переход и интерполяция. Подписи не означают математическое «разрешено/запрещено».
YaRN также меняет концентрацию весов внимания. Температура — делитель логитов перед softmax: меньшая температура при тех же логитах усиливает различия весов. В YaRN это можно реализовать через масштаб attention_factor. И исходная реализация gpt-oss, и её адаптация в Hugging Face используют при правило
При :
Важно понимать место применения. В обоих проверенных путях этот множитель применяется к вычисленным cos/sin. Если одинаковый множитель фактически входит и в повернутый , и в повернутый , их скалярное произведение получает фактор
Равенство для всего скалярного произведения предполагает масштабирование всех координат Q и K. При частичной RoPE масштабируется только соответствующая сумма, если остальные координаты отдельно не изменены. Формула для a эмпирическая, а не следствие тождества вращения.
Другие реализации могут переносить эквивалентное масштабирование в запрос, ключ или непосредственно в логит внимания. Поэтому поле attention_factor нужно читать вместе с кодом реализации.
LongRoPE и современное ветвление
LongRoPE ищет коэффициенты масштабирования по отдельным размерностям и допускает разные режимы на разных длинах. LongRoPE2 добавляет более явную привязку к критериям, учитывающим обучение. Llama3-style scaling по-разному обрабатывает диапазоны длин волн. Другие модели сочетают RoPE с NoPE-слоями, локальным вниманием, разбиением на блоки или динамической температурой.
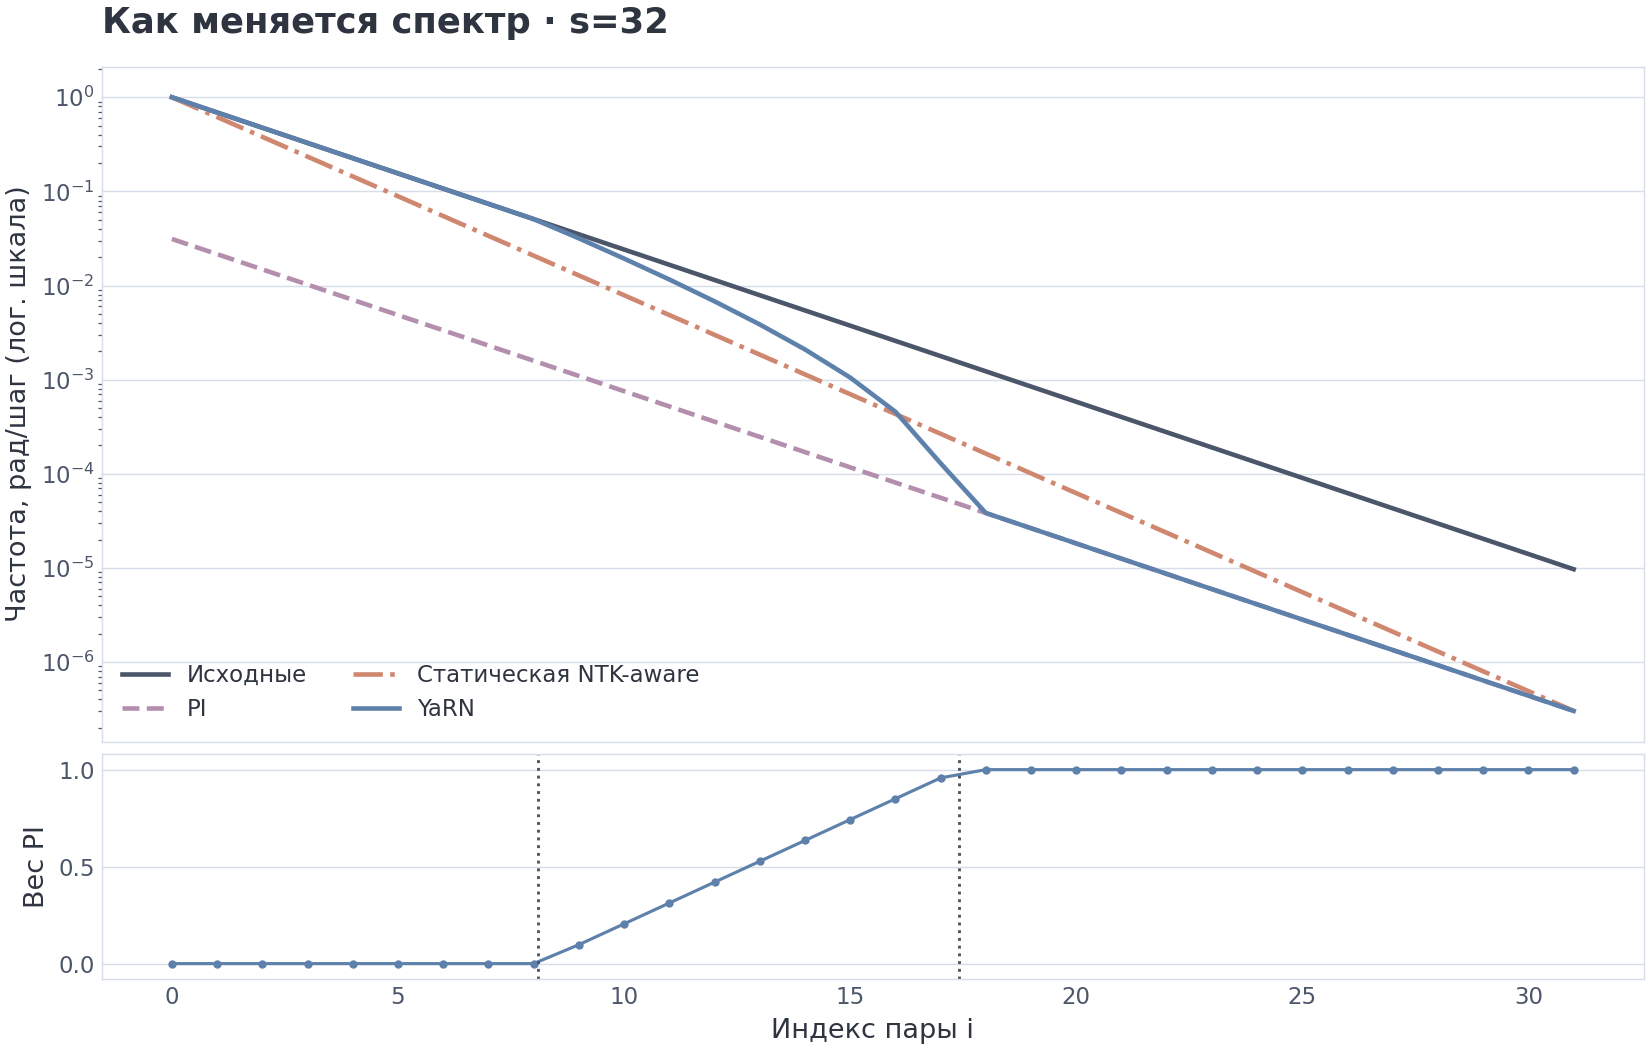 Один исходный спектр и три учебные трансформации: равномерная PI, статическая NTK-aware эвристика и кусочная YaRN. График сравнивает геометрию, а не гарантированное качество.
8. ALiBi: линейное позиционное смещение
ALiBi — Attention with Linear Biases не поворачивает и . Для головы к содержательному логиту добавляется штраф
в причинной области , где — фиксированный наклон для головы h, измеряемый в единицах логита на шаг позиции. Будущие ключи по-прежнему запрещает маска; конечный штраф ALiBi её не заменяет. У разных голов разные наклоны , поэтому одна голова сильнее ориентируется на близкий контекст, другая — слабее штрафует дальние позиции.
Если содержательная часть временно зафиксирована, после softmax линейный штраф соответствует экспоненциальному априорному предпочтению ближних позиций:
Полное внимание по-прежнему зависит от и нормировки по всем доступным ключам, поэтому не сводится к одному стационарному ядру расстояния.
Преимущество ALiBi — отсутствие таблицы позиций и естественное продолжение линейного штрафа на новые длины. Ограничение — форма этого позиционного предпочтения задана заранее.
Качество предсказания следующего токена часто измеряют перплексией (perplexity): , где средняя NLL из М3 вычислена в натах на оцениваемый токен. Чем меньше перплексия на одном и том же наборе при одинаковой токенизации и маске оценки, тем выше вероятность, которую модель в среднем назначает верным продолжениям. Сохранение этой метрики на большей длине ещё не гарантирует надёжного извлечения из середины огромного контекста или решения длинной причинной цепочки: для них нужны отдельные тесты.
9. NoPE: позиция без явного позиционного кодирования
NoPE — No Positional Encoding оставляет attention без отдельного абсолютного или относительного позиционного слагаемого. В каузальном декодере маска уже несёт часть информации: позиция видит префикс определённой длины, а скрытые состояния предыдущих слоёв зависят от порядка вычисления.
Эксперименты показывают, что Transformer способен изучать существенную позиционную структуру и без явного PE. Но отсюда не следует, что позиция стала не нужна. Скорее, информация приходит через маску, глубину, статистику данных и краевые эффекты.
Нужно различать два режима:
- чистый NoPE — все слои работают без явного позиционного кодирования;
- гибрид — часть слоёв использует RoPE, часть NoPE, либо разные слои имеют разные схемы внимания.
Llama 4 — пример второго режима: конфигурация предусматривает NoPE-слой через заданный интервал, а также блочное внимание (chunked attention) и настройку температуры на длинных позициях. В реализации Llama 4 эта настройка применяется при включённом attn_temperature_tuning именно к NoPE-слоям. Она меняет масштаб запросов и является отдельным механизмом, отличным от частотной рампы YaRN.
10. Разбор конфигурации: что говорит gpt-oss и чего она не говорит
Используем исходную конфигурацию gpt-oss-120b, зафиксированную ревизией b5c939de…. Полная копия и хеш входят в материалы модуля; вычисление не зависит от изменения ветки main. Читаем её вместе с реализацией OpenAI 7b583341… и Transformers 536ecc007…, проверенными 10 октября 2026 года.
Опубликованные поля:
{
  "head_dim": 64,
  "initial_context_length": 4096,
  "rope_theta": 150000,
  "rope_scaling_factor": 32.0,
  "rope_ntk_alpha": 1,
  "rope_ntk_beta": 32
}
Эти поля позволяют восстановить геометрию позиционного масштабирования:
- 32 вращаемые пары на голову;
- исходная база 150 000;
- опорная длина 4096;
- целевой коэффициент 32;
- границы частотной коррекции, соответствующие параметрам 1 и 32.
Эти параметры воспроизводятся в учебном расчёте с непрерывными границами low≈8.0928, high≈17.3980 и attention_factor≈1.346574. Округлённая пара 8/18 относится к отдельному режиму truncate=True, а не к исходной реализации gpt-oss.
Конфигурация описывает параметры позиционного механизма. Поле initial_context_length задаёт длину, относительно которой настроена формула. Чтобы установить, на каких длинах модель обучалась и когда расширяла контекст, нужен технический отчёт или опубликованная схема обучения.
При преобразовании модели в Hugging Face те же идеи могут быть представлены более общим словарём rope_parameters/rope_scaling: тип, коэффициент расширения, исходная длина, границы β и масштаб внимания. Названия полей между оригинальным и библиотечным форматом различаются, поэтому конфигурацию всегда читают вместе с кодом модели и версией библиотеки.
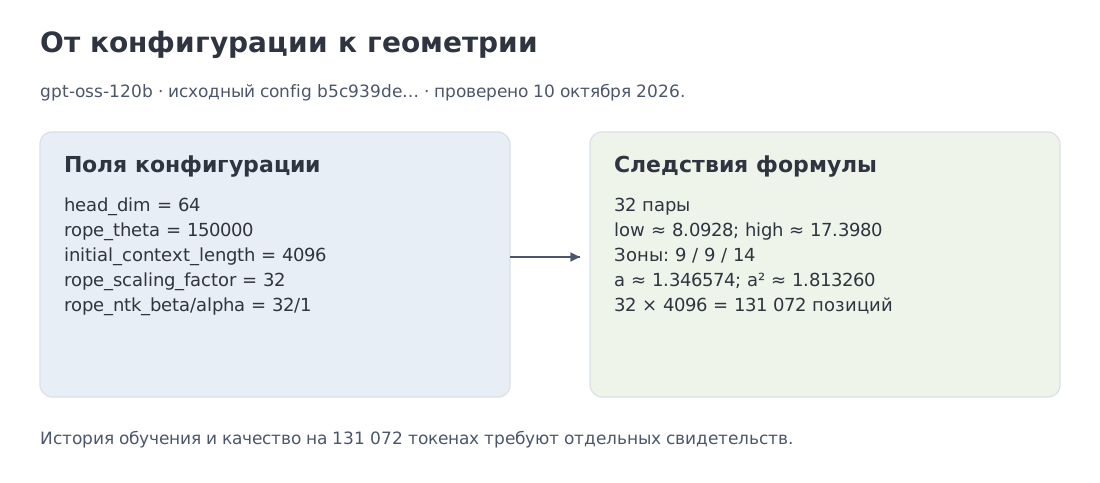 Конфигурация gpt-oss как паспорт позиционной геометрии:
base, опорная длина, factor и границы рампы. Отдельно показано, какие выводы она не подтверждает.
11. Код первого уровня: формы, позиции и масштабирование
Ниже — учебное ядро, а не оптимизированное объединённое вычислительное ядро (fused kernel). Оно проверяет чётность head_dim, формы , целочисленность позиций, положительность частот и корректность YaRN-рампы. Конвенция спаривания — split-half rotate_half, используемая в Llama-подобных реализациях.
Функция apply_rope ниже принимает Q и K одинаковой формы и один вектор позиций: это пример поворота полного блока последовательности. Для разных длин запросов и ключей ноутбук вращает каждый тензор отдельно. Вычисления ядра выполняются в float64; общий масштаб a применяется снаружи. YaRN-функция воспроизводит рассматриваемый сценарий, а не все режимы всех библиотек.
import math
import numpy as np

def rope_inv_freq(head_dim: int, base: float = 150_000.0) -> np.ndarray:
    """Return theta_i = base**(-2i/D) for D/2 rotary pairs."""
    if isinstance(head_dim, bool) or not isinstance(head_dim, int):
        raise TypeError("head_dim must be an integer")
    if head_dim < 2 or head_dim % 2:
        raise ValueError("head_dim must be positive and even")
    if not math.isfinite(base) or base <= 1.0:
        raise ValueError("base must be finite and greater than 1")
    i = np.arange(head_dim // 2, dtype=np.float64)
    return base ** (-2.0 * i / head_dim)

def rotate_half(x: np.ndarray) -> np.ndarray:
    """Quarter-turn the split-half coordinate pairs."""
    if x.ndim < 2 or x.size == 0 or x.shape[-1] % 2:
        raise ValueError("x must have shape [..., T, D] with even D")
    half = x.shape[-1] // 2
    return np.concatenate((-x[..., half:], x[..., :half]), axis=-1)

def apply_rope(q, k, positions, inv_freq):
    """Apply split-half RoPE to q/k of shape [..., T, D]."""
    if any(np.iscomplexobj(x) for x in (q, k, inv_freq)):
        raise TypeError("q, k and inv_freq must be real")
    q = np.asarray(q, dtype=np.float64)
    k = np.asarray(k, dtype=np.float64)
    positions = np.asarray(positions)
    inv = np.asarray(inv_freq, dtype=np.float64)
    if q.shape != k.shape or q.ndim < 2 or q.size == 0 or q.shape[-1] % 2:
        raise ValueError("q and k must share shape [..., T, D], with even D")
    if not np.isfinite(q).all() or not np.isfinite(k).all():
        raise ValueError("q and k must be finite")
    if positions.ndim != 1 or positions.dtype.kind not in "iu":
        raise ValueError("positions must be an integer vector [T]")
    if positions.size != q.shape[-2] or np.any(positions < 0):
        raise ValueError("positions do not match the sequence axis")
    if inv.shape != (q.shape[-1] // 2,) or not np.isfinite(inv).all() or np.any(inv <= 0):
        raise ValueError("inv_freq must be positive and have shape [D/2]")

    angles = positions.astype(np.float64)[:, None] * inv[None, :]
    angles = angles.reshape((1,) * (q.ndim - 2) + angles.shape)
    if not np.isfinite(angles).all():
        raise FloatingPointError("phase overflow")
    full = np.concatenate((angles, angles), axis=-1)
    cos, sin = np.cos(full), np.sin(full)
    qr, kr = q * cos + rotate_half(q) * sin, k * cos + rotate_half(k) * sin
    if not np.isfinite(qr).all() or not np.isfinite(kr).all():
        raise FloatingPointError("rotation overflow")
    return qr, kr

def yarn_inv_freq(head_dim, base, factor, original_context,
                  beta_fast=32.0, beta_slow=1.0, *, truncate=False):
    """Blend original and interpolated frequencies with a YaRN-style ramp."""
    inv = rope_inv_freq(head_dim, base)
    if not math.isfinite(factor) or factor < 1.0:
        raise ValueError("factor must be at least 1")
    if isinstance(original_context, bool) or not isinstance(original_context, int):
        raise TypeError("original_context must be an integer")
    if not math.isfinite(beta_fast) or not math.isfinite(beta_slow):
        raise ValueError("beta parameters must be finite")
    if original_context <= 0 or beta_fast <= beta_slow or beta_slow <= 0:
        raise ValueError("invalid context or beta parameters")
    if not isinstance(truncate, bool):
        raise TypeError("truncate must be bool")

    def correction_dim(turns: float) -> float:
        return head_dim * math.log(
            original_context / (turns * 2 * math.pi)
        ) / (2 * math.log(base))

    pair_count = head_dim // 2
    low_raw = correction_dim(beta_fast)
    high_raw = correction_dim(beta_slow)
    low = math.floor(low_raw) if truncate else low_raw
    high = math.ceil(high_raw) if truncate else high_raw
    low = min(max(float(low), 0.0), float(pair_count - 1))
    high = min(max(float(high), 0.0), float(pair_count - 1))
    if high <= low:
        raise ValueError("the YaRN ramp collapsed")

    ramp = np.clip(
        (np.arange(pair_count, dtype=np.float64) - low) / (high - low),
        0.0,
        1.0,
    )
    scaled = inv * (1.0 - ramp) + (inv / factor) * ramp
    attention_factor = 1.0 if factor <= 1 else 1.0 + 0.1 * math.log(factor)
    return scaled, attention_factor, attention_factor**2, low, high
Для нашего сценария функция возвращает непрерывные границы low≈8.0928, high≈17.3980, attention_factor≈1.346574 и множитель скалярного произведения ≈1.813260, если масштаб одинаково входит во все координаты повёрнутых запроса и ключа. Параметр truncate=True можно включить отдельно, чтобы получить целочисленные границы 8/18.
13. Мультимодальная позиция: M-RoPE и TMRoPE
M-RoPE — Multimodal Rotary Position Embedding делит вращаемые координаты головы на секции, связанные со временем (temporal), высотой (height) и шириной (width). Это не три независимых механизма внимания: одна операция использует разные идентификаторы позиций для разных групп координат.
Для текста все три ряда ID одинаковы:
Поэтому текстовая часть M-RoPE функционально совпадает с обычной одномерной RoPE: каждая частотная пара получает один и тот же индекс независимо от своей секции.
Для неподвижного изображения временной ID остаётся постоянным, а пространственные координаты меняются:
Например, сетка может получить
Для видео изменяются все три оси. В Qwen2.5-VL шаг по временной оси может учитывать реальное время между элементами сетки, а не просто номер кадра.
TMRoPE — Time-aligned Multimodal Rotary Position Embedding опубликована в техническом отчёте Qwen2.5-Omni в марте 2025 года. Она синхронизирует аудио и видео по времени. В описанной модели один временной ID соответствует 40 мс; это характеристика конкретной временной сетки Qwen2.5-Omni, а не универсальная константа TMRoPE.
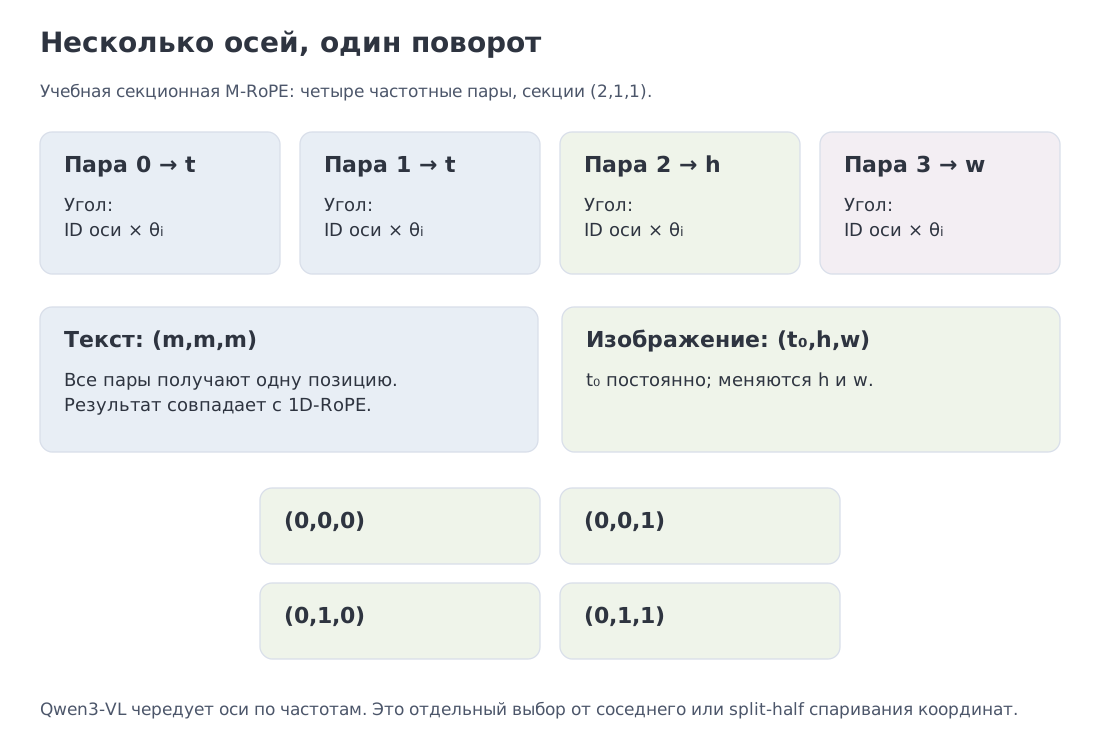 Текст использует одинаковые ID по трём осям; изображение фиксирует время и меняет h/w; видео и синхронизированное аудио используют временную ось.
Чередование осей в Qwen3-VL
В исходной секционной M-RoPE время, высота и ширина получают отдельные группы частот. В Qwen3-VL, §2.1 оси чередуются по частотным парам: так каждой оси достаются и быстрые, и медленные компоненты. Это Interleaved-MRoPE. Не путайте чередование осей с соседним или split-half спариванием двух координат одной пары: это разные решения.
Тот же отчёт описывает явные текстовые отметки времени для видео (§2.3). Поэтому сетку 40 мс из Qwen2.5-Omni нельзя автоматически переносить на всю семью Qwen. Наш пример сетки 2×2 показывает секционную M-RoPE, а не полную реализацию Qwen3-VL. Для смешанной последовательности также нужно согласовать начало координат и позиции последующего текста; маленькая сетка здесь начинается с нуля только ради наглядности.
14. Современный ландшафт: методы сосуществуют
Ниже — выборочная карта реализаций, проверенная 10 октября 2026 года. Она показывает разные способы работы с позицией. Это справочный раздел: механизмы уже объяснены, а строки помогают найти соответствующий первоисточник.
| Семейство или работа | Позиционный механизм | Контекст/цель | Основание |
|---|---|---|---|
| Transformer | детерминированное синусоидальное PE | исходная архитектура | статья |
| RoFormer / RoPE | вращательная фаза в | относительная зависимость в механизме внимания | статья |
| ALiBi | линейное позиционное смещение | экстраполяция по длине без позиционных эмбеддингов | статья |
| Position Interpolation | равномерное сжатие позиций + дообучение | расширение RoPE-контекста | статья |
| YaRN | кусочное смешение исходного и интерполированного спектров с дополнительным масштабированием | работа с более длинным контекстом | статья и библиотеки |
| LongRoPE / LongRoPE2 | коэффициенты по размерностям и стадиям | экстремально длинный контекст | статьи |
| gpt-oss | base=150K, опорная длина 4096, factor=32, параметры | позиционная геометрия до 128K | официальная конфигурация; полное расписание обучения этим файлом не раскрывается |
| Llama 4 | чередующиеся RoPE/NoPE, блочное внимание, настройка температуры | гибридная архитектура длинного контекста | открытая конфигурация/реализация |
| Qwen2-VL / Qwen2.5-VL | M-RoPE | координаты текста, изображения и видео | статья и код |
| Qwen2.5-Omni | TMRoPE | синхронизация аудио и видео | технический отчёт |
| Qwen3-VL | Interleaved-MRoPE и текстовые отметки времени | распределение частот между осями и привязка событий видео | отчёт, §2 и открытая реализация |
| Inkling | относительное позиционное представление, скользящие/глобальные слои | контекст 1M | официальный технический анонс |
| Закрытые модели с API-доступом | механизм может быть не опубликован | заявленное окно не раскрывает формулу | документация API, если доступна |
Таблица показывает не рейтинг методов, а разнообразие инженерных решений. Номинальная длина контекста также не доказывает рабочее качество на всей длине; это отдельная задача оценки, к которой курс вернётся в модуле 19.
17. Ключевые выводы модуля
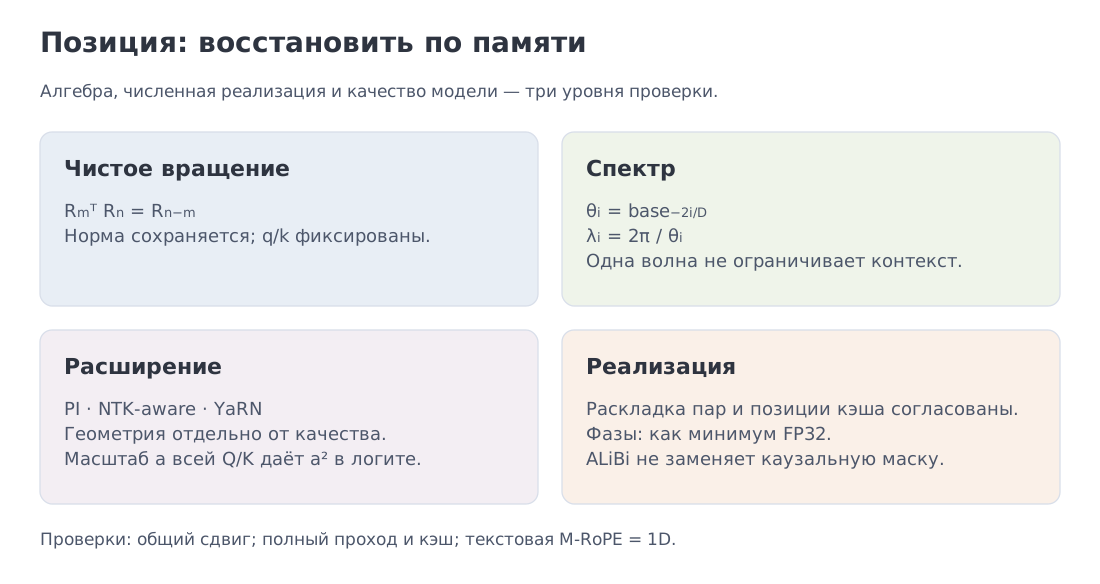 Шпаргалка: перестановочная симметрия, тождество RoPE, диагностика спектра, семейства масштабирования, ALiBi/NoPE и мультимодальные оси.
- Без позиционного сигнала двунаправленный self-attention перестановочно-эквивариантен; каузальная маска добавляет порядок доступа, но не полноценную геометрию расстояний.
- Синусоидальные пары уже имеют точную зависимость от относительного смещения, однако аддитивное PE смешивает позицию с содержанием. RoPE помещает относительную фазу непосредственно в .
rope_thetaуправляет распределением частот. Большая база добавляет медленные компоненты, не удаляя самую быструю пару.- Длина волны одной пары и число оборотов — диагностические величины, а не жёсткая граница контекста.
- PI равномерно сжимает спектр; static NTK-aware scaling — эвристика; YaRN смешивает исходные и интерполированные частоты; LongRoPE и современные гибриды предлагают другие компромиссы.
attention_factorнужно читать вместе с местом применения в коде.- ALiBi задаёт линейное позиционное смещение; NoPE полагается на маску и динамику сети; гибриды могут чередовать разные схемы.
- M-RoPE использует одинаковые три ID для текста и разные оси для визуальных токенов. TMRoPE синхронизирует время аудио и видео.
config.jsonописывает архитектурную геометрию, но не заменяет отчёт об обучении.
Дальше: модуль 5 — механизмы внимания. Позиция уже вошла в Q/K или логит; теперь разберём, как организовать головы и вычислить это внимание с разумными затратами памяти.
18. первоисточники
Основные источники:
- Vaswani et al., Attention Is All You Need — arxiv.org/abs/1706.03762
- Shaw et al., Self-Attention with Relative Position Representations — arxiv.org/abs/1803.02155
- Dai et al., Transformer-XL — arxiv.org/abs/1901.02860
- Su et al., RoFormer / RoPE — arxiv.org/abs/2104.09864
- Press et al., ALiBi — arxiv.org/abs/2108.12409
- Haviv et al., positional behavior without explicit PE — arxiv.org/abs/2203.16634
- Chen et al., Position Interpolation — arxiv.org/abs/2306.15595
- Peng et al., YaRN — arxiv.org/abs/2309.00071
- Ding et al., LongRoPE — arxiv.org/abs/2402.13753
- Shang et al., LongRoPE2 — arxiv.org/abs/2502.20082
- Bai et al., Qwen2-VL — arxiv.org/abs/2409.12191
- Xu et al., Qwen2.5-Omni — arxiv.org/abs/2503.20215
- Hugging Face RoPE utilities
- gpt-oss original configuration
- gpt-oss reference RoPE implementation
- Hugging Face GptOssConfig
- Llama 4 model documentation
- Qwen3-VL — report, §2; implementation
- Inkling architecture announcement
Углубление. Признаки Фурье, ядра и информационная геометрия подробнее разбираются в Information Theory for ML. Рекуррентные архитектуры и модели пространства состояний, которые учитывают порядок через обновление состояния, рассматриваются в М8 Modern LLMs.
Выборочная карта реализаций сверена: 10 октября 2026 года. Числа спектра и YaRN относятся к явно заданному учебному сценарию. Для закрытых моделей неизвестный позиционный механизм не реконструируется по размеру контекстного окна.