Модуль 14. Обучение по обратной связи: RLHF, DPO, RLOO и GRPO
Курс «Modern LLMs» · лекция модуля 14 · редакция 2026.10.28
О чём этот модуль. В модуле 13 мы учили модель воспроизводить желательное поведение по демонстрациям. Однако для полезности, уместности, безопасности или убедительности часто невозможно написать единственный эталонный ответ. В одних задачах проще сравнить два варианта, в других — проверить результат программой, формальным доказательством или средой.
В первом случае обратная связь сообщает, какой ответ предпочтительнее; во втором — насколько успешно выполнена проверяемая задача. Дальше нужно решить, как превратить эту оценку в изменение вероятностей ответов. Мы разберём три пути: сначала обучить отдельный оценщик, напрямую использовать пары предпочтений или сравнивать несколько новых ответов модели внутри одной группы.
Мы сохраним инженерный фокус: разберём, какой сигнал получает каждый метод, какие модели и данные нужны, что именно измеряют его формулы и почему в современных RL-контурах генерация траекторий нередко обходится дороже самого обновления весов.
Дополнительное углубление. Этот модуль остаётся самодостаточным. В серии курсов автора по ML и LLM есть специализированный курс RL for LLM, где значительно подробнее рассматриваются policy gradients, модели вознаграждения, PPO, DPO, RLOO, GRPO/RLVR, интерактивные среды, инфраструктура генерации траекторий и взлом обучающего сигнала.
Что нужно знать заранее. Достаточно помнить механику SFT из модуля 13, оценку памяти обучаемых и замороженных весов из модулей 9 и 13, а также различие между
prefillиdecodeиз модуля 10. Все необходимые определения повторяются здесь, поэтому модуль остаётся самодостаточным. Как читать модуль. При первом проходе пройдите §§1, 3–7 и 9: сначала определите источник оценки, затем проследите, как она меняет вероятность ответа. В §8 достаточно понять различие требований к данным. После §§10–11 прочитайте §15 о проверяемой награде и ограничениях проверяющего сигнала. Выполните практику §14 и ответьте на В1–В4 из §18; В5 завершает справочный разбор §17. При втором проходе разберите вывод DPO, усреднение и смещение в §§9 и 12, затем проекты §19. §§2, 8, 16–17 служат справочником по методам и системам; названия не нужно заучивать до знакомства с механикой.
1. Мотивация: когда демонстрации уже недостаточно
SFT отвечает на вопрос: какой ответ следует показать модели как пример? Для некоторых задач этого достаточно. Если требуется вернуть JSON по строгой схеме, вызвать правильный инструмент или оформить отказ в заданном формате, качественная демонстрация задаёт почти весь контракт.
Но теперь представим два развёрнутых объяснения одной и той же идеи. Оба фактически верны. Одно точнее отвечает на вопрос пользователя, второе лучше структурировано, но немного длиннее. Какой текст записать в набор как единственный эталон? Такой выбор часто искусственен: желательное поведение задаётся не одной строкой, а отношением «ответ A предпочтительнее ответа B».
Есть и другой тип задач. В математике, программировании или работе с инструментами результат иногда можно проверить автоматически. Ответ либо проходит тест, либо нет; доказательство либо удовлетворяет формальному проверяющему модулю, либо нарушает правило. Здесь сравнение людей можно заменить проверяемой наградой (verifiable reward).
Под политикой здесь понимается сама обучаемая модель как распределение вероятностей ответов. Для запроса запись означает вероятность ответа при параметрах . Полученный ответ вместе с контекстом и оценкой называют траекторией, а его генерацию — сбором траектории, или rollout. Пока среда не делает промежуточных ходов, траектория может состоять из одного ответа. Слово «онлайн» описывает обновление обучающих данных в ходе обучения; подключение к интернету для этого не требуется.
Источник оценки — один вопрос, а время сбора ответов — другой. Независимо от того, кто оценивает результат, данные можно собрать заранее или обновлять в ходе обучения. В модуле мы сопоставим два распространённых режима.
- Офлайн-оптимизация по предпочтениям работает с заранее собранными парами или бинарными метками. Исходный рецепт DPO относится к этому режиму.
- Онлайн-RL генерирует ответы текущей политикой, оценивает их и обновляет модель по собственным траекториям. PPO, RLOO и GRPO требуют такого цикла.
Различие принципиально. Офлайн-метод проще и воспроизводимее, но ограничен распределением уже собранных ответов. Онлайн-метод может исследовать новые области поведения, однако должен постоянно выполнять дорогую генерацию и следить за устойчивостью награды.
Весь модуль можно читать как ответ на один вопрос: во что мы превращаем сигнал «этот ответ лучше»? В явную модель вознаграждения, в прямую функцию потерь по парам или в преимущество, вычисленное внутри группы сгенерированных ответов.
Метод и способ сбора данных — разные решения. Здесь мы изучаем исходный DPO на фиксированных парах; можно также периодически собирать новые пары и снова применять DPO. И наоборот, наличие проверяемой награды само по себе ещё не задаёт ни GRPO, ни конкретную функцию потерь.
2. Как менялся основной маршрут постобучения
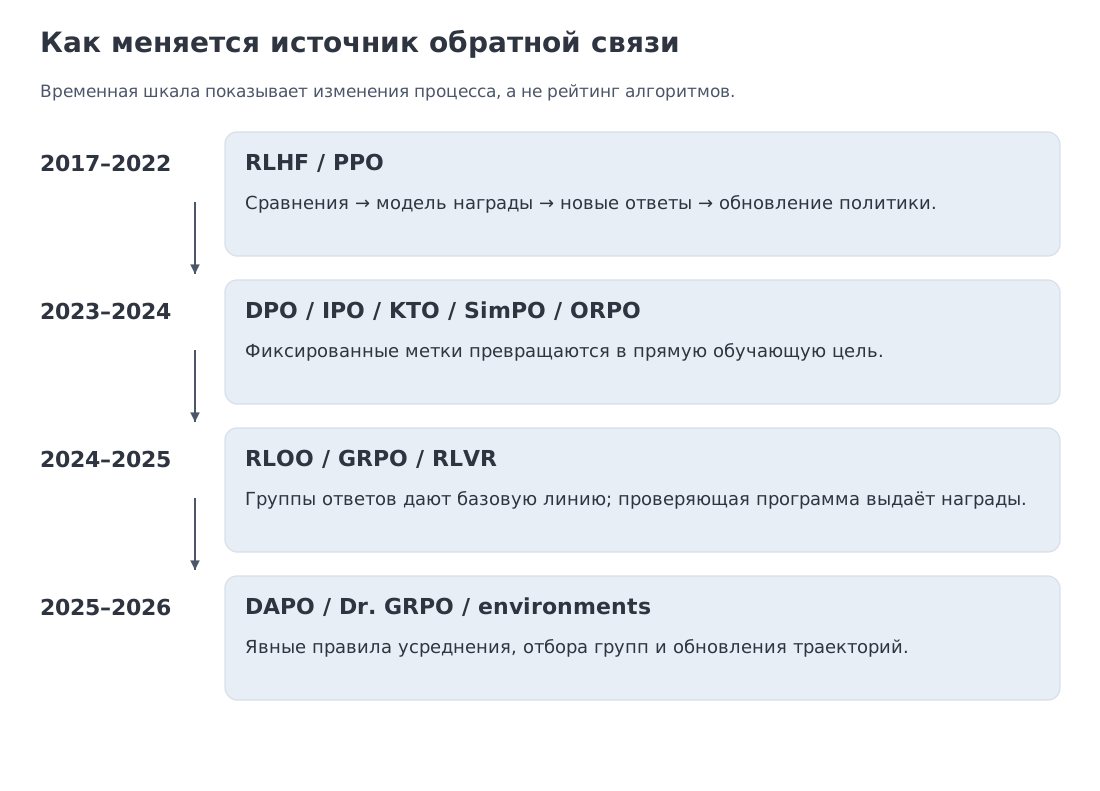
Современный маршрут складывался поэтапно.
В работе Christiano et al. (2017) человеческие сравнения использовались для обучения модели вознаграждения. В InstructGPT (2022) эта идея стала частью трёхстадийного конвейера для языковой модели: SFT создавал исходную политику, модель вознаграждения училась на предпочтениях, а PPO оптимизировал политику, одновременно удерживая её рядом с исходной моделью.
В 2023 году DPO показало, что при определённой постановке ту же пару предпочтений можно использовать без отдельной модели вознаграждения и без онлайн-RL. Сложный конвейер превратился в обычное обучение классификационного типа по парам ответов.
В 2023–2024 годах развитие пошло в двух направлениях. С одной стороны, появились IPO, KTO, SimPO и ORPO — методы, меняющие форму прямой функции потерь, требования к данным или необходимость референсной модели. С другой стороны, исследователи вернулись к простым алгоритмам градиента политики (policy gradient): RLOO и GRPO отказались от отдельного критика — модели ценности, используя несколько ответов на один запрос для построения базовой линии.
Публикации DeepSeek-R1, DAPO и Dr. GRPO в 2025 году сделали RL с проверяемой наградой заметной частью открытого постобучения рассуждающих моделей. Одновременно стало ясно, что сама формула обновления — лишь часть системы. К 2026 году открытые инструменты вроде verl, NeMo RL и NeMo Gym уделяют не меньше внимания генерации, асинхронности, средам, проверяющим модулям и свежести траекторий.
Так историческая линия возвращается к RL, но уже в другом масштабе: не как к одному финальному запуску PPO, а как к непрерывной системе взаимодействия модели со множеством задач и сред.
3. Три классические идеи за современной терминологией
Чтобы не воспринимать RLHF, DPO и GRPO как набор новых аббревиатур, свяжем их с тремя давно известными идеями.
Bradley–Terry: вероятность предпочтения из разности оценок
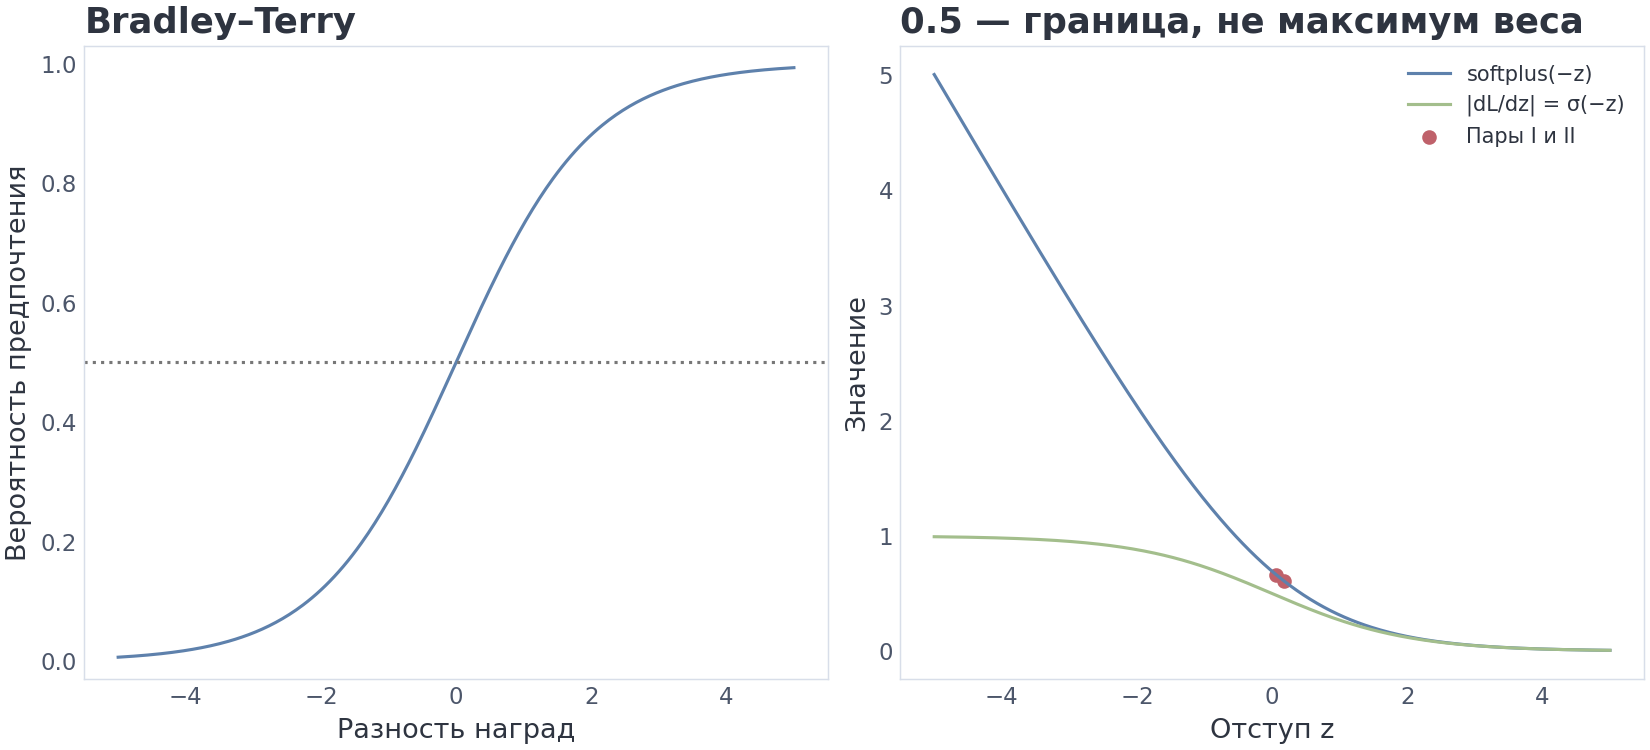
Модель Bradley–Terry описывает парные сравнения. Если у двух объектов есть скрытые скалярные оценки и , вероятность предпочесть первый объект равна
где — сигмоида. В языковой модели объектами становятся ответы, а скрытой оценкой — награда. Поэтому функция потерь модели вознаграждения
не является особой конструкцией LLM-эпохи. Это логистическая модель парного выбора.
Здесь — сигмоида: она переводит любую действительную разность оценок в вероятность от 0 до 1. Индексы и обозначают выбранный и отклонённый ответы; «отклонённый» означает проигравший в данной паре, а не обязательно ошибочный.
REINFORCE и базовая линия
Обозначим через ожидаемую награду модели с параметрами . В одношаговой задаче ; в многошаговой обозначает суммарную будущую награду. Градиент этой цели можно записать как
Оценка корректна, но часто имеет высокую дисперсию. Если вычесть базовую линию , не зависящую от текущего действия, ожидание градиента не меняется:
RLOO строит такую базовую линию из остальных ответов на тот же запрос. GRPO использует статистики всей группы. Внешне формулы похожи, но их статистические свойства не тождественны — к этому мы вернёмся в разделе 9.
В этой записи — контекст перед действием, — выбранное действие, а — полученная награда. Действием можно считать целый ответ или следующий токен; во втором случае контекст включает уже сгенерированный префикс. Величина называется преимуществом: это превышение награды над базовой линией. При вычислении градиента базовую линию не дифференцируют. Для независимых ответов, полученных одной зафиксированной политикой при данном запросе, награды остальных ответов подходят на роль независимой от текущего действия базовой линии.
Теория перспектив и точка отсчёта
Люди оценивают выигрыш и потерю относительно некоторой точки отсчёта, причём реакция на положительное и отрицательное отклонение может быть асимметричной. KTO переносит эту идею в обучение языковых моделей: вместо пар «лучше/хуже» можно использовать отдельные примеры с метками «желательно/нежелательно» и оценивать их относительно статистической точки отсчёта.
Эти три классические линии дают нам три языка описания: парный выбор, преимущество относительно базовой линии и полезность относительно точки отсчёта.
Углубление. Полный вывод DPO из KL-регуляризованной цели, связь с RL с максимальной энтропией (maximum-entropy RL) и подробная механика PPO разбираются в курсе RL for LLM, модули 7–8. Информационно-теоретический взгляд на KL-якорь дан в Information Theory for ML, модуль 8.
4. Классический RLHF: три стадии и четыре логические роли
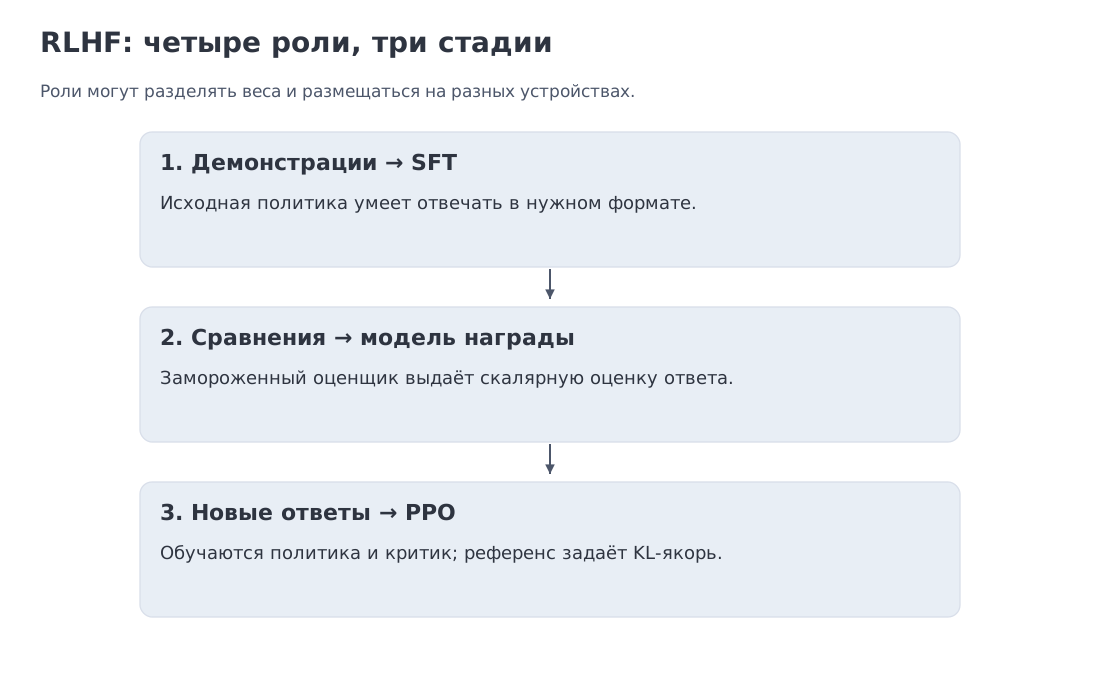
Классический конвейер RLHF (Reinforcement Learning from Human Feedback, обучение с подкреплением по обратной связи человека) начинается с модели после SFT. Обозначим её .
Стадия 1 — SFT. Демонстрации формируют исходную политику и задают разумное распределение ответов.
Стадия 2 — модель вознаграждения (Reward Model, RM). Для одного запроса разметчик сравнивает два ответа: предпочтительный и менее предпочтительный . Модель обучается объяснять это сравнение:
Стадия 3 — PPO (Proximal Policy Optimization). Текущая политика генерирует ответы, получает скалярную награду и обновляется так, чтобы улучшать её, не уходя слишком далеко от референсной политики:
Здесь задаёт цену отклонения от референса, а усредняет по обучающим запросам. Как в М13, KL сравнивает два распределения; в данном случае порядок аргументов таков:
Сумма берётся по полным ответам, и логарифм отношения усредняется по текущей политике. KL-штраф поощряет близость к фиксированному референсу, но не задаёт жёсткой границы изменения за один шаг. Ограничение цели PPO относительно политики, собравшей текущие ответы, — отдельный механизм (§9). Ни один из них не исправляет ошибочную награду и не гарантирует безопасное поведение.
Критик предсказывает ожидаемую будущую награду из текущего контекста. Сравнение полученного результата с этим прогнозом помогает оценить преимущество: насколько действие оказалось лучше ожидаемого. Это отличается от модели вознаграждения, которая оценивает сам ответ по выученным предпочтениям.
В учебном изображении мы различаем четыре логические роли: обучаемая политика, референсная политика, модель вознаграждения и критик — модель ценности (critic/value model). В конкретной реализации части могут разделять базовую сеть, выгружаться, квантизоваться или распределяться между ускорителями. Поэтому выражение «четыре модели» описывает алгоритмический контракт, а не обязательно четыре полные независимые копии в памяти.
5. Решённый пример A: читаем Bradley–Terry в обе стороны
Пусть разность наград равна . Тогда
| 0.5 | 1.0 | 2.0 | 4.0 | |
|---|---|---|---|---|
| 0.622 | 0.731 | 0.881 | 0.982 |
При модель считает ответы равными. Разность 1 соответствует вероятности предпочтения около 73%, а разность 2 — уже около 88%. Важно не приписывать этим числам абсолютный смысл: масштаб награды определяется обучением и регуляризацией.
Формулу можно прочитать и в обратную сторону. Если первый ответ выбирают в 75% сравнений, то соответствующий логит равен
Это не означает, что мы уже восстановили «истинную полезность» ответа. Мы лишь перевели наблюдаемую долю побед в шкалу конкретной логистической модели. Но именно такая шкала позволяет сопоставить парные данные, модель вознаграждения и коэффициент регуляризации DPO.
6. DPO: как исключить явную модель вознаграждения
DPO (Direct Preference Optimization, прямая оптимизация по предпочтениям) опирается на KL-регуляризованную задачу из §4. Для фиксированного запроса её оптимальная политика имеет вид
Чтобы вероятности суммировались в единицу, правую часть делят на нормировочную сумму
Условимся, что эта сумма конечна и референс даёт ненулевую вероятность рассматриваемым ответам. Теперь формулу можно обратить:
Последнее слагаемое зависит только от запроса. В разности наград двух ответов оно сокращается. Подставляя результат в Bradley–Terry, получаем функцию потерь непосредственно по паре:
Величину
часто называют неявной наградой (implicit reward). Это удобная интерпретация, но DPO не обучает отдельную функцию, способную независимо оценивать произвольный ответ. Награда определена через отношение двух политик и существует внутри выбранной модели предпочтений.
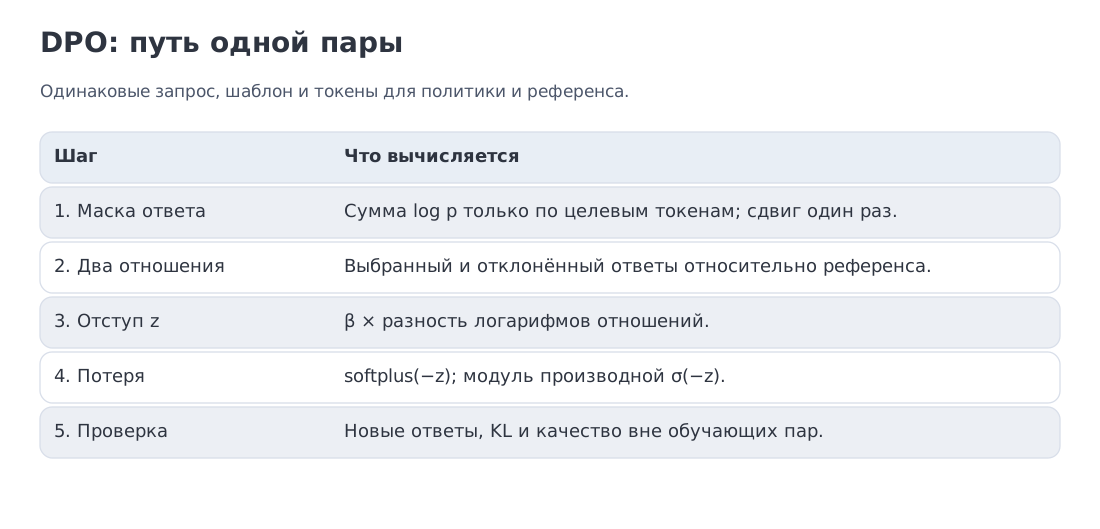
В исходном офлайн-рецепте DPO новые ответы на каждом шаге не нужны. Для фиксированной пары можно заранее сохранить логарифмы вероятностей референсной модели и затем убрать её из памяти оптимизатора. При добавлении новых пар нужно вычислить их значения; при изменении токенизации или самой референсной политики прежний кэш становится недействительным. Обновляемый набор данных не запрещает кэширование, но требует отслеживать его соответствие каждому примеру.
Неявную награду можно вычислить и для нового ответа, если обе политики задают ему ненулевую вероятность. Но для этого нужны обе политики; это не отдельный, независимо обученный оценщик. Положительная разность таких наград показывает порядок относительно референса, а не гарантирует качество ответа вне обучающих сравнений.
Логарифм вероятности полного ответа — сумма по его целевым токенам. Как в М13, нужно один раз совместить логиты предыдущей позиции с текущим токеном, затем исключить запрос и паддинг из суммы. У обеих политик должны совпадать шаблон диалога, токенизация и правило включения конца ответа. Иначе разность оценивает ещё и различие представлений данных.
7. Решённый пример B: что именно делает коэффициент
Рассмотрим пару I. Для предпочтительного ответа
поэтому логарифм отношения равен . Для отклонённого ответа имеем и , то есть логарифм отношения равен .
При аргумент сигмоиды равен
Отсюда
Последнее число — модуль производной по отступу , а не полный градиент по параметрам модели. Оно показывает локальную чувствительность функции потерь: чем увереннее политика уже упорядочила пару, тем меньше дополнительный сигнал.
Для пары II оставим вероятности политики прежними, а референс зададим значениями для выбранного и отклонённого ответов. Логарифмы отношений равны и , их разность — . Поэтому и . Такая пара ближе к границе и даёт более сильный локальный сигнал, чем пара I. На границе вес равен 0.5; при неверном порядке он больше 0.5 и стремится к 1 при .
Теперь увеличим до 0.5 для пары I. Получим , функцию потерь 0.356 и модуль производной по около 0.299. Но из этого нельзя делать вывод, что увеличение всегда «ослабляет обучение»: полный градиент содержит также множитель , а само значение коэффициента меняет масштаб относительного отклонения от референсной политики. Настройку следует оценивать по итоговому качеству, KL-дрейфу и распределению отступов, а не по одному числу .
8. Семейство прямых методов: какую часть контракта они меняют
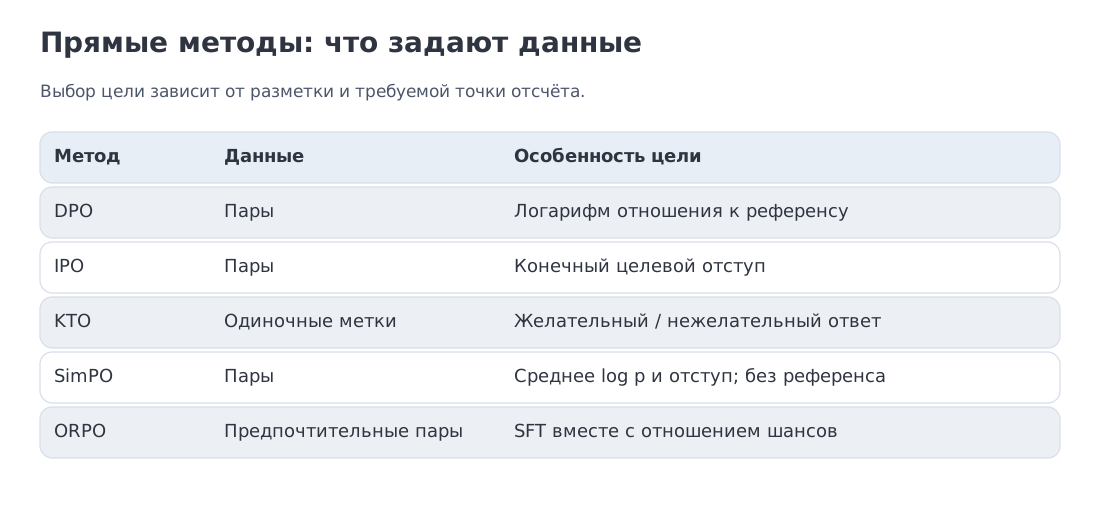
Прямые методы похожи внешне, но решают разные инженерные задачи. Полезнее сравнивать их не по названию, а по четырём вопросам: нужны ли пары, нужна ли референсная модель, как определяется отступ и объединяется ли обучение по демонстрациям с предпочтениями.
IPO: ограниченный целевой отступ
IPO (Identity Preference Optimization) возникает внутри более общей теории PO. Вместо логистической цели DPO используется задача, стремящаяся к конечному целевому отступу. Это важно при шумных или почти равных парах: функция потерь не обязана бесконечно увеличивать различие между выбранным и отклонённым ответом.
IPO следует понимать как изменение статистического предположения о предпочтениях, а не как универсальное исправление DPO. Если целевой отступ выбран плохо, ограничение само становится источником смещения.
KTO: отдельные метки вместо пар
KTO (Kahneman–Tversky Optimization) работает с бинарным сигналом для каждого ответа: желательный он или нежелательный. Такой формат естественен для потоковой обратной связи, где пользователь ставит оценку одному ответу, но не сравнивает два варианта.
Одиночные оценки часто проще получить из пользовательской обратной связи: второй ответ показывать не требуется. Зато метка не указывает, с какой альтернативой сравнивали результат. Силу и причину предпочтения не сообщает ни одиночная бинарная метка, ни один бинарный выбор в паре; для этого нужны дополнительные оценки или объяснения. Практический результат зависит от качества отрицательных примеров, баланса классов и выбора точки отсчёта.
SimPO: без референсной модели
SimPO (Simple Preference Optimization) определяет неявную награду через среднюю логарифмическую вероятность ответа и добавляет целевой отступ. Нормировка меняет сравнение полных последовательностей: используется среднее по токенам вместо суммы, а отсутствие отдельной референсной модели уменьшает вычислительные затраты.
Нормировка на длину не гарантирует отсутствия всех длиновых эффектов. Она меняет стимул, но поведение всё равно зависит от распределения пар, диапазона длин и процедуры оценки.
Для ответа длины положим . Тогда одна пара SimPO имеет потерю , где — желательный отступ. Обычное авторегрессионное сэмплирование не ранжирует полные ответы по этому среднему; его распределение задаётся произведением токенных вероятностей. Поэтому нормировка — изменение обучающей цели, которое нужно проверять на длинах и качестве генераций.
ORPO: предпочтения внутри SFT-этапа
ORPO (Odds Ratio Preference Optimization) объединяет отрицательную логарифмическую правдоподобность предпочтительного ответа с дополнительным отношением шансов, штрафующим нежелательный ответ. Метод не требует отдельной референсной модели и позволяет объединять обучение следованию инструкциям (instruction tuning) и оптимизацию по предпочтениям в одном этапе.
Цена монолитной постановки — более тесная связь двух целей. Если качество ухудшается, нужно отдельно диагностировать демонстрационную часть, предпочтения и их относительный вес.
В качестве воспроизводимой отправной точки DPO остаётся удобным базовым методом. Но выбор должен следовать из данных и операционного контракта: KTO — когда доступны одиночные метки, SimPO — когда важен режим без референсной модели, ORPO — когда предпочтения встроены в SFT, IPO — когда требуется контролировать геометрию отступа.
9. RLOO и GRPO: базовая линия из нескольких ответов
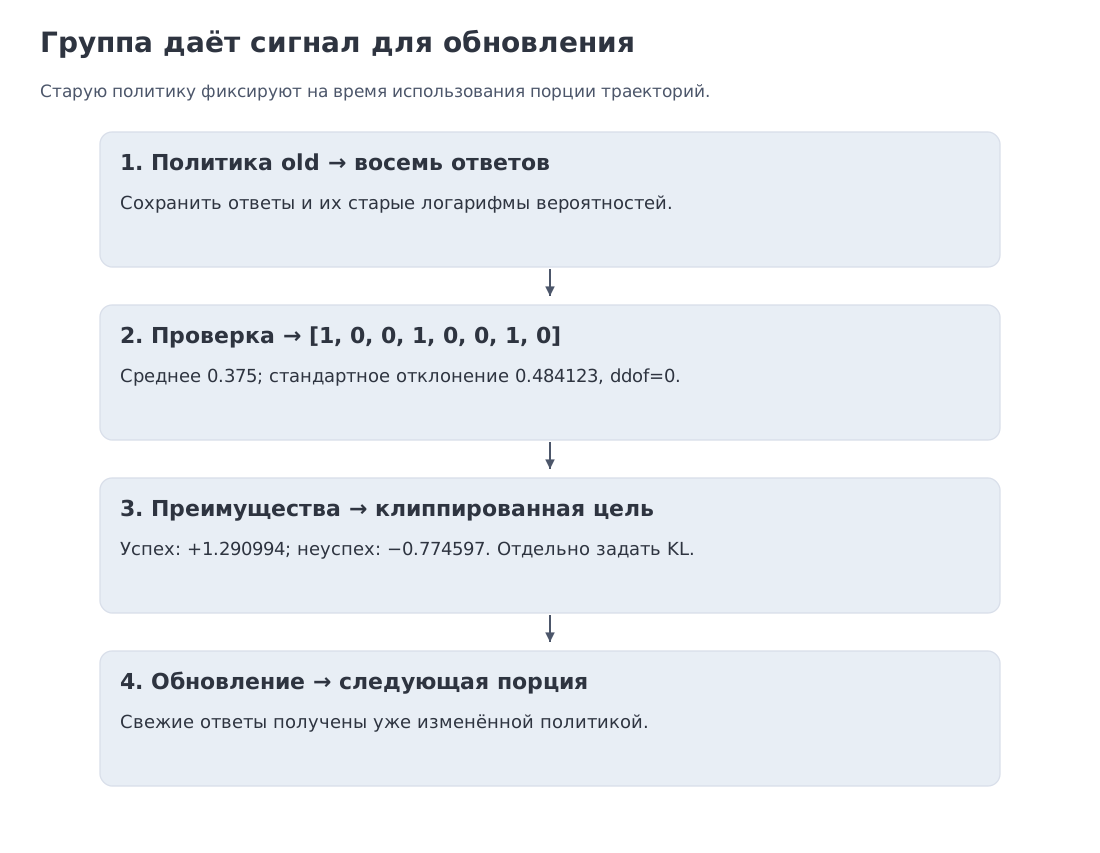
Офлайн-пары удобны, но они фиксируют прошлое распределение политики. В задачах с автоматической проверкой можно поступить иначе: сгенерировать несколько ответов текущей моделью, оценить каждый и использовать результат сразу для обновления.
RLOO (REINFORCE Leave-One-Out) для каждого запроса создаёт ответов. Для -го ответа базовой линией служит средняя награда остальных ответов:
При стандартных предположениях такая базовая линия не зависит от текущего действия и сохраняет несмещённость REINFORCE-оценки.
GRPO (Group Relative Policy Optimization) использует среднее и стандартное отклонение всей группы:
Затем это преимущество входит в PPO-подобную клиппированную цель. Отдельная модель ценности не нужна. При этом GRPO не обязательно означает RLVR: награду может выдавать и обученная модель. Проверяемая награда просто делает этот режим особенно привлекательным для математики, кода и формальных задач.
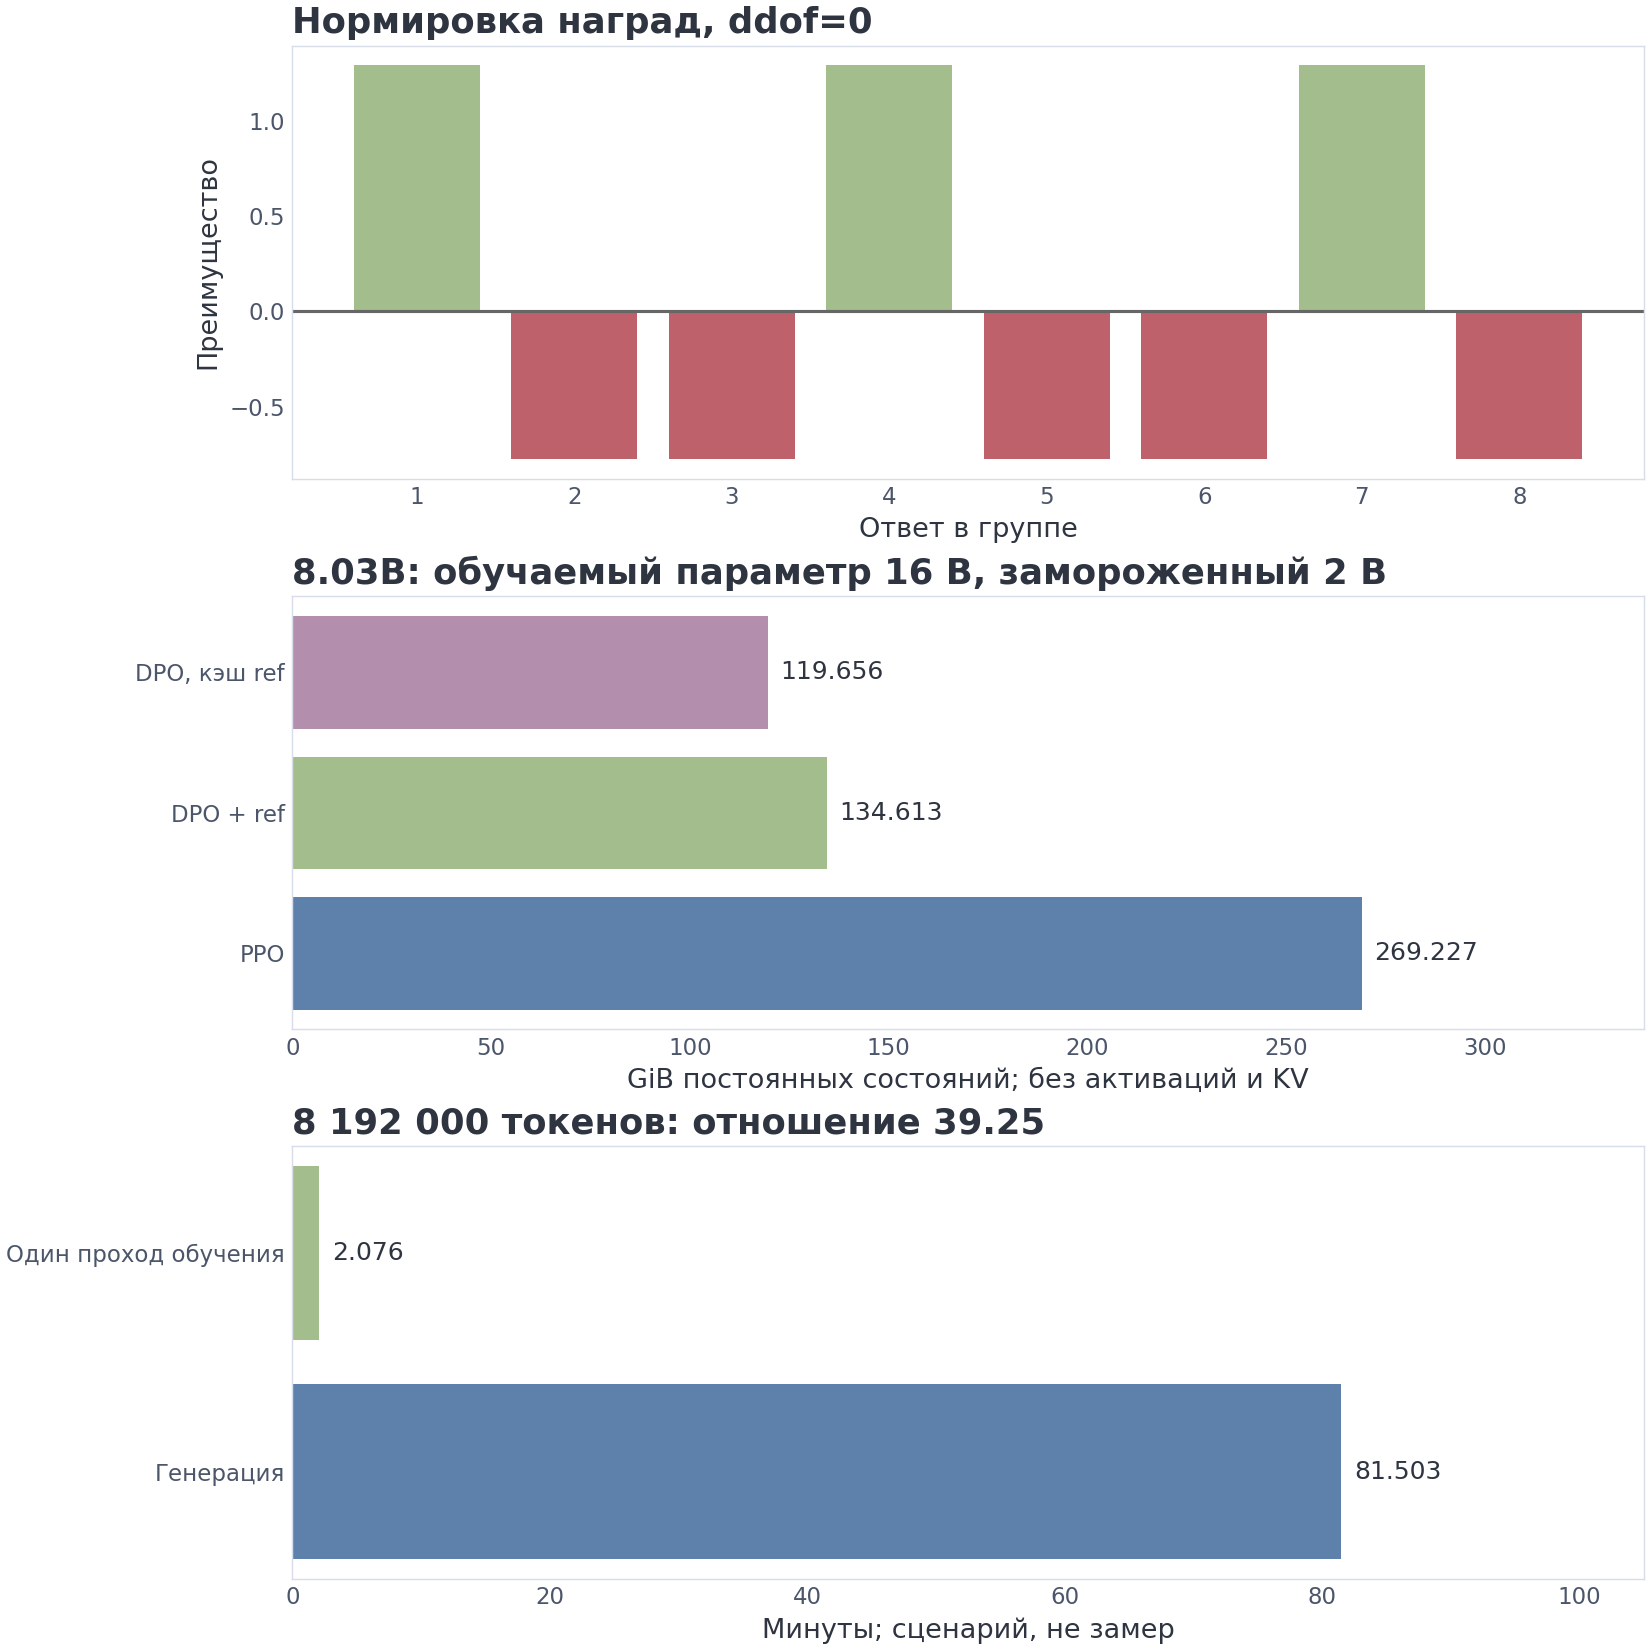
Рассмотрим группу из восьми ответов с наградами
[1, 0, 0, 1, 0, 0, 1, 0].
Среднее равно , а стандартное отклонение совокупности — 0.4841. Поэтому успешный ответ получает
а неуспешный —
Сумма преимуществ равна нулю. Это подтверждает центрирование внутри группы, но не доказывает несмещённость относительно истинного преимущества. Статистики GRPO включают награду самого образца, а в 2025–2026 годах несколько работ подробно исследовали возникающие смещения по сложности запросов и длине ответа.
Если все награды одинаковы, стандартное отклонение равно нулю. При бинарной награде и независимой вероятности успеха доля таких групп размера 8 составляет
То есть около 5.77% групп в этом учебном сценарии не несут относительного сигнала. Их можно исключить или обработать отдельным правилом, но добавление малого числа в знаменатель не создаст информацию там, где её нет.
Здесь мы используем стандартное отклонение совокупности, то есть ddof=0. При ddof=1 оно больше, а преимущества умножаются на . Это не мелочь оформления: при одном и том же шаге оптимизатора меняется масштаб обновления. Если все награды равны, нулевые преимущества убирают член градиента политики, но отдельный KL-штраф всё ещё может менять веса. Исключение группы меняет знаменатель усреднения, а повторный сбор расходует дополнительные генерации.
Как преимущество становится обновлением. Сначала зафиксируем политику , которой получены ответы. Она отличается от : первая обновляется между порциями траекторий, вторая задаёт более долговременную точку отсчёта. Для токена ответа определим
Увеличиваем среднее или минимизируем его отрицание. Старые вероятности и преимущества считаем константами. При увеличение вероятности выше верхнего порога перестаёт приносить дополнительный выигрыш; при аналогично ограничивается её уменьшение. Это ограничение целевой функции, а не жёсткая гарантия, что все отношения вероятностей после шага попадут в заданный интервал.
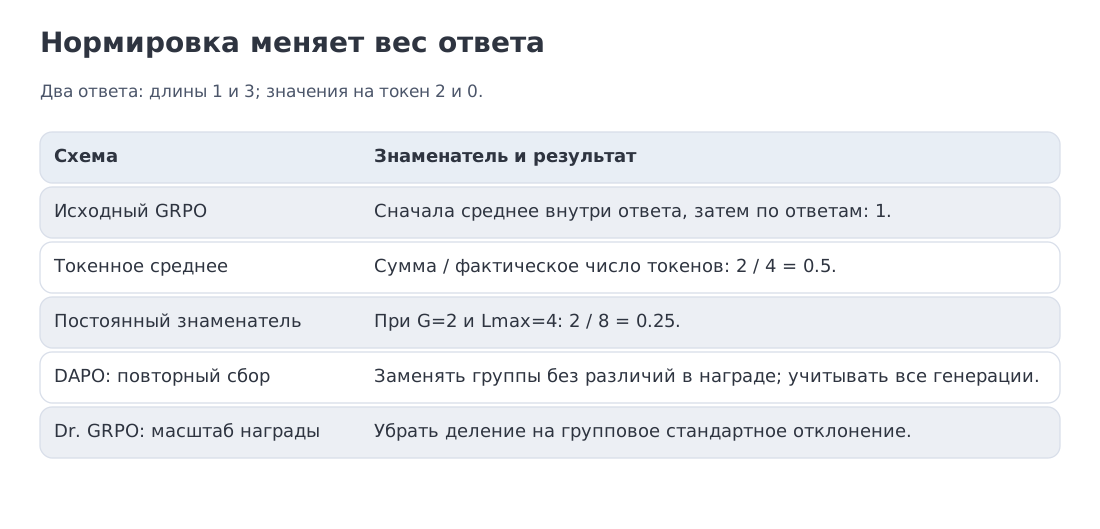
Осталось назвать знаменатель. Исходный GRPO усредняет токены внутри ответа, а затем ответы: . Токенное усреднение делит на ; именно его показывает численный пример ноутбука, как в соответствующей части DAPO. При двух ответах длины 1 и 3 с постоянными внутри ответа значениями 2 и 0 первая схема даёт 1, вторая — 0.5. Паддинг не входит ни в одну сумму. KL-регуляризацию, если она нужна, добавляют отдельно с явно выбранной нормировкой.
10. Решённый пример D: учебная анатомия памяти
Оценим только постоянные состояния моделей. Пусть модель содержит 8.03 млрд параметров. Для обучаемой копии примем 16 байт на параметр: bf16-веса (2 байта), bf16-градиенты (2), основная копия весов fp32 (4) и два состояния Adam fp32 (4 + 4). Для замороженной bf16-копии — 2 байта на параметр.
Тогда одна обучаемая модель занимает
а одна замороженная копия — 14.96 GiB.
В максимально наглядной конфигурации PPO считаем две обучаемые полноразмерные сети — политику и критика — и две замороженные — референс и модель вознаграждения:
Для DPO с находящейся в памяти референсной моделью:
Отношение в этой учебной модели равно 2.00. Критик отвечает примерно за 44% получившегося PPO-бюджета.
Эти числа полезны как анатомия, но не как калькулятор конкретного кластера. Мы не учитывали активации, KV-состояния генерации, временные буферы, шардирование, общую базовую сеть с отдельной головкой ценности, распределение ролей между узлами, оптимизаторы с иным состоянием и PEFT. Реальный GRPO-контур также содержит генераторы, старую политику или снимок логарифмов вероятностей и иногда референс для KL-регуляризации.
Для фиксированного DPO-набора логарифмы вероятностей референсной модели можно вычислить заранее. Тогда на этапе оптимизации остаётся одна обучаемая модель, и постоянный бюджет действительно приближается к SFT-сценарию. Это свойство данных и рабочего процесса, а не автоматическое свойство любой реализации DPO.
11. Решённый пример E: почему сбор траекторий становится узким местом
Возьмём иллюстративный RLVR-шаг:
- 256 запросов;
- 8 ответов на каждый запрос;
- в среднем 4000 токенов в ответе.
Всего нужно сгенерировать
токенов.
Предположим, что восемь ускорителей выдают по 209.4 токена в секунду. Тогда время генерации составляет
Теперь оценим один проход обучения приближением для модели 8.03B. Если каждый из восьми ускорителей имеет пиковую производительность 990 TFLOP/s, а MFU равен 0.4, получаем минуты.
Делим исходные, ещё не округлённые оценки времени; с шестью знаками после запятой это даёт
Это не универсальная характеристика GRPO и не измерение конкретного фреймворка. Результат следует из выбранных длины ответа, пропускной способности, размера модели и MFU. Но он демонстрирует системный факт: длинные авторегрессионные траектории способны сделать decode доминирующей частью RL-контура.
Отсюда понятен интерес к четырём инженерным направлениям:
- ускорению инференса и уменьшению стоимости длинных ответов;
- динамическому выбору числа траекторий и длины ответа;
- параллельному выполнению генерации и обновления;
- контролю свежести данных, если обучение использует ответы, полученные более старой версией политики.
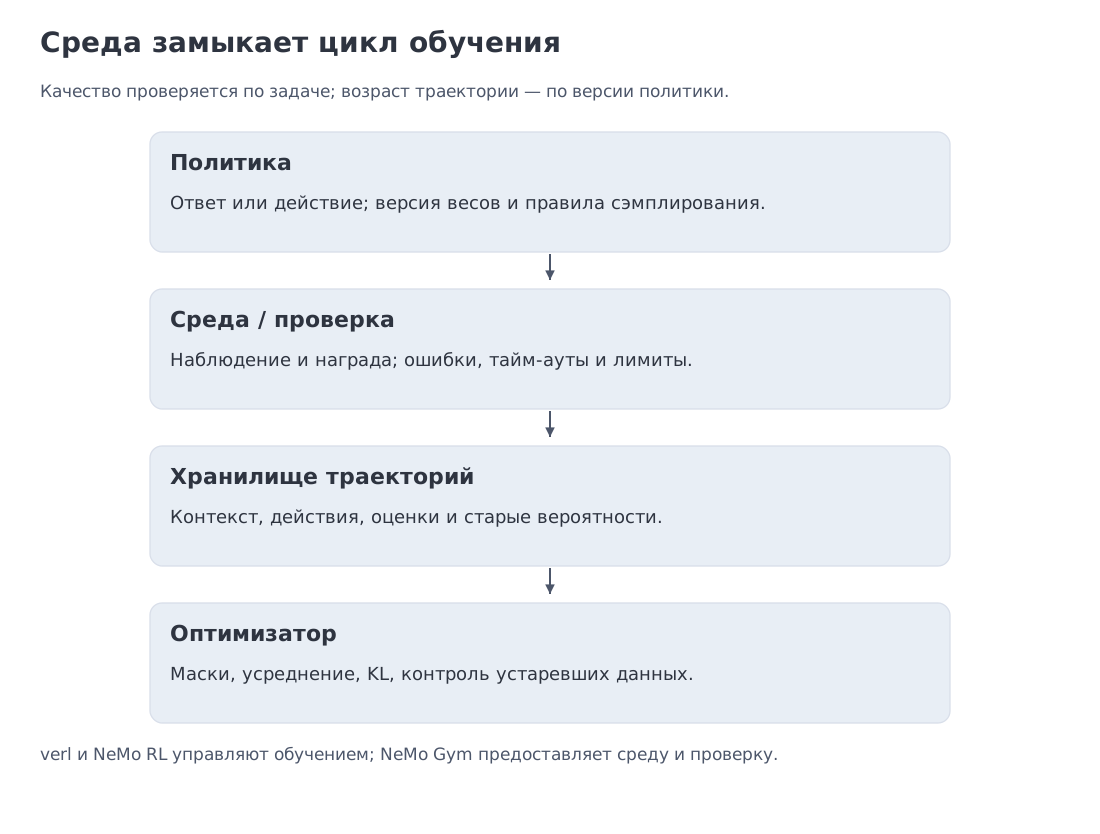
Открытые системы verl и NeMo RL прямо поддерживают раздельные или асинхронные контуры генерации и обучения. Но ускорение всегда связано с компромиссом: чем дольше траектории живут в очереди, тем сильнее распределение данных отличается от текущей политики.
В этой смете 209.4 токена/с — допущение о суммарном потоке на ускоритель при выбранном пакетировании, а не гарантированная скорость одного пользователя. Мы считаем только генерируемые токены и один обучающий проход по ним. Запросы, их prefill, вычисления оценщика и референса, дополнительные эпохи и обмен данными увеличивают реальную стоимость. Эти статьи нужно добавлять явно; коэффициент 39.25 не заменяет измерение системы.
12. После GRPO: какие проблемы исправляют новые методы
GRPO не является конечной точкой. Его широкое применение быстро выявило несколько разных проблем, которые нельзя свести к одной формуле: вырожденные группы, схлопывание разнообразия, смещение по длине, неодинаковая сложность запросов и высокая цена генерации.
DAPO: рецепт масштабируемого RLVR
DAPO (Decoupled Clip and Dynamic sAmpling Policy Optimization) описывает четыре практических механизма:
- Clip-Higher допускает более широкий рост вероятности для низковероятных токенов, чем её уменьшение, поддерживая исследование.
- Dynamic Sampling исключает группы, где все ответы успешны или все неуспешны.
- Token-Level Policy Gradient Loss меняет нормировку функции потерь, чтобы ответы разной длины вносили более контролируемый вклад.
- Overlong Reward Shaping смягчает резкий штраф на границе максимальной длины.
Авторы также убирают явный KL-штраф в своём рецепте. Это эмпирический выбор конкретной системы, а не общее доказательство ненужности KL-регуляризации.
Dr. GRPO: критика нормировки
Работа Understanding R1-Zero-Like Training показывает, что сочетание нормировки по длине ответа и стандартному отклонению группы может создавать нежелательное смещение. Предложенный вариант Dr. GRPO упрощает нормировку и улучшает токенную эффективность в экспериментах авторов.
Особенно важен более широкий вывод этой работы: улучшение после RL зависит не только от алгоритма, но и от возможностей базовой модели. Наблюдаемое «возникновение рассуждения» нельзя приписывать RL, не проверив, какие шаблоны уже присутствовали после претрейна.
Теоретическая проверка групповых преимуществ
В 2026 году появились работы, показывающие смещение группового относительного преимущества (group-relative advantage) относительно истинного ожидаемого преимущества и связь GRPO с контрастивными целями. Эти результаты не отменяют практическую полезность GRPO, но меняют язык обсуждения: групповая нормировка — удобная оценка, а не бесплатный эквивалент критика с гарантированно правильной оценкой ценности.
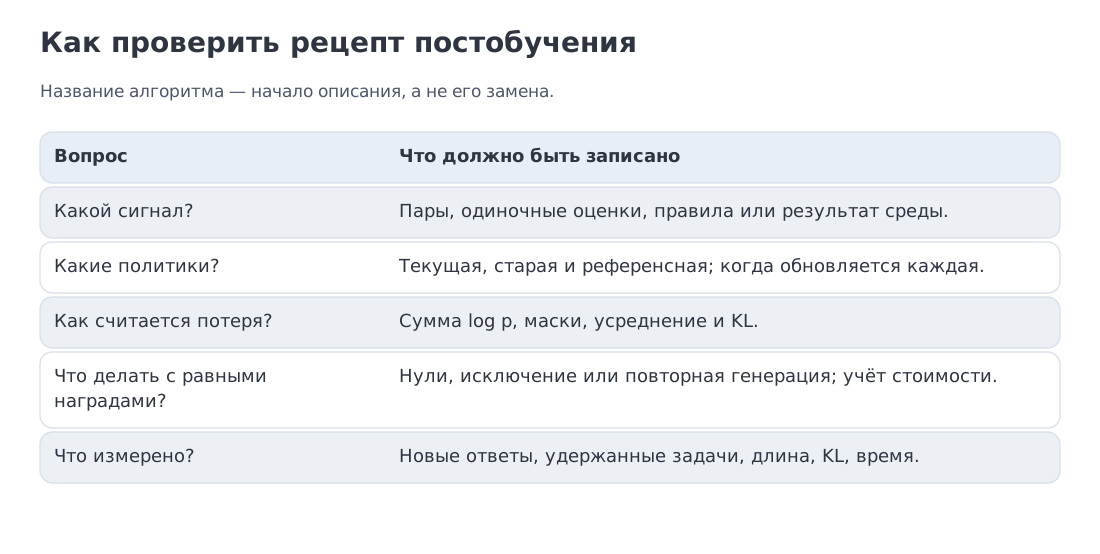
Практический вывод прост. Выбирая вариант GRPO, нужно явно записать:
- как определяется награда;
- что происходит с группами нулевой дисперсии;
- по каким единицам усредняется функция потерь — запросам, ответам или токенам;
- используется ли KL-регуляризация;
- насколько свежи траектории;
- как меняется распределение длин и сложностей во время обучения.
Смещение можно увидеть без большой модели. Пусть ответ принимает значения 0 или 1 с вероятностью успеха , а награда равна . Истинный градиент средней награды равен . Вычитание среднего всей группы, куда входит сам ответ, даёт в среднем ; базовая линия по остальным ответам сохраняет . При и получаем соответственно 0.18375 и 0.21. Это пример без деления на стандартное отклонение: после такого деления появляется ещё одна зависимость от состава группы. Ноутбук проверяет результат полным перебором всех групп, а затем сопоставляет его с симуляцией.
В Dr. GRPO вклад токенов делится на постоянную величину , а нормировка награды на групповое стандартное отклонение убирается. Постоянный знаменатель нужно отличать как от среднего по ответам, так и от среднего по фактическому числу токенов. Название семейства GRPO поэтому недостаточно для воспроизведения конкретного запуска.
13. Код первого уровня: минимальные вычислительные примитивы
Ниже собраны функции, необходимые для воспроизведения численных примеров. Они не реализуют полный обучающий контур, но фиксируют математику без скрытых допущений.
import math
import numpy as np

def stable_sigmoid(x):
    """Numerically stable sigmoid."""
    x = np.asarray(x, dtype=np.float64)
    return np.exp(-np.logaddexp(0.0, -x))

def dpo_loss(policy_lp_w, policy_lp_l, ref_lp_w, ref_lp_l, beta=0.1):
    """DPO from completion-token log-probability sums."""
    if not math.isfinite(beta) or beta <= 0:
        raise ValueError("beta must be finite and positive")

    pw, pl, rw, rl = np.broadcast_arrays(
        np.asarray(policy_lp_w, dtype=float),
        np.asarray(policy_lp_l, dtype=float),
        np.asarray(ref_lp_w, dtype=float),
        np.asarray(ref_lp_l, dtype=float),
    )
    if not all(np.all(np.isfinite(v)) for v in (pw, pl, rw, rl)):
        raise ValueError("log probabilities must be finite")

    z = beta * ((pw - rw) - (pl - rl))
    loss = np.logaddexp(0.0, -z)
    local_slope = stable_sigmoid(-z)
    return loss, local_slope, z > 0

def grpo_advantages(rewards, *, on_degenerate="raise"):
    """Population normalization with explicit zero-variance handling."""
    r = np.asarray(rewards, dtype=np.float64)
    if r.ndim != 1 or r.size < 2 or not np.all(np.isfinite(r)):
        raise ValueError("rewards must be a finite one-dimensional group of size >= 2")

    if on_degenerate not in ("raise", "zeros"):
        raise ValueError("on_degenerate must be raise or zeros")
    std = float(r.std(ddof=0))
    if std == 0.0:
        if on_degenerate == "zeros":
            return np.zeros_like(r)
        raise ValueError("the group contains no relative signal")
    return (r - r.mean()) / std

def stage_memory_gib(n_params, stack):
    """Teaching estimate of persistent model states, excluding activations."""
    if not math.isfinite(n_params) or n_params <= 0:
        raise ValueError("n_params must be finite and positive")
    bytes_per_parameter = {"train": 16, "frozen_bf16": 2}
    return sum(bytes_per_parameter[kind] * n_params for kind in stack) / 2**30

ppo = stage_memory_gib(
    8.03e9,
    ["train", "train", "frozen_bf16", "frozen_bf16"],
)
dpo = stage_memory_gib(8.03e9, ["train", "frozen_bf16"])
np.logaddexp(0, -z) вычисляет устойчиво даже при больших по модулю значениях. local_slope — модуль производной по аргументу , а не норма градиента модели. Функция grpo_advantages требует явного решения для вырожденной группы, вместо того чтобы незаметно породить NaN. Наконец, stage_memory_gib честно ограничивает область результата: это только постоянные состояния моделей.
15. RLVR, Goodhart и взлом проверяющего сигнала
RLVR (Reinforcement Learning with Verifiable Rewards) заменяет субъективную модель вознаграждения формальной проверкой. Для задачи по программированию это может быть набор тестов, для математики — совпадение ответа или формальный проверяющий модуль, для агента — достигнутое состояние среды.
Проверяемость уменьшает неоднозначность, но не устраняет закон Гудхарта. Модель оптимизирует именно то, что измерено.
- Слабый тест можно пройти с неправильным общим решением.
- Проверяющий модуль может принимать особый формат, который не отражает качество рассуждения.
- Награда только за конечный ответ не различает надёжное решение и удачное угадывание.
- Ограничение длины может побуждать модель преждевременно завершать ответ или, наоборот, заполнять весь доступный бюджет.
- Если простые задачи быстро дают только успешные ответы, они перестают давать относительный сигнал, а обучение концентрируется на другом подмножестве запросов.
Поэтому в хорошем RLVR-контуре оценивают не только среднюю награду. Нужны распределения длин, доля вырожденных групп, энтропия политики, доля ошибок проверяющего модуля, качество на скрытых тестах и ручной просмотр траекторий.
Граница между SFT и RLVR также не абсолютна. Лучшие траектории можно вернуть в набор демонстраций и провести ещё один SFT-этап. Наоборот, обученная по демонстрациям модель может стать исходной политикой для онлайн-RL. Современное постобучение обычно чередует эти источники сигнала, а не выбирает один навсегда.
16. Constitutional AI, R1 и интерактивные среды
Constitutional AI: обратная связь от модели
В Constitutional AI человек задаёт набор принципов, а модель используется для масштабирования обратной связи. Оригинальный рецепт состоит из двух частей.
В контролируемой части модель генерирует ответ, создаёт его критику по выбранному принципу и переписывает текст. Переработанные ответы используются для дополнительного SFT. Затем в RL-части модель сравнивает пары ответов, по этим AI-предпочтениям обучается модель вознаграждения, а политика оптимизируется с RL. Этот режим называют RLAIF (Reinforcement Learning from AI Feedback).
AI-обратная связь снижает потребность в ручных метках, но не делает стоимость и качество контроля нулевыми. Нужно выбирать конституцию, калибровать судью, отслеживать систематические ошибки и проверять, не усиливает ли модель собственные предпочтения и слепые зоны.
DeepSeek-R1: пример многостадийного открытого рецепта
DeepSeek-R1 полезен не только итоговыми результатами, но и публичным описанием четырёх стадий:
- начальный SFT (cold-start SFT) на небольшом наборе длинных решений;
- RL, ориентированный на рассуждение, с проверяемыми наградами;
- отбор лучших сгенерированных решений (rejection sampling) и новый SFT на отобранных данных;
- дополнительный RL для более широкого набора сценариев, включая полезность и безопасность.
R1-Zero начинает RL непосредственно от базовой модели и демонстрирует, что масштабное обучение с проверяемой наградой может усилить уже существующие возможности рассуждения. При этом работа отмечает проблемы читаемости и смешения языков, а последующие исследования показывают, что многое зависит от свойств базовой модели.
От статического набора к среде
Для одношаговой математической задачи достаточно пары «запрос — ответ». Агент, работающий с браузером, кодом или внешней системой, проходит много состояний. Награда зависит не только от финальной строки, но и от действий, результатов инструментов, ошибок и восстановления после них.
NeMo Gym формализует среду как сочетание данных, оболочки агента, инструментов и проверяющей логики. NeMo RL и verl поддерживают многотуровые траектории, различные алгоритмы обновления и раздельную инфраструктуру генерации и обучения. Это и есть практический смысл выражения RL, встроенное в интерактивные среды (environment-native RL): среда становится частью обучающего контракта, а не только источником конечной метки.
Если разработчик закрытой модели не публикует полный рецепт постобучения, поведение модели не позволяет восполнить эти сведения. Наличие регулируемого «усилия рассуждения», длинного скрытого рассуждения или уверенной работы с инструментами не позволяет однозначно восстановить алгоритм обучения. Надёжная карта должна различать опубликованный рецепт, официально сообщённую характеристику и внешнюю гипотезу.
17. Как читать паспорт постобучения
Название алгоритма — только первая строка паспорта. Для воспроизводимого понимания нужно задать более подробные вопросы.
Данные и режим
- Используются демонстрации, парные предпочтения, одиночные бинарные метки или онлайн-траектории?
- Ответы созданы исходной моделью, текущей политикой или более сильным учителем?
- Есть ли повторное использование старых траекторий?
- Как предотвращаются утечки между обучением и проверкой?
Награда и проверка
- Награду даёт человек, модель-судья, набор правил, тесты или интерактивная среда?
- Это одно число на ответ или процессный сигнал по шагам?
- Как обрабатываются неоднозначные, частично правильные и слишком длинные ответы?
- Как измеряется качество самого проверяющего модуля?
Оптимизация
- Метод офлайн или обучается по данным текущей политики (on-policy)?
- Нужны ли референсная политика, старая политика, критик и модель вознаграждения?
- Где применяется KL: внутри награды, отдельным слагаемым или не применяется?
- По каким единицам усредняется функция потерь?
- Как обрабатываются вырожденные группы и выбросы?
Инфраструктура
- Генерация и обучение используют одни ускорители или разные пулы?
- Контур синхронный, отстаёт на один шаг (one-step-off) или полностью асинхронный?
- Как ограничивается устаревание траекторий?
- Какая часть времени уходит на
decode, проверку, передачу данных и обновление модели?
Если этих сведений нет, корректнее говорить «точный рецепт постобучения не раскрыт», чем восстанавливать его по имени модели или внешнему поведению.
20. Ключевые выводы и источники
Источники сигнала. Демонстрация задаёт один желательный ответ. Предпочтение сравнивает ответы. Проверяемая награда оценивает результат. Источник сигнала, способ сбора данных и правило обновления нужно указывать отдельно.
Классический RLHF. SFT → модель вознаграждения → PPO с KL-регуляризацией. Четыре логические роли не обязательно означают четыре независимые полные копии в памяти.
Bradley–Terry. . Доля побед 75% соответствует логиту внутри этой модели сравнения.
DPO. Неявная награда определяется отношением текущей и референсной политик. Метод работает офлайн по парам и не требует отдельной модели вознаграждения или генерации на каждом шаге.
Прямые варианты. IPO меняет целевую геометрию отступа; KTO использует одиночные бинарные метки; SimPO работает без отдельной референсной модели и нормирует по длине; ORPO объединяет SFT и предпочтения в одной цели.
RLOO и GRPO. Оба строят сигнал из нескольких ответов на один запрос. RLOO использует базовую линию по остальным ответам (leave-one-out). GRPO нормирует по всей группе и не требует отдельной модели ценности, но получаемая оценка имеет собственные смещения и вырожденные случаи.
Численные сценарии. Для заданной модели постоянных состояний PPO занимает 269.2 GiB, DPO с референсом — 134.6 GiB. Для заданного сценария длинных траекторий генерация в 39.3 раза дольше одного оценочного прохода обучения. Оба результата зависят от допущений.
RLVR. Формальная проверка уменьшает субъективность, но не устраняет взлом награды (reward hacking). Нужно оценивать проверяющий модуль, распределение длин, долю вырожденных групп, энтропию и качество на скрытых задачах.
Современный системный сдвиг. Постобучение переходит от статических пар к многотуровым средам, раздельным пулам генерации и обучения и асинхронным очередям. Вместе с производительностью возникает проблема свежести траекторий.
Основные первоисточники:
- Christiano et al., Deep Reinforcement Learning from Human Preferences — arxiv.org/abs/1706.03741
- Ouyang et al., Training Language Models to Follow Instructions with Human Feedback — arxiv.org/abs/2203.02155
- Rafailov et al., Direct Preference Optimization — arxiv.org/abs/2305.18290
- Azar et al., PO / IPO — arxiv.org/abs/2310.12036
- Ethayarajh et al., KTO — arxiv.org/abs/2402.01306
- Meng et al., SimPO — arxiv.org/abs/2405.14734
- Hong et al., ORPO — arxiv.org/abs/2403.07691
- Ahmadian et al., RLOO — arxiv.org/abs/2402.14740
- Shao et al., DeepSeekMath / GRPO — arxiv.org/abs/2402.03300
- Guo et al., DeepSeek-R1 — arxiv.org/abs/2501.12948
- Yu et al., DAPO — arxiv.org/abs/2503.14476
- Liu et al., Understanding R1-Zero-Like Training / Dr. GRPO — arxiv.org/abs/2503.20783
- Wu et al., It Takes Two: Your GRPO Is Secretly DPO — arxiv.org/abs/2510.00977
- Yang et al., Your Group-Relative Advantage Is Biased — arxiv.org/abs/2601.08521
- Bai et al., Constitutional AI — arxiv.org/abs/2212.08073
- Lambert et al., Tülu 3 — arxiv.org/abs/2411.15124
- NeMo Gym — docs.nvidia.com/nemo/gym
- NeMo RL — github.com/NVIDIA-NeMo/RL
- verl — github.com/verl-project/verl
Дальше: модуль 15 рассматривает модели рассуждения и вычисления во время инференса. Здесь мы учились изменять политику; там будем решать, сколько вычислений выделять уже обученной модели на конкретный запрос.
Ландшафт сверен: 11 октября 2026 года. Современные утверждения проверены по первоисточникам; точные рецепты закрытых моделей не реконструируются по внешнему поведению. Учебные оценки памяти и времени воспроизводятся локальными расчётами и действуют только при явно указанных допущениях.