Модуль 11. Спекулятивное декодирование и квантизация
Курс «Modern LLMs» · лекция модуля 11 · редакция 11 октября 2026
О чём этот модуль. В модуле 10 мы увидели, почему последовательная генерация часто упирается не в число арифметических операций, а в перемещение данных: ради одного нового токена ускорителю приходится снова читать значительную часть весов модели и обращаться к KV-кэшу. Здесь мы рассмотрим два независимых способа изменить эту экономику. Квантизация (Quantization) уменьшает объём данных, который нужно хранить и перемещать. Спекулятивное декодирование (Speculative Decoding) пытается получить несколько токенов за один дорогой проход основной модели. Оба подхода давно вышли за пределы лабораторных трюков, но ни один из них не даёт универсального множителя ускорения: результат зависит от модели, нагрузки, аппаратуры, режима выборки и реализации.
Что нужно знать заранее. Полезно помнить различие между
prefillиdecode, введённое в модуле 10, и идею multi-token prediction (MTP) из модуля 9. Все необходимые определения и вычисления повторяются здесь, поэтому модуль остаётся самодостаточным.
Как читать модуль. При первом проходе проследите одну мысль: какие вычисления можно предложить заранее и какие данные можно хранить короче. Прочитайте §§1, 3–12 и 15–20; внутри §5 достаточно таблицы и доказательства баланса, а большие блоки NumPy/PyTorch можно пока пропустить. Формулы и читайте вместе с объяснениями допущений.
При втором проходе вернитесь к мостам в §§5 и 13, выполните §§13–14 и ноутбук. Сопоставьте каждый тест с условием доказательства, затем решите упражнения до просмотра ответов. Проектные демо переводят локальные вычисления в последовательную генерацию и проверку ошибки слоя.
Для справочного чтения используйте §2 как историческую карту, §§8–9 как указатель источников предложений, §§11–12 как описание форматов и §17 как паспорт эксперимента. Справочник не заменяет вывод точного правила в §§4–5.
1. Мотивация: два способа снизить стоимость токена
При prefill модель обрабатывает известный запрос и сохраняет ключи и значения внимания — KV-кэш. При decode она продолжает построенную последовательность. В обычном авторегрессионном режиме новый токен становится входом следующего шага. Поэтому даже быстрый отдельный шаг повторяется много раз: последовательная зависимость и стоимость одного шага — разные источники задержки.
Представим обычный шаг авторегрессионной генерации. Модель уже обработала запрос, KV-кэш построен, и теперь нужно получить один следующий токен. Для крупной модели этот шаг часто оказывается ограничен пропускной способностью памяти: ускоритель выполняет сравнительно мало полезной матричной работы на каждый байт, который приходится прочитать.
В упрощённом виде весовую часть ограничения можно записать так:
Здесь измеряется в токенах в секунду для одной последовательности, — в байтах в секунду, а — в байтах весов, прочитанных за шаг. Для приведённой ниже плотной 8B-модели предполагается чтение всех весов один раз за шаг. Это не формула полного сервиса: в ней нет KV-трафика, временных буферов, межпроцессорных обменов и накладных расходов. Но она хорошо показывает два разных рычага.
Первый рычаг — уменьшить . Если хранить вес не в 16 битах, а в 8 или 4, арифметический предел чтения весов растёт. Для учебного сценария с моделью 8B и пропускной способностью 3,35 TB/s получаются такие оценки: 16 GB весов в bf16 дают 209,4 токена/с; 8 GB в FP8 — 418,8; 4,5 GB в условном NVFP4-представлении — 744,4. Это верхние оценки только по весам, а не обещания реальной скорости.
Второй рычаг — получать больше одного токена за чтение весов основной модели. Быстрая черновая модель предлагает продолжение, а основная модель проверяет несколько позиций одним проходом. Если часть предложений принята, одно дорогое чтение весов окупается несколькими токенами.
Эти два метода действуют на разные составляющие задачи, поэтому их можно сочетать. Но перемножать их идеальные коэффициенты без повторного профилирования нельзя: после квантизации система может перестать быть ограниченной памятью, а проверка нескольких позиций может вывести её в другой режим загрузки.
2. Как сложились два направления
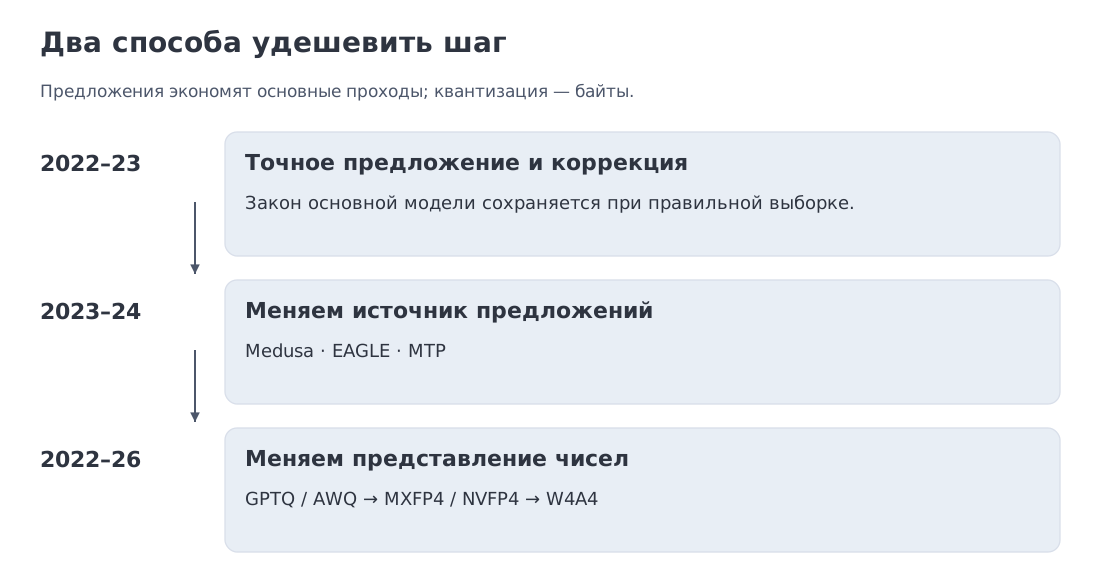 Две линии развития: точное спекулятивное декодирование, затем встроенные и обучаемые черновики; квантизация после обучения, затем микромасштабируемые FP4-форматы и аппаратно поддерживаемые режимы W4A4.
У спекулятивного декодирования есть чёткая отправная точка. Работы Leviathan, Kalman и Matias, а также Chen и соавторов показали, как использовать более дешёвую модель-предложение и при этом точно сохранить распределение основной модели. Существенен именно второй пункт: метод ускоряет выборку, а не подменяет её приближённым декодером.
Затем исследователи стали избавляться от отдельной полноценной черновой модели. Medusa добавила несколько предсказывающих голов и дерево кандидатов. Семейство EAGLE перенесло часть прогнозирования во внутреннее пространство представлений основной модели; EAGLE-3 перешла к прямому предсказанию токенов и объединению признаков нескольких уровней. Параллельно развивались методы без нейронного черновика — поиск повторяющихся фрагментов в контексте, n-граммные предложения и декодирование по совпадающим суффиксам (suffix decoding).
Ещё одна линия возникла из самого обучения основной модели. Цель multi-token prediction учит сеть предсказывать не только ближайший токен. Если архитектура сохраняет соответствующие головы или модули, они могут служить встроенным источником предложений при инференсе. Технический отчёт DeepSeek-V3 прямо отмечает, что MTP-цель может использоваться для спекулятивного декодирования; современные движки, включая vLLM, поддерживают такой режим для совместимых моделей.
История квантизации развивалась похожим образом: сначала уменьшали число битов, затем выяснили, что одного названия формата недостаточно. GPTQ и AWQ сделали низкобитную квантизацию после обучения практически применимой для LLM. SmoothQuant, вращения и другие преобразования стали перераспределять выбросы между каналами. С появлением аппаратной поддержки FP4 внимание сместилось к микромасштабированию: значение хранится в четырёх битах, но каждая небольшая группа получает собственный масштаб.
К 11 октября 2026 года обе области уже представляют не один алгоритм, а набор совместимых решений: разные источники черновика, разные правила проверки, весовая и активационная квантизация, несколько FP4-схем и специализированные ядра. Поэтому инженерный вопрос звучит не «включить ли ускорение», а «какой механизм соответствует моей модели и моей нагрузке».
3. Три классические идеи под современными названиями
Современная терминология скрывает три старых и очень полезных идеи.
Первая — выборка с отбраковкой (rejection sampling). Мы умеем дешёво выбирать из распределения , похожего на нужное . Предложение из принимается с вероятностью, зависящей от отношения . В классическом варианте при отказе приходится делать новую попытку. В спекулятивном декодировании остаточная масса используется напрямую, поэтому цикл всё равно выдаёт корректный токен.
Вторая — спекулятивное исполнение из архитектуры процессоров. Процессор выполняет работу по предсказанной ветви, а затем либо сохраняет результат, либо откатывает его. В LLM валютой становятся не инструкции, а предложенные токены. Аналогия полезна, но не полна: здесь нужно не только откатить неверное продолжение, но и сохранить точный закон выборки.
Третья — блочная плавающая точка (block floating point) и групповые масштабы. Если одна группа чисел использует общий масштаб, динамический диапазон оплачивается один раз на группу, а каждому элементу остаётся короткий код. Чем меньше группа, тем точнее масштаб подстраивается к локальным значениям, но тем выше служебный расход.
Эти три связи помогают не воспринимать методы как набор флагов в движке. Спекулятивное декодирование — это статистически корректное предложение и проверка; квантизация — управляемый компромисс между объёмом представления, ошибкой и поддержкой на конкретном оборудовании.
4. Точный спекулятивный цикл
Будем различать основную модель (target) и черновую модель (draft). Первая определяет закон, из которого требуется получить ответ, а вторая предлагает кандидатов. Обозначение означает вероятность токена при условии принятой истории и предыдущих предложений текущего цикла; относится к той же истории. Индекс в коротких формулах опускается, но распределения могут меняться от позиции к позиции.
В М3 (§12.1) мы разобрали цепочку temperature → top-k → top-p на числах. Здесь используем уже полученное после этих преобразований распределение. Черновик выбирает токены из своего фактического распределения . Температура меняет резкость распределения, top-p оставляет минимальный набор наиболее вероятных токенов с заданной суммарной массой, а грамматическая маска запрещает недопустимые продолжения. Если такая обработка включена, в формулу подставляются вероятности после неё и нормировки, а не исходные выходы softmax. Основная модель аналогично задаёт обработанный закон , который мы хотим сохранить.
Пусть основная модель задаёт распределение следующего токена , а черновая — . Черновая модель авторегрессивно предлагает последовательность . Затем основная модель одним пакетным проходом вычисляет свои распределения для всех проверяемых позиций.
Для предложенного токена используется вероятность принятия
Проверка идёт слева направо. Как только предложение отклонено, оставшаяся черновая ветвь отбрасывается, а новый токен выбирается из нормированного остатка
При пакетной проверке сохраняется каузальная маска: строка не видит более поздние предложения. Выходы основной модели нужно правильно сдвинуть относительно входных токенов, чтобы предсказывало именно . Если приняты все предложений, распределение следующей позиции даёт дополнительный токен. При отказе дальнейшие предложения и соответствующая им часть KV-кэша откатываются: следующий цикл продолжается с исправленного префикса.
Здесь покомпонентно, а означает деление на сумму положительных элементов. Она ненулевая, когда отказ возможен. Конец последовательности (EOS) и предел длины останавливают выдачу даже внутри цикла; формула длины в §6 пока рассматривает цикл без такого досрочного завершения.
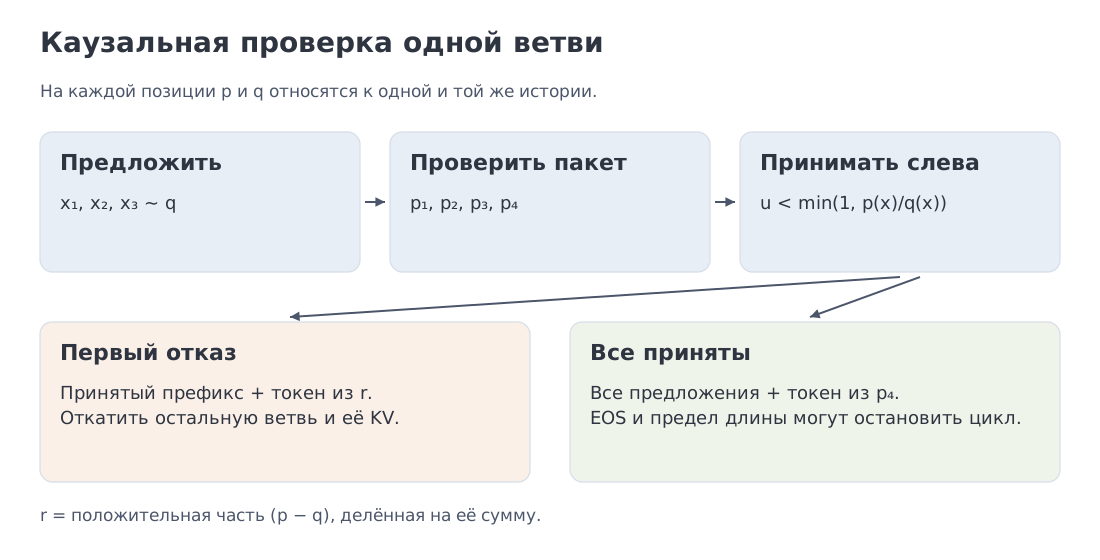 Один цикл: черновик предлагает последовательность, основная модель проверяет несколько позиций одним проходом, а первый отказ исправляется выборкой из положительной части .
Почему распределение сохраняется? Для любого токена вклад принятой ветви равен . Вероятность попасть в корректирующую ветвь равна
а сама корректирующая ветвь распределяет эту массу пропорционально . Поэтому
Черновик доставляет общую часть двух распределений, а коррекция — массу, которой не хватило основной модели. Применяя это рассуждение последовательно к каждой принятой истории, получаем закон всей авторегрессионной последовательности. Равенство законов не обещает одинаковую строку при одном seed: два алгоритма расходуют случайные числа по-разному.
У гарантии есть условия. Основная и черновая модели должны говорить об одном пространстве токенов либо использовать специально согласованную схему отображения; проверка должна иметь доступ к вероятностям основной модели и следовать точному правилу. Жадная проверка, эвристическое отсечение дерева или ослабленное правило принятия могут быть полезны, но их свойства уже нужно анализировать отдельно.
Наконец, точность относится к фактически используемой основной модели. Если её веса квантованы, алгоритм воспроизводит распределение квантованной модели, а не исходного чекпойнта в bf16.
5. Решённый пример A: баланс на пяти токенах
Возьмём
| токен | ||||
|---|---|---|---|---|
| 0 | 0.40 | 0.25 | 1.000 | 0.15 |
| 1 | 0.30 | 0.35 | 0.857 | 0 |
| 2 | 0.15 | 0.20 | 0.750 | 0 |
| 3 | 0.10 | 0.10 | 1.000 | 0 |
| 4 | 0.05 | 0.10 | 0.500 | 0 |
Средняя вероятность принять предложение равна
Для одной позиции эта величина имеет простую геометрическую интерпретацию:
Здесь — расстояние полной вариации: половина общей абсолютной разницы вероятностей. Чем ближе черновое распределение к основному, тем большую часть массы они перекрывают и тем выше доля принятия.
В нашем примере вся положительная разность сосредоточена на токене 0, поэтому . Проверяем баланс:
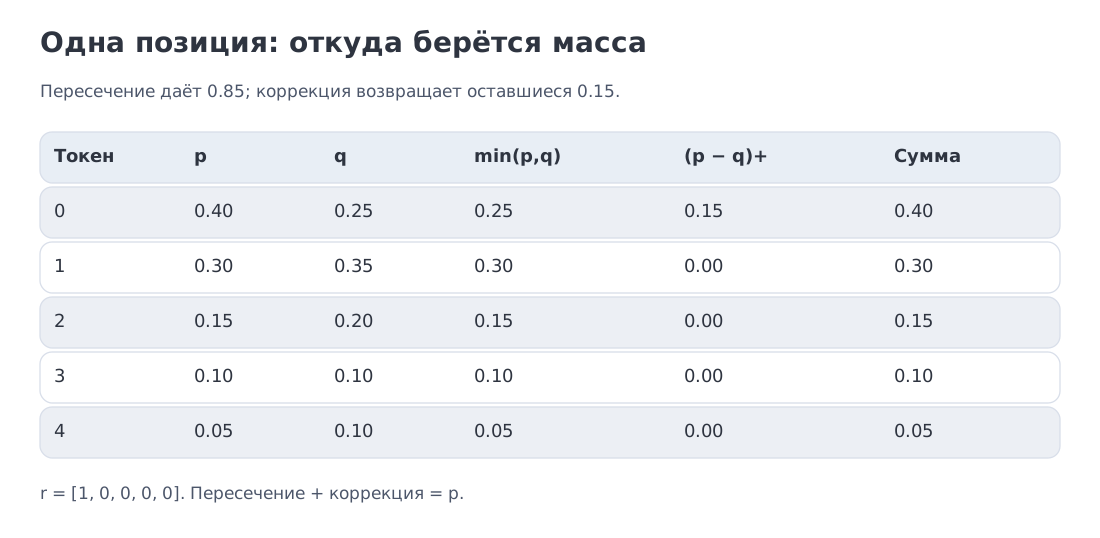 Численный след: перекрытие и , остаточная масса и покомпонентное восстановление исходного распределения.
Два граничных случая полезно держать в коде явно. Если , отказ невозможен и корректирующее распределение вообще не требуется. Если , делить не нужно: черновик никогда не предложит токен , а недостающая масса попадёт в остаток. Именно эти случаи проверяет ноутбук модуля.
NumPy → PyTorch · B18 — Точная спекулятивная коррекция
NumPy показывает принятую массу и положительный остаток (p-q)+. PyTorch использует тот же баланс и torch.multinomial; проверки передают отдельный генератор случайных чисел.
import numpy as np
import torch
1. Явная NumPy-реализация
def numpy_rejection_kernel_explicit(
    p: np.ndarray,
    q: np.ndarray,
) -> tuple[np.ndarray, np.ndarray, np.ndarray]:
    acceptance = np.zeros_like(p, dtype=np.float64)
    support = q > 0
    acceptance[support] = np.minimum(1.0, p[support] / q[support])
    overlap = np.minimum(p, q)
    positive = np.maximum(p - q, 0.0)
    residual_mass = positive.sum()
    residual = positive / residual_mass if residual_mass > 0 else np.zeros_like(p)
    reconstructed = overlap + residual_mass * residual
    return acceptance, residual, reconstructed
NumPy делает видимыми три части доказательства: вероятность принятия min(1,p/q), перекрытие min(p,q) и нормированный положительный остаток (p-q)_+.
2. Та же математика явными операциями PyTorch
def torch_rejection_kernel_explicit(
    p: torch.Tensor,
    q: torch.Tensor,
) -> tuple[torch.Tensor, torch.Tensor, torch.Tensor]:
    acceptance = torch.zeros_like(p)
    support = q > 0
    acceptance[support] = torch.minimum(torch.ones_like(p[support]), p[support] / q[support])
    overlap = torch.minimum(p, q)
    positive = torch.clamp(p - q, min=0)
    residual_mass = positive.sum()
    residual = positive / residual_mass if bool(residual_mass > 0) else torch.zeros_like(p)
    reconstructed = overlap + residual_mass * residual
    return acceptance, residual, reconstructed

def torch_sample_speculative_token_explicit(
    p: torch.Tensor,
    q: torch.Tensor,
    proposal: int,
    *,
    generator: torch.Generator | None = None,
) -> tuple[int, bool]:
    if isinstance(proposal, bool) or not isinstance(proposal, int) or not 0 <= proposal < p.numel() or q[proposal] <= 0:
        raise ValueError("proposal must be an integer in the positive support of q")
    acceptance, residual, _ = torch_rejection_kernel_explicit(p, q)
    draw = torch.rand((), generator=generator, device=p.device, dtype=p.dtype)
    if draw < acceptance[proposal]:
        return int(proposal), True
    return int(torch.multinomial(residual, 1, generator=generator).item()), False
Явное ядро предполагает два неотрицательных нормированных вектора p и q одной одномерной формы, длины не меньше двух. Все значения конечны; PyTorch-векторы имеют общий тип float32 или float64 и находятся на одном устройстве. Остаток нормируется по сумме положительных разностей без отсечения малой массы. Код выборки предназначен для инференса; дискретный выбор не имеет обычного градиента. Параметр generator необязателен: без него используется глобальный генератор. В проверках передаём отдельный torch.Generator для воспроизводимости. Предложение должно быть выбрано из q, а не задано произвольно.
| Аспект | NumPy | PyTorch |
|---|---|---|
| Носитель q | явная маска q>0 | булев тензор маски |
| Принятие | np.minimum | torch.minimum |
| Остаток | np.maximum(p-q,0) | torch.clamp(..., min=0) |
| Выборка | вне математического ядра | torch.rand / multinomial, генератор необязателен |
| Проверка | точное восстановление p | Монте-Карло и проверка баланса |
Исполняемая проверка эквивалентности и граничных случаев
p_np = np.array([0.40,0.30,0.15,0.10,0.05]); q_np = np.array([0.25,0.35,0.20,0.10,0.10])
a_np, r_np, b_np = numpy_rejection_kernel_explicit(p_np, q_np)
a_t, r_t, b_t = torch_rejection_kernel_explicit(torch.tensor(p_np), torch.tensor(q_np))
np.testing.assert_allclose(a_np, a_t.numpy()); np.testing.assert_allclose(r_np, r_t.numpy()); np.testing.assert_allclose(b_np, b_t.numpy()); np.testing.assert_allclose(b_np, p_np)
gen = torch.Generator().manual_seed(18); counts = torch.zeros(5)
q = torch.tensor(q_np); p = torch.tensor(p_np)
for _ in range(12000):
    proposal = int(torch.multinomial(q, 1, generator=gen))
    token, _ = torch_sample_speculative_token_explicit(p, q, proposal, generator=gen)
    counts[token] += 1
assert torch.max(torch.abs(counts / counts.sum() - p)) < 0.02

# A real, tiny residual must remain a probability distribution.
near_q = np.array([1.0, 0.0]); near_p = np.array([1.0-1e-14, 1e-14])
for kernel, args in [
    (numpy_rejection_kernel_explicit, (near_p, near_q)),
    (torch_rejection_kernel_explicit, (torch.tensor(near_p), torch.tensor(near_q))),
]:
    _, residual, balance = kernel(*args)
    np.testing.assert_allclose(np.asarray(residual), [0.0, 1.0], rtol=0, atol=1e-15)
    np.testing.assert_allclose(np.asarray(balance), near_p, rtol=0, atol=1e-15)
# Uniform RNG can return zero: a zero-acceptance proposal must still be rejected.
from unittest.mock import patch
with patch.object(torch, "rand", return_value=torch.tensor(0.0, dtype=torch.float64)):
    token, accepted = torch_sample_speculative_token_explicit(
        torch.tensor([0.,1.], dtype=torch.float64),
        torch.tensor([1.,0.], dtype=torch.float64), 0, generator=gen)
    assert token == 1 and not accepted

print("B18 exact balance, tiny residual, zero draw, Monte Carlo: PASS")
Полный исполняемый файл: m11_inference_bridges.py
6. Сколько токенов приносит один цикл
Чтобы получить простую аналитическую модель, предположим, что условная вероятность принять очередное предложение, если все предыдущие приняты, одинакова на каждой позиции и равна . Это приближение: в реальной генерации она меняется вместе с контекстом, позицией и самим предложенным продолжением.
Первый выданный токен гарантирован. Второй появляется, если принято первое предложение; третий — если приняты первые два, и так далее. Поэтому ожидаемое число токенов за цикл равно
При это геометрическая сумма
а при следует использовать конечную сумму напрямую: .
Несколько чисел дают хорошую интуицию. При и получаем . При и — . Если принять из предыдущего примера за одинаковую условную вероятность на всех достигнутых позициях и взять , среднее равно токена за цикл.
Главное свойство — насыщение. При фиксированном сумма стремится к . Поэтому бесконечно удлинять черновик бессмысленно: дальние токены будут редко достигать проверки. Повышение доли принятия обычно ценнее, чем механическое увеличение .
7. Цена цикла и выбор длины черновика
Прежде чем вводить стоимость, уточним формулу длины. Пусть — событие принятия первых предложений. В общем случае При условных вероятностях получаем . Для и выход равен . Подстановка их среднего дала бы . Поэтому одного усреднённого процента принятия недостаточно: нужно знать вероятность дойти до каждой глубины.
Число токенов за цикл ещё не определяет скорость. Черновик тоже требует времени, проверка нескольких позиций имеет собственную стоимость, а фактическая загрузка оборудования меняется вместе с .
Для учебного анализа введём относительную стоимость одного чернового шага в долях обычного прохода основной модели. Тогда простая сценарная модель имеет вид
Единица в знаменателе предполагает, что проверка блока стоит столько же, сколько обычный основной шаг. Если её измеренная стоимость равна таких шагов, а прочие расходы — , знаменатель становится . Доказательство точности выборки ничего не утверждает об этих временах. При выборе метода стоит включить в перебор и : обычное декодирование имеет нормированную скорость 1 и может оказаться лучшим вариантом.
Эта формула намеренно не претендует на точную модель времени. В неё не входят построение дерева, передача KV, пакетирование, синхронизация, специальные ядра и зависимость стоимости проверки от длины. Её задача — показать противоборство двух эффектов: более длинный черновик повышает потенциальный выход, но увеличивает цену предложения.
Для второго прохода: когда полезно ещё одно предложение? При постоянных и имеем . Сравнение двух отношений даёт Справа стоит цена дополнительного предложения, пересчитанная в токены при текущей скорости. Просто сравнивать с недостаточно: первое измеряет прирост ожидаемого выхода, второе — время в единицах основного шага. В ноутбуке можно сопоставить это условие с полным перебором.
Для и перебор даёт максимум при :
Кривая около максимума пологая: при получается 2.46, при — 2.35. Это хороший инженерный урок: грубо правильная длина обычно важнее идеальной, а основные усилия стоит направлять на стоимость черновика и его согласованность с основной моделью.
Рассмотрим теперь учебный MTP-сценарий. Пусть встроенная голова предлагает один дополнительный токен, поэтому ; зададим и . Тогда
Число — результат выбранных параметров сценария, а не восстановление конкретного промышленного измерения. Оно показывает, какой порядок выигрыша возможен при дешёвом одношаговом MTP-модуле с высокой долей принятия. Для также сразу виден потолок .
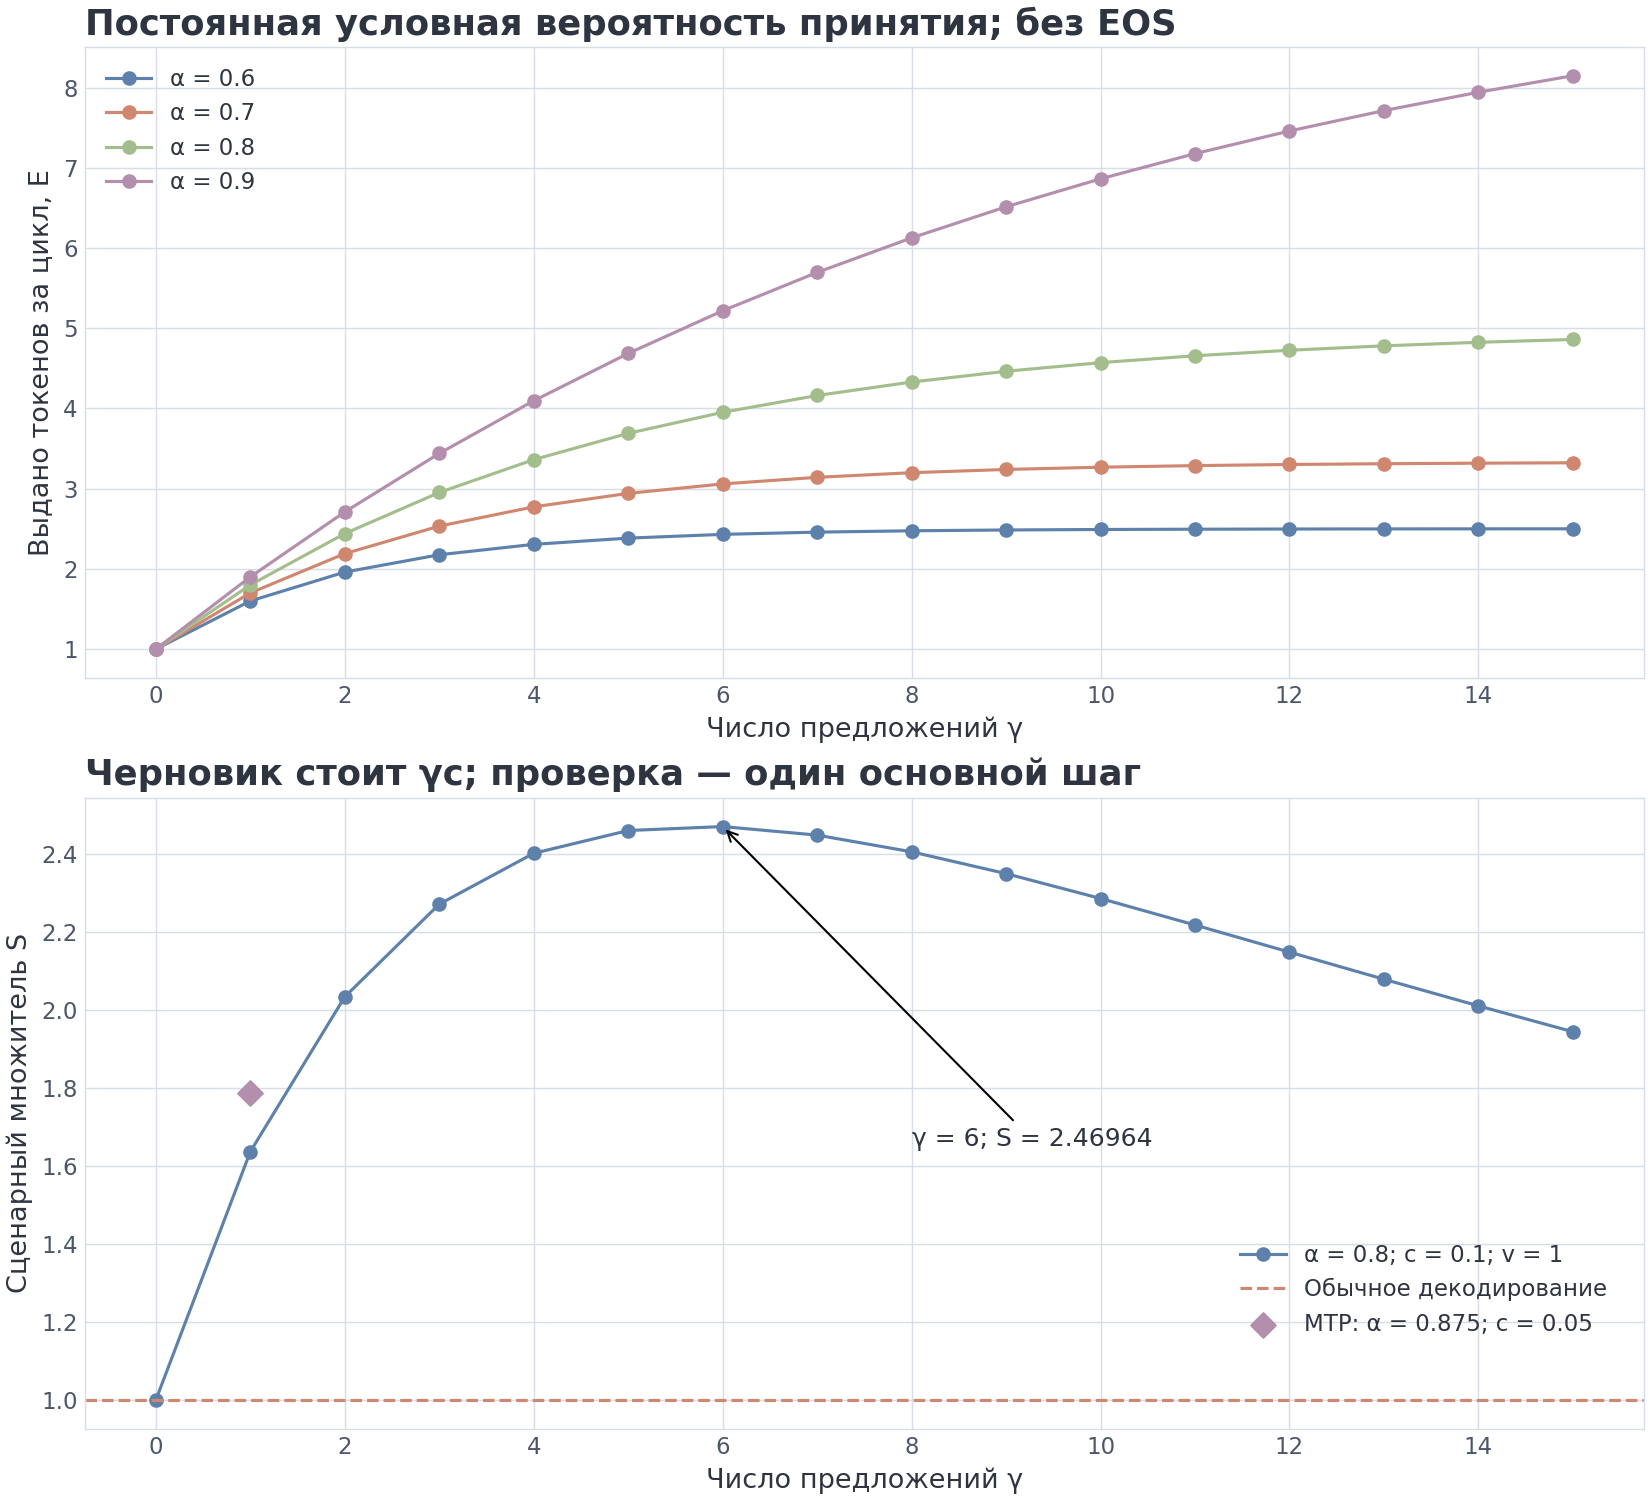 Сверху — насыщение ожидаемой длины цикла; снизу — пологий оптимум сценарной модели скорости и отдельная иллюстративная MTP-точка.
В реальном движке длину полезно выбирать динамически. Уверенность черновика, тип текста, текущая нагрузка и размер пакета меняются от запроса к запросу. Современные реализации всё чаще используют адаптивное число предложений вместо одного глобального .
8. Откуда брать черновик
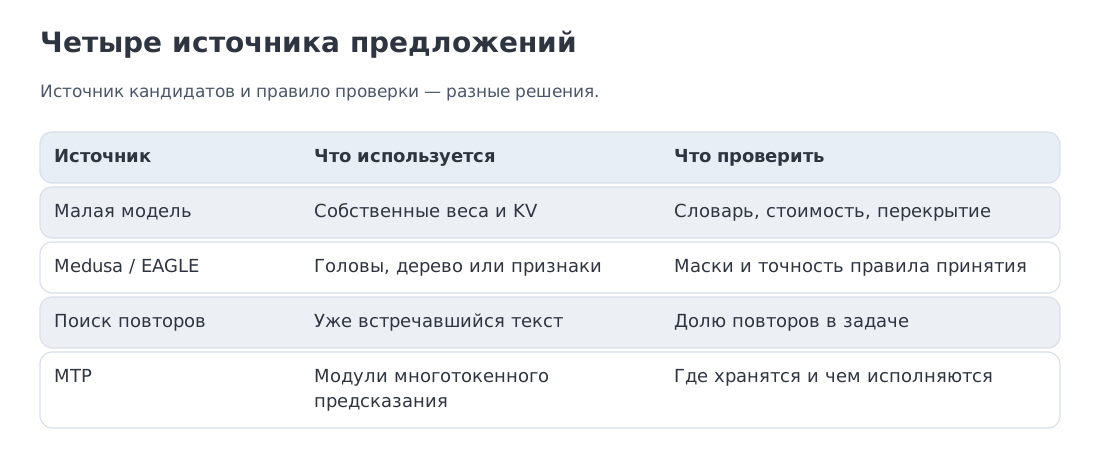 Основные семейства: отдельная модель, дополнительные головы и обучаемые черновики, поиск повторов в контексте и нативный MTP.
Отдельная модель. Небольшая модель того же семейства предлагает линейную последовательность. Это понятный базовый вариант: легко измерить её стоимость и качество. Но сервису приходится держать второй набор весов, а расхождение между моделями может снизить долю принятия. Совместимый словарь и токенизация здесь особенно важны.
Дополнительные головы и деревья. Medusa предсказывает несколько будущих позиций параллельными головами и формирует дерево кандидатов. Предложенная авторами схема typical acceptance контролирует качество, но не наследует автоматически доказательство точного стохастического правила из §4. Дерево увеличивает шанс найти принимаемую ветвь, но усложняет маски, выбор кандидатов и оценку стоимости проверки.
EAGLE использует внутренние представления основной модели для обучения компактного черновика. EAGLE-3 отказалась от регрессии будущего скрытого состояния в пользу прямого предсказания токенов и объединяет признаки нескольких уровней. Авторы сообщают ускорение до 6,5 раза в своих экспериментальных постановках и отдельно 1,38× по пропускной способности SGLang при пакете 64; перенос этого числа на другой движок, модель или нагрузку требует отдельного измерения.
Поиск в уже известном тексте. N-граммные методы и поиск по совпадающим суффиксам ищут продолжения в запросе, предыдущем ответе или общем дереве суффиксов. Они особенно естественны для кода, копирования документов и шаблонных ответов. Их преимущество — отсутствие нейронной черновой модели; ограничение — зависимость от буквальных повторов.
Нативный MTP. Если модель уже содержит модуль multi-token prediction, он может предлагать будущие токены без отдельного внешнего чекпойнта. Это уменьшает эксплуатационную сложность, но не отменяет профилирование: нативность предложения не гарантирует высокую долю принятия на любой задаче.
Нет универсальной «красной линии» по размеру пакета или длине ответа. Документация vLLM рекомендует спекулятивное декодирование прежде всего для нагрузок, ограниченных пропускной способностью памяти, со средней или низкой интенсивностью запросов, где важна задержка между токенами. При высокой конкуренции запросов обычное пакетирование уже хорошо загружает ускоритель, и дополнительная работа черновика может не окупиться.
9. MTP как встроенный источник предложений
MTP возникает раньше инференса. Во время обучения модель получает дополнительную цель: предсказывать токены дальше ближайшего. В зависимости от архитектуры это могут быть отдельные головы, дополнительные блоки или более сложная схема совместного использования весов.
В техническом отчёте DeepSeek-V3 MTP представлена прежде всего как обучающая цель, улучшающая предсказание; авторы также отмечают возможность использовать её для спекулятивного декодирования. Это важное разграничение: наличие MTP в архитектуре ещё не является числом ускорения. Для использования MTP при инференсе нужны сохранённый модуль, поддержка формата движком и измерения доли принятия и стоимости предложения.
Документация vLLM описывает нативный MTP как режим без отдельной полноценной черновой модели. Упаковка зависит от семейства: путь Gemma 4 MTP использует отдельный совместимый assistant-чекпойнт, тогда как другие модели содержат необходимые модули в основном артефакте. Конфигурация может быть компактной, но набор поддерживаемых архитектур и точный синтаксис меняются вместе с версией движка.
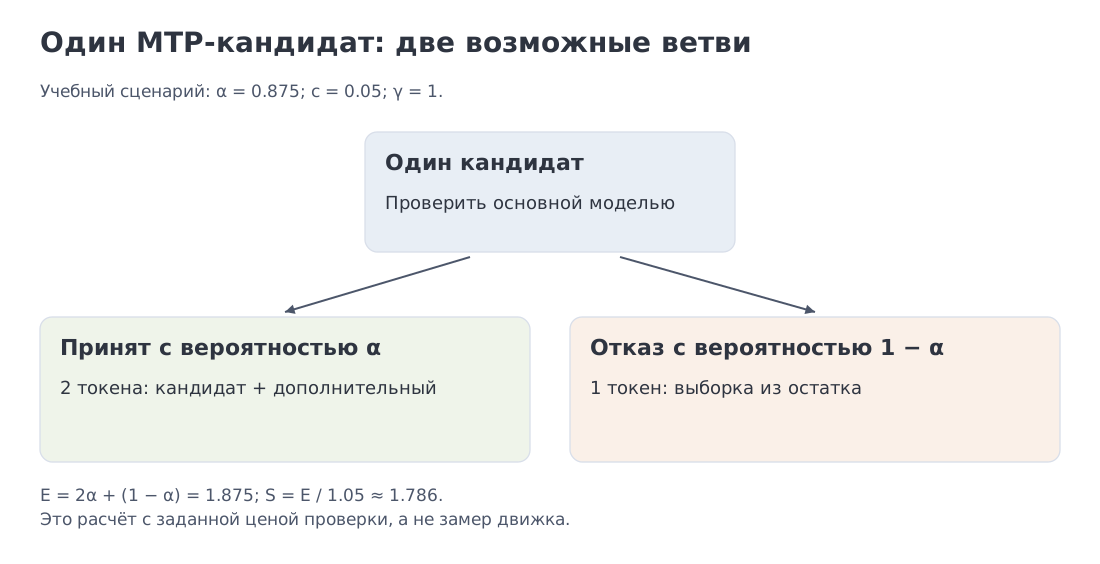 Общий ствол модели, нативный MTP-модуль, предложения будущих токенов и проверка основной моделью. Учебное число 1,79× показано как сценарий, а не как результат внешнего измерения.
У одношагового MTP есть прозрачное ограничение: если предлагается только один будущий токен, цикл не может вернуть больше двух. Многошаговые и рекурсивные схемы пытаются поднять этот предел, но увеличивают стоимость и сложность предложения. Поэтому сравнивать архитектуры следует по нескольким величинам одновременно: среднему числу принятых токенов, времени черновика, времени проверки, дополнительной памяти и поведению под нагрузкой.
В постобучении с подкреплением (RL) модель генерирует ответы или более длинные траектории действий для последующей оценки и обучения. Такой сгенерированный опыт называют роллаутом (rollout). Его получение может занимать большую долю времени постобучения. В курсе RL for LLM, модуль 12, подробно разбираются исполнители генерации, асинхронность и стоимость роллаутов; спекулятивное декодирование можно рассматривать как один из внутренних ускорителей этого контура, а не как изменение алгоритма RL.
10. Почему проверка похожа на короткий prefill
При обычном decode модель обрабатывает одну новую позицию. При спекулятивной проверке основная модель получает сразу несколько предложенных позиций. Матричные операции выполняются над более широким блоком, поэтому отношение вычислений к прочитанным весам растёт. В этом ограниченном смысле проверка напоминает короткий prefill.
В простейшей весовой модели одно чтение весов даёт не один, а токенов. Если относительную стоимость предложения оценить через тот же параметр , можно умножить исходную оценку 209,4 токена/с на . Для , , получаем
Это арифметическая оценка, а не измерение. Она предполагает, что весовой трафик остаётся главным ограничением и что стоимость проверки хорошо аппроксимирована одним проходом. В реальном сервисе в знаменатель возвращаются KV-кэш, планировщик, передача результатов черновика, ветвление дерева и неполная загрузка ядер.
Польза спекулятивного декодирования поэтому зависит от режима. Оно может уменьшить задержку между токенами при небольшом числе одновременных запросов, но не обязано увеличить полезную пропускную способность (goodput) насыщенного сервера. Нужны как минимум три графика: задержка между токенами, токены в секунду на запрос и общая полезная пропускная способность при изменении нагрузки.
11. Квантизация после обучения: что именно уменьшается
Рассмотрим симметричную целочисленную сетку. Для группы весов выбирают масштаб , сохраняют коды и восстанавливают . Здесь округляет до целого, а ограничивает результат интервалом от −7 до 7. Масштаб переводит безразмерные коды в единицы исходного тензора. Большой масштаб покрывает выбросы, но увеличивает шаг между соседними значениями; малый точнее описывает окрестность нуля, но обрезает крайние веса.
Для слоя ошибка выхода равна . Один и тот же промах веса может сильно менять выход на часто активном входном канале и почти не влиять на другом. Калибровочная выборка — небольшой набор характерных входов, на котором оценивают такую чувствительность слоя.
Квантизация переводит числа модели в более короткое представление. Но фраза «четырёхбитная модель» недостаточна: нужно знать, что квантуется, как устроен масштаб, какие операции выполняются в низкой точности и где происходит обратное преобразование.
Квантизация после обучения (post-training quantization, PTQ) преобразует готовый чекпойнт. Её весовой вариант (weight-only PTQ) уменьшает веса, сохраняя активации и накопление в более высокой точности. W8A8 или W4A4 уменьшают и веса, и активации, но требуют более строгого контроля выбросов и подходящих матричных ядер. Обучение с учётом квантизации (quantization-aware training, QAT) включает её эффекты в обучение. Многие методы PTQ используют калибровочные данные; простое округление может обходиться без них. В записи W4A4 буква W обозначает веса, A — активации, цифры — число битов представления. Точность накопления суммы произведений задаётся отдельно.
GPTQ последовательно квантует веса слоя, используя информацию о влиянии ошибки на выход. AWQ опирается на статистику активаций, чтобы лучше защитить чувствительные каналы. Это соседние, а не взаимоисключающие идеи: обе пытаются минимизировать не абстрактную ошибку веса, а последствия для вычисления слоя.
Полезно считать фактический объём. Для параметров и эффективной цены бит на вес:
В учебной лестнице для 8B параметров:
| представление | эффективные биты на вес | объём, десятичные GB | весовой предел при 3,35 TB/s |
|---|---|---|---|
| bf16 | 16.00 | 16.00 | 209.38 токена/с |
| FP8 | 8.00 | 8.00 | 418.75 |
| NVFP4-подобный расчёт | 4.50 | 4.50 | 744.44 |
| MXFP4-подобный расчёт | 4.25 | 4.25 | 788.24 |
| идеализированный W4 | 4.00 | 4.00 | 837.50 |
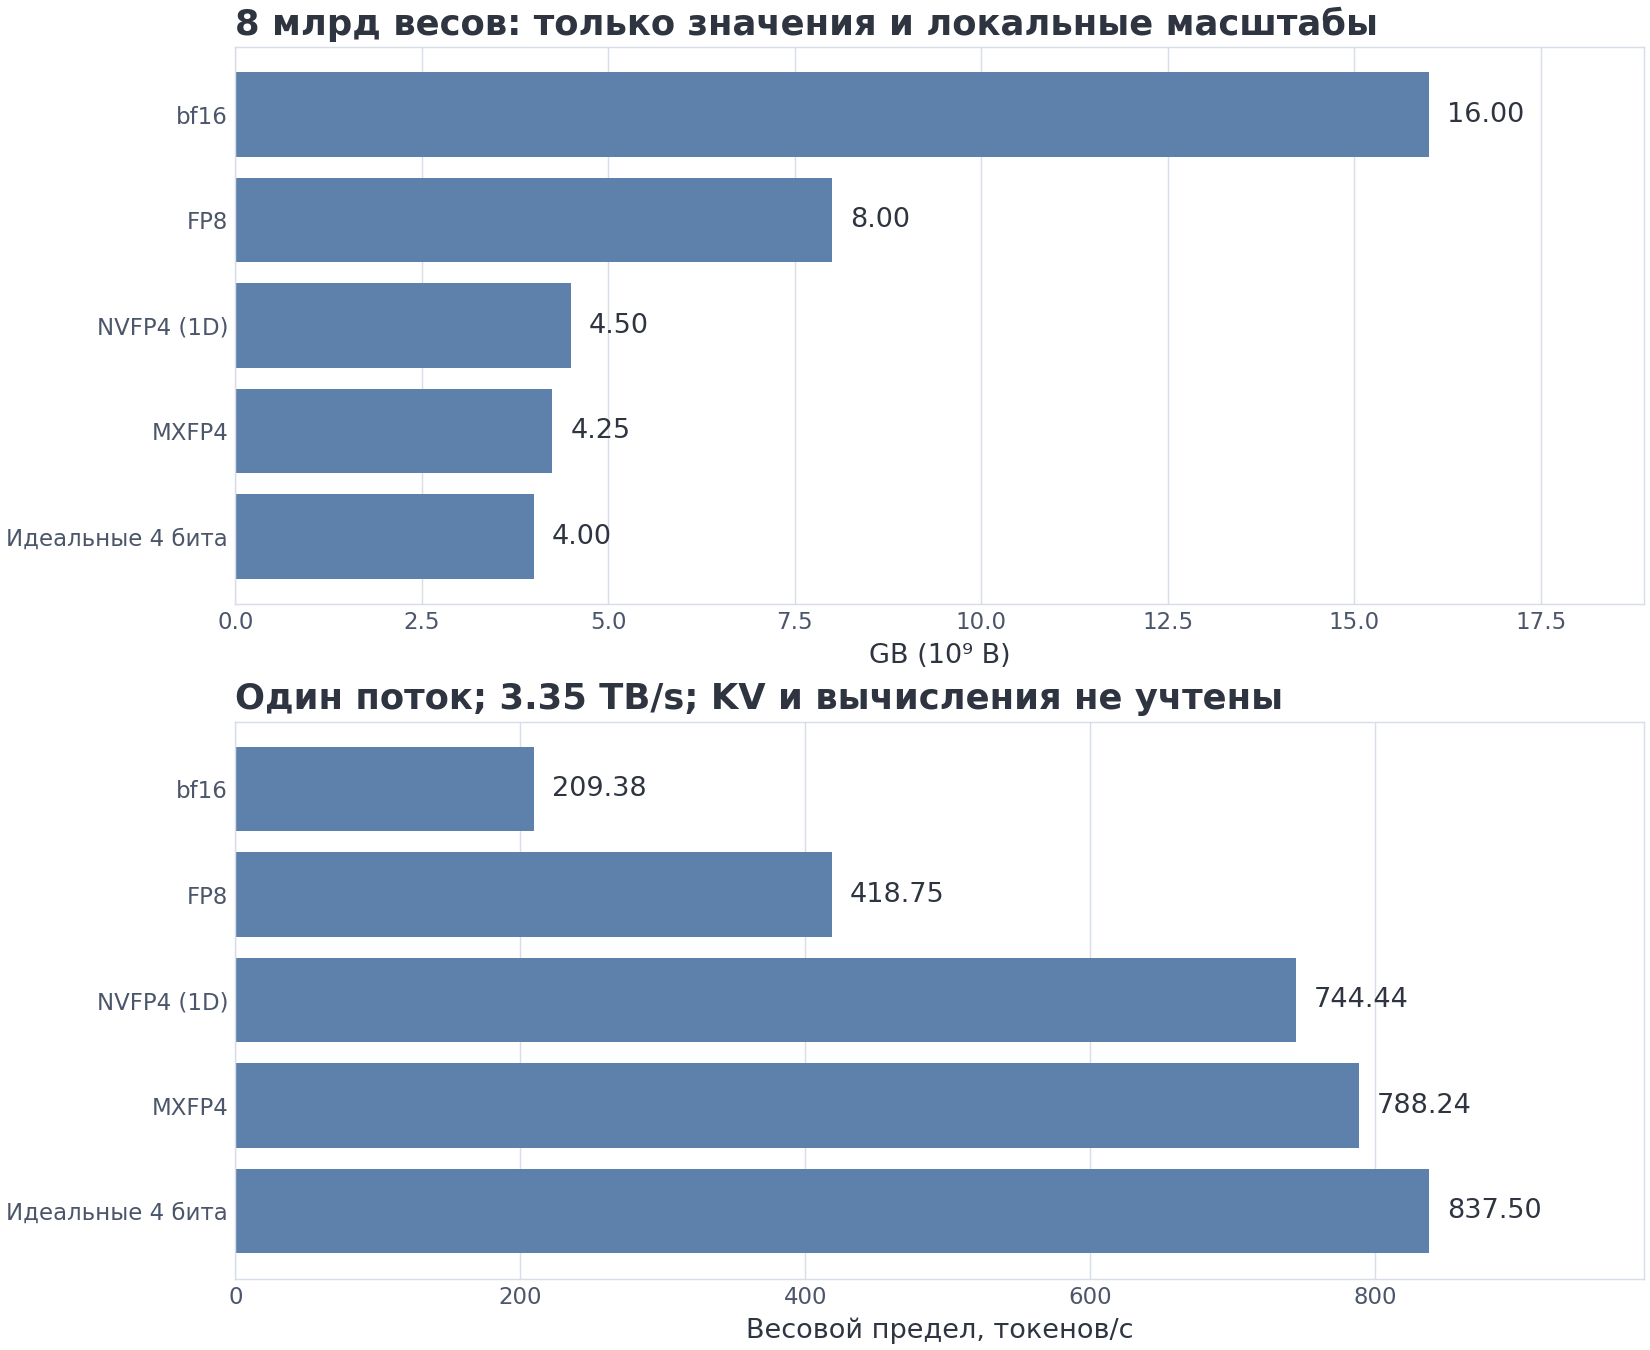 Лестница показывает арифметический объём весов и соответствующий предел чтения. В значениях 4.50 и 4.25 бита уже учтены локальные масштабы. Дополнительные метаданные, упаковка, выравнивание и неквантизованные тензоры не учтены.
Последняя строка особенно важна: «4 бита» не всегда означают ровно четыре бита на параметр. Масштабы, нулевые точки, кодовые книги и выравнивание тоже занимают место.
12. FP4, микромасштабирование и W4A4
В обозначении E2M1 один бит отведён знаку, два — порядку (exponent), один — дробной части значащего числа (mantissa). Соседние уровни расположены неравномерно. Представимые абсолютные значения — ; два знака нуля дают 16 кодов, но 15 различных чисел. Учебный квантайзер хранит именно эти 15 численных уровней. E4M3 — восьмибитное число с четырьмя битами порядка и тремя дробными битами; E8M0 у масштаба MX кодирует степень двойки без дробной части.
У FP4 мало уровней, поэтому один общий масштаб на большой тензор слишком груб. Микромасштабирование делит тензор на небольшие группы и хранит масштаб для каждой.
В документации NVIDIA формат NVFP4 описан как E2M1-значение плюс иерархическая система масштабов. Для одномерной схемы один E4M3-масштаб обслуживает группу из 16 значений, а дополнительный FP32-масштаб действует на тензор целиком. В учебном подсчёте только локальный восьмибитный масштаб даёт
Реальная упаковка и варианты для весов могут отличаться; например, в рецептах обучения NVIDIA используется также двумерная гранулярность 16×16.
MXFP4 обычно связывают с группой из 32 E2M1-значений и E8M0-масштабом:
Разница 4.25 против 4.5 — только часть картины. Меньшая группа и более выразительный масштаб могут уменьшить ошибку, а поддержка конкретных форматов аппаратурой определяет, превращается ли компактное представление в реальное ускорение.
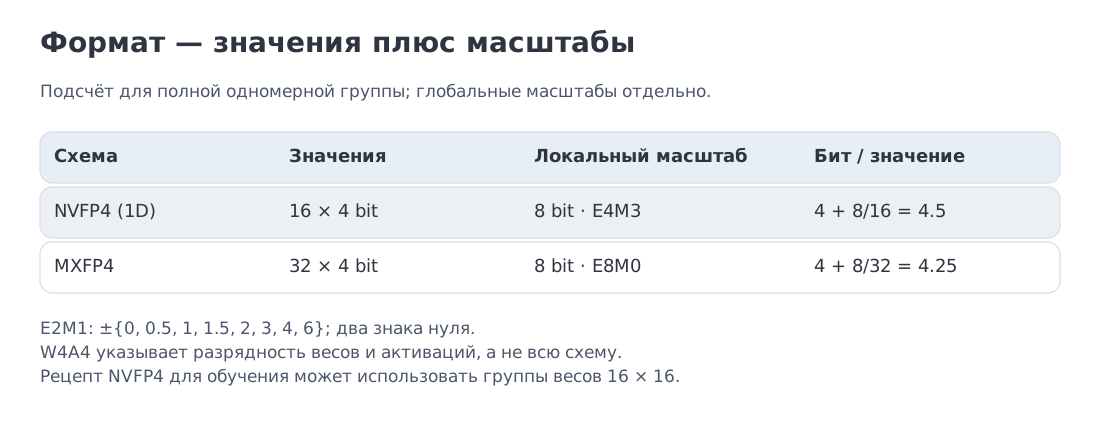 Сравнение двух схем микромасштабирования, W4A4 и исследовательских тернарных представлений. На схеме отделены формат, служебные масштабы и аппаратная поддержка.
Работа MR-GPTQ показывает, что методы калибровки должны учитывать геометрию самого формата. Авторы существенно улучшают MXFP4/NVFP4-результаты и демонстрируют аппаратные ускорения в своих постановках, но отдельно подчёркивают: FP4 не является автоматическим улучшением по сравнению с INT4.
W4A4 идёт дальше и уменьшает не только веса, но и активации. Cohere сообщает, что Command A+ — MoE-модель с 218 млрд параметров всего и 25 млрд активных — может разворачиваться в W4A4 на одной B200 или двух H100. Это характеристика конкретного чекпойнта, калибровки и программного стека, а не универсальная гарантия для любой модели того же размера.
В ноутбуке есть маленький E2M1-подобный опыт. На одном специально выбранном векторе с выбросом MSE равномерного INT4 оказывается в 3,32 раза выше, чем у учебной FP4-сетки. Это иллюстрация динамического диапазона, а не общий результат сравнения форматов.
Отдельная ветвь — тернарные веса BitNet. Они потенциально радикально уменьшают память и арифметику, но выигрыш зависит от нативных ядер и всей архитектуры обучения. Упаковать веса в два бита недостаточно, если массовый ускоритель всё равно исполняет обычное умножение после распаковки.
13. Код: корректность раньше ускорения
Ниже — два учебных ядра. Первое проверяет баланс точного спекулятивного шага. Второе показывает E2M1-подобную сетку с одним масштабом на группу. Это не CUDA-ядро и не побитовое воспроизведение NVFP4.
"""M11 minimal probability and grouped-value teaching kernels."""
import numpy as np

def probability_vector(values, *, name="p", atol=1e-12):
    """Validate a distribution without hidden clipping or renormalization."""
    x = np.asarray(values, dtype=np.float64)
    if x.ndim != 1 or x.size < 2 or not np.isfinite(x).all():
        raise ValueError(f"{name}: expected a finite one-dimensional vector")
    if np.any(x < 0) or not np.isclose(x.sum(), 1.0, rtol=0.0, atol=atol):
        raise ValueError(f"{name}: probabilities must be >= 0 and sum to 1")
    return x

def rejection_kernel(p_values, q_values):
    """Acceptance probabilities, residual, and exact one-position balance."""
    p = probability_vector(p_values, name="p")
    q = probability_vector(q_values, name="q")
    if p.shape != q.shape:
        raise ValueError("p and q must use the same vocabulary")

    acceptance = np.zeros_like(p)
    support = q > 0  # q_t=0 means the proposer cannot emit token t
    acceptance[support] = np.minimum(1.0, p[support] / q[support])

    overlap = np.minimum(p, q)
    positive = np.maximum(p - q, 0.0)
    residual_mass = positive.sum()
    residual = (
        positive / residual_mass
        if residual_mass > 0.0
        else np.zeros_like(p)
    )
    balance = overlap + residual_mass * residual
    np.testing.assert_allclose(balance, p, rtol=0.0, atol=1e-12)
    return acceptance, residual, balance

def quantize_grouped_e2m1(values, group_size=16):
    """Teaching E2M1-like grid with one scale per group."""
    grid = np.array(
        [-6, -4, -3, -2, -1.5, -1, -0.5, 0,
          0.5, 1, 1.5, 2, 3, 4, 6],
        dtype=np.float64,
    )
    x = np.asarray(values, dtype=np.float64)
    if x.ndim != 1 or x.size == 0 or not np.isfinite(x).all():
        raise ValueError("expected a non-empty finite one-dimensional vector")
    if isinstance(group_size, bool) or not isinstance(group_size, (int, np.integer)) or group_size <= 0 or x.size % group_size:
        raise ValueError("length must be divisible by a positive group_size")

    groups = x.reshape(-1, group_size)
    max_abs = np.max(np.abs(groups), axis=1, keepdims=True)
    scale = np.where(max_abs > 0, max_abs / 6.0, 1.0)
    normalized = groups / scale
    codes = np.abs(normalized[..., None] - grid).argmin(axis=-1)
    return (grid[codes] * scale).reshape(x.shape)
В коде нет молчаливой нормировки вероятностей: ненормированный вход считается ошибкой данных. Полностью нулевая группа получает служебный масштаб 1 и остаётся нулевой. Эти детали кажутся мелкими, пока NaN не начинает распространяться по большому тензору.
Производственная реализация добавит пакетные формы, выбранное правило округления, упаковку битов, метаданные масштабов, совместимые GEMM-ядра и тесты на конкретном оборудовании.
NumPy → PyTorch · B19 — Групповая имитационная квантизация
Группы формируются только вдоль последней размерности, поэтому элементы разных экспертов не попадают под один масштаб.
import numpy as np
import torch
import torch.nn.functional as F
1. Явная NumPy-реализация
def numpy_grouped_fake_quant_explicit(
    x: np.ndarray,
    *,
    grid: np.ndarray,
    group_size: int,
) -> np.ndarray:
    pad = (-x.shape[-1]) % group_size
    padded = np.pad(x, [(0, 0)] * (x.ndim - 1) + [(0, pad)])
    groups = padded.reshape(*x.shape[:-1], -1, group_size)
    max_abs = np.max(np.abs(groups), axis=-1, keepdims=True)
    scales = np.where(max_abs > 0, max_abs / np.max(np.abs(grid)), 1.0)
    normalized = groups / scales
    codes = np.abs(normalized[..., None] - grid).argmin(axis=-1)
    return (grid[codes] * scales).reshape(padded.shape)[..., : x.shape[-1]]
NumPy дополняет только последнюю размерность, разбивает её на группы, вычисляет локальный масштаб и выбирает ближайший уровень сетки. Ведущие оси — например, индекс эксперта — никогда не смешиваются.
2. Та же математика явными операциями PyTorch
def torch_grouped_fake_quant_explicit(
    x: torch.Tensor,
    *,
    grid: torch.Tensor,
    group_size: int,
) -> torch.Tensor:
    grid = grid.to(device=x.device, dtype=x.dtype)
    pad = (-x.shape[-1]) % group_size
    padded = torch.nn.functional.pad(x, (0, pad)) if pad else x
    groups = padded.reshape(*x.shape[:-1], -1, group_size)
    max_abs = groups.abs().amax(dim=-1, keepdim=True)
    scales = torch.where(max_abs > 0, max_abs / grid.abs().max(), torch.ones_like(max_abs))
    normalized = groups / scales
    codes = (normalized[..., None] - grid).abs().argmin(dim=-1)
    return (grid[codes] * scales).reshape(padded.shape)[..., : x.shape[-1]]
Явное ядро принимает конечные вещественные массивы с непустыми осями; для сопоставления используем float32/float64. Размер группы — положительное целое число. Сетка — конечный одномерный массив с точным нулём и хотя бы одним ненулевым уровнем; после приведения к типу входа эти свойства должны сохраняться. Промежуточные масштабы и расстояния должны помещаться в рабочий тип. PyTorch повторяет изменение формы, максимум amax, расширение размерностей и выбор argmin. Это имитационная квантизация (fake quantization): результат хранится как обычный тензор. Коды не упаковываются в четыре бита. При равном расстоянии argmin выбирает первый уровень; это учебное правило не воспроизводит все аппаратные режимы округления.
| Аспект | NumPy | PyTorch |
|---|---|---|
| Группировка | reshape последней оси | тот же reshape |
| Дополнение нулями | np.pad | F.pad |
| Масштаб | max_abs / max_grid | то же выражение для тензоров |
| Код | argmin по сетке | argmin(dim=-1) |
| Результат | деквантированный массив | деквантированный тензор без упаковки битов |
Исполняемая проверка эквивалентности и граничных случаев
rng = np.random.default_rng(19)
x_np = rng.standard_normal((3,2,11))
grid_np = np.array([-6,-4,-3,-2,-1.5,-1,-0.5,0,0.5,1,1.5,2,3,4,6.0])
np_q = numpy_grouped_fake_quant_explicit(x_np, grid=grid_np, group_size=4)
t_q = torch_grouped_fake_quant_explicit(torch.tensor(x_np), grid=torch.tensor(grid_np), group_size=4)
np.testing.assert_allclose(np_q, t_q.numpy())
zeros = torch.zeros(2,3,7, dtype=torch.float64)
zero_q = torch_grouped_fake_quant_explicit(zeros, grid=torch.tensor(grid_np), group_size=4)
torch.testing.assert_close(zero_q, zeros)
print("B19 explicit grouped fake quantization: PASS")
Полный исполняемый файл: m11_inference_bridges.py
15. Как сочетать квантизацию и спекулятивное декодирование
Механизмы совместимы по смыслу. Квантизация уменьшает объём одного прохода основной модели; спекулятивное декодирование пытается получить больше токенов из этого прохода. В верхней весовой оценке их можно объединить.
Для 8B-модели условный NVFP4-объём равен 4,5 GB. Весовой предел при 3,35 TB/s — 744,44 токена/с. Применим к нему учебный MTP-сценарий из §7:
Относительно bf16-оценки 209,38 это 6,35 раза. Но смысл числа строго ограничен: это совместный сценарий с неизменной относительной стоимостью черновика . Расчёт не включает KV-кэш, стоимость деквантизации, дополнительные MTP-параметры, планировщик и переход системы от ограничения пропускной способностью памяти к ограничению вычислениями.
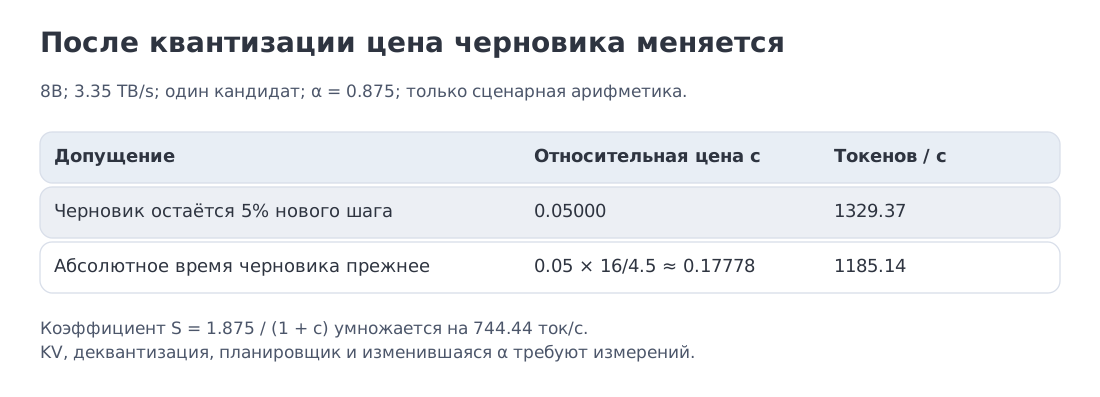 Два сценария различаются тем, ускоряется ли черновик вместе с основной моделью. Относительная стоимость c пересчитывается в единицах нового основного шага.
Точная гарантия спекулятивного алгоритма сохраняется относительно распределения квантованной основной модели. При этом квантизация может изменить логиты и тем самым изменить долю принятия по сравнению с bf16. Поэтому совместный эксперимент обязан повторно измерять , а не переносить её из неквантованного запуска.
Проверим ещё одно скрытое допущение совместного сценария. Если черновик в абсолютном времени не ускорился, а основной шаг стал в раз дешевле, то относительная стоимость возрастёт в раз. Для прежние превращаются в : при том же получается около 1185.14 токена/с вместо 1329.37. Разница возникла ещё до учёта KV-кэша — только из-за согласования единиц времени.
QLoRA использует родственную, но другую идею: базовые веса хранятся в четырёхбитном виде, а обучаются небольшие адаптеры более высокой точности. Это метод экономии памяти при дообучении, а не ускоритель точной авторегрессионной выборки. Его механика подробнее рассматривается в следующих модулях курса.
Для информационно-теоретического углубления полезны модуль 9 курса Information Theory for ML — скорость–искажение — и §14.7 модуля 14, где квантизация модели рассматривается как задача с неполной локальной мерой искажения. Эти материалы необязательны: все расчёты текущего модуля завершены здесь.
16. Движки и безопасный порядок развёртывания
TTFT — время от поступления запроса до первого токена, ITL — интервал между следующими выдаваемыми токенами. Пропускная способность считает весь поток работы; полезная пропускная способность (goodput) учитывает только результаты, удовлетворяющие заданным требованиям качества и задержки. Такие требования называют SLO — целями уровня обслуживания. Рост общего потока не считается улучшением, если большинство ответов приходит позже допустимого срока.
По состоянию на 11 октября 2026 года vLLM поддерживает несколько семейств спекулятивного декодирования: внешние черновые модели, EAGLE, MTP, n-граммные предложения и предложения по совпадающим суффиксам, а также другие специализированные варианты. Документация подчёркивает главный рабочий режим: снижение задержки между токенами при средней или низкой интенсивности запросов, когда генерация ограничена пропускной способностью памяти.
Это не означает, что достаточно скопировать один флаг. Надёжный порядок выглядит так.
Сначала фиксируют обычный запуск: версию модели, движка, ядра, аппаратуры, размер пакета, длины входа и выхода, режим выборки. Затем отдельно включают квантизацию и проверяют качество, память и производительность. После этого добавляют спекулятивный метод и измеряют среднее число принятых токенов, время предложения, время проверки и полезную пропускную способность (goodput). Только в конце включают оба механизма вместе.
Для нативного MTP нужно проверить, где хранятся модули предложения: в основном чекпойнте или в совместимом дополнении. Движок должен поддерживать именно эту архитектуру. Для EAGLE или внешней модели требуется совместимый артефакт. Для n-граммных методов и поиска по суффиксам ключевым становится характер текста, а не сходство нейронных моделей.
У квантизации та же дисциплина. Название NVFP4, MXFP4, GPTQ или AWQ должно вести к конкретной схеме масштабов и совместимому ядру. Компактный чекпойнт, который на лету полностью распаковывается перед каждым GEMM, может экономить память и почти не ускорять вычисление.
Наконец, сравнивать следует не только среднее число токенов в секунду. Для интерактивного сервиса нужны TTFT, ITL и хвостовые квантили задержки; для пакетной генерации — полезная пропускная способность при целевом SLO; для RL-роллаутов — стоимость сгенерированного и принятого опыта на итерацию обучения.
17. Паспорт запуска: квантизация и спекулятивное декодирование
Одна из практических целей модуля — научиться читать не рекламное название модели, а воспроизводимый паспорт запуска.
Основная модель: точный чекпойнт и его редакция (revision), токенизатор, режим выборки, максимальный контекст, тип внимания и KV-представление.
Квантизация: какие тензоры квантуются; формат значений; размер и форма группы; тип локального и глобального масштаба; способ калибровки; точность накопления; наличие исключённых слоёв; версия ядра и оборудования.
Спекулятивная часть: источник предложений; чекпойнт черновой модели или нативная MTP-конфигурация; число кандидатов и глубина дерева; совместимость словаря; правило принятия; средняя доля и длина принятия по классам задач.
Нагрузка: распределение длин запросов и ответов; число одновременных запросов; размер пакета; температура и top-p; доля повторяющегося текста; ограничения SLO.
Результат: TTFT, ITL, общая и полезная пропускная способность (throughput и goodput), память и качество на одной и той же выборке; средние значения вместе с хвостовыми квантилями; дата и полный программно-аппаратный стек.
Размер группы сам по себе не доказывает формат: число 16 может встречаться в разных схемах. Суффикс имени чекпойнта тоже недостаточен. Паспорт должен связывать конфигурацию, артефакт и исполняемое ядро.
20. Ключевые выводы модуля и источники
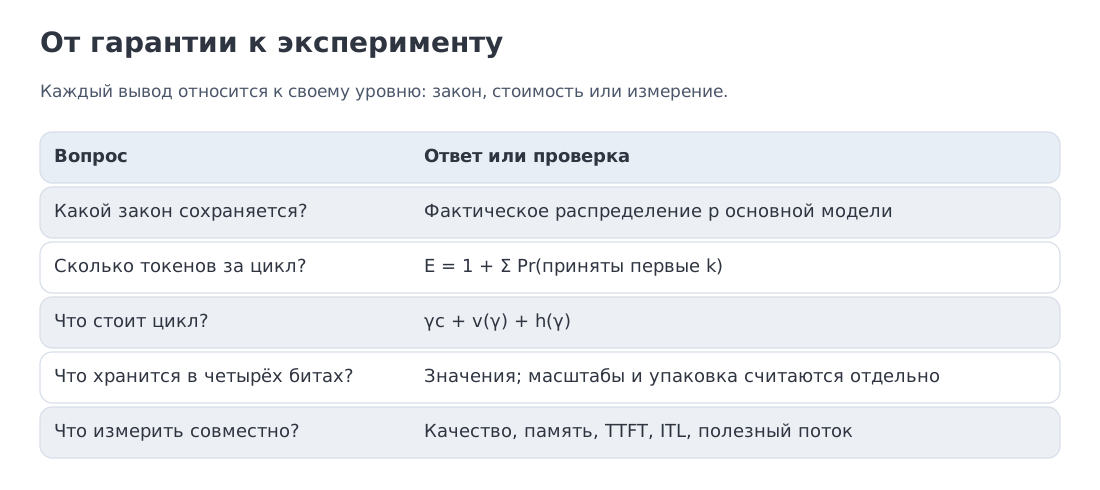 Формулы точного алгоритма, сценарная модель скорости, семейства черновиков, разрядность и контрольный список развёртывания.
Спекулятивное декодирование не угадывает ответ вместо основной модели. Оно дешёво предлагает продолжение и использует основную модель как точный проверяющий механизм. При корректной выборке
а итоговый закон остаётся равным .
При одинаковой условной вероятности принятия на каждой достигнутой позиции
но скорость требует учитывать цену предложения. Формула полезна как учебная модель и инструмент первого расчёта, а не как замена профилированию.
Квантизация уменьшает трафик и память, но реальный формат включает сетку значений, масштабы, гранулярность, накопление и аппаратное ядро. FP4 не обязательно лучше INT4; W4A4 не является автоматически безопасным; локальная MSE не заменяет сквозную оценку качества.
Совместная оценка квантизации и спекулятивного декодирования должна заново измерять долю принятия и профиль узких мест. Множители из разных публикаций не складываются в гарантированное ускорение.
Основные источники:
- Leviathan, Kalman, Matias — Fast Inference from Transformers via Speculative Decoding.
- Cai et al. — Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads.
- Li et al. — EAGLE и EAGLE-3.
- DeepSeek-AI — DeepSeek-V3 Technical Report.
- Frantar et al. — GPTQ.
- Lin et al. — AWQ.
- Dettmers et al. — QLoRA.
- Egiazarian et al. — MR-GPTQ.
- NVIDIA Transformer Engine — NVFP4 format and scaling.
- OCP — Microscaling Formats (MX), version 1.0.
- vLLM — Speculative Decoding и MTP.
- Cohere — Command A+.
Дополнительное углубление: скорость–искажение и квантизация — в курсах Information Theory for ML, модули 9 и 14; стоимость генерации роллаутов и асинхронная инфраструктура — в RL for LLM, модуль 12.
Дальше: модуль 12 меняет сам порядок генерации: диффузионная модель уточняет несколько позиций за проход. Сравним этот подход с авторегрессионной и спекулятивной генерацией. Затем модуль 13 вернёт нас к SFT и данным постобучения.
Ландшафт сверен: 11 октября 2026 года. Утверждения о движках, форматах и выпусках проверены по первоисточникам. Математические примеры и числа весового потока являются сценариями модуля; результаты внешних работ атрибутированы их авторам и экспериментальным условиям.