Модуль 20. LLM целиком: от токенов до обучения и генерации
Курс «Modern LLMs» · дополнительный итоговый модуль · редакция 2026.10.31
Мы уже рассматривали языковую модель с разных сторон: разбирали внимание, считали память, обучали параметры, выбирали следующий токен и оценивали ответы. Теперь полезно сделать обратное движение — собрать эти части в одну математическую конструкцию. Тогда за короткой записью «модель предсказывает следующий токен» будет виден весь путь от строки таблицы эмбеддингов до распределения вероятностей, а за словом «обучение» — конкретное изменение тех же матриц.
Основой станет плотная авторегрессионная MiniLLM с предварительной RMS-нормализацией, RoPE, GQA и SwiGLU. Это определённая конфигурация, а не утверждение о единственном устройстве LLM. После её сборки мы заменим FFN на MoE, затем отдельно разберём SSM и диффузионную генерацию. К завершению модуля у нас будет и компактная итоговая формула, и понимание её границ.
Как читать модуль
Для первого прохода нужны матричное умножение, условная вероятность и смысл градиента. Если вы пока неуверенно владеете этими темами, вернитесь к М3; позиции, внимание и внутренности блока подробнее разобраны в М4–М6. Прочитайте §1–10, затем §13–14 и §17–20. В §11–12 сначала достаточно проследить, что именно изменяет обучение. Выполните У1–У3 и У6 из §18: их предпосылки входят в этот маршрут.
1. Какие три задачи должна описать математика
Начнём с фиксированных весов. На вход модели поступают идентификаторы уже известных токенов. На выходе получается вектор вероятностей следующего токена. Прямой проход — вычисление этого вектора. Он сам по себе не выбирает ответ и не меняет веса.
Обучение добавляет известный правильный следующий токен, функцию потерь и правило обновления параметров. Генерация вместо правильного продолжения использует выбранный моделью или алгоритмом декодирования токен, дописывает его к контексту и повторяет прямой проход. Поэтому формулы распределения, потери и обновления нельзя незаметно подменять друг другом. Все три нужны для полной картины.
Мы будем считать один пример, без отдельной оси для пакета. Для пакета те же операции выполняются над каждым примером, а потеря объединяет выбранные целевые позиции. Маска внимания отвечает за доступ к контексту; маска потери — за то, какие предсказания участвуют в обучении. Их различие сохранится и в окончательной записи.
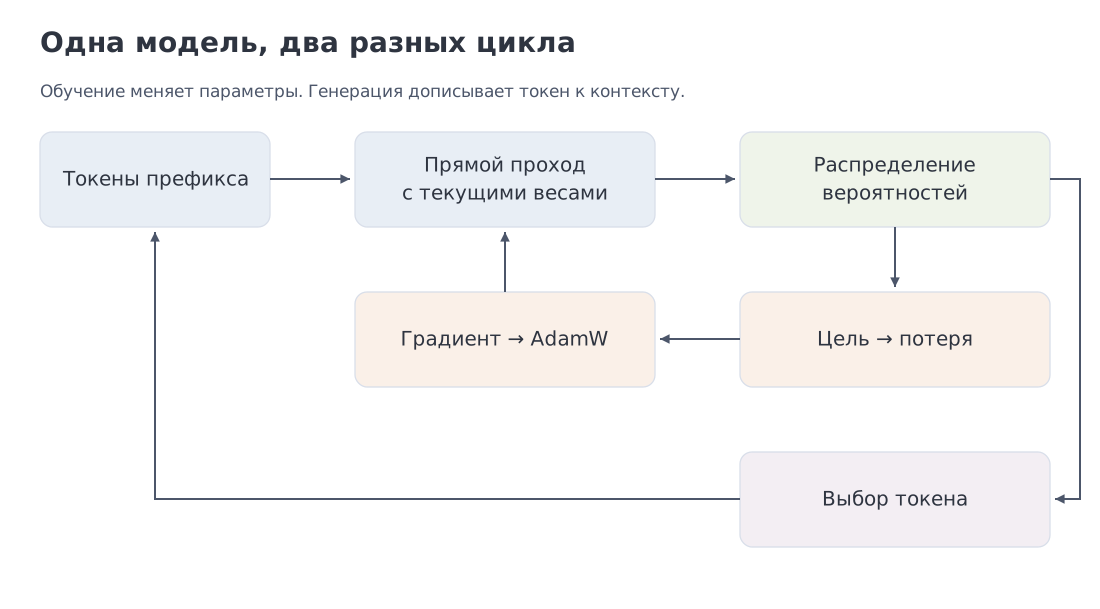
Рисунок 1. У прямого прохода есть выход; у обучения и генерации — разные обратные связи. Обучение возвращает градиент к параметрам, генерация возвращает выбранный токен ко входу.
2. Договоримся об обозначениях и границах примера
Обозначим начальный токен как . Последовательность содержит продолжение и, когда он предусмотрен разметкой, завершающий токен EOS. При предсказании известен префикс длины . Позиции внутри него нумеруются с нуля. Индекс строки обозначает последнюю известную позицию, а не сам предсказываемый токен.
| Обозначение | Значение и форма |
|---|---|
| Размер словаря, ширина представления, число блоков, ширина FFN | |
| Число голов запросов, число голов ключей/значений, размер головы | |
| Входная таблица эмбеддингов | |
| Представления после блока | |
| Выходная проекция в логиты словаря | |
| Обучаемые множители RMSNorm | |
| Все обучаемые параметры выбранной конфигурации | |
| Поэлементное умножение | |
| Нормировка отдельно каждой строки |
В этом модуле , делится на , а чётно. Такие ограничения удобны для рассматриваемой конфигурации; они не являются определением любой архитектуры. Смещений линейных слоёв, dropout, QK-нормализации, attention sinks и скользящего окна в базовой записи нет. RoPE используется без растяжения частот. Токены принадлежат одному непрерывному примеру; упаковка независимых документов потребовала бы дополнительной маски границ.
Строка текста превращается в идентификаторы алгоритмом токенизации из М2. Этот дискретный алгоритм не входит в дифференцируемый прямой проход. В численном примере мы зададим идентификаторы непосредственно: так можно проверить всю арифметику без зависимости от корпуса и версии токенизатора.
3. От токенов к начальным представлениям
Входной слой просто выбирает строки таблицы:
Если один идентификатор встретился несколько раз, выбирается одна и та же обучаемая строка. У каждой позиции затем появляется собственная активация, поскольку доступный контекст различается. Таблица — параметры; выбранная матрица — результат вычисления на конкретном входе.
Для сквозного примера возьмём словарь с идентификаторами и последовательность . Модель увидит вход и будет предсказывать цели . Размеры: , , . Это специально сконструированные данные и веса, а не модель, обученная понимать четыре слова.
У нас три входные позиции и три предсказания. Цель первой строки — , хотя вход этой строки — BOS. Именно этот сдвиг позволяет учить продолжение, а не копирование текущего идентификатора.
4. RMSNorm: масштаб перед вычислением подслоя
Пусть — строка длины . Введём её среднеквадратичный масштаб и нормализованную строку:
Положительное предотвращает деление на ноль. Мы используем . В отличие от LayerNorm, среднее значение элементов здесь не вычитается. При единичной и пренебрежимо малом вкладе средний квадрат результата близок к единице. Деление на евклидову длину, напротив, сделало бы единичной длину вектора.
Каждая строка нормируется независимо. Поэтому RMSNorm не смешивает позиции и не нарушает причинность. В блоке будут две разные обучаемые : перед вниманием и перед FFN. Ещё одна стоит после всех блоков. Даже если они инициализированы одинаково, при обучении это разные параметры.
Для всех трёх норм примера начнём с . Тогда вход внимания равен
Последняя строка напечатана с округлением: её элементы на самом деле немного меньше единицы из-за . Дальше код использует полную точность, а не округлённые числа из таблиц.
5. Проекции и RoPE: содержание встречается с позицией
Из получаются запросы, ключи и значения. Для головы запросов и головы ключей/значений :
Каждая из этих матриц имеет форму , а каждая соответствующая проекция — . В этой записи по-прежнему обозначает размер словаря; обозначает активации значений. Запрос и ключ будут сравниваться, а значения — складываться с найденными весами.
RoPE вращает координаты запросов и ключей отдельно в каждой позиции. Для конвенции rotate_half координата спаривается с , где . При частоте и позиции :
Запишем этот оператор как . Он применяется к строкам и , давая и ; значения в данной архитектуре не вращаются. Вращение не добавляет обучаемых параметров. При сравнении двух вращённых векторов в скалярном произведении возникает разность позиций — поэтому внимание получает информацию об относительном расположении токенов. Порядок спаривания координат является частью конфигурации, а не свободной косметической заменой.
В примере , . Есть единственная пара координат и . Для позиций 0, 1 и 2 углы равны соответственно 0, 1 и 2 радианам:
Равенство запросов и ключей здесь вызвано выбранными весами. Общая формула его не предполагает.
6. Причинное внимание и совместное использование K/V
При GQA несколько голов запросов используют одну голову ключей и значений. При нумерации голов с нуля определим . Головы остаются различными, поскольку их запросы вычислены разными . Совместное использование K/V сокращает соответствующие проекции и кэш; оно не усредняет запросы.
Для строки разрешим ключи только из позиций :
Теперь голова внимания определена полностью:
Softmax превращает разрешённые оценки строки в положительные веса с суммой 1; запрещённые получают ноль. Первая позиция может смотреть на себя, поэтому полностью закрытых строк здесь нет. Выход головы имеет форму . Склеив головы по координатам и применив выходную проекцию , получим оператор .
В нашем примере веса последней строки примерно равны . Например, первая из её трёх оценок до softmax — . Здесь виден весь путь: скалярное произведение, масштаб, маска, нормировка, взвешенная сумма значений.
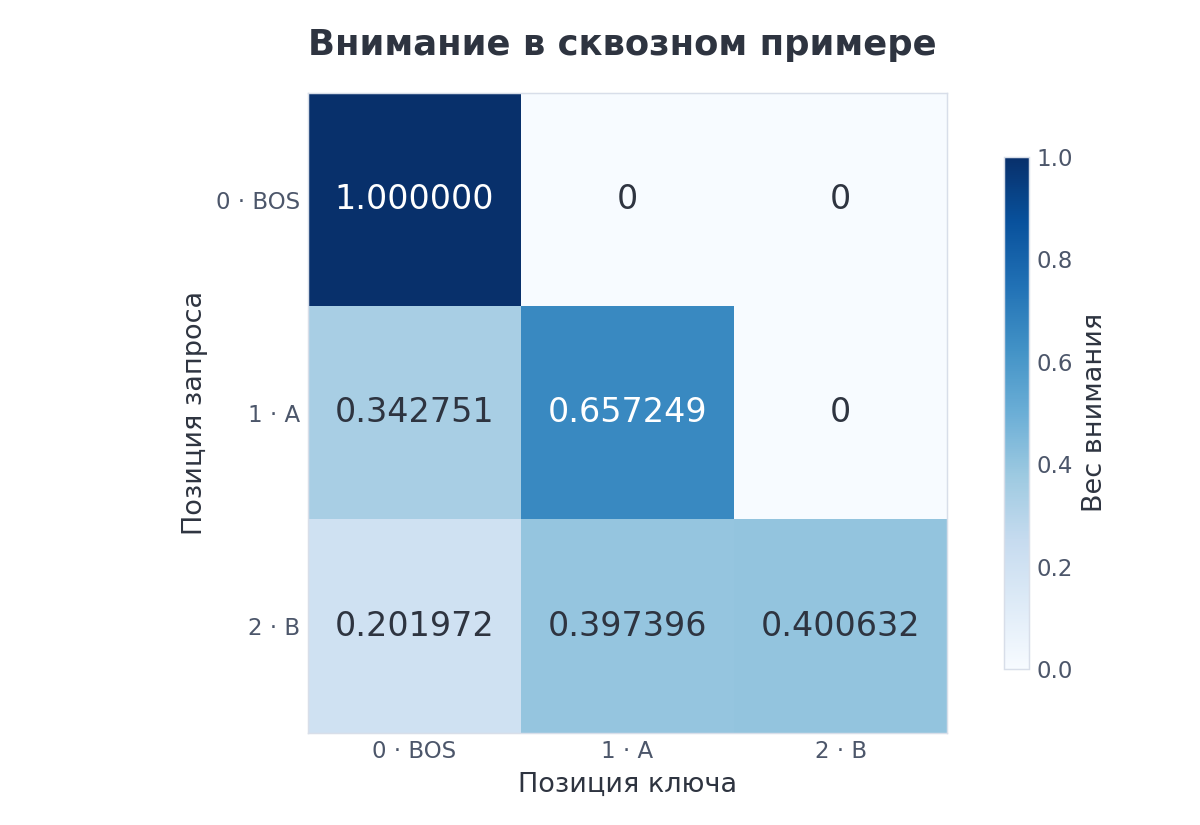
Рисунок 2. Матрица сквозного примера. Нули справа от диагонали заданы маской, остальные числа вычислены из запросов и ключей.
Возьмём . После первой остаточной связи получаем
Добавляется результат внимания, а не нормализованный вход . По остаточной ветви проходит исходное представление ; эта деталь будет существенна и в обратном проходе.
7. FFN и полный блок: где заканчивается один слой
Внимание переносило информацию между позициями. FFN преобразует каждую строку по отдельности, уже после этого обмена. Для входа введём
Матрицы и имеют форму , а — . Две ветви переводят представление в пространство ширины ; нелинейная ветвь регулирует поэлементное произведение, после чего выход возвращается к ширине . Это SwiGLU из М6.
Для примера зададим
Нормализация даёт первую строку примерно . Её gate-ветвь равна , up-ветвь — , выход FFN — . Отрицательная компонента допустима: SiLU не обнуляет все отрицательные входы.
Полный блок теперь можно записать без пропусков:
У каждого слоя свои проекции и свои множители нормализации. В примере слой один:
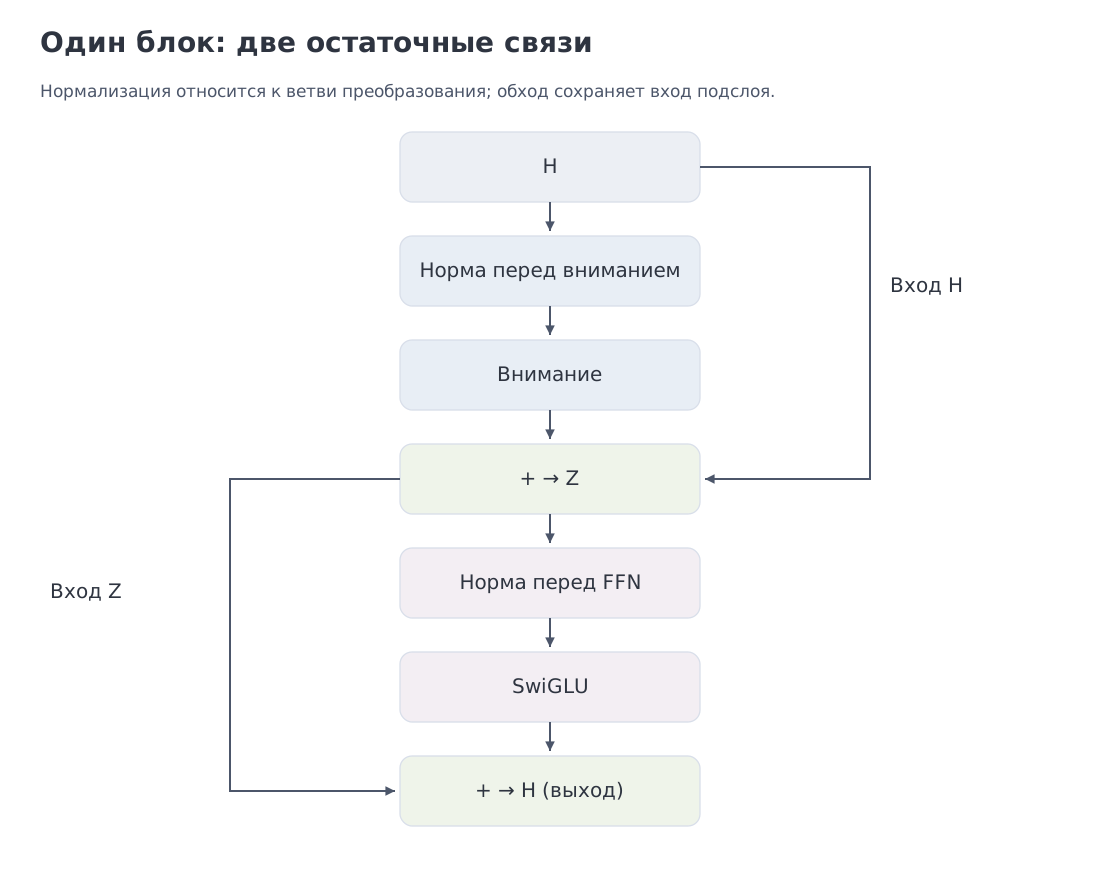
Рисунок 3. Норма находится на входе каждой преобразующей ветви. На линиях обхода сохраняется представление до соответствующего подслоя.
8. Стек блоков, выход и состав параметров
Последовательное применение блоков обозначим композицией: правый оператор действует первым. После последнего блока ещё раз нормализуем представление и получим логиты:
Логиты — произвольные вещественные оценки, не вероятности. Выходной softmax применяется к столбцам каждой строки. При связанных эмбеддингах : это одна таблица с двумя ролями, а не две копии, которые случайно равны. В базовом численном примере независима от .
Число параметров помогает проверить, что ни одна обучаемая часть не исчезла из формулы. Для одинаковых плотных блоков выбранной конфигурации:
Здесь — запросы и выход внимания, — ключи и значения, — три матрицы FFN, — две нормы блока, последний — конечная норма. Для наших размеров получаем . При связывании таблиц осталось бы 42. Для независимые таблицы дают 128 параметров; при было бы 144.
Таким образом, содержит таблицы, линейные проекции и множители нормализации. Идентификаторы токенов, причинная маска и фиксированные частоты RoPE не обучаются. Активации, градиенты, кэш и моменты оптимизатора занимают память, но не прибавляются к числу параметров модели. Это различие связывает формулу с расчётами памяти из М9–М10.
9. Вероятности: завершаем сквозной прямой проход
Используем выходную матрицу
После конечной RMSNorm строки примерно равны , и . Умножение на даёт следующие результаты. В каждой четвёрке порядок столбцов один: BOS, A, B, EOS.
| Префикс | Логиты | Вероятности | Правильная цель |
|---|---|---|---|
| BOS | A | ||
| BOS A | B | ||
| BOS A B | EOS |
Третья цель имеет невысокую вероятность. Это не ошибка вычисления: выбранные вручную веса не обязаны хорошо предсказывать нашу последовательность. Напротив, теперь есть понятная ошибка, на которой можно проследить обучение.
Softmax вычисляем устойчиво: из всех логитов строки вычитаем их максимум. Прибавление одной константы ко всем логитам не меняет распределение, но прямое экспоненцирование больших положительных чисел может переполниться. Во всей арифметике модуля используются натуральные логарифмы; потери измеряются в натах.
10. От условного распределения к вероятности текста и потере
Последняя строка прямого прохода по префиксу задаёт . Вероятность определённой последовательности при фиксированном BOS раскладывается так:
Если требуется вероятность завершённого ответа, в последовательность включают EOS. Если EOS не включён, произведение описывает вероятность данного префикса. При обучении весь правильный текст уже известен, поэтому можно вычислить все условные распределения одним причинно замаскированным проходом. Это teacher forcing: в контекст каждой позиции попадает правильное прошлое, а не ранее сгенерированное продолжение. Параллельное вычисление строк не открывает доступ к будущему.
Пусть выбирает целевые позиции, а . Средняя кросс-энтропия равна
Запись включает BOS и все предшествующие токены. Для пакета сумма и охватывают все выбранные цели пакета. Это конкретная нормировка по токенам; усреднение сначала по ответам, а затем по примерам задаёт другую весовую схему.
В примере все три . Отдельные потери равны , и , среднее — 1.109373924. Можно получить его и напрямую из логитов, используя . Если выбрать только EOS, потеря станет , а не третью этого значения. Пустая маска не задаёт среднее; код сообщает об ошибке.
11. Обратный проход: как ошибка достигает каждой матрицы
Компактная запись полезна только тогда, когда понятно, через какие операции проходит производная. Для начала возьмём строку логитов и правильный идентификатор . После softmax и кросс-энтропии:
Для последней строки нашего примера градиент равен примерно . Его сумма равна нулю: прибавление общей константы к логитам не влияет на потерю. Отрицательная производная правильного логита означает, что его увеличение при прочих равных уменьшает ошибку.
Обозначим входящий градиент через . Для линейного слоя правило цепочки даёт и . Для остаточного сложения оно даёт , если строки развёрнуты в вектор. Единичная ветвь сохраняет прямой путь градиента, но не отменяет производную преобразования.
В SwiGLU положим , и . Тогда
Далее обе ветви проходят через линейные проекции и складываются на входе . Для нормы одной строки удобно сначала умножить входящий градиент на обучаемый множитель: . Получаем
Градиенты суммируются по всем строкам. Здесь используется та же с , что и в прямом проходе; убирать при дифференцировании нельзя.
Для одной головы внимание разбивается на знакомые операции. Из следуют и . Если — строка softmax, то её обратный проход записывается без полной матрицы Якоби:
На запрещённых маской позициях производная равна нулю. Для разрешённых оценок :
RoPE возвращает градиент обратным вращением. В GQA градиенты общего K/V от всех использующих его голов складываются. При выборе строк градиенты накапливаются в соответствующих строках таблицы; повторный токен добавляет ещё одно слагаемое. При к ним прибавляется градиент выходной проекции. Так путь замыкается на всех параметрах, перечисленных в §8.
Ноутбук проверяет этот путь двумя способами. PyTorch строит обратный проход автоматически, а NumPy оценивает каждую из 50 производных независимо по центральной разности при . Отдельная проверка связывает эмбеддинги и проверяет все 42 параметра. Это проверка конкретной гладкой конфигурации в float64, а не доказательство для любой модификации архитектуры.
12. Шаг AdamW: градиент превращается в новые веса
Чтобы получить следующую модель, одного градиента недостаточно: нужно правило обновления и состояние оптимизатора. Пусть — градиент на шаге обучения . Если задан порог , сначала выполним глобальное ограничение нормы:
При нулевом градиенте множитель считается равным 1. Норма охватывает все обучаемые скаляры. Это не обрезание каждого элемента независимо. Затем AdamW обновляет два накопителя:
Квадрат, корень и деление в этих формулах поэлементные. — скорость обучения; — коэффициент weight decay, который может различаться по группам параметров. В нашем опыте матрицы получают , множители норм — . Это выбранное правило эксперимента, не универсальное требование AdamW. Оптимизаторное отлично от в RMSNorm.
Начнём с нулевых моментов, , , , . Норма градиента равна 0.587186334, поэтому ограничение не срабатывает. После коррекции смещения на первом шаге и . Потеря на той же последовательности снижается с 1.109373924 до 1.084831548.
Это наблюдение для одного конкретного шага. Оно не доказывает ни монотонного уменьшения потери на каждом шаге, ни улучшения на новых данных. Дальнейшие шаги используют историю моментов: нельзя каждый раз подставлять формулу первого шага. Ноутбук сравнивает наше обновление с torch.optim.AdamW, а затем отдельно выполняет короткое обучение с сохраняющимся состоянием оптимизатора.
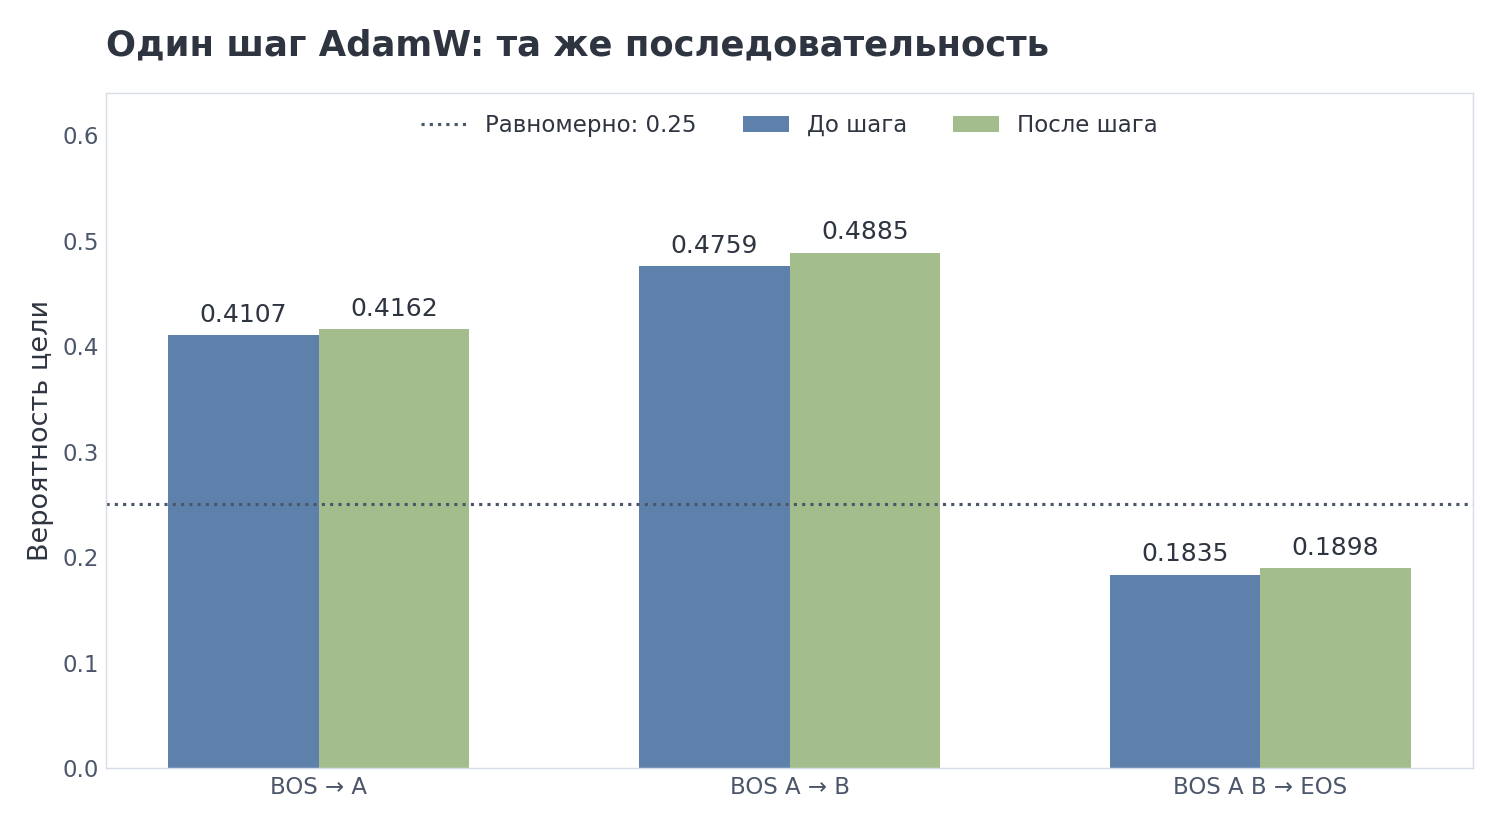
Рисунок 4. Изменяется одно и то же распределение из §9. Столбцы показывают вероятности правильных целей; линия случайного равномерного распределения равна 0.25.
13. Генерация: распределение не равно выбранному тексту
Во время инференса фиксируем и начинаем с известного префикса. Можно выбрать токен с максимальной вероятностью, а можно сэмплировать. Температура и множество разрешённых кандидатов задают распределение декодера
При и полном словаре . При top-k множество содержит наибольших логитов, после чего оставшиеся вероятности перенормируются. Выбор токена, его добавление и условие остановки относятся к алгоритму генерации. Argmax описывается отдельно: подставлять нулевую температуру в формулу нельзя.
Для последней строки примера top-2 оставляет A и B. При получаем . EOS в этот шаг исключён, хотя базовая модель назначала ему вероятность 0.183502. Поэтому вероятности сгенерированных текстов при таком декодере образуются из , а не из исходного .
После выбора токена новый префикс проходит через ту же модель. Цикл завершается при EOS или при достижении заданного предела длины. Без предела наличие EOS в словаре ещё не гарантирует остановку за конечное число шагов для произвольных весов и правил выбора. Воспроизводимый опыт фиксирует веса, префикс, параметры декодирования и seed генератора случайных чисел.
14. KV-cache: то же вычисление с сохранённым прошлым
В причинной модели добавление нового токена не меняет активации старых позиций. Это следует по слоям: норма и FFN действуют отдельно по строкам, а внимание старой строки не получает новых разрешённых ключей. Поэтому ключи и значения уже обработанного префикса можно сохранить.
На следующем шаге каждый слой вычисляет запрос, ключ и значение только для новых позиций, добавляет новые K/V к своему кэшу и обращается ко всем разрешённым ключам. В нашей конвенции сохраняются уже повёрнутые ключи и обычные значения. Новый запрос должен использовать абсолютную позицию в префиксе: после трёх токенов это 3, а не 0.
Для полного внимания объём элементов кэша на один пример после токенов равен . В однослойном примере после трёх входов это 12 скаляров; при float32 — 48 байт без служебных накладных расходов. Веса не меняются и не входят в эту сумму. GQA экономит K/V по числу , хотя запросов остаётся .
Кэш допустим для того же префикса, тех же весов и тех же правил позиций. После обновления весов его нужно пересчитать. Ограничение окна, квантизация кэша и смена позиционной схемы требуют отдельных условий эквивалентности. Наши проверки сравнивают полный проход, по одному токену и по нескольку новых токенов; небольшие расхождения float32 допустимы, изменение математического результата — нет.
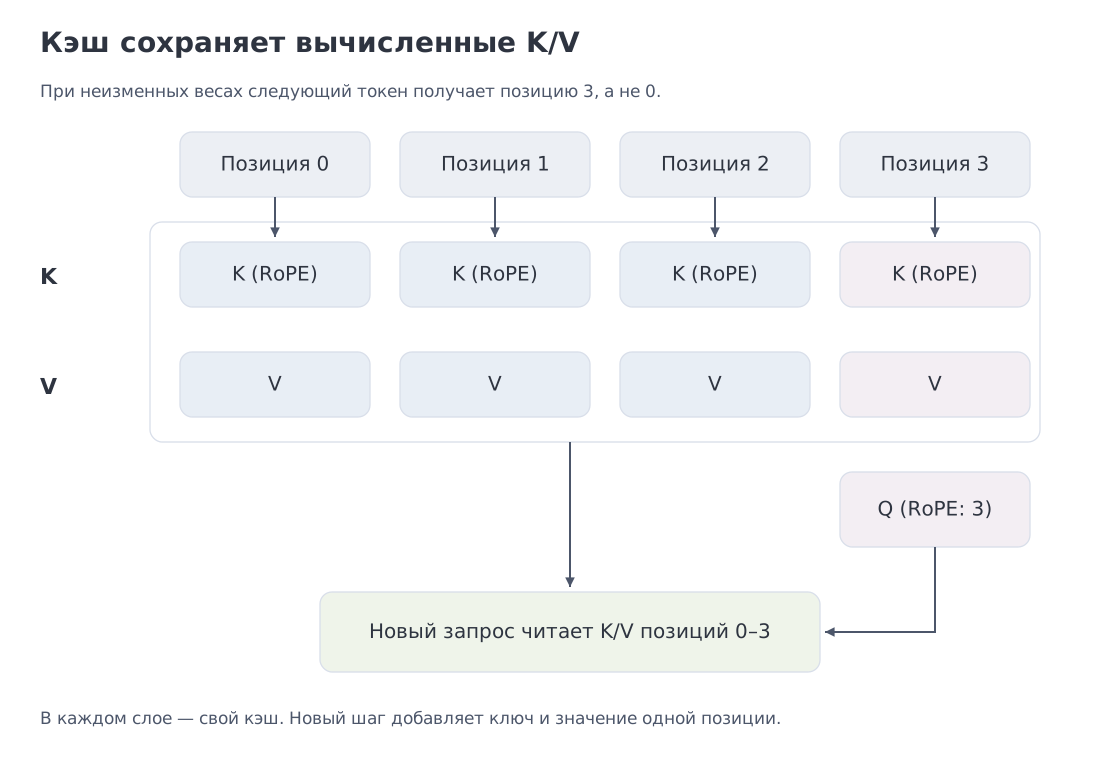
Рисунок 5. Кэш меняет организацию вычисления. Он не является дополнительной обучаемой памятью модели.
15. MoE: заменяем конкретный оператор, сохраняя остальную конструкцию
В М7 мы заменяли плотный FFN набором экспертов. Теперь можно точно указать место замены: в §7 вместо подставляется . Внимание, остаточные связи, выходная проекция и авторегрессионное разложение остаются на месте, если остальные настройки сохранены.
Опишем вариант MiniLLM с sigmoid-маршрутизацией без ограничения ёмкости экспертов. Пусть маршрутизируемых экспертов , а матрица роутера . Для одной нормализованной строки роутер вычисляет и . Балансировочная поправка влияет на выбор множества экспертов , но веса смеси считаются из исходных :
В MiniLLM стабилизатор знаменателя равен . Без него веса выбранных экспертов в точности суммировались бы в 1; с ним сумма чуть меньше. При обычных значениях это малая численная поправка, но при почти нулевых sigmoid-оценках её уже нельзя игнорировать. Каждый эксперт — свой SwiGLU. Общие эксперты из включены всегда и в данном варианте складываются без нормировки вместе с маршрутизируемой частью. Другие реализации могут использовать иное масштабирование; оно должно быть явно добавлено в формулу.
Возьмём три логита , поправки и top-2. Получаются оценки sigmoid , а для выбора — . Выбраны эксперты 2 и 0 с нормированными весами примерно . Прибавлять поправку ещё раз к этим весам было бы другой моделью.
При фиксированном наборе выбранных экспертов градиент проходит через их выходы и нормированные веса. Сам top-k дискретен: на границе смены набора обычной гладкой производной нет. Поправки балансировки MiniLLM обновляет отдельным правилом, а не AdamW по кросс-энтропии. Поэтому они относятся к состоянию маршрутизации, а не к обучаемых градиентом матриц. Ограничение ёмкости и отбрасывание токенов здесь исключены: они добавили бы зависимость от состава и порядка назначений в пакете.
16. Что меняет постобучение и что остаётся за пределами модели
SFT может оставить весь прямой проход прежним, но выбрать маской только целевые токены ответа. Токены инструкции при этом по-прежнему доступны вниманию: исключение из потери не исключает их из контекста. При LoRA изменяется параметризация некоторых матриц: для можно записать , где , , — ранг адаптера, а — заданный масштаб. Замороженная часть участвует в вычислении, но не обновляется оптимизатором; обучаются матрицы адаптера.
При обучении по предпочтениям меняется сама цель. Для DPO введём , то есть сумму логарифмов вероятностей токенов ответа при условии промпта . Пусть предпочтительнее , а — фиксированная опорная модель. Обозначим такую же сумму токенных логарифмов для неё через . Тогда для одной пары:
Коэффициент регулирует масштаб сравнения. Превращение суммы токенных логарифмов в среднее по длине изменило бы эту цель. Подробный вывод и ограничения разобраны в М14; здесь важна связь: одно и то же можно обучать разными способами.
В мультимодальной модели входной оператор может вставлять проекции изображений или аудио, а не только строки . Поиск добавляет найденные материалы к контексту; агентная обвязка вызывает инструменты и формирует следующий запрос. Эти механизмы не возникают из одного умножения на . Формула ядра объясняет вычисление распределения, но не является доказательством истинности ответа, качества поиска или надёжности всей системы. Именно поэтому курс завершается не только архитектурой, но и оценкой в М19.
19. Где итоговая конструкция меняется: SSM и диффузия
SSM: другое представление прошлого
Внимание сохраняет отдельные K/V прошлых позиций и читает их в зависимости от нового запроса. Модель пространства состояний, SSM, переносит между позициями состояние фиксированной для выбранной архитектуры формы. В дискретном виде ядро такого оператора можно записать так:
В этой локальной записи используем векторы-столбцы: — вход в позиции , — состояние, — выход. Тогда , , и . В селективных моделях некоторые коэффициенты зависят от текущего входа. Черта означает уже дискретизированные коэффициенты; переход от непрерывной системы разобран в М8.
Для прозрачного частного случая положим , , , . На входах получаем состояния и выходы . Старые входы влияют на ответ через состояние, а не через отдельные адресуемые записи K/V. Число скаляров этого состояния не растёт с длиной префикса; это не означает сохранения любой информации о прошлом без потерь.
В формуле стека теперь нужен SSM-блок вместо соответствующего attention-блока. Нельзя объявить, что вся Mamba получается буквальной заменой одного произведения : конкретный блок может включать проекции, свёртку и гейтирование, а отдельного FFN может не быть. Гибридная сеть чередует разные блоки. Но если модель по-прежнему причинно предсказывает следующий токен, выходной softmax, произведение условных вероятностей и токенная кросс-энтропия сохраняют свой смысл. Основная перемена — оператор обработки контекста и переносимое состояние. Mamba даёт конкретную реализацию этой идеи.
Диффузия: другой путь от случайности к тексту
У диффузионной модели изменяется уже организация генерации. Чтобы не смешивать шаги с позициями токенов, обозначим целую последовательность на уровне шума через . Чистая последовательность — . Начальная берётся из заданного распределения шума; в маскирующем варианте это может быть строка из MASK. Деноизер получает текущую последовательность и информацию об уровне шума, а не только неизменяемый левый префикс.
Если обозначает нормированное обратное переходное распределение при условии промпта , то для фиксированной длины:
Произведение описывает одну траекторию уточнения. Сумма учитывает все скрытые промежуточные последовательности: одной и той же чистой строке могут предшествовать разные пути. Для непрерывного шума соответствующие суммы заменяются интегралами. Если длина тоже генерируется, её распределение нужно добавить отдельно.
Выход деноизера часто задаёт вероятности чистых токенов, а переход дополнительно строится с учётом схемы зашумления и расписания. Поэтому нельзя автоматически приравнять к softmax одного токена. Маска внимания также может быть двунаправленной: позиции читают доступное состояние всей зашумлённой последовательности. Простое снятие причинной маски при обучении копировать открытые правильные токены дало бы утечку ответа, а не корректную диффузионную задачу. В М12 обучение восстанавливает скрытые токены из испорченного входа; в общем случае цель задаётся прямым процессом зашумления и выбранным выводом обратной модели. D3PM формализует такие дискретные процессы.
Проверим смысл суммы на крошечной заданной вручную обратной цепи, не выдавая её за обученный деноизер. Есть две бинарные позиции и четыре строки: 00, 01, 10, 11. Из двух MASK первый переход выдаёт распределение . На втором переходе каждый бит независимо сохраняется с вероятностью 0.8 и меняется с вероятностью 0.2. Если две строки отличаются в позициях, переход между ними равен . Умножение даёт . Например, вероятность 00 равна — это сумма четырёх путей, а не предсказание первого, затем второго бита.
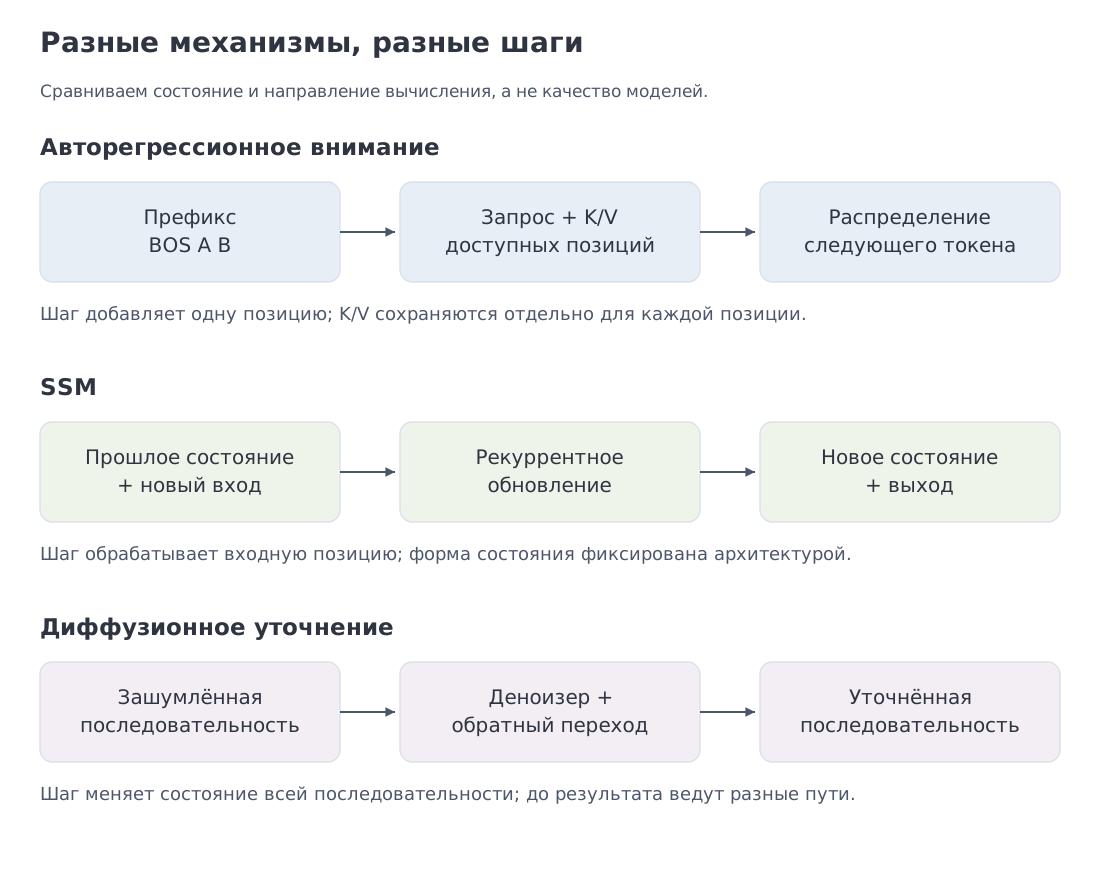
Рисунок 6. У SSM может сохраниться авторегрессионная постановка. У диффузии шаг уточнения относится к целой последовательности; повторное вычисление её представлений обычно не допускает обычного append-only KV-cache.
Любое нормированное совместное распределение можно формально разложить по цепному правилу на условные вероятности токенов. Однако это тождество не делает диффузионный алгоритм авторегрессионным: вычисление таких условных вероятностей может потребовать суммирования по скрытым траекториям. Архитектура деноизера, вероятностная модель и алгоритм выборки — связанные, но разные уровни описания.
20. Итоговая запись и как её читать
Вернёмся к выбранной плотной MiniLLM. Обозначим остаточное добавление через . Тогда . Все внутренние операции и уже раскрыты в §5–7. Одна условная вероятность записывается так:
Читаем изнутри наружу: выбираем эмбеддинги префикса; проводим их через последовательность полностью определённых блоков; нормализуем; берём последнюю строку; умножаем на выходную матрицу; нормируем логиты; выбираем компоненту нужного токена. В вычислении всех обучающих позиций последнюю строку не выделяют: выходная проекция применяется ко всей матрице.
Для вероятности последовательности умножаем эти условные вероятности. Для обучения берём выбранную потерю, дифференцируем по и применяем обновление вместе с состоянием оптимизатора. Для генерации строим из последней строки и повторяем шаг после выбора токена. Таким образом, окончательная запись всей процедуры состоит из согласованных частей:
В оператор AdamW здесь входят ограничение нормы, расписание скорости обучения и группы weight decay, определённые в §12. Последняя строка описывает сэмплирование; при жадном декодировании вместо неё используется argmax. Эти строки не исполняются одновременно: обучение меняет веса, генерация использует выбранный чекпойнт.
У формулы теперь есть проверяемая область действия. MoE заменяет и добавляет маршрутизацию. SSM меняет блок и форму состояния, сохраняя авторегрессионную цель, если она выбрана. Диффузия использует другую траекторию генерации и другое разложение через скрытые состояния. Масштаб модели, данные и обучение определяют то, чему научились параметры; архитектурная запись сама по себе не сообщает уровень её способностей. Зато она позволяет точно указать, какое вычисление выполняет модель, что в нём обучается и где начинается следующий алгоритм.
Источники и продолжение работы
Подробные выводы отдельных механизмов остаются в М3–М9, М12–М14. Первичные описания: Attention Is All You Need, RMSNorm, RoFormer, GQA, AdamW, DPO. Формулы этого модуля фиксируют конкретную конфигурацию учебной MiniLLM; численные матрицы созданы специально для сквозного примера.
Завершите чтение самопроверкой: на первом проходе выполните 13 вопросов без пометки, а к 20.11.1 и 20.15.1 вернитесь после подробного разбора §11 и §15 соответственно. Затем можно вернуться к практикуму MiniLLM и сопоставить его config.json с членами формулы. Теперь изменение числа голов, связывания эмбеддингов или вида FFN должно означать для вас определённую замену размеров, операций и параметров, которую можно проверить вычислением.