Модуль 9. Претрейн: данные, законы масштабирования, оптимизаторы
Курс «Modern LLMs» · лекция модуля 9 · редакция 2026.10.25
Что это за модуль. В модулях 2–8 мы последовательно собирали языковую модель: выбрали токенизацию и позиционное кодирование, разобрали механизм внимания и блок Transformer, добавили MoE и посмотрели на альтернативные архитектурные ветви. Теперь у нас есть машина, но она пока ничего не знает. Этот модуль посвящён тому, как такую машину обучают на масштабе, где неудачный выбор уже нельзя исправить несколькими дополнительными экспериментами.
Мы будем держать в поле зрения три решения одного и того же обучающего запуска: какие данные дать модели, как разделить вычислительный бюджет между числом параметров и числом токенов и каким оптимизатором провести модель через триллионы токенов без потери устойчивости. Математическая линия модуля строится от вычислительного бюджета: мы выведем аналитический оптимум выбранной параметрической аппроксимации Chinchilla, посчитаем цену сверхдолгого обучения 8B-модели внутри этой аппроксимации и найдём точку окупаемости с учётом будущего инференса. Практическая линия объясняет Muon, MuonClip, перенос гиперпараметров µP/MetaP и расчёт памяти при разделении обучающего состояния между устройствами. Мы читаем принципы и ресурсные ограничения; реализация распределённого запуска и вычислительных ядер требует отдельного курса.
Что нужно знать заранее. Модули 3 и 6 описывают вычислительный граф и блок модели, модуль 7 — MoE и параллелизм экспертов, модуль 5 — геометрию внимания. Здесь достаточно различать число операций (FLOP) и скорость их выполнения (FLOP/s): время вычислений оценивается как их отношение. Реальная скорость ниже пикового значения из-за загрузки устройств, обменов и ожидания данных; более полную модель этих ограничений построим в модуле 10.
Как читать модуль
- Первый проход: §§1–3 и 5 — постановка задачи и данные; в §4 сначала прочитайте смысл переменных и итоговую формулу, затем §§6–9, 10–11 и 15. Закончите В1–В3 и В6 из §18 и упражнениями У1–У3. В4 относится к §14, а В5, В7–В8 — к справочным разделам §§16–17.
- Второй проход: пройдите вывод §4, запустите §§12–13 и оба демонстрационных проекта. Затем разберите перенос гиперпараметров (§14), числовые форматы (§16) и паспорта запусков (§17).
- Справочный маршрут: §4 — формулы, §§10–11 — геометрия обновления и контроль логитов, §15 — память и параллелизм, §20 — источники. Паспорта §17 можно читать выборочно.
Предобучение (pretraining) здесь означает обучение базовой модели на большой смеси данных, обычно с предсказанием следующего токена. Позднейшая настройка поведения — отдельная стадия, к которой курс вернётся дальше.
1. Мотивация: три вопроса одного запуска
Представим, что архитектура уже выбрана, код прошёл маломасштабные тесты, а вычислительный кластер выделен на несколько месяцев. В этот момент задача «обучить LLM» перестаёт быть одним действием. Перед командой возникает цепочка решений, каждое из которых может определить судьбу всего запуска.
Первый вопрос — на каких данных обучать модель. Сырые страницы из веба не образуют учебник автоматически. В них есть дубликаты, навигационный мусор, машинно сгенерированные фермы текста, личные данные, испорченная кодировка и документы, формально написанные на нужном языке, но почти не содержащие полезного сигнала. Поэтому корпус — не найденный в интернете объект, а продукт отдельного конвейера: извлечения, очистки, дедупликации, оценки качества и смешивания доменов.
Второй вопрос — как распорядиться вычислительным бюджетом. При фиксированном бюджете можно обучать большую модель на сравнительно небольшом числе токенов или меньшую модель — гораздо дольше. Оба крайних решения плохи: в первом случае параметрам не хватает данных, во втором модель ограничена ёмкостью. Законы масштабирования дают эмпирическую карту этого компромисса, но карта зависит от постановки. Chinchilla отвечает на вопрос об оптимуме обучения при заданном вычислительном бюджете в FLOP; анализ с учётом инференса добавляет стоимость дальнейшей эксплуатации модели.
Третий вопрос — как делать шаги оптимизации. На небольшом эксперименте неустойчивость часто означает потерянный час. На обучении на триллионах токенов она означает откат к прежней контрольной точке, расследование численной причины и дни простоя дорогого кластера. Поэтому оптимизатор, расписание темпа обучения, числовой формат и мониторинг логитов внимания становятся частями одной системы управления риском.
Эти три вопроса связаны сильнее, чем кажется. От качества данных зависит форма кривой функции потерь; от выбранного соотношения — длительность и экономика инференса; от оптимизатора — можно ли вообще дойти до конца запланированного числа токенов. Хороший претрейн — не сумма трёх независимых рецептов, а согласованный проект.
В этом модуле каждое утверждение будет сохранять свой статус свидетельства. Мы разберём, что именно описывает выбранная модель, какие величины получены аналитически внутри эмпирической модели, какие числа сообщены разработчиками конкретных LLM и где начинается экстраполяция. Такое разделение необходимо: похожие графики могут представлять эмпирический закон, инженерную эвристику или результат конкретного обучающего запуска; читать их нужно по-разному.
2. Историческая прогрессия: как менялся главный ограничивающий ресурс
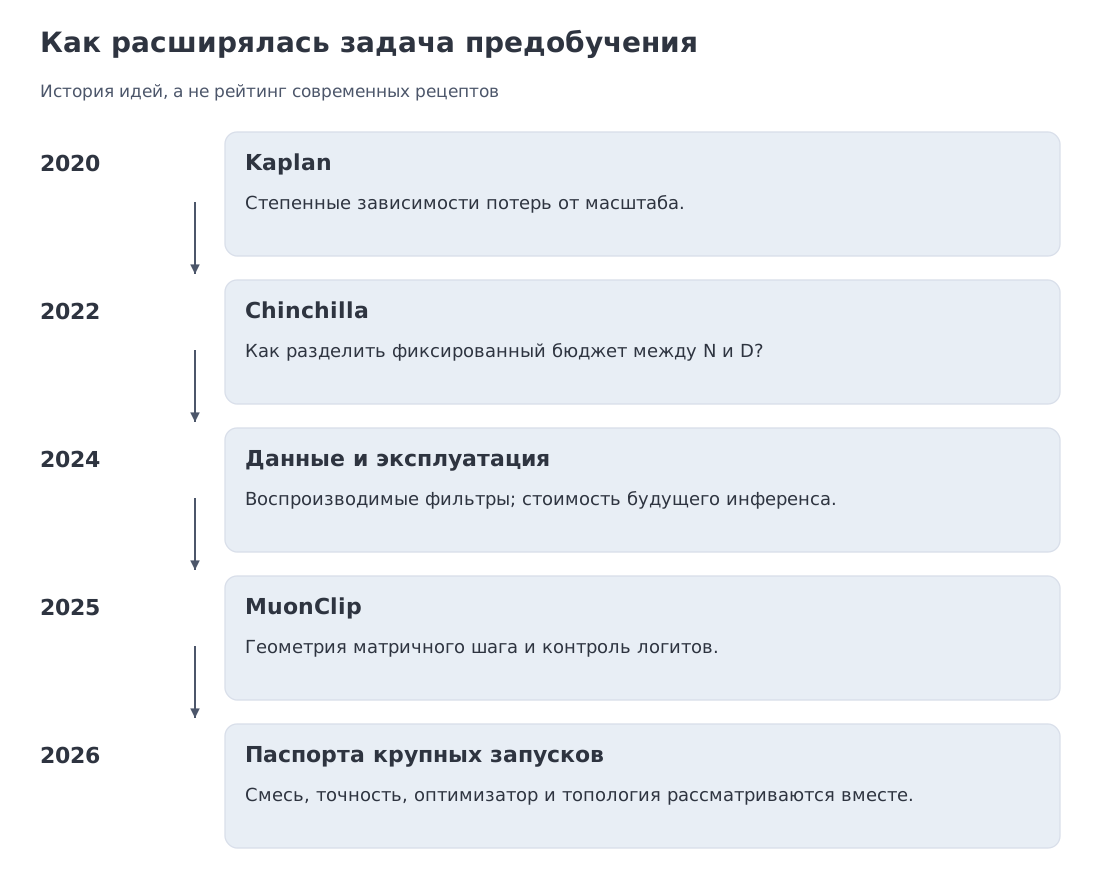 Линия претрейна: Kaplan '20 (эмпирические степенные законы) → Chinchilla '22 (баланс параметров и данных при фиксированном вычислительном бюджете) → анализ с учётом инференса '24 → крупные открытые конвейеры данных и FP8 → Muon/MuonClip в Kimi K2 '25 → 2026: претрейн в NVFP4 Nemotron 3, Muon+mHC в DeepSeek V4 и открытый Kimi K3.
История законов масштабирования развивалась как последовательное расширение постановки: по мере роста моделей менялся главный вопрос, который требовал количественного ответа.
В 2020 году работа Kaplan et al. показала, что функция потерь языковых моделей в широком диапазоне экспериментов хорошо описывается степенными зависимостями от размера модели, объёма данных и вычислительного бюджета. Практический вывод той серии экспериментов подталкивал увеличивать число параметров быстрее, чем число обучающих токенов. Это хорошо соответствовало эпохе GPT-3: очень большая модель, сравнительно небольшой по современным меркам корпус.
Chinchilla в 2022 году пересмотрела этот баланс на более широкой сетке экспериментов. Центральный вывод был прост и важен: многие крупные модели того времени недообучены по данным; при фиксированном вычислительном бюджете полезно расти примерно согласованно по числу параметров и токенов. Популярная формула «около 20 токенов на параметр» стала удобной памятью об одном рабочем режиме, хотя сама статья не превращала это число в вечную константу.
Следующий поворот возник, когда обучение перестали рассматривать отдельно от эксплуатации. Модель обучают один раз, но затем она может сгенерировать триллионы токенов. Если два варианта достигают близкого качества, меньшая, но дольше обученная модель способна потребовать больше вычислений при обучении и выиграть по полной стоимости жизненного цикла. Эту логику формализуют законы масштабирования, учитывающие стоимость инференса и практические стратегии вроде Llama 3 8B, обученной более чем на 15T токенов.
Параллельно выяснилось, что «данные» — не просто число . Появились крупные воспроизводимые корпуса и воспроизводимые стенды для сравнения конвейеров данных: FineWeb и FineWeb-Edu, DCLM, Nemotron-CC, позже FineWeb2. Их ценность не только в масштабе, но и в возможности сравнивать фильтры, дедупликацию, доменные смеси и образовательную ценность в контролируемых экспериментах на целевых задачах.
Наконец, на первый план вышла устойчивость оптимизации. AdamW по-прежнему остаётся сильным базовым выбором, а рядом с ним в нескольких публично описанных передовых системах обучения появились Muon и его варианты для больших матриц. Kimi K2 документировал MuonClip и 15.5T токенов без скачков функции потерь; DeepSeek V4 включил Muon в систему обучения вместе с mHC и гибридным вниманием; Kimi K3 развил эту линию до варианта Muon с обработкой по головам. Таким образом, матрично-геометрические оптимизаторы прошли путь от небольших скоростных экспериментов до документированных запусков триллионного масштаба, сохранив при этом статус одного из нескольких практических семейств оптимизации.
Инфраструктурная линия развивалась одновременно. ZeRO и FSDP уменьшили дублирование состояния, трёхмерный параллелизм (3D parallelism) стал обычным способом раскладывать большие модели, FP8 вошёл в публичные претрейны, а в 2026 году Nemotron 3 Super и Ultra продемонстрировали претрейн в NVFP4. Технический отчёт подтверждает возможность такого низкоточного обучения и подробно описывает его численную организацию; универсальный коэффициент ускорения относительно FP8 из этих данных не выводится.
История претрейна поэтому выглядит не как смена одного победившего алгоритма другим, а как постепенное расширение задачи. Сначала мы учились предсказывать функцию потерь. Затем — правильно распределять вычислительный бюджет. Потом — учитывать стоимость инференса, качество данных, устойчивость и топологию кластера. Современный стек обучения возник именно на пересечении этих линий.
3. Мостик к классике: три знакомых сюжета
Хотя масштабы современного претрейна выглядят экзотично, его логика опирается на три старых сюжета из статистики и оптимизации.
Степенной закон — модель наблюдаемого режима, а не обещание вечной экстраполяции
Зависимость вида
возникает во многих эмпирических областях. При и сначала вычтем уровень : тогда и . Именно в координатах и получается прямая. График без вычитания лишь приближённо прямолинеен там, где степенное слагаемое намного больше этого уровня. Законы масштабирования используют ту же идею: измеряют несколько моделей и корпусов, подбирают параметры функции, а затем спрашивают, где при фиксированном вычислительном бюджете окажется минимум.
Сила этого подхода — в сжатии большого числа экспериментов в несколько коэффициентов. Его слабость — в соблазне считать аппроксимирующую кривую законом природы. При смене архитектуры, токенизатора, качества данных, диапазона масштабов или численного формата коэффициенты могут измениться. Различие между результатами Kaplan и Chinchilla подчёркивает общий принцип: эмпирический закон действителен в той области и при той постановке, на которых он оценён.
Кураторство корпуса — масштабированная работа с выборкой
В классическом ML мы проверяем пропуски, дубликаты, выбросы, перекос классов и утечки между обучающей и тестовой выборками. В веб-корпусе происходят те же проблемы, но единицей становится не строка таблицы, а документ, а число объектов измеряется миллиардами.
При таком масштабе меняется техника. Сравнить каждый документ с каждым нельзя: это . Поэтому используют хешированные признаки, MinHash и локально-чувствительное хеширование (LSH). Ручную оценку качества нельзя распространить на триллионы токенов напрямую, поэтому люди размечают небольшую выборку или задают большой модели рубрику оценки, после чего обучается дешёвый классификатор. Но статистическая сущность задачи остаётся прежней: мы пытаемся приблизить неизвестное «полезное обучающее распределение» доступной процедурой отбора.
Три соседние линии оптимизации
Adam является адаптивным методом первого порядка: он поддерживает экспоненциальные оценки первого и второго моментов градиента и использует их для покоординатного масштабирования шага. Методы, явно строящие аппроксимацию кривизны или матричный предобуславливатель, образуют соседнюю, но концептуально отдельную линию.
Рядом существуют по меньшей мере три семейства:
- методы первого порядка с историей градиента — AdamW, Lion и их варианты;
- методы с явным предобуславливанием или оценкой кривизны — Shampoo, SOAP, Sophia;
- матрично-геометрические методы — Muon, который ортогонализует матрицу накопленного обновления больших двумерных параметров.
Эти семейства связаны; существуют и интерпретации Muon через геометрию метода Ньютона. Но для понимания практического алгоритма полезнее начать не с лозунга «дешёвый второй порядок», а с конкретного действия: Muon берёт матрицу обновления и сжимает разброс её сингулярных чисел. В результате разные направления матрицы получают более сопоставимый масштаб шага. Именно это мы увидим численно в §10.
Углубление. Для текущего вывода достаточно понимать кросс-энтропию как измеряемую функцию потерь и эмпирическую аппроксимирующую зависимость. Более подробная связь кросс-энтропии, KL-дивергенции, энтропийной скорости источника и пределов кодирования разобрана в курсе Information Theory for ML, модули 3 и 6.
Так три линии модуля возвращаются к общей методологической мысли. Закон масштабирования, фильтр данных и оптимизатор — это модели и процедуры с областью применимости. Их надо не запоминать как названия, а читать через вопрос: какую проблему решает этот объект, на каких допущениях и что останется истинным за пределами конкретного эксперимента?
Перед вычислениями договоримся о единицах: — средняя кросс-энтропия в натах на токен, и подставляются как количества, а не числа в миллиардах. Обозначения B и T в таблицах означают и . Смена токенизатора меняет и токены, и сопоставимость такой функции потерь.
4. Формализм: бюджет, эмпирическая модель и аналитический оптимум
Начнём с упрощённой плотной модели вычислений. Пусть
- — число параметров модели;
- — число обучающих токенов;
- — общий бюджет операций с плавающей точкой.
Для стандартного авторегрессионного претрейна часто используют оценку
Интуиция такова: прямой проход требует порядка операций на токен, а обратный — ещё примерно . Это не бухгалтерская формула для любого реального стека. Эмбеддинги, внимание по длинному контексту, MoE, пересчёт промежуточных активаций вносят дополнительные операции, а обмены — затраты времени; для разреженных MoE важно различать общее и активное число параметров. Здесь — единая учебная конвенция, позволяющая прозрачно сравнивать сценарии.
Теперь возьмём одну из параметрических аппроксимаций, использованных в анализе Chinchilla:
У этой записи есть удобная интерпретация. — асимптотический уровень, к которому аппроксимированная функция потерь стремится при неограниченных и . Слагаемое — штраф за недостаточную ёмкость модели. Слагаемое — штраф за недостаток данных. Оба штрафа убывают, но с убывающей отдачей.
Мы хотим минимизировать при фиксированном . Ограничение позволяет исключить одну переменную:
После подстановки остаётся функция одного аргумента:
Теперь хорошо видно происхождение U-образной кривой isoFLOP. Первый штраф уменьшается при росте : большая модель лучше использует структуру. Второй растёт, потому что при фиксированном увеличение оставляет меньше токенов . Минимум возникает в точке, где эти тенденции уравновешиваются.
Дифференцируем:
Условие первого порядка даёт
откуда
Звёздочка здесь означает аналитический оптимум именно этой округлённой аппроксимирующей функции при допущении . Это важная оговорка. Результат вычислен точно внутри модели, но сама модель остаётся эмпирической аппроксимацией данных 2022 года.
Из формулы сразу следуют показатели масштабирования:
Поскольку в данной параметризации немного больше , число токенов растёт с бюджетом несколько быстрее числа параметров. Поэтому
медленно увеличивается. Число 20 токенов на параметр здесь не является математической константой. Экстраполяция конкретной округлённой аппроксимации на бюджеты далеко выше исходного диапазона даёт медленный дрейф отношения . В §6 мы посчитаем этот дрейф и будем трактовать его как учебную экстраполяцию модели 2022 года, а не как современную схему большого обучающего запуска.
5. Данные: как сырой веб становится обучающим корпусом
Выражение набор данных создаёт обманчивое впечатление готового объекта: будто существует огромная папка с «текстом интернета», которую остаётся подать токенизатору. На практике современный корпус — результат длинного конвейера, и каждый его этап отвечает на отдельный тип ошибки.
Проследим путь условной веб-страницы.
Стадия 1. Извлечение текста и определение языка
Сначала из HTML нужно извлечь собственно содержимое, не перепутав его с меню, баннером согласия на использование файлов cookie, футером и рекламными блоками. Затем модель определения языка оценивает язык документа. Для английского корпуса страница с низкой вероятностью английского будет отброшена; для многоязычного корпуса пороги приходится калибровать по языкам, потому что качество классификатора и типичные длины документов неодинаковы.
FineWeb2 хорошо показывает, почему простой фильтр «английский / не английский» недостаточен: корпус строится более чем для тысячи языков, и одна глобальная эвристика систематически ухудшила бы малоресурсные языки.
Стадия 2. Эвристики формата и повторов внутри документа
Далее ловят текст, который формально читается, но не похож на содержательный документ: длинные серии одинаковых символов, обрывки навигации, списки ключевых слов, автоматически сгенерированные SEO-страницы, аномально короткие или длинные «слова». В конвейерах, подобных Gopher, используются десятки правил: доля буквенных символов, средняя длина слова, наличие служебных слов, повторяемость n-грамм и другие признаки.
Конкретные пороги — инженерные параметры, а не универсальные константы. Например, правило о доле повторяющихся n-грамм может быть полезно для веб-прозы и вредно для кода или таблиц. Поэтому зрелый конвейер применяет доменно-зависимые фильтры и измеряет их эффект на пробном обучении малой модели, а не только на визуально «чистом» тексте.
Стадия 3. Дедупликация между документами
Шингл — последовательность из нескольких соседних слов или токенов. Сходство документов можно измерить коэффициентом Жаккара для множеств шинглов. MinHash приближённо сохраняет это сходство в короткой сигнатуре; LSH группирует похожие сигнатуры, чтобы не сравнивать все пары. Это поиск кандидатов, а не доказательство тождества документов.
Один и тот же текст часто встречается на тысячах доменов: лицензии, новости из синдикации, зеркала документации, цитаты, шаблоны интернет-магазинов. Если оставить всё, модель будет многократно видеть почти одинаковый градиент, а загрязнение тестовой выборки обучающими данными станет вероятнее.
Полное попарное сравнение миллиардов документов невозможно. Поэтому документы представляют множествами шинглов, строят сигнатуры MinHash и используют локально-чувствительное хеширование (LSH), чтобы быстро найти кандидатов на почти полные дубликаты. После этого кластер дубликатов схлопывается по выбранному правилу — например, оставляется наиболее полный или наиболее качественный экземпляр.
Стадия 4. Модельная оценка качества
Эвристика хорошо ловит мусор, но плохо отвечает на более тонкий вопрос: чему этот текст может научить модель? Для этого берут сравнительно небольшую размеченную выборку и обучают дешёвый классификатор.
FineWeb-Edu — показательный пример. Llama 3 70B использовалась для оценки образовательной ценности около 460 тысяч документов, после чего на этих метках обучили масштабируемый классификатор и применили его к большому пулу. Итоговый образовательный срез FineWeb-Edu содержит около 1.3T токенов, тогда как полный FineWeb — около 15T. Здесь LLM выступает не генератором корпуса, а дорогим учителем для более дешёвого фильтра.
Стадия 5. Безопасность, персональные данные и правовые ограничения
На следующем слое ищут персональные идентифицирующие данные (PII, personally identifiable information), явно нежелательный контент и документы, которые нельзя или не следует использовать при заданной политике. Простые сущности — адрес электронной почты, телефон, идентификатор — частично ловятся регулярными выражениями и моделями распознавания именованных сущностей (NER, named entity recognition). Более сложные категории требуют классификаторов и человеческой политики.
Важно не смешивать две цели. Фильтр качества отвечает: «полезен ли документ для обучения?» Фильтр безопасности и соответствия отвечает: «допустимо ли его использовать?» Высококачественный документ может не пройти второй тест; безопасный документ может быть бесполезным для модели.
Стадия 6. Смесь и расписание предъявления
Даже хороший набор документов ещё не задаёт обучающее распределение. Нужно решить, сколько раз модель увидит код, математику, разговорный текст, научные статьи и малоресурсные языки. Эти веса способны изменить модель сильнее, чем добавление очередного миллиарда случайных веб-токенов. Кроме того, смесь может меняться по ходу обучения: широкая и разнообразная фаза в начале, более качественная или специализированная — ближе к концу.
Что означают названия крупных корпусов
Несколько чисел полезно держать в голове, но их надо сравнивать аккуратно:
- FineWeb — около 15T токенов очищенного англоязычного веба; FineWeb-Edu — около 1.3T токенов образовательного среза.
- FineWeb2 расширяет подход на более чем тысячу языков и содержит порядка 20 TB текста / около 5 млрд документов; токен-эквивалент зависит от токенизатора.
- Nemotron-CC публикуется как семейство корпусов общим объёмом 6.3T токенов, где используются классификаторы качества и синтетическое перефразирование части документов.
- DCLM — сравнительный стенд со стандартизированным исходным пулом примерно на 240T токенов, предназначенный для проверки стратегий отбора данных. Один из сильных вариантов, DCLM-Baseline, использовал 2.6T обучающих токенов. Поэтому размер исходного пула и объём конкретного обучающего запуска в паспорте данных указываются отдельно.
Код, математика и научные документы обычно проходят специализированные ветви: другие парсеры, другие критерии дубликатов, проверки лицензий, иногда выполнение или формальная верификация. Мультимодальные данные добавляют проверку соответствия изображения и подписи, перцептивную дедупликацию и отдельную работу с лицами и персональными данными.
Конвейер данных как часть цепочки поставки программного обеспечения
Есть ещё один слой, который легко пропустить: предварительная обработка запускает код. Июльский инцидент Hugging Face 2026 года включал злоупотребление конвейером обработки наборов данных, в том числе чтение внешнего хранилища HDF5 и внедрение шаблона в загрузчике, управляемом конфигурацией. Следовательно, команда не должна считать загрузчик датасета «безобидным чтением файлов».
Практический вывод такой же, как для любой цепочки поставки программного обеспечения: неизменяемые образы, разрешительный список загрузчиков, отсутствие секретов в процессах предварительной обработки, ограниченный исходящий сетевой доступ, проверяемые версии и отдельный контроль допуска конфигураций. Качество корпуса и доверие к коду его построения — разные оси, и обе относятся к претрейну. Раскрытие Hugging Face.
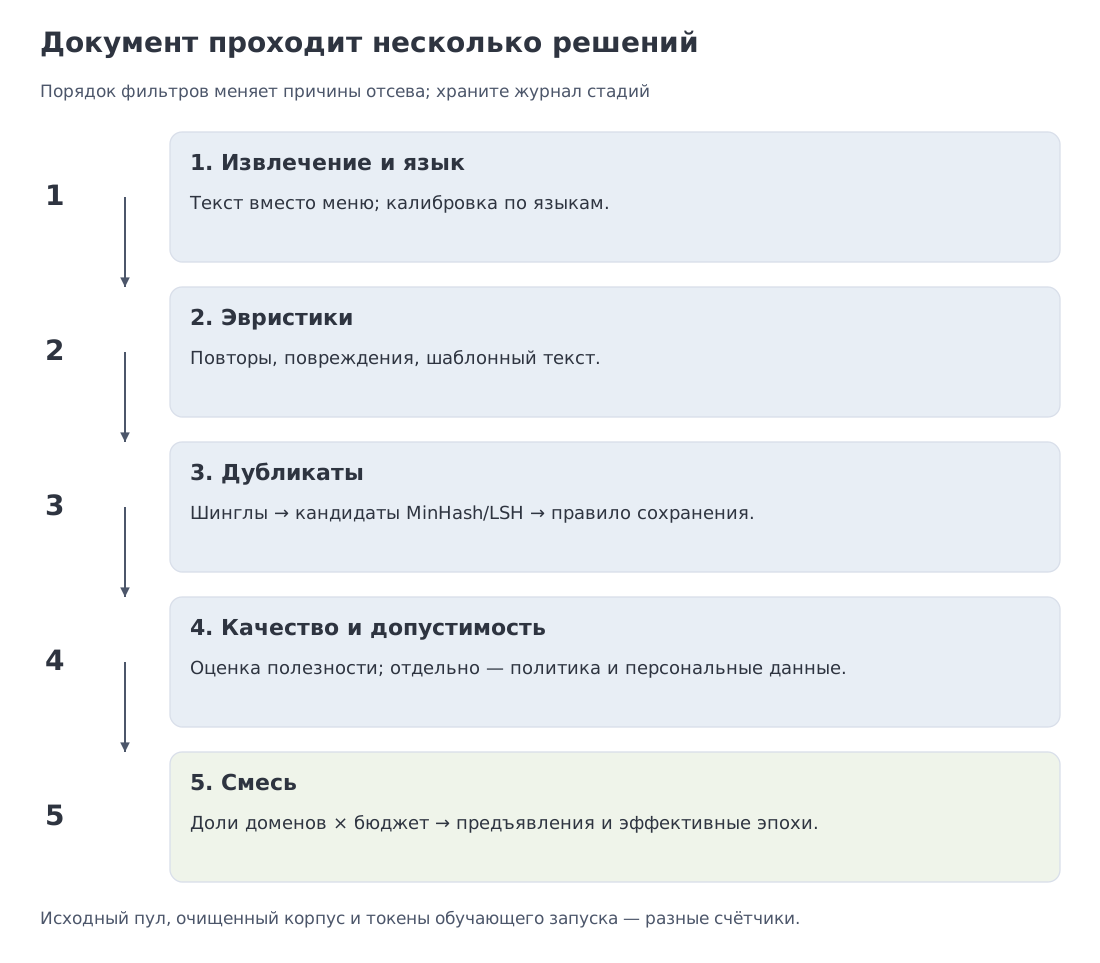 Конвейер фильтрации: извлечение и определение языка → эвристики → дедупликация → модельная оценка качества → PII/политики → доменная смесь; на выходе показаны FineWeb, FineWeb-Edu, Nemotron-CC и DCLM-Baseline с корректным различением исходного пула и обучающих токенов.
6. Решённый пример A: два бюджета и цена упрощённого правила
Теперь применим формулу §4. Нам важно не просто получить числа, а увидеть, насколько чувствителен вывод к замене эмпирической модели удобным правилом памяти.
Часто встречается упрощённая конструкция: принять и совместить её с . Тогда
Это самосогласованная арифметика, но она фиксирует отношение токенов к параметрам заранее. Аналитический оптимум эмпирической модели ничего такого заранее не фиксирует: отношение получается из коэффициентов и бюджета.
| Бюджет | Аналитический | Аналитический | Правило : , | |
|---|---|---|---|---|
| (= бюджет сценария Llama-3 8B/15T) | 35.7B | 3.38T | 94.7 | 77.6B, 1.55T |
| FLOP (второй условный бюджет) | 63.6B | 6.82T | 107.2 | 147.2B, 2.94T |
Почему расхождение получилось таким большим? Правило наследует примерно линейное совместное масштабирование параметров и токенов. Выбранная округлённая аппроксимация имеет разные показатели и , поэтому её аналитический оптимум при экстраполяции сдвигается в сторону большего .
Здесь легко сделать неправильный вывод: «значит, правильный современный рецепт — 100 токенов на параметр». Нет. Мы сравнили две математические конструкции:
- жёсткое правило ;
- оптимум конкретной аппроксимации с коэффициентами 2022 года, продолженной на более высокий бюджет.
Расхождение показывает не новую вечную константу, а опасность смешивать эмпирическую аппроксимацию, практическую эвристику и проектное решение. Реальная команда перед большим запуском строит собственные кривые isoFLOP на малых вспомогательных моделях и на своей смеси данных. Наш калькулятор нужен как прозрачная модель рассуждения и как проверка арифметики, а не как замена этим экспериментам.
7. Геометрия isoFLOP — и решённое У1: цена долгого обучения маленькой модели
При фиксированном каждому значению соответствует ровно одно значение . Поэтому двумерную функцию можно рассматривать вдоль линии равного вычислительного бюджета. Получается профиль isoFLOP .
Слева на такой кривой модель слишком мала. Токенов много, но ёмкости не хватает, и доминирует . Справа модель велика, зато данных мало, и доминирует . Между ними лежит минимум.
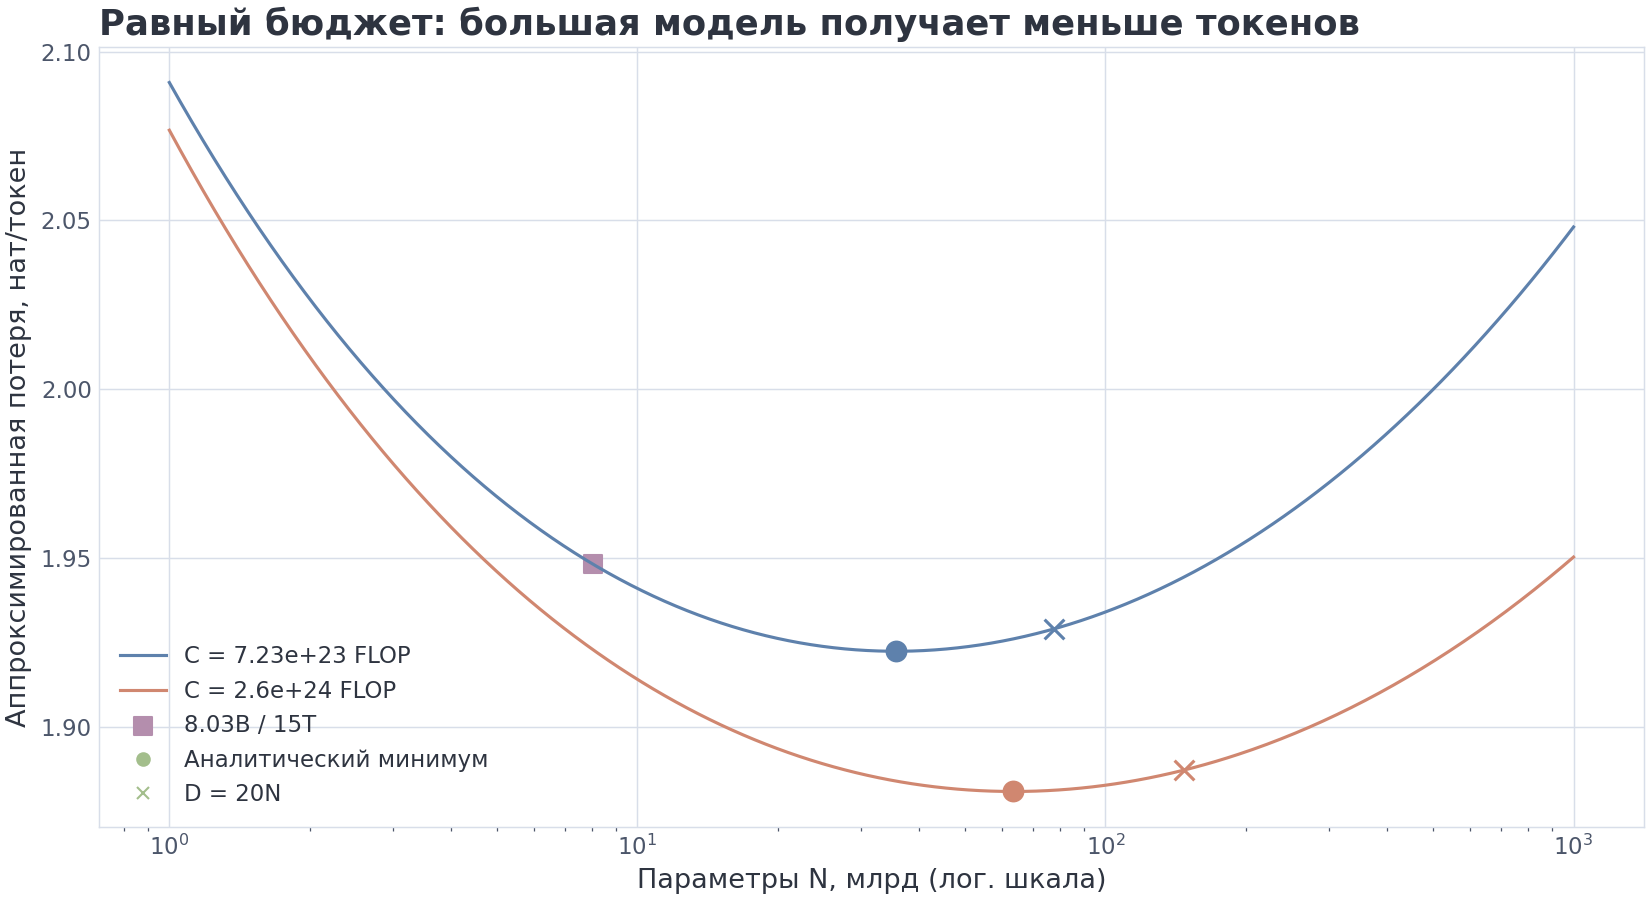 Долины isoFLOP эмпирической модели для двух бюджетов: функция потерь в зависимости от N при C = const; отмечены аналитический оптимум, правило D=20N и сценарий Llama-3 8B/15T. Разность ΔL вычислена в соседнем решённом примере.
Для стратегии, учитывающей стоимость инференса, особенно важна форма долины. Уход от оптимума в сторону меньшей модели и большего числа токенов часто стоит сравнительно небольшой прибавки к аппроксимированной функции потерь. Это не бесплатный ход, но он покупает более дешёвый инференс.
Рассмотрим учебный сценарий, соответствующий масштабу Llama 3 8B:
Его вычислительный бюджет в нашем приближении для плотной модели:
Это около 1868 токенов на параметр. Аналитический оптимум той же эмпирической модели и того же бюджета находится в точке
Подставим обе точки в функцию потерь:
Вычислим разность до округления значений функции:
Как это читать? Не как предсказание реального качества Llama 3 и не как утверждение, что её разработчики «заплатили 0.0258 по функции потерь». Реальная модель обучалась на другой смеси, с другой архитектурой и схемой обучения; коэффициенты аппроксимации не калиброваны специально под неё. Это контрфактический расчёт внутри выбранной модели: если принять эту функцию буквально, перенос вычислительного бюджета от 35.7B/3.38T к 8.03B/15T увеличивает значение функции потерь на 0.0258, но уменьшает размер модели примерно в 4.4 раза.
Именно последнее число делает сделку интересной. Обучающий запуск заканчивается, а каждый следующий сгенерированный токен продолжает платить цену, приблизительно пропорциональную активным параметрам. Поэтому вопрос «стоит ли 0.0258?» нельзя решить, пока мы не добавим будущий поток запросов при инференсе.
8. За пределами Chinchilla: когда более долго обученная маленькая модель окупается
Поставим задачу иначе. Нас интересуют не минимальные вычисления на обучение при произвольном качестве, а два варианта, достигающие одного целевого значения аппроксимированной функции потерь.
В качестве цели возьмём уровень сценария 8.03B/15T:
Модель с B параметров может достичь того же уровня после существенно меньшего числа токенов. Решая уравнение
получаем
Вычислительные затраты на её обучение:
То есть по нашей модели вариант 70B достигает того же значения аппроксимированной функции потерь примерно на 36% меньшими вычислительными затратами на обучение, чем 8.03B/15T. Если смотреть только на обучение, большая модель выигрывает.
Но после релиза знак сравнения начинает меняться. В простейшей упрощённой оценке плотного декодирования один сгенерированный токен стоит порядка FLOP. Разница между вариантами на каждом токене равна
Маленькая модель потратила на обучение дополнительно
Точка окупаемости получается из равенства дополнительных вычислений на обучение и будущей экономии при декодировании:
После примерно 2.12T сгенерированных токенов вариант 8.03B становится дешевле по сумме обучение + вычисления плотного декодирования.
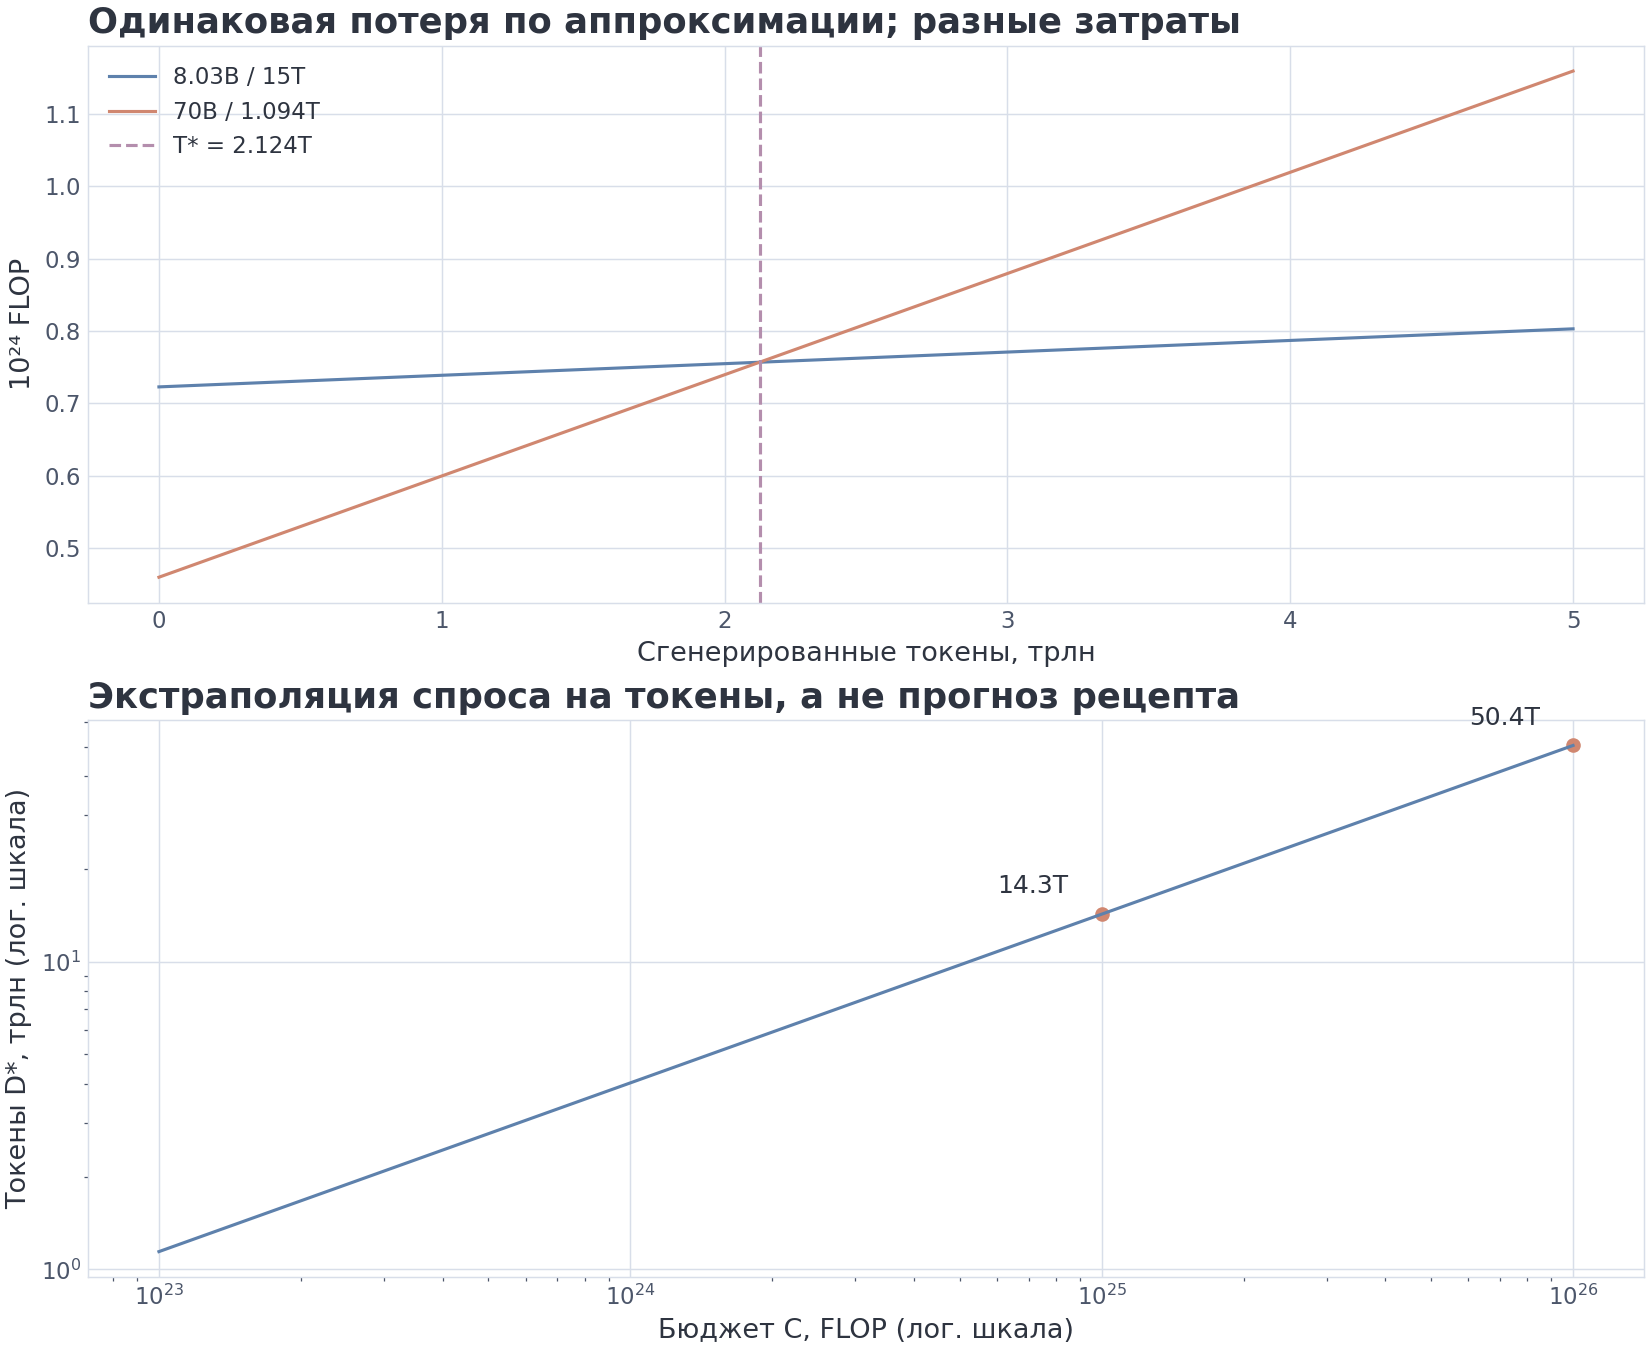 Сверху — суммарные вычисления в зависимости от числа обслуженных токенов для вариантов 8.03B/15T и 70B/1.09T с одинаковым значением аппроксимированной функции потерь; снизу — рост D(C) выбранной аппроксимации при увеличении бюджета.*
У расчёта несколько явных ограничений. Он не учитывает пакетную обработку, пропускную способность памяти, KV-кэш, спекулятивное декодирование и квантование и разную полезность одного токена у разных моделей. Кроме того, равенство аппроксимированной функции потерь не гарантирует равенства качества на целевых задачах. Но даже в таком упрощённом виде формула делает важный сдвиг мышления: оптимум по вычислениям для обучающего запуска не обязан минимизировать стоимость продукта.
Так Beyond Chinchilla не отменяет Chinchilla. Он меняет целевую функцию. В первом случае минимизируется функция потерь при фиксированном бюджете обучения. Во втором — стоимость жизненного цикла при требованиях к качеству и ожидаемом объёме использования.
9. Стена данных: когда токены перестают быть взаимозаменяемыми
Нижняя панель предыдущего рисунка показывает вторую проблему экстраполяции. Внутри эмпирической модели аналитический оптимум требует всё больше данных: около 14.3T токенов при и около 50.4T при . Эти числа не являются прогнозом реальной схемы передового обучения, но хорошо иллюстрируют напряжение: рост вычислительного бюджета может опережать рост доступного высококачественного и достаточно независимого текста.
Почему нельзя просто сказать: «в интернете токенов больше»? Потому что сырой токен, прошедший фильтры токен и эффективно новый учебный сигнал — разные вещи. Десять копий одной статьи дают десять записей в счётчике , но намного меньше десяти независимых порций информации. Слабое перефразирование тоже может менять поверхность текста, почти не меняя содержание.
Отсюда возникает несколько ответов, которые не исключают друг друга.
Оптимизация доменной смеси
DoReMi рассматривает веса доменов как гиперпараметры. Вместо того чтобы навсегда зафиксировать «столько-то процентов кода, столько-то Википедии», можно обучить малую вспомогательную модель и подбирать смесь так, чтобы уменьшить максимальный по доменам избыточный уровень функции потерь по сравнению с фиксированной опорной моделью.
Это не делает смесь объективной: результат зависит от набора доменов, вспомогательной модели и целевых метрик. Но подход превращает часть кураторского искусства в воспроизводимый эксперимент.
Повторное использование лучшей части корпуса
Повторы не бесполезны автоматически. Работы о масштабировании при ограниченных данных показывают, что несколько эпох по качественным данным могут оставаться выгодными, хотя их вклад убывает. Важно различать «эффективные дополнительные токены» и буквальный счётчик предъявлений. Чем больше повторов, тем меньше следующая эпоха похожа на новую независимую выборку.
Поэтому повторное предъявление обычно сочетается с учебным расписанием или финальной фазой снижения темпа обучения (annealing): широкая смесь строит общее представление, а ближе к концу повышается доля отборного текста, кода, математики или данных целевого языка.
Синтетика и преобразование существующих документов
Генеративная модель может создать учебникоподобное объяснение, решение задачи, диалог, кодовый пример или очищенное перефразирование веб-страницы. Такое преобразование способно повысить плотность полезного сигнала. Но оно не создаёт знания из ничего: ошибки учителя, стилистическое однообразие и коллапс разнообразия переносятся в ученический корпус.
Поэтому синтетические данные полезнее понимать как оператор над распределением: они меняют форму, структуру и доступность уже имеющегося содержания, иногда соединяют факты в новые задачи, но требуют фильтрации и проверки не меньше сырого веба.
Претрейн с акцентом на рассуждения
Всё чаще доказательства, пошаговые решения, трассировки работы с инструментами и агентные траектории входят не только в SFT, но и в поздние фазы претрейна и промежуточного обучения. Цель — чтобы база уже имела подходящую вычислительную привычку, а постобучение не пыталось создать её из почти отсутствующего сигнала.
При этом термин данные с рассуждениями не гарантирует правильности. Длинная цепочка рассуждений может быть убедительной и ошибочной. Для математики и кода особенно ценны данные, которые можно выполнить или верифицировать.
Углубление. Здесь траектории рассуждений рассматриваются как часть смеси данных. Их получение через RLVR/GRPO, массовую генерацию траекторий и проверяемую награду подробно разбирает курс RL for LLM, модули 9–10. Информационный взгляд на сигнал рассуждений дан в Information Theory for ML, модуль 13.
Связь с ветвью диффузионных языковых моделей из модуля 12
Маскированная диффузионная модель (masked diffusion) при повторном предъявлении документа может видеть новую маску и, следовательно, новую условную задачу восстановления. Это действительно создаёт более разнообразный обучающий сигнал на том же тексте, чем буквальное повторение одного и того же авторегрессионного порядка. Но из этого не следует автоматическое превосходство dLLM при любой нехватке данных: эффективность зависит от целевой функции, архитектуры и того, насколько новые маски дают действительно полезные ограничения.
«Стена данных» поэтому не является одной датой, когда интернет закончится. Это постепенное падение предельной ценности очередного токена и рост цены его очистки. Чем ближе мы к этой стене, тем важнее становится не только , но и происхождение токена, степень независимости, проверяемость и место в расписании обучения.
В ноутбуке смесь получает явный численный смысл. При 15T предъявленных токенов и доле математики 15% математическая часть получает 2.25T токенов. Если её уникальный пул равен 0.4T, это эффективной эпохи — среднее число предъявлений, а не 5.625 новых корпусов.
10. Оптимизаторы: зачем Muon выравнивает спектр обновления
Переходим к третьему вопросу запуска — как обновлять параметры. AdamW остаётся сильной и хорошо изученной базой. Его главное практическое достоинство — покоординатная адаптация масштаба: параметры с разной историей градиентов получают разные эффективные шаги.
Темп обучения задаёт общий масштаб шага. Накопление градиента с импульсом (momentum) сглаживает меняющееся направление, сохраняя часть предыдущих градиентов. Затухание весов (weight decay) отдельно уменьшает сами параметры. В AdamW оно отделено от адаптивного масштабирования градиента; поэтому добавление L2-штрафа к функции потерь не даёт в общем случае того же обновления.
Второй проход: один шаг AdamW
Пусть — вектор параметров, — градиент функции потерь по нему, а . Коэффициенты управляют памятью двух экспоненциальных средних. Все операции ниже покоординатные:
Здесь — коэффициент затухания весов, защищает знаменатель. Поправки с шляпкой компенсируют нулевую инициализацию средних. Использована конвенция API, где затухание умножается на текущий темп обучения.
Для , , , , , и получим . Один лишь спад весов дал бы ; адаптивный шаг добавляет примерно . Ноутбук продолжает этот опыт при изменении знака градиента, чтобы показать влияние его истории. AdamW.
Но большие веса Transformer — не просто длинный вектор. Большинство из них естественно являются матрицами: проекции механизма внимания и MLP. Если обновление такой матрицы имеет несколько очень больших сингулярных направлений и множество слабых, один шаг может почти целиком уйти в узкое подпространство.
Muon начинает с обычного накопленного обновления с импульсом:
Затем для двумерного параметра строится приближение к полярному фактору
Здесь — матрица обновления, а SVD — сингулярное разложение. Запись с обратным корнем предполагает полный строчный ранг; у высокой матрицы вырождена. В общем случае используется псевдообратный корень: нулевые сингулярные направления остаются нулевыми. Формула подразумевает компактное SVD по ненулевым направлениям. В коде высокая матрица транспонируется, чтобы матрица Грама имела размер .
Если записать SVD , идеальный полярный фактор равен . Матрицы и сохраняют направления, а ненулевые сингулярные значения заменяются единицами. Иными словами, Muon не просто уменьшает норму всего обновления. Он сжимает разброс сингулярных значений и делает шаг более изотропным в матричной геометрии.
Формула импульса выше показывает накопление направления. Реальная реализация дополнительно задаёт нормировку импульса, вариант Нестерова, масштаб шага по форме матрицы и затухание весов. Матрицу в ноутбуке следует понимать как уже подготовленное обновление. GEMM — обычное матричное умножение; пять итераций ниже не являются полным шагом оптимизатора.
Вычислять SVD каждой большой матрицы на каждом шаге слишком дорого. Поэтому используется несколько матричных итераций Ньютона–Шульца, реализуемых через GEMM и хорошо ложащихся на ускорители. В учебном примере применяется квинтическая итерация с коэффициентами
После нормировки матрицы шаг имеет вид
Наша фиксированная трассировка использует матрицу с начальным значением генератора 7. До обработки отношение максимального сингулярного числа к минимальному равно примерно (). После пяти квинтических итераций сингулярные числа оказываются в полосе примерно .
Это не точная ортогональная матрица: остаётся заметной. Но практическая цель Muon — не получить формально безупречный результат численной линейной алгебры, а достаточно выровнять обновление за несколько дешёвых GEMM. Если добавить три классические кубические итерации, спектр можно дотянуть примерно до , однако дополнительная точность стоит времени. Для оптимизатора важен общий компромисс, а не идеальная полярная декомпозиция.
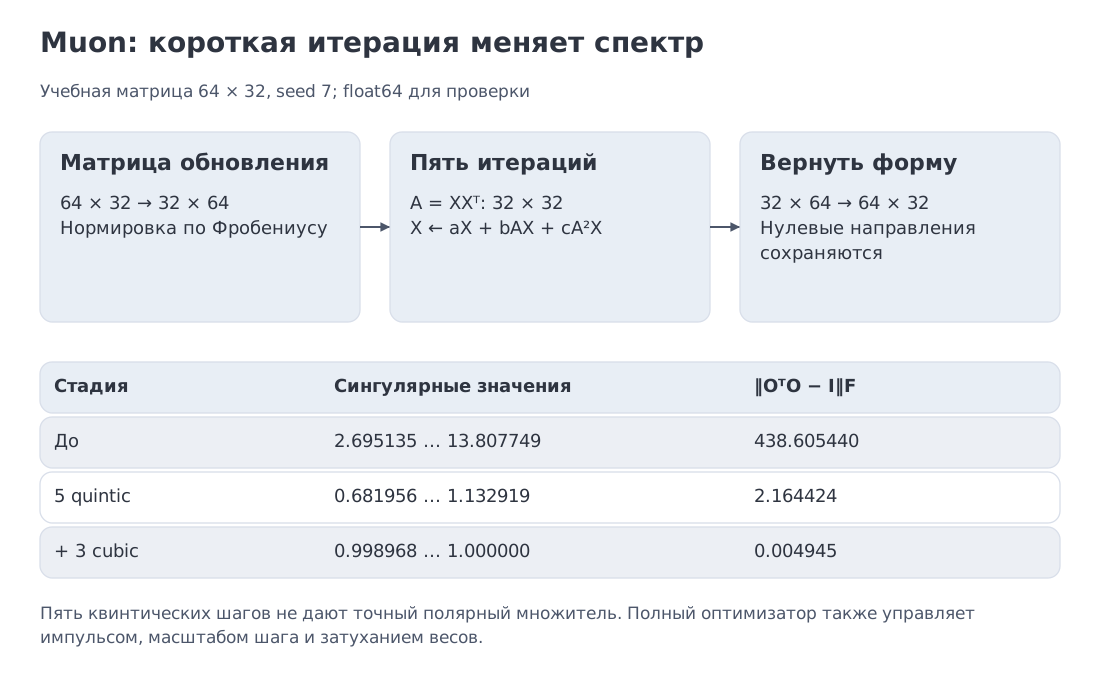 Шаг Muon: накопленное обновление → пять квинтических итераций Ньютона–Шульца → обновление со сжатым спектром. В учебной трассировке разброс ×5.1 превращается в полосу [0.68, 1.13]; дополнительная врезка показывает цену почти точной ортогонализации.
Некоторые теоретические интерпретации связывают Muon с нормировкой в духе метода Ньютона для матричных параметров. Практический алгоритм при этом не строит Гессиан: он использует структуру матрицы обновления и напрямую меняет её спектральную геометрию. Поэтому в инженерном описании Muon естественнее относить к матрично-геометрическим методам, а не к явным аппроксимациям кривизны.
К 2026 году эта идея присутствует в нескольких публично описанных системах обучения — Kimi K2, DeepSeek V4, Inkling и Kimi K3. Схема обычно гибридна: большие матрицы обновляются Muon, а эмбеддинги, параметры нормализации, смещения и другие параметры могут оставаться на Adam или AdamW. Поэтому выражение «оптимизатор модели» в реальной системе обучения часто означает набор правил для разных классов параметров.
11. MuonClip: почему иногда надо исправлять не логиты, а веса
Спектральное выравнивание обновления решает не все проблемы. При масштабировании Muon на Kimi K2 разработчики наблюдали особый режим отказа: некоторые головы внимания постепенно наращивали величину логитов между запросами и ключами. Когда значения становятся очень большими по модулю, функция softmax насыщается, градиенты и активации становятся плохо управляемыми, а локальная проблема может перерасти в скачок функции потерь.
Можно ограничить логиты в текущем прямом проходе. Но тогда параметры и , породившие выброс, останутся прежними и снова создадут его на следующем шаге. QK-Clip действует глубже: после шага оптимизатора он проверяет статистику головы внимания и при превышении порога масштабирует сами матрицы запросов и ключей.
Пусть максимум положительных немаскированных логитов головы (после обычного масштабирования внимания), ограниченный снизу нулём, равен , а допустимый порог — . Определим
Затем
Поскольку произведение масштабов равно , билинейный логит этой головы уменьшается в нужной пропорции. При симметричном разделении масштаба обе матрицы умножаются на .
Возьмём четыре головы с текущими максимумами
Тогда
а симметричные множители для и равны приблизительно
Новые максимумы:
Для прежних входов в упрощённой билинейной модели головы ниже порога не затронуты, а две остальные возвращаются к . Это не ограничение логитов будущего пакета. При общих K в GQA головы также нельзя корректировать как независимые пары матриц.
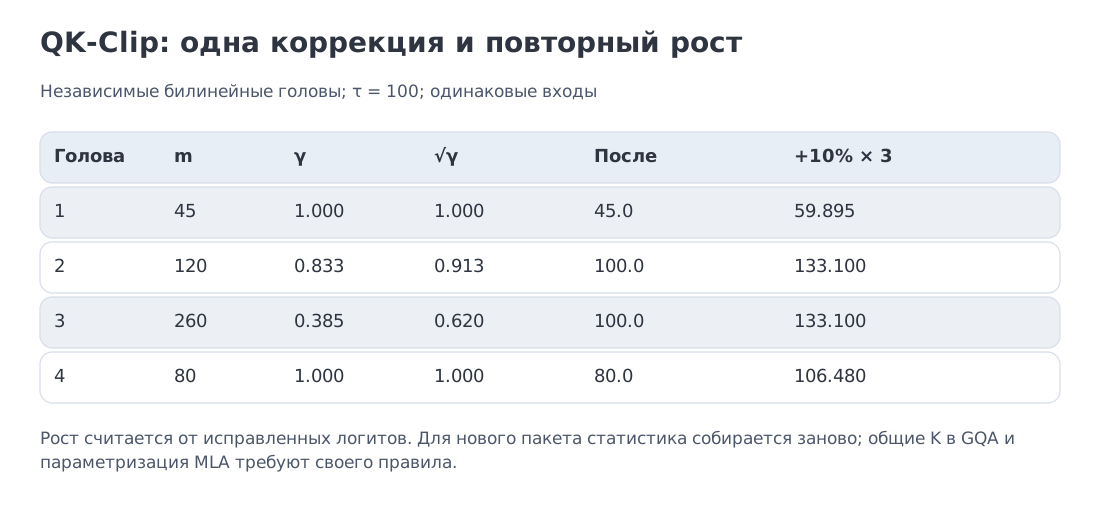 Трассировка QK-Clip: четыре головы, порог τ=100; max(QKᵀ) → γ → симметричное масштабирование WQ/WK → новые максимумы. Внизу — отличие от одноразового ограничения текущих логитов.
После вмешательства следующий прямой проход использует обычную функцию softmax. Мы не «замораживаем» распределение внимания и не гарантируем, что голова навсегда останется ниже порога: последующие шаги оптимизатора могут снова увеличить веса. Поэтому QK-Clip — часть контура мониторинга, а не одноразовая вакцина.
Технический отчёт Kimi K2 связывает этот механизм с MuonClip и сообщает о 15.5T обучающих токенов без скачков функции потерь. Там же описано расписание WSD: разогрев, длинная стабильная фаза, затухание темпа обучения и последующие фазы расширения контекста. Формулировка «ноль скачков» относится к документированному результату конкретного запуска, а не к математической гарантии MuonClip для любой архитектуры.
В нашей учебной трассировке используется обычная запись, подобная MHA, . Реальная Kimi K2 применяет MLA, и механизм ограничения в её параметризации сложнее. Упрощение здесь сознательное: оно сохраняет билинейную причину масштабирования и позволяет вручную проверить, почему произведение двух множителей возвращает максимальный логит к порогу.
12. Код (уровень 1): маленькие функции, которые не скрывают допущения
В модуле много формул, которые легко переписать в одну строку и так же легко применить к некорректному входу. Поэтому минимальная реализация делает две вещи одновременно: сохраняет математическую прозрачность и явно валидирует область определения.
ScalingLaw хранит коэффициенты эмпирической модели вместе с конвенцией . newton_schulz принимает только конечную непустую матрицу, нормирует её и одинаково обрабатывает высокие и широкие матрицы. qk_clip_scales отделяет вычисление множителей от реального изменения параметров, чтобы трассировку можно было проверить независимо.
"""Minimal mechanisms embedded verbatim in the lecture and notebook."""
from dataclasses import dataclass
import math
from numbers import Real
import numpy as np

def positive(name, value):
    if isinstance(value, (bool, np.bool_)) or not isinstance(value, Real):
        raise ValueError(f"{name} must be a real number")
    value = float(value)
    if not math.isfinite(value) or value <= 0:
        raise ValueError(f"{name} must be positive and finite")
    return value

@dataclass(frozen=True)
class ScalingLaw:
    E: float = 1.69
    A: float = 406.4
    B: float = 410.7
    alpha: float = 0.34
    beta: float = 0.28
    kappa: float = 6.0

    def __post_init__(self):
        for name in ("A", "B", "alpha", "beta", "kappa"):
            object.__setattr__(self, name, positive(name, getattr(self, name)))
        if isinstance(self.E, (bool, np.bool_)) or not isinstance(self.E, Real):
            raise ValueError("E must be a real number")
        if not math.isfinite(self.E) or self.E < 0:
            raise ValueError("E must be finite and non-negative")
        object.__setattr__(self, "E", float(self.E))

    def loss(self, N, D):
        N, D = positive("N", N), positive("D", D)
        return self.E + self.A * N**(-self.alpha) + self.B * D**(-self.beta)

    def optimal_split(self, C):
        C = positive("C", C)
        N = (
            (self.alpha * self.A) / (self.beta * self.B)
            * (C / self.kappa) ** self.beta
        ) ** (1 / (self.alpha + self.beta))
        return N, C / (self.kappa * N)

def newton_schulz(G, quintic_steps=5):
    """Trace a rectangular polar-factor approximation."""
    X = np.asarray(G, dtype=np.float64)
    if X.ndim != 2 or 0 in X.shape or not np.isfinite(X).all():
        raise ValueError("G must be a finite non-empty matrix")
    if isinstance(quintic_steps, bool) or not isinstance(quintic_steps, int) or quintic_steps < 0:
        raise ValueError("quintic_steps must be a non-negative integer")
    scale = np.max(np.abs(X))
    if scale == 0:
        raise ValueError("G must not be all zeros")
    transposed = X.shape[0] > X.shape[1]
    X = (X.T if transposed else X) / scale
    X /= np.linalg.norm(X, ord="fro")
    for _ in range(quintic_steps):
        XXt = X @ X.T
        X = 3.4445 * X - 4.7750 * XXt @ X + 2.0315 * XXt @ XXt @ X
    return X.T if transposed else X

def qk_clip_scales(max_logits, tau=100.0, split=0.5):
    """Return gamma and Q/K scales for one monitoring step."""
    maxima = np.asarray(max_logits, dtype=np.float64)
    if maxima.ndim != 1 or maxima.size == 0 or not np.isfinite(maxima).all():
        raise ValueError("max_logits must be a finite vector")
    if np.any(maxima < 0) or not 0 <= split <= 1:
        raise ValueError("maxima must be non-negative and split must lie in [0, 1]")
    tau = positive("tau", tau)
    gamma = np.ones_like(maxima)
    over = maxima > tau
    gamma[over] = tau / maxima[over]
    q_scale = gamma**split
    k_scale = gamma**(1 - split)
    return gamma, q_scale, k_scale, maxima * q_scale * k_scale
Эти функции намеренно не изображают промышленный оптимизатор. В реальном Muon есть группы параметров, буферы накопленного обновления, коэффициент затухания весов, смешанная точность и распределённое состояние. В реальном QK-Clip статистика собирается из обучающего пакета и применяется к конкретной параметризации механизма внимания. Здесь оставлены ровно те операции, которые нужны для проверки логики.
Есть и важная временная оговорка. qk_clip_scales возвращает коррекцию для текущего шага мониторинга. После следующих градиентных шагов веса способны вырасти снова, поэтому регулятор должен наблюдать динамику и при необходимости повторять вмешательство.
14. µP и MetaP: как переносить гиперпараметры с малой вспомогательной модели
Предположим, что нужно выбрать темп обучения для модели со 100B параметров. На маленькой сети можно провести десятки запусков. На целевом масштабе один неудачный темп обучения уже слишком дорог. Поэтому естественен вопрос: можно ли настроить гиперпараметры на малой вспомогательной модели и перенести их без нового полного поиска?
Наивный перенос обычно ломается. При увеличении ширины меняются масштабы активаций, градиентов и относительных обновлений разных слоёв. Значение темпа обучения, устойчивое на 100M, может оказаться слишком большим или слишком маленьким на 100B.
µP — Maximal Update Parametrization (параметризация максимального обновления) — задаёт специальные правила масштабирования для инициализаций и темпов обучения и некоторых множителей так, чтобы при росте ширины сохранялись содержательные изменения представлений в пределе большой ширины. В правильно согласованной µP-семье оптимальные гиперпараметры могут переноситься между ширинами значительно лучше, чем в стандартной параметризации.
Слово могут здесь важно. µTransfer требует, чтобы малая и целевая модели действительно принадлежали одной согласованной семье: одинаковая архитектурная логика, правильная классификация типов параметров и соответствующие правила масштабирования. Это не лицензия настроить произвольный маленький Transformer и механически перенести всё на другой MoE.
Практический выигрыш огромен. Дорогой поиск превращается в серию дешёвых экспериментов на малых вспомогательных моделях, а на большом масштабе остаётся проверка переноса, а не полный перебор сетки.
Meta описала родственную технику MetaP в публичном рассказе о Llama 4. По заявлению команды, она позволяла переносить критические гиперпараметры — послойные темпы обучения и масштабы инициализации — между разными размерами пакета, шириной, глубиной и числом обучающих токенов. Публичное описание MetaP менее формально и не тождественно автоматически µP; корректнее считать его родственником по инженерной цели, а не переименованием одного метода.
Связь с основной темой модуля прямая. Законы масштабирования позволяют измерять, сколько параметров и токенов покупать. µP-подобные методы позволяют дешевле выяснить, как обучать выбранную конфигурацию. Оба подхода заменяют интуитивный выбор серией маломасштабных экспериментов с явно заданным правилом переноса.
15. Параллелизм: как разложить состояние модели по кластеру
Даже идеальные данные и оптимизатор бесполезны, если состояние не помещается в память. Начнём с грубой, но полезной арифметики AdamW со смешанной точностью.
На один параметр могут приходиться:
- веса bf16 — 2 байта;
- градиент в bf16 — 2 байта;
- главная копия весов fp32 — 4 байта;
- первый момент — 4 байта;
- второй момент — 4 байта.
Итого — 16 байт на параметр без учёта активаций, временных буферов и накладных расходов распределителя памяти. Для 7B это
При обычном параллелизме по данным каждая реплика хранит весь этот объём состояния. Увеличение числа GPU ускоряет обработку пакета, но не уменьшает память на каждом процессе.
Процесс распределённого обучения обычно называют rank; здесь каждому процессу соответствует одно устройство. ZeRO (Zero Redundancy Optimizer) устраняет дублирование состояния, а FSDP (Fully Sharded Data Parallel) — семейство реализаций полного распределения параметров, градиентов и состояния оптимизатора. Конкретная реализация может хранить градиенты в fp32: тогда схема 16 байт уже не подходит.
ZeRO/FSDP: не дублировать то, что можно разделить
ZeRO последовательно распределяет состояние между процессами параллелизма по данным:
- состояния оптимизатора;
- затем градиенты;
- затем параметры.
В идеализированном ZeRO-3 на 64 процесса объём перечисленного состояния на процесс уменьшается со 112 GB до
Это нижняя граница только для перечисленного состояния. На практике добавятся активации, коммуникационные буферы, окна сборки параметров, фрагментация и рабочая память для сохранения промежуточных активаций. Зато расчёт показывает сам механизм: ZeRO превращает число реплик в ресурс памяти, а не только в способ увеличить пропускную способность.
Тензорный параллелизм (tensor parallelism): разрезать одну матрицу
Если слой слишком велик даже после шардинга состояния, его матричные операции распределяют по устройствам. Тензорный параллелизм разрезает проекции по строкам или столбцам и синхронизирует частичные результаты. Он особенно эффективен внутри узла с быстрым NVLink или NVSwitch; через медленную сеть коллективные операции могут поглотить выигрыш.
Конвейерный параллелизм (pipeline parallelism): разрезать модель по глубине
Конвейерный параллелизм отдаёт разные группы слоёв разным стадиям. Проблема — пузырь конвейера: в начале и конце часть стадий простаивает. Для сбалансированного расписания 1F1B (чередования прямого и обратного проходов), без времени обменов доля пузыря оценивается как
где — число стадий, — число микропакетов.
При и :
При :
Пузырь уменьшается не магией планировщика, а тем, что длинный поток микропакетов амортизирует заполнение и опустошение конвейера. При фиксированном размере микропакета растёт глобальный пакет. В расписании 1F1B число одновременно сохранённых активаций ограничивается глубиной конвейера и не обязано расти линейно с числом микропакетов; у GPipe с накоплением всех прямых проходов картина другая.
Параллелизм экспертов (expert parallelism): распределить экспертов
Для MoE появляется ещё одна ось. Эксперты размещаются на разных процессах, а токены маршрутизируются через коллективный обмен all-to-all. Здесь балансировка маршрутизатора становится частью системной эффективности: перегруженный эксперт заставляет остальных ждать, даже если среднее число токенов выглядит разумным.
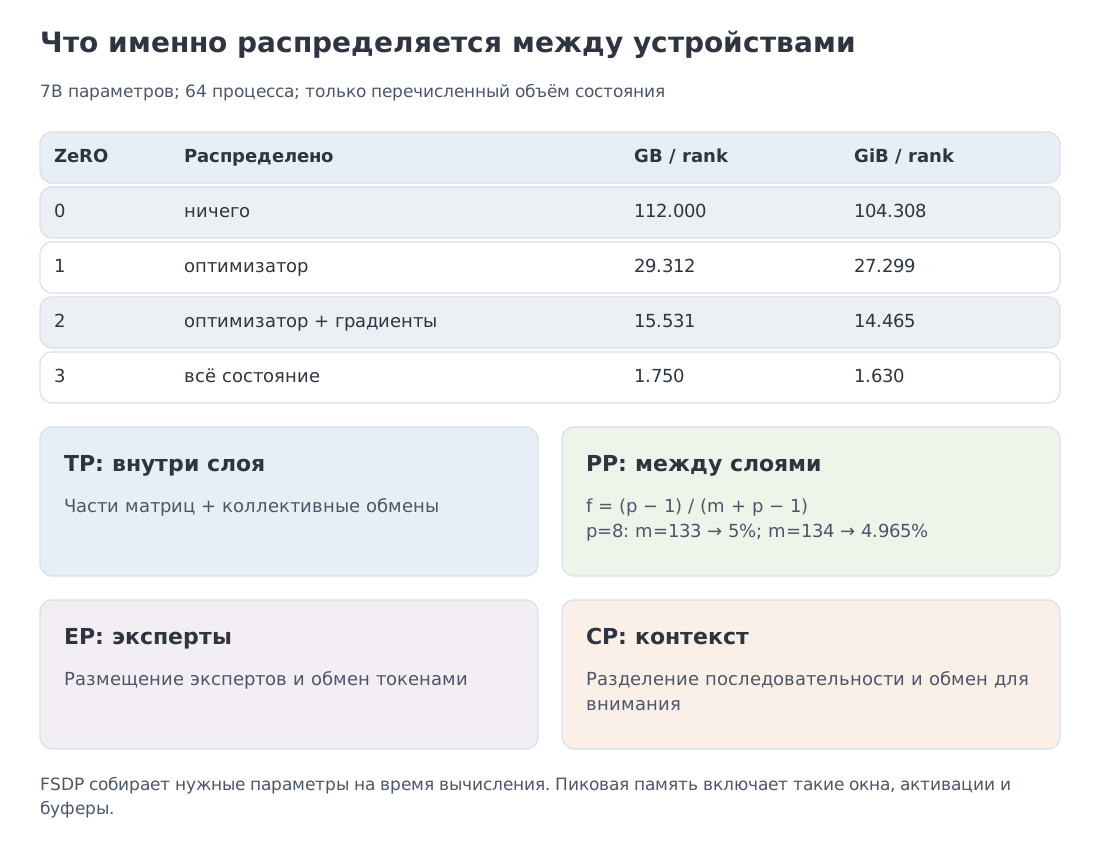 Карта параллелизма: DP → ZeRO/FSDP → TP → PP с формулой пузыря → EP для MoE → их комбинация в 3D+EP. Числовой пример сохраняет 112 GB для 7B и идеальные 1.75 GB на процесс при ZeRO-3/64.
Реальный крупный запуск комбинирует эти оси. Официальное описание Llama 4 сообщает, что Behemoth обучался в FP8 на 32K GPU и достигал 390 TFLOP/s на GPU. Это число полезно не как универсальный эталон, а как иллюстрация масштаба, при котором топология и планирование становятся не менее важны, чем отдельное вычислительное ядро.
Полное распределённое обучение — отдельная дисциплина. В неё входят параллелизм контекста и последовательности, расписания типа DualPipe, коллективные операции с учётом топологии, асинхронное сохранение контрольных точек, эластичное восстановление, зависания NCCL и тихое повреждение данных. Задача этого модуля скромнее: дать арифметику памяти и объяснить, какую именно величину шардит каждая ось.
16. Претрейн в 2026 году: не список приёмов, а четыре направления
Вместо длинного перечня названий полезнее увидеть четыре направления, в которых изменилась схема обучения поверх классической основы «корпус + предсказание следующего токена + AdamW». Эти направления связаны между собой: более сложная смесь данных требует нового расписания, длинный контекст меняет вычислительную цену, более плотная целевая функция повышает требования к устойчивости, а низкая точность становится частью алгоритма, а не только способом ускорить матричное умножение.
1. Данные превращаются в расписание
Важен не только состав смеси, но и момент, когда модель видит каждый тип материала. Широкая ранняя фаза даёт разнообразие и формирует общие представления. Ближе к концу можно увеличить долю проверяемых, образовательных или целевых данных. Это напоминает расписание темпа обучения: один и тот же набор значений, поданный в другом порядке, способен привести к иной траектории.
DoReMi и родственные подходы делают веса доменов объектом оптимизации на малых вспомогательных моделях. Синтетические данные переходят из постобучения в претрейн и промежуточное обучение, однако требуют контроля разнообразия и происхождения. Смесь с акцентом на рассуждения добавляет решения задач, доказательства, трассировки работы с инструментами и проверяемый код. При этом длинная цепочка рассуждений не считается правильной только потому, что она длинная: особенно ценны траектории, результат которых можно выполнить или проверить формально.
2. Длинный контекст осваивают поэтапно
Проводить весь претрейн на сотнях тысяч или миллионах токенов слишком дорого: растут стоимость внимания, объём активаций и коммуникации. Поэтому распространённый маршрут начинается с основного обучения на более коротком контексте и завершается отдельными фазами расширения окна на специализированной смеси.
Llama 4 Scout публично описана как модель, прошедшая обучение на этапах предобучения и постобучения на контексте 256K с последующей способностью обобщаться до 10M. DeepSeek V4 и Kimi K3 проектировались вокруг окна 1M. Однако фраза «поддерживает 1M» не означает, что каждый токен основного корпуса был обработан в последовательностях длиной миллион. Контекстное окно является итогом архитектурных решений и нескольких этапов обучения.
3. Целевая функция становится плотнее
Multi-Token Prediction добавляет головы, предсказывающие несколько следующих токенов. Вместо одного сигнала на позицию модель получает надзор по нескольким будущим позициям; позднее те же головы могут использоваться как черновой механизм для спекулятивного декодирования. Реальный выигрыш зависит от весов дополнительных слагаемых функции потерь, устройства голов и стоимости дополнительного вычисления.
Дистилляция также перемещается в претрейн. Meta сообщала, что Llama 4 Maverick совместно дистиллировалась от Behemoth. В такой схеме старшая модель помогает младшей быстрее сформировать полезные представления, хотя итог всё равно определяется данными, архитектурой и режимом обучения младшей модели.
4. Числовой формат становится частью алгоритма
Претрейн в FP8 уже документирован для крупных запусков, включая Llama 4. В Nemotron 3 Super и Ultra NVIDIA пошла дальше: значительная часть операций прямого прохода, градиентов по активациям и градиентов по весам выполнялась с NVFP4 GEMM, тогда как чувствительные компоненты сохранялись в более высокой точности.
Здесь речь идёт не о простой замене одного типа числа другим. В отчёте Nemotron 3 Ultra описаны двумерное блочное масштабирование, стохастическое округление, случайные преобразования Адамара и перечень слоёв, оставленных в BF16 или FP8. Команда проводила ответвления в BF16 от контрольных точек 5T, 10T и 16T; средний относительный разрыв по функции потерь оставался ниже 0.4%. Одновременно запуск пережил два эпизода расходимости, один из которых связали с понижением точности локального накопления градиента выходного слоя. Педагогический вывод здесь особенно важен: низкая точность работает потому, что политика числовых форматов проектируется и диагностируется как часть всей системы оптимизации.
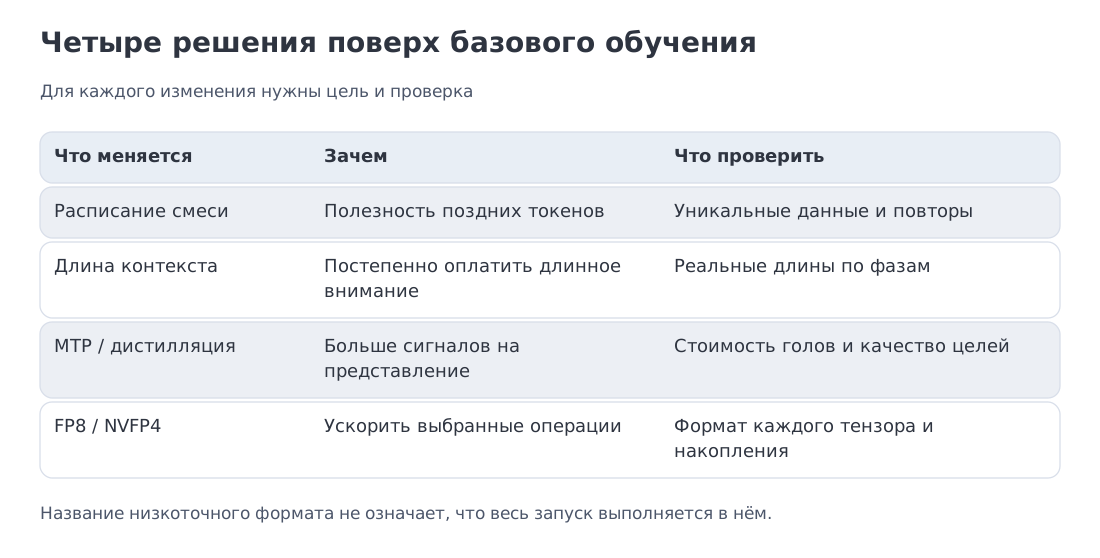 Четыре направления: расписание данных; поэтапное расширение контекста; более плотная целевая функция и дистилляция; FP8/NVFP4 как спроектированная система смешанной точности.
17. Паспорта запусков: что можно узнать из технического отчёта
Передовые модели полезно сравнивать не по одной итоговой таблице качества, а по паспорту обучающего запуска. В него входят общее и активное число параметров, объём и модальности данных, распределение оптимизаторов по группам параметров, политика числовых форматов, этапы расширения контекста, механизмы устойчивости и статус каждого свидетельства — независимое измерение или результат, сообщённый разработчиком.
Рассмотрим несколько публичных примеров.
Kimi K2: MuonClip в модели MoE триллионного масштаба
Kimi K2 имеет 1T параметров всего и 32B активных параметров. Технический отчёт сообщает 15.5T токенов претрейна, использование MuonClip и отсутствие скачков функции потерь в этом запуске. Для истории Muon это важный переход: метод вышел за пределы малых скоростных экспериментов и стал частью публично описанного обучения триллионной модели MoE.
Из этого не следует, что итоговое качество K2 определяется одним MuonClip. Оно складывается из данных, архитектуры, числа активных параметров, расписания и постобучения. Паспорт подтверждает более узкий и надёжный вывод: MuonClip был одним из механизмов стабилизации успешно завершённого крупного запуска.
Nemotron 3 Ultra: NVFP4 как полный режим обучения
Nemotron 3 Ultra — модель MoE, сочетающая Mamba и внимание, с 550B параметров всего и 55B активных параметров, обученная на 20T текстовых токенов. Отчёт подробно описывает претрейн в NVFP4: какие GEMM выполняются в формате E2M1 с блочным масштабированием, где сохраняется более высокая точность и как применяются стохастическое округление и преобразования Адамара.
Паспорт ценен и разбором неустойчивостей. Расходимость около отметки 8T связали с переводом локального накопления градиента выходного слоя из FP32 в BF16; возврат более высокой точности восстановил устойчивость. Второй эпизод около 16T оказался сложнее. Такой разбор полезнее общего лозунга о стабильности низкой точности: он показывает, какие численные решения действительно критичны.
DeepSeek V4: Muon, гибридное внимание и mHC
DeepSeek V4 включает две предварительные модели: V4-Pro 1.6T/49B активных параметров и V4-Flash 284B/13B активных параметров, обе с контекстом 1M. В техническом отчёте указано более 32T токенов претрейна и три существенных компонента: гибридное внимание CSA + HCA, mHC и Muon.
mHC — Manifold-Constrained Hyper-Connections — развивает идею Hyper-Connections, где остаточный поток расширяется до нескольких взаимодействующих каналов. Свободно обучаемые матрицы смешивания способны нарушить близость остаточного преобразования к единичному и вызвать усиление сигнала. mHC ограничивает пространство остаточных связей; в работе используется структура, связанная с многогранником Биркгофа, чтобы сделать смешивание более контролируемым при масштабировании.
mHC описан в отдельной работе arXiv:2512.24880 и применён в DeepSeek V4, поэтому это публично документированный рабочий компонент. Его переносимость на другие семейства моделей ещё требует независимых реализаций и сравнений.
Первая версия отчёта DeepSeek V4 опубликована 26 апреля 2026 года. NIST CAISI выпустил независимую оценку 1 мая 2026 года: V4 была названа наиболее сильной из рассмотренных китайских моделей, но отчёт одновременно оценивал её отставание от передового мирового уровня примерно в восемь месяцев и отмечал расхождения с результатами, сообщёнными разработчиком. Такая оценка характеризует внешнее качество системы, но не устанавливает причинный вклад каждого внутреннего решения.
Kimi K3: открытый релиз с Muon по головам и LatentMoE
Технический отчёт Kimi K3 и полные веса опубликованы 27 июля 2026 года. Модель имеет 2.8T параметров всего и 104B активных параметров, поддерживает изображения и контекст 1M. Механизм Stable LatentMoE эффективно активирует 16 из 896 маршрутизируемых экспертов; архитектура использует Kimi Delta Attention и остаточные связи внимания (Attention Residuals).
Команда сообщает примерно 2.5-кратное улучшение общей эффективности масштабирования относительно K2. Это результат разработчика, полученный внутри собственного семейства моделей и режима обучения, а не универсальная константа масштабирования. Для превращения такого коэффициента в общий закон потребовались бы независимые эксперименты isoFLOP.
Система обучения развивает тему модуля. Muon применяется с обработкой отдельных голов внимания, Quantile Balancing управляет распределением экспертов, а QAT начинается с SFT и использует веса MXFP4 и активации MXFP8. Сбалансированный параллелизм экспертов поддерживает статические формы тензоров без синхронизации с CPU на критическом пути. K3 показывает, что естественной единицей геометрии оптимизатора может быть не вся физически сохранённая матрица, а семантическая структура — отдельная голова внимания.
Qwen3.8-Max: открытые веса и неполный паспорт обучения
На 11 октября 2026 года доступны API Max и текстовые веса Qwen3.8-2.4T-A95B под лицензией qwen3.8-max. Для контрольной точки указаны 2.4T параметров всего, 95B активных и контекст 1M. Возможности API и скачиваемой текстовой модели следует различать.
Карточка весов не превращается автоматически в полный отчёт об обучении: для воспроизведения нужны состав и объём данных, политика оптимизаторов и точности, расписание контекста и журнал устойчивости. Результаты задач, опубликованные разработчиком, тоже не позволяют выделить причинный вклад одного решения в предобучении. Доступ, лицензия и прозрачность процесса — разные характеристики.
Inkling: гибридный оптимизатор и 45T мультимодальных токенов
Thinking Machines Lab сообщает для Inkling 975B параметров всего, 41B активных параметров, контекст 1M и 45T токенов текста, изображений, аудио и видео. Крупные матричные веса обучались Muon, остальные параметры — Adam. Коэффициент затухания весов (weight decay) связывался с квадратом темпа обучения, чтобы контролировать масштаб весов на разных горизонтах.
Этот паспорт важен не рекордом размера, а прозрачным разделением групп параметров. Он показывает практическую норму: современная система оптимизации может быть гибридной и зависеть от геометрии конкретного параметра.
Llama 4 Behemoth: паспорт инфраструктуры
Meta сообщала о претрейне Behemoth в FP8 на 32K GPU с производительностью 390 TFLOP/s на GPU и смесью данных более 30T токенов. Это редкий публичный ориентир эффективности крупного кластера. В исходном анонсе Behemoth оставалась предварительной моделью в процессе обучения, поэтому эти числа следует читать как характеристики описанного запуска, а не как паспорт полностью выпущенной контрольной точки.
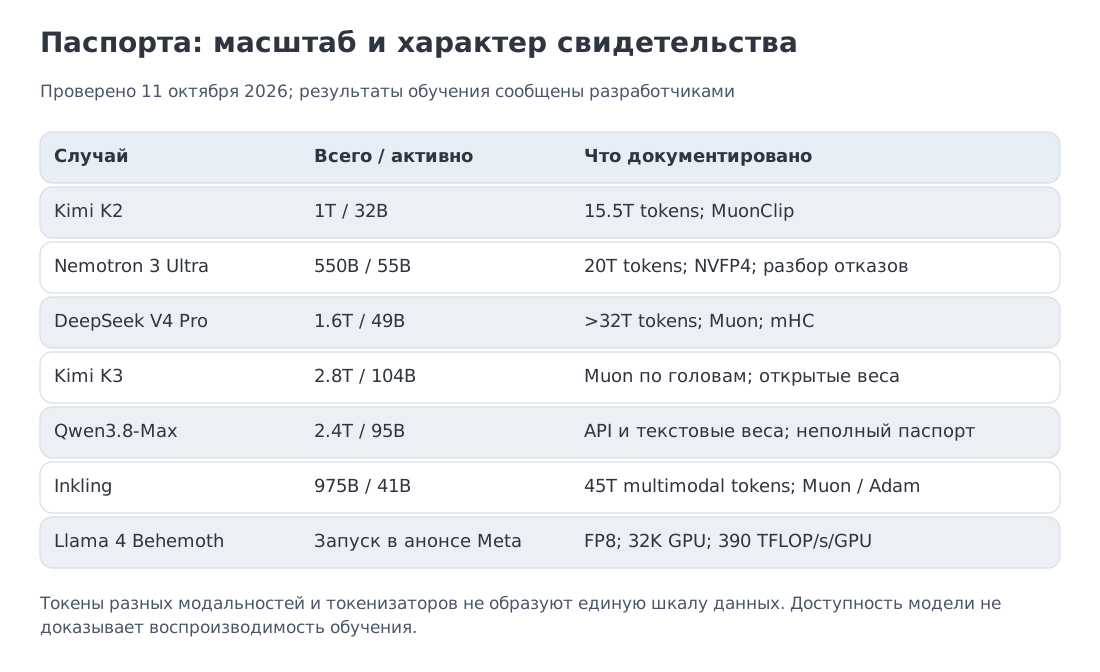 Паспорта запусков: K2 — MuonClip и 15.5T токенов без скачков функции потерь; Nemotron 3 Ultra — 550B/55B, 20T и подробная схема NVFP4; DeepSeek V4 — Muon, mHC и гибридное внимание; K3 — выпущенные веса 2.8T/104B и Muon с обработкой по головам; Behemoth — публичный ориентир инфраструктуры.
Главный навык этого раздела — не запомнить несколько названий, а различать четыре уровня утверждений:
- архитектурный факт, подтверждённый отчётом, конфигурацией или опубликованными весами;
- метрика конкретного запуска, сообщённая разработчиком;
- причинная интерпретация, объясняющая полученный результат;
- универсальный вывод, который требует нескольких независимых воспроизведений.
Большинство ошибок в обзорах возникает при незаметном переходе от первого или второго уровня сразу к четвёртому.
20. Ключевые выводы модуля и источники
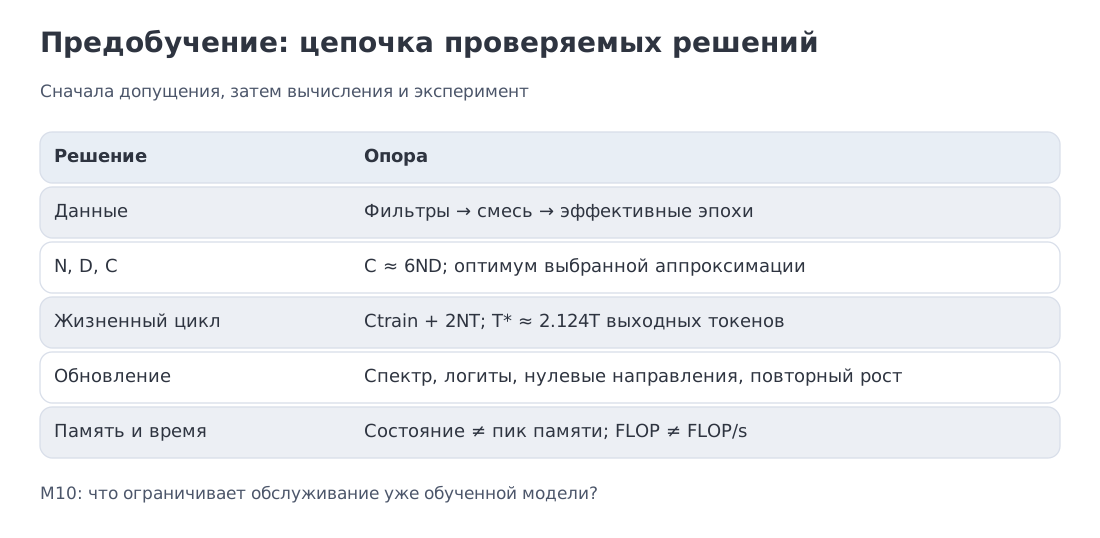 Шпаргалка модуля: эмпирическая модель масштабирования и её аналитический оптимум; точка окупаемости с учётом инференса; конвейер данных и стена данных; Muon/QK-Clip; память, ZeRO и пузырь конвейера; паспорта публичных обучающих запусков.
Мы начали с трёх вопросов одного обучающего запуска и увидели, что они неразделимы.
Законы масштабирования дают эмпирическую модель компромисса между числом параметров и числом токенов. В выбранной аппроксимации
а аналитический оптимум равен
Математическая точность этого оптимума относится к самой аппроксимирующей функции, а не гарантирует точность её экстраполяции за пределы исходного диапазона. Для наш учебный расчёт даёт 35.663B параметров и 3.377T токенов.
Анализ с учётом инференса меняет целевую функцию. Сценарий 8.03B/15T имеет значение аппроксимированной функции потерь на 0.025804 выше оптимума того же бюджета обучения, но модель примерно в 4.4 раза меньше. В упрощённом сравнении с 70B-моделью того же значения функции потерь дополнительные вычисления на обучение малой модели окупаются после сгенерированных токенов.
Данные не сводятся к числу . Корпус проходит извлечение текста и определение языка, эвристическую очистку, поиск почти полных дубликатов, модельную оценку качества, фильтры персональных данных и политик, а затем формирование доменной смеси. FineWeb 15T, FineWeb-Edu 1.3T, Nemotron-CC 6.3T и DCLM представляют разные типы артефактов; особенно важно различать исходный пул DCLM около 240T токенов и объём токенов конкретного обучающего запуска.
Muon обрабатывает крупные матричные обновления как матрицы, а не как плоский вектор. Накопленное обновление проходит несколько итераций Ньютона–Шульца, которые сжимают спектр. В нашей трассировке разброс сингулярных чисел ×5.1 превращается в полосу [0.68, 1.13]. Для шага оптимизатора этого достаточно, хотя результат не является точной ортогонализацией.
QK-Clip воздействует не только на выросшие логиты внимания, но и на их источник — матрицы и . При симметричное масштабирование на возвращает билинейный максимум к порогу. Kimi K2 сообщает 15.5T токенов без скачков функции потерь при использовании MuonClip; это результат конкретного запуска, а не общая теорема.
Память и параллелизм начинаются с арифметики. Состояние AdamW смешанной точности в нашем соглашении занимает 16 байт на параметр; для 7B это 112 GB = 104.31 GiB на процесс при полном дублировании. Идеальный ZeRO-3 на 64 процессах уменьшает перечисленное состояние до 1.75 GB = 1.63 GiB на процесс. Для расписания 1F1B доля пузыря равна : при восьми стадиях она составляет 17.9% для 32 микропакетов и 5.2% для 128.
Современную систему обучения следует читать по паспортам, а не по лозунгам. DeepSeek V4 документирует Muon, mHC, гибридное внимание и более 32T токенов. Kimi K3 выпущена с полными весами; модель имеет 2.8T параметров всего, 104B активных параметров и использует Muon с обработкой по головам. В отчёте Nemotron 3 Ultra описаны претрейн на 20T токенов в NVFP4 и зафиксированные численные отказы. Для Inkling указаны гибридный Muon/Adam и 45T мультимодальных токенов. На дату среза для Qwen3.8-Max известны 2.4T параметров всего, 95B активных параметров и доступ через API и текстовые веса, а значительная часть паспорта претрейна ещё не раскрыта.
Основные первоисточники
- Kaplan et al., Scaling Laws for Neural Language Models — arxiv.org/abs/2001.08361
- Hoffmann et al., Training Compute-Optimal Large Language Models — arxiv.org/abs/2203.15556
- Sardana et al., inference-aware scaling — arxiv.org/abs/2401.00448
- FineWeb / FineWeb-Edu — arxiv.org/abs/2406.17557
- FineWeb2 — arxiv.org/abs/2506.20920
- DCLM — arxiv.org/abs/2406.11794
- Nemotron-CC — arxiv.org/abs/2412.02595
- DoReMi — arxiv.org/abs/2305.10429
- Muon reference implementation — github.com/KellerJordan/Muon
- Kimi K2 — arxiv.org/abs/2507.20534
- µP — arxiv.org/abs/2203.03466
- ZeRO — arxiv.org/abs/1910.02054
- mHC — arxiv.org/abs/2512.24880
- DeepSeek V4 — arxiv.org/abs/2606.19348
- Kimi K3 — arxiv.org/abs/2607.24653, официальный технический блог и полные веса
- Qwen3.8-Max — официальный анонс Qwen
- Hugging Face, июльский инцидент безопасности — техническая хронология
- Nemotron 3 Ultra — технический отчёт NVIDIA
- Inkling — официальное описание
- Llama 4 / MetaP / инфраструктура FP8 — официальный анонс Meta
- оценка DeepSeek V4 организацией NIST CAISI — nist.gov
Дальше: модуль 10 переходит от стоимости обучения к стоимости обслуживания. KV-кэш, арифметическая интенсивность, пакетная обработка и размещение состояния покажут, почему две модели с одинаковым числом параметров могут вести себя совершенно по-разному при реальной нагрузке инференса.
Источники и доступность сверены 11 октября 2026 года. Числа запусков принадлежат их авторам; расчёты по исторической аппроксимации не являются прогнозом качества современных моделей.