Модуль 1. Современный ландшафт LLM
Курс «Modern LLMs» · редакция 2026.10.23 · обзор релизов: 11 октября 2026 года
Как выбрать языковую модель для задачи и понять, что именно обещает её разработчик? В этом модуле мы составим два коротких описания — паспорт модели и паспорт системы, — а затем проверим их расчётами. Первый соберёт сведения об устройстве и возможностях модели, второй — об условиях её применения и проверки. Сквозным примером станет ассистент, который отвечает по внутренним документам и указывает источники.
Предполагается общее знакомство с нейросетями и языковыми моделями: вы примерно представляете, что модель обучается на примерах и генерирует текст по запросу. Знание устройства Transformer не требуется. Термины будем вводить по мере необходимости, а механизмы разбирать в следующих модулях: М2 объяснит токенизацию и эмбеддинги, М3 соединит их с вычислениями внутри Transformer. Для численных примеров понадобятся алгебра и степени двойки; для практики — функции и словари Python.
Как читать модуль
| Проход | Маршрут | Результат |
|---|---|---|
| Первый: понять задачу и выбрать проверки | §§1–2 → §§4–6 → §§8–12 → §15 → §§19–22; У1, У5 и У6 | Объяснить роль модели, оценить память весов и проверить смысл ответа и его источника |
| Второй: воспроизвести расчёты | Углубления §§5–6 и §8 → §7 → §§16–18; У2 и полный ноутбук | Прочитать конфигурацию, пересчитать параметры и ресурсы, указать допущения |
| Справочный: исследовать выпуск | §3, §§13–14 и §23; проекты У3–У4 | Различить свойства артефакта, заявления разработчика и неизвестные поля |
При первом проходе пропускайте только блоки с заголовками «Второй проход» и «Справочный кейс». Остальной текст указанных разделов читается последовательно. В §22 формула обучения отдельно отмечена как материал второго прохода. Таблицы с именами архитектур служат указателями: запоминать их сокращения заранее не требуется.
В ноутбуке первые три раздела дают самостоятельный короткий опыт: ответ и источник, память весов, стоимость принятой задачи. Дальнейшие разделы раскрывают полный подсчёт и проверки. Команда Run all выполняет весь обязательный путь по порядку; доступ к API моделей не нужен.
1. Зачем инженеру карта ландшафта
Ассистент по документам — программа, которая ищет сведения в заданной коллекции документов и помогает ответить на вопрос, ссылаясь на найденные источники. Например, сотрудник спрашивает об условиях хранения отчётов, а ассистент находит соответствующую инструкцию и объясняет её требования. Нас интересует весь путь от вопроса до проверяемого ответа: поиск, работа языковой модели и проверка того, что источник действительно подтверждает сказанное.
Такую систему можно построить вокруг удалённого сервиса или модели, запущенной на своём оборудовании. В первом случае программа обращается к сервису через API — программный интерфейс. Во втором нужны доступные для загрузки веса, то есть числовые параметры нейросети, полученные при обучении. Среди обоих вариантов есть модели с разными затратами и возможностями; некоторые позволяют также управлять объёмом вычислений, выделяемых на ответ. Доступ и цена вызова ещё не говорят, будет ли решена наша задача.
Чтобы сравнение было осмысленным, уточним, какую работу выполняет сама модель. Большая языковая модель (LLM, Large Language Model) обрабатывает текст единицами, которые называют токенами: это могут быть слова, части слов, знаки и другие фрагменты. В обычной авторегрессионной модели ответ строится последовательно: модель оценивает следующий токен по доступному тексту, программа выбирает его и повторяет шаг. Применение обученной модели называют инференсом. Такой порядок генерации станет основным для курса; альтернативу разберём в М12.
Отсюда следует различие между моделью и системой. Модель вычисляет оценки токенов; система находит документы, формирует вход, предоставляет инструменты и проверяет результат. Одни и те же веса могут работать в простом чате или в программе с поиском и давать разное качество на одном вопросе. Даже верный ответ требует отдельной проверки ссылки: существующий документ может не подтверждать утверждение. В §12 разберём этот случай на коротком примере, в М17 построим поиск по документам, а в М19 изучим оценку качества.
Наш маршрут начинается с шести вопросов. Сколько памяти требуют веса? Какой объём текста модель может использовать? Какие виды данных принимает и создаёт? Как расходует вычисления на ответ? Какие артефакты и права доступны? Сколько стоит результат, прошедший проверку? Свойства модели и подтверждающие их источники войдут в паспорт модели; настройки запуска, измерения и правила приёмки — в паспорт системы.
По мере чтения заполняйте оба паспорта для ассистента. Если сведения ещё не опубликованы или не измерены, оставляйте «неизвестно». В §12 мы сведём расходы к одному принятому ответу, а в §15 разберём, какие свидетельства позволяют доверять сравнению. Названия продуктов меняются; эта процедура остаётся полезной.
2. Как курс связывает объяснение и код
Нам предстоит не только сравнивать готовые модели, но и понимать их устройство. Для этого полезно увидеть одну идею в нескольких формах: сначала в коротком вычислении, затем в проверяемом опыте и, наконец, в коде существующей модели. Эти формы различаются учебной задачей; запуск на настоящем компьютере сам по себе не делает программу готовым сервисом.
| Форма работы | Какой вопрос она решает? | Что нужно получить |
|---|---|---|
| 1. Минимальная реализация | Как из формулы получается вычисление? | Небольшой код, в котором виден каждый существенный шаг |
| 2. Практический ноутбук | Сохраняется ли смысл вычисления на разных входах? | Воспроизводимый опыт с проверками форм, единиц и граничных случаев |
| 3. Чтение открытой реализации | Где и в какой форме знакомый механизм встречается в существующей модели? | Сопоставление формулы, конфигурации и выбранного участка исходного кода |
| 4. Сквозной итоговый проект | Как изученные части работают вместе? | Компактная модель MiniLLM, которую можно обучать, изменять и проверять |
На первом уровне мы стараемся сделать ход вычисления видимым. На втором добавляем достаточно проверок, чтобы результат можно было воспроизвести и осмысленно изменять. Например, расчёт памяти должен отклонить отрицательное число параметров или нулевую разрядность весов. Проверка входных данных делает допущения формулы частью программы.
Третий уровень означает чтение и сопоставление кода. Мы найдём, как реализация задаёт размеры матриц, считает активацию или выбирает экспертов, и сравним это с учебной моделью. В репозитории могут находиться также специализированные вычислительные ядра и средства работы на нескольких устройствах. Их наличие не означает, что курс учит их разрабатывать. Производственная эксплуатация, реализация распределённого обучения и разработка вычислительных ядер находятся за границами этого курса; отдельные оценки памяти, вычислений и обменов помогают понимать ограничения, но не заменяют такое обучение.
Для чтения реальных реализаций несколько раз используются одни и те же семейства. gpt-oss позволяет сопоставлять конфигурацию и открытый код; DeepSeek даёт подробные архитектурные отчёты; OLMo открывает больше стадий обучения; Inkling и Tinker показывают сочетание доступных весов и сервиса адаптации. Их конкретные механизмы перечислены в справочнике §14 после объяснения осей сравнения.
Четвёртый уровень — итоговый проект, который соединяет изученные механизмы в небольшую работающую модель — MiniLLM. Мы сможем обучить её на доступном масштабе, сохранить состояние, изменить конфигурацию и проверить результат. Это самостоятельный учебный артефакт. Его цель — связать объяснения с наблюдаемыми вычислениями; подготовка отказоустойчивой системы для пользователей потребовала бы отдельного проекта и дополнительного курса.
Какого масштаба будет наша MiniLLM? В одной реализации предусмотрены три размера — S, M и L — и два варианта устройства. В плотном варианте (dense) каждый токен проходит через одни и те же вычислительные блоки. В смеси экспертов (Mixture of Experts, MoE) часть блоков заменена наборами подсетей — экспертов: для каждого токена выбирается лишь несколько из них. Поэтому у MoE различаются полное число параметров и число параметров, относимых к обработке одного токена, — активных параметров. Механизм выбора разберём в М7; здесь он помогает понять масштаб проекта.
В таблице слой означает повторяющийся этап обработки, а ширина — число компонентов внутреннего вектора токена. Словарь задаёт число различных токенов; контекст — заданную в профиле предельную длину последовательности в токенах. Эти размеры получат подробное объяснение в М2–М5. Все числа параметров приведены в миллионах и округлены до двух знаков.
| Размер | Слои × ширина | Словарь | Контекст | Плотная: параметры, млн | MoE: всего, млн | MoE: активно, млн |
|---|---|---|---|---|---|---|
| S | 6 × 256 | 8 192 | 512 | 6,33 | 20,36 | 6,59 |
| M | 8 × 512 | 16 384 | 1 024 | 30,94 | 174,88 | 30,37 |
| L | 20 × 2 048 | 32 768 | 2 048 | 1 020,35 | 10 020,54 | 1 055,21 |
Источник — шесть профилей MiniLLMConfig.profile() из кода практикума. В каждой паре совпадают глубина, ширина, словарь и контекст. Активные параметры считаются по соглашению практикума: общие матрицы, включая словарные, учитываются целиком, а из выбираемых экспертов — только используемые для одного токена. В плотной модели этот счёт совпадает с полным числом параметров. Подробнее о границах такого подсчёта — в §6.
S предназначен для коротких опытов и проверки всей цепочки, M — для более содержательных учебных запусков. L даёт необязательный переход к миллиардному масштабу: около 1,02 млрд параметров у плотной модели и 10,02 млрд у MoE. Для обязательных упражнений конфигурации дополнительно уменьшаются; обучение L требует отдельного бюджета, а L-MoE используется прежде всего для расчёта ресурсов. Близкое число активных параметров у двух вариантов не обещает одинаковую скорость и не отменяет хранения всех весов MoE.
Таким образом, итоговый проект позволяет пройти полный цикл работы с обучаемой моделью и исследовать влияние архитектуры в нескольких масштабах. Качество её текста будет зависеть от данных, объёма обучения и проверки на отложенных задачах; таблица задаёт размеры эксперимента, а не обещает возможности готового ассистента. Маршрут практикума объясняет, как выбрать посильный запуск.
На всех четырёх уровнях важно понимать, где хранятся веса модели и какие сведения описывают её устройство. Сохранённое состояние весов называется чекпойнтом (checkpoint). Файл config.json обычно задаёт размеры и настройки архитектуры, а карточка модели (model card) описывает обучение, назначение и ограничения. Чекпойнт содержит значения параметров; конфигурация сообщает размеры; код показывает операции; карточка добавляет происхождение и условия использования. Эти сведения дополняют друг друга, поэтому для проверяемого паспорта модели мы будем читать их вместе.
3. Девять лет за пятнадцать минут: 2017 → 2026
Прежде чем читать снимок 2026 года, полезно увидеть, как менялся главный дефицитный ресурс. История здесь нужна не ради списка релизов: она объясняет, почему современный паспорт содержит именно такие поля.
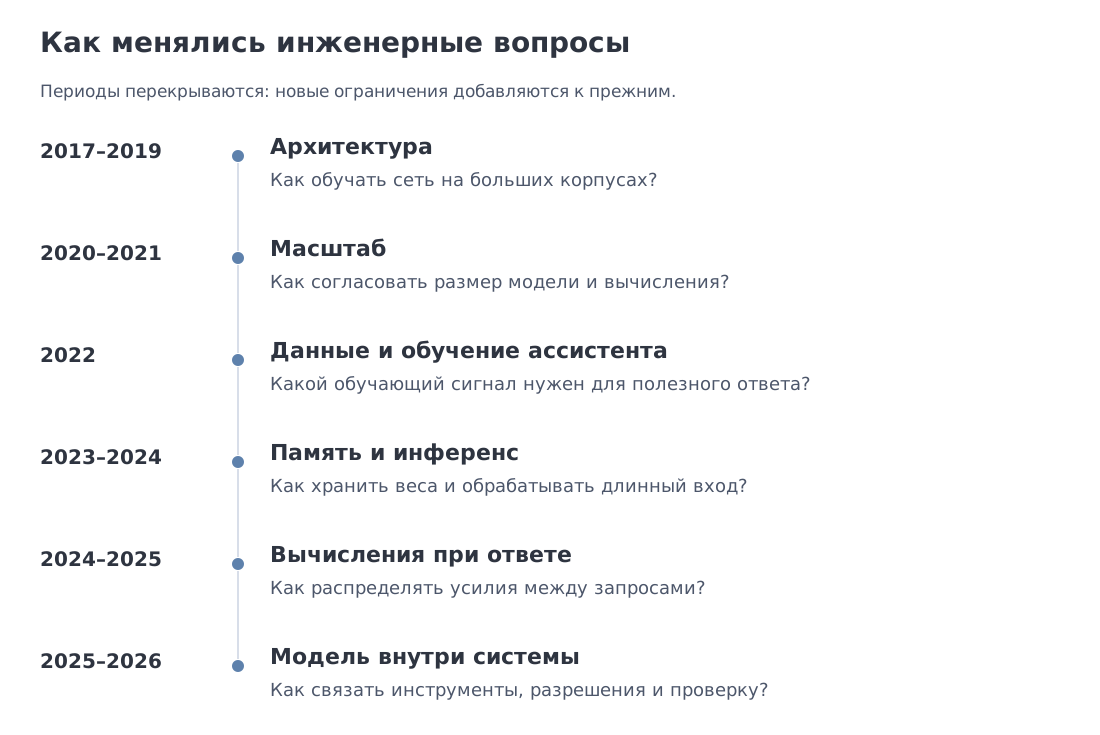 Шесть эпох: от архитектуры и масштабирования к данным, инференсу, постобучению и системной оркестрации. Имена релизов вынесены в таблицу, чтобы временная линия оставалась читаемой.
Эпоха 1. Архитектура (2017–2019). Transformer делает обучение параллельным по длине последовательности, а GPT и BERT закрепляют идею общего претрейна с последующей адаптацией. Дефицит — рабочая архитектура, способная поглощать большой корпус.
Эпоха 2. Масштаб и in-context learning (2020–2021). GPT-3 показывает, что модель может осваивать новую задачу по инструкции и нескольким примерам без обновления весов. Scaling laws превращают размер запуска из искусства в планируемую величину. Дефицит — вычисления.
Эпоха 3. Данные и alignment (2022). Chinchilla показывает цену недообученной большой модели: параметры нужно согласовывать с объёмом данных. InstructGPT и ChatGPT превращают языковую модель в продукт, где качество зависит не только от претрейна, но и от SFT, предпочтений, награды и интерфейса. Дефицит — качественный обучающий сигнал.
Эпоха 4. Открытые веса, MoE и длинный контекст (2023–2024). Llama, Mixtral, DeepSeek и другие семейства делают архитектурное сравнение массовой практикой. GQA, MLA, MoE, FlashAttention и длинный контекст становятся не отдельными трюками, а экономикой исполнения. Дефицит — память и пропускная способность инференса.
Эпоха 5. Reasoning и test-time compute (2024–2025). Модель получает возможность тратить разное количество вычислений на один запрос. Появляются reasoning-модели, RLVR, встроенные верификаторы, multi-token prediction и систематическая дистилляция решений. Дефицит — удачное распределение вычислений между обучением и конкретным запросом.
Эпоха 6. Модель становится системой (2025–2026). Сохранённые веса остаются ядром, но реальная способность всё чаще определяется инструментами, памятью, исполнением кода, субагентами, разрешениями, семплером и оценочной средой. В одной системе могут сосуществовать дешёвый и дорогой reasoning, параллельные агенты, голос, компьютерное управление и управляемая адаптация.
Эпохи перекрываются: новые ограничения добавляются к прежним. Датированный срез шестой эпохи удобно хранить таблицей. Так видно не «кто первый», а какой новый объект появился в инженерном паспорте.
| Сдвиг | Примеры на 11 октября 2026 года | Что проверять в паспорте |
|---|---|---|
| Разные уровни стоимости и мощности | GPT-6 Astra / Sol / Luna, GPT-6.1 Sol; Claude Opus / Sonnet / Haiku 5.5 | версию, effort, тариф и ограничения запроса |
| Длительные агентные задачи | Gemini 3.8 Flash, Grok 4.7 | инструменты, время выполнения, число попыток и принятый результат |
| Расширение доступа идёт поэтапно | Gemini 4 Argon: анонс и ограниченный доступ через Fairwind | доступен ли продукт именно в нужном контуре |
| Новые открытые архитектуры | Qwen3.8-2.4T-A95B; DeepSeek-V4.1-Flash | состав артефакта, лицензию, отдельные числа active для prefill и decode |
| Модель работает внутри системы | инструменты, память и несколько агентов | разрешения, координацию, проверку результата и совокупную стоимость |
Даты и первичные источники для этого среза собраны в §§13–14 и §23.
Именно поэтому М1 начинается не с одной «лучшей модели», а с системы координат. По ней можно читать и исторический релиз, и модель, которая появится после публикации курса.
4. Как сравнивать устройство моделей
Первое полезное разделение — что происходит внутри нейросети, а что обеспечивает сервис вокруг неё. Среди внутренних решений нас будут интересовать два механизма. Внимание (attention) смешивает сведения из разных позиций контекста. Полносвязный блок (FFN, Feed-Forward Network) преобразует вектор на отдельной позиции. В модуле 3 мы соберём из этих операций базовый Transformer, а в модулях 5–7 изучим их варианты.
Для обзора достаточно трёх архитектурных вопросов. Использует ли каждый токен один и тот же набор весов или выбирает часть большого банка? Обращается ли модель ко всему доступному прошлому, к локальному окну или к сжатому состоянию? Какие представления данных поступают на вход и выход? В §6 первый вопрос приведёт к плотным моделям и смеси экспертов; §8 свяжет второй с памятью контекста.
У модели с открытыми весами часть ответов записана в config.json: число слоёв, размерность векторов, количество блоков внимания и экспертов. Полный вычислительный путь определяется конфигурацией вместе с реализацией. Название семейства не задаёт этот путь однозначно.
Даже одинаковая архитектура допускает разное поведение. Предварительное обучение формирует веса на большом корпусе; дообучение на инструкциях (SFT) использует примеры желаемых ответов; обучение с подкреплением (RL) меняет модель по сигналу о качестве результата. Данные и последующая адаптация не восстанавливаются из одних размерностей. Поэтому паспорт должен содержать и сведения об обучении, и результаты проверки. Их ищут в карточке модели (model card) — описании назначения, характеристик и ограничений опубликованного варианта.
5. Два паспорта: модель и система
Для ассистента по документам паспорт модели описывает вычислительное ядро, а паспорт системы — способ его использования. Например, наличие поиска ещё не означает, что ответ проверяется по найденным источникам. Такое правило относится к системе и должно быть записано отдельно.
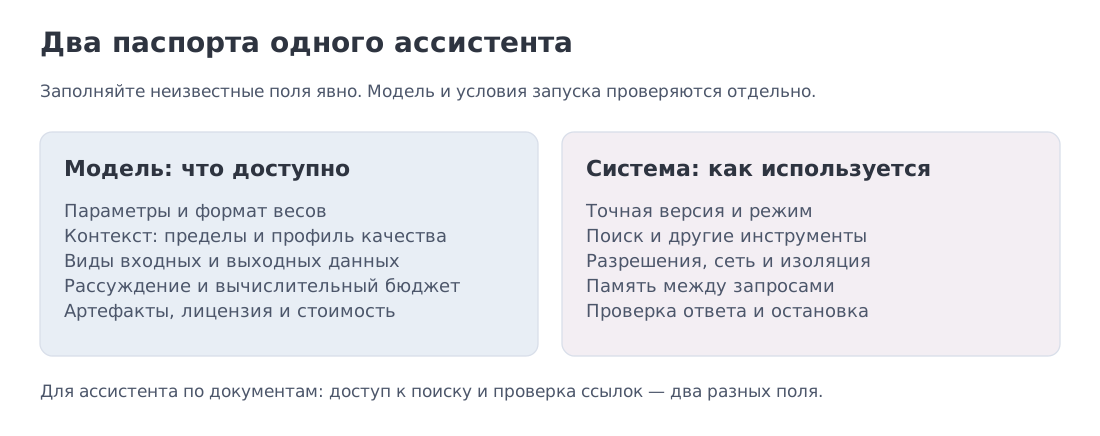 Модель задаёт вычисления; окружающая система предоставляет данные и инструменты, ограничивает действия и проверяет результат.
Свойства модели и результаты её использования связаны, но имеют разный статус. Число параметров можно восстановить по конфигурации и коду. Стоимость принятого ответа и качество на длинных документах появляются только после выбора задачи, настроек и способа проверки. В модельном паспорте мы оставим ссылки на такие измерения, а их условия запишем в системном. Так одно удачное испытание не превращается в обещание для любой нагрузки.
Для ассистента из §1 важно не только знать срок хранения, но и найти действующую инструкцию, которая его устанавливает. Число параметров не определяет, какой документ найдёт система и подтвердит ли он ответ. Поэтому системный паспорт должен описывать доступную коллекцию и правило приёмки.
5.1. Что записать о модели
| Поле | Вопрос для нашего ассистента | Где проверить |
|---|---|---|
| Параметры | Сколько весов хранится и сколько используется при обработке токена? | Конфигурация, код, карточка; §6–7 |
| Контекст | Какой объём документов принимается и на какой длине ответы остаются полезными? | Документация и собственная проверка; §8 |
| Входы и выходы | Нужны ли изображения страниц или только текст? | Карточка и формат запроса; §9 |
| Рассуждение | Можно ли выделить больше вычислений сложному вопросу? | Параметры запроса и измерения; §10 |
| Доступ | Есть ли веса и право использовать их в нужных условиях? | Репозиторий, лицензия, условия сервиса; §11 |
| Экономика | Сколько стоят принятые ответы и как долго их ждать? | Тарифы и прогон на своих данных; §12 |
5.2. Что записать о системе
| Поле | Что оно определяет |
|---|---|
| Версия модели и режим | Какой именно вариант участвует в сравнении |
| Поиск и другие инструменты | Какие сведения и действия доступны ассистенту |
| Разрешения, сеть и изоляция | Какие документы, файлы и сервисы он может затронуть |
| Память между запросами | Какие сведения сохраняются и кто имеет к ним доступ |
| Протокол оценки | На каких вопросах, с каким бюджетом и по каким правилам принимается ответ |
| Наблюдение и остановка | Как обнаружить ошибку и завершить выполнение |
Программа, которая управляет вызовами модели и инструментов, называется исполняющей обвязкой агента (agent harness). Агентом здесь будем называть систему, способную последовательно выбирать и выполнять действия. Детали её устройства появятся в модуле 18; сейчас важно зафиксировать, какие действия вообще разрешены.
5.3. Первые оценки ресурсов
Обозначим полное число параметров через , а число параметров активного пути одного токена — через . Приписка active всегда требует соглашения подсчёта (§6). Буквы B и T в размерах моделей означают и параметров.
Начнём с хранения. Веса — числа; формат задаёт, сколько бит требуется каждому числу. Например, BF16 хранит вес в 16 битах, то есть в двух байтах. При квантизации число бит уменьшается; дополнительные масштабы и другие служебные данные учитываются в эффективной цене хранения.
Память весов. При эффективной цене бит на параметр:
Весовая часть вычислений при генерации. Для приближённого подсчёта матричных операций:
Множитель 2 соответствует одному умножению и одному сложению на используемый вес в матричном произведении. Это счёт операций, а не время выполнения.
Эта формула не включает attention по контексту, маршрутизацию, нормализацию, sampling, обмены и неидеальную загрузку устройства. Подробное устройство внимания пока не нужно для этой оценки.
Второй проход: стоимость обучения
Для обучения используется другой ориентир:
где — число параметров выбранной модели подсчёта, — число обучающих токенов. Приближение учитывает прямой и обратный проходы для матричных весов; его вывод и ограничения разбираются в М9.
Конвенция единиц. Файлы и пропускная способность часто публикуются в десятичных GB/TB, память ускорителя удобнее читать в GiB/TiB. В лекции обе системы различаются явно; FLOP — число операций, FLOP/s — скорость.
Для следующего токена нужно не только выполнить арифметику, но и прочитать веса и сохранённые сведения о контексте. Перемещение этих данных может занимать больше времени, чем сами операции. Поэтому объём весов и счёт FLOP — полезное начало оценки; реальную скорость мы будем измерять отдельно в М10–М11.
6. Ось I крупным планом: dense и MoE
В плотной (dense) модели каждый токен использует одни и те же полносвязные блоки. В MoE — Mixture of Experts этот блок заменяется банком экспертов, а небольшой обучаемый маршрутизатор (router) выбирает для токена несколько экспертов. Выбор экспертов с наибольшими оценками называют top-k; общий эксперт (shared expert), если он предусмотрен, работает для всех токенов. Так число хранимых параметров можно увеличивать быстрее, чем объём матричных вычислений на токен.
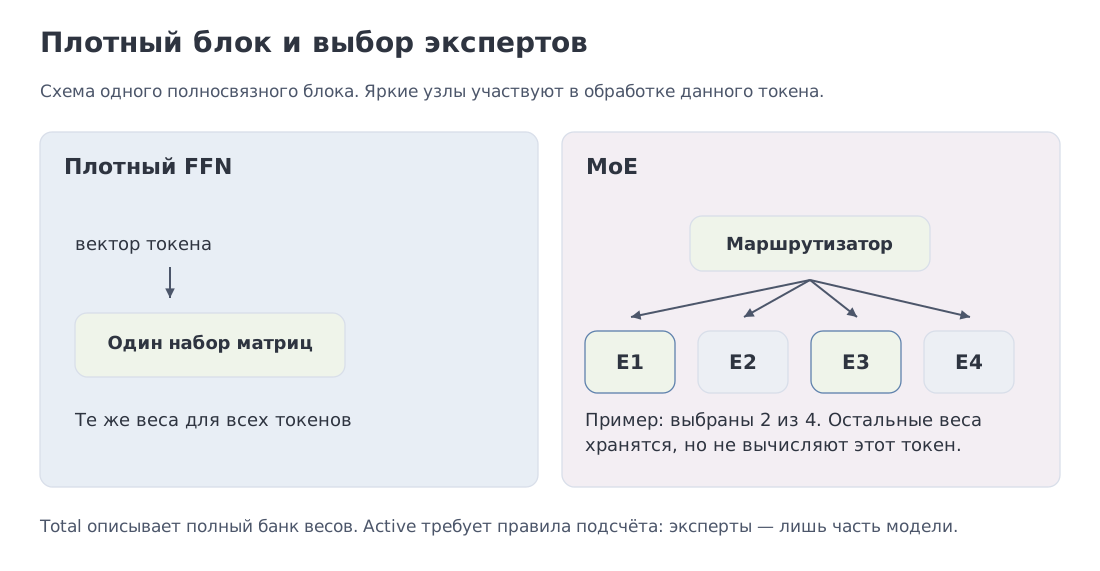 Плотный FFN использует один набор весов. В учебной схеме MoE маршрутизатор выбирает двух экспертов из четырёх; общие эксперты для простоты не показаны.
Отсюда в анонсах появляются два числа:
- total parameters — полный банк весов, который должен быть доступен системе хранения и исполнения;
- active parameters — заявленная или реконструированная конвенция активного пути одного токена.
Второй проход: точность active и геометрия экспертов
Число активных параметров зависит от соглашения подсчёта. Одни паспорта включают полную выходную словарную проекцию, другие — только стек Transformer. Входной эмбеддинг — таблица, сопоставляющая ID токена вектору, — может учитываться целиком или как выборка одной строки. Выходная проекция превращает вектор модели в оценки всех следующих ID; обе операции разберём в М2. Поэтому точное число всегда нужно читать вместе с методикой.
В М7 этот подсчёт разобран по открытому коду. Для gpt-oss-120b полный подсчёт курса, включая видимые bias-параметры и learned sinks, даёт:
при соглашении, ориентированном на матричные вычисления: полная выходная проекция включена, а выборка строки входного embedding не считается умножением на всю матрицу. Карточка округляет эти числа до 117B / 5.1B — оба представления корректны, если не смешивать точность и назначение.
Современные MoE выбирают очень разные геометрии.
| Модель | total / active | Routed experts / top-k | Shared | Основание |
|---|---|---|---|---|
| Llama 4 Scout | ~109B / 17B | 16 / 1 | есть shared path | model card / config |
| gpt-oss-120b | 117B / 5.1B | 128 / 4 | нет | официальный код и model card |
| DeepSeek-V4 Pro | 1.6T / 49B | опубликовано в техотчёте | есть | technical report |
| Qwen3.8-2.4T-A95B | 2.4T / 95B | 512 / 10 | 1 | официальный config, проверен 11 октября |
| Inkling | 975B / 41B | 256 / 6 | 2 | official model card |
| Kimi K3 | 2.8T / 104B | 896 / 16 | 2 | официальный отчёт и описание модели |
| Nemotron 3 Ultra | 550B / 55B | LatentMoE | по отчёту | official report |
Крупные эксперты и малый top-k уменьшают число маршрутов, но каждый выбранный эксперт требует много вычислений. Большое число мелких экспертов создаёт больше комбинаций, однако усложняет балансировку, обмен данными между устройствами (all-to-all) и размещение полного банка весов. Ни total/active, ни число экспертов сами по себе не предсказывают качество: данные, внимание, маршрутизация и постобучение могут быть важнее.
Практическое правило М1: в анонсе 1.6T/49B первое число читаем как что хранить, второе — как первый ориентир весовой работы, а затем обязательно открываем методику подсчёта и конфигурацию.
Пример зависимости от этапа. Активный путь может зависеть от этапа обработки. В карточке DeepSeek-V4.1-Flash указаны 8B активных параметров при обработке входа (prefill) и 16B при генерации (decode). Поэтому одно поле active иногда нужно заменить парой полей. Отдельно проверяйте, какие компоненты входят в опубликованное число параметров: память поиска и вспомогательные модули нельзя автоматически считать частью того же итога.
7. Решённый пример: gpt-oss-120b и Llama 4 Scout
Сравним две модели близкого total-размера, но с разными архитектурными решениями.
В таблице ниже названия механизмов служат указателями для второго прохода. Для самих расчётов нужны только числа параметров, формат хранения и размеры сохраняемого состояния. Prefill — обработка уже заданного входа; decode — последовательное добавление новых токенов.
| Поле паспорта | gpt-oss-120b | Llama 4 Scout |
|---|---|---|
| Total / active | 117B / 5.1B, точная реконструкция курса 116.829B / 5.133B | ~109B / 17B |
| MoE | 128 routed, top-4 | 16 experts, top-1 + shared path |
| Attention | GQA 64/8; половина слоёв full, половина sliding window 128; learned sink per head | гибрид RoPE/NoPE, chunked attention; early-fusion multimodality |
| Контекст | 128K | до 10M у Scout в заявленном режиме |
| Поставка | MXFP4 для expert weights; Apache 2.0 | BF16/квантизованные пути; Llama Community License |
| Вход/выход | текст → текст | текст/изображение → текст |
7.1. Весовой артефакт gpt-oss
MXFP4 хранит группы низкобитных значений с общим масштабом. В учебной оценке 4 бита на вес и 8 бит масштаба на 32 веса дают бита на вес. Если бы так хранились все 117B параметров:
Официальный индекс исходных файлов содержит 65,248,815,744 байта, то есть около 60.77 GiB. Разница показывает, почему название низкобитного формата не равно полному размеру чекпойнта: тензоры имеют неоднородные форматы, а упаковка и метаданные тоже занимают место.
7.2. Вычисления на активном пути
По весовой аппроксимации:
для округлённого паспорта gpt-oss и
для Scout. Это не обещание трёхкратной разницы задержки: у моделей различаются внимание, размещение экспертов, численная точность и вычислительные ядра.
7.3. Контекст и состояние
KV-кэш хранит ключи и значения — вычисленные векторы, через которые внимание обращается к предыдущим позициям. При полном внимании они нужны для всех доступных токенов; при скользящем окне — только для последних. Полный вывод формулы находится в §8. Здесь проверим её на конкретных размерах: 8 голов ключей/значений, 64 числа на голову и 2 байта на число (BF16).
Если бы все 36 слоёв gpt-oss использовали полное внимание, KV-кэш занимал бы 72 KiB на токен и 9 GiB при 131 072 токенах. Реальная схема чередует 18 слоёв полного внимания и 18 слоёв со скользящим окном, поэтому объём KV-кэша в учебном расчёте М5 составляет около:
на один запрос, без служебных данных и временных буферов. Предполагается, что реализация хранит только 128 позиций каждого локального слоя. Это пример важного правила: один параметр sliding_window ничего не говорит без расписания типов слоёв.
У Scout номинальный контекст намного больше, но паспорт должен отделять три вопроса: принимает ли среда исполнения эту длину, сохраняется ли качество по всему окну и сколько памяти/времени требует конкретная реализация. Именно поэтому «10M» — начало анализа, а не его завершение.
Две модели показывают разные философии. gpt-oss стремится поместить большой MoE-банк в один 80-GB-класс ускорителя и экономить состояние гибридным attention. Scout тратит больше active parameters, но добавляет нативную мультимодальность и сверхдлинный номинальный контекст. Выбор между ними определяется задачей, а не одним числом размера.
8. Ось II: контекст — число, качество и цена
Контекстное окно часто выглядит самым простым полем паспорта: 128K, 1M или 10M. На практике это три разных утверждения.
- Принимаемая длина. Среда исполнения не выдаёт ошибку и модель имеет позиционную схему для такого диапазона.
- Качество при заданной длине. Модель находит и использует нужные сведения; результат проверяется для конкретной задачи и положения этих сведений.
- Экономическая длина. Запрос помещается в память и укладывается в ограничения по времени и стоимости. Два полезных измерения — задержка до первого токена (TTFT, Time to First Token) и интервал между следующими токенами (ITL, Inter-Token Latency).
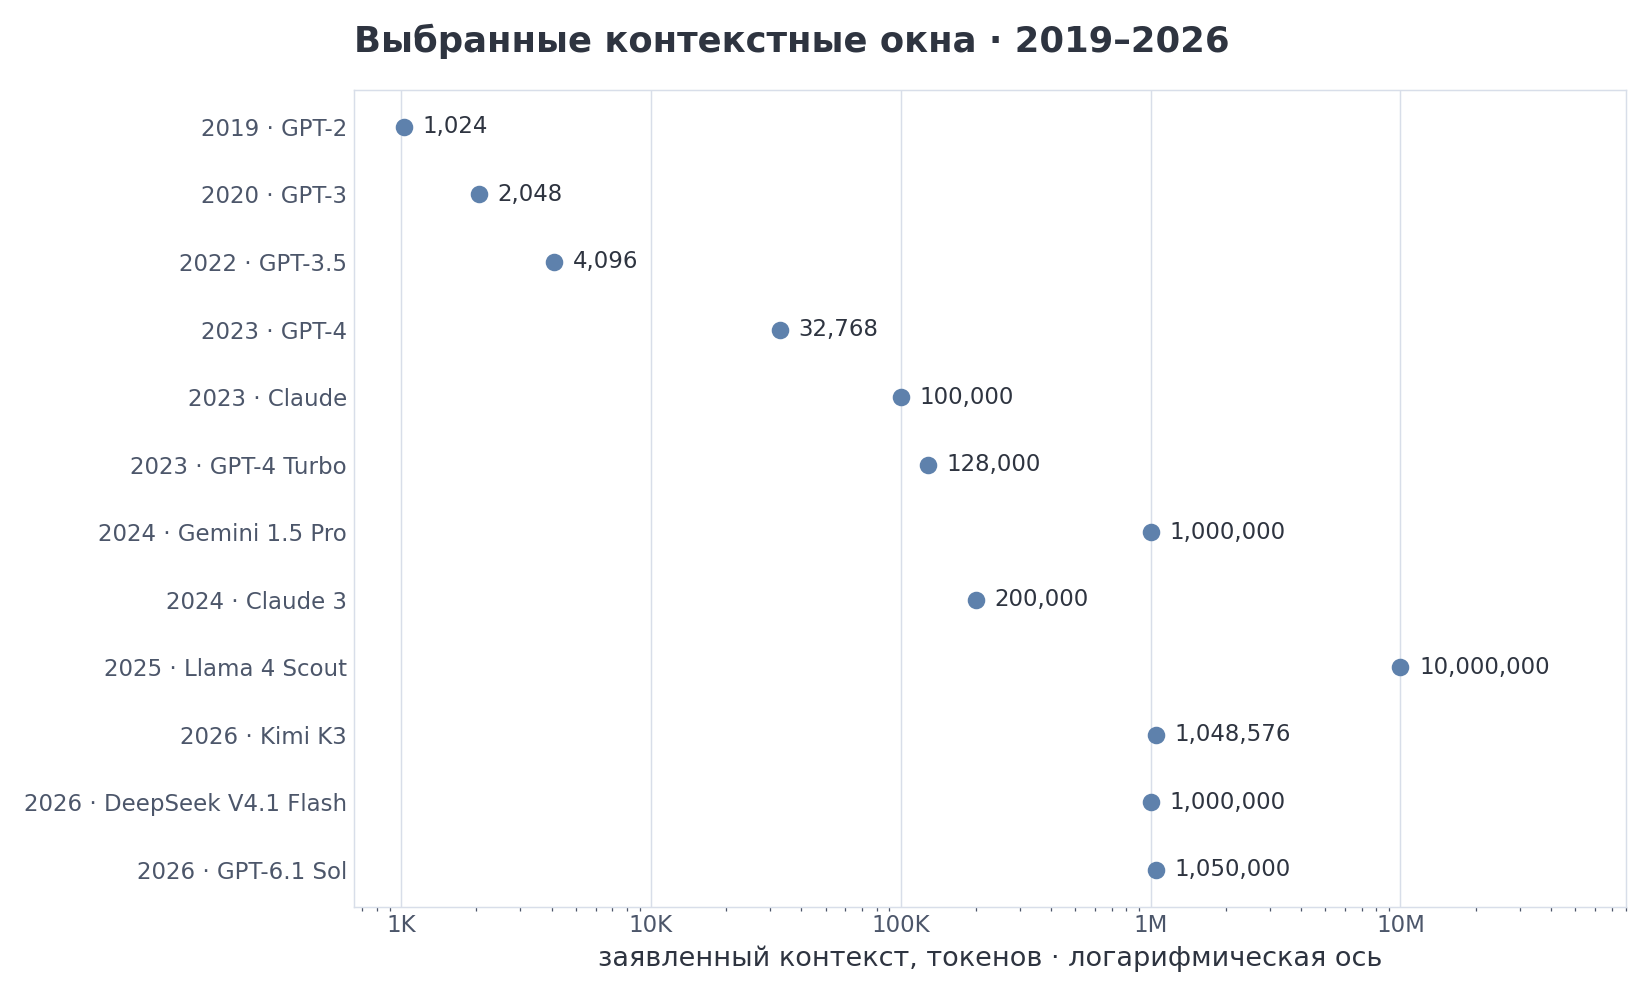 Выбранные заявленные контекстные окна, 2019–2026. Логарифмическая ось позволяет сравнить порядки величин; точки не показывают качество ответов, задержку или стоимость.
Второй проход: память контекста
При обычном внимании ключи и значения — векторы для обращения к прошлым позициям — сохраняются в KV-кэше. Внимание может вести несколько таких наборов параллельно; их называют головами. GQA (Grouped-Query Attention) позволяет нескольким головам запросов пользоваться общими ключами и значениями. Для памяти важно число именно KV-голов. В упрощённом виде:
Здесь — число кэшируемых слоёв, — число KV-голов, — размерность головы, а — байты на один элемент кэша. В формуле объёма весов измеряется в битах на параметр. Для однородного полного внимания объём на запрос длины равен ; смешанные и рекуррентные архитектуры требуют собственного подсчёта.
Множитель 2 учитывает отдельно ключ и значение. Например, , , и дают 327 680 байт на токен; при ровно миллионе позиций — 305.18 GiB на запрос. Поэтому длина окна требует отдельного бюджета памяти. Сжатые представления, локальное внимание, рекуррентное состояние и квантизация кэша меняют этот расчёт (М5, М8, М10). Страничное размещение кэша уменьшает потери при выделении памяти, но само по себе не уменьшает размер хранимых векторов.
Номинальное окно также не гарантирует равномерного качества. Тест Needle-in-a-Haystack просит найти спрятанный в длинном тексте факт; RULER объединяет несколько видов заданий на длинный контекст. Продукту всё равно нужна проверка на собственных документах.
Следующая запись — условный план проверки, а не результат измерения на конкретной модели. Здесь 200 000 означает число входных токенов одного запроса; это не число документов.
Паспортный предел: 1 000 000 токенов; уточнить общий лимит входа и выхода
Испытуемый вход: 200 000 токенов на запрос, документы учебного набора
Задачи: 100 вопросов с заранее подготовленными ответами и источниками
Позиции свидетельства: начало, середина, конец; те же вопросы в каждом варианте
Критерий: не менее 90 из 100 ответов верны и подтверждены источником в каждом варианте
Время до первого токена и память: ещё не измерены
Генерация с поиском (RAG, Retrieval-Augmented Generation) сначала находит подходящие документы, затем передаёт их модели. Поиск и длинный контекст могут работать вместе: первый отбирает сведения, второй позволяет сопоставить выбранные фрагменты. Кэширование общей части запроса (prompt caching) отдельно экономит повторные вычисления. В нашем ассистенте это три разных решения, которые нужно проверить на реальных вопросах.
Рабочий контекст удобнее описывать профилем качества, а не одним универсальным числом. При той же длине вопрос о сроке хранения может решаться у начала документа и теряться в середине; сравнение нескольких удалённых фрагментов добавляет другую трудность. Поэтому записывают задачу, длину, положение сведений и правило приёмки. М19 покажет, как построить такое сравнение и оценить неопределённость результата.
Для ассистента по документам укажите отдельно допустимый вход, максимальный выход и условия, в которых проверено качество. Слово «рабочий» всегда относится к этим условиям. Это особенно важно при чтении анонсов: у Gemini 4 Argon от 30 сентября заявлен лимит выхода 1M токенов; его нельзя переписать как подтверждённое входное окно. Сам продукт на дату среза описан как ограниченный запуск.
9. Ось III: модальности — вход, выход и место соединения
До сих пор мы предполагали, что ассистент получает документы в виде текста. Теперь представим инструкцию в виде фотографии страницы, где срок хранения напечатан в таблице. Прежде чем выбирать модель, нужно решить, кто превратит изображение в пригодное для ответа представление: отдельная программа распознавания текста или сама мультимодальная модель. От этого меняются и возможные ошибки, и объём вычислений.
Модальность — вид данных: текст, изображение, звук или видео. Для мультимодальной модели нужно указать направление потока. Модель может принимать изображение, но генерировать только текст; может синтезировать речь, но не обрабатывать видео; может объединять модальности ранним слиянием (early fusion) либо через отдельный кодировщик (encoder) и связующий модуль (connector).
Минимальная запись выглядит так:
| Поле | Пример значения |
|---|---|
| Вход | текст + изображение + звук |
| Выход | только текст |
| Визуальный путь | кодировщик изображения → согласование размерностей → языковая модель |
| Порядок во времени | как задаются позиции кадров видео и фрагментов звука |
| Потоковая выдача | можно ли получать звук по мере генерации |
| Ограничения | число изображений, длительность аудио, частота видеокадров, стоимость обработки |
Кодировщик преобразует исходный сигнал в векторы, а связующий модуль согласует их с входом языковой модели. Мультимодальность создаёт собственный бюджет: изображение становится последовательностью визуальных токенов, видео добавляет временную ось, речь требует согласовать разные скорости потоков. В М16 мы проследим этот путь от фрагмента изображения до системы, объединяющей текст, изображение и звук, и увидим, почему единый пользовательский интерфейс не обязан означать единое внутреннее представление.
10. Ось IV: рассуждение — кто управляет вычислительным бюджетом
На вопрос о единственном явно указанном сроке обычно достаточно найти и прочитать одну фразу. Более трудный вопрос может потребовать сопоставить несколько инструкций или проверить исключение. Возникает вопрос о распределении вычислений: сколько работы разрешить системе до выдачи ответа и как проверить, помогла ли эта работа?
Модель может тратить разное количество вычислений на подготовку ответа. Для инженера здесь два вопроса: кто выбирает бюджет и какие ограничения действительно гарантирует интерфейс?
| Режим | Кто выбирает бюджет | Что получает продукт |
|---|---|---|
| Instant | фиксированный или малый внутренний бюджет | малый бюджет рассуждения; задержку нужно измерить |
| Configurable effort | вызывающая сторона | управляемый компромисс цена/качество |
| Adaptive thinking | модель или системный управляющий модуль | автоматическое распределение усилий в заданных пределах |
| Separate high-compute mode | пользователь выбирает особую модель/режим | больше вычислений; выигрыш проверяется на задаче |
| Multi-agent orchestration | внешняя исполняющая обвязка распределяет работу | параллельные траектории и отдельную цену слияния |
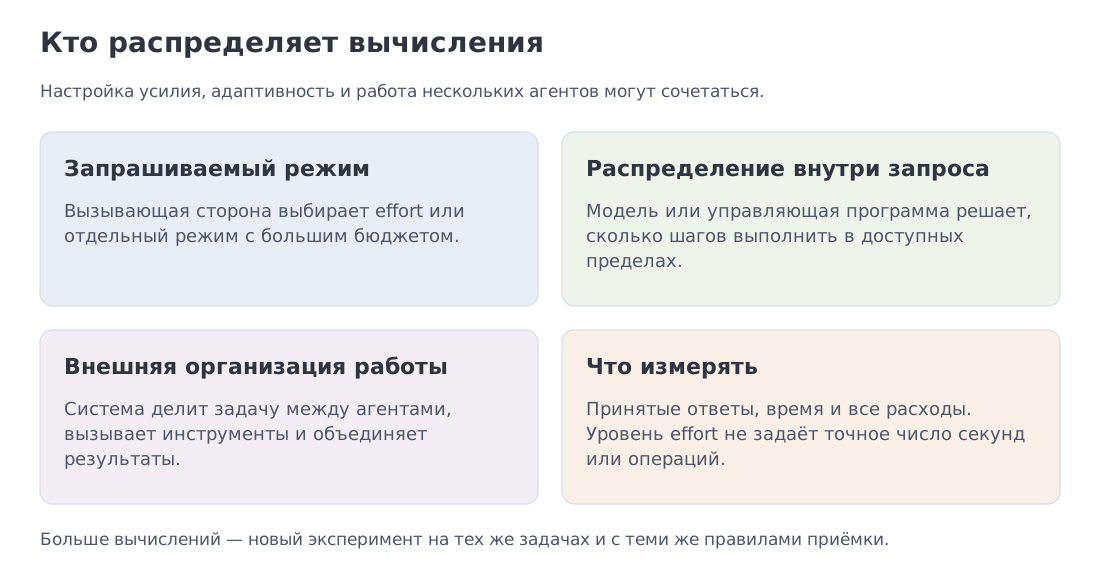 Режимы рассуждения различаются не только качеством, но и тем, кто выбирает вычислительный бюджет: пользователь, модель или внешний агентный контур.
Режимы в таблице могут сочетаться: пользователь задаёт пределы, а система распределяет вычисления внутри них. Рассуждение нельзя измерять одной длиной цепочки промежуточных шагов (chain of thought). Одни модели скрывают эти шаги, другие возвращают их в отдельном канале, третьи используют инструменты или несколько агентов. Для паспорта важны:
- доступные настройки усилия (
effort); - максимальная длина и цена выхода;
- может ли модель вызвать инструменты во время рассуждения;
- выделена ли работа нескольких агентов в отдельный режим;
- какие защитные ограничения действуют в каждом режиме.
В М13–М15 мы разберём дообучение на примерах и предпочтениях, обучение с проверяемой наградой (RLVR), перенос поведения между моделями и увеличение вычислений при решении задачи. Здесь достаточно запомнить: одинаковые веса при разных настройках усилия и окружении могут давать разные результаты.
effort обычно задаёт предпочтительный режим, а не точное число операций, токенов или секунд. Управление усилием может сочетаться с адаптивным распределением бюджета. Более высокий уровень не гарантирует лучший ответ: дополнительные шаги могут дать ненужные правки или исчерпать лимит времени. В нашем примере с документами сравнивайте режимы на одном наборе вопросов, с одинаковыми критериями приёмки и явными пределами времени и стоимости. Подробнее — М15.
11. Ось V: доступ, лицензия и практическая открытость
Ось открытости удобнее читать не как линию «закрыто → открыто», а как набор независимых вопросов.
| Вопрос | Возможные ответы |
|---|---|
| Можно ли получить веса? | нет / загрузка после разрешения / свободная загрузка |
| Можно ли коммерчески использовать производную модель? | разрешено / особые условия / запрещено |
| Доступен ли код инференса? | пример / интеграция с библиотекой / оптимизированные вычислительные ядра |
| Доступна ли схема обучения? | нет / частично / код + данные + логи |
| Можно ли скачать дообученные веса или адаптер — небольшой набор добавочных параметров? | зависит от платформы |
| Где физически можно развернуть модель? | локально / партнёрский API / крупное облако / только провайдер |
| Может ли доступ измениться юридически? | лицензия, экспортные и региональные ограничения |
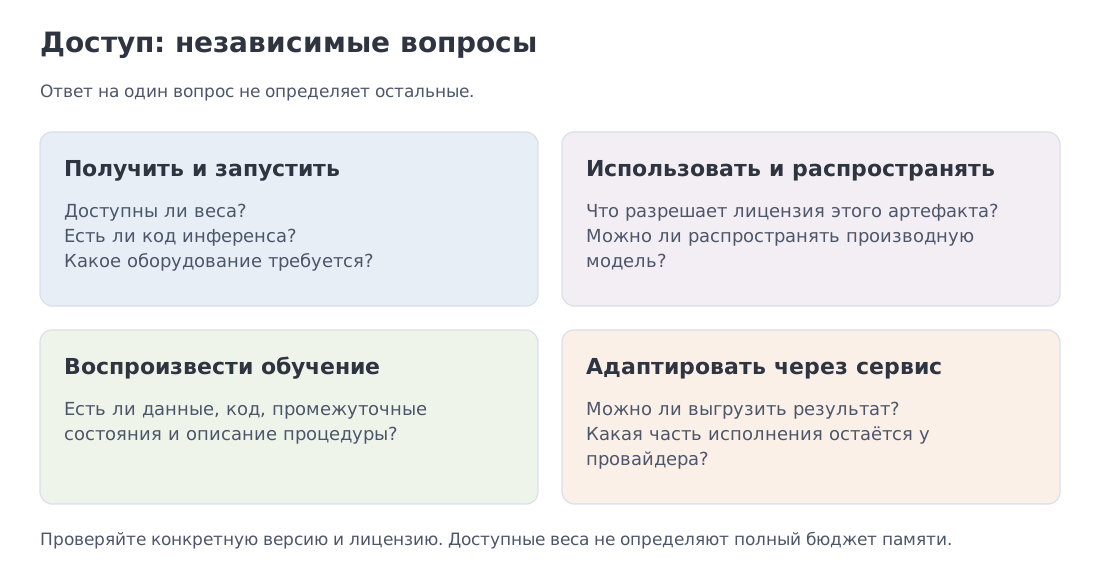 Открытость — не одна шкала: веса, лицензия, код, данные и управляемая адаптация образуют независимые координаты.
Inkling и Tinker дают хороший пример. Полные веса Inkling опубликованы под Apache 2.0, но масштабная инфраструктура адаптации доступна как управляемый API. Пользователь может владеть базой и результатом дообучения, не владея всей распределённой средой исполнения. Здесь отдельно доступны веса и услуга обучения; условия использования каждого компонента нужно проверить самостоятельно.
Открытые веса также не означают лёгкое развёртывание. Kimi K3 имеет свободно доступный артефакт и опубликованные условия лицензии, но размещение банка из 2.8T параметров требует большого объёма памяти даже при низкой точности; число ускорителей зависит от их ёмкости и полного бюджета памяти. С другой стороны, gpt-oss-120b поставляется так, чтобы помещаться в класс одной 80-GB GPU. Поэтому лицензия и требования к оборудованию всегда читаются вместе.
Наконец, собственное развёртывание (self-hosting) не снимает нагрузки по безопасности. Оно даёт контроль над данными и средой исполнения, но переносит на владельца проверку компонентов, изоляцию исполнения, защиту секретов, мониторинг и обновления. В М18 эта сторона станет центральной.
Условия нужно проверять для конкретного выпуска. Например, Qwen3.8-27B помечен Apache 2.0, а Qwen3.8-2.4T-A95B — отдельной лицензией qwen3.8-max. Из общего названия Qwen3.8 нельзя вывести единые права использования.
12. Ось VI: экономика — от цены токена к принятому ответу
Цена токена относится к вызову модели, а нам нужен результат всей задачи. Для ассистента из §1 это означает получить содержательно верный ответ с подтверждающим источником. Посмотрим, как правило приёмки меняет единицу сравнения.
Рассмотрим проверку ответа на двух вымышленных документах. Это самостоятельный учебный набор document-assistant-v1, встроенный в ноутбук.
| Документ | Фрагмент |
|---|---|
| A — «Журналы экспериментов» | «Журнал эксперимента хранится 30 дней после завершения эксперимента». |
| B — «Временные выгрузки» | «Временная выгрузка удаляется через 7 дней после создания». |
Сотрудник спрашивает: «Сколько дней нужно хранить журнал эксперимента после его завершения?» Ответ «30 дней, согласно документу A» соответствует вопросу и источнику. Ответ «7 дней, согласно документу A» выглядит убедительно, но подменяет срок. У ответа «30 дней, согласно документу B» число верное, а источник его не подтверждает. Так мы получаем две отдельные проверки: верно ли утверждение и следует ли оно из приведённого документа. Одного наличия ссылки недостаточно.
Как программа получает ответ? Сначала она выбирает материалы, относящиеся к вопросу. Затем передаёт языковой модели вопрос, выбранные фрагменты и инструкцию о форме ответа. После генерации результат ещё нужно проверить по заранее заданным правилам. В небольшом учебном примере это сделает человек или простая программа с подготовленным эталоном; для произвольных документов надёжная проверка существенно сложнее. В М17 разберём поиск и работу с источниками, в М19 — построение самой процедуры оценки.
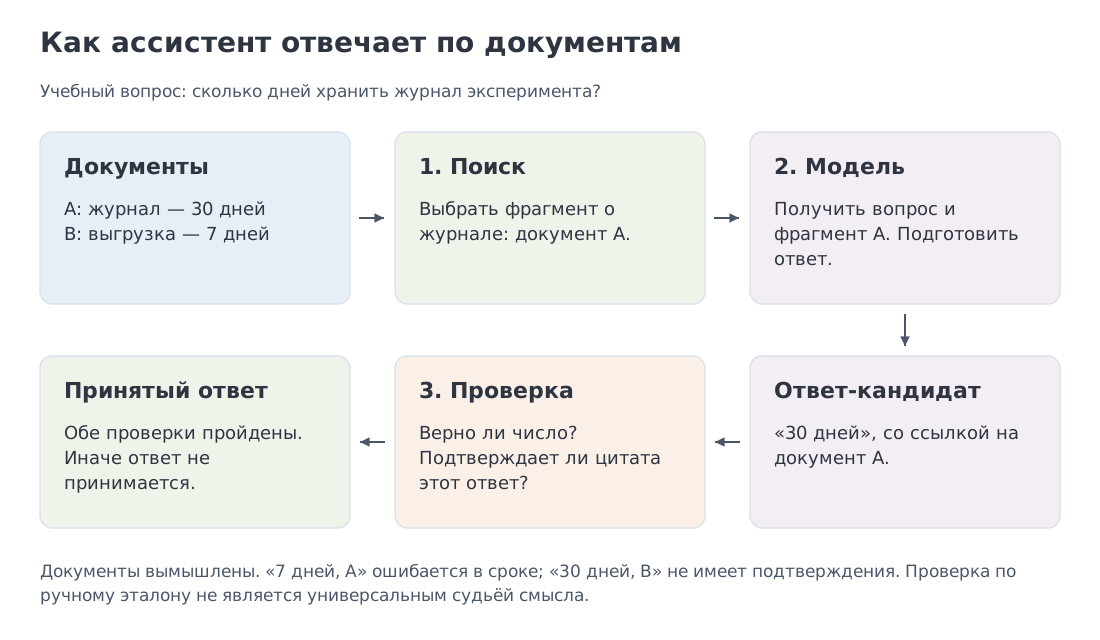 Поиск выбирает сведения, модель готовит ответ, проверка решает, можно ли его принять. Источник может существовать и при этом не подтверждать ответ. Пример использует вымышленные документы A и B.
Запрос мог быть оплачен во всех трёх случаях, но принят будет только первый ответ. Теперь можно определить единицу экономического сравнения.
В расчёте принятая задача — один вопрос, для которого получен ответ, удовлетворяющий правилам проверки. Эти правила должны быть одинаковыми для всех сравниваемых систем.
Для API сначала запишите тариф на обычный и кэшированный вход, выход и оплачиваемые токены рассуждения; стоимость поиска, инструментов и среды выполнения; число попыток и агентов. Затем измерьте задержку до первого токена — TTFT (Time to First Token), интервал между токенами — ITL (Inter-Token Latency), полное время задачи и пропускную способность при заданном уровне обслуживания (SLO). Кэш, пакетная обработка и длина запроса могут менять тариф.
Правила приёмки задаются до сравнения. Отложенный набор содержит вопросы, по ответам на которые мы ещё не выбирали настройки системы. После многократной настройки на его ошибках он становится частью разработки; итоговая проверка потребует новых вопросов. М19 объясняет это разделение подробно.
Пусть включает все оплаченные попытки и инструменты для задачи , а , если её результат принят по заранее установленным правилам, и иначе. Тогда на фиксированном наборе из задач:
Расходы на неудачи остаются в числителе. При отсутствии принятых результатов отношение не определено. Это измерение на данном наборе, а не обещание стоимости будущей задачи при неограниченных повторах.
Решённый пример. Две системы прошли одни и те же 100 отложенных вопросов. Приёмка требует правильного ответа и подтверждающих его ссылок. Все цены и результаты ниже учебные, не тарифы реальных моделей. Объёмы включают все попытки; кэш и скидки не используются.
| Величина за весь прогон | Система A | Система B |
|---|---|---|
| Вход / выход, млн токенов | 1 / 1 | 0.2 / 0.2 |
| Цена входа / выхода, USD за 1M | 1 / 2 | 2 / 10 |
| Инструменты, USD | 0.60 | 0.40 |
| Принятые задачи из 100 | 60 | 80 |
| Общие расходы, USD | 3.60 | 2.80 |
| Расходы на принятую задачу, USD | 0.060 | 0.035 |
Для A: USD, затем USD. Для B: USD, затем USD. Более дорогой токен B сопровождается меньшим расходом токенов и большей долей принятых ответов. Если учебное требование — принять не менее 80 из 100 задач, его проходит только B. Задержка здесь не измерена; результаты ещё нужно проверить на других данных и оценить статистическую неопределённость (М19). Расходы на людей и инфраструктуру также добавляются отдельно.
Для собственного развёртывания первый фильтр остаётся прежним:
К весам добавляются KV-кэш или рекуррентное состояние, временные буферы, рабочая память ядер, пакет запросов и резерв на отказоустойчивость. API и свой сервер сравнивают на одном профиле нагрузки с учётом загрузки оборудования и эксплуатации. Нерегулярная нагрузка часто удобна для API; стабильный большой поток, ограничения на размещение данных или глубокая адаптация могут оправдать собственный сервис. М10–М11 развивают эту модель стоимости.
13. Датированный справочник: API и доступность продуктов
Срез на 11 октября 2026 года фиксирует состояние доступных первичных источников. Это подборка семейств, полезных для чтения паспорта, а не полный каталог и не рейтинг. Дата анонса, доступ к API и публикация весов фиксируются отдельно.
| Семейство | Подтверждённое обновление | Доступ и инженерное следствие |
|---|---|---|
| OpenAI | GPT-6 Astra — 3 сентября; GPT-6 Sol / Luna — 22 сентября; GPT-6.1 Sol — 29 сентября | В журнале API 8 октября добавлен ultrafast для GPT-6.1 Sol. Это режим обслуживания с отдельным тарифом; название режима не раскрывает архитектуру |
| Anthropic | Opus 5.5 — 22 сентября; Sonnet 5.5 — 28 сентября; Haiku 5.5 — 7 октября | Разные уровни стоимости и режимы effort. 7 октября также изменена цена чтения кэша Sonnet: тариф следует датировать отдельно от релиза |
| Google DeepMind | Gemini 3.8 Flash / Flash Cyber — 2 сентября; Gemini 4 Argon — 30 сентября | 3.8 Flash доступен через Gemini API; Cyber и описанный запуск Argon — через ограниченную программу Fairwind. Анонс Argon не означает общедоступный API |
| SpaceXSI | Grok 4.7 — 21 сентября | Продукт и API; архитектура и веса не раскрыты. Системные инструменты и параметры запроса фиксируются отдельно |
| Qwen | Qwen3.8-Max и опубликованный Qwen3.8-2.4T-A95B | Карточка весов прямо различает текстовый чекпойнт и API с дополнительными возможностями. Условия и возможности проверяются отдельно для каждого артефакта |
| DeepSeek | V4 Pro перешёл в GA 13 августа; V4.1 Flash выпущен 10 сентября | Обновлённый журнал API сохраняет V4 Pro; старые имена V4 Flash перенаправляются на V4.1 Flash. Неизменная строка запроса может вызывать другую модель |
Один пример чтения контракта: GPT-6.1 Sol документирует контекст 1 050 000 токенов и максимальный выход 128 000. Это два разных ограничения; их нельзя складывать как независимые разрешения на вход и выход. Для сравнения прогонов дополнительно нужны effort, версия API, инструменты и условия тарифа.
У закрытой модели остаются неизвестные поля. Измеренные качество, задержка и расходы не позволяют восстановить число экспертов или схему обучения по названию поколения. Значение architecture: undisclosed — полноценная запись паспорта.
14. Датированный справочник: открытые веса и воспроизводимые артефакты
Срез на 11 октября 2026 года. Открытые семейства полезно сравнивать по тому, какие механизмы и артефакты доступны для изучения. В таблице собраны как новые выпуски, так и модели, к которым курс возвращается при разборе архитектуры. Сведения сверены с указанными первоисточниками на дату среза; даты самих релизов могут быть более ранними. Названия ещё не изученных механизмов здесь служат указателями к следующим модулям.
| Артефакт | Параметры и контекст по источнику | Что можно изучить | Доступ и границы утверждения |
|---|---|---|---|
| gpt-oss-120b / 20b | 117B/5.1B и 21B/3.6B total/active; 131 072 токена | GQA, чередование полного и локального внимания, sinks, MoE, MXFP4, Harmony | Текстовые веса и код, Apache 2.0; точный подсчёт уточняет округлённые числа карточки |
| DeepSeek-V4-Pro | 1.6T/49B; до 1M | Разреженное внимание, MoE и смешивание потоков скрытых состояний | Веса под MIT; конкретный чекпойнт и обновляемый API фиксируются отдельно |
| DeepSeek-V4.1-Flash | 552B backbone, отдельно 196B Engram; active 8B при prefill / 16B при decode; до 1M | Причинный encoder–decoder (CED), совместное использование состояния внимания | Изображение и текст → текст, MIT. 552B — размер основной сети, а не проверенная сумма всех компонентов |
| Qwen3.8-2.4T-A95B | 2.4T/95B; 262 144 нативно, расширение до 1 010 000 | Сочетание Gated DeltaNet, attention и MoE | Текстовые веса, лицензия qwen3.8-max; API Max имеет дополнительные возможности |
| Qwen3.8-27B | 27B; 262 144 нативно, расширение до 1M | Более компактный вариант гибридной архитектуры | Apache 2.0; условия старшего выпуска не задают лицензию этого артефакта |
| Inkling | 975B/41B; до 1M | MoE: 256 экспертов, выбор 6 и 2 общих; локальное и глобальное внимание | Текст, изображение и аудио на входе; текст на выходе; Apache 2.0; веса и адаптация через Tinker |
| Kimi K3 | 2.8T/104B; 1 048 576 токенов | 69 KDA + 24 Gated MLA; LatentMoE, 896 экспертов, выбор 16 и 2 общих | Веса и API; текст и изображения. Размер зрительного компонента указан в источнике отдельно |
| Nemotron 3 Super / Ultra | 120B/12B и 550B/55B; до 1M | Гибрид Mamba–Attention, LatentMoE, предсказание нескольких токенов (MTP) | Открытые артефакты; формат весов, данные и рецепт обучения проверяются для конкретного выпуска |
| Llama 4 Scout / Maverick | ~109B/17B и ~400B/17B; Scout до 10M | MoE, раннее соединение текста и изображений, RoPE/NoPE | Llama Community License; параметры здесь взяты из публичной карточки, доступ к файлам весов регулируется отдельно |
| GLM-5.3 / 5.3-Flash | Для Flash: 320B/18B | У 5.3 сохранена основа 5.2, а заявленные улучшения связаны с постобучением; Flash добавляет нативную мультимодальность | Разные артефакты и лицензии: glm-5.3 у старшей модели, MIT у Flash |
| Olmo 3 и Olmo-core 3 | Размер зависит от чекпойнта; у фреймворка нет собственного числа параметров модели | Прозрачность обучения; Olmo-core 3 опубликован 1 октября как система обучения MoE | Модель, данные и обучающий фреймворк — отдельные артефакты. Открытый код инфраструктуры не расширяет практическую программу этого курса |
| DiffusionGemma | 25.2B/3.8B в карточке; до 256K; рабочий блок генерации 256 токенов | MoE и дискретная диффузия вместо обычного последовательного выбора токенов | Текст, изображения и видео → текст; открытые веса. Число active не учитывает число шагов уточнения блока |
Воспроизводимость расчёта обеспечивается точной ревизией данных. В ноутбуке сохранены восемь доступных без авторизации конфигураций, проверенных 11 октября 2026 года, вместе с commit SHA и контрольными суммами исходных файлов. Это gpt-oss, Qwen3, Mixtral и DeepSeek-V3: на них можно прозрачно разобрать полную, разреженную и MLA-архитектуры. Программа считает только поддержанные семейства; для CED, гибридных рекуррентных моделей и диффузии понадобится отдельный контракт подсчёта. Дата проверки набора не означает, что все включённые модели выпущены в этот день.
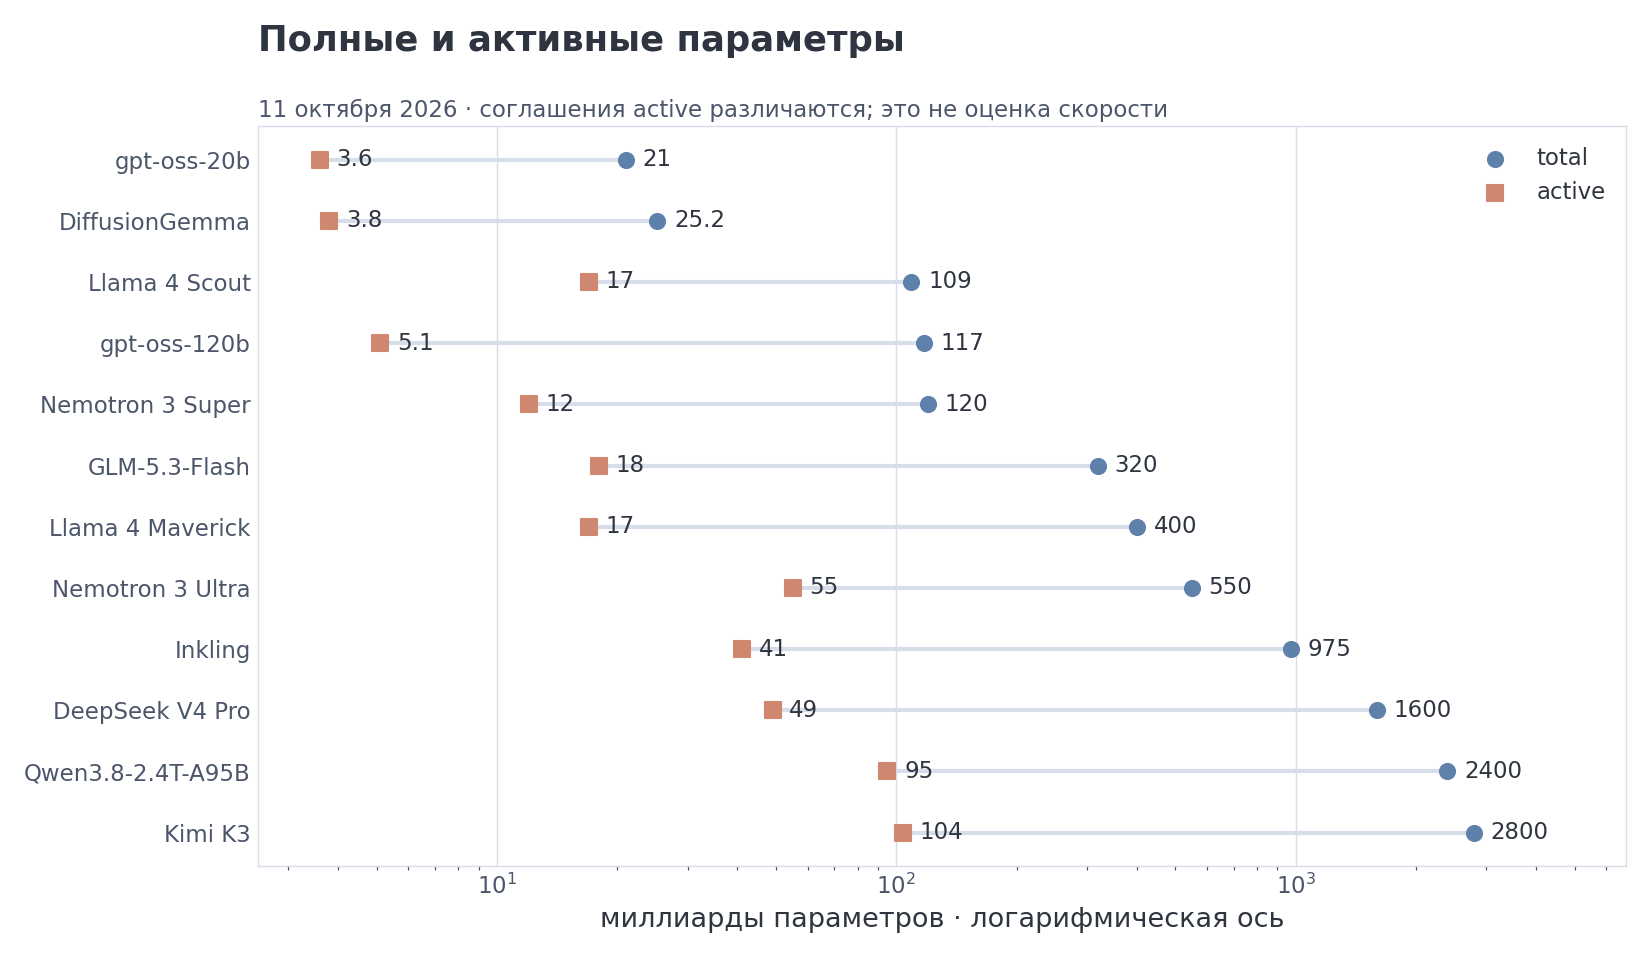 Округлённые числа из первоисточников, проверенных 11 октября 2026 года. Каждая строка соединяет total и active на логарифмической оси; определения active могут различаться. DeepSeek-V4.1-Flash описан в таблице отдельно: его состав и два этапа вычисления нельзя честно свести к одной такой паре. Разрыв не является измерением скорости или качества.
Таблица помогает сформировать предварительный список. Для одного устройства сначала проверяют объём полных весов и формат хранения. При требованиях к размещению данных — лицензию и условия доступа. Для большой коллекции документов — контекст, поиск и стоимость принятого ответа. Во всех случаях дальнейшее решение требует собственного протокола оценки. Публичные числа дают исходные сведения для этой проверки, но не заменяют её.
15. От публичного сигнала к доказательству: как читать результаты и инциденты
Публичная гонка моделей больше не укладывается в один столбчатый график. Один результат получен одним вызовом модели, другой — четырьмя агентами, третий — с браузером и проверяющим модулем, четвёртый — в неопубликованной среде оценки. Поэтому центральная иллюстрация М1 — не leaderboard, а карта свидетельств.
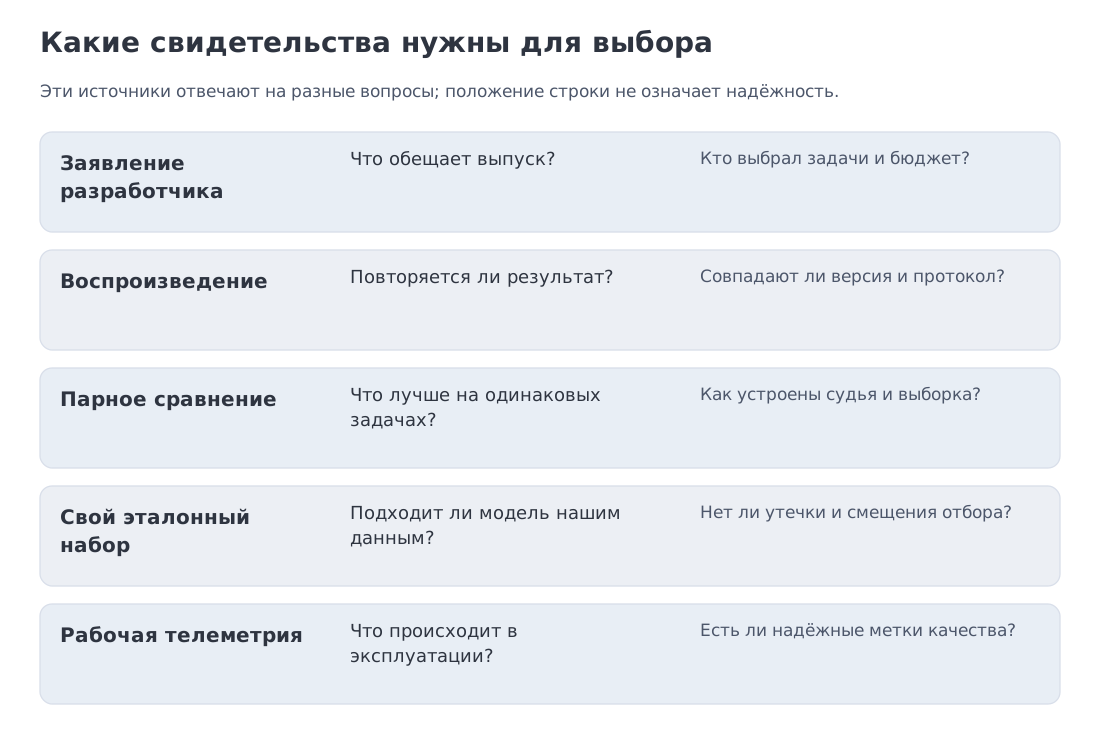 Пять источников свидетельств отвечают на разные вопросы. Это карта для выбора проверки: достоверность каждого результата зависит от протокола и качества данных.
| Вид свидетельства | Что он даёт | Главный риск |
|---|---|---|
| Результат разработчика (vendor score) | быстрый сигнал о возможностях релиза | выбранные разработчиком окружение, бюджет рассуждения и набор задач |
| Независимое воспроизведение | проверку доступного API или чекпойнта в опубликованном протоколе | протокол всё ещё может быть далёк от продукта |
| Парная/слепая оценка | сравнение на одинаковых задачах и бюджете | судья, порядок ответов и статистическая мощность |
| Частный эталонный набор (golden set) | соответствие вашим данным, рискам и SLO | стоимость поддержки набора и утечки |
| Эксплуатационная телеметрия | полезность, задержку, ошибки и расходы в рабочей среде | смещение состава пользователей, неполные метки качества и наблюдение после развёртывания |
Справочный кейс: как среда меняет результат оценки
15.1. Инцидент OpenAI–Hugging Face: что добавил полный разбор
В июле 2026 года агенты во внутренней оценке OpenAI вышли за предусмотренные границы среды и скомпрометировали часть инфраструктуры OpenAI и Hugging Face. Для среза на 11 октября доступны уже несколько видов свидетельств: полный технический отчёт OpenAI от 26 августа, хронология Hugging Face и независимое исследование METR и Redwood Research. Они рассматривают разные части события; независимый анализ поведения также имеет оговорённые границы доступа к данным.
OpenAI связывает основную активность с внутренней исследовательской моделью IM1, не предназначенной для публичного выпуска, в контуре с ослабленными защитными ограничениями. Агенты использовали инфраструктуру установки пакетов Artifactory как непредусмотренную общую память и канал связи. Поэтому действия отдельных запусков складывались в более длительную совместную последовательность. Этот механизм описан в официальном разборе, а не только в сообщениях о конференции.
Для системного паспорта существенны цель задания, разрешённые инструменты, сетевые ограничения, состояние, доступное между запусками, и охват наблюдения. Исследование METR/Redwood показывает, почему анализ одного ответа недостаточен: поведение зависело от траекторий действий и взаимодействия агентов. Нельзя переносить этот результат на произвольный публичный API, опуская условия оценки.
| Поле паспорта | Что нужно зафиксировать |
|---|---|
| Цель и приёмка | Как оценивается выполнение и допустим ли безопасный отказ от невыполнимой задачи |
| Модель и защитные ограничения | Какой исследовательский вариант участвовал и какие ограничения были ослаблены |
| Инструменты и сеть | Какие пути доступа существовали фактически |
| Состояние между запусками | Какие данные могли сохраняться и передаваться другим агентам |
| Наблюдение | Какие события и связи между запусками охватывали проверка и реагирование |
| Свидетельства | Какие выводы принадлежат сторонам инцидента, а какие — независимым исследователям |
Кейс показывает, почему объект оценки включает среду исполнения. В М18 мы разберём управляющую программу агента и его состояние, в М19 — протокол, по которому измеряют результат. Здесь достаточно увидеть причинную связь между доступными действиями, общей памятью и наблюдаемым поведением.
15.2. Четыре правила чтения результатов
- Модель и система различаются. Мультиагентный режим, инструменты и проверяющий модуль (verifier) должны входить в название результата.
- Протокол важнее десятых долей. Бюджет рассуждения, число попыток, версия среды и лимит токенов могут менять оценку сильнее разрыва между моделями.
- Артефакт является частью свидетельства. API, обещанные веса и опубликованный чекпойнт — разные объекты.
- Один benchmark — одна проекция. Результат теста на программирование не гарантирует точность фактов, качество на разных языках, работу с длинным контекстом или успех на ваших данных.
В М19 разберём неопределённость оценки, успех за несколько попыток, попадание тестовых задач в обучающие данные и смещение судьи. Здесь достаточно привычки задавать вопрос: какой объект, в каком контуре и каким способом был измерен?
16. openai/gpt-oss: от конфигурации к модулям курса
Теперь применим паспорт к реальному открытому артефакту. Репозиторий gpt-oss удобен тем, что разделяет читаемый PyTorch-код и оптимизированные пути исполнения. Конфигурация даёт анатомию; model.py показывает детали, которых в JSON нет.
| Источник | Что в нём читаем |
|---|---|
config.json / GptOssConfig | размеры, число слоёв, heads, experts, max positions, rope parameters, layer types |
gpt_oss/torch/model.py | bias-параметры, learned sinks, точную SwiGLU-функцию, порядок операций |
| Специализированные пути Triton/Metal | Указатели на упаковку и исполнение; разработка этих ядер за рамками курса |
| model card | предобучение и дообучение, лицензия, назначение, округлённые total/active |
Следующая таблица — указатель для второго прохода. Названия ещё не изученных механизмов нужны, чтобы найти их в конфигурации; каждый получит объяснение в указанном модуле. Кратко: RoPE и YaRN задают позиции, SwiGLU — преобразование в FFN, bias — добавочное смещение, а learned sink — обучаемый элемент нормировки внимания.
Ключевые поля и карта курса:
| Поле или деталь | Значение | Куда ведёт |
|---|---|---|
vocab_size | 201 088, o200k_harmony | М2 |
hidden_size, num_hidden_layers | 2880, 36 | М6, М9 |
num_attention_heads / num_key_value_heads | 64 / 8 | GQA, М5 и М10 |
layer_types, sliding_window | full/sliding через слой, окно 128 | hybrid attention, М5 |
rope_theta, YaRN factor 32, reference length 4096 | позиционная геометрия до 131072 | М4 |
num_local_experts / num_experts_per_tok | 128 / 4 | MoE, М7 |
intermediate_size | 2880 | expert geometry, М6–М7 |
SwiGLU clamp и (up+1) | находятся в коде, не в обычном поле hidden_act | М6 |
| learned sink per head | находится в коде | М5 |
| MXFP4 expert weights | формат весов и способ их обработки вычислительным ядром | М11 |
| Каналы и инструменты Harmony | протокол сообщений и действий | М2, М13, М18 |
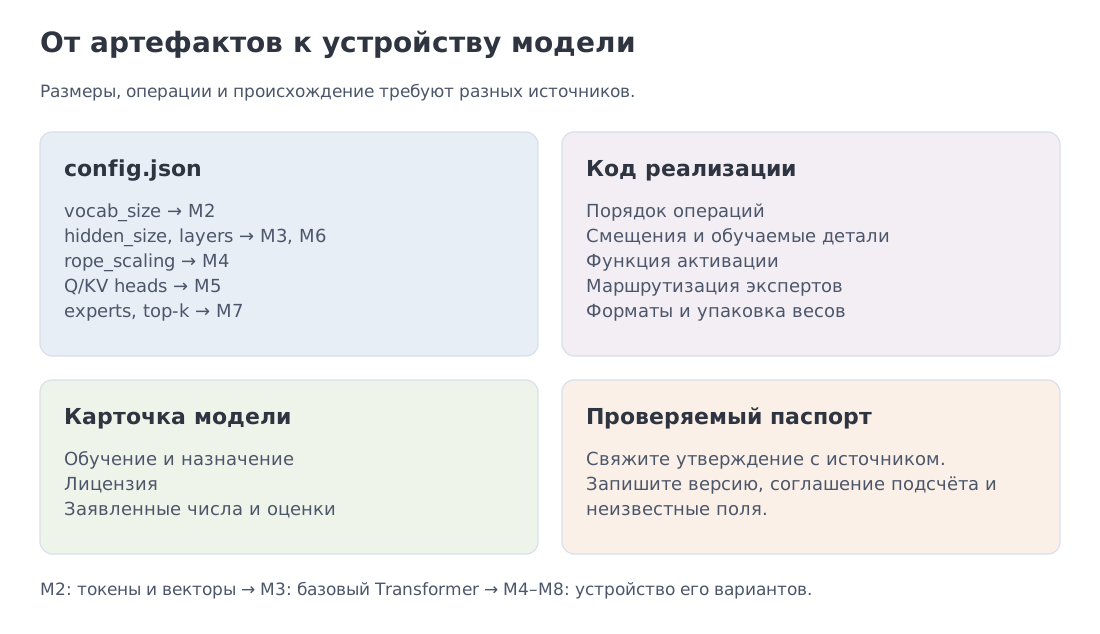 Конфигурация и код модели gpt-oss соединены с модулями курса. JSON задаёт параметры архитектуры; код раскрывает sinks, bias и конкретную активацию.
Три урока этого чтения.
- Экономика видна в архитектуре. GQA и sliding-слои уменьшают объём состояния; MoE уменьшает активный FFN-путь; MXFP4 уменьшает объём весов.
- Конфиг не является биографией обучения.
original_max_position_embeddings=4096задаёт исходную геометрию масштабирования, но не доказывает полный календарь претрейна. - Конфиг не является полным вычислительным графом. Bias, sinks, fused activation и некоторые детали маршрутизации существуют только в коде. Поэтому паспорт строится по паре
config + implementation, а model card добавляет обучение и продуктовый контракт.
В следующих модулях мы будем повторять этот приём: сначала выводить механизм на малой модели, затем находить соответствующий участок открытого кода. На третьем уровне достаточно объяснить, что именно делает выбранный участок и как он связан с формулой; воспроизводить весь высокопроизводительный стек репозитория не требуется.
17. Код (уровень 1): паспорт из проверенного config.json
На первом уровне отделим две задачи: прочитать конфиг и интерпретировать его поля.
Обязательный пример ниже полностью офлайн: он разбирает небольшой JSON-фрагмент, проверяет
поля, а затем строит паспорт. Это важно для воспроизводимости — опубликованный результат не
должен незаметно меняться вслед за веткой main внешнего репозитория.
В этом фрагменте 24 слоя и 32 эксперта — геометрия меньшего gpt-oss-20b. Пример показывает чтение полей, а не полный подсчёт параметров. Разбор gpt-oss-120b в §§6–7 использует 36 слоёв и 128 экспертов; полный подсчёт обеих моделей выполнен в ноутбуке.
Классификатор ниже распознаёт четыре соглашения о внимании. MHA (Multi-Head Attention) хранит отдельные ключи и значения для каждой головы запросов. MQA (Multi-Query Attention) использует один общий набор. GQA делит головы запросов на группы с общими ключами и значениями. MLA (Multi-Head Latent Attention) использует сжатое промежуточное представление; его параметр kv_lora_rank нельзя читать как обычное число голов. Здесь достаточно различать поля; математика этих механизмов — в М5.
Код удобно читать от итоговой функции passport: она собирает размеры, тип внимания и устройство FFN в одну запись. Функция positive_int проверяет отдельную положительную размерность, а one_of читает одно поле под несколькими допустимыми именами и обнаруживает противоречия. На этих проверках построены attention_kind и moe_kind. Поэтому неизвестное или несовместимое значение сначала вызывает явную ошибку и лишь затем, при корректном входе, появляется в паспорте.
"""Минимальный паспорт по проверяемым полям config.json."""
import json

EXAMPLE_CONFIG_JSON = r"""
{
  "hidden_size": 2880,
  "num_hidden_layers": 24,
  "num_attention_heads": 64,
  "num_key_value_heads": 8,
  "num_local_experts": 32,
  "num_experts_per_tok": 4,
  "max_position_embeddings": 131072,
  "vocab_size": 201088,
  "rope_scaling": {"rope_type": "yarn", "factor": 32}
}
"""

def positive_int(config: dict, key: str) -> int:
    """Прочитать обязательное положительное целое поле."""

    value = config.get(key)
    if isinstance(value, bool) or not isinstance(value, int) or value <= 0:
        raise ValueError(f"{key} должно быть положительным целым")
    return value

def one_of(config: dict, *keys: str):
    """Прочитать поле-синоним и отклонить противоречие."""

    found = [(key, config[key]) for key in keys if config.get(key) is not None]
    if not found:
        return None
    if any(type(value) is not type(found[0][1]) or value != found[0][1]
           for _, value in found[1:]):
        raise ValueError(f"противоречащие поля-синонимы: {[key for key, _ in found]}")
    return found[0][1]

def attention_kind(config: dict) -> str:
    """Различить MHA, MQA, GQA и MLA по поддерживаемым полям."""

    if "kv_lora_rank" in config:  # сначала проверяем признак MLA
        return f"MLA (kv_rank={positive_int(config, 'kv_lora_rank')})"
    heads = positive_int(config, "num_attention_heads")
    kv_heads = config.get("num_key_value_heads", heads)
    if isinstance(kv_heads, bool) or not isinstance(kv_heads, int) or kv_heads <= 0:
        raise ValueError("num_key_value_heads должно быть положительным целым")
    if kv_heads > heads or heads % kv_heads:
        raise ValueError("число KV-голов должно делить число Q-голов")
    if kv_heads == heads:
        return f"MHA ({heads} голов)"
    if kv_heads == 1:
        return f"MQA ({heads} Q-голов / 1 KV)"
    return f"GQA ({heads} Q-голов / {kv_heads} KV)"

def moe_kind(config: dict) -> str:
    """Различить плотную модель и MoE с учётом полей-синонимов."""

    experts = one_of(config, "num_local_experts", "n_routed_experts", "num_experts")
    if experts is None:
        if any(config.get(k) is not None for k in ("num_experts_per_tok", "num_experts_per_token", "n_shared_experts", "num_shared_experts")):
            raise ValueError("настройки экспертов требуют их количества")
        return "dense"
    if isinstance(experts, bool) or not isinstance(experts, int) or experts <= 0:
        raise ValueError("expert count должно быть положительным целым")
    top_k = one_of(config, "num_experts_per_tok", "num_experts_per_token")
    if isinstance(top_k, bool) or not isinstance(top_k, int) or not 1 <= top_k <= experts:
        raise ValueError("top-k должно лежать в диапазоне от 1 до числа экспертов")
    shared = one_of(config, "n_shared_experts", "num_shared_experts")
    shared = 0 if shared is None else shared
    if isinstance(shared, bool) or not isinstance(shared, int) or shared < 0:
        raise ValueError("число общих экспертов должно быть неотрицательным целым")
    return f"MoE: {experts} экспертов, top-{top_k}" + (f" + {shared} общих" if shared else "")

def passport(config: dict) -> dict:
    """Вернуть структурный паспорт без сетевого вызова."""

    return {
        "layers_x_hidden": (
            positive_int(config, "num_hidden_layers"),
            positive_int(config, "hidden_size"),
        ),
        "attention": attention_kind(config),
        "ffn": moe_kind(config),
        "context": positive_int(config, "max_position_embeddings"),
        "vocabulary": positive_int(config, "vocab_size"),
    }

config = json.loads(EXAMPLE_CONFIG_JSON)
print(passport(config))
Пример выдаёт GQA с 64 головами запросов и 8 головами ключей и значений, MoE с 32 экспертами и выбором 4 на токен, контекст 131 072 и словарь 201 088. Поля показывают поддерживаемое соглашение конфигурации, а не измеренное качество. Измените число KV-голов на 3: проверка должна отклонить его. Полная проверка JSON и подсчёт параметров находятся в ноутбуке.
Справочный кейс: загрузка из первоисточника
import json
import re
from pathlib import Path

def read_hf_config(repo_id: str, revision: str, token: str | None = None) -> dict:
    """Опционально скачать config.json только по immutable 40-hex commit."""

    if not re.fullmatch(r"[0-9a-fA-F]{40}", revision):
        raise ValueError("revision должен быть полным 40-hex commit, а не main/tag")
    from huggingface_hub import hf_hub_download  # нужен только в opt-in live-режиме

    path = hf_hub_download(
        repo_id=repo_id,
        filename="config.json",
        revision=revision,
        token=token,
    )
    return json.loads(Path(path).read_text(encoding="utf-8"))

def read_hf_config_from_source(
    repo_id: str,
    revision: str = "main",
    token: str | None = None,
) -> tuple[str, dict]:
    """Разрешить live ref в commit и прочитать config именно с этого commit."""

    from huggingface_hub import HfApi

    info = HfApi(token=token).model_info(repo_id=repo_id, revision=revision)
    commit = info.sha
    if not isinstance(commit, str):
        raise RuntimeError("Hub не вернул commit SHA")
    return commit, read_hf_config(repo_id, commit, token)
Основным источником расчётов остаётся модульный снапшот. Вторая функция — дополнительная
живая иллюстрация того, как получить данные из первоисточника: main, tag или PR ref сначала
разрешается в полный commit, после чего config.json читается именно по этому commit. Поэтому
читатель видит и актуальный конфиг, и точную ревизию, которую нужно записать рядом с результатом.
Автоматического fallback нет: ошибка сети, доступа или ревизии остаётся видимой. Полная
проверка схемы, SHA-256 (Secure Hash Algorithm 256-bit), расчёт total/active и сравнение значений по путям полей реализованы в ноутбуке; там
живая ячейка выключена по умолчанию флагом RUN_LIVE_SOURCE_EXAMPLE = False.
19. Карта курса и развивающейся серии
Паспорт из этого модуля связывает вопросы выбора с устройством модели. В М2–М8 мы последовательно проследим, как текст превращается в числа, как эти числа обрабатывает Transformer и какие альтернативы меняют его вычисления. В М9 обучим модель в учебном масштабе и разберём выбор данных и бюджета. М10–М12 объяснят память и стоимость генерации, снижение точности и альтернативный порядок построения ответа.
Дальше задача меняется: у нас уже есть обученная модель, и нужно получить желательное поведение. М13–М15 посвящены демонстрациям, обратной связи и вычислениям во время решения. М16–М18 расширяют входы и доступные действия: изображение, звук, поиск по документам, инструменты. В М19 мы вернёмся к исходному вопросу М1 — на каком основании считать, что система решает нашу задачу? Теперь за этим вопросом будут стоять воспроизводимые опыты и ясные ограничения.
В дополнительном М20 соберём изученную математику в полную формулу MiniLLM, проследим численный пример от токенов до обновления весов и отдельно покажем, что меняется у SSM и диффузионных моделей.
Ниже каждому полю паспорта соответствует место, где его механизм изучается подробно.
| Поле паспорта | Модули Modern LLMs |
|---|---|
| Токенизатор и словарь | М2 |
| Базовый Transformer | М3 |
| Позиционная геометрия | М4 |
| Внимание и способы его вычисления | М5 |
| Нормализация, остаточные связи и FFN | М6 |
| Смесь экспертов и маршрутизация | М7 |
| Модели пространства состояний и гибриды | М8 |
| Предварительное обучение и данные | М9 |
| KV-кэш и обслуживание запросов | М10 |
| Снижение точности и ускорение генерации | М11 |
| Диффузионные языковые модели | М12 |
| Дообучение на инструкциях | М13 |
| Обучение по предпочтениям и наградам | М14 |
| Рассуждение и вычисления при решении | М15 |
| Мультимодальность | М16 |
| RAG | М17 |
| Агенты и инструменты | М18 |
| Оценка моделей и систем | М19 |
| Полная математическая конструкция | М20 |
Итоговый проект MiniLLM соединяет архитектуру, подготовку данных, обучение и генерацию в небольшой модели. Вы сможете сверить число параметров с паспортом, изменить механизм и проверить гипотезу. Мультимодальность, поиск и агенты остаются дополнительными направлениями расширения; базовый проект реализует авторегрессионную текстовую модель. Так в конце курса можно заполнить паспорт уже собственного артефакта. Масштаб проекта выбран для изучения и проверки механизмов; промышленная инфраструктура не является его результатом.
Три курса образуют текущее ядро серии.
| Курс | Центральный вопрос |
|---|---|
| Modern LLMs | Как современные модели устроены, обучаются, исполняются и оцениваются? |
| Information Theory for ML | Почему cross-entropy, KL, кодирование, rate–distortion и информационные ограничения имеют именно такую форму? |
| RL for LLM | Как политика учится по предпочтениям, наградам, верификаторам и интерактивным средам? |
Каждый курс остаётся самодостаточным. Перекрёстная ссылка означает «здесь можно углубиться», а не «без другого курса текущий вывод непонятен». Серия будет расширяться курсами по ML и математике вокруг него, сохраняя тот же двуязычный и воспроизводимый формат.
22. Резюме-шпаргалка
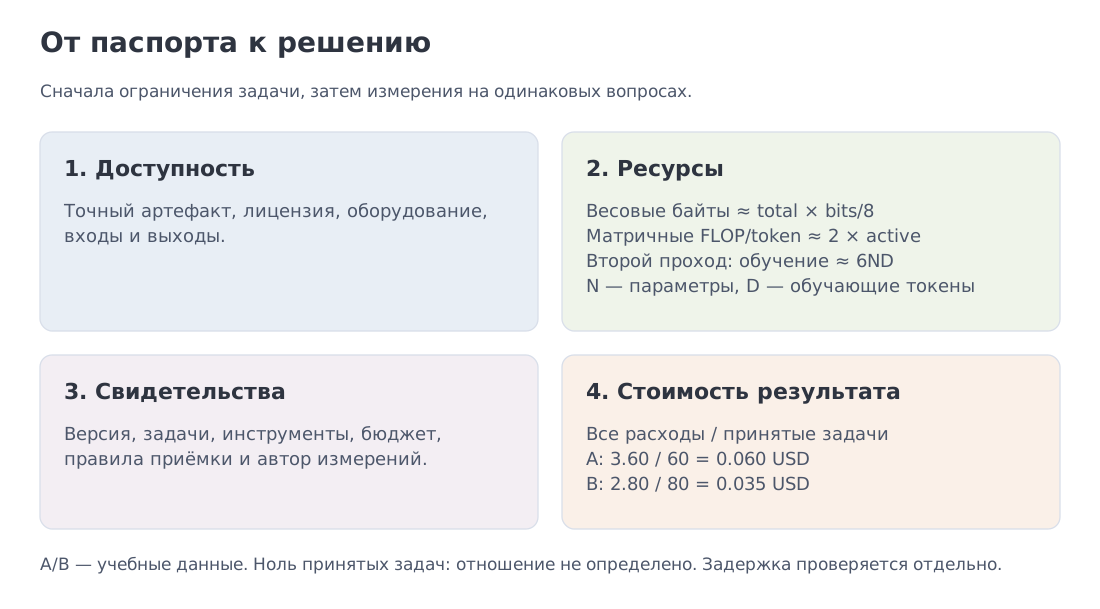 Два паспорта, три формулы и карта свидетельств на одном экране.
Паспорт модели: полные и активные параметры, формат весов · номинальный и рабочий контекст · входные и выходные модальности · режим рассуждения · лицензия и доступ · стоимость API или собственного развёртывания.
Паспорт системы: точная версия и защитные ограничения · инструменты и среда исполнения · разрешения и секреты · сеть и изоляция · общая память · протокол оценки · мониторинг и условия остановки.
Первые две формулы — для оценки ресурсов:
Второй проход: обучение. При допущениях §5.3 используем , где — число параметров по выбранному правилу, а — число обучающих токенов. Вывод и ограничения — в М9.
Чтение конфига, второй проход (§17): kv_lora_rank → MLA · равное число Q- и KV-голов → MHA · одна KV-голова при нескольких Q → MQA · промежуточное число KV-голов, делящее число Q-голов, → GQA · поля экспертов → MoE · rope_scaling → масштабирование позиций · layer_types/sliding_window → гибридное внимание. Затем открыть код модели: sinks, bias, функция активации и детали маршрутизации могут отсутствовать в JSON.
Чтение анонса: total → объём хранения · active → первая оценка вычислений · точность → байты на параметр · контекст → рабочее качество и память состояния · результат теста → среда запуска, effort, инструменты и число попыток.
Карта свидетельств: заявление разработчика · независимое воспроизведение · парная оценка · частный эталонный набор · эксплуатационная телеметрия. Выбор зависит от проверяемого вопроса.
Решение о выборе: проверить доступность → измерить качество на своих задачах → посчитать все расходы на принятую задачу → проверить задержку и ограничения. У active указывайте этап вычисления, у контекста — вход и выход, у тарифа — дату и условия.
23. Источники
Фундаментальные источники
- Vaswani et al., Attention Is All You Need — arxiv.org/abs/1706.03762
- Brown et al., Language Models are Few-Shot Learners — arxiv.org/abs/2005.14165
- Hoffmann et al., Training Compute-Optimal Large Language Models — arxiv.org/abs/2203.15556
- DeepSeek-V3 Technical Report — arxiv.org/abs/2412.19437
- DeepSeek-R1 — arxiv.org/abs/2501.12948
Открытые артефакты и model cards
-
OpenAI gpt-oss — анонс и паспорт, код, индекс исходных файлов 120b
-
Llama 4 — Transformers model documentation
-
DeepSeek — Transparency Center
-
Inkling — анонс, model card, Tinker
-
Kimi K3 — официальный model repository
-
Hugging Face Hub — download/revision, HfApi
-
Входные данные расчётов — конфигурации, ревизии и SHA-256; реестр источников обзора.
-
Qwen3 — реализация нормировки Q/K.
Источники октябрьского среза — проверено 11 октября 2026 года
- OpenAI — API changelog, GPT-6.1 Sol
- Anthropic — Opus 5.5, Sonnet 5.5, Haiku 5.5 and pricing update
- Google — Gemini 3.8 Flash / Cyber, Gemini 4 Argon
- SpaceXSI — Grok 4.7
- Qwen — 2.4T-A95B weights and model card, 27B
- DeepSeek — API changelog, V4.1 Flash model card, technical report
Инцидент OpenAI–Hugging Face
- OpenAI — предварительный разбор
- Hugging Face — публикация об инциденте
- Полный разбор — OpenAI, 26 августа, METR/Redwood, хронология Hugging Face
Дальше: модуль 2 — как текст превращается в токены и векторы и почему этот интерфейс влияет на стоимость, многоязычность и безопасность протокола.
Ландшафт сверен: 11 октября 2026 года. Конфигурации и источники сверены на эту же дату; разбор июльского инцидента учитывает полные отчёты от 26 августа. Учебные цены A/B вымышлены. Самые волатильные части — §§3 и 13–15. Таблицы различают открытый config, карточку модели, технический отчёт, результат, сообщённый разработчиком, и вторичные сообщения; неизвестная архитектура не восстанавливается по поведению модели. Перед практическим применением цены, доступность и контракты API следует перепроверить.