Модуль 10. KV-кэши и эффективный инференс
Курс «Modern LLMs» · лекция модуля 10 · редакция 2026.10.25
Что это за модуль. В модуле 9 мы рассматривали, как довести модель до конца предобучения. Теперь изменим точку зрения: веса уже зафиксированы, и модель должна отвечать на запросы с заданными ограничениями по задержке, пропускной способности и стоимости. При авторегрессионном decode ради каждого нового токена приходится читать веса и состояние предыдущего контекста. Поэтому память здесь становится не второстепенной деталью реализации, а одной из центральных переменных экономики обслуживания модели.
Мы последовательно пройдём весь маршрут: выведем размер KV-кэша на токен, добавим его в модель roofline, найдём точку насыщения пакетной обработки, разберём PagedAttention и кэширование префикса, затем перейдём к многоуровневому хранению, раздельным пулам prefill и decode и компрессии кэша. Все численные значения в решённых примерах относятся к явно заданному учебному сценарию. Они являются арифметическими пределами или воспроизводимыми расчётами, а не результатами скрытого испытания в производственной среде.
Что нужно знать заранее. В модуле 5 разобраны MHA, GQA и MLA; в модуле 8 — рекуррентное состояние; в модуле 9 — стоимость инференса за жизненный цикл модели. Roofline вводится ниже: время ограничено как минимум вычислением операций и переносом данных. Их идеализированная совместная нижняя граница — максимум двух времён, если они перекрываются.
Как читать модуль
Первый проход — от токена к обслуживанию. Прочитайте §§1, 3–9, затем §11 до подзаголовка «Примеры реализаций» и основные выводы §20; пункты «Уровни хранения», «Компрессия» и части схемы про уровни хранения оставьте до §§10, 14–15. Получится цепочка: что хранится → сколько байтов → что ограничивает скорость → как выделять и повторно использовать память. В §6 достаточно формулы пропускной способности и таблицы; уточнение FLOP можно оставить на второй проход. Решите У1 и проверьте У2 в ноутбуке.
Второй проход — механизмы и границы. Вернитесь к истории (§2), уточнениям вычислений (§§6, 9), многоуровневому хранению (§10), коду (§§12–13) и сжатию (§§14–15). Запустите ноутбук целиком: ошибки формы, нехватка страниц и откат за пределы окна — часть контракта. Затем решите У3 и запустите оба проектных демо.
Для справки. §§16–17 помогают составить паспорт конкретного движка и модели; §18 проверяет понимание, §19 задаёт проекты. Тарифы и поддержка соединителей привязаны к дате проверки, формулы — к явно указанным допущениям.
1. Мотивация: почему инференс становится задачей о памяти
Во время обучения мы платим за большой, но конечный обучающий запуск. После релиза та же модель может выполнить на порядки больше шагов инференса, причём каждый шаг должен уложиться в заданные целевые ограничения качества обслуживания — SLO (service-level objectives). Здесь возникает неприятная асимметрия: чтобы получить один следующий токен, плотная модель с полным вниманием снова использует почти все свои веса и накопленные ключи и значения всего доступного контекста. У MoE и механизмов с ограниченной памятью набор читаемых данных иной; поэтому далее всегда будем указывать архитектуру.
Назовём prefill обработку входного промпта, а decode — последующее добавление токенов по одному. HBM — высокоскоростная память ускорителя; DRAM — оперативная память CPU. В §5 свяжем фазы с задержками, видимыми пользователю.
В обычном Transformer это состояние представлено KV-кэшем. Для каждого уже обработанного токена слои внимания сохраняют векторы ключей и значений (K/V), чтобы на следующем шаге не пересчитывать прошлое заново. Такой обмен почти всегда выгоден по вычислениям, но при сохранении всей истории память растёт линейно с длиной контекста и числом одновременных запросов.
Рассмотрим один ориентир, который будет сопровождать нас по модулю. Для модели 70B с GQA и кэшем в bf16 миллион токенов означает около 327.68 GB, или 305.18 GiB, памяти для KV-состояния при пакете из одного запроса. Объём весов той же модели в bf16 — примерно 140 GB. На этой длине динамическое состояние одного запроса уже тяжелее самих весов.
Из этого наблюдения следуют три инженерных вопроса.
Первый: как быстро может идти decode, если с ростом контекста на каждом шаге нужно читать всё больше байтов? Второй: насколько долго пакетная обработка продолжает амортизировать чтение весов, если у каждого запроса собственный KV-кэш? Третий: что делать с повторяющимися или временно неактивными блоками — держать в HBM, повторно использовать, вынести на более медленный уровень или сжать?
Весь модуль является последовательным ответом на эти три вопроса.
2. Историческая прогрессия: от компактного KV-состояния к платформе, построенной вокруг кэша
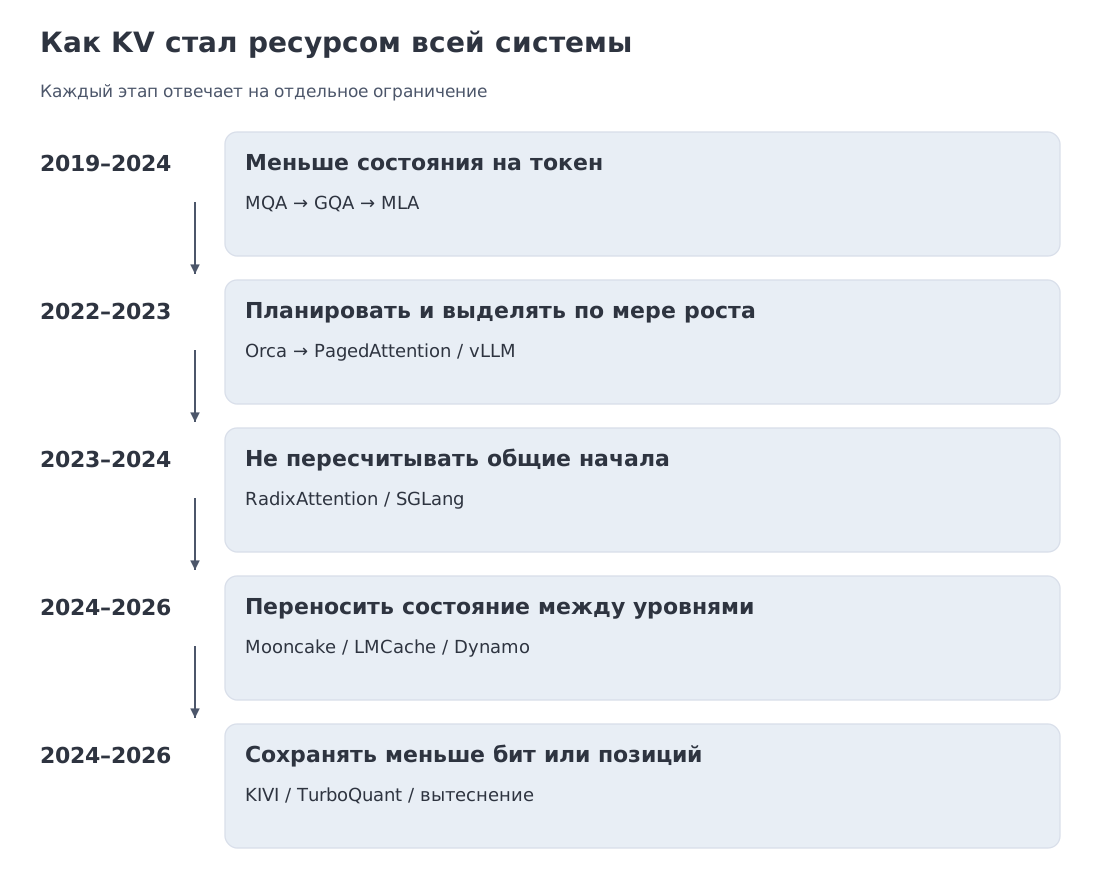 Четыре линии развития: архитектурное сокращение KV, страничное управление памятью, распределённое хранение и компрессия.
Историю эффективного инференса полезно читать не как список фреймворков, а как последовательность ограничений, которые становились заметны по мере роста моделей и контекста.
Сначала изменялась архитектура механизма внимания. Multi-Query Attention в 2019 году предложила делить одну пару K/V между всеми головами запросов. Grouped-Query Attention в 2023 году заняла промежуточное положение между MHA и MQA: несколько групп голов запросов используют меньшее число KV-голов. MLA в DeepSeek-V2 пошла дальше и стала сохранять компактное латентное представление вместо полного набора K/V по головам. Во всех трёх случаях цель одна: уменьшить число байтов, которое сопровождает каждый токен при decode.
Следующий предел оказался системным. Даже компактный кэш нужно размещать, освобождать и совместно использовать между запросами разной длины. Непрерывная пакетная обработка (continuous batching) в Orca позволила обновлять состав пакета на каждом шаге. PagedAttention и vLLM перенесли на KV-кэш блочное распределение памяти и копирование при записи (copy-on-write). SGLang развил идею повторного использования общих префиксов через RadixAttention.
Затем KV-кэш перестал помещаться в границах одного процесса или одной GPU. Mooncake построил глобальный KV-пул из HBM, CPU DRAM, SSD и сети и отделил prefill от decode. LMCache оформил перенос и совместное использование KV между уровнями и экземплярами движка как отдельный слой. NVIDIA Dynamo 1.0 добавил оркестрацию распределённого инференса, а CMX был анонсирован как специализированный уровень хранения контекста для целого вычислительного пода в экосистеме Vera Rubin.
Наконец, стала активно развиваться компрессия самого представления: политики вытеснения оставляют лишь часть позиций, KIVI и другие методы квантуют K/V, TurboQuant применяет векторное квантование, а гибридные архитектуры сочетают обычный KV-кэш с рекуррентным состоянием. Эти линии не заменяют друг друга. Рабочая система обычно использует несколько из них одновременно.
3. Мостик к классическим системам: страницы, иерархия и очереди
Почти все механизмы этого модуля имеют хорошо знакомых предков в системном программировании. Эта аналогия полезна, если не принимать её слишком буквально.
Первый предок — виртуальная память. Последовательность видит логически непрерывный контекст, хотя физические KV-блоки могут лежать в разных местах. Таблица блоков выполняет роль таблицы страниц. Общий префикс можно разделять между несколькими последовательностями, а при первой записи в общий неполный блок используется копирование при записи (copy-on-write). Именно эту идею мы разберём в PagedAttention.
Второй предок — иерархия кэшей. HBM быстрее и меньше CPU DRAM; DRAM быстрее NVMe; локальный NVMe обычно ближе, чем удалённое хранилище. Поэтому вопрос «где лежит KV?» превращается в обычную задачу о локальности данных, доле попаданий, вытеснении и стоимости переноса. Разница лишь в масштабе объекта: один контекст может занимать десятки или сотни гигабайт.
Третий предок — теория очередей и профилирование фаз. Prefill и decode используют ускоритель по-разному. Длинный prefill может задержать короткие шаги decode других пользователей, даже если средняя пропускная способность сервера выглядит высокой. Отсюда различие между обычной пропускной способностью и полезной пропускной способностью (goodput) — числом запросов или токенов, обслуженных при соблюдении заданных ограничений времени до первого токена (TTFT) и интервала между токенами (ITL).
Эти три аналогии заранее подсказывают архитектуру решения: память нужно виртуализировать, горячие данные — удерживать ближе к GPU, а фазы с разной физикой — планировать независимо.
4. Формализм и решённый пример A: сколько памяти добавляет один токен
Начнём с обычного механизма внимания MHA/GQA. Пусть в модели слоёв, сохраняющих KV-кэш, в каждом слое KV-голов размерности , а один элемент занимает байт. Для одного токена нужно сохранить и ключ, и значение, поэтому
Это число не зависит от текущей длины контекста. Оно отвечает на более локальный вопрос: сколько байтов добавит ещё один токен во всех слоях внимания. Для контекста длины и размера пакета получаем
При bf16, то есть , получаем следующую лестницу:
| Архитектура | Конфигурация учебного расчёта | KiB/токен | Что именно сокращено |
|---|---|---|---|
| 70B, MHA-эквивалент | 2 560 | базовый полный KV по головам | |
| Llama-3.3-70B, GQA | 320 | KV-голов в восемь раз меньше | |
| Llama-3-8B, GQA | 128 | меньшая глубина при том же числе KV-голов | |
| DeepSeek-V3, MLA | , латент | 68.625 | сохраняется latent+RoPE-компонента |
| рекуррентный слой или слой пространства состояний | фиксированное состояние слоя | не растёт с | хранится состояние, а не KV для каждой позиции |
В строке MLA используется отдельная геометрия:
где — размерность латента, а — сохраняемая позиционная компонента. Стандартная формула через к MLA неприменима: модель кэширует другой объект.
Здесь и далее 8K = 8192, 32K = 32768, 128K = 131072 токенов; 1M = 1 000 000. Это условные обозначения длин, а не единицы памяти. означает число одновременных запросов, — число сохранённых позиций на запрос.
Единицы в таблице бинарные: деление выполняется на , поэтому результат указан в KiB, а не в десятичных килобайтах. Для 70B GQA один запрос даёт 2.5 GiB на 8K, 10 GiB на 32K, 40 GiB на 128K и 305.18 GiB на 1M токенов.
Главный вывод здесь не в том, что одна архитектура «хороша», а другая «плоха». Формат состояния является частью паспорта инференса модели. Для GQA достаточно числа KV-голов; для MLA нужны латентные размерности; для внимания со скользящим окном важна ширина окна; для гибридов — число слоёв каждого типа. Например, DeepSeek-V4 использует сочетание CSA/HCA, а Kimi K3 — слои KDA и Gated MLA, поэтому их память нельзя надёжно оценить одной строкой из таблицы без чтения конфигурации.
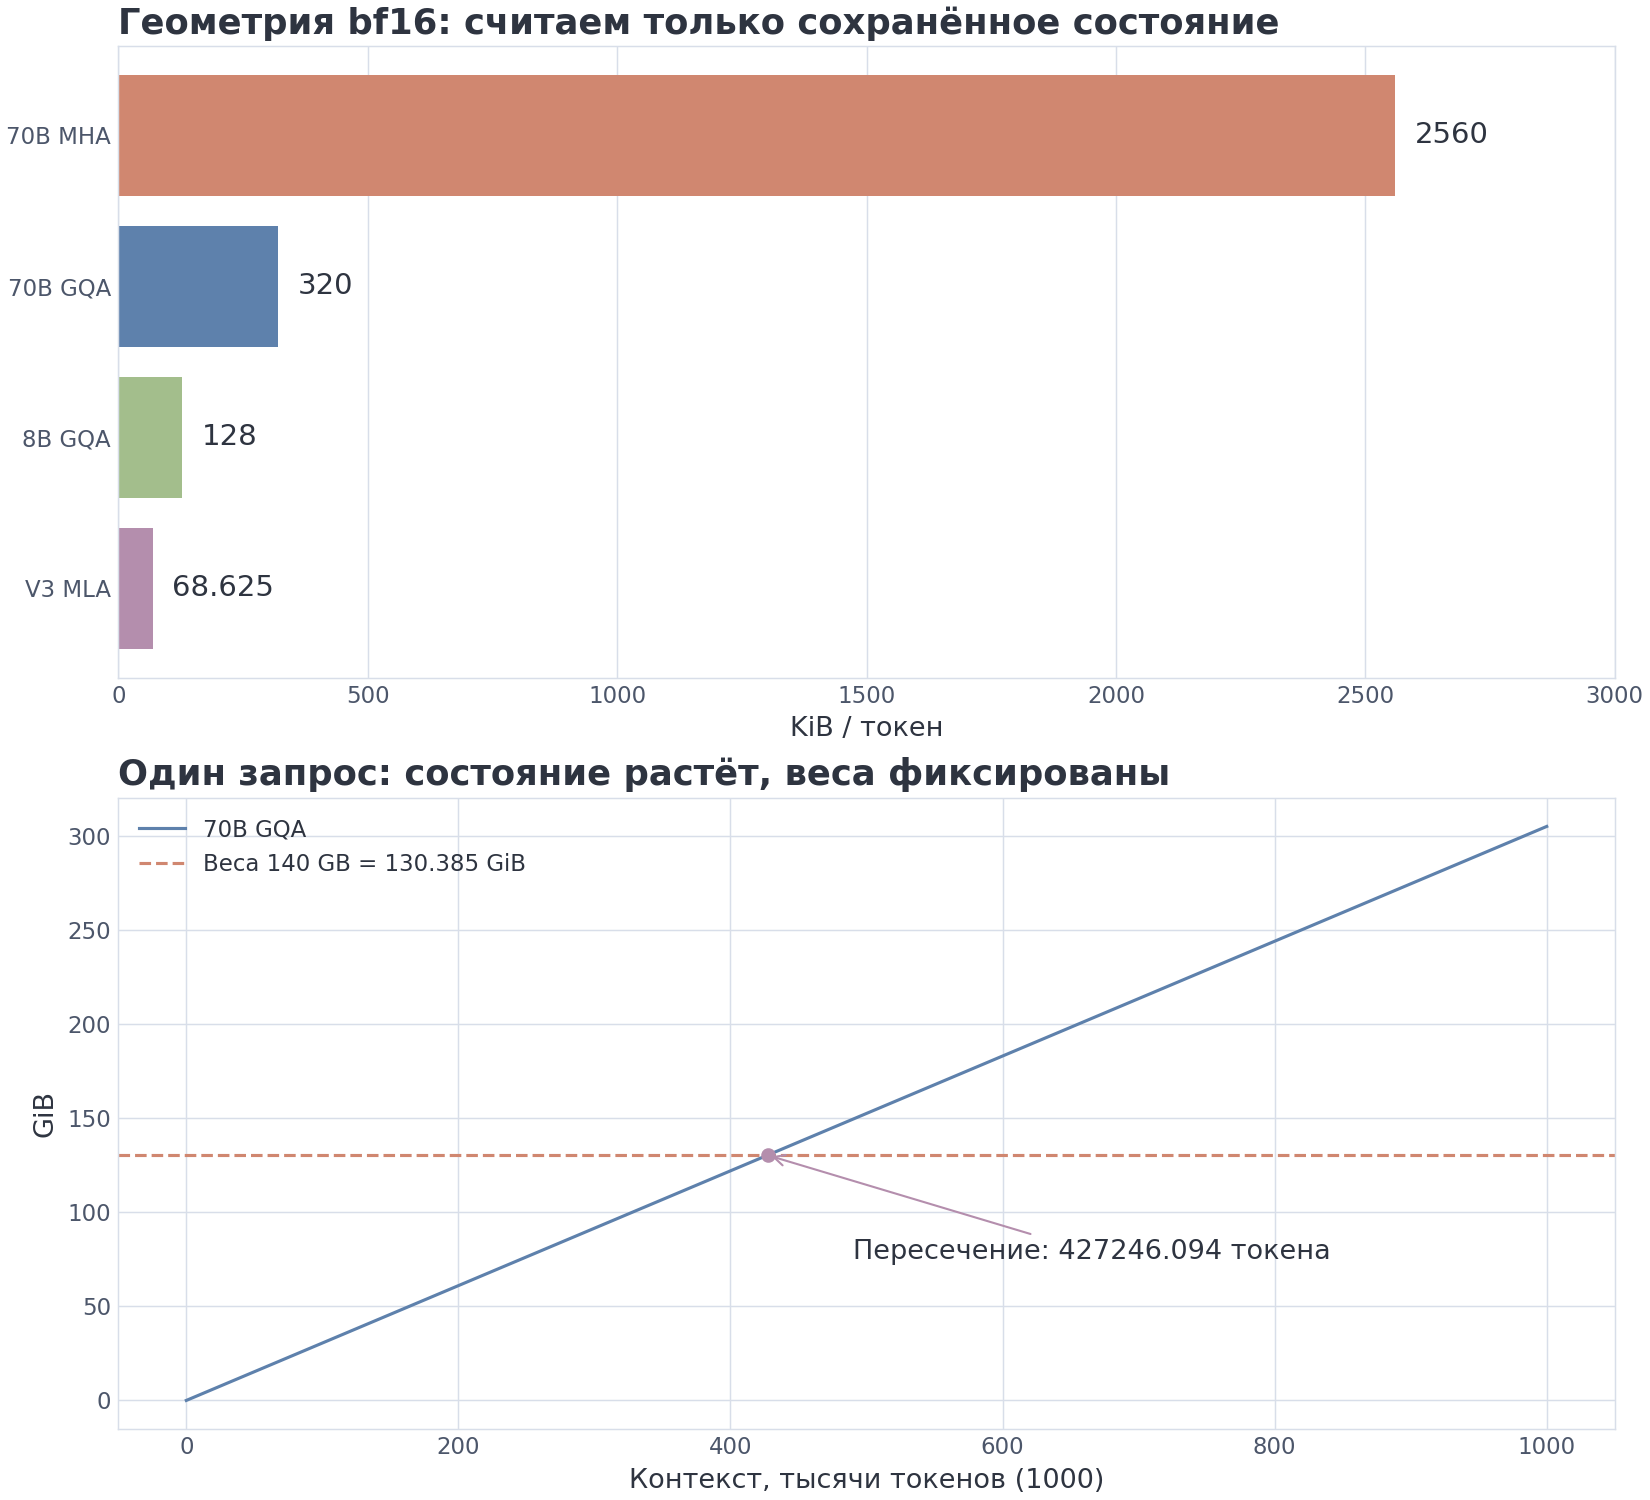 Сверху — учебная лестница KiB на токен; снизу — рост памяти, занятой KV-состоянием модели 70B GQA и пересечение с объёмом весов.
5. Две фазы одного запроса: prefill и decode
Один запрос инференса проходит по крайней мере две существенно разные фазы.
Во время prefill модель обрабатывает весь входной промпт и строит его состояние. Многие операции выполняются над матрицами сразу для большого числа позиций, поэтому при достаточной длине и удачной пакетной обработке эта фаза часто ближе к режиму, ограниченному вычислительной производительностью. Пользователь видит её прежде всего через TTFT — время до первого токена (time to first token).
Во время decode за один шаг появляется один новый токен для каждой активной последовательности. Веса снова читаются, но матричная работа по длине последовательности уже не амортизирует этот трафик так же эффективно. Дополнительно механизм внимания читает накопленный KV-кэш. Поэтому decode часто оказывается ограниченным пропускной способностью памяти. Его пользовательская метрика — ITL — задержка между токенами (inter-token latency), или эквивалентная ей скорость потока после первого токена.
Для ориентира возьмём модель 8B в bf16 и контекст 128K. Если считать проекции и операции внимания QK/AV, получим 2.553 FLOP на прочитанный байт. Отношение пиковой производительности к пропускной способности памяти в нашем сценарии — 295.52 FLOP/B. Значит, даже идеализированный расчёт указывает на ограничение по памяти. В §6 выведем оба числа и сравним с более простой оценкой только по проекциям.
SLO не имеет универсального значения: интерактивный чат, пакетная генерация и агентные траектории допускают разные TTFT и ITL. Однако принцип одинаков. Сервер должен оптимизировать не только среднюю пропускную способность, но и полезную пропускную способность при конкретных ограничениях, иначе редкие длинные операции prefill будут скрываться за красивой средней цифрой.
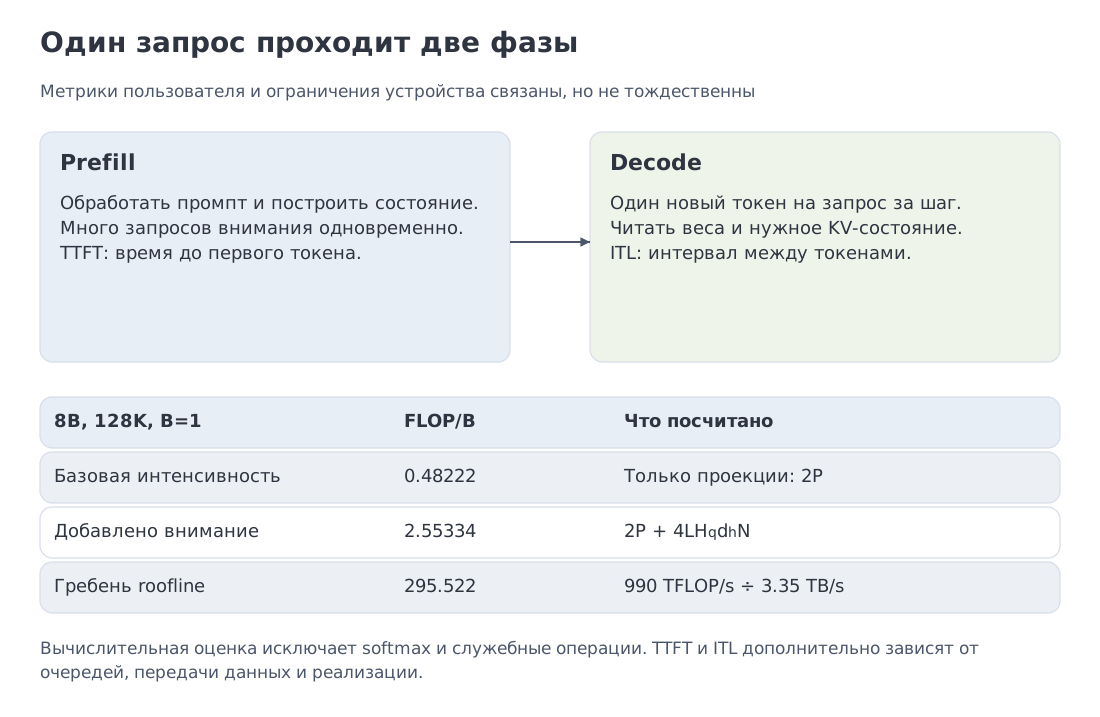 Prefill и decode как две фазы с разным профилем ресурсов; числа помечены как сценарий расчёта, а не универсальный SLO.
6. Решённый пример B: как KV-кэш снижает верхнюю границу по пропускной способности памяти
Теперь добавим поток данных KV в простую модель roofline. Пусть — байты весов, — пропускная способность памяти, — кэш на один токен, а — текущая длина контекста. Если каждый шаг decode хотя бы один раз читает веса и резидентный KV-кэш, то
Первая формула — нижняя граница времени, вторая — верхняя граница скорости. Реальный движок будет медленнее из-за неполного использования пропускной способности памяти, временных буферов, коммуникации, запусков вычислительных ядер и других расходов.
Возьмём Llama-3-8B в bf16: GB, KiB/токен, TB/s.
| Контекст | KV, десятичные GB | KV, двоичные GiB | Арифметическая верхняя граница, ток/с |
|---|---|---|---|
| 0 | 0 | 0 | 209.4 |
| 8K | 1.074 | 1.000 | 196.2 |
| 128K | 17.180 | 16.000 | 101.0 |
| 1M | 131.072 | 122.070 | 22.8 |
На 128K KV-память сравнима с весами, поэтому верхняя граница почти вдвое ниже. На 1M суммарный объём весов и KV равен 147.072 GB, или 136.97 GiB. Такой сценарий не помещается в 80-GiB устройство ещё до учёта активаций, резерва распределителя памяти и рабочих областей.
Формула также показывает, где работают архитектурные улучшения. GQA и MLA уменьшают число байтов на сохраняемую позицию — . Скользящее окно ограничивает число таких позиций: вместо в оценку входит , где — ширина окна. Рекуррентный слой хранит состояние фиксированной формы; его объём учитывается отдельным слагаемым, не растущим с длиной истории. Эти механизмы меняют разные части модели памяти и её чтения. Более быстрые вычислительные ядра полезны, но они не могут устранить обязательный трафик данных, заложенный в выбранное представление состояния.
Уточнение: вычисления внимания тоже зависят от контекста
— число параметров; — число голов запросов. приближённо считает проекции, а — скалярные произведения QK и взвешивание V; умножение со сложением даёт два FLOP. Здесь — число ключей, доступных текущему запросу, включая его позицию; разницу чтения и записи нового KV мы в этой модели не детализируем. Softmax, нормировки и служебные операции пока исключены.
Арифметическая интенсивность — число операций на прочитанный байт. Пусть пик вычислений равен 990 TFLOP/s, а пропускная способность — 3.35 TB/s. Их отношение задаёт гребень roofline: при такой интенсивности времена вычислений и чтения в идеальной модели равны. Ниже гребня больше времени требует память.
Для 8B при : , , , . Получаем GFLOP, FLOP/B и гребень roofline FLOP/B. Отношение — 115.74. Если оставить только , выйдет 0.48222 FLOP/B и отношение 612.84: это оценка по проекциям, а не полная интенсивность decode. GQA уменьшает число KV-голов для памяти, но в этом расчёте операций используется число Q-голов.
Совместная нижняя граница времени шага — . Реальная реализация добавляет операции и трафик; мы оцениваем масштаб ограничения, а не обещаем задержку.
7. Батч-экономика: где заканчивается амортизация весов
Пакетная обработка помогает decode, потому что один проход по весам обслуживает сразу активных последовательностей. Но KV-кэш у каждой последовательности собственный. В той же упрощённой модели
При малом доминируют веса, и суммарная пропускная способность растёт почти линейно. По мере увеличения батча суммарный поток данных KV догоняет . Удобная точка перехода —
Для нашего сценария с моделью 8B равно 14.9 при 8K, 3.7 при 32K и 0.93 при 128K. Последнее число читается так: уже один 128K-контекст несёт больше байтов KV, чем объём весов. Пакетная обработка всё ещё увеличивает суммарную пропускную способность, но прирост быстро становится сублинейным, потому что каждый новый запрос добавляет почти столько же памяти, сколько предыдущий.
Контрольная точка: при пакете 32 и 8K получаем верхнюю границу 2 128.7 ток/с вместо 6 700 ток/с в гипотетической модели без потока данных KV. Отношение равно 3.15. Это и есть дополнительная цена KV-кэша данного сценария — не универсальный результат измерения, а цена, которую в арифметической модели добавляет состояние запросов.
— суммарные токены пакета в секунду. При одинаковом обслуживании запросов скорость каждого равна : для это 66.52 ток/с, а соответствующий идеальный шаг — 15.03 ms. Вместимость проверяется отдельно: из условных 80 GiB вычитаем веса 16 GB и резерв 8 GiB. Для контекстов 8K, 32K, 128K остаётся не более 57, 14 и 3 запросов; для 1M — ноль. Число 80 GiB задаёт учебную ёмкость, а не переименовывает спецификацию любого H100.
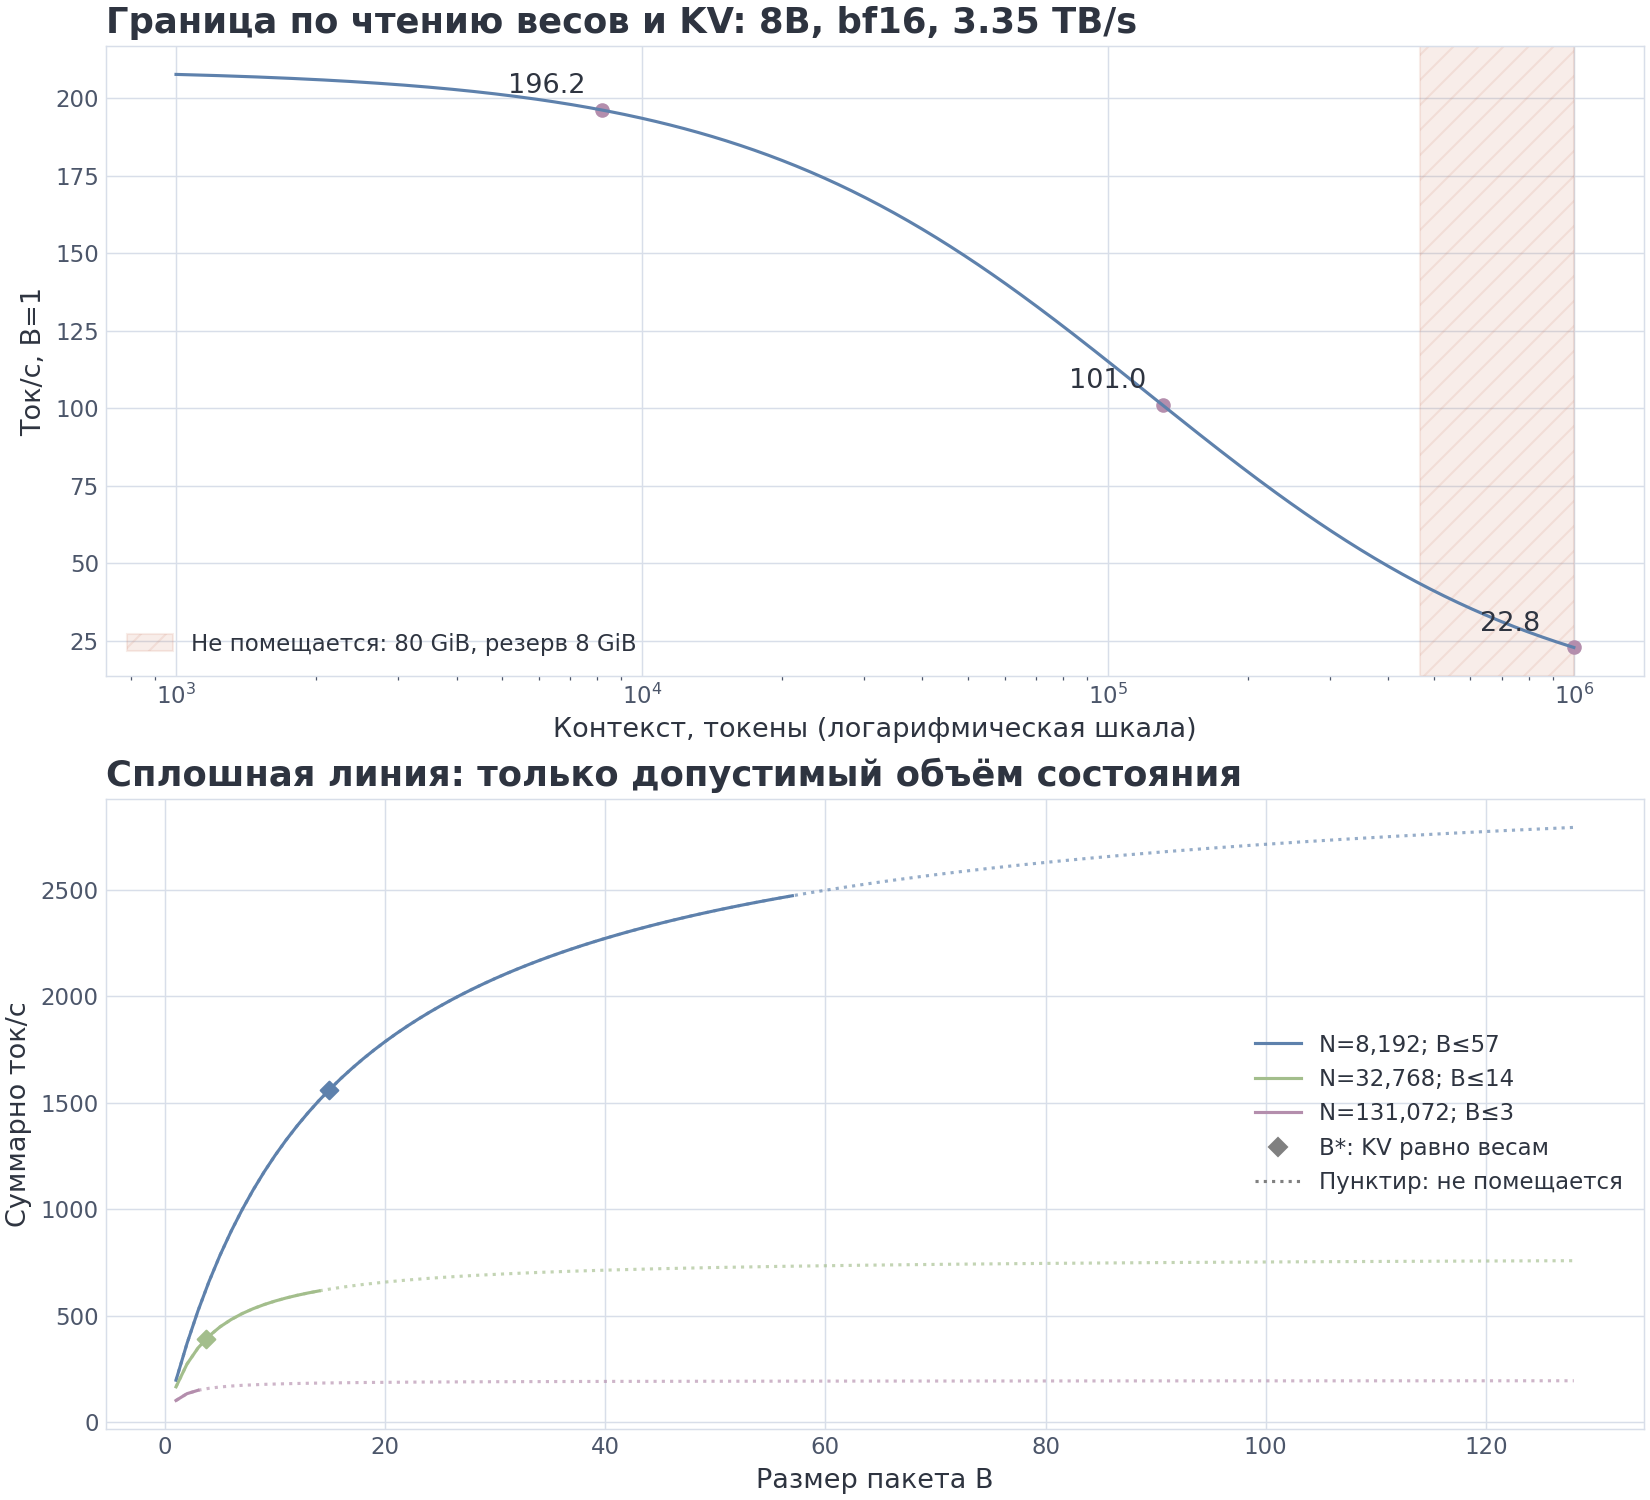 Сверху — верхняя граница скорости decode в зависимости от длины контекста; снизу — суммарная пропускная способность от размера пакета и точки .
8. PagedAttention: отделить логический контекст от физического размещения
Предположим, что сервер заранее резервирует для каждого запроса непрерывный буфер длиной max_seq_len. Тогда короткий запрос удерживает память, которой, вероятно, никогда не воспользуется, а свободные фрагменты могут оказаться слишком разрозненными для следующего большого выделения.
PagedAttention заменяет непрерывный буфер набором фиксированных KV-блоков. У каждой последовательности есть логический список блоков, а физически они могут находиться в разных местах общего пула. Когда последовательность растёт, распределитель памяти выдаёт следующий блок; после завершения запроса блоки немедленно возвращаются в пул.
В учебном сценарии максимум равен 32K, а фактическая длина — 2K. Полная преаллокация оставляет неиспользованными
зарезервированной памяти. При этой фиксированной длине 2048 блоки по 16 заполняются без потерь. Для другого сценария — распределения длин со средним 2048 и равномерным остатком по модулю 16 — в среднем остаётся 7.5 свободного слота. Отношение среднего неиспользованного объёма к среднему выделенному равно
Каждая цифра относится к своим условиям. В исходной работе vLLM сообщалась близкая к нулю потеря KV-памяти и 2–4-кратный рост пропускной способности относительно сравниваемых систем, но конкретный выигрыш зависит от распределения длин и нагрузки. Размер блока 16 также является удобным исходным ориентиром; современные реализации и исполняющие системы могут использовать иные параметры.
Разные условия примера. При строго фиксированной длине 2048 и блоке 16 потери равны нулю. Число 0.365% относится к модели распределения длин со средним 2048 и равномерным остатком: в среднем остаётся 7.5 незанятых слота. Это отношение ожидаемых незанятых слотов к ожидаемым выделенным, а не ожидание доли потерь отдельного запроса. Деление на 2048 дало бы другой показатель — накладной объём относительно полезного (0.366%).
Блочная организация даёт ещё один важный механизм — копирование при записи (copy-on-write). Несколько последовательностей могут ссылаться на одни и те же полные блоки общего префикса. Физическая копия появляется только тогда, когда ветвь должна изменить совместно используемый неполный блок.
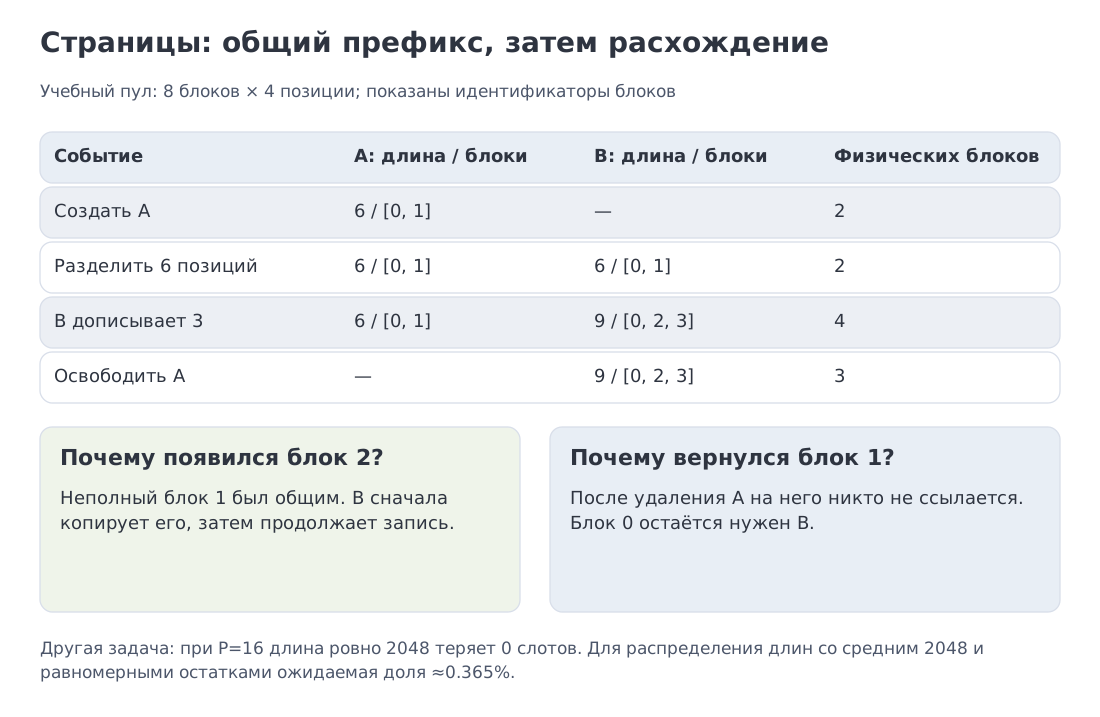 Таблицы страниц, физический пул блоков и арифметика учебного сценария 32K/2K.
9. Кэширование префикса: не пересчитывать одинаковое начало
Во многих нагрузках запросы начинаются одинаково. Это может быть системная инструкция, набор few-shot примеров, описание инструментов, большой документ или уже состоявшаяся часть диалога. Если последовательность токенов и все влияющие на вычисление параметры совпадают, её KV-состояние можно построить один раз и использовать повторно.
Рассмотрим 8192 токена: 7680 уже в кэше, 512 ещё нужно обработать. Базовая оценка только по проекциям даёт 132.396 ms против 8.275 ms — отношение 16. Но запросы суффикса всё ещё обращаются ко всему префиксу. Для причинного внимания, где — длина нового суффикса, а — длина кэшированного префикса:
Для новых запросов число допустимых пар равно . Поэтому выражение в скобках равно удвоенному числу пар. Каждая пара требует FLOP для QK и AV; после деления скобки на два получается множитель в формуле. Softmax и накладные операции исключены. При , , и пике 990 TFLOP/s полный prefill даёт 150.168 ms, а суффикс — 10.427 ms; отношение 14.402. Это снова арифметические оценки. Перенос KV, поиск записи, очереди и фактическая производительность меняют измеряемый TTFT.
Кэширование стало частью публичных API: сервис отдельно определяет границу совпадения, срок хранения и оплату записи и чтения. Условия OpenAI разобраны в §16. Kimi K3 также различает попадания и промахи; Moonshot сообщает более 90% попаданий на своих нагрузках с кодом. Это доля конкретного сервиса, а не ожидаемый результат любого приложения.
Практическое правило следует из точного совпадения префикса: устойчивые инструкции и документы располагают в начале, а изменяющуюся часть запроса — ближе к концу. Одновременно нужно читать семантику конкретной исполняющей системы: длину блока, способ построения ключа, TTL (время жизни записи), область совместного использования, поддержку изображений и схем инструментов, а также условия сброса записи при смене модели или параметров.
Состояние зависит от всей истории слева. Одинаковый блок токенов после разных начал не даёт одинаковых K/V. В ключе нужны как минимум идентичность модели и применённых адаптеров, конфигурация позиционирования и весь предшествующий префикс; область совместного использования задаётся отдельно.
Кэширование префикса почти не помогает, если общая часть мала, токенизация различается или каждый запрос несёт уникальный контекст. Кроме того, локальный кэш процесса ограничен его памятью и жизненным циклом. Следующий раздел переносит ту же идею за пределы одной GPU и одного экземпляра движка.
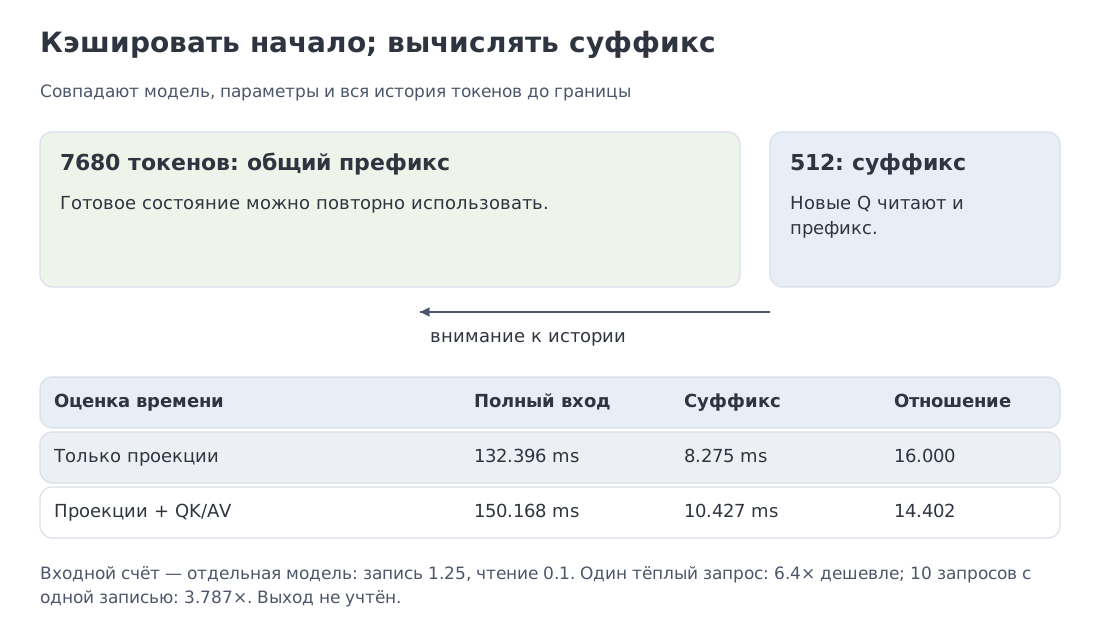 Повторное использование общего префикса, арифметический выигрыш сценария и устойчивый порядок частей промпта.
10. Многоуровневое размещение: когда одного уровня памяти недостаточно
Если активный KV-кэш не помещается в HBM, остаются два принципиальных пути: пересчитать его позднее или сохранить на более дешёвом уровне и вернуть по требованию. Второй путь создаёт иерархию
Каждый переход увеличивает доступную ёмкость, но добавляет задержку переноса и расход пропускной способности. Поэтому выгрузка не выгодна автоматически. Сохранение блока оправдано, когда вероятность повторного использования и стоимость повторного вычисления превышают цену записи, хранения и обратной загрузки.
LMCache отделяет хранение и перенос KV-состояния от конкретного движка инференса. В простом режиме он использует память CPU или диск внутри узла; в многопроцессной конфигурации отдельный сервер LMCache обслуживает несколько экземпляров vLLM и может пережить перезапуск отдельного процесса движка. Поддерживаемые механизмы хранения включают CPU RAM, локальный SSD, Redis/Valkey, Mooncake, InfiniStore, S3-совместимое хранилище, NIXL и GDS. Помимо повторного использования точного префикса, CacheBlend позволяет переиспользовать блоки в других позициях с выборочным пересчётом. Перед нами уже не один большой кэш, а программируемый слой данных.
Mooncake решает ту же задачу на уровне распределённой платформы. В опубликованной системе Kimi фазы prefill и decode разделены, свободные CPU/DRAM/SSD объединены в глобальный пул KV, а механизм передачи Transfer Engine перемещает блоки по сети. Планировщик учитывает SLO и может заранее отклонить запрос, который всё равно не успеет быть обслужен. В статье FAST 2025 авторы сообщают увеличение эффективной ёмкости обслуживания на 59–498% в экспериментах с реальными трассами при соблюдении SLO, работу на тысячах узлов и более 100 млрд токенов в день. Это результат, сообщённый авторами системы для их нагрузок и базовых конфигураций.
По состоянию на 11 октября 2026 года vLLM документирует соединители LMCache и хранилище Mooncake Store для выгрузки в CPU/диск, совместного использования KV и разделённого prefill. Эти интеграции показывают важный сдвиг: KV-кэш становится объектом с собственным протоколом переноса и хранения, а не приватным массивом одного вычислительного ядра внимания.
NVIDIA CMX представляет аппаратно-инфраструктурное продолжение этой идеи. В анонсе от 16 марта 2026 года CMX описан как уровень памяти контекста для пода на базе BlueField-4 и Spectrum-X в экосистеме Vera Rubin. NVIDIA заявляет до пятикратного роста числа токенов в секунду и до пятикратного повышения энергоэффективности относительно выбранной традиционной схемы хранения. Это заявленное разработчиком сравнение будущей инфраструктуры, а не универсальный результат для любого существующего кластера H100.
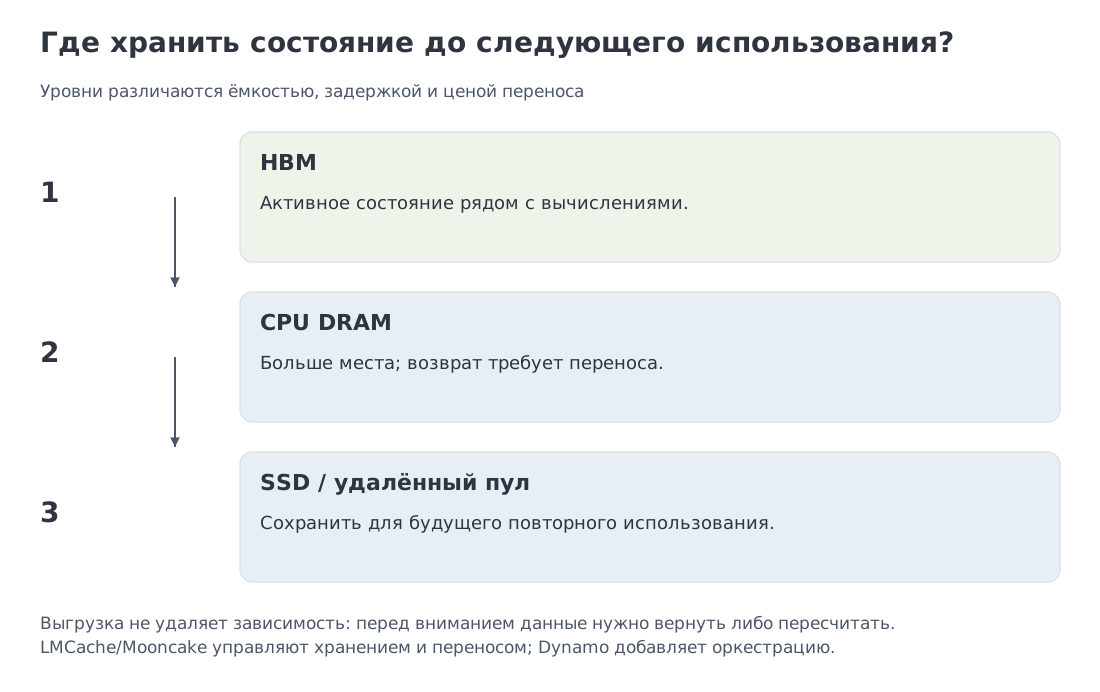 Иерархия HBM–DRAM–SSD–удалённое хранилище, роли LMCache и Mooncake и анонсированный уровень CMX.
11. Разделение prefill и decode: каждой фазе свой пул
Вернёмся к двум фазам из §5. В общей очереди длинный prefill способен задержать активные потоки decode. Сначала изолируем эффект планирования в условной модели: полный prefill считаем только по проекциям (132.396 ms), а decode — только по чтению весов (4.776 ms). Сумма 137.172 ms — нижняя граница этих выбранных работ при последовательном выполнении; она не предсказывает фактическую паузу.
Prefill по фрагментам (chunked prefill) разрешает вставлять decode между частями промпта. Для 512 токенов проекции дают 8.275 ms; сумма выбранных оценок становится 13.051 ms. Но с вниманием одинаковые по длине фрагменты стоят по-разному: последний читает больше истории. Ноутбук проверяет, что сумма работы всех 16 фрагментов равна работе полного prefill; для последнего фрагмента оценка с вниманием равна 10.427 ms.
Более радикальный ответ — разделение prefill и decode (prefill/decode disaggregation), то есть физическое разделение фаз. Рабочие процессы prefill строят KV, слой передачи переносит его процессам decode, а те продолжают генерацию без конкуренции с крупными операциями над промптом. Раздельные пулы позволяют независимо выбирать тензорный и конвейерный параллелизм, политику пакетной обработки и число реплик под TTFT и ITL.
У архитектуры есть цена. KV необходимо физически передать; планировщик должен знать, где находятся полезные блоки; сетевой путь и обратное давление становятся частью критического контура. При небольшой нагрузке или коротких промптах единый пул с непрерывной пакетной обработкой и обработкой prefill частями может быть проще и эффективнее.
Примеры реализаций
В стабильной документации vLLM разделённый prefill по состоянию на 11 октября 2026 года всё ещё помечен как экспериментальный, хотя поддерживает раздельную настройку TTFT и ITL и несколько соединителей KV. NVIDIA Dynamo 1.0, выпущенная 16 марта 2026 года, оркестрирует vLLM, SGLang и TensorRT-LLM, использует NIXL для переноса данных и маршрутизацию с учётом расположения KV. NVIDIA приводит результат до 7× большего числа обслуженных запросов на Blackwell в тесте SemiAnalysis InferenceX для конкретной конфигурации DeepSeek-R1. Эту цифру следует читать как результат одного стека и одного протокола измерения, а не как гарантированный коэффициент самого разделения фаз.
Связь с RL-инфраструктурой. Здесь рассматривается обслуживание интерактивного инференса. Массовая генерация траекторий (rollouts), разделение генераторов и обучающего процесса (actor/learner), устаревание политик и асинхронные очереди подробно разобраны в курсе RL for LLM, модуль 12. Для текущего модуля достаточно помнить, что процессы генерации траекторий используют те же механизмы памяти и планирования, но при другом профиле нагрузки.
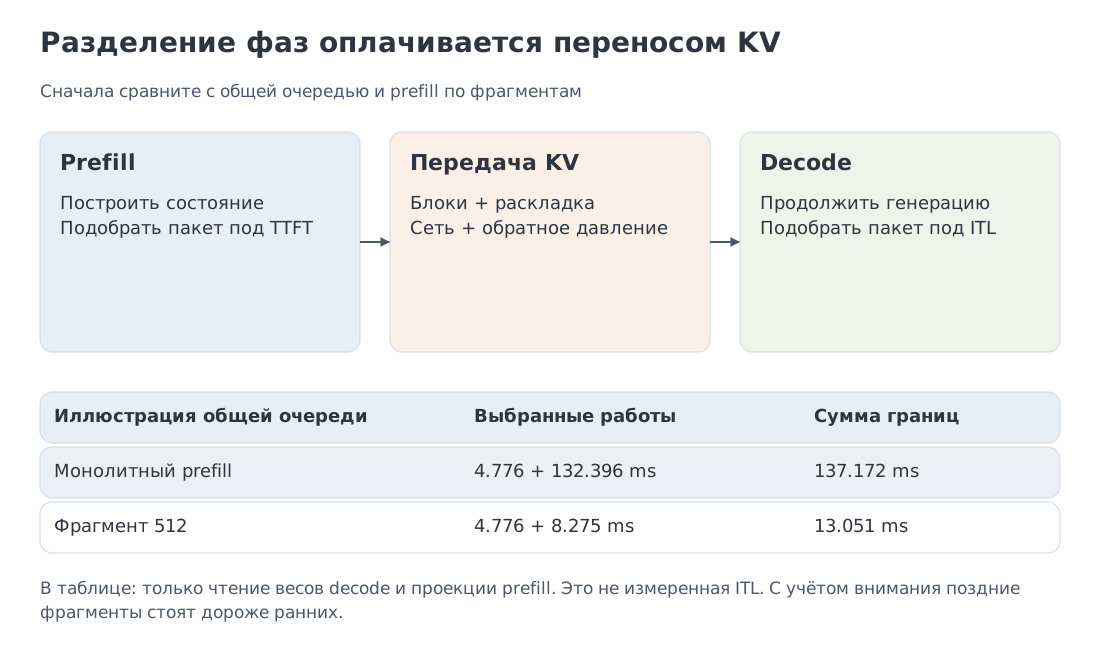 Пул prefill, передача KV и пул decode; отдельно показана арифметика монолитного и дроблёного сценариев.
12. Код (уровень 1): геометрия, пропускная способность и страницы
Сначала три небольших объекта. KVGeometry считает байты; decode_bandwidth_ceiling возвращает суммарные токены в секунду; PagedKV выделяет частные страницы по мере роста. Последний объект пока не разделяет префиксы. Счётчики ссылок, копирование при записи и атомарность при нехватке страниц добавляет PagedKVPool в ноутбуке.
"""Lecture-level geometry, bandwidth bound, and private page allocation."""
from dataclasses import dataclass, field
import math

def count(value, minimum=0):
    if isinstance(value, bool) or not isinstance(value, int) or value < minimum:
        raise ValueError(f"expected an integer >= {minimum}")
    return value

@dataclass(frozen=True)
class KVGeometry:
    attention_layers: int
    kv_heads: int
    head_dim: int
    bytes_per_element: int = 2

    def __post_init__(self):
        for value in (self.attention_layers, self.kv_heads, self.head_dim, self.bytes_per_element):
            count(value, 1)

    @property
    def bytes_per_token(self):
        return 2 * self.attention_layers * self.kv_heads * self.head_dim * self.bytes_per_element

def decode_bandwidth_ceiling(context_tokens, weight_bytes, geometry, bandwidth_Bps,
                             batch_size=1, kv_scale=1.0):
    """Aggregate tok/s, assuming one weight read and one KV read per step."""
    count(context_tokens); count(weight_bytes, 1); count(batch_size, 1)
    for value in (bandwidth_Bps, kv_scale):
        if isinstance(value, bool) or not math.isfinite(value) or value <= 0:
            raise ValueError("bandwidth and scale must be positive and finite")
    kv = geometry.bytes_per_token * context_tokens * batch_size * kv_scale
    if not math.isclose(kv, round(kv), rel_tol=0, abs_tol=1e-9):
        raise ValueError("the scaled payload must contain an integer number of bytes")
    return batch_size * bandwidth_Bps / (weight_bytes + round(kv))

@dataclass
class PagedKV:
    """Private logical pages only; the notebook adds sharing and copy-on-write."""
    n_blocks: int
    block_size: int = 16
    free: list = field(init=False)
    tables: dict = field(default_factory=dict, init=False)
    lengths: dict = field(default_factory=dict, init=False)

    def __post_init__(self):
        count(self.n_blocks, 1); count(self.block_size, 1)
        self.free = list(range(self.n_blocks - 1, -1, -1))

    def append_to(self, seq_id, total_tokens):
        count(total_tokens)
        hash(seq_id)
        if total_tokens < self.lengths.get(seq_id, 0):
            raise ValueError("append_to cannot shorten a sequence")
        table = self.tables.get(seq_id, [])
        needed = (total_tokens + self.block_size - 1) // self.block_size - len(table)
        if needed > len(self.free):
            raise MemoryError("not enough free blocks")
        self.tables.setdefault(seq_id, table)
        table.extend(self.free.pop() for _ in range(needed))
        self.lengths[seq_id] = total_tokens

    def release(self, seq_id):
        self.free.extend(self.tables.pop(seq_id))
        del self.lengths[seq_id]
Проверьте: 2048 токенов занимают ровно 128 страниц по 16. Запрос, которому не хватает свободных страниц, должен оставить все таблицы в прежнем состоянии. Минимальное ядро встроено в ноутбук и исполняется там вместе с этими проверками.
Следующий мостик хранит уже реальные тензоры K/V. Его окно оставляет только последние позиции. Это учебный контракт для одиночных запросов внимания; при обработке нескольких запросов внутри одного фрагмента маску и доступ к более ранним позициям нужно организовать отдельно. Откат возможен лишь внутри сохранённого интервала: удалённый префикс он не восстанавливает. Абсолютные позиции остаются абсолютными и при сдвиге окна.
NumPy → PyTorch · B17 — Ограниченный KV-cache: append, окно и rollback
Кэш хранит не только K/V, но и абсолютный диапазон позиций. Локальное окно физически отбрасывает старый префикс, а rollback обрезает только сохранённый хвост.
import numpy as np
import torch
import torch.nn.functional as F
1. Явная NumPy-реализация
class NumpyKVCacheExplicit:

    def __init__(self, *, window: int | None = None) -> None:
        if window is not None and (isinstance(window, bool) or not isinstance(window, int) or window <= 0):
            raise ValueError("window must be a positive integer or None")
        self.window = window
        self.k = self.v = None
        self.start_pos = self.next_pos = 0

    def append(self, k_new, v_new):
        k_new, v_new = np.asarray(k_new), np.asarray(v_new)
        if k_new.ndim != 4 or k_new.shape != v_new.shape or min(k_new.shape) <= 0:
            raise ValueError("K and V need the same non-empty [B,H,T,D] shape")
        if k_new.dtype != v_new.dtype or not np.issubdtype(k_new.dtype, np.floating):
            raise ValueError("K and V need the same floating dtype")
        if self.k is not None:
            if self.k.shape[:2] + self.k.shape[3:] != k_new.shape[:2] + k_new.shape[3:]:
                raise ValueError("cache geometry changed")
            if self.k.dtype != k_new.dtype:
                raise ValueError("cache dtype changed")
        # Validate first; keep old state intact if an input is rejected.
        k = k_new.copy() if self.k is None else np.concatenate([self.k, k_new], axis=-2)
        v = v_new.copy() if self.v is None else np.concatenate([self.v, v_new], axis=-2)
        drop = max(0, k.shape[-2] - self.window) if self.window is not None else 0
        # A slice alone retains its backing allocation. Make owned bounded copies.
        self.k = k[..., drop:, :].copy() if drop else k
        self.v = v[..., drop:, :].copy() if drop else v
        self.start_pos += drop
        self.next_pos += k_new.shape[-2]
        return self.k, self.v

    def truncate(self, absolute_end: int) -> None:
        if isinstance(absolute_end, bool) or not isinstance(absolute_end, int):
            raise ValueError("absolute_end must be an integer")
        if not self.start_pos <= absolute_end <= self.next_pos:
            raise ValueError("rollback lies outside the retained interval")
        keep = absolute_end - self.start_pos
        if self.k is not None:
            self.k = self.k[..., :keep, :].copy()
            self.v = self.v[..., :keep, :].copy()
        self.next_pos = absolute_end

    @property
    def positions(self):
        return np.arange(self.start_pos, self.next_pos, dtype=np.int64)
Минимальный кэш показывает три состояния: сохранённые K/V, абсолютную позицию первого сохранённого токена и позицию следующей записи. После сдвига окна создаётся отдельная копия оставшихся данных: срез сам по себе удерживал бы старый буфер.
2. Та же математика явными операциями PyTorch
class TorchKVCacheExplicit:

    def __init__(self, *, window: int | None = None) -> None:
        if window is not None and (isinstance(window, bool) or not isinstance(window, int) or window <= 0):
            raise ValueError("window must be a positive integer or None")
        self.window = window
        self.k = self.v = None
        self.start_pos = self.next_pos = 0

    def append(self, k_new, v_new):
        if not isinstance(k_new, torch.Tensor) or not isinstance(v_new, torch.Tensor):
            raise TypeError("K and V must be tensors")
        if k_new.ndim != 4 or k_new.shape != v_new.shape or min(k_new.shape) <= 0:
            raise ValueError("K and V need the same non-empty [B,H,T,D] shape")
        if k_new.dtype != v_new.dtype or k_new.device != v_new.device or not k_new.is_floating_point():
            raise ValueError("K and V need the same floating dtype and device")
        if k_new.requires_grad or v_new.requires_grad:
            raise ValueError("this cache is for inference; detach inputs first")
        if self.k is not None:
            if self.k.shape[:2] + self.k.shape[3:] != k_new.shape[:2] + k_new.shape[3:]:
                raise ValueError("cache geometry changed")
            if self.k.dtype != k_new.dtype or self.k.device != k_new.device:
                raise ValueError("cache dtype or device changed")
        # Validate first; keep old state intact if an input is rejected.
        k = k_new.clone() if self.k is None else torch.cat([self.k, k_new], dim=-2)
        v = v_new.clone() if self.v is None else torch.cat([self.v, v_new], dim=-2)
        drop = max(0, k.shape[-2] - self.window) if self.window is not None else 0
        # A slice alone retains its backing allocation. Make owned bounded copies.
        self.k = k[..., drop:, :].clone() if drop else k
        self.v = v[..., drop:, :].clone() if drop else v
        self.start_pos += drop
        self.next_pos += k_new.shape[-2]
        return self.k, self.v

    def truncate(self, absolute_end: int) -> None:
        if isinstance(absolute_end, bool) or not isinstance(absolute_end, int):
            raise ValueError("absolute_end must be an integer")
        if not self.start_pos <= absolute_end <= self.next_pos:
            raise ValueError("rollback lies outside the retained interval")
        keep = absolute_end - self.start_pos
        if self.k is not None:
            self.k = self.k[..., :keep, :].clone()
            self.v = self.v[..., :keep, :].clone()
        self.next_pos = absolute_end

    @property
    def positions(self):
        device = self.k.device if self.k is not None else None
        return torch.arange(self.start_pos, self.next_pos, dtype=torch.long, device=device)
PyTorch-класс изменяет состояние на месте, проверяет тип и устройство тензоров и копирует сохранённое окно. Это контейнер для инференса: входы не должны хранить граф градиентов. Реальный движок использует страницы или заранее выделенную память; временное объединение тензоров здесь может занять больше памяти, чем итоговое окно.
| Аспект | NumPy | PyTorch |
|---|---|---|
| Добавление | np.concatenate | torch.cat |
| Физическое окно | срез + копия | срез + clone |
| Абсолютные позиции | Python integers | Python integers + tensor state |
| Rollback | обрезает сохранённый хвост | тот же контракт |
| Выделение памяти | учебный контейнер с копированием | в движке обычно буфер или пул блоков |
Исполняемая проверка эквивалентности и граничных случаев
np_cache = NumpyKVCacheExplicit(window=3); t_cache = TorchKVCacheExplicit(window=3)
for value in range(5):
    k_np = np.full((1,1,1,2), value, dtype=np.float64); v_np = k_np + 100
    np_cache.append(k_np, v_np); t_cache.append(torch.tensor(k_np), torch.tensor(v_np))
np.testing.assert_allclose(np_cache.k, t_cache.k.numpy())
np.testing.assert_array_equal(np_cache.positions, t_cache.positions.numpy())
assert (np_cache.start_pos, np_cache.next_pos) == (2,5)
np_cache.truncate(4); t_cache.truncate(4)
np.testing.assert_allclose(np_cache.k, t_cache.k.numpy())
rng = np.random.default_rng(17)
keys = rng.standard_normal((1,1,6,4)); values = rng.standard_normal((1,1,6,4)); queries = rng.standard_normal((1,1,6,4))
cache = TorchKVCacheExplicit(window=3)
for step in range(6):
    cache.append(torch.tensor(keys[..., step:step+1, :]), torch.tensor(values[..., step:step+1, :]))
    cached = F.scaled_dot_product_attention(torch.tensor(queries[..., step:step+1, :]), cache.k, cache.v)
    lo = max(0, step - 2)
    full = F.scaled_dot_product_attention(torch.tensor(queries[..., step:step+1, :]), torch.tensor(keys[..., lo:step+1, :]), torch.tensor(values[..., lo:step+1, :]))
    torch.testing.assert_close(cached, full)

# Rejected input must not mutate state; rollback cannot resurrect evicted tokens.
for cache_type, convert in ((NumpyKVCacheExplicit, np.asarray), (TorchKVCacheExplicit, torch.tensor)):
    c = cache_type(window=3)
    c.truncate(0)
    x = convert(np.ones((1,1,5,2), dtype=np.float64))
    c.append(x,x)
    assert (c.start_pos,c.next_pos) == (2,5)
    for bad in (-1,1,6,2.5,True):
        try: c.truncate(bad)
        except ValueError: pass
        else: raise AssertionError("invalid rollback accepted")
    assert (c.start_pos,c.next_pos) == (2,5)
    try: c.append(convert(np.zeros((1,2,1,2))),convert(np.zeros((1,2,1,2))))
    except ValueError: pass
    else: raise AssertionError("geometry change accepted")
    c.truncate(2)
    assert c.k.shape[-2] == 0
    c.append(convert(np.ones((1,1,1,2))),convert(np.ones((1,1,1,2))))
    assert (c.start_pos,c.next_pos) == (2,3)
    for window in (0,-1,2.5,True):
        try: cache_type(window=window)
        except ValueError: pass
        else: raise AssertionError("invalid window accepted")
a = NumpyKVCacheExplicit(window=3)
a.append(np.ones((1,1,10,2)),np.ones((1,1,10,2)))
assert a.k.flags.owndata and a.k.nbytes == 3*2*8
t = TorchKVCacheExplicit(window=3)
t.append(torch.ones(1,1,10,2),torch.ones(1,1,10,2))
assert t.k.untyped_storage().nbytes() == t.k.numel()*t.k.element_size()

print("B17 window, ownership, rollback, and invalid inputs: PASS")
Полный исполняемый файл: m10_cache_bridges.py
14. Компрессия I: вытеснение — выбрать, какие позиции сохранить
Если полный контекст невозможно удерживать даже при многоуровневом размещении, можно ограничить число сохраняемых позиций. Это наиболее сильная форма компрессии: удалённый KV нельзя восстановить без повторного prefill исходных токенов.
StreamingLLM сохраняет небольшое число начальных опорных токенов внимания (attention sinks) и скользящее окно последних токенов. Политика почти не требует оценки важности на лету и хорошо соответствует потоковому языковому моделированию. H2O удерживает смесь недавних токенов и позиций с высокой накопленной массой внимания (heavy hitters). SnapKV оценивает важность позиций промпта по окну наблюдения. Ada-KV и PyramidKV распределяют ограниченный бюджет сохраняемого кэша между головами или слоями.
Выбор страниц для чтения решает другую задачу. QUEST сохраняет весь KV-кэш, но по текущему запросу и сводкам ключей выбирает страницы для приближённого внимания. Это уменьшает чтение на данном шаге, а не объём хранимой истории; другая позиция может снова понадобиться следующему запросу. Ошибка приближения и стоимость выбора страниц требуют отдельной оценки.
Ни одна политика не универсальна. В детерминированной трассировке ноутбука есть 16 позиций и бюджет 8. Упрощённый выбор top-mass сохраняет , тогда как правило «первые четыре + последние четыре» сохраняет и теряет важные позиции . Пример не доказывает превосходство H2O; он показывает разницу между решением, зависящим от содержимого, и правилом, использующим только позицию.
Исследования 2025–2026 годов добавили две важные оговорки. На задачах рассуждения H2O и версия SnapKV, работающая во время декодирования, часто сохраняют качество лучше StreamingLLM. Однако при малом бюджете компрессия способна удлинять саму цепочку рассуждений и переносить стоимость из памяти в дополнительные токены. Отдельная работа о глобально ограниченном вытеснении показывает, что защита структурных границ промпта иногда влияет на качество сильнее выбора функции оценки. Поэтому проверка должна включать реальные форматы промптов, длительное декодирование и полную стоимость, а не только точность извлечения.
В ноутбуке top-mass — выбор наибольших накопленных оценок из готового массива. Это не полная H2O: нет онлайн-обновления оценок и отдельной квоты недавних токенов. Проектное демо дополнительно измеряет ошибку выхода внимания, а не только сохранённую норму K/V; отдельный запрос показывает, как вчерашняя важность перестаёт предсказывать сегодняшний ответ.
15. Компрессия II: квантование, низкоранговое представление и порядок рычагов
Вытеснение уменьшает число позиций. Квантование решает другую задачу: сохраняет позиции, но уменьшает число бит, используемых для их представления.
KIVI применяет асимметричное двухбитное квантование: ключи квантуются по каналам, значения — по токенам. Авторы сообщают до 2.6× меньшую пиковую память с учётом весов, до четырёх раз больший размер пакета и 2.35–3.47× большую пропускную способность на исследованных нагрузках инференса. Эти коэффициенты меньше простого отношения 16/2, потому что в системе остаются веса, остаточный кэш высокой точности, масштабы, метаданные и расходы вычислительных ядер.
TurboQuant рассматривает KV-кэш как задачу потокового векторного квантования. PolarQuant переводит векторы в представление, удобное для квантования, а QJL корректирует оценку скалярных произведений. В статье режим без заметной потери качества указан примерно для 3.5 бита на канал, а 2.5-битный режим даёт небольшую деградацию. Google Research отдельно сообщает до восьмикратного ускорения вычисления логитов внимания для четырёхбитных ключей по сравнению с неквантованными 32-битными ключами на H100. Это тест конкретной операции, а не восьмикратное ускорение всей модели.
Ноутбук задаёт более простой вопрос: что произойдёт с арифметической верхней границей, если идеальный объём 16-битного KV уменьшить до трёх бит без метаданных и стоимости вычислительных ядер? Масштаб поднимает границу при 128K примерно со 101 до 174 ток/с. Результат показывает направление эффекта. Реальный объём памяти и скорость выполнения необходимо измерять отдельно.
Низкоранговое и архитектурное сжатие меняет не точность, а сам размер сохраняемого представления. MLA является главным примером: модель обучается кэшировать латент меньшей размерности. Слои со скользящим окном и рекуррентные слои ограничивают зависимость от полного . В DeepSeek V4 и Kimi K3 используются гибридные структуры состояния, где разные группы слоёв требуют разных диспетчеров кэша.
Удобно применять инженерные рычаги в таком порядке:
- Архитектура: изменить представление состояния. GQA и MLA сокращают байты на позицию, окно ограничивает число позиций, а рекуррентный слой хранит отдельное состояние фиксированной формы.
- Числовое представление: выбрать FP8, целочисленное или векторное квантование и проверить качество вместе с поддержкой вычислительных ядер.
- Размещение: распределить данные между HBM, DRAM, SSD и удалённым уровнем с учётом вероятности повторного использования.
- Вытеснение: удалять позиции, когда предыдущих трёх ступеней недостаточно и потеря контекста измерена на целевой задаче.
Углубление. Для текущего модуля достаточно понимать связь между числом бит на координату, искажением и объёмом хранения. Более подробный разбор кодирования и информационных границ дан в курсе Information Theory for ML, модули 6–7.
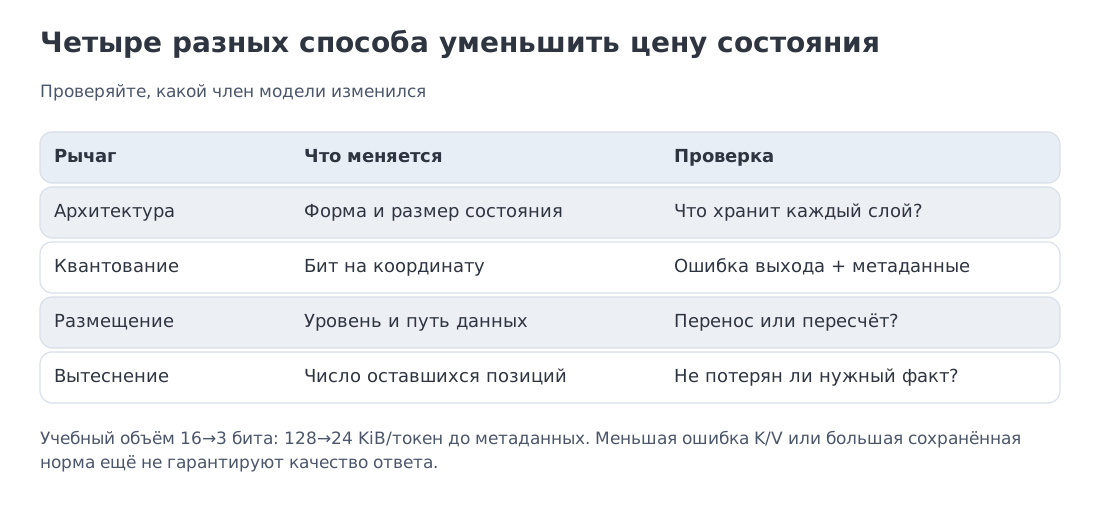 Вытеснение, квантование, низкоранговое/архитектурное сжатие и четырёхступенчатый порядок применения.
16. Движки и контракты кэширования: карта стека на 11 октября 2026 года
Система инференса одновременно отвечает за выполнение вычислительных ядер, планирование запросов, размещение KV, параллелизм, структурированный вывод и распределённую оркестрацию. Поэтому сравнение движков по одной цифре токенов в секунду почти ничего не говорит о пригодности для конкретного сервиса.
| Компонент | Основная роль в стеке |
|---|---|
| vLLM | управление KV, совместимое с PagedAttention; непрерывная пакетная обработка (continuous batching); prefill по фрагментам (chunked prefill); кэширование префикса; квантование; экспериментальное разделение prefill и decode |
| SGLang | среда выполнения для сложных программ на основе LLM; RadixAttention для автоматического повторного использования префиксов; структурированная генерация |
| TensorRT-LLM | оптимизированные вычислительные ядра NVIDIA, квантованное выполнение и примитивы обслуживания на нескольких GPU |
| NVIDIA Dynamo 1.0 | распределённая оркестрация нескольких движков, маршрутизация с учётом KV, транспорт NIXL и топология разделённых фаз |
| LMCache / Mooncake | внешние уровни KV, совместное использование между экземплярами и перенос между процессами prefill/decode |
| llama.cpp / MLX | локальный инференс и компромиссы памяти CPU/GPU/Apple Silicon |
Таблица намеренно не фиксирует номера минорных версий: набор поддерживаемых механизмов меняется быстрее учебного текста. При проектировании сервиса нужно проверять стабильную документацию конкретной версии, поддержку модели, тип данных KV-кэша и совместимость выбранных соединителей.
Важная перемена последних лет состоит в том, что семантика кэширования стала частью внешнего API.
На 11 октября 2026 года документация OpenAI для GPT-5.6 и более новых моделей описывает явные границы кэша, минимум 1024 видимых входных токена и TTL 30 минут от последней записи или использования. Запись стоит 1.25 базовой цены входа; чтение обычно 0.1, у GPT-6.1 Sol — 0.05. Поэтому счёт определяется не одной «скидкой», а количеством записей, чтений и некэшированных токенов.
У Kimi K3, технический отчёт и полные веса которой опубликованы 27 июля 2026 года, структура кэша гибридна. Слои Gated MLA хранят латентное состояние по позициям, а слои KDA обновляют рекуррентное и свёрточное состояние. vLLM реализовал отдельный путь гибридного кэширования префикса: мелкозернистое сопоставление префиксов согласуется с более крупными снимками состояния KDA. Новая архитектура внимания потребовала не только нового вычислительного ядра, но и нового диспетчера кэша.
DeepSeek V4 даёт третий вариант. По техническому отчёту её гибрид CSA/HCA в режиме 1M требует около 10% KV-кэша DeepSeek-V3.2; vLLM оценивает кэш в bf16 одной последовательности длиной 1M в 9.62 GiB для поддерживаемой раскладки. Эти значения нельзя получить простой подстановкой num_key_value_heads в формулу GQA: паспорт инференса должен описывать собственную структуру гибридного состояния.
Именно поэтому context_window сам по себе почти ничего не говорит о стоимости обслуживания. Нужны геометрия кэша, тип данных, правила повторного использования, исполняющая система и профиль нагрузки.
17. Как читать паспорт инференса модели
Паспорт начинается с вопроса: какое состояние растёт вместе с контекстом? Для обычного внимания смотрим num_hidden_layers, num_key_value_heads, head_dim и тип данных. Для MLA — kv_lora_rank, позиционную компоненту и число слоёв MLA. Для локального внимания или внимания со скользящим окном — размер окна и расписание слоёв. Для гибридов — доли полного внимания, рекуррентных, свёрточных и разреженных компонентов.
Затем фиксируются параметры хранения:
- тип данных или схема квантования KV, размер группы, масштабы и остаточное окно полной точности;
- размер блока и политика распределителя памяти;
- максимальная длина и фактическое распределение контекстов;
- гранулярность сопоставления префикса, TTL и область совместного использования;
- уровни HBM/CPU/SSD/удалённого хранения и пропускная способность между ними;
- движок, версия, вычислительные ядра и поддерживаемый соединитель кэша;
- схема параллелизма и топология разделённых фаз;
- профиль нагрузки: длины входа и выхода, параллелизм запросов, доля попаданий, SLO по TTFT/ITL и допустимая потеря качества.
Только после этого имеет смысл подставлять числа в §§4, 6 и 7. Полученная арифметическая верхняя граница служит первой проверкой здравого смысла: показывает физическое узкое место и помещается ли состояние в память. Затем нужен тест на целевом железе и реальном распределении запросов.
Таким образом, фраза «модель поддерживает контекст 1M» описывает возможность. Паспорт инференса отвечает на другой вопрос: какой ценой, с каким состоянием, при какой пакетной обработке и с какими гарантиями этот миллион обслуживается?
20. Ключевые выводы и источники
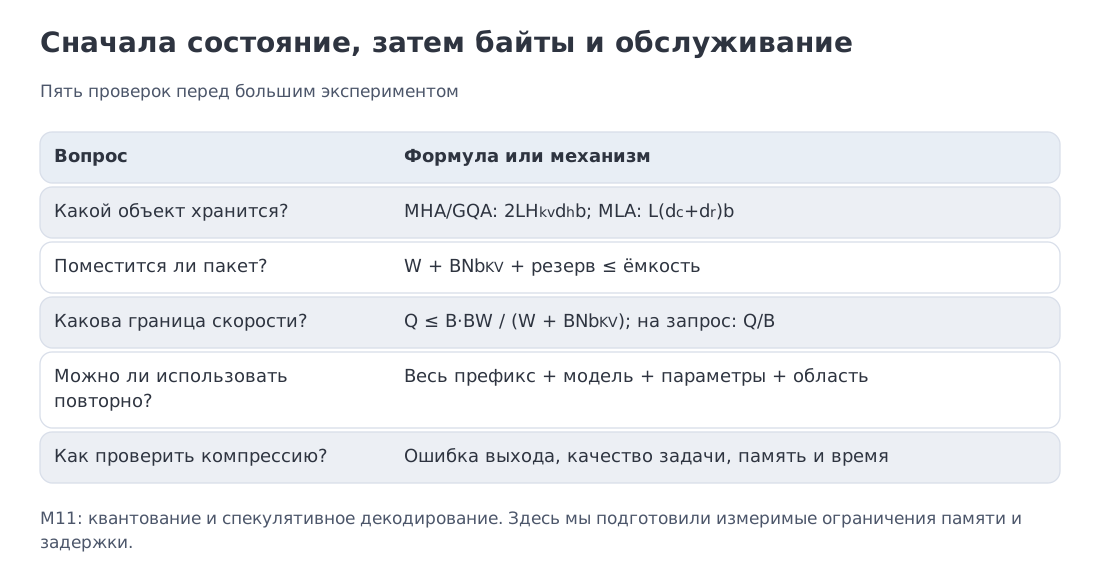 Шпаргалка: геометрия KV, верхняя граница по пропускной способности памяти, пакетная обработка, страничное размещение, повторное использование, уровни хранения, разделение фаз и компрессия.
Геометрия KV. Для обычного механизма внимания . В учебной лестнице получаем 2 560, 320 и 128 KiB/токен для MHA/GQA-конфигураций и 68.625 KiB/токен для отдельной геометрии MLA. Для гибридной модели сначала нужно определить фактическую структуру её состояния.
Верхняя граница по памяти. В упрощённой модели . Для сценария 8B в bf16 она меняется с 209.4 ток/с при нулевом KV до 101.0 при 128K и 22.8 при 1M. Это арифметическая граница, а не измерение конкретного движка.
Пакетная обработка. отмечает область, где суммарный поток данных KV догоняет чтение весов. Рост пакета после этой точки остаётся полезным, но всё хуже амортизирует память.
Управление памятью. PagedAttention выделяет KV блоками и поддерживает совместное использование. Кэширование префикса устраняет повторный prefill для точных общих начал.
Уровни хранения (справочно). LMCache и Mooncake расширяют повторное использование и размещение за пределы одного процесса и одного уровня памяти. Разделение prefill/decode изолирует чувствительный к задержке decode от длинных prefill ценой переноса и оркестрации.
Компрессия. Архитектура задаёт представление и размер состояния: байты на позицию, ширину окна или фиксированную рекуррентную память; квантование сокращает число байтов на координату; многоуровневое размещение меняет место хранения; вытеснение уменьшает число позиций. Эти рычаги воздействуют на разные части системы и могут комбинироваться.
Основные первоисточники
- MQA: Fast Transformer Decoding: One Write-Head is All You Need
- GQA: GQA: Training Generalized Multi-Query Transformer Models
- Непрерывная пакетная обработка (continuous batching): Orca
- PagedAttention/vLLM: Efficient Memory Management for Large Language Model Serving и стабильная документация vLLM
- RadixAttention/SGLang: SGLang
- Уровни KV: репозиторий LMCache, примеры LMCache в vLLM, Mooncake, FAST 2025
- Распределённая оркестрация: NVIDIA Dynamo 1.0 и NVIDIA CMX
- Контракты кэширования: OpenAI prompt caching, кэширование промптов Anthropic, Kimi K3, обслуживание Kimi K3 в vLLM
- Современная гибридная геометрия: технический отчёт DeepSeek V4 и заметка vLLM об обслуживании DeepSeek V4
- Вытеснение: StreamingLLM, H2O, SnapKV, исследование на задачах рассуждения, исследование защиты структурных границ
- Квантование: KIVI, KVQuant, TurboQuant и обзор Google Research
Дальше: модуль 11 — квантизация и спекулятивное декодирование: как читать меньше байтов и получать несколько принятых токенов за один дорогой проход модели. Ограничения формата ответа вернутся в модуле 18 об инструментах и агентах.
Источники и контракты проверены 11 октября 2026 года. Учебные числа воспроизводятся из локального численного контракта; свойства движков и тарифы сверяйте для выбранной версии перед экспериментом.