Модуль 7. Mixture of Experts
Курс «Modern LLMs» · лекция модуля 7 · редакция 2026.10.25
О чём этот модуль. В М6 мы увидели, что при разобранных размерах блока Transformer большая часть параметров приходится на сеть прямого распространения (FFN). Смесь экспертов (Mixture of Experts, MoE) использует это устройство: слой хранит несколько отдельных FFN — экспертов, а для каждого токена запускает лишь часть из них. Так можно увеличивать общий запас параметров, не заставляя каждый токен проходить через весь банк.
Выбор выполняет небольшая обучаемая сеть — роутер. Мы проследим, как она оценивает экспертов, как смешиваются их выходы и почему нагрузку между ними приходится балансировать. Затем посчитаем параметры и объём пересылаемых данных на конкретных примерах. Более сложные варианты маршрутизации опираются на тот же разбор и останутся для справочного прохода.
Что нужно знать заранее. Полезны модули 1, 5 и 6: общий и активный размер модели, attention и бюджет FFN с SwiGLU. Все необходимые обозначения вводятся заново, поэтому модуль остаётся самодостаточным.
Как читать. Первый проход: §1 → §§4–10, пропуская длинные реализации B09/B10, → §19, кроме пункта о LatentMoE. Для самопроверки используйте В1–В5 и В7 в §17, затем У1, У3–У4 в §18. В6 и У5 продолжат раздел §11, а У2 и У6 — справочную и проектную работу. Первый маршрут отвечает на три вопроса: что выбирает роутер, как складываются результаты и за что платит система. Второй проход: §§6–7 → §§12–14 и ноутбук; здесь проверяются крайние значения, градиенты, переполнение ёмкости и подсчёт параметров. Справочный проход: §§2–3, 11, 15–16 — история, альтернативы и конкретные архитектуры. Для каждого прохода достаточно основ attention из М5 и FFN из М6.
1. Мотивация: большая модель без полного вычисления на каждом токене
Пусть в обычном блоке Transformer после attention стоит один FFN с SwiGLU. Каждый токен проходит через все его матрицы. Если мы удваиваем ширину FFN, почти удваиваются и параметры, и соответствующая часть вычислений. Параметрическая ёмкость и цена токена растут вместе.
MoE позволяет раздельно увеличивать хранимую ёмкость и объём вычислений. Вместо одного FFN мы создаём экспертов и небольшой роутер. Здесь — вектор состояния токена, а не его целочисленный идентификатор. Роутер присваивает экспертам оценки и выбирает наибольших — это правило top-k. Далее их выходы смешиваются, а остальные экспертные веса на этом шаге не участвуют в матричных умножениях.
Отсюда возникают две разные величины:
- total parameters — весь банк весов, который система должна хранить и обслуживать;
- active parameters — параметры, реально участвующие в выбранной конвенции вычислений одного токена.
Это не означает, что total равен «знаниям», а active — точной стоимости. Качество зависит от данных, обучения, маршрутизации и архитектуры; полная стоимость включает attention, общие слои, выходную проекцию, обмены и загрузку оборудования. Но разделение total/active даёт первый полезный паспорт разреженной модели.
Открытые примеры показывают масштаб идеи. gpt-oss-120b имеет 117B общих и 5.1B активных параметров, 128 экспертов и top-4. DeepSeek-V3 заявляет 671B/37B. Kimi K3 — 2.8T/104B при выборе 16 из 896 routed experts. Эти числа относятся к различным архитектурам и соглашениям подсчёта; задача модуля — научиться видеть, что именно стоит за каждым паспортом.
Экономия экспертных вычислений требует организации хранения и обменов. Полный банк экспертов должен быть доступен системе, токены нужно доставлять на устройства с выбранными экспертами, нагрузку — удерживать в допустимых границах, а небольшие матричные умножения — собирать в эффективные групповые операции. Поэтому крупные распределённые MoE требуют согласовать архитектуру модели с устройством системы исполнения. Здесь мы разбираем причины затрат и их арифметику; разработка распределённого движка остаётся за рамками курса.
2. Историческая линия: от локальных специалистов к триллионным моделям
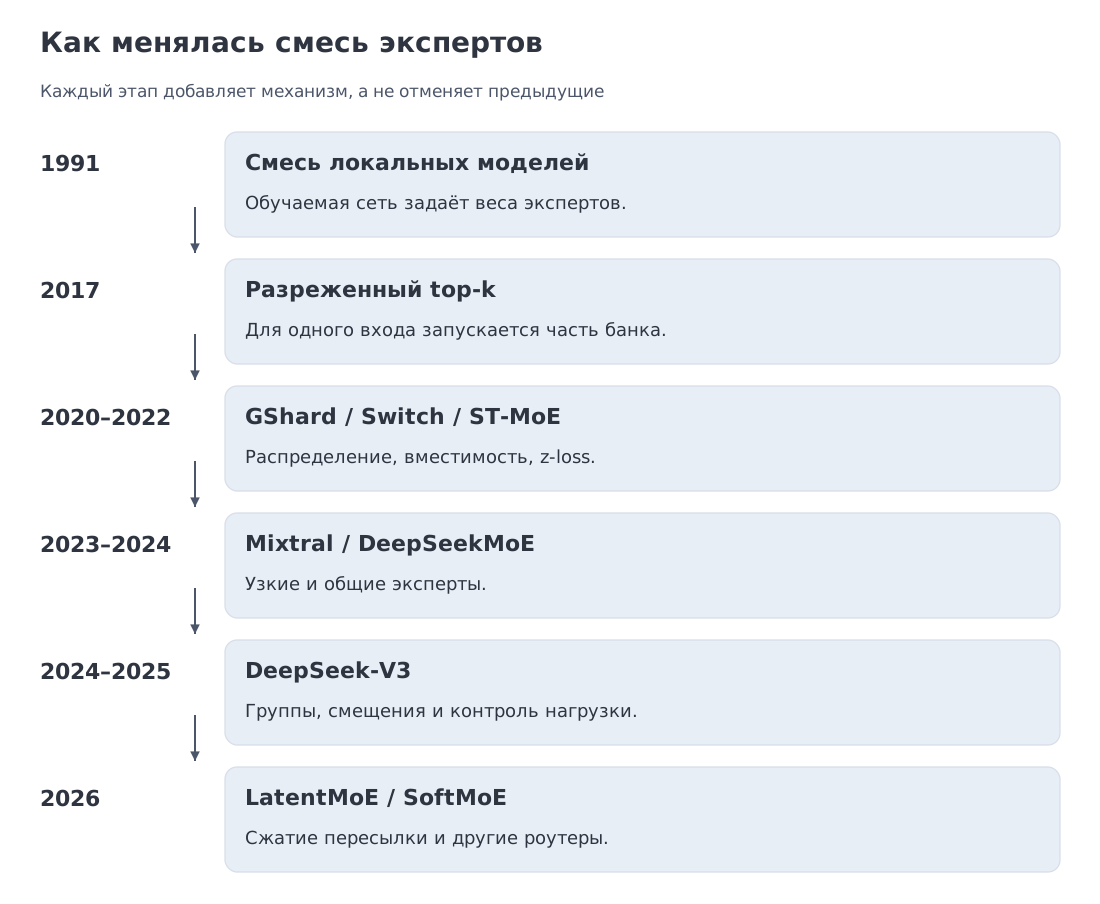 История MoE как последовательность возникающих ограничений: обучаемый диспетчер, разреженный top-k, capacity и expert parallelism, fine-grained/shared experts, балансировка без auxiliary loss и сжатие маршрутизируемого представления.
Идея обучаемой смеси локальных специалистов появилась задолго до Transformer. В работе Jacobs и Jordan 1991 года управляющая сеть определяла, какой локальный эксперт должен объяснять конкретный пример. Уже там присутствовали две центральные идеи: специализация и конкуренция за данные.
В 2017 году Shazeer и соавторы показали крупную разреженную MoE. Слой содержал множество экспертов, но выбор top-k активировал лишь несколько. Вместе с масштабом проявилась первая системная болезнь: если роутер слишком рано предпочитает малое число экспертов, остальные получают мало данных и перестают развиваться.
GShard и Switch Transformer перенесли эту схему в крупные Transformer. Появились распределение экспертов по устройствам (Expert Parallelism, EP), обмен all-to-all, ограничение вместимости и отбрасывание лишних назначений. Switch упростил маршрутизацию до top-1; ST-MoE добавил router z-loss для контроля логитов.
Mixtral 8×7B сделал открытый top-2 MoE практически доступным сообществу. DeepSeekMoE затем предложила две связанные идеи: дробить экспертную ёмкость на большее число узких блоков и отделять всегда исполняемые общие эксперты от выбираемых. DeepSeek-V3 сочетает узкие эксперты, сигмоидальные оценки и балансировку через отдельные смещения; небольшая дополнительная потеря контролирует баланс внутри последовательности (§7).
После этого развитие разветвилось. Одни системы увеличивают число экспертов и совершенствуют распределённое исполнение. Другие уменьшают объём пересылаемых векторов — так устроена LatentMoE. Третьи исследуют дифференцируемые варианты или схемы без центрального роутера как альтернативы фиксированному top-k. Поэтому современная картина не сводится к одному «победившему рецепту»: сохраняется общий принцип условных вычислений, а правила роутера и исполнения различаются.
3. Мост к классическим идеям: комитет, условные вычисления и диспетчер
Смесь локальных моделей
Классическая смесь экспертов имеет вид
где — эксперты, а — веса управляющей сети. В разреженной смеси (sparse MoE) большинство коэффициентов зануляется: top-k оставляет лишь экспертов с наибольшими оценками. Формула остаётся узнаваемой, но вычислительная единица меняется: эксперт — это отдельный FFN. Его матричные операции удобно выполнять как плотное умножение матриц, обычно обозначаемое GEMM.
Условные вычисления
MoE — один из способов условных вычислений (conditional computation): модель выбирает, какую часть параметров применить к данному входу. Выигрыш возникает потому, что внутри выбранного эксперта сохраняется плотная матричная арифметика. Это важное отличие от неструктурированной разреженности, где множество нулей не обязательно превращается в быстрое вычислительное ядро.
Диспетчер распределённой системы
Роутер напоминает диспетчер очереди. Он принимает решение, но эффективность определяется не только качеством решения: нужны буферы назначений, размещение экспертов, сеть и порядок обработки. Если один эксперт получает в два раза больше токенов, чем остальные, все устройства могут ждать его завершения. Поэтому балансировка нагрузки является частью не только оптимизации модели, но и времени шага.
Эти три взгляда будут повторяться дальше. Статистическая формула объясняет смешивание выходов, условные вычисления — разницу общего и активного размера, а диспетчер — почему низкое число FLOP ещё не гарантирует дешёвый инференс.
4. Формализм: выбираемые и общие эксперты, правила подсчёта
Пусть состояние токена имеет ширину . Выбираемые эксперты (routed experts) участвуют только при назначении роутера; общие эксперты (shared experts) выполняются для каждого токена. Сначала разберём роутер с независимыми сигмоидальными оценками. Его обучаемый вектор даёт логит , а сигмоида переводит логит в оценку:
Чтобы регулировать нагрузку, к оценке можно прибавить отдельное смещение выбора (selection bias) . Оно не является смещением линейной проекции . Множество индексов выбранных экспертов:
Теперь нужно решить, с каким весом сложить выбранные выходы. Вес смеси (gate weight) может вычисляться из исходной, или чистой, оценки , без балансировочного смещения:
Здесь — заданный архитектурой масштаб: сумма весов равна , а при — единице. Если общих экспертов , выход экспертной ветви имеет вид:
Обе суммы дают векторы ширины . Затем блок прибавляет эту ветвь к остаточному потоку по схеме М6. Веса смеси определяют вклад экспертов, но не доказывают, что оценки роутера являются калиброванными вероятностями. Softmax-роутер gpt-oss устроен иначе; его контракт разберём в §14.
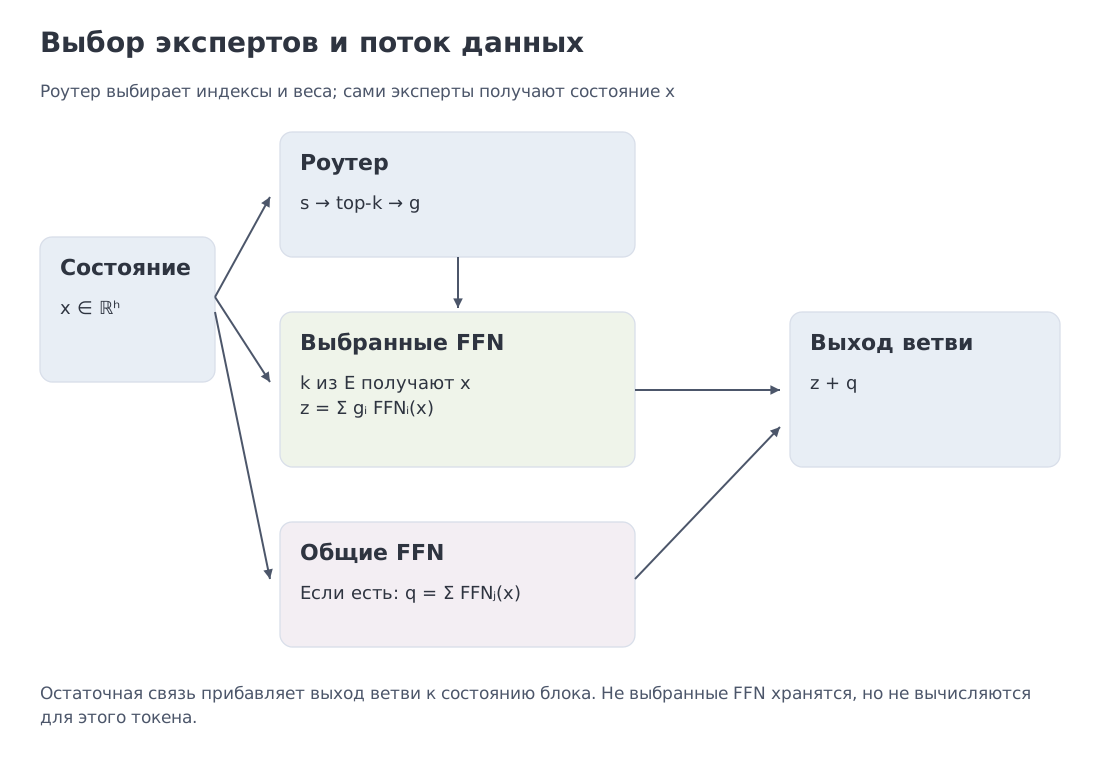 Слой MoE: состояние токена поступает в роутер; выбираемые и постоянно работающие общие эксперты формируют добавку к остаточному потоку. Отдельно показаны хранимый банк и активный путь токена.
Почему одной универсальной формулы недостаточно
Количество параметров зависит от архитектурного контракта:
- сколько слоёв плотные, а сколько используют MoE;
- связаны ли входные эмбеддинги и выходная проекция;
- есть ли параметры смещения в attention, роутере и экспертах;
- сколько общих экспертов;
- одинаковы ли размеры всех экспертов;
- присутствуют ли модули предсказания нескольких следующих токенов (MTP) или дополнительные нормы;
- какой тип attention используется.
Поэтому в численном коде модуль использует типизированную спецификацию MoEModelSpec. Она требует явно объявить каждую из этих частей.
Обозначим внутреннюю ширину эксперта через . Как в М6, у SwiGLU две входные матрицы размера и одна выходная . Для эксперта без смещений:
Если есть смещения у двух входных проекций и выходной проекции:
В активный подсчёт выбираемые эксперты входят с множителем , а общие — целиком. Attention, нормы и роутер обычно являются общими параметрами. Но даже здесь остаётся выбор: считать ли поиск строки эмбеддингов как полную активную матрицу и включать ли выходную проекцию. В этом модуле для gpt-oss используется вычислительная конвенция: выходная проекция считается полной активной матрицей, а входная матрица эмбеддингов — нет. Конвенция записывается рядом с числом, а не скрывается внутри формулы.
5. Решённый пример A: gpt-oss с параметрами смещения
Открытая реализация позволяет посчитать больше, чем округлённые 117B/5.1B. Для обеих моделей:
- ;
- ;
- 64 головы запросов, 8 голов K/V, размерность головы 64;
- раздельные входная матрица эмбеддингов и выходная проекция;
- смещения в QKV, выходной проекции attention, роутере и экспертах;
- обучаемый attention sink на каждую голову запросов (М5).
gpt-oss-120b
Параметры архитектуры:
Покомпонентный подсчёт:
| Компонент | Параметры |
|---|---|
| две словарные матрицы | 1 158 266 880 |
| attention во всех слоях, включая смещения | 955 802 880 |
| полный банк экспертов, включая смещения | 114 701 598 720 |
| роутеры | 13 275 648 |
| нормы | 210 240 |
| learned sinks | 2 304 |
| Итого | 116 829 156 672 |
Под нашей активной конвенцией один токен использует:
- одну полную словарную проекцию;
- все параметры attention, роутеров, норм и attention sinks;
- четыре выбираемых эксперта в каждом слое.
Итог:
Отношение:
Полученные значения округляются до опубликованных 117B/5.1B. Чтобы повторить точный расчёт, нужно сохранить перечисленные компоненты и правило активного подсчёта.
gpt-oss-20b
Для , , получаем:
Меньшая модель сохраняет top-4, но её банк содержит всего 32 эксперта. Поэтому доля активного банка экспертов значительно выше.
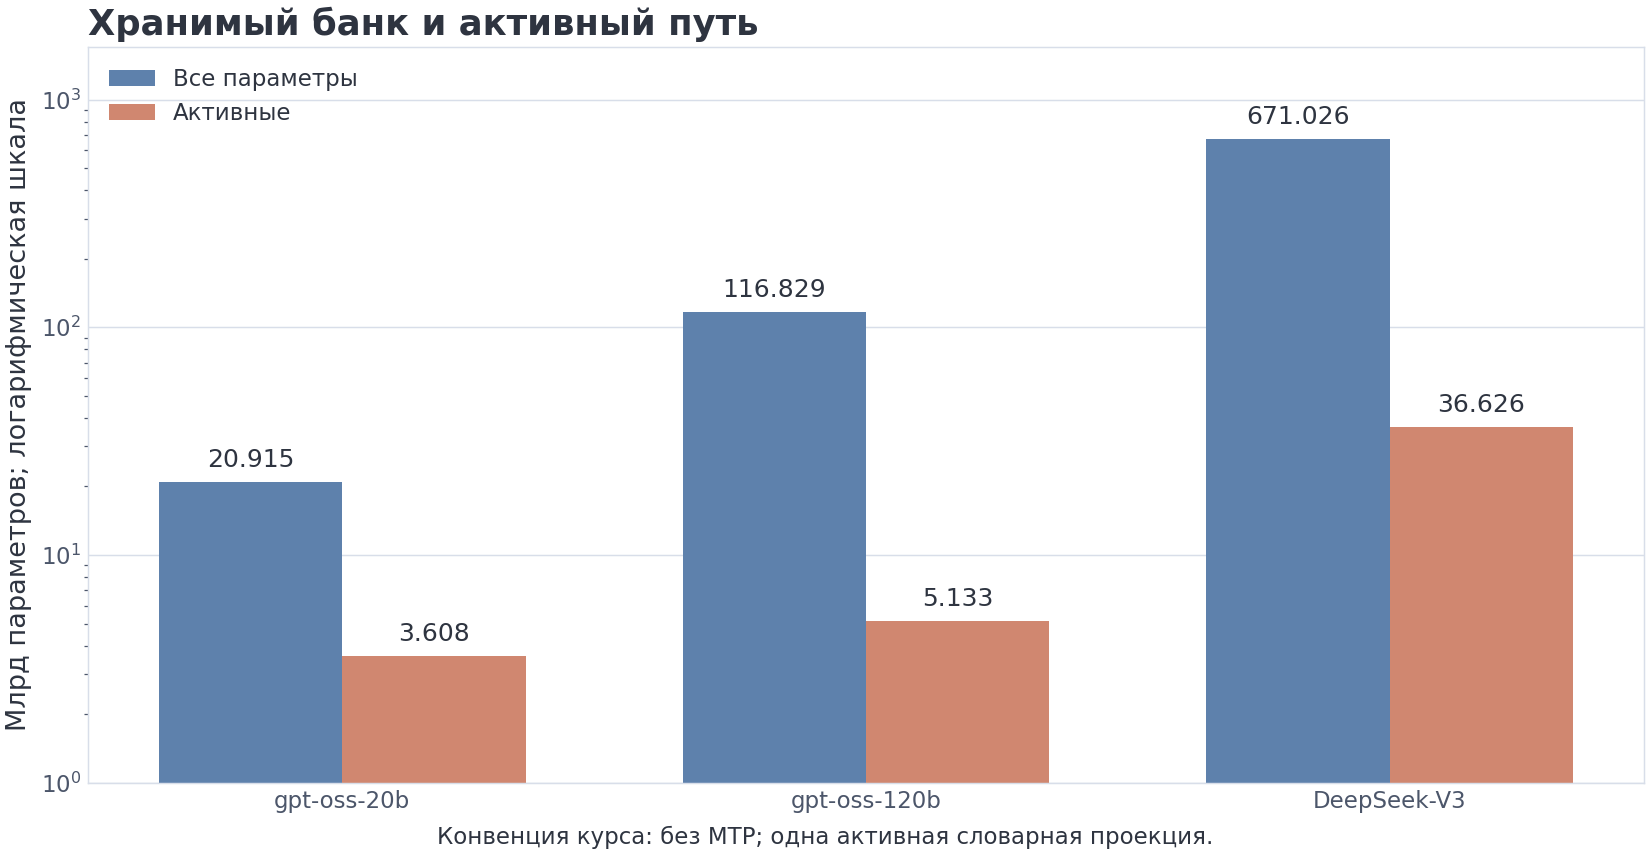 Общий и активный параметрические бюджеты gpt-oss-120b, gpt-oss-20b и реконструкции DeepSeek-V3. Логарифмическая шкала не подменяет различия в соглашениях подсчёта.
Приближение можно использовать для весовой части матричных умножений плотного типа, но отношение 22.76× не является гарантированным ускорением: полный банк весов остаётся в системе, а маршрутизация и all-to-all добавляют собственную цену.
6. Роутер крупным планом: числовая трассировка
Пусть для одного токена роутер выдал логиты:
[1.2, -0.3, 2.1, 0.4, 1.7, -1.0, 0.9, 2.5]
После sigmoid:
[0.7685, 0.4256, 0.8909, 0.5987,
 0.8455, 0.2689, 0.7109, 0.9241]
При top-4 выбираются эксперты:
[7, 2, 4, 0]
Нормированные веса смеси:
[0.2695, 0.2598, 0.2466, 0.2241]
Теперь добавим эксперту 3 смещение выбора . Приоритеты для выбора меняются, и top-4 становится:
[3, 7, 2, 4]
Но после выбора веса вычисляются из чистых сигмоидальных оценок. Эксперт 3 получает вес не из , а из :
[0.1837, 0.2835, 0.2733, 0.2594]
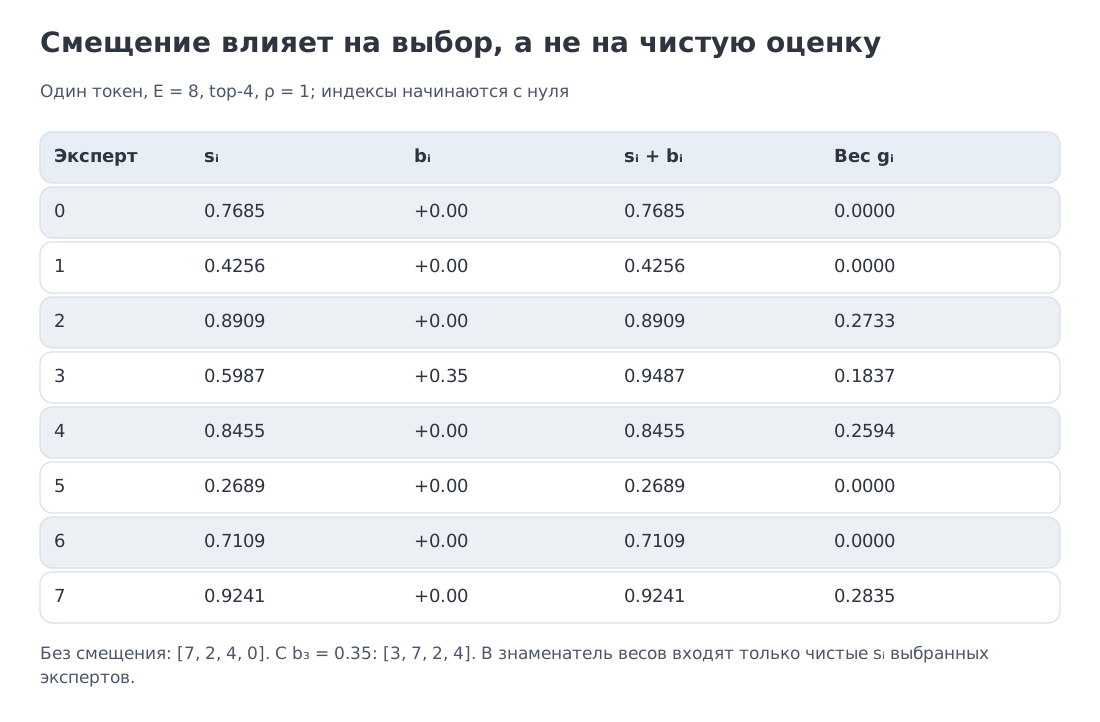 Чистые оценки, смещение выбора, top-k и веса смеси: смещение меняет состав команды, а вклад нового эксперта определяется его чистой оценкой.
Групповая предварительная селекция
В DeepSeek-V3 256 выбираемых экспертов разбиты на восемь групп. Для токена сначала выбираются четыре группы, затем top-8 экспертов внутри разрешённого множества. Такая двухступенчатая схема ограничивает число узлов, которым нужно отправить токен.
В опубликованной реализации с балансировочным смещением оценка группы равна сумме двух её наибольших скорректированных оценок. После выбора веса смеси нормируются по чистым оценкам и умножаются на масштаб .
Это важный пример общего принципа: приоритет выбора и вес вклада могут быть разными объектами.
Выбор индексов top-k дискретен. Пока набор выбранных экспертов не меняется, градиент может идти через их веса смеси. При нормированном top-1 единственный вес равен 1: этот путь не обучает роутер. Поэтому правило нормировки и дополнительные обучающие сигналы нужно читать вместе; не все top-1-архитектуры нормируют выбранный вес до единицы.
Разобрать реализацию и проверки B09
NumPy → PyTorch · B09 — Top-k MoE: выбор экспертов и веса смеси
Смещение может менять выбор экспертов, а веса смеси по-прежнему вычисляются из чистых оценок. NumPy делает эту границу видимой; PyTorch использует topk и gather.
import numpy as np
import torch
1. Явная NumPy-реализация
def numpy_topk_router_explicit(
    logits: np.ndarray,
    top_k: int,
    *,
    selection_bias: np.ndarray | None = None,
) -> tuple[np.ndarray, np.ndarray]:
    logits = np.asarray(logits, dtype=np.float64)
    if logits.ndim != 2 or not logits.size or not np.isfinite(logits).all():
        raise ValueError("expected non-empty finite logits[T,E]")
    if isinstance(top_k, (bool, np.bool_)) or not isinstance(top_k, (int, np.integer)) or not 1 <= top_k <= logits.shape[1]:
        raise ValueError("top_k must be an integer in [1,E]")
    log_scores = -np.logaddexp(0.0, -logits)
    clean = np.exp(log_scores)
    # Without bias, monotonic sigmoid permits ranking logits before saturation.
    selection = logits if selection_bias is None else clean + selection_bias
    if selection.shape != logits.shape or not np.isfinite(selection).all():
        raise ValueError("selection_bias must broadcast to [T,E] and be finite")
    indices = np.argsort(-selection, axis=-1, kind="stable")[:, :top_k]
    selected_log = np.take_along_axis(log_scores, indices, axis=-1)
    weights = np.exp(selected_log - selected_log.max(axis=-1, keepdims=True))
    weights = weights / weights.sum(axis=-1, keepdims=True)
    return indices, weights
Чистые оценки, приоритеты выбора и веса смеси разделены. Вес нормируется в логарифмической области, поэтому отрицательные логиты около −1000 не дают деления 0/0. Без смещения выбор по логитам избегает искусственных равенств после насыщения sigmoid.
2. Та же математика явными операциями PyTorch
def torch_topk_router_explicit(
    logits: torch.Tensor,
    top_k: int,
    *,
    selection_bias: torch.Tensor | None = None,
) -> tuple[torch.Tensor, torch.Tensor]:
    if logits.ndim != 2 or not logits.numel() or not logits.is_floating_point() or not torch.isfinite(logits).all():
        raise ValueError("expected non-empty finite floating logits[T,E]")
    if isinstance(top_k, bool) or not isinstance(top_k, int) or not 1 <= top_k <= logits.shape[1]:
        raise ValueError("top_k must be an integer in [1,E]")
    z = logits.float() if logits.dtype in (torch.float16, torch.bfloat16) else logits
    log_scores = -torch.logaddexp(torch.zeros_like(z), -z)
    selection = z if selection_bias is None else log_scores.exp() + selection_bias
    if selection.shape != logits.shape or not torch.isfinite(selection).all():
        raise ValueError("selection_bias must broadcast to [T,E] and be finite")
    _, indices = torch.topk(selection, top_k, dim=-1)
    selected_log = log_scores.gather(-1, indices)
    weights = selected_log.softmax(dim=-1)
    return indices, weights
PyTorch использует log-sigmoid, topk и gather. FP16/BF16 повышается до FP32. Градиент проходит через веса выбранных экспертов; индексы дискретны, а порядок topk при равенствах не гарантирован. При нормированном top-1 вес равен 1, и этот путь не даёт градиента роутеру.
| Аспект | NumPy | PyTorch |
|---|---|---|
| Чистые оценки | log-sigmoid → exp | log-sigmoid → exp |
| Селекция | stable argsort | torch.topk |
| Вес выбранного эксперта | take_along_axis | gather |
| Bias | влияет только на выбор | тот же контракт |
| Ties | stable sort в эталоне | порядок не гарантирован |
Исполняемая проверка эквивалентности и граничных случаев
logits_np = np.array([[2.1, -0.4, 0.8, 1.3], [0.2, 1.9, -1.1, 0.7]])
bias_np = np.array([0.0, 0.08, -0.03, 0.02])
i_np, w_np = numpy_topk_router_explicit(logits_np, 2, selection_bias=bias_np)
i_t, w_t = torch_topk_router_explicit(torch.tensor(logits_np), 2, selection_bias=torch.tensor(bias_np))
np.testing.assert_array_equal(i_np, i_t.numpy())
np.testing.assert_allclose(w_np, w_t.numpy())
extreme = np.array([[-1002., -1000., -1001., -1003.]])
with np.errstate(over="raise", invalid="raise", divide="raise"):
    ei, ew = numpy_topk_router_explicit(extreme, 2)
ti, tw = torch_topk_router_explicit(torch.tensor(extreme), 2)
np.testing.assert_array_equal(ei, [[1, 2]])
np.testing.assert_array_equal(ei, ti.numpy())
np.testing.assert_allclose(ew, tw.numpy(), rtol=1e-12, atol=1e-12)
z = torch.tensor(logits_np, requires_grad=True)
assert torch.autograd.gradcheck(lambda x: torch_topk_router_explicit(x, 2)[1], (z,))
one = torch_topk_router_explicit(z, 1)[1]
np.testing.assert_allclose(torch.autograd.grad(one.sum(), z)[0].numpy(), 0., atol=1e-12)
print("B09 routing, extreme logits, and selected-gate gradients: PASS")
Полный исполняемый файл: m07_moe_bridges.py
Контракт tie-breaking: PyTorch topk.
7. Балансировка: от дополнительной потери к управлению маршрутом
Если небольшая случайная флуктуация направляет больше токенов к одному эксперту, он получает больше обучающих примеров и может становиться ещё привлекательнее. Возникает положительная обратная связь: маршрутизация схлопывается к немногим экспертам.
Дополнительная потеря для балансировки
Возьмём пакет из токенов и softmax-роутер с вероятностями . Для top-1 определим как долю токенов, назначенных эксперту , а — как среднюю вероятность. Потеря Switch без внешнего коэффициента:
При равномерных частотах и вероятностях эта величина равна 1. Жёсткие назначения при обратном проходе рассматриваются как константы; градиент проходит через . К языковой потере прибавляют , поэтому слишком большой меняет приоритет обучения. В обобщении ноутбука на top-k используется доля назначений , а не . Это явно выбранная нормировка.
Router z-loss
ST-MoE добавляет штраф
где — логит эксперта для токена . Сначала вычисляются logsumexp и его квадрат для каждого токена, затем берётся среднее. Это не квадрат среднего. Штраф ограничивает логарифм нормировочной суммы softmax; он не является покомпонентным ограничением каждого логита. К языковой потере он добавляется со своим коэффициентом. Баланс назначений и численная устойчивость — разные задачи.
Loss-Free Balancing
Другой способ управления нагрузкой — обновлять смещения выбора по счётчикам назначений вне обратного распространения градиента. Пусть — нагрузка эксперта, — её среднее по экспертам, — шаг. Основное правило Loss-Free Balancing:
Перегруженный эксперт теряет приоритет, недогруженный получает прибавку. У этого обновления нет собственного градиента, который складывался бы с градиентом языковой задачи. Однако новые маршруты меняют набор обучаемых на токене экспертов.
В DeepSeek-V3 этот механизм отвечает за баланс пакета, а небольшая дополнительная потеря на уровне последовательности предотвращает крайний перекос внутри одного примера. Поэтому название метода не означает отсутствия всех вспомогательных потерь в модели (отчёт, §2.1.2).
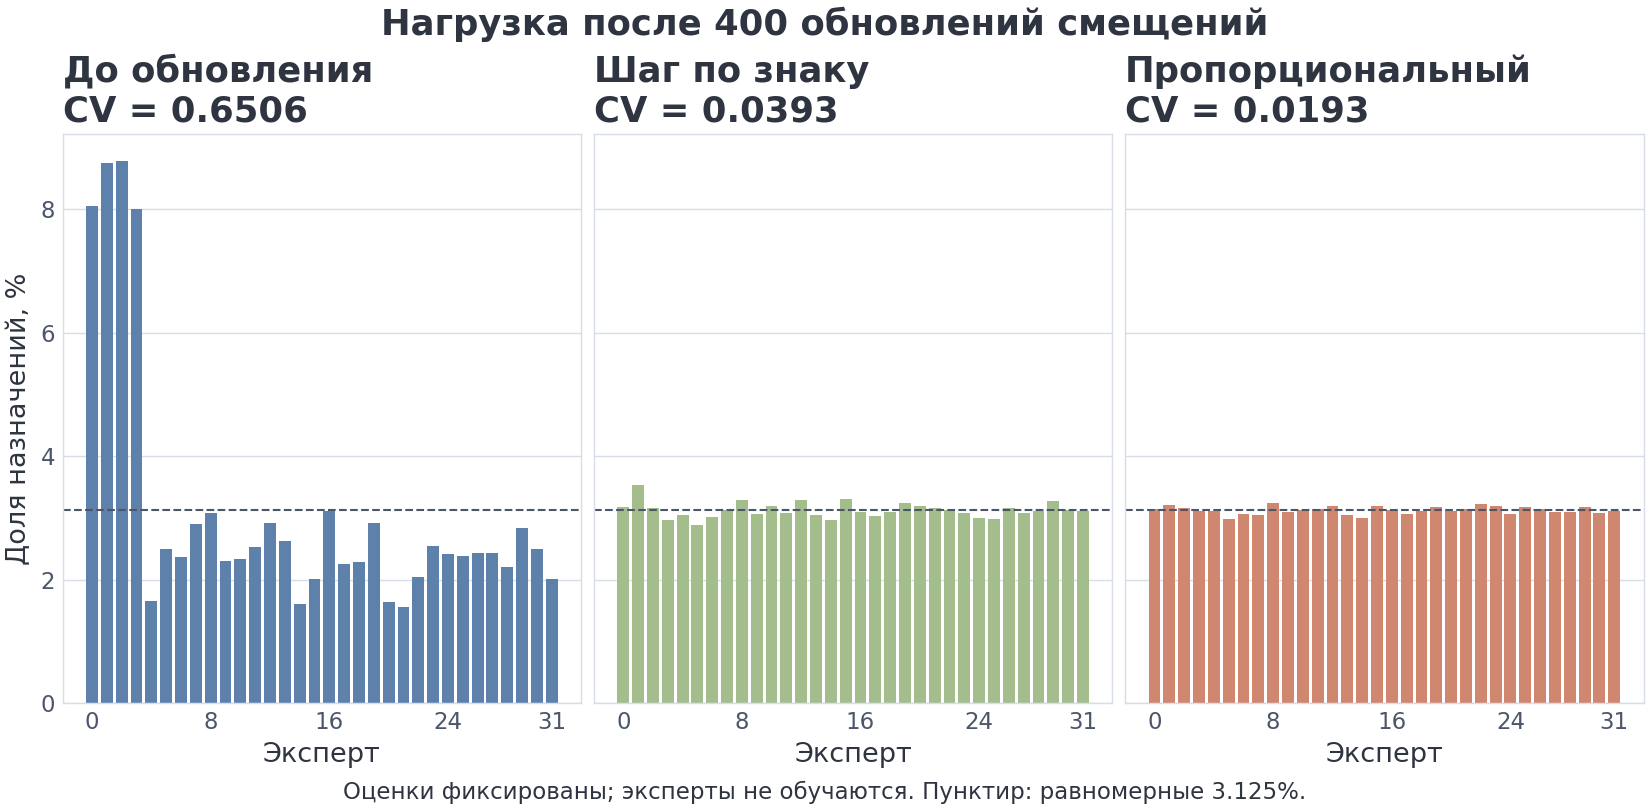 Распределение назначений до и после 400 шагов двух контроллеров при одинаковых исходных оценках. Пунктир показывает равномерную нагрузку.
Неравномерность измерим коэффициентом вариации: . Ноль означает одинаковую нагрузку. В симуляции оценки роутера зафиксированы: меняются только смещения, а эксперты не обучаются. Начальное значение CV равно 0.6506. После 400 шагов:
- обновление по знаку при даёт 0.0393;
- учебный пропорциональный контроллер при даёт 0.0193.
Пропорциональный контроллер изменяет величину шага вместе с ошибкой нагрузки. Его результат следует сравнивать с правилом по знаку как отдельный эксперимент на фиксированных оценках.
Вместимость эксперта и переполнение
Пусть в пакете токенов, каждый получает назначений, а банк содержит экспертов. Средняя нагрузка равна . Коэффициент вместимости (capacity factor) задаёт запас относительно среднего. На эксперта выделяется не более
назначений. Если их больше, нужно выбрать политику: отбросить лишние, перенаправить их, увеличить буфер или обработать все назначения без отбрасывания. В ноутбуке первыми принимаются первые поступившие токены — FIFO; веса уцелевших назначений перенормируются. Политика зависит от порядка токенов и может отдавать преимущество началу пакета.
Токен, потерявший все выбираемые назначения, не исчезает из модели: его выбираемая ветвь равна нулю. Общие эксперты, если они есть, и остаточная связь продолжают работать. Потеря назначения и потеря всего токена — разные события.
8. Узкие и общие эксперты: больше комбинационной гибкости
Для сравнения при одинаковом бюджете возьмём 8 экспертов ширины и top-2. Разделим каждый на 4 эксперта ширины : получится 32 эксперта и top-8. И полный объём экспертных матриц, и активная матричная арифметика сохраняются: и . При этом роутер и обмены становятся дороже. Это идея мелкого разбиения экспертов (fine-grained experts).
Число возможных команд меняется с до . Такое сравнение отделяет выигрыш комбинационной гибкости от простого увеличения числа весов.
Другая пара размеров банка, удобная для иллюстрации комбинаторики:
У пары 8/top-2 и 128/top-4 выше не заявлено равенство параметров или вычислений. Число подмножеств само по себе не является числом независимых навыков. Реальное поведение зависит от непрерывных весов смеси, содержимого экспертов, корреляций и ограничений роутера.
Для DeepSeek-V3 формальное
является лишь верхней оценкой без учёта ограничений: групповая предварительная селекция запрещает часть подмножеств.
Общие эксперты выполняются для каждого токена. Авторы DeepSeekMoE предлагают поручить им общую работу и тем самым уменьшить дублирование в выбираемом банке. Чтобы установить, какую функцию выучил конкретный эксперт, нужно провести эксперимент с вмешательством: архитектура сама по себе не задаёт ему тему.
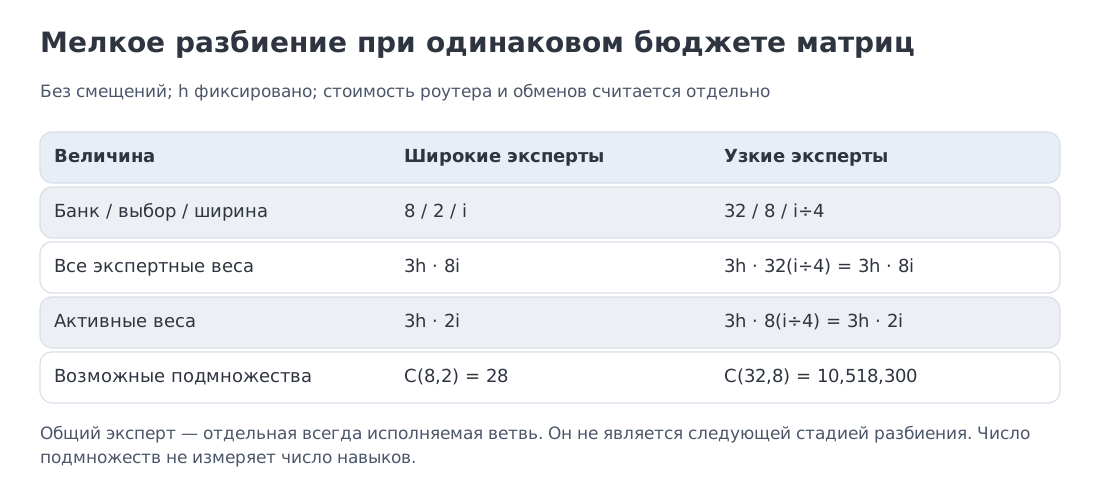 Разбиение 8/top-2 на 32/top-8 при одинаковом бюджете экспертных матриц. Число возможных подмножеств растёт; стоимость роутера и обменов сравнивается отдельно.
Решённый пример B: реконструкция DeepSeek-V3
С использованием опубликованной конфигурации и явно заданной конвенции модуль получает:
Официальный паспорт округляет эти величины до 671B/37B. Отдельно опубликованный пакет весов Hugging Face содержит около 685B параметров вместе с 14B модулем MTP. Поэтому в таблицах нужно различать:
- основную модель;
- полный пакет с MTP;
- активный размер для выбранного пути исполнения.
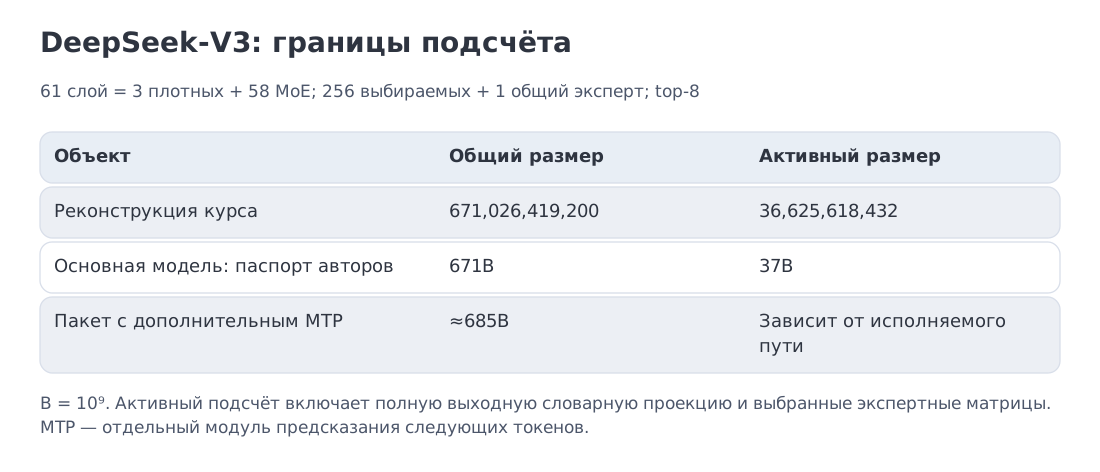 DeepSeek-V3: 3 плотных + 58 слоёв MoE, 256 выбираемых + 1 общий эксперт, top-8, MLA и отдельный модуль MTP. Числа реконструкции сопоставлены с округлённым официальным паспортом.
9. Специализация: что можно и чего нельзя заключать из маршрутов
MoE создаёт условия для специализации: разные эксперты видят разные подраспределения токенов. Но путь от маршрутов к понятному ярлыку «эксперт по физике» слишком длинен.
Надёжно измеряются:
- частота выбора по слоям и доменам;
- частота совместного выбора экспертов;
- изменение выхода при отключении (ablation) или замене эксперта;
- чувствительность роутера к синтаксическим и семантическим признакам;
- устойчивость паттерна на разных корпусах.
Гораздо осторожнее нужно обращаться с интерпретацией. Один эксперт может предпочитать определённую морфологическую конструкцию, тип границы токена или операцию преобразования представления, а не широкую тему. Несколько экспертов могут быть взаимозаменяемы, а общая ветвь — выполнять разные функции на разных слоях.
Поэтому хороший анализ имеет три ступени:
- Предпочтение маршрута: какие токены чаще выбирают эксперта;
- Эффект вмешательства: что изменяется после отключения или замены;
- Смысловой ярлык: человеческое описание наблюдаемого эффекта с указанием ограничений.
При дообучении на примерах (SFT, подробно в М13) полезно сравнивать эти три уровня до и после обновления весов. Изменение качества языков проверяется на отложенных данных, а не выводится только из частот маршрутизации.
Для сервинга важна другая специализация — часто выбираемые эксперты (hot experts). Реальный трафик неравномерен, и самые популярные эксперты могут создавать коммуникационный узкий участок даже у хорошо сбалансированной обучающей смеси. Именно поэтому профиль обслуживания нужно измерять на целевой нагрузке.
10. Инференс MoE: память, all-to-all и эксперты, затронутые пакетом
MoE уменьшает экспертные вычисления на токен, но полный банк весов должен быть доступен системе. Это не означает, что все эксперты обязаны находиться на одной GPU. Возможны:
- Expert Parallelism;
- хранение части весов в CPU DRAM или NVMe;
- репликация часто выбираемых экспертов;
- подгрузка весов по мере выполнения;
- многоуровневый кэш;
- шардирование между узлами.
Распределение экспертов и обмен all-to-all
Expert Parallelism (EP) распределяет экспертов по устройствам. Операция dispatch собирает назначения и отправляет векторы владельцам экспертов; combine возвращает и складывает результаты. Обмен, в котором каждое устройство может посылать данные каждому, называется all-to-all. Матричные умножения для разных экспертов объединяют в группы — grouped GEMM.
Посчитаем логический объём пересылки, если каждое из назначений переносит полный вектор ширины и такой же выход возвращается. Пусть — байт на координату. Для одного слоя и всего рассматриваемого пакета:
Для , , , bf16:
Это 448 MiB полезных данных для всех назначений пакета, а не на устройство. Сетевые байты могут быть меньше из-за локальных экспертов или объединения назначений на одном узле и больше из-за выравнивания и протокола. Формула не является универсальной нижней границей сетевого трафика.
Сколько экспертов затронет пакет
При независимом равномерном выборе вероятность, что данный эксперт не будет выбран ни одним из токенов:
Ожидаемая доля затронутых экспертов:
Для gpt-oss 128/top-4 и DeepSeek 256/top-8 отношение одинаково, поэтому теоретическая кривая совпадает: при ожидаемая доля затронутых экспертов составляет около 86.9%.
Для Kimi K3 896/top-16:
- : около 25.0%;
- : около 68.4%.
Это не предсказание реального сервера. Маршруты коррелированы и неравномерны, общие эксперты всегда активны, а групповая селекция может создавать дополнительные зависимости. Если маргинальная вероятность выбора каждого эксперта всё ещё и токены независимы, сама группировка не нарушает формулу. Формула — базовая оценка для проверки фактической телеметрии.
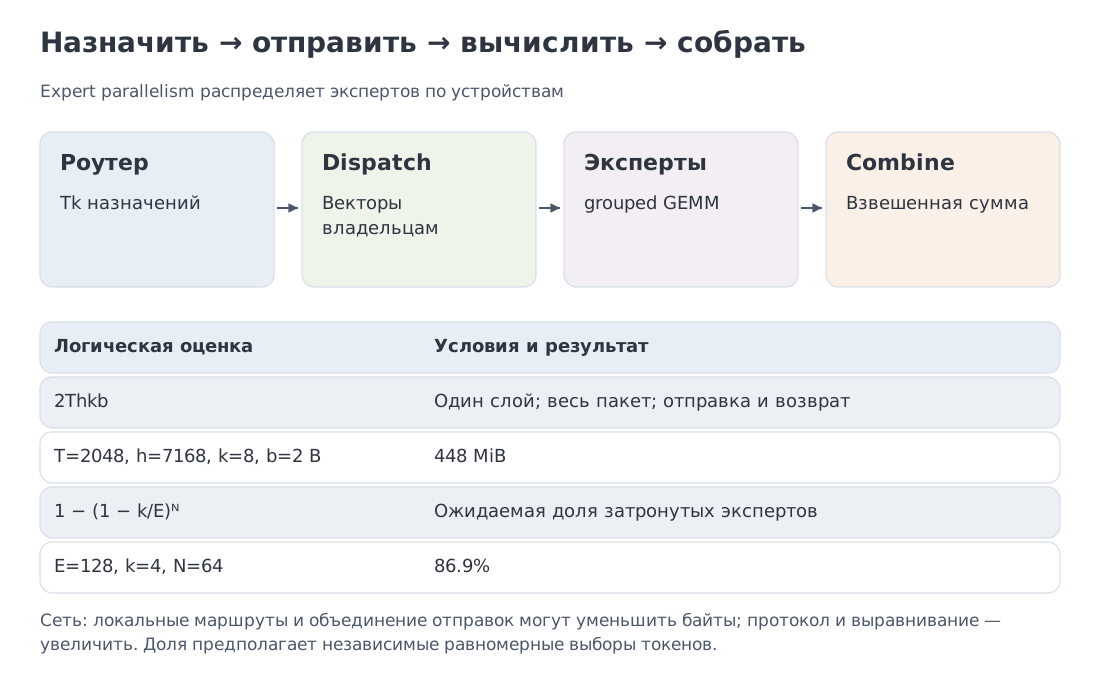 Expert Parallelism: dispatch → all-to-all → grouped GEMM → возврат. Рядом — предпосылки формулы объединения экспертов в пакете и условия оценки байтов.
Чтобы оценить пользу подгрузки экспертов, нужно измерить их популярность, повторное использование и задержку транспорта. Даже большой пакет может обращаться к неравномерному подмножеству банка. Предварительная загрузка помогает лишь тогда, когда успевает скрыть нужные обмены.
11. LatentMoE и адаптивная маршрутизация
LatentMoE
Обычное распределение экспертов пересылает вектор состояния ширины . LatentMoE сохраняет дискретную маршрутизацию, но перед отправкой проецирует вектор в более узкую размерность :
Роутер читает исходное состояние и выбирает top-k. Выбираемые FFN, отправка и сборка работают в размерности ; затем результат проецируется обратно:
Если , , объём пересылаемых активаций уменьшается в идеальной оценке в два раза. Сходным образом уменьшается размер экспертных матриц при соответствующей архитектуре.
Два общих проектора добавляют весов без смещений. Поэтому двукратное сокращение ширины пересылки не означает двукратного сокращения всей модели. В схеме NVIDIA общие эксперты остаются в исходной размерности ; формула выше описывает именно выбираемую ветвь. NVIDIA использует этот подход в Nemotron 3 Super/Ultra; Kimi K3 описывает Stable LatentMoE с 896 выбираемыми экспертами, top-16 и двумя общими.
Другие варианты маршрутизации
Несколько работ меняют сам контракт top-k:
| Метод | Как маршрутизирует | Адаптивное число экспертов | Исходная область |
|---|---|---|---|
| Soft MoE (2023) | мягкие смеси между токенами и слотами | фиксированная слотная схема | визуальные Transformer |
| ReMoE | дифференцируемая маршрутизация через ReLU | эффективная динамическая разреженность | языковые модели |
| SoftMoE (2026) | дифференцируемое усечённое приближение top-k | да, с глобальным бюджетом | LLM |
| Routing-Free MoE | без отдельного центрального роутера | зависит от метода | исследовательские модели |
Эти направления нельзя объединять в одну линейную «смену стандарта». Одни методы меняют путь градиента, другие — распределение вычислений между слоями или устройство роутера. Для оценки стоимости также важно, удаётся ли сгруппировать назначения в эффективные матричные операции.
12. Код первого уровня: прозрачный MoE с явными политиками
Учебный код модуля не пытается имитировать распределённую исполняющую систему. Он делает видимыми четыре контракта:
- чистая оценка и приоритет выбора — разные величины;
- правило выбора при равных оценках объявлено;
- переполнение вместимости имеет объявленную политику;
- общий и активный подсчёт имеют явную архитектурную спецификацию.
Этот фрагмент проверяет порядок операций z-loss. Роутер уже показан в B09; полный слой в ноутбуке добавляет вместимость, SwiGLU и общую ветвь.
from typing import Any
import numpy as np

def _finite_array(name: str, value: Any, *, ndim: int | None = None) -> np.ndarray:
    """Return ``value`` as a finite float64 array with an optional rank contract."""

    array = np.asarray(value, dtype=np.float64)
    if ndim is not None and array.ndim != ndim:
        raise ValueError(f"{name} must have rank {ndim}; got shape {array.shape}")
    if array.size == 0:
        raise ValueError(f"{name} must be non-empty")
    if not np.all(np.isfinite(array)):
        raise ValueError(f"{name} must contain only finite values")
    return array

def router_z_loss(logits: Any) -> float:
    """Compute the ST-MoE router z-loss ``mean(logsumexp(logits)^2)``."""

    raw = _finite_array("logits", logits)
    if raw.ndim != 2:
        raise ValueError("logits must have shape [T,E]")
    maximum = np.max(raw, axis=1, keepdims=True)
    log_partition = maximum[:, 0] + np.log(np.exp(raw - maximum).sum(axis=1))
    return float(np.mean(log_partition**2))
Разобрать реализацию и проверки B10
NumPy → PyTorch · B10 — MoE dispatch и combine
Входы имеют формы hidden [T,D], индексы и веса смеси [T,K], матрицы экспертов [E,D,F] и [E,F,D]. Индексы — целые числа от 0 до E−1; одинаковые номера в разных назначениях допустимы, их вклады складываются. Вещественные массивы конечны и используют совместимый плавающий тип; в PyTorch все тензоры находятся на одном устройстве. Минимальный мост проверяет индексы, затем раскрывает отправку и суммирование; вместимость здесь не ограничена.
import numpy as np
import torch
1. Явная NumPy-реализация
def numpy_expert_dispatch_explicit(
    hidden: np.ndarray,
    expert_indices: np.ndarray,
    gates: np.ndarray,
    w_in: np.ndarray,
    w_out: np.ndarray,
) -> np.ndarray:
    if expert_indices.ndim != 2 or expert_indices.shape != gates.shape or expert_indices.shape[0] != hidden.shape[0]:
        raise ValueError("indices and gates must have matching shape [T,K]")
    if not np.issubdtype(expert_indices.dtype, np.integer):
        raise ValueError("expert indices must be integers")
    if np.any(expert_indices < 0) or np.any(expert_indices >= w_in.shape[0]):
        raise ValueError("expert index out of range")
    output = np.zeros_like(hidden)
    for token in range(hidden.shape[0]):
        for slot in range(expert_indices.shape[1]):
            expert = int(expert_indices[token, slot])
            mid = np.tanh(hidden[token] @ w_in[expert])
            output[token] += gates[token, slot] * (mid @ w_out[expert])
    return output
В этом мосте используются простые двухматричные tanh-эксперты: так видна именно сборка результатов. NumPy проходит по токенам и назначениям, затем прибавляет каждый взвешенный выход. Это не замена SwiGLU основного слоя.
2. Та же математика явными операциями PyTorch
def torch_expert_dispatch_explicit(
    hidden: torch.Tensor,
    expert_indices: torch.Tensor,
    gates: torch.Tensor,
    w_in: torch.Tensor,
    w_out: torch.Tensor,
) -> torch.Tensor:
    if expert_indices.ndim != 2 or expert_indices.shape != gates.shape or expert_indices.shape[0] != hidden.shape[0]:
        raise ValueError("indices and gates must have matching shape [T,K]")
    if expert_indices.dtype not in (torch.int8, torch.int16, torch.int32, torch.int64, torch.uint8):
        raise ValueError("expert indices must be integers")
    if torch.any(expert_indices < 0) or torch.any(expert_indices >= w_in.shape[0]):
        raise ValueError("expert index out of range")
    output = torch.zeros_like(hidden)
    for expert in range(w_in.shape[0]):
        token_ids, slots = torch.where(expert_indices == expert)
        if token_ids.numel() == 0:
            continue
        mid = torch.tanh(hidden[token_ids] @ w_in[expert])
        expert_out = (mid @ w_out[expert]) * gates[token_ids, slots, None]
        output.index_add_(0, token_ids, expert_out)
    return output
PyTorch меняет порядок работы: сначала собирает все назначения одного эксперта в пакет, затем возвращает результаты токенам через index_add_.
| Аспект | NumPy | PyTorch |
|---|---|---|
| Порядок | token → slot | expert → assigned tokens |
| Экспертный batch | нет | индексация hidden[token_ids] |
| Combine | output[token] += ... | output.index_add_ |
| Autograd | нет | через expert matmul и combine |
| CUDA-детерминизм | CPU reference | index_add_ может зависеть от порядка атомарных сложений |
Исполняемая проверка эквивалентности и граничных случаев
rng = np.random.default_rng(10)
x_np = rng.standard_normal((6, 4))
idx_np = np.array([[0,1],[1,2],[2,0],[0,2],[1,0],[2,1]])
gates_np = np.full((6,2), 0.5)
w1_np = rng.standard_normal((3,4,5)); w2_np = rng.standard_normal((3,5,4))
np_out = numpy_expert_dispatch_explicit(x_np, idx_np, gates_np, w1_np, w2_np)
t_out = torch_expert_dispatch_explicit(torch.tensor(x_np), torch.tensor(idx_np), torch.tensor(gates_np), torch.tensor(w1_np), torch.tensor(w2_np))
np.testing.assert_allclose(np_out, t_out.numpy(), rtol=1e-10, atol=1e-10)
args = [torch.tensor(x_np, requires_grad=True), torch.tensor(idx_np),
        torch.tensor(gates_np, requires_grad=True), torch.tensor(w1_np, requires_grad=True),
        torch.tensor(w2_np, requires_grad=True)]
assert torch.autograd.gradcheck(
    lambda x, g, a, b: torch_expert_dispatch_explicit(x, args[1], g, a, b),
    (args[0], args[2], args[3], args[4]))
for invalid in (-1, w1_np.shape[0], .5, np.nan, True):
    bad = np.full(idx_np.shape, invalid)
    for dispatch, values in (
        (numpy_expert_dispatch_explicit, (x_np,bad,gates_np,w1_np,w2_np)),
        (torch_expert_dispatch_explicit, tuple(torch.tensor(a) for a in (x_np,bad,gates_np,w1_np,w2_np))),
    ):
        try: dispatch(*values)
        except ValueError: pass
        else: raise AssertionError("invalid expert index accepted")
duplicate = np.zeros_like(idx_np)
expected = idx_np.shape[1] * (np.tanh(x_np @ w1_np[0]) @ w2_np[0])
actual = numpy_expert_dispatch_explicit(x_np,duplicate,np.ones_like(gates_np),w1_np,w2_np)
np.testing.assert_allclose(actual,expected)
actual_t = torch_expert_dispatch_explicit(torch.tensor(x_np),torch.tensor(duplicate),
    torch.ones_like(torch.tensor(gates_np)),torch.tensor(w1_np),torch.tensor(w2_np))
np.testing.assert_allclose(actual_t.numpy(),expected)
print("B10 values, gradients, repeated assignments, and invalid indices: PASS")
Полный исполняемый файл: m07_moe_bridges.py
Контракт накопления: PyTorch index_add_.
14. Чтение открытого кода gpt-oss
Публичная реализация полезна тем, что позволяет увидеть то, что исчезает в кратком config.json.
Роутер
MLPBlock.gate содержит:
- матрицу ;
- смещение длины ;
- top-k по логитам роутера;
- softmax только по выбранным логитам.
Это отличается от sigmoid со смещением выбора DeepSeek. Обе архитектуры используют top-k, но оценки и способы балансировки различаются.
Экспертные тензоры
Экспертный блок хранит:
- упакованные матрицы gate/up;
- смещения gate/up;
- выходные матрицы down;
- выходные смещения.
Параметры смещения дают отдельный вклад 40 105 728 в модели 120b. При чтении кода также нужно проверить упаковку входных проекций: в исходной реализации столбцы gate и up чередуются.
Банк экспертов и распределённое исполнение
Исходная реализация выбирает тензоры назначенных экспертов и выполняет проекции и взвешенную сумму через einsum. В учебном мосте B10 используется другой порядок: цикл по экспертам и накопление по индексам. Оптимизированная система может объединять матричные умножения и пересылки; математический результат должен сохраняться.
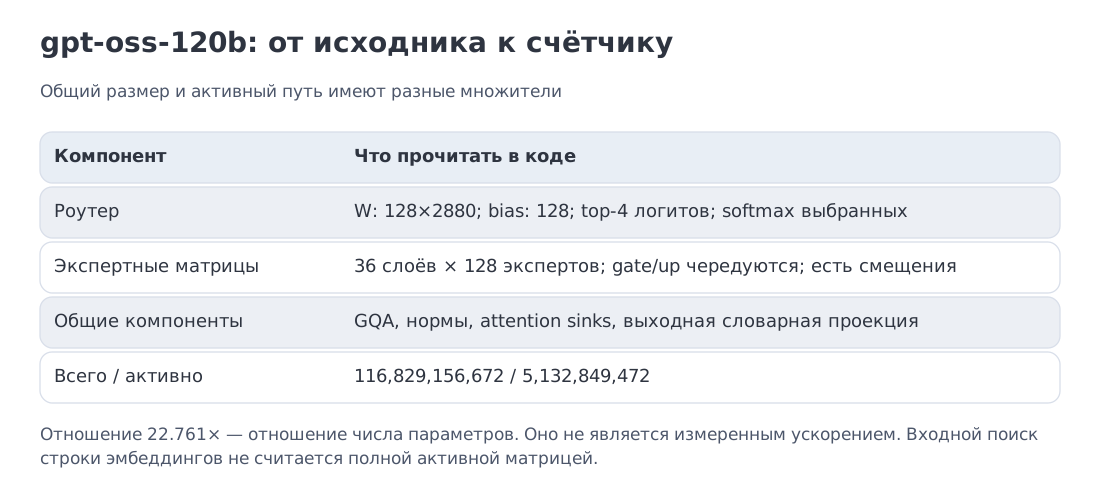 Паспорт gpt-oss-120b из открытого кода: роутер, 128 экспертов, top-4, смещения и правило активного подсчёта.
При чтении исходника проверяйте функцию оценивания, смещения, нормировку весов смеси, форму экспертных матриц, общие эксперты, политику переполнения и распределённый путь исполнения.
15. Современный ландшафт как паспорт свидетельств
Таблица фиксирует проверенные примеры архитектур, а не исчерпывающий список новых релизов. Срез на 11 октября 2026 года. Она не ранжирует модели; её цель — показать разные MoE-контракты и источник каждого поля.
| Модель | Total / active | Экспертная ветвь | Маршрутизация и особенности | Основание |
|---|---|---|---|---|
| gpt-oss-120b | 117B / 5.1B | 128 routed, top-4, без shared | softmax по выбранным logits | официальный анонс, конфигурация и код |
| DeepSeek-V3 | 671B / 37B | 256 routed + 1 shared, top-8 | sigmoid, group preselection, loss-free bias | технический отчёт и открытый код инференса |
| Qwen3.5-35B-A3B | 35B / 3B | 256 routed + 1 shared, top-8 | hybrid DeltaNet/attention, MTP | официальная карточка и конфигурация |
| Kimi K3 | 2.8T / 104B | 896 routed + 2 shared, top-16 | Stable LatentMoE, latent width 3584 | официальный отчёт и веса |
| Nemotron 3 Ultra | 550B / 55B | LatentMoE | hybrid Mamba–Attention, MTP, NVFP4 | официальный технический отчёт |
| GLM-5 | 744B / 40B | 256 routed + 1 shared, top-8 | sigmoid/noaux, DSA в attention | официальная карточка и конфигурация |
| DeepSeek-V4 Pro / Flash | 1.6T / 49B; 284B / 13B | по техническому отчёту | MoE + гибридный attention | технический отчёт |
Эти строки нельзя механически сравнивать по отношению общего и активного размера. Различаются attention, число плотных слоёв, MTP, модальности, правила подсчёта и аппаратное исполнение.
Qwen3.5 как упражнение по чтению конфигурации
Реальный паспорт 35B-A3B:
- ширина состояния 2048;
- 40 слоёв;
- 256 выбираемых экспертов;
- top-8 + один общий эксперт;
- внутренняя ширина выбираемых и общего экспертов — 512;
- один слой MTP;
- гибрид Gated DeltaNet и full attention.
Один общий эксперт дополнительно управляется сигмоидальным скалярным гейтом. Само наличие MTP в конфигурации не делает его обязательной частью каждого шага обычного авторегрессионного инференса. Чтобы считать активные параметры, сначала нужно выбрать исполняемый путь.
16. Мультимодальность: общий роутер — один из вариантов, а не правило
MoE естественно сочетается с несколькими модальностями, но архитектурный выбор может быть разным.
Общий банк выбираемых экспертов
Текстовые и визуальные токены поступают в один остаточный поток и используют общий роутер. Тогда эксперты могут разделяться по функциям, модальностям или смешанным признакам. Kimi K3 является примером нативной мультимодальной системы MoE.
Эксперты для отдельных модальностей
Некоторые эксперты могут назначаться только визуальным или звуковым токенам. Это уменьшает конкуренцию, но усложняет размещение и баланс.
Отдельный визуальный энкодер и языковая MoE
Изображение сначала кодируется отдельной сетью, а полученные визуальные токены проходят через языковой MoE. Тогда роутер видит уже спроецированное представление, а не исходные участки изображения.
Если каждый токен по-прежнему активирует выбираемых экспертов, объём экспертных вычислений для него не растёт только из-за модальности. Но смешанный пакет может затронуть больше различных экспертов и изменить коммуникационный профиль. Поэтому мультимодальный MoE нужно оценивать по маршрутам, all-to-all и загрузке экспертов, а не только по total/active паспорту.
19. Ключевые выводы модуля
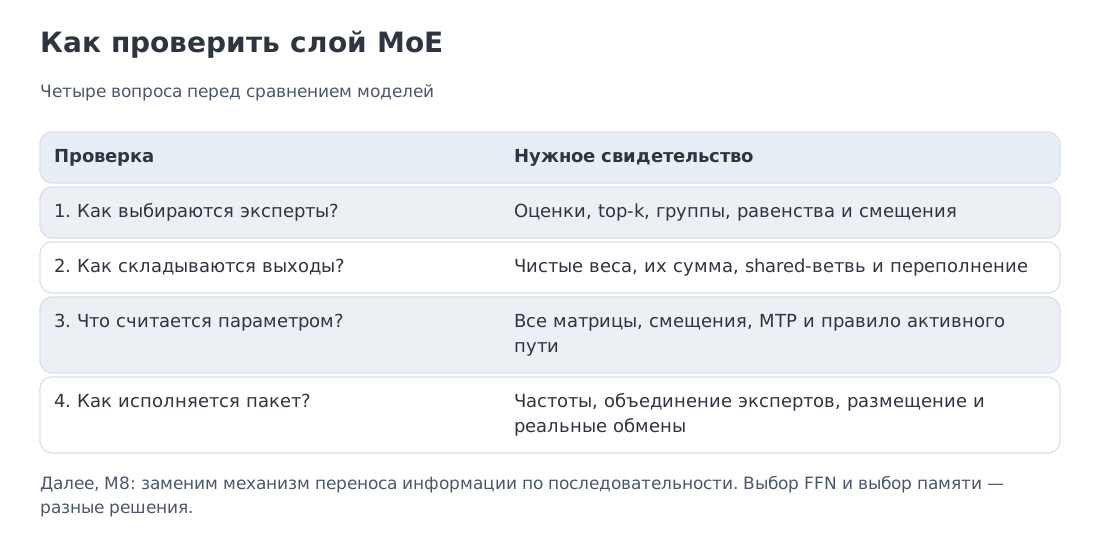 Четыре проверки: выбор экспертов, сложение выходов, подсчёт весов и исполнение пакета.
- MoE увеличивает полный банк параметров быстрее, чем экспертные вычисления одного токена, но не отменяет память и коммуникации.
totalиactiveимеют смысл только вместе с правилом подсчёта.- Смещение выбора может менять top-k, не входя в веса смеси.
- Loss-Free Balancing устраняет собственный вспомогательный градиент, но всё равно меняет распределение обучающих маршрутов.
- Узкие эксперты увеличивают комбинационную гибкость; не равно числу независимых навыков.
- Общие эксперты уменьшают стимул дублировать общую работу, но их семантику нужно измерять.
- Большой пакет может затронуть значительную часть банка экспертов; равномерная формула — базовая оценка, а не закон реального роутера.
- LatentMoE сохраняет дискретный top-k и сжимает выбираемую ветвь.
- Современный ландшафт нужно читать по конфигурации, отчёту и коду, не перенося свойства между поколениями моделей.
20. Источники
Основные источники:
-
Jacobs et al., Adaptive Mixtures of Local Experts — Neural Computation
-
Shazeer et al., Outrageously Large Neural Networks — arXiv:1701.06538
-
GShard — arXiv:2006.16668
-
Switch Transformer — arXiv:2101.03961
-
ST-MoE — arXiv:2202.08906
-
DeepSeekMoE — arXiv:2401.06066
-
Auxiliary-Loss-Free Load Balancing — arXiv:2408.15664
-
DeepSeek-V3 — technical report и официальный репозиторий
-
gpt-oss — официальный анонс и открытая реализация
-
LatentMoE — NVIDIA Research
-
Nemotron 3 Ultra — официальная страница
-
Qwen3.5-35B-A3B — официальная карточка
-
Soft MoE — arXiv:2308.00951
-
ReMoE — arXiv:2412.14711
-
SoftMoE 2026 — arXiv:2606.17952
-
Routing-Free MoE — arXiv:2604.00801
-
DeepSeek-V4 — model card
Дальше: модуль 8 рассматривает архитектуры, которые меняют уже не FFN, а сам механизм перемещения информации по последовательности: рекуррентное состояние, State Space Models и гибриды с attention.
Ландшафт сверен: 11 октября 2026 года. Численные реконструкции курса отделены от округлённых заявлений разработчиков; результаты отдельных работ сохраняют их экспериментальный протокол.