Модуль 5. Современные механизмы внимания
Курс «Modern LLMs» · редакция 2026.10.25 · источники проверены 10 октября 2026 года
В модуле 3 мы собрали Transformer, а в модуле 4 разобрались, как он учитывает порядок токенов. Теперь спросим: как сохранить внимание к длинному контексту, когда память и скорость ограничены? Для ответа нужно различать три задачи: хранить прошлые ключи и значения, вычислять взаимодействия с ними и выбирать, какие позиции вообще доступны запросу.
Перед началом. Понадобятся матричное умножение, softmax и понятие головы внимания из М3; для MLA — вращательные позиционные представления RoPE из М4. Термины, связанные с памятью GPU, введём по ходу объяснения.
Маршруты чтения
- Первый проход: §§1–2 → §4 до блока реализации → §§5–11 → §§15–19. В §7 сначала проследите, что хранится в кэше, затем прочитайте вывод формул. Ответьте на вопросы §17 и решите упражнения 1–4. После этого вы сможете объяснить, какую именно стоимость меняет каждый механизм.
- Проход с кодом: вернитесь к раскрывающимся блокам B04/B05 в §§4/6, к §§12–14 и ноутбуку. Сравните прямое вычисление с потоковым и воспроизведите ошибки маски и порядка голов. Упражнения 6–7 связывают алгебру с этими опытами.
- Справочный проход: §3 связывает внимание со статистикой; §§5, 9, 11 и 15 помогают читать новую архитектуру. GPU-проект в упражнении 5 необязателен для понимания модуля. Источники и переход к М6 находятся в конце.
1. Мотивация: что растёт вместе с контекстом
Модель обработала входной текст и генерирует следующий токен. Его запрос (query, ) сравнивается с ключами (keys, ) доступных позиций. Полученные веса смешивают значения (values, ). Голова внимания выполняет такое сопоставление в своём пространстве признаков. Число голов запросов обозначим ; число наборов ключей и значений — . Они могут различаться: несколько голов запросов способны использовать общие K/V.
Старые K/V не нужно вычислять заново: их сохраняют в KV-кэше. Для одной последовательности, одинаковых слоёв и одинаковой размерности ключа и значения один сохранённый токен занимает
где — число байтов на элемент, а множитель 2 учитывает и ключи, и значения. Например, , , , BF16 () дают 73 728 байт, то есть 72 KiB на токен. Если все слои хранят все 131 072 позиции, это 9 GiB только для K/V. Здесь байт, байт. Окна и неодинаковые слои потребуют отдельного суммирования — сделаем его в §5.
Есть и другой расход. При обработке всего входа за один проход, prefill, простая реализация строит матрицу попарных логитов размера на голову. При одна такая матрица в FP32 занимает MiB. Это временный массив; он отличается от KV-кэша, который нужен и на следующих шагах. При decode, генерации одного нового токена, запрос обычно сопоставляется с сохранёнными позициями: строка имеет длину , а не .
Эти расходы сокращают разными способами. MQA/GQA/MLA меняют формат сохраняемых K/V. FlashAttention сокращает пересылку промежуточных данных. Окна и разреженные схемы уменьшают число выбранных взаимодействий. Их можно сочетать, поэтому одного названия механизма для оценки памяти недостаточно.
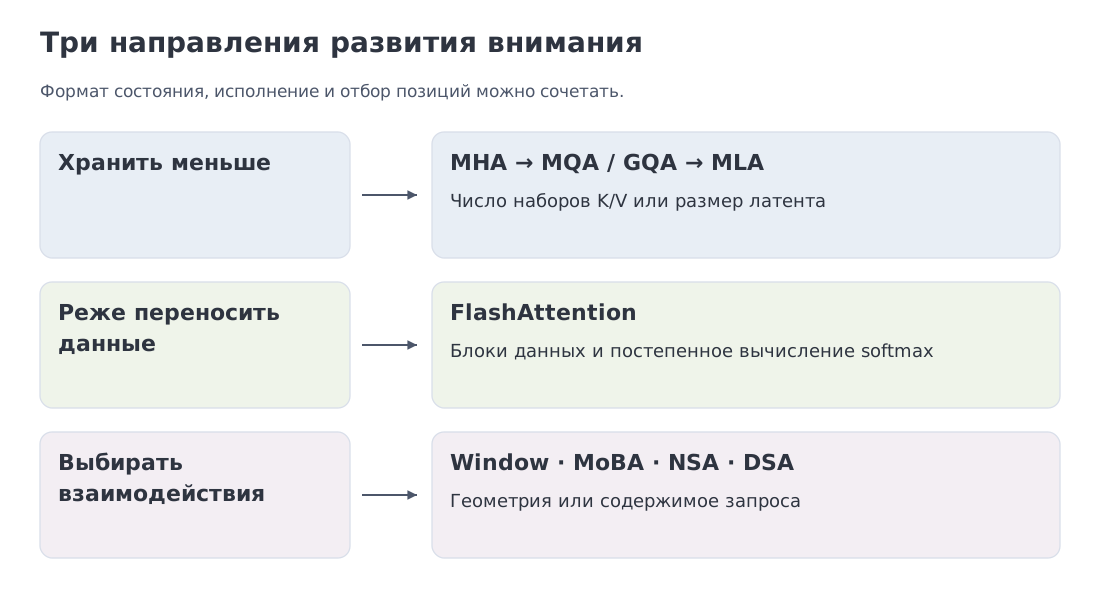 Сжатие состояния, организация вычислений и отбор позиций отвечают на разные вопросы.
2. Три направления развития внимания
MHA — Multi-Head Attention: каждой голове запроса соответствуют собственные K/V-проекции. При фиксированном это наиболее объёмный из трёх следующих форматов кэша.
MQA — Multi-Query Attention: все головы запросов используют один набор K/V. При равных остальных размерах это уменьшает кэш в раз относительно MHA, но совместное использование признаков может снижать качество.
GQA — Grouped-Query Attention: головы запросов разделены на группы, каждая со своим набором K/V. Размер группы должен быть целым. При получается MHA, при — MQA. Авторы GQA показали близкое к MHA качество при скорости, сопоставимой с MQA, в своих экспериментах с продолжением обучения. Это результат конкретной постановки, а не гарантия для любого . GQA.
MLA — Multi-head Latent Attention: кэшируется компактное промежуточное представление, общий KV-латент, и небольшая позиционная часть. Их устройство разберём в §7. DeepSeek-V2 сообщает сокращение KV-кэша на 93.3% относительно DeepSeek 67B и до 5.76× большей максимальной скорости генерации в авторском сравнении систем. Это другой базовый вариант, чем наш численный пример §5. DeepSeek-V2.
Второе направление — организация вычислений. FlashAttention обрабатывает небольшие блоки, или тайлы, в быстрой памяти ускорителя. HBM — High Bandwidth Memory — основная память GPU; SRAM — Static Random-Access Memory — меньшая быстрая память на кристалле. Алгоритм переносит в неё нужные блоки и обновляет softmax постепенно, без записи полной матрицы вероятностей в HBM. С математической точки зрения результат остаётся тем же. FlashAttention.
Третье направление — набор доступных взаимодействий. Скользящее окно оставляет близкие позиции. StreamingLLM дополнительно сохраняет несколько начальных реальных токенов; в §10 объясним, почему они важны. MoBA, NSA и DSA используют содержимое запросов и ключей для отбора блоков или токенов (§11). Отбор может сократить вычисления основного внимания, но сам по себе ещё не означает, что все невыбранные записи можно удалить из кэша: следующий запрос может выбрать их.
3. Мостик к классике: сглаживание, распределение и состояние
Этот раздел можно прочитать позже: он связывает уже знакомую операцию с классическими конструкциями, но не вводит обязательных предпосылок для следующего раздела.
Ядерное сглаживание
Оценка Надарая–Уотсона усредняет значения с весами, заданными функцией сходства :
В softmax attention такую положительную функцию задаёт для разрешённых ключей. Индекс перебирает ключи, а — их значения. Это полезная аналогия с ядерной регрессией. При этом Q/K/V обучаются совместно, а дальнейшие слои меняют смысл смеси. Слово «ядро» здесь означает функцию сходства; вычислительное GPU-ядро в §8 — программа, исполняющая операцию.
Распределение Гиббса
Для немасштабированных оценок и температуры
имеет форму распределения Гиббса. При физической записи энергия равна . Выбор воспроизводит масштаб SDPA: он мотивирован дисперсией скалярных произведений (§4). Если уже поделены на , повторно делить их на тот же множитель не нужно.
Состояние для продолжения вычисления
При фиксированных весах и правилах позиций KV-кэш хранит прошлые признаки, необходимые для следующего шага внимания. MHA хранит K/V по головам, GQA — по группам, MLA — общий латент с позиционной частью. Рекуррентные механизмы и модели пространства состояний могут вместо списка по позициям поддерживать состояние фиксированного размера; к ним вернёмся в М8. Для полного декодирования дополнительно нужны текущий токен, позиции и правила генерации.
4. Формализм: SDPA, маски и масштаб логитов
SDPA — Scaled Dot-Product Attention определяется как
Здесь , , , а — аддитивная маска. Нулевое значение разрешает пару, запрещает её.
Softmax нормирует каждую строку, то есть распределяет вес одного запроса между ключами. Каузальность сравнивает позиции токенов: . Только при одинаковом начале Q и K это сокращается до . Окно ширины , включая текущую позицию, добавляет условие .
Например, запрос в позиции 5 должен видеть ключи 0–5. Маска tril(ones(1, 6)) оставит только ключ 0: номер строки принят за позицию токена. Для блока запросов после префикса длины берите . В PyTorch SDPA прямоугольная маска при is_causal=True выровнена по верхнему левому углу; для кэшированного префикса здесь передаём явную маску и is_causal=False. Булева маска SDPA использует True = разрешено; это соглашение отличается от key_padding_mask в MultiheadAttention. При проверке без случайного отключения весов задаём dropout_p=0.0. Контракт PyTorch.
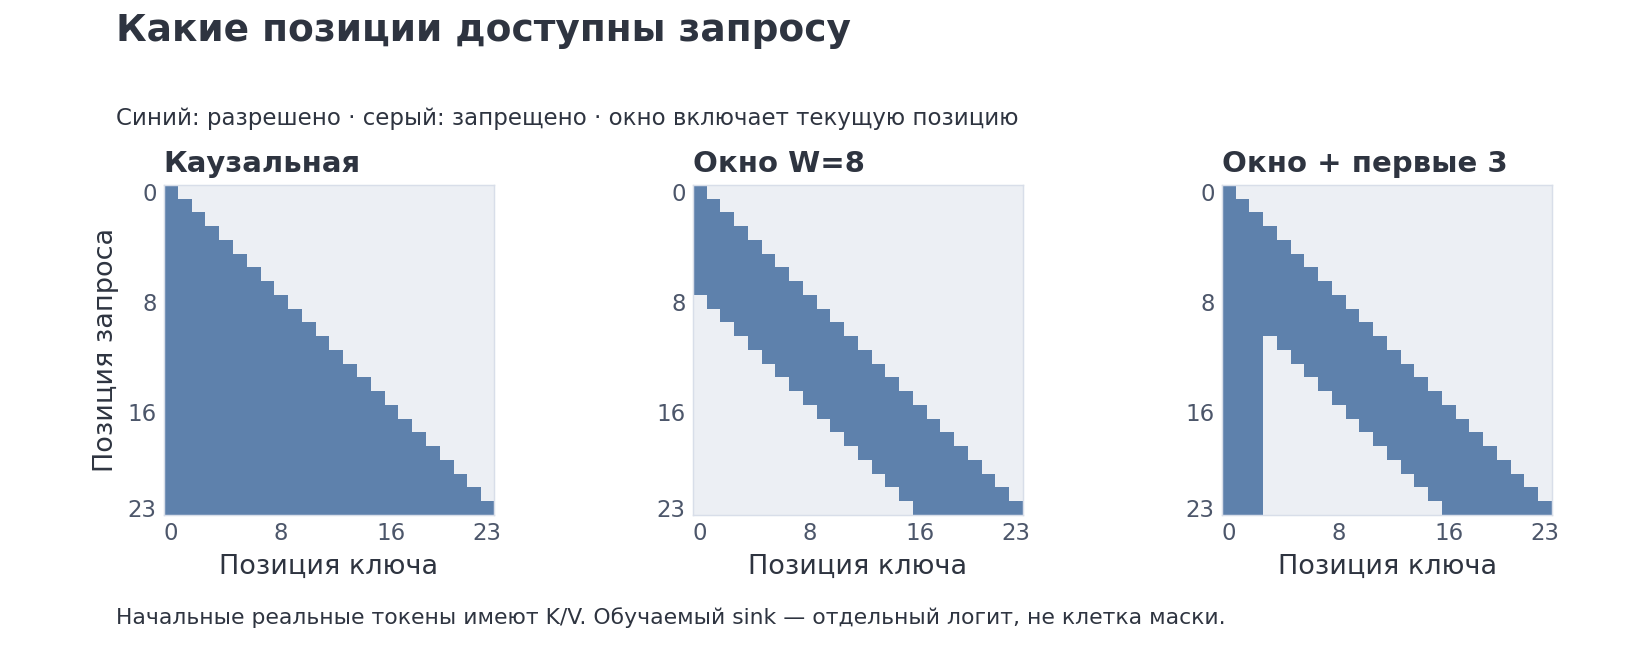 Строки соответствуют запросам, столбцы — ключам. Начальные реальные токены добавляют видимые позиции; обучаемый sink из §10 не является такой позицией.
Почему делим на ? При идеализированных независимых компонентах с нулевым средним и единичной дисперсией
Типичный масштаб логита растёт как . Деление возвращает его к порядку единицы и уменьшает риск чрезмерного насыщения softmax. В обученной сети независимость уже не обязана выполняться, поэтому это мотивационный расчёт, а не точное описание всех логитов.
Полностью замаскированная строка требует явной политики. Многие стабильные реализации softmax сначала вычитают максимум. Для строки из одних выражение уже неопределено и может породить NaN. Учебная реализация по умолчанию сообщает ошибку; для padding-строк допускает явно заданный нулевой результат. В §10 мы добавим отдельный конечный логит с нулевым значением: он также делает такую нормировку определённой.
Второй проход: NumPy → PyTorch → API
NumPy → PyTorch · B04 — SDPA строка за строкой
Здесь Q/K/V уже проверены: это конечные вещественные массивы с непустыми осями и совместимыми формами [..., T_q, D], [..., T_k, D], [..., T_k, D_v]. Точки обозначают совместимые ведущие оси, например батч и головы. Для сравнения с API используем один тип данных и одно устройство; булева маска находится на том же устройстве и расширяется до формы логитов. Пример намеренно возвращает ноль для пустой строки. Выбор error/zero показан отдельно в §12. NumPy раскрывает логиты, маску, softmax и умножение на V; PyTorch API может выбрать оптимизированное ядро.
import math
import numpy as np
import torch
import torch.nn.functional as F
1. Явная NumPy-реализация
def numpy_sdpa_explicit(
    q: np.ndarray,
    k: np.ndarray,
    v: np.ndarray,
    *,
    allowed_mask: np.ndarray | None = None,
) -> np.ndarray:
    output_dtype = np.result_type(q.dtype, k.dtype, v.dtype)
    if output_dtype.kind not in "fc":
        output_dtype = np.dtype(np.float64)
    work_dtype = np.result_type(output_dtype, np.float32)
    q, k, v = (x.astype(work_dtype, copy=False) for x in (q, k, v))
    scale = 1.0 / math.sqrt(q.shape[-1])
    scores = np.matmul(q, np.swapaxes(k, -1, -2)) * scale

    if allowed_mask is None:
        row_has_key = np.ones_like(scores[..., :1], dtype=bool)
    else:
        mask = np.broadcast_to(np.asarray(allowed_mask, dtype=bool), scores.shape)
        row_has_key = mask.any(axis=-1, keepdims=True)
        scores = np.where(mask, scores, -np.inf)

    safe_scores = np.where(row_has_key, scores, 0.0)
    shifted = safe_scores - safe_scores.max(axis=-1, keepdims=True)
    exp = np.exp(shifted)
    weights = exp / exp.sum(axis=-1, keepdims=True)
    weights = np.where(row_has_key, weights, 0.0)
    return np.matmul(weights, v).astype(output_dtype, copy=False)
В NumPy видны все стадии: , масштаб , расширение маски до нужной формы, softmax по оси ключей и смешивание . row_has_key задаёт нулевой выход полностью закрытой строки. Входы FP16 повышаются до FP32 для вычислений, затем выход возвращается в исходный формат. Стандартный NumPy не предоставляет встроенный BF16; этот тип проверяется в PyTorch-варианте.
2. Та же математика явными операциями PyTorch
def torch_sdpa_explicit(
    q: torch.Tensor,
    k: torch.Tensor,
    v: torch.Tensor,
    *,
    allowed_mask: torch.Tensor | None = None,
) -> torch.Tensor:
    output_dtype = q.dtype
    work_dtype = torch.float32 if q.dtype in (torch.float16, torch.bfloat16) else q.dtype
    q, k, v = (x.to(work_dtype) for x in (q, k, v))
    scale = 1.0 / math.sqrt(q.shape[-1])
    scores = q @ k.transpose(-2, -1) * scale

    if allowed_mask is None:
        row_has_key = torch.ones_like(scores[..., :1], dtype=torch.bool)
    else:
        mask = torch.broadcast_to(allowed_mask.to(torch.bool), scores.shape)
        row_has_key = mask.any(dim=-1, keepdim=True)
        scores = scores.masked_fill(~mask, -torch.inf)

    safe_scores = torch.where(row_has_key, scores, torch.zeros_like(scores))
    weights = torch.softmax(safe_scores, dim=-1)
    weights = torch.where(row_has_key, weights, torch.zeros_like(weights))
    return (weights @ v).to(output_dtype)
Tensor.transpose, dim=-1 и masked_fill выражают ту же цепочку с поддержкой autograd. Входы FP16/BF16 переводятся в FP32 до скалярных произведений; выход возвращается в тип Q. Устройство остаётся общим для всех тензоров.
3. Оптимизированный или библиотечный PyTorch API
def torch_sdpa_optimized(
    q: torch.Tensor,
    k: torch.Tensor,
    v: torch.Tensor,
    *,
    allowed_mask: torch.Tensor | None = None,
    dropout_p: float = 0.0,
) -> torch.Tensor:
    return F.scaled_dot_product_attention(
        q,
        k,
        v,
        attn_mask=allowed_mask,
        dropout_p=dropout_p,
    )
Однострочный API передаёт тот же оператор диспетчеру PyTorch, который может выбрать math-, memory-efficient-, FlashAttention- или другой доступный backend.
| Аспект | NumPy | PyTorch |
|---|---|---|
| Транспонирование K | np.swapaxes | Tensor.transpose |
| Ось softmax | axis=-1 | dim=-1 |
| Булева маска | задаём явно | в API True означает «разрешено» |
| Пустая строка | нулевой выход — политика этого примера | поведение API проверяется тестом |
| Dropout | нет | в API нужен явный dropout_p=0.0 при оценке |
| Backend | последовательность NumPy-операций | eager или fused kernel |
Исполняемая проверка эквивалентности и граничных случаев
rng = np.random.default_rng(4)
q_np = rng.standard_normal((1, 2, 4, 8))
k_np = rng.standard_normal((1, 2, 4, 8))
v_np = rng.standard_normal((1, 2, 4, 6))
mask_np = np.tril(np.ones((4, 4), dtype=bool))

np_out = numpy_sdpa_explicit(q_np, k_np, v_np, allowed_mask=mask_np)
q = torch.tensor(q_np, dtype=torch.float64, requires_grad=True)
k = torch.tensor(k_np, dtype=torch.float64, requires_grad=True)
v = torch.tensor(v_np, dtype=torch.float64, requires_grad=True)
mask = torch.tensor(mask_np)
explicit_out = torch_sdpa_explicit(q, k, v, allowed_mask=mask)
api_out = torch_sdpa_optimized(q, k, v, allowed_mask=mask, dropout_p=0.0)

torch.testing.assert_close(explicit_out, torch.from_numpy(np_out), rtol=1e-10, atol=1e-10)
torch.testing.assert_close(api_out, explicit_out, rtol=1e-10, atol=1e-10)

mask_np[0] = False
np_empty = numpy_sdpa_explicit(q_np, k_np, v_np, allowed_mask=mask_np)
t_empty = torch_sdpa_explicit(q, k, v, allowed_mask=torch.tensor(mask_np))
api_empty = torch_sdpa_optimized(q, k, v, allowed_mask=torch.tensor(mask_np), dropout_p=0.0)
np.testing.assert_array_equal(np_empty[..., 0, :], 0.0)
torch.testing.assert_close(t_empty[..., 0, :], torch.zeros_like(t_empty[..., 0, :]))
torch.testing.assert_close(api_empty, t_empty, rtol=1e-10, atol=1e-10)

grads_explicit = torch.autograd.grad(explicit_out.square().sum(), (q, k, v), retain_graph=True)
grads_api = torch.autograd.grad(api_out.square().sum(), (q, k, v), retain_graph=True)
for ge, ga in zip(grads_explicit, grads_api):
    torch.testing.assert_close(ge, ga, rtol=1e-9, atol=1e-10)
explicit_out.sum().backward()
assert all(t.grad is not None and torch.isfinite(t.grad).all() for t in (q, k, v))
print("B04 explicit NumPy / explicit PyTorch / optimized API: PASS")
Полный исполняемый файл: m05_attention_bridges.py
Официальный контракт: PyTorch scaled_dot_product_attention.
5. Решённый пример: MHA, MQA, GQA, MLA и гибридная схема
Начнём с одной модели и изменим только число KV-голов. Для 36 слоёв, , и bf16:
| Схема | Размер группы | Кэш на токен, если все слои полные | |
|---|---|---|---|
| MHA | 64 | 1 | 576 KiB |
| GQA | 8 | 8 | 72 KiB |
| MQA | 1 | 64 | 9 KiB |
На 131 072 токенах это соответственно 72 GiB, 9 GiB и 1.125 GiB. Значение MHA относится к гипотетической модели той же глубины и размерности голов. В таблице считаются только K/V одной последовательности: веса, временные массивы и служебные расходы не включены.
Теперь вернём фактическое расписание gpt-oss. Один GQA-слой добавляет
Если исполняющая система ограничивает кэш каждого локального слоя последними 128 позициями, полные слои занимают GiB, локальные — MiB. Итого 4.50439453125 GiB. Сама оконная маска не гарантирует освобождения старых записей.
Общая формула для обычных K/V, пакета из одинаковых по длине последовательностей и разных слоёв:
Здесь — число сохраняемых позиций: для полного слоя и для ограниченного оконного кэша. Для разных длин суммируйте по последовательностям. Формула считает содержимое массивов, без выравнивания, страниц, репликации и параметров квантования. У MLA другой формат состояния и своя формула.
MLA использует другую геометрию. В учебном DeepSeek-подобном сценарии 61 слой хранит латент и отдельную RoPE-компоненту 64:
Сравним с выбранным базовым вариантом MHA: 128 голов, :
Отношение объёмов этих массивов равно
Это не тот же показатель, что опубликованное сокращение 93.3% относительно DeepSeek 67B. Первый — арифметика двух заданных форматов хранения; второй — системное сравнение авторов модели.
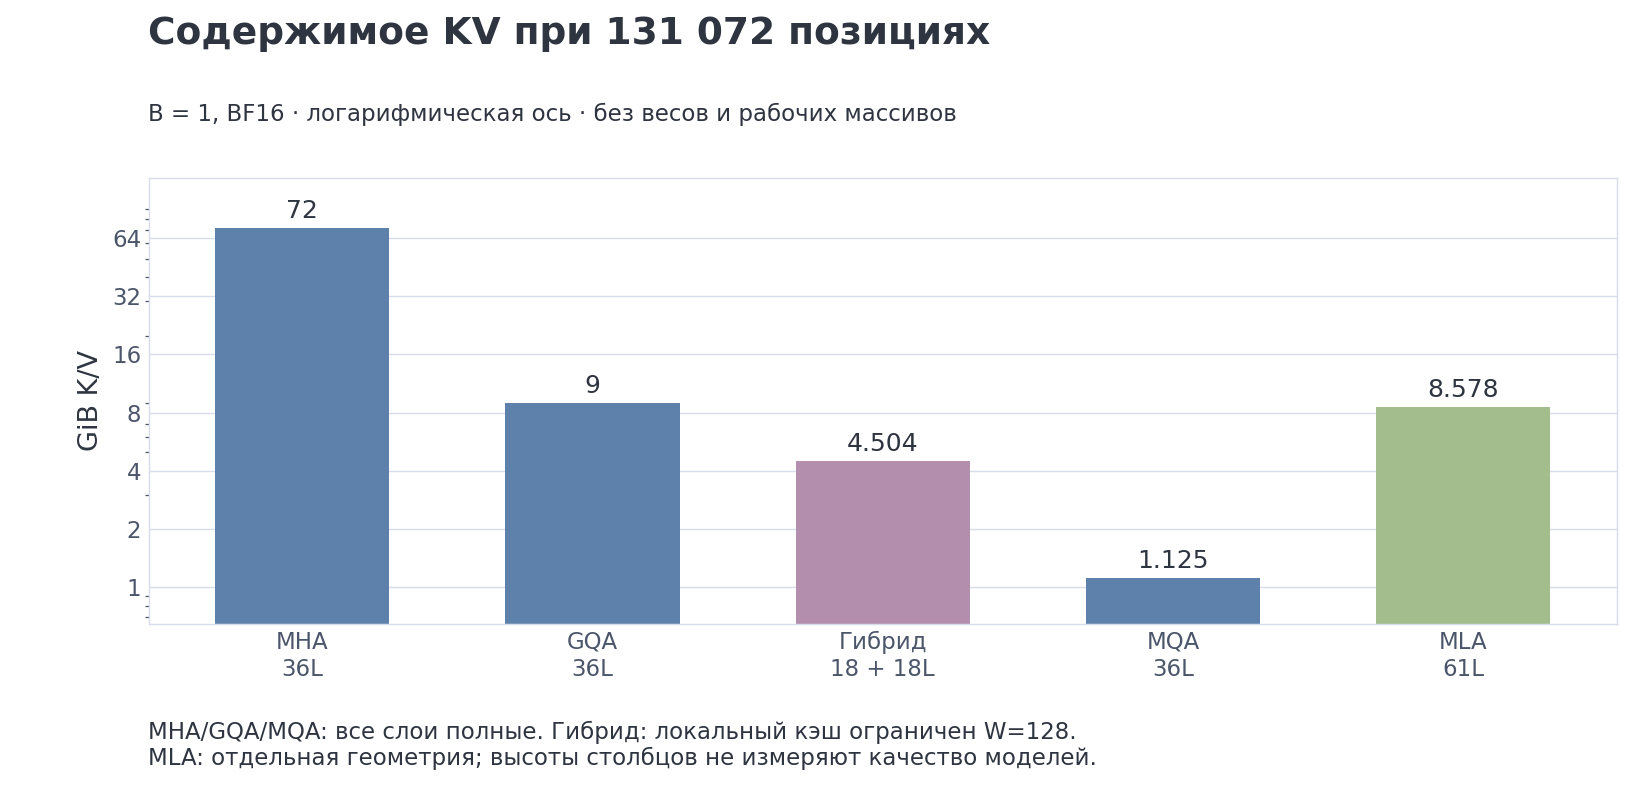 Содержимое KV при 131 072 позициях: три полные схемы одинаковой глубины, гибрид с ограниченным оконным кэшем и отдельный пример MLA.
6. MQA и GQA: как запросы делят ключи и значения
В MHA каждая голова запроса имеет собственные K/V. В MQA все запросы используют один набор K/V. В GQA голов запросов разделены на равных групп; требуется .
Для , размер группы . Голова запроса с индексом использует набор K/V с индексом
Выход головы равен
Поэтому эталонная реализация может повторить каждый набор K/V восемь раз подряд: [KV0, …, KV0, KV1, …, KV1]. np.repeat и repeat_interleave сохраняют этот порядок. tile чередует наборы и меняет соответствие голов, хотя форма массива остаётся правильной. Проверка §18 воспроизводит эту ошибку.
Математически GQA совпадает с MHA с таким повторением K/V. Побитовое равенство разных вычислительных ядер не требуется: порядок операций с плавающей точкой может различаться. Само повторение удобно для проверки, но создаёт лишние массивы; эффективное ядро использует общие K/V без такого копирования.
Меньшее уменьшает кэш и трафик, большее оставляет больше независимых признаков K/V. Качество определяется обучением и задачей. Размер группы восемь — свойство примера, а не универсальный оптимум.
Второй проход: NumPy → PyTorch → API
NumPy → PyTorch · B05 — GQA: повторение K/V и enable_gqa
В этом блоке фиксированы четыре оси: Q [B,H_q,T_q,D], K [B,H_kv,T_k,D], V [B,H_kv,T_k,D_v]. Ось голов имеет индекс 1; H_q кратно положительному H_kv. Конечность значений, общий тип/устройство и булева маска предполагаются проверенными, как в B04. NumPy повторяет K/V-головы явно; PyTorch выражает группировку через enable_gqa=True, если выбранная реализация его поддерживает. Формат §12 с объединёнными головами [T,H*D] — отдельный интерфейс; перед вызовом нужны reshape и перестановка осей.
import numpy as np
import torch
import torch.nn.functional as F
1. Явная NumPy-реализация
def numpy_gqa_explicit(
    q: np.ndarray,
    k: np.ndarray,
    v: np.ndarray,
    *,
    allowed_mask: np.ndarray | None = None,
) -> np.ndarray:
    if q.shape[1] % k.shape[1]:
        raise ValueError("Hq must be divisible by Hkv")
    group = q.shape[1] // k.shape[1]
    k_repeated = np.repeat(k, group, axis=1)
    v_repeated = np.repeat(v, group, axis=1)
    return numpy_sdpa_explicit(q, k_repeated, v_repeated, allowed_mask=allowed_mask)
GQA не меняет формулу attention. NumPy явно повторяет каждую K/V-голову g = H_q/H_{kv} раз, после чего использует уже разобранный SDPA.
2. Та же математика явными операциями PyTorch
def torch_gqa_explicit(
    q: torch.Tensor,
    k: torch.Tensor,
    v: torch.Tensor,
    *,
    allowed_mask: torch.Tensor | None = None,
) -> torch.Tensor:
    if q.shape[1] % k.shape[1]:
        raise ValueError("Hq must be divisible by Hkv")
    group = q.shape[1] // k.shape[1]
    k_repeated = k.repeat_interleave(group, dim=1)
    v_repeated = v.repeat_interleave(group, dim=1)
    return torch_sdpa_explicit(q, k_repeated, v_repeated, allowed_mask=allowed_mask)
Явный PyTorch-вариант делает то же через repeat_interleave. Это полезный эталон для форм и порядка голов, но он материализует повторённые K/V.
3. Оптимизированный или библиотечный PyTorch API
def torch_gqa_optimized(
    q: torch.Tensor,
    k: torch.Tensor,
    v: torch.Tensor,
    *,
    allowed_mask: torch.Tensor | None = None,
    dropout_p: float = 0.0,
) -> torch.Tensor:
    if q.shape[1] % k.shape[1]:
        raise ValueError("Hq must be divisible by Hkv")
    return F.scaled_dot_product_attention(
        q,
        k,
        v,
        attn_mask=allowed_mask,
        dropout_p=dropout_p,
        enable_gqa=True,
    )
enable_gqa=True выражает группировку без явного повторения в пользовательском коде; доступность и эффективность конкретного пути зависят от backend.
| Аспект | NumPy | PyTorch |
|---|---|---|
| Условие | Hq % Hkv == 0 | то же |
| K/V | np.repeat(..., axis=1) | repeat_interleave(..., dim=1) |
| Память эталона | повторённые массивы | повторённые тензоры |
| Оптимизированный путь | нет | enable_gqa=True |
| Проверка | совпадение с MHA после повтора | явный путь ↔ API |
Исполняемая проверка эквивалентности и граничных случаев
rng = np.random.default_rng(5)
q_np = rng.standard_normal((1, 4, 3, 8))
k_np = rng.standard_normal((1, 2, 3, 8))
v_np = rng.standard_normal((1, 2, 3, 7))
np_out = numpy_gqa_explicit(q_np, k_np, v_np)
q, k, v = (torch.tensor(a, dtype=torch.float64, requires_grad=True) for a in (q_np, k_np, v_np))
explicit = torch_gqa_explicit(q, k, v)
api = torch_gqa_optimized(q, k, v, dropout_p=0.0)
torch.testing.assert_close(explicit, torch.from_numpy(np_out), rtol=1e-10, atol=1e-10)
torch.testing.assert_close(api, explicit, rtol=1e-10, atol=1e-10)
for ge, ga in zip(torch.autograd.grad(explicit.square().sum(), (q,k,v)),
                  torch.autograd.grad(api.square().sum(), (q,k,v))):
    torch.testing.assert_close(ge, ga, rtol=1e-9, atol=1e-10)
print("B05 explicit repetition / enable_gqa: PASS")
Полный исполняемый файл: m05_attention_bridges.py
Официальный контракт: PyTorch SDPA GQA.
7. MLA: хранить общий латент и переносить линейные проекции
В MLA — Multi-head Latent Attention вместо развернутых K/V сохраняется компактный вектор , общий для голов. Слово латент здесь означает промежуточное представление, из которого линейные проекции получают признаки ключей и значений. Рядом хранится небольшая позиционная часть. Разберём, почему полный K/V-кэш можно не восстанавливать при каждом обращении.
Для одной головы запишем и , где , , . Тогда
Мы перенесли проекцию на сторону запроса: один преобразованный запрос сравнивается со всеми сохранёнными латентами. Получив веса , аналогично переставим операции со значениями:
Если далее применяется выходная проекция , произведение можно заранее объединить. Для нескольких голов рассуждение повторяется с их собственными , и соответствующими частями выходной проекции. Эту перестановку называют поглощением матриц (matrix absorption). Число операций не становится нулевым; меняются размерность вычислений и хранимый объект.
Почему нужна отдельная позиционная ветвь? RoPE линейно для фиксированной позиции. Но если вращать восстановленные ключи, при позициях запроса и ключа получим
Теперь эффективный запрос зависит от . Один запрос нельзя один раз преобразовать и использовать для всех ключей, как в предыдущей формуле. Сравнивать и было бы некорректно ещё и по размерам: обычно прямоугольная.
В DeepSeek-V2 RoPE применяется в отдельной небольшой ветви; логит складывается из содержательной и позиционной частей. Поглощение остаётся доступным для содержательной части, а позиционный ключ хранится рядом с латентом. В ноутбуке проверяются обе части логита и выход после проекции. Это алгебраическое равенство; качество обученной модели проверяется отдельными экспериментами. DeepSeek-V2, §2.1.
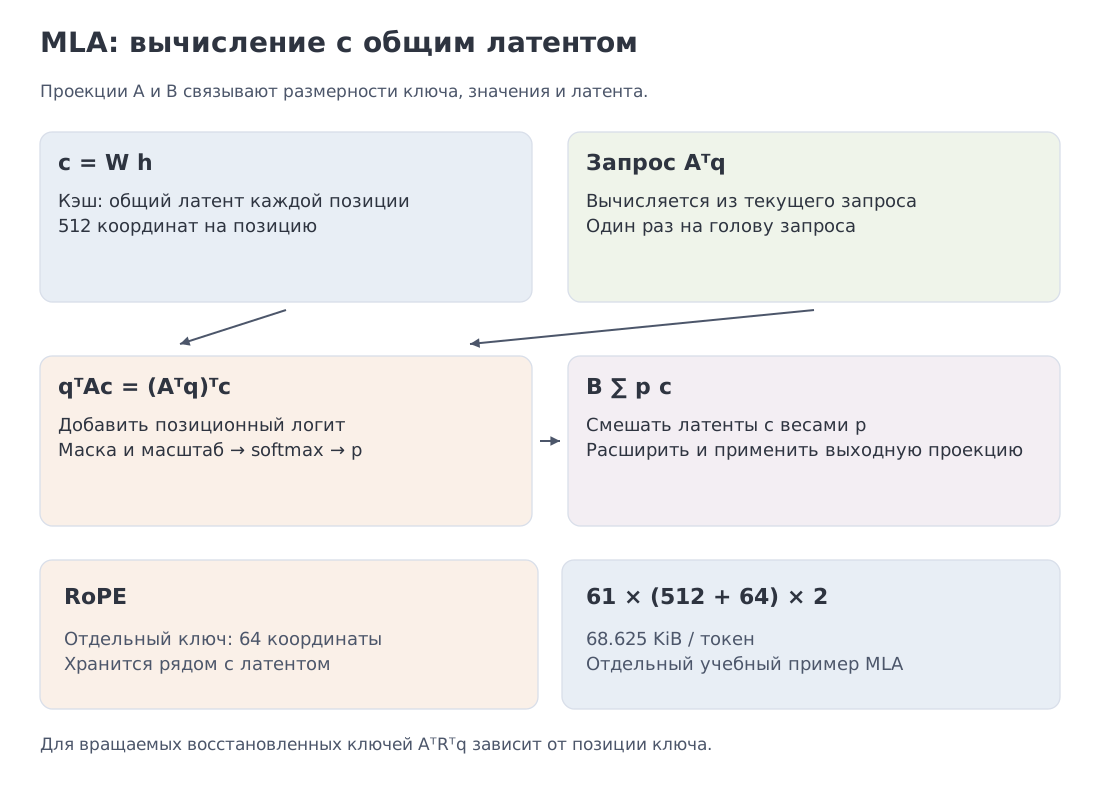 Проекции ключей переносятся к запросу, проекции значений — после взвешивания. Позиционная ветвь остаётся отдельной.
8. FlashAttention: вычислять блоками и реже обращаться к памяти
Здесь для оценки сложности используем — одинаковую ширину ключей и значений. Обозначим матрицу вероятностей через .
Стандартная реализация часто разбивается на три шага:
- вычислить ;
- записать и вероятности softmax в HBM;
- прочитать их и вычислить .
Математика плотного внимания остаётся квадратичной по длине. Проблема в том, что большие промежуточные матрицы перемещаются между HBM и быстрой SRAM на кристалле.
FlashAttention разбивает Q, K и V на тайлы. Для каждого блока запросов он последовательно проходит по блокам ключей, обновляя три состояния строки:
- текущий максимум ;
- нормировочную сумму ;
- взвешенный числитель или накопленный вектор .
Если новый блок содержит больший максимум, старые и пересчитываются через . В конце выход равен . Полная матрица вероятностей не записывается в HBM.
Для одного запроса пусть — логиты нового блока разрешённых ключей, а — их значения. Обновление состояния имеет вид:
Начальное состояние: , , . При первом непустом блоке положим ; полностью закрытый блок пропускаем. Если все блоки пусты, применяется явно выбранная политика §4. Это исключает неопределённость . В §18 и ноутбуке есть пошаговый численный пример.
Линейная память требует учитывать все создаваемые массивы. Если заранее построить плотную маску , она сохранит квадратичный расход. Наш потоковый код может создавать каузальную маску непосредственно для текущего блока. Учебный код на CPU проверяет математику. Скорость GPU-реализации FlashAttention он не воспроизводит.
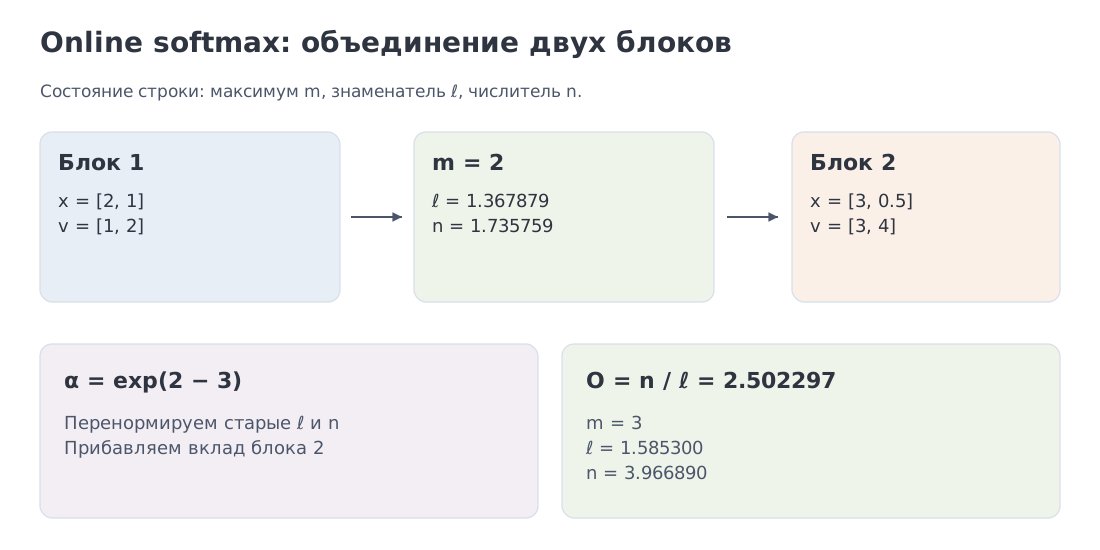 Online softmax сохраняет максимум, нормировочную сумму и числитель; новый тайл корректно перенормирует прежнее состояние.
Что именно улучшается?
| Свойство | Обычная материализующая реализация | FlashAttention |
|---|---|---|
| Плотные FLOPs | ||
| Полная матрица в HBM | да | нет |
| Дополнительная память | квадратичная | линейная по |
| HBM↔SRAM обмен | высокий | меньше; зависит от SRAM и размера блока |
Объём обмена с памятью (IO) нельзя универсально свести к . В аналитической модели FlashAttention число HBM-доступов зависит от ёмкости быстрой памяти и размеров тайлов; работа доказывает улучшение и оптимальность в определённом диапазоне , а не исчезновение квадратичной арифметики.
FlashAttention называется точным, потому что не отбрасывает позиции и реализует ту же математическую функцию. Конкретные вычислительные ядра могут не совпадать побитово с наивным кодом из-за иного порядка операций, смешанной точности и низкоуровневых приближений.
FlashAttention-4 для B200 сообщает до 1613 TFLOP/s в BF16, около 71% теоретического пика, до 1.3× относительно cuDNN 9.13 и до 2.7× относительно Triton в исследованных конфигурациях. Это результаты авторов на заданном оборудовании, а не коэффициент для любой модели. FlashAttention-4.
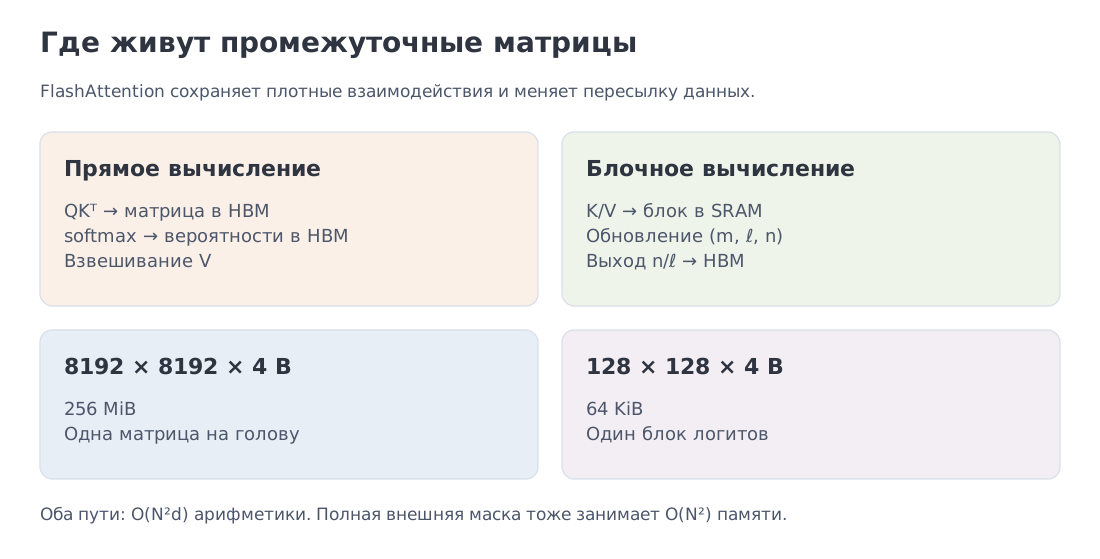 Тайлинг меняет маршрут данных: полная матрица не уходит в HBM, но арифметика плотного внимания остаётся квадратичной.
9. Скользящее окно и сочетание локальных и полных слоёв
SWA — Sliding Window Attention, внимание со скользящим окном, разрешает каждому запросу видеть последние ключей, включая текущую позицию. При генерации локальному слою достаточно K/V окна. Память хранения перестаёт расти после токенов, если реализация освобождает или переиспользует старые записи.
Сколько информации может пройти через стек? После одного локального слоя токен зависит от окна. После последовательных локальных слоёв с одинаковым окном, без пропусков позиций, максимальное расстояние зависимости равно : в каждом слое доступны текущая и предыдущих позиций. Это верхняя граница достижимости, а не гарантия, что конкретный факт сохранится без искажений. Глубокая цепочка локальных передач отличается от прямого глобального взаимодействия.
Mistral-7B-v0.1 использует окно 4096 во всех слоях. Версия здесь существенна: более поздние Mistral нельзя автоматически считать такой же архитектурой. Гибридные схемы добавляют полные слои, создающие прямые связи между дальними позициями.
| Семейство | Схема |
|---|---|
| Mistral-7B-v0.1 | окно 4096 во всех слоях декодера |
| gpt-oss-120b | 18 оконных слоёв с W=128 и 18 полных, чередование 1:1 |
| Gemma 2 | чередование окна 4096 и полного внимания в контексте 8192 |
| Gemma 4 | локальные и полные слои; последний слой полный, расписание зависит от варианта |
Для оценки KV-кэша нужны расписание слоёв и политика хранения, а не только поле sliding_window. При ограничении локального кэша окном получаем расчёт §5; реальное выделение памяти проверяем в конкретной системе.
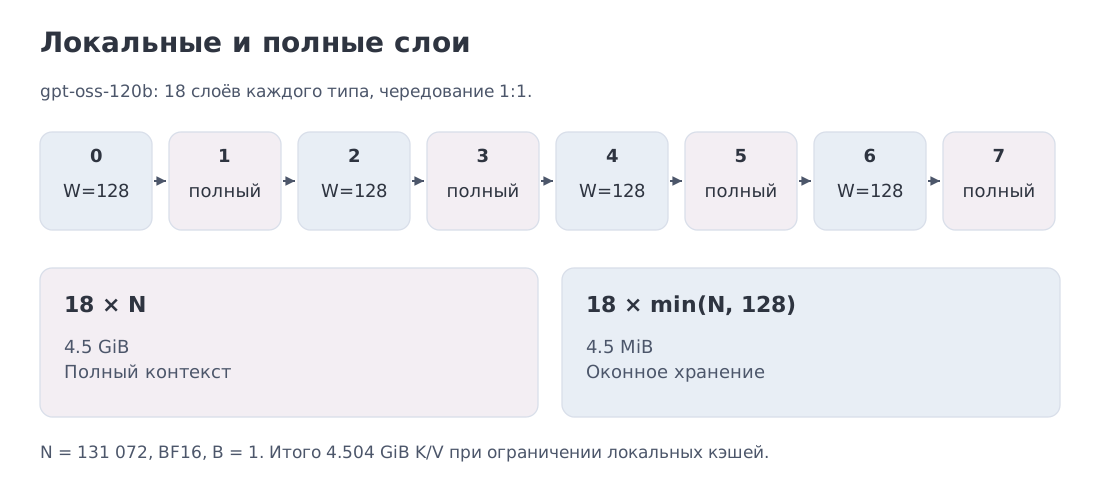 Локальные и полные слои создают разные пути зависимости и требуют разного числа сохраняемых позиций.
10. Два разных attention sink
Термин attention sink используется по меньшей мере для двух связанных, но разных механизмов.
Ранние реальные токены
StreamingLLM обнаружила, что модели часто направляют заметную массу внимания на первые позиции, даже если они не несут текущей семантической информации. Удаление этих K/V при простом переходе к окну может нарушить распределение внимания. Практическое решение — хранить несколько начальных реальных токенов вместе с последним окном. Это наблюдаемое поведение существующей модели.
Обучаемый логит sink
В gpt-oss у каждой головы запроса есть обучаемый скаляр . Он добавляется как дополнительный столбец матрицы логитов. Затем softmax вычисляется по токенам и sink-слоту, после чего столбец sink удаляется перед умножением на .
Если все 128 логитов токенов равны нулю, доля sink равна
При получаем примерно 0.78%, 5.46% и 53.69%. Сумма весов реальных токенов может быть меньше единицы: часть вероятности приходится на sink, значение которого равно нулю.
Обучаемый sink задаёт постоянный относительно запроса логит. Обычный фиксированный ключ дал бы , меняющийся вместе с . Нулевой ключ даёт константу 0, но произвольный требует отдельного смещения или дополнительной постоянной координаты. Значение sink равно нулевому вектору: он участвует в знаменателе, но не в числителе выхода.
Проверка понимания: если прибавить константу только к логитам токенов, сохранив , выход изменится. Инвариантность softmax к сдвигу работает, только если одинаково сдвинуть все логиты, включая sink.
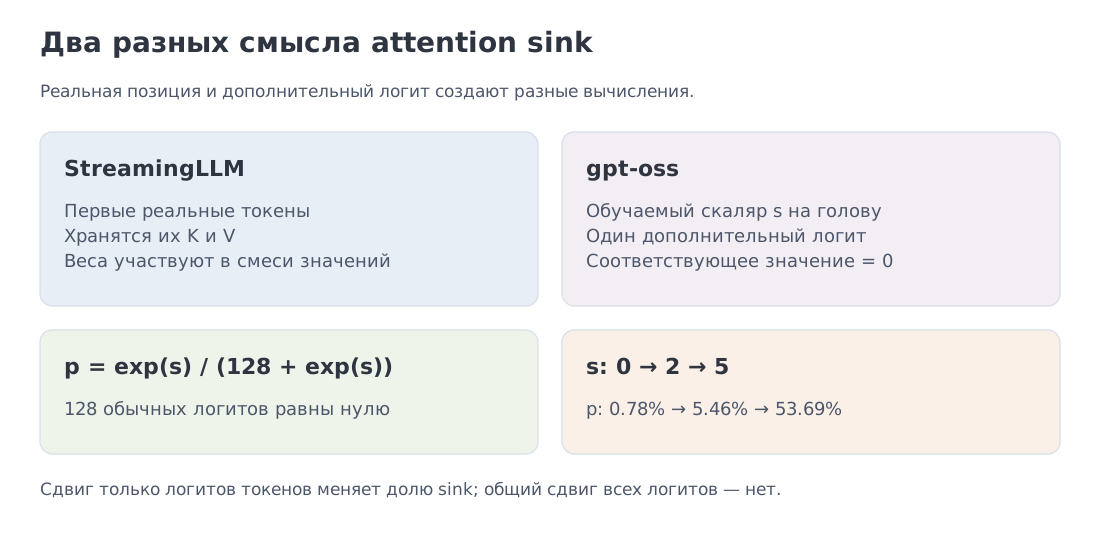 StreamingLLM сохраняет K/V начальных реальных токенов; gpt-oss добавляет обучаемый слот логита без вклада значения.
11. Разреженное внимание: как выбрать часть позиций
Окно выбирает ключи по расстоянию до запроса. Отбор по содержанию оценивает их полезность по признакам запроса и ключей. Если выбрано множество , основной механизм вычисляет
Это точное внимание по выбранному подмножеству, но обычно другой результат, чем внимание по всем разрешённым позициям. Чем дешевле отбор, тем больше риск пропустить нужную информацию.
| Механизм | Что отбирается | Правило и условия |
|---|---|---|
| Фиксированная разреженная маска | блоки или позиции | Заданный шаблон; качество зависит от модели и задачи |
| MoBA — Mixture of Block Attention | блоки K/V | Скалярное произведение запроса со средним ключом блока; выбор лучших блоков |
| NSA — Native Sparse Attention | сжатые представления, выбранные блоки, локальное окно | Совместно обучаемые ветви с учётом аппаратного исполнения |
| DSA — DeepSeek Sparse Attention | токены | Обучаемый лёгкий индексатор, затем выбор лучших позиций, top-k |
В MoBA нет отдельного набора обучаемых параметров маршрутизатора: оценка блока использует уже полученные Q/K. Их проекции обучаются вместе с моделью. Текущий блок включают обязательно и маскируют каузально; будущие блоки исключают. Такая конструкция не гарантирует сохранения качества при произвольной замене внимания в готовой модели: в статье исследуются обучение и гибридные режимы. MoBA, §2.2.
NSA объединяет сжатие, выбор блоков и локальное окно. Сжатое представление даёт грубый обзор, выбранные блоки — подробности, окно — близкий контекст. Ветви обучаются совместно; опубликованные результаты относятся к авторским моделям и вычислительным ядрам. NSA.
DSA появилась в DeepSeek-V3.2-Exp 29 сентября 2025 года и вошла в DeepSeek-V3.2. Индексатор — небольшой механизм оценки релевантности, который предлагает позиции для более дорогого основного внимания. Нужно учитывать и его вычисления, память и обучение. Перебор всех ключей индексатором сам может оставаться квадратичным по длине при prefill, пусть и с меньшей стоимостью пары. V3.2, технический отчёт.
Для одного запроса, ключей, размерности основного сопоставления и индексатора , простая двухэтапная оценка числа скалярных умножений равна . Относительно это , а не только . Здесь ещё не учтены проекции индексатора, top-k, softmax, смешивание значений и пересылка данных. В проектном демо мы измеряем отдельно попадание нужного ключа в список, итоговый поиск и ошибку выхода внимания.
К 10 октября 2026 года направление включает и сжатие нескольких позиций в одну запись. DeepSeek-V4 сочетает CSA — Compressed Sparse Attention и HCA — Heavily Compressed Attention. В отчёте DeepSeek-V4.1-Flash описаны CSA2, повторное использование KV между слоями и FP4-кэш. Это новые сочетания формата состояния, отбора и размещения памяти; числа из нашего MLA-примера на них автоматически не переносятся. Заявления о субквадратичности следует проверять для всей цепочки, а не одного её этапа. V4, карточка разработчика, V4.1-Flash, отчёт.
12. Первый уровень реализации: прозрачный NumPy
Реализация ниже использует аддитивную маску: 0 разрешает пару, -inf запрещает. Это малый проверочный вариант с явными формами и политикой пустых строк. В §13 и ноутбуке добавляются потоковый путь и опыты MLA.
Открыть код SDPA и GQA
import math
from typing import Literal
import numpy as np

EmptyRowPolicy = Literal["error", "zero"]

def make_mask(n: int, window: int | None = None, n_sink: int = 0) -> np.ndarray:
    """Return an additive causal mask of shape [n, n].

    Allowed entries are 0 and forbidden entries are -inf. `window` keeps only the
    latest `window` causal keys; `n_sink` preserves initial real positions as StreamingLLM-style anchors.
    """
    if isinstance(n, bool) or not isinstance(n, int) or n <= 0:
        raise ValueError("n must be positive")
    if window is not None and (isinstance(window, bool) or not isinstance(window, int) or window <= 0):
        raise ValueError("window must be positive")
    if isinstance(n_sink, bool) or not isinstance(n_sink, int) or not 0 <= n_sink <= n:
        raise ValueError("n_sink must satisfy 0 <= n_sink <= n")
    if n_sink and window is None:
        raise ValueError("n_sink is meaningful only together with a finite window")

    query_pos = np.arange(n)[:, None]
    key_pos = np.arange(n)[None, :]
    allowed = key_pos <= query_pos
    if window is not None:
        allowed &= (query_pos - key_pos) < window
        allowed |= (key_pos < n_sink) & (key_pos <= query_pos)
    return np.where(allowed, 0.0, -np.inf)

def sdpa(
    Q: np.ndarray,
    K: np.ndarray,
    V: np.ndarray,
    mask: np.ndarray | None = None,
    *,
    sink: float | np.ndarray | None = None,
    empty_row: EmptyRowPolicy = "error",
    return_weights: bool = False,
) -> np.ndarray | tuple[np.ndarray, np.ndarray]:
    """Compute transparent scaled dot-product attention.

    Shapes:
        Q [..., T_q, d_k], K [..., T_k, d_k], V [..., T_k, d_v].
        `mask` must broadcast to [..., T_q, T_k]. A finite entry is an additive
        bias; -inf forbids the key. A per-head sink should be reshaped so it
        broadcasts to [..., T_q, 1].

    `empty_row="error"` rejects a row with no key and no sink. `"zero"` returns
    zero weights/output for that row, which is useful for explicit padding rows.
    """
    if empty_row not in {"error", "zero"}:
        raise ValueError("empty_row must be 'error' or 'zero'")

    Q, K, V = (np.asarray(x) for x in (Q, K, V))
    if min(Q.ndim, K.ndim, V.ndim) < 2 or any(0 in x.shape for x in (Q, K, V)):
        raise ValueError("Q, K, and V must each have at least two dimensions")
    if Q.shape[-1] != K.shape[-1]:
        raise ValueError("Q and K must have the same d_k")
    if K.shape[-2] != V.shape[-2]:
        raise ValueError("K and V must have the same T_k")
    try:
        np.broadcast_shapes(Q.shape[:-2], K.shape[:-2], V.shape[:-2])
    except ValueError as exc:
        raise ValueError("Q/K/V batch dimensions are not broadcast-compatible") from exc
    if not all(np.isfinite(x).all() for x in (Q, K, V)):
        raise ValueError("Q, K, and V must contain only finite values")

    # Keep float32/float64 inputs in their precision; integer examples become float64.
    dtype = np.result_type(Q.dtype, K.dtype, V.dtype, np.float32)
    Q, K, V = (x.astype(dtype, copy=False) for x in (Q, K, V))
    d_k = Q.shape[-1]
    scale = np.asarray(1.0 / math.sqrt(d_k), dtype=dtype)
    with np.errstate(over="ignore", invalid="ignore"):
        scores = (Q @ np.swapaxes(K, -1, -2)) * scale
    if not np.isfinite(scores).all():
        raise FloatingPointError("Q @ K.T overflowed; rescale the inputs")

    if mask is not None:
        mask = np.asarray(mask, dtype=dtype)
        if np.isnan(mask).any() or np.isposinf(mask).any():
            raise ValueError("mask may contain finite biases and -inf, but not NaN/+inf")
        try:
            mask = np.broadcast_to(mask, scores.shape)
        except ValueError as exc:
            raise ValueError(f"mask shape {mask.shape} does not broadcast to {scores.shape}") from exc
        finite_bias = np.isfinite(mask)
        with np.errstate(over="ignore", invalid="ignore"):
            scores = scores + mask
        if np.any(finite_bias & ~np.isfinite(scores)):
            raise FloatingPointError(
                "adding the finite mask bias overflowed; reduce the bias magnitude"
            )

    has_token = np.isfinite(scores).any(axis=-1, keepdims=True)
    token_max = np.max(scores, axis=-1, keepdims=True)

    sink_logits = None
    if sink is not None:
        sink_logits = np.asarray(sink, dtype=dtype)
        if not np.isfinite(sink_logits).all():
            raise ValueError("sink logits must be finite")
        try:
            sink_logits = np.broadcast_to(sink_logits, token_max.shape)
        except ValueError as exc:
            raise ValueError(
                f"sink shape {sink_logits.shape} does not broadcast to {token_max.shape}"
            ) from exc
        row_max = np.maximum(token_max, sink_logits)
    else:
        if empty_row == "error" and not has_token.all():
            bad = np.argwhere(~has_token.squeeze(-1))
            raise ValueError('Attention contains fully masked rows' + f": {bad[:8].tolist()}")
        # A zero-policy row gets a harmless max of 0; all its exponentials stay 0.
        row_max = np.where(has_token, token_max, np.zeros_like(token_max))

    token_exp = np.where(
        np.isfinite(scores), np.exp(scores - row_max), np.zeros_like(scores)
    )
    denominator = token_exp.sum(axis=-1, keepdims=True)
    if sink_logits is not None:
        denominator += np.exp(sink_logits - row_max)

    weights = np.divide(
        token_exp,
        denominator,
        out=np.zeros_like(token_exp),
        where=denominator > 0,
    )
    output = weights @ V
    return (output, weights) if return_weights else output

def gqa(
    Q: np.ndarray,
    K: np.ndarray,
    V: np.ndarray,
    n_heads: int,
    n_kv_heads: int,
    mask: np.ndarray | None = None,
) -> np.ndarray:
    """Educational grouped-query attention for 2D projected sequences.

    Q [T, H*d_k], K [T, H_kv*d_k], V [T, H_kv*d_v].
    The output has shape [T, H*d_v].
    """
    Q, K, V = (np.asarray(x) for x in (Q, K, V))
    if any(x.ndim != 2 or 0 in x.shape for x in (Q, K, V)):
        raise ValueError("GQA expects 2D projected sequences")
    if not (Q.shape[0] == K.shape[0] == V.shape[0]):
        raise ValueError("Q, K, and V must have the same sequence length")
    if any(isinstance(h, bool) or not isinstance(h, int) or h <= 0 for h in (n_heads, n_kv_heads)) or n_heads % n_kv_heads:
        raise ValueError("n_heads must be a positive multiple of n_kv_heads")
    if Q.shape[1] % n_heads:
        raise ValueError("Q width must be divisible by n_heads")
    if K.shape[1] % n_kv_heads or V.shape[1] % n_kv_heads:
        raise ValueError("K/V widths must be divisible by n_kv_heads")

    T = Q.shape[0]
    d_k = Q.shape[1] // n_heads
    if K.shape[1] // n_kv_heads != d_k:
        raise ValueError("Q and K head dimensions must match")
    d_v = V.shape[1] // n_kv_heads

    q = Q.reshape(T, n_heads, d_k).transpose(1, 0, 2)
    k = K.reshape(T, n_kv_heads, d_k).transpose(1, 0, 2)
    v = V.reshape(T, n_kv_heads, d_v).transpose(1, 0, 2)
    group_size = n_heads // n_kv_heads
    # repeat preserves groups [kv0, kv0, ..., kv1, kv1, ...].
    k = np.repeat(k, group_size, axis=0)
    v = np.repeat(v, group_size, axis=0)
    z = sdpa(q, k, v, mask)
    return z.transpose(1, 0, 2).reshape(T, n_heads * d_v)
n_sink в make_mask сохраняет начальные реальные позиции. sink в sdpa добавляет логит с нулевым значением. Они проверяются отдельно.
14. Читаем конфигурацию и реализацию gpt-oss
Возьмём внешний воспроизводимый пример: конфигурацию gpt-oss-120b, ревизия b5c939de…, и эталонный код openai/gpt-oss, ревизия 7b583341…. Полные идентификаторы и SHA-256 находятся в описании данных. Конфигурация зафиксирована внутри M5; редактирование соседних модулей не меняет этот опыт.
Группы голов. Запросы имеют форму [tokens, H_kv, H_q/H_kv, head_dim], ключи и значения — [tokens, H_kv, head_dim]. Здесь 64 головы запросов используют 8 наборов K/V: по 8 запросов на группу.
Маски слоёв. В AttentionBlock чётные индексы, начиная с нуля, получают окно 128; нечётные — полное каузальное внимание. Для 36 слоёв это 18 локальных и 18 полных.
Обучаемый sink. На каждую голову запроса хранится скаляр sinks. Функция sdpa добавляет его к логитам, нормирует всю строку и удаляет последний столбец перед умножением на V. Это подтверждает разбор §10. RoPE применяется к Q/K до сопоставления.
Граница вывода. Этот эталонный PyTorch-код строит полную матрицу логитов и не реализует ограниченный оконный KV-кэш. Из маски следует, какие ключи нужны слою; освобождение старых записей — обязанность исполняющей системы. Поэтому 4.504 GiB — расчёт содержимого K/V при оконном ограничении хранения, а не измеренный пик памяти этой функции. Ноутбук проверяет конфигурацию и расчёт; валидатор отдельно сопоставляет формулу sink/GQA с зафиксированной функцией источника.
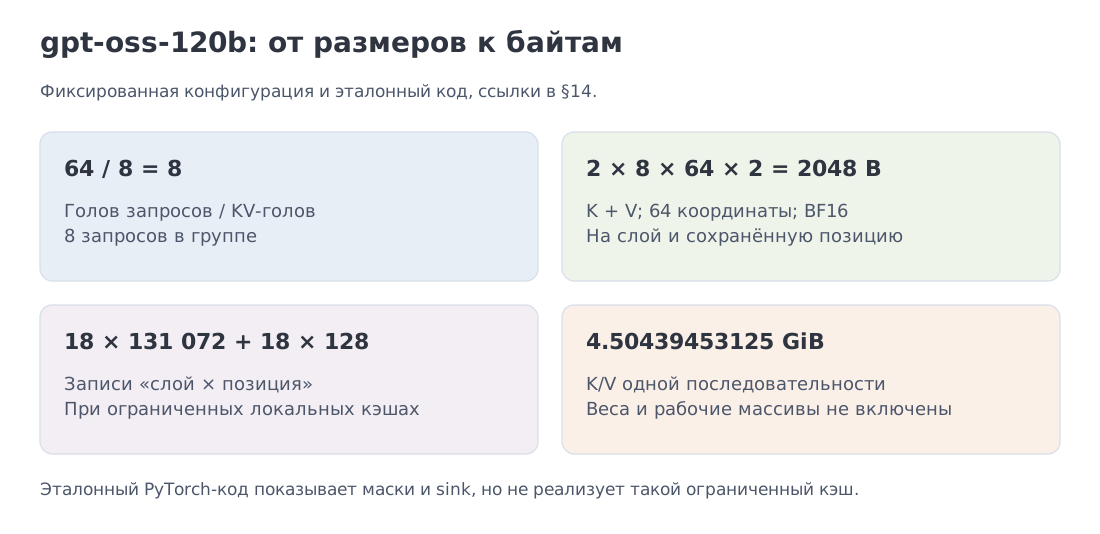 Конфигурация задаёт размеры, код — порядок голов и маски; политика хранения определяет фактический объём выделенной памяти.
15. Ландшафт на 10 октября 2026 года
Эта таблица служит картой механизмов. Семейства приведены с конкретными версиями или с оговоркой о вариантах; одинаковое имя механизма не означает одинаковую память или скорость.
| Пример | Представление состояния | Видимые позиции и условия |
|---|---|---|
| Llama 3.x | GQA | Полное каузальное внимание; число голов зависит от размера модели |
| Mistral-7B-v0.1 | GQA | Окно 4096 во всех слоях; это свойство данной версии |
| gpt-oss-120b | GQA, 8 KV-голов | Чередование окна 128 и полного внимания; обучаемый sink |
| Gemma 2 / Gemma 4 | Параметры зависят от варианта | Локальные и глобальные слои; в Gemma 4 последний слой глобальный |
| DeepSeek-V2/V3 | MLA | Общий латент и отдельная позиционная часть |
| DeepSeek-V3.2 | MLA и индексатор DSA | Основное внимание по выбранным токенам; учитывать индексатор |
| DeepSeek-V4 / V4.1-Flash | Сжатые записи; в V4.1 также межслойное повторное использование | Сжатие, отбор и локальные механизмы сочетаются; формат кэша требует отдельного расчёта |
| FlashAttention-4 | Не задаёт формат KV модели | Организует вычисления; поддержка масок и точностей зависит от ядра |
Строки опираются на открытые конфигурации и отчёты: Llama 3, Mistral v0.1, Gemma 2, Gemma 4. Для gpt-oss см. §14; для MLA, DSA, V4 и FlashAttention — §§7–11.
Читая новую модель, запишите четыре вещи: что хранится; сколько позиций нужно каждому слою; как выбираются позиции; как выполняется вычисление. Затем добавьте формат чисел, размер пакета последовательностей и правила размещения кэша. Только после этого длина контекста превращается в проверяемую оценку ресурсов.
16. Мультимодальность: где хранится информация об изображении
При early fusion, раннем объединении модальностей, визуальные представления включаются в последовательность языкового декодера. Тогда они используют его механизм внимания и формат KV-кэша.
Пусть учебный декодер имеет только полные слои и расходует 72 KiB K/V на позицию. Для одной последовательности 4096 добавленных визуальных позиций потребуют
Это только добавленные K/V: в число не входят веса, активации визуального кодировщика и временные массивы. Для оконных слоёв нужно учитывать, какие визуальные позиции ещё остаются в окне.
При cross-attention, перекрёстном внимании, визуальный кодировщик создаёт отдельную последовательность признаков, а языковые запросы обращаются к ней. Повторно запускать кодировщик на каждом языковом слое не нужно. Но разные слои могут иметь собственные K/V-проекции визуальных признаков, поэтому стоимость их кэширования считается отдельно.
Связь между модальностями определяет не только размерности проекций, но и место хранения состояния. В модуле 16 мы разберём эти архитектуры подробнее.
19. Ключевые выводы модуля
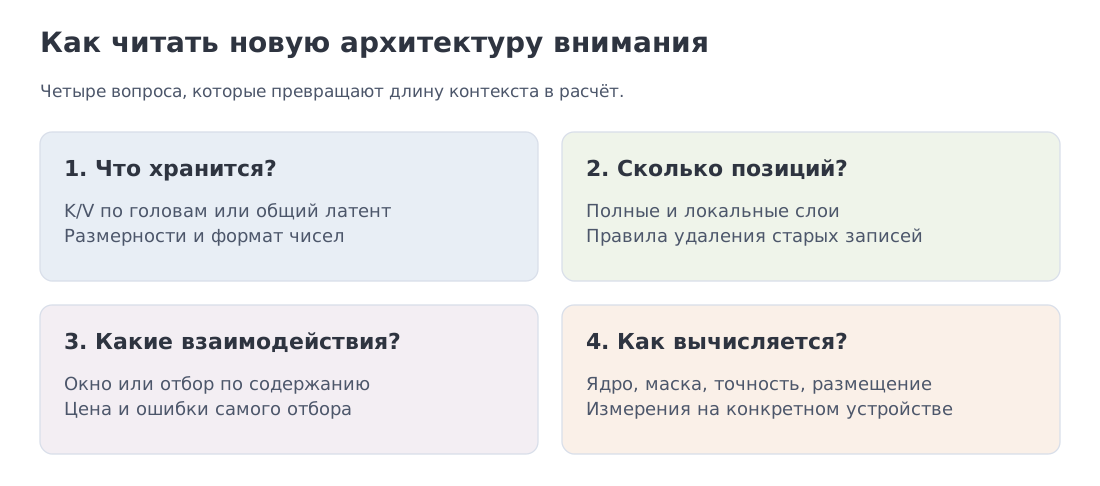 Формат KV, расписание слоёв, выбор позиций и исполнение — четыре части описания внимания.
- Кэш считаем по слоям и последовательностям. Формула даёт байты на сохранённую позицию для одинаковых слоёв. Для окон используем число действительно удерживаемых позиций; память процесса измеряем отдельно.
- MQA/GQA сокращают число наборов K/V. Группировка задаёт точный порядок голов; качество зависит от обучения.
- MLA сохраняет общий латент и позиционную часть. Перестановка линейных операций объясняет, почему не нужен полный восстановленный кэш. Отношение 56.89× относится к двум заданным геометриям.
- FlashAttention сохраняет плотную арифметику . Экономия получается благодаря блочному вычислению и сокращению промежуточных пересылок. Плотная внешняя маска тоже требует памяти.
- Окно ограничивает прямую видимость. Глубина расширяет пути зависимости, но не гарантирует точного сохранения далёкого факта.
- У attention sink два значения. Начальный реальный токен имеет K/V; обучаемый дополнительный логит gpt-oss имеет нулевое значение.
- Отбор позиций имеет собственную цену. Учитываем работу индексатора, потери при отборе и изменение результата основного внимания.
Переход к М6. Внимание смешивает информацию между позициями. Далее изучим, как нормализации, нелинейности и остаточные связи управляют масштабом и преобразованием этой информации внутри блока.
20. Источники
Основные первоисточники:
- Vaswani et al., Attention Is All You Need — arXiv:1706.03762
- Shazeer, Fast Transformer Decoding: One Write-Head is All You Need — arXiv:1911.02150
- Ainslie et al., GQA — arXiv:2305.13245
- DeepSeek-V2 / MLA — arXiv:2405.04434
- FlashAttention — arXiv:2205.14135
- FlashAttention-4 — arXiv:2603.05451
- Mistral 7B — arXiv:2310.06825
- StreamingLLM — arXiv:2309.17453
- MoBA — arXiv:2502.13189
- NSA — arXiv:2502.11089
- DSA / DeepSeek-V3.2-Exp — официальный анонс
- DeepSeek-V3.2 — technical report
- DeepSeek-V4 — model card
- DeepSeek-V4.1-Flash — technical report
- gpt-oss — официальный репозиторий
Углубление. Страничное размещение KV-кэша, выгрузка в другие уровни памяти и разделение prefill/decode между устройствами рассматриваются в модуле 10. Архитектурный контекст мультимодального внимания — в модуле 16.
Ландшафт сверен: 10 октября 2026 года. Числа памяти являются воспроизводимыми расчётами заданных конфигураций; внешние коэффициенты производительности сохраняют условия и атрибуцию авторов.