Модуль 2. Токенизация и эмбеддинги
Курс «Modern LLMs» · лекция модуля 2 · редакция 2026.10.24 · 11 октября 2026 года
В М1 мы выбирали модель для ассистента, который отвечает на вопросы по документам. Один из практических вопросов остался открытым: сколько текста действительно помещается в её контекст? Ответ зависит не только от объявленного предела. Один и тот же документ разные модели могут представить последовательностями разной длины. Чтобы объяснить эту разницу, нужно проследить, как строка становится входом нейросети.
Сначала токенизатор разбивает строку на фрагменты и заменяет их целыми идентификаторами — ID. Затем операция выбора эмбеддинга сопоставляет каждому ID вектор: строку обучаемой таблицы. Мы разберём обе операции, научимся измерять длину полученной последовательности и посчитаем память таблицы. В конце вернёмся к обратному направлению: как сеть получает оценки следующего ID и как выбранные токены превращаются в текст ответа.
Понадобится Python на уровне списков, словарей и функций. Роль регулярных выражений объясняется в §4, а умножение матриц в §11 сопровождается маленьким примером. Для дополнительного шага обучения в §11.4 введём производную и градиент ровно в объёме, необходимом для вычисления. Архитектуру Transformer знать заранее не требуется: её построим в М3.
Как читать модуль
| Проход | Маршрут | Что должно стать понятным |
|---|---|---|
| Первый: механизм | §1 → §3 до углубления → §4 → §5.1–5.2 → §11.1–11.2 → §16.1; У1 и часть У6 про выбор строк | Чем различаются байт, токен, ID и вектор; как работает слияние и выбор строки таблицы |
| Второй: расчёт и код | §5.3–5.4, §6–7, §11.3–11.4; ноутбук, У2–У3 и шаг обучения из У6 | Как обучить и проверить BBPE, прочитать метрики, посчитать память и выполнить шаг обучения |
| Справочный: реальные системы | §2, §8–10, §12–13, §16.2, углубление в §3; проекты У4–У5 | Как исследовать артефакт токенизатора и поставить корректное сравнение |
При первом проходе полную регулярку можно только просмотреть: сначала важны её результаты. В ноутбуке выполняйте ячейки сверху вниз; маршруты относятся к чтению объяснений, а не к пропуску зависимостей кода.
1. От одной строки к входу модели
Возьмём Привет. В нём шесть кодовых точек Unicode — числовых обозначений букв. UTF-8 задаёт, как записать эти обозначения байтами; здесь каждая буква занимает два байта. Байт — целое от 0 до 255, то есть восемь бит. В нашем примере токенизатор объединяет некоторые соседние байты в более длинные фрагменты — токены. Такой алгоритм называется байтовым BPE (Byte-level Byte Pair Encoding, BBPE). Одно объединение соседних единиц будем называть слиянием; в §3 выполним его на короткой строке.
| Этап | Результат для Привет |
|---|---|
| Unicode | 6 кодовых точек |
| UTF-8 | 12 байтов: D0 9F D1 80 D0 B8 D0 B2 D0 B5 D1 82 |
| Замороженный учебный BBPE, 4096 слияний | 3 ID: [943, 370, 301] |
| Таблица эмбеддингов | 3 вектора: |
Числа ID обозначают строки конкретного словаря. ID 943 не означает «больше смысла», чем ID 370; другой токенизатор присвоит фрагментам другие номера. Сами векторы обучаются вместе с нейросетью. Токенизатор в обычной схеме строится отдельно и остаётся фиксированным во время обучения модели.
Зачем иногда объединять байты? Модель обрабатывает последовательность токенов, поэтому три позиции вместо двенадцати уменьшают её длину. Но более крупные фрагменты требуют большего словаря и более крупной таблицы векторов. Этот компромисс проходит через весь модуль.
Контекст и стоимость. Если одинаковое по смыслу содержание занимает втрое больше входных токенов, при одинаковом тарифе за токен входная часть запроса стоит втрое больше. Она занимает втрое больше позиций контекста. Универсального коэффициента для языка нет: его измеряют на выбранном корпусе и токенизаторе.
Форма задачи. 123456 как шесть цифр, две трёхзначные группы или один токен — разные последовательности. То же относится к отступам кода и именам функций. Удобное разбиение помогает представить задачу, но не гарантирует, что модель научится арифметике или программированию.
Границы сообщений. Помимо фрагментов текста существуют специальные ID: они обозначают начало сообщения, роль или вызов инструмента. Их обработку разберём в §8. Сначала научимся кодировать обычный текст, не смешивая его с управляющей разметкой.
Размер модели. В историческом примере Llama-3.1-8B входная и выходная матрицы имеют по параметров; вместе это около 1,05 млрд, примерно 13% от 8 млрд. §11 объяснит, зачем нужны две матрицы и когда их веса можно связать.
2. Историческая прогрессия: от слов к байтам
Словарные модели. Классический NLP часто использовал словарь из десятков тысяч словоформ и один токен <UNK> для всего остального. Отсюда возникли две проблемы: OOV — Out of Vocabulary для новых слов и быстро растущий словарь в морфологически богатых языках.
Символьные модели. Символы уменьшают проблему неизвестных слов в пределах заданного алфавита, но удлиняют последовательность и заставляют модель заново собирать частые слова из мелких единиц.
BPE — Byte Pair Encoding. Алгоритм Филипа Гейджа 1994 года был создан для сжатия: наиболее частая соседняя пара заменяется новым символом. Sennrich, Haddow и Birch в 2015 году перенесли эту идею в нейронный машинный перевод. Частые формы становятся крупными единицами, редкие распадаются на более мелкие.
SentencePiece. SentencePiece обучает модели BPE или Unigram непосредственно по строкам и представляет пробел специальным символом ▁. Unigram выбирает разбиение по вероятностям фрагментов. Он сделал токенизацию воспроизводимой для языков без обязательного пробельного разделения и получил широкое распространение в T5, Llama 1/2, Gemma и многих других семействах. Это не означает, что закрытые Gemini-модели обязаны использовать тот же артефакт: родство модельных семейств не доказывает идентичность токенизатора.
BBPE — Byte-level Byte Pair Encoding. GPT-2 выбрал базовым алфавитом 256 байтов UTF-8. Любая корректная UTF-8-строка кодируема без <UNK>; цена состоит в том, что не-ASCII символ сначала представлен несколькими байтами. Слияния выбираются по частотам соседних пар. Они могут собрать целую букву, часть слова или фрагмент, пересекающий границу символа; языковая иерархия в алгоритме не задана.
tiktoken и рост словарей. В открытой библиотеке OpenAI семейство прошло путь от r50k_base к cl100k_base и o200k_base. Более крупный словарь не автоматически лучше: он сокращает последовательности на целевых данных, но увеличивает матрицы эмбеддингов и требует достаточного числа обучающих наблюдений для каждой строки словаря.
Harmony и gpt-oss. В августе 2025 года вместе с gpt-oss был опубликован формат Harmony и кодировка o200k_harmony. Она наследует ранги слияний обычных токенов и регулярное выражение o200k_base, но добавляет большой диапазон протокольных и зарезервированных идентификаторов. Официальный tiktoken сопоставляет модели gpt-oss-* с o200k_harmony, а семейство gpt-5-* — с o200k_base; эти два случая не следует смешивать.
Модели без выученного словаря подслов. MEGABYTE, MambaByte, Byte Latent Transformer и другие работы исследуют байтовый вход и динамические патчи. Эта ветвь важна, но опубликованные конфигурации из §9 по-прежнему выделяют фиксированный словарь. Замена входного представления затрагивает всю систему: хранение промежуточных состояний внимания (KV-cache), повторное использование вычислений для одинаковых запросов и алгоритмы генерации. Эти механизмы появятся в следующих модулях.
3. Токенизация как сжатие последовательности
На маленьком примере идея видна без Unicode: при обучении на ababab пара a,b встречается три раза. Заменив каждое её непересекающееся вхождение новым токеном ab, получаем три единицы вместо шести. Это один шаг BPE — Byte Pair Encoding, алгоритма последовательного объединения соседних пар.
Для корпуса измерим, сколько исходных байтов в среднем покрывает один токен:
Чем выше это отношение на одном и том же тексте, тем короче последовательность. В нашем ASCII-примере оно выросло с 1 до 2. Это удобная метрика длины входа, но для битового сжатия нужно учесть и цену самих ID.
Пусть ID лежат в диапазоне от 0 до . Чтобы записать каждый из них фиксированным числом бит, требуется бит. Тогда цена полезной нагрузки на исходный байт равна
Если ID плотные, совпадает с числом токенов словаря. При пропусках это разные величины (§9). Полный архив дополнительно хранит словарь, слияния и метаданные. В LLM основная выгода связана с меньшим числом обрабатываемых позиций, а не с размером архива.
Углубление: несовпадение распределений и связь с word2vec
Если источник выдаёт событие с вероятностью , а код строится по , идеальная средняя длина равна
— энтропия источника в битах; KL-дивергенция — добавочная цена несовпадения вероятностей. Предполагается там, где . BPE не является вероятностным арифметическим кодом: различия bytes/token между корпусами не измеряют KL. Более того, сравнение RU train и EN eval в §5 одновременно меняет язык и участие в обучении; RU eval служит отдельным контролем.
Ещё одна связь пригодится после §11. В SGNS — skip-gram с отрицательными примерами (negative sampling) — два набора векторов можно интерпретировать как неявную факторизацию сдвинутой матрицы PMI, поточечной взаимной информации:
Здесь — слово, — контекст, — число отрицательных примеров. Равенство для отдельных скалярных произведений относится к идеализированному анализу SGNS с контекстным распределением отрицательных примеров; ограниченная размерность векторов и иная выборка меняют результат. GloVe использует другой, явно заданный критерий для статистики совместной встречаемости. Эмбеддинги Transformer сохраняют интерфейс «ID → вектор», но обучаются всей задачей предсказания, а не обязаны факторизовать эту PMI-матрицу.
Теория кодирования подробнее разобрана в Information Theory for ML, модули 2 и 6. Для этой лекции достаточно помнить: свойства представления зависят от распределения данных.
4. Токенизатор как последовательность операций
encode(s) возвращает список целых ID, а decode(ids) восстанавливает текст из байтов, связанных с этими ID. Обозначим множество определённых ID через ; тогда результат кодирования — последовательность , где и — её длина. Пустая строка в нашем BBPE даёт пустой список.
Для учебного BBPE без изменения исходного текста выполняется
на строках, представимых корректным UTF-8. Python допускает строки с одиночными суррогатами Unicode; они в этот контракт не входят и отклоняются при кодировании.
Нормализация — предварительное преобразование текста, например приведение полноширинных букв к обычным или сведение повторных пробелов к одному. Если токенизатор выполняет нормализацию , при полном покрытии нормализованного текста словарём он восстанавливает , а не обязательно . У SentencePiece по умолчанию используется nmt_nfkc и удаляются лишние пробелы. При <UNK> может теряться и часть нормализованного текста; обратимость проверяют для конкретной конфигурации.
Шаг 0. Предварительное разбиение (pre-tokenization)
Регулярное выражение делит строку на чанки — фрагменты, внутри которых разрешены слияния. Например, учебная PAT.findall даёт:
| Вход | Чанки (в записи Python) |
|---|---|
Hello world! | ['Hello', ' world', '!'] |
1234567 | ['123', '456', '7'] |
Привет | ['Привет'] |
Пробел перед world входит в чанк. BPE не может объединить конец Hello с началом следующего чанка. Группы цифр заранее ограничены тремя позициями. Так алгоритм получает индуктивное смещение: ограничение пространства возможных разбиений, которое может облегчить обучение, но не гарантирует арифметических способностей.
Полный cl100k-подобный учебный шаблон приведён ниже. Пробелы вокруг | добавлены только для чтения; исполняемая версия без них находится в §6.
'(?i:[sdmt]|ll|ve|re) | [^\r\n\p{L}\p{N}]?+\p{L}+ | \p{N}{1,3} | ?[^\s\p{L}\p{N}]++[\r\n]* | \s*[\r\n] | \s+(?!\S) | \s+
Ветви обрабатывают английские сокращения, буквы с возможным ведущим знаком, цифры, пунктуацию и пробелы. Настоящий шаблон o200k_base сложнее; мы не заявляем побитовую совместимость с ним.
Шаг 1. Обучение BPE
После разбиения каждый чанк превращается в список байтов. На каждом шаге выбирается самая частая соседняя пара:
Все её непересекающиеся вхождения заменяются новым ID. Пара (a,b) означает конкатенацию байтов двух токенов. При равной частоте наш код выбирает первую встреченную пару: это правило влияет на весь последующий словарь.
Если каждый шаг добавляет один новый ID, а специальные ID отделены от обычных, число определённых ID равно
Число имён специальных токенов может быть больше числа их ID. Размер матрицы модели тоже может отличаться от ; оба случая разберём в §8–9.
Шаг 2. Кодирование нового текста
Новая строка проходит то же разбиение и преобразование в байты. Ранг слияния — его приоритет в выученном упорядоченном списке. Кодировщик выбирает присутствующую пару с минимальным рангом и повторяет шаг, пока допустимые пары не закончатся. Он не обучается на новой строке и не пересчитывает частоты корпуса. В нашем формате ID новых токенов 256,257,… одновременно задают порядок рангов.
Шаг 3. Декодирование и метрики
Декодировщик объединяет байты всех выбранных ID и читает результат как UTF-8. Отдельный токен может содержать только часть буквы: потоковый декодер должен сохранять незавершённый байтовый хвост. Замена ошибочного фрагмента на � удобна для отображения, но теряет исходные байты.
Базовый байтовый алфавит обеспечивает покрытие любого корректного UTF-8-текста без <UNK>, даже если каждый байт останется отдельным токеном. Качество сжатия оценивают на корпусе: bytes/token — байты на токен; chars/token — кодовые точки на токен при явном правиле подсчёта; fertility — токены на слово; single-token retention — доля выбранных слов, представленных одним токеном. Последние две метрики требуют определить, что считается словом и учитывается ли ведущий пробел.
5. Решённый пример: от строки до кривой компрессии
Прежде чем считать руками, посмотрим на полный путь.
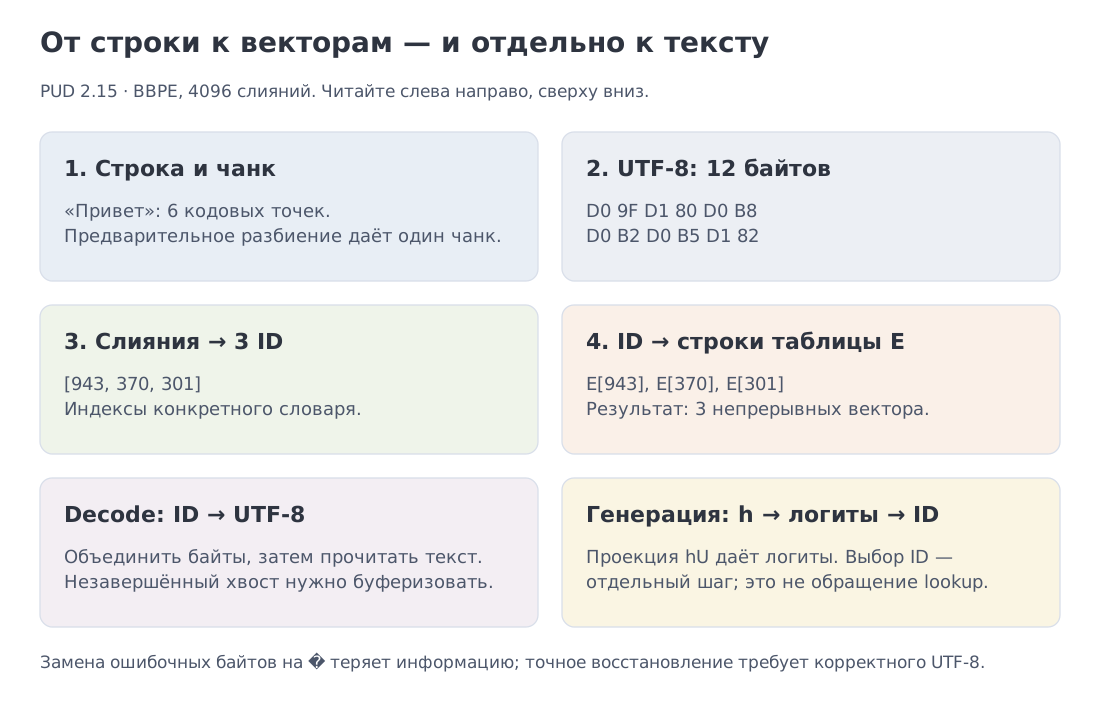 Строка → предварительное разбиение → байты UTF-8 → BPE-слияния по рангам → идентификаторы → выбор строк матрицы эмбеддингов. Декодирование ID восстанавливает байты напрямую; выходная проекция сети предсказывает следующий ID (§11).
5.1. Что видит модель на уровне байтов
UTF-8 кодирует символы переменным числом байтов:
| Строка | Кодовых точек | Байтов | Байты (hex) |
|---|---|---|---|
Привет | 6 | 12 | D0 9F D1 80 D0 B8 D0 B2 D0 B5 D1 82 |
é | 1 | 2 | C3 A9 |
🚀 | 1 | 4 | F0 9F 9A 80 |
ток | 3 | 6 | D1 82 D0 BE D0 BA |
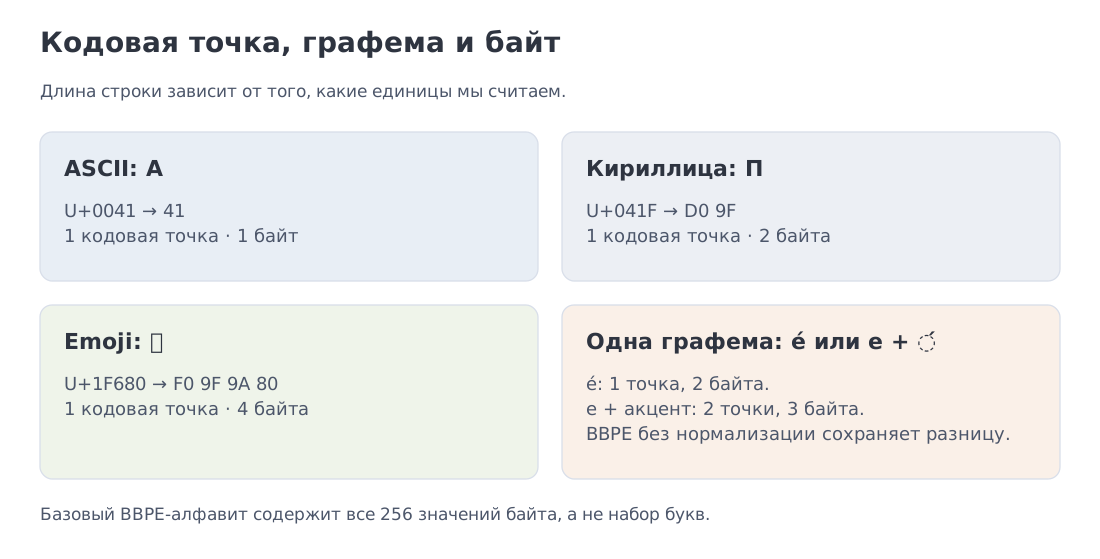 В показанных примерах П занимает два байта, 🚀 — четыре, ASCII-буква A — один. Эмодзи и видимые символы в общем случае могут состоять из нескольких кодовых точек. BBPE начинает с байтов.
До слияний каждая русская буква представлена двумя токенами-байтами. Для Hello отношение равно 5 символов к 5 байтам; для Привет — 6 к 12. Это исходная асимметрия, которую словарь затем частично компенсирует.
Кодовая точка не всегда совпадает с видимым символом: é содержит одну точку, а визуально похожее e\u0301 — две (букву и комбинирующий акцент), но одну графему. Наш BBPE не нормализует эти записи и сохраняет их разные байты.
5.2. Шесть слияний глазами
Игрушечный корпус: низко низко летали ласточки, ласточки летали низко. После предварительного разбиения в нём 93 байта. Первые шесть шагов:
| Шаг | Пара | Частота | Новый фрагмент |
|---|---|---|---|
| 1 | D0 + B8 | 7 | и |
| 2 | пробел + D0 | 6 | пробел + первый байт кириллицы |
| 3 | D0 + BA | 5 | к |
| 4 | D0 + BE | 5 | о |
| 5 | (пробел+D0) + BB | 4 | ' л' |
| 6 | ' л' + D0 | 4 | начало более длинного фрагмента |
93 байта превращаются в 62 токена. Первое слияние собирает букву «и», а второе соединяет пробел с первым байтом следующей кириллической буквы. Порядок определяется частотами пар, поэтому целые символы и их части появляются вперемешку. Промежуточные единицы остаются в словаре даже после того, как длинные токены делают их редкими.
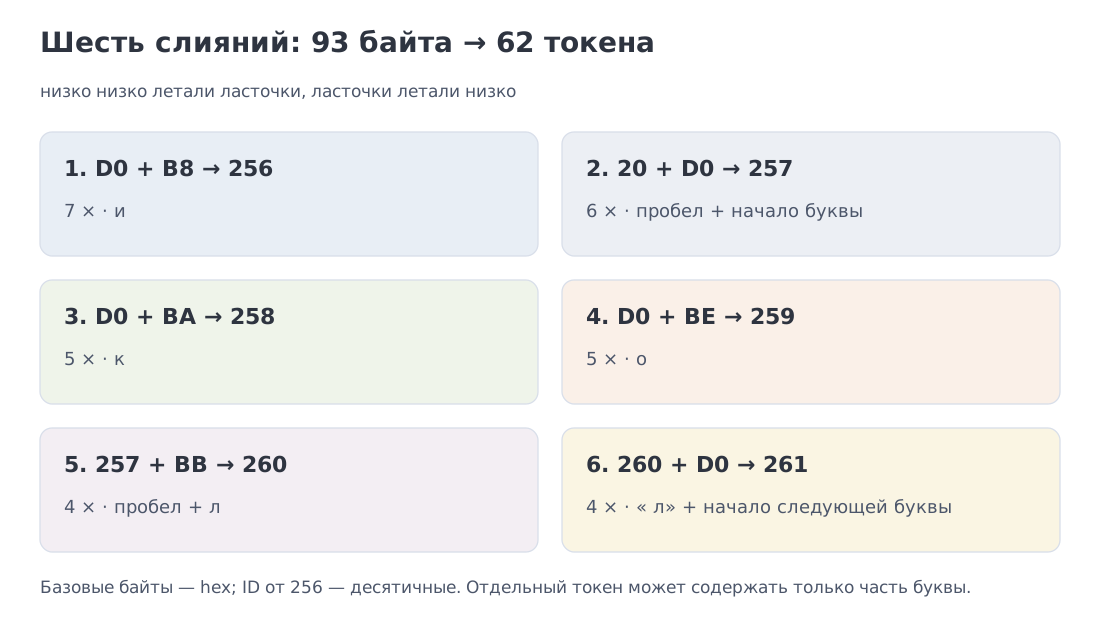 Шесть шагов BBPE: от байтов к буквам и фрагменту с ведущим пробелом.
5.3. Обучающие и проверочные данные
Обучим BBPE на русском тексте из Parallel Universal Dependencies (PUD), выпуск UD 2.15. Это внешний корпус новостных и энциклопедических предложений с параллельными переводами. В курсе хранится точная локальная копия: commit обеих языковых версий, SHA-256, правила извлечения и лицензия CC BY-SA 3.0 перечислены в паспорте корпуса. Для запуска ноутбука сеть не нужна, кроме установки отсутствующих библиотек.
Части разделены по исходным документам: 833 пары предложений (331 документ) отданы обучению, 167 пар (66 документов) — проверке. В обучение BBPE входит только русский текст: 180 112 байт. Два проверочных текста содержат одни и те же 167 пар: 33 654 байта RU и 18 168 байт EN. Считаем также разделители строк, включая последний LF. Это учебное разбиение для токенизатора; исходный PUD является тестовым набором для синтаксического анализа. В PUD считаются выровненные сегменты: иногда один сегмент содержит два грамматических предложения. Большинство исходных текстов было написано по-английски; переводы и тематика ограничивают обобщение на язык в целом.
| Слияний | RU обучение, bytes/token | RU проверка, bytes/token | EN проверка, bytes/token | RU-фраза, токенов | EN-фраза, токенов |
|---|---|---|---|---|---|
| 0 | 1.000 | 1.000 | 1.000 | 61 | 26 |
| 64 | 2.236 | 2.244 | 1.009 | 35 | 26 |
| 256 | 3.231 | 3.213 | 1.011 | 19 | 26 |
| 1024 | 4.531 | 4.360 | 1.047 | 15 | 26 |
| 4096 | 6.535 | 5.542 | 1.317 | 13 | 22 |
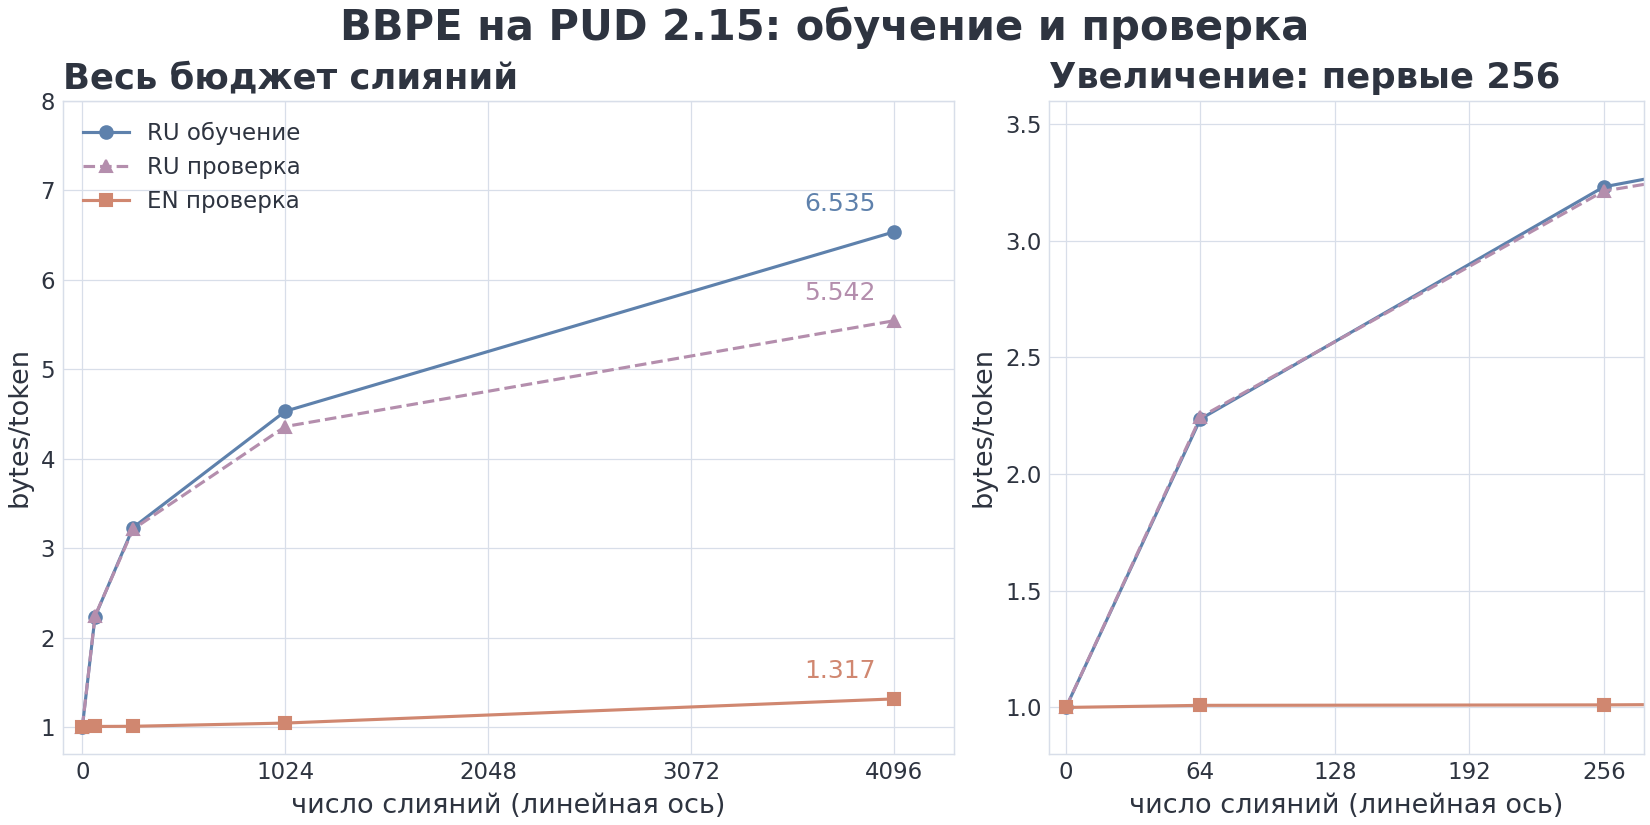 Один RU-обученный BBPE, три части корпуса. Русская проверочная часть отделяет новые документы от материала обучения; английская содержит переводы тех же проверочных предложений.
При 4096 слияниях получаем 6.535 bytes/token на обучении и 5.542 на новых русских документах. Разница показывает поведение на этих двух частях корпуса; она не является универсальной оценкой переобучения. EN-проверка даёт 1.317: большинство байтов английского текста остаются мелкими единицами, поскольку словарь обучался на русских данных.
RU- и EN-проверка контролируют содержание и участие в обучении лучше, чем сравнение RU train с EN eval. Но bytes/token всё ещё зависит от UTF-8 и не измеряет цену одинакового смысла: русская буква часто занимает больше байтов. Если кодировать каждое из 167 выровненных предложений отдельно, без добавленного LF, получаем 6079 токенов RU и 13789 EN: в среднем 36.40 и 82.57. Это сравнение одинакового содержания для одного словаря. Его нельзя получить простым вычитанием разделителей из предыдущей таблицы: добавленный LF может изменить границы и слияния заключительного фрагмента. Для вывода о влиянии обучающего языка нужен симметричный опыт с EN-обучением; его данные тоже включены в ноутбук.
Фразовые столбцы относятся к Внимание — это всё, что вам нужно. и Attention is all you need.. Это две короткие контрольные строки, а не часть параллельного теста. Поздние слияния дают меньший выигрыш на одно новое правило; сравнивайте наклоны по линейной оси числа слияний.
5.4. Fertility на четырёх строках
Для модели с 4096 слияниями измерим четыре коротких примера. «Словом» здесь считается совпадение \p{L}+|\p{N}+: непрерывная последовательность букв или цифр. Это удобный счётчик, а не лингвистическая сегментация кода и дат.
| Пример | Токенов | Серий букв/цифр | Fertility | bytes/token |
|---|---|---|---|---|
| RU-проза | 16 | 7 | 2.29 | 6.94 |
| EN prose | 44 | 8 | 5.50 | 1.18 |
| Python | 63 | 13 | 4.85 | 1.08 |
| Числа и даты | 29 | 6 | 4.83 | 1.03 |
Наибольшее отношение в этих четырёх примерах дала английская строка. Словарь обучался на русской прозе, поэтому такой результат объясним, но сам по себе ещё не выделяет причину. Здесь всего один пример на категорию: из него нельзя вывести рейтинг доменов или причину разницы. Группировка цифр, разделители и состав обучающего корпуса совместно влияют на результат.
Исходные строки (в Python \n означает перевод строки):
Языковые модели предсказывают следующий токен по контексту.Language models predict the next token from context.def encode(text):\n return [merges.get(p, p) for p in pairs(text)]1234 + 5678 = 6912; 2026-07-04
6. Код первого уровня: учебный BBPE
Теперь запишем шаги §4 на Python. Переменная ids хранит список чанков, а каждый чанк — список целых ID. Граница между списками запрещает слияние: даже частую пару нельзя собрать из конца одного чанка и начала другого.
Функция get_stats считает соседние пары, merge заменяет непересекающиеся вхождения выбранной пары, а train_bbpe повторяет эти две операции. Новые ID начинаются с 256, поскольку числа 0–255 уже обозначают исходные байты. Регулярное выражение задаёт учебное разбиение, похожее на cl100k_base; совпадение с разбиением других токенизаторов проверяется отдельно.
import regex as re
from collections import Counter

PAT = re.compile(
    r"""'(?i:[sdmt]|ll|ve|re)|[^\r\n\p{L}\p{N}]?+\p{L}+|\p{N}{1,3}| ?[^\s\p{L}\p{N}]++[\r\n]*|\s*[\r\n]|\s+(?!\S)|\s+"""
)

def get_stats(ids):
    counts = Counter()
    for chunk in ids:
        for pair in zip(chunk[:-1], chunk[1:]):
            counts[pair] += 1
    return counts

def merge(ids, pair, new_id):
    out = []
    for chunk in ids:
        new_chunk, i = [], 0
        while i < len(chunk):
            if i < len(chunk) - 1 and (chunk[i], chunk[i + 1]) == pair:
                new_chunk.append(new_id)
                i += 2
            else:
                new_chunk.append(chunk[i])
                i += 1
        out.append(new_chunk)
    return out

def train_bbpe(text, num_merges=1000):
    if type(num_merges) is not int or num_merges < 0:
        raise ValueError("num_merges must be a non-negative integer")
    chunks = re.findall(PAT, text)
    ids = [list(chunk.encode("utf-8")) for chunk in chunks]
    merges = {}
    for i in range(num_merges):
        stats = get_stats(ids)
        if not stats:
            break
        pair = max(stats, key=stats.get)
        ids = merge(ids, pair, 256 + i)
        merges[pair] = 256 + i
    return merges
После обучения merges содержит упорядоченное отображение «пара → новый ID». Для корпуса из §5.2 первые шесть записей должны дать те же пары и 62 токена. Сравните в коде подсчёт через zip и проход с шагом два в merge: соседние пары могут перекрываться при подсчёте, но один исходный элемент не может участвовать в двух заменах на одном шаге.
Наивная сложность равна , потому что статистика пересчитывается полным проходом. Промышленные тренеры поддерживают индексы пар и обновляют только затронутые области. При равной частоте действует правило разрешения ничьей (tie-break): max выбирает первую встреченную пару. Если это правило изменить, изменится словарь. Учебная реализация делает оба решения видимыми; ноутбук проверяет, что ускорение через хранение одинаковых чанков в одном экземпляре сохраняет результат.
8. Реальная реализация: o200k_base, Harmony и специальные токены
8.1. Учебная регулярка и реальная o200k
Учебная PAT хорошо показывает пять инженерных решений: клитики, слова с ведущим пробелом, короткие группы цифр, пунктуацию и пробельные последовательности. o200k_base развивает ту же идею, но использует более сложные Unicode-ветви для сочетаний регистра и буквенных категорий. o200k_harmony наследует этот шаблон без изменения.
Это хороший пример чтения промышленного токенизатора: нужно исследовать не только vocab_size, но и регулярное выражение, ранги слияний и специальные ID. Два словаря одинакового размера могут давать разную сегментацию ещё до BPE.
8.2. Точная арифметика o200k_harmony
Файл .tiktoken хранит пары base64(token_bytes) rank; ранг одновременно служит идентификатором обычного токена и приоритетом. В официальной реализации:
o200k_baseсодержит 199 998 обычных ID:0…199997;o200k_harmonyдобавляет 1091 имени специальных токенов;- эти имена используют 1090 уникальных специальных ID;
- десять имён имеют текущую протокольную функцию, 1081 имя имеет форму
<|reserved_N|>; <|endofprompt|>и<|reserved_200018|>являются алиасами — двумя именами одного ID200018.
Следовательно, число уникальных идентификаторов равно
Считая ID, нужно взять множество значений словаря имён: алиас не добавляет новый элемент.
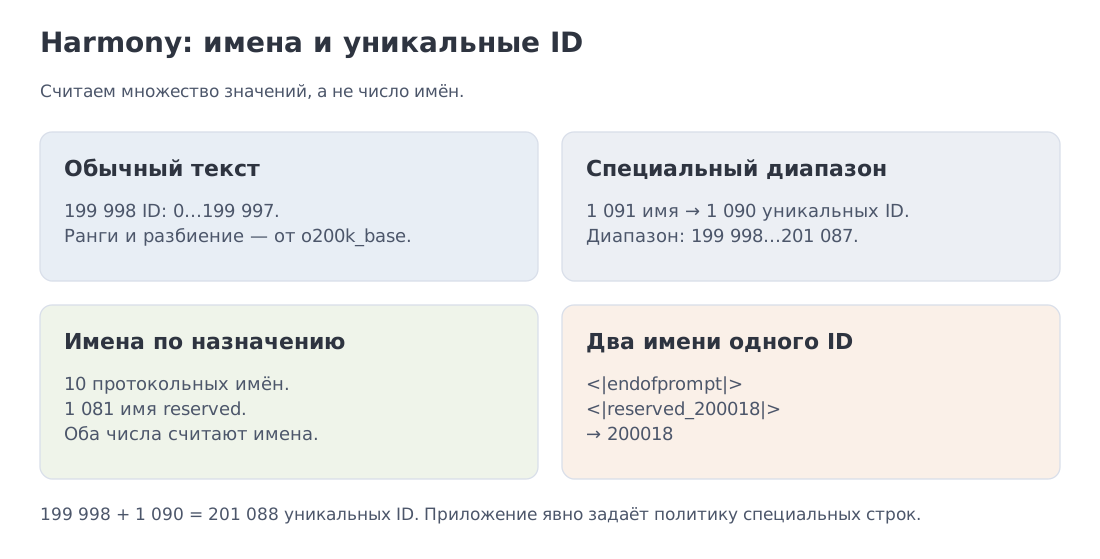 Точная структура
o200k_harmony: 199 998 обычных ID, 1091 специальных имени, 1090 уникальных специальных ID и один алиас.
8.3. Политика специальных токенов
В tiktoken обычный encode() по умолчанию выдаёт ошибку, если строка совпадает с зарегистрированным специальным токеном. Есть три явных режима:
allowed_special={...}— интерпретировать разрешённые строки как специальные ID;disallowed_special=()— не выдавать ошибку и кодировать их как обычный текст;encode_ordinary()— игнорировать специальную семантику.
Поэтому строка <|start|> не должна молча превращаться в управляющий токен и не обязана автоматически разбиваться как обычный текст: результат определяется вызванным API и политикой разрешений. Именно здесь токенизация соприкасается с безопасностью протокола.
8.4. tokenizer.json
В Hugging Face-артефактах BPE обычно видны model.vocab, model.merges, pre_tokenizer и added_tokens. Отдельный tokenizer_config.json может содержать chat_template, который вставляет роли и управляющие токены. Шаблон диалога использует словарь, но не является самим алгоритмом BPE; его подробно разбирает модуль 13.
9. Три разных размера словаря
Вопрос «сколько токенов в словаре?» недостаточно точен. Для чтения артефакта и расчёта памяти нужны три величины:
- — число определённых уникальных ID: объединение обычных и специальных ID.
- — размер диапазона ID от нуля; он включает возможные пропуски.
- — словарная размерность модели, обычно поле
vocab_size: число выделенных строк входной таблицы и выходных оценок. Для прямого индексирования нужно .
| Точный артефакт | Обычные ID | Дополнительные уникальные ID | модели | ||
|---|---|---|---|---|---|
o200k_base | 199 998 | 2 | 200 000 | 200 019 | из токенизатора не следует |
o200k_harmony / gpt-oss-120b | 199 998 | 1 090 | 201 088 | 201 088 | 201 088 |
Qwen/Qwen3-8B | 151 643 | 26 | 151 669 | 151 669 | 151 936 |
В o200k_base специальные ID равны 199999 и 200018: в диапазоне остаётся 19 неиспользованных значений. Поле tiktoken.n_vocab возвращает , а не . У Qwen3-8B матрица выделяет на 267 строк больше, чем определено уникальных ID. Дополнительные строки нельзя автоматически считать декодируемыми токенами или приписывать им специальное назначение. Если выход включает такие позиции, реализация генерации должна задавать политику их допустимости. Семантика n_vocab, конфигурация Qwen3-8B.
Следующая таблица сравнивает только поле модели, а не число определённых токенов. Имена обозначают конкретные опубликованные варианты, проверенные 11 октября 2026 года. Снимок данных хранит неизменяемые ревизии, URL, поля и SHA-256; исходные файлы включены в материалы модуля. Эти примеры позволяют исследовать разные конфигурации и не образуют рейтинг новизны или качества моделей.
| Опубликованная конфигурация | Поле | Выделенная размерность |
|---|---|---|
openai/gpt-oss-120b | vocab_size | 201 088 |
deepseek-ai/DeepSeek-V4-Flash | vocab_size | 129 280 |
Qwen/Qwen3-8B | vocab_size | 151 936 |
mistralai/Mistral-Small-3.1-24B-Instruct-2503 | params.json: vocab_size | 131 072 |
moonshotai/Kimi-K3 | text_config.vocab_size | 163 840 |
zai-org/GLM-5 | vocab_size | 154 880 |
nvidia/NVIDIA-Nemotron-3-Super-120B-A12B-BF16 | vocab_size | 131 072 |
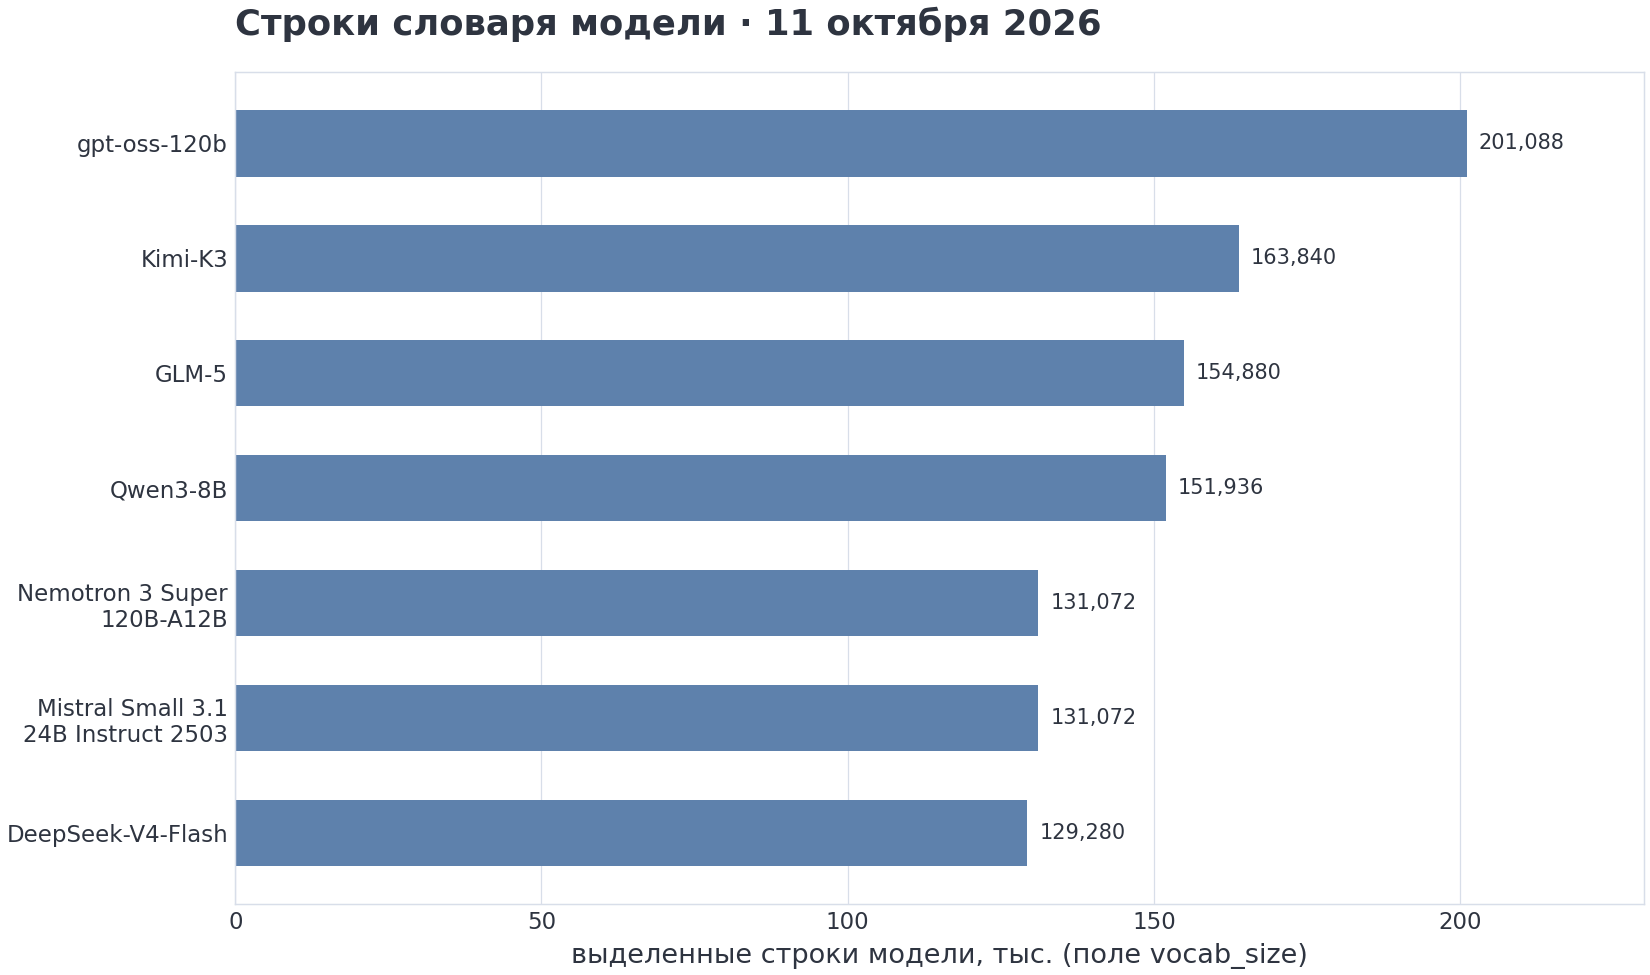 Сравнивается число выделенных строк модели. Ни число специальных имён, ни
tiktoken.n_vocab сюда не подмешиваются.
Исторические примеры тоже полезны, если указать их статус. Llama-3.1-8B с используется в §11 как отдельный пример подсчёта памяти. В зафиксированной версии библиотеки Transformers класс Llama4TextConfig задаёт по умолчанию 202048; это свидетельство о классе конфигурации, а не о каждом сохранённом наборе весов семейства. Gemma3TextConfig задаёт 262208: число из класса не определяет состав конкретного файла токенизатора. Для расчёта по опубликованной модели нужен её собственный артефакт. Конфигурации Llama, Gemma и Command A, для которых не удалось получить исходные файлы без авторизации, в график не включены.
Для Claude и Gemini здесь рассматриваются официальные API подсчёта токенов, а не предполагаемый локальный словарь. Claude token counting возвращает оценку, которая может отличаться от фактического использования; Gemini countTokens также требует выбрать модель и состав запроса. Нельзя выводить словарь Gemini из родства с Gemma. Для практического подсчёта фиксируют модель, формат сообщений, инструменты и мультимодальные части.
Исследовательское обозначение tokenizer-free обычно означает отсутствие фиксированного словаря фрагментов текста. Сегментация при этом может остаться: BLT строит динамические группы байтов. Сравнивать такие системы нужно по качеству и стоимости всей вычислительной последовательности.
10. Fertility, fairness и доменные различия
Fertility — токены на слово. Bytes/token — среднее число байтов на токен. Первая метрика зависит от определения слова, вторая не требует определения слова. Обе зависят от самого текста, включая пробелы: one two и one two дают соответственно 1.1667 и 1.1429 bytes/token в нашем артефакте.
Четыре отдельные строки из §5.4 дают следующие результаты:
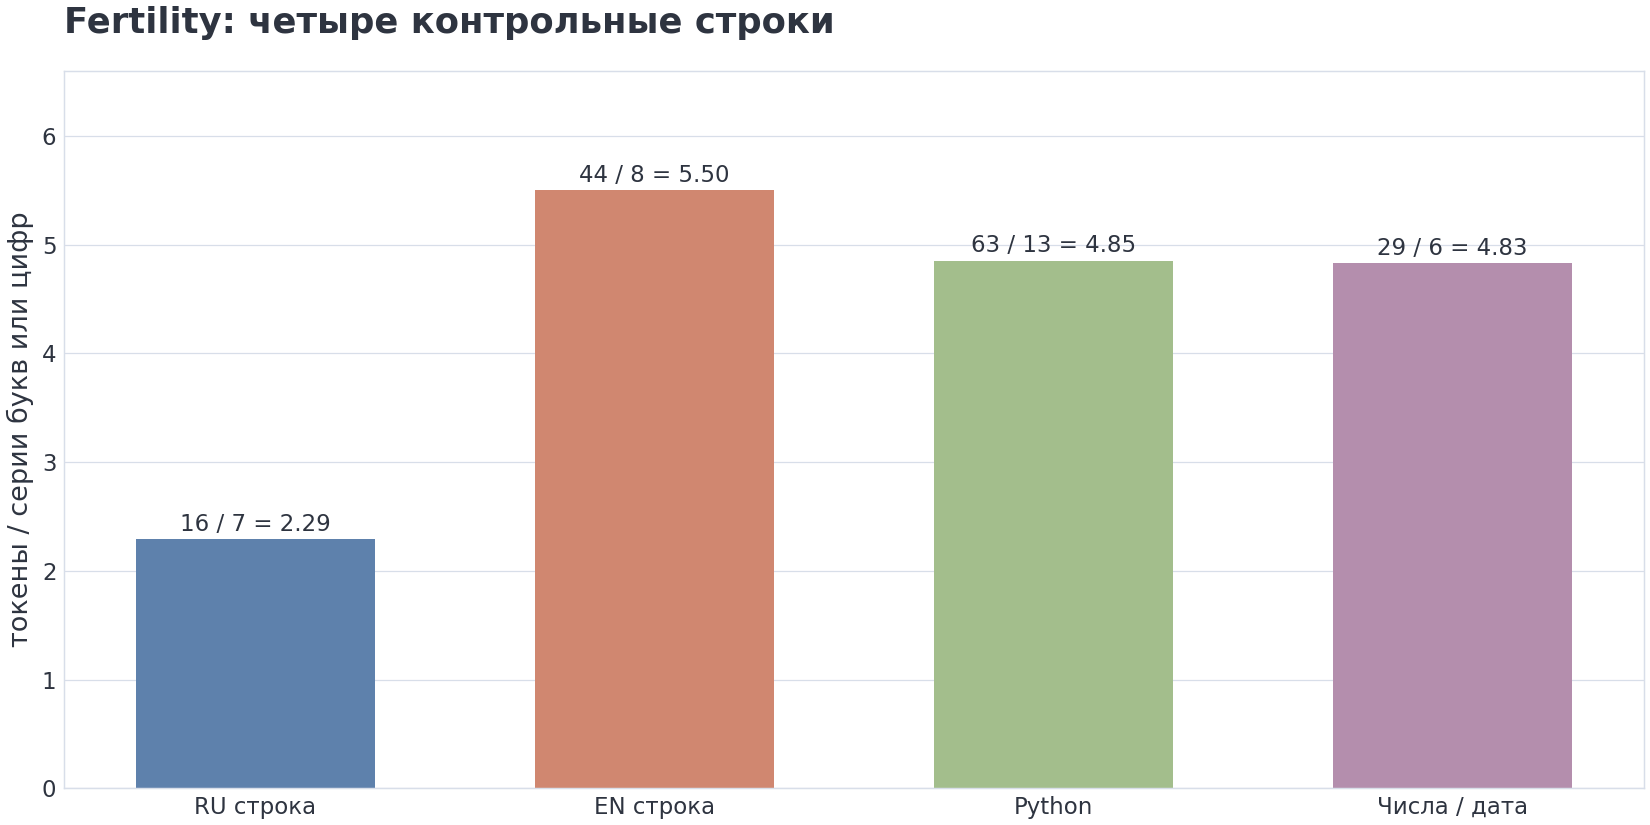 Fertility на четырёх строках для одного RU-обученного токенизатора: 2.29 для русской прозы, 5.50 для английской, 4.85 для Python и 4.83 для чисел.
Многоязычность
На параллельном тексте разные токенизаторы действительно могут давать многократные различия между языками. Это влияет на цену, доступную длину документа и задержку. Но корректный отчёт должен фиксировать:
- конкретный текст или параллельный корпус;
- версию токенизатора и модели;
- определение слова;
- специальные токены и chat template;
- тариф, если делается вывод о деньгах.
При одинаковой модели и цене за токен трёхкратное число входных токенов означает трёхкратную стоимость входной части запроса. Оно не означает трёхкратную стоимость всего ответа, если выход, кэш или инструменты тарифицируются иначе.
Числа
Частотные слияния могут нарезать числа по-разному в разных словарях. Регулярное ограничение на длину цифровой группы уменьшает вариативность. И BPE, и Unigram после фиксации артефакта могут быть детерминированы; они различаются обучением словаря и способом поиска сегментации.
Код
Код выигрывает от токенов для пробельных шаблонов, операторов, частых идентификаторов и фрагментов синтаксиса. Однако число токенов — лишь один фактор: модель должна увидеть достаточно кода и научиться использовать эти единицы. Новый словарь без соответствующего предварительного обучения может содержать плохо обученные строки матрицы эмбеддингов.
Недостаточно обученные токены
Токенизатор и LLM нередко обучаются на разных стадиях и даже на разных смесях. Редкие ID дают мало наблюдений для соответствующих строк входной таблицы. У полной выходной softmax градиент обычно получают все строки, даже когда соответствующий токен не является целевым; редкость означает мало положительных примеров, а не отсутствие любых обновлений. Поэтому возможны плохо обученные представления. Их наличие нельзя определить только по рангу слияния — требуется статистика претрейна и анализ входных и выходных весов.
11. Эмбеддинги: чтение ID и предсказание следующего токена
11.1. Выбор строки
Пусть модель выделяет строк словаря, а каждый вектор содержит чисел. Входная таблица — обучаемая матрица . Поиск эмбеддинга (embedding lookup) для ID возвращает строку . Здесь нет поиска ближайшего слова или умножения на само число .
Возьмём игрушечный словарь из трёх ID и двумерную таблицу:
Три входных ID дают матрицу размера . Два появления ID 0 выбирают одну строку. После обработки контекста сеть может получить для них разные скрытые состояния — внутренние векторы на соответствующих позициях. Входной эмбеддинг и контекстное представление — разные этапы.
11.2. От состояния к вероятностям
Пусть последнее скрытое состояние — строка . Выходная проекция выдаёт логиты — ещё не нормированные оценки следующего ID:
Softmax превращает оценки в вероятности, сумма которых равна 1. Вычитание максимума не меняет результат и помогает избежать переполнения экспоненты. Для простоты здесь нет выходного смещения, ограничений допустимых ID и преобразований логитов, которые может добавлять конкретная модель.
Связанные веса (tied embeddings) задают . При пример выше даёт и . Если выбрать максимум, следующим станет ID 1. Даже когда , на выходе не обязательно получается 0: выходная проекция не является обратной операцией поиска эмбеддинга.
При несвязанных весах (untied) обучается независимо. Например,
Декодирование токенов — отдельная операция: уже выбранные ID отображаются в байты и затем в текст. Для decode([943,370,301]) не нужны ни , ни .
Практика. В разделе 10 ноутбука вычислите X = E[ids], оба варианта h @ U и устойчивый softmax. Затем посмотрите, как шаг обучения меняет повторно выбранную строку, и проверьте накопление её градиента. Матрицы заданы вручную: они показывают операции, а не семантику обученной языковой модели.
11.3. Сколько это стоит
Одна таблица содержит параметров. Если веса независимы, нужны ; если связаны — только уникальных обучаемых параметров. В этом расчёте нет выходного смещения. BF16 занимает два байта на параметр, а байтов.
| Сценарий | Одна матрица, параметров | Две матрицы, параметров | BF16 для двух |
|---|---|---|---|
| gpt-oss-120b, | 579 133 440 | 1 158 266 880 | 2.1574 GiB |
| Llama-3.1-8B, | 525 336 576 | 1 050 673 152 | 1.9570 GiB |
| Расширение ровно 100 000 → 262 000, | +663 552 000 | +1 327 104 000 | +2.4719 GiB |
Последняя строка — условное расширение словаря, а не конфигурация Gemma. Таблица считает только хранение весов. Градиенты, состояния оптимизатора, активации и временные буферы увеличат память обучения; связи весов недостаточно, чтобы определить полный расход.
В прочитанных конфигурациях gpt-oss-120b, Qwen3-8B, DeepSeek-V4-Flash и Kimi-K3 флаг tie_word_embeddings равен false. В опубликованном классе Gemma3TextConfig значение по умолчанию — true. Для иной модели нужен её точный config: размер, цена API и принадлежность к семейству сами по себе не устанавливают связывание весов.
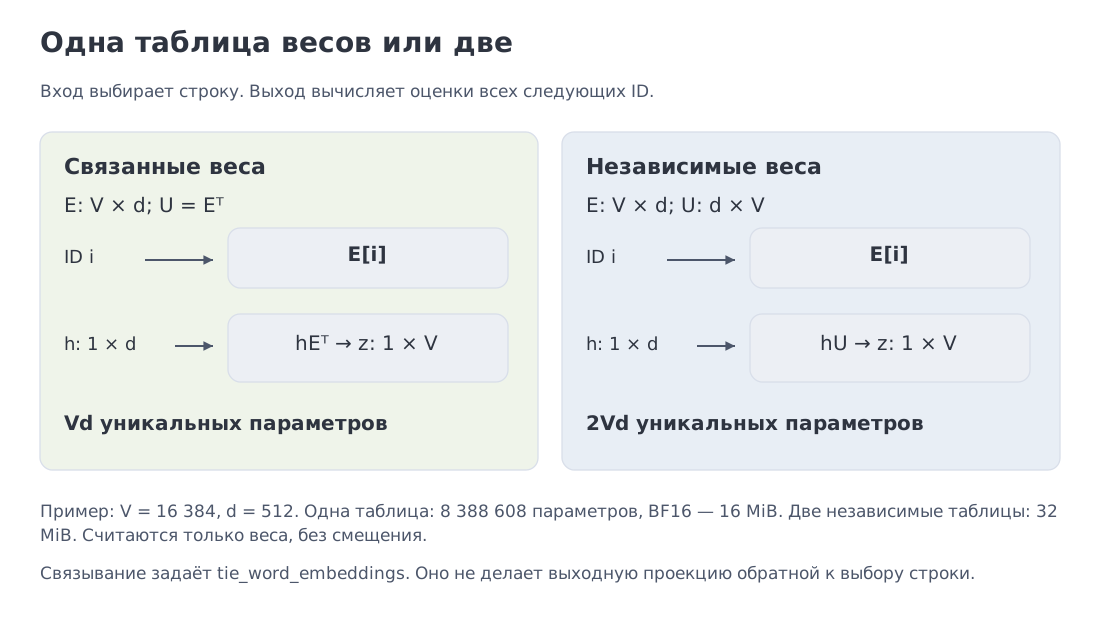 Вход выбирает строку E; выход вычисляет оценки hU. Связывание весов экономит параметры, но не делает эти операции взаимно обратными.
11.4. Как выбранная строка учится
До сих пор таблица была задана вручную. Чтобы увидеть, что означает «обучаемая», изменим её по простому правилу. Возьмём те же ID [0,2,0] и для каждой позиции зададим целевой вектор . Будем уменьшать сумму квадратов расстояний от выбранных строк до целей:
Здесь — число позиций, — ID на позиции , а квадрат нормы означает сумму квадратов координат. Функция называется функцией потерь: меньшее значение означает, что таблица лучше выполняет именно эту учебную задачу. Нулевые цели выбраны для удобства счёта; так не обучают полезную языковую модель.
Нужно понять, какое небольшое изменение каждого числа в уменьшит . Производная показывает локальную скорость изменения потерь по одному числу; градиент собирает такие производные по всем параметрам. У выражения производная по равна . Поэтому каждое использование строки даёт ей вклад «выбранный вектор минус цель», а вклады повторных использований складываются:
ID 0 встречается дважды и получает . ID 2 выбран один раз и получает . Строка 1 не участвует в этой функции потерь, поэтому её градиент нулевой. Получаем
Число — размер шага обучения. При строки становятся [[0.8,0],[2,0],[0,0.9]], и потери уменьшаются с до . Небольшой шаг против градиента уменьшает эту функцию; слишком большой шаг может, наоборот, увеличить её.
В NumPy накопление записывается как np.add.at(grad, ids, X - targets). Эта операция складывает все вклады для повторяющихся индексов. Запись grad[ids] += X - targets использует временный результат расширенной индексации и не обеспечивает такого накопления. В ноутбуке сравниваются оба варианта, а правильный градиент дополнительно проверяется конечными разностями: один параметр слегка увеличивается и уменьшается, после чего разность потерь делится на удвоенное возмущение. Это независимая численная проверка производной, а не способ обучать большую сеть.
В настоящей LLM сигнал приходит от ошибки предсказания следующего токена через остальные слои. Здесь мы изолировали только обучение таблицы по выбранным строкам. При общей входной и выходной матрице полный градиент включал бы и выходную проекцию; в этой квадратичной задаче её нет.
12. Мультимодальная проекция: где аналогия с токенизацией полезна
Текстовый токенизатор заканчивает работу последовательностью ID. Для изображения часто выбирают другой интерфейс. В Vision Transformer (ViT) изображение делят на патчи — небольшие прямоугольные участки, — и преобразуют каждый участок в вектор. Затем визуальный энкодер обрабатывает эти векторы. Их ширина определяется визуальной сетью и не обязана совпадать с шириной языковой модели.
Чтобы передать визуальные признаки в языковой декодер, используют коннектор: преобразование, которое согласует размерность, а иногда и сокращает число векторов. Разделение изображения на патчи напоминает предварительное разбиение текста, но обычному входному патчу не назначают дискретный ID из словаря текстовых токенов. В М16 разберём весь путь «изображение → визуальные признаки → коннектор → языковая модель» и варианты соединения этих частей.
Изображение 896×896 при патче 14×14 содержит патчей до последующего объединения или сжатия. Это число исходных участков, а не обязательно число позиций в языковом контексте. Если полученные векторы включаются в самовнимание языкового декодера, они увеличивают его контекст и кэш промежуточных состояний — KV-cache. Устройство внимания и кэша появится в М3 и М5; здесь важно различать исходное изображение и представление, которое в итоге получает LLM.
Аудиокодеки EnCodec/SoundStream используют RVQ — Residual Vector Quantization: несколько кодбуков дают дискретные ID, из которых можно восстановить сигнал. Здесь аналогия ближе: есть конечный словарь, последовательность идентификаторов и декодер обратно в волну.
Кодбук — конечная таблица векторов; квантование заменяет вектор индексом ближайшего элемента. В RVQ последующие таблицы кодируют остаток ошибки. При частоте кадров в секунду и передаваемых индексах на кадр поток содержит ID/с: например, 50 кадров/с и 8 кодбуков дают 400 ID/с до дальнейшего упаковывания. Это условный расчёт, а не универсальная частота аудиомоделей.
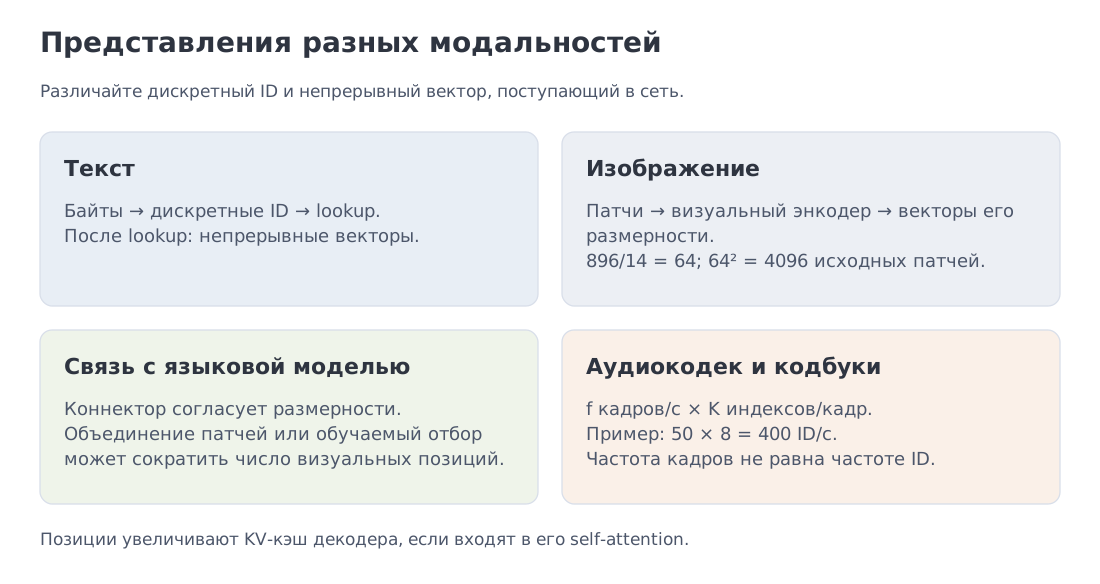 Текст создаёт дискретные ID фрагментов; изображение — непрерывные векторы патчей; аудиокодек — ID из нескольких кодбуков.
Полная архитектура мультимодальной системы — коннекторы, динамическое разрешение, видео и потоковая речь — рассматривается в модуле 16.
13. Карта связей
Теперь у нас есть последовательность векторов и понятен выходной шаг . Между ними пока остаётся главное вычисление: как получить состояние , учитывающее контекст? М3 заполнит этот промежуток механизмом внимания и блоком Transformer. Один и тот же входной эмбеддинг сможет дать разные контекстные состояния в разных предложениях.
Таблица сама по себе не зависит от позиции. В М4 рассмотрим явные сигналы положения и расстояния. Порядок также ограничивает причинная маска, которая запрещает читать будущие позиции; поэтому отсутствие позиционных эмбеддингов не означает полного отсутствия информации о порядке. Это различие станет понятнее после вычислений М3. Специальные токены и шаблоны диалога вернутся в М13, цена визуальных позиций и KV-кэша — в М10 и М16, а эффективное выполнение генерации — в М11.
Углубление. Теория кодирования, KL-дивергенция и информационная цена несовпадения распределений разобраны в Information Theory for ML, модуль 6.
16. Ключевые выводы модуля
16.1. После первого прохода
Текст проходит несколько разных преобразований. UTF-8 представляет строку байтами. Предварительное разбиение задаёт границы, внутри которых BPE может объединять соседние единицы. Обучение выбирает частые пары и фиксирует порядок слияний; кодирование новой строки использует этот порядок, не переобучая токенизатор. Меньшее число токенов означает более короткую последовательность для модели. Метрика bytes/token показывает этот эффект на заданном тексте, но сама по себе не учитывает всю стоимость хранения словаря и ID.
Полученные ID — номера строк, а не числовые оценки смысла. Таблица заменяет каждый ID вектором. Сеть обрабатывает контекст и формирует скрытое состояние , из которого выходная проекция получает логиты. Softmax превращает их в вероятности следующего токена. Выбор ID и его декодирование — отдельные операции; даже связанные входные и выходные веса не делают проекцию обратным поиском строки.
Байтовое покрытие обеспечивает представимость корректного UTF-8. Точное восстановление требует также сохранить исходное написание: нормализация или замена ошибочных байтов могут потерять информацию. Перед М3 полезно уметь своими словами проследить путь строка → байты → ID → векторы и отдельно объяснить возвращение от выбранных ID к тексту.
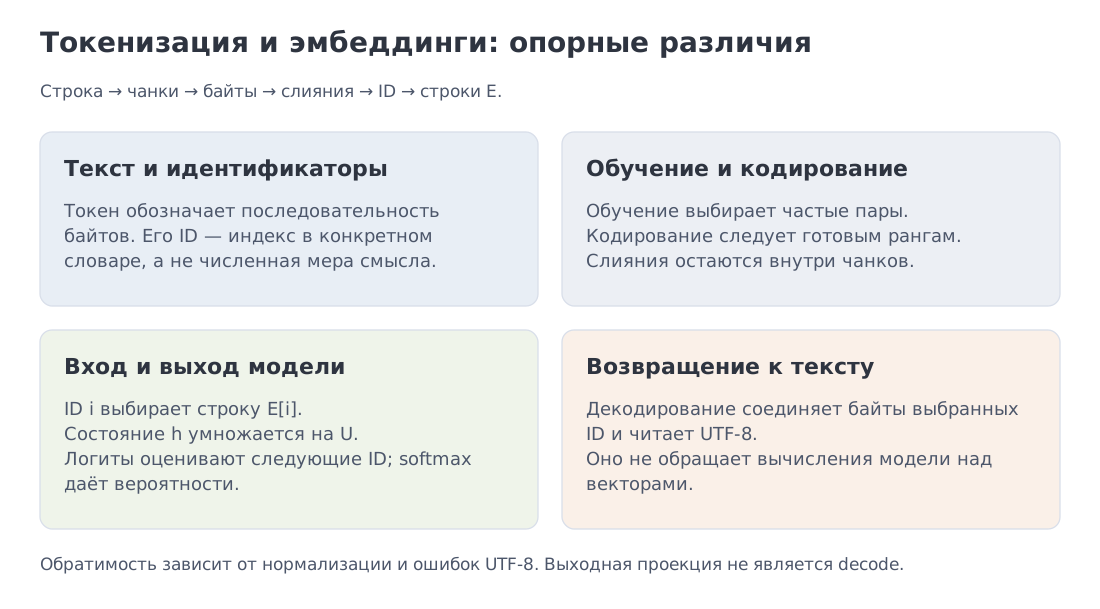 Опора первого прохода: байтовое представление, обучение и применение слияний, выбор строк E и отдельное декодирование.
16.2. После расчётов и чтения реальных артефактов
- В большинстве текстовых LLM токенизатор строится отдельно и фиксируется до обучения основной сети. Сравнение токенизаторов требует также знать, на каких данных обучались их словари.
- Сначала сравните RU train с RU eval, затем параллельные RU/EN eval. Это разные вопросы; bytes/token не является оценкой KL или цены одинакового содержания.
o200k_harmonyсодержит 199 998 обычных ID и 1090 уникальных специальных ID; 1091 специальное имя возникает из-за одного алиаса.tiktoken.encode()по умолчанию не пропускает буквальные специальные строки молча: разработчик явно задаёт политику.- Число определённых ID , диапазон и выделенная размерность модели отвечают на разные вопросы.
- Fertility сравнивают на фиксированном корпусе и вместе с bytes/token.
- Связанные веса экономят параметров. Выходная проекция предсказывает ID, а декодировщик восстанавливает текст из уже выбранных ID.
- Градиент выбранной строки суммирует вклады всех её использований. В полной языковой модели к нему добавляются пути вычисления, которых нет в изолированной квадратичной задаче §11.4.
17. Источники
Ключевые источники:
-
Universal Dependencies PUD 2.15 — RU, EN; локальный паспорт и атрибуция, CC BY-SA 3.0.
-
Gage, A New Algorithm for Data Compression — PDF
-
Sennrich, Haddow, Birch, Neural Machine Translation of Rare Words with Subword Units — arxiv.org/abs/1508.07909
-
Kudo, Richardson, SentencePiece — arxiv.org/abs/1808.06226
-
OpenAI
tiktoken: official repository -
SentencePiece normalization — documentation
-
Llama4TextConfig — исходный код
-
Gemma3TextConfig — исходный код
-
OpenAI Harmony: official repository
-
Petrov et al., Language Model Tokenizers Introduce Unfairness Between Languages — arxiv.org/abs/2305.15425
-
Press, Wolf, Using the Output Embedding to Improve Language Models — arxiv.org/abs/1608.05859
-
Levy, Goldberg, Neural Word Embedding as Implicit Matrix Factorization — NeurIPS 2014
-
Yu et al., MEGABYTE — arxiv.org/abs/2305.07185
-
Pagnoni et al., Byte Latent Transformer — arxiv.org/abs/2412.09871
-
Claude Token Count API — official documentation
-
Gemini
models.countTokens— official documentation
Дальше: модуль 3 связывает токены и эмбеддинги с вниманием, блоком Transformer и предсказанием следующего токена. Если весь вычислительный путь уже знаком, пройдите диагностику и переходите к позиционным представлениям в модуле 4.
Публичные поля и первичные исходники проверены 11 октября 2026 года и закреплены по ревизиям и SHA-256. Учебный BBPE обучен на фиксированном внешнем корпусе PUD 2.15. Исторические расчёты и значения классов конфигурации имеют отдельный статус.