Модуль 3. Базовый Transformer
Курс «Modern LLMs» · лекция модуля 3 · редакция 2026.10.25 · 11 октября 2026 года
В М2 мы выбирали из таблицы вектор токена. У одного и того же токена этот начальный вектор одинаков в разных предложениях. Здесь выясним, как модель превращает его в контекстное представление — вектор, который учитывает окружающие токены, — и получает вероятности продолжения текста.
Понадобятся умножение матриц, их формы и эмбеддинги из М2. Тензор как многомерный массив введём в §2. Всё остальное вводится по ходу. Цель — проследить путь от входа до следующего токена, затем собрать и проверить небольшую модель.
Как читать модуль
- Первый проход — понять механизм. Прочитайте §§1–12 по порядку, пропуская только явно свёрнутые справочные блоки. В §2 пока достаточно формы входа; в §4.3 — смысла масштабирования. Остановитесь на числовом примере §4.5 и различии обучения и генерации в §§11–12. Завершите §§16, 18 и 22. Большие блоки кода можно оставить на второй проход.
- Второй проход — воспроизвести. Вернитесь к полной карте форм §2, выводу §4.3 и §§13–15. Запустите ноутбук из §20 и решите задачи §19: числа и проверки превращают узнавание схемы в умение её собрать.
- Справочный проход — найти конкретное место. Формы — §§2 и 15; маски — §5; порядок нормализации — §8; обучение и генерация — §§11–12; частые ошибки — §17. Если можете без подсказки восстановить эти связи и ответить на §18, переходите к М4.
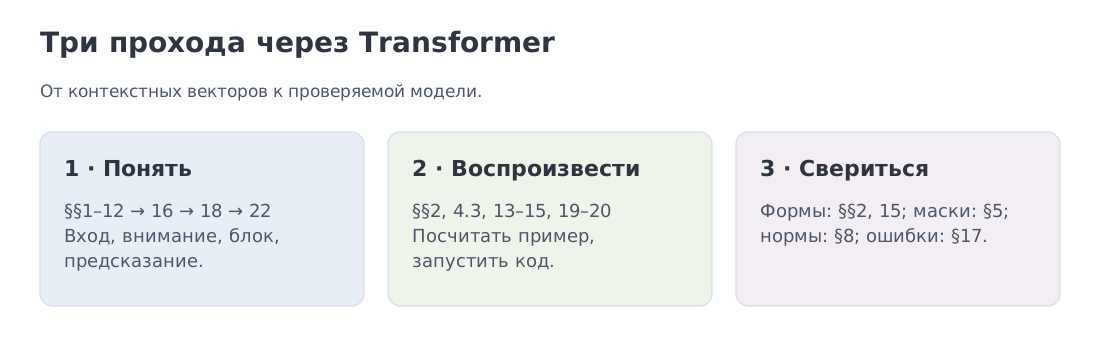 Три маршрута используют один материал: сначала проследить вычисление, затем воспроизвести его, позже возвращаться за конкретной формой или проверкой.
1. Зачем Transformer вообще понадобился
Начнём не с формулы, а с инженерной задачи. Пусть модель переводит предложение, суммирует документ или предсказывает следующий токен. На каждой позиции ей нужно совместить две вещи:
- локальное содержание текущего токена;
- сведения из других позиций, причём полезные позиции зависят от контекста.
В предложении «банк поднял ставку» слово «ставка» получает смысл через «банк». В коде закрывающая скобка зависит от конструкции, открытой десятки строк назад. При переводе очередное слово перевода должно учитывать и уже сгенерированный префикс, и весь исходный текст.
В рекуррентной сети состояние шага строится из состояния . Это создаёт цепочку зависимостей: внутри одного примера нельзя сразу вычислить все позиции. Transformer использует механизм внимания (attention): каждая позиция собирает взвешенную смесь векторов других доступных позиций. Если запрос и читаемые векторы принадлежат одной последовательности, это self-attention. Затем полносвязная сеть прямого распространения (feed-forward network, FFN) нелинейно преобразует вектор каждой позиции. Слои выполняются друг за другом, а позиции внутри слоя могут вычисляться параллельно.
Доступ к другим позициям нужно ограничивать в соответствии с задачей. При предсказании следующего токена будущее неизвестно, поэтому каузальная маска запрещает читать более поздние позиции. Отдельный позиционный сигнал сообщает координату токена. В §§3 и 5 мы увидим, как оба механизма участвуют в вычислении.
В оригинальной статье Васвани и соавторов (2017) Transformer решает задачу перевода. Encoder обрабатывает исходный текст и выдаёт последовательность контекстных векторов — память входа. Decoder строит перевод, читая уже известную часть перевода и эту память. Чтение другого потока векторов называется cross-attention. В decoder-only модели отдельного encoder нет: запрос пользователя и продолжение образуют одну последовательность. Ниже полная схема служит картой; её детали разберём постепенно.
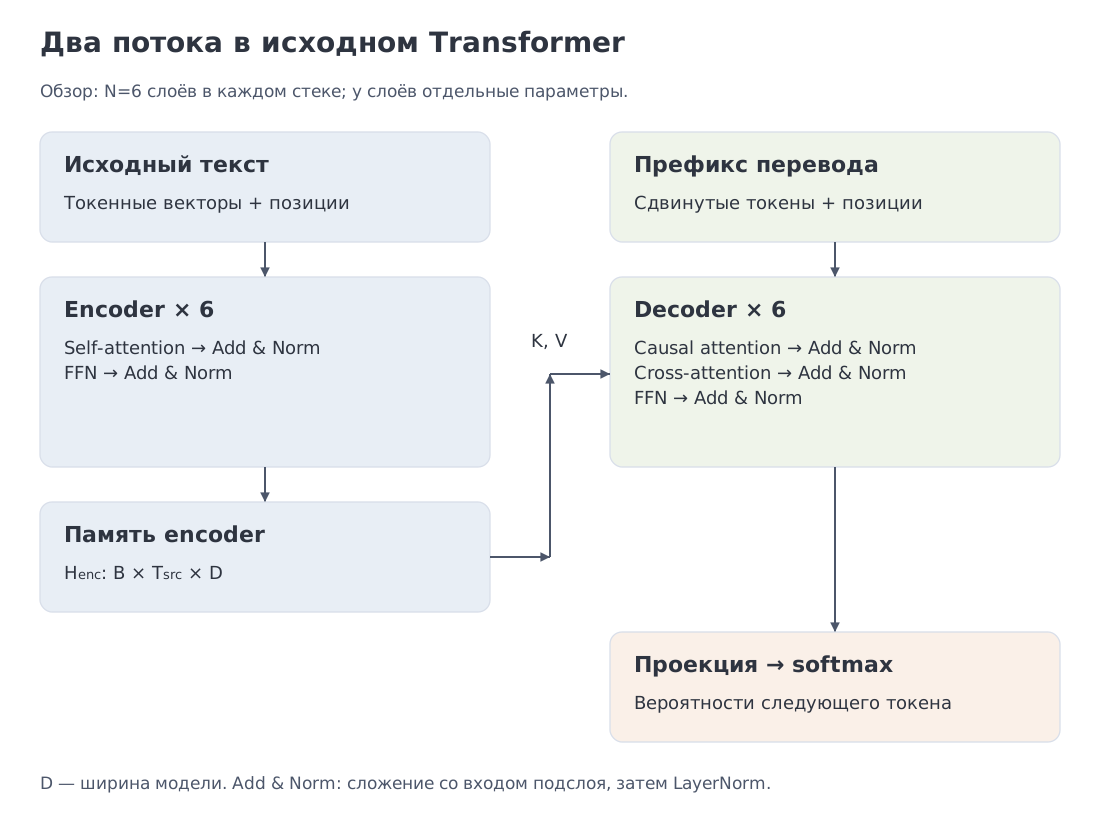 Слева исходный текст превращается в память входа; справа строится перевод. Стрелка между ветвями несёт векторы encoder в cross-attention. Внутренние подслои и их остаточные связи раскрываются в §§8–10.
1.1. Что именно обещает этот урок
Сначала изучим базовую механику. Позднейшие варианты не нужно знать заранее. Ссылки ниже — указатель продолжения:
- модуль 4 заменит обзор позиций на современную картину;
- модуль 5 развернёт attention от MHA до GQA, MLA и FlashAttention;
- модуль 6 разберёт устройство современного блока;
- модуль 10 покажет, как выполнять генерацию и обслуживать запросы эффективно.
Модуль самодостаточен: эти ссылки расширяют материал, но не нужны для прохождения урока.
2. Карта обозначений и форм тензоров
У каждой позиции есть вектор из чисел. Если одновременно обрабатываются последовательностей длины , их векторы образуют тензор — многомерный массив — формы . Такой набор примеров называют батчем. Первое полезное правило: каждая ось отвечает на отдельный вопрос — какой пример, какая позиция, какой признак.
Для первого прохода достаточно . В §§4 и 6 мы введём запросы, ключи, значения и головы; полная карта ниже пригодится после их появления.
Полная карта форм — для второго и справочного проходов
| Символ | Смысл |
|---|---|
| число одновременно обрабатываемых примеров | |
| длина последовательности | |
| , | число запросов и ключей; в self-attention обычно равны |
| число признаков в основном потоке векторов | |
| число attention-голов | |
| , | ширина ключа/запроса и значения в одной голове |
| внутренняя ширина FFN | |
| размер словаря |
После выбора строк матрицы эмбеддингов имеем
Для multi-head attention удобно временно вынести ось голов:
Матрица весов attention имеет форму
После смешивания значений результат каждой головы будем обозначать :
Последняя ось — ось ключей. Именно по ней применяется softmax: для фиксированных примера, головы и запроса веса ключей должны суммироваться в единицу. Последняя ось уже имеет ширину вектора значения .
Это первый полезный инвариант. Второй: после объединения голов и выходной проекции результат снова имеет ширину , иначе его нельзя сложить с исходным входом.
2.1. Остаточный поток как основной путь
Слои постепенно уточняют представления, сохраняя основной тензор формы . Его называют остаточным потоком (residual stream). Подслой — attention или FFN — вычисляет добавку той же формы. Остаточная связь (residual connection) прибавляет её к входу:
Если в реализации внезапно меняется последняя размерность, это не «тонкость Transformer», а почти наверняка ошибка формы или пропущенная выходная проекция.
3. Шаг 1. Токены, эмбеддинги и позиции
Для учебной модели примем непрерывные ID от 0 до и ровно строк таблицы. Это явное упрощение: различие числа определённых ID, их диапазона и выделенных строк из М2 сохраняется для реальных артефактов.
Нейросеть не получает строку напрямую. Токенизатор превращает текст в идентификаторы
Матрица эмбеддингов
работает как обучаемая таблица: строка — вектор токена на позиции . Для батча результат выбора строк имеет форму .
В оригинальной архитектуре токенные эмбеддинги масштабировались на и складывались с позиционной кодировкой:
Множитель не является универсальным законом всех LLM; это часть конкретного рецепта 2017 года. Смысл сложения важнее: токенное содержание и позиционный сигнал оказываются в одном пространстве признаков.
3.1. Почему без позиции порядок теряется
Рассмотрим self-attention без маски и без позиционной информации. Если переставить входные векторы, выходные векторы переставятся тем же образом. Механизм знает набор векторов и связи между ними, но не знает, какой вектор был «первым».
У слова «кот» будет тот же контекстный вектор при перестановке «кот укусил пса» → «пса укусил кот», если переставить только входные векторы и не добавить позиции или маску. Выходные строки тоже переставятся: это эквивариантность, а не полная неизменность результата. Каузальная маска уже нарушает такую симметрию; утверждение относится именно к немаскированному attention.
3.2. Синусоидальная кодировка оригинальной статьи
Для чётных и нечётных измерений использовались пары синуса и косинуса с разными частотами:
Здесь — целочисленная позиция, начиная с нуля, а нумерует пары координат от до при чётной ширине. Малые дают быстрые колебания, большие — медленные. Вместе координаты задают несколько масштабов изменения. Возможность вычислить код за пределами обучающих длин сама по себе не гарантирует, что модель хорошо обработает такой контекст.
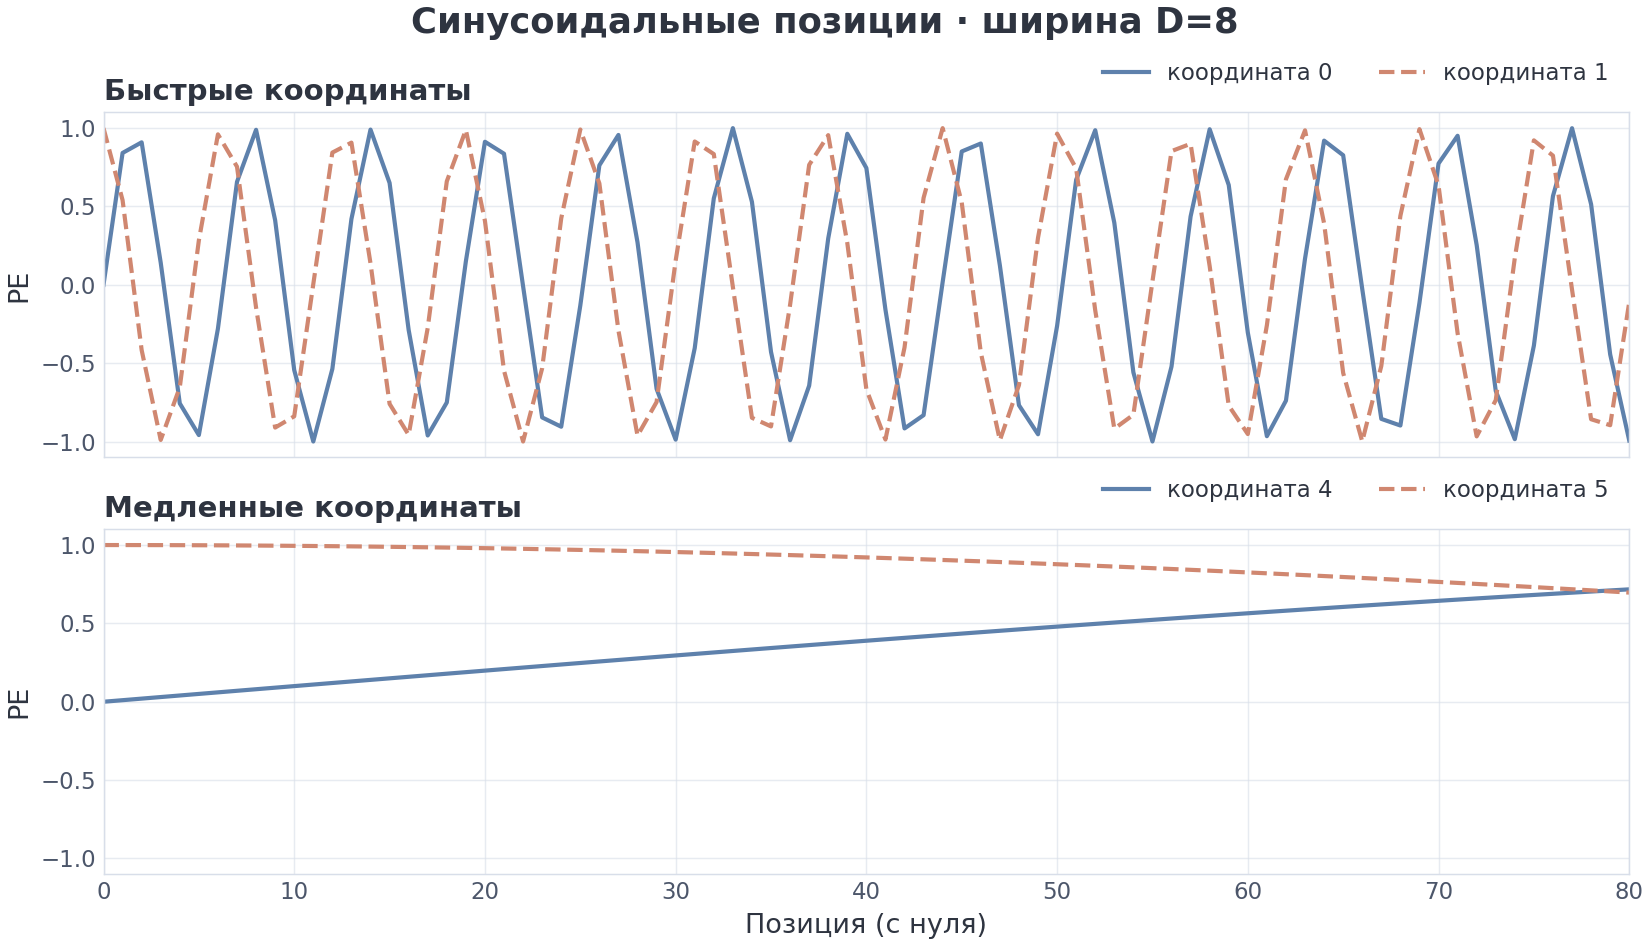 Четыре измерения одной кодировки. Пара высокочастотных координат быстро меняется от позиции к позиции, а низкочастотная пара задаёт медленный фон.
Синусоидальная кодировка даёт простой пример явного позиционного сигнала. М4 сравнит её с обучаемыми таблицами, относительными смещениями и вращениями RoPE. Для текущей лекции достаточно понимать, что к содержанию токена добавилась информация о его месте.
3.3. Мини-проверка форм
Пусть , , . Тогда:
token_ids:[2, 5];embedding(token_ids):[2, 5, 8];position_encoding[:5]:[5, 8];- после распространения таблицы по оси батча (broadcasting) и сложения:
[2, 5, 8].
Ось батча в позиционной таблице не нужна: одна и та же координата применяется ко всем примерам батча.
4. Шаг 2. Scaled dot-product attention
Возьмём одну позицию: ей нужен контекст из других векторов. Запрос (query) описывает, что она ищет; ключ (key) каждой доступной позиции участвует в сравнении с запросом; значение (value) несёт вектор, который будет передан. Attention сравнивает запрос с ключами и по результатам смешивает значения. Один такой расчёт называют головой внимания. Матрицы , , собирают соответствующие векторы по строкам. Длина запроса и ключа в одной голове — , длина значения — ; запросов , ключей и значений .
Операция одной головы записывается так:
Softmax превращает числовые оценки в неотрицательные веса с суммой 1. В этой формуле он работает отдельно для каждой строки запроса, по всем доступным ключам. Знак означает транспонирование последних двух осей: произведение сравнивает каждый запрос с каждым ключом. Маску пока не вводим; сначала разберём саму смесь.
Удобно распаковать формулу на три шага:
Матрица содержит масштабированные оценки совместимости, — веса внимания, — полученные векторы. Буква обозначает результат головы, а в §6 будет матрицей выходной проекции.
Матричное равенство означает построчно:
Каждая позиция запроса получает взвешенную сумму значений. В §5 та же схема сохранится, но перед softmax оценки будут заменены на маскированные оценки .
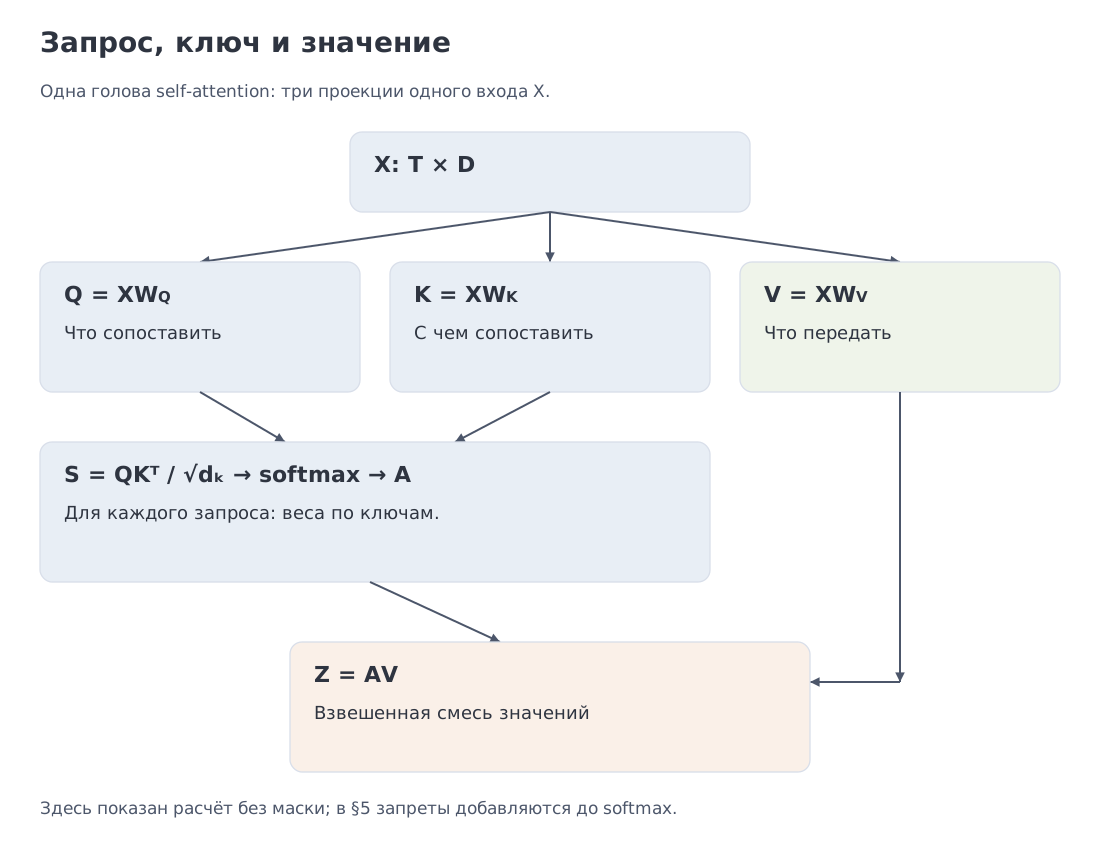 , и — не три типа токенов, а три обучаемые роли одних и тех же представлений. Аналогия с поиском в таблице помогает, пока мы помним, что и запрос, и индекс, и полезная нагрузка учатся совместно.
4.1. Откуда берутся , и
В self-attention все три тензора получаются из одного входа линейными проекциями:
Для одной головы можно считать
Линейная проекция — умножение на обучаемую матрицу — выделяет разные признаки для сравнения и для передачи. и учатся задавать совместимость, — содержимое передаваемого вектора. Это три роли одного представления, а не три независимых вида токенов.
В cross-attention источник разный:
В cross-attention запросы строятся из состояния decoder, а ключи и значения — из памяти encoder. Формула смешивания остаётся той же; меняется источник векторов.
4.2. Почему dot product
До масштабирования скалярное произведение одного запроса и ключа равно
Оценки перед softmax называют логитами внимания. Они ещё не являются вероятностями: нормировка превратит строку этих оценок в веса ключей. Позже тот же термин встретится для выходных оценок токенов словаря.
При прочих равных больший результат даст ключу больший вес. Знак сам по себе не решает, полезен ли токен: softmax сравнивает оценки внутри строки. Для ненулевых векторов косинусное сходство равно : деление на нормы оставляет только сравнение направлений. Внимание здесь использует скалярное произведение, поэтому на оценку влияют и направления, и длины векторов.
4.3. Зачем делить на
Пусть координаты и независимы, имеют нулевое среднее и единичную дисперсию. Тогда
и при этих упрощающих предположениях
В этом предположении дисперсия равна точно; экспериментальная оценка лишь приближается к ней. Стандартное отклонение растёт как . Без масштабирования при большой ширине логиты легко становятся крупными, softmax насыщается, распределение приближается к one-hot, а градиенты по проигравшим позициям становятся малы.
После деления
Это не доказательство поведения обученной сети: реальные координаты не независимы и не обязаны иметь единичную дисперсию. Но вывод точно объясняет, почему масштаб естественен и почему в ноутбуке отношение дисперсий видно уже на случайных векторах.
4.4. Softmax и правильная ось
Для запроса в немаскированном attention:
Тогда
В коде это softmax(scores, dim=-1), если последняя ось действительно соответствует . Ошибка dim=-2 не вызовет исключение: код выполнится и нормирует запросы вместо ключей. Поэтому проверка суммы строк — обязательная проверка. При наличии маски та же нормировка применяется к из §5.
4.5. Attention руками: полностью числовой пример
Возьмём одну голову, три позиции и :
Масштабированные оценки:
Каузальное ограничение в этом примере означает: строка 1 читает только ключ 1, строка 2 — ключи 1–2, строка 3 — все три. Запретим будущие ключи, заменив их оценки на до softmax. Их экспоненты станут нулевыми; остальные веса нормируем заново. Получаем:
Обозначим выход головы . В матричной форме , а для каждой строки запроса
В нашем примере (веса и выход вычислены до округления)
Третья строка особенно полезна для чтения формулы словами:
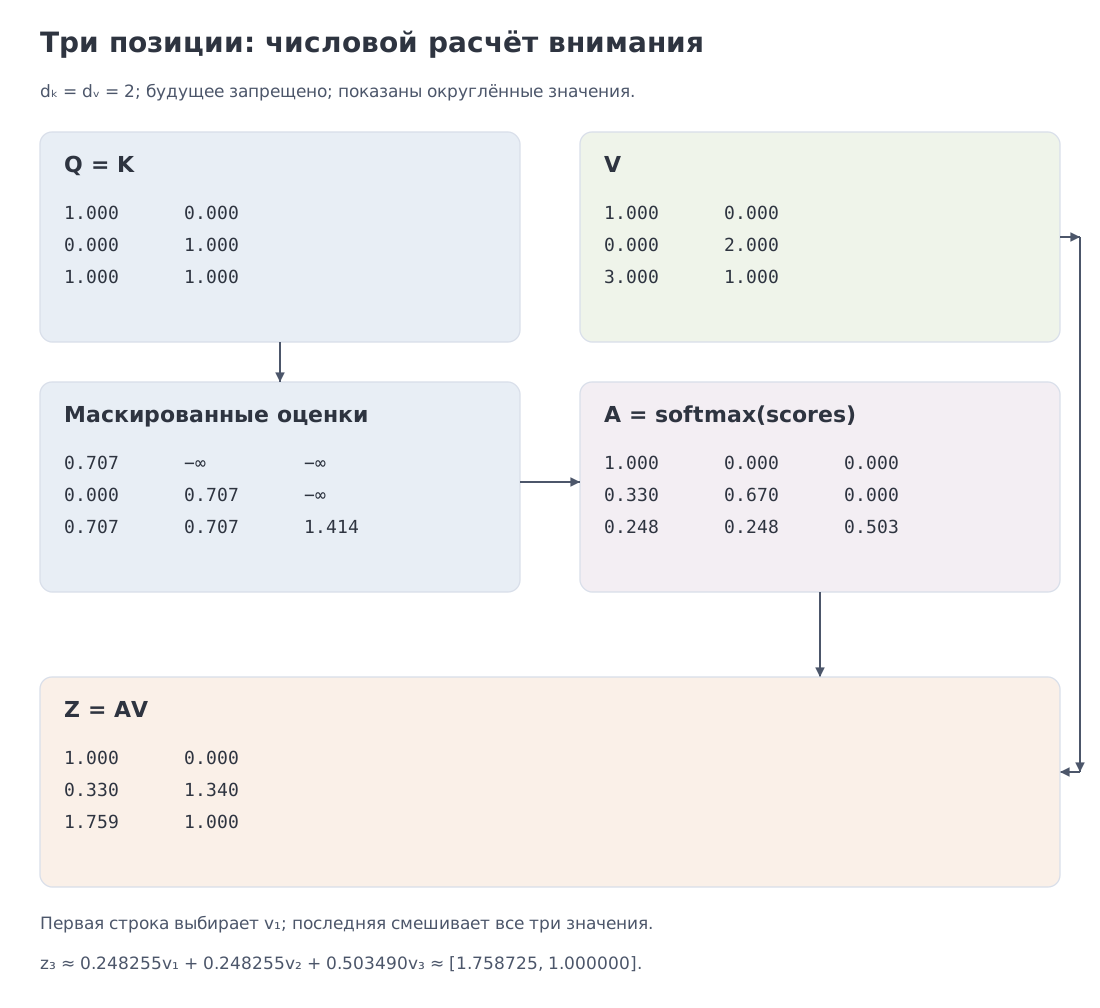 Полный путь одной головы: матрица совместимости, запрет будущего, softmax по ключам и смесь значений. Числа воспроизводятся ноутбуком модуля.
Здесь видно важное различие: вес внимания — коэффициент смешивания, а не готовое объяснение решения модели. Даже большой вес говорит лишь о том, сколько соответствующего вектора значения вошло в текущую смесь; содержимое этого вектора уже преобразовано, а итог пройдёт через следующие слои.
5. Маски: кто имеет право кого видеть
Слово «маска» используют для двух связанных, но разных объектов: булевой матрицы допустимости и добавляемого к логитам числового смещения. Чтобы не прятать смысл за суммой «scores + mask», начнём с булевой матрицы
где означает, что запросу разрешено читать ключ . Маскированные оценки определим непосредственно:
После этого
Поскольку , запрещённая связь получает нулевой вес. Это буквально соответствует формулировке оригинальной статьи: недопустимые значения на входе softmax устанавливаются в .
В реализации ту же операцию часто записывают как
Здесь — добавляемая к оценкам числовая матрица, построенная из ; она не обучается. В этой записи разрешённая связь получает добавку 0, запрещённая — . Очень большое отрицательное конечное число лишь приближает запрет и не решает проблему строки без доступных ключей (§5.6).
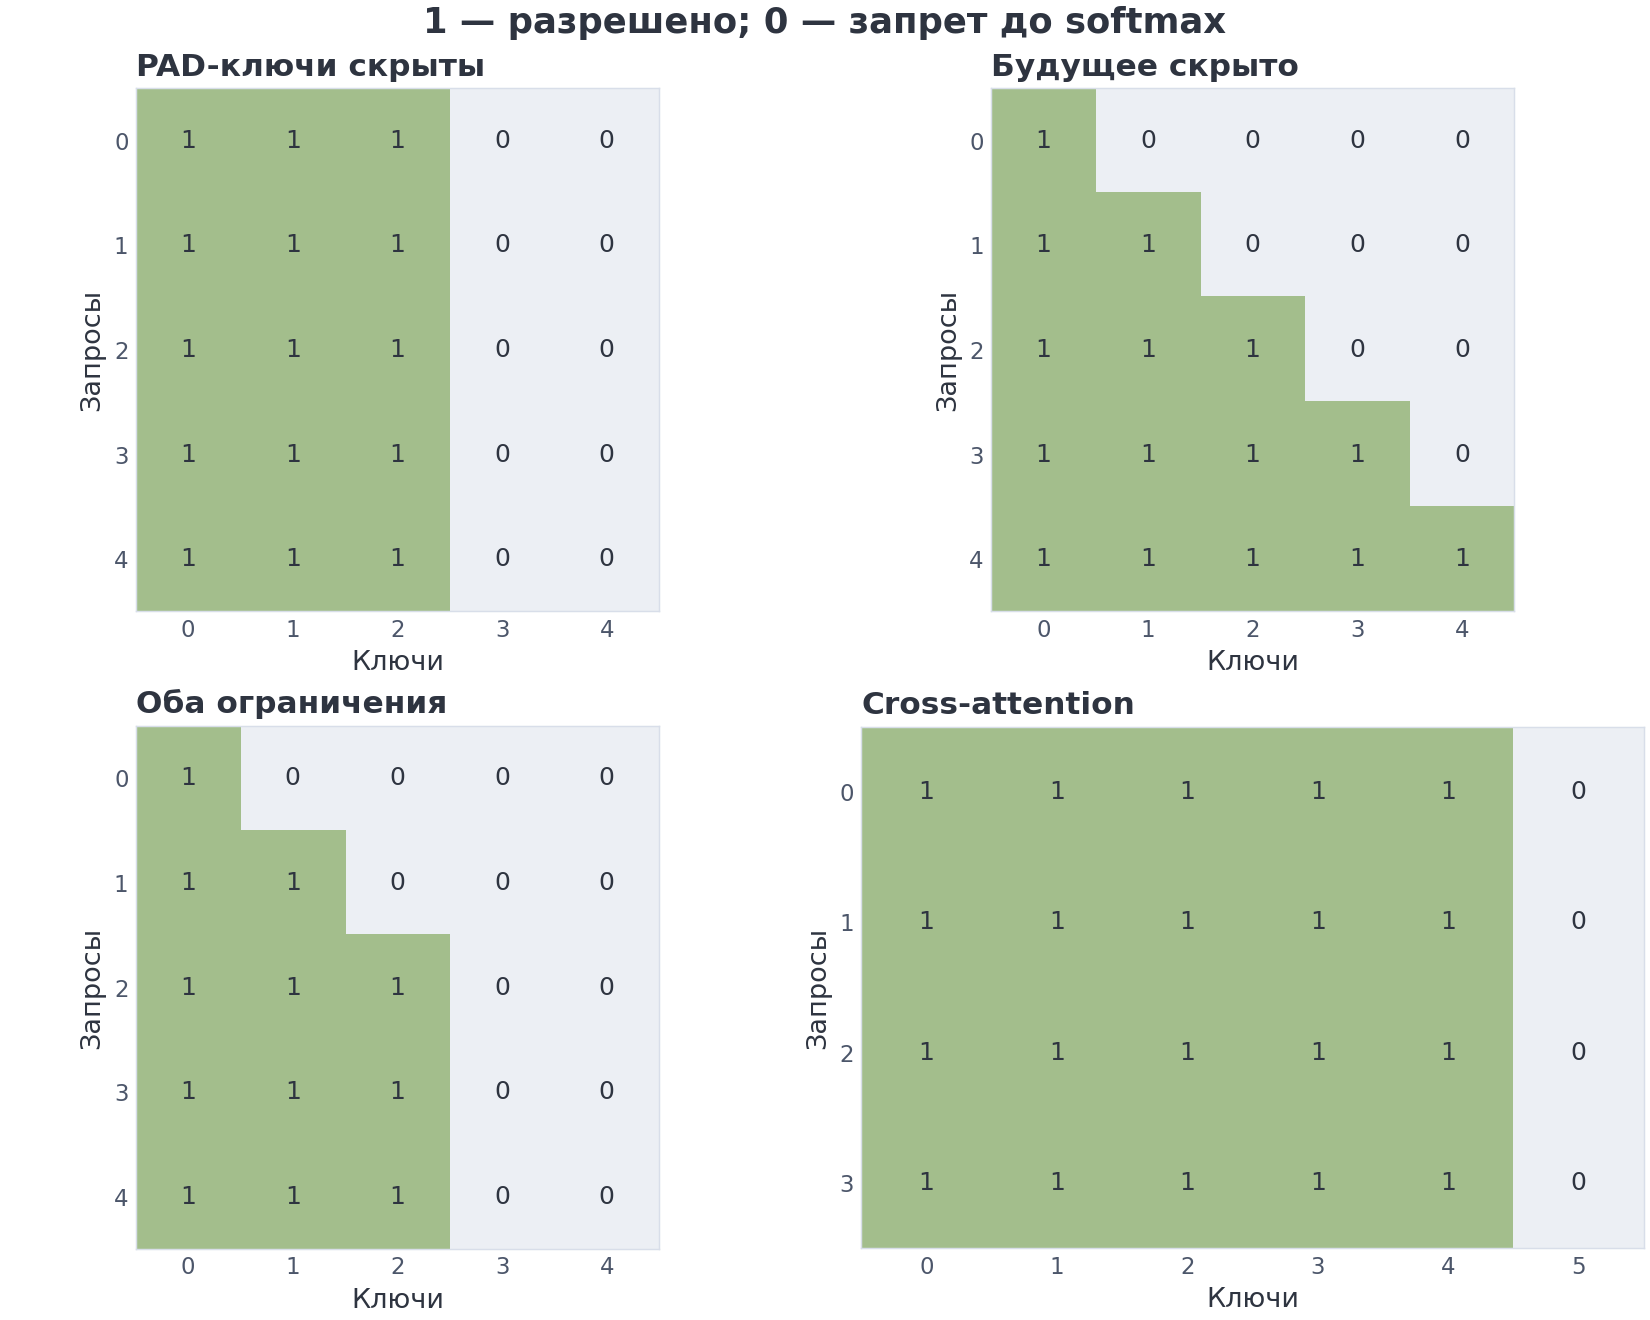 Маски ключей PAD и будущих позиций можно объединять. Четвёртая панель показывает прямоугольную маску cross-attention. Здесь замаскированы ключи; запросы PAD отдельно не удалены.
5.1. Маска заполнителей (padding mask)
Примеры в батче имеют разную длину, но тензор прямоугольный. Более короткие последовательности дополняются PAD. Эти позиции не несут содержания, поэтому их запрещают как ключи. Предсказания на позициях заполнителей также исключают из функции потерь — численного штрафа при обучении (§11).
5.2. Каузальная маска
В decoder-only языковой модели позиция предсказывает токен и не имеет права использовать будущий контекст. Поэтому разрешены ключи :
Это нижнетреугольная матрица. Маска делает параллельное обучение корректным: все позиции вычисляются одним прямым проходом, но каждая получает только допустимый префикс.
5.3. Encoder self-attention
В классическом encoder весь исходный текст известен заранее. Каждая позиция может читать его целиком; нужно скрыть лишь ключи PAD.
5.4. Cross-attention mask
Запросы decoder читают память encoder; их число может отличаться от числа ключей исходного текста. Запрещены ключи PAD, но каузальный треугольник по исходному тексту обычно не нужен: этот текст известен целиком.
5.5. Частая ошибка с булевой семантикой
Даже внутри PyTorch соглашения различаются: у functional.scaled_dot_product_attention булево True разрешает связь, у MultiheadAttention.attn_mask — запрещает. В нашем коде аргумент назван allowed: True всегда означает «разрешено». Проверяем это по нулевым весам запрещённых связей.
5.6. Полностью замаскированная строка
Если запросу не разрешено читать ни одного ключа, строка не задаёт распределение вероятностей. Наивный вызов
import torch

torch.softmax(torch.tensor([-float("inf"), -float("inf")]), dim=0)
# tensor([nan, nan])
даёт NaN: после вычитания максимума возникает неопределённость . Поэтому безопасная учебная реализация должна выбрать политику явно:
error— значение по умолчанию: остановиться и показать ошибку маски;zero— вернуть нулевые веса и выход для строки, когда это осознанная семантика, например для запроса PAD, исключённого из функции потерь.
В режиме zero сумма весов строки равна нулю, а не единице. Это не обычное вероятностное распределение, а контракт «этот запрос не создаёт выхода внимания». Незаметно подставлять равномерное распределение или оставлять NaN нельзя.
6. Многоголовое внимание (multi-head attention)
Одна голова создаёт один набор весов смешивания. Несколько голов могут выбрать разные смеси для одной позиции. Чтобы сохранить смысл обозначений, назовём входы до проекций , а — уже спроецированные векторы головы :
В self-attention ; в cross-attention приходит из decoder, — из encoder. Каждая голова видит весь входной вектор, но возвращает свою более узкую проекцию.
Обозначим число голов через . В распространённой конфигурации
Тогда после конкатенации ширина снова равна .
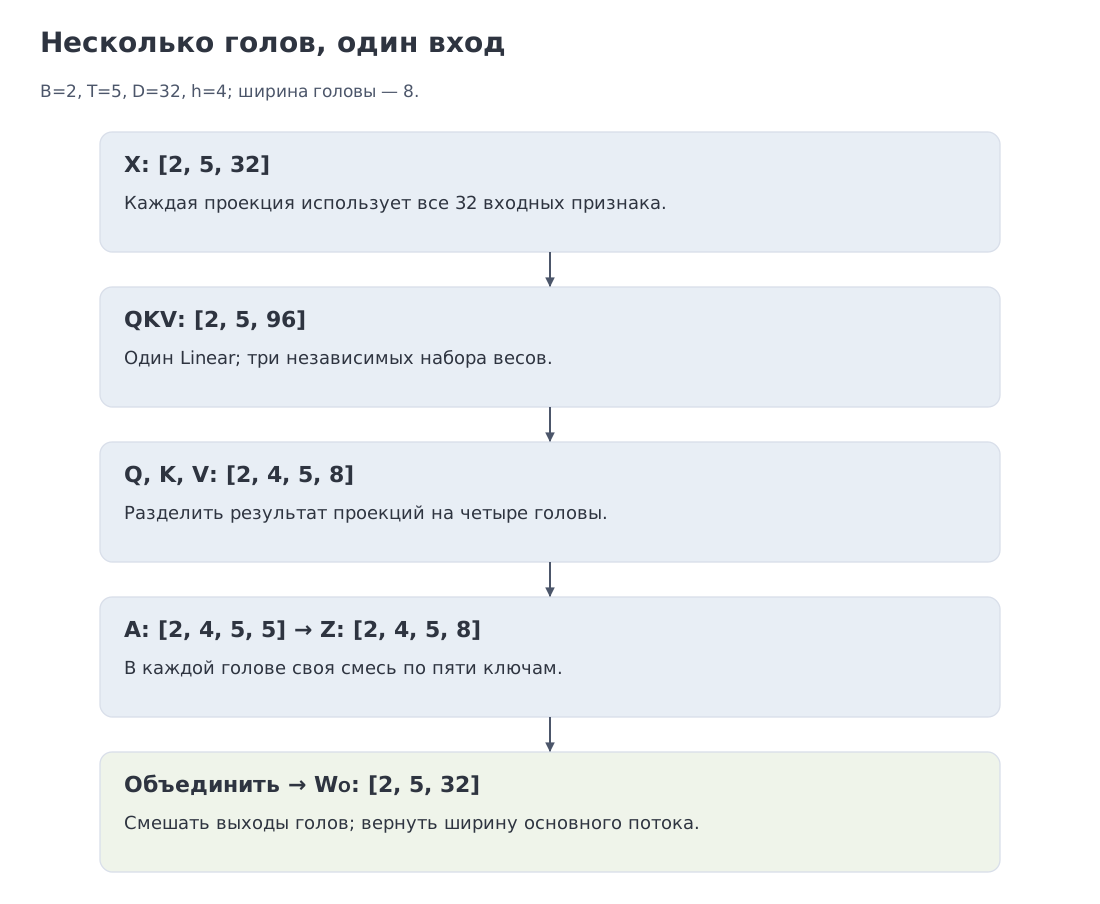 В self-attention три проекции можно объединить в один линейный слой, а результат разделить по головам. После независимого attention головы конкатенируются и проходят через .
6.1. Почему несколько голов могут помочь
Разные головы получают разные матрицы , , . Поэтому одна голова может оказаться чувствительной к ближнему синтаксису, другая — к дальнему совпадению, третья — к разделителям или структуре. Но это возможность, а не гарантия интерпретируемой специализации. Головы могут быть избыточны, распределять функцию между собой или менять роль по слоям и примерам.
6.2. Параметры базового MHA
Если не считать смещения и предположить суммарную ширину голов равной , то:
- , , : по параметров;
- : ещё .
При этих допущениях — точно
Для это весов. Число голов при фиксированной общей ширине меняет разбиение вычисления, но не этот главный порядок параметров.
6.3. Что изменится дальше в курсе
Указатель к М5. Там появятся MQA и GQA — варианты с общими ключами и значениями для нескольких голов запросов, — а также MLA, использующая сжатое представление. Эти названия пока не нужны для вычислений: сначала освоим обычный MHA с отдельными проекциями каждой головы.
7. FFN: нелинейное преобразование каждой позиции
После обмена информацией между позициями нужно преобразовать признаки внутри каждой позиции. Для этого служит FFN: два линейных преобразования с нелинейной функцией между ними. По соглашению этой лекции — строка:
Внутренняя ширина FFN обозначается . В оригинальной статье:
Функция — ReLU: она заменяет отрицательные координаты нулями, . Без нелинейности две линейные проекции можно было бы свернуть в одну. Для базовой конфигурации , .
7.1. Что значит position-wise
Если имеет форму , линейный слой применяется к последней оси. Каждый токен проходит одну и ту же многослойную полносвязную сеть (MLP); между позициями на этом шаге нет смешивания. В коде не нужен цикл по : nn.Linear автоматически работает по последней оси.
7.2. Почему FFN так велик
Без смещений число весов равно
При это параметра — вдвое больше, чем четыре проекции MHA того же слоя. В простом encoder-слое FFN отвечает примерно за две трети весов attention+FFN. Attention решает, откуда взять информацию, FFN — как нелинейно преобразовать полученное представление.
В М6 мы заменим эту простую нелинейность механизмом управляемого пропускания признаков (gating), в частности SwiGLU. Сейчас важно разделить две функции: attention связывает позиции, FFN преобразует признаки каждой позиции.
8. Остаточная связь и LayerNorm
Глубокая сеть должна не только добавлять новые преобразования, но и сохранять путь для сигнала и градиента — производной потери, по которой при обучении корректируются веса. Вокруг каждого подслоя Transformer располагаются остаточная связь и нормализация.
8.1. LayerNorm по последней оси
Для вектора одной позиции:
и — обучаемые векторы масштаба и сдвига; означает поэлементное умножение. Малое положительное предотвращает деление на ноль при нулевой дисперсии. Статистики вычисляются по признакам одной позиции, отдельно от других токенов и примеров.
Для , , и пренебрежимо малого :
8.2. Post-norm в оригинале
В Attention Is All You Need использован порядок
Сначала подслой, затем остаточное сложение, затем LayerNorm. В схеме статьи это Add & Norm.
8.3. Pre-norm в современных LLM
Во многих поздних decoder-only архитектурах норму ставят до подслоя:
При таком порядке вход проходит к сумме напрямую, а нормализация действует внутри добавляемой ветви. Это меняет путь сигнала и градиента, поэтому перестановка нормы меняет саму модель. М6 сравнит LayerNorm с RMSNorm — нормализацией по среднему квадрату координат.
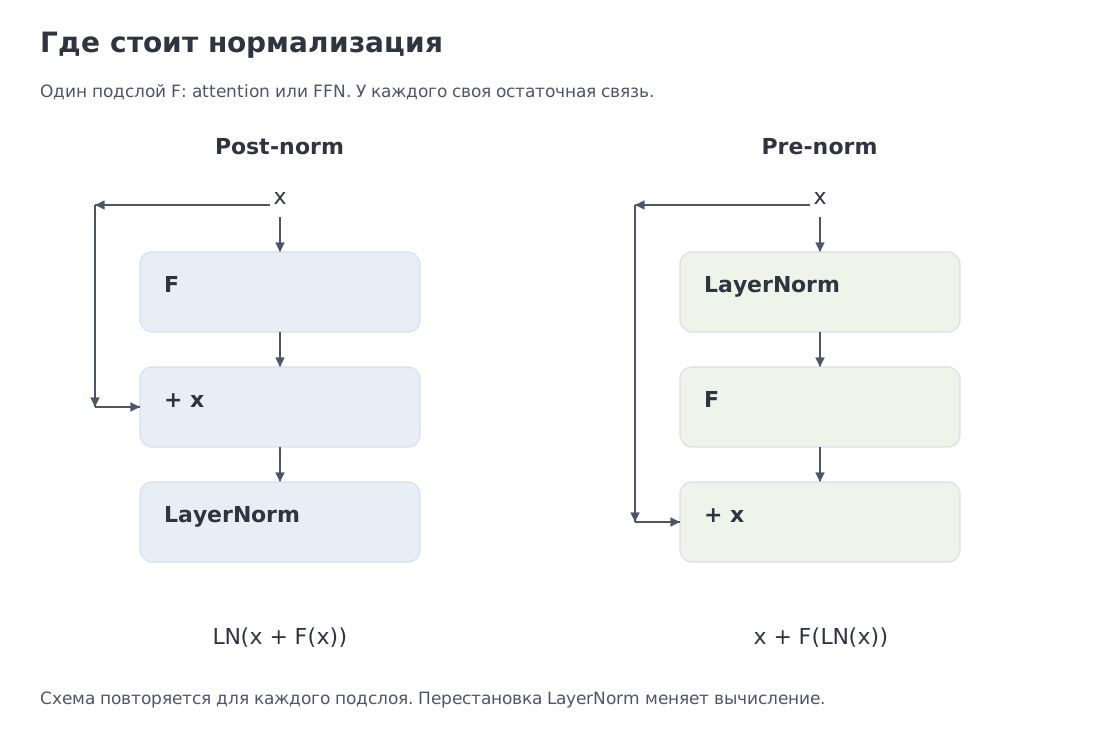 Каждая схема оборачивает один подслой F — attention или FFN. Слева нормализация следует за остаточным сложением, справа находится внутри добавляемой ветви.
8.4. Dropout в оригинальной архитектуре
Dropout во время обучения случайно зануляет часть значений и масштабирует оставшиеся; при обычной генерации его отключают. В оригинальном Transformer он применяется к выходам подслоёв до остаточного сложения и к сумме токенных и позиционных векторов. В формулах выше dropout опущен, чтобы было видно устройство связей.
9. Encoder-слой и encoder-стек
Один encoder-слой выполняет две операции:
- двунаправленное внимание к той же последовательности;
- FFN для каждой позиции.
Каждая обёрнута своей остаточной связью и отдельной LayerNorm. В post-norm записи:
Стек повторяет слой раз с разными обучаемыми параметрами. В базовой конфигурации статьи . Выход последнего слоя — память encoder:
Представление каждой исходной позиции теперь может учитывать все доступные позиции исходного текста.
9.1. Когда полезен encoder
Encoder удобен, когда весь вход известен заранее: например, для классификации или построения поискового эмбеддинга документа. Двунаправленность означает, что позиция может читать токены и слева, и справа. В каузальной decoder-only модели даже токены готового запроса читают только свои префиксы; последнее представление запроса может учитывать весь запрос.
10. Decoder-слой и cross-attention
Оригинальный decoder-слой содержит три подслоя:
- каузальное self-attention по префиксу перевода;
- cross-attention к памяти encoder;
- FFN.
В упрощённой post-norm записи:
Во второй строке запрос приходит из decoder, а ключи и значения — из encoder. Так decoder выбирает сведения из исходного текста для следующего токена перевода.
10.1. Почему вход и цель сдвинуты
Пусть правильная последовательность перевода:
Я люблю модели <EOS>
На вход decoder подаётся:
<BOS> Я люблю модели
А правильные токены для оценки:
Я люблю модели <EOS>
Считаем каждое слово одним игрушечным токеном; реальный токенизатор может разбить его иначе. <BOS> обозначает начало, <EOS> — конец последовательности. Вход и правильный ответ сдвинуты на один токен: позиция <BOS> предсказывает «Я», позиция «Я» — «люблю». Маска разрешает диагональ, потому что токен на входе этой позиции уже относится к известному префиксу.
10.2. От скрытого состояния к вероятностям
Последний вектор каждой позиции — её скрытое состояние (hidden state) — умножается на матрицу . Получаем по одной ненормированной оценке, или логиту, на токен словаря:
Вероятности:
В некоторых моделях выходная матрица связана с входной матрицей эмбеддингов (weight tying). Это экономит параметры и связывает пространство чтения и записи токенов, но не является обязательным условием Transformer.
11. Обучение: teacher forcing и cross-entropy
Teacher forcing означает, что при обучении модель получает известное правильное продолжение, сдвинутое на одну позицию. За каждое предсказание она получает штраф — отрицательный логарифм вероятности (negative log-likelihood, NLL) правильного токена. Сумма штрафов для последовательности:
Здесь обозначает все обучаемые веса, — правильный токен, — предшествующие токены, — исходный текст в задаче перевода. В decoder-only модели отдельного нет. Используем натуральный логарифм, поэтому единица NLL — нат. Для одного правильного токена этот штраф совпадает с перекрёстной энтропией (cross-entropy) между целевым распределением с вероятностью 1 на правильном ответе и распределением модели.
11.1. Почему обучение параллельно
Хотя факторизация авторегрессивна, все правильные токены уже известны в обучающем примере. Мы подаём всю сдвинутую последовательность одним тензором и применяем каузальную маску. Позиции вычисляются параллельно, но каждая не видит будущего.
Это принципиальное различие:
- зависимость распределения авторегрессивна;
- вычисление прямого прохода при обучении параллельно по позициям.
11.2. Числовой NLL-пример
Пусть логиты словаря для одной позиции:
После softmax:
Если правильный токен имеет индекс 3 при нумерации с нуля, потеря этой позиции:
Cross-entropy, KL и связь NLL с кодированием подробно выводятся в соседнем курсе: курс Information Theory for ML, модуль 3. Здесь достаточно инженерного чтения: потеря штрафует модель за вероятность, которую она выделила правильному токену.
11.3. Маска функции потерь
Не все позиции нужно оценивать. Введём для оцениваемой позиции и для пропуска. Средняя потеря равна
Позиции заполнителя PAD исключаются. При обучении на парах «запрос — ответ» часто оценивают только ответ. Маска внимания управляет доступом к информации; маска потерь выбирает предсказания для оценки. Во втором случае токен всё ещё может участвовать в контексте.
12. Генерация: тот же прямой проход, другой цикл
При генерации готового правильного продолжения нет. Алгоритм:
- подать текущий префикс;
- получить логиты последней позиции;
- выбрать следующий токен;
- добавить его к префиксу;
- повторять до
<EOS>или лимита.
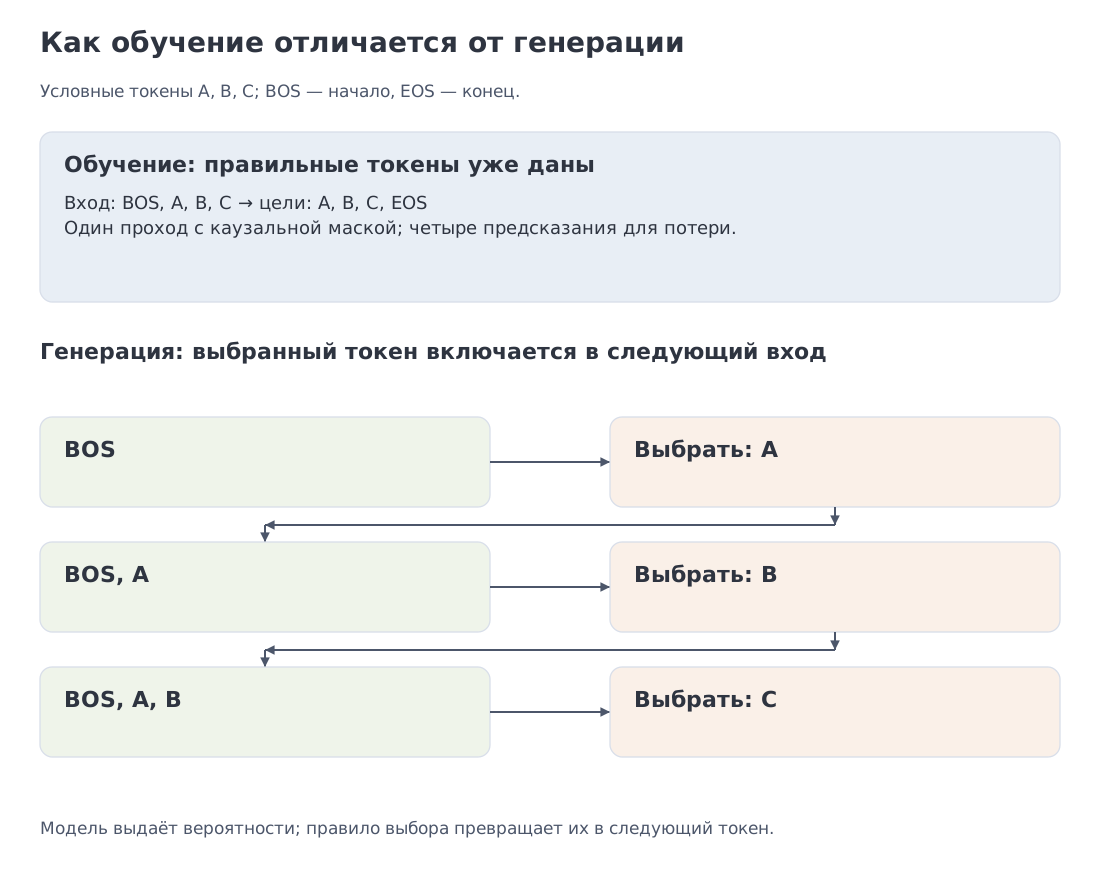 Один и тот же механизм выдаёт вероятности следующего токена. При обучении правильный префикс известен; при генерации он пополняется собственными решениями модели.
12.1. Как выбрать следующий токен
После прямого прохода у нас есть логиты для всех ID словаря. Это ещё не выбранный токен. Жадный выбор (greedy decoding) берёт ID с максимальным логитом; случайный выбор (sampling) использует распределение вероятностей. Для одного и того же состояния модели эти правила могут дать разные продолжения.
Температура меняет распределение перед случайным выбором:
При получаем обычный softmax. При преимущество больших логитов усиливается; при распределение становится ровнее. Порядок логитов не меняется, поэтому жадный выбор при положительной температуре остаётся тем же. Деление на ноль здесь не определено: жадный режим реализуют отдельно, даже если интерфейс обозначает его значением temperature=0.
Возьмём четыре ID с логитами . При вероятности приблизительно равны , а при — . Жадный выбор в обоих случаях даёт ID 0. Случайный выбор при второй температуре чаще обращается к остальным ID; это изменение разнообразия, а не доказательство повышения качества.
Фильтры ограничивают множество допустимых кандидатов . Top-k оставляет наиболее вероятных ID. Top-p, или nucleus sampling, сортирует ID по вероятности и берёт кратчайший начальный отрезок, суммарная вероятность которого достигает порога . Токен, на котором порог впервые достигнут или превышен, входит в набор. Затем выбранные вероятности снова нормируются:
Применим каждый фильтр отдельно при . Top-k с оставляет ID 0 и 1: после нормировки получаем . Для top-p с двух кандидатов мало: их масса около 0.880797. Добавление ID 2 поднимает массу до 0.967941; итоговое распределение равно . Таким образом, top-k фиксирует число кандидатов, а top-p позволяет этому числу меняться вместе с формой распределения. Определение и исходная мотивация nucleus sampling даны в Holtzman et al., §3.
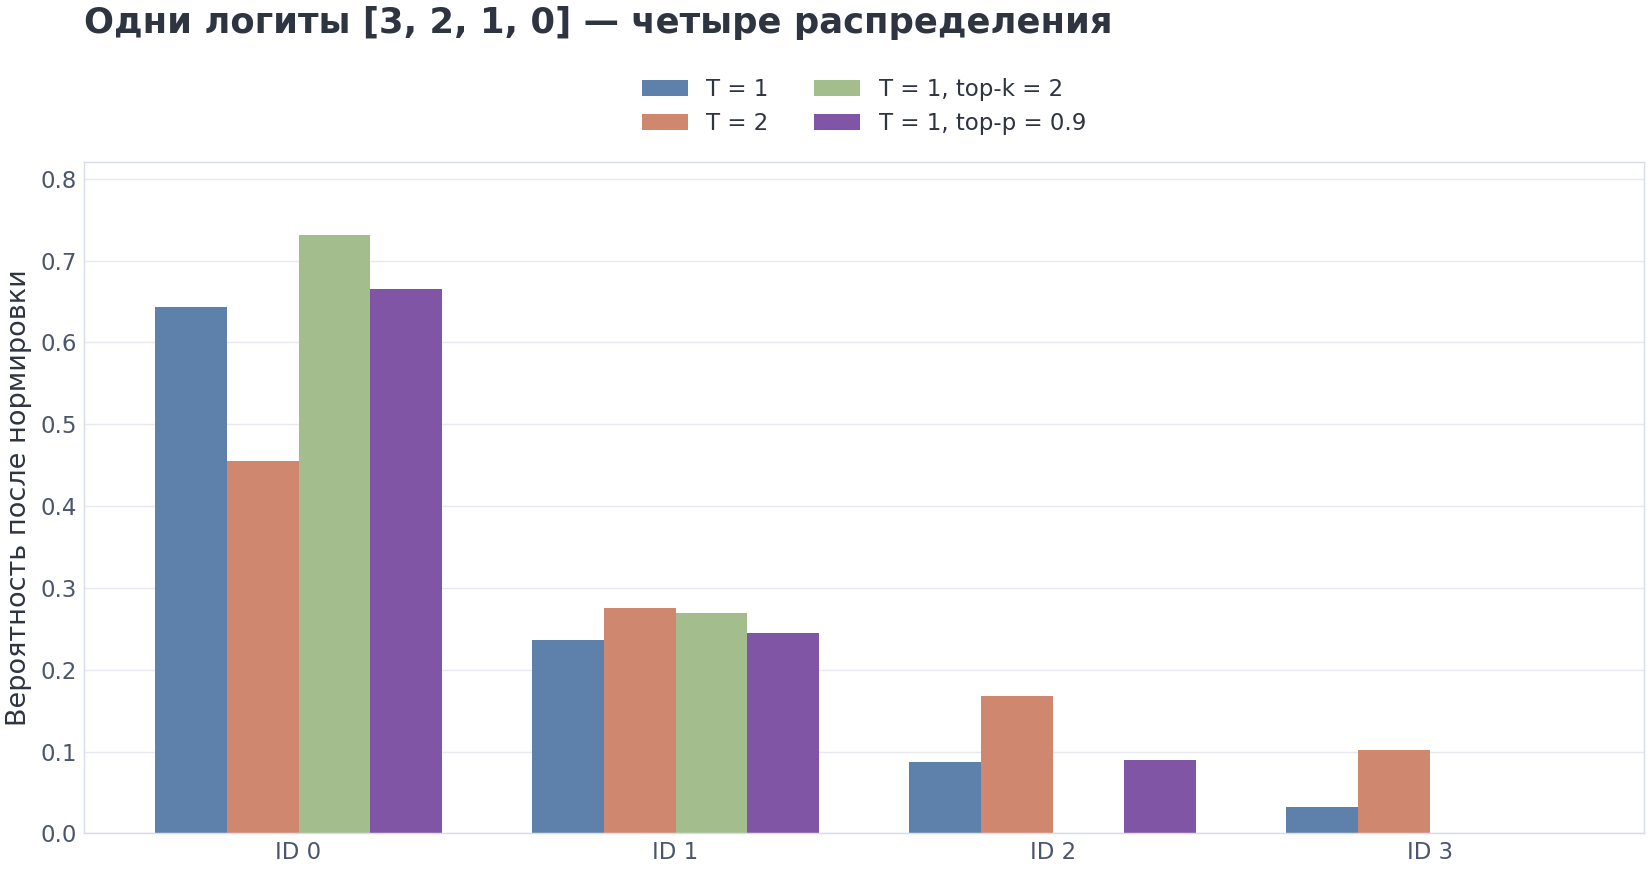 Одни логиты дают разные распределения выбора. Фильтры на рисунке применены отдельно при температуре 1; нулевая высота означает исключённый ID.
В ноутбуке эти числа воспроизводятся явным алгоритмом: экспоненты, сортировка, накопление массы и нормировка. Равные логиты упорядочены по ID. При совместном применении сначала меняется температура, затем выполняются top-k и top-p; последний считает массу уже внутри оставшегося набора. Такой порядок — часть протокола генерации. В М11 спекулятивное декодирование должно сохранять именно выбранное целевое распределение, включая эти преобразования.
12.1.1. Когда закончить ответ
Выбранный токен добавляется к префиксу и влияет на следующий прямой проход. Если это EOS — end of sequence, цикл завершает последовательность. В диалоговых форматах могут использоваться другие маркеры конца хода; их точный смысл задаёт шаблон из М13. Система также ограничивает число новых токенов. Это отдельная причина остановки: достижение лимита не означает, что модель сочла ответ законченным.
Фильтр может исключить EOS на текущем шаге, а на следующем логиты уже будут другими. Поэтому ни жадное правило, ни sampling сами по себе не гарантируют своевременного завершения. Практика отдельно проверяет остановку по EOS и по лимиту на подготовленных трассах; этот небольшой опыт объясняет управление циклом, не измеряя качество обученной модели.
12.2. Почему ошибки накапливаются
На обучении префикс правильный. На генерации ранний неудачный токен становится частью следующего входа. Модель оказывается на префиксах, которые могли редко встречаться в данных. Это один из источников различия между потерей на отдельных токенах и качеством длинного продолжения.
12.3. Зачем KV-cache
В каузальном стеке представление старого токена зависит только от прежнего префикса. Если веса, позиции и доступный контекст не меняются, а dropout отключён, добавление нового токена не меняет старые ключи и значения. KV-кэш сохраняет каждого слоя, чтобы не пересчитывать их. Для нового токена остаётся одна строка запроса, а ось накопленных ключей и значений растёт. При изменении самого префикса или перенумерации позиций это рассуждение нужно проверить заново.
М10 разберёт память KV-кэша и обслуживание запросов. Необязательное углубление: в курсе RL for LLM, модуль 6, выбор токена рассматривается как действие политики; для текущего вычислительного маршрута этот материал не требуется.
13. Минимальная реализация scaled dot-product attention
Код ниже показывает вычисление и основные проверки входа. Выполните блоки §§13–14 по порядку. Все входы — конечные тензоры с непустыми осями на одном устройстве; булева маска должна распространяться до формы оценок. Функция считает в float32 или float64 и возвращает пару (output, weights). Ноутбук расширяет этот интерфейс диагностическими полями и обработкой заполнителей.
from __future__ import annotations

import math
from typing import Literal

import torch
from torch import Tensor

def scaled_dot_product_attention(
    q: Tensor,
    k: Tensor,
    v: Tensor,
    allowed: Tensor | None = None,
    *,
    empty_row: Literal["error", "zero"] = "error",
) -> tuple[Tensor, Tensor]:
    """Educational attention with an explicit fully-masked-row policy.

    q: [..., T_q, d_k]
    k: [..., T_k, d_k]
    v: [..., T_k, d_v]
    allowed: broadcastable bool mask [..., T_q, T_k], True = allowed
    """
    if empty_row not in {"error", "zero"}:
        raise ValueError("empty_row must be 'error' or 'zero'")
    if min(q.ndim, k.ndim, v.ndim) < 2:
        raise ValueError("q, k and v must have at least two dimensions")
    if any(size <= 0 for t in (q, k, v) for size in t.shape):
        raise ValueError("q, k and v must have non-empty axes")
    if not all(t.is_floating_point() and torch.isfinite(t).all() for t in (q, k, v)):
        raise ValueError("q, k and v must be finite floating-point tensors")
    if not (q.device == k.device == v.device):
        raise ValueError("q, k and v must be on one device")
    if q.shape[-1] != k.shape[-1]:
        raise ValueError("q and k must share d_k")
    if k.shape[-2] != v.shape[-2]:
        raise ValueError("k and v must share T_k")

    dtype = torch.float64 if torch.float64 in {q.dtype, k.dtype, v.dtype} else torch.float32
    q, k, v = (t.to(dtype=dtype) for t in (q, k, v))
    batch_shape = torch.broadcast_shapes(q.shape[:-2], k.shape[:-2], v.shape[:-2])
    q, k, v = (t.expand(*batch_shape, *t.shape[-2:]) for t in (q, k, v))
    scores = (q @ k.transpose(-2, -1)) / math.sqrt(q.shape[-1])

    if not torch.isfinite(scores).all():
        raise FloatingPointError("attention scores overflowed")

    if allowed is None:
        allowed = torch.ones_like(scores, dtype=torch.bool)
    else:
        if allowed.dtype is not torch.bool:
            raise TypeError("allowed must be a bool mask")
        allowed = torch.broadcast_to(allowed.to(scores.device), scores.shape)

    empty = ~allowed.any(dim=-1)
    if empty_row == "error" and empty.any():
        raise ValueError("attention contains a fully masked row")

    masked_scores = scores.masked_fill(~allowed, float("-inf"))
    row_max = torch.where(
        (~empty)[..., None],
        masked_scores.max(dim=-1, keepdim=True).values,
        torch.zeros_like(masked_scores[..., :1]),
    )
    exponentials = torch.where(
        allowed,
        torch.exp(masked_scores - row_max),
        torch.zeros_like(masked_scores),
    )
    denominator = exponentials.sum(dim=-1, keepdim=True)
    denominator = torch.where(denominator > 0, denominator, torch.ones_like(denominator))
    weights = exponentials / denominator
    output = weights @ v
    if not torch.isfinite(output).all():
        raise FloatingPointError("attention output overflowed")
    return output, weights
Полностью замаскированная строка не задаёт распределение вероятностей: наивный softmax([-inf, …, -inf]) даёт NaN. Поэтому безопасное значение по умолчанию — ошибка. Политику zero следует включать только явно, например для запроса PAD, чей выход внимания должен быть нулевым.
13.1. Каузальная маска
def causal_allowed(
    t_q: int,
    t_k: int,
    *,
    query_offset: int = 0,
    device=None,
) -> Tensor:
    if any(type(n) is not int for n in (t_q, t_k, query_offset)):
        raise TypeError("lengths and offset must be integers")
    if min(t_q, t_k) <= 0 or query_offset < 0:
        raise ValueError("positive lengths and non-negative offset required")
    q_pos = query_offset + torch.arange(t_q, device=device)[:, None]
    k_pos = torch.arange(t_k, device=device)[None, :]
    return k_pos <= q_pos
Для обычного self-attention и query_offset=0. При декодировании с кэшем новый запрос может иметь локальный индекс 0, но глобальную позицию ; тогда query_offset=t, иначе маска ошибочно разрешит только самый первый ключ.
13.2. Минимальный multi-head модуль
import torch.nn as nn

class MultiHeadSelfAttention(nn.Module):
    def __init__(self, d_model: int, n_heads: int) -> None:
        super().__init__()
        if any(type(n) is not int or n <= 0 for n in (d_model, n_heads)):
            raise ValueError("d_model and n_heads must be positive integers")
        if d_model % n_heads != 0:
            raise ValueError("d_model must be divisible by n_heads")
        self.d_model = d_model
        self.n_heads = n_heads
        self.d_head = d_model // n_heads
        self.qkv = nn.Linear(d_model, 3 * d_model, bias=False)
        self.out = nn.Linear(d_model, d_model, bias=False)

    def forward(self, x: Tensor, causal: bool = True) -> Tensor:
        b, t, _ = x.shape
        qkv = self.qkv(x)
        q, k, v = qkv.chunk(3, dim=-1)

        def split_heads(z: Tensor) -> Tensor:
            return z.view(b, t, self.n_heads, self.d_head).transpose(1, 2)

        q, k, v = map(split_heads, (q, k, v))
        allowed = None
        if causal:
            allowed = torch.ones(t, t, dtype=torch.bool, device=x.device).tril()
        y, _ = scaled_dot_product_attention(q, k, v, allowed)
        y = y.transpose(1, 2).contiguous().view(b, t, self.d_model)
        return self.out(y.to(dtype=x.dtype))
После явной реализации полезно сравнить результат с torch.nn.functional.scaled_dot_product_attention. Эта функция выбирает доступный способ вычисления; конкретный выбор зависит от устройства, типа данных и маски. Сам вызов API не гарантирует FlashAttention или отсутствие полной матрицы промежуточных значений. В ноутбуке сравниваем выходы и градиенты, задавая dropout_p=0.0 явно.
14. Минимальный Transformer-блок
Соберём минимальный decoder-only блок: нормализация перед подслоем, каузальное внимание и FFN. Здесь вместо ReLU используется GELU, гладкая нелинейность , где — функция распределения стандартной нормали. Это учебный вариант для понимания вычислений; оригинал 2017 года использует post-norm и ReLU.
class FeedForward(nn.Module):
    def __init__(self, d_model: int, d_ff: int) -> None:
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(d_model, d_ff),
            nn.GELU(),
            nn.Linear(d_ff, d_model),
        )

    def forward(self, x: Tensor) -> Tensor:
        return self.net(x)

class DecoderBlock(nn.Module):
    def __init__(self, d_model: int, n_heads: int, d_ff: int) -> None:
        super().__init__()
        self.ln1 = nn.LayerNorm(d_model)
        self.attn = MultiHeadSelfAttention(d_model, n_heads)
        self.ln2 = nn.LayerNorm(d_model)
        self.ffn = FeedForward(d_model, d_ff)

    def forward(self, x: Tensor) -> Tensor:
        x = x + self.attn(self.ln1(x), causal=True)
        x = x + self.ffn(self.ln2(x))
        return x
Проверьте граф словами:
ln1(x)нормирует каждую позицию;- каузальное внимание смешивает только допустимый префикс;
- выход складывается с исходным
x; - вторая нормализация и FFN преобразуют каждую позицию;
- остаточное сложение снова сохраняет основной поток и его форму.
14.1. Проверяем независимость от будущего
Сильный тест маски: измените будущий токен и проверьте, что выходы более ранних позиций не изменились. Для позиции :
Проверку выполняют при фиксированных весах в режиме eval(), чтобы dropout не добавлял случайных различий. Числа с плавающей точкой сравнивают через torch.testing.assert_close. Контроль без маски тоже нужен: он показывает, что выбранный пример действительно обнаруживает утечку.
15. Полная трассировка форм на игрушечной модели
Пусть:
- ;
- ;
- ;
- ;
- ;
- ;
- .
Тогда один прямой проход decoder-only модели:
| Этап | Форма |
|---|---|
| Идентификаторы токенов | |
| Эмбеддинги + позиции | |
| Общая проекция QKV | |
| Q/K/V после разделения по головам | |
| Оценки | |
| Выход внимания по головам | |
| Объединение + | |
| Внутренние признаки FFN | |
| Выход блока | |
| Логиты словаря |
Эта таблица — практический дебаггер. Большая часть ошибок в первой реализации Transformer — не в математике, а в transpose, view, broadcasting маски и выборе оси softmax.
15.1. Число весов основных проекций
Теперь вернёмся от игрушечных размеров к базовой конфигурации статьи: , . Считаем один слой без смещений, параметров LayerNorm и таблиц эмбеддингов:
- self-attention в encoder: ;
- FFN: ;
- слой encoder: ;
- слой decoder: два attention-подслоя + FFN = .
Для этих допущений числа точные; полный слой содержит ещё смещения и параметры нормализаций. В модели также есть эмбеддинги и выходная проекция словаря, а слоёв несколько. Сравнение показывает, откуда берётся большая доля FFN: две его широкие матрицы содержат вдвое больше весов, чем четыре проекции MHA.
16. Оригинал 2017 и современная LLM: что сохранилось
Слово «Transformer» легко создаёт ложное ощущение одной неизменной архитектуры. На деле это семейство.
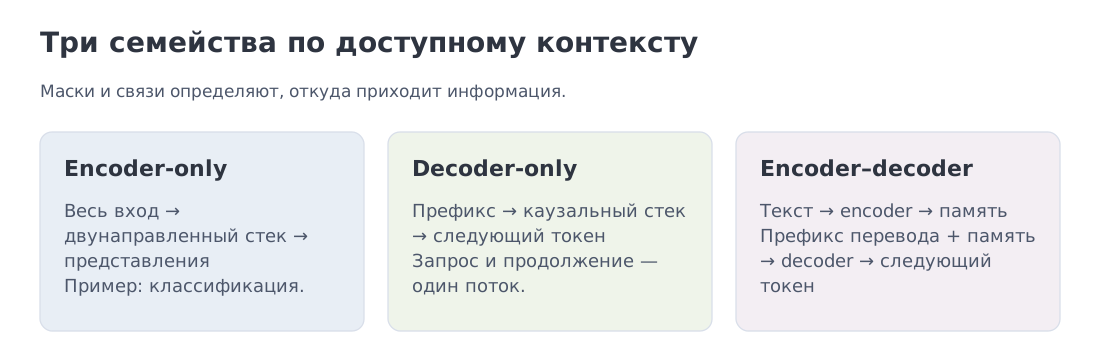 Три семейства используют общее ядро, но различаются масками и потоком информации. Для Modern LLMs центральна decoder-only ветвь, однако encoder и cross-attention нужны для понимания происхождения конструкции и многих мультимодальных систем.
Таблица для справки. Названия замен здесь служат указателями: позиционные методы — М4, варианты внимания — М5, нормы и FFN — М6, обучение — М9, исполнение — М10. Это распространённые варианты, а не обязательные свойства каждой LLM.
| Компонент | Оригинальный Transformer | Типичная современная decoder-only LLM |
|---|---|---|
| архитектура | encoder–decoder | decoder-only |
| attention | MHA | MHA, GQA, MQA, MLA или гибрид |
| позиция | абсолютные синусоиды | чаще RoPE и расширения |
| порядок нормы | post-norm | чаще pre-norm |
| норма | LayerNorm | часто RMSNorm |
| FFN | ReLU MLP | часто SwiGLU/gated MLP |
| задача | перевод последовательности | предобучение на следующем токене |
| генерация | авторегрессивный decoder | авторегрессивный decoder с KV-кэшем |
| эффективность | обычное attention-вычисление | FlashAttention, fused kernels, paging |
16.1. Неподвижное ядро
Несмотря на изменения, узнаваемая схема остаётся:
- дискретные токены превращаются в векторы;
- позиционные сигналы и маски задают структуру последовательности;
- attention маршрутизирует информацию между позициями;
- FFN нелинейно преобразует каждую позицию;
- остаточные связи и нормализация позволяют строить глубокий стек;
- выходная проекция словаря задаёт распределение следующего токена.
Эта схема связывает эмбеддинги М2 с позиционными механизмами М4. Всё дальнейшее в курсе отвечает на вопросы: как этот механизм масштабировать, стабилизировать, обучать, обслуживать и расширять.
16.2. Почему GPT — не «Transformer без encoder» в бытовом смысле
Формально decoder-only стек действительно убирает encoder и cross-attention. Но инженерно важнее положительное описание: это стек блоков каузального внимания, обучаемый предсказывать следующий токен. Запрос и продолжение живут в одном токенном потоке. Поэтому схема не просто «обрезана» — у неё другой основной режим использования и масштабирования.
17. Что часто путают
17.1. «Attention хранит знания»
Веса вычисляются заново из текущего входа. Обученные матрицы проекций, FFN и эмбеддинги сохраняются между запросами. Поэтому нужно различать параметры модели и временные веса смешивания. Само число параметров FFN не доказывает, какая доля знаний хранится именно в нём.
17.2. «Большой вес внимания доказывает причинность»
Вес показывает локальный коэффициент смеси в конкретной голове и слое. Он не учитывает альтернативные пути через остаточные связи, другие головы, FFN и последующие слои. Это диагностический сигнал, не универсальное объяснение.
17.3. «Каузальная маска делает вычисление последовательным»
Она делает зависимость каузальной. Прямой проход при обучении остаётся параллельным по позициям. Последовательным становится цикл генерации, потому что будущие токены ещё неизвестны.
17.4. «Self-attention всегда квадратный»
Матрица оценок имеет . В обычном self-attention , но cross-attention и генерация с KV-кэшем дают прямоугольные формы.
17.5. «Вход делится на непересекающиеся куски до проекций»
Каждая голова строит проекции из всех входных признаков. Делится уже результат проекций: при стандартном разбиении ширина головы равна . Поэтому разные головы могут использовать одни и те же входные координаты.
17.6. «LayerNorm нормирует батч»
LayerNorm нормирует признаки одной позиции. BatchNorm использует статистики по примерам; это другая операция.
17.7. «Маска после softmax — то же самое»
Если просто занулить веса после softmax, строки перестанут суммироваться в единицу. Можно перенормировать, но это уже лишняя и часто нестабильная операция. Канонически запрет вносится в логиты до softmax.
17.8. «Post-norm и pre-norm различаются только рисунком»
Положение нормы меняет путь сигнала и градиента. Формулы и код должны совпадать с выбранным вариантом.
17.9. «Эмбеддинги и выходная проекция обязаны делить веса»
Weight tying распространён, но архитектура корректна и без него. Всегда проверяйте конфиг и реализацию.
17.10. «Базовый Transformer объясняет всё про современную LLM»
Он объясняет вычислительный скелет. Остальные модули рассматривают данные, оптимизацию, масштабирование, дообучение, поиск, обслуживание запросов, мультимодальность и оценку качества.
21. Маршрут чтения и источники
Материалы ниже не дублируют друг друга; у каждого своя функция.
- Первоисточник: Vaswani et al., “Attention Is All You Need”. Читайте аннотацию, §3, Figure 1, §5 и таблицу гиперпараметров; подробные настройки обучения можно разобрать при повторном чтении.
- Визуальная интуиция: Jay Alammar, “The Illustrated Transformer”. Хорош для первого прохода через encoder–decoder и Q/K/V.
- Код рядом с текстом: Harvard NLP, “The Annotated Transformer” и репозиторий. Полезен для точного сопоставления статьи и реализации.
- Геометрическая интуиция: 3Blue1Brown, “Attention in transformers” и “Transformers, the tech behind LLMs”.
- Сборка decoder-only модели с нуля: Andrej Karpathy, “Let’s build GPT” и маршрут Zero to Hero. Это уже GPT-ветвь, а не точное воспроизведение encoder–decoder статьи.
- Учебник с упражнениями: Dive into Deep Learning, Transformer chapter.
- Современный PyTorch API: Scaled Dot Product Attention tutorial и документация функции.
- Короткая реализация self-attention: Sebastian Raschka, “Understanding and Coding Self-Attention…”.
Рекомендуемый порядок новичку: этот урок → Alammar → ноутбук → Figure 1 и §3 оригинальной статьи → Karpathy или Annotated Transformer. Читателю с опытом достаточно первоисточника, VIZ 11 и тестов ноутбука.
22. Итоговая шпаргалка и переход к позициям
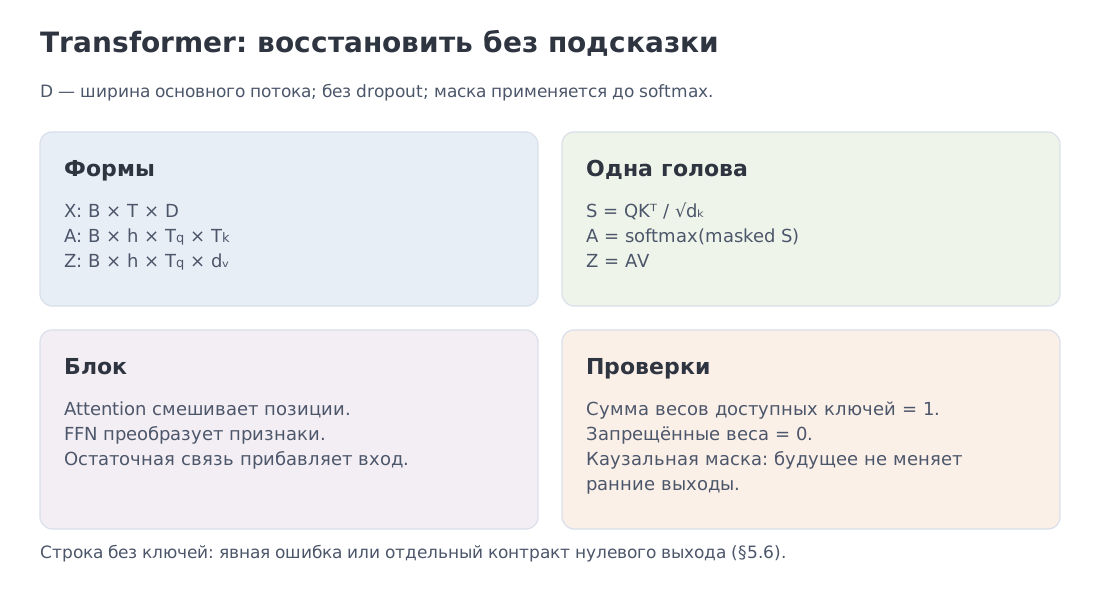 Четыре панели, которые стоит уметь восстановить без текста: формы, вычисление одной головы, роли подслоёв и проверки корректности.
Соберём урок в один маршрут:
- токенизатор даёт идентификаторы; эмбеддинги и позиции превращают их в ;
- строит логиты связей, маска удаляет запрещённые, softmax нормирует по ключам;
- смешивает значения, головы объединяются через ;
- FFN преобразует каждую позицию, остаточные связи и нормализация поддерживают глубокий стек;
- encoder читает весь исходный текст; decoder читает префикс продолжения и, если она есть, память encoder;
- teacher forcing обучает все позиции параллельно, генерация создаёт их последовательно;
- современные LLM меняют позиции, нормы, FFN, головы и способы исполнения, но этот вычислительный скелет остаётся узнаваемым.
Дальше: модуль 4 — позиционные представления. Теперь можно отдельно изучать, как модель различает порядок токенов и работает с длинным контекстом.
Устойчивая математическая основа. Современные варианты этих механизмов разобраны в модулях 4–6 и 10. Теория cross-entropy/KL: курс Information Theory for ML, модуль 3. Токенная модель как политика: курс RL for LLM, модуль 6.