Модуль 13. SFT и работа с данными
Курс «Modern LLMs» · лекция модуля 13 · редакция 11 октября 2026 года
О чём этот модуль. После претрейна модель хорошо решает задачу продолжения текста, но из этого ещё не следует, что она будет вести диалог, соблюдать роли, пользоваться инструментами и завершать ответ в нужном месте. Контролируемое дообучение по демонстрациям — SFT (Supervised Fine-Tuning) — показывает модели, какое продолжение мы считаем желательным в конкретной ситуации.
Маршрут рассуждения. В этом модуле мы разберём две стороны SFT. Первая — механика: шаблон диалога, маскирование функции потерь, упаковка примеров и стоимость обучения. Вторая — данные: отбор демонстраций, синтетическая генерация, перенос рассуждений, обучение работе с инструментами, дистилляция и LoRA. Практика опирается на четыре основных сценария: 21 обучаемый токен из 56; упаковка 24 примеров в 5 контейнеров; оценка вычислительного бюджета SFT; 13,63 млн параметров LoRA вместо обновления всей модели. Позже к ним добавятся отбор синтетических ответов и оценка s1.
Что нужно знать заранее. Полезно помнить устройство токенизатора и специальных токенов из модуля 2, конвейер подготовки данных и приближение из модуля 9, а также связь 4-битного хранения с QLoRA из модуля 11. Все необходимые определения повторяются здесь, поэтому модуль остаётся самодостаточным.
1. Мотивация: от продолжения текста к управляемому поведению
Как читать модуль. В первом проходе пройдите §§1–6, прочитайте смысл оценок в §7, затем §§8–12 и объяснения дистилляции и LoRA в §§15–16. Блоки мостов NumPy → PyTorch можно пока свернуть: необходимые определения даны перед ними. Во втором проходе воспроизведите четыре численных сценария, §§13–14 и ноутбук; проверьте сдвиг меток и независимость упакованных примеров. §§2, 8, 16.1 и 17 служат также справочником по источникам и файлам модели. Длинные решения и инструменты сначала рассматриваются как данные для имитации; обучение по награде начинается в следующем модуле.
В модуле 12 мы изучали диффузионную цель. Здесь подробный код возвращается к авторегрессионному Transformer: SFT — название этапа обучения по демонстрациям, а не требование использовать только одну архитектуру. У диффузионной модели можно дообучать ответы по условной цели денойзинга, но причинный сдвиг меток из этого модуля к ней механически не переносится.
При предобучении модель минимизировала одну и ту же локальную потерю миллиарды раз:
Этот критерий чрезвычайно продуктивен: чтобы хорошо предсказывать следующий токен, модель вынуждена усвоить язык, множество фактов, стили текста и некоторые способы рассуждения. Но в нём нет отдельного требования «ответь пользователю», «соблюдай системную инструкцию» или «верни вызов функции в заданной схеме».
Представим, что в обучающих данных часто встречались страницы с арифметическими упражнениями. После строки What is 2+2? естественным продолжением может оказаться не ответ, а следующий пункт списка: What is 3+3?. С точки зрения языкового моделирования это не ошибка. С точки зрения пользователя — модель не выполнила задачу.
SFT меняет условное распределение поведения с помощью демонстраций. Каждая демонстрация говорит не просто «какой текст вероятен», а «какой ответ следует дать при таком контексте, такой роли и таком формате». Это всё ещё обучение следующему токену, но теперь последовательность специально организована как диалог и градиент направлен прежде всего на токены желательного ответа.
Полезно сразу сделать оговорку. SFT способен добавить узкий навык или часть предметных сведений, однако его главная роль — адаптация поведения, а не надёжная загрузка больших объёмов знаний. Продолженное обучение меняет веса; извлечение и инструменты поставляют сведения в контекст при ответе. Внешний документ сам по себе не закрепляет знание в параметрах модели. Выбор зависит от того, насколько часто сведения обновляются, нужен ли проверяемый источник и какому навыку мы хотим научить систему. SFT может дополнять каждый из этих способов.
Отсюда возникают четыре инженерных вопроса.
- Как сериализовать диалог? Роли и границы сообщений должны превратиться в точную последовательность токенов.
- На каких токенах считать ошибку? Обычно нас интересует ответ ассистента, а не воспроизведение пользовательского запроса.
- Как не тратить вычисления на дополнение коротких примеров пустыми позициями? Для этого нужна упаковка примеров.
- Какие демонстрации действительно меняют поведение в нужную сторону? На практике именно этот вопрос чаще всего определяет качество результата.
Механика защищает обучение от тихих ошибок. Данные определяют, чему модель научится.
2. Как сложился современный SFT
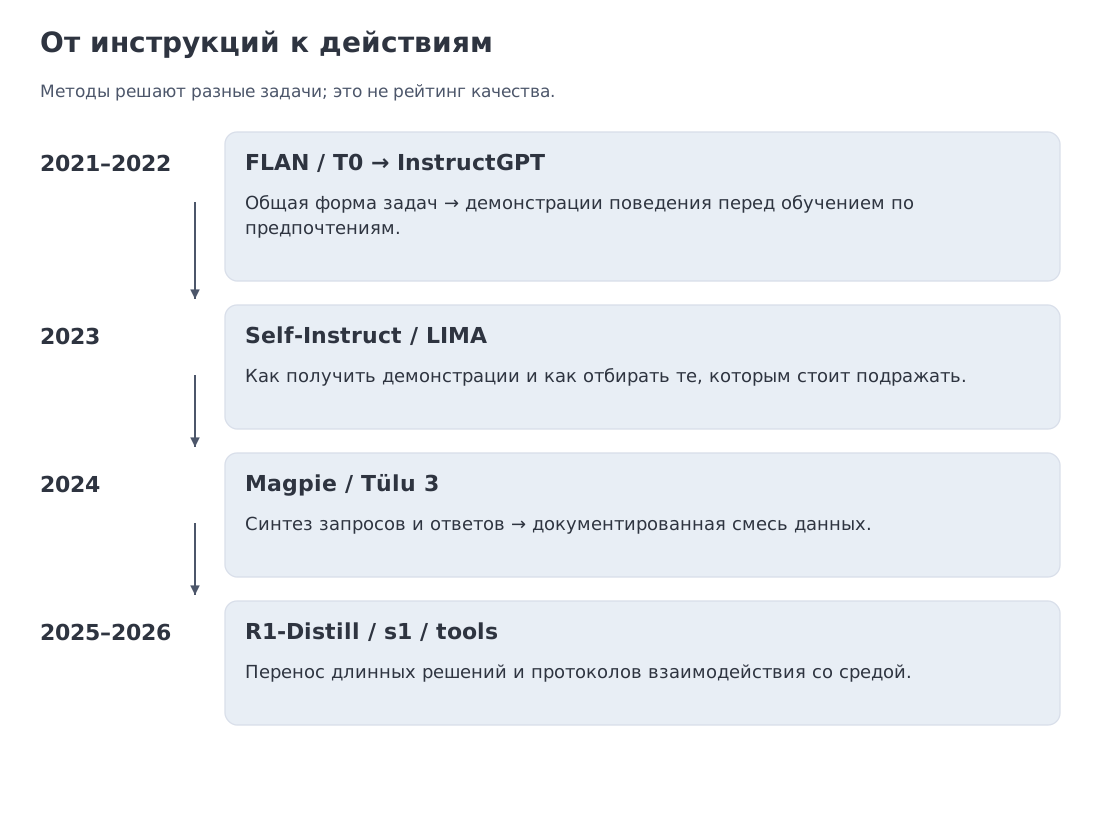 Линия развития: многозадачное дообучение на инструкциях (instruction tuning) → SFT как первый этап постобучения (post-training) → открытые рецепты и малые тщательно отобранные наборы → синтетические данные → перенос рассуждений и обучение работе с инструментами.
История SFT не сводится к одному изобретению. Скорее, несколько исследовательских линий постепенно сошлись в современном постобучении.
Работы FLAN и T0 показали, что одна модель может обучаться на множестве задач, представленных в форме естественно-языковых инструкций, и затем переносить этот навык на новые формулировки. В InstructGPT SFT стал первым этапом более длинного маршрута: демонстрации задавали исходное поведение, после чего модель дополнительно оптимизировалась по человеческим предпочтениям. RLVR, встречающееся далее в обзоре, означает обучение с подкреплением по проверяемой награде: например, за решение, прошедшее тесты. Механику этого этапа мы разберём в модуле 14.
В 2023 году открытые рецепты сделали дообучение на инструкциях (instruction tuning) воспроизводимым. Self-Instruct автоматизировал расширение набора инструкций, а LIMA продемонстрировала, насколько много может дать всего тысяча тщательно отобранных примеров для уже сильной 65B-модели. Правильный вывод из LIMA не в том, что «данные больше не нужны», а в том, что ценность демонстрации определяется не только её присутствием в наборе, но и точностью, разнообразием и соответствием целевому поведению.
Следующий шаг — массовая синтетика. Magpie показала, что модель, дообученная на инструкциях, может сама породить пользовательский запрос, если ей передать только левую часть её собственного шаблона до позиции пользовательского сообщения. Авторы сгенерировали 4 млн инструкций и отобрали 300 тыс. качественных примеров. Tülu 3 затем продемонстрировала открытый, документированный маршрут, где SFT является первой стадией наряду с обучением по предпочтениям и RLVR.
В 2025 году SFT стал важным способом переносить длинные решения от сильных рассуждающих моделей к меньшим. DeepSeek дообучила несколько открытых моделей на примерно 800 тыс. примеров, сформированных с помощью DeepSeek-R1; проект s1 показал, что тщательно отобранная тысяча длинных решений уже способна заметно изменить поведение 32B-модели.
Наконец, формат ответа стал частью архитектуры продукта. Вызовы инструментов, скрытые и видимые каналы, служебные роли и структурированные результаты требуют не только хорошего текста, но и точного протокола. Спецификация Harmony, используемая gpt-oss, — один из примеров формата, где каналы analysis, commentary и final заданы явно, а не восстанавливаются эвристикой из одной строки.
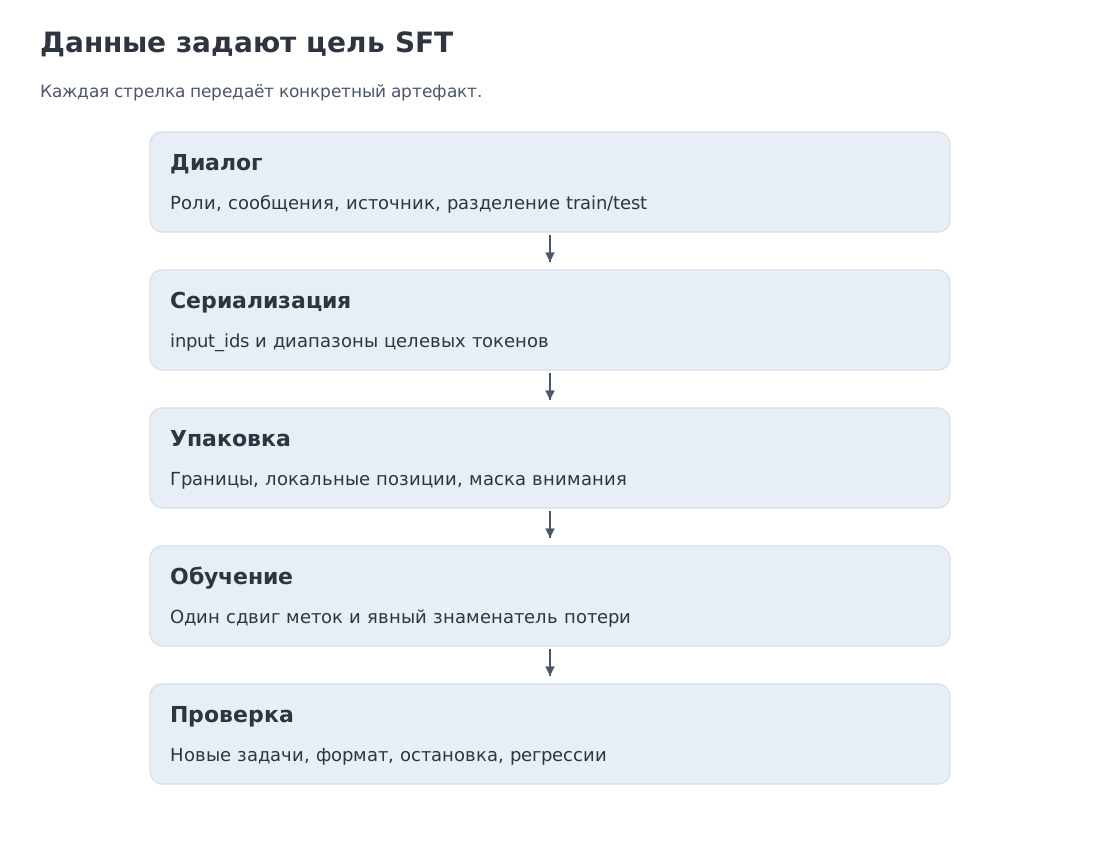 Современный конвейер SFT: базовая модель → шаблон и токенизация → отобранный набор демонстраций → упаковка и изоляция примеров → целевая маска → полное дообучение или адаптер → проверка поведения.
3. Три классические идеи за современной терминологией
SFT легче понять, если увидеть в нём продолжение трёх хорошо известных направлений машинного обучения.
Перенос обучения (transfer learning): большое общее обучение, малая адаптация
Сначала модель приобретает общие представления на огромном корпусе, затем адаптируется к более узкой задаче. В компьютерном зрении таким источником служил ImageNet, в языковых моделях — претрейн на триллионах токенов. Разница в масштабе огромна, но логика та же: дорогой общий этап выполняется один раз, а последующие адаптации сравнительно дешевы.
Небольшой объём SFT не означает, что веса «почти не меняются» в математическом смысле или что модель затрагивает только отдельный «поведенческий слой». Обновления проходят через выбранные параметры всей сети. Однако малый шаг, ограниченное число эпох и узкое распределение демонстраций действительно делают этот этап прежде всего настройкой способа использования уже усвоенных представлений.
Behavior cloning: имитация демонстраций
В имитационном обучении политика — условное распределение действий при состоянии . По набору демонстраций она учится повышать вероятность экспертных действий:
Для языковой модели состоянием становится префикс диалога, а действием — следующий токен ответа. Такая аналогия объясняет ограничение SFT: модель обучается на состояниях, созданных экспертными демонстрациями, но во время генерации встречает и собственные, иногда ошибочные префиксы. Ошибка может изменить дальнейшее распределение контекста — это разновидность сдвига распределения (distribution shift).
Обучение по предпочтениям и RL могут работать уже с ответами, сгенерированными самой политикой, и тем самым частично уменьшать этот разрыв. Но они не являются универсальным «лечением» любой галлюцинации: качество данных, базовой модели, награды и среды остаётся определяющим.
Углубление. Связь SFT с behavior cloning, on-policy обучением и накоплением ошибок в траекториях подробнее рассматривается в курсе RL for LLM, модули о policy optimization и генерации rollouts.
Качество разметки: старое правило в новом масштабе
Дедупликация, согласованность аннотаций, покрытие редких случаев и контроль утечек были важны задолго до LLM. В SFT меняется объект проверки. Для веб-корпуса мы спрашивали, похожа ли страница на полезный текст. Для демонстрации ассистента нужно проверить другое:
- верен ли ответ;
- соответствует ли он инструкции и роли;
- полон ли он ровно настолько, насколько требует задача;
- корректно ли оформлены отказ, уточнение и вызов инструмента;
- не воспроизводит ли он шаблонные словесные привычки учителя;
- не дублирует ли он уже представленные навыки.
Поэтому SFT — не просто запуск оптимизатора на готовом файле. Это проектирование распределения желательного поведения.
4. Формат данных: шаблон является частью модели
Большинство современных наборов для SFT представляют пример как последовательность сообщений с ролями: system, user, assistant, а при работе с инструментами — также tool. Однако Transformer получает не список словарей, а одну последовательность идентификаторов токенов. Преобразование выполняет шаблон диалога (chat template).
В экосистеме Hugging Face шаблон часто хранится как строка шаблона Jinja в tokenizer_config.json и вызывается через tokenizer.apply_chat_template. Он задаёт:
- специальные токены начала и конца сообщения;
- способ кодирования роли;
- место системной инструкции;
- разделители ходов;
- токены завершения ответа;
- формат вызовов инструментов и результатов;
- при необходимости — отдельные каналы ответа.
У Llama используются заголовки ролей и токен конца хода <|eot_id|>. Семейство шаблонов, обычно называемое ChatML, использует маркеры наподобие <|im_start|> и <|im_end|>. Конкретные реализации Qwen, DeepSeek и других семейств могут добавлять собственные служебные токены для рассуждений или инструментов; название «ChatML» не гарантирует полного совпадения шаблонов.
Harmony делает структуру ещё явнее. Сообщение содержит роль, содержимое и канал; каналы analysis, commentary и final различают внутреннее рассуждение, служебные преамбулы или вызовы инструментов и текст, предназначенный пользователю. Для обучения важен не сам набор названий, а то, что модель видела точно такую же грамматику токенов, с какой она будет работать при инференсе.
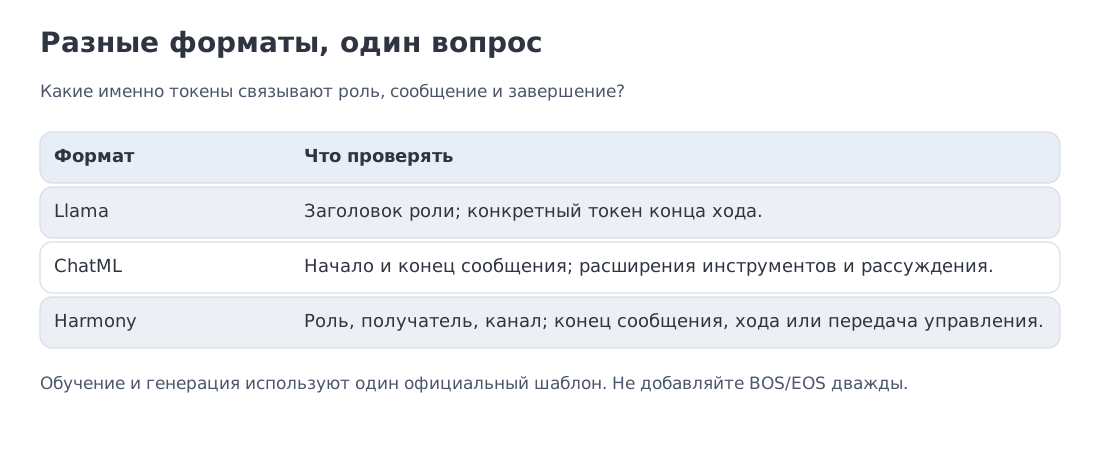 Несколько форматов одного диалога: заголовки Llama, маркеры ChatML, каналы Harmony и специфичные для семейства токены рассуждений или инструментов. Общий принцип: шаблон — часть контракта модели.
Ошибка шаблона особенно неприятна тем, что обучение может внешне выглядеть нормальным: функция потерь снижается, а модель учится распределению токенов, которое не встретится при реальном использовании. Поэтому перед SFT полезно распечатать несколько сериализованных примеров, сравнить их с карточкой модели (model card) и проверить токены завершения буквально по идентификаторам.
5. Маскирование функции потерь и пример A: 21 токен из 56
Уточним два разных смысла слова «маска». Маска внимания определяет, какой контекст видит позиция. Маска потери определяет, за какие предсказания начисляется ошибка. Если пользовательский текст исключён из потери, его представления всё равно участвуют в вычислении ответа, и градиент ответа может проходить через эти вычисления. Маскирование не равнозначно отсоединению контекста от графа дифференцирования.
Для токенов введём , когда токен является целью, и иначе. Средняя потеря по целевым токенам равна
Знаменатель считает цели после сдвига. Если их не осталось после обрезки длинного запроса, среднее не определено: пример следует отфильтровать или явно обработать, а не продолжать обучение с NaN. В сценарии ниже 21/56 — доля целевых позиций в хранимой последовательности. После удаления непредсказываемого BOS имеется 55 возможных пар «логит — метка», из которых активна 21.
При объединении примеров нужно выбрать и единицу усреднения. Сумма всех потерь, делённая на общее число целей, придаёт больший вес длинным ответам. Среднее отдельных средних придаёт одинаковый вес примерам. Если в одном ответе одна цель с потерей 2, а в другом три с потерей 1 каждая, получаем соответственно 1,25 и 1,5. Обе цели допустимы, но дают разные градиенты. При накоплении градиентов по микропакетам эта договорённость должна сохраняться.
После сериализации у нас есть input_ids. Здесь массив labels хранит идентификатор целевого токена в его собственной позиции. При вычислении потери логит позиции сопоставляется с меткой позиции : это и есть причинный сдвиг. Одни библиотеки делают его внутри модели, другие ожидают уже сдвинутые массивы. Выполнить сдвиг нужно ровно один раз. Но не все позиции обязаны участвовать в функции потерь.
Распространённая схема функции потерь только по ответу ассистента (assistant-only loss) заменяет метки системных и пользовательских токенов на -100. В PyTorch это стандартный ignore_index: такие позиции проходят через модель как контекст, но не дают прямого слагаемого в кросс-энтропии.
Это не единственно возможная цель. Полная потеря по всей последовательности иногда используется осознанно — например, при продолженном претрейне или отдельных рецептах дообучения на инструкциях. Однако для обычного SFT ассистента такая маска хорошо соответствует задаче: мы хотим условно моделировать ответ при уже заданном запросе, а не расходовать градиент на повторное предсказание текста пользователя.
Рассмотрим учебную конвенцию:
- один токен BOS;
- три сообщения: system, user и assistant;
- по пять служебных токенов на сообщение;
- содержимое сообщений занимает соответственно 12, 8 и 20 токенов.
Тогда полная длина равна
Если обучаемыми являются 20 токенов содержимого ответа и его завершающий <|eot_id|>, получаем
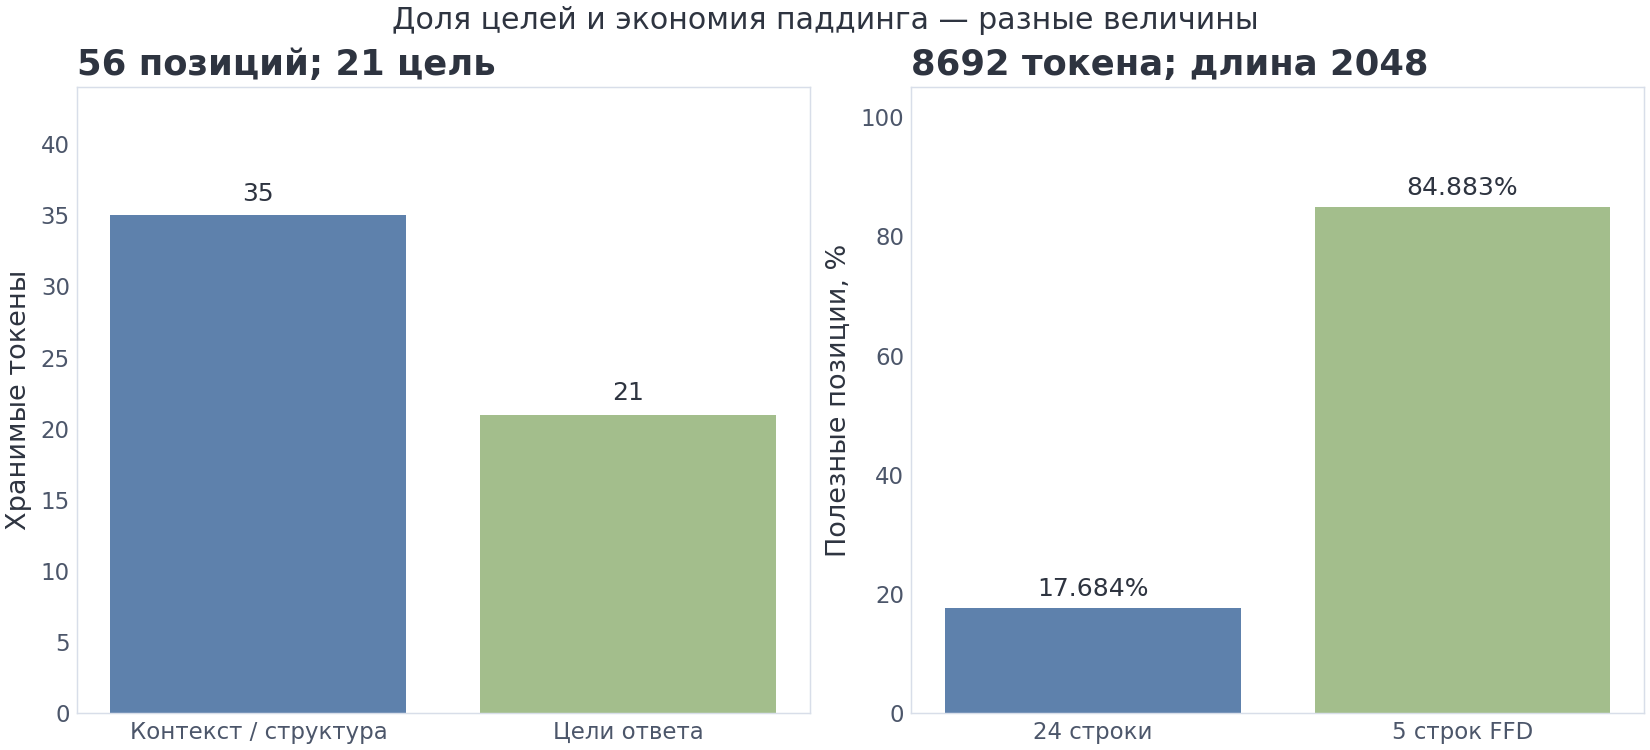 Слева — состав 56-токенного диалога и 21 обучаемая позиция. Справа — учебный сценарий упаковки 24 последовательностей в 5 контейнеров длины 2048.
Завершающий токен ответа важен: он обучает модель заканчивать ход в том месте, где это сделал автор демонстрации. Но конкретный токен и правило его включения зависят от шаблона. Нельзя механически переносить <|eot_id|> на модель, использующую другой протокол.
Отдельное решение требуется для рассуждений. Если длинное решение является частью целевого ответа, его токены обычно участвуют в потере. Если формат содержит скрытый канал, команда может обучать его, маскировать часть токенов или вообще не хранить такие данные — это уже выбор модели поведения и политики раскрытия, а не универсальное свойство SFT.
NumPy → PyTorch · B20 — Метки только для ответа ассистента
Метка содержит реальный идентификатор токена либо -100; булева маска только выбирает позиции, участвующие в функции потерь.
import numpy as np
import torch
1. Явная NumPy-реализация
def numpy_assistant_labels(input_ids: np.ndarray, assistant_mask: np.ndarray, *, ignore_index: int = -100) -> np.ndarray:
    ids, mask = np.asarray(input_ids), np.asarray(assistant_mask)
    if ids.dtype != np.int64 or mask.dtype != np.bool_:
        raise TypeError("use int64 token IDs and a boolean assistant mask")
    if np.any(ids < 0):
        raise ValueError("input token IDs must be nonnegative")
    if ids.shape != mask.shape:
        raise ValueError("input_ids and assistant_mask must have identical shapes")
    return np.where(mask, ids, ignore_index).astype(np.int64)
Булева маска не является самой меткой. NumPy оставляет настоящий идентификатор токена на позициях ответа ассистента и записывает ignore_index в остальных позициях.
2. Та же математика явными операциями PyTorch
def torch_assistant_labels(input_ids: torch.Tensor, assistant_mask: torch.Tensor, *, ignore_index: int = -100) -> torch.Tensor:
    if input_ids.dtype != torch.long or assistant_mask.dtype != torch.bool:
        raise TypeError("use torch.long token IDs and a boolean assistant mask")
    if input_ids.device != assistant_mask.device:
        raise ValueError("input IDs and mask must share a device")
    if torch.any(input_ids < 0):
        raise ValueError("input token IDs must be nonnegative")
    if input_ids.shape != assistant_mask.shape:
        raise ValueError("input_ids and assistant_mask must have identical shapes")
    labels = input_ids.clone()
    return labels.masked_fill(~assistant_mask.to(torch.bool), ignore_index)
Для сопоставления используем неотрицательные np.int64 / torch.long идентификаторы и булеву маску той же формы; в PyTorch оба тензора находятся на одном устройстве. masked_fill создаёт метки в их собственных позициях. Перед кросс-энтропией нужно ровно один раз выровнять logits[..., :-1, :] и labels[..., 1:]. Если модель сдвигает метки внутри, ей передают несдвинутые массивы. Наличие целевых токенов и их принадлежность словарю проверяет функция потерь.
| Аспект | NumPy | PyTorch |
|---|---|---|
| Источник метки | идентификатор токена | тот же ID |
| Игнорирование | np.where | masked_fill |
| Форма | совпадает с маской | проверяется до операции |
| Autograd | не нужен для целочисленных меток | потеря дифференцируется по логитам |
Исполняемая проверка эквивалентности и граничных случаев
ids_np = np.array([10,11,12,13,14,15]); mask_np = np.array([0,0,0,1,1,1], dtype=bool)
np_labels = numpy_assistant_labels(ids_np, mask_np); t_labels = torch_assistant_labels(torch.tensor(ids_np), torch.tensor(mask_np))
np.testing.assert_array_equal(np_labels, t_labels.numpy()); assert np_labels.tolist() == [-100,-100,-100,13,14,15]
# Labels are stored at their own positions. Shift them once for explicit CE.
scores = torch.zeros((len(ids_np), 20), dtype=torch.float64, requires_grad=True)
loss = torch.nn.functional.cross_entropy(scores[:-1], t_labels[1:], ignore_index=-100)
torch.testing.assert_close(loss, torch.log(torch.tensor(20.,dtype=torch.float64)))
loss.backward()
assert torch.count_nonzero(scores.grad[-1]) == 0
assert torch.count_nonzero(scores.grad[:2]) == 0
for ids_bad, mask_bad in [(ids_np.astype(float),mask_np),
                           (ids_np,mask_np.astype(int)),
                           (np.array([-1,1]),np.array([False,True]))]:
    for run in (lambda: numpy_assistant_labels(ids_bad,mask_bad),
                lambda: torch_assistant_labels(torch.tensor(ids_bad),torch.tensor(mask_bad))):
        try:
            run()
        except (TypeError,ValueError):
            pass
        else:
            raise AssertionError("invalid label input was accepted")
print("B20 assistant labels: PASS")
Полный исполняемый файл: m13_sft_bridges.py
6. Упаковка примеров и пример B: 24 последовательности → 5 контейнеров
Короткие демонстрации плохо сочетаются с большим max_seq_length. Если каждый пример длиной 300 токенов дополнить до 2048, большая часть элементов тензора окажется паддингом. Модель не обучается на них, но плотная пакетная обработка всё равно резервирует память и может выполнять лишнюю работу.
Упаковка примеров (sample packing) помещает несколько независимых последовательностей в один контейнер фиксированной длины. В нашем воспроизводимом списке находятся 24 длины с общей полезной длиной 8692 токена. При отдельном дополнении каждого примера до 2048 утилизация составляет
Жадный алгоритм First-Fit Decreasing (FFD) сначала сортирует примеры по убыванию, затем кладёт очередной пример в первый контейнер, где достаточно места. Для данного списка он создаёт пять контейнеров с заполнением 2045, 2017, 2044, 2047 и 539 токенов. Утилизация становится
Число строк фиксированной длины сократилось с 24 до 5, то есть в раза. Это не обещание ускорить реальное обучение в 4,8 раза. Выигрыш зависит от реализации механизма внимания, распределения длин, размера пакета, загрузки устройства и того, поддерживает ли ядро переменную длину. Расчёт показывает устранённый паддинг, а не готовый замер производительности.
Главная корректностная проблема — изоляция примеров. Если просто склеить последовательности под обычной причинной маской, токены второго примера смогут обращаться к токенам первого. Разделитель EOS сообщает модели о границе, но сам по себе не запрещает такое внимание.
Надёжные варианты два:
- блочно-диагональная причинная маска;
- ядро внимания для последовательностей переменной длины (variable-length attention), которому передаются границы последовательностей, например через
cu_seq_lens.
Сброс position_ids может быть частью реализации, но не заменяет изоляцию механизма внимания. Именно поэтому хороший ноутбук должен проверять не только количество контейнеров, но и отсутствие межпримерных связей.
Вторая граница проходит через целевые метки. После склейки обычный сдвиг сопоставляет последний логит примера A с первым токеном B. Блочная маска внимания этого не исправляет: запрещено внимание, а ошибочная пара для потери уже существует. Поэтому первая метка каждого независимого сегмента должна быть исключена. В нашем шаблоне это BOS, который и так маскирован; функция упаковки дополнительно обеспечивает правило для произвольных входных примеров.
Полезная проверка сильнее просмотра маски: при отключённом dropout сравнить логиты и сумму потерь каждого диалога отдельно и в общей упаковке, затем сравнить градиенты. Позиции, нормировка потери и сами токены при этом должны совпадать. Именно эту проверку выполняет практика. Паддинг требует отдельной осторожности: полностью запрещённая строка внимания в наивном softmax даёт неопределённость; такие строки исключают из вычисления либо используют ядро с явно проверенным поведением.
NumPy → PyTorch · B21 — Изоляция упакованных диалогов
segment_ids задают независимые диалоги, position_ids сбрасываются внутри каждого сегмента, а булева маска разрешает только причинное внимание внутри одного сегмента.
import numpy as np
import torch
1. Явная NumPy-реализация
def numpy_segment_position_ids(segment_ids: np.ndarray, *, padding_id: int = -1) -> np.ndarray:
    segments = np.asarray(segment_ids)
    if segments.ndim not in (1, 2):
        raise ValueError("segment_ids must be [T] or [B,T]")
    batch = segments[None, :] if segments.ndim == 1 else segments
    positions = np.zeros_like(batch, dtype=np.int64)
    for row in range(batch.shape[0]):
        for col in range(1, batch.shape[1]):
            current, previous = batch[row, col], batch[row, col - 1]
            if current != padding_id and current == previous:
                positions[row, col] = positions[row, col - 1] + 1
    return positions[0] if segments.ndim == 1 else positions

def numpy_block_causal_mask(segment_ids: np.ndarray, *, padding_id: int = -1) -> np.ndarray:
    segments = np.asarray(segment_ids)
    if segments.ndim not in (1, 2):
        raise ValueError("segment_ids must be [T] or [B,T]")
    batch = segments[None, :] if segments.ndim == 1 else segments
    t = batch.shape[-1]
    boundaries = np.ones_like(batch, dtype=bool)
    if t > 1:
        boundaries[:, 1:] = batch[:, 1:] != batch[:, :-1]
    run_ids = np.cumsum(boundaries, axis=-1)
    same = run_ids[:, :, None] == run_ids[:, None, :]
    valid = (batch[:, :, None] != padding_id) & (batch[:, None, :] != padding_id)
    causal = np.arange(t)[None, None, :] <= np.arange(t)[None, :, None]
    out = same & valid & causal
    return out[0] if segments.ndim == 1 else out
NumPy сначала нумерует непрерывные сегменты, затем разрешает внимание только внутри одного сегмента и только назад по времени. position_ids сбрасываются на каждой границе.
2. Та же математика явными операциями PyTorch
def torch_segment_position_ids(segment_ids: torch.Tensor, *, padding_id: int = -1) -> torch.Tensor:
    if segment_ids.ndim not in (1, 2):
        raise ValueError("segment_ids must be [T] or [B,T]")
    batch = segment_ids.unsqueeze(0) if segment_ids.ndim == 1 else segment_ids
    positions = torch.zeros_like(batch, dtype=torch.long)
    for col in range(1, batch.shape[-1]):
        continues = (batch[:, col] != padding_id) & (batch[:, col] == batch[:, col - 1])
        positions[:, col] = torch.where(continues, positions[:, col - 1] + 1, 0)
    return positions[0] if segment_ids.ndim == 1 else positions

def torch_block_causal_mask(segment_ids: torch.Tensor, *, padding_id: int = -1) -> torch.Tensor:
    if segment_ids.ndim not in (1, 2):
        raise ValueError("segment_ids must be [T] or [B,T]")
    batch = segment_ids.unsqueeze(0) if segment_ids.ndim == 1 else segment_ids
    t = batch.shape[-1]
    boundaries = torch.ones_like(batch, dtype=torch.bool)
    if t > 1:
        boundaries[:, 1:] = batch[:, 1:] != batch[:, :-1]
    run_ids = boundaries.to(torch.long).cumsum(dim=-1)
    same = run_ids[:, :, None] == run_ids[:, None, :]
    valid = (batch[:, :, None] != padding_id) & (batch[:, None, :] != padding_id)
    idx = torch.arange(t, device=batch.device)
    causal = idx[None, None, :] <= idx[None, :, None]
    out = same & valid & causal
    return out[0] if segment_ids.ndim == 1 else out
PyTorch строит те же номера непрерывных сегментов run_ids, маску и позиции на устройстве исходного тензора. Сравниваются именно непрерывные сегменты: одно и то же числовое обозначение может повториться позже и не должно соединять их внимание.
| Аспект | NumPy | PyTorch |
|---|---|---|
| Граница | изменение соседнего segment_id | та же проверка границы |
| Позиции | цикл по T | цикл по позициям на исходном устройстве |
| Изоляция | same_run & causal & valid | та же булева маска |
| Дополнение | сегмент -1 запрещён | тот же контракт |
| Регрессия | изменяем A, B неизменен | SDPA проверяет выход сегмента B |
Исполняемая проверка эквивалентности и граничных случаев
segments_np = np.array([0,0,0,1,1,1,-1]); np_pos = numpy_segment_position_ids(segments_np); np_mask = numpy_block_causal_mask(segments_np)
t_segments = torch.tensor(segments_np); t_pos = torch_segment_position_ids(t_segments); t_mask = torch_block_causal_mask(t_segments)
np.testing.assert_array_equal(np_pos, t_pos.numpy()); np.testing.assert_array_equal(np_mask, t_mask.numpy())
rng = np.random.default_rng(21); x = torch.tensor(rng.standard_normal((1,1,7,4)), dtype=torch.float64); mask = t_mask[None,None]
out_a = torch.nn.functional.scaled_dot_product_attention(x, x, x, attn_mask=mask)
x_changed = x.clone(); x_changed[..., :3, :] += 1000
out_b = torch.nn.functional.scaled_dot_product_attention(x_changed, x_changed, x_changed, attn_mask=mask)
torch.testing.assert_close(out_a[..., 3:6, :], out_b[..., 3:6, :], rtol=0, atol=0)
repeated = np.array([0,0,1,1,0,0])
np.testing.assert_array_equal(numpy_segment_position_ids(repeated), [0,1,0,1,0,1])
repeat_mask = numpy_block_causal_mask(repeated)
assert not repeat_mask[4,0] and repeat_mask[5,4]
print("B21 packed isolation: PASS")
Полный исполняемый файл: m13_sft_bridges.py
7. Гиперпараметры и стоимость этапа: пример C
Сначала оценим порядок вычислительного бюджета. Пусть мы дообучаем модель с параметров на 200 тыс. примеров средней длиной 1200 токенов в течение трёх эпох. Число токенов за одну эпоху равно
Используя то же приближение обучения Transformer, что и в модуле 9,
Величина здесь считает все обработанные токены, включая запрос. Даже при потере только по ответу контекст проходит через модель. Умножить вычислительный бюджет на долю 21/56 было бы неверно. Формула приближённо учитывает прямой и обратный проходы плотной модели, но не является строгой нижней границей: она опускает отдельные операции и зависит от того, какие параметры обновляются. MFU — доля пиковых FLOP/s, реализованная полезными операциями модели. Подставленные 40% — условие сценария, а не замер запуска.
Для сравнения, сценарий претрейна той же 8.03B-модели на 15 трлн токенов даёт FLOP. Отношение равно примерно 20 833. Это сравнение конкретных учебных сценариев, а не универсальная константа: SFT может быть длиннее, модель — больше, а претрейн — короче.
Если предположить ускоритель с теоретической производительностью 990 TFLOP/s и MFU 40%, арифметическая оценка времени составляет
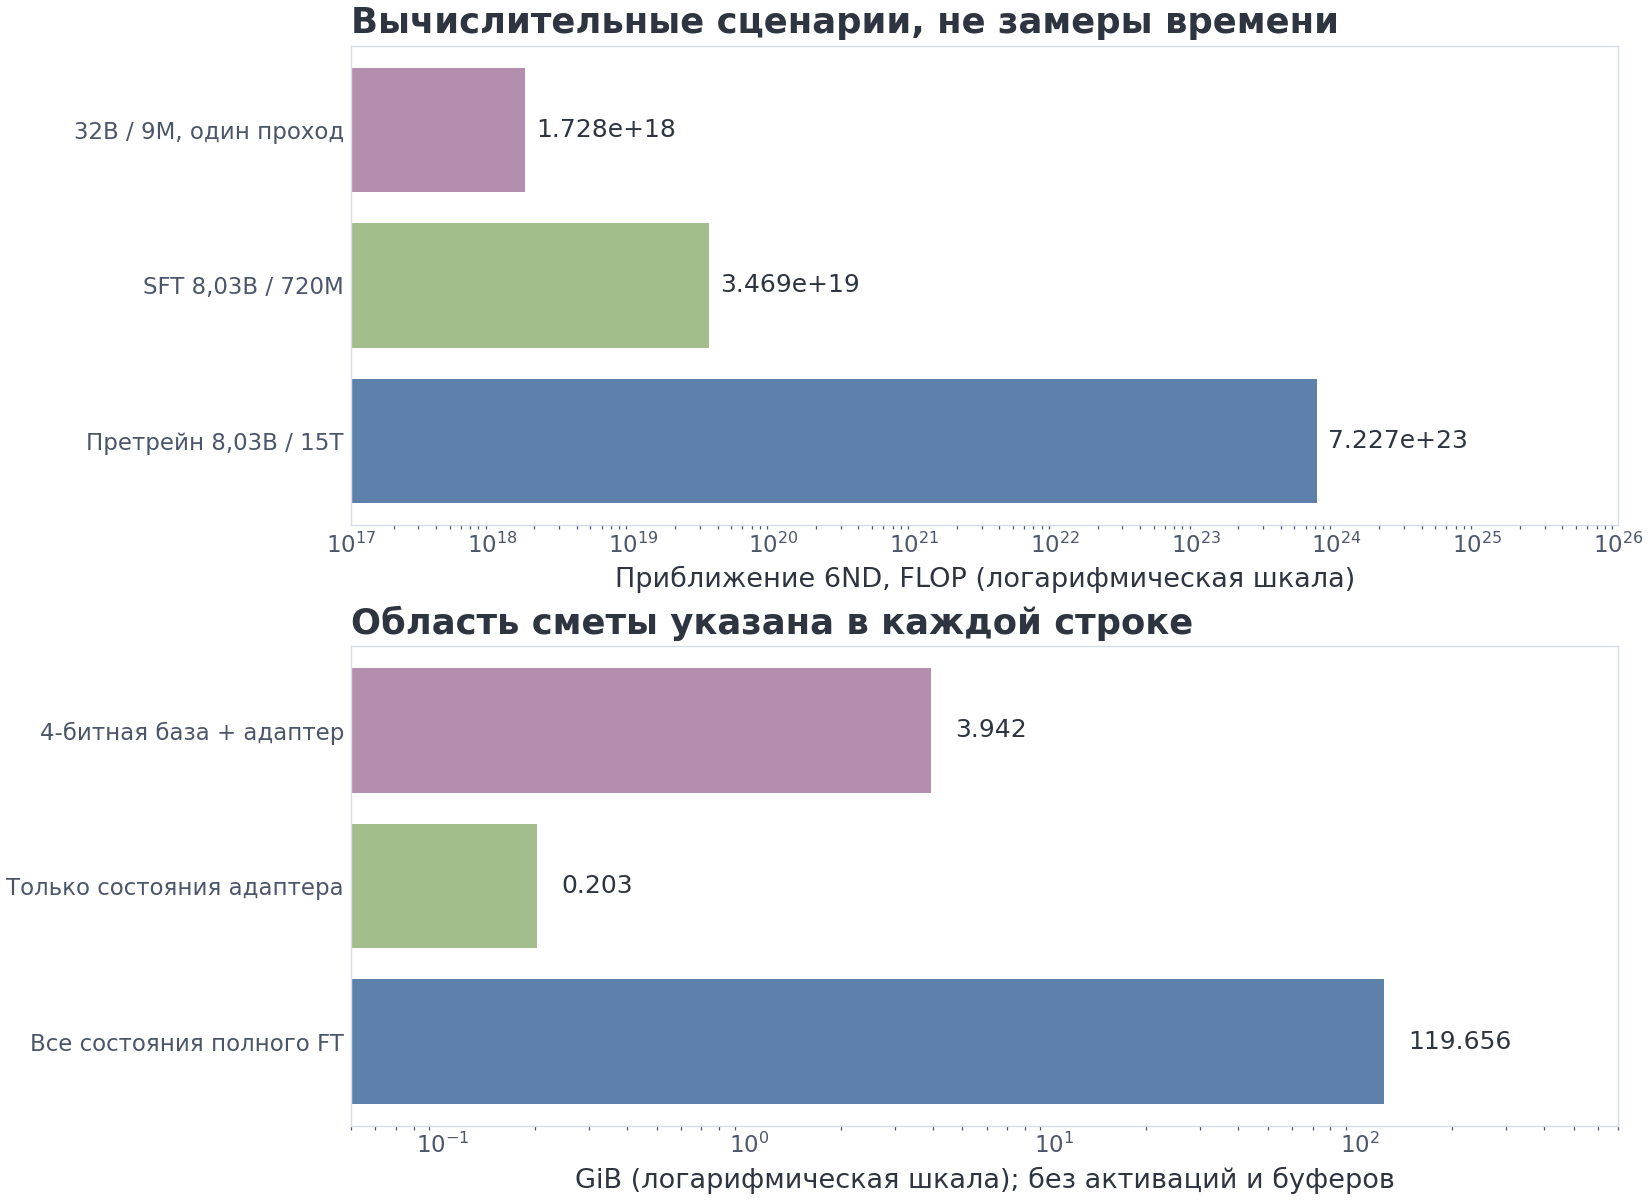 Слева — порядки вычислительных бюджетов претрейна, учебного SFT и однопроходной оценки s1. Справа — память состояний параметров при полном дообучении, LoRA и 4-битной замороженной базе.
Эта оценка объясняет рабочую культуру SFT: чаще выгоднее провести несколько аккуратных экспериментов с составом данных, чем один раз обучить огромный, но плохо спроектированный набор.
Ниже — не «стандарт 2026 года», а разумные начальные диапазоны, которые требуют проверки на конкретной модели.
| Параметр | Практическая отправная точка |
|---|---|
| Эпохи | 1–3; ранняя остановка по валидации и поведению |
| Скорость обучения, полное дообучение | примерно … |
| Скорость обучения, LoRA | часто … |
| Ранг LoRA | 8–64 в зависимости от сложности сдвига |
| Эффективный размер пакета | подбирается по числу токенов и стабильности градиента |
| Максимальная длина | определяется целевым распределением, а не максимальной возможностью модели |
| График скорости обучения | косинусный или другой плавный спад; короткий разогрев (warmup) |
| Ограничение нормы градиента | полезно как защита, но не заменяет диагностику данных |
Главное — измерять не только ошибку на обучении. Нужны удержанные наборы по навыкам, проверка общей деградации, форматные тесты и ручное чтение ответов.
8. Данные I: не каталог, а карта функций
Известные названия наборов данных легко создают ложное ощущение, что SFT — задача выбора одного файла. На практике набор собирается по функциям, которые должна выполнять модель.
Общие инструкции и диалог
Сюда входят OpenAssistant, UltraChat, WildChat, наборы, производные от FLAN, математические, кодовые и многоязычные поднаборы. Один из наиболее прозрачных примеров — Tülu 3 SFT Mixture: карточка набора указывает 939 344 примера и документирует состав поднаборов и их лицензии. Важен не только размер, но и то, что рецепт можно исследовать и воспроизвести.
У Tülu 3 полезно различать описание и конкретный файл: на дату проверки карточка сообщает 939 344 примера, а счётчик просмотрщика показывает 939 343 строки. Для воспроизведения следует закрепить ревизию и посчитать загруженные записи. Общая лицензия коллекции не заменяет лицензий поднаборов; в карточке явно отмечены некоммерческие части. Здесь набор служит документированным примером смеси, а не встроенным корпусом практики.
Демонстрации рассуждений
Это задачи с проверяемым ответом и развёрнутым решением. DeepSeek сообщила, что для дистилляции моделей семейства R1 использовалось около 800 тыс. отобранных примеров: примерно 600 тыс. связанных с рассуждениями и 200 тыс. общих. Были опубликованы веса моделей-учеников, но эти 800 тыс. примеров не следует автоматически называть открытым набором данных.
В открытой экосистеме появились отдельные наборы, например AM-DeepSeek-R1-Distilled-1.4M, где авторы описывают дедупликацию и проверку математических и программных ответов. Такие наборы полезны, но требуют собственного аудита на загрязнение тестов, стиль учителя и качество длинных решений.
Работа с инструментами
Здесь пример содержит схему доступных функций, запрос, один или несколько вызовов и результаты инструментов. xLAM-function-calling-60k предоставляет 60 тыс. однопроходных примеров. ToolACE строит синтетические данные из большого пула API и использует правила вместе с модельной проверкой. Для многошаговых агентов нужны также диалоги, где следующий вызов зависит от результата предыдущего.
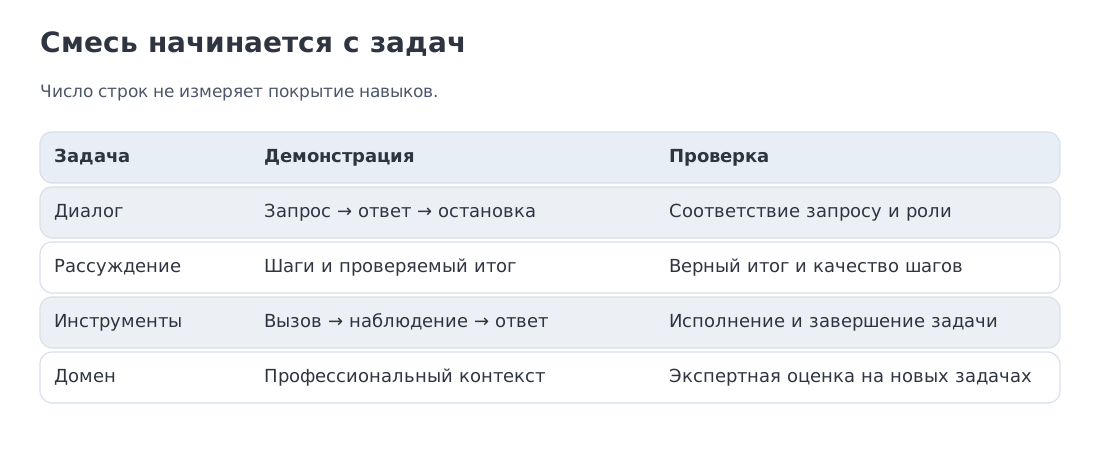 Карта данных для SFT по функции: общий диалог, рассуждения, инструменты и доменная адаптация. Размер набора не заменяет проверку лицензии, качества, покрытия и соответствия целевой модели.
Состав смеси следует начинать не с числа строк, а с профиля модели. Какие запросы она должна обслуживать? Где ответ проверяем автоматически? Какие ошибки недопустимы? Какие роли и форматы встретятся при промышленной эксплуатации? Ответы на эти вопросы определяют доли данных лучше, чем универсальная пропорция.
9. Данные II: чему действительно учит LIMA
Разделение на обучение и проверку выполняют до генерации производных примеров. Представим одну задачу, для которой учитель дал пять переформулировок: случайное разделение строк может отправить четыре в обучение и одну в тест. Формально тексты различаются, но тест проверяет уже знакомую задачу. Поэтому вместе хранят семейство исходной задачи, её версии и все синтетические ответы; в отложенную часть уходит целое семейство. Такой способ нужен и для документов, диалогов одного пользователя, тестов одного проекта.
Работа LIMA: Less Is More for Alignment дообучила LLaMA 65B на 1000 тщательно отобранных запросах и ответах без RL и отдельного моделирования предпочтений. Модель показала сильное следование инструкциям и в человеческом исследовании часто была сопоставима с гораздо более дорогими системами того времени.
Авторы сформулировали гипотезу поверхностного выравнивания (Superficial Alignment Hypothesis): основная часть знаний и возможностей появляется во время претрейна, а сравнительно небольшой объём данных для выравнивания учит модель выбирать подходящий формат и стиль взаимодействия.
Эта гипотеза полезна, но её нельзя превращать в закон «тысячи примеров достаточно всегда». Результат зависит от силы базовой модели, широты требуемого поведения, качества оценки и того, насколько новая задача уже представлена в претрейне. Тысяча демонстраций может хорошо задать стиль и общие инструкции; она не обязана покрыть редкий профессиональный домен, сложные инструменты, безопасность и многоязычие одновременно.
Практический урок LIMA состоит из трёх частей.
- Демонстрация должна быть достойна подражания. Модель усваивает не только правильный ответ, но и длину, тон, структуру, осторожность и словесные привычки.
- Разнообразие важнее механического роста. Тысяча почти одинаковых задач остаётся узким набором.
- Отрицательный вклад реален. Ошибочные и шаблонно плохие ответы создают прямой градиент в нежелательную сторону.
Поэтому очистка набора для SFT обычно включает:
- проверку фактической или исполняемой корректности;
- поиск дубликатов и почти дубликатов;
- контроль распределения длины и сложности;
- обнаружение загрязнения оценочными задачами;
- анализ шаблонных фраз учителя;
- стратификацию по навыкам, языкам и типам отказов;
- ручную выборочную проверку после каждого автоматического фильтра.
10. Синтетические данные и пример E: best-of-N с верификатором
Синтетика полезна не потому, что модельный текст автоматически хорош, а потому, что позволяет управлять покрытием и многократно генерировать кандидатов для проверяемых задач.
Self-Instruct начинал с небольшого набора затравок и расширял его новыми инструкциями. Evol-Instruct усложнял задания последовательными преобразованиями. Magpie убрал даже затравочный запрос: выровненной модели передавалась только часть шаблона до пользовательской реплики, после чего она продолжала диалог собственным запросом и ответом.
Общий современный конвейер выглядит так:
- выбрать распределение задач;
- сгенерировать один или несколько кандидатов;
- проверить формат и безопасность;
- применить исполняемый или символический верификатор там, где он возможен;
- оценить сложность, разнообразие и сходство с существующими примерами;
- сохранить исходные метаданные, чтобы позже можно было понять происхождение записи.
Рассмотрим упрощённый best-of-. Пусть каждый независимо сгенерированный ответ проходит проверку с вероятностью . Вероятность получить хотя бы один прошедший ответ равна
Получаем:
| Вероятность хотя бы одного успеха | Ожидаемый выход на одну генерацию, если сохраняем не более одного ответа | |
|---|---|---|
| 1 | 0.3000 | 0.3000 |
| 4 | 0.7599 | 0.1900 |
| 8 | 0.9424 | 0.1178 |
| 16 | 0.9967 | 0.0623 |
Рост повышает покрытие задач, но отдача на одну генерацию убывает. Кроме того, независимость кандидатов — учебное допущение: ответы одной модели на близких настройках коррелированы. Часто выгоднее повысить улучшением постановки задачи, выбором учителя или промежуточной проверкой, чем бесконечно увеличивать .
Наличие прошедшего кандидата ещё не означает, что выбран верный ответ. Разберём отдельный сценарий качества проверки. Пусть вероятность правильности равна , чувствительность верификатора — (доля принятых среди верных), а вероятность принять ошибку — . Тогда
При , и проверку проходят всех кандидатов. Доля верных среди принятых равна . Значит, примерно каждый пятый принятый ответ ошибочен. Это другой набор предпосылок, чем в таблице: здесь , а там — 0.3. Увеличение числа кандидатов не превращает ошибающийся фильтр в доказательство правильности.
Последний столбец таблицы делит вероятность сохранить один ответ на затратных генераций. Это выход данных на попытку при ограничении «не более одного», а не вероятность правильности выбранного ответа.
Второй проход: почему попарной корреляции недостаточно
Для трёх кандидатов зададим число успехов вероятностями . При фиксированном все наборы успешных позиций равновероятны. Тогда каждый кандидат успешен с вероятностью , а любая пара — одновременно с вероятностью . Попарные корреляции положительны, но шанс хотя бы одного успеха равен 0.9, что выше независимого . Вероятность объединения зависит от полного совместного закона. При полностью совпадающих исходах, наоборот, новые кандидаты не повышают покрытие. Оба случая проверяются в ноутбуке.
Связь с инфраструктурой RL. Best-of-, фильтрация по верифицируемой награде и сбор выбранных/отклонённых ответов становятся строительными блоками оптимизации по предпочтениям (preference optimization) и RLVR. Подробный разбор дан в курсе RL for LLM.
11. SFT на решениях и пример F: что означают «девять минут»
Длинные решения можно рассматривать как особый вид демонстраций. Учитель выдаёт не только финальный ответ, но и последовательность промежуточных шагов; ученик обучается предсказывать всю эту последовательность.
DeepSeek сообщила, что модели DeepSeek-R1-Distill были получены простым SFT открытых базовых моделей на примерно 800 тыс. отобранных примеров. В опубликованной таблице DeepSeek-R1-Distill-Qwen-7B набрала 55,5% pass@1 на AIME 2024, а 32B-версия — 72,6% на AIME 2024 и 94,3% на MATH-500. Это результаты авторов в конкретном протоколе; они показывают силу переноса, но не гарантируют такие же числа на другом наборе данных или в другом контуре оценки (evaluation harness).
Проект s1 исследовал противоположный край масштаба: 1000 задач с тщательно выбранными решениями, Qwen2.5-32B-Instruct и простое SFT. Авторы сообщают, что обучение пяти эпох заняло 26 минут на 16 H100. Кроме того, они предложили budget forcing: при попытке модели закончить рассуждение ей можно добавить слово Wait, увеличивая бюджет генерации; в их эксперименте это подняло AIME 2024 с 50% до 57%.
Теперь разберём учебную оценку. Если взять 1000 трасс средней длиной 9000 токенов и один проход по данным, то
При восьми ускорителях по 990 TFLOP/s и условном MFU 40% получаем
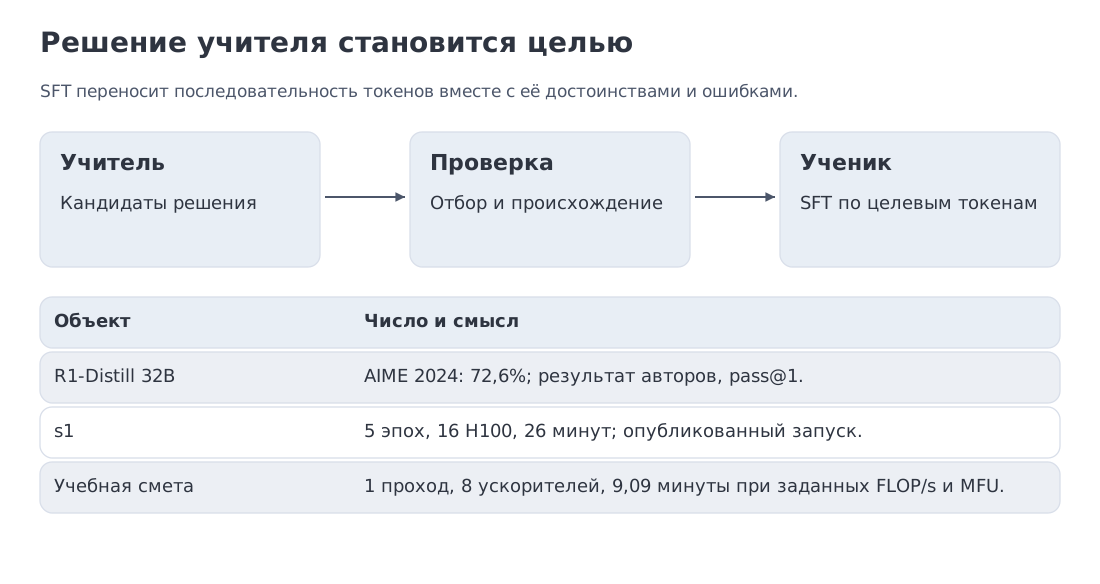 Перенос решений: учитель → проверяемые задачи → отобранные длинные ответы → SFT ученика. Отдельно показаны опубликованные результаты DeepSeek-R1-Distill и учебная однопроходная оценка, которую нельзя смешивать с реальным пятиэпоховым запуском s1.
Эти девять минут — арифметическая оценка одного прохода при заданных предположениях, а не воспроизведение s1. Оригинальный эксперимент использовал пять эпох, 16 ускорителей, FSDP и собственную реализацию. Сопоставлять два числа можно только после учёта эпох, реального MFU и всех накладных расходов.
У длинных решений есть особые риски:
- учитель может многословно имитировать рассуждение, не повышая точность;
- неверный промежуточный шаг становится обучающим сигналом даже при правильном финале;
- длинные ответы резко меняют распределение токенов и память активаций;
- тестовые задачи легче случайно включить в синтетический набор;
- раскрываемые пользователю рассуждения и внутренние каналы — разные продуктовые решения.
SFT хорошо переносит форму и множество приёмов решения. Дальнейшая оптимизация по проверяемой награде может улучшить выбор стратегий, но не отменяет требования к качеству демонстраций.
12. SFT для работы с инструментами
Умение выводить JSON ещё не означает умение пользоваться инструментом. Модель должна выбрать подходящую функцию, сопоставить аргументы со схемой, дождаться результата, включить его в контекст и решить, нужен ли следующий вызов.
Типичный обучающий диалог содержит два специальных вида сообщений.
- Вызов ассистента. Это целевой токенизированный объект: имя инструмента и аргументы в формате, ожидаемом исполняющей системой.
- Результат инструмента. Это наблюдение среды. В рассматриваемой цели оно входит в контекст, а его токены исключены из потери: мы обучаем выбор действия и реакцию на полученное свидетельство. Другие рецепты могут намеренно моделировать наблюдения. Маска сама по себе не предотвращает галлюцинации; при исполнении настоящий результат должен поступить от инструмента.
Например, в одном шаблоне вызов может выглядеть как JSON внутри <tool_call>, а Harmony кодирует канал, получателя и ограничение формата отдельными токенами. Здесь нельзя выбирать синтаксис «по вкусу»: он является частью контракта модели и исполняющей среды.
Хороший набор должен учить по меньшей мере пяти решениям:
- нужен ли инструмент вообще;
- какой инструмент выбрать;
- как заполнить обязательные и необязательные аргументы;
- как обработать ошибку или недостаток данных;
- когда продолжить цепочку, а когда сформулировать финальный ответ.
xLAM-function-calling-60k даёт масштабируемый набор однопроходных примеров. ToolACE синтезирует более разнообразные API и применяет двойную проверку. Многоходовые наборы добавляют зависимость между последовательными действиями. Для оценки полезно использовать не одно число «точности вызова», а раздельные показатели: корректность схемы, исполнимость, релевантность выбора, параллельные вызовы и многоходовое завершение задачи. BFCL V4, например, расширяет оценку от одиночных функций к многошаговым и агентным сценариям.
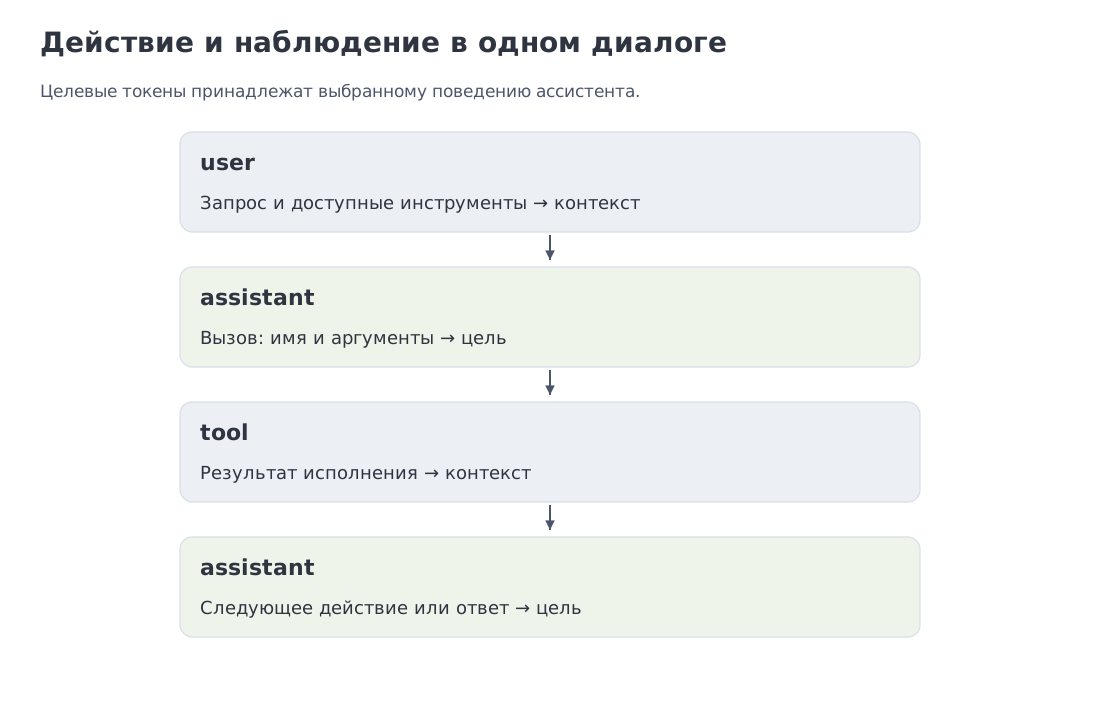 Траектория работы с инструментами (tool use): запрос → решение о вызове → структурированный вызов → результат инструмента → следующий вызов или финальный ответ. Результат среды служит контекстом, но не целевым текстом модели.
Нельзя обещать универсальный прирост вроде «50% → 80%» от фиксированного числа примеров: результат зависит от базовой модели, шаблона, набора инструментов и версии оценочного набора. Надёжный вывод скромнее и полезнее: специализированные демонстрации способны быстро улучшить формат и выбор действий, но это нужно измерять на целевой схеме и в реальном исполнении.
13. Код первого уровня: метки и трассируемая упаковка
Ниже три примитива, которые отражают численный контракт модуля. Метки содержат реальные идентификаторы целевых токенов, а не бинарный индикатор «обучать/не обучать».
import numpy as np

IGNORE_INDEX = -100

def build_sft_example(messages, special_ids):
    """Build input_ids and labels; supervise assistant content and EOT."""
    role_id = {
        "system": special_ids["role_system"],
        "user": special_ids["role_user"],
        "assistant": special_ids["role_assistant"],
        "tool": special_ids["role_tool"],
    }
    input_ids = [special_ids["bos"]]
    labels = [IGNORE_INDEX]

    for message in messages:
        header = [
            special_ids["start_header"],
            role_id[message["role"]],
            special_ids["end_header"],
            special_ids["newline"],
        ]
        body = [*message["token_ids"], special_ids["eot"]]

        input_ids.extend(header + body)
        labels.extend([IGNORE_INDEX] * len(header))
        labels.extend(
            body
            if message["role"] == "assistant"
            else [IGNORE_INDEX] * len(body)
        )

    return np.asarray(input_ids), np.asarray(labels)

def first_fit_decreasing(lengths, max_length=2048):
    """Keep original example indices in every First-Fit Decreasing bin."""
    if not isinstance(max_length, int) or isinstance(max_length, bool) or max_length <= 0:
        raise ValueError("max_length must be a positive integer")
    if any(not isinstance(n, (int, np.integer)) or isinstance(n, (bool, np.bool_)) for n in lengths):
        raise ValueError("lengths must be integers")
    bins = []
    for index in sorted(range(len(lengths)), key=lambda i: (-lengths[i], i)):
        length = lengths[index]
        if length <= 0 or length > max_length:
            raise ValueError("invalid sequence length")

        for bucket in bins:
            if bucket["used"] + length <= max_length:
                bucket["indices"].append(index)
                bucket["used"] += length
                break
        else:
            bins.append({"indices": [index], "used": length})

    return bins

def lora_params(d=4096, d_kv=1024, layers=32, rank=16):
    """Count q/k/v/o LoRA parameters for a GQA transformer."""
    per_layer = rank * (
        (d + d) + (d + d_kv) + (d + d_kv) + (d + d)
    )
    return per_layer * layers
Функция build_sft_example оставляет обучаемым завершающий токен ответа, но маскирует системные, пользовательские и инструментальные сообщения. В реальном проекте правила ролей следует задавать конфигурацией: некоторые наборы содержат несколько типов ассистентских сообщений и отдельные каналы.
first_fit_decreasing возвращает исходные индексы. Это принципиально: одного числа заполненных токенов недостаточно, чтобы построить segment_ids, границы последовательностей и диагностировать ошибочный пример.
15. Дистилляция: что именно переносит учитель
Слово «дистилляция» объединяет несколько разных каналов передачи сигнала.
Дистилляция по ответам
Учитель генерирует текст, а ученик обучается на выбранных токенах обычной кросс-энтропии. Этот вариант часто называют дистилляцией по ответам (hard distillation). Он работает даже через API, потому что не требует доступа к логитам или весам учителя.
Преимущество — простота. Ограничение — мы видим только один реализованный ответ. Неизвестно, какие альтернативы учитель считал почти столь же вероятными, а какие — невозможными. Поэтому качество отбора, разнообразие генерации и верификатор особенно важны.
Дистилляция по распределениям
В классической дистилляции по распределениям (soft distillation) ученик приближает смягчённое распределение учителя. Один из вариантов цели:
В этой формуле — температура: логиты делят на перед softmax; задаёт вес дистилляции. KL имеет направление «учитель к ученику»: штрафует ученика за малую вероятность событий, которые учитель считает вероятными. Множитель компенсирует изменение масштаба градиента при смягчении распределений, но не делает любую температуру равноценной. Когда температуры велики, становятся заметнее относительные предпочтения между альтернативами; выбор и остаётся частью эксперимента.
Для дискретных распределений , где суммируем по общим событиям — здесь токенам. При вклад равен нулю; если , а , дивергенция бесконечна. Она равна нулю при совпадении распределений и обычно несимметрична. Такой сигнал требует вероятностей учителя: их можно получить из логитов или передать непосредственно. Нужны также совместимые токенные события либо специальное выравнивание. Открытые веса сами по себе не решают проблему: две модели могут использовать разные токенизаторы, архитектуры и длины контекста.
Углубление. Энтропия, кросс-энтропия (cross-entropy), дивергенция KL и роль температуры подробно разобраны в курсе Information Theory for ML.
Несколько учителей
Можно собирать ответы разных моделей и выбирать их верификатором, маршрутизировать задачи к специализированным учителям или объединять доступные распределения. Этот режим полезен, когда сильные стороны учителей дополняют друг друга, но одновременно усложняет контроль стиля, лицензий и происхождения данных.
Практический выбор начинается с вопроса: какой сигнал реально доступен? Если API возвращает только текст — собираем и проверяем ответы. Если доступны полные вероятности или логиты родственной модели — можно исследовать дистилляцию по распределениям. Ограниченный список top-logprobs сам по себе не задаёт полную цель по всему словарю. Если задача проверяема автоматически — качество верификатора часто важнее числа учителей.
16. PEFT и пример D: сколько действительно обучает LoRA
Здесь PEFT (parameter-efficient fine-tuning) означает дообучение ограниченного набора параметров. Для сметы зафиксируем 16 байт на обучаемый параметр: 2 байта веса bf16, 2 байта градиента, 4 байта основной копии fp32 и по 4 байта двух моментов Adam. Некоторые реализации хранят эти объекты иначе, поэтому 16 — явная бухгалтерская конвенция, а не свойство LoRA. Вес адаптера уже входит в эту сумму.
Полное дообучение обновляет все параметры и хранит для них градиенты и состояния оптимизатора. Для 8.03B параметров учебная оценка по 16 байт на параметр даёт
только для параметрических состояний. Активации и временные буферы сюда не входят.
LoRA (Low-Rank Adaptation) замораживает базовую матрицу и обучает низкоранговое обновление
где , , а — задаваемый коэффициент масштаба адаптера. При фиксированном ранге множитель регулирует силу добавки. Число параметров адаптера для одной матрицы равно
Ранг ограничивает ранг добавки , а не ранг всей матрицы . Обычно одну матрицу адаптера инициализируют случайно, вторую нулями: начальная добавка равна нулю, но одна из матриц уже получает ненулевой градиент. Если обнулить обе, обе могут остаться без градиента. Замороженные веса не получают обновлений, однако обратный проход через них нужен для обучения адаптеров в предыдущих слоях. Поэтому сокращение числа обучаемых параметров не равно такому же сокращению FLOP.
В нашем сценарии , ширина проекций ключей и значений в GQA равна 1024, слоёв 32, ранг , а LoRA применяется к q/k/v/o. Получаем
Если считать 16 байт состояний на обучаемый параметр, это 208 MiB вместо 119.656 GiB — отношение около 589. Сравниваются именно параметрические состояния при выбранной бухгалтерии, а не полная память обучения.
QLoRA дополнительно хранит замороженную базу в 4-битном виде и пропускает через неё градиент к адаптерам. Для нашего упрощённого подсчёта:
- сырые 4-битные веса: 3.739 GiB;
- состояния адаптера: 208 MiB, включая 26 MiB весов в bf16;
- суммарная нижняя оценка: 3.942 GiB.
Реальная память будет выше из-за масштабов квантизации, активаций, временной деквантизации, кэшей ядра и накладных расходов диспетчера памяти.
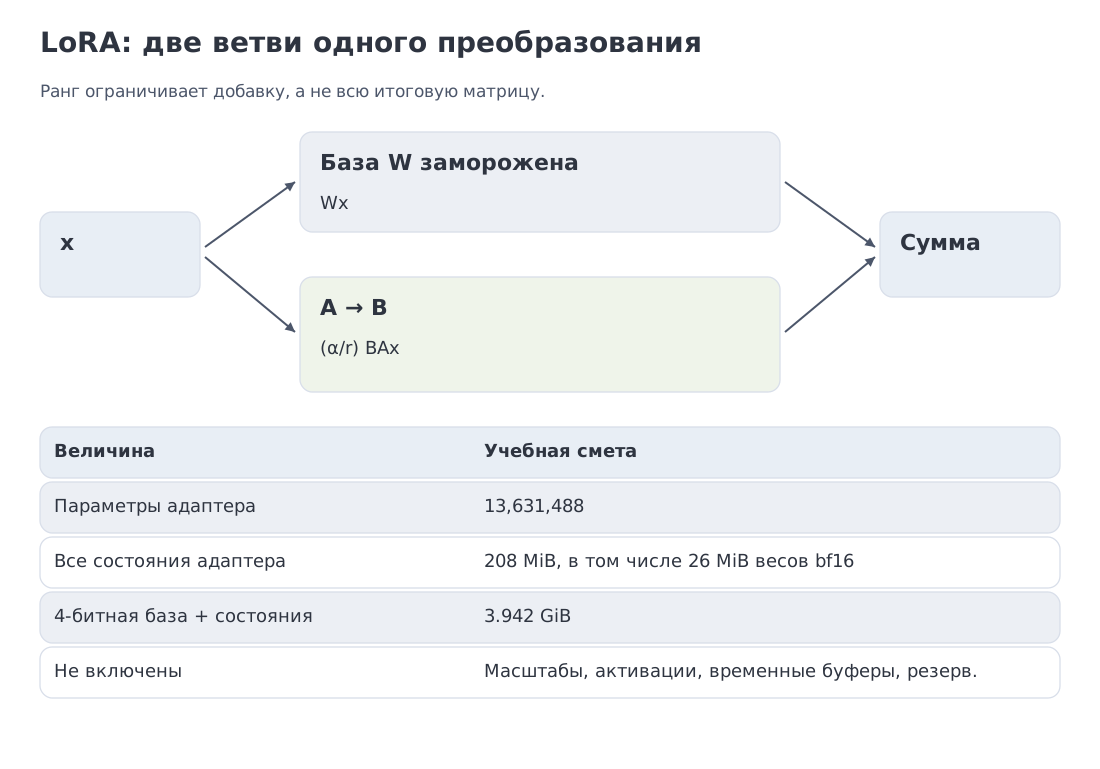 LoRA как низкоранговое обновление замороженной матрицы; рядом — воспроизводимый подсчёт 13,63 млн параметров и границы упрощённой сметы QLoRA.
LoRA — сильная отправная точка, но не автоматический победитель. Полное дообучение может быть предпочтительно при глубоком изменении распределения и достаточных ресурсах; адаптер может требовать большего ранга или включения проекций MLP; QLoRA добавляет ошибку квантизации. Выбор следует делать по качеству, памяти и стоимости развёртывания, а не по лозунгу «адаптеры всегда не хуже».
16.1. От алгоритма к управляемой тренировочной платформе: Tinker и Inkling
В 2026 году Thinking Machines опубликовала модель с открытыми весами (open-weight) Inkling: MoE с 975 млрд общих и 41 млрд активных параметров. Одновременно платформа Tinker предложила облачный API для пользовательских циклов обучения.
Его центральные операции — forward_backward, optim_step, sample и сохранение состояния. Пользователь задаёт данные, функцию потерь и последовательность шагов; платформа выполняет распределённую работу. Это позволяет собирать SFT, LoRA, дистилляцию и RL поверх одних и тех же примитивов.
Важно различать три степени открытости:
- можно ли скачать веса модели;
- можно ли задать собственный алгоритм дообучения через API;
- можно ли воспроизвести распределённую инфраструктуру, которая исполняет этот алгоритм.
Inkling отвечает «да» на первый вопрос, Tinker расширяет контроль над вторым, но обслуживающая инфраструктура остаётся управляемым сервисом. Такая тройка вопросов полезнее бинарной метки open/closed.
17. Как читать паспорт модели после SFT
Перед загрузкой контрольной точки модели можно восстановить значительную часть рецепта по его файлам.
Шаблон и специальные токены
В tokenizer_config.json ищем chat_template. В special_tokens_map.json и списке добавленных токенов проверяем роли, окончания ходов, инструменты и каналы. Не нужно угадывать семейство по одному маркеру: лучше отрендерить пример официальным токенизатором.
При переносе на библиотеку важно проверить три конкретных соглашения. Для обучающей демонстрации обычно не добавляют незаполненный заголовок следующего ответа. Если сначала получен текст шаблона, его повторная токенизация не должна второй раз добавлять BOS/EOS. Наконец, автоматическая маска ассистента должна соответствовать реальным диапазонам шаблона: в TRL assistant_only_loss требует поддержки таких диапазонов, обычно через блоки Jinja generation. Эти детали сверяются с установленной версией и официальным шаблоном, после чего несколько примеров снова проверяются по токенам.
Адаптер
adapter_config.json обычно показывает:
- ранг
r; lora_alpha;- список
target_modules; - dropout;
- использование DoRA или других вариантов;
- базовую модель, к которой относится адаптер.
По размерам входа и выхода целевых матриц можно воспроизвести число обучаемых параметров, как в §16.
Косвенные следы данных и поведения
generation_config.json показывает стоп-токены и параметры генерации, но не доказывает состав обучающих данных. Карточка модели может сообщать источники, лицензии, число эпох и формат. Отсутствие этих сведений — тоже часть паспорта: рецепт нельзя считать воспроизводимым только потому, что опубликованы веса.
Полезный порядок проверки:
- отрендерить несколько диалогов;
- определить обучаемые роли и токены завершения;
- проверить адаптер и число параметров;
- сопоставить заявленный набор данных с лицензиями;
- воспроизвести хотя бы часть контура оценки (evaluation harness);
- только затем интерпретировать сводную таблицу результатов.
20. Ключевые выводы модуля и источники
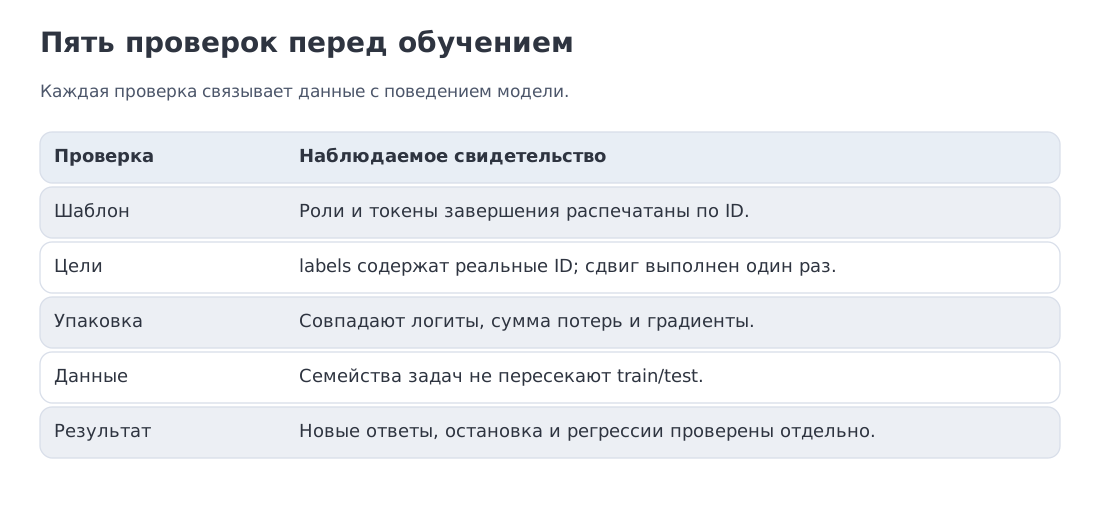 Шпаргалка: шаблон как контракт, целевая маска, корректная упаковка, стоимость SFT, качество данных, синтетика и верификация, демонстрации рассуждений и работы с инструментами, дистилляция и LoRA.
Для рассматриваемой авторегрессионной модели SFT остаётся обучением следующего токена, но демонстрации и маска превращают его в обучение желательному условному поведению.
- Шаблон — часть контракта модели. Роли, окончания ходов, инструменты и каналы должны совпадать с реальным инференсом.
- Маска следует цели. В учебном примере функция потерь только по ответу ассистента оставляет 21 обучаемый токен из 56; это конвенция сценария, а не свойство всех токенизаторов.
- Упаковка экономит паддинг, а не обещает готовый множитель скорости. В нашем списке 24 последовательности помещаются в 5 контейнеров, но между примерами нужна строгая изоляция механизма внимания.
- SFT намного дешевле заданного претрейн-сценария. Поэтому качество смеси, абляции и удержанные тесты обычно важнее одной большой тренировки.
- LIMA — аргумент за качество, не против данных. Малый набор работает, когда базовая модель сильна, а демонстрации точны и разнообразны.
- Синтетика требует происхождения и проверки. Best-of- быстро насыщается; улучшение вероятности прохождения часто выгоднее роста .
- Длинные решения переносят приёмы, но также ошибки и стиль учителя. Результаты DeepSeek-R1-Distill и s1 следует читать вместе с протоколом и ограничениями.
- SFT для работы с инструментами обучает решениям, а не просто JSON. Результат инструмента — наблюдение среды; вызов и реакция ассистента — целевые действия.
- LoRA резко уменьшает число обучаемых параметров. Коэффициенты памяти относятся к конкретной бухгалтерии и не равны сокращению полной памяти GPU.
Основные источники:
-
InstructGPT — Training language models to follow instructions with human feedback
-
Self-Instruct — Aligning Language Models with Self-Generated Instructions
-
LIMA — Less Is More for Alignment
-
Tülu 3 — technical report and open recipe
-
DeepSeek-R1 — reasoning and distillation report
-
Harmony — official response-format specification
-
Inkling — official model announcement
-
Tinker — official training API documentation
Дальше: модуль 14 переходит от демонстраций к предпочтениям и наградам. SFT задаёт исходную политику и формат ответа; DPO, RLHF и RLVR будут использовать предпочтения и награды. При этом DPO может обучаться на фиксированных парах, а обучение с подкреплением обычно обновляет набор собственных генераций.
Редакция и проверка источников: 11 октября 2026 года. Сведения о форматах, наборах данных и сервисах проверены по первоисточникам. Числа учебных примеров воспроизводятся локальными расчётами; опубликованные результаты оценивания сохраняют протокол и статус, указанные их авторами.