Модуль 16. Мультимодальные LLM: зрение, аудио и видео
Курс «Modern LLMs» · лекция модуля 16 · редакция 2026.10.25
О чём этот модуль. Представим один обычный пользовательский запрос: «посмотри на этот скриншот, учти голосовое пояснение и найди соответствующий момент в видео». Для пользователя это одна задача. Для модели — три физических сигнала с разной геометрией и разной временной частотой. Каждый из них нужно превратить в представление, сжать до приемлемого бюджета, сохранить его пространственную или временную структуру и, возможно, породить ответ не только текстом. Поэтому будем рассматривать четыре связанные задачи: представление, бюджет, структура и выход.
Мы проследим путь от изображения до текстового ответа, а затем добавим видео и потоковую речь. По мере движения появятся компоненты, которые извлекают признаки, связывают их с языковой моделью и восстанавливают звук или изображение. Это позволит сравнить архитектуры по распределению работы, а не только по названиям.
Расчёты связывают геометрию с работой системы: 576, 2880 и 1296 визуальных токенов; 72, 360 и 162 MiB KV на изображение в заданной GQA-геометрии; симметричный InfoNCE на учебном батче; параметрический бюджет LLaVA-подобного рецепта; и двухчасовое видео, которое при наивной дискретизации превращается в миллионы токенов. Числа нужны не сами по себе: каждый расчёт отвечает на вопрос, где архитектура оплачивает новую модальность и какой следующий компромисс из этого возникает.
Что нужно знать заранее. Модуль 4 вводит многомерные позиционные схемы, модуль 5 — геометрию GQA и KV-кэша, модуль 9 — приближение , модуль 10 — различие между
prefillиdecode, а модуль 15 — цену дополнительного контекста во время инференса. Все необходимые определения повторяются здесь, поэтому М16 остаётся самодостаточным.
Как читать модуль
Первый проход: §§1–4 вводят устройство системы; §§6–7 показывают цену одного изображения; §§9–12 связывают разрешение, видео и речь. Затем прочитайте §§15–17 и выводы §20. В историческом §2 названия обозначают семейства: подробности их устройства появятся дальше. Для этого маршрута достаточно помнить, что контрастивный энкодер обучает связанные изображения и подписи получать близкие векторы.
Второй проход: вернитесь к функции потерь в §5, обучению коннектора в §8, коду и ноутбуку в §§13–14. Выполните упражнения §19. Здесь важно самостоятельно пройти путь от пикселей до предсказанного ответа и сопоставить каждый результат с допущениями.
Справочный проход: §§6–8 и §11 содержат расчёты, §16 — карту источников на дату проверки, §17 — порядок чтения конфигурации. Одна и та же надпись «256K» в паспортах может означать разные точные пределы; в учебном видео-примере явно принято 256 000 позиций.
1. Мотивация: новая модальность становится новым бюджетом
Пользователь редко мыслит категориями «текстовый запрос» и «визуальный запрос». Он показывает скриншот, прикладывает PDF, диктует голосовое сообщение или просит найти момент в видео. Для системы это не вариации одного и того же входа, а сигналы с разной естественной структурой. Текст уже разбит токенизатором. Изображение нужно дискретизировать по двум пространственным осям, видео — ещё и по времени, аудио — по коротким временным окнам; далее его представление может быть непрерывным или дискретным.
Модели, соединяющие зрение и язык, называют моделями зрения и языка (Vision-Language Models, VLM). Более широкий мультимодальный интерфейс может включать также звук и видео.
Поэтому слово «мультимодальная» скрывает по меньшей мере три разных способности.
- Восприятие: модель принимает изображение, видео или звук как контекст.
- Совместное рассуждение: она связывает сведения между модальностями — например, сопоставляет речь с происходящим в кадре.
- Генерация: она способна выводить не только текст, но также речь, изображение или другой медиапоток.
Эти способности не следуют друг из друга автоматически. Модель может хорошо читать диаграммы и отвечать только текстом. Другая умеет генерировать изображения, но теряет мелкие надписи при понимании. Третья ведёт живой голосовой диалог, хотя её визуальный тракт остаётся отдельным энкодером.
Чтобы не потеряться в названиях моделей, будем всякий раз задавать четыре вопроса.
- Представление: во что превращается физический сигнал до встречи с языковой моделью?
- Бюджет: сколько позиций, памяти и вычислений покупает такое представление?
- Структура: как сохраняются пространство изображения и время аудио или видео?
- Выход: какой компонент порождает текст, изображение или речь и с какой скоростью?
Уже первый вопрос быстро приводит ко второму. Если изображение превращается в 576 токенов, оно удлиняет prefill, занимает контекст и, в архитектуре с визуальными токенами внутри декодера, добавляет 576 позиций в KV-кэш. Если один кадр стоит 576 токенов, двухчасовое видео при одном кадре в секунду создаёт более четырёх миллионов токенов ещё до текста пользователя.
Так появляется сквозной вопрос модуля:
Как архитектура превращает физический сигнал в вычислительный бюджет — и какую новую проблему создаёт выбранный способ представления?
Ответ нельзя получить по одной надписи «поддерживает изображения». Нужно проследить весь путь: процессор входа, энкодер, способ слияния, число визуальных или аудиопозиций, структуру памяти и выходной декодер.
2. Историческая прогрессия: четыре семейства, которые продолжают сосуществовать
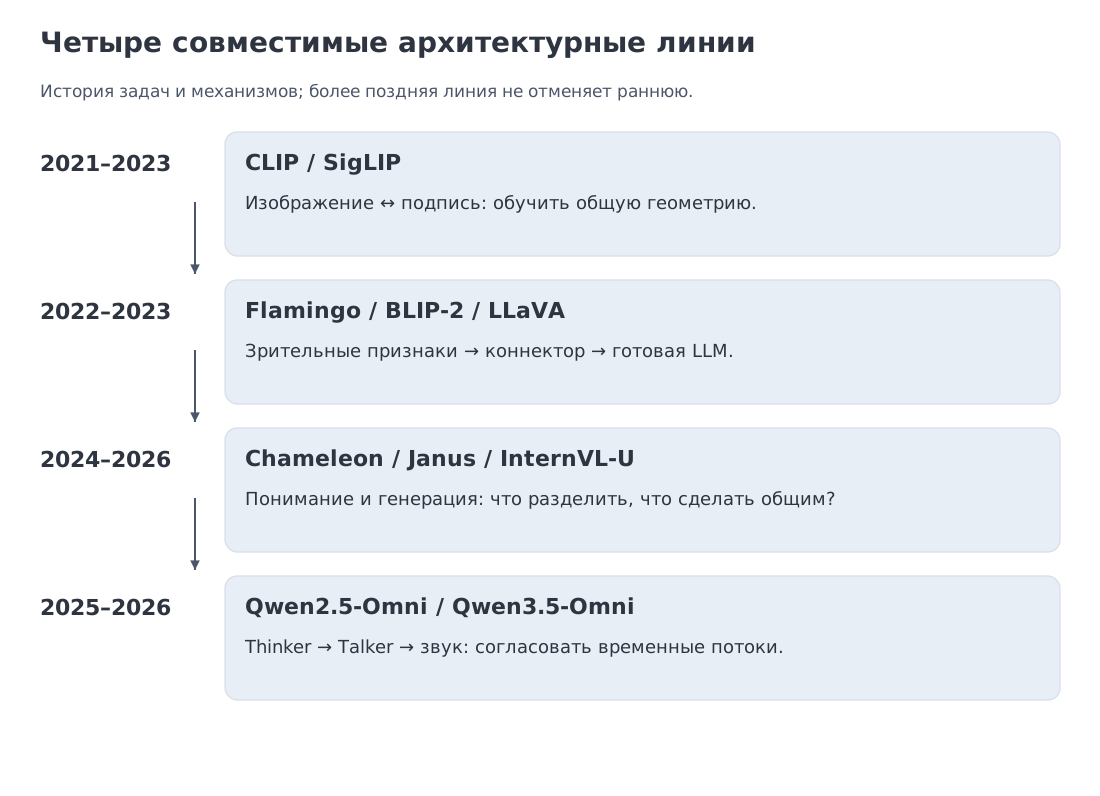 Четыре архитектурные линии: выровненные пространства CLIP/SigLIP; коннекторы между готовым зрением и LLM; единое моделирование понимания и генерации; omni-системы с потоковым аудио. Новое семейство не отменяет предыдущие.
Историю мультимодальных моделей удобно читать как последовательность вопросов. Каждый новый ответ закрывал одно ограничение, но оставлял открытым следующее.
Первый вопрос звучал так: можно ли вообще поместить изображение и текст в сопоставимое семантическое пространство? CLIP в 2021 году обучил визуальную и текстовую башни на 400 млн пар так, чтобы соответствующие объекты оказывались рядом. SigLIP изменила функцию потерь, сохранив двухбашенную логику. Такие модели отлично подходят для поиска, классификации и отбора, но сами по себе ещё не являются диалоговыми генераторами.
Отсюда возник второй вопрос: как передать уже выученное зрение готовой языковой модели, не обучая всё с нуля? Flamingo, BLIP-2 и LLaVA поставили между визуальным энкодером и LLM сравнительно небольшой коннектор. Модульный путь сохранил текстовые способности языковой модели и сделал мультимодальную адаптацию значительно дешевле. Но теперь стоимость зависела от того, сколько визуальных позиций коннектор передаст в языковой контур и где они будут храниться.
Третий вопрос появился, когда от системы потребовали не только понимания, но и генерации изображения: может ли один интерфейс обслуживать обе стороны? Chameleon выбрала единый поток дискретных текстовых и визуальных токенов. Janus сохранила общий Transformer, но разделила визуальные пути понимания и генерации, потому что семантическая инвариантность и восстановление деталей требуют разных представлений. InternVL-U сделала ещё один шаг: мультимодальная LLM отвечает за понимание и рассуждение, а специализированная голова генерации изображений — за генерацию и редактирование изображения.
Наконец, потоковый голосовой диалог поставил четвёртый вопрос: как согласовать несколько временных шкал и начать выдавать речь до завершения всего ответа? Qwen2.5-Omni и Qwen3.5-Omni используют Thinker–Talker: один контур интегрирует мультимодальное свидетельство и формирует языковое содержание, другой генерирует поток аудиотокенов. Единый пользовательский интерфейс по-прежнему скрывает специализированные внутренние модули.
Эти семейства сосуществуют, поскольку по-разному распределяют четыре задачи из §1. Контрастивный энкодер дешёво решает семантическое выравнивание. Коннектор быстро добавляет новую модальность к существующей LLM. Единая модель упрощает общий интерфейс ценой более сложного внутреннего компромисса. Omni-система добавляет потоковую координацию времени и выхода.
Читая любую мультимодальную архитектуру, полезно спросить не «к какому поколению она относится», а какую задачу решает общий модуль, а какую — специализированный.
3. Мостик к классике: метрическое обучение, ViT и сигнальные конвейеры
Четыре вопроса из предыдущего раздела не требуют совершенно нового математического языка. Их удобно разложить на три старые инженерные идеи.
Метрическое обучение (Metric Learning): сначала согласовать смысл
Сиамские сети и двухбашенные модели учатся располагать связанные объекты близко, а несвязанные — далеко. В CLIP объектами становятся изображение и подпись. Косинусная близость в общем пространстве позволяет искать текст по картинке, картинку по тексту и переносить классификацию на новые словесные метки.
Главный результат здесь — не буквальное превращение пикселей в слова. Контрастивное обучение создаёт семантически организованное пространство, в котором визуальные признаки уже различают содержательные категории. Именно поэтому небольшой коннектор иногда способен связать готовый визуальный энкодер с LLM: ему не нужно заново извлекать смысл из сырых пикселей.
Vision Transformer: затем превратить площадь в последовательность
ViT предложил простой механизм: разбить изображение на патчи, линейно спроецировать каждый патч и обработать получившуюся последовательность с помощью Transformer. Для изображения высоты , ширины и квадратного патча базовое число позиций равно
если обе стороны делятся на без остатка. Эта формула делает цену представления видимой: удвоение линейного разрешения примерно в четыре раза увеличивает число патчей. В текстовой токенизации длина зависит от содержания строки; в визуальной — ещё и от площади входа.
Сигнальный конвейер: наконец, согласовать разные частоты и выходы
Классические системы распознавания речи разделяли акустическую модель, языковую модель и декодер. Современная мультимодальная система часто делает то же самое в обучаемой форме: энкодер сжимает физический сигнал, языковой модуль связывает его с задачей, специализированный декодер возвращает речь или изображение.
Это объясняет, почему «сквозное обучение» не обязано означать один однородный Transformer. Компоненты могут обучаться совместно и обмениваться скрытыми представлениями, сохраняя собственную временную частоту, геометрию и функцию потерь. Модульность здесь не исторический пережиток, а способ не заставлять один кодек одновременно быть лучшим для семантики, пиксельной точности и потоковой задержки.
Теперь у нас есть три инструмента: общее семантическое пространство, визуальная последовательность и модульный сигнальный тракт. На их основе можно собрать первую VLM и затем посчитать его цену.
4. Базовый рецепт VLM: энкодер, коннектор и языковой декодер
Начнём с самой прозрачной конструкции. Пусть пользователь прикрепил изображение и задал вопрос. Система должна сначала извлечь визуальные признаки, затем перевести их в язык, понятный LLM, и лишь после этого породить ответ. Эти три обязанности естественно распределяются между тремя компонентами.
- Визуальный энкодер (Vision Encoder) превращает изображение в последовательность признаков. Обычно это ViT или родственная сеть.
- Коннектор (Connector) переводит ширину и распределение визуальных признаков в формат, который ожидает LLM. Простейший вариант — многослойный перцептрон (MLP), то есть несколько линейных преобразований с нелинейностью между ними. Q-Former и Perceiver Resampler дополнительно извлекают короткую последовательность признаков с помощью обучаемых запросов. Возможен и доступ через перекрёстное внимание.
- Языковой декодер связывает визуальное свидетельство с текстовым запросом и авторегрессионно генерирует ответ.
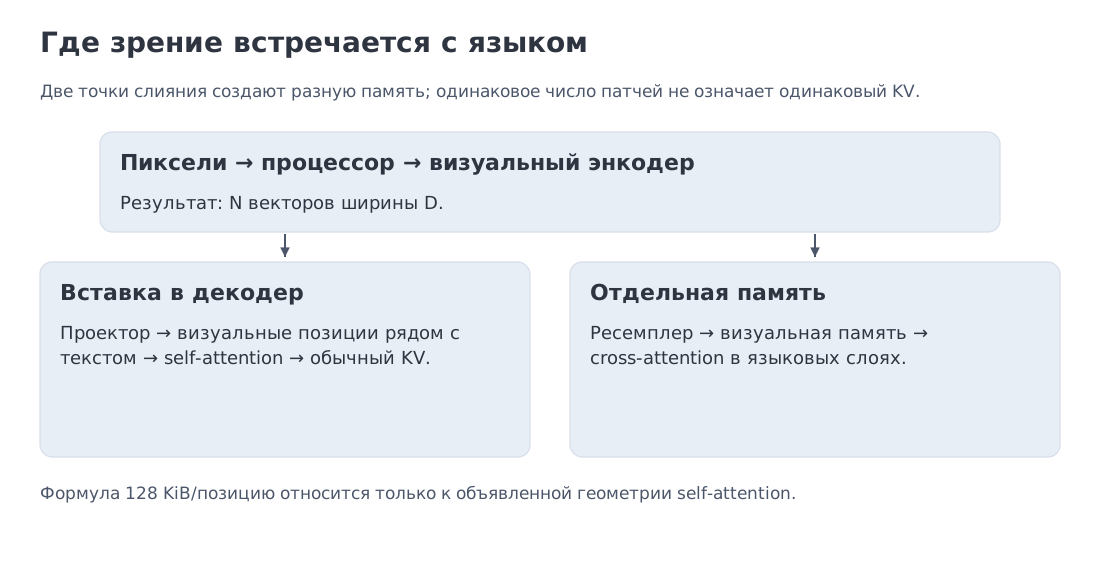 Модульный VLM: процессор изображения и энкодер создают визуальные признаки; коннектор меняет их число или ширину; языковой декодер использует их как часть контекста либо через отдельное cross-attention.
На схеме один и тот же коннектор не обязан выполнять все функции сразу. От выбранной точки слияния зависит, где система заплатит за визуальную информацию.
В М2–3 текстовый токен имел дискретный ID: по нему выбиралась строка таблицы эмбеддингов. Здесь «визуальным токеном» часто называют сам непрерывный вектор признаков в одной позиции. Проектор передаёт его декодеру напрямую, без выбора ID из текстового словаря. Общее у этих представлений — роль позиции в последовательности; способ их получения различается. В §10 встретится и другой случай: визуальный кодек действительно выдаёт дискретные индексы.
Вставка в поток декодера. После проектора визуальные векторы занимают позиции рядом с текстовыми эмбеддингами. Они участвуют в самовнимании (self-attention) и создают KV-состояния подобно текстовым токенам. Архитектура получается простой, но каждая визуальная позиция увеличивает длину языкового контекста. Именно для такого режима применимы расчёты §7.
Отдельное перекрёстное внимание (cross-attention). Flamingo-подобный декодер хранит визуальную память отдельно и периодически обращается к ней из языковых слоёв через перекрёстное внимание. Визуальные признаки не обязаны занимать обычные позиции текстового KV-кэша, зато появляются отдельные операции внимания и отдельная память.
Сжатие перед декодером. Q-Former или ресемплер (resampler) преобразует большое число патчей в фиксированное или ограниченное число запросов. Система тратит вычисления внутри коннектора, чтобы не переносить всю визуальную последовательность в LLM.
Модульная архитектура удобна и организационно. Энкодер можно заменить без полного переобучения языковой модели, разместить на отдельном ускорителе или кэшировать его признаки для нескольких вопросов к одному документу. Но такая свобода не отменяет следующего шага: сначала нужно понять, чему обучен визуальный энкодер, а затем буквально посчитать, сколько позиций он создаёт. Этому посвящены §§5–7.
5. CLIP, SigLIP и пример C: читаем InfoNCE числом
Почему небольшой коннектор вообще может связать зрение и язык? Потому что сильный контрастивный энкодер уже выполнил значительную часть семантической работы. Посмотрим, какой сигнал создаёт это общее пространство.
CLIP обучается на батче пар «изображение — текст». Пусть нормированные эмбеддинги изображений образуют матрицу , текстов — , а сходства равны
Для направления изображение→текст (image→text) строка матрицы делится на температуру и проходит softmax. Симметричная функция потерь CLIP усредняет cross-entropy в обоих направлениях: изображение должно найти свой текст, а текст — своё изображение.
Чтобы запись оставалась однозначной, пусть , где — число пар, — общая ширина, а каждая строка имеет единичную евклидову норму. Индекс указывает изображение, индекс — подпись; совпадающие индексы задают положительную пару. Полная симметричная функция потерь имеет вид
Первое слагаемое сравнивает подписи для заданного изображения, второе — изображения для заданной подписи. Температура задаёт масштаб логитов. Матрица не обязана быть симметричной: два направления усредняются, а не подменяют друг друга.
Рассмотрим батч из четырёх пар. На диагонали сходство 0.8, вне диагонали — 0.2. При логиты равны 8 для положительной пары и 2 для трёх отрицательных. Вероятность правильного соответствия:
а функция потерь
При более мягкой температуре вероятность падает до 0.525325, а функция потерь растёт до 0.643738. Температура меняет не исходное сходство, а остроту соревнования между парами.
Если все сходства одинаковы, softmax равномерный и функция потерь равна
Для это 1.386294. Такой уровень служит удобным ориентиром случайного сопоставления, но не является фундаментальным «полом»: плохо упорядоченная матрица может дать и большее значение.
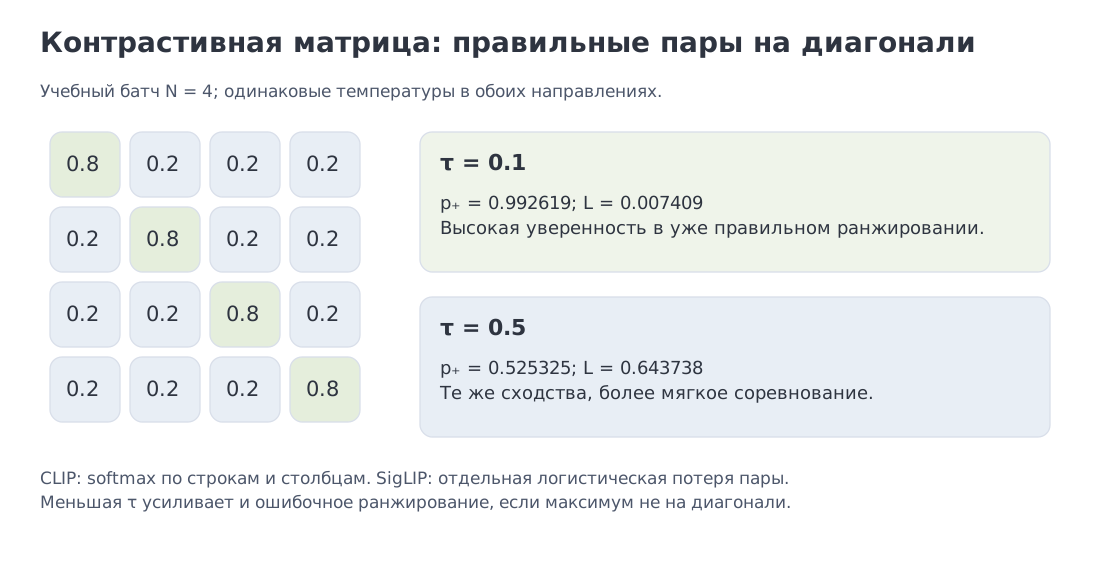 Матрица сходств 4×4, две температуры и различие CLIP/SigLIP. Числа относятся к учебному батчу, а не к опубликованной кривой обучения.
В большом CLIP-батче каждый объект видит отрицательных примеров в соответствующей строке или столбце. Но увеличение батча не даёт бесконечной выгоды: отрицательные примеры становятся избыточными, а глобальная softmax-нормировка усложняет распределённое обучение.
SigLIP заменяет нормировку по всей строке независимой сигмоидной потерей для пар. Для вычисления одного слагаемого не нужен глобальный знаменатель softmax. Это упрощает распределённую реализацию и позволяет гибче выбирать соотношение положительных и отрицательных пар. Качество при этом зависит от состава батча и от того, какие пары используются при обучении.
В SigLIP для пары вводятся метка и логит , где — масштаб, — смещение. Одно слагаемое равно , или устойчивому softplus(-y*z). Исходная запись суммирует пары и делит на , поэтому сумму по парам нельзя без оговорки сравнивать с их средним. Независимость знаменателя каждой пары от остальных пар не отменяет ни этой нормировки, ни влияния отбора отрицательных примеров.
Уменьшение температуры улучшает наш пример, поскольку правильный партнёр уже имеет наибольшее сходство. Если максимум находится вне диагонали, низкая температура делает ошибку увереннее и увеличивает потерю. Две подписи одного содержания также могут стать ложными отрицательными примерами. Контрастивная геометрия зависит от разметки, а не только от формулы.
Контрастивное обучение объясняет семантическую совместимость признаков. Но оно ещё ничего не говорит об их количестве. Следующий шаг — превратить разрешение изображения в явное число позиций.
6. Решённый пример A: от разрешения к числу визуальных токенов
Первый платёж за изображение возникает ещё до языковой модели. Процессор должен решить, на сколько пространственных элементов разбить вход. Эта геометрия определит длину последующих вычислений.
Начнём с фиксированного изображения 336×336 и патча 14×14. Сетка содержит
позиций. Это геометрия пространственных патчей CLIP-ViT-L/14@336, использованная в LLaVA-1.5. Служебная CLS-позиция энкодера, агрегирующая изображение, в эти 576 патчей не входит.
Следующий пример требует осторожности. Число 2880 в учебном контракте — не просто . Оно моделирует LLaVA-NeXT-подобный режим: четыре локальных фрагмента 336×336 плюс одну глобальную миниатюру (thumbnail). Получаем
визуальных токенов до служебных разделителей и возможного дополнительного преобразования. Эта схема покупает мелкие детали ценой многократного повторения пространственного бюджета.
Для Qwen2-VL-подобной геометрии возьмём изображение 1008×1008. С патчем 14:
пространственных патча. Пространственное объединение 2×2 (spatial merger) объединяет четыре соседних патча в один визуальный токен:
Здесь высокое разрешение сохраняется на раннем этапе, а перед языковым декодером число позиций уменьшается. Мы видим два разных способа распределить один бюджет: тайлинг сохраняет локальную детализацию через большее число блоков, merger сжимает сетку перед дорогой языковой частью.
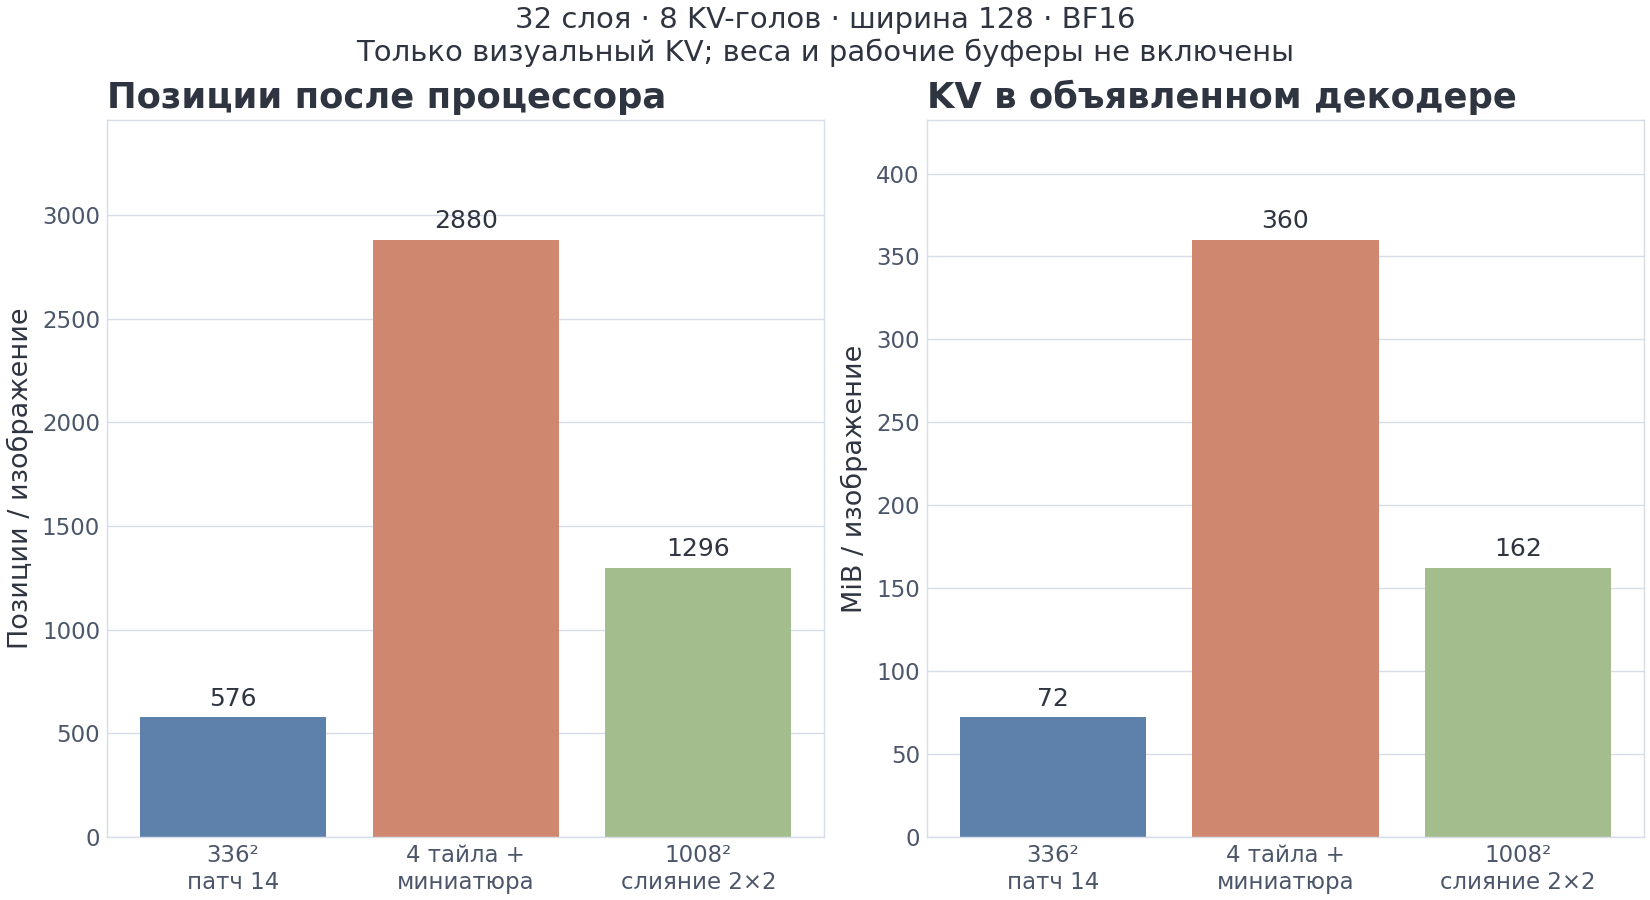 Слева — три явно заданных способа представить изображение; справа — их KV-цена в учебной GQA-геометрии. Число 2880 означает четыре локальных тайла и глобальную миниатюру, а не одну сетку 672×672.
Эти числа нельзя переносить на любую модель с тем же входным разрешением. Реальный процессор может округлять размеры до допустимой сетки, сохранять соотношение сторон, ограничивать число пикселей, добавлять миниатюру или перекрывающиеся тайлы, использовать временные патчи для видео и вставлять служебные токены.
Поэтому арифметика патчей — первая проверка паспорта, а не окончательный счёт. Точный ответ даёт конкретный процессор входов (processor) и конфигурация модели. Но полученное число уже позволяет задать следующий вопрос: куда попадут эти позиции и сколько памяти они создадут?
7. Решённый пример B: когда визуальные токены попадают в KV-кэш
Пусть языковой декодер имеет 32 слоя, 8 голов ключей и значений (KV), размер головы 128 и хранит K и V в bf16. Один токен занимает
Если визуальные токены вставлены в обычный поток самовнимания, их KV-цена вычисляется тем же умножением, что и для текста.
| Представление | Визуальные токены | KV на изображение |
|---|---|---|
| LLaVA-336 | 576 | 72 MiB |
| NeXT-подобные 4 тайла + миниатюра | 2880 | 360 MiB |
| 1008 px + merger 2×2 | 1296 | 162 MiB |
Таблица превращает абстрактный выбор процессора в системную цену. Четыре локальных тайла и миниатюра создают в пять раз больше KV, чем базовое изображение 336×336. В сценарии с объединением энкодер получает более высокое разрешение, а декодер — меньше половины KV тайлового сценария. Сохранилась ли полезная детализация после обучения и сжатия, проверяется по задаче, а не выводится из числа токенов.
Предположим, что из 80 GiB памяти 15 GiB занимают веса и для простоты вся остальная память доступна только под KV. Получаем верхние границы 924, 184 и 410 изображений соответственно.
Это намеренно завышенная вместимость. В реальном сервисе нужны активации, временные буферы, резерв распределителя памяти, текстовый контекст, токены ответа и служебные разделители. Кроме того, визуальный энкодер тоже требует память и вычисления.
Самое важное ограничение формулы архитектурное. Она применима, когда визуальные позиции проходят через самовнимание декодера и их K/V сохраняются в том же формате, что и текст. Ресемплер может уменьшить число таких позиций, сохраняя ту же формулу на одну позицию; его собственная работа считается отдельно. Отсечение также может менять лишь набор сохраняемых позиций. Иная структура памяти — например, перекрёстное внимание или рекуррентное состояние — требует отдельного расчёта.
Следовательно, фраза «изображение стоит 162 MiB KV» всегда должна сопровождаться паспортом геометрии. И это возвращает нас к коннектору: он определяет не только совместимость признаков, но и где именно система будет платить за зрительную память.
8. Коннекторы и пример D: цена модульного рецепта
После §§6–7 у нас появилась неприятная арифметика: высокое разрешение даёт больше визуальных позиций, а позиции могут превращаться в сотни MiB KV на один запрос. Коннектор становится не просто «переходником между ширинами», а регулятором того, где именно система заплатит за зрение.
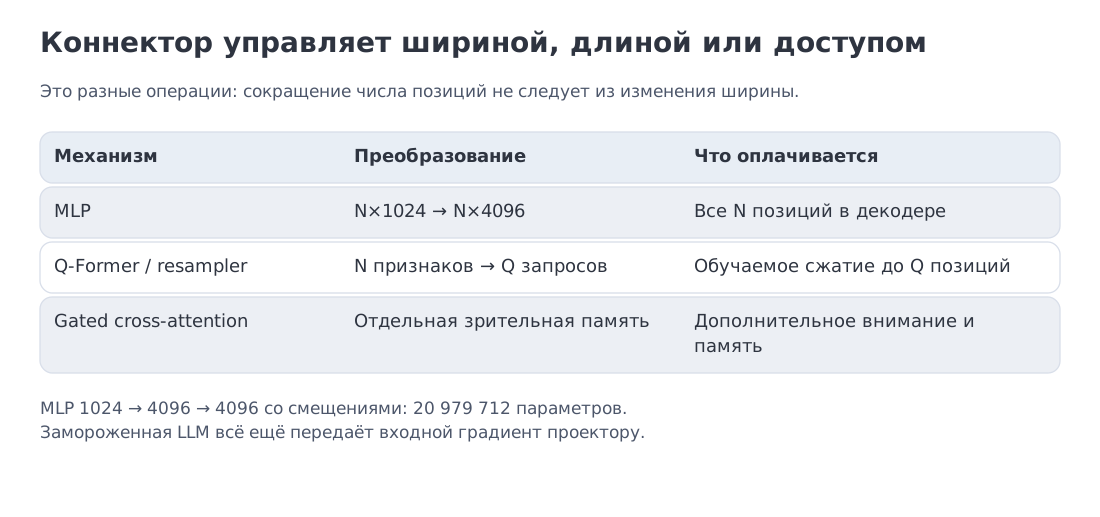 MLP, Q-Former/Resampler и gated cross-attention решают разные задачи: изменение ширины, сжатие числа визуальных позиций или хранение зрительной памяти вне текстового потока.
MLP-проектор: сохранить все позиции, изменить пространство
LLaVA-1.5 использует двухслойный MLP между признаками CLIP и шириной LLM. Для размеров 1024→4096→4096 со смещениями (bias) число параметров равно
Проектор меняет ширину признаков, но не обязан сокращать их число. Если энкодер выдал 576 патчей, декодер обычно получает 576 визуальных токенов. Число позиций сохраняется, но сами признаки преобразуются: MLP не гарантирует обратимого отображения. Весь позиционный бюджет переносится внутрь LLM.
Q-Former и resampler: сжать перед дорогим декодером
BLIP-2 использует обучаемые векторы-запросы, которые через перекрёстное внимание извлекают информацию из большого набора визуальных признаков. Число выходных запросов задаёт явное узкое горлышко: декодер получает короткую последовательность даже для изображения высокого разрешения.
Цена сжатия не исчезает. Она перемещается в коннектор и проявляется как риск потерять мелкую, но важную деталь. Поэтому число запросов — одновременно параметр стоимости и предположение о том, сколько независимых фрагментов свидетельства нужно задаче.
Gated cross-attention: хранить зрение рядом, а не внутри текста
Flamingo хранит визуальные признаки отдельно и периодически подключает их к языковому потоку через cross-attention. Так снимается давление на длину текстовой последовательности, но языковые слои меняются, а визуальная память получает собственный жизненный цикл и стоимость.
Теперь оценим учебный LLaVA-подобный рецепт. Возьмём две стадии:
- 558 тыс. пар для выравнивания коннектора, условно по 600 токенов;
- 665 тыс. мультимодальных инструкций, условно по 1000 токенов.
В формуле величина — число параметров языковой части, — число обработанных позиций, а — приближённое число операций. Коэффициент использования вычислений модели (MFU) задаёт долю пикового темпа, которую мы принимаем полезной: здесь TFLOP/s. Стоимость энкодера и квадратичные операции внимания отдельно не включены.
Если для единой сравнительной бухгалтерии применить к 7B-модели на обеих стадиях и разделить на 990 TFLOP/s при MFU 0.4, получим 9.864 и 19.592 часа. Суммируя до округления, получаем 29.455 часа одного H100-эквивалента.
Эта цифра не является измеренным временем LLaVA или строгой нижней границей. На первой стадии веса LLM заморожены: не вычисляются их градиенты и не хранятся состояния оптимизатора для них. Но градиент по входным активациям проходит через LLM к проектору; no_grad() вокруг всей LLM оборвал бы этот путь. Поэтому считать стоимость только по 21 млн параметров проектора тоже неверно; реальный запуск, с другой стороны, включает загрузку данных, обмены и неполную утилизацию. Число 29.455 — сценарий, эквивалентный плотному обучению (dense-equivalent), удобный для сравнения порядков.
Исторический LLaVA-1.5 имел собственную конфигурацию и измеренное время на 8 A100. Наш расчёт отвечает на более узкий вопрос: почему соединение уже обученных компонентов может быть на порядки дешевле мультимодального претрейна с нуля.
Но коннектор не способен восстановить детали, которые процессор изображения уничтожил ещё до энкодера. Как только задача требует мелкого текста, схем или документов, основной конфликт смещается к разрешению входа. Следующий раздел показывает, почему решение этого конфликта делает вычислительный бюджет переменным от запроса к запросу.
9. Динамическое разрешение, тайлинг и M-RoPE
Представим два изображения. На первом крупный предмет занимает почти весь кадр. На втором — таблица с мелкими подписями. Если привести оба к 336×336, первый запрос почти ничего не потеряет, а второй может лишиться ключевого свидетельства. Если всегда использовать максимальное разрешение, простые изображения будут напрасно занимать контекст и память.
Первый естественный ответ — сделать разрешение зависимым от самого входа. Qwen2-VL формализовала Naive Dynamic Resolution: процессор сохраняет геометрию изображения, выбирает допустимый масштаб и создаёт последовательность переменной длины. Число позиций зависит от размеров и соотношения сторон после обработки и от заданных пределов пикселей. Сам по себе этот процессор не определяет, является ли картинка простой фотографией или сложным документом: два входа одной геометрии могут получить одинаковый бюджет. Пространственное объединение затем уменьшает число позиций перед языковым декодером.
Однако переменная длина создаёт следующую задачу. Одномерного номера позиции уже недостаточно, если токен должен помнить, к какой строке, столбцу и моменту видео он относится. M-RoPE (Multimodal Rotary Position Embedding) распределяет координаты по временной, вертикальной и горизонтальной осям. Для текста оси развиваются согласованно; для изображения существенны высота и ширина; для видео добавляется время. Так одна операция внимания получает явную пространственно-временную геометрию.
Qwen2.5-VL усилила временное описание видео, а Qwen3-VL объединила чередование текста, изображений и видео с улучшенной Interleaved-MRoPE, многоуровневым подключением признаков ViT через DeepStack и текстово выровненными временными метками. Здесь хорошо видна причинная цепочка: динамический вход меняет число токенов; чередование смешивает разные фрагменты свидетельства; позиционная схема должна не дать им потерять пространственный и временной адрес.
InternVL решает проблему детализации другим способом. Изображение разбивается на локальные тайлы, часто с дополнительной глобальной миниатюрой. Миниатюра сохраняет общий план, а тайлы возвращают мелкие детали. В варианте InternVL3.5-Flash маршрутизатор ViR выбирает степень сжатия каждого тайла: 256 либо 64 позиции после 1024 визуальных позиций энкодера. Здесь решение действительно обучается по содержимому. Раздельное размещение визуальной и языковой частей — другая, системная возможность семейства, а не сама маршрутизация разрешения.
Оба пути покупают точность переменным числом визуальных токенов. Это означает, что стоимость запроса больше нельзя оценивать по числу изображений. Нужны распределения площадей после процессора, числа тайлов, длин визуальных последовательностей и качества пакетирования. Размеры входа и, при наличии обученного маршрутизатора, его содержимое становятся переменными вычислительного бюджета.
На этом месте возникает более глубокий вопрос. Пока модель только отвечает текстом, можно позволить визуальному представлению быть прежде всего семантическим. Но если та же система должна ещё и генерировать изображение, ей понадобятся детали, которые семантический энкодер склонен отбрасывать. Отсюда начинается следующий архитектурный конфликт.
10. Единое моделирование: общий интерфейс не требует одного представления
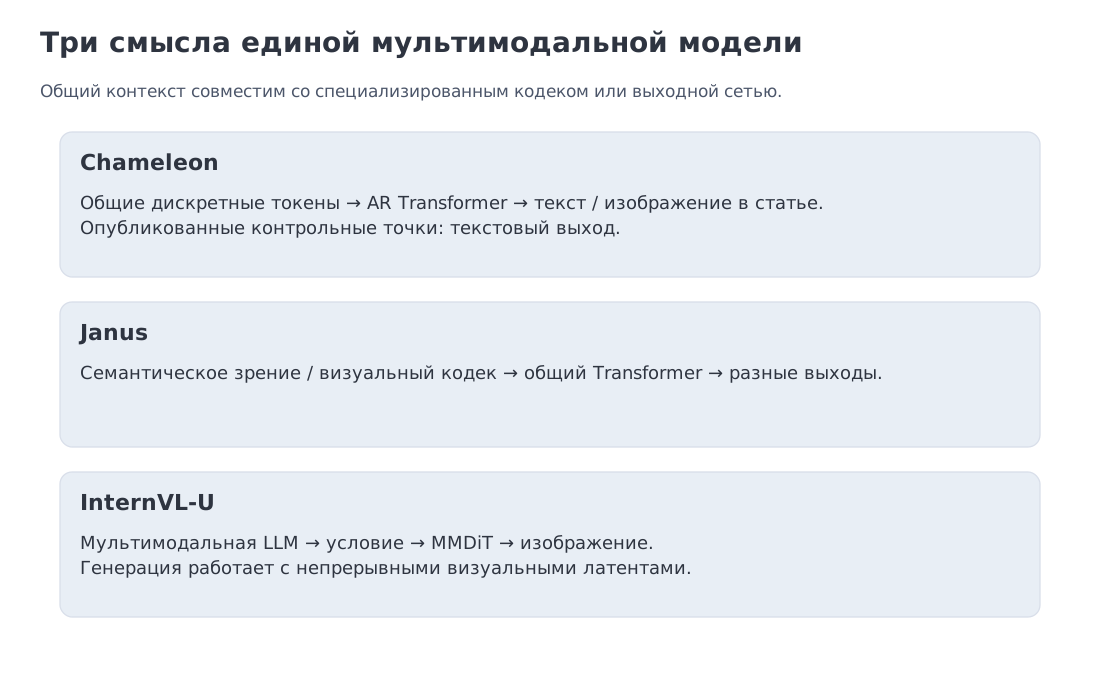 Chameleon, Janus и InternVL-U показывают три разных способа объединить понимание и генерацию: общие дискретные токены; разделённые визуальные энкодеры при общем Transformer; мультимодальная LLM плюс специализированная генеративная голова.
Задачи понимания и генерации предъявляют к изображению разные требования. Для ответа «на фотографии велосипед» полезно отбросить множество несущественных пиксельных вариаций и сохранить семантику. Для генерации или редактирования нужно, наоборот, удержать текстуру, расположение деталей и высокочастотную структуру. Слово единая (unified) поэтому скрывает настоящий проектный выбор: что именно должно быть общим — токены, Transformer, контекст, обучение или только внешний интерфейс?
Chameleon: один поток и один визуальный кодек
Chameleon токенизирует изображения визуальным кодеком и обучает Transformer на смешанных последовательностях текста и изображений. В статье одна авторегрессионная модель продолжает документ в обеих модальностях. Опубликованные Meta контрольные точки Chameleon имеют текстовый выход; наличие генерации изображений в исследовании не означает её доступность в этих весах. Это самый прямой ответ на идею единого словаря: изображение становится последовательностью дискретных токенов рядом с текстом.
Прямота создаёт и самый жёсткий компромисс. Один визуальный кодек должен одновременно быть достаточно семантическим для понимания и достаточно детальным для генерации. Если он слишком сильно сжимает, страдает восстановление; если сохраняет слишком много локальных деталей, растёт последовательность и усложняется обучение рассуждению.
Janus: общий Transformer, разные входные представления
Janus сохраняет единый последовательный Transformer, но использует разные визуальные пути для понимания и генерации. Семантический энкодер может быть инвариантным к несущественным деталям, а генеративный тракт — сохранять информацию, необходимую визуальному декодеру.
Здесь унификация переносится с уровня кодека на уровень основного Transformer. Система сохраняет общий контекст и последовательную модель, не заставляя одну входную сетку одинаково хорошо решать противоположные задачи.
InternVL-U: общий рассуждающий контекст, специализированная генеративная голова
InternVL-U идёт ещё дальше в разделении обязанностей. Мультимодальная LLM отвечает за понимание, рассуждение и формирование условия, а голова MMDiT (Multimodal Diffusion Transformer, диффузионный Transformer для нескольких модальностей) выполняет генерацию и редактирование изображений. Общей остаётся система принятия решения и контекст, а пиксельный выход поручается диффузионному модулю.
Из трёх примеров следует важный принцип:
Унификация интерфейса и обучения не обязана означать унификацию внутреннего представления.
Чем сильнее различаются требования к семантике, точности и частоте выхода, тем больше оснований сохранять специализированные пути. Видео усиливает эту проблему: к пространственным деталям добавляется необходимость выбрать, какие моменты вообще попадут в контекст.
11. Решённый пример E: почему видео требует выборки и сжатия
Изображение имеет пространственную цену. Видео добавляет к ней время. Если просто повторять обработку изображения для каждого кадра, токенный бюджет растёт не только с разрешением, но и с длительностью.
Возьмём двухчасовое видео и выберем один кадр в секунду. Получаем 7200 кадров. Если каждый кадр представлять 576 визуальными токенами, полная последовательность содержит
токенов. Это более чем в 16 раз превышает контекст 256K ещё до текста.
Оставим 4000 токенов для запроса и ответа. Визуальный бюджет равен 252 000 токенов.
Без пространственного объединения (spatial merger) помещается
кадров — примерно один кадр каждые 16.48 секунды.
Если учебное объединение уменьшает представление кадра до 144 токенов, помещается
кадров — один кадр примерно каждые 4.11 секунды.
Здесь K означает 1000, а интервалы 16.48 и 4.11 с — обратную среднюю плотность . В ноутбуке выбираются первый и последний из 7200 кадров: средний промежуток между выбранными временными отметками равен , то есть 16.5115 и 4.1161 с. После округления индексов соседние промежутки различаются. Обе характеристики полезны, но описывают разные величины.
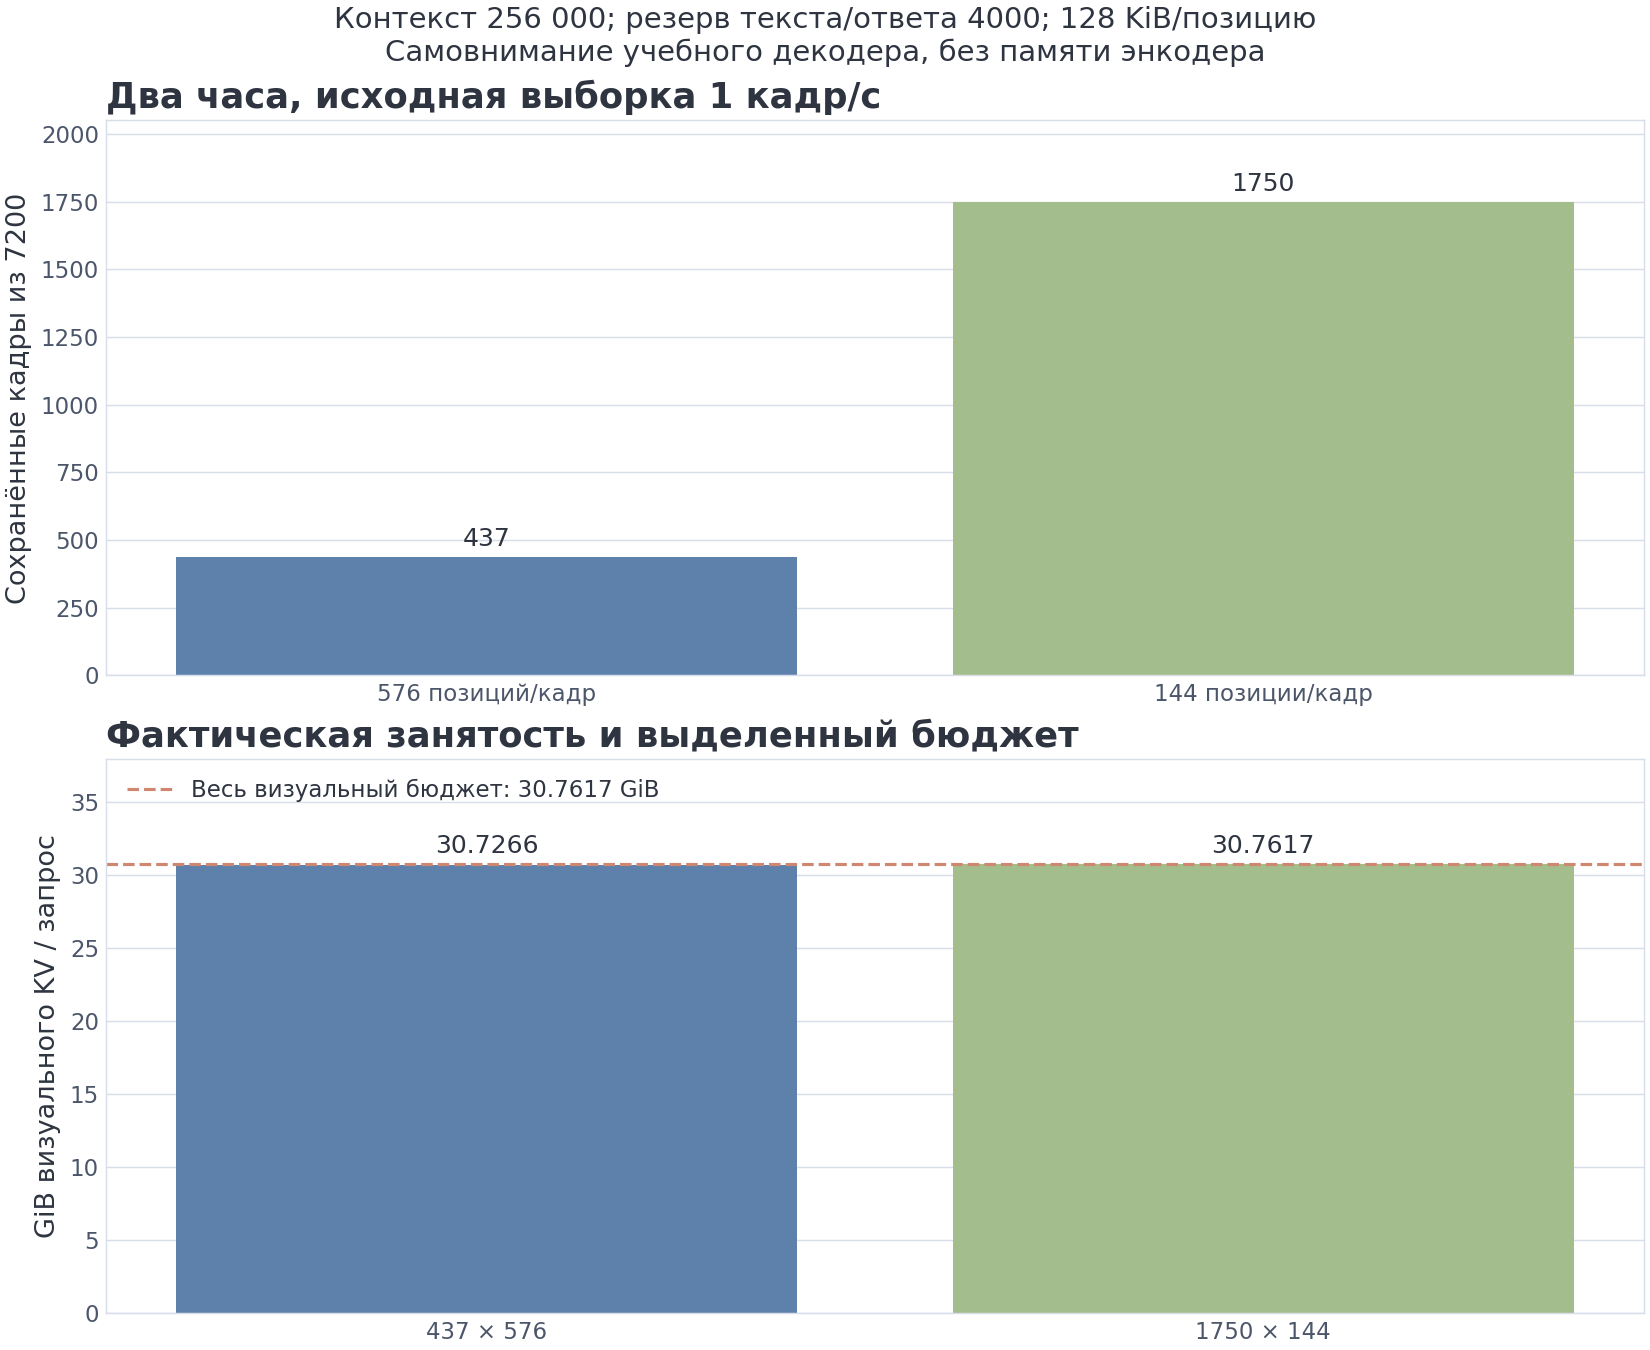 Учебный двухчасовой сценарий показывает цену наивной покадровой дискретизации. Он не описывает внутренний процессор конкретной видеомодели.
При 128 KiB KV на токен 252 тыс. визуальных токенов занимают 30.7617 GiB, а полный контекст 256K — 31.25 GiB. Это только KV одного запроса в заданной 8B-GQA-геометрии.
При 437 целых кадрах фактически занято визуальных позиций, то есть 30.7266 GiB KV. С полным резервом получается 255 712 позиций и 31.2148 GiB; свободные 288 позиций не заняты кадром. Для 1750 кадров по 144 позиции визуальный бюджет заполняется полностью. Резерв для будущего ответа — планируемая вместимость, а не уже выделенный кэш сгенерированных токенов.
Числа показывают не просто «нехватку контекста». Они заставляют выбрать, какие события достойны представления. Равномерная редкая выборка может пропустить короткий, но важный эпизод. Частая выборка сохранит событие, но вытеснит другие части видео. Поэтому реальные системы комбинируют несколько рычагов:
- адаптивную частоту кадров;
- временные патчи и пулинг (pooling);
- удаление почти одинаковых кадров;
- выбор ключевых событий;
- локальное внимание по времени;
- иерархические резюме;
- отдельную долговременную визуальную память.
Большое контекстное окно не решает задачу отбора информации автоматически. Технический паспорт должен объяснять фактическую выборку, разрешение, сжатие и распределение бюджета. Например, отчёт Qwen3.5-Omni отдельно указывает режимы более 10 часов аудио и 400 секунд 720p-видео при 1 fps — это разные временные бюджеты, а не один универсальный предел.
Видео тем самым ставит новую задачу — отбор информации. Изображение требовало решить, сколько деталей сохранить; видео требует ещё решить, какие моменты вообще достойны токенов. Голосовой ответ добавит следующую сложность: поток продолжается непрерывно, а входные события и выходная речь живут на разных скоростях.
12. Thinker–Talker: совместное рассуждение и потоковая речь
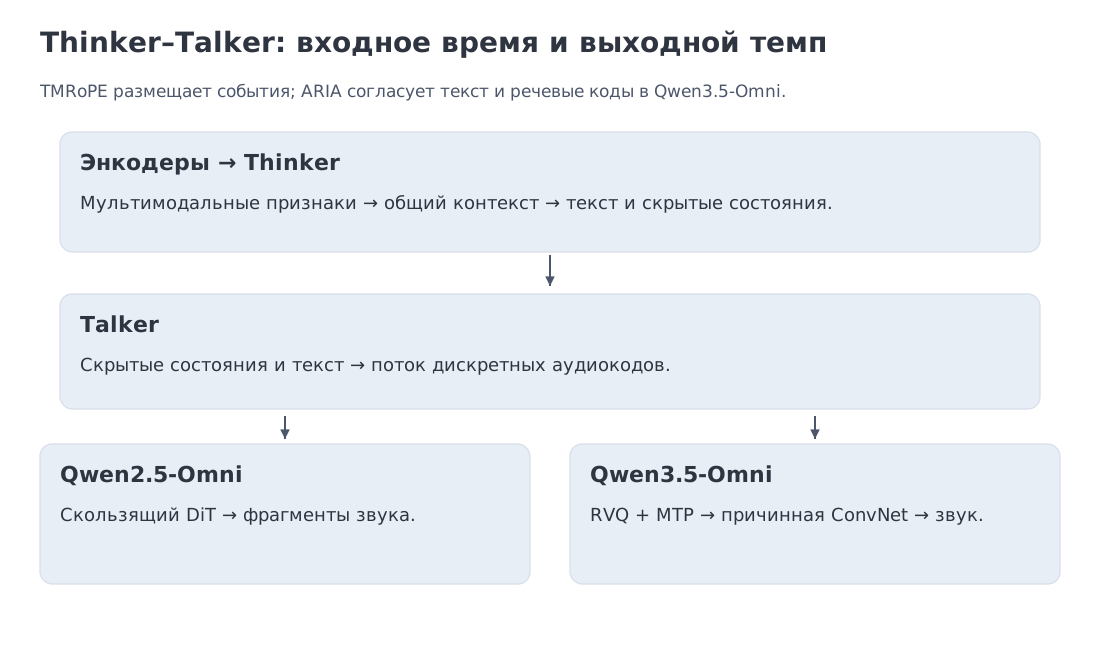 Thinker связывает текст, изображение, аудио и видео; Talker превращает его скрытые представления в поток аудиотокенов. TMRoPE и ARIA решают разные задачи: временное позиционирование входов и согласование скоростей текстового и речевого выхода.
Видео уже заставило модель учитывать время. Живой голосовой диалог добавляет вторую временную проблему. Система должна одновременно понимать, когда произошло входное событие, и согласовывать выходы, которые порождаются с разной скоростью: текстовый токен, аудиокод и пакет звука не образуют одну фиксированную шкалу.
Прежде чем разделять роли компонентов, уточним, что они передают друг другу. Волновая форма — последовательность отсчётов амплитуды. Короткое временное окно называют акустическим кадром; из него можно вычислить вектор спектральных признаков. Такой вектор непрерывен и сам по себе не является индексом словаря. Энкодер может дополнительно объединить несколько кадров, чтобы языковой модуль получил более редкую последовательность.
Для восстановления звука применяют другой путь — нейронный аудиокодек, то есть обучаемые кодировщик и декодировщик сигнала. Кодировщик создаёт векторы, а векторный квантователь заменяет каждый из них номером ближайшей записи в кодовой книге — таблице обученных векторов. Этот номер и называют дискретным аудиокодом. Декодировщик по выбранным векторам восстанавливает приближённую волновую форму. Кодовая книга не является словарём слов или фонем, а один временной кадр может требовать нескольких кодов. В §15 мы посчитаем оба пути отдельно.
Qwen2.5-Omni даёт хорошо документированный пример того, как разделить эти обязанности внутри одной сквозно обучаемой системы.
Thinker принимает текст, изображения, видео и аудио и формирует текстовые токены и скрытые представления. Визуальный и аудиоэнкодеры могут работать блоками, что позволяет принимать потоковый вход. TMRoPE (Time-aligned Multimodal RoPE) отвечает за временной адрес входного свидетельства: аудио и видео получают согласованные временные координаты, а изображение сохраняет пространственные оси.
После этого возникает уже не вопрос понимания, а вопрос выдачи. Talker использует скрытые представления Thinker и авторегрессионно генерирует дискретные аудиотокены. Скользящий диффузионный Transformer (DiT) превращает их в фрагменты звука, не дожидаясь завершения всего ответа. Так первый аудиопакет может появиться значительно раньше последнего.
Qwen3.5-Omni сохраняет разделение Thinker–Talker, масштабирует обе части до Hybrid-Attention MoE и вводит ARIA (Adaptive Rate Interleave Alignment). ARIA решает другой класс проблемы, чем TMRoPE: TMRoPE размещает входные события на временной шкале, а ARIA согласует переменные скорости выходных текстовых и речевых токенов.
Важно проследить и конец тракта. Скользящая диффузионная реконструкция относится к Qwen2.5-Omni. В Qwen3.5-Omni используется остаточная векторная квантизация (RVQ): дополнительные кодовые книги уточняют ещё не представленную часть сигнала. Модуль многотокенного предсказания (MTP) выдаёт коды этих книг, а причинная свёрточная сеть Code2Wav восстанавливает звук. TMRoPE дополнена явными текстовыми временными метками. Это детали конкретных поколений, а не обязательные свойства любой схемы Thinker–Talker.
Получается важная архитектурная картина. Система может быть сквозной и поддерживать общий мультимодальный контекст, оставаясь многокомпонентной внутри. «Одна модель» на уровне продукта означает согласованный контракт, а не обязательное совпадение всех декодеров и частот.
Из этой конструкции прямо следуют метрики. Нельзя свести голосовой режим к одной задержке. Нужно отдельно измерять:
- качество смыслового ответа;
- задержку до первого аудиопакета;
- коэффициент реального времени : значение меньше единицы означает генерацию быстрее воспроизведения;
- стабильность и просодию потоковой речи;
- задержку и качество прерывания;
- синхронизацию речи с видео;
- качество голоса там, где поддерживается его воспроизведение.
Так мы завершаем путь от пространственного патча к нескольким согласованным временным потокам. Прежде чем смотреть на полный ландшафт моделей, в §§13–14 зафиксируем минимальную механику: сетку патчей, KV-стоимость и выборку кадров.
13. Код первого уровня: геометрия до фреймворка
Ниже собраны минимальные функции, которые фиксируют три контракта модуля: точную сетку патчей, KV-стоимость визуального блока и число кадров в контексте.
"""Exact visual geometry and decoder-KV accounting; no implicit resize."""
from dataclasses import dataclass
from numbers import Integral

def positive_count(value):
    if isinstance(value, bool) or not isinstance(value, Integral) or value <= 0:
        raise ValueError("expected a positive integer")
    return int(value)

@dataclass(frozen=True)
class PatchLayout:
    grid_h: int
    grid_w: int
    merge: int
    visual_tokens: int

def patch_layout(height, width, *, patch=14, merge=1):
    height, width, patch, merge = map(positive_count, (height, width, patch, merge))
    if height % patch or width % patch:
        raise ValueError("image dimensions must be divisible by patch")
    gh, gw = height // patch, width // patch
    if gh % merge or gw % merge:
        raise ValueError("patch grid must be divisible by merge on both axes")
    return PatchLayout(gh, gw, merge, (gh // merge) * (gw // merge))

def kv_mib(tokens, *, layers=32, kv_heads=8, head_dim=128, bytes_per_value=2):
    tokens, layers, kv_heads, head_dim, bytes_per_value = map(
        positive_count, (tokens, layers, kv_heads, head_dim, bytes_per_value))
    return tokens * 2 * layers * kv_heads * head_dim * bytes_per_value / 2**20

def video_frames_fit(context=256_000, text_reserve=4_000, tokens_per_frame=576):
    context, tokens_per_frame = map(positive_count, (context, tokens_per_frame))
    if (isinstance(text_reserve, bool) or not isinstance(text_reserve, Integral)
            or not 0 <= text_reserve < context):
        raise ValueError("text_reserve must be an integer in [0, context)")
    return (context - int(text_reserve)) // tokens_per_frame
Проверки из лекции:
assert patch_layout(336, 336).visual_tokens == 576
assert 5 * patch_layout(336, 336).visual_tokens == 2880
assert patch_layout(1008, 1008, merge=2).visual_tokens == 1296
assert kv_mib(2880) == 360.0
assert video_frames_fit() == 437
Код намеренно отказывается округлять несовместимое разрешение. Реальный процессор может явно изменить размер или дополнить изображение. Дополнение требует учёта добавленных областей; отдельная маска пикселей нужна не каждому интерфейсу, поэтому проверяйте контракт процессора. Иначе «удобное» целочисленное деление незаметно выбросит край изображения.
15. Аудио как временная модальность
После Thinker–Talker полезно вернуться к аудио как к самостоятельному входу. Оно воспроизводит те же четыре задачи, что и изображение, но делает их жёстче: сигнал приходит непрерывно, а его естественная частота намного выше частоты слов.
Начнём с минуты речи. Даже если пользователь произнёс несколько коротких фраз, фронтенд создаёт длинную последовательность акустических кадров или кодек-токенов. Перед языковой моделью поэтому стоит не только задача распознавания, но и задача сильного временного сжатия.
Фронтенд и энкодер: что считать содержанием
Волновая форма преобразуется в спектрограмму, признаки или дискретные аудиотокены. Модель автоматического распознавания речи (ASR), например Whisper, главным образом сохраняет лингвистическое содержание. Omni-системе могут понадобиться также интонация, музыка, фоновые события, свойства говорящего и синхронизация со зрительным рядом.
Выбор энкодера определяет, какое свидетельство вообще дойдёт до языкового контура. Семантически удобное представление может оказаться слишком бедным для восстановления голоса или эмоции.
Временное сжатие: сколько позиций покупать в секунду
Сырые акустические кадры слишком плотны для прямого внимания LLM. Свёртки с шагом (stride), пулинг или нейронный кодек уменьшают число позиций в секунду. Это тот же бюджетный компромисс, что пространственное объединение в зрении: сильнее сжимаем — дешевле контекст, но выше риск потерять фонетику, эмоцию или точную временную привязку.
Решённый пример F: секунды, кадры, позиции и коды
Возьмём шесть секунд монофонического звука с частотой дискретизации отсчётов/с. Это отсчётов, а не 96 тысяч языковых токенов. Учебный фронтенд начинает окна длиной 400 отсчётов через каждые отсчётов: 25 мс на окно, 10 мс между началами. Последние окна дополняются нулями справа; нового окна после конца сигнала нет. При таком правиле
Окна перекрываются, поэтому не является длиной исходной записи. Преобразование Фурье каждого действительного окна даёт 201 частотную компоненту; в ноутбуке используются их модули. Получается матрица признаков . Это прозрачная учебная спектральная обработка, а не реконструкция энкодера Whisper или Qwen.
Теперь усредним каждые четыре соседних вектора. Останется позиций, каждая ширины 201. Неполную последнюю группу, если она появится при другой длине, усредняем только по существующим кадрам. Ширина признака и длина последовательности — разные оси: 150 позиций не означают 150 скалярных значений. Если после проекции эти позиции входят в декодер из §7, их KV занимает MiB. Работа фронтенда и проектора сюда не включена.
Сравним это с отдельным сценарием кодека: 75 кадров/с, восемь кодовых книг, по 1024 записи в каждой. За шесть секунд получим 450 временных кадров и индексов. При фиксированном десятибитном представлении индекса полезная нагрузка равна 36 000 бит, а темп — бит/с. Это расчёт без заголовков, служебных данных и энтропийного сжатия; речь не идёт о фактическом размере файла.
Из 3600 индексов ещё нельзя вывести размер KV. Модель может развернуть их в 3600 последовательных позиций, объединить восемь кодов одного кадра в одно представление или предсказывать часть кодов отдельным модулем. В коде EnCodec, например, явно разделены оси партии, кодовых книг и времени: [B,K,T]. Эти оси помогают читать интерфейс, но численный сценарий выше не задаёт устройство произвольной omni-модели. EnCodec: кодирование и декодирование
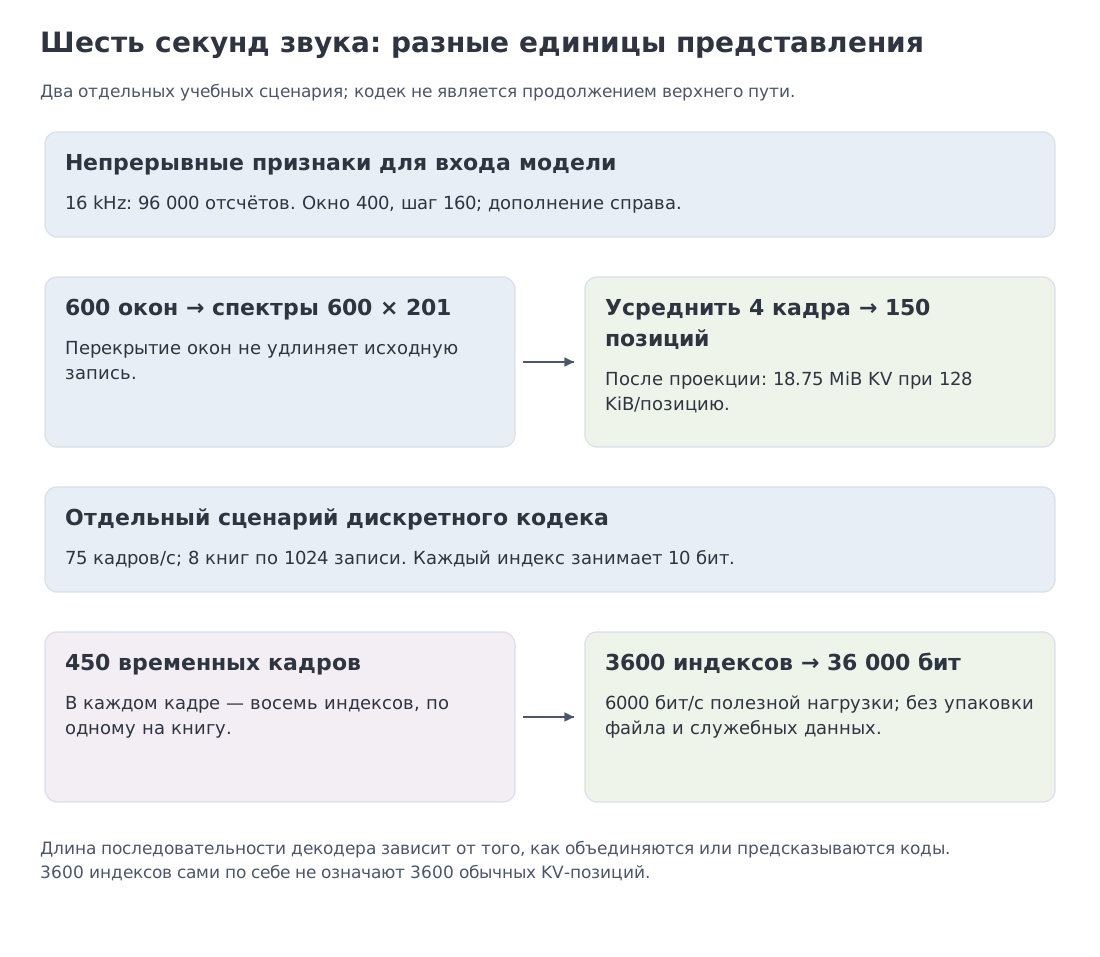 Учебный путь спектральных признаков и отдельный сценарий кодека с несколькими кодовыми книгами. Число кодов, число временных кадров и число позиций декодера требуют разных подсчётов.
Второй проход: что уточняет RVQ. Остаточная векторная квантизация (Residual Vector Quantization) последовательно кодирует ещё не объяснённую часть вектора. Если исходный вектор — , первая книга выбирает , вторая приближает остаток , а реконструкция после двух книг равна . В учебном примере , , . Квадрат ошибки уменьшается с после первой книги до после второй. Здесь книги заданы вручную, и в каждой есть нулевой вектор: поэтому ближайшее уточнение не хуже отсутствия уточнения. Это свойство данного примера; произвольный набор книг такой гарантии не даёт. Механизм последовательного кодирования остатка виден в реализации EnCodec.
Наконец, отделим объём представления от скорости выдачи. Если условный речевой декодер создал шесть секунд звука за 2.4 с, его . Первая порция при этом могла появиться через 0.18 с: это другая метрика. Эти времена заданы для расчёта, а не измерены нашим спектральным кодом. Средний ещё не гарантирует отсутствие пауз между порциями: для потокового диалога нужны также времена готовности отдельных фрагментов.
Семантический контур: связать поток с задачей
Языковой модуль отвечает на вопрос, планирует действие или формирует содержание ответа. Временная позиционная схема связывает аудио с видео и текстом. Если пользователь говорит поверх происходящего в кадре, модели недостаточно знать порядок токенов — нужно понимать, какие события были одновременными.
Речевой декодер: вернуть непрерывный сигнал
Содержание ответа превращается в кодек-токены, затем в звук. Потоковый режим требует начать речь до завершения всей последовательности и корректно остановиться при прерывании пользователем. Поэтому качество декодера проявляется не только в тембре, но и в задержке, устойчивости и поведении при двустороннем потоковом взаимодействии (full duplex).
Qwen2.5-Omni и Qwen3.5-Omni дают публично документированные примеры такого тракта; Step-Audio 2 — ещё один открытый технический отчёт о сквозной аудиомодели. Сравнивать их по одной цифре задержки нельзя без одинакового языка, оборудования, буферизации и формата выхода.
Аудио хорошо подводит нас к последнему вопросу модуля. Модельный паспорт должен описывать не только поддерживаемые модальности, но и фактическую скорость, сжатие и место хранения каждого потока.
16. Публично документированный ландшафт на 11 октября 2026 года
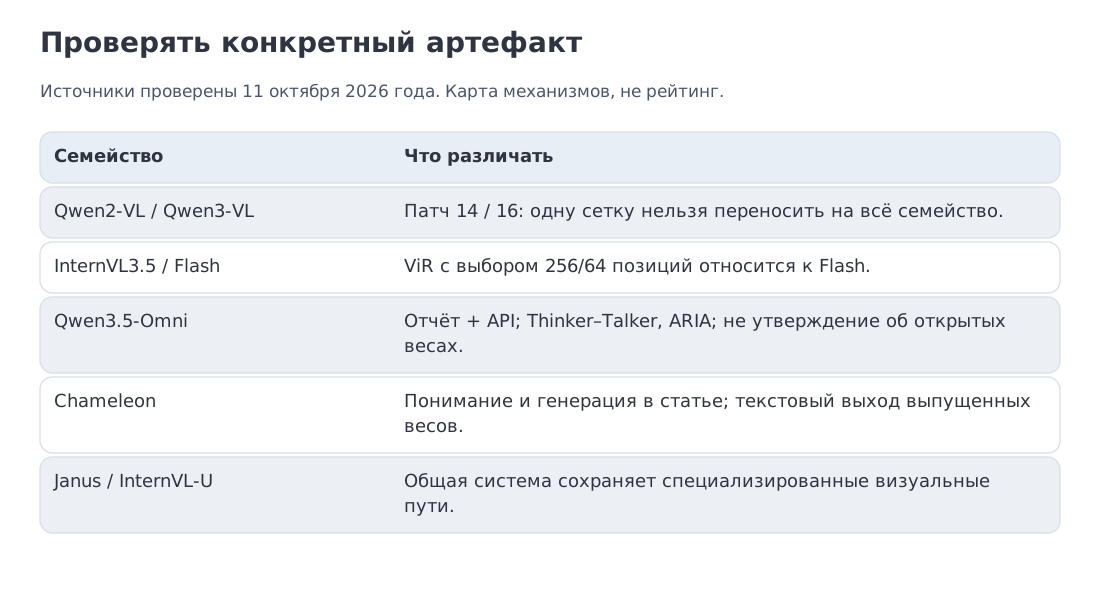 Карта открыто описанных систем: зрение→текст, omni→текст/речь и совместное понимание/генерация. Для закрытых API фиксируются только заявленные входы и выходы; внутренняя архитектура не реконструируется по интерфейсу.
Вместо рейтинга «лучших мультимодальных моделей» полезнее сопоставить несколько публично документированных топологий. Таблица ниже читается не как турнирная доска, а как набор ответов на четыре задачи из §1.
| Система | Вход | Выход | Архитектурный акцент | Открытость |
|---|---|---|---|---|
| Qwen3-VL | текст, изображения, видео | текст | динамическое разрешение, interleaved M-RoPE, DeepStack, 256K | отчёт, код и семейство весов |
| InternVL3.5 / Flash | текст, изображения, видео | текст | ViR в Flash, раздельное размещение vision/LLM, Cascade RL | отчёт, код и веса |
| Qwen3.5-Omni | текст, изображения, аудио, видео | текст и потоковая речь | Thinker–Talker, TMRoPE, ARIA, Hybrid-Attention MoE, 256K | отчёт и документированный API; не заявление об открытых весах |
| InternVL-U | текст и изображения | текст, изображение, редактирование | мультимодальная LLM + специализированная MMDiT-голова | отчёт о 4B-системе |
| Chameleon | текст и изображения | статья: текст/изображения; выпущенные веса: текст | раннее слияние дискретных токенов | отчёт и опубликованные артефакты семейства |
| Janus | текст и изображения | текст и изображения | отдельные визуальные пути, общий Transformer | отчёт, код и веса семейства |
Это выборка архитектур для сравнения механизмов, проверенная 11 октября 2026 года, а не исчерпывающий список последних релизов. Даже внутри семейства нужно читать конкретную конфигурацию: в Qwen3-VL размер патча равен 16, тогда как пример 1008×1008 с патчем 14 относится к Qwen2-VL-подобной геометрии. Отчёт Qwen3.5-Omni называет окно 256K, а в описании обучения уточняет 262 144 позиции; наш расчёт для 256 000 не является реконструкцией этого запуска.
Первая ось сравнения — как система управляет входным бюджетом. Qwen3-VL связывает динамическое разрешение с interleaved-MRoPE, DeepStack и контекстом 256K. Вариант InternVL3.5-Flash выбирает степень сжатия через ViR и может размещать визуальный энкодер отдельно от LLM. Обе системы выводят текст, но распределяют стоимость зрения по-разному: одна делает акцент на общей длинной последовательности, другая — на маршрутизации разрешения и системном разделении компонентов.
Вторая ось — какой выход обещает пользовательский контракт. Qwen3.5-Omni должна не только понять вход, но и начать потоковую речь. Поэтому в её паспорте важны Thinker–Talker, TMRoPE и ARIA. Отчёт указывает разные пределы для разных сигналов — более десяти часов аудио и 400 секунд 720p-видео при одном кадре в секунду. Эти числа принадлежат конкретному процессору и архитектуре; общий контекст 256K сам по себе их не объясняет.
Третья ось — где проходит граница между общей семантикой и генеративной точностью. Chameleon делает общими дискретные токены. Janus разделяет визуальные пути, сохраняя общий Transformer. InternVL-U оставляет рассуждение мультимодальной LLM, а генерацию — MMDiT-голове. Эти системы предоставляют сходный внешний набор возможностей, но по-разному отвечают на конфликт из §10.
Так таблица завершает не каталог названий, а аргумент модуля: мультимодальная система определяется тем, где она сжимает сигнал, где хранит структуру и как организует выход. Для закрытого API мы можем надёжно записать только документированные входы, выходы, ограничения, цену и дату. По внешнему интерфейсу нельзя установить, скрывается ли за ним одна сквозная модель или согласованный каскад.
17. Как читать мультимодальный паспорт модели
Паспорт удобно строить не с названия модели, а с одного реального запроса. Возьмём изображение, видеофрагмент или аудиозапись и проследим, что происходит с ним на каждом этапе.
Шаг 1. Определить, как обрабатывается исходный сигнал
Сначала выясняем, во что вход будет превращён до языковой модели:
patch_size,temporal_patch_sizeиspatial_merge_size;- пределы числа пикселей и правила округления;
- политика тайлинга и глобальной миниатюры;
- выборка кадров видео;
- частота аудио, шаг временного сжатия энкодера и число позиций в секунду.
Эти поля превращают мегапиксели и секунды в токенный бюджет. Без них максимальное контекстное окно почти ничего не говорит о фактической вместимости мультимодального запроса.
Шаг 2. Проследить путь представления
Затем определяем, где визуальные или аудиопризнаки встречаются с LLM.
- входят ли визуальные векторы в самовнимание декодера;
- уменьшает ли ресемплер их число;
- обращается ли декодер к отдельной памяти через перекрёстное внимание;
- обучаются ли зрение и язык совместно;
- разделены ли пути понимания и генерации;
- существуют ли специализированные выходные декодеры.
Именно здесь решается, применима ли формула обычного KV-кэша или нужен отдельный расчёт памяти.
Шаг 3. Проследить выход
Поддержка входной модальности не означает способность её генерировать. Нужно установить, какой компонент выдаёт текст, изображение, аудиокоды или поток речи, с какой частотой он работает и какие промежуточные состояния использует.
Шаг 4. Измерить систему на реальном запросе
Для выбранного входа фиксируем:
- число визуальных или аудиопозиций после процессора;
- задержку энкодера;
- время языкового
prefill; - KV и пиковую память;
- время до первого текстового токена (TTFT), интервал между токенами (ITL) или задержку первого аудиопакета;
- повторное использование признаков при нескольких вопросах к одному медиадокументу.
Такой профиль показывает не только «поместился ли запрос», но и где именно находится узкое место.
Шаг 5. Зафиксировать статус артефакта
Наконец, различаем статью, исходный код, открытые веса, размещённый API и продуктовую демонстрацию. Они дают разные уровни проверяемости. Поведенческий тест способен подтвердить доступную функцию, но не внутреннюю топологию: API может маршрутизировать запросы между несколькими моделями, а генеративная голова может быть отключена политикой продукта.
Теперь паспорт отвечает на вопрос, с которого начался модуль. Он показывает, как физический сигнал стал представлением, сколько стоил, какую структуру сохранил и какой компонент породил выход. Без этой цепочки слово «мультимодальная» остаётся слишком общим для инженерного решения.
20. Ключевые выводы и источники
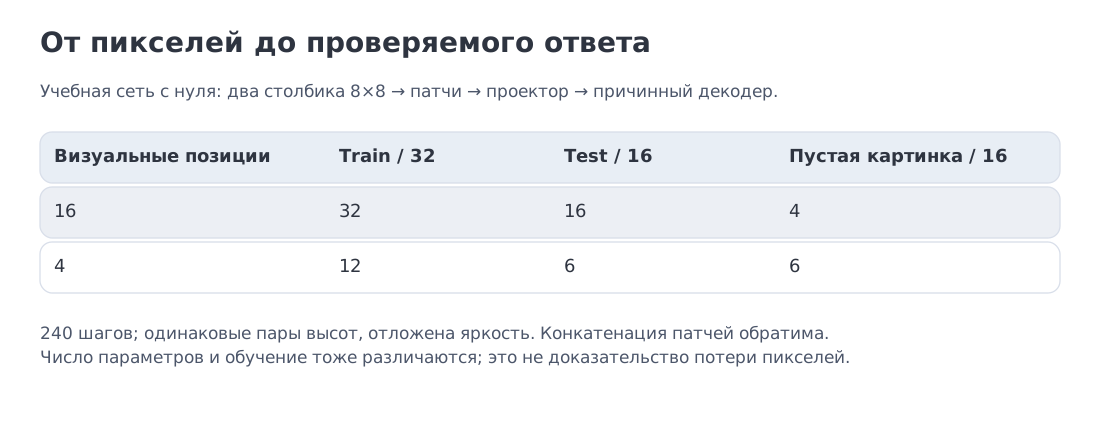 Обучаемый путь от изображения к ответу. Сравниваются полные режимы с 16 и 4 визуальными позициями: на отложенной яркости 16/16 и 6/16 правильных ответов; контроль без изображения даёт 4/16 и 6/16. Это учебный опыт, не измерение большой VLM.
В начале модуля мы взяли один физический сигнал и задали четыре вопроса. К концу видно, что почти все архитектурные различия являются разными ответами именно на них.
Представление. CLIP и SigLIP строят общее семантическое пространство. ViT превращает площадь изображения в последовательность патчей. Аудиоэнкодеры и кодеки делают то же для временного сигнала. Представление определяет, какое свидетельство вообще сможет использовать языковой контур.
Бюджет. В объявленных сценариях изображение создаёт 576, 2880 или 1296 визуальных позиций. В 32-слойной GQA-геометрии это 72, 360 или 162 MiB KV, если позиции входят в обычное самовнимание декодера. Другой способ слияния требует другой формулы.
Сжатие и коннектор. MLP меняет ширину, но сохраняет число позиций. Q-Former или ресемплер сокращает последовательность ценой узкого информационного канала. Перекрёстное внимание хранит зрительную память отдельно. Коннектор переносит стоимость между частями системы, а не отменяет её.
Структура. Динамическое разрешение делает вычислительный бюджет зависимым от входа. M-RoPE и родственные схемы сохраняют координаты высоты, ширины и времени. Видео превращает длину контекста в задачу отбора информации: наивные 7200 кадров по 576 токенов дают 4.15 млн позиций.
Выход. Chameleon, Janus и InternVL-U показывают, что единый интерфейс не требует одного визуального представления. Thinker–Talker показывает то же для речи: входные события и выходные токены живут на разных временных шкалах, поэтому интеграция и генерация могут оставаться специализированными.
Инженерный итог. Надпись «vision/audio/video supported» недостаточна. Нужны процессор, геометрия токенов, точка слияния, структура памяти, выходной декодер, метрики и статус артефакта. Именно такой паспорт превращает мультимодальную возможность в воспроизводимую систему.
Основные первоисточники
- ViT — An Image is Worth 16×16 Words
- CLIP — Learning Transferable Visual Models From Natural Language Supervision
- SigLIP — Sigmoid Loss for Language Image Pre-Training
- Flamingo — a Visual Language Model for Few-Shot Learning
- BLIP-2 — Bootstrapping Language-Image Pre-training
- LLaVA — Visual Instruction Tuning
- LLaVA-1.5 — Improved Baselines with Visual Instruction Tuning
- Qwen2-VL — Dynamic Resolution and M-RoPE
- Qwen2.5-VL — технический отчёт
- Qwen3-VL — технический отчёт
- InternVL3.5 — технический отчёт
- Chameleon — Mixed-Modal Early-Fusion Foundation Models
- Janus — Decoupling Visual Encoding for Understanding and Generation
- InternVL-U — Understanding, Reasoning, Generation and Editing
- Qwen2.5-Omni — технический отчёт
- Qwen3.5-Omni — технический отчёт
- Chameleon — документация опубликованного интерфейса
- Qwen3-VL — код процессора и инструкции разработчиков
- SigLIP — реализация функции потерь
- Step-Audio 2 — технический отчёт
Дальше: модуль 17 переходит к эмбеддингам, поиску и RAG. Контрастивная геометрия §5 станет там не этапом претрейна, а рабочим механизмом доступа к внешним данным.
Ландшафт сверен: 11 октября 2026 года. Числа патчей, KV, InfoNCE, эквивалентного плотному обучения и бюджета видео являются воспроизводимыми сценариями модуля; конкретный процессор входов может добавлять изменение размера, дополнение, временные патчи и служебные токены.