Модуль 8. Альтернативы Transformer: SSM, Mamba и гибриды
Курс «Modern LLMs» · лекция модуля 8 · редакция 2026.10.25
О чём этот модуль. Внимание с softmax хранит прошлое как адресуемый KV-cache: это даёт возможность обращаться к отдельным позициям, но память растёт вместе с контекстом. Модель пространства состояний (State Space Model, SSM) предлагает противоположную сделку: после каждого токена обновлять состояние фиксированного размера. Мы пройдём путь от непрерывной линейной системы и точной ZOH-дискретизации до селективной Mamba, двойственности Mamba-2 с линейным вниманием, дельта-правила и современных гибридов. Сквозной вопрос будет один: какую информацию можно сжать в постоянное состояние, а для какой всё ещё нужна адресуемая память?
Что нужно знать заранее. Модуль 5 вводит KV-cache и геометрию внимания; модуль 6 — остаточный поток и блок Transformer; модуль 7 пригодится для гибридов с MoE. Все необходимые определения повторяются здесь, поэтому модуль остаётся самодостаточным.
Как читать модуль
Первый проход: §1 → §§3–4 → §§6–11 → §§17 и 19. В §4 сначала достаточно дискретной рекуррентности и смысла матриц; вывод точных коэффициентов и У1 из §18 оставьте на второй проход. Для первого расчёта подходят У2–У3 о памяти. Начните с различия между списком прошлых токенов и фиксированным состоянием; затем разберите запись, забывание и гибриды. Числовые детали памяти в §1 можно отложить до §10.
Второй проход: §4–5, §7 и §12–14 вместе с ноутбуком. Выведите дискретный шаг, проследите композицию переходов и проверьте крайние случаи.
Справочный проход: §2, §15 и §20. Названия архитектур в этих разделах служат указателями; основные механизмы объясняются в §§3–11.
1. Мотивация: две разные цены длинного контекста
Обычный Transformer хранит для каждого ранее обработанного токена ключи и значения. При prefill плотное внимание рассматривает попарные взаимодействия и требует квадратичной арифметики по длине. При decode новый токен обращается ко всему накопленному KV-cache, поэтому стоимость одного шага и объём состояния растут вместе с контекстом.
SSM меняет сам формат памяти. Вместо списка адресуемых записей она поддерживает состояние
фиксированной размерности. Длина уже прочитанного текста не входит в размер . Это даёт линейный проход по последовательности и постоянную память при авторегрессионной генерации.
Но у сделки есть обратная сторона. KV-cache похож на картотеку: модель может обратиться к конкретной записи. Рекуррентное состояние похоже на постоянно переписываемое резюме. Оно дешёво, но несколько фактов могут интерферировать, а произвольный точный поиск по далёкому прошлому не возникает автоматически.
В учебной конфигурации полный KV-cache стоит 128 KiB на токен. Mamba-стек хранит не только основное состояние SSM, но и короткое состояние причинной свёртки. Для 32 слоёв, , , полный фиксированный кэш равен
Он сравнивается по объёму с KV-cache уже на 80 токенах. Для Mamba-2-подобной геометрии с получаем 66.0625 MiB и точку пересечения 528.5 токена — то есть первый целый токен, после которого KV-cache больше, равен 529.
Эти числа объясняют привлекательность рекуррентных моделей. Но они ещё не отвечают, достаточно ли такого состояния для сложного языка. Для этого придётся понять, что именно записывает SSM и как она решает, что забыть.
2. Историческая линия: от линейных систем к гибридным LLM
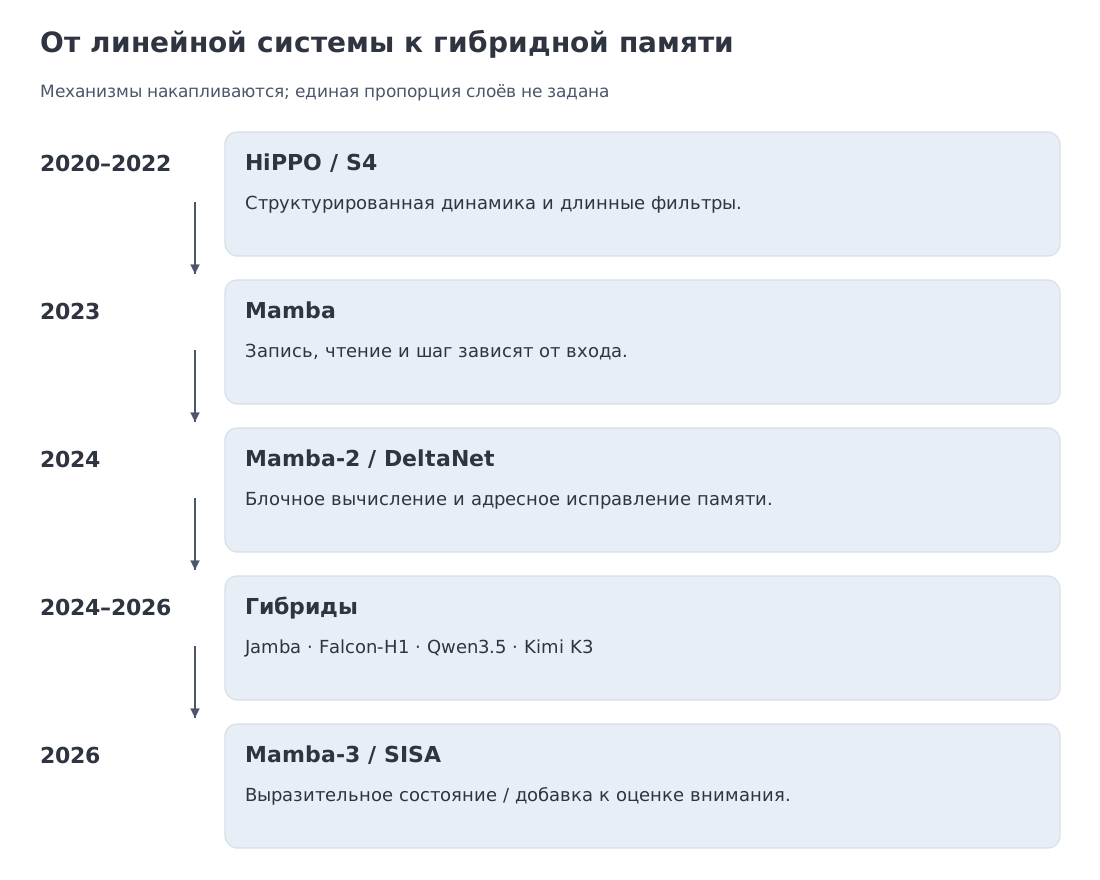 Классическая теория состояния → HiPPO/S4 → селективная Mamba → Mamba-2/SSD и DeltaNet → гибридные Jamba, Falcon-H1, Qwen3.5 и Kimi → новые рекуррентные и разреженные ветви 2026 года.
Линейные модели состояния задолго до нейросетей использовались в теории управления и фильтрации. Их задача — поддерживать компактную достаточную статистику наблюдаемого процесса. S4 — Structured State Spaces for Sequence Modeling перенесла эту идею в глубокие модели и показала, как специальная структура матрицы состояния позволяет эффективно работать с длинными последовательностями.
У ранних SSM оставалась проблема: правило обновления почти не зависело от содержания токена. Mamba сделала размер шага и часть параметров входозависимыми. Модель получила возможность пропускать малозначимые элементы, сильнее записывать важные и управлять скоростью забывания. Авторы дополнили это алгоритмом селективного прохода, учитывающим устройство GPU, чтобы зависящая от содержания рекуррентность оставалась эффективно обучаемой. В статье сообщается до пяти раз большей пропускной способности относительно сравниваемых Transformer-конфигураций; это результат их реализации и протокола, а не универсальный множитель.
Mamba-2 ввела SSD — State Space Duality. Для структурированного класса SSM один и тот же оператор можно читать как рекуррентность или как структурированную матрицу линейного внимания с маской. Это позволило использовать плотную матричную работу внутри чанков и компактно переносить состояние между ними. Авторы сообщают ускорение основного слоя примерно в 2–8 раз в своих конфигурациях.
Параллельно развивалась линия линейного внимания. DeltaNet использовала дельта-правило для адресного исправления ассоциативной памяти. Gated DeltaNet позже объединила этот механизм с входозависимым забыванием. Статья об эффективном параллельном обучении DeltaNet вышла в июне 2024 года; Gated DeltaNet — в декабре того же года. Само дельта-правило ассоциативной памяти использовалось и раньше.
Практические крупные системы всё чаще выбирали гибрид. Jamba чередовала Transformer-, Mamba- и MoE-компоненты. Falcon-H1 соединила Mamba-2 и внимание параллельными ветвями. Qwen3.5 использовала повторяющийся паттерн из трёх Gated DeltaNet-слоёв и одного слоя полного внимания. Kimi K3 сочетала 69 KDA-слоёв и 24 Gated MLA-слоя. Эти архитектуры не доказывают, что существует одна оптимальная пропорция. Они показывают более общий итог: фиксированное состояние выгодно как основной носитель последовательности, а адресуемый механизм добавляется там, где сжатия недостаточно.
3. Три взгляда на одну рекуррентность
Динамическая система
Непрерывная линейная SSM задаётся уравнениями
Матрица определяет внутреннюю динамику, — запись входа, — чтение состояния, — прямой путь от входа к выходу.
Здесь , , ; поэтому имеет форму , — , — , — . Точка над обозначает производную по непрерывному времени. В токенном потоке время станет номером шага.
Фильтр
Если вещественные части всех собственных значений отрицательны, свободная динамика — движение без входа — со временем стремится к нулю. Это асимптотическая устойчивость. У произвольной матрицы отдельные координаты могут сначала вырасти; монотонное затухание каждой координаты из условия не следует. В диагональных примерах ниже разные отрицательные коэффициенты непосредственно задают разные времена затухания: одни компоненты реагируют быстро, другие сохраняют более долгую историю. В таком прочтении SSM похожа на обучаемый набор фильтров.
Ассоциативная память
Линейное внимание часто записывается как состояние-матрица
Здесь выбирает направление записи, задаёт содержимое, а — запрос. Такая память уже напоминает внимание, но имеет фиксированный размер и потому накапливает интерференцию.
В ассоциативной записи , и . Внешнее произведение записывает одну пару во всю матрицу; последующее умножение на запрос возвращает вектор длины . Это ненормированное линейное внимание: softmax здесь отсутствует.
Эти взгляды дополняют друг друга. Динамическая система объясняет стабильность и забывание, фильтр — временные масштабы, ассоциативная память — запись и извлечение. Mamba-2 показывает, что для специальной структуры это не только метафоры, а разные вычислительные представления одного оператора.
4. Формализм: дискретная SSM и Zero-Order Hold
Текст приходит дискретными шагами, поэтому непрерывную систему нужно дискретизировать. При ZOH — Zero-Order Hold вход считается постоянным на интервале длиной :
Черта отличает матрицы одного дискретного шага от матриц непрерывной системы: переносит прежнее состояние, а добавляет вклад текущего входа. Для чтения Mamba сначала достаточно этой рекуррентности. Следующие формулы показывают, как получить её коэффициенты при точно заданной непрерывной динамике.
Если обратима, интеграл равен . Интегральная форма определена и для необратимой матрицы. В следующих числовых опытах прямой путь равен нулю.
Для диагонального формулы применяются покоординатно. При выражение для выглядит как , но предел существует:
В учебном коде этот случай обработан явно. Это важно не только ради красоты: скрытый NaN в редкой координате быстро распространяется по всем следующим шагам.
В практических архитектурах параметризация может отличаться от буквальной ZOH-формулы. Например, открытая реализация Mamba-2 использует входной член вида в своём эффективном алгоритме. Поэтому модуль разделяет две вещи:
- точную дискретизацию заданной непрерывной линейной системы;
- конкретную обучаемую параметризацию Mamba-подобного блока.
Первая даёт математический ориентир. Вторая выбирается ради выразительности и эффективной реализации.
5. Решённый пример A: когда приближение заметно отличается от ZOH
Возьмём один устойчивый режим:
Точный входной коэффициент равен
а малошаговое приближение — . Относительная ошибка:
Для трёх шагов:
| точный коэффициент | приближение | относительная ошибка | |
|---|---|---|---|
| 0.1 | 0.09516 | 0.1 | 5.08% |
| 0.5 | 0.39347 | 0.5 | 27.07% |
| 1.0 | 0.63212 | 1.0 | 58.20% |
Решим также обратную задачу: при каком ошибка достигает ровно 10%?
Численное решение:
Этот пример не говорит, что Mamba обязана использовать точную ZOH во всех ветвях. Он показывает, что выражения и нельзя считать взаимозаменяемыми без указания параметризации и диапазона шагов.
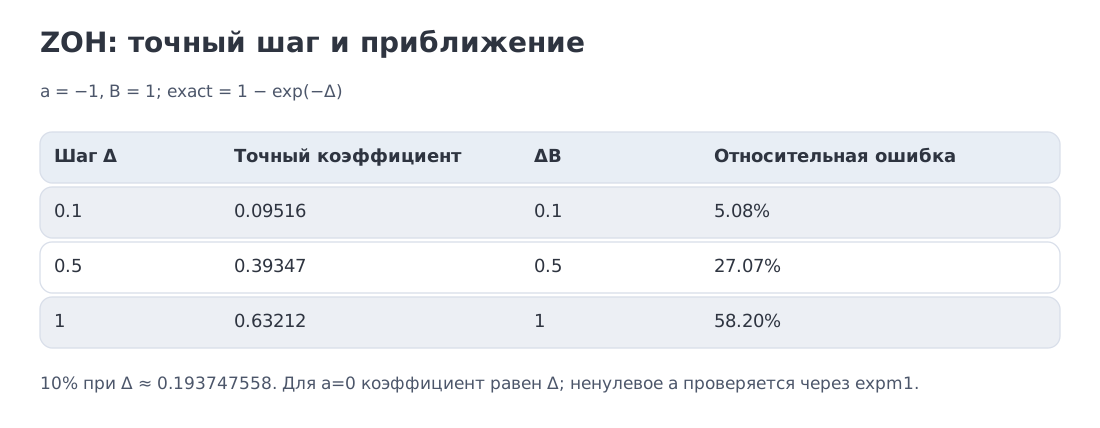 Точный ZOH-трейс для двух устойчивых режимов, предел при и рост ошибки приближения .
6. Mamba: селективность и блок
У линейной SSM с неизменными во времени параметрами одинаковая динамика применяется к любому содержанию. Для языка этого недостаточно: имя, закрывающая скобка и частый артикль не должны записываться одинаково.
Mamba делает часть параметров функциями входа. — положительный шаг, а обеспечивает положительность. Упрощённая запись:
Через токен управляет скоростью обновления. При большом шаге состояние сильнее меняется; при малом — дольше сохраняет прошлое. задаёт запись, — чтение.
Архитектурный блок включает и короткую поканальную свёртку (depthwise convolution). Её роль не в том, что SSM «не видит порядок», а в явном предпочтении локальных закономерностей. Ближайшие шаблоны обрабатываются коротким фильтром, а более длинная динамика переносится рекуррентным состоянием.
Эта свёртка имеет значение и при обслуживании модели: авторегрессивный кэш содержит не только состояние SSM, но и последние элементов конволюционной ветви. Именно поэтому честная оценка памяти в §10 включает оба компонента.
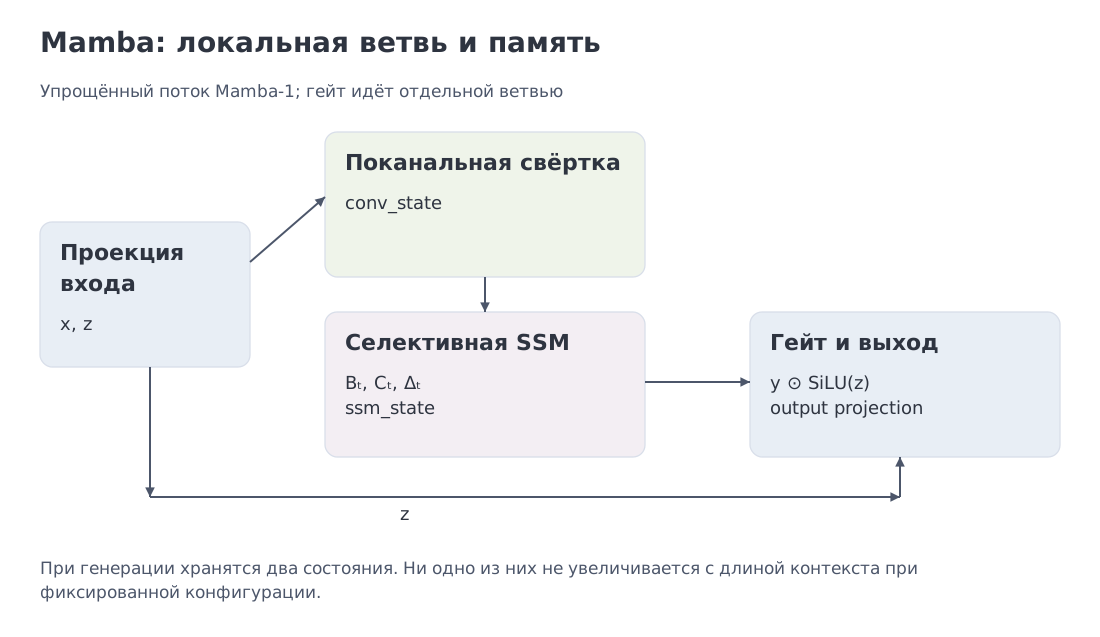 Входная проекция разделяет локальную ветвь и гейт; свёртка подаёт вход в селективную SSM, затем выход умножается на гейт. Два постоянных состояния отмечены отдельно.
7. Mamba-2 и State Space Duality
Mamba-1 хорошо работает как рекуррентность, но обучение длинных последовательностей требует эффективного параллелизма. SSD рассматривает структурированный класс переходов, у которого матрица связи позиций имеет полусепарабельную структуру. Для этого класса один оператор можно вычислять тремя способами:
- последовательной рекуррентностью;
- параллельным префиксным проходом (scan);
- чанковой матричной формой, похожей на линейное внимание с маской.
Слово scan означает вычисление всех префиксных состояний, а не только последнего. Аффинный шаг задаётся парой . Два шага составляются как
Скобки можно переставлять, порядок шагов — нельзя. Например, , затем дают ; обратный порядок — .
Для следующей записи возьмём скалярные вход и выход , состояние и векторы . Чтение теперь записывается как ; это векторное обозначение строки чтения из §3. При переходе и нулевом начальном состоянии коэффициент вклада входа в выход равен
Произведение переходов переносит запись через промежуточные позиции. Блок матрицы ниже диагонали факторизуется через компактное состояние: это и выражает полусепарабельная структура. Внутри блока последовательности можно использовать матричные операции; между блоками достаточно передать состояние.
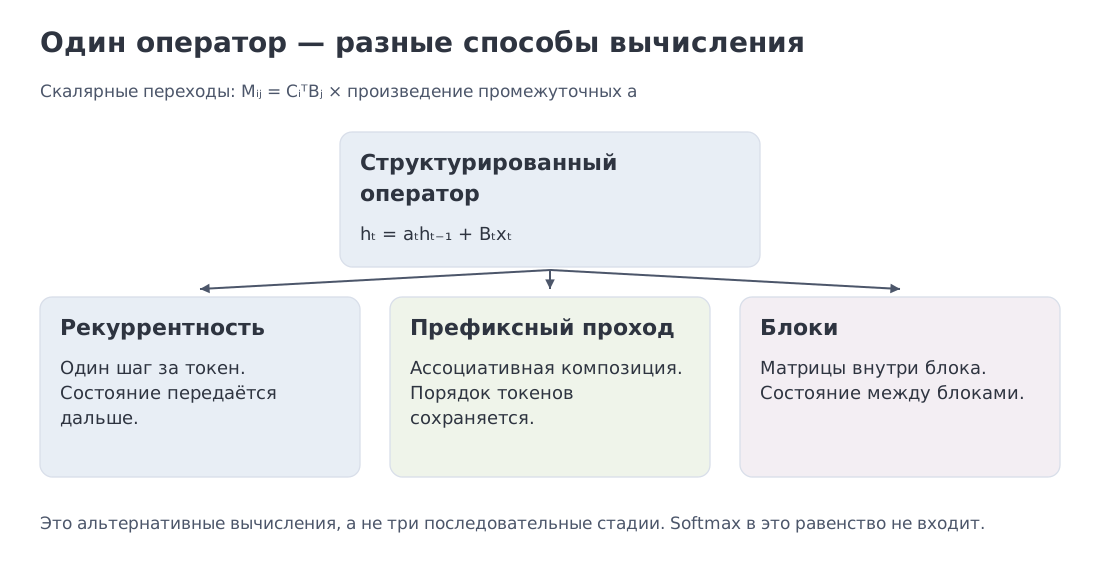 Один структурированный оператор: рекуррентный шаг, префиксный проход или блочная матричная форма. Двойственность относится к определённому классу SSM, а не ко всем возможным динамическим системам.
Это не утверждение, что любая SSM равна любому линейному вниманию. Эквивалентность требует конкретной структуры переходов. И даже математически равные формы не обязаны давать побитово одинаковый результат: порядок операций с плавающей точкой в scan и GEMM различается.
Практическая выгода Mamba-2 состоит в выборе вычислительной формы под фазу работы. На обучении выгодны чанки и плотные матричные операции. На decode — рекуррентный шаг с фиксированным состоянием. Авторы сообщают ускорение основного слоя в 2–8 раз относительно Mamba-1 в своих конфигурациях. Это не end-to-end гарантия для любого стека: проекции, FFN, kernel launch и движение весов остаются.
8. DeltaNet и Gated DeltaNet: память, которую можно исправлять
Обычная аддитивная линейная память записывает новую пару сложением:
Если один и тот же ключ встречается снова, старое и новое значения складываются. Дельта-правило сначала измеряет текущее чтение, а затем исправляет ошибку:
Для нормированного и чтение по этому направлению становится ровно . При происходит частичная замена.
Пусть
После первой записи . Вторая аддитивная запись дала бы чтение — старое и новое значения смешались. Обновление по дельта-правилу при даёт , а при — точно .
DeltaNet развивает это правило и эффективный параллельный алгоритм. Gated DeltaNet добавляет отдельное адаптивное забывание. Эти механизмы дополняют друг друга: дельта-правило адресно исправляет запись, gate может быстро уменьшить влияние более широкой части состояния.
Обозначим общий коэффициент забывания через . Сначала затухает всё состояние, затем исправляется выбранное направление:
При единичном ключе чтение равно . Поэтому даёт точную замену и при . Направления других, неортогональных ключей тоже меняются: адресная запись не означает полной независимости записей.
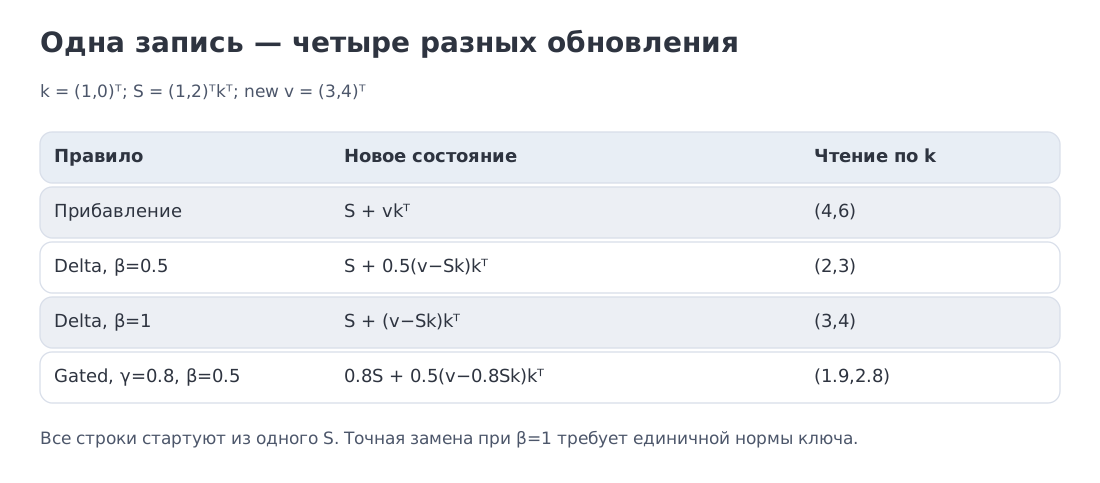 Сложение, частичная коррекция, полная замена и вариант с забыванием на одном направлении ключа.
9. Фиксированное состояние и цена адресуемости
Чтобы увидеть фундаментальный компромисс, рассмотрим простую аддитивную ассоциативную память:
При случайных нормированных ключах они не ортогональны, поэтому перекрёстные члены создают интерференцию. В замороженном сценарии с средняя квадратичная ошибка растёт примерно от 0.14 при четырёх парах до 4.14 при 128.
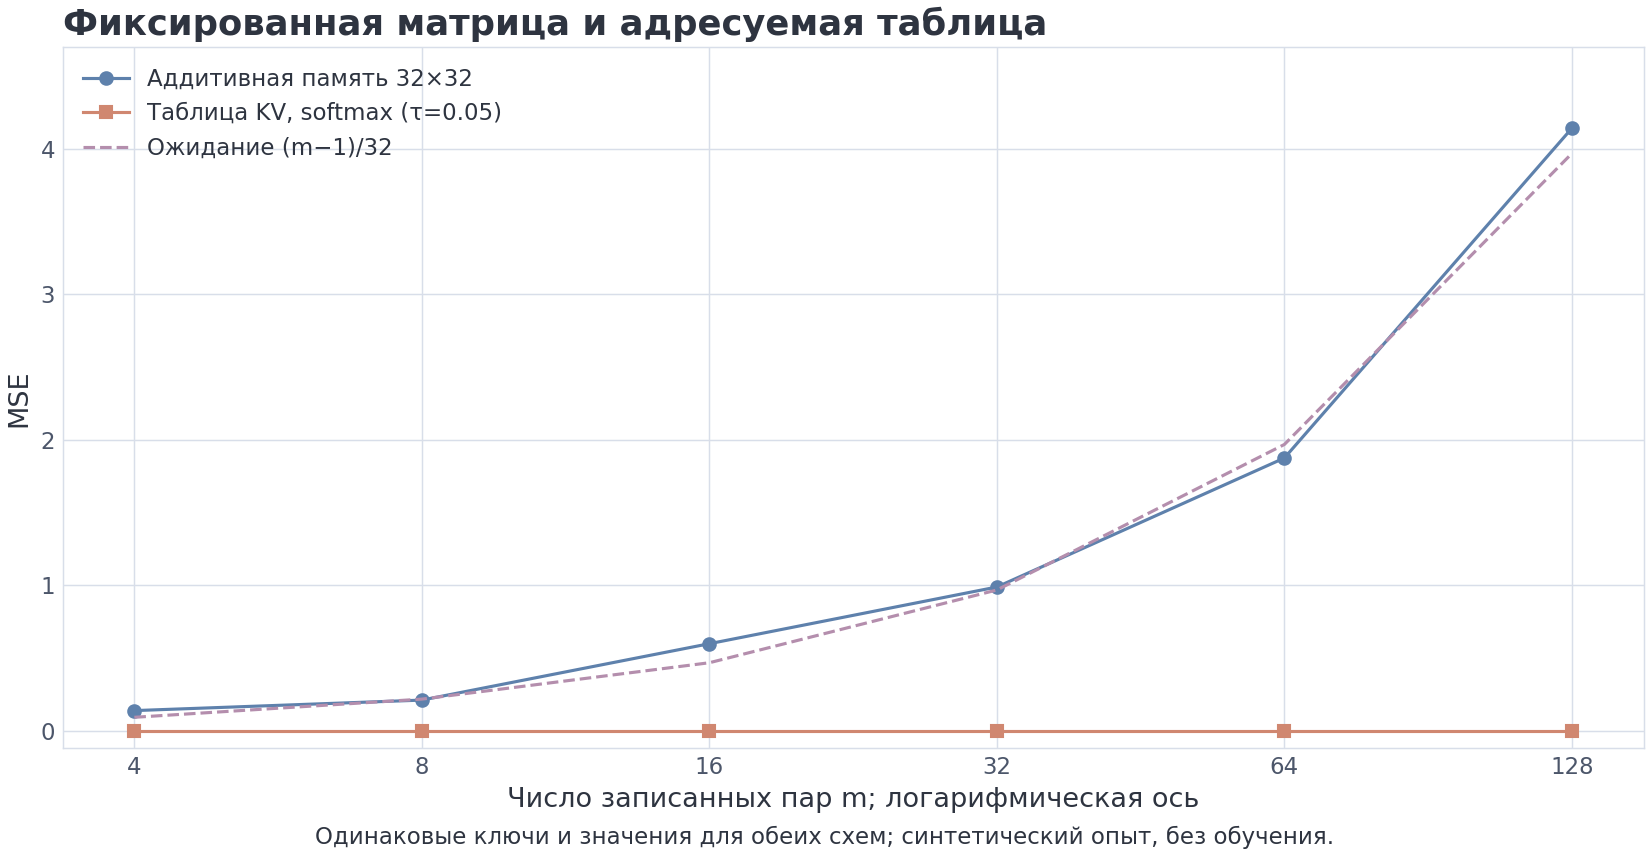 Интерференция в игрушечной аддитивной ассоциативной памяти. Это не измерение качества Mamba и не доказательство поведения всех SSM.
Контрольная softmax-кривая использует явную таблицу ключей и значений и большой множитель логитов (обратную температуру 20, то есть температуру 0.05); она почти восстанавливает записанные значения в этом опыте. Но это тоже не универсальный результат Transformer. График лишь противопоставляет адресуемое хранение фиксированному матричному сжатию.
Обобщить опыт можно в следующей форме:
при фиксированной численной точности состояние фиксированного размера создаёт ограничение на объём сохраняемой информации; качество зависит от его размерности, структуры обновления, обучения и задачи.
Mamba-3 и новые методы с линейной рекуррентностью именно поэтому повышают выразительность состояния. Они могут улучшать отслеживание состояния и поиск записей, но не превращают конечный вектор в бесплатную бесконечную базу данных.
На графике обе схемы получают одни и те же случайные ключи и значения при каждой нагрузке. Для независимых единичных ключей, изотропных в измерениях, и значений с независимыми координатами нулевого среднего и дисперсии 1 ожидаемая ошибка аддитивной памяти на координату равна . Пунктир показывает это ожидание; одна фиксированная выборка не обязана совпадать с ним.
10. Арифметика сделки: полный кэш и основные операции
Память
Все объёмы ниже относятся к одной последовательности и всем указанным слоям; веса модели и рабочие буферы считаются отдельно. — число слоёв, — число KV-голов, — ширина головы, — байтов на значение. Используем , , , . Во внутренних обозначениях — число каналов, — размер состояния на канал, — хранимая ширина свёртки. Здесь K=1024 и M=1024² токенов.
Для GQA-Transformer из модуля 5:
Для Mamba-1-подобного стека считаем два постоянных состояния:
Итого:
Для Mamba-2-подобной учебной геометрии . Открытая реализация может хранить в кэше свёртки не только , но и B/C-каналы; при :
Точное пересечение — 528.5 токена, первый целый токен за границей — 529.
Гибрид из 32 слоёв, где четыре используют attention, на 256K хранит 4 GiB KV плюс 8.75 MiB рекуррентное состояние остальных 28 слоёв. Память всё ещё растёт как из-за attention-слоёв, но коэффициент перед длиной в восемь раз меньше.
Арифметика центрального оператора
Сравним один слой и один новый токен при decode. Здесь отдельно задаём , и — размер состояния из Mamba-1-подобного примера. обозначает число доступных ключей. Умножение и сложение считаются двумя операциями, даже если аппаратно выполняются одной инструкцией.
Внимание вычисляет скалярные произведения QK и взвешенную сумму V: каждое из двух матричных произведений требует примерно операций. Softmax и подготовка Q/K/V считаются отдельно. Для диагональной SSM с уже вычисленными коэффициентами шаг требует три операции на координату состояния: два умножения и сложение. Чтение добавляет примерно ещё две на координату. Ведущие оценки поэтому равны
и дают отношения 25.6× на 1K, 819.2× на 32K и 26 214.4× на 1M. При подсчёте каждой скалярной операции чтение содержит на одно сложение меньше на канал; ведущая оценка опускает эту малую поправку. Это не скорость всей модели: вне сравнения остаются подготовка коэффициентов SSM, softmax, проекции, свёртка, гейты, FFN, движение весов и эффективность исполнения.
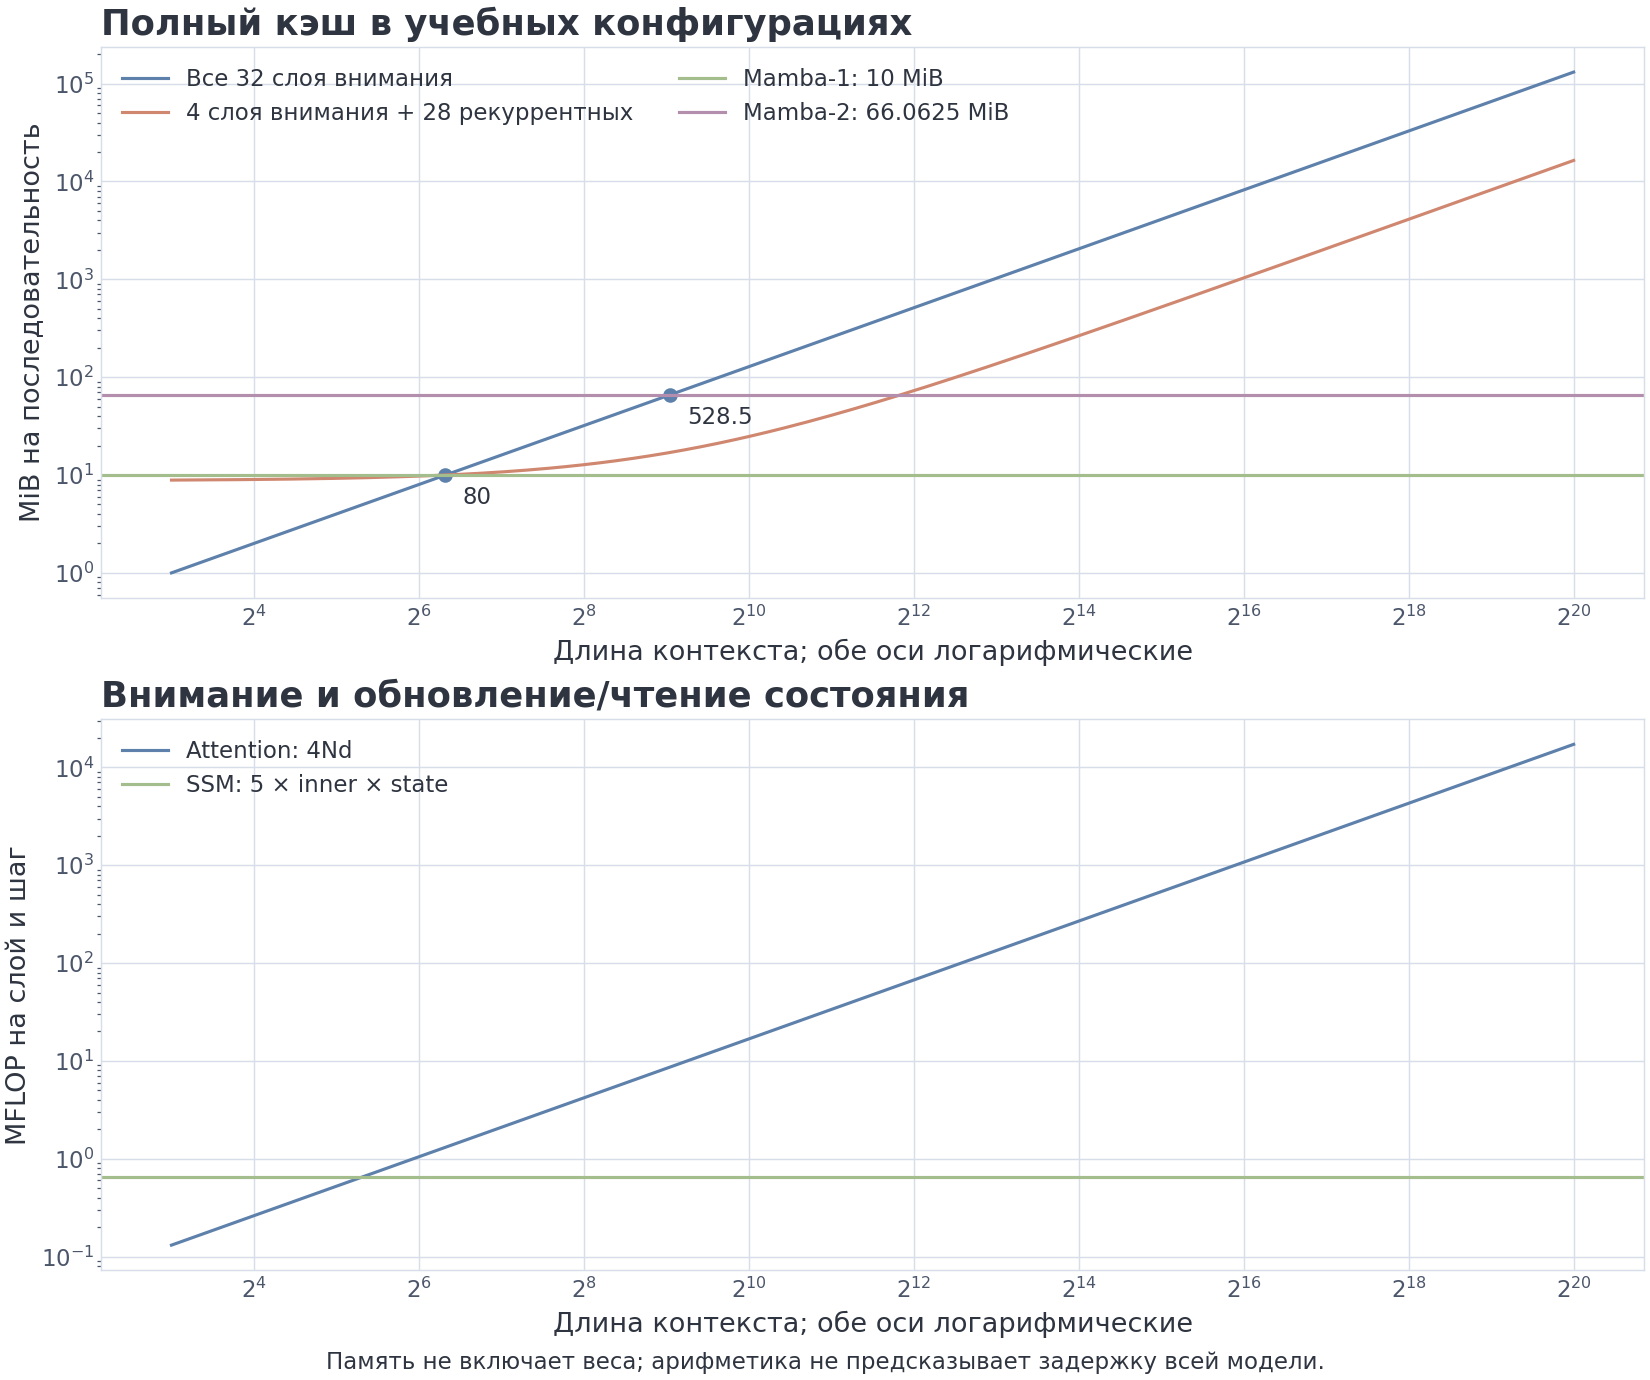 Сверху — полный кэш фиксированного размера и растущий KV-кэш; снизу — только число операций смешивания токенов, без оценки задержки полного шага.
В примере Mamba-2 используется одна группа B/C и все 8192 каналов участвуют в SSM. В общем случае число каналов свёртки равно , где — число групп. Состояние SSM может храниться в другом формате, чем свёртка: bf16 для обоих — условие данного расчёта.
11. Гибриды: три способа совместить сводку и адресацию
Чередование слоёв
Jamba чередует Transformer-, Mamba- и MoE-компоненты. Qwen3.5-35B-A3B использует точный повторяющийся паттерн:
Так 75% слоёв несут фиксированное состояние, а 25% сохраняют адресуемый KV-cache.
Параллельные ветви
Falcon-H1 проводит вход через ветви Mamba-2 и внимания внутри одного блока. Обе ветви участвуют на каждой глубине, поэтому вычисления внимания нужны в каждом таком блоке. Эксперименты с удалением ветвей обученной модели выявляют функциональную специализацию, но не задают универсальную роль каждой ветви во всех гибридах.
Специализированные комбинации
Kimi K3 имеет 93 слоя: 69 KDA и 24 Gated MLA. Attention Residuals управляет смешиванием по глубине и не является названием softmax-ветви. Nemotron 3 Super и Ultra сочетают Mamba, attention, LatentMoE и MTP при разных масштабах — 120B/12B и 550B/55B.
Линия MiniMax напоминает, что название семейства не гарантирует архитектурную преемственность. MiniMax-01 и M1 использовали Lightning Attention. MiniMax M2 стала моделью с полным вниманием после недостаточного качества на длинном контексте гибридной схемы в описанном разработчиком эксперименте. MiniMax M3 затем ввела MiniMax Sparse Attention — уже другую ветвь, относящуюся к разреженному вниманию, а не к фиксированному рекуррентному состоянию.
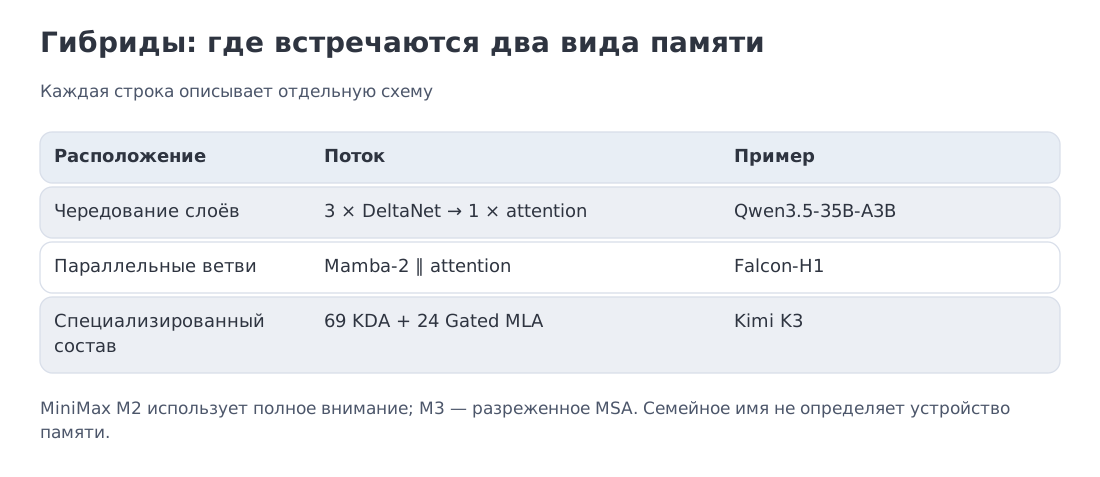 Чередование, параллельные ветви и специализированные гибриды. Пропорция слоёв является свойством конкретной модели, а не универсальным стандартом.
12. Код первого уровня: scan, дельта-правило и чанки
import numpy as np

def zoh_diagonal(a, b, delta):
    """Diagonal A: [n], B: [n,p], positive scalar step; caller validates shapes."""
    a = np.asarray(a, dtype=np.float64)
    b = np.asarray(b, dtype=np.float64)
    transition = np.exp(delta * a)
    factor = np.full_like(a, float(delta))
    np.divide(np.expm1(delta * a), a, out=factor, where=a != 0)
    return transition, factor[:, None] * b

def delta_step(state, key, value, beta, decay=1.0):
    """State [dv,dk], unit key [dk], value [dv]; decay before correction."""
    base = decay * state
    prediction = base @ key
    return base + beta * np.outer(value - prediction, key)

def compose_affine_pair(later, earlier):
    """Elementwise transforms; returns later(earlier(h)), not the reverse."""
    a2, b2 = later
    a1, b1 = earlier
    return a2 * a1, a2 * b1 + b2
Три функции показывают разные части механизма. zoh_diagonal относится к точной дискретизации выбранной непрерывной системы. delta_step — к редактируемой ассоциативной памяти. compose_affine_pair даёт ассоциативный оператор, необходимый для параллельного префиксного прохода.
Промышленный Mamba-kernel добавляет входозависимые параметры, пакетные формы, fused convolution, layout для Tensor Cores и внимательную работу с точностью. Учебный код нужен не для скорости, а чтобы численный контракт был видимым.
14. Как читать открытый код Mamba
У реализации есть два важных уровня состояния.
В Mamba-1 кэш обычно содержит:
conv_stateформы примерно[batch, d_inner, d_conv];ssm_stateформы[batch, d_inner, d_state].
В Mamba-2 свёртка включает каналы x и B/C. Состояние SSM имеет форму [batch, nheads, headdim, d_state], где nheads × headdim = d_ssm. Для подсчёта нужны формы в коде и число групп B/C.
Второй важный момент — различие непрерывной модели и обучаемой параметризации. Открытая Mamba-2 записывает вход членом . При этом полная матрица входа точной ZOH-дискретизации из §4 не вычисляется. Поэтому при чтении исходного кода нужно ответить на два отдельных вопроса:
- какую непрерывную интуицию использует архитектура;
- какое дискретное обновление исполняет конкретное вычислительное ядро.
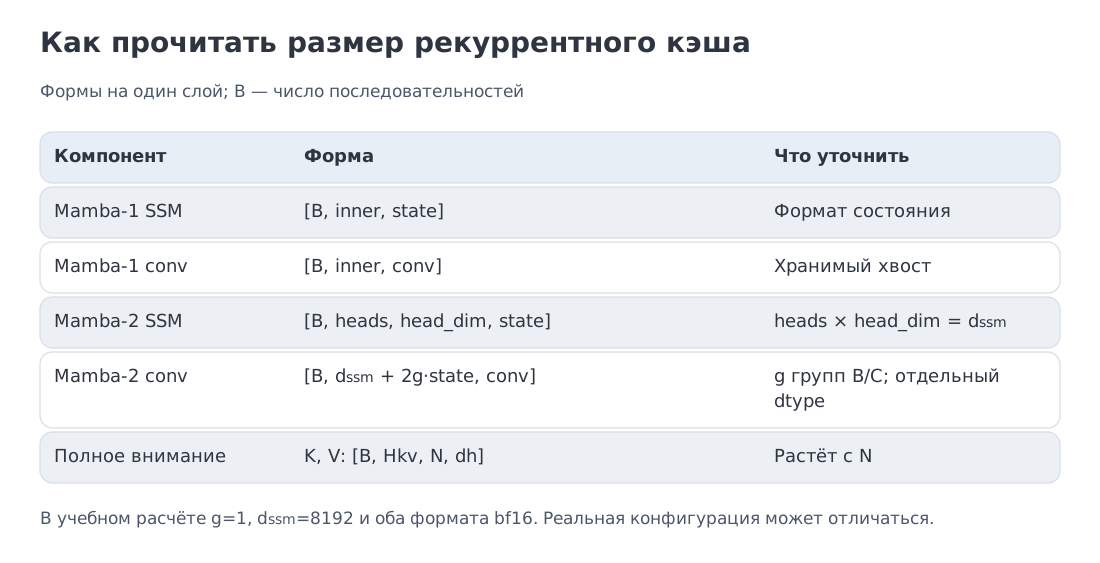 Паспорт кэша: типы слоёв, формы обоих состояний, число групп и форматы чисел. Одного ярлыка «Mamba» недостаточно.
15. Современный ландшафт: читать не название, а контракт
| Семейство | Последовательный механизм | Архитектурный контракт | Контекст | Основание |
|---|---|---|---|---|
| Mamba | селективная SSM | основная сеть без внимания | до 1M в экспериментах авторов | статья и код |
| Mamba-2 | SSD/SSM | рекуррентная и блочная формы | зависит от конкретной модели | статья и код |
| Jamba | Mamba + attention + MoE | чередование слоёв | до 256K | статья и выпуск модели |
| Falcon-H1 | Mamba-2 ∥ attention | параллельные ветви, 0.5B–34B | до 256K | технический отчёт |
| Qwen3.5-35B-A3B | 3 Gated DeltaNet : 1 полное внимание | 40 слоёв, 35B/3B, MoE | 262 144 исходно; до 1 010 000 с расширением | официальная карточка и конфигурация |
| Kimi K3 | 69 KDA + 24 Gated MLA | AttnRes отдельно, 2.8T/104B | 1M | технический отчёт/repo |
| Nemotron 3 Super | Mamba–Attention + LatentMoE + MTP | 120B/12B | до 1M | официальный отчёт |
| Nemotron 3 Ultra | Mamba–Attention + LatentMoE + MTP | 550B/55B | до 1M | официальный отчёт |
| MiniMax M2 | полное внимание | полное внимание вместо Lightning | около 196K в открытой конфигурации | заметка разработчика и конфигурация |
| MiniMax M3 | разреженное внимание | MSA, состояние не фиксировано | 1M в условиях отчёта | статья, результаты авторов |
| Mamba-3 | расширенная рекуррентная SSM | комплексное состояние, MIMO | исследовательский режим | статья |
| SISA | добавка к оценке внимания в SDPA | сохраняет KV-cache | исследовательский режим | статья |
Таблица специально разделяет архитектуру и уровень доказательств. Для закрытой модели или неполной карточки корректный ответ — «не раскрыто», а не реконструкция по максимальной длине контекста.
16. Аудио, видео и другие длинные потоки
Рекуррентный носитель особенно привлекателен там, где вход создаёт много последовательных временных шагов: аудио, видео, сенсорные потоки, геномные последовательности. Постоянное состояние позволяет обновлять модель без линейного роста кэша.
Это не значит, что модальности «однородны» или не требуют точного поиска. В видео может понадобиться вернуться к конкретному кадру, в аудио — к ранней реплике, в агентной траектории — к определённому действию. Одно фиксированное состояние затрудняет произвольную точную адресацию.
Архитектурные ответы знакомы:
- редкие слои внимания;
- внешний поиск;
- иерархическая память;
- отдельные событийные индексы;
- параллельные рекуррентная и адресуемая ветви.
Поэтому мультимодальный паспорт должен указывать не только размер состояния, но и способ возврата к отдельным событиям.
19. Ключевые выводы модуля
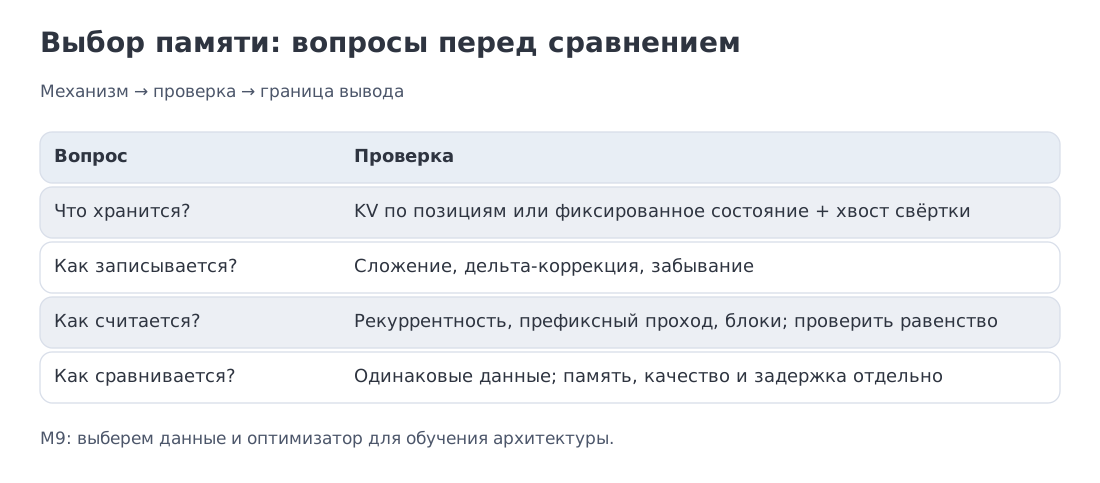 SSM в одной схеме: точная дискретизация, селективность, два компонента состояния, SSD, дельта-правило, ограниченная адресуемость и гибриды.
- SSM заменяет растущий список прошлых токенов состоянием фиксированной размерности.
- Mamba делает запись, чтение и скорость забывания зависимыми от входа.
- Полный кэш включает состояние SSM и состояние короткой свёртки.
- SSD даёт несколько вычислительных форм для структурированного класса SSM, а не для любой динамической системы.
- Дельта-правило позволяет исправлять ассоциативную запись; гейт добавляет адаптивное забывание.
- Фиксированное состояние экономит память, но создаёт ограничение на объём сохраняемой информации.
- Гибриды с полным вниманием возвращают адресуемость ценой линейно растущего KV-кэша в части слоёв; фиксированные локальные окна задают другую границу памяти.
- Арифметику основного оператора следует отличать от задержки полного шага.
- Названия семейств не гарантируют архитектурную преемственность: MiniMax M2 и M3 — наглядный пример.
- Современную модель следует читать по типам слоёв, формам состояния и геометрии KV и источнику каждого утверждения.
20. первоисточники
Основные источники:
- Gu, Dao — Mamba: Linear-Time Sequence Modeling with Selective State Spaces
- Dao, Gu — Transformers are SSMs / Mamba-2
- Yang et al. — DeltaNet
- Yang et al. — Gated Delta Networks
- Lieber et al. — Jamba
- Открытая реализация Mamba
- Qwen3.5-35B-A3B model card
- Kimi K3 repository and report
- Nemotron 3 Super
- Nemotron 3 Ultra
- Почему MiniMax M2 использует full attention
- MiniMax M3
- Falcon-H1
- Mamba-3
- SISA
Дальше: модуль 9 — претрейн. Мы уже разобрали архитектуру; теперь выберем данные, распределим вычислительный бюджет и изучим оптимизацию. К ограничениям пропускной способности памяти и roofline вернёмся в модуле 10.
Источники повторно сверены 11 октября 2026 года. Числа памяти — учебные сценарии; результаты авторов сохраняют исходные условия.