Модуль 12. Диффузионные LLM
Курс «Modern LLMs» · лекция модуля 12 · редакция 11 октября 2026
О чём этот модуль. До этого момента мы рассматривали генерацию как наращивание готового префикса. Здесь попробуем другой порядок работы: начнём с последовательности масок и будем восстанавливать несколько позиций за один проход. Такая последовательность называется холстом, а повторное восстановление — денойзингом. На этом принципе строятся диффузионные большие языковые модели (dLLM, diffusion large language models). Мы проследим, чему учится модель, как семплер выбирает очередные позиции и почему меньшее число последовательных вызовов может потребовать больше вычислений. Затем отделим учебную оценку скорости от характеристик выпущенных систем.
Что нужно знать заранее. Авторегрессионная генерация из М3, претрейн из М9, стоимость инференса из М10 и точное спекулятивное декодирование из М11. Раздел о разрежённых моделях использует MoE из М7.
Первый проход. §§1, 4–9 дают механизм, §10 — один расчёт стоимости, §14 — переход к блокам. В §7 сначала прочитайте смысл цели и численный пример; интегральную формулу можно оставить на второй проход. Завершите вопросами §18.
Второй проход. Вернитесь к происхождению цели в §7, сравнению пакетов в §11 и коду §§12–13; выполните ноутбук и упражнения §19. Справочный проход: §§2–3 объясняют происхождение идей, §§15–17 помогают читать паспорта моделей и сравнивать опубликованные результаты.
Оглавление
- Мотивация: изменить единицу последовательной работы
- Историческая линия
- Три интеллектуальные родословные
- Карта парадигм
- Прямой процесс: поглощающее маскирование
- Решённый пример A: расписание руками
- Цель обучения: ELBO и masked cross-entropy
- Any-order и границы симметрии
- Семплинг и решённый пример B
- Учебная roofline-модель: экономика одного прохода
- Шаги, батчи и точность весов
- Код первого уровня
- Что проверяет notebook
- Блочная диффузия, длина и KV-кэш
- Паспорт DiffusionGemma
- Ландшафт dLLM на 11 октября 2026 года
- Мультимодальные системы
- Вопросы для самопроверки
- Упражнения с решениями
- Ключевые выводы и источники
1. Мотивация: изменить единицу последовательной работы
Проблема авторегрессионного декодирования не в том, что один шаг обязательно содержит много арифметики. Напротив, при пакете из одного запроса он часто выполняет слишком мало полезной матричной работы относительно объёма весов, который приходится прочитать. Ради одного следующего токена ускоритель вновь проводит через вычислительный тракт почти всю модель, обращается к KV-кэшу и лишь затем может перейти к следующей позиции.
Рассмотрим намеренно простой сценарий: плотная модель с 8 млрд параметров, bf16-веса объёмом 16 GB, пропускная способность памяти 3.35 TB/s и арифметический пик 990 TFLOP/s. Если считать только чтение весов, один AR-шаг не может быть быстрее
Идеальная арифметика заняла бы
Отношение равно 0.338%. Это не измеренная загрузка GPU: мы всего лишь видим, какую долю выбранной нижней границы занимает идеальное время матричной арифметики. В этой упрощённой модели предел задаёт поток весов, а верхняя граница при пакете из одного запроса равна 209.375 токена/с.
Диффузионный декод меняет единицу работы. Один вызов модели обрабатывает не одну позицию, а весь холст из позиций. За это приходится платить итерациями денойзинга. Число операций становится примерно
но каждое чтение весов обслуживает множество позиций. В том же учебном сценарии при один проход уже требует около 16.55 мс арифметики и становится ограниченным вычислениями (compute-bound). При арифметическая верхняя оценка составляет 966.8 токена/с — в 4.62 раза выше AR-границы при пакете из одного запроса, хотя суммарных FLOP примерно в 64 раза больше.
Эта сделка и определяет всю ветвь dLLM: мы покупаем меньше последовательных барьеров ценой большей общей работы. Выигрыш не гарантирован. Его могут съесть число шагов, двунаправленное внимание внутри холста, маршрутизация MoE, активации, вычислительные ядра, планировщик и требования к качеству. Поэтому ниже мы сначала разберём вероятностный механизм, а уже затем вернёмся к скорости.
У dLLM есть и второй мотив. Поскольку модель несколько раз видит весь текущий черновик, она может нативно заполнять пропуски и пересматривать слабые позиции. Стандартный одношаговый AR-сэмплер уже записанный префикс не меняет; для редактирования ему нужен второй проход, верификатор, Fill-in-the-Middle (FIM) или агентная обвязка. В диффузионном семплере повторное уточнение является частью самой процедуры.
2. Историческая линия
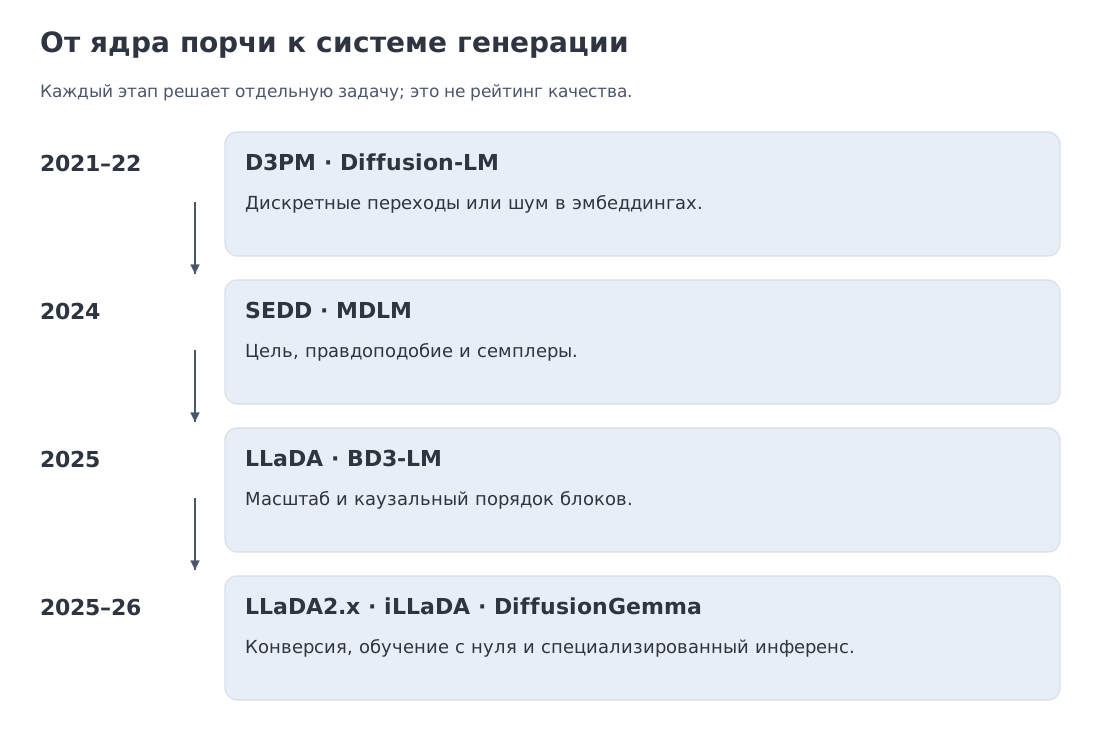 От дискретных переходных ядер к masked diffusion, блочной диффузии, моделям с открытыми весами и коммерческим API. Каждый этап решает отдельную проблему: корректность дискретного процесса, оценка правдоподобия, масштаб, переменную длину или системную скорость.
D3PM — Discrete Denoising Diffusion Probabilistic Models (2021) перенесла диффузионную конструкцию в дискретные пространства. Работа рассматривала несколько переходных ядер: равномерные замены, переходы по близости в пространстве эмбеддингов и поглощающее состояние. Последний вариант особенно важен для текста: одна специальная маска превращается в состояние, из которого обратная модель должна восстановить токен.
Diffusion-LM (2022) пошла другим путём: добавляла непрерывный шум к эмбеддингам и затем отображала результат обратно в дискретные токены. Эта ветвь показала управляемость генерации, но её дополнительная геометрия округления осложняла масштабирование.
В 2024 году две линии сделали дискретную диффузию значительно практичнее. SEDD — Score Entropy Discrete Diffusion ввела подходящую функцию оценки для дискретного процесса. MDLM — Masked Diffusion Language Models и родственные работы показали, что поглощающая маска даёт простую цель, ориентированную на оценку правдоподобия и близкую к знакомому Masked Language Modeling (MLM), и поддерживает эффективные семплеры, включая полуавторегрессионную генерацию переменной длины.
В 2025 году вопрос сменился с «работает ли формализм?» на «может ли он стать LLM?». LLaDA 8B была обучена с нуля на 2.3T токенов и показала, что masked diffusion масштабируется до миллиардов параметров. BD3-LM предложила блочную диффузию: блоки идут авторегрессионно, а позиции внутри блока восстанавливаются параллельно. LLaDA-MoE, Dream, Seed Diffusion, Mercury и Gemini Diffusion исследовали разные пути — обучение с нуля, конверсию авторегрессионной модели, MoE и специализированные системы инференса.
В 2025–2026 годах появились модели на десятках и сотнях миллиардов параметров. LLaDA2.0 конвертировала AR-MoE через Warmup–Stable–Decay (WSD) и выпустила варианты 16B и 100B. LLaDA2.1 добавила редактирование уже открытых токенов; речь идёт о Token-to-Token correction, а не об обязательном контракте изменения длины через INSERT/DELETE. iLLaDA усилила линию обучения с нуля: модель 8B прошла претрейн на 12T токенов, использует полностью двунаправленное внимание и поддерживает генерацию переменной длины.
Коммерческая ветвь развивалась параллельно. Mercury 2, Gemini Diffusion и Seed Diffusion публиковали очень высокие скорости, но на разном оборудовании и в разных задачах. DiffusionGemma, выпущенная 10 июня 2026 года, стала особенно полезным открытым примером: блочно-авторегрессионная архитектура «кодировщик — декодер», разреженная MoE, холст на 256 токенов и подробная карточка режима семплирования.
История не ведёт к одному победившему рецепту. Она образует спектр: masked diffusion с полным холстом, блочную диффузию, редактирование токенов, вставки для изменения длины и коммерческие проприетарные системы. Чтобы сравнивать их, нам нужны две оси — вероятностная факторизация и единица последовательного прогресса.
3. Три интеллектуальные родословные
Первая родословная — непрерывная диффузия изображений. Там объект постепенно портится гауссовым шумом, а сеть учится обращать процесс. Для идентификатора токена «малое численное смещение» не имеет лингвистического смысла, поэтому дискретные модели задают явное переходное ядро.
Вторая — BERT и MLM. Двунаправленный Transformer уже умеет восстанавливать скрытый токен по левому и правому контексту. Но BERT использует один или несколько заранее заданных уровней маскирования и не определяет полноценную генеративную траекторию от полностью испорченной последовательности к чистой. Диффузионная постановка добавляет время , распределение уровней порчи и обратный марковский процесс — последовательность переходов, зависящих от текущего состояния.
Третья — переменный порядок факторизации. Авторегрессионная модель выбирает один порядок:
Masked diffusion обучается на множестве подмножеств наблюдаемых и скрытых позиций. Для некоторых целей это можно интерпретировать как усреднение множества порядков раскрытия. Но это утверждение относится к конкретной целевой функции и распределению масок; оно не делает любую dLLM архитектурно равной ансамблю всех AR-моделей.
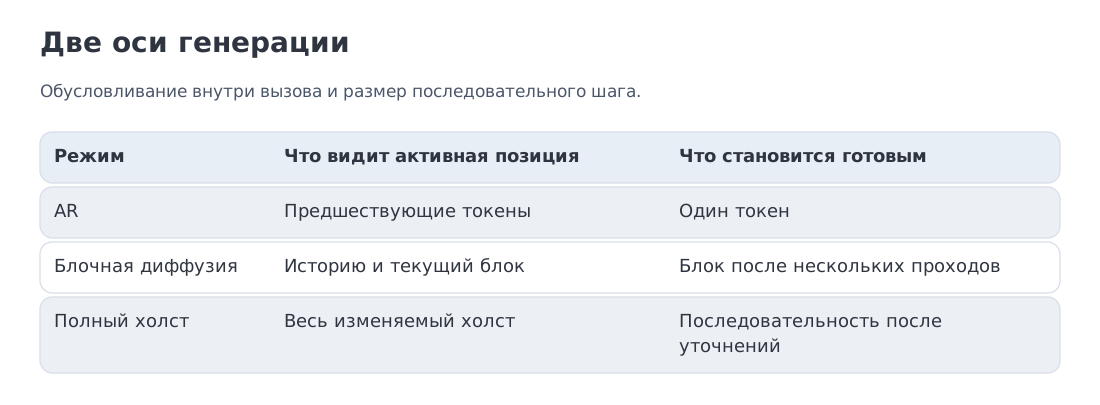 Две независимые оси: каузальное или двунаправленное обусловливание; один токен, блок или полный холст как единица прогресса.
4. Карта парадигм
Удобно отделить способ обучения распределения от способа исполнения генерации.
| Режим | Что фиксировано | Что обновляется за один шаг | Кэширование |
|---|---|---|---|
| AR | весь префикс | один новый токен | точный KV-кэш префикса |
| Полная диффузия с маскированием | условие/промпт | весь холст | меняющийся холст пересчитывается |
| Блочная диффузия | завершённые блоки | текущий блок | завершённый префикс кэшируется |
| Редактирование токенов | часть черновика | выбранные позиции | зависит от стабильности сегментов |
| Гибкая диффузия с маскированием | текущая последовательность | маски и вставки | зависит от конкретного алгоритма |
Эта таблица сразу убирает несколько ложных противопоставлений. Диффузионная модель не обязана иметь фиксированную длину: полуавторегрессионная MDLM, блочная диффузия, FlexMDM и iLLaDA предлагают разные решения. И наоборот, блочная диффузия не становится «почти обычной AR»: внутри блока остаются двунаправленное обусловливание и параллельное раскрытие.
5. Прямой процесс: поглощающее маскирование
В этом модуле основным примером служит absorbing masked diffusion — диффузия с поглощающей маской. Это одна важная, но не единственная форма дискретной диффузии. D3PM допускает и другие переходные матрицы, включая случайные замены токенов.
Пусть чистая последовательность равна . При линейном расписании в момент каждая разрешённая позиция независимо сохраняется с вероятностью и заменяется специальным токеном с вероятностью :
Здесь равно 1 при и 0 в остальных случаях: это точечное распределение на токене . Формула описывает один срез времени. Для одной монотонной траектории можно заранее выбрать для каждой позиции порог и скрывать её, когда . Тогда маски только накапливаются. Независимое повторное бросание монеты на каждом срезе даёт верные маргинальные распределения, но уже не одну поглощающую траекторию.
Слово «поглощающее» означает, что в прямом процессе маска не превращается обратно в содержательный токен. Обратная модель решает противоположную задачу: по частично наблюдаемой последовательности предсказывает исходные значения скрытых позиций.
При условной генерации промпт можно защитить от порчи: маскирование действует только на область ответа. Это важно при работе с инструментами и длинным контекстом: условие остаётся фиксированным, а генерируемая часть итеративно уточняется.
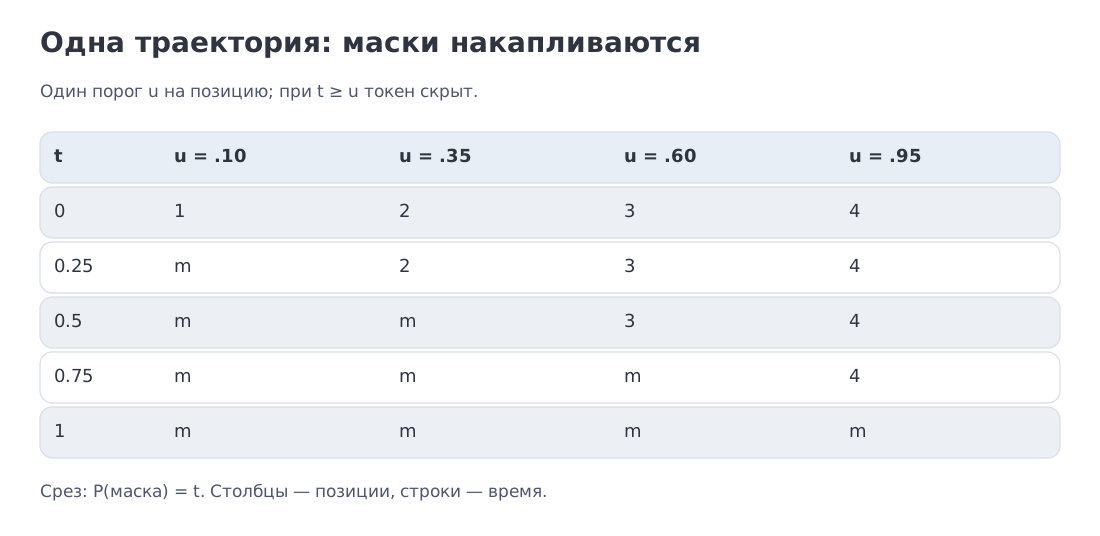 Поглощающее маскирование — выбранное в модуле ядро прямого процесса. Другие дискретные диффузионные модели могут использовать замены токенов или более общие матрицы переходов.
6. Решённый пример A: расписание руками
Возьмём восемь позиций и четыре модельных вызова. Полностью замаскированная последовательность должна пройти через целевые количества масок
Удобная явная политика:
На каждом шаге открываются ровно две позиции. Если , некоторые соседние значения совпадут: вызов модели может не открыть ни одной новой позиции. Это не математическая ошибка, но такое расписание тратит вычисления без изменения числа масок.
Здесь — целый номер итерации, а в прямом процессе — непрерывный уровень порчи. Расписание задаёт число раскрываемых позиций, но ещё не объясняет, чему должна научиться сеть. Для этого нужна функция потерь.
7. Цель обучения: ELBO и masked cross-entropy
Мы умеем испортить пример, но ещё не сказали, как оценивать модель. Для наблюдаемого текста хотелось бы максимизировать его вероятность. У диффузионной модели к нему ведёт множество скрытых траекторий; суммирование по ним обычно трудно. Вариационная нижняя граница правдоподобия (ELBO, evidence lower bound) заменяет эту задачу вычислимой границей для логарифма вероятности. При смене знака получается NELBO — верхняя граница отрицательного логарифма правдоподобия, которую минимизируют.
Для поглощающего процесса с линейным расписанием и параметризацией, сохраняющей видимые токены и запрещающей предсказание маски как чистого токена, непрерывновременная цель принимает простой вид. Её случайный вклад на одном временном срезе равен:
Здесь — множество скрытых позиций, а — предсказанная вероятность исходного токена. Используем натуральный логарифм: вклад измеряется в натах. В среднем по порче и равномерно выбранному времени получаем цель
Неравенство относится к полной цели в этой постановке, а не к одному случайному срезу. Вес возникает из при вероятности сохранения . Он компенсирует редкость масок на малых временах; он не означает, что каждому примеру нужно вручную выбрать одинаковое число скрытых токенов.
Для непрерывного линейного процесса в моменты вес среза равен соответственно
При малом скрыто мало позиций, поэтому каждая из них получает больший вес. На уровне небольшого пакета это может повышать дисперсию; практические рецепты используют дискретизацию времени, выборку по важности или другие расписания шума.
Мы суммируем вклады скрытых позиций. Деление на фиксированную длину даёт другой постоянный масштаб. Деление на случайное число масок меняет относительные веса примеров и, без поправки, уже не оценивает ту же цель. Если ни одна позиция не скрылась, сумма равна нулю. Отбрасывание таких примеров или принудительное добавление маски тоже меняет распределение выборки и требует отдельного обоснования.
Пусть правильные токены получают вероятности
и все четыре позиции скрыты при . Тогда
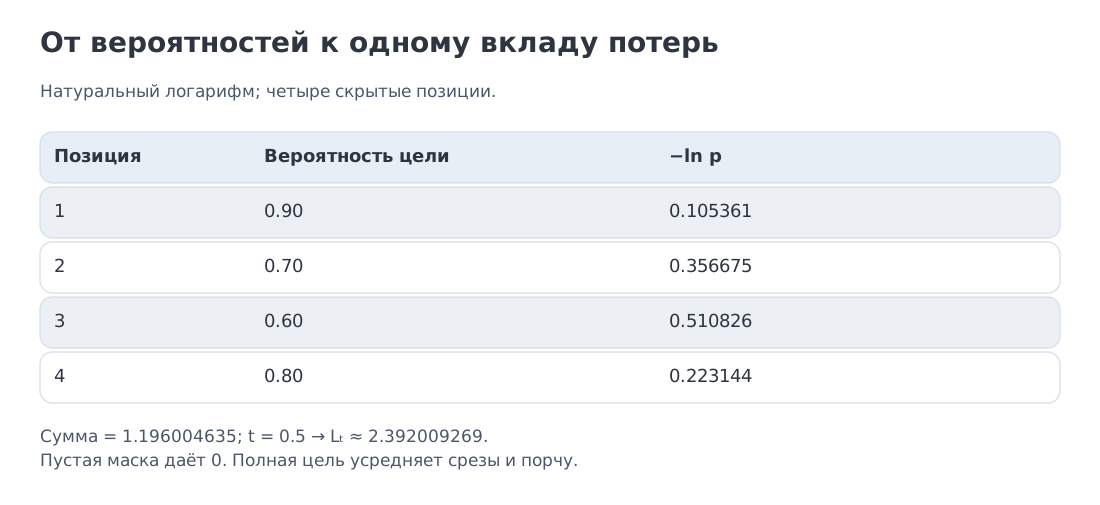 Вклад скрытых позиций суммируется и взвешивается по времени. Полная цель требует усреднения по порче и временным срезам.
В коде нужно обрабатывать отдельно. В непрерывном распределении одна точка имеет нулевую меру, но вычисление всё равно должно явно отклонять ноль.
Здесь полезно аккуратно говорить о правдоподобии (likelihood). AR-модель имеет точную левостороннюю факторизацию, поэтому её NLL — Negative Log-Likelihood вычисляется непосредственно. Многие dLLM оптимизируют ELBO или оценивают NELBO — Negative Evidence Lower Bound, но существуют формулировки masked diffusion, ориентированные на оценку правдоподобия, включая MDLM. Поэтому perplexity для dLLM нельзя объявить бессмысленной; нужно фиксировать способ оценки, число временных срезов и общий протокол.
8. Any-order и границы симметрии
Случайные маски заставляют сеть решать множество условных задач на одном документе. В одном мини-батче скрыто начало сущности, в другом — её конец, в третьем — отношение между двумя уже наблюдаемыми фрагментами. Это даёт более симметричный обучающий сигнал, чем единственная левая факторизация.
Для целей с равномерным распределением порядков masked diffusion можно связать с авторегрессией, усреднённой по порядкам. Но не все порядки одинаково информативны для естественного языка: работа Any-Order GPT показывает, что естественная структура языка слева направо остаётся полезным индуктивным смещением. Здесь нет противоречия. Диффузия расширяет множество условных задач, а не доказывает бесполезность последовательного порядка.
То же ограничение относится к «проклятию обратного отношения» (reversal curse): модель, обученная на фразе «Анна Ветрова написала роман „Тихая гавань“», может продолжать имя названием книги, но ошибаться в ответе на вопрос «Кто написал „Тихую гавань“?». Имена и название здесь вымышлены. Обратный вопрос восстанавливает автора по книге; он не утверждает, что отношение авторства симметрично. LLaDA сообщала сильный результат при восстановлении стихотворной строки по последующей строке, однако более поздняя работа DiffER обнаружила ошибки обратных отношений и у dLLM. Причины включают фрагментацию сущностей, асимметрию данных и отсутствие обратных отношений. Двунаправленное маскирование может смягчать позиционную асимметрию, но не создаёт отсутствующий факт автоматически.
Наконец, при ограниченном корпусе случайные маски действительно могут работать как неявное расширение задач. Работа Diffusion Beats Autoregressive in Data-Constrained Settings обнаружила преимущество masked diffusion при многократном использовании конечного набора данных. Это эмпирический результат выбранных масштабов и режимов повторения, а не универсальное доказательство большей эффективности использования данных.
9. Семплинг и решённый пример B
После обучения сеть выдаёт распределения токенов, но они ещё не определяют весь алгоритм генерации. Для линейной поглощающей модели один стандартный обратный переход от времени к оставляет скрытую позицию маской с вероятностью и раскрывает её с вероятностью , используя предсказание чистого токена. Уже видимая позиция сохраняется. Это связывает прямой процесс с обратным переходом; практические семплеры часто меняют порядок и расписание ради качества и скорости.
Ниже используем иной, полностью явный учебный выбор: фиксированное число масок и жадного кандидата в каждой позиции. Это политика декодирования, а не доказательство точной выборки из исходного распределения. В отличие от спекулятивного алгоритма М11, произвольное раскрытие по уверенности не снабжено универсальной корректировкой распределения.
Одна итерация такого семплера:
- при необходимости скрывает открытые позиции, выбранные по сохранённым оценкам предыдущих шагов;
- один раз вызывает модель на полученном холсте;
- выбирает кандидатов и ранжирует скрытые позиции;
- раскрывает столько позиций, сколько нужно для следующего числа масок;
- сохраняет результат и оценки уверенности для следующей итерации.
Распространённые критерии:
- случайный порядок;
- максимальная вероятность выбранного токена;
- минимальная энтропия;
- обучаемый порядок;
- повторное маскирование позиций с низкой уверенностью;
- расписания, зависящие от блока или задачи.
Уверенность в выбранном кандидате — одно число ; энтропия описывает неопределённость всего распределения позиции. Низкая энтропия означает, что масса сосредоточена на небольшом числе вариантов. Эти критерии могут ранжировать позиции по-разному, особенно при категориальной, а не жадной выборке кандидата.
В первой трассе восемь позиций раскрываются группами по две. Распределения здесь фиксированы: итог совпадает с шестью из восьми эталонных токенов при любом порядке полного жадного раскрытия. Этот пример проверяет расписание и выбор позиций. В следующем опыте ноутбука предсказания уже зависят от открытого контекста: сначала восстановленная опорная позиция помогает соседней. Только во втором опыте порядок способен изменить конечный ответ.
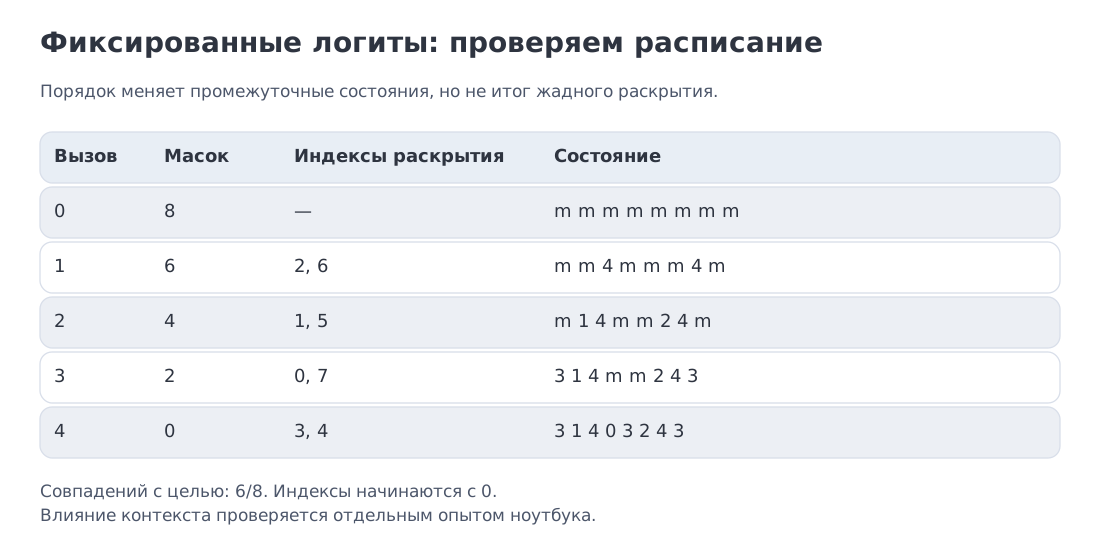 Детерминированная трасса: один вызов модели на шаг, кандидаты токенов, ранжирование по уверенности и ровно запланированное число открытых позиций.
Почему нельзя всегда раскрывать весь холст сразу? Рассмотрим источник, выдающий только пары и с равными вероятностями. Из двух масок каждая отдельная позиция имеет вероятности . Независимое одновременное раскрытие даст четыре пары по , в том числе невозможные и . Если сначала раскрыть первую позицию, а затем пересчитать условное распределение второй, исходная зависимость сохранится. Реальные модели сложнее, но этот маленький пример объясняет, за что мы платим дополнительными проходами.
Повторное маскирование (remasking) даёт слабой позиции второй шанс после того, как вокруг появилось больше контекста. При обычной авторегрессионной выборке аналогичный эффект требует внешней процедуры редактирования; dLLM включает его в семплер. Дополнительный шанс оплачивается бюджетом проходов или меньшим чистым прогрессом при прежнем бюджете. В нашей реализации позиции скрываются до единственного вызова модели на шаге: предсказание для ещё видимого токена не подменяет предсказание по испорченному входу.
DiffusionGemma рекомендует более сложный семплер EB — Entropy Bound. Он выбирает низкоэнтропийные токены при ограничении оценки зависимости между совместно раскрываемыми позициями (mutual-information bound), снова зашумляет остальные позиции и может остановиться адаптивно, когда энтропия мала, а наиболее вероятный токен стабилен два шага подряд. Это хороший пример того, что семплер является частью модели-паспорта, а не второстепенным флагом.
10. Учебная roofline-модель: экономика одного прохода
Теперь вернёмся к сценарию плотной 8B-модели из §1. Подчеркнём его статус: это не DiffusionGemma, не MoE и не измерение H100. Модель изолирует только два нижних предела — поток весов и идеальную матричную арифметику.
Для полного холста длины 1024 один проход требует
При 990 TFLOP/s:
Чтение 16 GB весов остаётся 4.776 мс, поэтому проход становится ограниченным вычислениями. С итерациями:
Отсюда:
| Шаги | Арифметическая верхняя оценка |
|---|---|
| 16 | 3867.2 ток/с |
| 64 | 966.8 ток/с |
| 128 | 483.4 ток/с |
Паритет с AR-границей при пакете из одного запроса находится около
На целых шагах 295 ещё немного быстрее, 296 — уже нет. Это не рекомендация использовать 295 итераций. Формула лишь показывает, насколько дорогим может стать параллельное денойзинг-уточнение до потери арифметического преимущества в заданной абстракции.
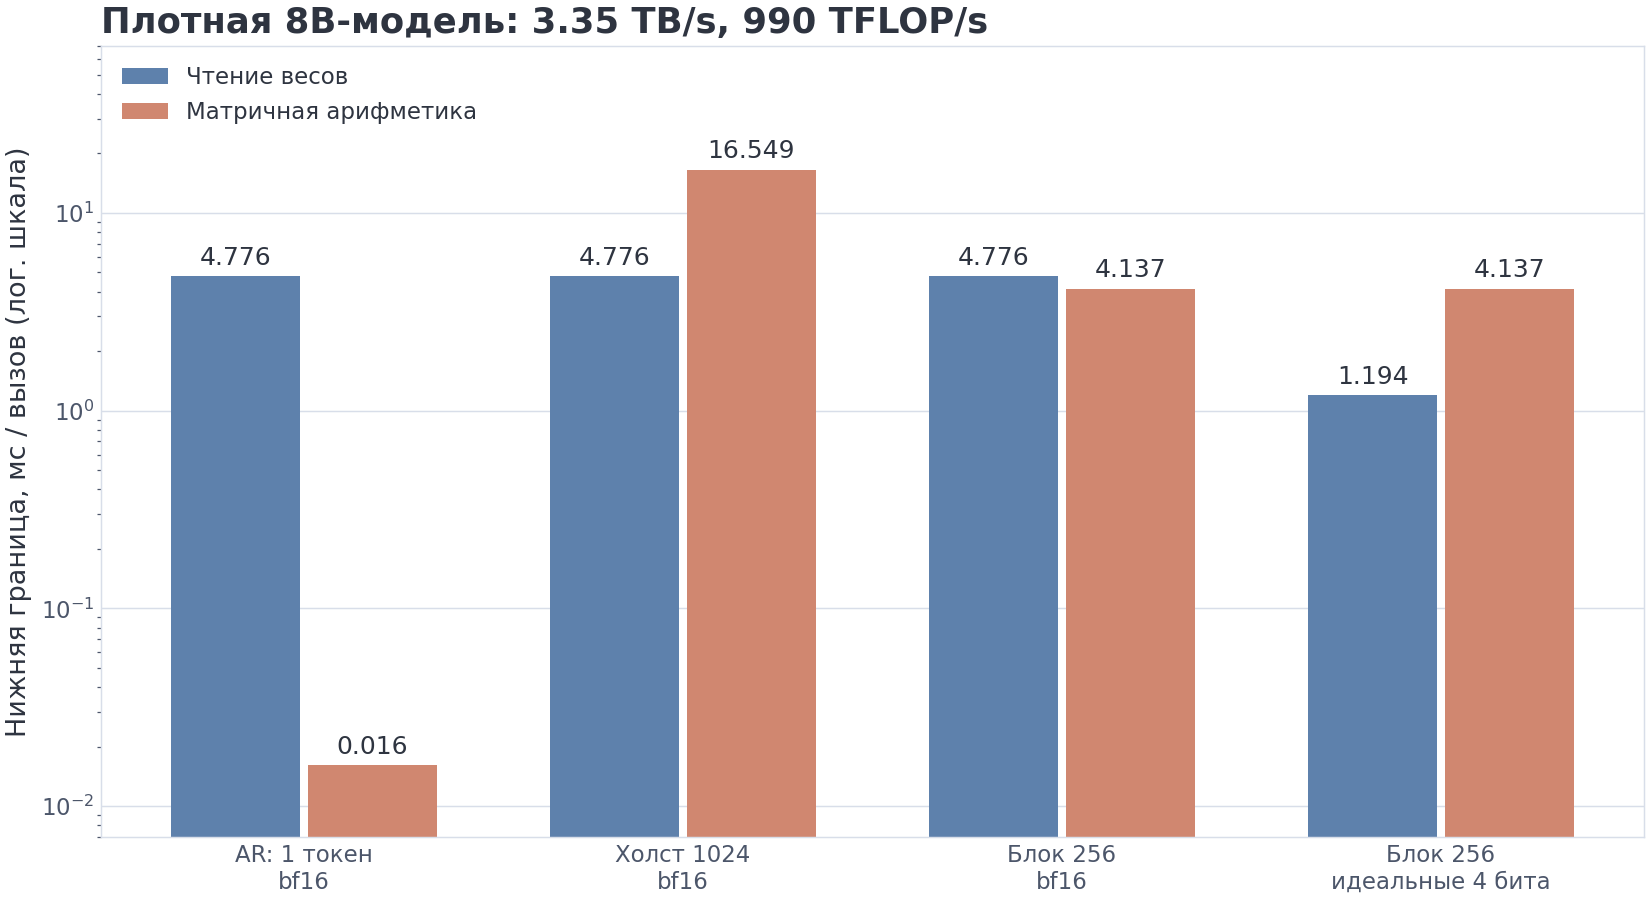 Учебная roofline-модель плотной 8B-сети: отношение идеального времени вычислений к нижней границе шага, а не измеренная загрузка GPU. Сценарий не относится к DiffusionGemma.
11. Шаги, батчи и точность весов
Увеличение размера пакета помогает и AR: одно чтение весов обслуживает несколько последовательностей. Если грубо предположить линейный рост пропускной способности AR, dLLM с сравнивается с ним при
Эта точка не универсальна. При нескольких одновременных запросах добавляются KV-трафик, разные длины, накладные расходы планировщика и эффекты насыщения вычислительных ядер. Но вывод важен: преимущество параллельного демаскирования особенно естественно для интерактивного инференса с малым пакетом, а не автоматически для сервера с уже насыщенной пакетной обработкой.
Рассмотрим отдельно блок 256 в той же плотной 8B-модели. Арифметика прохода занимает 4.137 мс. При bf16 чтение 16 GB занимает 4.776 мс, поэтому нижнюю границу задаёт память. Если идеализированно считать весь банк четырёхбитным, объём весов равен 4 GB, чтение — 1.194 мс, и нижняя граница переходит к вычислениям. При 16 шагах получается 3867.2 токена/с.
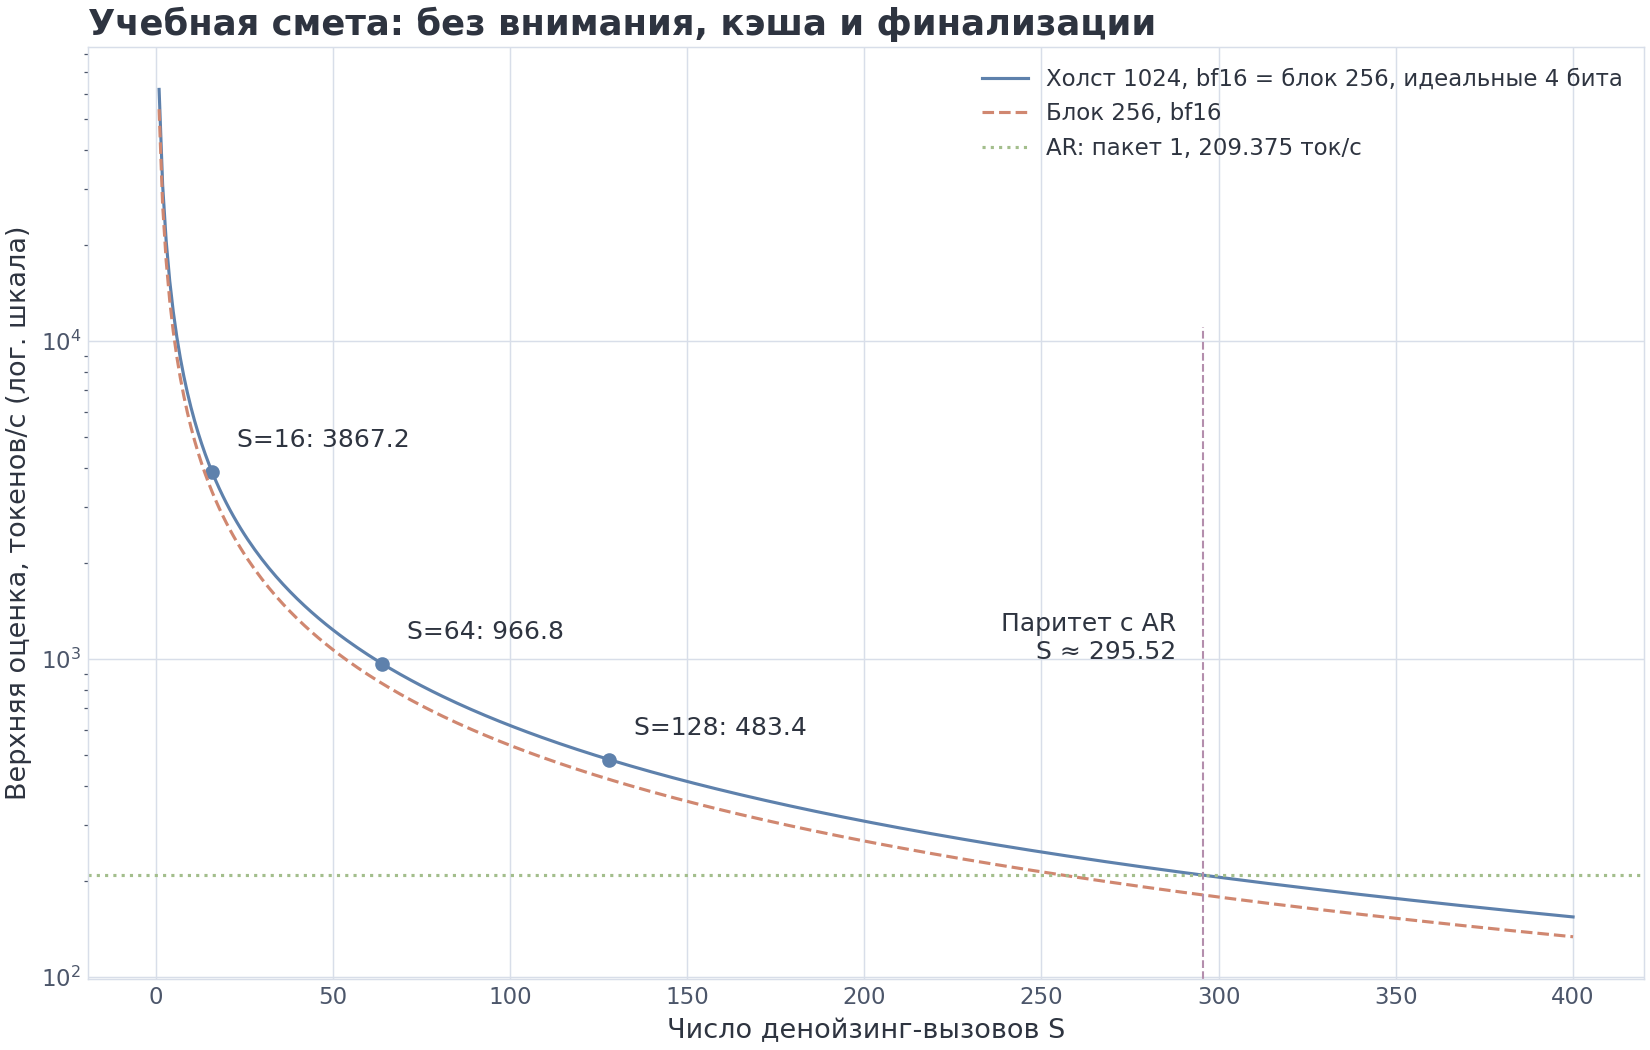 Число вызовов модели определяет пропускную способность в учебном сценарии плотной 8B-модели. Четырёхбитный объём весов — арифметическая гипотеза, а не характеристика чекпойнта DiffusionGemma.
Сравнение показывает роль численной точности, но не позволяет просто взять число 3867 и приписать его реальной MoE-модели. В разреженной MoE разные позиции одного холста могут маршрутизироваться к разным экспертам; весовой трафик определяется объединением затронутых экспертов, форматом тензоров и средой исполнения. Именно поэтому в следующем разделе с паспортом мы не будем выводить скорость DiffusionGemma из 3.8B активных параметров одной формулой.
12. Код первого уровня
Два базовых контракта: функция потерь учитывает только испорченные позиции, а семплер вызывает модель один раз на итерацию и открывает строго запланированное число токенов.
"""M12: summed masked loss and deterministic reveal schedule."""
import numpy as np

def linear_mask_schedule(length: int, steps: int) -> tuple[int, ...]:
    """Target counts from fully masked to fully revealed."""
    if any(isinstance(v, (bool, np.bool_)) or
           not isinstance(v, (int, np.integer)) or v <= 0
           for v in (length, steps)):
        raise ValueError("length and steps must be positive")
    return tuple(
        (int(length) * remaining + int(steps) - 1) // int(steps)
        for remaining in range(steps, -1, -1)
    )

def dllm_loss(logits, target_ids, loss_mask, time: float) -> float:
    """(1/t) times the summed NLL on explicitly masked positions."""
    logits = np.asarray(logits, dtype=np.float64)
    target_ids = np.asarray(target_ids)
    loss_mask = np.asarray(loss_mask)
    if logits.ndim != 2 or target_ids.shape != (logits.shape[0],):
        raise ValueError("expected logits [T,V] and target_ids [T]")
    if logits.shape[1] == 0 or target_ids.dtype.kind not in "iu":
        raise ValueError("target_ids must be integers and vocabulary non-empty")
    if np.any(target_ids < 0) or np.any(target_ids >= logits.shape[1]):
        raise ValueError("target IDs must be in [0, V)")
    if loss_mask.shape != target_ids.shape or loss_mask.dtype.kind != "b":
        raise ValueError("loss_mask must be boolean [T]")
    if isinstance(time, (bool, np.bool_)) or not (0.0 < time <= 1.0):
        raise ValueError("time must be in (0,1]")
    if not np.isfinite(logits).all():
        raise ValueError("logits must be finite")
    shifted = logits - logits.max(axis=-1, keepdims=True)
    log_probs = shifted - np.log(np.exp(shifted).sum(axis=-1, keepdims=True))
    nll = -log_probs[np.arange(target_ids.size), target_ids]
    return float(nll[loss_mask].sum() / time)

def sample_dllm(predict, length: int, steps: int, mask_id: int):
    """Greedy confidence reveal with one model invocation per iteration."""
    schedule = linear_mask_schedule(length, steps)
    if isinstance(mask_id, (bool, np.bool_)) or not isinstance(mask_id, (int, np.integer)):
        raise ValueError("mask_id must be an integer")
    vocabulary = None
    tokens = np.full(length, mask_id, dtype=np.int64)
    trace = []
    for step, target_masked in enumerate(schedule[1:], start=1):
        logits = np.asarray(predict(tokens.copy(), step), dtype=np.float64)
        if logits.ndim != 2 or logits.shape[0] != length or logits.shape[1] == 0 or not np.isfinite(logits).all():
            raise ValueError("predict must return finite logits [T,V]")
        if vocabulary is not None and logits.shape[1] != vocabulary:
            raise ValueError("predict changed vocabulary size")
        vocabulary = logits.shape[1]
        if 0 <= mask_id < vocabulary:
            raise ValueError("mask_id must lie outside the vocabulary")
        shifted = logits - logits.max(axis=-1, keepdims=True)
        probs = np.exp(shifted)
        probs /= probs.sum(axis=-1, keepdims=True)
        candidates = probs.argmax(axis=-1)
        confidence = probs[np.arange(length), candidates]
        masked = np.flatnonzero(tokens == mask_id)
        open_count = masked.size - target_masked
        order = np.lexsort((masked, -confidence[masked]))
        opened = masked[order[:open_count]]
        tokens[opened] = candidates[opened]
        trace.append((tuple(opened), tokens.copy()))
    return tokens, trace
Прочитайте цикл как журнал операций: копия входа передаётся модели, один сохранённый результат используется и для кандидатов, и для их ранжирования, затем обновляется состояние. Равные оценки разрешаются меньшим индексом позиции. Число масок проверяется по расписанию; при числе шагов больше длины возможны вызовы без раскрытия.
Идентификатор −1 вне словаря — упрощение этого интерфейса. Настоящая модель обычно имеет специальный токен маски в своём словаре; её выходная параметризация или фильтр запрещает выбирать его как окончательный содержательный токен. Ноутбук добавляет случайный выбор, ранжирование по энтропии и повторное маскирование. Адаптивные семплеры могут следовать другому расписанию, поэтому точное число оставшихся масок является контрактом нашего примера, а не свойством всех dLLM.
14. Блочная диффузия, длина и KV-кэш
Полный двунаправленный холст меняется на каждой итерации. Если пересчитать один токен, его новое представление может изменить все остальные позиции; обычный авторегрессионный KV-кэш внутри холста неприменим.
Блочная диффузия проводит границу между завершённой историей и изменяемым блоком длины . История не должна зависеть от будущего блока: именно это делает её состояния пригодными для кэширования. Внутри прежних блоков внимание может оставаться двунаправленным, если они уже завершены. В учебной маске §19 выбран более простой частный случай — каузальный префикс из трёх токенов.
Текущий блок читает завершённый префикс и все свои позиции. После окончательного выбора токенов требуется получить состояния именно чистого блока. Кэш последнего денойзинг-вызова мог быть вычислен ещё по маскам и прежним значениям, поэтому автоматически присоединять его к истории нельзя. В BD3-LM для кэша выполняется проход по готовому блоку; у DiffusionGemma эту роль играет отдельный кодировщик. Этот проход и обработка промпта входят в полную задержку, хотя упрощённая смета §§10–11 их не включает.
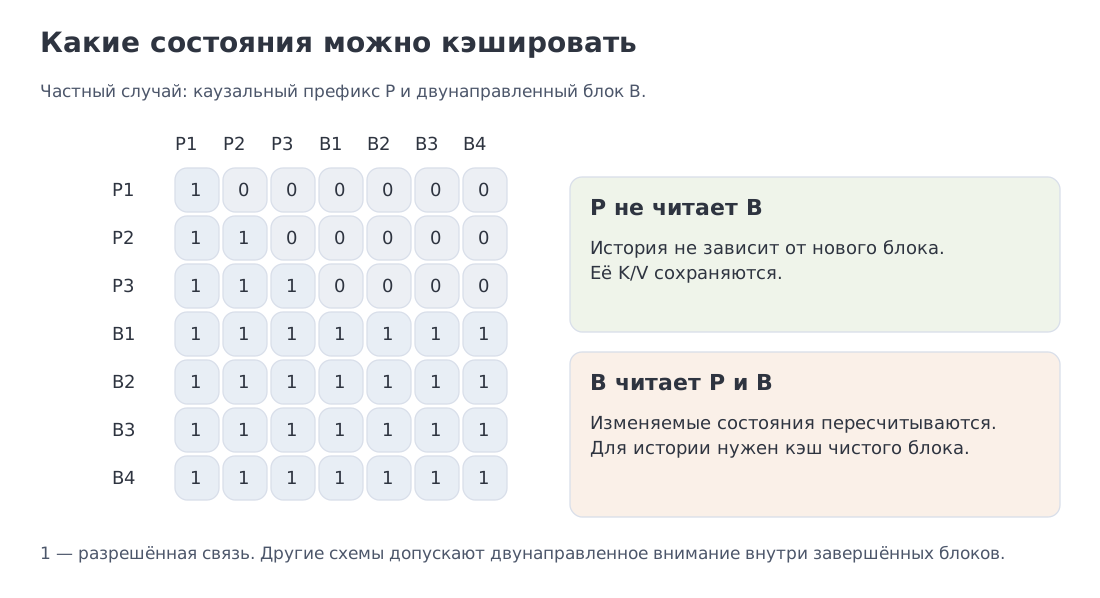 В учебной матрице завершённый префикс не читает активный блок. Завершённая история кэшируется при отсутствии связей с будущим блоком. Длина ответа может расти по мере добавления блоков.
Пределы понятны:
- даёт AR-подобный порядок;
- большой увеличивает параллелизм, но делает каждый проход дороже;
- завершённый префикс кэшируется;
- текущий блок пересчитывается;
- последовательность может расти блок за блоком.
BD3-LM формализует этот промежуточный класс и поддерживает генерацию произвольной длины. MDLM также описывает полуавторегрессионное семплирование переменной длины, а FlexMDM вводит вставки масок. Следовательно, блочная диффузия — важный, но не единственный ответ на ограничение фиксированного холста.
LLaDA2.0 использует размер блока ещё и как учебную траекторию преобразования авторегрессионного чекпойнта. На этапе разогрева размер блока растёт
стабильная фаза работает с маской всей последовательности, а фаза спада возвращает компактный размер блока. LLaDA2.1 добавляет Token-to-Token editing: открытый токен можно заменить, если последующая итерация считает его слабым. Опубликованный механизм пересматривает значения в имеющихся позициях.
15. Паспорт DiffusionGemma
Теперь применим дисциплину паспорта к реальной модели, не подменяя её сценарием плотной 8B-модели.
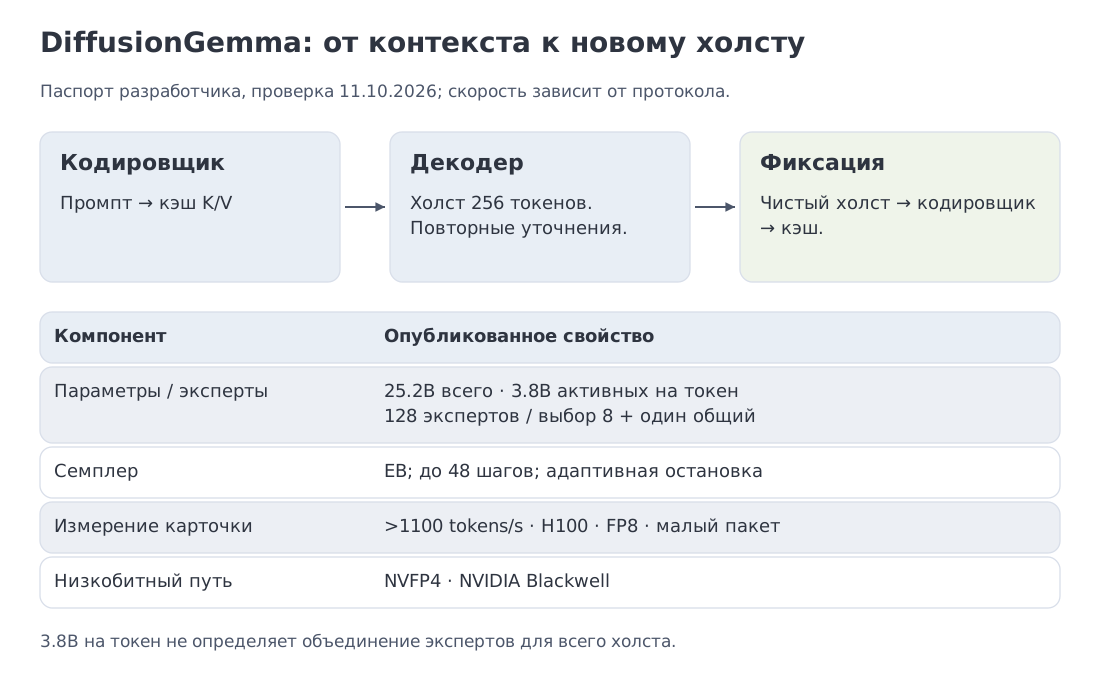 DiffusionGemma: авторегрессионный кодировщик и кэш контекста промпта, двунаправленный холст декодера, разреженная MoE, семплер EB и раздельные аппаратные пути H100 FP8 / Blackwell NVFP4.
| Поле | Опубликованный контракт |
|---|---|
| Архитектура | кодировщик — декодер, блочно-авторегрессионная диффузия по нескольким холстам |
| Всего параметров / активно на токен | 25.2B / 3.8B |
| Слои | 30 |
| Эксперты | 128 маршрутизируемых, выбор восьми, плюс один общий |
| Холст | 256 токенов |
| Контекст | до 256K |
| Локальное окно | 1024 |
| Вход | текст, изображения и видео как последовательности кадров |
| Выход | текст |
| Семплер | Entropy-Bounded Denoising, адаптивная остановка, до 48 шагов |
| Прогресс одного прохода | обычно 15–20 окончательно зафиксированных токенов |
| Опубликованная скорость | более 1100 ток/с, H100, FP8, малый пакет |
| Нативный низкобитный путь | NVFP4 на NVIDIA Blackwell |
Промпт обрабатывается авторегрессионным кодировщиком и превращается в кэшируемый контекст. Декодер итеративно уточняет двунаправленный холст через перекрёстное внимание (cross-attention) к этому префиксу. После завершения холст проходит через кодировщик и добавляется к кэшу. Поэтому модель одновременно использует блочную диффузию и кэш завершённой истории.
Четырёхбитная арифметика даёт две полезные, но неполные границы:
Первая — полный банк, вторая — число активных параметров на токен. Ни одна не равна трафику одного вызова модели: 256 позиций могут выбрать разные наборы экспертов, а реальная среда исполнения использует неоднородные форматы, метаданные, кэш и специализированные вычислительные ядра.
Совместный отчёт vLLM от 10 июня даёт другой конкретный результат: 1008 токенов/с на H100 FP8 в его тесте. Он не опровергает «более 1100» из карточки модели: это разные записи протокола. Сохранять нужно обе вместе с условиями, а не усреднять их.
Опубликованные результаты также показывают цену скорости: на многих сравнительных тестах DiffusionGemma уступает AR-Gemma 4 того же семейства, хотя на отдельных задачах ведёт себя конкурентно. Поэтому корректный продуктовый вопрос звучит не «быстрее ли diffusion?», а «какое соотношение качества и задержки даёт конкретный семплер на моей задаче?»
16. Ландшафт dLLM на 11 октября 2026 года
Скорости ниже нельзя сортировать одной колонкой: различаются оборудование, численная точность, нагрузка, размер пакета, семплер и определение выходного токена.
| Система | Ветка и доступ | Опубликованный сигнал | Как читать |
|---|---|---|---|
| LLaDA 8B | открытые веса, обучение с нуля | 2.3T токенов претрейна | свидетельство масштабируемости masked diffusion; результат задачи на обратное восстановление — отдельное измерение |
| LLaDA-MoE 7B-A1B | открытые веса | разреженная MoE-диффузия, 1.4B активных параметров | число активных параметров не определяет системную скорость без паспорта среды исполнения |
| LLaDA2.0 16B / 100B | открытые веса, конверсия AR | WSD и блочная диффузия | скорость зависит от CAP/dInfer, оборудования и порога фиксации токенов |
| LLaDA2.1 | открытые веса | Token-to-Token editing | пересмотр открытых токенов не равен вставкам для изменения длины |
| iLLaDA 8B | открытые веса, обучение с нуля | 12T токенов претрейна, переменная длина | сильная ветвь обучения с нуля; универсальный множитель TPS не заявляется |
| Mercury 2 | коммерческий API | 1009 ток/с на Blackwell, 128K | результат разработчика для конкретной продуктовой конфигурации |
| Gemini Diffusion | экспериментальная демонстрация | 1479 ток/с семплирования, накладные расходы 0.84 с | опубликованная скорость явно не включает фиксированную задержку |
| Seed Diffusion Preview | эксперимент, фокус на коде | 2146 ток/с на H20 | результат разработчика на задачах программирования |
| DiffusionGemma | открытые веса | >1100 ток/с, H100 FP8; 15–20 токенов за проход | подробный открытый паспорт с границами измерения |
Mercury 2 особенно полезна как коммерческий пример dLLM с рассуждением с использованием инструментов и JSON по заданной схеме. Gemini Diffusion демонстрирует, почему скорость семплирования нужно отделять от полной задержки: фиксированные 0.84 секунды не входят в 1479 ток/с. Seed Diffusion показывает другую границу — специализированную модель для программирования на H20.
iLLaDA важна по другой причине. Она не гонится за одной цифрой TPS, а показывает, что полностью двунаправленную цель с маскированием можно масштабировать до 12T токенов претрейна и сохранить в SFT. Это напоминание: поле развивается одновременно по трём осям — качество базовой модели, гибкость семплера и системная реализация.
17. Мультимодальные системы
Слово «diffusion» в мультимодальной модели может обозначать разные процессы.
LLaDA-V использует masked diffusion для визуально-языкового понимания: изображение кодируется, а текстовый ответ восстанавливается диффузионно.
LLaDA2.0-Uni идёт дальше. SigLIP-VQ переводит визуальные входы в дискретные семантические токены; основная MoE-dLLM работает с текстовыми и визуальными токенами, а отдельный диффузионный декодер восстанавливает пиксели. Диффузия текстовых токенов и диффузия в декодере изображений — разные слои системы.
DiffusionGemma принимает текст, изображения и видео в одном контексте, но генерирует текст. Визуальный кодировщик не означает, что пиксели восстанавливаются тем же masked-token процессом, которым создаётся ответ.
Полезный вопрос для любого мультимодального паспорта:
где именно находится diffusion — в токенах языка, в декодере визуальных латентных представлений, в общей дискретной основе или сразу в нескольких компонентах?
Без этого две «мультимодальные диффузионные модели» могут иметь почти несопоставимые вычислительные контракты.
20. Ключевые выводы и источники
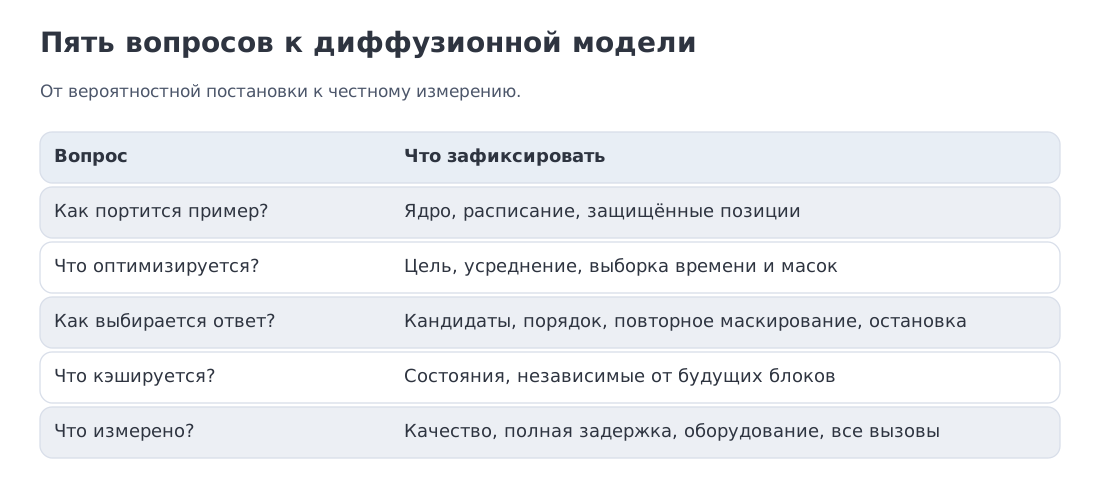 Пять вопросов связывают вероятностную постановку, функцию потерь, семплер, кэш и измерение системы.
Парадигма. Обычный AR-семплер добавляет токен к фиксированному префиксу; пересмотр требует отдельного механизма редактирования. Masked diffusion итеративно уточняет множество позиций. Блочная диффузия сочетает каузальный префикс и двунаправленный текущий блок.
Прямой процесс. В выбранной постановке с поглощающей маской позиция маскируется с вероятностью . Это не единственное дискретное диффузионное ядро.
Функция потерь. Для линейного процесса используется взвешенная cross-entropy по маскам. Число 2.392009269 относится к суммированию в конкретном примере.
Семплирование. Порядок раскрытия, энтропия/уверенность, повторное маскирование и адаптивная остановка являются частью алгоритма. Один и тот же чекпойнт может давать разные соотношения качества и задержки при разных семплерах.
Roofline. Расчёт плотной 8B-модели на H100 — учебная нижняя граница, не бенчмарк DiffusionGemma. 0.338% — доля идеального арифметического времени, а не измеренная загрузка GPU.
DiffusionGemma. 25.2B параметров всего / 3.8B активных на токен, 128 маршрутизируемых экспертов с выбором восьми и один общий эксперт, холст 256, 15–20 финализируемых токенов за проход, >1100 ток/с на H100 FP8; NVFP4 — нативный путь для Blackwell. Идеализированные четырёхбитные объёмы весов не равны трафику одного прохода.
Ландшафт. Mercury 2, Gemini Diffusion, Seed Diffusion и DiffusionGemma публикуют скорости в разных протоколах. Таблица без оборудования, численной точности, семплера и накладных расходов вводит в заблуждение.
Ключевые первоисточники:
- D3PM
- Diffusion-LM
- SEDD
- FlexMDM
- DiffusionGemma in vLLM
- MDLM
- LLaDA
- BD3-LM
- Any-Order GPT as Masked Diffusion
- Data-Constrained Diffusion
- LLaDA2.0
- DiffER
- LLaDA2.1
- LLaDA2.0-Uni
- iLLaDA
- DiffusionGemma model card
- DiffusionGemma announcement
- Mercury 2
- Gemini Diffusion
- Seed Diffusion
Дальше: модуль 13 — SFT и данные постобучения. Он продолжает авторегрессионный маршрут: как превратить предсказатель продолжения в модель, которая следует формату диалога и примерам желаемого поведения.
Ландшафт сверен: 11 октября 2026 года. Скорости Mercury, Gemini, Seed и DiffusionGemma являются результатами разработчиков в разных аппаратных протоколах и режимах семплирования. Числа §§10–11 принадлежат отдельному учебному сценарию плотной 8B-модели.