Модуль 9. RLVR и GRPO: проверяемые награды, групповые оценки и устойчивость
Версия материала: 2026.21
Фактический снимок: 2026-08-05
Язык: RU
Основная практика: уровень A — браузер и центральный процессор (CPU); уровень B — бесплатный Colab T4 с низкоранговой адаптацией (Low-Rank Adaptation, LoRA)
Структура: 5 уроков, 25 шагов
Ориентировочное время: 10–13 часов без факультативного обучения модели
В Модуле 8 «RLHF и прямые методы оптимизации предпочтений» (rl_llm.module_08_rlhf_dpo) мы оптимизировали политику по фиксированным парам предпочтений. Теперь данные будут собираться самой политикой: для одного запроса она породит несколько ответов, проверяющая система присвоит им награды, а следующий шаг обучения изменит распределение будущих ответов.
Этот режим называется обучением с подкреплением на основе проверяемой награды (reinforcement learning with verifiable rewards, RLVR). Часто для него используют групповую относительную оптимизацию политики (Group Relative Policy Optimization, GRPO), но два названия не являются синонимами:
- RLVR описывает источник обратной связи: результат можно проверить программой, формальной системой, тестами или средой;
- GRPO описывает способ построить оценку преимущества и обновить политику без обучаемого критика.
Практическая задача модуля:
Собрать воспроизводимый RLVR-контур, в котором награда действительно проверяет нужное свойство, а выбранная версия GRPO не скрывает смещения нормировки, рассогласование политик и потерю разнообразия.
После прохождения модуля вы сможете:
- отличать RLVR от GRPO, PPO, прямой оптимизации предпочтений и поиска на этапе вывода;
- описывать роли текущей, старой и базовой политик в групповом обновлении;
- выводить групповую оценку преимущества и каноническую клиппированную цель GRPO;
- объяснять, почему «без критика» не означает «без опорного уровня»;
- проектировать проверяющую систему и различать ложноположительные и ложноотрицательные награды;
- вычислять вероятность информативной группы и цену динамического добора;
- сравнивать исходную GRPO, Dr. GRPO, DAPO и GSPO по точной единице нормировки и поправки отношений вероятностей;
- диагностировать потерю энтропии, дрейф длины, усечение и рассогласование генерации с обучением;
- осторожно интерпретировать спор «извлечение уже доступного поведения или появление новых стратегий»;
- выполнить детерминированную практику на CPU и подготовить факультативный запуск на модели класса 0,6 млрд параметров.
Датированные утверждения, первичные источники и границы допустимых выводов собраны в Module_9_Sources.md. Практический маршрут выполнен в отдельном исполняемом ноутбуке.
Практический маршрут. После лекции идут оцениваемые задания, решения, открывающиеся после попытки, и исполняемая практика. Само объяснение остаётся самодостаточным.
Урок 9.1. RLVR как контракт обратной связи
Урок 9.1. RLVR как контракт обратной связи
- Что именно делает награду проверяемой
- DeepSeek-R1-Zero как исторический пример, а не универсальный рецепт
- Проверяющая система состоит из нескольких слоёв
- Числовой верификатор: полезное ядро и честная граница
- Когда группа даёт сигнал
далее — 5 проверочных шагов
Шаг 9.1.1 — Что именно делает награду проверяемой
В обычном RL награда может поступать от человека, обученной модели, среды или физического измерения. В RLVR выделяется более узкий случай: для ответа или траектории существует процедура, которая возвращает воспроизводимый результат проверки.
Примеры:
- число или алгебраическое выражение сравнивается с эталоном после канонизации;
- программа запускается в изолированной среде на тестах;
- доказательство проверяется формальным ядром;
- вызов инструмента оценивается по фактическому состоянию среды;
- ответ в игре или симуляторе получает награду по правилам среды.
Проверяемость не означает бинарность. Награда может быть вещественной, многокомпонентной или частичной. Важно другое: одинаковый вход при зафиксированной версии проверяющей системы должен давать одинаковый результат, а критерий должен быть достаточно близок к тому свойству, которое мы хотим улучшить.
Полный контур выглядит так:
Здесь — запрос, — ответы старой политики, — результаты проверки, а — оценки относительной полезности ответов внутри группы.
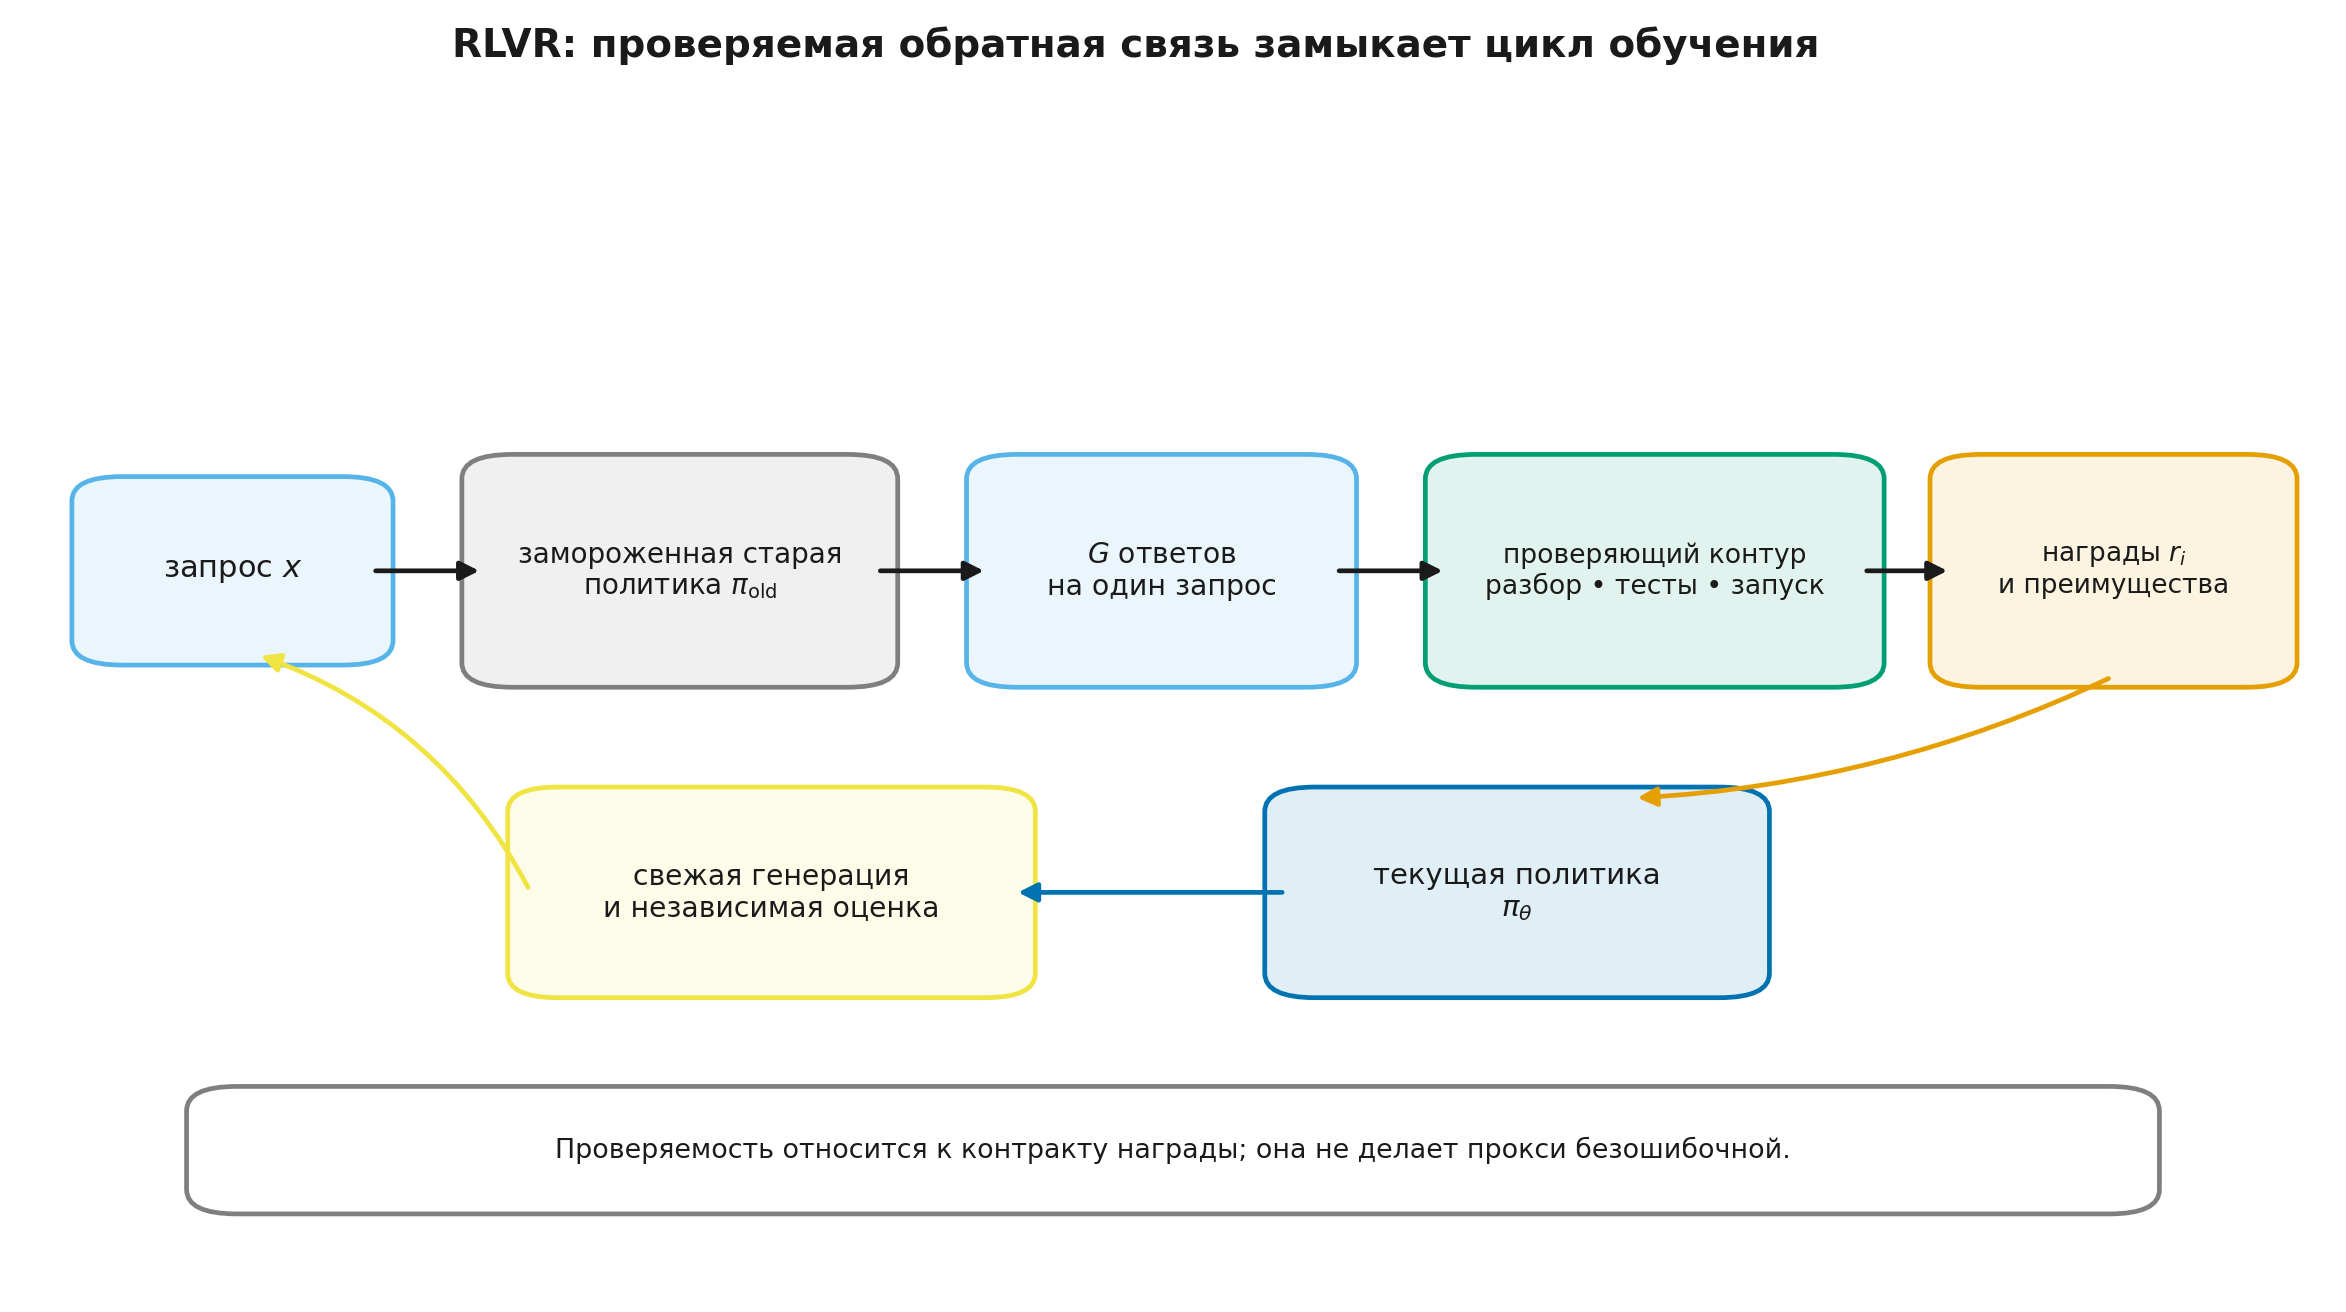
Граница понятия. Best-of-N с тем же проверяющим правилом остаётся поиском на этапе вывода, если веса модели не меняются. DPO остаётся обучением на фиксированных парах, если внутри стадии не собираются свежие ответы. RLVR начинается там, где проверяемый результат входит в обновление политики.
Шаг 9.1.2 — DeepSeek-R1-Zero как исторический пример, а не универсальный рецепт
Технический отчёт DeepSeek-R1 описывает DeepSeek-R1-Zero как RL-стадию, начатую непосредственно от DeepSeek-V3-Base, без предварительной SFT-стадии с размеченными цепочками рассуждений. Авторы сообщают, что в ходе обучения ответы становились длиннее и чаще содержали проверку промежуточных шагов, возврат к предыдущим решениям и альтернативные подходы.
В том же отчёте зафиксированы ограничения R1-Zero: ухудшенная читаемость, смешение языков и узкая ориентация на задачи с формальной проверкой. Финальный DeepSeek-R1 поэтому использовал многостадийный процесс с данными холодного старта, дополнительной SFT, отбором сгенерированных данных и последующими RL-стадиями. Исторический пример важен именно целиком: чистый запуск показывает, что проверяемый сигнал способен сильно перестроить распределение ответов, а финальный конвейер показывает, что одной этой стадии недостаточно для общей полезности модели.
Для R1-Zero авторы описывают две компоненты награды, заданные правилами:
Для математики проверялся итоговый ответ, для кода — результат компиляции и тестов, а отдельная компонента поощряла требуемую структуру ответа.
В опубликованном отчёте компактная формула GRPO содержит KL-член с коэффициентом и отношение вероятностей полного ответа. Однако сам отчёт не задаёт настолько полный машинно-воспроизводимый паспорт запуска, чтобы по одной формуле восстановить все детали расписания базы, повторного использования роллаутов и реализации оценивателя. Поэтому корректно говорить: показанная авторами цель допускает KL-регуляризацию; точный коэффициент и остальные инженерные детали должны проверяться по версии кода или конфигурации конкретного запуска. Формулировки «R1-Zero по определению обучался совсем без KL» и «любой RLVR должен повторять конфигурацию R1» одинаково сильнее доступных оснований.
Статус утверждений: архитектура конвейера, типы награды и наблюдавшееся поведение — сообщения авторов технического отчёта. Они демонстрируют один масштабный успешный процесс, но не доказывают, что отсутствие предварительной SFT, та же награда или те же гиперпараметры оптимальны для другой модели и другого набора задач.
Шаг 9.1.3 — Проверяющая система состоит из нескольких слоёв
Фраза «награда равна правильности» скрывает последовательность решений:
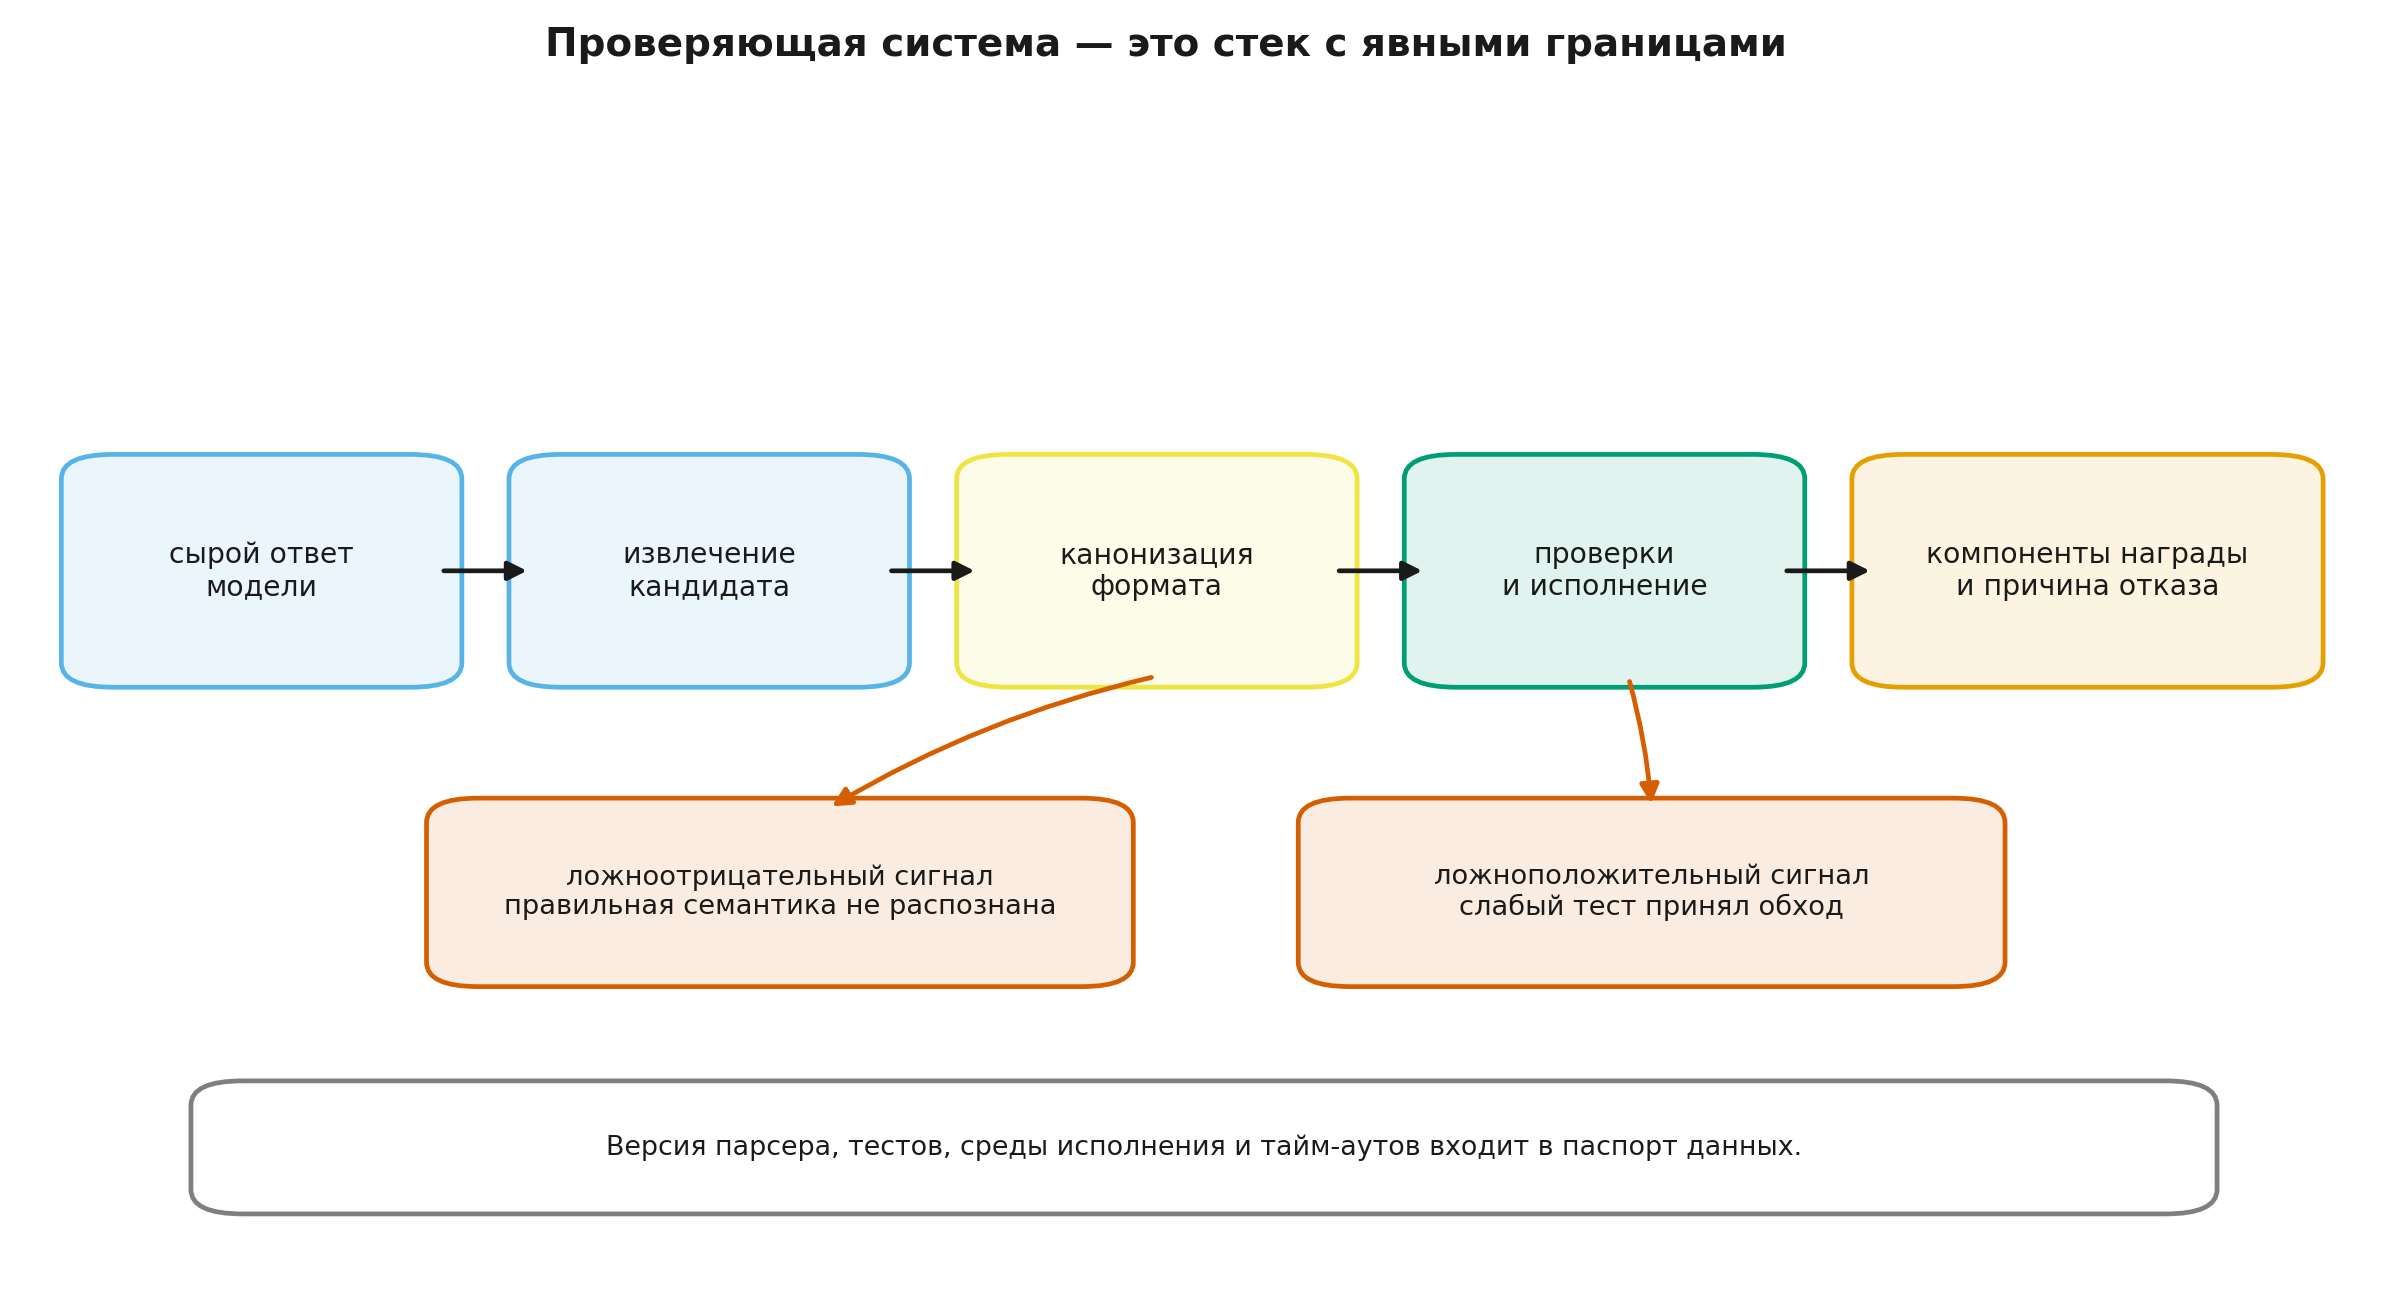
Для числовой задачи нужно решить, где искать ответ, как понимать дроби, допускается ли округление и что делать с несколькими финальными ответами. Для кода добавляются версия языка, зависимости, ограничения времени и памяти, сеть, файловая система, случайность и скрытые тесты.
Две ошибки принципиально различны:
- ложноположительная награда: неверный ответ принят; политика получает прямой стимул эксплуатировать ошибку;
- ложноотрицательная награда: правильный ответ отклонён; полезная траектория подавляется.
Ложноположительные ошибки особенно опасны при многократной оптимизации: редкая лазейка может быстро стать доминирующей стратегией. Ложноотрицательные ошибки уменьшают эффективное число успехов и делают сигнал более разреженным.
Минимальный паспорт проверяющей системы должен фиксировать:
- версию парсера и эталонов;
- правила канонизации;
- допустимые форматы;
- ограничения среды исполнения;
- набор положительных, отрицательных и состязательных тестов;
- причины отказа: нет ответа, ошибка разбора, тайм-аут, исключение, неверный результат;
- хэш конфигурации, чтобы награду можно было воспроизвести позже.
Проверяющая система — часть спецификации задачи, а не вспомогательная строка кода.
Шаг 9.1.4 — Числовой верификатор: полезное ядро и честная граница
В учебном коде используется ограниченный, но тестируемый контракт:
- взять содержимое последнего
\\boxed{...}, если оно есть; - иначе найти последнее число или дробь;
- удалить разделители тысяч;
- преобразовать дробь точно через
Fraction; - сравнить с абсолютным и относительным допуском.
from module_9_reference import verify_numeric_answer

assert verify_numeric_answer(r"Итог: \\boxed{3/7}", "0.428571") == 1
Такое правило удобно для арифметического практикума, но оно не является общим математическим доказчиком. Оно не понимает автоматически эквивалентность и , интервалы, множества решений, единицы измерения и условия существования.
Прежде чем подключать правило к RL, нужно проверить как минимум:
- верные ответы во всех разрешённых форматах;
- правдоподобные неверные ответы;
- упоминание эталонного числа внутри неверного рассуждения;
- несколько блоков
\\boxed{}; - нулевой знаменатель;
NaN, бесконечность и переполнение;- очень длинный текст;
- попытки внедрить управляющие последовательности или код.
Инженерный вывод. Сначала запускаются тесты проверяющей системы, затем пробный сбор наград без обновления весов, и только после анализа ошибок включается обучение. Иначе политика исследует не задачу, а недокументированное поведение парсера.
Шаг 9.1.5 — Когда группа даёт сигнал
Пусть каждый из независимых ответов верен с вероятностью , а награда бинарна. Группа информативна для центрированной групповой оценки, если в ней есть хотя бы один успех и хотя бы одна неудача. Поэтому
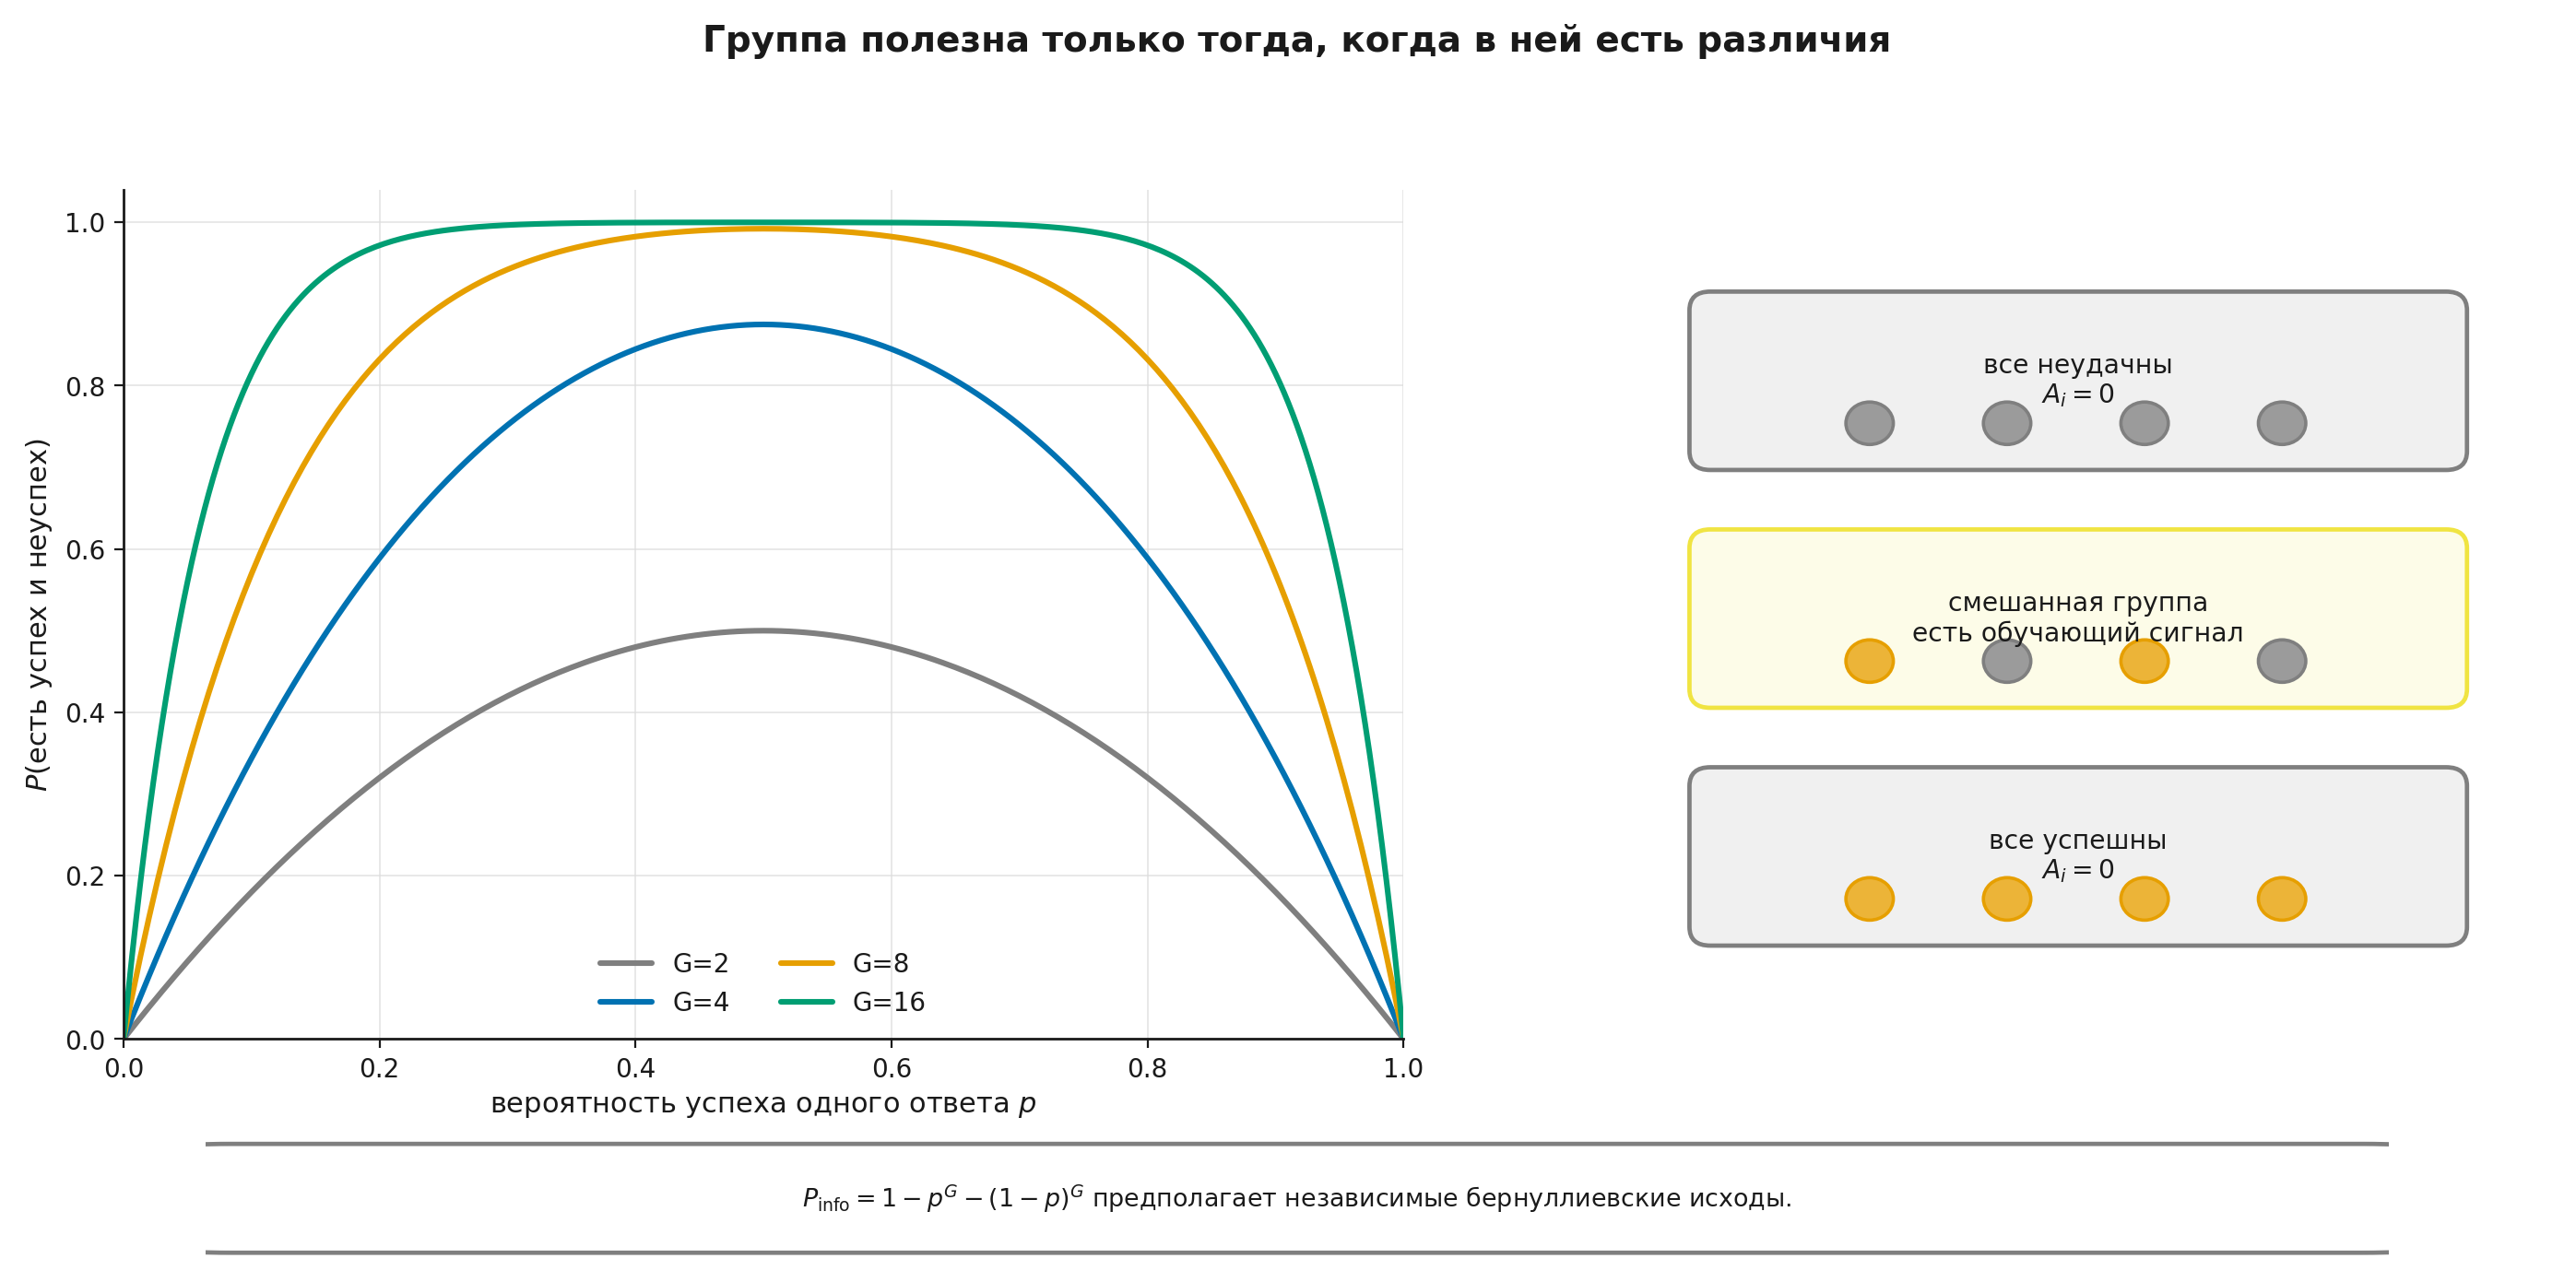
При почти все группы полностью неверны; при — полностью верны. Наибольшая вероятность сигнала находится около .
Примеры для :
| 0,01 | 0,0773 |
| 0,10 | 0,5695 |
| 0,50 | 0,9922 |
| 0,90 | 0,5695 |
| 0,99 | 0,0773 |
Если нужно получить информативных запросов, а вероятность остаётся примерно постоянной, ожидаемое число просмотренных запросов равно
Это объясняет динамический добор и учебную программу по сложности. Но фильтрация меняет распределение обучающих запросов: лёгкие и невозможные задачи перестают участвовать в градиенте. Поэтому отдельно сохраняются исходный поток, доля отброшенных групп и качество на полном отложенном наборе.
Формула предполагает независимые выборки при одном фиксированном запросе и протоколе генерации. Низкая температура, общий шаблон и независимо повторившиеся префиксы могут снижать энтропию без нарушения независимости. Переиспользование случайно выбранного префикса или ветви поиска между кандидатами уже может связывать выборки. Между запросами различается и вероятность успеха: усредняйте формулу по запросам, а не подставляйте общую долю успехов. Дубли ответов сами по себе не доказывают зависимость.
Урок 9.2. Каноническая GRPO
Урок 9.2. Каноническая GRPO
- Три политики и один источник данных
- Групповой опорный уровень и оценка преимущества
- Клиппированная цель
- Почему на первом шаге отношение вероятностей иногда равно единице
- Связь с REINFORCE, RLOO и PPO
далее — 3 проверочных шага
Шаг 9.2.1 — Три политики и один источник данных
Для запроса старая политика порождает группу
После генерации различаются три роли:
- старая политика — фактический источник сохранённых действий и знаменатель отношений вероятностей;
- текущая политика — модель, для которой вычисляется градиент;
- базовая политика — необязательный KL-якорь.
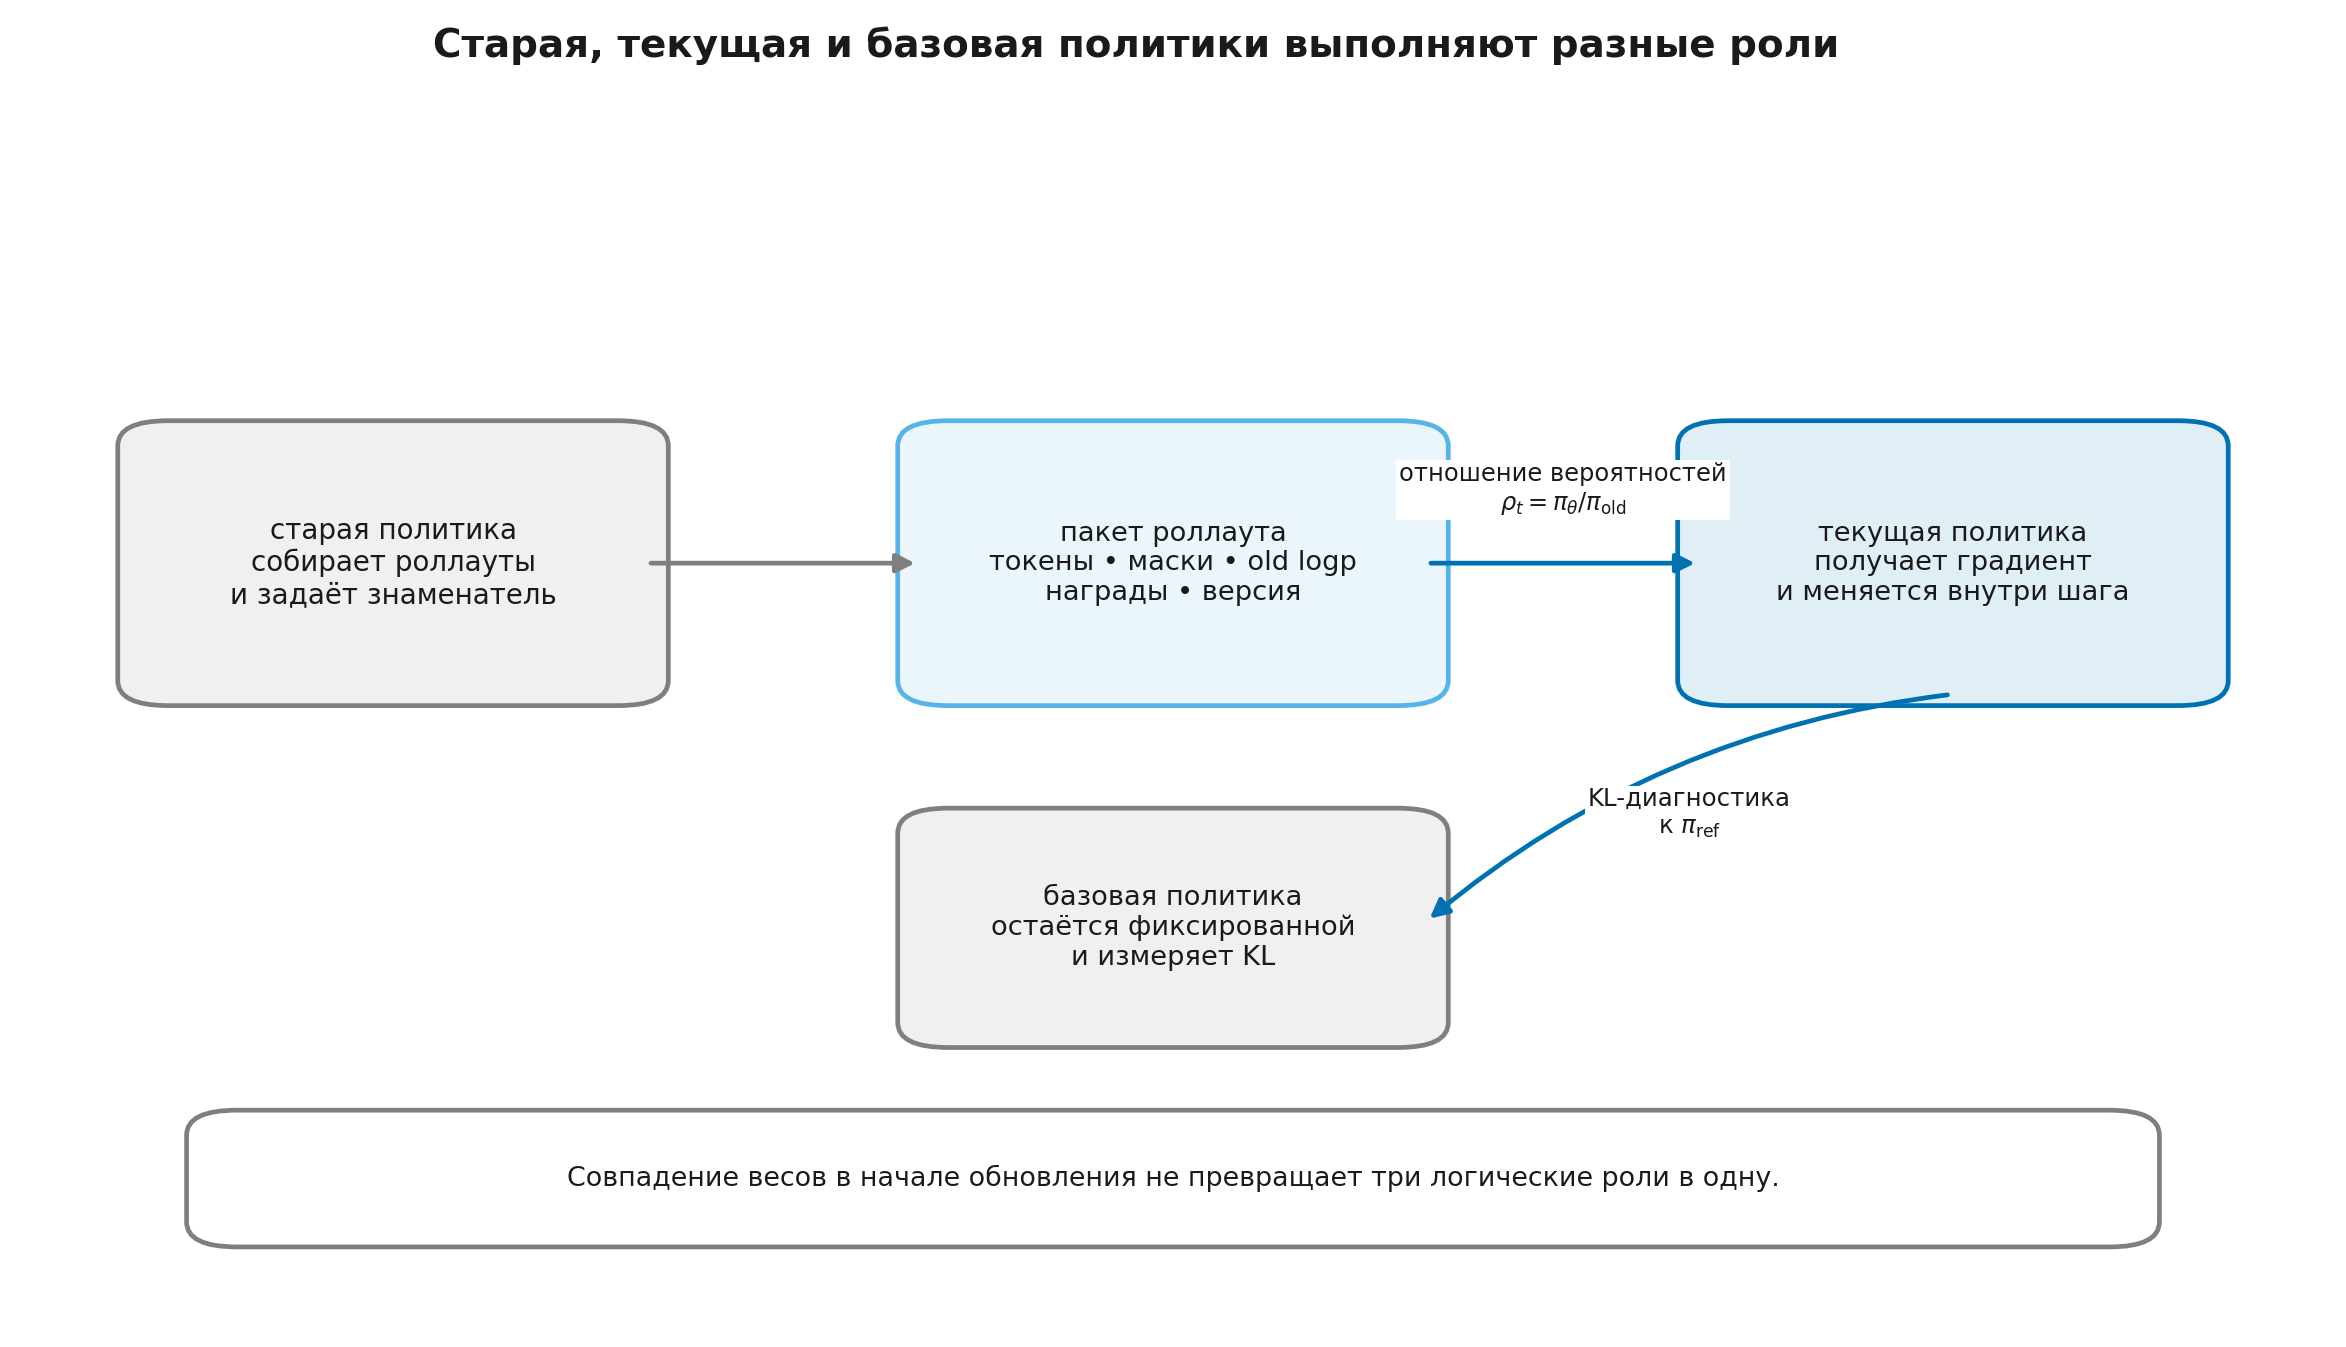
Старая и базовая политика могут начинаться с одинаковых весов, но математически это разные объекты. Старая политика фиксируется на время работы с конкретным пакетом и заменяется при сборе следующего пакета. Базовая политика может оставаться замороженной, периодически заменяться по явному расписанию или отсутствовать. Текущая политика меняется внутри оптимизации пакета.
Для токена вводится отношение
Знаменатель должен соответствовать фактической политике поведения после температуры, масок, top-k/top-p и других процессоров логитов. Если генератор использовал преобразованное распределение, нельзя подставить в знаменатель логарифмы вероятностей исходного softmax только потому, что они удобнее доступны. Сохранённые логарифмы вероятностей старой политики, параметры декодирования и версия генератора входят в пакет роллаута.
Шаг 9.2.2 — Групповой опорный уровень и оценка преимущества
Для наград каноническая GRPO использует
где — стандартное отклонение наград внутри группы.
Одна и та же обычно применяется ко всем токенам ответа . Это снимает необходимость обучать отдельную модель ценности, но не решает токеновое распределение заслуги: каждый токен успешного ответа получает один знак, независимо от того, был ли он критическим, нейтральным или случайным.
Фраза «GRPO работает без опорного уровня» неверна. Опорный уровень есть — средняя награда всех ответов группы на тот же запрос, включая текущий ответ. Нет обучаемого критика, который предсказывал бы ценность состояния.
Если все награды одинаковы, числитель равен нулю и группа не даёт градиента. Для бинарной группы с одним успехом получаем
а для каждой неудачи
если используется популяционное стандартное отклонение без добавки . Нормировка сохраняет сумму оценок равной нулю, но меняет масштаб в зависимости от состава группы.
Шаг 9.2.3 — Клиппированная цель
В исходной статье DeepSeekMath GRPO записана через токеновые отношения и усреднение токеновых членов сначала внутри ответа, затем между ответами:
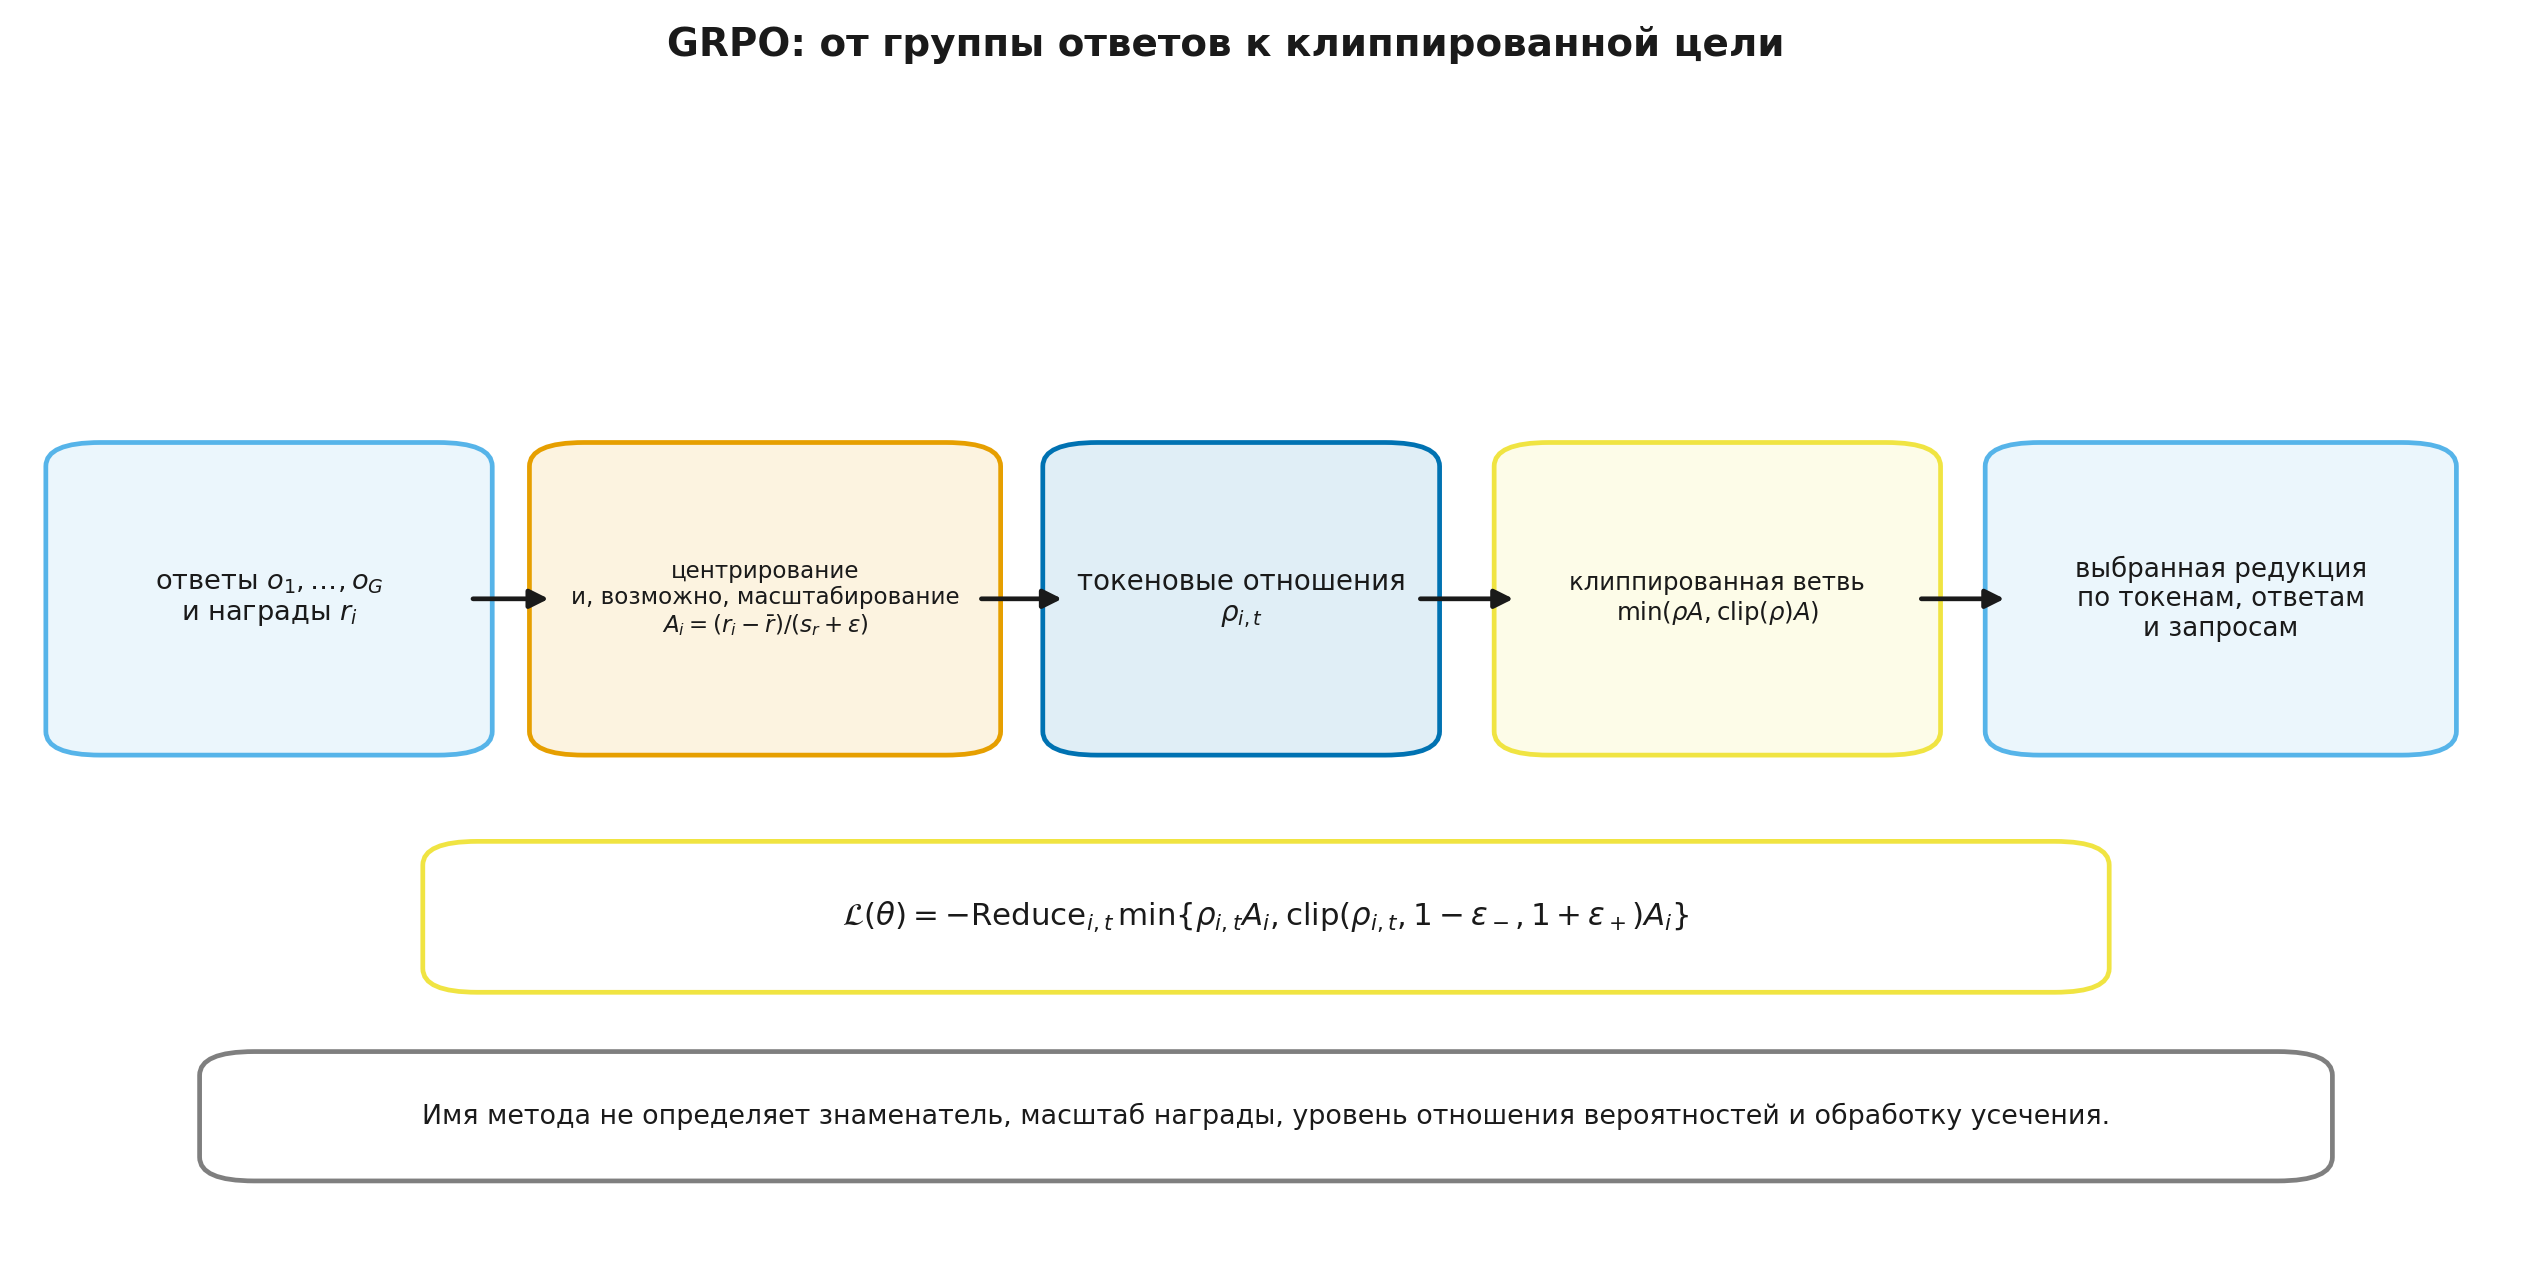
— выбранный оцениватель отклонения от базовой политики. Его точную форму нужно называть: сэмплированный логарифм отношения, неотрицательная выборочная форма типа и точный категориальный KL имеют разные дисперсию, смещение и градиентный контракт.
Клиппирование действует по-разному в зависимости от знака преимущества:
- при верхняя ветвь прекращает дальнейший рост суррогатного вклада после слишком большого увеличения отношения;
- при нижняя ветвь ограничивает суррогатный выигрыш от слишком сильного уменьшения вероятности;
- клип не проецирует саму политику в доверительную область, не заставляет каждое лежать внутри интервала и не задаёт строгую границу для KL.
Нотация публикаций и библиотек различается. DeepSeekMath использует токеновые отношения; отчёт DeepSeek-R1 показывает компактную последовательностную запись; современные библиотеки предлагают несколько уровней отношения и несколько редукций. Поэтому по слову GRPO нельзя восстановить фактический алгоритм. Нужны как минимум единица отношения, знаменатель редукции, число эпох по одному пакету, обработка усечения и KL-контракт.
Шаг 9.2.4 — Почему на первом шаге отношение вероятностей иногда равно единице
Если роллауты сгенерированы текущими весами и выполняется ровно один прямой и обратный проход до изменения политики, то численно
в точке вычисления, поэтому . Суррогатная цель всё равно даёт градиент через логарифмы вероятностей текущей политики, но клиппирование пока не активно.
Отношения становятся содержательными, когда один пакет используется несколько раз, обновление выполняется несколькими мини-пакетами или генератор отстаёт от обучающего процесса. Тогда данные постепенно становятся менее похожими на текущую политику.
Это позволяет точно классифицировать режим:
- свежие ответы и один шаг — данные почти совпадают с распределением текущей политики;
- несколько итераций по одному пакету — режим ограниченного повторного использования данных недавней политики;
- большой асинхронный лаг или долгий буфер — внеполитический (
off-policy) режим, требующий отдельного анализа.
num_iterations, возраст роллаута, версия весов генератора и распределение отношений должны логироваться. Фраза «используется GRPO» не сообщает ни одного из этих параметров.
Шаг 9.2.5 — Связь с REINFORCE, RLOO и PPO
Если убрать клип, KL и повторное использование пакета, а групповую среднюю применять как опорный уровень, обновление становится близким к REINFORCE с общей наградой ответа:
REINFORCE с исключением текущего ответа (REINFORCE Leave-One-Out, RLOO) использует для ответа среднее остальных наград:
Такой опорный уровень условно независим от текущего действия при независимой генерации ответов и не создаёт конечновыборочный коэффициент , возникающий у общего среднего. GRPO обычно сохраняет общее групповое среднее, добавляет нормировку, клип и, в некоторых версиях, KL.
PPO использует обучаемый критик и токеновые или шаговые оценки преимущества. GRPO заменяет критик сравнением ответов на один запрос. Это экономит память, но переносит требования на число роллаутов, качество проверки и разнообразие группы.
Короткая карта: RLVR говорит, откуда пришла награда; REINFORCE, RLOO, GRPO и PPO говорят, как оценён и применён градиент.
Урок 9.3. Нормировка и семейство вариантов
Урок 9.3. Нормировка и семейство вариантов
- Деление на стандартное отклонение меняет вес запросов
- Нормировка по длине определяет, кто получает градиент
- DAPO: четыре связанные, но независимые правки
- GSPO: отношение вероятностей на уровне ответа
- Название метода не заменяет полную спецификацию
далее — 6 проверочных шагов
Шаг 9.3.1 — Деление на стандартное отклонение меняет вес запросов
Нормировка
делает разброс оценок внутри каждой невырожденной группы примерно единичным. Это удобно для масштаба оптимизации, но одновременно меняет относительный вес запросов.
Пусть две группы имеют центрированные награды
и
Вторая содержит в десять раз меньшие различия. После деления на собственное стандартное отклонение обе группы дают одинаковые нормированные преимущества. Запрос с едва различимым частичным сигналом получает тот же масштаб, что запрос с большим разрывом наград.
Авторы работы Understanding R1-Zero-Like Training: A Critical Perspective называют это смещением по сложности вопроса и предлагают в Dr. GRPO использовать
без деления на групповое стандартное отклонение. В терминах анализируемой ими цели это убирает названный механизм перевзвешивания; слово «несмещённый» в названии и выводах работы следует читать именно относительно этой постановки, а не как универсальную гарантию отсутствия любого смещения.
Это не бесплатное исправление. Без нормировки масштаб обновления зависит от единиц награды и состава пакета. Если одна компонента лежит в , а другая — в , их нельзя складывать без явной калибровки.
Шаг 9.3.2 — Нормировка по длине определяет, кто получает градиент
В исходной GRPO каждый ответ сначала усредняется по своим токенам:
Поэтому суммарный вес ответа не зависит от длины, а вес одного токена обратно пропорционален . Длинный неудачный ответ получает слабое отрицательное давление на каждый отдельный токен; короткий успешный — сильное положительное.
Dr. GRPO заменяет индивидуальный знаменатель фиксированной константой , например максимальной длиной ответа:
DAPO нормирует по общему числу активных токенов пакета:
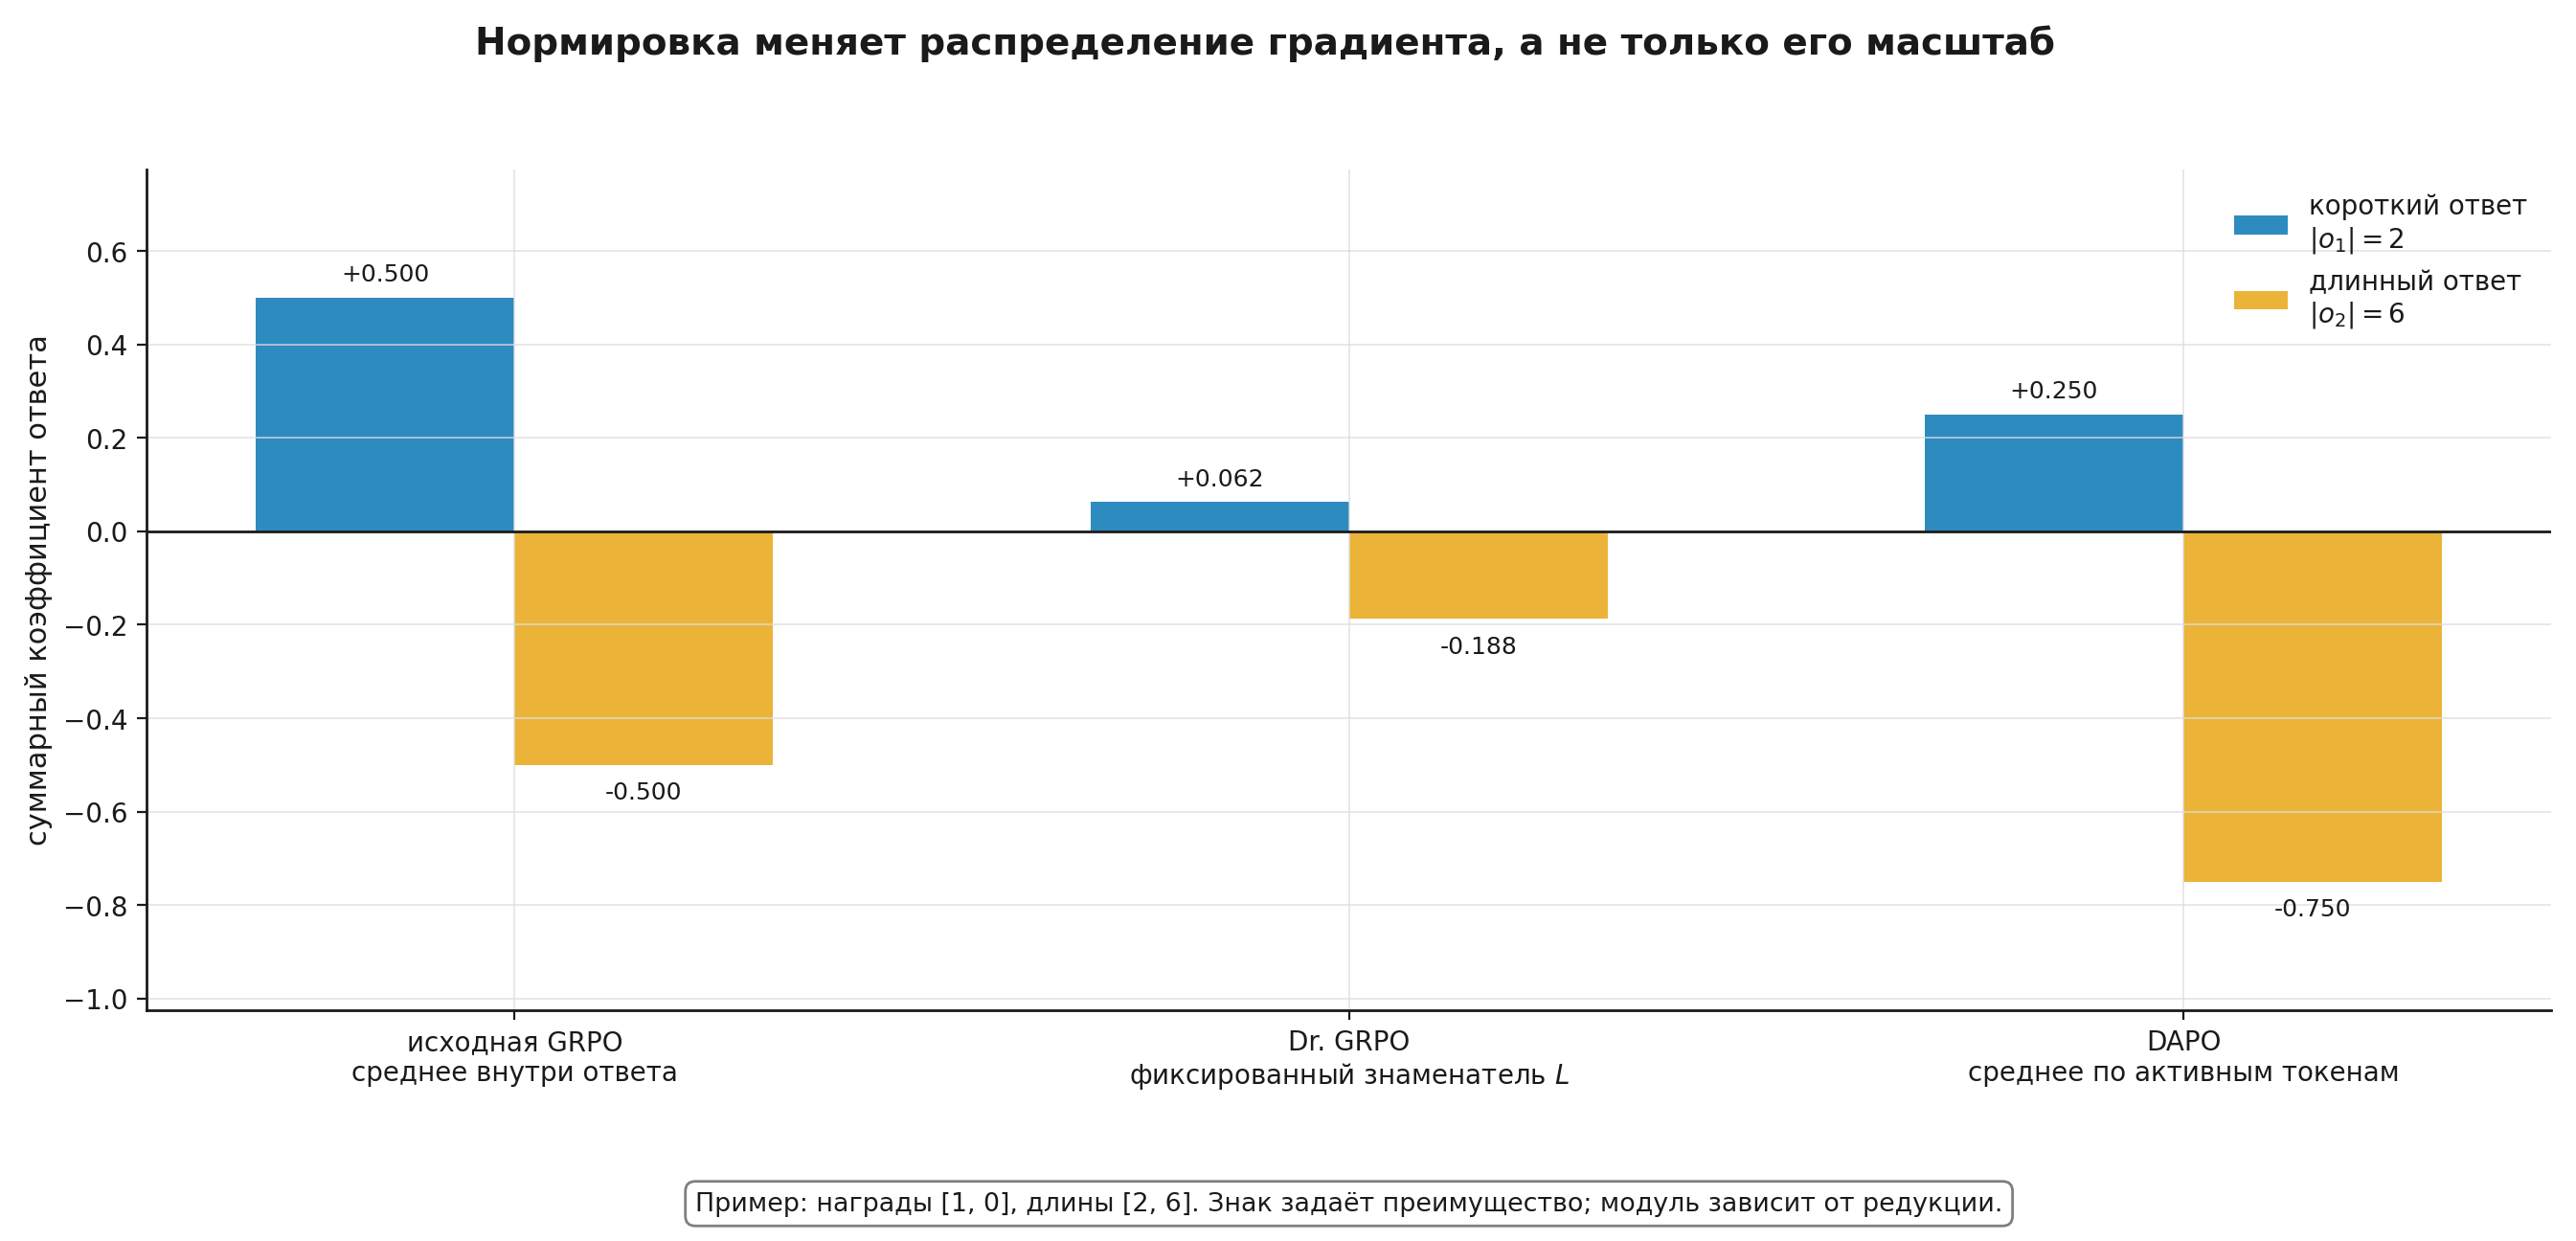
Обе схемы убирают индивидуальное деление на длину, но не тождественны. У Dr. GRPO знаменатель не зависит от случайных длин текущего пакета. У DAPO общий знаменатель меняется вместе с суммарным числом токенов. Разница может быть важна при сравнении разных распределённых конфигураций и накоплении градиента.
Ни одна схема сама по себе не доказывает, что длинные ответы полезны. Она лишь задаёт, как токены делят бюджет градиента.
Шаг 9.3.3 — DAPO: четыре связанные, но независимые правки
Оптимизация политики с раздельным клиппированием и динамическим отбором (Decoupled Clip and Dynamic sAmpling Policy Optimization, DAPO) объединяет четыре приёма.
- Clip-Higher. Нижняя и верхняя границы разделяются:
Авторы мотивируют это тем, что верхний клип может рано прекращать рост маловероятных, но полезных токенов. Это эмпирическая гипотеза и приём стабилизации, а не гарантия сохранения разнообразия.
-
Динамический добор. Полностью одинаковые по награде группы отбрасываются, а сбор продолжается до заданного числа информативных запросов. Цена измеряется дополнительными генерациями и изменением распределения задач.
-
Токеновая функция потерь. Токены всего пакета нормируются совместно, без предварительного усреднения каждого ответа.
-
Обработка слишком длинных ответов. В работе сначала проверяется маскирование усечённых ответов, затем вводится мягкий штраф
Поэтому DAPO нельзя свести к фразе «все усечённые ответы исключаются». Маскирование было отдельным исследованным вариантом; итоговый пакет включает плавное изменение награды у границы длины.
Шаг 9.3.4 — GSPO: нормированное отношение на уровне ответа
Групповая последовательностная оптимизация политики (Group Sequence Policy Optimization, GSPO) меняет единицу поправки. Вместо отдельного используется одно нормированное отношение для всего ответа:
Затем клиппируется последовательностный член:
Это геометрическое среднее токеновых отношений, а не ненормированное произведение вероятностей всей последовательности. Авторы GSPO аргументируют, что единица отношения и клипа должна совпадать с единицей награды — полным ответом. Они сообщают о более устойчивом обучении в исследованных длинных конфигурациях и моделях со смесью экспертов (mixture of experts, MoE). Это результат их экспериментов, а не доказательство универсального превосходства.
Длина входит в GSPO дважды по-разному: геометрическое среднее стабилизирует масштаб отношения, но градиент последовательностного члена всё равно распределяется по токеновым логарифмам вероятностей. Диапазоны клипа GSPO нельзя численно переносить из токеновой GRPO: сами отношения имеют другую шкалу.
Шаг 9.3.5 — Название метода не заменяет полную спецификацию
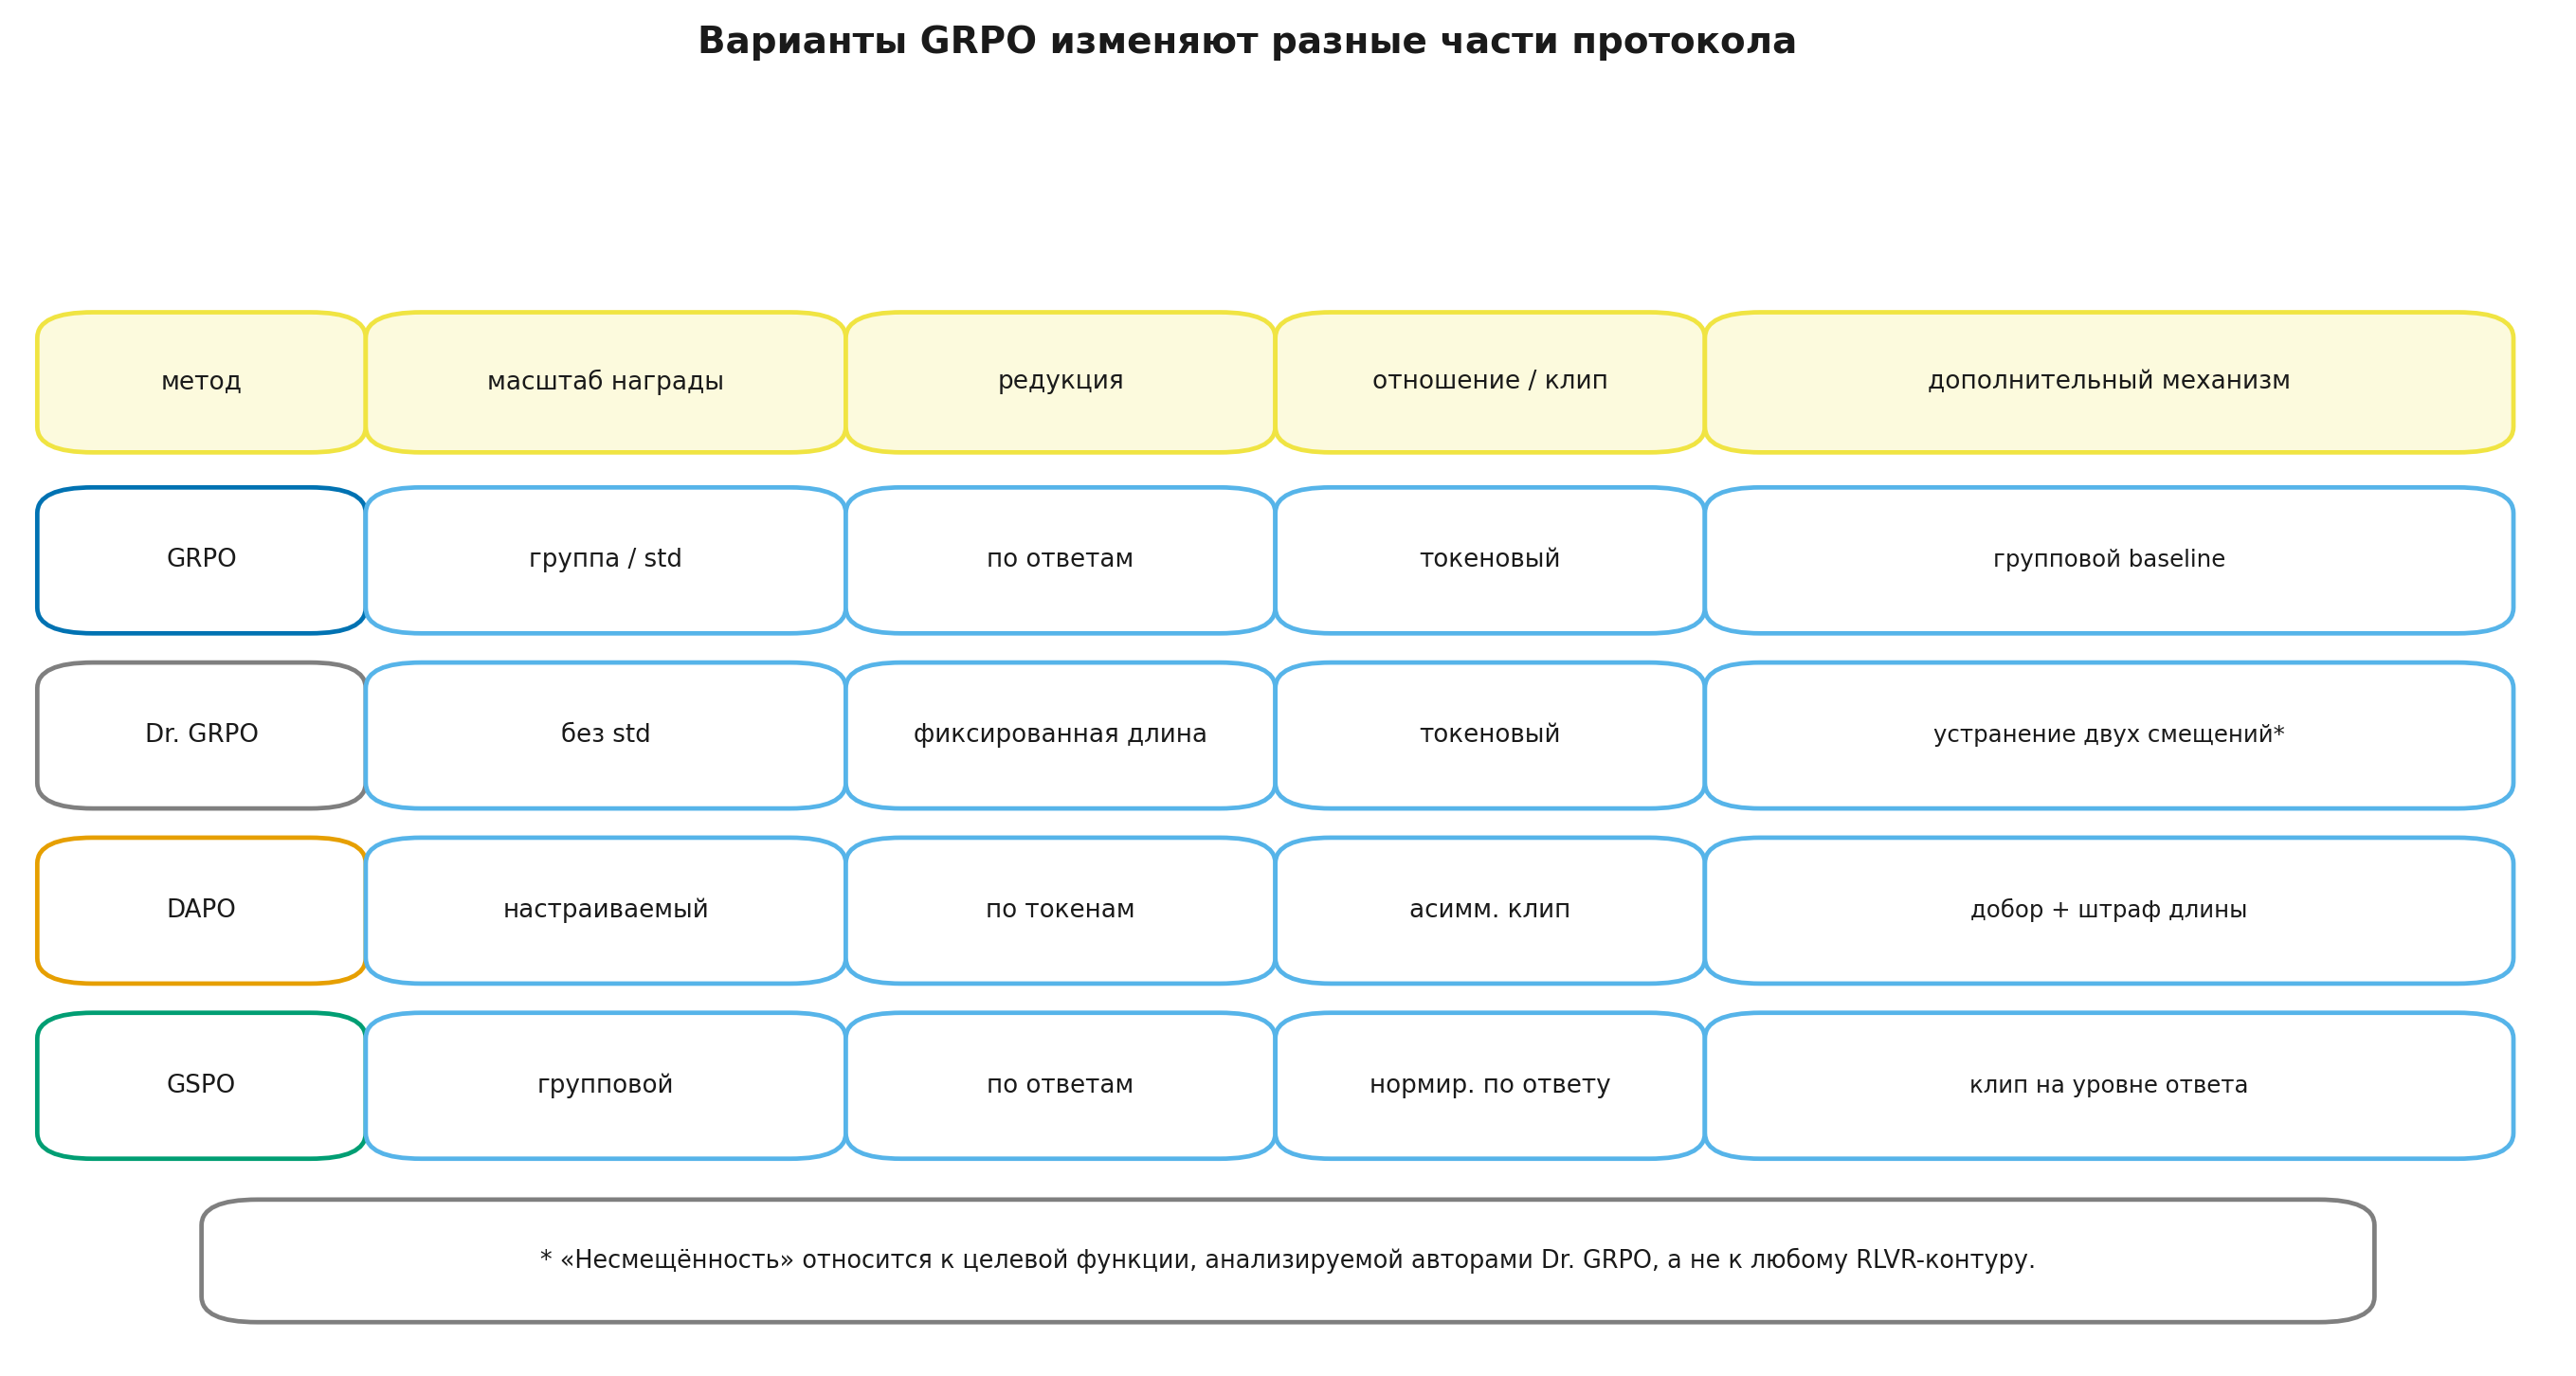
| Вариант | Масштаб награды | Нормировка токеновых членов | Уровень отношения | Дополнительные решения |
|---|---|---|---|---|
| Исходная GRPO | центрирование и деление на стандартное отклонение группы | сначала по длине ответа | токен | симметричный клип, возможен KL |
| Dr. GRPO | только центрирование | фиксированная константа | токен | убирает два механизма смещения, выделенные авторами |
| DAPO | обычно групповая нормировка | по активным токенам пакета | токен | Clip-Higher, динамический добор, штраф длины |
| GSPO | групповая относительная оценка | последовательностная цель | нормированное отношение ответа | геометрическое среднее отношений и клип ответа |
В реальном коде встречаются гибриды: токеновая нормировка DAPO без деления награды на стандартное отклонение, асимметричный клип вместе с Dr. GRPO или последовательностное отношение с другой редукцией. Такой запуск нельзя честно описать одним названием.
Минимальная запись алгоритмического протокола должна содержать:
- источник и версию политики поведения;
- число ответов на запрос;
- способ объединения компонент награды;
- центрирование и масштабирование наград;
- уровень отношения вероятностей;
- функцию клиппирования;
- нормировку по токенам, ответам и устройствам;
- число повторных итераций по роллаутам;
- KL-оцениватель и коэффициент;
- маски усечения и причины остановки.
Снимок программного интерфейса на 2026-08-05. В TRL 1.9.2 оси задаются независимо. Для GRPOConfig документация указывает, в частности:
loss_type="dapo"
scale_rewards="group"
importance_sampling_level="token"
beta=0.0
mask_truncated_completions=False
Доступны и другие режимы, включая loss_type="dr_grpo", пакетное масштабирование наград, последовательностный уровень отношения и явное маскирование усечённых ответов. Эти значения по умолчанию описывают конкретную версию библиотеки, а не математическое определение GRPO. При обновлении TRL паспорт запуска должен хранить реальные параметры, а не полагаться на память о прежних значениях по умолчанию.
Урок 9.4. Динамика обучения и диагностика
Урок 9.4. Динамика обучения и диагностика
- Энтропия: что именно измерять
- Потеря разнообразия и способы вмешательства
- Длина, EOS и техническое усечение
- Извлечение доступного поведения и появление новых стратегий
- Минимальный дашборд
далее — 5 проверочных шагов
Шаг 9.4.1 — Энтропия: что именно измерять
Для префикса токеновая энтропия политики равна
В журнале обычно агрегируют по активным токенам и ответам. Но одна средняя скрывает структуру: начало рассуждения, выбор операции, служебные теги и финальный ответ могут иметь разные режимы.
Нужно различать:
- энтропию базового softmax;
- энтропию фактической политики поведения после температуры и фильтров;
- разнообразие полных ответов;
- разнообразие семантических стратегий;
- pass@k на отложенных задачах.
Они связаны, но не тождественны. Высокая токеновая энтропия может расходоваться на пунктуацию, а низкая — соответствовать устойчивому, но правильному алгоритму.
Работа 2025 года об энтропийном механизме RL для reasoning-моделей сообщает для исследованных запусков быстрое уменьшение энтропии и непропорциональный вклад небольшой доли высокоэнтропийных токенов в обновление. Более поздняя работа 2026 года предлагает отдельный механизм управления потоком энтропии по данным текущей политики для предотвращения коллапса. Обе работы полезны как источник диагностических гипотез, но ни одна не задаёт универсальный порог «здоровой энтропии» для любой модели, награды и длины ответа; вывод 2026 года дополнительно следует считать предварительным результатом недавнего препринта.
Шаг 9.4.2 — Потеря разнообразия и способы вмешательства
Признаки опасного сужения распределения:
- энтропия падает без стабилизации;
- ответы внутри группы становятся почти одинаковыми;
- доля информативных групп уменьшается быстрее, чем объясняет рост точности;
- pass@1 растёт, а кривая pass@k перестаёт улучшаться;
- растут доли верхнего клипа и отношения с тяжёлыми хвостами;
- разные начальные значения генератора приводят к одному шаблону рассуждения.
Возможные вмешательства:
- увеличить разнообразие фактической политики поведения;
- расширить верхний клип для положительных преимуществ;
- добавить осторожную энтропийную регуляризацию;
- увеличить или разнообразие запросов;
- обновить полосу сложности;
- сократить число повторных эпох по одному пакету;
- остановить обучение до необратимого сужения;
- разделить компоненты награды, если одна из них доминирует.
У каждого вмешательства есть цена. Более высокая температура может снизить долю правильных ответов и увеличить расходы. Энтропийный бонус поощряет и полезную, и бессмысленную неопределённость. Больший повышает стоимость генерации. Clip-Higher ослабляет один ограничитель, но не исправляет неверную награду.
Шаг 9.4.3 — Длина, EOS и техническое усечение
Рост средней длины может означать разные процессы:
- модель использует дополнительные шаги для решения более трудных задач;
- функция потерь слабее наказывает токены длинных неудачных ответов;
- формат или награда поощряют повторение;
- вероятность токена конца последовательности (EOS) уменьшается;
- лимит генерации обрезает всё большую долю ответов.
Поэтому рядом с длиной нужны:
- точность или награда по диапазонам длины;
- доля естественно завершённых и усечённых ответов;
- позиция EOS;
- длина после удаления служебных тегов;
- число повторов и доля неразобранных ответов;
- стоимость генерации.
Усечённый ответ — не обязательно неверный: проверяющая система просто не увидела завершение. Но безусловно игнорировать все усечённые ответы тоже опасно — политика может научиться избегать отрицательного сигнала, никогда не заканчивая. Нужен явный контракт: маскирование, мягкий штраф, отдельная метка или увеличение бюджета длины.
Полезная цель — не «делать ответы длиннее» и не «делать их короче», а повышать качество при заданном бюджете и понятной причине остановки.
Шаг 9.4.4 — Извлечение доступного поведения и появление новых стратегий
После RL часто наблюдается большой рост pass@1. Это ещё не отвечает на вопрос, откуда взялось улучшение.
Одна гипотеза: политика перераспределила вероятность к удачным траекториям, которые базовая модель уже могла породить при большом числе попыток. Это извлечение практически доступного поведения. Другая: обучение сделало практически достижимыми стратегии, которые до него почти не появлялись. Это появление новых эффективных стратегий.
Слово «поддержка» нужно использовать осторожно. При обычном softmax почти каждый токен имеет ненулевую вероятность. Практически важна эффективная поддержка при фиксированном бюджете сэмплирования, температуре и ограничении длины.
Минимальный протокол сравнения:
- строить кривые pass@k базы и RL-модели при одинаковом декодировании;
- сравнивать не только ответы, но и кластеры стратегий;
- использовать свежие задачи и контролировать загрязнение;
- повторять оценивание на нескольких начальных значениях генератора;
- отделять рост доступности стратегии от передачи знаний через SFT или дистилляцию.
Одна работа 2025 года на исследованных ею моделях и задачах заключает, что существенная часть улучшения объясняется перевзвешиванием уже доступных траекторий. Это важный контрвес сильным заявлениям о «создании рассуждения», но не окончательный ответ для всех масштабов и доменов.
Полный разбор Best-of-N, самосогласования и поиска находится в Модуле 10 «Поиск, проверка и вычислительный бюджет на этапе генерации» (rl_llm.module_10_test_time_search).
Шаг 9.4.5 — Минимальный дашборд
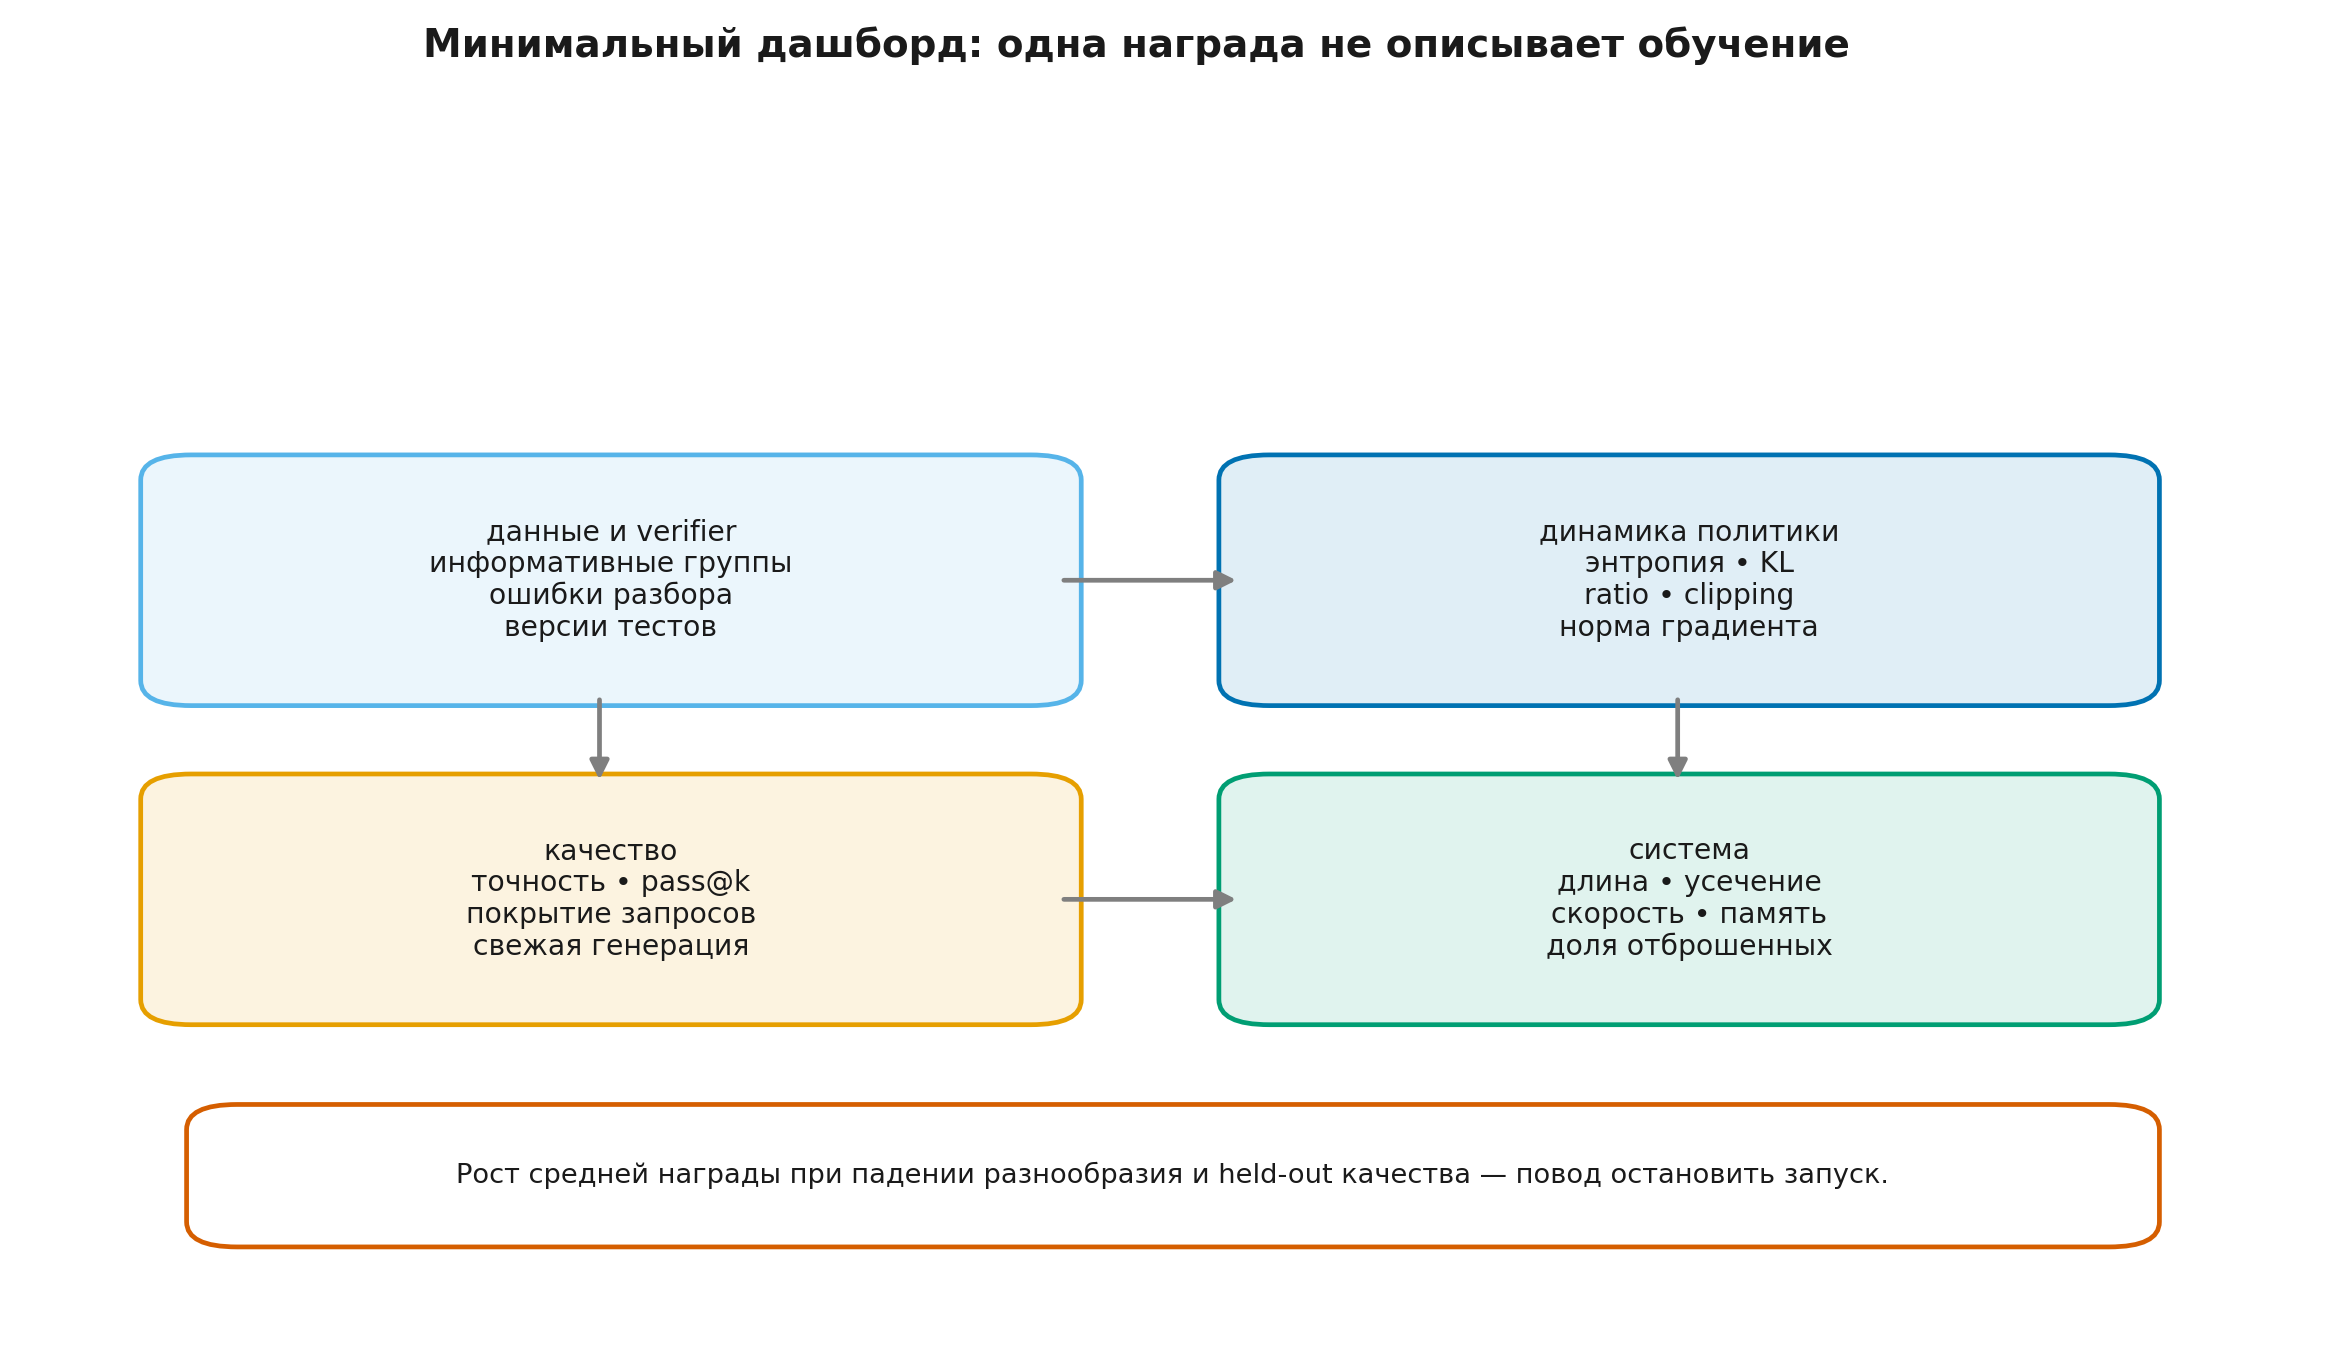
Минимальный дашборд группового RLVR должен содержать не одну среднюю награду, а несколько независимых осей.
Данные и проверка
- средняя каждая компонента награды;
- доли ошибок разбора, тайм-аутов и исключений;
- доля информативных групп;
- распределение наград по источникам и сложности.
Политика и оптимизация
- энтропия в среднем и по позициям;
- KL к выбранной базе, если он вычисляется;
- распределение токеновых или последовательностных отношений;
- доля клиппированных положительных и отрицательных членов отдельно;
- возраст роллаутов и число повторных итераций.
Ответы и качество
- pass@1 и несколько значений pass@k на отложенном наборе;
- средняя, медианная и хвостовая длина;
- доля EOS, усечений и неразобранных ответов;
- разнообразие строк и семантических стратегий;
- качество на контрольных задачах вне обучающего домена.
Система
- число сгенерированных токенов на эффективный запрос;
- время генерации и обучения;
- пиковая память;
- доля повторно использованных или слишком старых роллаутов.
Сигнал остановки задаётся до запуска: например, отсутствие улучшения независимого показателя при продолжающемся росте прокси-награды, резкое падение pass@k или рост ошибок проверяющей системы.
Урок 9.5. От формулы к воспроизводимому запуску
Урок 9.5. От формулы к воспроизводимому запуску
- Паспорт данных и проверяющей системы
- Паспорт роллаута и обновления
- Ресурсные профили и отсутствие универсального рецепта
- Практикум: синтетический контур и факультативный GRPO
- Итоги и границы модуля
далее — 8 проверочных шагов
Шаг 9.5.1 — Паспорт данных и проверяющей системы
До первого обновления весов нужно зафиксировать:
- происхождение запросов и правила разделения на обучающую и оценочную части;
- эталоны и их лицензии;
- версию проверяющей системы;
- доли ложноположительных и ложноотрицательных решений на ручной выборке;
- распределение исходной доли успешных ответов;
- формат ответа и шаблон диалога;
- причины остановки;
- ограничения длины и среды исполнения;
- политику обработки неоднозначных и повреждённых примеров.
Для программного кода дополнительно фиксируются образ контейнера, компилятор, зависимости, сеть, время, память и детерминизм тестов. Для формальной математики — версия ядра и набор разрешённых аксиом. Для числовых задач — канонизация и допуски.
Динамический добор не должен стирать следы исходного распределения. В журнале остаются как принятые, так и отброшенные запросы с причиной отбора.
Шаг 9.5.2 — Паспорт роллаута и обновления
Пакет роллаутов должен позволять восстановить функцию потерь без повторной генерации. Минимальные поля:
- идентификатор запроса и его токены;
- токены ответа и маска активных действий;
- логарифмы вероятностей фактической старой политики;
- версия весов генератора;
- параметры декодирования и случайное начальное значение;
- награды по компонентам;
- результат разбора и причина остановки;
- длина до и после усечения;
- при необходимости логарифмы вероятностей базы;
- идентификатор группы и число ответов на запрос.
Паспорт обновления добавляет:
- способ центрирования и масштабирования награды;
loss_typeи точный знаменатель;- уровень отношения вероятностей;
- границы клипа;
- число итераций по пакету;
- коэффициенты KL и энтропии;
- глобальный размер пакета и схему накопления градиента.
Версии генератора и обучающей модели могут расходиться даже при одинаковом идентификаторе контрольной точки из-за разных библиотек, точности, процессоров логитов и шаблонов. Это рассогласование измеряется, а не предполагается нулевым.
Шаг 9.5.3 — Ресурсные профили и отсутствие универсального рецепта
Уровень A: CPU. Эталонные NumPy-функции, тесты проверяющей системы, синтетические группы, сравнение нормировок, клиппирования и последовательностных отношений. Этот маршрут обязателен для понимания механики и не требует модели.
Уровень B: бесплатный Colab T4. Модель класса 0,6 млрд параметров, LoRA, короткие ответы, небольшое число генераций и явный проверочный режим. Главная цель — увидеть полный путь данных, а не воспроизвести результат крупного отчёта.
Уровень C: факультативный полный запуск. Более крупная модель, длинные ответы, отдельный движок генерации, несколько GPU и воспроизводимая инфраструктура. Бюджет определяется длиной роллаутов, числом ответов, повторным использованием и стоимостью проверки.
Нельзя переносить числа , , , температуру и скорость обучения как «рецепт R1». Они связаны с моделью, наградой, длиной, размером пакета, оптимизатором и выбранной нормировкой. Даже изменение знаменателя функции потерь меняет эффективный масштаб градиента.
Шаг 9.5.4 — Практикум: авторегрессионный CPU-контур и факультативная реальная модель
Практика разделена по языкам:
Основная ветвь выполняется на CPU и использует небольшую, но полноценную авторегрессионную модель: слой векторных представлений, GRU и языковую голову. Ответы порождаются токен за токеном из ограниченной грамматики, а проверяющая система отдельно возвращает правильность, согласованность промежуточного вычисления, статус формата и итоговую награду. Для каждого запроса собирается группа ответов старой политики; затем текущая политика обучается по клиппированной групповой цели. Базовая политика хранится отдельно и используется для KL-диагностики при подаче эталонной последовательности.
Контур намеренно реалистичен по контрактам, но мал по масштабу. Он показывает:
- фактическую политику поведения после маски допустимых токенов;
- воспроизводимость сохранённых логарифмов вероятностей замороженной старой политикой;
- групповые преимущества и нулевой сигнал вырожденной группы;
- несколько эпох обновления по одному пакету;
- энтропию, клиппирование, длину, KL и долю информативных групп;
- проверку на свежей генерации, а не только уменьшение обучающей функции потерь;
- перенос на удержанные арифметические запросы и покрытие отдельных запросов.
В зафиксированном проверочном профиле курса получены следующие значения:
| Показатель | До RL, обучение | После RL, обучение | До RL, удержанные | После RL, удержанные |
|---|---|---|---|---|
| точность | 0,313 | 0,408 | 0,033 | 0,000 |
| средняя награда | 0,341 | 0,448 | 0,037 | 0,000 |
| средняя длина | 7,03 | 8,38 | 6,92 | 9,24 |
| токеновая энтропия | 0,292 | 0,148 | 0,382 | 0,285 |
| KL к базе при подаче эталонной последовательности | 0,000 | 0,219 | 0,000 | 0,195 |
| pass@4 | 0,583 | 0,450 | 0,111 | 0,000 |
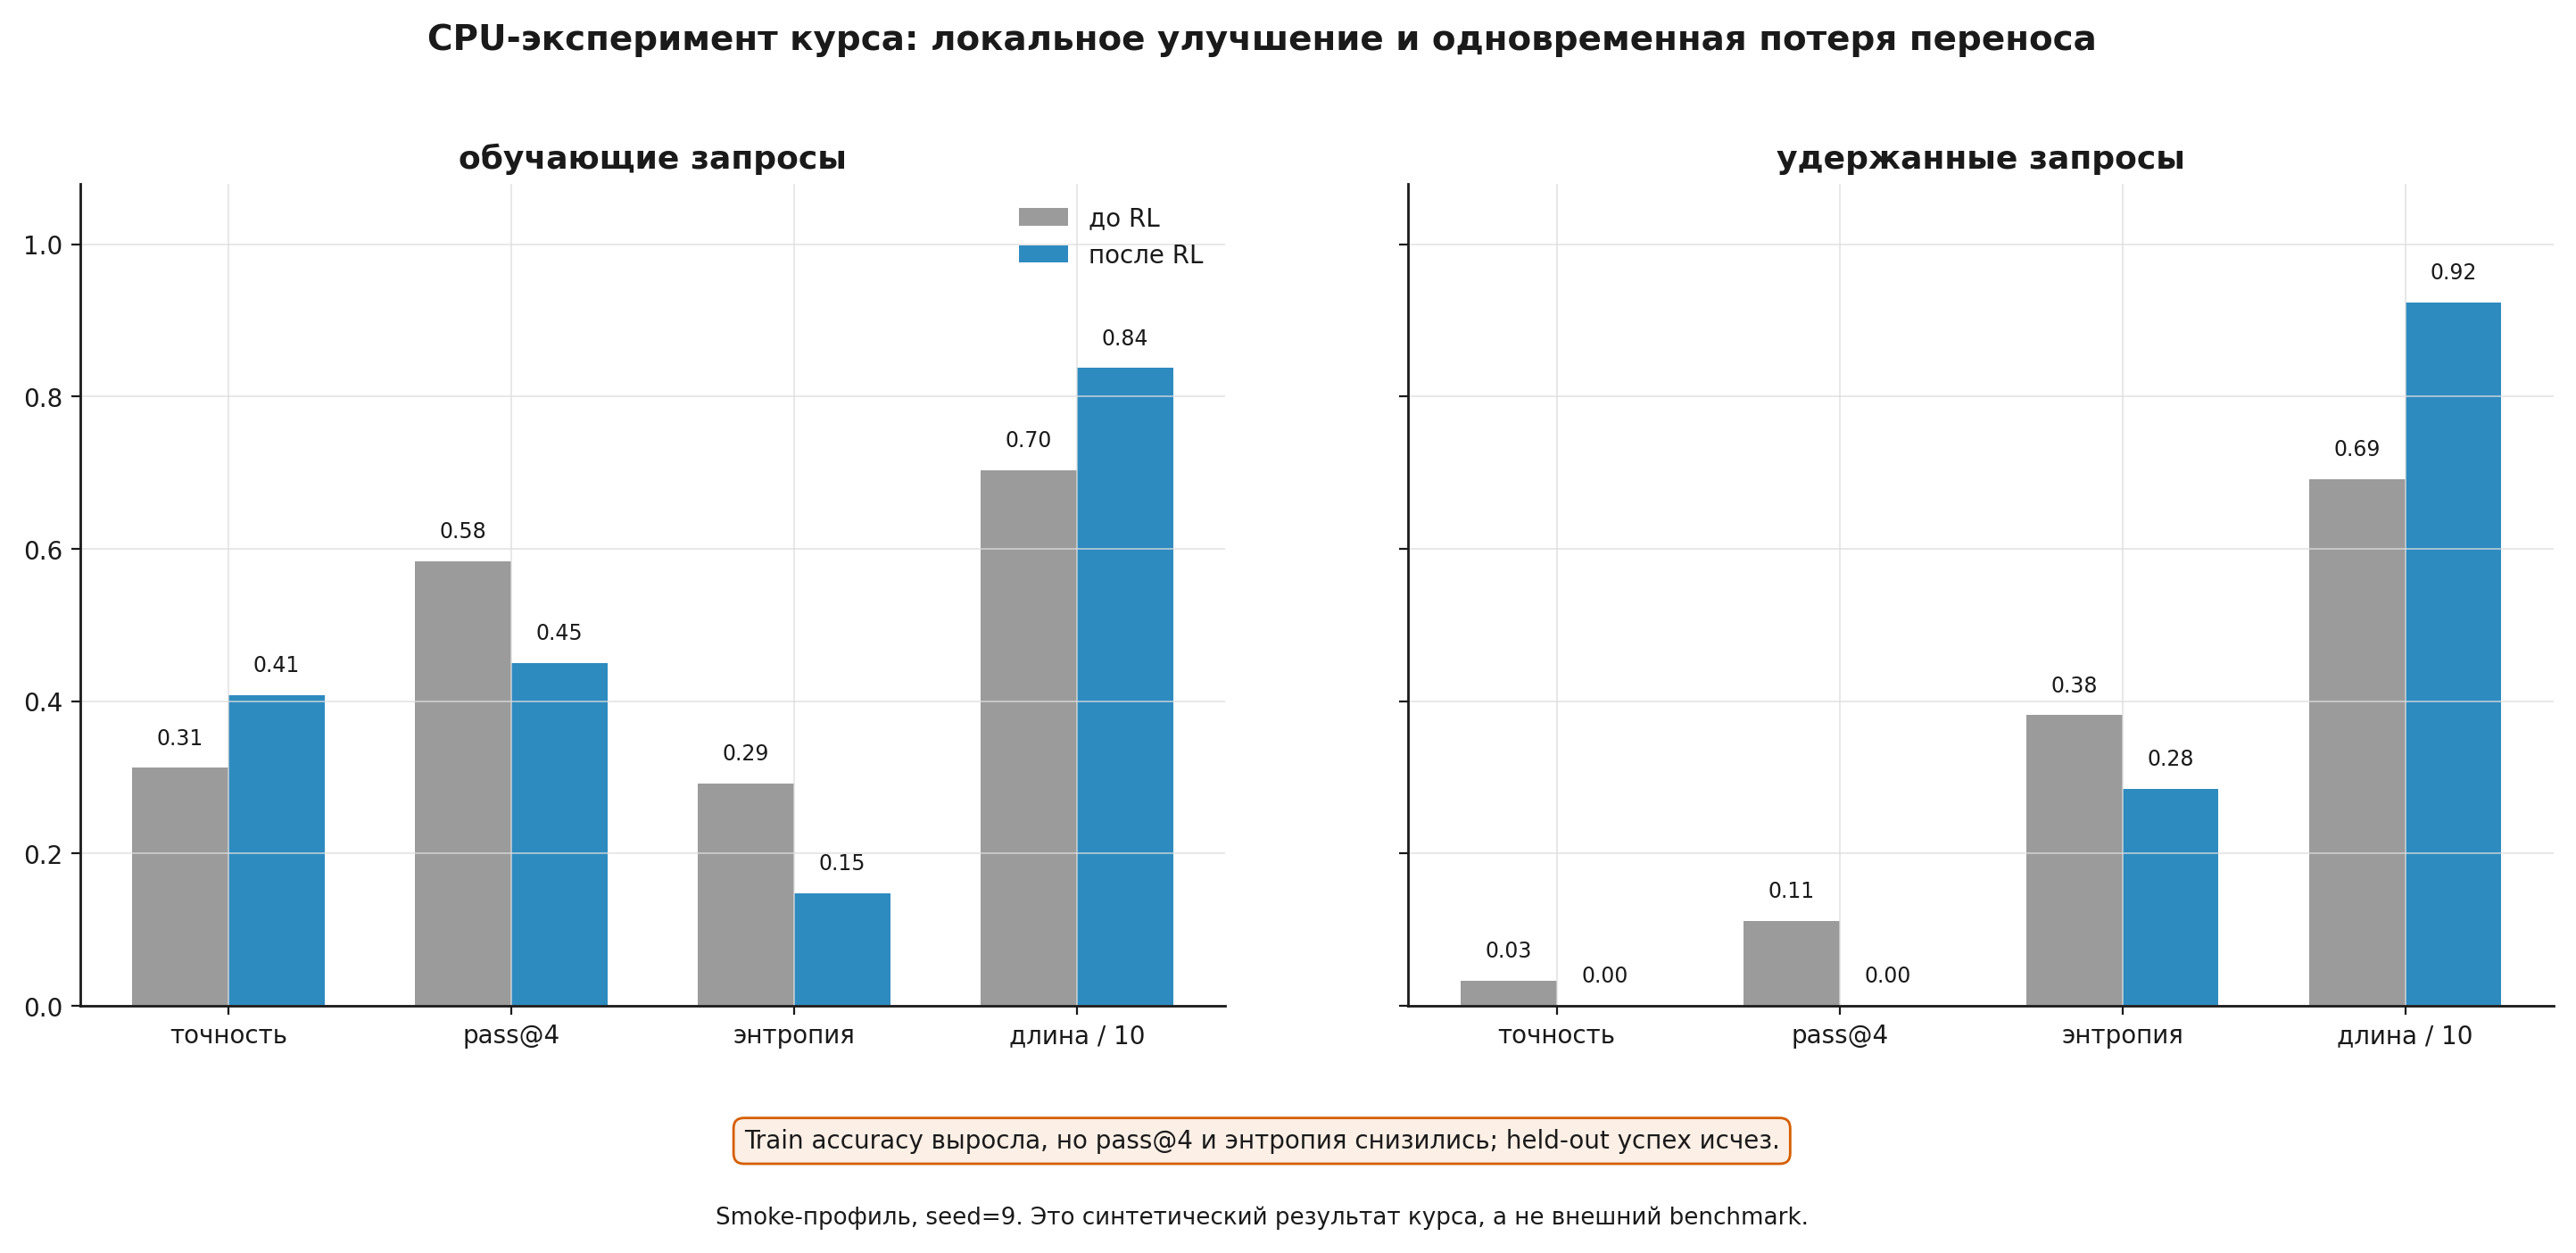
Это собственный синтетический результат курса, а не внешний бенчмарк. Средняя обучающая точность выросла, но энтропия и pass@4 уменьшились, успехи сосредоточились на меньшем числе обучающих запросов, а перенос на удержанные комбинации исчез. Именно поэтому одна средняя награда не является достаточным свидетельством хорошего обучения. Небольшой пример не доказывает неизбежность коллапса GRPO; он воспроизводимо показывает диагностическую возможность, которую полноценная система обязана обнаруживать.
Факультативная ветвь с реальной моделью выключена по умолчанию:
RUN_REAL_MODEL = False
SMOKE_MODE = True
Её конфигурационный каркас рассчитан на Qwen/Qwen3-0.6B, LoRA и интерфейс GRPOTrainer. На дату снимка в нём зафиксированы TRL 1.9.2, Transformers 5.14.1, Datasets 5.0.1, PEFT 0.20.0, Accelerate 1.14.0 и bitsandbytes 0.50.0. Эта ветвь не выполнялась в выпускном контуре: для неё не заявляются время, расход памяти или качество. Перед запуском в Colab нужно проверить совместимость текущего образа CUDA, модели, библиотек и параметров GRPOConfig.
Шаг 9.5.5 — Итоги и границы модуля
Основные выводы:
- RLVR — режим обратной связи, а GRPO — семейство обновлений политики; одно не определяет другое.
- Проверяемая награда остаётся прокси-целью. Парсер, канонизация, тесты и среда исполнения входят в контракт обучения.
- Каноническая GRPO заменяет обучаемый критик групповым опорным уровнем, но не решает распределение заслуги внутри ответа.
- Старая, текущая и базовая политики выполняют разные роли. Знаменатель отношения должен соответствовать фактической политике поведения.
- Деление на групповое стандартное отклонение и индивидуальную длину ответа не нейтрально: оно распределяет вес между запросами и токенами.
- Dr. GRPO, DAPO и GSPO меняют разные части протокола; сравнивать их можно только после записи полной функции потерь и редукции.
- Энтропия, разнообразие ответов, pass@k и доля информативных групп — разные диагностические величины.
- Рост длины не доказывает улучшение рассуждения, а усечение не тождественно неправильному ответу.
- Спор об извлечении и появлении стратегий требует одинакового бюджета сэмплирования и анализа самих траекторий.
- Проверочный запуск доказывает работоспособность контура, но не воспроизводит крупномасштабный результат статьи.
Продолжение внутри курса:
- Модуль 10 «Поиск, проверка и вычислительный бюджет на этапе генерации» (
rl_llm.module_10_test_time_search) разбирает Best-of-N, самосогласование и поиск; - Модуль 12 «Инфраструктура RL для LLM: память, роллауты и асинхронность» (
rl_llm.module_12_infrastructure) рассматривает разнесённую генерацию, версии политик и стоимость роллаутов; - Модуль 13 «Оценивание RL-систем для LLM: статистика, взлом награды и безопасность» (
rl_llm.module_13_evaluation) строит статистический и безопасностный контур оценки.
Расширение в соседних курсах:
- Modern LLMs, Модуль 14 «Обучение по обратной связи: RLHF, DPO, RLOO и GRPO» (
modern_llms.module_12_preference_optimization) даёт общий посттренировочный контекст; - Modern LLMs, Модуль 15 «Модели рассуждения и вычисления во время инференса (test-time compute)» (
modern_llms.module_13_reasoning) связывает RLVR с архитектурами reasoning-моделей и тестовым бюджетом; - Information Theory for ML, Модуль 2 «Энтропия» (
it_ml.module_02_entropy) формализует энтропию; - Information Theory for ML, Модуль 3 «Кросс-энтропия и KL-дивергенция» (
it_ml.module_03_cross_entropy_kl) разбирает KL как дивергенцию распределений; - Information Theory for ML, Модуль 8 «Максимальная энтропия, экспоненциальные модели и KL-регуляризация» (
it_ml.module_08_maxent_kl_policy) показывает вариационную роль KL-регуляризации.
Эти ссылки углубляют отдельные темы, но Модуль 9 остаётся самодостаточным: все определения и формулы, необходимые для его заданий и практики, введены здесь.
Источники и маршрут чтения
- DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models — исходное введение GRPO и токеновой клиппированной цели.
- DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning — описание R1-Zero, rule-based reward и многостадийного финального конвейера.
- Understanding R1-Zero-Like Training: A Critical Perspective — анализ нормировок, длины и сложности вопроса, лежащий в основе Dr. GRPO.
- DAPO: An Open-Source LLM Reinforcement Learning System at Scale — Clip-Higher, динамический добор, токеновая редукция и штраф слишком длинных ответов.
- Group Sequence Policy Optimization — последовательностная единица отношения и клиппирования.
- The Entropy Mechanism of Reinforcement Learning for Reasoning Language Models — эмпирический и механистический анализ энтропии в исследованных RL-запусках.
- Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model? — одна из работ об извлечении практически доступных траекторий; её выводы не следует переносить на все модели и режимы.
- TRL GRPOTrainer documentation — текущий инженерный интерфейс; это документация реализации, а не первичный источник математических гарантий.
Полный реестр утверждений, включая точный эпистемический статус собственных экспериментов курса, находится в Module_9_Sources.md.