Модуль 5. Обучение по фиксированным данным: имитация, глубокие Q-методы и офлайн-RL
Версия материала: 2026.10
Фактический снимок: 2026-08-05
Язык: RU
Основная практика: NumPy для локальных вычислений и отдельный русскоязычный PyTorch-ноутбук с собственной средой KeyDoorGrid, BC, DAgger, DQN, Double DQN, BCQ-подобным ограничением, CQL, IQL, FQE, Decision Transformer и токеновым ILQL-подобным контуром
Структура: 5 уроков, 25 шагов
Ориентировочное время: 9–13 часов вместе с основным ноутбуком; полный профиль экспериментов необязателен
В Модуле 4 политика улучшалась по траекториям, которые сама же и собирала. Теперь запретим новые взаимодействия на время обучения. У нас останутся демонстрации, журналы переходов, награды или пары предпочтений — и придётся понять, что из них действительно можно восстановить.
Это важный поворот. Фиксированный набор данных делает обучение дешевле и безопаснее, но одновременно лишает алгоритм возможности проверить собственные догадки. Если в журнале нет некоторого действия, его последствия неизвестны не потому, что нейросеть «недостаточно умна», а потому, что данных для ответа может не существовать в принципе.
Предварительный курс по классическому RL не требуется. Мы начнём с имитационного обучения и точной связи между поведенческим копированием и обучением с учителем на демонстрациях (supervised fine-tuning, SFT), затем разберём глубокую Q-сеть, сформулируем основную проблему офлайн-RL, сравним несколько семейств методов и завершим разбором Decision Transformer и картой данных для дообучения LLM.
Цели модуля. После прохождения вы сможете:
- записать поведенческое копирование как максимум правдоподобия и объяснить, при каких условиях токеновый SFT является его частным случаем;
- различать распределение состояний эксперта и распределение, которое порождает обученная политика;
- вывести точную потерю на простом «канате» и объяснить квадратичное по горизонту накопление ошибки в худшем случае;
- описать алгоритм агрегации данных (
Dataset Aggregation, DAgger) и не смешивать разметку действий экспертом с предпочтениями или скалярной наградой; - собрать целевое значение глубокой Q-сети (
deep Q-network, DQN) и объяснить разные роли буфера опыта и целевой сети; - вычислить цель Double DQN и показать источник смещения максимизации;
- отличать офлайн-RL от обычного обучения на данных другой политики и от поведенческого копирования;
- сформулировать проблему покрытия данных и доказать простую невозможность оценить ненаблюдавшееся действие без дополнительных предположений;
- объяснить четыре разных механизма защиты офлайн-RL — ограничение действий, поведенческий якорь, консервативную Q-функцию и обучение ценности по действиям набора — без обещания универсального превосходства одного метода;
- описать Decision Transformer как условную модель последовательности и корректно обновлять желаемую оставшуюся награду;
- развести SFT, классический офлайн-RL, прямую оптимизацию предпочтений, языковое Q-обучение и онлайн-оптимизацию политики в LLM.
Оцениваемая практика содержит постановку и подробное решение каждого задания рядом, в раскрываемом блоке ``. Русский и английский исполняемые маршруты используют общее вычислительное ядро и самостоятельные пояснения. Реестр проверенных утверждений и первичных источников находится в Module_5_Sources.md.
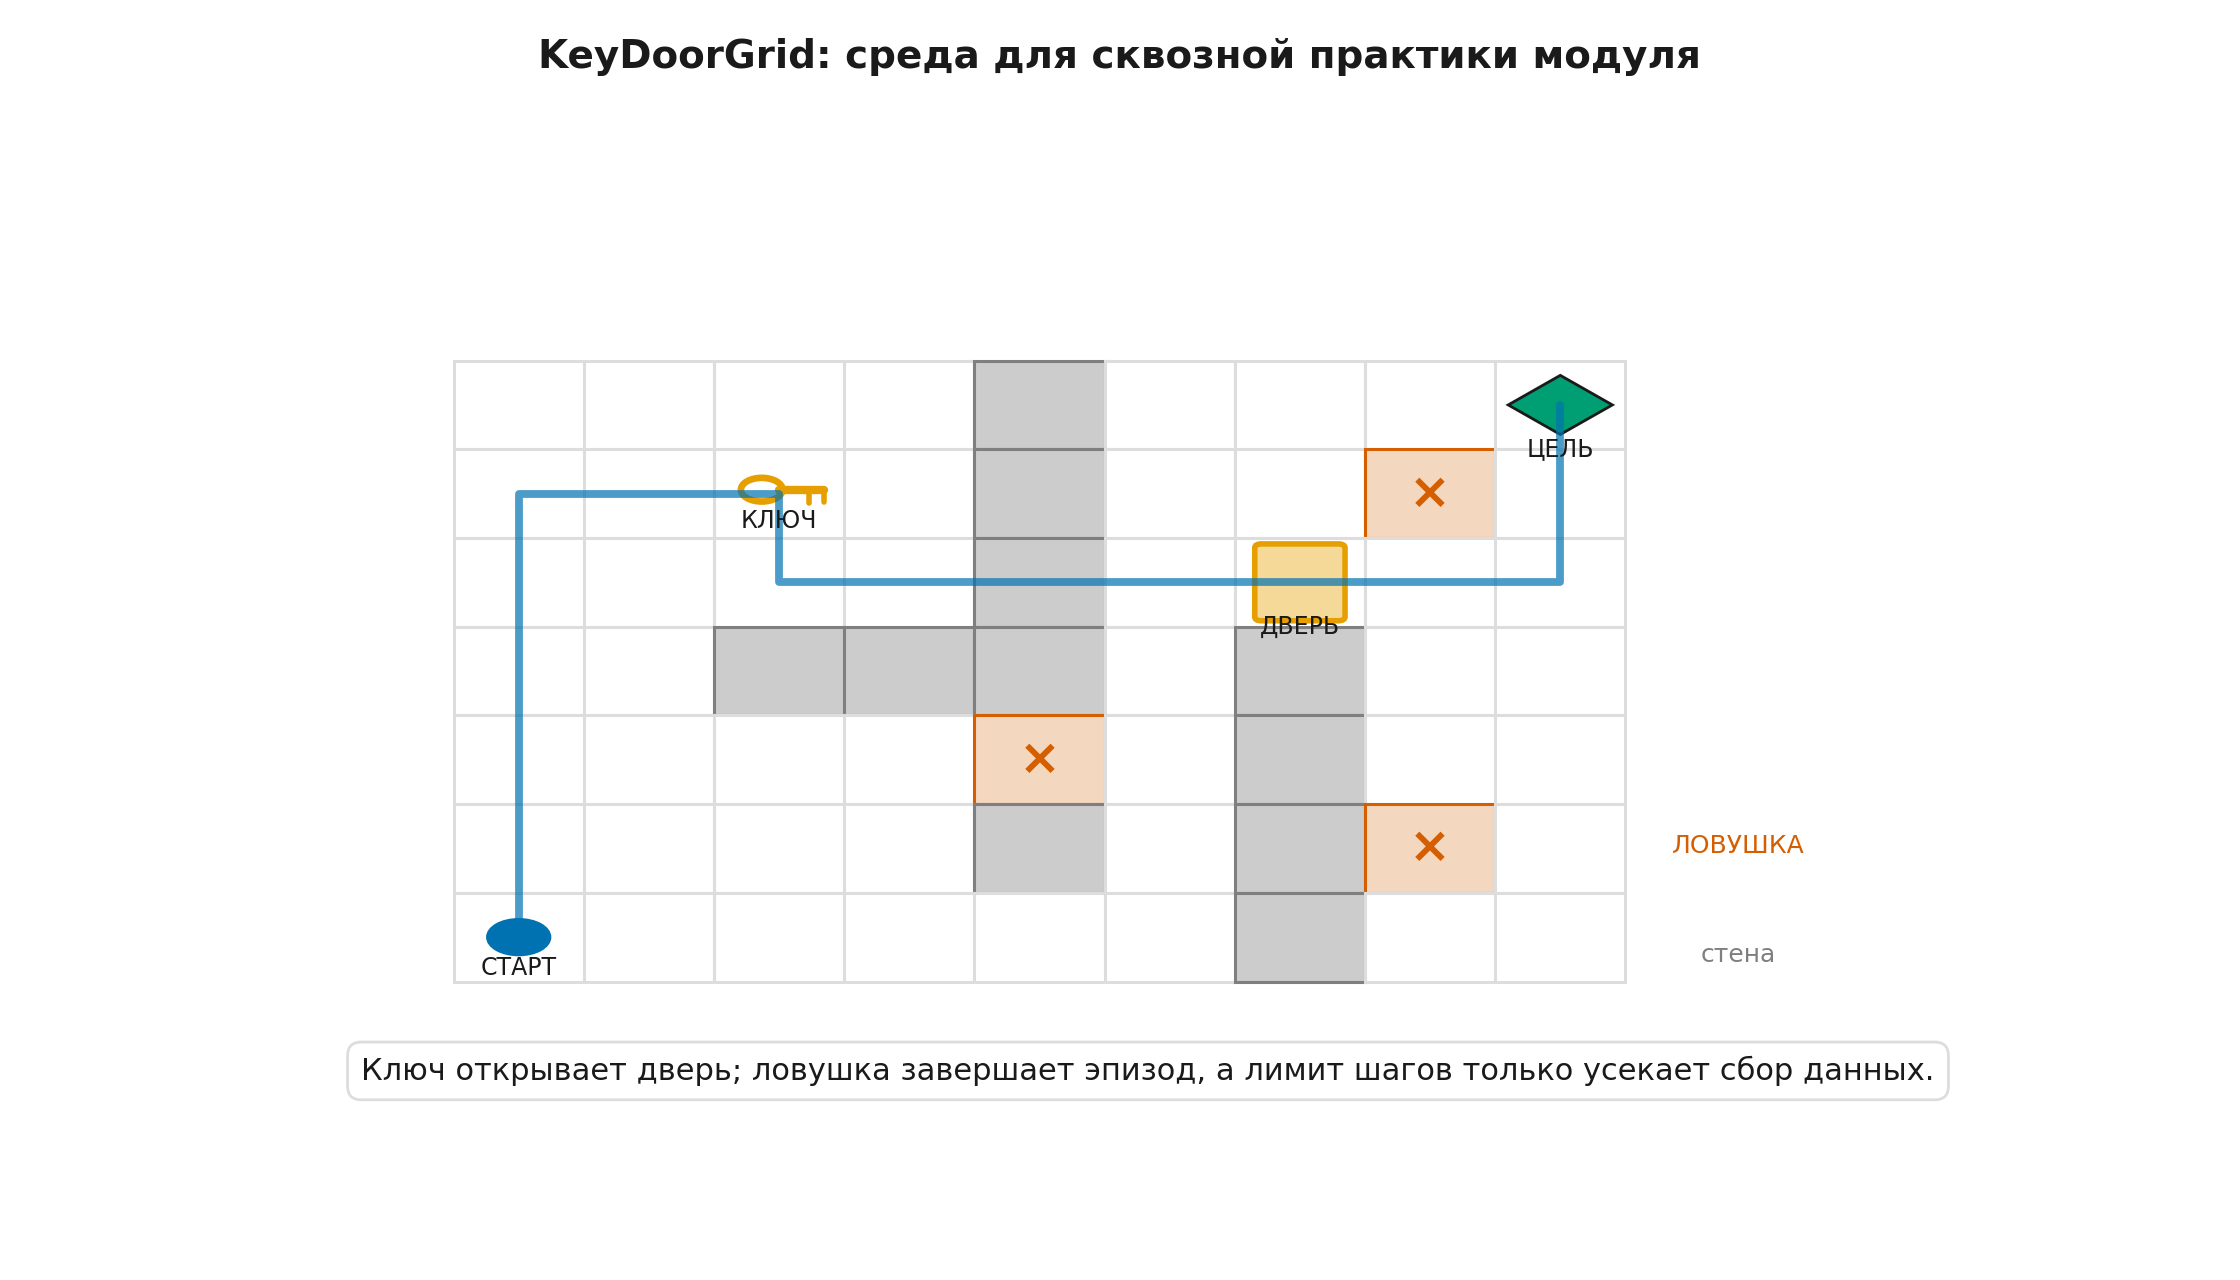
Сквозная практика использует одну и ту же небольшую среду KeyDoorGrid. Агент стартует в разных клетках, должен подобрать ключ, пройти через запертую дверь и добраться до цели, не попав в ловушки. Ловушка является настоящим терминалом; внешний лимит шагов лишь усекает сбор данных. Благодаря этому одна среда связывает демонстрации, DAgger, DQN, офлайн-журнал, оценивание политики и условную модель траектории, не подменяя различия между методами.
Практический маршрут. После лекции идут оцениваемые задания, решения, открывающиеся после попытки, и исполняемая практика. Само объяснение остаётся самодостаточным.
Урок 5.1. Имитационное обучение и SFT
Урок 5.1. Имитационное обучение и SFT
- Демонстрации вместо награды
- Префикс из данных на обучении и собственный префикс при генерации
- Канат: точный расчёт накопления ошибки
- DAgger: разметить состояния, которые посещает ученик
- Что BC объясняет в дообучении LLM, а чего не объясняет
далее — 6 проверочных шагов
Шаг 5.1.1 — Демонстрации вместо награды
Начнём с самого простого вида фиксированных данных: эксперт показал, что делать, но не сообщил функцию награды. Набор демонстраций состоит из пар
где — состояние, которое встретил эксперт, а — выбранное им действие.
Поведенческое копирование (behavioral cloning, BC) обучает параметризованную политику предсказывать экспертное действие:
Это обычный максимум правдоподобия. Для дискретных действий он эквивалентен минимизации перекрёстной энтропии. Награды, функции ценности и уравнения Беллмана в целевой функции отсутствуют.
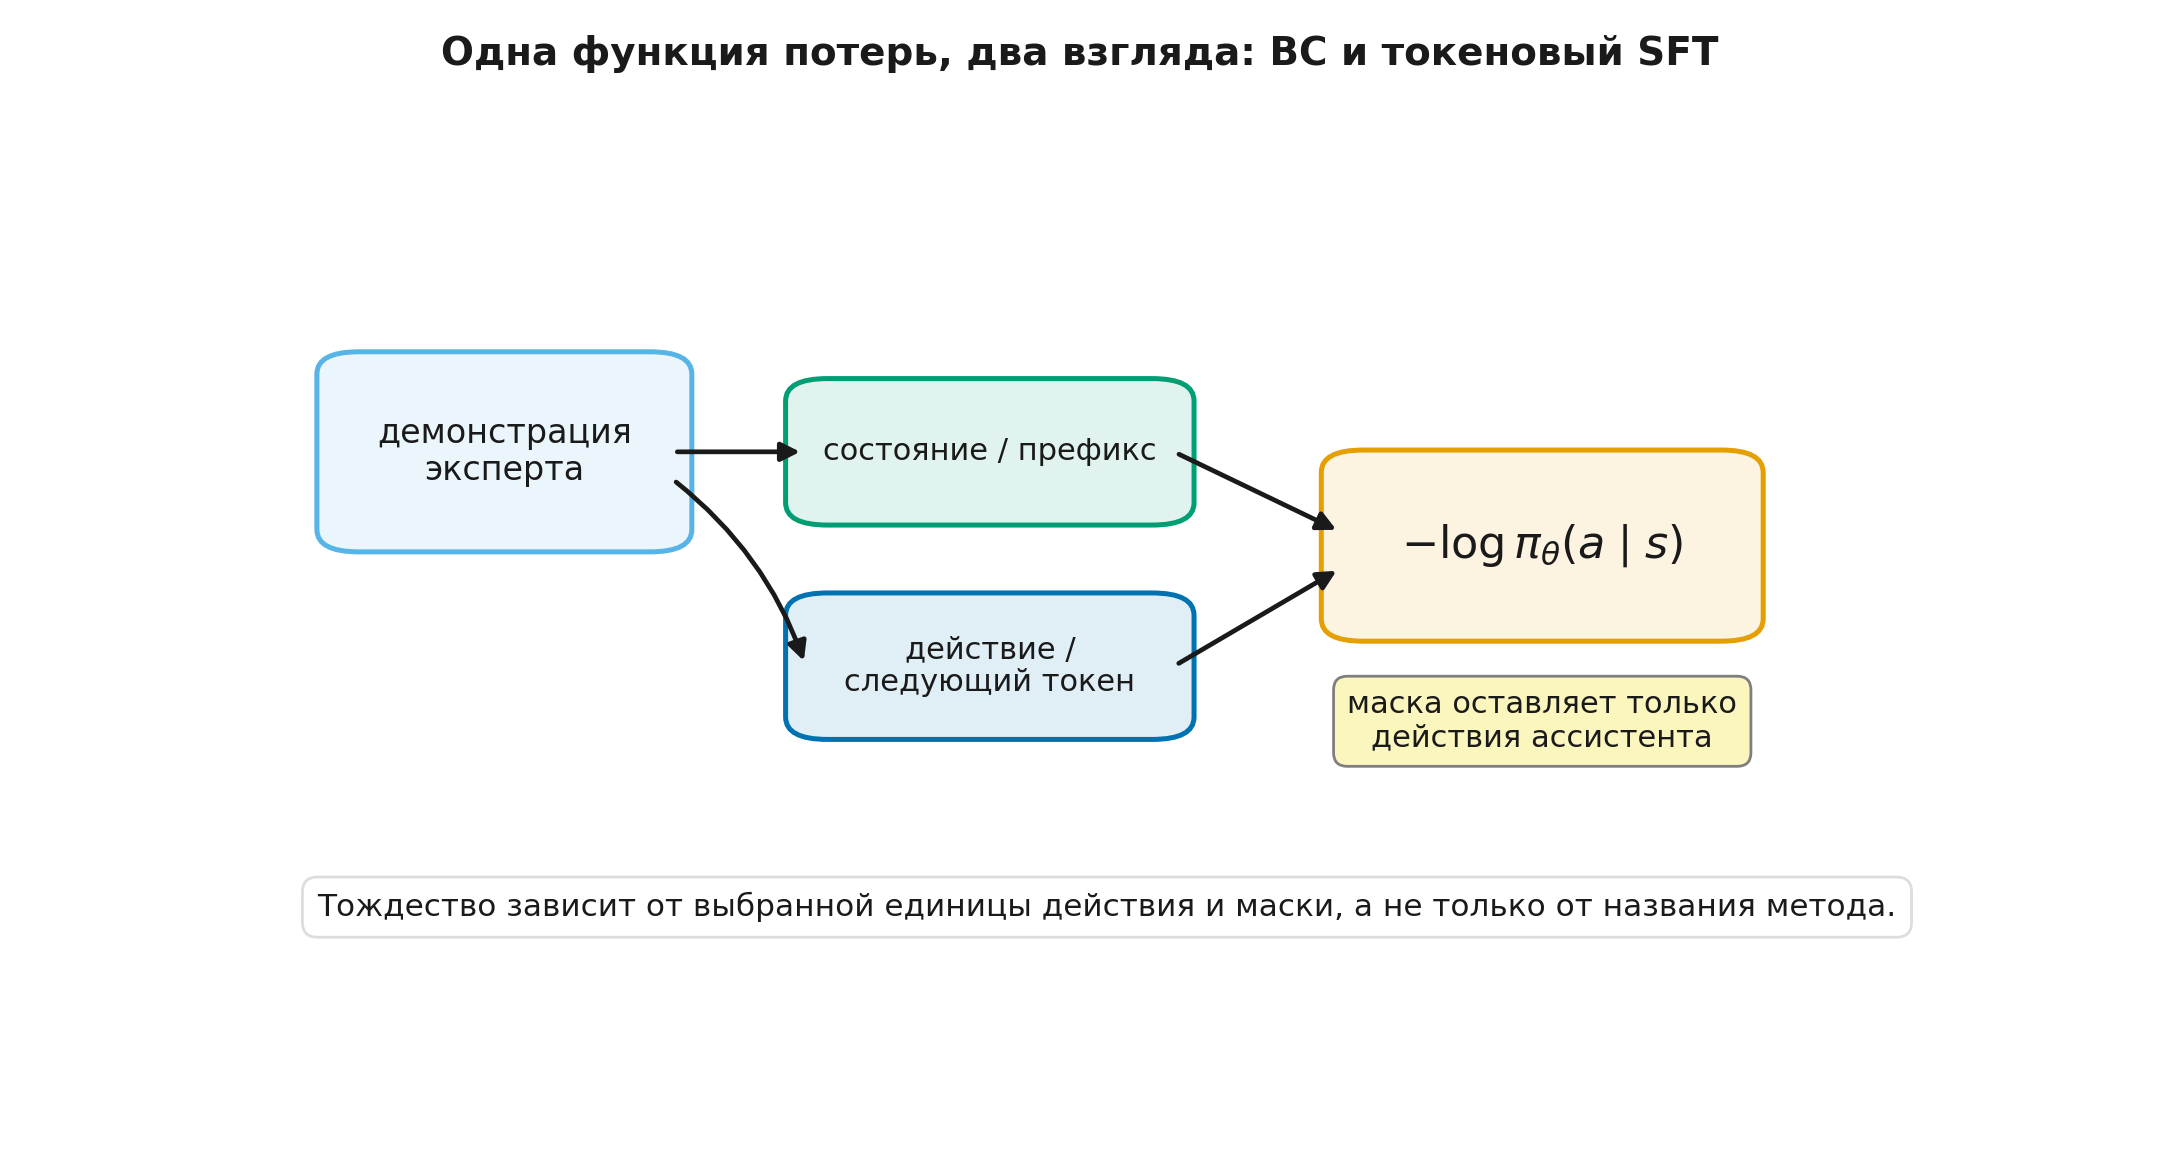
Теперь перенесём запись на LLM. Пусть демонстрация состоит из запроса , ответа и маски , которая равна единице только на токенах, включённых в функцию потерь. Тогда
При токеновой абстракции состояния и действия это и есть BC на экспертных префиксах. Слово «при» здесь существенно. Равенство относится к выбранной единице действия, способу построения префикса и маске. Например, если в функцию потерь включены служебные токены, сообщения пользователя или результаты инструментов, мы всё ещё решаем задачу максимума правдоподобия, но уже копируем более широкий процесс формирования последовательности.
Подготовка демонстраций, упаковка последовательностей, маскирование и полный SFT-конвейер подробно разбираются в Modern LLMs, Модуле 13 «SFT и работа с данными» (modern_llms.module_11_sft). Токенизация, специальные токены и границы между сообщениями даны в Modern LLMs, Модуле 2 «Токенизация и эмбеддинги» (modern_llms.module_02_tokenization). Для текущего модуля эти ссылки необязательны: здесь нужен один алгоритмический факт — обучение видит действия демонстратора в состояниях, созданных демонстратором.
Связь отрицательного логарифмического правдоподобия с перекрёстной энтропией и KL-дивергенцией можно углубить в Information Theory for ML, Модуле 3 «Кросс-энтропия и KL-дивергенция» (it_ml.module_03_cross_entropy_kl).
Шаг 5.1.2 — Префикс из данных на обучении и собственный префикс при генерации
Во время обучения токеновая модель получает правильный предыдущий префикс из набора данных. Этот режим называют обучением на истинном префиксе (teacher forcing). Во время генерации следующий вход уже содержит токены самой модели.
Обозначим через распределение состояний на шаге при политике эксперта, а через — распределение при обученной политике. Обычная ошибка BC измеряется на состояниях эксперта:
Но качество развёрнутой политики зависит от состояний, которые она посещает сама: .
После первой ошибки эти распределения могут разойтись. Политика попадает в состояние, редко встречавшееся в демонстрациях, ошибается там чаще и уходит ещё дальше. В последовательном предсказании этот механизм часто называют накоплением ошибок (compounding errors), а в авторегрессионных моделях — смещением из-за обучения на истинных префиксах (exposure bias).
Здесь легко сделать слишком сильный вывод. Различие распределений не доказывает, что всякая длинная генерация неизбежно развалится. Модель может обобщать на новые префиксы, а ошибка может оказаться обратимой. Утверждение точнее:
малая ошибка на распределении экспертных состояний сама по себе не гарантирует малую ошибку на распределении состояний обученной политики.
Это различие между статистической точностью предсказателя и качеством замкнутого контура управления.
Шаг 5.1.3 — Канат: точный расчёт накопления ошибки
Рассмотрим предельно простую задачу. Эксперт проходит шагов и получает за каждый успешно завершённый шаг. Имитатор на каждом ещё не проваленном шаге ошибается независимо с вероятностью . После первой ошибки дальнейшие награды равны нулю.
Вероятность получить награду на шаге равна , поэтому ожидаемая сумма наград:
При геометрическая сумма даёт
Эксперт получает , следовательно,
Если , разложение приводит к
Главная зависимость — . Один ранний промах стоит не одну единицу, а весь оставшийся хвост эпизода.
Это не универсальный закон для любой среды. Он показывает худший механизм в задаче, где ошибка необратима. Если система быстро возвращается к хорошим состояниям, стоимость ошибки меньше. Если ошибка создаёт ещё более опасное состояние, ситуация может быть хуже. Поэтому правильный практический вопрос звучит не «какова точность действий на демонстрациях?», а «какова стоимость ошибки и умеет ли политика восстанавливаться из состояний, которые создаёт сама?»
Шаг 5.1.4 — DAgger: разметить состояния, которые посещает ученик
Алгоритм агрегации данных (Dataset Aggregation, DAgger) меняет распределение обучающих состояний.
- Обучить начальную политику на демонстрациях эксперта.
- Запустить текущую политику или смесь текущей политики с экспертом.
- Собрать состояния, которые фактически встретил ученик.
- Запросить у эксперта правильное действие для каждого такого состояния.
- Добавить новые пары в общий набор данных и переобучить политику.
- Повторить цикл.
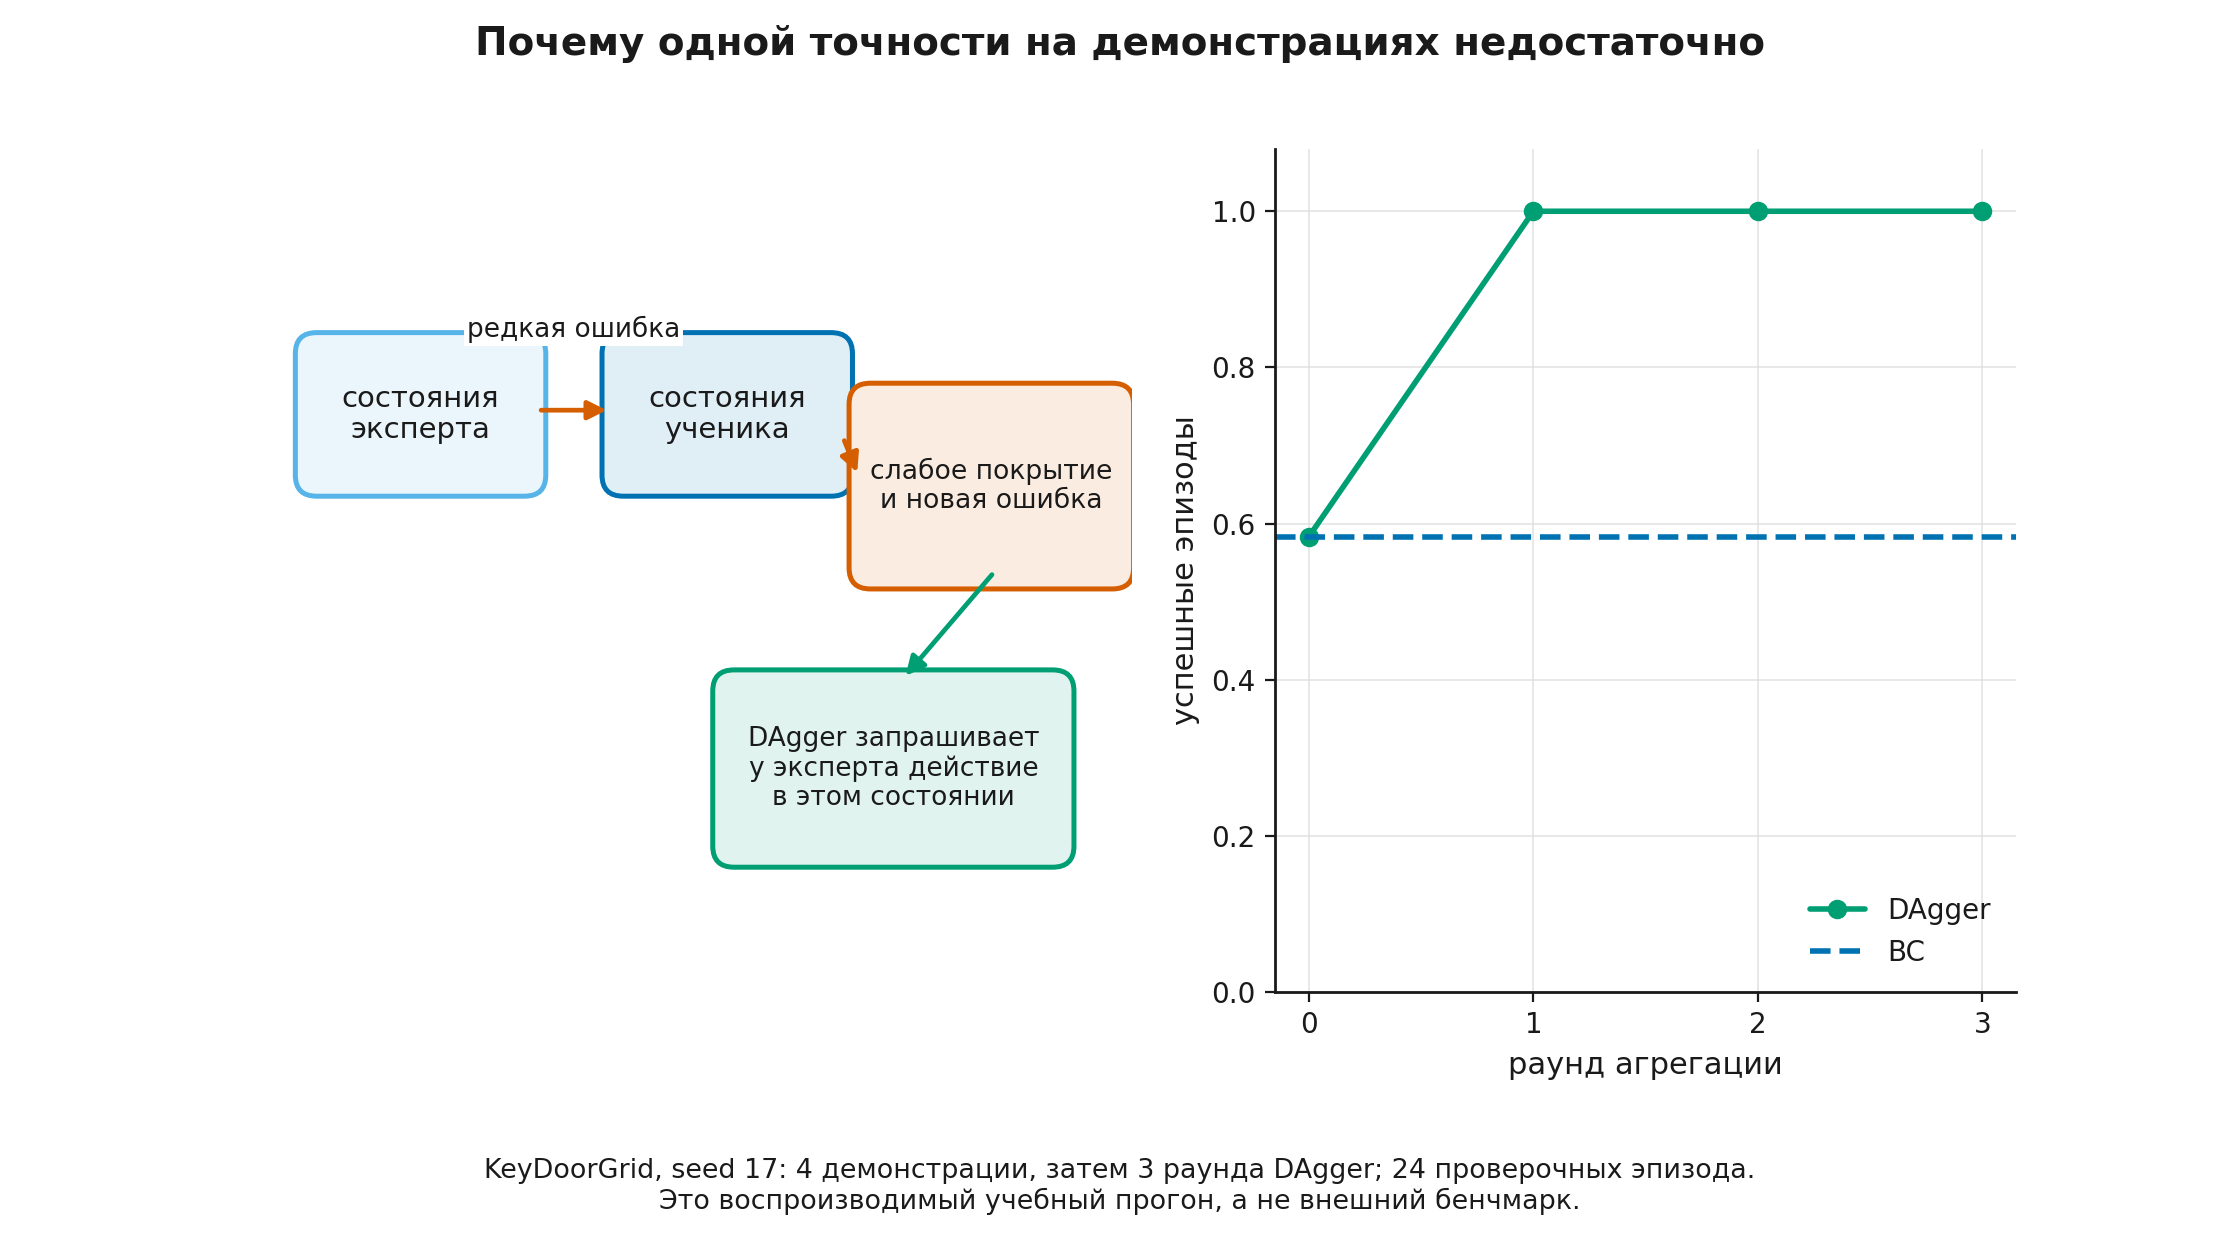
Вместо одной задачи обучения с учителем на возникает последовательность задач на распределениях, связанных уже с поведением ученика. В исходной работе DAgger это превращается в редукцию к онлайн-обучению без регрета. При ограниченной разнице будущей стоимости действий и малом среднем регрете базового классификатора итоговая добавочная стоимость масштабируется как , тогда как для наивного BC стандартная худшая оценка имеет порядок .
Эту фразу нельзя отрывать от предпосылок. Величина, ограничивающая разницу будущей стоимости действий, качество онлайн-алгоритма, число итераций, способ смешивания эксперта и ученика и выбор возвращаемой политики входят в точную гарантию. DAgger не обещает, что один дополнительный раунд автоматически исправит любую среду или любую ошибку представления.
В воспроизводимом прогоне курса начальная BC-политика обучалась всего на четырёх демонстрациях KeyDoorGrid и успешно завершила 14 из 24 проверочных эпизодов. После первого раунда DAgger, когда эксперт разметил состояния, посещённые учеником, успех вырос до 24 из 24 и сохранился в последующих раундах. Это иллюстрация механизма при одном фиксированном начальном значении генератора случайных чисел, а не внешняя оценка эффективности DAgger. Числа и протокол находятся в data/M5_experiment_protocol.json.
DAgger также нельзя отождествлять с обучением с подкреплением по обратной связи от человека (reinforcement learning from human feedback, RLHF). В DAgger эксперт сообщает действие, которое следовало выполнить в конкретном состоянии. В RLHF человек или модель чаще сравнивает целые ответы, выставляет оценку или задаёт предпочтение. Общая структурная идея одна — собирать обратную связь на состояниях или ответах текущей политики, — но формат сигнала и математическая целевая функция различаются.
Шаг 5.1.5 — Что BC объясняет в дообучении LLM, а чего не объясняет
Токеновый SFT наследует сильные и слабые стороны BC.
Что он делает хорошо:
- переносит стиль и формат демонстраций;
- быстро вводит полезное поведение без определения награды;
- использует устойчивую и масштабируемую функцию потерь;
- сохраняет знания базовой модели при аккуратной настройке данных и скорости обучения.
Где появляется ограничение:
- обучающие префиксы взяты из демонстраций, а при генерации префиксы создаёт модель;
- редкие ошибки восстановления могут почти не встречаться в данных;
- одинаково правдоподобные действия не ранжируются по внешней полезности, если это ранжирование не отражено в демонстрациях;
- BC стремится воспроизвести условное распределение действий в данных, а не максимизировать отдельно заданную награду.
Поэтому RL после SFT нужен не только из-за сдвига распределения. Он может использовать проверяемую награду, предпочтения, взаимодействие со средой и исследование альтернатив. И наоборот, не каждый цикл дообучения обязан начинаться с нового SFT: базовая модель уже может быть достаточно подготовлена, а конкретный исследовательский протокол может переходить сразу к другому сигналу.
На этом месте полезно удержать простую границу:
BC отвечает на вопрос «что сделал бы демонстратор в таком состоянии?», а RL — «какое действие повышает ожидаемый итог по выбранной награде?»
Эти вопросы могут вести к одной политике, но не обязаны.
Урок 5.2. DQN: Q-learning с нейросетью
Урок 5.2. DQN: Q-learning с нейросетью
- От таблицы Q к глубокой Q-сети
- Буфер повторного использования опыта
- Целевая сеть: медленно меняющаяся правая часть
- Смещение максимизации и Double DQN
- Опасная триада и граница переноса на LLM
далее — 3 проверочных шага
Шаг 5.2.1 — От таблицы Q к глубокой Q-сети
В Модуле 2 Q-learning обновлял табличную оценку
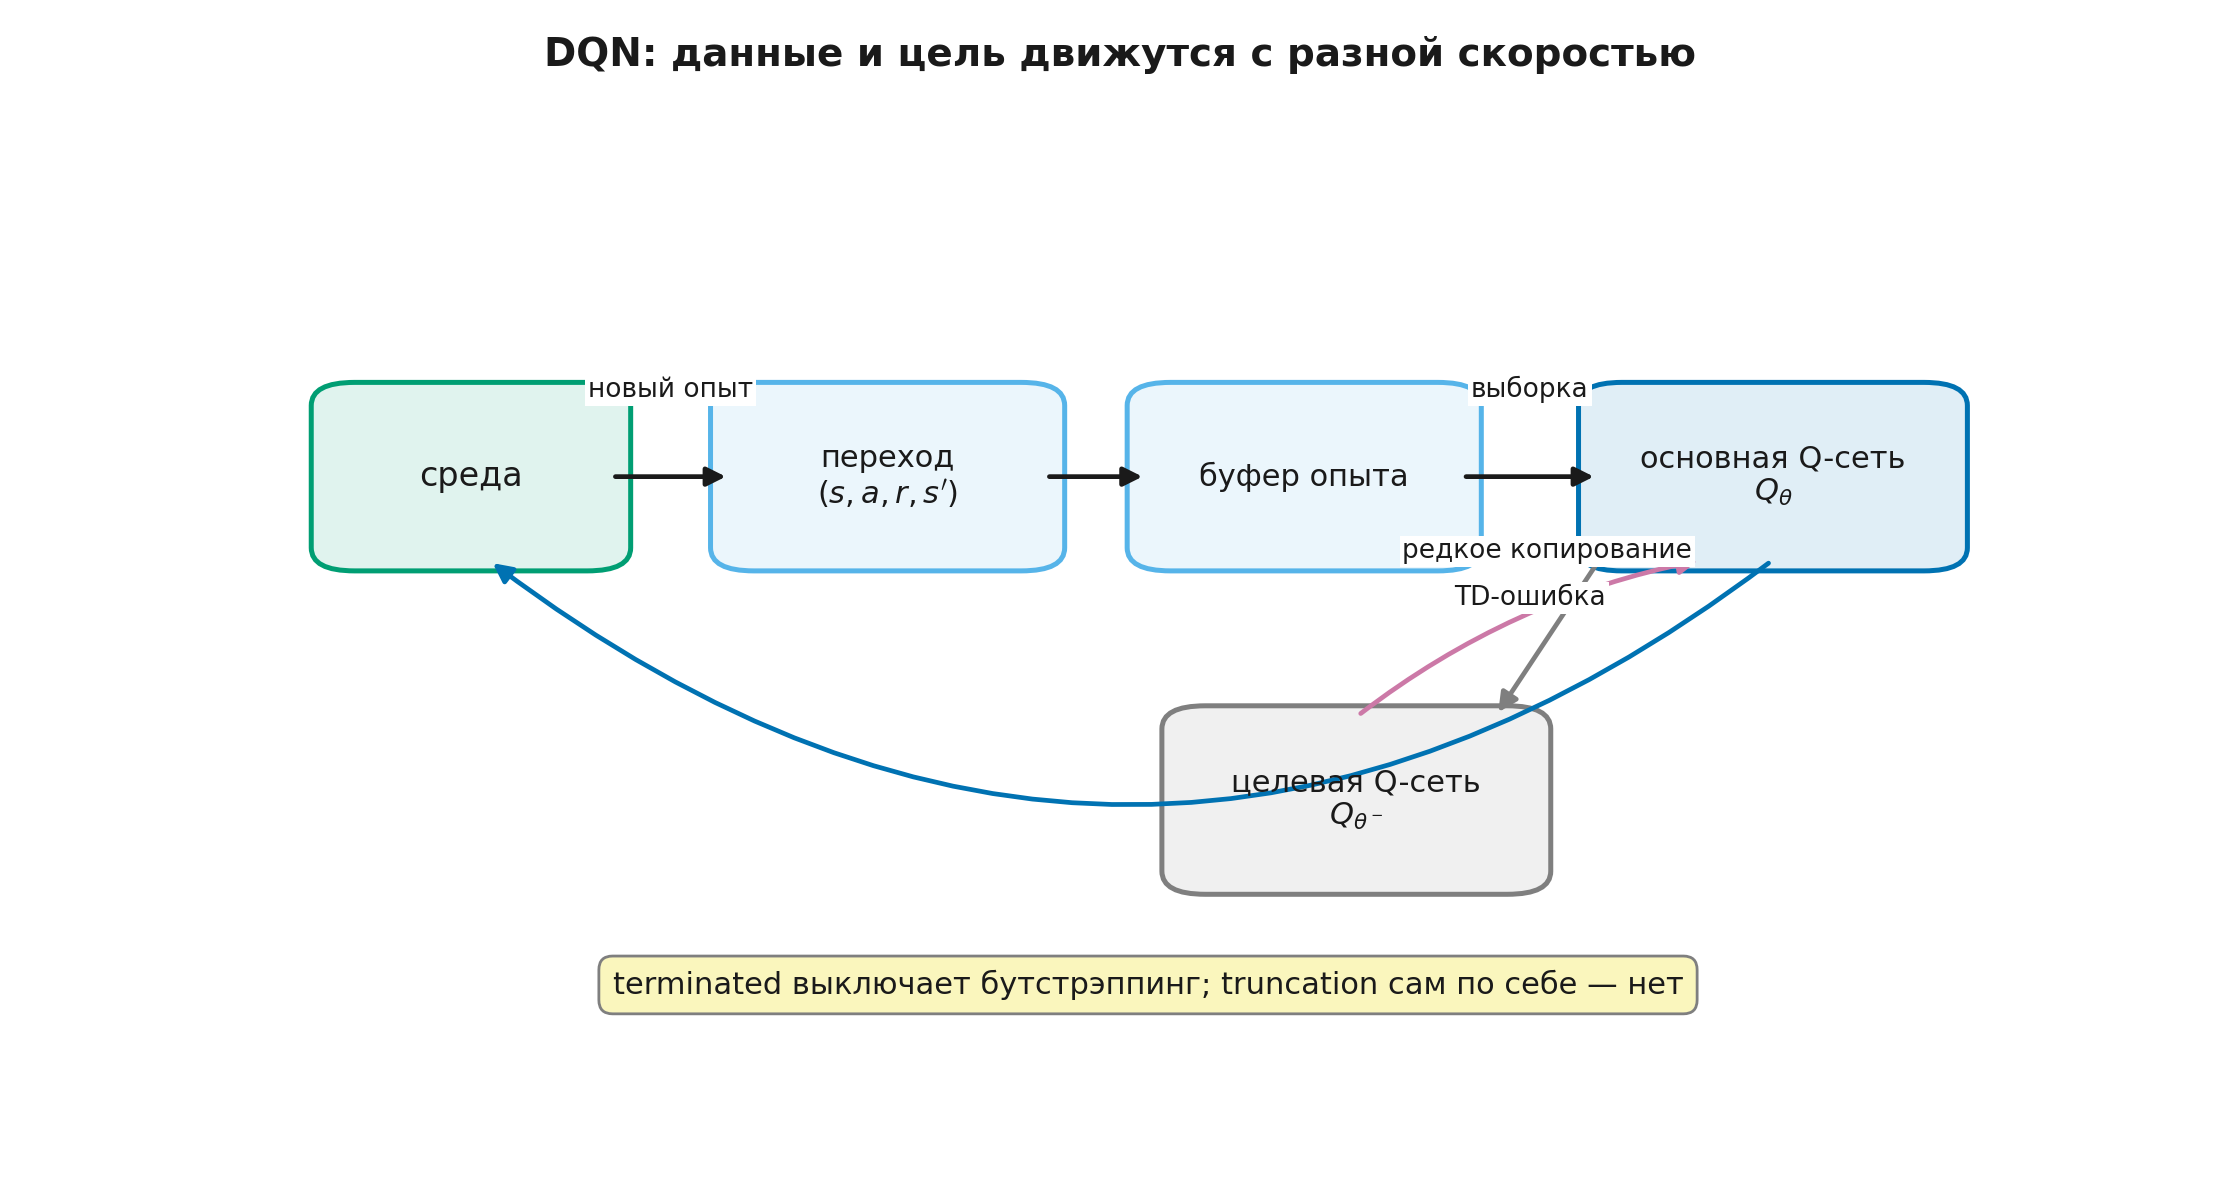
Для изображений, длинных наблюдений или огромного пространства состояний таблица невозможна. Глубокая Q-сеть (deep Q-network, DQN) заменяет таблицу нейросетью . Для дискретного пространства действий сеть обычно получает состояние и возвращает вектор значений для всех действий.
На переходе строится цель
где только при естественном завершении задачи, а — параметры отдельной целевой сети. Затем минимизируется, например, квадратичная или сглаженная абсолютная ошибка:
Политика выбирает действие с наибольшим текущим значением, добавляя исследование при сборе данных:
Это всё ещё Q-learning: обучение использует максимум по следующему действию, а не действие, которое действительно выбрала поведенческая политика.
Шаг 5.2.2 — Буфер повторного использования опыта
Последовательные переходы сильно коррелированы: соседние кадры почти одинаковы, а политика долго посещает одну область среды. DQN помещает переходы в буфер повторного использования опыта (experience replay) и обучается на случайных мини-пакетах из этого буфера.
У буфера три практические роли.
- Один переход используется в нескольких обновлениях.
- Перемешивание уменьшает краткосрочную корреляцию мини-пакета.
- В одном обновлении могут смешиваться данные нескольких недавних версий политики, поэтому оно выполняется не только по данным текущей политики.
Однако буфер не превращает DQN в офлайн-RL. В обычном DQN агент продолжает взаимодействовать со средой, добавляет новые переходы и тем самым может исправлять пробелы покрытия. В офлайн-RL набор данных фиксирован: действие, которого нет в журнале, нельзя попробовать позднее.
Случайная выборка также не устраняет статистическую зависимость переходов: они по-прежнему происходят из одной динамической системы и меняющегося процесса сбора. Буфер лишь делает оптимизационный поток менее локально коррелированным.
Шаг 5.2.3 — Целевая сеть: медленно меняющаяся правая часть
Если одна и та же сеть одновременно задаёт и цель , каждое обновление двигает обе стороны уравнения. Мы пытаемся попасть в мишень, которая мгновенно отскакивает вслед за выстрелом.
DQN хранит вторую сеть . Её параметры либо периодически копируются из основной сети,
либо медленно усредняются. В течение нескольких шагов оптимизации цель меняется слабее, чем предсказание .
У целевой сети и базовой модели в RLHF есть поверхностное сходство: обе могут быть замороженной копией более ранней модели. Но роли различаются.
- Целевая сеть DQN поставляет бутстрэппинговое значение в правой части уравнения Беллмана и регулярно обновляется.
- Базовая политика RLHF задаёт меру отклонения, например штраф по дивергенции Кульбака—Лейблера (KL), и не является оценкой будущей награды.
Одинаковая инженерная конструкция «замороженная копия» не делает математические цели одинаковыми.
Шаг 5.2.4 — Смещение максимизации и Double DQN
Пусть истинные значения двух действий одинаковы, но оценки содержат шум:
Даже при несмещённости каждой оценки максимум обычно завышен:
Причина проста: оператор максимума предпочитает действие с удачным положительным шумом. После бутстрэппинга завышение может распространяться назад по траектории.
Double DQN разделяет выбор и оценивание следующего действия:
Основная сеть выбирает действие, а целевая оценивает выбранное действие. Ошибки двух оценок не независимы полностью, но такое разделение уменьшает систематическое завышение, наблюдавшееся в DQN.
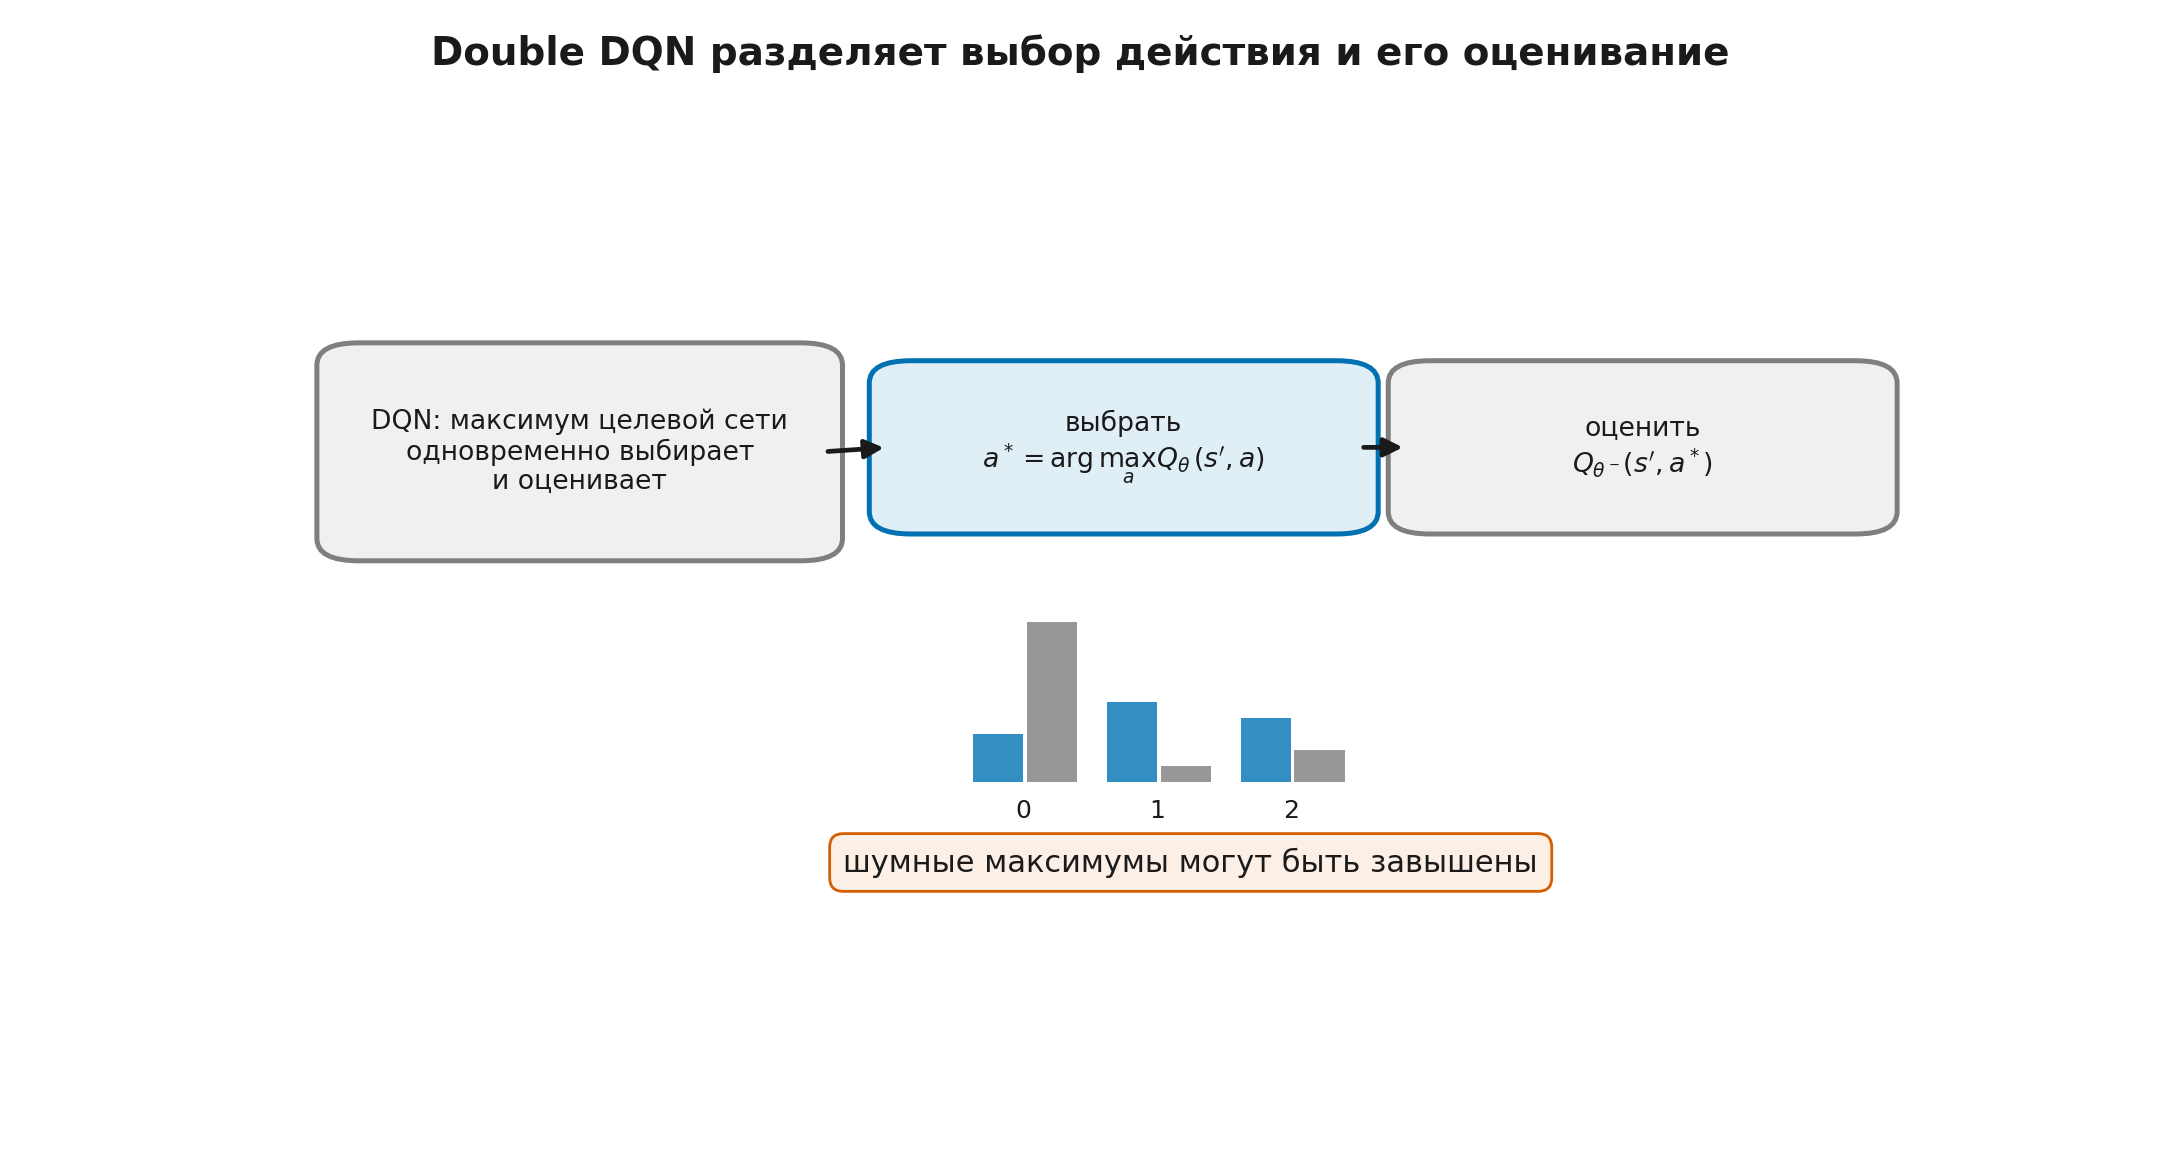
Double DQN не гарантирует отсутствие любого смещения. Возможны недооценка, коррелированные ошибки и ошибки аппроксимации. Метод исправляет конкретный механизм: использование одного и того же шумного оценщика одновременно для выбора максимума и его оценки.
Шаг 5.2.5 — Опасная триада и граница переноса на LLM
Приближённые Q-методы объединяют три источника сложности:
- аппроксимацию функции нейросетью;
- бутстрэппинг от собственных оценок;
- данные другой политики, отличной от обновляемой;
Эту комбинацию называют опасной триадой (deadly triad), потому что она способна приводить к расходимости или сильной нестабильности. Но из этого не следует упрощённая формула «любые два элемента всегда безопасны». Сходимость зависит от алгоритма, представления, распределения данных, шага обучения и других условий.
Для LLM ценностный подход возможен: токен — дискретное действие, а префикс — состояние. Но пространство действий велико, состояния практически никогда не повторяются, награда часто приходит только за полный ответ, а хорошая предварительно обученная политика уже доступна. Поэтому на практике удобно оптимизировать саму авторегрессионную политику или использовать её как ограничение на действия.
Это инженерный выбор, а не математический запрет. В Уроке 5.5 мы увидим ILQL — реальный пример ценностного офлайн-RL для генерации текста.
В ноутбуке DQN и Double DQN реализованы с буфером опыта, целевой сетью, -жадным сбором, раздельными флагами завершения и усечения и небольшой предварительной загрузкой буфера шумными экспертными траекториями. В зафиксированном прогоне при начальном значении генератора случайных чисел, равном 5, после 130 эпизодов обычный DQN решил 20 из 24 проверочных эпизодов, а Double DQN — 24 из 24. Этот результат показывает исполняемость полного контура и различие целей; он не доказывает универсального превосходства Double DQN. Другое начальное значение генератора, иной объём буфера или режим исследования могут изменить ранжирование.
Урок 5.3. Офлайн-RL: что можно узнать из фиксированного журнала
Урок 5.3. Офлайн-RL: что можно узнать из фиксированного журнала
- Фиксированный набор переходов
- Невозможность без покрытия: два мира с одинаковыми данными
- Ошибка экстраполяции и петля самоусиления
- Четыре семейства защиты от действий вне данных
- Набор данных, оценивание и выбор модели
далее — 4 проверочных шага
Шаг 5.3.1 — Фиксированный набор переходов
В офлайн-обучении с подкреплением (offline RL) дан набор переходов
собранный одной или несколькими поведенческими политиками . Во время обучения новые взаимодействия со средой запрещены. Цель — построить политику, максимизирующую ожидаемую накопленную награду.
Сравним три постановки.
| Постановка | Что есть в данных | Что оптимизируется | Можно ли собирать новые данные во время обучения |
|---|---|---|---|
| BC | состояния и действия демонстратора | правдоподобие действий демонстратора | не обязательно |
| обычный RL с повторным использованием опыта | переходы и награды из пополняемого буфера | накопленная награда | да |
| офлайн-RL | фиксированные переходы и награды | накопленная награда | нет |
Офлайн-RL пытается превзойти среднее поведение в журнале, используя последствия действий и структуру многошаговой задачи. Но улучшение возможно только при достаточном покрытии и подходящих предположениях об обобщении. Наличие награды не превращает отсутствующий переход в наблюдавшийся.
Шаг 5.3.2 — Невозможность без покрытия: два мира с одинаковыми данными
Рассмотрим одно состояние и два действия: и . В журнале тысячу раз встречается только с наградой . Действие отсутствует.
С фиксированным журналом совместимы как минимум два мира:
- мир A: ;
- мир B: .
Наблюдаемые данные в этих мирах полностью одинаковы. Любой алгоритм, получивший только этот журнал, обязан вывести один и тот же результат в обоих мирах. Следовательно, он не может одновременно гарантированно выбрать оптимальное действие в мире A и избежать плохого действия в мире B.
Это аргумент не про конкретную нейросеть и не про недостаток вычислений. Это неидентифицируемость: данные не содержат ответа.
В последовательной задаче проблема усиливается. Если политика выбирает действие вне покрытия, модель значения оценивает его по обобщению. Затем максимум или актор предпочитает завышенную оценку, а бутстрэппинг распространяет ошибку на предыдущие состояния.
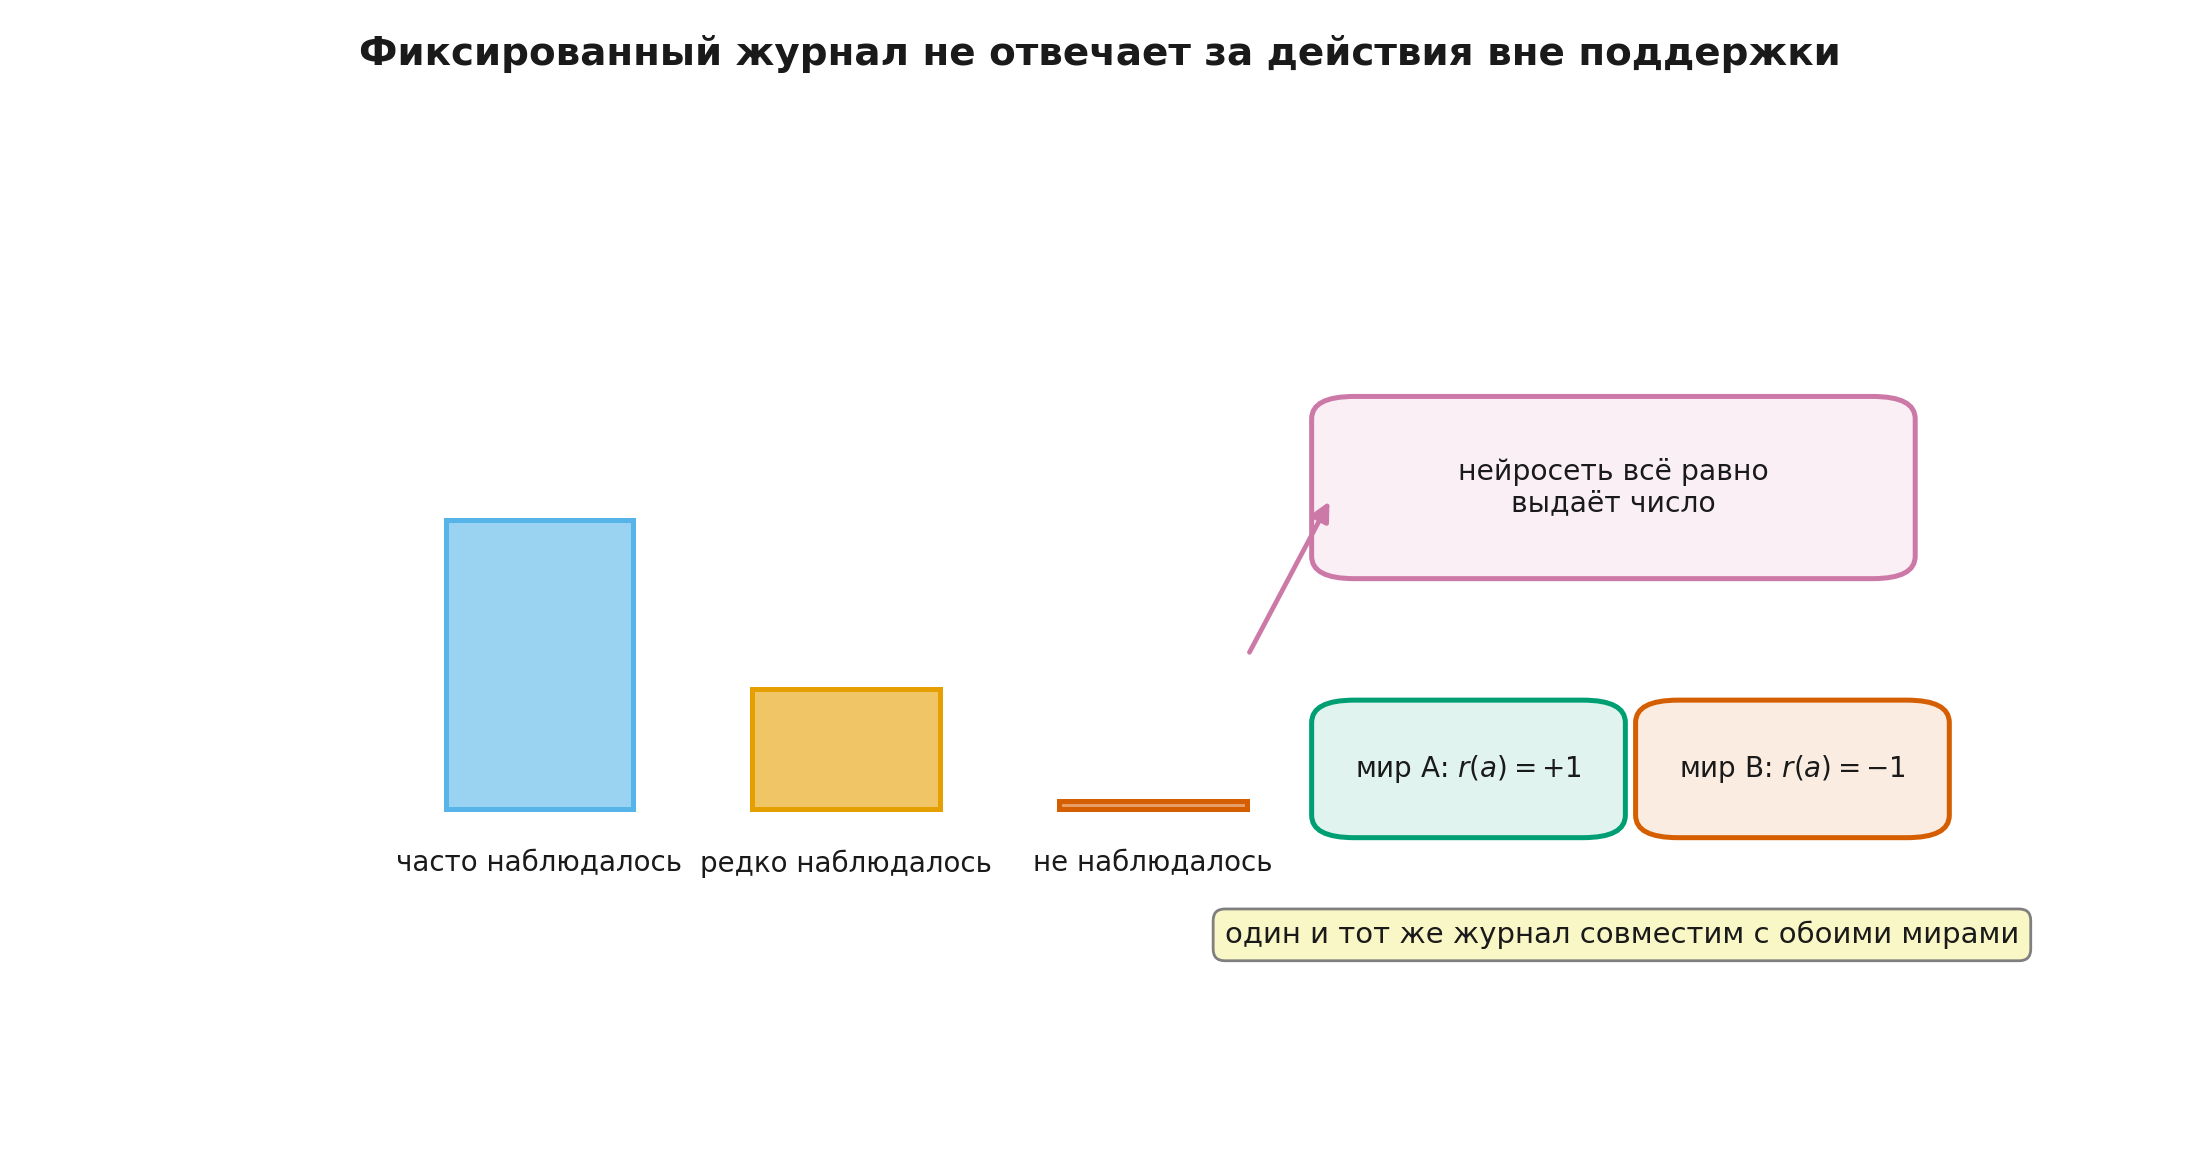
Для теоретических гарантий обычно нужны условия покрытия: например, целевая политика не должна назначать существенную вероятность действиям, которые почти не встречались при соответствующих состояниях. В непрерывных и высокоразмерных пространствах буквальное совпадение состояний невозможно, поэтому покрытие формулируют через плотности, коэффициенты концентрации или свойства представления.
Шаг 5.3.3 — Ошибка экстраполяции и петля самоусиления
Пусть обучена на действиях из журнала, но в цели используется .
Максимум перебирает и действия, для которых обучающих примеров мало или нет. Если одно из них случайно завышено, оно попадает в цель:
Затем новая политика начинает предпочитать это действие, хотя его истинные последствия не проверялись. Получается петля:
слабое покрытие → ошибка значения → выбор ошибки максимумом → бутстрэппинг → ещё более уверенная политика вне данных.
В ранней литературе этот механизм часто называли ошибкой экстраполяции (extrapolation error). Современное описание обычно шире: важны и сдвиг распределения между данными и новой политикой, и неопределённость значения, и способ улучшения политики.
Наивное решение «просто сильнее регуляризовать нейросеть» не даёт общей гарантии. Регуляризация может уменьшить амплитуду функции, но не сообщает, какое из ненаблюдавшихся действий хорошо. Нужен способ ограничить улучшение политики, занизить сомнительные значения или строить обновление только на действиях из данных.
Шаг 5.3.4 — Четыре семейства защиты от действий вне данных
Ниже не рейтинг методов, а карта разных механизмов.
1. Ограничить множество действий
Q-обучение с ограничением на пакет данных (Batch-Constrained deep Q-learning, BCQ) обучает модель действий, похожих на действия набора данных, и ищет улучшение внутри этого множества. Идея: не позволять актору свободно выбирать действие, для которого Q-функция не обучалась.
2. Добавить поведенческий якорь
TD3 с поведенческим копированием (Twin Delayed Deep Deterministic Policy Gradient plus Behavioral Cloning, TD3+BC) модифицирует обновление актора, сочетая высокое значение Q и близость к действию из журнала. В упрощённом виде:
Первый член улучшает политику по оценкам Q, второй удерживает её около данных.
3. Занизить значения сомнительных действий
Консервативное Q-обучение (Conservative Q-Learning, CQL) добавляет штраф, минимизация которого уменьшает разрыв между логарифмом суммы экспонент значений всех действий и средним значением действий журнала. Консервативное давление понижает значения неподдержанных действий относительно действий из данных. Для дискретных действий одна из форм имеет вид
Исходная работа выводит нижнюю оценку ценности при своих условиях. В конечной нейросетевой реализации это не следует трактовать как автоматическую гарантию для любого набора гиперпараметров.
4. Не запрашивать Q на действиях вне набора при обучении значения
Неявное Q-обучение (Implicit Q-Learning, IQL) подгоняет к верхнему экспектилю значений действий из данных. Для остатка используется асимметричная квадратичная потеря
Затем обучается по целевому значению , а политика извлекается взвешенным BC: действия с положительным преимуществом получают больший вес,
обычно с ограничением максимального веса.
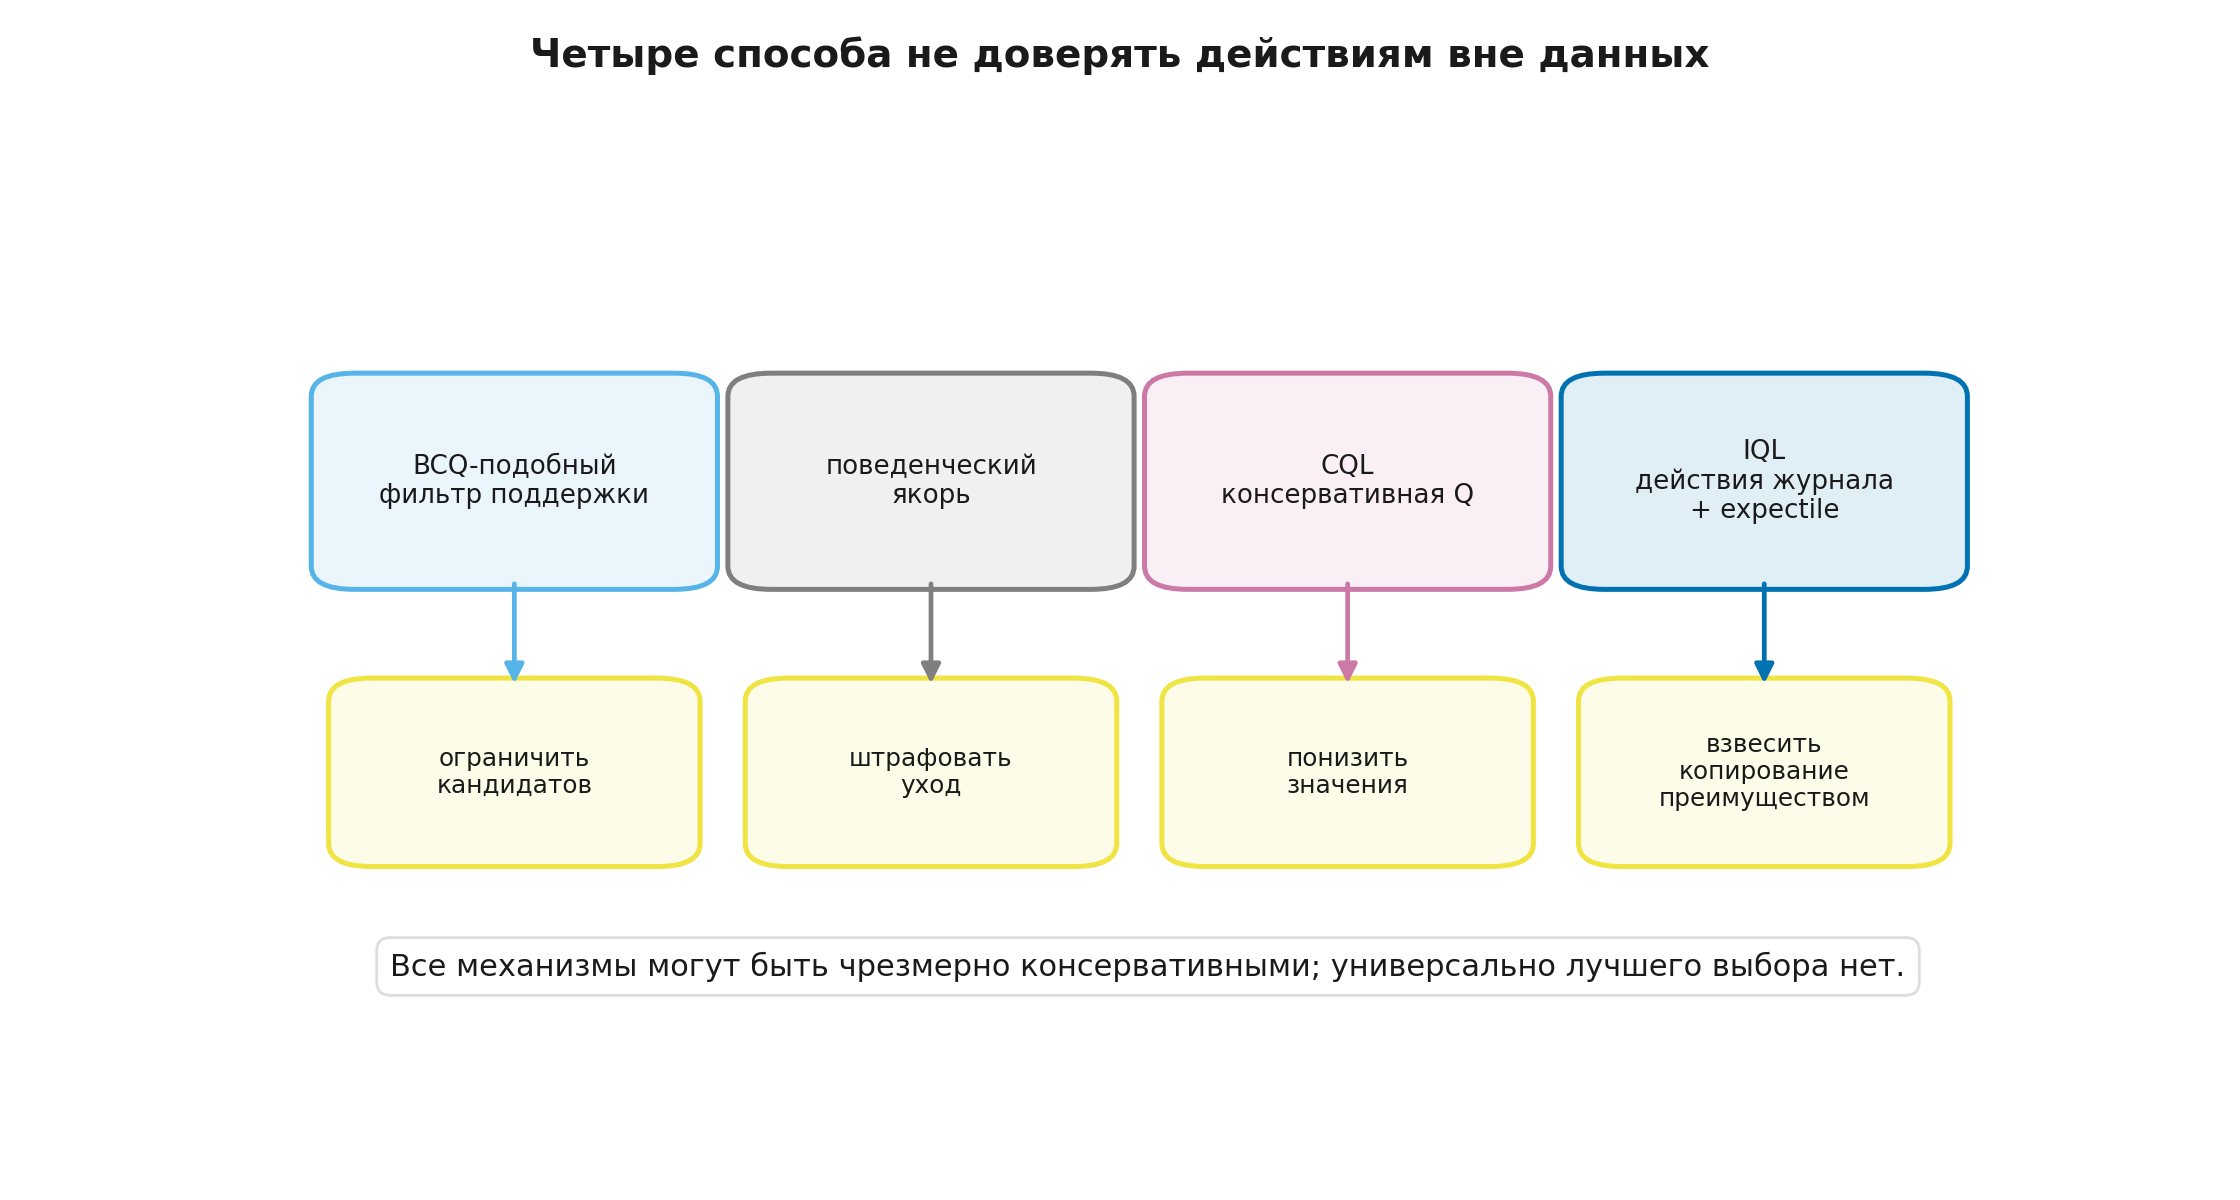
Общая идея у этих методов похожа: улучшение должно учитывать, где данным можно доверять. Но «оставаться рядом с данными» — не одна формула. Ограничение действия, поведенческий штраф, консервативная Q-функция и обучение по действиям набора создают разные смещения и требуют разных гиперпараметров.
Шаг 5.3.5 — Набор данных, оценивание и выбор модели
Качество офлайн-RL определяется не только числом переходов. Два журнала одинакового размера могут давать принципиально разную возможность улучшить политику. Существенны:
- какие состояния и действия покрыты;
- собран ли журнал одной политикой или смесью;
- есть ли в нём и удачные, и неудачные траектории;
- насколько надёжны награды, признаки завершения и порядок переходов;
- совпадает ли среда развёртывания со средой сбора;
- можно ли отделить данные для обучения оценивателя от данных для выбора гиперпараметров.
Набор D4RL был предложен как общий комплект задач и фиксированных журналов для офлайн-RL, включая демонстрации, смеси политик и многоцелевые данные. Он сыграл важную историческую роль, но результат на D4RL не является сертификатом качества метода в другом домене: меняются динамика, вид покрытия, масштаб награды и цена ошибки.
Выбор модели особенно труден. Низкая ошибка Беллмана на отложенных переходах не обязана означать хорошую политику: оцениватель может точно подгонять значения в журнале и ошибаться на действиях, которые начнёт выбирать улучшенная политика. Один из инструментов — оценивание подогнанной Q-функцией (fitted Q evaluation, FQE). Для фиксированной проверяемой политики оно итеративно обучает оценку по целям
Здесь нет максимума по действиям: FQE оценивает заранее выбранную политику, а не улучшает её. Но это всё равно бутстрэппинг по фиксированному журналу. Слабое покрытие, конечная выборка, ошибка аппроксимации и сдвиг между журналом и проверяемой политикой могут испортить оценку. Поэтому FQE полезно сопровождать анализом покрытия, несколькими разбиениями данных, проверкой устойчивости к гиперпараметрам и, когда это безопасно, независимым симулятором или ограниченным онлайн-испытанием.
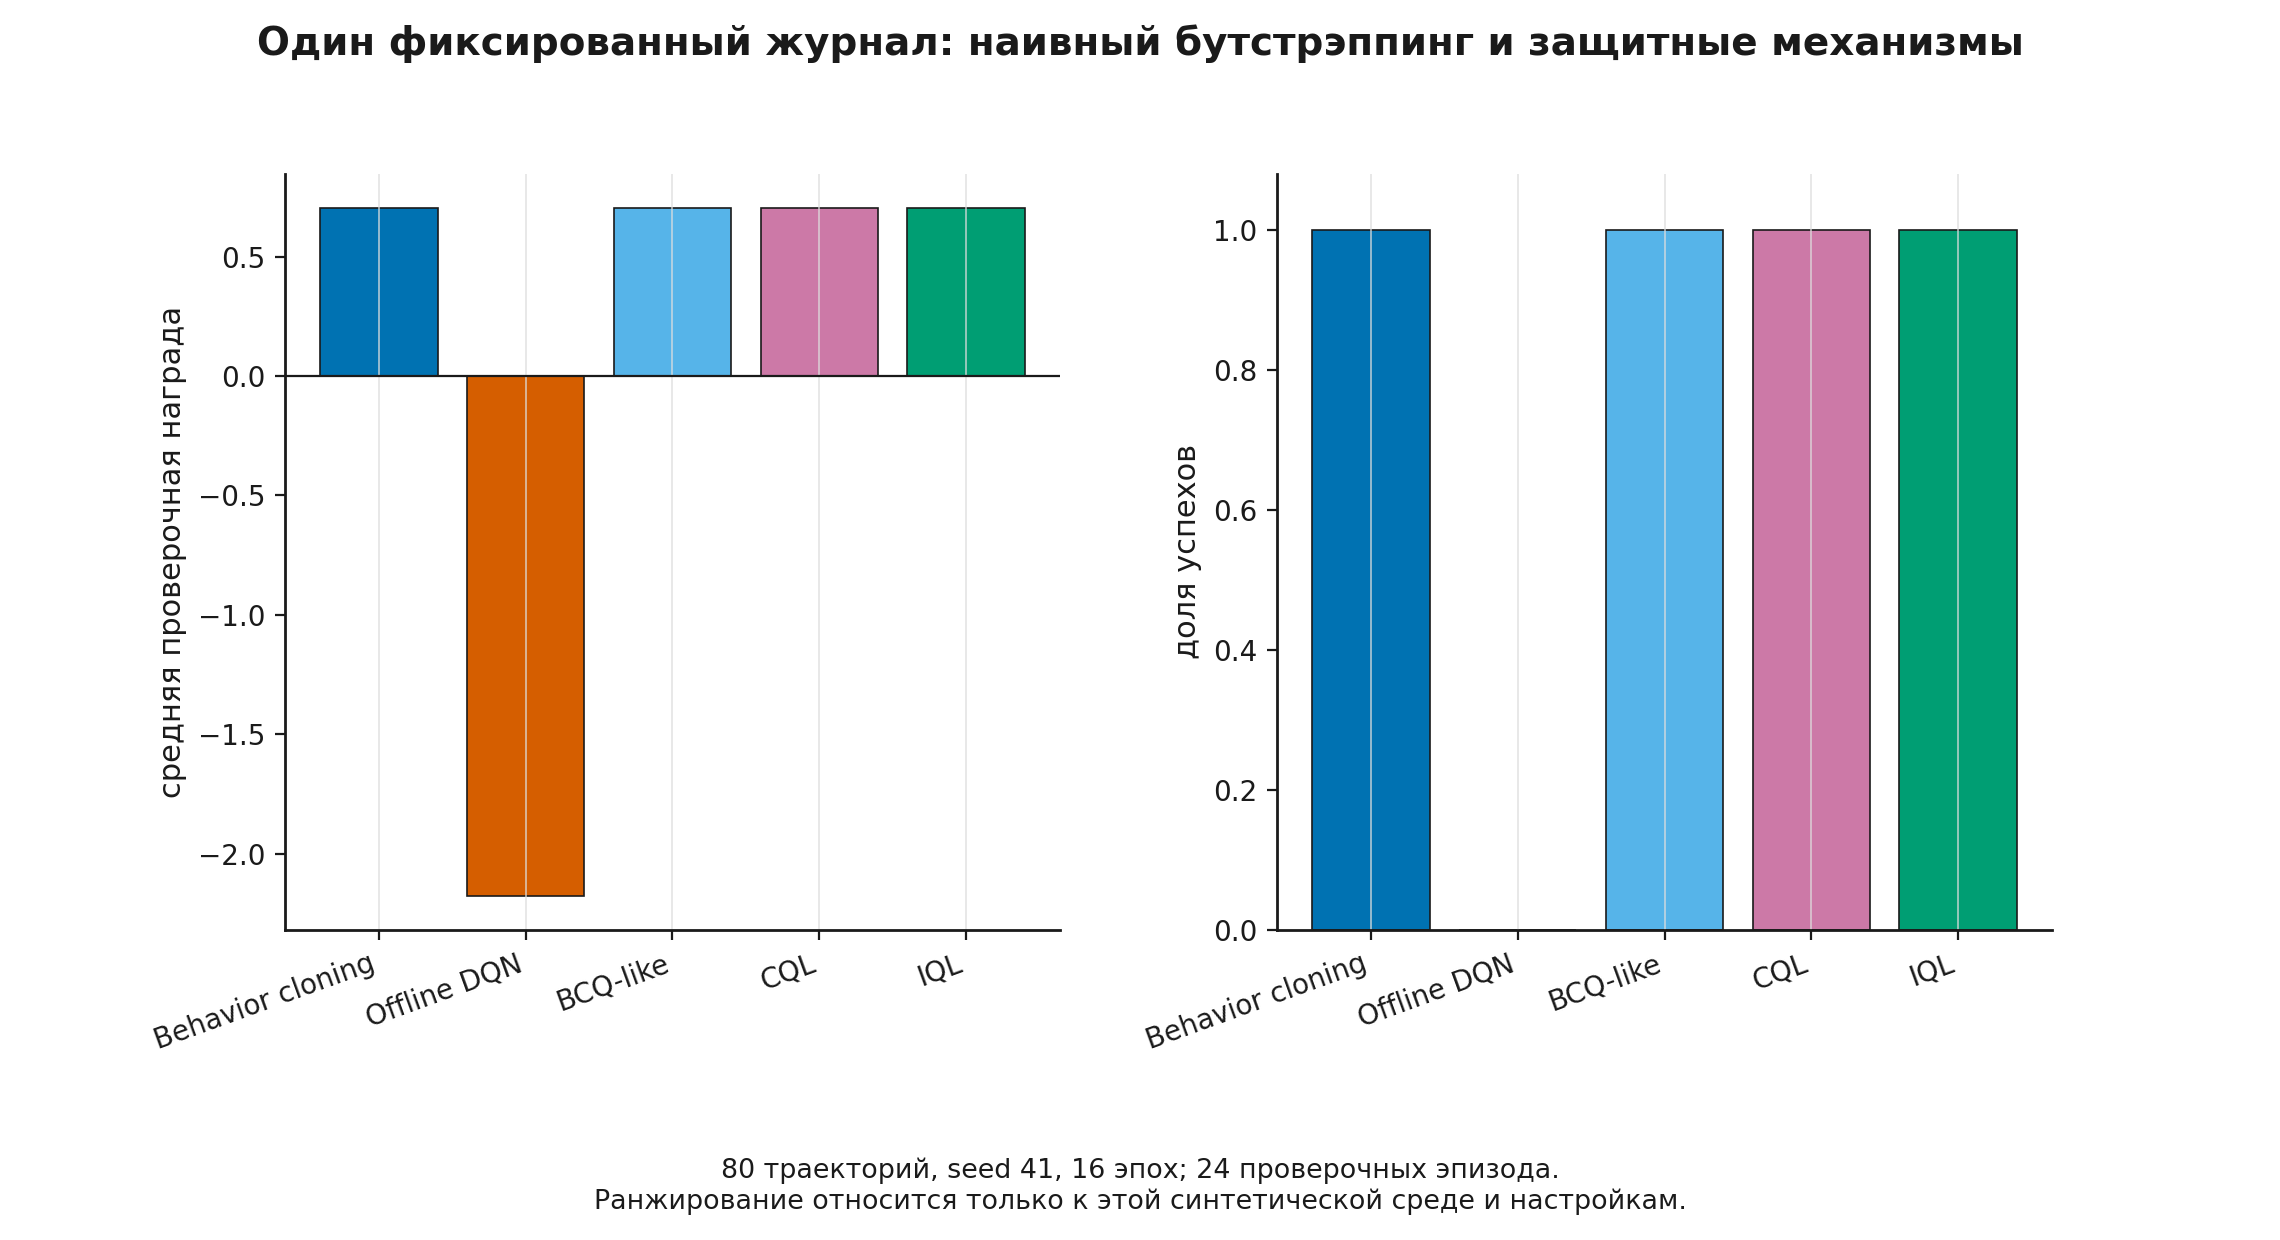
В зафиксированном эксперименте курса один журнал из 80 траекторий использовался для BC, наивного офлайн-DQN, BCQ-подобного ограничения, CQL и IQL. При начальном значении генератора случайных чисел, равном 41, после 16 эпох обучения и на 24 проверочных эпизодах BC, BCQ-подобный метод, CQL и IQL решили все эпизоды, а наивный офлайн-DQN не решил ни одного и получил среднюю награду . Это демонстрирует конкретный сбой экстраполяции в данной среде, но не устанавливает универсальный рейтинг методов. В том же прогоне FQE присвоила BC и IQL начальные значения примерно и , хотя непосредственная проверка в симуляторе дала обеим политикам около . На этом небольшом журнале оцениватель оказался плохо калиброван и различил политики с одинаковым наблюдаемым результатом. Полный протокол находится в data/M5_experiment_protocol.json.
В Модуле 3 мы оценивали политику по одношаговому журналу с известными вероятностями логирующей политики. Здесь задача сложнее: ошибка значения переносится через последовательность переходов, а новая политика может посещать иные области состояния. Пессимизм не отменяет модельный выбор. Слишком слабый пессимизм позволяет эксплуатировать ошибки; слишком сильный превращает улучшение в копирование посредственного поведения.
Урок 5.4. Decision Transformer: политика как условная модель траектории
Урок 5.4. Decision Transformer: политика как условная модель траектории
- Добавить в последовательность желаемую награду
- Как работает условие на награду при развёртывании
- Чем DT отличается от Q-learning
- «Склеивание» фрагментов поведения не гарантировано
- Почему сходство с LLM полезно, но ограничено
далее — 2 проверочных шага
Шаг 5.4.1 — Добавить в последовательность желаемую награду
Decision Transformer (DT) предлагает не строить явную Q-функцию и не вычислять градиент политики. Траектория записывается как последовательность
где
— оставшаяся сумма наград от шага при .
Каузальный трансформер обучается предсказывать действие по желаемой оставшейся награде и истории:
Для дискретных действий можно использовать отрицательное лог-правдоподобие, для непрерывных — регрессионную потерю. Это обучение с учителем на последовательностях фиксированных траекторий.
В этом смысле DT — условное имитационное обучение: модель копирует действия, но получает дополнительный признак качества траектории. Она может различать «как действовали в траекториях с высокой наградой» и «как действовали в траекториях с низкой наградой».
Шаг 5.4.2 — Как работает условие на награду при развёртывании
Перед началом эпизода задаётся желаемая сумма наград . После выбора действия среда возвращает награду . Для недисконтированного определения следующая цель обновляется так:
Если использовать дисконтированную договорённость
то при
Модель видит, сколько награды ещё «нужно набрать», текущее состояние и предыдущие действия.
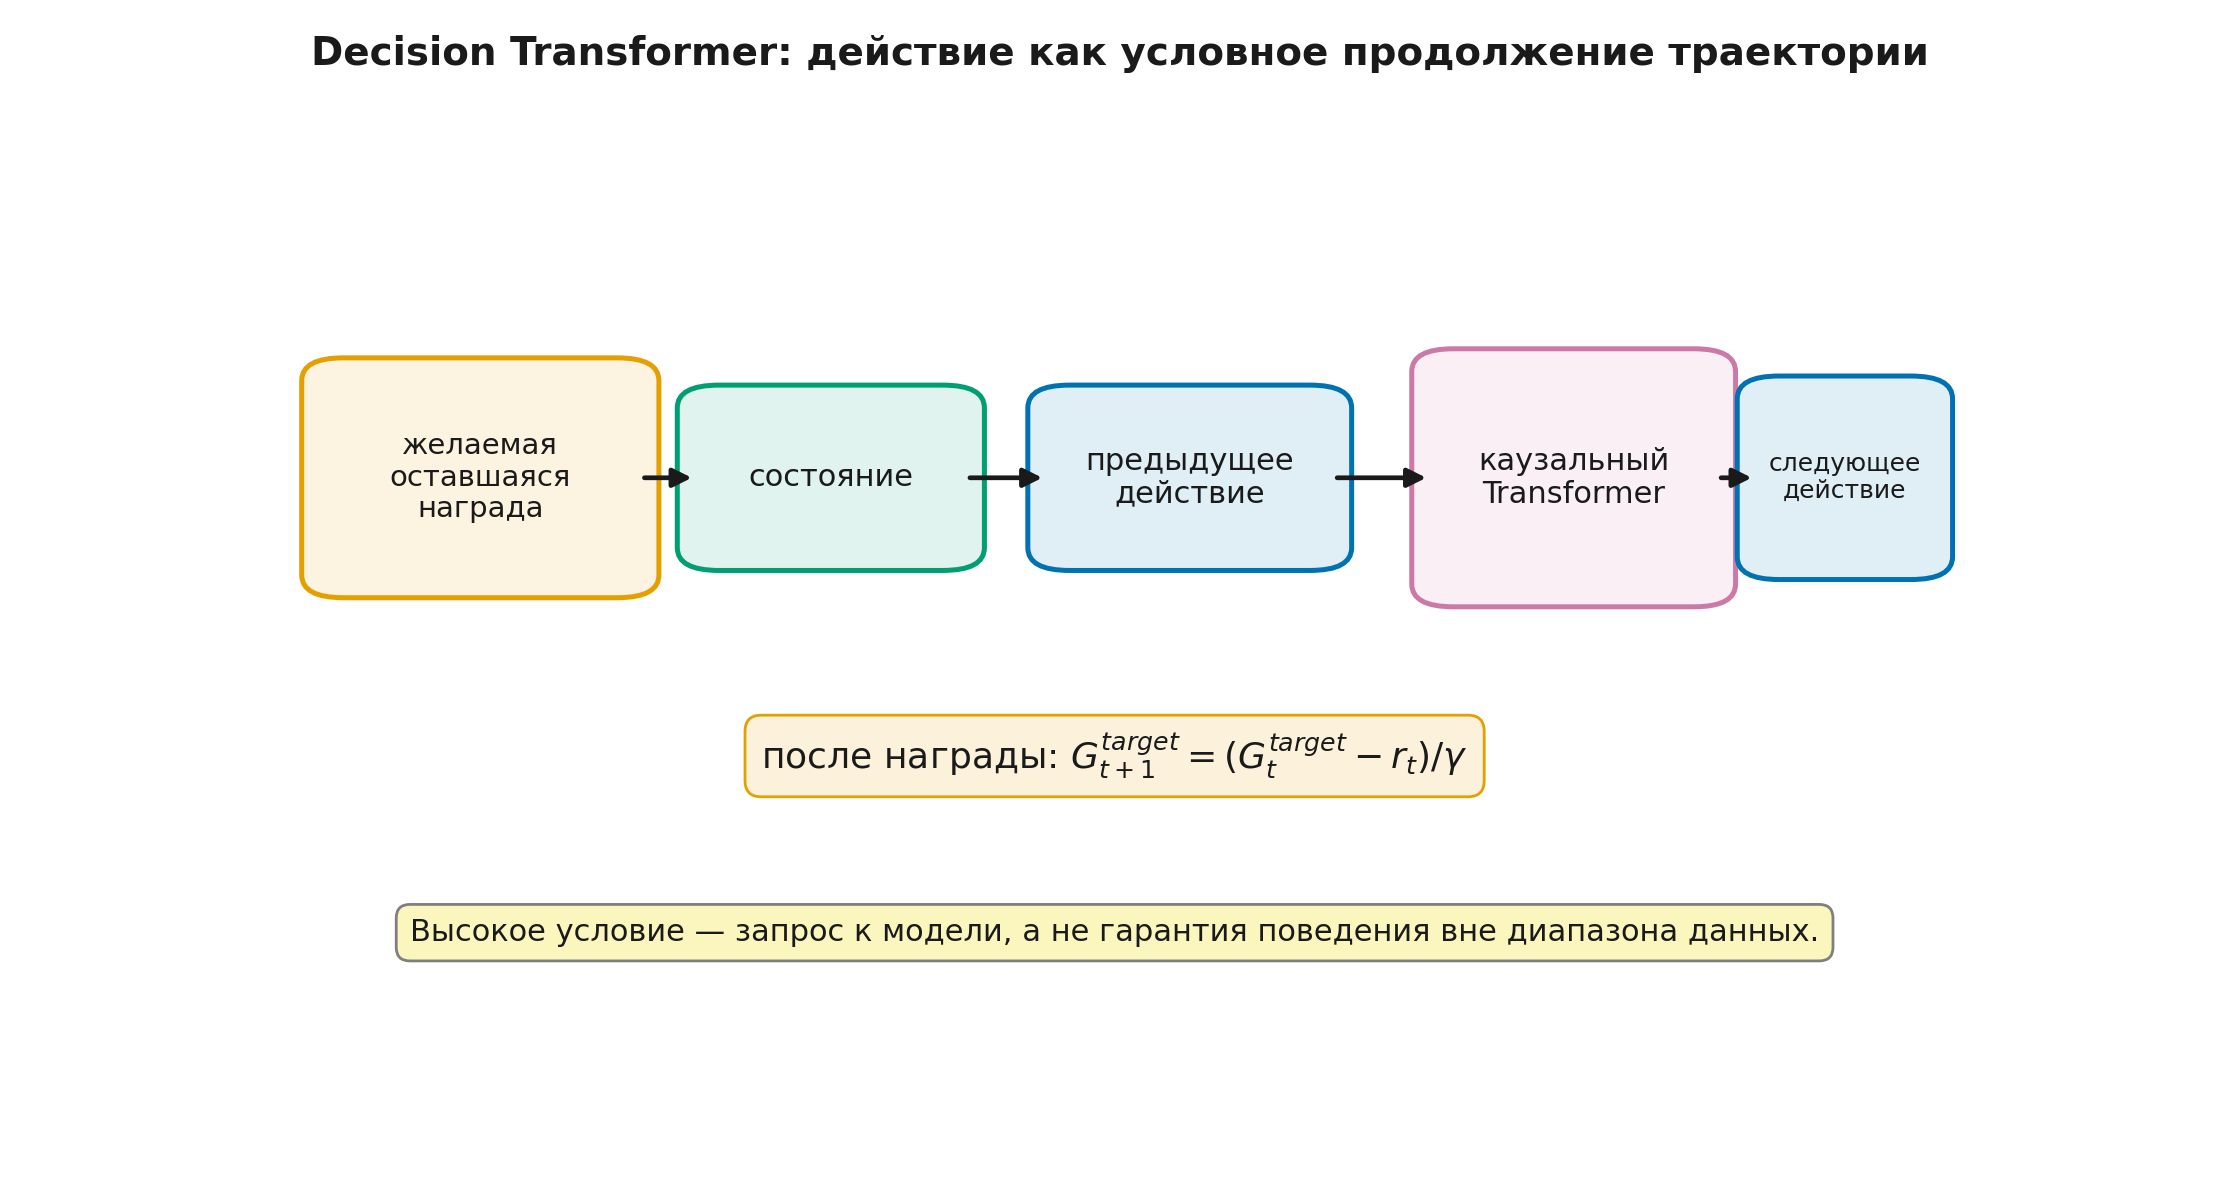
Желаемая награда — условие, а не обещание. Если запросить значение, далеко выходящее за диапазон обучающих траекторий, модель экстраполирует. Никакое поле target_return=1000 само по себе не создаёт поведения, которого не было и которое модель не умеет составить из данных.
В ноутбуке это проверяется без риторики. Decision Transformer обучается на 120 траекториях KeyDoorGrid, а затем запускается с начальными условиями , , и . В шести проверочных эпизодах на каждое условие все четыре режима достигли цели, а средняя награда лежала примерно между и и не росла монотонно вместе с запрошенным значением. Модель научилась устойчивому успешному поведению, но не превратила числовое условие в точный регулятор результата. Это один синтетический прогон; он иллюстрирует смысл условия и не сравнивает DT с внешними реализациями.
Шаг 5.4.3 — Чем DT отличается от Q-learning
Q-learning строит рекуррентную связь между текущим значением и лучшим будущим действием:
DT не использует этот максимум и не подгоняет явную функцию ценности. Он учит условное распределение действий по траекториям.
Из этого следуют разные сильные стороны.
- DT использует стандартные инструменты последовательного моделирования и может естественно обрабатывать длинную историю.
- Q-методы явно используют локальную динамическую рекурсию и могут комбинировать оценки последствий действий.
- DT зависит от того, насколько в данных представлены нужные сочетания состояния, истории и награды.
- Q-методы зависят от качества бутстрэппинга и значений действий вне данных.
Нельзя заключать, что один подход всегда лучше. Исходная работа показала конкурентные результаты DT на выбранных офлайн-бенчмарках, но это эмпирический результат конкретных задач, архитектур и наборов данных.
Шаг 5.4.4 — «Склеивание» фрагментов поведения не гарантировано
Представим две траектории: в первой агент умеет добраться из в , во второй — из в . Хотелось бы, чтобы модель вывела путь , даже если целая траектория отсутствует.
Динамическое программирование делает такую композицию явной через значения состояний. Последовательная модель может научиться композиции за счёт обобщения представлений и внимания, но в её функции потерь нет общей теоремы, гарантирующей такое «склеивание» для любого набора данных.
Столь же неверно утверждать, что DT принципиально не способен составлять новые траектории. Способность зависит от структуры данных, архитектуры, контекста, масштаба и оптимизации.
Точная формулировка скромнее:
DT переносит проблему улучшения политики в условное моделирование траекторий; он не устраняет проблему покрытия, а выражает её в пространстве последовательностей и условий на награду.
Шаг 5.4.5 — Почему сходство с LLM полезно, но ограничено
DT и LLM используют каузальный трансформер и авторегрессионное предсказание. Это делает многие инженерные решения переносимыми: маскирование, позиционные признаки, упаковку последовательностей, выбор контекста и масштабирование модели.
Но из этого сходства не следует прямая родословная от Decision Transformer ко всякой системе с LLM-агентом, а системный запрос не равен условию на оставшуюся награду. В DT числовое условие имеет определённый смысл в траектории и обновляется по полученным наградам. Текстовая инструкция может описывать цель, стиль или ограничения, но не обязана быть калиброванной оценкой оставшейся суммы наград.
Полезная связь такова: сложную политику можно представить как условную модель последовательности. Граница связи: качество условной генерации не заменяет проверку динамики среды, покрытия данных и соответствия числовой награды реальной цели.
Урок 5.5. Карта фиксированных данных для дообучения LLM
Урок 5.5. Карта фиксированных данных для дообучения LLM
- Сначала определить, что именно записано
- Почему DPO не следует просто переименовывать в офлайн-RL
- ILQL: ценностный офлайн-RL для языка
- KL-регуляризация и пессимизм решают разные задачи
- Итоговая карта модуля
далее — 10 проверочных шагов
Шаг 5.5.1 — Сначала определить, что именно записано
Перед выбором алгоритма нужно назвать единицу данных.
| Данные | Типичная цель | Нужны новые роллауты во время оптимизации | Что изучается |
|---|---|---|---|
| демонстрации | SFT / BC | нет | действия демонстратора на его префиксах |
| переходы | классический офлайн-RL | нет | значения последствий и политика по награде |
| пары | DPO и родственные методы | нет | относительное предпочтение между ответами |
| свежие ответы с наградой | PPO, RLOO, GRPO | да | изменение текущей политики по её роллаутам |
| набор кандидатов без обновления весов | Best-of-N, поиск | нет обучения | выбор ответа на этапе вывода |
Слово «офлайн» иногда используют широко — для всякой оптимизации по фиксированному набору. Для точности курса классический офлайн-RL означает последовательную задачу с переходами и наградами, где алгоритм оценивает последствия действий и улучшает политику без новых взаимодействий.
Шаг 5.5.2 — Почему DPO не следует просто переименовывать в офлайн-RL
Прямая оптимизация предпочтений (Direct Preference Optimization, DPO) обучается на фиксированных парах предпочтений и не требует генерации роллаутов внутри каждого шага оптимизации. В этом широком смысле её можно назвать методом оптимизации политики по офлайн-данным.
Но математическая постановка отличается от классического офлайн-RL:
- данные содержат сравнения полных ответов, а не обязательно переходы с наградами;
- не обучается Q-функция и не выполняется бутстрэппинг Беллмана;
- целевая функция выводится из KL-регуляризованной RLHF-постановки и модели парных предпочтений;
- обучение реализуется как классификационная потеря по отношению вероятностей текущей и базовой политик.
Поэтому в этом курсе DPO называется прямой оптимизацией предпочтений на фиксированных парах, а не синонимом классического офлайн-RL. Полный вывод будет в Модуле 8. Для параллельного чтения полезны Modern LLMs, Модуль 14 «Обучение по обратной связи: RLHF, DPO, RLOO и GRPO» (modern_llms.module_12_preference_optimization) — там DPO помещён в современный LLM-конвейер, — и Information Theory for ML, Модуль 8 «Максимальная энтропия, экспоненциальные модели и KL-регуляризация» (it_ml.module_08_maxent_kl_policy) — там подробно выведен KL-регуляризованный вариационный оптимум.
Шаг 5.5.3 — ILQL: ценностный офлайн-RL для языка
Неявное языковое Q-обучение (Implicit Language Q-Learning, ILQL) переносит идеи IQL на генерацию текста. Состояние — префикс, действие — следующий токен, а фиксированные траектории снабжены наградами или итоговыми оценками.
Метод обучает функции и с консервативным отношением к действиям вне данных, а затем использует преимущество для смещения генерации в сторону более ценных токенов. В отличие от SFT, качество примера влияет не только через частоту токена: награда позволяет предпочесть одни продолжения другим. В отличие от DPO, основными объектами остаются токеновые функции ценности и последовательные переходы.
ILQL важен здесь не как рекомендация «использовать всегда», а как контрпример утверждению, будто Q-методы неприменимы к LLM. Они применимы; вопрос состоит в вычислительной цене, устойчивости значений, качестве награды и преимуществах по сравнению с более прямыми целями.
В языковой части ноутбука построен небольшой, но настоящий офлайн-контур: фиксированный журнал ответов для нескольких классов запросов, поведенческая политика, токеновые - и -головы, экспектильная регрессия значения, взвешенное преимуществом обучение политики и декодирование, ограниченное поддержкой поведенческой модели. Реализация намеренно названа ILQL-подобной: она воспроизводит ключевой интерфейс метода, но не заявляет полного совпадения с архитектурой, масштабом и всеми потерями исходной работы.
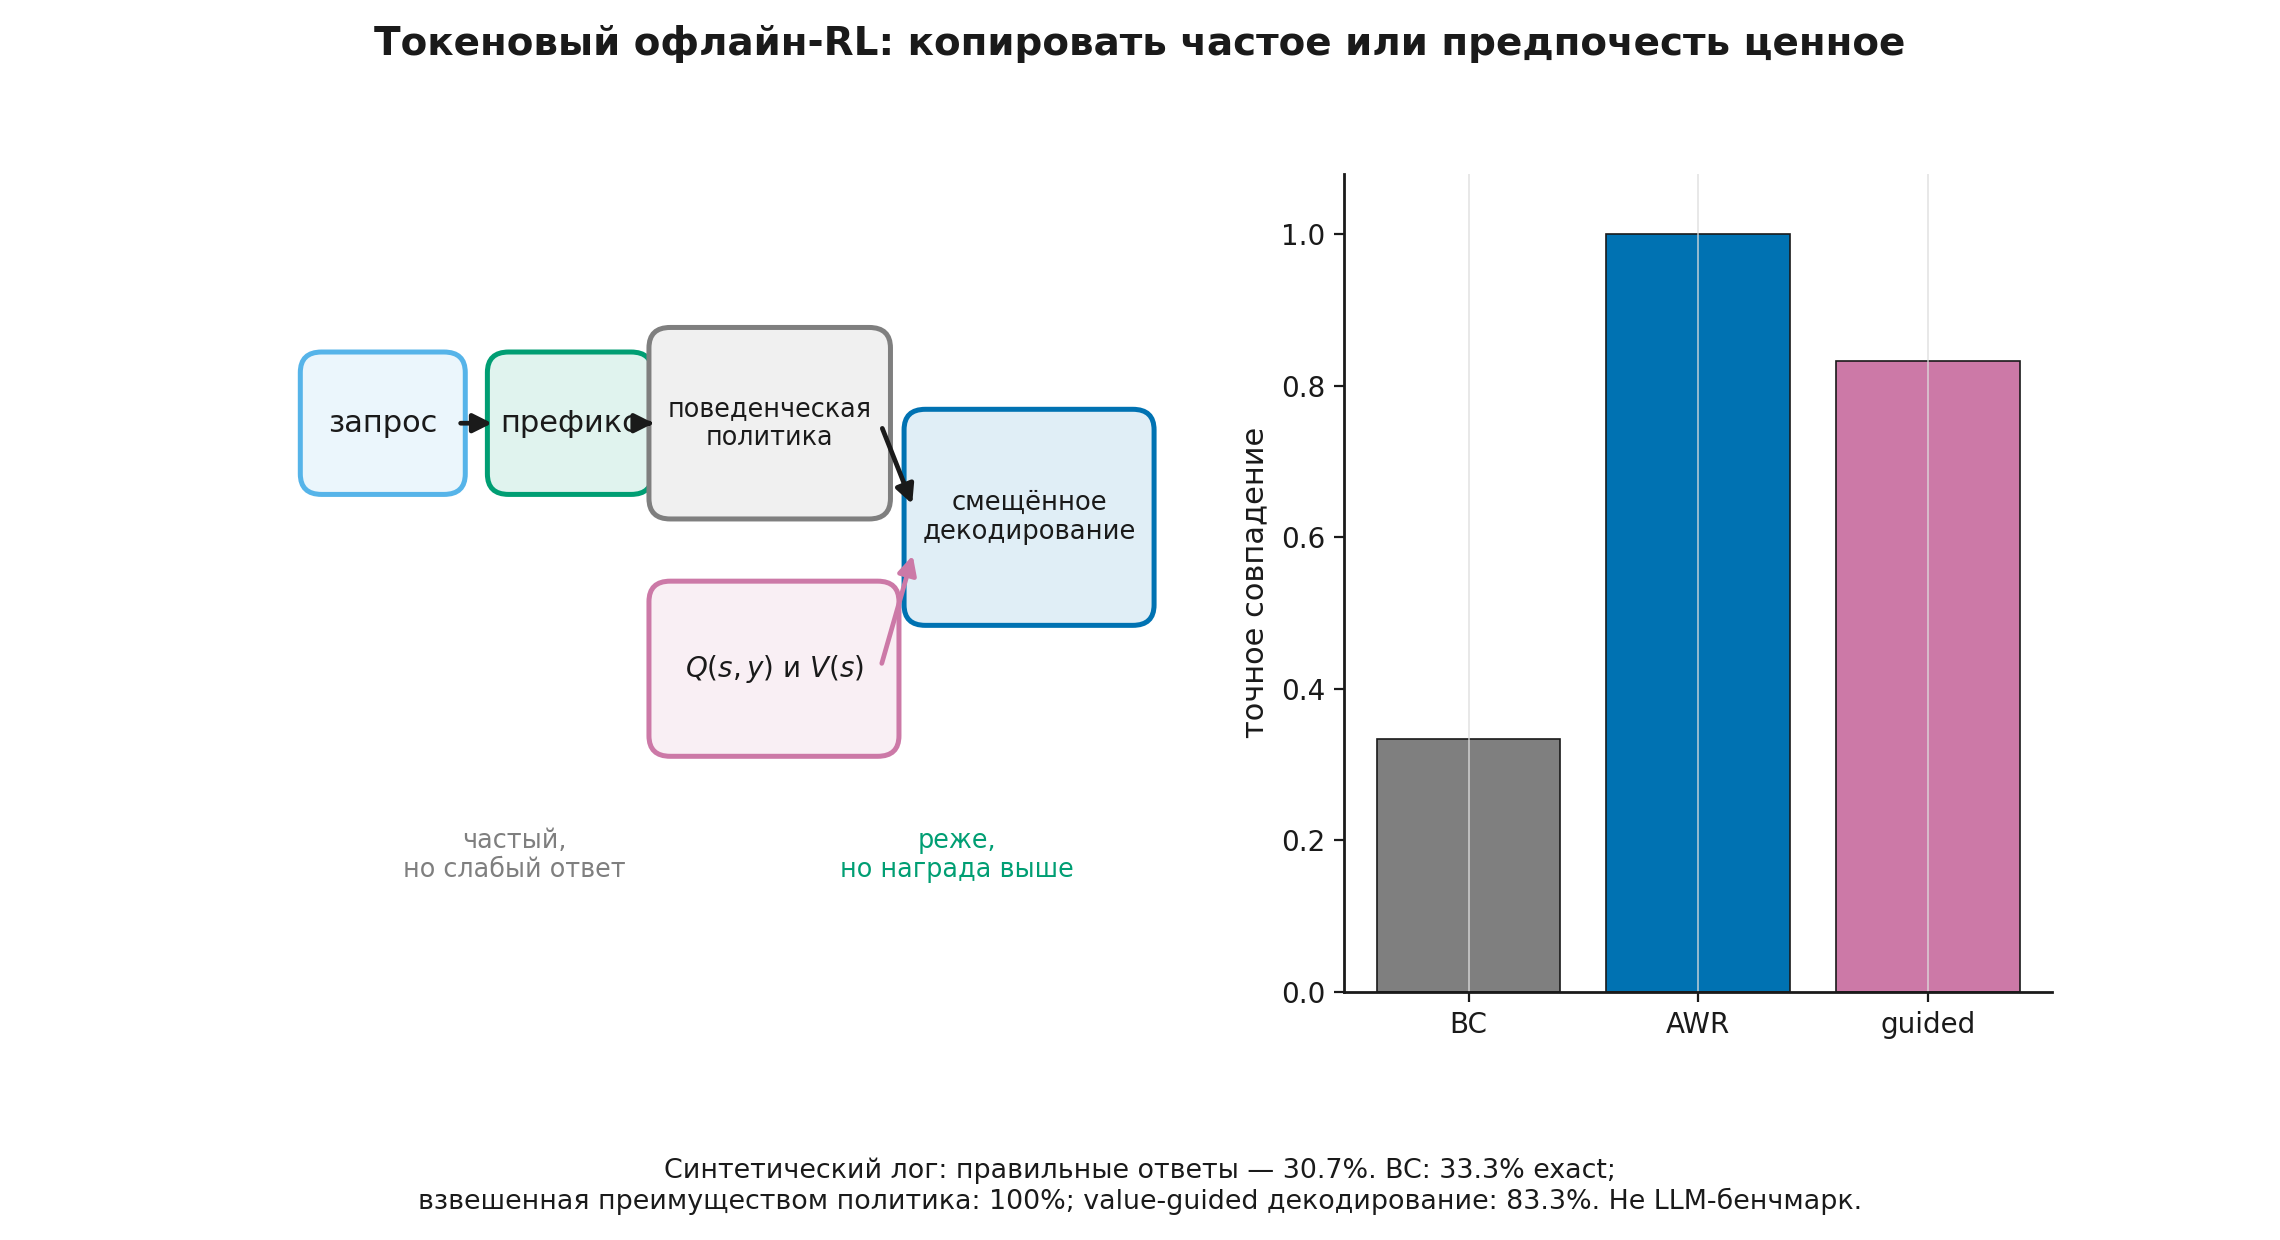
В зафиксированном синтетическом прогоне доля точных ответов в исходном журнале составляла около . Обычное BC дало точных жадных ответов, политика с преимуществами — , а декодирование с совместным учётом поддержки и ценности — . Эти числа нужны для проверки механики на известной награде; они не являются бенчмарком языкового качества и не показывают, что ILQL-подобная цель всегда превосходит SFT.
Шаг 5.5.4 — KL-регуляризация и пессимизм решают разные задачи
В RLHF часто штрафуют отклонение новой политики от базовой:
В офлайн-RL консервативный метод стремится не доверять значениям действий, плохо поддержанным данными. Эти конструкции действительно разделяют инженерную интуицию: резкое движение в неизвестную область опасно.
Однако механизмы различаются.
- KL ограничивает изменение распределения политики относительно выбранной базы.
- CQL изменяет оценки значения.
- BCQ ограничивает множество допустимых действий.
- IQL строит обновления ценности по действиям набора и извлекает политику взвешенным копированием.
Малое значение KL не доказывает корректность модели награды и не гарантирует покрытие всех важных состояний. Консервативная Q-функция не проверяет истинность награды и может быть чрезмерно пессимистичной. Аналогия полезна как карта риска, но не как тождество целей.
Полный вариационный вывод политики с KL-якорем дан в Information Theory for ML, Модуле 8 «Максимальная энтропия, экспоненциальные модели и KL-регуляризация» (it_ml.module_08_maxent_kl_policy). Здесь нам важна не повторная деривация, а различие интерфейсов: KL действует на распределение политики, тогда как пессимистические методы меняют допустимые действия, оценки ценности или веса примеров.
Шаг 5.5.5 — Итоговая карта модуля
Теперь можно разложить методы по источнику данных и механизму улучшения.
- BC / SFT: копировать действия демонстратора на демонстрационных состояниях.
- DAgger: добавить экспертные действия для состояний текущей политики.
- DQN: собирать новые переходы, повторно использовать их и бутстрэппить Q-функцию.
- Офлайн-RL: улучшать политику по фиксированным переходам и наградам, явно учитывая покрытие.
- Decision Transformer: предсказывать действие как часть траектории, при заданной желаемой оставшейся награде.
- DPO: оптимизировать фиксированные пары предпочтений без явной Q-функции.
- ILQL: обучать токеновые функции ценности по фиксированным награждённым траекториям текста.
Главный вывод модуля:
фиксированность данных — не мелкая инженерная деталь. Она определяет, какие контрфактические действия можно оценить, какие ошибки нельзя исправить новым опытом и какой вид регуляризации вообще имеет смысл.
В Модуле 6 мы вернёмся непосредственно к LLM-политике: вычислим токеновые логарифмы вероятностей и KL-дивергенцию относительно базовой модели и связь между сэмплированием и последовательностной целевой функцией.
Практический маршрут
Практика содержит 20 заданий основного маршрута и 12 дополнительных вопросов для проверки знаний. Подробные решения упражнений раскрываются по кнопке. Основной набор охватывает:
- маскированную потерю BC/SFT и точный расчёт накопления ошибки;
- цели DQN и Double DQN с правильной терминальной маской;
- диагностику покрытия и действия вне поддержки;
- CQL, экспектильную потерю и веса IQL;
- FQE и риск выбора модели по фиксированному журналу;
- оставшуюся награду и условие Decision Transformer;
- токеновый ценностный контур и границы аналогии с LLM.
Источники и маршрут дальнейшего чтения
Ниже перечислены первичные работы, на которые опираются исторические и алгоритмические утверждения модуля. Подробный реестр утверждений, ограничений и собственных экспериментов находится в Module_5_Sources.md.
- Ross, Gordon, Bagnell — DAgger. Читать вместе с шагом 5.1.4: работа задаёт редукцию к онлайн-обучению и условия гарантии; она не обещает, что один раунд исправит любую задачу.
- Mnih et al. — DQN. Источник архитектурного сочетания глубокой Q-сети, повторного использования опыта и целевой сети. Результаты Atari не переносятся автоматически на KeyDoorGrid или LLM.
- van Hasselt, Guez, Silver — Double DQN. Поддерживает разделение выбора и оценки следующего действия и эмпирический анализ завышения; не гарантирует превосходство при каждом начальном значении генератора случайных чисел.
- Fujimoto, Meger, Precup — BCQ. Нужна для идеи ограничения действий поддержкой фиксированного набора и описания ошибки экстраполяции.
- Kumar et al. — CQL. Даёт консервативную Q-цель и теоретические свойства при предпосылках работы; гиперпараметр не превращает произвольную нейросеть в автоматическую нижнюю оценку.
- Kostrikov, Nair, Levine — IQL. Источник экспектильного , обновлений по действиям набора и взвешенного преимуществом извлечения политики.
- Fu et al. — D4RL. Исторический набор данных и задач для офлайн-RL; его нормированные оценки не являются универсальной шкалой качества.
- Chen et al. — Decision Transformer. Источник условного моделирования траектории по оставшейся награде (return-to-go). Работа сообщает результаты на выбранных бенчмарках, но не доказывает универсальное «склеивание» траекторий.
- Rafailov et al. — DPO. Поддерживает классификационную цель на фиксированных предпочтениях и её связь с KL-регуляризованной постановкой; DPO не является Bellman-методом.
- Snell et al. — ILQL. Источник токеновых функций ценности и управляемого ценностью декодирования для языка; реализация курса является уменьшенной ILQL-подобной моделью, а не воспроизведением всех результатов статьи.
Необязательное углубление по соседним курсам: Modern LLMs, Модуль 13 «SFT и работа с данными» (modern_llms.module_11_sft) — полный конвейер демонстраций и масок; Modern LLMs, Модуль 14 «Обучение по обратной связи: RLHF, DPO, RLOO и GRPO» (modern_llms.module_12_preference_optimization) — место фиксированных предпочтений в дообучении LLM; Information Theory for ML, Модуль 3 «Кросс-энтропия и KL-дивергенция» (it_ml.module_03_cross_entropy_kl) — логарифмическое правдоподобие; Information Theory for ML, Модуль 8 «Максимальная энтропия, экспоненциальные модели и KL-регуляризация» (it_ml.module_08_maxent_kl_policy) — вариационная логика KL-якоря.