Модуль 10. Поиск, проверка и вычислительный бюджет на этапе генерации
Версия материала: 2026.22
Фактический снимок: 2026-08-05
Язык: RU
Основная практика: уровень A — браузер и центральный процессор (CPU); уровень B — бесплатный Colab T4 или платный API для факультативного запуска
Структура: 5 уроков, 25 шагов
Ориентировочное время: 9–11 часов без факультативного запуска модели
В Модуле 9 «RLVR и GRPO: проверяемые награды, групповые оценки и устойчивость» (rl_llm.module_09_rlvr_grpo) мы изменяли параметры политики по свежим роллаутам. Теперь веса модели останутся замороженными. Вопрос другой: как получить лучший ответ, потратив больше вычислений на один запрос, и как не перепутать рост числа попыток с ростом качества реально выбранного ответа?
Дополнительные вычисления можно направить на несколько независимых кандидатов, одну более длинную траекторию, ветвящийся поиск или адаптивное распределение бюджета между запросами. Во всех случаях возникает одна и та же инженерная цепочка:
Сам генератор определяет, какие решения вообще доступны. Правило выбора определяет, удастся ли распознать хорошее решение среди доступных. Бюджет определяет, сколько возможностей мы успеем проверить. Если один из трёх компонентов слаб, простое увеличение числа токенов или кандидатов может не помочь и даже ухудшить результат.
Практическая задача модуля:
Спроектировать и проверить систему увеличения вычислений на этапе генерации, отдельно измеряя покрытие, качество выбора, стоимость и устойчивость к ошибкам проверяющей системы.
После прохождения модуля вы сможете:
- различать параллельное, последовательное, поисковое и адаптивное увеличение вычислений;
- выводить формулу pass@N и указывать необходимые предположения;
- вычислять конечновыборочный оцениватель pass@k;
- объяснять, когда голосование по самосогласованности помогает, а когда усиливает систематическую ошибку;
- отличать наличие правильного кандидата от способности выбрать его;
- анализировать Best-of-N с точной и несовершенной проверкой;
- выводить предел конкретного протокола с двоичной проверяющей системой;
- распознавать переоптимизацию прокси-оценки при росте числа кандидатов;
- различать итоговую и процессную оценку, а также несколько способов агрегирования шагов;
- проектировать лучевой, приоритетный поиск и поиск по дереву Монте-Карло без приписывания им универсальных гарантий;
- распределять ограниченный бюджет по предельному приросту качества;
- сравнивать затраты на обучение и на более дорогую генерацию;
- реализовать воспроизводимые эксперименты на CPU и подготовить факультативный запуск небольшой открытой LLM.
Урок 10.1. Что именно масштабируется на этапе генерации
Урок 10.1. Что именно масштабируется на этапе генерации
- Замороженные веса, изменившийся алгоритм ответа
- Четыре разных бюджета
- Параллельное и последовательное увеличение бюджета
- Поиск добавляет состояния и правило возврата оценки
- Контракт оценивания до первого запуска
Шаг 10.1.1 — Замороженные веса, изменившийся алгоритм ответа
Вычисления на этапе генерации (test-time compute) — дополнительные вычисления, выполняемые после обучения модели для конкретного запроса. Параметры модели могут оставаться неизменными, но алгоритм получения ответа становится сложнее одиночного жадного прохода.
Полезно разделить четыре механизма.
- Параллельный бюджет: сгенерировать несколько кандидатов и затем агрегировать или отобрать один.
- Последовательный бюджет: дать одной траектории больше шагов, токенов, проверок или исправлений.
- Поисковый бюджет: ветвить рассуждение, оценивать промежуточные состояния и возвращаться к более перспективным ветвям.
- Адаптивный бюджет: выделять разное число попыток разным запросам.
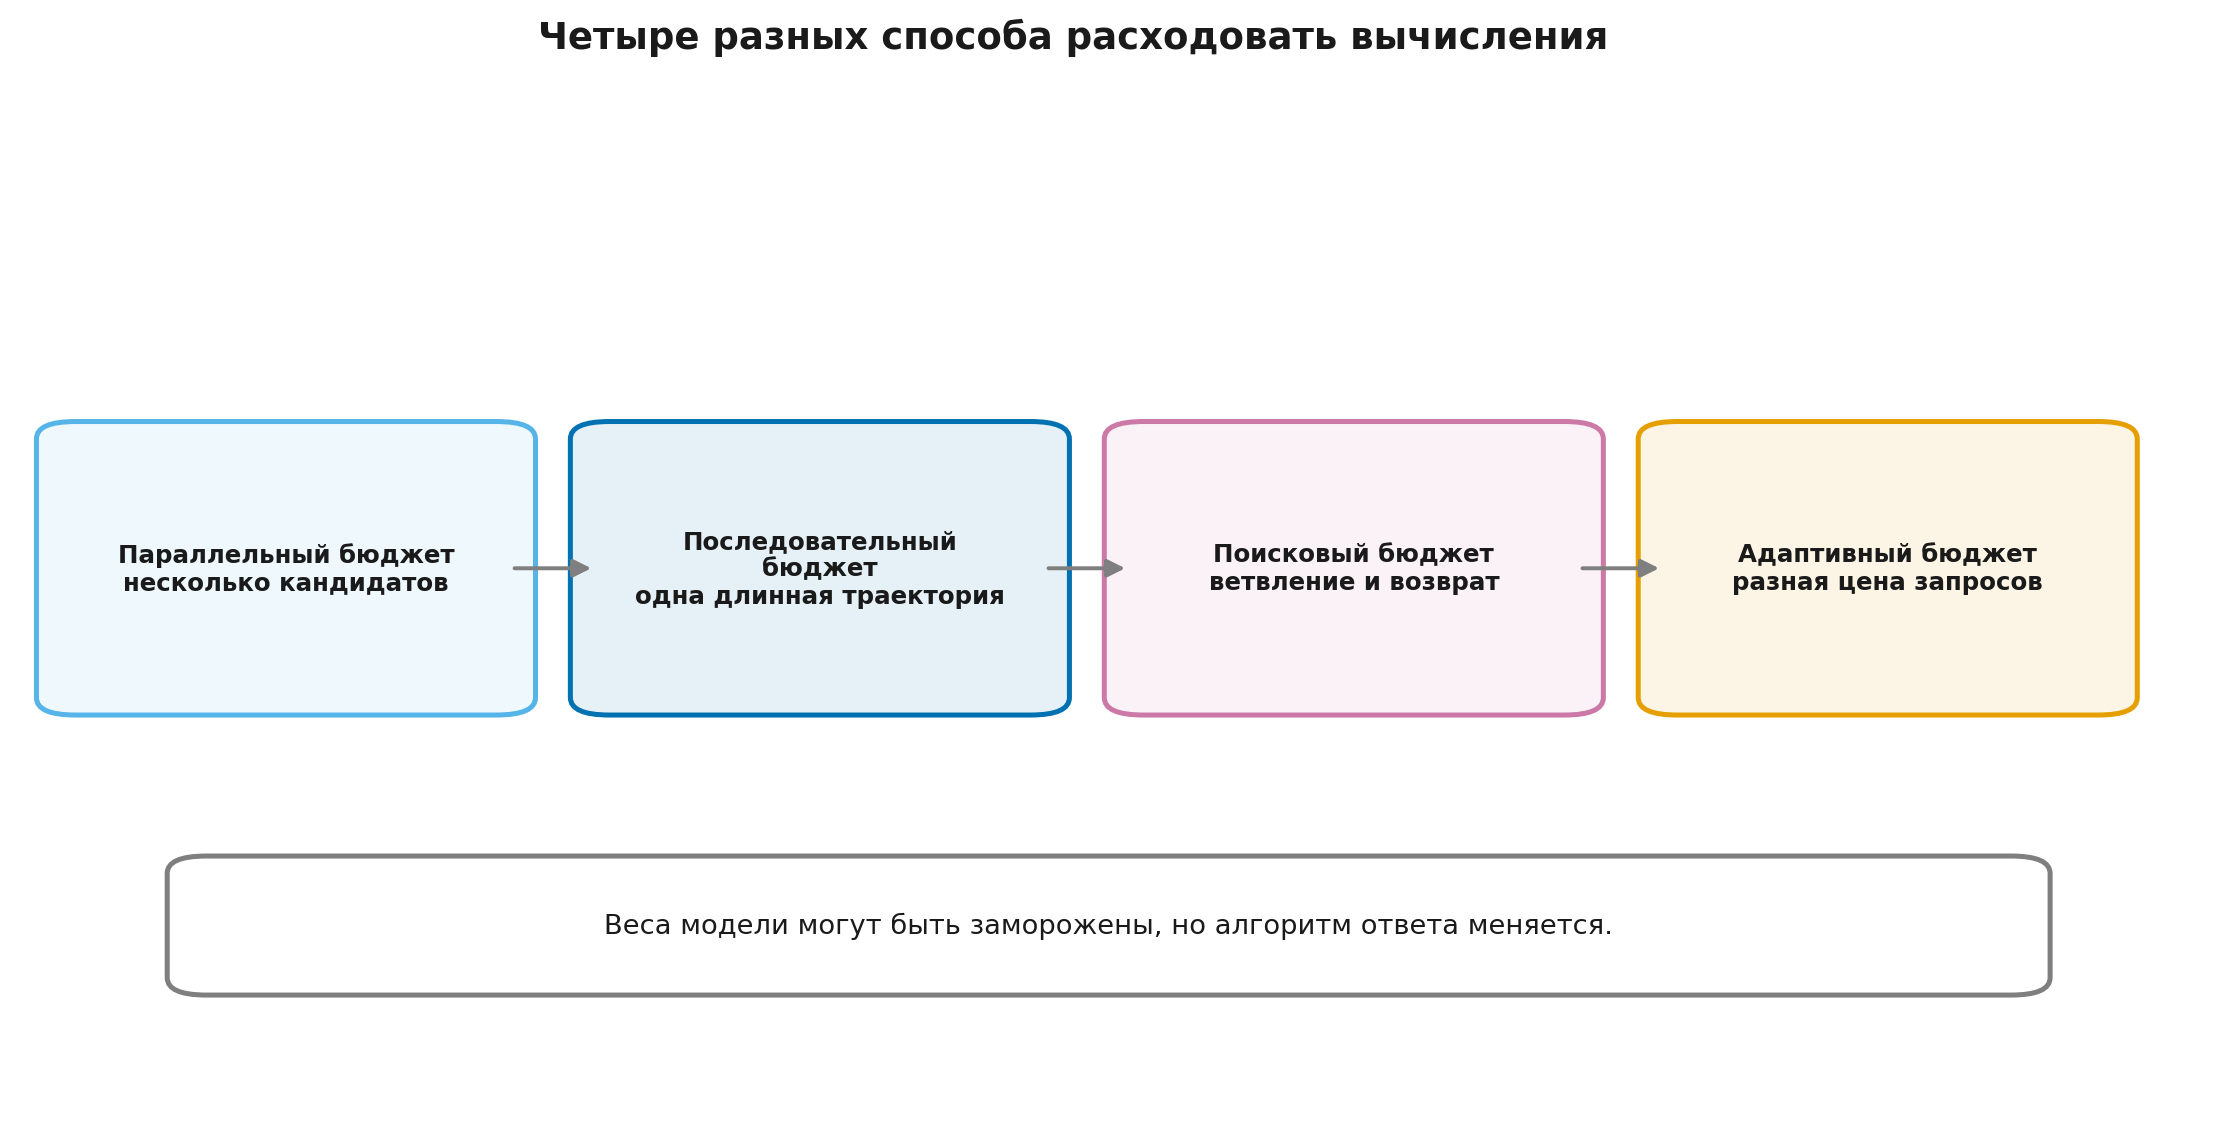
Эти механизмы можно сочетать. Например, система может породить четыре длинные траектории, проверить промежуточные шаги каждой, а затем дополнительно развернуть только две наиболее перспективные ветви.
Главная оговорка: больше вычислений — это не самостоятельная цель. Нужно заранее определить, что считается качеством, чем оно проверяется и какую стоимость допустимо заплатить.
Шаг 10.1.2 — Четыре разных бюджета
Фраза «потратить в четыре раза больше вычислений» недостаточна для воспроизводимого эксперимента. Возможны разные единицы:
- число сгенерированных кандидатов;
- число токенов запроса и ответа;
- число прямых проходов генератора;
- число вызовов проверяющей модели или программы;
- число раскрытых узлов поиска;
- задержка до первого токена и до полного ответа;
- секунды работы графического процессора (GPU-секунды);
- пиковая память;
- стоимость внешнего API.
Два метода с одинаковым числом кандидатов могут иметь разную цену: один генерирует короткие ответы и использует дешёвые тесты, другой — длинные траектории и отдельную модель-судью. Поэтому минимальная строка отчёта имеет вид
Для интерактивной системы также важны квантили задержки, а не только среднее. Метод с высоким средним качеством, но редкими задержками в минуты может быть непригоден для диалога и приемлем для пакетной проверки кода.
Шаг 10.1.3 — Параллельное и последовательное увеличение бюджета
Параллельный режим меняет ширину выборки:
Последовательный режим меняет длину или внутреннюю структуру одного ответа:
Это разные вмешательства. При параллельном режиме успех зависит от разнообразия кандидатов и качества агрегатора. При последовательном — от того, умеет ли политика использовать дополнительные шаги для проверки и исправления, а не только повторять уже выбранную ошибочную линию.
Принудительное управление бюджетом (budget forcing) — искусственное управление длиной рассуждения: преждевременное завершение блокируется или, наоборот, траектория принудительно останавливается после заданного бюджета. Такой приём может быть полезным диагностическим инструментом. Но рост длины сам по себе не гарантирует рост правильности: модель может зациклиться, испортить уже верный ответ или тратить токены на несущественные детали.
Шаг 10.1.4 — Поиск добавляет состояния и правило возврата оценки
В поисковом режиме единицей становится не только готовый ответ, но и промежуточное состояние:
Нужны как минимум четыре компонента:
- правило порождения продолжений;
- правило оценки промежуточного состояния;
- структура хранения открытых кандидатов;
- правило остановки и выбора финального ответа.
Поиск способен использовать внешний сигнал раньше конца ответа. Одновременно он создаёт новый режим отказа: ошибочная ранняя оценка может отсечь ветвь, которая привела бы к правильному решению. Поэтому поиск не просто «даёт модели больше времени»; он вводит отдельную управляющую систему со своей политикой и собственными ошибками.
Шаг 10.1.5 — Контракт оценивания до первого запуска
До эксперимента зафиксируйте:
- набор запросов и единицу усреднения;
- правила извлечения и канонизации финального ответа;
- генератор, токенизатор, шаблон диалога и параметры декодирования;
- максимальные бюджеты;
- способ выбора или агрегирования;
- версию проверяющей системы;
- метрики качества и стоимости;
- обработку ничьей, отказа, тайм-аута и технической ошибки;
- независимый набор, не участвующий в выборе гиперпараметров.
В противном случае можно незаметно сравнить разные задачи. Например, pass@32 измеряет наличие хотя бы одного успеха, самосогласованность при 32 попытках — качество голосования, а выбор лучшего из 32 — качество конкретного ранжировщика. Одинаковое число 32 не делает метрики взаимозаменяемыми.
Расширение: историческая карта моделей рассуждения, режимов генерации и продуктовых интерфейсов находится в курсе Modern LLMs, Модуль 15 «Модели рассуждения и вычисления во время инференса (test-time compute)» (
modern_llms.module_13_reasoning). Здесь основной акцент сделан на проверяемой математике выбора и стоимости.
Урок 10.2. Повторная генерация и агрегирование
Урок 10.2. Повторная генерация и агрегирование
- Формула pass@N и её предположения
- Предельный прирост и убывающая отдача
- Конечновыборочный оцениватель pass@k
- Самосогласованность: голосование по финальному ответу
- Канонизация, ничьи и отказ
далее — 4 проверочных шага
Шаг 10.2.1 — Формула pass@N и её предположения
Пусть каждая попытка независимо решает задачу с вероятностью . Вероятность того, что все попыток неудачны, равна . Поэтому
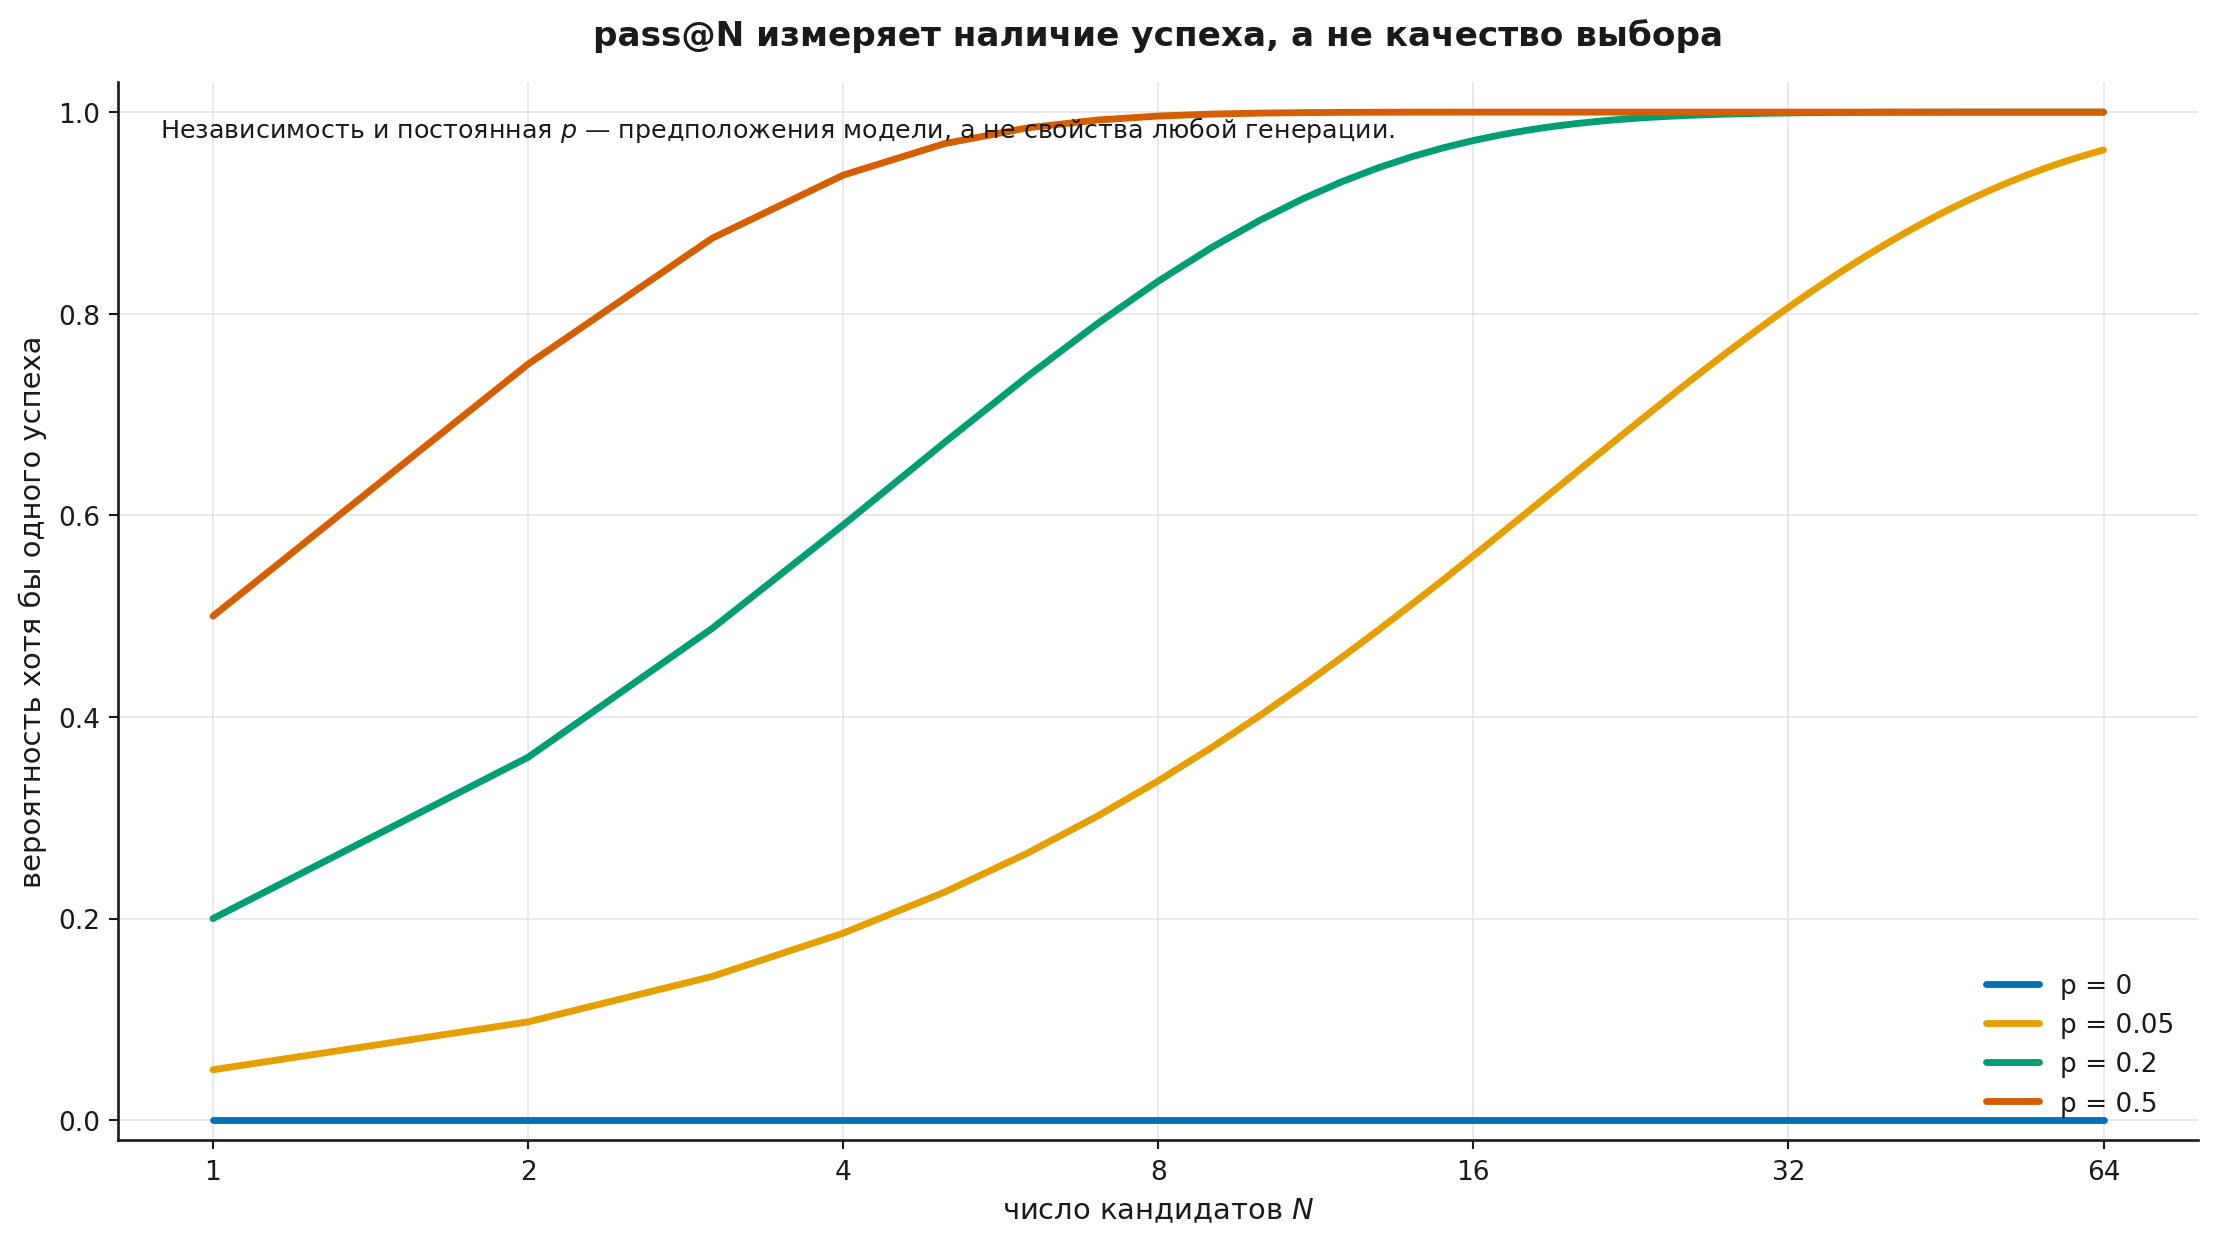
Формула описывает покрытие: вероятность того, что среди кандидатов существует хотя бы один правильный. Она не сообщает, умеет ли система распознать этого кандидата и выдать его пользователю.
Условия записываются рядом с результатом:
- попытки условно независимы при фиксированном запросе;
- вероятность успеха одинакова для каждой попытки;
- критерий правильности определён до просмотра кандидатов;
- относится к тому же режиму декодирования, который используется при .
Если генерации положительно коррелированы и повторяют одну ошибку, независимая формула обычно завышает выигрыш. Однако слово «корреляция» само по себе не задаёт строгую универсальную поправку: зависимость может быть кластерной, обусловленной скрытой сложностью запроса или изменяться с температурой. Поэтому эмпирическое pass@k следует измерять непосредственно по группам кандидатов, сохраняя результаты на уровне запроса.
При увеличение бесполезно: выборка не создаёт решение, которому генератор не даёт положительной вероятности. При малом, но положительном покрытие может стать высоким, хотя практическое правило выбора всё ещё будет ошибаться.
Шаг 10.2.2 — Предельный прирост и убывающая отдача
Прирост при добавлении ещё одной попытки:
Он не возрастает с . Для :
| Текущий бюджет | Прирост от следующего кандидата |
|---|---|
| 0 | 0.2000 |
| 1 | 0.1600 |
| 3 | 0.1024 |
| 7 | 0.0419 |
| 15 | 0.0070 |
Это не означает, что большой всегда экономически невыгоден. Для редкой, но очень ценной задачи даже небольшой дополнительный шанс может оправдать цену. Формула лишь показывает, что решение должно учитывать предельную, а не среднюю отдачу.
Шаг 10.2.3 — Конечновыборочный оцениватель pass@k
На практике неизвестна истинная вероятность . Для одного запроса часто генерируют кандидатов, из которых проходят проверку. Если мысленно выбрать кандидатов без возвращения, вероятность не выбрать ни одного из успешных равна
Отсюда оцениватель
а если , значение равно 1.
Для , , получаем
Этот оцениватель относится к определённому протоколу конечной выборки. Нельзя подставлять в него число кандидатов из одного режима декодирования и интерпретировать как свойство другого режима.
Шаг 10.2.4 — Самосогласованность: голосование по финальному ответу
Самосогласованность (self-consistency) генерирует несколько траекторий, извлекает из каждой канонический финальный ответ и выбирает наиболее частый. Это голосование по ответам, а не по тексту рассуждения.
Метод помогает, когда правильный канонический ответ является наиболее вероятной отдельной модой, а ошибки распределены между многими вариантами. Тогда при независимой генерации относительные частоты сходятся к истинным вероятностям, и правильная мода побеждает всё стабильнее.
Но большинство не знает, какой ответ правильный. Если одна систематическая ошибка вероятнее правильного ответа, дополнительные голоса усиливают именно её.
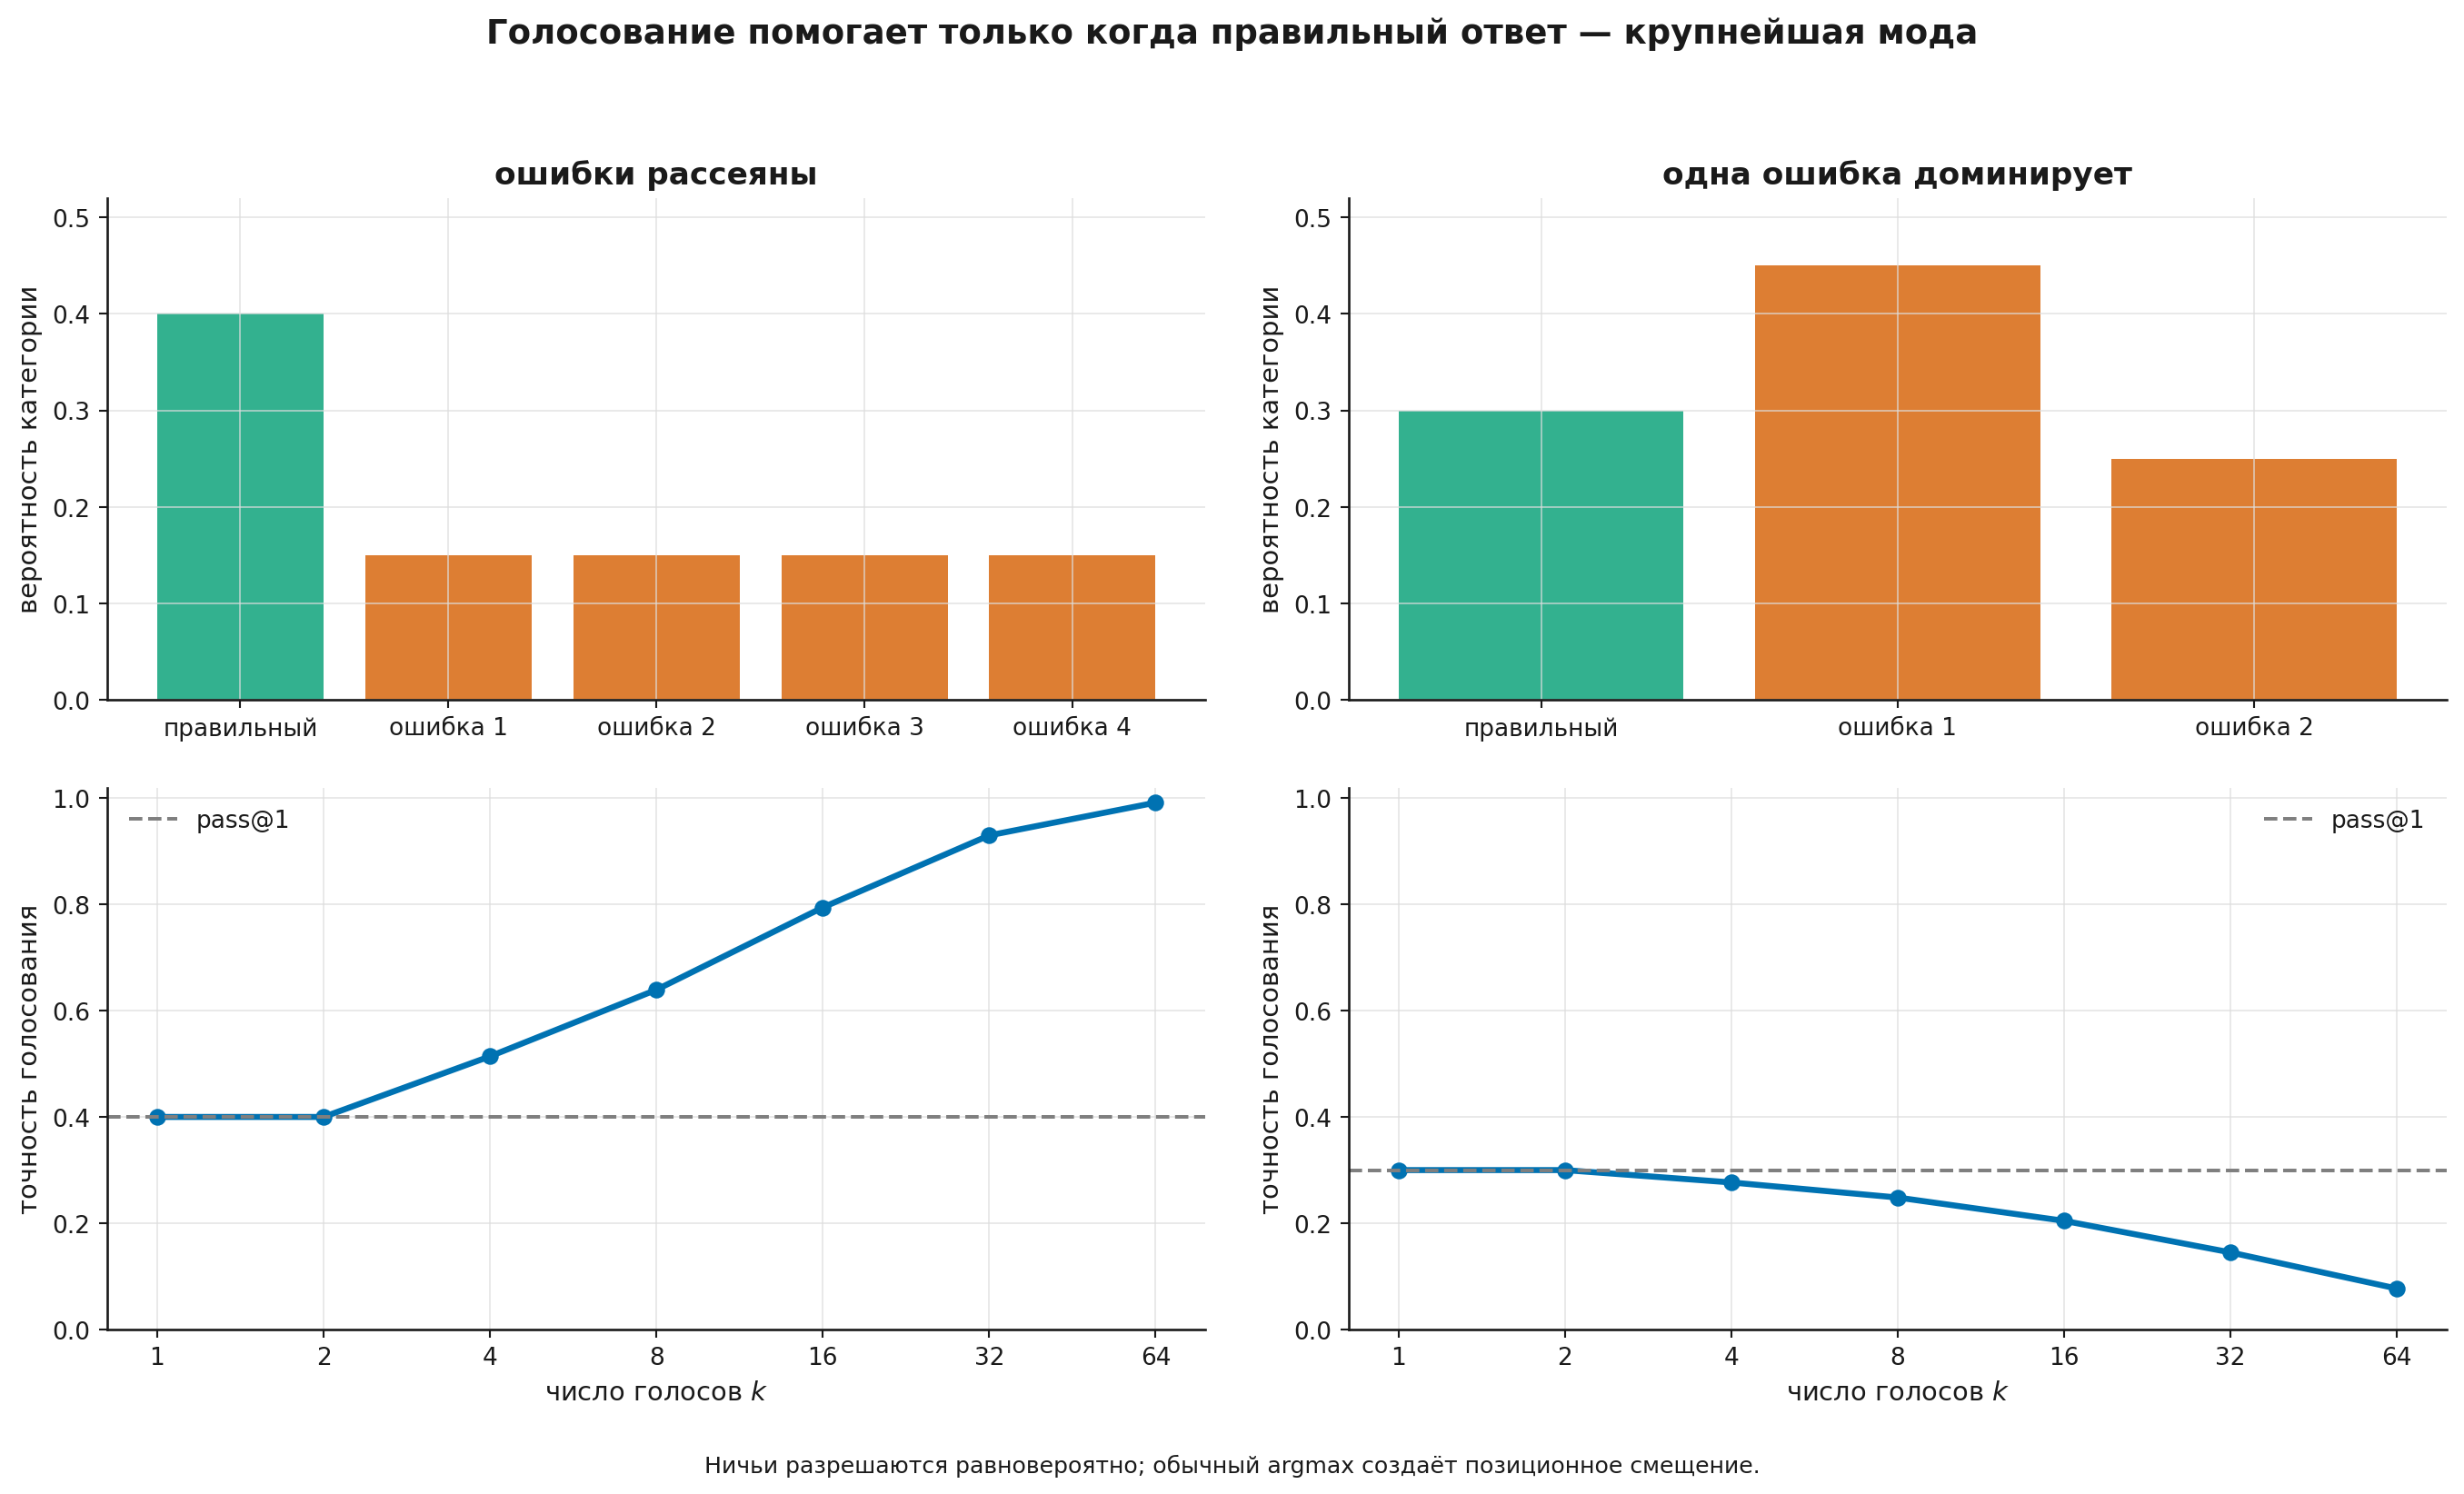
Для небольшого числа категорий вероятность победы можно вычислить точно, суммируя мультиномиальную массу по всем векторам счётчиков и равновероятно разрешая ничьи. В двух учебных конфигурациях получаем:
- при вероятностях точность голосования при равна приблизительно ;
- при вероятностях точность при равна приблизительно , хотя
pass@64для правильного ответа практически равен единице.
Так возникает принципиальное расхождение: правильный ответ почти всегда присутствует в корзине, но правило выбора почти всегда предпочитает другую моду.
Монте-Карло полезен для более крупных пространств ответов, но тогда следует указывать число испытаний, начальное значение генератора случайных чисел и статистическую погрешность. Детерминированный argmax при ничьей не нейтрален: он создаёт преимущество категории с меньшим индексом.
Шаг 10.2.5 — Канонизация, ничьи и отказ
Голосование определено только после задания функции
Для числа можно удалить пробелы и нормализовать десятичную запись. Для программы — выполнить тесты. Для свободного текста канонизация значительно сложнее: два семантически одинаковых ответа могут выглядеть по-разному, а два похожих — противоречить друг другу.
Протокол должен явно задавать:
- что извлекается из ответа;
- как обрабатывается ошибка парсинга;
- как разрешается ничья;
- допускается ли отказ;
- учитывается ли уверенность или внешний балл;
- считается ли повтор одного и того же текста независимым голосом.
Детерминированный выбор первого индекса при ничьей удобен для тестов кода, но может создавать скрытое позиционное преимущество. В прикладной системе разумнее случайное разрешение ничьей, дополнительная проверка или отказ от ответа.
Урок 10.3. Проверяющие системы и Best-of-N
Урок 10.3. Проверяющие системы и Best-of-N
- Наличие хорошего кандидата и его выбор
- Точная модель двоичной проверки
- Ранжирование и ошибка победителя
- Пять протоколов выбора
- Проверка как часть модели угроз
далее — 7 проверочных шагов
Шаг 10.3.1 — Наличие хорошего кандидата и его выбор
Выбор лучшего из (Best-of-N, BoN) состоит из двух стадий:
- генератор создаёт кандидатов;
- проверяющая система или ранжировщик выбирает один.
При совершенной проверке итоговая точность совпадает с pass@N. При несовершенной — нет. Полезно разложить ошибку:
Первый член относится к генератору и бюджету. Второй — к правилу выбора. Увеличение уменьшает первый член только при наличии поддержки, но может усложнять второй: среди большего числа кандидатов чаще появляются убедительные ложноположительные ответы.
Проверяющая система может быть точной программой, набором тестов, моделью награды, моделью награды процесса (process reward model, PRM), моделью-судьёй или комбинацией. Эти варианты нельзя объединять словом «верификатор» без описания их ошибок.
Шаг 10.3.2 — Точная модель двоичной проверки
Рассмотрим полностью определённый учебный протокол.
- Кандидат правильный с вероятностью .
- Правильный кандидат принимается с вероятностью — доля истинно положительных решений (
true positive rate, TPR). - Неправильный принимается с вероятностью — доля ложноположительных решений (
false positive rate, FPR). - Если принят хотя бы один кандидат, система случайно выбирает среди принятых.
Вероятность принятия отдельного кандидата:
Доля правильных среди принятых:
А среди отклонённых:
Эта вторая условная вероятность важна для резервного правила. Если никто не принят, возможны как минимум два разных протокола.
Резерв из той же отклонённой корзины
Свежий независимый кандидат без проверки
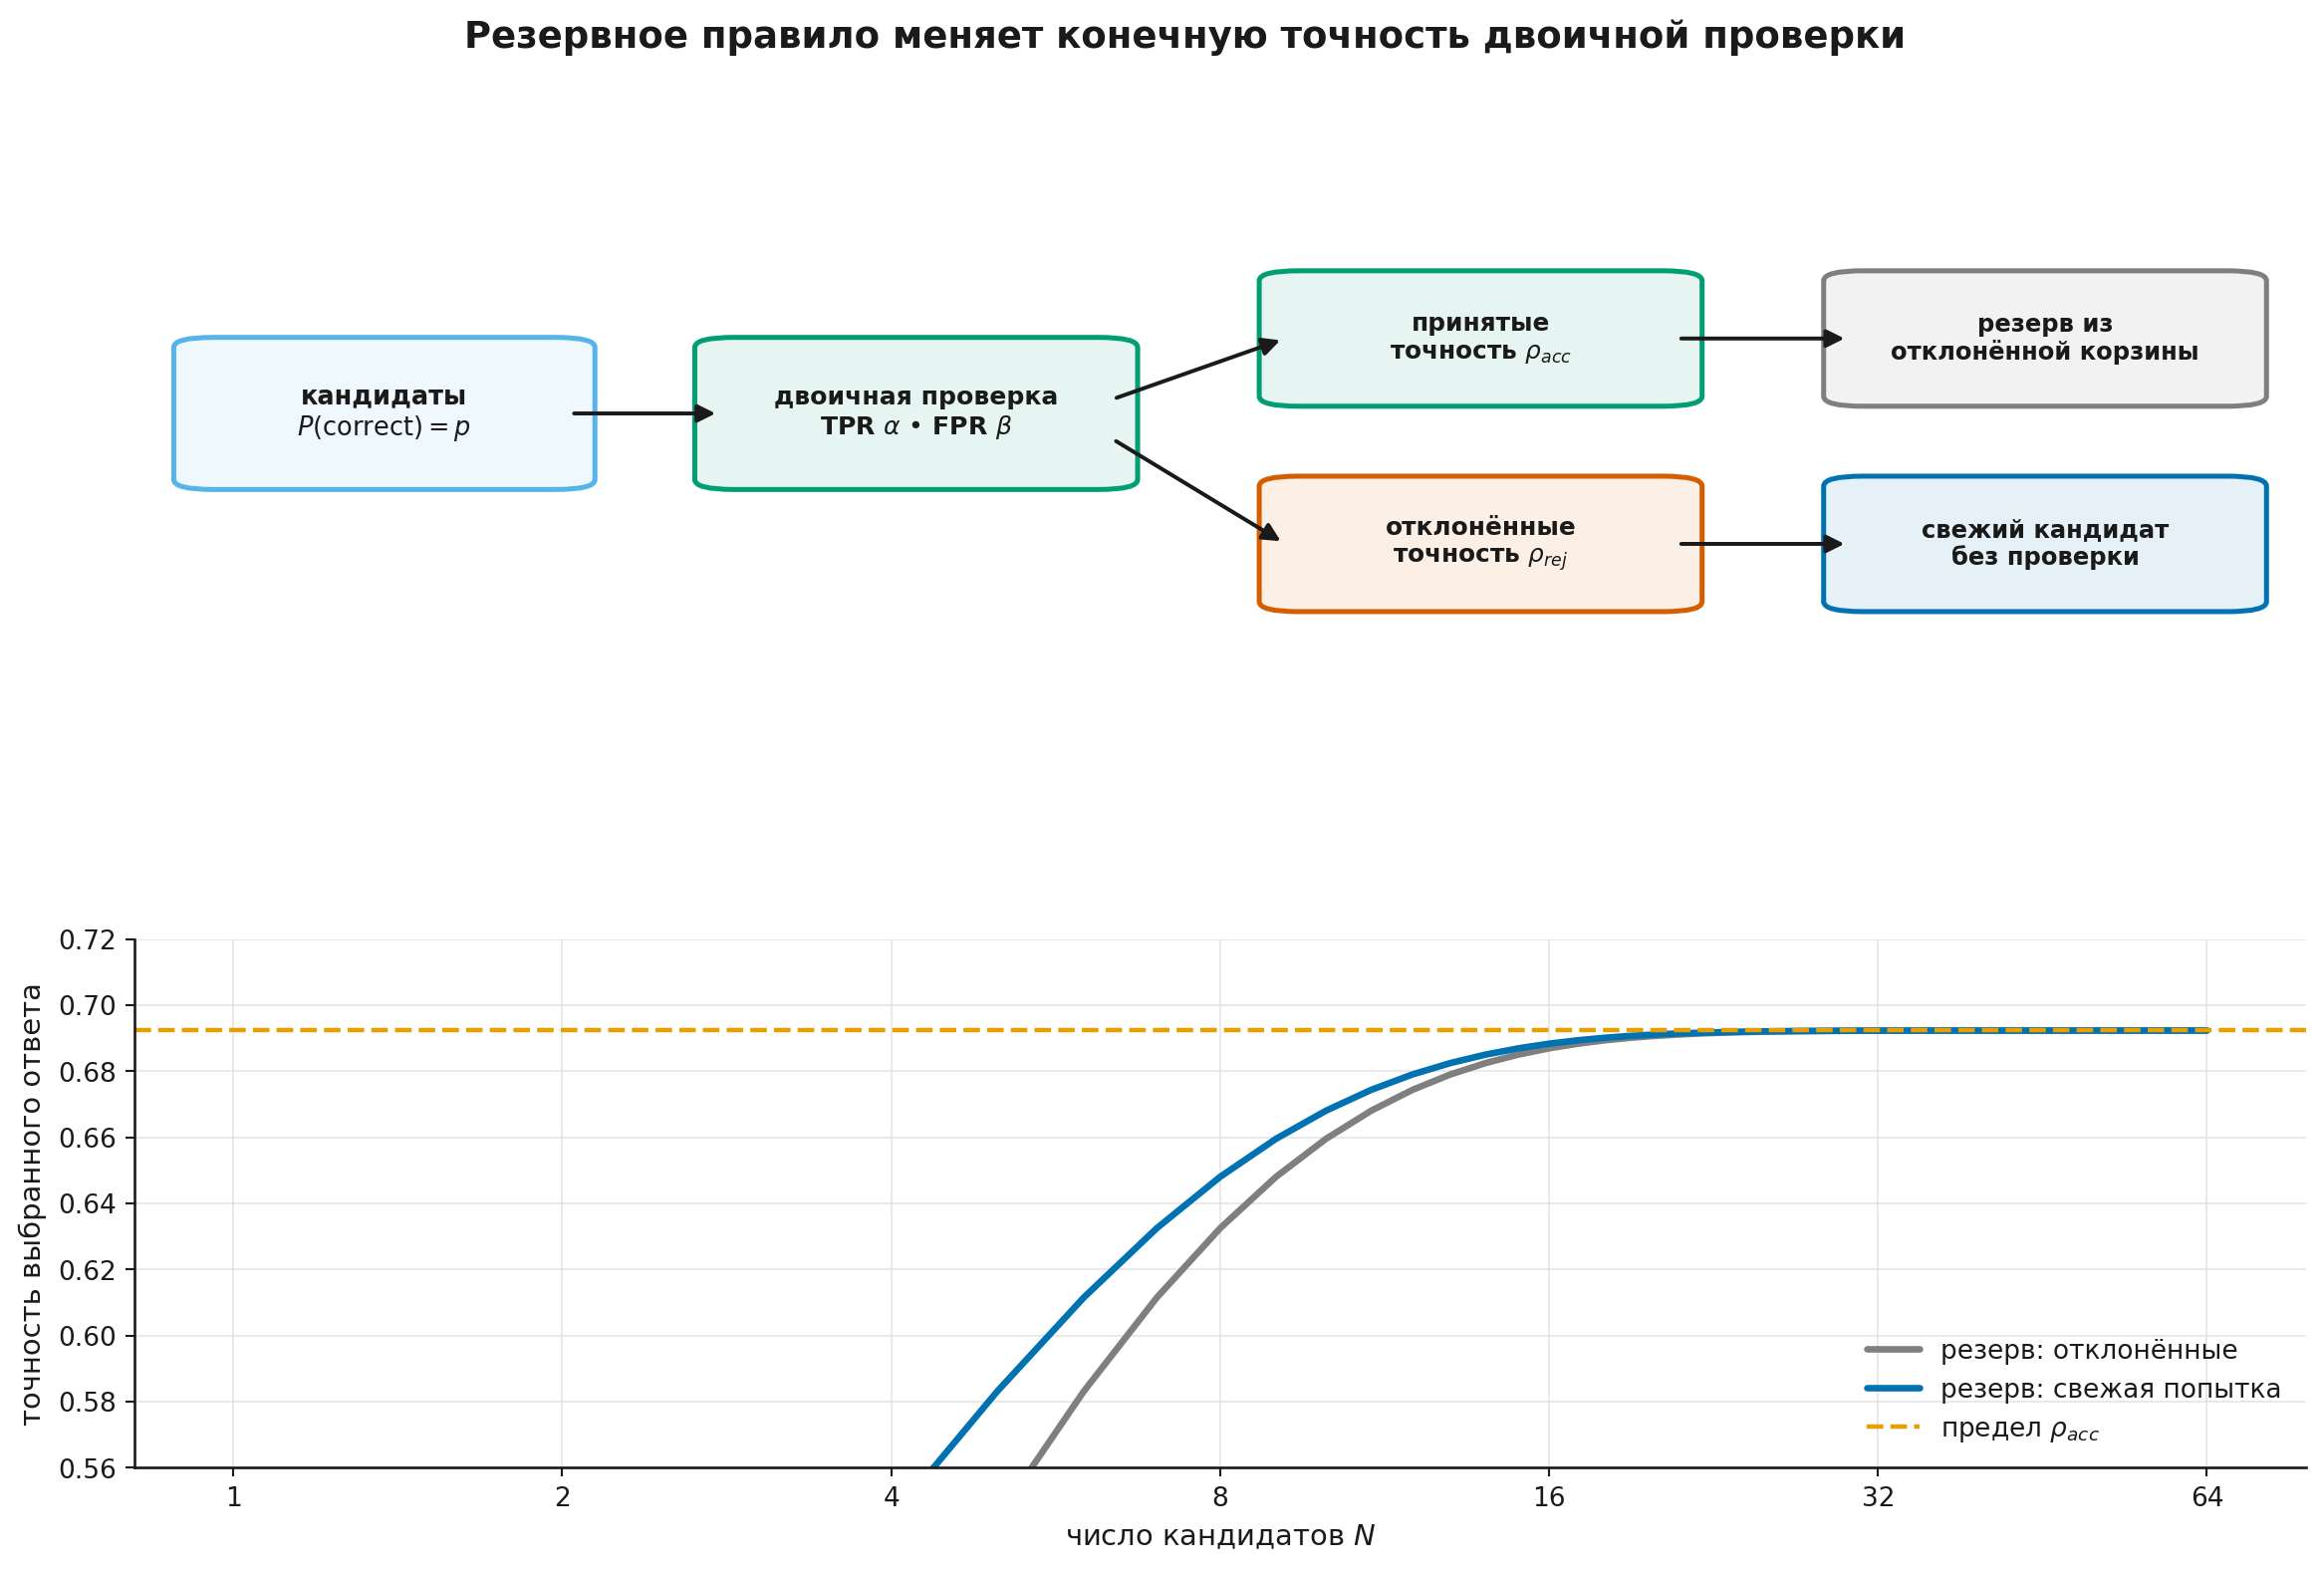
Для , , :
При :
Если , то при вероятность пустого множества принятых исчезает и оба протокола сходятся к . Но конечное значение зависит от резервного правила. Запись с неверна, если система выбирает среди кандидатов, о которых уже известно, что они отклонены.
Граница результата. Этот предел относится только к двоичному принятию и случайному выбору среди принятых. Он не является потолком непрерывного ранжировщика, попарного турнира или точной проверки.
Шаг 10.3.3 — Ранжирование и ошибка победителя
Пусть каждый кандидат имеет истинную полезность , а проверяющая система выдаёт
BoN выбирает индекс
Одного нулевого безусловного среднего недостаточно для положительной средней ошибки победителя: важно совместное распределение полезности и ошибки. При независимом невырожденном аддитивном шуме оценивателя, независимом от полезностей кандидатов, максимизация отбирает и полезность, и удачный шум. Этот механизм ошибки победителя может приводить к переоптимизации прокси; без указанных условий знак не гарантирован.
В синтетическом эксперименте модуля прокси-оценка растёт при каждом увеличении , а независимая цель достигает максимума при и затем падает.
| Прокси-оценка | Независимая цель | |
|---|---|---|
| 1 | -0.004 | -0.075 |
| 8 | 2.005 | 0.653 |
| 32 | 2.931 | 0.723 |
| 128 | 3.670 | 0.604 |
| 512 | 4.306 | 0.253 |
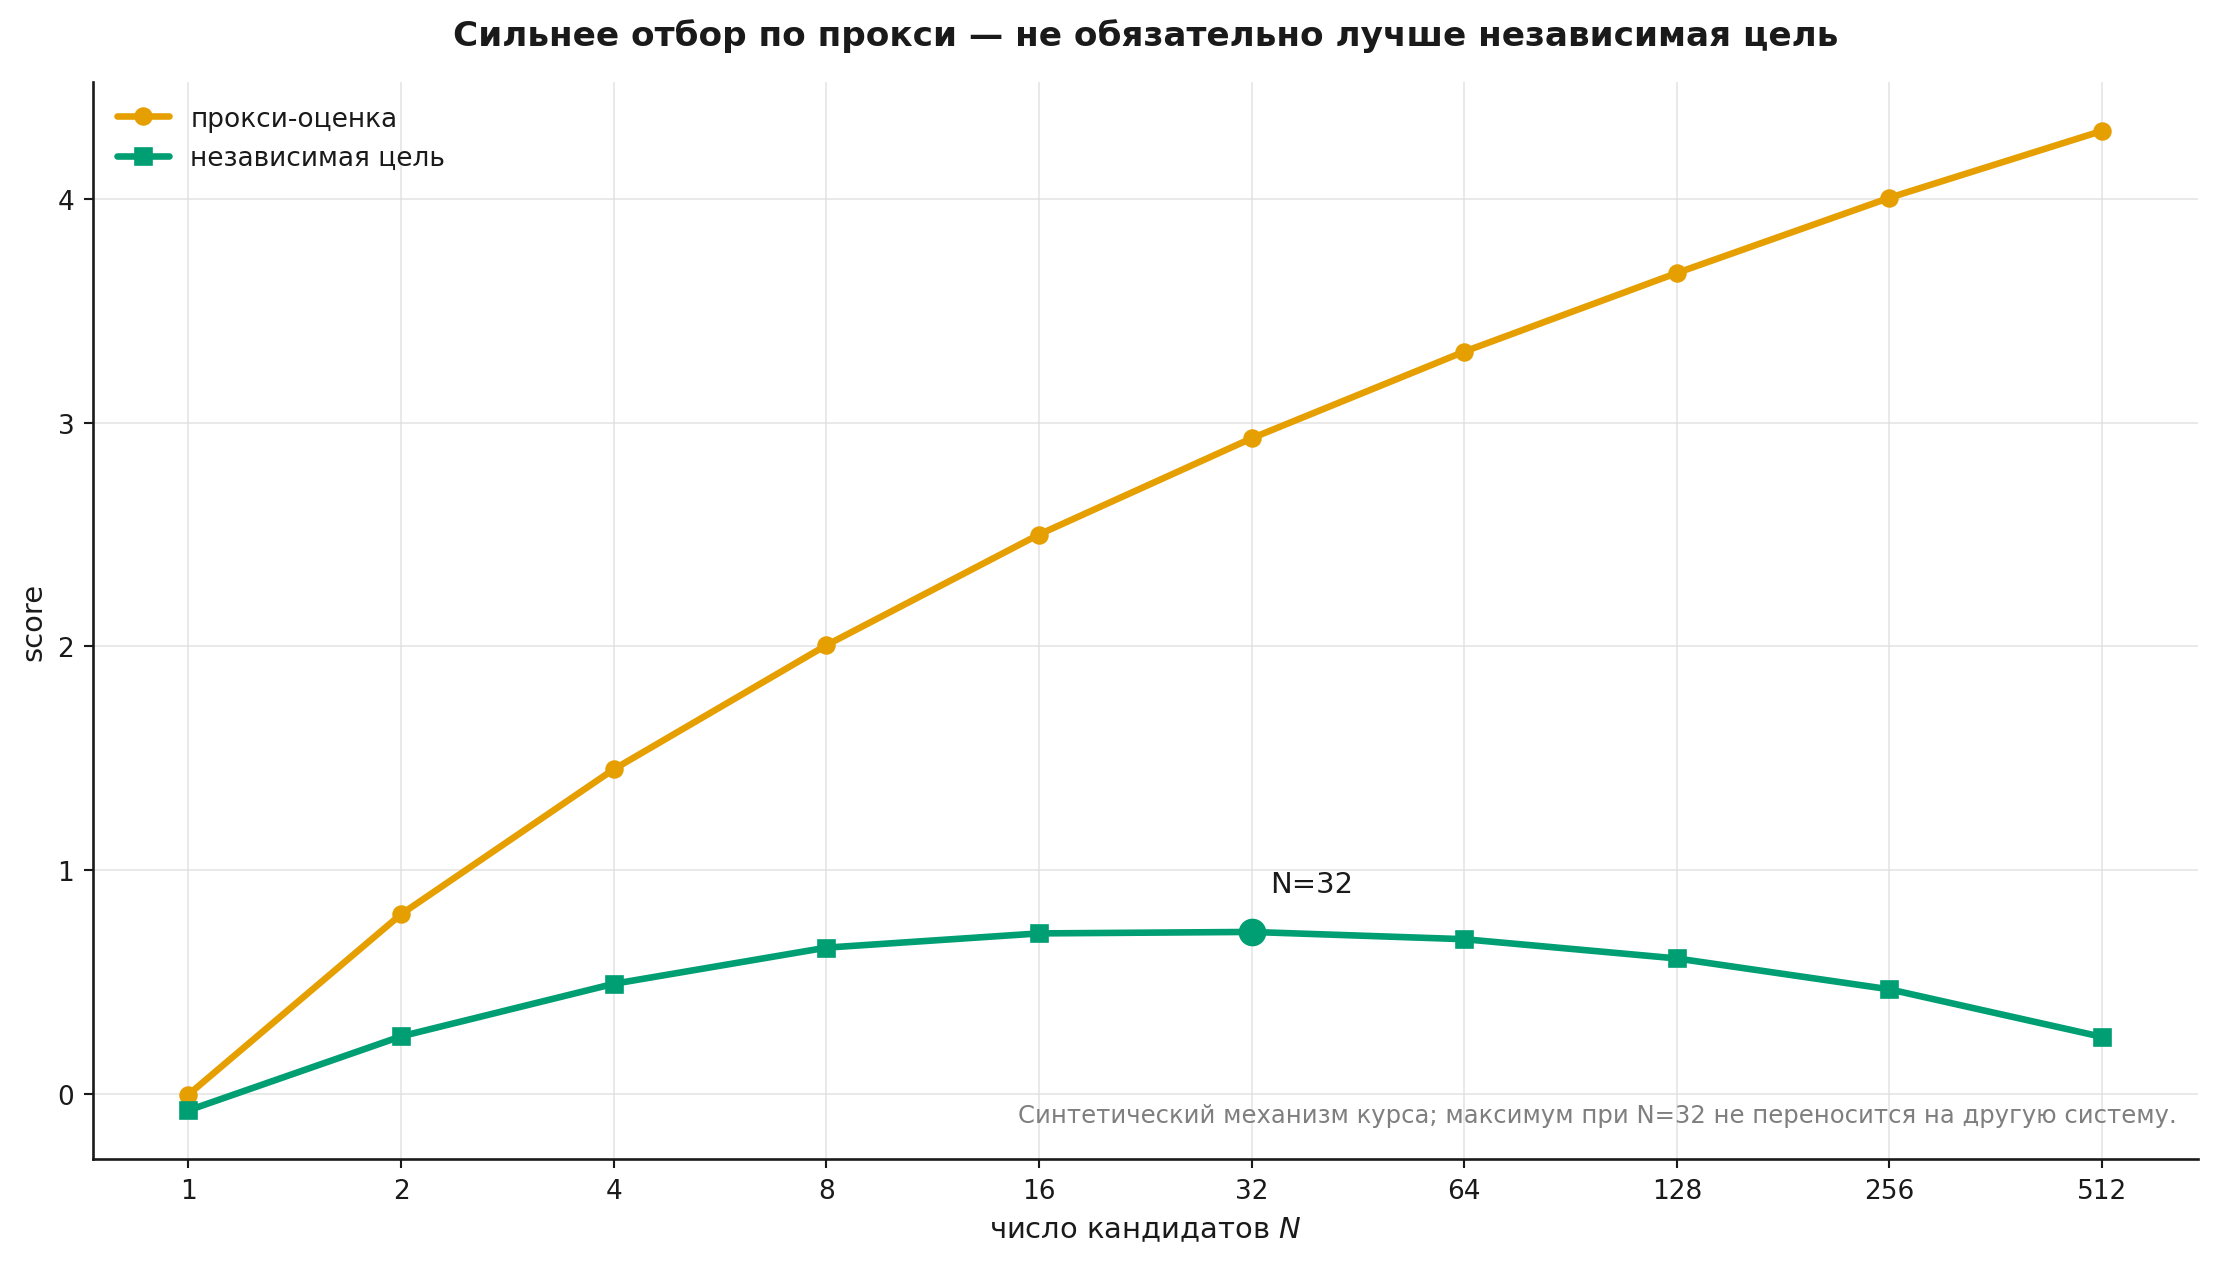
Это не универсальная кривая для LLM. Она показывает механизм: чем сильнее отбор по несовершенной оценке, тем важнее независимая проверка качества.
Шаг 10.3.4 — Пять протоколов выбора
Один и тот же набор кандидатов можно обработать по-разному.
| Протокол | Что требуется | Основной риск |
|---|---|---|
| Точная проверка | исполнимый критерий | неполные тесты и уязвимая среда |
| Порог и отказ | калиброванный балл | слишком много отказов или ложных принятий |
| Максимальный балл | сопоставимая шкала | ошибка победителя в хвосте |
| Попарный турнир | устойчивые сравнения | нетранзитивность и порядок пар |
| Голосование | канонический ответ | систематическая мода |
Нет универсально лучшего протокола. Для программирования точные тесты обычно сильнее модельной эстетической оценки, но неполный набор тестов может принять решение, нарушающее скрытое требование. Для открытого текста точной программы часто нет; тогда особенно важны калибровка, отказ, перестановка кандидатов и независимые рубрики.
Шаг 10.3.5 — Проверка как часть модели угроз
При большом генератор фактически ищет вход, на котором проверяющая система ошибётся. Поэтому проектирование BoN включает безопасность:
- выполнение кода только в песочнице;
- ограничения времени, памяти, файловой системы и сети;
- разделение обучающих и закрытых тестов;
- версионирование парсера и проверяющей среды;
- сохранение причины принятия или отклонения;
- аудит ложноположительных примеров;
- независимый контрольный критерий;
- защита текста рубрики и системных инструкций модели-судьи.
Это тот же принцип, что и в RLVR: воспроизводимая награда остаётся прокси. На этапе генерации давление отбора может быть очень сильным даже без изменения весов модели.
Урок 10.4. Процессные оценки и структурированный поиск
Урок 10.4. Процессные оценки и структурированный поиск
- Итоговая и процессная обратная связь
- Метки Монте-Карло для префикса
- Как агрегировать оценки шагов
- Лучевой, приоритетный и MCTS-поиск
- Режимы отказа поиска
далее — 4 проверочных шага
Шаг 10.4.1 — Итоговая и процессная обратная связь
Итоговый оцениватель видит полный ответ:
PRM оценивает промежуточные префиксы или шаги:
Процессная оценка полезна, когда финальная награда слишком разрежена и поиск должен решать, какую ветвь продолжать. Но смысл зависит от разметки.
- Метка «этот шаг локально корректен» оценивает свойство шага.
- Метка «из этого префикса часто получается правильный ответ» оценивает вероятность успеха при конкретной политике продолжения.
- Метка «эксперт предпочитает этот префикс» задаёт ещё один объект.
Называть все три значения «ценностью состояния» без уточнения нельзя.
Шаг 10.4.2 — Метки Монте-Карло для префикса
Пусть из префикса генерируют независимых продолжений политикой , а показывает итоговый успех. Тогда
оценивает
Это связь с методом Монте-Карло из Модуля 2 «Состояние, ценность и уравнения Беллмана» (rl_llm.module_02_values_bellman). Одновременно она фиксирует границу: метка зависит от политики продолжения , декодирования, бюджета и итогового критерия. После смены политики та же оценка может устареть.
Нулевая метка при малом не доказывает невозможность успеха. Если истинная вероятность равна , то вероятность не увидеть ни одного успеха за продолжений составляет
Даже наблюдение 6 успехов из 8 даёт точечную оценку , но приблизительный 95%-й интервал Уилсона остаётся широким: примерно . Для процессной модели это означает, что два близких сырых среднего могут не нести надёжного порядка.
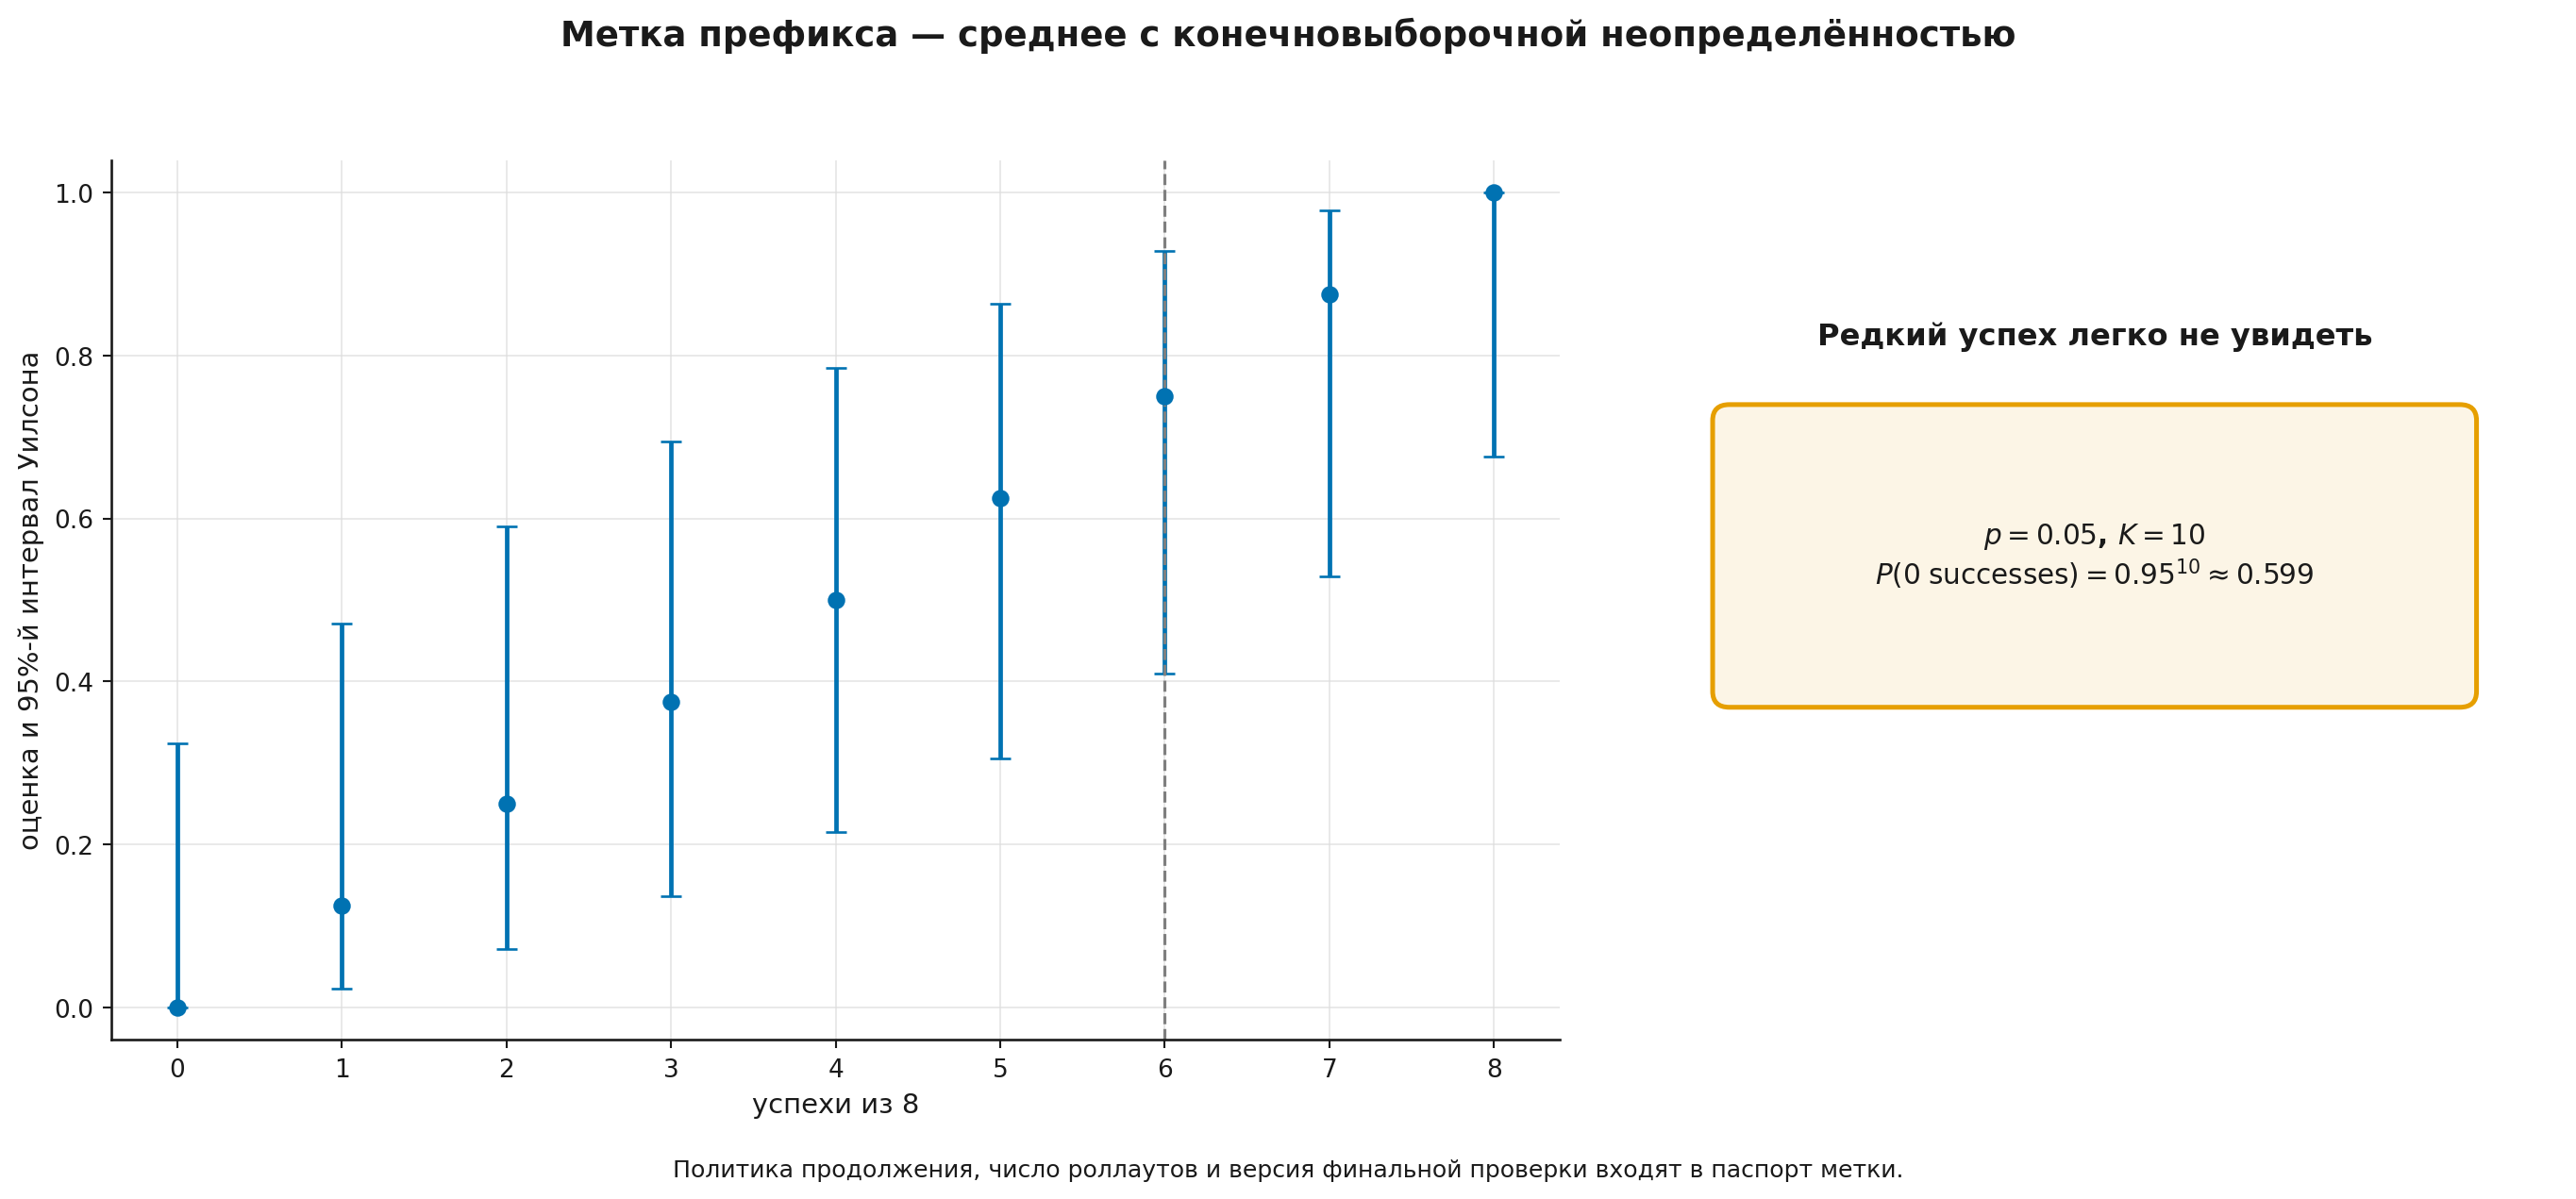
Поэтому паспорт метки включает число продолжений, политику и параметры декодирования, версию итоговой проверки, а также оценку неопределённости или правило сглаживания. Если префиксы получают разное число продолжений, равный вес всех сырых средних также требует обоснования.
Шаг 10.4.3 — Как агрегировать оценки шагов
Пусть PRM выдала значения . Часто используются:
Для :
| Правило | Значение | Что оно подчёркивает |
|---|---|---|
| минимум | 0.3000 | самый слабый шаг |
| среднее | 0.7875 | общий уровень |
| произведение | 0.2572 | совместную цепочку при сильных предположениях |
| последний шаг | 0.9500 | только финальное состояние |
Произведение имеет встроенную зависимость от длины. Даже постоянная оценка даёт и . Это может быть осмысленно, если значения являются совместимыми условными вероятностями множителей одной цепи. В противном случае получается скрытый штраф за длину.
Минимум чувствителен к одному шумному провалу, среднее может скрыть критическую ошибку, а последний шаг игнорирует ранние нарушения. Выбор агрегирования должен следовать семантике меток, а не привычке библиотеки.
Шаг 10.4.4 — Лучевой, приоритетный и MCTS-поиск
Лучевой поиск (beam search) хранит лучших текущих префиксов, расширяет их и снова оставляет . Он прост и хорошо векторизуется, но раннее отсечение необратимо.
Поиск по наилучшей оценке (best-first search) хранит общую очередь открытых состояний и раскрывает наиболее перспективное. Он допускает неравномерную глубину, но требует сопоставимой оценки состояний разной длины.
Поиск по дереву Монте-Карло (Monte Carlo tree search, MCTS) обычно чередует выбор, расширение, оценивание или симуляцию и возврат результата к предкам.
Классический UCT (Upper Confidence bounds applied to Trees) для уже посещённого дочернего узла использует индекс вида
где — средний возврат дочернего узла, — число посещений родителя, — число посещений ребёнка, а управляет исследованием. Для непосещённых детей обычно задаётся отдельный приоритет расширения.
Связь с UCB из Модуля 3 «Бандиты, исследование и одношаговые решения» (rl_llm.module_03_bandits) полезна концептуально, но не переносит гарантии автоматически. В текстовом дереве ветвление огромно, семантически одинаковые состояния имеют разные строки, оцениватель смещён, а действия могут быть фрагментами разной длины. Современные реализации часто используют априорные вероятности и варианты PUCT; их формула и единица стоимости должны быть названы явно.
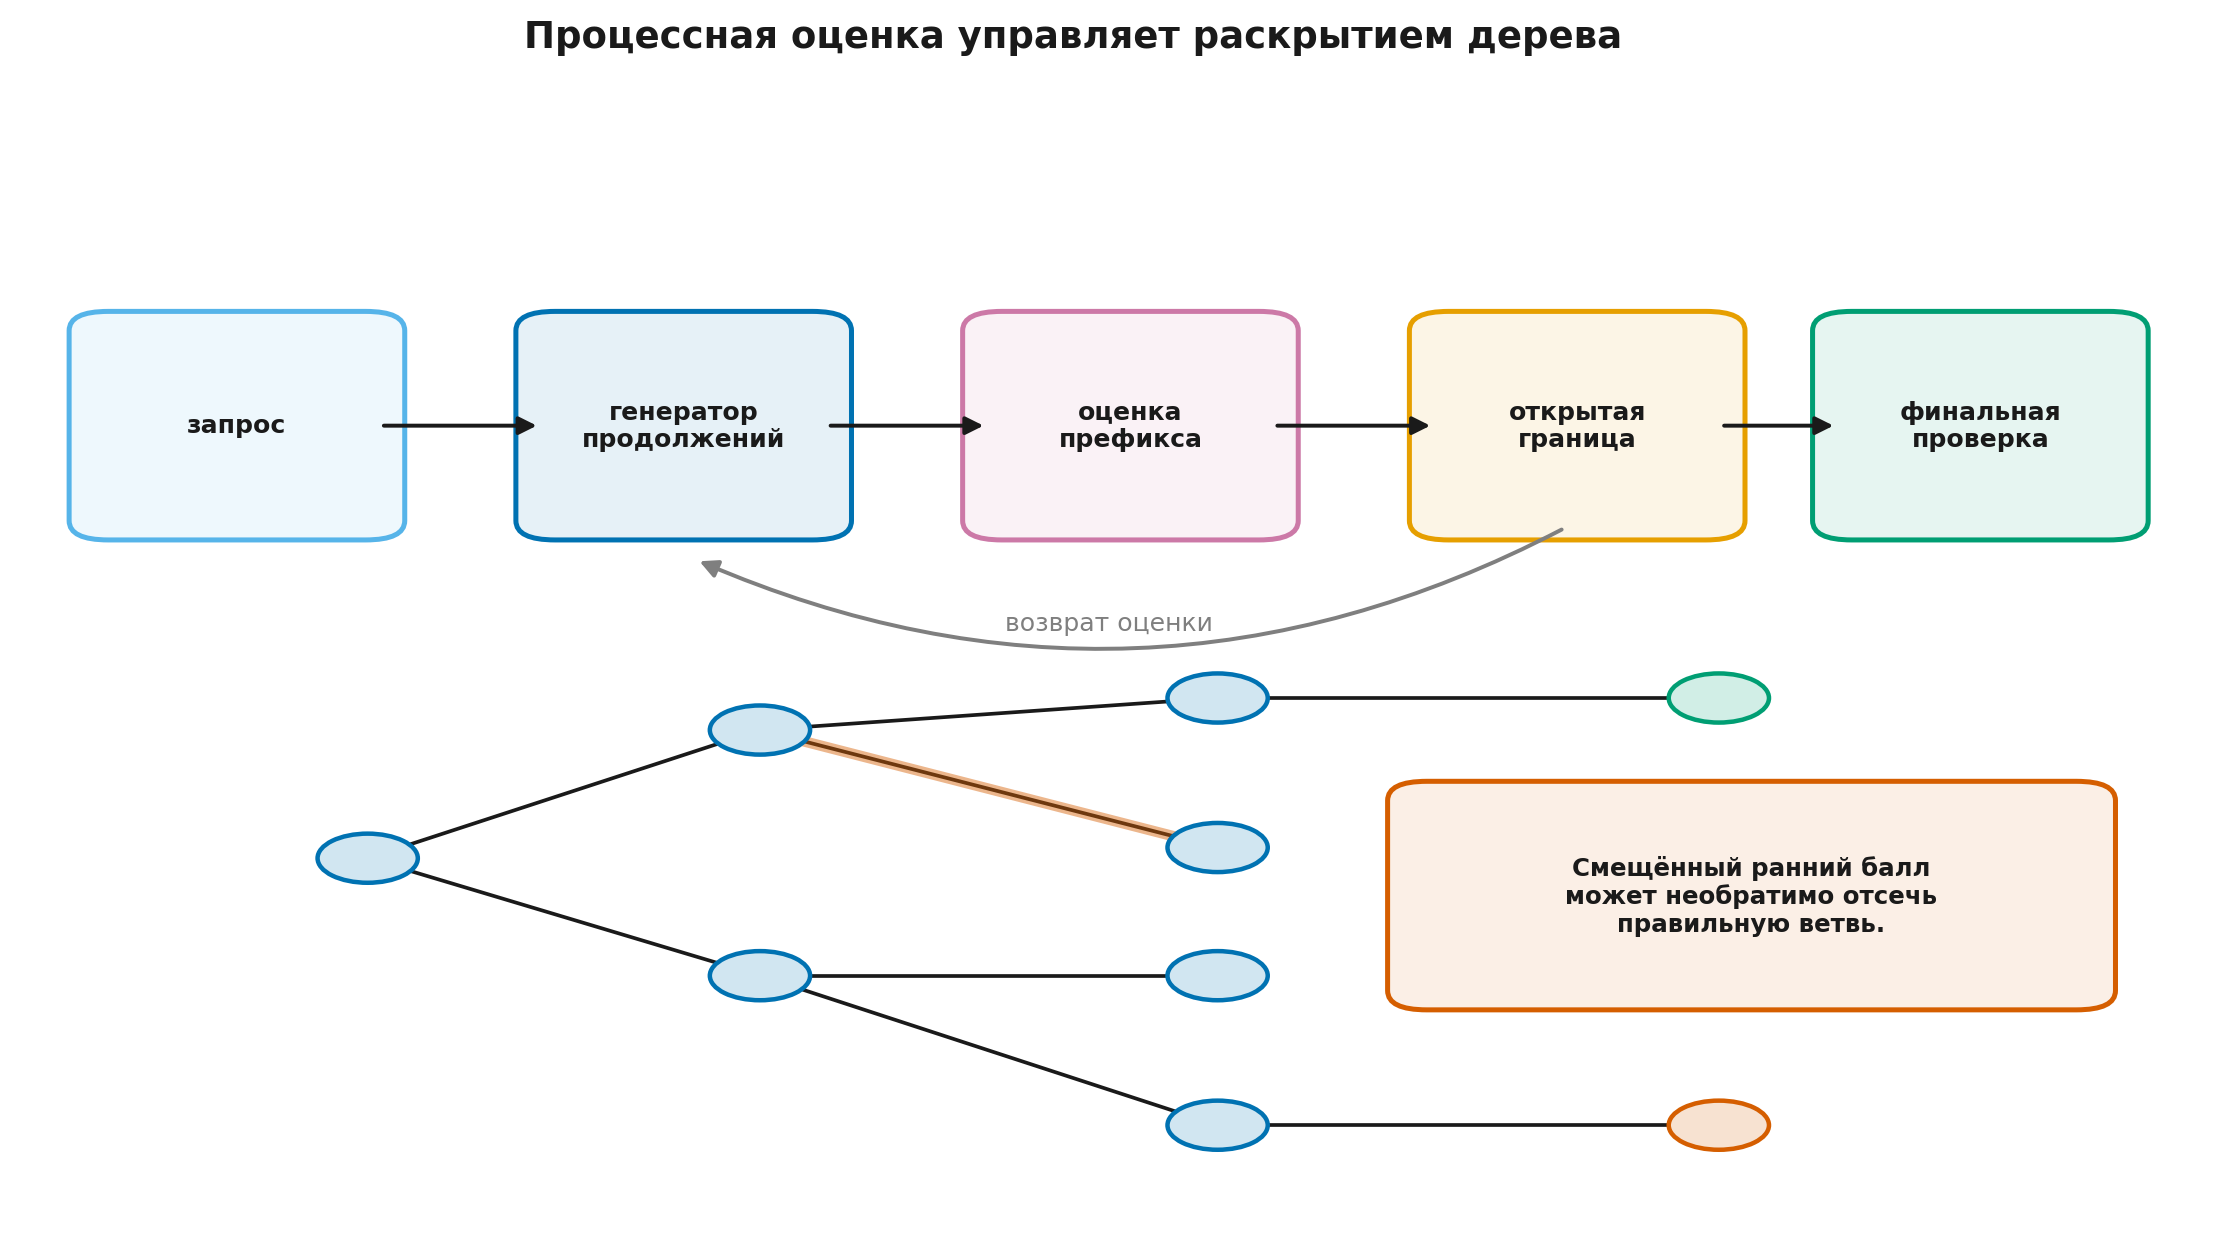
Шаг 10.4.5 — Режимы отказа поиска
Структурированный поиск может проиграть простой повторной генерации, если:
- оценка префикса хуже итоговой проверки;
- верная ветвь выглядит слабой на ранних шагах;
- генератор предлагает почти одинаковые продолжения;
- глубина и ширина выбраны без учёта задачи;
- баллы разных глубин несопоставимы;
- проверяющая система эксплуатируется локально;
- стоимость управления деревом съедает выигрыш;
- несколько путей на деле являются перефразировками одной ошибки.
Ноутбук содержит небольшую «лабиринтную среду рассуждения». Замороженная политика предлагает следующий шаг, точная проверка распознаёт цель, а процессная оценка направляет лучевой, приоритетный и PUCT-подобный поиск. Каждый вызов предложения считается одной единицей бюджета.
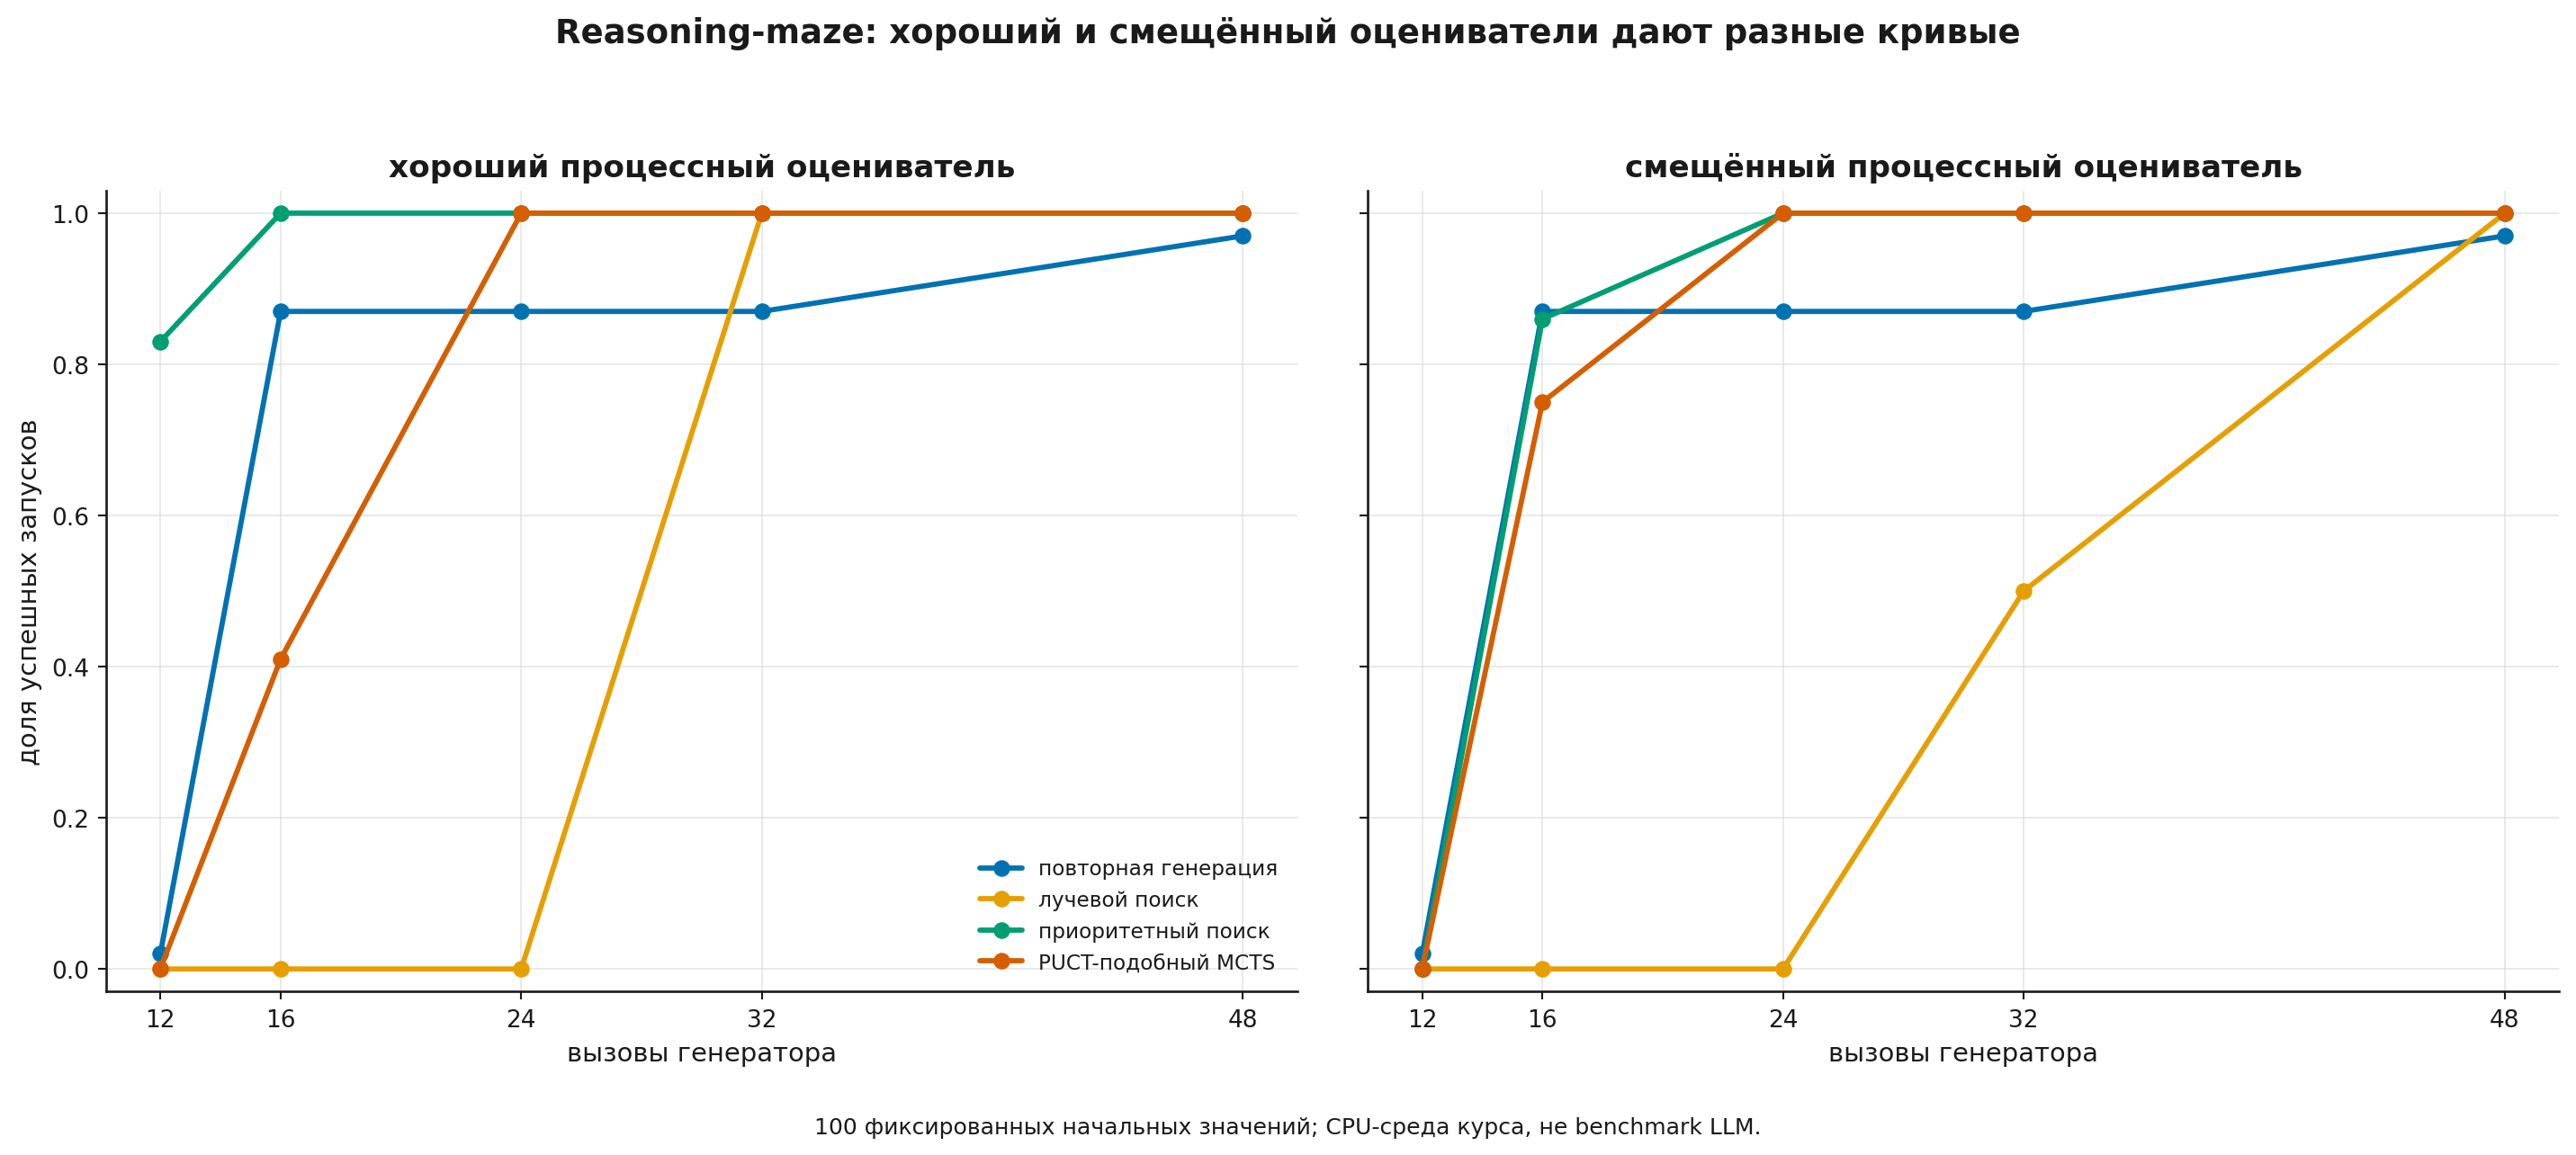
В фиксированном синтетическом протоколе хороший геометрический оцениватель позволяет приоритетному поиску найти путь раньше повторной генерации. Смещённый оцениватель, напротив, задерживает приоритетный поиск и ухудшает раннее отсечение луча. При достаточном бюджете маленькая среда становится простой почти для всех методов. Эти числа — результат кода курса, а не внешний бенчмарк LLM и не доказательство превосходства одного алгоритма.
Поэтому сравнение должно включать простые контрольные варианты: один ответ, повторную генерацию, самосогласованность и BoN при той же полной стоимости. Поиск оправдан не сложностью схемы, а улучшением независимой границы качество–стоимость. Кроме итогового успеха сохраняются покрытие дерева, число вызовов генератора, версия процессного оценивателя и примеры ветвей, отсечённых ошибочно.
Урок 10.5. Адаптивный бюджет и экономика
Урок 10.5. Адаптивный бюджет и экономика
- Целевая функция с ценой вычислений
- Предельный прирост и адаптивное распределение
- Когда остановиться
- Обучить лучше или генерировать дороже
- Выпускной протокол системы поиска
далее — 7 проверочных шагов
Шаг 10.5.1 — Целевая функция с ценой вычислений
Один способ формализовать решение:
где — режим генерации, — ожидаемое качество, — стоимость, а переводит стоимость в единицы полезности.
Альтернативная форма:
Обе записи заставляют указать, что входит в цену. При пакетной обработке число GPU-секунд может быть важнее задержки одного ответа; в интерактивном сервисе — наоборот. Если используется платный судья, его вызовы входят в так же, как токены генератора.
Набор недоминируемых точек образует границу Парето (Pareto frontier): нельзя улучшить качество, не увеличив хотя бы одну из затрат. Выбор рабочей точки является продуктовым решением, а не свойством одного алгоритма.
Шаг 10.5.2 — Предельный прирост и адаптивное распределение
Пусть для запроса независимая вероятность успеха одной попытки равна . Качество после попыток:
Прирост следующей попытки:
Поскольку приросты не возрастают, при таком точном модельном предположении дискретный бюджет можно распределять жадно: каждую следующую попытку отдавать запросу с максимальным текущим . Обменный аргумент показывает, что такое распределение оптимально среди распределений, удовлетворяющих объявленному минимуму на запрос.
Минимум является отдельным продуктовым решением, а не следствием формулы. Функция allocate_budget_greedy по умолчанию использует minimum_per_prompt = 1: каждый запрос получает хотя бы одну попытку, а жадно распределяется остаток. Это разумное требование сервиса — не оставлять запрос без единого ответа, — но оно уменьшает достижимое покрытие.
Для
и общего бюджета 16 равномерное распределение даёт и среднее покрытие . Жадное правило при minimum_per_prompt = 1 даёт
и среднее покрытие . Без минимума () то же правило даёт
и среднее покрытие — это глобальный оптимум задачи, подтверждённый полным перебором. Разность и есть цена гарантии «хотя бы одна попытка каждому запросу»: почти безнадёжный запрос с забирает попытку, которая дала бы больше на запросе с .
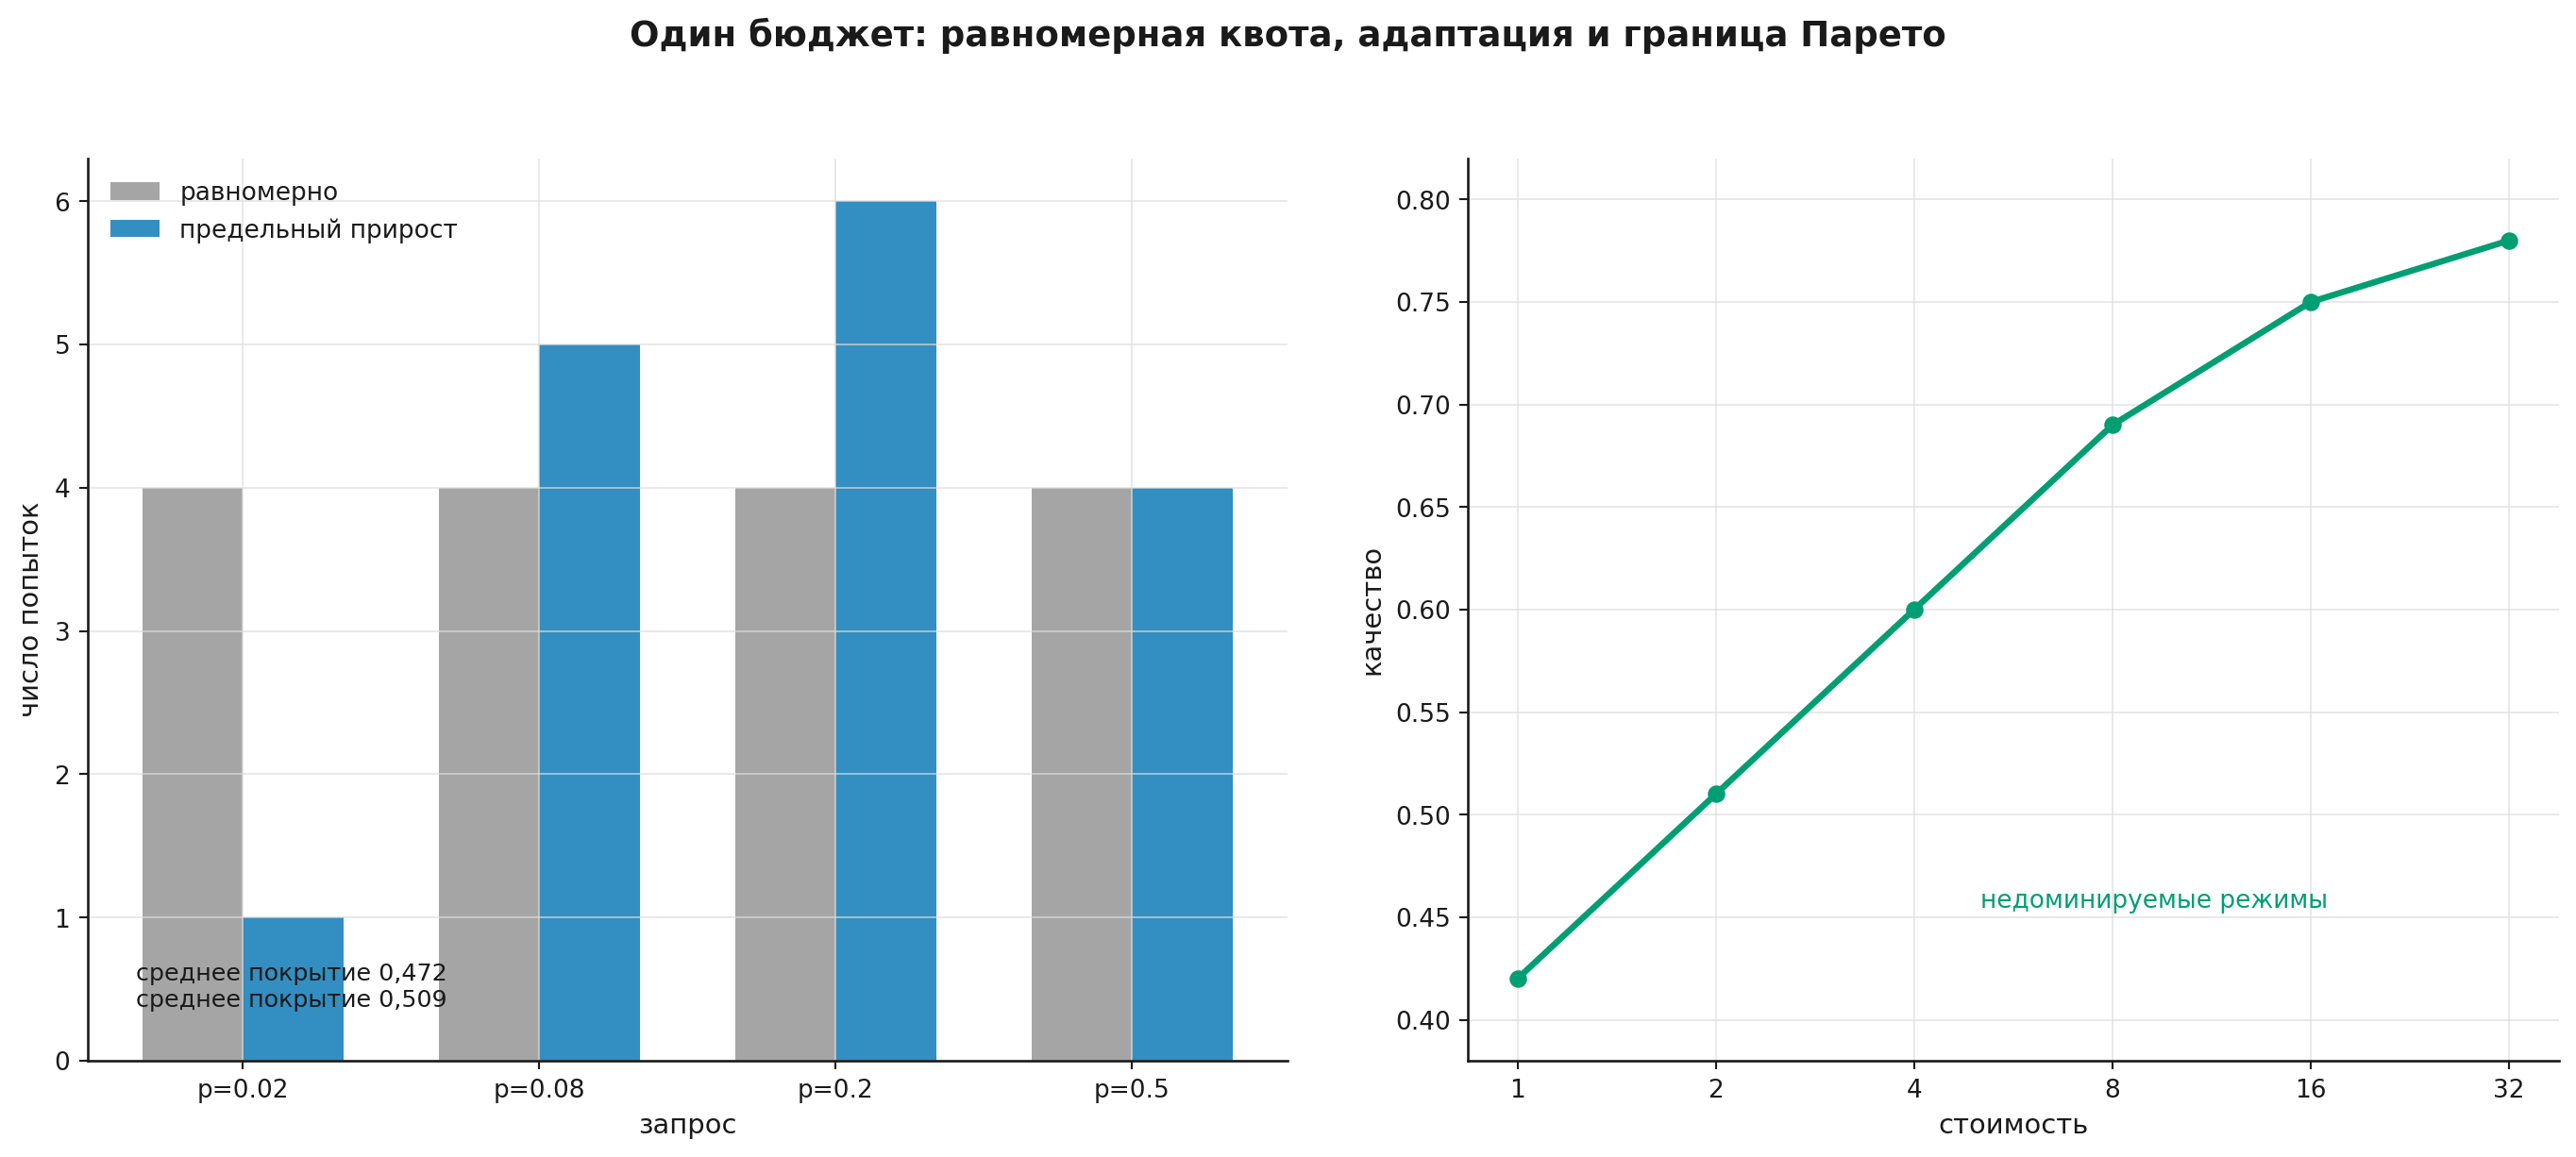
Это точный результат для известных и независимых попыток. В реальной системе нужно оценивать, а сам оцениватель сложности может ошибаться. Адаптивность добавляет ещё одну модель, которую необходимо калибровать.
Шаг 10.5.3 — Когда остановиться
Правило остановки может использовать:
- достигнутый порог точной проверки;
- устойчивое большинство;
- малый предельный прирост;
- высокий уровень согласия нескольких независимых оценивателей;
- исчерпание токенов, времени или денег;
- рост риска переоптимизации прокси;
- отказ при сохраняющейся неопределённости.
Для самосогласованности можно остановиться, когда текущий лидер уже не может быть догнан оставшимися голосами. Но это экономит бюджет только относительно заранее заданного максимума и не исправляет систематически неверного лидера.
Для BoN с непрерывным баллом универсального критерия «достаточно хорошо» нет. Калиброванная вероятность успеха и цена дополнительного кандидата полезнее сырого максимального балла.
Шаг 10.5.4 — Обучить лучше или генерировать дороже
Пусть дополнительное обучение стоит , а после него стоимость запроса уменьшается с до при приемлемом качестве. Точка окупаемости:
Например, при , и получаем
Если новая модель не дешевле на запрос, такой точки окупаемости только по затратам нет. И даже конечная точка по стоимости недостаточна: нужно сравнить качество, задержку, риск и срок жизни системы.
При малом или быстро меняющемся трафике переход к более дорогому режиму генерации обычно требует меньше времени. При большом стабильном трафике обучение, дистилляция или специализированный ранжировщик могут окупить фиксированную цену.
Шаг 10.5.5 — Выпускной протокол системы поиска
Перед публикацией системы зафиксируйте четыре слоя.
Генератор
- версия модели и токенизатора;
- шаблон диалога;
- температура, top-k, top-p и ограничения длины;
- начальное значение генератора случайных чисел и число кандидатов;
- правила последовательного увеличения бюджета.
Выбор и поиск
- канонизатор ответа;
- проверяющая система или PRM;
- способ агрегирования шагов;
- алгоритм поиска и его гиперпараметры;
- ничьи, отказ и остановка.
Стоимость
- токены генератора и судьи;
- число раскрытых узлов;
- задержка и GPU-секунды;
- цена API;
- доля повторных запусков и ошибок среды.
Независимое качество
- pass@1 и pass@k;
- точность реально выбранного ответа;
- калибровка и доля отказов;
- качество по срезам сложности;
- устойчивость к новой формулировке и новой проверяющей системе;
- аудит примеров, где прокси-оценка и независимая цель расходятся.
В этом модуле мы оставались внутри одного запроса и управляемого дерева рассуждения. Модуль 11 «RL для LLM-агентов: инструменты, среды и длинные траектории» (rl_llm.module_11_agentic_rl) добавит внешнюю среду, инструменты, скрытое состояние и многоходовые эпизоды. Модуль 12 «Инфраструктура RL для LLM: память, роллауты и асинхронность» (rl_llm.module_12_infrastructure) разберёт распределённое получение траекторий и версионирование политик. Модуль 13 «Оценивание RL-систем для LLM: статистика, взлом награды и безопасность» (rl_llm.module_13_evaluation) углубит независимую проверку и манипулирование метриками.
Источники и маршрут чтения
Ниже перечислены работы, которые поддерживают основные внешние утверждения модуля. Собственные формулы, точные вычисления и синтетические результаты курса дополнительно описаны в русском реестре утверждений и источников.
- Wang et al., Self-Consistency Improves Chain of Thought Reasoning in Language Models — исходный протокол выборки нескольких траекторий и агрегирования финальных ответов. Работа показывает эмпирические улучшения в выбранных задачах, но не гарантирует пользу при систематически доминирующей ошибке.
- Chen et al., Evaluating Large Language Models Trained on Code — HumanEval и конечновыборочный оцениватель
pass@k. Формула относится к явно заданному протоколу выборки и проверяемой правильности. - Brown et al., Large Language Monkeys: Scaling Inference Compute with Repeated Sampling — масштабирование повторной выборки и различие между наличием успешного кандидата и его распознаванием.
- Lightman et al., Let’s Verify Step by Step — процессный надзор, PRM800K и исходные эксперименты с выбором решений. Результаты не превращают любую процессную оценку в точную функцию ценности.
- Yao et al., Tree of Thoughts: Deliberate Problem Solving with Large Language Models — ветвящийся поиск по промежуточным состояниям, оценивание и возврат к альтернативным ветвям.
- Kocsis and Szepesvári, Bandit Based Monte-Carlo Planning — классический UCT. Его гарантии относятся к исходной постановке и не переносятся автоматически на текстовые деревья с обученным оценивателем.
- Snell et al., Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters — зависимость полезного режима вычислений от сложности запроса и идея адаптивного бюджета в исследованном протоколе.
- Muennighoff et al., s1: Simple test-time scaling —
budget forcingкак принудительное продолжение или остановка рассуждения; это эмпирический метод, а не теорема о пользе длины. - Gao, Schulman, Hilton, Scaling Laws for Reward Model Overoptimization — переоптимизация модели награды при усилении давления отбора, включая Best-of-N.
- Официальная документация Transformers по генерации и карточка Qwen3-0.6B — только для факультативной инженерной ветви ноутбука; основной маршрут выполняется офлайн на CPU.
Перекрёстные ссылки
- Модуль 2 «Состояние, ценность и уравнения Беллмана» (
rl_llm.module_02_values_bellman): Монте-Карло-оценка префикса и возврат значения по траектории. - Модуль 3 «Бандиты, исследование и одношаговые решения» (
rl_llm.module_03_bandits): UCB, исследование и распределение ограниченного бюджета. - Модуль 6 «LLM как политика: токены, логарифмы вероятностей и KL» (
rl_llm.module_06_llm_policy): фактическое распределение генерации и параметры декодирования. - Модуль 7 «Модели награды и данные о предпочтениях» (
rl_llm.module_07_reward_models): калибровка, ошибка победителя и переоптимизация прокси. - Модуль 9 «RLVR и GRPO: проверяемые награды, групповые оценки и устойчивость» (
rl_llm.module_09_rlvr_grpo): проверяющие системы, процессный сигнал и стоимость роллаутов. - Курс Information Theory for ML, Модуль 2 «Энтропия» (
it_ml.module_02_entropy): энтропия распределения кандидатов и ограничения интерпретации разнообразия. - Курс Information Theory for ML, Модуль 3 «Кросс-энтропия и KL-дивергенция» (
it_ml.module_03_cross_entropy_kl): логарифмические оценки, KL и сравнение распределений генерации. - Курс Modern LLMs, Модуль 10 «KV-кэши и эффективный инференс» (
modern_llms.module_09_inference): инженерные режимы декодирования, задержка и обслуживание. - Курс Modern LLMs, Модуль 15 «Модели рассуждения и вычисления во время инференса (test-time compute)» (
modern_llms.module_13_reasoning): более широкий ландшафт reasoning-моделей и современных интерфейсов.
Главное
- pass@N измеряет наличие успеха при явных предположениях, а не качество правила выбора.
- Самосогласованность помогает при рассеянных ошибках и усиливает наиболее вероятную систематическую моду.
- Несовершенная проверяющая система задаёт собственную границу качества и может переоптимизироваться при большом .
- PRM полезна только после определения смысла её меток и правила агрегирования шагов.
- Поиск добавляет возможность возврата и исправления, но также раннее отсечение и новые прокси-цели.
- Бюджет нужно распределять по предельному приросту и измерять в токенах, задержке, вычислениях и деньгах.
- Сравнение обучения и дорогой генерации требует трафика, срока жизни, качества и риска — одной цены запроса недостаточно.