Модуль 8. RLHF и прямые методы оптимизации предпочтений
Версия материала: 2026.20
Фактический снимок: 2026-08-05
Язык: RU
Основная практика: уровень A — воспроизводимый CPU-контур; уровень B — необязательный запуск открытой модели с низкоранговой адаптацией (Low-Rank Adaptation, LoRA) в среде с подходящим ускорителем
Структура: 5 уроков, 25 шагов
Ориентировочное время: 9–11 часов без факультативного обучения модели
В Модуле 7 «Модели награды и данные о предпочтениях» (rl_llm.module_07_reward_models) мы построили путь от попарной метки к модели награды. Теперь нужно решить следующий вопрос: как изменить политику так, чтобы предпочтительные ответы становились вероятнее, но модель не потеряла полезные свойства исходной версии и не научилась эксплуатировать недостатки сигнала?
Классический ответ — обучение с подкреплением на основе обратной связи от человека (reinforcement learning from human feedback, RLHF): обучить модель награды, собрать свежие ответы политики и оптимизировать ожидаемую награду с ограничением на отклонение от базовой политики. Более прямой ответ — прямая оптимизация предпочтений (direct preference optimization, DPO): перейти от пар ответов сразу к функции потерь политики, не обучая явную модель награды и не собирая новые роллауты внутри этой стадии.
Практическая задача модуля:
Выбрать между RLHF и прямой оптимизацией предпочтений, понимая данные, вычислительную цену, скрытые предположения и наблюдаемые режимы отказа.
После прохождения модуля вы сможете:
- записывать цель RLHF с регуляризацией по дивергенции Кульбака—Лейблера (KL) и объяснять роли политики, базы, модели награды и критика;
- отличать четыре логические роли от требования хранить четыре полные копии LLM;
- выводить точный экспоненциально перевзвешенный оптимум;
- получать DPO из этого оптимума и модели Брэдли—Терри;
- реализовывать DPO-потерю, её градиентный вес и сглаживание меток;
- объяснять, почему рост относительного зазора не гарантирует роста вероятности предпочтённого ответа;
- контролировать длины, маски, шаблоны диалога, причины остановки и кэш базы;
- различать DPO, IPO, SimPO, KTO и ORPO по контракту данных;
- выбирать между фиксированными парами, итеративным сбором предпочтений и онлайн-RL;
- различать модель награды и модель стоимости, записывать ограниченную цель и читать двойственное обновление множителя;
- выполнить синтетический эксперимент на CPU и подготовить проверочный запуск DPO на открытой модели класса 0,6 млрд параметров.
Практический код собран в отдельном русскоязычном ноутбуке; датированные утверждения, первичные источники и границы допустимых выводов — в Module_8_Sources.md.
Практический маршрут. После лекции идут оцениваемые задания, решения, открывающиеся после попытки, и исполняемая практика. Само объяснение остаётся самодостаточным.
Урок 8.1. От предпочтений к KL-регуляризованной политике
Урок 8.1. От предпочтений к KL-регуляризованной политике
- Что именно оптимизирует классический RLHF
- Четыре логические роли, а не четыре обязательные копии
- Как последовательностный KL превращается в токеновые награды
- Точный оптимум: экспоненциальный наклон базы
- Численная граница «награда–отклонение»
далее — 5 проверочных шагов
Шаг 8.1.1 — Что именно оптимизирует классический RLHF
Пусть — запрос, — полный ответ, — обучаемая политика, — модель награды, а — замороженная базовая политика. Одна из стандартных постановок имеет вид
где задаёт цену отклонения от базы.
Первый член сдвигает вероятность к ответам, которые высоко оценивает модель награды. Второй выставляет счёт за перераспределение массы относительно базы. При фиксированной награде в точной вариационной задаче больший делает уход дороже, а меньший разрешает сильнее следовать награде. В DPO тот же символ масштабирует логит парной классификации через вывод из этой задачи; конечный измеренный KL всё равно определяется данными, нормировкой, параметризацией и траекторией оптимизации, а не одним числом .
Связанная ограниченная форма:
В идеализированной выпуклой задаче штраф связан с ограничением через множитель Лагранжа. В конечном нейросетевом обучении выбранное не задаёт заранее точный наблюдаемый KL: параметризация, оптимизатор, шум оценки и число шагов меняют результат.
Граница результата. KL контролирует расстояние до базы в выбранной геометрии. Он не проверяет правильность модели награды, не запрещает все опасные изменения и не гарантирует сохранение каждой способности.
Шаг 8.1.2 — Четыре логические роли, а не четыре обязательные копии
В контуре проксимальной оптимизации политики (Proximal Policy Optimization, PPO) обычно различаются:
- политика , которая порождает ответы и обновляется;
- базовая политика , которая задаёт KL-якорь;
- модель награды , которая оценивает ответ;
- критик , который оценивает ожидаемую будущую награду и помогает строить преимущества.
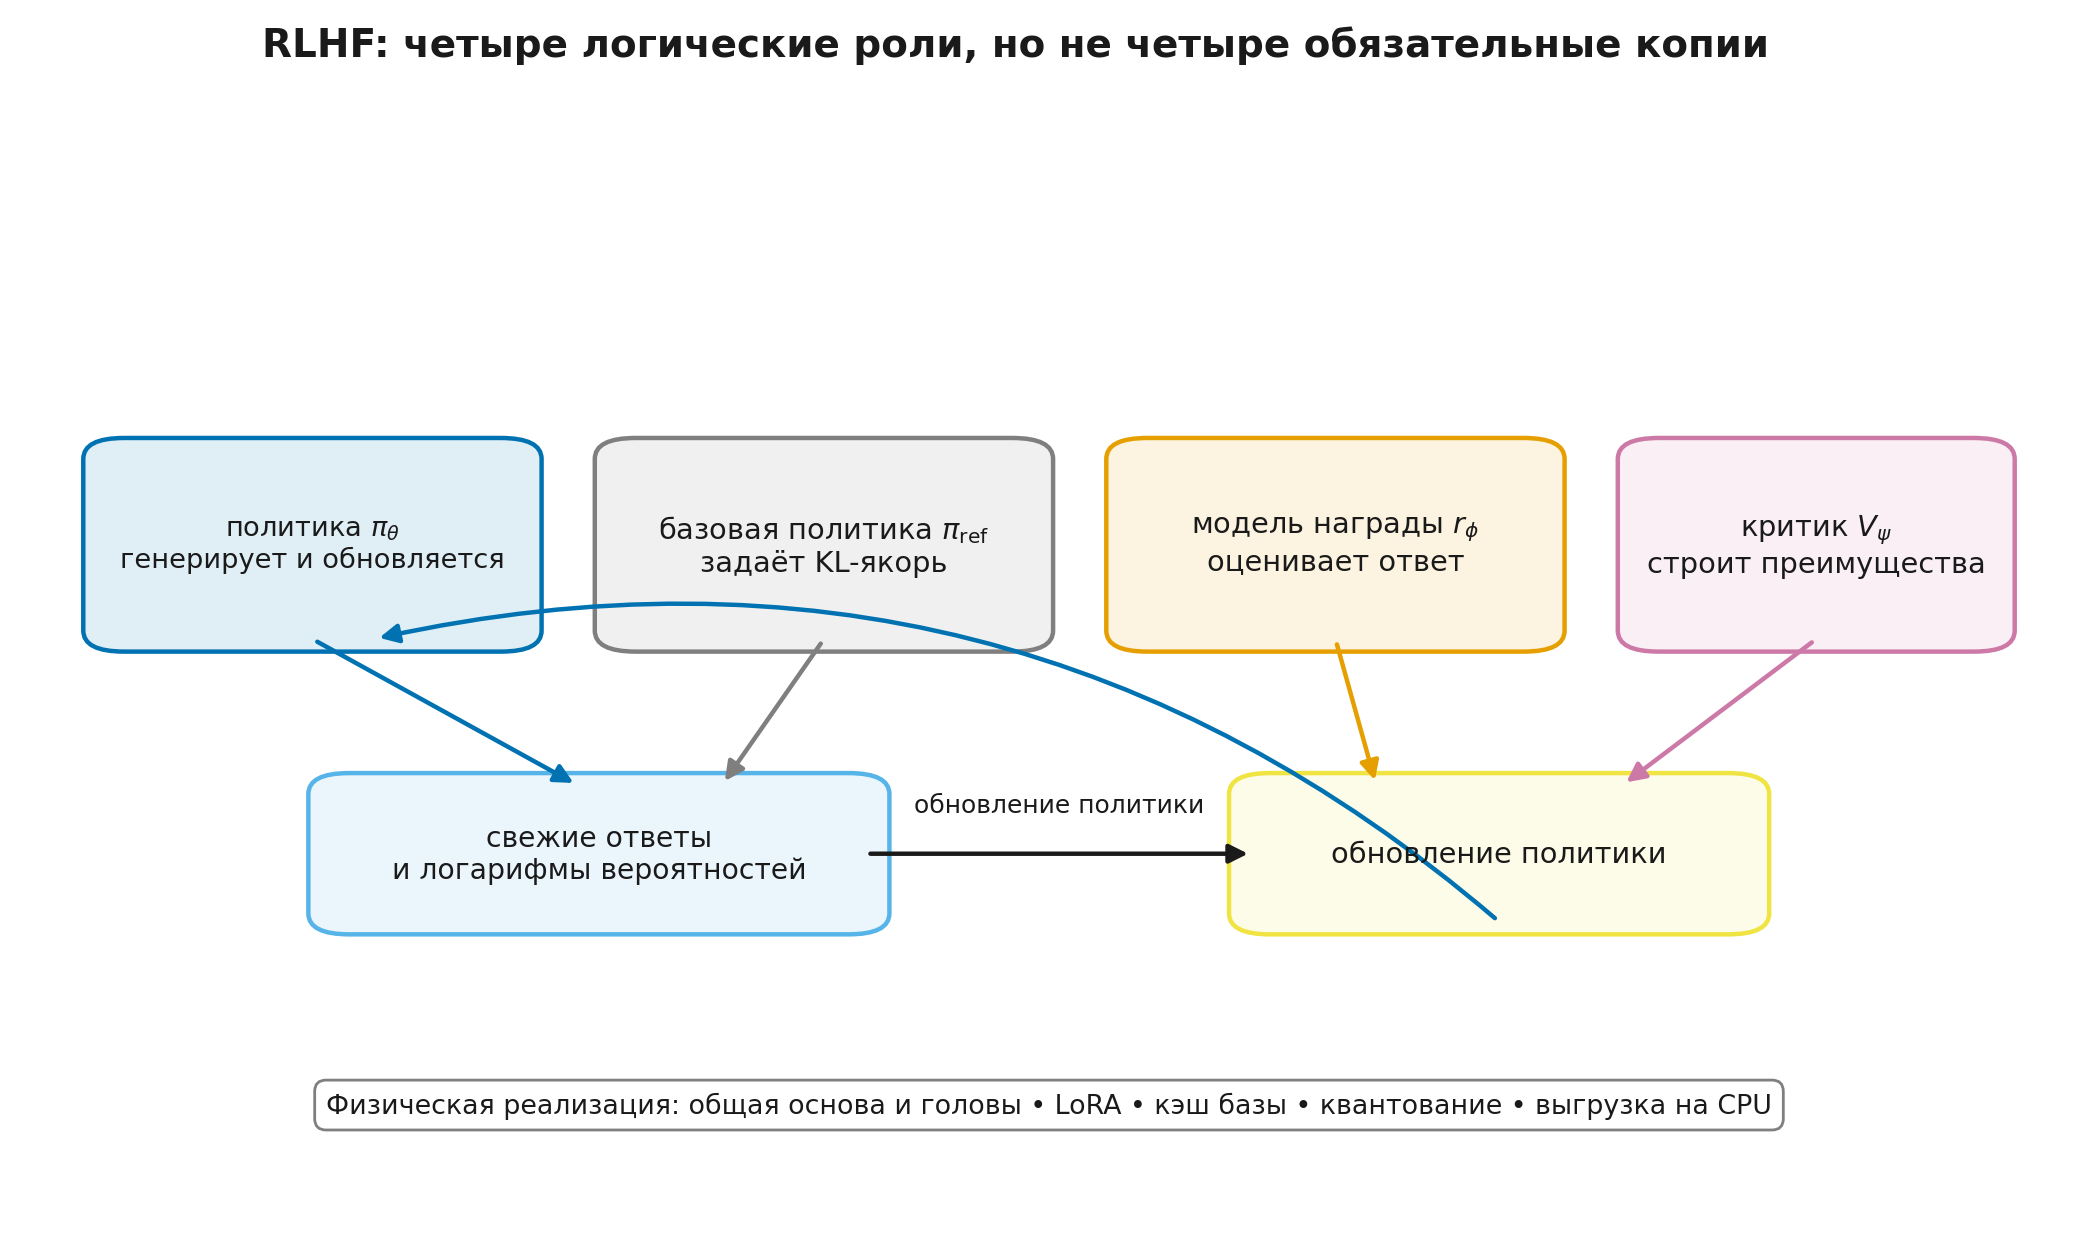
Это четыре математические и вычислительные роли. Реализация не обязана держать четыре независимых полных набора весов одного размера. Возможны общий трансформер политики и головы ценности, адаптеры, квантование замороженных компонентов, предварительный расчёт логарифмов вероятностей базы, выгрузка на CPU и разнесение генерации и обучения по процессам.
Точная инженерная формулировка:
RLHF содержит несколько логических моделей и вычислительных ролей; их физическое размещение и совместное использование параметров зависят от реализации.
Даже после оптимизации памяти остаются свежая генерация, прямые проходы базы и модели награды, оценивание ценности, хранение роллаутов и обратный проход политики. DPO сокращает этот контур, но не отменяет цену подготовки хороших пар.
Шаг 8.1.3 — Как последовательностный KL превращается в токеновые награды
Для авторегрессионной политики
Поэтому в токеновом RL удобно добавить на каждом активном шаге
а к последнему активному токену прибавить итоговую оценку . Сумма наград после такого преобразования равна
Отдельный сэмплированный логарифм отношения может быть отрицательным. Это не «отрицательный KL»: его ожидание по действию текущей политики равно неотрицательному KL от текущей политики к базовой. Различие между точным KL и сэмплированным вкладом подробно разобрано в Модуле 6 «LLM как политика: токены, логарифмы вероятностей и KL» (rl_llm.module_06_llm_policy).
В реализации обязательны маска ответа и корректная причина остановки. Токены запроса, заполнение до общей длины и наблюдения внешней среды не должны случайно входить в сумму наград политики.
Шаг 8.1.4 — Точный оптимум: экспоненциальный наклон базы
Зафиксируем один запрос и конечное пространство ответов. Оптимизируем всё распределение:
После введения множителя для и дифференцирования получаем
где
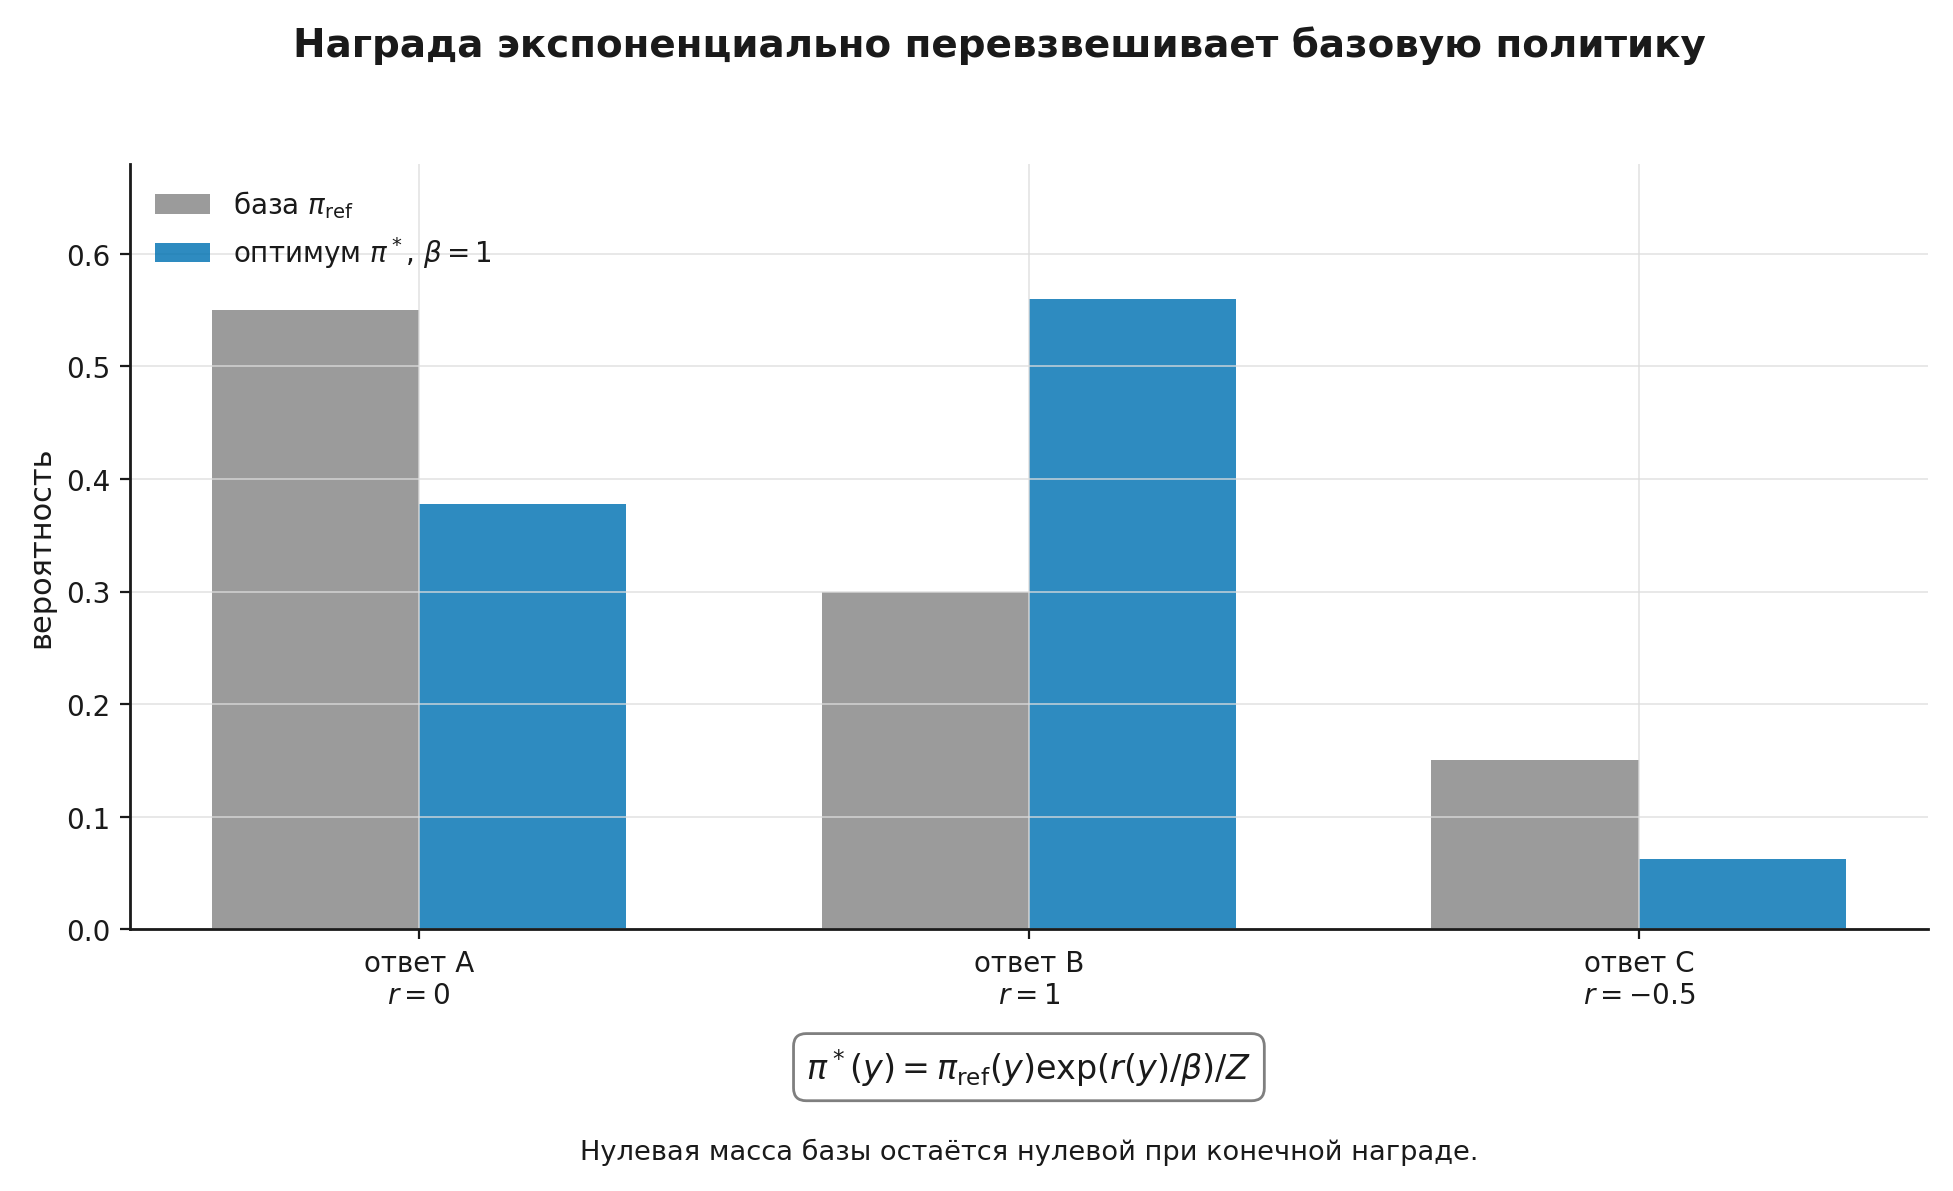
Награда не создаёт распределение с нуля, а перевзвешивает массу, доступную базе. Если , то при любой конечной награде. Добавление одной константы ко всем наградам не меняет оптимальную политику: общий множитель сокращается в .
При политика возвращается к базе. При масса концентрируется на максимумах награды внутри носителя базы.
Математическое расширение: вариационные формы, нормировочная константа и связь с максимальной энтропией подробнее рассматриваются в Information Theory for ML, Модуль 8 «Максимальная энтропия, экспоненциальные модели и KL-регуляризация» (
it_ml.module_08_maxent_kl_policy).
Шаг 8.1.5 — Численная граница «награда–отклонение»
Возьмём
Точный расчёт даёт:
| 4.0 | 0.299 | 0.009 | |
| 2.0 | 0.376 | 0.038 | |
| 1.0 | 0.529 | 0.153 | |
| 0.5 | 0.776 | 0.514 | |
| 0.25 | 0.966 | 1.033 |
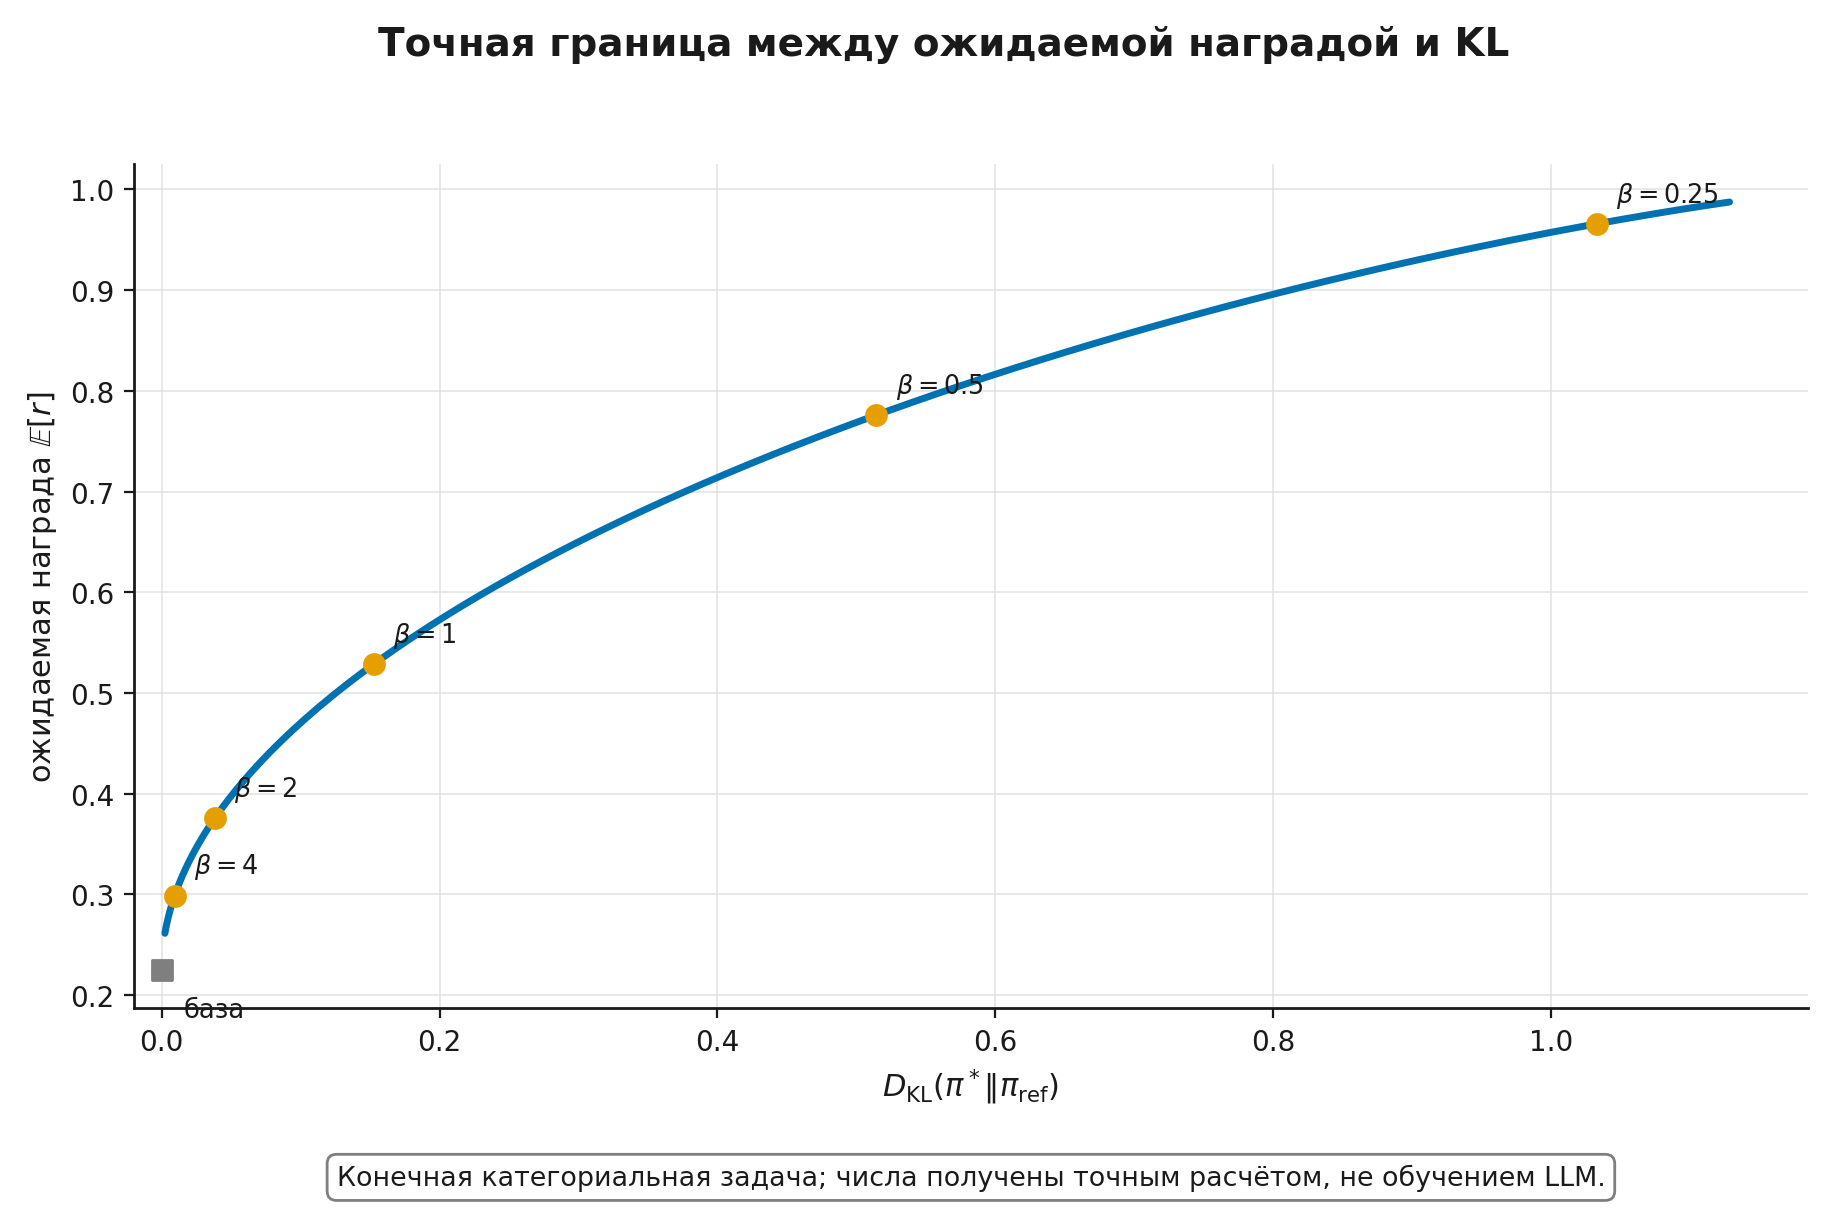
Числа получены кодом reward_kl_frontier из module_8_reference.py. В точном оптимуме уменьшение разрешает сильнее следовать награде и увеличивает KL. Это не обещает монотонной динамики каждого шага нейросетевого обучения: там мы видим лишь приближённую оптимизацию по конечной выборке.
Практический вывод: значение награды без KL и значение KL без независимой оценки качества не дают полной картины. Нужна граница компромисса, а не одна «лучшая» точка по прокси-награде.
Ограничения: полезность и стоимость — разные сигналы
KL удерживает политику около базы, но сам по себе не кодирует требование безопасности. Пусть — полезность ответа, а — отдельные стоимости: например, вероятность запрещённого действия, нарушение политики доступа или опасный побочный эффект. Тогда естественная ограниченная постановка имеет вид
Её лагранжева форма:
Политика максимизирует при текущих штрафах, а двойственная переменная увеличивается при нарушении ограничения:
Здесь модель награды и модель стоимости — разные статистические компоненты. Высокая полезность не должна автоматически компенсировать критическое нарушение. Фиксированная сумма является скаляризацией с заранее выбранным компромиссом; явное ограничение позволяет задать допустимый бюджет стоимости и адаптировать множитель по наблюдаемому нарушению.
Рассмотрим минимальный пример. Безопасное действие имеет награду и стоимость , рискованное — награду и стоимость . Если политика выбирает рискованное действие с вероятностью , то
При бюджете оптимум равен
Код two_action_constrained_optimum и dual_ascent_step воспроизводит этот расчёт.
Где заканчивается гарантия. Ограничение на среднее не обещает безопасность каждого отдельного запроса. Для критических действий нужны дополнительные механизмы: жёсткие фильтры, безопасное множество действий, отказ или прерывание, а также отдельные проверки по сценариям. Выученная модель стоимости тоже может ошибаться и подвергаться оптимизационному давлению. Поэтому ограничение во время обучения и контроль выпуска в Модуле 13 «Оценивание RL-систем для LLM: статистика, взлом награды и безопасность» (rl_llm.module_13_evaluation) дополняют, а не заменяют друг друга.
Классическая линия оптимизации политики с ограничениями (Constrained Policy Optimization, CPO) формализует обновления политики при ограничениях на ожидаемую стоимость. В работе Safe RLHF та же идея адаптируется к LLM через раздельные модели полезности и стоимости. Эти источники дают математическую и исследовательскую опору, но не превращают среднее ограничение в абсолютную гарантию безопасности.
Урок 8.2. DPO: вывод, функция потерь и градиент
Урок 8.2. DPO: вывод, функция потерь и градиент
- Пары предпочтений как вероятностные наблюдения
- Неявная награда и сокращение нормировки
- DPO-функция потерь
- Градиентный вес и роль коэффициента β
- Предположения DPO и граница с классическим офлайн-RL
далее — 3 проверочных шага
Шаг 8.2.1 — Пары предпочтений как вероятностные наблюдения
Для одного запроса имеются два ответа: предпочтённый и отклонённый . Модель Брэдли—Терри (Bradley–Terry model, BT) задаёт
В Модуле 7 «Модели награды и данные о предпочтениях» (rl_llm.module_07_reward_models) эта формула использовалась для обучения явной модели награды. DPO делает другой ход: выражает награду через политику и подставляет это выражение непосредственно в BT-правдоподобие.
Важно не потерять статистический смысл. Метка говорит: при данном запросе, кандидатах, рубрике и протоколе был выбран . Она не превращает в безусловно истинный ответ и не задаёт абсолютную награду, сравнимую между всеми запросами.
Хороший DPO-набор содержит исходный запрос, оба полных ответа, происхождение кандидатов, версию рубрики, возможность ничьей или отказа, одинаковую предобработку и разбиение по запросам.
Шаг 8.2.2 — Неявная награда и сокращение нормировки
Из точного оптимума следует
В разности двух ответов к одному запросу добавка сокращается:
Заменяя неизвестный оптимум обучаемой политикой , получаем логит предпочтения. Отдельную модель награды обучать не требуется: её роль в выводе выполняет логарифмическое отношение политики к базе.
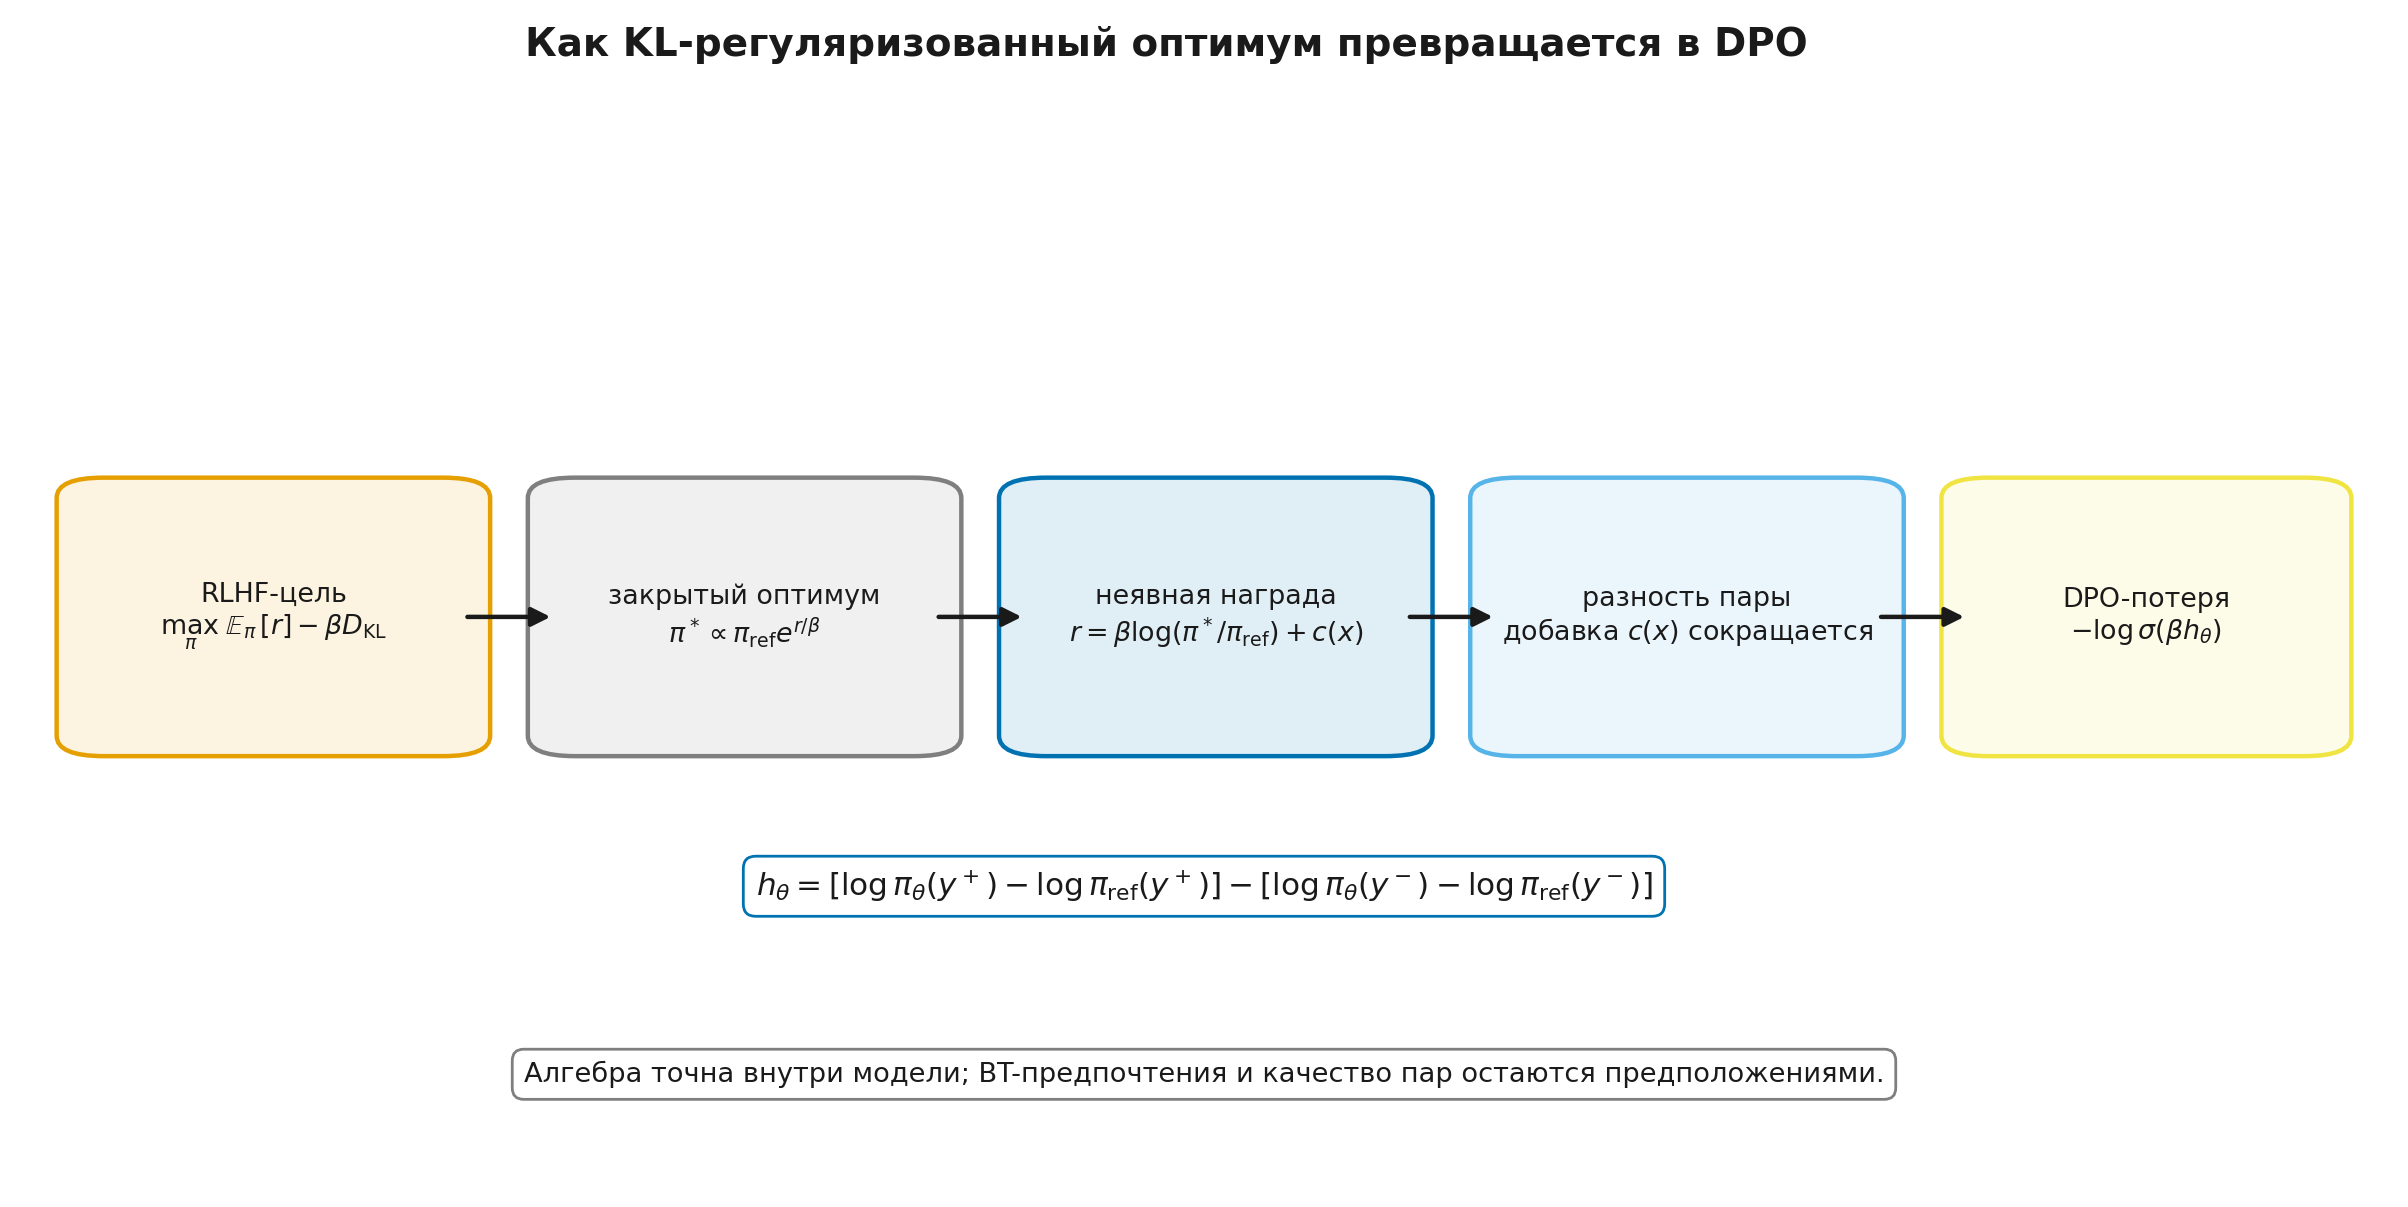
Это точное алгебраическое сокращение внутри принятой модели. Оно не доказывает, что реальные предпочтения действительно порождены одним скалярным и логистическим шумом.
Шаг 8.2.3 — DPO-функция потерь
Обозначим последовательностный зазор
Тогда
а функция потерь одной пары
Механика проста: политика должна повысить предпочтённый ответ относительно базы сильнее, чем отклонённый. DPO не максимизирует сырой логарифм вероятности изолированно.
Последовательностные логарифмы вероятностей — суммы по токенам ответа. Запрос и заполнение маскируются. Выбранный и отклонённый ответы должны проходить через один токенизатор, шаблон диалога и правило обрезки.
Шаг 8.2.4 — Градиентный вес и роль коэффициента β
Производная потери по зазору:
Положительная величина веса пары равна
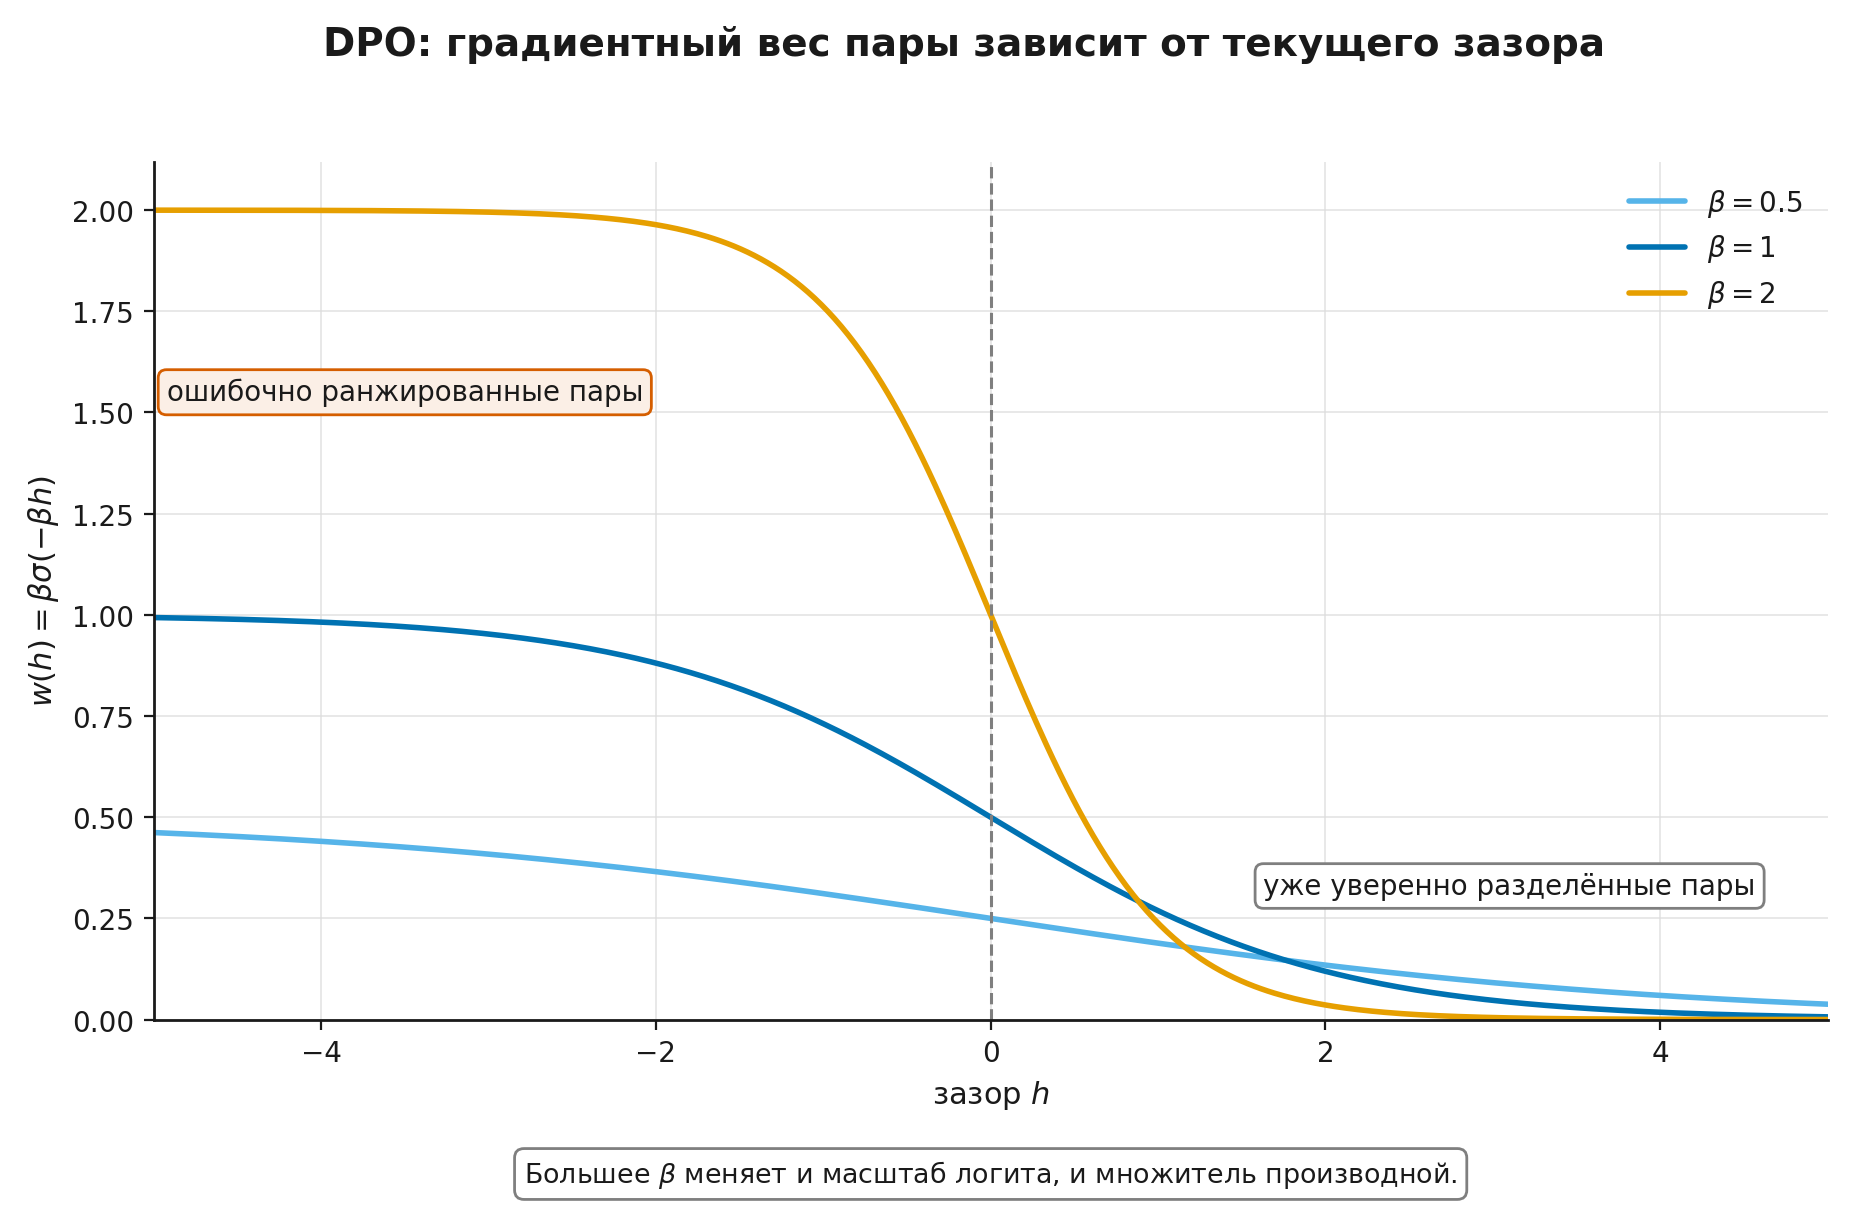
Если зазор отрицателен, пара получает сильный сигнал. При большом положительном зазоре вес затухает. Но одновременно масштабирует логит и множитель производной, поэтому фраза «большее всегда означает более сильное обновление» неверна без уточнения текущего , скорости обучения и договорённости конкретной реализации.
В исходном вариационном выводе — цена KL. В коде DPO он входит в классификационный логит. Эти роли связаны выводом, но конечный наблюдаемый KL зависит от данных, оптимизации и числа шагов. Сравнивать между библиотеками можно только после проверки точной формулы и нормировки логарифмов вероятностей.
Шаг 8.2.5 — Предположения DPO и граница с классическим офлайн-RL
DPO наиболее прозрачен, когда:
- пары относятся к одному запросу;
- предпочтение разумно аппроксимируется BT-моделью;
- база фиксирована и вычислена тем же шаблоном;
- оба ответа находятся в носителе базы;
- пары отражают нужный критерий;
- распределение данных достаточно близко к области будущего использования.
DPO обучается по фиксированным парам и не использует уравнения Беллмана, явную Q-функцию или бутстрэппинг. Поэтому называть его «классическим офлайн-RL в точности» слишком сильно. Более точная фраза:
DPO — прямой метод оптимизации политики по фиксированным предпочтениям, полученный из KL-регуляризованной постановки; он родственен офлайн-обучению, но не тождествен ценностным методам офлайн-RL.
Если BT-модель неточна, DPO остаётся определённой парной функцией потерь. Меняется интерпретация: это уже не точное восстановление идеальной неявной награды, а полезная дискриминативная аппроксимация.
Урок 8.3. Где ломается простая картина
Урок 8.3. Где ломается простая картина
- Относительный зазор не равен абсолютной вероятности
- Точный игрушечный пример смещения правдоподобия
- Длина, маски и шаблон диалога
- Шумные пары и консервативная DPO (cDPO)
- Фиксированные пары стареют
далее — 4 проверочных шага
Шаг 8.3.1 — Относительный зазор не равен абсолютной вероятности
DPO контролирует разность двух логарифмических отношений. Из роста не следует отдельно, что
растёт. Возможны три режима:
- вероятность растёт, а падает;
- обе вероятности растут, но быстрее;
- обе вероятности падают, но быстрее.
Третий режим особенно легко пропустить, если журнал содержит только DPO-потерю и точность пар. Нормировка softmax связывает пару со всеми другими последовательностями: неразмеченный ответ может забрать массу.
Минимальный отчёт должен содержать выбранный и отклонённый логарифмы вероятностей отдельно, их отношения к базе, зазор, градиентный вес, длины и независимые метрики генерации.
Шаг 8.3.2 — Точный игрушечный пример смещения правдоподобия
Рассмотрим три ответа с логитами
Первый предпочтён, второй отклонён, третий не входит в пару. Парный зазор равен
то есть строго растёт. Но вероятности ведут себя так:
| парный зазор | ||||
|---|---|---|---|---|
| 0 | 0.3333 | 0.3333 | 0.3333 | 0.0 |
| 0.25 | 0.1962 | 0.1190 | 0.6848 | 0.5 |
| 0.5 | 0.0738 | 0.0271 | 0.8991 | 1.0 |
| 1.0 | 0.0067 | 0.0009 | 0.9924 | 2.0 |
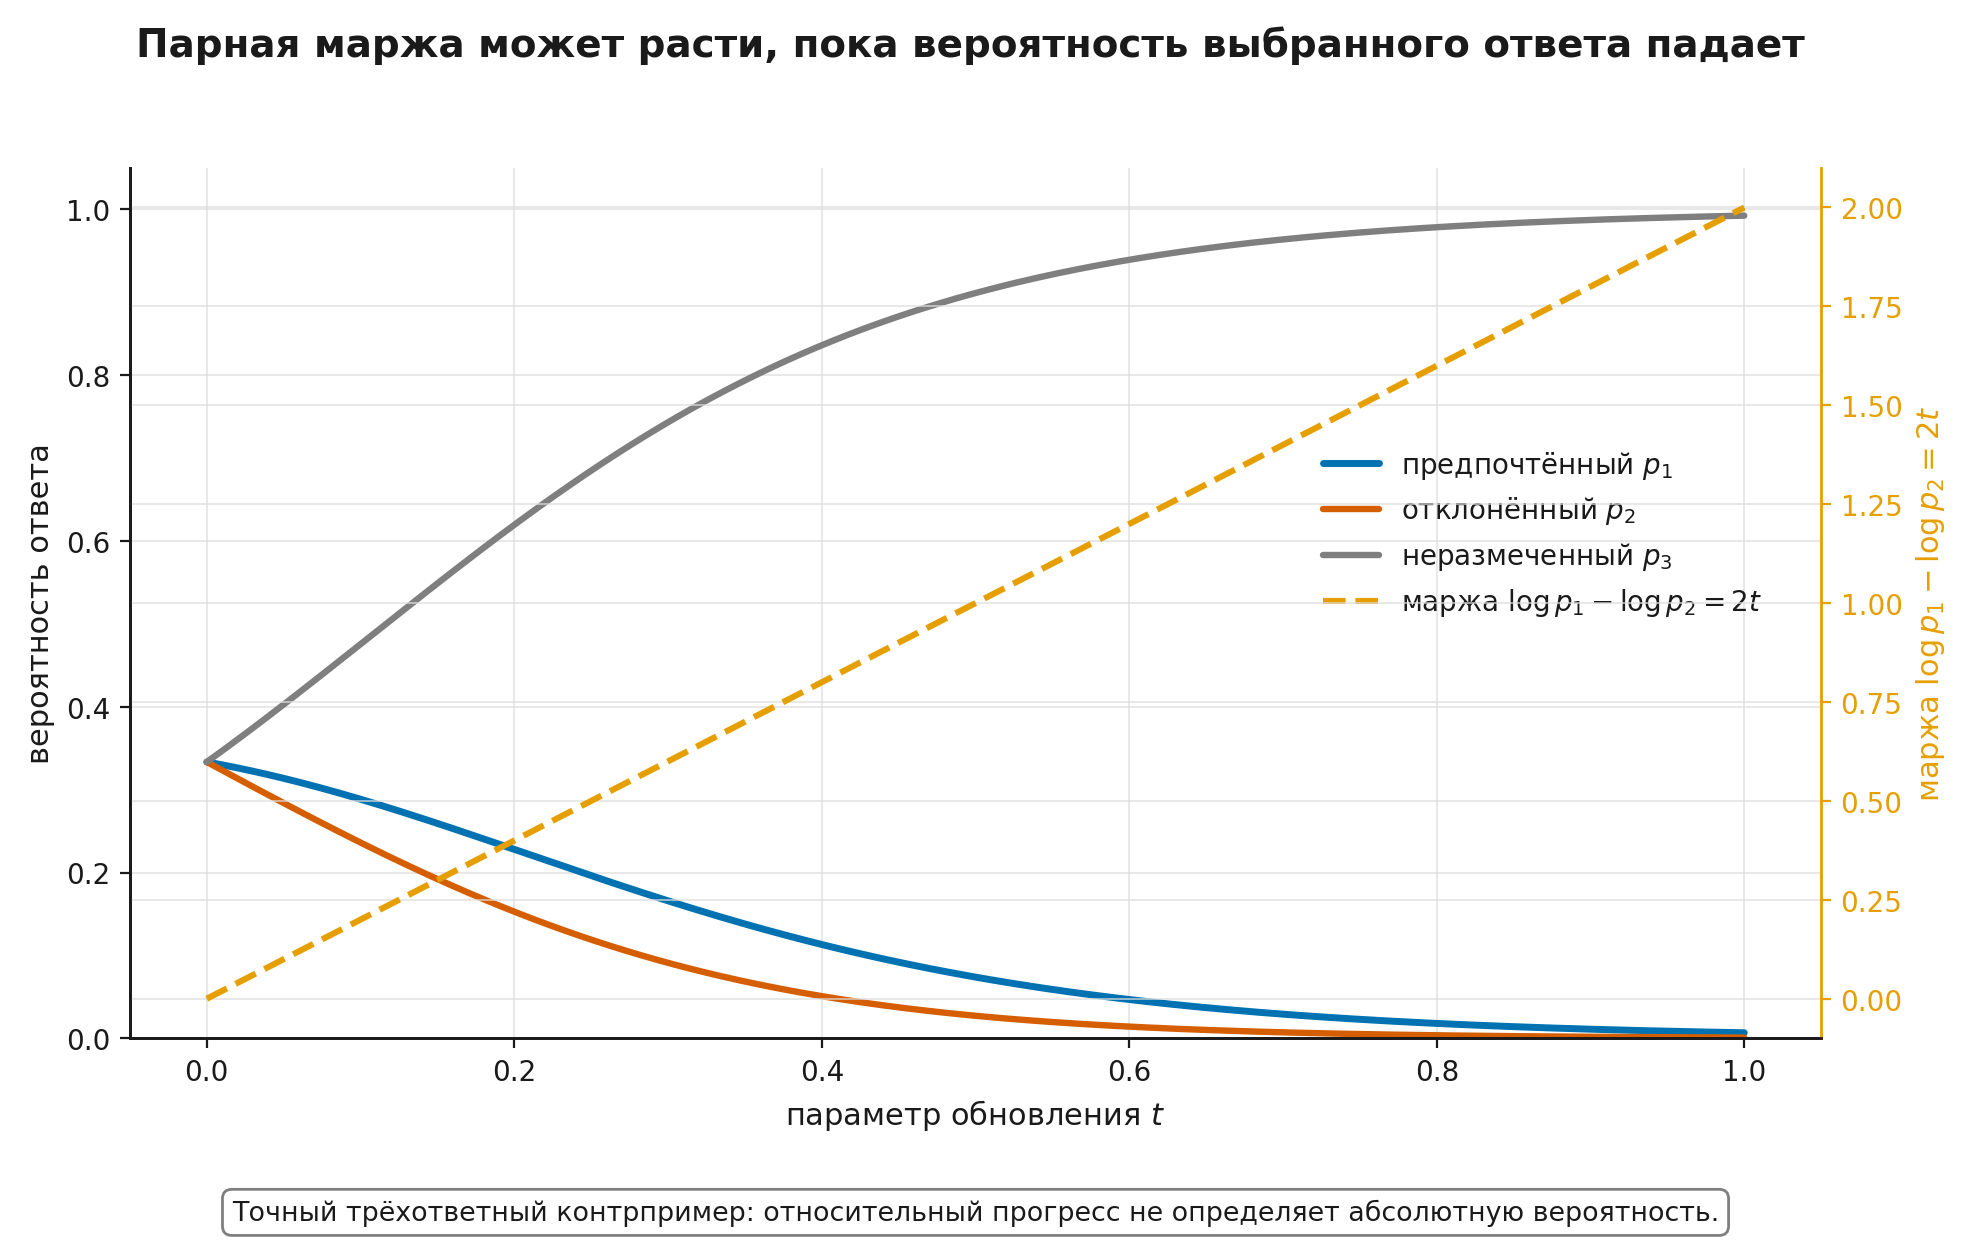
Модель всё лучше разделяет наблюдаемую пару, однако вероятность предпочтённого ответа падает. Этот пример не доказывает, что любой DPO-запуск ухудшается. Он доказывает более узкое утверждение: парная маржа не определяет абсолютную вероятность выбранного ответа.
Шаг 8.3.3 — Длина, маски и шаблон диалога
Последовательностный логарифм вероятности — сумма отрицательных токеновых вкладов. Поэтому длина непосредственно входит в масштаб. Если предпочтённые ответы длиннее, модель может учиться на корреляции длины с меткой. Но механическое деление на длину не является универсальным лекарством: оно меняет функцию потерь и способно создать смещение к слишком коротким ответам.
Перед обучением проверяются:
- распределения длин и ;
- одинаковые правила обрезки;
- доля обрезанных пар;
- токен конца последовательности (
end of sequence, EOS) и причины остановки; - маска только по токенам ответа;
- одинаковый шаблон диалога;
- версия токенизатора и базы;
- отсутствие служебных признаков победителя.
Если логарифмы вероятностей базы кэшируются, кэш становится недействительным после изменения токенизации, шаблона, обрезки или контрольной точки. Одинаково выглядящий текст не гарантирует одинаковой последовательности действий.
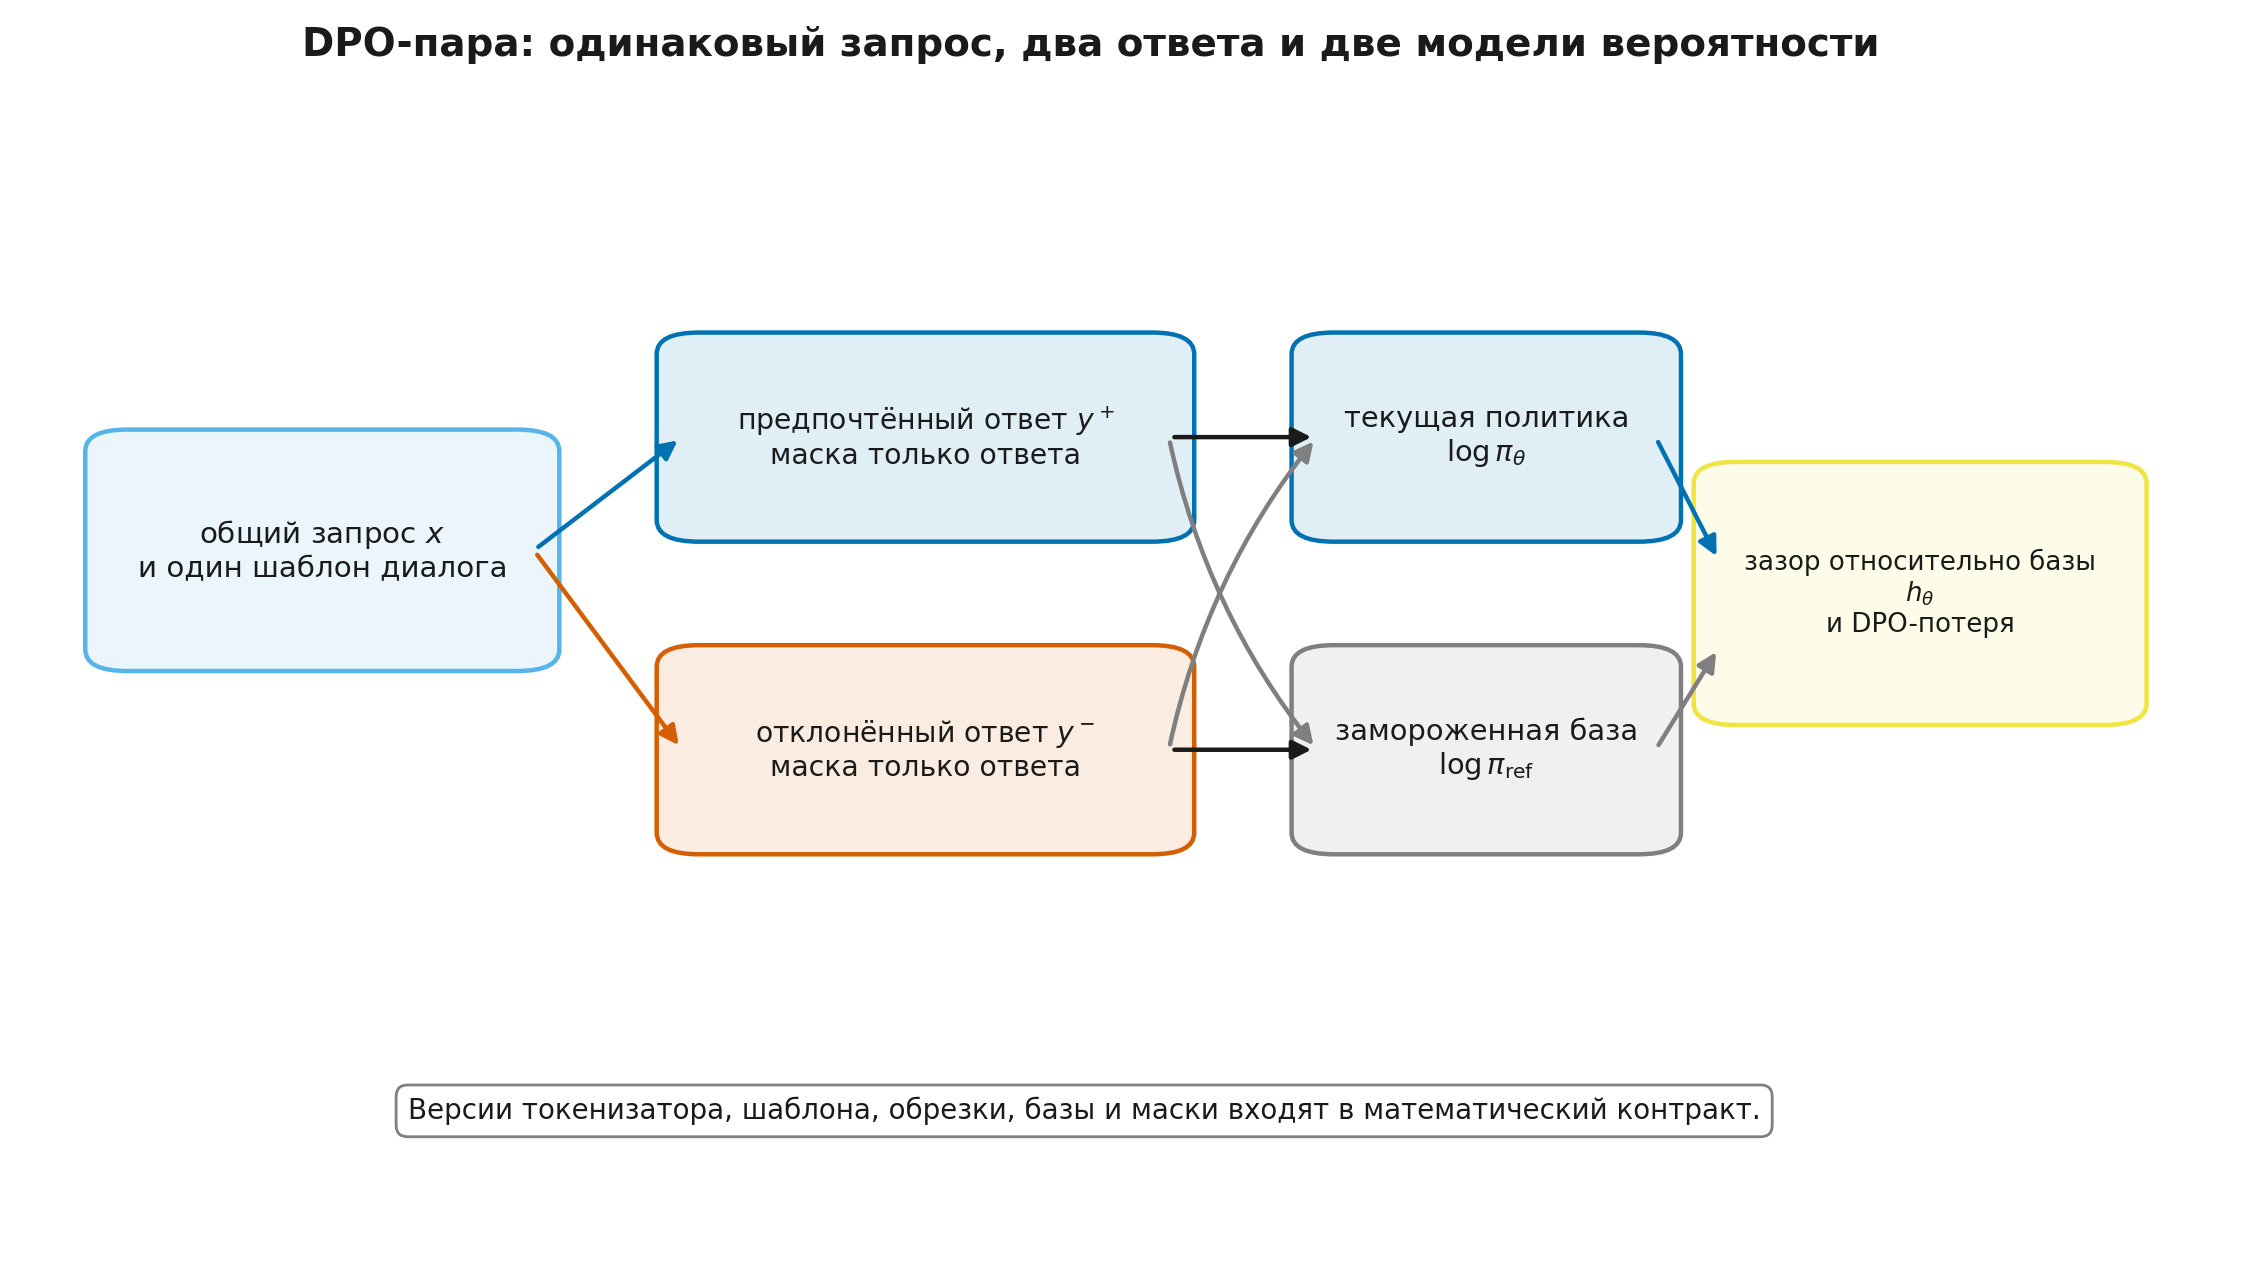
Версии токенизатора, шаблона, правила обрезки, опорной модели и маски ответа входят в математический контракт пары.
Инженерное расширение: подготовка диалоговых данных и шаблонов подробнее рассматривается в Modern LLMs, Модуль 13 «SFT и работа с данными» (
modern_llms.module_11_sft).
Шаг 8.3.4 — Шумные пары и консервативная DPO (cDPO)
Консервативная DPO (conservative DPO, cDPO) использует сглаживание бинарной метки. Если доля меток может быть ошибочной, то для :
При получаем обычную DPO-потерю. При положительном сглаживании модель не должна становиться бесконечно уверенной, что каждая метка верна.
Сглаживание не исправляет систематически неверную рубрику, утечку позиции или смещение источника. Поэтому вместе с потерей нужны:
- точность пар на отложенных запросах;
- выбранный и отклонённый логарифмы вероятностей;
- средний зазор и его распределение;
- KL к базе;
- длины;
- качество по доменам и генераторам;
- независимое оценивание после генерации.
Остановка по одной тренировочной потере особенно опасна: она продолжает улучшаться даже после того, как полезное качество перестало расти.
Шаг 8.3.5 — Фиксированные пары стареют
DPO обычно обучается на ответах, собранных некоторой исходной политикой. После обновления новая политика может породить ответы другого типа. Тогда старые пары всё хуже покрывают область, где требуется решение.
Есть три режима:
- одноразовый фиксированный набор — проще всего воспроизвести, но покрытие не обновляется;
- итеративная оптимизация предпочтений — новая политика генерирует кандидатов, после чего собираются свежие пары;
- онлайн-RL — текущая политика получает награду и обновляется непосредственно на свежих роллаутах.
Итеративный режим снижает разрыв между данными и текущей политикой, но требует версионирования генераторов, рубрик и судей. Он также не гарантирует улучшения, если источник обратной связи систематически ошибается.
Практическое правило: хранить policy_version, reference_version, параметры декодирования, дату, источник метки и идентификатор раунда. Без них нельзя восстановить, какое распределение породило пары.
Урок 8.4. Варианты прямой оптимизации предпочтений
Урок 8.4. Варианты прямой оптимизации предпочтений
- IPO: конечный целевой зазор
- SimPO: средний логарифм вероятности и целевая маржа
- KTO: отдельные метки вместо пар
- ORPO: обучение с учителем и отношение шансов в одной цели
- Карта методов: сначала данные, потом название
далее — 3 проверочных шага
Шаг 8.4.1 — IPO: конечный целевой зазор
Оптимизация предпочтений с тождественным преобразованием (Identity Preference Optimization, IPO) сохраняет парный логарифмический зазор, но задаёт ему конечную цель. В используемой здесь договорённости
где — тот же зазор логарифмических отношений, а управляет целевым значением.
Обычная DPO-потеря монотонно уменьшается при росте положительного зазора. IPO штрафует и недостаточный, и чрезмерный зазор относительно цели. Это полезная конструкция, когда бесконечное расширение маржи не отражает желаемого поведения.
Но конечная цель не устраняет плохие пары, несогласованный шаблон и слабое покрытие. Кроме того, параметр нельзя сравнивать с DPO только по числу: он входит в другую функцию потерь.
Шаг 8.4.2 — SimPO: средний логарифм вероятности и целевая маржа
Простая оптимизация предпочтений (Simple Preference Optimization, SimPO) использует оценку ответа без отдельной базы:
Парный логит строится из разности этих оценок и целевого зазора :
Преимущества — отсутствие отдельного прямого прохода базы и явная нормировка по длине. Цена — изменение математического контракта: база больше не задаёт якорь, а средняя логарифмическая вероятность создаёт свои смещения.
SimPO уместно сравнивать с DPO по одинаковым данным, бюджету и независимому оцениванию. Нельзя заключать, что нормировка длины автоматически решает все длиновые эффекты.
Шаг 8.4.3 — KTO: отдельные метки вместо пар
Оптимизация Канемана—Тверски (Kahneman–Tversky Optimization, KTO) рассчитана на данные, где отдельный ответ отмечен как желательный или нежелательный. Это другой контракт: не требуется явная пара к тому же запросу.
Метод сопоставляет полезность положительных и отрицательных примеров относительно базового уровня, вдохновляясь асимметрией восприятия выгод и потерь. Для курса важнее не название функции, а вопрос: действительно ли у нас есть надёжные отдельные бинарные метки?
KTO полезен, когда пары дороги или недоступны. Но нельзя автоматически спаривать ответы из разных запросов и выдавать это за DPO-данные. Также нужно контролировать баланс классов, семантику «нежелательного» и различия доменов.
Шаг 8.4.4 — ORPO: обучение с учителем и отношение шансов в одной цели
Оптимизация предпочтений по отношению шансов (Odds Ratio Preference Optimization, ORPO) объединяет обычный член обучения с учителем (supervised fine-tuning, SFT) для предпочтённого ответа с парным штрафом по отношению шансов. Схематически:
Отдельная базовая модель во время обучения не требуется. SFT-член поддерживает вероятность предпочтённого ответа, а парный член разделяет выбранный и отклонённый варианты.
Это не «DPO без одной модели» в буквальном смысле: меняются функция потерь, шкала и роль якоря. В отчёте нужно отдельно смотреть отрицательное логарифмическое правдоподобие (negative log-likelihood, NLL) SFT-части и парную часть. Сильный парный сигнал не должен скрывать деградацию языкового моделирования.
Шаг 8.4.5 — Карта методов: сначала данные, потом название
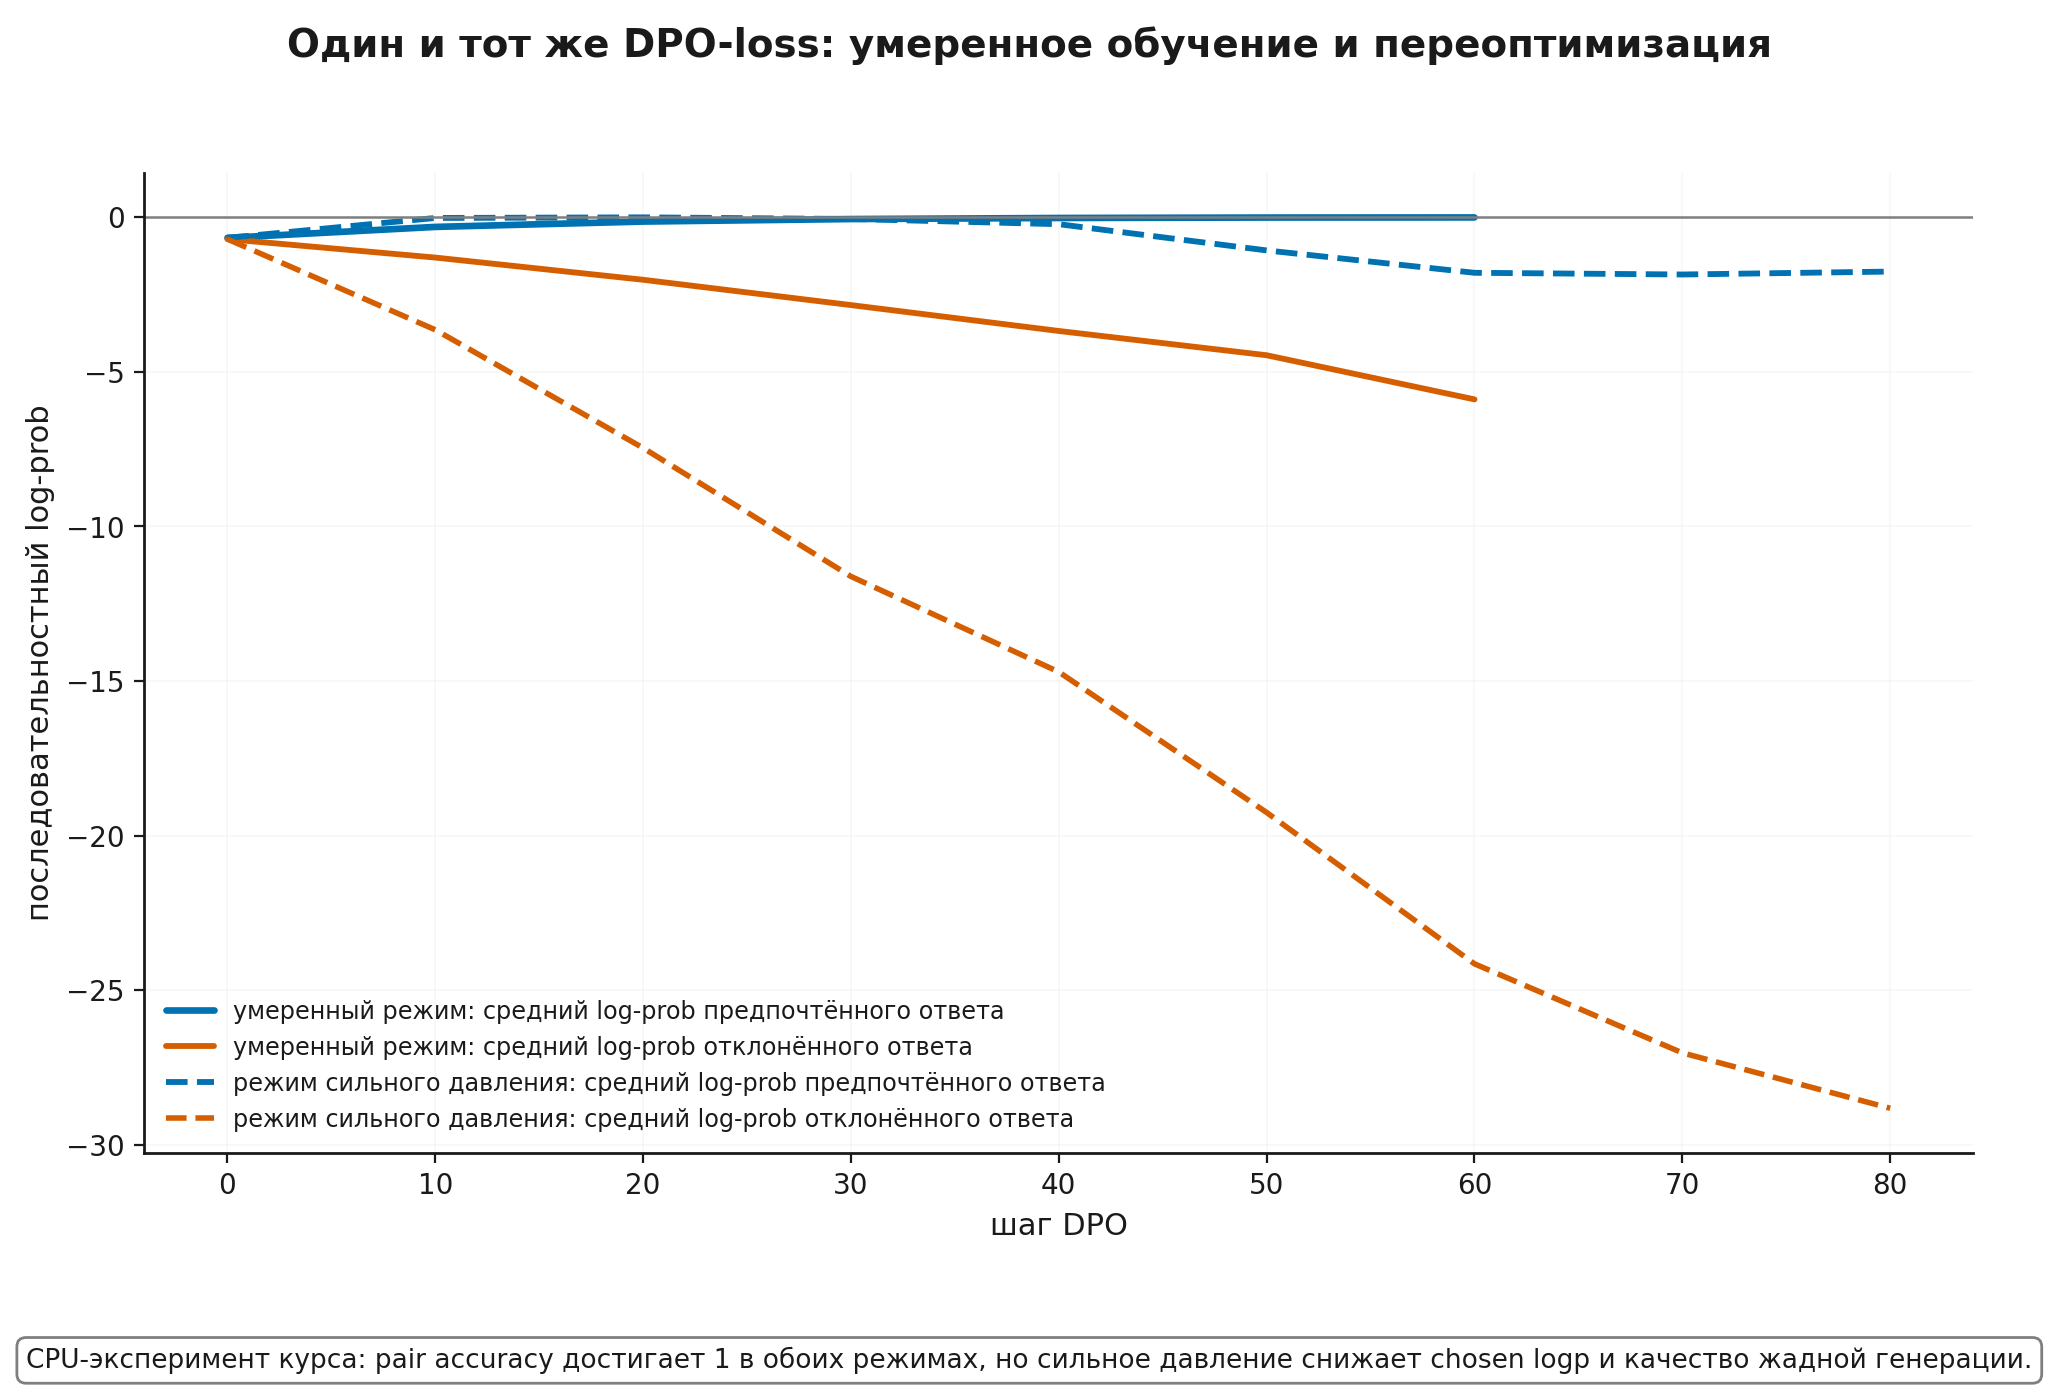
В зафиксированном smoke-протоколе оба DPO-режима достигают точности ранжирования пар 1,0. Умеренный режим сохраняет совпадение жадной генерации с предпочтёнными ответами на всех восьми шаблонах, тогда как режим сильного давления оставляет только 0,125. Одновременно средний логарифм вероятности предпочтённого ответа меняется примерно с в умеренном режиме до в режиме сильного давления. Это собственный синтетический результат курса, а не внешний бенчмарк; его функция — показать, почему точность попарного ранжирования и DPO-потеря недостаточны без абсолютных вероятностей и свободной генерации.
Команды:
python -B modules/module-08/test_module_8_reference.py
python -B modules/module-08/module_8_reference.py
Дополнительно python -B modules/module-08/module_8_training.py запускает весь воспроизводимый CPU-эксперимент. Оцениваемая практика даёт задания и решения, открывающиеся после попытки, а исполняемая практика — связный вычислительный маршрут.
Шаг 8.5.3 — Практика B: DPO на Qwen3-0.6B
- синтетический маршрут на CPU без скачивания модели;
- реальный маршрут с
Qwen/Qwen3-0.6B,trl-lib/ultrafeedback_binarized, TRLDPOTrainerи LoRA.
По умолчанию RUN_REAL_MODEL=False, поэтому выпускной маршрут не скачивает модель и не требует ускорителя. Реальная ветвь является актуальным инженерным шаблоном для среды с подходящим GPU; конкретная память, время и устойчивость запуска зависят от образа среды, длины последовательности, размера пакета, типа чисел и версии библиотек. Курс не обещает, что любой профиль T4 автоматически вместит выбранную конфигурацию.
Фактический снимок ветви зафиксирован как TRL 1.9.2, Transformers 5.14.1, PEFT 0.20.0, Accelerate 1.14.0 и Datasets 5.0.1; он записан в ноутбуке и реестре источников. API библиотек меняются, поэтому версии являются частью эксперимента, а не необязательной деталью.
Честная граница выпуска: ветвь с Qwen3 и TRL в этой редакции не запускалась. Поэтому курс не заявляет измеренное время, память, сходимость или качество обученной Qwen3-модели. Полностью выполнены NumPy-математика и авторегрессионный CPU-маршрут на небольшой GRU-политике.
Шаг 8.5.4 — Что измерять после обучения
Минимальный отчёт включает:
- DPO-потерю и точность пар;
- выбранный и отклонённый логарифмы вероятностей;
- средний зазор и градиентный вес;
- KL к базе на согласованном протоколе;
- длину и причины остановки;
- качество по доменам и генераторам;
- независимую оценку свежих генераций;
- проверку сохранения базовых способностей.
Нужны как минимум три набора:
- отложенные пары того же происхождения;
- новые запросы того же домена;
- сдвинутое распределение или ответы новой политики.
Высокая точность на фиксированных парах не доказывает, что модель хорошо генерирует. Она может запомнить стилистические признаки или улучшить относительный порядок, одновременно снизив абсолютное правдоподобие предпочтённых ответов.
Шаг 8.5.5 — Решение: DPO, RLHF или онлайн-RL
Удобная последовательность выбора:
- Есть ли надёжная обратная связь? Если нет, сначала исправляется рубрика и данные.
- Есть ли пары? Для фиксированных пар DPO и его варианты дают простой базовый маршрут.
- Нужны свежие данные текущей политики? Тогда требуется итеративный сбор или онлайн-RL.
- Награда проверяема программно? Это естественный вход в RL с проверяемой наградой (
reinforcement learning with verifiable rewards, RLVR), который подробно рассматривается в Модуле 9 «RLVR и GRPO: проверяемые награды, групповые оценки и устойчивость» (rl_llm.module_09_rlvr_grpo). - Нужна общая открытая награда и кредитование токенов? PPO или REINFORCE с исключением текущего ответа (
REINFORCE Leave-One-Out, RLOO) остаются уместны, хотя обходятся дороже. - Нужен простой одноэтапный режим? Рассматриваются ORPO или SimPO, но с их собственными предположениями.
Итоговая карта:
DPO не «заменил RLHF вообще». Он заменяет конкретный дорогой контур там, где фиксированные пары и его предположения подходят задаче. Онлайн-RL остаётся нужен, когда данные должны следовать за текущей политикой, а взаимодействие или проверяемая награда являются частью цели.
Итоги модуля
- RLHF оптимизирует награду под KL-ценой ухода от базы.
- Четыре роли RLHF не означают четыре обязательные полные копии модели.
- Точный KL-регуляризованный оптимум — экспоненциальный наклон базовой политики.
- DPO получается после подстановки неявной награды в BT-модель и сокращения нормировки.
- DPO управляет относительным зазором; абсолютные вероятности нужно измерять отдельно.
- Длина, маски, шаблоны, обрезка и версия базы входят в математический контракт.
- IPO, SimPO, KTO и ORPO решают разные задачи и используют разные данные.
- Фиксированные пары стареют по мере изменения политики; итеративный сбор и онлайн-RL остаются отдельными инструментами.
Краткий глоссарий
- RLHF — обучение политики по человеческой обратной связи через награду и RL-контур.
- DPO — прямая парная функция потерь политики относительно базы.
- KL-якорь — штраф или ограничение на отклонение от базовой политики.
- Неявная награда — величина с добавкой, зависящей от запроса.
- cDPO — DPO со сглаживанием меток.
- IPO — парная цель с конечным желаемым зазором.
- SimPO — парная цель на средней логарифмической вероятности без отдельной базы.
- KTO — метод для отдельных желательных и нежелательных примеров.
- ORPO — сочетание SFT-потери и парного отношения шансов.
- Смещение правдоподобия — режим, где парный зазор растёт, а вероятность предпочтённого ответа может падать.
Источники и маршрут углубления
- Ouyang et al. (2022), Training language models to follow instructions with human feedback — канонический LLM-контур SFT → модель награды → PPO; работа не предписывает единственную архитектуру хранения ролей.
- Rafailov et al. (2023), Direct Preference Optimization — основной вывод DPO из KL-регуляризованной постановки и парной модели предпочтений.
- Azar et al. (2023), A General Theoretical Paradigm to Understand Learning from Human Preferences — анализ парных целей и мотивация IPO.
- Meng, Xia, Chen (2024), SimPO, Ethayarajh et al. (2024), KTO и Hong, Lee, Thorne (2024), ORPO — первичные источники по альтернативным контрактам прямой оптимизации.
- Chowdhury et al. (2024), Provably Robust DPO — теоретическая коррекция для заданной модели шума; это не синоним обычного сглаживания меток cDPO.
- Razin et al. (2024), Unintentional Unalignment: Likelihood Displacement in DPO — мотивация отдельно отслеживать абсолютные вероятности выбранных и отклонённых ответов.
- Текущая документация TRL DPOTrainer — датированный инженерный интерфейс, а не математическая гарантия.
Полный построчный реестр утверждений, ограничений и воспроизводимых чисел находится в Module_8_Sources.md. Для вариационного вывода полезен Information Theory for ML, Модуль 8 «Максимальная энтропия, экспоненциальные модели и KL-регуляризация» (it_ml.module_08_maxent_kl_policy); для подготовки SFT-данных — Modern LLMs, Модуль 13 «SFT и работа с данными» (modern_llms.module_11_sft); для общей карты современных методов послеобучения — Modern LLMs, Модуль 14 «Обучение по обратной связи: RLHF, DPO, RLOO и GRPO» (modern_llms.module_12_preference_optimization).