Модуль 4. Градиенты политики: от REINFORCE к PPO
Версия материала: 2026.9
Фактический снимок: 2026-08-04
Язык: RU
Основная практика: браузер, Python и NumPy на центральном процессоре (CPU); отдельный русскоязычный ноутбук объединяет REINFORCE, GAE, полноценный PPO для CartPole и последовательностный пример для LLM
Структура: 5 уроков, 25 шагов
Ориентировочное время: 9–13 часов без полного многозапускового профиля ноутбука
В Модуле 2 мы улучшали поведение через функции ценности, а в Модуле 3 изучали одношаговые решения. Теперь перейдём к другому пути: будем оптимизировать параметры самой политики. Этот путь особенно важен для LLM, потому что итоговая награда может приходить от человека, проверяющей программы или недифференцируемой модели оценки — градиент через такую обратную связь напрямую не проходит.
Предварительный курс по RL не требуется. Сначала мы выведем оцениватель градиента для распределения, затем разберём REINFORCE, опорные уровни, актор–критик, обобщённое оценивание преимущества и проксимальную оптимизацию политики (proximal policy optimization, PPO). Читатель после классического курса RL может использовать первые два урока как точное повторение и уделить больше внимания смещению группового среднего при конечном размере группы, корректной обработке технического усечения, а также различию траекторных и локальных отношений вероятностей. Групповые методы для нескольких ответов появятся после того, как будет построен общий фундамент.
Цели модуля. После прохождения вы сможете:
- вывести тождество логарифмической производной и оцениватель REINFORCE;
- объяснить, при каких условиях динамика среды исчезает из производной, но не из распределения данных;
- различать градиент буквальной дисконтированной цели и распространённую запись через дисконтированное распределение посещений;
- доказать, почему опорный уровень, не зависящий от действия, не меняет математическое ожидание градиента;
- отличать естественный опорный уровень от скалярного опорного уровня, точно минимизирующего второй момент градиентного оценивателя;
- вычислять преимущества по групповому среднему и с исключением текущего ответа;
- реализовать обобщённое оценивание преимущества (
generalized advantage estimation, GAE) с разными масками для завершения задачи и технического усечения; - вывести локальную суррогатную и клиппированную цели PPO;
- читать основные диагностические показатели PPO, не принимая их за универсальные гарантии;
- связать последовательностный REINFORCE с оценивателем, который исключает текущий ответ из опорного среднего, и отделить эту конструкцию от более широкого семейства групповых методов.
На учебной платформе после каждой содержательной части предлагаются задачи, а подробное решение открывается после попытки или на следующем шаге. Исполняемая практика реализует не только отдельные формулы, но и полный путь от роллаутов и GAE до нескольких эпох PPO, а затем переносит ту же механику на авторегрессионные ответы. Реестр проверенных утверждений и первичных источников находится в Module_4_Sources.md.
Практический маршрут. После лекции идут оцениваемые задания, решения, открывающиеся после попытки, и исполняемая практика. Само объяснение остаётся самодостаточным.
Урок 4.1. Оценивание градиента политики и REINFORCE
Урок 4.1. Оценивание градиента политики и REINFORCE
- Прямая оптимизация политики
- Тождество логарифмической производной
- Вероятность траектории и исчезновение модели среды
- Каузальность и награда от текущего шага до конца
- Теорема о градиенте политики и REINFORCE
далее — 6 проверочных шагов
Шаг 4.1.1 — Прямая оптимизация политики
Пусть параметризованная политика порождает траектории, а цель равна ожидаемой накопленной награде:
В обычном обучении с учителем данные фиксированы, а производная проходит через функцию потерь. В RL распределение данных само зависит от : изменение политики меняет действия, состояния и будущие наблюдения. Кроме того, случайный выбор действия из дискретного распределения сам по себе недифференцируем. Поэтому нельзя просто провести обратное распространение через выбранный токен или внешнюю проверяющую систему.
Это не означает, что градиент цели недоступен. Нам нужен оцениватель, который:
- использует действия и траектории, полученные от текущей политики;
- не требует дифференцировать награду;
- не требует дифференцировать сам случайный выбор действия;
- остаётся корректным для дискретных действий.
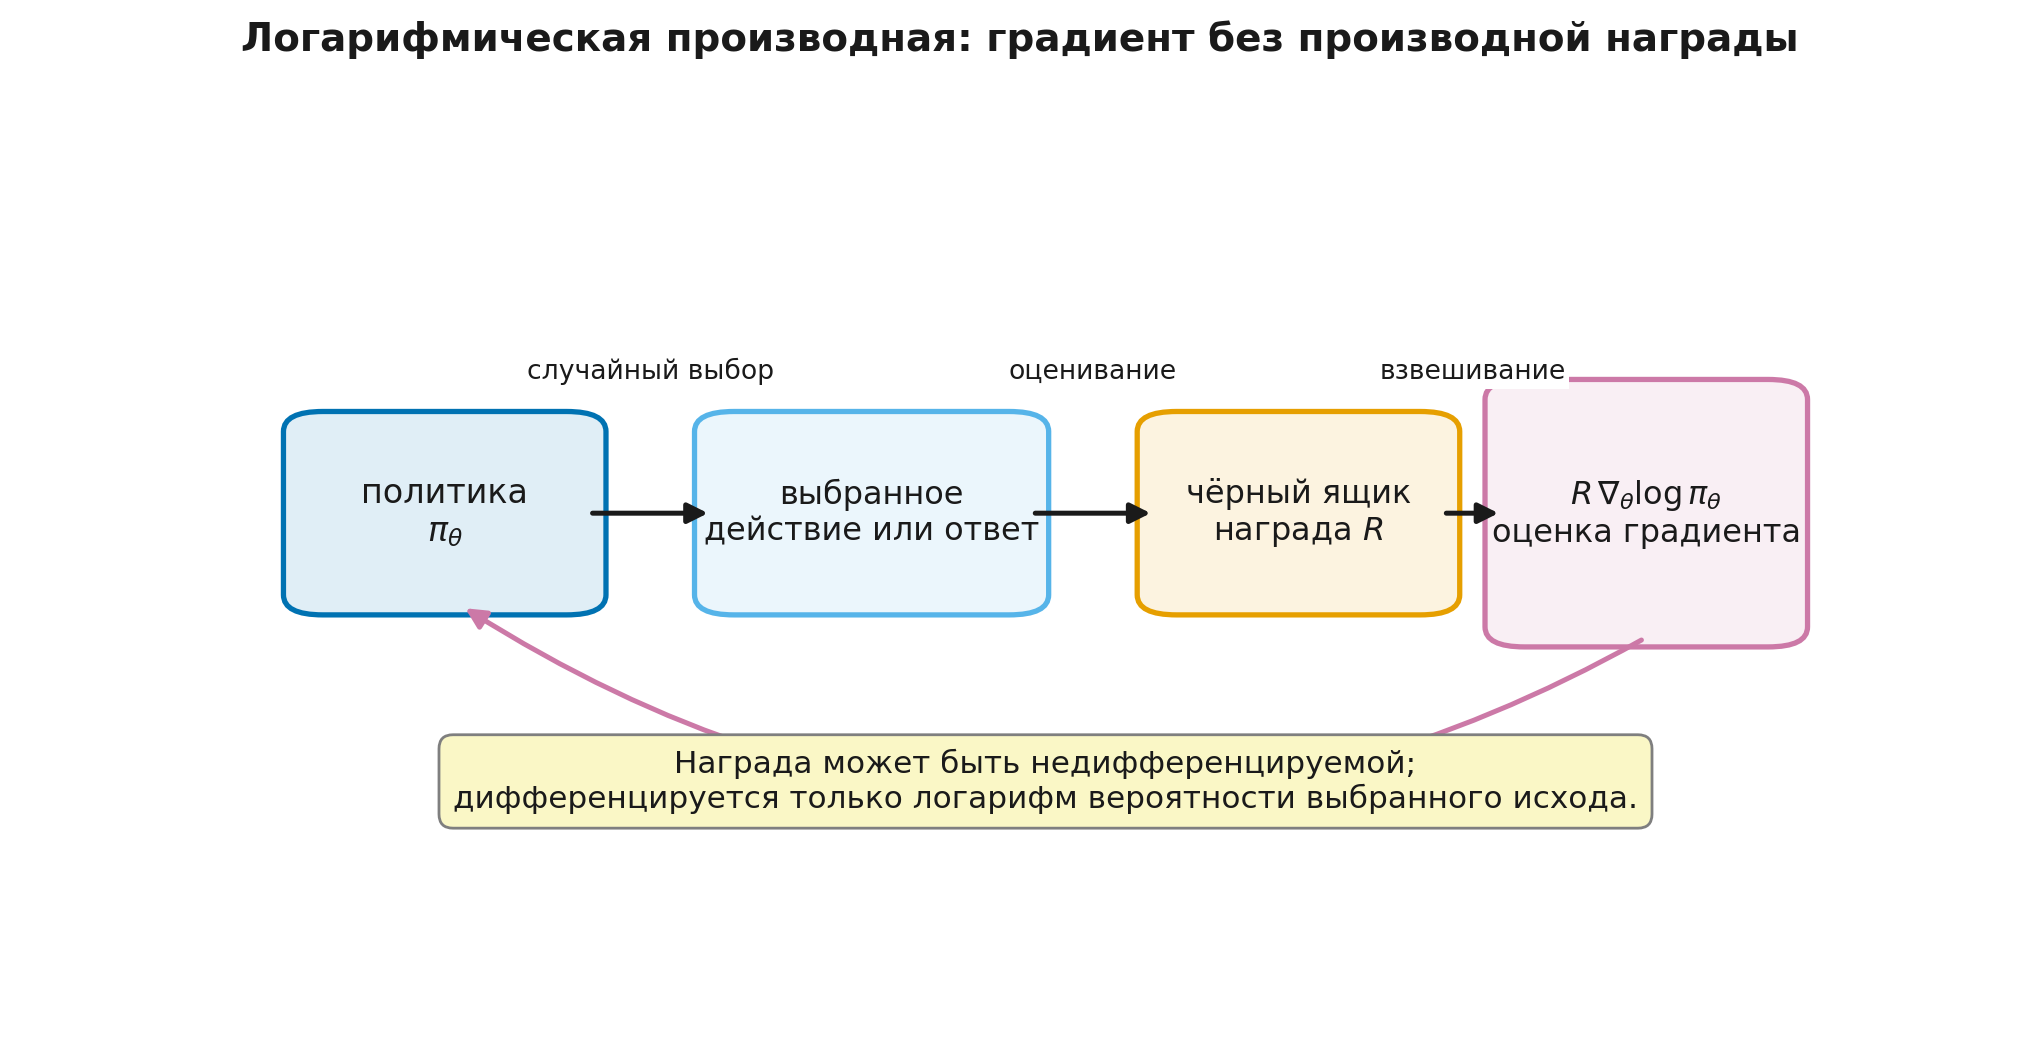
Именно такую конструкцию даёт тождество логарифмической производной. В статистике величину называют скор-функцией (score function). Дальше мы чаще будем говорить «градиент логарифма вероятности»: это более прозрачное название для той же величины.
На LLM можно смотреть так: модель генерирует последовательность токенов, проверяющая система возвращает число, а оптимизатор должен понять, в какую сторону изменить вероятности выбранных токенов. Следующие шаги превращают эту интуицию в формулу.
Шаг 4.1.2 — Тождество логарифмической производной
Для дискретной случайной величины и функции , не зависящей от напрямую,
Используем тождество
Тогда
Полученную величину можно оценить по независимым выборкам:
Вот цена приёма: мы не дифференцируем , но получаем дисперсию Монте-Карло. Если — результат компиляции, оценка человека или бинарный ответ проверяющей системы, формула остаётся применимой.
Оговорка « не зависит от напрямую» существенна. Для правило произведения даёт два слагаемых:
Первое слагаемое учитывает изменение распределения исходов, второе — прямое изменение самой величины . В классическом REINFORCE награда среды фиксирована относительно параметров политики, и второго слагаемого нет. Если же в «награду» включён дифференцируемый штраф, зависящий от текущей политики, его нельзя молча считать постоянным: нужно либо явно оставить прямую производную, либо сознательно остановить градиент и тем самым определить другую вычислительную цель.
Нужны обычные условия, разрешающие перенести производную под знак суммы или интеграла. В конечном пространстве действий это, как правило, не вызывает трудностей. В непрерывных пространствах условия регулярности следует проверять отдельно.
Для softmax-политики с логитами получаем особенно простую формулу:
где — вектор с единицей на месте выбранного действия и нулями на остальных местах (one-hot). Положительный вес повышает логит выбранного действия относительно остальных, отрицательный — понижает.
Шаг 4.1.3 — Вероятность траектории и исчезновение модели среды
Рассмотрим конечную траекторию
Если начальное распределение и динамика среды не зависят от , её вероятность факторизуется:
После логарифмирования произведение превращается в сумму. Производная по действует только на политику:
Подставляя это в тождество логарифмической производной, получаем
Фраза «динамика среды исчезла» требует точности. Она исчезла из явной производной, но продолжает определять, какие траектории наблюдаются и какие награды получает агент. Если переходы зависят от тех же параметров , если среда обучается совместно с политикой или если мы дифференцируем через известный симулятор, приведённое упрощение уже не описывает всю производную.
Для LLM внешняя проверяющая система обычно не зависит от весов политики, поэтому её производная не нужна. Но она по-прежнему формирует обучающий сигнал: плохая проверяющая система даст корректный градиент неправильной цели.
Шаг 4.1.4 — Каузальность и награда от текущего шага до конца
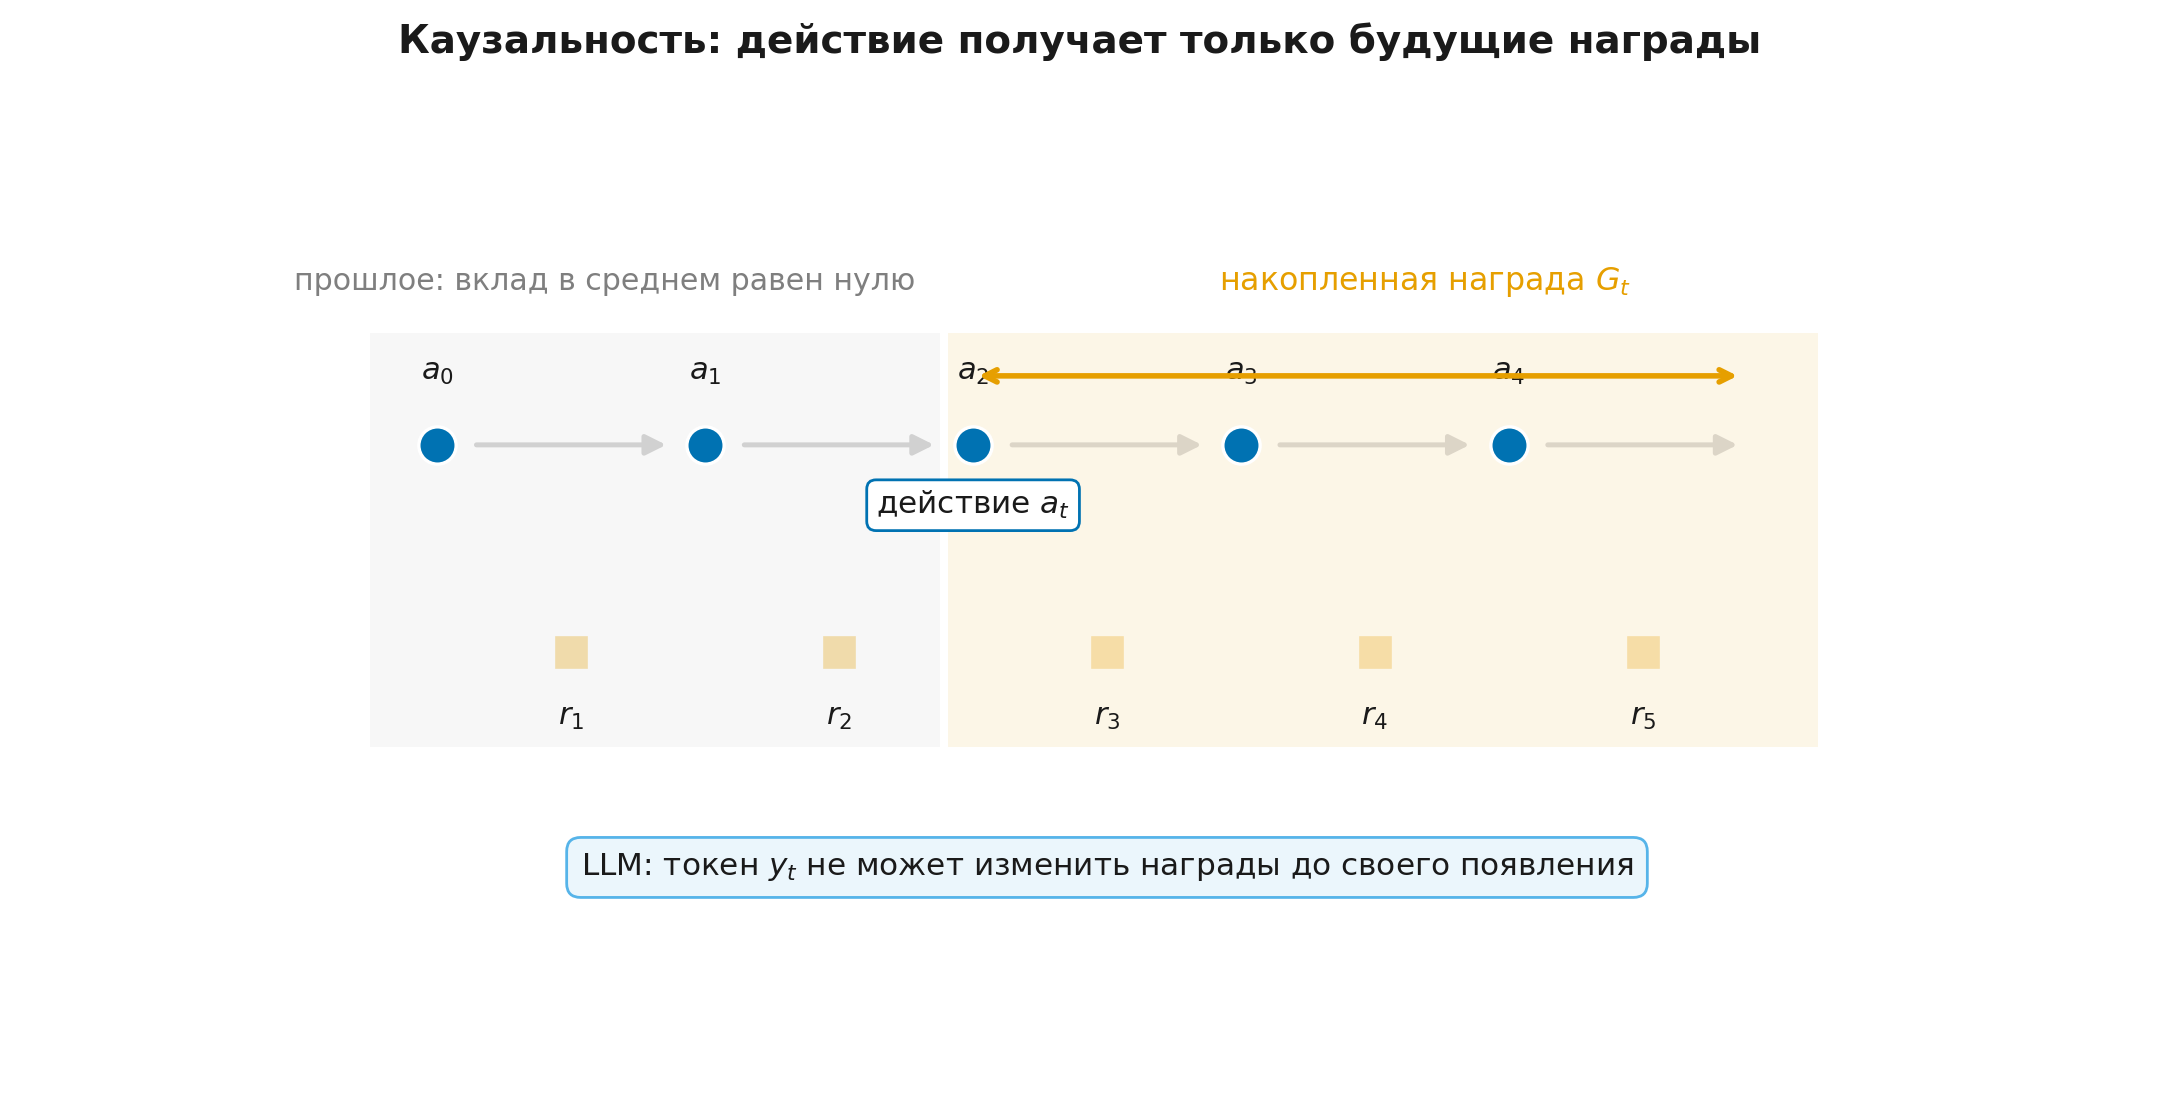
В предыдущей формуле каждый градиентный множитель умножался на полный результат траектории. Однако действие не может изменить награды, полученные до момента . Их вклад имеет нулевое математическое ожидание, потому что условное ожидание градиента логарифма вероятности равно нулю:
Поэтому вместо полного результата можно использовать накопленную награду от текущего шага:
Для буквальной цели
прямой вывод даёт вес :
В учебниках часто встречается запись без внешнего . Обычно она опирается на другую договорённость: дисконтирование уже встроено в распределение посещений состояний либо оптимизируется цель с иным взвешиванием моментов времени. Это не всегда безобидное изменение общего масштаба. При конечном горизонте удаление меняет относительный вес ранних и поздних решений и, вообще говоря, задаёт другой градиентный вектор. Реализация может сознательно выбрать такую цель ради удобной оптимизации, но вывод, код и интерпретация должны использовать одну и ту же договорённость.
Шаг 4.1.5 — Теорема о градиенте политики и REINFORCE
В форме через дисконтированное распределение посещений теорема о градиенте политики (policy gradient theorem) записывается как
Коэффициент пропорциональности зависит от нормировки распределения посещений. Практический смысл не меняется: вероятность действия повышается, если его ожидаемое продолжение лучше опорного уровня, и понижается, если хуже.
Алгоритм REINFORCE, предложенный Рональдом Уильямсом, заменяет неизвестное выборочной накопленной наградой:
- собрать траектории текущей политикой;
- вычислить или выбранный вариант дисконтированного веса;
- сформировать оценку
- сделать шаг градиентного подъёма.
При корректном сборе траекторий оценка несмещённа относительно выбранной цели, но может иметь большую дисперсию. Слово «несмещённа» не означает «быстро обучается»: отдельный пакет данных способен указывать почти произвольное направление. Следующий урок посвящён контрольным вариатам — величинам, которые уменьшают шум, не меняя математическое ожидание.
Для LLM сумма логарифмов вероятностей токенов заменяет логарифм вероятности траектории. Пока мы оставим итоговую награду на уровне полного ответа и вернёмся к распределению вклада между токенами в Уроке 4.5.
Урок 4.2. Опорные уровни и групповые оценки
Урок 4.2. Опорные уровни и групповые оценки
- Что можно вычесть, не меняя ожидание
- Почему ценность состояния естественна, но не всегда минимизирует дисперсию
- Среднее по группе и скрытая зависимость от текущего ответа
- Исключение текущего ответа из опорного среднего
- Воспроизводимый эксперимент с дисперсией и смещением
далее — 4 проверочных шага
Шаг 4.2.1 — Что можно вычесть, не меняя ожидание
Пусть — любая функция состояния, не зависящая от выбранного действия. Тогда
Следовательно,
без изменения ожидаемого градиента. Такую конструкцию называют контрольной вариатой (control variate), а — опорным уровнем (baseline).
Если выбрать
то коэффициент становится преимуществом:
Теперь положительный коэффициент означает не просто «награда положительна», а «действие оказалось лучше обычного продолжения из этого состояния». Это устраняет бессмысленное усиление всех действий в задаче, где каждое завершение приносит большую положительную константу.
Условие независимости от действия существенно. Нельзя без поправки вычесть произвольную функцию : её вклад обычно имеет ненулевое ожидание. Существуют более сложные контрольные вариаты, зависящие от действия (action-dependent), но они требуют компенсирующих членов и не нужны для основного маршрута.
Шаг 4.2.2 — Почему ценность состояния естественна, но не всегда минимизирует дисперсию
— естественный опорный уровень: он превращает в преимущество и хорошо согласуется с актором–критиком. Однако утверждение « всегда минимизирует дисперсию градиента» слишком сильное.
Для фиксированного состояния и скалярного минимизируем второй момент векторного оценивателя
Дифференцирование по даёт
Ценность состояния
совпадает с , только когда квадрат нормы градиента логарифма вероятности не коррелирует с или практически постоянен по действиям. В нейросети точный оптимум также зависит от того, по каким параметрам и какой норме измеряется дисперсия.
Эта оговорка не делает плохим выбором. Её можно обучать обычной регрессией; она имеет ясный смысл и часто существенно снижает дисперсию. Но это инженерно удачная аппроксимация, а не универсальный точный минимум.
Пример из заданий показывает сильное расхождение: для двух действий с логитами и ценностями получаются и .
Шаг 4.2.3 — Среднее по группе и скрытая зависимость от текущего ответа
В задачах LLM можно несколько раз сгенерировать ответ на один запрос. Пусть условно независимые ответы имеют награды и логарифмические градиенты .
Самый простой опорный уровень — среднее той же группы:
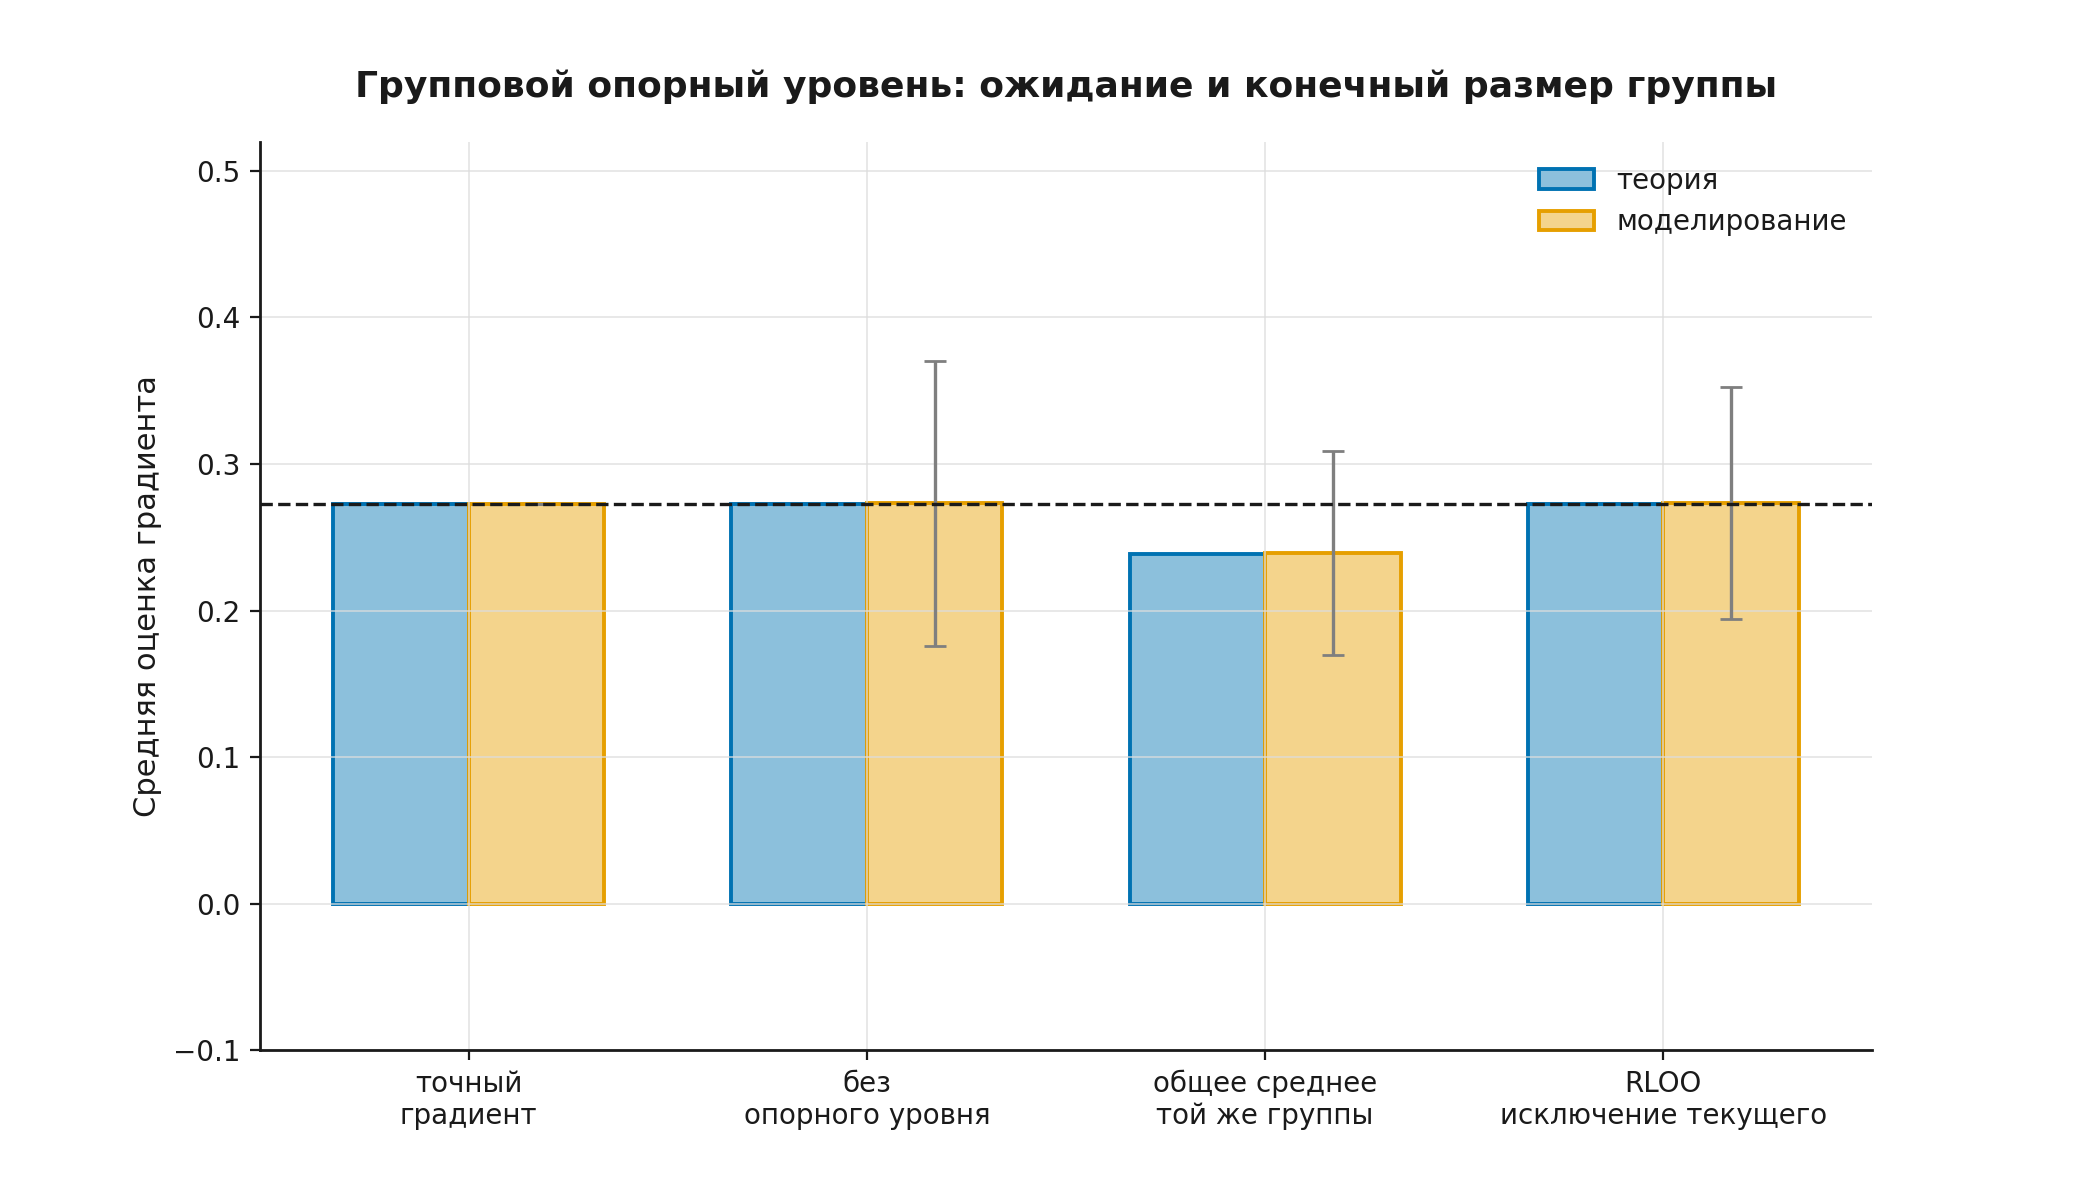
Преимущества суммируются в ноль, но содержит саму награду . Поэтому это не независимый от текущего действия опорный уровень. При условной независимости ответов можно вычислить ожидание точно:
Направление ожидаемого градиента сохраняется, но масштаб уменьшается на . При постоянном это можно поглотить скоростью обучения, однако оцениватель не следует называть буквально несмещённым.
Если дополнительно разделить центрированные преимущества на внутригрупповое стандартное отклонение, возникает ещё одна случайная нормировка. Она полезна для масштаба обновлений, но уже не является простой контрольной вариатой с сохранением исходного ожидания. Если все награды равны, стандартное отклонение равно нулю и практическая реализация возвращает нулевые преимущества с защитой .
Шаг 4.2.4 — Исключение текущего ответа из опорного среднего
Удалим текущий ответ из среднего:
При условно независимых ответах не зависит от действия , поэтому оцениватель сохраняет правильное математическое ожидание. Для одной и той же группы
Таким образом, центрирование по общему среднему и исключение текущего ответа дают коллинеарные коэффициенты, но различаются масштабом при конечном размере группы.
Алгоритм REINFORCE с исключением текущего ответа (REINFORCE Leave-One-Out, RLOO) использует эту идею для нескольких ответов на один запрос. В простейшей форме на уровне полного ответа каждый ответ получает награду, из неё вычитается средняя награда остальных ответов, а полученное преимущество умножает сумму токеновых логарифмических вероятностей.
Условия важны:
- ответы должны быть независимо сгенерированы одной зафиксированной политикой при заданном запросе;
- награды разных ответов не должны содержать общую случайную компоненту, зависящую от текущего ответа сложным образом;
- при неодинаковых длинах и масках нужно явно определить агрегирование токенов;
- RLOO не создаёт токеновую информацию о том, какой именно фрагмент ответа принёс награду.
Шаг 4.2.5 — Воспроизводимый эксперимент с дисперсией и смещением
Рассмотрим одношаговую бернуллиевскую политику:
с . Награда равна при и при . Точный градиент по логиту:
Для группы размера теория предсказывает ожидание оценивателя с общим средним:
Скрипт module_4_reference.py генерирует независимые группы и сравнивает три оценки:
- без опорного уровня;
- с общим внутригрупповым средним;
- с исключением текущего элемента.
Эксперимент подтверждает ожидаемые средние. При этом он не доказывает универсальный порядок дисперсий: дисперсия зависит от политики, наград, размера группы и параметризации. Его задача — отделить два вопроса, которые часто смешивают: правильное математическое ожидание и фактический шум конкретного оценивателя.
Урок 4.3. Актор–критик и обобщённое оценивание преимущества
Урок 4.3. Актор–критик и обобщённое оценивание преимущества
- Критик как обучаемый опорный уровень
- Ошибка временных различий и многошаговые цели
- Обобщённое оценивание преимущества
- Завершение, техническое усечение и граница роллаута
- Полный цикл актор–критик
далее — 3 проверочных шага
Шаг 4.3.1 — Критик как обучаемый опорный уровень
В больших пространствах состояний невозможно многократно возвращаться к каждому состоянию и усреднять будущие награды. Поэтому обучают функцию
где — параметры критика, а — параметры актора, то есть политики. Получается архитектура актор–критик (actor–critic):
- актор выбирает действия и получает градиент политики;
- критик предсказывает ожидаемое продолжение;
- разность между фактической целью и прогнозом критика служит оценкой преимущества.
Критик не обязан быть отдельной сетью. В LLM часто используют общий трансформер и дополнительную голову оценки ценности (value head). Но логические роли остаются разными: политика задаёт распределение действий, а критик оценивает ожидаемую накопленную награду.
Типичная функция потерь критика:
Если цель шумная или систематически смещена, критик наследует эти ошибки. Плохой критик способен не уменьшить, а увеличить дисперсию обновления актора. Поэтому ошибка предсказания ценности, доля объяснённой дисперсии и масштаб преимуществ — диагностические величины, а не второстепенные детали.
Есть и важный контракт вычислительного графа. При обновлении актора значения обычно рассматриваются как уже вычисленные числовые коэффициенты: градиент через критика и через процедуру построения цели останавливают (detach / stop-gradient). Иначе потери актора начинают невольно обучать критик или менять сам оцениватель преимущества. Критик получает свой отдельный градиент из . Это не запрет на общую нижнюю часть сети: если актор и критик делят представление, суммарная функция потерь всё равно обновляет общие параметры, но каждая ветвь должна иметь явно заданный маршрут градиента.
Шаг 4.3.2 — Ошибка временных различий и многошаговые цели
Одношаговая ошибка временных различий (temporal-difference error, TD-ошибка) равна
Если , её условное ожидание при фиксированных равно преимуществу . На практике критик приближённый, поэтому — смещённая, но локальная и часто малодисперсионная оценка.
Можно смотреть дальше:
При получаем TD-оценку; при до конца эпизода — Монте-Карло с вычитанием ценности. Увеличение уменьшает зависимость от ошибки критика, но добавляет случайность будущих наград и действий.
Эту шкалу нельзя свести к правилу «больше шагов лучше». В детерминированной среде длинная цель может быть почти бесшумной. В стохастическом диалоге или инструментальной задаче она может иметь огромную дисперсию. Нужен управляемый способ смешать горизонты.
Шаг 4.3.3 — Обобщённое оценивание преимущества
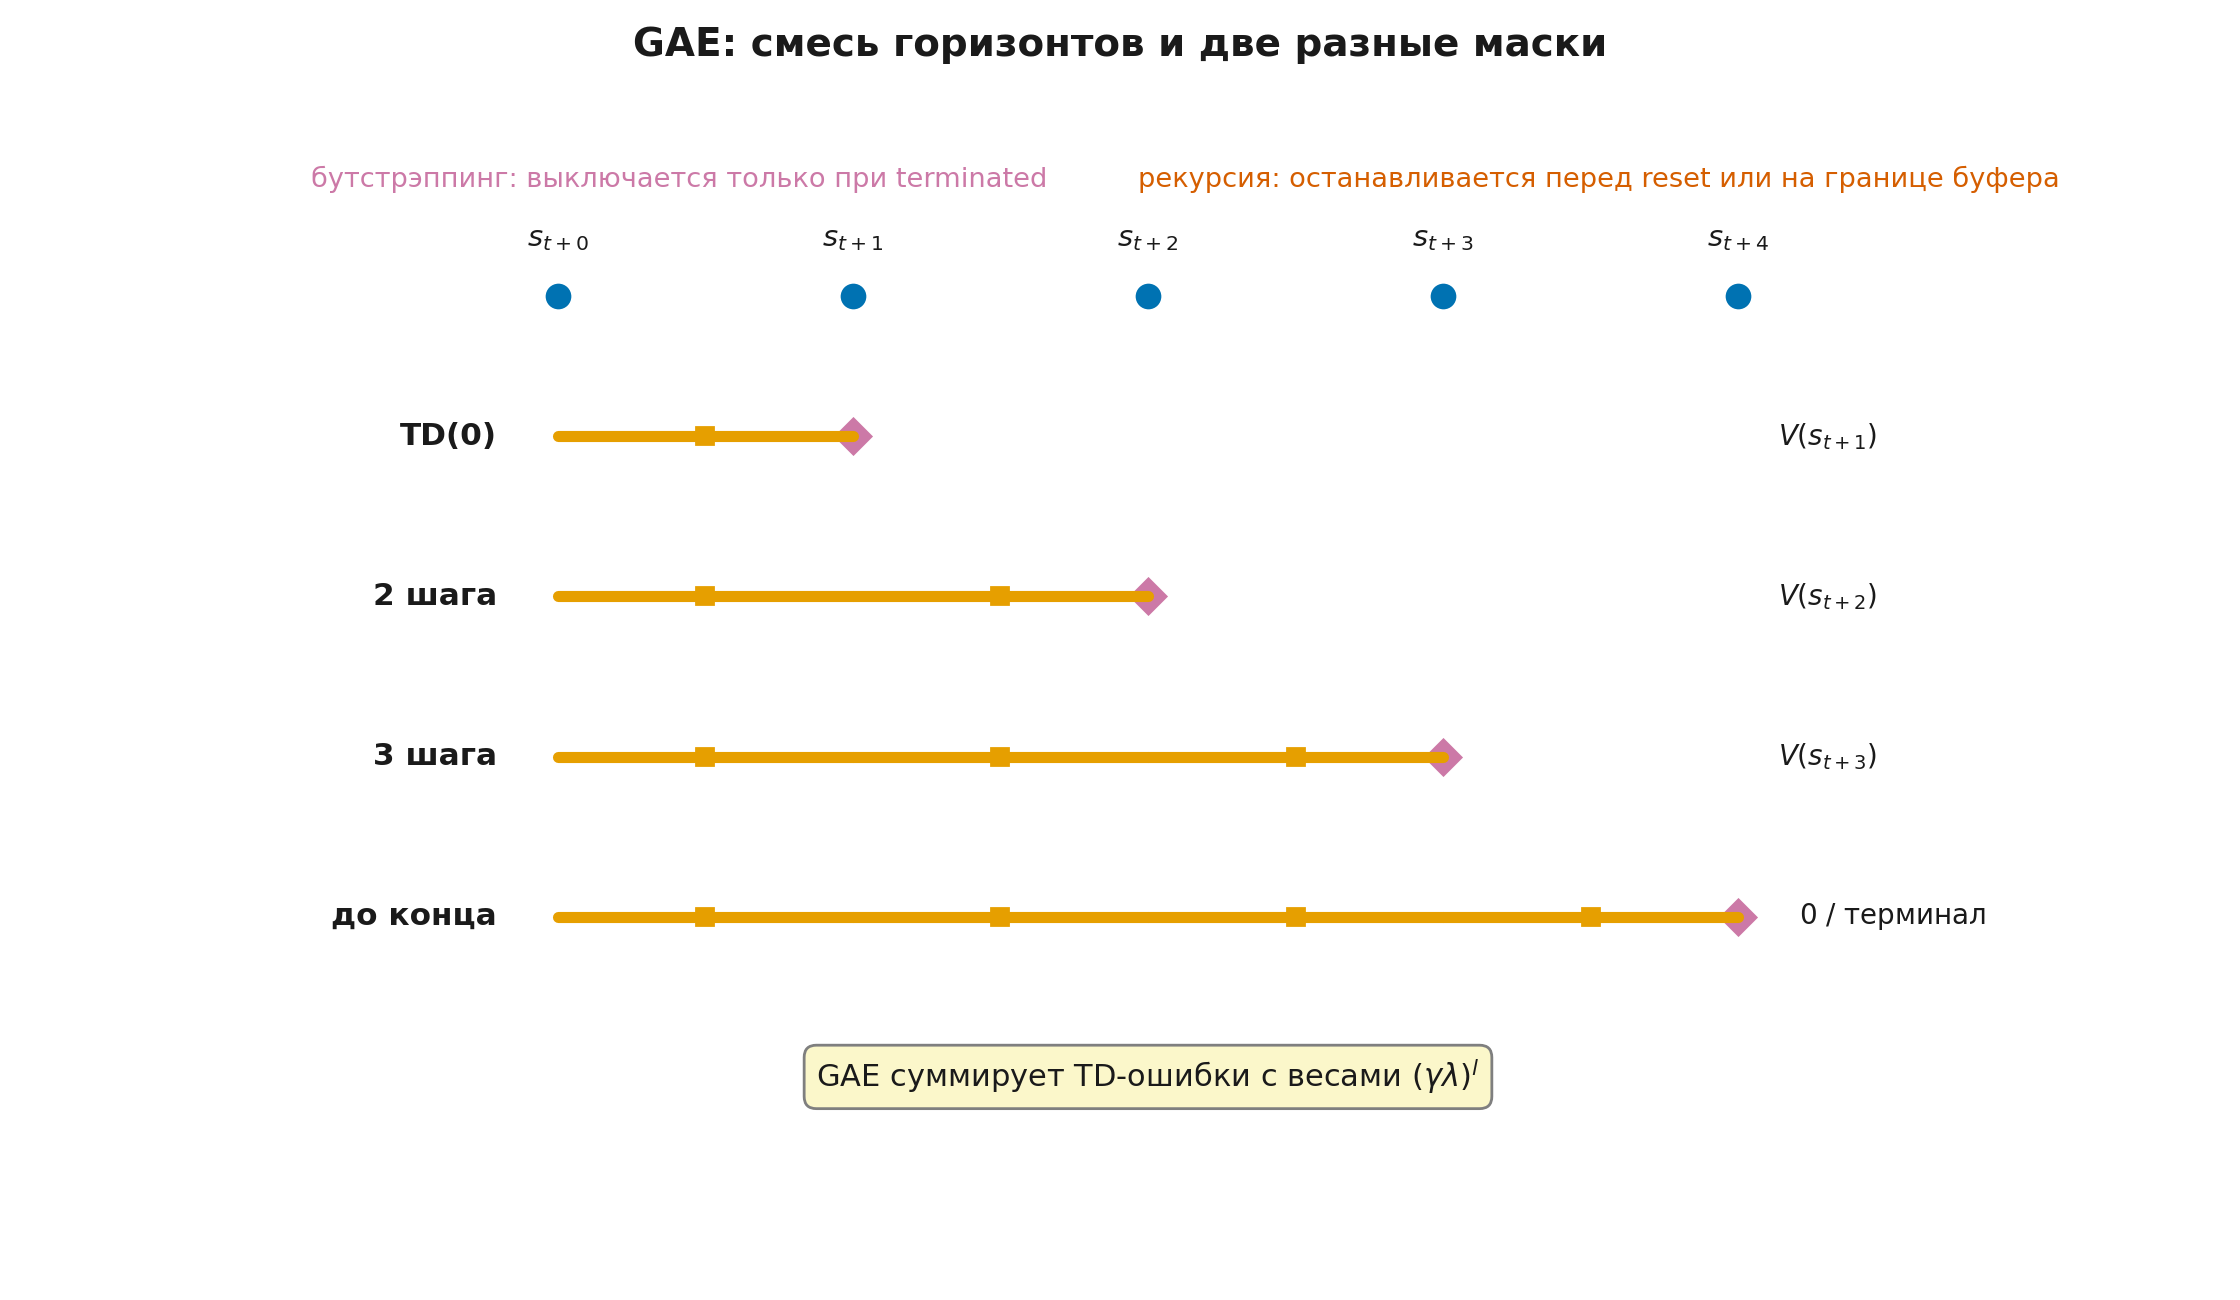
Обобщённое оценивание преимущества (generalized advantage estimation, GAE) смешивает многошаговые оценки геометрическими весами. Удобная рекуррентная запись:
Эквивалентно,
где — доступная длина непрерывного фрагмента до терминала, сброса среды или вычислительной границы роллаута. Параметр задаёт смесь:
- оставляет одношаговую TD-ошибку;
- промежуточные значения смешивают несколько горизонтов;
- не просто «похожа» на длинную цель: сумма телескопируется.
Если непрерывный фрагмент заканчивается индексом и для его последнего следующего состояния используется корректное значение , то
При истинном терминале последний прогноз равен нулю, и мы получаем возврат Монте-Карло минус . На границе собранного роллаута среда может продолжаться, поэтому остаётся бутстрэппинговый хвост. Это различие становится особенно важным при коротких буферах и длинных диалогах.
После вычисления преимущества цель критика часто строят как
Важно отделять три объекта: старый прогноз ценности, оценку преимущества и регрессионную цель. Нормирование преимуществ перед обновлением политики не должно автоматически менять цель критика.
Шаг 4.3.4 — Завершение, техническое усечение и граница роллаута
В коде легко встретить один флаг done, но математически полезно различать по крайней мере три ситуации.
- Истинное завершение (
terminated). Задача достигла терминального состояния; продолжения в этой постановке нет. - Техническое усечение (
truncated). Среду сбрасывают из-за внешнего ограничения — например, лимита времени, — хотя последнее состояние может иметь ненулевую ценность продолжения. - Граница буфера роллаута. Сборщик остановил текущий фрагмент после фиксированного числа переходов, но среда не завершилась и даже не была сброшена. Следующий фрагмент может продолжить тот же эпизод.
Бутстрэппинг регулируется только наличием истинного продолжения:
А обратная рекурсия должна понимать, присутствует ли в текущем вычисляемом фрагменте:
trace_cut равен единице перед сбросом среды и на конце локального буфера, если следующего преимущества в данном массиве уже нет. При техническом усечении используют ценность последнего наблюдения до reset(), но не переносят рекурсию в первое состояние нового эпизода. На обычной границе буфера роллаута также бутстрэппят из следующего наблюдения; потоковая реализация может перенести накопитель в следующий фрагмент, а пакетная — остановить локальную рекурсию и учесть хвост через .
| Событие | Бутстрэппинг из следующего состояния | Рекурсия внутри текущего массива |
|---|---|---|
| Истинное завершение | нет | нет |
Техническое усечение и reset() | да, из последнего наблюдения | нет |
Граница буфера без reset() | да | нет, если следующий фрагмент не присоединён |
| Обычный переход | да | да |
Распространённая ошибка — использовать один done и одновременно занулить следующий прогноз и оборвать рекурсию. Это смешивает два независимых вопроса и смещает цели около временных ограничений. При положительной ценности продолжения обнуление занижает цель, при отрицательной — завышает: удалённый член равен . Например, при нулевой награде, и цель ошибочно меняется с на . В генерации LLM аналогично нужно различать естественный токен конца последовательности (EOS), принудительный предел max_tokens и границу, на которой инфраструктура лишь завершила текущий пакет роллаутов.
Шаг 4.3.5 — Полный цикл актор–критик
Одна итерация актора–критика по данным текущей политики (on-policy) выглядит так:
- зафиксировать текущую политику ;
- собрать траектории и сохранить действия, старые логарифмические вероятности, награды, прогнозы ценности и маски;
- вычислить и цели ;
- обновить актор по оценке градиента политики;
- обновить критик регрессией к ;
- собрать свежие данные после достаточно большого изменения политики.
В простом варианте каждый пакет данных используется один раз. Это статистически чисто, но дорого: после одного шага оптимизации траектории выбрасываются. PPO пытается безопаснее использовать один пакет несколько эпох. Слово «безопаснее» здесь сравнительное: метод ограничивает суррогатную выгоду от больших локальных изменений, но не превращает обновление в строгую гарантию.
Урок 4.4. От старой политики к PPO
Урок 4.4. От старой политики к PPO
- Почему старые роллауты быстро устаревают
- Траекторное отношение, локальная цель и доверительная область
- Клиппированная целевая функция PPO
- Полная функция потерь и диагностика
- Почему детали реализации входят в алгоритм
далее — 3 проверочных шага
Шаг 4.4.1 — Почему старые роллауты быстро устаревают
Пусть траектории собраны политикой , а параметры уже изменились до . Тогда данные больше не распределены согласно новой политике. Для отдельного наблюдённого действия вводится отношение вероятностей
При новая политика делает выбранное действие вероятнее, при — менее вероятным. Локальная суррогатная цель
при преимуществах, зафиксированных по старой политике, и состояниях, выбранных из её распределения имеет в точке тот же градиент политики, что и исходная цель. Это локальное совпадение не означает равенства функций: вдали от этой точки суррогатная цель не равна новой ожидаемой награде. После нескольких эпох оптимизации отношения могут сильно уйти от единицы, и локальная аппроксимация становится ненадёжной.
Здесь важно не перепутать две конструкции. Точное отношение вероятностей полной траектории — произведение отношений всех действий и, при совпадающей динамике и перекрытии носителей, корректирует распределение всей траектории. PPO использует локальные отношения при состояниях из старого пакета и суррогатную цель. Это не точная замена полного перевзвешивания по отношениям вероятностей (importance sampling) для произвольно далёкой политики.
Шаг 4.4.2 — Траекторное отношение, локальная цель и доверительная область
Точное отношение для наблюдённой траектории при одинаковой среде:
Произведение быстро становится нестабильным на длинных траекториях: небольшие отклонения каждого множителя перемножаются. Поэтому практические методы работают с локальной аппроксимацией и стараются не позволять политике уйти слишком далеко за одно обновление.
Метод оптимизации политики в доверительной области (trust region policy optimization, TRPO) формулирует ограничение на среднюю дивергенцию Кульбака—Лейблера (Kullback–Leibler divergence, KL) между старой и новой политиками. Он мотивирован монотонной нижней границей при специальных условиях и использует приближённое решение ограниченной задачи.
Необязательное геометрическое углубление: связь локальной KL-метрики, матрицы Фишера и естественного градиента подробно разбирается в Information Theory for ML, Модуле 15 «Информационная геометрия: Fisher, естественный градиент и потоки распределений» (it_ml.module_15_information_geometry). Для понимания PPO эта ссылка не требуется: здесь достаточно идеи о том, что одна и та же длина шага в параметрах может означать очень разное изменение распределения политики.
PPO был предложен как более простой метод первого порядка: вместо явного второго порядка и жёсткого решения ограничения он модифицирует суррогатную цель. Это делает метод удобным, но важно сохранить точную формулировку:
PPO не гарантирует, что каждое отношение останется внутри заданного интервала, и не накладывает строгую границу на KL.
Клиппирование ограничивает дополнительное улучшение целевой функции в некоторых направлениях; оптимизатор всё ещё способен сдвинуть параметры из-за других примеров в пакете, общих параметров модели и нескольких эпох.
Шаг 4.4.3 — Клиппированная целевая функция PPO
Клиппированная цель PPO:
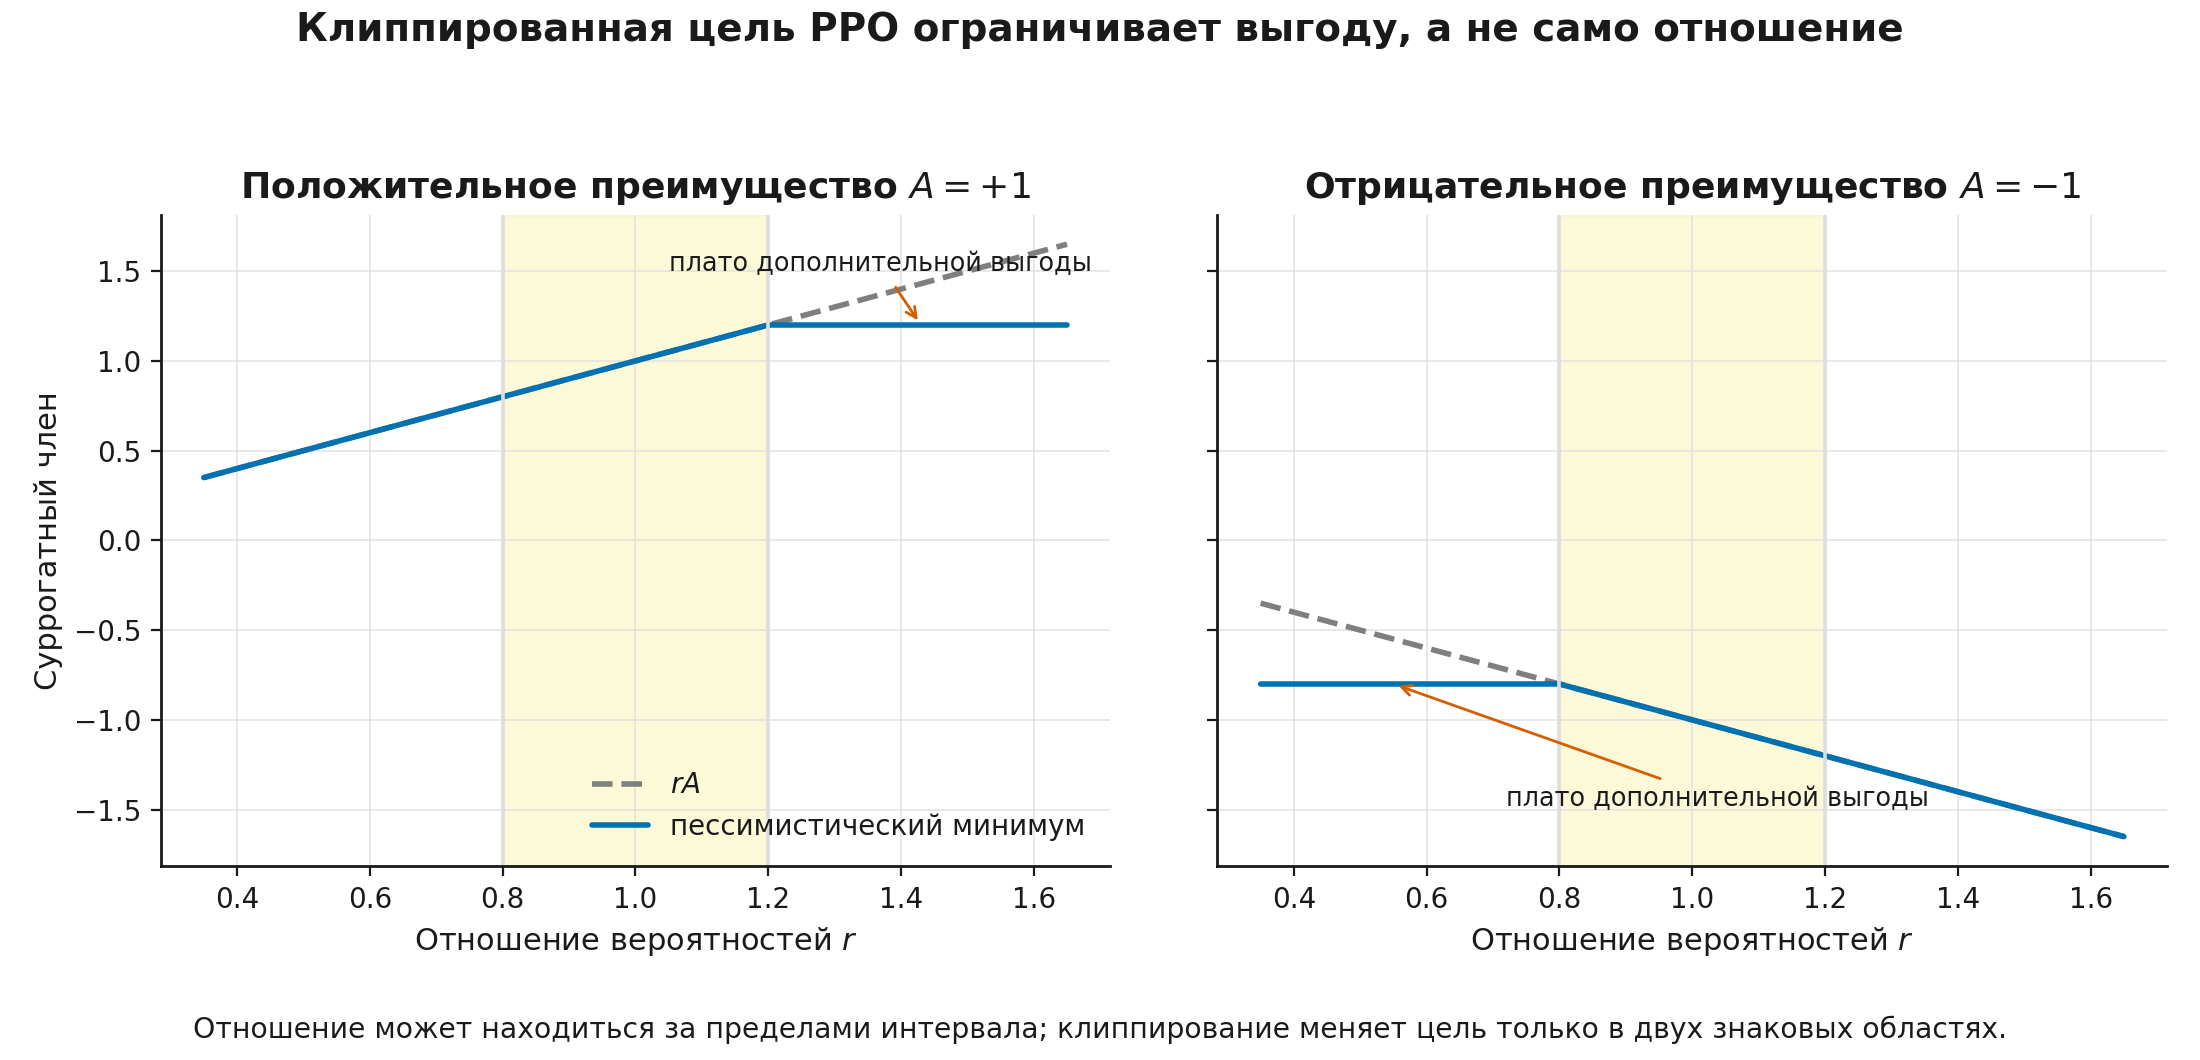
Минимум создаёт пессимистическую версию локальной выгоды.
Для действие желательно сделать вероятнее. Рост полезен только до ; выше цель перестаёт вознаграждать дальнейший рост. Падение ниже остаётся наказанным: клиппирование не устраняет ухудшение.
Для действие желательно сделать менее вероятным. Падение полезно до ; ниже цель перестаёт давать дополнительную выгоду. Рост выше остаётся полностью наказанным.
| Знак преимущества | Изменение отношения | Активно ли плато? |
|---|---|---|
| слишком большой рост | да | |
| слишком сильное падение | нет | |
| слишком большой рост | нет | |
| слишком сильное падение | да |
Из-за операции min доля отношений за пределами интервала и доля примеров, где клиппирование действительно меняет цель, — разные показатели.
Шаг 4.4.4 — Полная функция потерь и диагностика
В реализации обычно минимизируют сочетание трёх частей:
Здесь — ошибка критика, — энтропия политики, а коэффициенты задают относительные масштабы. Некоторые реализации также клиппируют изменение ценности, нормируют преимущества и останавливают эпоху при слишком большой выборочной оценке KL.
Полезные диагностические показатели:
- средняя награда и длина эпизода;
- ошибка критика и доля объяснённой дисперсии;
- энтропия политики;
- доля отношений вне ;
- доля примеров, где клиппированная ветвь действительно стала минимумом;
- выборочная оценка KL по данным старой политики;
- среднее и стандартное отклонение преимуществ;
- норма градиента.
Устойчивая неотрицательная выборочная величина строится по каждому отношению :
поскольку . Для фиксированного состояния, при выборке действий из старой политики и достаточном совпадении носителей,
Здесь использовано равенство . На конечном пакете оно выполняется лишь приближённо, поэтому — выборочная диагностика, а не точное измерение KL и не гарантия ограничения обновления.
Не существует универсального «правильного» значения доли клиппирования или KL для всех задач. Порог зависит от размера модели, способа агрегирования токенов, числа эпох, размера пакета, оптимизатора и качества преимуществ. Диагностика нужна для сравнения запусков одной постановки, а не для магического сертификата.
Шаг 4.4.5 — Почему детали реализации входят в алгоритм
Псевдокод PPO короток, но поведение сильно зависит от деталей:
- инициализации и масштаба ценностной головы;
- нормирования наблюдений, наград и преимуществ;
- обработки терминальных состояний и усечений;
- порядка перемешивания мини-пакетов;
- числа эпох по одному пакету;
- расписания скорости обучения;
- клиппирования нормы градиента;
- бонуса энтропии;
- численной стабильности логарифмических вероятностей;
- сохранения старых логарифмических вероятностей до обновления.
В исследованных авторами настройках PPO и TRPO такие решения существенно меняли результаты и иногда объясняли расхождения, которые прежде приписывали самим алгоритмам. Это не повод считать PPO «неалгоритмом». Правильный вывод другой: воспроизводимая спецификация включает не только математическую цель, но и протокол сбора данных, оптимизации и оценки.
Ноутбук модуля поэтому имеет два режима. smoke проверяет формы тензоров, маски, конечность потерь и один короткий цикл. full выполняет полноценное обучение и сообщает затраченное время и итоговую статистику. Успех одного случайного запуска не считается доказательством устойчивости; для сравнения вариантов нужны несколько начальных значений генератора случайных чисел (seed) и интервалы неопределённости.
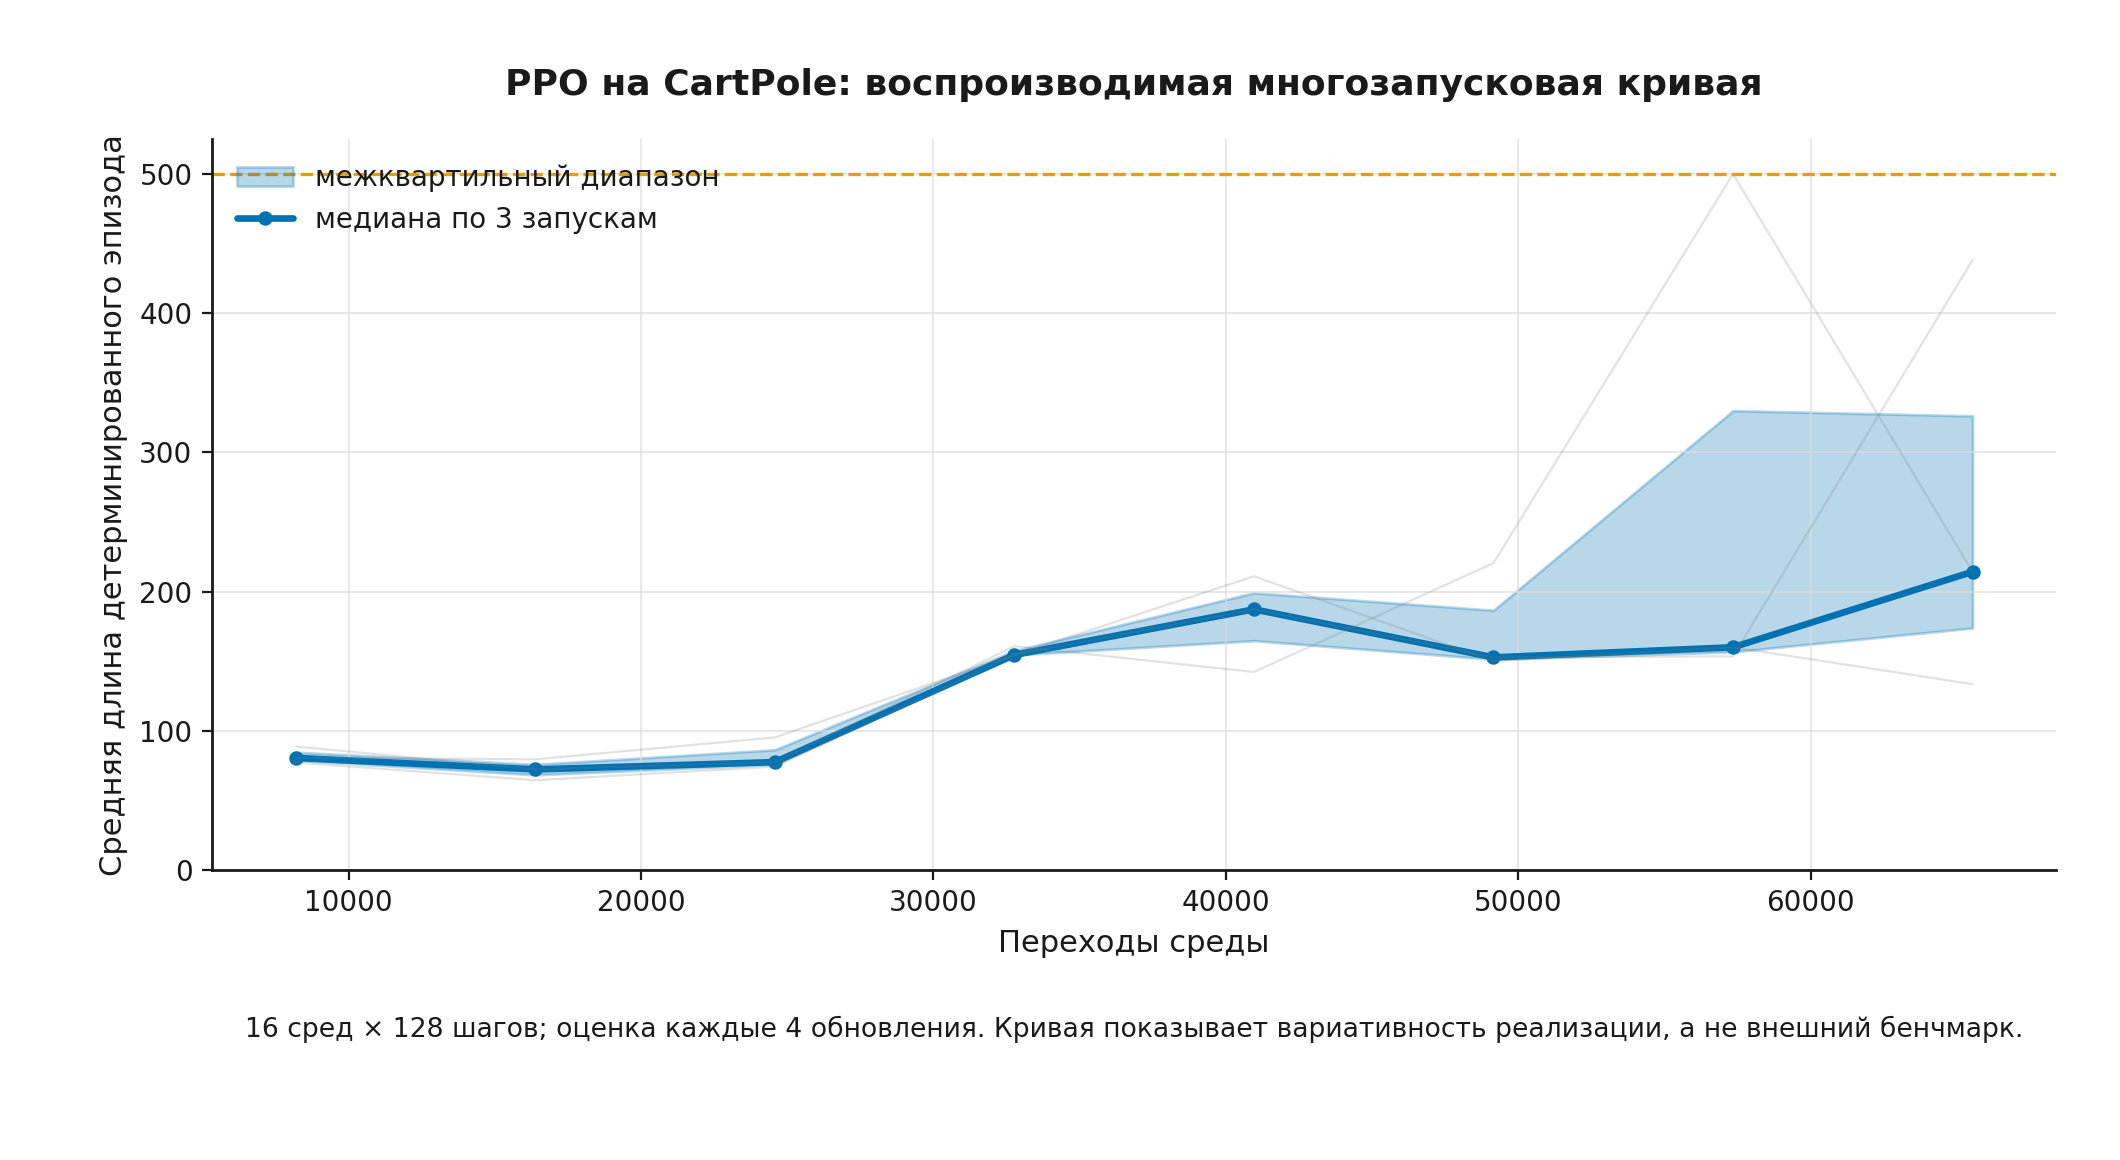
График строится тем же кодом, который обучает политику в ноутбуке. Он иллюстрирует проверяемость полного контура, а не объявляет CartPole доказательством качества PPO для LLM.
Урок 4.5. Мост к обучению LLM
Урок 4.5. Мост к обучению LLM
- Последовательностный REINFORCE
- RLOO для нескольких ответов на один запрос
- Где совпадает групповая относительная оптимизация, а где нет
- Один вес на все токены не решает распределение вклада
- Итоговая карта модуля
далее — 3 проверочных шага
Шаг 4.5.1 — Последовательностный REINFORCE
Для запроса и ответа
авторегрессионная политика факторизуется:
Следовательно,
Если проверяющая система возвращает одну награду на весь ответ, практическая оценка с маской токенов ответа имеет вид
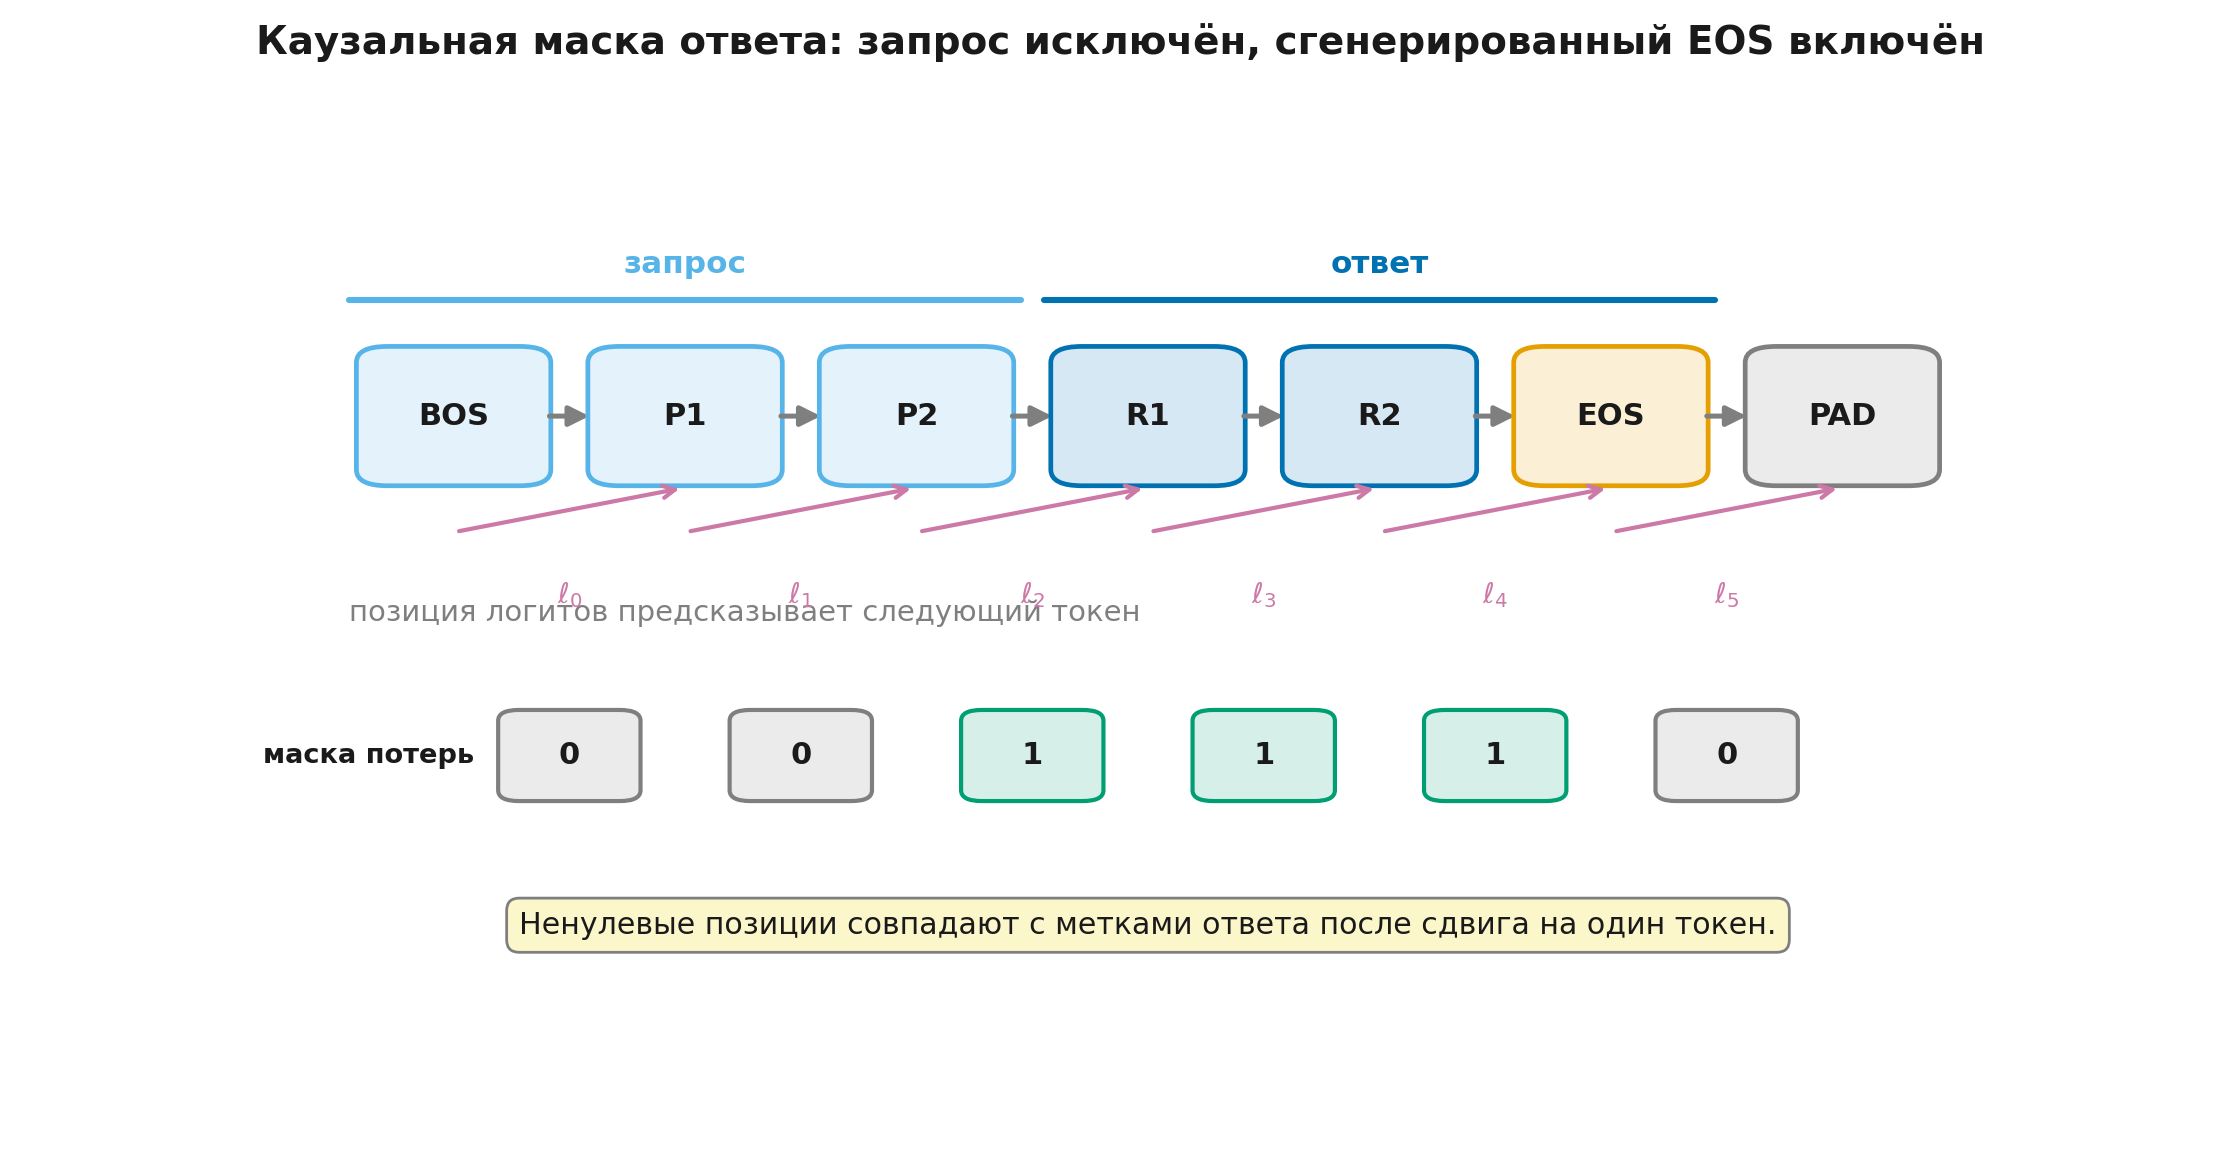
Здесь для сгенерированных токенов ответа, включая сгенерированный EOS, если он присутствует в последовательности, и для токенов запроса, заполнения (padding) и позиций после EOS. В каузальной языковой модели логиты позиции предсказывают токен позиции , поэтому метки, логарифмические вероятности и маску нужно сдвигать согласованно. Ошибка на один индекс способна незаметно обучать модель на запросе или исключать первый токен ответа.
Необязательное углубление по интерфейсу модели: токенизация, специальные токены и причинное выравнивание входов и меток подробнее разобраны в Modern LLMs, Модуле 2 «Токенизация и эмбеддинги» (modern_llms.module_02_tokenization). Текущего объяснения достаточно для реализации маски, а ссылка нужна только для полного контекста языковой модели.
Если собранный пакет повторно используется в PPO, для каждого допустимого токена можно вычислить локальное отношение
При одном преимуществе на весь ответ распространённая токеновая суррогатная цель имеет вид
Это локальная PPO-суррогатная цель, а не точное отношение вероятностей целой траектории. Точное последовательностное отношение равно произведению ; клиппировать каждый множитель отдельно и клиппировать произведение — разные операции. Поэтому реализация обязана назвать единицу усреднения: по токенам всего пакета, сначала внутри каждого ответа, либо по ответам после суммирования токенов. Эти варианты по-разному взвешивают длины и в общем случае задают разные цели.
Недифференцируемая награда не мешает: градиент проходит через логарифмические вероятности модели. Но один коэффициент всё ещё прикладывается ко всему ответу. Он говорит, что ответ в целом был лучше или хуже опорного уровня, а не выделяет токены, отвечающие за доказательство, ошибку или удачный вызов инструмента.
Нормировку нужно задавать явно. Сумма по токенам, среднее внутри ответа и среднее по всем ненулевым токенам пакета по-разному взвешивают короткие и длинные ответы. Естественный EOS и принудительное ограничение max_tokens также несут разный смысл: во втором случае ответ мог бы продолжиться, поэтому правило награды и трактовка незавершённости должны быть частью спецификации задачи.
Наконец, если некоторый штраф зависит от текущей политики напрямую — например, дифференцируемый KL-член, — действует расширенная формула Шага 4.1.2. Такой член либо добавляют к функции потерь с прямой производной, либо сознательно включают в остановленную по градиенту награду. Одновременное неявное использование обоих путей приводит к двойному учёту или к другой цели, чем записано в математике.
Шаг 4.5.2 — RLOO для нескольких ответов на один запрос
Пусть для одного запроса сгенерировано ответов с наградами . В RLOO:
Оценка градиента:
Преимущества отсчитываются от других ответов на тот же запрос, поэтому уменьшается влияние различий в базовом уровне награды между запросами. Отдельный критик не требуется. Это особенно удобно, когда запрос можно повторять, а несколько ответов генерируются параллельно.
Цена очевидна: нужно генераций на запрос. Кроме того, если все ответы получили одинаковую награду, RLOO-/REINFORCE-слагаемое даёт нулевые преимущества и не сообщает направления обновления. Это правильная реакция на отсутствие внутригруппового сигнала, но не означает, что политика уже оптимальна: проверяющая система могла оказаться слишком грубой. Отдельные члены общей функции потерь — например, KL-регуляризация, энтропийный бонус или вспомогательная потеря — при этом всё ещё могут менять параметры.
В вариантах, использующих данные другой политики (off-policy), к последовательностному коэффициенту добавляют отношения вероятностей или иные поправки. Их устойчивость зависит от длины ответа и отличия новой политики от политики сбора данных.
Шаг 4.5.3 — Где совпадает групповая относительная оптимизация, а где нет
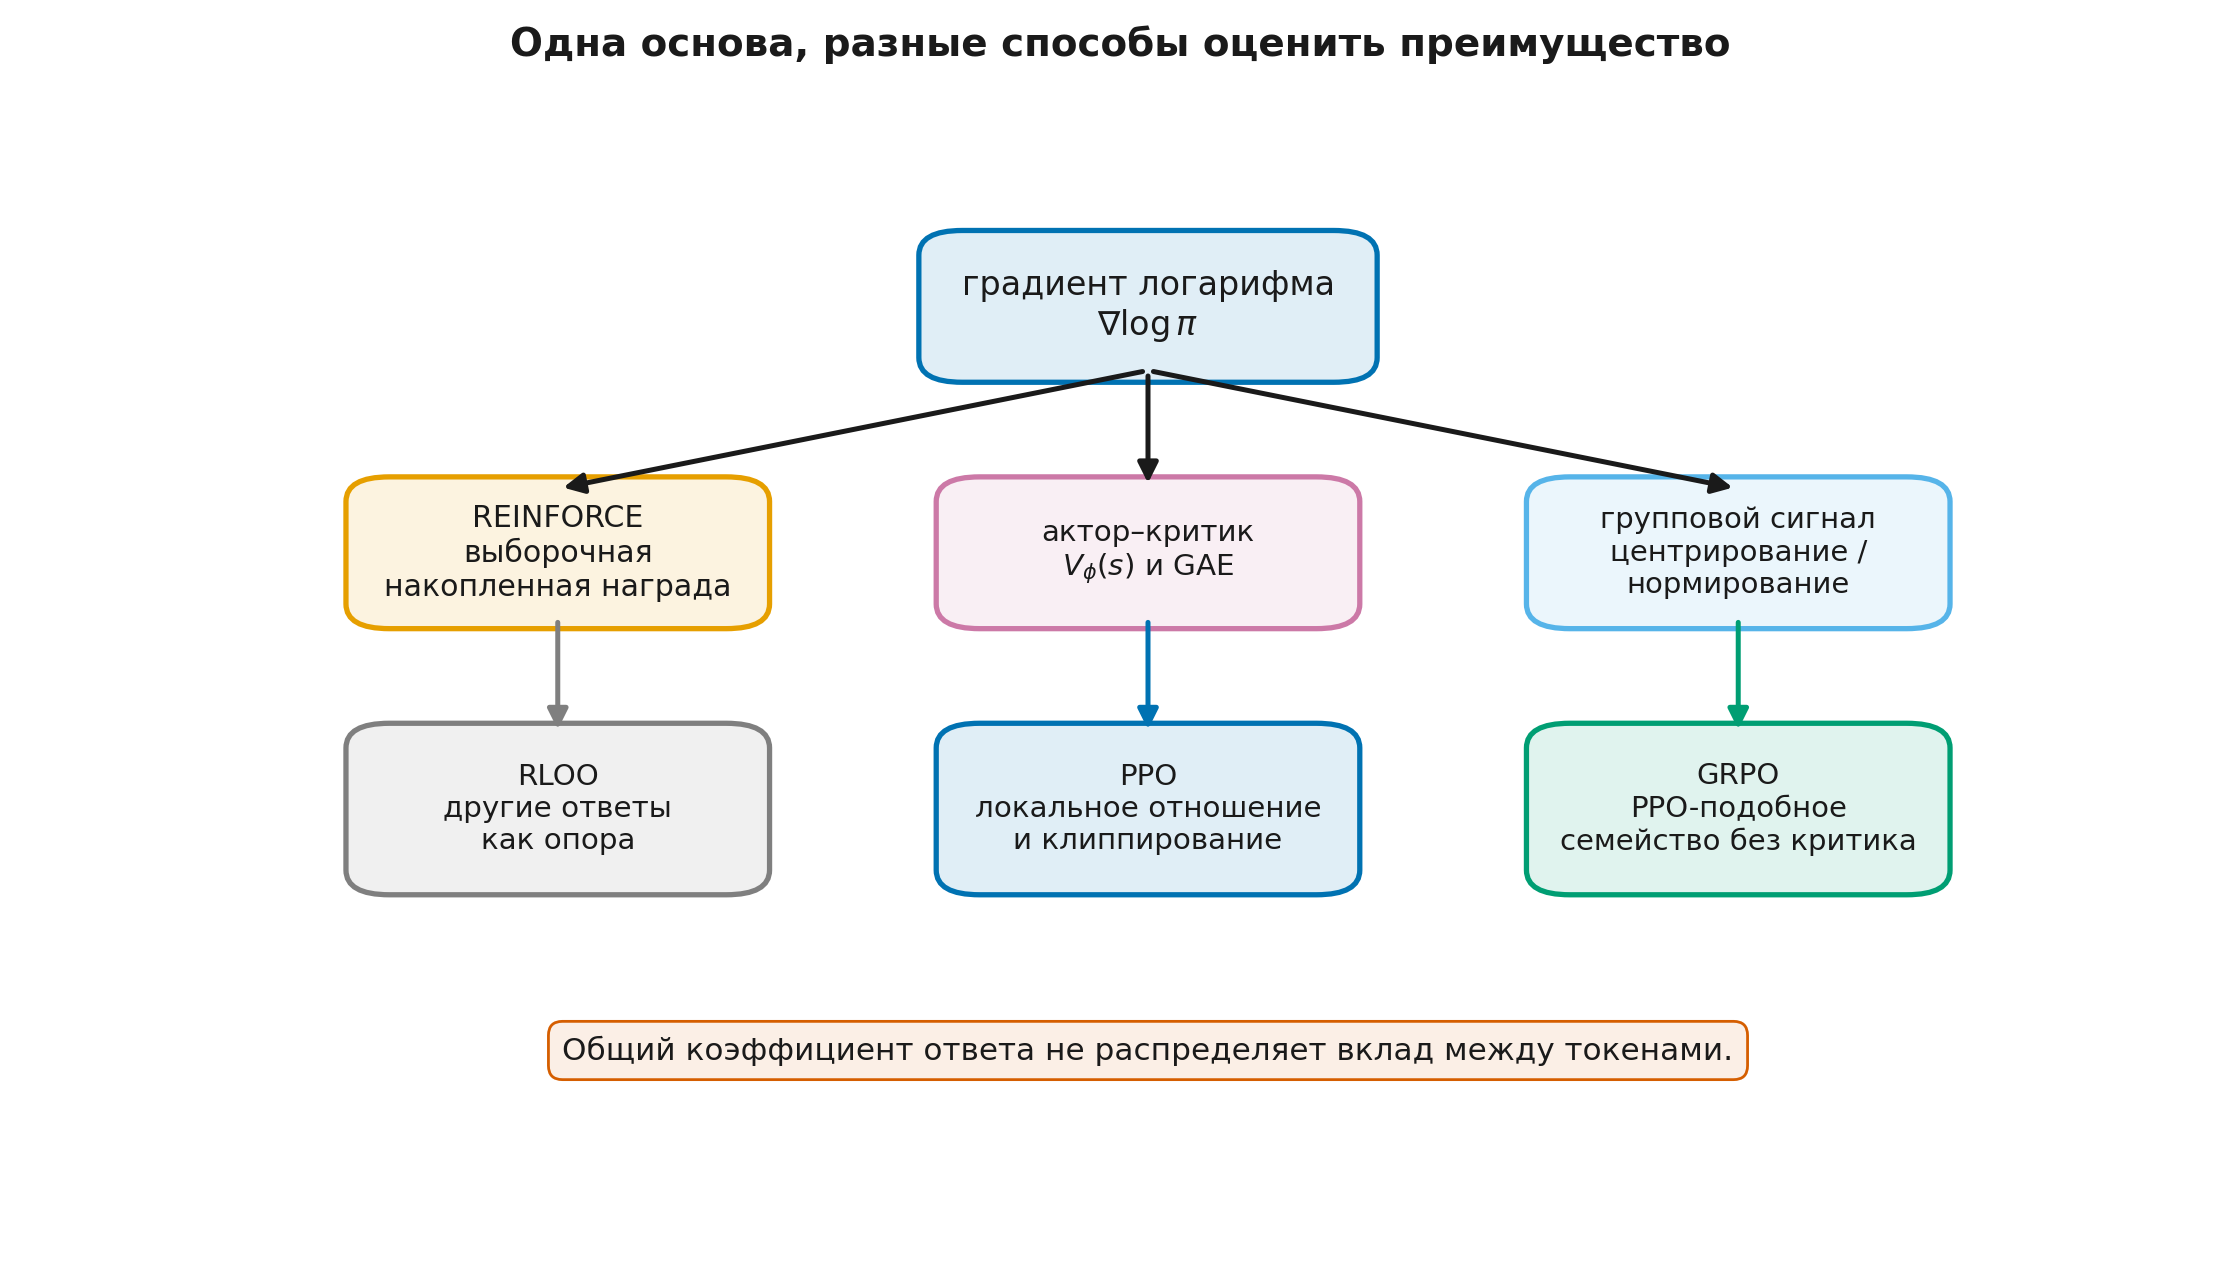
Групповая относительная оптимизация политики (Group Relative Policy Optimization, GRPO) также генерирует несколько ответов на один запрос и строит относительные преимущества без отдельного критика. Поэтому RLOO и GRPO действительно разделяют важную идею: сравнивать ответы внутри группы.
Но отождествлять их нельзя.
Каноническая формулировка GRPO, появившаяся в DeepSeekMath, использует PPO-подобные отношения вероятностей, клиппированную суррогатную цель, групповое центрирование и нормирование наград, а также регуляризацию относительно базовой политики. Более поздние варианты меняют знаменатель, способ агрегирования токенов, оценку KL, число обновлений и форму преимуществ.
RLOO в базовом виде — оцениватель REINFORCE с исключением текущего ответа из опорного среднего. Он не обязан включать клиппирование PPO, групповое стандартное отклонение или отдельный штраф KL.
Поэтому правильная карта такова:
- общая идея: несколько ответов на запрос и относительный сигнал;
- RLOO: опорный уровень с исключением текущего ответа для REINFORCE на уровне полного ответа;
- GRPO: семейство PPO-подобных алгоритмов без критика, использующих групповую относительную оценку;
- Модуль 9 текущего курса: «RLVR и GRPO: проверяемая награда, групповая оценка и устойчивость» (
rl_llm.module_09_rlvr_grpo) — варианты знаменателя, KL, токеновой агрегации и режимы отказа.
Широкий архитектурный обзор RLHF, DPO, RLOO и GRPO находится также в Modern LLMs, Модуле 14 «Обучение по обратной связи: RLHF, DPO, RLOO и GRPO» (modern_llms.module_12_preference_optimization). Текущий модуль остаётся самодостаточным и служит каноническим выводом градиентов политики и PPO для этой серии.
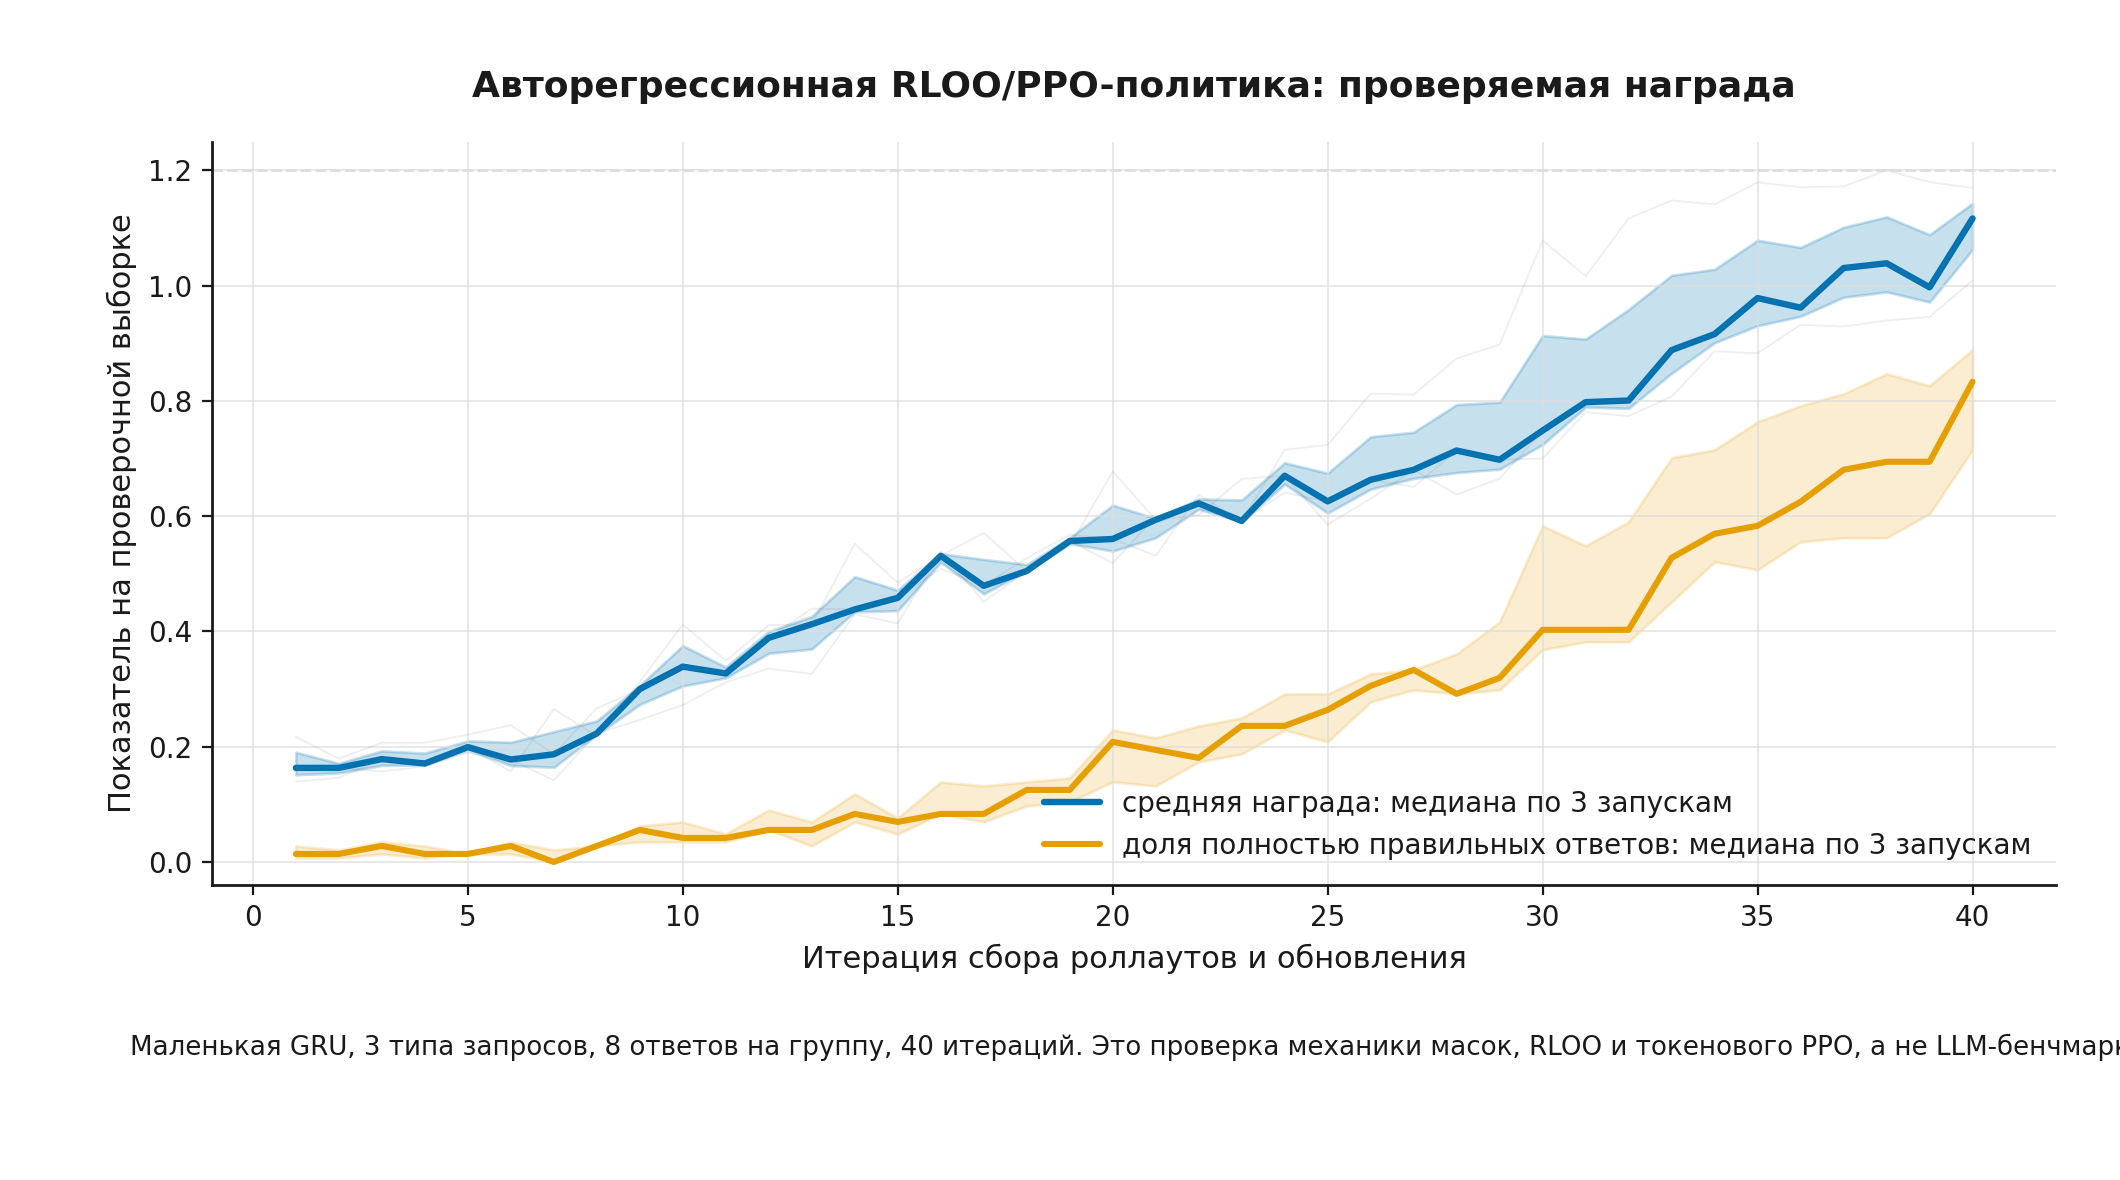
Чтобы эта карта не осталась только алгебраической, код модуля обучает маленькую авторегрессионную политику на основе GRU на трёх типах запросов. Ответ имеет переменную длину, EOS действительно выбирается политикой, запрос и заполнение исключаются маской, преимущества строятся по RLOO внутри группы, а несколько эпох используют замороженные старые токеновые логарифмические вероятности и клиппированную PPO-цель. На графике показаны медианы и межквартильные диапазоны трёх фиксированных запусков. Рост проверяемой награды подтверждает согласованность этого вычислительного контракта; он не является бенчмарком языкового качества и не доказывает масштабируемость на большие LLM.
Шаг 4.5.4 — Один вес на все токены не решает распределение вклада
Пусть итоговый ответ получил преимущество . Наиболее простая реализация создаёт токеновую матрицу
для каждого токена ответа и умножает её на маску. Это технически удобно и даёт корректный логарифмический градиент вероятности полного ответа:
Но такая запись не решает локальное распределение вклада между токенами (credit assignment). Все выбранные токены получают один знак и один масштаб, хотя реальные причины награды могут быть локальными. Возможные расширения:
- промежуточные проверяемые награды;
- процессные модели оценки;
- ценностная функция по префиксам;
- декомпозиция ответа на действия более высокого уровня;
- контрфактические или поисковые оценки;
- награды за вызовы инструментов и состояния среды.
Каждое расширение вводит новые предположения. Процессная награда может быть плотнее, но ошибочной; ценностная функция может снизить дисперсию, но внести смещение; автоматическая разметка шагов способна поощрять поверхностные признаки.
Здесь полезно сохранить скромную формулировку. При on-policy-выборке, награде, которая в данном оценивателе считается фиксированной относительно параметров оптимизации, и явно заданном суммировании по корректно замаскированным токенам REINFORCE на уровне полного ответа оценивает градиент ожидаемой награды за полный ответ. Но он не предоставляет локального объяснения этой награды. Повторное off-policy-использование ответов требует поправок на смену распределения, а усреднение по длине, обрезка или параметр-зависимые штрафы определяют уже другую целевую функцию.
Шаг 4.5.5 — Итоговая карта модуля
Модуль построил одну непрерывную цепочку:
- тождество логарифмической производной превращает градиент ожидания в ожидание, содержащее градиент логарифма вероятности;
- при прямой зависимости величины от к скор-функционному члену добавляется её собственная производная;
- факторизация траектории оставляет в явной производной только параметризованные части;
- каузальность заменяет полный результат наградой от текущего шага до конца;
- REINFORCE даёт простой, но шумный оцениватель;
- корректный опорный уровень уменьшает шум, если не зависит от текущего действия;
- критик приближает ценность состояния, а GAE смешивает горизонты и требует раздельных масок бутстрэппинга и рекурсии;
- PPO повторно использует пакет данных через пессимистическую локальную цель;
- RLOO использует другие ответы на тот же запрос как опорную группу;
- GRPO разделяет групповую идею, но является более широким PPO-подобным семейством.
Главные границы:
- исчезновение модели среды из производной не означает независимость результата от среды;
- удаление внешнего может менять относительное взвешивание моментов времени, а не только масштаб;
- — полезный, но не универсально оптимальный опорный уровень;
- общее групповое среднее имеет коэффициент , возникающий при конечном размере группы;
- истинное завершение, усечение среды и граница роллаута отвечают на разные вопросы;
- клиппирование PPO не является жёсткой доверительной областью;
- общая награда ответа не распределяет вклад между токенами;
- корректная маска обязана включать сгенерированный
EOS, исключать запрос и согласовываться со сдвигом меток; - одна успешная кривая обучения не подтверждает устойчивость реализации.
Следующие модули используют этот фундамент для обучения по человеческим предпочтениям, проверяемым наградам и взаимодействиям с внешними средами. Полный разбор GRPO намеренно отложен до Модуля 9 «RLVR и GRPO: проверяемая награда, групповая оценка и устойчивость» (rl_llm.module_09_rlvr_grpo), чтобы здесь сохранить ясную линию от логарифмической производной к PPO.
Необязательное математическое углубление: Information Theory for ML, Модуль 8 «Максимальная энтропия, экспоненциальные модели и KL-регуляризация» (it_ml.module_08_maxent_kl_policy) — вариационный вывод KL-регуляризованной политики, форма распределения Гиббса и роль нормировочной константы.
Архитектурный контекст: Modern LLMs, Модуль 14 «Обучение по обратной связи: RLHF, DPO, RLOO и GRPO» (modern_llms.module_12_preference_optimization) — место этих методов в полном цикле постобучения LLM. Ни одна из этих ссылок не требуется для понимания текущего модуля.
Практический маршрут
- дисперсию REINFORCE и эффект опорных уровней;
- телескопирование GAE и раздельные маски для терминала, усечения и границы буфера;
- полный PPO-контур на самодостаточной среде CartPole;
- многозапусковую оценку, а не одну удачную траекторию;
- авторегрессионный пример с маской ответа,
EOS, групповыми преимуществами и клиппированной целью.
На учебной платформе к этим материалам добавляются 32 задачи: 20 основного маршрута и 12 дополнительных, каждая с подробным решением, открываемым после попытки.
Основной профиль работает на CPU. Профиль smoke нужен для быстрой проверки всей вычислительной цепочки; full увеличивает число роллаутов и начальных значений генератора. Конкретные кривые являются результатом кода курса при указанном протоколе, а не внешним бенчмарком.
Источники и маршрут дальнейшего чтения
- Williams, “Simple Statistical Gradient-Following Algorithms for Connectionist Reinforcement Learning” — исходная работа о REINFORCE; поддерживает историческую и алгоритмическую часть Урока 4.1, но не обещает низкую дисперсию.
- Sutton, McAllester, Singh, Mansour, “Policy Gradient Methods for Reinforcement Learning with Function Approximation” — теорема о градиенте политики для аппроксимации функций; нормировка зависит от постановки.
- Schulman et al., “High-Dimensional Continuous Control Using Generalized Advantage Estimation” — GAE и его связь со смещением и дисперсией. Раздел о масках дополнен современной семантикой интерфейсов среды.
- Schulman et al., “Trust Region Policy Optimization” — мотивация доверительной области и границы теоретического результата.
- Schulman et al., “Proximal Policy Optimization Algorithms” — первичная спецификация PPO и клиппированной суррогатной цели; статья не превращает clipping в строгую KL-гарантию.
- Engstrom et al., “Implementation Matters in Deep Policy Gradients” — эмпирическое основание включать детали реализации в спецификацию эксперимента; вывод относится к изученным авторами бенчмаркам.
- Farama Foundation, “Handling Time Limits” — официальное объяснение различия
terminatedиtruncated; граница роллаут-буфера дополнительно разбирается в текущем модуле. - Ahmadian et al., “Back to Basics: Revisiting REINFORCE Style Optimization for Learning from Human Feedback in LLMs” — RLOO и последовательностный REINFORCE в постобучении LLM.
- Shao et al., “DeepSeekMath” — первичное описание GRPO; более поздние варианты не следует автоматически приписывать этой формулировке.
Полный реестр утверждений, типов оснований и ограничений находится в Module_4_Sources.md.