Модуль 13. Оценивание RL-систем для LLM: статистика, взлом награды и безопасность
Версия материала: 2026.25
Фактический снимок: 2026-08-06
Язык: RU
Основная практика: уровень A — браузер и центральный процессор (central processing unit, CPU); уровень B — бесплатный Colab T4 или собственная локальная модель; платный API допустим как факультативная замена
Структура: 5 уроков, 25 шагов
Ориентировочное время: 10–12 часов без факультативного прогона модели
К этому моменту курса мы умеем строить награду, оптимизировать политику, собирать роллауты, запускать поиск и проектировать инфраструктуру. Остался вопрос, от которого зависит смысл всех предыдущих результатов:
Как понять, что новая политика действительно стала лучше, а не научилась пользоваться шумом, утечкой данных, слабостью проверяющей системы или дырой в протоколе?
Оценивание здесь не является последней таблицей после обучения. Оно само образует систему принятия решений: выбирает контрольные точки, гиперпараметры, методы и иногда целое направление разработки. Поэтому бенчмарк, LLM-судья и набор тестов находятся под тем же оптимизационным давлением, что и модель награды.
Практическая задача модуля:
Спроектировать проверяемый контур оценивания, который отделяет полезное изменение политики от статистического шума, загрязнения данных, смещений оценивателя, взлома награды и регрессий безопасности, а затем сохраняет достаточный пакет доказательств для повторного прогона.
После прохождения модуля вы сможете:
- определить, что именно оценивается: веса модели, режим генерации, агентная обвязка или полная система;
- разделить целевую полезность, доступный прокси-сигнал и итоговую отчётную метрику;
- строить интервалы Уилсона для долей и планировать размер набора под нужную точность;
- сравнивать две системы на общих задачах с помощью парного протокола;
- объяснять, когда нужен точный тест Мак-Немара, а когда парная перестановка или бутстрэп;
- учитывать несколько источников случайности: выбор задач, случайную генерацию ответов, начальные значения генераторов и решения судьи;
- вычислять конечновыборочный оцениватель pass@k и не путать покрытие с выбором кандидата;
- распознавать насыщение бенчмарка и потерю различающей способности;
- различать дословное, семантическое и протокольное загрязнение данных;
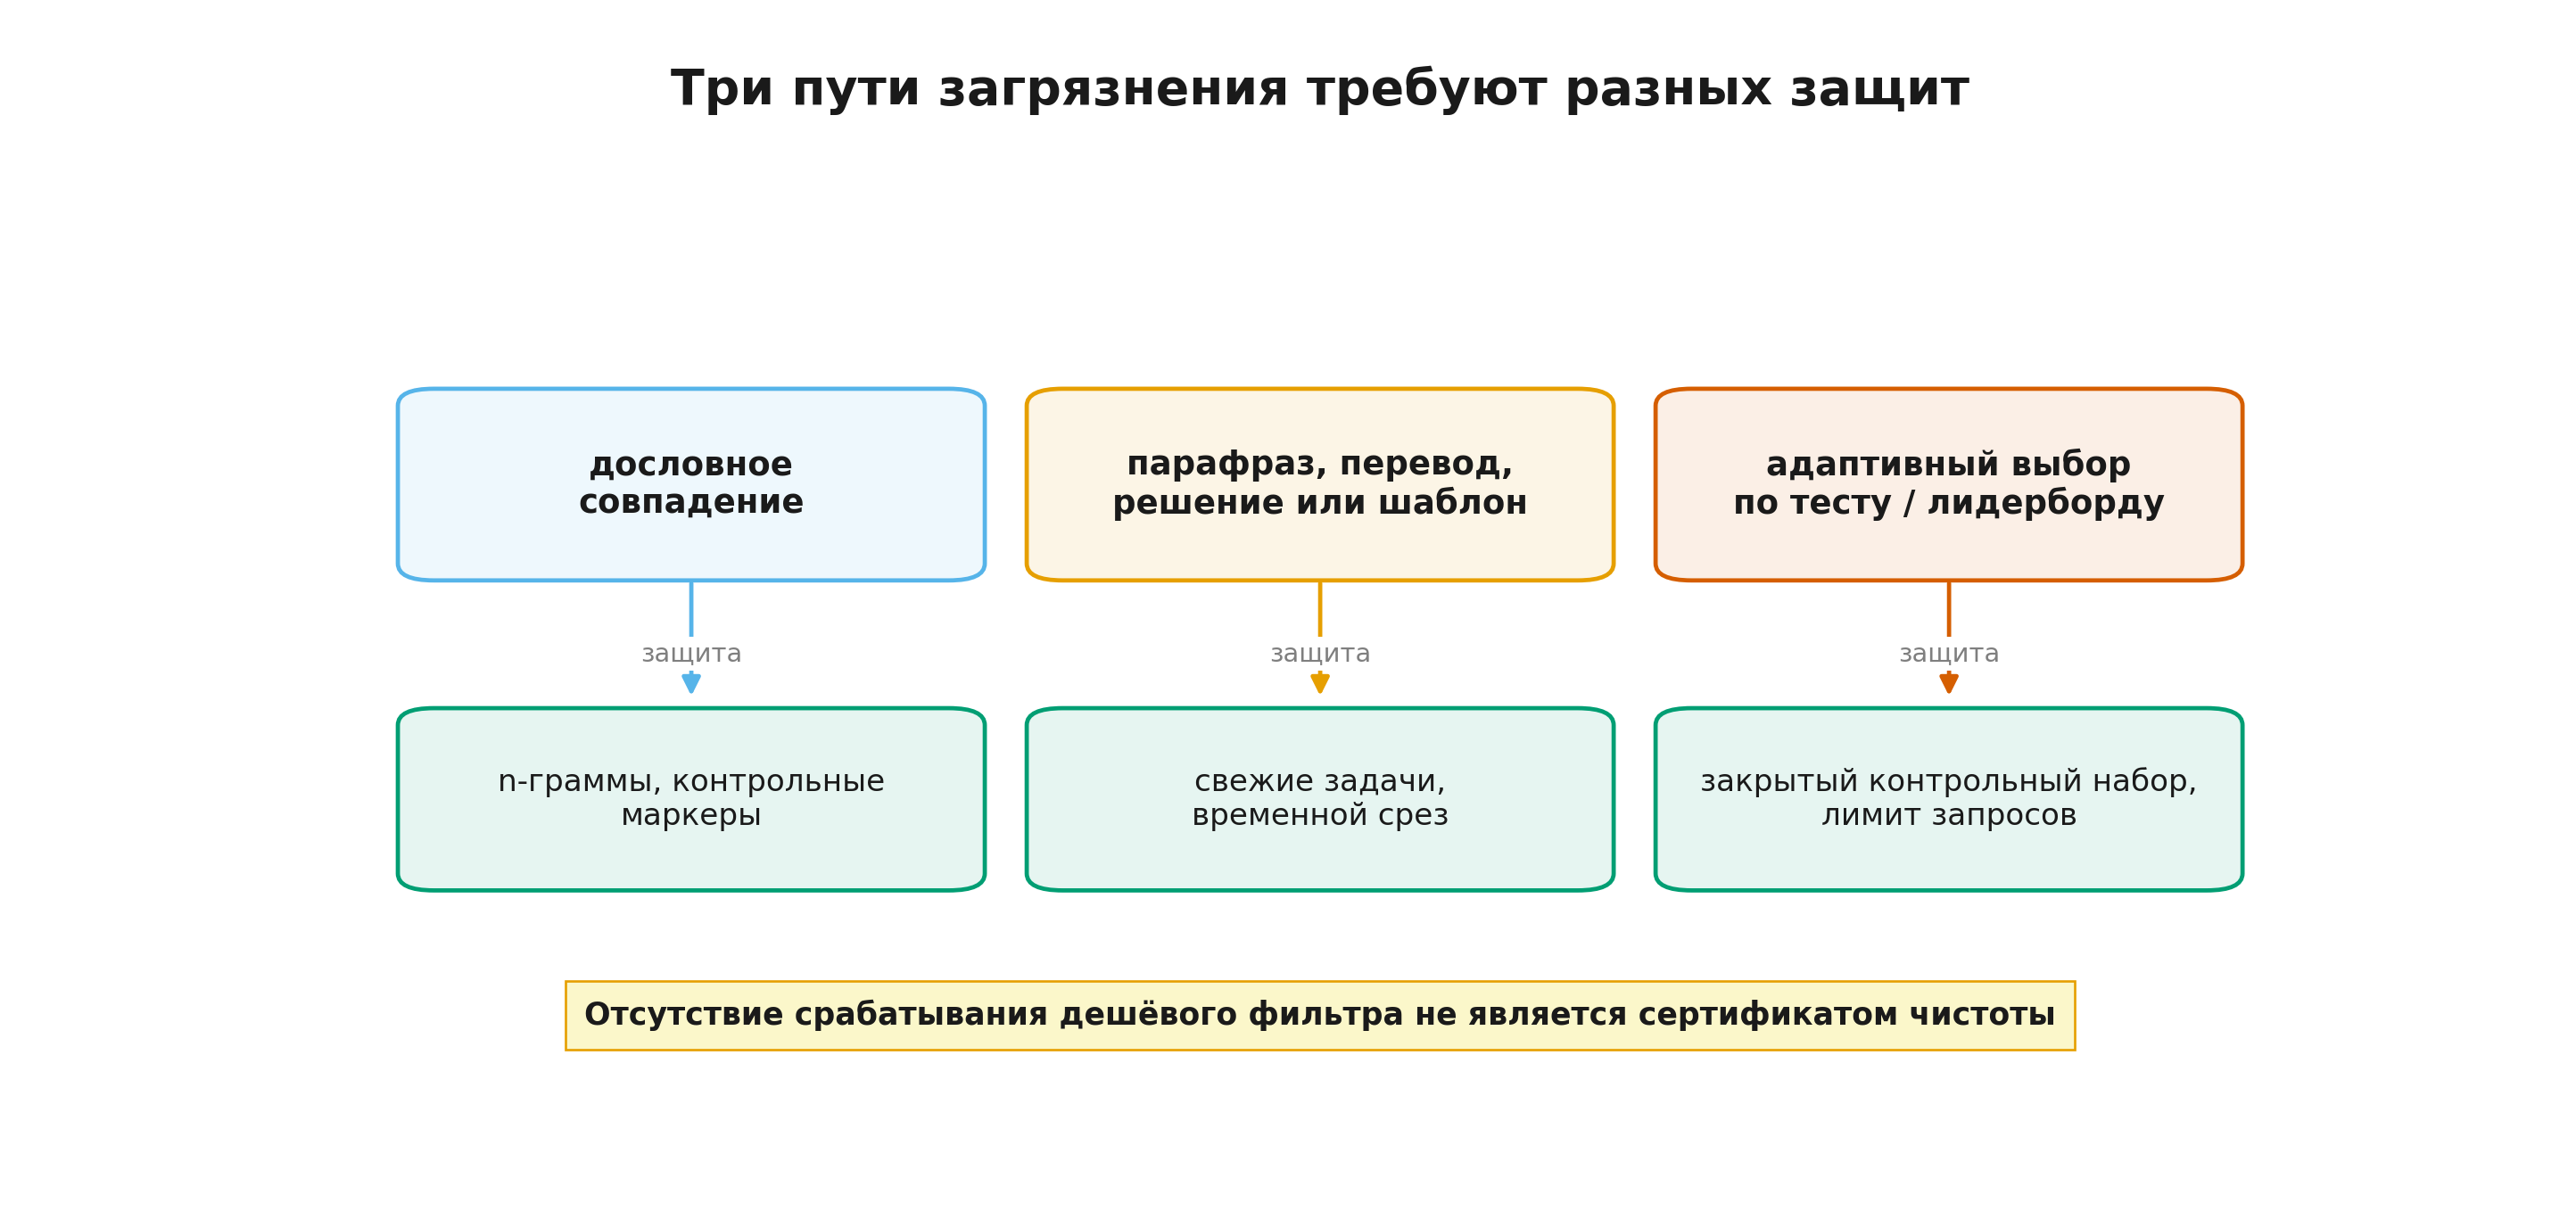
- объяснять, почему отсутствие срабатывания n-граммного фильтра не доказывает чистоту теста;
- проектировать закрытый контрольный набор и ограничивать адаптивное переобучение на лидерборде;
- классифицировать взлом награды по атакованному компоненту системы;
- проверять LLM-судью на позиционное, стилевое, длиновое и собственное предпочтение;
- измерять устойчивость к инъекциям через частоту успешных атак и цену ложных тревог;
- оценивать льстивое согласие относительно фактов, а не относительно одной частоты согласия;
- строить безопасность как многомерную оценку, включающую вредный ответ и избыточный отказ;
- связывать угрозы, тестовые случаи, тяжесть последствий и критерии выпуска;
- собирать паспорт протокола и воспроизводимый пакет доказательств;
- выбирать между
lm-evaluation-harness, Inspect, HELM и собственным кодом по контракту задачи; - подготовить честный итоговый отчёт и перейти к одному из капстоунов курса.
Практический маршрут. После лекции идут оцениваемые задания, решения, открывающиеся после попытки, и исполняемая практика по оцениванию. Само объяснение остаётся самодостаточным. Проверенные утверждения и границы выводов собраны в русском реестре утверждений и источников.
Урок 13.1. Оценивание как измерительная система
Урок 13.1. Оценивание как измерительная система
- Оценка принадлежит конфигурации, а не одному файлу весов
- Интервал Уилсона: доля без ложной уверенности
- Сначала единица анализа, затем формула
- Парное сравнение: какие задачи изменили исход
- Четыре источника случайности и честный план прогона
далее — 6 проверочных шагов
Шаг 13.1.1 — Оценка принадлежит конфигурации, а не одному файлу весов
Начнём с ошибки, которая выглядит безобидно: «модель набрала 61%». Какой именно объект получил это число?
Для обычного генеративного запуска результат зависит как минимум от следующих компонентов:
- контрольной точки и токенизатора;
- системного сообщения и шаблона диалога;
- температуры, top-p, лимита длины и числа попыток;
- включённого или отключённого режима рассуждения;
- доступных инструментов, памяти и правил повторного вызова;
- версии среды;
- канонизации ответа;
- проверяющей системы или судьи;
- правила агрегирования по задачам.
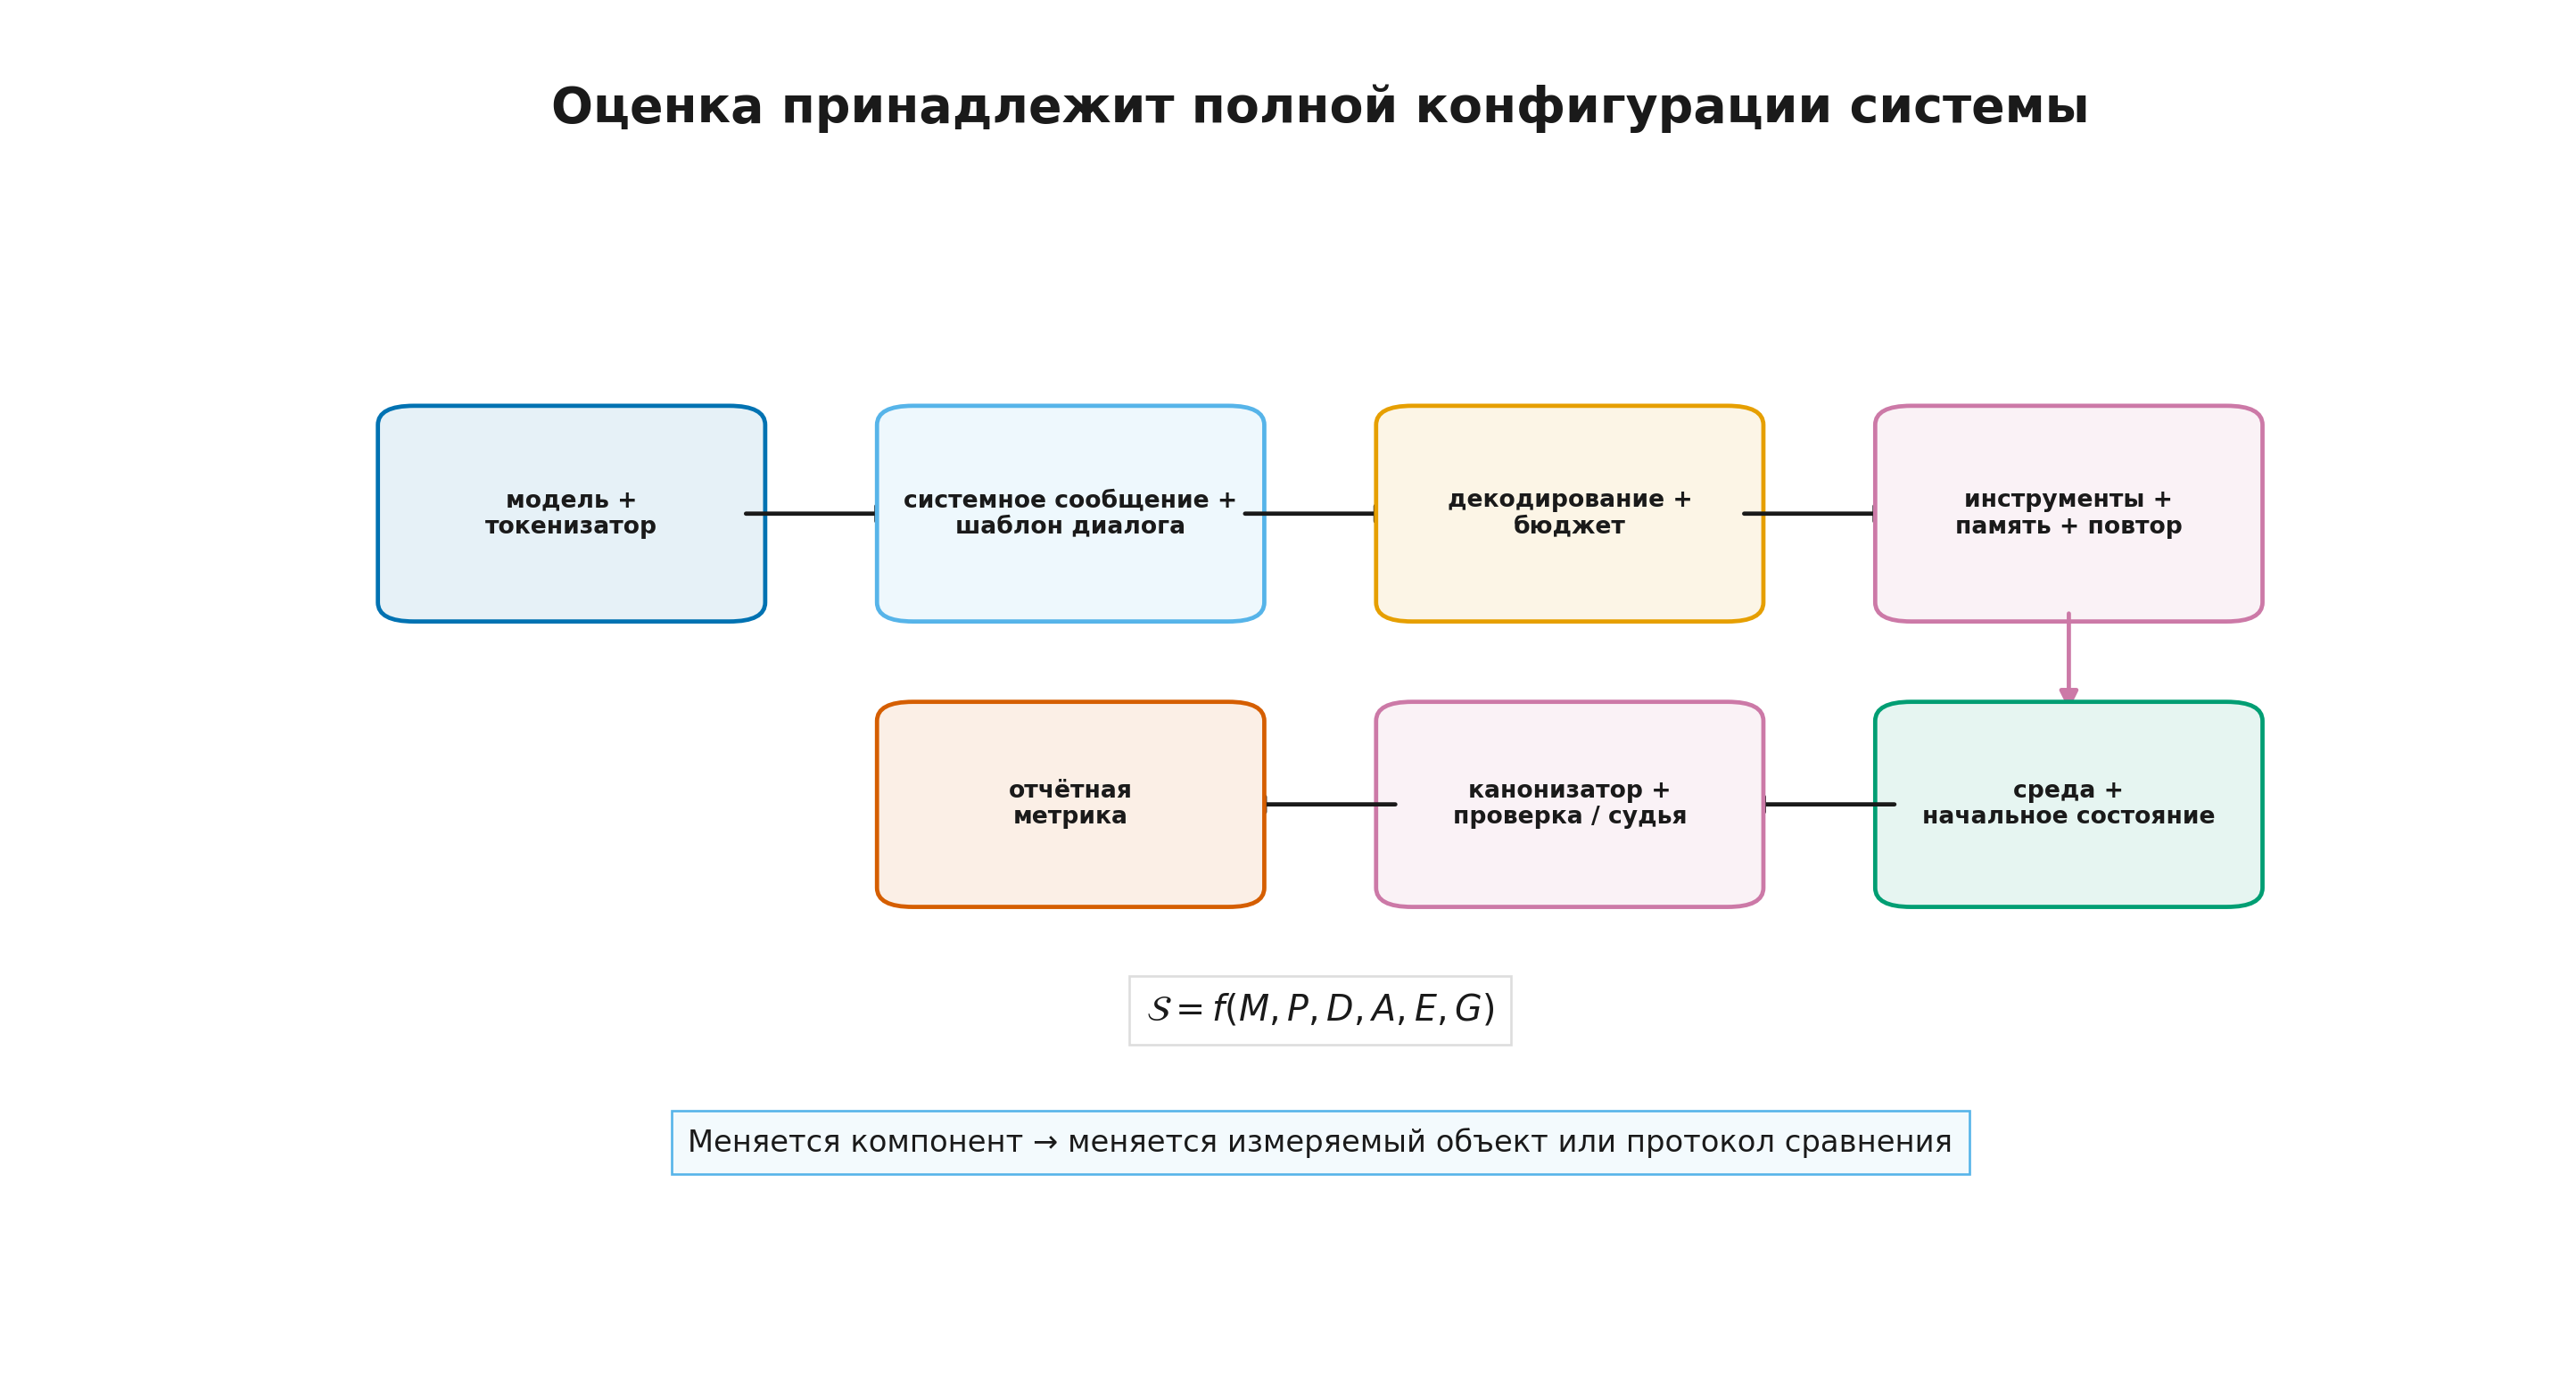
Поэтому корректная единица сравнения — не абстрактная «модель», а версионированная система:
где — модель и токенизатор; — системное сообщение и шаблон диалога; — параметры декодирования и вычислительный бюджет; — обвязка агента, включая инструменты, память и повторы; — среда и её начальное состояние; — проверяющая система и правило агрегирования результата.
В RL for LLM, Модуле 11 «RL для LLM-агентов: инструменты, среда и длинные траектории» (rl_llm.module_11_agentic_rl) мы уже видели, что один и тот же LLM может быть частью разных политик агента. Здесь следствие становится измерительным: изменение обвязки может улучшить результат без изменения весов, а изменение проверяющей системы может изменить число без изменения поведения.
Это не означает, что сравнение весов невозможно. Нужно лишь зафиксировать остальные компоненты. Если вопрос звучит «какая контрольная точка лучше», у обеих контрольных точек должны быть одинаковые шаблон, бюджет, инструменты и правило оценки. Если вопрос звучит «какая система лучше закрывает тикет», обвязка является частью объекта и должна меняться вместе с ним.
Углубление: Modern LLMs, Модуль 19 «Оценка современных LLM: от бенчмарка к инженерному решению» (
modern_llms.module_17_evaluation) даёт более широкую карту современных бенчмарков и показывает, почему результат зависит от обвязки. Здесь основной вопрос другой: как измерение ведёт себя под статистическим и оптимизационным давлением.
Шаг 13.1.2 — Интервал Уилсона: доля без ложной уверенности
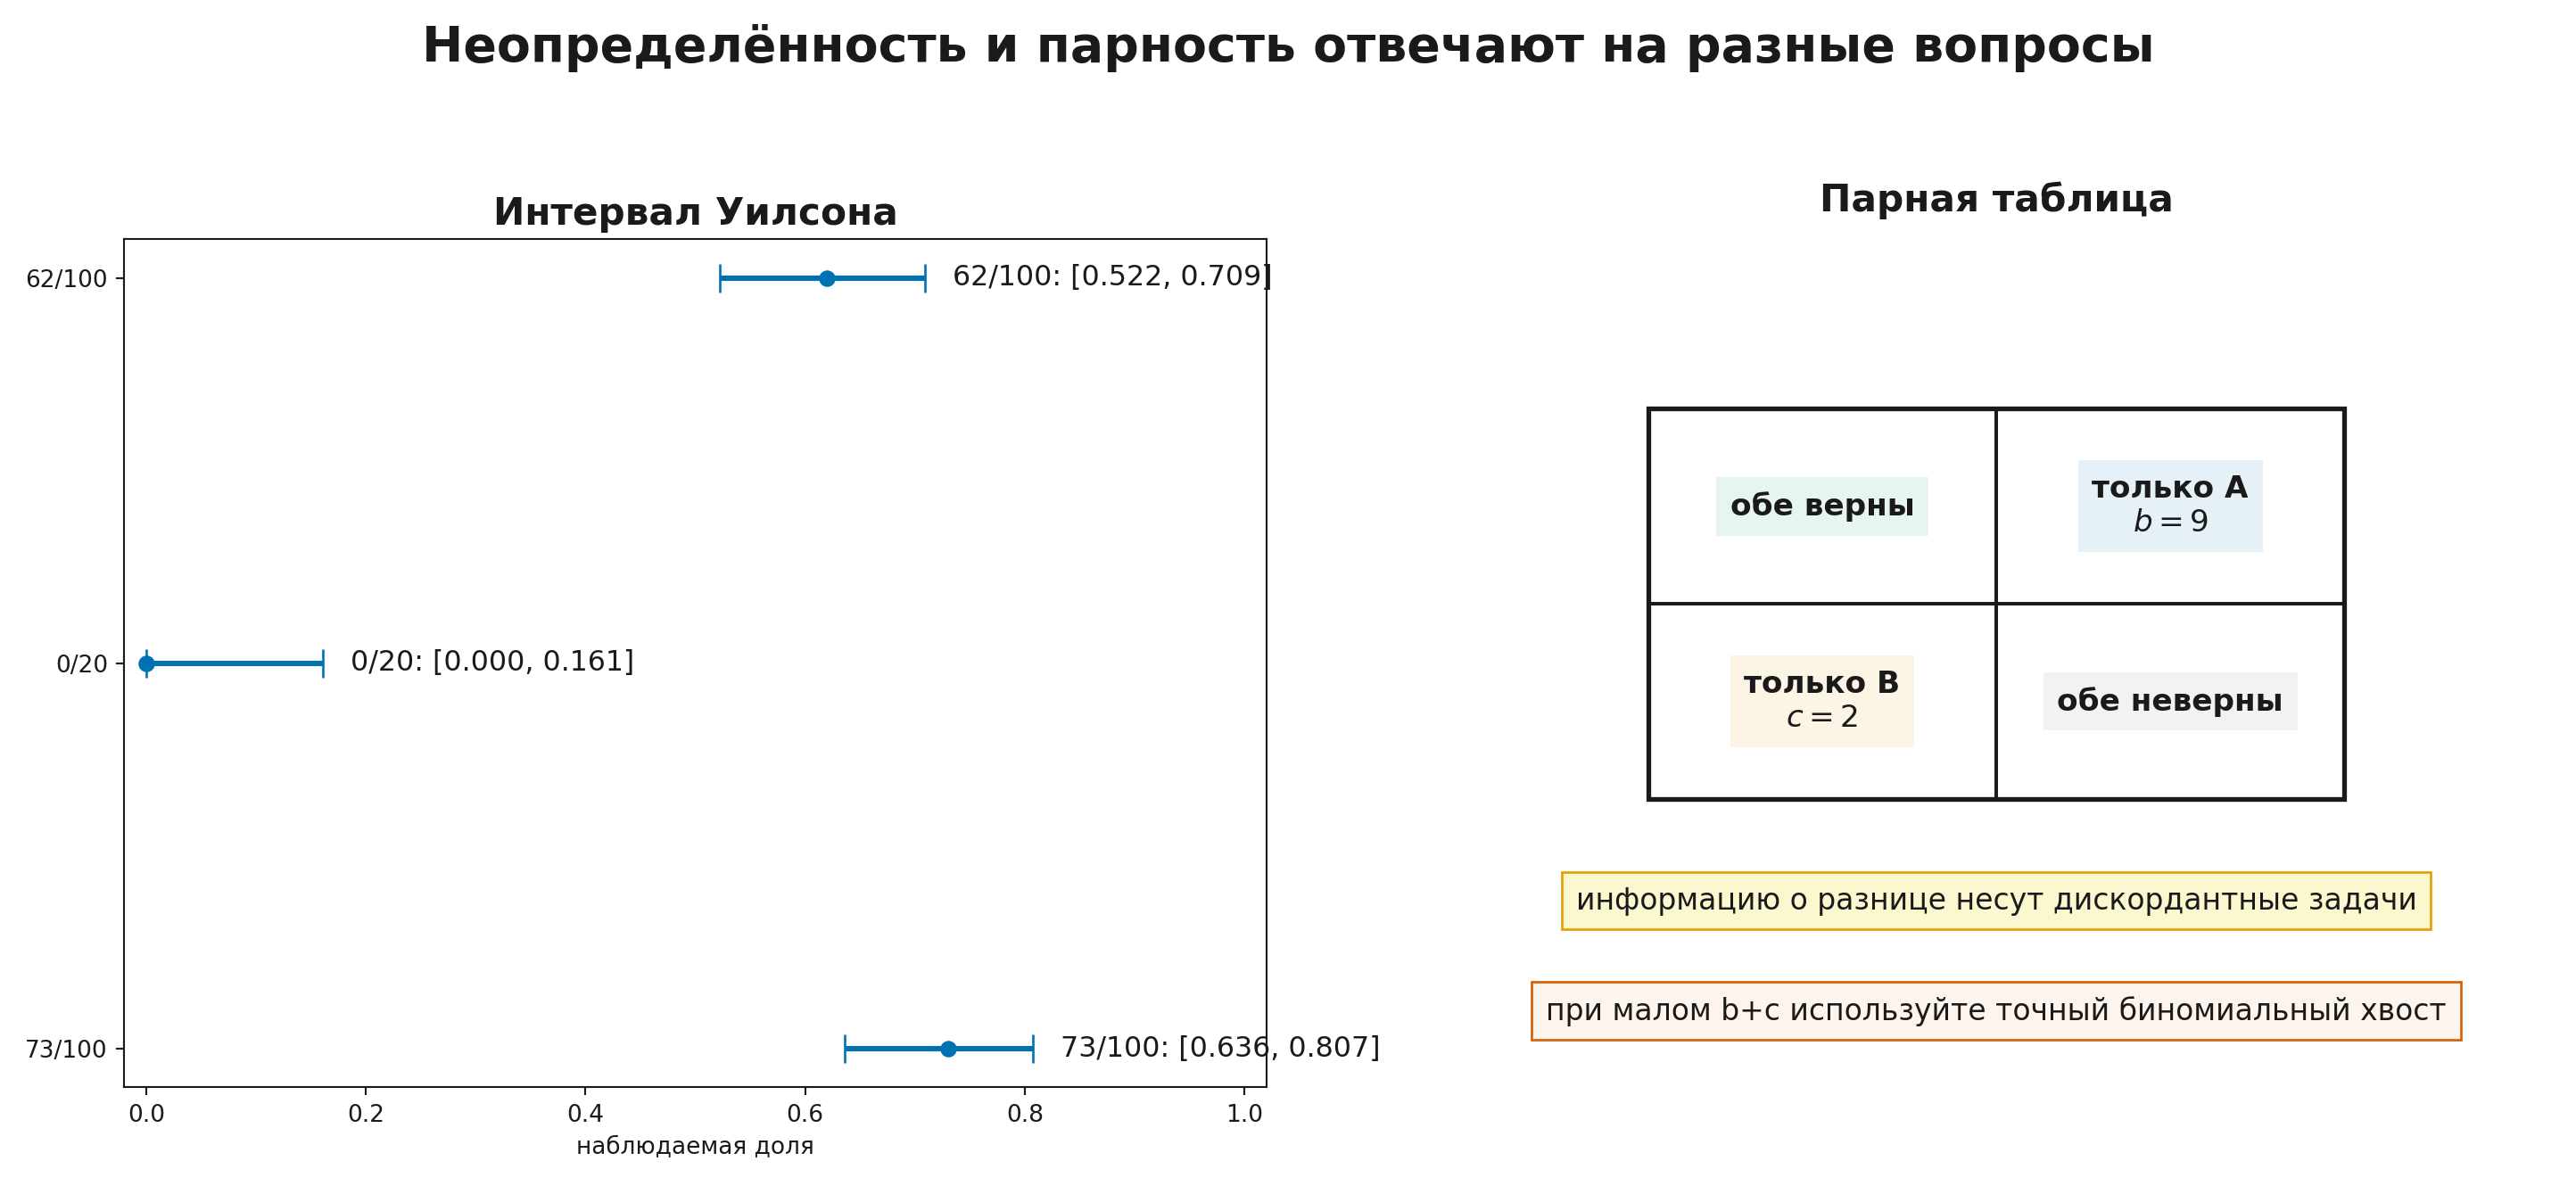
Пусть на задачах система успешно решила , а наблюдаемая доля равна
Одно число не показывает точность оценки. Наивная нормальная аппроксимация использует
но ведёт себя особенно плохо около нуля и единицы. Например, при она даёт вырожденный интервал , хотя двадцать неудач не доказывают нулевую вероятность успеха.
Для курса базовым интервалом для биномиальной доли будет интервал Уилсона (Wilson score interval). При уровне около 95% берём :
Интервал равен center ± margin.
Два примера:
| Результат | 95%-интервал Уилсона |
|---|---|
| примерно | |
| примерно |
Второй результат читается так: наблюдалось ноль успехов, но при таком малом наборе истинная доля, совместимая с данными, всё ещё может быть заметно выше нуля.
Для грубого планирования размера набора в худшем случае :
где — желаемая полуширина интервала. Чтобы получить около процентных пунктов, нужно примерно 1068 независимых задач, а не сто.
Граница утверждения. Узкий интервал говорит о малой выборочной неопределённости при выбранной статистической модели. Он не доказывает правильность разметки, чистоту данных, независимость задач или перенос результата в рабочую эксплуатацию.
Шаг 13.1.3 — Сначала единица анализа, затем формула
Биномиальная модель подходит, когда каждая задача даёт один бинарный исход и задачи рассматриваются как независимые единицы. В реальном оценивании часто есть дополнительные уровни:
- несколько генераций на одну задачу;
- несколько тестов внутри одного репозитория;
- несколько ходов одной агентной траектории;
- несколько оценок одного ответа разными судьями;
- несколько почти одинаковых задач из одного шаблона.
Если считать все эти наблюдения независимыми, интервал искусственно сузится. Например, сто генераций по десяти исходным задачам не превращаются автоматически в тысячу независимых задач. Общая трудность задачи создаёт корреляцию внутри группы.
Полезное правило:
Единицей анализа должна быть единица, на которую вы хотите переносить вывод.
Если вывод относится к новым задачам, агрегируйте повторные попытки внутри задачи, а затем оценивайте разброс по задачам. Если вывод относится к повторному декодированию фиксированного набора, отдельно оценивайте изменчивость случайной генерации.
Для непрерывной метрики, например стоимости или длины траектории, биномиальный интервал неприменим. Тогда удобно использовать парный бутстрэп (paired bootstrap): много раз с возвращением выбирать задачи из исходного набора, на каждой повторной выборке считать разность метрик и брать квантили распределения разностей.
Бутстрэп не является магией. Он наследует структуру исходных данных. Если задачи зависимы, нужно выбирать с возвращением целые группы, а не отдельные строки. Если набор систематически смещён, бутстрэп честно воспроизведёт это смещение.
Шаг 13.1.4 — Парное сравнение: какие задачи изменили исход
Для сравнения двух систем выгодно запускать их на одном и том же наборе. Для бинарного исхода каждая задача попадает в одну из четырёх клеток:
| B: успех | B: провал | |
|---|---|---|
| A: успех | обе успешны | только A: |
| A: провал | только B: | обе провалились |
Клетки, где системы совпали, важны для абсолютных долей, но не сообщают, какая система лучше. Различие определяется дискордантными задачами и .
При нулевой гипотезе «на дискордантной задаче каждая система одинаково вероятно оказывается единственной успешной» число случаев в пользу A имеет биномиальное распределение с вероятностью . Точный двусторонний вариант теста Мак-Немара (McNemar test) равен
Здесь легко увидеть опасность механической нормальной аппроксимации. При и величина
выглядит «значимой» при пороге 1.96, но точный двусторонний примерно равен . Для малого числа дискордантных задач используйте точный расчёт или корректную поправку, а не один .
Для непрерывных метрик сравнивайте парные разности по задачам:
Именно распределение , а не два независимых набора средних, отвечает на вопрос о разнице систем.
Статистическая значимость не заменяет размер эффекта. Разность в 0.2 процентного пункта может стать статистически различимой на огромном наборе, но оставаться несущественной для продукта. До запуска полезно задать минимально практически важное изменение.
Шаг 13.1.5 — Четыре источника случайности и честный план прогона
Один итоговый балл может меняться по нескольким причинам.
- Выбор задач. Другой набор из той же предполагаемой совокупности даст другое среднее.
- Декодирование. Стохастическая политика выдаёт разные ответы на одной задаче.
- Обучение. Другое начальное значение генератора случайных чисел, порядок мини-пакетов или аппаратная недетерминированность дают другую контрольную точку.
- Оцениватель. LLM-судья, человек или внешний сервис могут отвечать непоследовательно.
Эти источники нельзя исправить одним «общим начальным значением». Нужно решить, какие уровни входят в интересующий вывод.
Пример протокола для сравнения двух обучающих методов:
- обучить по три независимые контрольные точки каждого метода;
- оценить их на одном зафиксированном наборе задач;
- для каждой задачи использовать одинаковый бюджет генерации;
- по возможности применять общие случайные числа или одинаковые начальные значения декодирования;
- сравнивать методы по парным задачам внутри каждого запуска;
- отдельно сообщать разброс между обучающими запусками.
Если доступна только одна дорогая контрольная точка, это не запрещает оценку. Но вывод должен быть уже: «данная контрольная точка в данном протоколе», а не «метод в среднем».
Последний элемент плана — правило остановки. Если смотреть на метрику после каждого нового блока и остановиться при первом удачном пересечении порога, номинальный 95%-интервал больше не имеет прежней интерпретации. Для последовательного контроля нужны заранее заданные проверки, поправки или отдельный финальный набор, который не использовался для решений по ходу работы.
Урок 13.2. pass@k, жизненный цикл бенчмарка и загрязнение
Урок 13.2. pass@k, жизненный цикл бенчмарка и загрязнение
- pass@k измеряет покрытие, а не способность выбрать ответ
- Бюджет генерации является частью метрики
- Бенчмарк имеет жизненный цикл
- Загрязнение данных: дешёвое сито и его предел
- Адаптивное переобучение: тест становится частью обучения
далее — 4 проверочных шага
Шаг 13.2.1 — pass@k измеряет покрытие, а не способность выбрать ответ
Пусть для одной задачи сгенерировано несколько независимых кандидатов. Если вероятность успеха одной попытки равна , то вероятность увидеть хотя бы один успех среди попыток равна
Это модельная вероятность при независимых и одинаково распределённых попытках. В реальном эксперименте мы уже получили конечный набор из кандидатов, среди которых успешных. Для случайной подвыборки размера конечновыборочный оцениватель равен
Удобная численно устойчивая форма вычисляется произведением, без факториалов.
Ключевая интерпретация:
pass@k отвечает на вопрос, присутствует ли успешный кандидат среди , но не говорит, умеет ли система его распознать.
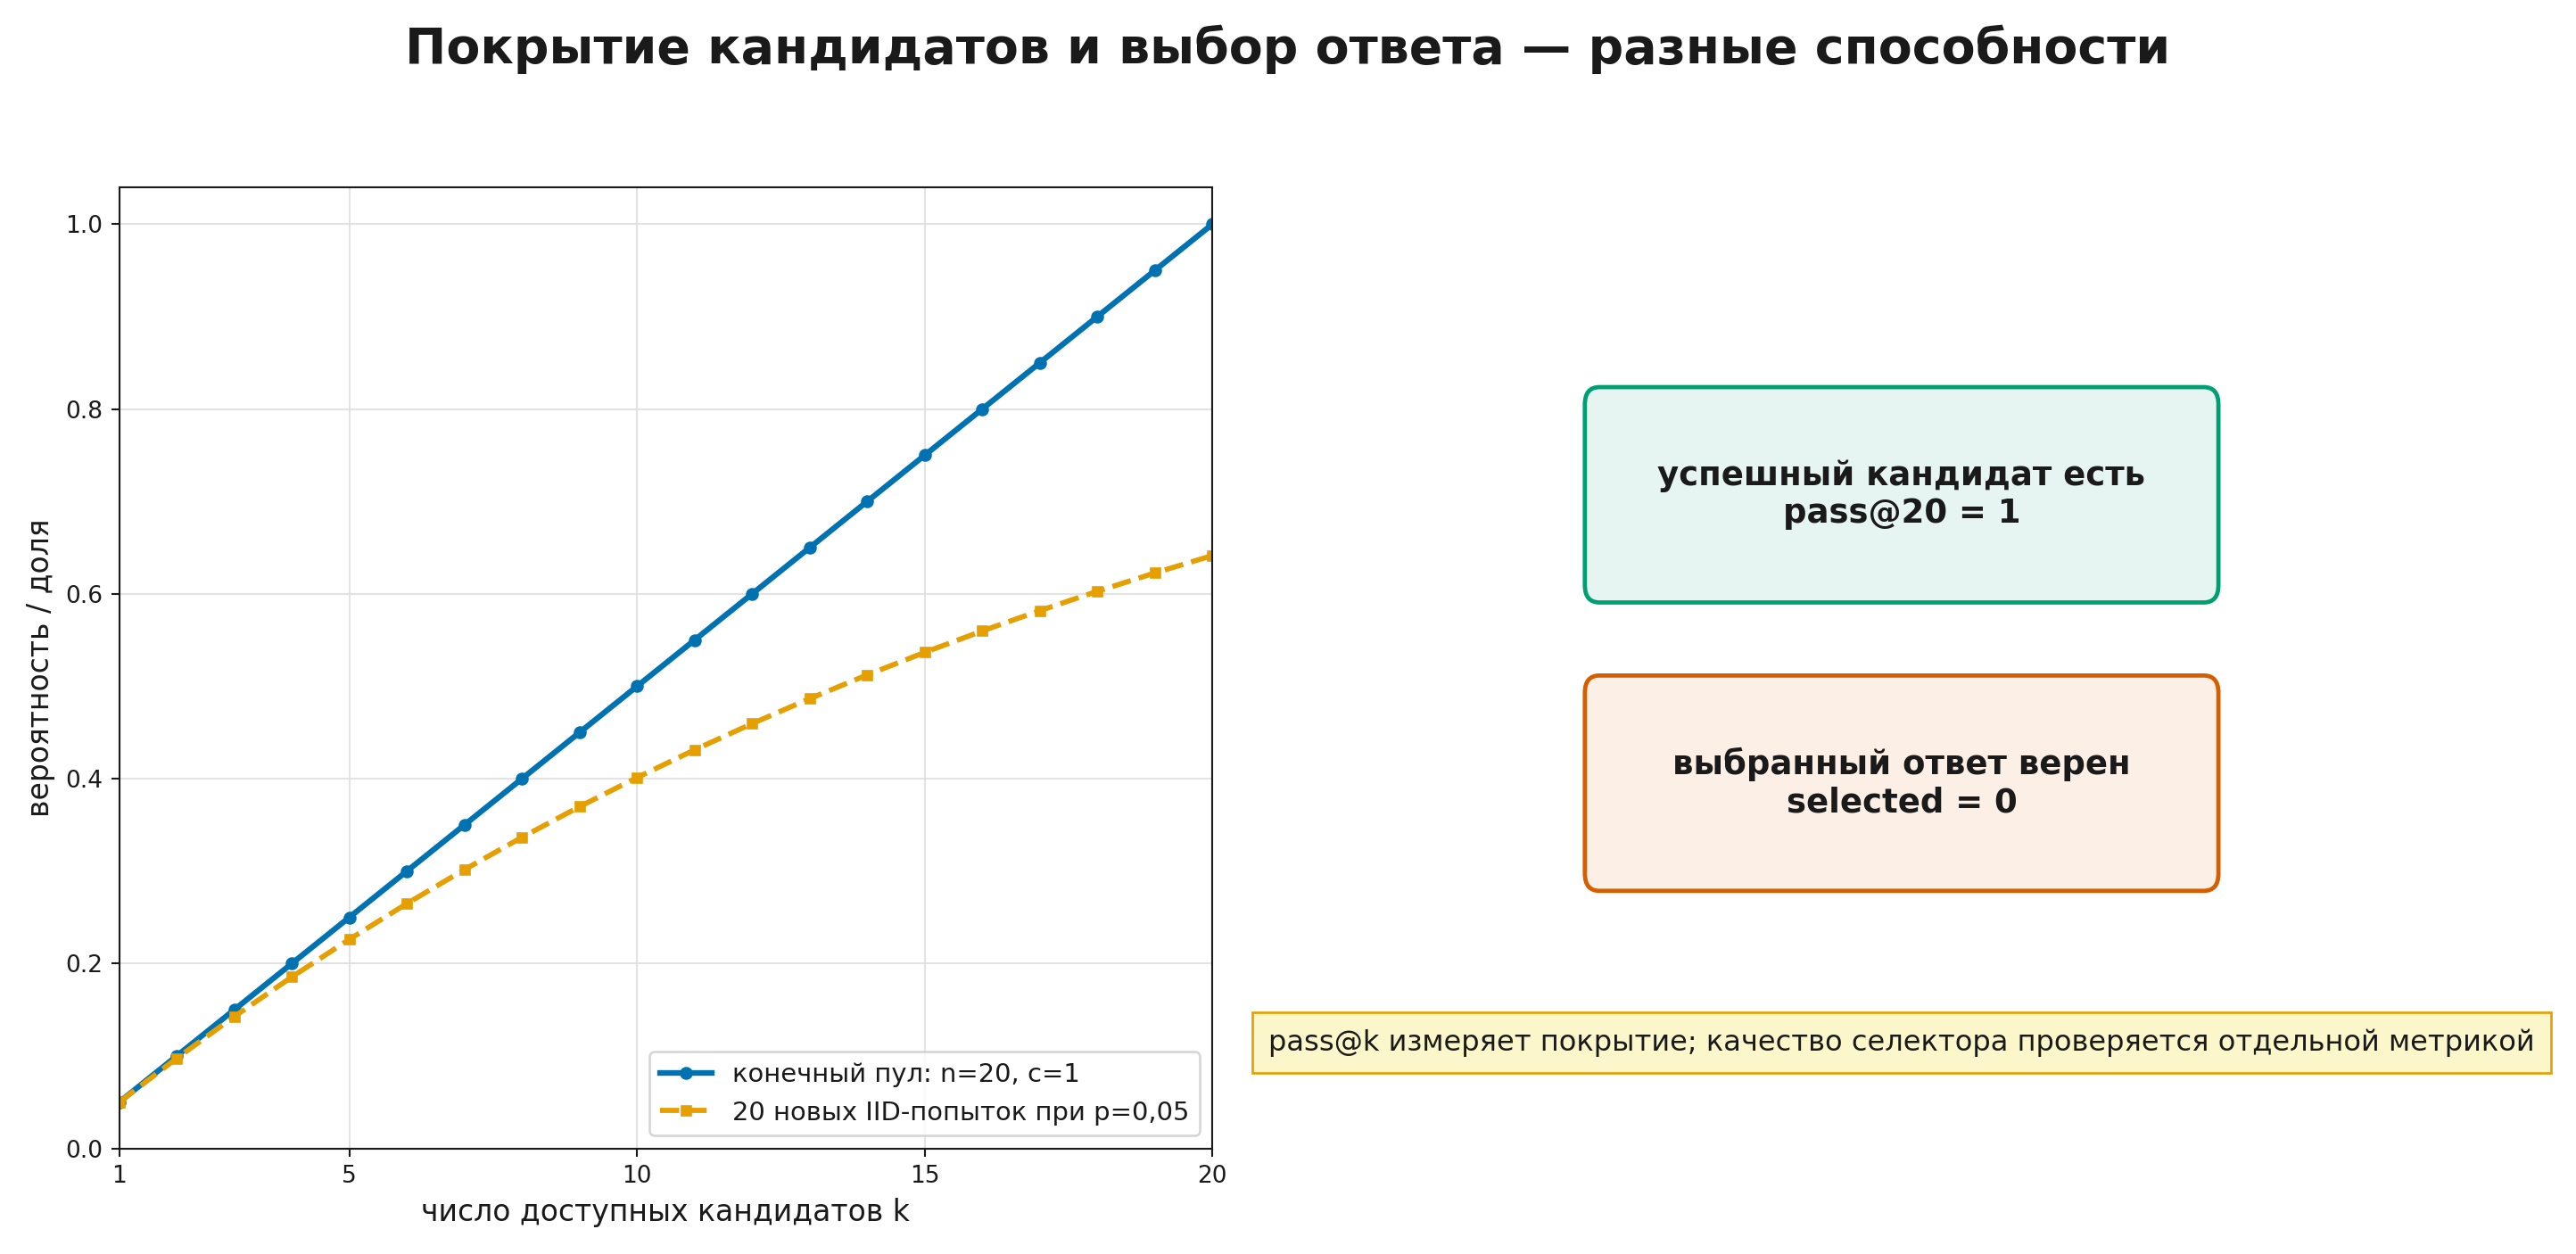
Если правильный ответ есть среди 32 кандидатов, а проверяющая система выбирает неправильный, pass@32 остаётся высоким, а фактически возвращаемое качество — низким. RL for LLM, Модуль 10 «Поиск, проверка и вычислительный бюджет на этапе генерации» (rl_llm.module_10_test_time_search) подробно разбирал это как различие покрытия и выбора.
При и конечновыборочный pass@20 равен 1: если взять все двадцать уже сгенерированных кандидатов, успешный точно попадёт в набор. Наивная подстановка в даёт примерно 0.642 и отвечает на другой мысленный эксперимент.
В отчёте рядом с pass@k должны находиться:
- — сколько кандидатов реально было сгенерировано;
- ;
- правило успешности;
- параметры декодирования;
- правило выбора финального ответа, если оно существует;
- стоимость в токенах, времени и вызовах проверяющей системы.
Шаг 13.2.2 — Бюджет генерации является частью метрики
Сравнение pass@1 одной системы с pass@64 другой не измеряет только качество политики. Оно измеряет разные вычислительные бюджеты.
Удобно представлять качество как функцию бюджета:
где может быть числом кандидатов, числом сгенерированных токенов, временем или стоимостью API. Тогда честное сравнение задаёт один из вопросов:
- какая система лучше при одинаковом бюджете;
- какой бюджет нужен каждой системе для достижения заданного качества;
- какова площадь под кривой «качество–стоимость» в выбранном диапазоне.
Для независимых попыток предельный прирост следующего кандидата равен
Он убывает, но скорость убывания зависит от . На трудных задачах с малым дополнительные попытки могут оставаться полезными дольше.
Независимость понимается условно при фиксированных запросе и протоколе генерации. Похожие ответы или численно близкие начальные значения генератора сами по себе не доказывают зависимость: независимые выборки из сосредоточенного распределения часто повторяются. Общий случайно выбранный префикс, переиспользуемая ветвь поиска или связанная генерация могут нарушать предположение; объединение задач с разными вероятностями успеха также не позволяет подставлять одно среднее p в формулу. Оценивайте pass@k по фактическим группам кандидатов с запросом как единицей анализа, а разнообразие показывайте отдельной диагностикой.
И ещё одна граница: pass@k не является мерой калибровки. Система может иметь высокий pass@k и не знать, какой ответ верен. Для продукта это особенно важно, если пользователь получает ровно один ответ.
Шаг 13.2.3 — Бенчмарк имеет жизненный цикл
Публичный набор не сохраняет одинаковую ценность навсегда. Упрощённый жизненный цикл выглядит так:
- новый набор труден и различает системы;
- методы адаптируются к формату;
- баллы растут, а ошибки концентрируются в спорных или дефектных элементах;
- набор попадает в обучающие корпуса и инструкции;
- верхняя часть лидерборда сжимается;
- появляется преемник, закрытая часть набора или динамическая версия.
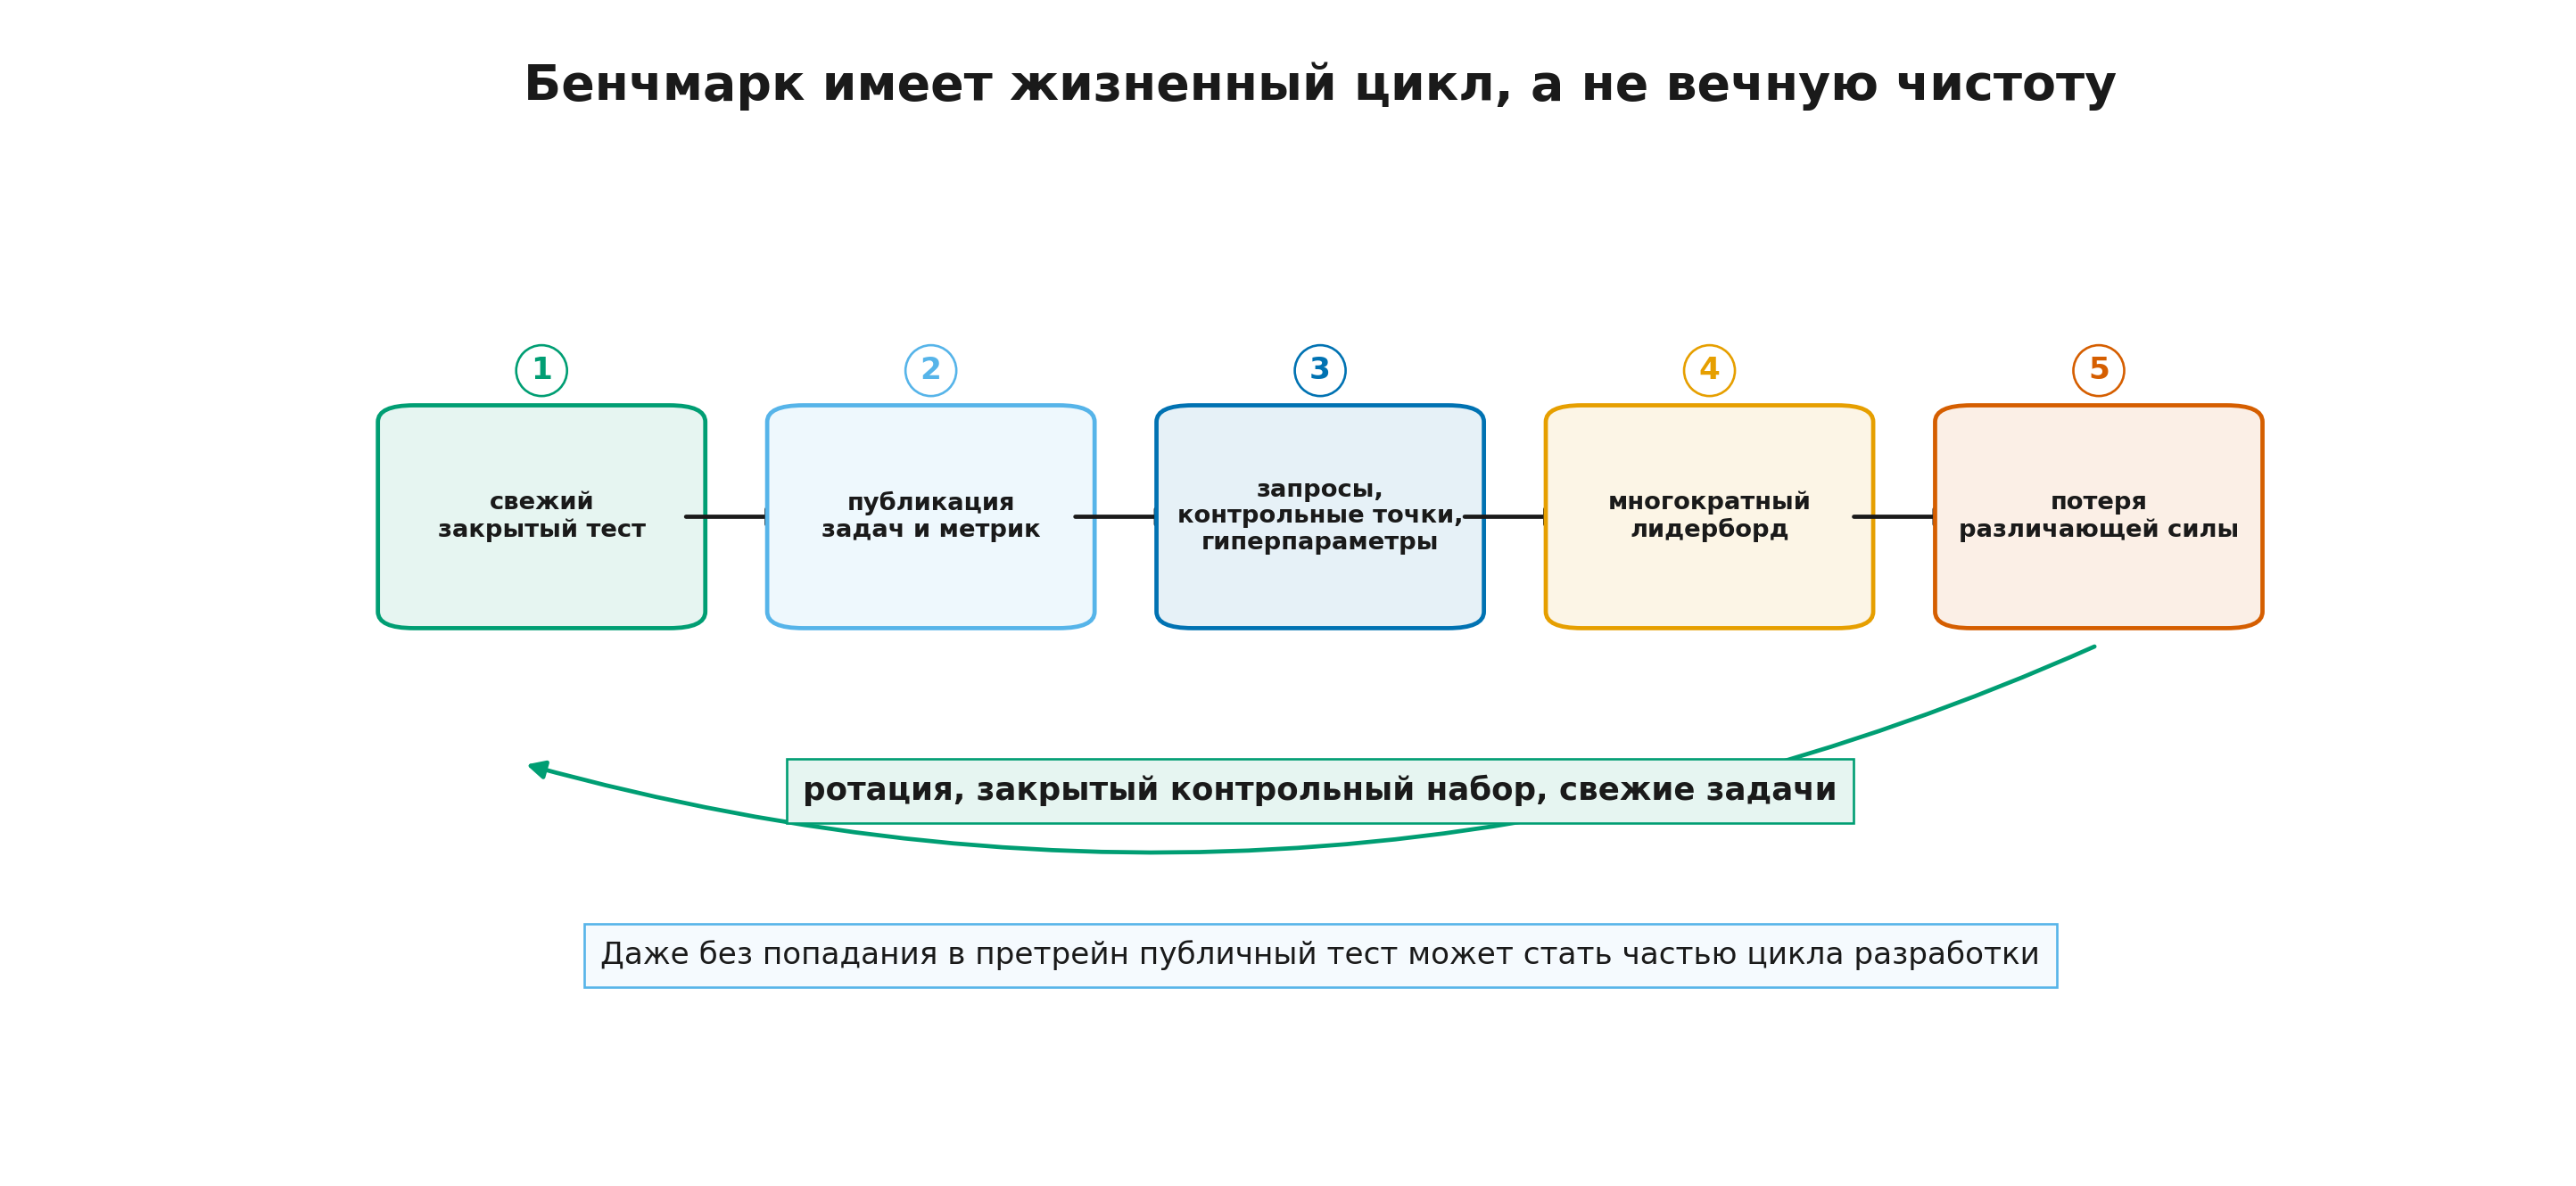
Насыщение — не просто высокий средний балл. Оно означает потерю различающей способности: большинство элементов уже не отделяет сильные системы друг от друга, а итоговый порядок определяется небольшим числом редких, неоднозначных или ошибочно размеченных задач.
На дату снимка полезно различать несколько классов оценок, не превращая их в универсальный рейтинг:
| Что проверяется | Примеры | Что обязательно зафиксировать |
|---|---|---|
| сложные закрытые знания и рассуждение | GPQA Diamond, HLE | версия, подмножество, формат ответа, правила проверки |
| соревновательная математика | AIME по конкретному году | год, доступ к инструментам, число попыток, извлечение ответа |
| программирование после временного среза | LiveCodeBench | период задач, язык, режим выполнения, pass@k |
| исправление реальных репозиториев | SWE-bench Verified | агентная обвязка, образ среды, бюджет, версия набора |
| вызовы инструментов | BFCL | версия лидерборда, категория, формат вызова, многоходовой режим |
| безопасность | AILuminate и собственное состязательное тестирование | версия таксономии, закрытая/открытая часть, оцениватель |
SWE-bench Verified, например, является человечески проверенным подмножеством из 500 задач, но результат всё равно зависит от агента и среды выполнения. BFCL V4 на дату снимка охватывает не только синтаксис вызова функции, но и агентные компоненты вроде поиска и памяти. Это датированные свойства конкретных версий, а не вечные определения.
Более широкая карта современных LLM-бенчмарков находится в Modern LLMs, Модуле 19 «Оценка современных LLM: от бенчмарка к инженерному решению» (modern_llms.module_17_evaluation). Здесь достаточно правила: выбирать набор по требуемому поведению и измерительному риску, а не по узнаваемости названия.
Шаг 13.2.4 — Загрязнение данных: дешёвое сито и его предел
Загрязнение теста (test contamination) возникает, когда информация о тестовых элементах попадает в обучение или настройку системы. Полезно различать несколько форм.
- Дословное пересечение: полный текст задачи или решения присутствует в корпусе.
- Почти дубликат: изменены форматирование, имена или небольшие фрагменты.
- Семантический дубликат: задача перефразирована, но сохраняет тот же информационный ключ.
- Утечка решений: условие могло быть новым, но эталонный ответ или разбор был доступен.
- Протокольная утечка: разработчики многократно настраивали запрос, инструмент или фильтр по тестовому набору.
Дешёвый фильтр — доля n-грамм примера, встречающихся в доступном обучающем корпусе. Для токенизированного текста :
В этой формуле знаменатель состоит только из n-грамм проверяемой задачи. Поэтому это асимметричная доля покрытия (benchmark n-gram containment): большой корпус не штрафуется за множество лишних n-грамм. Для другой задачи можно посчитать симметричный коэффициент Жаккара
но эти две величины отвечают на разные вопросы и не должны называться одним именем. Эталонный код модуля использует именно асимметричное покрытие, совпадающее с формулой выше.
Такой фильтр хорошо ловит дословные фрагменты и плохо ловит перевод, парафраз и перестановку частей. Он должен быть ситом, а не сертификатом.
Канареечная строка (canary) — уникальный маркер, который автор набора помещает в файлы, чтобы разработчики могли фильтровать их из обучения или обнаруживать очевидное воспроизведение. Наличие канарейки в выводе является сильной уликой доступа к соответствующему материалу. Отсутствие не доказывает чистоту: данные могли попасть без маркера, быть переформатированы или модель могла не воспроизвести строку.
Перед публикацией полезно сообщать:
- доступен ли обучающий корпус для прямой проверки;
- какой вид совпадений искался;
- порог и токенизация фильтра;
- долю помеченных элементов;
- балл на всём наборе и на подмножестве без флагов;
- ограничения метода.
Недавние работы о «мягком загрязнении» показывают именно эту границу: n-граммная дедупликация может пропускать семантически эквивалентные элементы.
Шаг 13.2.5 — Адаптивное переобучение: тест становится частью обучения
Даже если тест физически не входил в предобучение, его можно износить после релиза.
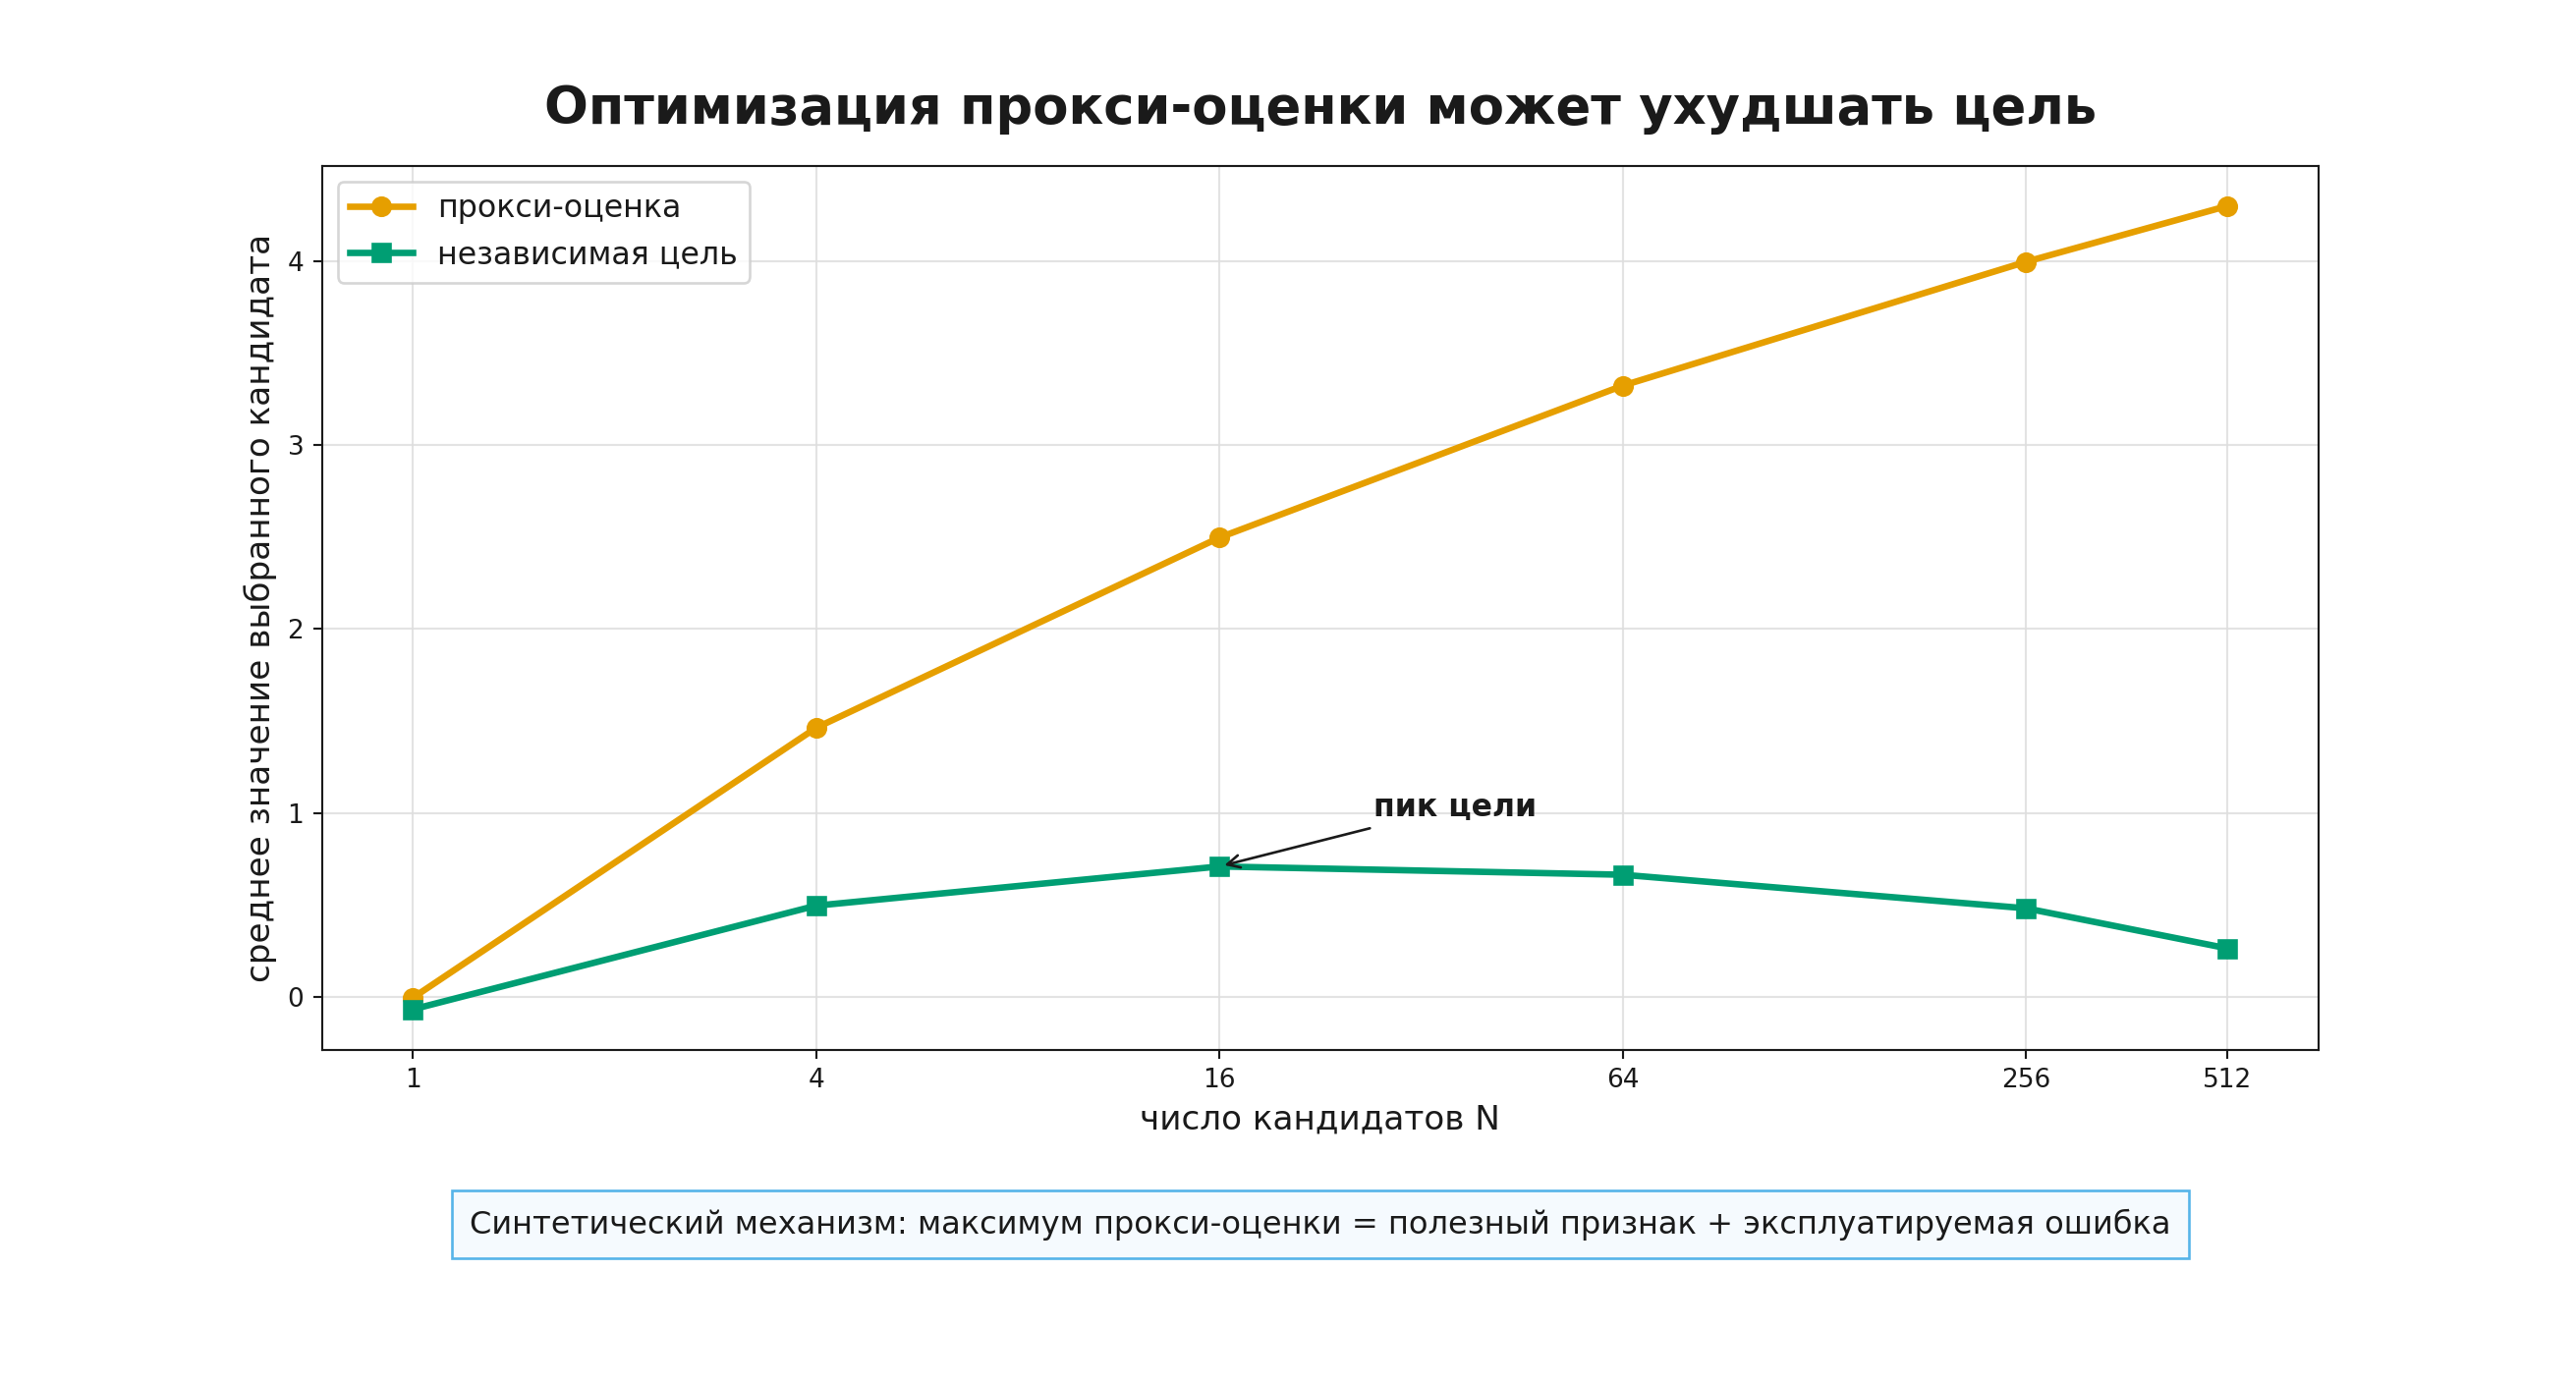
Предположим, что команда пробует 50 вариантов запроса, температуры и правил повторного вызова. У каждого варианта истинное качество одинаково, но наблюдаемая метрика содержит шум:
Если выбрать вариант с максимальным , выбранная оценка систематически завышена. Это смещение отбора (selection bias) — лучший шум принимается за лучший метод.
На уровне индустрии происходит то же самое: тысячи работ адаптируются к одному публичному лидерборду. Никто не обязан намеренно «жульничать». Информация о тесте всё равно постепенно проникает в решения.
Защита строится слоями:
- разработка: открытый набор для отладки;
- валидация: отдельный набор для выбора настроек;
- закрытая проверка: минимально используемый приватный набор;
- живые или обновляемые задачи: временное отделение от обучения;
- ротация форм и задач: уменьшение натаскивания на фиксированную форму;
- журнал запросов к лидерборду: сколько решений было принято по его сигналу;
- последний независимый аудит: набор, который не использовался до фиксации системы.
LiveCodeBench и LiveBench используют обновляемые задачи как один из способов ограничить загрязнение. Это не устраняет дефектные элементы, зависимость от протокола или последующее адаптивное переобучение; оно лишь закрывает один важный канал.
Собственный закрытый контрольный набор (private golden set) должен иметь владельца, версию, политику доступа, журнал изменений и план обновления. Секретность без качества разметки не помогает, а качество без контроля доступа быстро превращает тест в очередную валидацию.
Урок 13.3. Взлом награды и судья под давлением
Урок 13.3. Взлом награды и судья под давлением
- Таксономия: что именно эксплуатирует политика
- Синтетический аудит судьи: что исправляет очистка входа
- LLM-судья: перестановка порядка и структурная изоляция
- Три уровня оптимизационного давления
- Льстивое согласие: предпочтение пользователя не равно истине
далее — 5 проверочных шагов
Шаг 13.3.1 — Таксономия: что именно эксплуатирует политика
Взлом награды удобнее классифицировать по атакованному компоненту, а не по внешнему виду ответа.
RL for LLM, Модуль 7 «Модели награды и данные о предпочтениях» (rl_llm.module_07_reward_models) вводил модели награды и LLM-судей как источники обратной связи. Здесь те же компоненты рассматриваются уже как измерительные поверхности, на которые начинает давить оптимизируемая политика.
1. Подмена спецификации. Награда корректно вычисляет то, что написано, но написано не то, что хотел автор. «Сделай тесты зелёными» допускает удаление тестов; «увеличь вовлечённость» допускает кликбейт.
2. Эксплуатация проверяющей системы. Ответ проходит неполные тесты, пользуется ошибкой парсера, жёстко кодирует известные примеры или подбирает строку, которую принимает канонизатор.
3. Воздействие на проверяющую систему. Агент изменяет тесты, эталоны, файлы среды, системное время или состояние, от которого зависит награда. Это уже не просто поиск допустимого ответа, а вмешательство в прибор.
4. Взлом модели-судьи. Ответ использует длину, уверенный стиль, формат рубрики, инъекцию инструкций или особенности конкретного семейства судей.
5. Эксплуатация служебной метрики. Политика оптимизирует промежуточный показатель — например, число вызовов инструмента или длину рассуждения — вместо конечного исхода.
6. Распределительный обход. Политика находит область входов, где модель награды или проверяющая система экстраполирует особенно плохо.
Нельзя вывести универсальную защиту из одного названия «взлом награды». Защита зависит от поверхности:
- для спецификации нужно состязательное тестирование цели;
- для программного проверяющего — скрытые тесты, неизменяемость и песочница;
- для судьи — изоляция, перестановка, рубрика и независимый аудит;
- для распределительного обхода — свежие данные и проверка вне обучающего распределения.
Особенно подозрительны слишком лёгкие успехи и верхний хвост награды. Первые примеры для ручного просмотра — не случайные, а самые высоконаграждённые и самые быстро улучшившиеся.
Шаг 13.3.2 — Синтетический аудит судьи: что исправляет очистка входа
Рассмотрим учебного судью. У кандидата есть:
- истинное качество ;
- длина ;
- число уверенных оборотов ;
- флаг инъекции .
Сырой балл:
После удаления явных инструкций и уверенных самооценок:
Разность
можно использовать как сигнал подозрения.
Этот пример показывает три разных результата.
- Инъекция может полностью захватить сырого судью.
- Очистка удаляет конкретную строковую атаку.
- После очистки сохраняется длиновое смещение самого судьи.
То есть «очистили вход» не равно «получили объективный оцениватель». Защита от атаки и калибровка оценивателя — разные задачи.
Для реального аудита нужны две метрики:
ASR — частота успешных атак (attack success rate), FPR — доля ложноположительных тревог (false positive rate). Защитный фильтр, который блокирует все атаки и половину честных ответов, не является бесплатным улучшением.
Синтетическая формула не моделирует современного судью во всей сложности. Её педагогическая роль — заставить разделить уязвимость к содержимому ответа, систематическое смещение и ошибку детектора.
Шаг 13.3.3 — LLM-судья: перестановка порядка и структурная изоляция
LLM-судья удобен для открытых ответов, но его решение зависит не только от содержания. В первичных исследованиях описаны:
- позиционное смещение;
- предпочтение более длинных ответов;
- предпочтение знакомого стиля;
- собственное предпочтение к ответам того же семейства;
- ограниченная способность проверять сложное рассуждение;
- уязвимость к инструкциям внутри оцениваемого текста.
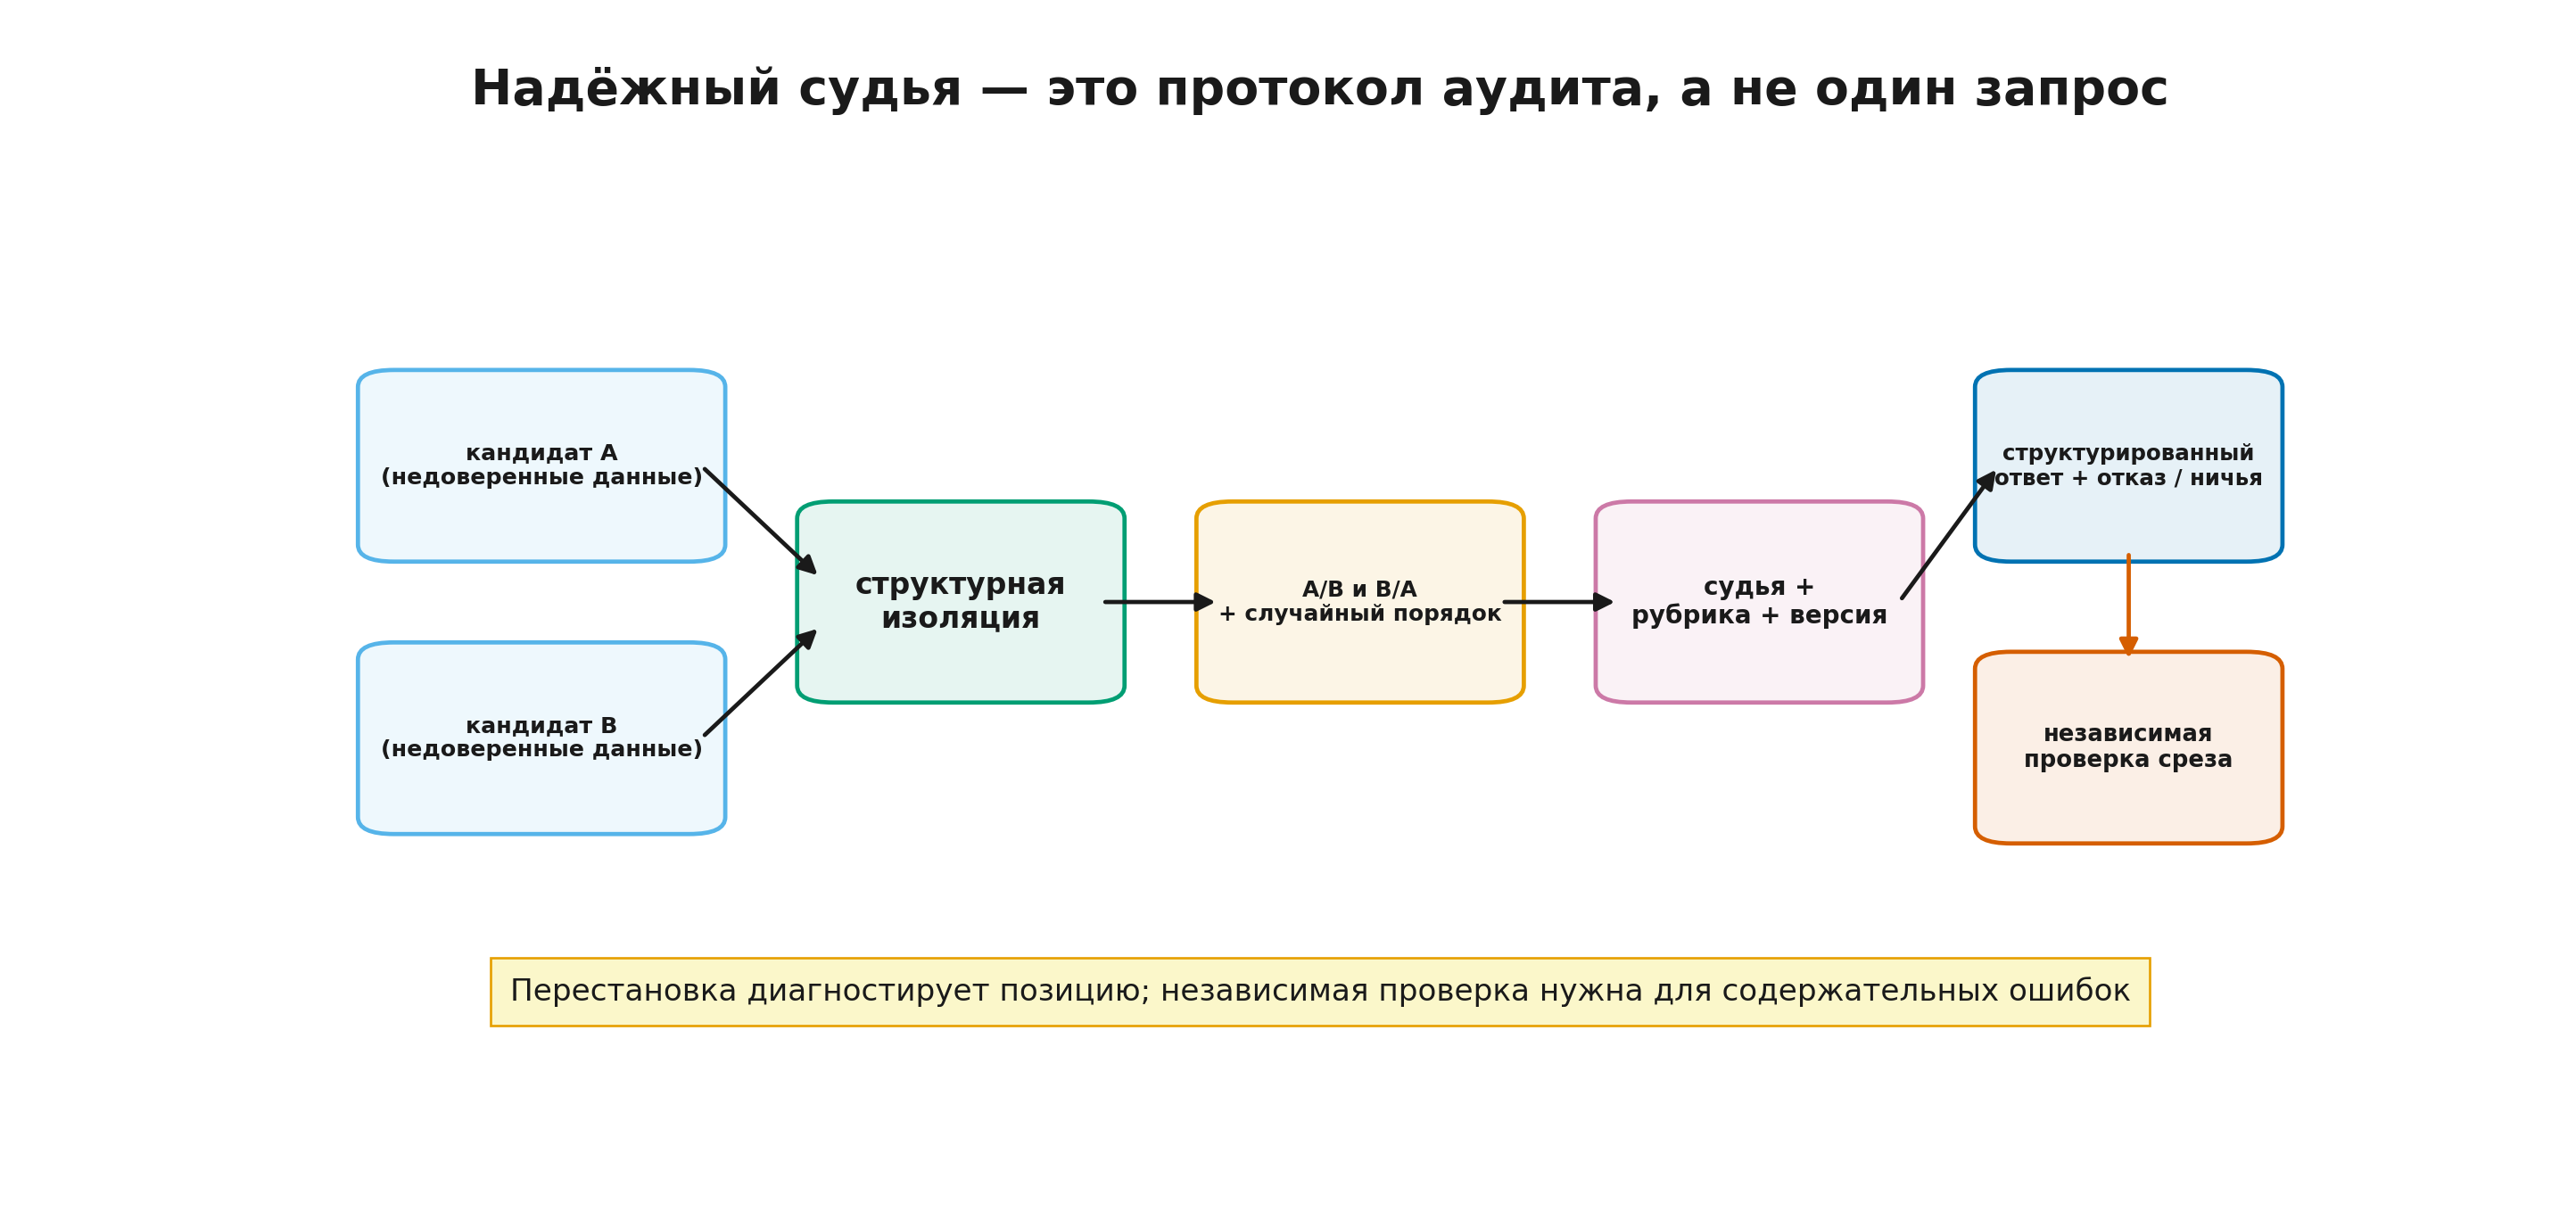
Минимальный парный протокол оценивает оба порядка:
- A как первый ответ, B как второй;
- B как первый, A как второй.
Результат полезно кодировать не одной победой, а тремя состояниями:
- устойчиво победила A;
- устойчиво победила B;
- решение зависит от порядка или судья объявил ничью.
Доля третьего состояния является диагностикой, а не мусором, который нужно случайно разрулить.
Структурная изоляция означает, что оцениваемый ответ передаётся как данные в чётко отделённом поле, а системная инструкция запрещает исполнять содержащиеся внутри команды. Это уменьшает прямую инъекцию, но не создаёт формальной границы безопасности: модель всё равно читает текст и может поддаться более тонкой атаке.
Рубрика с бинарными подпунктами обычно прозрачнее свободного балла от 1 до 10:
- соответствует ли ответ фактам;
- выполнил ли каждое обязательное требование;
- нарушил ли формат;
- содержит ли неподтверждённое утверждение.
Каждый подпункт должен иметь правило агрегации. Иначе «бинарная рубрика» снова превращается в скрытый свободный балл.
Наконец, LLM-судью нужно сравнивать с человеческими или программными якорями на том же распределении. Высокое согласие на обычных ответах не доказывает устойчивость к специально оптимизированным атакам.
Шаг 13.3.4 — Три уровня оптимизационного давления
Один и тот же несовершенный оцениватель ведёт себя по-разному под разной силой поиска.
Best-of-N. Политика порождает кандидатов, а оцениватель выбирает максимум. Ошибка судьи эксплуатируется случайно: чем больше , тем выше шанс найти кандидат с удачной ошибкой.
RL. Градиент или другой направленный алгоритм изменяет распределение политики в сторону признаков, которые повышают прокси-награду. Найденная уязвимость закрепляется в весах и появляется чаще.
Экосистема. Команды многократно выбирают модели, запросы и обвязки по одному публичному числу. Бенчмарк изнашивается даже без единого явного оптимизатора.
Работа о масштабировании переоптимизации моделей награды показала разные эмпирические формы ухудшения независимой эталонной оценки при Best-of-N и RL. Это не универсальная теорема «RL всегда опаснее», но важное предупреждение: устойчивость к слабому поиску не гарантирует устойчивость к направленной оптимизации.
Арсенал защиты:
- ограничение силы оптимизации и ранняя остановка;
- независимый оцениватель, не участвующий в обучении;
- ансамбль с разными ошибками;
- свежие человеческие или программные метки;
- состязательный набор известных атак;
- разделение обучающей награды и критерия выпуска;
- наблюдение за расхождением прокси и независимой цели;
- ручной аудит верхнего хвоста награды.
Ни один пункт не является гарантией. Ансамбль может разделять общую ошибку, а независимый набор может стать зависимым после многократного использования. Защита должна включать и технические, и процессные ограничения.
Шаг 13.3.5 — Льстивое согласие: предпочтение пользователя не равно истине
Льстивое согласие (sycophancy) — склонность модели поддерживать заявленную позицию пользователя даже тогда, когда она противоречит доступным фактам или собственному прежнему ответу модели.
Одна частота согласия не является корректной метрикой. В обычном диалоге пользователь часто прав, и согласие может быть уместным. Нужны парные случаи с известным ответом:
- нейтральный вопрос;
- тот же вопрос с правильным мнением пользователя;
- тот же вопрос с ошибочным мнением пользователя.
Полезные показатели:
Хорошая система должна не просто чаще противоречить, а лучше различать фактическую правоту. Иначе «лечение» льстивости создаёт упрямую модель.
Первичные исследования показали льстивое поведение у ассистентов и обнаружили, что предпочтительные метки могут поощрять ответы, согласующиеся с убеждением пользователя. Формулировка должна оставаться осторожной: это эмпирический механизм в изученных настройках, а не доказательство того, что вся оптимизация по человеческой обратной связи неизбежно порождает льстивость.
Для RL-систем важен следующий вывод: если модель награды предпочитает уверенное согласие, более сильная оптимизация может усилить эту черту. Поэтому тест на льстивость должен входить не только в общий набор безопасности, но и в независимый контроль после изменения награды или предпочтительных данных.
Урок 13.4. Безопасность и протокольный паспорт
Урок 13.4. Безопасность и протокольный паспорт
- Паспорт замера: число без протокола не переносится
- Безопасность не сводится к доле отказов
- Состязательное тестирование: ASR и цена ложной тревоги
- От оценки к решению о выпуске
- Инструменты оценивания: выбрать контракт, а не логотип
далее — 2 проверочных шага
Шаг 13.4.1 — Паспорт замера: число без протокола не переносится
Паспорт оценивания должен позволить другому человеку понять, что именно было запущено, и повторить эксперимент без угадывания скрытых настроек.
Минимальные разделы:
Объект. Модель, версия или хэш контрольной точки, токенизатор, шаблон диалога, адаптеры, режим рассуждения.
Обвязка. Системное сообщение, инструменты, память, правила повторов, агентная программа, версии зависимостей.
Данные. Название, версия, разбиение, хэш файлов, число задач, исключения, политика загрязнения и контроль доступа.
Генерация. Температура, top-p/top-k, лимит, число кандидатов, начальное значение, бюджет токенов и времени.
Оцениватель. Канонизатор, тесты, модель-судья, точный запрос с рубрикой, версия правила очистки, политика ничьих и отказов.
Статистика. Единица анализа, формула метрики, интервал, парный протокол, число запусков, правило множественных сравнений и остановки.
Стоимость. Число токенов, вызовов, GPU-часов, задержка и доля технических ошибок.
Изменения и инциденты. Что менялось после начала прогона, какие элементы были исключены и почему.
Полезно вычислить SHA-256 для набора, конфигурации, запроса судьи и кода проверяющей системы. Хэш не доказывает качество, но фиксирует идентичность артефакта.
Антипаттерны:
- «лучшая из пяти попыток» без отчёта остальных;
- сравнение с чужой таблицей при другой обвязке;
- изменение правил канонизации после просмотра ошибок;
- настройка запроса по тесту и сохранение названия «тест»;
- pass@k без и бюджета;
- метрика безопасности без набора безопасных соседних запросов;
- судья без версии и точной рубрики.
Шаг 13.4.2 — Безопасность не сводится к доле отказов
Система может выглядеть безопасной, если она отказывается отвечать на всё. Такой результат бесполезен и часто скрывает отсутствие способности различать риск.
Минимальная карта должна включать две стороны:
- опасное выполнение — система помогает выполнить запрещённое или вредное действие;
- избыточный отказ (
over-refusal) — система отвергает безопасный или полезный запрос, который похож на опасный лишь поверхностно.
Для каждого класса угроз полезно иметь пары:
- явно опасный запрос;
- безопасный соседний запрос с похожими словами;
- неоднозначный запрос, где требуется уточнение;
- допустимая защитная или образовательная версия темы.
Тогда можно сообщать:
- частоту вредного выполнения;
- частоту корректного отказа;
- частоту безопасной полезной альтернативы;
- долю избыточных отказов;
- калибровку уверенности или причины решения;
- тяжесть последствий.
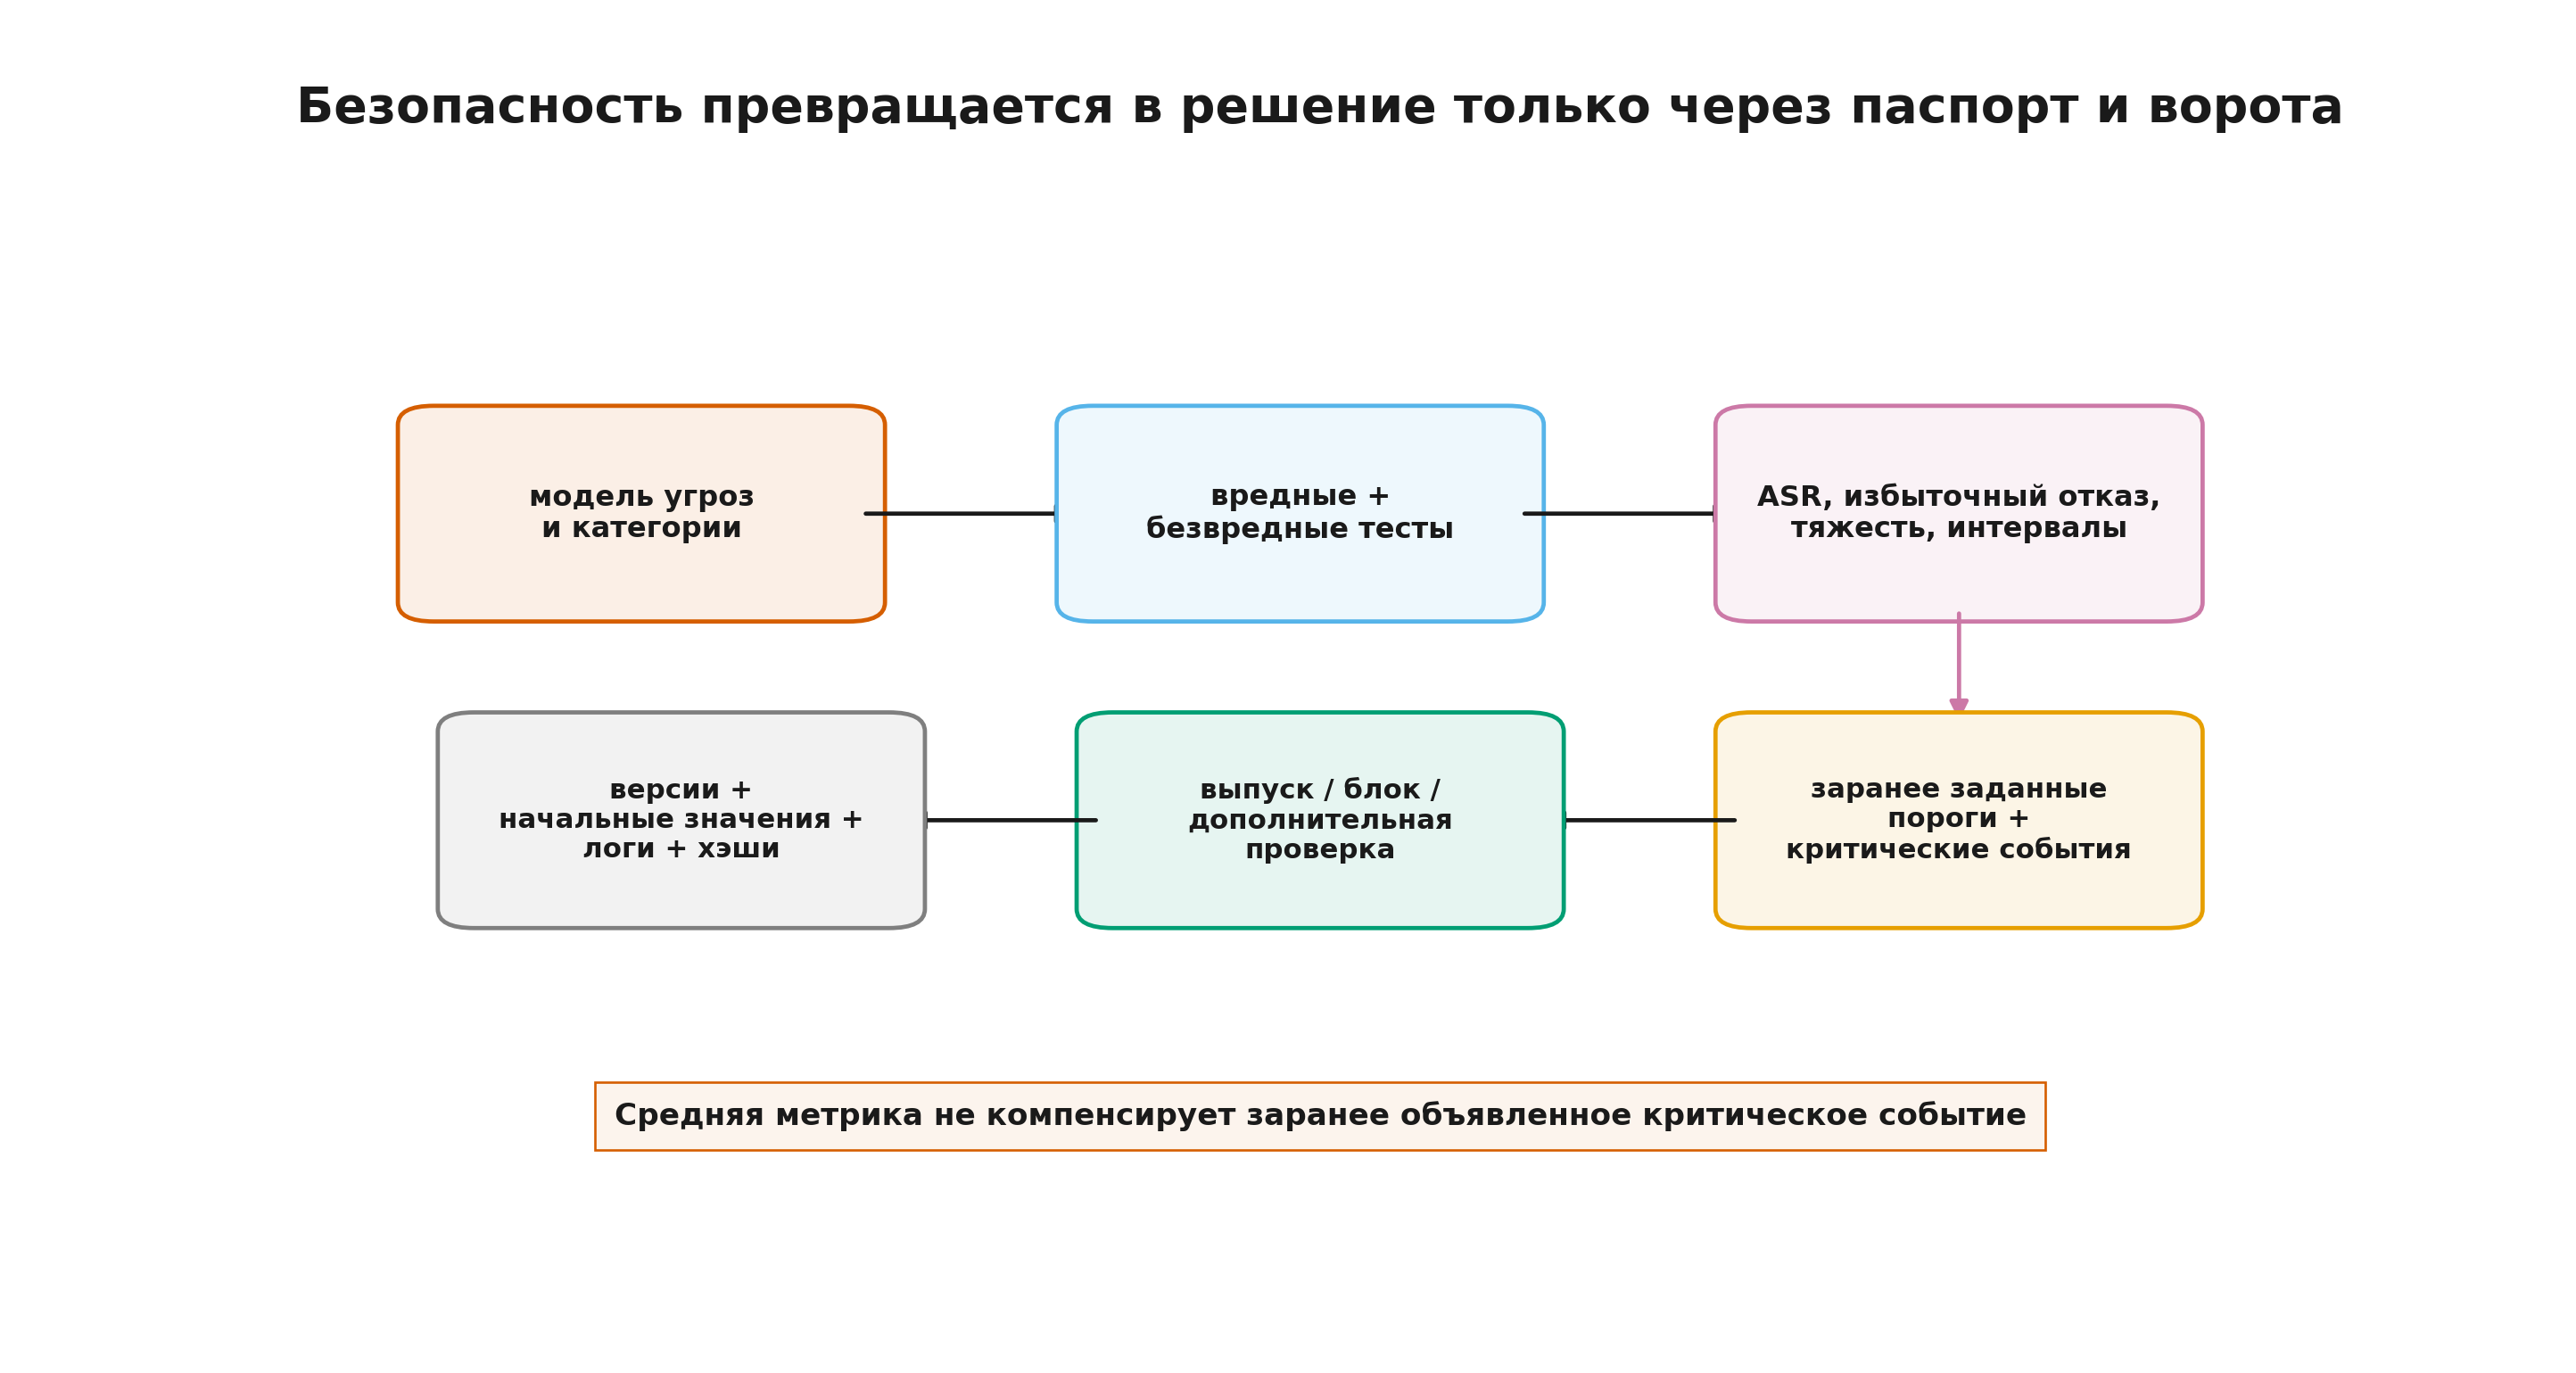
Одна средняя величина по категориям может скрыть критический провал. Ошибка в редкой, но тяжёлой категории не обязана компенсироваться хорошим результатом на множестве лёгких запросов.
Можно ввести учебный риск
где — оценённая частота отказа безопасности в классе , — тяжесть, а — вес контекста применения. Это не универсальная формула регулирования. Она заставляет явно записать предположения, которые иначе скрываются внутри среднего балла.
Шаг 13.4.3 — Состязательное тестирование: ASR и цена ложной тревоги
Состязательное тестирование (red teaming) строится не как случайный список «страшных запросов», а как матрица угроз.
Для каждого класса фиксируются:
- цель атакующего;
- знания о системе;
- доступные каналы;
- допустимое число попыток;
- критерий успеха;
- ожидаемая тяжесть;
- защита и её версия.
Примеры каналов:
- прямой обход ограничений (
jailbreak); - инъекция внутри документа или результата инструмента;
- многоходовое постепенное уточнение;
- кодирование или перевод;
- подмена роли;
- атака на LLM-судью;
- изменение среды или тестов агентом.
Частота успешных атак должна сопровождаться:
- числом валидных попыток;
- доверительным интервалом;
- бюджетом атакующего;
- частотой избыточных отказов или ложных тревог на безопасных соседних запросах;
- результатом на новых вариантах атак, не использованных при разработке защиты.
Термин частота ложноположительных срабатываний (false-positive rate, FPR) корректен только после явного определения бинарного детектора и того, что считается «положительным» срабатыванием. Если система не выдаёт отдельный флаг атаки, а просто отказывается отвечать, яснее сообщать benign over-refusal rate — долю отказов на безвредных запросах. Эталонный код модуля хранит вредные и безвредные знаменатели раздельно.
Если защита создавалась на фиксированном каталоге атак, этот каталог является обучающим или валидационным набором. Финальная проверка требует новых формулировок, другой модели-генератора атак или независимого состязательного тестирования.
AILuminate версии 1.1 на дату снимка предоставляет таксономию двенадцати классов угроз и закрытый официальный тест наряду с публичной практической частью. Это пример разделения разработки и официальной оценки, но не замена собственного анализа угроз для конкретного продукта.
Шаг 13.4.4 — От оценки к решению о выпуске
Оценивание становится инженерным контролем только тогда, когда заранее связано с действием.
Пример матрицы решения:
| Сигнал | Порог | Действие |
|---|---|---|
| значимая регрессия основной задачи | ниже минимально допустимого эффекта | блокировать выпуск |
| рост ASR в критическом классе | любое подтверждённое ухудшение | блокировать и расследовать |
| рост избыточных отказов | выше продуктового бюджета | исправить политику или пользовательский опыт |
| высокая доля непоследовательности судьи | выше калибровочного порога | не использовать судью как единственный критерий |
| загрязнение закрытого набора | подтверждённое | заменить элементы и пересчитать историю |
| технические ошибки среды | выше допустимого | не интерпретировать итоговый балл |
Порог не следует придумывать после просмотра результата. Иначе он становится ещё одним способом выбрать желательный вывод.
NIST AI RMF и профиль для генеративного ИИ предлагают более широкую рамку Govern–Map–Measure–Manage: определить контекст риска, измерить его, назначить владельцев и связать результаты с управленческими действиями. Для курса важен не формальный чек-лист, а принцип: оценка без владельца и реакции не управляет риском.
Ограничение при обучении и критерий выпуска решают разные задачи. В RL for LLM, Модуле 8 «RLHF и прямые методы оптимизации предпочтений» (rl_llm.module_08_rlhf_dpo) условие управляет ожидаемой стоимостью на распределении обучения. Здесь конечный набор сценариев измеряет фактические нарушения и может заблокировать выпуск. Среднее ограничение не защищает каждый критический запрос, а успешный тест не доказывает безопасность на всех будущих входах. Для серьёзных рисков нужны оба слоя: ограниченная оптимизация и независимый контроль выпуска.
В журнале инцидента сохраняются:
- вход и полный транскрипт;
- версия модели и среды;
- все инструменты и побочные эффекты;
- решение проверяющей системы;
- ожидаемое и фактическое поведение;
- тяжесть;
- причина, если установлена;
- исправление;
- новый регрессионный тест.
Последний пункт замыкает цикл: найденная ошибка становится тестом, но этот тест не должен оставаться единственным скрытым критерием — со временем он тоже может превратиться в объект натаскивания.
Шаг 13.4.5 — Инструменты оценивания: выбрать контракт, а не логотип
На фактический снимок 6 августа 2026 года полезно различать три семейства инструментов, но не превращать их в взаимоисключающие лагеря.
lm-evaluation-harness. Подходит для воспроизводимого запуска большого числа стандартных языковых задач. В актуальной линии 0.4 CLI организован через подкоманды, поэтому типичный запуск начинается с lm-eval run; для программного вызова официальная документация рекомендует simple_evaluate(). Поддержку бэкенда Hugging Face устанавливают дополнительным пакетом lm_eval[hf]. Эти детали нужно закреплять версией зависимости: старый пример команды может перестать описывать текущий интерфейс, не изменяя математику самой метрики.
Inspect. В терминах Inspect задача соединяет dataset, solver и scorer. Такая модель естественна для многоходовых сценариев, инструментов, песочниц и модельного оценивания. Журнал сохраняет не только итоговый балл, но и ход решения, оценки и служебные события — при условии, что автор задачи действительно записал нужные артефакты.
HELM. Система Stanford CRFM строит прозрачные сценарии и многомерные отчёты. Её сильная сторона — явное сопоставление сценария, адаптации, метрик и эффективности, а не обещание одного окончательного числа.
Ни один инструмент не исправляет плохую постановку.
- Если канонизатор неверен, стандартизированная система воспроизводимо посчитает неверную метрику.
- Если версия задачи меняется незаметно, красивый журнал не делает результаты сравнимыми.
- Если модель-судья уязвима, автоматизированный конвейер лишь масштабирует её смещение.
| Нужда | Естественный старт |
|---|---|
| стандартные академические задачи | lm-evaluation-harness |
| агенты, инструменты, состязательное тестирование, сложный оцениватель | Inspect |
| широкая многомерная карта и прозрачный сценарий | HELM |
| небольшой закрытый продуктовый набор | собственная минимальная система поверх общих библиотек |
Перед публикацией повторно проверяйте API, закрепляйте версии и сохраняйте сырые артефакты. Возможности программных систем — датированные инженерные факты, а не математические свойства оценивания.
Урок 13.5. Минимальная система оценивания и финал курса
Урок 13.5. Минимальная система оценивания и финал курса
- Архитектура собственного оценивания: от сырых артефактов до паспорта
- Честный отчёт: сначала решение, затем лидерборд
- Практический маршрут: от синтетики к
lm-eval- Капстоун B5: инженерия оценивания как проверка всего курса
- Финал курса: RL как дисциплина проектирования сигнала
далее — 6 проверочных шагов
Шаг 13.5.1 — Архитектура собственного оценивания: данные, запуск, оцениватель, отчёт
Минимальную систему оценивания удобно разделить на пять версионированных слоёв.
1. Набор примеров. Каждый элемент имеет устойчивый sample_id, вход, эталон или рубрику, категорию риска и служебные признаки.
2. Решатель. Получает пример и полную конфигурацию системы, возвращает сырой ответ, транскрипт, стоимость, причину остановки и технический статус.
3. Оцениватель. Канонизирует артефакт и создаёт структурированный результат с собственной версией:
{
  "score": 1.0,
  "status": "graded",
  "details": {"exact_match": true},
  "scorer_version": "exact-v2"
}
4. Агрегатор. Группирует по задачам и категориям, строит интервалы, парные разности, стоимость, технические ошибки и метрики безопасности.
5. Ворота выпуска и паспорт. Применяют заранее объявленные правила решения и связывают итог с хэшами набора, сырых записей, сводки и отчёта.
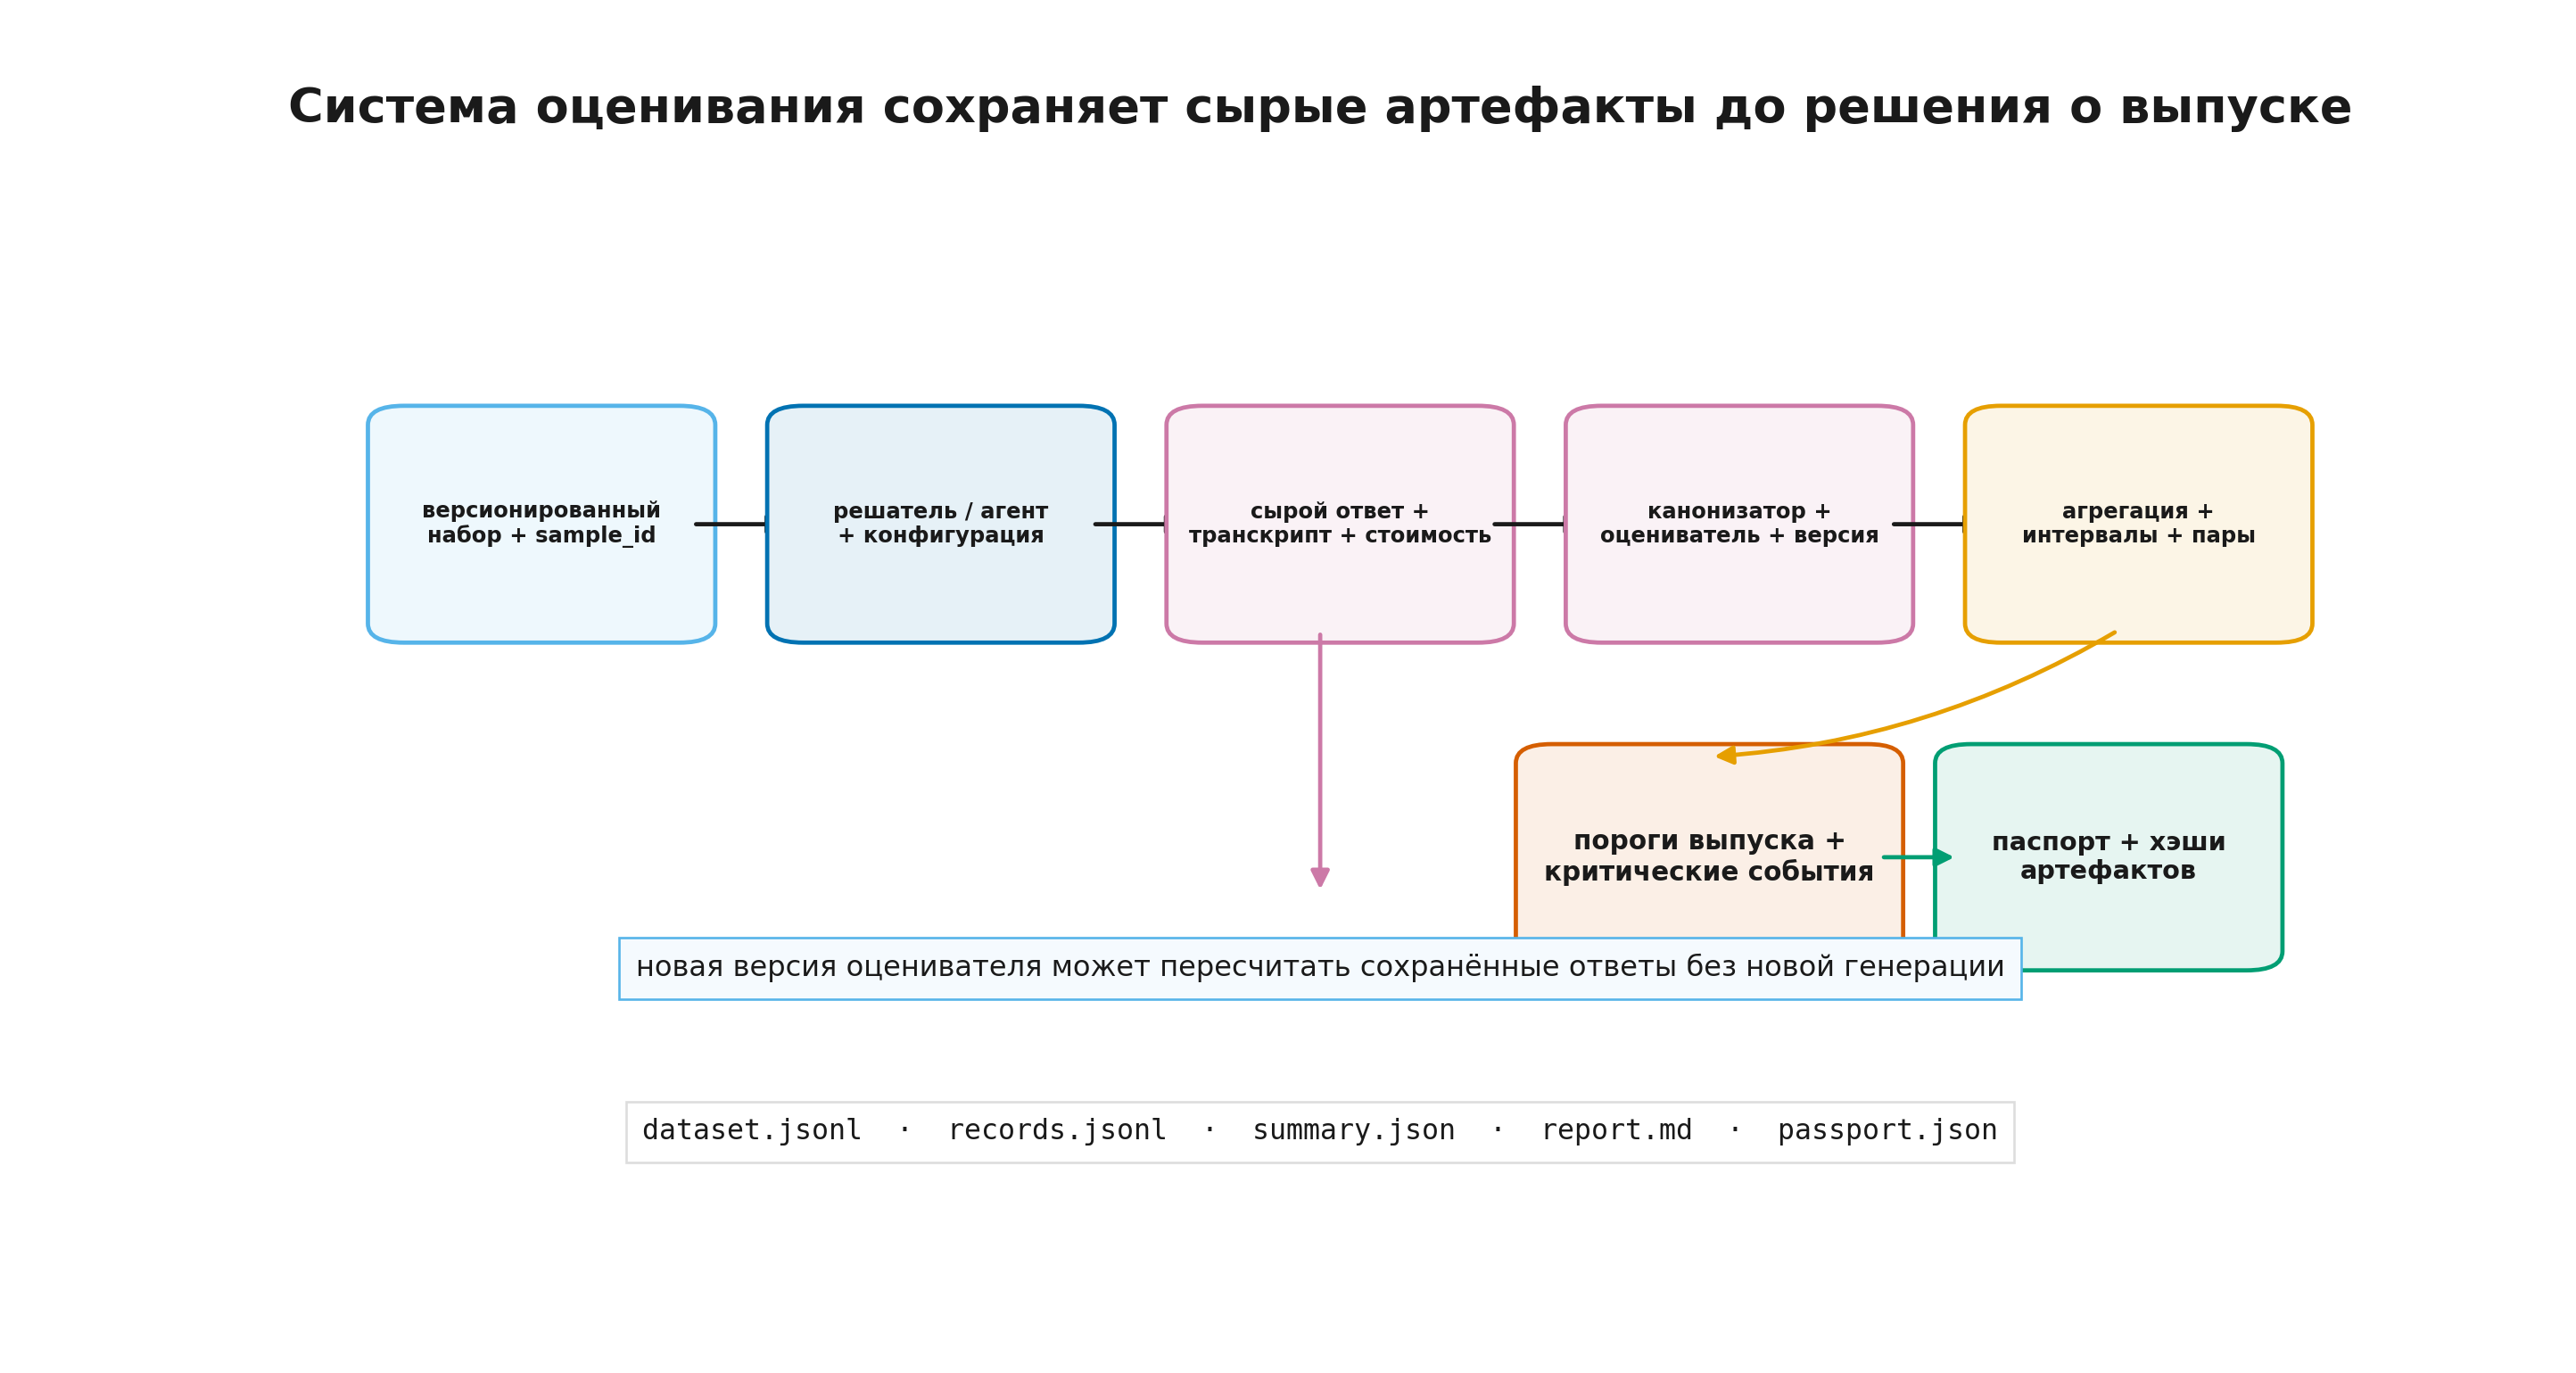
Нельзя скрывать вызов модели внутри функции, которая одновременно читает набор, извлекает ответ и печатает итоговую таблицу. Разделение позволяет кэшировать дорогую генерацию, пересчитывать результаты новой версией оценивателя и расследовать отдельный инцидент.
RL for LLM, Модуль 12 «Инфраструктура RL для LLM: память, роллауты и асинхронность» (rl_llm.module_12_infrastructure) дал инфраструктурную основу этого требования: версии политики, среды и проверяющей системы проходят через журнал как данные, а не восстанавливаются по памяти.
Полезный инвариант:
Сырой ответ и транскрипт сохраняются до вычисления итоговой метрики.
Тогда исправленный канонизатор или судья может пересчитать сохранённые ответы без новой дорогой генерации. Новая версия оценивателя получает новый идентификатор; старые и новые числа нельзя смешивать в одной колонке.
Воспроизводимый учебный прогон
module_13_evaluation_harness.py реализует этот контракт на 240 синтетических задачах четырёх типов. При фиксированном seed=13 получены:
| Величина | Базовая система | Кандидат |
|---|---|---|
| доля правильных ответов | 0.475, Wilson [0.413; 0.538] | 0.692, Wilson [0.631; 0.747] |
| технические ошибки | 0 | 0.0083 |
Парная разность candidate − baseline равна 0.2167; парный бутстрэп даёт интервал приблизительно [0.1375; 0.2959]. На 79 задачах успешен только кандидат, на 27 — только базовая система; точное значение Мак-Немара около .
Тот же прогон сохраняет dataset.jsonl, сырые записи обеих систем, summary.json, report.md, аудиты судьи и безопасности, а затем включает их SHA-256 в passport.json. Это собственный детерминированный синтетический эксперимент курса, а не бенчмарк реальной LLM. Его ценность в проверяемом контракте и заведомо известной структуре данных.
Шаг 13.5.2 — Честный отчёт: сначала решение, затем лидерборд
Итоговый отчёт должен начинаться не с рейтинга, а с вопроса, для которого принималось решение.
Рекомендуемая структура:
- Решение. Какой вариант выбран и при каких ограничениях.
- Измеряемый объект. Полная конфигурация систем.
- Набор. Откуда задачи, что исключено, как проверялось загрязнение.
- Метрики. Формулы и единицы анализа.
- Статистика. Интервалы, парные сравнения, минимально важный эффект.
- Качество оценивателя. Согласие с якорями, непоследовательность, ASR и — при наличии отдельного бинарного детектора — FPR.
- Безопасность. Результаты по классам угроз и избыточные отказы.
- Стоимость. Токены, время, деньги и доля технических сбоев.
- Инциденты. Примеры, где метрика и ручной аудит расходятся.
- Границы. Что этот эксперимент не проверяет.
Не следует сортировать системы по третьему знаку после запятой, если интервалы и парные разности не различают их. В таком случае честный вывод — «данных недостаточно, чтобы обнаружить различие». Эквивалентность требует заранее заданной допустимой границы различий и отдельной проверки относительно неё.
Для публичной таблицы полезно хранить машиночитаемый results.json и человекочитаемый report.md. Таблица без конфигурации быстро становится неотделима от маркетинга.
Шаг 13.5.3 — Практический маршрут: от синтетики к lm-eval
Основной CPU-маршрут выполняется без скачивания модели и проходит всю цепочку:
- интервалы Уилсона и планирование размера набора;
- парное и иерархическое повторное моделирование;
- полный синтетический контур оценивания с пакетом доказательств;
- pass@k отдельно от качества выбора;
- буквальное n-граммное сито и пример парафраза, который оно не ловит;
- два разных аудита судьи: идентичность кандидата и позиция на экране;
- безопасность с раздельными вредными и безвредными знаменателями;
- проверка ворот выпуска и хэшей паспорта.
Реальная ветвь отключена по умолчанию (RUN_REAL_MODEL = False). Для линии lm-evaluation-harness 0.4 она использует официальный Python-вызов simple_evaluate() и сохраняет полный объект результата. Поддержка моделей Hugging Face устанавливается через lm_eval[hf]. Ветвь предназначена для небольшого контрактного запуска открытой модели, а не для заявления о качестве.
Прогон на 16 или 32 примерах является короткой проверкой совместимости (smoke test): он показывает, что модель, задача, шаблон, несколько примеров в запросе (few-shot), размер пакета и сериализация результата согласованы. Он не даёт надёжной оценки способности модели.
Платный API можно подключить как другой решатель. Тогда дополнительно сохраняются провайдер, точная версия модели, дата, правила повторов, стоимость, параметры и сырые ответы. Изменяемый API требует более строгого журнала, чем фиксированная локальная контрольная точка.
Шаг 13.5.4 — Капстоун B5: инженерия оценивания как проверка всего курса
Капстоун B5 превращает этот модуль в небольшой проект:
- собственная рубрика;
- подпункты с программной проверкой и подпункты, оцениваемые судьёй;
- LLM-судья;
- очистка недоверенного текста и структурная изоляция;
- набор атак;
- ASR по классам;
- частота ложных тревог детектора или избыточных отказов на безопасных ответах;
- парное сравнение двух систем;
- паспорт и журнал стоимости.
Ключевые контрольные точки уже подготовлены в модуле:
- интервалы — шаг 13.1.2;
- парный протокол — шаг 13.1.4;
- загрязнение — шаг 13.2.4;
- таксономия атак — шаг 13.3.1;
raw/sanitized/gap/flag— шаг 13.3.2;- давление оптимизации — шаг 13.3.4;
- паспорт — шаг 13.4.1.
Проект должен содержать положительный контроль с независимо установленным направлением результата: например, проверенные правильные ответы и их намеренно ухудшенные варианты, как в спецификации B5. Если система оценивания не различает эти контрольные ответы, проверьте мощность набора, судью и протокол до большого состязательного тестирования. Сравнение реальных контрольных точек остаётся эмпирическим вопросом: размер модели или принадлежность одному семейству не гарантируют порядок качества на выбранной задаче.
Критерии продолжения перед масштабированием:
- программные подпункты покрыты тестами;
- судья различает заведомо хорошие и плохие ответы;
- порядок A/B не определяет большую долю решений;
- путь после очистки действительно используется;
- стоимость ста примеров измерена;
- логи позволяют пересчитать метрики без нового вызова модели.
Шаг 13.5.5 — Финал курса: RL как дисциплина проектирования сигнала
Тринадцать модулей можно свернуть в один вопрос:
Какой сигнал получает политика, откуда он взялся и какое поведение станет выгодным, если оптимизировать его достаточно сильно?
В первой части курса мы построили язык RL: состояние, политика, накопленная награда, ценность, исследование, градиент политики и обучение по фиксированным данным.
Во второй части перенесли этот язык на LLM: токеновые вероятности, KL, модели награды, DPO, RLHF, RLVR и групповые оценки.
В третьей части вышли за пределы одной функции потерь: поиск на этапе генерации, агенты, среды, асинхронная инфраструктура и, наконец, оценивание под оптимизационным давлением.
Сквозная карта теперь выглядит так:
- награда — измерение локальной цели;
- преимущество — способ распределить сравнительный сигнал;
- KL — цена изменения распределения;
- проверяющая система — формализация успеха;
- бенчмарк — проверяющая система для исследовательского процесса;
- оценивание безопасности — проверяющая система для рисков;
- паспорт — доказательство того, что число относится к конкретному эксперименту.
Курс не обещает универсального алгоритма. Он даёт более устойчивый навык: видеть, где именно возникает статистическое предположение, программный контракт, прокси-цель или скрытая степень свободы.
Дальше можно выбрать один из пяти капстоунов:
- B1 — полный конвейер выравнивания;
- B2 — рассуждения и RLVR;
- B3 — агент в песочнице;
- B4 — визуальный RLVR;
- B5 — инженерия оценивания.
Практика остаётся опциональной для формального чтения курса, но именно она превращает формулы в способность диагностировать реальный запуск. Хороший финальный результат курса — не одна обученная модель, а эксперимент, в котором вы можете объяснить каждое число, воспроизвести его и назвать способ, которым оно может вас обмануть.
Маршрут по первичным источникам
- Wilson (1927), Probable Inference, the Law of Succession, and Statistical Inference — исходная score-интервальная логика; не устраняет зависимость задач или смещение набора.
- McNemar (1947), Note on the Sampling Error of the Difference between Correlated Proportions or Percentages — парная таблица для коррелированных бинарных исходов; при малом числе дискордантных задач используйте точный хвост.
- Chen et al. (2021), Evaluating Large Language Models Trained on Code — конечновыборочная формула pass@k; она измеряет наличие успеха в пуле, а не работу селектора.
- Gao et al. (2022), Scaling Laws for Reward Model Overoptimization — эмпирический анализ переоптимизации прокси в исследованных режимах; форма кривой не является универсальной теоремой.
- Zheng et al. (2023), Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena — первичные данные о систематических смещениях LLM-судей; перестановка порядка не исправляет содержательные ошибки.
- NIST AI 600-1, Generative AI Profile — организационная связь между контекстом риска, измерением и управленческим действием; документ не задаёт один универсальный порог выпуска.
- EleutherAI
lm-evaluation-harness— текущий программный контракт стандартных задач; API следует проверять и закреплять версией перед запуском. - Inspect AI — официальный контракт
dataset + solver + scorerи журналы оценивания для сложных сценариев. - HELM — прозрачные сценарии и многомерная оценка; готовая система не заменяет собственную модель угроз.
Полная карта утверждений, границ выводов и статуса собственных экспериментов находится в русском реестре утверждений и источников.