Модуль 6. LLM как политика: токены, логарифмы вероятностей и KL
Версия материала: 2026.11
Фактический снимок: 2026-08-05
Язык: RU
Основная практика: уровень A — браузер и центральный процессор (CPU); уровень B — бесплатный Colab T4
Структура: 5 уроков, 25 шагов
Ориентировочное время: 8–10 часов без факультативного запуска реальной модели
Первые пять модулей дали общий аппарат RL. Теперь свяжем его с конкретными объектами авторегрессионной модели: токенами, логитами, масками, логарифмами вероятностей и настройками генерации. Именно здесь обычно обнаруживаются ошибки, которые не видны в компактной формуле PPO или GRPO: сдвиг на один токен, неверная маска ответа, вероятность не той политики или смешение естественного завершения с ограничением длины.
Практическая задача модуля формулируется одной фразой:
Как сделать так, чтобы генератор, сохранённый роллаут и тренер говорили об одной и той же политике и об одних и тех же токенах?
В этом модуле KL означает дивергенцию Кульбака—Лейблера (Kullback–Leibler divergence). Полный информационно-теоретический разбор находится в курсе Information Theory for ML, Модуле 3 «Кросс-энтропия и KL-дивергенция» (it_ml.module_03_cross_entropy_kl). Здесь мы не перекладываем на соседний курс обязательную часть объяснения: KL выводится и измеряется прямо в токеновой постановке, а межкурсовая ссылка нужна для более глубокого понимания энтропии, перекрёстной энтропии и кодовой интерпретации.
После прохождения модуля вы сможете:
- задать токеновый марковский процесс принятия решений (
Markov decision process, MDP) для обычной генерации и точно указать границу этой модели; - различать естественное завершение ответа, остановку по правилу и техническое усечение;
- извлекать логарифмы вероятностей выбранных токенов из тензора логитов без ошибки индексации;
- вычислять логарифм вероятности ответа, среднее по токенам и перплексию;
- объяснять цепное правило для KL между авторегрессионными политиками;
- различать точный условный KL, выборочный логарифм отношения и оцениватели k1, k2 и k3;
- восстанавливать фактическую политику поведения после температуры, top-k, top-p и других преобразований логитов;
- проверять, относятся ли сэмплирование, сохранённые логарифмы вероятностей и знаменатель отношения к одной политике;
- описывать минимальный контракт пакета роллаутов для обучения LLM с проверяемой наградой;
- воспроизводить эти измерения на открытой модели с 0,6 млрд параметров в Colab.
Оцениваемая практика объединяет задания и решения, которые открываются после попытки. Русскоязычный вычислительный маршрут даёт исполняемую проверку, а реестр проверяемых утверждений и первичных источников находится в Module_6_Sources.md.
Практический маршрут. После лекции идут оцениваемые задания, решения, открывающиеся после попытки, и исполняемая практика. Само объяснение остаётся самодостаточным.
Урок 6.1. Токеновый MDP без скрытых предположений
Урок 6.1. Токеновый MDP без скрытых предположений
- Зачем снова говорить, что LLM является политикой
- Формальная модель обычного текстового ответа
- EOS, стоп-токены, стоп-строки и ограничение длины
- Вероятность ответа переменной длины
- Где находится награда в токеновой траектории
далее — 3 проверочных шага
Шаг 6.1.1 — Зачем снова говорить, что LLM является политикой
В Модуле 1 мы установили точное соответствие
которое задаёт распределение следующего токена. Тогда эта формула вводила язык RL. Теперь она становится интерфейсом между четырьмя частями работающей системы:
- модель вычисляет логиты;
- процедура генерации превращает логиты в фактическое распределение действий;
- движок роллаутов выбирает токен и сохраняет данные;
- тренер повторно вычисляет вероятности и строит функцию потерь.
Ошибка на любом переходе меняет математическую политику, даже если программа продолжает выполняться. Поэтому нам нужен не повтор лозунга, а ответ на инженерный вопрос:
Какой именно объект в тензорах и журналах является политикой, действительно породившей токены?
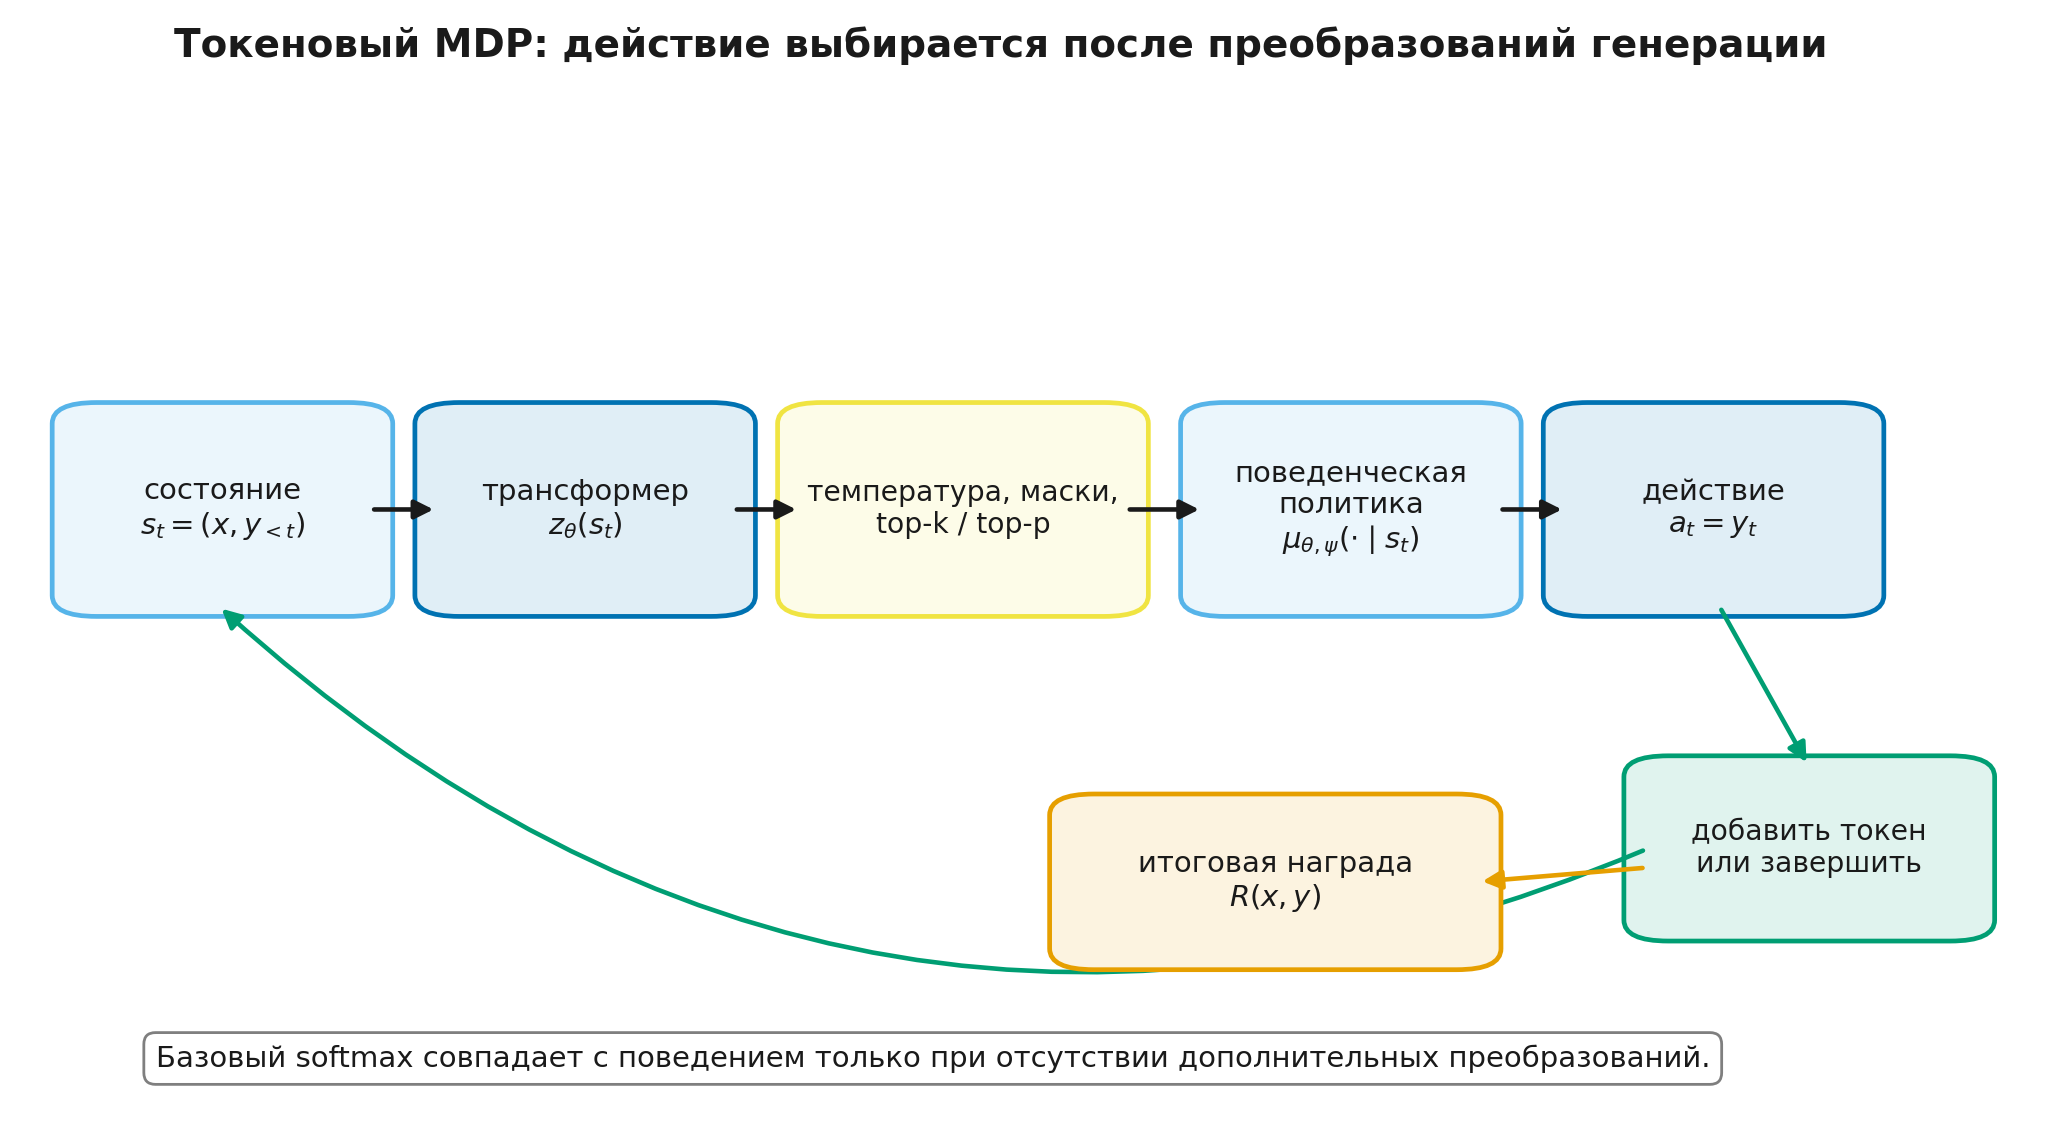
Схема разделяет два этапа. Трансформер выдаёт базовые логиты, но действие выбирается только после всех преобразований генерации. Если преобразований нет, политика поведения совпадает с softmax базовых логитов. В реальной системе это равенство нужно проверять, а не предполагать.
Шаг 6.1.2 — Формальная модель обычного текстового ответа
Пусть — подготовленный запрос, включая системное сообщение и шаблон диалога, а — уже сгенерированный префикс ответа. Определим
Для чистой авторегрессионной генерации переход детерминирован:
где означает дописывание токена к префиксу. Случайность находится в политике следующего токена, а не в операции конкатенации.
В этой абстракции:
- пространство действий состоит из допустимых идентификаторов токенов;
- начальное состояние определяется распределением запросов и правилами их подготовки;
- промежуточные награды часто равны нулю;
- завершённому ответу назначается терминальная награда;
- горизонт случаен, если политика может выбрать токен завершения.
Слово «допустимых» существенно. Словарь токенизатора и фактическое множество действий могут не совпадать. Маска способна запрещать отдельные токены; EOS может быть недоступен до минимальной длины; декодирование с грамматическим ограничением разрешает только продолжения, совместимые с текущим префиксом.
Граница модели. Состояние достаточно только тогда, когда между токенами не изменяется скрытое внешнее состояние. Вызовы инструментов, результаты поиска, ответы пользователя и постоянная память должны входить в состояние или наблюдение. Эту постановку подробно разберём в Модуле 11.
Архитектурное расширение: токенизация, специальные токены и шаблоны диалога подробнее рассматриваются в курсе Modern LLMs, Модуле 2 «Токенизация и эмбеддинги» (
modern_llms.module_02_tokenization). Здесь считается уже подготовленной токеновой последовательностью, поэтому корректность шаблона входит в контракт данных, но не выводится заново.
Шаг 6.1.3 — EOS, стоп-токены, стоп-строки и ограничение длины
Токен конца последовательности (end of sequence, EOS) может быть обычным действием политики. Если контракт задачи считает выбранный моделью EOS естественным окончанием ответа, переход после этого действия терминален. Важно не превращать это удобное соглашение в универсальное правило для любой причины, по которой движок перестал выдавать токены.
| Причина остановки | Что произошло на уровне системы | Как интерпретировать в RL |
|---|---|---|
| модель выбрала EOS | действие принадлежит политике | обычно содержательное завершение, если EOS входит в контракт задачи |
| сработал разрешённый стоп-токен или многотокеновая стоп-строка | правило задачи или генератора распознало границу | может быть завершением, но это определяется контрактом задачи, а не самим названием stop |
достигнут max_new_tokens | исчерпан технический бюджет генерации | обычно внешнее усечение: процесс мог бы продолжиться |
| сработал тайм-аут, фильтр безопасности или ручная отмена | генерацию прервала внешняя система | требуется отдельная причина; флаги terminated и truncated задаются семантикой задачи |
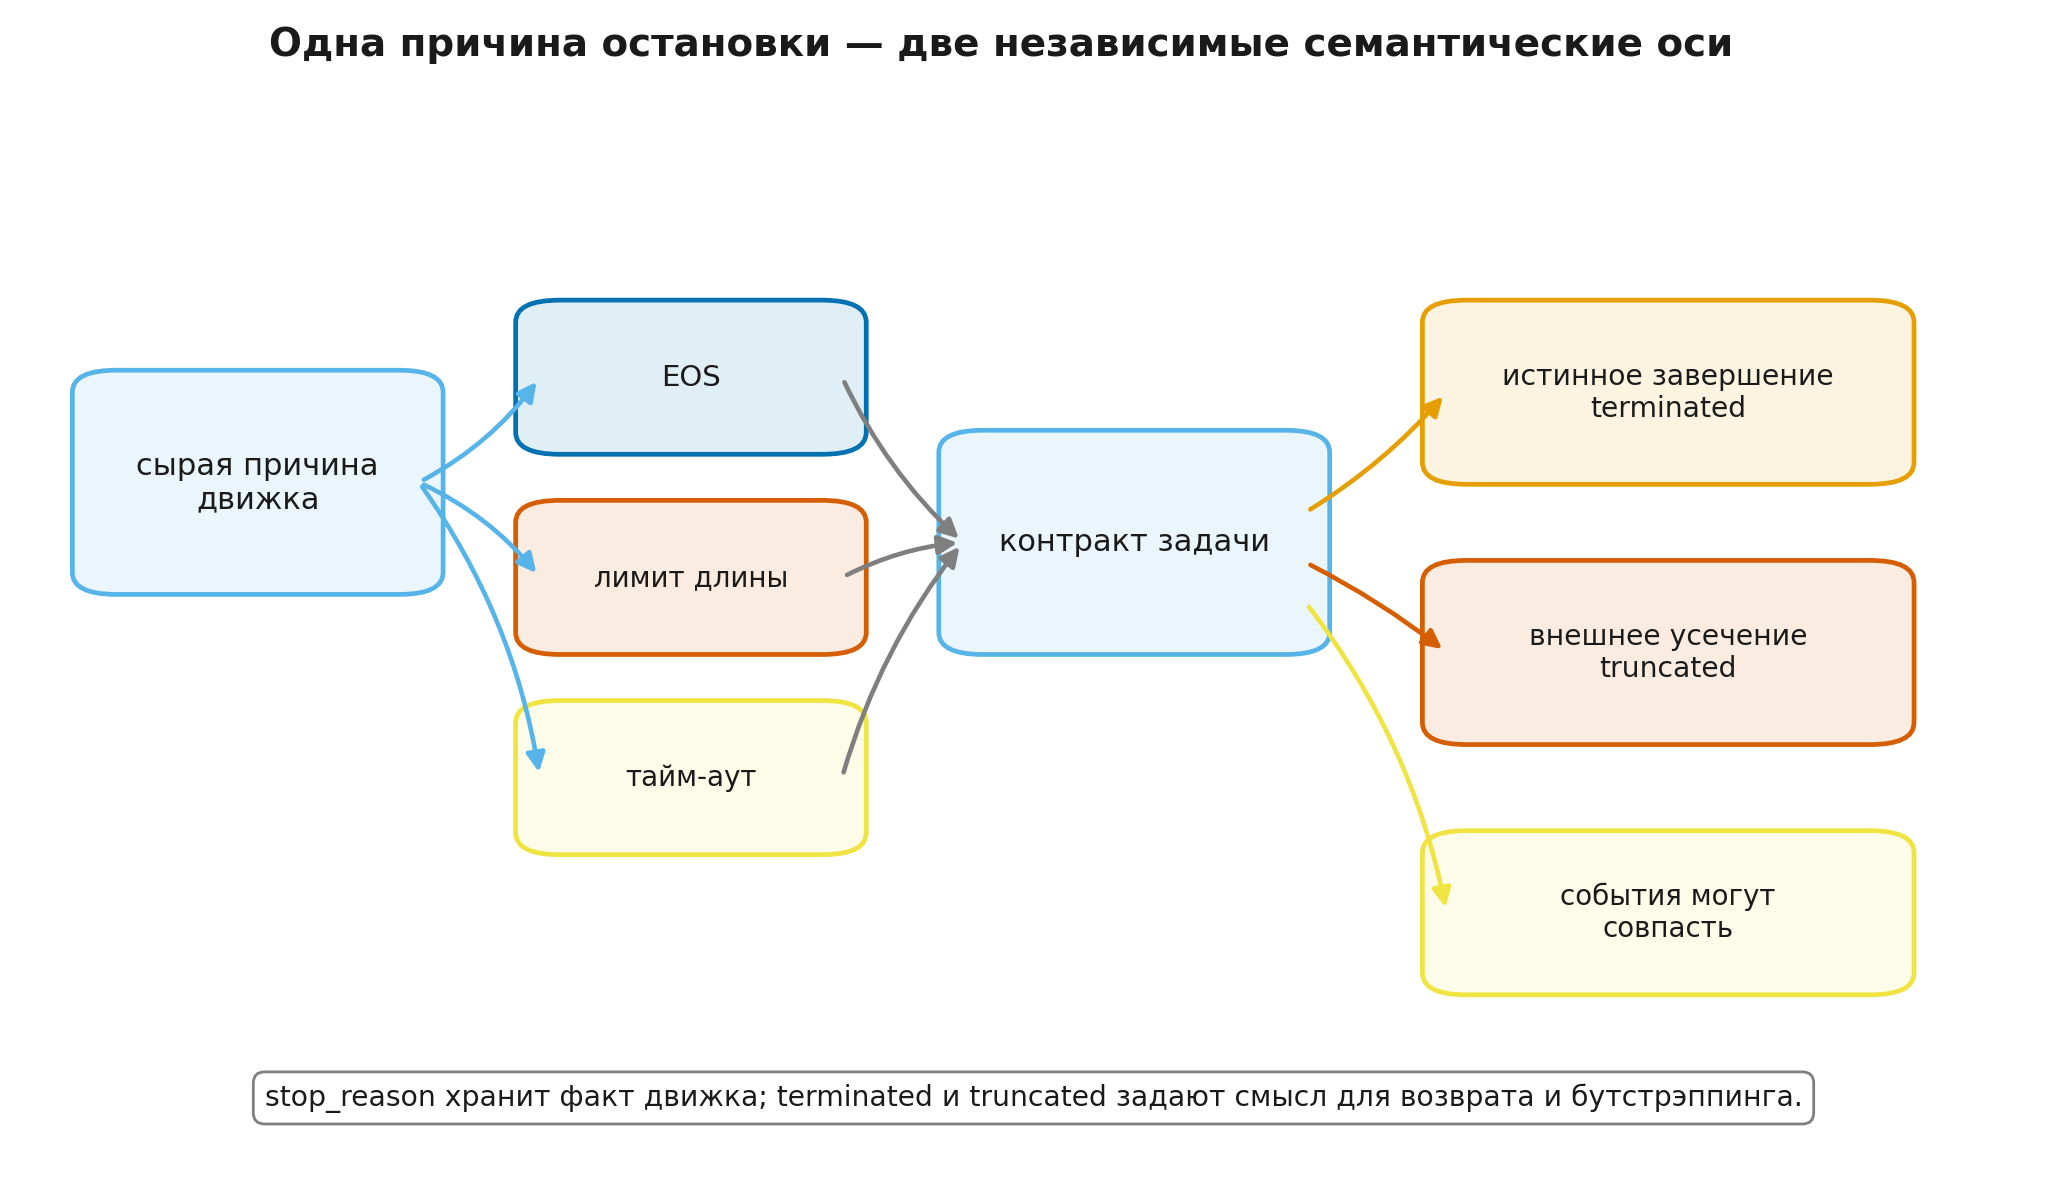
Здесь полезно разделить два слоя метаданных.
stop_reasonсообщает, почему движок остановился:eos,stop_token,stop_string,length,timeout,safetyи так далее.terminatedиtruncatedсообщают, как эту границу понимает RL-задача.terminated=Trueозначает, что продолжения в данной задаче нет;truncated=True— что сбор траектории оборван внешним пределом, хотя процесс мог бы продолжиться.
Поэтому нельзя считать всякую стоп-строку терминалом по одному только факту срабатывания строки остановки. Например, маркер </answer> может быть содержательным завершением, а строка, добавленная транспортным слоем для остановки потока, — лишь инженерным ограничением. Точно так же фильтр безопасности может завершать продуктовый запрос, но для исследуемой среды оставаться внешним прерыванием.
Длина возвращённого текста причинность не восстанавливает. Ответ мог естественно закончиться ровно на лимите, быть обрезан лимитом, завершиться многотокеновым шаблоном или потерять служебный EOS при декодировании. Поэтому машиночитаемая причина остановки хранится независимо от флагов границы эпизода.
Шаг 6.1.4 — Вероятность ответа переменной длины
Для авторегрессионная факторизация имеет вид
Если последовательность считается полной только после EOS, этот токен входит в произведение как последнее действие. Движок может удалить его из показываемой строки, но идентификатор EOS должен оставаться в машинной записи, если его вероятность участвует в целевой функции.
После логарифмирования произведение превращается в сумму:
Суммарный логарифм вероятности обычно уменьшается с длиной: каждый множитель не превосходит единицы, а каждый логарифм неположителен. Поэтому ответы разной длины нельзя сравнивать по сумме без дополнительного соглашения. Ниже мы будем делить её на число активных токенов, но и такая нормировка не устраняет все эффекты длины и токенизации.
Стоп-строка создаёт отдельный пограничный случай: вывод может завершиться после многотокенового шаблона, а не одного выделенного действия. Строгая вероятностная модель должна либо включить правило остановки в среду, либо сохранить исходные токены до удаления стоп-строки.
Шаг 6.1.5 — Где находится награда в токеновой траектории
В задачах с проверяемым результатом часто используется разреженная терминальная награда:
Например, может показывать, прошёл ли сгенерированный код тесты или совпал ли числовой ответ с эталоном. При каждый токен ответа получает одну и ту же накопленную награду .
Из этого не следует, что все токены были одинаково полезны. Общий скаляр — свойство оценивателя, а не причинное разложение вклада. В Модуле 4 мы видели, как градиент вероятности полного ответа умножает одним коэффициентом сумму токеновых логарифмов вероятностей. В Модуле 9 вернёмся к групповым оценкам, нормировке по длине и распределению вклада между токенами.
Система может добавлять и локальные слагаемые:
- стоимость каждого нового токена;
- штраф за неверный формат;
- промежуточный результат инструмента;
- токеновую KL-регуляризацию;
- оценку процесса рассуждения.
Каждое такое слагаемое меняет задачу. Поэтому журнал должен отдельно хранить исходную награду задачи, слагаемые формирования награды и регуляризаторы.
Урок 6.2. Логиты, маски и логарифмы вероятностей
Урок 6.2. Логиты, маски и логарифмы вероятностей
- От логитов к вероятности выбранного токена
- Сдвиг на один токен и маска ответа
- Сумма, среднее и перплексия
- Три роли логарифмов вероятностей
- Численная точность и воспроизводимый протокол
далее — 4 проверочных шага
Шаг 6.2.1 — От логитов к вероятности выбранного токена
Пусть модель возвращает логиты в позиции , где — размер словаря. Базовое распределение равно
На практике обычно нужен логарифм вероятности
где
Вычитание максимума не меняет распределение и предотвращает переполнение экспоненты. В PyTorch torch.log_softmax выполняет нормировку, а gather выбирает столбец действия, которое действительно было совершено.
Важно не смешивать три тензора:
- логиты всех токенов формы ;
- логарифмы вероятностей всех токенов той же формы;
- логарифмы вероятностей выбранных токенов формы .
Для PPO или GRPO обычно достаточно третьего тензора и маски ответа. Полные распределения требуются, например, для точного условного KL по словарю.
Шаг 6.2.2 — Сдвиг на один токен и маска ответа
В позиции каузальная модель предсказывает следующий токен . Для последовательности
правильные пары имеют вид
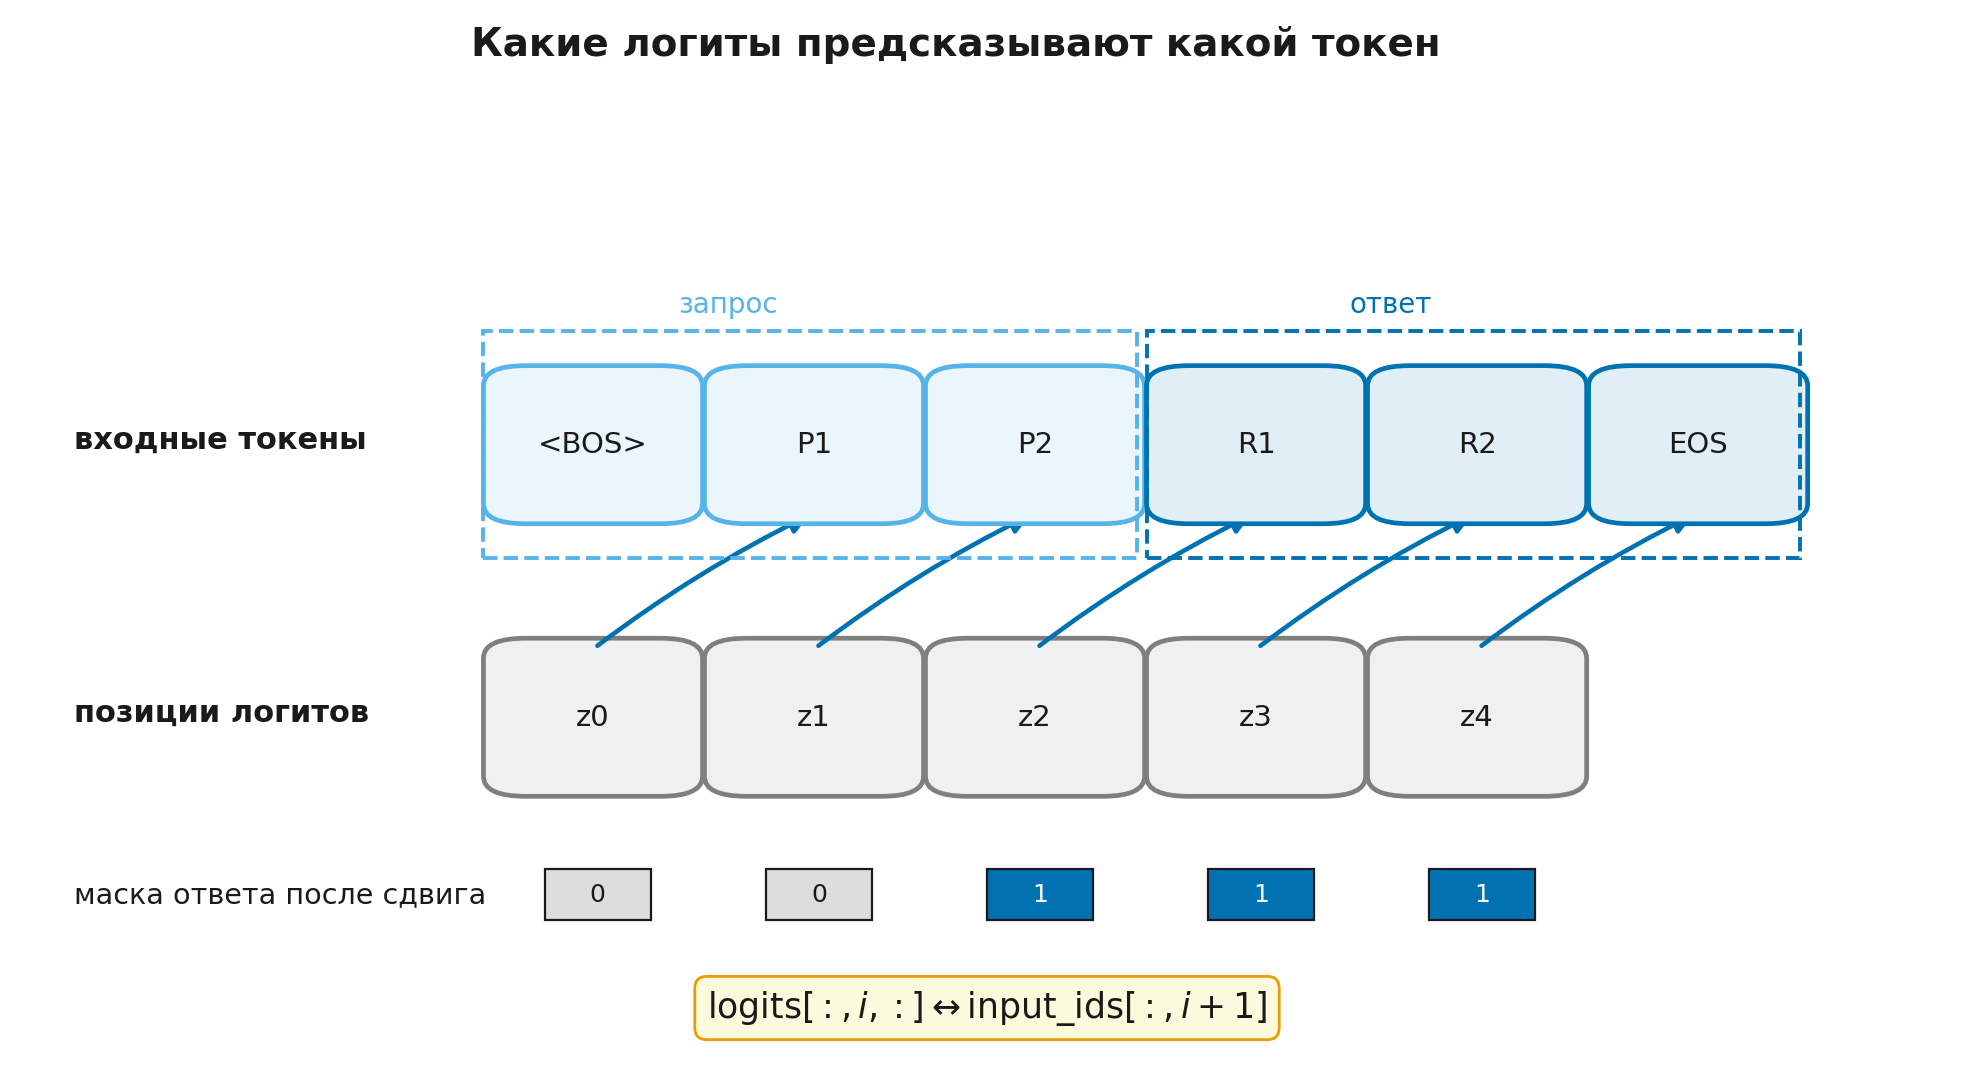
Типичная реализация:
shifted_logits = logits[:, :-1, :]
shifted_tokens = input_ids[:, 1:]
logp_all = torch.log_softmax(shifted_logits.float(), dim=-1)
selected_logp = logp_all.gather(-1, shifted_tokens[..., None]).squeeze(-1)
Затем применяется маска. Она отвечает на содержательный вопрос: какие действия относятся к политике, оптимизируемой этой целевой функцией?
Для обычного SFT или RL на уровне ответа:
- системные токены и токены запроса не входят в функцию потерь политики;
- токены ответа входят;
- заполнение пакета не входит;
- EOS входит, если его выбрала модель и он сохранён в последовательности;
- позиции после завершения не входят.
Ошибка на один токен опасна тем, что формы всех тензоров могут оставаться правдоподобными, хотя каждому действию назначена вероятность соседнего токена. Поэтому хороший тест использует короткий пример, который можно проверить вручную, а не только сравнивает формы.
Шаг 6.2.3 — Сумма, среднее и перплексия
Пусть — маска активных токенов, а — логарифм вероятности выбранного токена. Определим
а перплексию (perplexity, PPL) — как
При натуральных логарифмах PPL равна экспоненте средней перекрёстной энтропии в натах на токен. Если каждый активный токен имел вероятность , то PPL равна . Отсюда возникает интуиция «эффективного числа равновероятных вариантов», но для общего распределения это не буквальный подсчёт вариантов.
Нужно помнить три ограничения.
- PPL зависит от токенизатора. Разные токенизации дают разное число токенов, поэтому PPL не является универсальной физической шкалой.
- PPL зависит от маски и шаблона. PPL только по ответу, по всему диалогу и по содержательным токенам — разные величины.
- PPL не измеряет полезность ответа. Модель может назначать большую вероятность шаблонному или неверному продолжению.
Математическое расширение: перекрёстная энтропия, KL и интерпретация через длину кода подробно рассматриваются в курсе Information Theory for ML, Модуле 3 «Кросс-энтропия и KL-дивергенция» (
it_ml.module_03_cross_entropy_kl).
Шаг 6.2.4 — Три роли логарифмов вероятностей
В системах дообучения после предобучения рядом часто находятся несколько моделей или снимков одной модели.
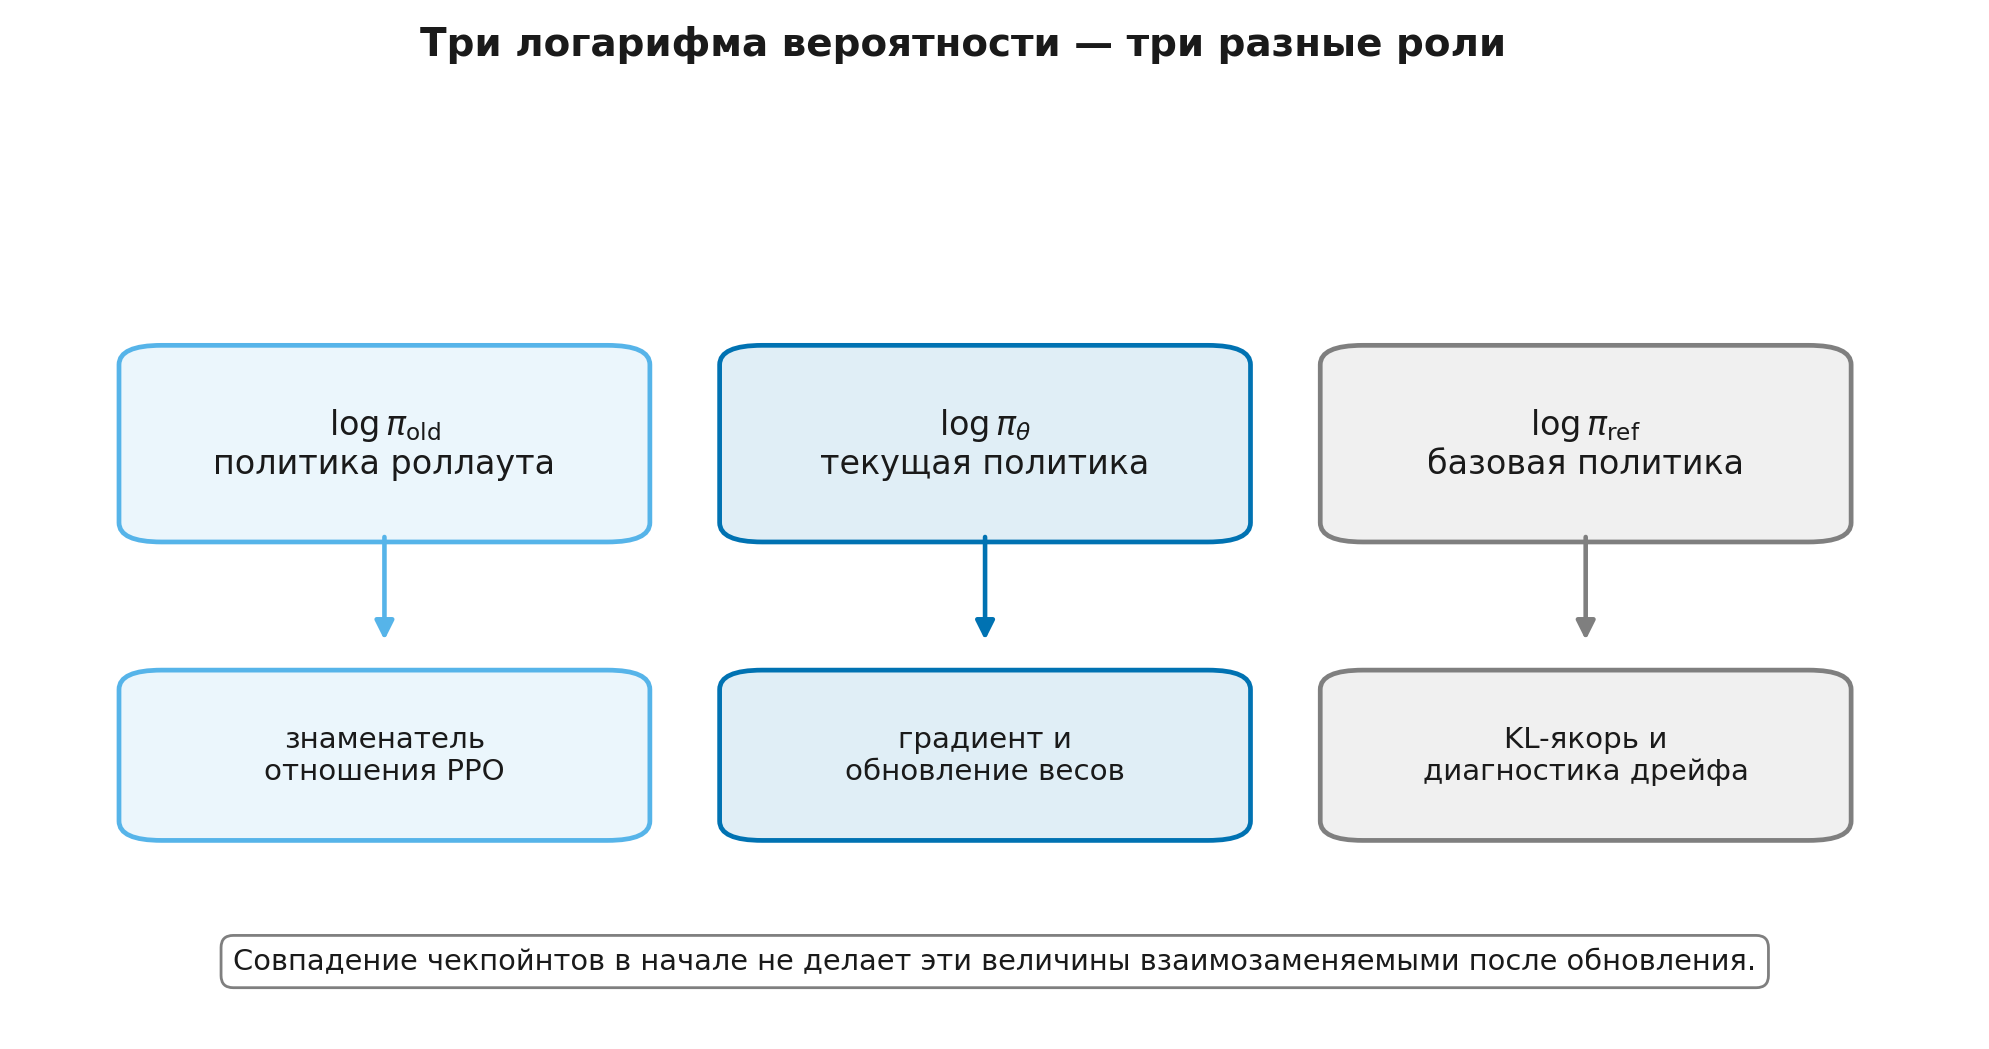
- — вероятность по политике, которая собрала роллаут. Она входит в знаменатель отношения PPO.
- — вероятность по текущим обучаемым параметрам. Тренер вычисляет её заново и проводит через неё градиент.
- — вероятность по замороженной базовой политике. Она задаёт KL-якорь.
Эти величины нельзя переставлять местами только потому, что все модели начинали с одного чекпойнта.
Есть и два разных режима вычисления.
- Сэмплирование. Токен выбирается из фактической политики поведения, а его логарифм вероятности сохраняется во время роллаута.
- Повторная оценка известной последовательности. Вся последовательность проходит через модель с подстановкой истинного префикса (
teacher forcing), после чего вероятности выбранных токенов извлекаются параллельно.
В идеальной синхронной системе повторно вычисленный совпадает с сохранённым. В распределённой системе они могут различаться из-за другой версии весов, порядка обработчиков, численной точности или особенностей движка генерации. Небольшая разность не обязательно означает ошибку, но её нужно измерить и объяснить.
Шаг 6.2.5 — Численная точность и воспроизводимый протокол
Различия логарифмов вероятностей могут накапливаться на длинной последовательности. Редкость сама по себе не усиливает равномерно ограниченную ошибку логитов: если , то для любого токена при softmax без усечения. Воспроизводимый протокол фиксирует:
- точный идентификатор и
commitлибоrevisionвесов модели; - идентификатор и
revisionтокенизатора; - применённый шаблон диалога и режим его вызова;
- все преобразования логитов и их порядок;
- тип данных для
log_softmaxи накопления сумм; - параметры генерации, случайное зерно и причину остановки;
- версии движка генерации,
Transformers,TRLи обучающего контура.
Практичная защита — выполнять нормировку softmax и накопление длинных сумм как минимум в 32-битном формате с плавающей точкой (32-bit floating point, FP32), даже если основная матричная арифметика идёт в bfloat16 (BF16). Это не гарантирует побайтового совпадения разных ядер и устройств, но устраняет один распространённый источник ненужной погрешности.
Интерфейсы движков различаются по объёму возвращаемой информации. Актуальная документация vLLM указывает, что при logprobs в результат включается выбранный токен, даже если он не входит в запрошенное число наиболее вероятных альтернатив; значение -1 запрашивает логарифмы вероятностей всего словаря, если это разрешено лимитами движка. Это удобно, но может быть дорого по памяти и передаче данных. Семантику поля всё равно нужно сверять с конкретной версией программного интерфейса.
В Hugging Face Transformers выбранные при генерации оценки можно извлечь через compute_transition_scores. Для сопоставления с нормированными токеновыми логарифмами вероятностей в учебном ноутбуке используется normalize_logits=True, а затем выполняется независимая повторная оценка с подстановкой истинного префикса. Совпадение двух путей — более сильная проверка, чем одна правдоподобная таблица чисел.
Инженерное расширение: кэш ключей и значений (
key–value cache, KV-кэш), пакетная генерация и устройство эффективного инференса подробно рассматриваются в курсе Modern LLMs, Модуле 10 «KV-кэши и эффективный инференс» (modern_llms.module_09_inference).
Урок 6.3. KL относительно базовой политики
Урок 6.3. KL относительно базовой политики
- Цена отклонения, а не сертификат качества
- Цепное правило для KL последовательностей
- Точный условный KL и выборочный логарифм отношения
- Оцениватели k1, k2 и k3
- Оценить число и продифференцировать нужную цель — разные задачи
далее — 4 проверочных шага
Шаг 6.3.1 — Цена отклонения, а не сертификат качества
Для фиксированного запроса рассмотрим
Первое слагаемое поощряет награду. Второе делает отклонение от базовой политики платным. Коэффициент задаёт компромисс.
KL-якорь может:
- ограничивать скорость изменения распределения ответов;
- сохранять часть поведения исходной модели;
- уменьшать стимул уходить в крайние области, где оцениватель награды ненадёжен;
- служить диагностикой дрейфа.
Малый KL не доказывает истинность, безопасность или полезность. Базовая политика может ошибаться, а небольшое изменение вероятности способно существенно повлиять на редкое, но важное поведение. Это также не то же самое, что пессимизм офлайн-RL из Модуля 5: пессимизм реагирует на неопределённые значения вне покрытия данных, а KL назначает геометрическую цену изменению распределения.
Полный вариационный вывод KL-регуляризованного оптимума дан в курсе Information Theory for ML, Модуле 8 «Максимальная энтропия, экспоненциальные модели и KL-регуляризация» (it_ml.module_08_maxent_kl_policy). Здесь нас интересует другой слой: что именно измеряется у авторегрессионной LLM и какой градиент потом нужен алгоритму.
Шаг 6.3.2 — Цепное правило для KL последовательностей
Для двух авторегрессионных политик и
После взятия ожидания по получаем KL последовательностей:
Эквивалентная запись:
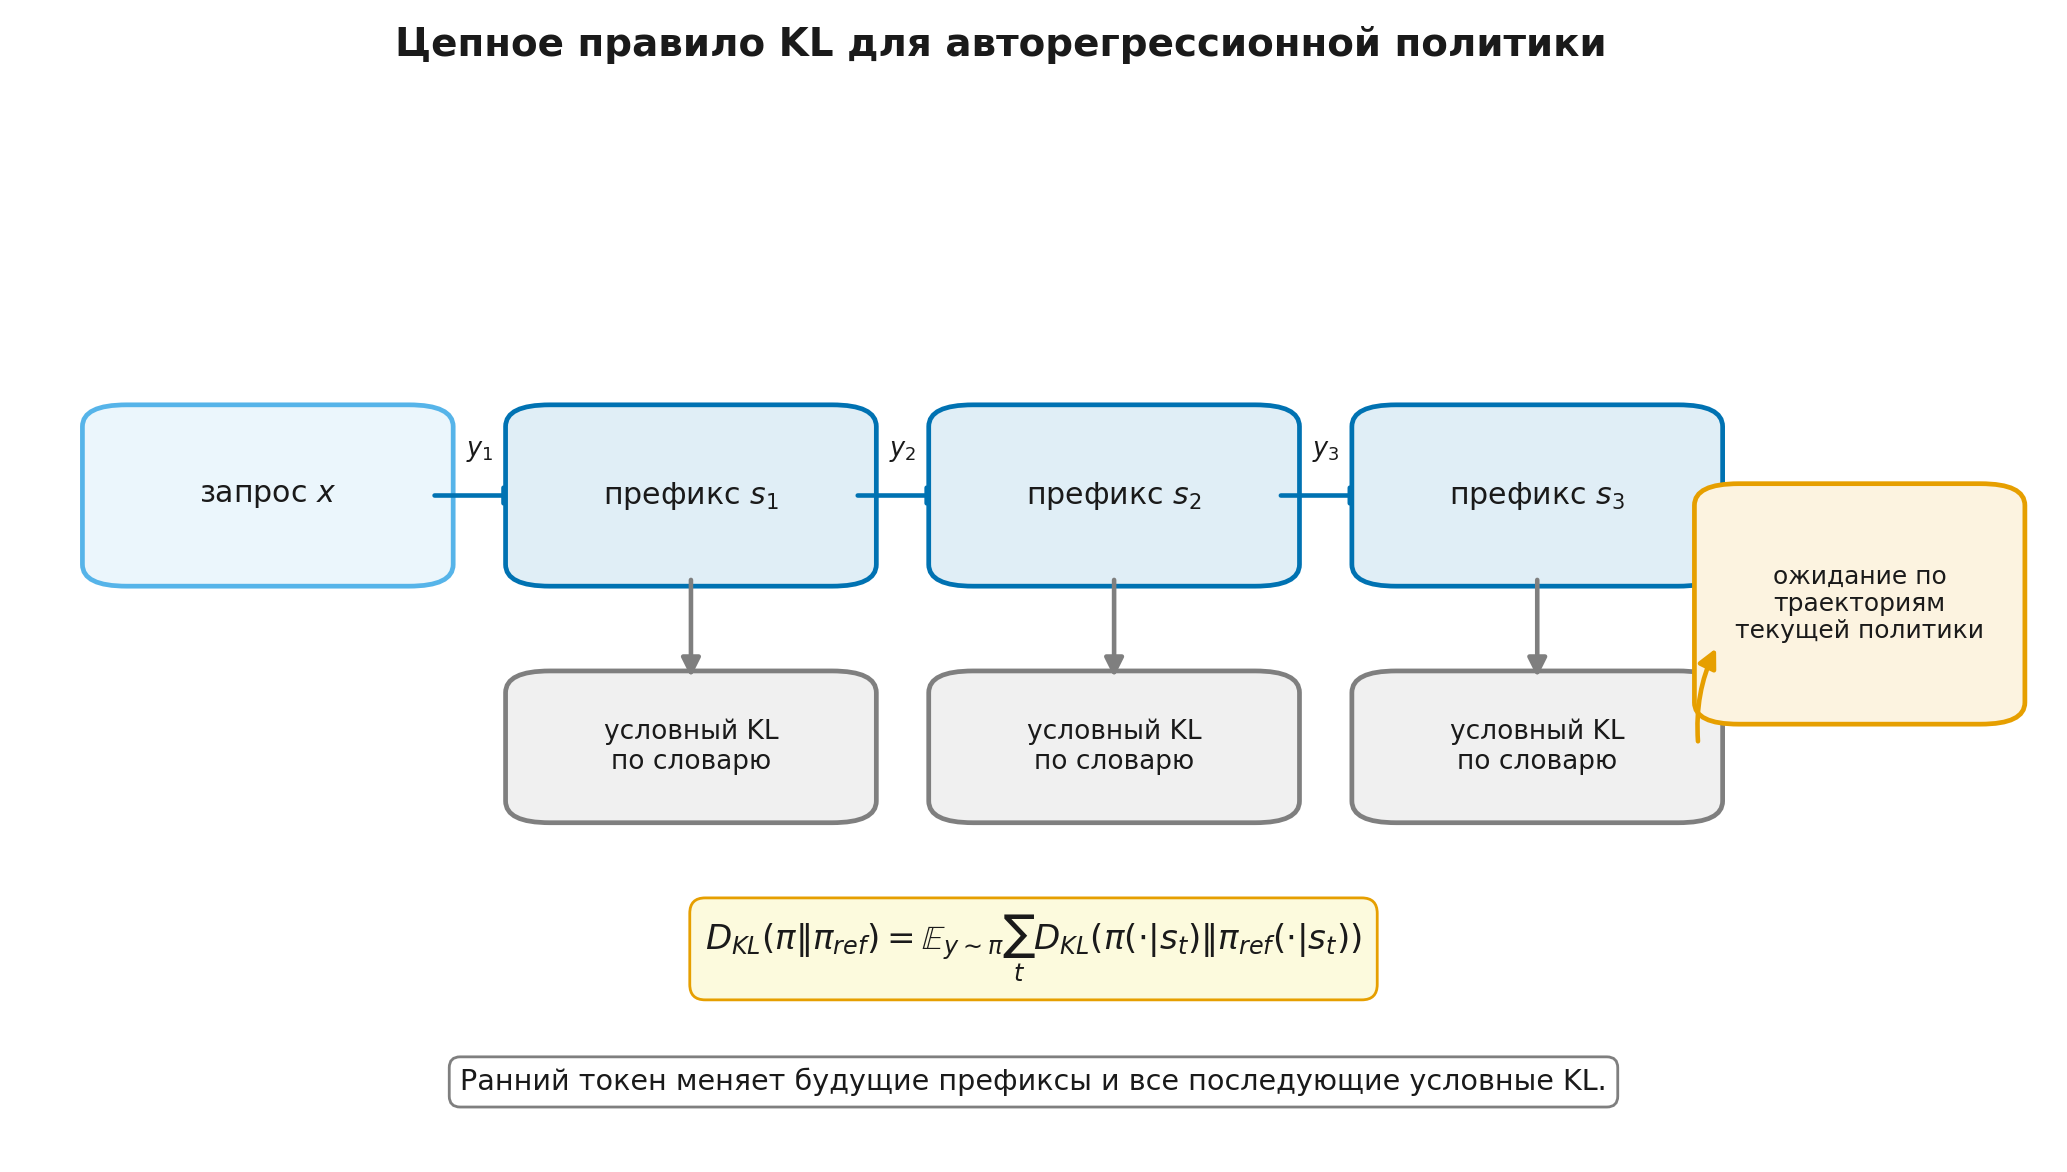
Прочитаем формулу внимательно. Ранний токен меняет не только свой локальный логарифм отношения, но и будущий префикс, а значит, все последующие условные KL. Регуляризация последовательности относится к распределению траекторий, а не к заранее независимым позициям.
При случайной длине можно считать EOS переходом в поглощающее терминальное состояние или суммировать только по активной маске. В обоих случаях сравниваемые распределения должны использовать совместимые правила остановки либо явно включать эти правила в процесс.
Шаг 6.3.3 — Точный условный KL и выборочный логарифм отношения
На посещённом префиксе точный условный KL равен
Для него нужны оба полных распределения по словарю; он всегда неотрицателен.
Если сэмплируется из , можно вычислить
Условное ожидание этой величины равно , но отдельное значение может быть отрицательным. Это не «отрицательный KL», а знакопеременный вклад одного случайного действия.
Вдоль траектории
является несмещённой оценкой KL последовательностей только когда сама траектория получена из . Если данные собрала другая политика поведения , нескорректированное среднее оценивает иной объект.
Это различие — точная сумма по действиям на посещённых префиксах против выборочной оценки и по действиям, и по префиксам — будет возвращаться в следующих алгоритмах.
Шаг 6.3.4 — Оцениватели k1, k2 и k3
Пусть , а требуется оценить
причём на носителе
Три распространённых выборочных значения:
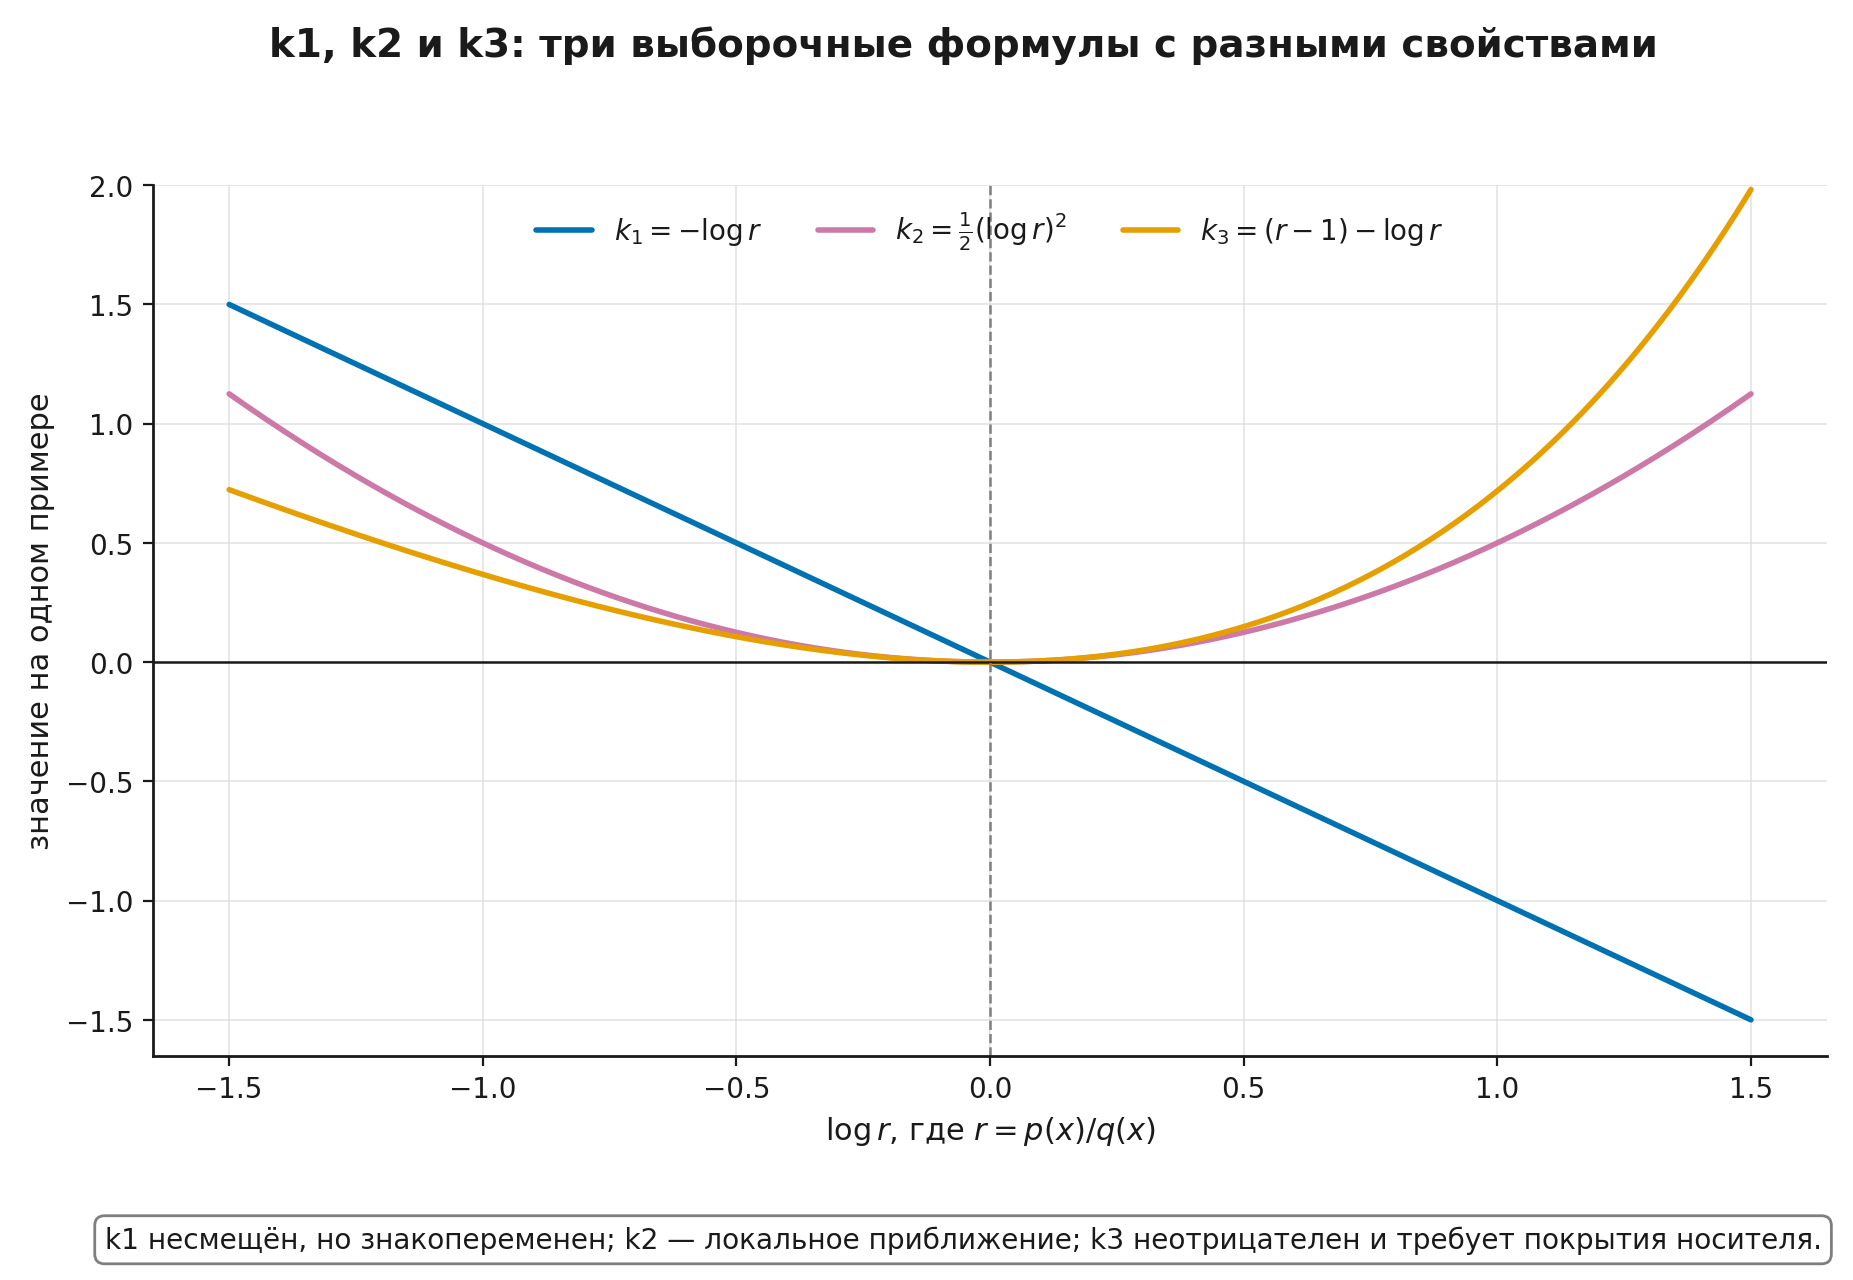
| Оцениватель | Неотрицателен на каждом примере | Статус ожидания | Практическая оговорка |
|---|---|---|---|
| нет | несмещён для , когда величина конечна | отдельные значения меняют знак | |
| да | вообще говоря смещён; это локальная квадратичная аппроксимация | может быть удобен как диагностика близких распределений | |
| да | несмещён при совместимых носителях, описанных ниже | контрольная вариата не гарантирует малую дисперсию в тяжёлых хвостах |
Неотрицательность следует из неравенства .
Условия поддержки здесь легко сформулировать слишком небрежно. Чтобы был конечным на сэмплах из , необходимо
Для дополнительного тождества
нужно также, чтобы не имело массы вне носителя , то есть . Поэтому точная несмещённость в данной записи требует общего совместимого носителя — в дискретном случае фактически взаимной абсолютной непрерывности. Если имеет массу там, где , контрольная вариата «не видит» эту массу; если , а , логарифм отношения бесконечен.
Для обычных softmax-распределений с конечными логитами общий носитель полный. Жёсткое top-k или top-p создаёт нулевые вероятности, поэтому доказательство нужно проверять заново, а не переносить по названию оценивателя.
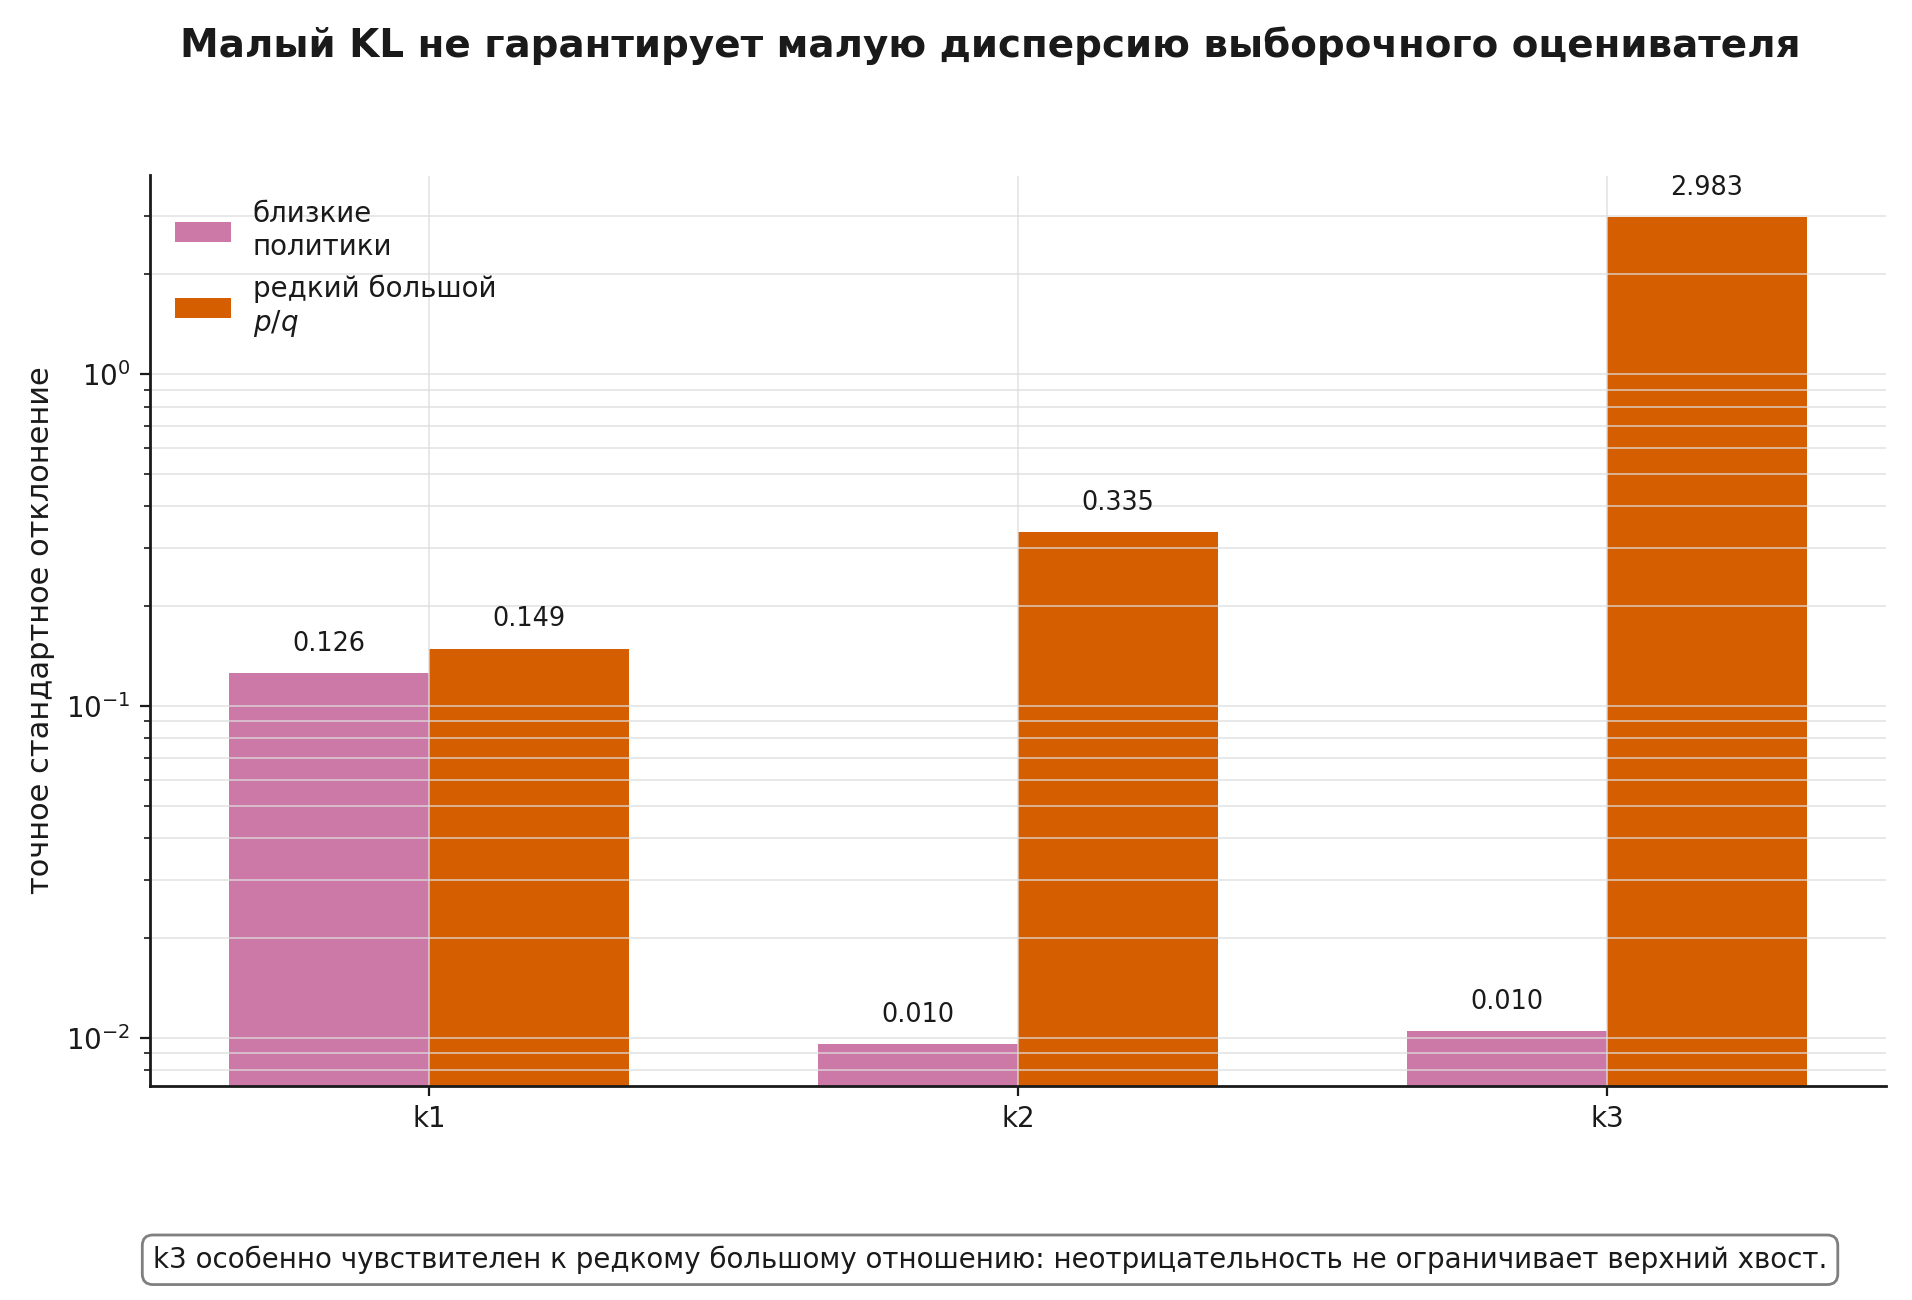
Синтетический конечный пример показывает обе стороны. Для близких четырёхточечных распределений стандартное отклонение мало. Но при и редкое событие создаёт тяжёлый хвост отношения: точный KL остаётся конечным, тогда как стандартное отклонение примерно равно против у . Это не внешний бенчмарк, а точный расчёт по двум конечным распределениям. Контрольная вариата может уменьшать дисперсию локально, но не является универсальной теоремой о превосходстве .
Шаг 6.3.5 — Оценить число и продифференцировать нужную цель — разные задачи
Формулы k1–k3 сначала отвечают на вопрос об оценке значения KL. Из этого не следует, что любую из них можно вставить в вычислительный граф и после автоматического дифференцирования получить градиент нужного KL последовательностей.
Причины две.
- Сэмплы зависят от параметров политики, но автоматическое дифференцирование через уже выбранный дискретный токен само по себе не учитывает производную распределения сэмплирования.
- В авторегрессионной модели ранний токен меняет распределение будущих префиксов и всех последующих KL-слагаемых.
Tang и Munos анализируют реализации, в которых скалярный оцениватель имеет нужное ожидание, но непосредственное дифференцирование даёт другой градиент или игнорирует последовательную зависимость. Более поздний анализ KL-регуляризации также подчёркивает, что несмещённость значения, конечность дисперсии и корректность градиента — три отдельных свойства. В этом модуле k1–k3 используются как диагностические величины с остановленным градиентом и численные оцениватели. Конкретная функция потерь должна выводиться из целевого регуляризованного градиента, а не из внешнего вида положительного скаляра.
Снимок 2026-08-05. Текущая документация тренера PPO в библиотеке
TRLописываетk1как базовый вариант для журналирования KL и предлагаетk3как неотрицательную альтернативу, которую документация характеризует как низкодисперсионную. Это описание реализации, а не универсальная теорема: тяжёлые хвосты отношения вероятностей способны сделать дисперсию намного больше. Роль KL в PPO, DPO, RLOO и GRPO связывается с полным контуром дообучения в курсе Modern LLMs, Модуле 14 «Обучение по обратной связи: RLHF, DPO, RLOO и GRPO» (modern_llms.module_12_preference_optimization).
Урок 6.4. Фактическая политика поведения при генерации
Урок 6.4. Фактическая политика поведения при генерации
- Базовый softmax и политика после декодирования
- Положительная температура сохраняет полный носитель
- Top-k и top-p: усечение с перенормировкой
- Рассогласование логарифмов вероятностей и условие покрытия
- Практическое правило согласованности
далее — 6 проверочных шагов
Шаг 6.4.1 — Базовый softmax и политика после декодирования
Пусть трансформер выдаёт логиты . Базовое распределение
может пройти через:
- масштабирование температурой;
- штрафы за повторение;
- запреты токенов;
- грамматические ограничения;
- усечение top-k, top-p или min-p;
- принудительный или запрещённый EOS.
Обозначим все настройки и правила генерации через . Тогда фактическая политика поведения равна
и она не обязана совпадать с .
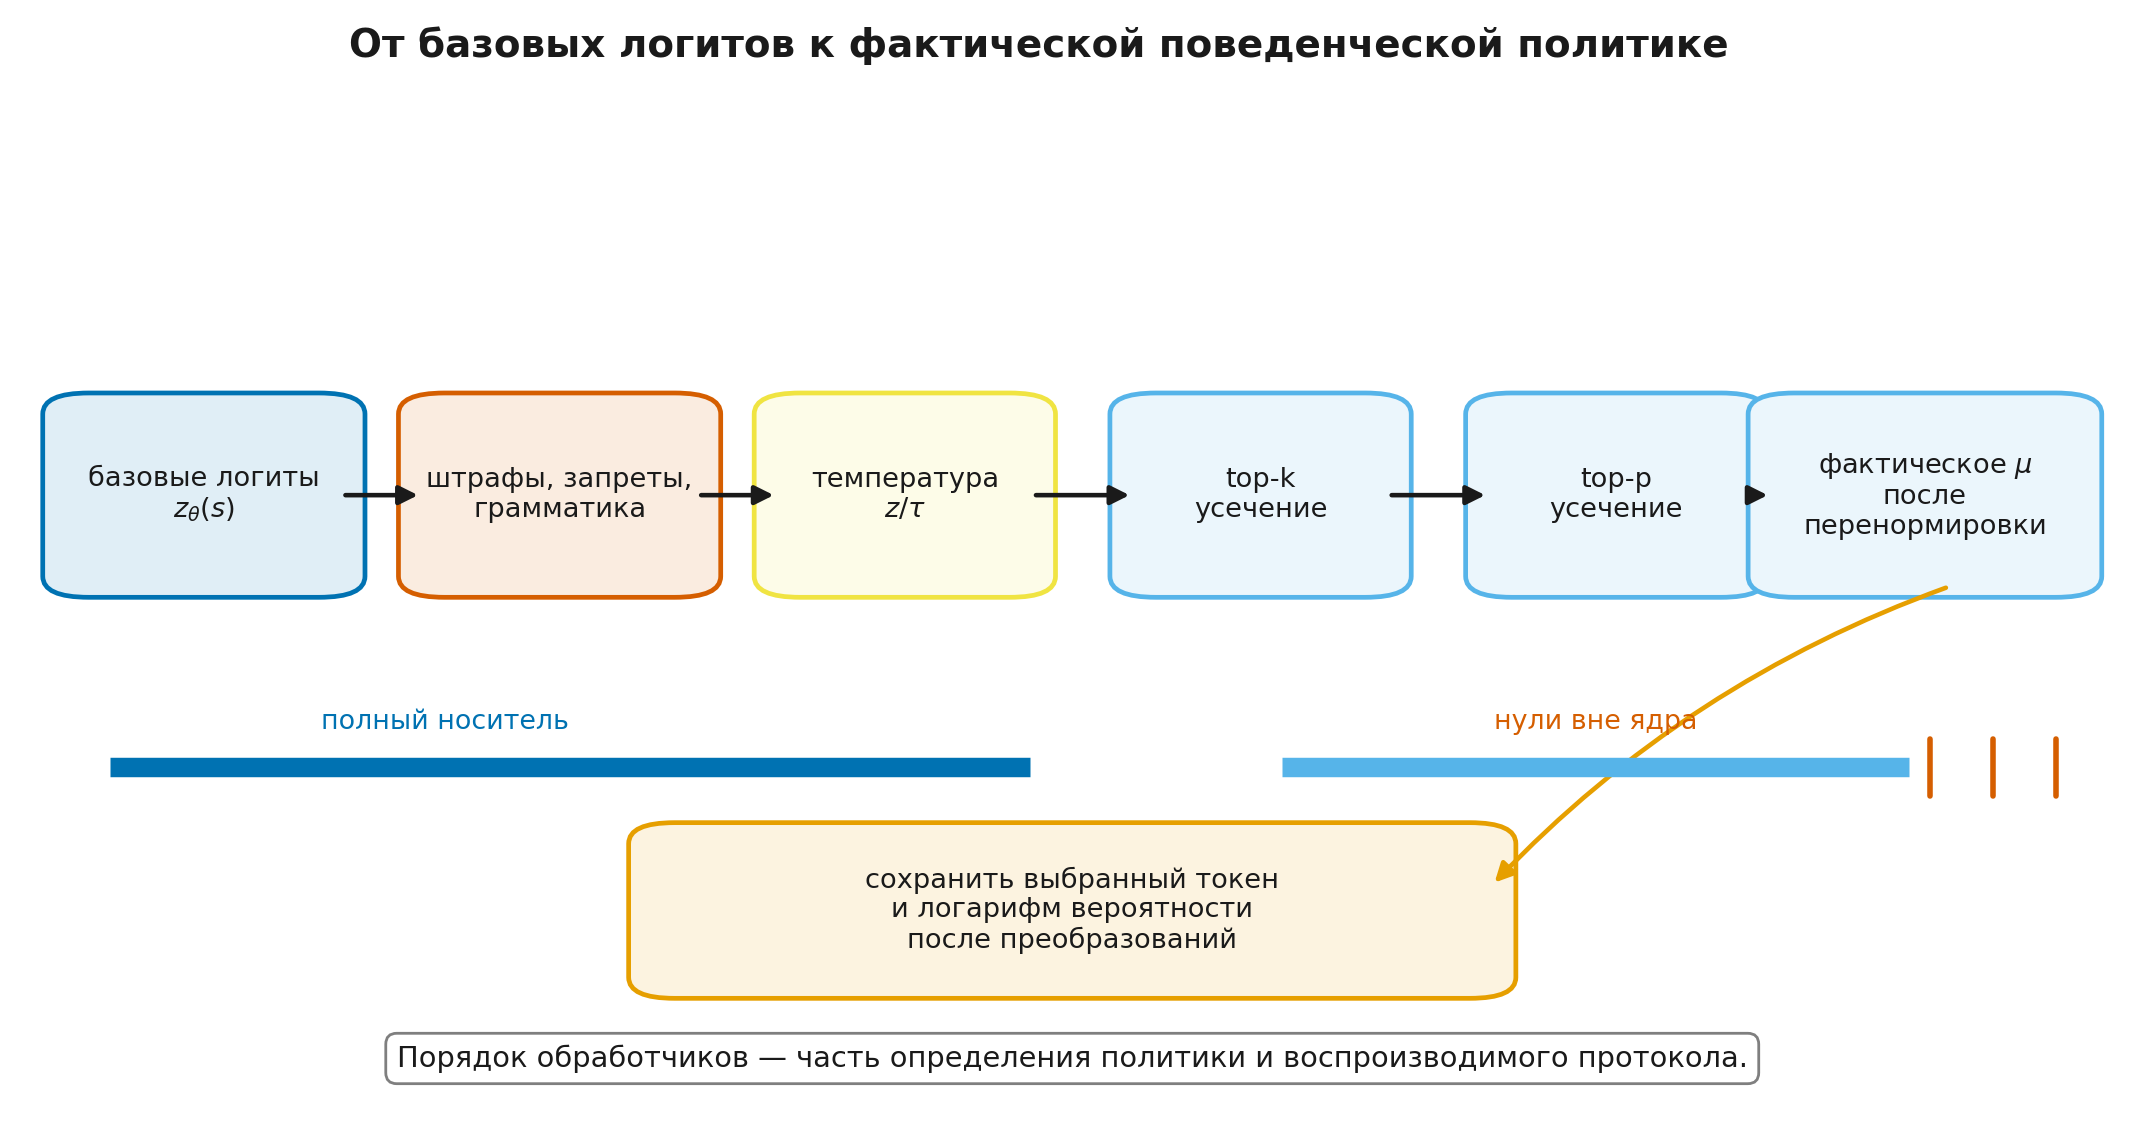
Hugging Face Transformers отделяет обработчики логитов от критериев остановки, а vLLM предоставляет параметры температуры, top-p, top-k, min-p, стоп-токенов и стоп-строк. Порядок операций является частью спецификации движка. Поэтому фраза «сэмплировали при top-p 0.9» неполна без версии и остальных настроек.
Шаг 6.4.2 — Положительная температура сохраняет полный носитель
При
Для фиксированных конечных логитов:
- делает распределение острее;
- делает его ровнее;
- каждый токен сохраняет положительную вероятность.
Последний пункт важен для отношений вероятностей: положительная температура перераспределяет массу, но не меняет носитель. Нулевая температура — отдельное правило, обычно жадный выбор argmax, а не обычный элемент семейства softmax с положительной температурой.
Логарифм вероятности, записанный при температуре , равен
Если генерация использовала температуру, а логарифмы вероятностей пересчитаны по немасштабированным логитам, знаменатель отношения будет неверным, хотя выбранный токен допустим в обоих распределениях.
Шаг 6.4.3 — Top-k и top-p: усечение с перенормировкой
top-k сохраняет наиболее вероятных токенов:
top-p, или выборка из ядра (nucleus sampling), сортирует токены по убыванию вероятности и выбирает минимальный префикс , масса которого достигает порога :
Затем распределение перенормируется на . Выборка из ядра была предложена как динамический способ удалить ненадёжный хвост; размер носителя меняется от позиции к позиции.
Воспроизводимая реализация должна указать:
- как разрешаются равные вероятности;
- включается ли токен, на котором сумма впервые пересекла порог;
- в каком порядке применяются top-k и top-p, если включены оба;
- выполняется ли усечение до или после масштабирования температурой.
В заданиях используется стабильная сортировка по убыванию, при равенстве первым идёт меньший идентификатор токена; затем применяются температура, top-k и top-p.
Шаг 6.4.4 — Рассогласование логарифмов вероятностей и условие покрытия
Пусть — сохранённое множество токенов, а
Для сохранённого токена
Если токен сэмплировался из , но в журнал записали , знаменатель ошибочен на . Для токенов вне
хотя базовый softmax назначает им конечную вероятность.
Это не просто ошибка округления. Оценивание по данным политики поведения требует покрытия: всякое событие целевой политики, которое оценивается через отношение вероятностей, должно лежать там, где . Жёсткое усечение может нарушить это условие.
Например, пусть политика поведения сохраняет токены с суммарной базовой массой . Корректный логарифм вероятности каждого сохранённого токена выше базового на
Ошибка повторяется на каждой позиции и экспоненцируется в отношении вероятностей последовательностей.
Шаг 6.4.5 — Практическое правило согласованности
Универсального запрета «top-p нельзя использовать при обучении» нет. Более точное требование звучит так:
Данные, сохранённые логарифмы вероятностей и математическая цель должны относиться к одной фактической политике поведения.
Самый простой режим использует полный носитель, фиксированную положительную температуру и отсутствие жёсткого усечения. Тогда отношение определено для каждого сэмплированного токена, а носители базовой политики и политики поведения совпадают.
Если усечение всё же применяется, система должна:
- сохранять логарифм вероятности после всех преобразований;
- хранить параметры и порядок преобразований;
- определить, оптимизируется базовая или преобразованная политика;
- проверить условие покрытия для выбранного оценивателя;
- учесть дискретную зависимость границ top-k и top-p от логитов.
Жадное декодирование и лучевой поиск (beam search) являются процедурами поиска, а не обычным сэмплированием из полного стохастического распределения. Они полезны при применении модели, но для стандартного REINFORCE или PPO требуют отдельной формализации. Best-of-N и поиск с верификатором разбираются в Модуле 10.
Урок 6.5. Контракт роллаута для RL с проверяемыми наградами
Урок 6.5. Контракт роллаута для RL с проверяемыми наградами
- Система из пяти компонентов
- Минимальная схема пакета
- Где детерминированной конкатенации уже недостаточно
- Практика уровня B: реальные логиты модели 0.6B
- Карта модуля
далее — 7 проверочных шагов
Шаг 6.5.1 — Система из пяти компонентов
Чистую систему обучения с проверяемыми наградами (reinforcement learning with verifiable rewards, RLVR) удобно разложить на пять ролей.
- Выборщик запросов задаёт начальные состояния.
- Движок роллаутов генерирует ответы из фактической политики поведения.
- Проверяющая система или модель награды вычисляет обратную связь.
- Тренер повторно вычисляет вероятности текущей и базовой политик и обновляет параметры.
- Синхронизация весов передаёт новую версию политики движку.
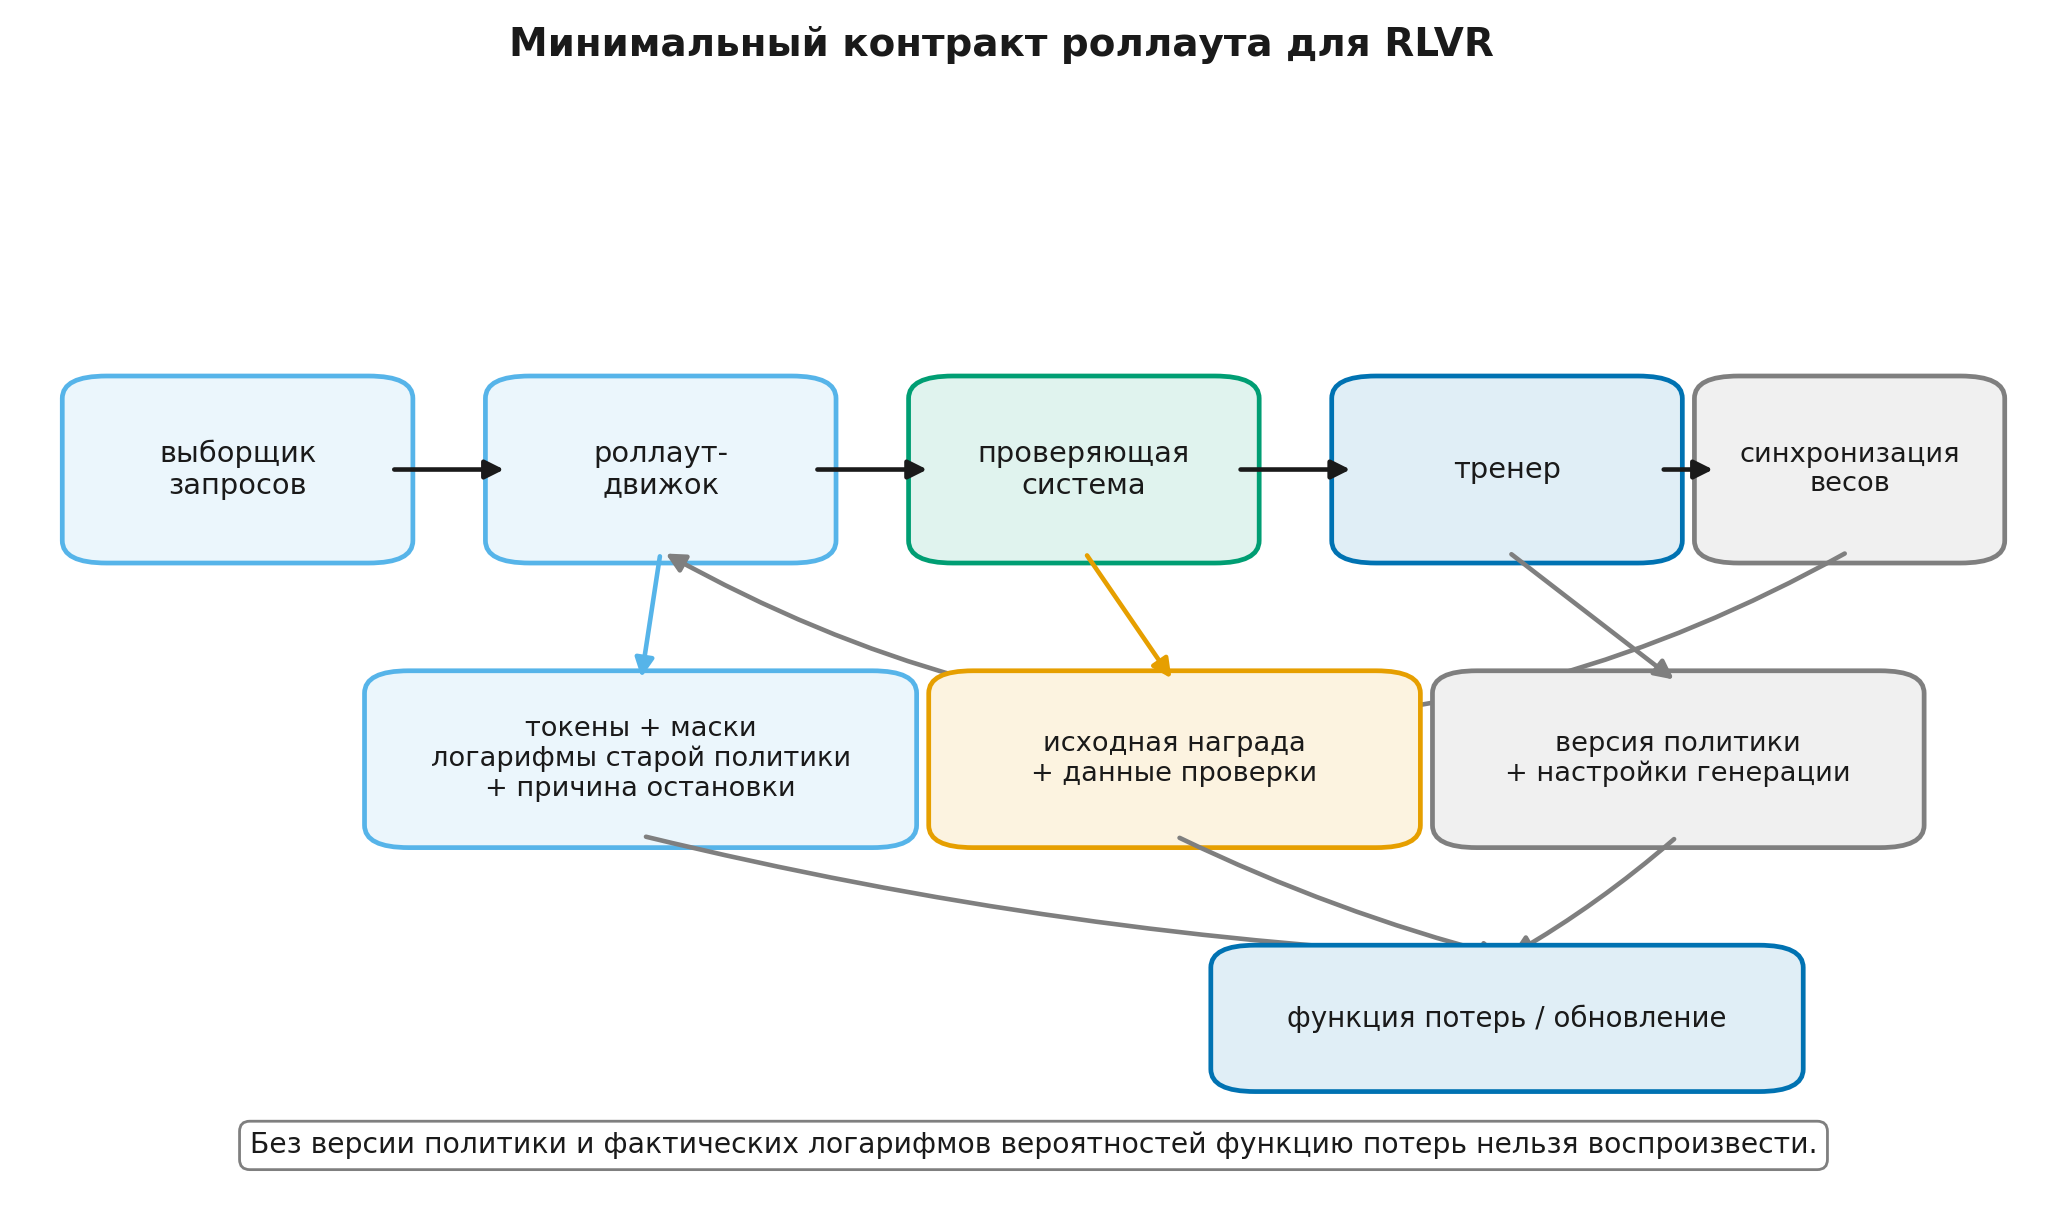
Такое разложение показывает три вида задержки:
- запросы могут выбираться заранее;
- награда может вычисляться асинхронно;
- движок может продолжать генерацию по более старой версии весов.
Распределённую инфраструктуру разберём в Модуле 12. Сейчас важно определить данные, без которых функцию потерь невозможно даже однозначно записать.
Шаг 6.5.2 — Минимальная схема пакета
Один элемент роллаута обычно требует следующих полей.
| Поле | Зачем оно нужно |
|---|---|
prompt_id и исходный запрос | воспроизводимость и анализ покрытия |
prompt_ids | точный токенизированный начальный контекст |
response_ids | действия политики, включая специальные токены по принятому соглашению |
attention_mask | допустимые входные позиции |
response_mask | позиции, входящие в функцию потерь политики |
old_logprobs | знаменатель фактической политики поведения |
ref_logprobs или версия базовой политики | вычисление KL и повторная оценка |
reward_raw | исходная награда задачи |
| дополнительные слагаемые награды | длина, формат, формирование награды и KL хранятся отдельно |
terminated, truncated, stop_reason | корректная обработка границы эпизода |
sampling_config | температура, усечение, правила остановки и случайное зерно |
policy_version | веса, по которым получен ответ |
| служебные данные проверяющей системы | версия, результат и диагностика |
Часть полей можно восстановить, но тогда результат зависит от внешних версий. Повторная токенизация строки после изменения шаблона способна дать другую последовательность, поэтому безопаснее хранить идентификаторы токенов.
Токеновые логарифмы вероятностей предпочтительнее одной суммы по последовательности: PPO, маски, анализ длины и локальная диагностика требуют позиционной информации.
Шаг 6.5.3 — Где детерминированной конкатенации уже недостаточно
Для обычного ответа без инструментов среда действительно может реализовать
После траектории проверяющая система назначает терминальную награду. В такой модели основная случайность ответа исходит от политики и выбора запросов.
Но если действие вызывает инструмент,
может зависеть от браузера, файловой системы, сети, пользователя или случайности симулятора. Результат инструмента является наблюдением, а не токеном, который модель свободно выбрала. Его нельзя включать в response_mask как действие политики лишь потому, что он записан внутри единого текстового протокола.
Это различие подготавливает центральную тему Модуля 11: градиентная маска должна отделять действия агента от наблюдений среды.
Шаг 6.5.4 — Практика уровня B: реальные логиты модели 0.6B
Модуль содержит два отдельных ноутбука:
Оба используют одно вычислительное ядро и три профиля: smoke, full и real-model. Канонический выпуск по умолчанию запускает только локальные синтетические профили; загрузка весов отключена (RUN_REAL_MODEL=False). Поэтому архив воспроизводимо проверяется без сети и GPU, а факультативная ветка реальной модели не маскируется под выполненный выпускной тест.
Для профиля real-model в configs/models.yaml указана публично доступная модель с открытыми весами Qwen/Qwen3-0.6B. Официальная карточка описывает её как каузальную языковую модель с 0,6 млрд параметров, 28 слоями и контекстом 32 768 токенов; версии Transformers ниже 4.51.0 не распознают архитектуру qwen3. Это характеристики карточки модели, а не утверждение о её превосходстве или пригодности для всех задач.
Факультативный запуск:
- применяет шаблон диалога и сохраняет точные
prompt_ids; - генерирует короткий ответ с включёнными
return_dict_in_generate=Trueиoutput_scores=True; - извлекает оценки выбранных токенов через
compute_transition_scores(..., normalize_logits=True); - независимо повторно оценивает ту же последовательность с подстановкой истинного префикса и проверяет сдвиг на один токен;
- вычисляет сумму, среднее и PPL только по
response_mask; - сравнивает точный условный KL между двумя температурными распределениями на посещённых префиксах;
- измеряет носитель top-p и поправку перенормировки;
- собирает минимальную JSON-запись роллаута вместе с версиями библиотек и параметрами генерации.
Прямой вызов transformers.generate() надёжно сообщает последовательность и оценки, но не предоставляет единый производственный stop_reason с той же семантикой, что API обслуживающего движка. Поэтому ноутбук помечает причину как выведенную из наличия EOS и достигнутой длины. Если нужен явный finish_reason, следует использовать API движка, который его возвращает, и сохранить версию этого контракта.
В реальном профиле обязательно фиксируются разрешённые версии модели и токенизатора, режим шаблона диалога, версии библиотек, устройство, тип данных, параметры генерации и случайное зерно. Результаты могут измениться при любом из этих факторов; проверяются тождества и выравнивание, а не заранее выбранная строка ответа.
Шаг 6.5.5 — Карта модуля
Основной путь данных теперь выглядит так:
Для аудита реализации достаточно семи вопросов.
- Что является состоянием и действием?
- Что считается завершением, а что — усечением?
- Какая позиция логитов дала вероятность каждого токена?
- Какие позиции входят в
response_mask? - Какая политика после всех преобразований действительно сэмплировала действия?
- Относится ли каждый сохранённый
old_logprobк этой политике? - Сохранены ли версия весов, токенизатор, шаблон и причина остановки?
Три формулы должны восстанавливаться без подсказки:
Модуль 7 заполнит следующий блок системы: откуда берётся награда, как строятся данные о предпочтениях, как работает модель Брэдли—Терри и почему качество модели награды нельзя свести к одной точности на отложенной выборке.
Практический маршрут
Основной набор содержит 20 упражнений: 8 концептуальных, 6 аналитических и 6 программных микрозадач. Ещё 12 вопросов для проверки знаний разбирают пограничные случаи: семантику остановки, EOS в вероятности последовательности, порядок обработчиков логитов, носители оценивателей и маскирование результатов инструментов. Подробные решения упражнений раскрываются по кнопке.
Источники и дальнейшее чтение
Ниже перечислены источники, на которые опираются конкретные инженерные и математические утверждения модуля. Полная карта утверждений, допустимой силы вывода и ограничений находится в Module_6_Sources.md.
- Hugging Face Transformers: Generation — интерфейс
compute_transition_scores, формат оценок генерации и параметрыnormalize_logits. Нужен для воспроизводимой сверки логарифмов вероятностей выбранных токенов. - Hugging Face Transformers: internal generation utilities — разделение обработчиков логитов и критериев остановки. Документация описывает программный интерфейс, но сама по себе не определяет, считать ли конкретную остановку терминалом RL-задачи.
- vLLM SamplingParams — семантика температуры, top-k/top-p, стоп-правил и
logprobs; выбранный токен включается в результат, а-1запрашивает весь словарь при допустимых лимитах. - John Schulman, “Approximating KL Divergence” — вывод k1, k2 и k3 как оценивателей значения KL. Условия поддержки и тяжёлые хвосты нужно проверять отдельно.
- Tang & Munos, “On a few pitfalls in KL divergence gradient estimation for RL” — почему корректное ожидание скалярной оценки ещё не гарантирует корректный градиент KL в RL.
- “Rethinking KL Regularization in RLHF: From Value Estimation to Gradient Optimization” — дополнительный анализ носителей, дисперсии отношений и различия между оцениванием значения и оптимизацией градиента.
- Holtzman et al., “The Curious Case of Neural Text Degeneration” — первичная работа о nucleus sampling; важна для определения top-p, но не доказывает пригодность одной настройки для любого RL-контура.
- Официальная карточка Qwen3-0.6B — характеристики факультативной открытой модели и минимальная версия Transformers.
Для углубления внутри серии:
- Information Theory for ML, Модуль 3 «Кросс-энтропия и KL-дивергенция» (
it_ml.module_03_cross_entropy_kl) — энтропия, перекрёстная энтропия, KL и перплексия; - Information Theory for ML, Модуль 8 «Максимальная энтропия, экспоненциальные модели и KL-регуляризация» (
it_ml.module_08_maxent_kl_policy) — вариационная логика KL-якоря; - Modern LLMs, Модуль 2 «Токенизация и эмбеддинги» (
modern_llms.module_02_tokenization) — токенизаторы, специальные токены и шаблоны; - Modern LLMs, Модуль 10 «KV-кэши и эффективный инференс» (
modern_llms.module_09_inference) — механика эффективной генерации; - Modern LLMs, Модуль 14 «Обучение по обратной связи: RLHF, DPO, RLOO и GRPO» (
modern_llms.module_12_preference_optimization) — местоold,currentиreferenceполитик в полном контуре обучения.