Модуль 3. Кросс-энтропия и KL-дивергенция
Как читать этот модуль. Основной маршрут — §§3.1–3.7. Он начинается с логарифмической функции потерь, затем разделяет неопределённость данных и ошибку модели, переносит это разложение в классификацию и языковое моделирование и заканчивается градиентом по логитам и перплексией. §3.8 — математическое углубление о направлении KL при ограниченном модельном семействе. §3.9 — карта применений; её можно читать выборочно и возвращаться к ней по мере знакомства с вариационным выводом, дистилляцией и RLHF.
3.1. Модель отвечает распределением, мир — одним исходом
Вероятностная модель почти никогда не отвечает одним классом. Она выдаёт распределение. argmax оставляет от него только победителя — и тем самым выбрасывает большую часть информации.
Представьте два классификатора для трёх классов:
Оба выбирают первый класс. Если он действительно наблюдался, модель получает гораздо лучший логарифмический счёт:
Но если правильным оказался второй класс, картина меняется:
Уверенность полезна, когда она направлена в правильную сторону, и дорога, когда модель уверенно ошибается. Именно это измеряет логарифмическая потеря (log-loss): для реализовавшегося исхода
Логарифм здесь делает две вещи одновременно. Он превращает произведение вероятностей последовательности в сумму токенных потерь и резко штрафует модель, если та объявила наблюдавшееся событие почти невозможным.
Теперь введём две роли, которые будут проходить через весь модуль:
- — распределение, порождающее данные;
- — вероятностная модель с параметрами .
В классификации это условные распределения
а в авторегрессионной языковой модели —
Мы не получаем в виде готовой таблицы. Мы видим отдельные исходы из и каждый раз спрашиваем: какую вероятность модель дала тому, что произошло? Усреднение этих счетов и приводит к кросс-энтропии.
В Модуле 2 энтропия измеряла неопределённость одного распределения. Теперь появятся два распределения, и вопрос станет инженерным: какая часть средней потери неизбежна из-за самих данных, а какая возникла потому, что модель не совпала с ними?
Если не оговорено иное, алфавит в основном маршруте конечен. Основание логарифма обозначаем через : при получаем биты, при — наты. В библиотеках глубокого обучения обычно используется натуральный логарифм, поэтому обучающая потеря чаще измеряется в натах.
Историческая линия здесь состоит из двух шагов. Шеннон связал с информационной длиной сообщения; Куллбэк и Лейблер формализовали направленный разрыв между двумя распределениями. Современная кросс-энтропийная функция потерь соединяет эти две идеи.
3.2. Кросс-энтропия: средний счёт по вероятностям модели
Для распределений и на одном алфавите кросс-энтропия определяется как
Формулу удобно читать по ролям:
- первый аргумент говорит, откуда приходят события и по чему усредняем;
- второй аргумент говорит, чьи вероятности стоят внутри логарифма.
Поэтому кросс-энтропия направлена:
в общем случае. Перестановка аргументов меняет не запись одной и той же ошибки, а сам эксперимент: меняются источник событий и модель, которой мы выставляем счёт.
От отдельной потери к ожидаемой
Если — наблюдения из , то средняя выборочная потеря
оценивает . При стандартных условиях закон больших чисел превращает выборочное среднее в ожидаемое. Именно поэтому цикл обучения (training loop) может работать с отдельными примерами, хотя формальное утверждение о качестве модели записано на уровне распределения.
Для условного прогноза — классификации, регрессии с вероятностным выходом или предсказания следующего токена — естественная величина имеет вид
Точка с запятой отделяет распределение данных от оцениваемого предиктора . Ниже мы обычно будем говорить просто «условная кросс-энтропия».
Одна метка — одно наблюдение, а не весь условный закон
В обучении с учителем целевую метку часто записывают one-hot-вектором . Тогда потеря одного примера равна
Это удобная запись фактически полученного исхода. Она не превращает истинное в вырожденный one-hot закон. Для одного и того же объекта могут существовать неоднозначная разметка, несколько допустимых продолжений, шум или скрытый контекст. Набор данных показывает по одному исходу за раз; распределение проявляется только через повторение и структуру выборки.
Когда модель объявляет возможное невозможным
На границе нужны два соглашения. Нулевой по исход не вносит вклад:
Но если , а , то
Модель назначила нулевую вероятность событию, которое иногда происходит, поэтому средний логарифмический счёт становится бесконечным. Условие конечности записывают как : носитель должен содержаться в носителе .
В нейросетях softmax при конечных логитах формально даёт положительные вероятности всем классам. Численно, однако, слишком малые значения могут округляться до нуля, поэтому кросс-энтропию вычисляют через устойчивую форму log_softmax, а не через отдельные операции softmax и log.
3.3. KL-дивергенция: часть потери, за которую отвечает модель
Энтропия источника равна
Добавим и вычтем внутри кросс-энтропии:
Второе слагаемое называется KL-дивергенцией, или относительной энтропией:
Получаем центральное тождество модуля:
Это разложение стоит прочитать словами.
- — неопределённость, которая остаётся даже у идеального предиктора, знающего ;
- — дополнительный счёт за несовпадение модели с распределением данных .
Поэтому полезная короткая формулировка такова:
KL — средняя доплата за чужую вероятностную модель.
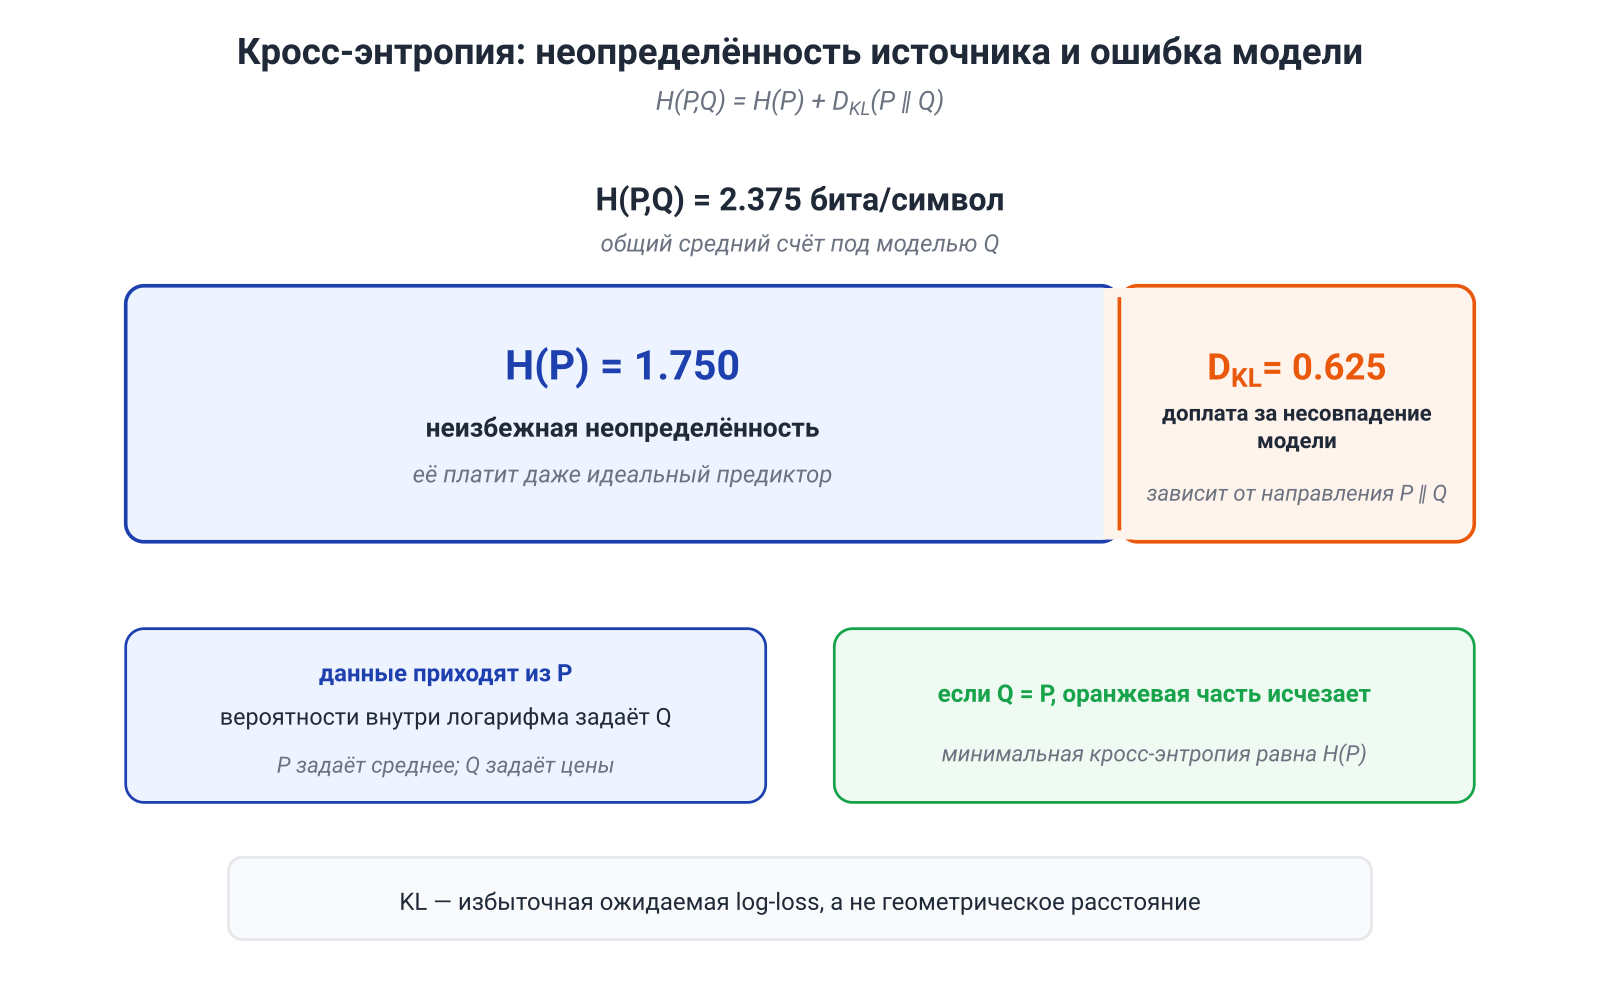
KL не является метрикой: она несимметрична и не обязана удовлетворять неравенству треугольника. Для оптимизации это не дефект. Нам как раз нужна направленная величина: данные приходят из , а счёт выставляется вероятностями .
Почему доплата неотрицательна
Если существует с и , KL равна . В конечном случае рассмотрим положительный носитель
и используем неравенство :
Следовательно,
Равенство требует одновременно на и отсутствия массы вне . Значит,
Это неравенство Гиббса. В Модуле 4 мы увидим, как тот же результат получается из неравенства Йенсена и логарифмического неравенства сумм. Здесь важен механизм: средняя логарифмическая потеря распадается на неизбежную часть и неотрицательную ошибку модели.
Логарифмическая потеря просит сообщить всё распределение
Из разложения немедленно следует
и минимум единственно достигается при . Поэтому логарифмическая потеря является строго правильным правилом оценки (strictly proper scoring rule): в ожидании выгоднее всего сообщать истинное распределение, а не только правильный наиболее вероятный класс.
Это сильнее гарантии для argmax. Два предиктора могут иметь одинаковую точность (accuracy), но разную кросс-энтропию, потому что один лучше распределяет вероятность между правильным исходом и альтернативами. Именно поэтому логарифмическая потеря подходит для задач, где важны вероятности, калибровка и последующее принятие решений под разными стоимостями ошибок.
Что именно делает максимальное правдоподобие
Для модели максимизация правдоподобия равна минимизации эмпирического отрицательного логарифмического правдоподобия (negative log-likelihood, NLL). На уровне ожидаемой целевой функции это
поскольку не зависит от .
Если модельное семейство содержит и выполняются обычные статистические условия, оптимум целевой функции на уровне распределения находится в истинном распределении. Если семейство ограничено, модель выбирает лучшую доступную KL-проекцию:
Это не ослабляет смысл MLE, а точно его формулирует. Целевая функция говорит, какое приближение считается лучшим внутри выбранного семейства. Конечность данных, качество выборки и оптимизатор определяют, насколько конкретный запуск приблизится к этому теоретическому решению.
3.4. Чужой код: как KL превращается в лишние биты
В битах величина
служит идеальной информационной длиной исхода под моделью . Если реальные символы приходят из , средний счёт такого кода равен
Идеальный код, согласованный с самим источником, имел бы среднюю информационную длину . Разница составляет
Так возникает операционное чтение KL: сколько бит в среднем мы переплачиваем, кодируя данные из вероятностями модели .
У реального двоичного префиксного кода длины должны быть целыми. Но и здесь связь остаётся точной с небольшой накладной платой. Для шенноновского кода, построенного под ,
и потому
Для блоков длины надбавка меньше одного бита на весь блок, то есть меньше бита на символ. Арифметическое и интервальное кодирование реализуют эту идею практически. Поэтому «KL — лишние биты» является не только образом, но и асимптотическим инженерным утверждением.
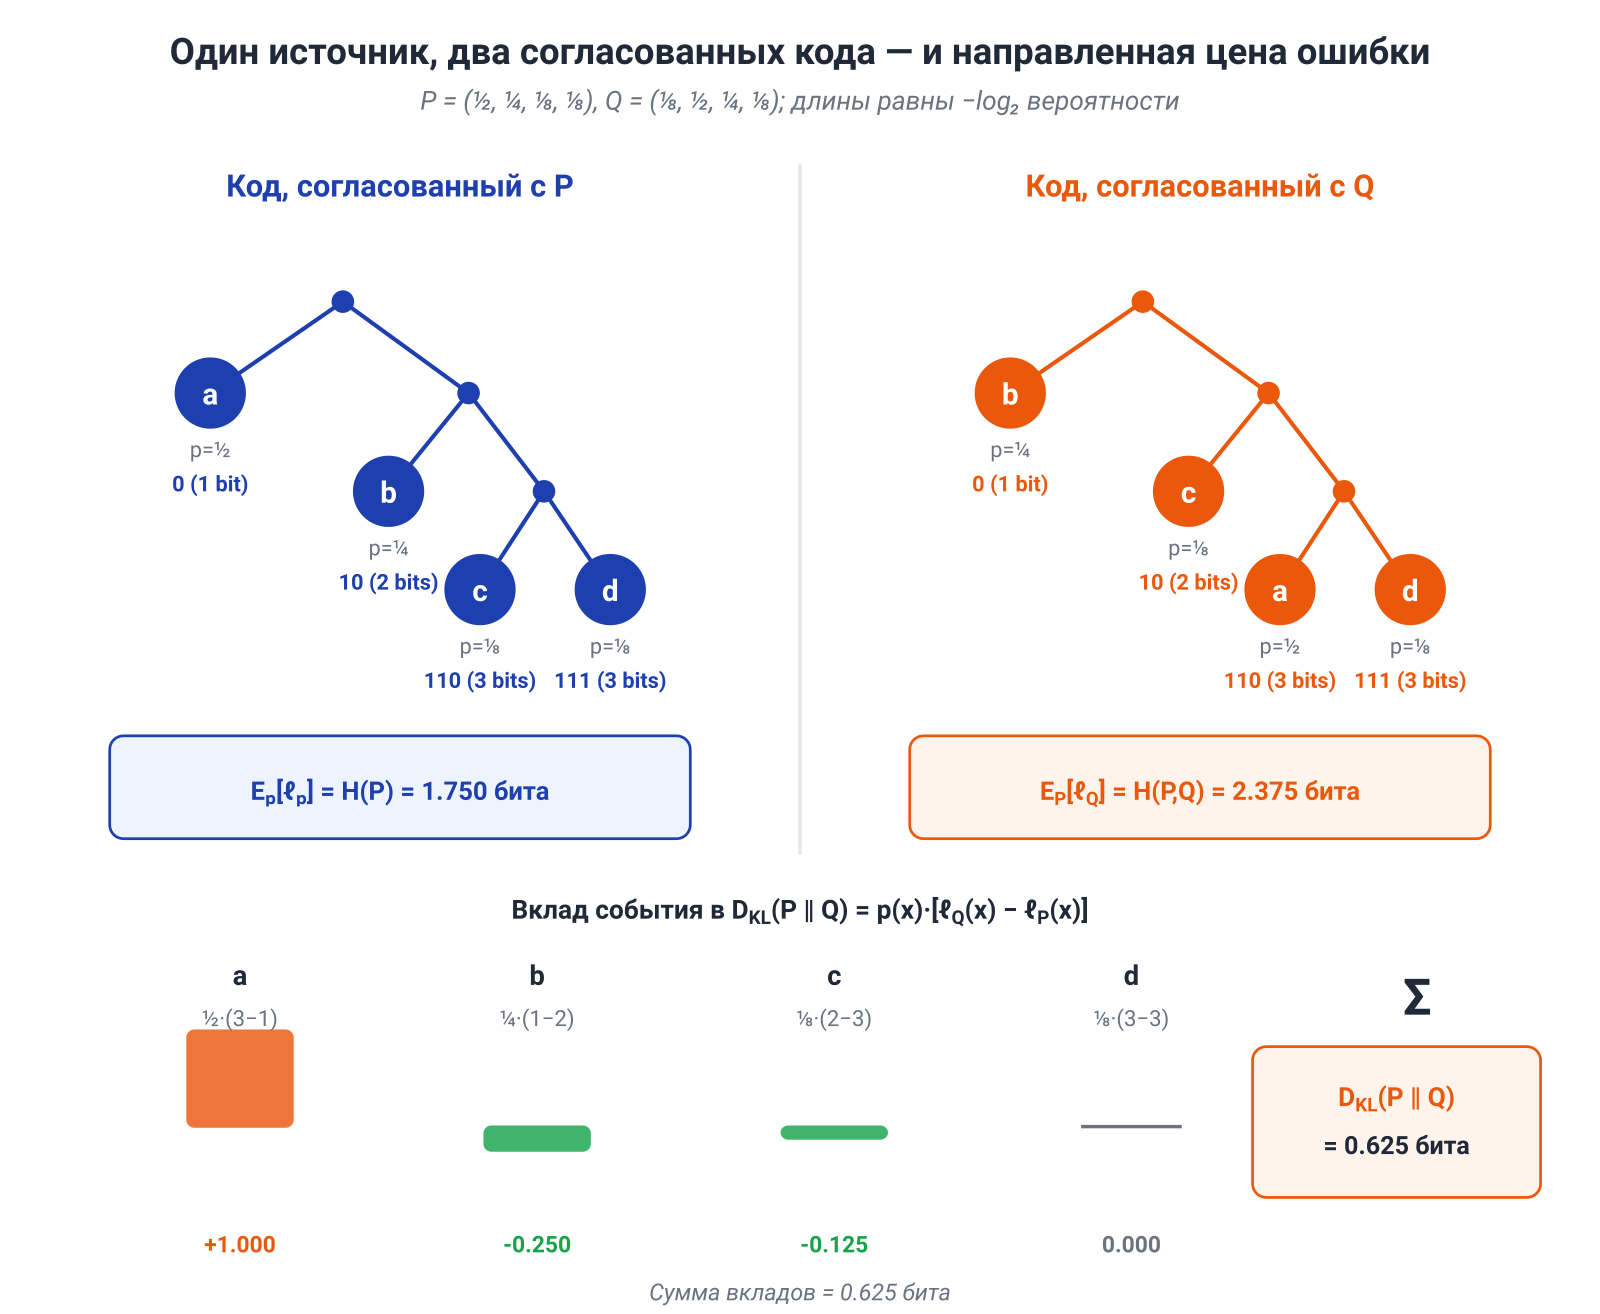
Диадический пример: одинаковая энтропия, разная цена ошибки
Пусть
Оба распределения диадические, поэтому идеальные длины целые:
| исход | ||||
|---|---|---|---|---|
| 1 | 3 | |||
| 2 | 1 | |||
| 3 | 2 | |||
| 3 | 3 |
Энтропии совпадают:
Но код под особенно дорог для самого частого события , поэтому
В обратном направлении
Одинаковая энтропия говорит, что два источника имеют одинаковую среднюю неопределённость. Она не говорит, что ошибки взаимной подстановки будут одинаковыми. Направление определяет, какие события встречаются часто и какие цены назначил им чужой код.
3.5. Одна формула для классификации и языковой модели
Пусть — контекст, а — метка или следующий токен. Ожидаемая условная логарифмическая потеря модели равна
Применим разложение предыдущего раздела отдельно при каждом контексте, а затем усредним по :
Теперь различие между «неопределённостью задачи» и «ошибкой модели» видно особенно ясно.
- — неоднозначность следующего исхода после доступного контекста;
- условная KL — средний разрыв между истинным и модельным распределениями продолжений.
Если один и тот же контекст допускает несколько естественных ответов, даже идеальная модель не обязана иметь нулевую потерю на каждом примере. Она должна правильно распределить вероятность между допустимыми продолжениями.
Авторегрессионная последовательность
Для последовательности длины
Логарифм превращает произведение в сумму:
После усреднения получаем
А цепное правило для KL раскладывает общий разрыв по шагам:
Вот точная информационно-теоретическая запись стандартного обучения языковой модели: каждый токен выставляет модели логарифмический счёт, а общий NLL складывает счета вдоль последовательности.
Teacher forcing: модель проверяют там, где живут данные
При teacher forcing контекст берётся из данных. Это делает целевую функцию вычислимой и даёт прямую оценку условных вероятностей модели на реальных префиксах. Именно по этим префиксам взвешена KL в формуле выше.
Во время свободной генерации контексты постепенно создаёт сама модель. Ранняя ошибка меняет следующий вход, затем следующий, и распределение посещаемых префиксов может уйти от к распределению, индуцированному . Поэтому NLL при teacher forcing точно измеряет качество условной модели на распределении данных, но не заменяет отдельную оценку поведения на собственных траекториях генерации.
Это полезная граница, а не приговор к кросс-энтропии. Она подсказывает устройство оценки: NLL на отложенной выборке проверяет вероятностное моделирование данных; генеративные тесты, интерактивные сценарии и проверки устойчивости оценивают поведение после накопления собственных решений.
Что обещает целевая функция следующего токена
На уровне распределения целевая функция поощряет совпадение
для контекстов из данных. Это сильное и точное утверждение. Фактическая корректность, полезный отказ от ответа и соответствие предпочтениям появляются в той мере, в какой они представлены в данных и постановке задачи. Retrieval, инструменты проверки, дообучение по предпочтениям и специальные оценивания добавляют сигналы, которых в обычном next-token NLL нет.
Поэтому низкий NLL — фундаментальная характеристика вероятностной языковой модели, но не единственная метрика готовой системы.
3.6. Почему CrossEntropyLoss так удобно оптимизировать
Пусть сеть выдаёт логиты , а вероятности получаются через softmax:
Для целевого распределения , где и , кросс-энтропийная потеря равна
Эта форма сразу показывает устройство оптимизации: logsumexp учитывает все классы, а второй член поднимает логиты в соответствии с целевым распределением.
Дифференцирование даёт одну из самых полезных формул в глубоком обучении:
Для one-hot-цели
Модель уменьшает логиты классов, которым дала больше вероятности, чем требуется целью, и увеличивает логит целевого класса. Величина поправки уже масштабирована текущей вероятностью — отдельный ручной коэффициент для softmax не нужен.
Матрица Гессе равна
Для любого вектора
Значит, кросс-энтропия выпукла по логитам. Глубокая сеть при этом не становится выпуклой по весам: логиты являются нелинейной функцией параметров многих слоёв.
Численно устойчивая форма
Вычислять softmax, а затем log отдельно не следует: экспоненты больших логитов могут переполниться, а малые вероятности — округлиться к нулю. Используется тождество
Поэтому в PyTorch nn.CrossEntropyLoss и F.cross_entropy принимают сырые ненормированные логиты. Для целевых индексов классов слитая операция соответствует log_softmax плюс NLL:
import torch
import torch.nn.functional as F

logits = torch.tensor([[2.0, -1.0, 0.5]], requires_grad=True)
target = torch.tensor([2])

loss_fused = F.cross_entropy(logits, target)
loss_manual = F.nll_loss(F.log_softmax(logits, dim=-1), target)

assert torch.allclose(loss_fused, loss_manual)
loss_fused.backward()
Слитая реализация нужна не только ради скорости: она сохраняет правильную численную шкалу вычисления.
Один API может задавать разные статистические задачи
При сглаживании меток (label smoothing) one-hot-цель заменяется, например, на
где — распределение сглаживания, часто равномерное. Градиент по-прежнему равен , но оптимум на уровне распределения теперь соответствует сглаженному условному распределению. Это осознанная регуляризация, а не обычный NLL исходных one-hot-наблюдений.
Веса классов меняют относительную стоимость ошибок. ignore_index, маскирование и режим reduction определяют, какие элементы и с какими коэффициентами входят в среднее. Поэтому имя CrossEntropyLoss ещё не описывает целиком оцениваемый риск: нужно смотреть на цели, веса и нормировку.
Для токенной перплексии обычно нужен несглаженный и невзвешенный средний NLL по тем целевым токенам, которые действительно входят в протокол оценки.
3.7. Перплексия: возврат из логарифмической шкалы
NLL удобен для сложения и оптимизации, но его логарифмическая шкала не всегда интуитивна. Перплексия (perplexity, PPL) возвращает среднюю потерю из логарифмической шкалы в мультипликативную, экспоненцируя её.
Для наблюдаемых целей
а
Если NLL измерен в натах,
если в битах,
Эквивалентная форма особенно полезна:
То есть PPL — геометрическое среднее обратных вероятностей, назначенных моделью наблюдаемым целям.
Небольшой пример
Пусть на трёх шагах модель назначила фактически наблюдаемым токенам вероятности
Средний NLL в битах равен
поэтому
То же самое видно из геометрического среднего:
Фраза «эффективное число равновероятных вариантов» точна, когда модель на каждом шаге действительно равномерна на одинаковом числе исходов. Для общего распределения это полезная шкала, а не буквальный подсчёт кандидатов.
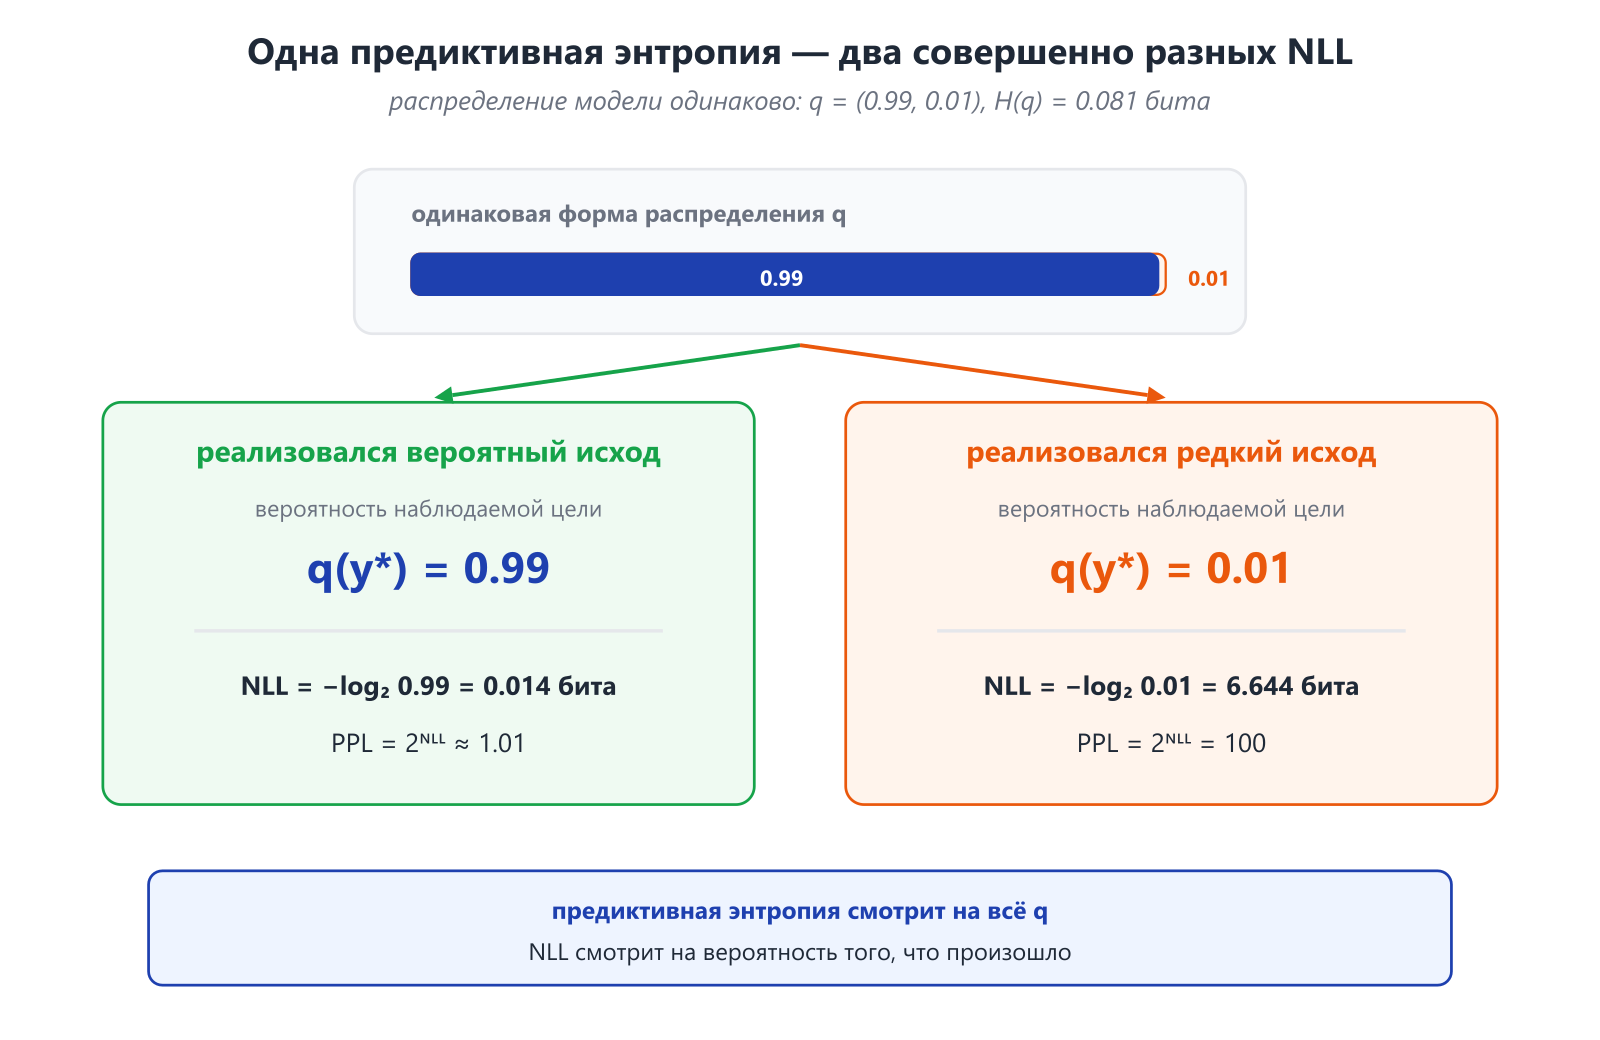
PPL и предиктивная энтропия отвечают на разные вопросы
Предиктивная энтропия модели при контексте
измеряет, насколько распределена сама модель. NLL и PPL смотрят на вероятность реализовавшегося исхода.
Поэтому уверенная модель может иметь очень низкую предиктивную энтропию и огромную PPL, если она уверена не в том ответе. И наоборот, объективно неоднозначный контекст может давать высокую энтропию, но хороший ожидаемый NLL, если модель правильно распределила массу между возможными продолжениями.
На уровне ожидаемого риска разложение из §3.5 даёт нижнюю границу
с равенством для идеального условного предиктора. В ограниченном модельном семействе минимум может быть выше. Конкретная оценка на конечной выборке случайна и иногда оказывается ниже своего ожидания, поэтому одно validation-число или экстраполированную асимптоту нельзя автоматически объявлять «истинной энтропией языка».
Сравнимость перплексии
PPL зависит от того, какие события считаются шагами предсказания. Разные токенизаторы разбивают одну строку на разное число токенов, поэтому их токенные PPL нельзя сравнивать напрямую.
Корректное сравнение требует как минимум:
- одного корпуса и одинаковой предобработки;
- одного токенизатора;
- одинаковой длины и политики контекста;
- одинаковой маски целевых токенов и нормировки.
Биты на байт или символ дают общую физическую единицу и улучшают сопоставимость, хотя состав корпуса и контекстный протокол всё равно остаются частью эксперимента. В Модуле 6 эта связь станет буквальной: вероятностная модель превратится в компрессор, а NLL — в измеримую длину файла.
3.8. Математическое углубление: почему направление KL меняет ответ
Можно пропустить при первом чтении. Для основного маршрута достаточно знать, что MLE минимизирует , а направление начинает особенно влиять на решение, когда модельное семейство не может точно представить целевое распределение.
Далее удобно перейти от сумм к плотностям:
В этом разделе будем называть
прямой KL (forward KL) от цели к приближению , а
— обратной KL (reverse KL). Термины зависят от того, какое распределение объявлено целью, поэтому важнее всегда смотреть на порядок аргументов.
У двух направлений различается место усреднения:
- прямая KL берёт ожидание по : каждый регион, где находятся данные, получает голос;
- обратная KL берёт ожидание по : модель платит прежде всего за те регионы, куда сама поместила массу.
Если допустимы все распределения и представимо точно, оба направления имеют общий минимум . Разница становится видимой при неверной спецификации модельного семейства (model misspecification).
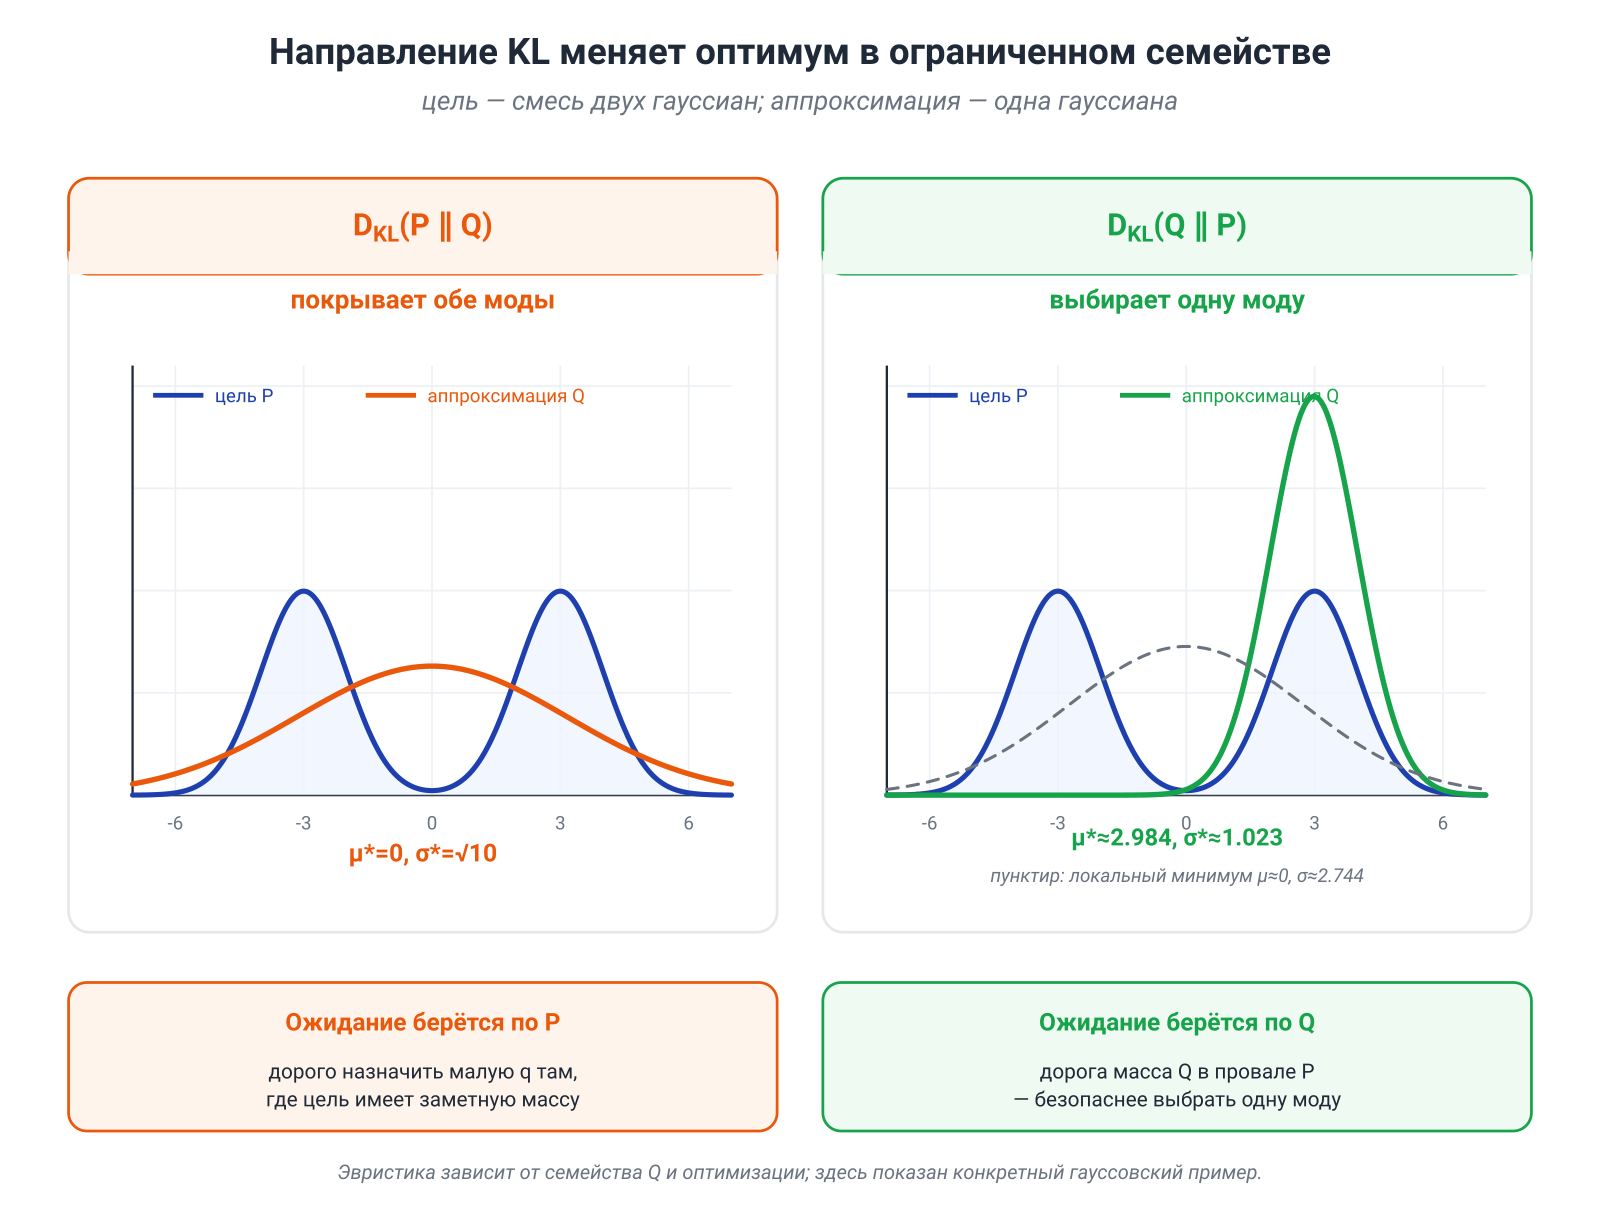
Канонический пример: два пика и один гауссиан
Пусть целевая плотность — симметричная смесь
а модель ограничена одним гауссианом
Прямая KL: каждый пик должен быть объяснён
При фиксированном минимизация эквивалентна минимизации
Оптимальный гауссиан совпадает с по среднему и дисперсии:
Итак,
Модель накрывает обе моды и неизбежно помещает массу между ними. В этом конкретном семействе возникает поведение, которое обычно называют покрытием мод (mode-covering) или стремлением к среднему (mean-seeking).
Обратная KL: выгодно выбрать один безопасный регион
Для
замкнутой формулы здесь нет. Численная оптимизация даёт два симметричных глобальных минимума приблизительно
Каждый из них хорошо описывает одну моду и почти игнорирует вторую. Это каноническое стремление к моде (mode-seeking).
Ландшафт при этом богаче одного лозунга. Существует также более широкий центральный локальный минимум около
но его значение обратной KL выше. Оптимизатор, инициализация и параметризация влияют на то, какое решение будет найдено.
Если носители распределений имеют жёсткие нули, направленность усиливается до бесконечных штрафов: не допускает нулей на массе , а — массы там, где . В гауссовском примере оба распределения положительны на всей прямой, поэтому различие возникает и без жёстких нулей — из-за разных весов в ожидании и ограниченности модельного семейства.
Картинку «прямая KL покрывает, обратная выбирает моду» полезно помнить как сильную эвристику. Это не универсальная теорема о каждой архитектуре, каждой дивергенции и каждом запуске оптимизации.
3.9. Карта KL-целевых функций в ML
Справочный раздел. Здесь одна и та же математика появляется в разных ролях. Для каждого примера сначала смотрите, кто стоит в первом аргументе KL, кто — во втором и по каким данным берётся ожидание.
Максимальное правдоподобие и языковое моделирование
Обычный NLL данных минимизирует
точнее — среднюю условную KL на контекстах из данных. Это строгий вывод §3.5. Эвристика покрытия мод может помогать думать об ограниченных семействах, но поведение большой LLM дополнительно определяется конечностью данных, архитектурой, декодированием, дообучением (post-training) и распределением эксплуатации.
Вариационный вывод
Для латентной модели стандартное тождество ELBO имеет вид
При фиксированной генеративной модели максимизация ELBO по вариационному распределению минимизирует обратную KL к апостериорному распределению. Если вариационное семейство слишком бедно, оно может недопредставлять некоторые моды апостериорного распределения.
Коллапс апостериорного распределения (posterior collapse) в VAE — другое явление: часто под ним понимают режим
в котором латентная переменная почти перестаёт нести информацию об . Недопокрытие мод и коллапс апостериорного распределения могут встречаться в одной системе, но это не два названия одного эффекта.
Дистилляция знаний
Классическая дистилляция с мягкими целями учителя минимизирует
что при фиксированном учителе эквивалентно
Ученик получает не только победивший класс, но и скрытую структуру относительных вероятностей остальных классов — то, что в исходной работе названо dark knowledge учителя.
Для авторегрессионной модели важен ещё один выбор: на чьих префиксах сравниваются распределения. Обучение на фиксированном наборе использует префиксы из данных или генераций учителя. Generalized Knowledge Distillation (GKD) добавляет последовательности, сгенерированные текущей политикой ученика (on-policy), и допускает разные дивергенции. Тем самым отдельно настраиваются два аспекта: распределение контекстов и локальная мера расхождения между учителем и учеником.
KL-регуляризованное обучение по предпочтениям
Идеализированная задача для запроса записывается как
Награда тянет политику к предпочтительным ответам, а KL назначает цену за отклонение от базовой политики. Коэффициент задаёт обменный курс между этими силами. В Модуле 8 мы точно решим эту вариационную задачу и получим экспоненциальный перенаклон базового распределения.
Практический PPO включает целевую функцию градиента политики (policy-gradient objective), ограничение шага (clipping), сэмплирование и приближённый контроль отклонения; его нельзя свести к одному KL-члену. DPO выводится из той же KL-регуляризованной постановки, но оптимизирует парную функцию потерь классификации предпочтений. Поэтому связь DPO с KL находится в исходной модели и выводе, а не в обязательном явном вычислении KL-штрафа на каждом мини-батче.
3.11. Литература и первоисточники
- C. E. Shannon, «A Mathematical Theory of Communication», Bell System Technical Journal, 1948.
- S. Kullback, R. A. Leibler, «On Information and Sufficiency», Annals of Mathematical Statistics, 22(1):79–86, 1951.
- T. M. Cover, J. A. Thomas, «Elements of Information Theory», 2-е изд., Wiley, 2006.
- T. Gneiting, A. E. Raftery, «Strictly Proper Scoring Rules, Prediction, and Estimation», JASA, 102(477):359–378, 2007.
- D. M. Blei, A. Kucukelbir, J. D. McAuliffe, «Variational Inference: A Review for Statisticians», JASA, 2017.
- G. Hinton, O. Vinyals, J. Dean, «Distilling the Knowledge in a Neural Network», 2015.
- R. Agarwal et al., «On-Policy Distillation of Language Models: Learning from Self-Generated Mistakes», 2023.
- L. Ouyang et al., «Training Language Models to Follow Instructions with Human Feedback», 2022.
- R. Rafailov et al., «Direct Preference Optimization: Your Language Model Is Secretly a Reward Model», 2023.
- J. He et al., «Lagging Inference Networks and Posterior Collapse in Variational Autoencoders», 2019.
- Документация PyTorch:
torch.nn.CrossEntropyLossиtorch.nn.functional.cross_entropy.