Модуль 9. Скорость–искажение и Information Bottleneck: как управлять потерей информации
Как читать этот модуль. Основной маршрут — §§9.1–9.8. Сначала мы разберём классическую теорию скорости–искажения, затем Information Bottleneck, его вариационную версию, VAE и реальные задачи сжатия и квантизации. §9.9 — математическое углубление про I–MMSE и гауссовское зашумление; его можно оставить на второй проход. §9.10 — упражнения.
9.1. Зачем модели забывать
После Модуля 6 легко прийти к правильной, но неполной интуиции: чем больше информации удалось сохранить, тем лучше. Для сжатия без потерь это действительно так — декодер обязан восстановить исходный объект точно.
Но большинство ML-систем решают другую задачу.
Изображение рукописной цифры содержит класс цифры, почерк автора, толщину линии, положение на холсте, фон и шум сенсора. Для распознавания цифры часть этих различий можно отбросить. Для идентификации автора почерка — уже нельзя. Для точной реконструкции изображения понадобится ещё больше деталей.
Одна и та же информация может быть:
- полезным сигналом для одной задачи;
- помехой для другой;
- обязательной частью исходного объекта для третьей.
Поэтому слово «лишняя» не имеет смысла без указания цели.
JPEG может забыть мелкие высокочастотные детали ради меньшего файла. Нейронный кодек может тратить больше бит на лицо, чем на гладкий фон. Энкодер классификатора может отбросить освещение и сохранить форму. Квантизатор LLM может грубо округлить многие веса, пока предиктивное распределение модели меняется мало.
Во всех случаях вопрос один:
Какой минимум информации нужно сохранить, чтобы качество по выбранному критерию осталось приемлемым?
Бутылочное горлышко здесь — не призыв забыть как можно больше. Это контракт: что разрешено потерять, какой ценой и ради какой задачи.
В модуле встретятся четыре тесно связанные конструкции:
- теория скорости–искажения (
rate–distortion theory) отвечает, сколько бит нужно при допустимой потере качества; - Information Bottleneck (IB) выводит цену ошибки из переменной, которую мы хотим предсказывать;
- Variational Information Bottleneck (VIB) и VAE заменяют недоступные информационные величины обучаемыми вариационными целями;
- обучаемое сжатие и квантизация показывают, когда абстрактная «скорость» становится реальным числом бит, а когда остаётся лишь полезным суррогатом.
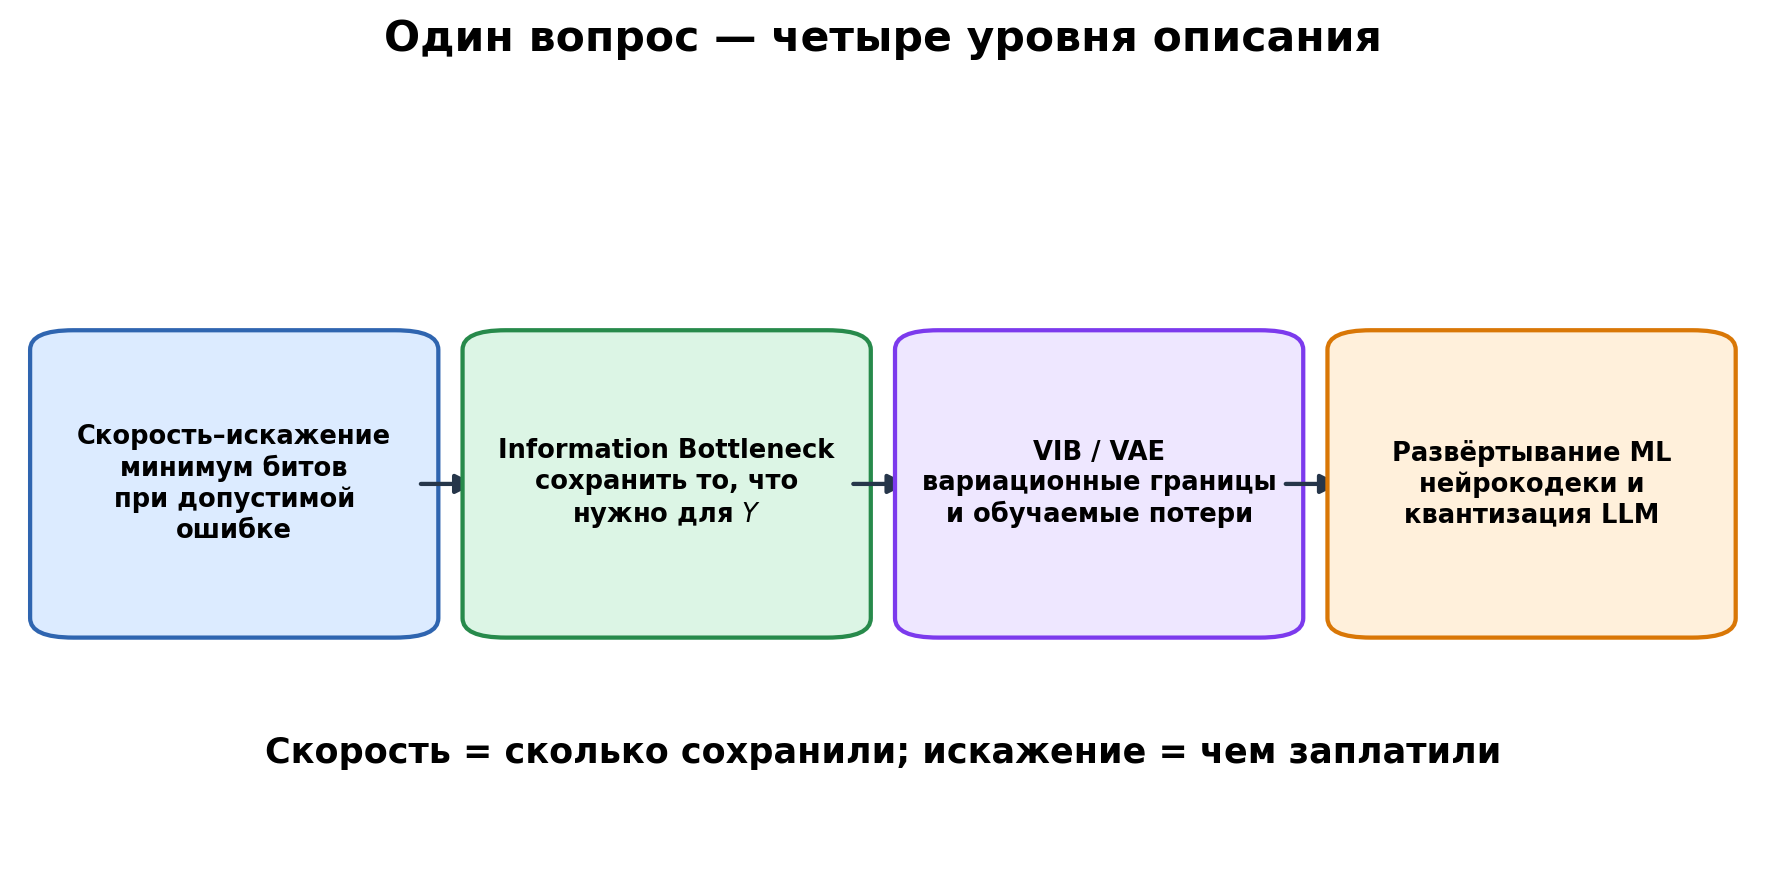
Сквозная пара понятий будет такой:
- скорость — сколько информации прошло через представление;
- искажение — чем мы заплатили за уменьшение этой скорости.
Если не сказано иное, классическая теория скорости–искажения записывается в битах. Вариационные ML-цели обычно реализуются с натуральным логарифмом и измеряются в натах. Основание логарифма будет указано там, где оно меняет численный коэффициент.
9.2. Теория скорости–искажения: сколько информации нужно сохранить
От двух крайних кодов к целой кривой
Пусть
а ошибка измеряется искажением Хэмминга:
Есть два очевидных решения.
Точное кодирование. Чтобы восстановить источник без ошибок, асимптотически требуется
Нулевая скорость. Можно не передавать ничего и всегда восстанавливать . Скорость равна нулю, а среднее искажение равно
Между этими точками находится целая область компромиссов. Например, если мы допускаем среднюю ошибку , оптимальная асимптотическая скорость уже равна
Теория скорости–искажения описывает именно эту границу: сколько информации неизбежно нужно передать при каждом допустимом качестве реконструкции.
Формальная постановка
Пусть источник выдаёт , а декодер строит реконструкцию из воспроизводящего алфавита . Функция
назначает цену замены на .
Типичные варианты:
- искажение Хэмминга: ;
- квадратичная ошибка: ;
- отрицательный логарифм правдоподобия реконструкции;
- KL между выходными распределениями исходной и сжатой моделей;
- перцептивное расстояние в пространстве признаков;
- рост ошибки в последующей задаче.
Для дискретного источника без памяти функция скорость–искажение определяется как
Условное распределение называют тестовым каналом (test channel). Это не обязательно физический канал и не обязательно готовый алгоритм кодирования. Оно задаёт желаемое совместное распределение исходов и реконструкций: какие замены допустимы и как часто они происходят.
Почему взаимная информация становится числом бит
На первый взгляд в определении нет ни файла, ни кодовых слов — только взаимная информация. Операционный смысл появляется на длинных блоках.
При стандартных условиях теорема Шеннона утверждает:
- любая скорость выше асимптотически достижима при среднем искажении не больше ;
- любая скорость ниже асимптотически недостаточна.
Кодер не обязан передавать независимое описание каждого символа. Он кодирует целый типичный блок и использует статистическую повторяемость источника. Поэтому минимум взаимной информации после оптимизации по тестовому каналу становится минимальной скоростью в битах на символ.
Это тот же интеллектуальный ход, что и в обычной теореме кодирования источника: локальные вероятности превращаются в глобальную геометрию длинных последовательностей.
Геометрия компромисса
Функция невозрастает и выпукла. Разрешили больше искажения — минимально необходимая скорость не может вырасти. Выпуклость означает, что смешивание двух режимов кодирования не хуже соответствующего среднего компромисса.
Нулевая скорость достигается при
потому что без сообщения декодер может выдавать только заранее выбранную константу.
Точка требует условий. Она верна для конечного дискретного источника, если нулевое искажение возможно только при точном воспроизведении. Для непрерывного источника с квадратичной ошибкой обычно
точное вещественное число требует неограниченной точности.
На практике часто оптимизируют лагранжиан
Если граница дифференцируема в рабочей точке, то
То есть — локальный обменный курс: сколько дополнительной скорости мы готовы заплатить за уменьшение искажения. Позже та же геометрия появится в IB, VAE и обучаемом сжатии.
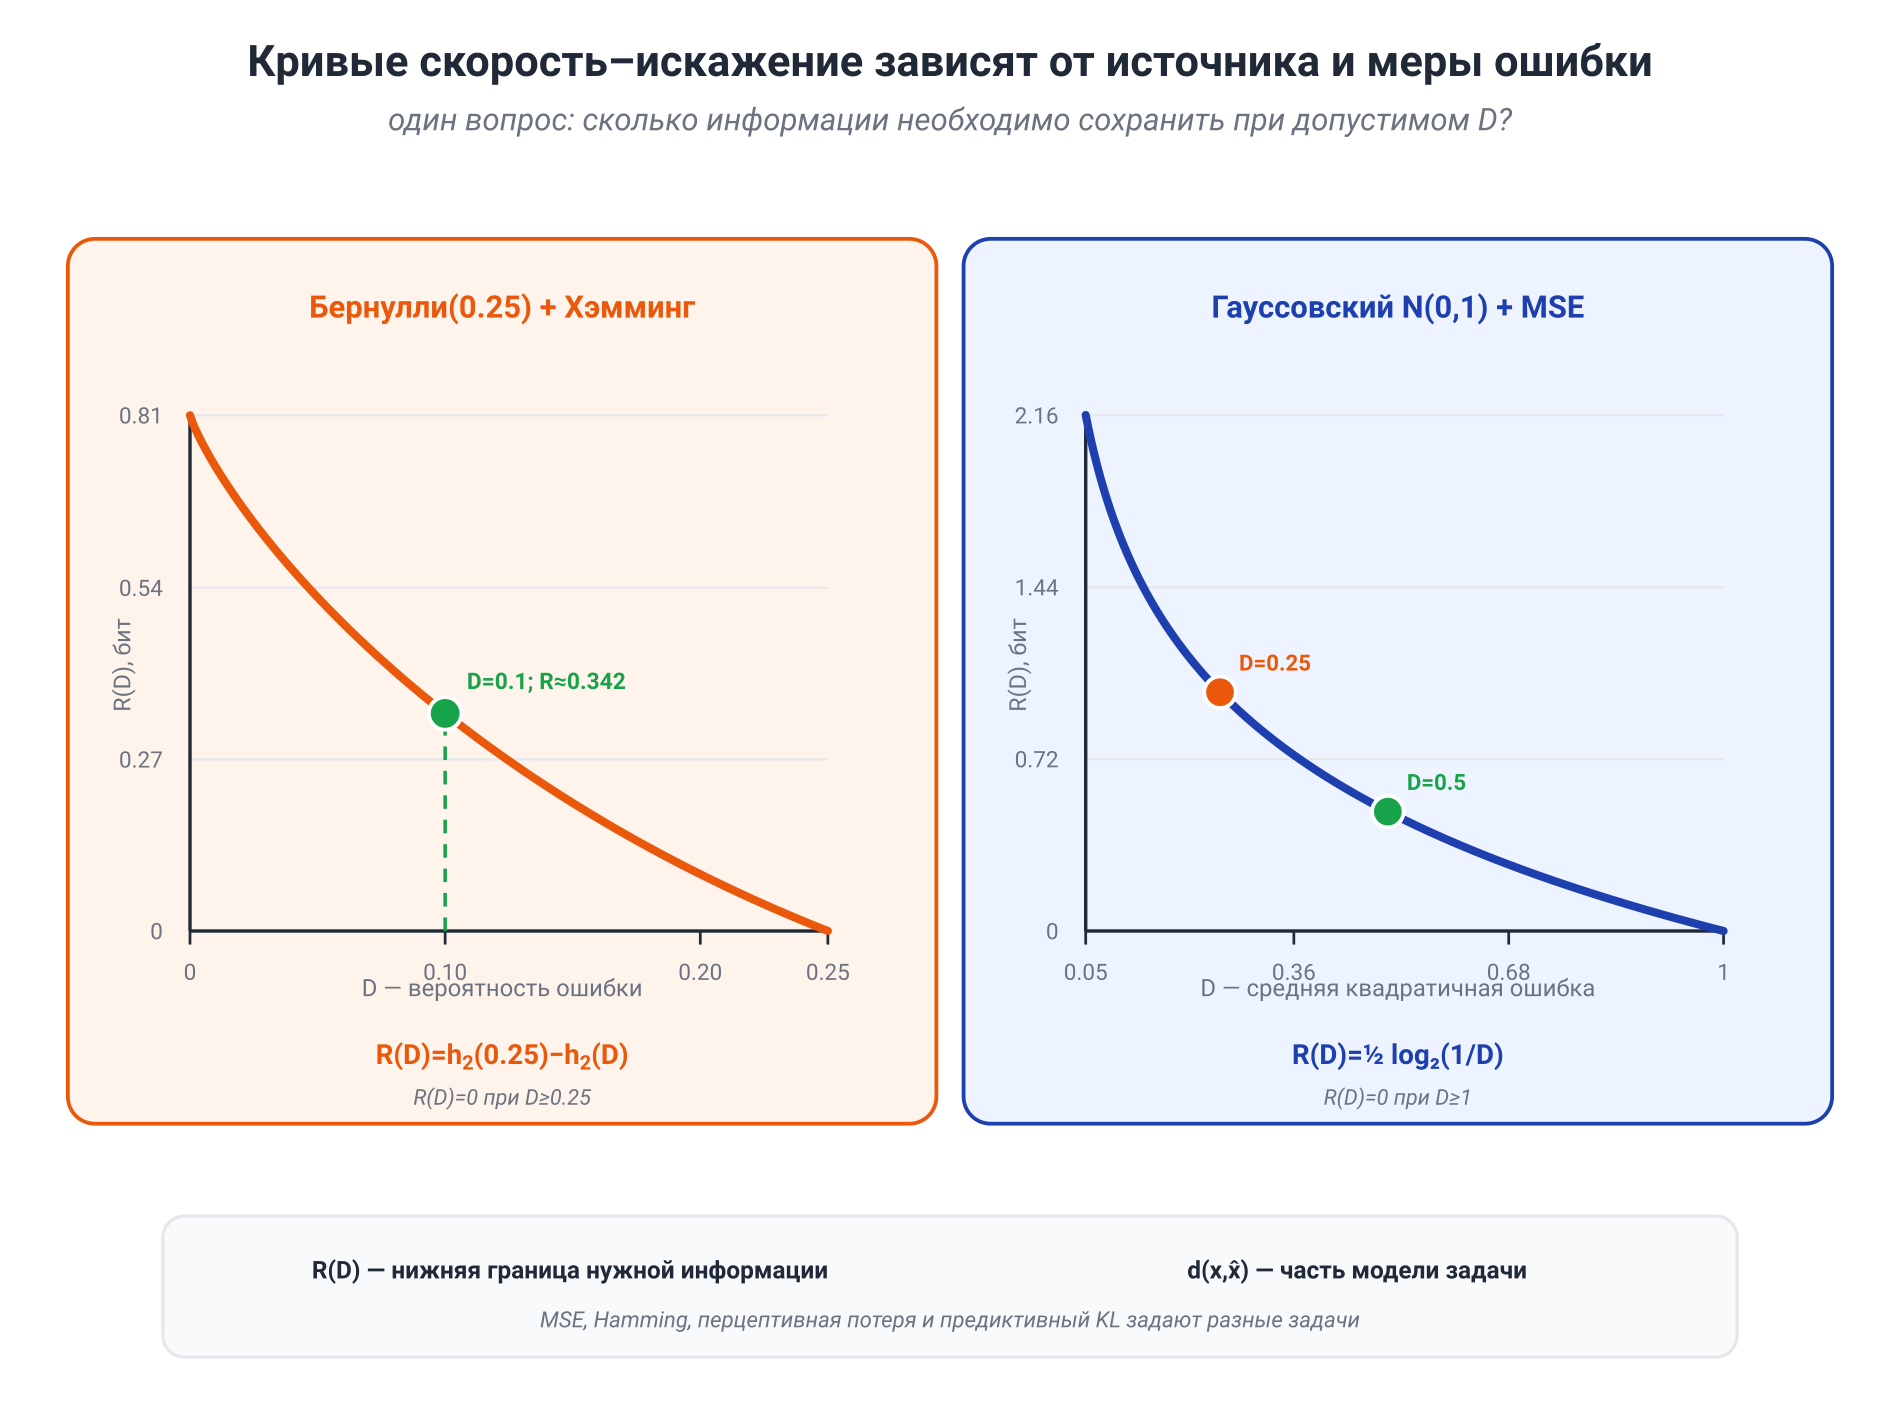
Два эталонных источника
Для , , и искажения Хэмминга:
Для гауссовского источника
с квадратичным искажением, при логарифме по основанию 2:
В этой конкретной модели уменьшение MSE вдвое стоит ещё бита на вещественный символ.
Искажение не дано природой
Вот где легко сделать слишком сильный вывод. Теория находит оптимальный код для заданной функции искажения. Она не выбирает за нас, какая ошибка важна человеку или последующей системе.
MSE удобно согласуется с гауссовским правдоподобием и PSNR, но может дорого штрафовать небольшой сдвиг изображения и поощрять усреднённую размытую реконструкцию. Перцептивная функция потерь может лучше сохранять визуальную структуру, но уже наследует предположения выбранной сети признаков. Для сжатой LLM естественным искажением может оказаться не MSE весов, а рост NLL или KL между предиктивными распределениями.
В визуальном сжатии появляется и третий объект — перцептивная правдоподобность распределения реконструкций. Низкое среднее искажение и реалистичный вид не тождественны; дополнительное требование к восприятию в общем случае поднимает достижимую границу скорость–искажение.
Это не ослабляет теорию. Напротив, она заставляет явно назвать то, что инженерные обсуждения часто прячут в слове «качество».
9.3. Information Bottleneck: сохранить то, что важно для
В классической задаче функцию задаёт инженер. Но в обучении представлений часто трудно заранее сказать, какие различия между входами существенны.
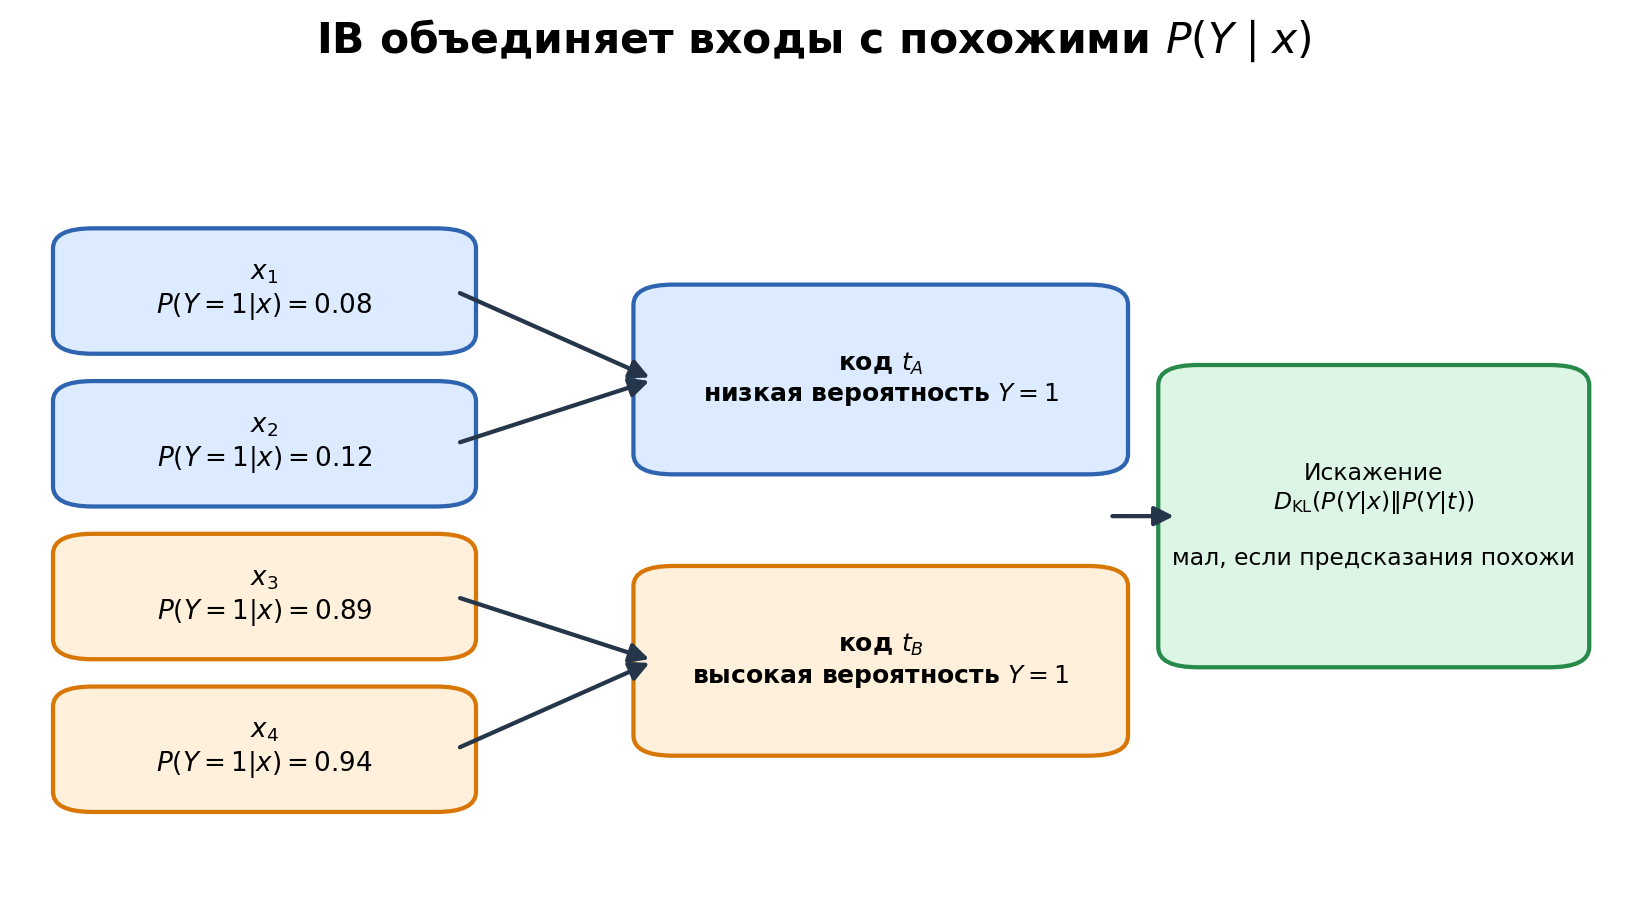
Представим два изображения одной и той же цифры. Пиксели отличаются, почерк отличается, фон отличается. Если их условные распределения метки почти одинаковы, классификатору выгодно считать их близкими. Если же целевая переменная — автор почерка, эти же различия становятся релевантными.
Information Bottleneck предлагает дать задаче самой определить цену забывания.
Пусть — релевантная переменная, а представление строится только из :
Мы хотим одновременно:
- уменьшить — не переносить через представление все детали входа;
- сохранить — не потерять предиктивную информацию о цели.
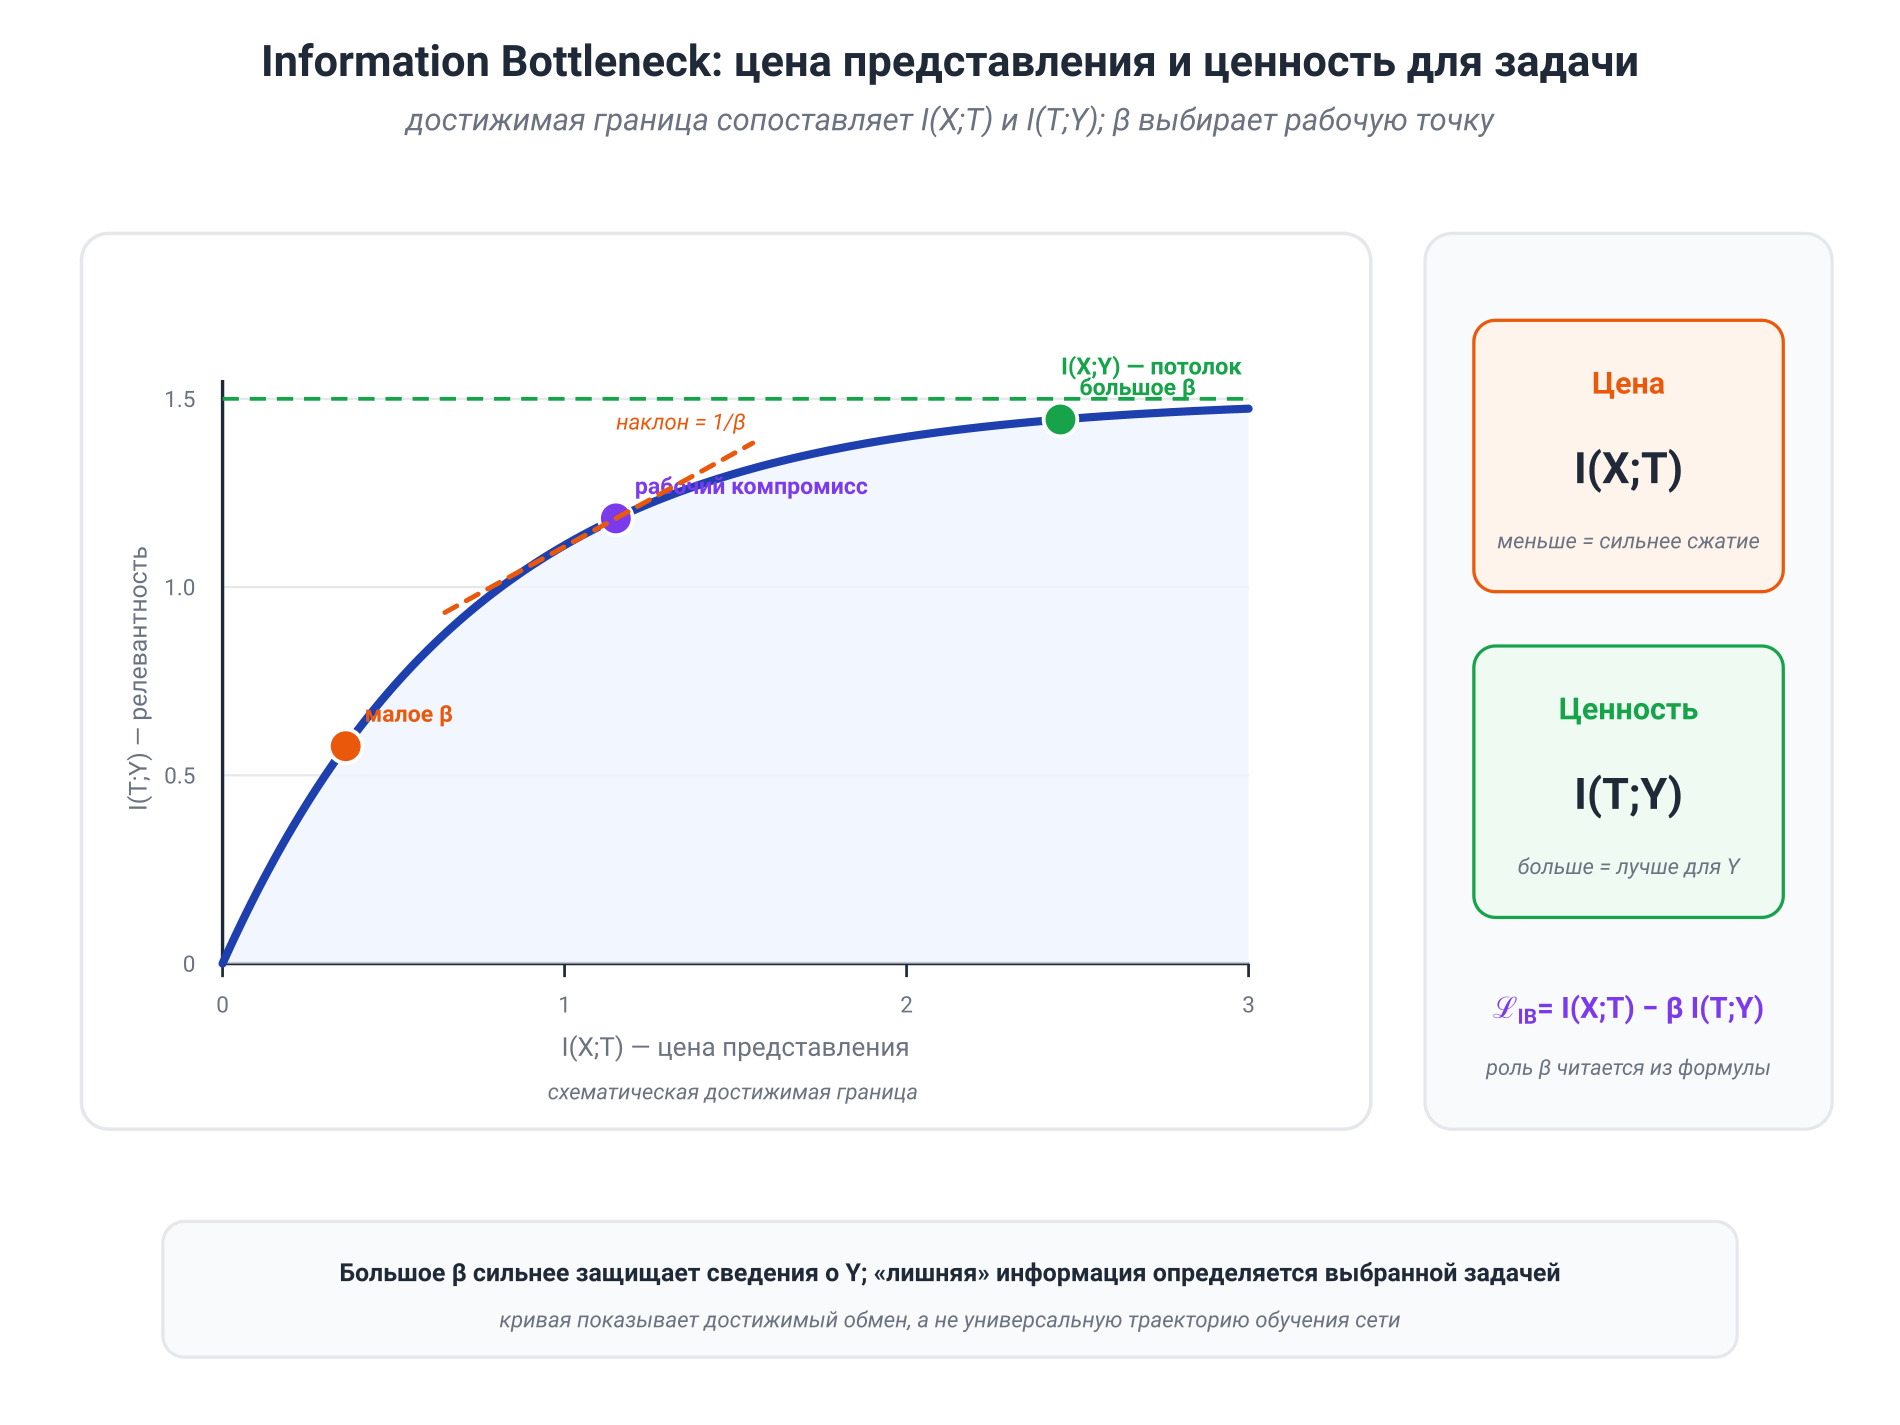
Одна постановка минимизирует скорость при заданной релевантности:
Соответствующая лагранжева форма:
При таком соглашении большое сильнее защищает информацию о . В других статьях встречаются обратные параметризации, поэтому роль коэффициента нужно читать из формулы, а не из буквы.
Предиктивная цена ошибки возникает сама
Из марковской цепи следует
Условную взаимную информацию можно записать как среднюю KL-дивергенцию:
Следовательно,
Определим
Тогда
Последний член не зависит от энкодера. Поэтому IB действительно является задачей скорость–искажение, где искажение измеряет не расстояние между входом и кодом, а ущерб предсказанию .
Это один из центральных результатов курса:
Два входа можно объединить, если после объединения почти не меняется то, что мы можем сказать о целевой переменной.
Если
то
и представление сохраняет всю доступную во входе информацию о . В этом смысле оно является достаточным для предсказания . IB ищет не просто достаточное представление, а по возможности самое компактное среди таких представлений.
Самосогласованное решение
Для конечных алфавитов стационарная точка классической IB-задачи удовлетворяет
Форма знакома по Модулю 8. Базовая масса экспоненциально наклоняется в пользу кодов с малым предиктивным искажением.
Но теперь уравнение самосогласованно:
- зависит от ;
- тоже зависит от ;
- а вычисляется через них обоих.
Итерации, родственные алгоритму Blahut–Arimoto, находят согласованное мягкое кластеризование. В большой нейросети истинные неизвестны, пространства огромны, а взаимные информации недоступны напрямую. Поэтому следующий шаг — заменить точные величины вариационными границами.
9.4. Variational Information Bottleneck: как сделать IB обучаемым
Классическая цель красива, но в ней есть три неудобных объекта:
- неизвестное истинное ;
- агрегированное распределение представления ;
- взаимные информации, которые трудно оценивать в высокой размерности.
VIB заменяет каждый из них обучаемой вероятностной моделью.
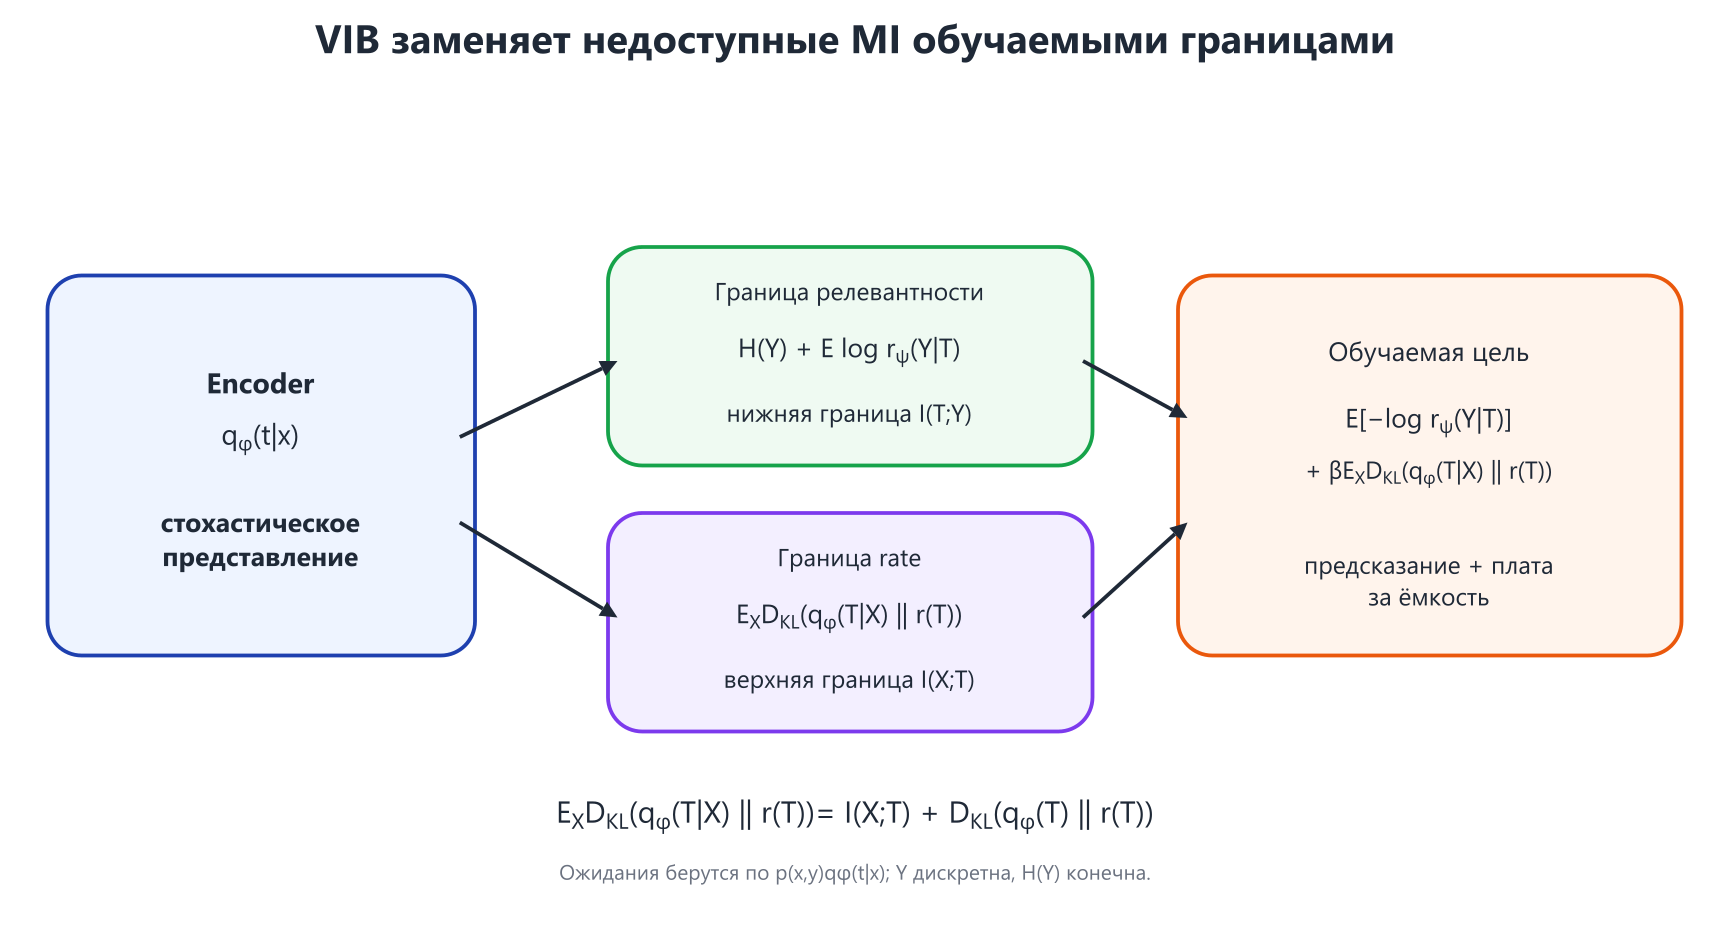
Пусть энкодер задаёт стохастическое представление
классификатор — вариационный декодер
а — простое априорное распределение, например .
Релевантность: классификатор как нижняя граница
Для любого :
Значит,
Кросс-энтропия не равна буквально. Вычитая её из , получаем обучаемую нижнюю границу на релевантность. Чем лучше декодер приближает истинное , тем плотнее граница.
Скорость: KL к априорному распределению как верхняя граница
Определим агрегированное распределение представления:
Тогда
Отсюда
У среднего KL два счёта:
- информация о конкретном входе, действительно прошедшая через ;
- цена несовпадения агрегированного распределения кодов с выбранным априорным распределением.
Если , второй счёт исчезает. Для простого фиксированного априорного распределения он обычно остаётся.
Обучаемая цель
Стандартная минимизируемая форма VIB:
Первый член платит за потерю предсказательной информации. Второй выставляет цену за ёмкость представления.
Для диагонального гауссовского энкодера
и KL вычисляется аналитически:
Это уже знакомая ML-функция потерь. Большое стоит дорого; слишком узкое условное распределение тоже стоит дорого, потому что оно позволяет передать много информации о конкретном .
Сэмплирование записывается через репараметризацию:
Стохастичность здесь не только технический трюк. Она позволяет определить и управлять вероятностной ёмкостью представления; конечность конкретного счёта обеспечивается конечностью выбранного KL.
Что именно гарантирует VIB
Положительный результат уже достаточно силён: мы получили обычную обучаемую функцию потерь, в которой предсказательная ошибка и цена представления имеют точное информационное происхождение.
Но нужно помнить, что именно оптимизируется:
- классификационный член — вариационная граница на релевантность;
- KL-член — верхняя граница на ;
- разрыв скорости зависит от несовпадения и ;
- малая скорость является индуктивным предположением, а не универсальным сертификатом обобщения или робастности.
Поэтому в эксперименте полезно логировать не только общую функцию потерь, но и её части: предиктивный NLL, средний KL, число активных координат и качество на отложенных данных. Один скаляр задаёт компромисс, но не объясняет автоматически, куда именно модель потратила свой информационный бюджет.
9.5. VAE как система скорость–искажение
VIB сохраняет информацию о внешней целевой переменной . У VAE такой переменной нет: модель должна объяснить сам объект через латентную переменную .
Генеративная модель задаётся как
а энкодер приближает апостериорное распределение:
Для одного объекта
Как мы видели в Модуле 4,
То есть ELBO одновременно является обучаемой нижней границей на логарифм правдоподобия и точной целью вариационного вывода.
После усреднения по данным отрицательная ELBO принимает форму
На этом месте удобно остановиться и прочитать формулу словами:
VAE платит за две вещи: насколько трудно восстановить объект по латенту и сколько информации латент потребовал относительно априорного распределения.
Правдоподобие декодера задаёт искажение
Если
с фиксированной , то
Искажение пропорционально MSE. Но коэффициент важен: изменение предполагаемого шума меняет обменный курс между реконструкцией и скоростью даже при формальном .
Для бернуллиевского декодера возникает бинарная кросс-энтропия. Для дискретного категориального декодера — многоклассовый NLL. Выбор правдоподобия — это выбор геометрии ошибок, а не только последней строки кода.
Скорость включает информацию и несовпадение с априорным распределением
Пусть
Тогда
Поэтому KL VAE — не просто «примерная взаимная информация». Он оплачивает:
- сведения о конкретном объекте ;
- несовпадение агрегированного распределения кодов с априорным распределением генеративной модели.
Второй член важен для генерации и для кодирования: декодер должен уметь получать латенты из того распределения, которое было объявлено априорным.
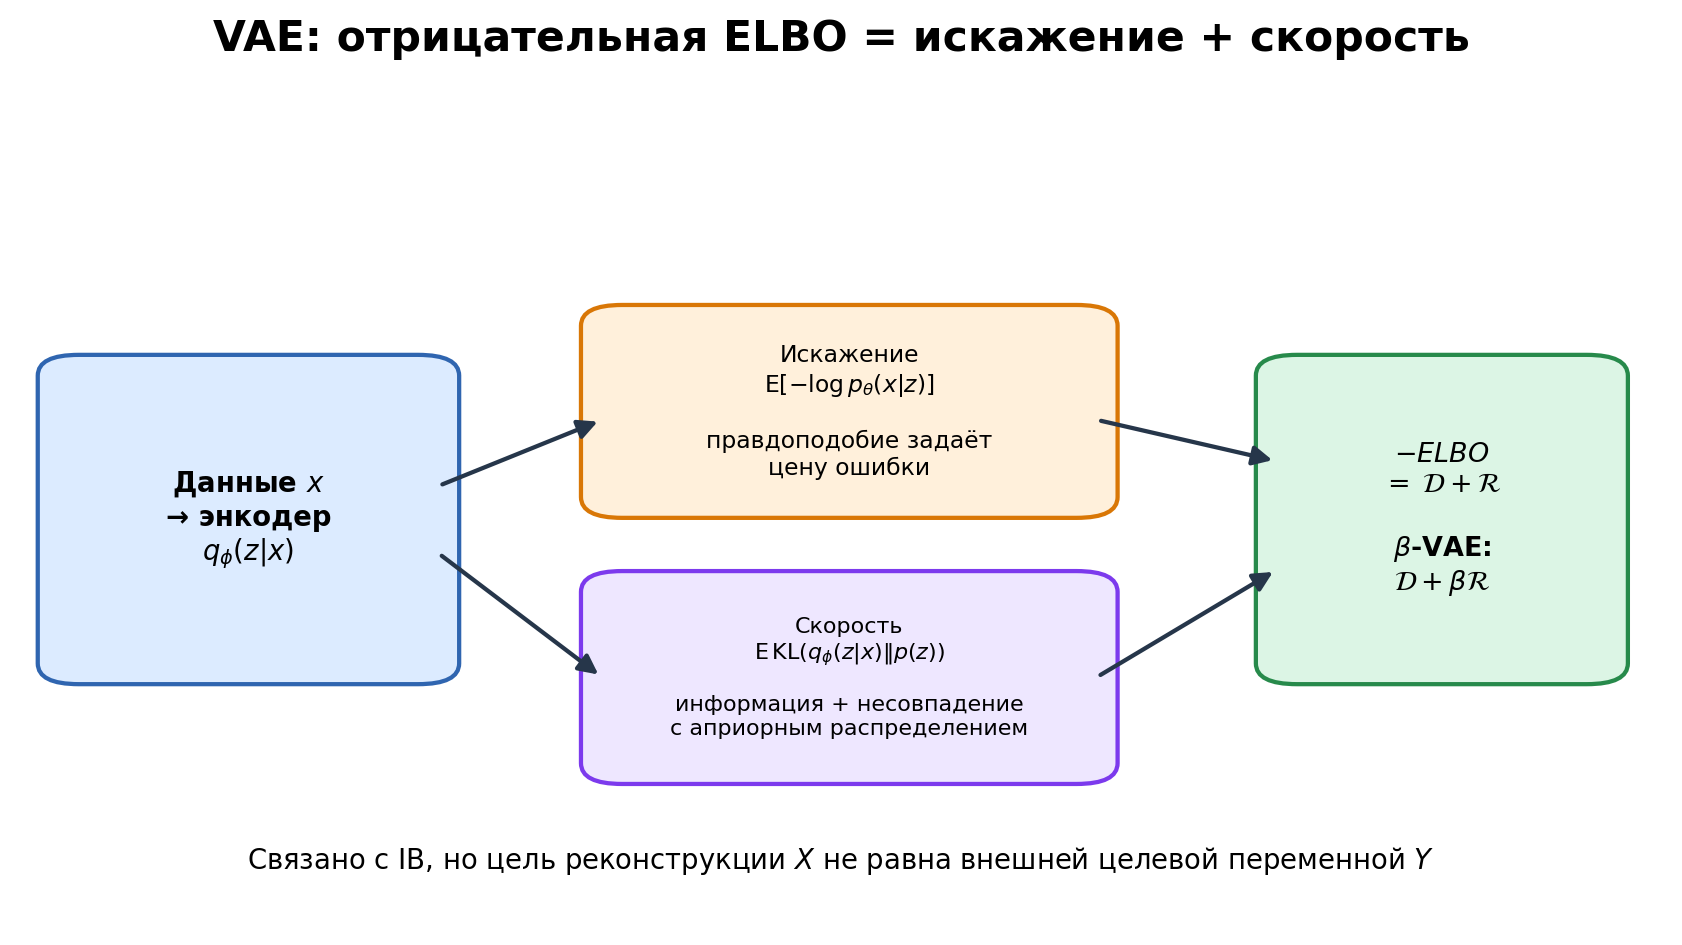
VAE, -VAE и IB: одна геометрия, разные задачи
-VAE минимизирует
При большем использование латентного канала штрафуется сильнее. В хорошо оптимизированной серии моделей это обычно сдвигает рабочую точку к меньшей скорости и большему искажению, хотя не выпуклая оптимизация не обещает идеальной монотонности для каждого запуска.
Важно не перепутать соглашения:
- в большое сильнее защищает релевантность;
- в большое сильнее штрафует скорость.
Стандартный VAE лучше понимать как вариационную систему скорость–искажение для генеративного моделирования и реконструкции. Он родствен IB общей математикой узкого места, но не является буквально supervised IB: внешней переменной здесь нет, а «полезность» латента определяется правдоподобием .
Коллапс апостериорного распределения
Если декодер достаточно мощный, он может хорошо моделировать , почти не используя :
Это коллапс апостериорного распределения (posterior collapse). С точки зрения ELBO модель нашла дешёвое решение: перестала платить за латентный канал. С точки зрения задачи, где нужен информативный латент, это неудача.
Практические способы управлять режимом:
- постепенное включение KL (
KL warm-up); free bitsили минимальная бесплатная ёмкость по координатам;- явная целевая ёмкость вместо немедленного давления к нулю;
- менее всесильный декодер;
- более выразительное априорное распределение;
- контроль активных латентных координат и фактической скорости.
Разделение факторов не следует из одного коэффициента
Повышенный штраф за скорость может поощрять более простые и факторизованные латенты. Но из цели не следует, что координаты обязаны совпасть с «истинными» факторами данных.
Без индуктивных предположений о данных, архитектуре или слабого учительского сигнала несупервизорное разделение факторов в общем случае неидентифицируемо. Поэтому -VAE — полезный механизм управления ёмкостью, но не автоматический извлекатель семантически правильных осей.
Факультативно: IWAE
IWAE использует сэмплов:
При стандартных условиях
Более плотная граница полезна для оценивания правдоподобия, но сама по себе не гарантирует более интерпретируемого или более полезного представления. Она меняет и геометрию градиента энкодера, поэтому «более плотная граница» и «более полезное представление» — разные вопросы.
9.6. Когда скорость становится реальными битами
В VIB и VAE слово «скорость» пока обозначало информационную цену внутри вероятностной модели. Чтобы получить файл, нужен ещё кодер и точный протокол — тот же урок, который мы уже видели в Модуле 6.
Есть два особенно полезных случая.
Обучаемое сжатие с потерями
Современный нейронный кодек обычно строит:
- непрерывный латент ;
- квантизованный латент ;
- энтропийную модель ;
- реконструкцию .
Типичная цель:
Если затем используется совместимым арифметическим или ANS-кодером, первый член уже имеет буквальный смысл ожидаемого числа бит, с точностью до конечной длины, округления и служебных данных.
В кодеке с гиперприором передаются и основные латенты, и служебные латенты:
Гиперлатент увеличивает собственный счёт, но может настолько улучшить предсказание , что общая скорость уменьшается. Это хороший пример того, почему «добавить ещё одну переменную» иногда означает сжать лучше, а не хуже.
Во время обучения жёсткое округление обычно заменяют дифференцируемым приближением: добавлением равномерного шума, прямым оценивателем градиента или другим суррогатом. На валидации нужно вернуться к настоящему квантизатору и физическому потоку бит.
ELBO как длина кода: идея bits-back
У VAE связь с кодированием тоже может быть буквальной. Рассмотрим один объект и латент .
Наивный код заплатил бы:
Но энкодер знает распределение . В bits-back-схеме часть случайных бит используется, чтобы выбрать , а после декодирования эти биты можно восстановить, снова закодировав под .
Чистая длина для выбранного становится
Если логарифмы взяты по основанию 2, то после усреднения по это ровно
Таким образом, отрицательная ELBO — не только удобная функция потерь. При подходящей bits-back-реализации она является ожидаемой чистой длиной кода латентной генеративной модели.
Практическая схема сложнее формулы: нужны начальные случайные биты, согласованный порядок операций, конечная точность и удобный стековый кодер вроде ANS. Но этот механизм объясняет, почему качество вариационного вывода влияет на компрессию: большой вариационный разрыв означает, что код не возвращает столько бит, сколько мог бы.
Квантизация весов LLM: та же дисциплина, но не тот же код
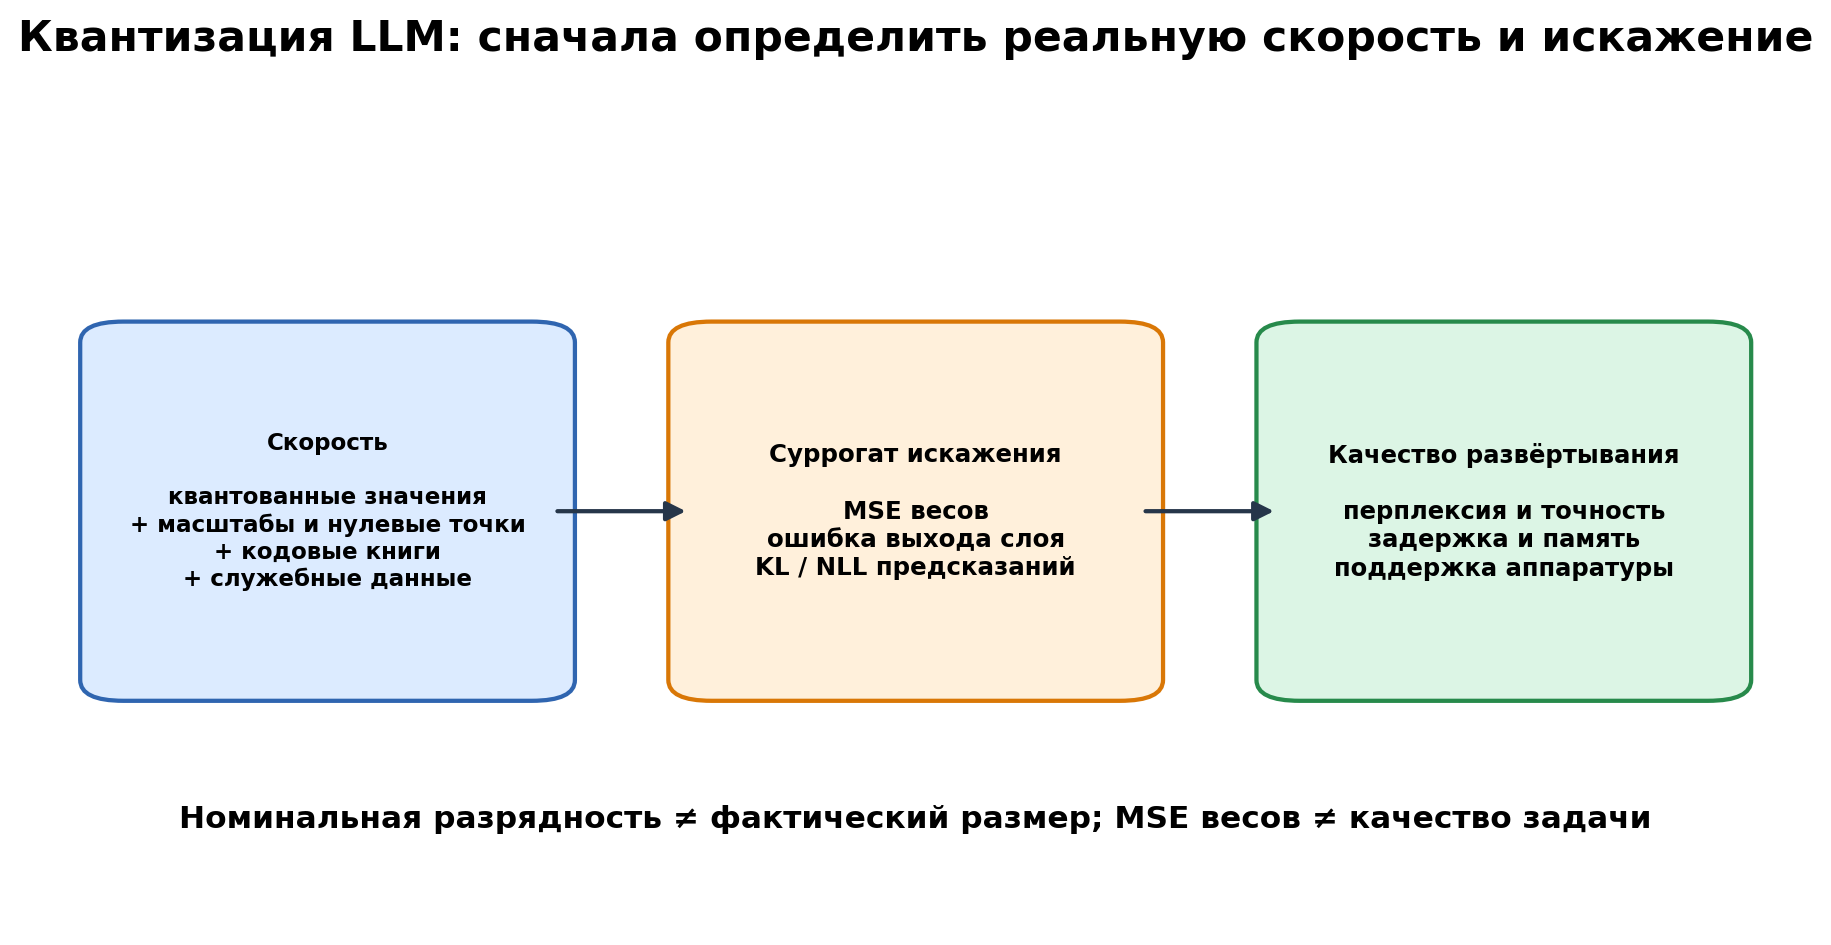
Пусть обученные веса заменяются на . Фраза «4 бита на параметр» задаёт только номинальную разрядность. Фактический размер может дополнительно включать:
- масштабы групп;
- нулевые точки;
- кодовые книги и индексы;
- выбросы, сохранённые в повышенной точности;
- выравнивание, упаковку и заголовки.
Искажение тоже нужно определить. Возможны:
или рост NLL и ошибки последующей задачи.
Одинаковая MSE весов в двух направлениях параметрического пространства может иметь совершенно разный функциональный эффект. Поэтому методы квантизации фактически ищут более полезный суррогат искажения:
- GPTQ использует приближённую информацию второго порядка для последовательной компенсации ошибки;
- AWQ определяет важные каналы по статистике активаций;
- SmoothQuant эквивалентным масштабированием переносит часть трудности квантизации между активациями и весами.
Эти методы естественно читать на языке скорости–искажения: они неравномерно распределяют ограниченный бюджет там, где ошибка дороже. Но они не являются доказательством достижения шенноновской для некоторого универсального источника весов.
9.7. Как построить честную кривую скорость–искажение
Одна модель при одном значении или одной разрядности — ещё не компромисс. Это всего одна точка, и она может оказаться плохо оптимизированной.
Полезный эксперимент строится как серия:
- фиксируем обучающее и оценочное распределения;
- точно определяем скорость;
- точно определяем искажение;
- меняем , , ёмкость или разрядность;
- оставляем недоминируемые точки — эмпирическую границу Парето;
- отдельно измеряем задержку, память и аппаратную стоимость.
Одни и те же слова в разных задачах обозначают разные величины:
| Постановка | Что играет роль скорости | Что играет роль искажения | Реальные биты? |
|---|---|---|---|
| VIB | средний KL энкодера к априорному распределению | предиктивный NLL | обычно нет, это верхняя граница и регуляризатор |
| VAE | средний KL к | возможны через bits-back при полном протоколе | |
| обучаемый кодек | NLL квантизованных латентов под энтропийной моделью | MSE, MS-SSIM, перцептивная или иная заданная мера | да, после энтропийного кодирования |
| квантизованная LLM | фактический размер весов и служебных данных | рост NLL, KL выходов или качество задачи | да для размера; функция искажения остаётся инженерным выбором |
Перед публикацией красивой кривой стоит задать четыре вопроса:
- Единица скорости — бит на пиксель, объект, параметр, токен или латент?
- Включены ли служебные данные и параметры энтропийной модели?
- Искажение измерено на отложенных данных и совпадает ли оно с задачей пользователя?
- Не скрывает ли среднее небольшое число катастрофических ошибок?
И ещё одна практическая граница: меньший файл не гарантирует более быстрый инференс. Неудобная распаковка, неподдерживаемая разрядность или лишние обращения к памяти могут уничтожить выигрыш. Теория задаёт информационную ось; инженерная система добавляет вычислительную.
Скорость–искажение — не название одной метрики. Это дисциплина постановки задачи.
9.8. Информационная плоскость: цель обучения или описание динамики?
Information Bottleneck как нормативный принцип точен: мы сами выбираем стохастическое отображение и оптимизируем явную цель.
Более сильное утверждение звучит иначе: обычная глубокая сеть, обучаемая стандартным SGD без IB-регуляризатора, якобы сама проходит характерную траекторию в плоскости
В ранних работах была предложена двухфазная картина:
- подгонка (
fitting) — растёт информация о метках; - сжатие (
compression) — уменьшается при почти неизменной .
Это красивая гипотеза: сначала сеть учится предсказывать, затем забывает детали входа. Но спор вокруг неё оказался полезнее самого лозунга, потому что заставил спросить: что именно нанесено на оси?
Для детерминированной сети возникают два режима.
Если дискретна, то
Если отображение инъективно на носителе, то
и истинная MI не обязана уменьшаться во время обучения.
Если непрерывна и детерминированно, совместное распределение часто лежит на подмногообразии, и взаимная информация в стандартной непрерывной постановке может быть бесконечной.
Чтобы получить конечную изменяющуюся величину, исследователь добавляет шум, квантование или дискретизацию. Но тогда он уже измеряет MI конкретной зашумлённой или квантованной модели, а не абстрактную «информацию слоя вообще».
Saxe и соавторы показали, что наблюдаемая фаза сжатия зависит от активаций и оценивателя. Goldfeld и соавторы уточнили, что старые биннинговые оценки могли хорошо отслеживать геометрическое сближение представлений одного класса, даже когда не оценивали буквальную истинную MI детерминированного слоя.
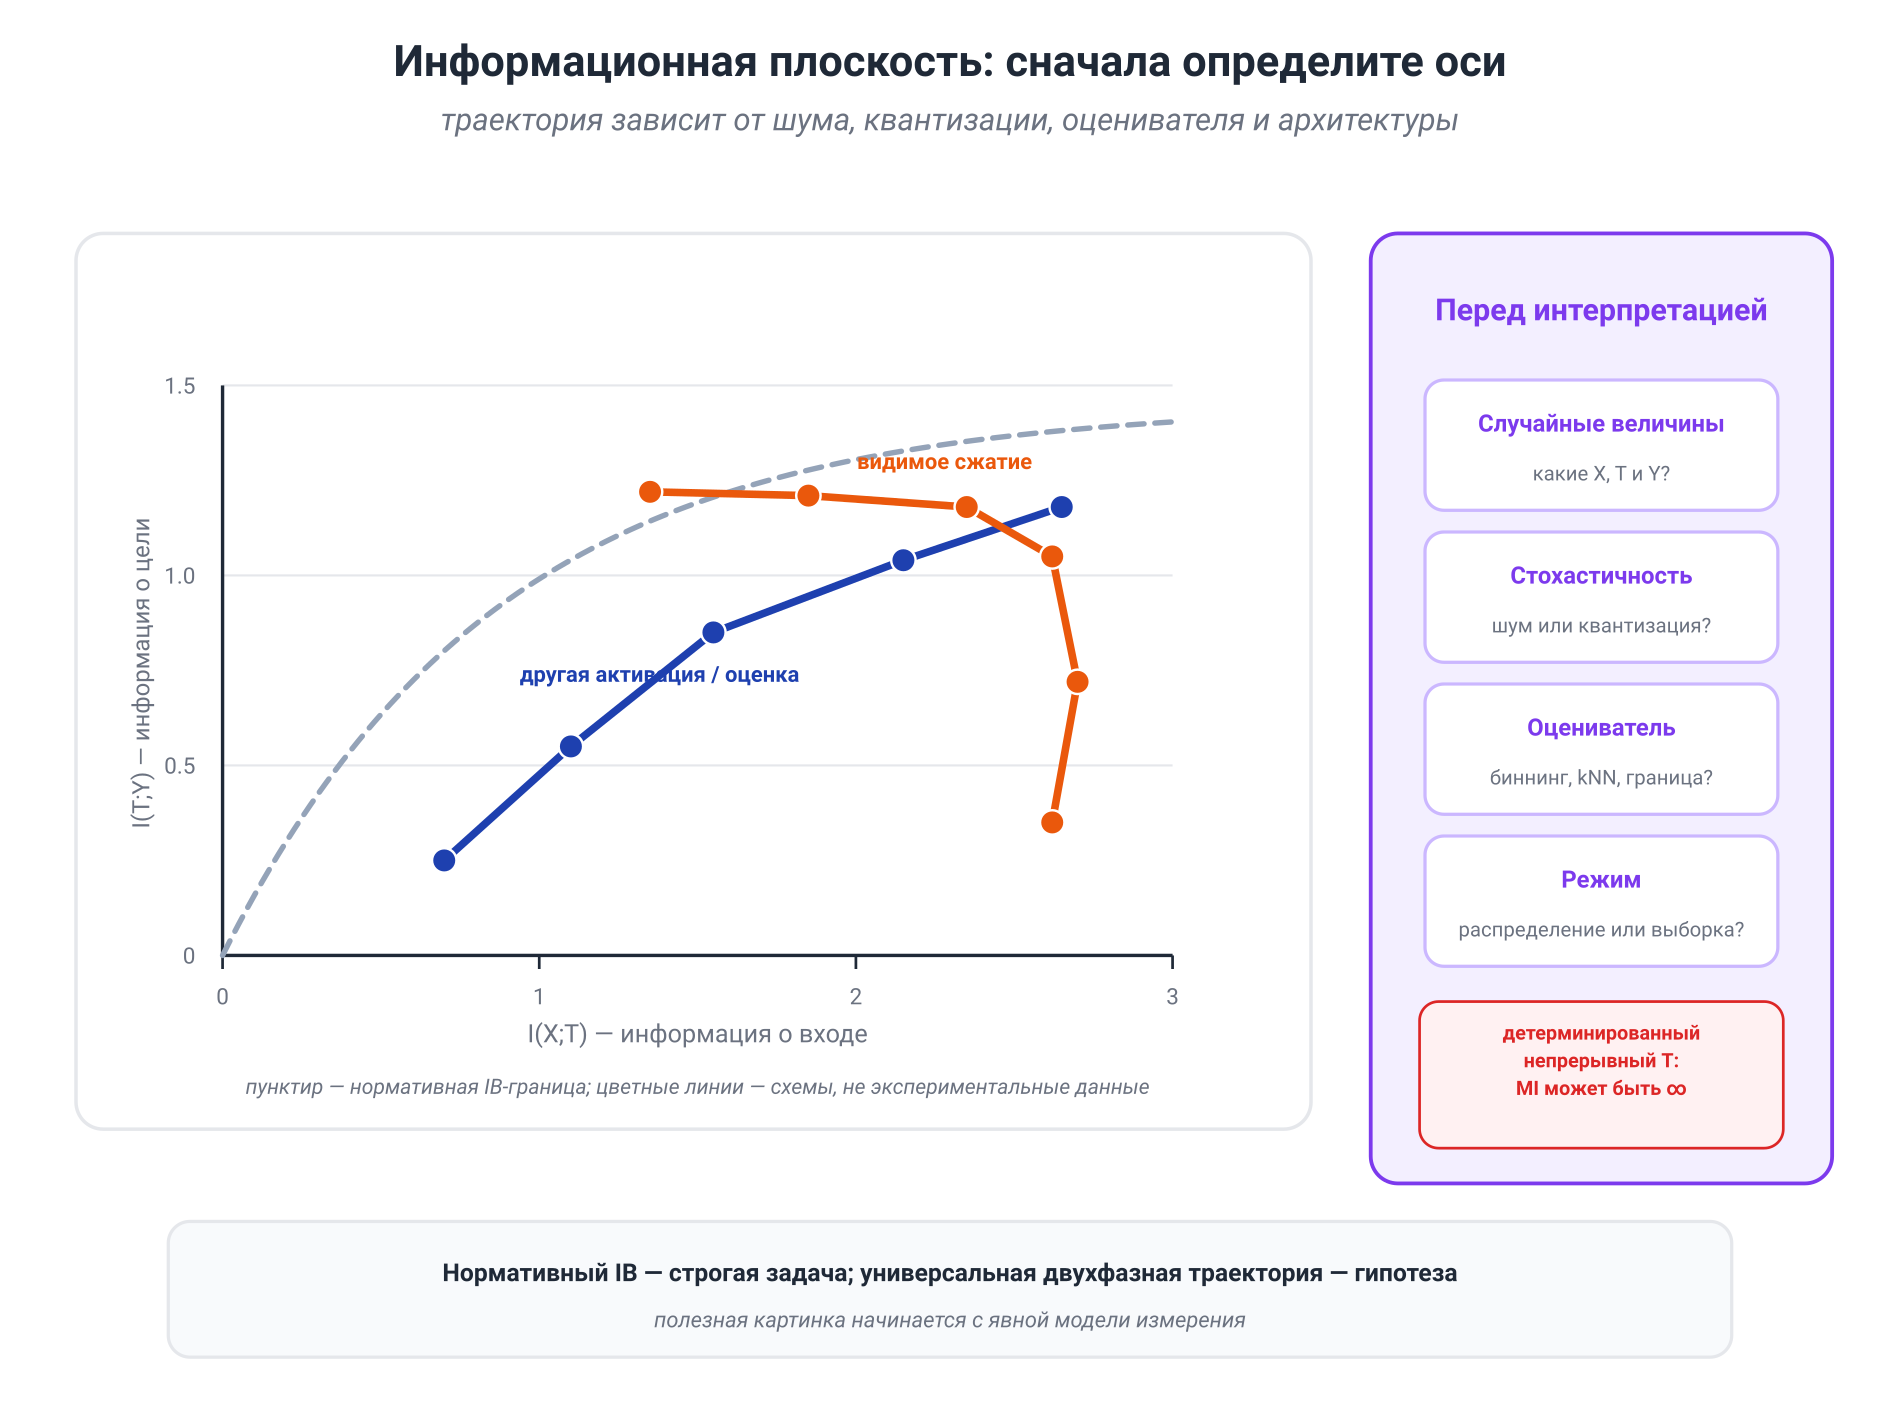
Главный вывод здесь — не запрет на информационные плоскости, а правильная иерархия утверждений:
- нормативный IB — строгая оптимизационная задача;
- VIB — конкретная обучаемая вариационная реализация;
- информационная плоскость шумной сети — осмысленный объект после явного задания шума и оценивателя;
- универсальная естественная IB-траектория всех глубоких сетей — эмпирическая гипотеза, а не следствие DPI.
Это хороший пример общей привычки курса: сначала определить случайные величины и распределения, а уже потом интерпретировать картинку.
9.9. Математическое углубление: I–MMSE и гауссовское зашумление
Этот раздел не нужен для понимания VIB и VAE. Он показывает ещё один точный мост между количеством оставшейся информации и качеством восстановления.
Теория скорости–искажения спрашивает: сколько информации нужно для заданной MSE? Тождество I–MMSE задаёт локальный обратный вопрос:
Насколько быстро растёт взаимная информация, если немного повысить SNR гауссовского наблюдения?
Рассмотрим канал
где .
Определим минимальную среднеквадратичную ошибку:
Для взаимной информации в натах:
В битах правая часть дополнительно делится на .
Для любого конечного :
Формула говорит буквально: площадь под кривой оптимальной ошибки восстановления равна накопленной информации, вошедшей в гауссовский канал.
Гауссовский пример замыкает круг
Пусть
Тогда
а
Обозначим достигнутую ошибку восстановления через
Тогда
и
В битах это ровно гауссовская функция скорость–искажение:
Так два раздела модуля сходятся в одной формуле: оптимальная ошибка оценивания вдоль гауссовского канала воспроизводит границу скорости–искажения гауссовского источника.
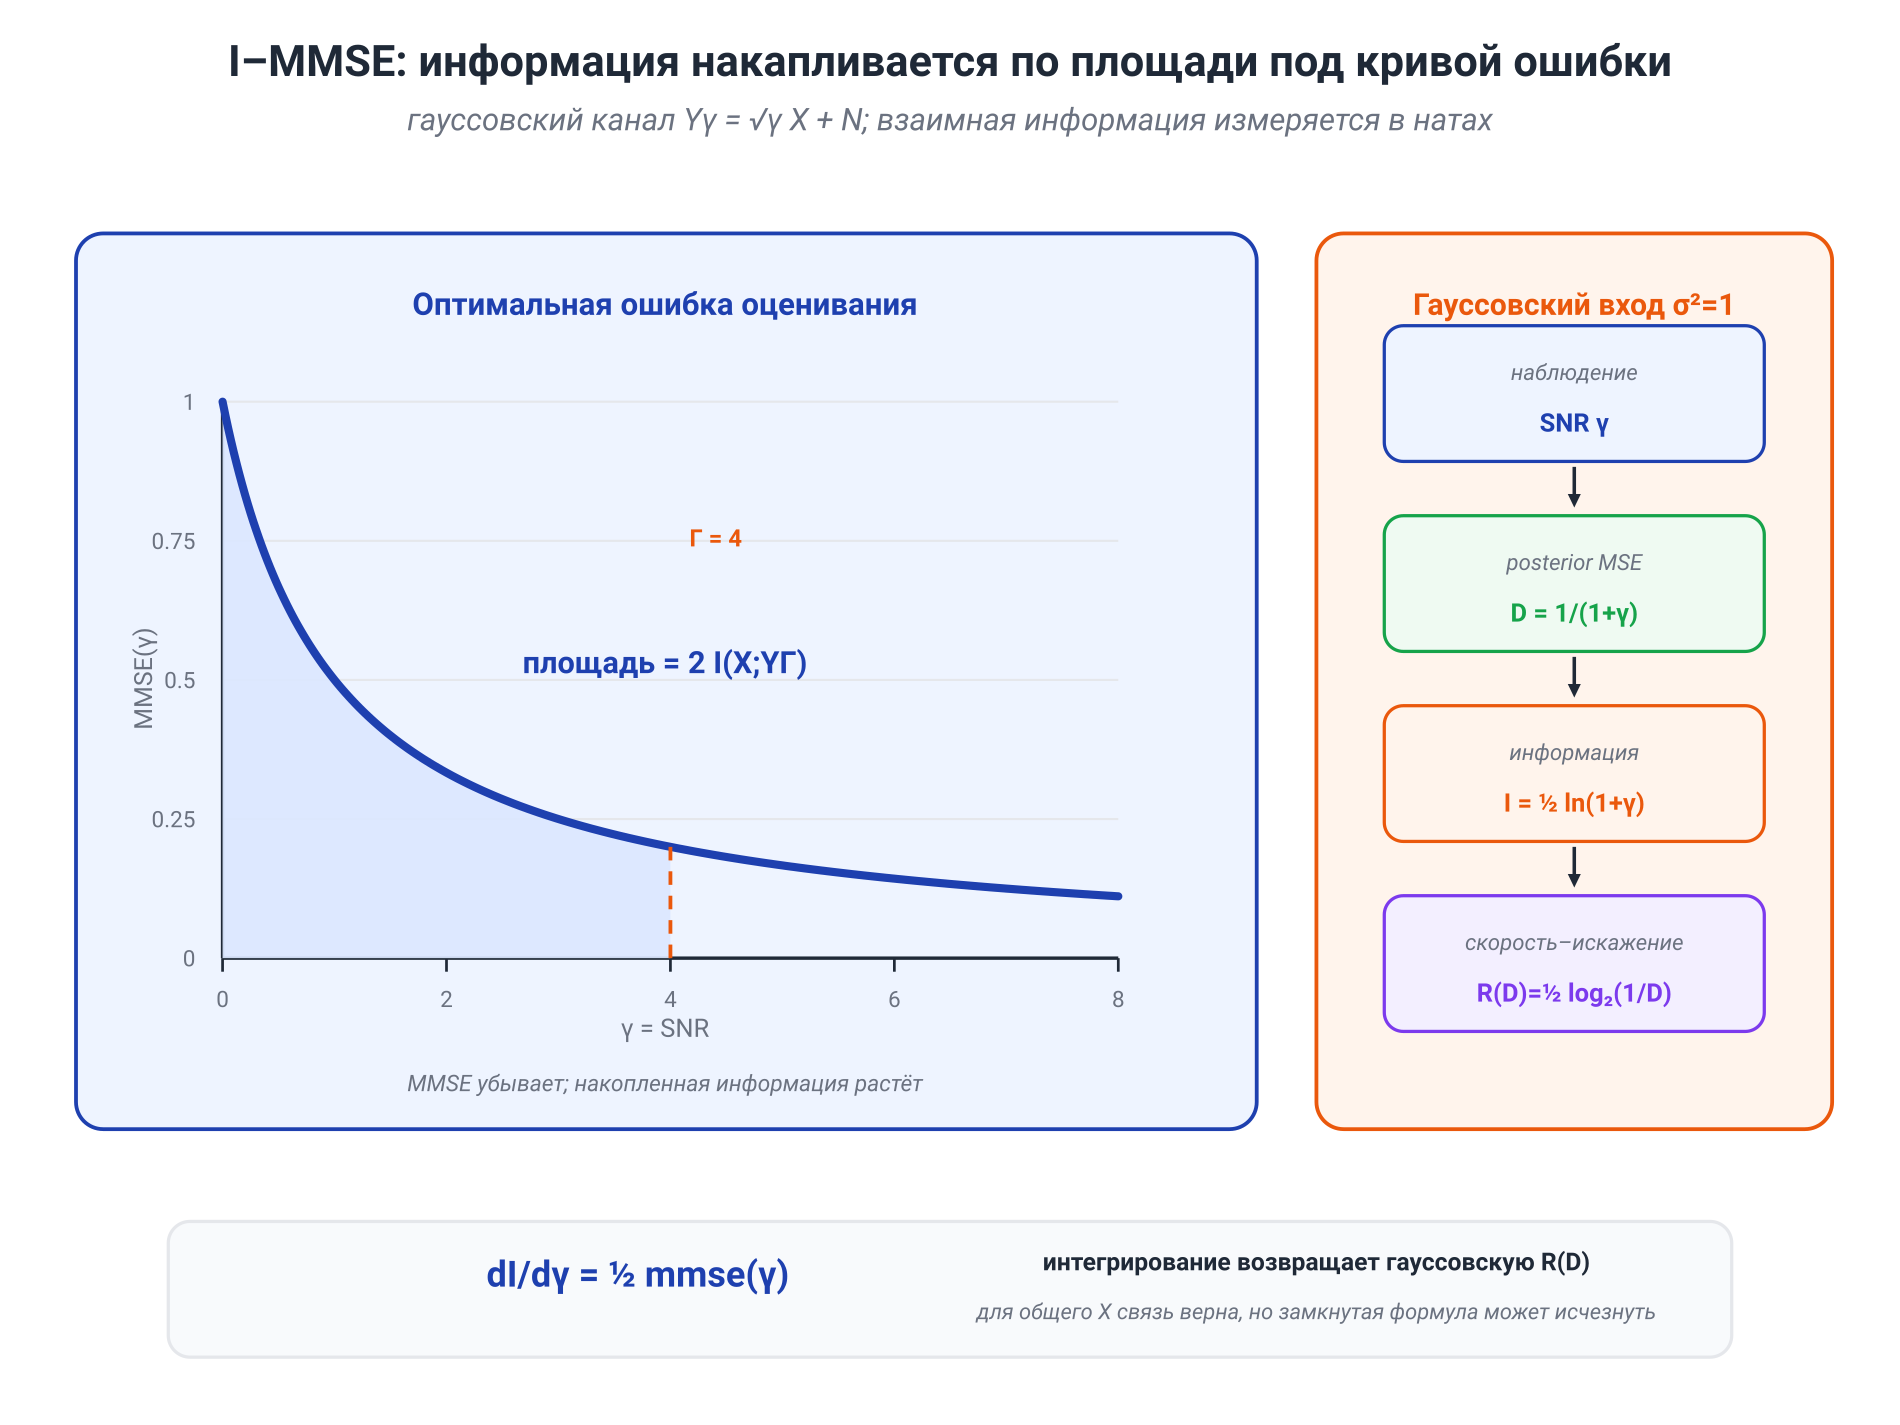
Почему интеграл до бесконечности требует осторожности
Для дискретного с конечной энтропией при обычно
Для невырожденного абсолютно непрерывного взаимная информация обычно растёт без границы. Поэтому нельзя без дополнительной перенормировки писать
У стандартного гауссиана интеграл расходится как , хотя дифференциальная энтропия конечна. Здесь снова важно не переносить формулу из дискретной интуиции в непрерывный случай без проверки опорной меры.
Связь с диффузионными моделями
Прямое зашумление в DDPM имеет вид
После нормировки это гауссовский канал с
Для истинного зашумлённого распределения формула Тведи даёт
Точная скор-функция (score function) определяет апостериорное среднее — оптимальный по MSE денойзер. Поэтому обучение скор-функции можно читать как обучение семейства оптимальных восстановителей на разных уровнях шума.
Но из I–MMSE одного не следуют:
- конкретные веса любой диффузионной функции потерь;
- перцептивно оптимальный график шума;
- число шагов сэмплирования;
- эквивалентность диффузии, flow matching и IB.
Variational Diffusion Models связывают непрерывновременную вариационную границу с SNR и показывают важные инвариантные свойства графика шума. Это уже дополнительная структура конкретной вероятностной модели, а не автоматическое следствие одного тождества I–MMSE.
9.11. Ключевые выводы модуля
Потеря информации полезна только относительно задачи. Различия, ненужные классификатору, могут быть необходимы реконструктору или другой целевой переменной.
Теория скорости–искажения задаёт фундаментальную границу после выбора источника и цены ошибки:
Information Bottleneck делает искажение предиктивным:
VIB превращает недоступные MI в обучаемую цель, но использует нижнюю границу на релевантность и верхнюю границу на скорость.
VAE естественно читается в координатах скорость–искажение:
Это роднит VAE с IB, но не делает их одной и той же задачей. В VAE цену ошибки задаёт правдоподобие реконструкции, а внешний отсутствует.
В реальном кодеке скорость должна дойти до битового потока. NLL латентов, KL-регуляризатор, номинальная разрядность и физический размер файла — связанные, но разные величины.
Информационная плоскость осмысленна только после определения случайности и оценивателя. Нормативный IB — теорема и оптимизационная постановка; естественная IB-динамика обычной сети — эмпирическая гипотеза.
И наконец, I–MMSE показывает ещё один способ прочитать информацию: как накопленную по SNR способность оптимально восстанавливать сигнал. Для гауссовского источника эта связь возвращает нас ровно к функции скорость–искажение, замыкая модуль.
Основные источники
- C. E. Shannon, Coding Theorems for a Discrete Source With a Fidelity Criterion.
- N. Tishby, F. Pereira, W. Bialek, The Information Bottleneck Method.
- A. Alemi et al., Deep Variational Information Bottleneck.
- D. P. Kingma, M. Welling, Auto-Encoding Variational Bayes.
- Y. Burda, R. Grosse, R. Salakhutdinov, Importance Weighted Autoencoders.
- C. Burgess et al., Understanding Disentangling in -VAE; F. Locatello et al., Challenging Common Assumptions in the Unsupervised Learning of Disentangled Representations.
- J. Ballé et al., Variational Image Compression with a Scale Hyperprior; J. Townsend, T. Bird, D. Barber, Practical Lossless Compression with Latent Variables using Bits Back Coding.
- Y. Blau, T. Michaeli, Rethinking Lossy Compression: The Rate-Distortion-Perception Tradeoff.
- E. Frantar et al., GPTQ; J. Lin et al., AWQ; G. Xiao et al., SmoothQuant.
- A. Saxe et al., On the Information Bottleneck Theory of Deep Learning; Z. Goldfeld et al., Estimating Information Flow in Deep Neural Networks.
- D. Guo, S. Shamai, S. Verdú, Mutual Information and Minimum Mean-Square Error in Gaussian Channels.
- J. Ho, A. Jain, P. Abbeel, Denoising Diffusion Probabilistic Models; D. P. Kingma et al., Variational Diffusion Models.