Модуль 6. Кодирование источника: от энтропии к реальным битам
Как читать этот модуль. Основной маршрут — §§6.1–6.8: от вероятностной модели и неравенства Крафта до арифметического кодирования, AEP, энтропийной скорости и метрик языковых моделей. §6.9 — математическое углубление про универсальное последовательное предсказание. §§6.10–6.11 возвращают теорию к оценке качества LLM и к воспроизводимому компрессионному эксперименту.
6.1. Инженерная постановка: вероятностная модель и энтропийный кодер
В предыдущих модулях величина появлялась прежде всего как функция потерь: чем меньшую вероятность модель назначила наблюдению, тем выше штраф. Теперь мы прочитаем ту же величину как длину описания.
Представим, что две модели оценивают один и тот же фрагмент данных и возвращают следующие вероятности этого фрагмента:
Это вероятности всего фрагмента, а не отдельного токена. Для авторегрессионной модели каждая из них является произведением условных вероятностей последовательных токенов, поэтому для длинного текста такие числа естественно оказываются очень малыми.
Перейдём от вероятностей к длинам:
У второй модели отрицательное логарифмическое правдоподобие меньше на
Иначе говоря, модель назначает этому фрагменту идеальную информационную длину на 84 бита меньше. Чтобы получить реальный обратимый файл, к вероятностям ещё нужно подключить энтропийный кодер; его служебная избыточность будет рассмотрена ниже.
Здесь у модели и кодера разные роли.
Вероятностная модель задаёт вероятности следующего символа. Энтропийный кодер использует эти вероятности, чтобы построить обратимый битовый поток.
Пусть источник порождает последовательность по распределению , а авторегрессионная модель задаёт
Идеальная информационная длина конкретной последовательности под моделью равна
Это та же по-токенная отрицательная логарифмическая потеря, только измеренная в битах. Если библиотека считает NLL натуральным логарифмом, достаточно разделить результат на .
Например, если модель назначила трём последовательным наблюдениям условные вероятности
то идеальный счёт равен
Логарифм делает здесь ту же работу, что и в Модуле 1: произведение условных вероятностей превращается в сумму кодовых затрат.
Идеальная длина, длина потока и полная длина описания
Для компрессионного эксперимента полезно держать рядом три величины.
- Идеальная длина данных Именно её измеряет NLL в битах.
- Фактически выпущенный поток Поправка включает конечную точность вероятностей, завершение кода, заголовки и выравнивание.
- Полная длина самостоятельного описания Она отвечает на вопрос, сколько стоит архив, если у декодера заранее нет модели и протокола.
Обычная валидационная функция потерь измеряет первый счёт. Практический кодер диапазонов (range coder) приближает второй. Автономный архив обязан оплатить третий.
Ещё одна граница понадобится на протяжении всего модуля. Энтропия ограничивает среднюю длину относительно заданного источника. Она не запрещает сжать отдельную регулярную строку значительно короче среднего. Строка из миллиона нулей может оказаться очень дешёвой; теорема утверждает, что для фиксированного источника нельзя систематически опустить ожидаемую длину без потерь ниже его энтропийной границы.
6.2. Префиксные коды и неравенство Крафта—Макмиллана
Начнём с простейшего кодера: каждому символу конечного алфавита
назначается отдельная двоичная строка.
Код называется префиксным (prefix code), если ни одно кодовое слово не является началом другого. Например,
— префиксный код, а
— нет: после чтения первого нуля декодер ещё не знает, закончился символ или началось слово 01.
Префиксность даёт мгновенное декодирование без разделителей. Но за это удобство приходится соблюдать строгий бюджет.
Теорема Крафта. Положительные целые числа являются длинами некоторого двоичного префиксного кода тогда и только тогда, когда
Почему возникает неравенство Крафта
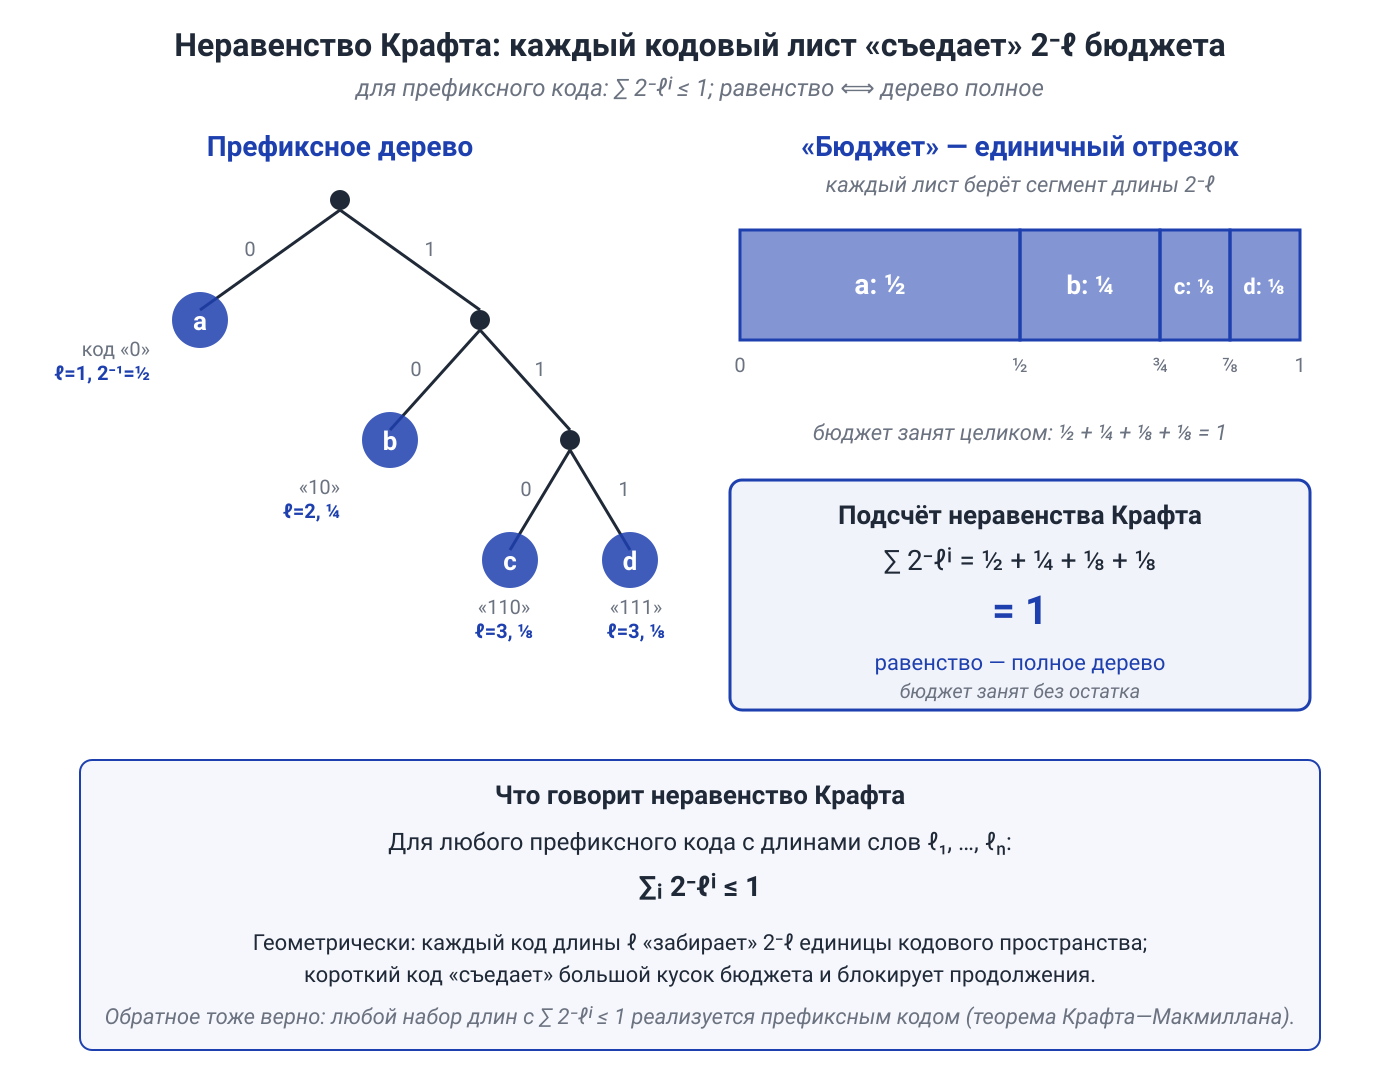
Полное бинарное дерево удобно читать как единицу ресурса. Кодовое слово длины занимает долю
всех достаточно длинных двоичных продолжений. Короткое слово дорого: код длины 1 сразу откусывает половину дерева; длины 2 — четверть; длины 3 — восьмую часть.
Для кода
бюджет использован полностью:
Хочется сделать частый символ короче — придётся освободить для него крупную ветвь и вытеснить другие символы глубже.
Именно поэтому не существует набора произвольно коротких кодовых слов. Неравенство Крафта — не техническая формальность, а геометрия ограниченного ресурса.
Обратная часть теоремы конструктивна: если длины укладываются в бюджет, листья можно разместить в дереве без пересечений. Для более общего класса однозначно декодируемых кодов та же необходимая оценка известна как часть теоремы Крафта—Макмиллана. В дальнейшем префиксных кодов достаточно: они дают ту же границу на среднюю длину и проще устроены.
6.3. Односимвольная теорема кодирования
Пусть , где
а символу назначено кодовое слово длины . Средняя длина равна
Теперь возникает центральный вопрос: насколько малым может быть ?
Нижняя граница средней длины кода
Для любого двоичного префиксного кода
Короткое доказательство стоит оставить в основном маршруте: оно показывает, из чего именно складывается цена неоптимального кода.
Положим
Тогда — распределение, неявно заданное длинами кода. Получаем
На этом месте удобно остановиться и прочитать формулу словами:
Это доказательство — бухгалтерия префиксного кода. Зазор возникает по двум причинам: длины ведут себя так, будто источник имеет распределение , а не , и код может оставить часть бюджета Крафта пустой.
Равенство возможно только если
Следовательно,
Точный односимвольный оптимум достигается для диадических распределений, у которых все являются целыми числами.
Верхняя граница: шенноновский код
Идеальные вещественные длины
автоматически исчерпывают бюджет Крафта, потому что . Но двоичное кодовое слово не может иметь длину 2.37 бита. Округлим вверх:
Тогда
поэтому длины удовлетворяют Крафту, а
Следовательно, существует префиксный код со средней длиной
Число — не фундаментальная потеря на каждый символ. Это плата за то, что в односимвольном коде каждая длина должна быть целой. В §6.5 мы отложим округление до конца длинного блока и разделим эту постоянную на число символов.
Код, построенный по неверной модели
Пусть данные идут из , а код строится по модели :
причём на носителе . Тогда
Используя
получаем
Теперь операционный смысл KL становится совсем буквальным:
при идеальном дробном кодировании — средняя доплата в битах за использование неверной вероятностной модели.
Односимвольный префиксный код добавляет к этой доплате менее одного бита округления.
6.4. Хаффман, арифметическое кодирование и кодирование диапазонов
Два классических алгоритма решают одну задачу, но округляют в разных местах.
Хаффман округляет длину каждого символа. Арифметический кодер откладывает округление до конца сообщения.
Код Хаффмана
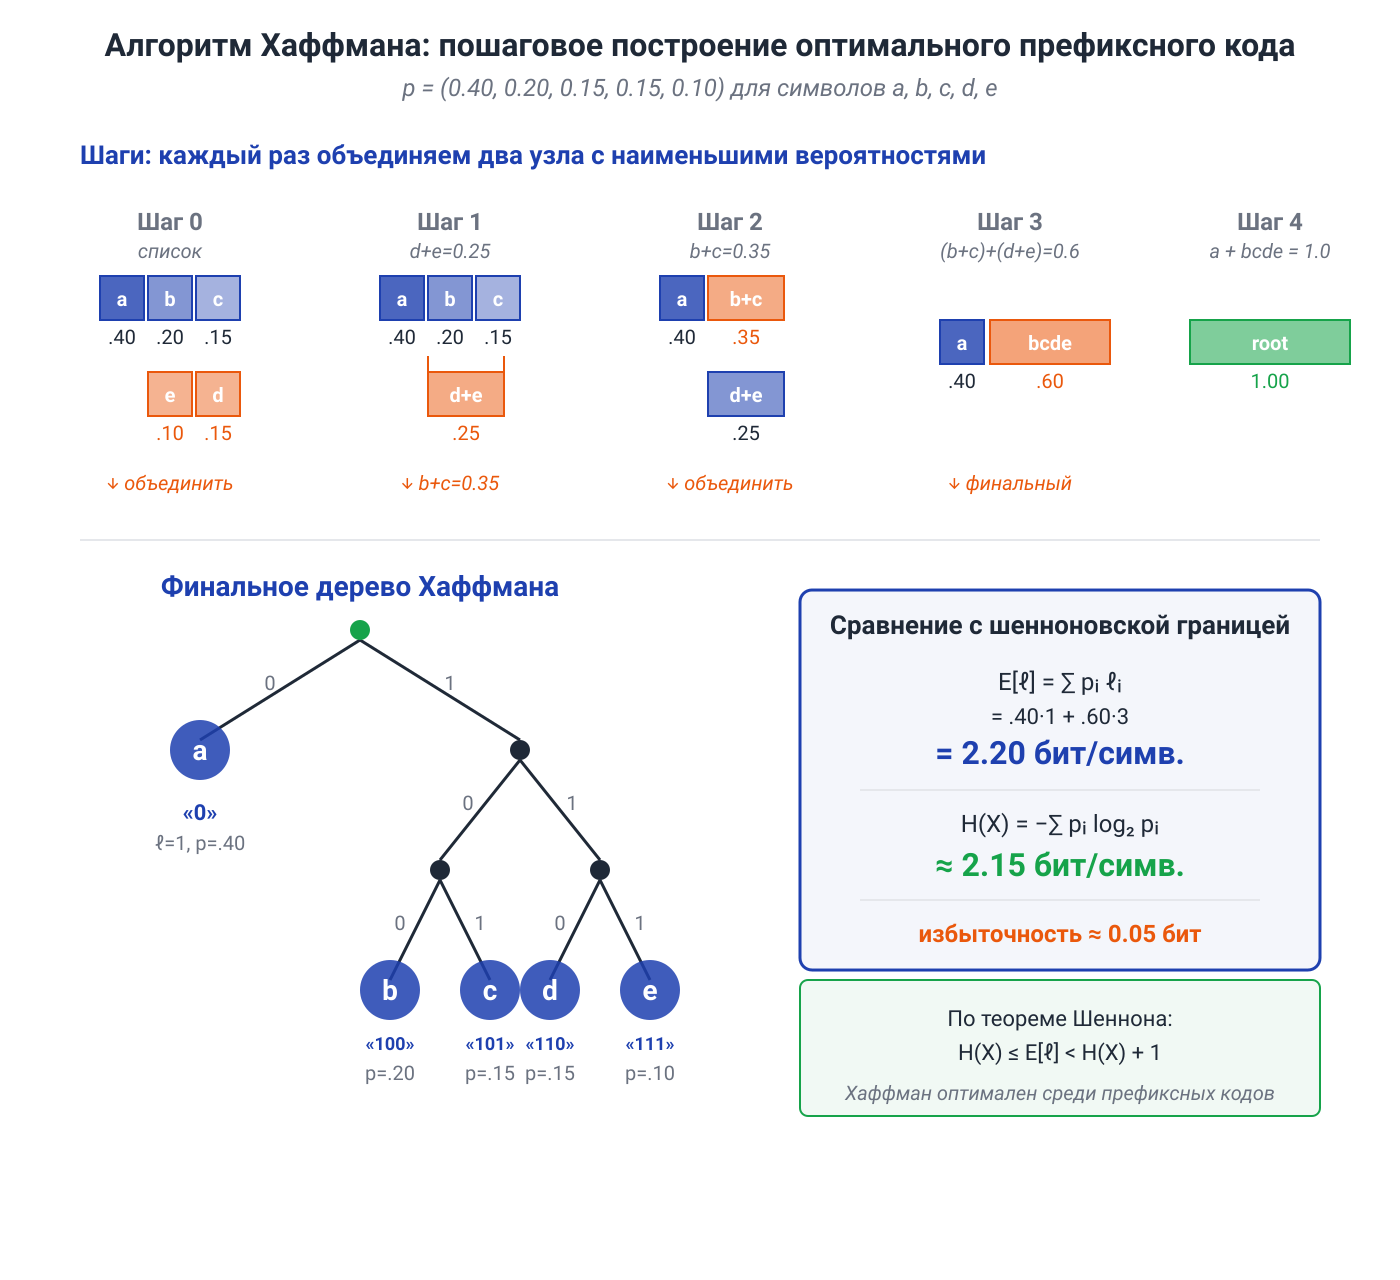
Алгоритм Хаффмана строит оптимальный бинарный префиксный код для известного конечного распределения.
- Берём два узла с наименьшими вероятностями.
- Объединяем их в узел с суммарной вероятностью.
- Повторяем, пока не останется корень дерева.
Для
один из оптимальных кодов имеет длины
поэтому
Зазор невелик. Но целочисленная гранулярность особенно заметна у сильно скошенного бинарного источника:
Любой непустой двоичный префиксный код тратит по одному биту на символ, тогда как
Это не провал Хаффмана и не нарушение теоремы. Алгоритм оптимален в своём классе; слишком груб сам класс односимвольных целых длин.
Арифметическое кодирование
Арифметическое кодирование не выдаёт каждому символу отдельное слово. Оно кодирует всю последовательность подынтервалом единичного отрезка.
Пусть
Разобьём на интервалы
Для строки ACB получаем
Ширина финального интервала равна
![
Идеальная информационная длина строки:
Но передать нужно не просто точку внутри , а конечный двоичный префикс, все продолжения которого остаются внутри целевого интервала. Пятибитное число
лежит внутри, однако префикс 01111 задаёт весь диадический интервал
который выходит за правую границу .
Зато шестибитный интервал
целиком помещается внутри финального. Ему соответствует префикс 011101.
Эта маленькая деталь полезна: арифметический код передаёт не «удачно выбранное вещественное число», а конечное двоичное описание, по которому декодер однозначно остаётся в нужном интервале.
Для стандартной идеализированной конструкции можно выбрать длину
Округление теперь платится один раз за сообщение, а не на каждом символе.
Условные вероятности и авторегрессионные модели
У фиксированного источника интервалы делятся одной и той же таблицей вероятностей. У языковой модели таблица меняется после каждого токена:
После шагов ширина выбранного интервала равна
а идеальная длина —
Вот и вся механика связи между языковым моделированием и сжатием: модель обновляет вероятности, а кодер обновляет интервал.
Реальные реализации чаще используют кодирование диапазонов (range coding) или Asymmetric Numeral Systems (ANS). Чтобы декодирование было точным, кодер и декодер должны одинаково воспроизводить:
- дискретизированные вероятности;
- токенизатор и порядок словаря;
- начальный контекст, EOS и правила сброса;
- конечную арифметику и обработку границ.
Поэтому фактический поток близок к NLL-длине, но не обязан отличаться от неё одной универсальной константой для любого программного стека. Конечная точность может давать малую накопительную избыточность; заголовки и служебные данные добавляют отдельную цену.
6.5. Длинные последовательности: блочное кодирование, AEP и энтропийная скорость
Односимвольный код спотыкается о целые длины. Длинный блок позволяет распределить одну единицу округления между многими символами.
Блочный код без потерь
Пусть независимы и одинаково распределены. Рассмотрим весь блок как один суперсимвол. Тогда
По односимвольной теореме для распределения блоков существует префиксный код с
Разделив на , получаем
Это код переменной длины (variable-length) с нулевой ошибкой: исходный блок восстанавливается точно, а средняя цена на символ стремится к энтропии.
Теперь утверждение «энтропия достижима» получает точный смысл. Мы не строим слово длины 2.37 бита для отдельного символа; мы кодируем длинный блок и позволяем дробным длинам взаимно компенсироваться.
AEP и концентрация удельной информационной длины
Для i.i.d.-источника с конечным алфавитом
Это асимптотическое свойство равнораспределённости (Asymptotic Equipartition Property, AEP).
Формулу удобно читать так: для длинной случайной последовательности её собственная информационная длина на символ почти наверняка оказывается близка к энтропии.
Определим типичное множество
При больших оно обладает тремя свойствами:
- в нём сосредоточена вероятность, сколь угодно близкая к единице;
- каждая типичная последовательность имеет вероятность порядка ;
- число типичных последовательностей имеет порядок .
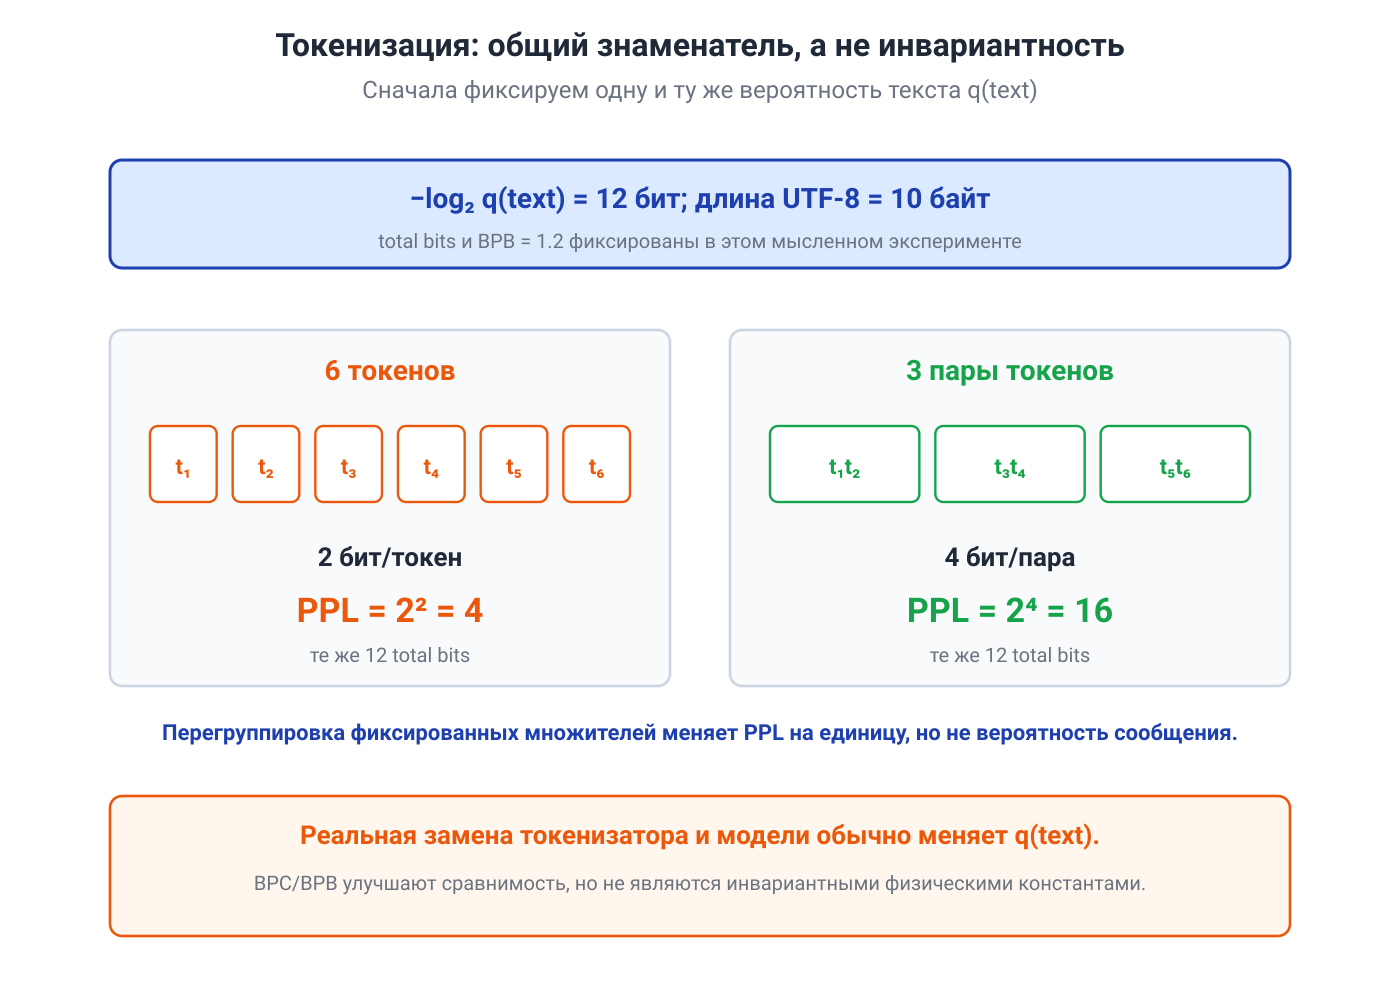
Поэтому PPL моделей с разными токенизаторами обычно нельзя сравнивать напрямую. Для общего знаменателя используют
или
BPB обычно воспроизводимее: байты требуют лишь зафиксировать исходный файл. BPC дополнительно зависит от того, что считается символом — байт, Unicode code point или графемой.
Сравнимость метрик и роль токенизации
BPC и BPB не становятся неизменными при замене токенизатора вместе с моделью. Новый токенизатор меняет длину контекста, словарь, вычислительную задачу и обычно само распределение .
Верно более узкое утверждение: если вероятность одного и того же байтового сообщения уже задана и мы только перегруппировали её множители, суммарное число бит и BPB сохранятся, а PPL на новую единицу изменится.
Поэтому BPC/BPB делают сравнение содержательнее, но не отменяют протокол. Нужно по-прежнему фиксировать корпус, кодировку, Unicode-нормализацию, границы документов, доступный контекст и способ обработки длинных последовательностей.
6.7. Языковая модель как часть компрессора
Теперь соберём конструкцию полностью.
Кодер и декодер заранее разделяют:
- параметры модели;
- токенизатор или другое обратимое представление входа;
- способ вычисления и квантования вероятностей;
- энтропийный кодер;
- правила начала, конца и сброса контекста.
Кодер видит следующий символ, получает и сужает интервал. Декодер, уже восстановив тот же префикс, вычисляет то же распределение и понимает, какой символ выбрал битовый поток.
В таком протоколе
а после усреднения по данным из :
Именно поэтому снижение отложенной логарифмической потери (log loss) на одном и том же распределении означает сокращение ожидаемого кода данных.
Здесь есть одна инженерная тонкость. Если токенизация нормализует текст необратимо, компрессор восстанавливает нормализованный текст, а не исходные байты. Для настоящего архива без потерь представление входа должно быть обратимым; иначе само преобразование и потерянные детали нужно отдельно включить в служебные данные.
Эксперимент Delétang et al.
В работе Language Modeling Is Compression (ICLR 2024) предварительно обученные модели соединялись с арифметическим кодером и применялись к байтовым потокам текста, изображений и аудио.
В таблице 1 статьи все наборы имели размер 1 GB и для Transformer-моделей разбивались на независимые блоки по 2048 байта. Для Chinchilla 70B приведены следующие необработанные коэффициенты сжатия (raw compression rates) — отношение длины сжатого кода данных к исходному размеру без стоимости весов:
- на enwik9;
- на grayscale-патчах ImageNet;
- на LibriSpeech.
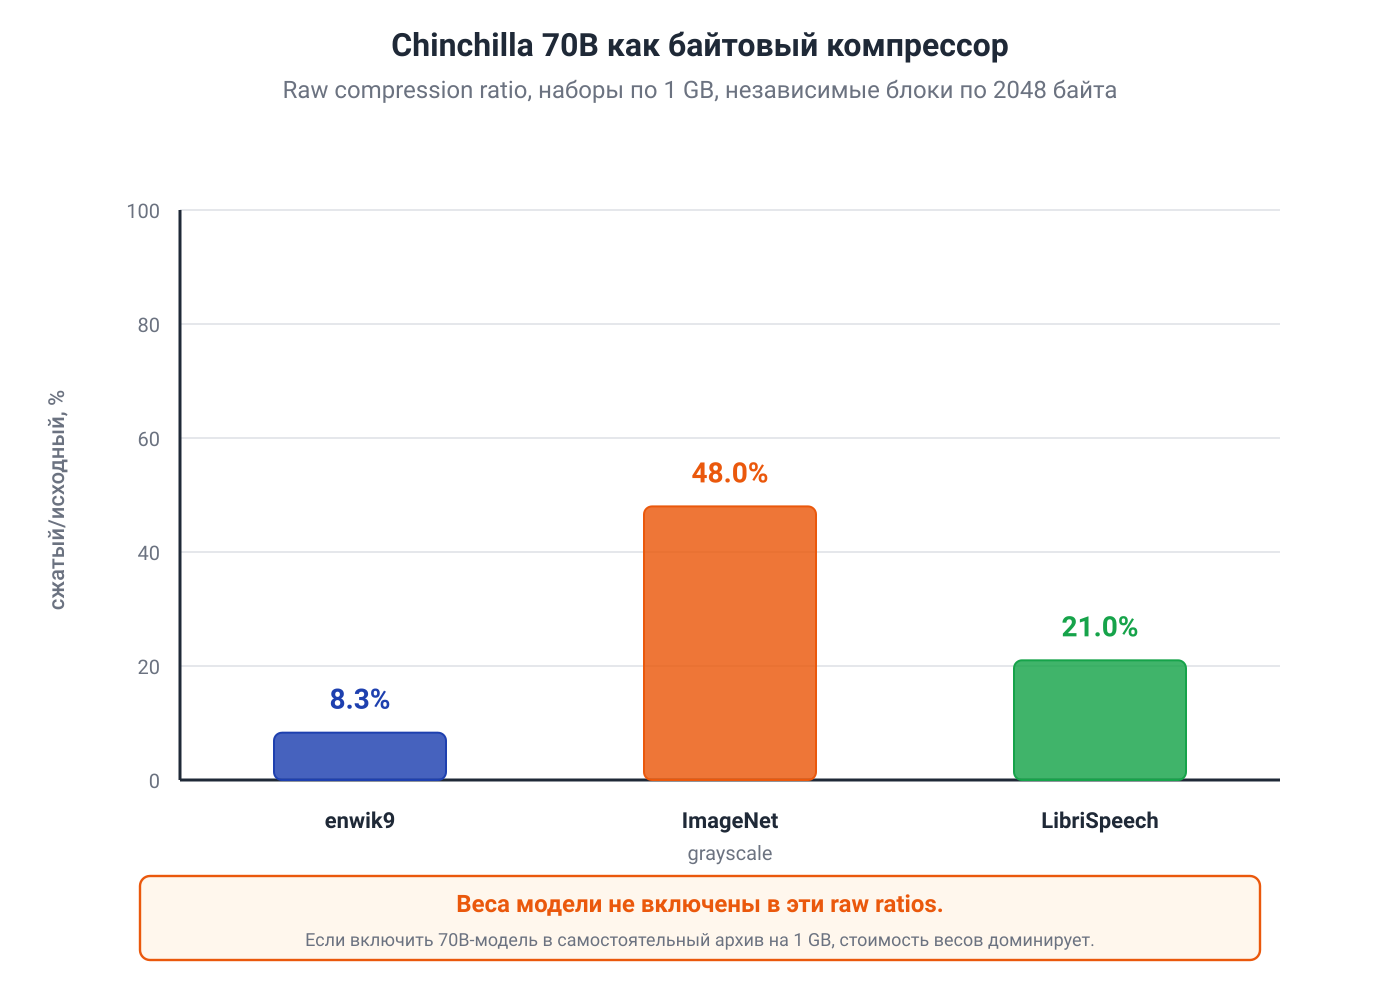
Результат действительно впечатляет: модель, предварительно обученная преимущественно на тексте, назначала полезные вероятности и нетекстовым байтовым последовательностям.
Но правильная интерпретация уже содержится в самом протоколе. Эксперимент показывает способность к вероятностному предсказанию байтов в конкретных 2048-байтовых блоках. Он не является доказательством семантического понимания изображения или речи. И необработанный коэффициент отвечает на вопрос: «насколько короток код данных, если модель уже бесплатна для обеих сторон?»
В аннотации статьи сообщаются несколько лучшие числа и для ImageNet и LibriSpeech. Чтобы не смешивать режимы, здесь и на диаграмме используются значения из таблицы 1 вместе с её явным 2048-байтовым протоколом.
6.8. Размер модели, законы масштабирования и полная длина описания
Валидационная функция потерь задаёт хороший вопрос:
сколько бит нужно данным, если модель уже лежит у кодера и декодера?
Автономный архив задаёт более строгий:
кто заплатит за саму модель?
Для двухчастного описания
Большая модель обычно уменьшает второй член и увеличивает первый. Поэтому для фиксированного объёма данных может существовать промежуточный размер модели, минимизирующий полную длину.
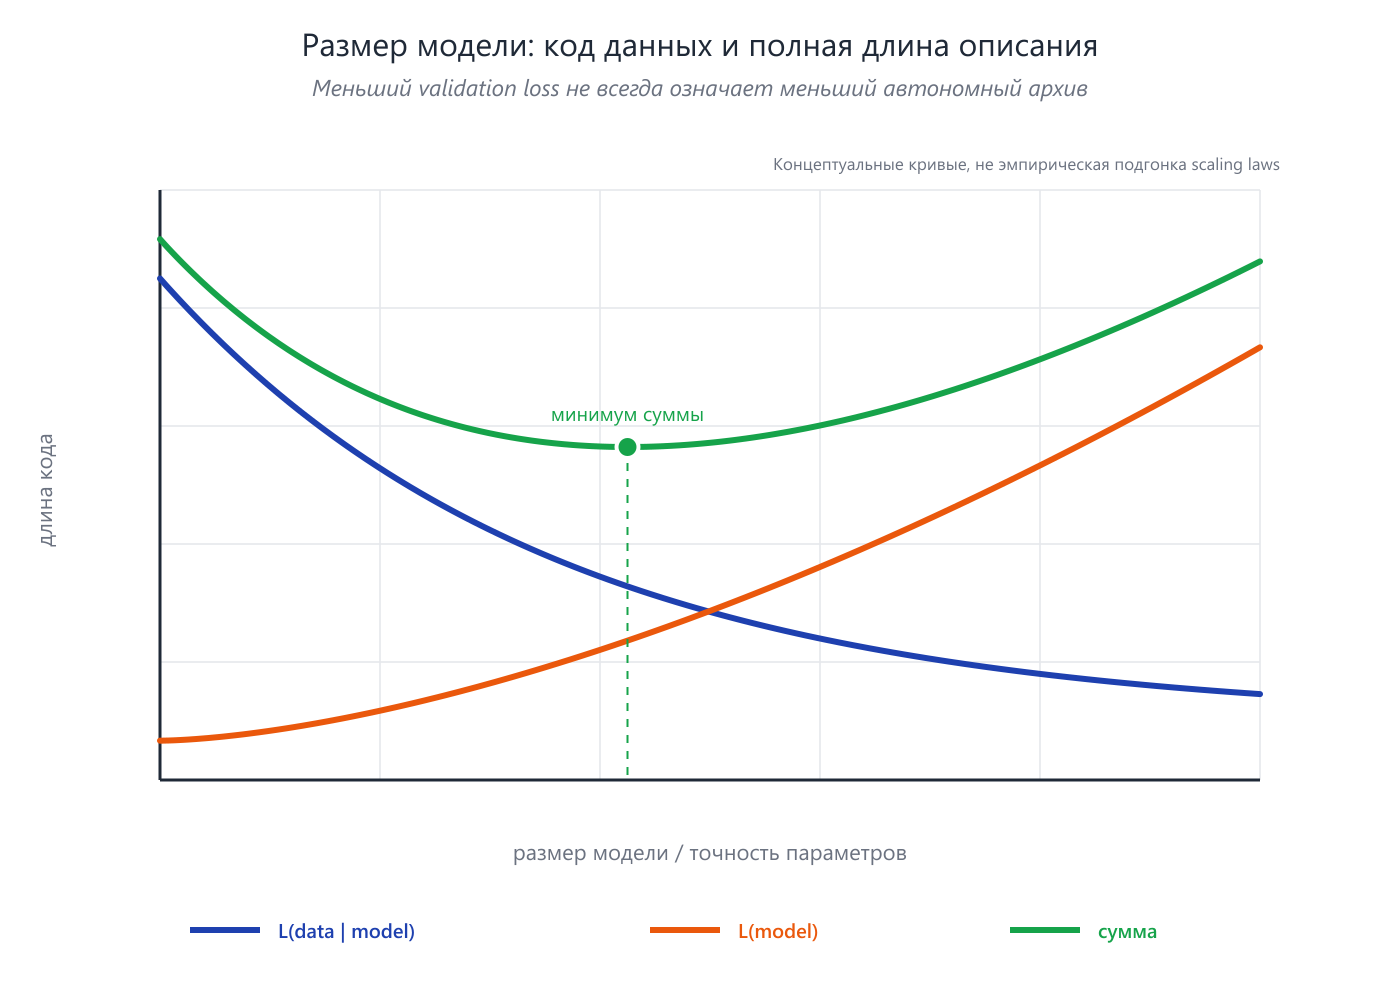
Delétang et al. считают веса нейросетей по 2 байта на параметр. Для Chinchilla 70B это примерно 140 GB только весов. На корпусе размером 1 GB код данных enwik9 занимает около GB, но полный двухчастный счёт становится примерно
то есть adjusted compression rate из таблицы равна примерно .
Это не опровержение пользы больших моделей. Если одна модель многократно используется для огромного потока данных, стоимость весов амортизируется. Но вопрос «хороший ли это предиктор?» и вопрос «хороший ли это самостоятельный архив для данного объёма?» имеют разные ответы.
Законы масштабирования и длина описания
Если отложенная кросс-энтропия уменьшается с масштабом, то уменьшается и длина кода данных при уже известной модели. Это точное и полезное чтение кривой масштабирования (scaling curve).
Более сильный вывод требует дополнительных предпосылок. Из гладкой степенной кривой само по себе не следует, что
или что подогнанная асимптота обязательно равна «истинной энтропии языка».
Причины не экзотические:
- семейство моделей может не содержать источник;
- оптимизация может не достигать лучшей модели семейства;
- конечное окно ограничивает доступное условное распределение;
- предобработка и токенизация определяют другую задачу;
- отложенный корпус не является универсальным распределением всего языка;
- эмпирическая кривая наблюдается на конечном диапазоне масштабов.
Точная формула по-прежнему сильна:
Но чтобы прочитать эмпирическую асимптоту как , нужно отдельно обосновать, что KL-разрыв действительно исчезает для конкретно заданного источника и режима контекста.
6.9. Математическое углубление: универсальное кодирование, последовательная логарифмическая потеря и ICL
Можно пропустить при первом чтении. Здесь связь «предсказание = код» расширяется на ситуацию, когда источник заранее неизвестен и предиктор адаптируется по ходу последовательности.
Пусть на шаге последовательный предиктор выдаёт
Его суммарная логарифмическая потеря в битах равна
Это одновременно идеальная длина последовательного кода. Онлайн-предсказание по логарифмической потере и последовательное сжатие — одна и та же бухгалтерия.
Смесь конечного числа моделей
Пусть имеются модели с априорными весами
Байесовская смесь задаёт
Для любой модели
поэтому
При равномерных весах смесь проигрывает лучшей модели из конечного класса не более бит на всю последовательность.
Это красивый результат универсального предсказания: не зная заранее, какая гипотеза окажется лучшей, мы платим за адаптацию конечным сожалением (regret). Но форма гарантии зависит от класса. Lempel—Ziv, CTW, байесовские смеси и другие универсальные кодеры имеют разные предпосылки и разные скорости избыточности; одной универсальной формулы для всех источников нет.
Связь с in-context learning и её ограничения
Промпт с демонстрациями меняет следующие условные распределения модели без обновления весов. В этом операционном смысле ICL напоминает адаптивный последовательный кодер: контекст помогает предсказывать продолжение, а уменьшение логарифмической потери сокращает код.
Теоретические работы дают более содержательные механизмы при специальных предпосылках. Xie et al. выводят неявный байесовский вывод для распределения предварительного обучения в виде смеси HMM. Hahn и Goyal связывают возникновение ICL со структурой и композиционностью обучающих данных.
Эти результаты не превращают произвольную LLM в оптимальный универсальный байесовский предиктор для любого промпта. Корректный измеримый вопрос звучит скромнее:
насколько быстро уменьшается последовательная логарифмическая потеря при добавлении релевантного контекста и относительно какого класса сравнения измеряется сожаление?
6.10. Связь качества сжатия и возможностей модели
Связь
является математическим утверждением. Переход от него к фразе «лучший компрессор умнее» уже требует выбрать определение способностей и протокол измерения.
Hutter Prize использует сжатие без потерь фиксированного 1 GB файла enwik9 как тест поиска структуры в большом текстовом корпусе. Официальный размер результата включает не только сжатые данные, но и программу, которая их восстанавливает. Поэтому конкурсная постановка ближе к полной длине описания, чем к NLL при бесплатной модели.
Huang et al. в работе Compression Represents Intelligence Linearly (COLM 2024) сравнили 31 публичную базовую LLM на 12 тестах знаний, программирования и математического рассуждения. В их протоколе средний результат на тестах коррелировал со средней BPC внешних корпусов с коэффициентом Пирсона около .
Это сильный эмпирический сигнал: хорошее моделирование распределения внешних данных действительно может служить метрикой возможностей без разметки. Но сама работа показывает зависимость силы связи от согласования корпуса с оцениваемой областью. А более позднее исследование моделей для кода (Xuyang et al., 2025) сообщило в своём протоколе скорее логарифмическую, чем универсально линейную зависимость.
Поэтому полезный вывод выглядит так:
эффективность сжатия на отложенном корпусе — содержательная безразметочная метрика качества вероятностной модели и возможный прокси некоторых способностей; форма связи зависит от домена, моделей и тестов и не является общим определением интеллекта.
Низкая BPC сама по себе не гарантирует фактическую истинность, согласование с целями, причинное рассуждение, устойчивое планирование или безопасное поведение. Это не ослабляет компрессионную метрику: она просто отвечает на свой точный вопрос.
6.11. Практический протокол оценки LLM как компрессора
Перед публикацией числа «модель получила 1.1 BPB» стоит зафиксировать весь договор между кодером и декодером.
- Исходные данные. Точный файл, версия, лицензия и контрольная сумма.
- Предобработка. Кодировка, Unicode-нормализация, переносы строк и удаление служебных областей.
- Единица. Bits/token, BPC или BPB; для BPC — что считается символом.
- Токенизатор. Версия, специальные токены и обратимость к исходным байтам.
- Границы. Как задаются BOS, EOS, длина сообщения и сброс контекста.
- Контекстная политика. Независимые блоки, скользящее окно или непрерывный поток; каждая целевая позиция должна быть посчитана ровно один раз.
- Модель. Точная ревизия, base или instruction-tuned версия, численная точность и режим вычисления.
- Вероятности кодера. Как логиты превращаются в целочисленные частоты; совпадает ли процедура у кодера и декодера.
- Что измерено. Эквивалентная NLL-длина или реально выпущенный битовый поток.
- Стоимость модели. Считаются ли веса и токенизатор заранее разделяемыми или входят в архив.
- Контаминация. Мог ли оценочный файл присутствовать в предварительном обучении.
- Сравнимость. Получили ли все методы один исходный байтовый поток и одинаковый доступный контекст.
Особенно легко ошибиться при оценке авторегрессионной модели со скользящим окном (sliding window). Библиотечная функция потерь обычно сравнивает
поэтому число учтённых целевых позиций нужно проверять после сдвига. Иначе один токен можно потерять или посчитать дважды на границе окон.
Хороший отчёт публикует отдельно:
- эквивалентное NLL число бит;
- размер фактического сжатого потока;
- служебные накладные расходы;
- стоимость модели, если она включена.
Тогда фраза «LLM сжимает данные» становится не аналогией, а воспроизводимым инженерным результатом.
6.13. Заключение
В начале модуля была знакомой функцией потерь. Теперь у неё появился физически проверяемый смысл: это идеальный счёт в битах, который вероятностная модель выставляет наблюдаемой последовательности.
Основную конструкцию можно собрать в одну строку:
Неравенство Крафта показало, почему короткие кодовые слова конкурируют за конечный бюджет. Теорема Шеннона разложила избыточность кода на несовпадение модели и неиспользованный ресурс. Хаффман дал лучший односимвольный префиксный код, а арифметическое кодирование позволило отложить округление до конца сообщения. AEP объяснило, почему длинные последовательности получают устойчивую удельную длину, а энтропийная скорость перенесла результат на источники с зависимостями.
Для ML главное следствие особенно простое:
меньшая отложенная логарифмическая потеря означает более короткий ожидаемый код данных — при том же источнике, той же единице и том же протоколе.
Дальше начинается инженерная честность. PPL зависит от токена; BPC и BPB требуют общего байтового протокола; фактический поток имеет кодовые накладные расходы; самостоятельный архив оплачивает модель; хороший компрессор является сильным предиктором, но не получает автоматически сертификат общего интеллекта.
Теория здесь не разрушает красивую связь предсказания и сжатия. Она делает её сильнее: показывает точное равенство, точную цену несовпадения и точное место, где к коду данных добавляется остальная система.
Основные источники
- C. E. Shannon, «A Mathematical Theory of Communication» (1948).
- D. A. Huffman, «A Method for the Construction of Minimum-Redundancy Codes» (1952).
- T. Cover, J. Thomas, «Elements of Information Theory», глава 5.
- G. Delétang et al., «Language Modeling Is Compression», ICLR 2024.
- Y. Huang et al., «Compression Represents Intelligence Linearly», COLM 2024.
- S. Xuyang, X. Luo et al., «Is Compression Really Linear with Code Intelligence?» (2025).
- S. M. Xie et al., «An Explanation of In-Context Learning as Implicit Bayesian Inference», ICLR 2022.
- M. Hahn, N. Goyal, «A Theory of Emergent In-Context Learning as Implicit Structure Induction» (2023).
- M. Hutter, «Human Knowledge Compression Contest» — официальные правила enwik9.