Модуль 5. Взаимная информация: сколько один объект говорит о другом
Как читать этот модуль. Основной маршрут — §§5.1–5.12. Мы начнём с привычного для ML вопроса о качестве вероятностного предсказания, затем перейдём к условной взаимной информации, представлениям, шумным меткам, InfoNCE и оцениванию MI по конечной выборке. Усиленное неравенство обработки данных в §5.5 и неравенство Фано в упражнениях — математические углубления для второго прохода.
5.1. Признак полезен не сам по себе
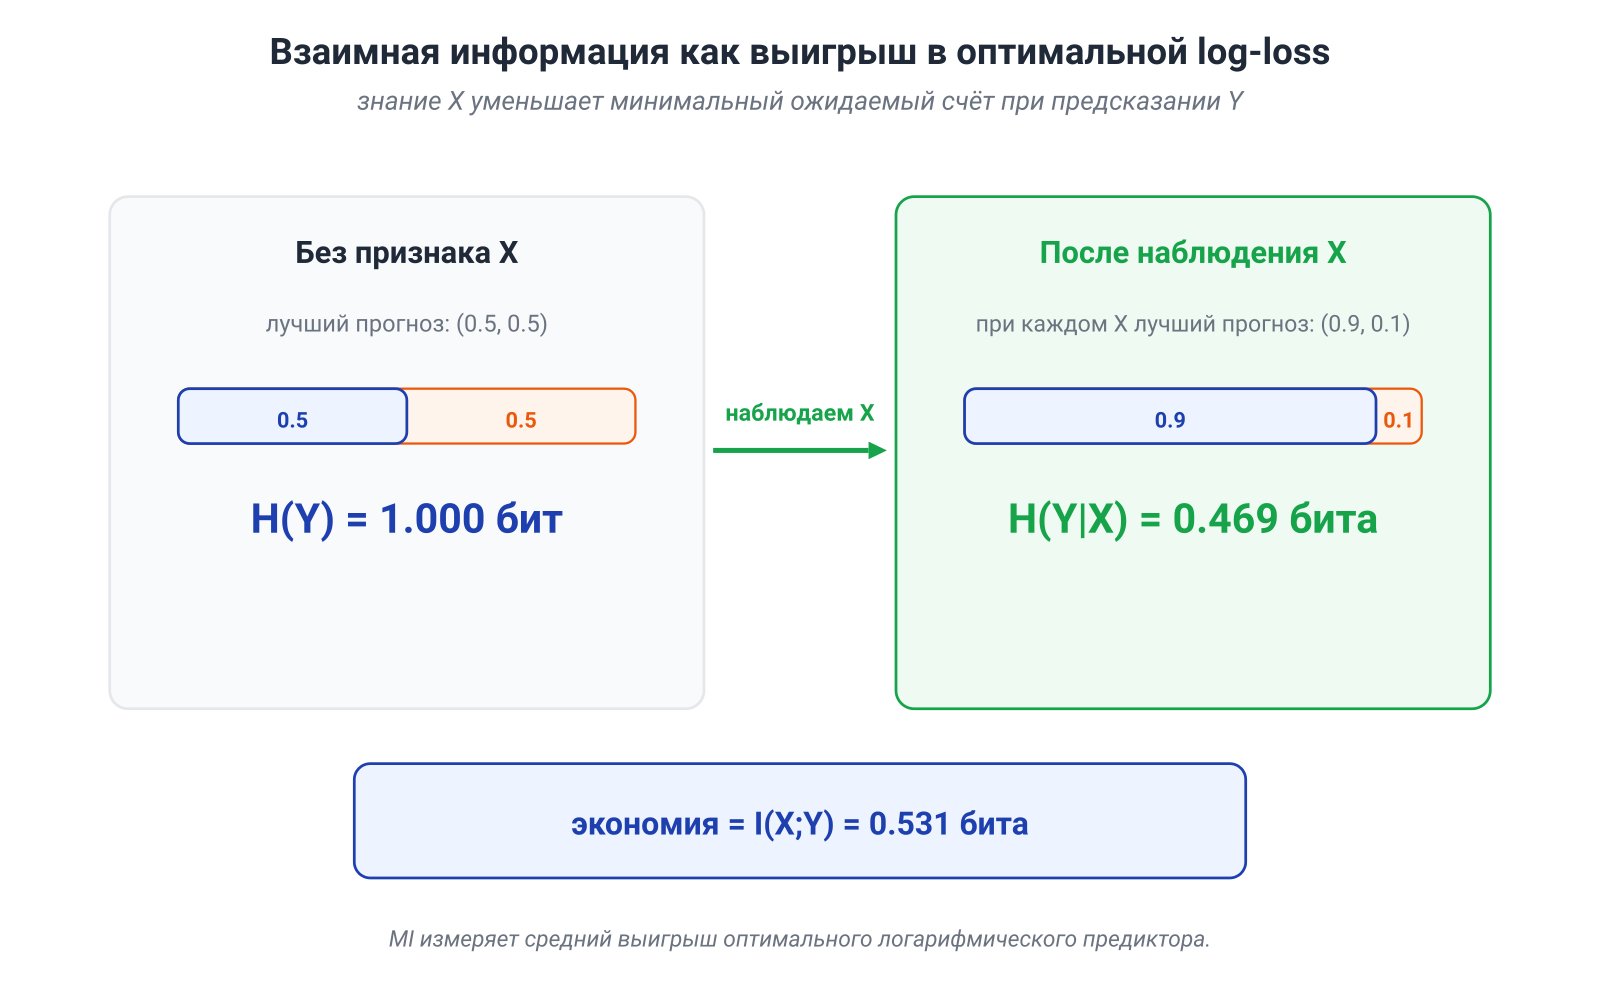
Пусть целевая переменная — честный бит. До того как модель увидела признаки, её лучший вероятностный прогноз прост:
Средняя логарифмическая потеря такого прогноза равна одному биту:
Теперь появляется признак , который совпадает с с вероятностью и инвертирован с вероятностью . Оптимальный предиктор уже не обязан отвечать : увидев , он назначает соответствующему значению вероятность . Его средняя потеря становится
бита. Признак сэкономил
бита логарифмической потери (log-loss) на одно наблюдение.
Это и есть взаимная информация:
Взаимная информация — это ожидаемый выигрыш в оптимальной логарифмической потере, который даёт знание одной переменной при предсказании другой.
Эта формулировка сразу связывает классическую теорию информации с ML. Взаимная информация отвечает не на расплывчатый вопрос «хороший ли это признак вообще?», а на точный вопрос:
насколько признак уменьшает неизбежную неопределённость целевой переменной при идеальном вероятностном предсказании на данном распределении?
Слово «идеальном» здесь существенно. Реальная модель конечной мощности может не извлечь всю доступную информацию; конечная выборка может не позволить её надёжно оценить; распределение на проде может отличаться от обучающего. MI описывает связь случайных величин на уровне распределения, а не автоматически качество конкретного обученного классификатора.
В ML этот вопрос возникает постоянно:
- насколько признак полезен для целевой переменной;
- что новый признак добавляет сверх уже выбранных;
- сколько информации о метке сохранил энкодер;
- связаны ли изображение и подпись сильнее, чем случайная пара;
- не попала ли целевая переменная в признаки через утечку данных;
- какую часть общего содержания сохраняют две аугментации одного объекта.
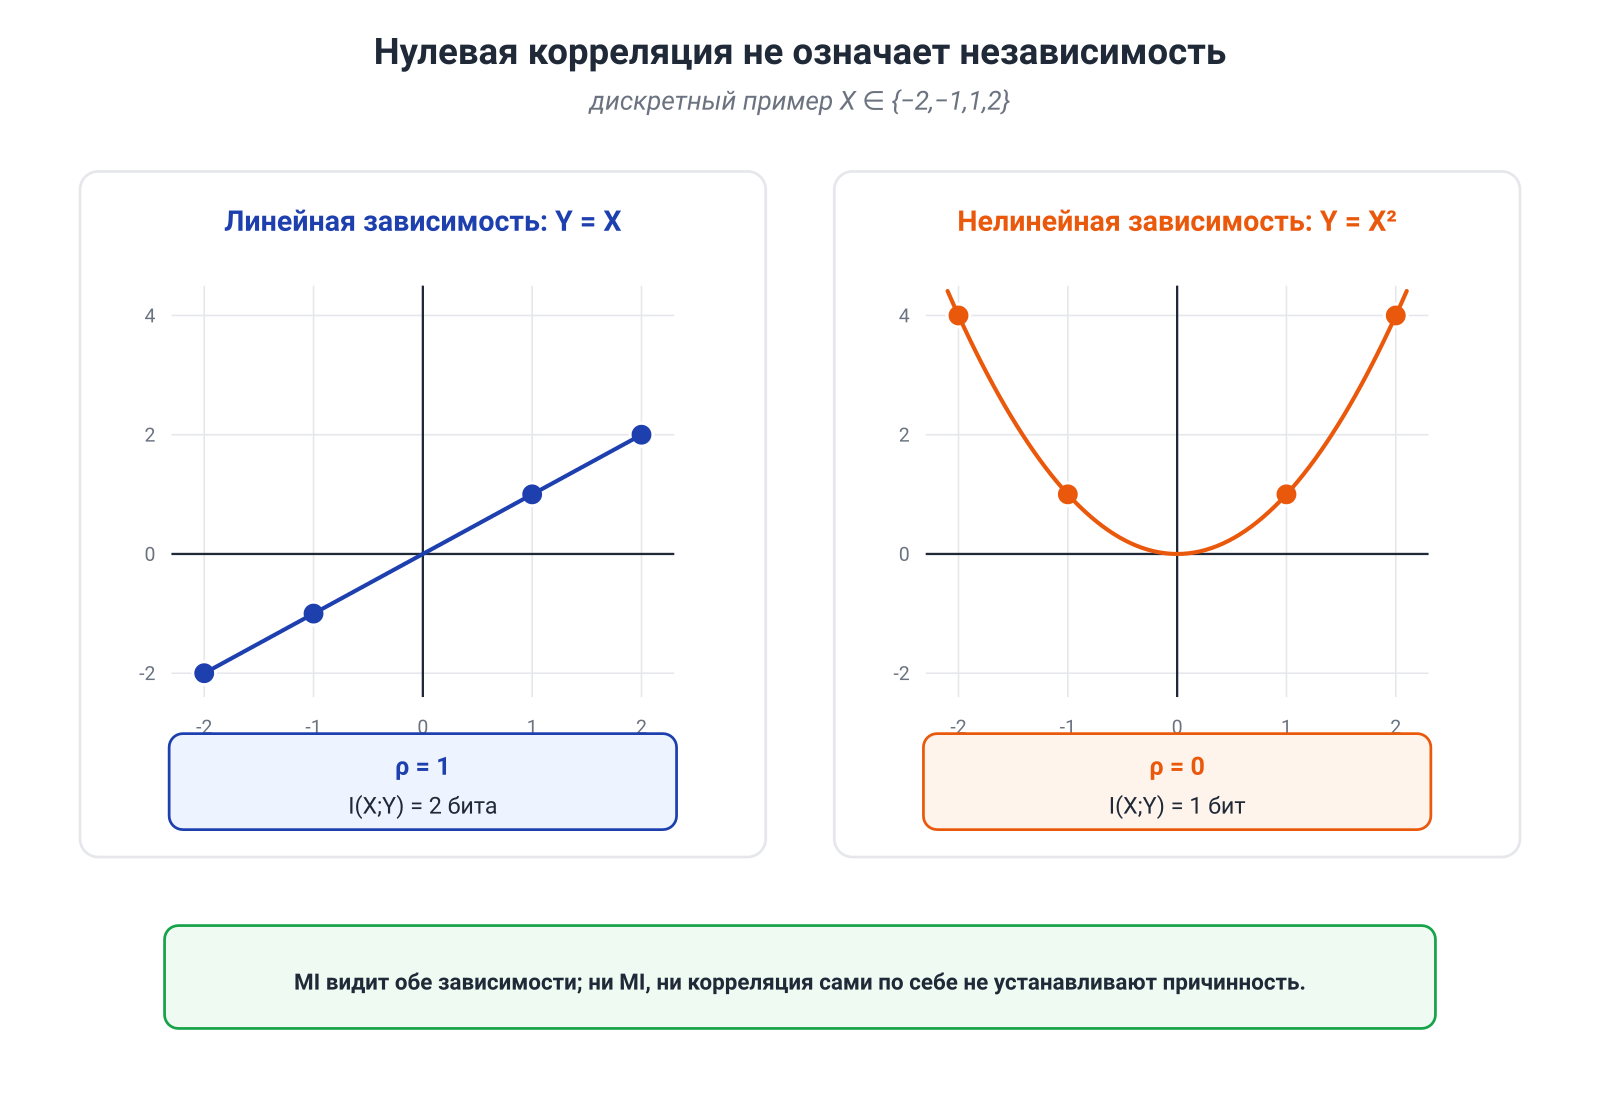
Корреляция — естественный первый кандидат, но она видит прежде всего линейную связь. Возьмём
Из симметрии . Однако полностью определяется по и принимает два равновероятных значения, поэтому
Нулевая корреляция здесь означает отсутствие линейного тренда, а не отсутствие зависимости.
Если не сказано обратное, дискретные примеры используют логарифм по основанию 2 и измеряются в битах. В функциях потерь ML обычно берут натуральный логарифм; тогда те же величины измеряются в натах.
5.2. Одна величина — три чтения
У взаимной информации несколько эквивалентных форм. Каждая отвечает на свой вопрос, и полезнее не выбирать «главную», а научиться переходить между ними.
Выигрыш в предсказании
Представим, что мы предсказываем дискретную по логарифмической потере. Без доступа к лучший на уровне распределения прогноз — маргинальное распределение , а минимальная ожидаемая потеря равна
С доступом к лучший прогноз — , а средняя минимальная потеря равна
Поэтому
Ту же формулу можно прочитать в обратную сторону:
Именно поэтому MI симметрична. Предсказательные задачи «угадывать по » и «угадывать по » различаются, но среднее сокращение логарифмической неопределённости оказывается одним и тем же.
Расстояние от мира независимости
Наиболее общая формулировка — через KL-дивергенцию:
— совместное распределение, которое получилось бы, если бы связь между переменными была разорвана, а маргинальные распределения остались прежними. Поэтому MI измеряет среднюю цену подмены реального совместного мира независимой моделью.
Для дискретных переменных
Из свойств KL сразу следуют
и
Это отличие от корреляции принципиально: нулевая MI означает полную статистическую независимость, а не только исчезновение одного момента.
Перекрытие неопределённостей
По цепному правилу
Для дискретных величин отсюда следуют границы
Если — дискретная детерминированная функция, то
Это не обязано равняться : необратимое отображение может забыть часть различий между значениями . При взаимно однозначном преобразовании сохраняется вся энтропия:
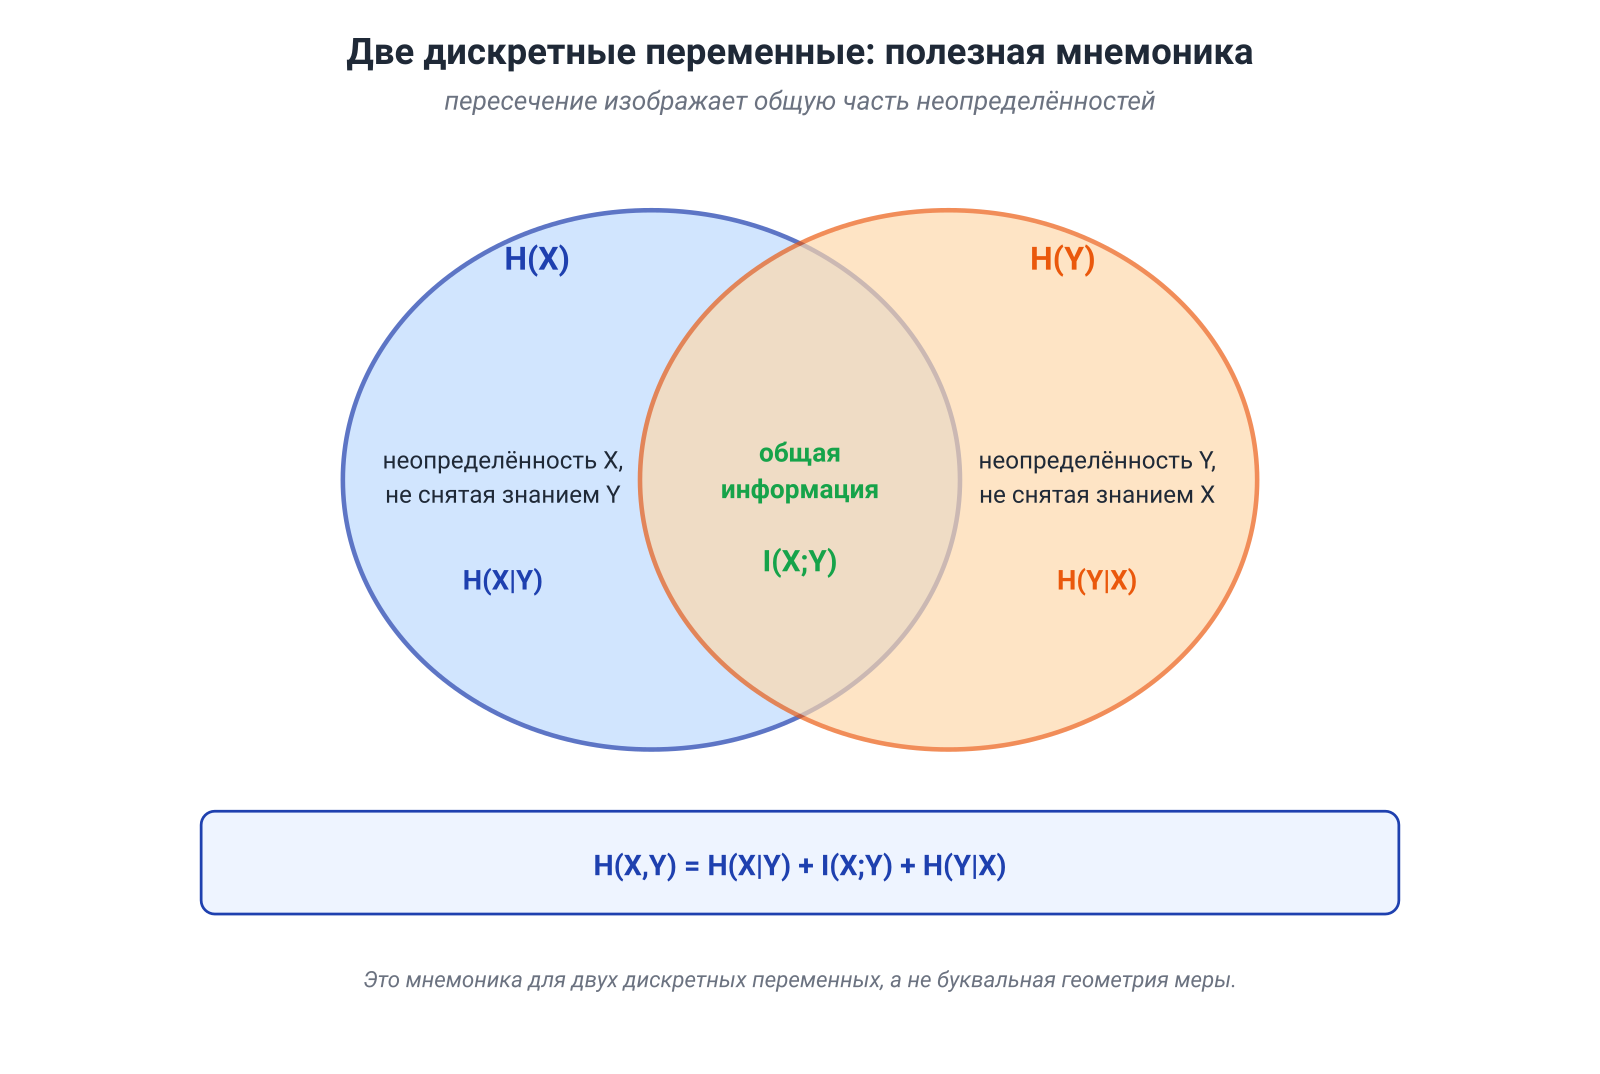
Диаграмма с пересекающимися областями — хороший мнемонический якорь для двух дискретных переменных. Но это не буквальная евклидова геометрия. Для трёх и более переменных появляются избыточность, синергия и взаимодействующая информация; простая картинка с кругами быстро перестаёт быть надёжной картой.
Где заканчиваются безопасные формулы. KL-определение остаётся базовым и для непрерывных величин. Записи через разности дифференциальных энтропий требуют, чтобы соответствующие величины были корректно определены и не возникало неопределённостей вида . Кроме того, для непрерывной неатомарной величины обычно бесконечна. А термин собственная информация (self-information) обычно означает неожиданность отдельного исхода , а не энтропию распределения.
5.3. PMI: локальный логарифм связи
MI усредняет зависимость по всем парам. Для конкретной пары исходов используется поточечная взаимная информация (pointwise mutual information, PMI):
Это логарифм коэффициента, показывающего, во сколько раз наблюдение изменило вероятность относительно базовой частоты.
Например, пусть
При независимости совместная вероятность была бы . Реальная пара встречается в пять раз чаще, поэтому
Знак PMI имеет прямое чтение:
- : пара встречается чаще независимого ожидания;
- : конкретная пара согласуется с независимостью;
- : пара встречается реже независимого ожидания.
В отличие от MI, отдельная PMI может быть отрицательной. Взаимная информация — её среднее по реальному совместному распределению:
В NLP PMI и её варианты используются для оценки ассоциации слова и контекста. Здесь же возникает типичная ловушка: редкая пара с одним-двумя наблюдениями может получить огромное значение из-за малого знаменателя. Поэтому практический анализ почти всегда требует порога по частоте, сглаживания, перестановочного контроля или другой проверки устойчивости. Большой логарифм ещё не означает надёжное свидетельство.
5.4. Условная MI: что новый признак добавляет сверх известных
Маргинальная отвечает на вопрос, полезен ли сам по себе. В модели с десятками признаков этого мало. Нужно понять, приносит ли что-то новое после того, как уже известна переменная .
Определим условную взаимную информацию:
Для дискретных переменных
Это ожидаемая экономия в оптимальной логарифмической потере от добавления к уже известному .
Цепное правило имеет вид
В отборе признаков эта формула объясняет два противоположных эффекта.
Избыточность
Новый признак может иметь высокую , но почти нулевую
потому что он повторяет уже выбранные признаки. Например, температура в градусах Цельсия и Фаренгейта по отдельности одинаково информативны о некоторой погодной метке, но второй признак почти ничего не добавляет после первого.
Синергия
Информация может появляться только в комбинации. Пусть — независимые честные биты, а
Тогда
но
Более того,
До знания первый бит бесполезен; после знания он полностью определяет метку. Это чистый пример взаимодействия, которое деревья, нейросети и признаки-пересечения способны использовать, а одномерный фильтр по — нет.
Условная MI даёт правильный язык для добавочной ценности, но не бесплатный алгоритм. В высокой размерности её оценивание ещё сложнее, чем оценивание маргинальной MI. Поэтому реальные методы часто используют приближения, жадные критерии или непосредственно проверяют улучшение целевой метрики на отложенных данных.
5.5. DPI: энкодер может перепаковать информацию, но не напечатать новые биты
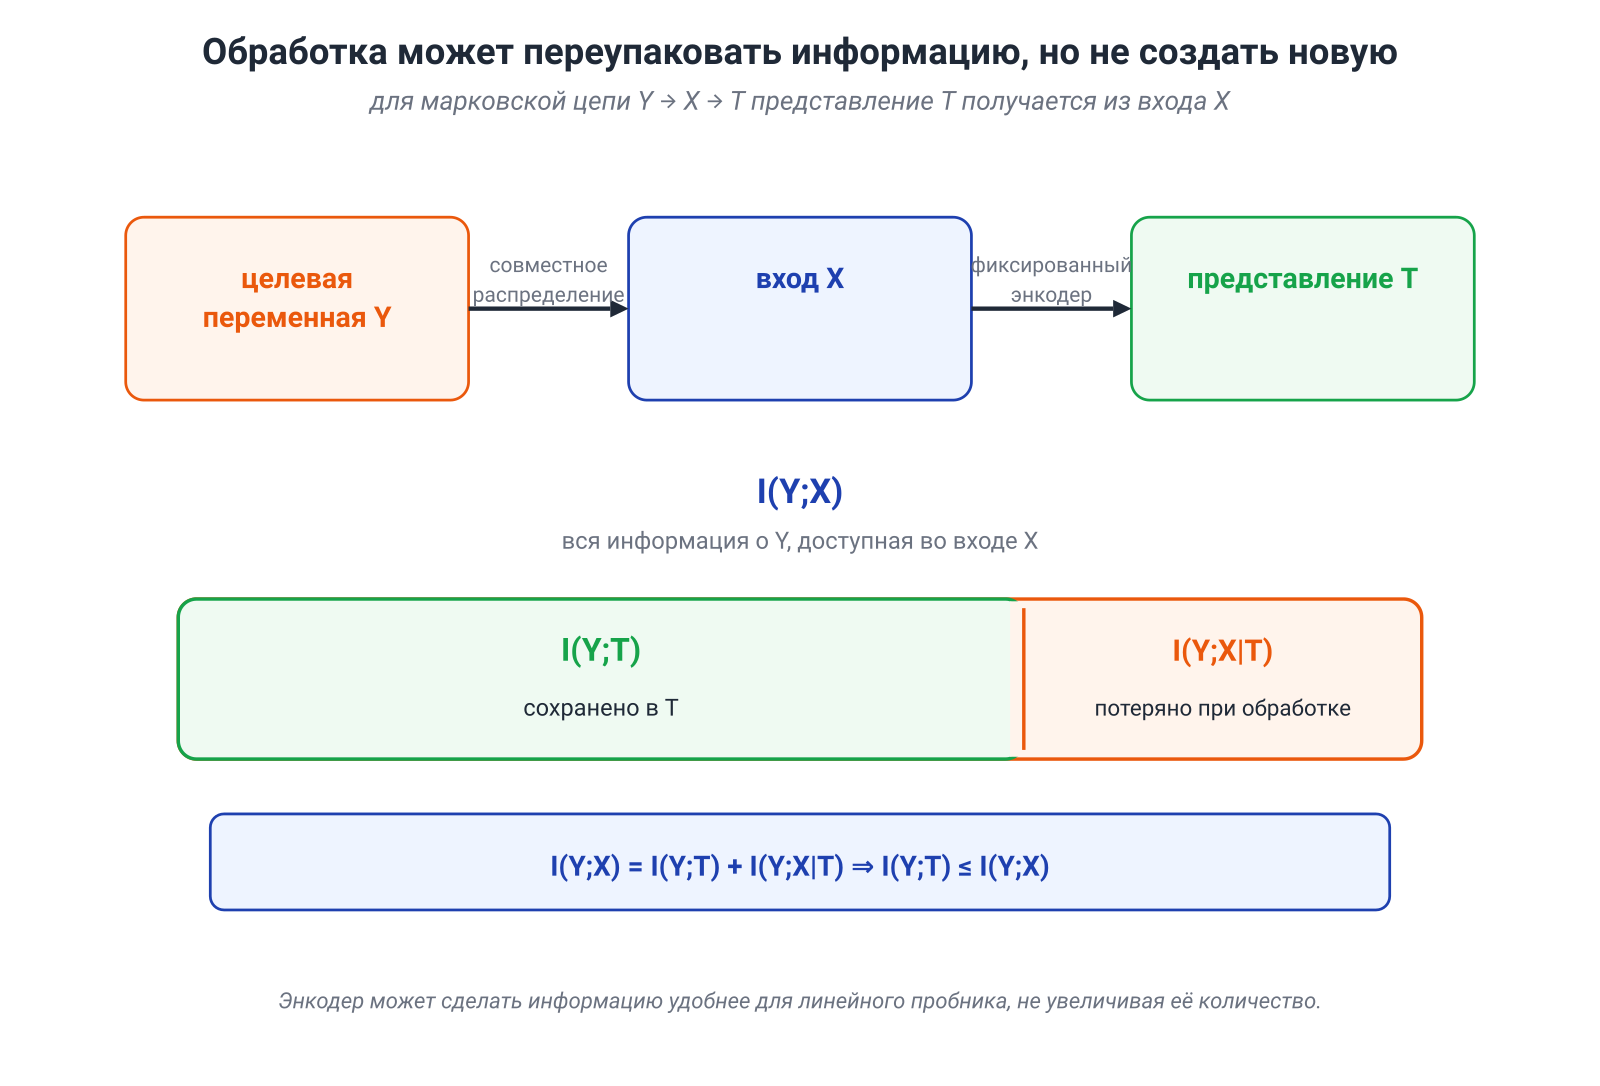
Пусть
— марковская цепь: представление строится из входа и не получает целевую переменную по другому пути. Тогда
Это неравенство обработки данных (Data Processing Inequality, DPI).
Фиксированная обработка может сохранить, отбросить или переупаковать информацию о метке, но не создать ту информацию, которой не было во входе.
Короткое доказательство показывает, откуда берётся потеря. По цепному правилу
и одновременно
Из марковости . Поэтому
Остаток
имеет содержательное значение: это информация о , которая ещё была во входе , но уже недоступна после перехода к .
Почему после энкодера классифицировать бывает легче
На первый взгляд DPI спорит с опытом deep learning: хороший энкодер повышает качество линейного пробника, иногда радикально. Противоречия нет. DPI ограничивает количество информации на уровне распределения, но не её доступность конкретному классу моделей.
Энкодер может:
- сделать релевантную информацию линейно доступной;
- удалить нерелевантные факторы, мешающие обучению на конечной выборке;
- сформировать полезные инвариантности;
- улучшить обусловленность и геометрию задачи;
- внести индуктивное смещение, усвоенное при предобучении.
Информация могла присутствовать во входе, но быть представлена в форме, которую простой считывающий слой не умеет извлечь. Нейросеть не обязана увеличивать , чтобы увеличить точность ограниченного считывающего слоя.
Где в вероятностной схеме находятся обученные веса
DPI относится к фиксированному каналу . Предобученная модель приносит информацию из обучающего набора в параметрах. Если параметры считаются случайными, корректная схема должна включать их явно, например
После фиксации весов для нового примера действует обычная DPI относительно выбранного совместного распределения. Поэтому лозунг «сеть ничего не знает сверх текущего входа» слишком груб: она не создаёт информацию из пустоты, но использует знание, закодированное в параметрах.
Достаточное для задачи представление
Если и
то сохраняет всю информацию о , доступную во входе:
Такое представление называют достаточным для задачи. Оно может отбросить цвет фона, идентификатор камеры или точную текстуру, если эти детали не помогают предсказывать целевую переменную.
Здесь важно развести две цели:
- сохранить близкой к ;
- при необходимости уменьшить , не перенося в представление все детали входа.
Этот компромисс лежит в основе информационного бутылочного горлышка (Information Bottleneck):
В M9 мы разберём, когда эта постановка полезна и почему её нельзя автоматически считать описанием динамики любой детерминированной нейросети.
Математическое углубление: усиленное DPI
Этот подраздел можно пропустить при первом чтении.
Обычная DPI говорит только, что информация не растёт. Для некоторых шумных каналов можно получить количественную контракцию:
Тогда каскад каналов даёт геометрическую верхнюю границу. Для двоичного симметричного канала с вероятностью инверсии глобальный коэффициент KL-контракции равен
Это сильный результат о конкретном стохастическом канале. Но он не превращается автоматически в теорему о том, что информация в любой глубокой детерминированной сети обязана экспоненциально исчезать, а residual-связь обязана иметь коэффициент контракции ровно единица. Для такого переноса нужно сначала определить случайные величины, канал и область супремума. SDPI — точный инструмент, а не универсальная архитектурная метафора.
5.6. MI, корреляция и причинность отвечают на разные вопросы
MI и корреляция
Корреляция Пирсона измеряет нормированную линейную ковариацию. MI проверяет, отличается ли всё совместное распределение от произведения маргиналов.
Поэтому
но
не гарантирует независимость.
Для совместно гауссовской пары связь особенно проста:
При натуральном логарифме результат измеряется в натах, при — в битах. Это формула для совместно гауссовского распределения, а не универсальный перевод корреляции в MI. За пределами гауссовского семейства одно значение не определяет всю зависимость.
MI и причинность
Большая говорит, что переменные статистически связаны. Она не сообщает, почему именно:
- может влиять на ;
- может влиять на ;
- обе переменные могут зависеть от общего фактора ;
- связь может возникнуть из-за отбора наблюдений;
- признак может содержать утечку из будущего или из этапа предобработки.
Высокая MI может сделать признак отличным предиктором и одновременно плохой переменной для вмешательства. Взаимная информация измеряет зависимость, а причинный эффект требует интервенционной или каузальной постановки.
5.7. Шумные метки: когда 100% ошибок всё ещё несут один бит
Рассмотрим двоичный симметричный канал (binary symmetric channel, BSC):
где — честный бит, а — наблюдаемая метка.
При равномерном входе наблюдаемая метка тоже равномерна, а
Следовательно,
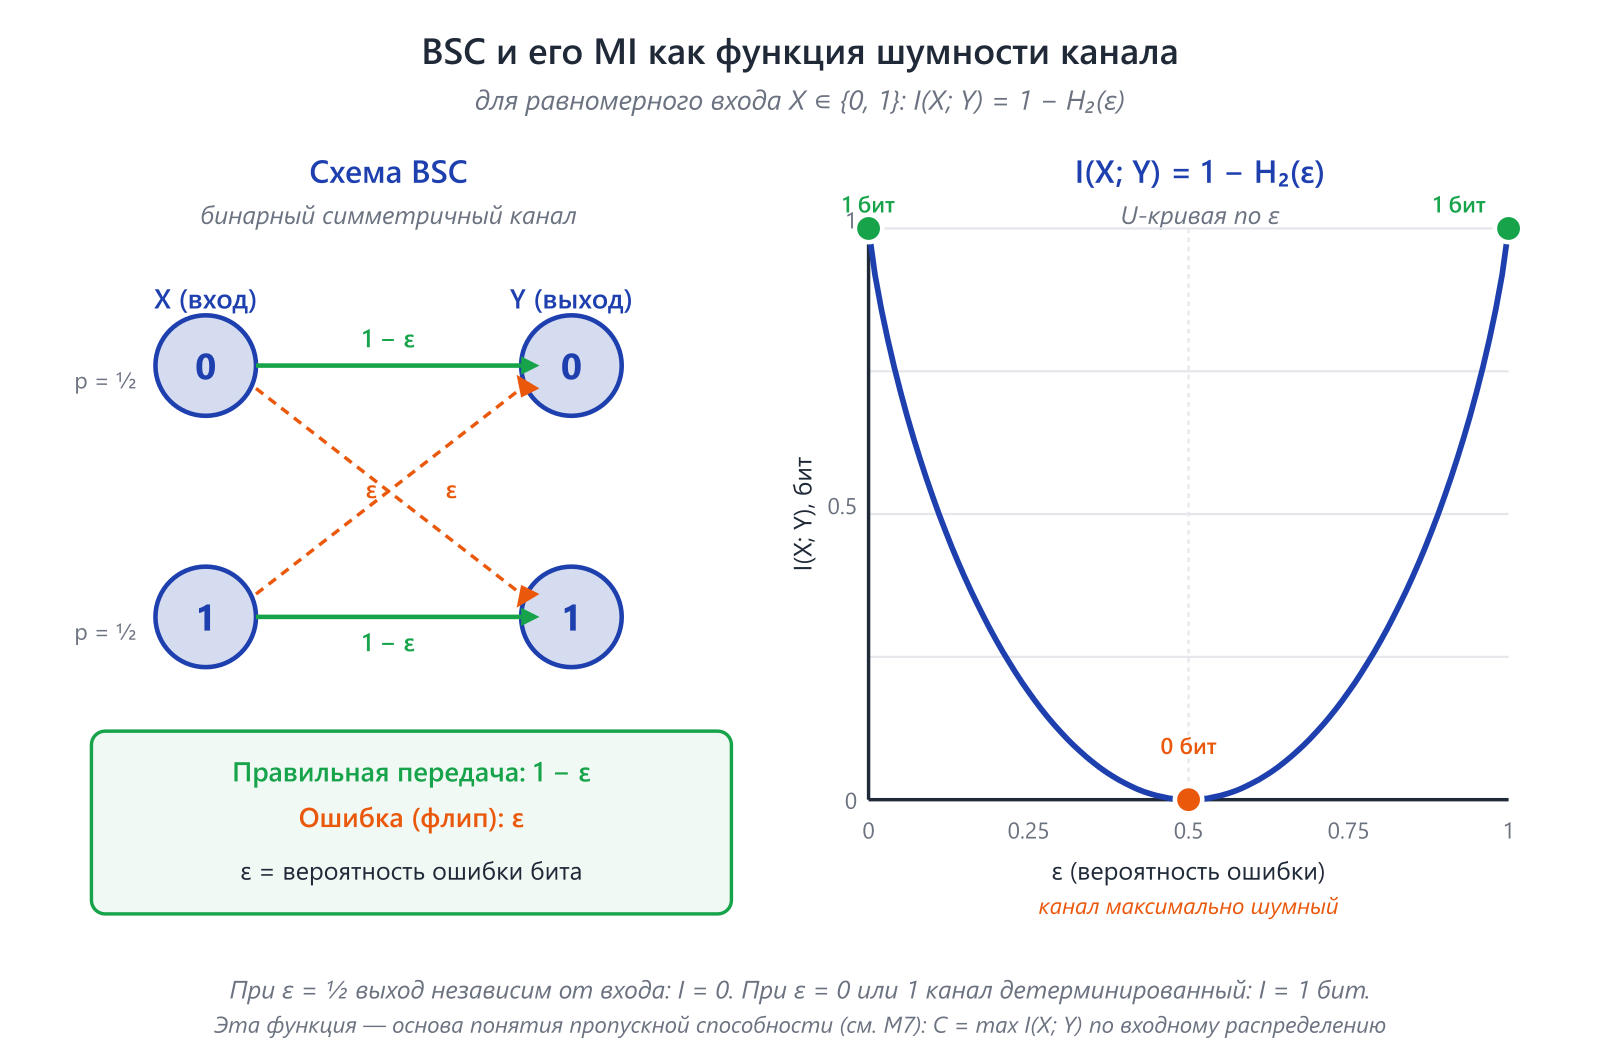
Кривая содержит три режима:
- : метка передаётся без ошибок, MI равна одному биту;
- : наблюдаемая метка независима от истинной, MI равна нулю;
- : метка всегда неправильна, но инверсия детерминирована и обратима, поэтому MI снова равна одному биту.
Последняя точка особенно полезна. Взаимная информация измеряет предсказуемую связь, а не семантическую правильность символа. Если известно, что разметчик всегда меняет 0 на 1 и 1 на 0, его ответы легко исправить. Гораздо хуже разметчик, который в половине случаев подбрасывает монету.
Для BSC равномерное входное распределение достигает пропускной способности:
бит на использование канала. В ML эта модель служит чистым базовым случаем симметричного шума меток. Реальные ошибки часто зависят от класса, сложности примера, разметчика и скрытого контекста; тогда одной недостаточно.
5.8. Отбор признаков: полезный фильтр, но не оракул
Простейший фильтр ранжирует признаки по
В сравнении с корреляцией это серьёзное расширение: можно обнаружить нелинейную зависимость. Но универсальность меры не делает процедуру универсально надёжной.
| Риск | Что происходит | Что проверять |
|---|---|---|
| Избыточность | несколько признаков повторяют одну и ту же информацию | условную MI или качество после добавления к выбранному набору |
| Синергия | признаки бесполезны по одному, но полезны совместно | взаимодействия, признаки-пересечения, модели с подходящим классом функций |
| Ошибка оценки | ранжирование меняется из-за малого , размерности и гиперпараметров оценивателя | бутстрэп, повторные разбиения, перестановочный контроль |
| Утечка | признаки выбираются с использованием валидационной части | выполнять отбор внутри каждого обучающего фолда |
mRMR-подобные критерии пытаются совместить релевантность и штраф за избыточность. Это разумная эвристика, но не точное решение общей многомерной задачи: попарные штрафы не обязаны замечать синергию высокого порядка.
Практический минимальный протокол:
- определить случайные величины и единицу наблюдения;
- считать оцениватель и его гиперпараметры частью обучающего конвейера;
- выполнять отбор только на обучающей части каждого разбиения;
- сравнивать оценки с перестановочной базовой линией;
- повторять оценивание для нескольких начальных состояний генератора (
seeds) и размеров выборки; - принимать решение по качеству на отложенных данных, а не по одному числу MI.
MI здесь полезна как фильтр и диагностический сигнал. Она не заменяет валидацию модели и не доказывает причинную полезность признака.
5.9. InfoNCE: найти согласованную пару среди случайных
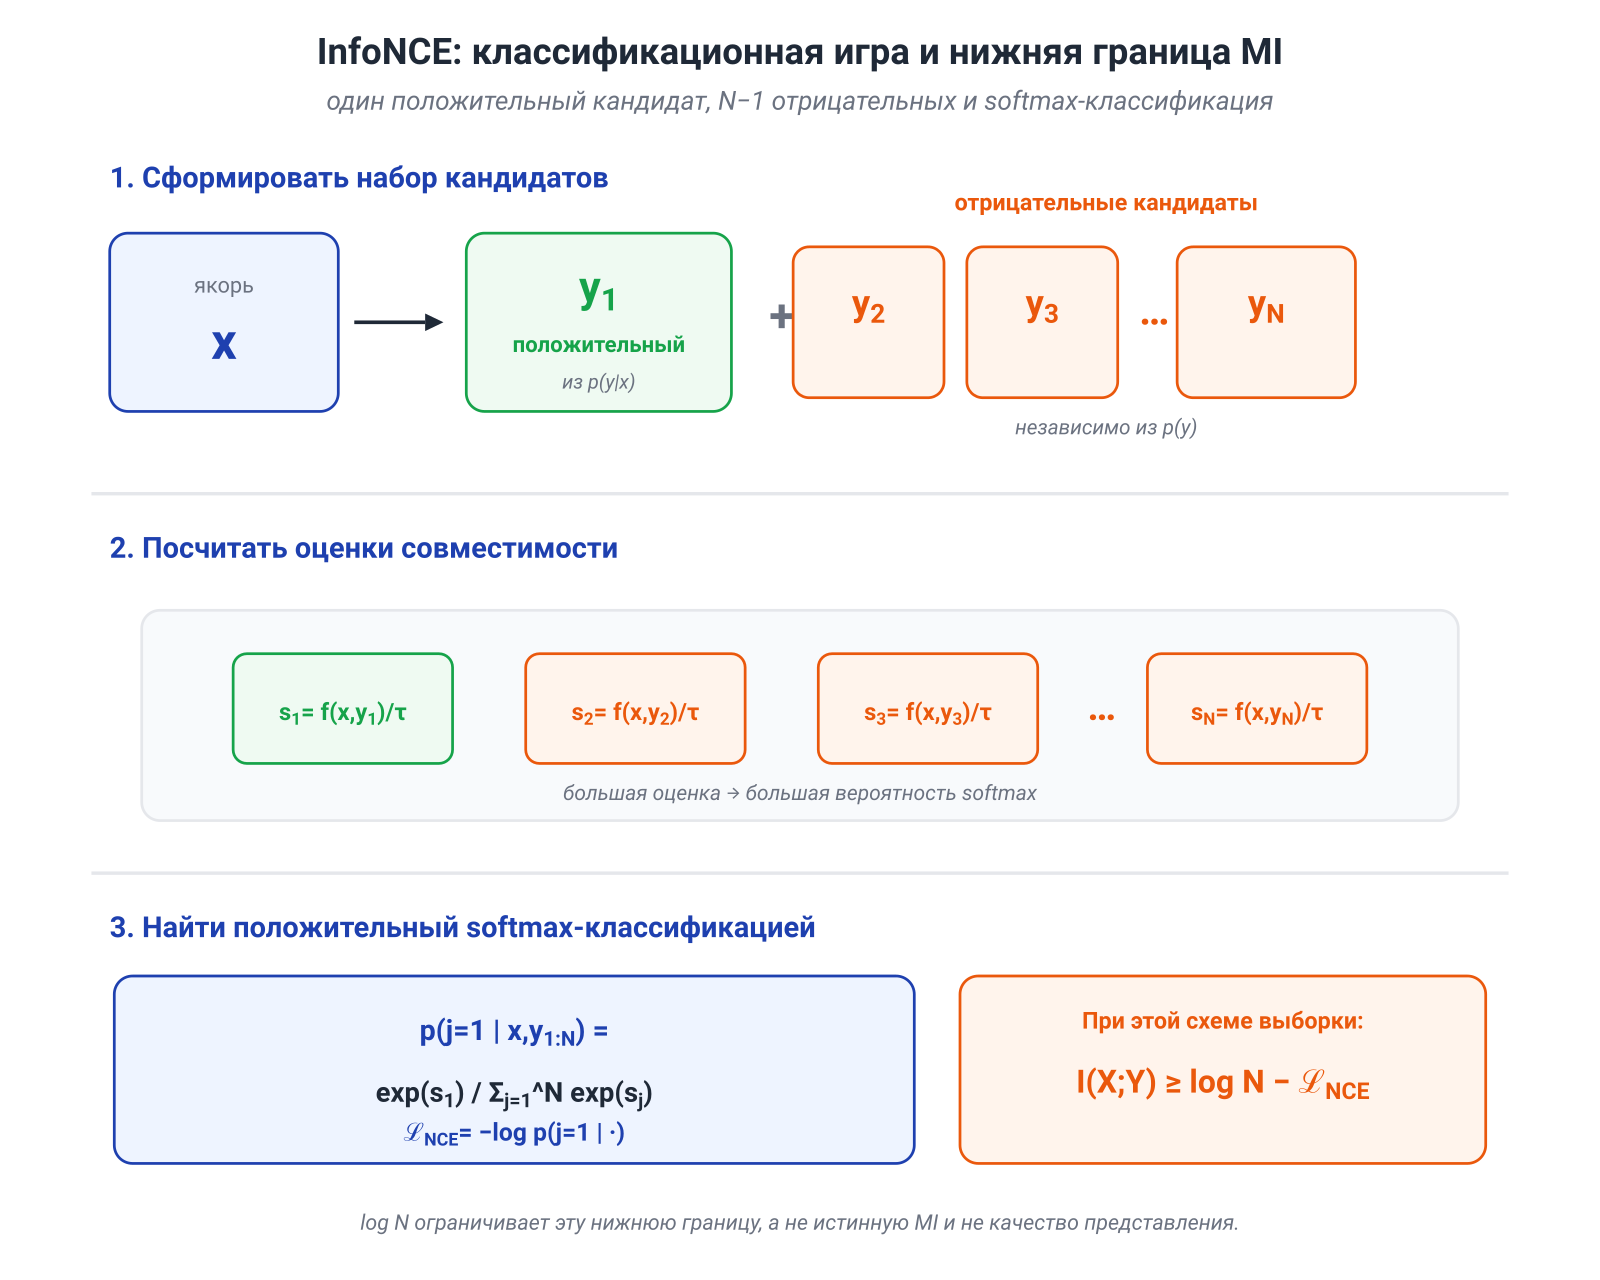
Пусть — согласованная пара: две аугментации одного объекта, изображение и подпись, аудиофрагмент и его контекст. Для якоря берётся один положительный кандидат
и отрицательных кандидатов
Модель получает вариантов и должна определить, какой из них образует реальную пару с . Для функции совместимости потеря InfoNCE равна
Это обычная -классовая кросс-энтропия. Но классы здесь необычны: «правильный класс» — позиция кандидата, пришедшего из условного распределения, а остальные пришли из маргинального.
При этой стандартной схеме выборки выполняется
Основание логарифма должно совпадать с функцией потерь. В большинстве реализаций используется натуральный логарифм, поэтому граница измеряется в натах.
Почему классификация связана с MI
Оптимальный критик имеет вид
где добавка сокращается внутри softmax. То есть классификатор учится оценивать логарифм отношения:
насколько кандидат вероятнее рядом с данным , чем в среднем по набору данных?
Это та же локальная величина, которая появилась в PMI. Контрастивная классификация учит представление различать совместное распределение и произведение маргиналов.
Положительный результат достаточно силён: уменьшение ожидаемой InfoNCE-потери повышает соответствующую нижнюю границу на MI. Но точная область действия границы определяется схемой выборки кандидатов.
Где заканчивается точное утверждение
- — потолок этой конкретной нижней границы, а не потолок истинной MI или качества представления;
- значение InfoNCE-потери не является точной оценкой MI;
- больше отрицательных примеров не гарантирует лучшую целевую метрику;
- кандидаты из одного батча могут быть зависимы и не совпадать с независимыми выборками из ;
- ложные отрицательные пары могут отталкивать семантически близкие объекты;
- температура, аугментации, состав батча и класс критика меняют обучающую задачу.
SimCLR и CLIP используют контрастивные классификационные цели этого семейства. Для CLIP задача симметризована: изображение ищет соответствующий текст, а текст — изображение. Корректная формулировка состоит в том, что такая цель связана с MI через контрастивную границу при соответствующей вероятностной схеме. Фраза «CLIP буквально измеряет истинную MI между изображением и текстом» была бы сильнее математики.
Не всё обучение без разметки является InfoNCE. BYOL, SimSiam и DINO используют другие механизмы предотвращения коллапса и не сводятся к стандартной классификации одного положительного примера среди независимых отрицательных.
5.10. Почему число MI трудно получить из выборки
Формула взаимной информации короткая. Её надёжная оценка по конечным данным — нет.
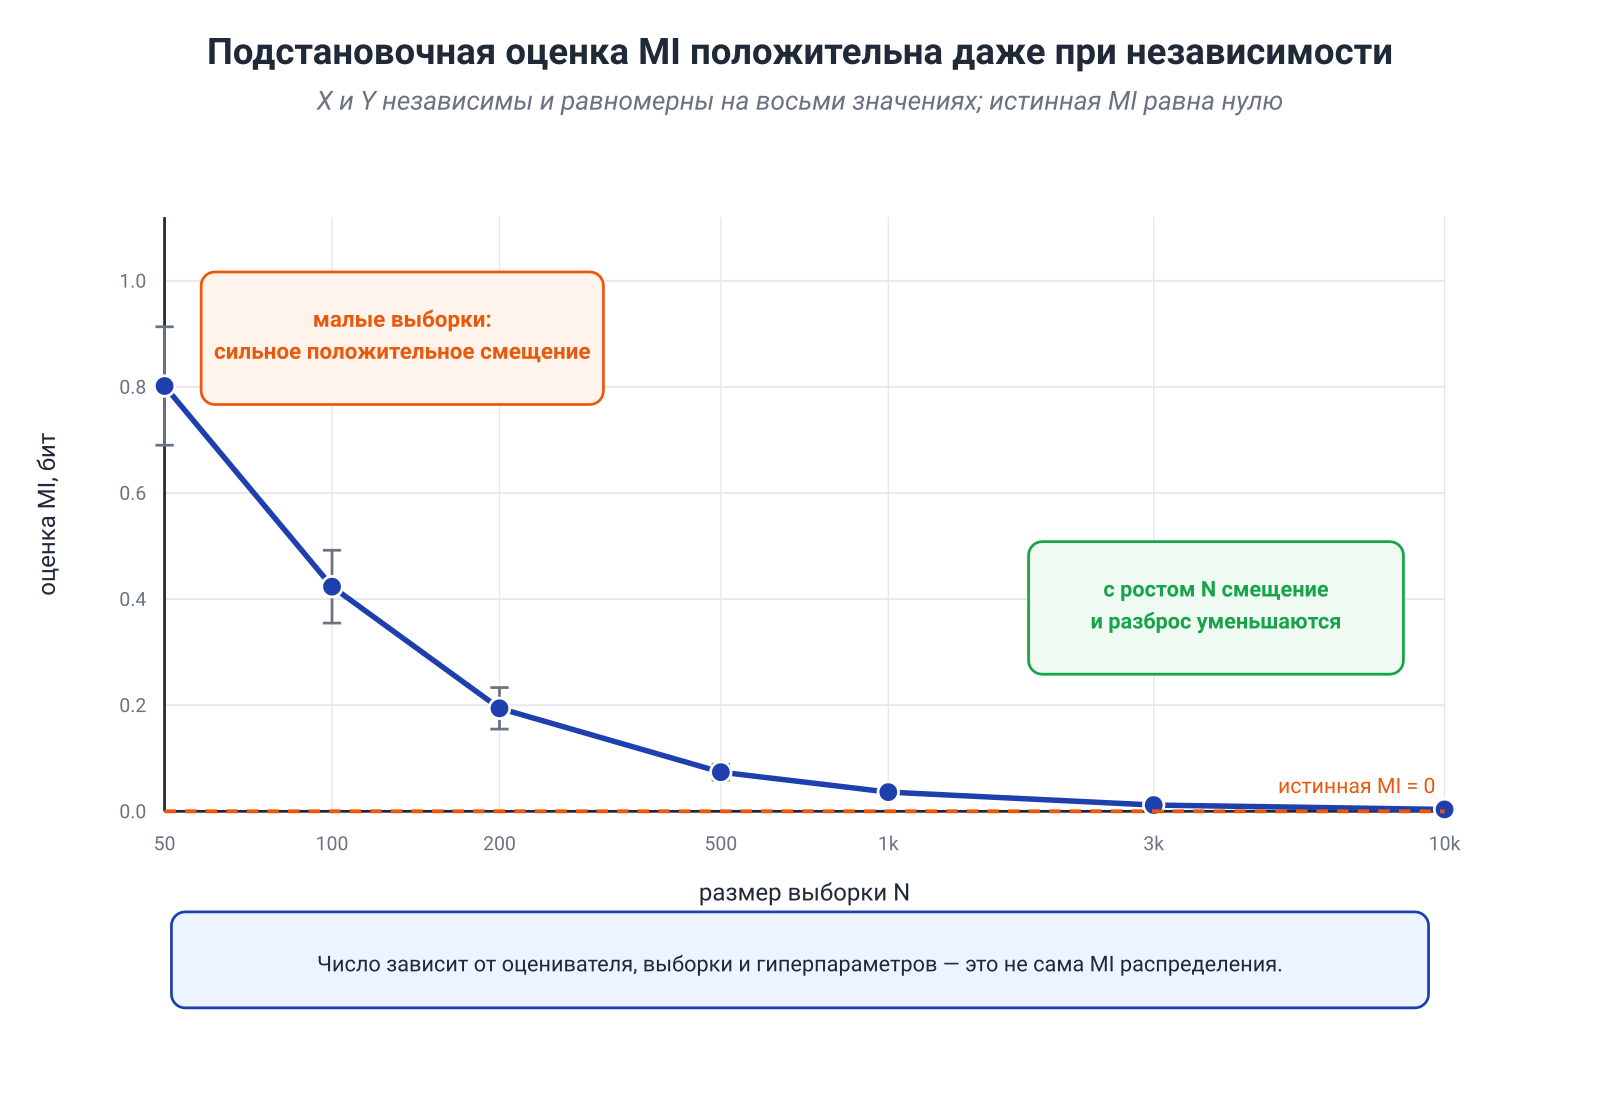
Дискретный подстановочный оцениватель
Для конечных алфавитов можно подставить эмпирические частоты:
Когда таблица сопряжённости мала и хорошо заполнена, метод прозрачен. При большом числе ячеек она становится разреженной: случайные единичные наблюдения выглядят как структура, а нулевые счётчики заставляют вводить сглаживание.
Дискретизация непрерывных величин
Разбиение на интервалы превращает непрерывные данные в дискретные. Результат зависит от числа и границ интервалов, выбросов, размера выборки и размерности. Слишком грубая сетка стирает зависимость; слишком мелкая начинает запоминать шум выборки.
Оцениватели на основе ближайших соседей
KSG-подобные методы выбирают локальный масштаб по расстояниям до ближайших соседей. В низкой размерности они часто полезнее фиксированного binning, но чувствительны к метрике, размерности, совпадающим значениям и предобработке. Выбор снова задаёт компромисс смещения и дисперсии.
Нейросетевые вариационные границы
MINE и родственные методы обучают критик для вариационной нижней границы на
Это превращает MI в дифференцируемую целевую функцию, но не отменяет статистическую трудность. Критик может переобучиться, а оценка и её градиент могут иметь большое смещение или дисперсию. Для нижних границ существует фундаментальное ограничение: без предположений о распределении высокодоверительная нижняя граница, построенная по наблюдениям, в общем случае не может надёжно расти существенно быстрее порядка .
Важно различать два утверждения:
- нейросеть способна вывести произвольное большое число;
- это число является гарантированной нижней границей истинной MI на генеральном распределении.
Первое возможно. Второе требует теоремы, условий и контроля обобщения.
Протокол, который делает число осмысленным
Перед публикацией «MI = 3.7 бита» стоит ответить:
- Какие случайные величины и какое распределение генеральной совокупности определены?
- Дискретны переменные или непрерывны?
- Какой оцениватель используется и какие у него предпосылки?
- На тех же данных обучался оцениватель и сообщается результат или есть отложенная проверка?
- Как выглядит перестановочная базовая линия?
- Стабильно ли число при изменении размера выборки, начального состояния генератора и гиперпараметров?
В обучении представлений MI часто полезнее как принцип построения цели или сравнительный диагностический сигнал, чем как абсолютный измерительный прибор.
5.11. Энтропия attention — не взаимная информация
Веса внимания после softmax образуют распределение по ключам:
Поэтому для запроса можно вычислить
Эта величина точно описывает концентрацию весов:
- низкая энтропия — масса сосредоточена на нескольких позициях;
- высокая энтропия — масса распределена шире.
Но MI требует совместного распределения двух случайных величин. Одна строка attention-весов сама по себе такого объекта не задаёт. Кроме того, выход слоя зависит не только от , но и от векторов значений, остаточного потока, последующих слоёв и нелинейностей.
Поэтому энтропия attention может быть полезной описательной статистикой маршрутизации, но из неё не следуют автоматически:
- количество информации, переданной между токенами;
- причинное влияние позиции на ответ;
- полнота объяснения решения модели;
- превосходство более резкого или более диффузного внимания.
Здесь не нужно отказываться от информационного языка. Нужно сначала задать случайные величины, канал и совместное распределение, а уже затем вычислять MI. В M7 мы сделаем это для настоящих каналов связи; к attention будем возвращаться как к механизму, для которого каналовая интерпретация требует отдельной модели.
5.12. Ключевые выводы модуля
Взаимная информация объединяет несколько задач, которые в ML часто обсуждают разными словами:
- зависимость: насколько совместное распределение отличается от независимой модели;
- предсказательная ценность: сколько оптимальной логарифмической потери экономит признак;
- добавочная ценность: что новый признак сообщает сверх уже известных;
- представления: какую информацию о целевой переменной сохранил энкодер;
- контрастивное обучение: насколько хорошо можно найти согласованную пару среди случайных;
- пределы обработки: что нельзя восстановить после необратимого преобразования.
Главная формула модуля теперь читается не как абстрактная разность энтропий:
Она говорит:
до наблюдения мы платили бит оптимальной логарифмической потери; после наблюдения — ; разница и есть ценность информации о .
Но для практической работы нужно держать раздельно три объекта:
InfoNCE может быть хорошей целью, даже если не даёт точного измерения MI. Высокая оценка MI может быть артефактом переобученного критика. Признак с высокой MI может оказаться утечкой. А представление может улучшить линейный считывающий слой, не нарушая DPI и не увеличивая истинную информацию о метке.
Это не набор исключений из красивой теории. Это и есть зрелое использование теории: сначала понять точный положительный результат, затем проверить, какой объект вычисляет конкретный код.
5.14. Источники и дальнейшее чтение
- C. E. Shannon, A Mathematical Theory of Communication, 1948.
- T. M. Cover, J. A. Thomas, Elements of Information Theory, 2nd ed., 2006.
- A. van den Oord, Y. Li, O. Vinyals, Representation Learning with Contrastive Predictive Coding, 2018.
- B. Poole et al., On Variational Bounds of Mutual Information, 2019.
- M. I. Belghazi et al., MINE: Mutual Information Neural Estimation, 2018.
- D. McAllester, K. Stratos, Formal Limitations on the Measurement of Mutual Information, 2020.
- A. Kraskov, H. Stögbauer, P. Grassberger, Estimating Mutual Information, 2004.
- N. Tishby, F. C. Pereira, W. Bialek, The Information Bottleneck Method, 2000.
- Y. Polyanskiy, Y. Wu, Strong Data-Processing Inequalities for Channels and Bayesian Networks, 2017.
- T. Chen et al., A Simple Framework for Contrastive Learning of Visual Representations, 2020.
- A. Radford et al., Learning Transferable Visual Models From Natural Language Supervision, 2021.
- M. Caron et al., Emerging Properties in Self-Supervised Vision Transformers, 2021.
- J.-B. Grill et al., Bootstrap Your Own Latent: A New Approach to Self-Supervised Learning, 2020.
- X. Chen, K. He, Exploring Simple Siamese Representation Learning, 2020.
В Модуле 6 мы перейдём от зависимости к кодированию источника. Там энтропия перестанет быть только мерой неопределённости и станет операционным пределом средней длины кода.