Модуль 12. Информационные границы обобщения: PAC-Bayes и взаимная информация
Как читать этот модуль. Основной маршрут — §§12.1–12.9. Сначала мы увидим, почему выбор лучшей модели по той же выборке делает её оценку оптимистичной. Затем построим два способа оплатить эту адаптивность: PAC-Bayes-сертификат через и границу в среднем через . В §12.7 эти две записи встретятся в точном тождестве. §12.10 — математическое углубление про априорные распределения, зависящие от данных, MI по отдельным примерам и условную MI; его удобно оставить на второй проход.
12.1. Почему лучшая обучающая ошибка почти неизбежно слишком хороша
Представим 32 классификатора. У каждого одна и та же истинная вероятность ошибки:
Ни один из них не лучше остальных. Но мы проверяем все 32 на одной выборке из 80 примеров и оставляем классификатор с минимальной эмпирической ошибкой. В воспроизводимом эксперименте этого модуля ошибка победителя в среднем получается около
хотя его истинная ошибка по-прежнему равна .
Алгоритм не обнаружил скрыто более сильную модель. Он обнаружил благоприятную случайную флуктуацию. Чем больше вариантов мы просмотрели, тем выше шанс, что один из них случайно окажется особенно удачным именно на этой выборке.
Та же механика работает в большом ML-пайплайне:
- мы подбираем архитектуру;
- запускаем несколько инициализаций;
- выбираем эпоху по метрике;
- настраиваем гиперпараметры;
- сравниваем варианты предобработки;
- иногда много раз смотрим на один и тот же валидационный набор.
Каждый отдельный результат может быть честной оценкой фиксированной модели. Но победитель выбирается после просмотра этих оценок. Поэтому его число уже содержит смещение выбора.
Запишем обучение как случайное отображение
где
— обучающая выборка, а — индекс гипотезы, параметры сети или случайная модель, возвращённая алгоритмом.
Для функции потерь
определим истинный и эмпирический риски:
Разность
называется разрывом обобщения (generalization gap). Положительный разрыв означает, что обучающая оценка была оптимистичнее популяционной.
Если не сказано обратное, логарифмы в модуле натуральные, а KL и взаимная информация измеряются в натах.
Главная проблема здесь не в том, что алгоритму запрещено смотреть на данные. Обучение без данных было бы бессмысленным. Проблема в другом:
Адаптивность нужно оплатить: чем сильнее результат зависит от случайных деталей выборки, тем большую статистическую цену мы должны добавить к обучающей ошибке.
В этом модуле появятся две книги учёта.
- PAC-Bayes сравнивает зависящее от данных распределение моделей с заранее выбранным распределением и выставляет счёт
- Информационная граница рассматривает обучение как канал и измеряет
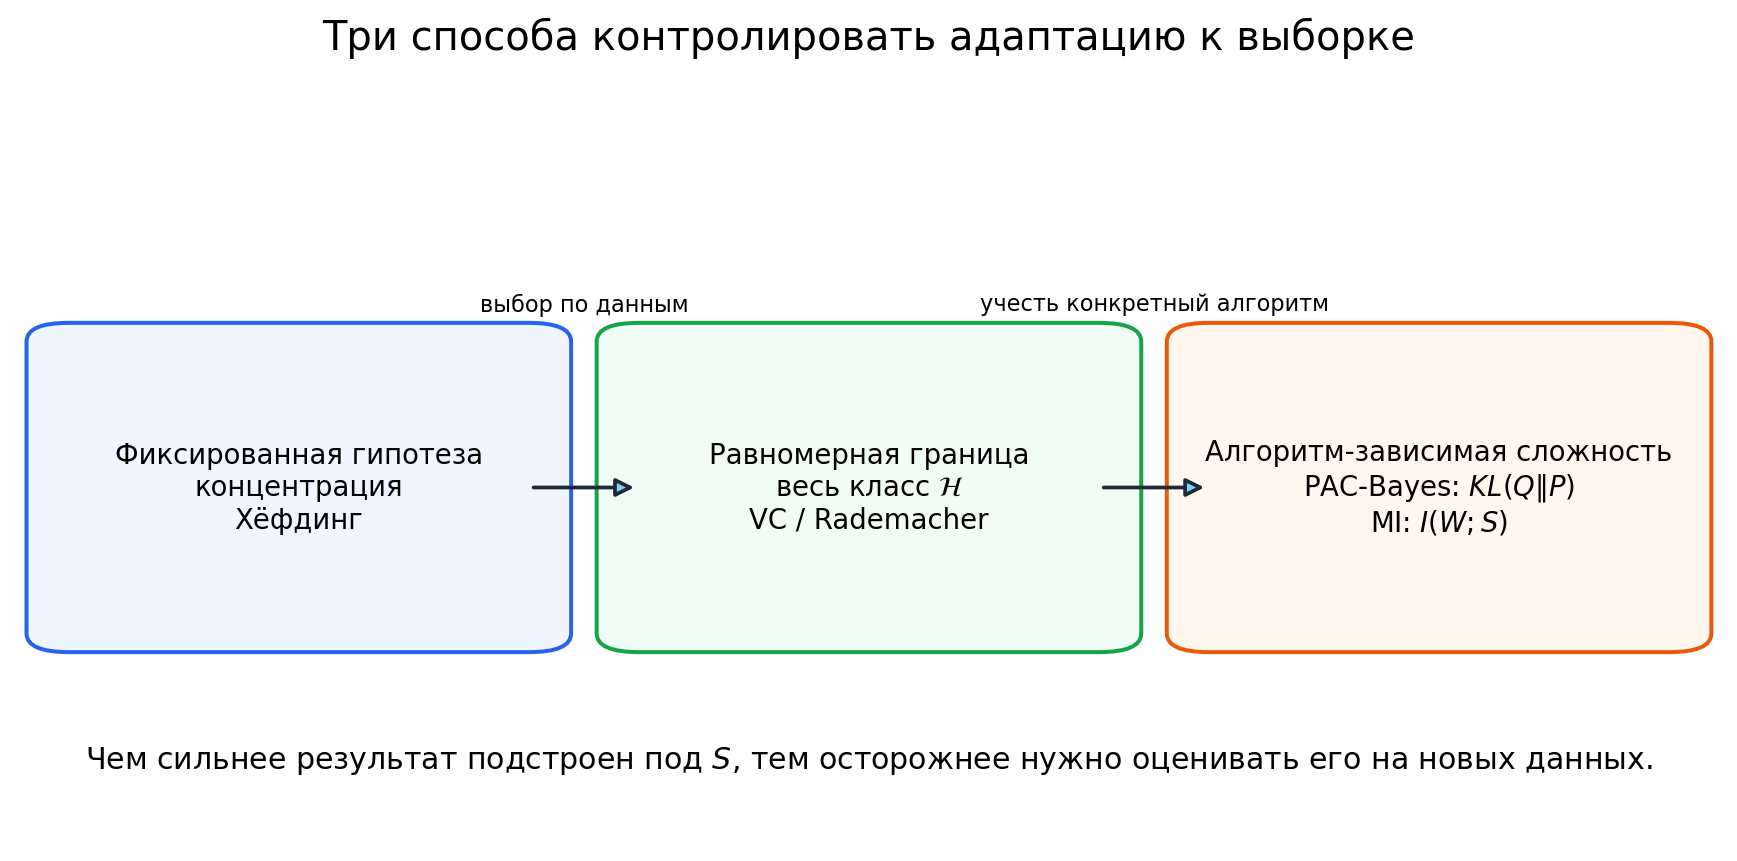
Обе конструкции локальнее грубого подсчёта всего класса гипотез. Но они отвечают на разные вопросы и дают разные типы гарантий. PAC-Bayes обычно сертифицирует конкретную выборку с высокой вероятностью. Базовая MI-граница контролирует ожидаемый разрыв по случайной выборке и случайности алгоритма.
Это различие будет важно на протяжении всего модуля.
12.2. От фиксированной модели к адаптивному выбору
Фиксированная модель
Пусть выбрано до того, как появилась выборка . Тогда неравенство Хёфдинга даёт
Здесь всё устроено просто: мы сравниваем среднее независимых ограниченных величин с их математическим ожиданием.
Но обученная модель
не является заранее фиксированной. Она выбиралась именно потому, что хорошо выглядела на . Подставить в границу для фиксированного нельзя: зависимость результата от выборки — и есть то, что требуется учесть.
Равномерная сходимость
Классический выход состоит в том, чтобы потребовать хорошую оценку одновременно для всех моделей класса . Если класс конечен, объединяющая оценка даёт
Следовательно, с вероятностью не меньше :
Цена выбора среди вариантов входит как . Это уже информационная подсказка: чтобы назвать одного победителя среди кандидатов, требуется порядка бит.
Для бесконечных классов роль размера играют VC-размерность, сложность Радемахера, нормы, отступы и другие меры сложности.
Здесь легко сделать слишком сильный вывод. Равномерные границы не «ошибаются на нейросетях». Они дают корректную гарантию наихудшего случая для всего класса. Проблема в том, что грубая глобальная сложность огромной сети часто делает численную границу вакуумной — больше единицы для риска в .
Но реальный алгоритм не исследует весь класс одинаково. SGD, архитектура, предобучение, регуляризация и данные направляют его в малую часть пространства параметров. Поэтому естественно спросить не только
насколько велик весь класс?
но и
насколько сложен именно результат, который вернул этот алгоритм на этой выборке?
Адаптивный выбор в миниатюре
Вернёмся к 32 одинаково хорошим гипотезам. Жёсткий выбор
почти полностью определяется случайными различиями между эмпирическими ошибками. В эксперименте:
а информационная граница, которую мы выведем в §12.6, даёт около
Если заменить argmin мягким Gibbs-выбором
то с ростом температуры выбор становится менее чувствительным к конкретным флуктуациям. Одновременно уменьшаются и , и смещение выбора.
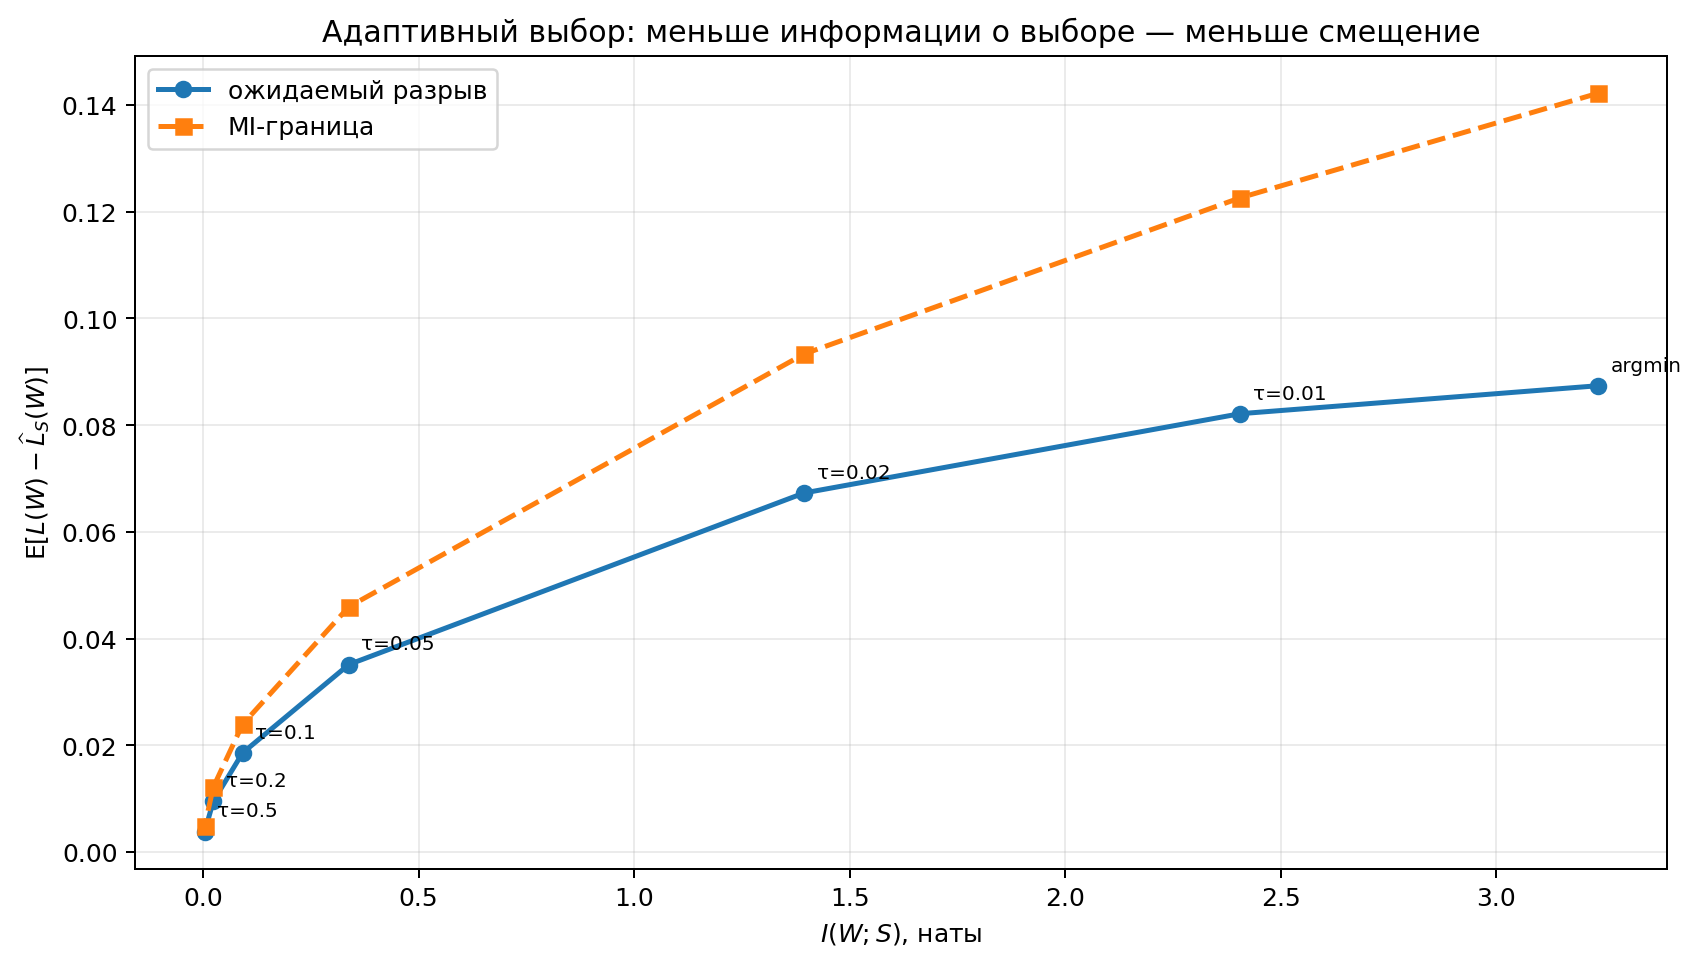
Этот пример не доказывает, что шум всегда улучшает обучение. Он показывает более точный механизм: рандомизация может ограничить объём выборочно-специфической информации, использованной при выборе результата.
12.3. PAC-Bayes: распределение до данных и распределение после обучения
PAC-Bayes меняет объект анализа. Вместо одной обученной гипотезы рассматривается распределение над гипотезами или параметрами.
- — априорное распределение (
prior), фиксированное независимо от сертифицирующей выборки ; - — апостериорное распределение (
posterior), которое может зависеть от всей выборки; - при предсказании модель случайно выбирается из .
Названия prior и posterior пришли из байесовской статистики, но PAC-Bayes не требует, чтобы был обычным байесовским апостериорным распределением. Это могут быть любые две вероятностные меры, удовлетворяющие условиям теоремы.
Определим риск Gibbs-предиктора:
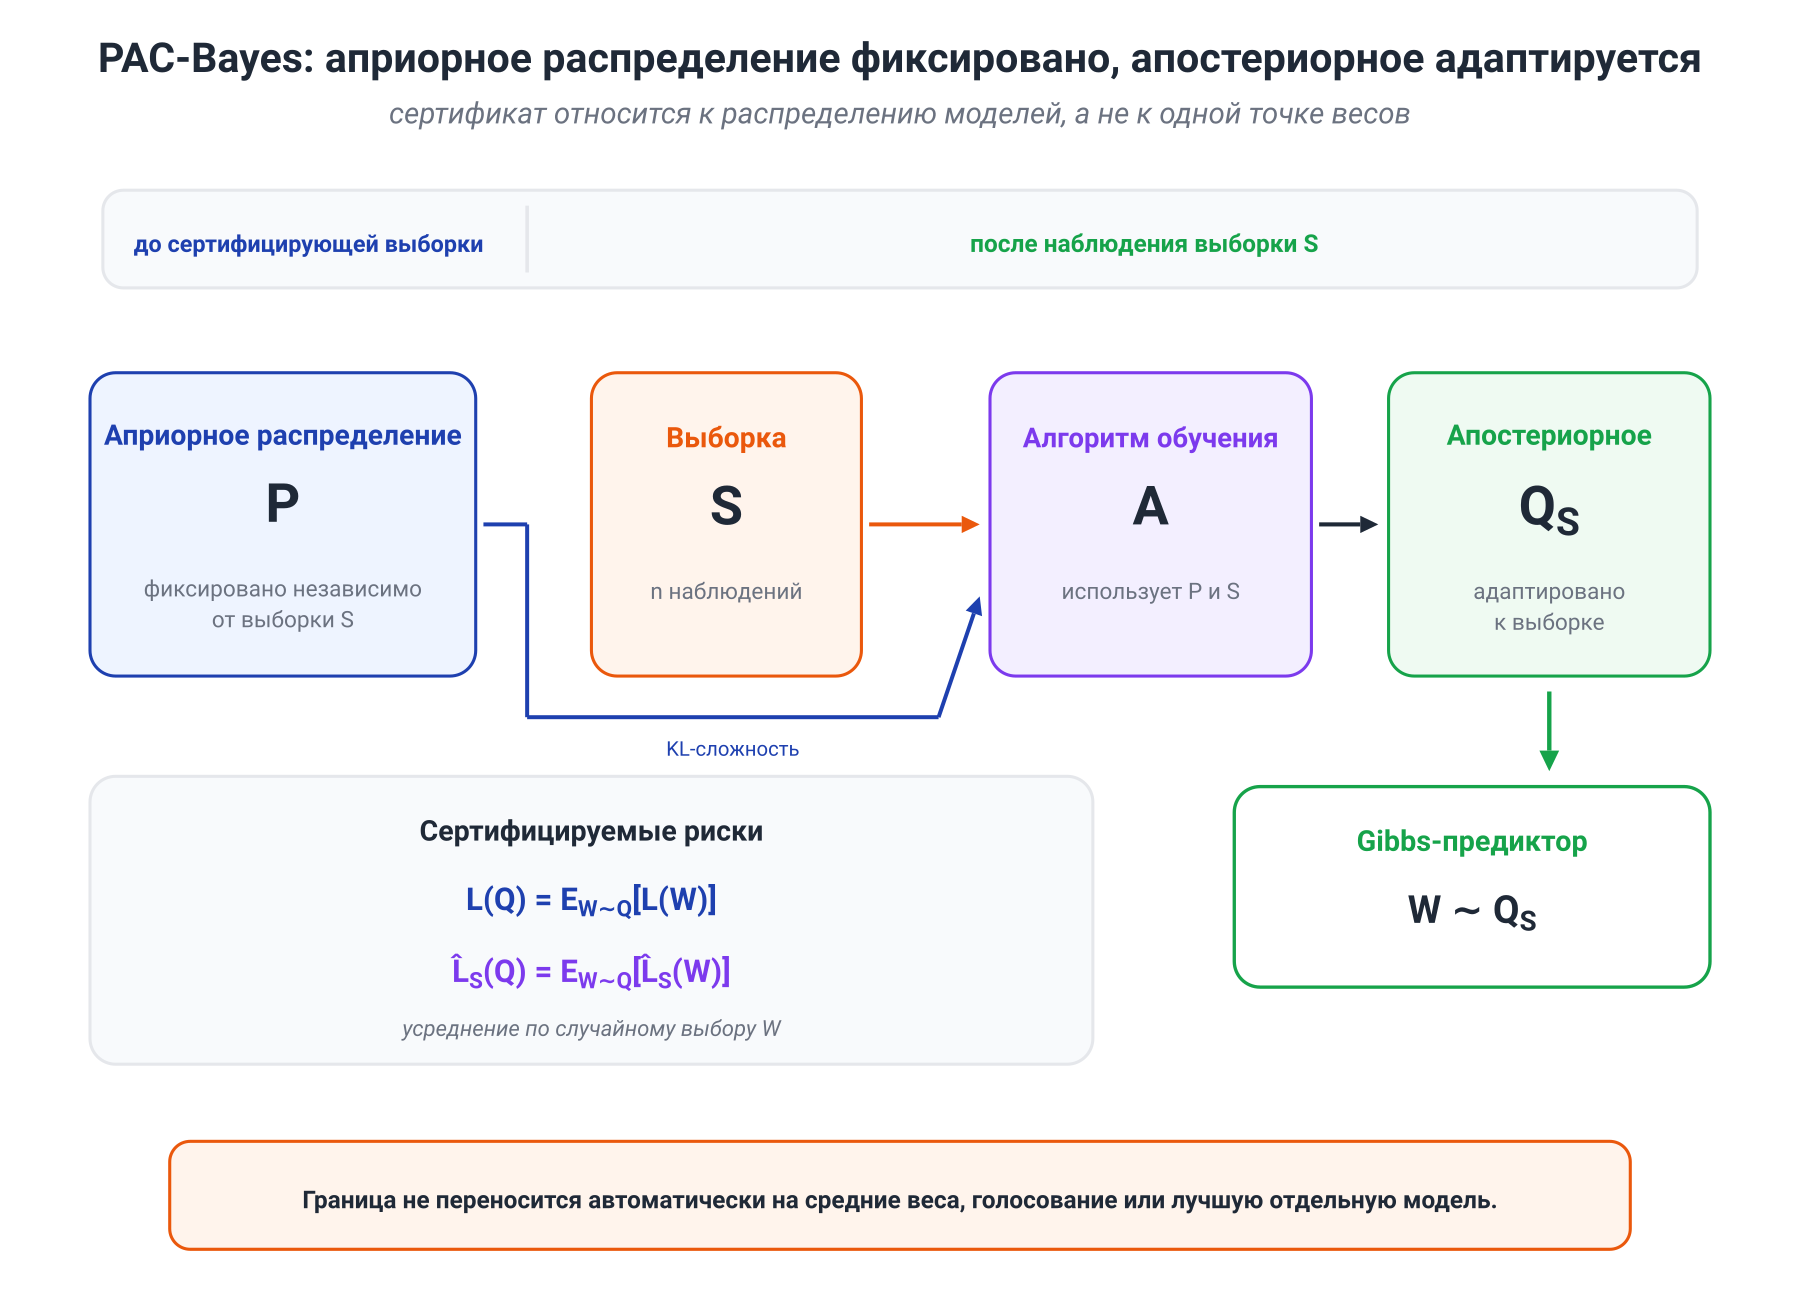
Здесь нужно не потерять сертифицируемый объект. Базовая граница относится к Gibbs-предиктору: модель выбирается из случайно, и риск усредняется по этому выбору.
Это не то же самое, что:
- сеть со средними весами ;
- усреднение логитов или вероятностей ансамбля;
- голосование большинства;
- лучшая отдельная модель на носителе .
Иногда для этих объектов можно вывести дополнительные границы. Но заменить Gibbs-риск риском среднего предиктора одним словом «ансамбль» нельзя.
Что оплачивает KL
Член
измеряет, насколько сильно распределение после обучения отклонилось от заранее выбранной точки отсчёта.
Если уже отдаёт большую массу областям, где находится хорошее решение, апостериорному распределению не требуется далеко уходить. Если же концентрируется там, где почти не имеет массы, цена велика.
Это не просто расстояние между начальными и конечными весами. KL зависит от полных распределений, их дисперсий, носителей и параметризации.
Почему априорное распределение нельзя бесплатно обучить на той же выборке
PAC-Bayes-теорема будет одновременно верна для всех , поэтому апостериорное распределение разрешено выбирать после просмотра данных. Но используется внутри концентрационного аргумента как распределение, не зависящее от .
Если сначала обучить на всей сертифицирующей выборке, затем выбрать рядом с ним и просто подставить маленькую KL в стандартную формулу, данные будут использованы дважды:
- для выбора точки отсчёта;
- для выбора апостериорного распределения.
Второе использование оплачено KL, первое — нет.
Корректные варианты существуют: разделение данных, иерархические априорные распределения, дифференциально-приватный выбор или специальные теоремы для априорных распределений, зависящих от данных. Но зависимость должна быть видна в гарантии.
12.4. PAC-Bayes-kl: сертификат для конкретной выборки
Для обозначим бинарную KL-дивергенцию
Малые буквы kl здесь важны: это KL между двумя распределениями Бернулли с параметрами и .
Теорема
Пусть
- i.i.d.;
- ;
- не зависит от ;
- .
Тогда с вероятностью не меньше по выбору одновременно для всех апостериорных распределений выполняется
Эту форму обычно называют PAC-Bayes-kl-границей; коэффициент соответствует уточнённой оценке экспоненциального момента Маурера.
На этом месте полезно прочитать формулу словами.
- Левая часть сравнивает наблюдаемый Gibbs-риск и неизвестный истинный Gibbs-риск.
- Первый член справа оплачивает отклонение апостериорного распределения от априорного.
- Второй задаёт уровень доверия.
- Деление на распределяет эту цену по размеру выборки.
Обозначим правую часть через
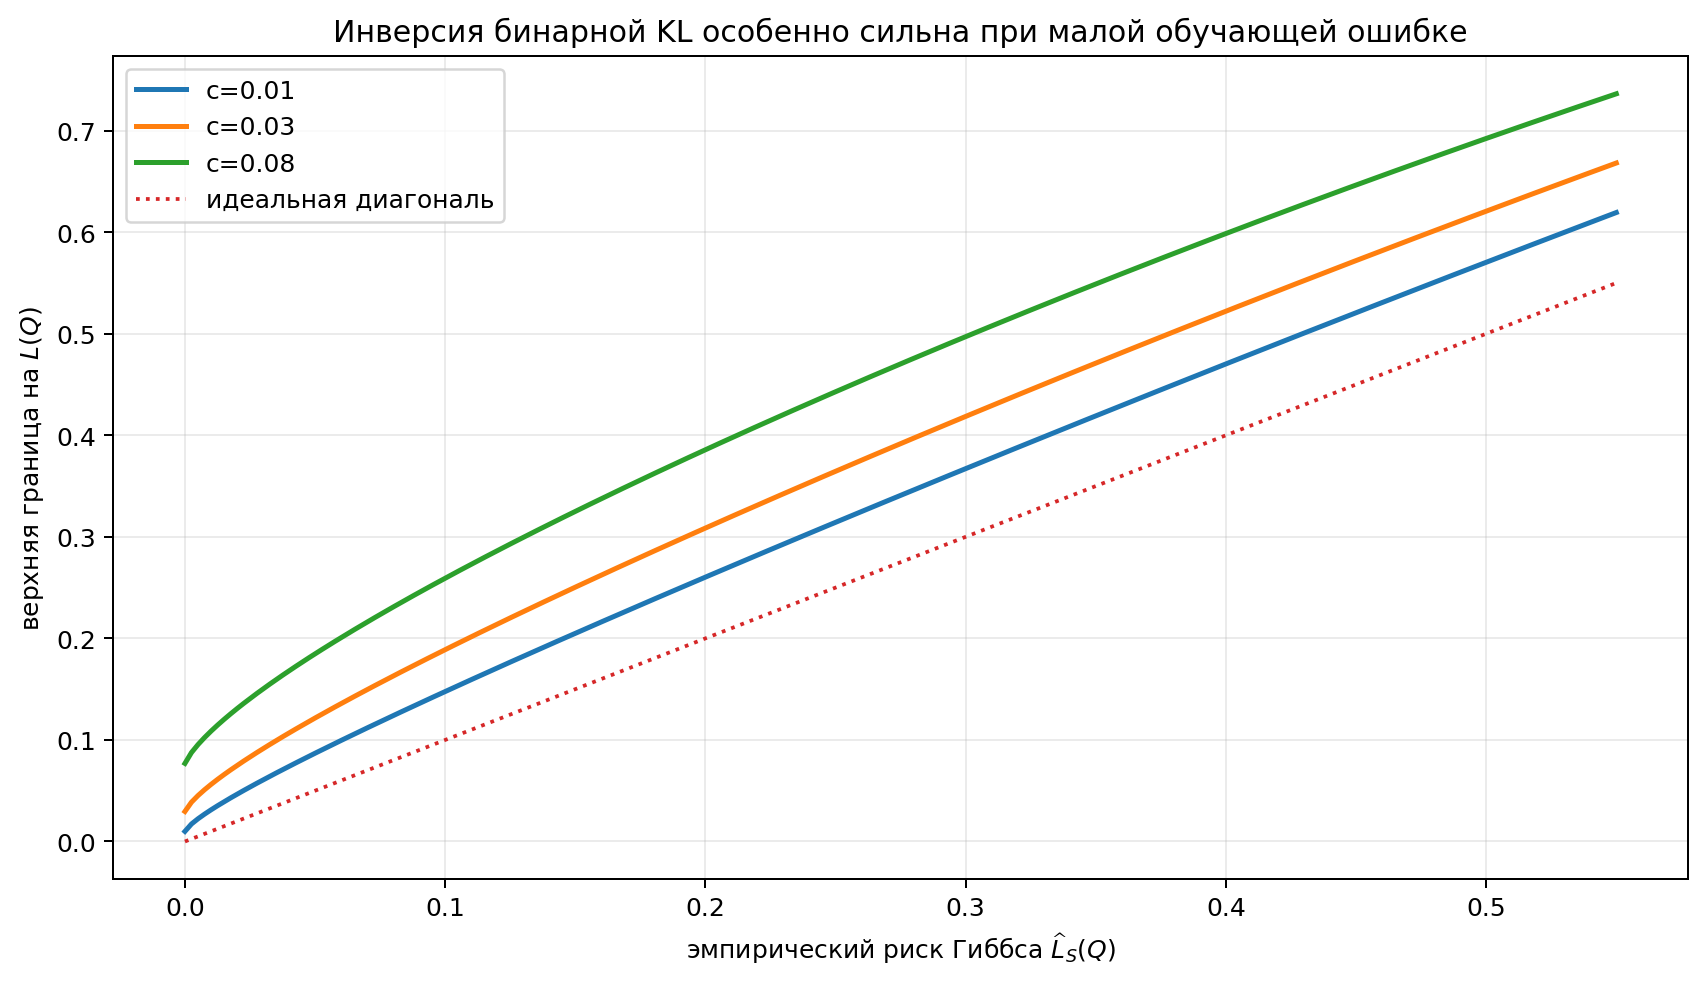
Тогда верхний сертификат получается численной инверсией бинарной KL:
Это не декоративная форма. Точная инверсия особенно полезна, когда эмпирический риск мал.
Почему квадратное следствие теряет точность
Неравенство Пинскера даёт
Поэтому из PAC-Bayes-kl следует более простая граница
Она удобна для чтения, но заменяет точную геометрию бинарной KL параболой.
Если
то
и потому
при малом . Точная граница имеет масштаб , тогда как квадратное следствие даёт только .
Например, если , то
а Пинскер даёт
Разница уже не косметическая.
Почему теорема верна: четыре шага
Полное доказательство остаётся в основном маршруте, потому что оно показывает центральный механизм PAC-Bayes — перенос концентрации с независимого априорного распределения на зависящее от данных апостериорное.
Шаг 1. Экспоненциальный момент для фиксированной гипотезы. Для каждого фиксированного :
Это усиленная концентрационная оценка для средних ограниченных случайных величин.
Шаг 2. Усреднение по априорному распределению. Поскольку не зависит от , можно поменять порядок ожиданий:
Шаг 3. Переход от среднего утверждения к событию высокой вероятности. По неравенству Маркова с вероятностью не меньше :
Шаг 4. Замена меры. Для любого и измеримой функции неравенство Донскера—Варадана даёт
Подставим
Тогда на событии из шага 3:
Наконец, совместная выпуклость бинарной KL даёт
Граница доказана.
Вот и вся механика: концентрация для фиксированной модели переносится на выбранное после данных распределение ценой KL.
Обратите внимание, где использована независимость : во втором шаге. Если , обмен ожиданий уже не имеет прежнего смысла, и доказательство требует дополнительного члена.
12.5. От сертификата к обучаемому распределению
PAC-Bayes можно использовать после обучения, но его естественная форма также подсказывает целевую функцию.
Рассмотрим для регуляризованный функционал
Вариационный принцип Гиббса даёт точный оптимум:
Эквивалентно,
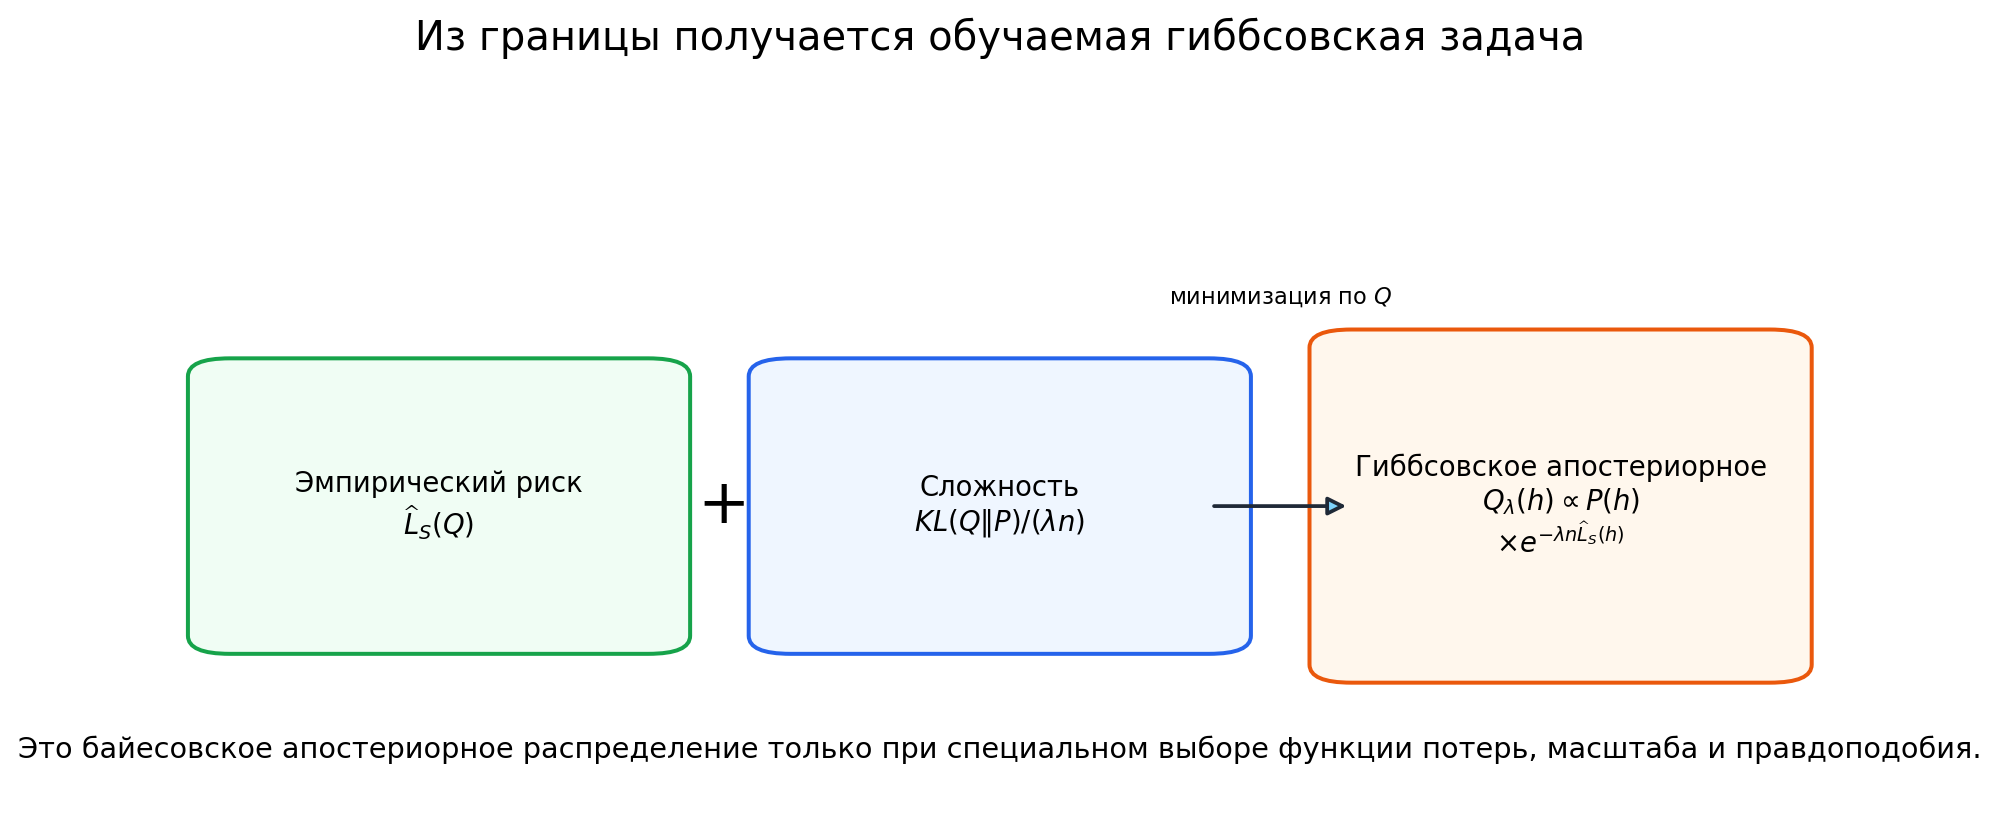
Это та же экспоненциальная перенормировка, которую мы уже встречали в MaxEnt и KL-регуляризованных политиках:
- эмпирический риск наклоняет массу в сторону хороших моделей;
- априорное распределение задаёт исходную геометрию;
- KL назначает цену сильному отклонению;
- задаёт обменный курс между подгонкой и сложностью.
Это не обязательно обычный байесовский апостериорный закон
Если
с точностью до не зависящей от константы, то совпадает с байесовским апостериорным распределением.
Для произвольной функции потерь это обобщённый Gibbs-апостериорный закон, а не результат обычного обновления по правдоподобию.
Кроме того, является точным оптимумом функционала , но не автоматически точным минимизатором любой выбранной PAC-Bayes-границы. Практические методы могут напрямую минимизировать дифференцируемую форму сертификата, его инверсию или удобный суррогат. Общий мотив остаётся тем же: эмпирический риск плюс информационная цена.
Гауссовские распределения над весами
Пусть
Тогда
Квадратичный член по средним действительно напоминает -регуляризацию. Но это только часть KL. Полная PAC-Bayes-постановка также учитывает дисперсии и относится к распределению предикторов.
Поэтому корректная формулировка такова:
У гауссовского PAC-Bayes-члена есть -подобная составляющая, но обычное детерминированное затухание весов не равно полному PAC-Bayes-обучению.
То же относится к dropout. Он вводит стохастичность, но конкретная PAC-Bayes-гарантия требует явно задать , , риск и способ сертификации.
Почему точечная модель часто имеет бесконечную KL
Если имеет непрерывную плотность, а
то
Точечная мера не абсолютно непрерывна относительно непрерывного априорного распределения.
Поэтому для практического сертификата обычно используют:
- стохастическое распределение вокруг весов;
- дискретизацию или квантизацию;
- априорное распределение с подходящими атомами;
- отдельную теорию для голосования большинства или детерминированного предиктора.
Рандомизация здесь не магический источник обобщения. Она делает сертифицируемый объект корректно определённым и позволяет торговать устойчивостью предсказаний против KL-цены.
12.6. MI-границы: обучение как канал от выборки к модели
Теперь откажемся от выбранного вручную априорного распределения и посмотрим на весь алгоритм обучения как на канал
Алгоритм может быть случайным из-за инициализации, порядка мини-батчей, dropout, добавленного шума или явной выборки из апостериорного распределения.
Взаимная информация
измеряет, насколько распределение результата меняется при знании конкретной обучающей выборки.
Это близко к интуиции «сколько данных модель запомнила», но точнее говорить:
измеряет статистическую зависимость результата алгоритма от всей выборки.
Она не сообщает напрямую, какие примеры можно восстановить, нарушена ли приватность и сохранены ли семантически важные факты. Для этих вопросов нужны отдельные операционные критерии.
Теорема Xu–Raginsky
Предположим, что для каждого фиксированного центрированная потеря
-субгауссовская:
для всех .
Тогда
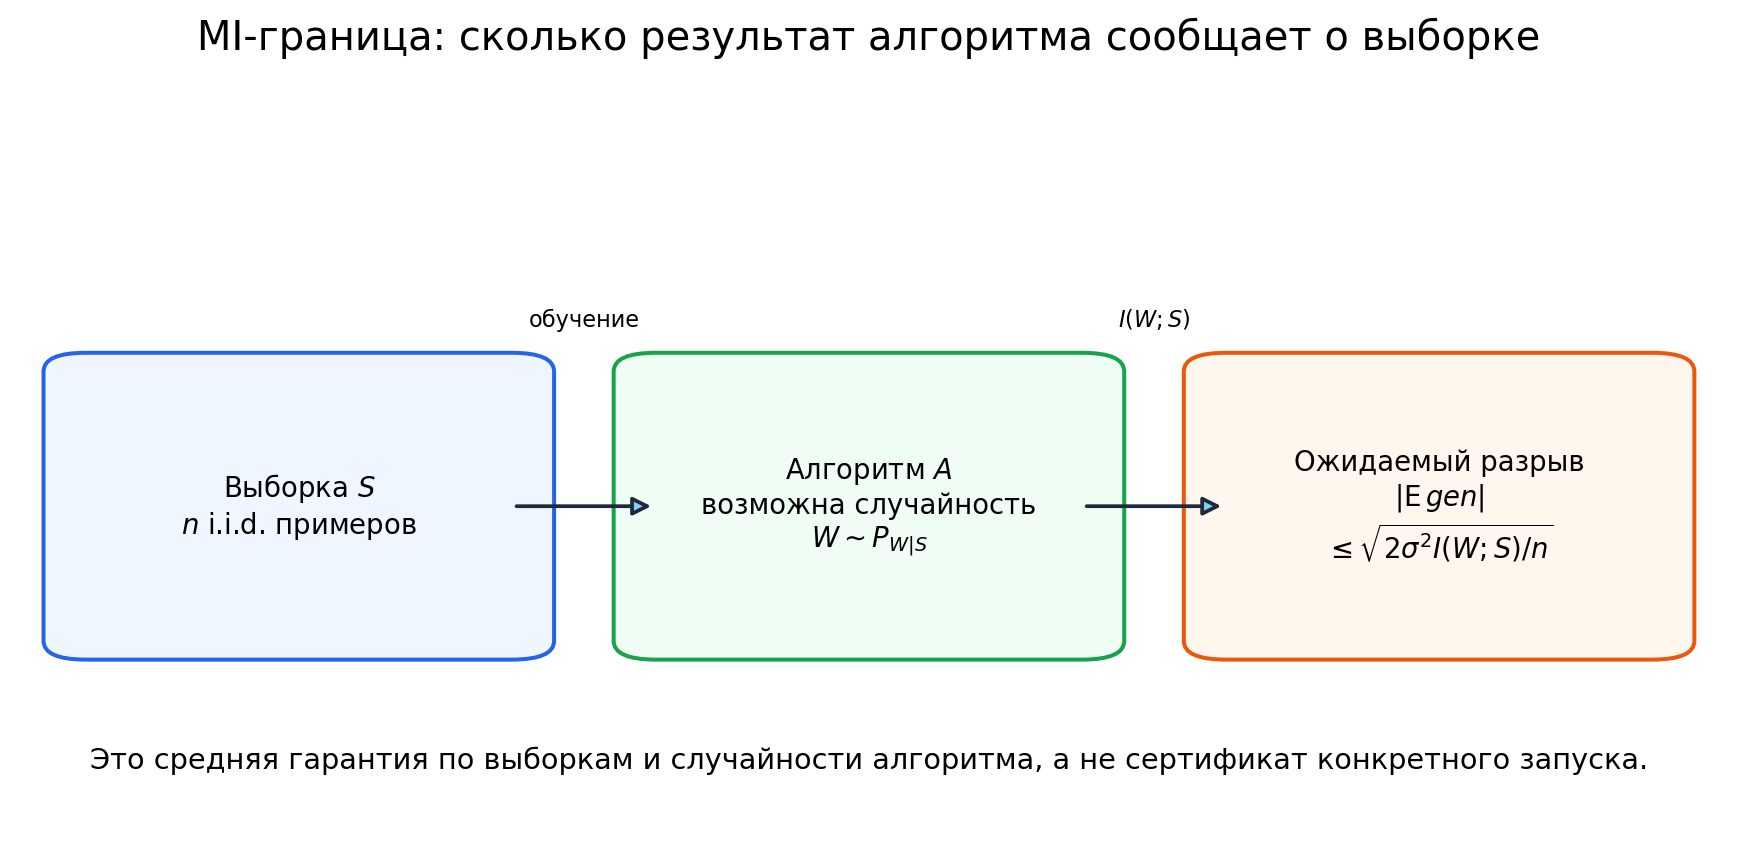
Если , лемма Хёфдинга позволяет взять
и получить
Откуда берётся формула
Под распределением произведения модель независима от выборки. Для фиксированного средний эмпирический риск концентрируется вокруг популяционного с субгауссовским параметром .
Но в реальном обучении используется совместное распределение . Неравенство замены меры из Модуля 11 сравнивает ожидания одной функции под совместным распределением и под произведением маргиналов. Цена замены равна
Оптимизация по параметру экспоненциального момента даёт квадратный корень. Так же, как в PAC-Bayes, концентрация переносится с независимой постановки на зависимую. Но теперь роль стоимости играет не KL к выбранному априорному распределению, а сама взаимная информация алгоритма.
Численный пример адаптивного выбора
Для жёсткого выбора среди 32 одинаковых гипотез эксперимент даёт
при , тогда как наблюдаемый ожидаемый разрыв равен примерно .
Граница не точна, но она правильно отслеживает механизм: когда температура Gibbs-выбора увеличивается, зависимость от случайных деталей выборки уменьшается, и вместе с ней уменьшается смещение выбора.
Какой именно тип гарантии мы получили
Базовая MI-граница контролирует
Это утверждение в среднем. Оно не является автоматически высоковероятностным сертификатом для конкретной обученной модели и конкретной выборки.
Кроме того, оно относится к выбранной функции потерь. Малый ожидаемый разрыв для кросс-энтропии не гарантирует малый разрыв по фактической корректности, безопасности или человеческим предпочтениям.
Почему детерминированная вещественная модель может иметь бесконечную MI
Если принимает конечное число значений и является детерминированной функцией , то
Но если — точный вещественный вектор, детерминированно вычисленный из непрерывной выборки, совместное распределение часто сингулярно относительно . Тогда
Алгоритм может хорошо обобщать, а базовая граница всё равно будет вакуумной. Это ограничение выбранной информационной меры, а не доказательство плохого обобщения.
Добавление шума способно сделать MI конечной, но при этом меняется сам алгоритм и его риск. Нельзя добавить шум только в доказательство и продолжать сертифицировать исходный детерминированный предиктор без отдельного аргумента.
MI по отдельным примерам
Более локальная оценка использует зависимости :
Она может быть существенно сильнее глобальной границы: каждый пример может влиять на результат слабо, даже если суммарная зависимость велика или бесконечна.
12.7. Точное разложение, связывающее PAC-Bayes и MI
Пусть алгоритм задаёт условное распределение
а — маргинальное распределение результата алгоритма при случайной выборке .
Для любого фиксированного априорного распределения , относительно которого соответствующие KL конечны, выполняется
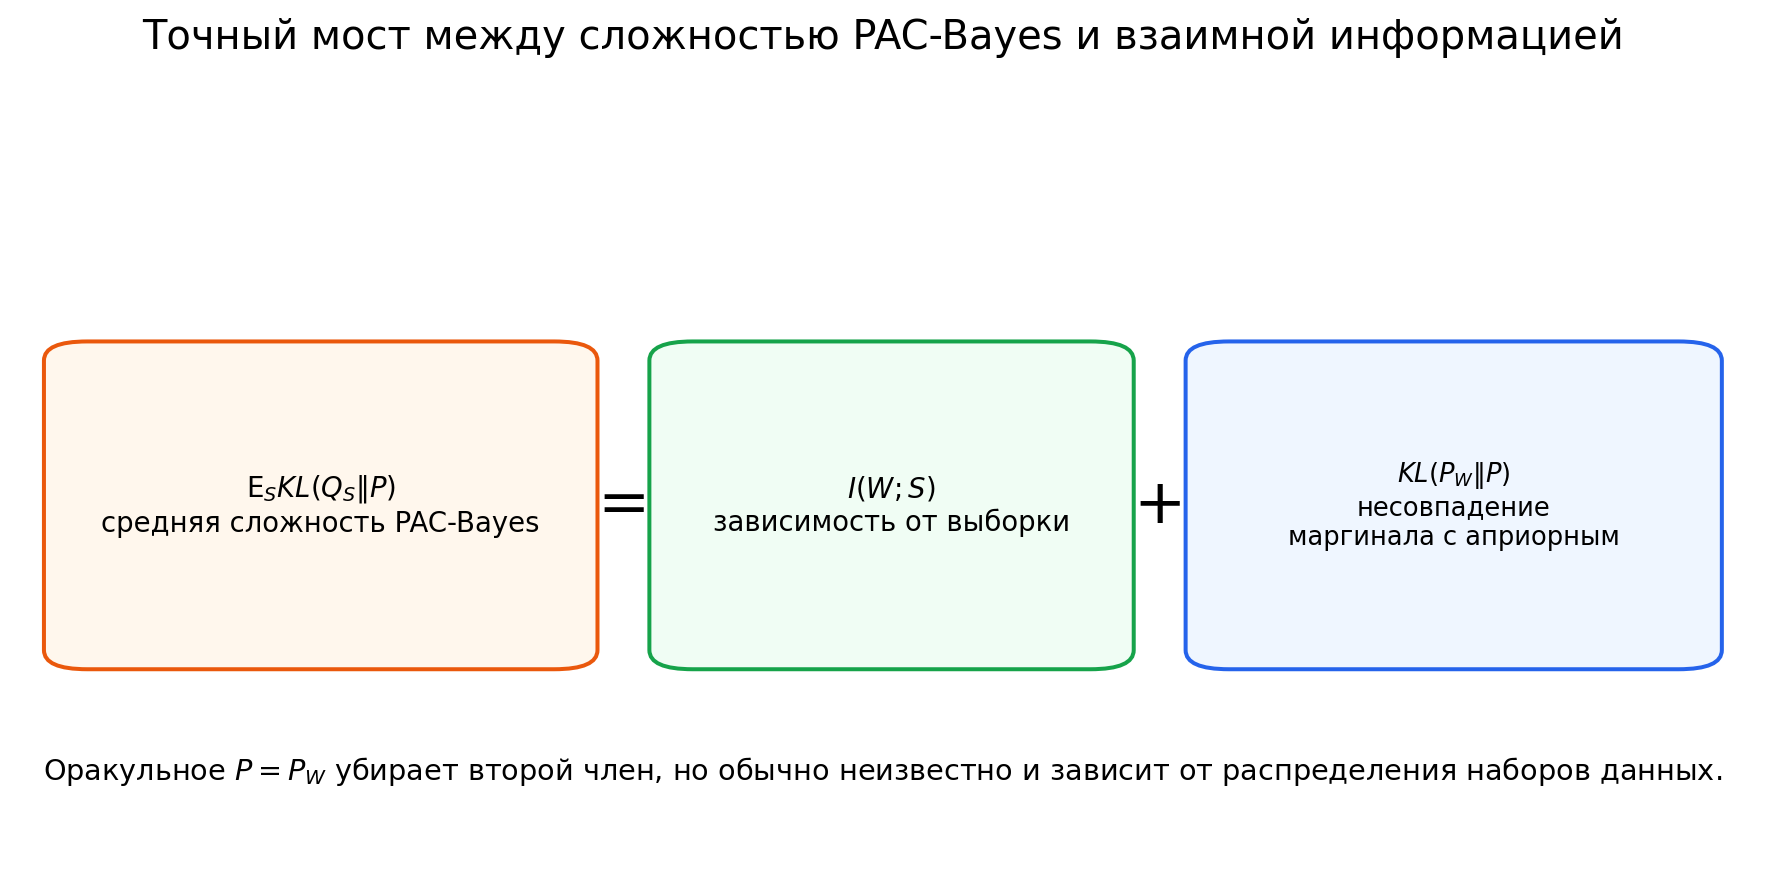
Это точная бухгалтерия, а не аналогия.
- — неизбежная средняя цена зависимости результата от выборки;
- — дополнительная цена несовпадения выбранной точки отсчёта с типичным распределением результатов алгоритма.
Доказательство
Добавим и вычтем логарифм плотности :
Оракульное априорное распределение
Среднюю величину
минимизирует
Тогда второй член исчезает, и средняя PAC-Bayes-сложность равна MI.
Почему же просто не использовать ? Теоретически, если распределение данных и алгоритм полностью известны, фиксировано до текущей выборки и является валидной точкой отсчёта. Практическая проблема в том, что оно зависит от неизвестного распределения всех возможных обучающих выборок и обычно недоступно.
Если оценивать по той же сертифицирующей выборке, априорное распределение становится зависящим от данных, и стандартная теорема требует поправки.
Что объединено, а что осталось разным
Тождество объясняет, почему PAC-Bayes и MI часто дают похожие регуляризаторы. Но типы гарантий не совпадают.
| PAC-Bayes | MI-граница |
|---|---|
| Обычно высоковероятностное утверждение по | Обычно утверждение об ожидаемом разрыве |
| Сертифицирует все на хорошем событии | Анализирует канал |
| Требует выбранное априорное распределение | Использует маргинал неявно |
| Может быть вычислима для конкретного | часто трудно оценить |
Поэтому фраза «MI — это усреднённый PAC-Bayes» полезна как первая карта, но не заменяет теоремы.
12.8. Связи с MDL, Information Bottleneck и KL-регуляризованными политиками
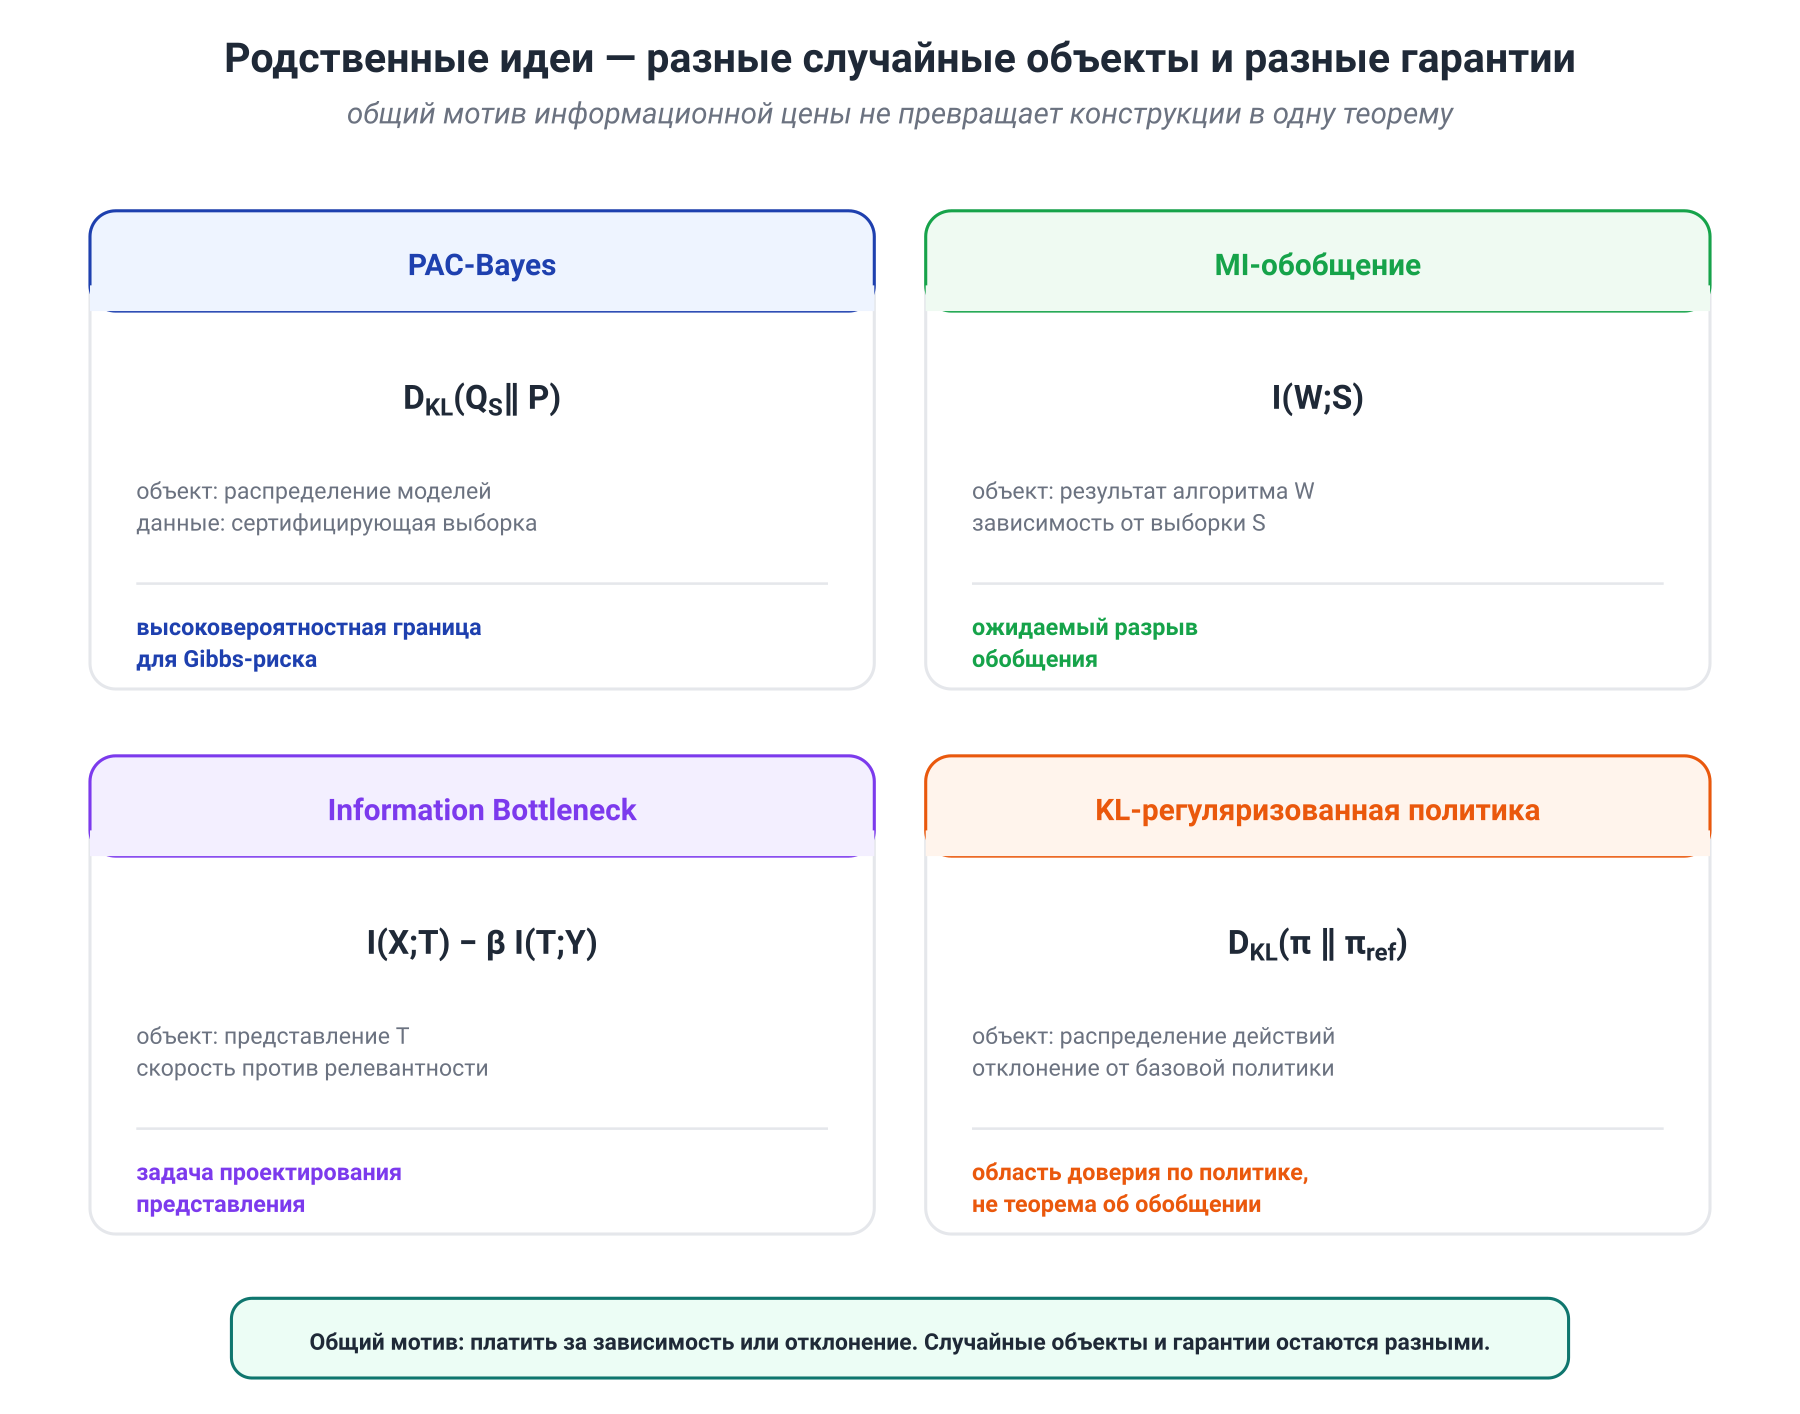
Информационные конструкции предыдущих модулей действительно родственны. Самый безопасный способ увидеть родство — выписать случайные переменные и операционный смысл каждого KL.
PAC-Bayes и MDL
Пусть класс дискретен и
Тогда
В битах:
то есть идеальная длина кода гипотезы под априорным распределением.
Это точный мост: PAC-Bayes оплачивает описание выбранной модели относительно заранее объявленного кода.
Но MDL шире одной формулы. В нём есть двухчастные, смесевые и предиктивно-последовательные коды; непрерывные параметры требуют точности или стохастического кода; стоимость данных под моделью может учитываться иначе.
MI-границы и Information Bottleneck
В Information Bottleneck измеряется
где — отдельный вход, а — его представление.
В теории обобщения измеряется
где — весь обучающий набор, а — результат алгоритма.
Обе величины штрафуют зависимость от деталей исходного объекта. Но это разные объекты и разные задачи:
- IB спрашивает, сколько информации представление хранит о входе;
- MI-граница спрашивает, насколько обученный результат зависит от конкретной выборки.
Малое само по себе не является доказательством малого и не даёт автоматически границу обобщения. Старый лозунг «MI-границы строго доказывают IB» слишком силён. Корректнее сказать: обе теории используют общий принцип информационного ограничения, а прямой вывод требует дополнительной модели обучения.
PAC-Bayes KL и KL-якорь в RLHF
В PAC-Bayes:
сравнивает распределения над моделями или весами.
В KL-регуляризованном RLHF:
сравнивает распределения ответов при фиксированном контексте.
Алгебра похожа, потому что обе задачи используют экспоненциальный наклон относительно базовой меры. Но случайные объекты различны.
И ещё одна граница особенно важна после Модуля 8: PAC-Bayes контролирует переход от эмпирического риска к популяционному для заданной функции потерь. Если прокси-награда систематически расходится с истинной целью, маленький разрыв обобщения по прокси не исправит это смещение.
12.9. Как построить практический PAC-Bayes-сертификат
Теорема становится инженерным инструментом только после того, как все случайные объекты определены без двусмысленности.
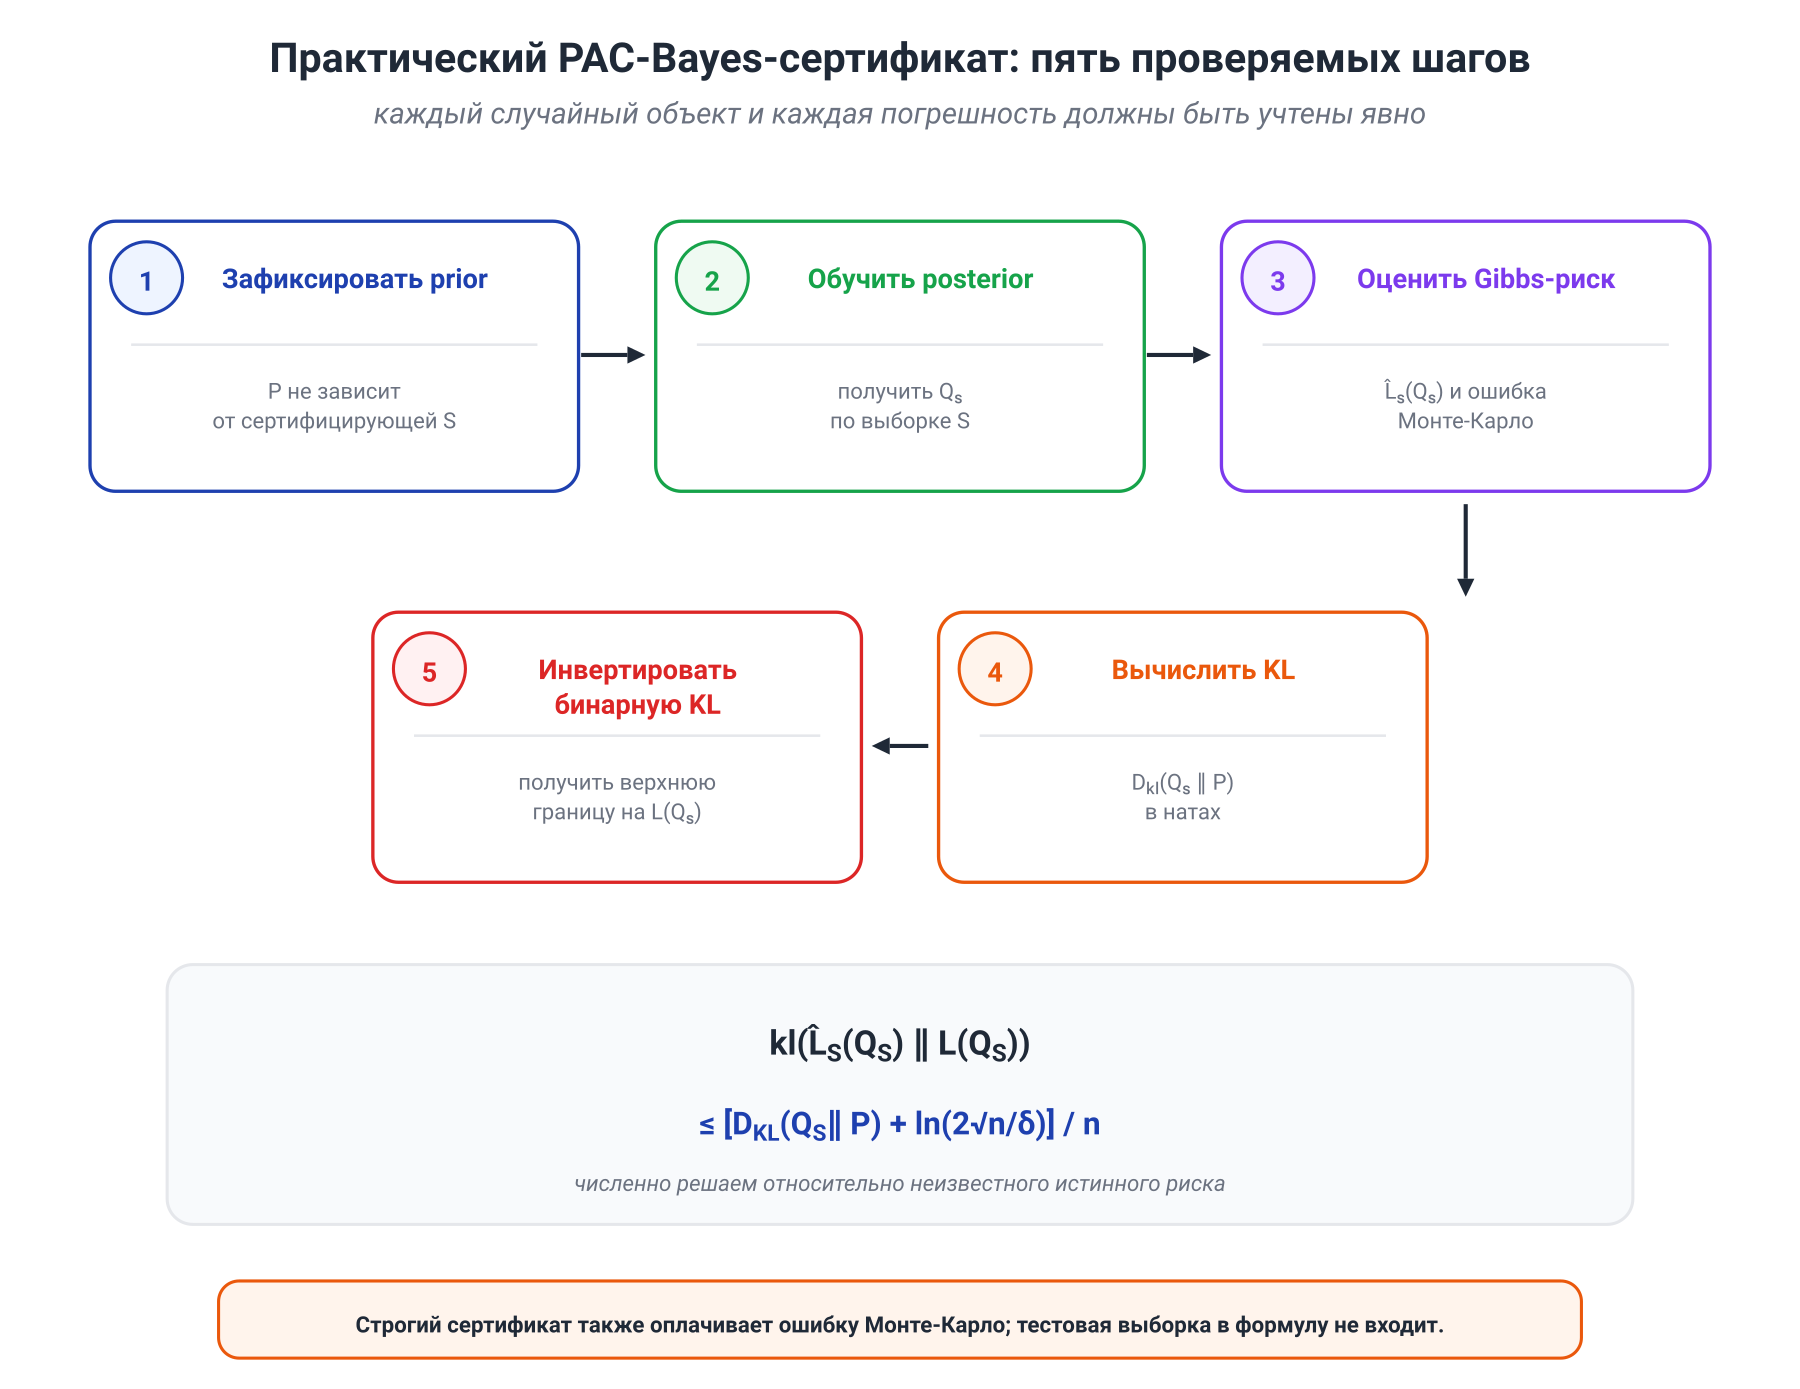
Шаг 1. Зафиксировать сертифицируемый предиктор и функцию потерь
Нужно решить, что будет работать при эксплуатации:
- Gibbs-предиктор;
- апостериорный ансамбль;
- голосование большинства;
- детерминированная сеть.
Базовая граница относится к Gibbs-риску. Для другого объекта требуется отдельный переход.
Также нужно выбрать ограниченную функцию потерь. Нельзя обучать по кросс-энтропии, оценивать 0–1 риск и незаметно подставлять одно вместо другого.
Шаг 2. Зафиксировать валидное априорное распределение
Простейший вариант — выбрать до сертифицирующих данных.
Практически более сильный вариант — разделить выборку:
- по построить информативное априорное распределение;
- по независимой части обучить и провести сертификацию условно на .
Цена очевидна: априорное распределение становится лучше, но эффективная сертифицирующая выборка уменьшается.
Шаг 3. Обучить распределение, а не только точку
Для диагонального гауссовского оптимизируются средние и дисперсии. Слишком малая дисперсия сохраняет хорошую подгонку, но создаёт большую KL. Слишком большая уменьшает часть сложности, но разрушает предсказания.
Поэтому сертификат ищет не просто «плоский минимум», а конкретный компромисс между робастностью стохастического предиктора и ценой относительно .
Шаг 4. Сертифицировать эмпирический Gibbs-риск
Ожидание по часто оценивается методом Монте-Карло. Тогда конечное число выборок из добавляет ещё одну статистическую ошибку.
Просто усреднить десять сетей и подставить результат в формулу недостаточно для строгого сертификата. Нужна отдельная доверительная граница на эмпирический Gibbs-риск или аналитическое вычисление ожидания.
Шаг 5. Вычислить KL и инвертировать бинарную KL
Для диагональных гауссов вычисляется аналитически. После этого PAC-Bayes-kl инвертируется численно.
В эксперименте модуля для стохастического линейного классификатора:
при . Диагностическая оценка тестового Gibbs-риска равна примерно
Тестовый набор не участвует в сертификате; он нужен только для проверки эксперимента.
Что уже удавалось получить для глубоких сетей
Dziugaite и Roy показали, что прямой оптимизацией PAC-Bayes-границы можно получить невакуумные сертификаты для стохастических глубоких сетей с миллионами параметров. Более поздний метод PAC-Bayes with Backprop в своём протоколе на MNIST сообщал тестовую ошибку около и сертификат около .
Это важный контрпример тезису «все теоретические границы для глубоких сетей обязательно больше единицы». Но он не является универсальным объяснением обобщения:
- результат зависит от архитектуры, параметризации и априорного распределения;
- сертифицируется стохастический предиктор;
- такая теснота границы на MNIST не переносится автоматически на LLM;
- вычислимый сертификат может оставаться значительно слабее отложенной оценки.
Правильный вывод скромнее и сильнее одновременно: PAC-Bayes способен давать реальную численную гарантию для большой модели, если вся система обучения и сертификации спроектирована под эту задачу.
12.10. Математическое углубление: более локальные информационные цены
Этот раздел не требуется для основного маршрута. Он показывает, как теория смягчает две слабости базовых формул: априорное распределение трудно выбрать до данных, а для детерминированной непрерывной модели может быть бесконечной.
Априорные распределения, зависящие от данных
Есть несколько корректных стратегий.
Разделение выборки. строится по , а теорема условно применяется к независимой части .
Иерархическое априорное распределение. Выбор одного из семейства априорных распределений кодируется верхним уровнем и оплачивается дополнительным KL или объединяющей оценкой.
Дифференциально-приватный выбор. Если механизм построения контролируемо зависит от данных, эта зависимость может быть включена в PAC-Bayes-гарантию.
Специализированные PAC-Bayes-теоремы для априорных распределений, зависящих от данных. Они напрямую добавляют член, измеряющий использование данных при выборе точки отсчёта.
Общий принцип не меняется:
Данные, использованные для уменьшения члена сложности, не исчезают из счёта бесплатно.
MI по отдельным примерам
Глобальная величина может скрывать локальную структуру. По цепному правилу
но граница
сначала суммирует все вклады, а затем берёт один корень.
Граница по отдельным примерам использует
Если каждый пример влияет слабо, такая локальная агрегация может быть существенно меньше.
Условная взаимная информация
Построим сверхвыборку (supersample)
содержащую по два независимых кандидата на каждую позицию. Пусть
и реальная обучающая выборка строится как
Алгоритм возвращает
Тогда условная информационная сложность измеряет
Её операционный смысл: если известны обе возможные выборки в каждой позиции, насколько по результату обучения можно восстановить биты , сообщающие, какой пример действительно попал в обучение?
Для детерминированного алгоритма эта величина всё равно конечна:
Именно поэтому CMI может оставаться содержательной там, где обычная для точных вещественных весов бесконечна.
CMI связывает информационный взгляд с VC-размерностью, схемами сжатия и дифференциальной приватностью. Но она не становится автоматически простой вычислимой метрикой для большой нейросети. Это более точный объект теории, а не готовая строка в панели мониторинга.
12.12. Ключевые выводы модуля
Обучающая выборка выполняет две роли: по ней выбирают модель и по ней оценивают её качество. Именно повторное использование делает оценку победителя оптимистичной.
PAC-Bayes оплачивает адаптацию относительно заранее объявленной точки отсчёта:
MI-граница оплачивает среднюю зависимость результата алгоритма от выборки:
Их связывает точное тождество
Но итоговая карта важнее одного лозунга.
- PAC-Bayes обычно даёт высоковероятностный сертификат для Gibbs-предиктора.
- Базовая MI-граница обычно контролирует ожидаемый разрыв алгоритма.
- Априорное распределение, обученное на сертифицирующих данных, требует отдельной оплаты.
- не равно из Information Bottleneck.
- KL над весами не равна KL между политиками в RLHF.
- Малый разрыв обобщения по прокси-функции потерь не устраняет смещение самой прокси.
- Невакуумная граница доказывает нетривиальное утверждение, но не обязана быть достаточно тесной для выбора модели.
Это не набор защитных оговорок, а рабочая дисциплина. Информационная теория обобщения становится полезной, когда мы точно называем:
- случайную выборку;
- результат алгоритма;
- сертифицируемый предиктор;
- функцию потерь;
- тип вероятностной гарантии;
- цену адаптивности, которую действительно удалось вычислить.
В Модуле 13 эта дисциплина понадобится особенно сильно. Там слова «канал», «сжатие», «поиск» и «информация» будут применяться к рассуждению LLM, и каждый такой мост придётся отделять от прямой теоремы.
Основные источники
- D. McAllester, «Some PAC-Bayesian Theorems», COLT 1998; «PAC-Bayesian Stochastic Model Selection», 2003.
- A. Maurer, «A Note on the PAC Bayesian Theorem», 2004.
- O. Catoni, «PAC-Bayesian Supervised Classification», 2007.
- D. Russo, J. Zou, «Controlling Bias in Adaptive Data Analysis Using Information Theory», 2016.
- A. Xu, M. Raginsky, «Information-Theoretic Analysis of Generalization Capability of Learning Algorithms», 2017.
- G. K. Dziugaite, D. M. Roy, «Computing Nonvacuous Generalization Bounds for Deep (Stochastic) Neural Networks», 2017.
- G. K. Dziugaite, D. M. Roy, «Data-Dependent PAC-Bayes Priors via Differential Privacy», 2018.
- O. Rivasplata, V. M. Tankasali, C. Szepesvári, «PAC-Bayes with Backprop», 2019.
- Y. Bu, S. Zou, V. V. Veeravalli, «Tightening Mutual Information Based Bounds on Generalization Error», 2019.
- T. Steinke, L. Zakynthinou, «Reasoning About Generalization via Conditional Mutual Information», 2020.