Модуль 15. Информационная геометрия: Fisher, естественный градиент и потоки распределений
Как читать этот модуль. Это заключительный бонусный модуль курса. Основной маршрут — §§15.1–15.8: почему обычный градиент зависит от координат, как информация Фишера задаёт локальную геометрию распределений, откуда возникает естественный градиент, какие приближения кривизны реально используются в глубоких сетях, как эта геометрия проявляется в TRPO, PPO и RLHF и почему для переноса вероятностной массы нужна уже Wasserstein-геометрия. §15.9 — математическое углубление об α-геометрии, точных геодезических и теореме Ченцова. Его можно оставить на второй проход.
15.1. Что значит «маленький шаг» для вероятностной модели
Оптимизатор двигает параметры. Но интересует нас обычно не сам вектор параметров, а распределение, функция или политика, которые он задаёт.
Начнём с самой маленькой вероятностной модели — распределения Бернулли. Вероятность события можно записать непосредственно как
или через логит
Это две системы координат для одного и того же статистического объекта. Если сделать обычный градиентный шаг по , а затем решить ту же задачу по , траектории вероятности в общем случае не совпадут. Алгоритм изменился только потому, что мы переименовали координату.
Есть и более физическая проблема. Одинаковое изменение вероятности не везде означает одинаковое изменение распределения. Переход
даёт
ната. А переход
при той же евклидовой длине шага даёт уже
ната — более чем в пятнадцать раз больше. В первом случае мы слегка сдвинули почти неопределённую монету. Во втором — удвоили вероятность редкого события.
В глубокой сети та же проблема скрыта миллионами координат:
- перестановка нейронов может не менять реализуемую функцию;
- масштабы соседних слоёв способны взаимно компенсироваться;
- softmax не меняется при добавлении общей константы ко всем логитам;
- один и тот же евклидов шаг в весах может почти не изменить выход модели или, наоборот, радикально перестроить распределение.
Поэтому центральный вопрос информационной геометрии звучит так:
Как измерять изменение модели в терминах самого вероятностного объекта, а не случайно выбранных координат?
Ответа «одна правильная геометрия для всего ML» не существует. В этом модуле встретятся три разных конструкции.
- Fisher–Rao и локальная KL измеряют различимость соседних вероятностных моделей.
- Дивергенции Брэгмана и зеркальный спуск задают удобную геометрию обновлений на симплексе и в экспоненциальных семействах.
- Wasserstein-геометрия учитывает стоимость переноса массы в пространстве наблюдений.
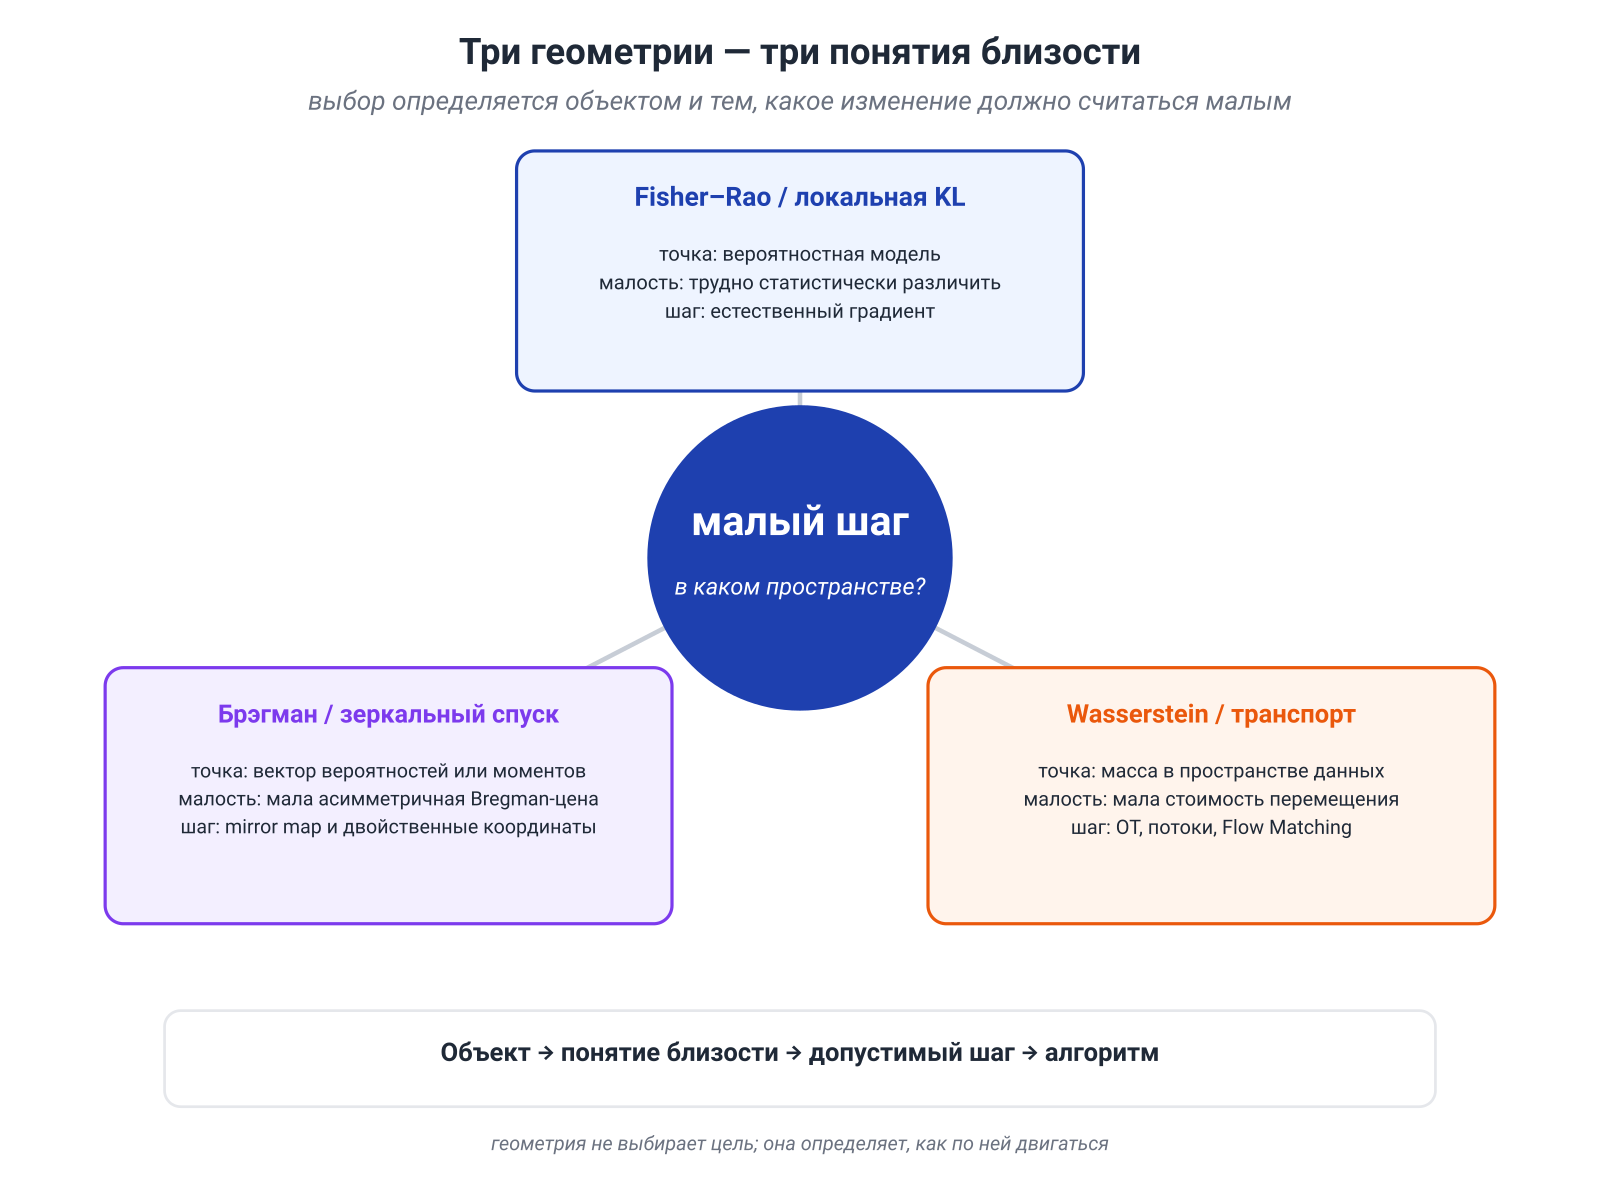
Полезная короткая формулировка:
Геометрия — это договор о том, какие изменения считать малыми.
Если объектом является политика, малость можно измерять средним KL между распределениями действий. Если мы переносим изображение из шума в данные, важна стоимость движения в пространстве пикселей или признаков. Если оптимизируем обычную детерминированную регрессию, Fisher может вообще оказаться не тем объектом, который нужен.
Сначала разберём геометрию соседних распределений.
15.2. Информация Фишера и локальная форма KL
Пусть модель задаёт гладкое семейство распределений
Вектор
называется скор-функцией (score function) по параметрам. При стандартных условиях регулярности его среднее равно нулю:
Матрица информации Фишера:
Для направления квадратичная форма имеет особенно прозрачный смысл:
Если это число велико, движение вдоль заметно меняет логарифмические вероятности типичных наблюдений. Соседние модели в этом направлении легче различить статистически. Если число равно нулю, малый сдвиг вдоль в первом порядке вообще не меняет распределение.
Почему Fisher появляется из KL
Рассмотрим соседнюю модель . Разложим её логарифм около :
Подставим в KL:
Линейный член исчезает, потому что среднее скор-функции равно нулю. При возможности перенести производные под знак интеграла
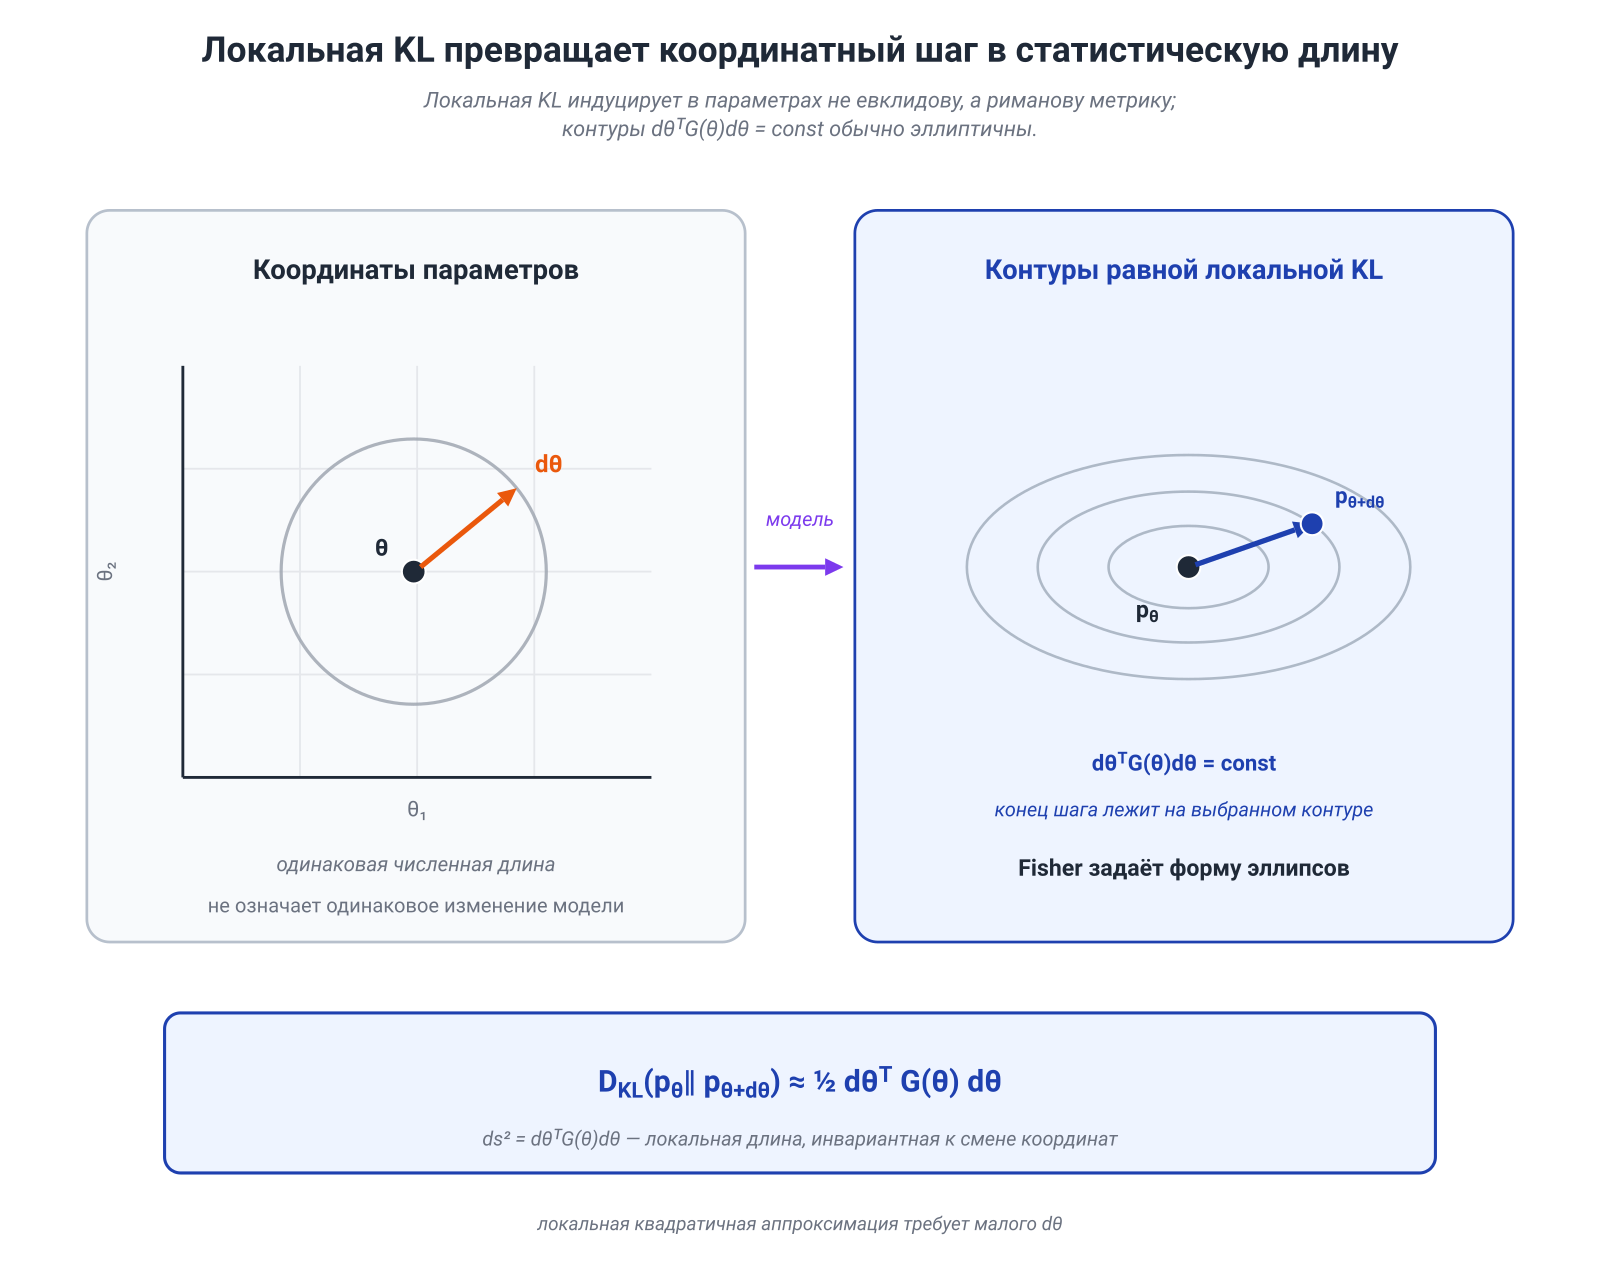
Получаем центральное локальное тождество:
На этом месте удобно остановиться и прочитать формулу словами:
Fisher — это второй порядок цены малого изменения распределения, измеренной через KL.
Прямая и обратная KL имеют один и тот же квадратичный член. Их асимметрия проявляется начиная с более высоких порядков. Поэтому Fisher даёт локальную риманову геометрию, но не превращает саму KL в глобальное расстояние: KL остаётся асимметричной и не удовлетворяет неравенству треугольника.
Почему длина не зависит от координат
Пусть та же модель записана в новых координатах , причём и
Тогда
Одновременно
Поэтому
Числа в матрице меняются, но локальная статистическая длина остаётся той же. Именно это означает, что Fisher ведёт себя как метрический тензор, а не как произвольный предобусловливатель.
Точный пример: Bernoulli
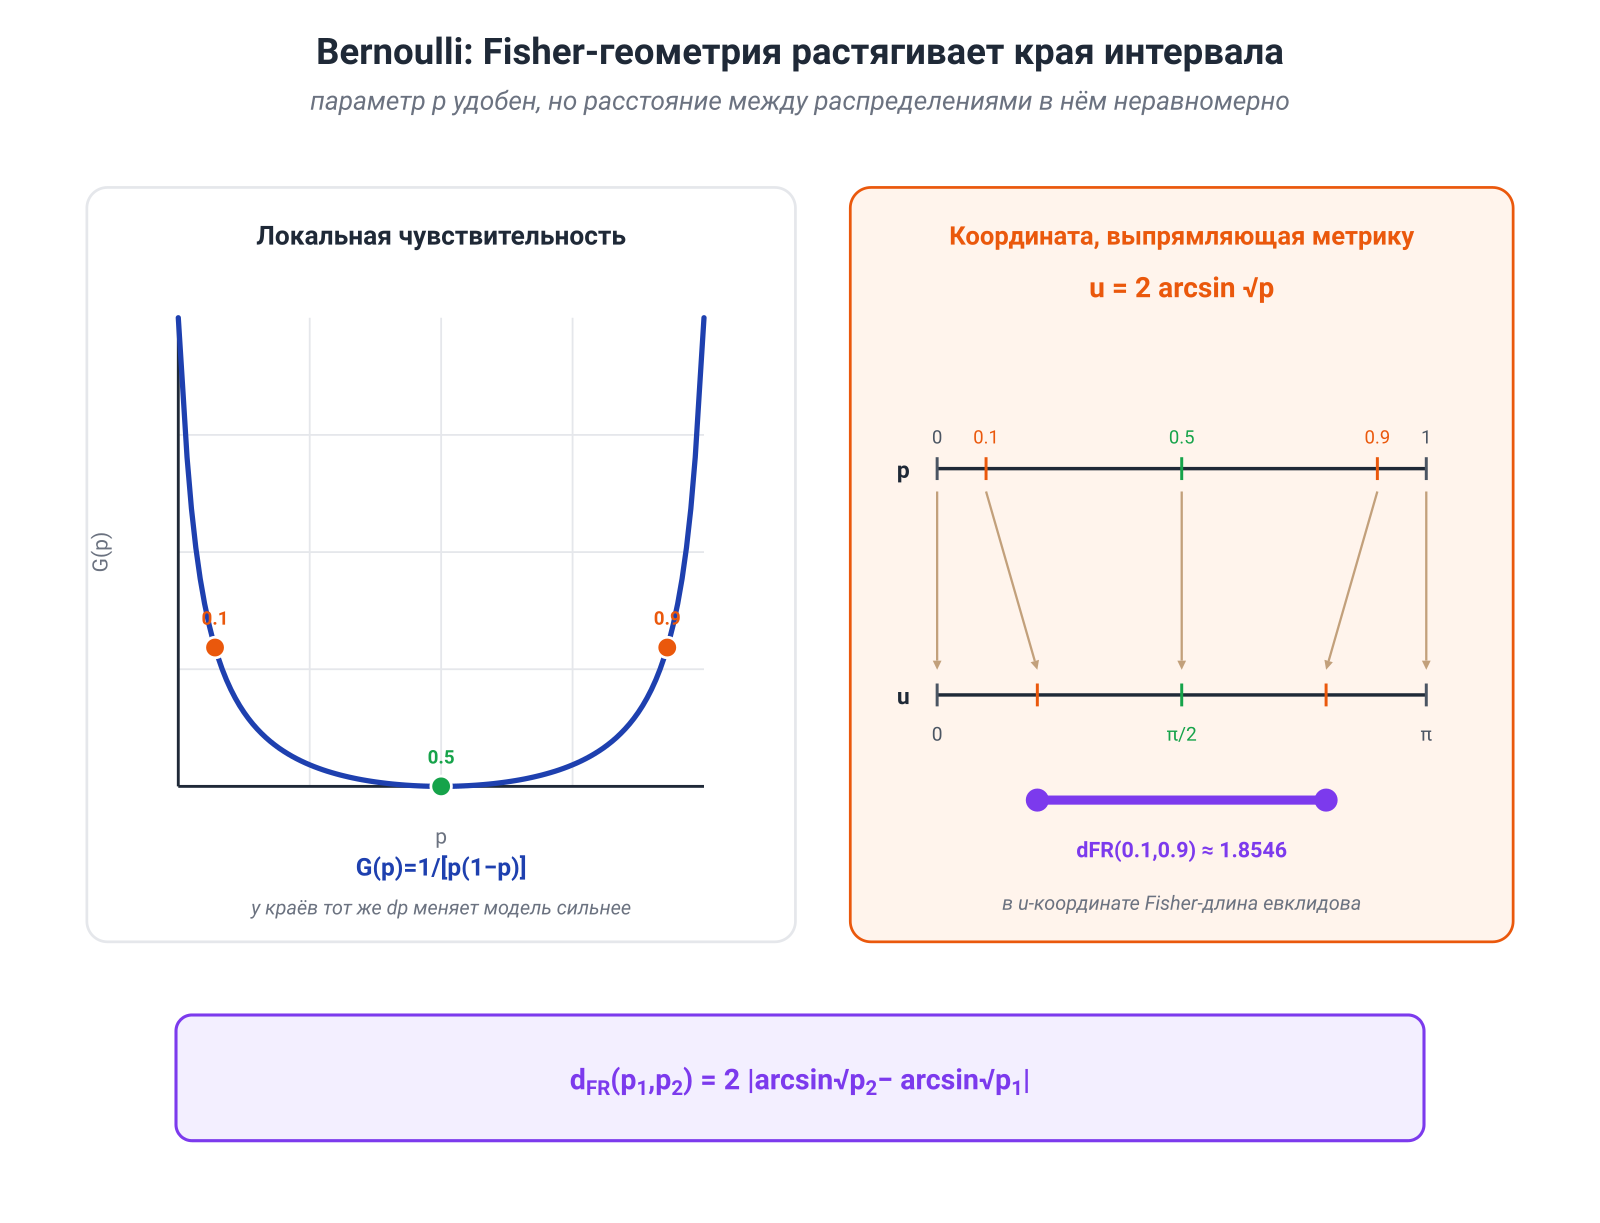
Для в координате :
В логит-координате :
Матрицы выглядят противоположно: одна растёт у края симплекса, другая там стремится к нулю. Но элемент длины совпадает:
Координата
выпрямляет эту одномерную геометрию:
Поэтому точное расстояние Fisher–Rao между двумя монетами равно
Для и :
Та же матрица ограничивает точность оценивания
Для независимых наблюдений и несмещённого оценивателя при условиях регулярности граница Крамера—Рао даёт
Это другая сторона той же идеи. Если соседние распределения легко различимы, параметр можно оценить точнее. Если разные значения параметра почти не меняют наблюдаемое распределение, никакой несмещённый оцениватель не сможет извлечь высокую точность из тех же данных.
Где заканчивается локальная картина
У результата есть три важные границы.
- Квадратичная аппроксимация надёжна только для достаточно малого шага.
- Положительная определённость Fisher требует локальной идентифицируемости. В глубоких сетях симметрии и избыточные параметры часто делают её сингулярной.
- Fisher зависит от того, какое распределение наблюдений и условную модель мы объявили статистическим объектом. «Матрица Fisher сети» без уточнения ожиданий — ещё не полное определение.
Последний пункт станет центральным в §15.4. Сначала посмотрим, какой шаг возникает, если именно Fisher использовать для измерения малости обновления.
15.3. Естественный градиент: наискорейший спуск при малом изменении модели
Пусть нужно минимизировать функцию , а
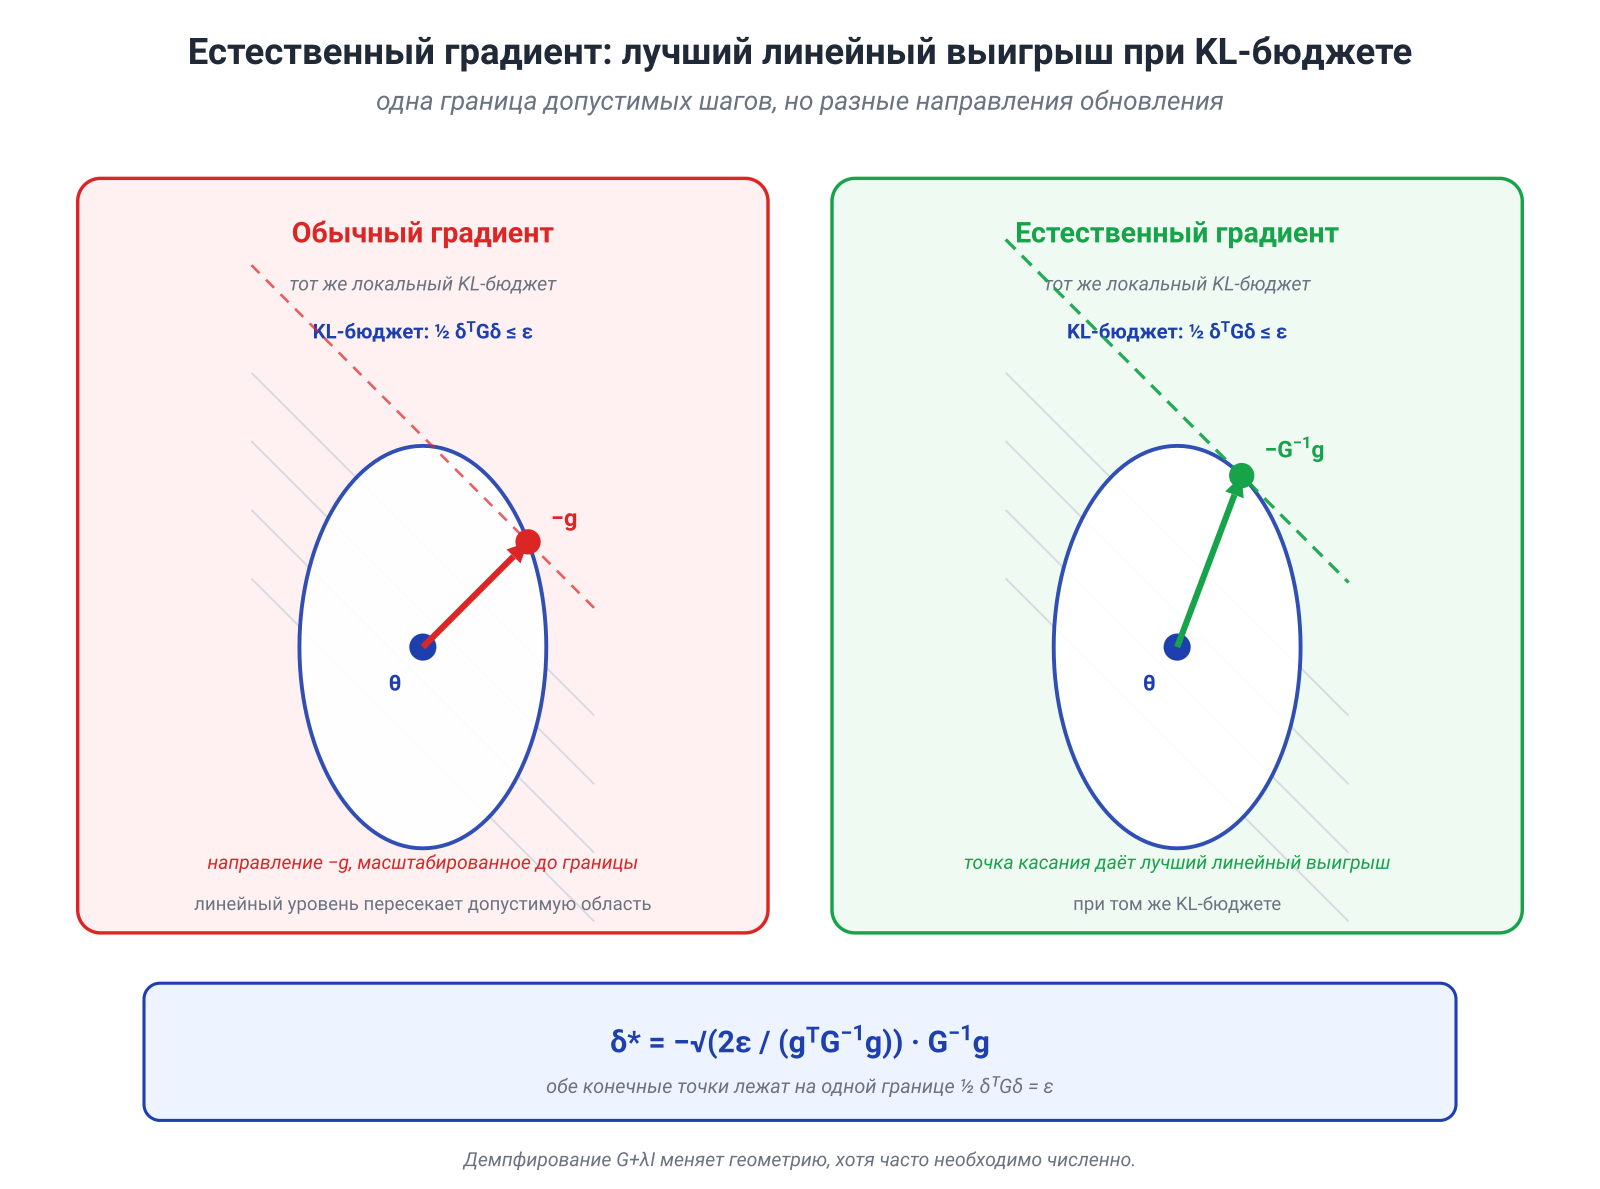
Обычный градиент является направлением наискорейшего спуска при евклидовом ограничении на шаг. Но если малость измеряется локальной KL, естественная задача другая:
Лагранжиан даёт направление
где — обратная или псевдообратная матрица. При невырожденной шаг, использующий весь допустимый бюджет, равен
Представьте
Обычный градиент предлагает одинаково двигаться по обеим координатам. Естественный градиент даёт направление
Первая координата в сто раз чувствительнее с точки зрения изменения распределения, поэтому тот же статистический бюджет разрешает значительно меньший сдвиг.
Инвариантность на примере Bernoulli
Пусть целевая функция зависит от вероятности: . В координате естественный градиентный поток имеет вид
В логит-координате
поэтому
После обратного преобразования:
Обе системы координат описывают один и тот же непрерывный поток распределений. Обычный градиентный поток такого свойства не имеет.
Это и есть сильный положительный результат естественного градиента: векторное поле не зависит от гладкой взаимно однозначной перепараметризации статистической модели.
Почему конечный шаг всё же зависит от реализации
Практический алгоритм делает не бесконечно малое движение, а шаг Эйлера:
После нелинейной замены координат конечные точки такого шага совпадают только с точностью первого порядка по . Для точной конечной инвариантности потребовалась бы геодезическая интеграция или согласованная ретракция на многообразии.
Поэтому на практике важны:
- малый или адаптивно выбранный шаг;
- проверка фактического KL после обновления;
- линейный поиск;
- демпфирование;
- качество приближения матрицы кривизны.
Демпфированный шаг
часто необходим численно. Но добавка вводит в задачу евклидову часть и тем самым меняет исходную геометрию. Это полезная инженерная уступка, а не нейтральная деталь.
Естественный градиент и метод Ньютона
Метод Ньютона использует гессиан самой целевой функции:
Естественный градиент использует Fisher статистической модели:
Они могут совпадать в специальных постановках правдоподобия — например, на уровне ожидаемой отрицательной логарифмической функции правдоподобия при подходящей спецификации модели. В нейросетях Fisher также тесно связана с обобщённой матрицей Гаусса—Ньютона для ряда выходных распределений экспоненциального семейства. Но эмпирический гессиан, модельная Fisher и GGN в общем случае различны. Подробный разбор этой связи и её практических последствий дан у Martens, 2020.
Полезно запомнить:
Обратная Fisher не является магическим ускорителем. Она меняет единицы измерения шага так, чтобы одинаковый бюджет означал примерно одинаковое изменение распределения.
15.4. Что именно называют «кривизной» в глубокой сети
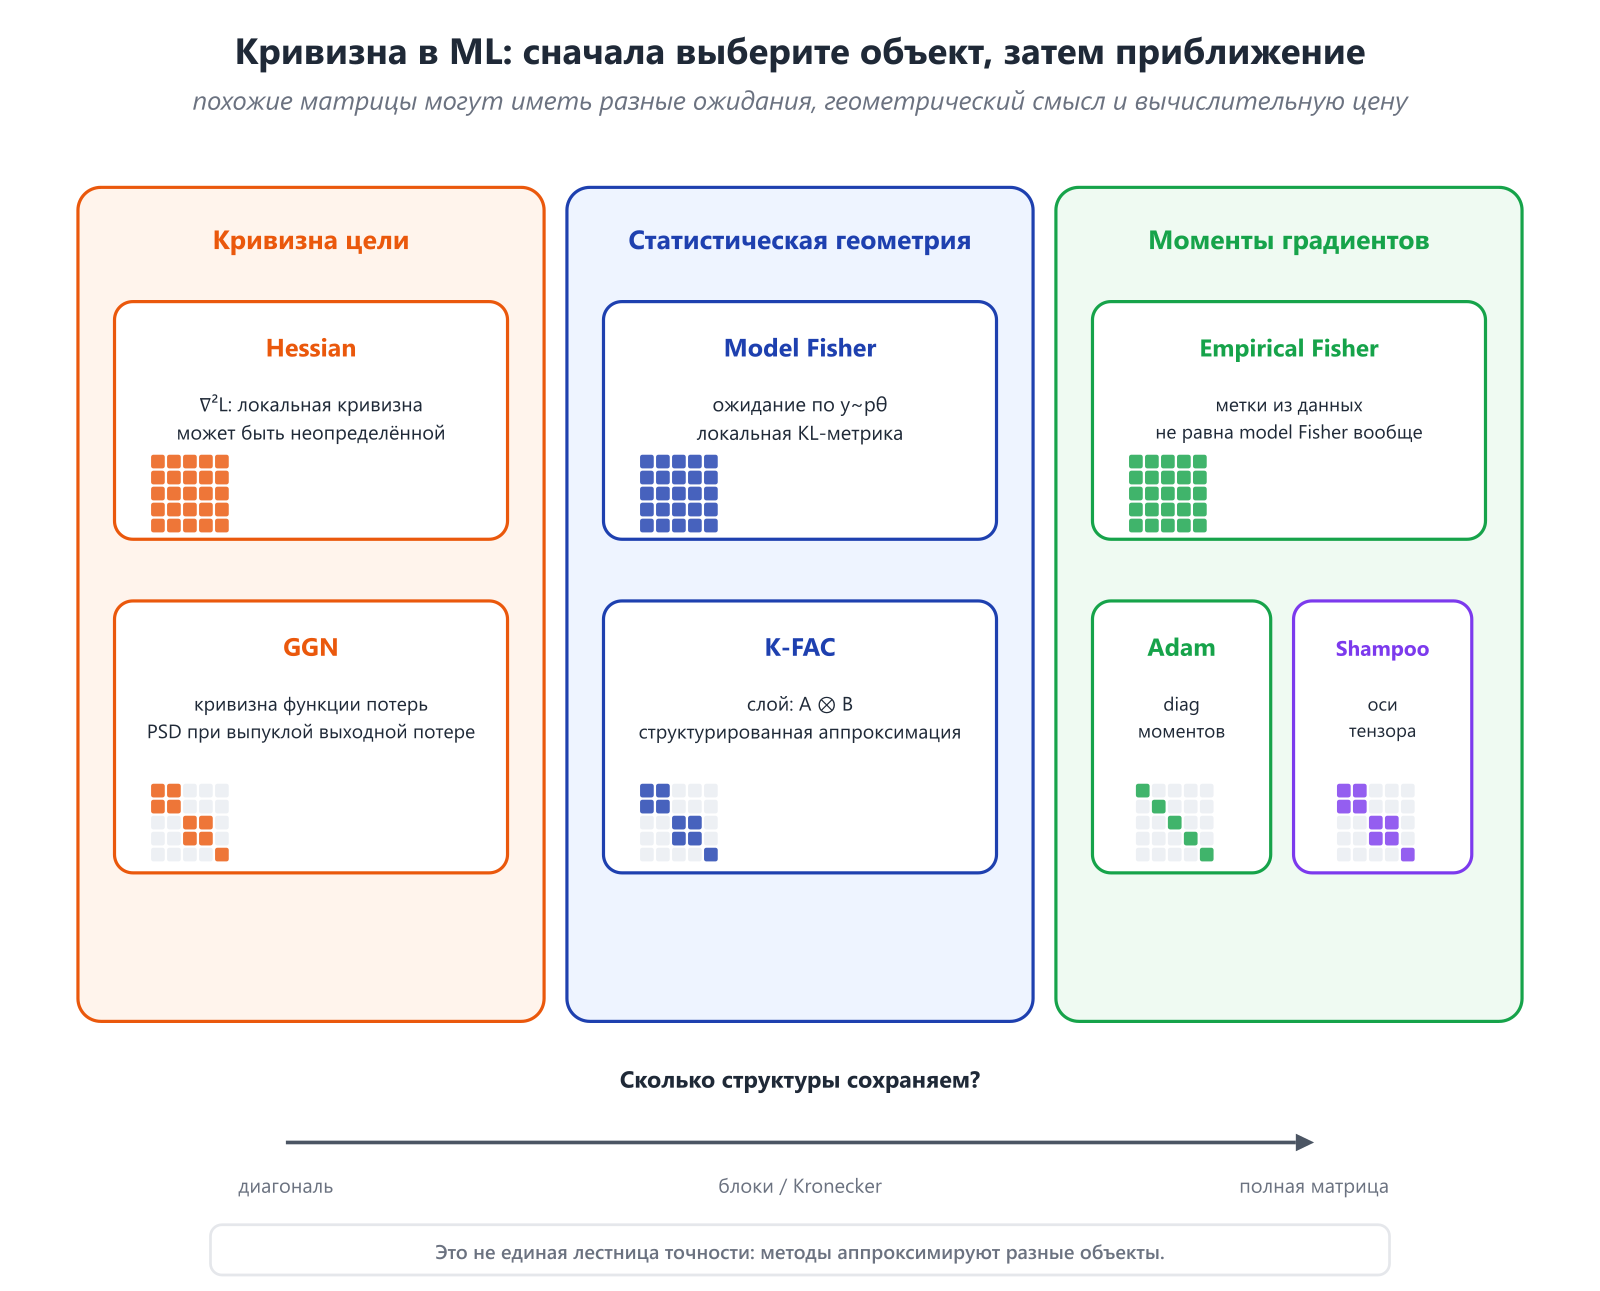
Полную матрицу Fisher модели с миллиардами параметров нельзя хранить и обращать напрямую. Но прежде чем обсуждать приближения, нужно понять, к какой матрице они вообще относятся.
Модельная Fisher
Для условной модели и выбранного распределения входов :
где
Ключевая деталь: внутреннее ожидание по метке берётся из текущей модели.
Эмпирическая Fisher
На наборе данных часто вычисляют
Здесь метки пришли из данных, а не из . Поэтому эта матрица является вторым моментом пообъектных градиентов, вычисленных по данным, но в общем случае не является несмещённой оценкой модельной Fisher и не обязана приближать гессиан. Это различие подробно анализируют Kunstner, Balles и Hennig, 2019.
Небольшой пример показывает масштаб расхождения. Для Bernoulli-модели в логит-координате:
Если истинная доля единиц в данных равна , то популяционный второй момент наблюдаемого градиента равен
При
получаем
Обе величины построены из квадратов градиентов, но отвечают на разные вопросы.
Обобщённая матрица Гаусса—Ньютона
Пусть сеть выдаёт , а функция потерь по выходу равна . GGN использует
где — якобиан выходов по параметрам, а — гессиан функции потерь по выходам. Если выпукла по , GGN положительно полуопределена. Для некоторых вероятностных моделей она совпадает с соответствующей Fisher, но это требует конкретной параметризации выходного распределения и функции потерь.
K-FAC, Adam и Shampoo
K-FAC приближает крупные блоки Fisher или GGN произведениями Кронекера:
Матрица описывает статистику входных активаций слоя, а — статистику сигналов обратного распространения. Такое разложение позволяет сравнительно дёшево применять приближённую обратную матрицу. Но оно сохраняет только часть корреляционной структуры и требует демпфирования. Именно как приближение естественного градиента K-FAC вводится у Martens и Grosse, 2015.
Adam накапливает покоординатные первые и вторые моменты стохастических градиентов и использует масштабирование вида
Это адаптивный диагональный предобусловливатель. Квадраты градиентов могут напоминать диагональ эмпирической Fisher, но Adam не обращает модельную Fisher и не обладает полной инвариантностью естественного градиента.
Shampoo строит структурированные матрицы вторых моментов по осям тензора. Он родственен full-matrix AdaGrad и использует больше структуры, чем покоординатные методы, но по умолчанию не является Fisher-аппроксимацией.
| Метод | Какой объект используется | Что сохраняется | Что не следует обещать автоматически |
|---|---|---|---|
| Newton | гессиан целевой функции | локальная кривизна самой цели | статистическая инвариантность модели |
| Естественный градиент | модельная Fisher | локальная KL-геометрия | точную глобальную область доверия |
| GGN | кривизна функции потерь по выходам | положительная полуопределённость при выпуклой выходной потере | равенство Fisher для любой задачи |
| Эмпирическая Fisher | второй момент наблюдаемых градиентов | доступность по данным | корректная Fisher-геометрия вдали от специальных режимов |
| Adam | диагональные моменты градиентов | дешёвое адаптивное масштабирование | инвариантность естественного градиента |
| K-FAC | Кронекеровы блоки Fisher/GGN | межкоординатную структуру внутри слоя | точное обращение полной матрицы |
| Shampoo | тензорные вторые моменты | структуру по осям параметра | интерпретацию через Fisher без дополнительных условий |
Вот и вся практическая мораль раздела: слово «кривизна» не называет одну универсальную матрицу. Каждый метод решает, какие зависимости сохранить, какие отбросить и сколько вычислений на это потратить.
15.5. Геометрия политик: NPG, TRPO, PPO и KL в RLHF
Политика уже сама является условным распределением:
Поэтому идея малого изменения распределения здесь особенно естественна. Для выбранного распределения состояний матрица Fisher политики равна
Естественный градиент политики:
Он масштабирует шаг так, чтобы чувствительные направления в распределении действий менялись осторожнее.
TRPO: доверительная область в пространстве политик
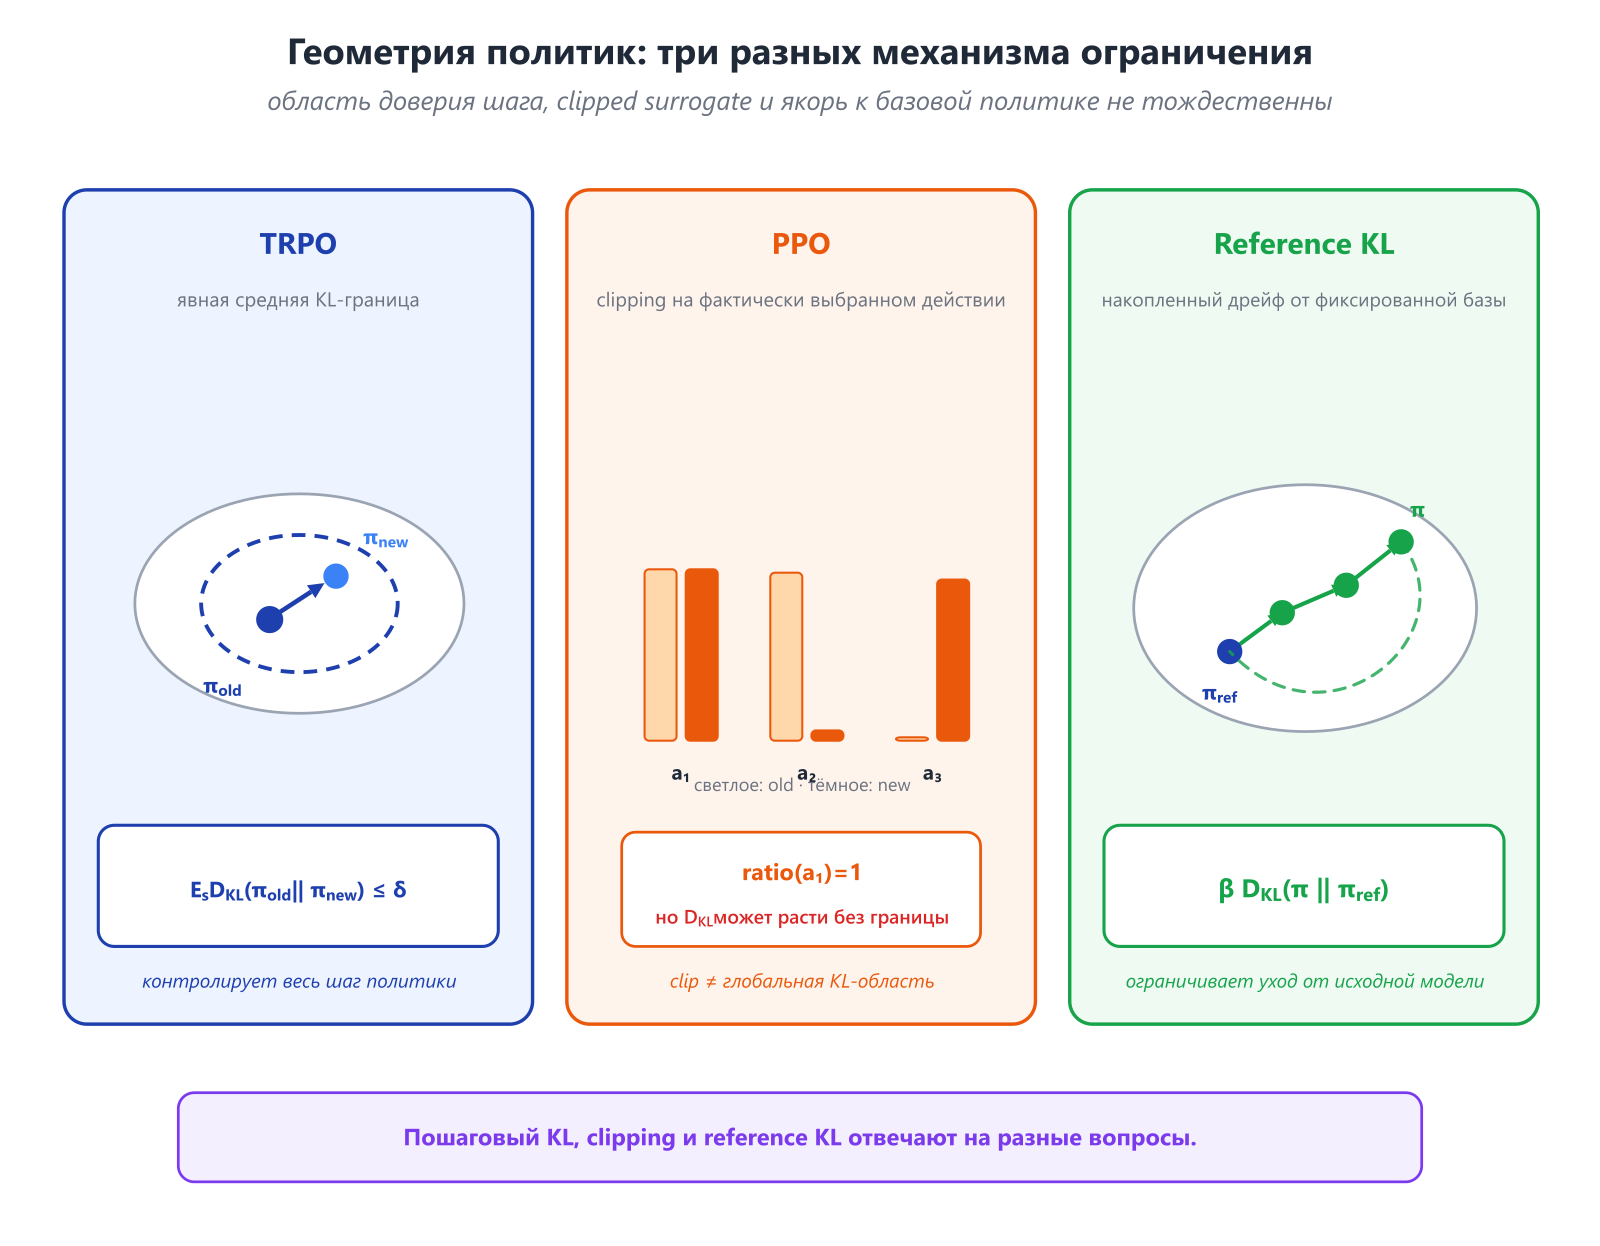
TRPO начинает с локальной суррогатной целевой функции и ограничивает среднее изменение политики:
После линеаризации цели и квадратичной аппроксимации KL возникает та же задача, что в §15.3, а значит — направление естественного градиента. Практический TRPO применяет сопряжённые градиенты и линейный поиск, а не строит точную геодезическую. Исходная работа прямо выводит практический алгоритм как последовательность приближений к теоретически мотивированному обновлению в области доверия. (Schulman et al., 2015)
Важно различать два уровня:
- теоретические гарантии улучшения используют более сильный контроль распределительного сдвига;
- практический алгоритм контролирует эмпирический средний KL и проверяет шаг численно.
PPO: полезная прокси, но не строгая область доверия
PPO использует отношение вероятностей
и клиппированную суррогатную цель
Это позволяет делать несколько эпох обновлений на одном пакете данных и часто стабилизирует обучение. Но clipping контролирует отношения для действий, попавших в выборку, а не всю политику.
Контрпример можно записать в трёх числах. Пусть
а в пакете встретилось только первое действие. Рассмотрим семейство
Отношение вероятностей фактически выбранного действия всегда равно единице, поэтому соответствующий sampled surrogate не меняется. Но
при . Следовательно, clipping не является глобальным ограничением на KL. Именно поэтому реализации часто дополнительно мониторят KL, используют раннюю остановку или явный штраф. PPO был предложен как более простой first-order метод с некоторыми практическими преимуществами TRPO, а не как точное решение той же constrained-задачи. (Schulman et al., 2017)
Два разных KL в RLHF
В RLHF и похожих процедурах легко смешать два ограничения.
- Пошаговый KL сравнивает текущую политику со снимком, который породил данные этого обновления. Его задача — не дать одному шагу стать слишком большим.
- KL к фиксированной базовой политике сравнивает текущую модель с SFT- или базовой моделью. Его задача — ограничивать накопленный дрейф на всём протяжении обучения.
Удобно сформулировать различие так:
TRPO спрашивает: «насколько далеко мы ушли за этот шаг?» Reference KL спрашивает: «насколько далеко мы ушли от исходной модели вообще?»
Для фиксированного контекста идеальная задача
имеет точный Gibbs-оптимум
Полный вывод уже был в Модуле 8. Здесь важно увидеть геометрию: KL задаёт цену ухода от базового распределения, а экспоненциальный наклон является точным проксимальным решением идеализированной задачи.
DPO использует эту аналитическую связь, чтобы выразить предпочтения через логарифмическое отношение вероятностей политики и базовой модели. Но DPO не выполняет обновление естественного градиента или шаг TRPO на каждом мини-пакете. Одинаковая KL-структура ещё не делает алгоритмы тождественными.
И ещё одна граница: KL между политиками в RLHF сравнивает распределения ответов, тогда как PAC-Bayes KL из Модуля 12 сравнивает распределения над гипотезами. Совпадение формулы не переносит сертификат обобщения из одной постановки в другую.
15.6. Wasserstein-геометрия и потоки распределений
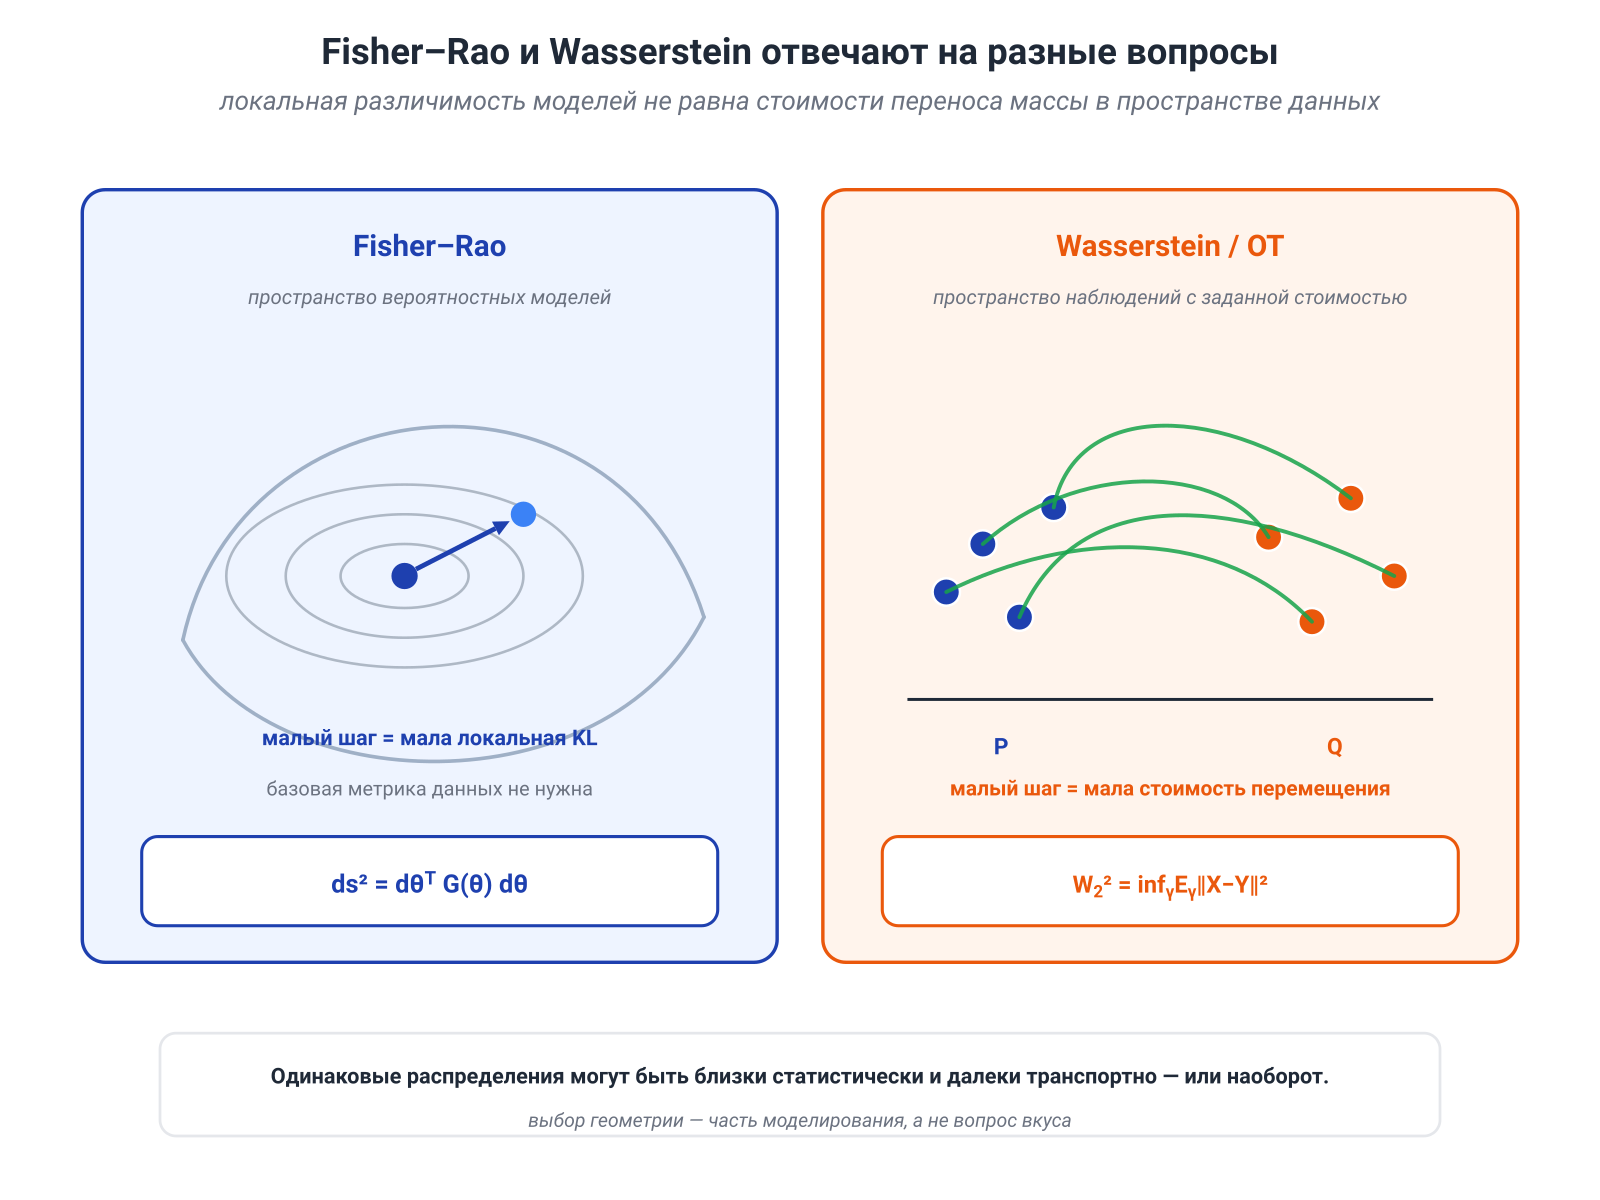
Fisher хорошо отвечает на вопрос о различимости соседних моделей. Но иногда главная структура находится не в параметрах, а в самом пространстве наблюдений.
Рассмотрим две точечные массы:
Для любого их носители не пересекаются. Поэтому обе направленные KL бесконечны, полная вариация равна единице, а Jensen–Shannon равна — независимо от того, находится ли вторая точка на расстоянии или .
Wasserstein видит именно то, что здесь важно:
Он использует геометрию пространства данных.
Определение через транспортный план
При квадратичной стоимости
Связка (coupling) определяет, какую массу из сопоставить какой массе из . Базовая метрика — часть постановки. Если одну координату измерять в метрах, а другую в миллиметрах, транспортная стоимость изменится.
Динамическая форма
Формула Бенаму—Бренье записывает ту же стоимость как минимальное кинетическое действие:
при уравнении непрерывности
Теперь точка пространства — целое распределение , а векторное поле переносит его массу. Не всякий путь между и является геодезической: геодезика должна минимизировать действие.
Непрерывный нормализующий поток
Пусть отдельная частица движется по ODE:
Тогда плотность вдоль траектории изменяется по формуле
Это непрерывный аналог формулы замены переменных и основа непрерывных нормализующих потоков (continuous normalizing flows). Neural ODE показали, как обучать такие модели и вычислять логарифм правдоподобия через интеграл дивергенции. (Chen et al., 2018)
Flow Matching: сначала выбирается путь
Flow Matching не начинает с неизвестного логарифма плотности. Сначала выбирается семейство промежуточных распределений или условных путей, затем нейросеть обучается регрессией к векторному полю, которое реализует выбранную эволюцию.
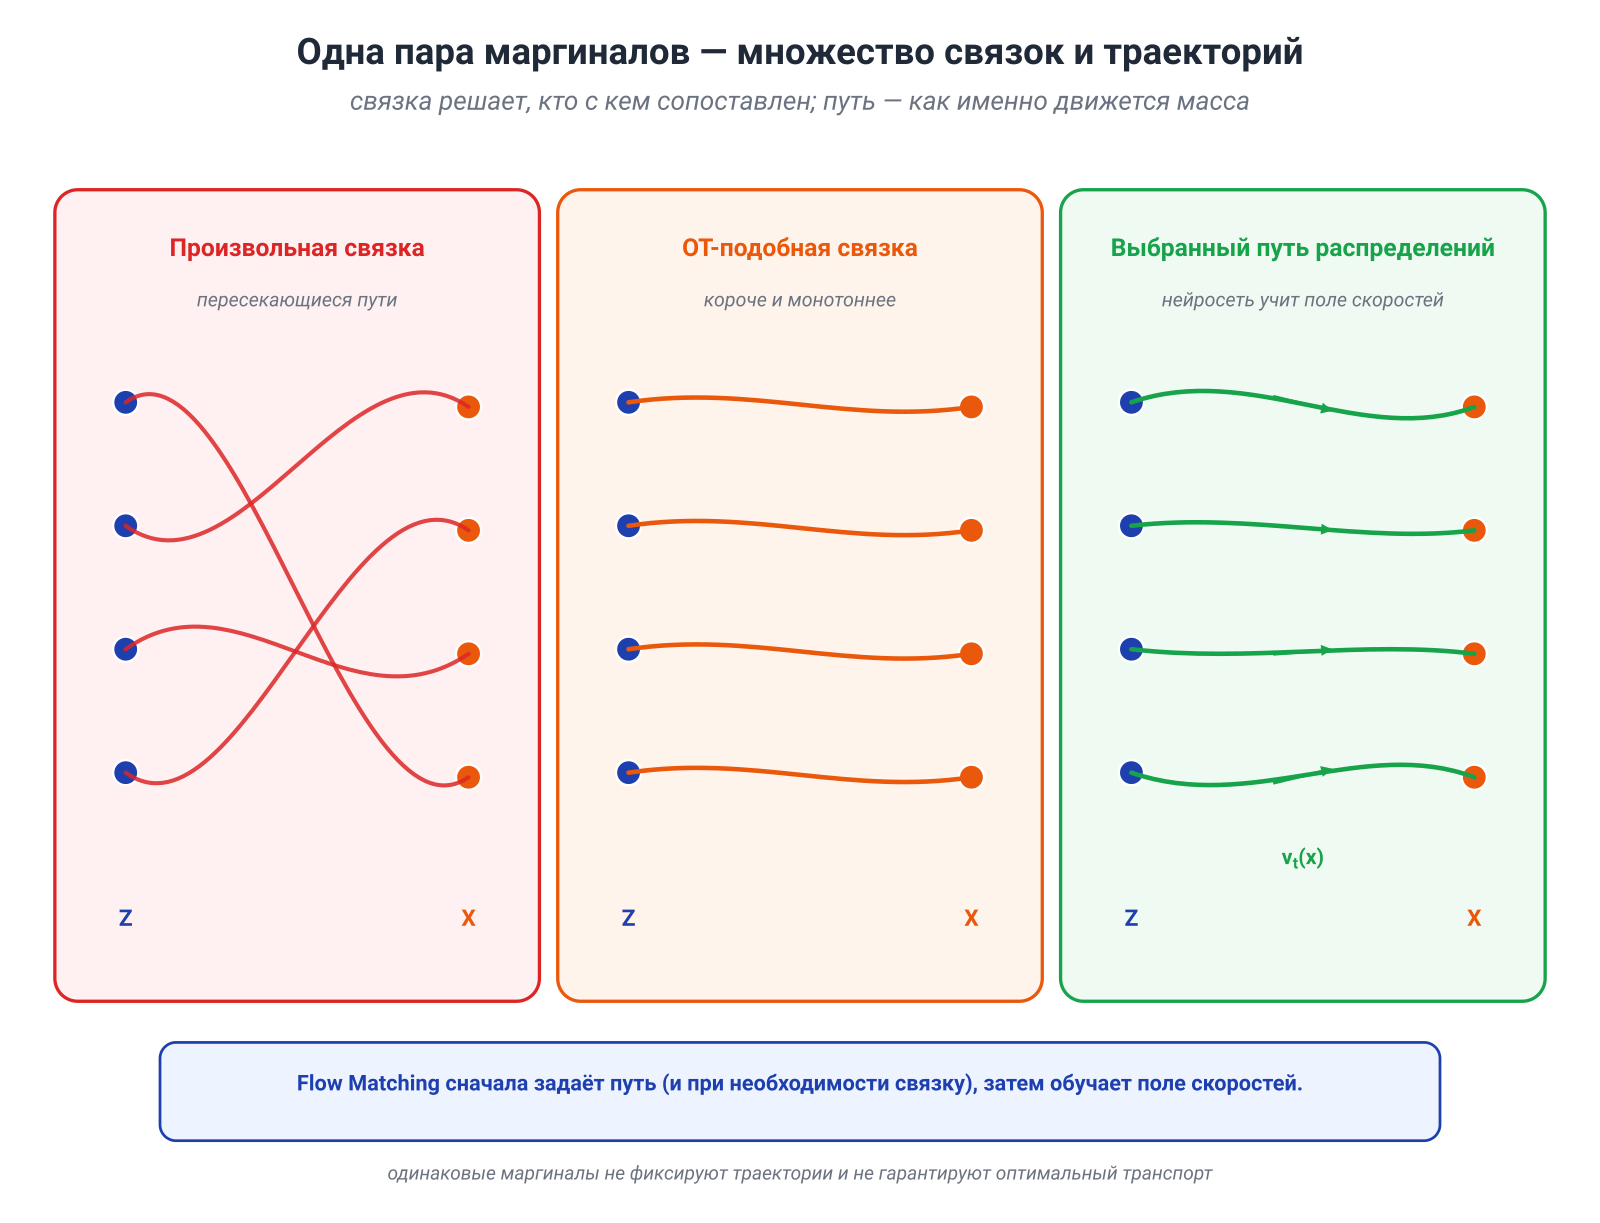
Главная свобода здесь двойная:
- какую связку между начальными и конечными точками выбрать;
- какой путь между связанными точками использовать.
Одна и та же пара маргинальных распределений допускает множество связок, а значит — множество скоростей и траекторий. В частности, Flow Matching совместим и с diffusion-путями, и с путями, построенными через оптимальный транспорт. Это часть исходной постановки метода, а не последующее переименование. (Lipman et al., 2022)
В одномерном гауссовском случае разницу видно особенно чисто. Пусть
с общим . Линейная интерполяция
даёт Wasserstein-геодезическую между гауссовскими маргиналами. Если же и выбрать независимо, конечные маргиналы останутся теми же, но кинетическое действие станет больше. Связка — не служебная деталь; она определяет геометрию траекторий.
Rectified Flow
Rectified Flow обучает ODE следовать прямым линиям между парами из выбранной связки и может повторно «выпрямлять» полученный транспорт. Исходная работа показывает, что rectification не увеличивает выпуклые транспортные стоимости выбранной связки и способна давать траектории, удобные для грубой дискретизации. (Liu, Gong и Liu, 2022)
Но отсюда не следует, что любой обученный rectified flow автоматически является точным отображением оптимального транспорта или глобальной Wasserstein-геодезической. Прямизна отдельных траекторий, качество выбранной связки, ошибка регрессии и ошибка численного интегратора — разные вопросы.
Probability-flow ODE и diffusion
Для SDE
со скалярным коэффициентом диффузии соответствующая probability-flow ODE имеет дрейф
При точной скор-функции SDE и ODE имеют одинаковые одномоментные маргинальные распределения . Но их траектории и связки различаются: одна динамика стохастическая, другая детерминированная. Именно такую эквивалентную Neural ODE выводит формализм score-based SDE. (Song et al., 2021)
Наконец, не смешивайте две скор-функции:
— градиент лог-плотности по наблюдению, используемый в diffusion;
— естественный градиент по параметрам модели. Оба выражения содержат слово «градиент» и работают с распределениями, но живут в разных пространствах.
15.7. Экспоненциальные семейства, двойственные координаты и зеркальный спуск
В Модуле 8 мы подробно вывели экспоненциальное семейство:
Теперь та же конструкция получает геометрическое чтение.
Параметры ожиданий равны
а Fisher:
KL между двумя членами семейства является дивергенцией Брэгмана лог-нормировки:
Обратите внимание на порядок: касательная к берётся в точке , а значение сравнивается в . В двойственных координатах:
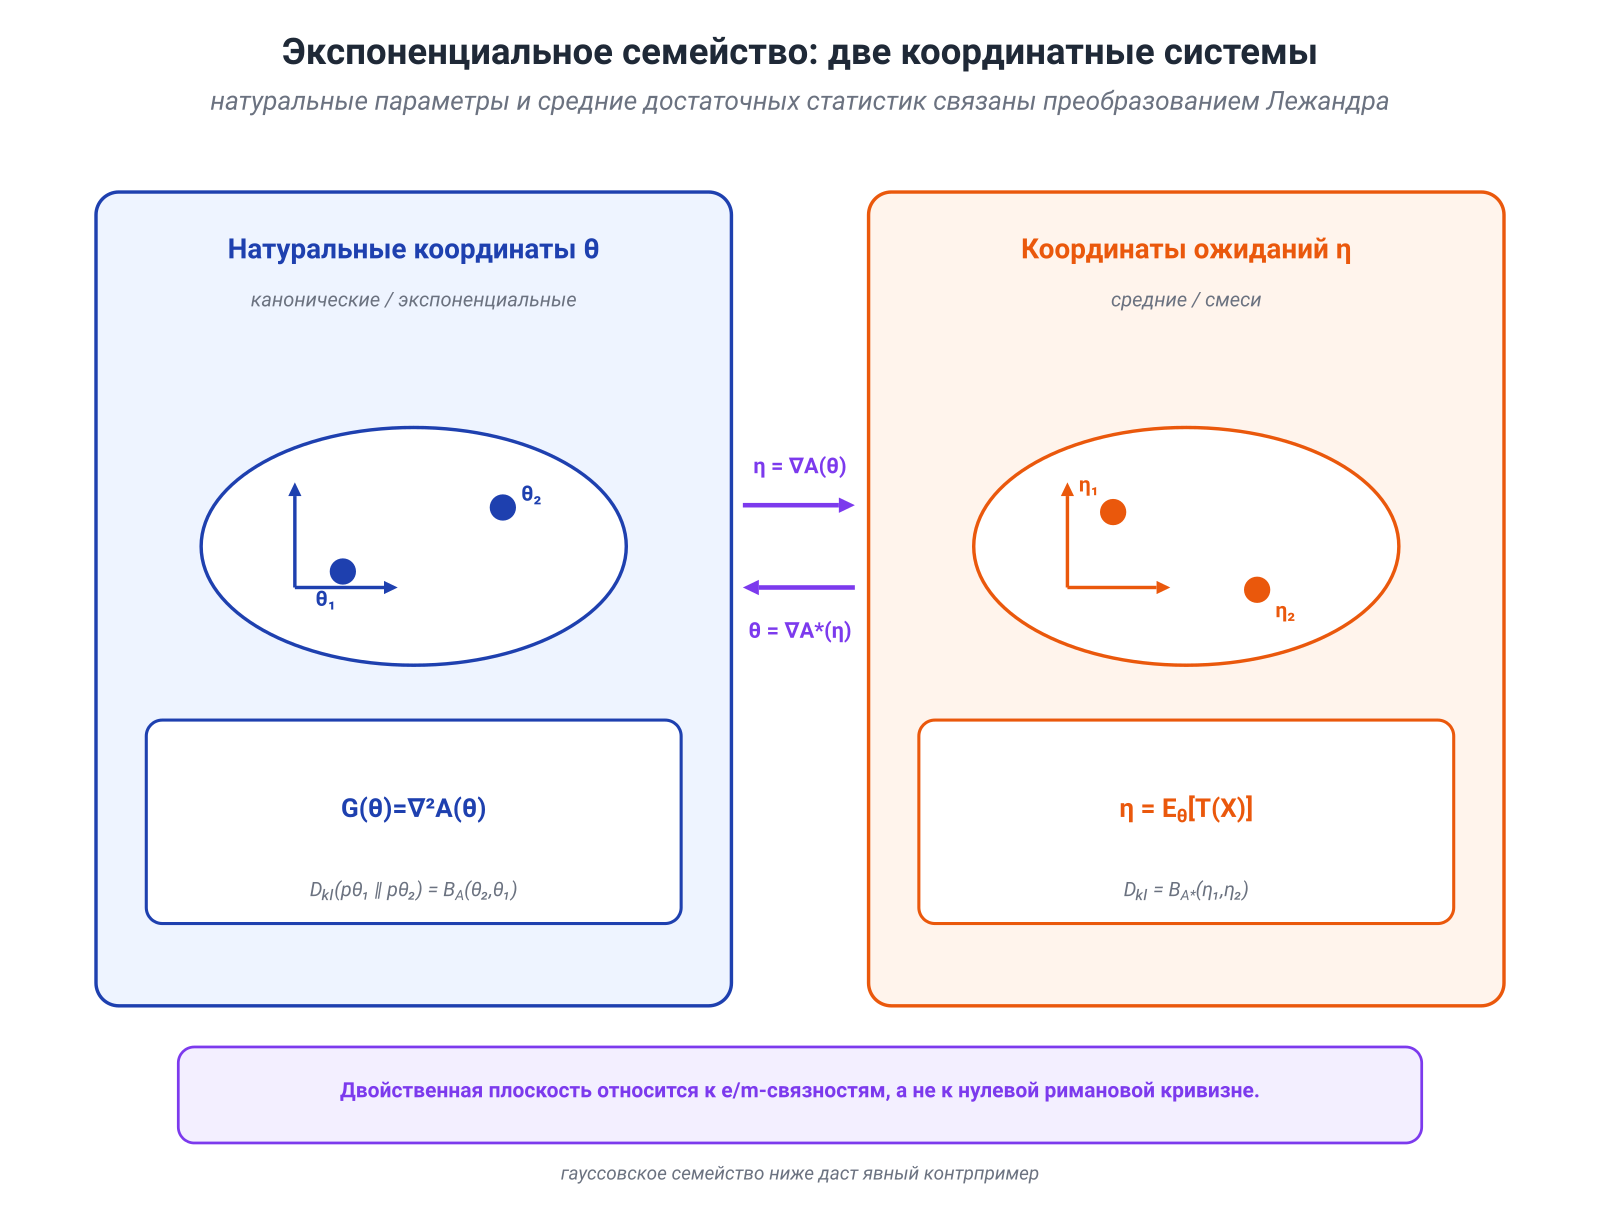
Натуральные координаты и координаты ожиданий образуют две аффинные системы, связанные преобразованием Лежандра. Это и есть смысл двойственно плоской (dually flat) структуры. Слово «плоская» относится к паре e/m-связностей, а не обещает нулевую риманову кривизну метрики Fisher–Rao. В §15.9 гауссовское семейство даст явный контрпример.
Зеркальный спуск
Зеркальный шаг имеет вид
где — дивергенция Брэгмана выпуклой функции .
На вероятностном симплексе естественный выбор
даёт
Решение шага:
Это знакомый по Модулю 8 экспоненциальный наклон. Там он возникал как MaxEnt- или KL-регуляризованный оптимум; здесь — как проксимальное обновление на симплексе.
Локально дивергенция Брэгмана задаётся гессианом:
Поэтому зеркальный спуск и естественный градиент тесно связаны через соответствующую локальную метрику; для экспоненциальных семейств связь особенно точна в двойственных координатах. Но глобально это не один алгоритм для произвольного и конечного шага. Зеркальный спуск использует всю асимметричную дивергенцию Брэгмана, а естественный градиент — локальную квадратичную метрику. Эту эквивалентность в двойственной геометрии экспоненциальных семейств подробно разбирают Raskutti и Mukherjee, 2013.
15.8. Практическая карта: сначала выберите объект, затем геометрию
После всех формул легко сделать последнюю чрезмерно сильную попытку: объявить Fisher «истинной геометрией ML» или, наоборот, заменить её Wasserstein. Правильная карта скромнее и полезнее.
| Задача | Что является точкой пространства | Что означает малое изменение | Подходящая конструкция |
|---|---|---|---|
| вероятностная модель правдоподобия | соседние распределения трудно различить | Fisher / локальная KL | |
| обновление политики | распределение действий мало изменилось на релевантных состояниях | усреднённая по состояниям KL политик / Fisher | |
| веса на симплексе | распределение | мала Bregman-цена относительно текущей точки | зеркальный спуск / KL |
| перенос выборок | распределение в пространстве данных | масса перемещена на малое расстояние | Wasserstein / OT |
| детерминированная регрессия | параметры или выходы | мала ошибка в выбранной задаче | гессиан, GGN или метрика задачи |
| крупная сеть | структурированные блоки параметров | вычислимо приближена полезная кривизна | K-FAC, Shampoo, адаптивные предобусловливатели |
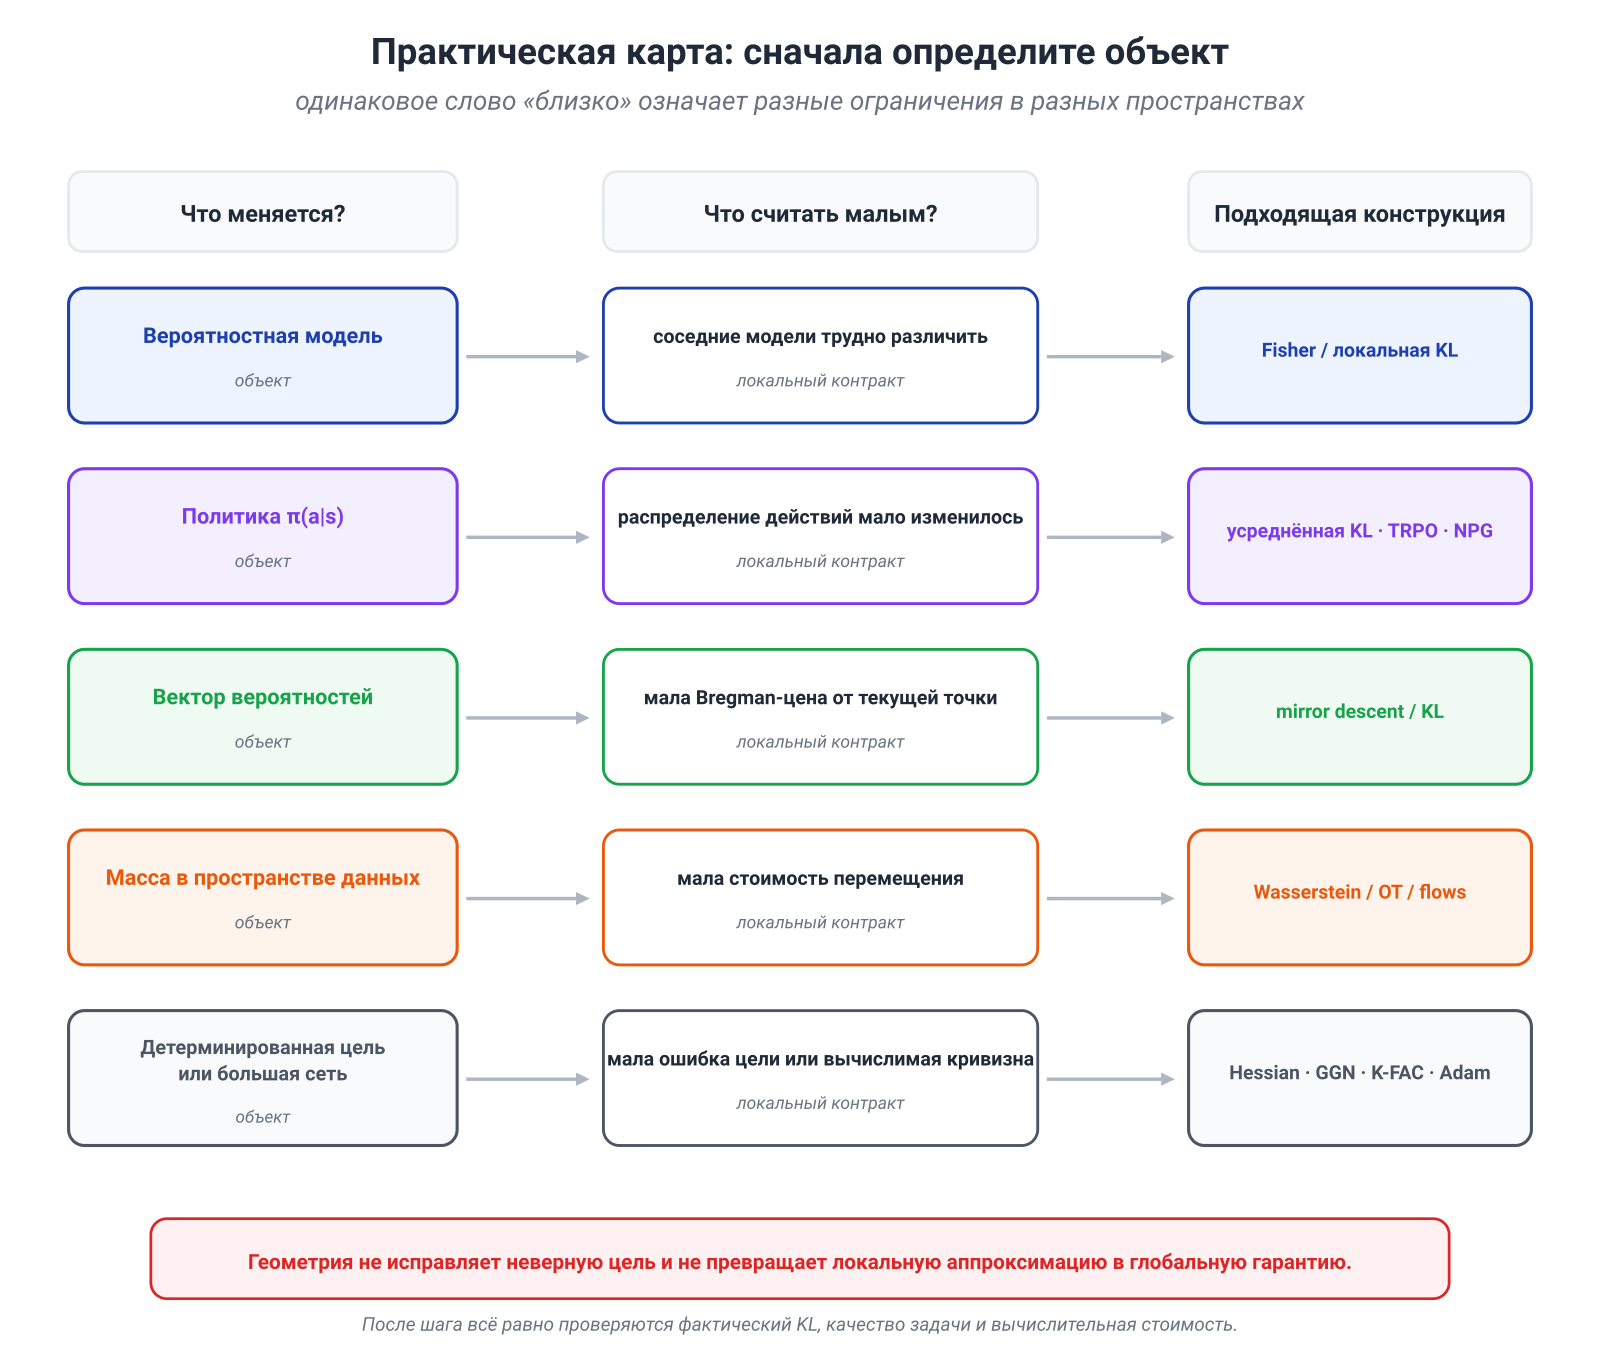
Перед применением геометрического языка полезно задать пять вопросов.
- Какой объект мы обновляем? Параметры, распределение ответов, представление или путь выборок?
- Что должно считаться малым? KL, транспортная стоимость, изменение логитов, функциональная ошибка?
- Локальна ли используемая аппроксимация? Если да, достаточно ли мал фактический шаг?
- Какую матрицу или дивергенцию код реально вычисляет? модельную Fisher, эмпирическую Fisher, GGN или лишь диагональный момент?
- Что проверяется после обновления? Фактический KL, качество на задаче, стоимость интегрирования, реальный дрейф политики?
Главный синтез модуля можно выразить одной строкой:
Геометрия не выбирает цель обучения. Она определяет, какие движения считаются близкими во время её оптимизации.
Естественный градиент не исправляет неверную награду. Wasserstein не гарантирует удобный путь для конечной нейросети. K-FAC не делает невыпуклую задачу выпуклой. Но правильная геометрия может убрать искусственную зависимость от координат, сделать область доверия содержательной и подсказать, какую структуру кривизны стоит сохранять.
15.9. Математическое углубление: α-геометрия и точные примеры
Можно пропустить при первом чтении. Основной ML-маршрут завершён. Здесь мы уточним, как одна и та же Fisher-метрика сосуществует с разными асимметричными связностями, и посмотрим на две геодезии, которые можно записать в закрытой форме.
α-дивергенции в соглашении Амари
Для :
Пределы:
При получается постоянный множитель квадрата расстояния Хеллингера.
Это параметр α-геометрии Амари, а не порядок дивергенции Реньи. У разных авторов встречаются другие знаки и масштабы, поэтому пределы нужно проверять рядом с определением.
Все гладкие α-дивергенции этого семейства порождают одну и ту же Fisher-метрику во втором порядке. Различие появляется в третьем порядке и задаёт разные аффинные связности:
- — e-связность;
- — m-связность;
- — связность Леви—Чивиты Fisher-метрики.
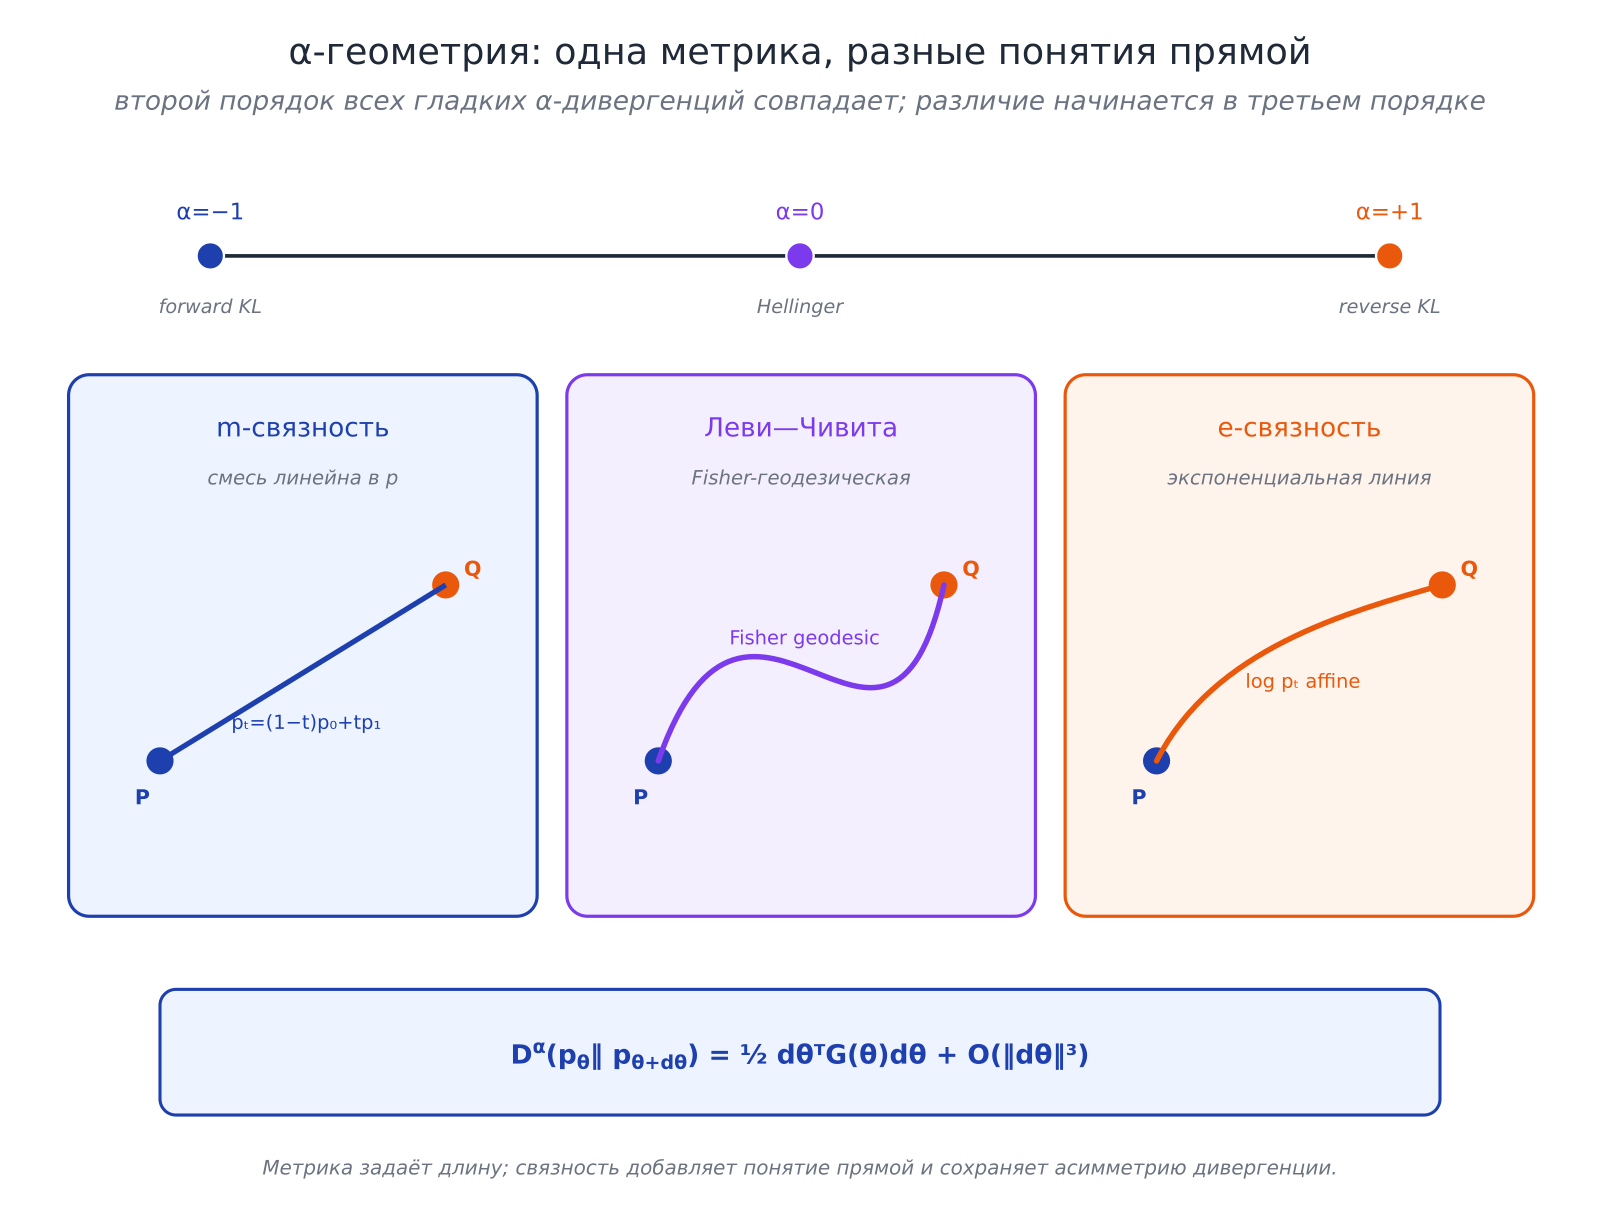
Это важная концептуальная точка: метрика описывает локальную длину, но одной метрики недостаточно, чтобы восстановить асимметрию дивергенции и понятие прямой линии.
Категориальное распределение как часть сферы
Для распределения внутри симплекса Fisher-элемент длины равен
Сделаем замену
Тогда
и
То есть внутренность вероятностного симплекса отображается в положительный ортант сферы радиуса . Отсюда точное расстояние:
Для эта формула сводится к Bernoulli-расстоянию из §15.2. Коэффициент
уже встречался в Модуле 11 как коэффициент Бхаттачарьи и в расстоянии Хеллингера. Здесь он становится косинусом сферического угла.
Геодезическая Bernoulli
В координате
геодезика является обычной прямой:
Возвращаясь к вероятности:
Она не совпадает с линейной интерполяцией вероятностей .
Нормальное семейство и гиперболическая плоскость
Для
Fisher в координатах :
Положим
Тогда
Это масштабированная метрика верхней полуплоскости Пуанкаре с постоянной гауссовой кривизной
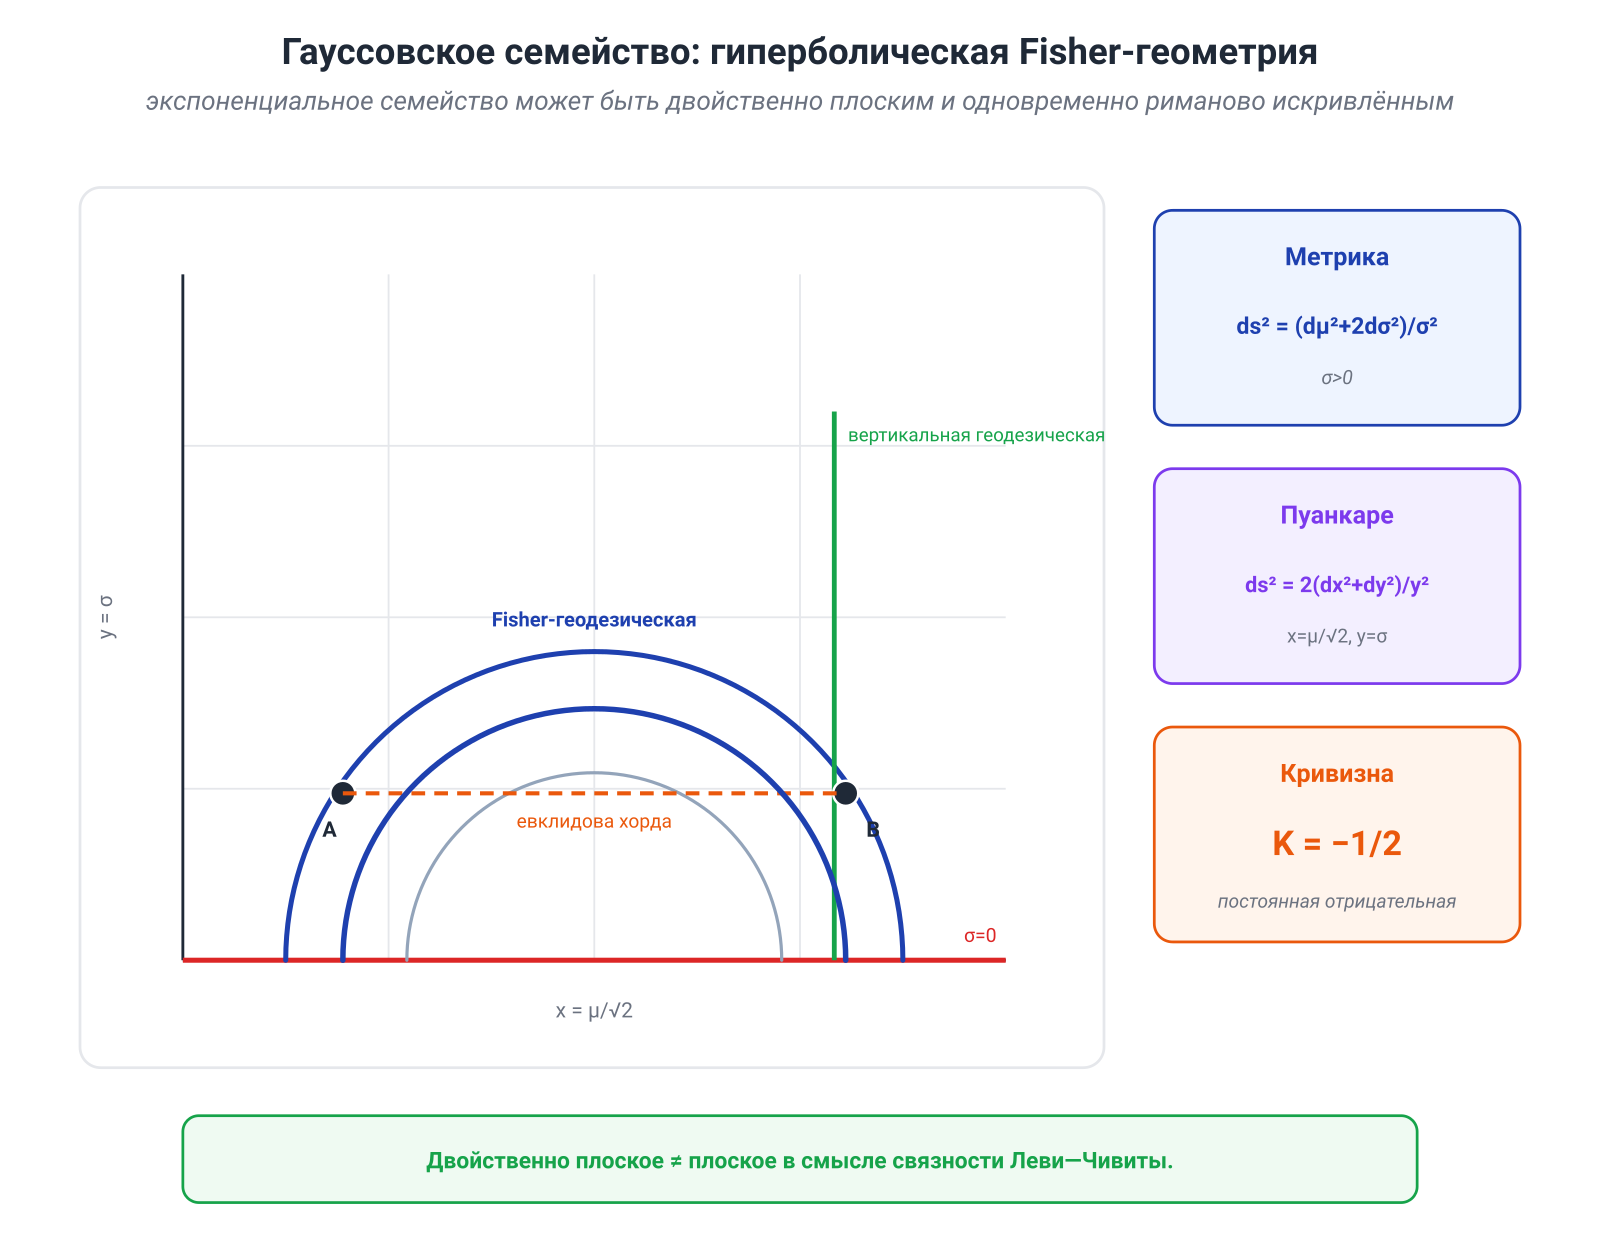
Таким образом, нормальное семейство является экспоненциальным и двойственно плоским, но не плоским в римановом смысле Леви—Чивиты. Два слова «плоский» относятся к разным связностям.
Теорема Ченцова
В классической конечномерной статистике теорема Ченцова, грубо говоря, утверждает: с точностью до общего множителя Fisher–Rao является единственной римановой метрикой на вероятностных симплексах, согласованной с достаточными статистиками и подходящими стохастическими отображениями.
Это сильное обоснование Fisher как статистической геометрии. Но оно не говорит, что Fisher обязана быть правильной стоимостью переноса изображений, физических координат или скрытых состояний. Базовая метрика пространства данных в теорему не входит. Wasserstein отвечает на другой вопрос — поэтому конкуренции между двумя конструкциями нет.
15.11. Заключение
К концу курса знакомые информационные величины получили ещё одну роль. Энтропия и KL начинались как счета за неопределённость и несовпадение моделей. Теперь их второй порядок задаёт локальную форму пространства распределений, а эта форма меняет само понятие градиентного шага.
Три вопроса помогают не потеряться:
- Fisher–Rao: насколько различимы соседние вероятностные модели?
- Дивергенции Брэгмана и зеркальный спуск: как обновить распределение, уважая геометрию его ограничений?
- Wasserstein: сколько стоит физически перенести вероятностную массу в пространстве данных?
Их нельзя бездумно заменять друг другом. Но вместе они дают зрелую карту современных ML-методов:
Главный урок не в том, что каждый популярный алгоритм «на самом деле» является одной геометрической теоремой. Он в другом:
Сначала определите объект, затем смысл близости, и только после этого выбирайте геометрию и её вычислимое приближение.
Так информационная геометрия завершает курс не новым универсальным лозунгом, а дисциплиной постановки задачи. Формула становится сильнее, когда мы точно знаем, что она измеряет — и где её обещание заканчивается.
Основные источники
- S.-I. Amari, «Information Geometry and Its Applications», Springer, 2016.
- S.-I. Amari, «Natural Gradient Works Efficiently in Learning», 1998.
- J. Martens, «New Insights and Perspectives on the Natural Gradient Method», 2020.
- J. Martens, R. Grosse, «Optimizing Neural Networks with Kronecker-factored Approximate Curvature», 2015.
- F. Kunstner, L. Balles, P. Hennig, «Limitations of the Empirical Fisher Approximation», 2019.
- S. Kakade, «A Natural Policy Gradient», NeurIPS 2001.
- J. Schulman et al., «Trust Region Policy Optimization», 2015.
- J. Schulman et al., «Proximal Policy Optimization Algorithms», 2017.
- R. Rafailov et al., «Direct Preference Optimization», 2023.
- R. T. Q. Chen et al., «Neural Ordinary Differential Equations», 2018.
- Y. Lipman et al., «Flow Matching for Generative Modeling», 2022.
- X. Liu, C. Gong, Q. Liu, «Flow Straight and Fast», 2022.
- Y. Song et al., «Score-Based Generative Modeling through Stochastic Differential Equations», 2021.
- G. Raskutti, S. Mukherjee, «The Information Geometry of Mirror Descent», 2013.