Модуль 14. Компьютерное зрение через теорию информации
Как читать этот модуль. Это бонусный модуль для тех, кто работает с изображениями, мультимодальными моделями и развёртыванием CV-систем. Основной маршрут — §§14.1–14.8. Он начинается с наиболее буквальной связи с теорией информации — сжатия изображения в настоящий поток битов, — затем переходит к перцептивному качеству, диффузионным моделям, CLIP, самообучению визуальных представлений и сжатию самой модели. §14.9 — математическое углубление: точный счёт битов в hyperprior-кодеке и гауссовские тождества удаления шума. Его можно оставить на второй проход.
14.1. Почему компьютерное зрение — хороший полигон для теории информации
Возьмём обычное RGB-изображение размером с восемью битами на канал. В несжатом виде это
бита, то есть ровно МиБ. Но для системы машинного зрения это изображение может играть несколько совершенно разных ролей.
- Его можно сохранить или передать, заплатив некоторым числом битов и допустив контролируемое искажение.
- Его можно наблюдать через шум и восстановить наиболее вероятный или наиболее точный чистый сигнал.
- Его можно превратить в компактное представление для классификации, поиска, сегментации или управления.
- Наконец, саму модель, которая всё это делает, приходится размещать в памяти, передавать на устройство и исполнять с ограниченной задержкой.
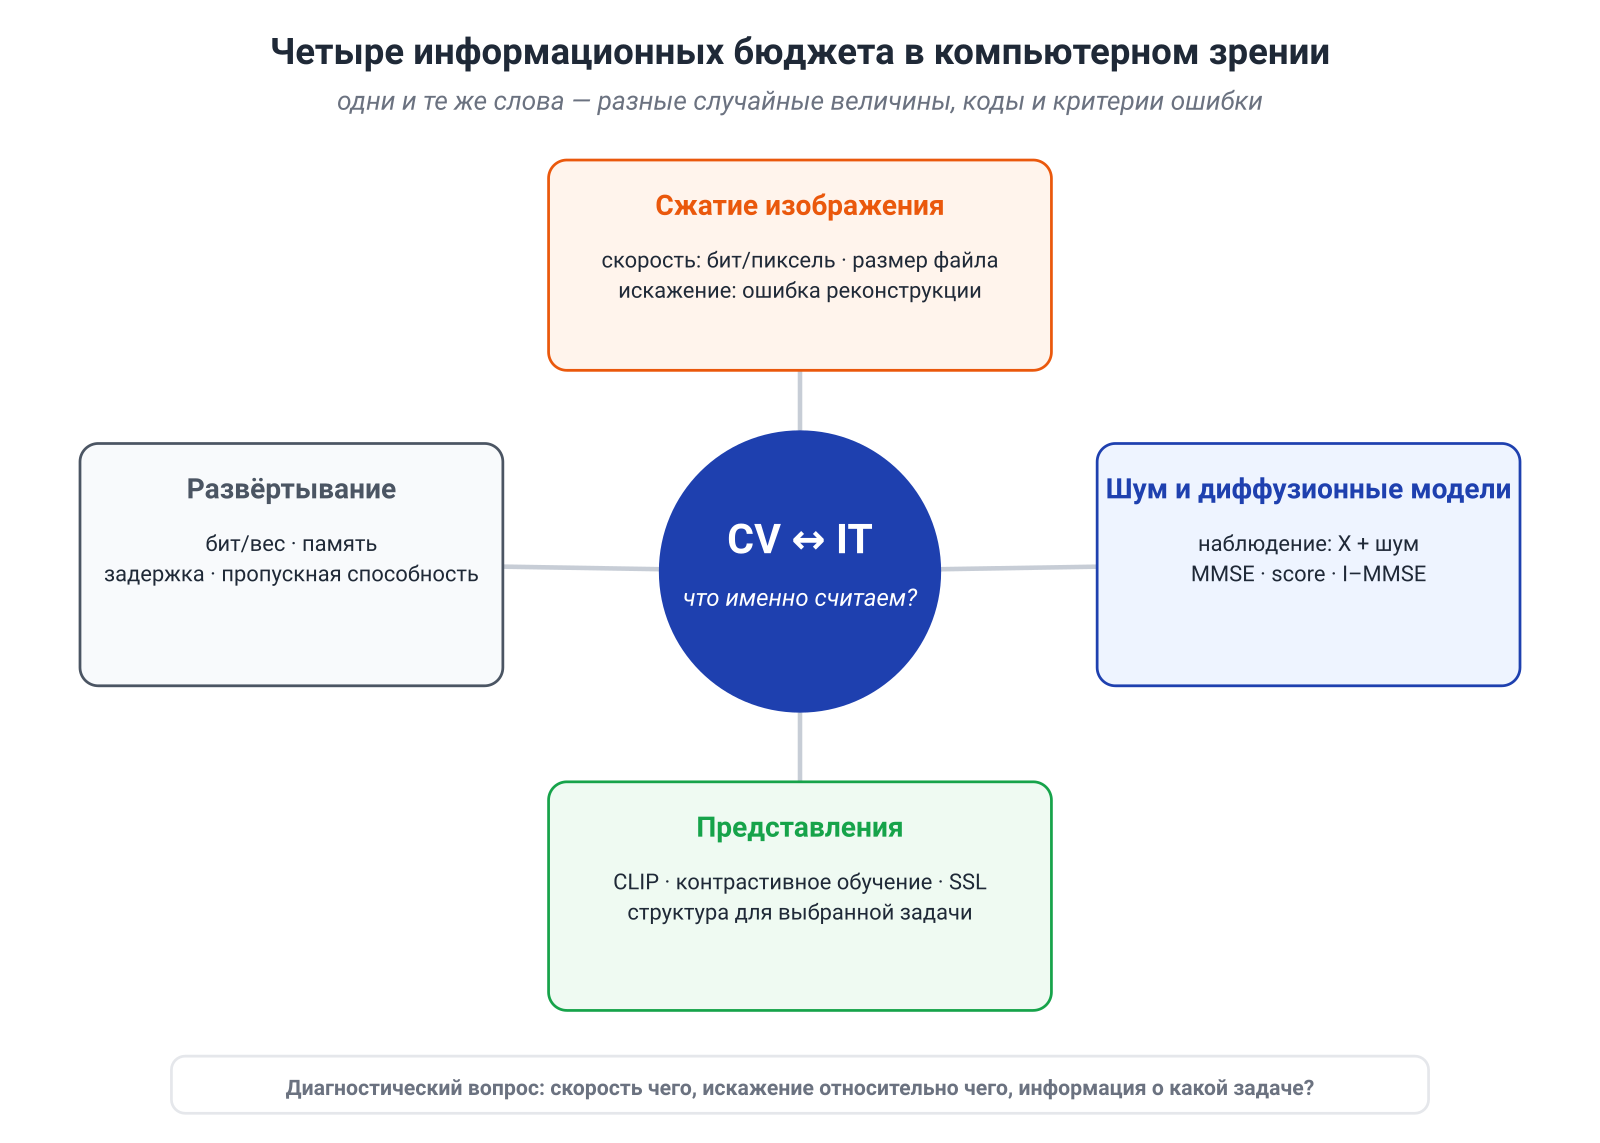
Во всех четырёх случаях появляются слова «сжатие», «информация», «шум» и «узкое место». Но математический смысл этих слов различается.
В нейронном кодеке всё почти по Шеннону: есть источник, квантованный символ, вероятностная модель, энтропийный кодер и файл, длину которого можно измерить. В диффузионной модели есть точные гауссовские тождества между условным средним, score и взаимной информацией, но они не определяют всю архитектуру и весь алгоритм генерации. В CLIP и self-supervised learning информационные величины помогают читать целевую функцию, однако не превращают каждый энкодер в оптимальный Information Bottleneck. В квантизации весов аналогия с rate–distortion полезна только после того, как мы честно определили, что считаем rate и какую ошибку называем distortion.
Эта шкала точности важнее списка методов:
| Постановка | Что задано точно | Что приходится выбирать инженеру |
|---|---|---|
| Сжатие изображения | поток битов, декодер, мера искажения | архитектуру, вероятностную модель, задержку |
| Удаление шума и diffusion | гауссовский канал, MSE-оптимум, score-тождества | расписание шума, параметризацию, sampler |
| CLIP и SSL | обучающая игра и суррогатная функция потерь | аугментации, отрицательные пары, downstream-задачу |
| Сжатие модели | формат чисел и вычислительный бюджет | реальную меру функционального искажения |
Главная привычка этого модуля будет очень простой:
Перед тем как говорить об информации, назовите случайные переменные, код или наблюдение и критерий ошибки.
С этой привычкой многие громкие аналогии становятся точнее — и, что важнее, полезнее.
14.2. Нейронное сжатие изображений: энтропийная модель и реальный поток битов
Начнём с места, где связь с теорией информации можно проверить буквально: сохранить изображение, затем восстановить его из полученного файла.
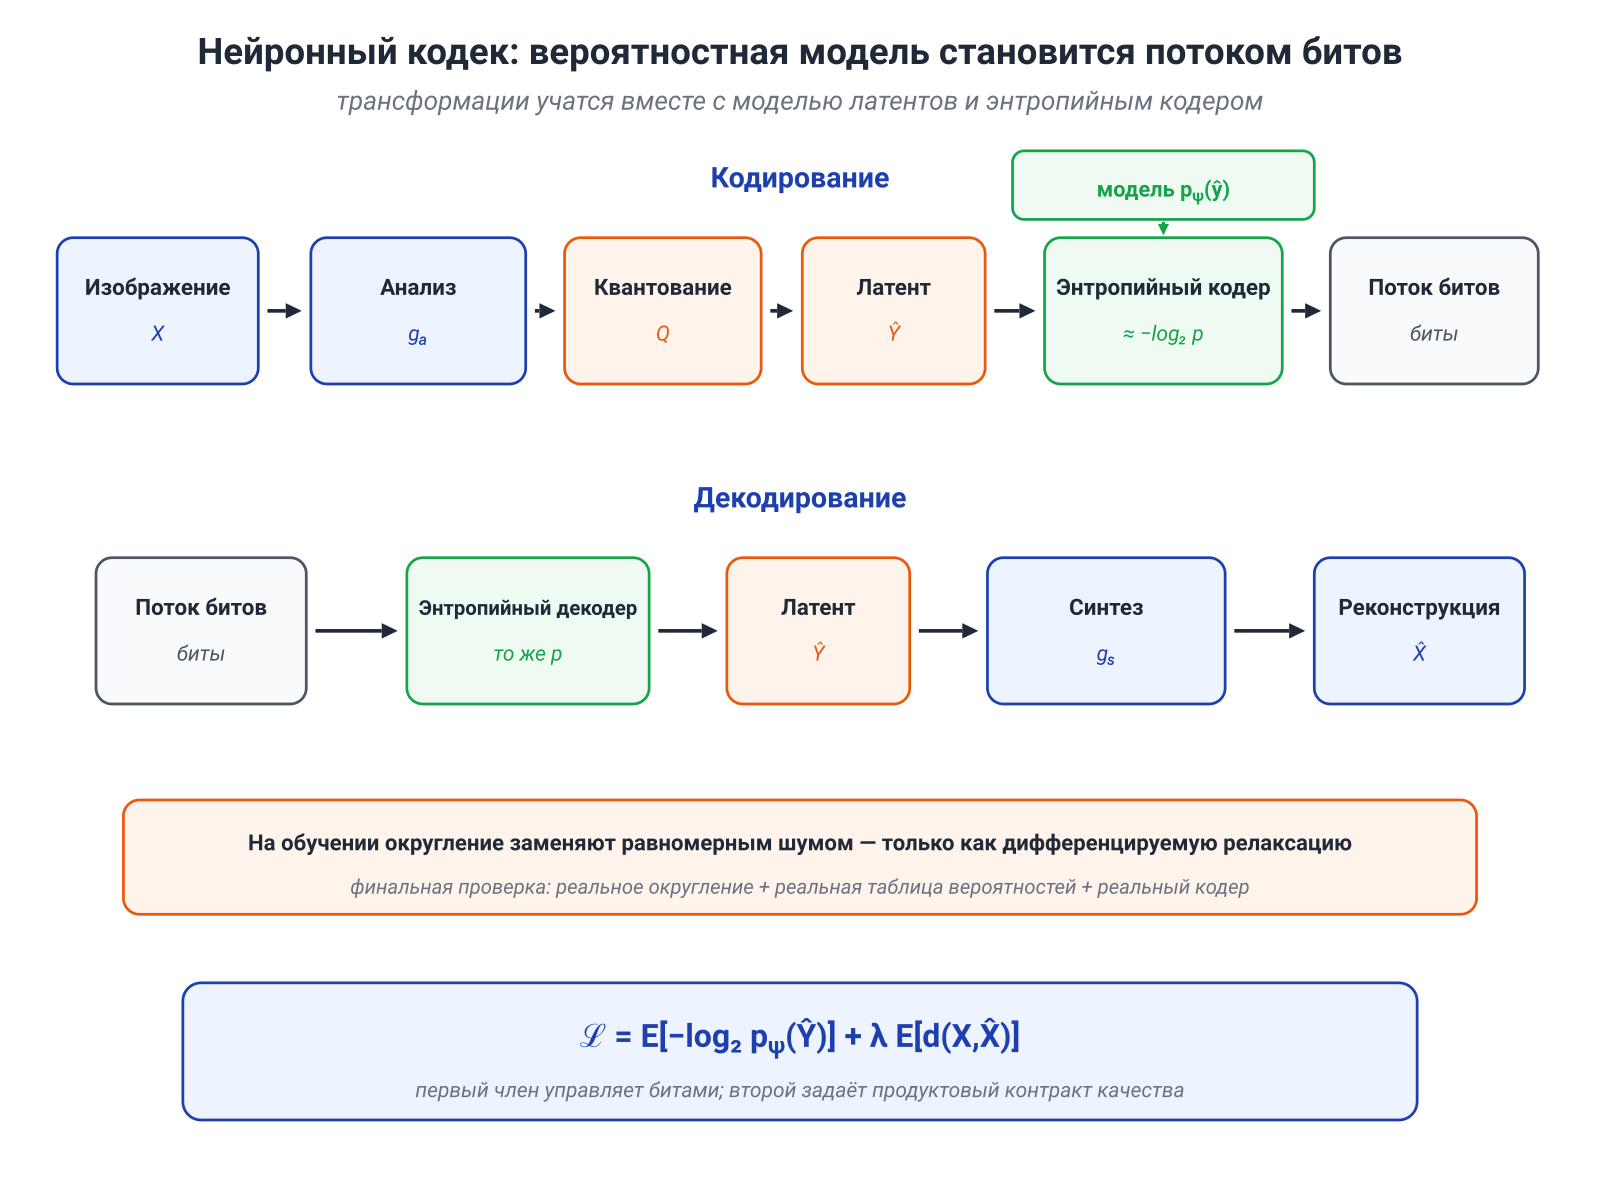
Нейронный кодек строит латентное представление
квантует его
и восстанавливает изображение
Здесь — анализирующее преобразование, — синтезирующее. По роли они напоминают преобразование и обратное преобразование в классическом кодеке, но теперь оба обучаются на данных.
Сам по себе латент ещё не является сжатым файлом. Чтобы получить поток битов, кодеру нужна вероятность каждого дискретного символа. Пусть энтропийная модель назначает латенту вероятность
Тогда арифметический или range coder способен передать этот латент примерно за
бит, плюс небольшой конечный расход на завершение потока, заголовки и арифметику конечной точности.
На этом месте удобно прочитать формулу совсем буквально. Если средний счёт модели равен бит/пиксель, то для изображения идеальная часть потока составляет
бита, то есть КиБ. Это уже не метафора о «компактном представлении»: это число, которое можно сравнить с реальным размером файла.
Целевая функция rate–distortion
Стандартная обучающая цель имеет вид
Параметр задаёт обменный курс между битами и качеством реконструкции. При разных одна и та же архитектура может дать разные рабочие точки на эмпирической кривой rate–distortion.
Именно здесь старый лозунг «нейросеть учится сжимать изображение» становится строгим. Вероятностная модель не просто регуляризует латент: её логарифмический счёт управляет энтропийным кодером. Первые сквозные нейронные кодеки обучали анализирующее преобразование, вероятностную модель и синтезирующее преобразование именно в такой совместной постановке. (Ballé, Laparra & Simoncelli, 2017)
Как обучать систему с недифференцируемой квантизацией
Округление удобно для файла, но неудобно для градиента. Распространённая релаксация заменяет его во время обучения аддитивным равномерным шумом:
Плотность непрерывного обучается так, чтобы её масса на единичном интервале соответствовала вероятности будущего дискретного символа. Это даёт гладкий суррогат для оптимизации.
Но суррогат остаётся суррогатом. Финальная проверка кодека должна выполняться с настоящим округлением, настоящей таблицей вероятностей и настоящим энтропийным кодером. Непрерывная функция потерь может хорошо предсказывать расход, но не обязана совпадать с каждым физическим файлом до последнего бита.
Hyperprior: иногда выгодно сначала описать контекст
Представьте два фрагмента изображения: ровное небо и густую листву. В обоих случаях основной латент имеет одинаковый формат, но ожидаемый масштаб и локальная вариативность коэффициентов различаются. Одна факторизованная модель вероятностей вынуждена описывать оба режима одним и тем же правилом.
Hyperprior передаёт дополнительный латент
который помогает декодеру предсказать параметры распределения основного латента:
Полный модельный счёт становится
Смысл прост: мы тратим несколько бит на описание режима, чтобы затем точнее кодировать большой массив основных символов. Scale hyperprior был введён именно как обучаемая служебная информация о пространственно меняющейся статистике латентов. (Ballé et al., 2018)
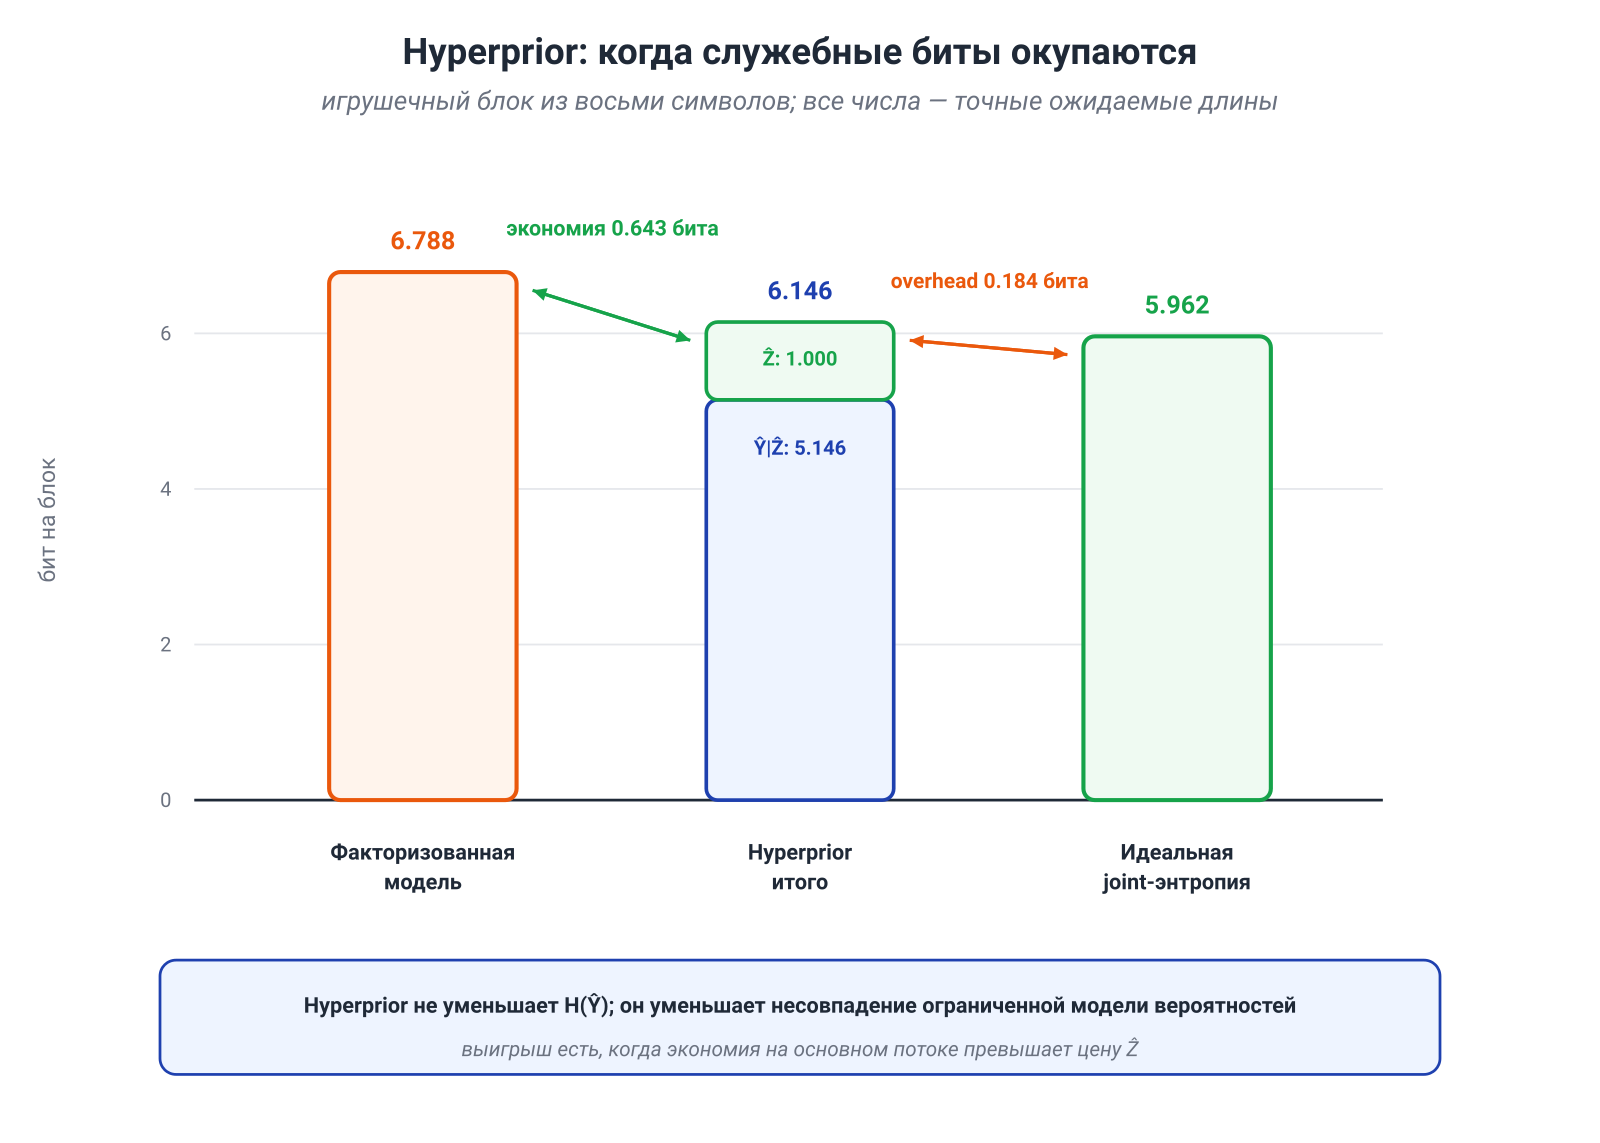
Здесь легко сделать слишком сильный вывод. Из цепного правила не следует, что добавление магически уменьшает фундаментальную энтропию :
Практический выигрыш возникает в сравнении ограниченных моделей. Простая факторизация плохо описывает зависимости в , а условная модель с hyperprior может сократить несоответствие настолько, что экономия на основном потоке превысит цену . В §14.9 мы запишем этот баланс как точное KL-разложение.
Контекстная модель: меньше битов, больше последовательности
Ещё один способ улучшить вероятностную модель — использовать уже декодированные символы:
Такой контекст способен снизить кросс-энтропию, поскольку учитывает локальные зависимости. Иерархический prior и авторегрессионный контекст дополняют друг друга; именно это показали модели с совместным авторегрессионным и иерархическим prior. (Minnen, Ballé & Toderici, 2018)
Но декодирование становится последовательным: для символа нужны предыдущие символы. Поэтому лучшая вероятностная модель не обязана быть лучшим продуктовым кодеком. Современные системы специально ищут компромисс между точностью контекста и параллелизмом декодирования.
Для честного сравнения кодеков нужны как минимум:
- фактический битовый расход, обычно бит/пиксель;
- мера искажения;
- задержка кодирования и декодирования;
- пиковая память;
- стоимость модели и служебной информации;
- совместимость и воспроизводимость потока битов.
В нейронном сжатии теория информации даёт ядро задачи. Инженерия решает, какой ценой это ядро будет реализовано.
14.3. Искажение и перцептивное качество
Функция rate–distortion требует выбрать
В компьютерном зрении этот выбор особенно заметен: он определяет, что кодек или восстановительная модель считают ошибкой.
Представьте, что по шумному наблюдению возможны две одинаково правдоподобные тонкие текстуры. Квадратичная ошибка предпочитает их среднее. Математически это правильно: условное среднее минимизирует MSE. Визуально среднее двух текстур может оказаться размытым и не похожим ни на одну из них.
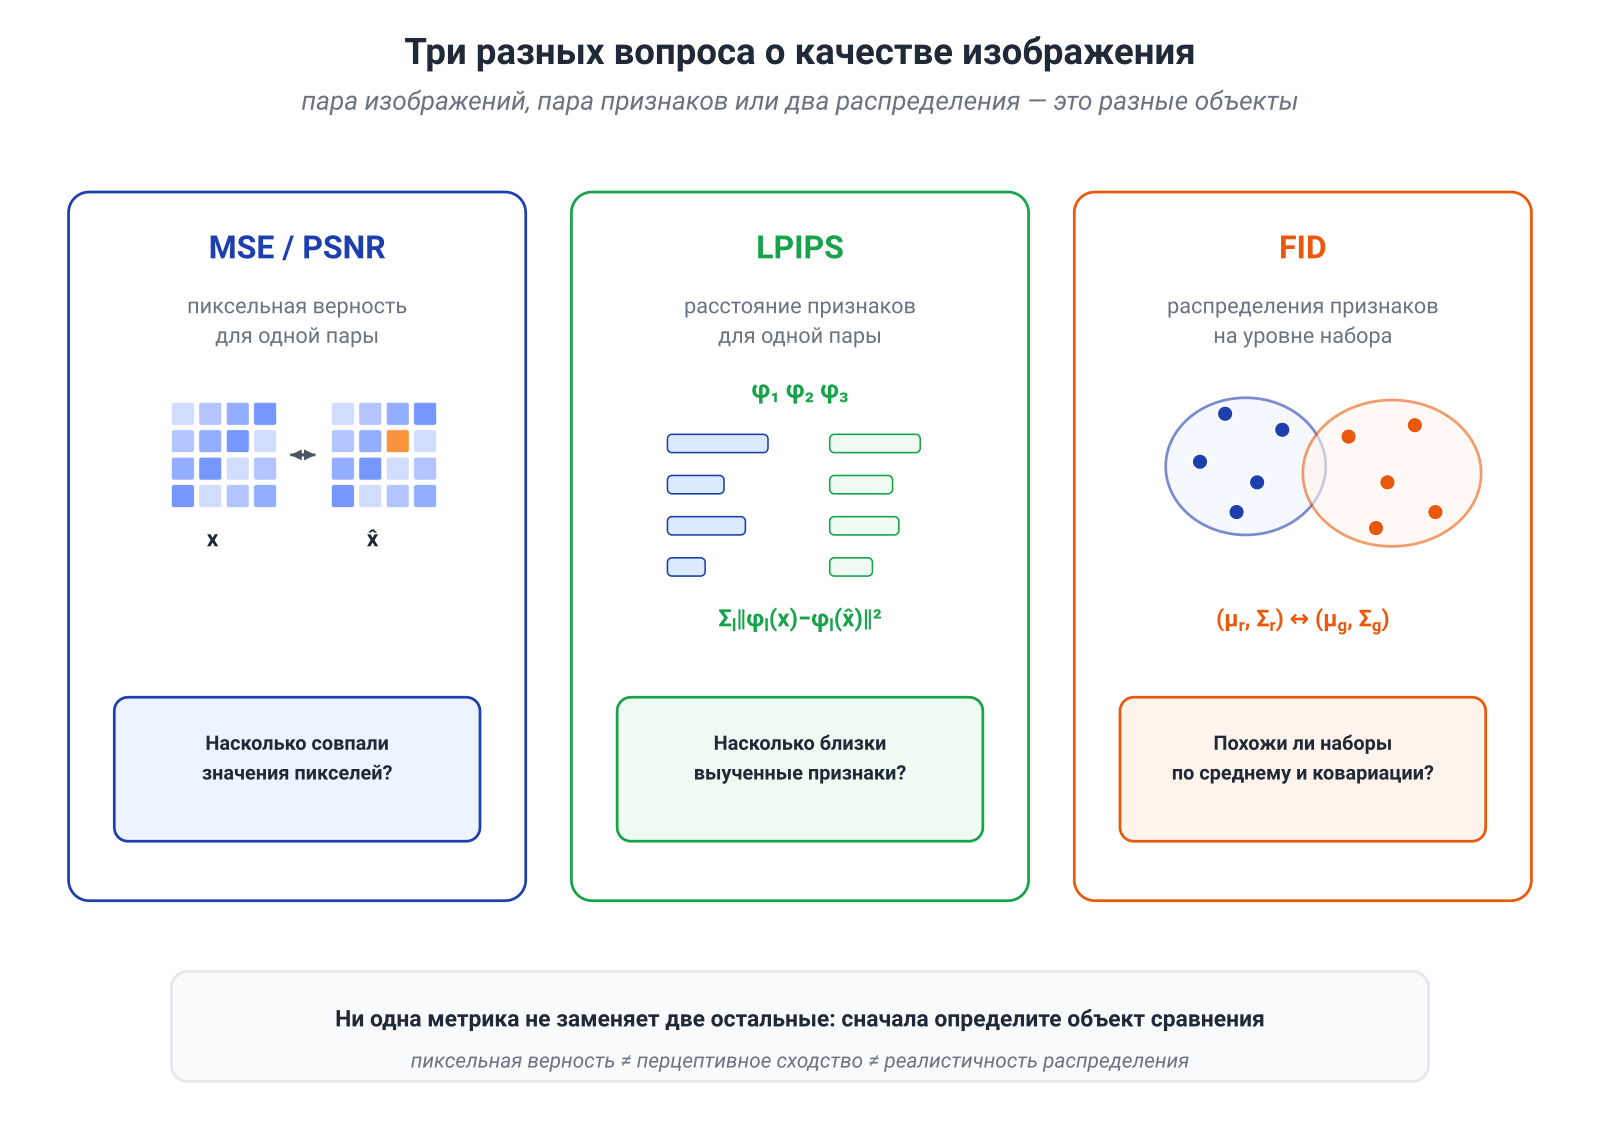
Отсюда возникают три разных вопроса.
- Насколько реконструкция близка к конкретному оригиналу?
- Насколько она похожа на оригинал в выбранном пространстве признаков?
- Насколько распределение реконструкций похоже на распределение естественных изображений?
Одна метрика редко отвечает сразу на все три.
MSE и PSNR: точность пикселей
Среднеквадратичная ошибка:
При фиксированном диапазоне значений PSNR является монотонным преобразованием MSE. Эти метрики стабильны, легко интерпретируются и естественны, когда важно восстановить численные значения пикселей.
Их ограничение не в том, что они «плохие», а в том, что они отвечают на узкий вопрос. Для медицинского изображения, астрономического наблюдения или удалённого зондирования пиксельная верность может быть принципиальнее зрительной правдоподобности. Для миниатюры в социальной сети продуктовый приоритет может быть противоположным.
LPIPS: расстояние между признаками пары изображений
LPIPS сравнивает нормированные признаки нескольких слоёв глубокой сети. Схематически:
Веса были калиброваны на человеческих суждениях о перцептивном сходстве, и на соответствующих тестах эта мера лучше согласовывалась с такими суждениями, чем ряд традиционных пиксельных метрик. (Zhang et al., 2018)
Важно правильно назвать объект: LPIPS — расстояние между конкретной парой изображений в выбранном пространстве признаков. Это не MMD, не f-дивергенция и не сравнение двух распределений изображений.
FID: сравнение распределений в пространстве признаков
Для генератора или генеративного кодека нужен другой вопрос: похож ли набор реконструкций на набор реальных изображений как распределение?
FID аппроксимирует оба распределения признаков Inception гауссовскими законами и вычисляет квадрат -расстояния между ними:
Это статистика уровня набора. Хороший FID не гарантирует, что конкретная реконструкция сохранила конкретную деталь исходного изображения. И наоборот, низкий MSE отдельной пары не гарантирует реалистичность распределения результатов. FID был введён в работе Heusel et al. (2017).
Rate–distortion–perception
Blau и Michaeli предложили добавить к ограничению на искажение отдельное ограничение на расхождение распределений:
при
При свободном возвращается обычная функция rate–distortion. Если же реконструкции должны одновременно хорошо соответствовать исходникам и выглядеть как выборки из правильного распределения, достижимая область обычно сужается. За улучшение восприятия приходится платить rate, distortion или обоими ресурсами. (Blau & Michaeli, 2019)
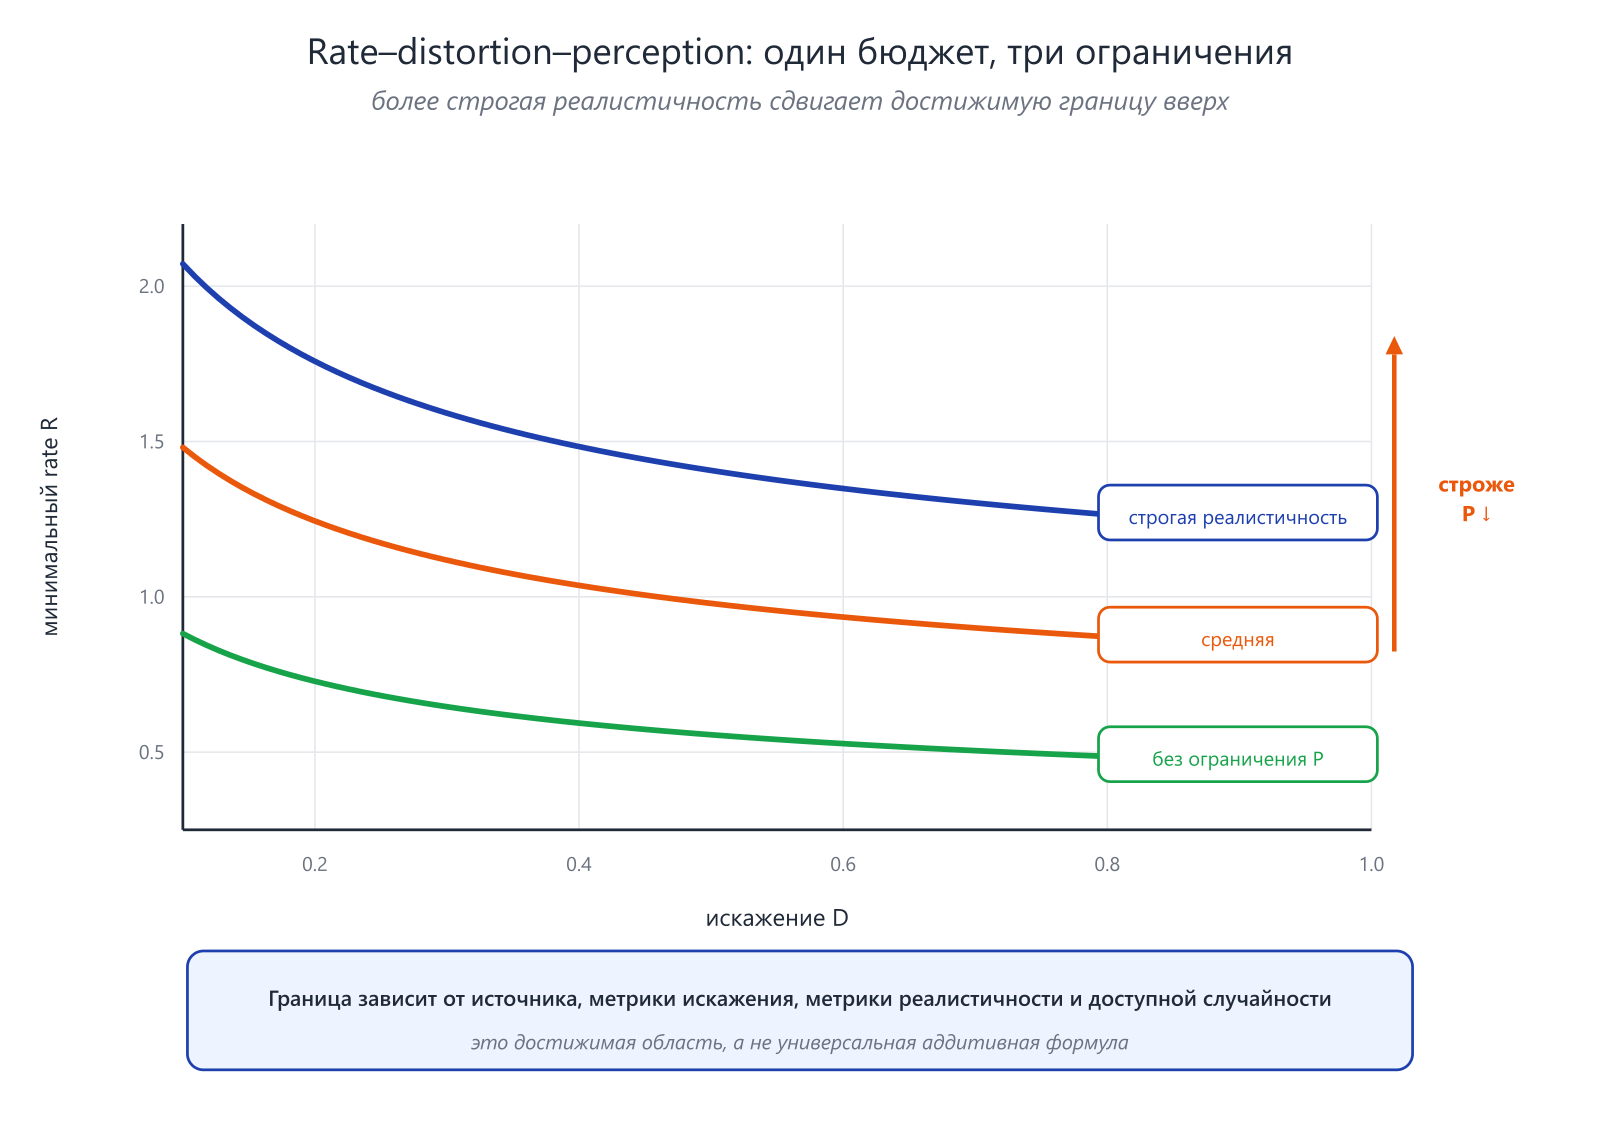
Универсальной аддитивной формулы, одинаковой для всех источников и всех мер, здесь нет. Форма границы зависит от источника, функции искажения, расхождения распределений, доступной случайности и протокола кодирования.
Что покупает генеративный декодер
Обычный MSE-декодер в неоднозначной ситуации тяготеет к условному среднему. Генеративный декодер может выбирать одну правдоподобную реализацию из условного распределения. Текстура становится убедительнее, но конкретные детали могут отличаться от оригинала.
HiFiC показал практический вариант такого компромисса: битовый расход сочетается с distortion-, perceptual- и adversarial-членами, а реконструкции оценивались и численно, и в пользовательском исследовании. (Mentzer et al., 2020)
Правильный вывод не состоит в том, что генеративный кодек «лучше». Он оптимизирует другой продуктовый контракт. Если вымышленные детали опасны, реалистичность не заменяет верность. Если важен внешний вид при крайне малом битовом расходе, жёсткая пиксельная точность может быть не лучшим расходованием бюджета.
14.4. Диффузионные модели: гауссовское зашумление, денойзинг и I–MMSE
На первый взгляд diffusion далека от кодирования. Но её прямой процесс — это последовательность гауссовских каналов с разным отношением сигнала к шуму.
Пусть
После деления на получаем
Каждый уровень шума можно читать как наблюдение одного и того же сигнала при своём SNR.
Что именно учит MSE
Если сеть предсказывает чистое изображение и минимизирует
то популяционный оптимум равен условному среднему:
Если сеть предсказывает шум,
оптимум имеет вид
Это не специальная магия diffusion. Условное среднее — обычный оптимальный предиктор для квадратичной функции потерь. Сила конструкции в том, что такие задачи решаются на множестве уровней шума.
От денойзера к score
Для гауссовского зашумления выполняется точное тождество:
При известных и апостериорное среднее, оптимальный предиктор шума и score содержат одну и ту же информацию в разных параметризациях.
Но один MMSE-денойзер ещё не является генератором. Обратная SDE или соответствующая ODE использует поле score на всех уровнях шума, чтобы провести случайную точку от простого базового распределения к распределению данных. Именно score определяет обратную динамику в score-based генеративном моделировании. (Song et al., 2021)
I–MMSE: сколько информации добавляет SNR
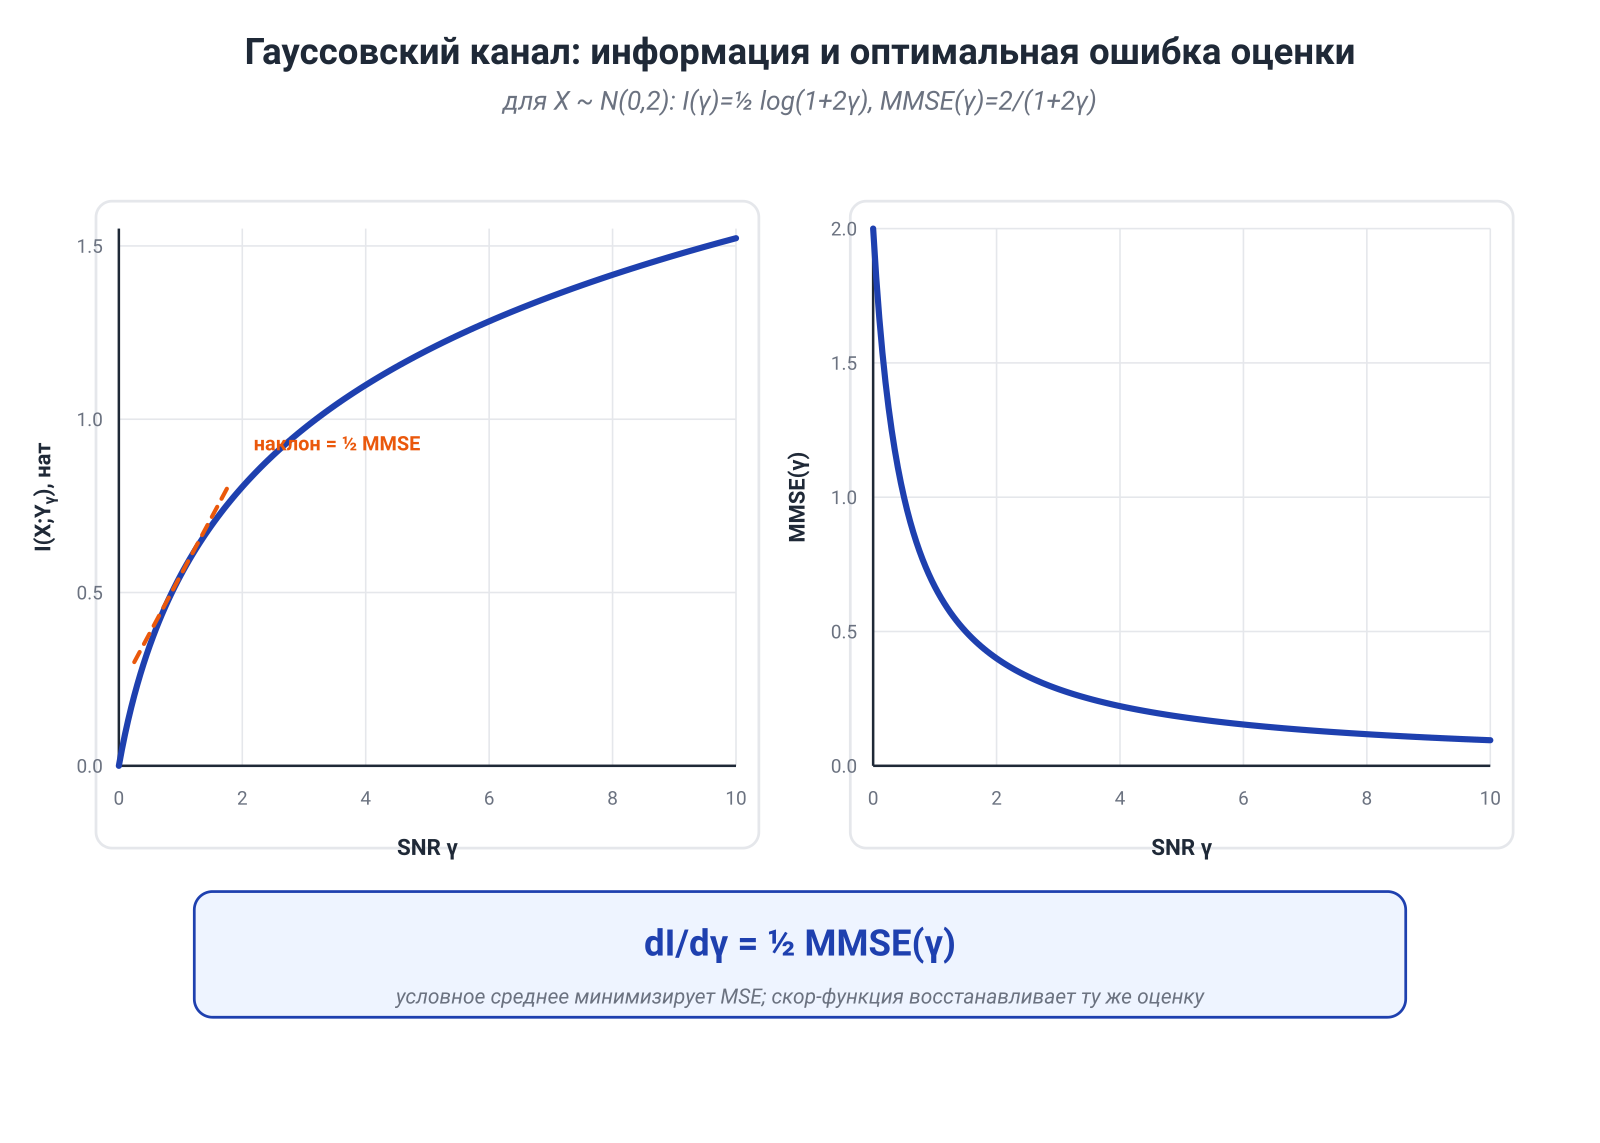
Для канала
и взаимной информации в натах выполняется
Здесь
Тождество справедливо для широкого класса входных распределений с конечным вторым моментом. (Guo, Shamai & Verdú, 2005)
Интегральная форма особенно наглядна:
Пока сигнал трудно восстановить, небольшой прирост SNR покупает заметный прирост информации. Когда апостериорная ошибка уже мала, следующие единицы SNR дают меньше нового.
Где заканчивается это объяснение
Тождества выше действительно связывают гауссовский шум, удаление шума, score и взаимную информацию. Но они не выбирают за нас:
- форму расписания шума;
- веса разных уровней в функции потерь;
- число шагов сэмплирования;
- численный solver;
- архитектуру U-Net или Transformer;
- способ conditioning и guidance.
Variational Diffusion Models показали, что непрерывная вариационная граница выражается через SNR и при фиксированных конечных SNR не зависит от формы расписания в среднем, хотя расписание влияет на дисперсию оценивателя, дискретизацию и удобство оптимизации. (Kingma et al., 2021)
Это хороший пример роли теории информации в современном ML. Она даёт точный скелет механизма, но не подменяет весь проект модели.
14.5. CLIP и контрастивное выравнивание изображений с текстом
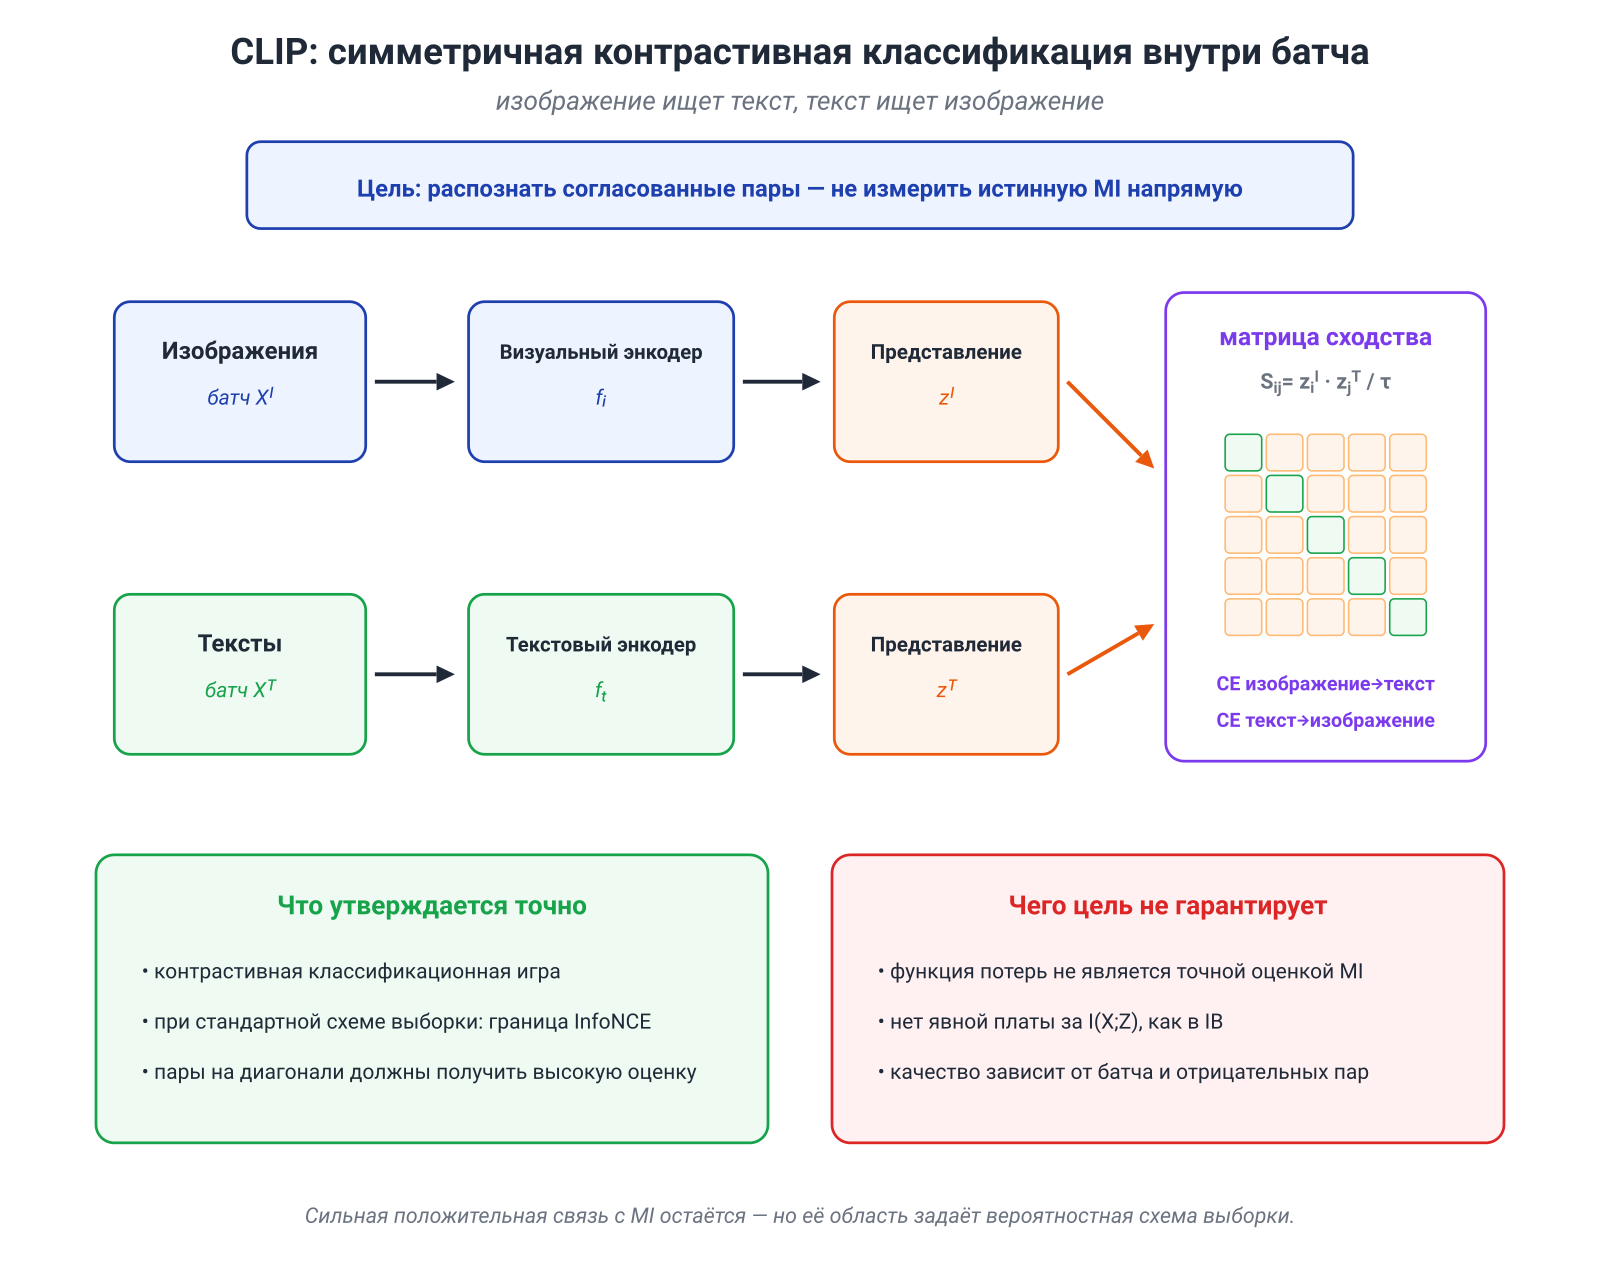
CLIP ставит простую, но масштабируемую задачу: среди текстов в батче найти подпись, соответствующую изображению, и симметрично среди изображений найти соответствие для текста.
Пусть
а — косинусное сходство или скалярное произведение нормированных представлений. Один из двух симметричных членов имеет вид
То есть визуальный энкодер обучается различать правильное текстовое соответствие среди кандидатов. Это контрастивная классификационная игра, а не реконструкция пикселей. (Radford et al., 2021)
Связь с InfoNCE
При стандартной вероятностной схеме — одна положительная пара из совместного распределения и независимых отрицательных примеров из маргинального — выполняется
Это важная связь. Контрастивная классификация заставляет оценочную функцию приближать отношение совместной плотности к произведению маргиналов, а её качество даёт нижнюю границу на MI.
Но численное значение эмпирической функции потерь CLIP не является точным измерением истинной взаимной информации. Граница зависит от схемы отрицательной выборки, класса критиков и популяционного ожидания. Число ограничивает именно эту нижнюю границу, а не само содержание представлений.
Большой батч даёт больше кандидатов и повышает возможный потолок границы. Он также меняет оптимизацию, число ложных отрицательных пар и вычислительную стоимость. Поэтому «больше negatives» — инженерный рычаг, а не монотонный закон качества.
Какой сигнал получает визуальный энкодер
Точный положительный вывод можно сформулировать без IB-лозунга:
CLIP усиливает в представлении те различия между изображениями, которые помогают сопоставлять их с текстами среди рассматриваемых кандидатов.
Это естественно создаёт сильную семантическую структуру: объекты, действия, стили и категории, которые регулярно выражаются в подписях, получают прямой обучающий сигнал. Именно поэтому представления CLIP хорошо переносятся на zero-shot classification и retrieval.
Information Bottleneck оптимизировал бы явный компромисс
В обычной функции потерь CLIP нет отдельной цены за . Поэтому из неё не следует, что энкодер нашёл минимальное достаточное представление или гарантированно выбросил всю нетекстовую информацию. Корректнее говорить о давлении задачи на релевантность, а не о решённом IB.
SigLIP хорошо показывает, что даже внутри одной общей идеи возможны разные обучающие игры: он заменяет общую softmax-нормировку попарной sigmoid-функцией потерь. Цель — согласовать изображения и тексты — остаётся, но статистика отрицательных пар и вычислительная организация меняются. (Zhai et al., 2023)
Почему одной информационной линзы недостаточно
Если модель ошибается в OCR, подсчёте объектов или пространственном grounding, причиной может быть не только обучающий сигнал. Важны также:
- разрешение изображения и размер патча;
- состав image–text данных;
- качество подписей;
- архитектура визуального энкодера;
- связующий модуль между визуальным энкодером и LLM;
- post-training и протокол оценки.
Достаточность представления всегда относится к конкретной целевой переменной. Условие
нужно проверять отдельно для поиска, OCR, сегментации и локализации. «Семантический эмбеддинг» не является универсальным достаточным статистиком для всех визуальных задач.
14.6. Самообучение визуальных представлений: инвариантности и защита от коллапса
В self-supervised learning разметку заменяет специально сконструированная задача. Часто берутся две аугментированные версии одного изображения:
Аугментации здесь не декоративное увеличение набора данных. Они являются частью спецификации задачи:
Если две версии объявлены эквивалентными, модель получает сигнал не использовать различия между ними.
Цветовое искажение, crop, blur и геометрические преобразования тем самым задают предполагаемые инвариантности представления.
Есть и строгая граница. Если преобразование уничтожило информацию о будущей метке , энкодер не сможет восстановить её из ничего:
поэтому по DPI
Сильная аугментация может улучшить одну целевую задачу и ухудшить другую. Инвариантность всегда относительна к тому, что мы собираемся делать дальше.
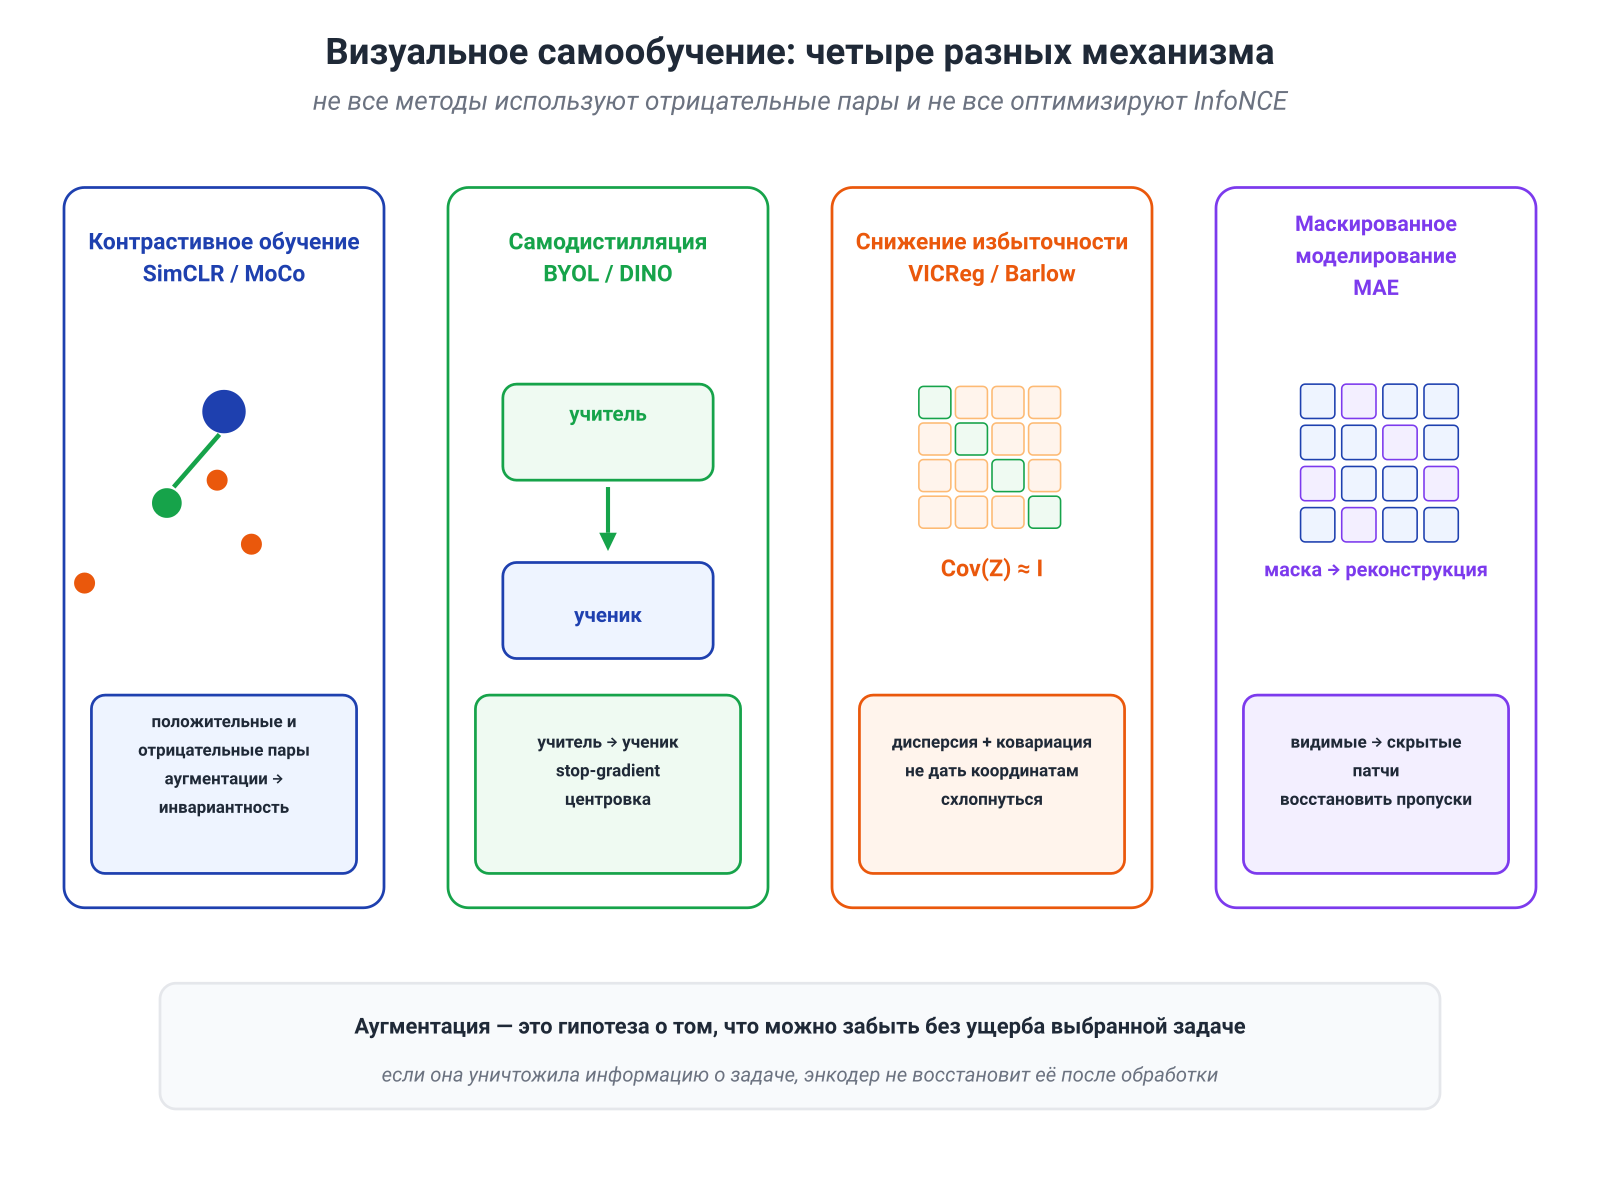
Контрастивные методы: SimCLR и MoCo
SimCLR сближает две версии одного изображения и раздвигает представления разных изображений с помощью InfoNCE-подобной функции потерь. В исходной работе критическими оказались композиция аугментаций, проекционная голова и достаточный объём отрицательных примеров. (Chen et al., 2020)
MoCo решает ту же общую задачу через динамический словарь: очередь отрицательных ключей и momentum-обновляемый энкодер позволяют поддерживать большой и относительно согласованный набор кандидатов без огромного текущего батча. (He et al., 2020)
Информационная граница объясняет одну часть механизма. Геометрическая картина alignment и uniformity объясняет другую: положительные пары должны сближаться, а представления всего набора не должны собраться в одной точке.
Self-distillation: BYOL и DINO
Если просто потребовать равенства представлений двух версий, постоянный вектор даст нулевую ошибку. Это и есть коллапс: цель согласования выполнена, но полезной структуры нет.
BYOL избегает обычных отрицательных пар. Online-сеть предсказывает представление медленно обновляемой target-сети, а stop-gradient и асимметрия ветвей меняют динамику задачи. (Grill et al., 2020)
DINO использует student–teacher self-distillation, centering, sharpening и multi-crop. В исходной работе представления self-supervised ViT демонстрировали выраженную пространственную структуру и хорошо работали в k-NN и линейных протоколах. (Caron et al., 2021)
Эти методы можно анализировать информационно, но их обучающие цели не являются стандартными оценивателями MI.
Ограничения на дисперсию и избыточность
VICReg сочетает три члена:
- согласование двух версий;
- нижнюю границу дисперсии каждой координаты;
- штраф за ковариации между координатами.
Дисперсионный член не даёт всем примерам стать одной точкой, а ковариационный уменьшает линейную избыточность. (Bardes, Ponce & LeCun, 2021)
Barlow Twins приближает матрицу взаимной корреляции двух представлений к единичной. (Zbontar et al., 2021)
Положительная дисперсия ещё не гарантирует семантическую полезность, а нулевая ковариация в общем случае не означает независимость. Эти члены решают конкретную проблему геометрии представлений, а не всю задачу достаточности.
Masked modeling: MAE
MAE скрывает большую долю патчей, кодирует только видимые и обучает декодер восстанавливать отсутствующие пиксели. (He et al., 2022)
Здесь защита от тривиального решения возникает через необходимость предсказывать скрытое содержание. Это реконструктивная цель, а не контрастивная классификация и не обычная InfoNCE-граница.
Получается полезная карта:
| Семейство | Что связывает две версии | Как избегает тривиального решения | Что особенно задаёт качество |
|---|---|---|---|
| SimCLR, MoCo | контрастивное различение | отрицательные кандидаты | аугментации и словарь negatives |
| BYOL, DINO | student–teacher prediction | асимметрия, stop-gradient, teacher dynamics | архитектура и динамика обновления |
| VICReg, Barlow Twins | согласование статистик | дисперсия и декорреляция | выбранные batch-статистики |
| MAE | реконструкция скрытых патчей | скрытая часть входа | mask ratio и декодер |
Общая идея не в том, что все методы «максимизируют MI». Они конструируют разные способы сохранить предсказуемую структуру, ввести полезные инвариантности и не позволить представлению схлопнуться. Именно различия между этими способами и определяют перенос на downstream-задачи.
14.7. Сжатие CV-модели: квантизация, pruning и distillation
До сих пор мы сжимали изображение или представление. Теперь ограниченным ресурсом становится сама система: размер файла модели, пропускная способность памяти, задержка и энергия.
Квантизация
Для равномерного аффинного квантизатора:
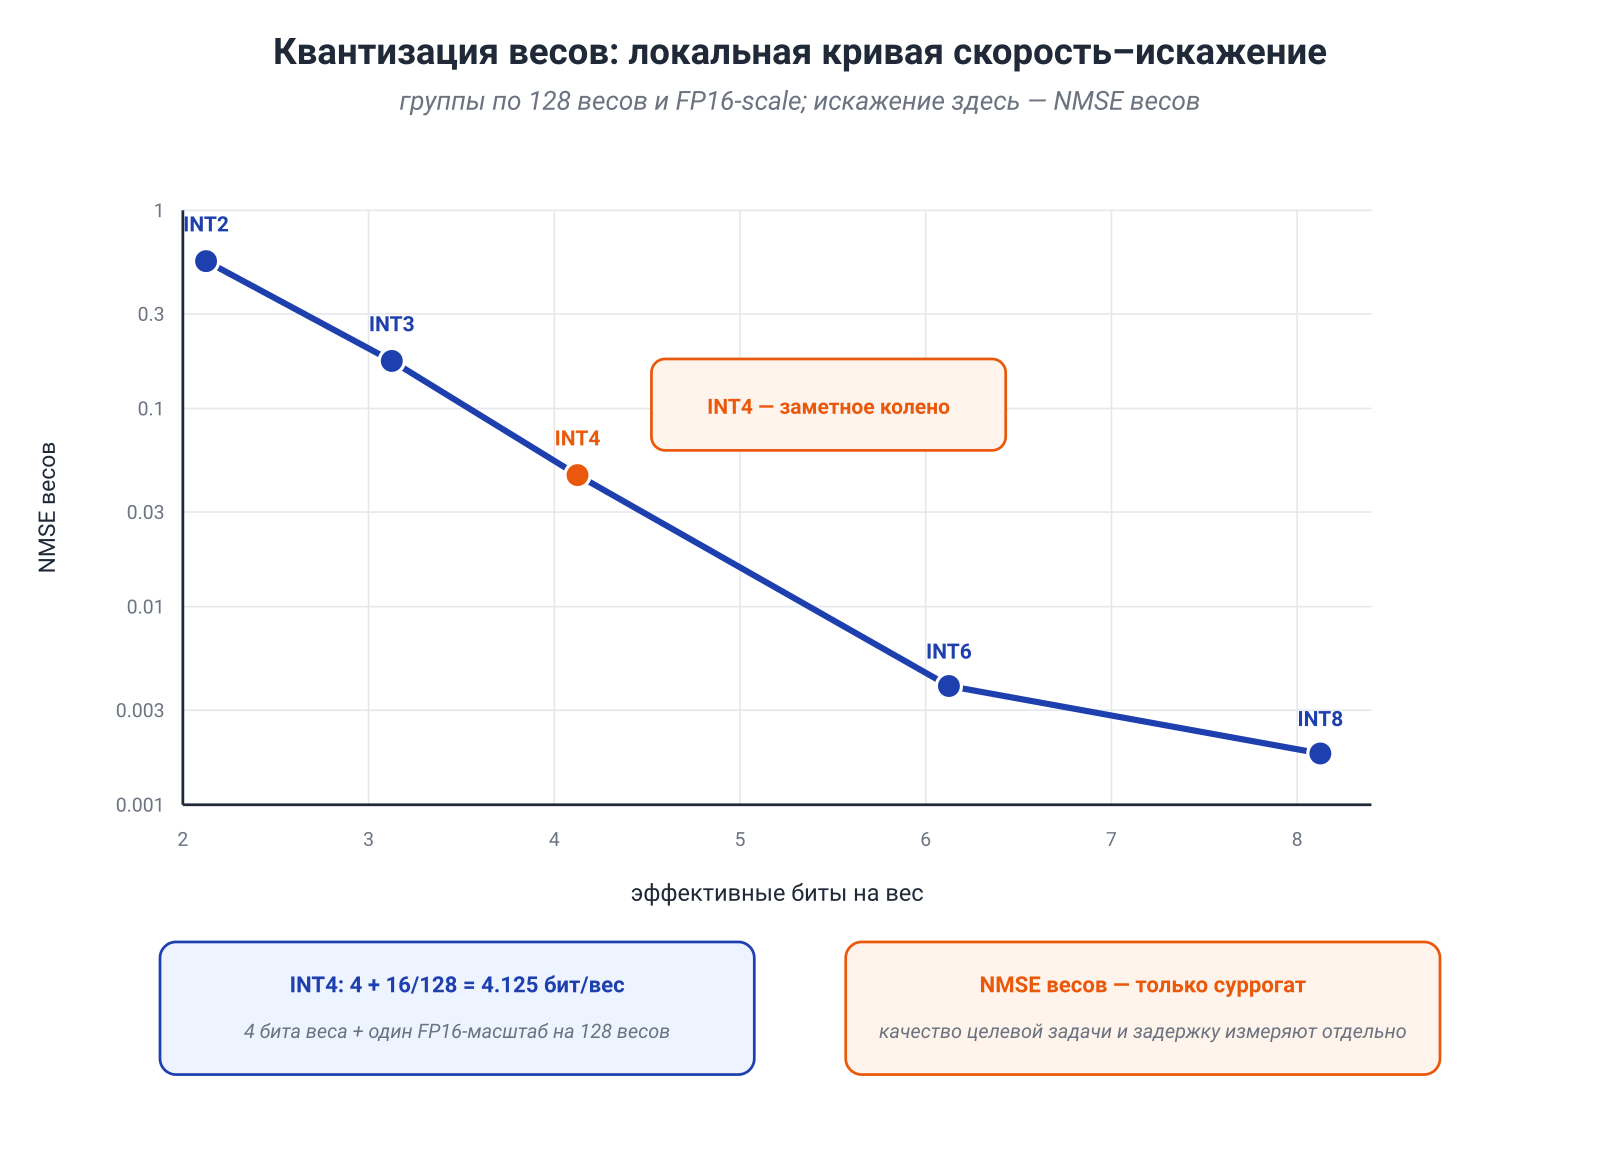
Номинальный INT4 говорит, что код одного значения занимает четыре бита. Но сериализованная модель дополнительно хранит масштабы, нулевые точки, границы групп, выравнивание и иногда кодовые книги.
Например, group-wise INT4 с группой из весов и одним 16-битным scale на группу требует без учёта выравнивания
бита на исходный вес.
Чтобы превратить квантизацию в настоящую rate–distortion-постановку, нужно выбрать distortion. Простая ошибка весов
может быть удобным локальным суррогатом, но одинаковое изменение разных весов по-разному влияет на активации, логиты и итоговую метрику. Поэтому практические методы используют калибровочные данные, ошибку выходов слоя, чувствительность по Гессиану или сквозную функцию потерь.
PTQ, QAT и особенности Vision Transformer
Post-training quantization (PTQ) калибрует уже обученную сеть. Quantization-aware training (QAT) включает имитацию квантизации в обучение и позволяет параметрам адаптироваться.
Vision Transformer создаёт специфические режимы: входы LayerNorm, выходы GELU и attention probabilities имеют разные масштабы и формы распределений. FQ-ViT и PTQ4ViT разрабатывали специальные квантизаторы и критерии калибровки именно для этих компонентов. (Lin et al., 2021; Yuan et al., 2021)
Смешанная точность как распределение бюджета
Если слой получает бит, естественная инженерная задача имеет вид
при
Это действительно напоминает распределение битов в классической rate–distortion-теории. Но функция задаётся конкретной моделью, данными и метрикой. Универсальной формулы для произвольной нейросети нет.
Pruning: нули тоже требуют формата
Неструктурированный pruning уменьшает число ненулевых параметров, но добавляет стоимость индексов и нерегулярного хранения. При умеренной разреженности sparse-представление может занимать не меньше плотного низкоразрядного тензора и плохо ускоряться на обычном оборудовании.
Структурный pruning удаляет каналы, головы или блоки. Он чаще превращается в реальное ускорение, потому что сохраняет регулярные операции.
MDL даёт здесь полезную дисциплину: оплачивать нужно и значения, и структуру маски. Но само слово «разреженность» ещё не сообщает фактический размер файла и задержку.
Distillation: сжатие функции
Knowledge distillation обучает student приближать распределение teacher, например через
Это удобно читать как функциональное сжатие: меньшая модель получает ограниченный вычислительный бюджет и должна воспроизвести поведение большей.
Здесь rate может означать число параметров, размер файла, FLOPs или latency. Distortion — KL по выходам, ошибка логитов или ухудшение downstream-метрики. Пока эти величины не названы, фраза «distillation — rate–distortion» остаётся только общей аналогией.
На синтетической кривой ниже используются группы по 128 весов, clipping по p99.9 внутри каждой группы и один хранимый FP16-scale на группу. Поэтому rate и нормированная MSE весов относятся к одной и той же схеме квантизации.
Хороший отчёт о развёртывании должен содержать:
- размер сериализованной модели;
- пиковую память;
- задержку на целевом устройстве;
- пропускную способность или энергию, если они измеряются;
- итоговую метрику задачи;
- калибровку и устойчивость после сжатия.
Номинальная разрядность — начало измерения, а не его итог.
14.8. Один CV-пайплайн, четыре разных информационных бюджета
Рассмотрим систему текстового поиска по изображениям на периферийном устройстве.
- Камера получает изображение .
- При необходимости кодек хранит или передаёт его.
- Визуальный энкодер строит embedding .
- Текстовый энкодер строит embedding запроса .
- Индекс ищет близкие .
- Квантованная модель должна уложиться в память и задержку устройства.
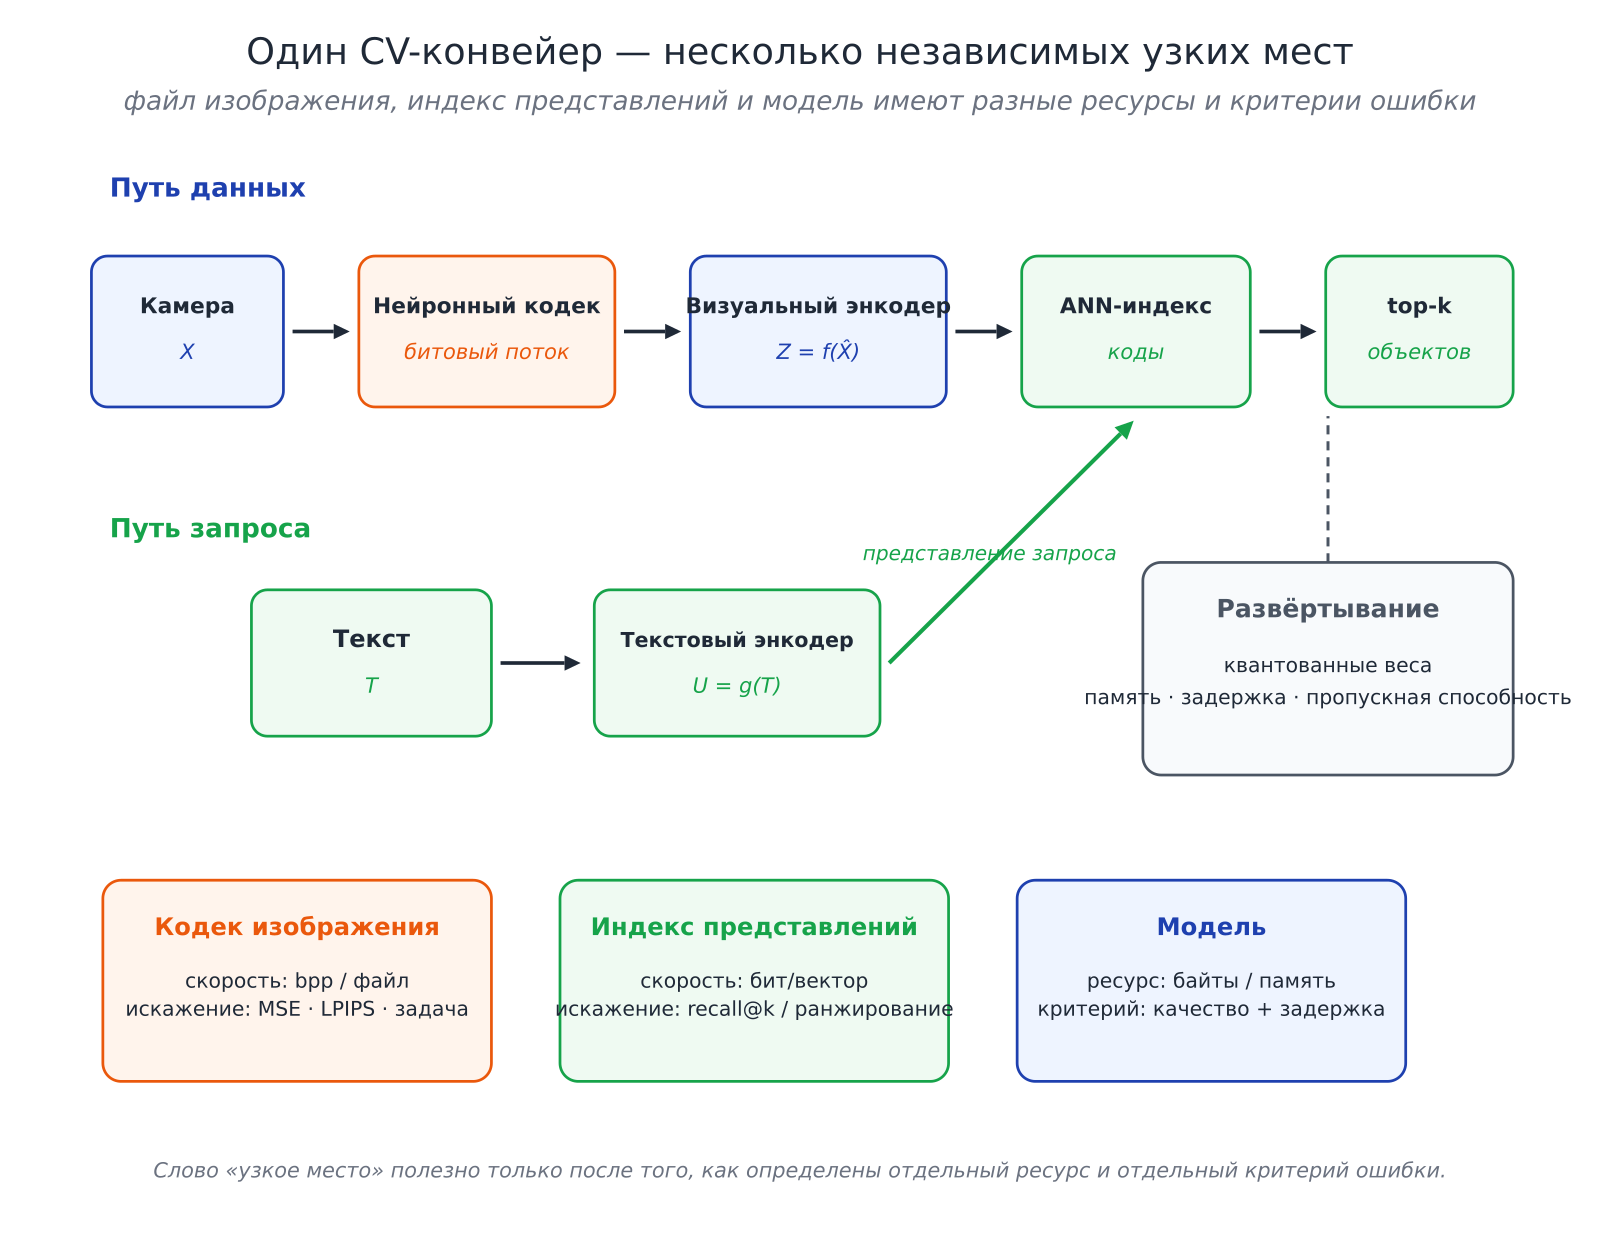
В одной системе присутствуют несколько независимых счетов.
| Компонент | Rate или ресурс | Distortion или критерий |
|---|---|---|
| кодек изображения | бит/пиксель, размер файла | MSE, LPIPS, задача downstream |
| визуальное представление | размерность и статистика | сохранение информации о выбранной задаче |
| поисковый индекс | байт на объект | recall@K, изменение ранжирования |
| модель | байты, память, FLOPs, latency | NLL, accuracy, retrieval quality |
Кодек данных
Для нейронного кодека
Здесь rate имеет прямой операционный смысл.
Представление
Эмбеддинг должен сохранять то, что важно для поиска по тексту. Для пиксельной сегментации, точной локализации или оценки качества изображения достаточное представление может быть другим.
Нельзя одновременно требовать, чтобы один вектор был минимальным и достаточным для всех возможных задач. Минимальность всегда определяется относительно выбранной релевантной переменной.
Индекс
Product quantization или binary hashing сжимают эмбеддинги. Здесь rate — число байт на объект. Возможные distortions:
- ошибка восстановления вектора;
- потеря recall@K;
- изменение порядка соседей.
Это три разные задачи, и улучшение одной не обязано улучшать остальные.
Модель
INT8 или INT4 уменьшают размер модели и нагрузку на память. Искажение нужно измерять сквозным образом: по качеству поиска, задержке и устойчивости на целевом устройстве.
Диагностические вопросы
В таком пайплайне особенно легко смешать разные геометрии и разные случайные величины.
- Косинусное расстояние между эмбеддингами не является f-дивергенцией распределений.
- Низкая энтропия координат не гарантирует хороший поиск.
- Большая не гарантирует релевантность для текста.
- Хороший FID не гарантирует сохранность детали конкретного изображения.
- INT4 не сообщает фактический размер файла без формата упаковки.
Поэтому финальная карта модуля укладывается в три вопроса:
14.9. Математическое углубление: два точных расчёта
Можно пропустить при первом чтении. Здесь мы разбираем два места, где короткая инженерная интуиция полезна, но точный счёт ещё полезнее.
14.9.1. Когда hyperprior действительно экономит биты
Пусть — истинное распределение основного квантованного латента, а факторизованная модель кодера равна . Её ожидаемая идеальная длина:
Теперь введём служебную переменную и иерархическую модель
Её ожидаемый счёт:
Следовательно,
Hyperprior выигрывает, когда уменьшение модельного несоответствия превосходит цену служебной переменной и остаточное несоответствие иерархической модели.
Если является детерминированной функцией уже кодируемого , то : идеальная совместная энтропия не выросла. В реальном кодеке всё равно остаются кросс-энтропийный зазор, конечная точность и накладные расходы. Если же содержит дополнительную случайность относительно , условная энтропия является настоящей ценой.
Вот и вся механика: hyperprior не нарушает предел Шеннона. Он позволяет ограниченному семейству вероятностных моделей приблизиться к нему.
14.9.2. Гауссовские тождества удаления шума
Пусть
Тогда
а апостериорная дисперсия равна
Поэтому
Теперь рассмотрим
Маргинальное распределение:
поэтому
Апостериорное среднее:
Подстановка даёт
В гауссовском случае весь мост между denoising, score и I–MMSE виден без скрытой техники. В негауссовском случае те же структурные тождества сохраняются, но апостериорное среднее и score уже нелинейны — именно их и приходится аппроксимировать нейросетью.
14.11. Заключение
Компьютерное зрение удобно тем, что здесь несколько смыслов слова «информация» встречаются в одной системе и быстро обнаруживают различия между собой.
В нейронном кодеке вероятность латента превращается в настоящий поток битов. Это точная операциональная связь.
В diffusion гауссовский канал связывает условное среднее, score и взаимную информацию. Это точный математический механизм, но не готовый рецепт всей генеративной системы.
В CLIP и self-supervised learning целевая функция определяет, какие различия между изображениями должны стать доступными представлению. Информационная теория помогает читать эту задачу, но качество также задают аугментации, данные, геометрия эмбеддингов и downstream-протокол.
При квантизации и pruning сжимается уже не изображение, а модель. Тогда rate нужно считать по реальному формату и оборудованию, а distortion — по функции системы, а не только по локальной ошибке весов.
Главный результат модуля можно сформулировать без метафоры:
Теория информации особенно полезна в CV не тогда, когда каждый метод называют каналом или bottleneck, а тогда, когда она заставляет точно назвать, что передаётся, что восстанавливается и как оплачивается ошибка.
Основные источники
- J. Ballé, V. Laparra, E. P. Simoncelli, End-to-end Optimized Image Compression, 2017.
- J. Ballé et al., Variational Image Compression with a Scale Hyperprior, 2018.
- D. Minnen, J. Ballé, G. Toderici, Joint Autoregressive and Hierarchical Priors for Learned Image Compression, 2018.
- Y. Blau, T. Michaeli, The Perception-Distortion Tradeoff, 2018.
- Y. Blau, T. Michaeli, Rethinking Lossy Compression: The Rate-Distortion-Perception Tradeoff, 2019.
- R. Zhang et al., The Unreasonable Effectiveness of Deep Features as a Perceptual Metric, 2018.
- F. Mentzer et al., High-Fidelity Generative Image Compression, 2020.
- D. Guo, S. Shamai, S. Verdú, Mutual Information and Minimum Mean-Square Error in Gaussian Channels, 2005.
- Y. Song et al., Score-Based Generative Modeling through Stochastic Differential Equations, 2021.
- D. P. Kingma et al., Variational Diffusion Models, 2021.
- A. Radford et al., Learning Transferable Visual Models From Natural Language Supervision, 2021.
- X. Zhai et al., Sigmoid Loss for Language Image Pre-Training, 2023.
- T. Chen et al., A Simple Framework for Contrastive Learning of Visual Representations, 2020.
- K. He et al., Momentum Contrast for Unsupervised Visual Representation Learning, 2020.
- J.-B. Grill et al., Bootstrap Your Own Latent, 2020.
- M. Caron et al., Emerging Properties in Self-Supervised Vision Transformers, 2021.
- A. Bardes, J. Ponce, Y. LeCun, VICReg, 2021.
- J. Zbontar et al., Barlow Twins, 2021.
- K. He et al., Masked Autoencoders Are Scalable Vision Learners, 2022.
- Y. Lin et al., FQ-ViT, 2021.
- Z. Yuan et al., PTQ4ViT, 2021.
- M. Heusel et al., GANs Trained by a Two Time-Scale Update Rule Converge to a Local Nash Equilibrium, 2017.