Модуль 2. Энтропия
Как читать этот модуль. Основной маршрут — §§2.1–2.4. Короткие доказательства базовых свойств входят в ядро курса: они объясняют механизм и понадобятся дальше. Два фрагмента отмечены как математическое углубление — вывод энтропийной скорости и производная энтропии по температуре. Их можно оставить для второго прохода. Инженерная вставка о speculative decoding тоже факультативна.
2.1. Энтропия: средний счёт за неопределённость
Представьте два классификатора, которые выбирают один и тот же класс. Первый выдаёт
а второй —
По argmax их ответы неразличимы: победил первый класс. Но сами распределения устроены совершенно по-разному. У первого почти вся масса собрана в одной точке; у второго остаётся несколько правдоподобных альтернатив. Энтропия замечает именно эту разницу:
Это и есть первый ML-смысл энтропии: она смотрит не только на победителя, а на всю форму распределения.
В Модуле 1 мы увидели, почему неожиданность отдельного исхода должна измеряться логарифмом. Теперь сделаем следующий шаг. Пусть дискретная случайная величина имеет распределение с вероятностями . Если не оговорено иное, алфавит в этом модуле конечен, логарифмы берутся по основанию 2, а единицей служит бит.
Неожиданность, или собственная информация (surprisal), конкретного исхода равна
Энтропия Шеннона — ожидаемая неожиданность исхода:
Соглашение задаётся по непрерывности, поскольку при .
У этой формулы есть простое чтение. Источник как будто выставляет счёт за каждый реализовавшийся исход: бит. Редкий исход дорог, но приходит редко; частый стоит мало, но встречается постоянно. Энтропия — средний счёт до того, как мы увидели результат.
Можно перевести его ещё в одну полезную шкалу. Величина
показывает, сколько равновероятных исходов соответствовало бы той же энтропии. Для общего распределения это эффективное число: оно не обязано быть целым и не равно буквальному размеру носителя. Так, энтропия бита соответствует по неопределённости восьми равновероятным вариантам.
Свойство 1. От полной определённости до равномерного распределения
Для распределения на возможных исходах
Нижняя граница достигается, когда исход фактически предопределён. Верхняя — когда все вариантов равновероятны. Иными словами, энтропия правильно ставит на противоположные концы шкалы детерминированность и полное отсутствие предпочтений между вариантами.
Неотрицательность. Для любого исхода с
Поэтому все ненулевые вклады в ожидание неотрицательны. Равенство возможно только тогда, когда единственный исход имеет вероятность 1.
Максимум. Здесь нулевые вероятности требуют небольшой аккуратности. Обозначим положительный носитель распределения через
Для вогнутого логарифма неравенство Йенсена имеет вид
Поэтому
Первое неравенство обращается в равенство только при одинаковых на носителе. Чтобы получить именно , носитель должен включать все исходов. Значит, максимизатор — полное равномерное распределение.
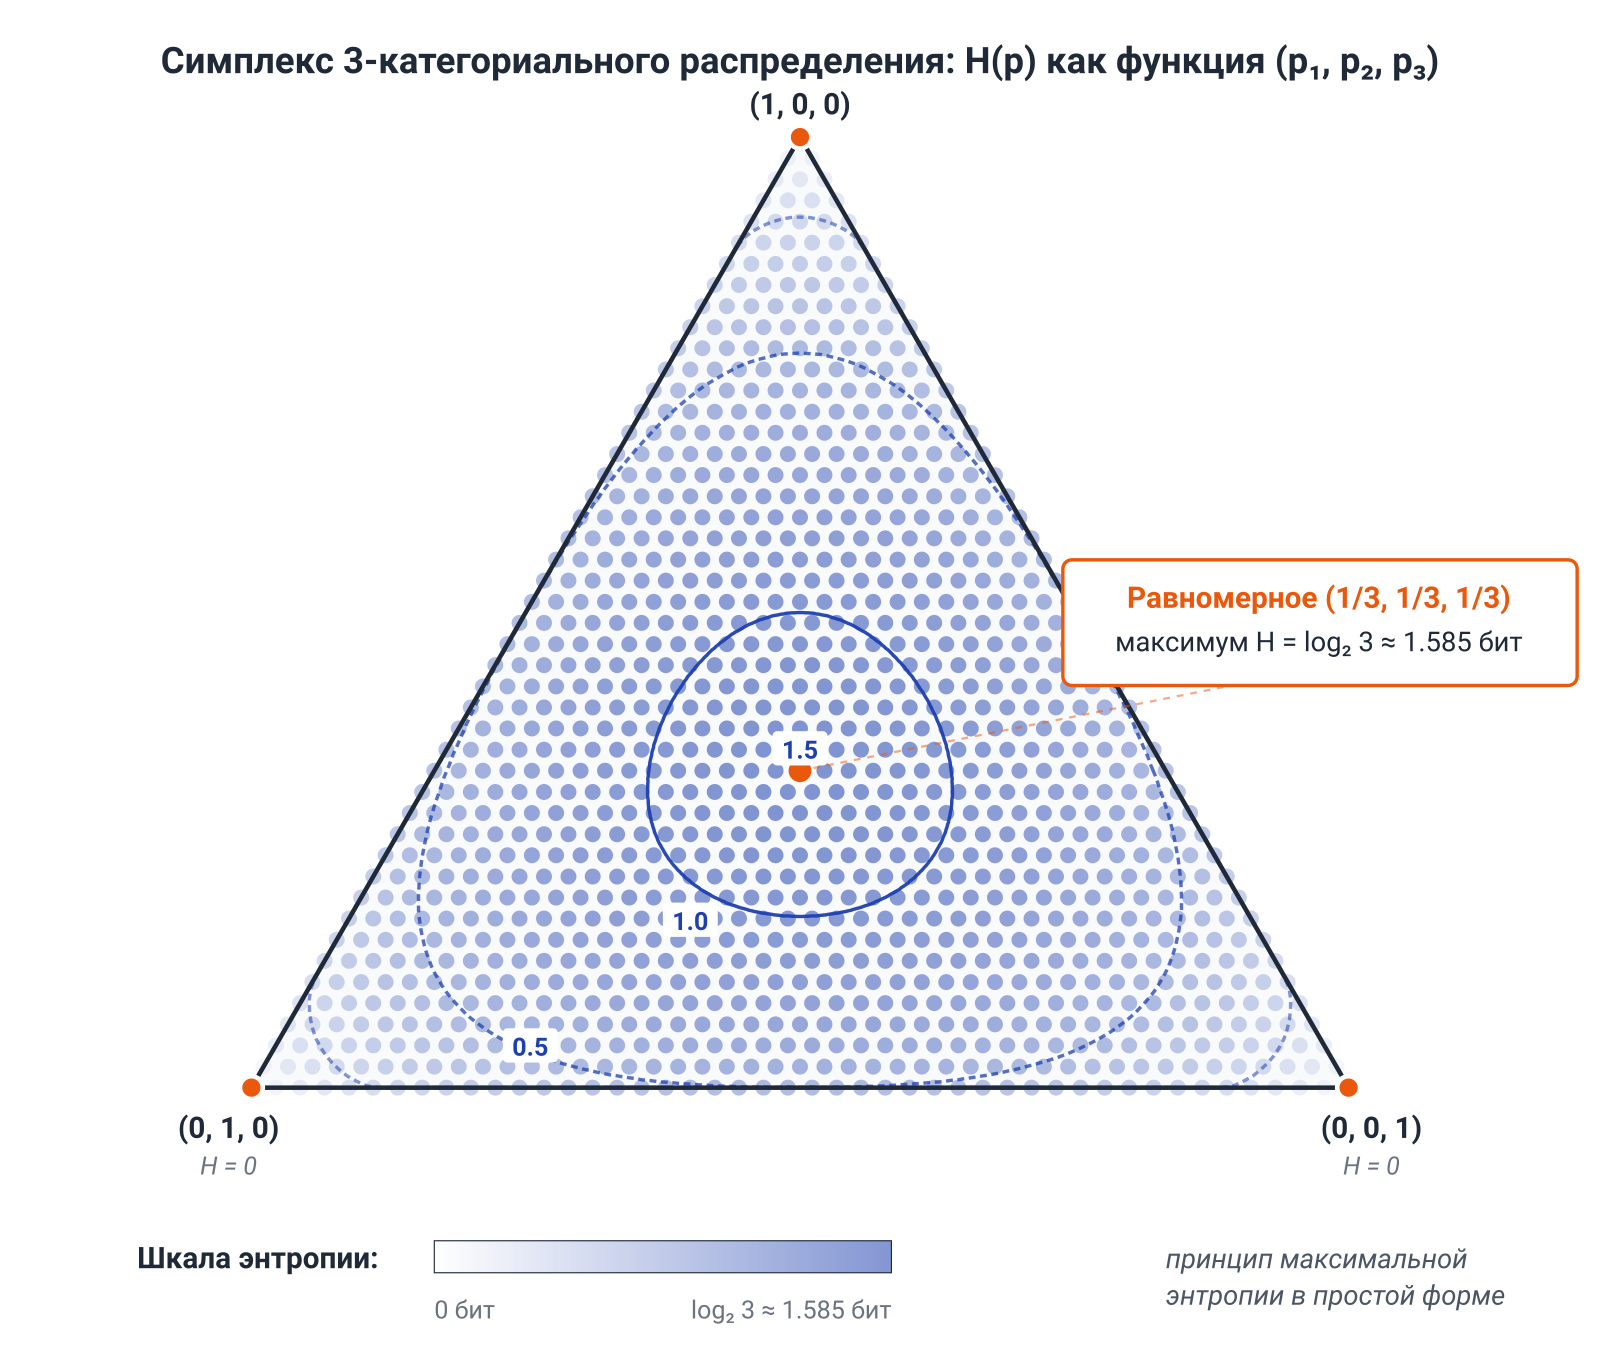
Это принцип максимальной энтропии в самой простой форме: если известно только множество допустимых исходов и больше никаких ограничений, равномерное распределение оставляет минимум необоснованных предпочтений. В Модуле 8 мы добавим ограничения на средние и увидим, как из того же принципа возникают уже неравномерные экспоненциальные распределения и softmax.
Эти границы полезны и как инженерная проверка. Если код для распределения по словарю из токенов возвращает отрицательную энтропию или значение выше , проблема не в тонкой интерпретации — в вычислении ошибка.
Свойство 2. Вогнутость: забытый источник смеси добавляет неопределённость
Пусть у нас есть два распределения и , а перед генерацией мы случайно выбираем одно из них: первое с вероятностью , второе с вероятностью . Если после этого забыть, какое распределение было выбрано, наблюдаемый закон станет смесью
Энтропия удовлетворяет неравенству
То есть потеря информации о том, какой компонент породил пример, не может уменьшить среднюю неопределённость. Это один из тех результатов, которые позже будут постоянно возвращаться: в смесях, латентных моделях, ансамблях и взаимной информации.
Доказательство. Функция
при имеет вторую производную
После непрерывного доопределения она строго вогнута на . Поскольку
энтропия вогнута на вероятностном симплексе. При равенство возможно только при .
Здесь легко сказать чуть больше, чем доказано. Энтропия смеси не меньше средней энтропии компонентов, но не обязана превосходить каждый компонент. Если смешать равномерное распределение с вырожденным, результат останется менее энтропийным, чем равномерная часть.
2.2. Цепное правило: как разбить один счёт на токены
Для последовательности можно получить один общий счёт за весь исход, а можно оплачивать его по частям. Цепное правило говорит, что при корректном условливании сумма не изменится.
Пусть и имеют совместное распределение . Совместная энтропия равна
Условная энтропия после наблюдения определяется как
Ключевое слово здесь — средняя. усредняет остаточную неопределённость по возможным значениям . Это не то же самое, что для одного конкретного события. Для значений с условное распределение можно задать произвольно: оно получает нулевой вес.
Цепное правило
Прочитаем формулу до доказательства. Сначала мы платим бит в среднем, чтобы узнать . После этого остаётся в среднем бит неопределённости о . Вместе это ровно тот же счёт, что и прямое описание пары .
Доказательство. На положительном носителе
Логарифм превращает произведение в сумму:
Порядок можно поменять:
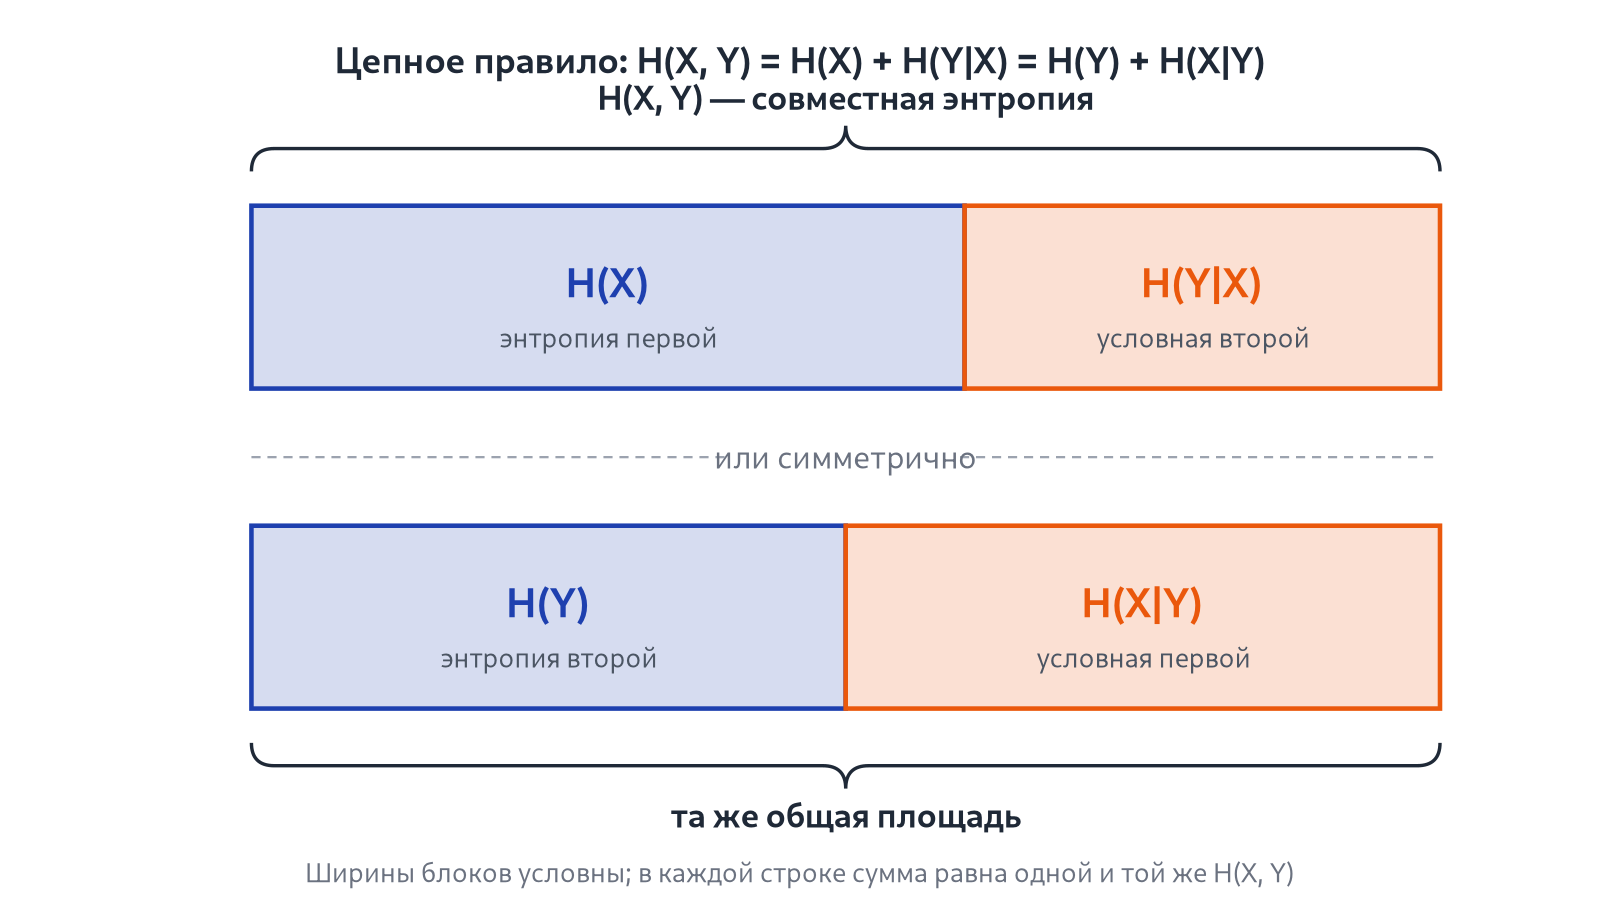
Для последовательности по индукции получаем
Вот сильная формулировка, которую стоит запомнить: цепное правило — бухгалтерия авторегрессии. Совместная неопределённость последовательности раскладывается на остаточную неопределённость каждого следующего элемента после уже известного префикса. Если после q почти всегда приходит u, контекст делает второй символ дешёвым. Если продолжение действительно многовариантно, счёт остаётся высоким.
Источник и модель: одна факторизация, два разных счёта
Фраза «цепное правило буквально описывает работу языковой модели» почти попадает в цель, но ей нужна одна важная развилка.
Пусть данные порождаются распределением :
Тогда цепное правило раскладывает энтропию самого источника:
Авторегрессионная модель задаёт своё распределение :
Для конкретной наблюдаемой последовательности модельный счёт также складывается по токенам:
Но после усреднения по данным мы получаем уже не автоматически, а кросс-энтропию источника относительно модели:
Эти величины совпадут, только если модельные условные распределения совпадают с условными распределениями источника почти всюду по . В Модуле 3 разница станет видна одной строкой:
Пока достаточно помнить смысл. Цепное правило действительно объясняет, почему функция потерь языковой модели складывается по токенам. Оно не утверждает, что любая такая функция потерь уже равна внутренней энтропии источника.
Условление уменьшает энтропию — но именно в среднем
Контекст в среднем помогает:
причём равенство выполняется тогда и только тогда, когда и независимы.
Доказательство. Маргинальное распределение является смесью условных распределений:
По вогнутости энтропии
При строгой вогнутости равенство означает, что все условные распределения с положительным весом одинаковы и равны , то есть и независимы.
Отсюда сразу следует субаддитивность:
с равенством ровно при независимости.
Граница утверждения компактна, но важна. Для отдельного значения вполне может оказаться
Некоторое конкретное наблюдение способно открыть более неоднозначный режим, хотя в среднем знание уменьшает неопределённость. Упражнение 3 строит такой пример без каких-либо трюков.
2.3. От монеты к языку: энтропийная скорость
Монета как лаборатория
Для монеты с вероятностью орла энтропия равна
Строчную букву обычно используют для бинарной энтропии; это заодно не даёт спутать её с энтропией Реньи порядка 2, которую часто обозначают .
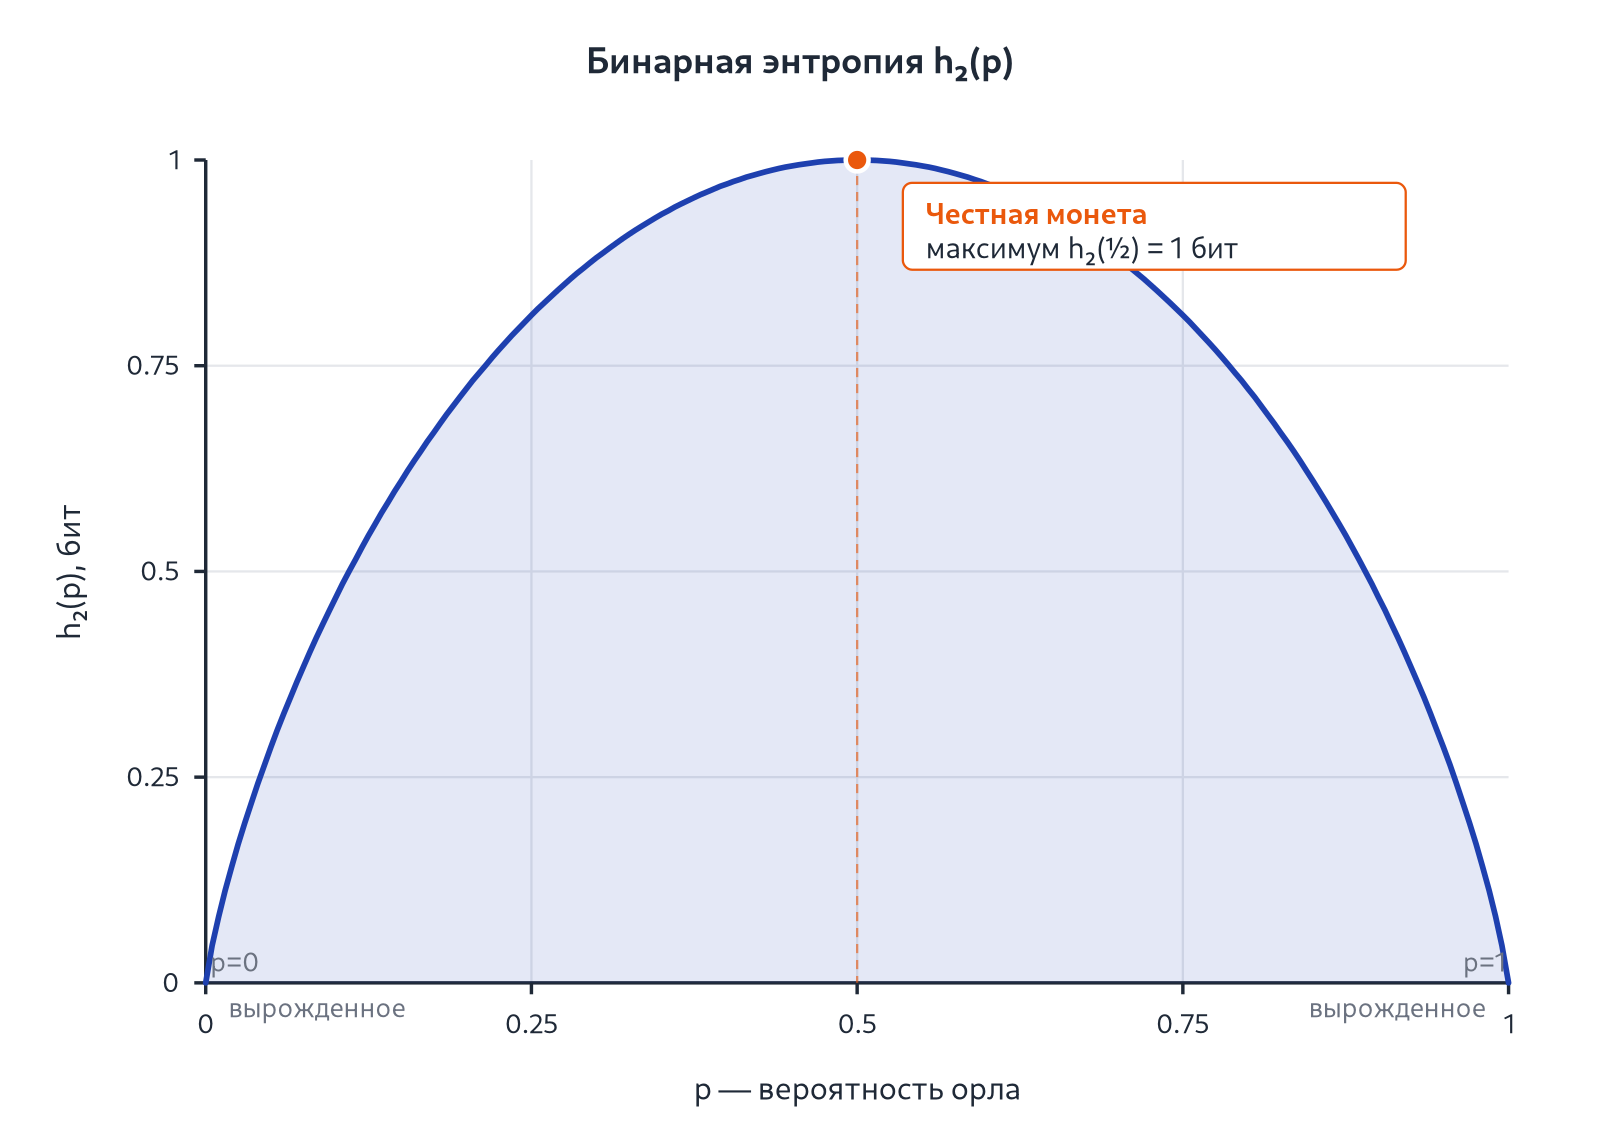
График говорит всю историю. При или будущий бросок уже известен и энтропия равна нулю. При ни один исход не предпочтительнее другого, поэтому неопределённость максимальна и равна одному биту. Производные и строгую вогнутость вы получите в Упражнении 1.
Но текст — не мешок независимо вытянутых букв. Если просто посчитать частоты символов и перемешать строку, мы сохраним односимвольную энтропию и уничтожим слова, синтаксис и тему. Поэтому для языка нужен объект, который учитывает зависимость от контекста.
Главный результат для источника с памятью
Пусть — стационарный процесс на конечном алфавите: распределение любого конечного блока не зависит от его абсолютной позиции во времени. Обозначим остаточную неопределённость следующего символа при контексте длины через
Тогда более длинный контекст не увеличивает эту величину в среднем, и существует предел
— энтропийная скорость (entropy rate) источника.
Это точная версия фразы «сколько новых бит в среднем приносит следующий символ, когда доступно всё прошлое». Односимвольная энтропия отвечает на вопрос о букве без контекста; энтропийная скорость — о неизбежном остатке после использования зависимостей источника.
Математическое углубление: почему предел существует. Для первого чтения можно перейти к эксперименту Шеннона ниже.
По свойству «условление уменьшает энтропию» и стационарности
Последовательность не возрастает и ограничена снизу нулём, поэтому сходится. По цепному правилу
Средние Чезаро сходящейся последовательности имеют тот же предел, что и сама последовательность. Отсюда следуют обе записи в рамке.
Теперь выражение «бит на символ» получило строгий объект, но вместе с ним появились и условия: источник, алфавит, стационарность и правила предварительной обработки должны быть заданы. Без этого «энтропия английского языка» звучит содержательно, но не обозначает единственную универсальную константу.
Шеннон просит человека быть языковой моделью
В статье Prediction and Entropy of Printed English 1951 года Шеннон рассматривал 27 символов: 26 букв и пробел. Последовательные приближения показывали, как контекст снимает неопределённость:
| Приближение | бит/символ |
|---|---|
| Равномерный 27-символьный источник, | 4.76 |
| Частоты отдельных символов, | 4.03 |
| Условные частоты второго порядка, | 3.32 |
| Условные частоты третьего порядка, | 3.10 |
| Приближение через частоты слов, | 2.14 |
Но самая красивая часть работы начинается там, где таблиц -грамм уже не хватает. Испытуемому показывали предыдущий текст и просили называть следующий символ. Если первая догадка была неверной, он пробовал второй вариант, затем третий — пока не находил правильный. Номер удачной догадки превращал человеческое знание слов, грамматики, клише и темы в измеримые ограничения на условную энтропию.
При контексте порядка ста предыдущих символов итоговая таблица дала приблизительно 1.3 бит/символ сверху и 0.6 бит/символ снизу. Шеннон сформулировал вывод осторожно: для обычного литературного английского длинные зависимости снижают энтропию до величины порядка одного бита на букву.
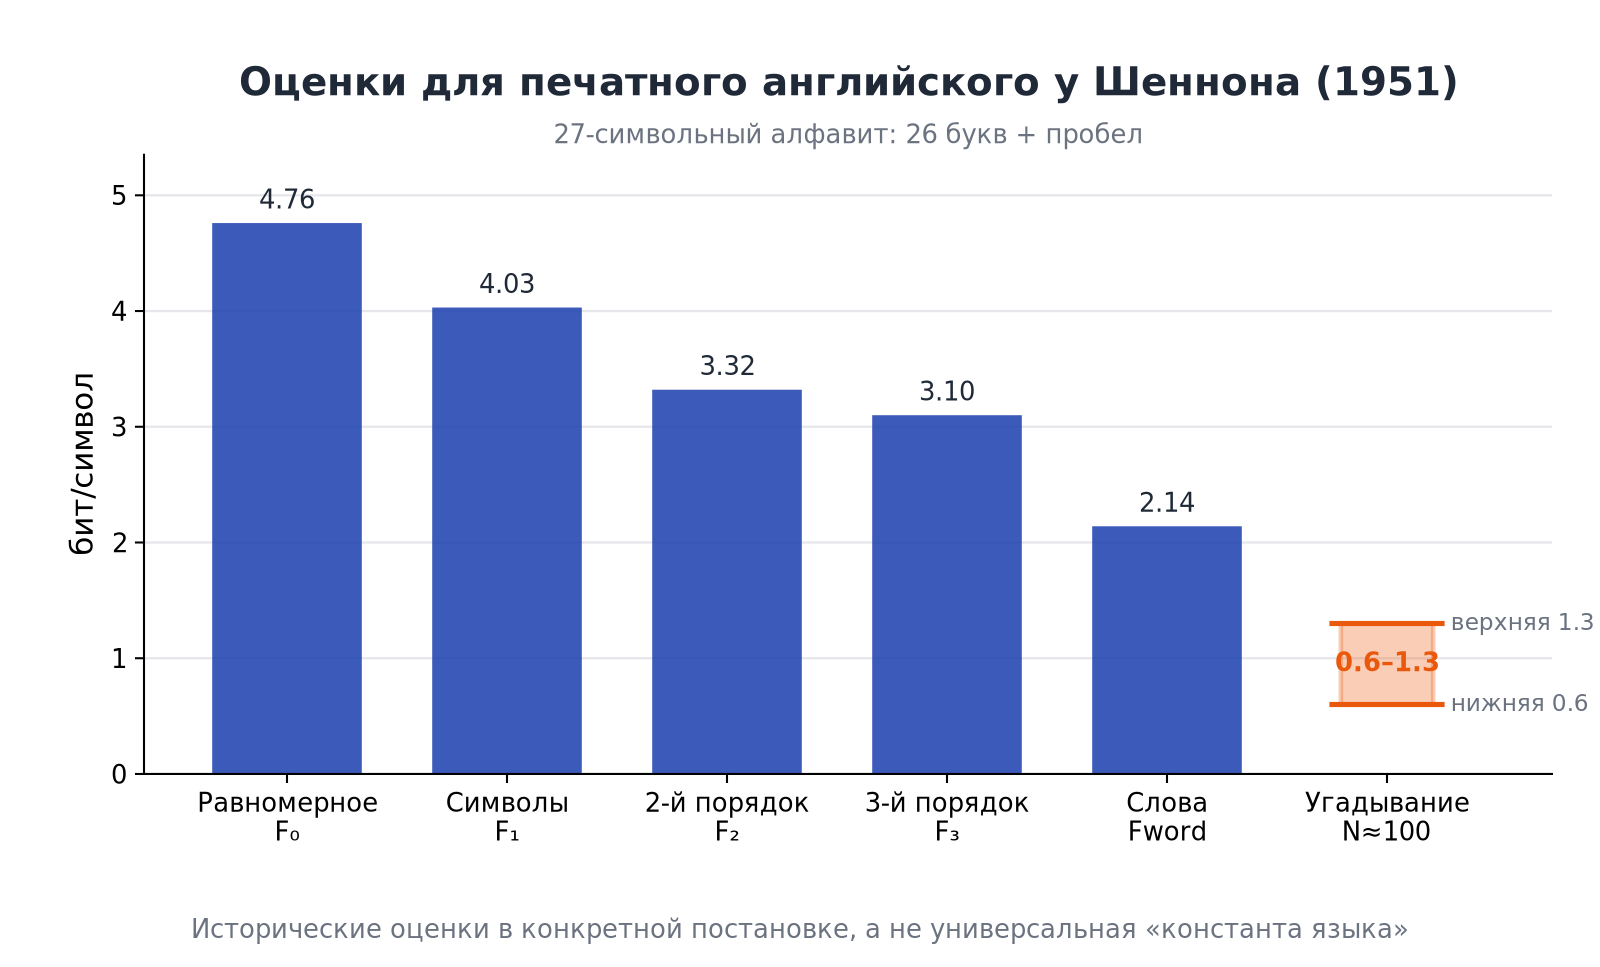
Почему этот эксперимент до сих пор впечатляет? Равномерный выбор из 27 символов стоит 4.76 бита. Человеческий предиктор, используя структуру языка на десятках позиций, обнаруживает, что большая часть этого счета предсказуема. Синтаксис, устойчивые выражения и тема текста здесь перестают быть абстрактным «смыслом» и проявляются как статистические ограничения на продолжение.
Но сильный результат не требует превращать число 1 в физическую константу. Выборка у Шеннона была небольшой; редкие номера догадок оценивались ненадёжно; человек не является идеальным предиктором; газетный текст, научная проза и поэзия дают разные режимы. Диапазон – — историческая оценка в конкретном эксперименте, а не нижний предел для любого файла на английском.
При стандартных условиях теоремы кодирования источника энтропийная скорость задаёт асимптотический предел сжатия без потерь. Это будет Модуль 6. Уже сейчас важно видеть предмет теоремы: предел относится к заданному стохастическому источнику, а не к слову «язык» без модели данных.
Современная языковая модель как компрессор
Авторегрессионная LLM решает задачу, очень похожую на эксперимент Шеннона: по префиксу назначает вероятности продолжениям. Если соединить эти вероятности с арифметическим или интервальным кодированием (range coding), модельный NLL превращается, с небольшими накладными расходами, в реально достижимую длину кода.
Отсюда возникает точная и полезная картина:
- лучшая модель на отложенном корпусе обычно даёт меньший счёт в битах и лучший компрессор;
- её кросс-энтропия остаётся верхней оценкой энтропии источника при той же постановке;
- приближение к оценке Шеннона интересно, но совпадение чисел из разных корпусов, алфавитов и протоколов само по себе ничего не доказывает.
Если назначает положительную вероятность всем последовательностям, возможным под , то для каждого
После деления на модельный битрейт может приближаться к энтропийной скорости сверху. Разрыв — цена несовпадения модели с источником; в следующем модуле она получит имя KL-дивергенции.
Неравенство относится к ожиданию по источнику. Например, при энтропия равна примерно бита, а корпус из одного исхода имеет NLL всего бита. Такой корпус встречается с вероятностью : отдельное измерение может лежать ниже энтропии, не нарушая теорему.
2.4. Как читать энтропию языковой модели
В ML словом «энтропия» часто называют несколько разных чисел. Они родственны, но отвечают на разные вопросы. Перед интерпретацией полезно спросить две вещи: чьё распределение стоит внутри логарифма и по какому распределению берётся среднее?
| Величина | Что усредняется | Что она говорит |
|---|---|---|
| Предиктивная энтропия | исходы, сэмплированные из самой модели при фиксированном контексте | насколько распределение модели рассеяно сейчас |
| Кросс-энтропия или эмпирический NLL | реальные данные из , оценённые вероятностями модели | сколько модель платит за наблюдаемые продолжения |
| Энтропия или энтропийная скорость | исходы истинного источника под его собственными вероятностями | сколько неопределённости содержит сам источник |
Именно смешение этих строк порождает многие слишком сильные выводы.
Предиктивная энтропия: насколько широк выбор модели
Для фиксированного контекста модель выдаёт распределение по словарю . Его энтропия равна
Низкое значение означает, что масса собрана на небольшом числе токенов. Высокое — что заметную массу делят многие продолжения. Величина
даёт удобный «эффективный размер меню»: для равномерного распределения она буквально равна числу вариантов, в общем случае служит энтропийным эквивалентом.
Это хороший локальный диагностический сигнал. Он может обнаружить резкое ветвление продолжения, чрезмерную концентрацию, изменение поведения после дообучения (fine-tuning) или необычный участок последовательности. Но энтропия отвечает на вопрос о концентрации, а не о фактической истинности. Модель способна уверенно ошибаться; высокая энтропия может означать не тупик, а реальную многовариантность. Калибровка и разделение эпистемической и алеаторной неопределённости требуют дополнительных конструкций и данных.
Особенно важно не путать предиктивную энтропию с NLL на тестовых данных. Модель может искусственно заострить распределение, уменьшить и одновременно повысить функцию потерь на реальном токене, если масса ушла не туда.
Температура: один случай, где направление известно точно
Пусть — фиксированные логиты, а
Здесь можно сказать без эмпирических оговорок: при фиксированных логитах повышение температуры не уменьшает энтропию. Низкая температура усиливает различия логитов и собирает массу у максимумов; высокая сглаживает их.
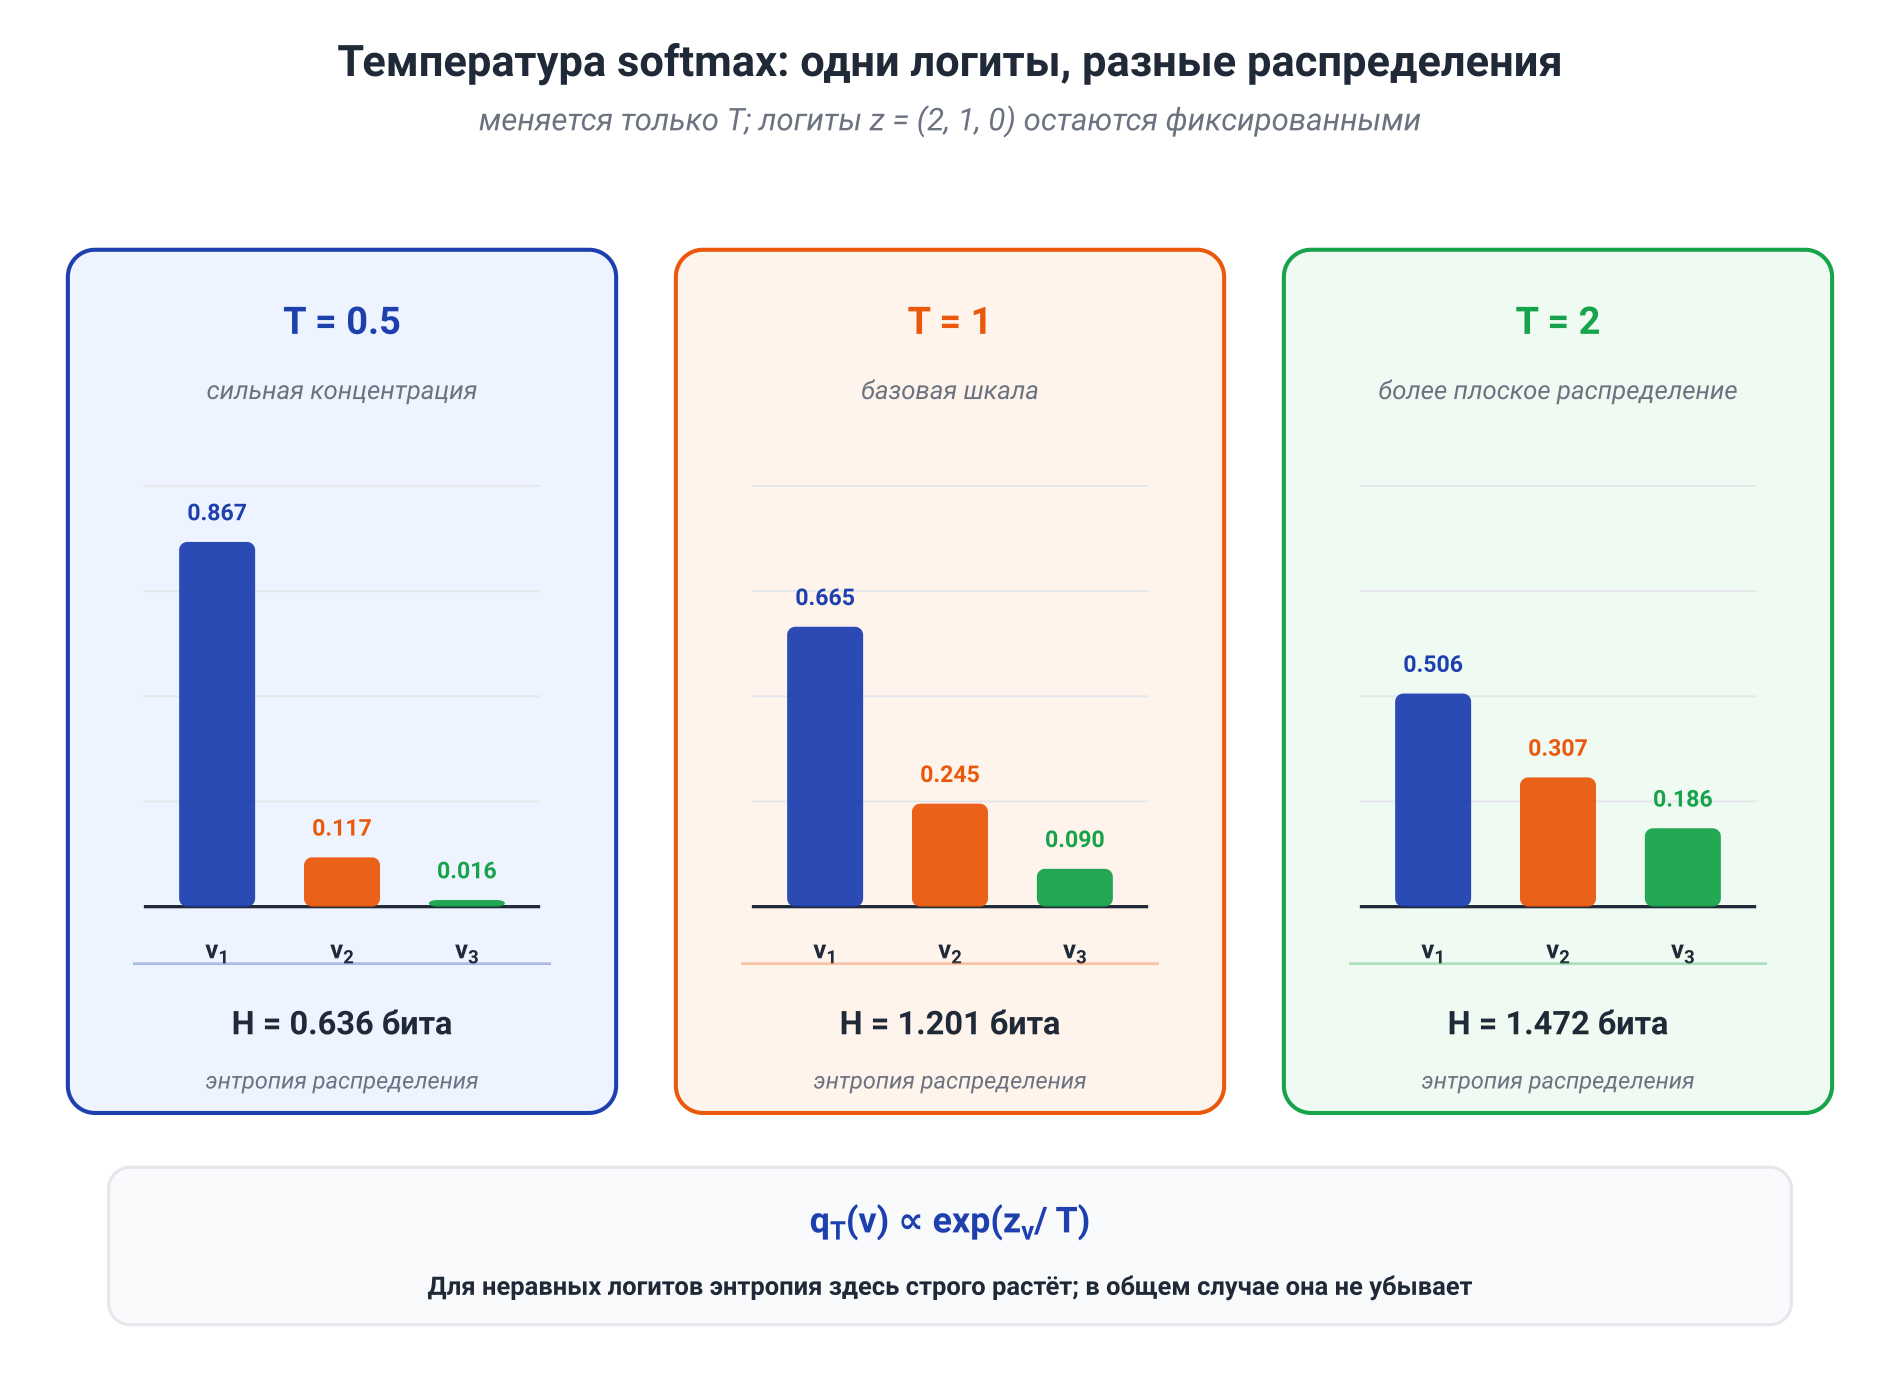
Если единственный токен имеет максимальный логит, то при энтропия стремится к нулю. Если максимум делят токенов, предел равен . При распределение стремится к равномерному на всём словаре и
Поэтому при неравных логитах любая целевая энтропия строго между предельными значениями задаёт единственную температуру.
Математическое углубление: производная по температуре. Положим и временно измерим энтропию в натах. Для
Поскольку
получаем
и, следовательно,
Для битов правая часть дополнительно делится на .
Точная монотонность относится именно к чистому масштабированию температурой (temperature scaling) при фиксированных логитах. Top-, top-, min- и другие фильтры сначала меняют носитель или относительные веса, а затем перенормируют распределение. Это уже другие преобразования; их нельзя без доказательства подменять утверждением о температуре.
Дообучение после предобучения: полезная гипотеза вместо универсального закона
У популярного тезиса «после инструктивного дообучения энтропия ниже» есть правдоподобное эмпирическое ядро: SFT, RLHF или DPO обучают модель предпочитать определённые форматы ответа. На конкретном наборе инструктивных промптов это может сконцентрировать массу, понизить среднюю предиктивную энтропию и уменьшить разнообразие. Модель реже продолжает промпт как случайный фрагмент интернета и чаще выбирает ожидаемую роль ассистента.
Но из самого ярлыка instruct это не следует. Дообучение после предобучения (post-training) меняет логиты контекстно-зависимым образом. Оно может увеличить энтропию там, где базовая модель была чрезмерно уверена в нежелательном продолжении, и уменьшить её там, где предпочтения задают узкий формат. Коллапс мод (mode collapse) — возможный режим отказа при агрессивной оптимизации, а не определение RLHF.
Поэтому правильный инженерный вопрос звучит не «у instruct-моделей энтропия ниже?», а так:
На фиксированном наборе промптов, при одном токенизаторе и до применения фильтров сэмплирования, как изменилось распределение токенов после дообучения?
Это уже измеримый эксперимент, а не спор лозунгов.
Инженерная вставка: почему одной энтропии мало для speculative decoding
Рассмотрим два распределения на токенах a и b:
У и одинаковая энтропия. Но первое распределение совпадает с , а второе почти переставляет его массу местами. Для exact speculative decoding это принципиальная разница.
В базовой одношаговой схеме exact speculative decoding средняя вероятность принятия draft-токена равна
где
Для имеем , для — только , хотя энтропии одинаковы. Урок здесь шире конкретного алгоритма: энтропия сжимает распределение в одно число и теряет информацию о том, где именно лежит масса. Когда инженерная задача зависит от совпадения двух распределений, нужна мера их близости, а не энтропия каждого по отдельности.
Кросс-энтропия и перплексия: счёт модели на данных
Для токенизированной тестовой последовательности определим среднюю функцию потерь с логарифмом по основанию :
Это эмпирическая кросс-энтропия, или средний NLL на токен при выбранной нормировке. Перплексия равна
Если функция потерь измерена в натах, ; если в битах, . Интерпретация как «эффективное число равновероятных вариантов» точна для равномерного распределения и полезна как эквивалентная шкала в общем случае. Она не означает, что на каждом шаге модель буквально выбирала из целого числа кандидатов.
Перплексия зависит от токенизации: разные токенизаторы разбивают один текст на разное число событий. Поэтому PPL надёжно сравнивать прежде всего на одном корпусе, с одним токенизатором и одинаковым протоколом подсчёта. Биты на символ или байт используют внешнюю единицу нормировки и облегчают сопоставление, но не устраняют зависимость от модели, контекста, предварительной обработки и состава данных.
То же различие важно для законов масштабирования (scaling laws). Они описывают эмпирическое снижение тестовой кросс-энтропии в исследованном диапазоне масштабов. Это сильный факт о моделях и данных, но не доказательство того, что экстраполированная асимптота обязана быть универсальной энтропией языка.
На этом месте полезно остановиться и свести модуль к одному вопросу. Когда вы видите слово «энтропия» в ML-статье или на панели метрик, спросите: распределение модели оценивает само себя, модель оценивается на данных или речь идёт о неизвестном источнике? Формулы похожи, но научные выводы различаются.
2.6. Литература и первоисточники
- C. E. Shannon, «A Mathematical Theory of Communication», 1948 — исходная постановка энтропии, кодирования и шумного канала.
- C. E. Shannon, «Prediction and Entropy of Printed English», 1951 — первичный источник экспериментов с угадыванием английского текста.
- T. M. Cover, J. A. Thomas, «Elements of Information Theory», 2-е изд., 2006 — свойства энтропии, цепное правило и энтропийная скорость.
- D. J. C. MacKay, «Information Theory, Inference, and Learning Algorithms», 2003 — интуитивная и ML-ориентированная подача.
- Y. Polyanskiy, Y. Wu, «Information Theory: From Coding to Learning», 2025 — современное строгое изложение.
- A. Holtzman et al., «The Curious Case of Neural Text Degeneration», 2019 — температура, truncation-based decoding и форма распределения языковой модели.
- Y. Leviathan, M. Kalman, Y. Matias, «Fast Inference from Transformers via Speculative Decoding», ICML 2023 — exact speculative decoding и вероятность принятия draft-токена.
- G. Delétang et al., «Language Modeling Is Compression», ICLR 2024 — кросс-энтропия языковой модели как кодовый счёт.
- J. Kaplan et al., «Scaling Laws for Neural Language Models», 2020 — эмпирические законы масштабирования тестовой кросс-энтропии.