Модуль 1. Введение
Как читать этот модуль. Обязательное первое прохождение — §§1.1–1.4. В §1.3 формулы входят как короткий мост от вероятности к энтропии и кросс-энтропии; §1.4 объясняет дальнейший маршрут. §§1.5–1.9 — обзорные и справочные материалы, которые не нужно читать подряд. §§1.10–1.11 сохраняют полный строгий вывод формулы Шеннона для второго прохода — лучше после Модуля 2 или Модуля 4.
Три курса — одна программа. «Теория информации для машинного обучения от NLP и LLM до CV и RL» — математический фундамент серии. Два самостоятельных смежных курса развивают прикладные линии: «Современные LLM» разбирает архитектуру, обучение, инференс и оценку современных языковых моделей, а «Reinforcement Learning для LLM» — обучение по обратной связи, RLVR и агентные системы. Все три курса можно проходить независимо: ссылки между ними ведут к углублению, а не заменяют необходимые объяснения.
1.1. Информация и смысл: почему это не одно и то же
В 1948 году Клод Шеннон строил не просто теорию передачи по телеграфному проводу, а общий язык для источников, кодов и шумных каналов. Инженерный вопрос звучал почти вызывающе просто: какой минимальный ресурс нужен, чтобы передать сообщение надёжно? Чтобы на него ответить, требовалось научиться измерять неопределённость до того, как сообщение пришло.
Начнём с интуиции. Сообщение «завтра в Париже взойдёт солнце» почти ничего не меняет в наших ожиданиях. Сообщение «завтра в Париже будет торнадо» — если оно оказалось верным — меняет их резко. Второе событие не обязательно важнее, полезнее или глубже по смыслу. Оно просто гораздо менее вероятно относительно выбранной модели мира и потому сильнее удивляет.
Это первая нетривиальная мысль курса: информация и смысл — не одно и то же. Шеннон сознательно вынес семантику за границы своей инженерной задачи. На первый взгляд кажется, что теория отказывается от самого интересного. На деле этот отказ и сделал возможной математику: вместо спора о ценности сообщения мы получили вероятности, коды, пределы сжатия и пропускную способность канала.
Сейчас этот ход выглядит естественным, но исторически он был радикальным. Найквист и Хартли уже связывали передачу с числом различимых сообщений и логарифмической шкалой. Шеннон добавил вероятностный источник, неравновероятные сообщения, длинные последовательности и шум — и собрал всё в единую теорию.
Запомните этот выбор: он будет возвращаться через весь курс. Вероятностную языковую модель можно превратить в компрессор без потерь, а её отрицательное логарифмическое правдоподобие связано с длиной кода. Но хорошее сжатие текста не тождественно пониманию текста; низкая функция потерь не является сертификатом истинности; выражение «энтропия языка» становится строгим только после того, как задан источник и уточнён режим длинных последовательностей. Шенноновский аппарат силён не потому, что измеряет всё, а потому, что очень точно измеряет выбранный слой задачи.
Три вопроса, которые пока достаточно различать словами
В дальнейшем у нас появятся три близкие, но разные величины:
- насколько неожидан именно этот реализовавшийся исход;
- насколько неопределён источник в среднем до наблюдения;
- насколько наблюдение одной переменной в среднем уменьшает неопределённость о другой.
В разговоре всё это легко назвать «информацией». В математике это будут разные объекты: surprisal, энтропия и взаимная информация. Формула неожиданности появится в коротком мосте §1.3, энтропия будет подробно разобрана в Модуле 2, а взаимная информация — в Модуле 5. Сейчас важнее не запомнить обозначения, а не смешать вопросы.
1.2. Шенноновский фрейм: сила и ограничения
Шенноновский фрейм продуктивен именно потому, что отвечает на ограниченный набор вопросов. Сначала посмотрим, что он даёт, а затем — где заканчивается точное утверждение.
Где шенноновский фрейм продуктивен
Обучение языковых моделей. Кросс-энтропийная функция потерь задаёт ясную задачу: распределение модели должно назначать высокую вероятность наблюдаемым продолжениям. Это делает кросс-энтропию, перплексию и биты на токен содержательными измерителями, а связь предсказания со сжатием — не метафорой, а математической конструкцией. При этом сама целевая функция не содержит отдельного критерия фактической истинности или понимания. Из этого не следует, что модель не способна формировать полезные представления; следует лишь, что такой результат не гарантируется одной записью loss.
Сжатие изображений и аудио. JPEG, MP3 и современные нейронные кодеки можно рассматривать как разные способы тратить rate ради допустимого distortion. Практический кодек не обязан лежать на теоретической границе , а выбор меры искажения уже кодирует наши предпочтения. Но именно язык rate–distortion позволяет честно сформулировать компромисс. В Модуле 9 та же логика появится при квантизации весов и активаций.
Обучение представлений через информационную узость. Information Bottleneck ставит нормативный вопрос: сколько информации о входе должно сохранить представление , чтобы не потерять релевантную информацию о целевой переменной ? Это сильная постановка, особенно когда переменные и стохастический энкодер заданы явно. Она не превращается автоматически в объяснение любой детерминированной глубокой сети: в непрерывных моделях взаимную информацию бывает трудно корректно определить и ещё труднее оценить.
Где шенноновского фрейма недостаточно
Галлюцинации LLM. Кросс-энтропийное обучение учит воспроизводить распределение текстовых продолжений. Оно не проверяет каждое утверждение о внешнем мире. Поэтому низкая кросс-энтропия сама по себе не гарантирует фактическую надёжность. Retrieval, инструменты, верификация и внешняя обратная связь добавляют сигналы, которых нет в чистом обучении по правдоподобию.
Эксплуатация награды и закон Гудхарта. Прокси-награда полезна, пока остаётся связана с истинной целью в области, где работает политика. Сильная оптимизация может вывести систему туда, где эта связь меняется. KL-регуляризация в RLHF назначает цену уходу от базовой политики и тем самым создаёт область доверия по распределению. Это важный механизм, но не сертификат того, что прокси стала истинной целью.
Рассуждение, факты и причинность. Вероятностная модель способна хранить факты в параметрах и реализовывать сложные вычисления; поэтому фраза «статистическая модель не умеет рассуждать» слишком груба. Точное ограничение скромнее: обучение по правдоподобию само по себе не гарантирует причинной корректности, точного выполнения алгоритма или устойчивой экстраполяции за пределы обучающего распределения.
Метакомментарий
Принципиальная граница проходит не по лозунгу «теория информации не учитывает смысл», а по способу задания объекта. Шенноновские величины определяются относительно вероятностной модели источника и канала. Смысл часто требует ещё внешнего мира, целей получателя, причинной структуры и критерия успешного действия.
Алгоритмическая теория информации в Модуле 10 сдвинет фокус к длине программ, вычислимости и универсальному предсказанию. Она расширит карту, но не даст готовой теории семантики. Это не поражение аппарата. Это дисциплина: понимать, что именно измеряет формула и где заканчивается её обещание.
1.3. Почему появляется логарифм: короткий мост к энтропии
Ровно один математический шаг. Здесь нужно увидеть механизм, а не выучить формулу заранее. Модуль 2 введёт энтропию систематически, а §§1.10–1.11 дадут полный аксиоматический вывод.
Начнём с одного естественного вопроса: как должна измеряться неожиданность отдельного события?
Пусть событие имеет вероятность , а его неожиданность обозначена . Если два события независимы, их совместная вероятность равна . Узнав оба события, мы хотим сложить полученную неожиданность:
Это требование переводит произведение вероятностей в сумму информационных вкладов. Именно такую работу делает логарифм. При обычных условиях регулярности — например, непрерывности и монотонном росте неожиданности при уменьшении вероятности — получаем
где положительная константа и основание логарифма задают единицу измерения.
При основании событие вероятности несёт бит неожиданности, событие вероятности — бита. Два независимых броска честной монеты дают четыре равновероятных последовательности и бита: один бит за первый выбор и один за второй. Логарифм здесь не декоративен. Он ровно выражает требование, чтобы независимые этапы складывались.
Для равномерного источника с исходами каждый исход имеет вероятность , поэтому неожиданность любого исхода равна
Отсюда уже виден ответ Хартли: число равновероятных альтернатив измеряется логарифмом. Неравномерный источник требует ещё одного шага — усреднить неожиданность по вероятностям самих исходов:
Это и есть формула Шеннона, которую мы подробно разберём в Модуле 2. Здесь она появляется не как символ, который нужно заранее выучить, а как ответ на два последовательных требования: редкий исход должен удивлять сильнее, а независимые этапы должны давать сумму.
Почему это сразу узнаётся в ML
Авторегрессионная модель раскладывает вероятность последовательности в произведение условных вероятностей:
После логарифма произведение превращается в сумму:
Для одной наблюдаемой последовательности эта величина является её отрицательным логарифмическим правдоподобием (negative log-likelihood, NLL). Среднее таких величин по набору данных — эмпирическая кросс-энтропия модели относительно данных. Поэтому в практической ML-речи NLL и кросс-энтропия часто стоят рядом, хотя формально первый термин относится к наблюдению или всей выборке, а второй — к среднему по распределению или эмпирической выборке.
По-токенные вклады NLL складываются в функцию потерь всей последовательности. Та же сумма задаёт идеальную длину кода, если предсказательные вероятности подать в энтропийный кодер. Реальный файл добавит накладные расходы кодера, а полная система — ещё и стоимость хранения или передачи самой модели, но математическая связь между предсказанием и длиной кода уже точна.
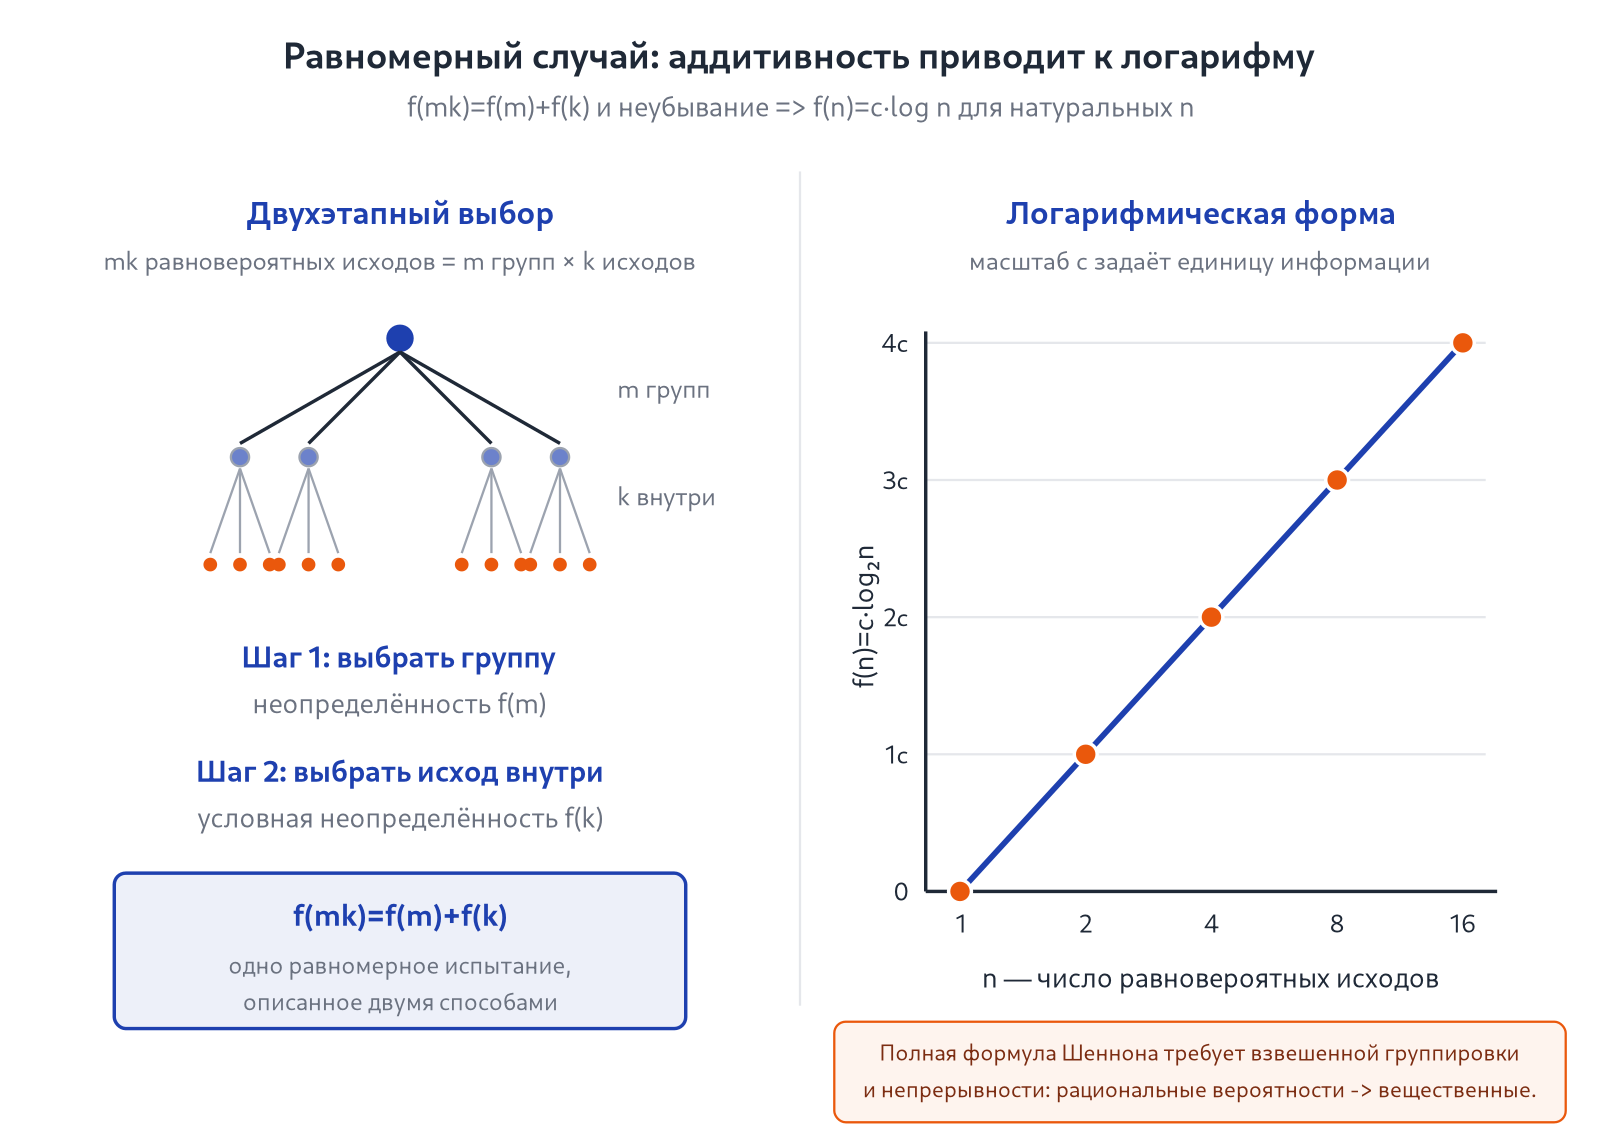
Где заканчивается короткий вывод
Из аддитивности мы получили логарифмическую неожиданность и значение для равномерного источника. Но этого ещё недостаточно, чтобы единственным образом выделить формулу Шеннона на всех неравномерных распределениях: энтропии Реньи тоже аддитивны на независимых произведениях и совпадают с на равномерном распределении.
Полный вывод требует более сильной идеи: если выбор совершается в два этапа, общая неопределённость должна равняться неопределённости первого этапа плюс средняя условная неопределённость второго. Эта взвешенная группировка и есть мост от равномерного случая к . В §§1.10–1.11 мост построен полностью; для первого прохождения достаточно знать, зачем он нужен.
1.4. Как устроен курс и как его читать
Основной маршрут и второй проход
В каждом модуле есть основной ML-маршрут и явно помеченные математические углубления. Основной маршрут начинается с узнаваемой задачи, вводит минимально необходимую математику и возвращается к моделям, данным или обучению. Углубление сохраняет полное доказательство, более общие условия и контрпримеры, но не служит входным экзаменом.
В этом модуле разделение уже работает на практике. Чтобы идти дальше, достаточно различать вероятность, неожиданность и смысл, понимать область действия шенноновского фрейма и увидеть короткий логарифмический механизм из §1.3. Полный вывод формулы энтропии ценен, но лучше читать его вторым слоем — после того, как энтропия стала знакомым рабочим объектом.
Язык курса
Поясняющий текст остаётся преимущественно русским. При первом появлении важного термина даётся общепринятый английский эквивалент: целевая функция (objective), сдвиг распределения (distribution shift), обучение представлений (representation learning). Далее используется прежде всего русский вариант. Названия методов, аббревиатуры, API и слова, без которых современный ML-текст звучит искусственно, — softmax, logits, teacher forcing, ELBO, InfoNCE, RLHF, DPO, PyTorch — сохраняются в стандартной форме.
По этой же причине §1.7 — справочная заметка о словах выпуклая и вогнутая, бытовые значения которых подталкивают к обратному прочтению convex и concave, — существует только в русской версии. Английскому читателю такая заметка не нужна, поэтому английский Модуль 1 короче на один раздел, а его последующая нумерация сдвинута на единицу. Во всех остальных модулях нумерация в обеих версиях совпадает.
Как устроен типичный модуль
Сначала появляется вопрос: зачем вообще нужен новый объект. Затем — интуиция, формальная модель и ключевая формула. Короткое доказательство остаётся в основном тексте, если раскрывает механизм; длинная техническая часть уходит в углубление. После этого мы смотрим классический пример, прямое ML-применение, границу интерпретации и проверяем понимание на задаче или коде.
Такой порядок важен. KL, MI или MaxEnt легко превратить в коллекцию символов. Гораздо полезнее увидеть, какой инженерный вопрос привёл к формуле, что именно она гарантирует и какую ошибку мышления предотвращает.
Темп курса не фиксирован жёстко. Один модуль может занять вечер, а может стать темой на неделю. Основной маршрут M1–M9 уже даёт самостоятельный инструментальный слой; M10–M13 добавляют продвинутую теорию и frontier-темы; M14–M15 остаются факультативными специализациями.
Обязательный маршрут Модуля 1 закончен. Следующий шаг — Модуль 2. §1.5 можно быстро просмотреть как карту курса; к §§1.6–1.9 возвращайтесь по необходимости; §§1.10–1.11 открывайте тогда, когда захочется увидеть полный математический механизм.
1.5. Обзор программы курса
Курс выстроен как четыре концентрические окружности — от ядра классической шенноновской теории до её современных расширений в ML.
Ядро языка (Модули 2–3, 5). Энтропия, кросс-энтропия, KL, взаимная информация — фундаментальные меры, на которых строится всё остальное. Технический Модуль 4 — это страховой полис: неравенство Йенсена и связанный аппарат, без которого следующие модули читаются с натяжкой.
Классическая теория Шеннона (Модули 6–7). Теоремы об источнике и канале. Здесь теория встречается с инженерной реальностью: компрессия и связь. Это исторический корень всего, и именно здесь начинают мерцать связи с современным ML — тезис «компрессия как тест интеллекта», контекст как ограниченный ресурс, attention как возможная аналогия канала. Важно: это перспективы и эвристики, а не прямые следствия теорем Шеннона.
Принципы вывода (Модули 8–9). MaxEnt, IB, rate–distortion. Здесь теория информации становится нормативным фреймом для построения систем. Softmax возникает как решение задачи «ожидаемый score + энтропийная регуляризация»; KL-регуляризованный RLHF-оптимум имеет гиббсовскую форму относительно reference policy; VAE допускает rate–distortion и information-bottleneck интерпретации. Каждое из этих утверждений требует явно заданной оптимизационной задачи — без неё красивые аналогии становятся слишком сильными.
Расширения (Модули 10–13). Алгоритмическая теория информации; -дивергенции и вариационные характеризации; информационная теория обобщения (PAC-Bayes и MI-bounds); frontier-модуль про reasoning в LLM. Эти темы выходят за пределы классической инженерной теории связи и показывают, насколько далеко распространяется информационно-теоретический язык в современном ML — иногда как точная теорема, иногда как исследовательская модель.
Бонусные модули (факультативно). Два дополнительных модуля расширяют охват курса в стороны от основного пути:
- Модуль 14 — Информационная теория в компьютерном зрении. Neural image codecs как продолжение M6 для непрерывных источников; связи диффузионных моделей с оцениванием, score identities и I–MMSE; contrastive, self-distillation и masked-reconstruction методы в CV; perceptual losses и distributional metrics. Не все эти методы являются MI-maximization, а LPIPS, SSIM и FID не являются информационно-теоретическими дивергенциями — модуль разделяет прямые теоремы и полезные интерпретации.
- Модуль 15 — Информационная геометрия. Fisher information как риманова метрика на статистическом многообразии, естественные градиенты и локальная квадратичная аппроксимация KL через матрицу Фишера. Сам KL не является римановым расстоянием. Углубление M3, M4, M11. Целевая аудитория: ML-инженеры в RL, normalizing flows и тонкой оптимизации, где обычный градиентный спуск сталкивается с плохо обусловленными параметризациями.
Три уровня глубины. Курс намеренно устроен так, что на любом из трёх уровней можно остановиться и иметь самостоятельную, целостную картину:
- Уровень 1 — базовый toolkit (M1-M9). Достаточно для практикующего ML-инженера: энтропия, KL/CE, MI, теоремы Шеннона о кодировании и канале, MaxEnt и IB/ELBO/rate-distortion. После M9 вы понимаете информационно-теоретический смысл cross-entropy loss, perplexity, KL-якоря в RLHF, ELBO в VAE, MI-интерпретации некоторых contrastive objectives. Это полный базовый минимум для современной работы.
- Уровень 2 — продвинутая теория (M10-M12). Алгоритмическая теория информации (Колмогоров, Соломонофф, AIXI), f-дивергенции и вариационные характеризации, PAC-Bayes и MI-границы обобщения. Это продвинутый теоретический слой над Уровнем 1 — он нужен тем, кто планирует читать современные исследовательские работы или вести свои.
- Уровень 3 — capstone и спецтемы (M13 + M14, M15). Reasoning в LLM как синтез всего пройденного (M13). Бонусные модули M14 (CV) и M15 (Information geometry) — углубления для специфической аудитории.
Конкретные рекомендованные траектории прохождения описаны в §1.8.
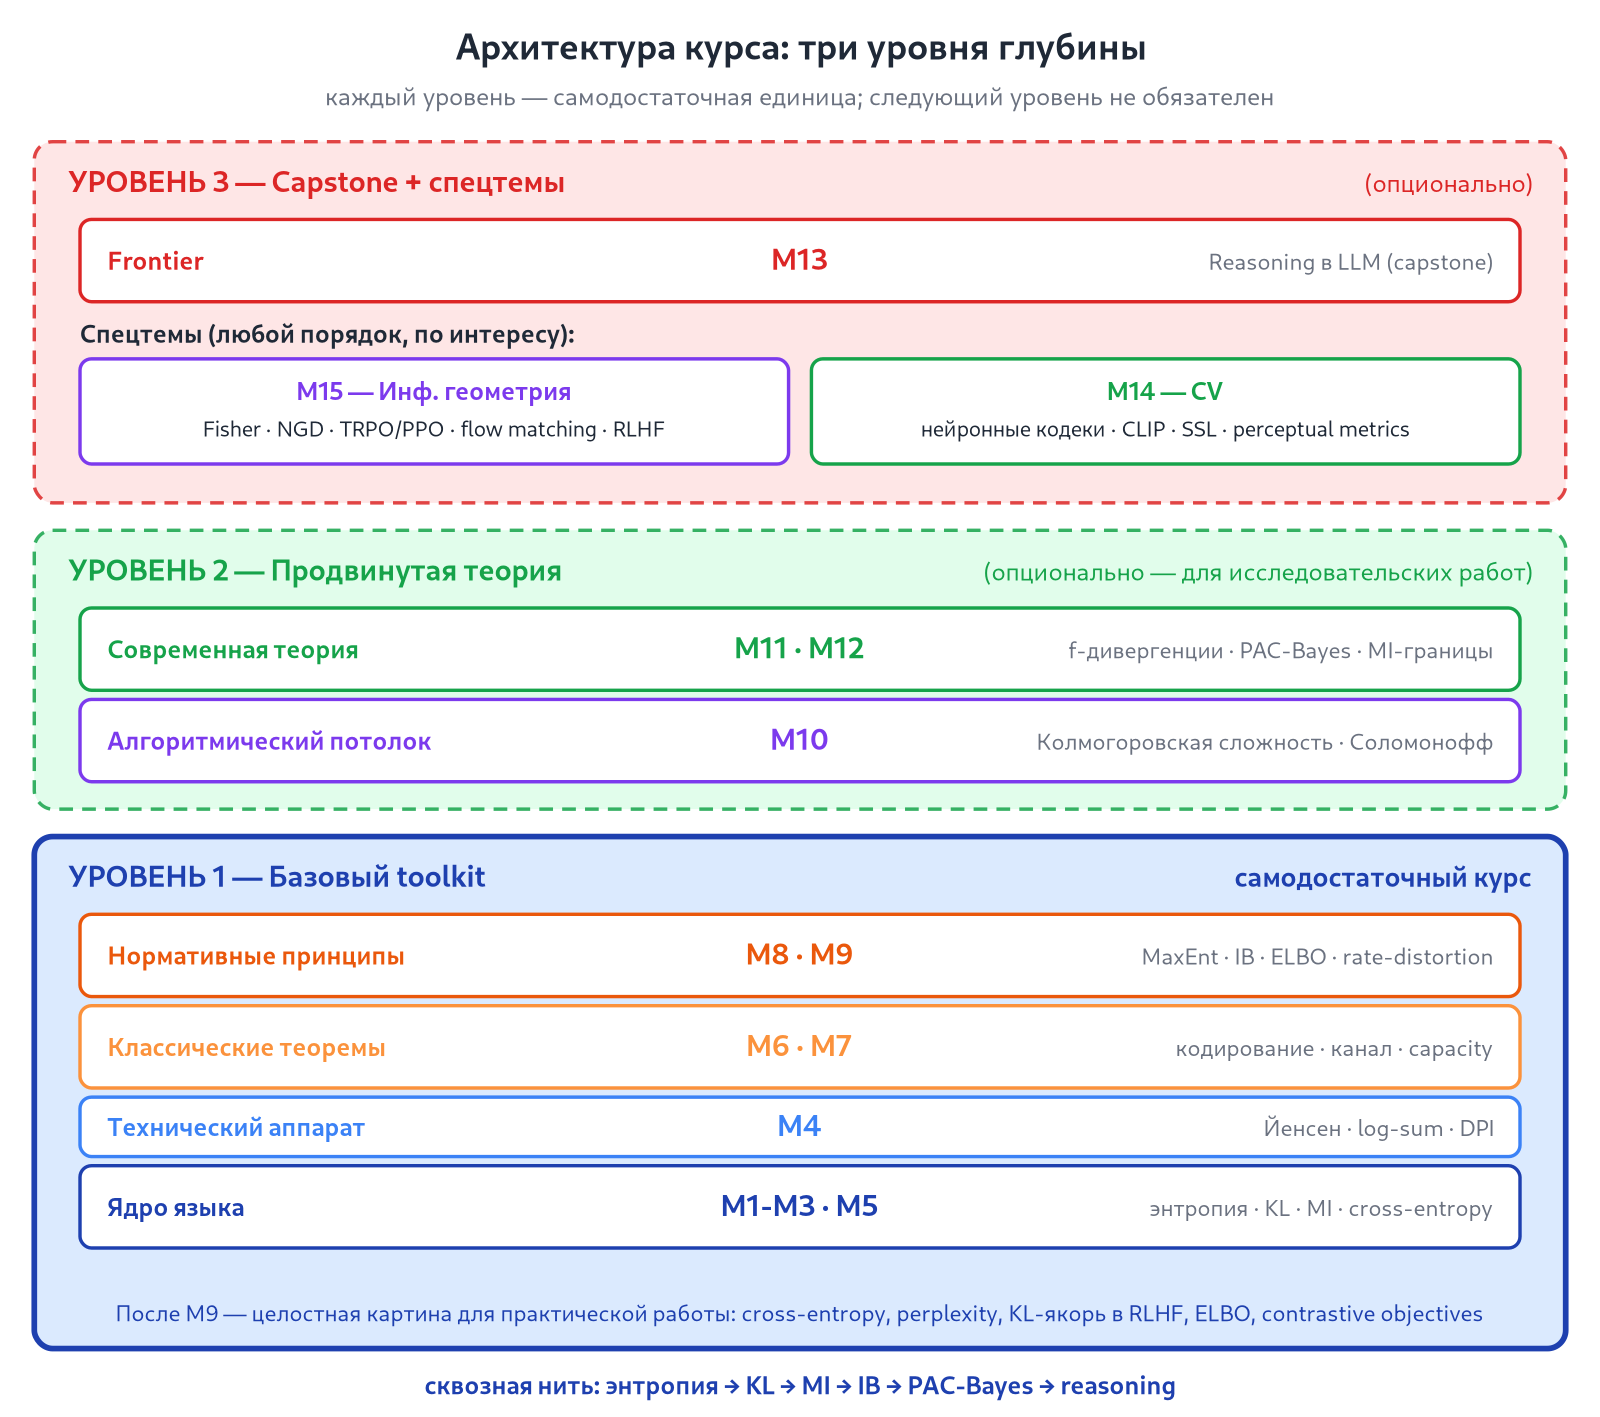
Подробная программа и полный список литературы вынесены в справочные §§1.8–1.9. Литература там сгруппирована по ролям (backbone, справочники, узкие специализации, оригинальные работы), и переходить к ней лучше по мере того, как возникает интерес или ступор в конкретной теме.
1.6. Литература: с чего начинать
Курс не привязан жёстко к одному учебнику. Несколько источников играют разные роли.
Polyanskiy & Wu, «Information Theory: From Coding to Learning» (2025) — современный backbone. Связь IT и ML в нём центральная с первой страницы, что соответствует духу нашего курса.
MacKay, «Information Theory, Inference, and Learning Algorithms» (2003) — классический ML-ориентированный учебник. Он свободно доступен на сайте автора и особенно хорош для интуиции и байесовской перспективы.
Cover & Thomas, «Elements of Information Theory» — справочник для аккуратных доказательств там, где Polyanskiy–Wu или MacKay лаконичны.
Murphy, «Probabilistic Machine Learning: An Introduction» и «Probabilistic Machine Learning: Advanced Topics» — связующий мост между нашими модулями и современным probabilistic ML.
Узкие специализации — Tsybakov для непараметрики, Yamanishi для MDL, Jurafsky–Martin для NLP, MIT VisionBook для CV и Amari для информационной геометрии — перечислены вместе с оригинальными работами Шеннона, Тишби, Хаттера и русскоязычными источниками в §1.9. Не надо пытаться прочитать всё заранее; гораздо эффективнее обращаться к источнику, когда возникает интерес или ступор.
1.7. Справочная заметка: convex / concave (выпуклая / вогнутая функция)
В русскоязычной литературе по математическому анализу есть две конкурирующих традиции именования выпуклых/вогнутых функций. Чтобы избежать путаницы, в этом курсе используется международное соглашение, принятое в Cover & Thomas, MacKay, и во всей оптимизационной и ML-литературе:
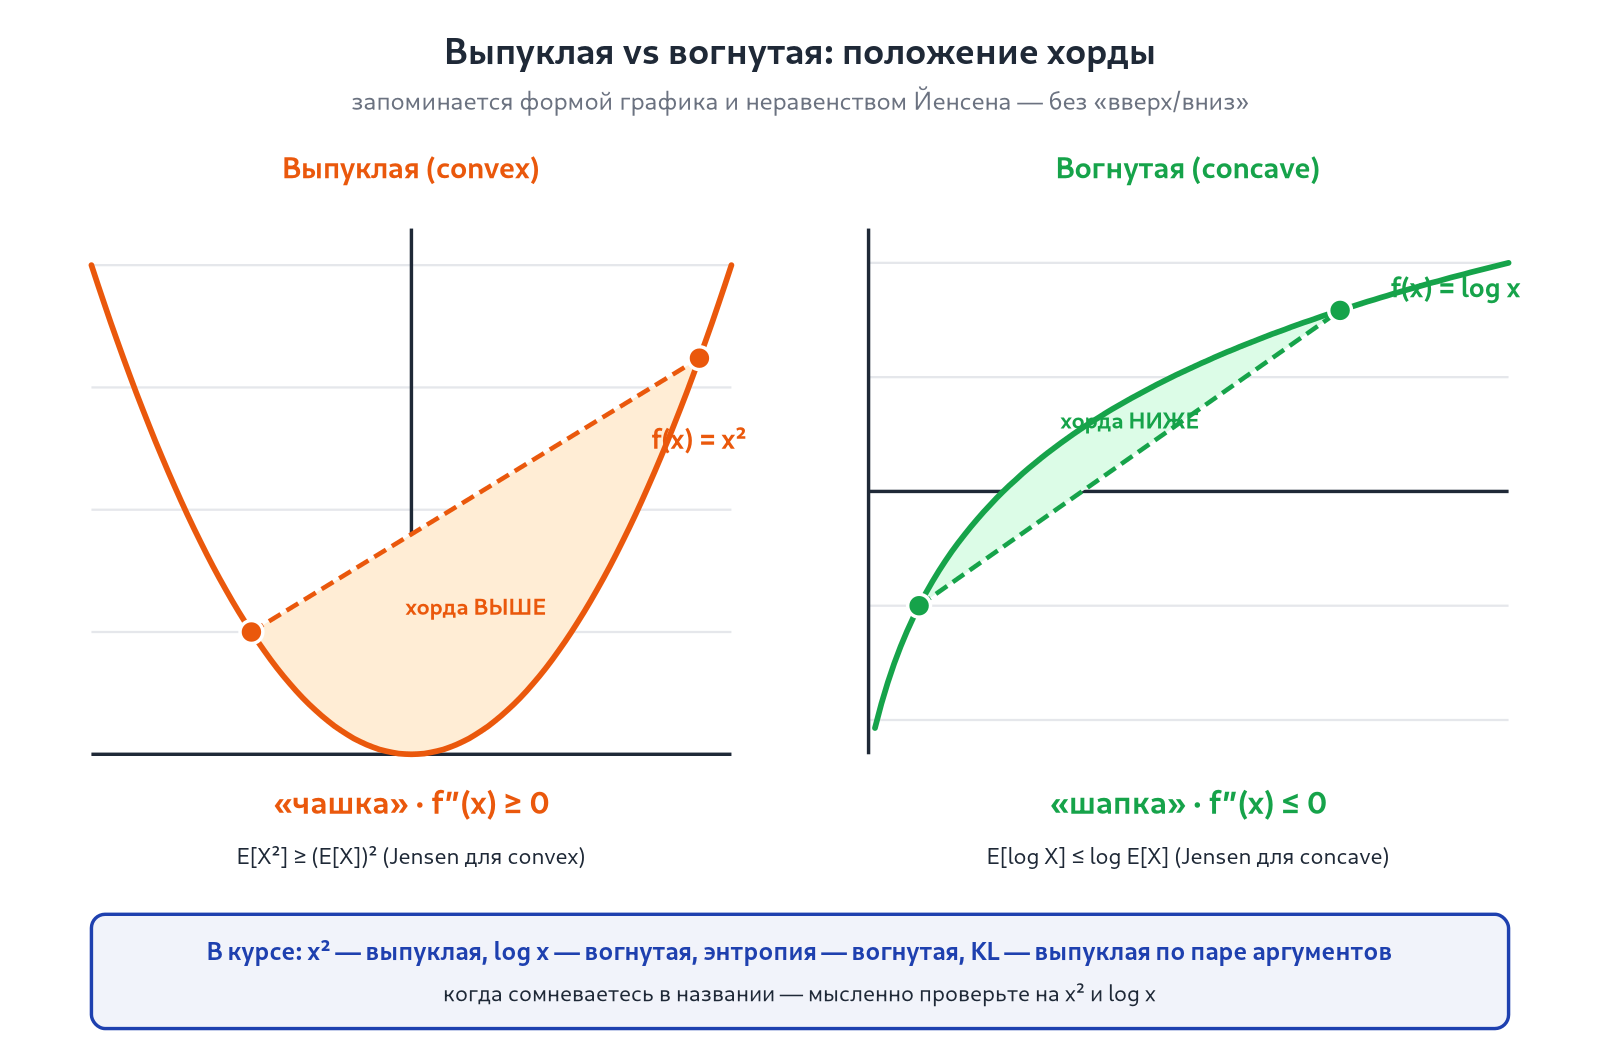
- Выпуклая (convex) функция — её график лежит ниже хорды, соединяющей две любые точки графика. Геометрически — «чашка». Примеры: , , . Для дважды дифференцируемой функции: .
- Вогнутая (concave) функция — график лежит выше хорды. Геометрически — «шапка». Примеры: , , энтропия . Для дважды дифференцируемой: .
Если в школе или старых учебниках вы учили иначе — в классической русской традиции (Фихтенгольц и т.д.) часто использовалось «выпуклая вверх» (= современная concave) и «выпуклая вниз» (= современная convex). Без уточнения «вверх/вниз» термины могли значить противоположное современному. Это вопрос терминологический, не математический: остаётся той же функцией, неравенство Йенсена работает одинаково.
В этом курсе для определённости: — вогнутая, — выпуклая, дискретная энтропия — вогнутая по распределению, KL-дивергенция — совместно выпуклая по паре распределений при стандартных соглашениях о носителях.
Мнемоника
Запомните не слова, а форму графика и неравенство Йенсена.
Для (типичный пример вогнутой), если почти наверное и соответствующие ожидания конечны: — «логарифм матожидания не меньше матожидания логарифма».
Для (типичный пример выпуклой), если : — «матожидание квадрата не меньше квадрата матожидания» (это в точности неотрицательность дисперсии).
Когда сомневаетесь в названии — мысленно проверяйте на этих двух примерах.
Почему я выбрал именно это соглашение
Все ключевые материалы курса используют его. Cover & Thomas, MacKay, Boyd & Vandenberghe («Convex Optimization» — стандартный учебник), статьи Tishby, работы Хаттера, Delétang et al., вся литература по VAE/RLHF/contrastive learning — везде называется concave, а — convex. Если откроете любую современную статью — придётся думать на этом языке.
Современная русскоязычная литература по оптимизации тоже на нём. Поляк, Юдин–Немировский, переводы Boyd, многие современные курсы МФТИ/ВШЭ — согласованы с этой традицией.
Один из двух классических русских терминов имеет встроенную двусмысленность. «Выпуклая» без уточнения «вверх/вниз» зависит от автора и эпохи. Поэтому в формулах и доказательствах надёжнее опираться не на направление слова «выпуклая», а на положение графика относительно хорды и знак второй производной.
P.S. Я сам учился по обратной традиции, принятой у Фихтенгольца. Это более интуитивно для русскоязычного читателя, но, к сожалению, не совпадает с основным подходом, принятым в современной литературе. Пришлось переучиваться и привыкать.
1.8. Справочник: подробная программа курса
Этот подраздел даёт детальное описание каждого модуля курса. Он не входит в обязательный маршрут первого чтения: к нему удобно возвращаться по мере прохождения, чтобы освежить, что будет в следующем модуле или почему тема разнесена между несколькими модулями.
Программа
Модуль 1. Введение. Информация и смысл — Шеннон сознательно отделил семантические вопросы от инженерной теории связи, и это решение оказалось одновременно силой и естественной границей теории. Основной маршрут объясняет, почему аддитивная мера неожиданности должна быть логарифмической, и связывает этот факт с NLL в авторегрессионных моделях. Факультативные §§1.10–1.11 дают полный аксиоматический вывод: от равномерного источника через взвешенную группировку и непрерывность к формуле Шеннона.
Модуль 2. Энтропия. как ожидаемая неожиданность. Свойства: неотрицательность, вогнутость, максимум на равномерном распределении. Совместная и условная энтропия, цепное правило . Классика: энтропия честной и нечестной монеты; эксперимент Шеннона с угадыванием английского текста и его оценка порядка – бит/символ при конкретной постановке эксперимента. ML/LLM: энтропия выходного распределения как мера его рассеянности — не то же самое, что калибровка или эпистемическая неопределённость; как post-training, decoding и temperature меняют энтропию, без универсального утверждения, что любая instruct-модель обязательно имеет меньшую энтропию, чем соответствующая base-модель.
Модуль 3. Кросс-энтропия и KL-дивергенция. Различие между энтропией источника и ожидаемой длиной кода, построенного по другой модели. Определения и , тождество , неравенство Гиббса. Асимметрия KL и распространённые mode-covering/mode-seeking эффекты при ограниченных семействах аппроксимаций — именно эффекты типичных постановок, а не абсолютная характеристика любого алгоритма. ML/LLM: empirical negative log-likelihood оценивает cross-entropy; если CE измерена в битах, , если в натах — , в общем случае . Роль reference policy и KL-регуляризации в PPO-подобном RLHF и в выводе DPO.
Модуль 4. Неравенство Йенсена: компактный инструментарий для ML. Основной маршрут: Йенсен, условия равенства, log-sum inequality, выпуклость KL, два способа ансамблирования и вывод ELBO. Это технический модуль, но каждая формула привязана к узнаваемой ML-задаче. Более поздние темы не раскрываются заранее: достаточные статистики переходят в Модуль 8, IWAE — в Модуль 9, Donsker–Varadhan и -GAN — в Модуль 11, PAC-Bayes — в Модуль 12.
Модуль 5. Взаимная информация. через разность энтропий, KL между совместным распределением и произведением маргиналов и ожидаемое сокращение неопределённости. Data Processing Inequality. MI обнаруживает любую зависимость в том смысле, что тогда и только тогда, когда и независимы (в стандартной постановке), тогда как нулевая корреляция исключает лишь линейную связь. ML: InfoNCE как contrastive objective и, при соответствующей схеме выборки, нижняя оценка MI; Information Bottleneck; MINE и трудности оценки MI в высокой размерности. Интерпретации attention как информационного обмена и residual connections через SDPI будут явно помечены как исследовательские линзы, а не как следствия DPI.
Модуль 6. Кодирование источника. Неравенство Крафта и два уровня теоремы о кодировании. Для оптимального двоичного префиксного кода символа конечного алфавита, если энтропия измерена в битах: . Для длинных блоков из стационарного эргодического источника средняя длина на символ может приближаться к entropy rate. Хаффман, арифметическое кодирование, AEP и типичные множества. ML/LLM: операционально точное соответствие вероятностного prediction и lossless compression через entropy coding, с учётом конечного coding overhead; результаты Delétang et al. как впечатляющая демонстрация, но с оговоркой, что в опубликованных compression ratios не учитывается размер параметров модели. Scaling laws могут описывать приближение cross-entropy к некоторому пределу, но отождествлять этот предел с «истинной энтропией языка» можно только при дополнительных предпосылках. Bits per character и bits per byte — полезные tokenizer-independent единицы, но не единственно допустимые.
Модуль 7. Канал и пропускная способность. Для дискретного канала без памяти capacity определяется как . Теорема кодирования для канала, BSC, BEC, гауссовский канал и формула Шеннона–Хартли. ML/LLM: контекстное окно, hidden states и attention можно рассматривать через язык ограниченного информационного потока, но это моделирующая аналогия: архитектура трансформера не становится дискретным каналом Шеннона без явного задания входов, шумов, ограничений и критерия передачи.
Модуль 8. Принцип максимальной энтропии. Принцип Джейнса: при заданных ограничениях выбирать распределение максимальной энтропии. При линейных ограничениях на ожидания решение, когда оно существует, имеет экспоненциальную форму. Это связано с экспоненциальными семействами, но не тождественно теореме Питмана–Купмана–Дармуа: последняя при регулярностных условиях характеризует i.i.d.-семейства, допускающие достаточную статистику фиксированной размерности. Для регулярных экспоненциальных семейств MLE даёт moment matching, если конечное внутреннее решение существует. Softmax удовлетворяет точной вариационной формуле, если измеряется в натах и :
Для неограниченной оптимизации по политикам на носителе reference policy задача
при и конечной нормировочной константе имеет решение . Это точное утверждение для указанной оптимизационной задачи; связь с Goodhart — полезная инженерная интерпретация, а не отдельная теорема MaxEnt.
Модуль 9. Information Bottleneck, ELBO, rate–distortion. IB-принцип, rate–distortion theory и variational objectives. VAE ELBO естественно раскладывается на distortion/reconstruction term и rate/KL term; связь с variational IB реальна, но зависит от того, какие переменные названы входом, представлением и target. ML: self-supervised representation learning, квантизация весов и активаций, спор об IB-интерпретации динамики нейросетей. Сверх классики: для , где независимо от и , и взаимной информации в натах
в битах справа появляется дополнительный множитель . I–MMSE, Tweedie/score identities и denoising дают важные мосты к diffusion models, но score matching не является следствием одной только I–MMSE identity.
Модуль 10. Алгоритмическая теория информации. Колмогоровская сложность, теорема инвариантности и невычислимость; соломоновская универсальная нижнеполувычислимая semimeasure и соответствующий предиктор; AIXI как идеализированный, невычислимый агент. ML/LLM: MDL, Occam's razor и осторожная аналогия между большой языковой моделью и вычислимым приближением к универсальному предсказанию — именно аналогия, а не установленная теорема Хаттера о конкретных LLM. Принцип Ландауэра, predictive information и free energy principle можно обсуждать рядом, но FEP происходит из вариационного вывода и статистической физики, а не «рождается» непосредственно из колмогоровской сложности.
Модуль 11. -дивергенции и вариационные характеризации. -дивергенции включают KL, total variation, , squared Hellinger и Jensen–Shannon divergence. Rényi divergence следует рассматривать отдельно: при фиксированном порядке она связана монотонным логарифмическим преобразованием с соответствующей Hellinger/power -дивергенцией, но сама в общем случае не является -дивергенцией. Donsker–Varadhan для KL, Gibbs variational principle, Pinsker и другие связи. ML: исходный minimax GAN при оптимальном discriminator и идеализированной постановке связан с JS divergence; f-GAN обобщает конструкцию на -дивергенции; MINE использует DV-представление.
Модуль 12. Информационная теория обобщения. PAC-Bayes и границы через взаимную информацию между выборкой и результатом алгоритма. Они могут быть data- и algorithm-dependent и потому концептуально тоньше грубого подсчёта параметров, но для глубоких сетей нередко остаются трудновычислимыми или численно vacuous. Почему LLM хорошо генерализуют, несмотря на overparameterization, — открытая исследовательская задача; MDL, flatness и information-theoretic bounds дают разные частичные объяснения, а не завершённую теорию.
Модуль 13. Reasoning в LLM через теорию информации (frontier). Capstone-модуль, где channel, bottleneck, compression и algorithmic search используются как исследовательские модели reasoning. Chain-of-thought можно моделировать как последовательный вычислительный процесс с промежуточным состоянием, но не следует без доказательства отождествлять его с «многократным использованием канала» или считать глубину CoT прямой аппроксимацией соломоновского поиска. В frontier-части — Ton, Taufiq & Liu, «Understanding Chain-of-Thought in LLMs through Information Theory» (arXiv 2024; ICML 2025), и другие недавние работы; все выводы здесь должны быть особенно чётко разделены на теоремы, эмпирику и гипотезы.
Бонусные модули (факультативно)
Два дополнительных модуля расширяют курс в стороны от основного пути. Они написаны так, чтобы их можно было пропустить, пройти не по номеру или подобрать по интересу. Они опираются на основной курс M1–M13, но не используются им обратно.
Модуль 14. Информационная теория в компьютерном зрении (бонус). Neural image compression непосредственно связан с rate–distortion и learned entropy models. Для generative modeling полезны I–MMSE, denoising и score identities. В representation learning методы нужно разделять: SimCLR, MoCo и CLIP используют contrastive objectives; DINO — self-distillation without labels; MAE — masked reconstruction of pixels. Их можно сравнивать информационно, но нельзя без дополнительного вывода объявлять все MI-maximization. LPIPS — learned perceptual feature distance, SSIM — structural similarity index, FID — квадрат -Wasserstein-расстояния между гауссовскими аппроксимациями распределений признаков (обычно Inception features); это не -дивергенции и не «информационно-теоретические дивергенции» в стандартном смысле. MSE уместен для squared-error/PSNR objectives, хотя часто плохо совпадает с человеческим perceptual quality.
Модуль 15. Информационная геометрия (бонус). Распределения как точки статистического многообразия, Fisher information matrix как риманова метрика и естественный градиент
Эта запись использует невырожденную в регулярной параметризации; вырожденный случай требует работы на идентифицируемом пространстве (§15.3).
KL не является метрикой или римановым расстоянием, но для близких параметров при регулярностных условиях
Регулярные экспоненциальные семейства обладают dually flat структурой относительно пары dual affine connections; это не означает нулевую кривизну Fisher–Rao metric во всех смыслах. TRPO использует приближённое решение KL-constrained surrogate problem и близок к natural-gradient methods, но не является «точным natural gradient». PPO clipping — практическая эвристика и не гарантирует строгого trust region. K-FAC аппроксимирует Fisher/Gauss–Newton curvature при определённых предпосылках; Shampoo — structured preconditioner из семейства full-matrix AdaGrad/second-order-inspired методов, а не просто ещё одна аппроксимация Fisher.
Рекомендуемые треки прохождения
Курс рассчитан так, что можно выбрать глубину под цели и время. Каждый из ниже описанных треков — самодостаточная единица, после прохождения которой у вас будет целостная картина соответствующего уровня.
Базовый трек — M1–M9 (≈30–40 часов). Информационно-теоретический toolkit для практической работы. Покрывает основные конструкции, регулярно встречающиеся вокруг cross-entropy loss, perplexity, KL-регуляризации, ELBO, contrastive objectives и rate–distortion. После M9 получается самостоятельная, целостная картина. Трек подходит ML-инженерам, которые хотят понимать математические основы повседневных методов, но пока не планируют глубоко уходить в исследовательскую теорию.
Полный основной курс — M1–M13 (≈60-80 часов). К базовому треку добавляются продвинутая теория (M10 — алгоритмическая теория информации; M11 — f-дивергенции и вариационные характеризации; M12 — PAC-Bayes и MI-границы обобщения) и capstone-модуль про reasoning в LLM (M13). Нужен тем, кто планирует читать современные исследовательские работы по теоретическому ML или вести собственные исследования.
Полный курс с CV-фокусом — M1–M9 + M14 + ключевые места M11. Базовый трек плюс бонусный модуль по computer vision (M14: neural codecs, диффузия через I-MMSE, contrastive в CV, perceptual losses). Из M11 обязательны §11.4-§11.5 (f-GAN и MINE), которые непосредственно используются в M14. Подходит CV-инженерам, которым нужна информационно-теоретическая база именно под их область.
Полный курс с теоретическим фокусом — M1–M13 + M15. Полный основной курс плюс бонусный модуль по Information Geometry. Подходит ML-инженерам в RL (естественный policy gradient), нормирующих потоках, тонкой оптимизации — везде, где обычный градиентный спуск сталкивается с плохо обусловленными параметризациями.
Замечания. Бонусные M14 и M15 не обязательны для основной линии курса — их можно проходить в любом порядке после M13 или подбирать по интересу. Если хочется и того и другого — порядок не важен, они независимы.
1.9. Справочник: полный аннотированный список литературы
Материалы
Курс не привязан жёстко к одному учебнику. Источники сгруппированы по их роли.
Современный backbone (математическая строгость + современная подача).
- Polyanskiy & Wu, «Information Theory: From Coding to Learning» (2025) — современный учебник, делающий связь IT и ML центральной с первой страницы. Используется как основной справочник по строгим доказательствам.
- MacKay, «Information Theory, Inference, and Learning Algorithms» (2003) — классика, в которой теория информации с самого начала подаётся в связке с машинным обучением и байесовским выводом. Свободно доступна на сайте автора; особенно хороша для интуиции и байесовской перспективы.
Классические доказательства как справочник.
- Cover & Thomas, «Elements of Information Theory», 2-е изд. (2006) — каноническая книга для аккуратных доказательств.
- Csiszár & Körner, «Information Theory: Coding Theorems for Discrete Memoryless Systems» — глубокая книга по комбинаторной стороне.
Probabilistic ML спутник.
- Murphy, «Probabilistic Machine Learning: An Introduction» и «Probabilistic Machine Learning: Advanced Topics» (2022, 2023) — стандартный современный учебник по ML с правильной информационно-теоретической базой. Хороший мост между нашими модулями и общим современным ML.
Узкие специализации.
- Tsybakov, «Introduction to Nonparametric Estimation» (2009) — для аккуратных нижних границ через теорию информации: Fano, Le Cam, Assouad. Используется в Модулях 5 и 12.
- Yamanishi, «Learning with the Minimum Description Length Principle» (2023) — углубление MDL. Используется в Модуле 10.
- Jurafsky & Martin, «Speech and Language Processing», 3-е изд., online manuscript (2026) — NLP-домен. Используется в Модулях 6 и 13.
Практика и код.
- Zhang, Lipton, Li, Smola, «Dive into Deep Learning» — практические Python-примеры для энтропии, кросс-энтропии и KL.
Квантизация моделей (для Модуля 9).
- Frantar et al., «GPTQ» (ICLR 2023); Lin et al., «AWQ» (MLSys 2024); Xiao et al., «SmoothQuant» (ICML 2023) — методы post-training quantization для развёртывания LLM. Они хорошо иллюстрируют инженерный компромисс «размер / скорость / ошибка», но не являются прямыми следствиями теоремы скорость–искажение.
Computer Vision (для Модуля 14).
- Torralba, Isola, Freeman, «Foundations of Computer Vision» (MIT VisionBook, 2024) — общий современный CV-фон.
- Ballé, Laparra, Simoncelli, «End-to-end Optimized Image Compression» (2017) и Ballé et al., «Variational Image Compression with a Scale Hyperprior» (2018) — основополагающие работы по нейронным кодекам, базис §14.2.
- Blau & Michaeli, «Rethinking Lossy Compression: The Rate-Distortion-Perception Tradeoff» (2019) — теоретический фундамент §14.4.
- Mentzer et al., «High-Fidelity Generative Image Compression» (HiFiC, 2020) — практический перцептивный кодек.
- Radford et al., «Learning Transferable Visual Models From Natural Language Supervision» (CLIP, 2021) — основа §14.5; IB-интерпретация возможна, но не является основным утверждением статьи.
- Chen et al., «A Simple Framework for Contrastive Learning» (SimCLR); He et al., «Momentum Contrast» (MoCo); Grill et al., «Bootstrap Your Own Latent» (BYOL); Caron et al., «Emerging Properties in Self-Supervised Vision Transformers» (DINO); Oquab et al., «DINOv2»; He et al., «Masked Autoencoders Are Scalable Vision Learners» (MAE) — разные семейства SSL-методов для §14.6.
Информационная геометрия, RL и generative flows (для Модуля 15).
- Amari, «Information Geometry and Its Applications» (Springer, 2016) — корневая учебниковая ссылка Модуля 15.
- Amari, «Natural Gradient Works Efficiently in Learning» (1998) — основополагающая работа по естественному градиенту.
- Schulman et al., «Trust Region Policy Optimization» (2015) и «Proximal Policy Optimization Algorithms» (2017) — основа §15.5.
- Kakade, «A Natural Policy Gradient» (2001) — переход естественного градиента в RL.
- Haarnoja et al., «Soft Actor-Critic» (2018) — maximum-entropy RL.
- Martens & Grosse, «Optimizing Neural Networks with Kronecker-factored Approximate Curvature» (K-FAC, 2015); Gupta, Koren & Singer, «Shampoo» (2018); Anil et al., «Scalable Second-Order Optimization for Deep Learning» (2020) — структурное предобусловливание и приближения кривизны.
- Lipman et al., «Flow Matching for Generative Modeling»; Liu et al., «Flow Straight and Fast»; Song et al., «Score-Based Generative Modeling through Stochastic Differential Equations» — основа §§15.6–15.7.
- Ouyang et al., «Training Language Models to Follow Instructions with Human Feedback» (InstructGPT); Rafailov et al., «Direct Preference Optimization» — основа capstone о RLHF/DPO.
Русскоязычные ресурсы.
- Верещагин, Успенский, Шень, «Колмогоровская сложность и алгоритмическая случайность» (МЦНМО, 2013) — фундаментальная книга по алгоритмической теории информации.
- Вьюгин, «Математические основы машинного обучения и прогнозирования» (МЦНМО, 2022) — современная книга, охватывающая PAC-Bayes и online learning.
- Учебник ШАД/Яндекса: «Энтропия и семейство экспоненциальных распределений» — полезный русскоязычный материал к Модулю 8.
Frontier reasoning.
- Ton, Taufiq & Liu, «Understanding Chain-of-Thought in LLMs through Information Theory» (ICML 2025) — информационно-теоретический анализ шагов CoT.
Обязательные оригинальные работы для полного прочтения.
- Shannon, «A Mathematical Theory of Communication» (1948) — один из лучших научных текстов XX века, читается неожиданно легко.
- Tishby, Pereira, Bialek, «The Information Bottleneck Method» (1999) — основа Модуля 9.
- Belghazi et al., «MINE: Mutual Information Neural Estimation» (2018) — связь MI и нейросетевых вариационных оценок.
- Delétang et al., «Language Modeling Is Compression» (ICLR 2024) — прямая связь IT и современных языковых моделей.
- Hutter, «Universal Artificial Intelligence» (2005) — основа Модуля 10.
- Guo, Shamai, Verdú, «Mutual Information and Minimum Mean-Square Error in Gaussian Channels» (2005) — I–MMSE identity, основа связи с диффузионными моделями.
- Amari, «Natural Gradient Works Efficiently in Learning» (1998) — фундаментальная работа по NGD.
Для интуиции.
1.10. Факультативное математическое углубление I: равномерный источник
Второй проход. Ни один следующий модуль не требует помнить детали этого доказательства. Его цель — показать, что логарифм не был угадан по красивой форме: он вынужден согласованностью многоэтапного выбора.
Пусть
обозначает неопределённость равномерного выбора из вариантов. Нам понадобятся два требования.
Монотонность. Если равновероятных вариантов стало больше, неопределённость не должна уменьшаться.
Согласованность двухэтапного выбора. Выбор одного из равновероятных исходов можно описать как выбор одной из равновероятных групп, а затем одного из элементов внутри группы. Поэтому
Теперь докажем точную теорему.
Теорема. Если не убывает и
для всех , то существует константа такая, что
Доказательство. Подставим :
откуда . Из монотонности следует для всех .
Здесь есть маленькая, но важная развилка. Аксиомы допускают вырожденное решение ; оно соответствует . Если решение невырождено, существует хотя бы одно с . Зафиксируем такое .
Из функционального уравнения по индукции получаем для любого целого
Теперь зафиксируем произвольное . Для каждого положим
Тогда
Поскольку не убывает,
Используя формулу для степеней, получаем
Можно разделить на , потому что и :
Но из определения одновременно следует
Обе величины, и , лежат в интервале длины . Следовательно,
Левая часть от не зависит, а оценка верна для любого . Переходя к пределу , получаем
Значит,
В невырожденном случае ; вместе с решением получаем .
Что именно мы доказали
Мы получили логарифмическую форму только на равномерных распределениях. Непрерывность здесь не использовалась: функция пока определена на натуральных . Чтобы перейти к произвольным вероятностям, понадобится взвешенная группировка — содержательно более сильное требование, чем простая аддитивность независимых источников.
1.11. Факультативное математическое углубление II: от группировки к формуле Шеннона
Второй проход. Этот раздел завершает доказательство. Основная идея важнее техники: неопределённость многоэтапного выбора должна раскладываться по тому же принципу, что и ожидаемая стоимость решения дерева.
Рассмотрим функцию на конечных вероятностных векторах. Переименование исходов ничего не меняет; исходы нулевой вероятности можно удалить; непрерывна на симплексе.
Ключевое требование — взвешенная группировка. Пусть сначала выбирается группа с вероятностью , а затем внутри неё исход с условной вероятностью . Тогда
Это конечная форма цепного правила: неопределённость первого этапа плюс средняя неопределённость второго.
Шаг 1. Рациональные вероятности
Пусть , где — положительные целые и . Представим равновероятных микроисходов и объединим их в группы размеров . Выбор микроисхода можно описать двумя способами.
Сразу выбрать один из исходов стоит . Сначала выбрать группу, а затем элемент внутри группы —
По группировке эти выражения равны:
Подставляем результат §1.10, :
Формула Шеннона получена для всех распределений с рациональными вероятностями.
Шаг 2. Произвольные вероятности
Рациональные точки плотны в вероятностном симплексе. Непрерывность переносит формулу на произвольные вещественные вероятности:
с соглашением .
Аксиомы всё ещё допускают нулевую меру . Нормировка одновременно исключает её и выбирает единицу. Если потребовать
то , и формула принимает привычный вид
Почему одной аддитивности независимых источников недостаточно
Здесь легко сделать слишком сильный вывод. Семейство энтропий Реньи
тоже аддитивно для независимых распределений и тоже равно на равномерном распределении. Поэтому логарифмическая шкала и product-additivity ещё не выделяют Шеннона. Выделяет его взвешенная группировка, то есть правильный учёт того, с какой вероятностью мы попадаем в каждую ветвь второго этапа.
Контрпример в числах
Этот контрпример стоит увидеть явно: качественное утверждение выше легко принять, не заметив, насколько оно точное. Возьмём энтропию Реньи порядка :
На равномерном источнике она даёт логарифм. Для
поэтому
На независимых произведениях она аддитивна. Для независимых и :
И тем не менее взвешенная группировка нарушается. Пусть
Прямое вычисление даёт
Опишем тот же выбор в два этапа: сначала группа или с вероятностями , затем исход внутри выбранной группы. Шенноновская правая часть была бы равна
Числа не совпадают: против . То есть проходит оба более слабых теста и не проходит тождество группировки — именно поэтому выводу выше и потребовалась более сильная аксиома. Обратите внимание и на то, чему это не противоречит: §§1.10–1.11 нигде не утверждали, что логарифмической шкалы и аддитивности на произведениях достаточно. Они являются необходимыми следствиями аксиом, а показывает, что сами по себе они этого не обеспечивают.
Вот теперь формула не постулирована и не угадана. Мы увидели весь механизм: многоэтапный выбор заставляет появиться логарифм в равномерном случае, группировка переносит его на рациональные вероятности, непрерывность закрывает вещественный симплекс, а нормировка выбирает биты.