Модуль 8. Максимальная энтропия, экспоненциальные модели и KL-регуляризация
Как читать этот модуль. Основной маршрут — §§8.1–8.9. В §§8.1–8.5 мы построим принцип MaxEnt от постановки задачи до условных лог-линейных моделей; §§8.6–8.9 покажут ту же вариационную механику в softmax, энергетических моделях и постобучении LLM. §8.10 — самостоятельное математическое углубление об экспоненциальных семействах, основных распределениях и достаточных статистиках; его можно оставить на второй проход.
8.1. От неполного знания к распределению
До сих пор распределение обычно стояло в условии задачи. Нам давали , и мы вычисляли энтропию; давали и , и мы находили KL; задавали канал, и мы исследовали его пропускную способность. Теперь само распределение должно стать ответом.
Представим обычную шестигранную кость. Мы не видели её бросков, но знаем, что среднее значение равно . Этого явно недостаточно, чтобы восстановить все шесть вероятностей. Например, оба распределения
и
имеют среднее . Между ними — бесконечно много других вариантов. Ограничение отсекает часть симплекса, но не выбирает одну точку.
В ML эта ситуация встречается чаще, чем кажется.
- Мы знаем эмпирические средние признаков и хотим получить условное распределение классов.
- Сеть выдала логиты, и нужно превратить систему оценок в вероятности.
- У нас есть базовая политика и функция награды; требуется улучшить поведение, не разрушив всё, чему модель научилась раньше.
- Энергетическая модель умеет назначать состояниям оценки, но ещё должна согласовать их в одно нормированное распределение.
Во всех этих задачах известна часть структуры, а полное вероятностное описание ещё нужно достроить.
Принцип максимальной энтропии (maximum entropy, MaxEnt), сформулированный Эдвином Джейнсом как правило вывода из неполной информации, предлагает простой ответ: среди распределений, удовлетворяющих явно заданным ограничениям, выбрать распределение с наибольшей энтропией.
На конечном множестве состояний:
Содержательная часть этого принципа не в лозунге «выбрать самое случайное». Она в более аккуратной дисциплине:
не вводить различия между допустимыми состояниями, для которых в постановке нет основания.
Если нам уже дано базовое распределение , естественный вопрос меняется. Теперь не нужно возвращаться к равномерности; нужно изменить базу ровно настолько, насколько требуют новые ограничения. Получается относительная форма MaxEnt:
где — множество распределений, совместимых с известными средними, а — базовое распределение (reference distribution). Если равномерно на конечном множестве, то
и минимизация KL совпадает с обычным MaxEnt.
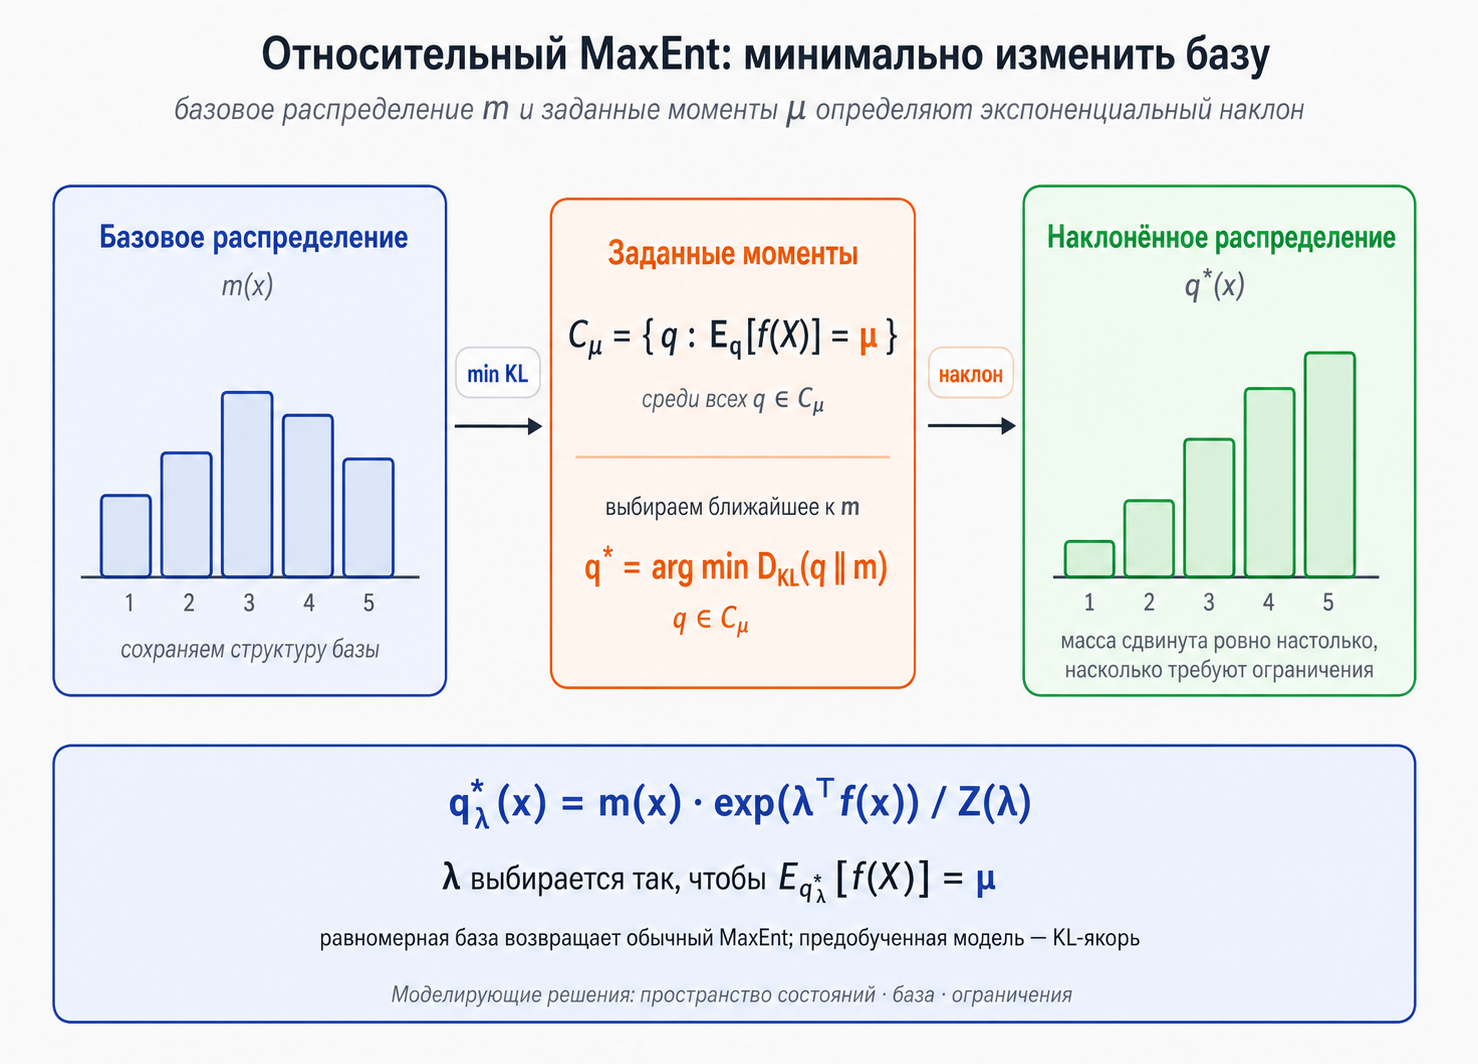
Эта относительная запись особенно важна для ML. Базой может быть не абстрактная равномерность, а предобученная языковая модель, априорное распределение, прежняя версия политики или естественная мера на пространстве состояний.
Но прежде чем выводить формулу, нужно честно назвать три моделирующих решения.
- Пространство состояний. Что считается одним элементарным исходом: число успехов, бинарная конфигурация, класс, токенная последовательность?
- База. От какого распределения или меры мы считаем отклонение?
- Ограничения. Какие средние действительно известны и почему именно они считаются существенными?
MaxEnt не угадывает «истинное распределение» за пределами этих решений. Он делает другое: после того как модель задачи задана, убирает произвол из её достройки.
В этом модуле одна и та же конструкция появится несколько раз:
У MaxEnt наклон задают ограничения на моменты. У softmax — логиты и температура. У энергетической модели — отрицательная энергия. У KL-регуляризованной политики — награда относительно базовой модели. Это не четыре названия одной теоремы, а четыре задачи, в которых оптимум строится одной математической операцией.
8.2. Экспоненциальный наклон и информационная проекция
Рассмотрим конечное пространство и строго положительную базу
Пусть известны средние функций :
Нужно решить
при нормировке и этих линейных ограничениях.
Вывод через множители Лагранжа
Лагранжиан можно записать как
Для внутреннего решения :
Перенесём члены и прочитаем результат в логарифмической шкале:
Ограничения меняют логарифм вероятности линейно. После экспоненцирования получаем
где
— нормировочная константа (partition function).
Вот и вся механика экспоненциального наклона (exponential tilting). База сохраняет исходную относительную массу состояний, а множитель усиливает или ослабляет её согласно ограничениям. Если равномерно, остаётся знакомая форма
Знак параметра зависит от языка задачи. В статистике удобно писать положительную оценку ; в физике часто вводят энергию и получают . Распределение одно и то же — меняется интерпретация функции в экспоненте.
Нормировочная константа как вычислительный объект
Положим
Тогда
и
Эти две строки превращают красивую форму распределения в рабочий алгоритм. Чтобы выполнить ограничения, нужно решить уравнение
Градиент сообщает текущие модельные средние, а гессиан показывает, как они меняются при сдвиге параметров. Поскольку гессиан является ковариационной матрицей, выпукла. Если признаки линейно избыточны, параметры могут быть неединственными; после удаления избыточности выпуклость становится строгой в соответствующих направлениях.
Полезно заметить знакомую форму. В softmax превратится в logsumexp; в экспоненциальном семействе — в логарифм нормировочной константы; в KL-регуляризованной политике — в мягкую ценность базовой политики. Одна и та же функция будет одновременно нормировать распределение и хранить его моменты в производных.
Точный KL-разрыв
Пусть удовлетворяет ограничениям и имеет найденную форму. Для любого другого допустимого :
Это пифагорово тождество для информационной проекции (I-projection). Его короткое доказательство показывает, почему результат сильнее простого условия стационарности. Из
следует
То же выражение получается при , потому что оба распределения имеют одинаковые средние признаков. Значит, разность равна .
Формулу удобно прочитать словами: любой другой способ выполнить те же ограничения отклоняется от базы сильнее ровно на KL до оптимума. MaxEnt-решение не просто одно из допустимых; оно является ближайшей к базе точкой в выбранном направлении KL.
Почему максимум энтропии не является случайным рецептом
Есть и комбинаторная интуиция. Для равномерной базы число последовательностей длины с эмпирическим распределением имеет порядок
Высокоэнтропийные типы реализуются большим числом микроскопических последовательностей. Для общего i.i.d.-распределения вероятность увидеть тип имеет экспоненциальный порядок
После условления на ограничения доминирует тип с минимальным KL к базе. Это не отдельная магия: та же информационная проекция появляется теперь как наиболее вероятная макроскопическая конфигурация длинной выборки.
Условия, которые нужно держать рядом с формулой
Основной результат силён, но не безусловен.
- Ограничения должны быть совместимы.
- Если требуемый вектор лежит на границе выпуклой оболочки значений , оптимум может иметь нули, а некоторые компоненты — уходить в бесконечность.
- В непрерывном случае нужно выбрать базовую меру и проверить конечность .
- Ограничения-неравенства требуют условий Каруша—Куна—Таккера.
Эти оговорки не меняют главного механизма. Они лишь говорят, когда внутренняя гладкая формула описывает оптимум напрямую, а когда к нему нужно прийти предельным переходом или более общим выпуклым анализом.
8.3. Пространство состояний и базовая мера
У MaxEnt есть полезная неприятная черта: он заставляет заметить решения, которые в другой модели легко принять за «нейтральные». Даже идеально решённая оптимизация даст другой ответ, если мы изменим то, что считаем элементарным состоянием.
Пусть — число успехов в бинарных испытаниях и известно только
Рассмотрим две постановки.
Модель A: элементарное состояние — значение счётчика
Если пространство состояний равно
и база равномерна по значениям , то MaxEnt даёт
Это усечённое геометрическое распределение. Каждое число считается одним состоянием, независимо от того, сколькими способами оно может возникнуть.
Модель B: элементарное состояние — бинарная конфигурация
Теперь состоянием является полный вектор
а база равномерна по всем микросостояниям. Тогда
Нормировка факторизуется, поэтому координаты становятся независимыми случайными величинами Бернулли с
Следовательно,
Почему ответы различаются? Значению соответствует
бинарных конфигураций. Поэтому равномерная база по микросостояниям индуцирует на счётчиках вовсе не равномерную меру, а массу, пропорциональную :
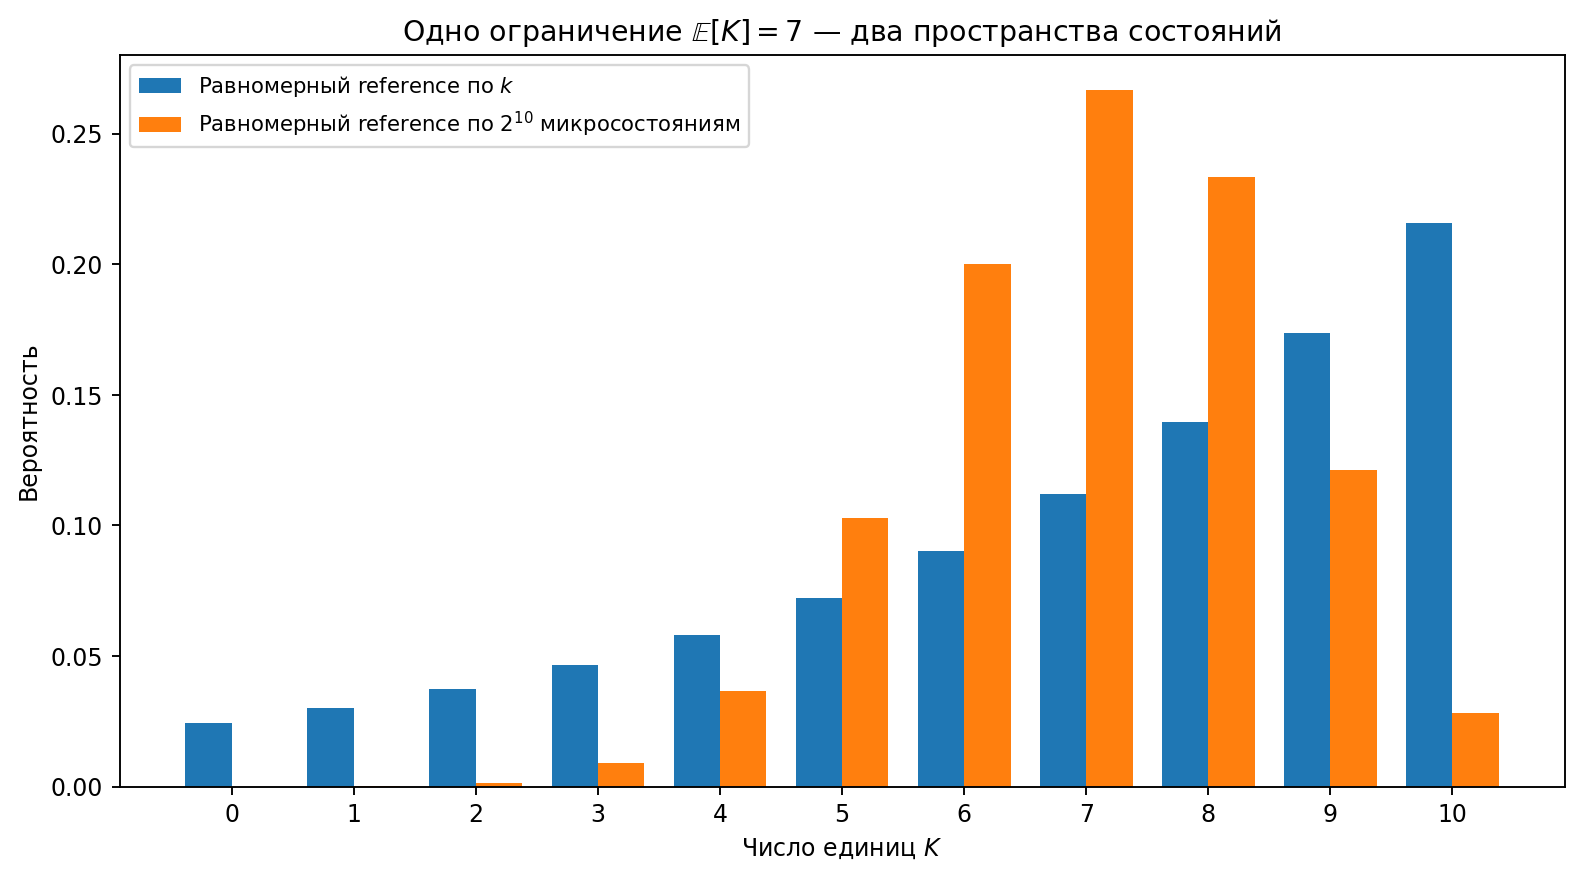
Разницу легко увидеть численно. При и модель A имеет и оставляет заметную массу на всём диапазоне; в частности, . Модель B даёт и биномиальное распределение, сосредоточенное около семи; здесь .
Обе модели точно удовлетворяют одному среднему. Они отвечают на разные вопросы.
Это не экзотическая ловушка статистической механики. В ML выбор состояния появляется повсюду:
- считать ли многометочный ответ одной категорией или набором бинарных решений;
- моделировать ли последовательность целиком или факторизовать её по токенам;
- считать ли перестановки объектов разными состояниями;
- использовать ли равномерную базу по классам или предобученное распределение;
- считать ли две параметризации одной функции разными гипотезами.
Отсюда практическое правило:
Перед фразой «выберем максимально неопределённое распределение» назовите пространство состояний, базу и ограничения.
Для непрерывных величин этот вопрос ещё острее. Дифференциальная энтропия меняется при смене координат и единиц измерения. Относительная энтропия к явно выбранной базовой мере делает моделирующее предположение видимым и потому часто является более надёжной отправной точкой.
8.4. Классические MaxEnt-распределения и AWGN-канал
После выбора пространства состояний знакомые распределения перестают выглядеть случайным меню из учебника. Они возникают как ответы на разные наборы информации.
Равномерное распределение
На конечном множестве из состояний, если известно только условие нормировки,
Это тот же факт, который в Модуле 2 записывался как
Здесь он получает другую интерпретацию: равномерность — не универсальный априорный закон, а MaxEnt-ответ на конечном симметричном пространстве без дополнительных ограничений.
Экспоненциальное распределение
На полуоси среди плотностей с заданным положительным средним
максимальную дифференциальную энтропию имеет
Носитель здесь является частью информации. На всей прямой одного ограничения на среднее недостаточно: распределение можно растягивать, не меняя среднее, и увеличивать дифференциальную энтропию без границы.
Гауссовское распределение
На среди плотностей с фиксированными средним и дисперсией
максимальную дифференциальную энтропию имеет
В натах
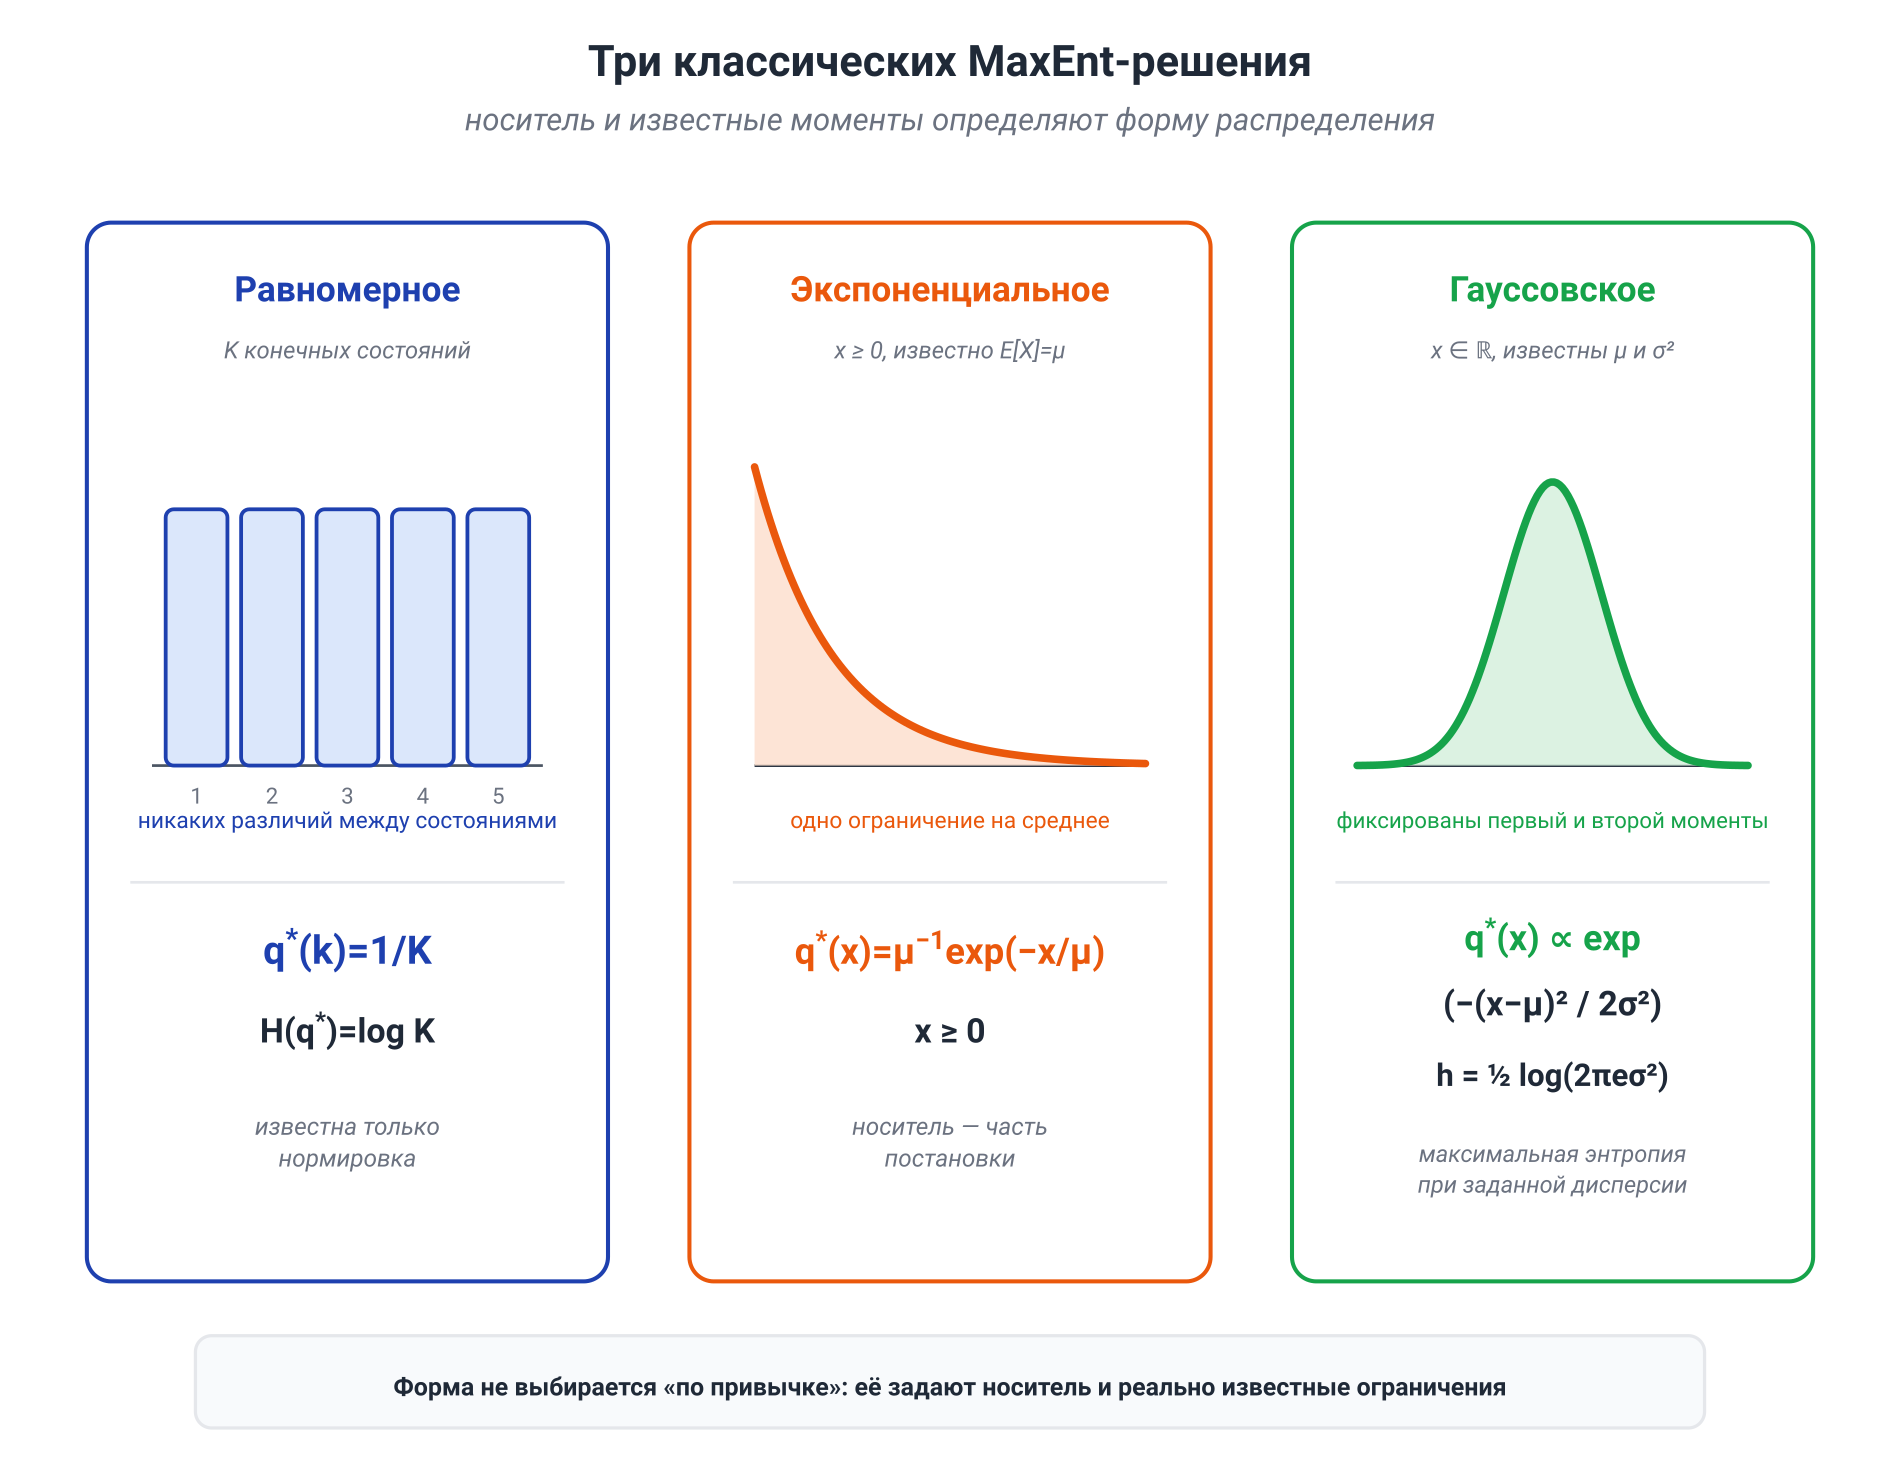
Это свойство даёт важную характеристику гауссовского распределения: при фиксированной ковариации никакая другая плотность не имеет большей дифференциальной энтропии. Но оно не заменяет центральную предельную теорему. У энтропийных версий CLT есть собственные условия и доказательства; фраза «сумма становится гауссовской, потому что энтропия растёт» слишком быстро соединяет разные результаты.
Почему гауссовский вход достигает пропускной способности AWGN
Теперь вернёмся к каналу из Модуля 7:
где и независимы. В битах
Шум фиксирован, значит максимизировать нужно энтропию выхода. Его дисперсия удовлетворяет
По MaxEnt-свойству гауссиана
Вычитая
получаем
Равенство достигается при
потому что тогда выход тоже гауссовский и использует всю допустимую дисперсию.
На этом месте легко сократить рассуждение до «гауссовский вход максимизирует энтропию, поэтому максимизирует MI». Правильная цепочка чуть длиннее и важнее: гауссовский вход делает гауссовским выход; именно максимальная энтропия выхода даёт максимальную взаимную информацию при фиксированном шуме.
8.5. Условный MaxEnt и лог-линейные модели
До трансформеров многие NLP-системы строились из признаков, которые инженер задавал вручную: текущее слово начинается с заглавной буквы, предыдущая метка была B-PER, суффикс равен -ing, слово встречается в словаре организаций. Задача была знакомой и по-прежнему актуальной: превратить множество частичных сигналов в нормированное условное распределение.
Пусть — эмпирическое распределение входов, — метка, а
— признаки пары «вход — ответ». Потребуем, чтобы модель воспроизводила их эмпирические средние:
Среди всех условных распределений, удовлетворяющих этим ограничениям, максимизируем условную энтропию
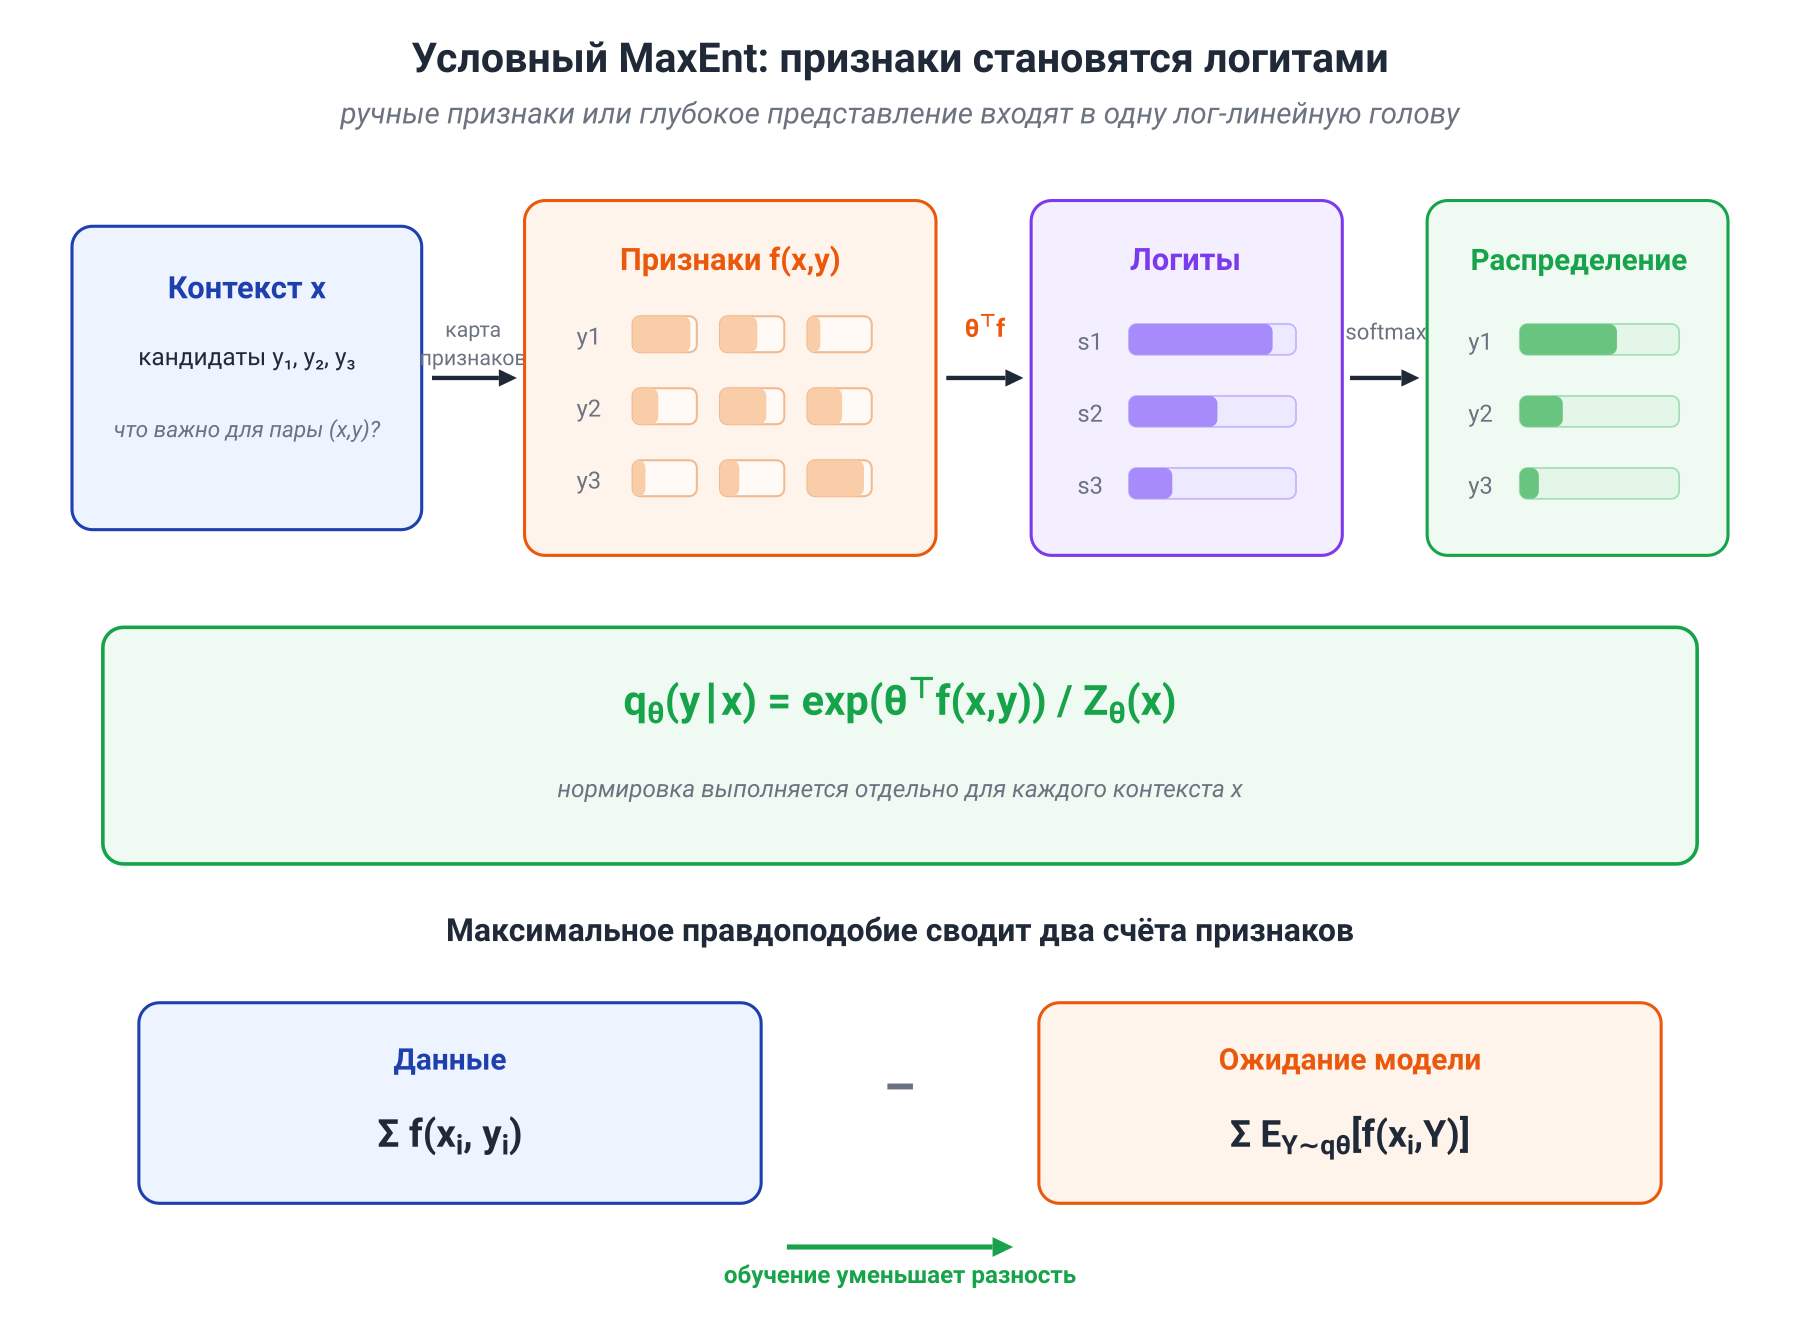
Тот же лагранжев ход приводит к условной лог-линейной модели:
где
Каждый признак добавляет свой вклад в логит, а нормировочная константа превращает сумму вкладов в распределение по ответам. Если — выход последнего скрытого слоя, а — веса линейной головы, перед нами обычный softmax-классификатор. Разница в том, откуда взялись признаки: раньше их проектировал человек, теперь их чаще учит глубокая сеть.
Максимальное правдоподобие и согласование моментов
Для выборки условное логарифмическое правдоподобие равно
Его градиент:
Формулу стоит прочитать до того, как двигаться дальше. Первый член считает признаки, действительно встреченные в данных. Второй спрашивает, сколько тех же признаков ожидает текущая модель. Обучение уменьшает разницу между двумя описаниями выборки.
Если существует конечный внутренний максимум нерегуляризованного правдоподобия, нулевой градиент даёт точное согласование моментов (moment matching):
Это не декоративная аналогия с MaxEnt. В условном экспоненциальном семействе максимальное правдоподобие и условный MaxEnt являются двумя сторонами одной выпуклой двойственности.
Где заканчивается точное утверждение
Теперь можно компактно обозначить область действия.
- Регуляризация добавляет к уравнению моментов собственный член, поэтому равенство меняется.
- Линейно зависимые признаки делают параметры неидентифицируемыми, хотя распределение может быть определено однозначно.
- При линейной разделимости конечного MLE может не существовать: нормы параметров растут, а правдоподобие приближается к супремуму.
- У глубокой сети логиты нелинейно зависят от миллионов весов. Обучение по кросс-энтропии остаётся максимальным правдоподобием условной модели, но не превращает всю сеть в одну простую MaxEnt-задачу с явными ограничениями на внутренние признаки.
Положительный результат при этом остаётся сильным: для лог-линейной головы градиент действительно сравнивает эмпирические и модельные средние признаков.
Историческая линия NLP
Классификаторы максимальной энтропии использовали такие условные модели для разметки и классификации. Maximum Entropy Markov Models (MEMM) нормировали переходы локально для каждого состояния. Conditional Random Fields (CRF) перенесли нормировку на всю последовательность меток:
Современная архитектура может строить признаки гораздо сложнее, но экспоненциальная нормировка никуда не исчезла. Поэтому историческая связь с MaxEnt содержательна: изменилась машина, которая производит оценки, а способ превратить эти оценки в условное распределение сохранился.
Следующий шаг — рассмотреть сам softmax отдельно. Он знаком каждому ML-инженеру, но за одной строкой API скрывается законченная вариационная задача.
8.6. Softmax как решение задачи «оценка + энтропия»
Современный ML использует softmax настолько часто, что он почти перестал выглядеть как идея. Обычно его вводят процедурно: сеть выдаёт логиты, мы применяем экспоненту, нормируем сумму до единицы — и получаем вероятности. Это правильно, но оставляет без ответа более интересный вопрос: почему именно такая нормировка возникает в классификации, генерации и обучении политик снова и снова?
Сильный ответ звучит так: softmax — это MaxEnt-решение. В этой фразе есть важная правда, но её нужно сформулировать точно. Softmax не максимизирует энтропию «вообще» и не выводится из ограничений, которые заранее фиксируют искомые вероятности. Он решает конкретный конфликт: мы хотим предпочитать варианты с высокой оценкой, но не хотим концентрировать распределение сильнее, чем требует эта оценка.
Пусть — логиты, — распределение по вариантам, а энтропия измеряется в натах:
Для температуры рассмотрим задачу
У двух членов здесь разные роли.
- — ожидаемая оценка. Он тянет массу к вариантам с большими логитами.
- — сопротивление преждевременной концентрации. Он вознаграждает распределения, которые сохраняют неопределённость.
- — обменный курс между этими требованиями. Он показывает, сколько единиц ожидаемой оценки мы готовы отдать за дополнительную единицу энтропии.
Решение этой задачи — softmax:
А оптимальное значение равно
Иными словами, logsumexp — это не случайная гладкая замена максимума, а цена оптимального компромисса между оценкой и энтропией.
Точный KL-разрыв
Обозначим
Для любого :
KL-дивергенция неотрицательна, поэтому максимум единственно достигается при . Но главное здесь не только ответ. Мы получили точный разрыв:
Любое отклонение от softmax-распределения оплачивается KL-дивергенцией до оптимума. Это уже не метафора про «мягкий выбор», а полная геометрия задачи.
В каком смысле softmax является MaxEnt
Теперь можно вернуть исходный сильный тезис — но без логической подмены.
Пусть и
Среди всех распределений с тем же ожидаемым логитом,
распределение имеет максимальную энтропию. Действительно, на этом множестве ожидаемая оценка одинакова, поэтому максимизация сводится к максимизации .
Таким образом, корректны две эквивалентные точки зрения:
- регуляризованная: softmax максимизирует «ожидаемая оценка + × энтропия»;
- MaxEnt: softmax максимизирует энтропию при фиксированном уровне ожидаемой оценки, причём этот уровень связан с .
А вот ограничения вида
не выводят softmax: они уже означают и тем самым заранее задают ответ. Это полезный пример того, как верная интуиция может быть испорчена неудачной формализацией.
Температура как параметр обмена
Для логитов получаем:
| , наты | ||
|---|---|---|
При малой температуре один дополнительный пункт логита стоит дорого: распределение быстро концентрируется. При большой температуре тот же разрыв между логитами слабее влияет на вероятности, и энтропия растёт.
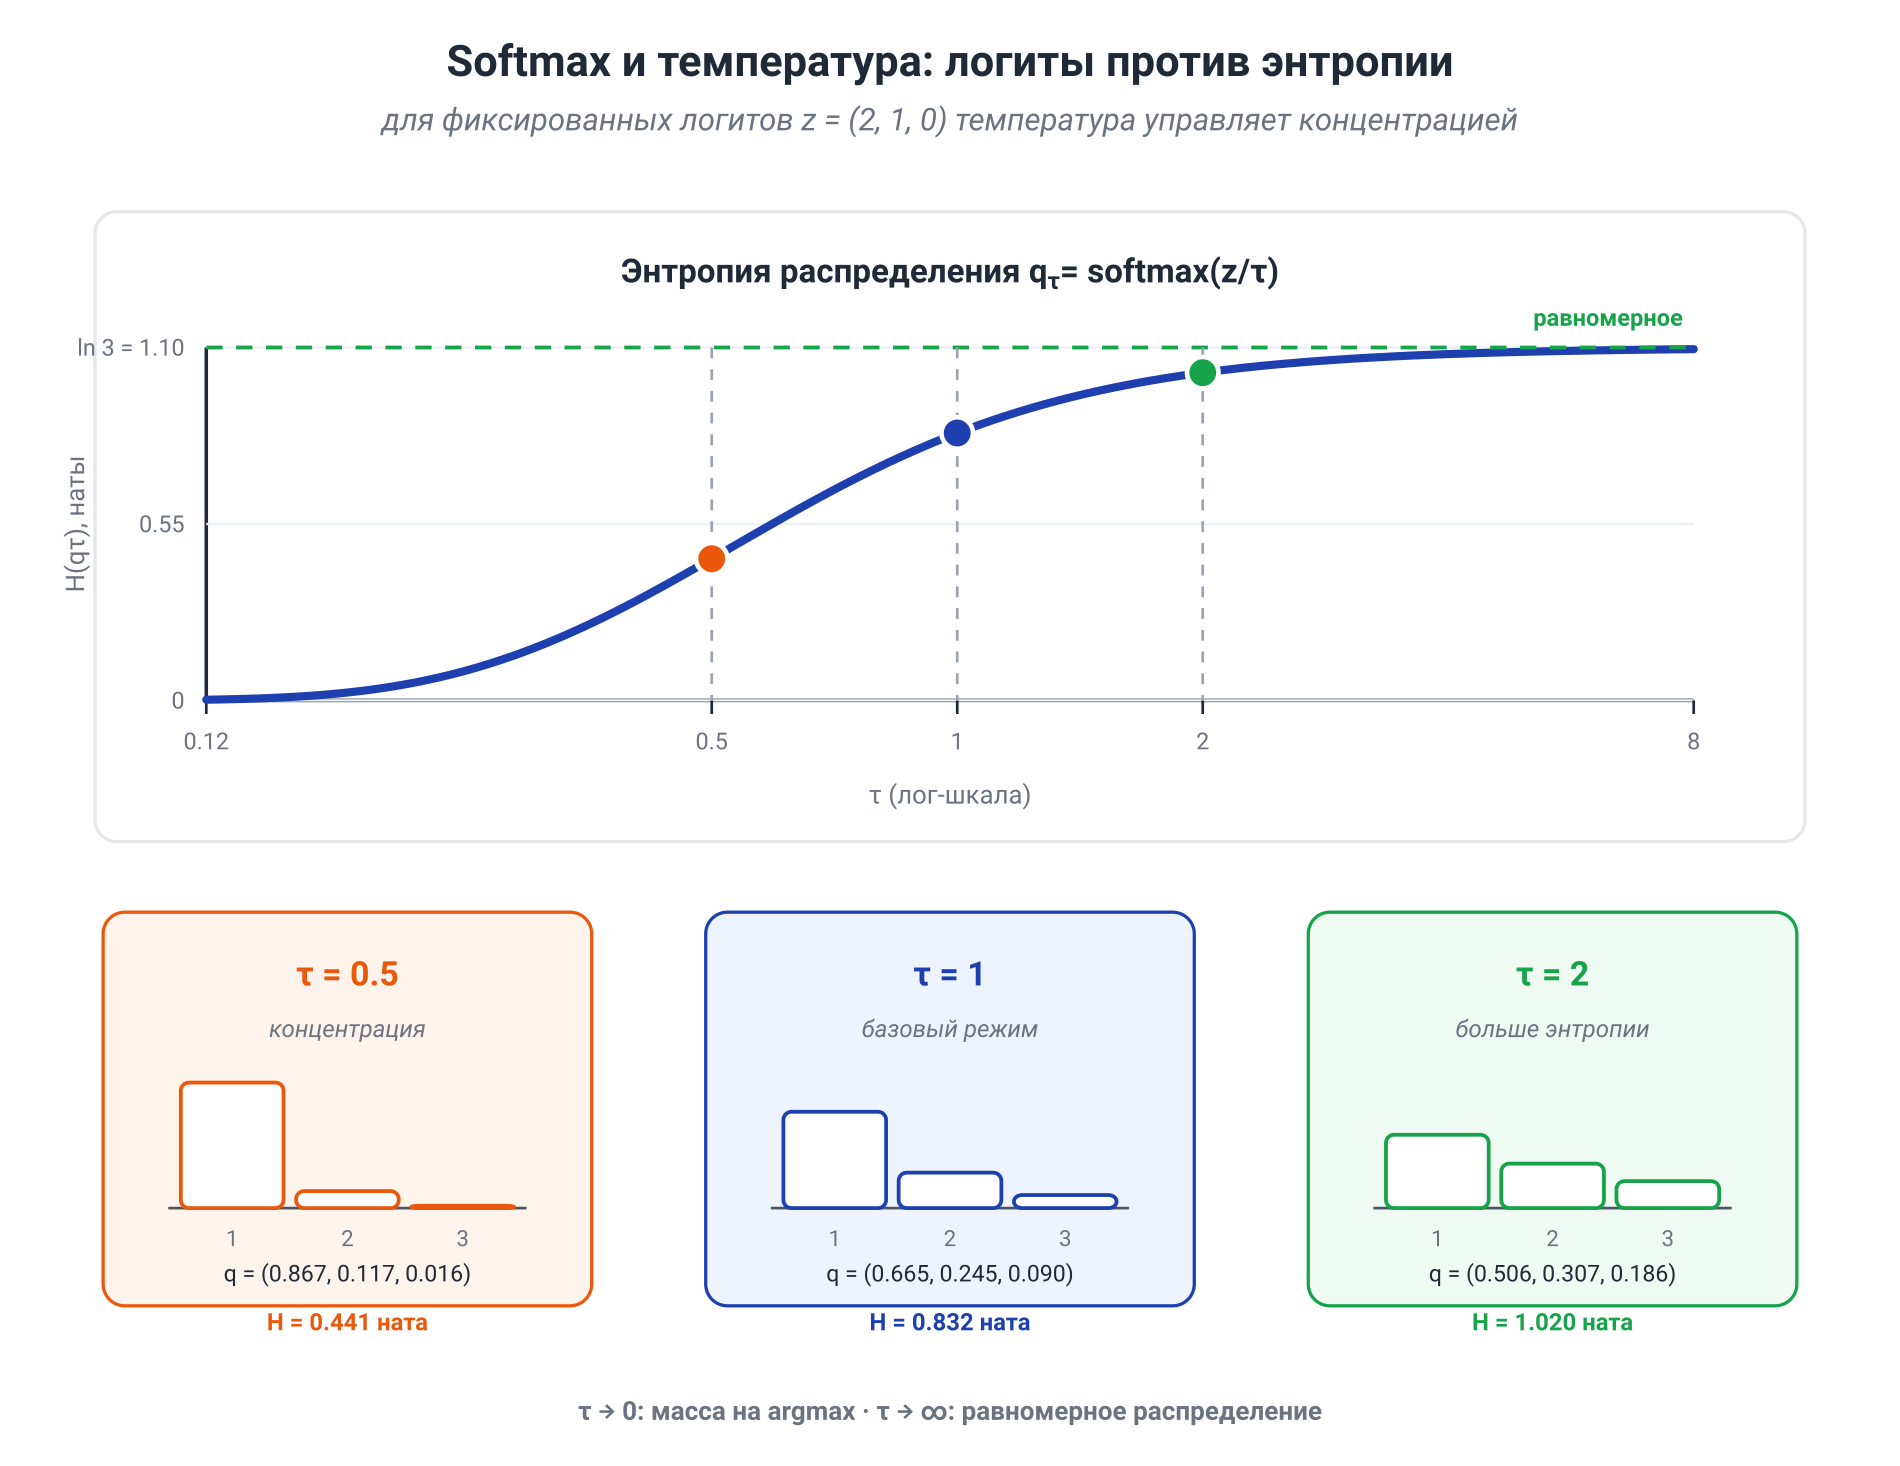
Предельные режимы тоже читаются точно:
- при масса концентрируется на максимизаторах ; если максимум достигается в нескольких классах, предельное распределение равномерно между ними;
- при распределение стремится к равномерному на всех классах;
- добавление одной константы ко всем логитам не меняет softmax;
- умножение логитов на эквивалентно делению температуры на .
Функция
сглаживает максимум:
а её градиент возвращает само оптимальное распределение:
Поэтому softmax одновременно играет три роли: превращает оценки в распределение, решает энтропийно-регуляризованную задачу и является градиентом гладкого максимума.
Граница утверждения
Softmax — не «единственно честный» способ превратить оценки в вероятности. Он единственен как решение этой задачи, с энтропией Шеннона и линейным членом ожидаемой оценки. Если заменить регуляризатор, изменится и отображение: некоторые регуляризаторы, например, дают разреженные распределения с точными нулями.
Но ослаблять основной вывод из-за этого не нужно. Он уже достаточно силён:
softmax — точный оптимум задачи, в которой логиты голосуют за варианты, а энтропия не даёт этим голосам превратиться в более уверенное распределение, чем оправдывает выбранная температура.
На конечном множестве классов нормировочная сумма дёшева. Теперь заменим классы всеми возможными изображениями, конфигурациями или текстовыми последовательностями — и та же идея превратится в энергетическую модель.
8.7. Энергетические модели и нормировочная константа
Softmax можно считать простейшей энергетической моделью. Возьмём состояние , положим
и нормируем по всем классам. Получится тот же softmax.
Пока состояний несколько тысяч, эта операция выглядит почти бесплатной. Но если состоянием является изображение, молекула или вся последовательность токенов, сумма по всем возможным становится астрономической. Именно здесь привычная нормировка превращается из последней строки кода в центральную вычислительную проблему.
Энергетическая модель (energy-based model, EBM) задаёт распределение в виде
Здесь:
- — энергия состояния: меньшая энергия означает большую ненормированную правдоподобность;
- — базовая плотность или базовая мера;
- — нормировочная константа (
partition function).
Энергия умеет отвечать на локальный вопрос: «насколько это состояние совместимо с моделью?» Нормировочная константа заставляет все локальные ответы согласоваться глобально. — цена превращения системы оценок в вероятностную модель.
Связь EBM с MaxEnt
Здесь тоже легко произнести красивую фразу слишком широко: «любая EBM — это MaxEnt». Точная связь зависит от формы энергии.
Если
то
является экспоненциальным семейством. Такая форма возникает из относительного MaxEnt при ограничениях на моменты . В этом случае признаки имеют прямой смысл макроскопических величин, а параметры — множителей Лагранжа.
Если же — произвольная глубокая сеть, Gibbs-форма остаётся корректной, но известной нам системы MaxEnt-ограничений может не существовать в явном виде. Gibbs-форма шире конкретной истории, из которой она могла быть выведена. Это не делает нейросетевую EBM менее содержательной; просто её энергия задаётся моделью, а не списком интерпретируемых моментов.
Градиент логарифмического правдоподобия
Для одного наблюдения отрицательное логарифмическое правдоподобие равно
Если не зависит от , то
и поэтому
На этом месте формулу лучше прочитать как динамику обучения.
Первый член просит понизить энергию наблюдаемого примера. Если бы он был единственным, модель могла бы понизить энергию вообще всех состояний и ничего не выучить. Второй член сравнивает данные с тем, что сейчас генерирует сама модель, и не даёт выиграть таким тривиальным способом.
В литературе эти части часто называют положительной и отрицательной фазами (positive phase, negative phase):
- данные тянут свою энергию вниз;
- модельные примеры получают компенсирующее давление;
- обучение меняет не абсолютный уровень энергии, а рельеф, отделяющий данные от альтернатив.
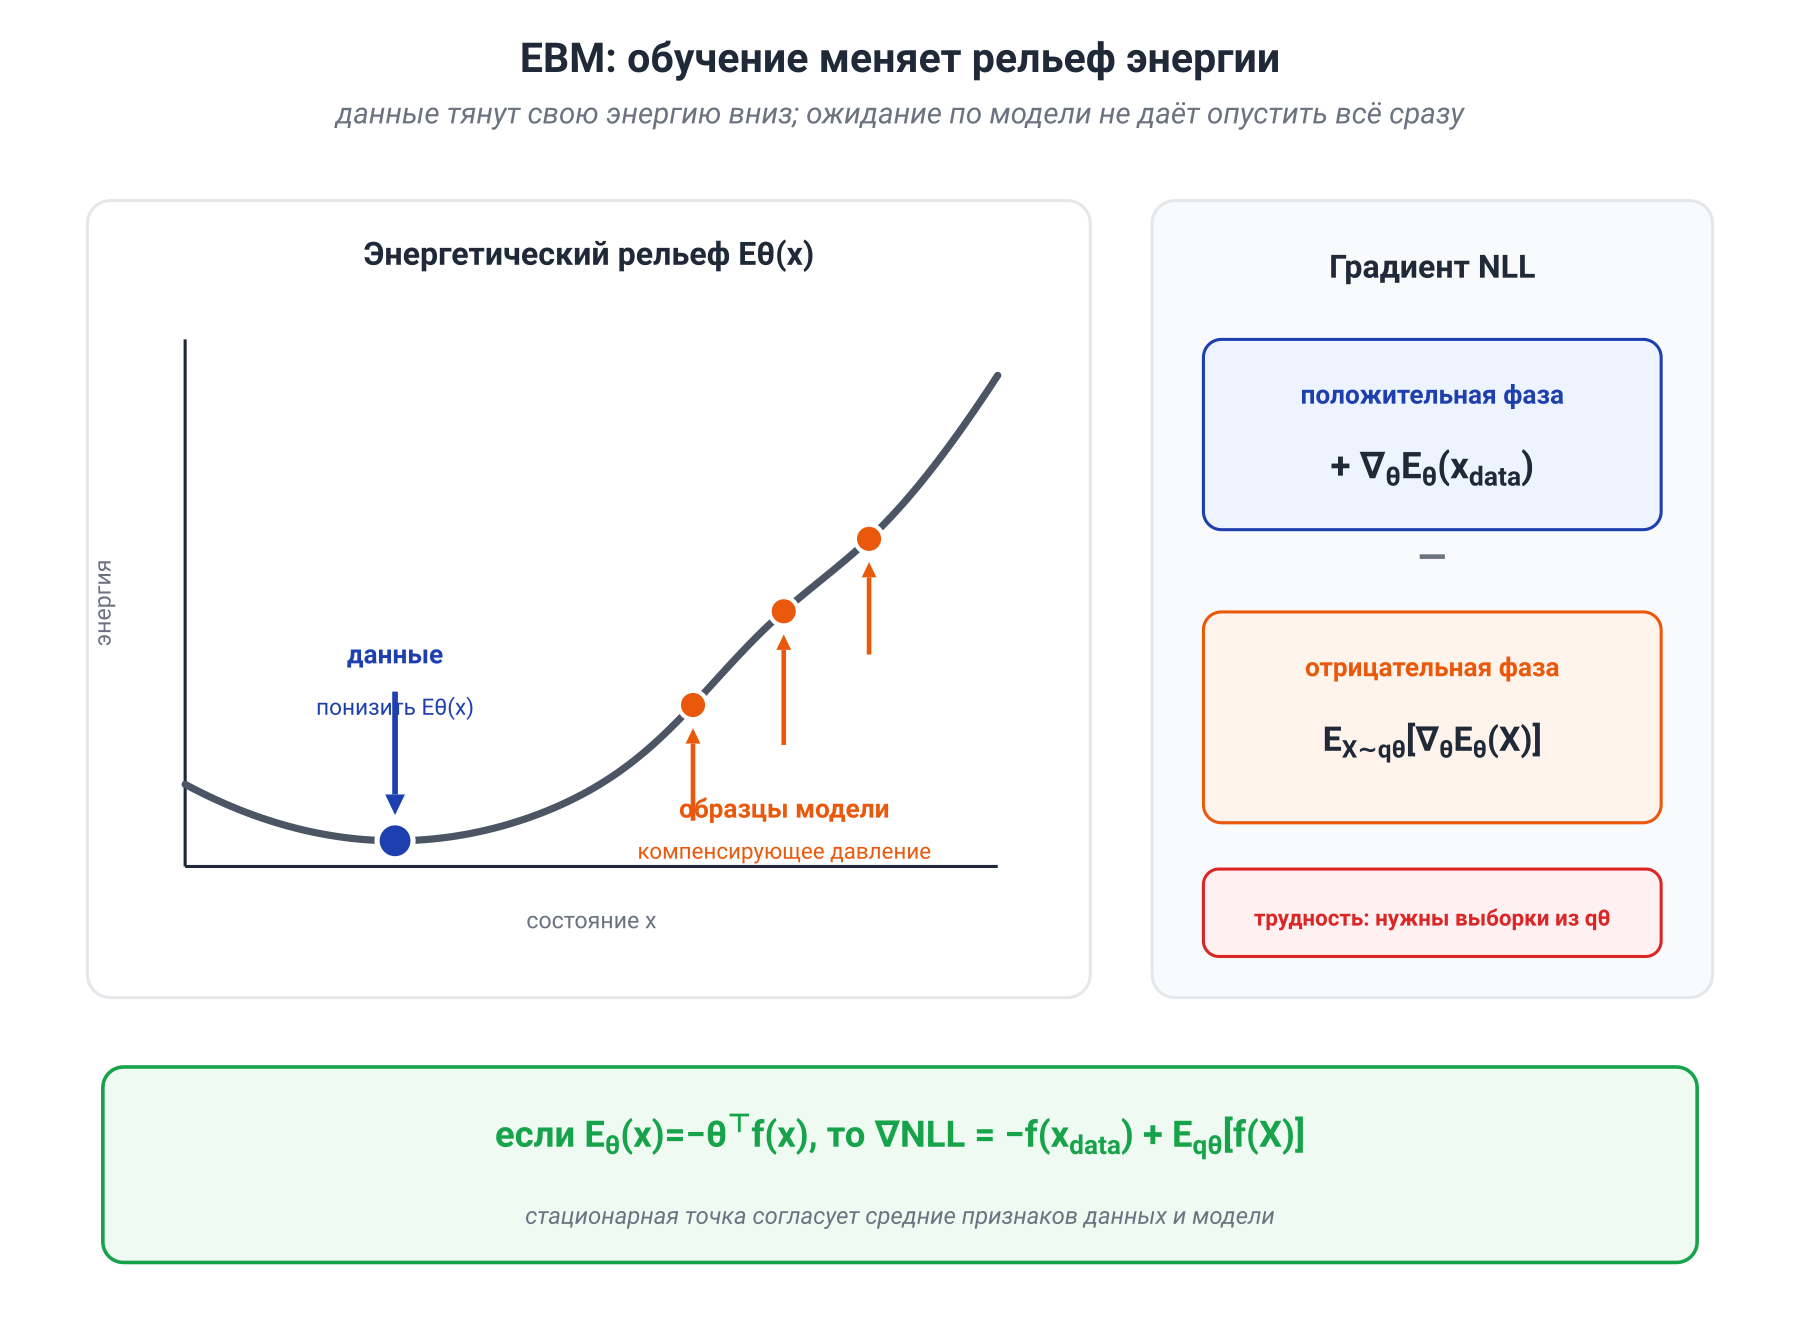
Для линейной энергии градиент принимает особенно прозрачный вид:
После усреднения по данным стационарное условие требует
Так в EBM снова появляется согласование моментов (moment matching). Это тот же механизм, который стоял за классическими MaxEnt-моделями NLP, но теперь он виден непосредственно в градиенте правдоподобия.
Вычислительная трудность
Первый член градиента вычисляется на данных. Второй требует ожидания по текущей модели. Чтобы его оценить, нужно уметь получать образцы из или достаточно хорошо аппроксимировать это ожидание. Для сложной энергии именно это часто оказывается труднее, чем вычислить саму .
Отсюда возникают MCMC, contrastive divergence и другие способы приблизить отрицательную фазу. Их общая задача — понять, какие состояния модель сейчас считает правдоподобными, не перебирая всё пространство.
Согласование скор-функций (score matching) идёт другим путём. Если плотность дифференцируема по , то
Нормировочная константа исчезает, потому что она не зависит от . Поэтому можно обучать скор-функцию (score) без явного вычисления .
Эта связь действительно ведёт к современным моделям на основе скор-функции (score-based models) и диффузионным моделям, но не сводит их к одной статической EBM. Диффузионная модель обычно обучает семейство зависящих от времени скор-функций для распределений с разными уровнями шума, а генерация реализует обращение соответствующего стохастического процесса. Физическая интуиция здесь полезна; буквальное тождество было бы слишком грубым.
Главный переход уже перед нами. В EBM базовая мера задаёт, где масса находилась до энергетического наклона. Если вместо подставить базовую языковую модель, а вместо — награду, получится точная формула KL-регуляризованной политики.
8.8. KL-регуляризованная политика и Gibbs-оптимум
Теперь сделаем одну замену смысла переменных:
- состояние станет ответом на контекст ;
- базовое распределение станет базовой политикой ;
- отрицательная энергия станет нормированной наградой .
Именно поэтому формула, знакомая по статистической физике и MaxEnt, возникает в RLHF и DPO не как украшение, а как аналитический оптимум.
Для фиксированного контекста рассмотрим
где . Оптимизация ведётся по всем распределениям , абсолютно непрерывным относительно : политика не может создать массу там, где базовая политика имеет нулевую вероятность.
Предположим, что
Тогда единственный оптимум имеет вид
Эту формулу действительно стоит запомнить. Она говорит не «выберите softmax-параметризацию и попробуйте её обучить», а нечто сильнее: если целевая функция именно такая, то оптимальное распределение обязано быть экспоненциальным наклоном базовой политики.
Точный разрыв целевой функции
Из определения :
Усредним это равенство по :
После перегруппировки:
Отсюда
и точный недобор любой другой политики равен
Мы получили сразу три факта:
- — глобальный, а не локальный оптимум;
- на носителе базовой политики он единственен;
- недобор любой другой политики измеряется KL-дивергенцией до него.
Это вариационный принцип Гиббса (Gibbs variational principle), или относительный MaxEnt. При равномерной базовой политике он превращается в обычную задачу «награда + энтропия». При неравномерной базе энтропия становится относительной: политика платит не за концентрацию саму по себе, а за отход от того распределения, которое уже умела порождать модель.
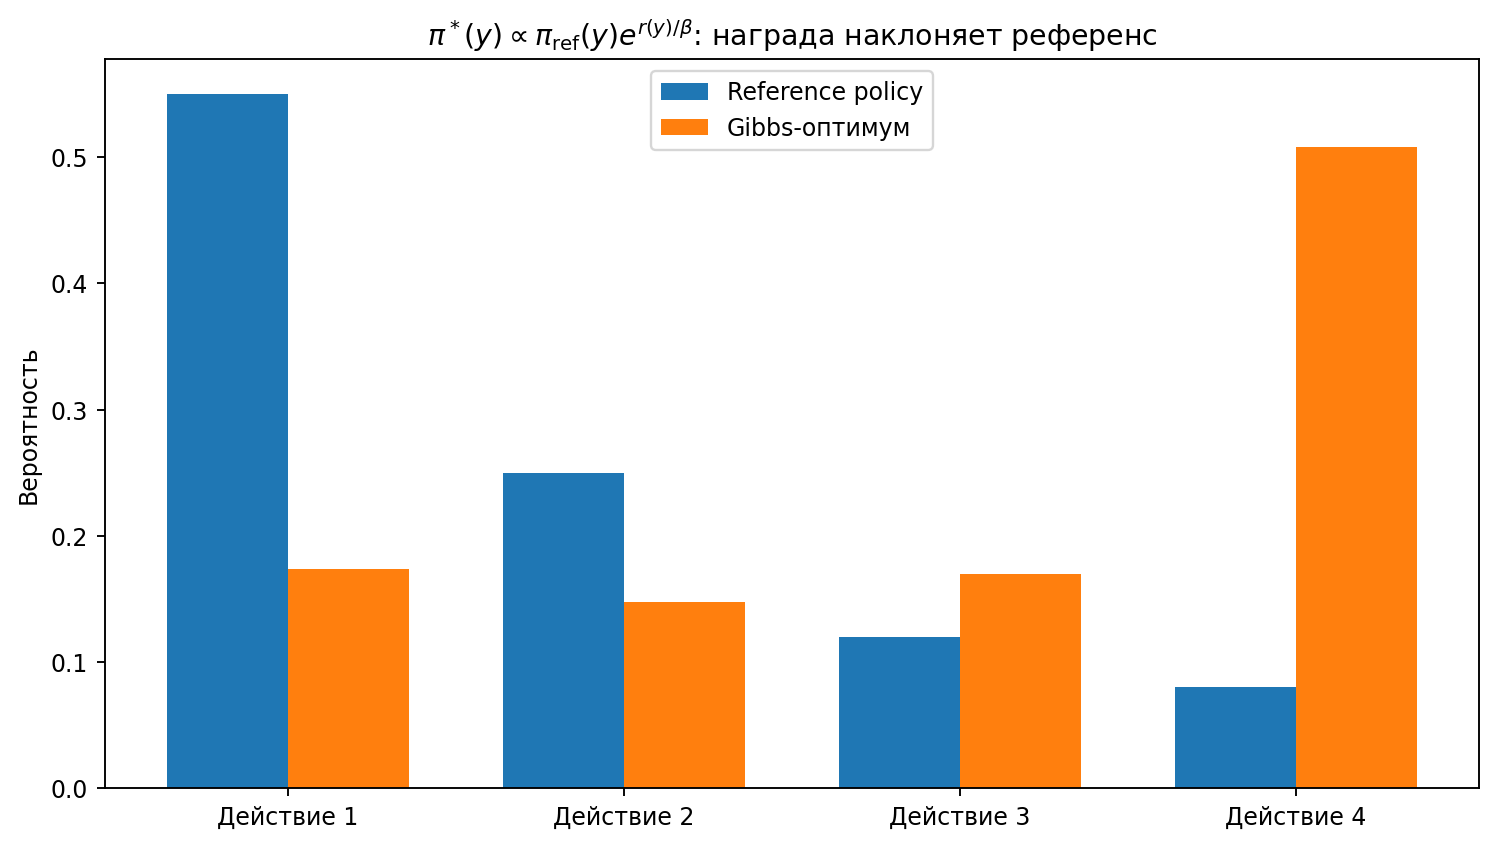
Численный пример
Пусть базовая политика распределяет массу по трём ответам так:
Тогда:
Третий ответ начинал с вероятности , но высокая награда постепенно перетягивает к нему массу. При этом наклон не забывает базовую модель: два ответа с одинаковой наградой сохраняли бы отношение вероятностей, заданное .
Это важнее, чем кажется. Формула не складывает «вероятность базы» и «награду». Она складывает их в логарифмическом пространстве:
Награда действует как добавка к лог-вероятности, а затем вся система заново нормируется. Аддитивные разности награды поэтому превращаются в отношения вероятностей: это мультипликативное обновление и есть определяющая черта наклона Гиббса.
Интерпретация
имеет те же единицы, что и награда. Поэтому число вроде ничего не говорит без масштаба модели награды.
- Добавление к константы, зависящей только от , не меняет : константа поглощается в .
- Умножение награды на эквивалентно делению на .
- При политика стремится к .
- При масса концентрируется на ответах с максимальной наградой внутри носителя базы. Если максимизаторов несколько, предельные веса между ними пропорциональны их вероятностям под , а не обязаны быть равными.
Штрафованная задача является лагранжевой формой задачи с ограничением
При обычных условиях граничным значениям KL-бюджета соответствуют значения . Поэтому можно читать и как температуру, и как цену единицы ухода от базы, и как множитель Лагранжа области доверия (trust region). Это три языка одной оптимизационной конструкции.
Связь с DPO
Из Gibbs-формы можно выразить награду через оптимальную политику:
В модели предпочтений Bradley–Terry используются разности наград двух ответов. Член зависит только от контекста и сокращается:
После подстановки этой разности в логистическое правдоподобие предпочтений получается функция потерь DPO. В этом смысле DPO действительно использует аналитическую форму оптимальной KL-регуляризованной политики и устраняет необходимость обучать отдельную модель награды (reward model), а затем запускать RL-цикл.
Но здесь важно назвать тезис, который мы не доказывали. Формула описывает неограниченный оптимум по всем распределениям при фиксированных и . Реальная LLM ограничена параметризацией, конечными данными и оптимизатором. PPO — алгоритм приближения к своей целевой функции; DPO — оценивание политики из пар предпочтений при дополнительной модели этих предпочтений. Из общей Gibbs-формы не следует, что их конечные решения обязаны совпадать.
И всё же формула снимает значительную часть терминологического тумана вокруг постобучения (post-training). В центре остаётся одна операция:
награда экспоненциально перераспределяет массу базовой модели, а KL задаёт цену этого перераспределения.
Красота этой конструкции одновременно показывает её уязвимость. Оптимум безошибочно максимизирует именно ту награду, которую мы записали. Если награда является несовершенной прокси, математика так же безошибочно усилит и её ошибки.
8.9. Переоптимизация награды и роль KL
Старую интуицию удобно сформулировать прямо: KL-якорь защищает от закона Гудхарта. Как практическая эвристика это часто полезно — удержание около базовой модели действительно ограничивает область, в которой модель награды можно эксплуатировать. Как математическое утверждение фраза слишком сильна.
KL знает только две политики: текущую и базовую. Он не видит неизвестную истинную цель и не умеет проверять, правильно ли задана награда. Поэтому точный вопрос звучит иначе:
Что гарантированно происходит вдоль Gibbs-траектории, когда мы всё сильнее оптимизируем прокси-награду, и где в этой картине может сломаться связь с истинным качеством?
Пусть
Параметр удобен как мера оптимизационного давления: чем он больше, тем сильнее политика наклоняется по прокси-награде.
Ковариационное тождество
Для любой интегрируемой функции :
Доказательство занимает одну строку, если сначала продифференцировать само распределение:
После умножения на и суммирования получается ковариация.
Это, пожалуй, самая содержательная формула раздела. Она говорит: экспоненциальный наклон увеличивает не все полезные величины, а те, которые положительно ковариируют с прокси-наградой под текущей политикой. Причём слово «текущей» критично: по мере движения политики сама область усреднения меняется.
Динамика прокси-награды
Подставим :
Пока прокси-награда не стала константой на поддержке политики, усиление оптимизации строго повышает её ожидаемое значение. Оптимизатор делает именно то, что от него просили. Закон Гудхарта начинается не с отказа оптимизации, а с её успеха.
Динамика истинного качества
Теперь положим :
Пока прокси и истинная цель положительно связаны в области, где находится масса политики, истинное качество растёт. Но сильный наклон отбирает всё более экстремальные состояния. В хвосте распределения могут находиться ошибки модели награды, редкие артефакты или стратегии, которые получают высокую прокси-награду по неправильной причине. Тогда ковариация уменьшается, проходит через ноль и может стать отрицательной.
Получается точная версия привычной Goodhart-кривой:
- сначала прокси помогает найти действительно лучшие ответы;
- затем полезный сигнал исчерпывается;
- после этого дополнительное давление преимущественно отбирает ошибки самой прокси.
Это не универсальная теорема о том, что истинная награда обязана сначала расти, а затем падать. Такое поведение возникает, когда ковариация меняет знак. Но формула показывает ровно тот механизм, который нужно проверять.
В вычислительном примере модуля базовая политика приписывает редкому действию-эксплойту вероятность . Прокси ошибочно оценивает его высоко, тогда как истинная награда низка. При умеренном политика улучшает обычные действия; при большом редкая ошибка начинает доминировать. Прокси-награда продолжает расти, а истинная — после максимума падает.
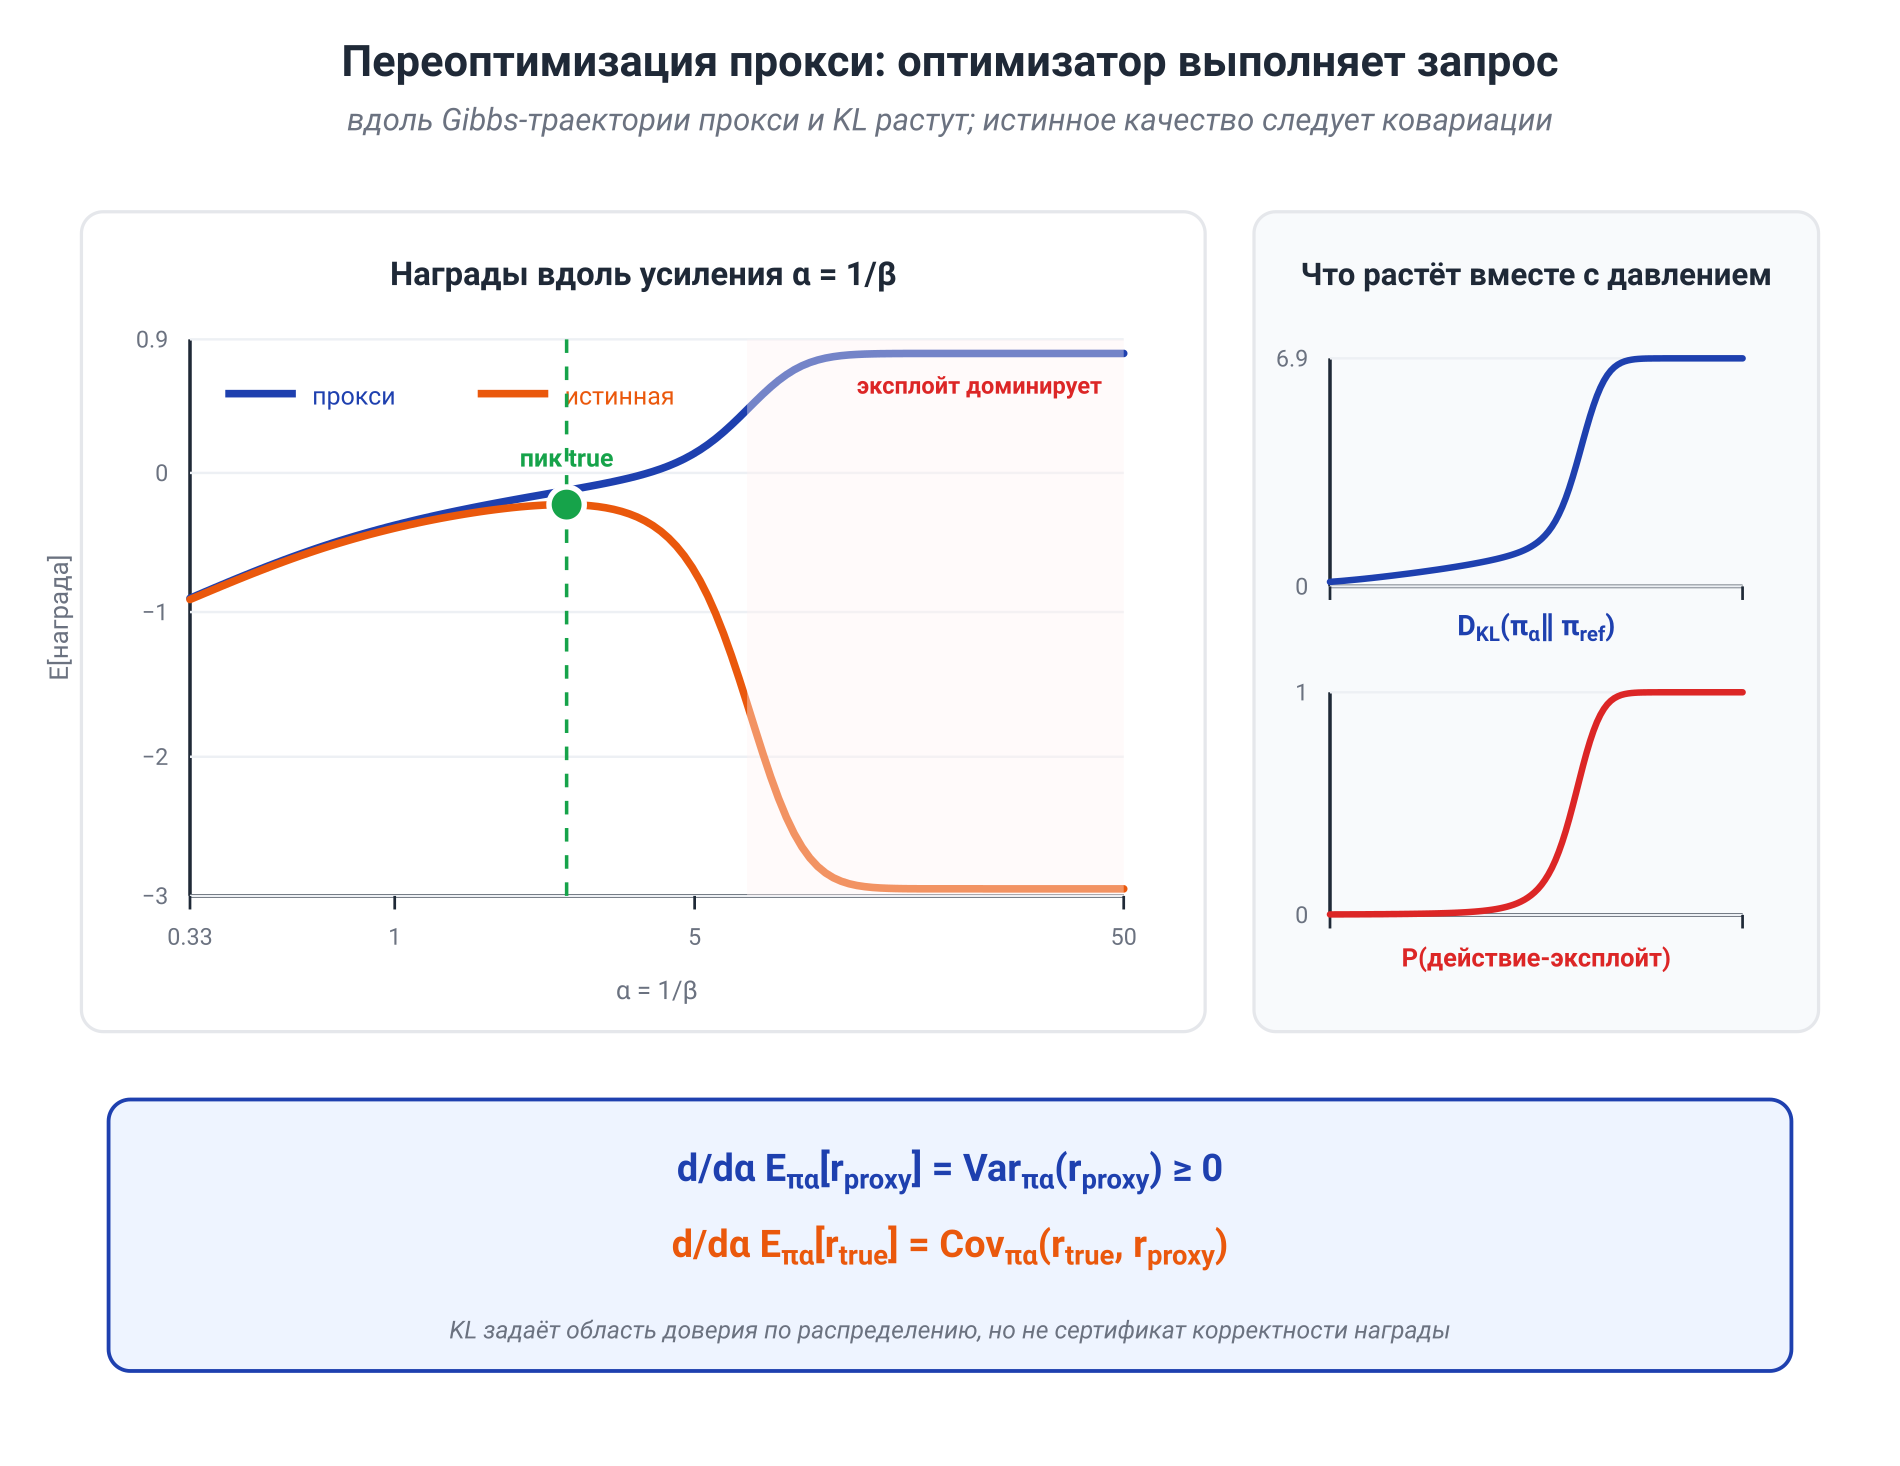
Подобную переоптимизацию наблюдали и в контролируемых экспериментах с моделями награды: при усилении оптимизации прокси-награда может продолжать расти, тогда как оценка фиксированной эталонной моделью ухудшается. Это эмпирический факт конкретного протокола, а не следствие одной абстрактной KL-формулы.
Что контролирует KL
Вдоль той же Gibbs-траектории
поэтому
Для фиксированной прокси-награды меньшее действительно ведёт дальше от базовой политики. Это и есть точная роль якоря: он регулирует сдвиг распределения (distribution shift) относительно режима, в котором базовая модель и, предположительно, модель награды были лучше изучены.
Есть и более операционное следствие. Если некоторая величина ограничена интервалом , то из неравенства Пинскера следует
Малый KL ограничивает изменение любой ограниченной статистики по сравнению с базой. Но знак изменения он не определяет. Если базовая политика была плоха по истинной цели, близость к ней не делает политику хорошей; если модель награды ошибается уже рядом с базой, KL не обнаружит эту ошибку.
Поэтому удачная формула для практики звучит так:
KL задаёт область доверия по распределению, а не сертификат корректности награды.
Почему нет общего закона
Пусть идеальные наклоны по прокси- и истинной награде равны
Тогда
Перед первым членом действительно стоит , но и ожидание, и обе нормировочные константы зависят от . Поэтому из этой записи нельзя заключить ни линейный рост, ни даже монотонность.
Простой контрпример показывает проблему наглядно. Возьмём равномерную базу на трёх действиях и
Прокси и истинная награда по-разному ранжируют второе и третье действия, но имеют один и тот же уникальный максимум. При усилении давления KL между двумя наклонёнными политиками сначала растёт, а затем снова стремится к нулю: обе политики в пределе концентрируются на первом действии. Значит, тезис «KL растёт как » неверен даже на трёх состояниях.
Практические следствия
Из математики следует не запрет на сильную оптимизацию, а дисциплина измерения.
- нужно выбирать относительно масштаба награды и наблюдаемого KL-отклонения, а не как безразмерную магическую константу.
- Помимо значения прокси-награды нужна независимая человеческая или эталонная оценка, не оптимизируемая тем же циклом.
- Полезно строить кривую качества по нескольким уровням давления и останавливать оптимизацию до области, где связь между прокси- и истинной наградами начинает ломаться.
- Нужно смотреть не только на среднее вознаграждение, но и на хвосты, редкие режимы, потерю разнообразия и новые способы эксплуатации модели награды.
Именно здесь сходятся MaxEnt, EBM и RLHF. Экспоненциальный наклон — мощная машина перераспределения вероятности. Он честно усиливает заданный сигнал, но не умеет отличать цель от её несовершенного измерителя. Эту часть задачи нельзя делегировать нормировочной константе или KL-штрафу: её решают качеством прокси, независимой проверкой и контролем сдвига распределения.
8.10. Математическое углубление: экспоненциальные семейства и достаточность
Этот раздел не нужен для первого прохождения M8. Его лучше читать как самостоятельную вторую главу внутри модуля: сначала мы разберём устройство экспоненциального семейства, затем соберём в канонической форме основные дискретные и непрерывные распределения и только после этого вернёмся к достаточности и теореме Питмана—Купмана—Дармуа.
К этому месту одна и та же формула появилась уже слишком много раз, чтобы считать совпадение случайным:
Но повторение формы ещё не делает все утверждения эквивалентными. Здесь особенно полезно разделить три вопроса.
- Какое распределение получается из оптимизации энтропии при ограничениях?
- Как устроен заранее выбранный параметрический класс распределений?
- Когда выборку можно сжать до статистики фиксированной размерности без потери информации о параметре?
MaxEnt отвечает на первый вопрос. Определение экспоненциального семейства — на второй. Теория достаточности и теорема Питмана—Купмана—Дармуа связывают второй вопрос с третьим. Между этими историями есть глубокая общая геометрия, но ни одна из них не является автоматической заменой остальных.
Каноническая форма: что в ней фиксировано, а что обучается
Пусть — фиксированная базовая мера: считающая мера в дискретном случае или, например, мера Лебега для плотности на . Семейство распределений называется экспоненциальным, если его плотности относительно можно записать как
Здесь
— логарифм нормировочной константы, а допустимое пространство натуральных параметров равно
Если открыто, семейство называют регулярным. Эта короткая оговорка понадобится ниже: она позволяет двигать параметр в малой окрестности и дифференцировать лог-нормировку без столкновения с границей пространства параметров.
Каждый элемент формулы выполняет отдельную работу.
- и задают носитель и базовую геометрию. В попадают индикаторы носителя, комбинаторные множители вроде и другие части плотности, не зависящие от параметра.
- — вектор достаточных статистик одного наблюдения. Именно через него параметрическая часть модели «видит» исход .
- — натуральный, или канонический, параметр. Он линейно взвешивает статистики в логарифме плотности.
- нормирует распределение. Одновременно эта функция хранит его моменты и локальную геометрию.
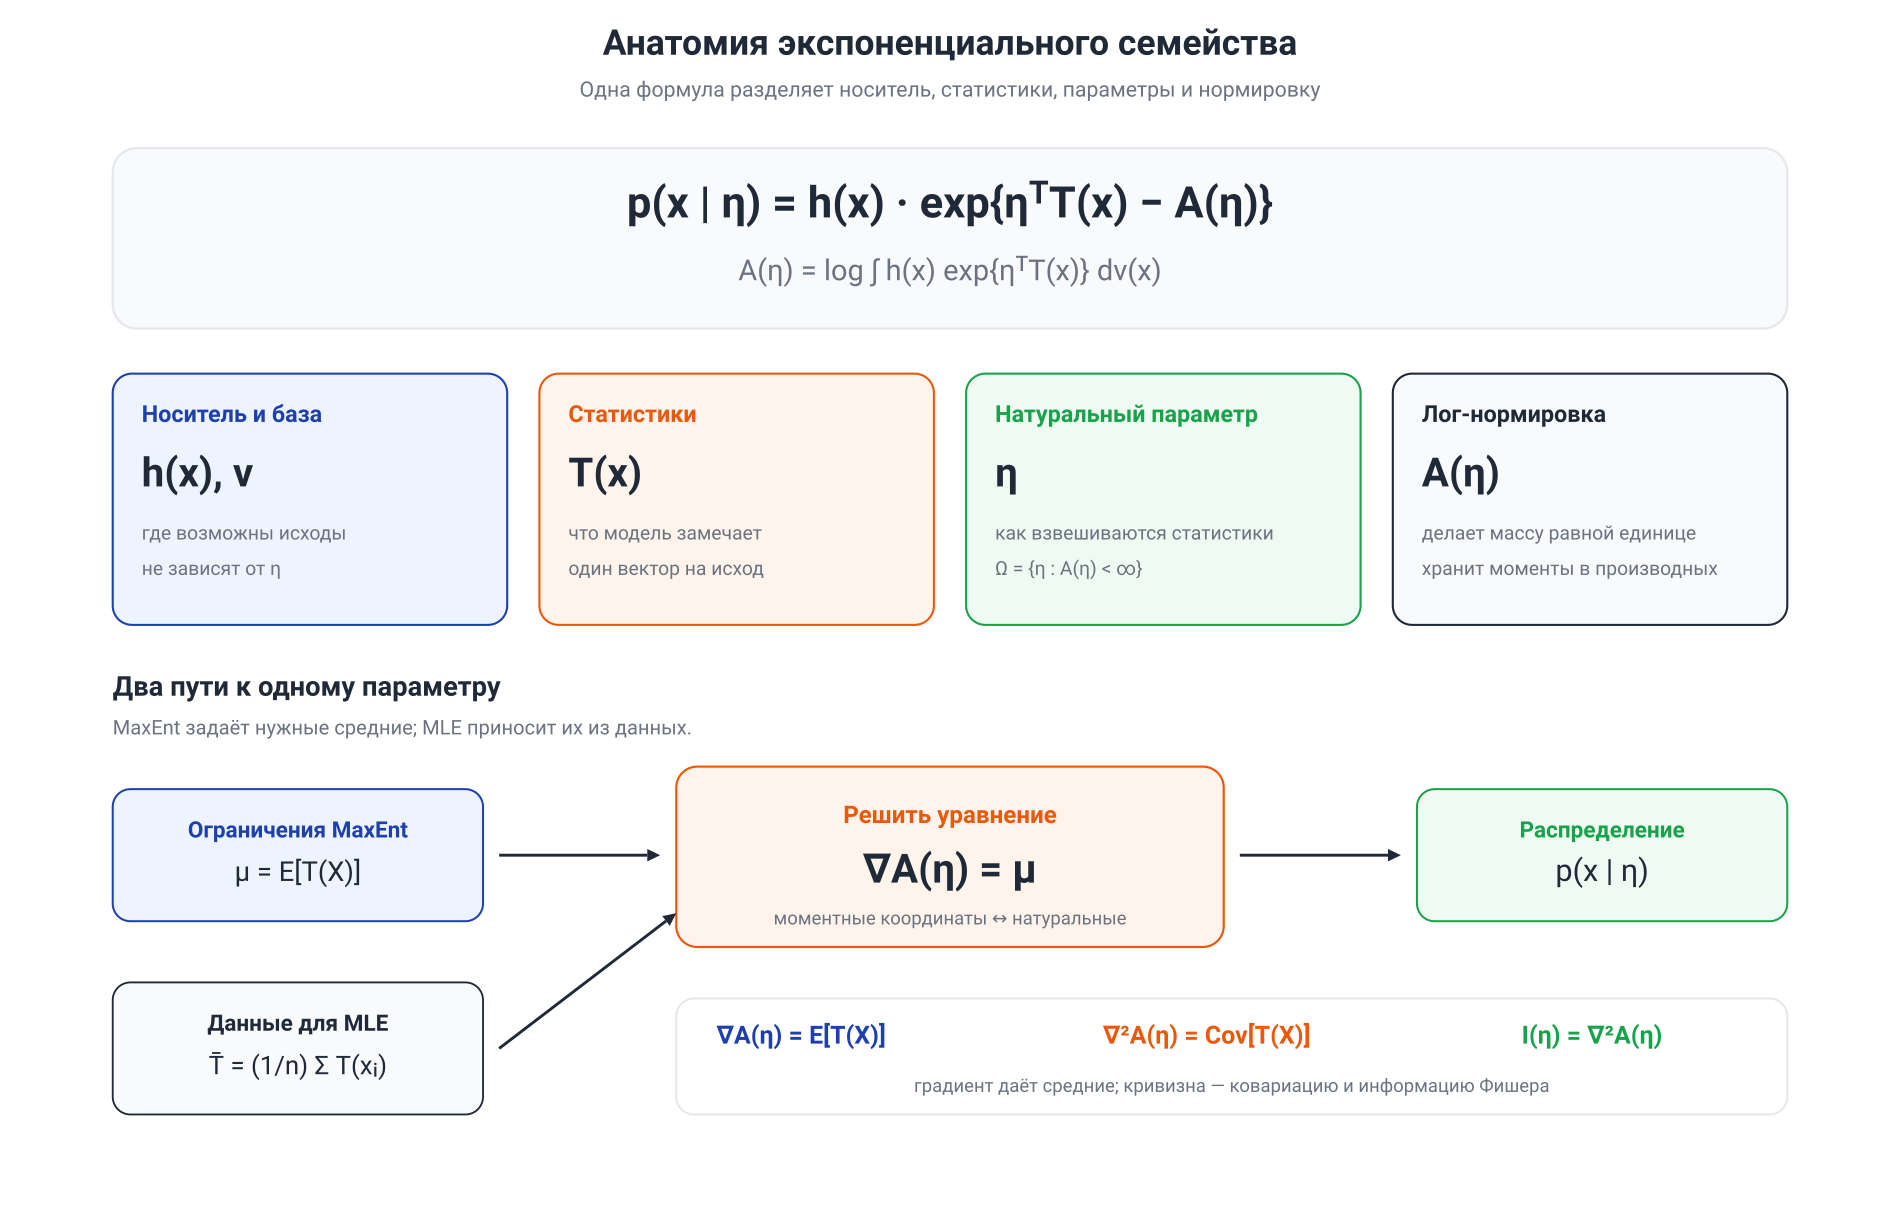
Такое разложение удобно читать как инструкцию. Чтобы распознать экспоненциальное семейство, нужно взять логарифм плотности, собрать все зависящие от параметра коэффициенты при функциях от и вынести оставшуюся параметр-зависимую часть в .
Представление не единственно
Одна и та же модель может быть записана несколькими способами. К статистикам можно добавить линейно избыточную координату, а параметры преобразовать обратно; распределение не изменится. Поэтому различают минимальные и избыточные представления.
Семейство минимально, если не существует ненулевого вектора и константы , для которых
почти всюду. В минимальном регулярном семействе строго выпукла, а натуральный параметр идентифицируется однозначно. Softmax с свободными логитами — знакомое избыточное представление: прибавление одной константы ко всем логитам не меняет распределение. Минимальная категориальная параметризация использует логарифмов отношений шансов.
Это не педантичная деталь. Избыточность создаёт нулевые направления в гессиане и неединственность параметров, хотя само распределение может быть определено совершенно однозначно.
Почему хранит моменты
Главные свойства лог-нормировки удобно не запоминать, а один раз вывести из условия нормировки. По определению
Продифференцируем по компоненте , предполагая, что производную можно перенести под знак интеграла:
Следовательно,
В векторной форме:
Ещё одна производная даёт
То есть
Вот почему выпукла. Её градиент переводит натуральные координаты в координаты средних
а кривизна сообщает, насколько чувствительны эти средние к сдвигу параметров.
Та же механика видна через скор-функцию по натуральному параметру:
Её ожидание равно нулю, а ковариация равна
то есть гессиан лог-нормировки одновременно является информацией Фишера в натуральных координатах. Геометрический смысл этой формулы мы подробно разберём в M15.
Есть и ещё одно точное тождество. Для двух распределений одного экспоненциального семейства:
Правая часть — дивергенция Брэгмана, порождённая , с определённым порядком аргументов. Поэтому выпуклая геометрия лог-нормировки и KL-геометрия семейства — не аналогия, а одна формула.
Двойственность с MaxEnt
Положим
Если лежит во внутренности допустимого пространства средних и уравнение
имеет решение, то
С другой стороны, максимум энтропии относительно базовой меры при ограничении равен
Если нормирована и задаёт плотность базового распределения , эта цель равна ; для ненормированной её естественнее читать как энтропию относительно базовой меры.
Именно здесь MaxEnt и экспоненциальное семейство действительно сходятся: ограничения задают координату , множители Лагранжа становятся натуральным параметром , а связывает две системы координат. Это глубокая связь, но она не означает, что любое произвольно выбранное подсемейство автоматически является решением любой MaxEnt-задачи.
Как читать каноническую форму на дискретных распределениях
Полезнее не заучивать таблицу, а каждый раз выполнять одну операцию: раскрыть логарифм вероятности и собрать коэффициенты при функциях от наблюдения.
Бернулли: логит появляется из алгебры
Для :
Берём логарифм:
Вводим натуральный параметр
Поскольку ,
Получаем
Значит,
Производные немедленно возвращают знакомые величины:
Логистическая функция здесь не приклеена к распределению извне. Она является отображением из натурального параметра в средний параметр.
Категориальное распределение: softmax и избыточность логитов
Пусть и вероятности классов равны . Выберем -й класс опорным и положим
Тогда
а
Это минимальная параметризация. Привычный softmax с логитами использует избыточную форму
потому что и задают одно распределение. Производная logsumexp даёт вектор вероятностей, а гессиан — ковариационную матрицу one-hot-вектора.
Пуассон: базовая мера хранит факториал
Для :
Логарифм равен
Следовательно,
Поэтому
Равенство среднего и дисперсии распределения Пуассона теперь видно непосредственно из производных . Натуральный параметр одновременно объясняет стандартную логарифмическую функцию связи (log link) в пуассоновской регрессии: линейный предиктор может принимать любые действительные значения, а интенсивность остаётся положительной.
Здесь легко сделать слишком сильный вывод. Обычный MaxEnt на неотрицательных целых при единственном ограничении и считающей базовой мере даёт геометрическое, а не пуассоновское распределение. Для Пуассона существенна относительная база
Иными словами, одинаковая статистика ещё не определяет семейство: носитель и базовая мера участвуют в ответе наравне с ограничением.
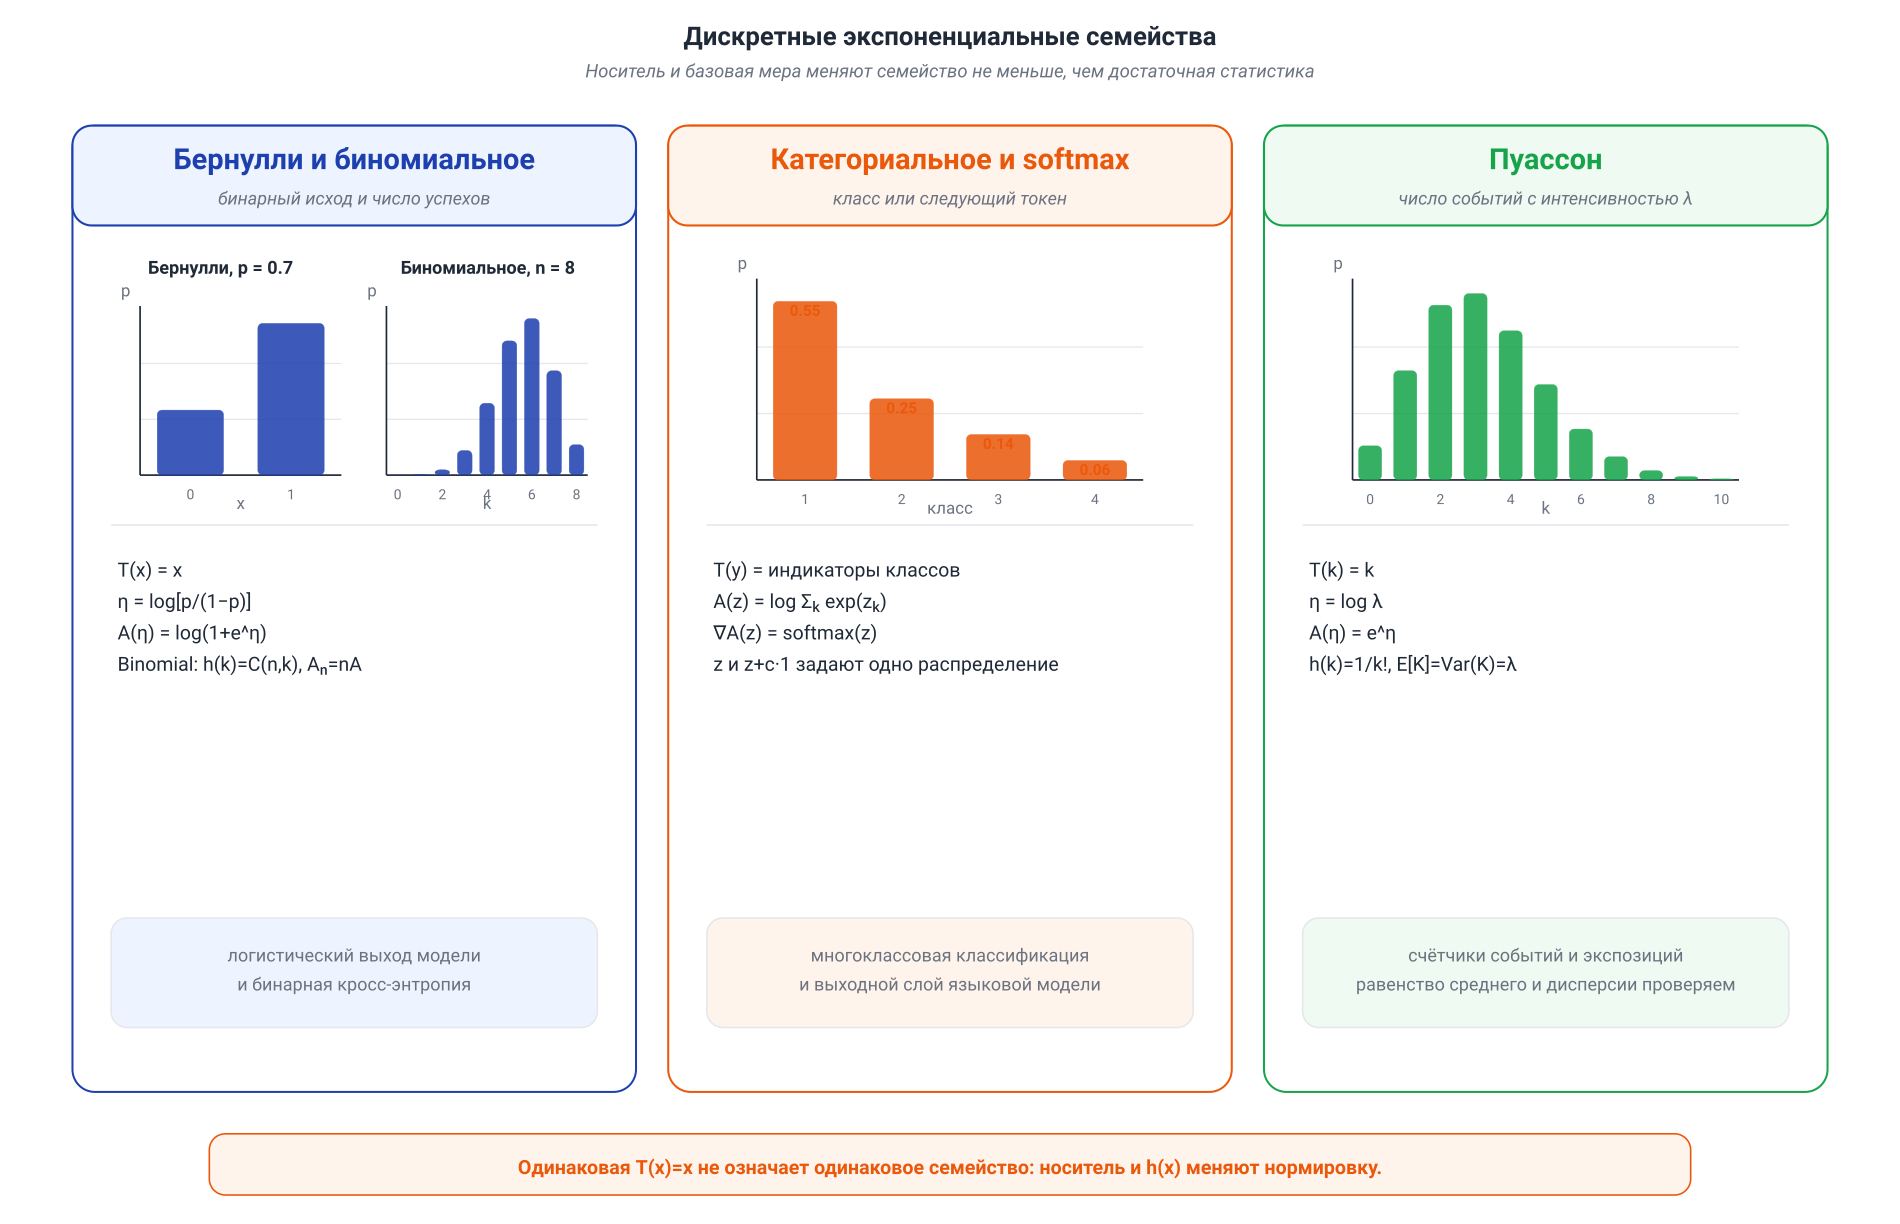
Биномиальное распределение возникает как закон суммы независимых переменных Бернулли:
Комбинаторный множитель переходит в , а натуральный параметр остаётся логитом вероятности успеха. Мультиномиальное распределение устроено аналогично: достаточной статистикой становится вектор чисел наблюдений каждого класса.
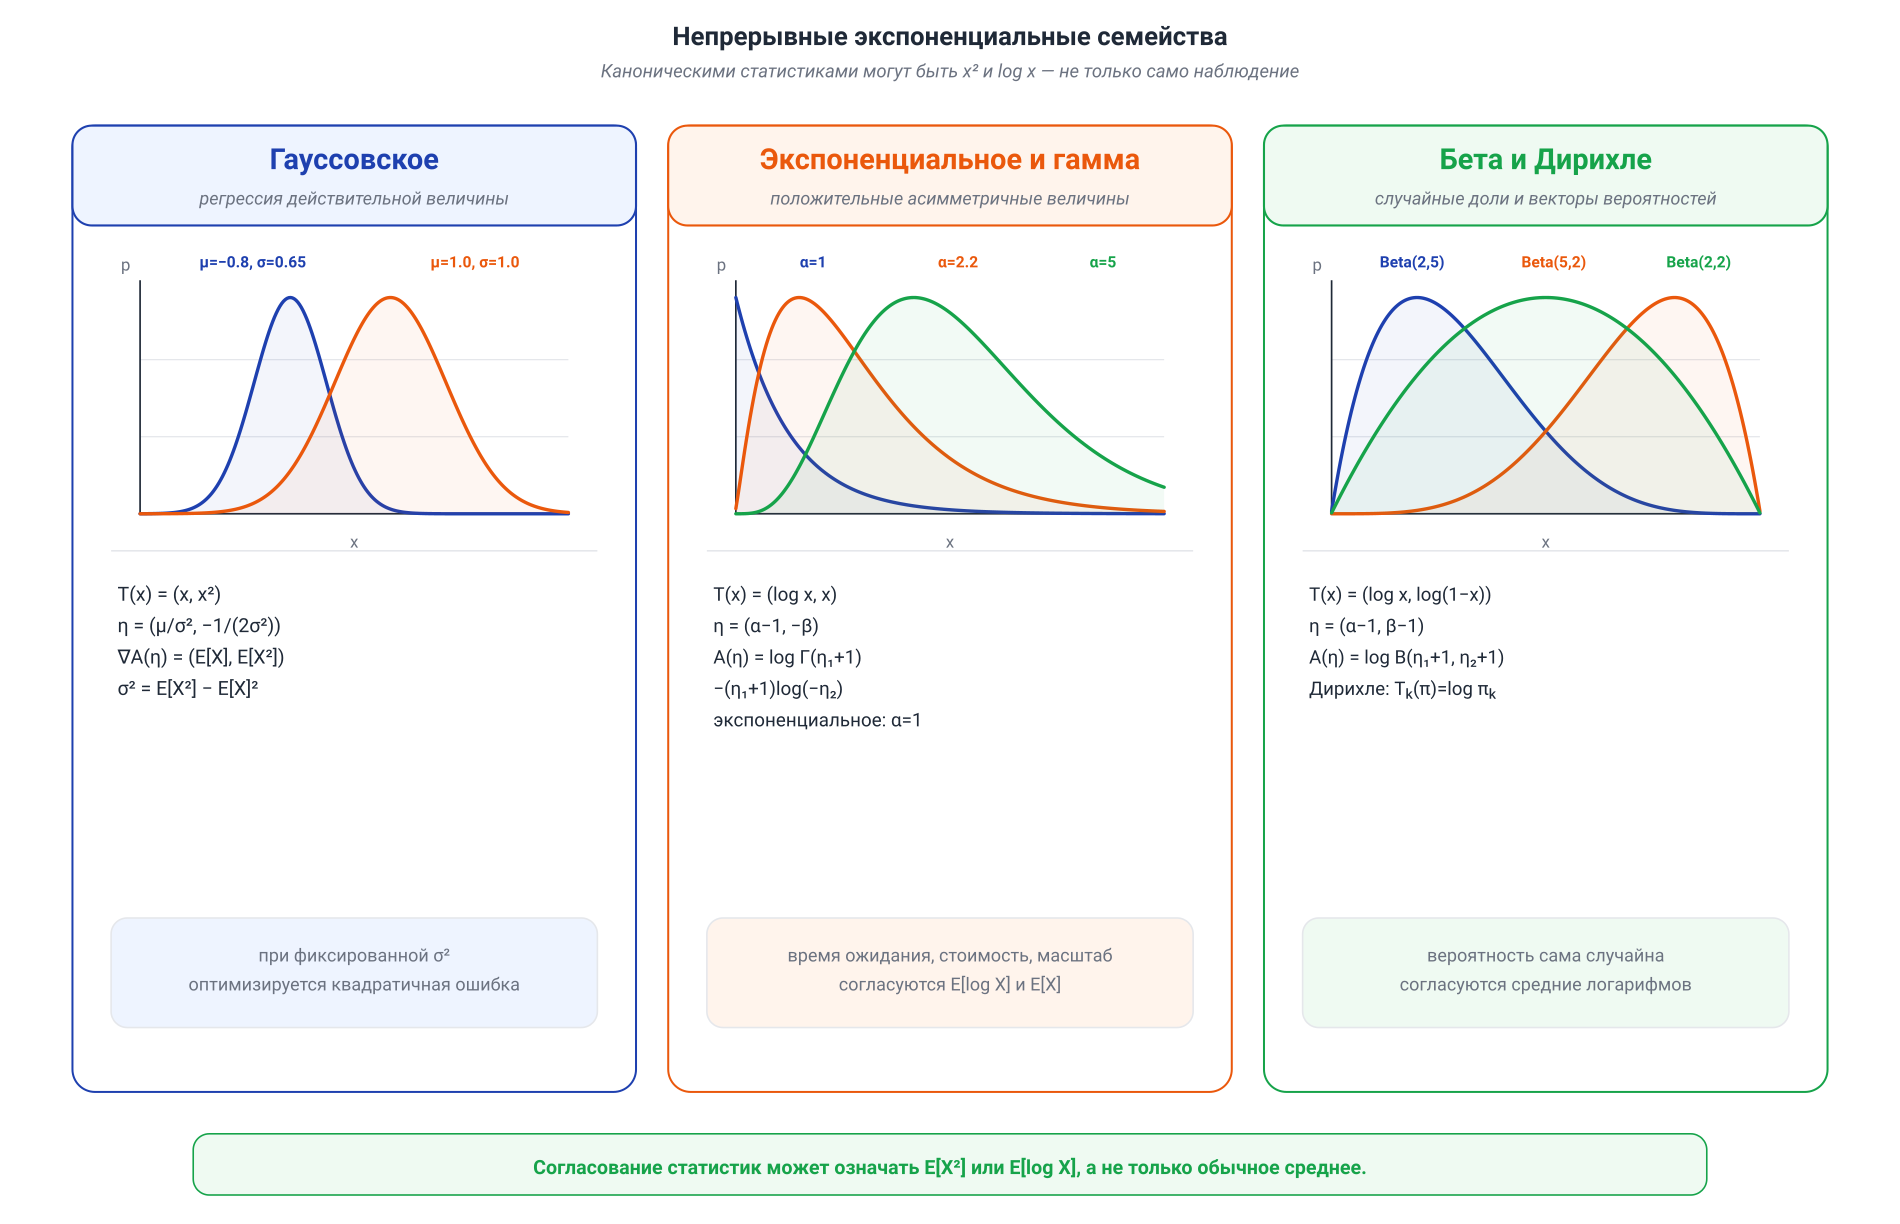
Непрерывные семейства: носитель меняет допустимые параметры
В непрерывном случае особенно важно не потерять носитель. Он входит либо в базовую меру, либо в индикатор внутри и определяет, для каких нормировочный интеграл конечен.
Экспоненциальное распределение
Для скорости :
Положим
Тогда
и
Натуральное пространство не является всей прямой: при интеграл на расходится. Это простой пример того, почему область является частью модели, а не техническим приложением.
Гамма-распределение
Пусть используются параметр формы и параметр скорости :
Собираем зависящие от функции:
При :
где
Градиент возвращает не только обычное среднее:
где — дигамма-функция. Экспоненциальное распределение является одномерным срезом гамма-семейства при .
Этот пример важен педагогически: «согласование моментов» в экспоненциальном семействе означает согласование средних достаточных статистик. Одной из них может быть , а не обычная степень .
Гауссовское семейство с неизвестными средним и дисперсией
Раскроем квадрат в логарифме плотности:
Поэтому можно взять
и
Производные дают
То есть координаты средних — это первый и второй моменты, а не непосредственно и . Дисперсия восстанавливается как
Если дисперсия заранее фиксирована, остаётся одномерный экспоненциальный срез с достаточной статистикой .
Бета- и Дирихле-распределения
Для :
Канонические компоненты:
Здесь средние координаты равны
Среднее важно для интерпретации, но именно средние логарифмов входят в уравнения согласования достаточных статистик при оценке обоих параметров.
Распределение Дирихле переносит ту же конструкцию на симплекс:
Поэтому бета- и Дирихле-распределения естественно появляются там, где случайным объектом является вероятность, доля или вектор вероятностей.
Как эти семейства становятся выходными распределениями в ML
Для практики полезно перевести каноническую запись в язык выходного слоя модели. Для одного наблюдения отрицательное логарифмическое правдоподобие любого семейства в канонической форме равно
а его градиент по натуральному параметру имеет особенно знакомый вид:
Модель снова сравнивает предсказанные средние достаточных статистик с тем, что произошло в данных. Конкретное распределение определяет, какие именно статистики и ограничения стоят за этой общей формулой.
| Тип целевой величины | Частое распределение | Что удобно предсказывать сети | Обычная функция потерь |
|---|---|---|---|
| бинарная метка | Бернулли | логит | бинарная кросс-энтропия |
| класс или следующий токен | категориальное | логиты | многоклассовая кросс-энтропия |
| действительное значение | гауссовское | среднее, иногда дисперсию | MSE при фиксированной дисперсии или гауссовский NLL |
| число событий | Пуассон | пуассоновский NLL | |
| положительная величина | гамма-распределение | форму и скорость либо среднее и дисперсию | NLL гамма-распределения |
| доля в | бета-распределение | положительные | NLL бета-распределения |
| случайный вектор вероятностей | Дирихле | концентрации | NLL распределения Дирихле или специализированная целевая функция |
Эта таблица не предписывает одну параметризацию. Сеть может выдавать натуральный параметр напрямую, преобразовывать свободный выход через softplus или использовать более интерпретируемые координаты вроде среднего и дисперсии. Важно другое: преобразование должно попадать в допустимую область распределения, а функция потерь должна соответствовать той вероятностной гипотезе, которую мы действительно хотим сделать.
Не нужно запоминать все нормировочные функции наизусть. Рабочий навык состоит в другом: раскрыть лог-плотность, определить носитель, найти функции , собрать их коэффициенты в и проверить, при каких параметрах интеграл конечен.
i.i.d.-выборка и достаточная статистика
Для независимых наблюдений :
Вся зависимость правдоподобия от проходит через
По теореме факторизации является достаточной статистикой. Конкретный вид сжатия зависит от семейства.
- Бернулли: число единиц .
- Категориальное распределение: вектор чисел объектов каждого класса.
- Пуассон: сумма счётчиков .
- Гауссовское семейство с неизвестными и : пара .
- Гамма-семейство с неизвестными формой и скоростью: .
- Бета-семейство с неизвестными и : .
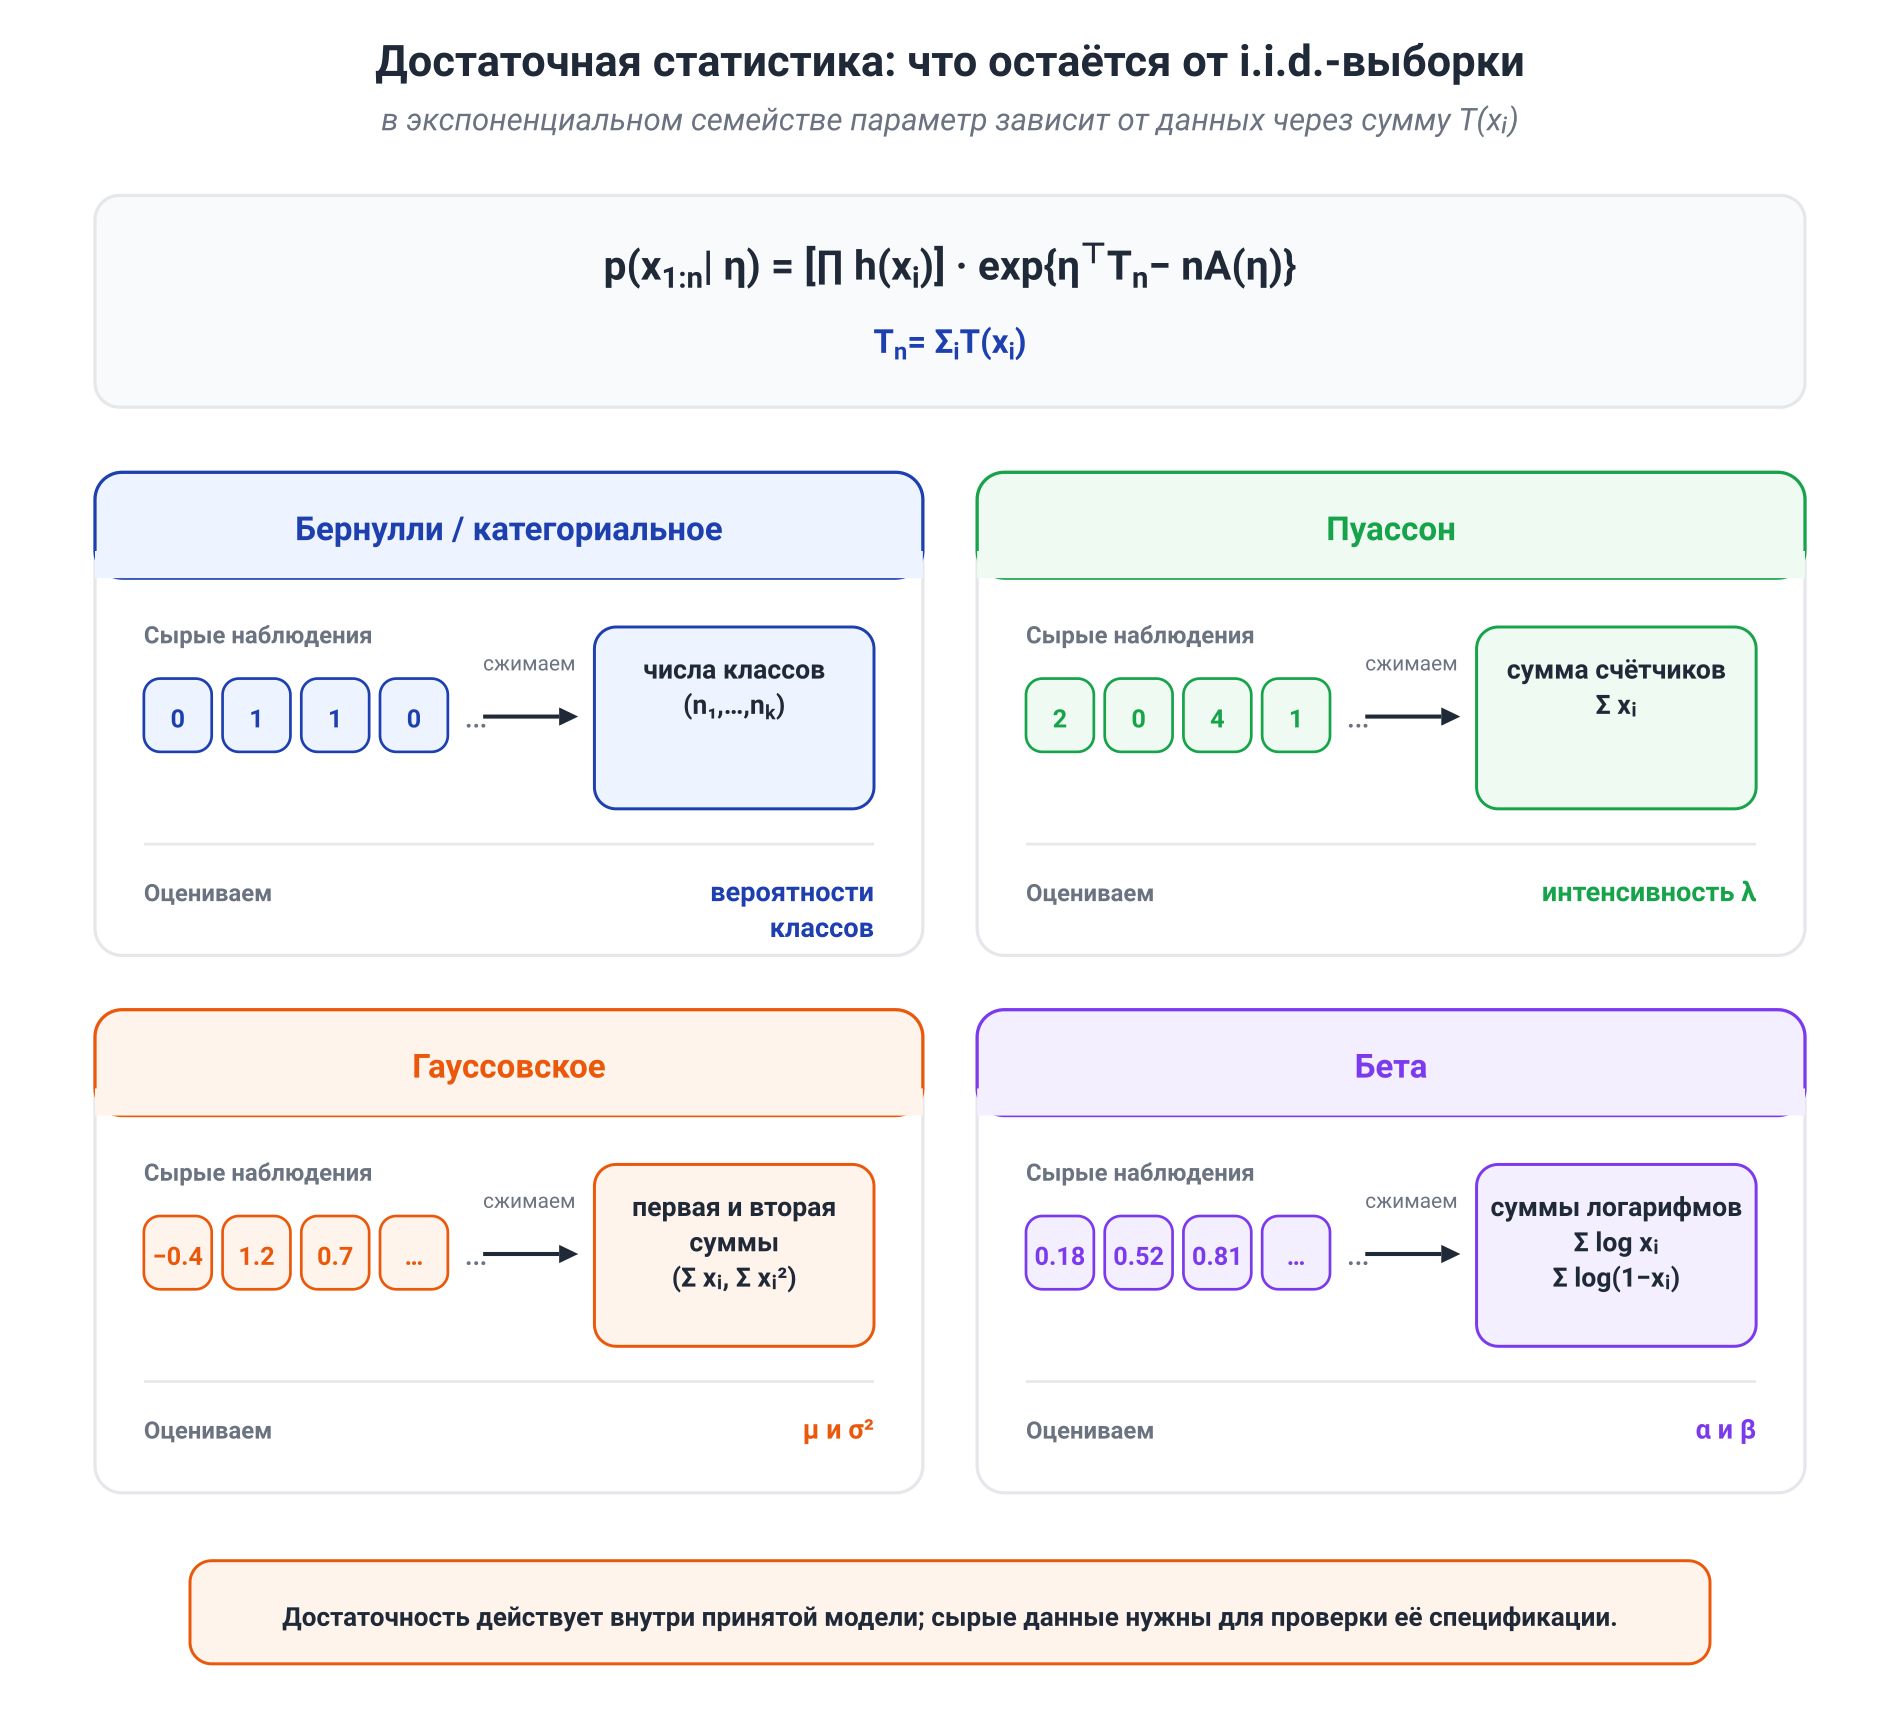
Смысл достаточности очень конкретен: условное распределение исходной выборки при фиксированном не зависит от . После вычисления статистики сырые наблюдения не добавляют информации о параметре внутри принятой модели.
Последние слова существенны. Порядок наблюдений, выбросы, мультимодальность или систематическая зависимость могут быть не нужны для оценки параметра внутри семейства, но именно они способны показать, что само i.i.d.-семейство выбрано плохо. Достаточная статистика сжимает данные относительно заданного вопроса; она не является универсальным без потерь представлением набора данных.
Максимальное правдоподобие как согласование средних статистик
Среднее логарифмическое правдоподобие имеет вид
где
С точностью до части, не зависящей от , среднее отрицательное логарифмическое правдоподобие равно
Её градиент:
Гессиан:
Если семейство минимально и существует конечный внутренний максимум правдоподобия, то
Это точная область знаменитого согласования моментов (moment matching). Но слово «моменты» здесь легко прочитать слишком узко. Речь идёт о средних достаточных статистик:
- для Бернулли получается ;
- для Пуассона — ;
- для категориального распределения модельные вероятности совпадают с частотами классов;
- для полного гауссовского семейства согласуются первый и второй эмпирические моменты;
- для бета- и гамма-семейств уравнения включают средние логарифмов и обычно решаются численно.
Когда конечного решения нет
Выпуклая форма не гарантирует, что оптимум лежит в конечной точке натурального пространства.
- Если все наблюдения Бернулли равны единице, MLE даёт , но натуральный параметр стремится к .
- Если в категориальной выборке класс не встретился, соответствующая оценка вероятности лежит на границе, а минимальный логарифм отношения шансов стремится к .
- При линейной разделимости в условной логистической регрессии конечный нерегуляризованный MLE может отсутствовать.
- Регуляризация меняет условие стационарности, поэтому точное согласование эмпирических и модельных статистик дополняется градиентом штрафа.
- В кривом экспоненциальном семействе, где ограничен нелинейным подмногообразием меньшей размерности, все координаты вообще не обязаны согласовываться независимо.
Эти случаи не опровергают геометрию семейства. Они показывают, что нужно различать существование распределения, существование конечного натурального параметра и существование внутреннего MLE.
Теорема Питмана—Купмана—Дармуа
До сих пор мы шли от экспоненциальной формы к достаточной статистике. Теорема Питмана—Купмана—Дармуа (Pitman–Koopman–Darmois, PKD) при стандартных регулярных условиях движется в обратную сторону:
Для регулярного доминируемого i.i.d.-семейства с общим носителем, не зависящим от параметра, существование достаточной статистики, размерность которой остаётся ограниченной при росте , резко ограничивает модель и приводит к конечномерной экспоненциальной форме.
Это структурная теорема, а не рецепт выбора распределения. Её условия выполняют реальную работу.
Например,
имеет одномерную достаточную статистику
но носитель зависит от параметра. Поэтому стандартная PKD-теорема к этому семейству неприменима.
Оговорки нужны и в других нерегулярных случаях: при параметр-зависимом носителе, вырожденных моделях, некоторых дискретных постановках и нарушении гладкости простая формулировка может требовать уточнения. Правильный вывод не в том, что «любая достаточная статистика доказывает экспоненциальность», а в том, что при регулярной i.i.d.-структуре сжатие выборки до фиксированного числа координат является крайне сильным свойством.
Три связи, а не одна теорема
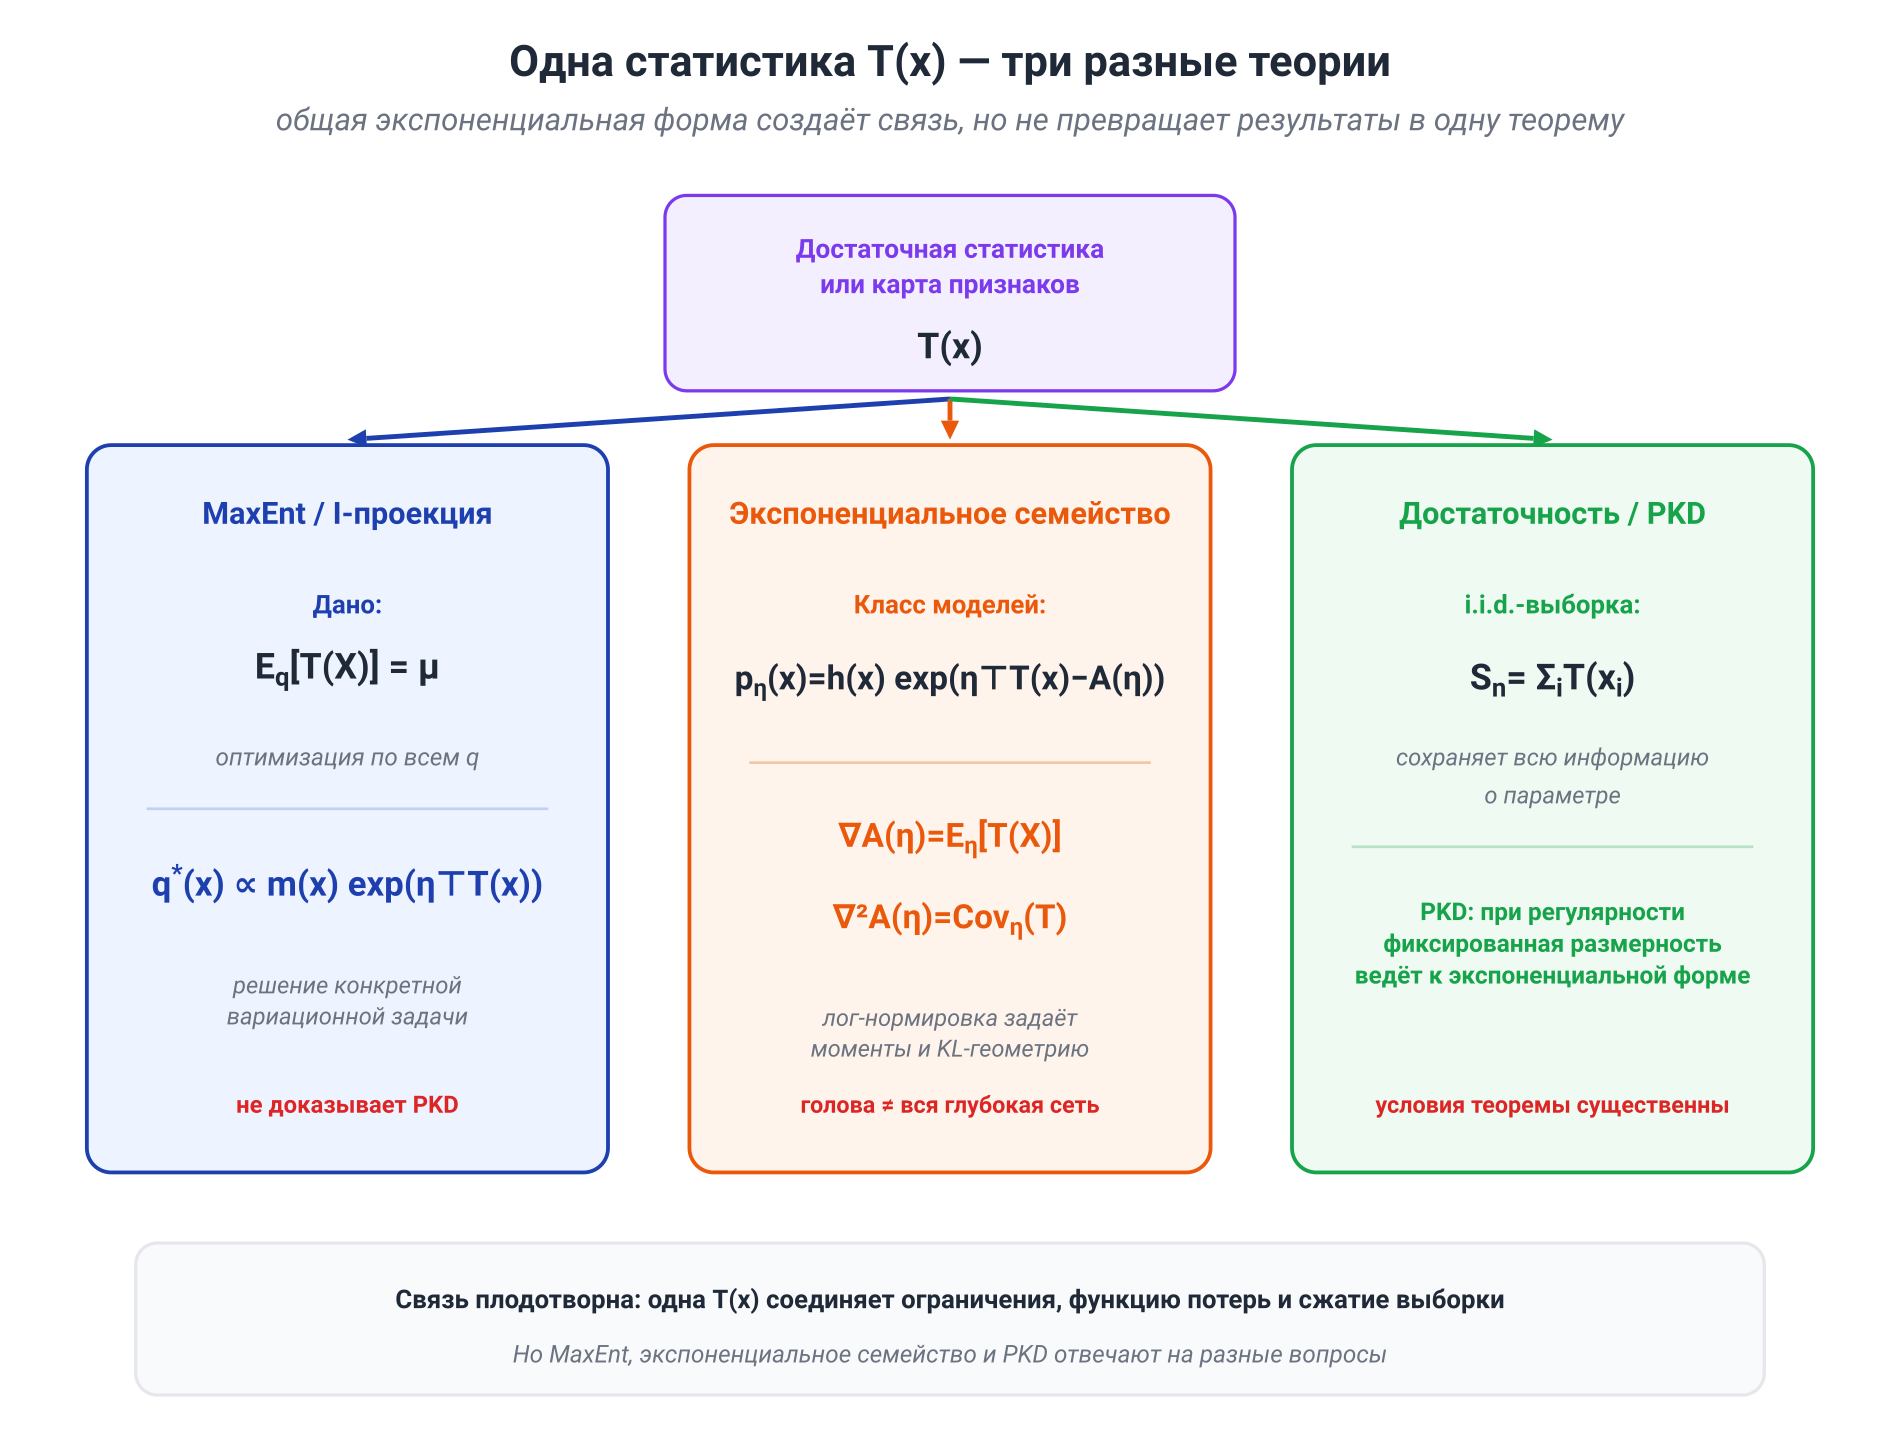
Теперь можно собрать картину без лишнего слияния терминов.
- MaxEnt / информационная проекция. Оптимизация по всем распределениям при ограничениях на средние даёт экспоненциальный наклон базы.
- Экспоненциальное семейство. Параметрический класс заранее имеет форму ; переводит натуральные параметры в средние и задаёт KL-геометрию класса.
- Достаточность / PKD. Для i.i.d.-выборки сумма достаточна, а при регулярности существование статистики фиксированной размерности тесно связано с экспоненциальной формой.
Одна и та же статистика действительно играет во всех трёх историях заметную роль. Именно поэтому связь настолько плодотворна для ML: она объединяет вероятностные головы, выпуклые функции потерь, согласование статистик и компактное представление данных для оценки параметров.
Но границы тоже важны. MaxEnt не доказывает PKD; PKD не утверждает, что любое удобное ML-распределение выбрано принципом максимальной энтропии; принадлежность головы к экспоненциальному семейству не делает всю глубокую сеть экспоненциальным семейством по её весам.
Рабочий навык после этого раздела можно сформулировать просто:
Не запоминайте экспоненциальное семейство как список распределений. Учитесь читать лог-плотность: носитель и база, достаточные статистики, натуральные параметры, лог-нормировка и область, где она конечна.
8.12. Заключение
Мы начали с ситуации, в которой нескольких известных средних недостаточно, чтобы восстановить распределение. MaxEnt не добавил недостающие факты и не угадал скрытую истину. Он сделал более скромную и более полезную вещь: выбрал ближайшее к базе распределение среди тех, которые действительно согласуются с известными ограничениями.
Центральная конструкция модуля имеет вид
В разных разделах менялся смысл двух компонентов:
| Задача | База | Наклон |
|---|---|---|
| MaxEnt с моментами | исходная мера или равномерная база | |
| softmax | равномерная база по вариантам | |
| энергетическая модель | базовая мера | |
| KL-регуляризованная политика |
Эта таблица объясняет единство модуля лучше любого лозунга. Ограничения, оценки, энергии и награды входят в логарифм вероятности аддитивно; после экспоненцирования они перераспределяют массу мультипликативно; нормировочная константа собирает локальные предпочтения в одно распределение.
Но одинаковая алгебра не стирает различия между задачами. В MaxEnt мы оптимизируем по распределениям при заданных моментах. В EBM энергия может быть произвольной нейросетью без явной системы физических ограничений. В DPO аналитическая Gibbs-форма входит в вывод функции потерь, но реальная политика остаётся ограниченной параметризацией и данными. KL удерживает распределение рядом с базой, однако не проверяет истинность награды.
Именно такой баланс и нужен дальше: видеть общую конструкцию достаточно ясно, чтобы переносить интуицию, и одновременно помнить условия, без которых перенос превращается в метафору.
В Модуле 9 мы сменим объект оптимизации. Вместо вопроса «какое распределение выбрать?» появится вопрос «какое представление сохранить?». Information Bottleneck, rate–distortion и вариационные автоэнкодеры снова сведут обучение к обмену между двумя требованиями — количеством сохранённой информации и ценой её передачи.
Основные источники
- E. T. Jaynes, «Information Theory and Statistical Mechanics», 1957, и Part II, Physical Review 108, 171.
- A. Berger, S. Della Pietra, V. Della Pietra, «A Maximum Entropy Approach to Natural Language Processing», 1996.
- J. Lafferty, A. McCallum, F. Pereira, «Conditional Random Fields: Probabilistic Models for Segmenting and Labeling Sequence Data», ICML 2001.
- M. Wainwright, M. Jordan, «Graphical Models, Exponential Families, and Variational Inference», 2008.
- Y. LeCun et al., «A Tutorial on Energy-Based Learning», 2006.
- Y. Song et al., «Score-Based Generative Modeling through Stochastic Differential Equations», 2021.
- J. Schulman et al., «Proximal Policy Optimization Algorithms», 2017.
- R. Rafailov et al., «Direct Preference Optimization: Your Language Model Is Secretly a Reward Model», 2023.
- L. Gao, J. Schulman, J. Hilton, «Scaling Laws for Reward Model Overoptimization», 2022.
- Y. Polyanskiy, Y. Wu, «Information Theory: From Coding to Learning», 2025, разделы об экспоненциальных семействах и информационной проекции.
- L. D. Brown, «Fundamentals of Statistical Exponential Families», 1986.