Модуль 4. Неравенство Йенсена: когда среднее встречает нелинейность
Как читать этот модуль. Основной маршрут — §§4.1–4.5. Одна теорема пройдёт через три знакомые ML-конструкции: ансамбли, ELBO и уменьшение KL при укрупнении состояний. Математическое углубление о разрыве Йенсена и дивергенции Брэгмана можно оставить на второй проход. Для перехода к Модулю 5 достаточно понимать направление неравенства, условия равенства и два рабочих следствия — для ансамблей и log-sum inequality.
4.1. Сначала усреднить или сначала посчитать функцию потерь?
В машинном обучении среднее почти никогда не ходит одно. Рядом обычно стоит нелинейность: логарифм, экспонента, квадрат, softmax или logsumexp. И тогда порядок операций начинает иметь значение.
Возьмём самый короткий пример. Две модели назначили правильному классу вероятности
Средний NLL моделей равен
Если сначала усреднить вероятности, получим , а затем
Ни одна из исходных моделей не стала лучше. Мы лишь поменяли порядок действий:
Разница возникает из-за кривизны функции . Тот же сюжет повторяется в гораздо более серьёзных местах:
- ансамбль сначала смешивает предсказания, а затем получает логарифмический счёт;
- модель с латентной переменной сначала суммирует или интегрирует скрытые объяснения, а затем берёт логарифм;
- обработка данных объединяет состояния, а затем мы сравниваем укрупнённые распределения по KL;
- усреднение логитов проходит через выпуклую функцию
logsumexp.
Во всех случаях вопрос один:
Неравенство Йенсена — это компас для ситуаций, где мы пытаемся протащить среднее через нелинейность. Оно показывает направление изменения; разрыв Йенсена показывает цену такой перестановки.
Если не оговорено иное, в модуле используются натуральные логарифмы. Смена основания лишь умножает все логарифмические величины на положительную константу и не меняет направления неравенств.
4.2. Неравенство Йенсена: направление задаёт кривизна
От хорды к случайной величине
Пусть — выпуклое множество. Функция называется выпуклой, если для любых и
Геометрически это означает: хорда между двумя точками графика лежит не ниже графика. Для вогнутой функции знак разворачивается.
Взвешенная версия для нескольких точек имеет вид
Переход от конечной смеси к случайной величине даёт привычную форму Йенсена. Если ожидания существуют и принимает значения в , то
Для вогнутой
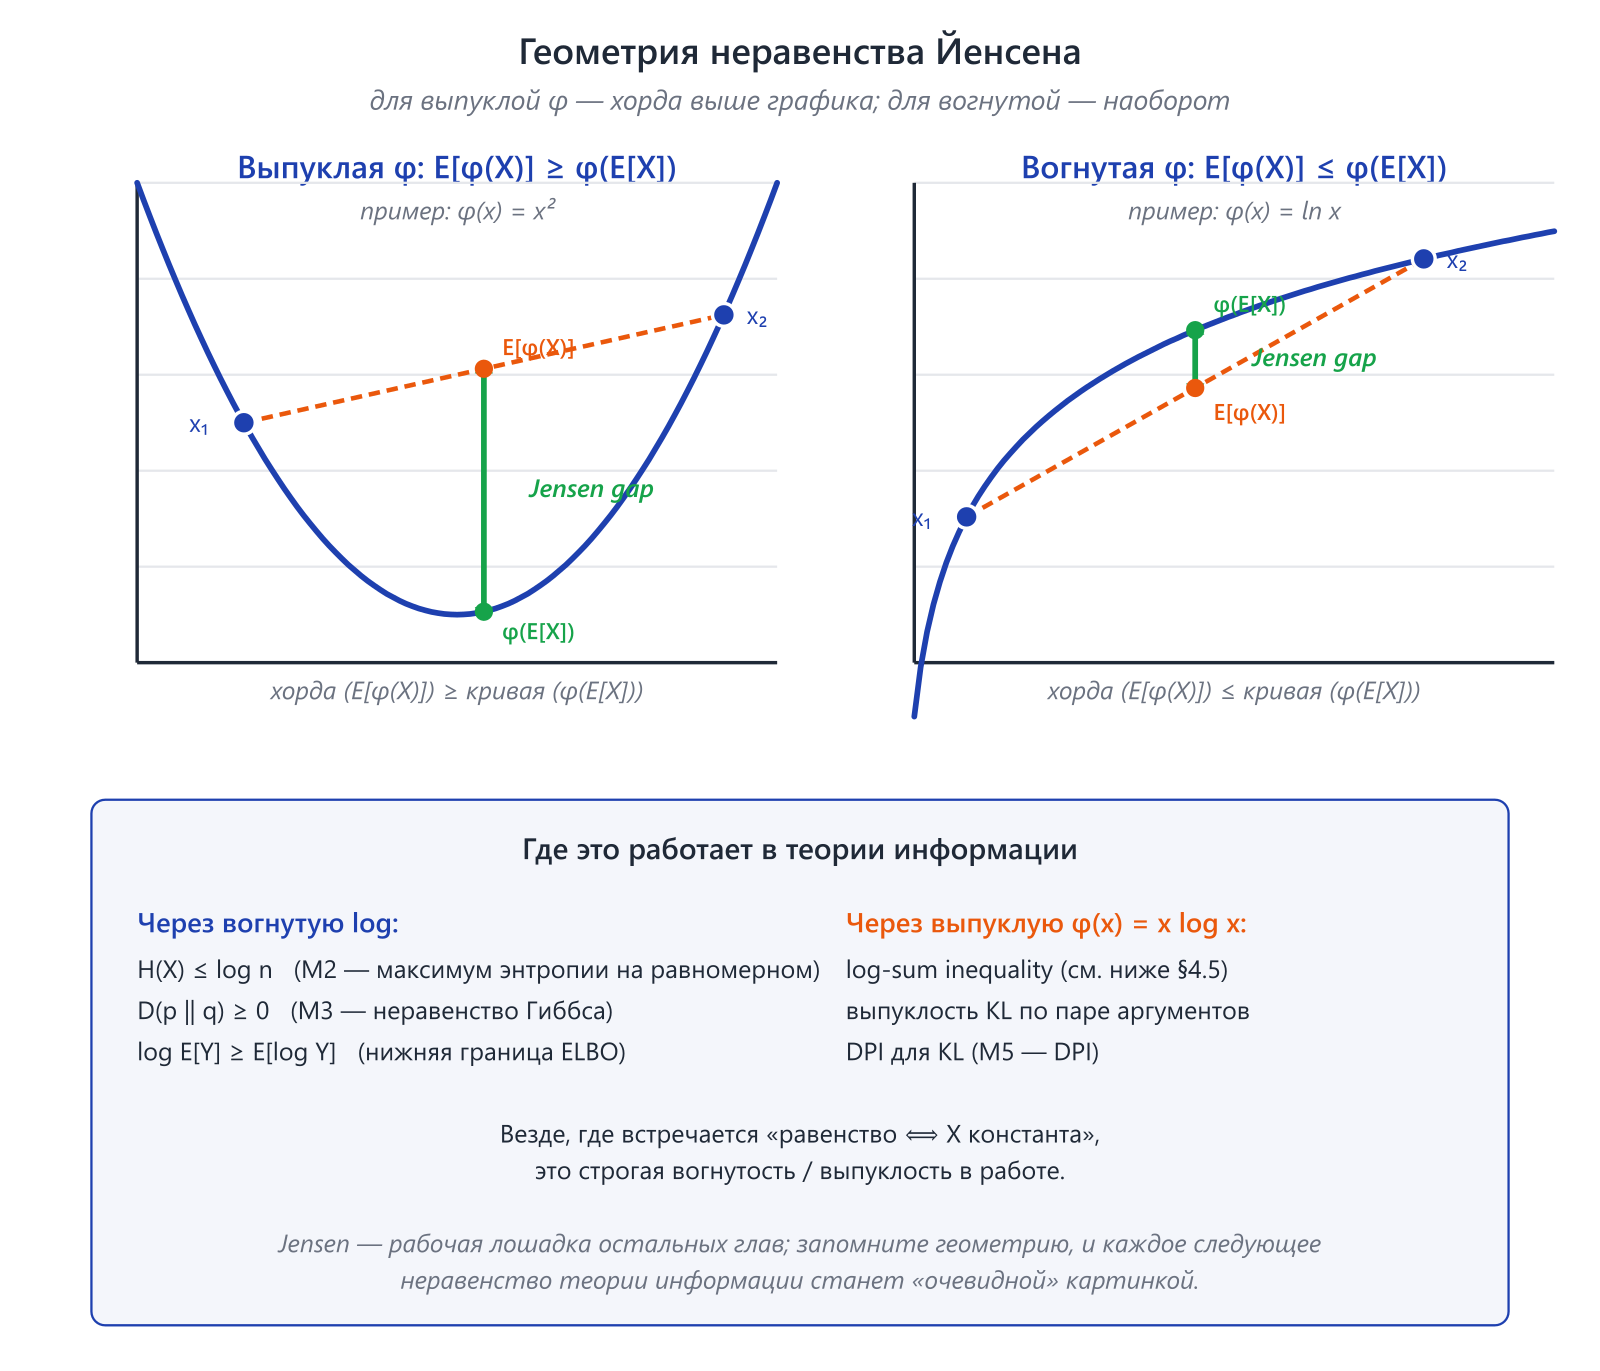
Вот четыре функции, которые будут постоянно возвращаться в курсе:
| Функция | Кривизна | Что она даст |
|---|---|---|
| , | строго выпуклая | гарантию для смеси вероятностей |
| , | строго вогнутая | ELBO и другие нижние границы |
| выпуклая | гарантию для усреднения логитов | |
| , | выпуклая | log-sum inequality и выпуклость KL |
Квадрат даёт самый знакомый частный случай:
или, что то же самое,
Короткое доказательство, которое стоит увидеть один раз
Пусть дифференцируема и выпукла, а
Касательная плоскость к выпуклой функции является глобальной нижней опорой:
Берём ожидание обеих частей:
Линейный член исчезает именно потому, что касательная проведена в среднем . Вот и вся механика. В общей недифференцируемой постановке ту же роль играет опорный субградиент; для наших ML-применений дифференцируемой версии достаточно.
Когда неравенство становится равенством
Если строго выпукла на выпуклой оболочке существенного носителя , то
возможно только тогда, когда почти наверное постоянна. В конечной смеси с положительными весами это означает: все аргументы, которые действительно участвуют в смеси, совпадают.
Для нестрого выпуклой функции возможны и нетривиальные случаи равенства — например, когда весь носитель лежит на участке, где функция аффинна.
Это условие не является технической сноской. Оно отвечает на практический вопрос: когда усреднение действительно что-то меняет? Если модели выдают одинаковый релевантный аргумент, Йенсен не создаёт выигрыша; если аргументы различаются и функция изгибается, возникает ненулевой разрыв.
Математическое углубление: разрыв, кривизна и дивергенция Брэгмана
Для выпуклой определим разрыв Йенсена
Если — скалярная случайная величина, сосредоточенная около , а дважды дифференцируема, разложение Тейлора даёт локальную оценку
В многомерном случае аналогичная формула имеет вид
Эта формула даёт полезную инженерную интуицию: эффект усреднения требует одновременно разброса аргументов и кривизны функции в соответствующих направлениях. Поэтому лозунг «чем разнообразнее модели, тем лучше ансамбль» слишком груб. Важен разброс их предсказаний именно там, где функция потерь имеет существенную кривизну.
Для дифференцируемой выпуклой функции введём дивергенцию Брэгмана
Тогда линейный член снова исчезает после усреднения:
При правая часть равна . Так разрыв Йенсена можно читать как среднюю «криволинейную дистанцию» от случайного аргумента до его среднего. Эта связь полезна, но для дальнейшего основного маршрута не обязательна.
4.3. Ансамбли: точная гарантия для log-loss
Пусть моделей выдают распределения
а веса суммируются в единицу. Есть как минимум два естественных способа построить ансамбль — и это разные модели.
Смешивание вероятностей
Определим арифметическую смесь
Для целевой метки функция строго выпукла, поэтому
Это сильнее, чем утверждение о среднем качестве на тестовой выборке: неравенство выполняется для каждого отдельного примера. После усреднения по набору данных оно, конечно, сохраняется.
Равенство достигается тогда, когда все модели с положительным весом назначают целевому классу одну и ту же вероятность. Полные распределения при этом могут различаться: для per-example NLL важна только координата правильного класса.
Формула гарантирует сравнение со средним участником, но не с лучшим. Она также не обещает автоматически повысить top-1 accuracy, улучшить калибровку на любом распределении или защитить от сдвига данных. Это не слабость результата, а его точная область действия: для фиксированных предсказаний смесь вероятностей не хуже среднего участника по log-loss.
Усреднение логитов
Пусть
и усредняются не вероятности, а логиты:
Кросс-энтропийная потеря для класса равна
logsumexp выпукла, а вычитание линейного члена не меняет выпуклость. Поэтому
И здесь ансамбль не хуже среднего участника по NLL. Но его распределение уже не является арифметической смесью. Из определения softmax следует
То есть усреднение логитов строит нормированное геометрическое среднее распределений, также известное как логарифмический пул (logarithmic opinion pool).
Полезно почувствовать разницу.
- Арифметическая смесь терпима к разногласиям: высокой вероятности одного участника может быть достаточно, чтобы класс сохранил заметную массу.
- Геометрическая смесь требует большего согласия: очень малая вероятность у одного участника сильнее подавляет класс.
Для конечных логитов равенство в логитном неравенстве возникает, в частности, когда все модели задают одно и то же softmax-распределение, то есть их логиты отличаются лишь общей добавочной константой.
Ни один способ не побеждает всегда
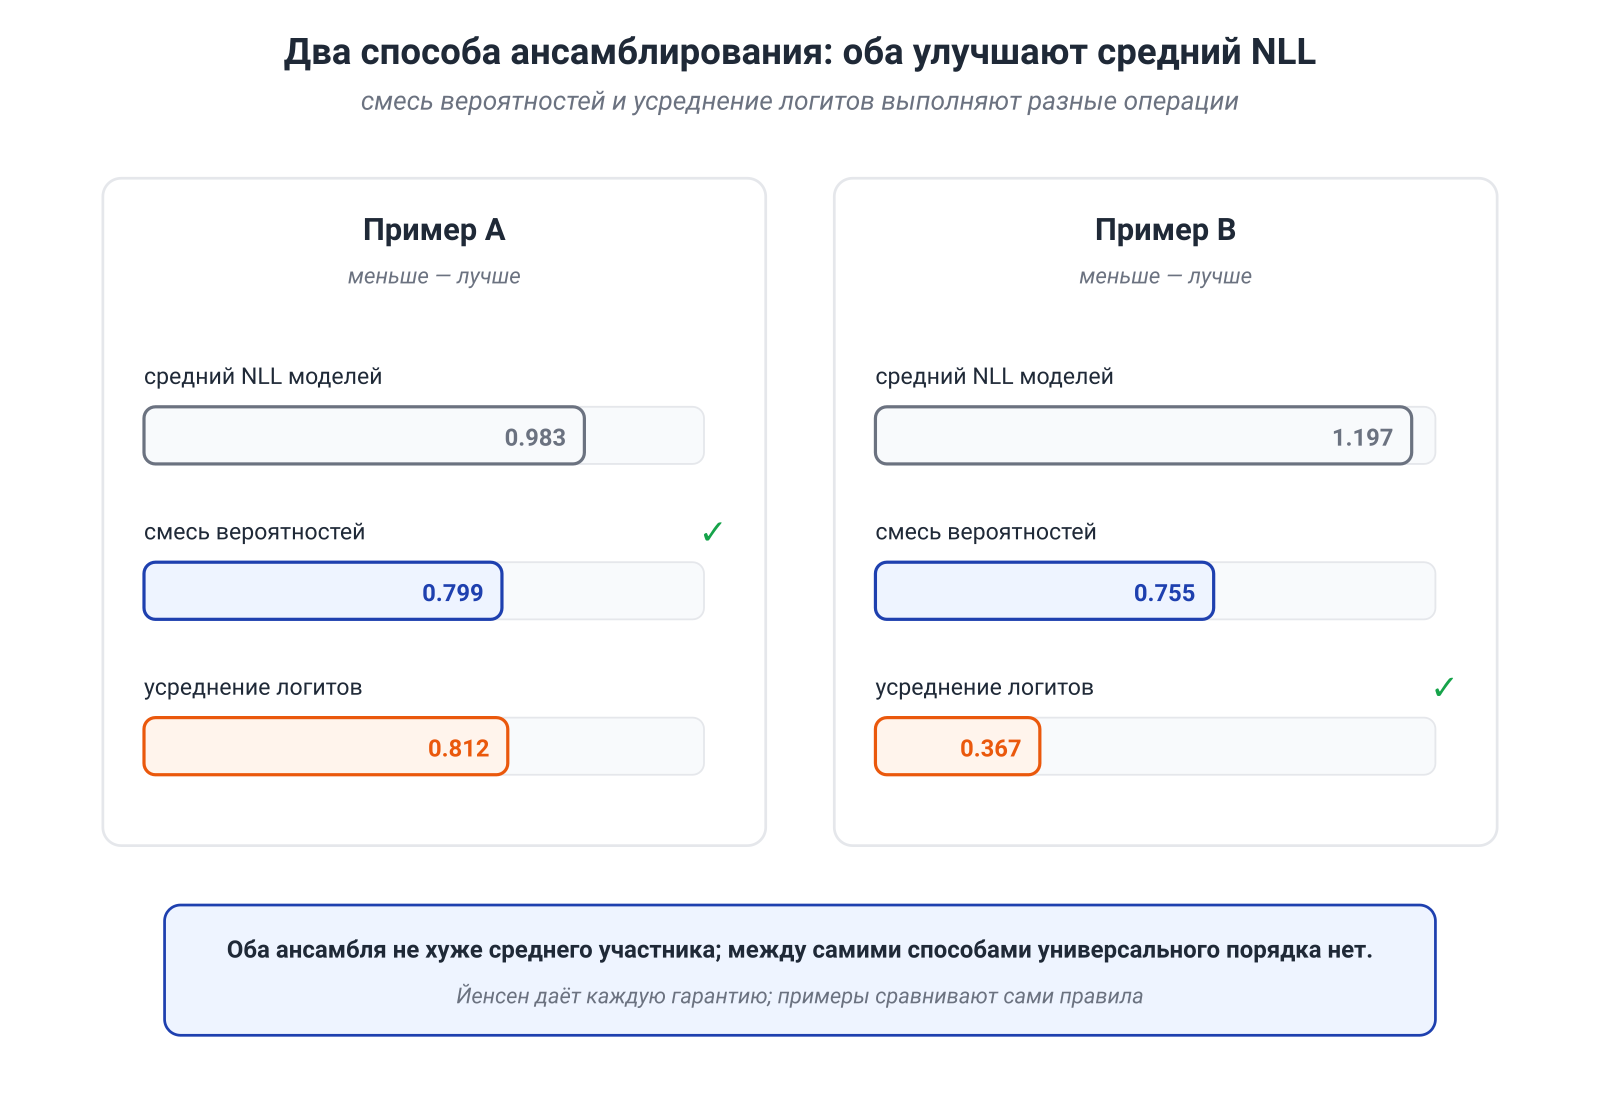
Рассмотрим два примера с правильным классом и равными весами.
| Пример | Средний NLL моделей | Смесь вероятностей | Средние логиты |
|---|---|---|---|
| , | |||
| , |
В первом примере лучше арифметическая смесь, во втором — геометрическая. Оба ансамбля выполняют свою гарантию Йенсена, но универсального порядка между ними нет.
Практическая деталь: это две разные строки кода
Если модели уже дали логиты, вероятностную смесь лучше считать в логарифмическом пространстве:
import torch
import torch.nn.functional as F

# logits: [num_models, num_classes]
# weights: [num_models], positive and summing to one
# target: scalar class index
log_probs = F.log_softmax(logits, dim=-1)
log_weights = weights.log()

# Arithmetic mixture of probabilities, computed stably.
log_q_mix = torch.logsumexp(
    log_probs + log_weights[:, None], dim=0
)
loss_probability_mix = -log_q_mix[target]

# Averaging logits gives a normalized geometric pool.
mean_logits = (weights[:, None] * logits).sum(dim=0)
loss_logit_mix = F.cross_entropy(
    mean_logits[None, :],
    torch.tensor([target], device=logits.device),
)
Среднее логитов нельзя использовать как численно удобную замену среднему вероятностей: оно реализует другую операцию и может дать другой ответ.
4.4. ELBO: логарифм стоит снаружи скрытых объяснений
В модели с латентной переменной наблюдение может иметь много скрытых объяснений . Маргинальное правдоподобие складывает их:
Для обучения нужен логарифм
но интеграл часто трудно вычислить. Проблема снова имеет знакомую форму: логарифм стоит после суммирования по скрытым состояниям.
Введём вариационное распределение , положительное там, где . Тогда
Логарифм вогнут, поэтому Йенсен разворачивает знак:
Правая часть называется нижней границей свидетельства (evidence lower bound, ELBO):
Здесь Йенсен не просто доказывает существование какой-то границы. Он превращает трудный логарифм интеграла в ожидание, которое можно оценивать сэмплами из и оптимизировать стохастическим градиентом.
Разрыв известен точно
Используем
Тогда
Итак,
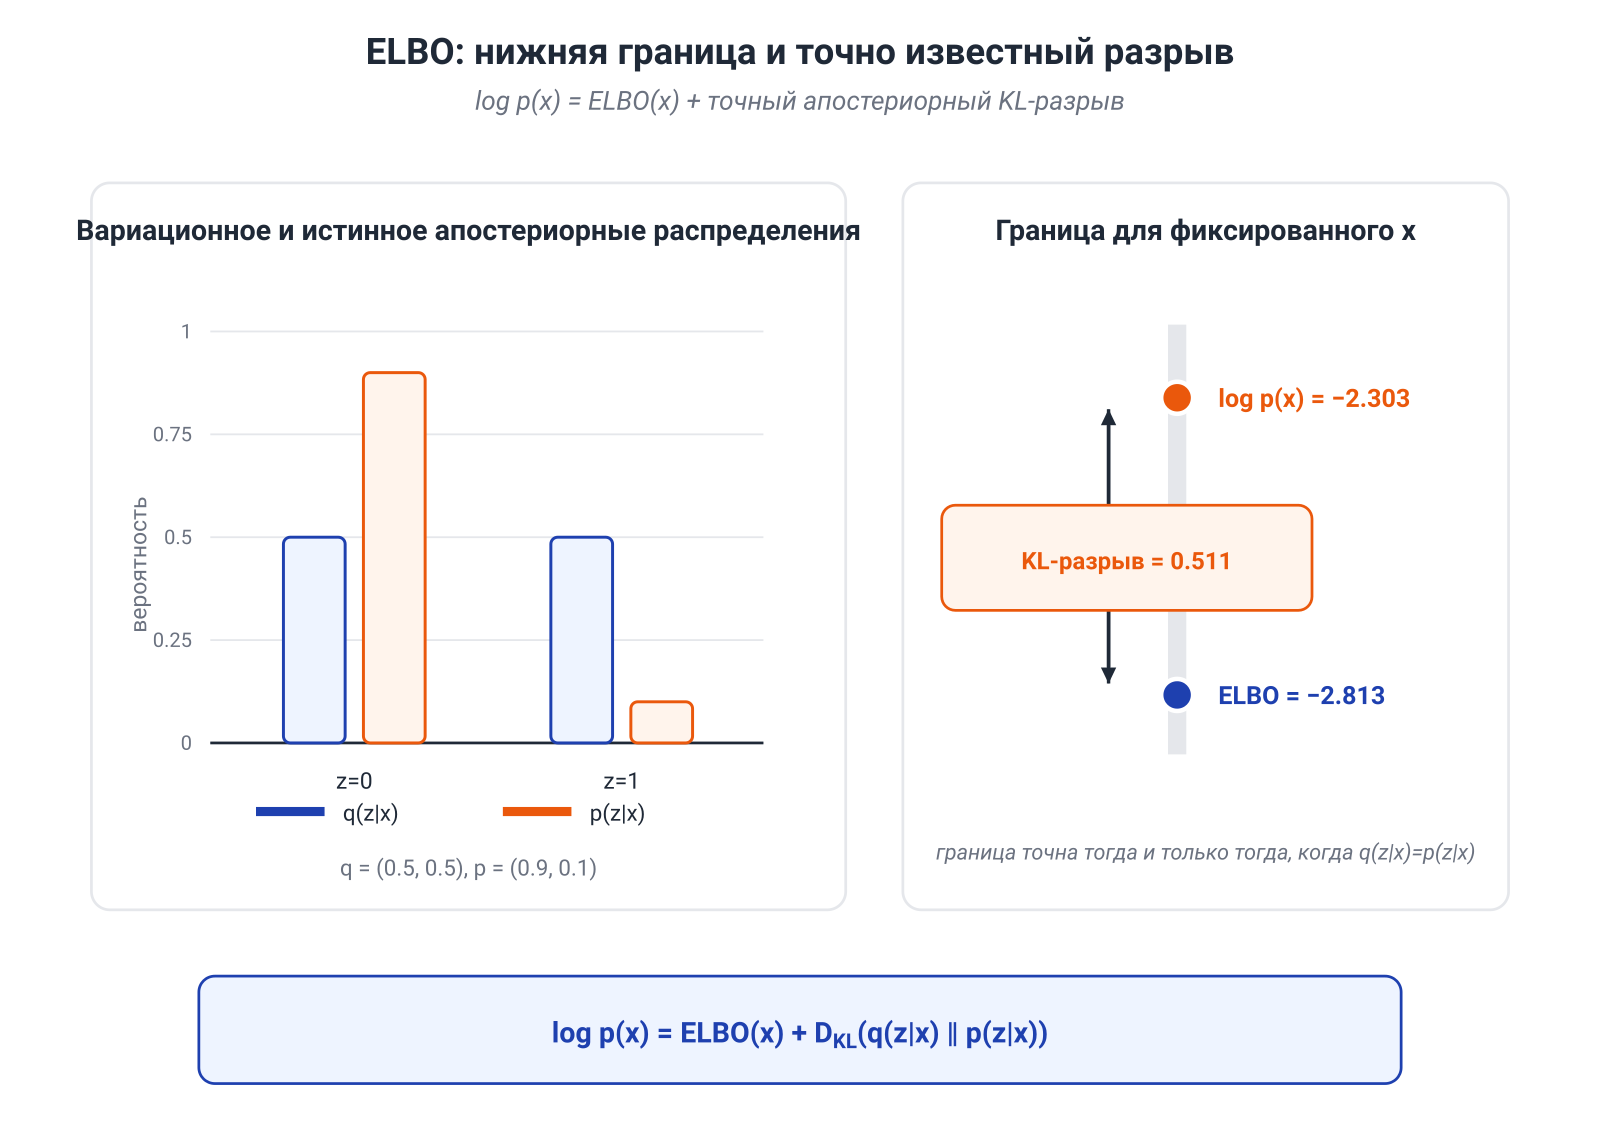
Теперь условие равенства Йенсена получает вероятностный смысл. Вес
должен быть постоянным при . Это происходит тогда и только тогда, когда
почти всюду: в этом случае и граница становится точной.
Небольшой дискретный пример
Для фиксированного пусть
Тогда
Возьмём грубое приближение
Получаем
Разрыв равен
и в точности совпадает с
Число здесь не «штраф, добавленный вручную». Это точная цена несовпадения выбранного с истинным апостериорным распределением.
Форма, знакомая по VAE
Если совместное распределение факторизуется как
то ELBO переписывается как
Первое слагаемое обычно называют реконструкционным, хотя математически это ожидаемое условное log-likelihood и его конкретная форма зависит от декодера. Второе сравнивает приближённое апостериорное распределение с априорным распределением (prior). Оно возникает из вероятностного разложения, а не как внешняя регуляризация, приклеенная к функции потерь.
Положительный результат уже достаточно силён:
- максимизация ELBO повышает вычислимую нижнюю границу на ;
- точность границы определяется KL до истинного апостериорного распределения;
- более выразительное семейство может уменьшить лучший достижимый вариационный разрыв.
Граница утверждения тоже важна. Более высокая ELBO не гарантирует глобальный оптимум, полезность латентного представления для любой внешней задачи или отсутствие проблем оптимизации. IWAE, амортизационный разрыв и posterior collapse будут естественнее обсуждаться в Модуле 9, где для них уже появится вся VAE-постановка.
4.5. Log-sum inequality: что теряется при объединении состояний
Представьте, что и различаются на четырёх состояниях, а затем мы склеиваем их в две группы. После такого укрупнения у нас стало меньше деталей. Может ли различимость распределений по KL увеличиться?
Ответ — нет. Алгебраический механизм этого факта называется логарифмическим неравенством сумм (log-sum inequality).
Формулировка
Пусть ,
Используем соглашения
Тогда
Если и левая часть конечна, равенство достигается тогда и только тогда, когда совпадают нормированные векторы:
для всех релевантных . Эквивалентно, отношения постоянны.
Почему это та же неотрицательность KL
Нормируем последовательности:
Тогда
Log-sum — не отдельный фокус, который нужно запоминать рядом с KL. Это неотрицательность KL после правильной нормировки.
Его можно также вывести напрямую из Йенсена для выпуклой функции , используя веса . Оба доказательства показывают одну структуру с двух сторон.
Совместная выпуклость KL: смешивание скрывает индекс компонента
Пусть есть пары распределений и веса . Для каждого исхода применим log-sum к
а затем просуммируем по . Получим
Это совместная выпуклость KL.
Формулу полезно прочитать как эксперимент. Сначала выбирается индекс , затем исход приходит либо из , либо из . Пока индекс известен, средняя различимость равна правой части. Если индекс скрыть и оставить только смеси, различимость не может вырасти. Смешивание удалило информацию о том, из какого компонента пришёл объект.
При фиксированном получаем частный случай
который снова объясняет гарантию вероятностного ансамбля на уровне распределений.
Укрупнение состояний не увеличивает KL
Пусть детальное состояние заменяется группой
Для каждой группы применим log-sum к значениям и внутри множества . После суммирования по группам получаем
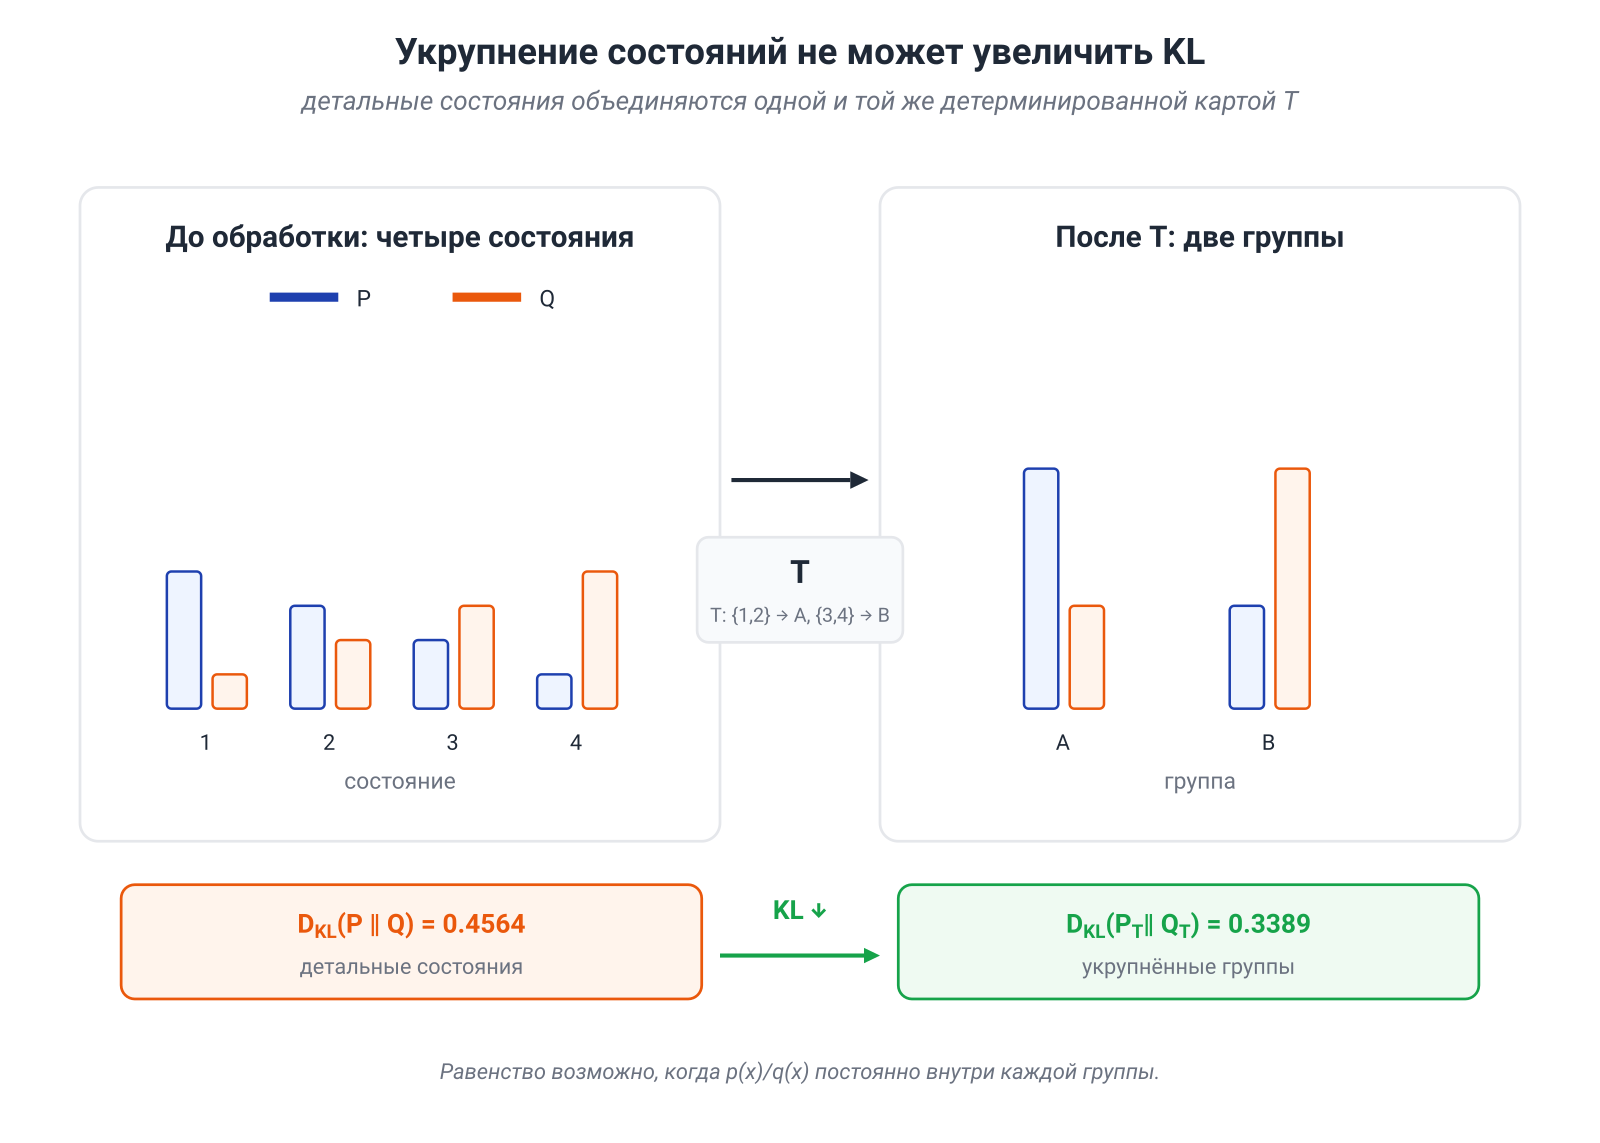
Для примера
имеем
Объединим первые два и последние два состояния:
Теперь
Различимость уменьшилась, потому что мы больше не видим, как масса распределена внутри каждой группы.
Условие равенства особенно содержательно. KL сохраняется тогда и только тогда, когда отношение правдоподобий
постоянно внутри каждой группы. Эквивалентно, при положительных групповых массах
Зная группу, детальное состояние больше не помогает различить и . Это точная алгебраическая форма идеи «сжатие ничего существенного не потеряло». В дальнейшем тот же рисунок приведёт к неравенству обработки данных (Data Processing Inequality) и к достаточным статистикам.
Для произвольного стохастического канала доказательство устроено так же: применяем log-sum к членам и . В Модуле 5 эта конструкция станет основой DPI для взаимной информации.
4.6. Одна теорема — четыре рабочих механизма
Теперь полезно собрать маршрут в одну таблицу.
| Где возникает среднее | Нелинейность | Что даёт Йенсен |
|---|---|---|
| вероятности моделей | NLL смеси не хуже среднего NLL | |
| логиты моделей | logsumexp | NLL средних логитов не хуже среднего NLL |
| скрытые объяснения | нижнюю границу ELBO | |
| компоненты сумм или объединяемые состояния | log-sum, выпуклость KL и сжатие различимости |
Важна не сама способность узнать слово «Йенсен» внутри очередного доказательства. Важен переносимый вопрос:
Что именно усредняется, какая функция применяется после усреднения и какова её кривизна на нужной области?
Этот вопрос защищает сразу от двух ошибок. Первая — переставить операции как будто линейность сохраняется. Вторая — увидеть выпуклость и сделать слишком сильный вывод о качестве всей системы. Йенсен сравнивает конкретные величины при фиксированной постановке; обобщение, оптимизация и поведение при сдвиге распределения требуют отдельных аргументов.
Дальше аппарат будет возвращаться в более богатых формах:
- в Модуле 5 log-sum станет DPI для KL и взаимной информации;
- в Модуле 8 условия равенства встретятся рядом с достаточными статистиками и экспоненциальными семействами;
- в Модуле 9 ELBO войдёт в VAE, Information Bottleneck и rate–distortion;
- в Модуле 11 выпуклость породит вариационные представления дивергенций;
- в Модуле 12 KL появится как мера сложности в PAC-Bayes.
4.7. Ключевые выводы модуля
- Для выпуклой функции а для вогнутой знак меняется.
- Разрыв возникает из сочетания разброса аргументов и кривизны функции. Усреднение одинаковых предсказаний ничего не даёт.
- Смесь вероятностей и средние логиты — разные ансамбли. Оба не хуже среднего участника по NLL, но ни один не доминирует другой всегда.
- ELBO — прямой Йенсен для логарифма маргинального правдоподобия; её точный разрыв равен .
- Log-sum — рабочая форма неотрицательности KL. Она объясняет совместную выпуклость и то, почему объединение состояний не может увеличить различимость.
- Выпуклость даёт точную локальную гарантию для заданных величин. Она не заменяет проверку оптимизации, обобщения, калибровки и качества на целевом распределении.
4.9. Литература и первоисточники
- Boyd & Vandenberghe, Convex Optimization — выпуклые функции, опорные гиперплоскости,
logsumexpи неравенство Йенсена. - Cover & Thomas, Elements of Information Theory — log-sum inequality, совместная выпуклость KL и неравенство обработки данных.
- Kingma & Welling, Auto-Encoding Variational Bayes — вариационная нижняя граница и амортизованный вывод в моделях с непрерывными латентными переменными.
- Lakshminarayanan, Pritzel & Blundell, Simple and Scalable Predictive Uncertainty Estimation Using Deep Ensembles — практический контекст для усреднения вероятностных предсказаний.
- Bregman, The relaxation method of finding the common point of convex sets and its application to the solution of problems in convex programming — исходная конструкция дивергенций Брэгмана.