Модуль 7. Канал и пропускная способность
Как читать этот модуль. §§7.1–7.7 образуют классическое ядро: модель канала, пропускная способность, три базовых примера и обе части теоремы кодирования. В §7.6 стоит пройти хотя бы интуитивный подсчёт случайного кодирования — именно там становится видно, откуда берётся порог . Нормальное приближение в конце §7.7 относится ко второму проходу. §§7.8–7.10 переносят канальный язык в ML: к шумным меткам, ECOC, обучаемой связи и LLM.
7.1. Надёжная передача через шум
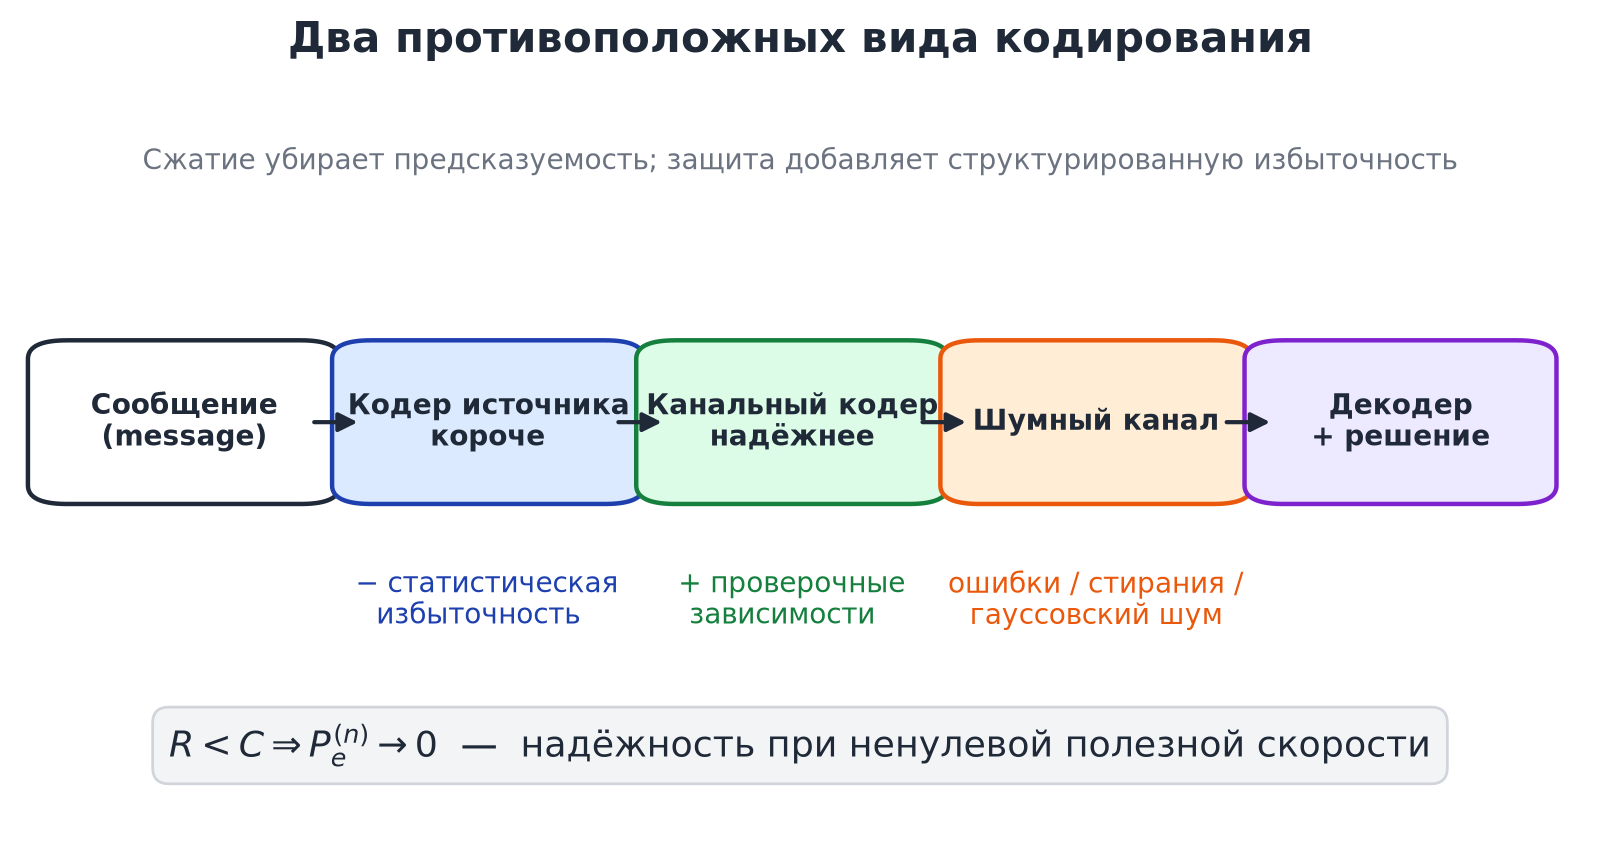
В Модуле 6 мы старались убрать из сообщения всё предсказуемое и записать его как можно короче. Теперь задача почти противоположна: сообщение нужно провести через среду, которая меняет, стирает или зашумляет символы. И здесь избыточность, от которой мы только что избавлялись, внезапно становится полезной.
Представим двоичный канал, который независимо переворачивает каждый переданный бит с вероятностью . Если отправить тысячу информационных бит без защиты, получатель в среднем увидит около ста ошибок. Самая очевидная защита — повторять каждый бит несколько раз и голосовать по большинству. Она действительно помогает, но быстро съедает скорость: трёхкратное повторение даёт лишь информационного бита на одно использование канала и всё равно не устраняет ошибку полностью.
Результат Шеннона говорит нечто гораздо более сильное. Для этого канала существует число
бита на использование. При любой скорости ниже можно выбрать всё более длинные блочные коды так, чтобы вероятность ошибки стремилась к нулю. В первом асимптотическом приближении тысяча информационных бит требует не меньше
использований канала, а не трёх тысяч. Это число ещё не обещает хороший короткий код длины — конечные блоки мы обсудим отдельно. Но оно уже разрушает наивную дилемму «либо скорость, либо надёжность».
Шум не обязательно оплачивается повторением каждого символа. Хороший код раздвигает целые сообщения в пространстве длинных последовательностей так, чтобы типичный шум не перепутал их.
Отсюда полезно сразу развести две операции.
| Операция | Что делает | Главный критерий |
|---|---|---|
Кодирование источника (source coding) | удаляет статистическую избыточность | средняя длина описания |
Канальное кодирование (channel coding) | добавляет структурированную избыточность | вероятность ошибки при заданной скорости |
Ключевое слово здесь — структурированную. Случайно дописанные биты не помогают. Дополнительные символы должны сделать кодовые слова различимыми после характерных для канала искажений.
Именно это утверждает теорема кодирования для канала: у заданного канала есть порог . Ниже него надёжная передача асимптотически достижима; выше него никакой код не заставит ошибку исчезнуть. Вторая часть особенно важна: пропускная способность — не характеристика конкретного алгоритма, а предел самой вероятностной модели канала при заданных ограничениях.
Для ML это не декоративная аналогия. Ошибки аннотатора, шумный латентный слой, квантованный сигнал, беспроводная передача признаков и кодовые представления классов действительно задают каналы, если мы можем назвать вход, выход и переходный закон. С LLM канальный язык тоже полезен, но там сначала придётся аккуратно отделить строгую модель от метафоры.
7.2. Дискретный канал без памяти и блочный код
Чтобы говорить о пределе надёжности, зафиксируем задачу. Нам понадобятся три объекта: сам канал, кодовая книга и декодер.
Дискретный канал без памяти
Дискретный канал без памяти (discrete memoryless channel, DMC) задаётся:
- конечным входным алфавитом ;
- конечным выходным алфавитом ;
- переходным законом
При использованиях канала условное распределение факторизуется:
Слово «без памяти» относится к шуму при фиксированной входной последовательности. Оно не требует, чтобы сами входные символы были независимыми. Напротив, хорошее кодовое слово обычно содержит сильную зависимость между координатами: именно она и создаёт защитную структуру.
Два базовых канала
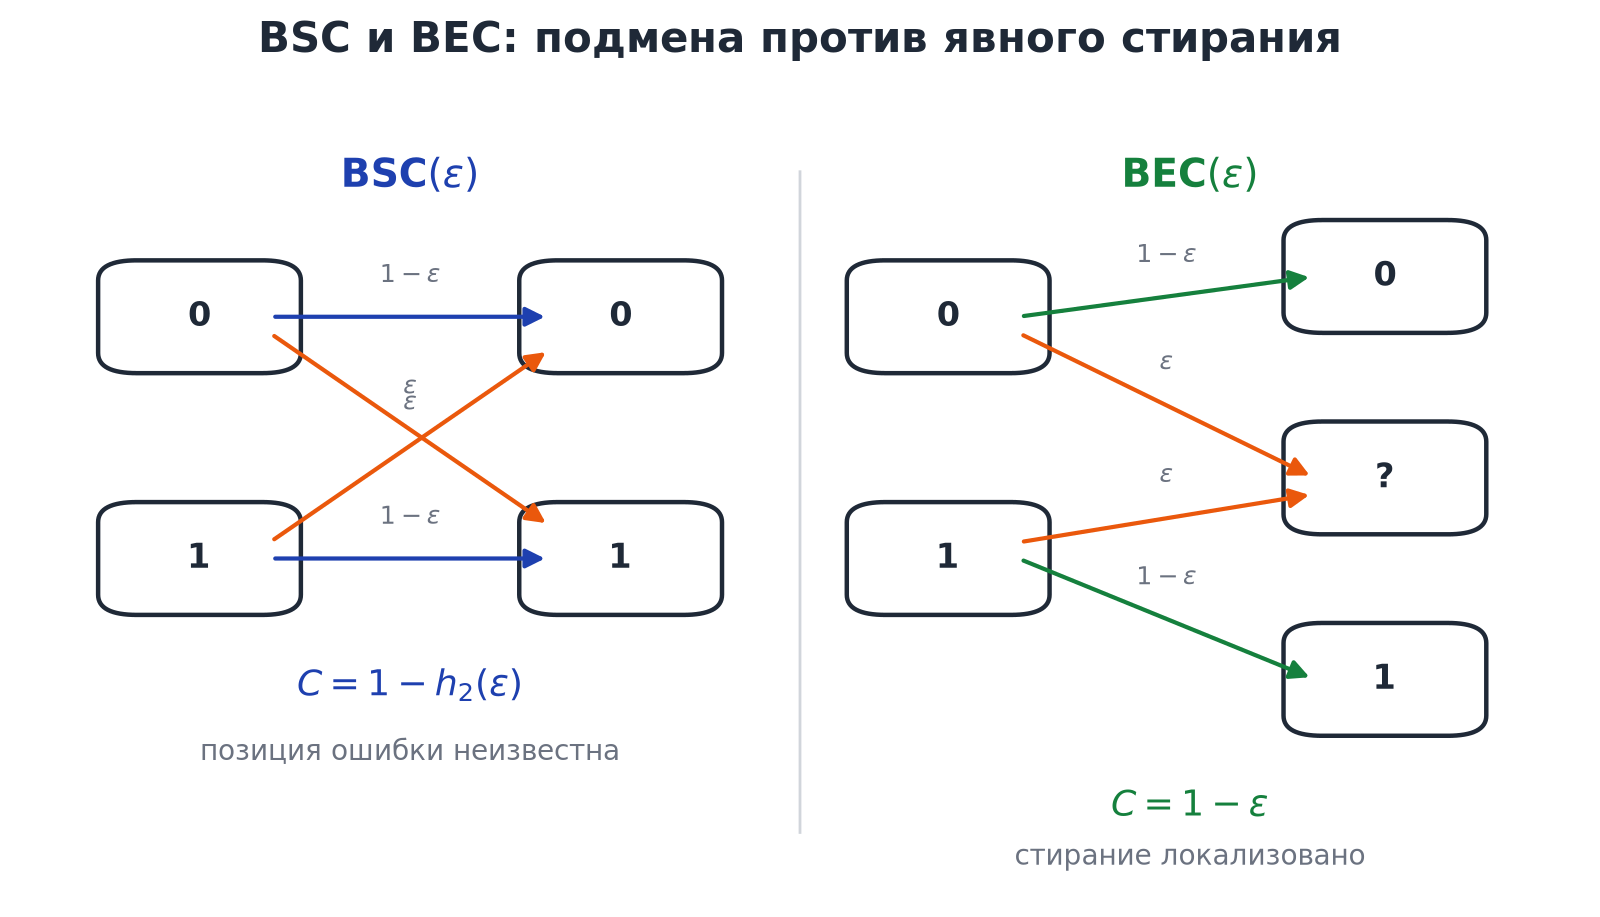
Двоичный симметричный канал (binary symmetric channel, BSC) с вероятностью инверсии имеет матрицу
Переданный бит независимо меняется на противоположный с вероятностью . Приёмник видит или , но не знает, в какой позиции произошла ошибка.
Двоичный канал со стиранием (binary erasure channel, BEC) с вероятностью стирания имеет выходной алфавит :
Здесь приёмник не знает значение стёртого бита, зато точно знает место потери. Позже мы увидим, насколько ценна эта дополнительная информация.
Блочный код
Пусть отправитель выбирает одно из равновероятных сообщений:
Код длины состоит из энкодера
и декодера
Энкодер отправляет кодовое слово
канал выдаёт , а декодер строит оценку
Средняя вероятность блочной ошибки равна
Иногда требуется контролировать и худшее сообщение:
Максимальная ошибка не меньше средней и предъявляет более сильное требование. Для обычного DMC обе постановки приводят к одной и той же пропускной способности; переход к максимальной ошибке требует дополнительного удаления худших кодовых слов (expurgation).
Скорость кода
измеряется в информационных битах на одно использование канала. Если , код различает сообщений и передаёт бит выбора за использований.
Скорость называется достижимой, если существует последовательность кодов, для которой
Пропускная способность определяется как
Пока это только операционное определение. Оно говорит, что мы хотим измерить, но ещё не даёт способа вычислить . Следующая формула связывает эту инженерную величину с взаимной информацией из Модуля 5.
Важно также не подменить единицу: бит на использование канала — не бит в секунду. Для физической скорости нужно знать, сколько независимых или эффективно независимых использований приходится на секунду.
7.3. Пропускная способность дискретного канала
Для конечного DMC без дополнительного ограничения на вход теорема Шеннона даёт
Распределение вместе с переходным законом задаёт совместное распределение
Для фиксированного величина отвечает на вопрос:
Сколько информации о случайном входе в среднем остаётся в одном выходе при данном способе использования канала?
Пропускная способность задаёт следующий вопрос:
Какое распределение входов использует канал лучше всего?
Это различие легко пропустить, потому что обе величины измеряются в битах на использование. Но — рабочая точка при выбранном , а — оптимум по всем допустимым рабочим точкам.
Теорема состоит из двух половин.
- Достижимость (
achievability): для любого существуют коды, у которых . - Обратная часть (
converse): если , ошибка не может стремиться к нулю. Для DMC сильная обратная теорема утверждает даже .
Таким образом, взаимная информация получает операционный смысл. Она не просто измеряет статистическую зависимость между и : после оптимизации по входу она становится максимально возможной скоростью надёжной связи.
Как читать оптимизацию по
Предположим, что матрица ошибок аннотатора рассматривается как канал от истинной метки к наблюдаемой . В реальном наборе данных распределение классов уже задано, поэтому
измеряет информацию, сохранившуюся при фактической частоте классов. А
описывает лучшее возможное использование той же матрицы переходов. Это разные вопросы: первый относится к данным, второй — к каналу как математическому объекту.
Несколько следствий
Для конечного DMC
Пропускная способность равна нулю тогда и только тогда, когда все строки переходной матрицы совпадают:
В этом случае выход имеет одно и то же распределение при любом входе, а значит, не позволяет различать сообщения.
Если входы имеют разную стоимость, оптимизация получает ограничение:
Эта строка особенно важна для непрерывных каналов. Без ограничения мощности можно было бы раздвигать сигналы всё дальше и получать неограниченную скорость. Ограничение ресурса — часть определения задачи, а не техническое приложение к формуле.
7.4. BSC, BEC и Z-канал
Три двоичных канала показывают, почему одного слова «шум» недостаточно. Важна не только частота повреждений, но и то, какую структуру ошибки наблюдает получатель.
Двоичный симметричный канал
Пусть . Для BSC выход также равномерен, а условная энтропия равна . Поэтому
Симметрия канала гарантирует оптимальность равномерного входа:
При получаем
Обычно достаточно рассматривать . Если , приёмник может инвертировать каждый выход и получить эквивалентный BSC с вероятностью ошибки . В крайней точке канал снова передаёт один бит без потери: он детерминированно меняет на и на .
Двоичный канал со стиранием
Пусть . Если символ не стёрт, вход известен точно; если стёрт, остаётся вся исходная неопределённость. Поэтому
и
Максимум достигается при :
При это бит/использование — заметно больше, чем у BSC с тем же численным параметром. Причина не в том, что стирание «слабее» само по себе. BEC сообщает позицию повреждения, а BSC заставляет декодер сначала угадать, где ошибка вообще произошла.
Асимметричный Z-канал
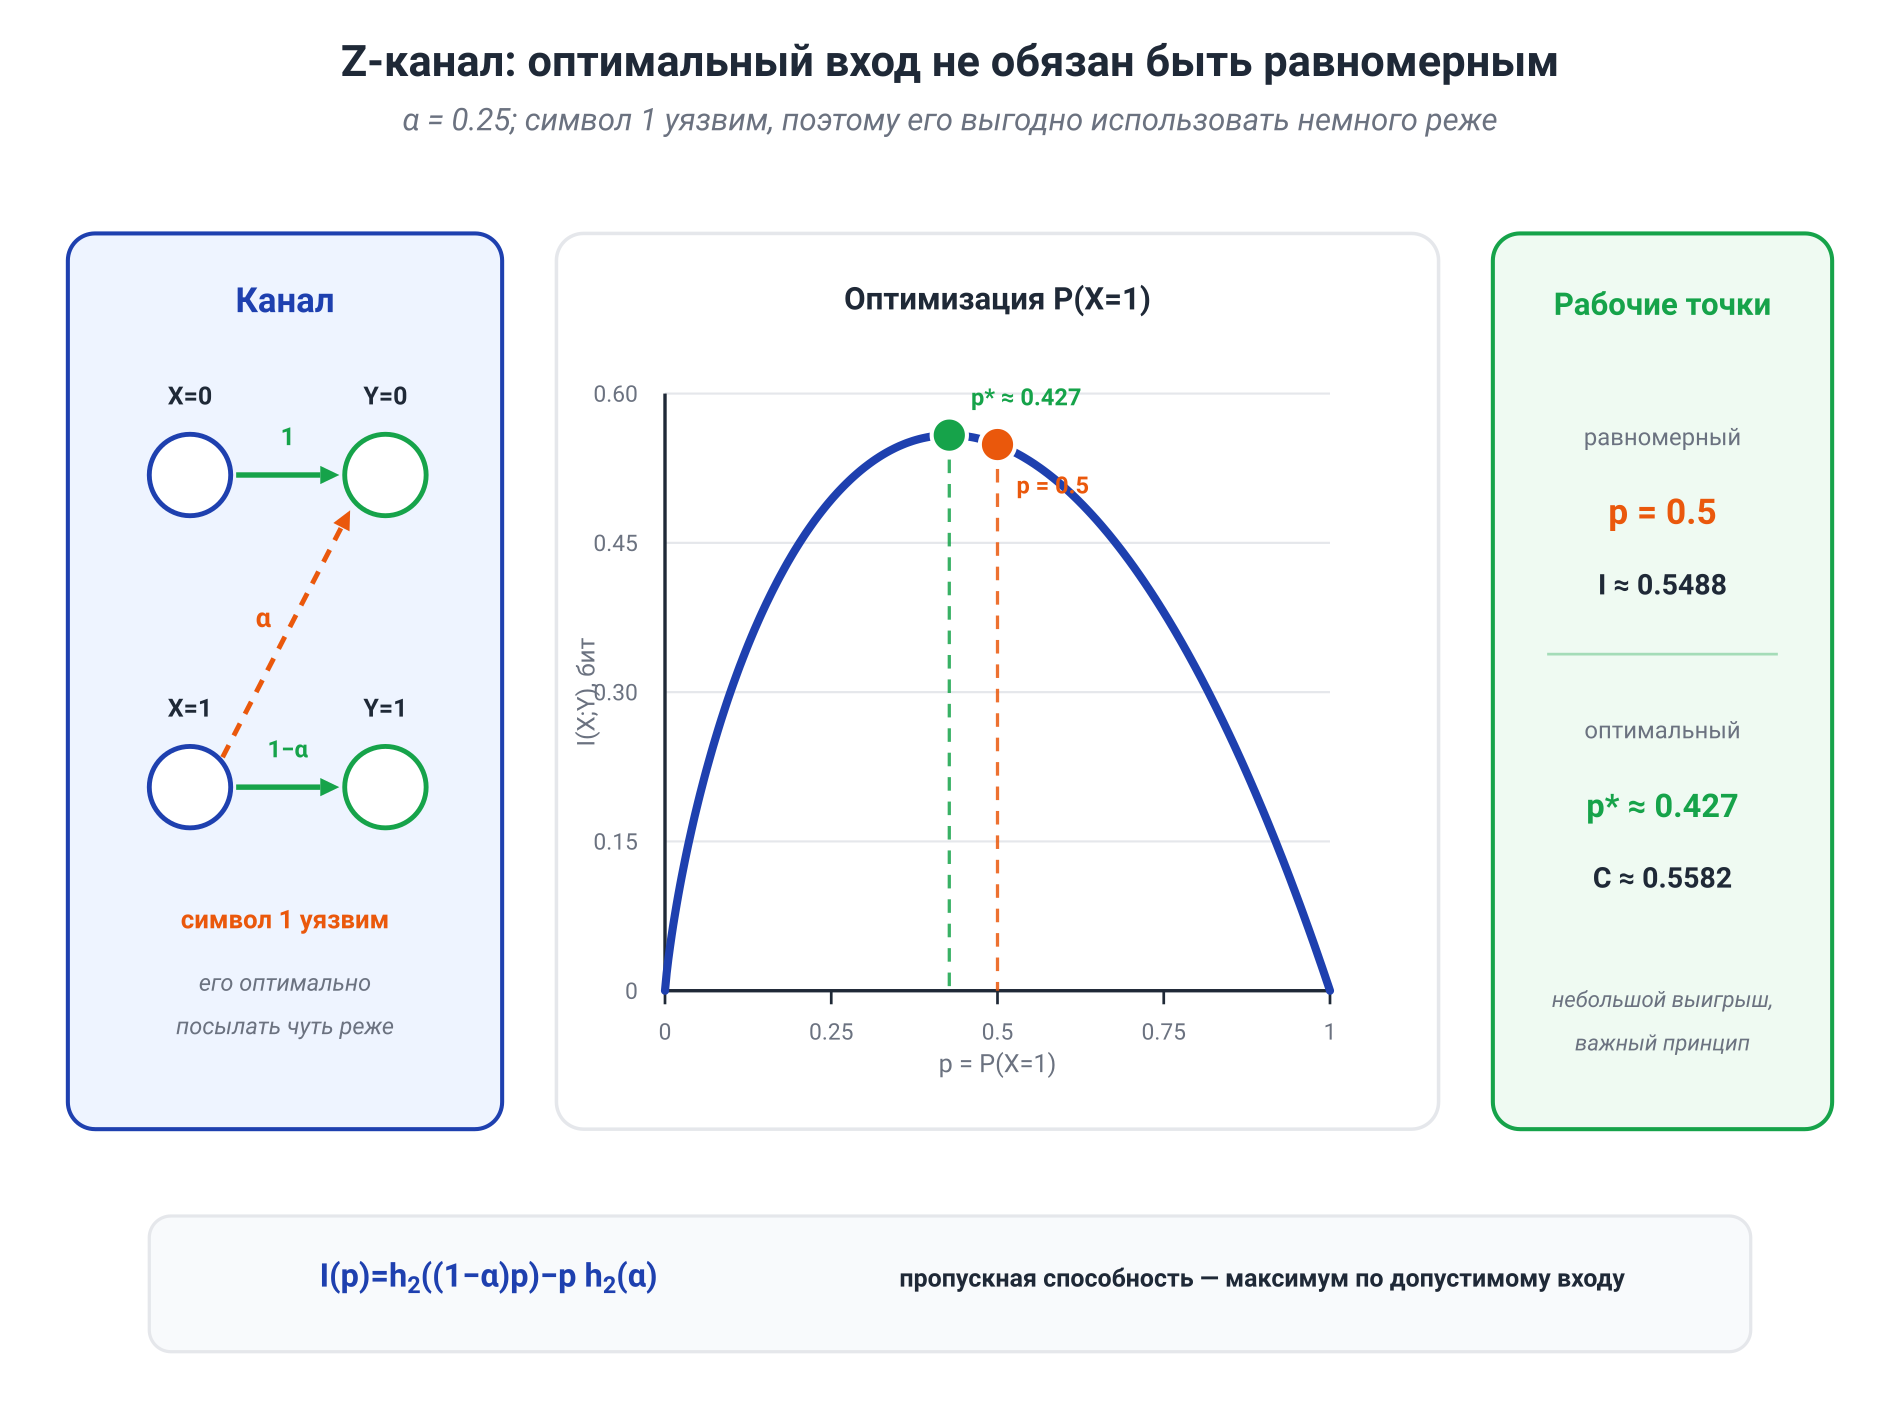
Теперь рассмотрим канал
Символ проходит безошибочно, а превращается в с вероятностью . Если
то
При максимум достигается приблизительно при
Равномерный вход даёт немного меньше:
Разница численно невелика, но концептуально важна. Уязвимый символ следует использовать реже. Именно поэтому в формуле пропускной способности стоит максимум по , а не автоматическое «возьмём равномерное распределение».
Для произвольной конечной матрицы этот максимум удобно находить алгоритмом Блахута—Аримото (Blahut–Arimoto); его реализация входит в вычислительное упражнение.
7.5. Гауссовский канал и ограничение мощности
В дискретном канале размер входного алфавита сам ограничивает число различимых сигналов. В вещественном канале такого естественного потолка нет, поэтому ресурс нужно задать явно.
Рассмотрим дискретновременной AWGN-канал
где шум независим от входа, а средняя мощность сигнала ограничена:
Пропускная способность одного вещественного использования равна
бит/использование. Оптимальный вход — гауссовский:
Механика формулы прозрачна. Поскольку ,
Шумовая энтропия фиксирована, а при заданной дисперсии энтропию выхода максимизирует гауссовское распределение. Гауссовский вход делает выход гауссовским и достигает верхней границы.
Для непрерывного канала с полосой Гц, средней мощностью сигнала и полной мощностью шума в этой полосе формула Шеннона—Хартли записывается как
бит/с. Первая формула измеряет биты на одно вещественное использование; вторая — биты в секунду. Совпадение логарифма не делает единицы взаимозаменяемыми.
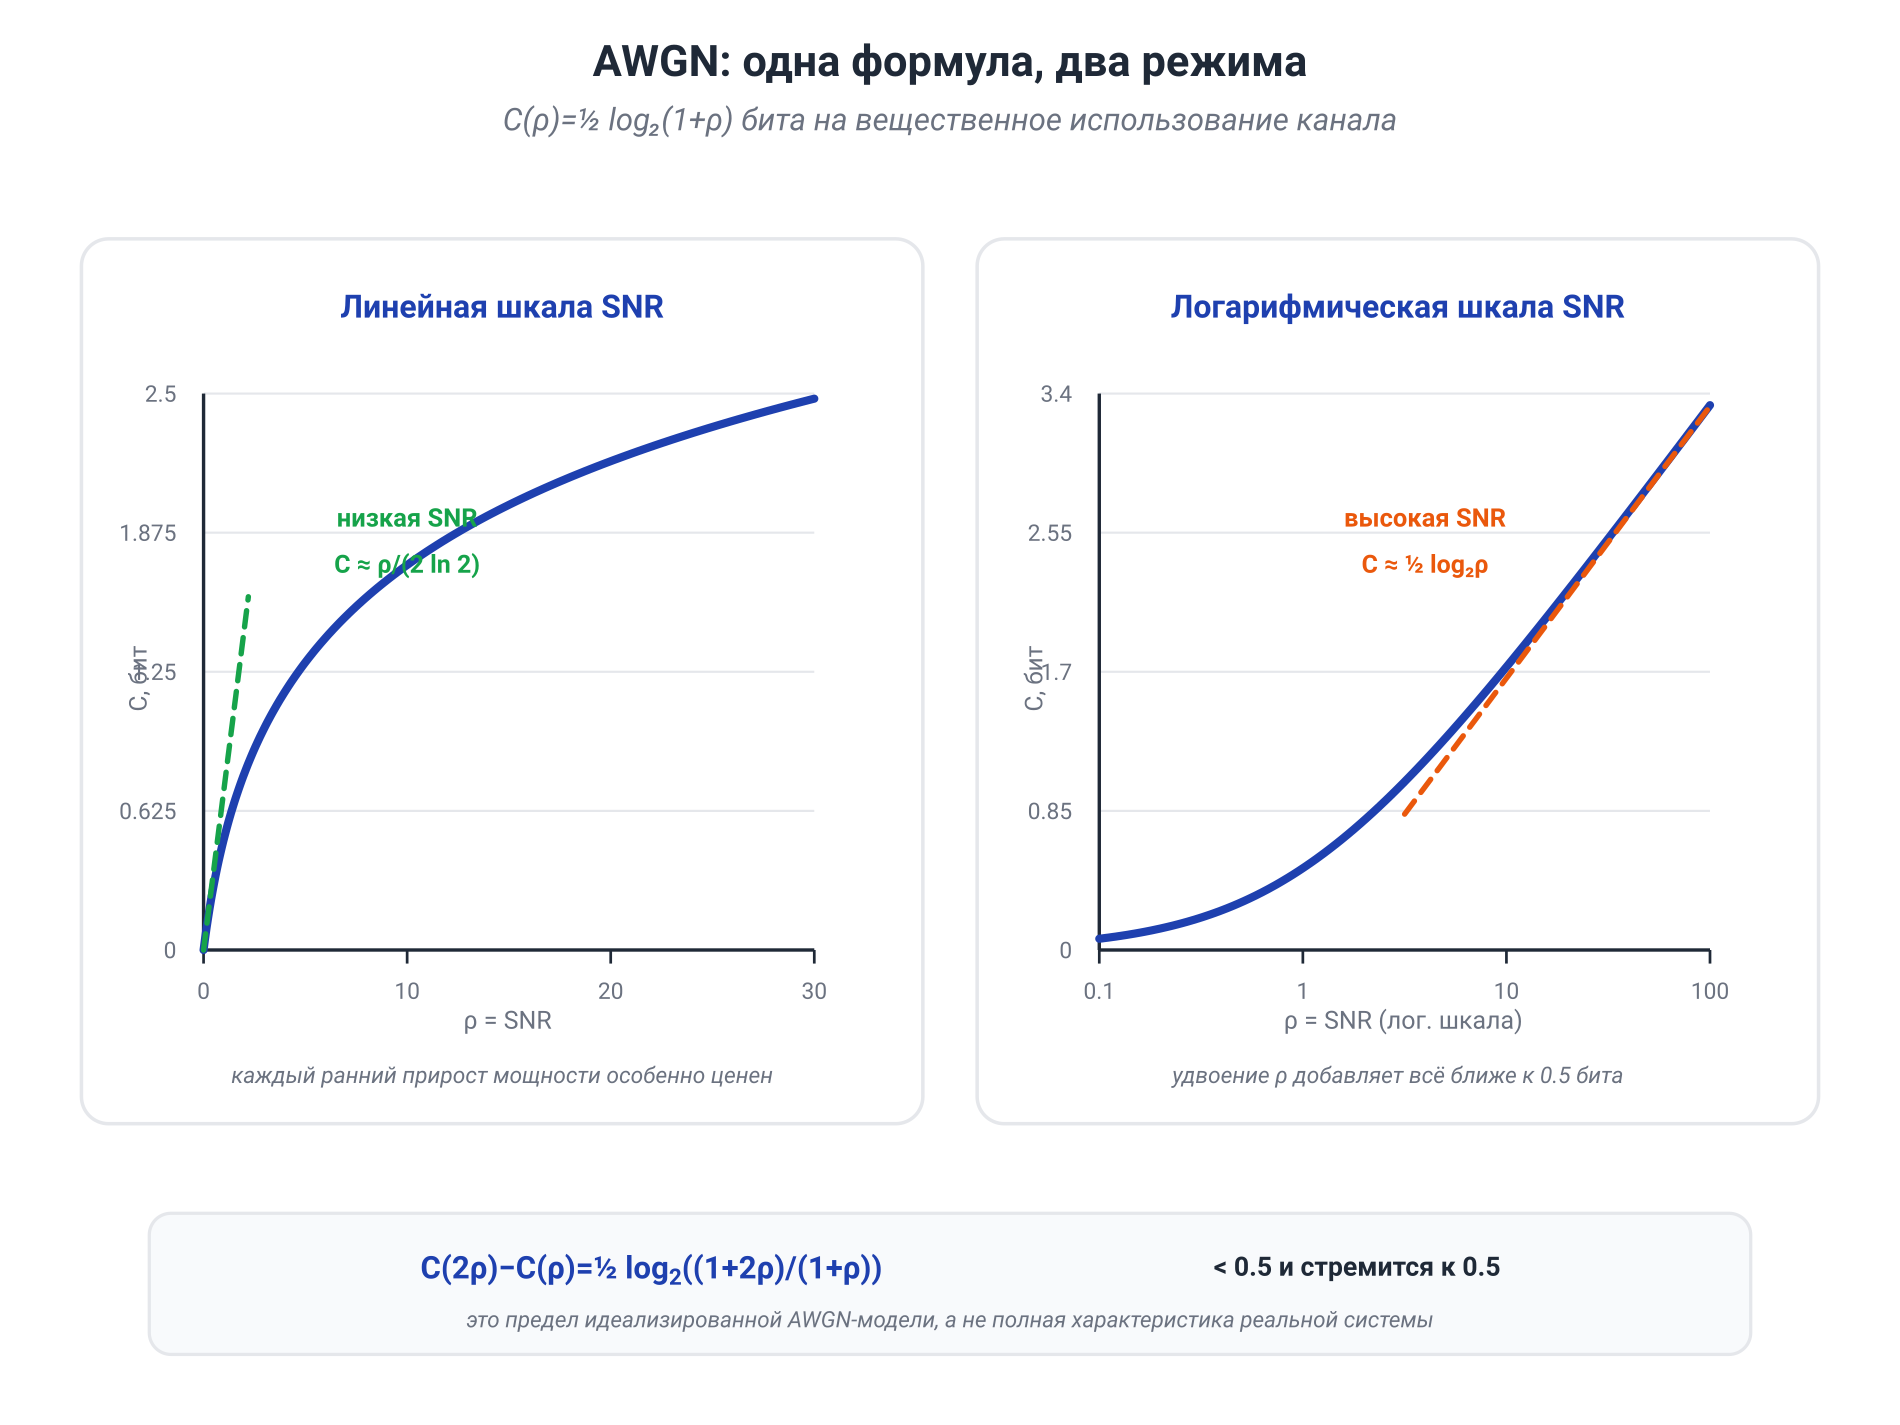
Что говорит форма кривой
Обозначим отношение сигнал/шум (signal-to-noise ratio, SNR) через . Тогда
- при
- при
На малой SNR дополнительная мощность почти линейно увеличивает скорость. На большой SNR начинается логарифмический режим убывающей отдачи. Точное приращение при удвоении SNR равно
Оно меньше бита/использование и лишь при высокой SNR приближается к . Поэтому правило «удвоение мощности даёт полбита» — полезная высоко-SNR оценка, а не точное равенство для всей кривой.
Формула задаёт предел идеализированной модели. Реальная система добавляет замирания (fading), интерференцию, конечную модуляцию, ограничения оборудования, задержку, служебные данные и конечный блок. Фраза «близко к пределу Шеннона» всегда должна заканчиваться уточнением: к пределу какой именно модели и при каком критерии ошибки.
7.6. Почему случайное кодирование достигает
Теперь мы подошли к самой неожиданной части теоремы. Чтобы доказать существование хорошего кода, Шеннон не начал с хитрой явной конструкции. Он предложил выбрать всю кодовую книгу случайно и оценить её среднюю ошибку.
Это один из тех случаев, когда случайный объект анализировать легче, чем лучший конкретный объект. Если средняя ошибка по ансамблю случайных кодовых книг стремится к нулю, то хотя бы одна детерминированная книга работает не хуже среднего.
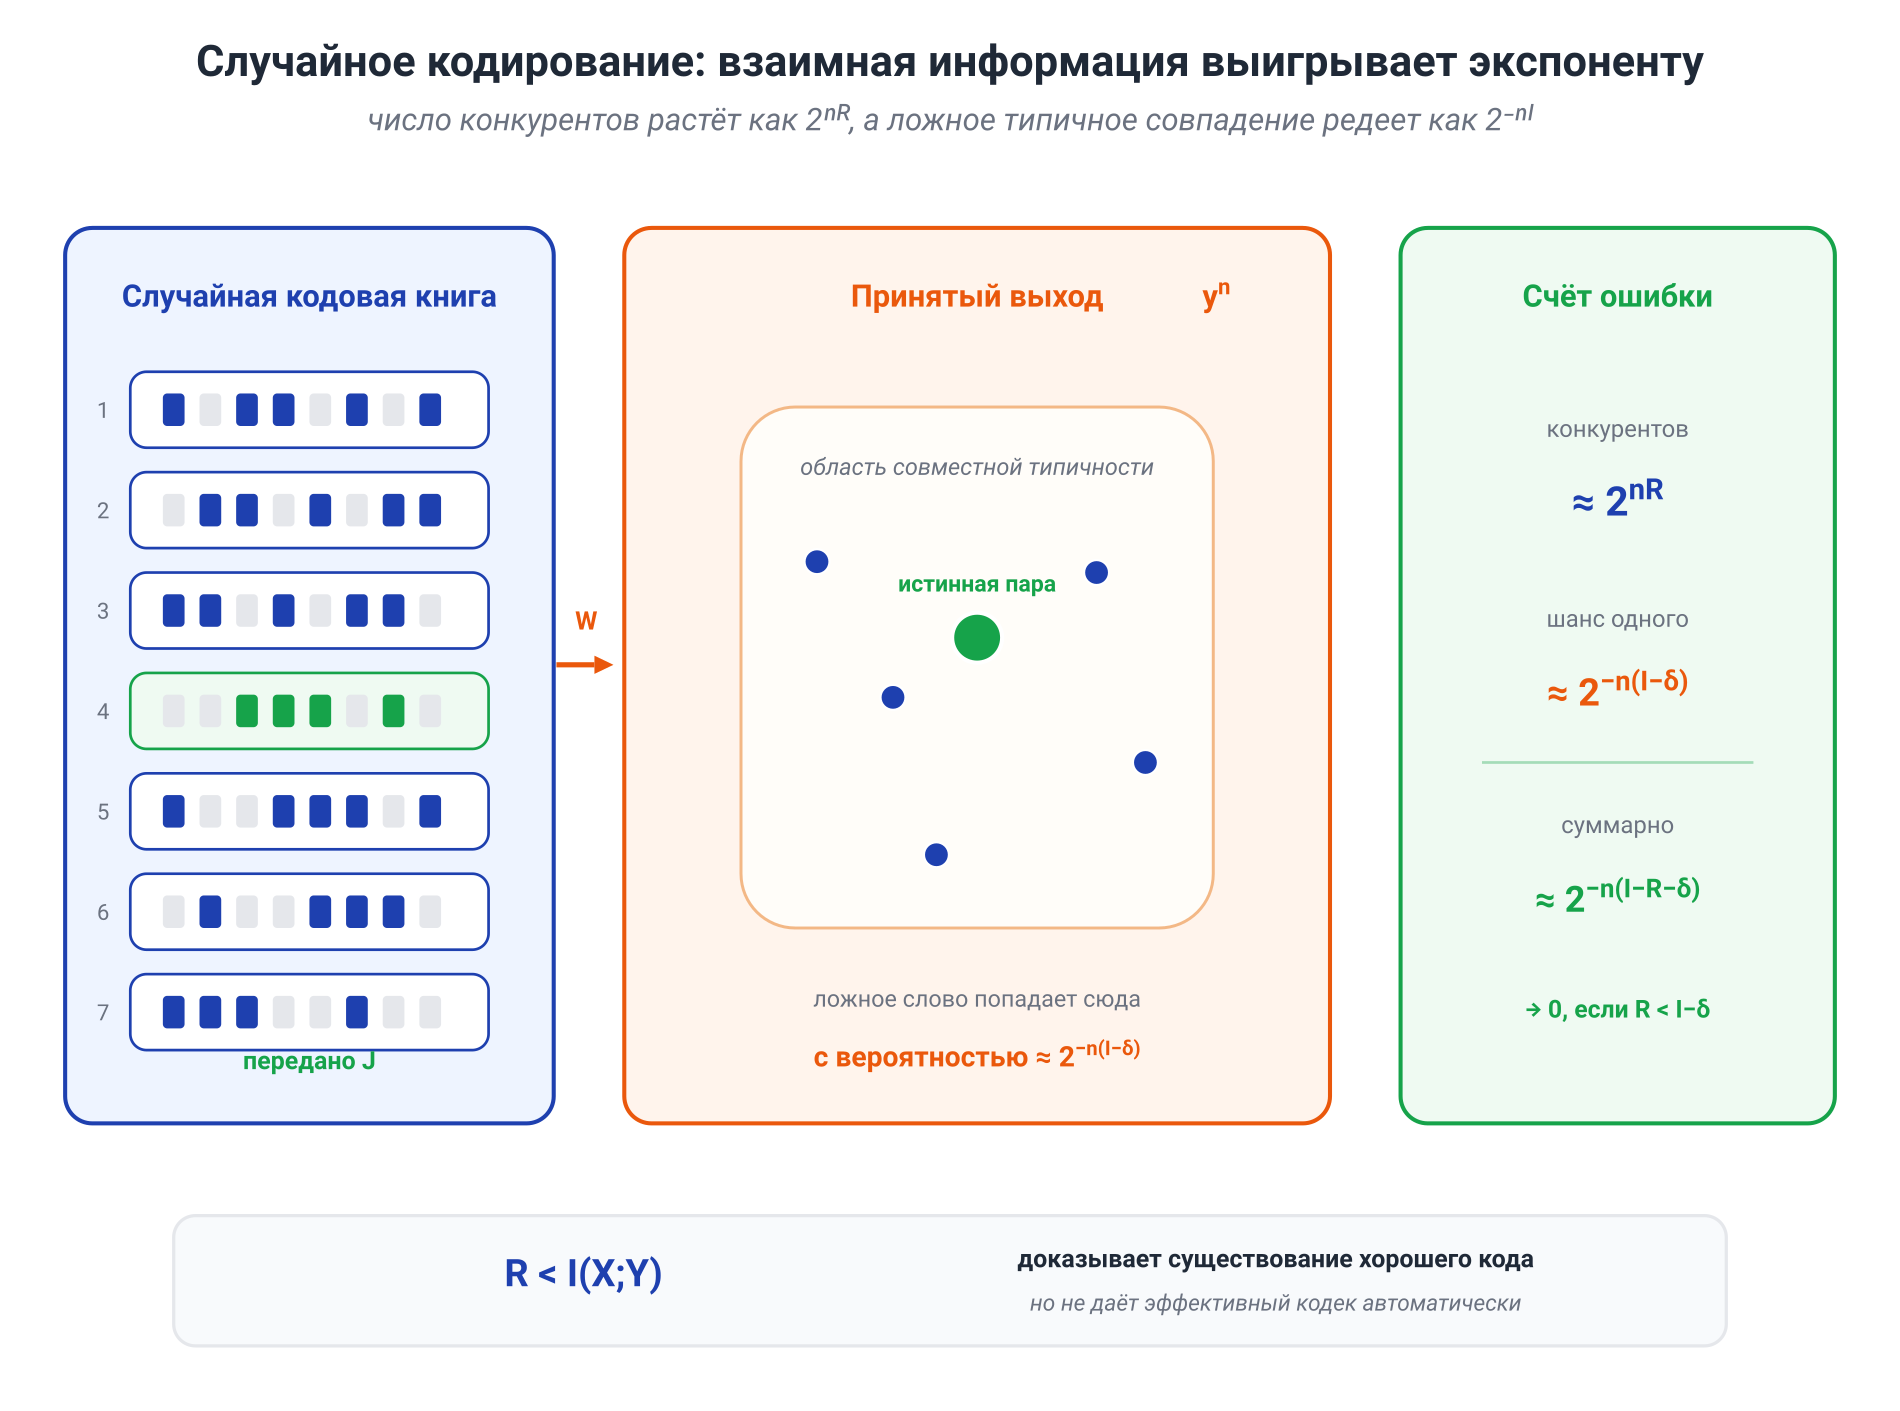
Сначала полезно увидеть весь подсчёт в одной строке. Пусть в книге около кодовых слов. Для фиксированного неверного слова вероятность случайно выглядеть правдоподобным рядом с принятым выходом имеет порядок . Тогда суммарный риск ложного совпадения имеет порядок
Если , количество конкурентов растёт медленнее, чем убывает вероятность ложного совпадения. В этом балансе и находится порог.
Теперь запишем аргумент точно. Зафиксируем входное распределение и скорость
Пусть — выходное распределение, индуцированное и каналом.
Шаг 1. Случайная кодовая книга
Для каждого сообщения , где
независимо генерируем кодовое слово
Шаг 2. Информационная плотность
Для одной пары введём информационную плотность (information density)
Её среднее под совместным распределением равно взаимной информации:
Для канала без памяти
По закону больших чисел у истинной пары
Шаг 3. Пороговый декодер
Декодер ищет единственное сообщение , для которого
Ошибка возникает по двум причинам.
- Истинная пара не достигает порога. Вероятность этого стремится к нулю по закону больших чисел.
- Какое-то неверное кодовое слово достигает порога.
Для неверного кодовое слово независимо от . Под произведением распределений
По неравенству Маркова
Неверных слов около , поэтому объединение событий даёт
Выбираем так, чтобы
Тогда обе части ошибки стремятся к нулю. Поскольку это верно для любого фиксированного , оптимизация по даёт достижимость всех скоростей ниже
Что дал этот аргумент
Во-первых, он доказал существование детерминированного кода: малая средняя ошибка по случайной книге означает, что среди реализаций есть хорошая. Более того, если средняя ошибка ансамбля стремится к нулю, доля книг с заметно большей ошибкой тоже исчезает при подходящем пороге. Хорошие книги в этом асимптотическом смысле не являются единственными иголками в стоге сена.
Во-вторых, доказательство показало, почему в формуле появляется взаимная информация. Она управляет экспонентой, с которой случайное чужое кодовое слово может притвориться согласованным с выходом.
Но доказательство существования ещё не является удобным кодеком. Случайная книга содержит порядка слов, её дорого хранить, а полный перебор при декодировании экспоненциален. Практические семейства — LDPC-, турбо- и полярные коды — добавляют структуру и эффективные декодеры. Теорема сначала показала, что искать имеет смысл; инженерная теория кодов научилась искать конструктивно.
7.7. Обратная теорема и конечная длина блока
Достижимость отвечает на вопрос «что можно сделать ниже ?». Обратная часть ставит предел любому возможному коду: выше надёжность нельзя вернуть более умным энкодером или декодером.
Короткая обратная граница через неравенство Фано
Пусть равномерно распределено по сообщениям, а
Неравенство Фано даёт
С другой стороны,
Последняя строка использует отсутствие памяти:
Отсюда
Если , правая часть при больших остаётся положительной. Значит, ошибка не может стремиться к нулю. Это слабая обратная теорема (weak converse).
Для DMC верна и сильная обратная теорема (strong converse): при фиксированном
Иначе говоря, выше пропускной способности канал не переходит в режим «чуть хуже». При растущем блоке он почти полностью теряет способность надёжно различать сообщения на такой скорости.
Почему ещё не отвечает на инженерный вопрос
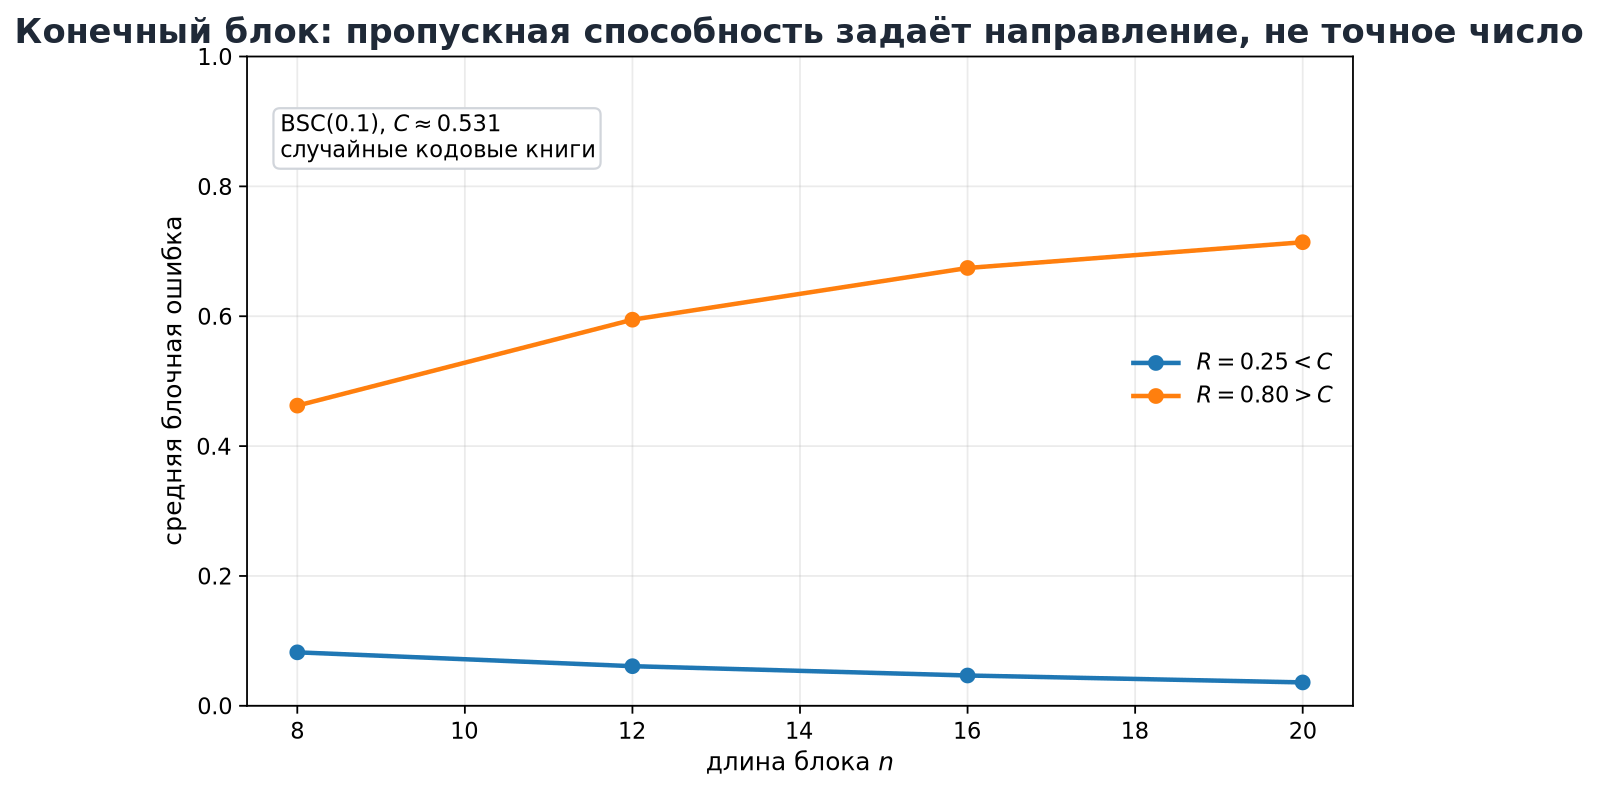
Пропускная способность — результат первого асимптотического порядка. Реальная система задаёт тройку
где — длина блока, — скорость, а — допустимая ошибка. Для короткого блока скорость ниже может всё ещё сопровождаться большой ошибкой. Между «асимптотически возможно» и «работает с задержкой 10 мс» лежит существенная инженерная задача.
Математическое углубление: нормальное приближение
Для многих регулярных каналов максимальная скорость при длине блока и целевой ошибке приближённо равна
где — дисперсия канала (channel dispersion), а — обратная функция гауссовского хвоста.
Пропускная способность задаёт центр, а описывает флуктуации информационной плотности и тем самым цену короткого блока. Чем больше требуемая надёжность и чем меньше , тем дальше приходится отступить от .
7.8. Шумные метки как канал
Теперь перенесём ту же схему из линии связи в набор данных. Пусть — истинная метка, а — метка, записанная после работы аннотатора или автоматического конвейера. Если ошибка зависит только от класса, переход задаётся матрицей
Получается буквальный вероятностный канал
Если признаки влияют на наблюдаемую метку только через чистую метку,
— марковская цепь, и неравенство обработки данных даёт
Шумная метка не может сохранить больше информации о входе, чем чистая. Но величина потери зависит не только от доли ошибок, а от всей матрицы переходов и распределения классов.
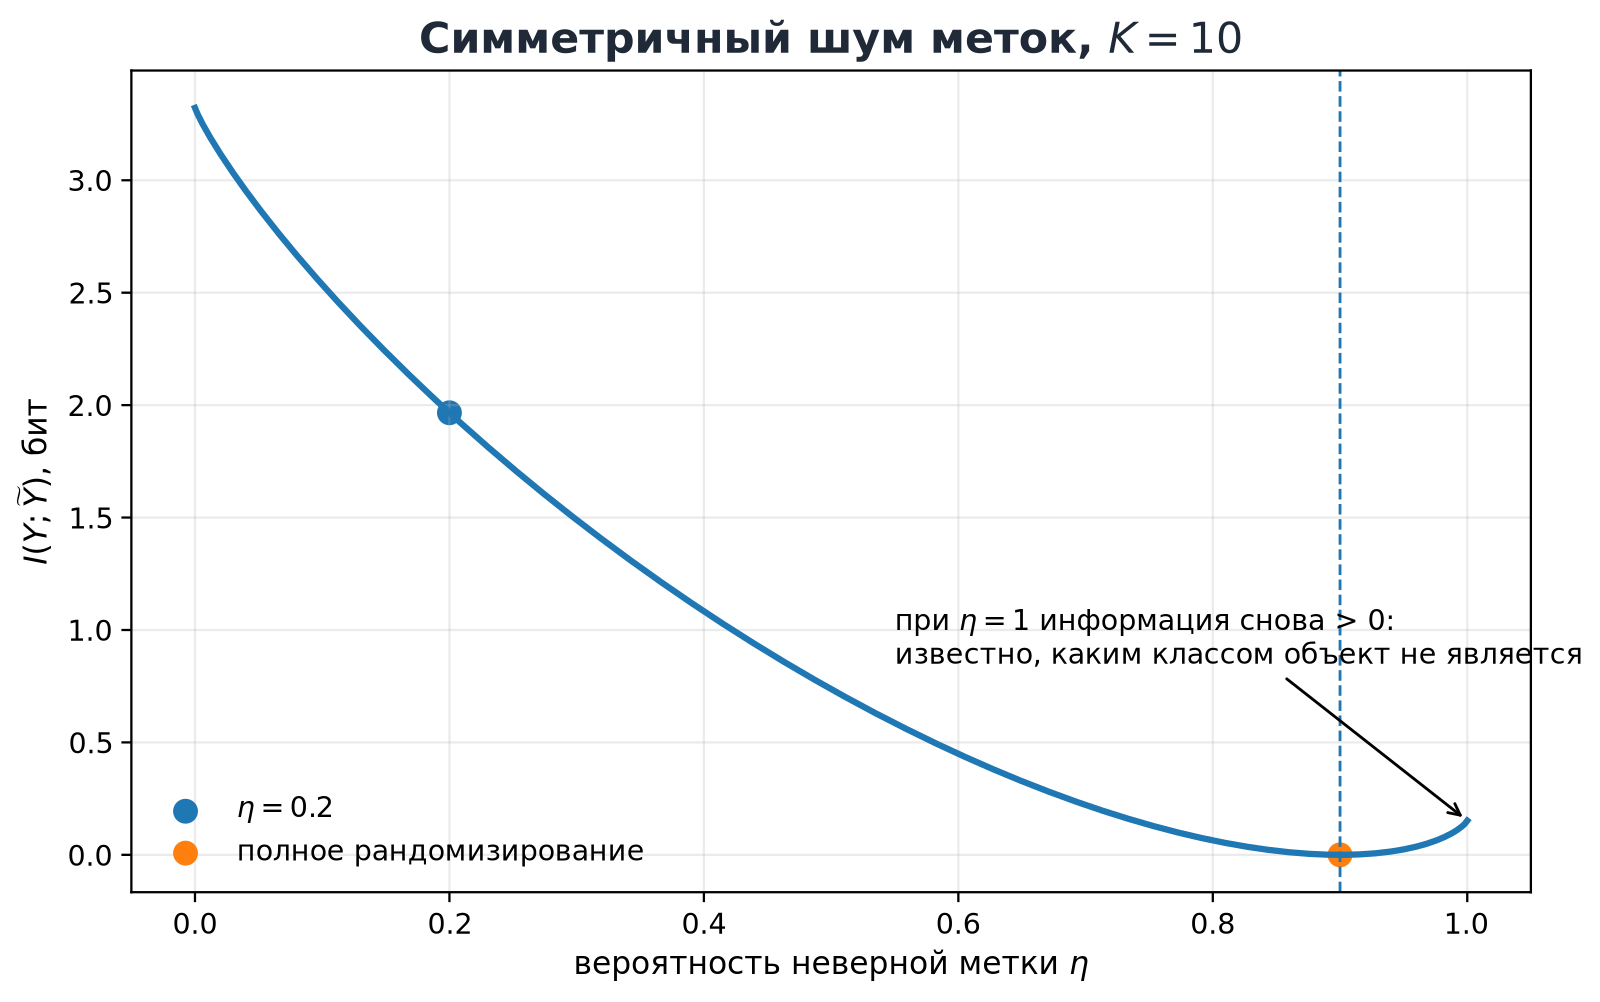
Симметричный -классовый шум
Пусть метка остаётся верной с вероятностью , а при ошибке равномерно заменяется одним из других классов:
При равномерном выход также равномерен, поэтому
Для этого слабосимметричного канала равномерный вход оптимален, так что та же формула задаёт его пропускную способность.
При и
из исходных бит.
Самая интересная точка — не , а
Здесь каждая строка матрицы становится равномерной, и информация исчезает полностью. При точность аннотатора равна нулю, но записанная метка сообщает одну достоверную вещь: истинный класс с ней не совпадает. Поэтому
Для остаётся около бита. Этот пример хорошо показывает, почему точность и взаимная информация отвечают на разные вопросы: систематически неправильный сигнал может быть полностью или частично обратимым.
Где заканчивается матрица шума
Реальные ошибки разметки часто зависят от самого объекта , от аннотатора, неоднозначности примера и процедуры фильтрации. Тогда одной матрицы классового шума (class-conditional noise) недостаточно.
Если известна, её можно использовать для прямой или обратной коррекции функции потерь. Однако обращение плохо обусловленной матрицы усиливает статистический шум, а оценённая добавляет собственную ошибку. Информационная потеря канала, идентифицируемость матрицы и численная устойчивость коррекции — три разные проблемы.
7.9. Канальное кодирование в ML: ECOC и DeepJSCC
В этом разделе слово «код» используется уже не как образ. В обеих конструкциях энкодер, канал и декодер являются частью алгоритма.
Коды выходов с исправлением ошибок
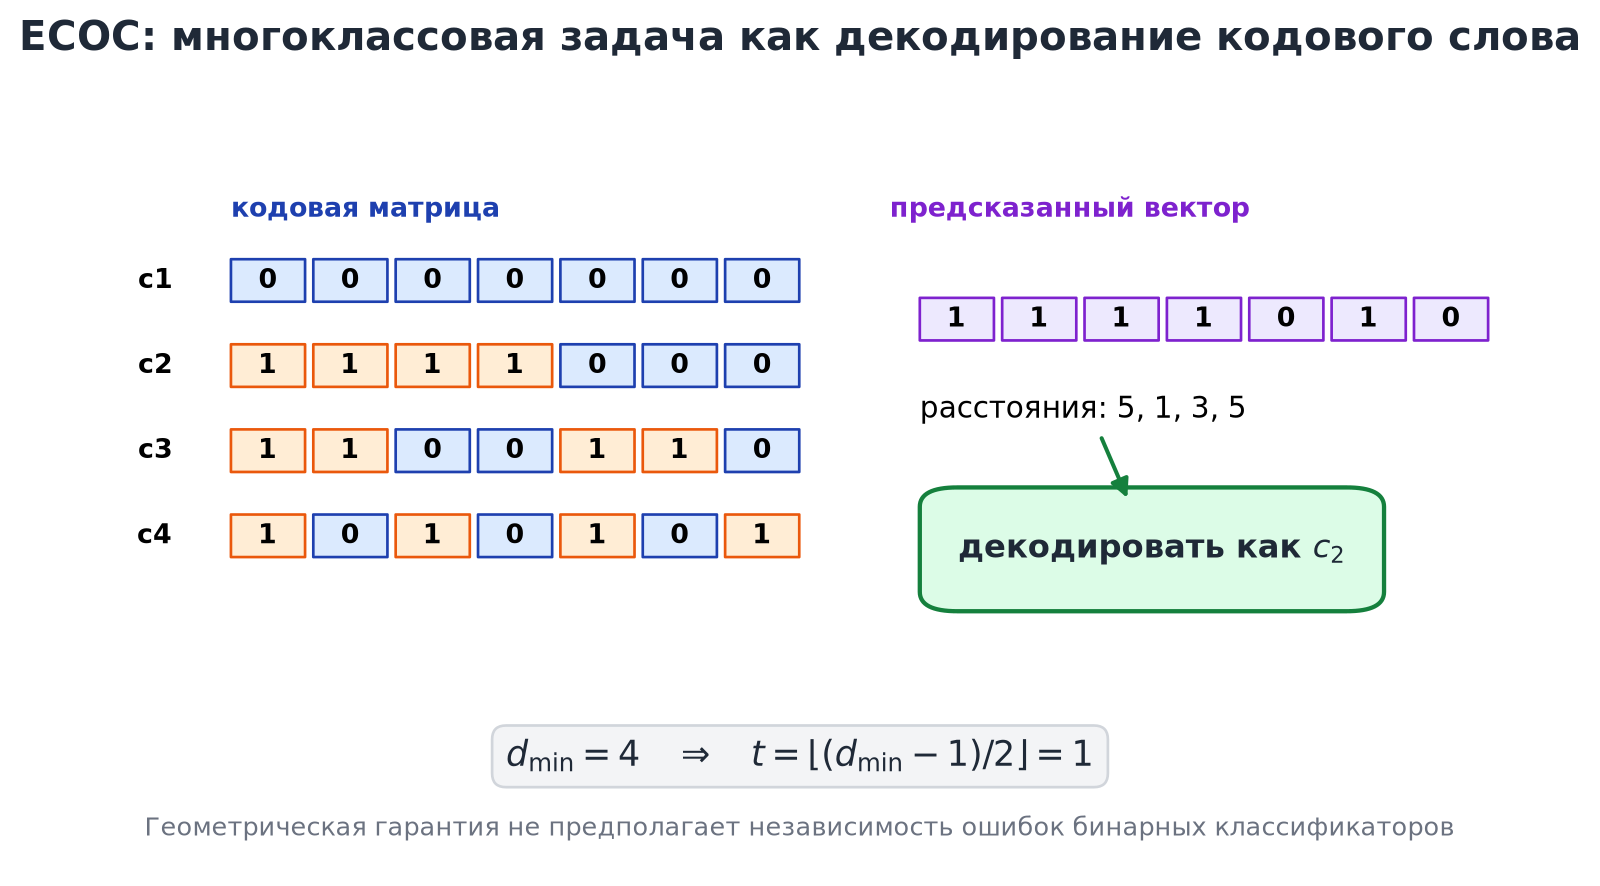
В кодах выходов с исправлением ошибок (error-correcting output codes, ECOC) каждому из классов назначается кодовое слово
Каждый столбец кодовой матрицы задаёт бинарную задачу, поэтому обучаются бинарных классификаторов. Их ответы образуют предсказанное слово , после чего выбирается ближайший класс-код.
Если минимальное расстояние Хэмминга между кодовыми словами равно , идеализированный декодер ближайшего слова исправляет до
битовых ошибок. Геометрия та же, что в канальном кодировании: шары ошибок вокруг разных классов не должны пересекаться.
Но в классификации «канал ошибок» редко является независимым BSC. Бинарные классификаторы обучаются на одних данных, их ошибки коррелированы, столбцы имеют разную сложность, а вероятность ошибки зависит от . Поэтому большой создаёт полезный геометрический запас, но не является самостоятельной гарантией качества классификатора.
Обучаемое совместное кодирование источника и канала
Классическая цифровая система часто разделяет три этапа:
- сжатие источника;
- защиту от ошибок;
- отображение кодовых символов в физический сигнал.
В совместном кодировании источника и канала (joint source-channel coding, JSCC) отображение оптимизируется целиком под меру искажения и модель канала. В DeepJSCC нейронный энкодер, дифференцируемый слой канала и нейронный декодер образуют цепочку
Параметры минимизируют реконструкционную или задачную функцию потерь. В исходных экспериментах с изображениями DeepJSCC выигрывал у выбранных раздельных базовых систем в ряде режимов низкой SNR и малого канального бюджета, а при рассогласовании SNR качество ухудшалось плавно, без резкого «обрыва» цифровой схемы.
Этот результат не отменяет теорему разделения источника и канала. При стандартных стационарных моделях, асимптотически длинных блоках и согласованных критериях раздельная схема может быть оптимальной. Если на один символ источника приходится использований канала, условие достижимости искажения имеет вид ; запись предполагает и согласованные единицы. DeepJSCC работает в том месте, где практическая постановка отличается от идеальной асимптотики: блок короток, задержка ограничена, модель канала может быть неточной, а качество измеряется непрерывным искажением, а не только безошибочным восстановлением битов.
7.10. LLM как канал: точная постановка и границы аналогии
Слово «канал» естественно возникает и вокруг языковых моделей. Здесь полезно не отказываться от аналогии, а сначала построить версию, в которой она математически точна.
Канал от промпта к ответу
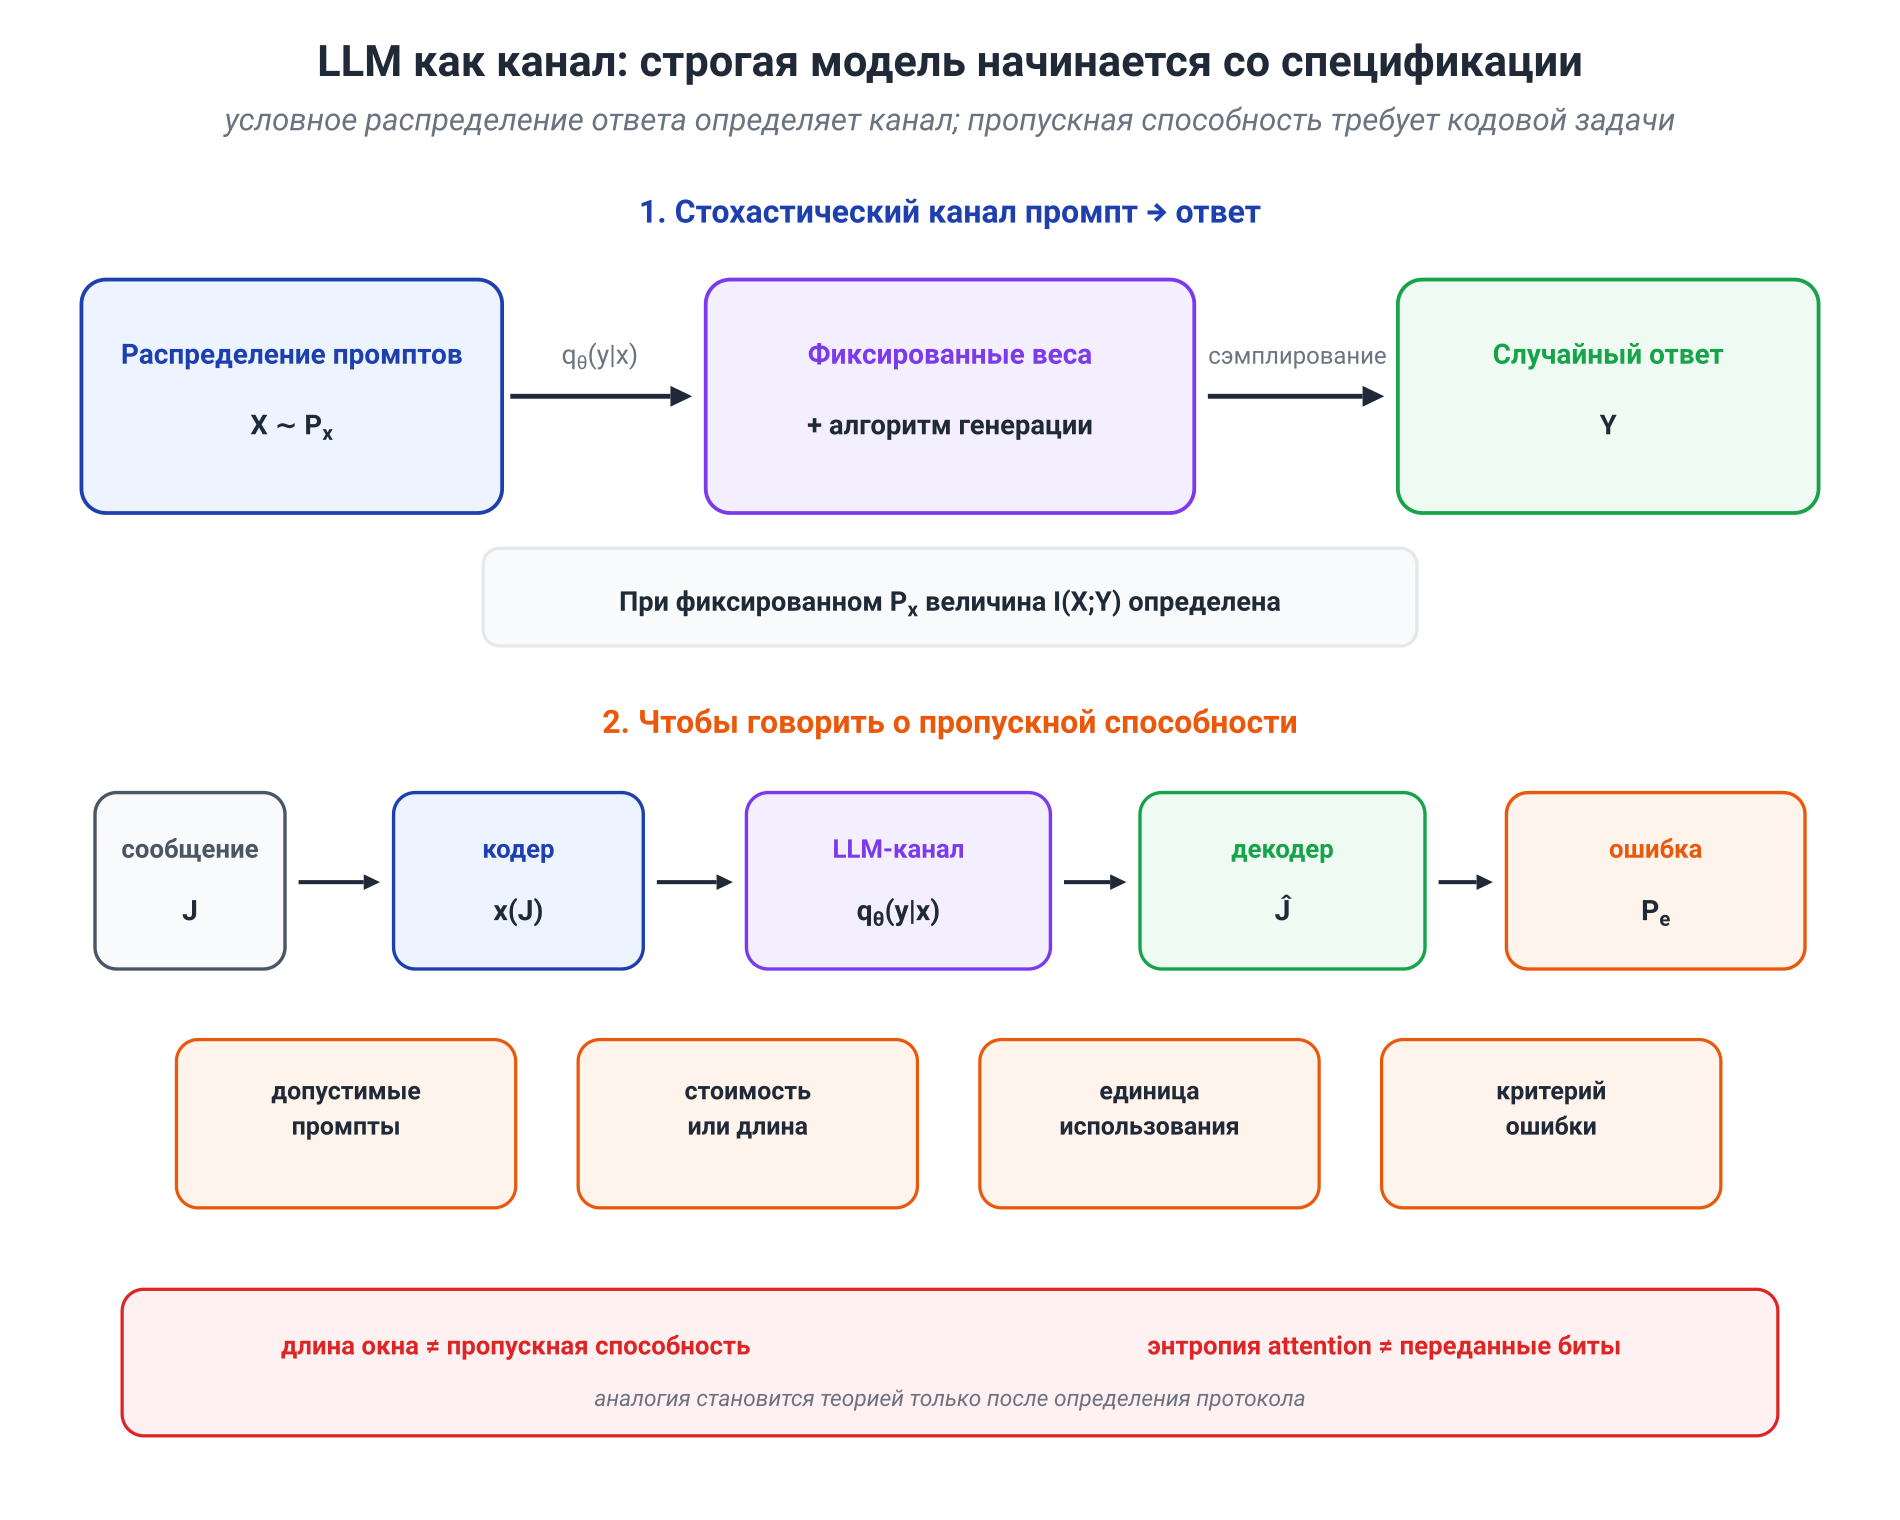
Зафиксируем веса модели, правила формирования контекста и алгоритм генерации. Пусть — случайный промпт, а — сгенерированный ответ. Тогда
задаёт условное распределение выхода и, следовательно, стохастический канал от к . При фиксированном распределении промптов можно вычислять
Если декодирование детерминировано, канал просто становится детерминированным отображением. Если используется сэмплирование с температурой, top- или иная случайная процедура, её правила входят в переходный закон.
Чтобы говорить именно о пропускной способности, нужно добавить операционную задачу. Например, отправитель выбирает сообщение , кодирует его допустимым промптом длины не более , модель генерирует ответ, а декодер пытается восстановить . Только после задания множества промптов, стоимости, единицы использования и критерия ошибки выражение «максимальная скорость» получает точный смысл.
Такой эксперимент можно поставить. Но он будет измерять пропускную способность конкретного протокола «промпт → модель → ответ», а не универсальную величину, присущую архитектуре трансформера вне задачи.
Контекстное окно как ресурс
Окно длины токенов — реальный ресурс: оно ограничивает объём входа и вычислительную стоимость. Но из числа токенов нельзя напрямую получить количество надёжно переданных битов.
Причины теперь можно сформулировать положительно. Чтобы перевести длину окна в канальную величину, пришлось бы задать:
- распределение и допустимый набор промптов;
- стоимость разных токенов или последовательностей;
- переходное распределение ответов;
- кодер и декодер сообщений;
- критерий ошибки;
- роль знаний, уже находящихся в параметрах модели.
Без этих элементов длина контекста остаётся размером ресурса, а не шенноновской пропускной способностью.
Работа Lost in the Middle показала, что качество извлечения релевантной информации может существенно зависеть от её позиции: в исследованных задачах модели часто лучше использовали начало и конец длинного контекста, чем середину. Это важное эмпирическое свойство конкретных моделей и протоколов. Оно не выводится автоматически из DPI или из абстрактной «ёмкости окна»; механизм зависит от архитектуры, позиционного кодирования, обучения и задачи.
RAG меняет протокол ещё до входа в модель: ретривер выбирает небольшой набор свидетельств вместо помещения всего корпуса в промпт. Практический выигрыш можно описать как экономию контекстного бюджета и уменьшение конкуренции со стороны нерелевантных фрагментов. Называть это автоматическим увеличением пропускной способности нет необходимости — более точная формулировка уже достаточно сильна.
Что измеряют веса внимания
Строка весов внимания (attention weights)
суммируется в единицу и потому внешне похожа на распределение. Но она является коэффициентами смешивания значений, а не переходным законом от входного токена к выходному сообщению. Результат слоя зависит также от векторов значений (value vectors), нескольких голов, остаточного потока и последующих нелинейностей.
Энтропия
имеет ясный локальный смысл: она описывает концентрацию весов маршрутизации по ключам. Низкое значение означает, что масса сосредоточена на нескольких позициях; высокое — что она распределена шире. Из одной этой величины не следует число переданных битов, причинное влияние или важность токена для конечного ответа.
Цепочка рассуждений
Цепочка рассуждений (chain-of-thought, CoT) увеличивает число сгенерированных токенов, объём внешнего промежуточного состояния и вычисления во время вывода (test-time compute). Это может улучшать решение сложных задач. Канальная метафора — «модель получила больше последовательных использований внешнего носителя» — может быть полезна как исследовательская интуиция. Но она пока не является теоремой о росте шенноновской пропускной способности модели. В Модуле 13 мы вернёмся к этой границе подробнее.
7.11. Как формализовать канал в ML-системе
Канальный язык наиболее полезен не тогда, когда даёт эффектную метафору, а когда заставляет точно описать эксперимент. Перед вычислением MI или пропускной способности удобно заполнить короткую спецификацию.
| Элемент | Вопрос |
|---|---|
| Вход | Какая случайная величина передаётся? |
| Выход | Что наблюдает получатель или следующая модель? |
| Переходной закон | Откуда берётся случайность и как записывается ? |
| Ограничение | Что ограничено: мощность, длина, число токенов, число бит, задержка? |
| Код и декодер | Как сообщения отображаются во входы и как восстанавливаются? |
| Критерий | Блочная ошибка, MSE, top-1 точность, семантическая полезность? |
| Режим | Фиксированный или асимптотика? Фактическое или максимум по ? |
Сравним две постановки.
| Система | Что определено строго | Какой вопрос можно задать |
|---|---|---|
| Шумные метки | , и матрица | фактическая ; при оптимизации по классам — пропускная способность матрицы |
| LLM с фиксированной процедурой сэмплирования | промпт , ответ , закон | при заданном распределении промптов; пропускная способность — только после задания кодовой задачи и стоимости |
Отсюда следуют два ключевых различия:
и
Это не запрет на аналогии. Это способ сделать их плодотворными: сначала понять, какая часть конструкции является настоящим каналом, а затем ясно обозначить, где начинается эвристика.
7.13. Заключение
В Модуле 6 вероятностная модель превратилась в счёт в битах. В Модуле 7 взаимная информация получила второй операционный смысл: после оптимизации по входу она задаёт предельную скорость надёжной передачи через шум.
За короткой формулой стоит целая конструкция.
- Канал задаёт переходный закон и ограничения ресурса.
- Кодовая книга превращает сообщения в длинные, хорошо разделённые последовательности.
- При случайное кодирование доказывает существование кодов с исчезающей ошибкой.
- При обратная теорема запрещает надёжную передачу любому коду.
- При конечном одной пропускной способности недостаточно: важны допустимая ошибка и дисперсия канала.
Главная интеллектуальная перемена состоит в том, что шум перестаёт быть локальной помехой, которую нужно исправлять по одному символу. Код работает с геометрией всего блока. Ошибки отдельных использований остаются, но целое сообщение можно сделать надёжно различимым.
Для ML эта идея имеет два уровня. В шумных метках, ECOC и DeepJSCC канал является частью строгой модели или алгоритма. В рассуждениях о контексте, внимании (attention) и CoT канальный язык пока чаще служит дисциплинирующей аналогией. В обоих случаях полезен один и тот же вопрос: можем ли мы явно записать вход, выход, переходный закон, ресурс и задачу декодирования?
Так завершается классическое ядро теории Шеннона. Кодирование источника убирает предсказуемую избыточность; канальное кодирование добавляет избыточность, специально устроенную для борьбы с шумом; взаимная информация связывает обе стороны с точными пределами.
В Модуле 8 мы перейдём от описания источников и каналов к нормативному вопросу: какое распределение выбирать, когда известны лишь ограничения? Ответом станет принцип максимальной энтропии (maximum entropy).
Основные источники
- C. E. Shannon, A Mathematical Theory of Communication, 1948.
- T. Cover, J. Thomas, Elements of Information Theory, 2nd ed., 2006, Chapters 7–9.
- Y. Polyanskiy, Y. Wu, Information Theory: From Coding to Learning, 2025, главы о канальном кодировании и конечной длине блока.
- Y. Polyanskiy, H. V. Poor, S. Verdú, Channel Coding Rate in the Finite Blocklength Regime, 2010.
- R. Blahut, Computation of Channel Capacity and Rate-Distortion Functions, 1972; S. Arimoto, An Algorithm for Computing the Capacity of Arbitrary Discrete Memoryless Channels, 1972.
- G. Patrini et al., Making Deep Neural Networks Robust to Label Noise: A Loss Correction Approach, 2017.
- T. Dietterich, G. Bakiri, Solving Multiclass Learning Problems via Error-Correcting Output Codes, 1995.
- E. Bourtsoulatze, D. B. Kurka, D. Gündüz, Deep Joint Source-Channel Coding for Wireless Image Transmission, 2019.
- N. F. Liu et al., Lost in the Middle: How Language Models Use Long Contexts, 2024.
- S. Jain, B. C. Wallace, Attention is not Explanation, 2019; S. Wiegreffe, Y. Pinter, Attention is not not Explanation, 2019.