Модуль 11. Сравнение распределений: f-дивергенции, вариационные критики и расстояние Вассерштейна
Как читать этот модуль. Основной маршрут — §§11.1–11.9. Сначала мы соберём семейство f-дивергенций, затем увидим, как классификатор и вариационный критик восстанавливают отношение плотностей по выборкам. После этого та же механика приведёт к GAN, f-GAN, MINE и InfoNCE. В §11.8 мы сменим точку зрения и добавим геометрию через интегральные вероятностные метрики, расстояние Вассерштейна и методы на основе ядер. §11.10 — математическое углубление про сингулярные части мер, совместную выпуклость и точные условия двойственности; его удобно оставить на второй проход.
11.1. От двух выборок к задаче сравнения распределений
KL-дивергенция была рабочей лошадкой предыдущих модулей. Через неё мы читали кросс-энтропию, взаимную информацию, ELBO, Information Bottleneck, KL-регуляризованную политику и MDL. Но в современной ML-задаче часто возникает более неудобная ситуация: из двух распределений можно получать примеры, а вычислять их плотности нельзя.
Так устроен неявный генератор (implicit generator). Он быстро строит выборку
но значение в отдельной точке обычно недоступно. Поэтому формула
остаётся математически осмысленной, но не превращается напрямую в вычислимую функцию потерь.
Представим теперь более простую задачу. Из первого источника приходят значения и с вероятностями
а из второго — с вероятностями
Если заранее оба источника равновероятны, оптимальный классификатор источника выдаст
Его логиты равны и . Это уже подсказка: классификатор не просто различает две выборки — в идеале он кодирует отношение их вероятностей. Точный вывод появится в §11.4.
В реальных задачах эта схема возникает снова и снова:
- данные сравниваются с распределением генератора ;
- совместное распределение — с произведением маргиналов при оценивании MI;
- представления двух групп — в задаче обнаружения сдвига распределения;
- выборки и — в двухвыборочном тестировании;
- базовая и новая политики — при контроле отклонения агента.
Отсюда появляются три отдельных вопроса.
- Что считать ошибкой между распределениями? Пропущенная масса, лишняя масса и геометрическое смещение — не одно и то же.
- Как превратить это расхождение в вычислимую цель по выборкам? Здесь появляются классификаторы и вариационные критики.
- Нужна ли метрика на самом пространстве объектов? f-дивергенции работают с отношениями вероятностей; расстояние Вассерштейна дополнительно учитывает, насколько далеко расположены точки.
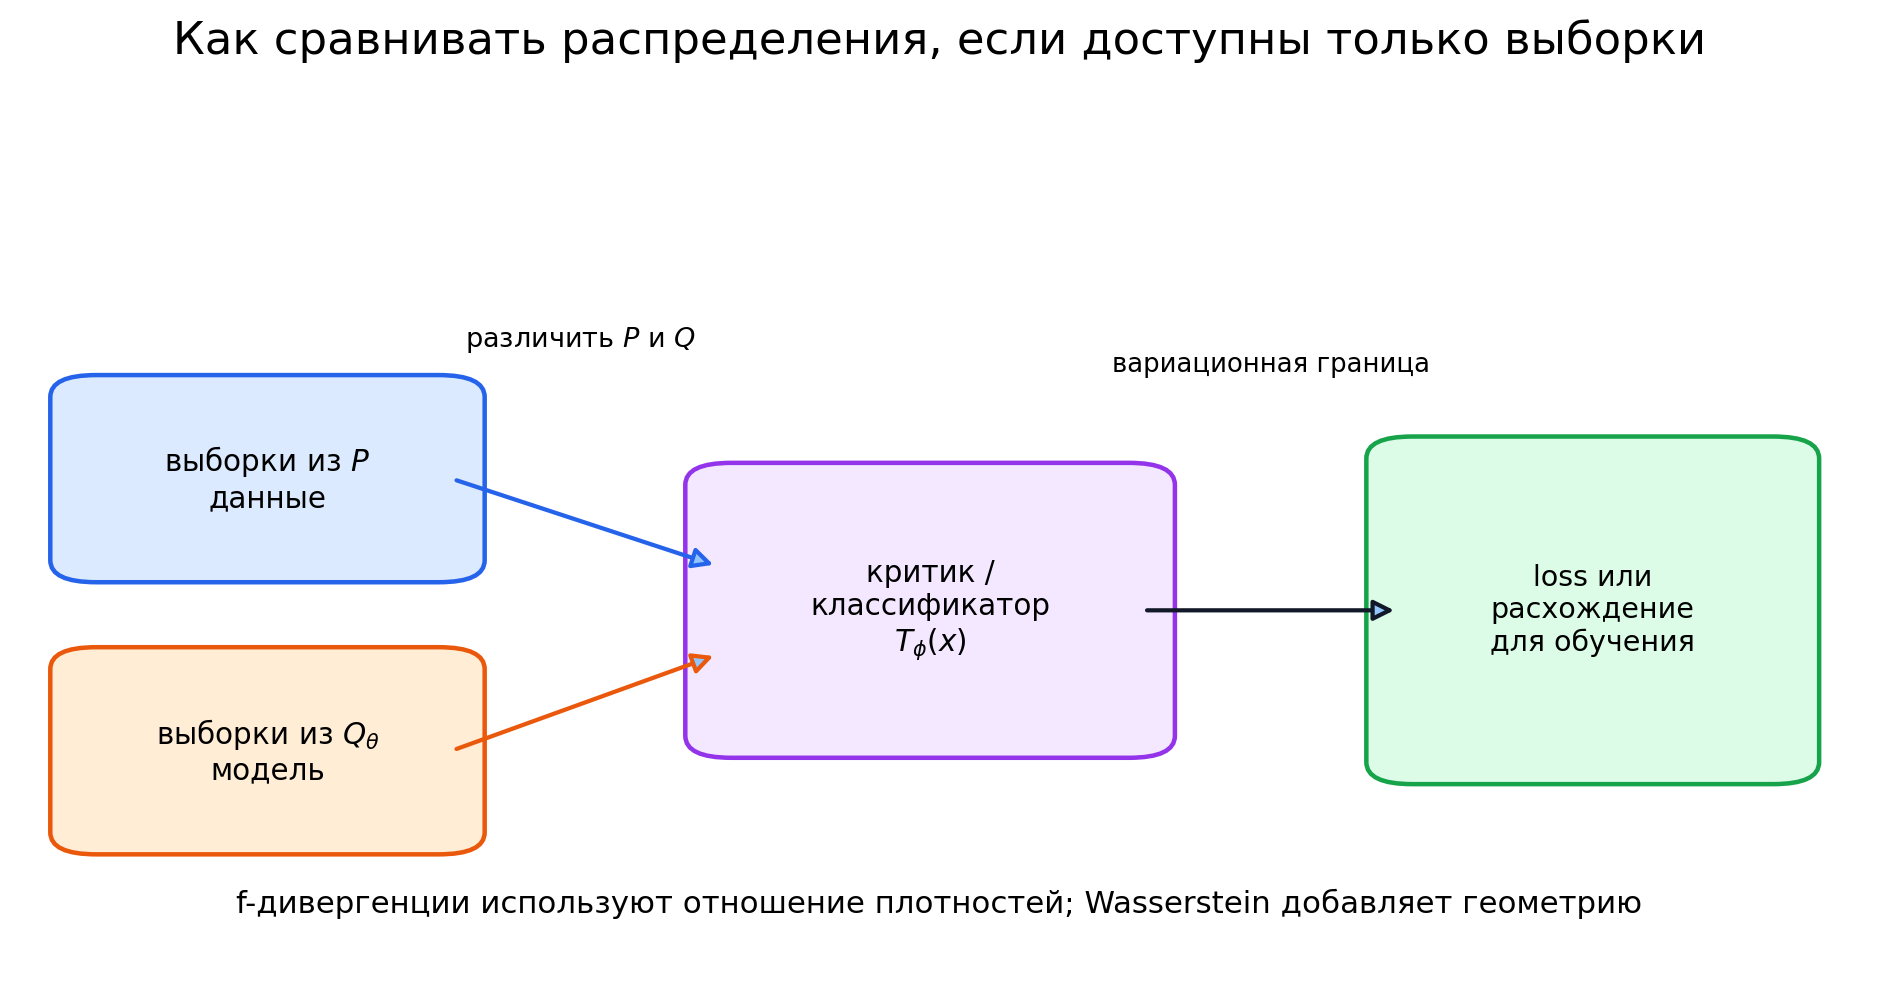
Главная конструкция модуля такова:
Вариационный критик заменяет недоступное отношение плотностей обучаемой задачей на выборках.
Полезно сразу увидеть всю лестницу, а затем разбирать её по ступеням:
Первая стрелка может оставить вариационный разрыв, если класс функций слишком узок. Вторая добавляет статистическую и оптимизационную ошибки. Это не повод отказываться от критиков; это карта того, какое именно число мы получили.
Если не сказано обратное, логарифмы в модуле натуральные, а информационные величины измеряются в натах.
11.2. f-дивергенции: одна схема, разные штрафы
Пусть и имеют плотности и относительно общей базовой меры, причём на основном маршруте пока предположим . Введём отношение плотностей
У него простое чтение:
- — распределения назначают точке одинаковую относительную массу;
- — недооценивает область по сравнению с ;
- — выделяет области больше массы, чем .
Теперь выберем выпуклую функцию
Она задаёт шкалу: насколько дорого обходится каждое значение отношения . Соответствующая f-дивергенция равна
Иными словами, — это шкала цены для ошибок в отношении плотностей. Разные шкалы дают разные расхождения.
Почему дивергенция неотрицательна
Поскольку
неравенство Йенсена даёт
Здесь есть полезная тонкость: сама функция не обязана быть неотрицательной при каждом . Неотрицателен её средний счёт при условии . Именно поэтому на графике некоторые эквивалентные генераторы могут заходить ниже нуля, не создавая отрицательной дивергенции.
Равенство всегда выполняется при . Чтобы из следовало , нужна достаточная строгость выпуклости на фактическом диапазоне .
Основные представители
В курсе используется следующая нормировка:
| Расхождение | Генератор | Явная форма |
|---|---|---|
| Прямая KL | ||
| Обратная KL | ||
| Пирсона | ||
| Квадрат расстояния Хеллингера | ||
| Полная вариация (TV) | ||
| Jensen–Shannon | , |
При этой нормировке
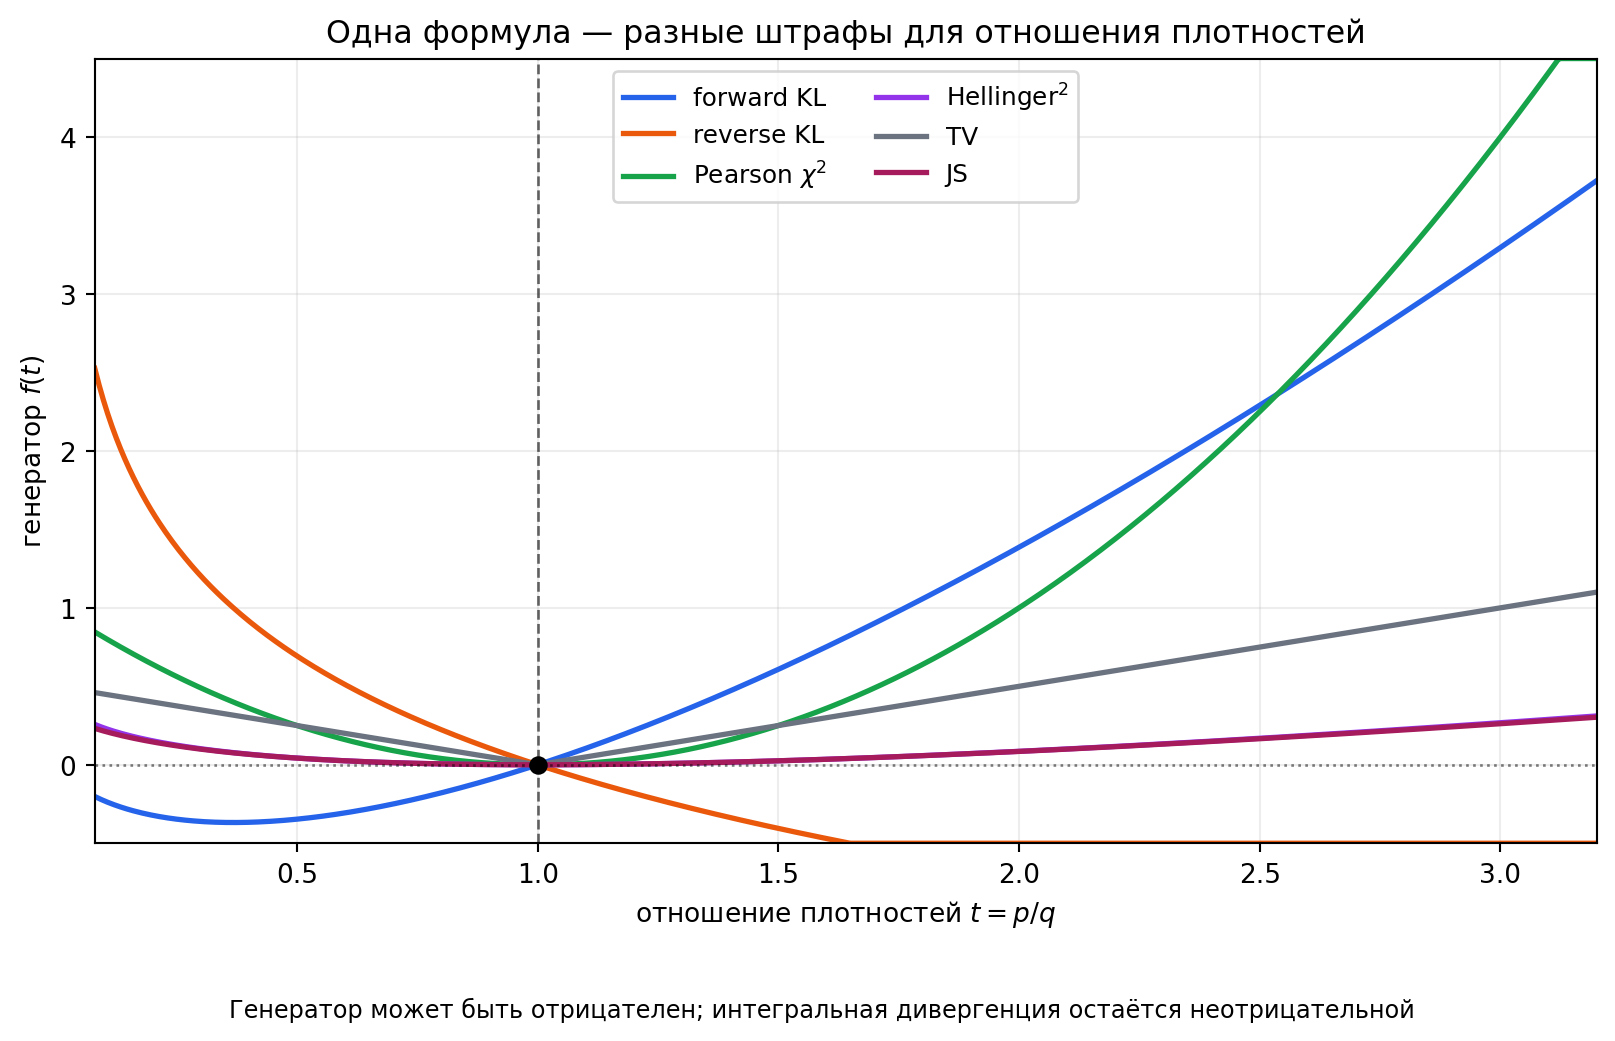
Почему генератор не единственен
Если заменить на
то
Следовательно,
Поэтому в разных таблицах можно встретить внешне разные формулы для одного и того же расхождения. Они отличаются линейным членом, который исчезает после усреднения.
Соседнее семейство: степенные дивергенции и дивергенции Реньи
Для функция
выпукла и задаёт семейство степенных f-дивергенций. В пределах и возникают генераторы, аффинно эквивалентные прямой и обратной KL.
Для , , дивергенция Реньи
использует ту же степенную сумму, но затем применяет к ней логарифм. Поэтому она является монотонным преобразованием соответствующей степенной дивергенции и при фиксированном задаёт тот же порядок пар распределений, однако сама в общем случае не имеет формы . Свойства f-дивергенций нельзя переносить на неё только по сходству обозначений.
11.3. Какие различия видят f-дивергенции
f-дивергенция смотрит на то, как одна мера перераспределяет вероятность относительно другой. Из этой конструкции следуют и её сильные стороны, и естественная граница.
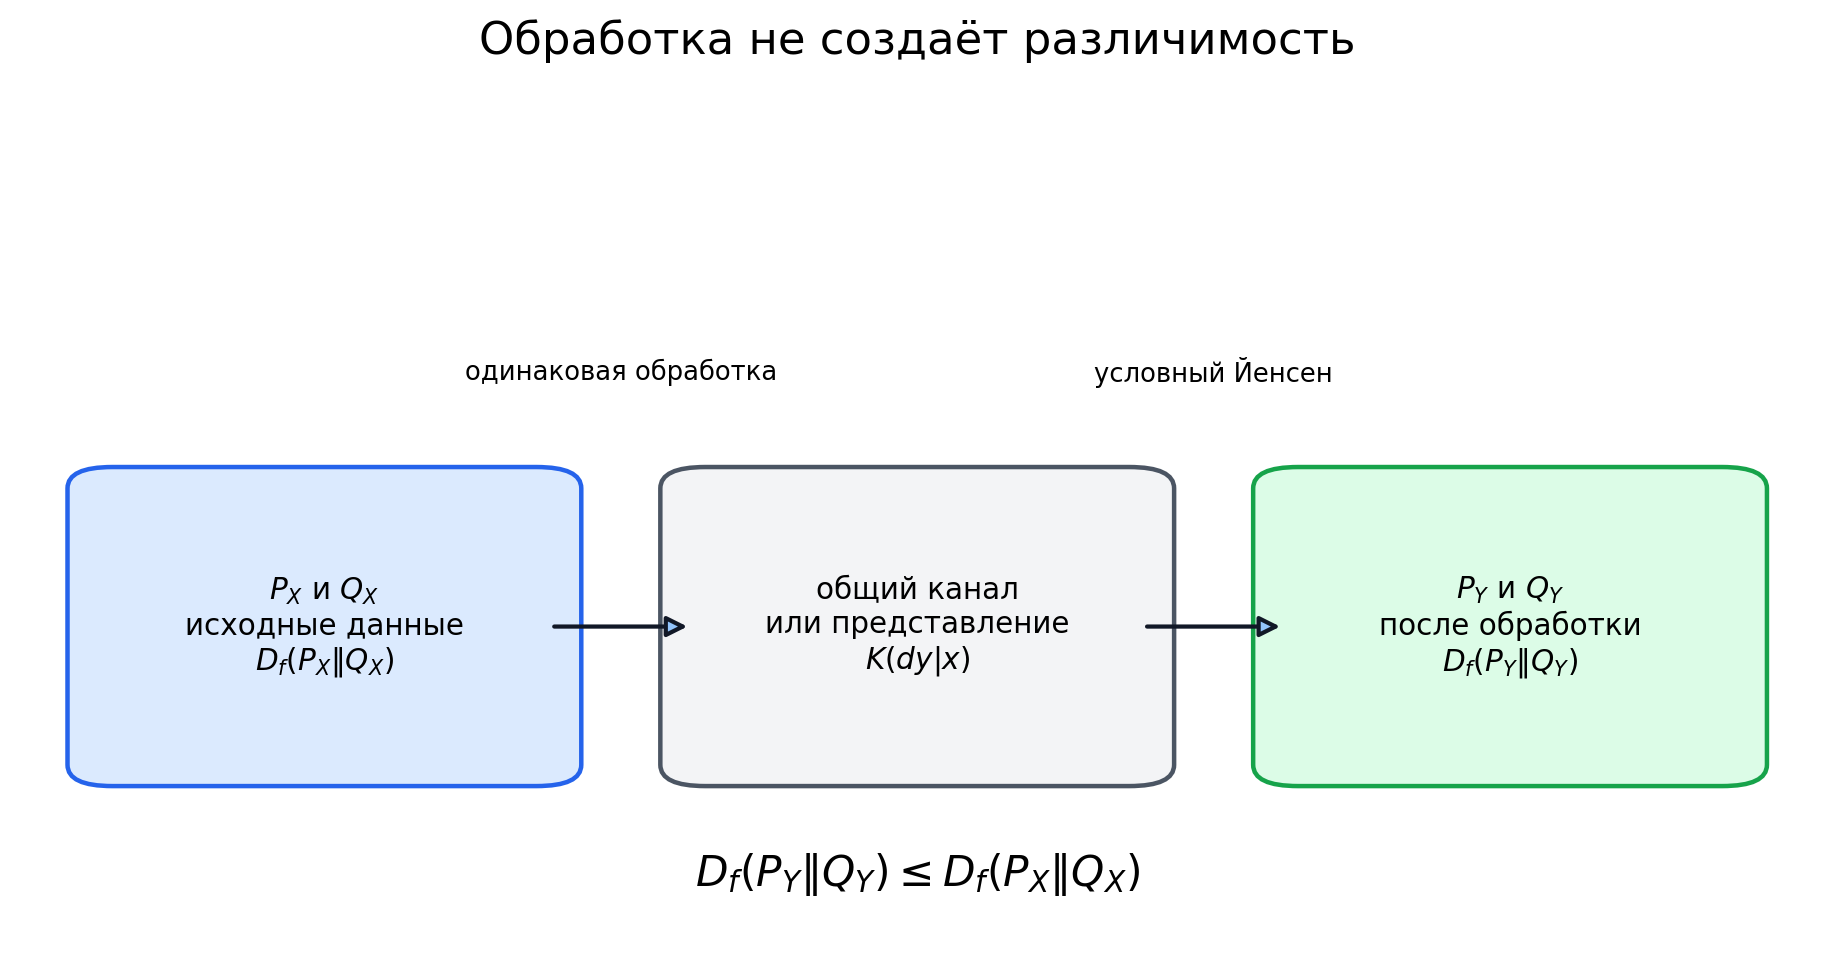
Обработка не увеличивает различимость
Пусть к и применяется один и тот же стохастический канал . Обозначим выходные распределения через и . Тогда
Это неравенство обработки данных (data processing inequality, DPI).
Короткое доказательство показывает механизм. Пусть
Отношение плотностей после канала равно условному среднему исходного отношения:
По условному Йенсену
Вот и вся механика: канал заменяет точное отношение его условным средним. Усреднение сглаживает различия, а выпуклость не позволяет среднему штрафу вырасти.
Для представления вывод читается так: после фиксированного энкодера две группы данных нельзя сделать более различимыми на уровне распределений, чем они были во входе. При этом ограниченный линейный классификатор вполне может работать по лучше, чем по : энкодер способен сделать уже существующее различие доступнее выбранному классу считывающих моделей.
Инвариантность к обратимой перепараметризации
Если — измеримая биекция с измеримым обратным отображением, то
При гладкой замене координат якобианы в отношении плотностей сокращаются. Поэтому f-дивергенция не зависит от того, описали ли мы один и тот же объект в исходных координатах, после нормализации или через обратимое преобразование признаков.
Это сильная инвариантность. Но она же подсказывает границу: f-дивергенция не использует внешнюю геометрию пространства. Она знает, как соотносятся вероятности, но не знает, близки ли две разные точки по евклидовой, косинусной или перцептивной метрике.
Что выбирает функция
При фиксированном направлении большие значения
соответствуют областям, где модель недооценивает данные . Малые значения — областям, где выделяет больше массы, чем .
Разные по-разному взвешивают эти два типа ошибки. Поэтому при ограниченном модельном семействе они могут выбирать разные проекции одного и того же распределения:
- прямая KL дорого штрафует области с заметной массой , которым назначила слишком малую вероятность;
- обратная KL дорого штрафует массу в областях, где почти отсутствует;
- ограниченные JS, расстояние Хеллингера и TV постепенно насыщаются при сильном расхождении.
Отсюда возникает знакомая эвристика: прямая KL часто ведёт к покрытию мод, обратная — к выбору одной из них. В M3 мы видели это на аппроксимации смеси одной гауссианой. Формулировать результат следует именно так: это типичное поведение проекции в ограниченное семейство, а не универсальный закон любого алгоритма с данной аббревиатурой в функции потерь.
Когда носители не пересекаются
Пусть и взаимно сингулярны. Тогда распространённые f-дивергенции достигают своих граничных значений:
а прямая KL и Пирсона в соответствующих направлениях становятся бесконечными.
Числа здесь разные. Общим является другое: они больше не сообщают, насколько далеко друг от друга находятся носители. Точки на расстоянии и могут получить один и тот же JS-счёт. В §11.8 именно эта потерянная геометрия приведёт нас к расстоянию Вассерштейна.
11.4. Классификатор оценивает отношение плотностей
Теперь вернёмся к игре из начала модуля и выведем её точно.
Сформируем бинарную выборку:
- с вероятностью берём и ставим метку ;
- с вероятностью берём и ставим метку .
По формуле Байеса оптимальный вероятностный классификатор равен
Разделим вероятность первого класса на вероятность второго:
После логарифмирования получаем
При равных априорных вероятностях классов второй член исчезает:
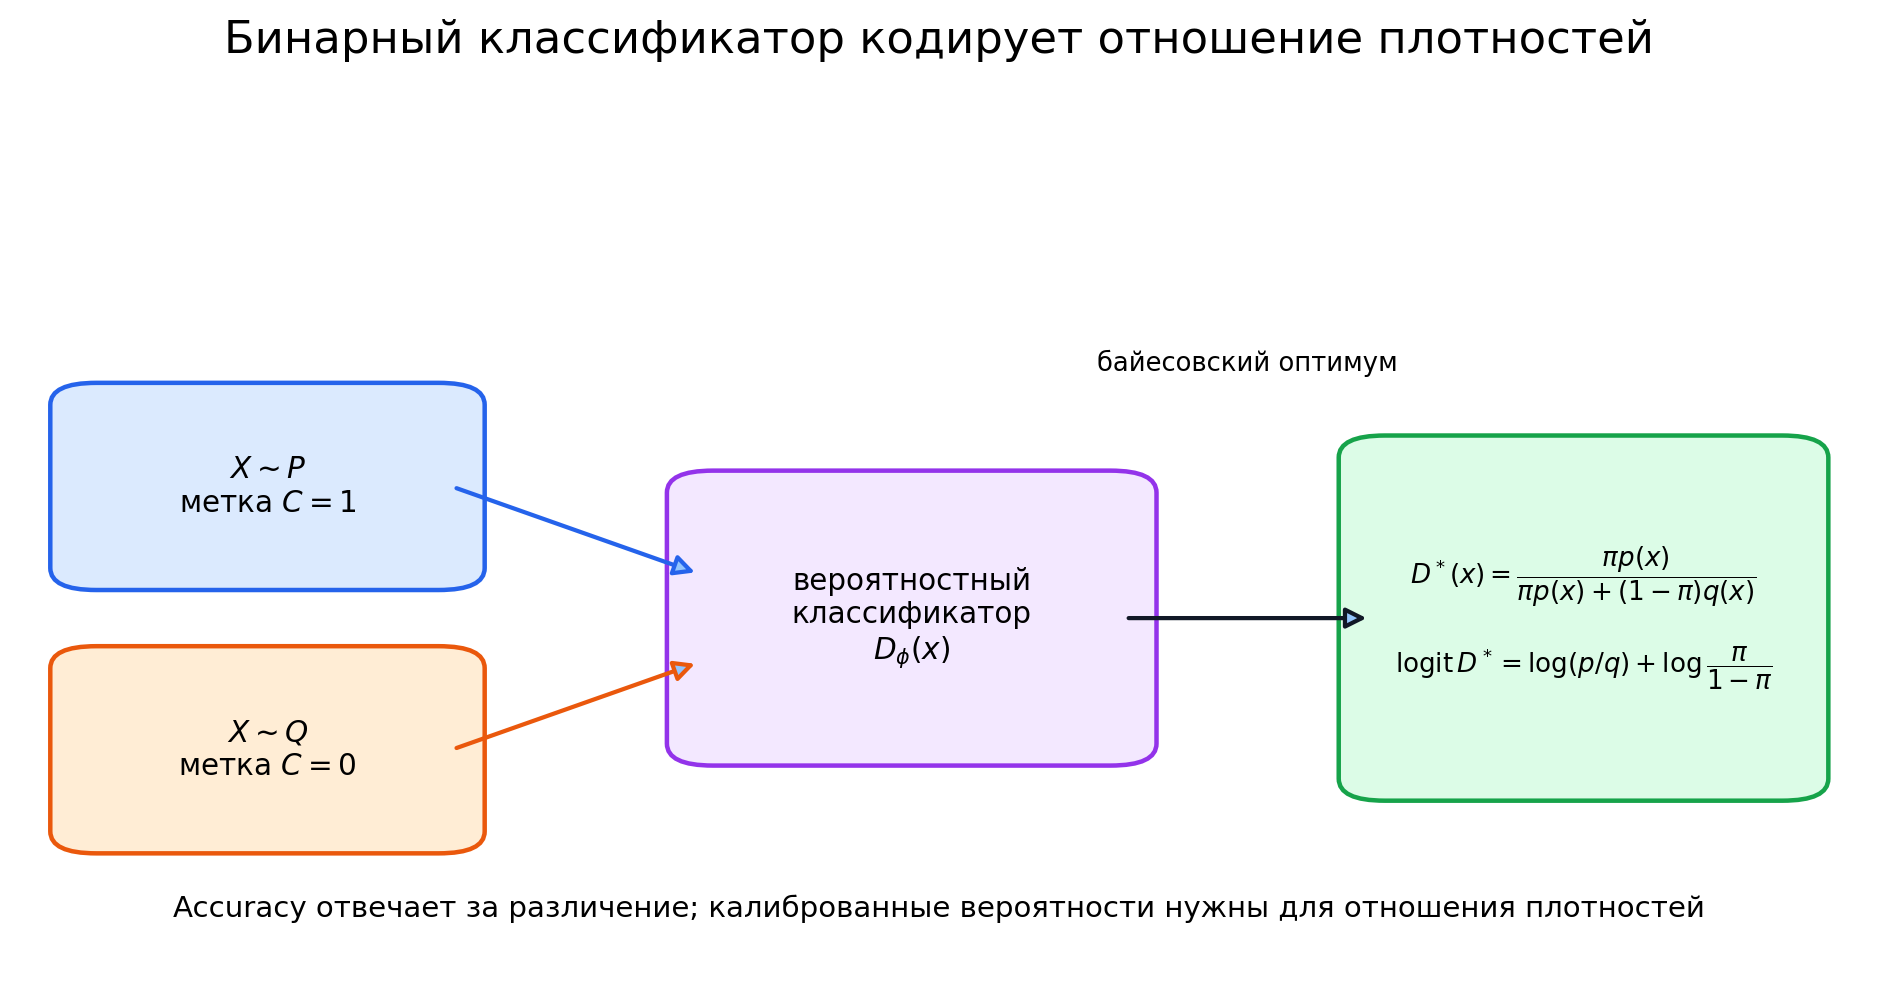
В двухточечном примере из §11.1:
и поэтому
Идеальный классификатор восстанавливает именно тот логарифм отношения, который нужен KL и многим другим дивергенциям.
Это один из центральных приёмов вывода без явного правдоподобия (likelihood-free inference): вместо двух плотностей оценивается одна функция, различающая их выборки.
На этом месте важно различить две задачи:
- классификация источника требует правильного решения или ранжирования;
- оценивание отношения плотностей требует ещё и хорошо откалиброванных вероятностей.
При почти разделимых классах точность классификации может быть идеальной, а логиты — произвольно завышенными. Поэтому высокий результат классификации подтверждает различимость выборок, но сам по себе ещё не даёт точной численной оценки отношения .
11.5. Вариационная форма: как сделать расхождение обучаемым
Классификация дала один способ получить отношение плотностей. Теперь выведем общий механизм, который работает сразу для всего семейства f-дивергенций.
От неравенства Фенхеля к нижней границе
Для выпуклой определим сопряжённую функцию
Из определения следует неравенство Фенхеля:
для любого допустимого . Выберем в каждой точке и подставим :
Умножим на и проинтегрируем:
Следовательно, каждая допустимая функция даёт нижнюю границу:
Если класс функций достаточно богат и условия двойственности выполнены, можно взять супремум:
Для дифференцируемой строго выпуклой поточечный оптимум удовлетворяет
Если обратима, идеальный критик позволяет восстановить отношение плотностей:
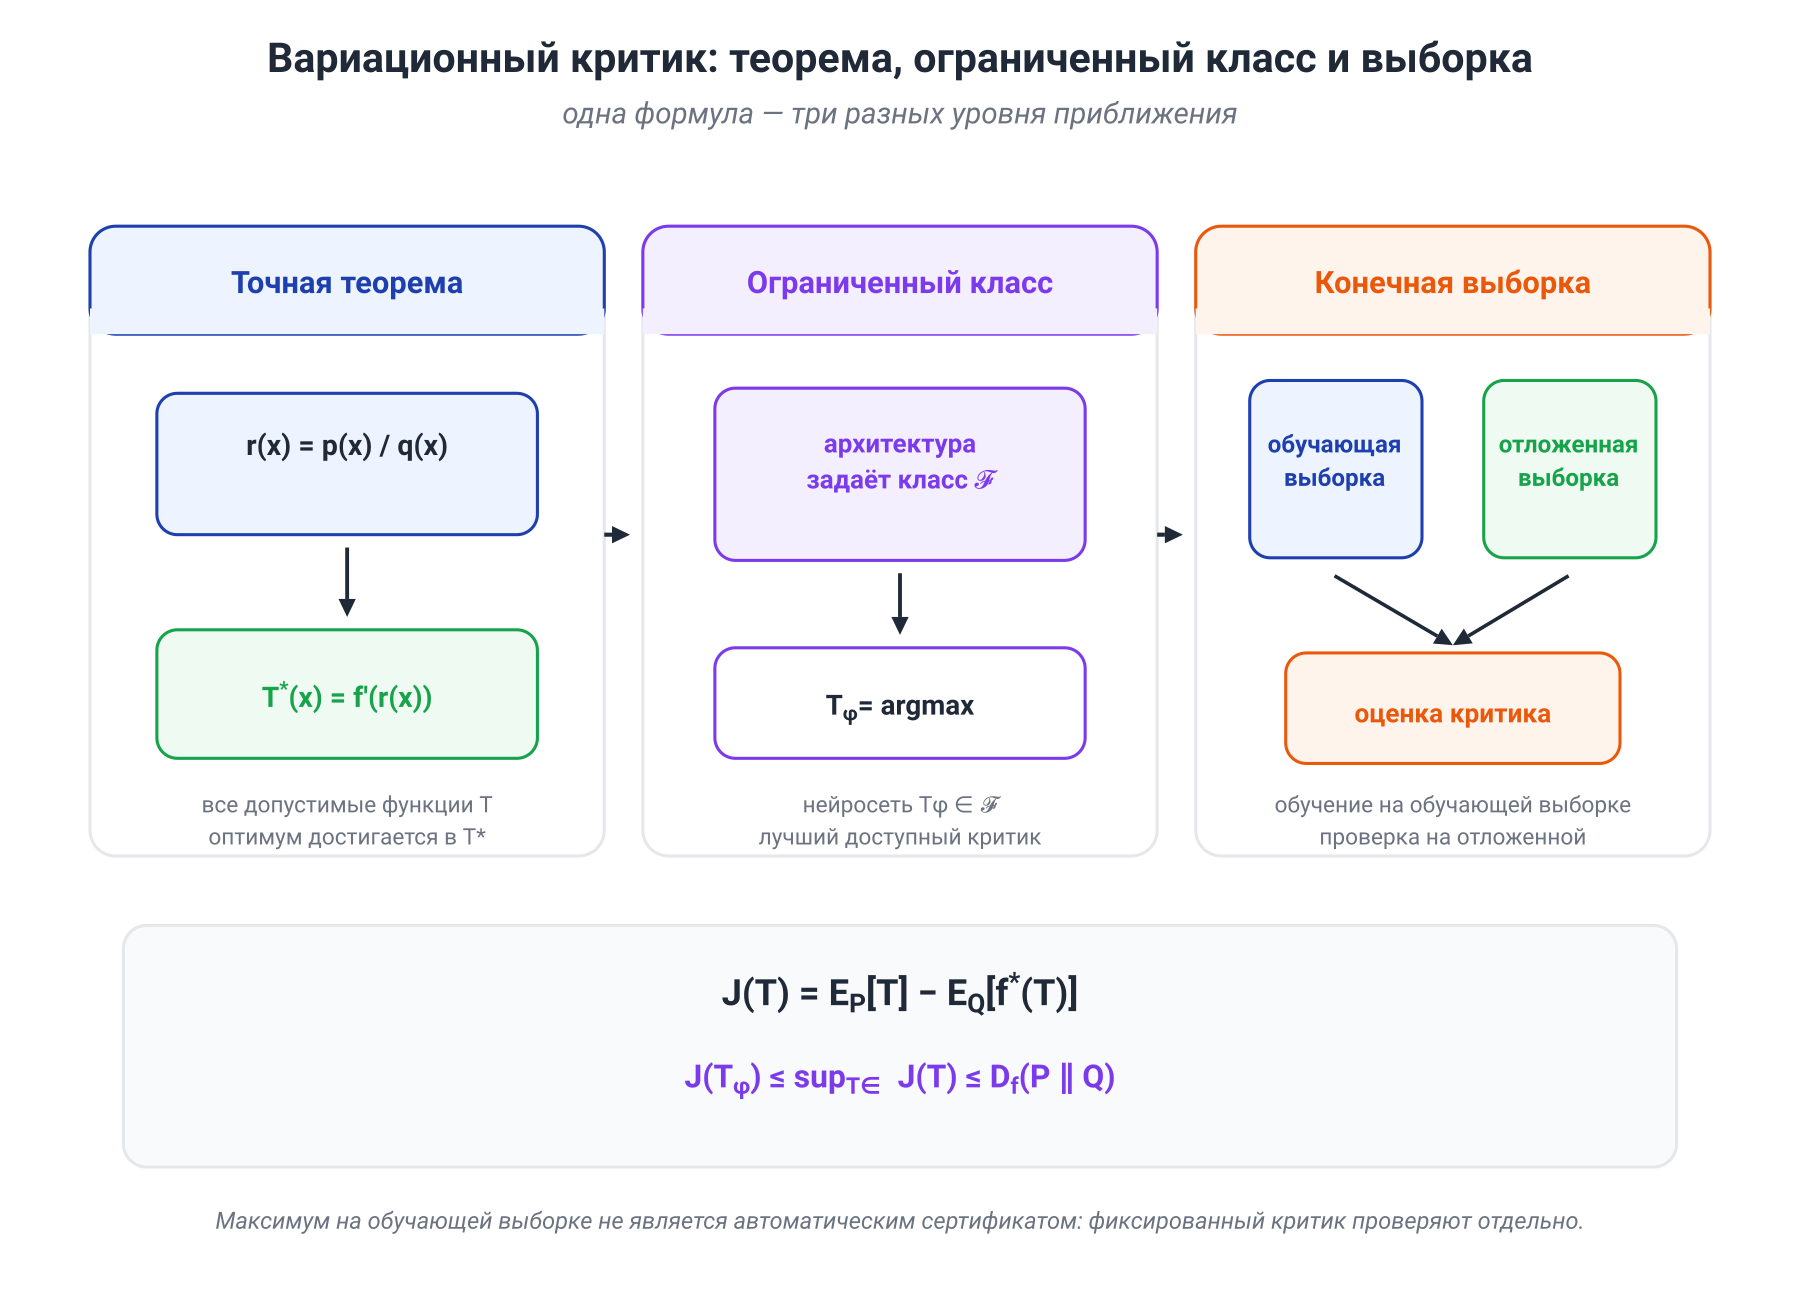
Теперь роль критика видна точно. Он не обязан выдавать вероятность класса; в общем случае он учится преобразованному отношению плотностей, выбранному функцией .
От теоремы к обучению нейросети
Пусть — класс критиков, например нейросети фиксированной архитектуры. Тогда
В практическом запуске к этому добавляются ещё три слоя приближения:
- ожидания заменяются средними по конечной выборке;
- оптимизатор находит не лучший критик даже внутри ;
- один и тот же набор данных часто используется для настройки критика и для отчёта его значения.
Последний пункт особенно важен. Для фиксированного популяционная цель является нижней границей. Но максимум эмпирической цели по гибкому классу может переобучиться и оказаться выше истинной дивергенции. Надёжный протокол отделяет обучение критика от оценки на отложенных парах и проверяет перестановочную базовую линию.
KL: формы NWJ и Donsker–Varadhan
Для прямой KL возьмём
Её сопряжённая функция равна
Общая формула даёт
В литературе по оцениванию MI эту запись часто называют формой Nguyen–Wainwright–Jordan, или NWJ. Её оптимальный критик:
Другая точная форма KL — Donsker–Varadhan:
Связь между ними удобно увидеть, а не запоминать. Положим в NWJ-цели:
Максимум по свободному сдвигу достигается при
После подстановки остаётся DV-цель. Поэтому оптимальный DV-критик определён с точностью до константы:
Обе формулы точны на уровне распределений, но их конечновыборочные оценки ведут себя по-разному. Экспонента и логарифм нормировочного среднего делают DV особенно чувствительной к редким большим значениям критика.
11.6. GAN и f-GAN
Теперь состязательная игра перестаёт выглядеть отдельным трюком: это один из способов обучать вариационный критик вместе с распределением, которое он сравнивает с данными.
Исходная минимаксная игра GAN
Целевая функция Goodfellow et al. имеет вид
Для фиксированного генератора поточечный оптимум равен
Подставим его обратно. Если
то
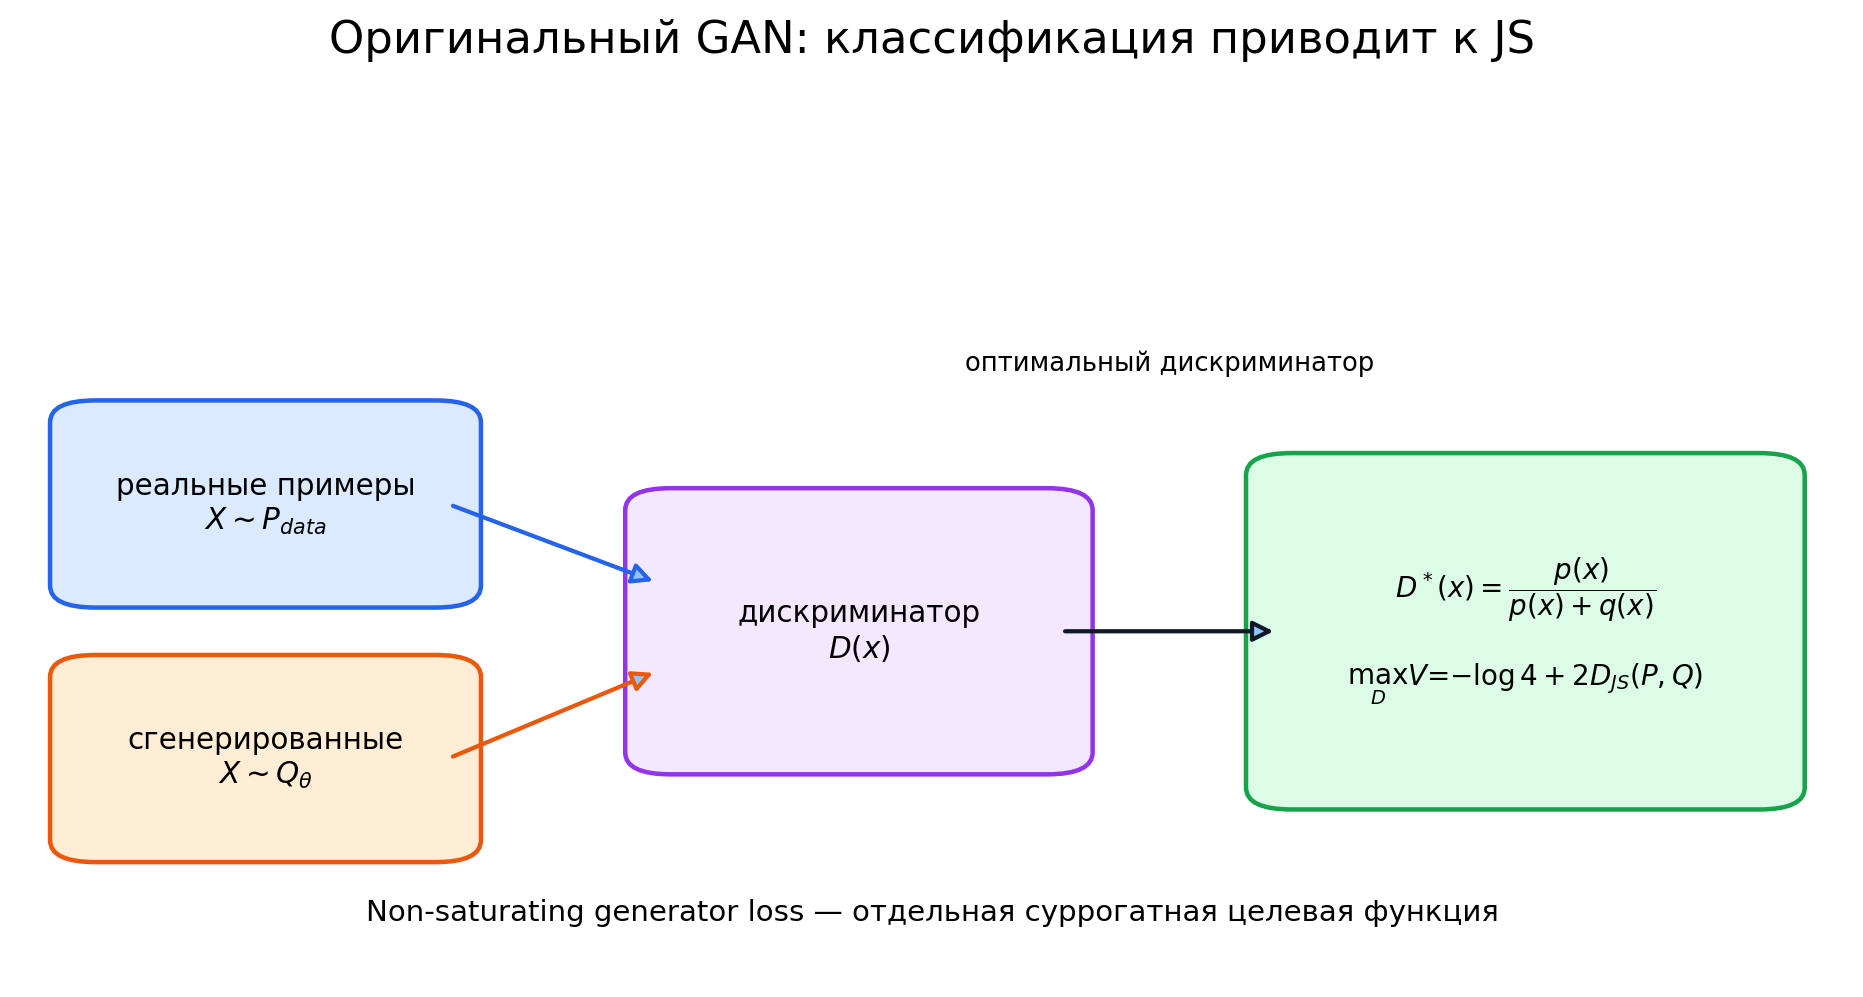
Это сильный и точный результат: идеализированная минимаксная игра с оптимальным дискриминатором сравнивает данные и генератор по JS-дивергенции.
Реальное обучение делает следующий шаг приближённо. Дискриминатор не оптимизируется до конца на каждом обновлении, генератор ограничен параметрическим семейством, а вместо исходной насыщаемой цели часто используется несатурирующаяся функция потерь
которая даёт более сильный градиент на ранних этапах. Желаемая точка сохраняется, но отдельный шаг генератора уже не является буквальным шагом градиентного спуска по точной JS.
f-GAN
Общая вариационная форма предлагает заменить JS другой f-дивергенцией:
Если класс критиков достаточно богат, а внутренний максимум найден, значение внутренней задачи равно
Для некоторых допустим не весь числовой диапазон. Поэтому выход неограниченной сети пропускают через специальное преобразование
гарантирующее
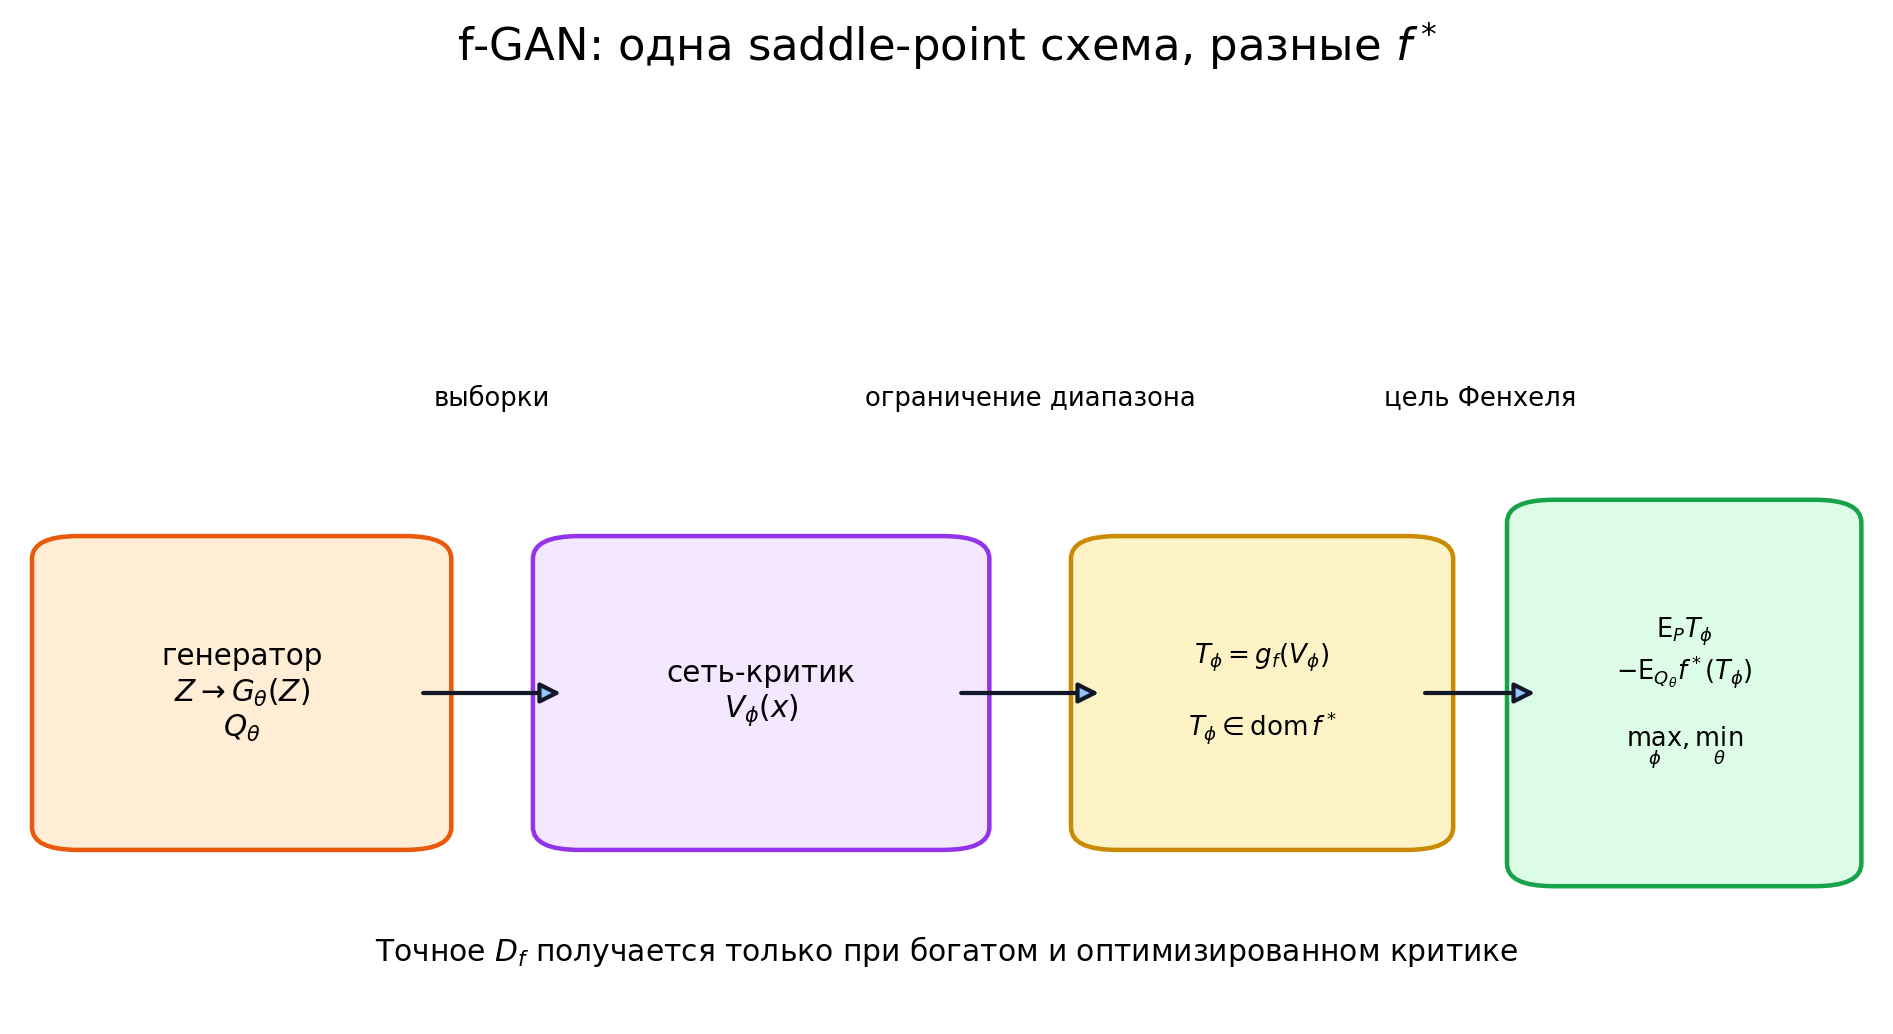
Выбор меняет сразу несколько вещей:
- какую проекцию данных выбирает ограниченное семейство генераторов;
- форму и кривизну функции потерь критика;
- допустимый диапазон его выхода;
- чувствительность к разным значениям отношения плотностей;
- статистический компромисс между смещением и дисперсией оценки.
Удобно разделить два уровня. В идеализированной задаче дивергенция задаёт цель. В реальном GAN динамика седловой оптимизации определяет, удастся ли к этой цели приблизиться. Коллапс мод, осцилляции и нестабильность зависят не только от , но и от архитектуры, регуляризации, относительных скоростей обучения и суррогатной цели генератора.
11.7. MINE и InfoNCE
Взаимная информация уже имеет вид задачи сравнения распределений:
Совместное распределение даёт настоящие пары . Произведение маргиналов даёт пары, собранные независимо. Поэтому оценивание MI можно превратить в различение связанных и перемешанных пар.
MINE: DV-критик для совместного распределения
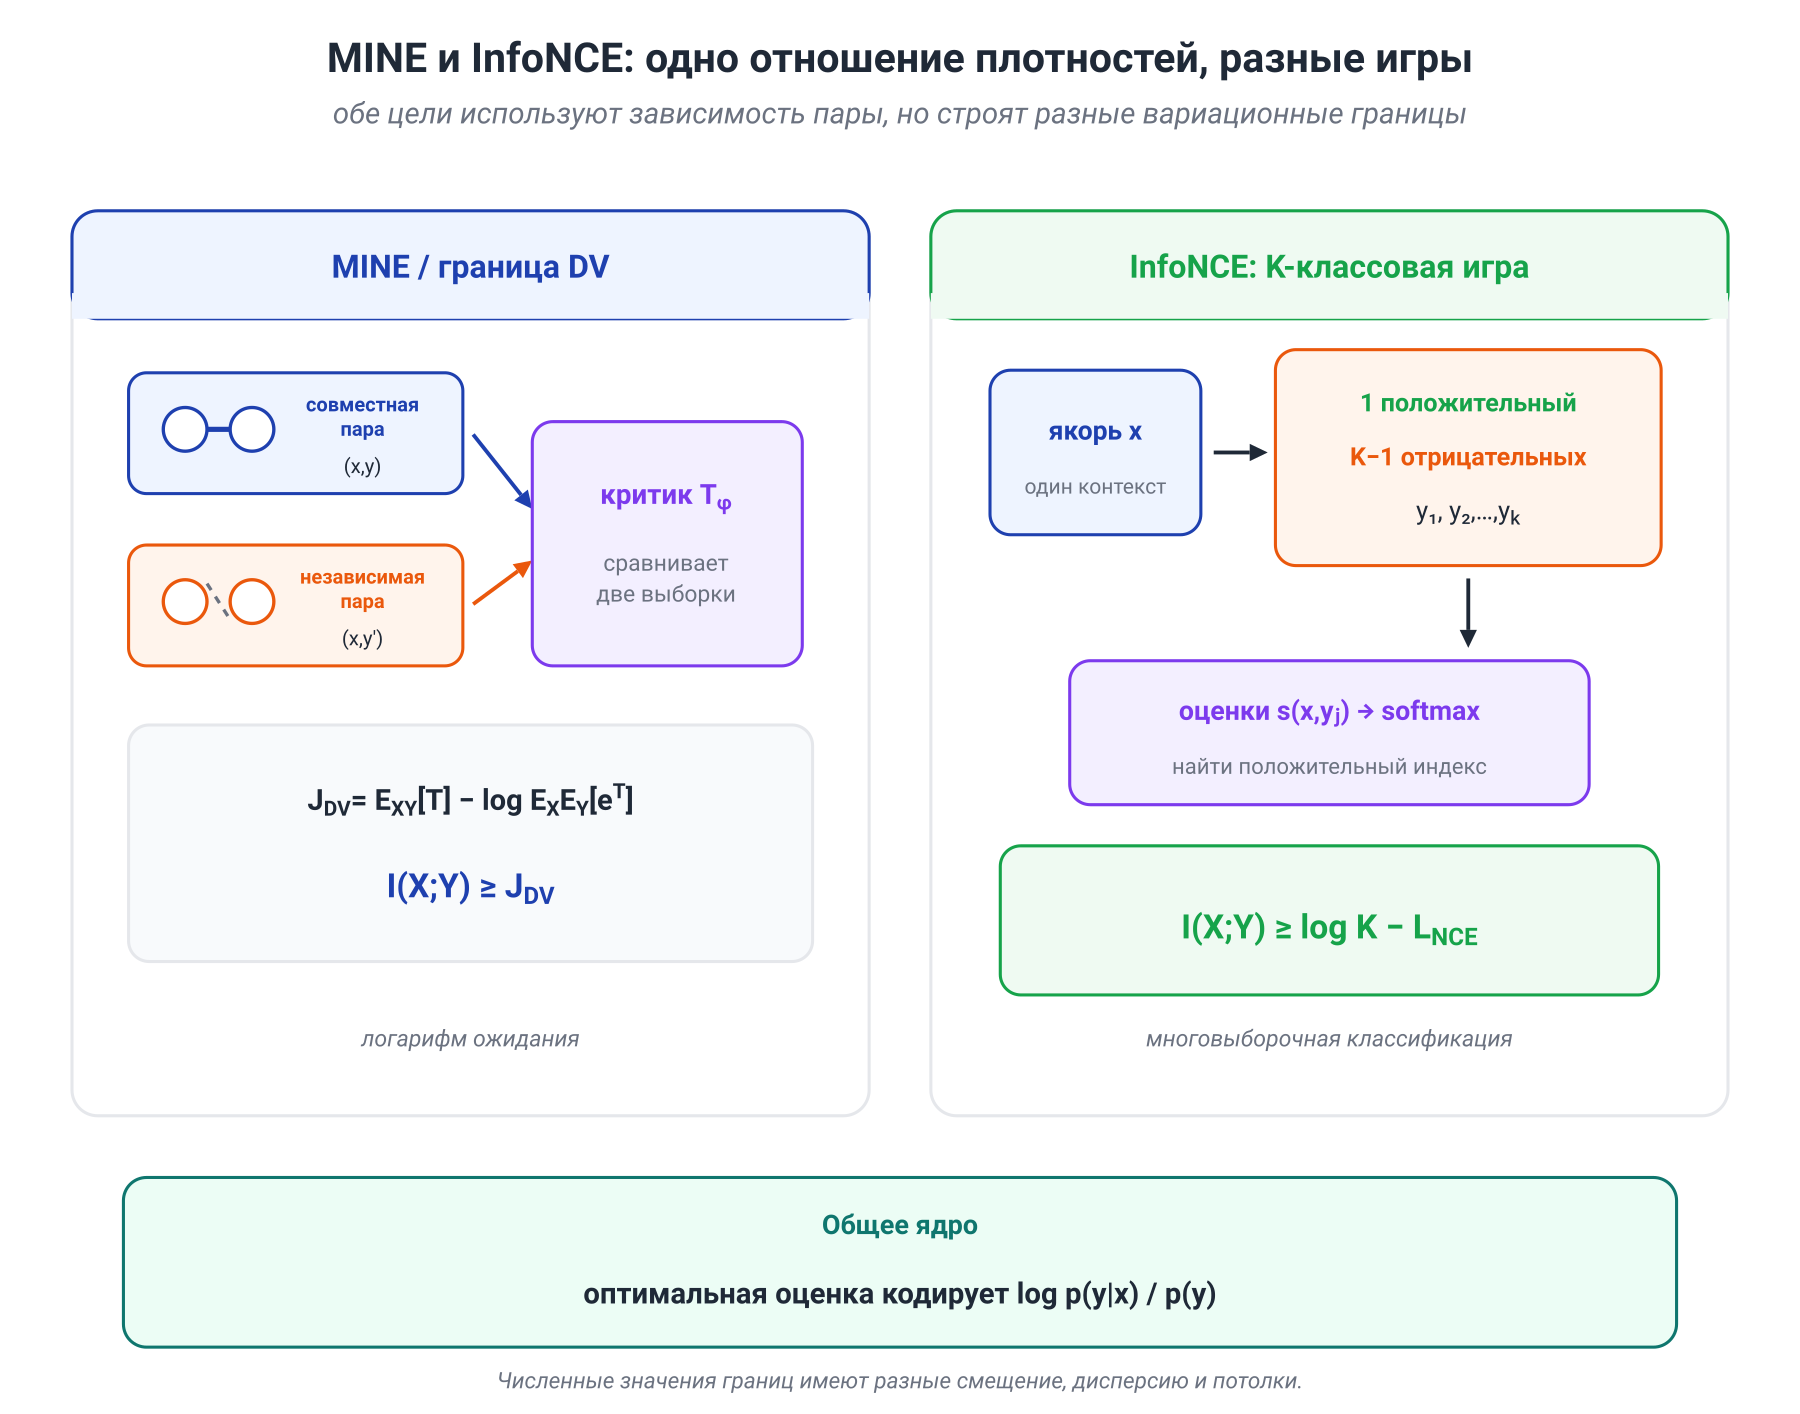
MINE подставляет эту пару распределений в формулу Donsker–Varadhan:
Положительные пары берутся из совместного распределения. Для произведения маргиналов можно независимо пересэмплировать и ; на практике часто перемешивают внутри мини-батча.
Популяционная формула проста, а конечновыборочное оценивание трудно именно из-за экспоненты. Редкие большие значения способны доминировать в знаменателе и создавать высокую дисперсию. Исходная работа MINE использовала скользящее среднее для стабилизации градиента нормировочного члена.
Хороший протокол разделяет три шага:
- критик обучается на тренировочных парах;
- значение оценивается на отложенных парах;
- перестановочный эксперимент проверяет, что оцениватель возвращается к нулевой базовой линии при разрушенной зависимости.
InfoNCE: выбор положительного кандидата
InfoNCE использует другую игру. Для каждого один кандидат берётся из , а
служат отрицательными кандидатами. Критик должен найти положительную пару:
При этой схеме выборки
Оптимальная оценочная функция имеет вид
то есть снова кодирует отношение плотностей.
Например, при и функции потерь ната получаем
Это нижняя граница на MI при заданной схеме, а не самостоятельное измерение всей информации в представлении.
Одно отношение плотностей, разные выборочные цели
MINE и InfoNCE сходятся к родственной оптимальной оценочной функции, но строят разные вариационные задачи:
- MINE использует DV-функционал с экспоненциальным ожиданием;
- InfoNCE решает -классовую задачу выбора положительного кандидата.
Поэтому InfoNCE некорректно описывать как «MINE с небольшим смещением».
У InfoNCE есть явный потолок:
Увеличение поднимает этот потолок и при идеальном критике может сделать границу плотнее. Но для обучения представлений важно не только численное значение границы: ложные отрицательные пары, схема аугментаций, вычислительный бюджет и сложность оптимизации могут изменить качество в последующей задаче.
Здесь возникает важное различие:
Вариационная граница может быть полезной функцией обучения даже тогда, когда её численное значение плохо оценивает само значение MI.
При большой истинной MI известные нейросетевые границы сталкиваются с компромиссом смещения и дисперсии. Более того, без дополнительных предположений распределительно-свободная нижняя граница с высокой вероятностью по наблюдениям не может надёжно расти существенно быстрее порядка . Это ограничение относится к статистической гарантии, а не запрещает использовать контрастивную цель как обучающий сигнал.
11.8. Интегральные вероятностные метрики: расстояние Вассерштейна и MMD
f-дивергенции отвечают на вопрос о перераспределении вероятностной массы. Но иногда задача должна различать близкие и далёкие несовпадения.
Две движущиеся точки
Пусть
При любом носители не пересекаются, поэтому
а KL бесконечна в обоих направлениях. Эти величины не меняются, когда движется от к .
Расстояние Вассерштейна первого порядка, напротив, видит величину сдвига:
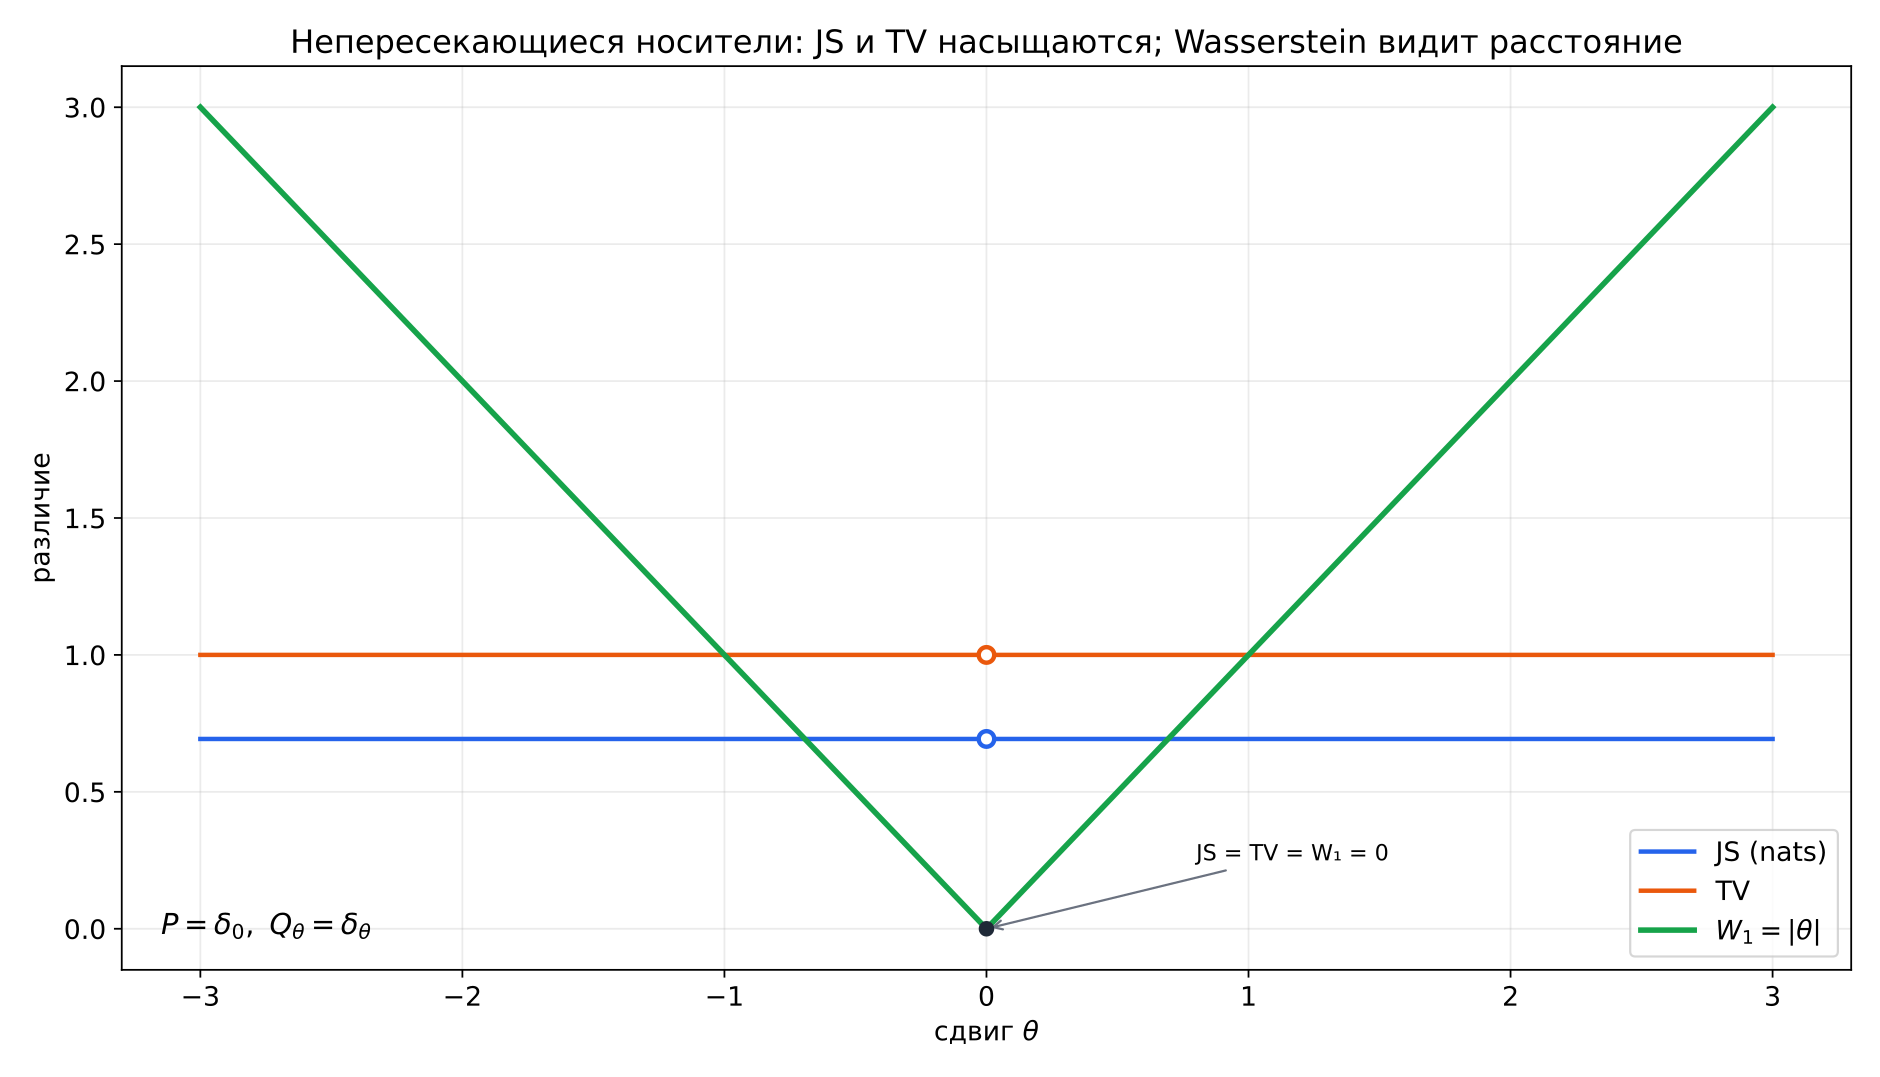
Этот пример объясняет, зачем нужен другой язык: не отношение плотностей, а класс тестовых функций, чувствительных к геометрии.
Интегральная вероятностная метрика
Для симметричного класса функций определим
Класс задаёт, какие различия способен увидеть критик. Если функции слишком просты, разные распределения могут иметь одинаковые ожидания для всех . Если класс богат, оценивание становится статистически и вычислительно сложнее.
Расстояние Вассерштейна первого порядка
Пусть — полное сепарабельное метрическое пространство, например , а и имеют конечный первый момент. Для класса всех 1-липшицевых функций двойственность Канторовича–Рубинштейна даёт
Та же величина имеет транспортную форму:
Здесь — все совместные распределения с маргиналами и . Первая формула говорит о лучшем 1-липшицевом критике; вторая — о минимальной средней стоимости переноса массы.
Расстояние Вассерштейна зависит от базовой метрики. Если умножить все координаты на сто, транспортная цена также изменится. Это не дефект: именно метрика сообщает, какие перемещения следует считать малыми.
WGAN: расстояние Вассерштейна как цель критика
Wasserstein GAN (WGAN) обучает критик по цели
В идеале внутренний максимум равен . Главная инженерная трудность — обеспечить условие Липшица.
Оригинальный WGAN использовал обрезку весов. WGAN-GP заменил её штрафом
на интерполированных точках. Такой штраф часто даёт более удобное обучение, но не является глобальным сертификатом того, что нейросеть 1-липшицева на всём пространстве.
Содержательный результат WGAN состоит не в обещании, что любой запуск сойдётся, а в более подходящей геометрии популяционной цели при близких раздельных носителях. Практическое качество всё равно зависит от класса критиков, способа ограничения Липшица и динамики оптимизации.
MMD: критик задаётся ядром
Если — единичный шар в пространстве с воспроизводящим ядром , получаем максимальное расхождение средних (maximum mean discrepancy, MMD):
Его квадрат вычисляется без внутреннего обучения нейросети:
Для характеристического ядра равенство MMD эквивалентно . Например, гауссовское ядро
является характеристическим на евклидовом пространстве. Но ширина определяет масштаб различий: слишком малая ширина видит только локальные совпадения, слишком большая сглаживает структуру.
MMD удобна для двухвыборочных тестов и контроля сдвига распределения: эмпирическая оценка строится из попарных значений ядра и не требует седловой оптимизации. Цена этого удобства — необходимость выбрать содержательное ядро; наивный расчёт также имеет квадратичную сложность по размеру выборки.
Семейства частично пересекаются
f-дивергенции и IPM — не две непроницаемые коробки. Полная вариация допускает обе формы:
и
Полезнее помнить механизм:
- f-дивергенция задаёт геометрию через отношение плотностей и функцию ;
- IPM задаёт геометрию через класс тестовых функций .
11.9. Выбор расхождения в практической задаче
Универсально лучшего расхождения нет. Выбор начинается не с названия функции потерь, а с того, какие данные доступны и что система должна считать ошибкой.
| Постановка | Естественный первый кандидат | Что проверить |
|---|---|---|
| Доступно нормированное правдоподобие | KL / NLL / MLE | направление KL, носители и несоответствие модельного семейства |
| Есть только выборки из и | классификационная оценка отношения или вариационная f-граница | мощность критика, калибровка, отложенная оценка |
| Обучается неявный генератор | GAN/f-GAN или IPM | суррогат генератора и динамика седловой оптимизации |
| Важна геометрическая близость носителей | расстояние Вассерштейна | базовая метрика и способ контроля Липшица |
| Нужен двухвыборочный тест | MMD или классификационный тест | ядро/критик выбираются без утечки тестовой выборки |
| MI используется как функция обучения | InfoNCE, NWJ, DV и другие границы | схема негативов, смещение–дисперсия и отличие границы от MI |
Перед выбором полезно ответить на четыре вопроса.
1. Что можно вычислить?
Есть ли доступ к и , или только к выборкам? Можно ли дифференцировать через генератор? Есть ли естественные положительные и отрицательные пары?
2. Какая ошибка важна?
Нужно ли дорого штрафовать пропущенную массу, лишнюю массу, геометрический сдвиг, изменение отдельных моментов или любую различимость выбранным классом функций?
3. Что действительно оптимизируется?
Точное расхождение, нижняя граница, конечновыборочный оцениватель и суррогатная функция потерь генератора — разные объекты. Их оптимумы могут совпадать в идеале, но траектории обучения и статистические свойства различаются.
4. Как будет проверяться результат?
Число критика следует дополнять независимыми проверками: значением цели на отложенных данных, метрикой последующей задачи, визуальным или предметным контролем, перестановочной базовой линией, несколькими ядрами или несколькими классами критиков.
Итоговый принцип можно сформулировать без лозунга о «лучшем расстоянии»:
Хорошее расхождение согласует три вещи: смысл ошибки, доступный способ оценивания и геометрию пространства, в котором работает модель.
11.10. Математическое углубление: общая мера и точная двойственность
Можно пропустить при первом чтении. Здесь мы делаем строгими места, которые в основном маршруте были сформулированы для плотностей с .
Общая f-дивергенция и сингулярная часть
Пусть и доминируются мерой :
Определим граничные значения
Тогда расширенная f-дивергенция равна
Формула не зависит от выбора общей доминирующей меры. Если , то
Отсюда сразу получаются граничные значения:
- TV: ;
- квадрат расстояния Хеллингера в нашей нормировке: ;
- JS: ;
- прямая KL и Пирсона: .
Совместная выпуклость
Функция двух неотрицательных аргументов
является перспективой выпуклой функции и потому совместно выпукла по . После интегрирования получаем для :
Это формальное выражение простой идеи: смешивание двух задач сравнения не создаёт больше расхождения, чем средний счёт до смешивания.
Когда вариационный супремум точен
Тождество
требует выпуклости и нижней полунепрерывности , корректной области , достаточно богатого класса измеримых функций и условий, позволяющих выбрать поточечный оптимум и обменять интегрирование с супремумом.
Если дифференцируема, оптимум имеет вид
Если недифференцируема, например для TV, вместо производной используется субградиент:
Нейросетевой класс почти всегда уже полного класса измеримых функций. Поэтому выражение, оптимизированное в коде, корректнее называть вариационной нижней границей, пока точность для выбранной архитектуры и процедуры не доказана отдельно.
11.12. Заключение
KL привела нас к этому модулю, но итог оказался шире одной дивергенции.
f-дивергенции собирают большой класс расхождений в одну формулу:
Функция задаёт, как оцениваются разные ошибки в отношении плотностей. Неравенство обработки данных объясняет, почему фиксированная обработка не усиливает популяционную различимость, а насыщение на раздельных носителях показывает, где отношению плотностей не хватает внешней геометрии.
Двойственность Фенхеля превращает недоступное расхождение в обучаемую задачу:
В идеале критик восстанавливает преобразование . В реальном запуске он работает внутри ограниченного класса, по конечной выборке и с конечным числом шагов оптимизации. Поэтому значение критика полезно ровно настолько, насколько ясно описан этот протокол.
Та же механика связывает несколько, на первый взгляд, разных методов:
- вероятностный классификатор оценивает логарифм отношения плотностей;
- исходная минимаксная игра GAN при оптимальном дискриминаторе связана с JS;
- f-GAN меняет функцию и сопряжённую функцию потерь критика;
- MINE сравнивает совместные и перемешанные пары через DV;
- InfoNCE решает многовыборочную классификационную задачу с тем же отношением плотностей в оптимальной оценочной функции.
Когда расстояние между точками имеет смысл само по себе, язык меняется. Расстояние Вассерштейна задаёт стоимость переноса в базовой метрике, а MMD — различимость классом функций, определённым ядром.
Главный инженерный вывод модуля:
Расхождение выбирают не по репутации его названия, а по тому, какую ошибку оно считает дорогой, как его можно оценить и какая геометрия нужна задаче.
В Модуле 12 вариационный аппарат появится в другой роли. KL будет измерять, насколько зависящее от данных апостериорное распределение отклонилось от априорного, а PAC-Bayes превратит эту стоимость в границу обобщения.
Основные источники
- X. Nguyen, M. Wainwright, M. Jordan, Estimating Divergence Functionals and the Likelihood Ratio by Convex Risk Minimization, 2010.
- S. Nowozin, B. Cseke, R. Tomioka, f-GAN: Training Generative Neural Samplers using Variational Divergence Minimization, 2016.
- I. Goodfellow et al., Generative Adversarial Nets, 2014.
- M. Belghazi et al., MINE: Mutual Information Neural Estimation, 2018.
- A. van den Oord, Y. Li, O. Vinyals, Representation Learning with Contrastive Predictive Coding, 2018.
- B. Poole et al., On Variational Bounds of Mutual Information, 2019.
- D. McAllester, K. Stratos, Formal Limitations on the Measurement of Mutual Information, 2020.
- M. Arjovsky, S. Chintala, L. Bottou, Wasserstein GAN, 2017.
- I. Gulrajani et al., Improved Training of Wasserstein GANs, 2017.
- A. Gretton et al., A Kernel Two-Sample Test, 2012.