Модуль 10. Алгоритмическая теория информации: кратчайшие описания, MDL и универсальное предсказание
Как читать этот модуль. Основной маршрут — §§10.1–10.8. Сначала мы перейдём от среднего числа бит для источника к длине описания одного конкретного объекта, затем свяжем эту идею с энтропией Шеннона, универсальным предсказанием, MDL и сходством через сжатие. §§10.9–10.10 — факультативные углубления об AIXI и принципе Ландауэра; их можно оставить на второй проход.
10.1. От распределения к одному конкретному объекту
Представим три файла одинакового размера — по миллиону бит каждый.
- Первый состоит из одних нулей.
- Второй содержит первые миллион двоичных знаков числа .
- Третий получен из физического источника случайности.
На уровне сырого представления они одинаковы: в каждом ровно миллион записанных бит. Но как описания они различаются радикально. Для первого достаточно команды «напечатай миллион нулей». Для второго — программы вычисления и числа знаков. Для третьего, вероятнее всего, не найдётся описания существенно короче самого файла.
Здесь возникает вопрос, которого не было в классической постановке источника:
Сколько бит нужно не в среднем для распределения, а для воспроизведения именно этого объекта?
Алгоритмическая теория информации (algorithmic information theory, AIT) отвечает: нужно искать кратчайшее эффективное описание, то есть программу, которая печатает объект и останавливается.
Это не замена теории Шеннона, а другой масштаб рассмотрения.
- Энтропия начинает с распределения и спрашивает о среднем счёте за множество возможных сообщений.
- Алгоритмическая сложность начинает с конкретной строки и спрашивает о кратчайшем исполнимом объяснении этой строки.
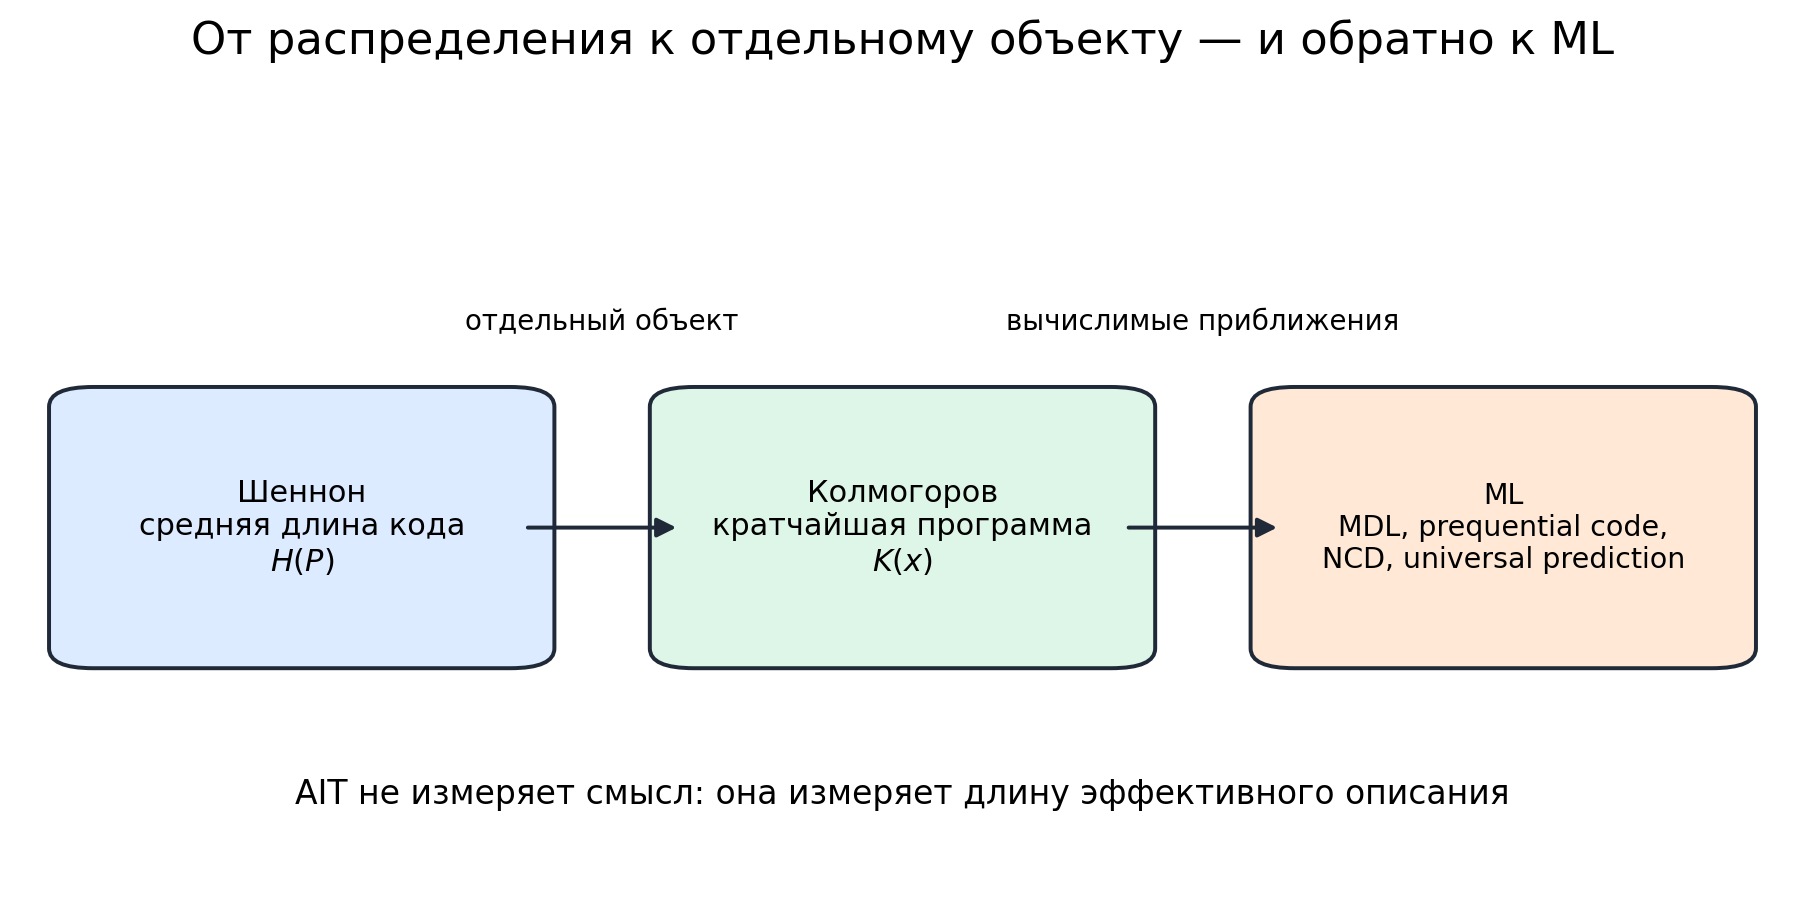
Такой взгляд особенно полезен в ML.
Выбор модели. Сложная модель может сильнее уменьшить функцию потерь, но за саму модель тоже приходится платить. Отсюда возникает MDL-счёт «модель + данные при модели».
Анализ представлений. Высокая точность диагностического классификатора (probe) ещё не говорит, легко ли извлекается признак. Предиктивно-последовательный код учитывает, сколько примеров и сколько бит понадобилось, чтобы научиться его извлекать.
Сходство объектов. Если после передачи объект требует лишь короткого дополнения, у них есть общая алгоритмическая структура. Практическая версия этой идеи приводит к NCD.
Универсальное предсказание. Если коротким вычислимым объяснениям дать больший априорный вес, можно определить идеализированный предиктор, который конкурирует со всеми вычислимыми моделями сразу.
Сразу установим границу понятия. Краткость описания говорит о регулярности, но не измеряет смысл, истинность, полезность или красоту. Короткая программа может печатать бессодержательную строку и работать астрономически долго. Алгоритмическая теория информации измеряет описательную сложность, а не все свойства объекта одновременно.
10.2. Колмогоровская сложность и язык описания
Кратчайшая программа
Описание имеет смысл только вместе с языком, на котором его умеет выполнять декодер. Зафиксируем универсальную префиксную машину . Её завершившиеся программы устроены так, что ни одна допустимая программа не является началом другой. Благодаря этому поток бит можно однозначно разделять на программы, а их длины ведут себя как длины префиксного кода.
Префиксная колмогоровская сложность строки определяется как
Это длина кратчайшей самоделимитирующейся программы, которая печатает и останавливается.
Индекс часто опускают, но машина не исчезает из определения. Вопрос всегда звучит так: насколько коротко объект описывается в выбранном универсальном языке?
Самоделимитирующееся буквальное описание
Для обычной, или простой, сложности можно положить строку внутрь программы и добавить фиксированную команду «напечатать остаток». Поэтому
Префиксная программа должна сообщить декодеру, где заканчивается описание длины и начинается сама строка. Один стандартный способ даёт
Для стоимость растёт лишь логарифмически; например,
при достаточно большом . Надбавка мала по сравнению с длинной строкой, но принципиальна: именно самоделимитируемость делает веса совместимыми с вероятностной суммой.
Теорема инвариантности
Теперь возникает естественное возражение. Одна и та же идея записывается на Python, C и языке машины Тьюринга разным числом бит. Не становится ли сложность просто свойством выбранного синтаксиса?
Пусть и — две оптимальные универсальные префиксные машины. Тогда существует константа , не зависящая от , такая что
Механика проста. На машине можно один раз написать интерпретатор для , а затем присоединять к нему любую -программу. Стоимость интерпретатора фиксирована и не растёт вместе с объектом.
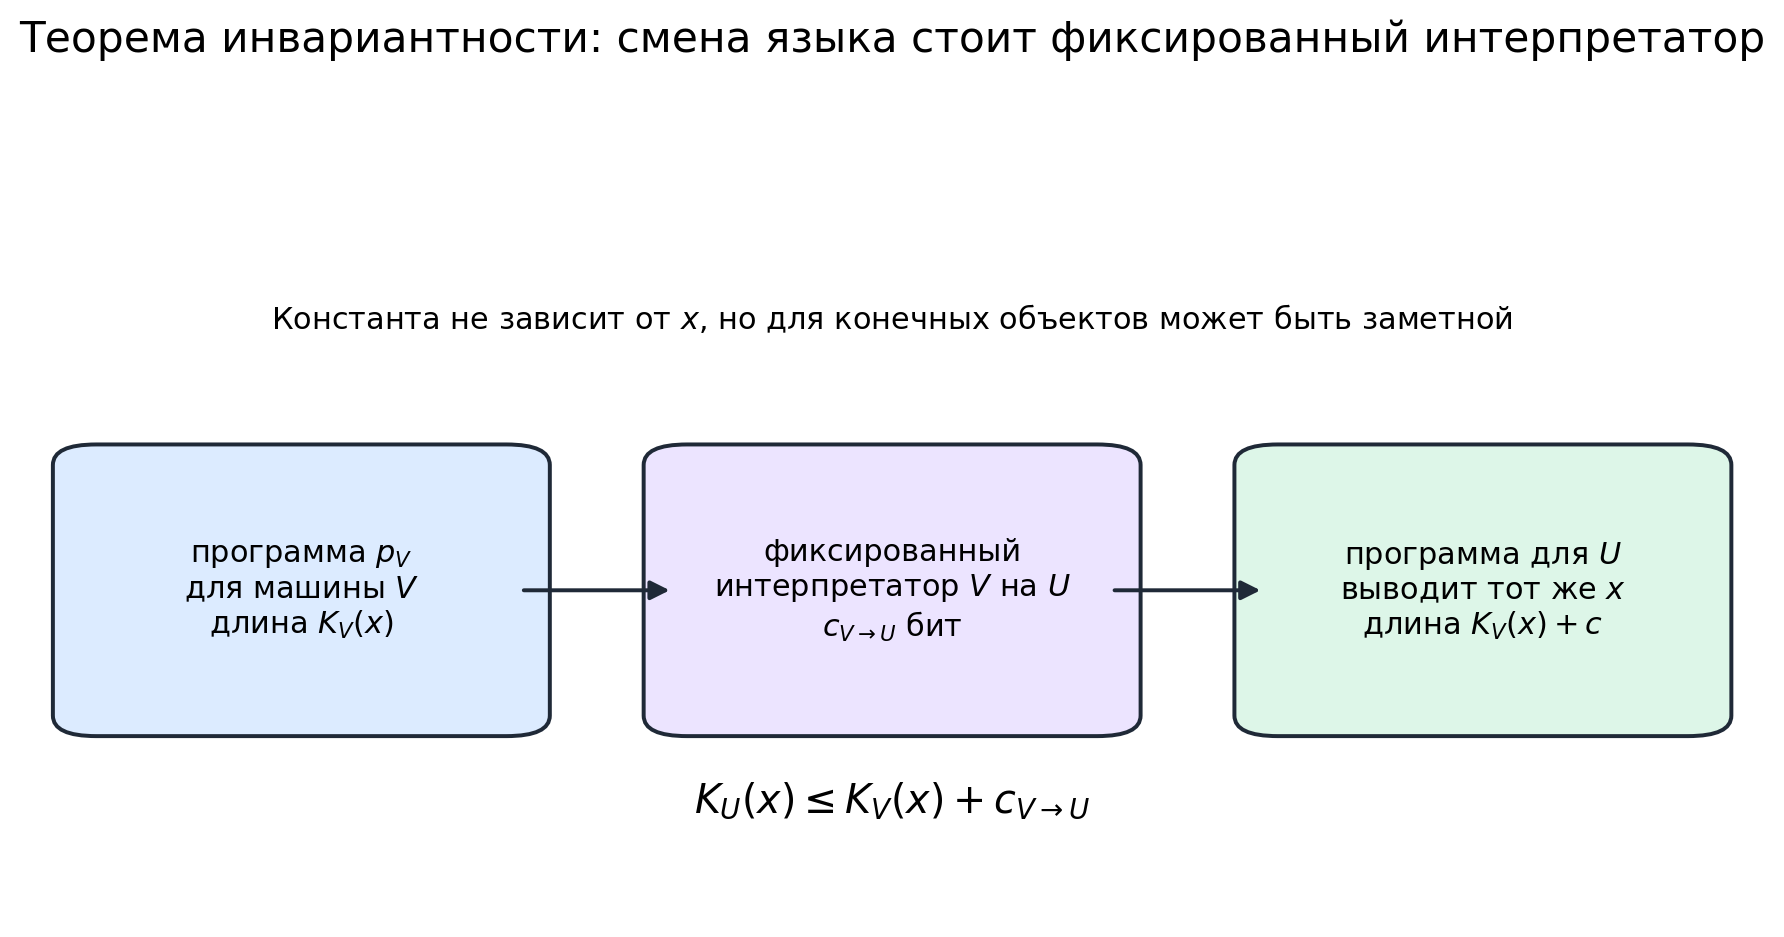
Теорема позволяет говорить о с точностью до аддитивной константы. Для больших объектов это сильная устойчивость. Для коротких строк константа может быть сопоставима с самой сложностью, поэтому абсолютное значение без указания машины не превращается в физическую константу объекта.
Условная сложность
Если декодеру уже известен объект , определяют
Это длина кратчайшего дополнительного описания при доступном .
Если и — две версии репозитория, то может быть близка к длине короткого разностного описания (patch), хотя каждый репозиторий сам по себе велик. Именно эта идея позже превратится в алгоритмическую меру сходства.
Что именно измеряет
Две строки одинаковой длины могут занимать разные места на шкале описательной сложности:
- миллион нулей задаётся числом повторов;
- периодическая строка — шаблоном и числом повторов;
- первые цифр — алгоритмом и значением ;
- типичная строка из независимых честных битов требует почти буквального описания.
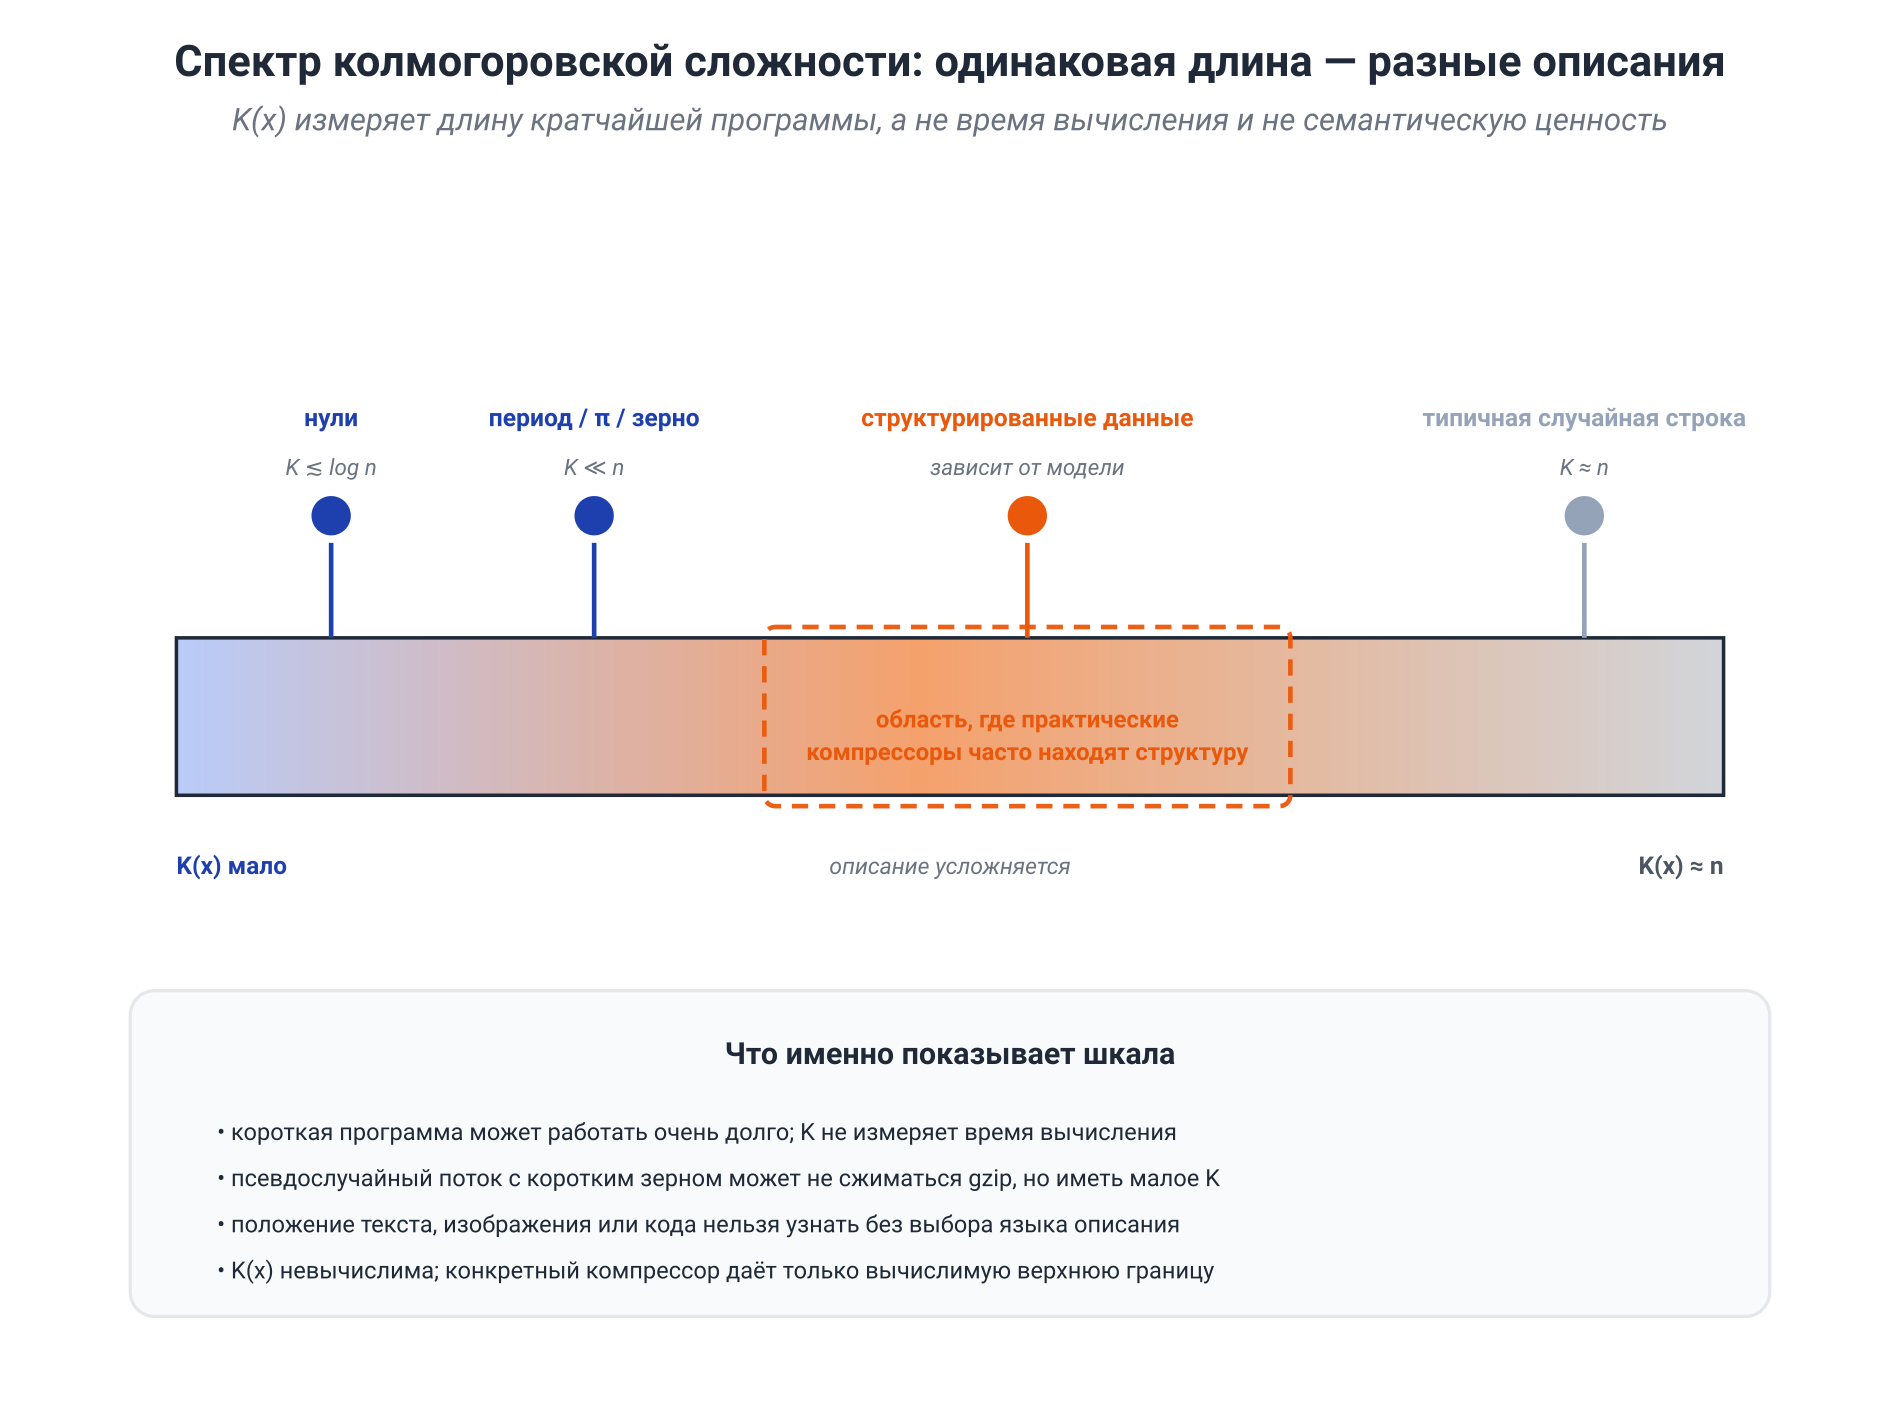
Здесь важно отделить длину программы от времени её исполнения. Короткая программа может вычислять результат чрезвычайно долго. И наоборот, большой файл весов может быстро выдавать ответы. Колмогоровская сложность измеряет длину описания, а не вычислительную стоимость.
Есть и ещё одна полезная неожиданность. Поток псевдослучайного генератора с коротким начальным значением (seed) имеет короткое алгоритмическое описание: генератор, начальное значение и длина потока. Но gzip может не сжать его вообще. Практический компрессор ищет ограниченный набор закономерностей; оптимизируется по всем программам.
10.3. Несжимаемость, невычислимость и реальные компрессоры
Почему большинство строк нельзя заметно сжать
Рассмотрим все бинарных строк длины . Программ длины меньше существует меньше . Каждая завершившаяся программа печатает не более одной строки. Следовательно,
Доля строк, которые можно сжать хотя бы на бит, меньше
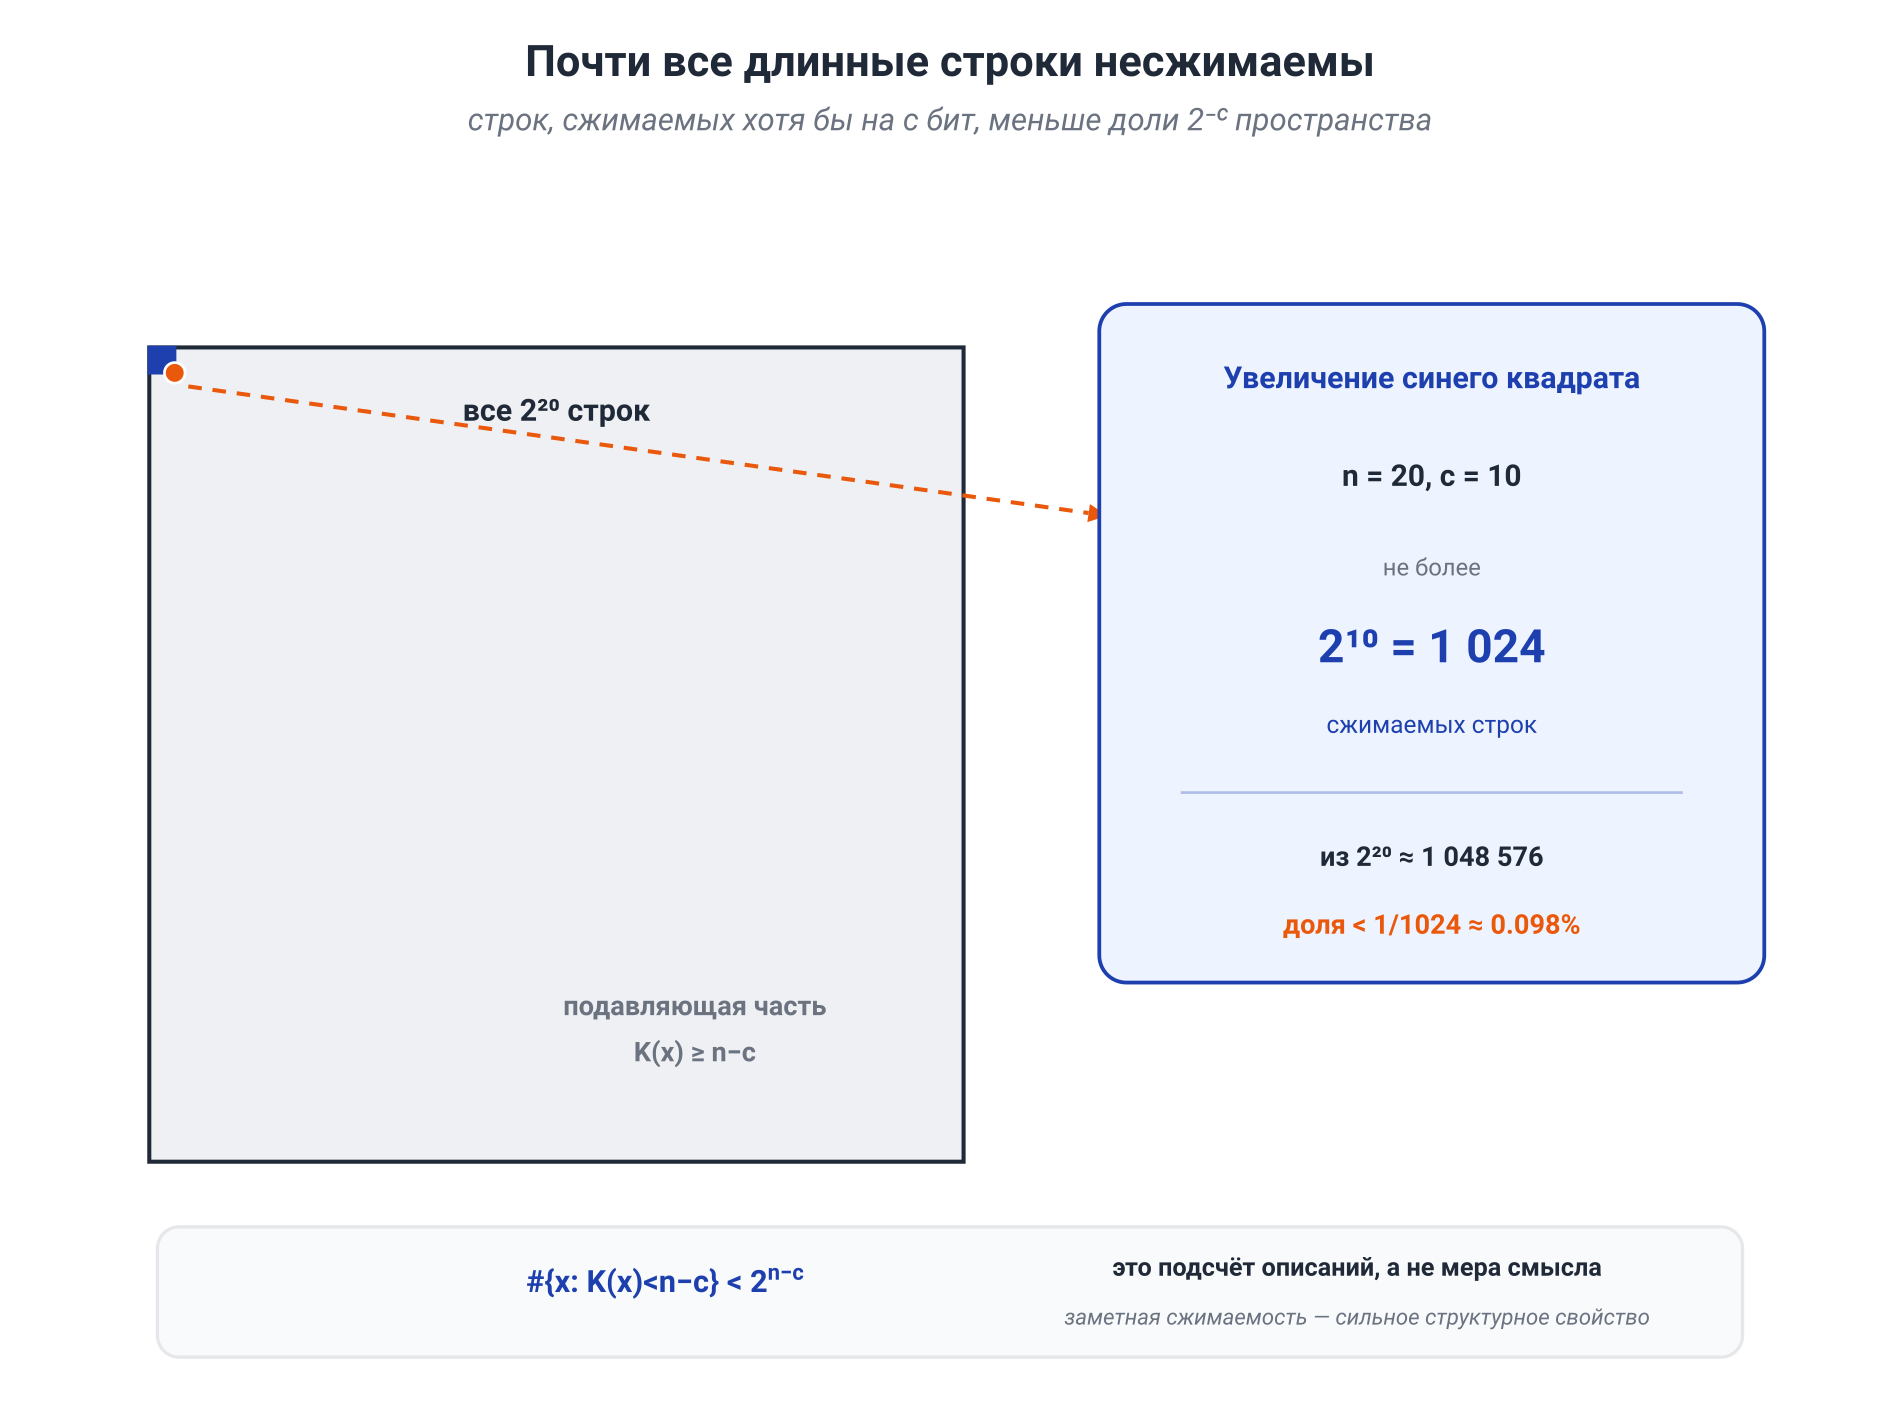
Например, сжимаемых минимум на бит строк среди всех строк фиксированной длины меньше одной миллионной доли. Структурированные объекты занимают очень малую часть пространства всех возможных битовых последовательностей.
Это чистый подсчёт описаний. Он не утверждает, что несжимаемая строка обязательно «выглядит случайной» человеку, и ничего не говорит о её семантической ценности.
Почему идеальный счёт нельзя вычислить
Предположим, что существует алгоритм, точно вычисляющий . Тогда по числу можно перебрать строки и найти первую строку , для которой
Но программа «получи , найди первую такую строку и напечатай её» имеет длину
что для большого намного меньше . Получается короткое описание объекта, который по построению не должен иметь короткого описания. Противоречие.
Следовательно,
При этом полувычислима сверху. Можно параллельно запускать всё больше программ, и всякий раз, когда находится более короткая программа для , улучшать текущую верхнюю оценку. Нельзя только узнать, что найденная программа уже кратчайшая: некоторые ещё более короткие кандидаты могут остановиться через неизвестно сколько времени.
Невычислимость здесь не техническая неприятность, которую исправит более быстрый процессор. Она является частью самой конструкции.
Что дают gzip, zstd и LZMA
Пусть конкретный компрессор выдаёт поток , а фиксированный декомпрессор без потерь восстанавливает . Тогда программа «запусти этот декомпрессор на » даёт
где оплачивает декомпрессор, формат и соглашения о входе.
Значит, реальный компрессор даёт вычислимую верхнюю границу на . Но он не даёт известной гарантии близости к идеалу.
Если файл плохо сжимается, возможны разные причины:
- объект действительно близок к алгоритмически несжимаемому;
- его закономерность не входит в класс, который умеет находить компрессор;
- файл слишком мал и служебные расходы доминируют;
- формат или предобработка скрывают полезную структуру.
Полезная инженерная формулировка звучит так:
Компрессор — это исполнимая теория регулярности. Его длина кода показывает, какие закономерности умеет использовать именно эта теория.
Математическое замечание: случайность бесконечной последовательности
Для бесконечных последовательностей недостаточно проверить один длинный префикс. Случайность по Мартину-Лёфу требует прохождения всех эффективных статистических тестов нулевой меры. Теорема Левина—Шнорра связывает это определение с префиксной сложностью: бинарная последовательность случайна по Мартину-Лёфу тогда и только тогда, когда существует константа , для которой
для всех . В дальнейшем нам в основном понадобятся конечные объекты, но это показывает, что алгоритмическая случайность — не синоним «архиватор не нашёл повторов».
10.4. Связь с энтропией Шеннона
Шеннон и Колмогоров начинают с разных сторон.
- Шеннон фиксирует распределение и ищет среднюю длину кода.
- Колмогоров фиксирует объект и ищет кратчайшее исполнимое описание.
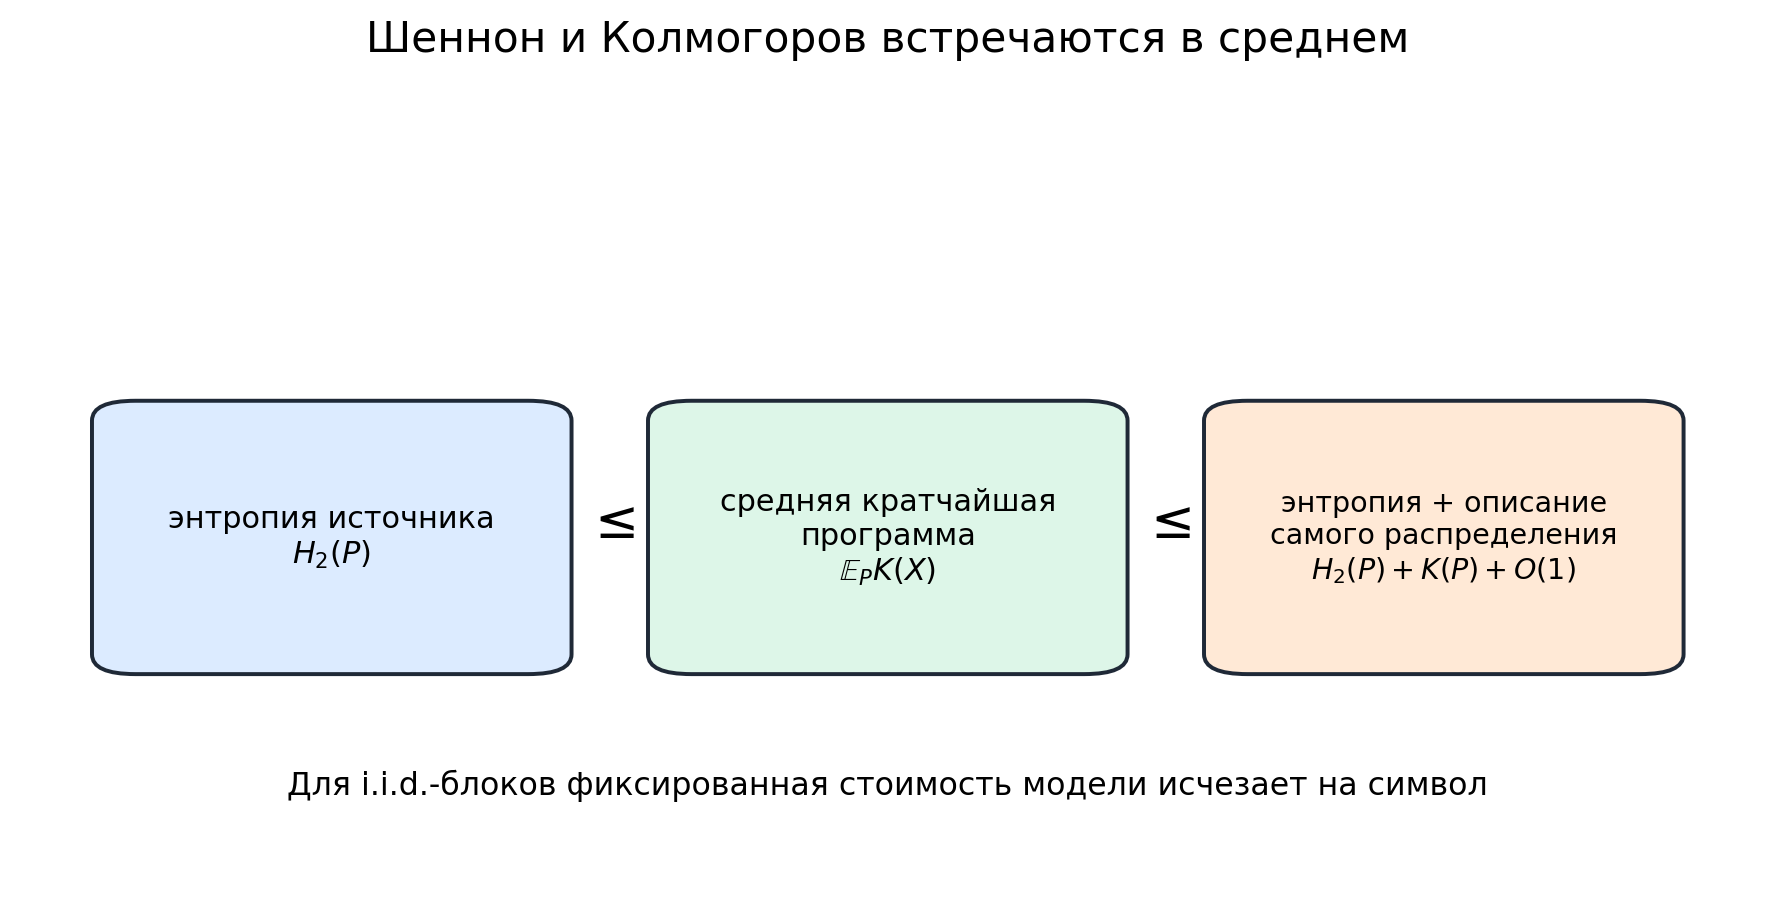
Тем не менее для вычислимого источника эти два счёта встречаются в среднем.
Пусть — вычислимое распределение на конечных строках, а — длина программы, которая вычисляет его вероятности с нужной точностью. Тогда
Нижняя граница
Выберем для каждого одну кратчайшую префиксную программу. Эти программы образуют префиксный код. Средняя длина любого префиксного кода не может быть меньше энтропии источника, поэтому
Верхняя граница
Можно передать два объекта:
- программу, описывающую распределение ;
- код строки длиной примерно бит.
Отсюда
После усреднения второй член превращается в энтропию.
Для i.i.d.-блока точнее написать
Если источник фиксирован и , то
Стоимость описания источника и длины блока распределяется по всё большему числу символов и исчезает на один символ.
Вот точный мост между двумя теориями:
Энтропия — типичная средняя алгоритмическая сложность длинных сообщений из известного вычислимого источника; позволяет обсуждать отдельный объект, когда источник не задан заранее.
Мост не стирает различие. Один файл не определяет единственное истинное распределение, а короткая программа, идеально воспроизводящая обучающий набор, не обязана хорошо предсказывать новые данные. Для генерализации важно, какую структуру описание переносит за пределы уже увиденного объекта.
10.5. Алгоритмическая вероятность и универсальное предсказание
Программы как гипотезы
Префиксность позволяет провести мысленный эксперимент: подбрасывать честную монету и читать получившиеся биты как программу. Программа длины получает вес
По неравенству Крафта суммарный вес завершившихся программ не превосходит единицу. Короткие программы получают больший вес, но длинные не исключаются.
Для программ, которые печатают конечную строку и останавливаются, определим алгоритмическую вероятность
Одну и ту же строку могут печатать многие программы, поэтому веса суммируются. Теорема кодирования связывает эту сумму с префиксной сложностью:
Иначе говоря,
Кратчайшая программа определяет главный экспоненциальный масштаб, а остальные программы добавляют массу.
Предсказание продолжения
Для последовательного предсказания удобнее взять универсальную монотонную машину, которая читает бесконечный поток честных случайных битов. Определим как вероятность того, что её выход начинается с префикса . Эквивалентно можно просуммировать веса минимальных входных префиксов, уже достаточных для печати :
Знак означает, что выведенная строка начинается с ; требование минимальности не позволяет повторно считать все продолжения одного и того же входного префикса.
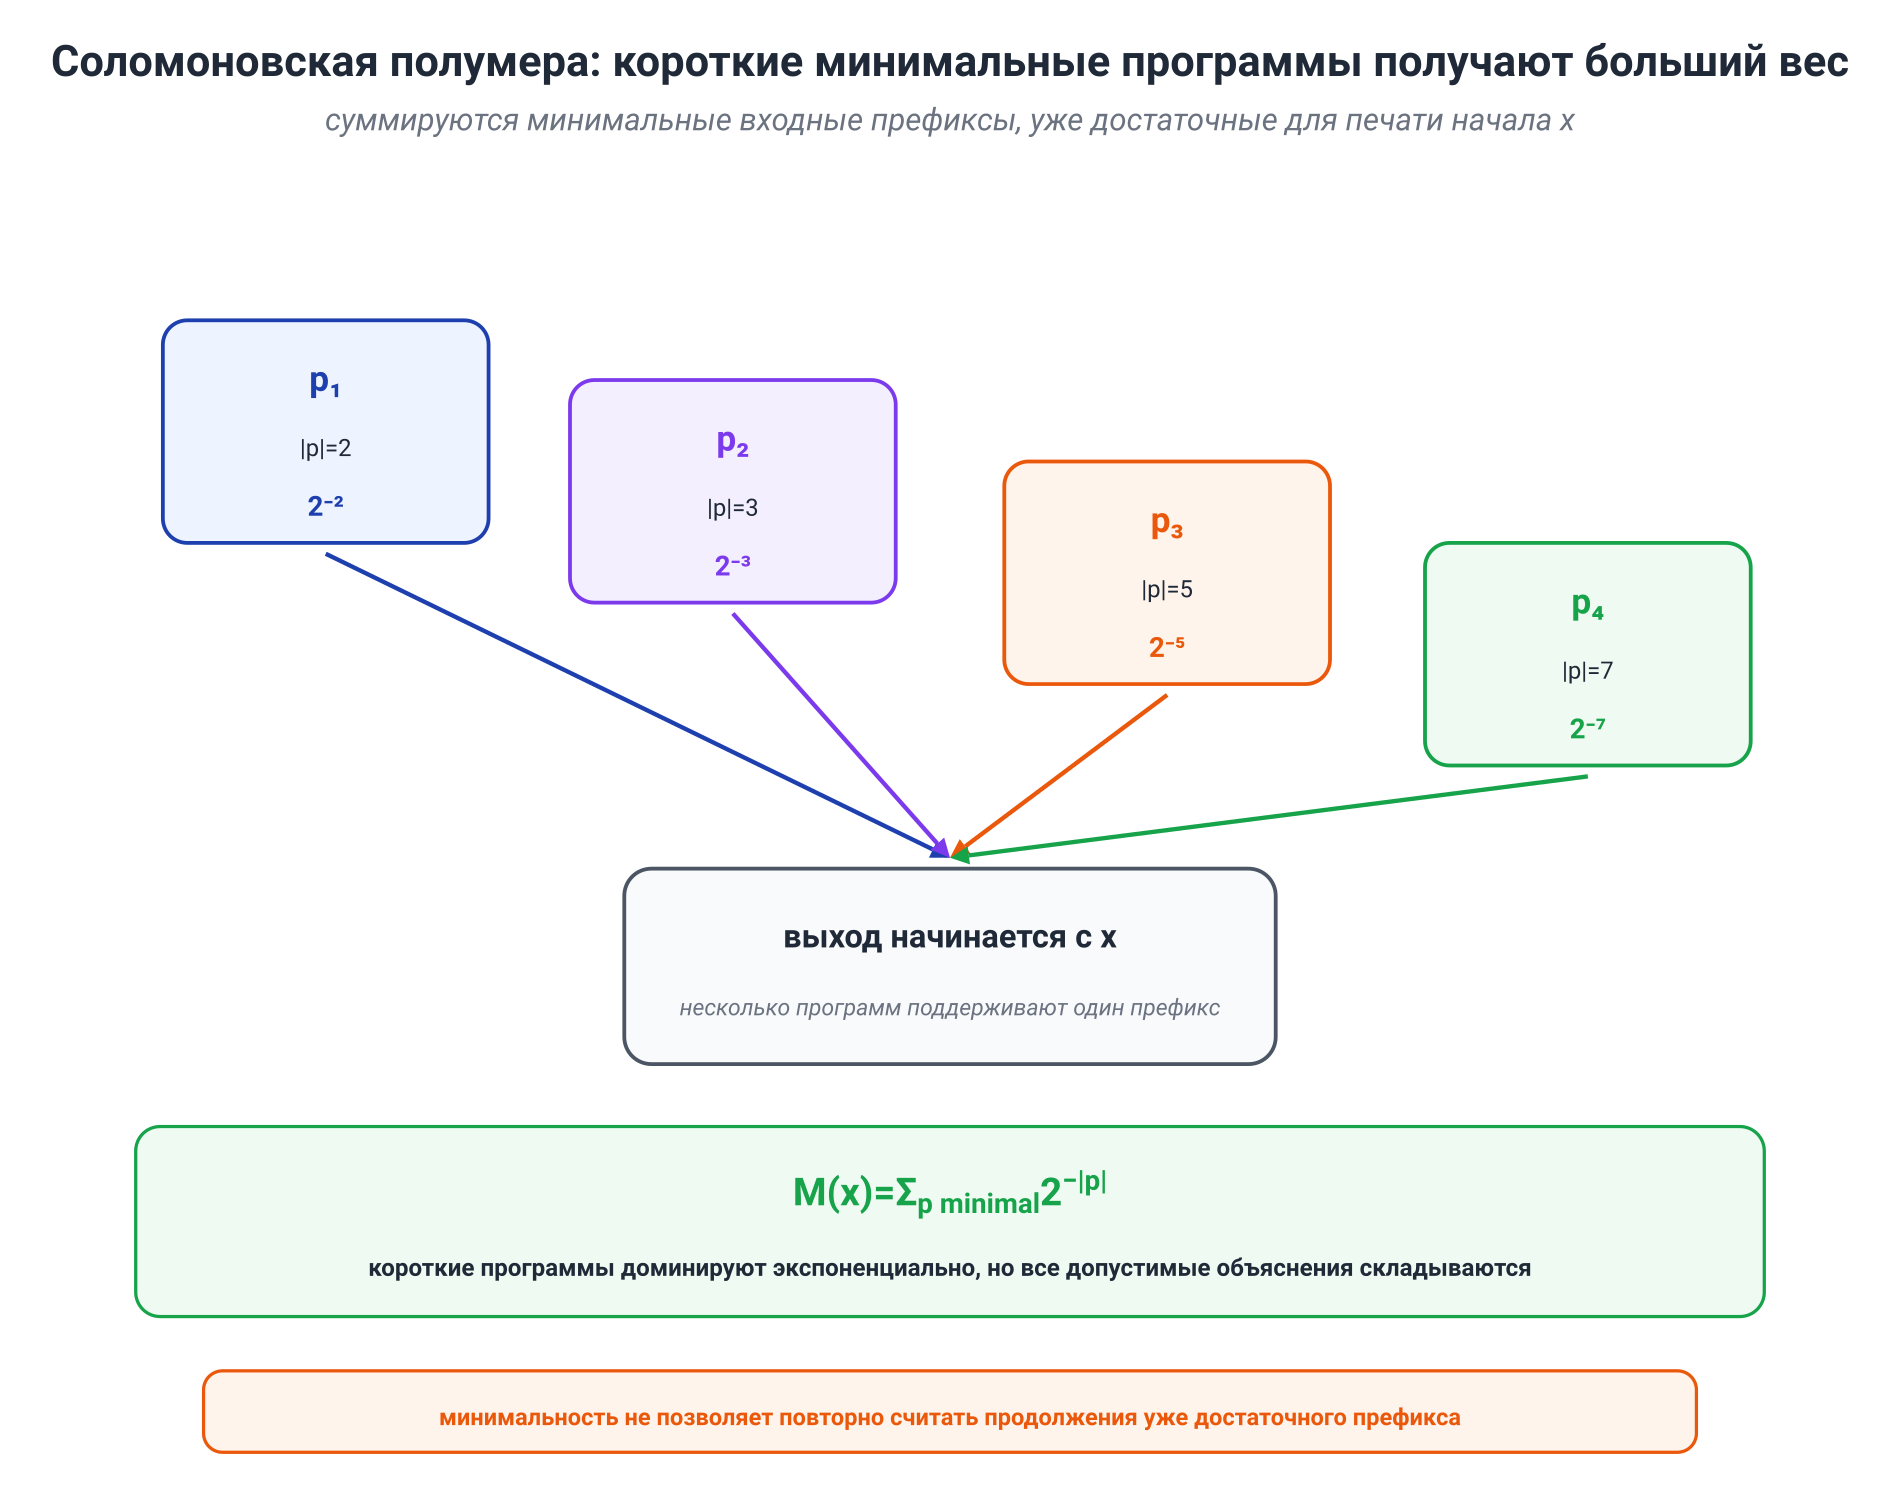
Это полумера (semimeasure): часть входной массы может соответствовать программам, которые остановились после или никогда не выдали следующий символ, поэтому
Отношения задают условные веса продолжений; при необходимости их нормируют, чтобы получить обычное распределение следующего символа.
Здесь есть техническое различие, которое полезно один раз назвать явно. Конечная алгоритмическая вероятность связана с префиксной сложностью . Последовательная полумера естественно связана с монотонной машиной и монотонной сложностью. Популярная формула «вероятность порядка » передаёт общую идею, но строгие теоремы требуют не смешивать варианты машин.
Универсальное доминирование
Пусть — вычислимая вероятностная модель источника. Универсальная полумера включает программу, вычисляющую , поэтому существует константа, для которой
для каждого конечного префикса .
Возьмём минус логарифм:
Эту формулу удобно прочитать как счёт:
Универсальный предиктор платит за незнание вычислимого источника не линейно с длиной данных, а один раз — длиной описания источника, с точностью до константы.
Для последовательности условных предсказаний отношение правдоподобий раскладывается по времени. В ожидаемой форме суммарный условный KL-разрыв между истинным предиктором и нормированной версией универсального предиктора ограничен величиной порядка бит. Поэтому для любого фиксированного вычислимого источника средняя избыточная логарифмическая потеря на шаг стремится к нулю.
Это одна из самых сильных идей модуля. Бритва Оккама и байесовское усреднение оказываются одной конструкцией: короткие вычислимые объяснения начинают с большим весом, а наблюдения перераспределяют массу между ними.
Почему это не практический алгоритм
Чтобы точно вычислить , пришлось бы узнать, какие программы когда-нибудь напечатают нужный префикс. Это снова приводит к проблеме остановки. Универсальная полумера нижнеполувычислима, но невычислима как обычная функция.
Кроме того, априорные веса зависят от выбранной универсальной машины. Теорема инвариантности контролирует эту зависимость аддитивной константой в сложности, но для коротких данных и решений, чувствительных к априорному распределению, константа может быть существенной.
Индукция Соломонова — не архитектура, которую можно просто реализовать. Это нормативный предел: как выглядело бы последовательное предсказание, если бы можно было байесовски усреднить все вычислимые объяснения с алгоритмическим приоритетом простых программ.
10.6. MDL в машинном обучении
Невычислимость не отменяет идею короткого описания. Она меняет инженерную задачу: вместо неизвестного идеального языка мы проектируем конкретный код и сравниваем модели внутри него.
Принцип минимальной длины описания (Minimum Description Length, MDL) формулируется так:
Предпочитайте модель, которая даёт самое короткое полное описание данных.
Двухчастный код: модель и остаток
Для гипотезы и набора данных простейший счёт имеет вид
Первый член оплачивает модель. Второй — то, что остаётся передать после её получения.
Пусть модель стоит бит и кодирует данные за бит. Модель стоит бит, но уменьшает длину данных до бит. По одной функции потерь выигрывает на бит; после оплаты модели её общий счёт всё равно меньше:
Если вероятностная модель задаёт и используется согласованный энтропийный кодер, то
MDL делает компромисс между подгонкой и сложностью не метафорой, а бухгалтерией в одной единице.
Как код связан с априорным распределением и регуляризацией
Для дискретного класса моделей априорное распределение задаёт префиксные длины
Тогда минимизация
совпадает с MAP-выбором модели с точностью до основания логарифма.
Для непрерывных параметров нужна дополнительная работа. Плотность априорного распределения зависит от координат и базовой меры, а точное вещественное число невозможно передать конечным кодом. Поэтому приходится фиксировать точность параметров, использовать интегрированный одночастный код или другую универсальную конструкцию.
Отсюда следует аккуратное чтение регуляризации. Гауссовское априорное распределение в фиксированной евклидовой параметризации приводит к квадратичному MAP-штрафу. Это полезная связь, но не доказательство того, что любой weight decay является канонической длиной описания нейросети. Код должен быть определён, а не подразумеваться.
Предиктивно-последовательный код
Иногда модель не передают отдельным файлом. Отправитель и получатель заранее договариваются об одном алгоритме обучения и кодируют данные по блокам.
- Первые метки отправляются простым базовым кодом.
- Обе стороны обучают модель на уже переданных примерах.
- Следующий блок кодируется вероятностями этой модели.
- После его получения модель переобучается, и процесс повторяется.
Полная длина равна сумме последовательных логарифмических потерь:
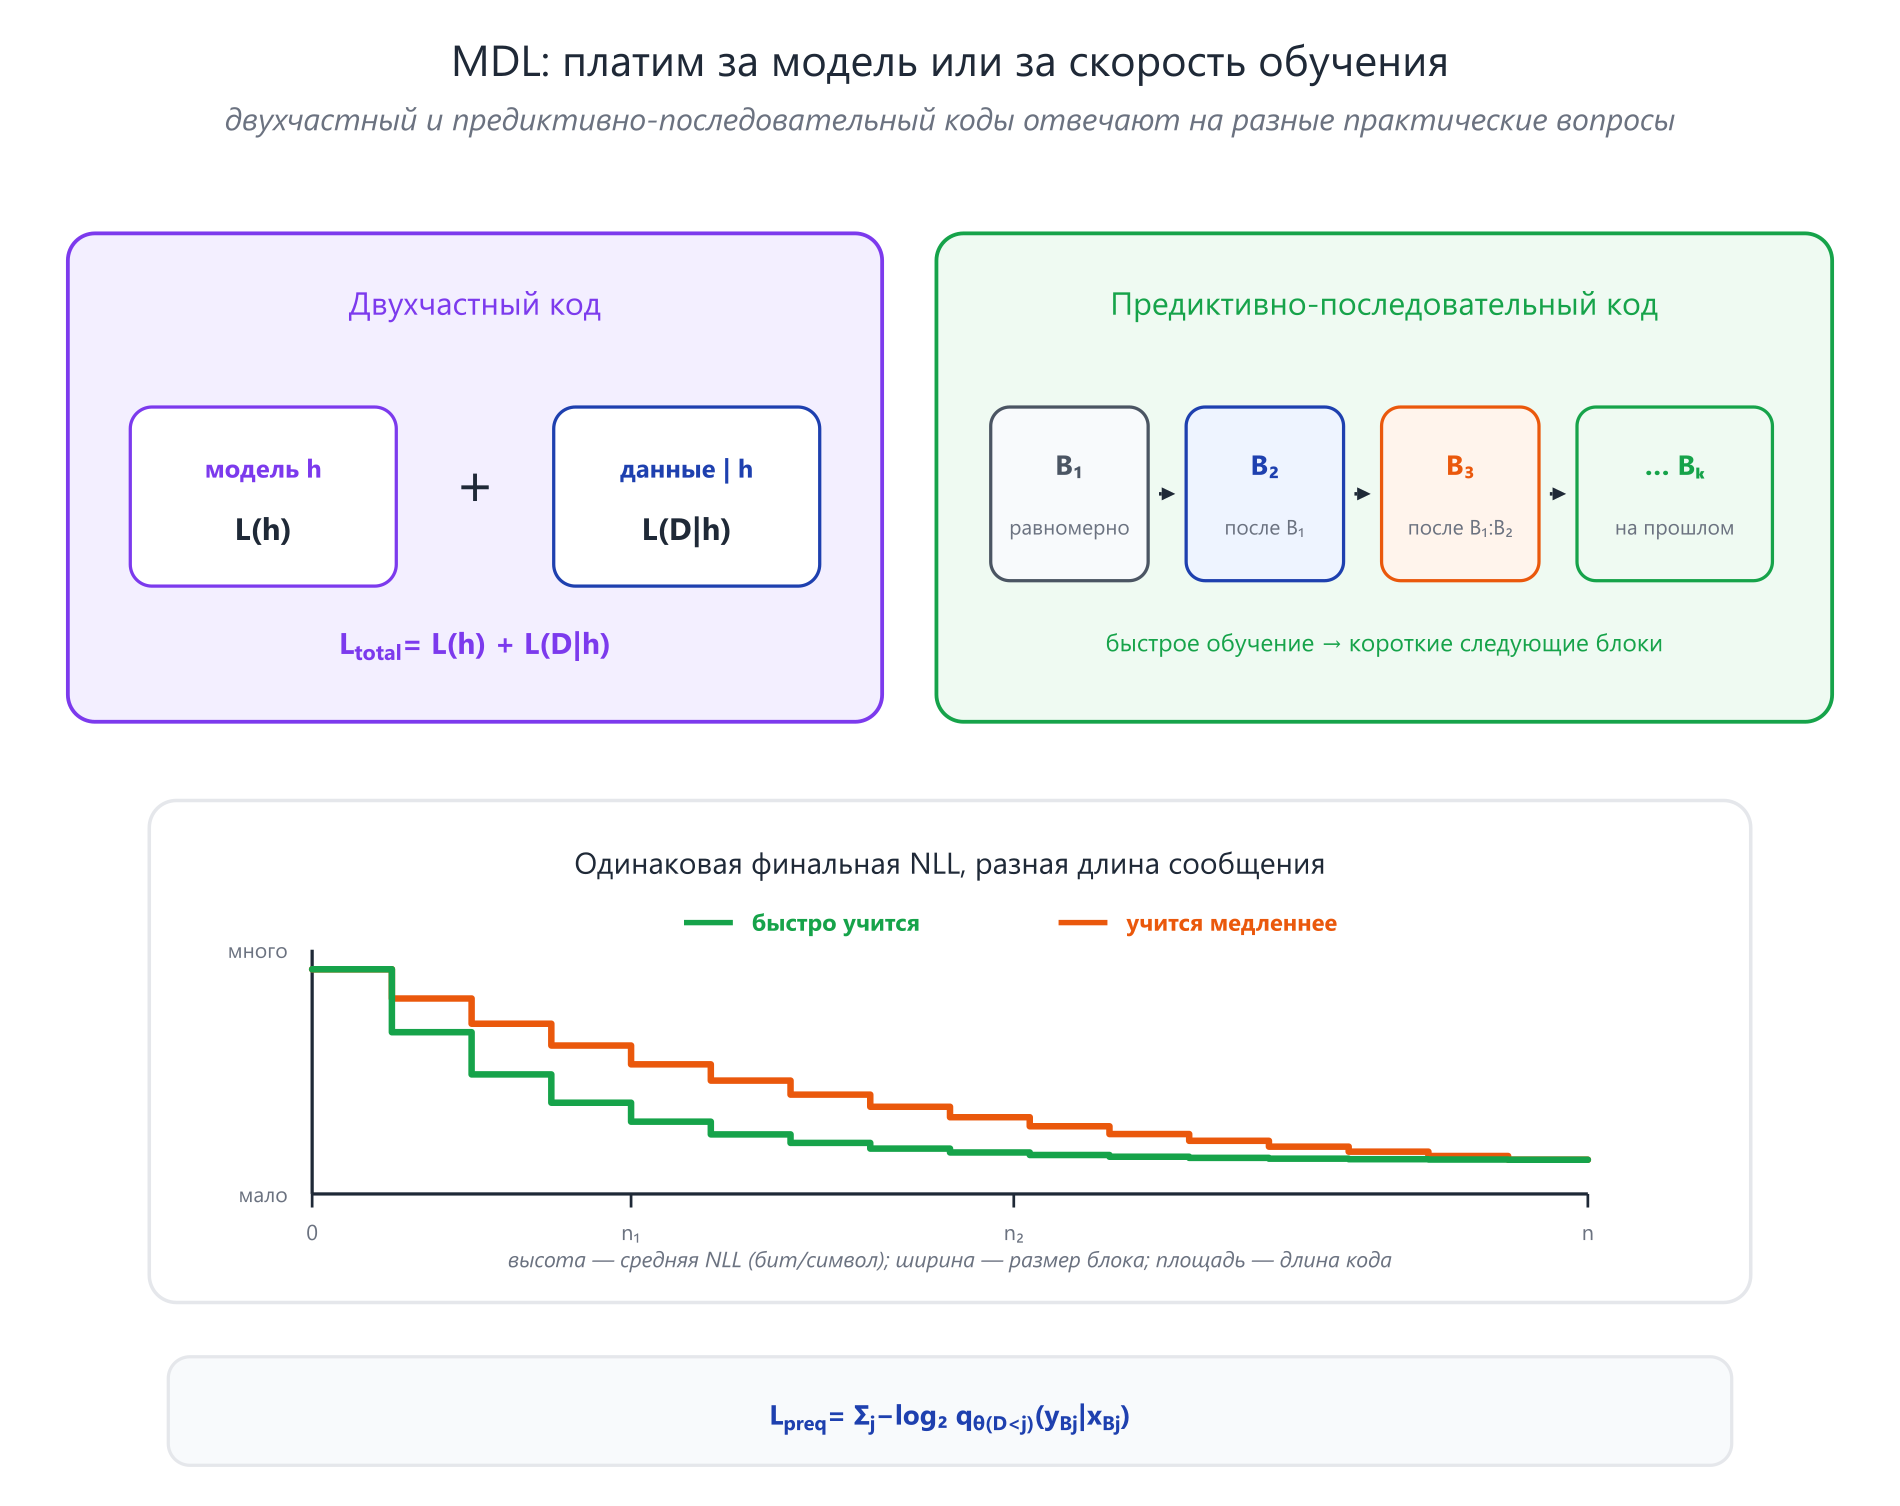
Этот код оценивает не только конечное качество, но и скорость обучения. Два представления могут позволить одному и тому же классификатору достичь одинаковой итоговой точности. Однако если для первого достаточно сотни примеров, а для второго нужны тысячи, первое даст более короткий последовательный код.
Именно так работает MDL-анализ представлений (MDL probing). Вопрос «можно ли извлечь свойство мощным классификатором?» заменяется вопросом «сколько бит нужно, чтобы передать метки, используя это представление и заранее зафиксированный протокол обучения?». Работа Voita и Titov рассматривает онлайн- и вариационные коды как практические способы оценить этот счёт.
Что означает результат MDL
MDL не устраняет моделирующие решения; оно заставляет их записать. Сравнение зависит от:
- способа кодировать класс моделей;
- точности параметров;
- алгоритма обучения;
- порядка данных и разбиения на блоки в последовательном коде;
- включённых служебных расходов.
Это не делает результат произвольным. Если код и протокол зафиксированы до сравнения, длина сообщения является точной воспроизводимой величиной для этой постановки. Правильный вывод звучит не «модель объективно проще вообще», а «в указанном коде она даёт более короткое полное описание данных».
10.7. Сходство через совместное сжатие
Если и разделяют структуру, знание одного должно сокращать описание другого. Условная сложность превращает эту мысль в расстояние.
Теоретическое нормализованное информационное расстояние (normalized information distance, NID) имеет вид
с точностью до стандартных малых поправок в условных описаниях и нормировке. Оно мало, когда каждый объект можно коротко восстановить из другого, и близко к единице для объектов без существенной общей алгоритмической структуры.
Поскольку невычислима, на практике используют длины конкретного компрессора :
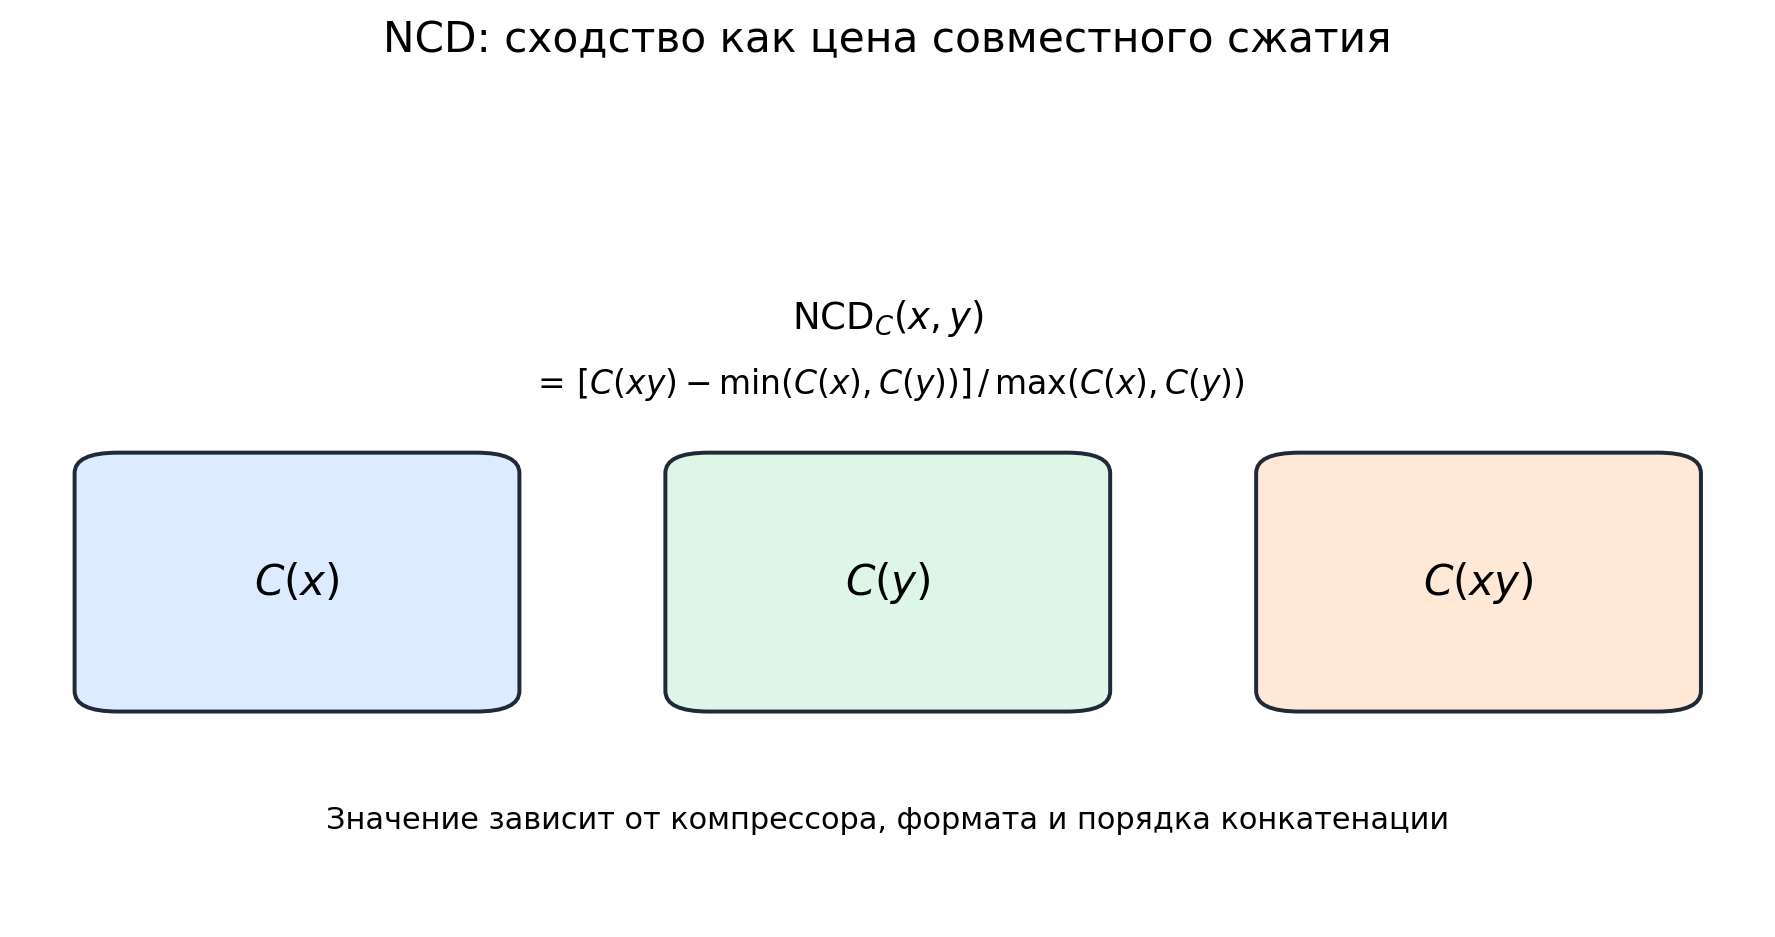
Например, если
байт, то
Идея понятна: после оплаты более короткого объекта совместное сообщение требует ещё сравнительно небольшого дополнения.
Реальный компрессор может быть чувствителен к порядку конкатенации, поэтому часто сравнивают и и берут минимум или среднее. Из-за заголовков и несовершенства компрессора практическая NCD может немного выходить за идеальный диапазон .
Что именно видит NCD
NCD не требует вручную заданного пространства признаков. Если компрессор замечает общий словарь, повторяющиеся фрагменты, похожий синтаксис или другую совместную регулярность, совместный код сокращается. Этот принцип применяли к текстам, геномам, музыке и другим последовательностям.
Но практическая метрика наследует индуктивное смещение компрессора:
- текстовый словарный кодер и кодек изображений видят разные закономерности;
- маленькие файлы чувствительны к заголовкам;
- формат и предобработка меняют результат;
- порядок конкатенации может создавать асимметрию;
- вычислимая NCD не наследует автоматически все универсальные свойства невычислимой NID.
Поэтому NCD полезна как базовая линия, не требующая ручных признаков, и как исследовательский инструмент, но её всё равно нужно проверять на отложенной задаче и сравнивать с содержательными альтернативами.
10.8. LLM и универсальное предсказание
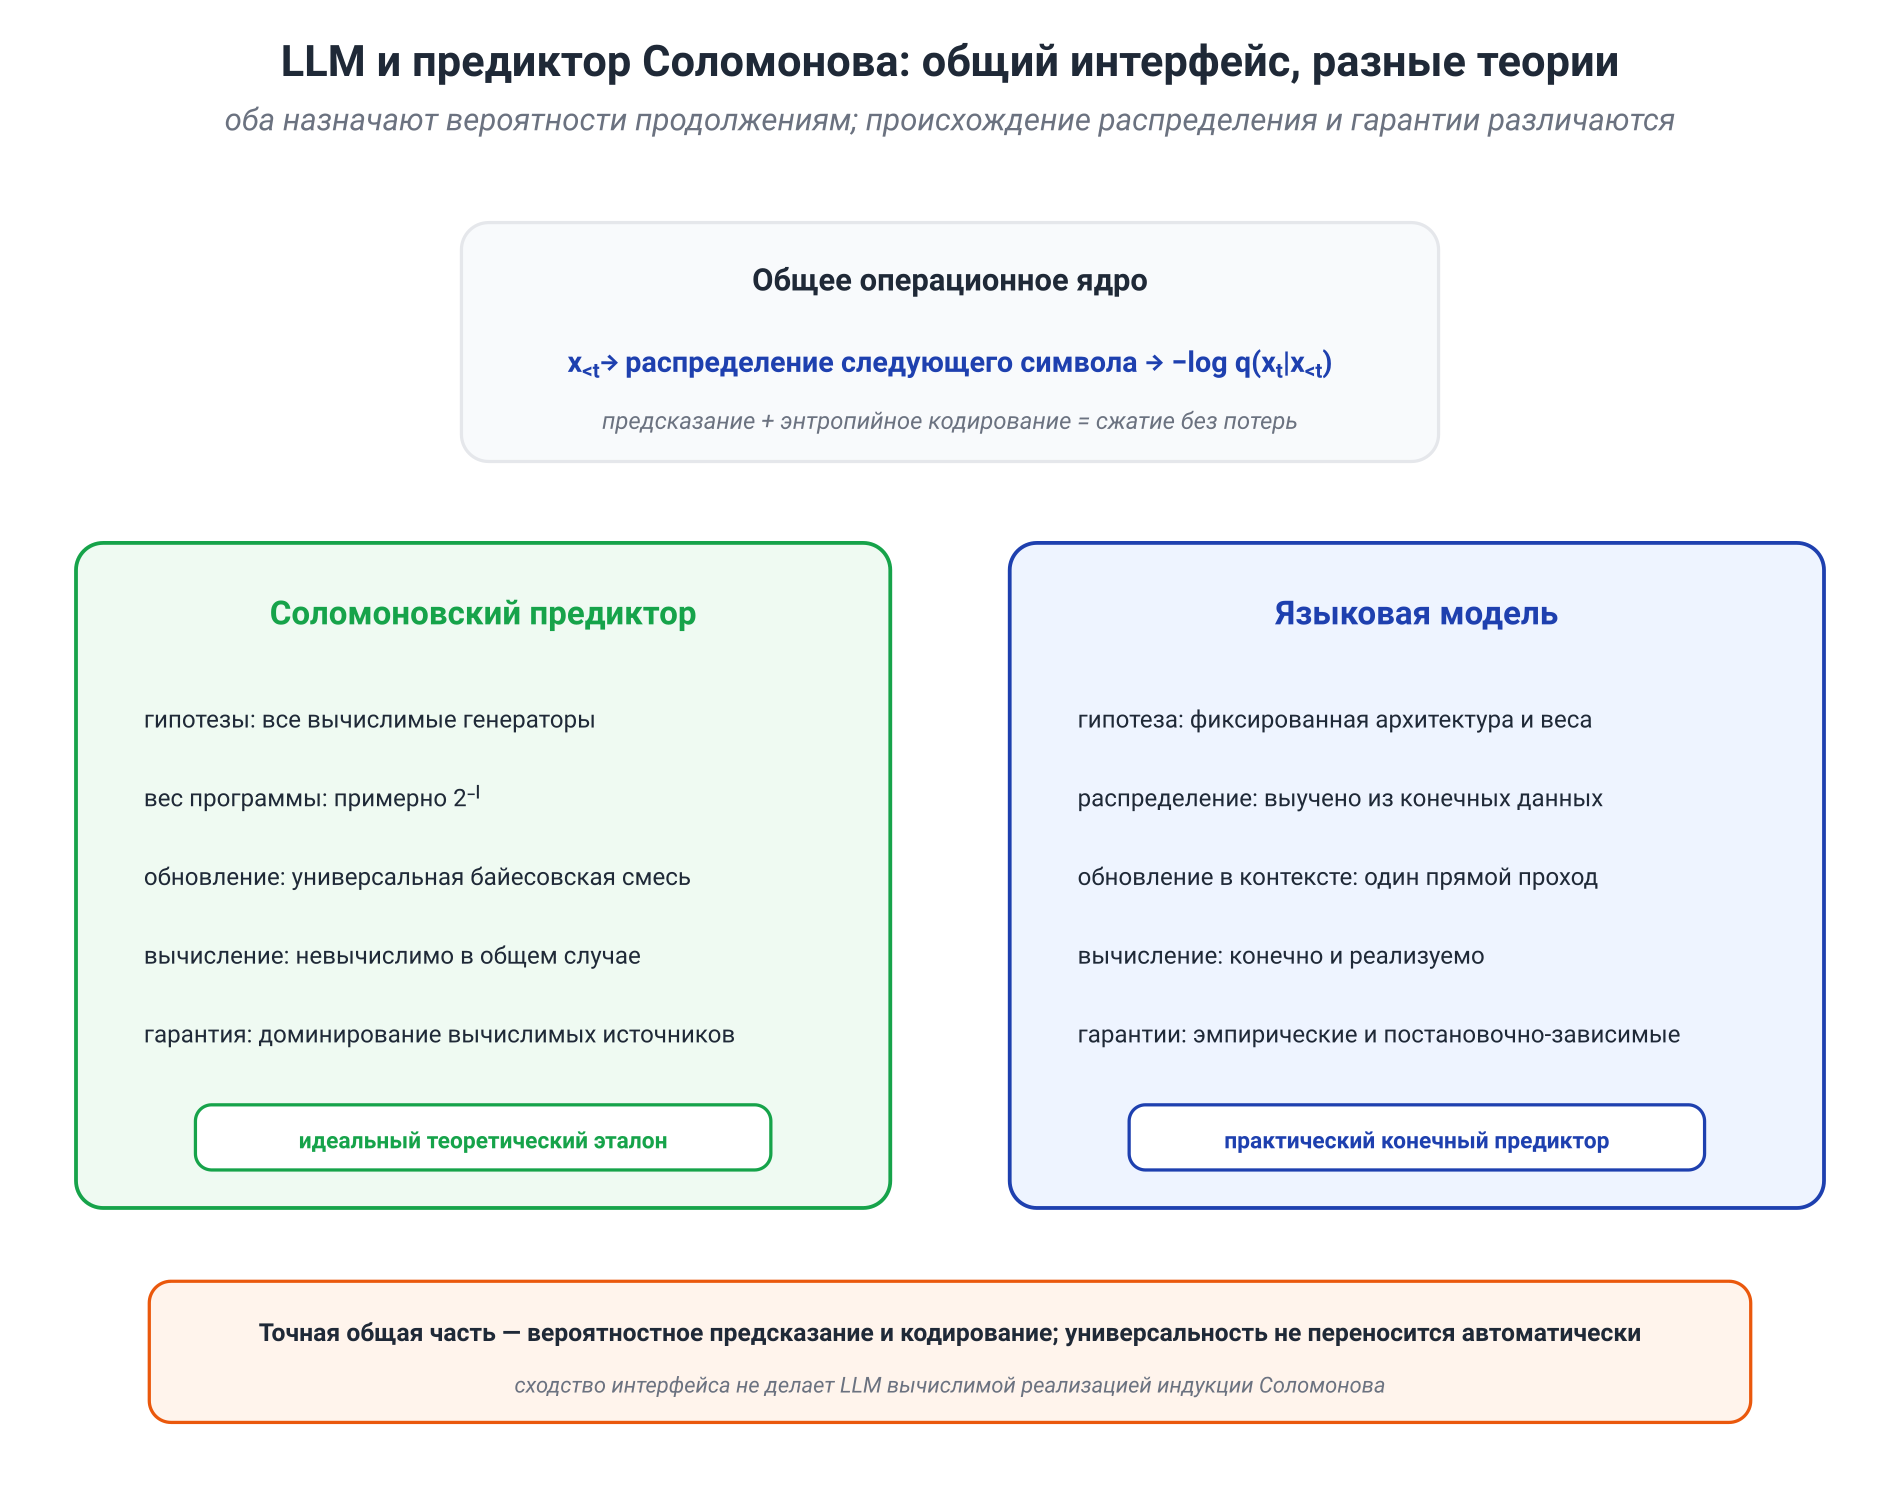
LLM и предиктор Соломонова принадлежат одной карте: оба назначают вероятности продолжениям последовательности. Но они находятся на этой карте в очень разных точках.
Точная общая часть
Для фиксированных весов, токенизатора и контекста языковая модель задаёт вычислимое распределение
Если передать эти вероятности арифметическому или интервальному кодеру (range coder), получится обратимый компрессор. Поэтому
— точное операциональное утверждение. Работа Language Modeling Is Compression показывает, что большие предиктивные модели действительно можно оценивать как компрессоры разных типов данных; для самостоятельного архива, как мы обсуждали в M6, нужно дополнительно учитывать стоимость модели и протокола.
Концептуальная связь
Индукция Соломонова усредняет все вычислимые объяснения, взвешивая их по длине программы. LLM реализует одно большое конечное распределение, обученное на конечных данных конкретным алгоритмом оптимизации.
Тем не менее в её весах могут быть представлены многие регулярности, а контекст способен выбирать между ними без обновления параметров. В специальных генеративных постановках обучение в контексте действительно можно вывести как неявный байесовский вывод по скрытой задаче. Например, Xie и соавторы доказывают такой механизм для структурированной смеси скрытых марковских моделей.
Это даёт полезную интерпретацию: контекст играет роль данных, а модельное предсказание — роль приближённого апостериорного предиктивного распределения (posterior predictive). Но область теоремы определяется устройством предобучающего распределения и класса задач.
Где заканчивается соответствие
Обычная LLM:
- имеет конечную архитектуру и конечное число параметров;
- обучена на конечном наборе данных;
- использует конкретный токенизатор и ограниченный контекст;
- не суммирует все вычислимые полумеры;
- не обладает универсальной гарантией доминирования;
- может быть плохо откалибрована и уверенно ошибаться вне обучающего распределения.
Поэтому наиболее точная формулировка такова:
LLM — вычислимый последовательный предиктор и потенциальный компрессор. Индукция Соломонова — невычислимый универсальный эталон, относительно которого можно обсуждать широту априорного распределения и адаптацию, но которому конкретная LLM не эквивалентна.
Эта граница не обесценивает сравнение. Она делает его полезным: мы видим точное общее ядро — вероятностное предсказание и кодирование — и отдельно перечисляем свойства, которых конечная обученная модель не получает автоматически.
Хорошее сжатие выбранного представления данных свидетельствует о хорошем вероятностном моделировании этого представления. Оно не является само по себе сертификатом понимания, фактической истинности или причинной модели мира.
10.9. Математическое углубление: AIXI
Предсказатель отвечает на вопрос «что произойдёт дальше?». Агенту нужно дополнительно решить, что сделать.
AIXI соединяет два компонента:
- универсальную байесовскую смесь по нижнеполувычислимым хронологическим полумерам среды; вычислимые среды входят в этот класс;
- последовательное планирование, максимизирующее ожидаемую награду.
Схематически, после истории агент выбирает
где — универсальная смесь сред, а задают горизонт или дисконтирование.
Что даёт эта конструкция
AIXI разделяет три вопроса, которые в практическом агенте легко смешать:
- какие миры считаются возможными;
- как обновляются предсказания после наблюдений;
- как предсказания превращаются в действия через функцию награды.
Поэтому AIXI полезна как нормативная схема универсального байесовского RL. Она показывает, как алгоритмическая вероятность могла бы войти не только в прогноз, но и в принятие решений.
Почему это не верхняя граница интеллекта
AIXI невычислима. Более того, её поведение зависит от выбранной универсальной машины, класса сред, системы вознаграждения и горизонта. Для AIXI нет теоремы инвариантности, которая делала бы все разумные универсальные априорные распределения практически эквивалентными.
Некоторые классические свойства оптимальности также слабее, чем звучат вне контекста. В классе всех вычислимых сред каждая политика может оказаться Pareto-optimal в слишком широком смысле; самооптимизация возможна лишь для классов сред, допускающих самооптимизирующиеся политики. Leike и Hutter показывают, что неудачный выбор универсальной машины способен радикально изменить поведение агента.
Поэтому AIXI разумно читать как идеализированную математическую декомпозицию универсального агента, а не как практический алгоритм или машинно-независимый максимум возможного интеллекта.
10.10. Факультативный физический мост: принцип Ландауэра
Алгоритмическая длина описания и физическая энергия вычисления — разные величины. Связь с термодинамикой появляется через логически необратимые операции.
Рассмотрим симметричную однобитную память, которая до стирания с равными вероятностями находится в состояниях и . Операция erase переводит оба состояния в один стандартный ноль:
По выходу невозможно восстановить вход: операция логически необратима. В изотермическом квазистатическом пределе при температуре минимальное среднее тепло, передаваемое среде при таком стирании, равно
При :
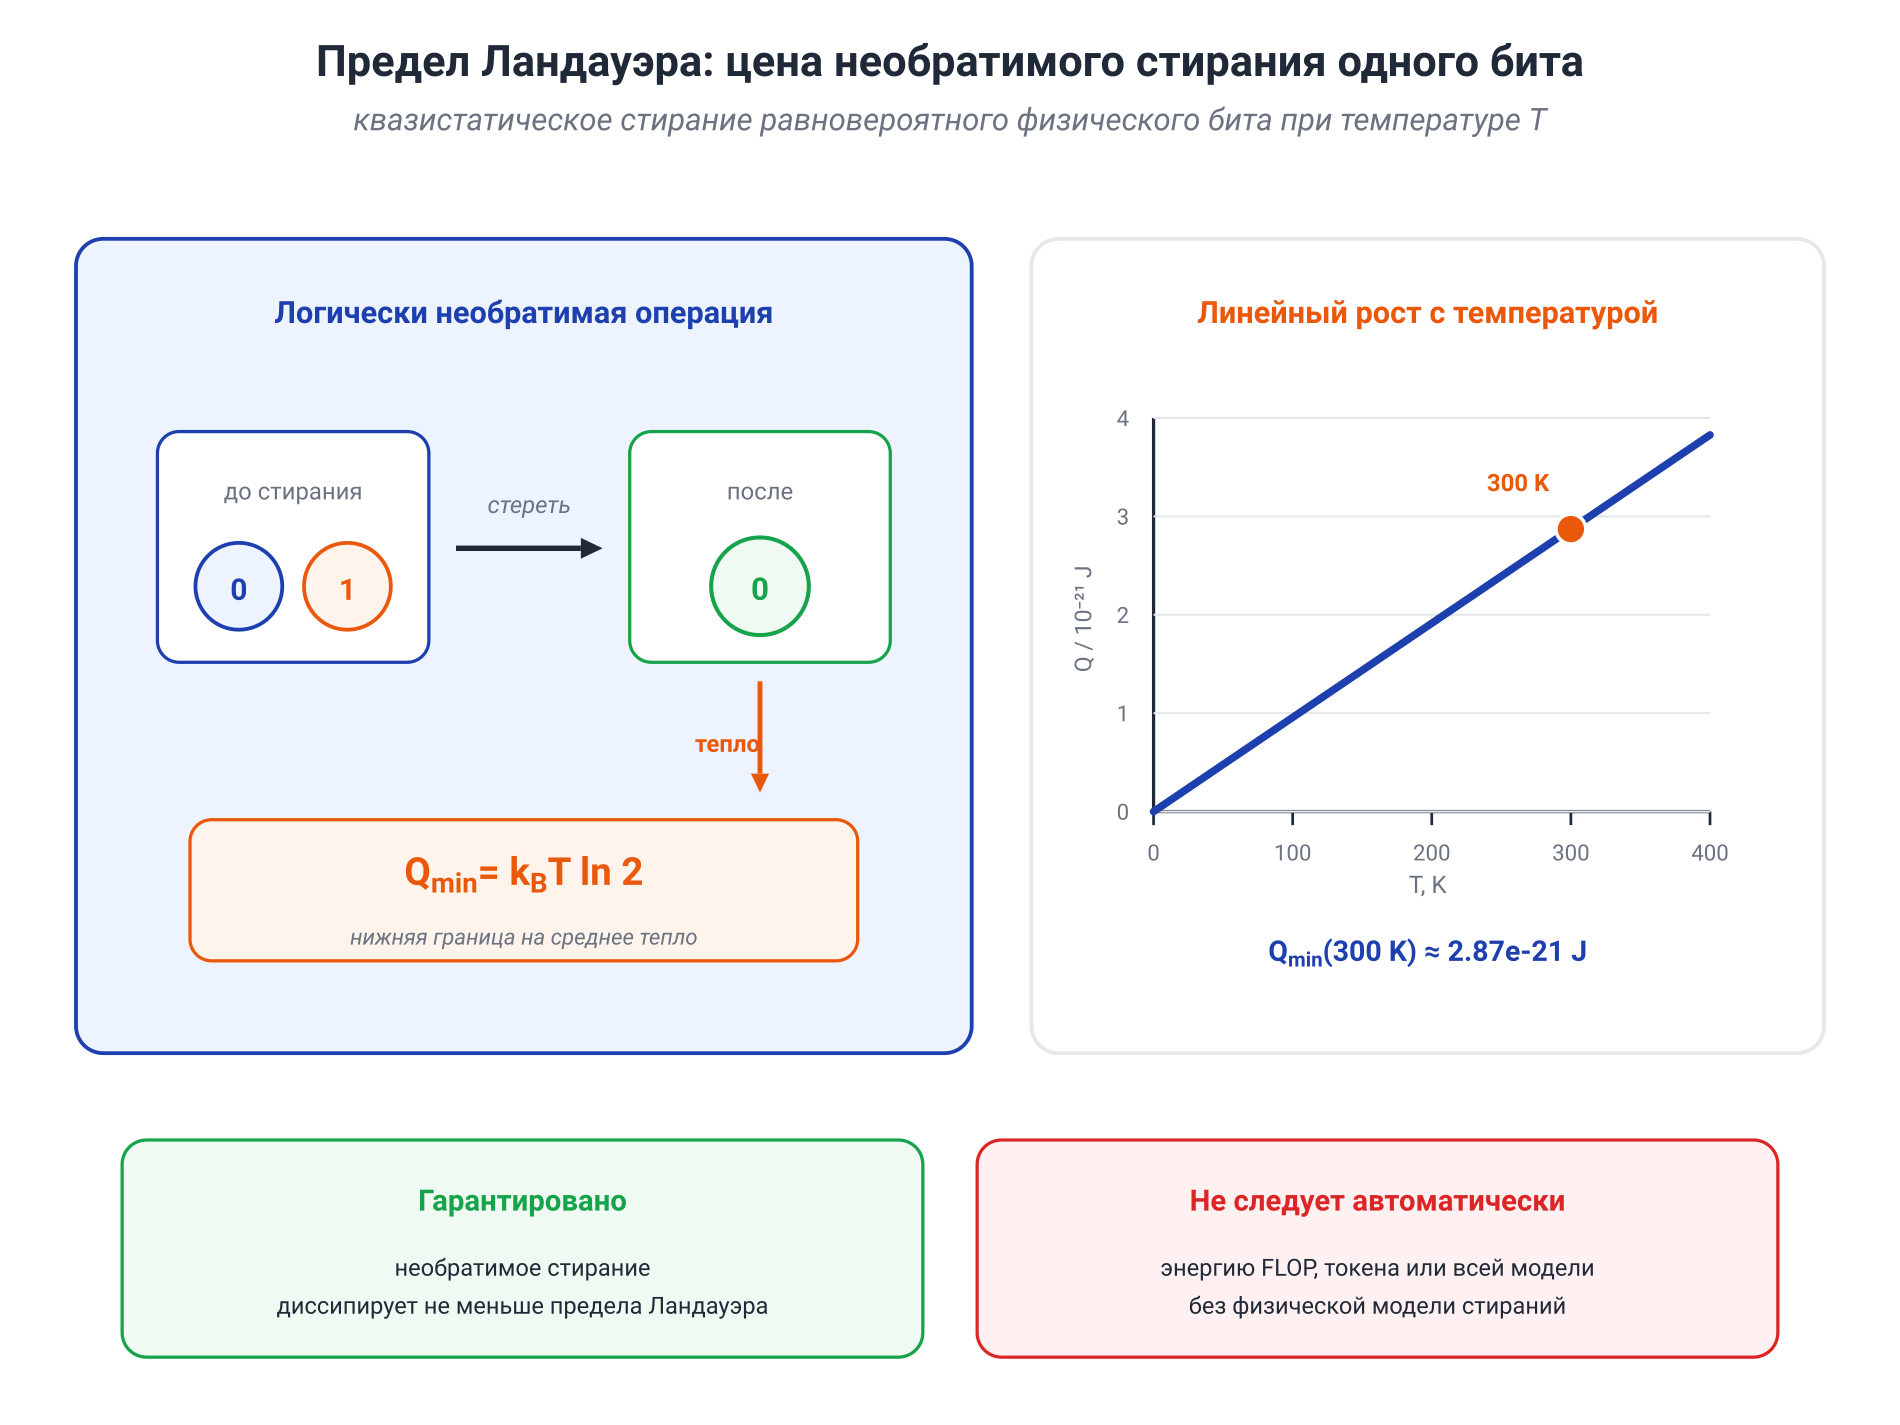
Ландауэр связал этот предел именно с логической необратимостью вычислительной операции. Эксперимент Bérut и соавторов реализовал однобитную память на коллоидной частице и показал приближение среднего тепловыделения к пределу при медленном стирании.
Эту формулу легко применить слишком прямолинейно. Нельзя оценить энергию одного токена LLM, просто умножив на число FLOP. Для такого перехода пришлось бы определить:
- какие физические состояния кодируют логические биты;
- где именно информация необратимо стирается;
- сколько энергии уходит на память и передачу данных;
- каковы утечки, тактирование и управление;
- насколько устройство далеко от обратимого квазистатического режима.
Логически обратимые вычисления в принципе не требуют платы Ландауэра за каждый логический шаг. Реальная система конечной скорости всё равно платит за шум, управление, связь и несовершенство устройства.
Полезно держать четыре разных счёта отдельно:
- — длина кратчайшей программы;
- вычислительная сложность — время и память алгоритма;
- предел Ландауэра — минимальная термодинамическая цена определённого стирания;
- энергопотребление ускорителя — свойство конкретной аппаратуры и нагрузки.
10.12. Ключевые выводы модуля
Алгоритмическая теория информации меняет исходный вопрос. Вместо «сколько бит в среднем требует источник?» она спрашивает:
Какова длина кратчайшего эффективного описания этого объекта?
Основной объект модуля — префиксная колмогоровская сложность
Из неё складывается единая линия.
- Большинство длинных строк несжимаемо. Коротких программ просто недостаточно, чтобы описать заметную долю всех строк.
- Идеальная сложность невычислима. Реальные компрессоры дают исполнимые верхние границы и отражают собственный класс закономерностей.
- Шеннон и Колмогоров согласуются в среднем. Для вычислимого источника ожидаемая равна энтропийному счёту с добавочной стоимостью описания источника.
- Алгоритмическая вероятность превращает краткость в априорный вес. Универсальная смесь один раз оплачивает описание вычислимого источника и затем конкурирует с ним по последовательной логарифмической потере.
- MDL делает идею практической. Код «модель + данные при модели» позволяет сравнивать подгонку, сложность и скорость обучения в битах.
- Совместное сжатие даёт меру сходства. NCD полезна тогда, когда выбранный компрессор видит общую структуру объектов.
- LLM находится на той же карте предсказания и сжатия, но не является индукцией Соломонова. Точное общее ядро — условные вероятности и энтропийное кодирование; универсальные гарантии не переносятся автоматически.
Самая важная инженерная привычка этого модуля:
Когда объект называют «простым» или «сложным», уточняйте язык описания, декодер, точность, вычислительные ресурсы и включённые расходы.
Основные источники
- A. N. Kolmogorov, «Three Approaches to the Quantitative Definition of Information», 1965.
- R. J. Solomonoff, «A Formal Theory of Inductive Inference, Part I» и Part II, 1964.
- M. Li, P. Vitányi, «An Introduction to Kolmogorov Complexity and Its Applications», 4-е изд., 2019.
- J. Rissanen, «Modeling by Shortest Data Description», 1978; P. Grünwald, «The Minimum Description Length Principle», 2007.
- E. Voita, I. Titov, «Information-Theoretic Probing with Minimum Description Length», 2020.
- R. Cilibrasi, P. Vitányi, «Clustering by Compression», 2003/2005.
- M. Hutter, «Universal Artificial Intelligence: Sequential Decisions Based on Algorithmic Probability», 2005.
- J. Leike, M. Hutter, «Bad Universal Priors and Notions of Optimality», 2015; «On the Computability of AIXI», 2015/2018.
- G. Delétang et al., «Language Modeling Is Compression», 2023/2024.
- S. M. Xie et al., «An Explanation of In-context Learning as Implicit Bayesian Inference», 2021/2022.
- R. Landauer, «Irreversibility and Heat Generation in the Computing Process», 1961; A. Bérut et al., «Experimental Verification of Landauer's Principle Linking Information and Thermodynamics», 2012.