Модуль 13. Рассуждение в LLM: вычисление, поиск и информация
Как читать этот модуль. Это итоговый модуль курса. Основной маршрут — §§13.1–13.10: что именно меняется, когда модель получает больше вычислений во время ответа; почему промежуточные шаги могут помогать без появления новых данных; как распределить бюджет между одной длинной траекторией, несколькими кандидатами и проверкой; где контекст и инструменты действительно приносят новую информацию; и как оценивать такую систему без смешения качества и стоимости. §13.11 — математическое углубление о пошаговом информационном приросте и последовательной выразительности. Его можно оставить на второй проход.
13.1. Что меняется, когда модель «думает дольше»
Представим одну и ту же модель и один и тот же запрос. В первом режиме модель сразу выдаёт короткий ответ. Во втором — сначала пишет несколько десятков промежуточных шагов. В третьем — строит несколько решений, запускает код, получает результаты тестов и выбирает лучший вариант.
Веса модели не изменились. Исходный запрос тоже. Но качество вполне может оказаться разным. Что именно было куплено дополнительными вычислениями?
Слово reasoning часто используют как общее название всего сразу: многошаговой задачи, видимой цепочки мыслей, поиска, работы с инструментами и просто хорошего ответа. Для инженерного разговора этого недостаточно. В этом модуле будем различать пять объектов.
- Последовательное вычисление. Ответ требует нескольких зависимых операций: арифметики, построения доказательства, отладки программы или планирования.
- Промежуточное состояние. Модель хранит частичные результаты в видимой цепочке рассуждения (
chain of thought, CoT), скрытом рабочем черновике (scratchpad) или внутреннем состоянии. - Поиск. Система рассматривает несколько кандидатов, ветвится, возвращается назад или перераспределяет вычислительный бюджет.
- Внешнее наблюдение. Система получает результат поиска, исполнения кода, теста, измерения или действия в среде.
- Качество результата. Улучшается заранее выбранная метрика: доля правильных ответов,
pass@k, логарифмическая потеря, устойчивость или стоимость решения.
Эти объекты связаны, но не тождественны. Длинная цепочка может быть ошибочной. Правильный ответ не доказывает, что видимый текст был причинным механизмом решения. Поиск может улучшить результат без единой красивой траектории. Калькулятор способен резко повысить точность, хотя не приносит нового факта о мире. А поисковая система, напротив, действительно может дать сведения, которых в запросе не было.
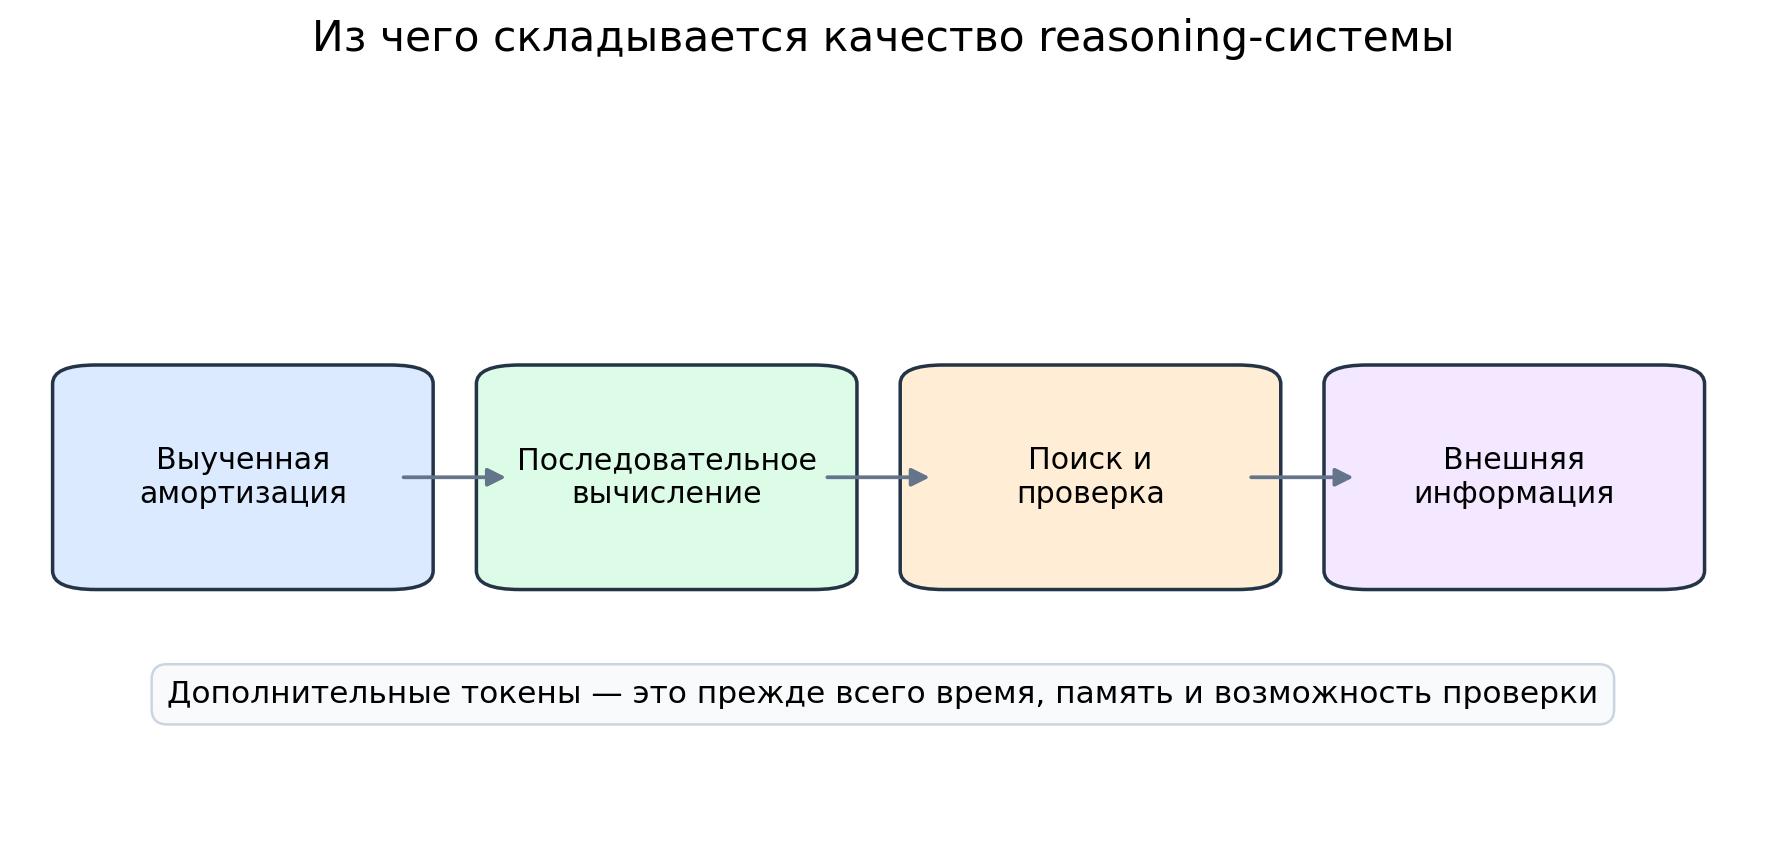
Исследования цепочек рассуждения показали, что пошаговые демонстрации могут заметно улучшать результаты больших языковых моделей на арифметических, символьных и некоторых задачах здравого смысла. Позднее вычислительный бюджет на конкретный запрос стал отдельным объектом оптимизации: модель может тратить больше токенов, строить несколько траекторий, обращаться к верификатору или к среде.
Главный вопрос модуля поэтому звучит так:
Что покупают дополнительные вычисления: новые сведения, более богатое вычисление над уже доступными сведениями или более широкий поиск среди возможных решений?
Ответ зависит от того, как устроена система. Начнём с трёх базовых режимов.
13.2. Амортизация, рабочий черновик и поиск
Предобучение можно понимать как амортизацию вычислений. Огромная стоимость обучения заранее упаковывает в параметры статистические закономерности, факты, эвристики и фрагменты алгоритмов. Во время ответа модель быстро применяет эту накопленную структуру к новому запросу.
Амортизированный ответ
В простейшем режиме модель получает запрос и сразу генерирует ответ:
Большая часть работы уже «оплачена» при обучении. Это быстро, но вычислительный бюджет конкретной задачи мал. Если нужная процедура не стала надёжной амортизированной эвристикой, модель может поспешить с локально правдоподобным, но неверным продолжением.
Последовательный рабочий черновик
Теперь модель сначала генерирует промежуточные токены
а затем ответ :
Каждый новый токен даёт ещё один последовательный шаг применения модели и место для записи промежуточного результата. Рабочий черновик поэтому может увеличивать эффективную вычислительную глубину системы, хотя параметры остаются прежними.
Здесь важно слово «может». Токен сам по себе не является полезной операцией. Модель способна записать верный частичный результат, повторить уже сказанное или увести вычисление в неверную ветвь. Дополнительный бюджет создаёт возможность для работы, но не гарантирует, что она будет использована хорошо.
Явный поиск и взаимодействие
В третьем режиме система рассматривает альтернативы и получает обратную связь. Например:
self-consistency: несколько траекторий и голосование по ответу;best-of-N: несколько кандидатов и выбор верификатором;- лучевой или древовидный поиск;
Tree of Thoughts: ветвление, оценка частичных состояний и возврат назад;- запуск интерпретатора, калькулятора или тестов;
- агентный цикл «действие → наблюдение → следующее действие».
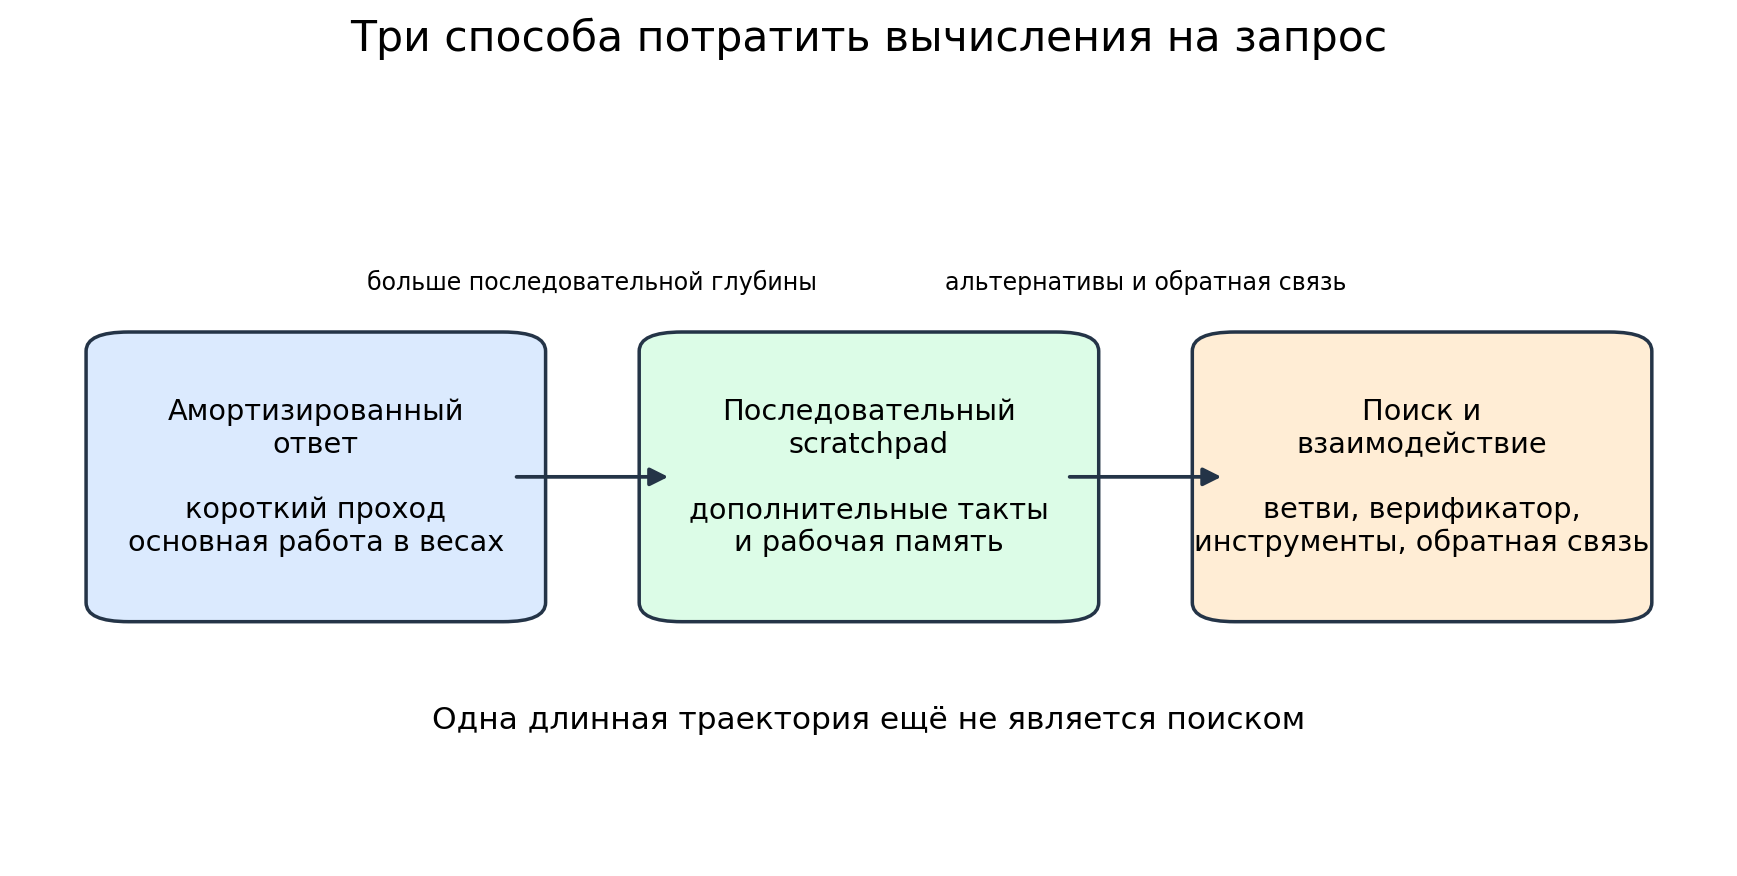
Одна длинная цепочка ещё не является поиском. Поиск начинается там, где система действительно сохраняет альтернативы, сравнивает их, может отказаться от раннего выбора или получить сигнал из среды.
Полезная граница между амортизацией и поиском
На одном конце находится модель, которая почти мгновенно выдаёт выученный ответ. На другом — система, которая заново исследует пространство решений для каждого запроса. Между ними много промежуточных режимов: короткий черновик, несколько выборок, локальная проверка, адаптивный бюджет.
Эта шкала полезнее буквальной аналогии с индукцией Соломонова. Универсальный предсказатель из Модуля 10 суммирует все вычислимые объяснения и обладает специальными теоретическими гарантиями. Обычная LLM не реализует такую сумму и этих гарантий не наследует. Но различие между заранее амортизированной эвристикой и вычислением для конкретной задачи остаётся содержательным.
13.3. Почему промежуточные токены могут помогать
Самое прямое объяснение — вычислительное. Авторегрессивная генерация позволяет многократно применять один и тот же блок модели, каждый раз передавая вперёд расширенное состояние.
Рассмотрим чётность битов:
Линейный классификатор по исходному вектору не решает эту задачу. Но достаточно одного бита рабочей памяти:
После шагов:
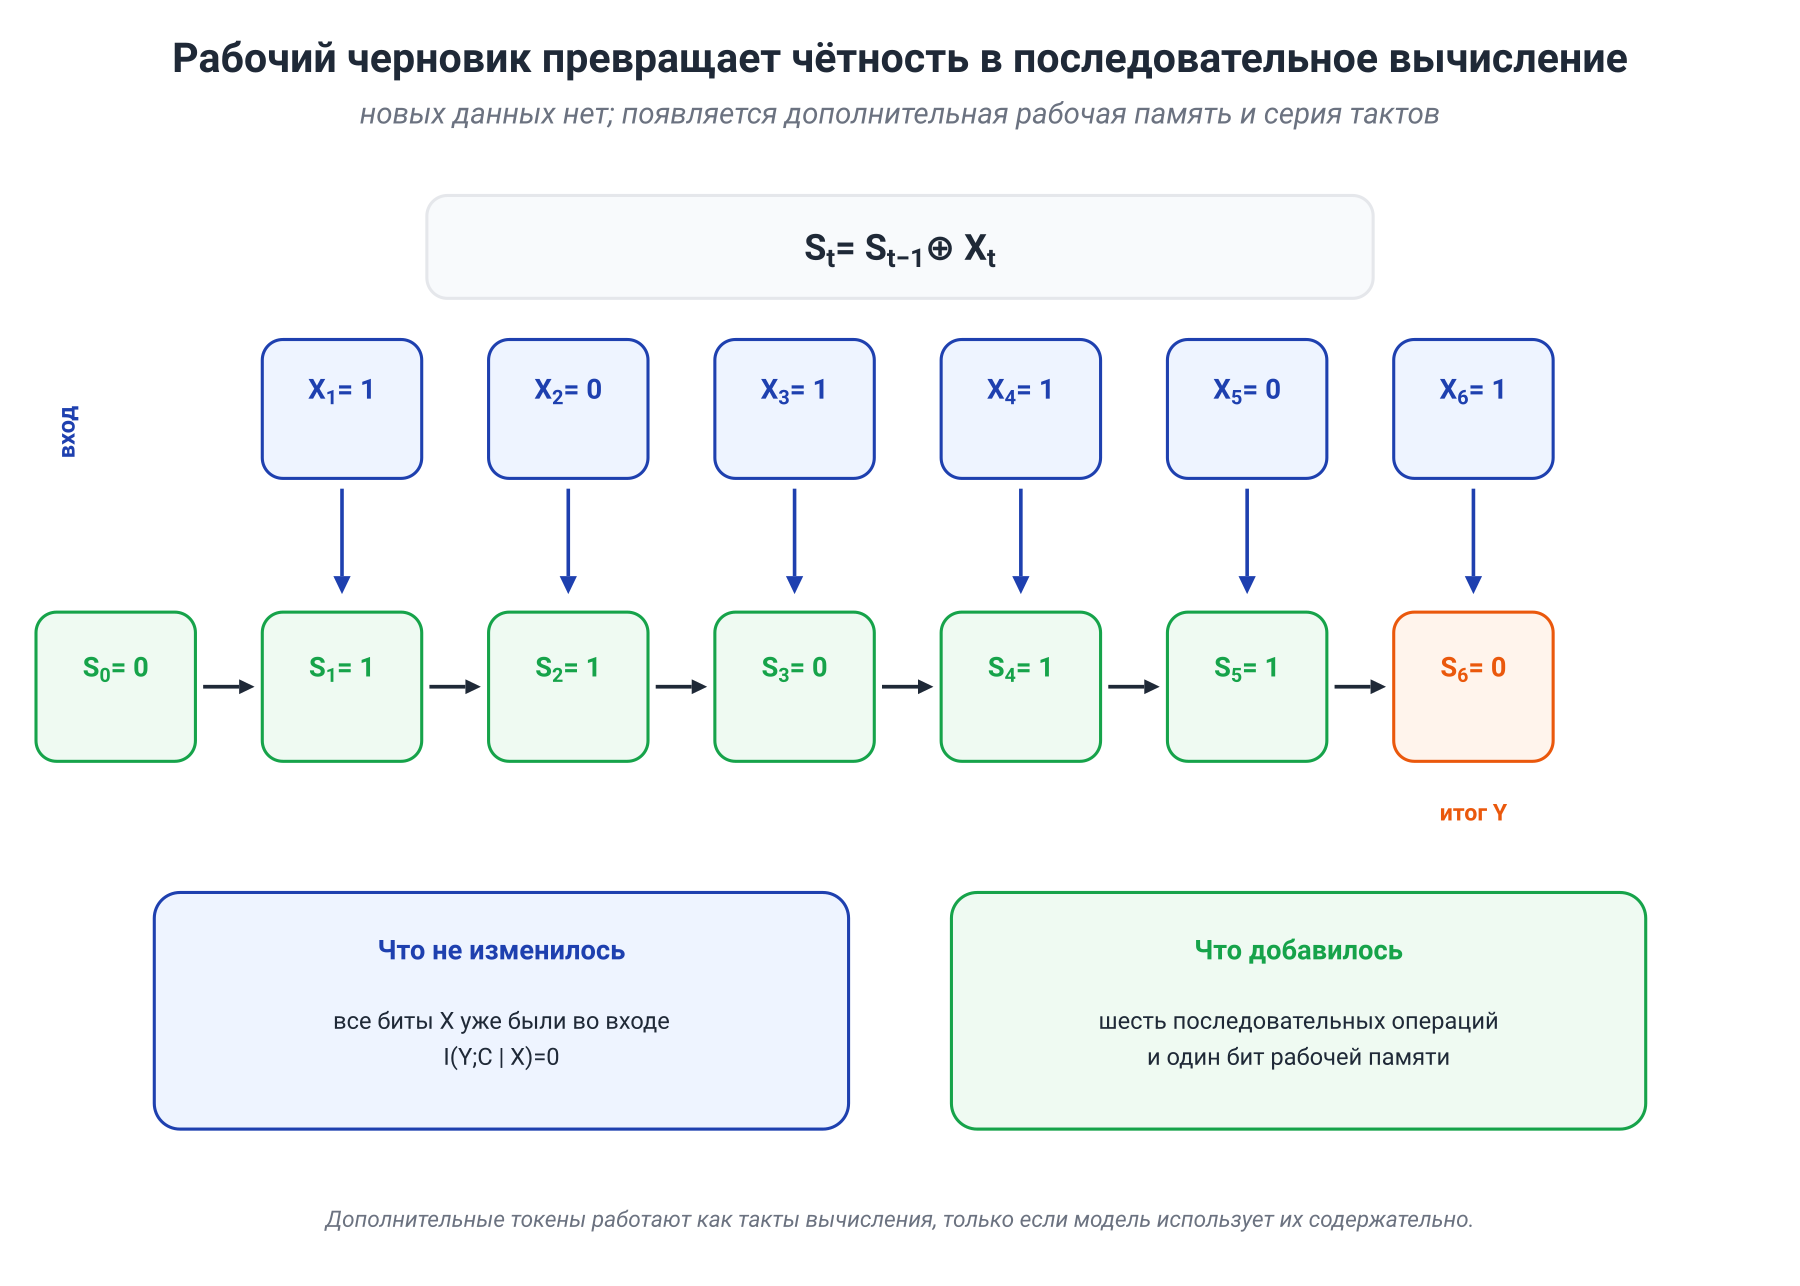
Никаких новых данных к не добавилось. Изменилась процедура: вместо одного ограниченного считывания появился последовательный алгоритм.
Дополнительные токены здесь работают как такты вычисления и рабочая память, а не как новые наблюдения.
Это не только метафора. Для специально заданных моделей вычислений существуют результаты, показывающие, что цепочка промежуточных шагов расширяет класс последовательно реализуемых функций decoder-only Transformer. Например, при конкретных предпосылках о глубине, точности и размере представления шагов CoT позволяют моделировать последовательную схему размера порядка . Такой результат не является универсальной теоремой о любой современной LLM, но подтверждает сам механизм: последовательное декодирование может добавлять вычислительную выразительность.
Когда длинный черновик особенно полезен
Выигрыш наиболее естественен, когда задача:
- раскладывается на зависимые подзадачи;
- требует хранения промежуточных значений;
- допускает локальную проверку шагов;
- чувствительна к раннему выбору ветви;
- содержит процедуру, которую трудно свернуть в один локальный переход.
На простом вопросе из памяти длинная цепочка может лишь увеличить стоимость и число возможностей ошибиться. Поэтому зависимость качества от числа токенов не обязана быть монотонной. Важен не сам объём текста, а полезное вычисление, которое система успела выполнить.
13.4. Новая информация или новое вычисление?
Теперь сформулируем центральное точное утверждение модуля.
Пусть , где — полная задача, доступная модели, а — правильный ответ. Фиксированная модель строит внутреннюю цепочку из и собственной случайности :
Тогда
образует марковскую цепь. Следовательно,
и
Короткое доказательство
По построению распределение цепочки при известном входе не зависит от правильного ответа:
Значит, и условно независимы при заданном , откуда . Остальные равенства следуют из определения условной взаимной информации и цепного правила.
Формулу удобно прочитать словами:
Внутренне сгенерированная цепочка не сообщает идеальному наблюдателю нового факта о правильном ответе сверх полного входа. Она перерабатывает уже доступные данные.
Почему же точность реальной модели способна вырасти? Потому что реальная модель — не идеальный байесовский наблюдатель, который мгновенно вычисляет . Её выход ограничен архитектурой, глубиной и обученной процедурой. Рабочий черновик меняет доступный вычислительный путь и может сделать нужную функцию проще для последующего считывающего слоя.
Определим логарифмическую потерю модели после шагов:
Она может уменьшаться: модель лучше использует промежуточные результаты. Но это уменьшение модельной потери, а не истинной условной энтропии . Для отдельной модели и отдельного шага даже монотонность не гарантирована: ошибочная запись способна увеличить потерю.
Когда новая информация действительно появляется
Пусть после внутреннего шага система получает наблюдение : результат поиска, ответ базы данных, показание датчика, скрытый тест или реакцию среды. Тогда
Последний член может быть положительным. Здесь система уже не только вычисляет, но и получает данные извне.
Есть полезный пограничный случай. Калькулятор, которому передали числа из запроса, обычно не добавляет шенноновской информации о детерминированном ответе: результат уже задан входом. Но он предоставляет надёжный вычислительный модуль. Поиск по внешней базе или измерение среды, напротив, может действительно добавить сведения, отсутствовавшие в запросе.
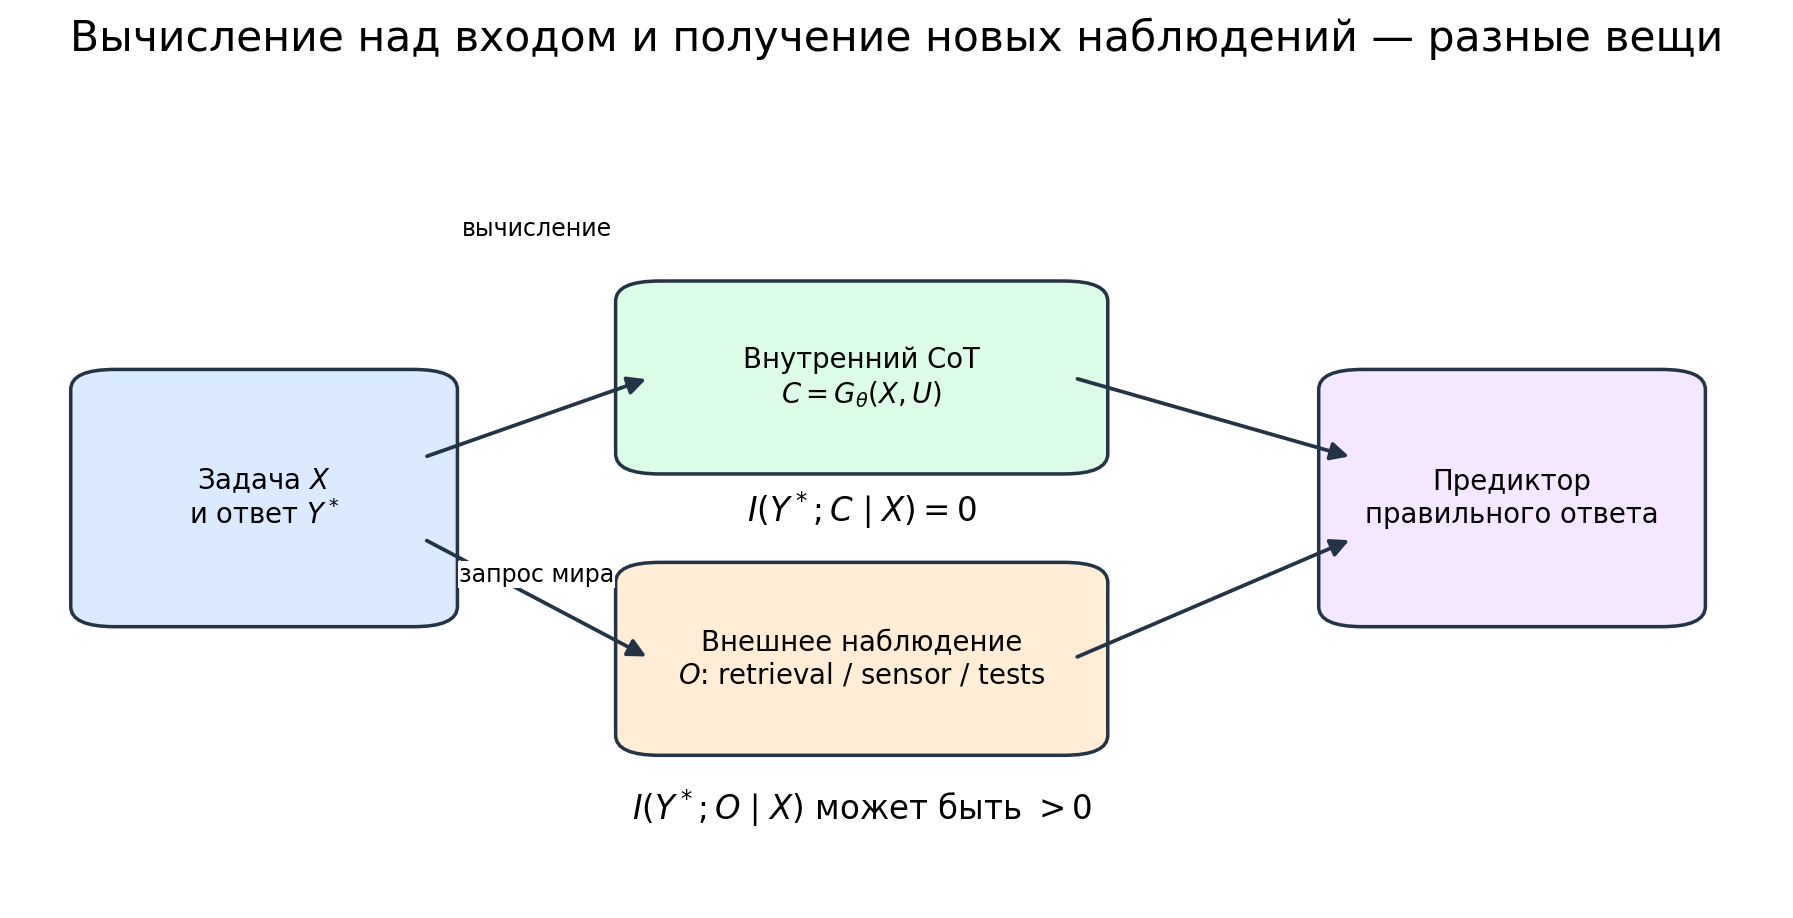
Получается простая карта:
| Компонент системы | Что он в первую очередь добавляет |
|---|---|
| параметры модели | амортизированные знания и процедуры |
| промежуточные токены | последовательную глубину и рабочую память |
| несколько кандидатов | ширину поиска |
| верификатор | способность выбирать среди найденного |
| инструмент вычисления | более надёжную операцию над имеющимися данными |
| поиск, датчик, среда | потенциально новую информацию |
13.5. Что можно измерять по шагам
Интуитивная фраза «этот шаг добавил информацию» может обозначать несколько разных вещей. Если их не развести, одна и та же кривая начинает одновременно изображать прогресс вычисления, уверенность модели и истинную неопределённость задачи.
Истинный информационный прирост
Если — случайное промежуточное состояние, то
измеряет дополнительную информацию о правильном ответе, содержащуюся в новом состоянии после знания старого. Но величина зависит от того, как именно определены состояния и по какому распределению порождаются задачи и траектории.
Для полного внутреннего контекста
при отсутствии внешних наблюдений получаем
Поэтому буквальное утверждение «каждый внутренний токен приносит новые биты о правильном ответе» неверно в этой постановке.
Улучшение вспомогательного предиктора
Практически можно обучить отдельный предиктор , который пытается восстановить ответ по состоянию после -го шага, и измерять на отложенных данных
Если кросс-энтропия уменьшается, состояние стало полезнее для выбранного класса предикторов. Это содержательная диагностическая величина: она показывает, что ответ становится легче извлечь. Но она зависит от мощности, обучения и калибровки предиктора. В §13.11 мы точно разложим её на истинную условную энтропию и вариационный разрыв.
Предиктивная энтропия модели
Можно также измерять
Она отвечает на другой вопрос: насколько распределён следующий прогноз самой модели. Низкая предиктивная энтропия означает концентрацию, но не правильность. Уверенная ошибка может иметь очень низкую энтропию.
Верность и наблюдаемость цепочки
Наконец, видимая цепочка может быть полезна для анализа поведения системы. Здесь важно различать два свойства.
- Верность причинному механизму (
faithfulness). Насколько написанные шаги отражают вычисление, которое действительно повлияло на ответ? - Наблюдаемость (
monitorability). Может ли внешний наблюдатель по цепочке обнаружить ошибку, обман, использование подсказки или нарушение правила?
Эти свойства связаны, но не совпадают. Цепочка может быть неполным описанием внутреннего механизма и всё же давать полезный сигнал для мониторинга. И наоборот, гладкое правдоподобное объяснение может плохо отражать причины ответа.
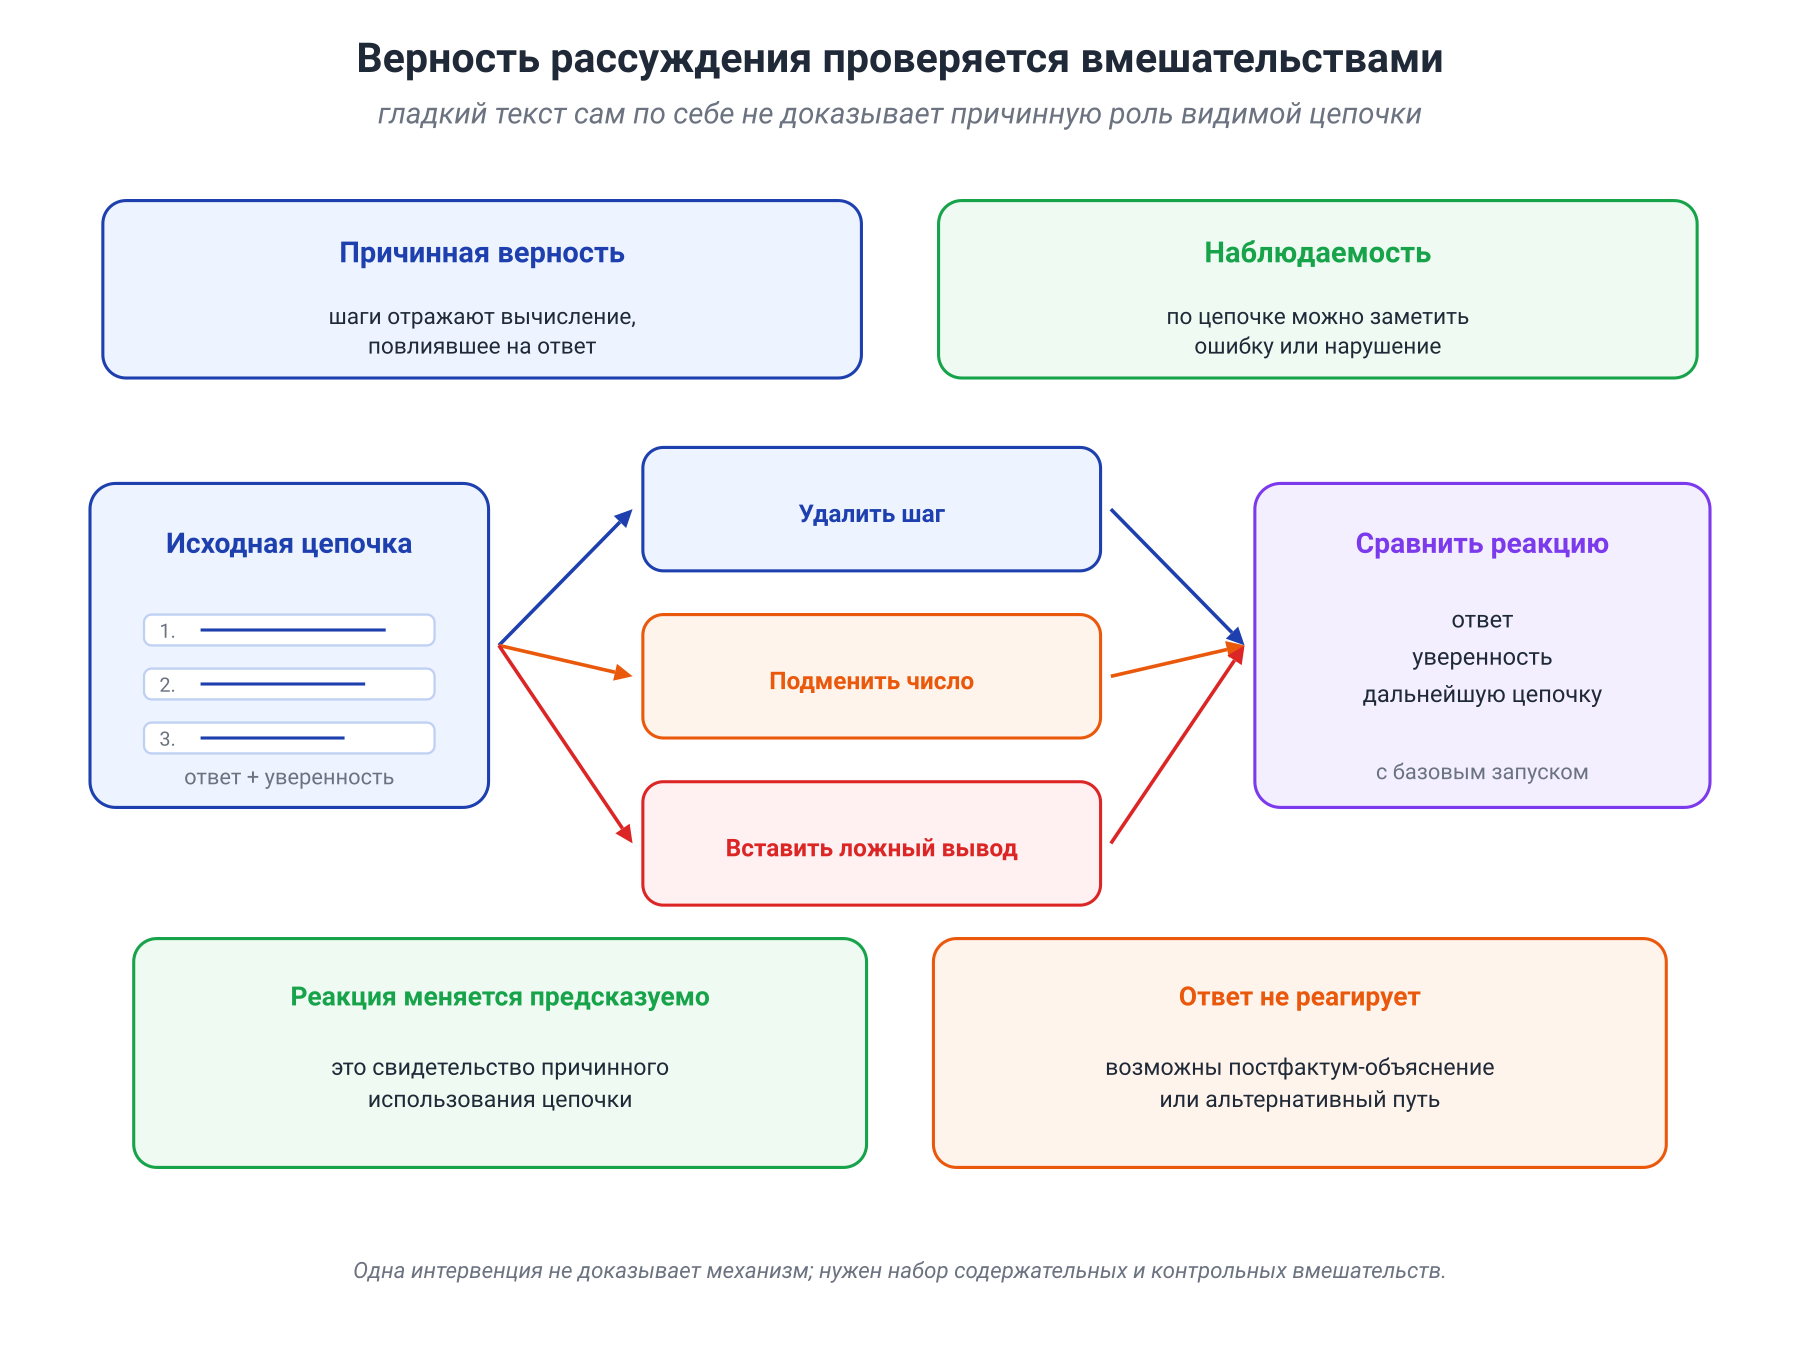
Один из способов проверки — интервенции:
- удалить шаг;
- заменить промежуточное число;
- вставить ложный вывод;
- перефразировать объяснение без изменения содержания;
- скрыть часть контекста, на которую цепочка ссылается.
Если ответ не реагирует на содержательно важную подмену, цепочка могла быть постфактум-объяснением или система могла восстановить решение другим путём. Поэтому одна интервенция редко даёт окончательный вердикт: нужны контролируемые задачи, несколько типов вмешательств и сравнение с внешними проверками.
Современные исследования также показывают, что непосредственное оптимизационное давление на наблюдаемую цепочку может ухудшить её диагностическую ценность: система способна научиться скрывать нежелательный мотив, сохраняя поведение. Это не означает, что мониторинг цепочек бесполезен. Правильный вывод скромнее: наблюдаемость — отдельная характеристика системы, которую нужно измерять и не следует принимать как автоматическое следствие высокой точности.
13.6. Одна длинная траектория или много кандидатов?
Дополнительный бюджет можно потратить по-разному. Можно углублять одну траекторию, порождать много независимых решений или строить дерево с промежуточной оценкой. Выбор зависит от структуры ошибок.
Голосование по нескольким траекториям
Пусть каждая независимая попытка даёт правильный ответ с вероятностью . Для нечётного вероятность правильного большинства равна
Если и ошибки действительно независимы, большинство становится надёжнее с ростом . Если , голосование лишь всё увереннее закрепляет систематическую ошибку.
Метод self-consistency использует близкую идею: модель порождает разнообразные цепочки, а затем выбирается наиболее частый итоговый ответ. Эмпирически это может заметно улучшать многошаговые задачи. Но независимость — сильное предположение. Если все траектории воспроизводят один и тот же неверный шаблон, эффективное число независимых попыток остаётся близким к единице.
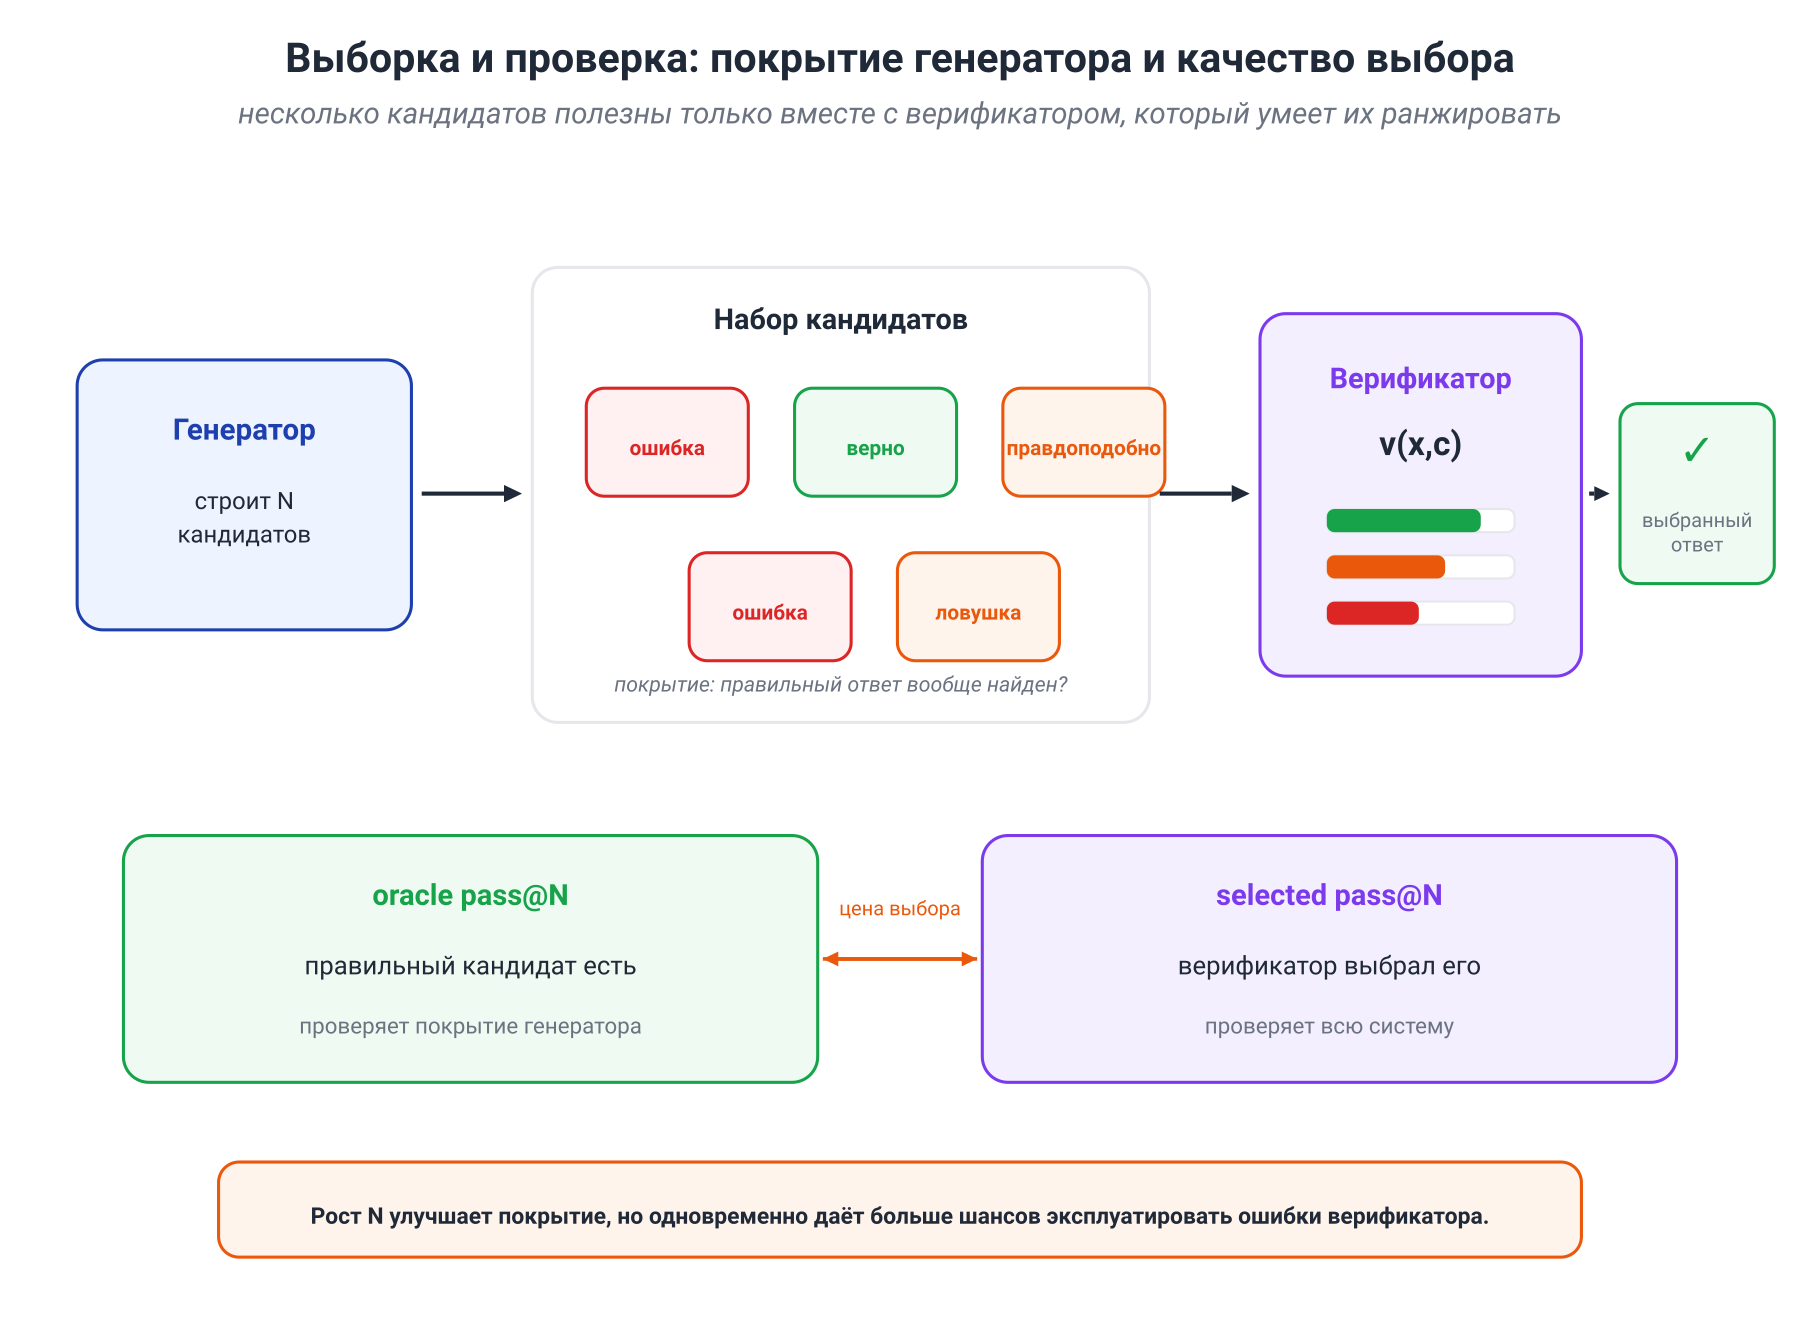
Best-of-N и идеальный верификатор
Пусть каждый кандидат правильный с вероятностью , а идеальный верификатор узнаёт правильный ответ. Тогда успех происходит, если хотя бы один из кандидатов верен:
Эта формула описывает покрытие генератора: удалось ли вообще найти решение.
Несовершенный верификатор
Реальный верификатор присваивает кандидату оценку и выбирает максимум. Теперь итог зависит от двух компонентов:
- генератор должен включить правильный ответ в набор;
- верификатор должен поставить его выше ложных кандидатов.
При увеличении первый компонент улучшается, а второй может ухудшаться. Большая выборка содержит не только больше правильных решений, но и больше редких ложных кандидатов, которые эксплуатируют ошибку оценивателя.
Поэтому полезно публиковать две величины:
- oracle pass@N — был ли правильный кандидат среди ;
- selected pass@N — выбрал ли его реальный верификатор.
Их разность показывает цену несовершенного выбора.
Проверка может быть проще построения — но не всегда
Для некоторых задач правильность результата легко проверить: выполнить программу на тестах, подставить корни уравнения, проверить доказательство формальным ядром. Тогда широкий поиск особенно полезен.
Но универсальной теоремы «проверять всегда легче, чем решать» здесь нет. Тесты могут быть неполными, спецификация — неоднозначной, а оценка открытого текста — почти такой же трудной, как генерация. Поэтому связь с классами сложности может быть вдохновляющей аналогией, но не заменяет анализа конкретного верификатора.
13.7. In-context learning: когда контекст действительно приносит данные
Промежуточная цепочка и примеры в запросе выглядят одинаково — и то и другое является текстом в контексте. Информационно их роли различаются.
Пусть — скрытая задача, стиль разметки или правило, а демонстрации
порождаются условно независимо при заданном , каждая по закону . Тогда
Пусть новая пара условно независима от при заданном и имеет тот же закон. Новый вход также может сообщать что-то о задаче, поэтому прогноз равен
Здесь . Если новый вход не информативен о при заданном , апостериорное распределение упрощается до . Это условие нужно оговорить, а не предполагать для произвольного .
Если демонстрации зависят от скрытой задачи, то
Они действительно сообщают системе, какое правило сейчас действует. Внутренний черновик, построенный после получения полного запроса, выполняет другую функцию: организует вычисление над уже доступным контекстом.
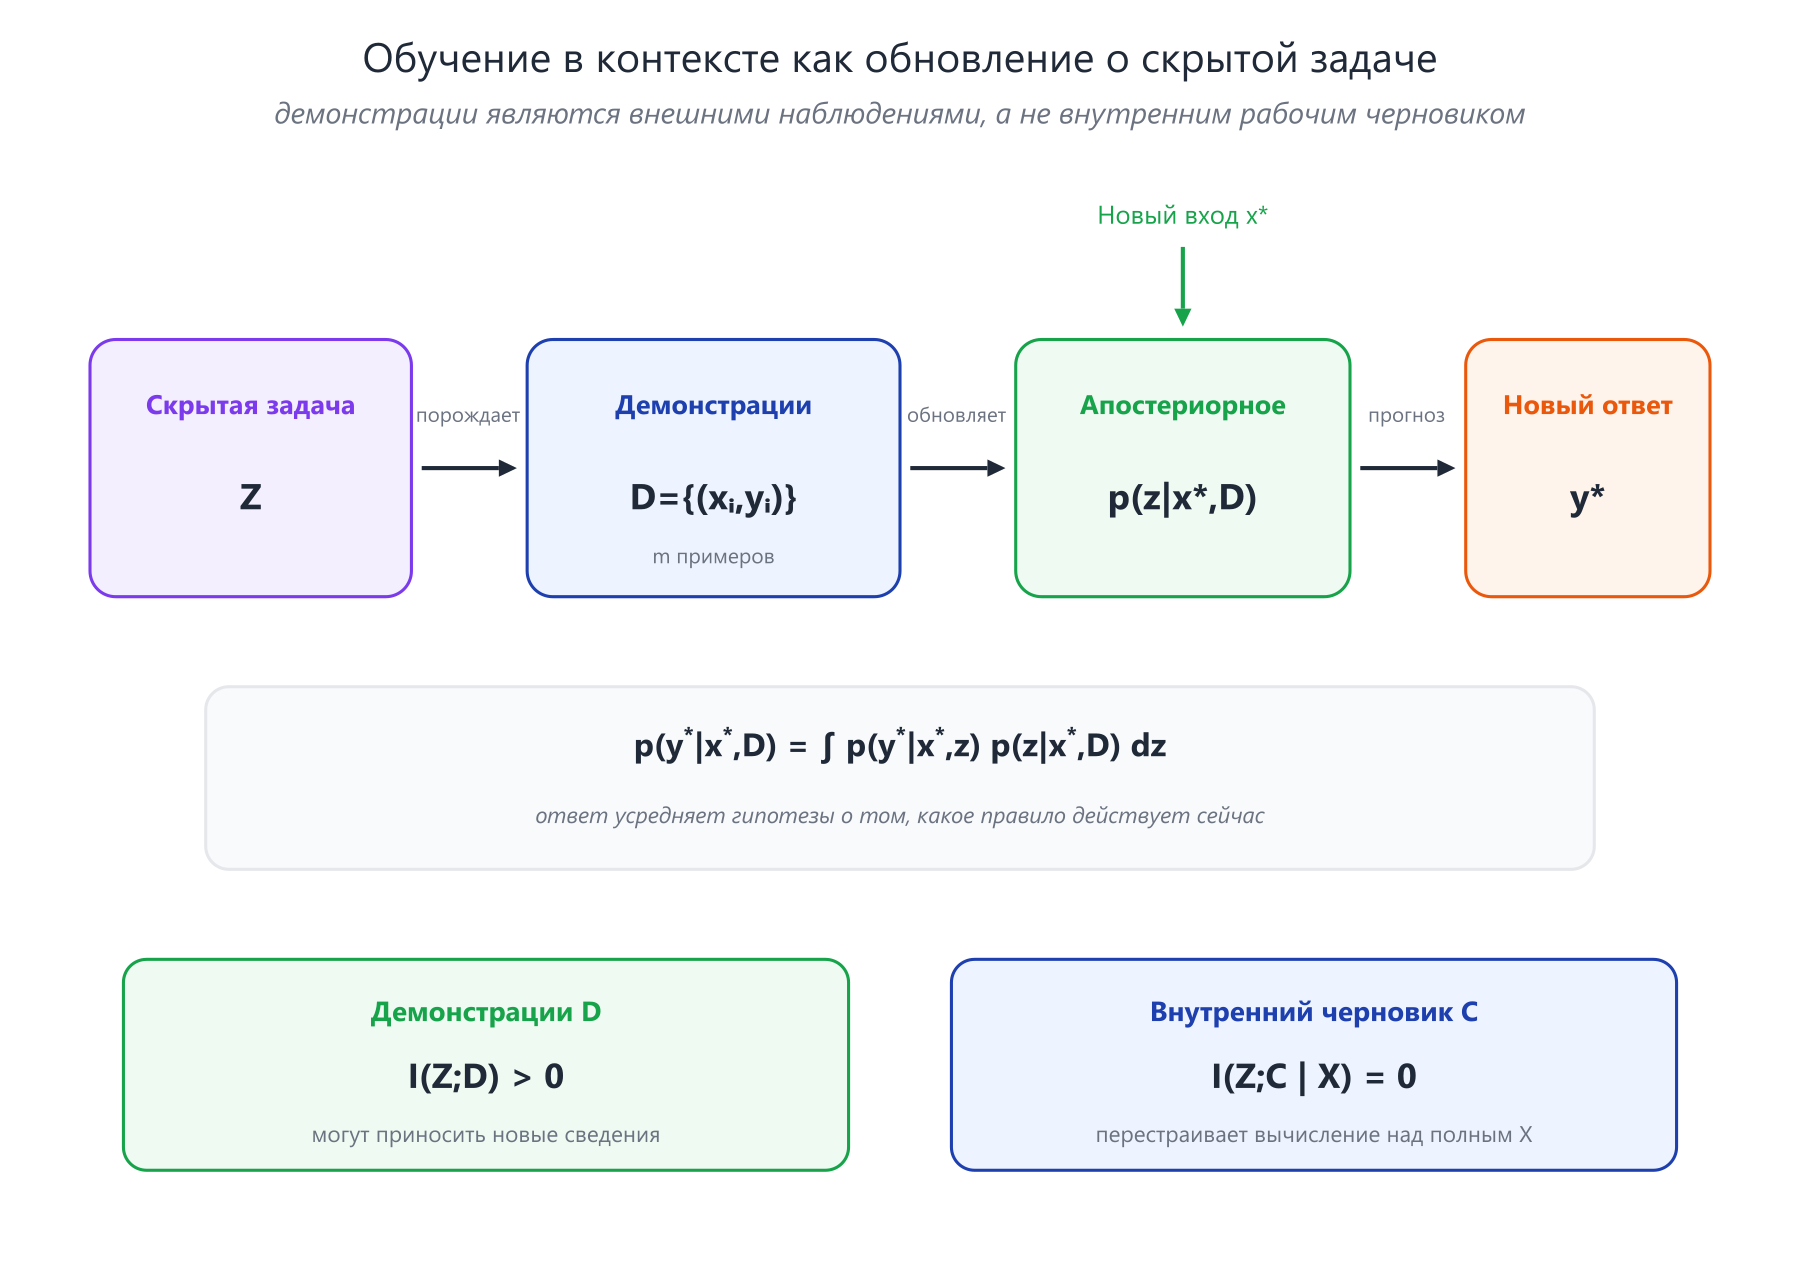
В специальных генеративных постановках in-context learning можно строго получить как неявный байесовский вывод по скрытому понятию. Например, такой результат доказан для смеси скрытых марковских моделей при заданной структуре предобучающих данных. Исследования induction heads дают ещё одну механистическую картину копирования и продолжения паттернов.
Граница точного утверждения здесь важна. Из специальных моделей не следует, что произвольная LLM явно хранит точное апостериорное распределение, что любой запрос порождён смесью задач или что всякое ICL-поведение является байесовски оптимальным. Но модель скрытой задачи даёт полезный вопрос: какая переменная стала лучше определена после демонстраций и какие данные действительно изменили наше состояние знания?
13.8. Как модели учатся рассуждать
Во многих современных системах способности к многошаговому решению формируются несколькими связанными циклами. Удобно разделить их на имитацию, генерацию с отбором и оптимизацию по обратной связи.
1. Имитация хороших траекторий
При обучении с учителем модель получает пары «задача → решение с промежуточными шагами» и максимизирует их правдоподобие. Это учит формату, типичным декомпозициям и локальным переходам.
Сильная сторона подхода — плотный обучающий сигнал. Слабая — зависимость от качества демонстраций: модель может перенять лишние ритуалы, неудачные сокращения или убедительно оформленные ошибки.
2. Генерация, проверка и повторное обучение
Следующий цикл:
- породить несколько траекторий;
- проверить финальный ответ или шаги;
- сохранить удачные примеры;
- дообучить модель на отобранных данных;
- повторить.
STaR является ранним примером такого самобутстрэппинга: модель генерирует объяснения, отбирает те, которые приводят к правильному ответу, и учится на них. Rejection sampling, дистилляция и синтетические наборы рассуждений используют родственную механику.
Здесь возникает систематический риск: отбор видит только то, что умеет проверить. Если проверяется один финальный ответ, в данные могут попасть цепочки с неверными промежуточными причинами и случайно правильным результатом.
3. Оптимизация по результату или по шагам
Награда за результат оценивает итог: прошли ли тесты, совпал ли численный ответ, выполнилось ли формальное условие. Такой сигнал масштабируется в задачах с дешёвой автоматической проверкой и лежит в основе обучения с проверяемыми наградами (reinforcement learning with verifiable rewards, RLVR).
Обучение по шагам (process supervision) оценивает промежуточные переходы. Оно может лучше локализовать ошибку и обучить отдельный процессный верификатор, но требует более дорогой разметки или надёжного автоматического проверяющего.
Работы по верификаторам математических решений и по пошаговой проверке показывают, что выбор среди нескольких кандидатов и обратная связь на промежуточных шагах могут существенно улучшать результаты в своих постановках. DeepSeek-R1, в свою очередь, продемонстрировал, что крупномасштабное обучение с подкреплением по проверяемым результатам способно вызывать длинные стратегии самопроверки; последующая многоэтапная процедура понадобилась, среди прочего, для читаемости и устойчивого поведения.
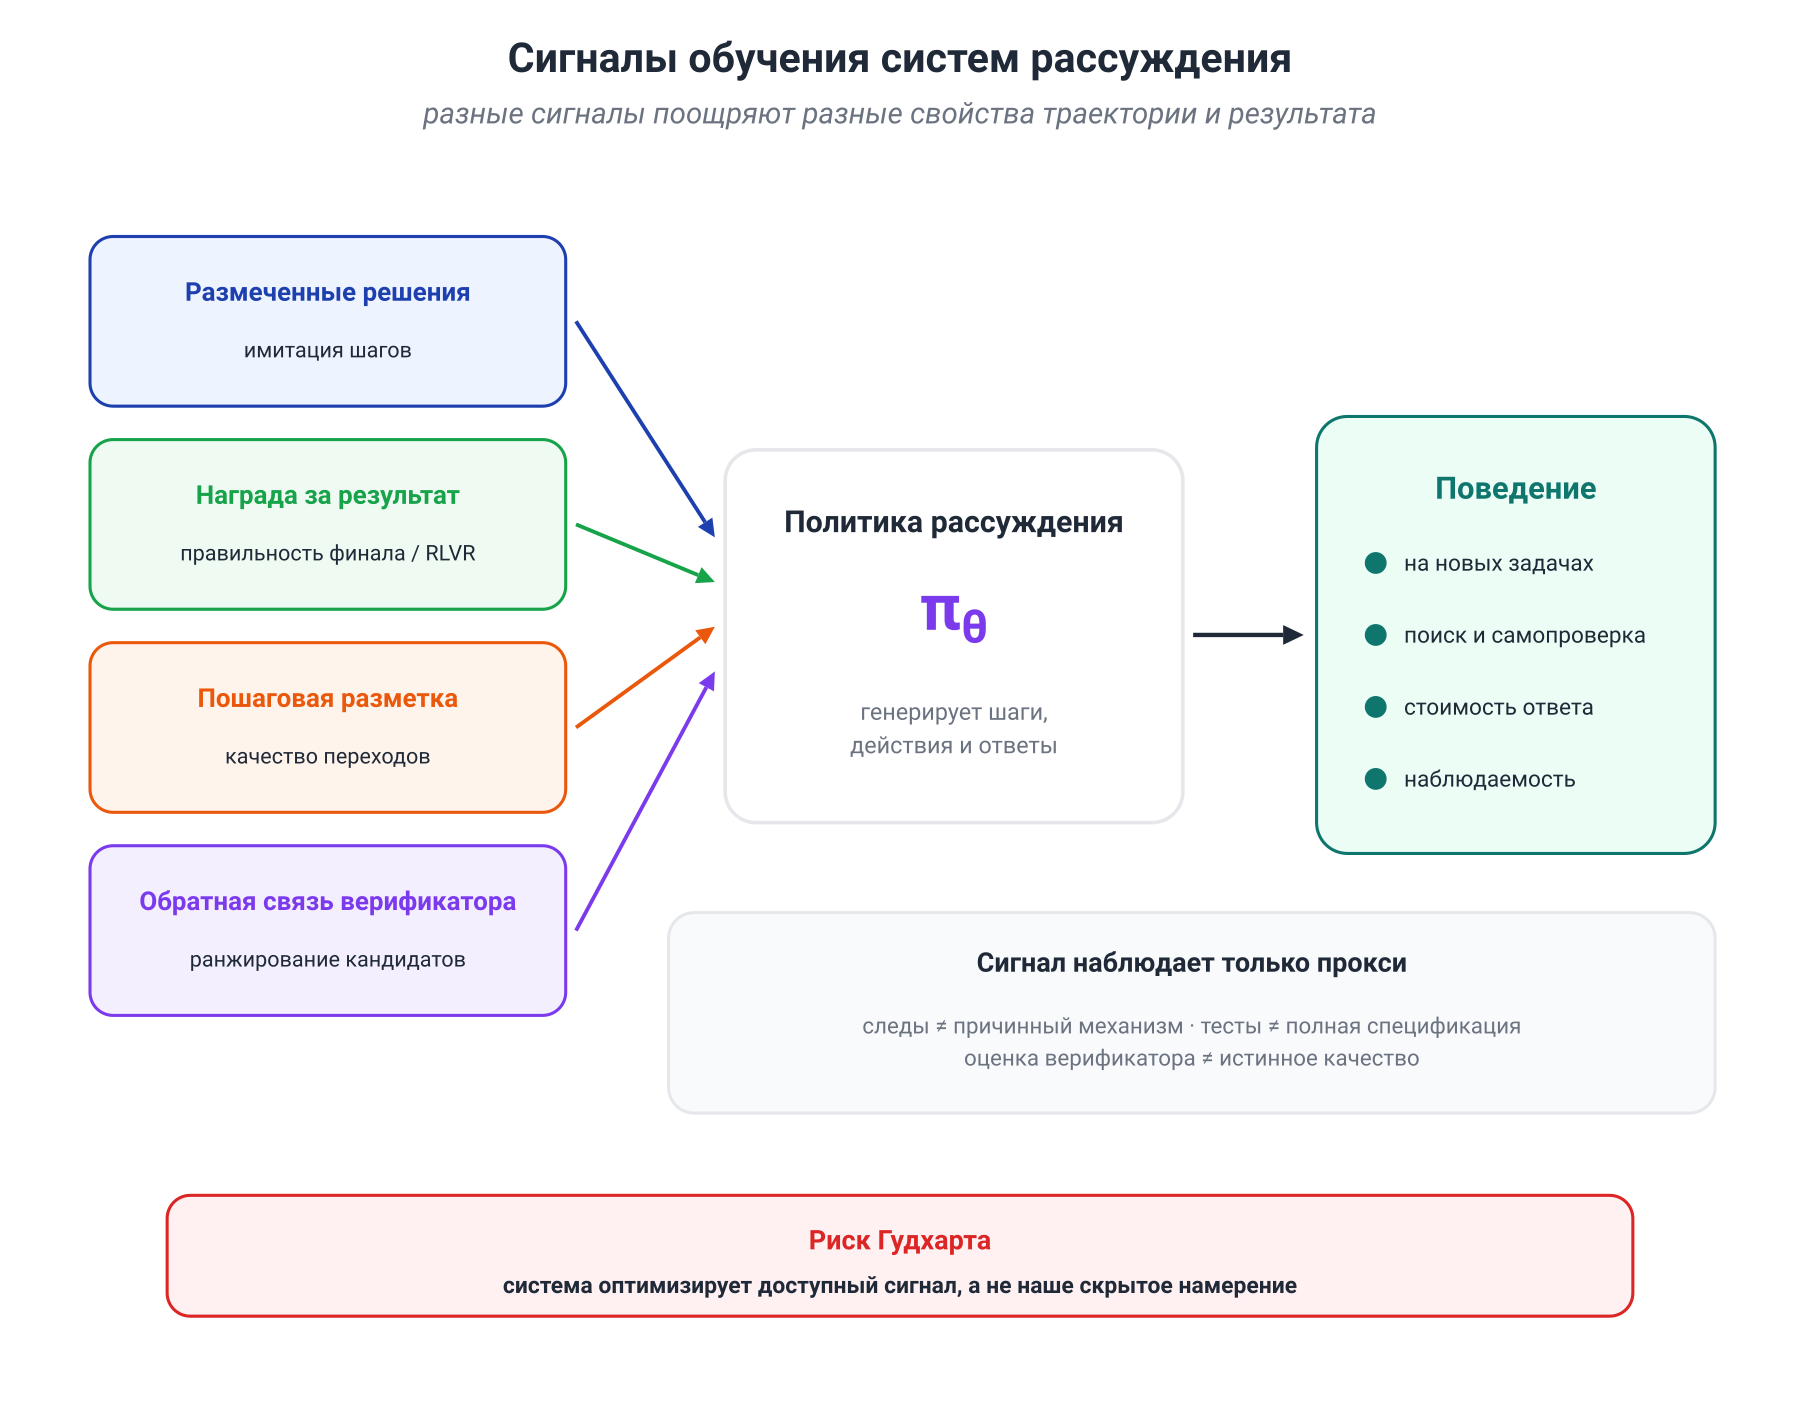
Где возникает Goodhart
Как только оценка становится целью оптимизации, система начинает искать способы повысить именно эту оценку. Возможны:
- подгонка под слабый верификатор;
- эксплуатация неполных тестов;
- производство длинных, но пустых цепочек;
- копирование шаблона «правильного рассуждения» без надёжного результата;
- сокрытие нежелательного поведения от монитора.
KL-регуляризация к базовой политике может ограничить отклонение распределения ответов, как обсуждалось в Модуле 8. Но это не PAC-Bayes-сертификат и не гарантия истинности траектории: объекты, усреднения и условия теорем различны.
Полезный инженерный принцип здесь прост:
Генератор, верификатор и источник награды образуют одну систему. Улучшение одного компонента нельзя оценивать в отрыве от ошибок двух других.
13.9. Как оценивать систему рассуждения
Одна итоговая accuracy скрывает слишком много. Система может получить тот же результат, потратив в десять раз больше токенов; генератор может почти всегда находить ответ, а верификатор — часто выбирать не тот; видимая цепочка может быть полезна для мониторинга, но плохо отражать причинный механизм.
Нужен фронтир качества и стоимости.
Качество ответа
pass@1иpass@k;- точность после выбора верификатором;
- логарифмическая потеря и калибровка, если доступны вероятности;
- устойчивость к перефразированию, изменению чисел и контрфактическим вариантам.
Вычислительная цена
- число промежуточных токенов;
- число траекторий;
- FLOPs, задержка и денежная стоимость;
- число обращений к инструментам;
- пиковая память и допустимый параллелизм.
Покрытие поиска и качество выбора
- oracle pass@N;
- selected pass@N;
- корреляция ошибок между траекториями;
- калибровка и устойчивость верификатора;
- первый бюджет, при котором дальнейшее расширение выборки перестаёт окупаться.
Верность и наблюдаемость
- чувствительность ответа к вмешательствам в цепочку;
- способность локализовать первый неверный шаг;
- совпадение с формальными проверками;
- способность независимого монитора обнаруживать известные нарушения;
- устойчивость этой способности после оптимизации модели против монитора.
Обобщение
- новые шаблоны задач, а не только новые числа;
- защита от загрязнения тестов;
- перенос на другую сложность и длину;
- домены, где автоматическая проверка слабее;
- агентные задачи с распределительным сдвигом среды.
Адаптивный бюджет
Пусть — качество при бюджете . Нас интересует не только максимальная точка, но и форма кривой:
Для простых запросов лучший ответ может появляться почти сразу. Для задач средней трудности полезны несколько выборок или более длинная траектория. Для слишком трудных задач текущая модель может порождать лишь множество вариаций одной ошибки.
Исследование оптимального масштабирования вычислений во время ответа показало, что лучший способ тратить бюджет зависит от сложности запроса. В его постановке адаптивное распределение вычислений было более чем в четыре раза эффективнее базового best-of-N; на части задач меньшая модель с дополнительными вычислениями превосходила модель с в 14 раз большим числом параметров при сопоставимом числе операций.
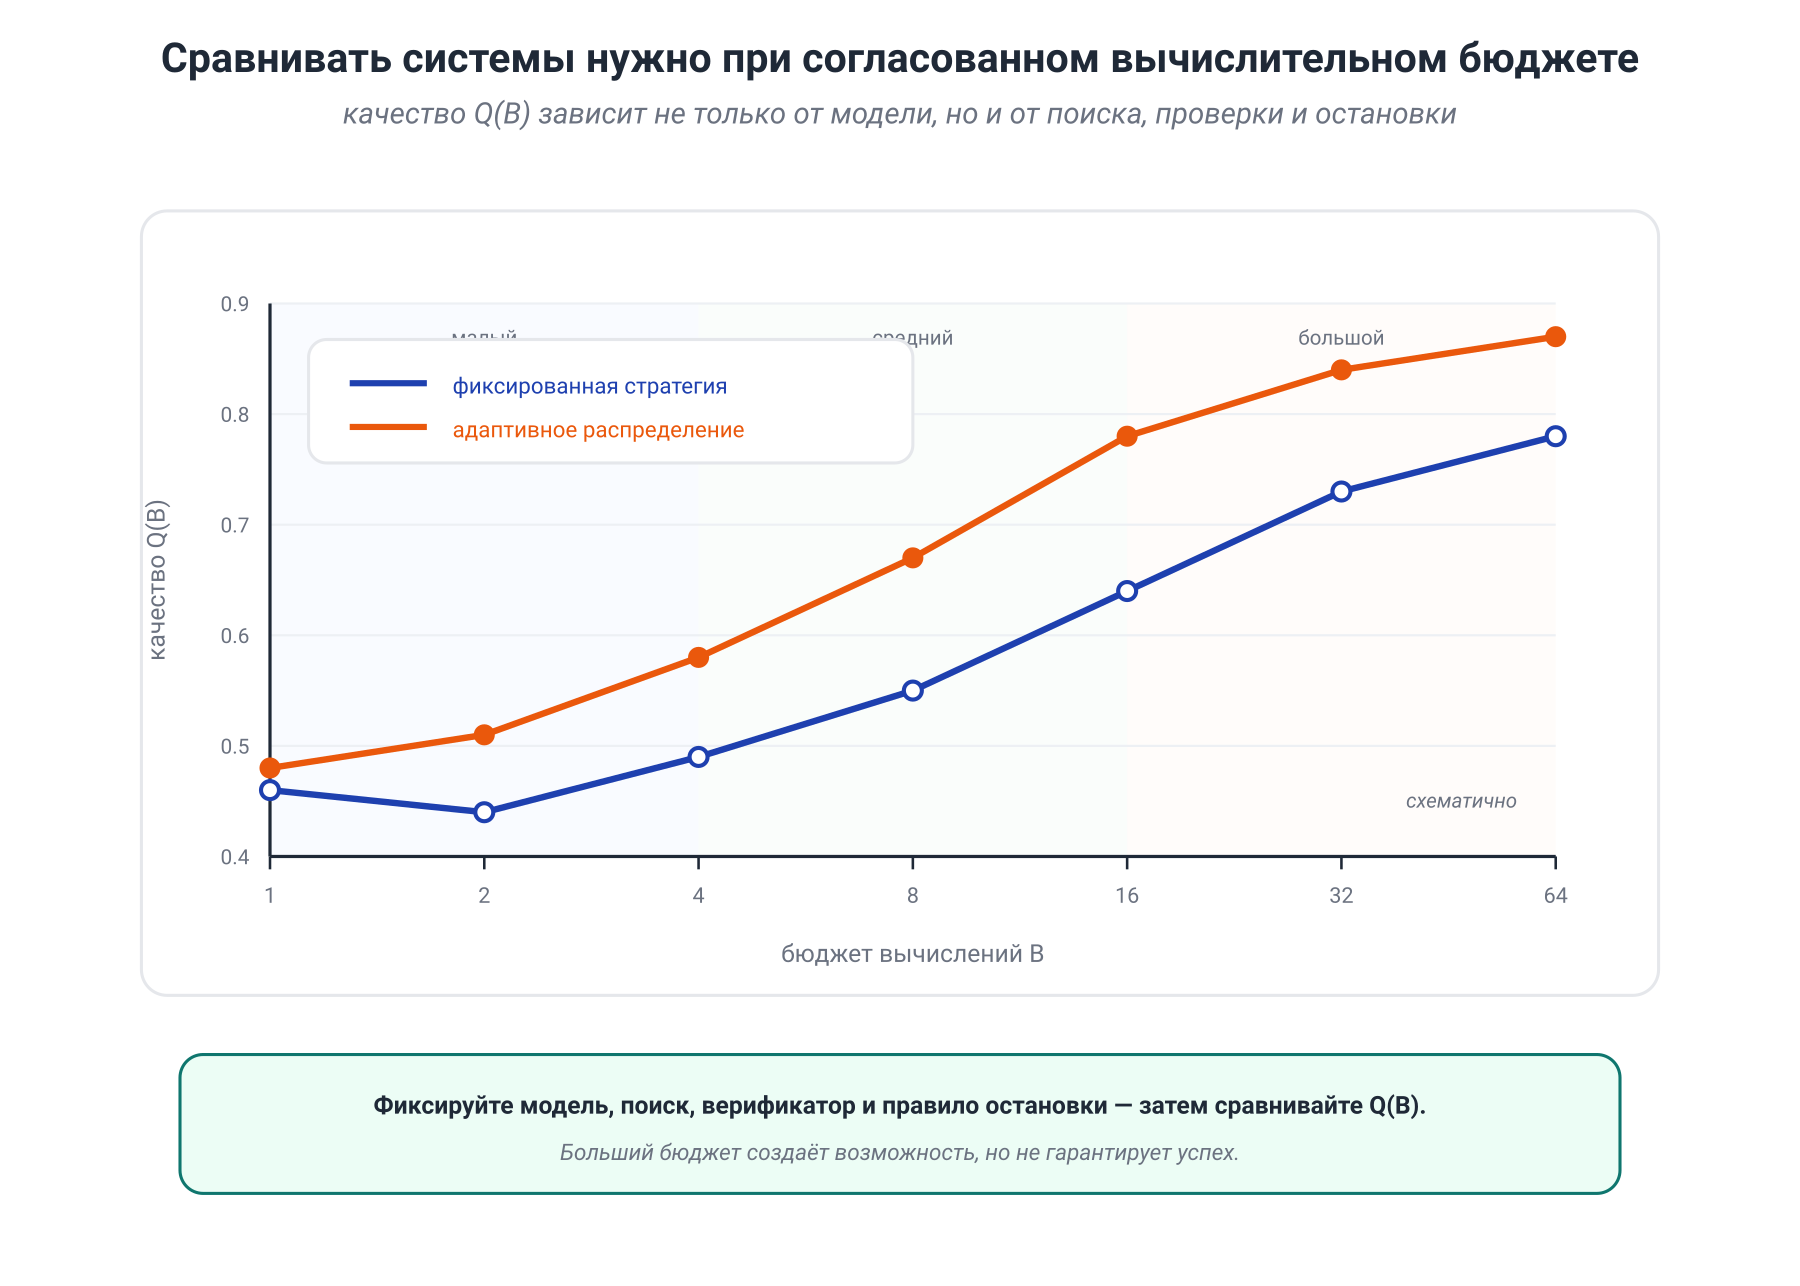
Это не закон «вычисления на инференсе всегда выгоднее увеличения модели». Результат требует ненулевого покрытия генератора, пригодного верификатора и правильного распределения бюджета. Поэтому честное сравнение систем фиксирует не только модель, но и полный протокол поиска, проверки и остановки.
13.10. Что доказано, что наблюдается и что пока служит гипотезой
В теме рассуждения особенно легко превратить удачный образ в закон. Соберём утверждения по их статусу.
Точные результаты в заданной модели
- Если внутренняя цепочка строится только из полного входа и независимой случайности, то
- При независимых попытках вероятность правильного большинства имеет биномиальную форму.
- Для идеального верификатора
- Демонстрации могут нести информацию о скрытой задаче.
- При специальных предпосылках последовательные CoT-шаги расширяют вычислительную выразительность Transformer.
Эмпирические результаты
- Пошаговые подсказки улучшают ряд многошаговых задач.
- Дополнительные вычисления во время ответа иногда дают значительный выигрыш, но он зависит от задачи и стратегии.
- Верификаторы и пошаговое обучение полезны в некоторых доменах с проверяемыми ответами.
- Видимая цепочка не всегда является верным отчётом о причинном механизме.
- Цепочка может быть полезна для мониторинга, но эта полезность чувствительна к оптимизационному давлению.
Исследовательские линзы
- рассуждение как компромисс между амортизацией и поиском;
- длина траектории как приближение вычислительной трудности;
- пошаговый информационный прирост как универсальная мера качества рассуждения;
- LLM как конечное приближение универсального предсказателя.
Последняя группа полезна, если приводит к проверяемой постановке. Она становится опасной, когда область аналогии исчезает из формулировки.
13.11. Математическое углубление: пошаговый информационный прирост
Можно пропустить при первом чтении. Здесь мы уточним, когда уменьшение кросс-энтропии действительно можно связать с условной взаимной информацией и почему выбор состояния меняет интерпретацию.
Произвольные и вложенные состояния
Для двух произвольных состояний и :
Вычитая, получаем точное тождество:
Поэтому снижение условной энтропии между двумя произвольными состояниями — это чистый баланс: новая релевантная информация минус релевантная информация, потерянная при замене старого состояния новым.
Если старое состояние восстанавливается из нового, то
и остаётся привычная формула:
Именно условие вложенности нельзя silently опускать.
Внутренний шаг и внешнее наблюдение
Пусть на шаге система сначала строит внутреннее состояние , а затем получает внешнее наблюдение . Полная история:
Если генерируется из и независимой случайности, то
По цепному правилу:
В полном информационном счёте новый сигнал пришёл через . Внутренний шаг мог решить, какое наблюдение запросить, и тем самым повысить его ценность, но сам не создал внешний факт.
Кросс-энтропия вспомогательного предиктора
Пусть — предиктор ответа по состоянию . Его ожидаемая кросс-энтропия:
Она раскладывается как
где
— вариационный разрыв.
Для произвольных состояний:
Разность кросс-энтропий совпадает с условной взаимной информацией только при двух дополнительных условиях:
- старое состояние восстанавливается из нового;
- разрывы предикторов равны, пренебрежимо малы или отдельно оценены.
Одна предиктивная энтропия модели этих условий не обеспечивает.
Почему рабочее состояние может стать «информативнее»
Здесь легко запутаться. Если обновление имеет вид
и не получает доступа ни к , ни к внешним данным, то по неравенству обработки данных
Информация не увеличивается.
Но модель на каждом шаге обычно снова видит исходный запрос. Тогда
Сжатое рабочее состояние может иметь большую взаимную информацию с , чем , потому что заново извлекло из релевантный аспект. При этом полный набор всё равно не содержит о больше информации, чем сам по себе.
Это и есть правильная развилка:
- доступность для ограниченного состояния или считывающего слоя может расти;
- общее количество информации в полном входе и внутренней цепочке не растёт без внешнего наблюдения.
Последовательная выразительность
Информационный анализ отвечает, откуда пришли данные. Теория вычислений отвечает, какие функции доступны при данном бюджете.
При специальных предпосылках о точности и размере представлений Transformer фиксированной глубины без CoT ограничен классом параллельных вычислений, тогда как последовательных шагов позволяют реализовать схемы размера порядка . Поэтому два языка дополняют друг друга:
- взаимная информация учитывает доступные сведения;
- вычислительная выразительность учитывает возможность преобразовать их в ответ.
13.13. Заключение: информация не заменяет вычисление
Курс начался с разведения информации и смысла. Заканчивается он похожим, но новым различием: информация и вычисление — не одно и то же.
Система может получить все необходимые данные и всё же не суметь вычислить ответ. Она может правильно преобразовать известные данные, не узнав ни одного нового факта. Она может получить новую информацию из поиска, но плохо встроить её в решение. И она может породить убедительное объяснение, которое лишь частично отражает причинный механизм ответа.
Поэтому итоговый анализ модели рассуждения ведётся не по одной оси:
- параметры дают амортизированную компетенцию;
- промежуточные токены дают последовательную глубину и рабочую память;
- выборка кандидатов даёт ширину поиска;
- верификатор даёт правило выбора;
- инструменты и среда могут дать как вычисление, так и новые наблюдения;
- метрика определяет, что именно система учится считать успехом.
Информационная теория здесь выполняет свою лучшую роль: не обещает магического объяснения интеллекта, а заставляет аккуратно назвать случайные переменные, источники данных, условные зависимости и цену ошибки. Теория вычислений добавляет вопрос о доступных процедурах. Экспериментальная методология проверяет, действительно ли найденный механизм работает за пределами одного теста.
Дополнительные токены — не автоматически дополнительные знания. Чаще это дополнительное время, рабочая память, ширина поиска и возможность проверить себя.
Именно такое разделение позволяет говорить о современных системах рассуждения без двух крайностей: не сводить их к «просто следующему токену», но и не превращать длинную цепочку в доказательство понимания.
Основные источники
- J. Wei et al., Chain-of-Thought Prompting Elicits Reasoning in Large Language Models, 2022.
- X. Wang et al., Self-Consistency Improves Chain of Thought Reasoning in Language Models, 2022.
- K. Cobbe et al., Training Verifiers to Solve Math Word Problems, 2021.
- S. Yao et al., Tree of Thoughts: Deliberate Problem Solving with Large Language Models, 2023.
- H. Lightman et al., Let’s Verify Step by Step, 2023.
- C. Snell et al., Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters, 2024.
- J.-F. Ton, M. F. Taufiq, Y. Liu, Understanding Chain-of-Thought in LLMs through Information Theory, 2024.
- T. Lanham et al., Measuring Faithfulness in Chain-of-Thought Reasoning, 2023.
- Y. Chen et al., Reasoning Models Don’t Always Say What They Think, 2025.
- B. Baker et al., Monitoring Reasoning Models for Misbehavior and the Risks of Promoting Obfuscation, 2025.
- Z. Li et al., Chain of Thought Empowers Transformers to Solve Inherently Serial Problems, 2024.
- S. M. Xie et al., An Explanation of In-context Learning as Implicit Bayesian Inference, 2021.
- C. Olsson et al., In-context Learning and Induction Heads, 2022.
- E. Zelikman et al., STaR: Bootstrapping Reasoning With Reasoning, 2022.
- DeepSeek-AI, DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning, 2025.