Модуль 2. Состояние, ценность и уравнения Беллмана
Версия материала: 2026.7
Фактический снимок: 2026-08-04
Язык: RU
Основная практика: уровень A — браузер, Python, NumPy и центральный процессор (CPU)
Структура: 4 урока, 20 шагов
Ориентировочное время: 8–12 часов вместе с основным практикумом
В Модуле 1 мы описывали RL как цикл выбора действий и обратной связи. Теперь возникает более трудный вопрос: как оценить состояние или действие до того, как станет известен окончательный результат? Ответ начинается с правильно выбранного состояния, продолжается функциями ценности и приводит к уравнениям Беллмана.
Предварительный курс по классическому RL по-прежнему не требуется. Новые понятия сначала объясняются словами, затем записываются формально и только после этого связываются с LLM. Читатель, уже знакомый с RL, может быстрее пройти §§2.1.1–2.1.4 и сосредоточиться на границах токеновой модели, различии завершения и усечения эпизода, точных условиях сходимости и связях с современным дообучением LLM.
Цели модуля. После прохождения вы сможете:
- проверить, содержит ли состояние достаточно информации для марковской модели;
- отличить состояние от наблюдения, а завершение задачи — от технического усечения траектории;
- вычислять , и преимущество и объяснять их смысл для генерации LLM;
- вывести уравнение ожидания Беллмана из рекуррентности накопленной награды;
- решать небольшую табличную задачу принятия решений как систему линейных уравнений или итерациями;
- различать оценивание методом Монте-Карло, одношаговое обучение по временным различиям и -шаговые цели;
- объяснять различие двух табличных методов управления через политику поведения и целевую политику;
- распознавать смещение максимизации и объяснять, как разделение выбора и оценивания его уменьшает;
- воспроизвести численные эксперименты на Gridworld, FrozenLake, коридоре и CliffWalking.
Публичный вычислительный практикум находится в исполняемой практике. Он содержит точное оценивание политики, итерацию ценности, MC, TD(0), многошаговый TD, Q-learning, SARSA и Double Q-learning. Для основного маршрута достаточно NumPy, Matplotlib и CPU; GPU не нужен.
Практический маршрут. После лекции идут оцениваемые задания, решения, открывающиеся после попытки, и исполняемая практика. Само объяснение остаётся самодостаточным.
Урок 2.1. От истории к состоянию, затем к ценности
Урок 2.1. От истории к состоянию, затем к ценности
- Зачем вообще нужно состояние
- Конечный MDP и соглашение о награде
- Завершение задачи и техническое усечение — не одно и то же
- Три функции ценности: V, Q и преимущество A
- Как читать ценности для LLM
далее — 7 проверочных шагов
Шаг 2.1.1 — Зачем вообще нужно состояние
Полная история взаимодействия к моменту может быть очень длинной:
Здесь важно сразу развести два употребления слова «состояние».
- Состояние среды — переменная, относительно которой будущая динамика обладает марковским свойством. Оно не обязано быть «сжатием истории»: у физической среды состояние может существовать независимо от того, что успел увидеть агент.
- Состояние или представление агента — то, что агент строит из доступной истории: полный журнал, окно наблюдений, вектор памяти рекуррентной сети, содержимое внешней памяти. Такое представление является лишь кандидатом на достаточное состояние.
Пусть — выбранное агентом представление. Оно достаточно для одношагового предсказания, если
Формула говорит не о том, что мир «забыл прошлое». Она говорит, что после фиксации и более ранняя история не должна дополнительно менять распределение следующего состояния и награды. Если меняет, представление потеряло существенную информацию.
Три разных вопроса. Что реально хранит среда? Что наблюдает агент? Какую внутреннюю запись агент использует для выбора действия? В простых задачах ответы совпадают. В системах с инструментами, пользователем и внешней памятью — часто нет.
Наблюдение может быть неполным. Если доступное состояние содержит всю существенную информацию, задачу можно описывать как марковский процесс принятия решений (Markov decision process, MDP). Если скрытая часть среды влияет на будущие переходы, естественной моделью становится частично наблюдаемый марковский процесс принятия решений (partially observable Markov decision process, POMDP). Тогда агент использует историю наблюдений, внутреннюю память или распределение убеждений о скрытом состоянии.
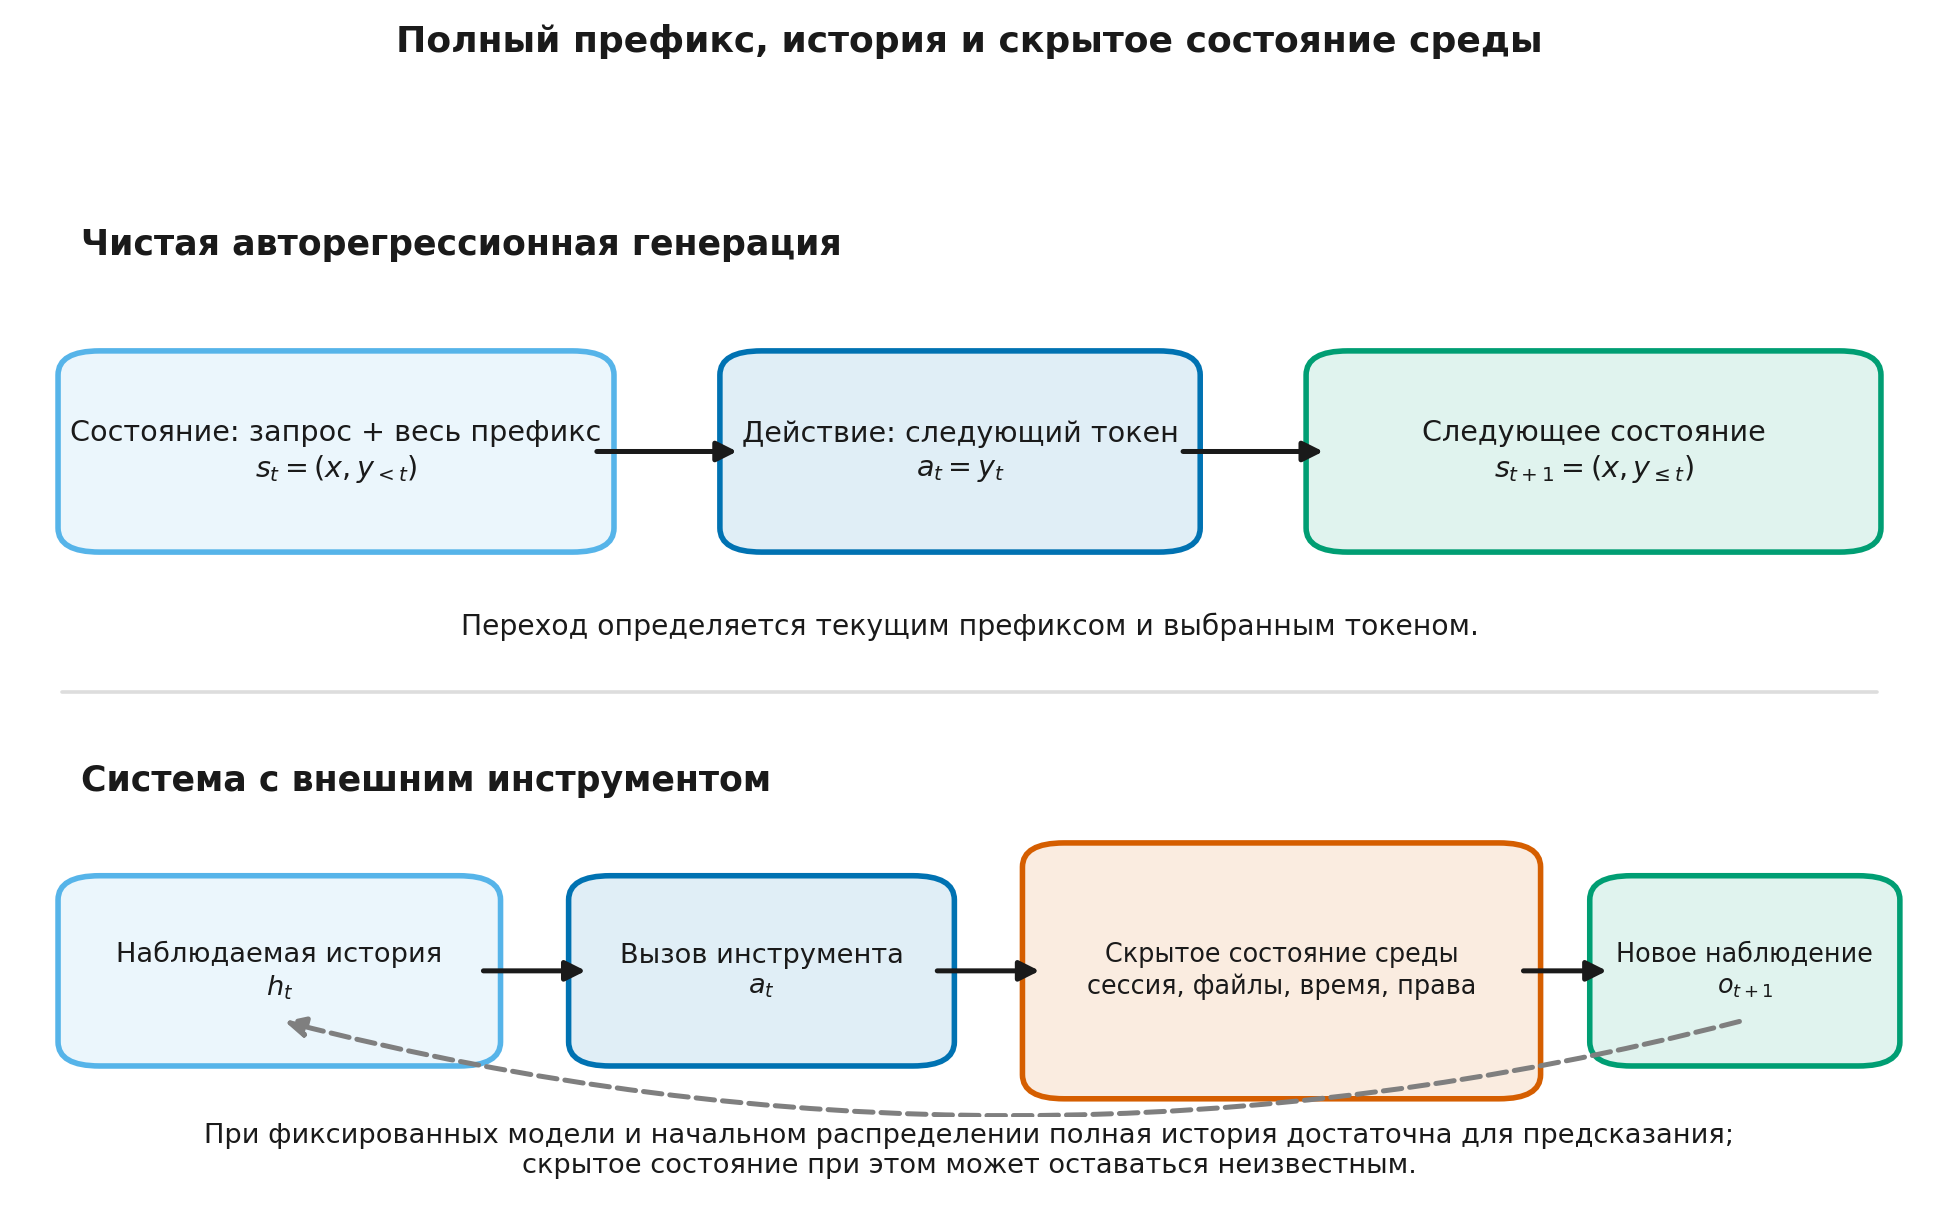
Для чистой авторегрессионной генерации можно положить
Если переход действительно состоит только в добавлении выбранного токена, параметры модели и правила декодирования фиксированы, а условие остановки определяется видимым префиксом, полный префикс является достаточным состоянием. Случайность сэмплирования при этом не нарушает марковское свойство: она относится к политике , а после фиксации выбранного токена переход к следующему префиксу детерминирован.
Система с браузером, файловой сессией, пользователем или внешним инструментом может иметь скрытое состояние. При фиксированных модели среды и начальном распределении полная история может служить растущим информационным состоянием: она определяет условное распределение будущих наблюдений и наград, даже если не раскрывает фактическое состояние мира. Распределение убеждений сжимает эту историю для предсказания в модели POMDP. Два возможных скрытых состояния при одной истории могут давать разные исходы; это совместимо с одним условным вероятностным законом.
Окно текстовых сообщений может содержать лишь часть . Например, сообщение о выбранном файле удалено из контекста, но файловая сессия продолжает использовать этот файл. Две полные истории тогда дают одинаковое окно, хотя сохранённые в них сведения меняют прогноз следующего ответа инструмента. Именно потеря существенной информации при построении представления, а не само наличие скрытого мира, нарушает достаточность такого окна.
Практический тест достаточности. Могут ли две полные истории, сжатые в одну запись , при одинаковом действии давать разные условные распределения следующего наблюдения и награды? Если да, представление потеряло существенную информацию. Разные случайные исходы при одном и том же условном распределении марковское свойство не нарушают.
Архитектурный контекст: Modern LLMs, Модуль 18 «Агенты и работа с инструментами» (modern_llms.module_16_agents), подробнее разбирает устройство таких систем. Здесь нам достаточно различия между состоянием среды, наблюдением и внутренним представлением агента.
Шаг 2.1.2 — Конечный MDP и соглашение о награде
Конечный MDP зададим набором
Здесь:
- — множество состояний;
- — множество действий;
- — вероятность следующего состояния;
- — распределение награды на переходе;
- — начальное распределение;
- — фактор дисконтирования.
В табличных вычислениях удобно хранить не всё распределение награды, а её условное среднее:
Ожидаемая награда при интегрируемой награде всегда определяется усреднением: . Для этой маргинализации не нужна условная независимость. Дополнительным предположением было бы равенство для каждого достижимого следующего состояния. Аналогично, может означать усреднение по действиям заданной политики, тогда как независимость модели награды от действия — более сильное условие. В модуле основной остаётся форма с условием на переход.
Политика не входит в динамику среды. Один и тот же MDP допускает разные политики. Совместное распределение одного перехода при фиксированной политике раскладывается как
Эта факторизация будет полезна дальше: уравнение Беллмана усредняет сначала по действиям политики, затем по переходам и наградам среды.
В эпизодической задаче взаимодействие достигает терминального состояния. В продолжающейся задаче естественного терминала может не быть; тогда при бесконечном горизонте обычно используют или другую постановку, обеспечивающую конечность цели.
В этом модуле награда относится к переходу. Если агент получает при входе в цель, это значение остаётся в , даже когда . Нулевая ценность терминала означает отсутствие дальнейшего продолжения, а не отмену последней награды.
Шаг 2.1.3 — Завершение задачи и техническое усечение — не одно и то же
В файле роллаута траектория может закончиться одинаково — «следующего шага нет». Математически причины окончания различаются.
- Завершение (
termination) означает, что достигнуто терминальное состояние самой задачи: цель выполнена, агент проиграл, ответ завершён токеном конца последовательности. В заданном MDP продолжения после перехода нет. - Усечение (
truncation) означает, что сбор данных остановили внешним ограничением: закончился бюджет шагов, время стенда, длина буфера или место в пакете. Сама задача могла бы продолжаться.
Удобно ввести маску продолжения
Тогда одношаговая цель записывается одной строкой:
Отсюда получаются два случая:
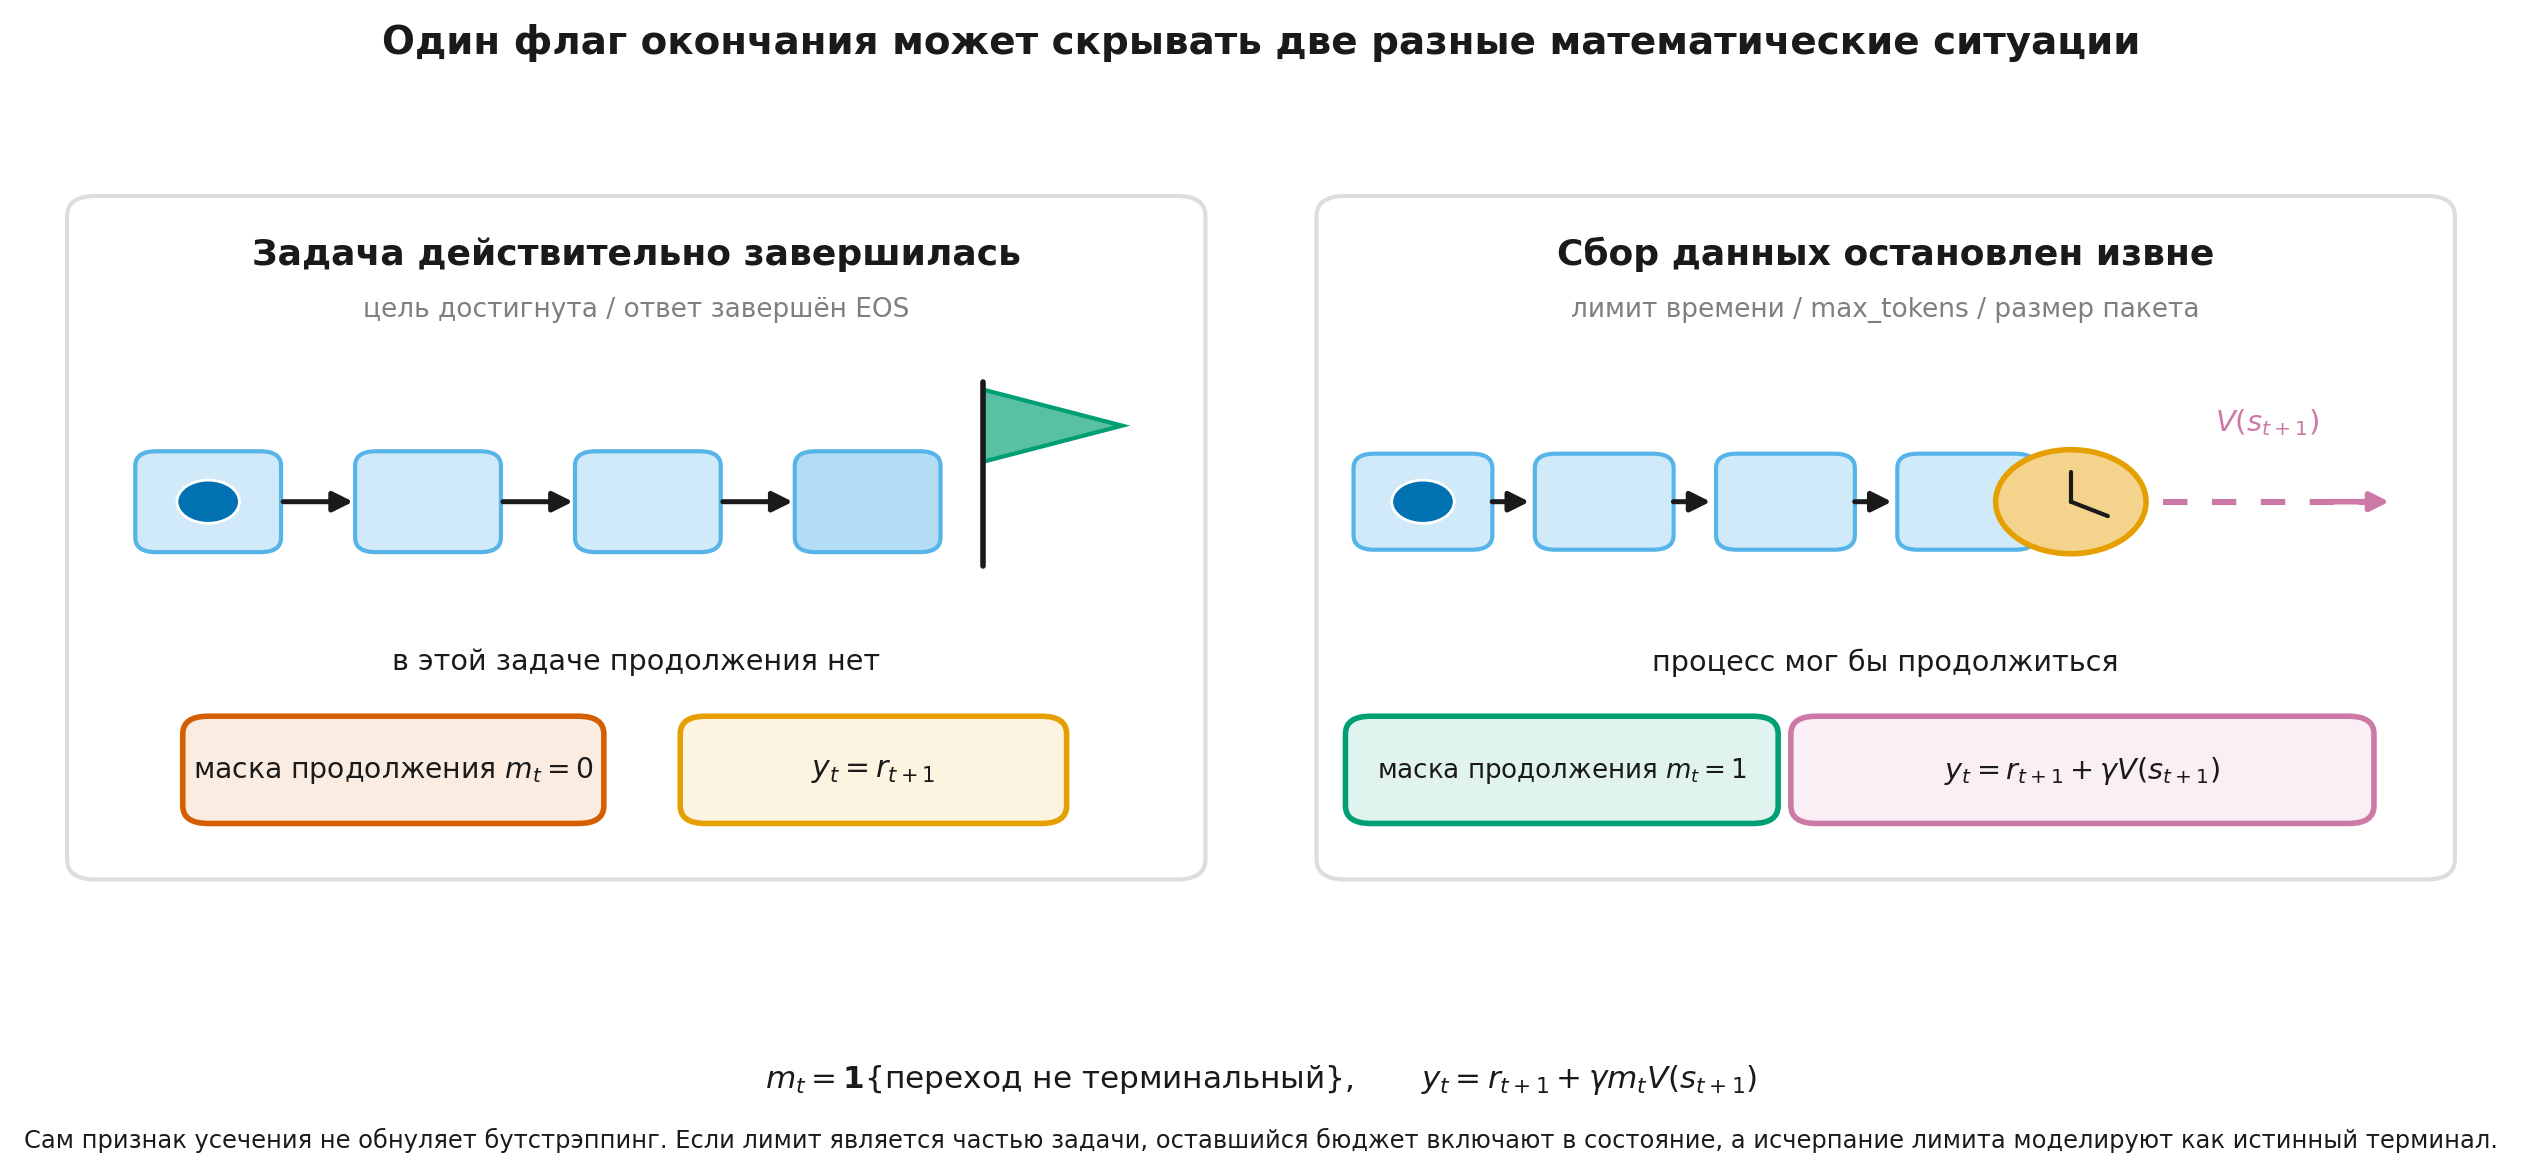
Если временной лимит является частью самой задачи, оставшийся бюджет нужно включить в состояние. Тогда исчерпание бюджета может быть настоящим терминальным условием. Если лимит введён только для удобства сбора данных, обнулять продолжение обычно ошибочно.
Для LLM различие видно особенно хорошо:
- токен конца последовательности (
end of sequence, EOS) обычно выражает завершение ответа; - остановка по
max_tokensчасто является усечением, если более длинная генерация всё ещё имела бы смысл; - в задаче «дать ответ не более чем за 256 токенов» тот же лимит входит в определение цели и может быть терминальным исходом;
- остановка роллаута из-за заполнения пакета — свойство инфраструктуры, а не задачи.
Смешение двух случаев вносит систематическое смещение. Если истинная ценность продолжения положительна, ошибочное обнуление усечённой траектории занижает цель; если отрицательна — завышает. Поэтому современные интерфейсы Gymnasium передают terminated и truncated раздельно. Само наличие двух флагов, однако, не снимает ответственность с автора среды: нужно правильно решить, является ли лимит частью задачи.
Шаг 2.1.4 — Три функции ценности: V, Q и преимущество A
Зафиксируем политику и накопленную награду
для продолжающейся задачи либо соответствующую конечную сумму для эпизода.
Ценность состояния — ожидаемый итог, если начать в и далее следовать политике:
Ценность действия — ожидаемый итог, если первое действие зафиксировать, а затем следовать политике:
Поэтому ценность состояния является средним значением по действиям политики:
Преимущество (advantage) сравнивает действие со средним поведением той же политики:
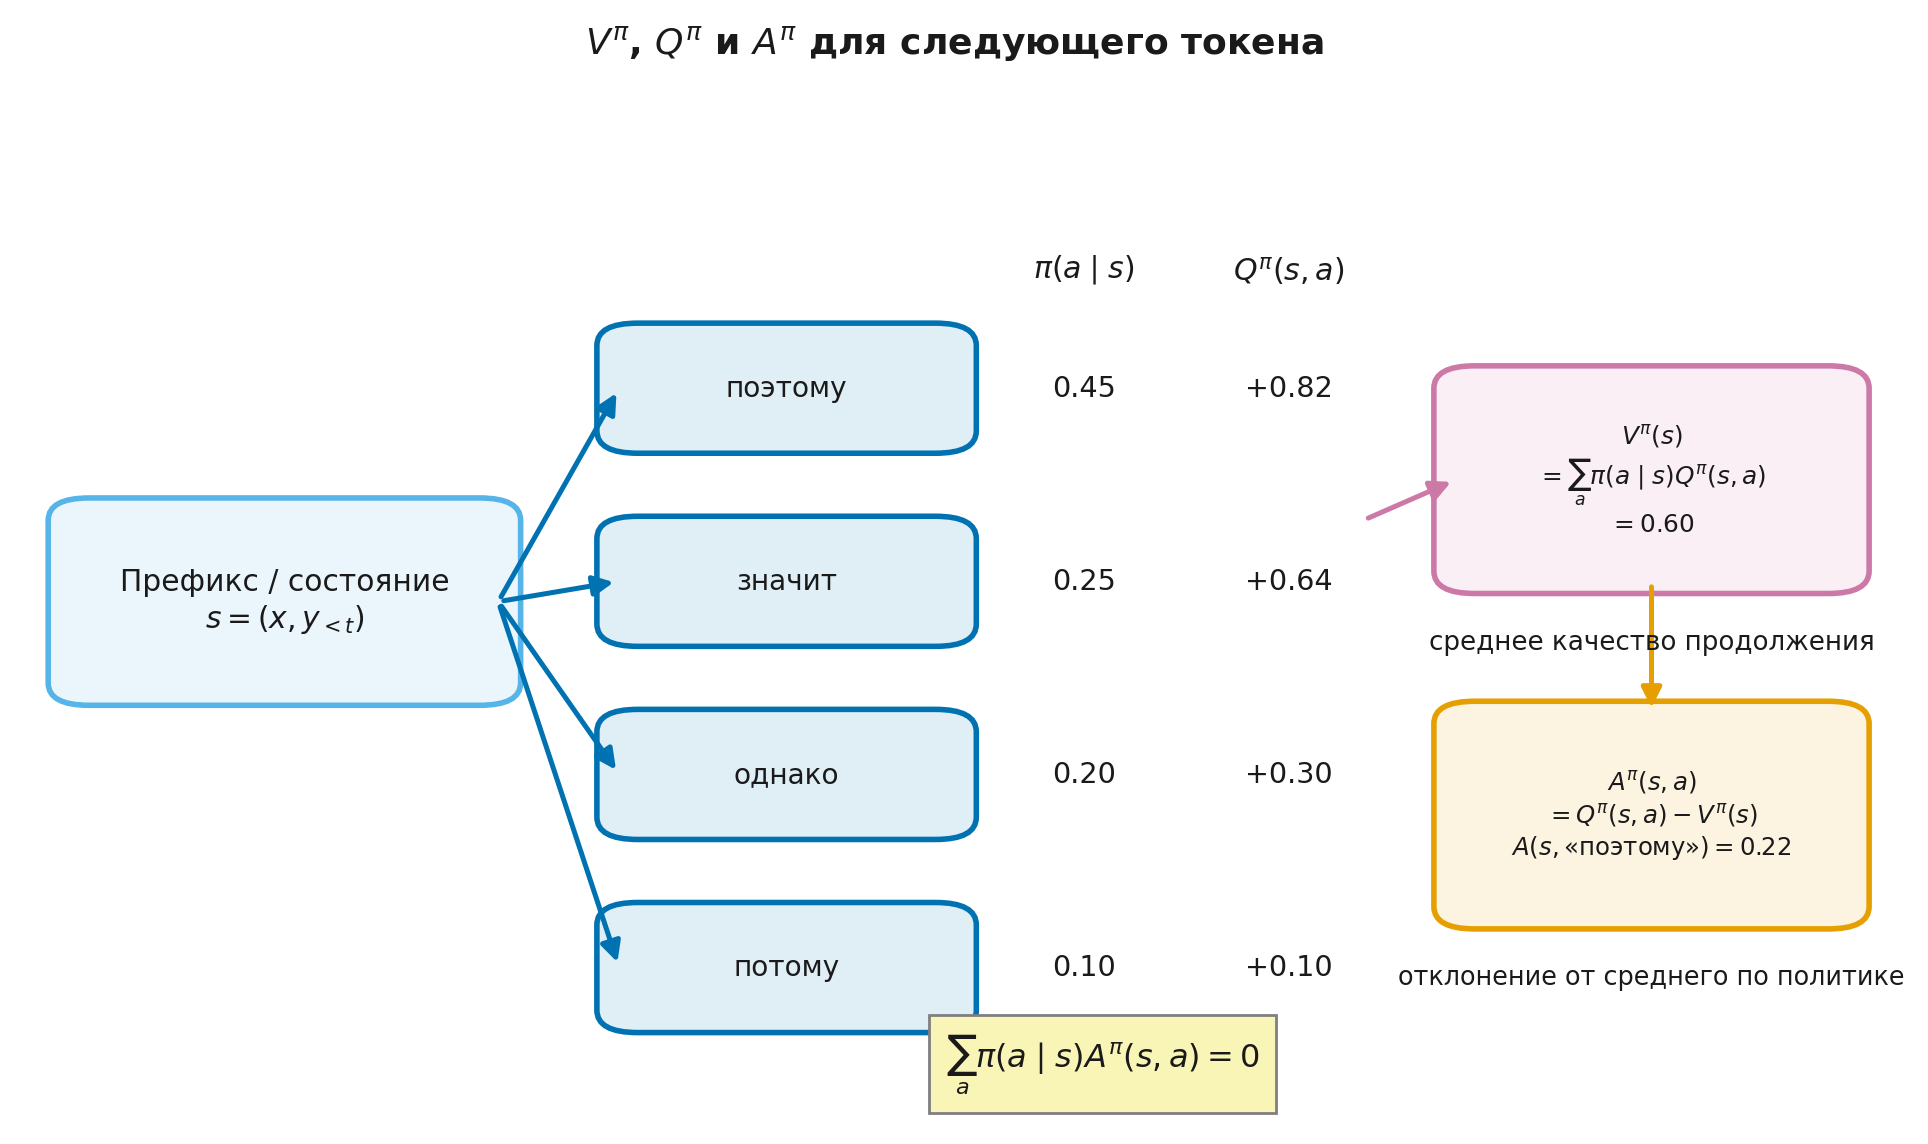
Из определения сразу следует
Положительное означает «лучше среднего действия текущей политики в этом состоянии», а не «объективно хорошее действие при любой политике».
Есть и полезная инвариантность. Если ко всем в одном состоянии прибавить одну и ту же константу , то пересчитанное сдвинется на ту же величину, а не изменится:
Это утверждение относится к сдвигу оценок действий в фиксированном состоянии. Оно не означает, что произвольное изменение функции награды оставляет преимущества неизменными во всём MDP.
Для терминального состояния в принятом соглашении . Финальная награда ответа или эпизода при этом относится к переходу в терминал и уже входит в .
Шаг 2.1.5 — Как читать ценности для LLM
В токеновой модели состояние — запрос и уже созданный префикс, а действие — следующий токен. Тогда:
- — ожидаемая итоговая награда, если сейчас выбрать токен , а дальше продолжать по ;
- — средняя итоговая награда продолжения, полученного из текущего распределения токенов;
- — насколько выбор токена лучше или хуже среднего выбора текущей политики.
Маленькое дерево префиксов помогает прочитать определения без нейросетевого шума. Пусть после слова «потому» политика с вероятностью выбирает «проверить» и получает награду , а с вероятностью выбирает «пропустить» и получает . Тогда
Если альтернативный префикс «угадаю» имеет ценность , а в пустом префиксе политика выбирает «потому» с вероятностью , то
Именно такой расчёт выполняется в ноутбуке. Он не моделирует масштаб настоящей LLM, но показывает точный смысл токенового : мы фиксируем один следующий токен и усредняем все последующие продолжения по политике.
В реальной модели оценивание трудно: пространство префиксов огромно, итоговая награда часто появляется только после полного ответа, а два почти одинаковых рассуждения могут получить разные оценки. Поэтому нейросетевой RL использует аппроксиматоры ценности, модели оценки промежуточных шагов или методы без отдельного обучаемого критика.
Здесь легко сделать слишком сильный вывод о групповой относительной оптимизации политики (group relative policy optimization, GRPO). В исходной постановке DeepSeekMath для одного запроса генерируется группа полных ответов, а награды нормируются внутри группы. Это даёт относительный сигнал без отдельной модели ценности. Но выборочная статистика конечной группы относится к запросу и полным ответам; она не является точным для каждого токенового префикса. Более поздние варианты GRPO меняют нормировку, агрегацию и распределение сигнала по токенам, поэтому название метода само по себе не фиксирует все детали.
Главный мост. Функция ценности отвечает на вопрос: «чего в среднем стоит продолжение, которого мы ещё не увидели целиком?» Критик в PPO, групповая базовая оценка в GRPO и оценка частичного рассуждения при поиске приближают эту идею разными способами. Они не являются одной математической конструкцией.
Дальнейшее углубление: Модуль 4 (rl_llm.module_04_policy_gradients) свяжет преимущество с градиентом политики и GAE; Модуль 9 (rl_llm.module_09_rlvr_grpo) подробно разберёт GRPO и его варианты. Modern LLMs, Модуль 15 «Модели рассуждения и вычисления во время инференса (test-time compute)» (modern_llms.module_13_reasoning), даёт архитектурный контекст для оценки промежуточных шагов.
Урок 2.2. Уравнения Беллмана: оценивание и улучшение
Урок 2.2. Уравнения Беллмана: оценивание и улучшение
- Одношаговое разложение накопленной награды
- Точное оценивание политики как линейная система
- Оптимальность и точное условие сжатия
- Оценивание, улучшение и обобщённая итерация политики
- Воспроизводимый пример: FrozenLake
далее — 6 проверочных шагов
Шаг 2.2.1 — Одношаговое разложение накопленной награды
В Модуле 1 мы получили рекуррентность
Возьмём условное математическое ожидание при и фиксированной политике . Получим уравнение ожидания Беллмана:
Терминальные состояния можно оставить в сумме, если договориться, что их продолжение равно нулю. Награда на переходе в терминал при этом сохраняется в .
Прочитаем формулу словами:
ценность состояния равна ожидаемой немедленной награде плюс дисконтированная ценность продолжения; ожидание берётся по действию политики и случайному переходу среды.
Для первое действие уже зафиксировано:
Введём оператор Беллмана фиксированной политики:
Истинная функция ценности является его неподвижной точкой:
Слово «оператор» означает правило, которое берёт целый вектор оценок и строит новый вектор одношаговых оценок.
Что уравнение Беллмана не делает само. Оно не выбирает способ сбора данных, не задаёт нейросетевую архитектуру и не гарантирует, что градиентный оптимизатор найдёт неподвижную точку. Это условие согласованности, из которого строятся разные точные и приближённые алгоритмы.
Шаг 2.2.2 — Точное оценивание политики как линейная система
При фиксированной политике можно объединить действия и получить:
Уравнение Беллмана становится векторным:
а значит,
Для конечного дисконтированного MDP с матрица обратима, поэтому решение единственно. При общая гарантия через дисконтирование исчезает. В эпизодической задаче систему всё же можно решить по нетерминальным состояниям, если при фиксированной политике терминал достигается почти наверное и соответствующая матрица невырождена.
Классический пример — поле с терминалами в левом верхнем и правом нижнем углах, наградой за каждый шаг и равновероятными движениями. Точное решение для :
Числа читаются как ожидаемое отрицательное число шагов до терминала при случайной политике. Чем дальше состояние в среднем от завершения, тем ниже его ценность.
Для приближённой функции полезен остаток Беллмана:
Нулевой остаток означает точное выполнение уравнения, но малый остаток нужно интерпретировать с учётом . При :
Когда близок к единице, даже небольшой одношаговый остаток может соответствовать заметной ошибке длинного горизонта.
Шаг 2.2.3 — Оптимальность и точное условие сжатия
Оценивание отвечает на вопрос «насколько хороша фиксированная политика?». Управление требует другого вопроса: «какое действие выбрать лучше всего?»
Оптимальная функция ценности удовлетворяет
Определим оператор оптимальности:
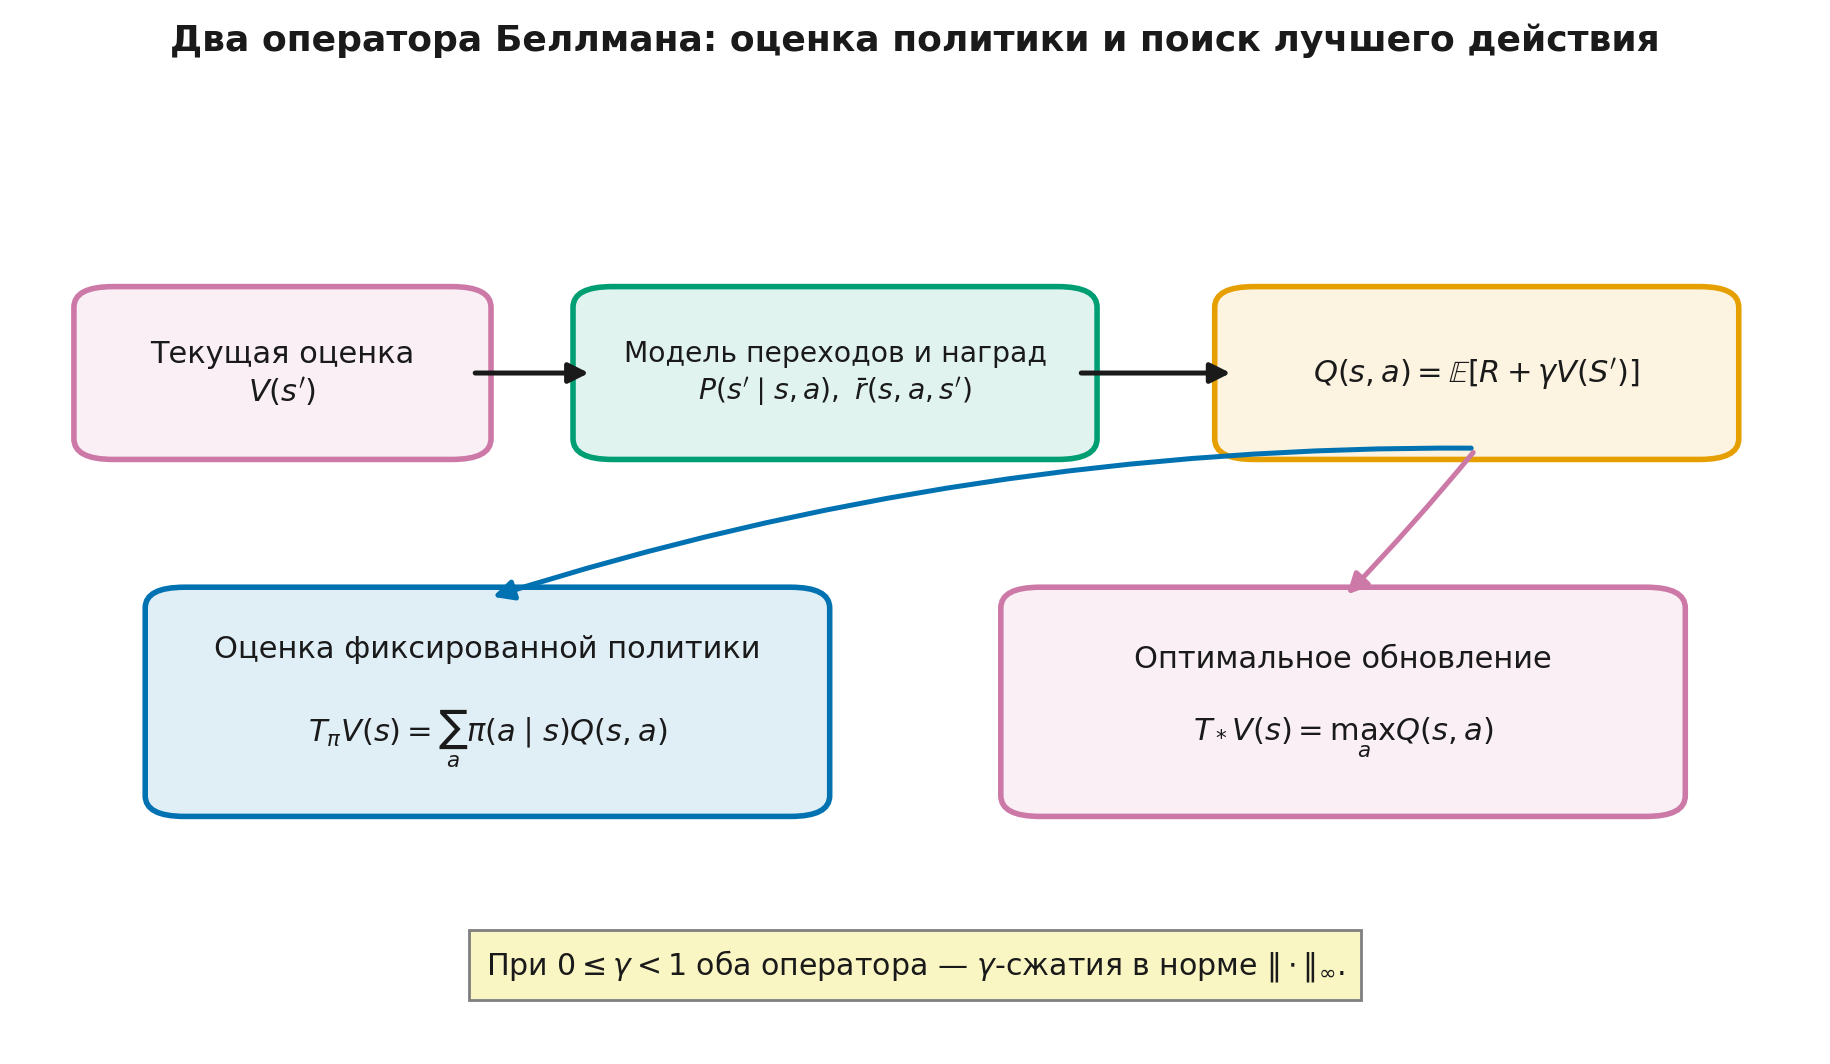
При оба оператора являются -сжатиями в норме максимума. Для ключевой шаг таков:
После максимизации по состояниям:
Отсюда следует единственность неподвижной точки и геометрическая сходимость итераций .
Граница результата существенна. При коэффициент сжатия равен единице, поэтому это доказательство уже не даёт сходимость. Некоторые конечные эпизодические задачи при всё равно корректно решаются методами динамического программирования, но для этого нужны дополнительные условия. Например, в постановке стохастического кратчайшего пути должна существовать политика, которая из каждого релевантного состояния достигает терминала почти наверное за конечное ожидаемое число шагов; незавершающиеся политики нельзя оставлять конкурентоспособными как будто они имеют обычную конечную стоимость. Одной фразы «в задаче есть терминал» недостаточно. Поэтому утверждение «оператор Беллмана всегда является строгим сжатием» без указания режима неверно.
Шаг 2.2.4 — Оценивание, улучшение и обобщённая итерация политики
Из уравнений Беллмана получаются два чередующихся действия.
- Оценивание политики: приблизить для текущей .
- Улучшение политики: выбирать действия, максимизирующие одношаговую оценку
Если оценивание доводить до сходимости, а затем делать жадное улучшение, получается итерация политики (policy iteration). Если на каждом проходе сразу применять максимум, получается итерация ценности (value iteration):
Более общий принцип называется обобщённой итерацией политики (generalized policy iteration, GPI): оценивание и улучшение могут быть неполными, асинхронными и выполняться с разной скоростью, но оба процесса постепенно приводят политику и её оценку к согласованности.
| Метод | Что фиксировано внутри обновления | Что получается после сходимости |
|---|---|---|
| Итеративное оценивание | политика | |
| Итерация политики | полное оценивание, затем жадное улучшение | оптимальная политика |
| Итерация ценности | максимум выполняется в каждом одношаговом обновлении | и жадная политика |
GPI — не отдельный алгоритм с одной формулой, а схема мышления. В методах «актор–критик» критик оценивает, а актор улучшает политику. В табличном управлении эту же пару операций видно без нейросетей и оптимизаторов.
Шаг 2.2.5 — Воспроизводимый пример: FrozenLake
В module_2_reference.py построена собственная NumPy-версия FrozenLake со скользкими переходами. В каждой клетке выбранное направление и два боковых отклонения имеют вероятность . Лунки и цель терминальны. Награда выдаётся только на переходе в цель.
Пусть — число переходов до окончания эпизода, то есть до цели или лунки. Поскольку единичная награда выдаётся только на переходе в цель, успешная траектория вносит в величину , а неуспешная — ноль. Поэтому для оптимального поведения
При это не простая вероятность успеха: раннее достижение цели имеет больший вес, чем позднее.
from module_2_reference import build_frozen_lake_4x4, value_iteration

P, R, terminal = build_frozen_lake_4x4()
V, sweeps = value_iteration(P, R, gamma=0.9, terminals=terminal)
print(sweeps)
print(V.reshape(4, 4))
При допуске синхронная итерация ценности из нулевого вектора выполняет 145 полных проходов и даёт
[[0.068891 0.061415 0.074410 0.055807]
 [0.091855 0.000000 0.112208 0.000000]
 [0.145436 0.247497 0.299618 0.000000]
 [0.000000 0.379936 0.639020 0.000000]]
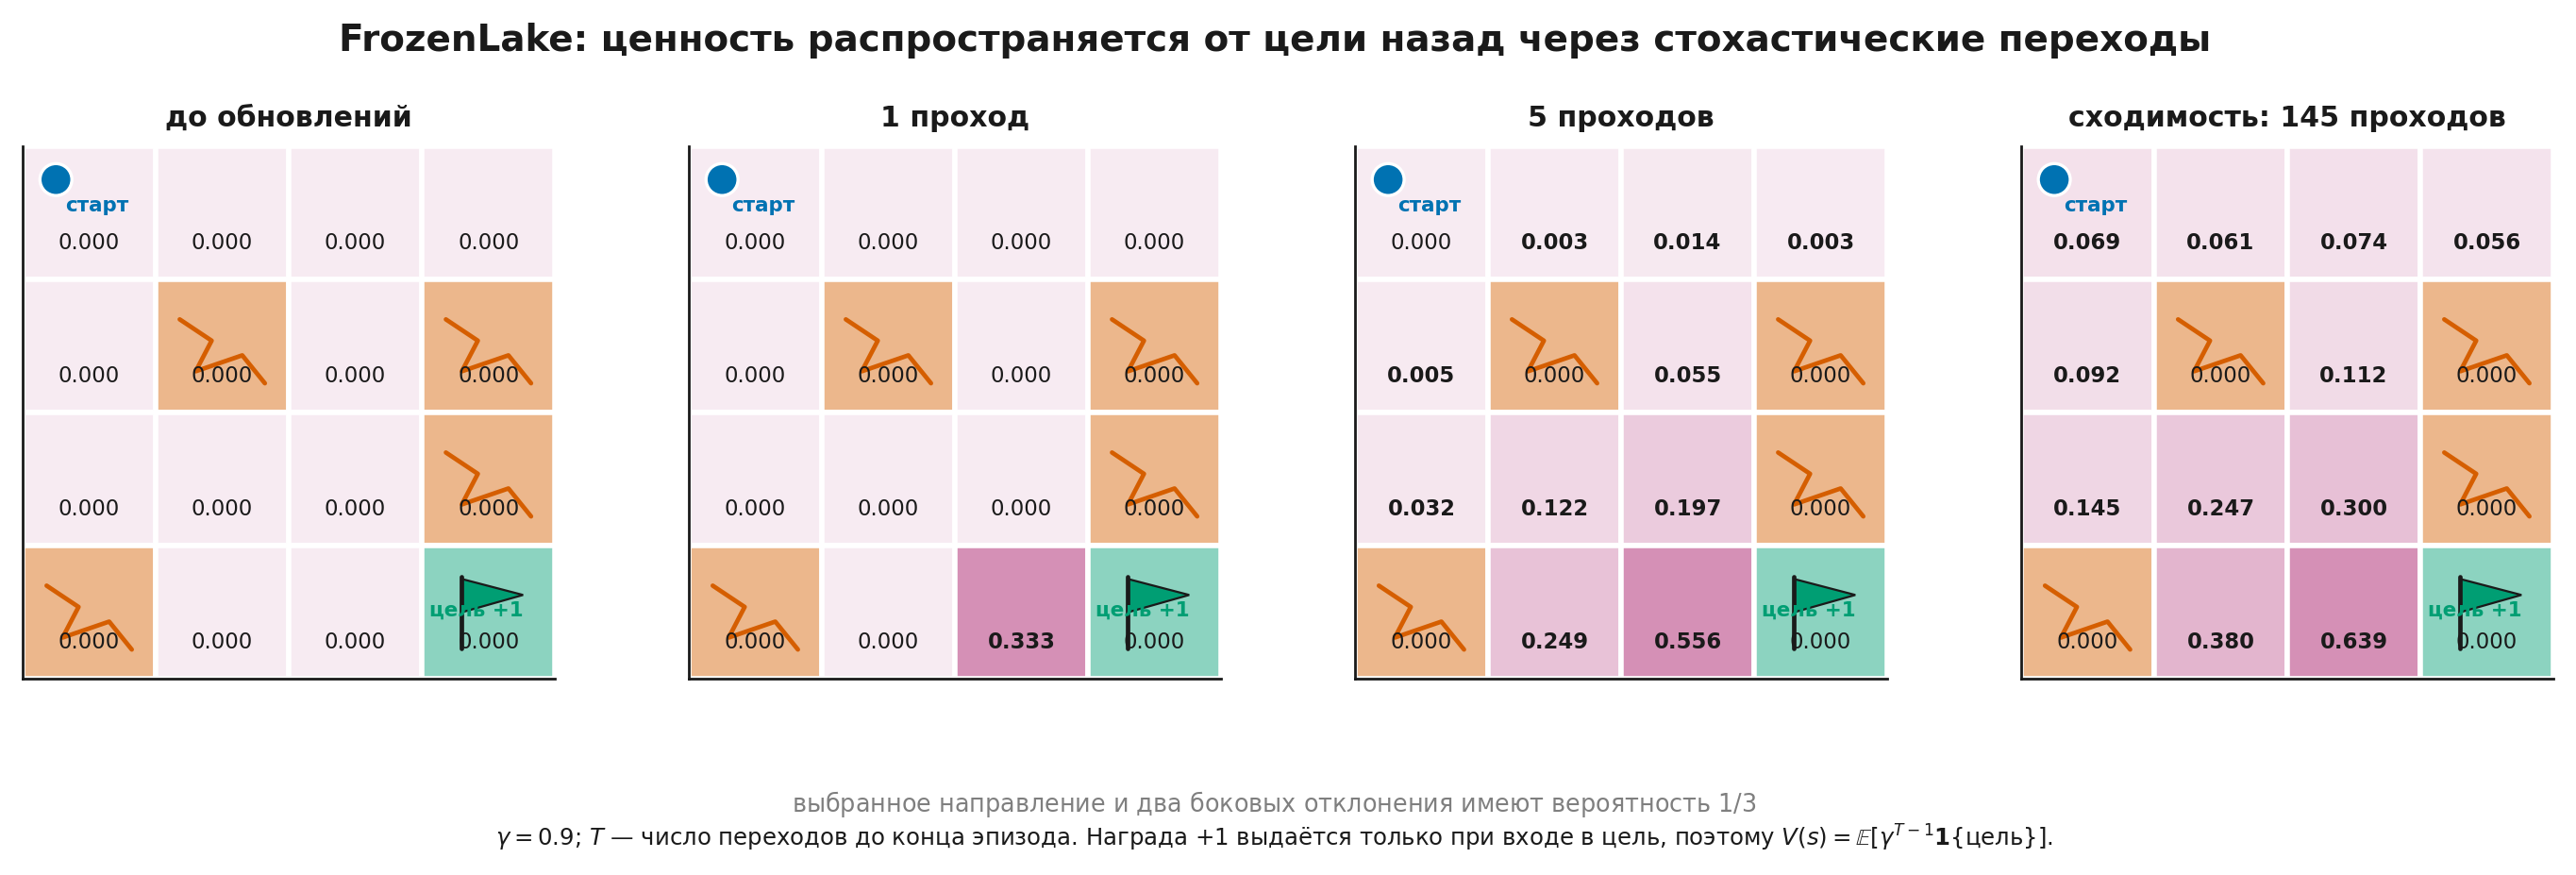
На первом проходе ненулевая ценность появляется только там, откуда можно попасть в цель одним переходом. Следующие проходы переносят сигнал назад через стохастическую динамику. Это не «награда физически течёт по клеткам», а повторное применение одношагового оператора к всё более точной оценке продолжения.
Число 145 — свойство этого протокола: модели переходов, нумерации действий, , нулевой инициализации, синхронных обновлений и критерия остановки. Асинхронный порядок, другой допуск или другое изменят число проходов.
Почему табличный алгоритм нужен в курсе про LLM? Не потому, что мы собираемся хранить таблицу для всех префиксов. Он делает видимыми три идеи, которые сохраняются при масштабировании:
- одношаговая цель связывает текущую оценку с оценкой продолжения;
- оценивание и улучшение образуют обратную связь;
- ошибка продолжения распространяется по горизонту.
При нейросетевой аппроксимации исчезают простые гарантии табличного случая: обновления зависят от распределения данных, оптимизации, архитектуры и совместного изменения параметров. Уравнение Беллмана остаётся целевой связью, но не обещает автоматической сходимости обучения.
Урок 2.3. Оценивание без модели: от полной траектории к бутстрэппингу
Урок 2.3. Оценивание без модели: от полной траектории к бутстрэппингу
- Задача предсказания по собранным траекториям
- Метод Монте-Карло
- Один наблюдённый шаг и оценка продолжения
- Многошаговая цель соединяет MC и TD
- Коридор: сравниваем оценки, а не лозунги
далее — 6 проверочных шагов
Шаг 2.3.1 — Задача предсказания по собранным траекториям
До сих пор мы предполагали, что известны и . В реальной среде агент обычно видит только выборку переходов
Задача предсказания (prediction) состоит в оценивании или для фиксированной политики по данным взаимодействия, без явной таблицы динамики.
Любой метод такого рода выбирает целевое значение и приближает к нему текущую оценку. Для табличного типичное обновление:
где — размер шага. Методы различаются прежде всего тем, что берут в качестве .
- Полная наблюдённая накопленная награда почти не опирается на текущую оценку, но требует дождаться конца эпизода.
- Одношаговая цель доступна сразу, но использует ещё не точное .
- Промежуточные -шаговые цели используют часть наблюдённых наград и затем выполняют бутстрэппинг.
Бутстрэппинг (bootstrapping) означает, что оценка обновляется с помощью другой текущей оценки. Это не то же самое, что статистический бутстрэп с повторной выборкой.
Шаг 2.3.2 — Метод Монте-Карло
Метод Монте-Карло (Monte Carlo, MC) использует фактически наблюдённую накопленную награду:
Для первого посещения состояния в каждом эпизоде можно хранить среднее всех последующих :
Если эпизоды действительно получены фиксированной политикой, завершение корректно, а накопленная награда имеет конечное ожидание, это обычное выборочное среднее наблюдений с математическим ожиданием . В таком ограниченном смысле MC-цель не использует смещённую текущую оценку продолжения.
Но из этого не следует, что любой практический MC-оцениватель автоматически несмещён. Техническое усечение, меняющаяся политика, постоянный размер шага, начальное значение оценки и зависимость повторно используемых данных могут изменить его статистические свойства.
Сильные стороны MC:
- не нужна модель переходов;
- нет бутстрэппинга;
- ошибка текущего не входит в целевое значение.
Ограничения:
- нужно дождаться достаточного продолжения или конца эпизода;
- одна терминальная награда может давать большую дисперсию;
- длинные эпизоды дороги;
- при редких посещениях данные накапливаются медленно.
Полный ответ LLM с одной итоговой оценкой даёт на уровне последовательности сигнал, похожий на MC-оценку: результат наблюдается после генерации, но вклад отдельных токенов остаётся скрытым.
Шаг 2.3.3 — Один наблюдённый шаг и оценка продолжения
Обучение по временным различиям (temporal-difference learning, TD) обновляет оценку до завершения эпизода. Одношаговый вариант TD(0) использует
для нетерминального перехода. Ошибка временного различия:
Обновление:
Для настоящего терминала продолжение обнуляется:
Для технического усечения, при котором процесс мог бы продолжаться, обычно сохраняется в цели.
TD(0) использует меньше случайных будущих наград, но опирается на текущую оценку. Поэтому в конечной выборке у цели появляется зависимость от ошибки . Часто это снижает дисперсию ценой смещения, однако универсального порядка «TD всегда лучше MC» или «MC всегда точнее TD» нет. Результат зависит от среды, представления, размера шага и бюджета данных.
Полезная интуиция: MC ждёт счёт за весь маршрут; TD пересчитывает текущую оценку после каждого нового участка пути.
Шаг 2.3.4 — Многошаговая цель соединяет MC и TD
Если в следующих переходах задача не завершилась, -шаговая цель имеет вид
При получаем TD(0). Если окно дошло до истинного терминала раньше , сумма обрывается на последней наблюдённой награде, а бутстрэппинг отсутствует. В частности, когда покрывает весь остаток эпизода, цель превращается в MC-цель.
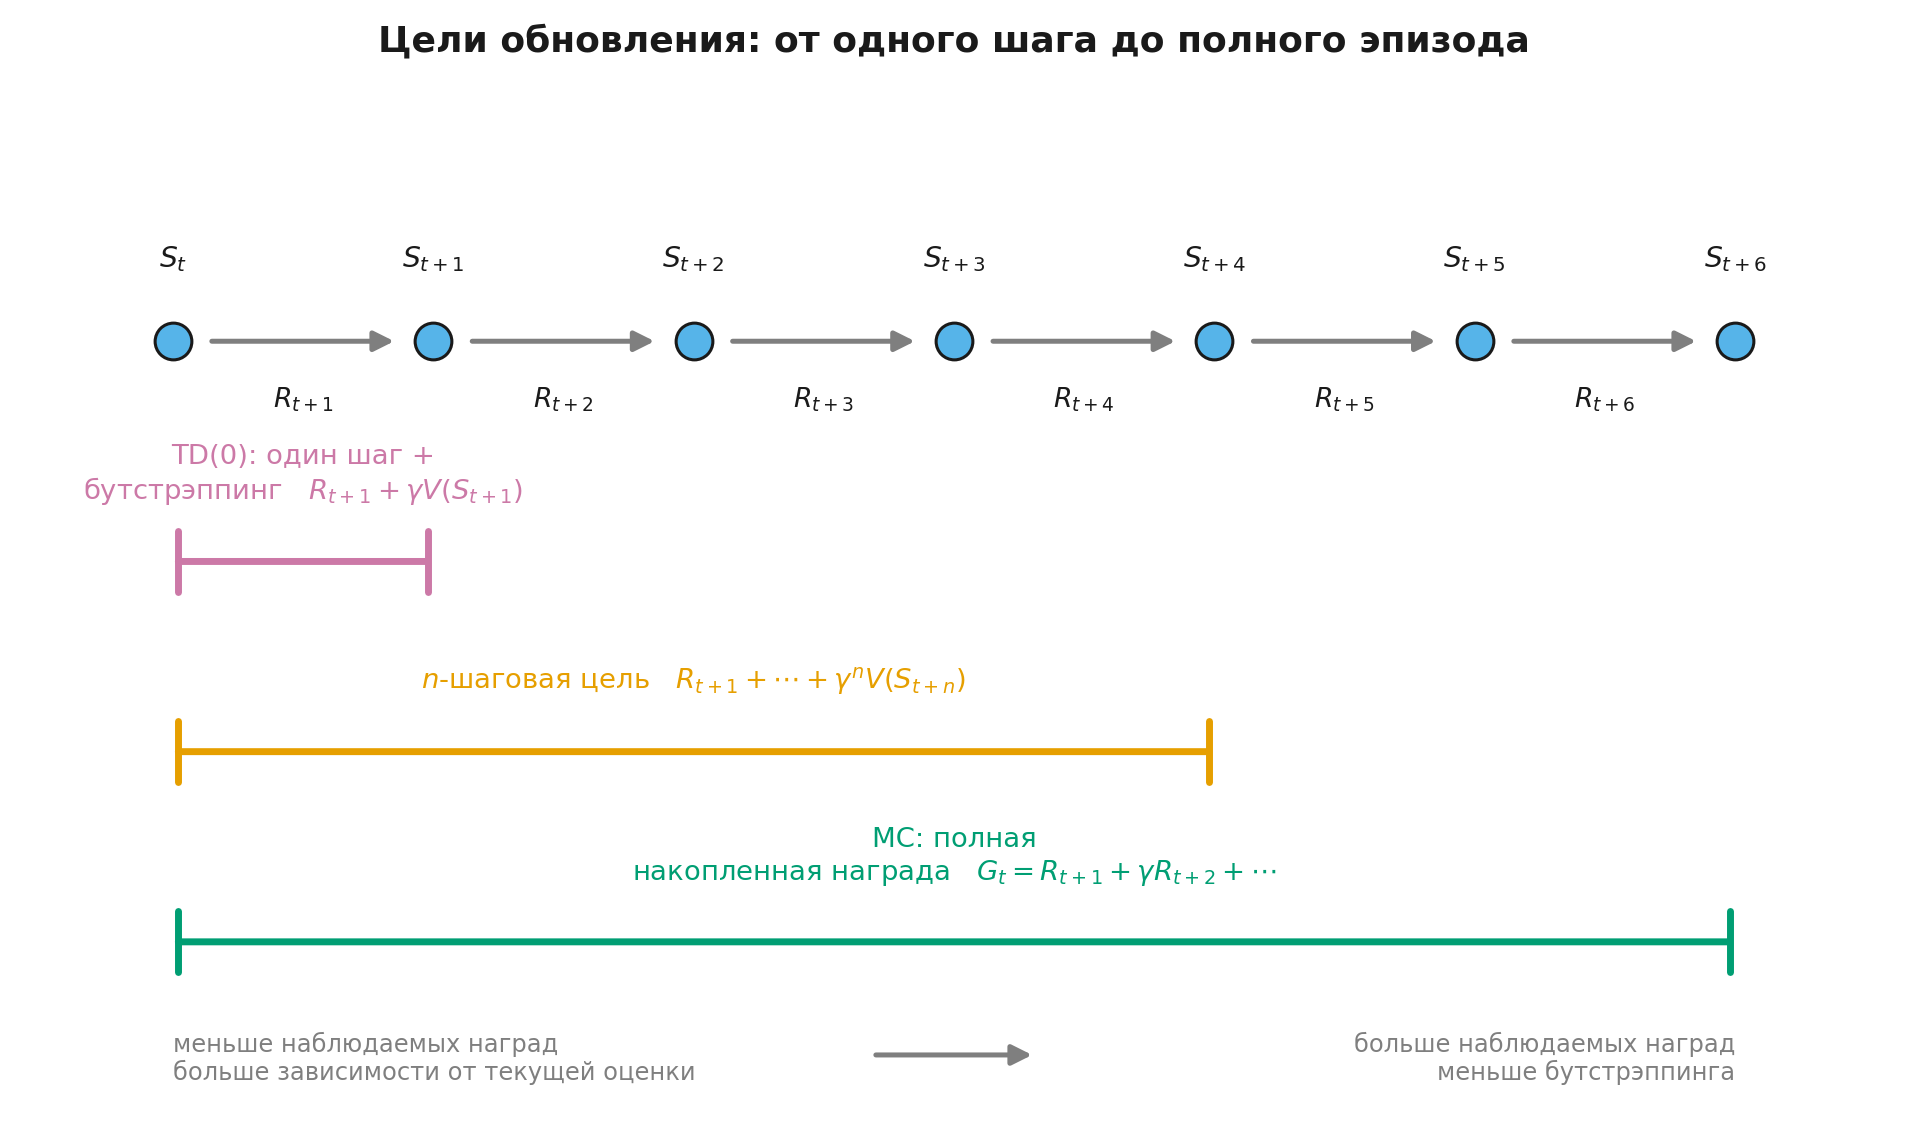
С ростом :
- в цель входит больше реально наблюдённых наград;
- уменьшается зависимость от текущего ;
- обновление приходится ждать дольше;
- обычно возрастает влияние случайности более длинного хвоста.
Это не монотонная гарантия качества. Ошибка текущего , корреляция переходов, размер шага и длина эпизода могут менять оптимальный горизонт.
Позже обобщённая оценка преимущества (generalized advantage estimation, GAE) объединит TD-ошибки разных горизонтов экспоненциальными весами. Здесь важно увидеть основу: многошаговая цель — не новая функция ценности, а способ выбрать место, где наблюдённая часть траектории уступает место текущей оценке продолжения.
Функция n_step_target() в эталонном модуле принимает список наблюдённых наград, значение продолжения, и явный признак терминального конца окна. Это не даёт случайно принять внешнее усечение за настоящий терминал.
Шаг 2.3.5 — Коридор: сравниваем оценки, а не лозунги
Возьмём симметричный коридор с терминалами 0 и 4, стартом из середины и равновероятными действиями влево и вправо. Награда выдаётся только при входе в правый терминал. При точные значения равны вероятностям добраться вправо раньше, чем влево:
График построен по единому протоколу:
- бюджеты от 20 до 2500 эпизодов;
- 40 независимых начальных значений генератора;
- MC первого посещения;
- TD(0) и трёхшаговый TD с постоянным ;
- ошибка — корень из средней квадратичной ошибки (
root mean squared error, RMSE) по трём нетерминальным состояниям; - линия показывает медиану, полоса — межквартильный диапазон.
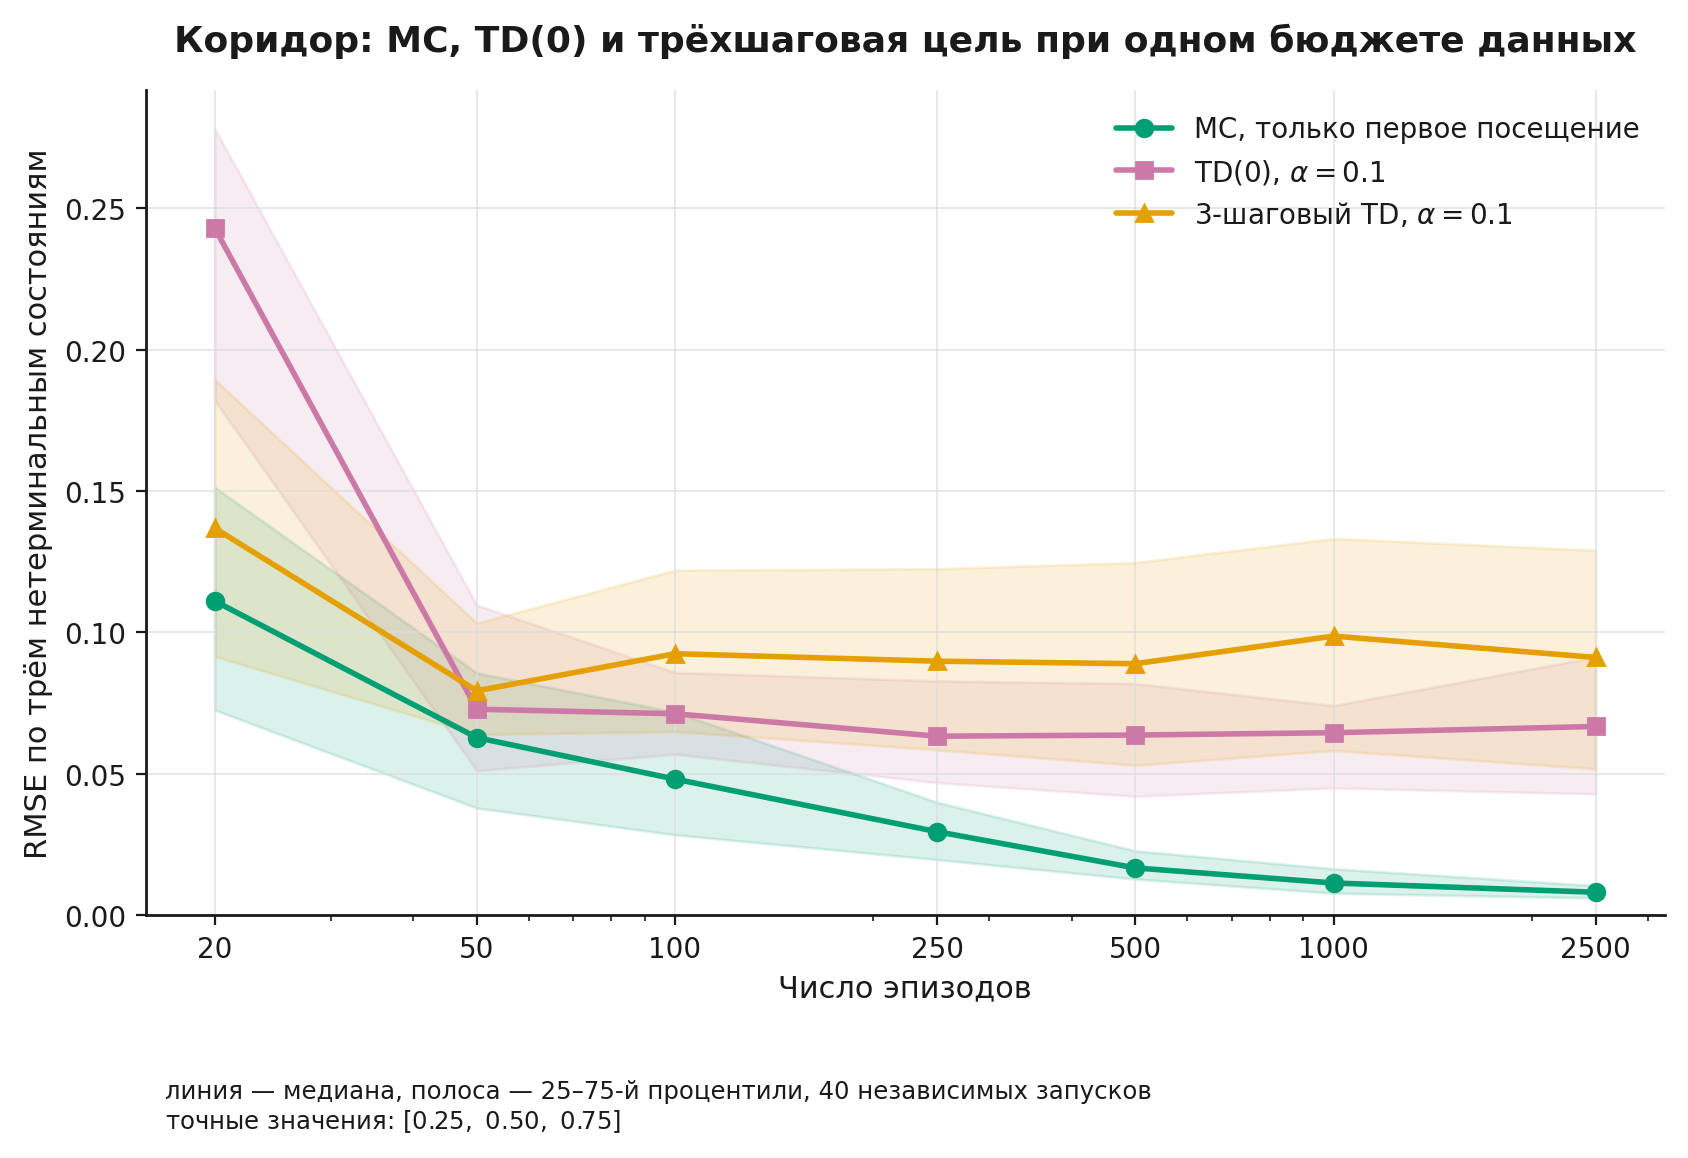
Эксперимент намеренно не поддерживает лозунг «один метод всегда лучше». При малом бюджете важны шум и начальные условия. При большом бюджете выборочное среднее MC продолжает приближаться к точному значению. TD с постоянным размером шага сохраняет остаточные колебания; трёхшаговая цель в этом протоколе занимает не постоянное «среднее место», а собственную кривую, зависящую от того, как наблюдённые награды сочетаются с текущей оценкой.
Воспроизводимые контрольные значения:
exact: [0.00, 0.25, 0.50, 0.75, 0.00]
MC, 1000 episodes, seed=7:
       [0.00, 0.255539, 0.496000, 0.733728, 0.00]
TD(0), 1000 episodes, seed=42, alpha=0.1:
       [0.00, 0.233105, 0.582660, 0.829850, 0.00]
3-step TD, 1000 episodes, seed=42, alpha=0.1:
       [0.00, 0.248712, 0.523243, 0.769480, 0.00]
Разные начальные значения генератора в контрольных строках нужны для воспроизводимости конкретных функций, а не для объявления победителя. Если уменьшать , менять горизонт, использовать аппроксимацию, повторное использование данных или нестационарную среду, картина изменится.
Мост к LLM. Итоговая награда полного ответа похожа на MC-наблюдение. Критик, модель оценки промежуточного шага или иной предсказатель продолжения вводит бутстрэппинг. Групповая нормировка сравнивает полные ответы, но сама по себе не становится точной токеновой функцией ценности.
Урок 2.4. Управление: текущая и целевая политики
Урок 2.4. Управление: текущая и целевая политики
- От оценки фиксированной политики к улучшению поведения
- Две цели обновления различаются одной строкой, но не смыслом
- CliffWalking: один протокол, разные маршруты
- Почему максимум завышает шумные оценки
- Что переносится в RL для LLM, а что остаётся табличной учебной моделью
далее — 6 проверочных шагов
Шаг 2.4.1 — От оценки фиксированной политики к улучшению поведения
В задаче управления политика меняется во время обучения. Полезно различать:
- политику поведения (
behavior policy) — ту, которая фактически выбирает действия и собирает данные; - целевую политику (
target policy) — ту, чью функцию ценности мы оцениваем или улучшаем.
Если они совпадают, метод обучается по данным текущей политики (on-policy). Если целевая политика отличается от политики поведения, метод обучается по данным другой политики (off-policy). Эти определения относятся не к наличию буфера опыта и не к самому факту случайного исследования, а к тому, о какой политике делается вывод из каких данных.
Для исследования можно использовать -жадную политику:
- с вероятностью выбрать действие с максимальным ;
- с вероятностью выбрать случайное действие.
Это простейший способ не замкнуться сразу на первом найденном маршруте. Систематическое исследование будет темой Модуля 3; здесь нужен, чтобы увидеть различие двух целей обновления.
Шаг 2.4.2 — Две цели обновления различаются одной строкой, но не смыслом
Оба метода обновляют табличное :
Метод «состояние–действие–награда–состояние–действие» (state–action–reward–state–action, SARSA) использует следующее действие, действительно выбранное политикой поведения:
Если поведение -жадное, SARSA оценивает последствия вместе с будущим исследованием. Это метод по данным текущей политики.
Q-learning использует жадную цель независимо от того, какое следующее действие будет фактически выполнено:
Данные может собирать -жадная политика, но цель относится к жадной политике. Поэтому Q-learning является методом по данным другой политики.
Для терминального перехода обе цели равны только . Для технически усечённой траектории продолжение обычно не обнуляется.
В конечном дисконтированном табличном MDP с ограниченными наградами Q-learning сходится к при классических условиях: каждая пара состояние–действие посещается бесконечно часто, а последовательности размеров шага для каждой пары удовлетворяют и . Это асимптотическое утверждение о табличной стохастической аппроксимации. Постоянный размер шага, конечный набор данных, нейросетевая функция , меняющаяся цель и совместно обучаемые компоненты не наследуют гарантию автоматически.
Шаг 2.4.3 — CliffWalking: один протокол, разные маршруты
В CliffWalking агент идёт из левого нижнего угла в правый. Обычный шаг даёт . Попадание в обрыв даёт и возвращает агента к старту. Во время обучения политика остаётся -жадной.
Фиксированный протокол статической иллюстрации:
- начальное значение генератора 0;
- 500 эпизодов;
- ;
- ;
- ;
- жадная проверка после обучения.
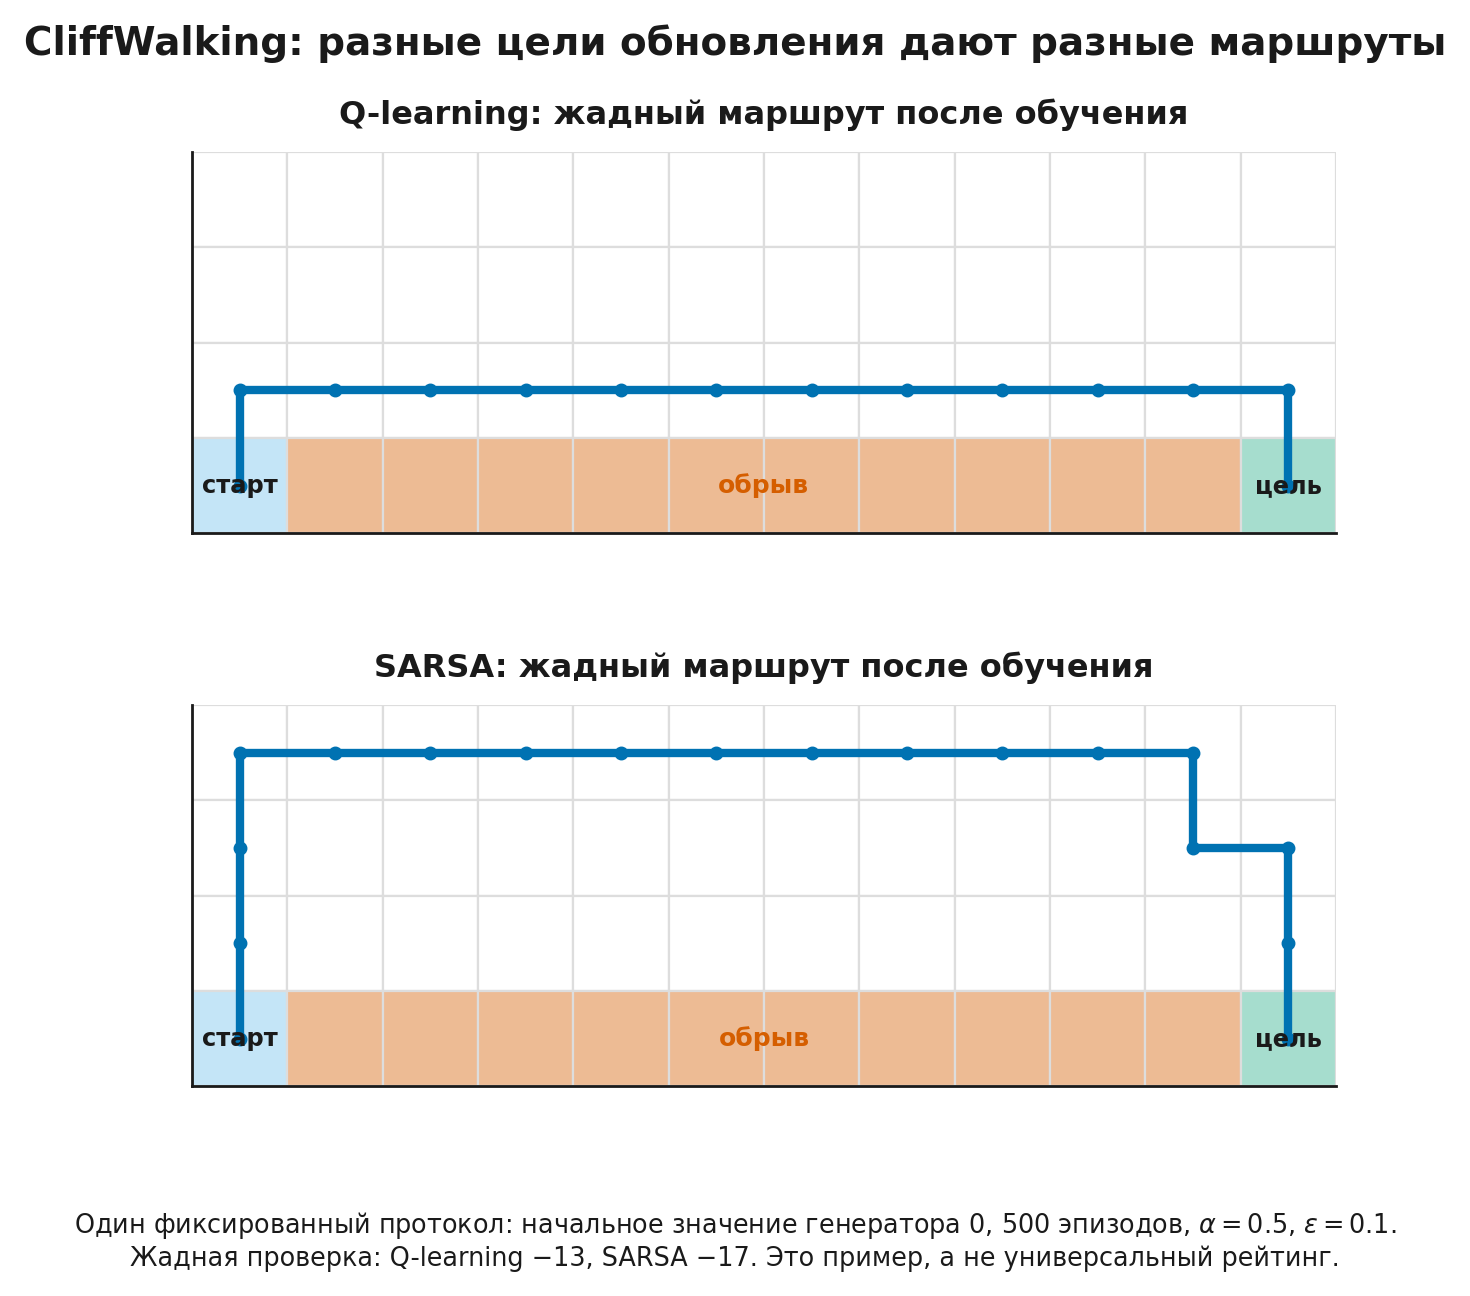
Результаты этого воспроизводимого запуска:
| Метод | Накопленная награда жадного маршрута | Средняя накопленная награда во время обучения |
|---|---|---|
| Q-learning | ||
| SARSA |
Q-learning оценивает маршрут так, будто будущие действия будут жадными, поэтому находит короткий путь рядом с обрывом. Но фактическое -жадное поведение иногда отклоняется и дорого падает. SARSA учитывает будущие исследовательские действия и в этом запуске выбирает более длинный маршрут с большим запасом.
Это не универсальный рейтинг. Изменятся , штраф, число эпизодов, инициализация или правило оценки — изменятся и результаты. Эксперимент показывает причинную связь между целью обновления и тем риском, который представляет обучаемая функция .
Шаг 2.4.4 — Почему максимум завышает шумные оценки
Пусть истинные ценности нескольких действий одинаковы, но оценки содержат шум:
Каждая оценка по отдельности может быть несмещённой, однако максимум выбирает действие, которому случайно досталась положительная ошибка:
Это смещение максимизации (maximization bias). Q-learning использует одну и ту же таблицу и для выбора действия, и для его оценки в цели, поэтому ошибка выбора может войти в обновление как завышенное продолжение.
Double Q-learning разделяет две роли. При обновлении первой таблицы действие выбирается по , а оценивается по :
Затем роли таблиц могут меняться. Если ошибки оценок достаточно независимы, случайное завышение, определившее выбор в , не обязано повториться в . Метод уменьшает типичное переоценивание, но не гарантирует отсутствие любой ошибки и в некоторых режимах может недооценивать максимум.
Есть полезная LLM-аналогия. Если из множества ответов выбрать тот, которому шумная модель награды присвоила наибольшую оценку, выбранный ответ часто выигрывает не только качеством, но и случайной ошибкой оценивателя. Разделение генерации, отбора и независимой проверки может уменьшить этот эффект. Это общий статистический механизм, а не утверждение, что ранжирование LLM буквально является Q-learning.
Шаг 2.4.5 — Что переносится в RL для LLM, а что остаётся табличной учебной моделью
Соберём главные идеи модуля.
- Состояние — не просто запись входа. Оно должно быть достаточным для будущей динамики. Полный префикс подходит для чистой авторегрессии, но внешняя среда может сделать задачу частично наблюдаемой.
- , и отвечают на разные вопросы. усредняет по политике, фиксирует первое действие, сравнивает действие со средним текущей политики.
- Уравнение Беллмана — одношаговая согласованность, а не готовый алгоритм обучения. Оно связывает оценку сейчас с наградой и оценкой продолжения.
- MC и TD выбирают разные места для бутстрэппинга. MC использует наблюдённый хвост; TD заменяет часть хвоста текущей оценкой; -шаговые цели соединяют крайние случаи.
- Политика поведения и целевая политика могут различаться. Именно это различие, а не наличие буфера, делает Q-learning off-policy.
- Максимизация шумных оценок создаёт систематическую проблему отбора. Double Q-learning разделяет выбор и оценивание, уменьшая один конкретный источник переоценивания.
- Причина окончания траектории входит в математику. Истинный терминал обнуляет продолжение, внешнее усечение — нет.
Табличные гарантии опираются на конечные пространства, корректную марковскую модель, достаточное исследование и специальные условия размеров шага. В RL для LLM пространства огромны, политика и функции ценности аппроксимируются нейросетями, награда может быть ошибочной, а распределение данных движется вместе с политикой. Формулы этого модуля дают язык описания и локальные цели обновления, но не обещают автоматической сходимости большой системы.
Краткий справочник:
| Сокращение | Полное название | Роль в модуле |
|---|---|---|
| MDP | Markov decision process | полностью наблюдаемая марковская модель |
| POMDP | partially observable Markov decision process | модель со скрытым состоянием |
| MC | Monte Carlo | оценивание по наблюдённой накопленной награде |
| TD | temporal-difference learning | обновление с бутстрэппингом |
| GPI | generalized policy iteration | чередование оценивания и улучшения |
| GAE | generalized advantage estimation | взвешенное сочетание TD-ошибок разных горизонтов |
| RMSE | root mean squared error | метрика ошибки эксперимента |
| EOS | end of sequence | токен завершения последовательности |
Источники и маршрут чтения
Ссылки проверены 4 августа 2026 года. Ни один источник ниже не заменяет ограничения, явно указанные в тексте.
- Sutton & Barto, Reinforcement Learning: An Introduction, 2-е изд. — https://incompleteideas.net/book/the-book-2nd.html. Основной источник для конечных MDP, функций ценности, уравнений Беллмана, MC, TD, SARSA, Q-learning и GPI. Табличная теория из книги не доказывает сходимость нейросетевого RL для LLM.
- Farama Foundation, “Handling Time Limits”. — https://gymnasium.farama.org/tutorials/gymnasium_basics/handling_time_limits/. Поддерживает инженерное различие
terminated/truncatedи правило бутстрэппинга. Это руководство по интерфейсу и постановке среды, а не отдельная общая теорема о всех конечных горизонтах. - Watkins & Dayan, “Q-learning” (1992). — https://doi.org/10.1007/BF00992698. Первичный источник классического табличного алгоритма и его сходимости при специальных условиях посещаемости и размеров шага. Эти условия нельзя молча переносить на нелинейную аппроксимацию.
- van Hasselt, “Double Q-learning” (2010). — https://proceedings.neurips.cc/paper/3964-double-q-learning.pdf. Первичный источник анализа смещения максимизации и разделения выбора с оцениванием. Double Q-learning уменьшает характерное завышение, но не является универсально несмещённым оценивателем.
- Schulman et al., “High-Dimensional Continuous Control Using Generalized Advantage Estimation”. — https://arxiv.org/abs/1506.02438. Нужен для перехода от многошаговых TD-ошибок к GAE; использование GAE в policy gradient будет разобрано в Модуле 4.
- Shao et al., DeepSeekMath. — https://arxiv.org/abs/2402.03300. Это авторское описание исходной GRPO-конструкции с группой ответов и без обучаемого критика. Оно подтверждает устройство предложенного метода, но не является независимой проверкой всех его эмпирических выводов и не описывает все более поздние варианты.
- Официальные описания FrozenLake и CliffWalking в Gymnasium. — https://gymnasium.farama.org/environments/toy_text/frozen_lake/ и https://gymnasium.farama.org/environments/toy_text/cliff_walking/. Они фиксируют канонические учебные среды; численные значения курса вычислены собственной проверяемой NumPy-реализацией с явно указанным протоколом.
Расширенный реестр утверждений, статусов проверки и границ вывода находится в Module_2_Sources.md.
Дальше — Модуль 3: бандиты и исследование. Мы временно уберём многошаговую динамику и отдельно разберём цену исследования, методы верхней доверительной границы, сэмплирование Томпсона и связь отбора из нескольких ответов с контекстными бандитами.