Модуль 3. Бандиты, исследование и одношаговые решения
Версия материала: 2026.9
Фактический снимок: 2026-08-04
Язык: RU
Основная практика: браузер, Python и NumPy на центральном процессоре (CPU); отдельный русскоязычный ноутбук объединяет бандитные алгоритмы, оценивание по журналу и LLM-подобную маршрутизацию
Структура: 4 урока, 21 шаг
Ориентировочное время: 7–10 часов без полного многозапускового профиля ноутбука
В Модуле 2 последствия действия описывались через следующее состояние и функции ценности. Теперь мы на время уберём последовательность: решение принимается один раз, награда приходит сразу, а действие не меняет состояние следующего раунда. Такая постановка называется задачей о бандите. Она достаточно проста для точного анализа и одновременно показывает главную трудность исследования: как получать награду сейчас и всё же собирать сведения, необходимые для лучших решений позже?
Предварительный курс по RL не требуется. Мы начнём с определения, затем введём регрет, метод верхней доверительной границы (upper confidence bound, UCB) и его классический вариант UCB1, сэмплирование Томпсона и контекстные бандиты. После этого аккуратно перенесём идеи на LLM. Читатель после классического курса RL может быстрее пройти первые два урока и сосредоточиться на оценивании по журналам взаимодействий, границах бандитной модели, формуле Best-of-N и различии между температурой генерации и исследованием во время обучения.
Цели модуля. После прохождения вы сможете:
- отличать стационарный многорукий бандит и контекстный бандит от марковского процесса принятия решений (
Markov decision process, MDP); - вычислять ожидаемый регрет и разлагать его по числу выборов неоптимальных действий;
- объяснять, почему чистая жадность и постоянное случайное исследование могут давать линейный регрет;
- реализовать ε-жадную стратегию, UCB1 и сэмплирование Томпсона для бернуллиевских наград;
- формулировать точные условия логарифмической гарантии UCB1 и границы нижних оценок регрета;
- построить линейного контекстного бандита и интерпретировать индекс линейного варианта UCB — LinUCB;
- оценивать новую политику по журналу с поправкой на вероятность выбора действия и понимать условие перекрытия;
- объяснять, когда весь ответ LLM можно считать одним действием, а когда бандитная модель теряет существенную динамику;
- вывести оптимальную одношаговую политику с энтропийной регуляризацией или штрафом за отклонение от базовой политики;
- различать исследование во время обучения, стохастическую генерацию, Best-of-N и метрику pass@k;
- обсуждать падение энтропии при обучении с проверяемыми наградами (
reinforcement learning with verifiable rewards, RLVR) как эмпирический режим отказа, а не как универсальный закон.
На учебной платформе после ключевых идей предлагаются задачи, а подробное решение открывается после попытки или на следующем шаге. Исполняемая практика воспроизводимо сравнивает стратегии исследования, показывает нестационарность и строит полный маршрут от журнала взаимодействий к IPS, SNIPS, direct method и doubly robust evaluation. Реестр проверенных утверждений и первичных источников находится в Module_3_Sources.md.
Практический маршрут. После лекции идут оцениваемые задания, решения, открывающиеся после попытки, и исполняемая практика. Само объяснение остаётся самодостаточным.
Урок 3.1. Одношаговое решение и цена незнания
Урок 3.1. Одношаговое решение и цена незнания
- Что остаётся от RL, когда будущего состояния нет
- Дилемма исследования и использования знаний
- Накопленная награда, регрет и псевдорегрет
- Выборочное среднее и ловушка жадной стратегии
- Воспроизводимый стенд: одна картинка, несколько уроков
далее — 7 проверочных шагов
Шаг 3.1.1 — Что остаётся от RL, когда будущего состояния нет
В MDP действие влияет не только на ближайшую награду, но и на состояния, в которых агент окажется позже. В задаче о бандите это звено удалено. На каждом раунде агент:
- выбирает одно из действий ;
- получает случайную награду ;
- наблюдает награду только выбранного действия;
- переходит к следующему независимому раунду без управляемого состояния.
Для стационарного стохастического бандита награды действия имеют неизвестное, но неизменное распределение со средним
В классической метафоре действия называют руками игрового автомата. В дальнейшем мы преимущественно будем говорить «действие»: так легче переносить формулы на выбор модели, маршрута обработки запроса или варианта ответа.
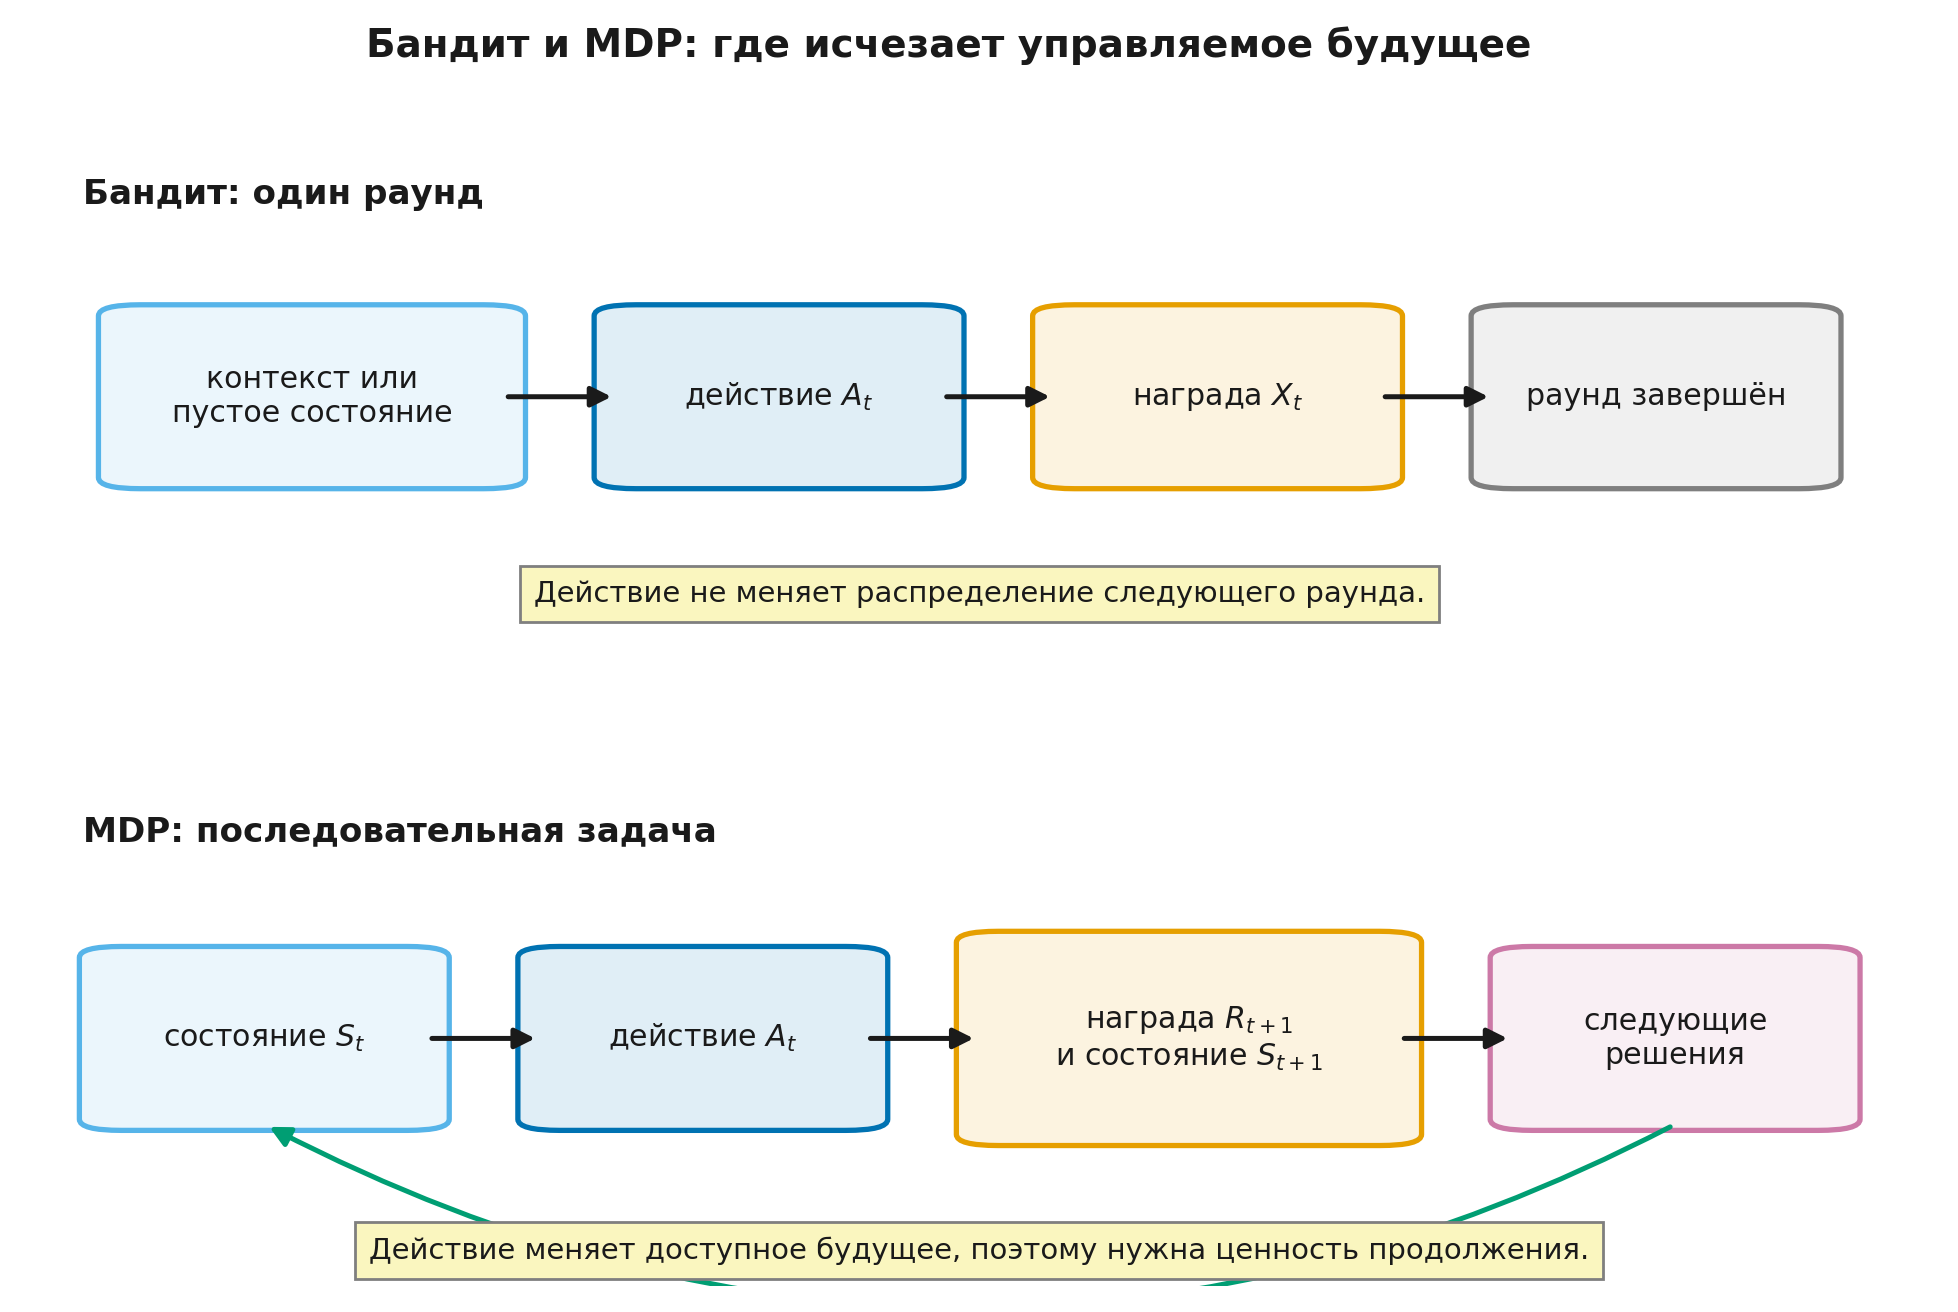
Бандит — не «RL без математики состояний», а отдельная модель с конкретными предположениями:
- множество действий фиксировано;
- распределения наград стационарны;
- наблюдается только результат выбранного действия;
- действие не меняет распределение контекста или наград следующего раунда;
- раунды не воздействуют друг на друга.
Последние два пункта особенно важны. Поочерёдный показ двух заголовков можно описать бандитом, пока показ одному пользователю не меняет аудиторию и будущие предпочтения. Управление диалогом, роботом или инструментальным агентом обычно требует состояния: каждое действие меняет дальнейшую задачу.
Практический критерий. Если для оценки действия нужно знать, в какое состояние оно приведёт и что станет возможно после этого, перед нами уже не чистый бандит.
Шаг 3.1.2 — Дилемма исследования и использования знаний
Пусть
— средняя награда лучшего действия. Если бы все были известны, агент всегда выбирал бы оптимальное действие. Но значения неизвестны, поэтому приходится одновременно решать две задачи:
- использовать накопленные знания (
exploitation) — выбирать действие с наибольшей текущей оценкой; - исследовать (
exploration) — пробовать действия, которые могут оказаться лучше, чем сейчас кажется.
Исследование имеет немедленную цену: вместо наиболее многообещающего действия выбирается другое. Отказ от исследования имеет отложенную цену: агент может навсегда принять случайно удачное действие за лучшее.
Эта дилемма появляется только потому, что данные зависят от политики. Если действие не выбиралось, новых наблюдений о нём не возникнет. Поэтому жадная стратегия способна сама поддерживать собственную ошибку: «я не выбираю действие, потому что плохо его оценил; я плохо его оценил, потому что не выбираю».
Важно не переносить слово «исследование» слишком широко. Случайность сама по себе ещё не означает, что система учится. Если LLM с фиксированными весами генерирует несколько ответов при высокой температуре, она создаёт разнообразные кандидаты, но её оценки и политика не меняются. Это поиск или сэмплирование во время вывода; обучающим исследованием оно станет лишь тогда, когда полученная обратная связь повлияет на последующие решения.
Шаг 3.1.3 — Накопленная награда, регрет и псевдорегрет
Один способ оценить стратегию — посмотреть на случайную накопленную награду
Для теории удобнее сравнить её ожидание с ожиданием всезнающего агента. Ожидаемый регрет (expected regret) за раундов определим как
При стационарных наградах он равен ожидаемому псевдорегрету
Слово «псевдо» здесь не означает «ненастоящий». Оно подчёркивает, что случайные награды заменены их средними. Для конкретной траектории величина
не содержит шум наград и потому удобна для воспроизводимого эксперимента, когда истинные средние известны симулятору.
Введём разрыв качества действия
и число его выборов
Тогда
Вот и вся механика регрета: алгоритм платит разрыв каждый раз, когда выбирает неоптимальное действие. Поэтому анализ обычно сводится к вопросу, сколько раз стратегия вернётся к каждому такому действию.
- означал бы конечную суммарную цену незнания;
- — медленно растущую цену;
- — исчезающую среднюю потерю ;
- — постоянную долю потерь даже на длинном горизонте.
Не всякая задача допускает логарифмический регрет. Гарантия зависит от стационарности, класса распределений, разделимости действий и того, с каким эталоном проводится сравнение.
Шаг 3.1.4 — Выборочное среднее и ловушка жадной стратегии
Пусть действие уже выбиралось раз, а его текущая оценка равна . После новой награды выборочное среднее обновляется без хранения всей истории:
Форма знакома по обучению по временным различиям: новая оценка равна старой плюс размер шага, умноженный на ошибку. Но здесь нет продолжения и бутстрэппинга — целью служит наблюдаемая одношаговая награда.
Чистая жадность выбирает
Если ранний шум сделал посредственное действие лидером, другие действия могут больше не получить данных. На некоторых запусках жадность быстро находит оптимум, на других застревает; усреднённый регрет способен расти линейно.
Два простых способа нарушить этот замкнутый круг:
- ε-жадная стратегия: с вероятностью выбрать случайное действие, иначе — жадное;
- оптимистичная инициализация: начать с завышенных , чтобы непроверенные действия выглядели привлекательными.
Постоянное не выключает исследование после накопления данных. Если есть хотя бы одно неоптимальное действие, случайная ветвь продолжает выбирать его с положительной частотой, поэтому ожидаемый регрет обычно остаётся линейным. Убывающее может дать сублинейный или логарифмический режим, но расписание должно соответствовать предположениям задачи.
Для нестационарных наград выборочное среднее, напротив, может слишком долго помнить прошлое. Тогда часто используют постоянный размер шага
который экспоненциально уменьшает вес старых наблюдений. Это инженерная эвристика для отслеживания дрейфа, а не перенос стационарной гарантии без изменений. В нестационарной задаче меняется и эталон: вместо лучшего фиксированного действия может потребоваться динамический регрет относительно меняющегося оптимума.
Шаг 3.1.5 — Воспроизводимый стенд: одна картинка, несколько уроков
Рассмотрим пять бернуллиевских действий со средними
Протокол:
- горизонт ;
- 400 независимых запусков;
- для каждого алгоритма свой фиксированный генератор случайных чисел;
- на графике — средний псевдорегрет и нормальная аппроксимация 95%-го доверительного интервала по запускам;
- при равенстве жадных оценок действие выбирается случайно;
- UCB1 сначала выбирает каждое действие по одному разу;
- сэмплирование Томпсона использует априорные распределения .
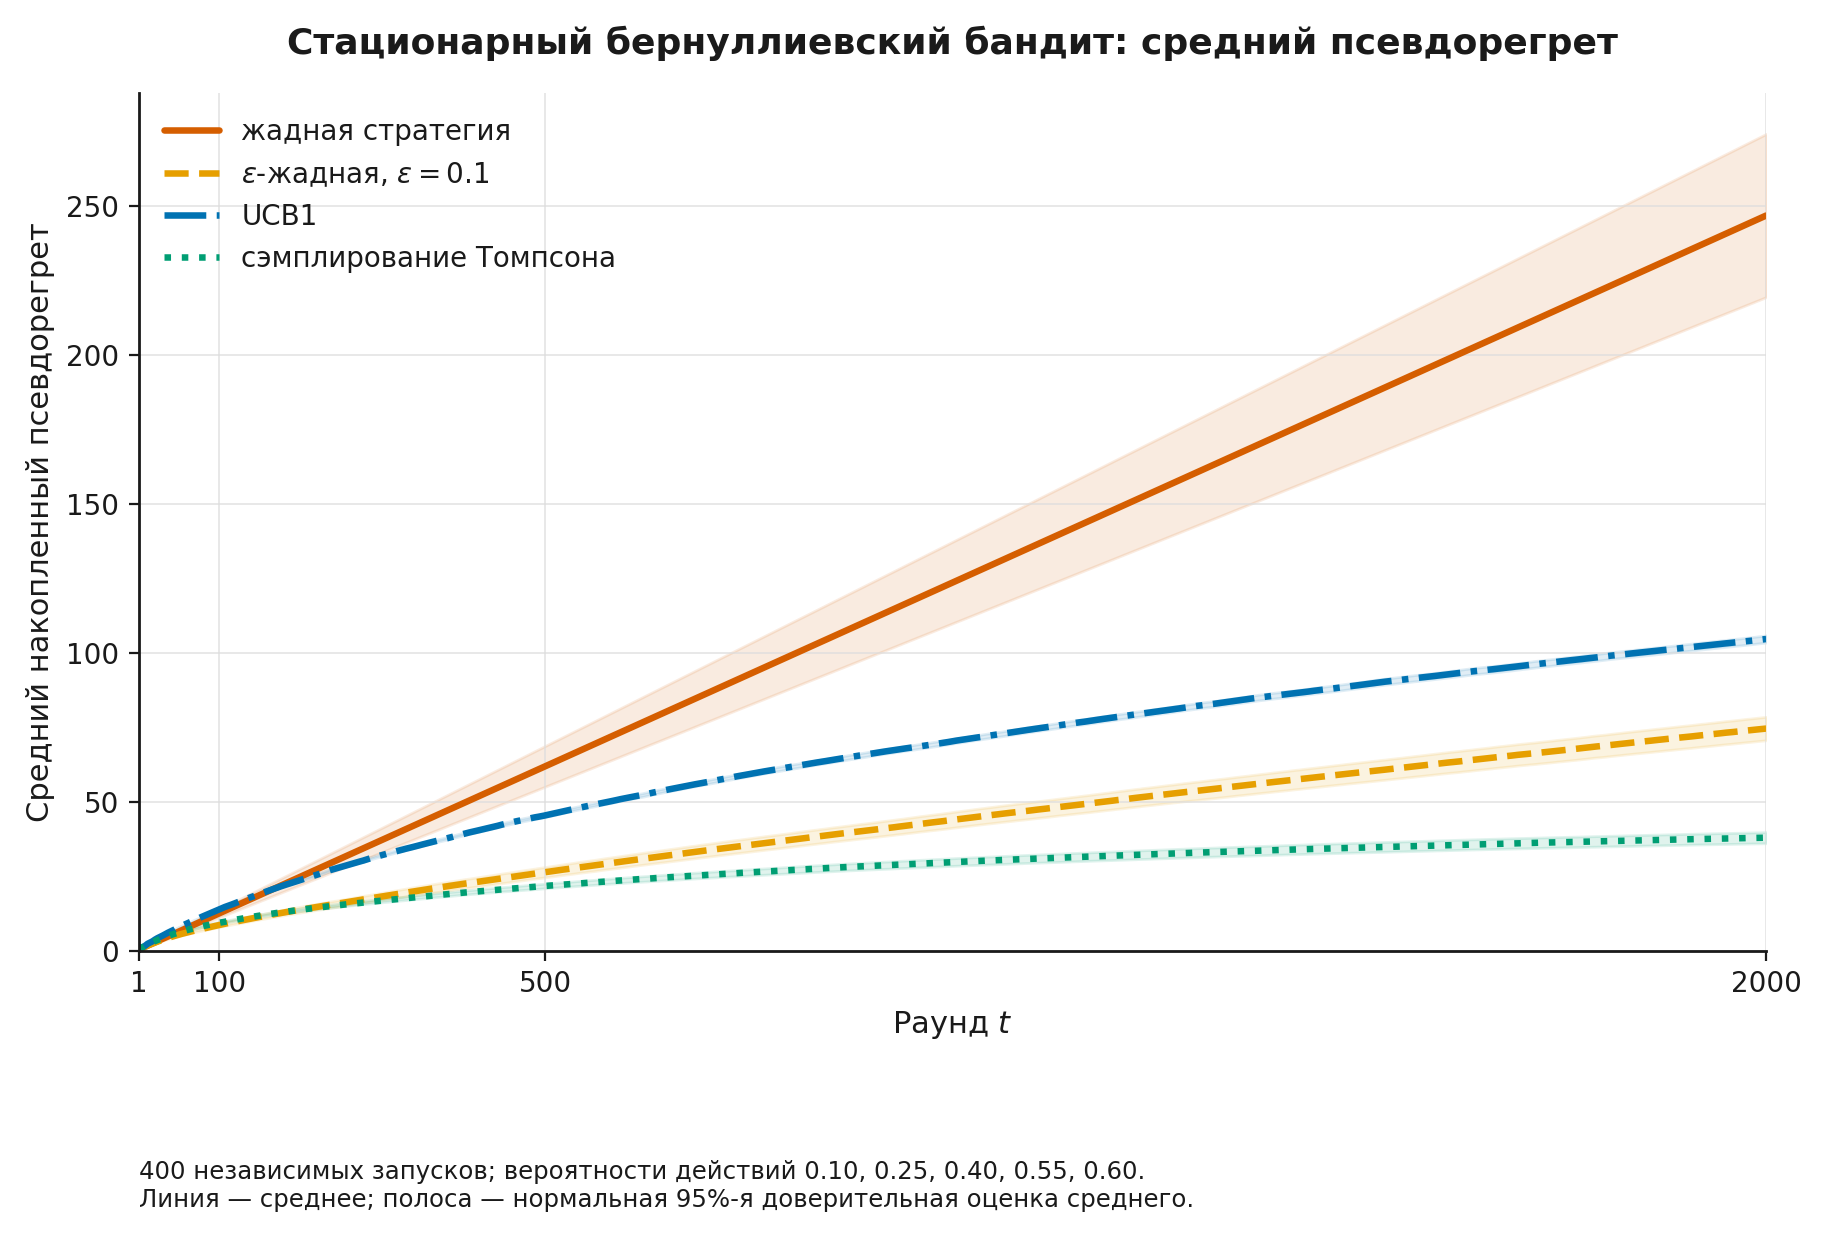
Средний псевдорегрет:
| Алгоритм | Доля оптимального действия к | |||
|---|---|---|---|---|
| Жадный | 12.54 | 61.84 | 246.72 | 0.297 |
| ε-жадный, | 8.64 | 26.34 | 74.55 | 0.684 |
| UCB1 | 13.88 | 45.39 | 104.60 | 0.586 |
| Сэмплирование Томпсона | 9.37 | 21.72 | 37.92 | 0.786 |
Этот стенд специально не превращён в соревнование «какой алгоритм всегда лучше».
- Жадная стратегия действительно застревает в части запусков.
- Постоянное помогает, но продолжает платить за случайные действия.
- Канонический UCB1 здесь исследует консервативно: при близких средних и его теоретический бонус долго остаётся заметным.
- Сэмплирование Томпсона даёт наименьший конечный регрет именно в этом протоколе, но это эмпирическое наблюдение, а не универсальный порядок алгоритмов.
Код чисел и рисунка хранится в module_3_reference.py и generate_m3_diagrams.py.
Урок 3.2. Исследование, направляемое неопределённостью
Урок 3.2. Исследование, направляемое неопределённостью
- От доверительной границы к индексу UCB
- Что именно гарантирует UCB1
- Сэмплирование Томпсона
- UCB и Томпсон: различие не только в случайности
- Стационарность, отложенная обратная связь и другие границы
далее — 7 проверочных шагов
Шаг 3.2.1 — От доверительной границы к индексу UCB
Равномерное случайное исследование не различает два случая:
- действие проверили три раза и почти ничего о нём не знаем;
- действие проверили три тысячи раз и уже оценили достаточно точно.
Метод верхней доверительной границы (upper confidence bound, UCB) добавляет к выборочному среднему бонус за неопределённость. Для наград в неравенство Хёффдинга даёт
Если выбрать порядка , вероятность того, что истинное среднее окажется выше построенной верхней оценки, уменьшается с номером раунда. Канонический индекс UCB1 имеет вид
Каждое действие сначала выбирается хотя бы один раз, поэтому деления на ноль дальше нет.
Первое слагаемое отвечает за использование знаний, второе — за исследование. Бонус:
- уменьшается после новых наблюдений данного действия;
- медленно растёт, если действие долго не выбиралось;
- велик именно там, где оценка пока ненадёжна.
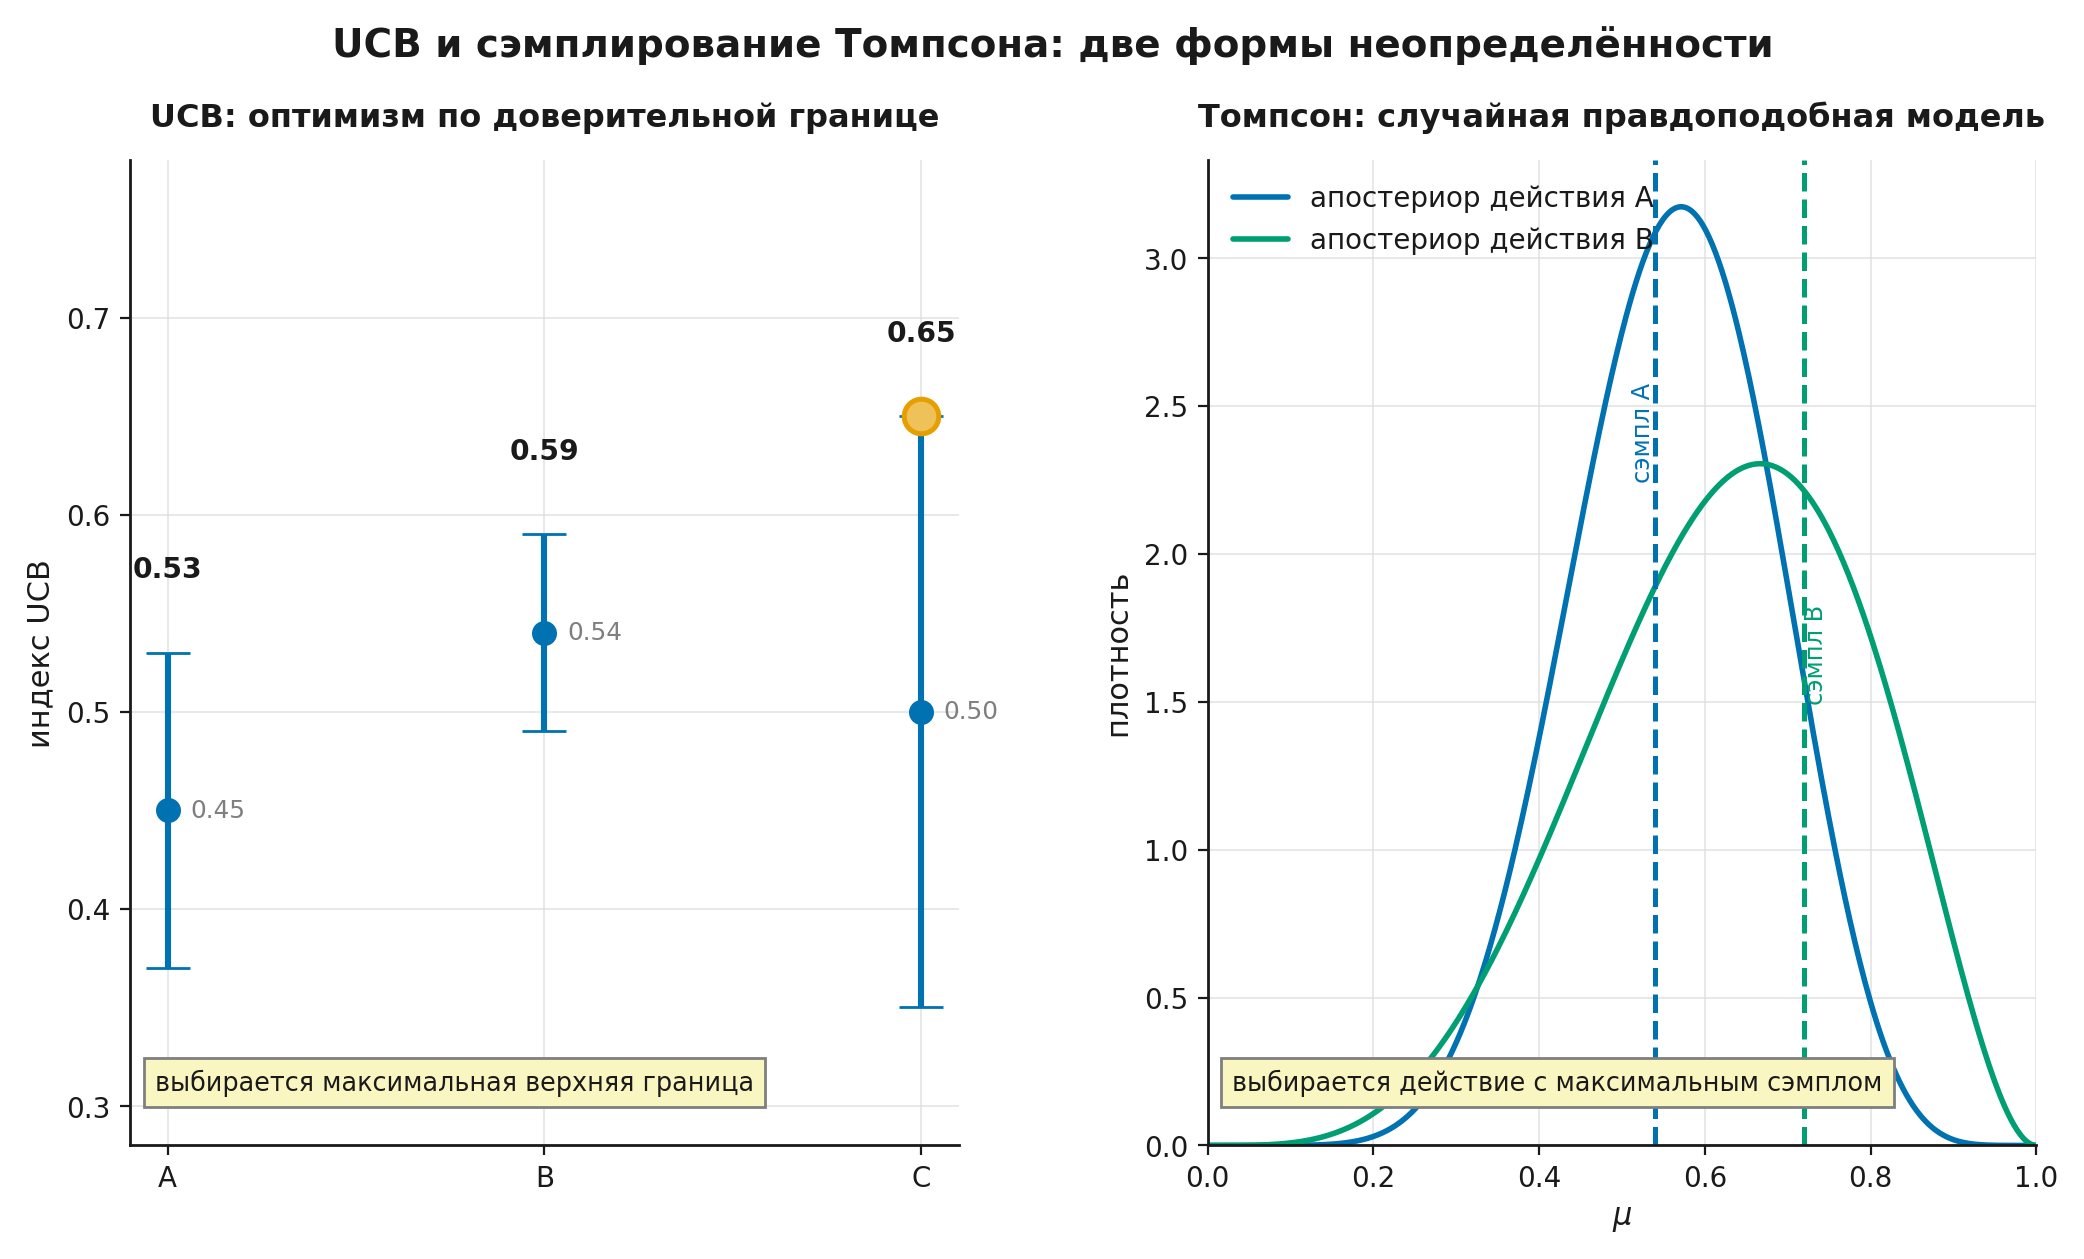
Фраза «доверительная граница» здесь относится к математической конструкции при конкретных предположениях. В нейросетевой системе произвольный показатель неопределённости не становится автоматически корректной доверительной границей.
Шаг 3.2.2 — Что именно гарантирует UCB1
Для стационарных действий с независимыми наградами в и разрывами анализ UCB1 даёт для каждого неоптимального действия оценку
После умножения на и суммирования:
Это зависимая от конкретной задачи оценка: близкое к лучшему действие имеет малый и требует много наблюдений, чтобы статистически отличить его от оптимального. Поэтому логарифмическая асимптотика не обещает небольшой регрет на любом конечном горизонте.
Нижняя оценка Лая—Роббинса тоже требует аккуратной формулировки. Для определённых параметрических семейств и достаточно хороших, равномерно эффективных стратегий число выборов неоптимального действия асимптотически не может быть меньше порядка
где — дивергенция Кульбака—Лейблера между распределениями наград. Из этого не следует, что любой алгоритм на каждом экземпляре обязан иметь регрет ровно . В вырожденных задачах, при дополнительной информации о структуре или вне класса равномерно эффективных стратегий возможны иные режимы. Точная область действия нижней оценки — часть результата, а не мелкий шрифт.
Практический вывод остаётся ясным: в классическом неизвестном стационарном бандите нельзя одновременно почти не проверять альтернативы и надёжно исключать их.
Шаг 3.2.3 — Сэмплирование Томпсона
UCB выражает неопределённость детерминированным бонусом. Сэмплирование Томпсона (Thompson sampling) хранит распределение правдоподобных параметров и на каждом раунде действует согласно одному случайному предположению о мире.
Для бернуллиевской награды удобно использовать сопряжённую пару:
После успехов и неудач апостериорное распределение равно
Алгоритм выполняет три действия:
- для каждого сэмплирует из текущего апостериорного распределения;
- выбирает ;
- обновляет распределение только выбранного действия.
Действие выбирается с вероятностью, равной апостериорной вероятности того, что оно оптимально, если не учитывать ничьи. Это часто называют сопоставлением вероятностей (probability matching). Слабо изученное действие иногда получает высокий сэмпл и проверяется; по мере накопления данных его апостериорное распределение сужается.
Исходная идея Томпсона опубликована в 1933 году для последовательного распределения наблюдений. Современные оценки регрета и общая теория появились значительно позже, поэтому историческую дату не следует выдавать за доказательство нынешних гарантий.
Шаг 3.2.4 — UCB и Томпсон: различие не только в случайности
Оба метода направляют исследование неопределённостью, но кодируют её по-разному.
| Вопрос | UCB | Сэмплирование Томпсона |
|---|---|---|
| Представление неопределённости | аналитический верхний индекс | апостериорное распределение параметров |
| Выбор действия | обычно детерминированный максимум индекса | максимум случайного сэмпла |
| Что нужно задать | форму бонуса и предположения концентрации | вероятностную модель и априорное распределение |
| Типичная сила | ясная оптимистичная гарантия | естественная адаптивная рандомизация |
| Типичный риск | слишком широкий или неверно откалиброванный бонус | неверно заданная модель или априорное распределение |
Ни один столбец не является автоматическим рецептом для LLM. Например, ансамбль моделей может давать полезный сигнал разброса, но этот разброс ещё не обязан быть апостериорной неопределённостью. Аналогично, энтропия токенового распределения не является доверительным интервалом истинной полезности ответа.
Полезный перенос состоит в более скромной мысли: исследование должно зависеть от того, чего система ещё не знает, а не только от фиксированной монетки ε.
Шаг 3.2.5 — Стационарность, отложенная обратная связь и другие границы
Классические формулы предполагают, что награда действия имеет одно и то же распределение во все раунды. В реальной системе это может нарушаться:
- меняется аудитория запросов;
- пользователи привыкают к варианту интерфейса;
- обновляется базовая модель;
- награда приходит с задержкой;
- один пользователь взаимодействует несколько раз;
- показ влияет на будущую вероятность посещения.
При дрейфе можно использовать скользящее окно, дисконтирование старых наблюдений или алгоритм с явной моделью изменений. При задержке важно не считать ещё не пришедшую награду нулевой. При повторных взаимодействиях контекст должен включать релевантную историю либо задача становится последовательной.
Здесь легко сделать слишком сильный вывод: «раз UCB имеет логарифмический регрет, его достаточно добавить к любой системе рекомендаций». Теорема относится к определённой статистической модели. Инженерная система сначала должна доказать хотя бы правдоподобие этой модели, а затем отдельно проверить калибровку, задержки, ограничения безопасности и стоимость исследования.
Урок 3.3. Контекстные бандиты и оценивание по журналам
Урок 3.3. Контекстные бандиты и оценивание по журналам
- Один раунд, но разные ситуации
- Линейный контекстный бандит и LinUCB
- Когда ответ LLM является одним действием
- Почему журнал не содержит всех контрфактических исходов
- Двойная устойчивость и предел оценивания по журналу
далее — 5 проверочных шагов
Шаг 3.3.1 — Один раунд, но разные ситуации
В обычном многоруком бандите одно действие имеет одно среднее значение для всех раундов. Однако лучший вариант может зависеть от запроса, пользователя или задачи. Контекстный бандит (contextual bandit) добавляет наблюдаемый контекст :
- среда показывает ;
- политика выбирает ;
- наблюдается только ;
- раунд заканчивается.
Цель политики — максимизировать
для детерминированной политики либо соответствующее ожидание по действиям стохастической политики.
Контекст — это не состояние в полном смысле MDP. Он помогает выбрать действие в текущем раунде, но выбранное действие по предположению не меняет будущий контекст. Если ответ системы меняет дальнейший диалог, доверие пользователя или состояние инструмента, такое предположение уже требует проверки.
Примеры:
- контекст: признаки пользователя; действие: рекомендация; награда: клик;
- контекст: медицинские признаки; действие: вариант лечения; награда: наблюдаемый исход;
- контекст: запрос; действие: одна из нескольких моделей; награда: оценка качества с учётом задержки и стоимости;
- контекст: запрос; действие: полный ответ; награда: скалярная оценка ответа, после которой эпизод заканчивается.
Последний пример создаёт мост к LLM, но не утверждает, что внутренняя генерация токенов перестала быть последовательной.
Шаг 3.3.2 — Линейный контекстный бандит и LinUCB
Пусть каждой паре контекста и действия соответствует вектор признаков
а ожидаемая награда приближённо линейна:
После наблюдений оценка с -регуляризацией задаётся
Метод LinUCB выбирает действие по индексу
Первое слагаемое — предсказанная награда. Второе — эллиптический бонус за направление признаков, которое плохо покрыто прошлыми наблюдениями. Два действия могут иметь одинаковое число выборов, но разную неопределённость, если их признаки лежат в по-разному изученных направлениях.
LinUCB полезен как прозрачная модель механизма, но линейность — содержательное предположение. Если векторное представление запроса из LLM подаётся в линейный выходной слой, это не доказывает, что истинная награда линейна по этому представлению или что бонус откалиброван. В реальной системе это проверяется на отложенных данных и в безопасном онлайн-эксперименте.
Шаг 3.3.3 — Когда ответ LLM является одним действием
Для одного запроса можно определить:
- контекст — запрос и доступные служебные признаки;
- действие — полный ответ;
- награду — оценку человека, модели награды или проверяющей программы;
- завершение раунда сразу после выставления оценки.
В такой внешней абстракции полного ответа задача действительно является контекстным бандитом. Именно так среда описана, например, в работе InstructGPT: случайный запрос, один ответ, скалярная награда и завершение эпизода.
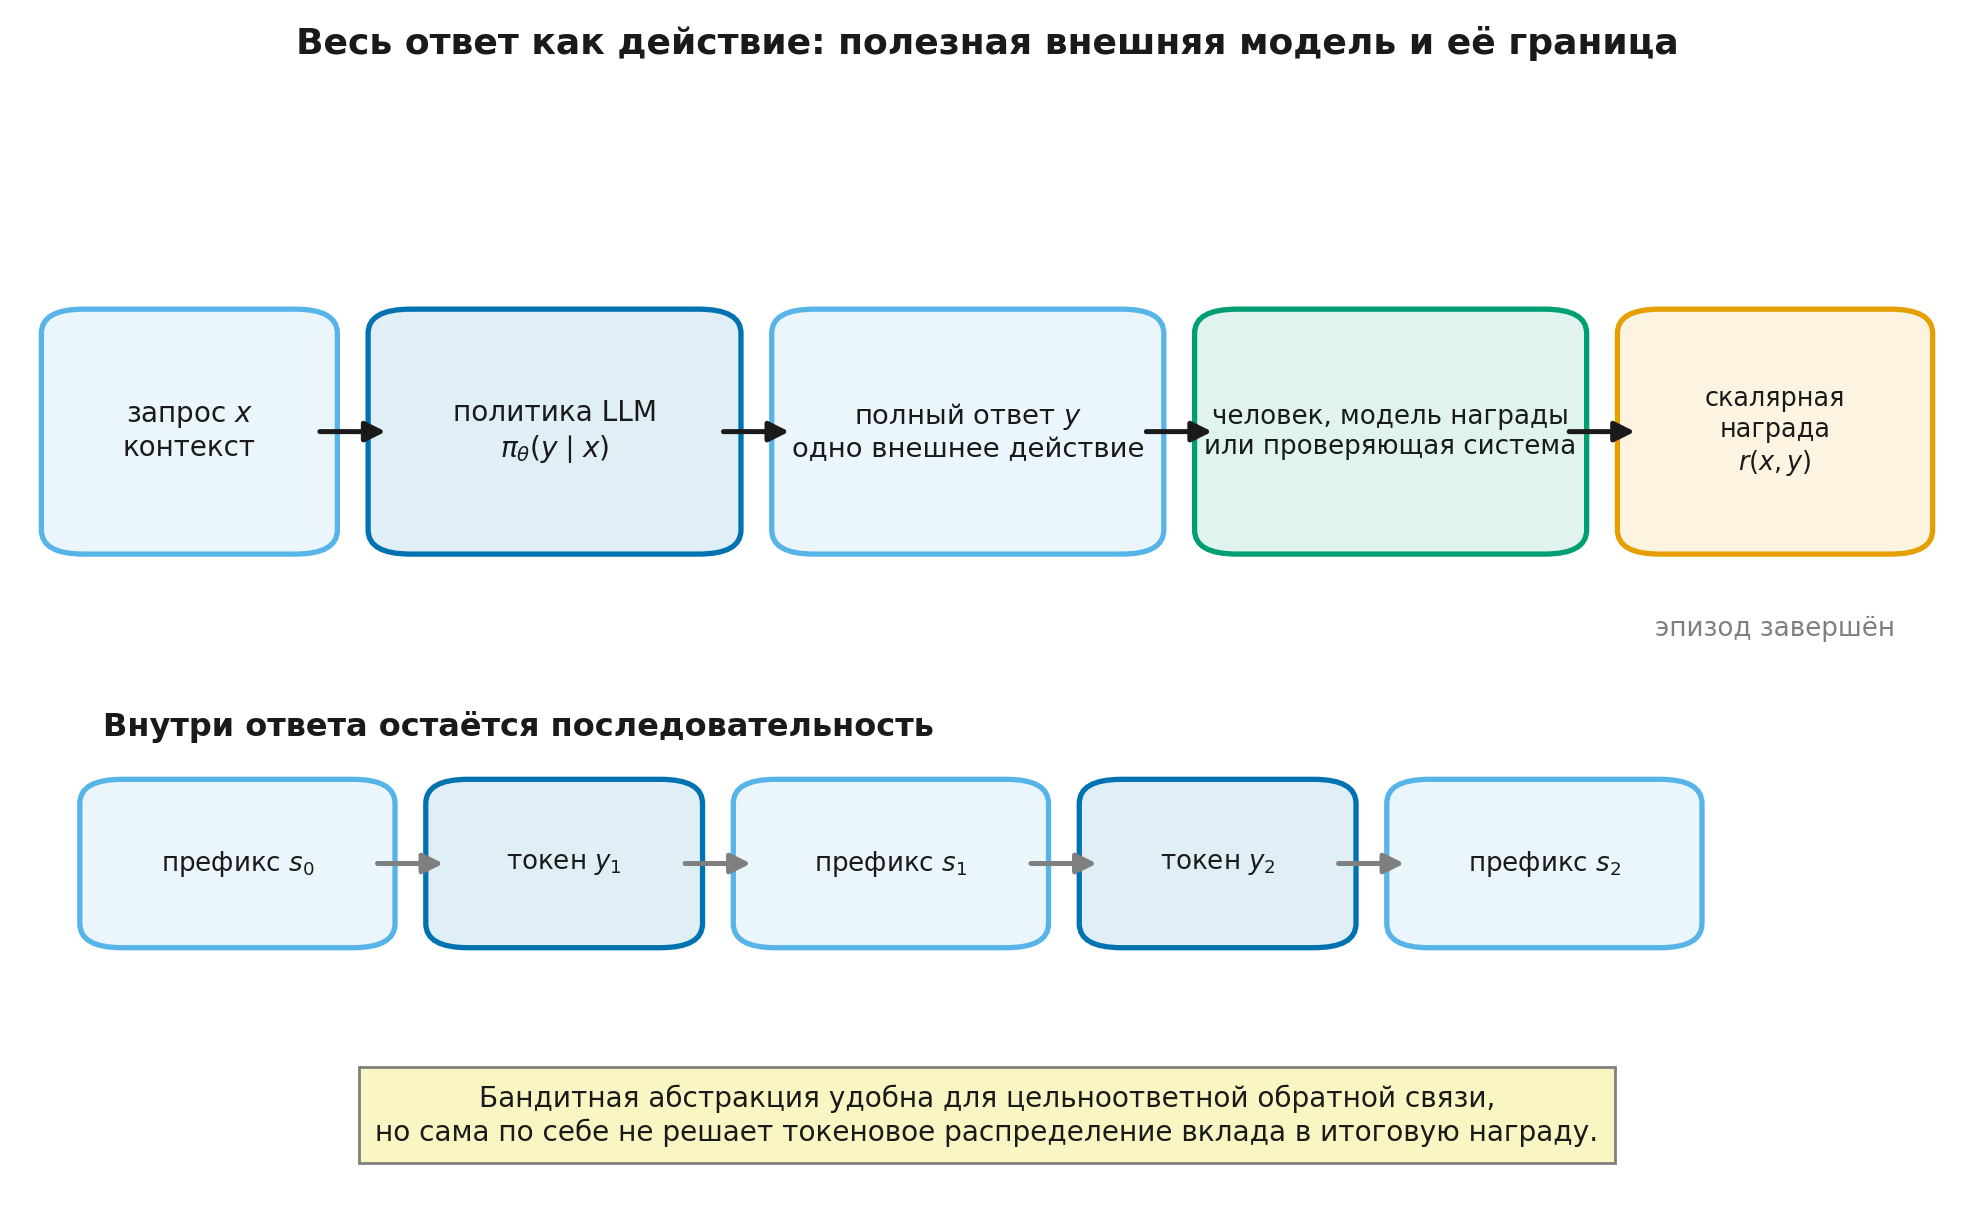
Но внутри действия остаётся авторегрессионная факторизация
Поэтому одновременно верны две модели:
- на внешнем уровне весь ответ — одно действие контекстного бандита;
- на внутреннем уровне токены — последовательность действий, а префикс — состояние.
Какую модель использовать, зависит от вопроса. Для сравнения двух законченных ответов бандитная абстракция удобна. Для распределения заслуги между токенами, ограничения длины, работы с инструментами и многоходового диалога она скрывает важную структуру.
Граница переноса. Обучение с наградой за полный ответ на один запрос можно представить контекстным бандитом, если после награды раунд заканчивается. Но утверждение «любое обучение LLM является бандитом» уже неверно.
Перекрёстная ссылка: подготовка данных и обучение с учителем на инструкциях (supervised fine-tuning, SFT) подробнее рассматриваются в Modern LLMs, Модуле 13 «SFT и работа с данными» (modern_llms.module_11_sft), а архитектурная карта RLHF, DPO и GRPO — в Модуле 14 «Обучение по обратной связи: RLHF, DPO, RLOO и GRPO» (modern_llms.module_12_preference_optimization). Здесь канонической темой остаётся статистика одношаговой обратной связи.
Шаг 3.3.4 — Почему журнал не содержит всех контрфактических исходов
После развёртывания система обычно хранит записи
где — вероятность, с которой поведенческая политика выбрала фактически показанное действие. Награды непоказанных действий неизвестны.
Пусть нужно оценить новую политику без немедленного онлайн-развёртывания. Метод оценивания с обратной вероятностью выбора (inverse propensity scoring, IPS) использует
Почему вес работает? При фиксированном и потенциальных наградах:
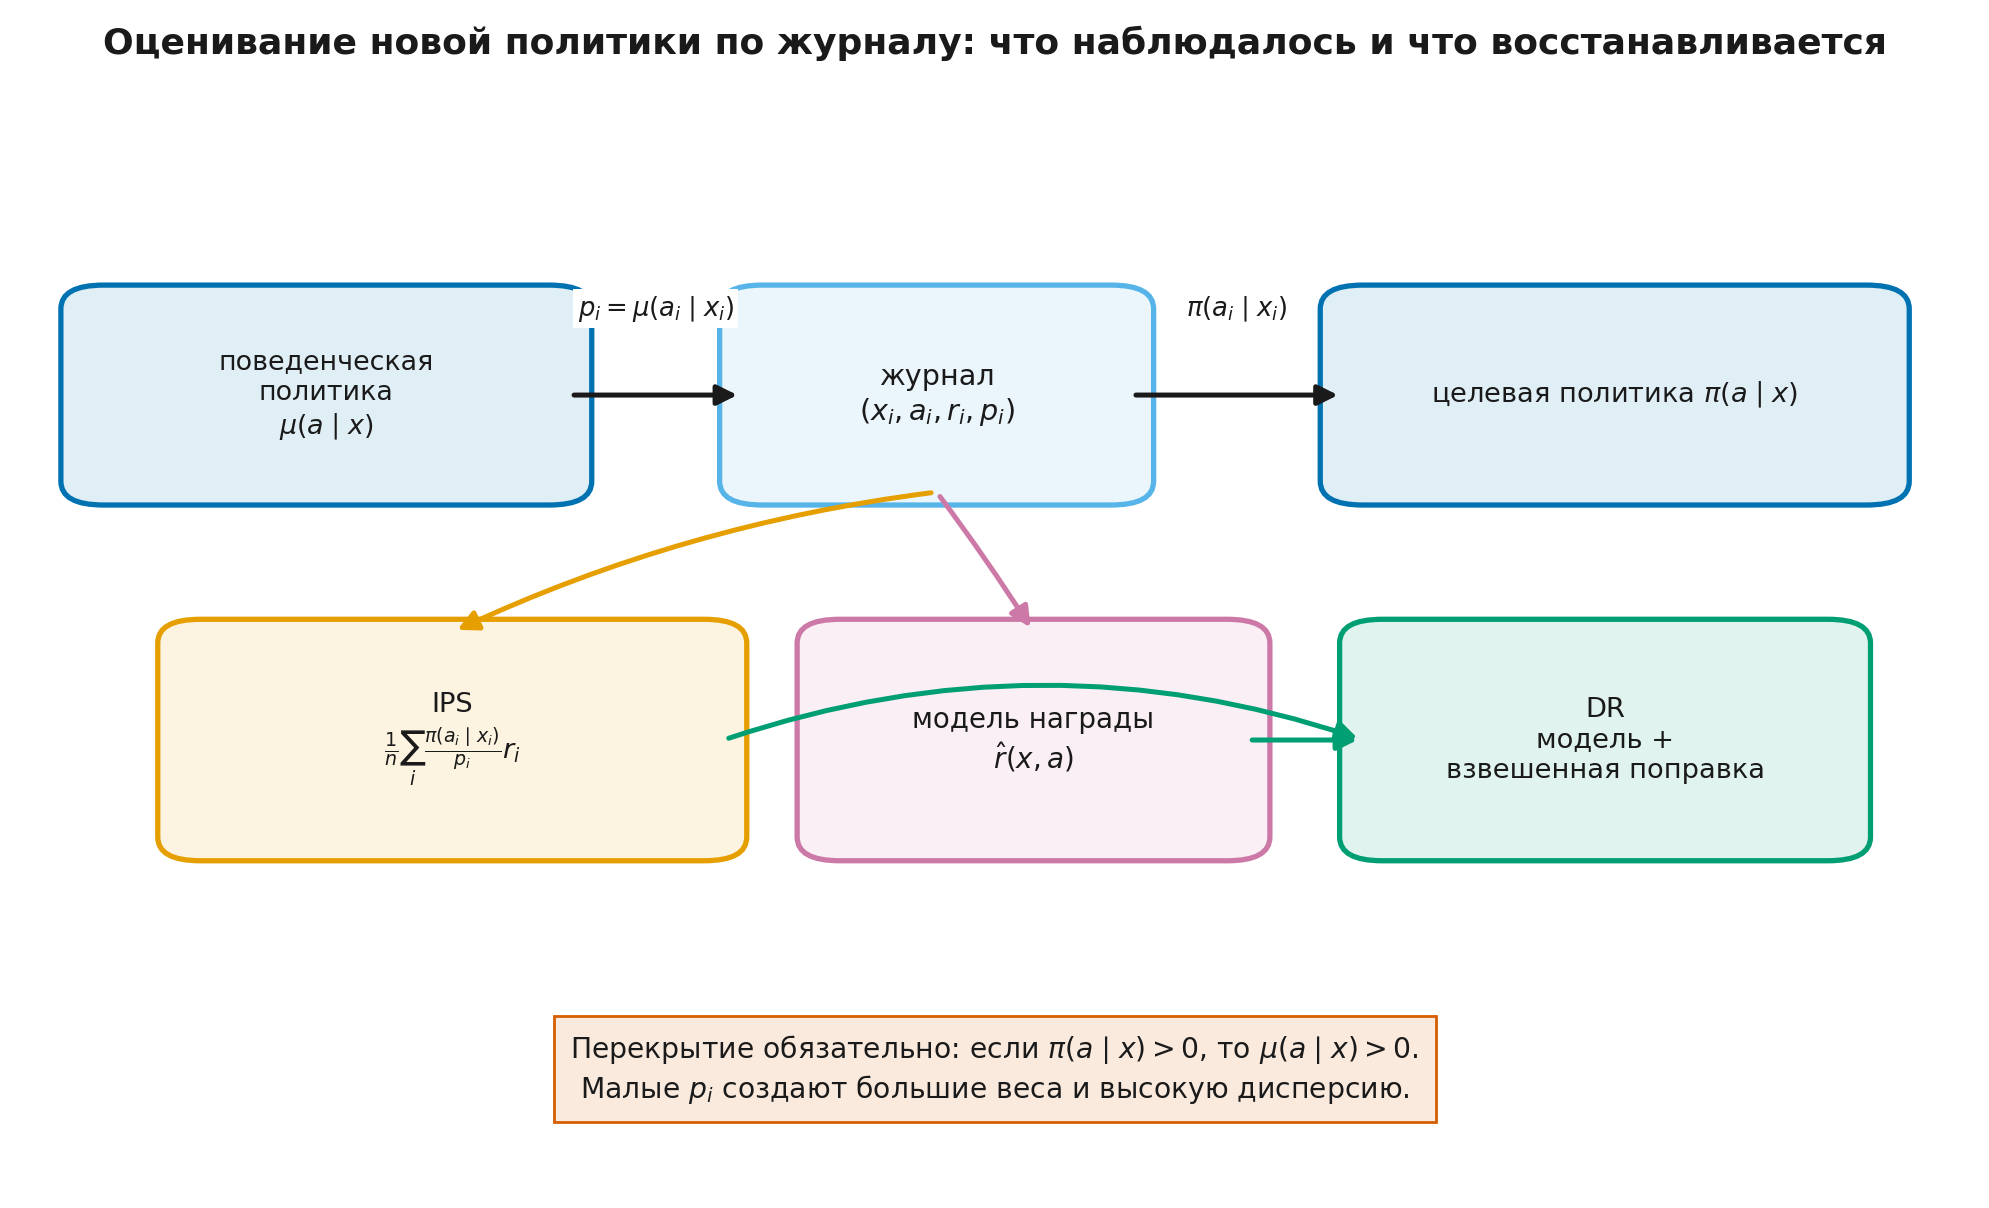
Для несмещённости нужны существенные условия:
- перекрытие (
overlap): если , то ; - сохранённые соответствуют реальной вероятности выбора;
- награда и контекст записаны корректно;
- при фиксированном контексте выбор действия не зависит от неучтённого фактора, который одновременно влияет на потенциальную награду; это условие обеспечивается корректной рандомизацией или содержательной моделью назначения.
Малое создаёт большой вес и высокую дисперсию. Самонормированная оценка с обратной вероятностью выбора (self-normalized inverse propensity scoring, SNIPS) имеет вид:
Такая оценка часто устойчивее численно, но в общем случае уже смещена.
Поэтому в журнале важно сохранять вероятности выбора, версию политики, схему рандомизации и время. Без них исторический журнал может оказаться непригодным для честной оценки новой политики.
Шаг 3.3.5 — Двойная устойчивость и предел оценивания по журналу
IPS использует модель поведенческой политики, но может иметь большую дисперсию. Прямая модель награды использует меньше шумных весов, но может быть смещена из-за ошибки аппроксимации. Оцениватель с двойной устойчивостью (doubly robust estimator, DR) объединяет оба источника:
Первое слагаемое даёт прогноз модели награды для новой политики. Второе исправляет прогноз на тех действиях, которые действительно наблюдались. При стандартных условиях оценка остаётся согласованной, если корректна хотя бы одна из двух моделей: модель награды или модель вероятностей поведения. Название «двойная устойчивость» относится именно к этой структуре.
Но DR не создаёт сведения там, где журнал не содержит перекрытия. Если новая политика выбирает действие, которое старая никогда не показывала в данном контексте, контрфактическая награда не определяется по одному журналу взаимодействий. Модель может экстраполировать, но это уже дополнительное предположение, а не статистический факт.
Для LLM проблема особенно остра: пространство полных ответов огромно, точная вероятность конкретной строки может быть чрезвычайно мала, а две строки могут быть семантически близки. Поэтому IPS на уровне произвольных полных ответов часто непрактичен. Более реалистичные варианты ограничивают набор действий, оценивают выбор маршрута или модели, используют структурированную политику либо проводят контролируемый онлайн-эксперимент.
Урок 3.4. Энтропия, температура и несколько кандидатов
Урок 3.4. Энтропия, температура и несколько кандидатов
- Энтропийно-регуляризованное одношаговое решение
- Температура генерации не равна обучающему исследованию
- Best-of-N: точная вероятность и неточное название «бандит»
- pass@k: вероятность в модели и оценка по конечной выборке
- Падение энтропии в RLVR: наблюдаемый режим, а не теорема
- Итоговая карта и переход к градиентам политики
далее — 7 проверочных шагов
Шаг 3.4.1 — Энтропийно-регуляризованное одношаговое решение
Пусть для конечного множества действий известны оценки качества . Если максимизировать только среднее качество,
оптимум сосредоточит всю массу на одном максимальном действии. Добавим энтропию
с коэффициентом :
Лагранжиан для ограничения даёт условие
Следовательно,
Температура определяет компромисс между качеством и энтропией: при политика концентрируется на максимуме, при большой приближается к равномерной.
Более общая постановка использует штраф в виде дивергенции Кульбака—Лейблера (Kullback–Leibler divergence, KL) относительно базовой политики :
имеет решение
Это точный одношаговый результат. Он не говорит, что произвольное нейросетевое обучение обязательно достигнет этого распределения, а оценка обязательно верна.
Математическое углубление: полный вариационный вывод, Gibbs-форма и роль нормировочной константы рассматриваются в Information Theory for ML, Модуле 8 «Максимальная энтропия, экспоненциальные модели и KL-регуляризация» (it_ml.module_08_maxent_kl_policy). Текущий модуль остаётся самодостаточным: формулы и их смысл уже выведены здесь.
Шаг 3.4.2 — Температура генерации не равна обучающему исследованию
Для фиксированных логитов температура декодирования задаёт
Повышение делает чистое softmax-распределение более плоским и увеличивает его энтропию; понижение — более концентрированным. Но это утверждение требует трёх оговорок.
- Логиты фиксированы. Во время обучения меняются сами .
- Температура меняет распределение кандидатов, но не обновляет оценки качества.
- После top-, top-, запретов токенов и других фильтров итоговое распределение уже не является одной чистой температурной кривой. Токен, которому фильтр присвоил нулевую вероятность, нельзя вернуть одним увеличением температуры.
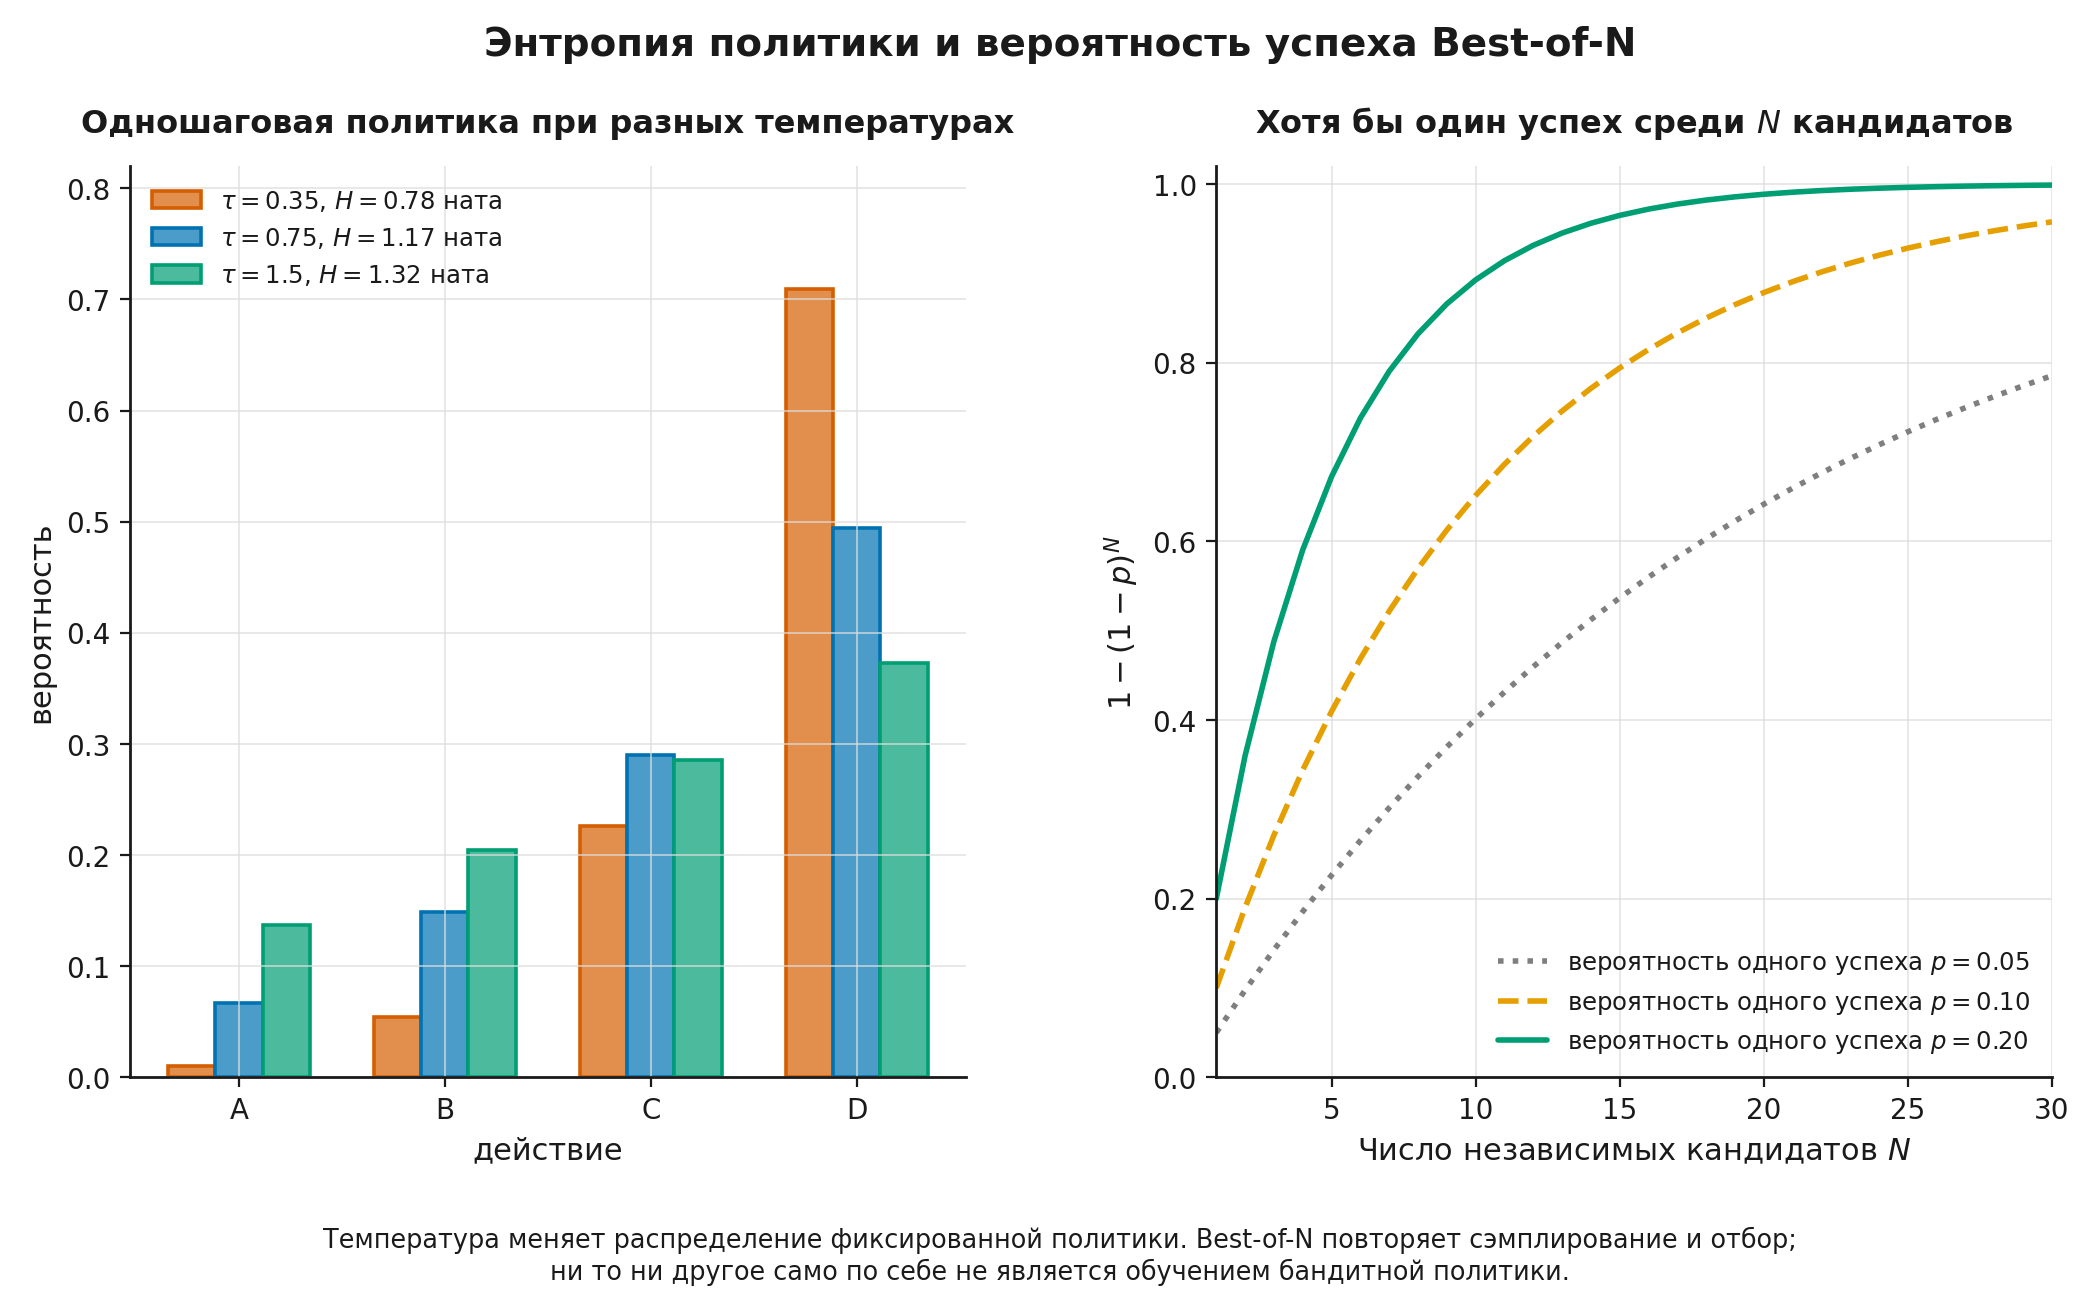
Поэтому полезно разделять:
- исследование при обучении: действия дают обратную связь, которая изменяет последующую политику;
- стохастическую генерацию: фиксированная политика создаёт разные кандидаты;
- поиск во время вывода: система тратит больше вычислений на выбор, проверку или улучшение кандидата.
Эти механизмы могут работать вместе, но не являются синонимами. Декодирование, выбор кандидатов и вычисления во время вывода подробнее рассматриваются в Modern LLMs, Модуле 15 «Модели рассуждения и вычисления во время инференса (test-time compute)» (modern_llms.module_13_reasoning).
Шаг 3.4.3 — Best-of-N: точная вероятность и неточное название «бандит»
Пусть каждый независимый кандидат успешен с вероятностью , а идеальный проверяющий выбирает успешный ответ, если он есть. Тогда вероятность хотя бы одного успеха среди кандидатов равна
Например, при :
и для достижения не менее 90% требуется
то есть минимум 11 независимых кандидатов.
Это хорошая математика, но её условия сильны:
- кандидаты независимы и имеют одинаковую вероятность успеха;
- проверяющий безошибочно распознаёт успех;
- стоимость генерации и проверки не входит в цель;
- выбранный ответ не влияет на будущие задачи.
Обычный Best-of-N с фиксированной LLM — не стандартный многорукий онлайн-бандит. Здесь нет конечного набора неизвестных действий, оценки которых постепенно уточняются по раундам. Это повторное сэмплирование из одной политики и выбор по проверяющему или ранжировщику.
Бандитная задача появляется, если система многократно выбирает между несколькими моделями, вариантами запроса, температурами или маршрутами обработки и обновляет эти решения по обратной связи. Не следует называть «бандитом» любую процедуру, где существует несколько кандидатов.
Наконец, реальный ранжировщик может ошибаться. Тогда вероятность качества выбранного ответа зависит не только от наличия хорошего кандидата, но и от точности выбора. Формула задаёт верхнюю границу при идеальном проверяющем в этой модели, а не обещание реального качества.
Шаг 3.4.4 — pass@k: вероятность в модели и оценка по конечной выборке
В задачах программирования метрика pass@ отвечает на вопрос: какова вероятность, что хотя бы один из сгенерированных вариантов пройдёт тесты? Если истинная вероятность успеха одного независимого варианта равна , снова получаем
Но на практике неизвестна. Пусть для одной задачи сгенерировано программ, из них прошли тесты. Подстановка в даёт смещённую оценку. В работе по оцениванию Codex использован следующий оцениватель по конечной выборке:
Он равен вероятности, что случайно выбранное без возвращения подмножество из программ содержит хотя бы одну из успешных. Затем значения усредняются по задачам.
Две величины не нужно смешивать:
- — модельная вероятность при независимых одинаково распределённых генерациях;
- комбинаторная формула — оценка по конечному набору уже сгенерированных программ.
Если кандидаты почти дублируют друг друга, эффективное разнообразие меньше, чем предполагает простая интуиция независимости. Повышение температуры иногда помогает разнообразию, но может снизить качество одного кандидата; оптимальный режим зависит от модели, задачи и бюджета. Более широкий протокол оценки рассматривается в Модуле 13 текущего курса «Оценивание, reward hacking и безопасность» (rl_llm.module_13_evaluation).
Шаг 3.4.5 — Падение энтропии в RLVR: наблюдаемый режим, а не теорема
В RLVR модель получает автоматически проверяемый сигнал, например за правильный математический ответ или прошедшие тесты программы. Один из обсуждаемых режимов отказа — коллапс энтропии (entropy collapse): токеновое распределение преждевременно становится слишком концентрированным, разнообразие траекторий уменьшается, а обучение может застрять.
Для состояния токеновая энтропия равна
Снижение среднего не является само по себе ошибкой: успешная политика часто должна стать увереннее. Проблема возникает, если разнообразие исчезает раньше, чем пространство решений достаточно исследовано, или если концентрация вызвана патологией обновления, а не устойчивым улучшением награды.
В препринте 2026 года авторы сообщают о существенном снижении энтропии при нескольких конфигурациях RLVR на математических задачах и анализируют вклад обновлений отдельных токенов в изменение энтропии. Это первичное эмпирическое сообщение конкретной работы, а не доказательство того, что любой запуск групповой относительной оптимизации политики (group relative policy optimization, GRPO) неизбежно приводит к коллапсу.
Простая алгебра объясняет один источник потери сигнала в GRPO. Если для одного запроса все ответов имеют одинаковые награды,
то после вычитания среднего
для каждого ответа. При стандартной групповой нормировке относительные преимущества становятся нулевыми, если не учитывать другие члены целевой функции. Группа не сообщает, какое действие предпочтительнее. Это не полное объяснение динамики энтропии, но точная локальная граница: без различий в обратной связи относительный групповой сигнал исчезает.
В Модуле 9 текущего курса «RLVR и GRPO: проверяемая награда, групповая оценка и устойчивость» (rl_llm.module_09_rlvr_grpo) мы вернёмся к GRPO, клиппингу, отношениям политик, формированию групп и RLVR уже на уровне полной целевой функции.
Шаг 3.4.6 — Итоговая карта и переход к градиентам политики
Модуль свёл несколько похожих по внешнему виду механизмов к разным математическим объектам.
| Механизм | Что неизвестно | Что меняется после обратной связи | Основной риск |
|---|---|---|---|
| Стационарный бандит | средние награды действий | оценки и последующие действия | недостаточное или чрезмерное исследование |
| Контекстный бандит | зависимость награды от контекста и действия | политика выбора для новых контекстов | отсутствие перекрытия, неверная модель |
| Температурная генерация | ничего не оценивается заново | только текущий набор кандидатов | путаница разнообразия с обучением |
| Best-of-N | вероятность успеха кандидата и ошибки проверяющего | обычно ничего в весах модели | корреляция кандидатов и ошибки ранжировщика |
| Энтропийная регуляризация | компромисс между качеством и энтропией | оптимизируемая политика | неверная награда или слишком сильная регуляризация |
| RLVR | качество траекторий по проверяемой награде | параметры LLM | недостаток разнообразия, разреженный сигнал, эксплуатация проверяющего |
Главные выводы:
- бандит — точная одношаговая модель, а не общее слово для любого выбора;
- регрет измеряет цену незнания относительно явно заданного эталона;
- UCB и сэмплирование Томпсона направляют исследование с помощью оценки неопределённости, но представляют её по-разному;
- контекстный бандит подходит для одношаговой абстракции с наградой за полный ответ LLM, но не заменяет токеновый MDP и многоходовую среду;
- оценивание по журналу требует вероятностей поведения и перекрытия;
- температура, Best-of-N и pass@ относятся к генерации и оцениванию, а не автоматически к обучающему исследованию;
- энтропия — полезная характеристика распределения действий, но не мера истинности ответа.
В Модуле 4 текущего курса «Градиенты политики: от REINFORCE к PPO» (rl_llm.module_04_policy_gradients) мы вернём последовательность и научимся менять параметры стохастической политики напрямую. Бандитная постановка станет простейшим случаем градиента политики: действие уже случайно выбирается из , остаётся понять, как награда превращается в несмещённый градиент ожидаемого результата.
Мини-словарь сокращений
| Сокращение | Полная форма | Роль в модуле |
|---|---|---|
| MDP | Markov decision process | последовательная постановка, с которой сравнивается бандит |
| UCB | upper confidence bound | индекс «оценка плюс бонус неопределённости» |
| IPS | inverse propensity scoring | оценивание новой политики по журналу действий |
| SNIPS | self-normalized inverse propensity scoring | самонормированная версия IPS |
| DR | doubly robust | оцениватель, объединяющий модель награды и веса вероятностей |
| RLVR | reinforcement learning with verifiable rewards | обучение по автоматически проверяемой награде |
| GRPO | group relative policy optimization | семейство групповых относительных обновлений политики |
| KL | Kullback–Leibler | мера отклонения политики от базового распределения |
Итоговая проверка: вы должны уметь объяснить, почему Best-of-N не является автоматически многоруким бандитом, вывести разложение регрета по , прочитать бонус UCB, обновить апостериорное бета-распределение, назвать условие перекрытия для IPS и разделить температуру генерации от исследования при обучении.
Практический маршрут
- многозапусковое сравнение ε-жадной стратегии, UCB1 и сэмплирования Томпсона;
- поведение при смене лучшего действия в нестационарной среде;
- формирование журнала контекстного бандита с известной политикой сбора данных;
- IPS, SNIPS, direct method и doubly robust evaluation;
- стресс-тест ухудшения перекрытия, концентрацию весов и эффективный размер выборки;
- LLM-подобную маршрутизацию между моделями с учётом качества, стоимости и задержки.
На учебной платформе к этим материалам добавляются 20 заданий основного маршрута и 12 дополнительных платформенных заданий; каждое снабжено подробным решением, открываемым после попытки. Основной профиль работает на CPU; полный профиль увеличивает число повторов и нужен для более устойчивых кривых, но не превращает учебный эксперимент во внешний бенчмарк.
Источники и маршрут дальнейшего чтения
- Lattimore и Szepesvári, Bandit Algorithms — систематическое изложение стохастических и контекстных бандитов, регрета и нижних границ. Теоремы относятся к явно заданным классам бандитных задач и не переносятся автоматически на произвольные нейросетевые оценки неопределённости.
- Auer, Cesa-Bianchi и Fischer, “Finite-time Analysis of the Multiarmed Bandit Problem” — первичный источник конечновременной гарантии UCB1 для ограниченных наград. Он не утверждает, что любой индекс вида «оценка плюс бонус» наследует ту же гарантию.
- Thompson, “On the Likelihood that One Unknown Probability Exceeds Another…” — исторический источник идеи probability matching. Современные гарантии сэмплирования Томпсона опираются на более поздний анализ.
- Li et al., “A Contextual-Bandit Approach to Personalized News Article Recommendation” — LinUCB и практическая контекстная постановка. Линейная модель награды остаётся предположением, а не свойством произвольных эмбеддингов.
- Ouyang et al., “Training Language Models to Follow Instructions with Human Feedback” — пример внешней трактовки полного ответа как одного бандитного действия в PPO-этапе InstructGPT. Внутри генерация всё равно остаётся последовательностью токенов.
- Dudík, Langford и Li, “Doubly Robust Policy Evaluation and Learning” — первичный источник doubly robust evaluation. «Двойная устойчивость» не устраняет отсутствие перекрытия, скрытое смешение причин или испорченные вероятности поведения.
- Chen et al., “Evaluating Large Language Models Trained on Code” — источник конечновыборочного оценивателя pass@. Его нельзя смешивать с популяционной формулой независимых испытаний .
- Xu et al., “Understanding and Preventing Entropy Collapse in RLVR with On-Policy Entropy Flow Optimization” — авторский отчёт 2026 года о падении энтропии в изученных авторами режимах RLVR. В модуле этот результат используется как современное наблюдение, а не как универсальная теорема.
Полный реестр утверждений, типов оснований и границ переноса находится в Module_3_Sources.md.