Модуль 12. Инфраструктура RL для LLM: память, роллауты и асинхронность
Версия материала: 2026.24
Фактический снимок: 2026-08-06
Язык: RU
Основная практика: уровень A — браузер и центральный процессор (central processing unit, CPU); уровень B — бесплатный Colab T4; уровень C — факультативный многопроцессорный запуск
Структура: 5 уроков, 25 шагов
Ориентировочное время: 10–12 часов без факультативного запуска модели
В Модулях 8–11 мы обсуждали целевые функции, групповые роллауты, проверяемые награды и длинные траектории агента. Последняя из этих тем подробно разобрана в RL for LLM, Модуле 11 «RL для LLM-агентов: инструменты, среда и длинные траектории» (rl_llm.module_11_agentic_rl). Теперь возникает инженерный вопрос: как превратить формулы в систему, которая действительно собирает данные, обновляет модель и не теряет смысл политики по дороге между двумя программами?
Представьте один роллаут. Он начинается как запись в планировщике, превращается в запрос движку генерации, обрастает токенами и KV-кэшем, проходит проверяющую систему, ждёт в очереди, попадает в обучающий пакет, влияет на градиент и в конце должен быть связан с новой версией весов. Если на любом переходе потерялась маска, версия политики, фактический логарифм вероятности или происхождение награды, проблема уже не сводится к «неудачной инженерии»: меняется статистический смысл обновления.
Одну и ту же формулу GRPO можно запустить как последовательный скрипт на одной видеокарте, как конвейер из отдельных пулов генерации и обучения или как полностью асинхронную систему с очередью. Математическая механика RLVR и GRPO введена в RL for LLM, Модуле 9 «RLVR и GRPO: проверяемые награды, групповые оценки и устойчивость» (rl_llm.module_09_rlvr_grpo). Здесь нас интересует другой слой: разные исполнения этой механики порождают разные задержки, требования к памяти и риски несвежести данных.
Практическая задача модуля:
Спроектировать и измерить RL-контур так, чтобы генерация, обучение, синхронизация весов, журнал роллаутов и восстановление после сбоя образовывали одну проверяемую систему с контролируемой памятью, пропускной способностью и несвежестью данных.
После прохождения модуля вы сможете:
- представить RL-контур как поток данных между политикой, движком генерации, проверяющей системой, тренером и хранилищем;
- различать совместное и раздельное размещение вычислительных ролей;
- отделять синхронность алгоритма от физического размещения процессов;
- составлять минимальный контракт роллаута с версией политики поведения;
- считать логическую память параметров, градиентов и состояний Adam без мифа об одном универсальном числе байт на параметр;
- объяснять, что именно шардируют полностью шардированный параллелизм данных (
Fully Sharded Data Parallel, FSDP) и оптимизатор с нулевой избыточностью (Zero Redundancy Optimizer, ZeRO), а также какие временные буферы остаются; - оценивать память ключей и значений внимания (
key–value cache, KV-кэш) по архитектуре и числу сохранённых токенов; - отличать память обучения, память генерации и пиковую память совместного размещения;
- вычислять время последовательного и перекрытого конвейеров;
- измерять потери из-за неодинаковой длины ответов и медленных роллаутов;
- формулировать условие устойчивости очереди и вводить обратное давление;
- различать задержку политики и рассогласование обучения с генерацией;
- вычислять отношения вероятностей, долю клиппирования и эффективный размер выборки;
- выбирать между пересчётом логарифмов вероятностей, поправкой важности и отбрасыванием несвежих данных;
- проектировать атомарную синхронизацию полной модели или адаптеров;
- составлять полную контрольную точку RL-запуска и проверять восстановление до аварии;
- собирать трассировку, которая связывает запрос, роллаут, версию весов, награду и шаг оптимизатора;
- сравнивать TRL, verl, OpenRLHF, NeMo RL, PRIME-RL, SkyRL и AReaL по архитектурным осям, а не по одному рейтингу;
- профилировать синтетический RL-контур на CPU и факультативно измерять малую открытую модель на Colab T4.
Практический маршрут. После лекции идут оцениваемые задания, решения, открывающиеся после попытки, и исполняемая практика. Само объяснение остаётся самодостаточным.
Урок 12.1. RL-контур как поток данных
Урок 12.1. RL-контур как поток данных
- Почему одного
trainer.generate()недостаточно- Контракт между ролями важнее формата очереди
- Две независимые оси: размещение и синхронность
- Политика поведения и атомарная версия роллаута
- Сначала базовый профиль, затем распределённая система
далее — 2 проверочных шага
Шаг 12.1.1 — Почему одного trainer.generate() недостаточно
Начнём не с названий библиотек, а с физического цикла.
Для одного обновления онлайн-RL система должна:
- выбрать запрос или состояние среды;
- получить один или несколько роллаутов от политики поведения;
- вычислить награды и служебные признаки;
- восстановить маски и логарифмы вероятностей;
- собрать мини-пакет;
- вычислить функцию потерь и градиенты;
- обновить параметры;
- сделать новую версию политики доступной сборщикам данных.
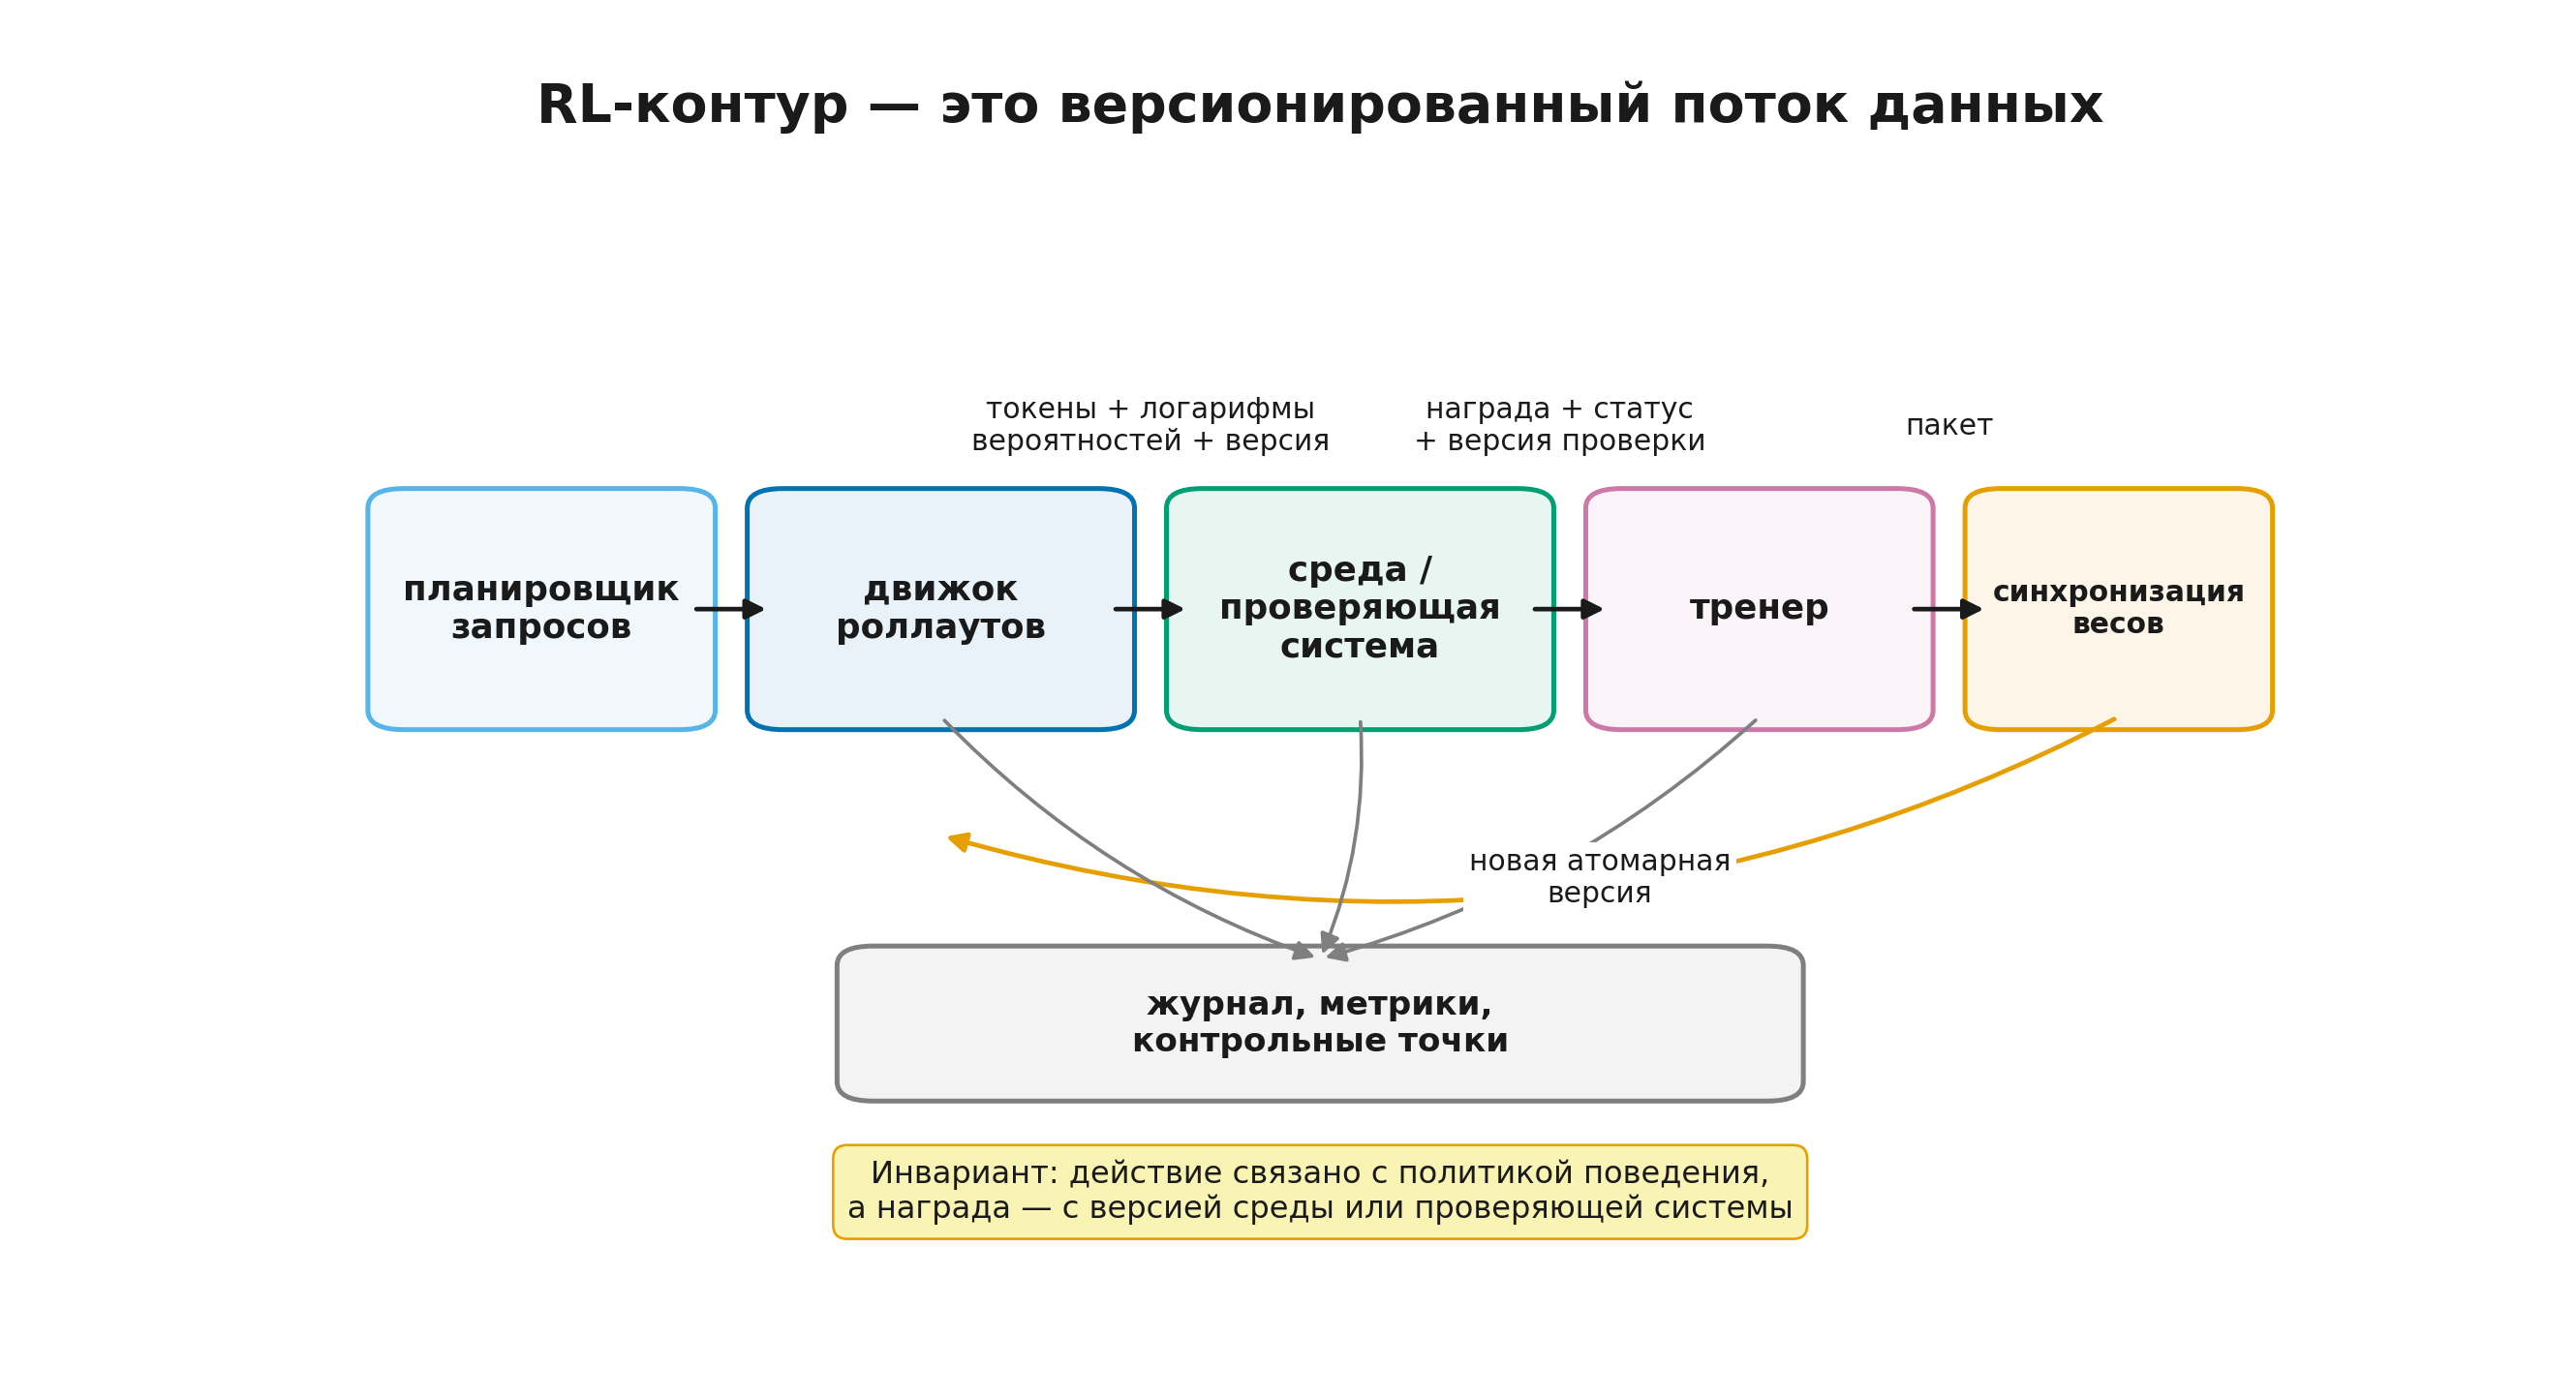
В маленьком скрипте все роли может исполнять один процесс. На большом запуске они распадаются на самостоятельные программы:
- планировщик запросов выбирает задачи;
- движок генерации эффективно декодирует ответы;
- среда или проверяющая система вычисляет исходы;
- тренер выполняет прямой и обратный проходы;
- служба синхронизации переносит новую версию весов;
- хранилище и телеметрия сохраняют опыт, метрики и контрольные точки.
Это разделение не является обязательной теоремой. Оно возникает потому, что генерация и обучение предъявляют разные требования к аппаратуре и программному стеку.
- При декодировании модель делает много коротких последовательных шагов, а память KV-кэша зависит от числа и длины активных последовательностей.
- При обучении выгодны плотные мини-пакеты, сохранённые активации, обратный проход и коллективные операции над градиентами.
Поэтому оптимизированный движок генерации вроде vLLM или SGLang и тренер на FSDP, DeepSpeed или Megatron могут использовать одну модель, но решают разные вычислительные задачи.
Граница утверждения. Тренировочная библиотека умеет генерировать текст, а движок генерации может выполнять прямой проход. Разделение ролей — инженерный выбор, а не невозможность. На одной видеокарте последовательный скрипт часто является лучшим проверочным вариантом именно потому, что в нём меньше движущихся частей.
Шаг 12.1.2 — Контракт между ролями важнее формата очереди
Передача строки ответа между двумя процессами недостаточна для корректного обновления политики. Минимальная запись роллаута должна отвечать по крайней мере на следующие вопросы.
| Поле | Зачем оно нужно |
|---|---|
sample_id, prompt_id | связать запрос, группу ответов и последующую диагностику |
| идентификаторы токенов | точно восстановить действия политики |
| маска токенов политики | не обучаться на тексте среды или шаблона |
| логарифмы вероятностей поведения | вычислить отношение вероятностей или проверить совпадение стеков |
policy_version | измерить задержку политики |
| параметры декодирования | восстановить фактическое распределение поведения |
| награда и её компоненты | отделить проверяемый исход от штрафов формата и стоимости |
| причина остановки | различить токен конца последовательности (end of sequence, EOS), лимит, задачный провал и сбой среды |
| версия проверяющей системы | не смешивать разные спецификации награды |
| временные метки | измерить очередь, генерацию, проверку и обучение |
Данные полезно представлять не как «ответ плюс число», а как событие с явной схемой. Например:
{
  "sample_id": "run42-p008-g03",
  "policy_version": 127,
  "prompt_tokens": [101, 42, 17],
  "response_tokens": [314, 159, 2],
  "policy_mask": [0, 0, 0, 1, 1, 1],
  "behavior_logprobs": [-0.31, -1.07, -0.22],
  "decoding": {"temperature": 0.8, "top_p": 1.0},
  "reward": {"correctness": 1.0, "format": 0.0},
  "stop_reason": "eos",
  "verifier_version": "arith-v4"
}
Схема не обязана быть именно JSON. В реальном запуске это может быть Apache Arrow, Parquet, очередь сообщений или объект в памяти. Важен не контейнер, а сохранённая семантика.
Модуль 11 уже ввёл происхождение токенов в многоходовой траектории. Здесь добавляется системное требование: происхождение должно пережить сериализацию, очередь и перезапуск процесса. Если после чтения файла невозможно отличить токены политики от наблюдений среды, данные непригодны для честного обновления независимо от качества кода тренера.
Шаг 12.1.3 — Две независимые оси: размещение и синхронность
Инфраструктуру удобно классифицировать по двум осям, которые часто ошибочно смешивают.
Ось 1 — размещение вычислительных ролей.
- Совместное размещение (
colocation): генерация и обучение по очереди используют одни и те же графические процессоры (graphics processing unit, GPU). Это снижает минимальное число устройств и упрощает передачу весов, но роли конкурируют за память и не работают одновременно. - Раздельное размещение (
disaggregation): движки генерации и тренеры находятся на разных GPU или узлах. Это позволяет перекрывать работу и независимо масштабировать пулы, но требует сети, синхронизации весов и контроля очереди.
Ось 2 — порядок данных и обновлений.
- Синхронный режим: тренер ждёт определённый пакет роллаутов, выполняет обновление и только затем начинает следующий логический цикл.
- Асинхронный режим: сборщики продолжают генерировать, пока тренер обновляет модель; данные приходят с разными версиями политики.
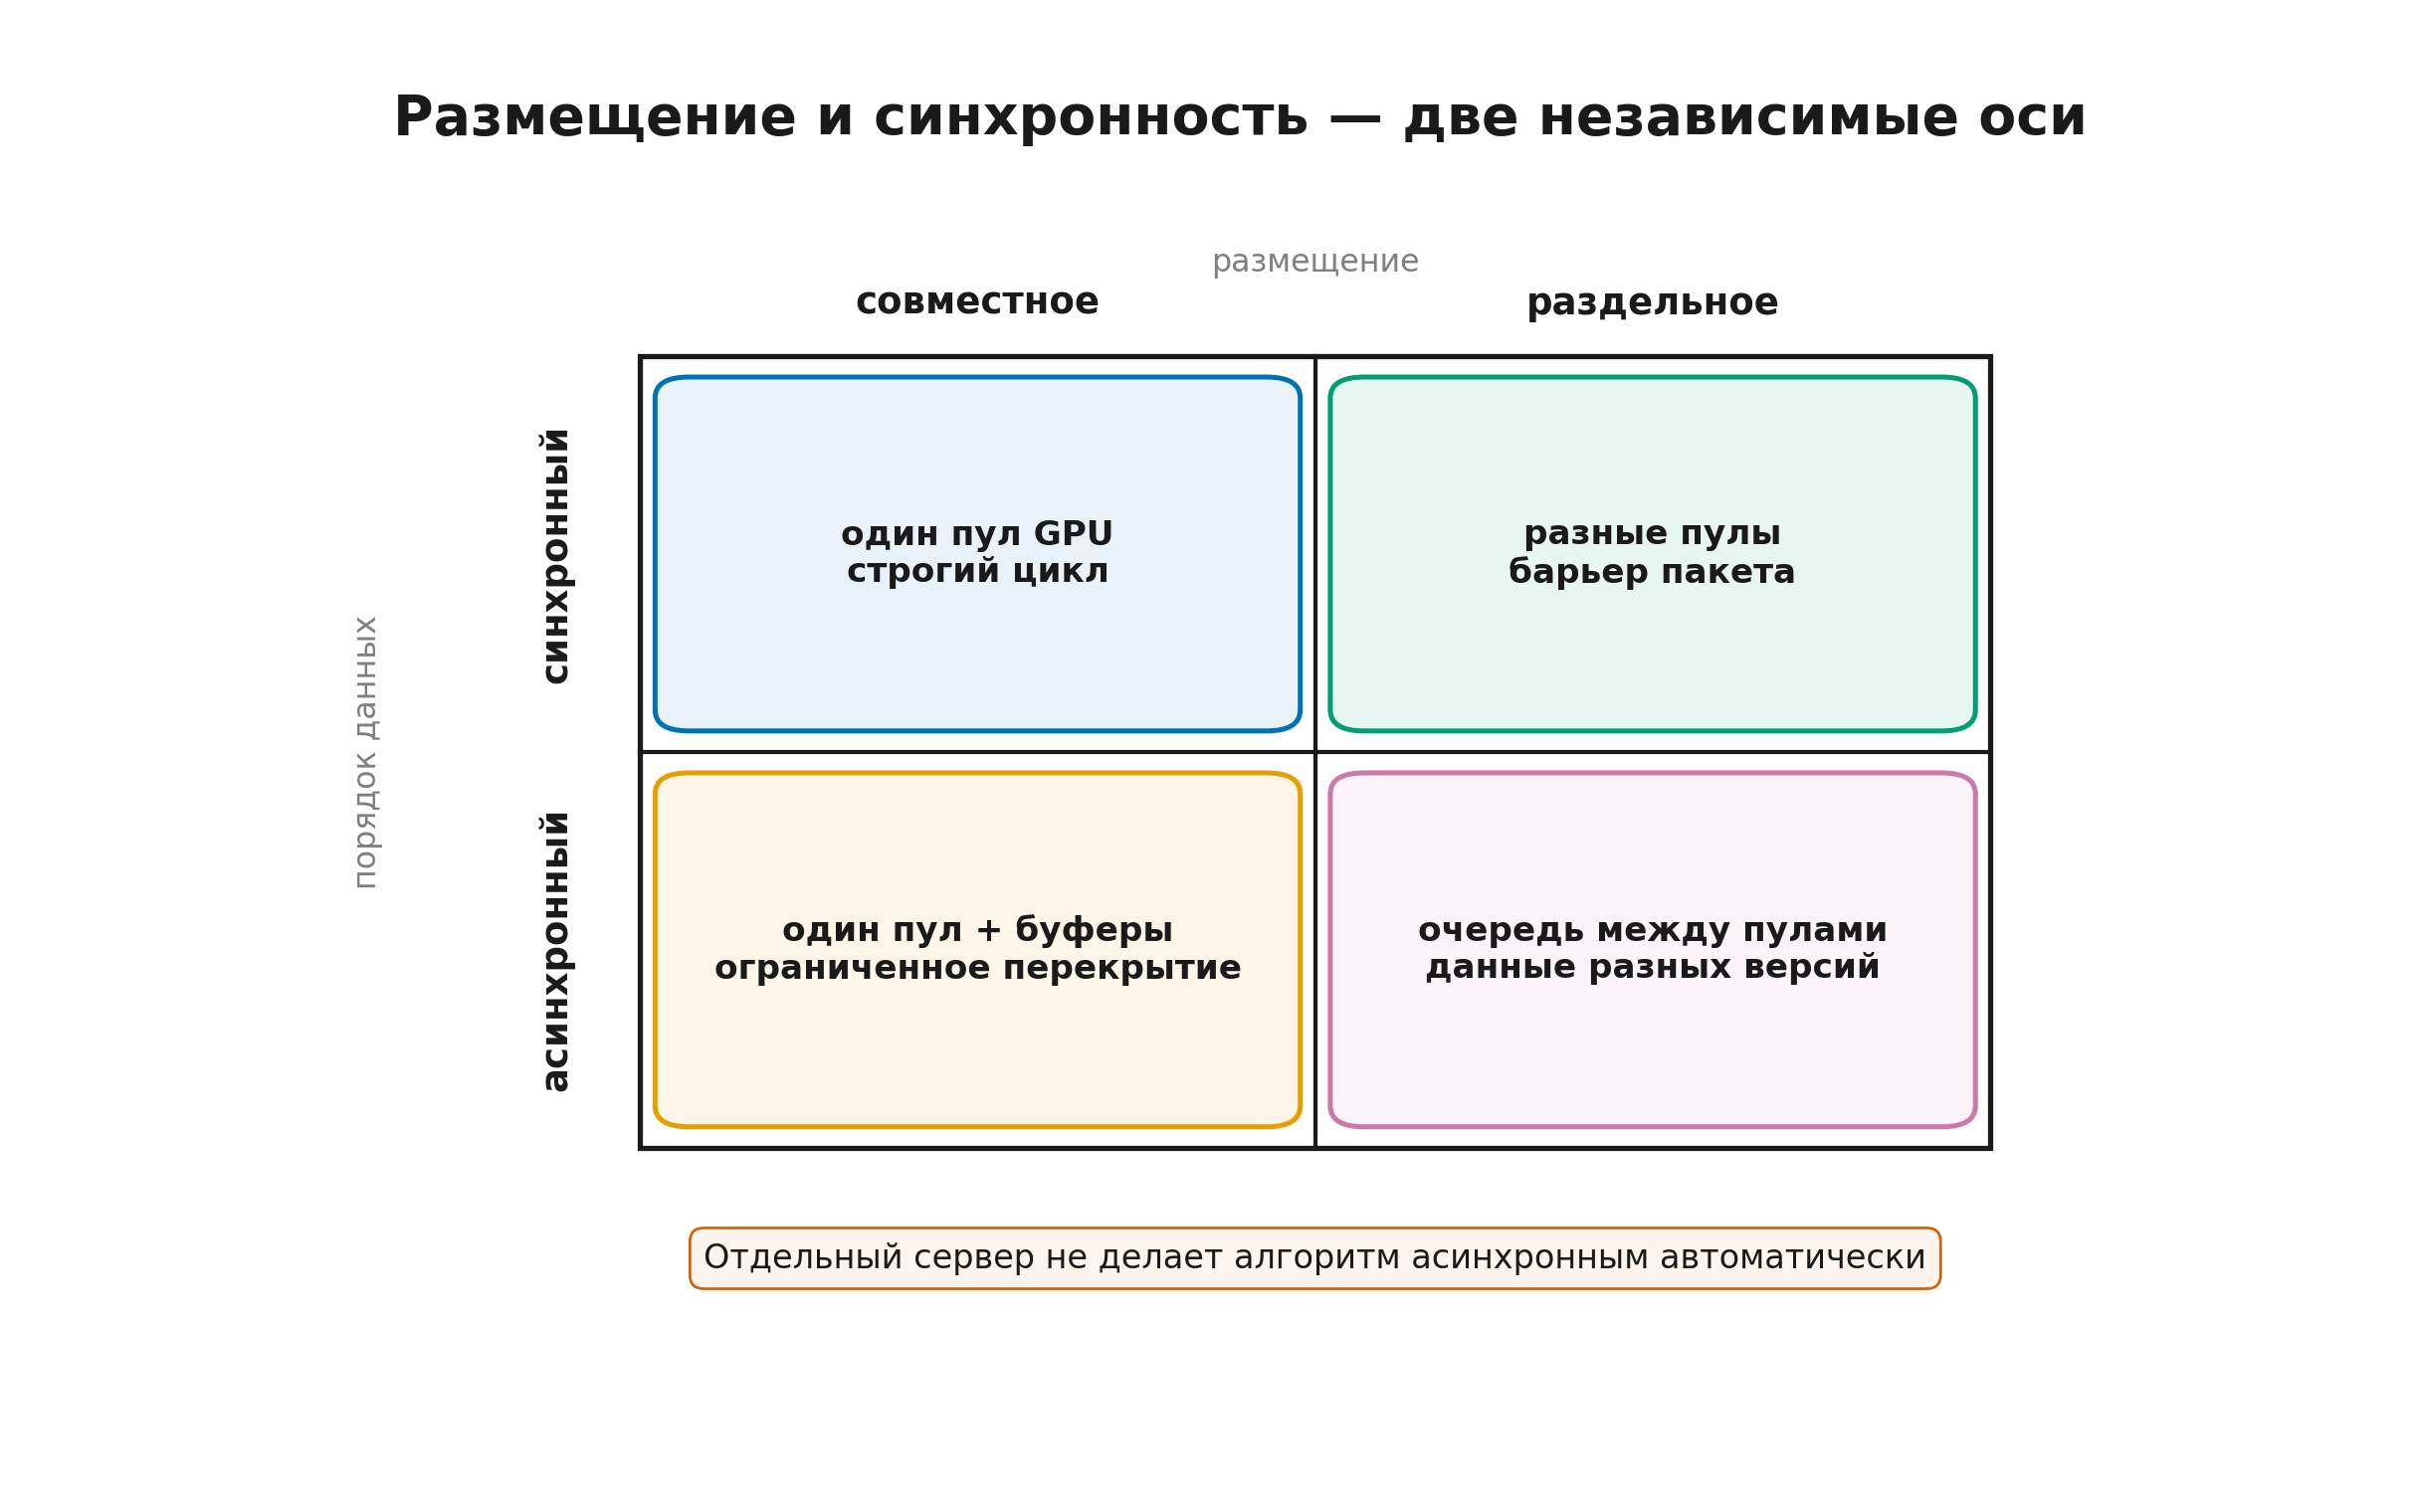
Эти оси независимы.
- Совместное размещение обычно последовательное, но может использовать буферы и частичное перекрытие на уровне центрального процессора.
- Раздельные пулы могут оставаться строго синхронными: движки готовят пакет, затем ждут окончания обновления и синхронизации.
- Раздельные пулы могут быть полностью асинхронными с очередью и ограничением на возраст данных.
Такая карта помогает избежать ложного вывода «отдельный vLLM-сервер автоматически делает алгоритм асинхронным». Физически отдельный сервер может всё равно обслуживать строго последовательные запросы тренера.
Для первого воспроизводимого эксперимента полезно начинать с простейшей клетки карты: один процесс, один мини-пакет, одна версия политики. Затем каждое усложнение должно окупаться измеренным узким местом.
Шаг 12.1.4 — Политика поведения и атомарная версия роллаута
Пусть движок генерации использует версию весов , а тренер к моменту обновления уже находится на версии . Обозначим фактическую политику поведения через
Текущая обучаемая политика равна
В синхронном запуске обычно в момент сбора данных, хотя внутри нескольких эпох проксимальной оптимизации политики (Proximal Policy Optimization, PPO) текущая политика уже изменяется относительно зафиксированной старой политики. В асинхронном запуске разность
называют задержкой политики (policy lag).
Версия должна относиться не к имени файла, а к конкретному набору вероятностей. Есть три безопасных варианта.
- Версия на весь ответ. Движок завершает уже начатые запросы старыми весами, затем атомарно переключается на новую версию.
- Версия на каждый ход агента. Допустимо для длинных эпизодов, если журнал хранит версию и логарифмы вероятностей каждого действия.
- Точная политика поведения в записи. Если движок меняет веса в середине ответа, нужны поточечные логарифмы вероятностей и однозначный порядок обновлений; это значительно усложняет анализ.
На практике первый вариант проще всего для одноразовых ответов. Для многоходовых агентов второй вариант иногда неизбежен.
Ключевое требование:
Нельзя пометить весь роллаут одной версией, если разные его действия действительно были выбраны разными версиями политики.
Атомарность относится и к декодированию. Температура, top-p, запрещённые токены и обработка EOS входят в политику поведения. Одинаковые веса при разных правилах декодирования задают разные распределения.
Шаг 12.1.5 — Сначала базовый профиль, затем распределённая система
Перед тем как выбирать Ray, Kubernetes или многопроцессорный движок, полезно измерить последовательный эталонный цикл. Для каждого мини-пакета записываются:
- время подготовки запросов;
- время предварительного прохода по запросу (
prefill); - время декодирования;
- время проверки награды;
- время пересчёта логарифмов вероятностей;
- время прямого и обратного проходов;
- время шага оптимизатора;
- время синхронизации весов;
- число входных и выходных токенов;
- пиковая память.
Общая длительность последовательного цикла:
Это не модель производительности кластера, а бухгалтерия. Она отвечает на первый вопрос: какой этап действительно доминирует в выбранной конфигурации?
Фраза «генерация всегда является узким местом» слишком сильна. Она часто верна для длинных рассуждений и малых групп обучения, но может стать неверной при коротких ответах, большом числе эпох, тяжёлом критике, медленной проверяющей системе или дорогой передаче весов.
В факультативном ноутбуке этого модуля сначала строится именно такой синтетический профиль. Реальная ветвь затем измеряет генерацию и прямой проход с известным продолжением (teacher forcing) на небольшой открытой модели. Проверочный запуск не воспроизводит производительность крупного кластера; он учит правильно задавать таймеры и единицы.
Урок 12.2. Память и пропускная способность
Урок 12.2. Память и пропускная способность
- Почему «16 байт на параметр» — не закон природы
- Репликация, FSDP и ZeRO
- Память движка: веса и KV-кэш
- Совместное размещение: считать нужно пик по времени
- Пропускная способность измеряется токенами и событиями
далее — 3 проверочных шага
Шаг 12.2.1 — Почему «16 байт на параметр» — не закон природы
Для оценки памяти часто используют короткое правило: обучение Adam в смешанной точности требует около 16 байт на параметр. Оно полезно как один сценарий, но опасно как универсальная константа.
Логическая память состояния модели равна сумме реально хранимых представлений:
где — число параметров, а — число байт на один параметр соответствующего объекта.
Для одного распространённого сценария:
| Компонент | Тип | Байт/параметр |
|---|---|---|
| рабочие параметры | bfloat16 | 2 |
| градиенты | bfloat16 | 2 |
| первый момент Adam | float32 | 4 |
| второй момент Adam | float32 | 4 |
| отдельная мастер-копия | float32 | 0 или 4 |
| Итого | 12 или 16 |
Почему диапазон, а не одно число?
- Некоторые реализации сохраняют отдельную float32-копию параметров, другие уже считают высокоточную шардированную копию основным состоянием.
- Градиенты могут храниться в bfloat16 или float32.
- Оптимизатор может использовать восьмибитные состояния, Adafactor, SGD или другой набор буферов.
- При низкоранговой адаптации (
Low-Rank Adaptation, LoRA) обучается только небольшая доля параметров, а базовые веса остаются замороженными.
Кроме модельного состояния остаются активации, временные буферы коллективных операций, логиты, маски, KV-кэш, фрагментация распределителя памяти и память среды. Поэтому оценка по байтам на параметр — нижний слой сметы, а не ответ «поместится ли запуск».
Шаг 12.2.2 — Репликация, FSDP и ZeRO
При обычном распределённом параллелизме данных (Distributed Data Parallel, DDP) каждый процесс хранит полную копию параметров и состояний оптимизатора. Мини-пакет делится между процессами, а градиенты суммируются.
FSDP и ZeRO уменьшают репликацию модельного состояния. В наиболее полном режиме параметры, градиенты и состояния оптимизатора разделяются между участниками параллелизма данных.
В грубой оценке постоянная часть на один процесс становится
Но знак приблизительного равенства принципиален. Во время прямого и обратного проходов отдельные модули временно собираются, создаются коммуникационные буферы, а крупные параметры могут быть обёрнуты неидеально. Пиковая память зависит от:
- границ шардирования;
- размера собираемого модуля;
- предварительной выборки следующего слоя;
- пересчёта активаций (
activation checkpointing); - числа одновременно активных микропакетов;
- размера логитов и способа их вычисления;
- коммуникационной библиотеки.
Поэтому расчёт является проверкой порядка величины, а не заменой профилировщика памяти.
Углубление: общий аппарат DDP, FSDP/ZeRO, тензорного и конвейерного параллелизма рассматривается в Modern LLMs, Модуле 9 «Претрейн: данные, законы масштабирования, оптимизаторы» (
modern_llms.module_08_pretraining). Здесь нас интересует дополнительная роль движка роллаутов и перемещение одной политики между режимами обучения и генерации.
Шаг 12.2.3 — Память движка: веса и KV-кэш
Движок генерации обычно не хранит градиенты и состояния оптимизатора. Его основные крупные статьи памяти:
- веса модели;
- KV-кэш активных последовательностей;
- временные рабочие буферы и графы;
- иногда несколько версий адаптеров или весов.
Для трансформера с слоями, головами ключей и значений, размерностью головы и суммарными сохранёнными токенами память KV-кэша равна
где множитель 2 отвечает за ключи и значения, а — байт на одно число.
Пример. Пусть
Тогда один сохранённый токен требует
Здесь KiB — кибибайт, равный байтам. Если одновременно хранятся 64 последовательности по 4096 токенов, суммарно это токена и ровно 32 гибибайта (GiB) KV-кэша в данной упрощённой архитектуре.
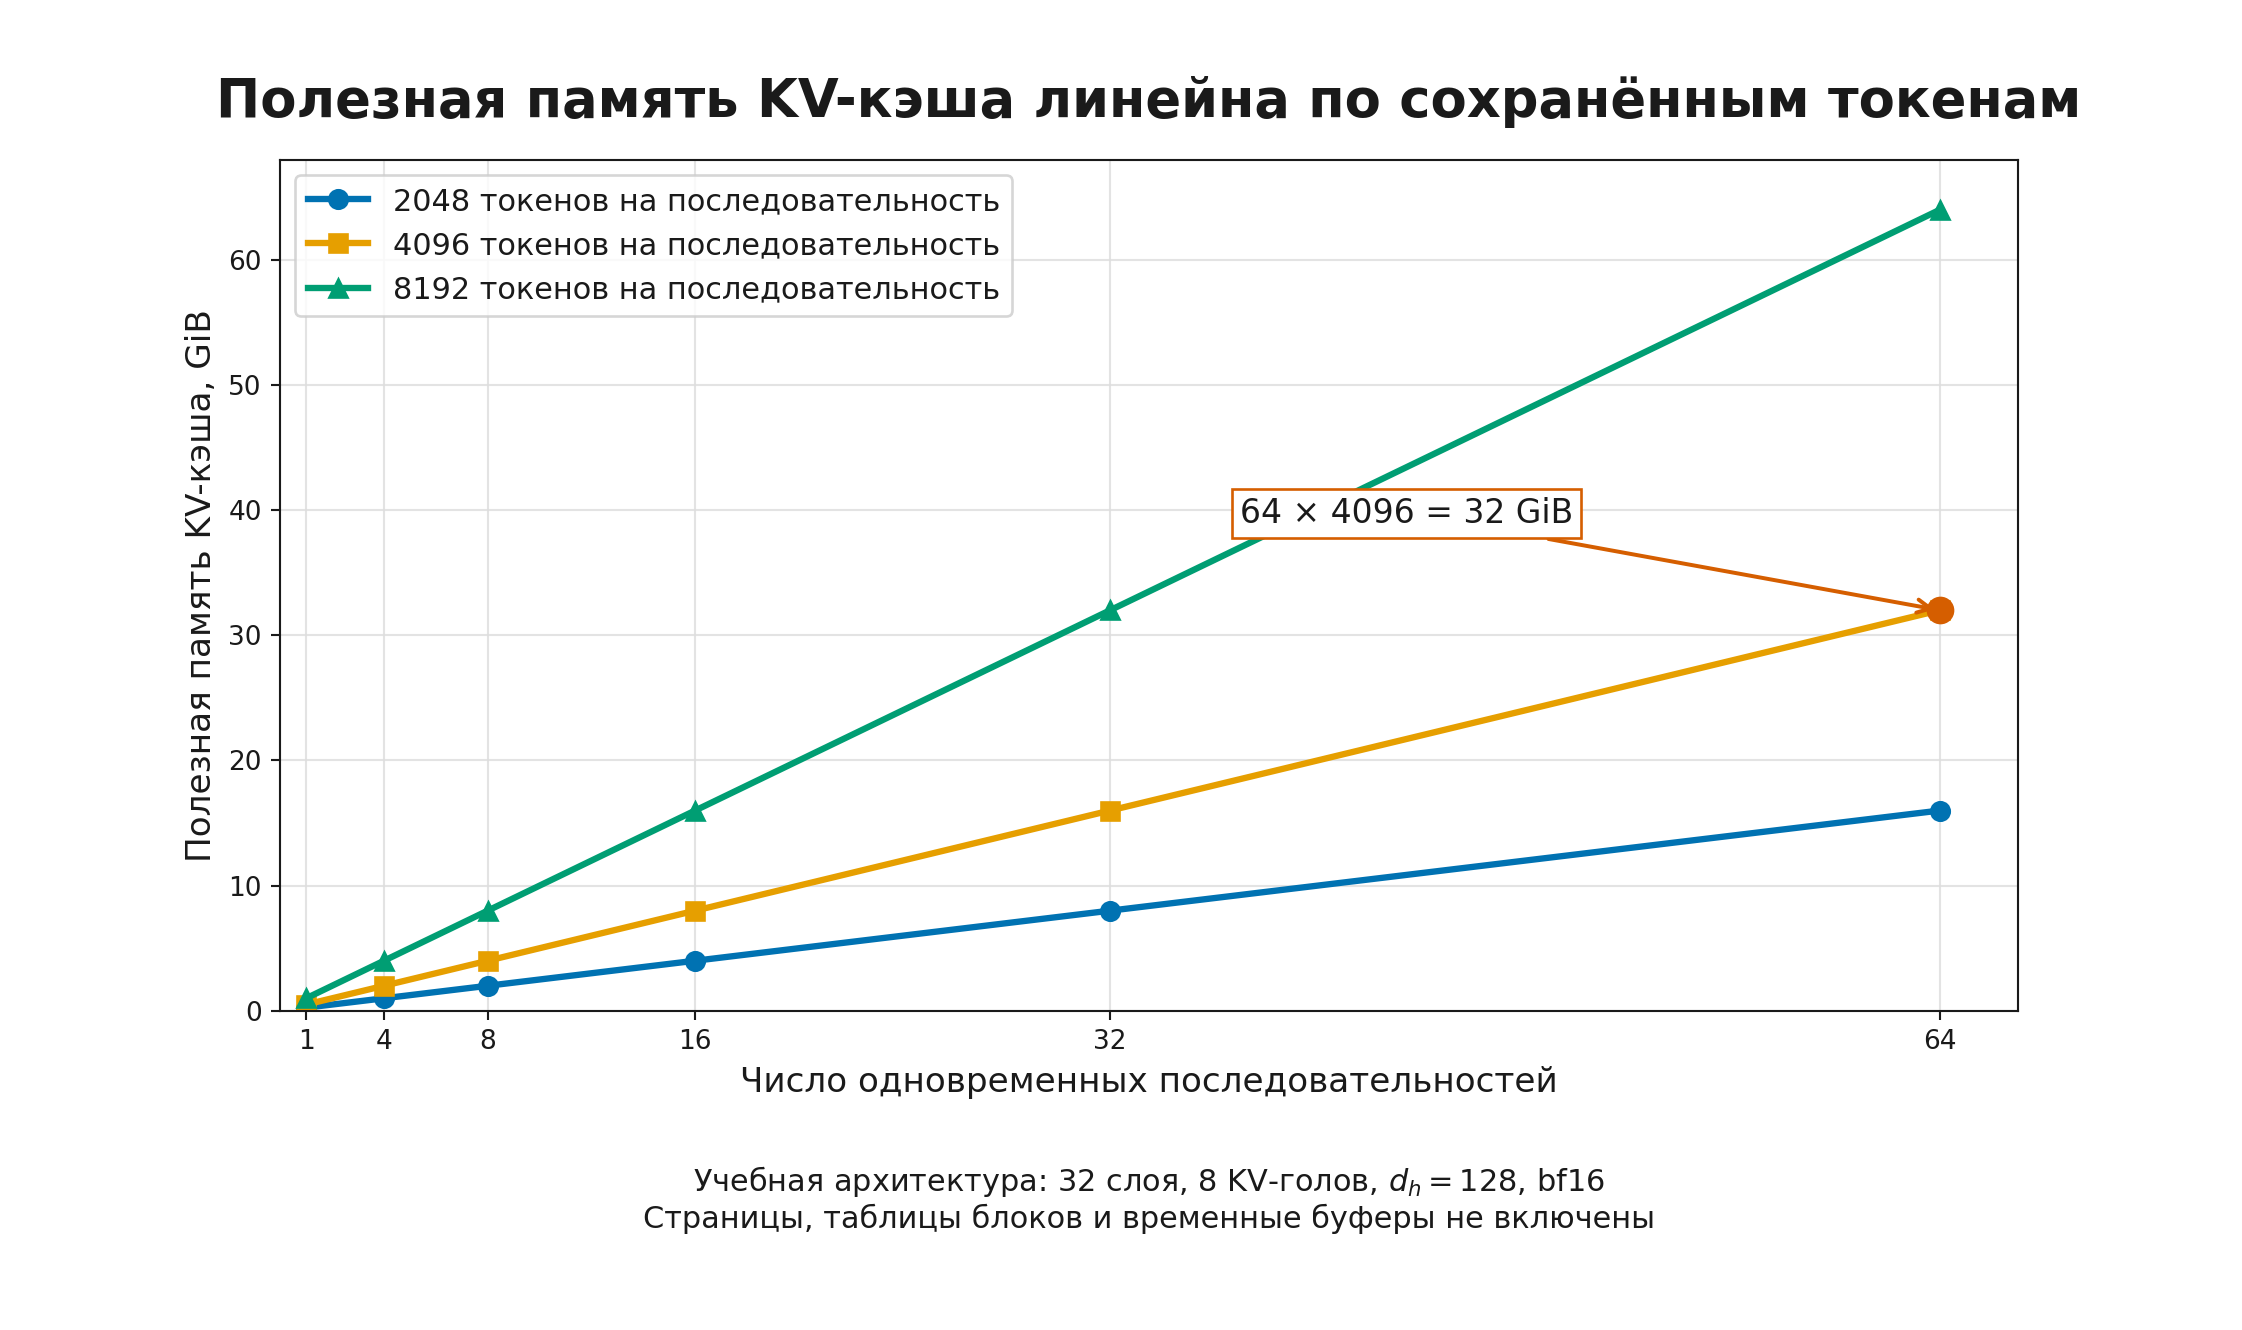
Формула объясняет, почему размер группы GRPO и длина рассуждения являются инфраструктурными параметрами. Увеличение числа ответов на запрос пропорционально увеличивает число активных последовательностей, а длинные ответы удерживают страницы кэша дольше.
PagedAttention в vLLM уменьшает потери от фрагментации и позволяет гибко распределять блоки KV-кэша; RadixAttention в SGLang помогает переиспользовать общие префиксы. Ни один из этих механизмов не отменяет саму линейную стоимость сохранённых ключей и значений.
Углубление: архитектурные варианты внимания с одной, сгруппированными или латентными KV-головами, PagedAttention, повторное использование префиксов и распределённое обслуживание подробно рассматриваются в Modern LLMs, Модуле 10 «KV-кэши и эффективный инференс» (
modern_llms.module_09_inference).
Шаг 12.2.4 — Совместное размещение: считать нужно пик по времени
При раздельном размещении тренер и движок имеют разные GPU, поэтому их памяти складываются на уровне кластера, но не на одном устройстве.
При совместном размещении роли используют один набор GPU по очереди. Здесь нельзя просто сложить максимумы обеих фаз: часть памяти может выгружаться или освобождаться между генерацией и обучением. Нужно построить временную шкалу.
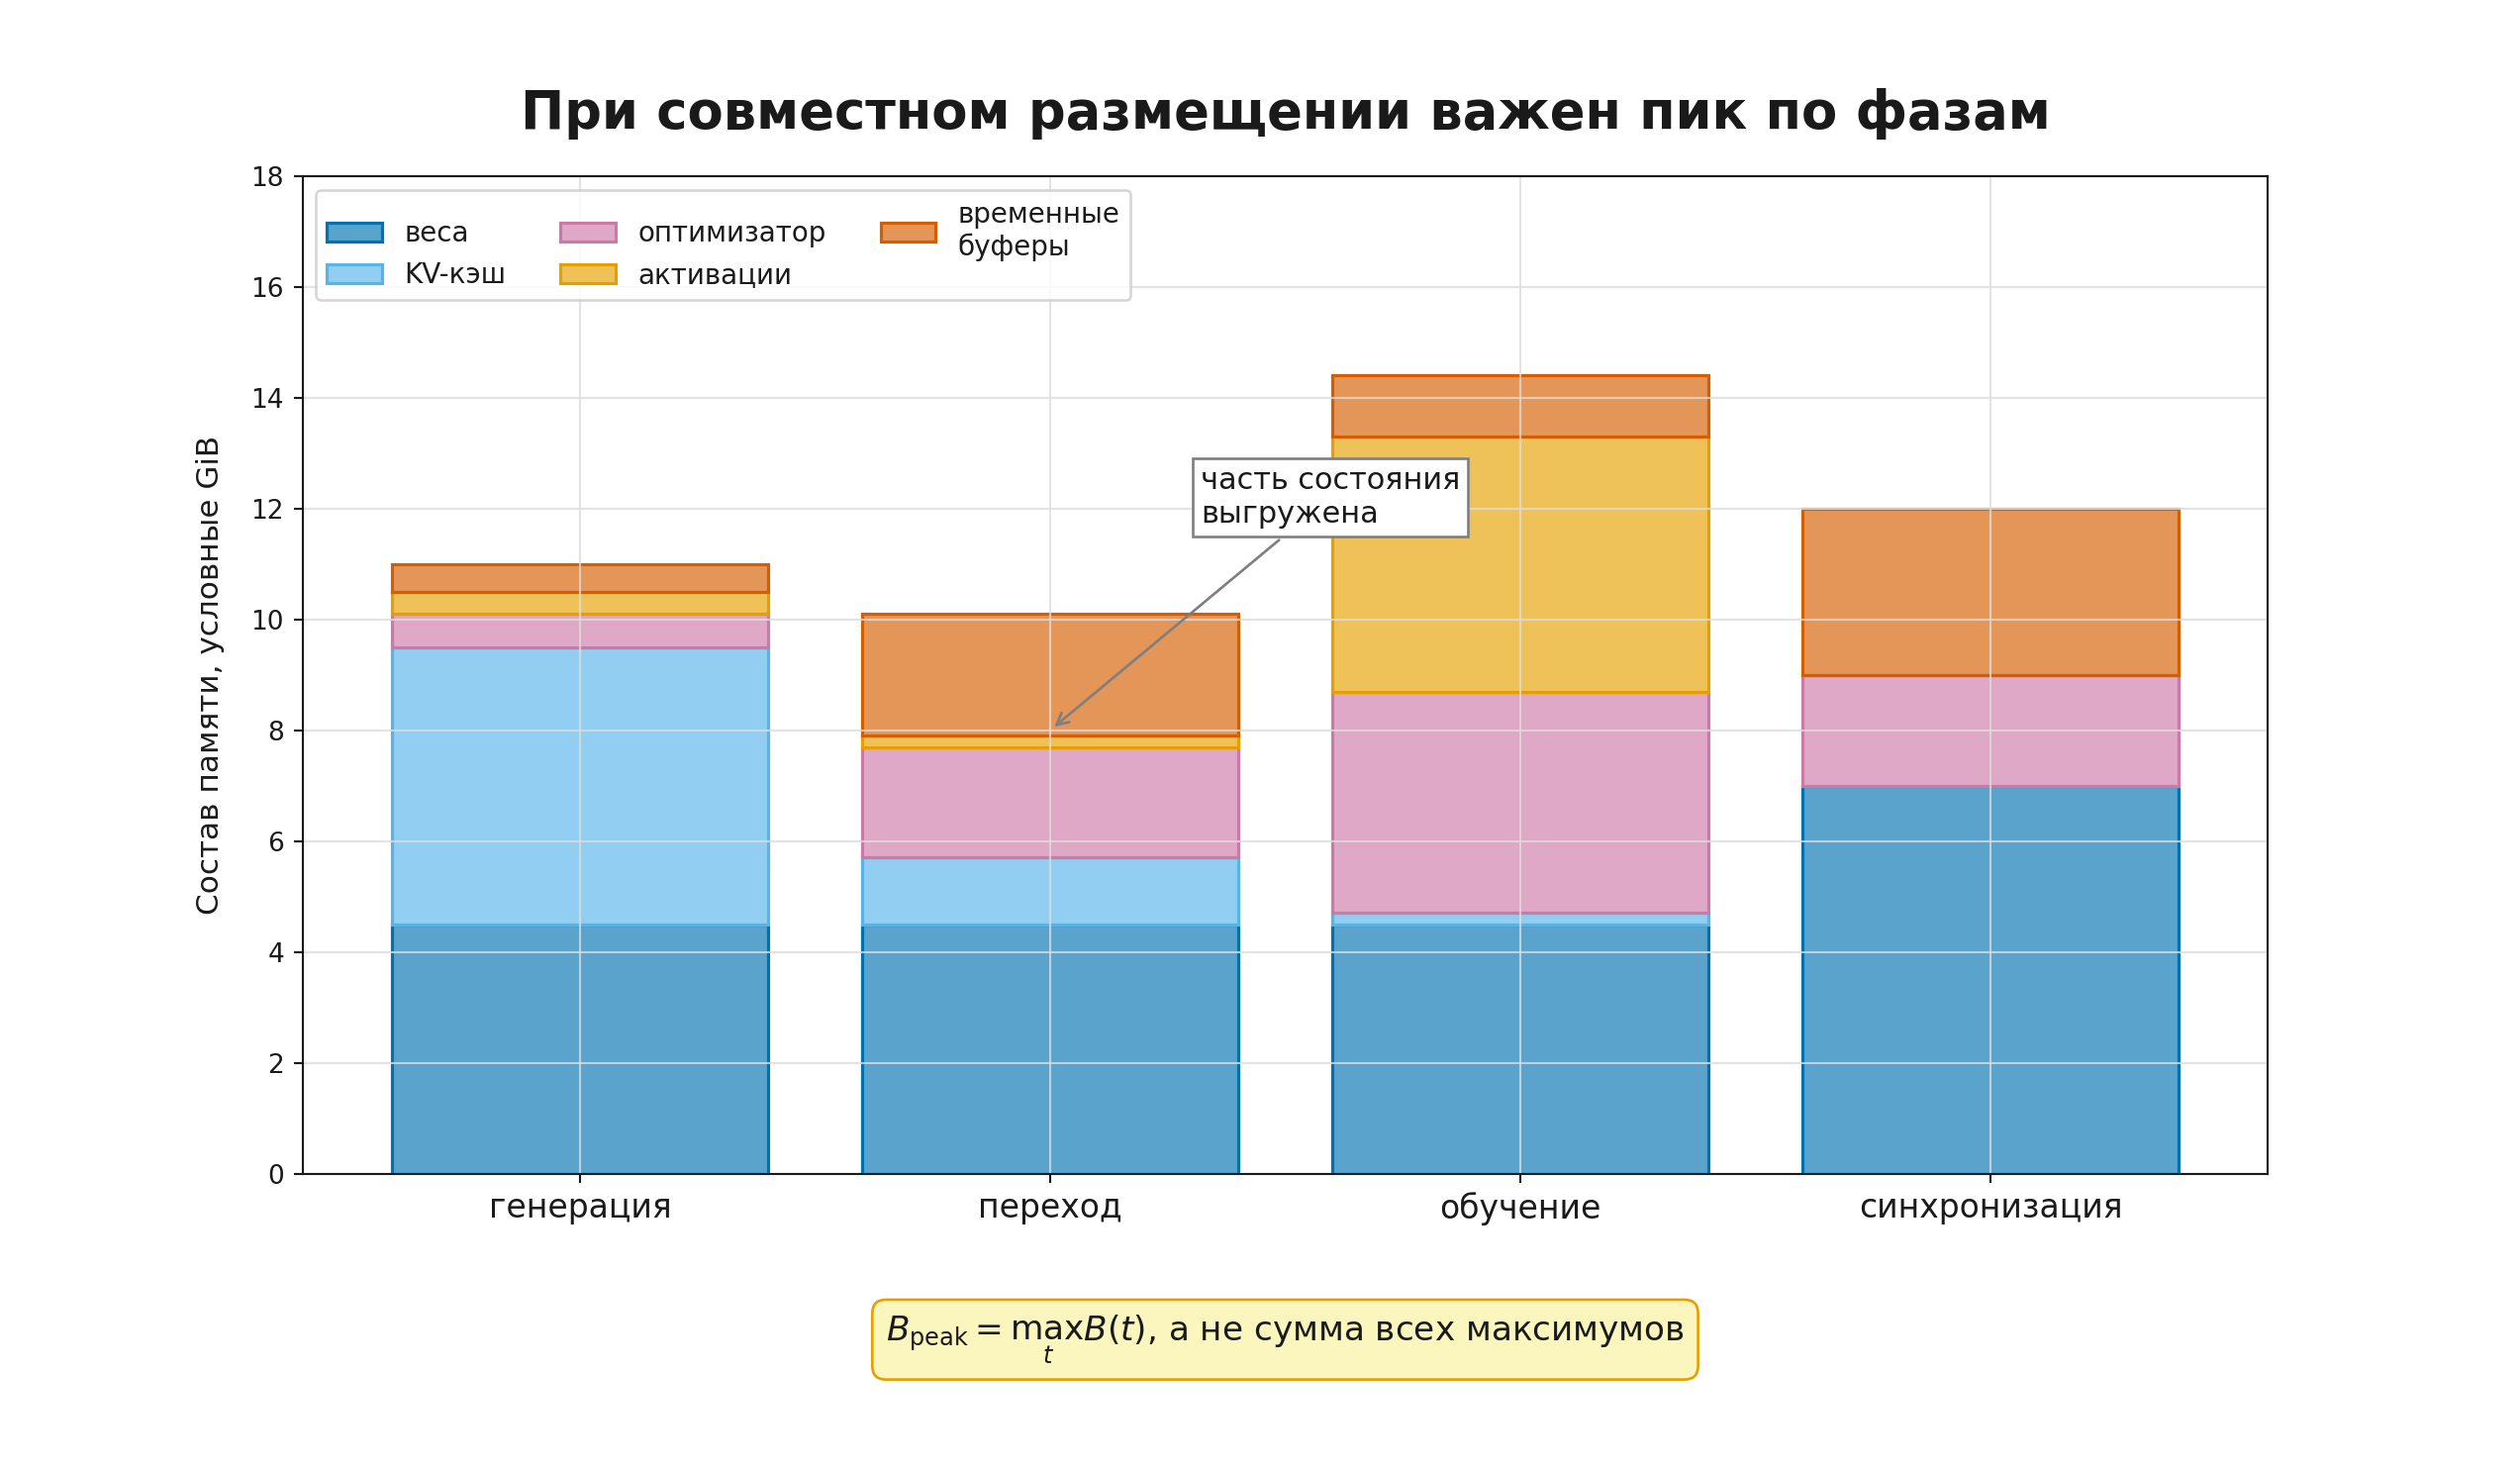
Типичная последовательность:
- Фаза генерации: активны веса политики в формате движка и большой KV-кэш; состояния оптимизатора могут быть шардированы, выгружены на CPU или «усыплены».
- Переход: KV-кэш освобождается или уменьшается, обновлённые параметры становятся доступными тренеру.
- Фаза обучения: активны параметры, градиенты, состояния оптимизатора и активации; движок освобождает большую часть рабочих буферов.
- Синхронизация: новая версия весов загружается в представление движка.
Пиковая память равна максимуму по фазам, включая переходные буферы:
LoRA меняет смету двумя способами.
- Состояния оптимизатора и градиенты нужны только адаптерам.
- Базовые веса всё равно должны присутствовать для прямого прохода, а движок должен получить согласованную версию адаптеров или их объединённое представление.
Поэтому LoRA резко уменьшает память обучения, но не делает память генерации нулевой. Для совместного размещения это часто решающий выигрыш, однако доступность конкретного пути синхронизации адаптеров зависит от библиотеки и версии.
Шаг 12.2.5 — Пропускная способность измеряется токенами и событиями
Число «примеров в секунду» плохо сравнивает RL-запуски с разной длиной запросов и ответов. Минимальный отчёт должен разделять:
- входные токены в секунду;
- выходные токены в секунду;
- завершённые роллауты в секунду;
- проверенные исходы в секунду;
- обучающие токены в секунду;
- шаги оптимизатора в час;
- стоимость одного информативного обновления.
Для генерации полезно отдельно измерять время предварительного прохода и время между выходными токенами. Для обучения — число непустых токенов политики, а не только общую длину упакованной последовательности.
Простая оценка пропускной способности этапа:
Но «полезная работа» зависит от вопроса. Если 90% групп имеют одинаковую награду, высокий поток выходных токенов не означает высокий поток обучающего сигнала. Поэтому панель инфраструктурных метрик связывает скорость с качеством данных:
Такой показатель не заменяет целевую метрику, но помогает понять, почему дорогое оборудование производит мало обновлений с ненулевым преимуществом.
Урок 12.3. Конвейеры, очереди и медленные роллауты
Урок 12.3. Конвейеры, очереди и медленные роллауты
- Последовательный цикл и перекрытый конвейер
- Среднее время скрывает медленные хвосты
- Непрерывное пакетирование и повторное использование префиксов
- Очередь, обратное давление и условие устойчивости
- Профилирование: сначала временная шкала, потом проценты GPU
далее — 4 проверочных шага
Шаг 12.3.1 — Последовательный цикл и перекрытый конвейер
Пусть один логический пакет проходит два крупных этапа:
- сбор роллаутов и вычисление награды занимает секунд;
- обучение и синхронизация занимает секунд.
В последовательном режиме один пакет требует
Если этапы находятся на разных ресурсах и могут работать одновременно, то после заполнения двухступенчатого конвейера период выпуска пакетов равен
Для пакетов полное время идеального конвейера:
Первый пакет всё равно проходит оба этапа последовательно; выигрыш появляется на длинном потоке.
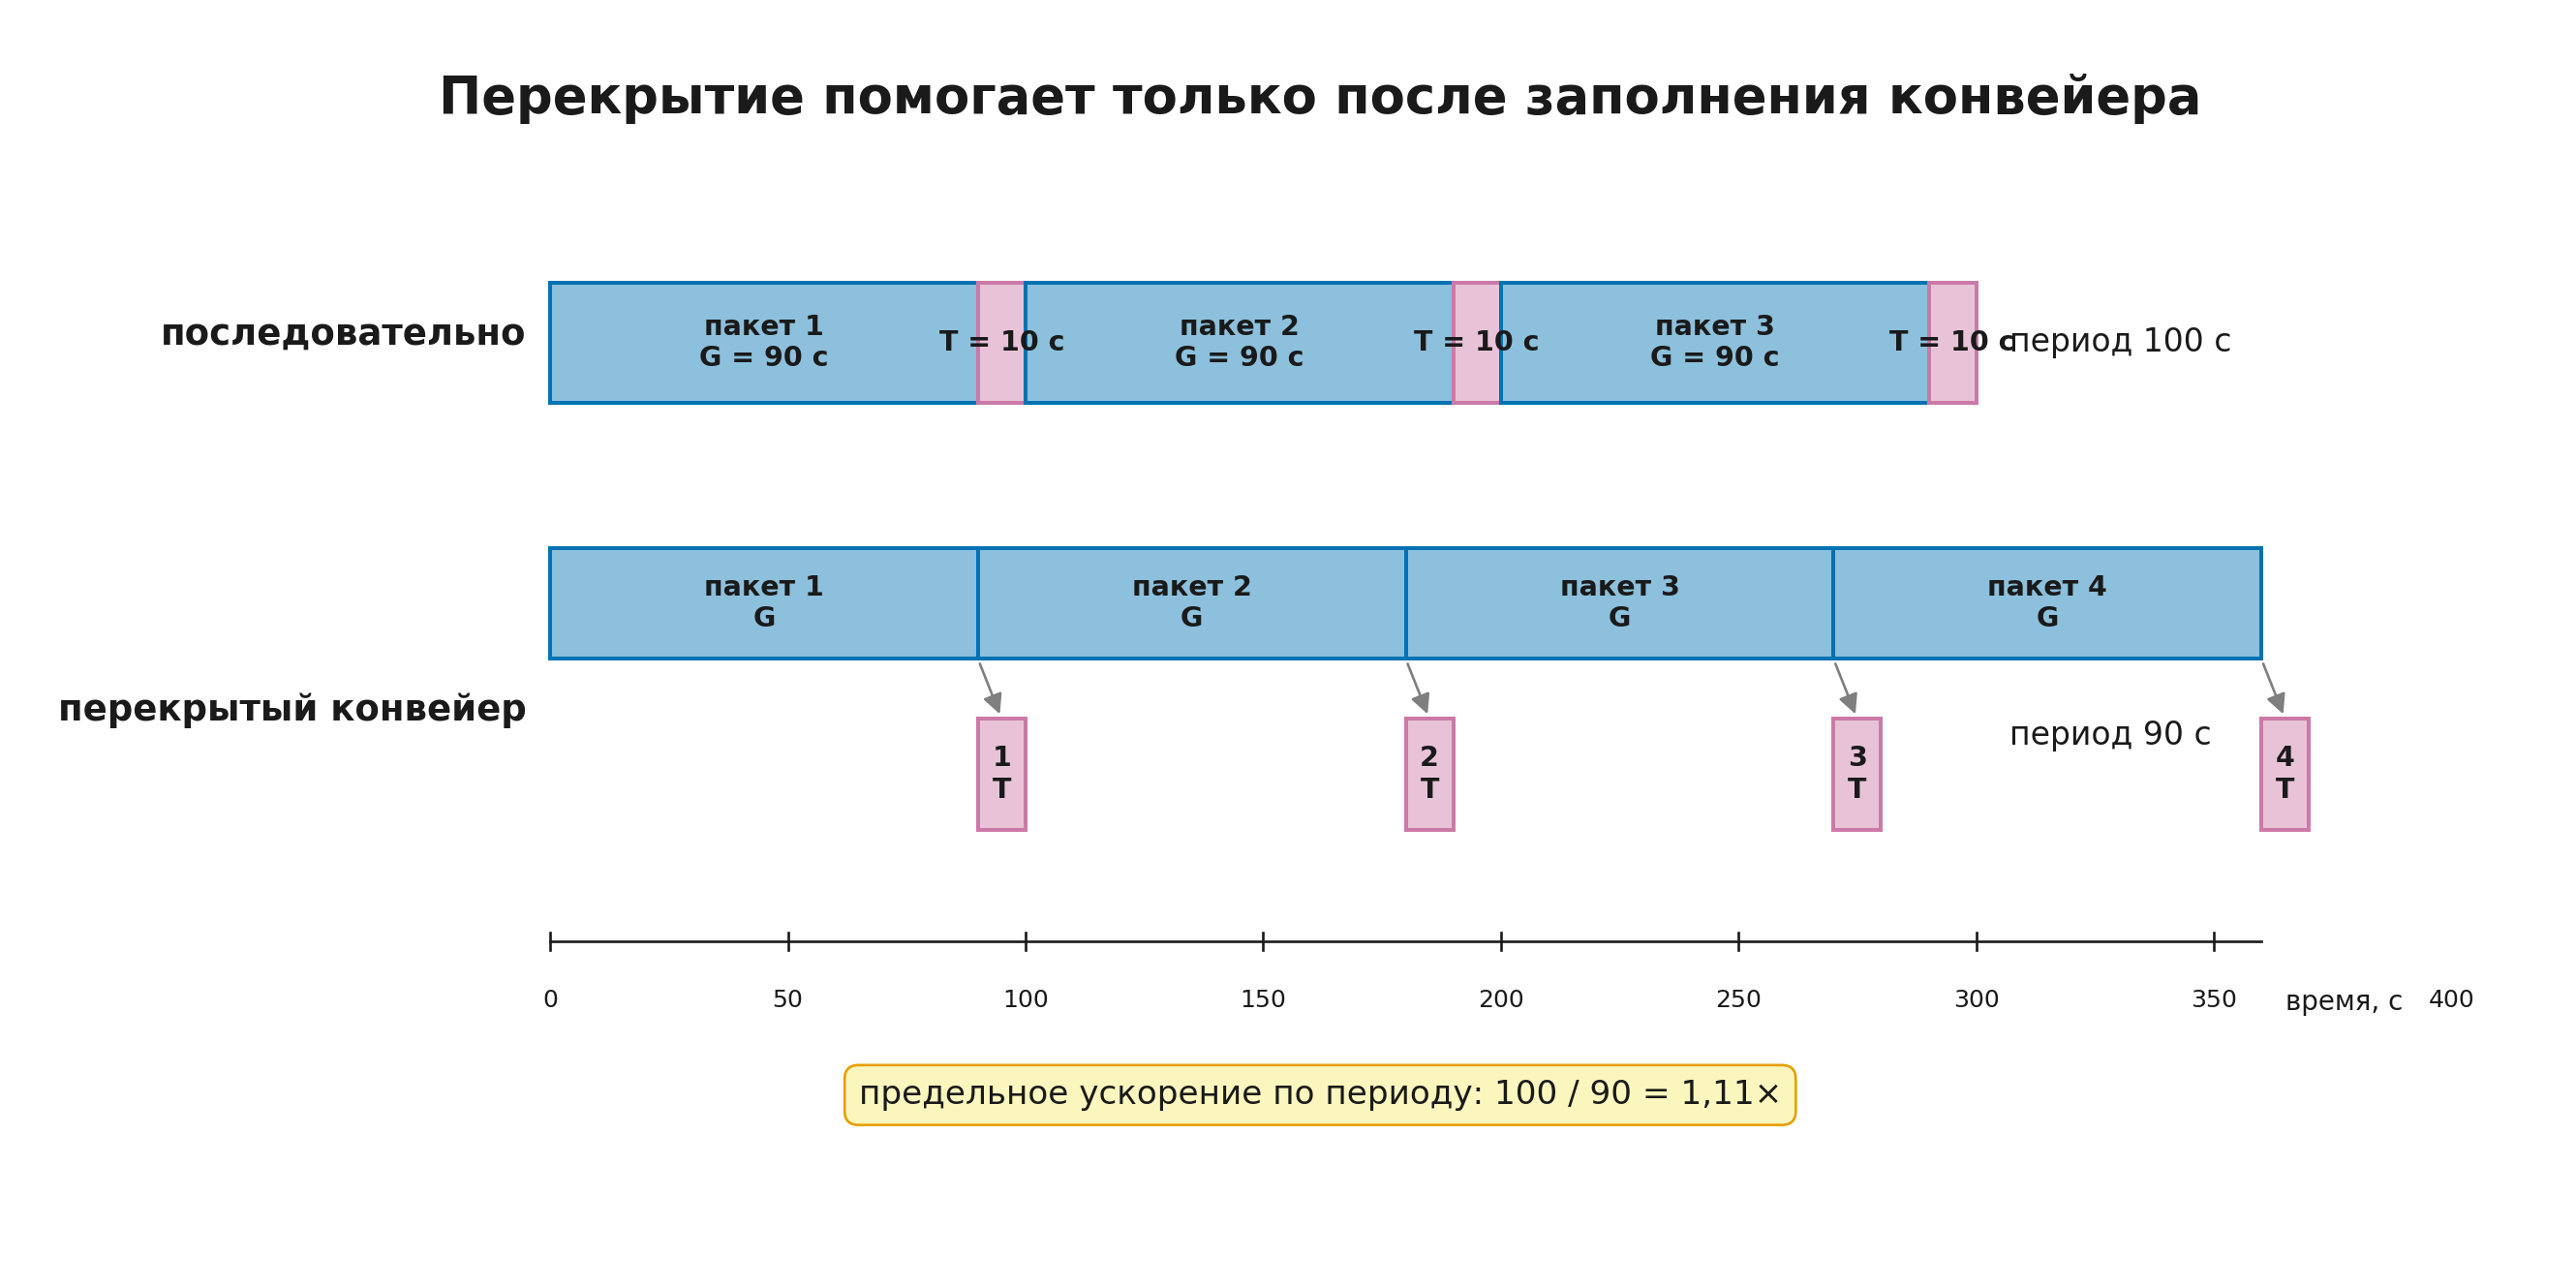
Максимальное ускорение двух этапов приближается к двум только при . Если генерация занимает 90 секунд, а обучение 10, перекрытие уменьшает период со 100 до 90 секунд — всего в 1,11 раза. Быстрый тренер большую часть времени ждёт данные.
Отсюда практический вывод: разделение GPU-пулов имеет смысл настраивать по измеренным скоростям роллаутов и обучения, а не поровну по числу устройств. Дополнительные GPU направляют этапу, который ограничивает период конвейера, пока не появится другое узкое место — сеть, проверяющая система или память.
Шаг 12.3.2 — Среднее время скрывает медленные хвосты
Групповой метод часто ждёт ответов для одного запроса. Если ответы генерируются параллельно, время группы определяется самым медленным:
Пусть восемь роллаутов заняли
Суммарная работа равна 55 GPU-секундам, но восемь исполнителей заняты в течение 20 секунд. Утилизация относительно идеального параллельного прямоугольника:
Один длинный ответ оставил большую часть ресурсов без работы.
Причины медленного хвоста:
- различная длина ответа;
- повторные вызовы инструмента;
- тайм-ауты среды;
- неодинаковый размер префикса;
- повторная попытка после сбоя;
- неравномерное распределение запросов между репликами.
Меры не сводятся к одному лимиту длины:
- группировать запросы по ожидаемой стоимости;
- использовать динамическое пакетирование;
- ограничивать время и число ходов как часть постановки;
- собирать готовые роллауты потоково;
- отделять технические повторы от действий политики;
- для асинхронного режима разрешать тренеру не ждать полный глобальный барьер.
Обрезка хвоста экономит время, но меняет распределение данных. Если сложные задачи систематически дольше, безусловное отбрасывание медленных эпизодов создаёт смещение в сторону простых примеров. Поэтому правило тайм-аута и доля усечённых эпизодов входят в отчёт.
Шаг 12.3.3 — Непрерывное пакетирование и повторное использование префиксов
Движок генерации эффективен не потому, что «умеет генерировать», а потому, что планирует множество неодинаковых запросов.
Непрерывное пакетирование (continuous batching) позволяет добавлять новый запрос на место завершившегося, не ожидая окончания всего статического пакета. Это особенно важно для RL, где длины ответов имеют широкий разброс.
PagedAttention управляет KV-кэшем блоками и уменьшает потери от фрагментации. SGLang использует RadixAttention для повторного использования общих префиксов. В GRPO на один запрос часто генерируется несколько ответов, поэтому их запросная часть совпадает и может быть вычислена один раз или эффективно разделена.
Но повторное использование префикса имеет точную границу.
- Совпадать должны фактические токены и параметры модели.
- Изменение шаблона диалога, системного сообщения или версии политики делает старый кэш недействительным.
- После обновления весов KV-кэш, вычисленный старой моделью, нельзя считать кэшем новой политики.
- В многоходовой среде общая часть может закончиться раньше, чем кажется по тексту, если наблюдения различаются.
Поэтому синхронизация весов часто делает прежний кэш недействительным. Это одна из причин, по которой частые обновления весов могут быть дороже простого объёма передаваемых параметров: система теряет прогретое состояние генерации.
Граница курса. Подробная реализация PagedAttention, RadixAttention, предварительного прохода по частям (
chunked prefill) и распределённого обслуживания относится к Modern LLMs, Модулю 10 «KV-кэши и эффективный инференс» (modern_llms.module_09_inference). Здесь важно их влияние на границу пакета и момент смены политики.
Шаг 12.3.4 — Очередь, обратное давление и условие устойчивости
В асинхронной системе роллауты поступают в очередь со скоростью , а тренер потребляет их со скоростью . Если единицы согласованы, необходимое условие долгосрочной устойчивости:
При средняя длина очереди растёт. Вместе с ней растут:
- задержка политики;
- объём памяти или диска;
- время от сбора данных до обновления;
- вероятность того, что роллаут будет отброшен как слишком старый.
Наращивать очередь бесконечно нельзя. Нужен механизм обратного давления (backpressure): генераторы замедляются, получают меньше запросов или временно переключаются на другой тип работы, когда очередь достигает заданного уровня.
Ограничение можно задавать несколькими способами:
- максимальное число роллаутов;
- максимальное число токенов;
- максимальный возраст в секундах;
- максимальная задержка политики;
- максимальная суммарная память;
- комбинация этих ограничений.
Считать только число записей опасно: один многоходовой эпизод может быть в сотни раз тяжелее короткого математического ответа. Поэтому очередь обычно учитывает токены или оценочную стоимость.
Важна и обратная ситуация. Если , тренер голодает и простаивает. Решение — не всегда добавить генераторов: возможно, проверяющая система медленна, запросы слишком длинны или движок плохо использует общие префиксы. Трассировка должна показывать время ожидания на каждой границе.
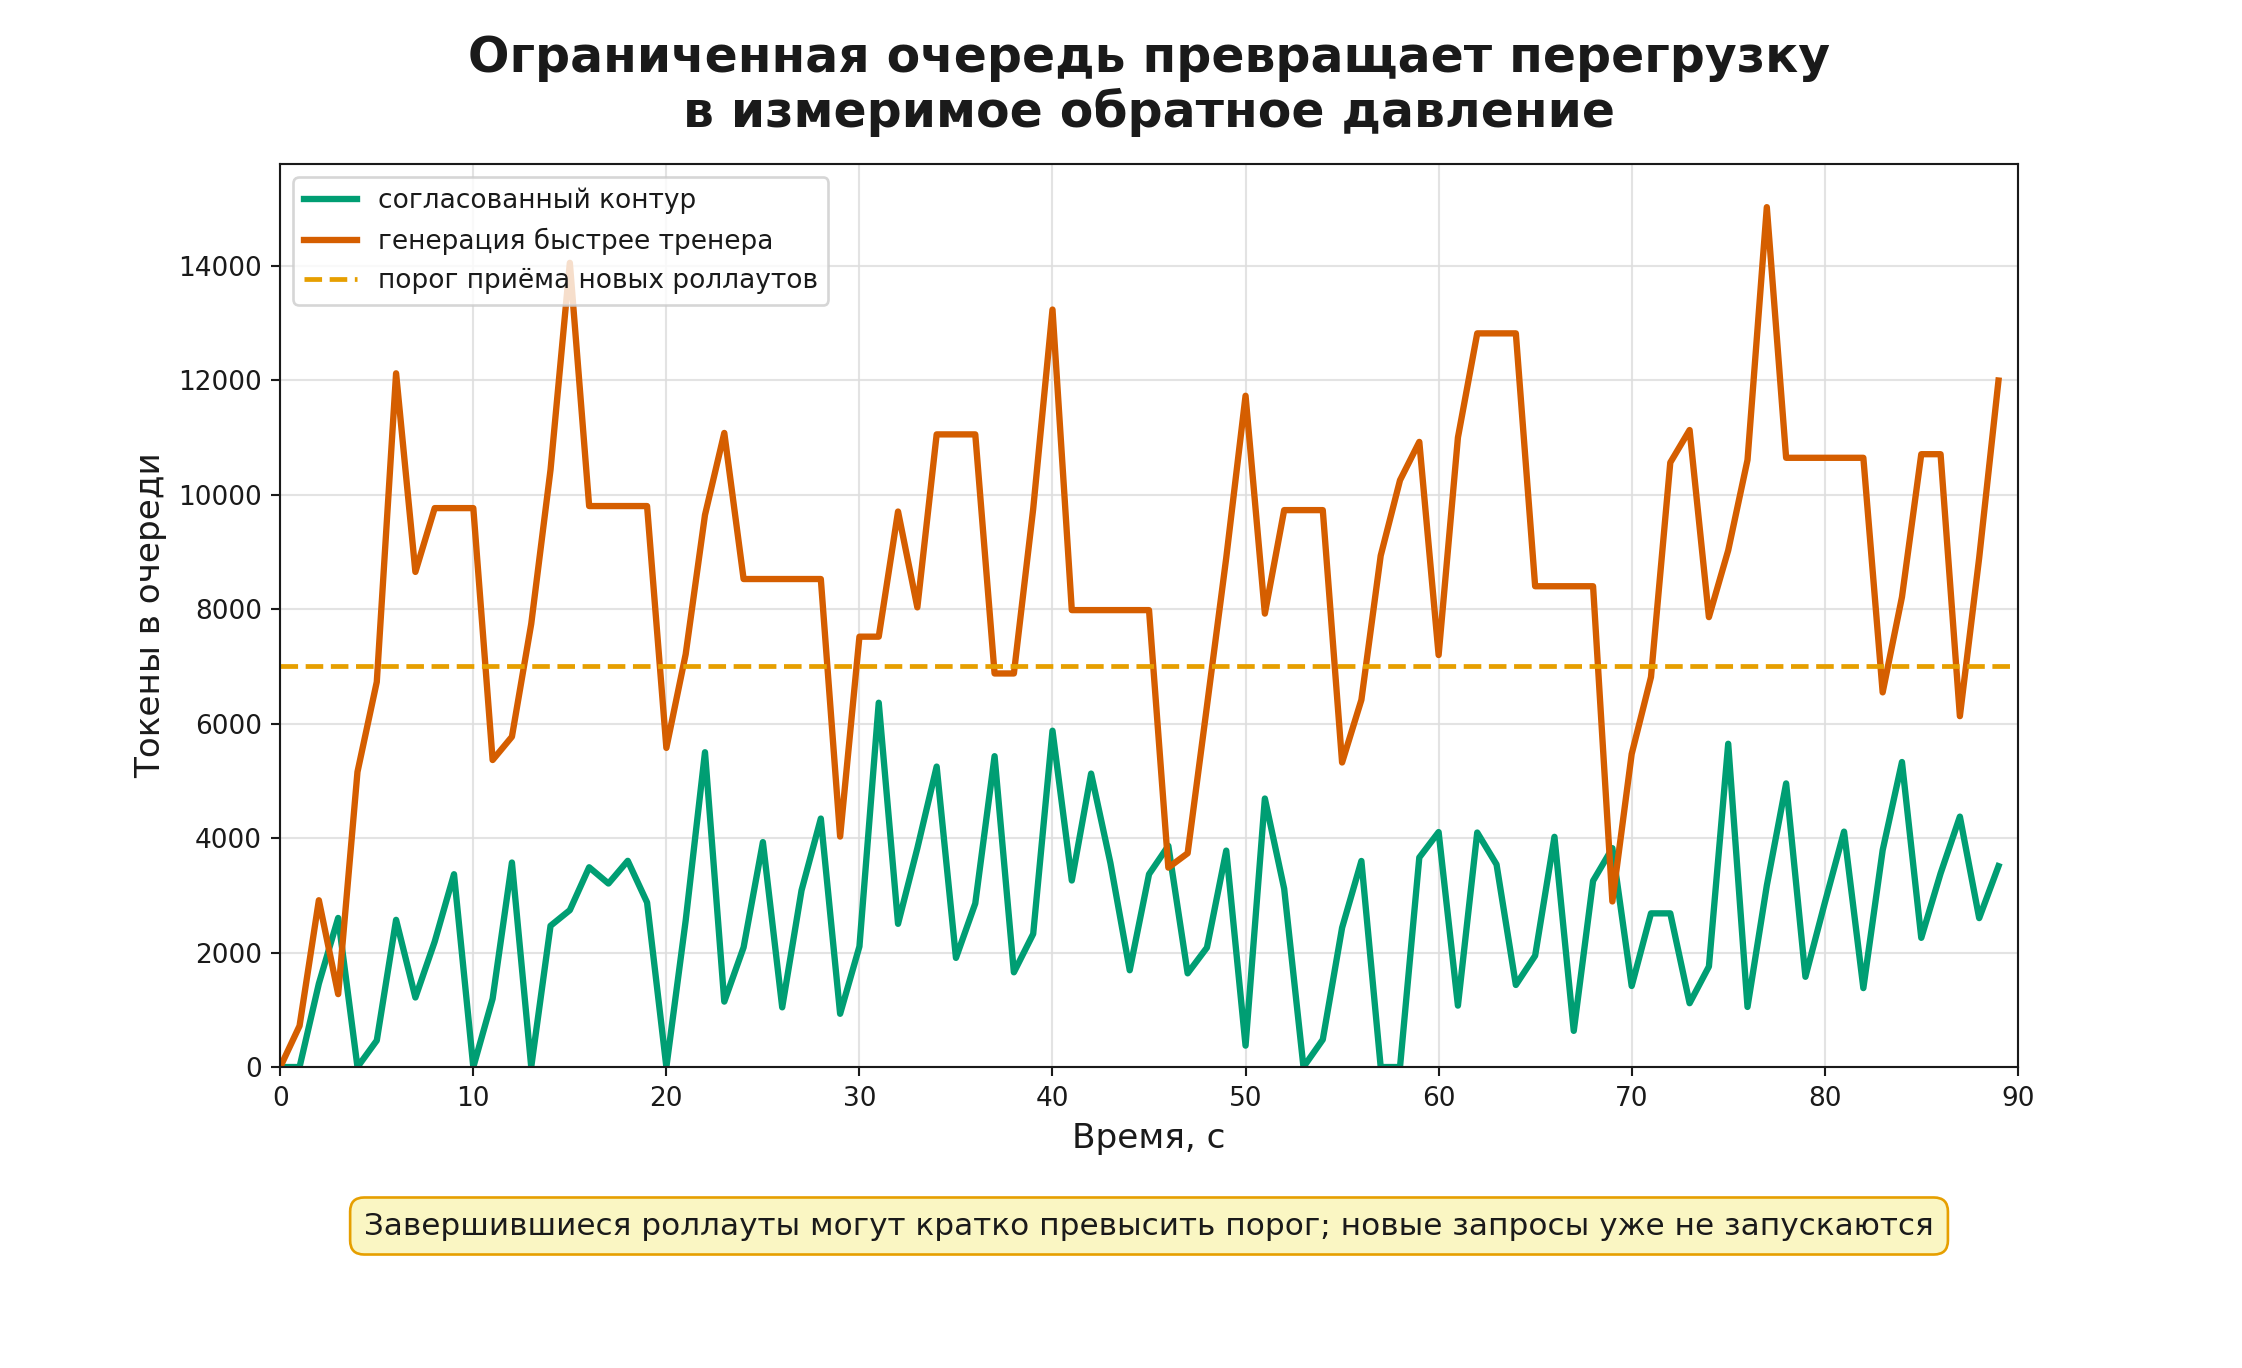
Синтетический дискретно-событийный контур модуля делает это различие наблюдаемым. В проверочном профиле длительностью 120 виртуальных секунд использованы одинаковое начальное значение генератора, восемь сборщиков, пакеты по 4096 токенов и один тренер. Это не сравнительный тест библиотек, а проверяемая модель контракта очереди.
| Профиль | Обучающие токены/с | Средняя задержка, версий | Средний нормированный ESS | Отброшено роллаутов | Время обратного давления |
|---|---|---|---|---|---|
| последовательный | 566,64 | 0,000 | 1,0000 | 0 | 0,0 с |
| ограниченно-асинхронный, синхронизация после каждого обновления | 1442,38 | 1,803 | 0,9798 | 74 | 18,6 с |
| более глубокое перекрытие, синхронизация раз в три обновления | 1800,82 | 3,550 | 0,8804 | 0 | 52,8 с |
В этой конкретной модели более глубокое перекрытие повышает пропускную способность, но увеличивает задержку и концентрацию синтетических весов важности. Из таблицы нельзя вывести универсальный «лучший» интервал синхронизации: коэффициенты симулятора выбраны для демонстрации механизма. Полезный вывод скромнее — скорость и свежесть нужно измерять одновременно.
Порог очереди ограничивает запуск новых работ, а не отменяет уже начатые роллауты. Поэтому наблюдаемая глубина может ненадолго превысить порог: завершившиеся запросы ещё поступят в очередь. Если это поведение не записано в контракте, оператор легко принимает нормальный переходный процесс за ошибку счётчика.
Шаг 12.3.5 — Профилирование: сначала временная шкала, потом проценты GPU
Средняя загрузка GPU не объясняет, почему система медленна. Например, 90% загрузки может означать полезное декодирование, дорогое преобразование весов или ожидание коллективной операции внутри активного ядра.
Минимальный протокол профилирования:
- назначить сквозной
trace_idзапросу, роллауту и обучающему пакету; - записать начало и конец каждой стадии;
- измерять токены, а не только число примеров;
- отдельно записывать время ожидания очереди и собственное вычисление;
- отмечать версию политики и проверяющей системы;
- повторить измерение после прогрева;
- приводить медиану и хвостовые квантили, а не только среднее;
- менять один параметр за эксперимент.
Полезный набор времён:
queue_wait
prefill
decode
verifier
logprob_recompute
forward_backward
optimizer_step
weight_sync
checkpoint
После этого узкое место определяется по критическому пути, а не по впечатлению. Если генерация занимает 70% последовательного цикла, но уже полностью перекрыта обучением, ускорение декодирования может почти не изменить общий период. Если синхронизация лежит на критическом пути каждого шага, даже идеальный движок не спасёт систему.
Факультативный ноутбук строит диаграмму стадий для синтетических роллаутов и показывает различие между:
- суммой работы;
- временем критического пути;
- утилизацией каждого пула;
- пропускной способностью в устойчивом режиме.
Урок 12.4. Несвежесть, рассогласование и синхронизация весов
Урок 12.4. Несвежесть, рассогласование и синхронизация весов
- Три политики и два разных рассогласования
- Отношения вероятностей и эффективный размер выборки
- Те же веса не гарантируют те же вероятности
- Что делать с несвежими данными
- Синхронизация весов должна быть атомарной и измеримой
далее — 4 проверочных шага
Шаг 12.4.1 — Три политики и два разных рассогласования
В инфраструктурном контексте полезно различать три политики.
- Политика поведения фактически породила токены в движке генерации.
- Старая политика является зафиксированным знаменателем PPO-подобной цели внутри обновления.
- Текущая политика получает градиент.
Токеновый контракт этих величин — причинный сдвиг, маска ответа и различие old/current/reference log-probabilities — подробно построен в RL for LLM, Модуле 6 «LLM как политика: токены, логарифмы вероятностей и KL» (rl_llm.module_06_llm_policy). Инфраструктура не меняет определения, но обязана сохранить их при сериализации и передаче между процессами.
Отдельно может существовать базовая политика для регуляризации дивергенцией Кульбака—Лейблера (Kullback–Leibler divergence, KL). Она не заменяет политику поведения.
Теперь разделим два вида ошибки.
Задержка политики (policy lag). Пусть текущая опубликованная и обучаемая версия имеет номер , а роллаут был собран версией . Данные являются несвежими, если
Рассогласование обучения и генерации (training–inference mismatch, TIM). Движок и тренер объявляют одну и ту же версию весов, но вычисляют разные вероятности из-за:
- разных численных ядер и порядка редукций;
- различной точности или квантования;
- разного тензорного параллелизма;
- различий шаблона, масок и обработки EOS;
- преобразований логитов при декодировании.
Эти причины требуют разных диагностик. Задержка измеряется номером версии и возрастом данных. TIM проверяется на нулевой задержке: сразу после синхронизации одинаковая последовательность прогоняется через движок и тренер, а логарифмы вероятностей сравниваются токен за токеном.
Нельзя объяснять всякое отношение вероятностей, отличное от единицы, только несвежестью. И наоборот, точное совпадение стеков не устраняет задержку разных версий.
Шаг 12.4.2 — Отношения вероятностей и эффективный размер выборки
Для действия в состоянии отношение важности равно
Это отношение определено только там, где политика поведения имеет положительную вероятность: . Для полных утверждений выборки по важности требуется условие поддержки: целевая политика не должна назначать положительную вероятность действиям, невозможным при политике поведения. Численное клиппирование не восстанавливает отсутствующую поддержку.
Для полного авторегрессионного ответа последовательностное отношение является произведением токеновых отношений:
или, устойчивее численно,
Даже небольшие поточечные различия накапливаются по длине. Поэтому длинные ответы особенно чувствительны к задержке и TIM.
Для набора неотрицательных весов вводится эффективный размер выборки (effective sample size, ESS):
Если все веса равны, ESS равен . Если один пример доминирует, ESS приближается к 1. Нормированная величина удобна для сравнения пакетов разного размера.
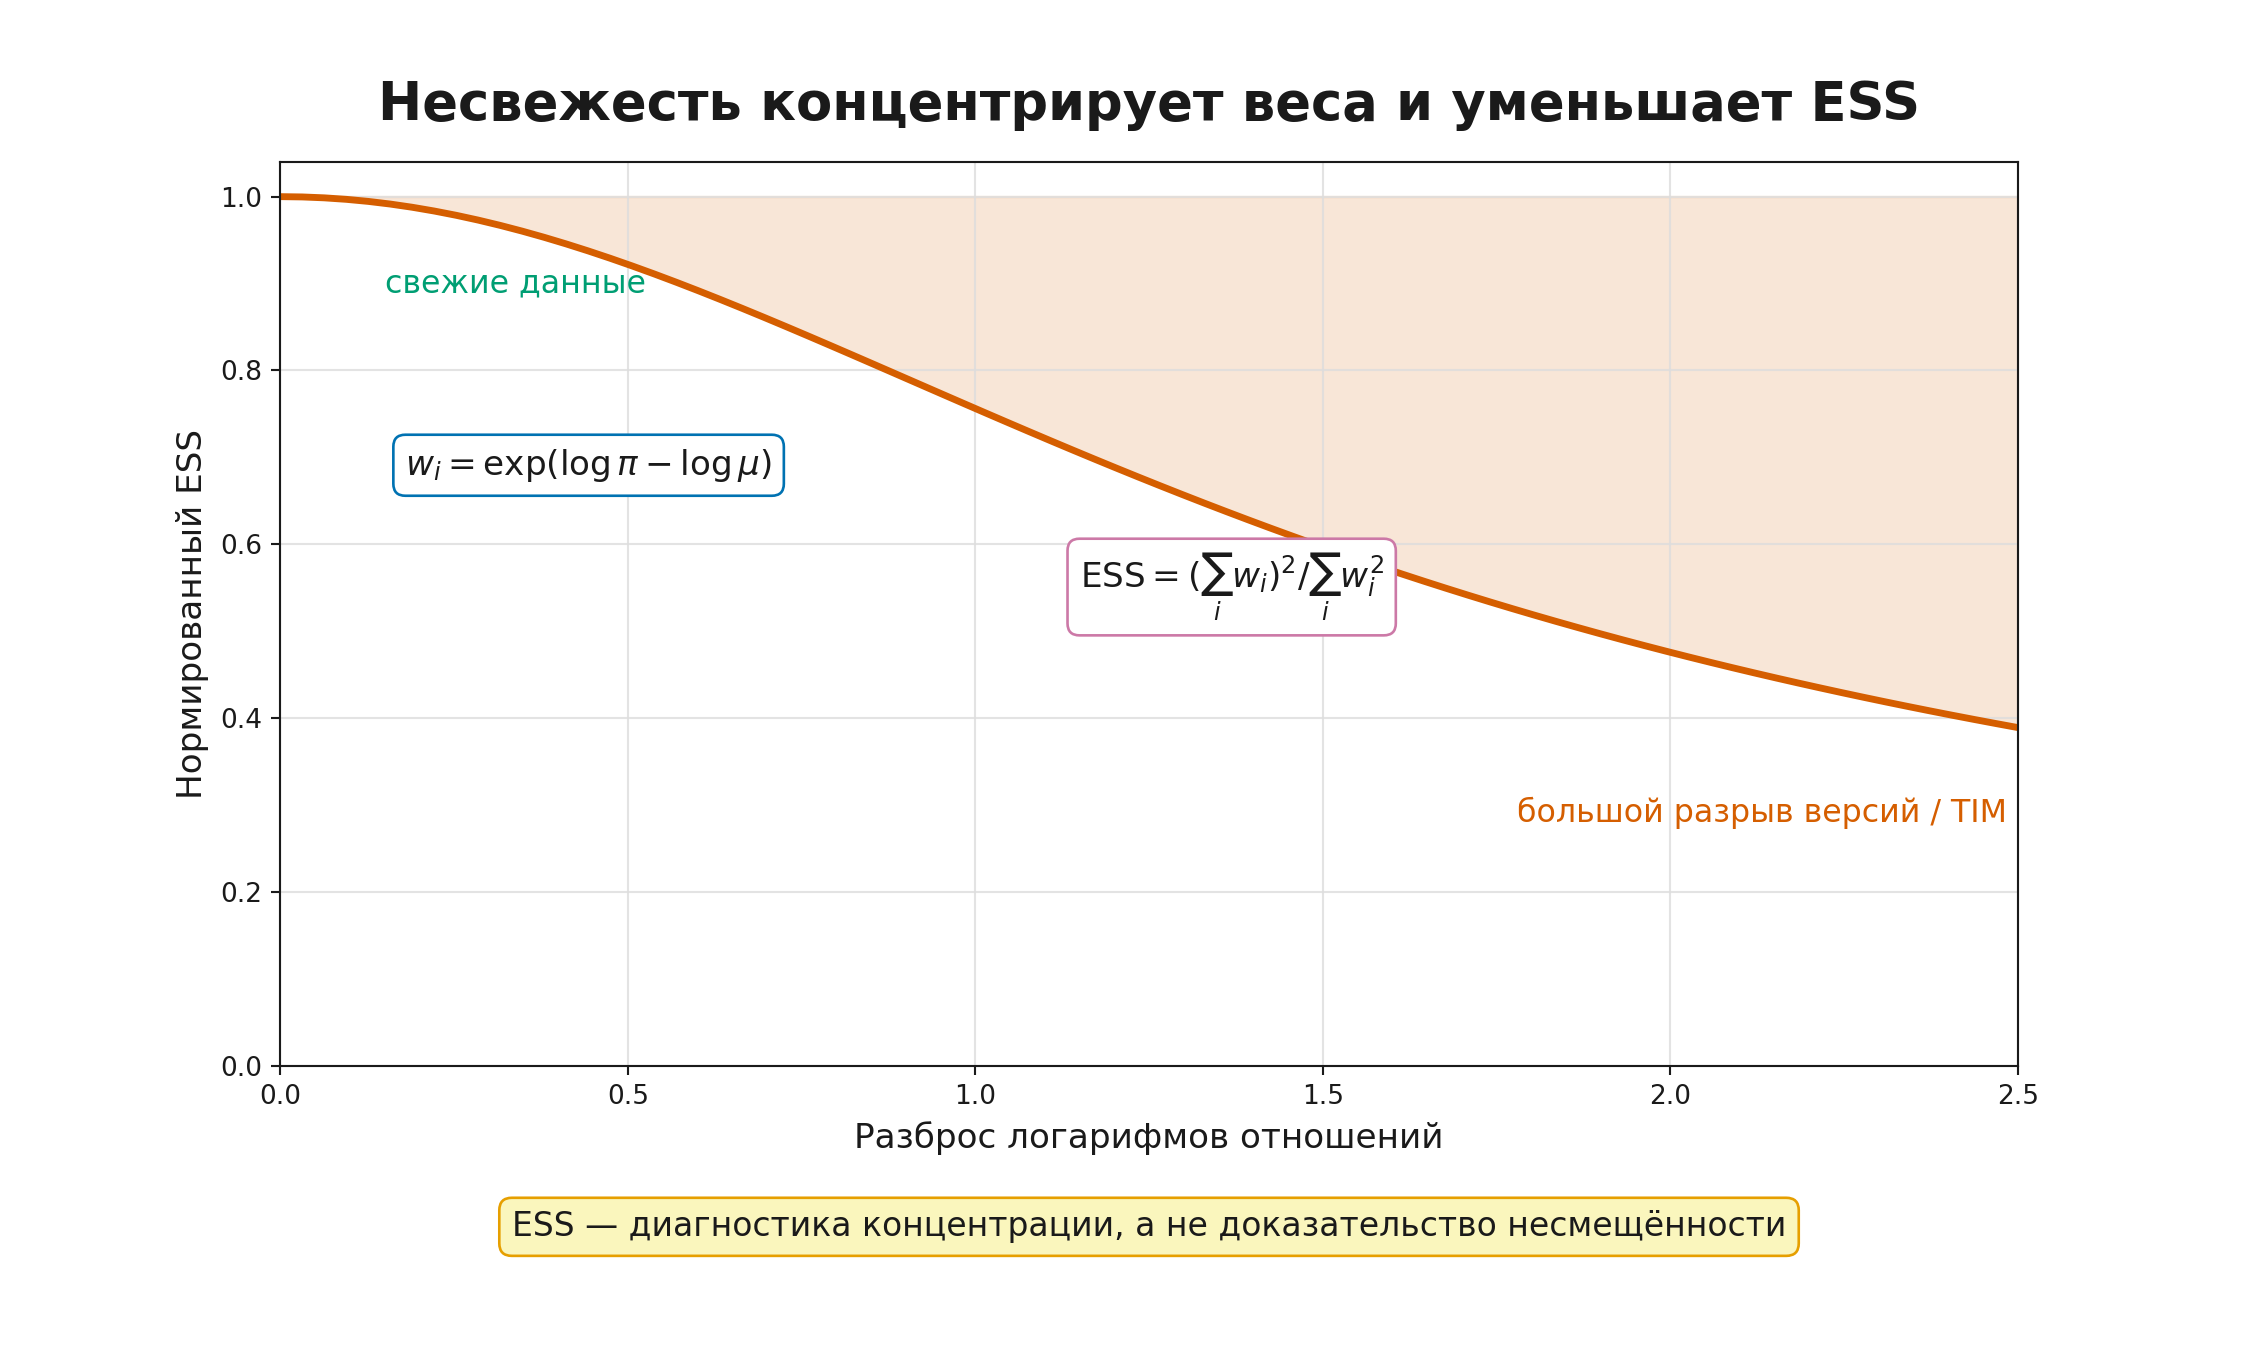
ESS не является доказательством несмещённости обновления. Это диагностика концентрации весов. Вместе с ним полезно записывать:
- распределение задержки политики;
- средний и максимальный ;
- долю клиппирования;
- долю отброшенных токенов или последовательностей;
- градиентную норму;
- длину ответа.
Шаг 12.4.3 — Те же веса не гарантируют те же вероятности
Предположим, веса движка и тренера побайтно совпадают. Из этого ещё не следует
Плавающая точка неассоциативна: изменение порядка суммирования может изменить логиты. Разные размеры пакета, тензорный параллелизм, объединённые вычислительные ядра (fused kernels), квантование и реализация softmax также способны дать небольшое различие. Для softmax без усечения равномерная граница даёт для любого токена; сама редкость не усиливает относительное изменение. Однако малые различия могут накапливаться на длинной последовательности, а пересечение порога top-k/top-p меняет множество оставшихся токенов.
Ещё более прямой источник — процесс декодирования. Если движок применяет top-p и затем перенормирует оставшееся множество, фактическая вероятность выбранного токена равна вероятности после усечения. Логарифм вероятности исходного softmax не является логарифмом политики поведения.
На снимке 2026-08-06 официальная документация TRL описывает отдельный экспериментальный контур Async GRPO и интеграцию vLLM, а документация verl — поправки для роллаутов, собранных другим вычислительным контуром или более старой политикой. Это свойства конкретных реализаций, а не универсальное правило всех систем RL. Работа о TIM показывает, что численное рассогласование способно быть самостоятельным фактором нестабильности в исследованных конфигурациях; это эмпирическое предупреждение, а не доказательство неизбежного коллапса каждого запуска.
Три практических режима:
- Пересчитать логарифмы вероятностей тренером. Дороже, но даёт значения в том же стеке, где вычисляется градиент.
- Сохранить логарифмы фактического движка и применить явную поправку. Требует корректного определения политики поведения и контроля дисперсии.
- Унифицировать ядра и конфигурацию. Уменьшает источник различий, но может ограничить производительность или доступные оптимизации.
Выбор должен фиксироваться в протоколе эксперимента.
Шаг 12.4.4 — Что делать с несвежими данными
Асинхронность не превращает роллаут в «неправильный» автоматически. Она меняет статистическую задачу. Возможные стратегии:
- ограничивать максимальную задержку ;
- отбрасывать данные старше порога;
- применять выборку по важности с клиппированием или маскированием;
- уменьшать число обновлений на один роллаут;
- снижать скорость обучения при падении ESS;
- балансировать размеры пулов, чтобы очередь не росла;
- периодически возвращаться к строго синхронному контрольному запуску.
У каждой меры есть цена.
- Отбрасывание повышает свежесть, но тратит дорогие роллауты и может смещать набор в сторону коротких эпизодов.
- Клиппирование ограничивает дисперсию, но изменяет оцениватель.
- Полное последовательностное отношение статистически естественно для траекторного градиента, но быстро становится тяжёлым по дисперсии на длинных ответах.
- Поточечные отношения удобны и лежат в основе многих реализаций, но не являются автоматически точной заменой последовательностного исправления при большой несвежести.
Работы AReaL и последующие асинхронные системы сообщают об ускорении в собственных конфигурациях, одновременно вводя контроль задержки или специальные механизмы для данных другой политики. Эти результаты показывают, что асинхронность может окупаться; они не задают универсальный безопасный порог.
Групповые преимущества, ограничение отношений и диагностики GRPO разобраны в RL for LLM, Модуле 9 «RLVR и GRPO: проверяемые награды, групповые оценки и устойчивость» (rl_llm.module_09_rlvr_grpo). Инфраструктурная добавка здесь состоит в том, что распределение задержек и очередь определяют, к какой политике относится знаменатель отношения вероятностей.
Правильный порядок эксперимента:
- получить устойчивый синхронный эталон;
- включить перекрытие с известной задержкой;
- измерить ESS, клиппирование и качество;
- увеличивать глубину очереди только при сохранении статистического сигнала.
Шаг 12.4.5 — Синхронизация весов должна быть атомарной и измеримой
Существует несколько путей доставки новой политики движку.
- Полный снимок: собрать модель, сохранить или передать её и перезагрузить движок. Просто, но дорого по времени и дополнительной памяти.
- Шардированная передача: напрямую преобразовать раскладку FSDP/Megatron в раскладку движка и передать части через коллективные операции.
- Обновление адаптеров: передать только LoRA-параметры, если движок и библиотека поддерживают их согласованную загрузку.
- Совместное размещение: переключить роли на одних GPU и использовать общий или преобразуемый набор параметров.
Независимо от способа нужны четыре свойства.
- Идентификатор версии. После синхронизации движок сообщает версию, которую реально обслуживает.
- Атомарность. Новый запрос не видит смесь старых и новых тензоров.
- Барьер готовности. Тренер не считает версию доступной до завершения загрузки на всех необходимых репликах.
- Проверка. Контрольный набор тензоров или логитов подтверждает, что ожидаемая версия действительно установлена.
Для длинных запросов есть два безопасных пути: завершить их старой версией или явно хранить версию каждого действия. Обновлять веса «под ногами» у запроса и затем записывать одну общую версию нельзя.
Текущая документация verl описывает движок контрольных точек и переноса весов между обучающим контуром и контурами генерации. OpenRLHF и NeMo RL документируют варианты совместного размещения либо приостановки и возобновления генерации. Официальная документация vLLM по NCCL-передаче весов описывает многоузловую синхронизацию, фазовый протокол обновления и пример асинхронной генерации с приостановкой выполняющихся запросов, публикацией весов, продолжением и проверкой результата. Это примеры изменяемых инженерных контрактов, а не обязательные стандарты.
Урок 12.5. Восстановление, наблюдаемость и выбор стека
Урок 12.5. Восстановление, наблюдаемость и выбор стека
- Контрольная точка RL-запуска шире весов модели
- Трассировка должна связывать данные с обновлением
- Восстановление проверяется аварией, а не наличием файла
- Карта стеков на 2026-08-06
- Итоги: инфраструктура является частью алгоритма
далее — 8 проверочных шагов
Шаг 12.5.1 — Контрольная точка RL-запуска шире весов модели
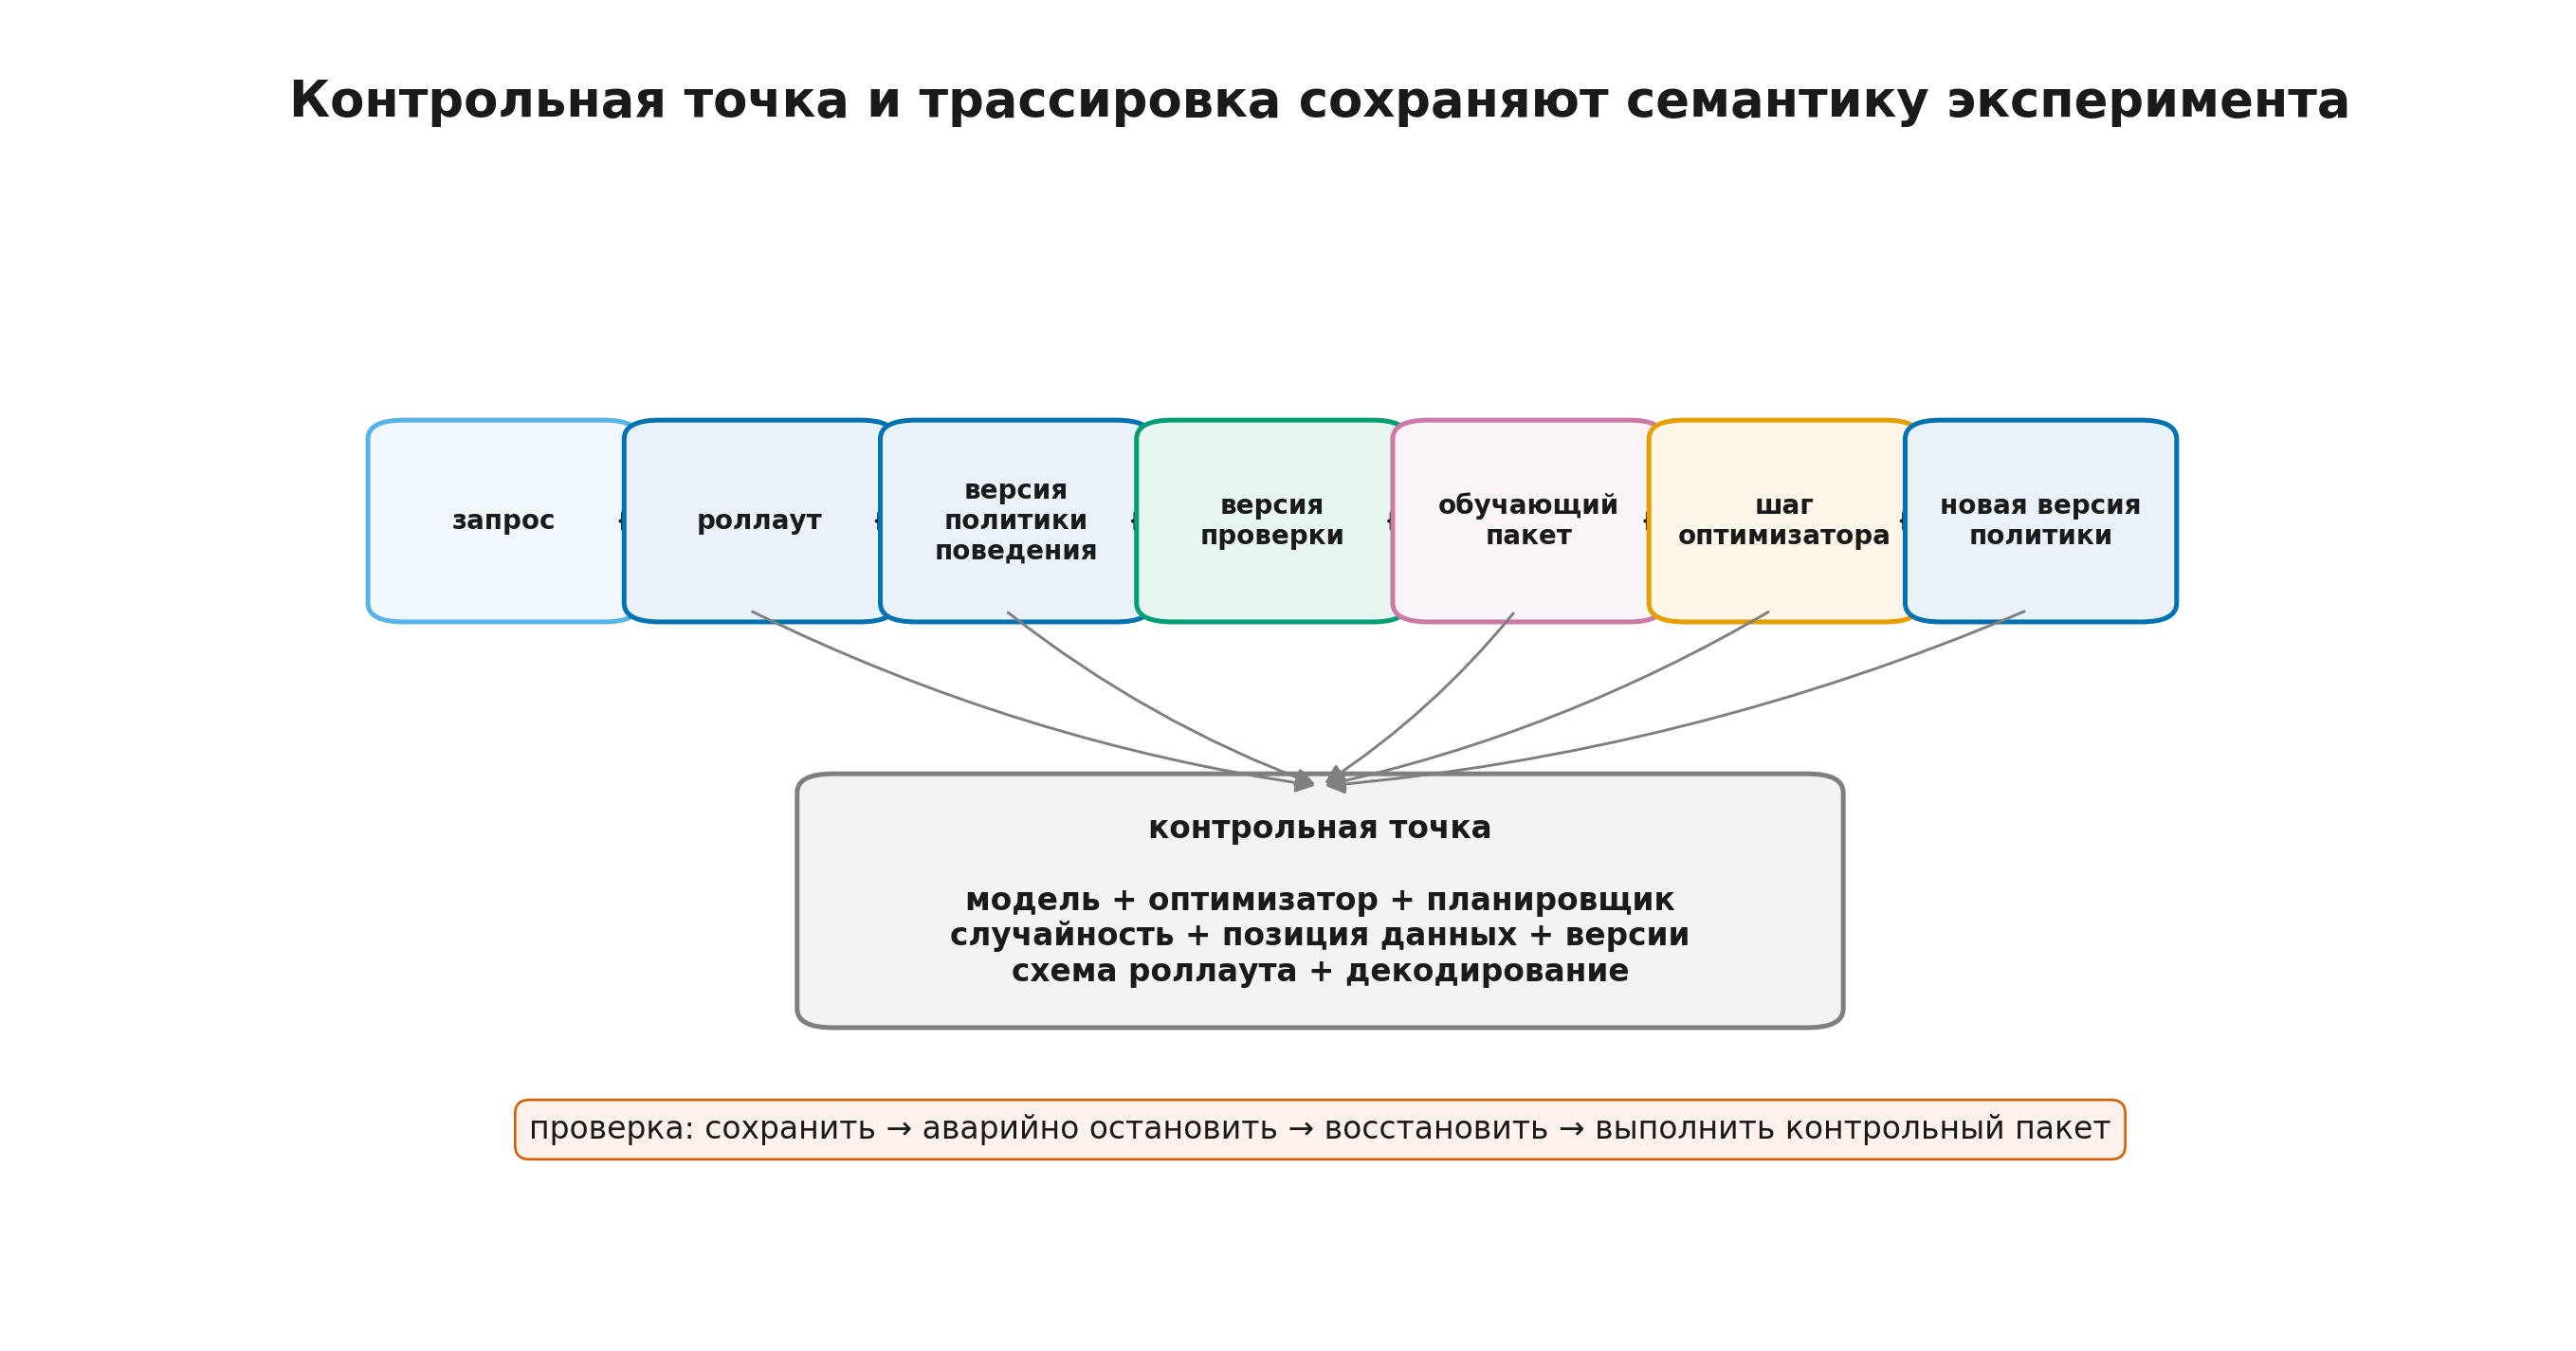
Для честного возобновления нужно восстановить не только параметры политики. Минимальная контрольная точка включает:
- параметры модели и адаптеров;
- состояния оптимизатора;
- планировщик скорости обучения;
- счётчик глобальных шагов и версию политики;
- состояния генераторов случайных чисел;
- положение в наборе данных;
- состояние планировщика задач или учебной программы;
- параметры нормировки награды и преимущества;
- версии токенизатора, шаблона, проверяющей системы и среды;
- схему роллаута;
- конфигурацию декодирования;
- метаданные распределённой раскладки.
Если очередь содержит несвежие роллауты, при восстановлении нужно либо сохранить её вместе с версиями поведения, либо явно отбросить. Для незавершённых агентных эпизодов аналогично: состояние среды сохраняется или эпизоды начинаются заново и помечаются как потерянные.
Веса движка генерации обычно не требуется хранить отдельной копией, если они однозначно восстанавливаются из контрольной точки тренера и рецепта синхронизации. Но сам рецепт — версия движка, точность, квантование и преобразование адаптеров — должен быть зафиксирован.
Для простой модели отказов ожидаемая доля времени на сохранение контрольных точек и потерянную работу приближённо равна
где — интервал между сохранениями, — время записи, а — среднее время между отказами. Минимум этой приближённой функции достигается при
Это ориентир, а не готовая политика: асинхронная запись, стоимость перезапуска и коррелированные отказы меняют модель.
Шаг 12.5.2 — Трассировка должна связывать данные с обновлением
Панель наблюдения отвечает «что изменилось», а трассировка — «через какие события прошёл конкретный пример».
Минимальная цепочка идентификаторов:
prompt_id
  → rollout_id
  → behavior_policy_version
  → verifier_version
  → training_batch_id
  → optimizer_step
  → resulting_policy_version
Полезные группы метрик:
Данные
- длины запросов и ответов;
- причины остановки;
- доля технических ошибок;
- доля вырожденных групп;
- распределение наград.
Политика
- KL к базе;
- энтропия;
- логарифмы вероятностей;
- отношение вероятностей;
- ESS;
- задержка политики.
Система
- токены в секунду по этапам;
- время очереди;
- 50-й, 95-й и 99-й процентили длительности роллаута (p50/p95/p99);
- утилизация каждого пула;
- время синхронизации;
- пиковая память;
- число повторов после ошибок.
Надёжность
- время последней успешной контрольной точки;
- длительность сохранения и восстановления;
- число потерянных роллаутов;
- расхождение метрик до и после перезапуска.
Метрика без версии конфигурации часто бесполезна. Например, скачок длины ответа после изменения max_new_tokens не является спонтанной динамикой политики.
Шаг 12.5.3 — Восстановление проверяется аварией, а не наличием файла
Наличие каталога checkpoint-1000 не доказывает, что запуск можно продолжить. Нужен регулярный проверочный сценарий.
- Запустить несколько шагов и сохранить контрольную точку.
- Зафиксировать хэш конфигурации и краткий набор метрик.
- Принудительно остановить один или несколько процессов.
- Восстановить тренер, движок и планировщик.
- Отбросить или восстановить очередь по объявленной политике.
- Выполнить один контрольный пакет.
- Проверить конечность потерь, номер версии, токенизацию и состав пакета.
- Сравнить статистику с допустимым диапазоном.
Полный побитовый детерминизм распределённого запуска часто слишком дорог или недостижим при изменении числа процессов. Цель проверочного восстановления скромнее: сохранить семантику эксперимента и не выдать холодный оптимизатор, сброшенный планировщик задач или старую проверяющую систему за продолжение того же запуска.
Полезны три вида отказов:
- падение одного сборщика роллаутов;
- падение тренера после записи контрольной точки;
- сбой проверяющей системы с частично записанным пакетом.
Каждый пакет должен либо быть принят целиком, либо отклонён. Частичный пакет с неизвестной версией награды не должен молча попадать в обновление.
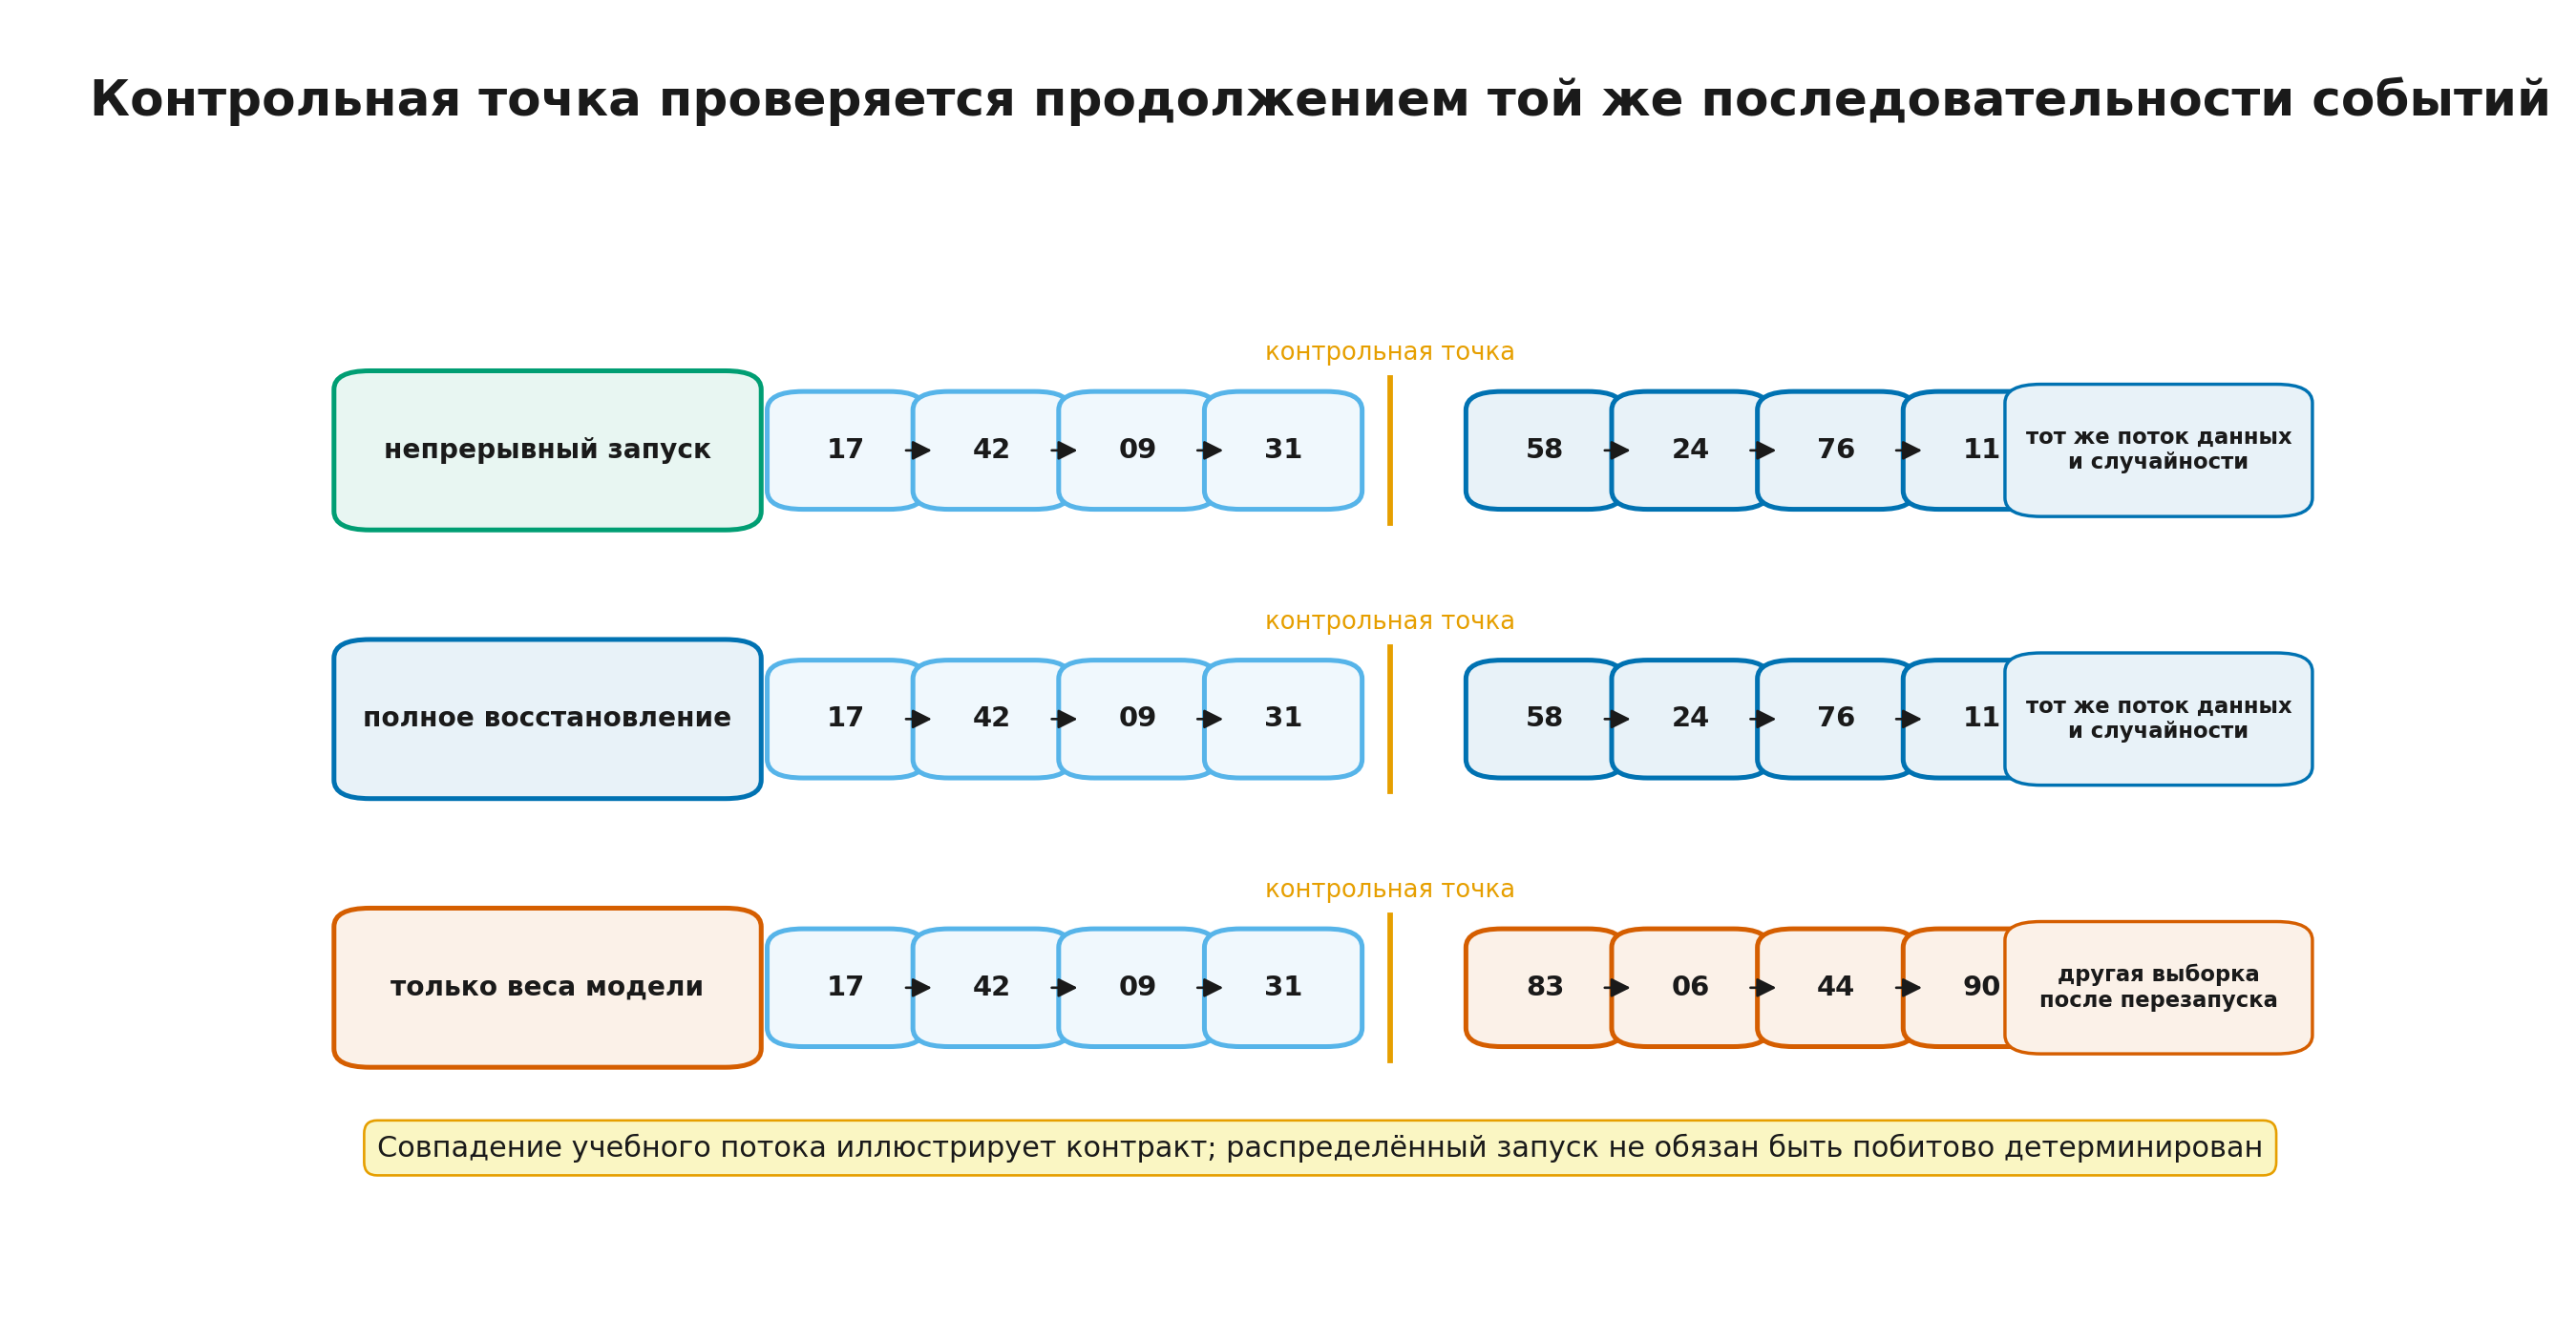
Ноутбук выполняет три ветви одного учебного запуска. Непрерывная ветвь и полное восстановление, где сохранены состояние генератора случайных чисел, курсор данных и версии компонентов, создают одну и ту же последовательность событий. Ветка «только веса модели» расходится сразу после перезапуска. Совпадение здесь намеренно строгое, потому что однопроцессный пример детерминирован. Распределённый запуск не обязан быть побитово идентичен; он обязан сохранить объявленную семантику эксперимента и явно зафиксировать допустимые источники расхождения.
Шаг 12.5.4 — Карта стеков на 2026-08-06
Ниже — датированная карта, а не рейтинг. Функции библиотек быстро меняются, поэтому перед запуском нужно повторно проверить документацию и примеры конкретной версии.
| Стек | Основной уровень абстракции | Обучение | Генерация и размещение | Асинхронность и агенты | Практический профиль |
|---|---|---|---|---|---|
| TRL | готовые тренеры вокруг Transformers | Accelerate, DeepSpeed и связанные интеграции | vLLM в совместном или серверном режиме | экспериментальный Async GRPO и интеграции сред в текущей документации | быстрый исследовательский маршрут и малые/средние эксперименты |
| verl | программируемый RL-поток HybridFlow | FSDP/DTensor и варианты на основе Megatron | vLLM или SGLang; совместные и раздельные схемы | полностью асинхронные и «на один шаг отстающие» рецепты, цикл агента, движок контрольных точек и поправки роллаутов | гибкая крупномасштабная система с явным управлением версиями |
| OpenRLHF | Ray-оркестрация ролей | DeepSpeed ZeRO | vLLM; гибридный движок с поочерёдным использованием GPU | асинхронное обучение, частичные роллауты и агентный интерфейс в текущей версии | готовые распределённые рецепты RLHF/RLVR |
| NeMo RL | распределённые рецепты NVIDIA | DTensor или Megatron Core | vLLM и несколько путей генерации | документированный асинхронный GRPO с поправкой по важности и интеграциями сред | крупные запуски в экосистеме NVIDIA |
| PRIME-RL | полностью асинхронный поток по описанию проекта | FSDP2 и специализированные пути | vLLM, раздельная генерация | акцент на полностью асинхронном обучении и длительных запусках | современный инженерный стек; заявления проекта требуют локального воспроизведения |
| SkyRL | модульный полноуровневый стек | поддерживаемые проектом распределённые системы исполнения | vLLM и единый интерфейс обучения и генерации | отдельный агентный слой и асинхронная диспетчеризация | исследование рассуждений и многоходовых задач |
| AReaL | исследовательская полностью асинхронная система | собственный распределённый тренер | потоковые роллауты отдельными исполнителями | явный контроль задержки и механизмы для данных другой политики | изучение выигрыша и рисков полной асинхронности |
HybridFlow описывает RLHF как распределённый поток, где каждая логическая модель является собственной программой, а движок преобразует раскладку параметров между обучением и генерацией. Документация verl для полностью асинхронного рецепта приводит авторские ускорения 2,35–2,67 раза для указанных конфигураций Qwen2.5-7B на 128 GPU; работа AReaL сообщает ускорение до 2,57 раза относительно сравниваемых синхронных систем. Это результаты собственных протоколов авторов, а не гарантия для другого кластера, модели или распределения длин.
Выбор стека начинается не с таблицы «кто быстрее», а с требований:
- один или несколько узлов;
- полное обучение или LoRA;
- одноразовые или многоходовые роллауты;
- синхронность, допустимая задержка и политика очереди;
- FSDP, Megatron или DeepSpeed;
- vLLM или SGLang;
- требования к восстановлению и телеметрии;
- способность команды отлаживать выбранный уровень сложности.
Шаг 12.5.5 — Итоги: инфраструктура является частью алгоритма
К концу модуля можно собрать одну непрерывную цепочку.
- Политика поведения генерирует токены при конкретной версии весов и правилах декодирования.
- Роллаут сохраняет токены, маску, логарифмы вероятностей, награду, причины остановки и версии компонентов.
- Очередь ограничивает возраст, объём и стоимость данных.
- Тренер строит обновление относительно объявленной политики поведения и контролирует отношения вероятностей.
- Служба синхронизации атомарно публикует новую версию.
- Контрольная точка сохраняет состояние, достаточное для продолжения того же эксперимента.
- Трассировка позволяет пройти от отдельного ответа до шага оптимизатора и обратно.
Главный вывод:
В онлайн-RL инфраструктура определяет не только скорость вычислений, но и статистический смысл данных. Очередь, версия весов, декодирование и синхронизация являются частью спецификации алгоритма.
Перед большим запуском полезно пройти короткий порядок действий.
- Получить последовательный эталон на одном процессе.
- Проверить контракт роллаута и нулевую задержку.
- Составить память по компонентам и фазам.
- Измерить критический путь и хвосты длительности.
- Добавить перекрытие и только затем асинхронность.
- Записывать задержку, TIM, ESS и долю клиппирования.
- Проверить восстановление принудительным сбоем.
- Сравнивать стеки на одной и той же задаче и единицах стоимости.
Следующий, заключительный теоретический модуль — RL for LLM, Модуль 13 «Оценивание RL-систем для LLM: статистика, взлом награды и безопасность» (rl_llm.module_13_evaluation). Инфраструктурный контракт этого модуля задаёт происхождение данных; Модуль 13 проверит, можно ли доверять выводам, сделанным по этим данным.
Источники и дальнейшее чтение
Ниже перечислены работы и официальные документы, которые поддерживают наиболее важные утверждения модуля. Полный построчный реестр с классом доказательства, датой проверки и границей каждого вывода находится в Module_12_Sources.md.
- ZeRO: Memory Optimizations Toward Training Trillion Parameter Models — исходная работа о поэтапном устранении избыточной репликации состояния модели; она не заменяет измерение активаций и временных буферов конкретного запуска.
- Efficient Memory Management for Large Language Model Serving with PagedAttention — первичное описание PagedAttention и vLLM; опубликованные ускорения относятся к конфигурациям статьи.
- SGLang: Efficient Execution of Structured Language Model Programs — источник идеи RadixAttention и повторного использования префиксов.
- HybridFlow / verl и официальная документация полностью асинхронного рецепта — архитектура распределённого RL-потока и датированные авторские результаты асинхронного исполнения.
- AReaL: A Large-Scale Asynchronous Reinforcement Learning System for Language Reasoning — первичная работа о полностью асинхронном RL с контролем задержки; численные выигрыши являются результатами авторов.
- Diagnosing Training–Inference Mismatch in LLM Reinforcement Learning — анализ расхождения вероятностей между контуром генерации и обучения; это не утверждение, что каждое различие ядер обязательно разрушает обучение.
- TRL: Asynchronous GRPO, verl: rollout correction, NeMo RL: Async GRPO, OpenRLHF: RL training и vLLM: NCCL weight transfer — изменяемые программные контракты, проверенные на снимке 2026-08-06; перед запуском нужно закрепить фактические версии.
- A First Order Approximation to the Optimum Checkpoint Interval — источник учебной формулы Янга; распределённые сбои и многоуровневое хранение требуют более богатой модели.