Модуль 1. Введение: Reinforcement Learning для LLM
Версия материала: 2026.18
Фактический снимок: 2026-07-16
Язык: RU
Основная практика: уровень A — браузер и центральный процессор
Структура: 4 урока, 19 шагов
Ориентировочное время: 5–7 часов без дополнительных упражнений
Этот курс посвящён применению RL к LLM. Предварительный курс по RL не требуется. Достаточно знать Python, владеть базовыми приёмами работы в PyTorch и понимать основы вероятностей, градиентной оптимизации и архитектуры трансформеров.
Два маршрута чтения. Если вы раньше не изучали RL, проходите Урок 1.1 последовательно: в нём вводится вся необходимая терминология. Если вы уже знакомы с классическим RL, быстро просмотрите §§1.1.1–1.1.3 и внимательнее прочитайте §§1.1.4–1.1.6: там привычные обозначения связываются с LLM и уточняется граница между RL и соседними методами дообучения.
Цели модуля. После прохождения вы сможете:
- описать цикл «агент → действие → среда → наблюдение и награда»;
- различать состояние, наблюдение, действие, награду, эпизод, траекторию и политику;
- объяснить, в каком точном смысле LLM является стохастической политикой;
- вычислить накопленную дисконтированную сумму наград и прочитать цель словами;
- выбрать между одношаговой моделью полного ответа, токеновой марковской моделью и многошаговой постановкой с агентом;
- различать обучение на демонстрациях, прямую оптимизацию предпочтений, обновление политики по свежим роллаутам и отбор кандидатов без изменения параметров;
- выполнить четыре воспроизводимые задачи уровня A: накопленная награда, численно устойчивый softmax, энтропия и оценка политики методом Монте-Карло.
Практический маршрут. После лекции идут оцениваемые задания, решения, открывающиеся после попытки, и исполняемая практика. Само объяснение остаётся самодостаточным.
Урок 1.1. Минимальный язык обучения с подкреплением
Урок 1.1. Минимальный язык обучения с подкреплением
- Что такое RL: один цикл вместо списка алгоритмов
- Агент, среда, состояние, действие и награда
- Политика: правило выбора действий
- LLM как политика: точное соответствие и его граница
- Награда, накопленная награда и цель RL
- Почему RL не сводится к фразе «нет правильного ответа»
далее — 9 проверочных шагов
Шаг 1.1.1 — Что такое RL: один цикл вместо списка алгоритмов
Начнём не с названий алгоритмов или уравнений Беллмана, а с задачи.
В обучении с учителем (supervised learning) у каждого примера обычно известен целевой ответ: класс изображения, перевод, метка спама. В самоконтролируемом обучении (self-supervised learning) цель извлекается из самих данных: при предсказании следующего токена правильное продолжение уже находится в корпусе.
В RL в центре внимания находится агент: он выбирает действия в среде и получает награду — скалярную обратную связь о результате. Агент не просто предсказывает заранее записанную цель: его решения влияют на то, что произойдёт дальше и какие данные он увидит.
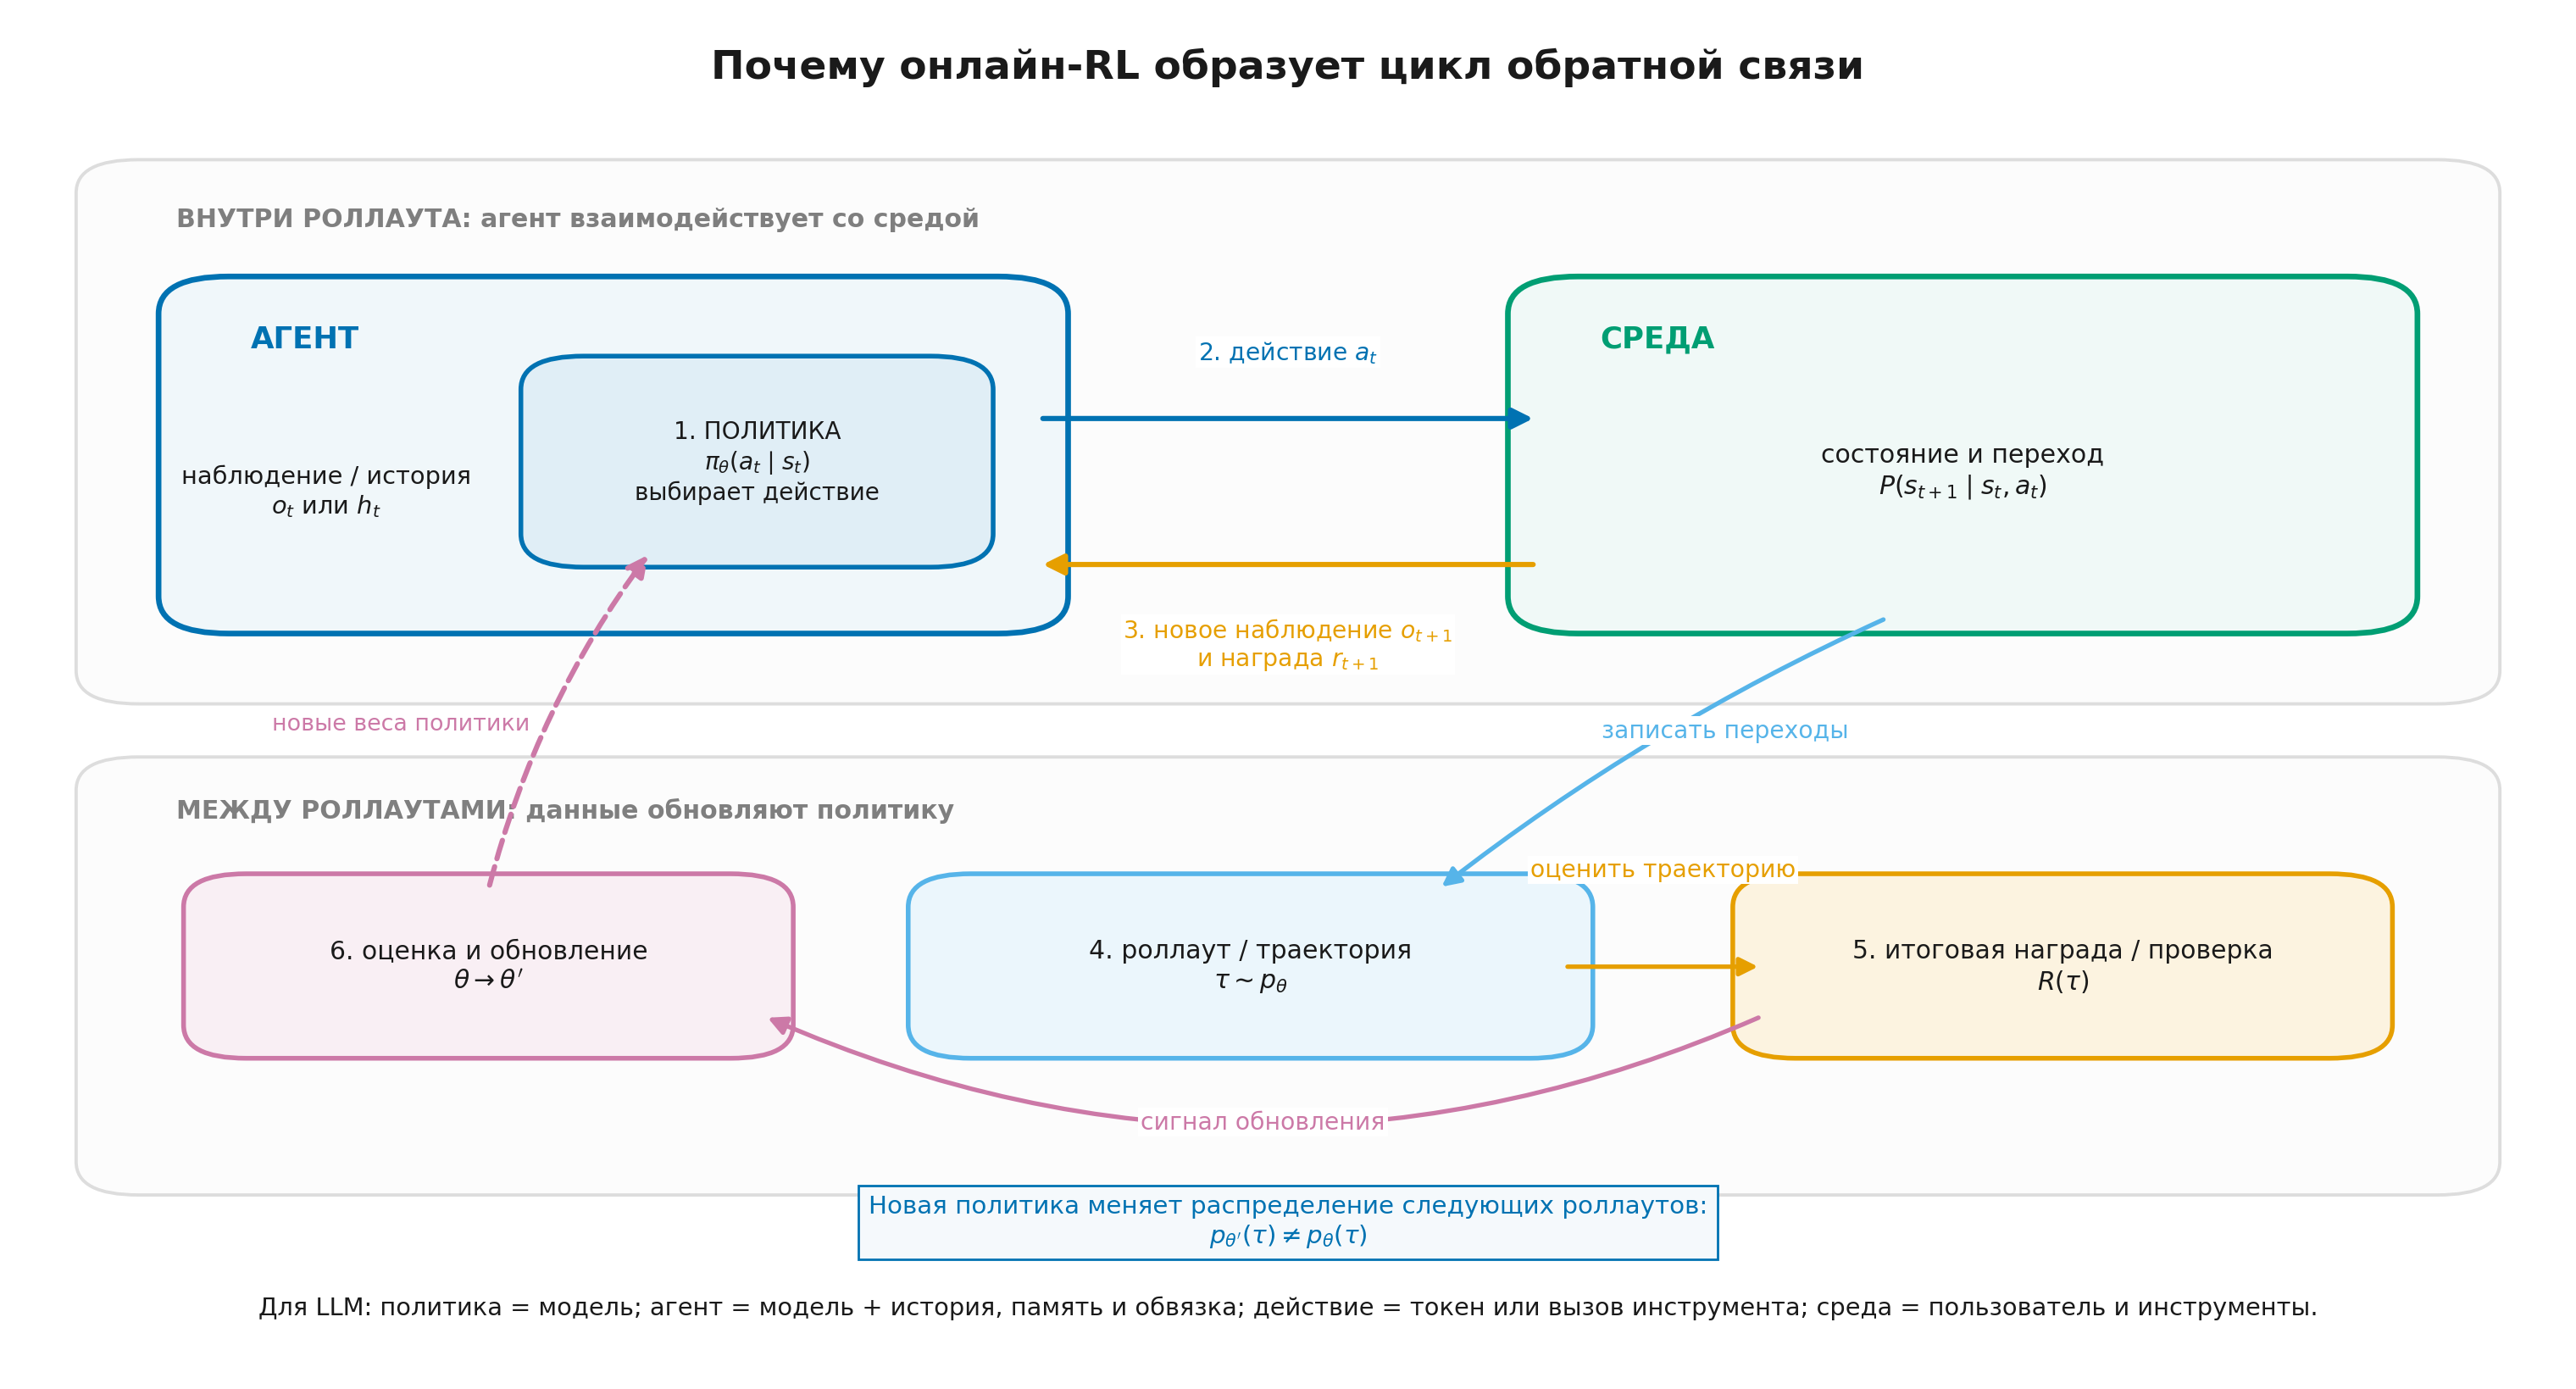
На схеме показаны два связанных масштаба. Верхняя часть — взаимодействие внутри одного роллаута. Нижняя — обучение между роллаутами.
- Агент получает состояние или наблюдение. Внутри агента находится политика , то есть правило выбора действий.
- Политика выбирает действие и передаёт его среде.
- Среда изменяет своё состояние и возвращает следующее наблюдение и локальную награду .
- Последовательность таких переходов образует роллаут, или траекторию .
- Итог траектории оценивается: это может быть сумма наград, программная проверка, модель награды или результат внешней среды.
- Алгоритм использует собранные данные и оценки, чтобы обновить параметры . Обновлённая политика меняет распределение следующих траекторий: уже не обязано совпадать с .
Именно поэтому онлайн-RL образует обратную связь. Политика влияет на данные, данные — на обновление политики, а обновление — на будущие данные. При этом агент и политика не являются синонимами: политика — механизм выбора действий внутри агента, а среда — всё, что принимает действия и возвращает их последствия.
Два коротких примера.
- Коридор. Агент находится в клетке, выбирает «влево» или «вправо» и получает , когда достигает правого терминального состояния.
- LLM. Модель видит запрос и уже сгенерированный текст, выбирает следующий токен или более крупное действие, а система проверки оценивает результат.
На первом проходе достаточно одной фразы:
RL изучает, как выбирать действия по обратной связи, чтобы ожидаемый итог последовательности решений был как можно лучше.
Позже мы сделаем это определение точнее. В частности, увидим, почему фраза «в RL нет правильного ответа» полезна как интуиция, но не задаёт строгой границы между RL и соседними методами.
Шаг 1.1.2 — Агент, среда, состояние, действие и награда
Зафиксируем базовый словарь. В момент времени :
- агент — система, принимающая решения;
- среда — всё, что отвечает на действия агента и определяет их последствия;
- состояние — описание ситуации, достаточное для определения распределения следующего перехода;
- наблюдение — информация, которую агент реально получает; она может быть неполной;
- действие — выбор агента из пространства действий ;
- награда — локальный скалярный сигнал после действия;
- переход — правило изменения среды;
- эпизод — взаимодействие от старта до терминального условия или временного лимита;
- траектория (
trajectory) — запись эпизода.
Если выбранное состояние содержит всю информацию, необходимую для распределения следующего состояния и награды, мы получаем марковский процесс принятия решений (Markov decision process, MDP). Слово «марковский» означает не «мир не имеет памяти», а «вся информация, важная для следующего перехода, уже включена в состояние».
Формально конечный MDP часто описывают следующим набором объектов:
где — состояния, — действия, — динамика, — правило назначения награды, — начальное распределение, а — фактор дисконтирования. Не нужно заучивать эту запись отдельно: смысл каждого элемента уже дан словами выше.
Посмотрим на одну и ту же схему в игрушечной среде и в LLM.
| Понятие | Коридор | Токеновая генерация LLM |
|---|---|---|
| Агент | политика движения | трансформер с заданными весами |
| Среда | клетки и терминалы | добавление токена, ограничение на длину, оцениватель |
| Состояние | номер клетки | запрос + уже сгенерированный префикс |
| Действие | влево / вправо | следующий токен |
| Награда | за правое терминальное состояние | например, результат тестов или итоговая оценка ответа |
| Эпизод | путь до терминала | генерация до токена конца последовательности или лимита |
Токен конца последовательности (end of sequence, EOS) завершает ответ так же, как терминальная клетка завершает эпизод в коридоре.
Важно не перепутать награду и среду. Награду может вычислять обученная модель, набор модульных тестов, программа математической проверки или пользователь. Но среда включает и переходы, ограничения, скрытое состояние инструментов и всё остальное, что определяет следующий шаг.
Шаг 1.1.3 — Политика: правило выбора действий
Политика (policy) — правило, по которому агент выбирает действие.
Детерминированная политика всегда возвращает одно действие:
Стохастическая политика задаёт распределение над действиями:
В задачах глубокого RL политику обычно параметризуют нейросетью:
где — обучаемые веса. Сеть сначала вычисляет логиты действий, затем превращает их в распределение, из которого выбирается конкретное действие.
Здесь полезно развести три объекта.
- Политика — всё распределение .
- Действие — один конкретный выбор из этого распределения.
- Награда — последующая оценка результата действия; она не является вероятностью политики.
Стохастичность нужна не только ради «случайности». Она позволяет исследовать альтернативы, собирать разнообразный опыт и плавно менять относительные вероятности действий. На этапе генерации политику можно сделать почти детерминированной, но во время обучения слишком ранняя концентрация на одном варианте часто лишает агента возможности исследовать полезные альтернативы.
Шаг 1.1.4 — LLM как политика: точное соответствие и его граница
Теперь построим главный мост курса.
Пусть — запрос, а — уже сгенерированный префикс. В токеновой постановке
Трансформер вычисляет логиты и задаёт распределение следующего токена:
То есть LLM действительно является : контекст играет роль состояния, следующий токен — действия, веса трансформера — параметров политики. В этой токеновой абстракции это не метафора, а точное математическое соответствие.
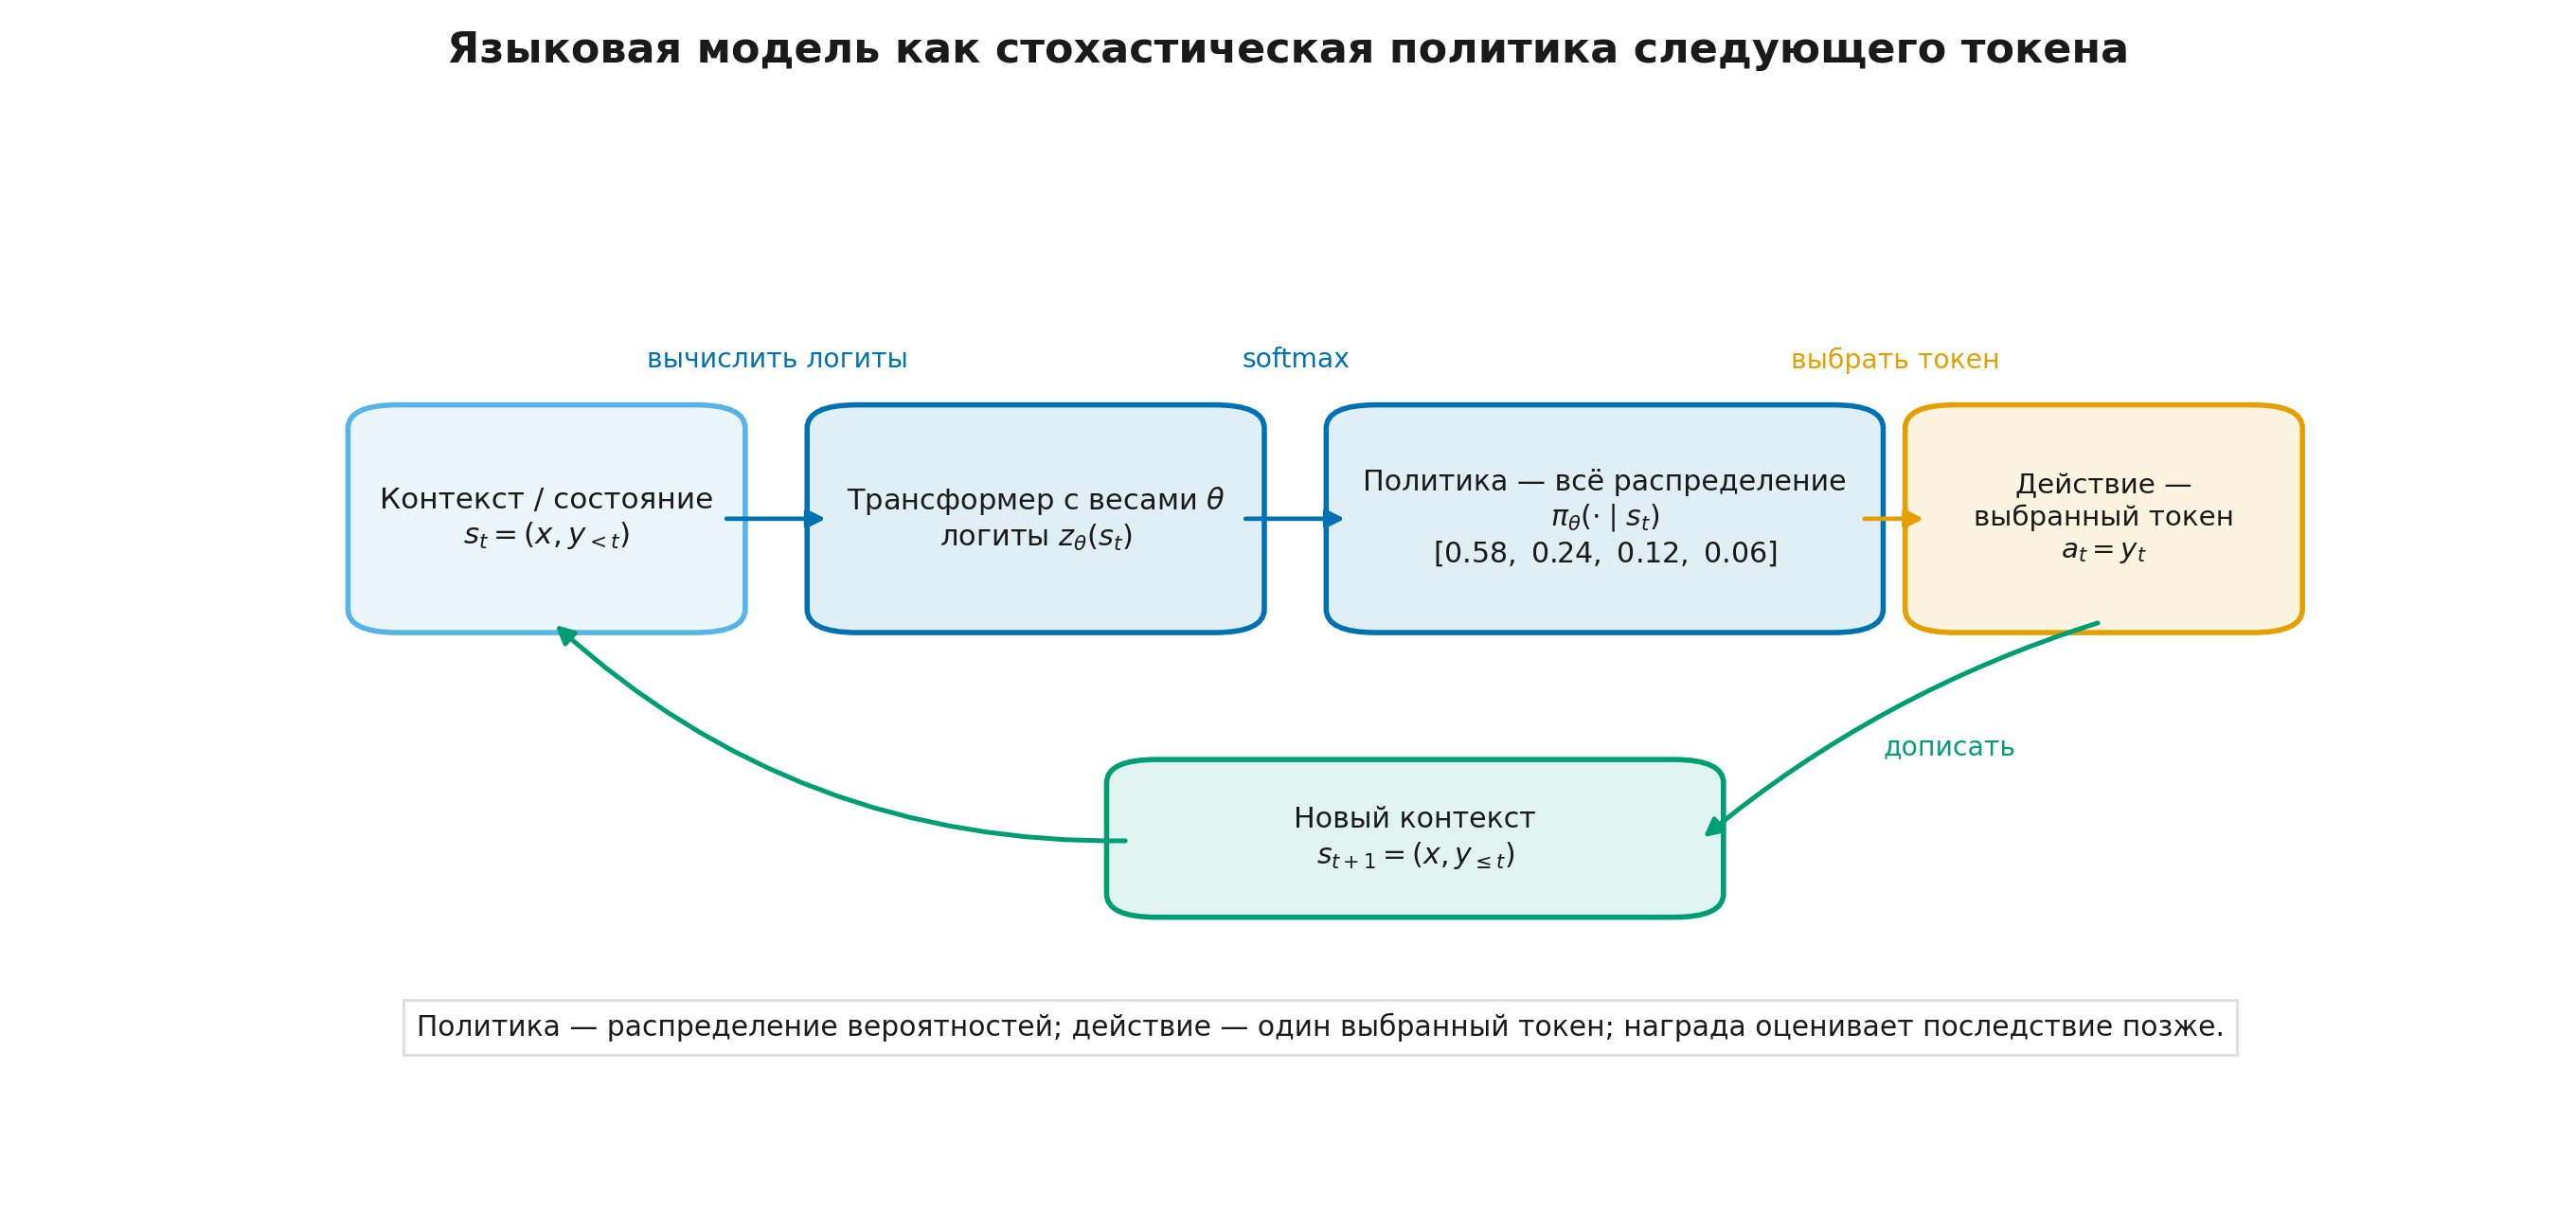
Вероятность полного ответа раскладывается авторегрессионно:
а лог-вероятность превращает произведение в сумму:
К этим двум формулам мы будем возвращаться при выводе градиента политики и при использовании дивергенции Кульбака–Лейблера (Kullback–Leibler divergence, KL) для регуляризации. Конкретные алгоритмы появятся после того, как мы закончим базовую постановку.
У этого соответствия есть две важные границы.
- Называть LLM политикой — значит описывать способ выбора действий, а не утверждать, что её веса обязательно получены с помощью RL. Предобученная модель уже задаёт политику, хотя обучалась предсказывать следующий токен.
- В полной прикладной системе LLM обычно является политикой или её частью, но не всей средой. Внешние инструменты, файлы, браузер, пользователь и проверяющие системы имеют собственное состояние и динамику.
Иными словами, фраза «LLM — это политика» точна после того, как мы явно сказали, что считается состоянием и действием.
Шаг 1.1.5 — Награда, накопленная награда и цель RL
Награда относится к одному переходу. Накопленная награда (return) — дисконтированная сумма будущих наград с момента :
Здесь — фактор дисконтирования (discount factor). Его используют по нескольким причинам:
- задавать меньший вес более далёким последствиям;
- определять эффективный горизонт планирования;
- обеспечивать сходимость суммы в бесконечном горизонте.
Для конечного ответа LLM часто используют : эпизод уже ограничен EOS или максимальной длиной, а итоговая оценка относится ко всему ответу. Это не универсальное правило. В длинных задачах с агентом задержка, стоимость времени и вероятность прерывания могут сделать содержательным выбором.
Пример. Эпизод дал награды , а . Тогда
Цель RL записывается одной строкой:
Прочитаем её словами: мы ищем такие параметры политики, при которых ожидаемая накопленная награда по траекториям этой политики в выбранной среде была максимальной.
Обратите внимание на замкнутый цикл обратной связи. Параметры определяют политику; политика определяет, какие траектории будут собраны; по этим траекториям оценивают целевую функцию; затем параметры обновляют.
Математическое углубление: где именно параметры политики входят в распределение
Этот фрагмент можно пропустить при первом чтении. Полный вывод и его использование при вычислении градиента политики появятся в Модуле 4.
Для конечного полностью наблюдаемого MDP
Здесь — распределение награды; если награда детерминирована, вся вероятностная масса сосредоточена в одном значении. В стандартной постановке без модели (model-free) динамика и правило награды не зависят от : зависимость от параметров возникает только в множителях политики . После обновления меняются вероятности действий, а значит — посещаемые состояния, исходы и награды. Для LLM новая версия модели генерирует другое распределение ответов, а в задаче с инструментами может приводить систему в другие состояния внешней среды.
Шаг 1.1.6 — Почему RL не сводится к фразе «нет правильного ответа»
Теперь можно уточнить первое интуитивное объяснение.
Фраза «в обучении с учителем есть правильный ответ, а в RL есть только награда» полезна, но не задаёт точную границу.
- В имитационном обучении (
imitation learning) могут быть демонстрации правильных действий, хотя задача остаётся последовательной. - В офлайн-RL (
offline RL) политика обучается по фиксированному набору траекторий и не собирает новый опыт во время самого обучения. - В контекстном бандите (
contextual bandit) действие получает награду, но будущего состояния может не быть. - В обучении по предпочтениям есть явная метка «ответ A лучше ответа B», однако не всякая парная функция потерь является RL-алгоритмом.
В этом курсе мы будем задавать четыре вопроса.
- Какое решение принимает политика? Токен, полный ответ, вызов инструмента?
- Какая обратная связь доступна? Демонстрация, предпочтение, модель награды, исход, который можно проверить автоматически?
- Есть ли у действий отложенные последствия и нужно ли оценивать вклад каждого действия в итоговую награду (
credit assignment)? - Как были получены данные? Из фиксированного набора данных, от текущей или предыдущей политики либо только во время поиска при генерации?
Эти вопросы точнее любого короткого ярлыка. Главная особенность онлайн-RL (online RL) состоит в том, что политика влияет на данные, которые будут собраны дальше. В офлайн-RL во время обучения нет нового цикла взаимодействия со средой, но задача улучшения решений по накопленному опыту сохраняется. Имитация поведения (behavior cloning) использует траектории, однако оптимизирует правдоподобие действий эксперта, а не ожидаемую накопленную награду текущей политики.
Итог первого урока:
Политика выбирает действия; среда определяет последствия и награды; RL ищет политику с максимальной ожидаемой накопленной наградой. Конкретный алгоритм определяется тем, как собираются данные и как оценивается это ожидание.
Урок 1.2. Какую RL-постановку выбрать для LLM
Урок 1.2. Какую RL-постановку выбрать для LLM
- Три полезные абстракции: ответ, токен и макродействие
- Разреженная награда, вклад действий и стоимость роллаутов
далее — 4 проверочных шага
Шаг 1.2.1 — Три полезные абстракции: ответ, токен и макродействие
Фраза «LLM — это MDP» неполна, пока не выбрана единица действия. В этом курсе понадобятся три постановки.
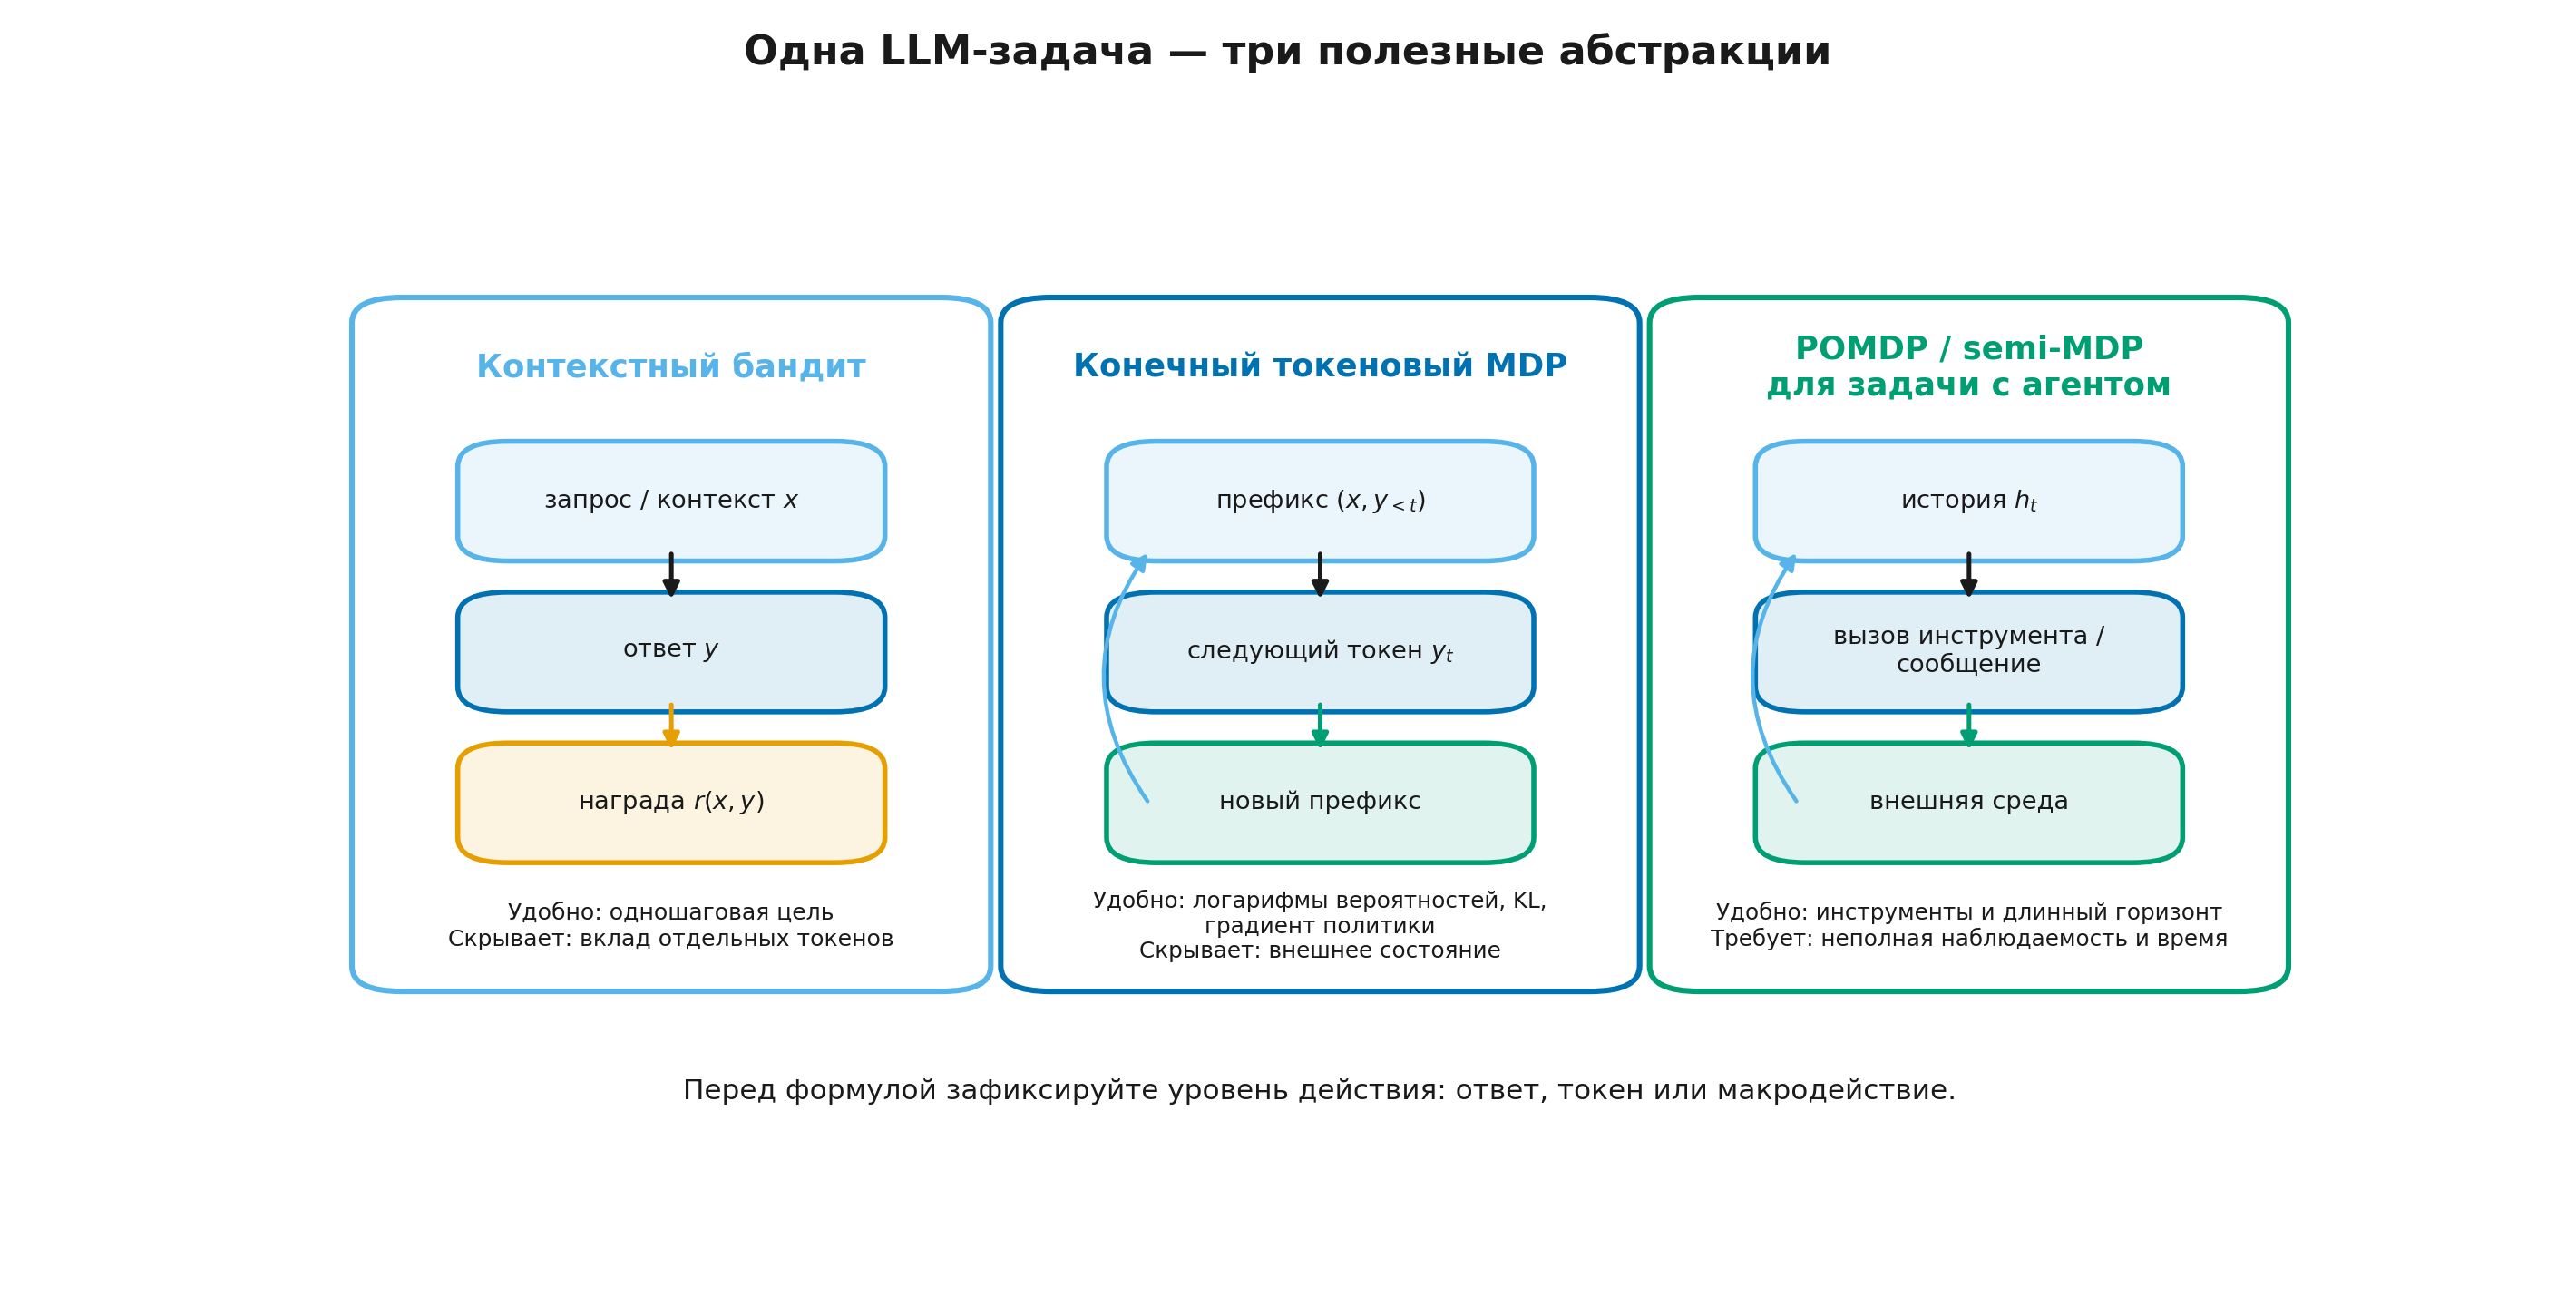
| Постановка | Контекст или состояние | Действие | Переход | Когда полезна | Что намеренно скрывает |
|---|---|---|---|---|---|
Контекстный бандит (contextual bandit) | запрос | весь ответ | следующий шаг не моделируется | одношаговое обучение по предпочтениям с итоговой наградой | вклад отдельных токенов и стоимость декодирования |
| Конечный токеновый MDP | полный префикс | следующий токен | детерминированное добавление токена | логарифмы вероятностей, KL, градиент политики, длина ответа | скрытое внешнее состояние и крупные действия |
Частично наблюдаемый марковский процесс принятия решений (partially observable Markov decision process, POMDP) или полумарковский процесс принятия решений (semi-Markov decision process, semi-MDP) | наблюдения, история, память | сообщение, вызов инструмента или макродействие | меняется внешняя, возможно скрытая среда | браузер, выполнение кода, игры, длинный диалог | требует явной модели времени, ошибок инструментов и неполноты наблюдений |
Что именно утверждает каждое название
Три модели отличаются не сложностью, а тем, какое предположение каждая из них делает и от какого отказывается.
- MDP предполагает, что состояние содержит всё существенное для следующего перехода: путь, которым агент в него попал, на будущее не влияет. Для чистой авторегрессии это выполняется точно — полный префикс и есть состояние. Формальное определение дано на шаге 1.1.2.
- POMDP отказывается от полной наблюдаемости, а не от марковского свойства скрытого состояния. Агент видит не состояние, а
наблюдение (
observation) — частичную и, возможно, зашумлённую его проекцию. Часть мира остаётся скрытой: содержимое непрочитанного файла, состояние удалённого сервиса, настоящее намерение пользователя. Поэтому решение приходится принимать по истории взаимодействия и памяти, а не по одному текущему входу. - semi-MDP отказывается от другого предположения — что все шаги одинаковы по длительности. Приставка «полу-» означает, что марковость сохраняется в моменты принятия решений, а между ними может пройти произвольное время. Длительность действия становится частью модели наравне с наградой: вызов, занимающий секунду, и вызов, занимающий минуту, перестают быть одним и тем же ходом.
Токеновая модель — это MDP. Для агента в браузере или командной оболочке часто нужно учитывать частичную наблюдаемость, а при разной длительности действий — ещё и полумарковскую модель времени. Эти два свойства могут сочетаться: учёт длительности не устраняет скрытое состояние.
Полный ответ как одно действие
Пусть — запрос, — завершённый ответ, а — награда. Тогда
Это постановка контекстного бандита. Она удобна для записи целевой функции на уровне полного ответа: для одного контекста выбирается одно макродействие и получается одна награда. При этом не утверждается, что ответ физически возник за один шаг: внутренняя последовательность токенов просто не моделируется явно.
Один токен как действие
Берём
До EOS переход детерминирован: выбранный токен дописывается к префиксу. Эта модель естественна для логарифмов вероятностей, KL, градиента политики и анализа длины. Если полный префикс содержит всю информацию, существенную для выбранной задачи, получается марковская постановка.
Сообщение или вызов инструмента как действие
После обращения к браузеру, командной оболочке или системе запуска тестов внешний мир меняется: файл может быть перезаписан, сервер — вернуть ошибку, пользователь — уточнить цель. История взаимодействия не обязательно содержит полное описание состояния, поэтому POMDP может быть точнее MDP. Если действия имеют разную длительность — например, один вызов инструмента занимает секунду, а другой минуту и несколько внутренних шагов, — semi-MDP может оказаться естественнее токеновой модели.
Правило курса: перед каждой важной формулой мы будем говорить, что считается состоянием, действием и наградой. Одна и та же LLM может быть политикой во всех трёх моделях, но смысл траектории и трудность оценки вклада отдельных действий будут разными.
Шаг 1.2.2 — Разреженная награда, вклад действий и стоимость роллаутов
Роллаут (rollout) — одна сгенерированная траектория политики: ответ целиком или последовательность действий агента в среде.
Во многих LLM-задачах награда известна только после окончания роллаута:
- прошли ли модульные тесты;
- совпал ли итоговый численный ответ;
- выполнил ли агент задачу в браузере;
- предпочёл ли оцениватель один ответ другому.
Такая награда называется разреженной (sparse reward) и часто терминальной (terminal reward). Если ответ содержит тысячу токенов, а сигнал равен только или в конце, возникает задача оценки вклада отдельных действий: какие именно решения привели к успеху или ошибке?
Дальше мы разберём несколько способов сделать такой сигнал информативнее.
- Функция ценности (
value function) и критик (critic) оценивают ожидаемый будущий результат и дают более локальный ориентир. - Сравнение нескольких ответов на один запрос позволяет построить групповую базовую оценку (
baseline). - Награды за промежуточные шаги (
process rewards) дают обратную связь до конца траектории, если её можно определить надёжно. - Разбиение задачи и продуманная структура награды помогают связать сигнал с действиями более крупного уровня.
Предварительный взгляд на градиент политики
Этот фрагмент можно пропустить при первом чтении. Полный вывод появится в Модуле 4.
Во многих методах градиента политики вклад выбранного действия имеет вид
где — преимущество (advantage): мера того, насколько выбранное действие оказалось лучше или хуже базовой оценки. В простейшем варианте классического алгоритма REINFORCE одна итоговая накопленная награда влияет на логарифмы вероятностей всех действий траектории. Получаемая оценка градиента может быть несмещённой, но иметь высокую дисперсию.
Ни один из этих методов не превращает плохую награду в правильную цель. Более плотная или менее шумная обратная связь лишь помогает точнее оптимизировать то, что действительно задано.
Есть и вычислительная сторона. В абстрактном токеновом MDP сам переход «дописать токен» почти ничего не стоит, но для выбора токена нужен прямой проход через большую модель. Для длинных ответов генерация роллаутов часто становится главной статьёй вычислительных затрат. В RL-задачах с инструментами добавляются время их работы, изоляция сред, сетевые задержки и повторные попытки. Поэтому важно одновременно учитывать эффективность использования роллаутов и пропускную способность системы генерации.
Урок 1.3. Современная карта дообучения LLM
Урок 1.3. Современная карта дообучения LLM
- Где RL находится в процессе обучения LLM
- Что изменилось после классического RL: исторические опорные точки
- Классические оси и их границы
- Пять дополнительных координат для систем с LLM
- Основные методы и режимы дообучения
- Маршрут курса и связь с соседними курсами
далее — 7 проверочных шагов
Шаг 1.3.1 — Где RL находится в процессе обучения LLM
Обучение современной LLM обычно включает несколько этапов. Сначала расшифруем основные названия, которые будут встречаться дальше.
- обучение с учителем на демонстрациях (
supervised fine-tuning, SFT); - обучение с подкреплением на основе обратной связи от человека (
reinforcement learning from human feedback, RLHF); - прямая оптимизация предпочтений (
direct preference optimization, DPO); - проксимальная оптимизация политики (
proximal policy optimization, PPO); - групповая относительная оптимизация политики (
group relative policy optimization, GRPO); - обучение с подкреплением с проверяемыми наградами (
reinforcement learning with verifiable rewards, RLVR); - KL — мера различия распределений, которую часто используют, чтобы ограничить отклонение от базовой политики.
Теперь разведём пять операций.
| Операция | Данные и обратная связь | Что оптимизируется | Нужно ли генерировать свежие ответы текущей политикой? | Обновляются параметры? |
|---|---|---|---|---|
| Предобучение | текстовые последовательности; целевой следующий токен известен из корпуса | максимизация логарифма правдоподобия или минимизация кросс-энтропии | нет, корпус фиксирован | да |
| SFT / имитация поведения | демонстрации желаемых ответов или действий | правдоподобие демонстраций | нет | да |
| DPO и другие методы прямой оптимизации предпочтений | фиксированные пары «лучше/хуже» | парная функция потерь относительно базовой политики | нет | да |
| PPO-RLHF или GRPO/RLVR | ответы или траектории текущей либо недавней политики + модель награды или автоматическая проверка | ожидаемая награда, часто с KL-регуляризацией | да | да |
| Best-of-N | кандидатов + оцениватель или проверяющий алгоритм | выбор кандидата при фиксированной модели | для каждого запроса нужно сгенерировать кандидатов | нет |
Два вывода особенно важны.
Дообучение (post-training) не тождественно RL. SFT и DPO могут быть ключевыми стадиями, но используют фиксированные данные. Best-of-N использует оцениватель, однако не меняет параметры.
Название алгоритма не описывает весь эксперимент. Нужно указывать, как были получены данные, какая награда использовалась, насколько свежа политика, собиравшая роллауты, сколько раз переиспользовался пакет данных и какие компоненты обновлялись.
Расширение: архитектура трансформеров, предобучение и SFT подробно разбираются в Modern LLMs. Здесь они введены ровно настолько, чтобы часть курса по RL оставалась самодостаточной.
Шаг 1.3.2 — Что изменилось после классического RL: исторические опорные точки
Классическое ядро не устарело. Уравнения Беллмана, функции ценности, градиенты политики, исследование среды и поправки при использовании данных другой политики по-прежнему остаются основой. Изменилась область применения: действиями стали токены и вызовы инструментов, награды начали вычислять модели предпочтений и автоматические проверяющие системы, а стоимость сбора опыта теперь во многом определяется авторегрессионной генерацией большой модели.
| Год | Работа или направление | Что переносится в курс |
|---|---|---|
| 2015 | глубокая Q-сеть (deep Q-network, DQN) на Atari | нейросетевая оценка ценности и буфер повторного использования опыта (replay buffer) как классическая линия обучения по данным другой политики |
| 2016–2018 | AlphaGo / AlphaZero | самоигра, совместное обучение политики и ценности, а также поиск по дереву Монте-Карло (Monte Carlo tree search, MCTS) как отдельные компоненты системы |
| 2017 | PPO | роллауты, близкие к текущей политике, и несколько эпох по суррогатной целевой функции с клиппингом |
| 2022 | InstructGPT | практическая схема SFT → модель награды → PPO-RLHF |
| 2023 | DPO | прямая парная целевая функция, выведенная из KL-регуляризованной постановки RLHF с предпочтениями |
| 2024 | DeepSeekMath | GRPO: PPO-подобная оптимизация с групповой базовой оценкой без отдельного обучаемого критика |
| 2025 | Decoupled Clip and Dynamic sAmpling Policy Optimization (DAPO), GRPO Done Right (Dr. GRPO), Group Sequence Policy Optimization (GSPO) | разные изменения клиппинга, нормировки, отбора групп и уровня, на котором вычисляется отношение вероятностей |
| 2025–2026 | открытые технические отчёты о моделях-агентах | RL всё чаще применяется к интерактивным средам, инструментам и длинным траекториям |
Оригинальные источники и точный статус утверждений собраны в Module_1_Sources.md.
Актуальный снимок на 2026-07-14. Публичные отчёты не описывают единого универсального процесса дообучения. Они показывают несколько разных подходов: обучение по фиксированным данным о предпочтениях, PPO/GRPO-подобную оптимизацию по свежим роллаутам, RLVR для математики и программирования, а также интерактивный RL для работы с инструментами и задач с агентами. В отчёте Qwen3 говорится об объединении режимов с рассуждением и без него. В материалах Kimi K2 описан этап RL с взаимодействием в реальных и синтетических средах, а в отчёте Kimi K2.5 — совместное RL на текстовых и визуальных данных. В отчёте GLM-5 описаны асинхронная инфраструктура RL и обучение на длинных траекториях в задачах с агентами. Это заявления авторов первичных технических отчётов, а не независимая проверка полного процесса обучения и не основание утверждать, что все модели в отрасли обучают одинаково.
Практический вывод скромнее: современному инженеру нужен понятийный аппарат классического RL вместе с явным описанием данных, обратной связи и инфраструктуры.
Шаг 1.3.3 — Классические оси и их границы
Классическая классификация остаётся полезной, если представить каждую ось как вопрос.
| Ось | Вопрос | Примеры |
|---|---|---|
без модели / с моделью (model-free / model-based) | используется ли модель динамики среды для планирования последствий? | PPO — без модели; MCTS с моделью переходов — планирование с моделью |
на основе ценности / на основе политики / актор–критик (actor–critic) | какой объект обучается для выбора действий? | DQN; REINFORCE; PPO |
по данным текущей / другой политики (on-policy / off-policy) | насколько данные соответствуют политике, которую обновляют? | REINFORCE и PPO используют данные текущей или недавней политики; DQN — данные другой политики |
с новым взаимодействием / по фиксированным данным (online / offline) | собираются ли новые взаимодействия во время обучения? | онлайн-RL; офлайн-RL по фиксированным траекториям |
Небольшое пояснение ко второй оси.
- Методы на основе ценности (
value-based) оценивают ценность состояния или действия, например , а политика выбирает действие с высокой оценкой. - Методы на основе политики (
policy-based) оптимизируют напрямую. - Методы актор–критик учат и политику актора, и функцию ценности критика, которая помогает оценивать действия и снижать дисперсию.
Две пары часто путают.
Данные текущей политики не означают «использовать каждый пример ровно один раз». PPO обычно собирает пакет данных с помощью политики , а затем выполняет несколько эпох по мини-пакетам. В суррогатной целевой функции используется клиппинг отношения вероятностей выбранного действия при новой и старой политиках; он не задаёт жёсткой границы для фактического отношения или KL. Поэтому в описании эксперимента нужно явно указывать, сколько раз переиспользуются данные и насколько политика, собиравшая их, отстаёт от обновляемой.
Офлайн-режим не тождествен обучению по данным другой политики. Офлайн-RL — постановка без нового взаимодействия и с фиксированными данными. Обучение по данным другой политики (off-policy) — свойство оценивателя или алгоритма относительно политики поведения, породившей данные. Понятия связаны, но отвечают на разные вопросы.
Само наличие LLM не делает систему модельной по отношению к внешней среде. Для этого система должна действительно моделировать последствия действий и использовать модель переходов для планирования.
Шаг 1.3.4 — Пять дополнительных координат для систем с LLM
Классической карты недостаточно для DPO, Best-of-N и сложных систем с агентами. Для любой системы задайте ещё пять вопросов.
- Источник обратной связи: демонстрация, пара предпочтений, обученная модель награды, оценка другой LLM, проверка по правилам, исход взаимодействия со средой?
- Источник данных: фиксированный набор данных, свежие роллауты текущей политики, роллауты старой политики, буфер повторов, кандидаты только на этапе генерации?
- Единица решения: токен, последовательность, вызов инструмента, длинная траектория?
- Что обновляется: политика, критик или функция ценности, модель награды, базовая политика, несколько компонентов или ничего?
- Где происходит оптимизация: параметры обновляются при обучении или результат выбирается поиском и отбором во время генерации?
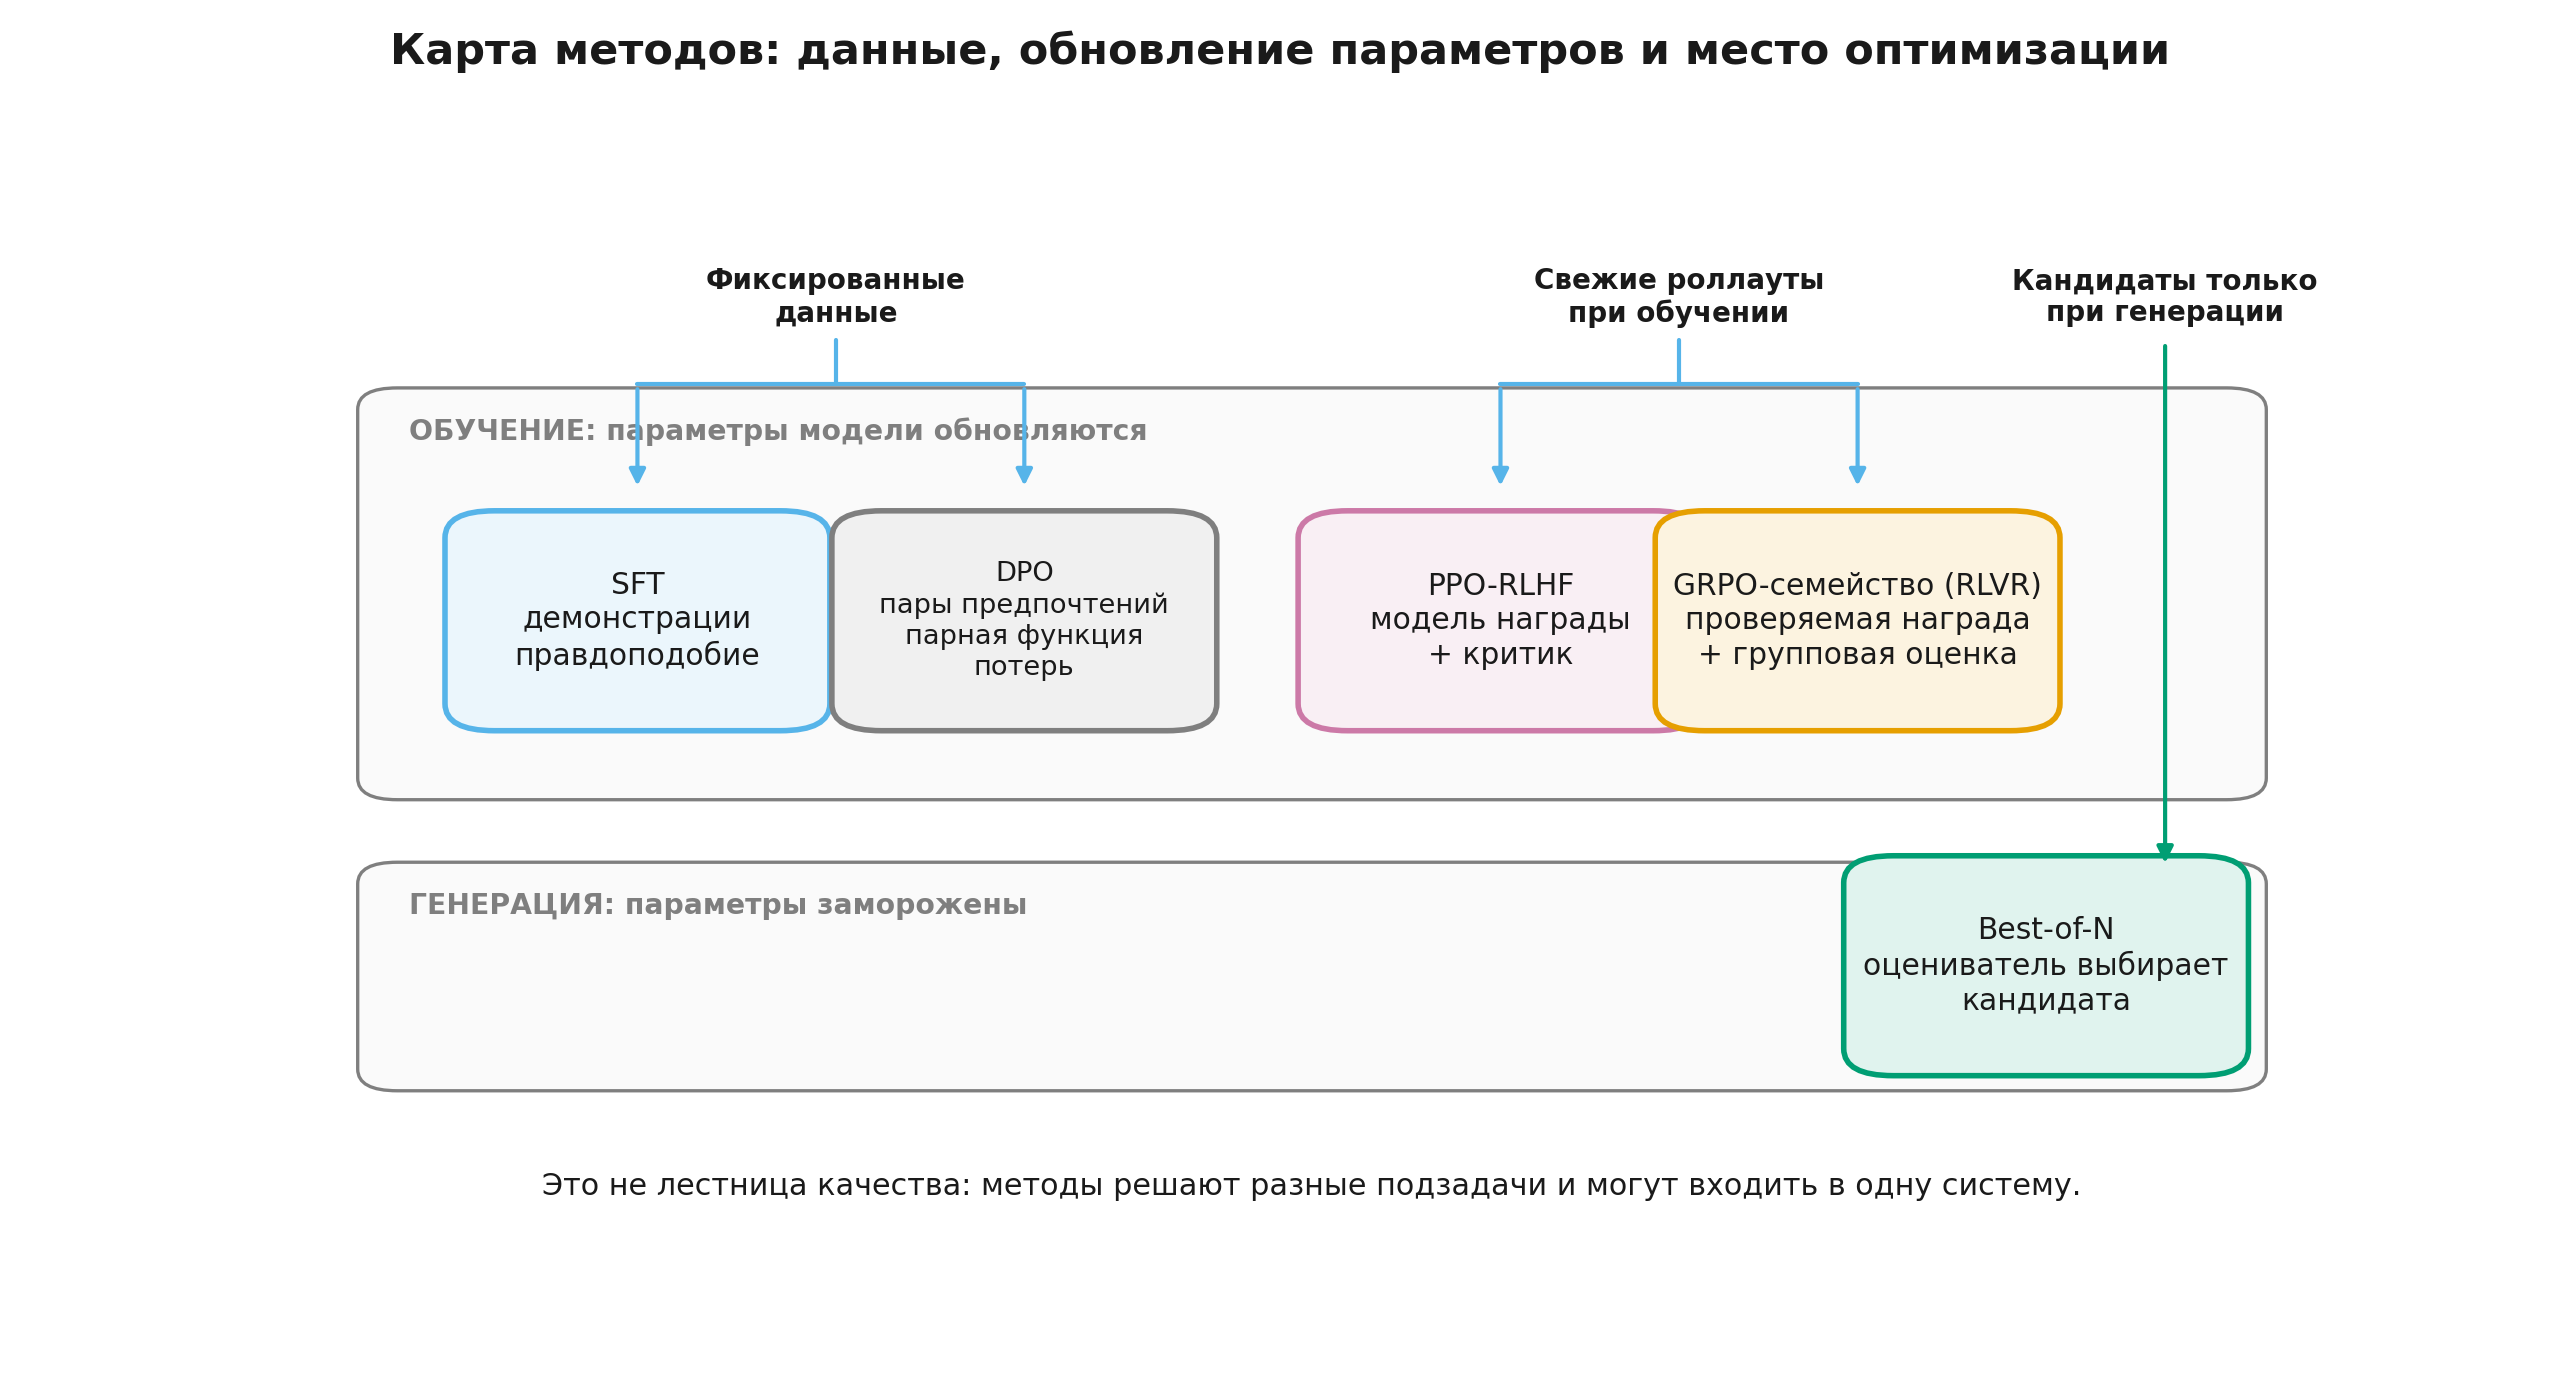
Карта намеренно не изображает методы как лестницу «хуже → лучше». SFT, DPO, PPO, GRPO и Best-of-N решают разные подзадачи и могут входить в одну систему.
Шаг 1.3.5 — SFT, DPO, PPO-RLHF, GRPO/RLVR и Best-of-N
| Метод | Данные | Обратная связь и целевая функция | Свежие роллауты при обучении | Дополнительные обучаемые модели | Точная характеристика |
|---|---|---|---|---|---|
| SFT | фиксированные демонстрации | правдоподобие на уровне токенов | нет | нет | имитация поведения по демонстрациям, не RL |
| DPO | фиксированные пары предпочтений | прямая парная функция потерь относительно базовой политики | нет | нет отдельной модели награды или критика | офлайн-оптимизация предпочтений, выведенная из KL-регуляризованной постановки RLHF; не классический офлайн-RL |
| PPO-RLHF | роллауты политики | обученная модель награды + KL-ограничение + суррогатная целевая функция PPO | да | обычно модель награды и критик | схема актор–критик на данных текущей или недавней политики |
| Семейство GRPO в RLVR | группы кандидатов на один запрос | автоматически проверяемая или иная скалярная награда + групповое относительное преимущество + PPO-подобная суррогатная целевая функция | обычно да | в каноническом GRPO нет обучаемого критика | RLVR описывает тип обратной связи, GRPO — алгоритм; отсутствие критика не означает отсутствия базовой оценки |
| Best-of-N | кандидатов на этапе генерации | оцениватель или проверяющий алгоритм выбирает лучший | не относится к обучению | нет | поиск и отбор при замороженных параметрах |
Почему DPO не следует просто называть офлайн-RL
DPO использует фиксированные данные и потому является офлайн-методом в обычном инженерном смысле. Но классический офлайн-RL обычно работает с переходами или траекториями политики поведения, наградами и обновлениями Беллмана; его центральная проблема — улучшение политики вне распределения данных. DPO использует парные сравнения и оптимизирует другую целевую функцию. Короткая корректная формулировка: прямая офлайн-оптимизация предпочтений, выведенная из KL-регуляризованной постановки RLHF.
Что в PPO и GRPO означает «данные текущей политики»
Роллауты обычно генерирует зафиксированная версия текущей или недавней политики , а обновляется . Клиппированная суррогатная цель убирает стимул к некоторым дальнейшим изменениям отношения вероятностей, но не гарантирует жёсткой границы для фактического отношения или KL. Из-за нескольких эпох и асинхронного сбора часть данных может быть получена устаревшей политикой. Поэтому допустимое отставание политики нужно явно указывать в описании эксперимента.
Почему последующие методы нельзя считать одной линейкой улучшений GRPO
DAPO меняет клиппинг и динамически исключает неинформативные группы; Dr. GRPO удаляет спорные нормировки; GSPO переносит отношение вероятностей и клиппинг на уровень последовательности. Это изменения разных частей алгоритма. Их нельзя сворачивать в фразу «одно и то же улучшение GRPO». Полный вывод и сравнение отложены до Модуля 9.
Шаг 1.3.6 — Маршрут курса и связь с соседними курсами
| Модуль | Основной вопрос |
|---|---|
| 1 | как освоить язык RL и выбрать постановку для LLM |
| 2 | как MDP, уравнения Беллмана, и формализуют последовательную задачу |
| 3 | как исследование среды, бандиты и бюджеты выборки связаны с генерацией кандидатов |
| 4 | откуда берётся градиент политики и как от REINFORCE переходят к PPO |
| 5 | что меняется при имитационном обучении, данных другой политики и офлайн-RL |
| 6 | как считать токеновые логарифмы вероятностей, KL и целевые функции последовательности у LLM |
| 7 | как строятся данные о предпочтениях и модели награды |
| 8 | как устроены PPO-RLHF, DPO и методы прямой оптимизации предпочтений |
| 9 | как выводятся и стабилизируются GRPO, DAPO, Dr. GRPO, GSPO и RLVR |
| 10 | что относится к поиску при генерации, оценке промежуточных шагов и увеличению вычислительного бюджета на этапе применения |
| 11 | как формулировать многошаговое взаимодействие с инструментами и средой |
| 12 | как устроена инфраструктура роллаутов, генерации и обучения |
| 13 | как оценивать политику без самообмана и распознавать манипулирование несовершенной наградой |
Перекрёстные ссылки используются для углубления, а не для закрытия пробелов.
- Information Theory for ML, Модуль 2: энтропия и единицы;
- Information Theory for ML, Модуль 3: кросс-энтропия и KL;
- Information Theory for ML, Модуль 8: принцип максимальной энтропии, softmax, экспоненциальное наклонение и точный KL-регуляризованный оптимум;
- Modern LLMs: архитектура трансформеров, предобучение, SFT, генерация и обзор систем с агентами и инструментами.
Основной текст курса RL for LLM остаётся самодостаточным. Стабильные идентификаторы ссылок находятся в configs/course_links.yaml; публичные веб-адреса будут подставлены после публикации репозиториев.
Урок 1.4. Практика и первые численные эксперименты
Урок 1.4. Практика и первые численные эксперименты
- Четыре профиля практики
- Softmax с температурой: первый вычислимый пример политики
- Как энтропия зависит от температуры: воспроизводимый эксперимент
- Накопленная награда и оценка Монте-Карло в коридоре
- Итоги и мини-словарь
далее — 9 проверочных шагов
Шаг 1.4.1 — Четыре профиля практики
Практика не влияет на формальное завершение курса. Но без запусков методы легко остаются знакомыми словами, а не рабочими навыками.
Сначала расшифруем вычислительные сокращения.
- центральный процессор (
central processing unit, CPU); - графический процессор (
graphics processing unit, GPU); - интерфейс программирования приложений (
application programming interface, API); - видеопамять (
video random-access memory, VRAM).
| Профиль | Среда | Назначение | Что считается результатом |
|---|---|---|---|
| A | Тесты на сайте или Stepik; код — локально на CPU | функции, мини-MDP, оцениватели, модульные тесты | тесты проходят; числа воспроизводятся |
| B | бесплатный Colab T4 | короткий учебный запуск на открытой модели | учебный ноутбук выполняется сверху вниз; сохранены метрики и конфигурация |
| B+ | платный API крупного провайдера | альтернативный маршрут для задач с агентами и оценивания без локальной большой модели | сохранены провайдер, идентификатор модели, дата, параметры декодирования, исходные ответы и стоимость |
| C | платный GPU или несколько GPU | полный факультативный запуск или итоговый проект | обработан заявленный объём данных, выполнено заданное число шагов, сохранены контрольные точки и протокол оценивания |
В следующих модулях практикумы по DPO, обучению модели награды, GRPO и RL для задач с агентами будут иметь как минимум два режима:
- проверочный профиль — пройти весь процесс на малом объёме;
- полный учебный профиль — провести содержательный эксперимент, сохранить метрики или кривую обучения и явно указать требования к VRAM, времени выполнения и стоимости.
Проверочный запуск не выдаётся за воспроизведение статьи. Модуль 1 требует только профиль A.
Минимальная локальная среда:
python -m venv .venv
source .venv/bin/activate        # Windows: .venv\Scripts\activate
python -m pip install --upgrade pip
pip install numpy matplotlib
Эталонная реализация находится рядом в module_1_reference.py.
Шаг 1.4.2 — Softmax с температурой: первый вычислимый пример политики
Пусть модель выдаёт логитов . Логит — ненормированная численная оценка действия. Политика с температурой задаётся как
Численно устойчивая форма вычитает максимальный логит:
При малом распределение концентрируется на действиях с высокими логитами. При большом оно становится более равномерным. Это один из простейших способов увидеть политику не как «выбранный токен», а как полное распределение над возможными действиями.
Энтропия политики в натах:
Для фиксированных конечных логитов без top-k, top-p и других преобразований энтропия не убывает с температурой:
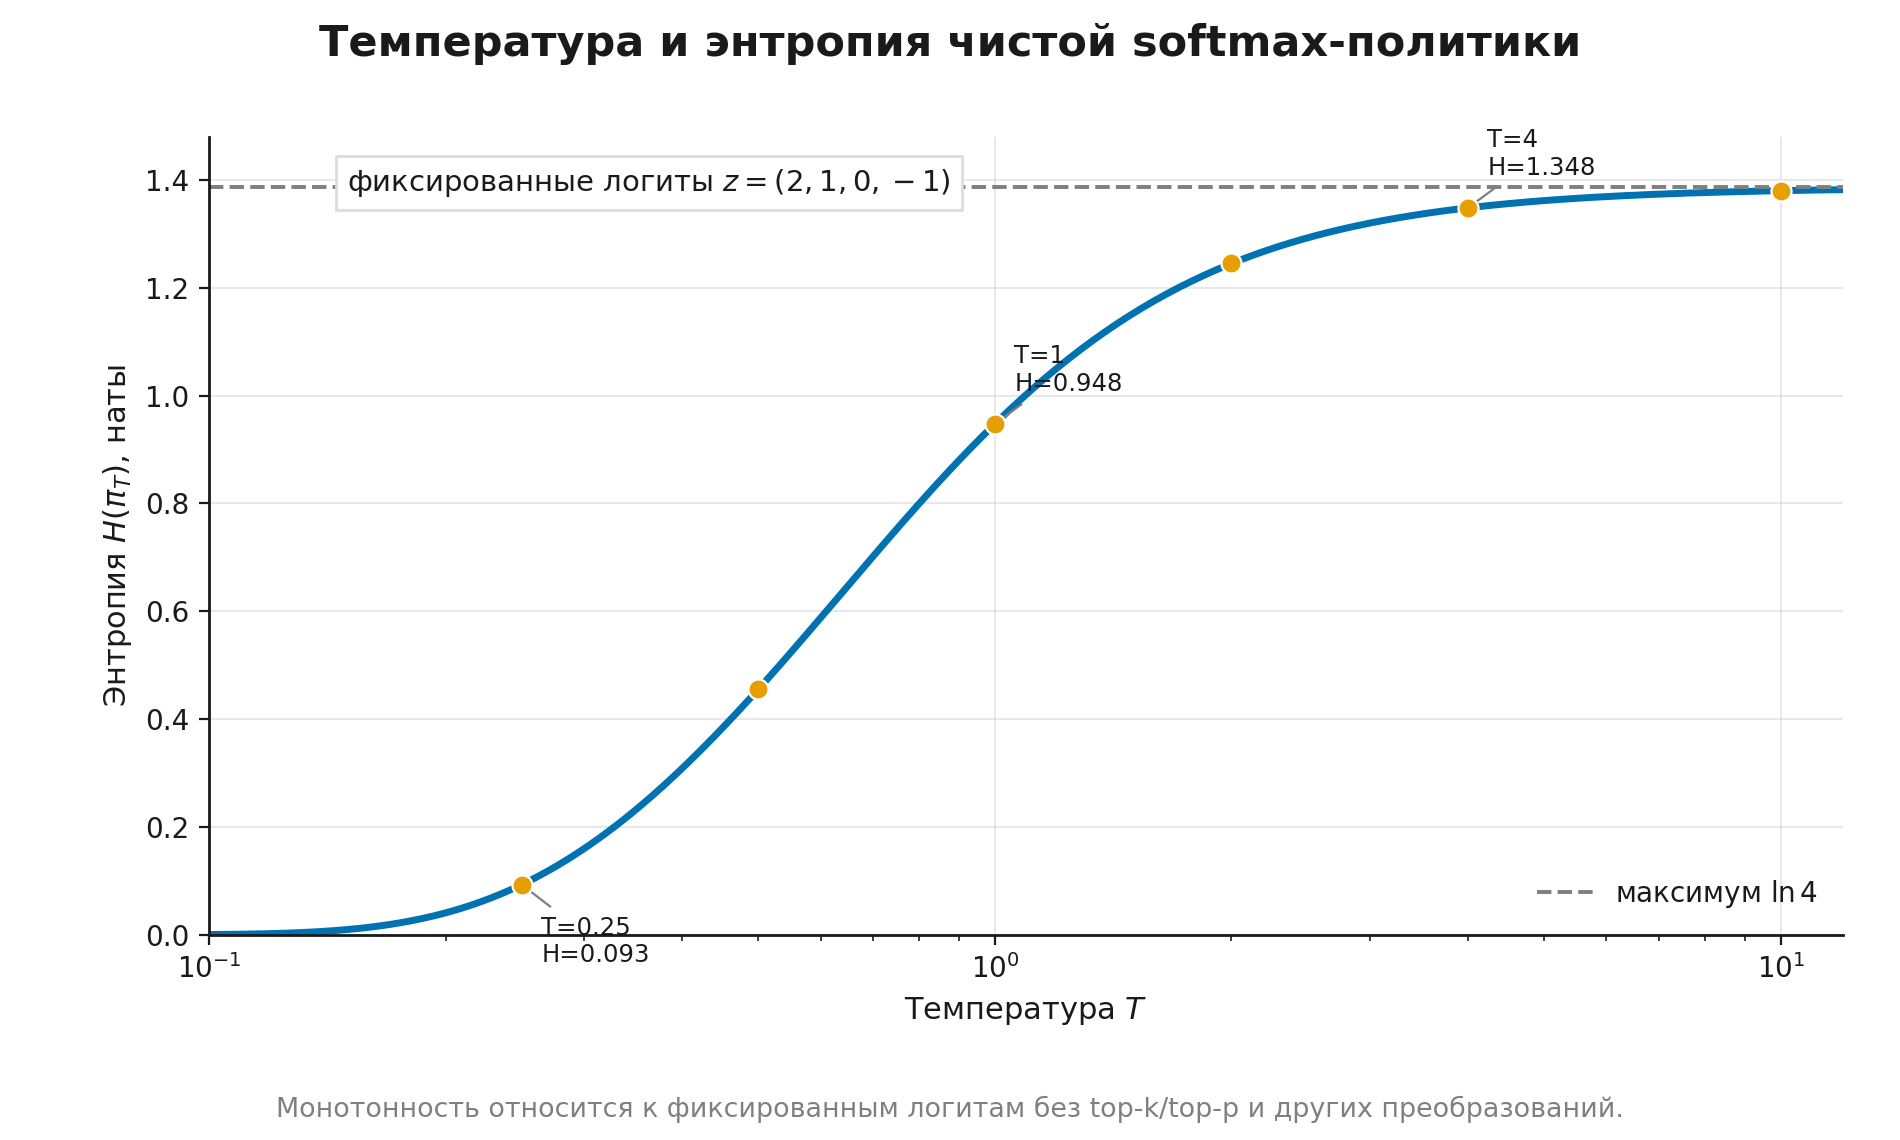
Граница утверждения. Параметр temperature в конкретном API может применяться вместе с top-p, top-k, штрафами за повторение, фильтрами безопасности и дополнительными преобразованиями провайдера. Формула описывает чистый softmax с температурой для заданного набора логитов, а не весь процесс декодирования.
Углубление: Information Theory for ML, Модуль 2 — энтропия; Модуль 8 — softmax как решение задачи максимальной энтропии и распределение Гиббса.
Шаг 1.4.3 — Как энтропия зависит от температуры: воспроизводимый эксперимент
Для логитов получаем:
| Температура | Энтропия, наты | Доля от максимума |
|---|---|---|
| 0.25 | 0.093113 | 0.0672 |
| 0.50 | 0.455429 | 0.3285 |
| 1.00 | 0.947537 | 0.6835 |
| 2.00 | 1.245050 | 0.8981 |
| 4.00 | 1.348243 | 0.9726 |
| 10.00 | 1.380071 | 0.9955 |
Минимальный код:
from __future__ import annotations

import numpy as np

def softmax_with_temperature(logits: np.ndarray, temperature: float) -> np.ndarray:
    logits = np.asarray(logits, dtype=np.float64)
    if logits.ndim != 1 or logits.size == 0:
        raise ValueError("logits must be a non-empty 1D array")
    if not np.isfinite(logits).all():
        raise ValueError("logits must be finite")
    if not np.isfinite(temperature) or temperature <= 0:
        raise ValueError("temperature must be finite and positive")

    scaled = logits / temperature
    scaled -= scaled.max()
    weights = np.exp(scaled)
    return weights / weights.sum()

def policy_entropy(logits: np.ndarray, temperature: float) -> float:
    p = softmax_with_temperature(logits, temperature)
    positive = p > 0
    return float(-(p[positive] * np.log(p[positive])).sum())
В практической части эти функции становятся небольшими задачами с проверкой и подробным разбором. Там проверяется не только формула, но и численная устойчивость: , пустой вектор и nan должны приводить к понятной ошибке, а логиты порядка 1000 — к конечным вероятностям.
Шаг 1.4.4 — Накопленная награда и оценка Монте-Карло в коридоре
Классический пример модуля — симметричное случайное блуждание по пяти клеткам:
терминал           старт             терминал, награда +1
   [0] ---- [1] ---- [2] ---- [3] ---- [4]
Действие 0 двигает влево, 1 — вправо. Эпизод завершается в 0 или 4; при достижении 4 агент получает .
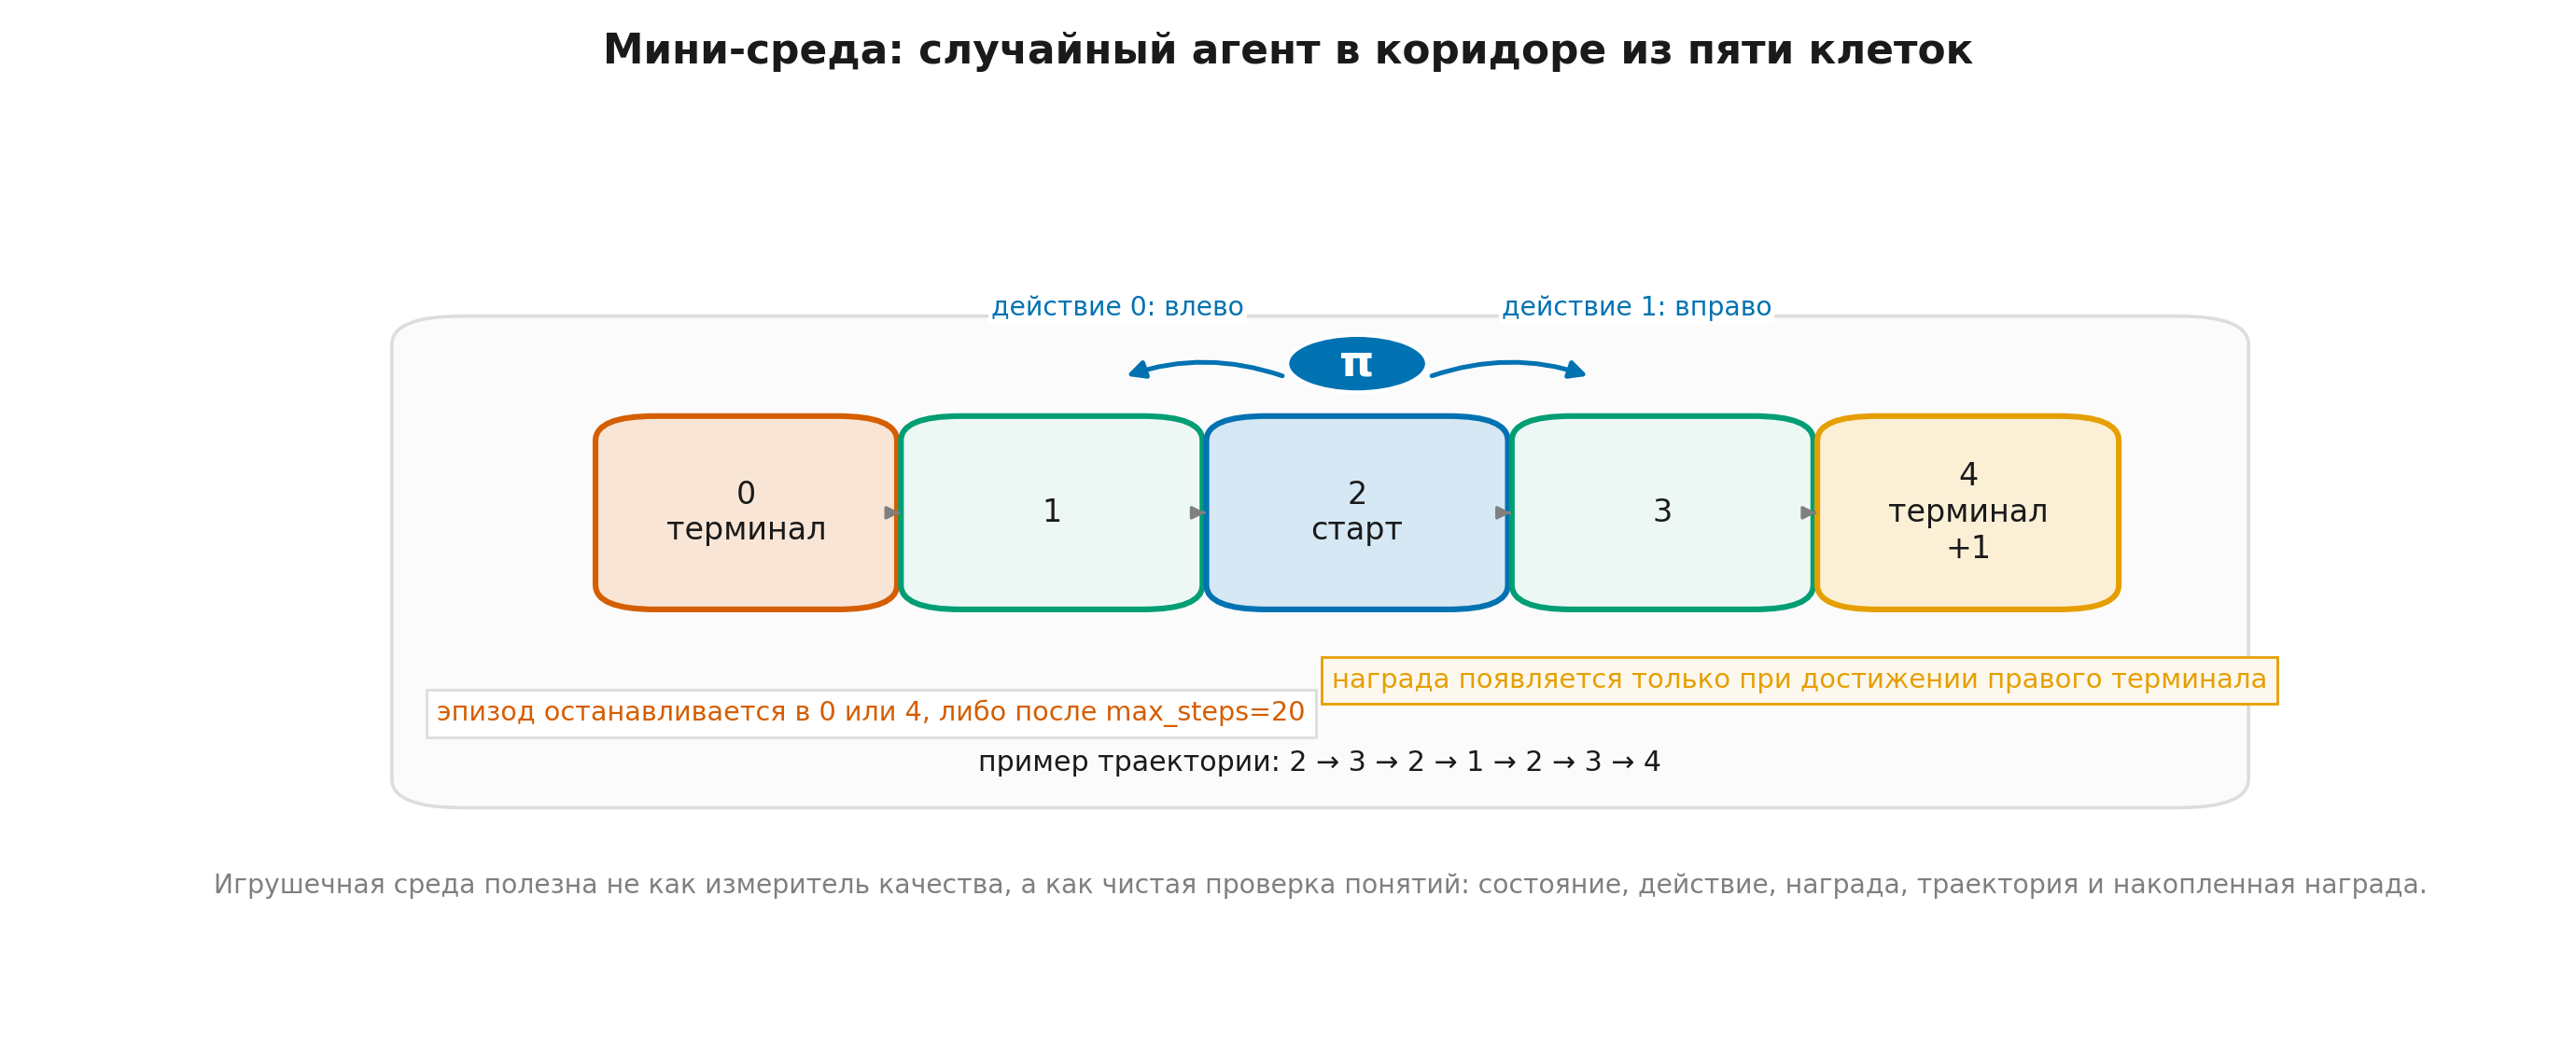
Такой коридор нарочито простой, но в нём уже есть все объекты RL: состояние — текущая клетка, действие — шаг влево или вправо, награда — событие достижения правого терминала, траектория — весь путь до остановки. Важно не то, что среда игрушечная, а то, что она позволяет проверить формулу до того, как мы перенесём ту же логику на токены, ответы и роллауты LLM.
Функция ценности состояния (state-value function) определяется как ожидаемая накопленная награда при старте из этого состояния:
Без искусственного ограничения длины для равновероятной случайной политики из центра
В коде эпизод обрывается после 20 действий. Обозначим через число действий до первого достижения состояния 4. Тогда точное значение для используемого протокола немного меньше:
Разница мала, но принцип важен: результат эксперимента нужно сравнивать с точной постановкой, реализованной в коде, а не с почти совпадающей версией с неограниченным горизонтом.
Метод Монте-Карло (Monte Carlo method) оценивает ожидание средним по независимым эпизодам:
Накопленная награда здесь является бернуллиевской случайной величиной с , поэтому стандартная ошибка при примерно равна
Значения 0.48, 0.50 или 0.52 не противоречат теории: это обычная статистическая погрешность конечной выборки. При фиксированных , seed=7 и max_steps=20 эталонный код возвращает 0.494.
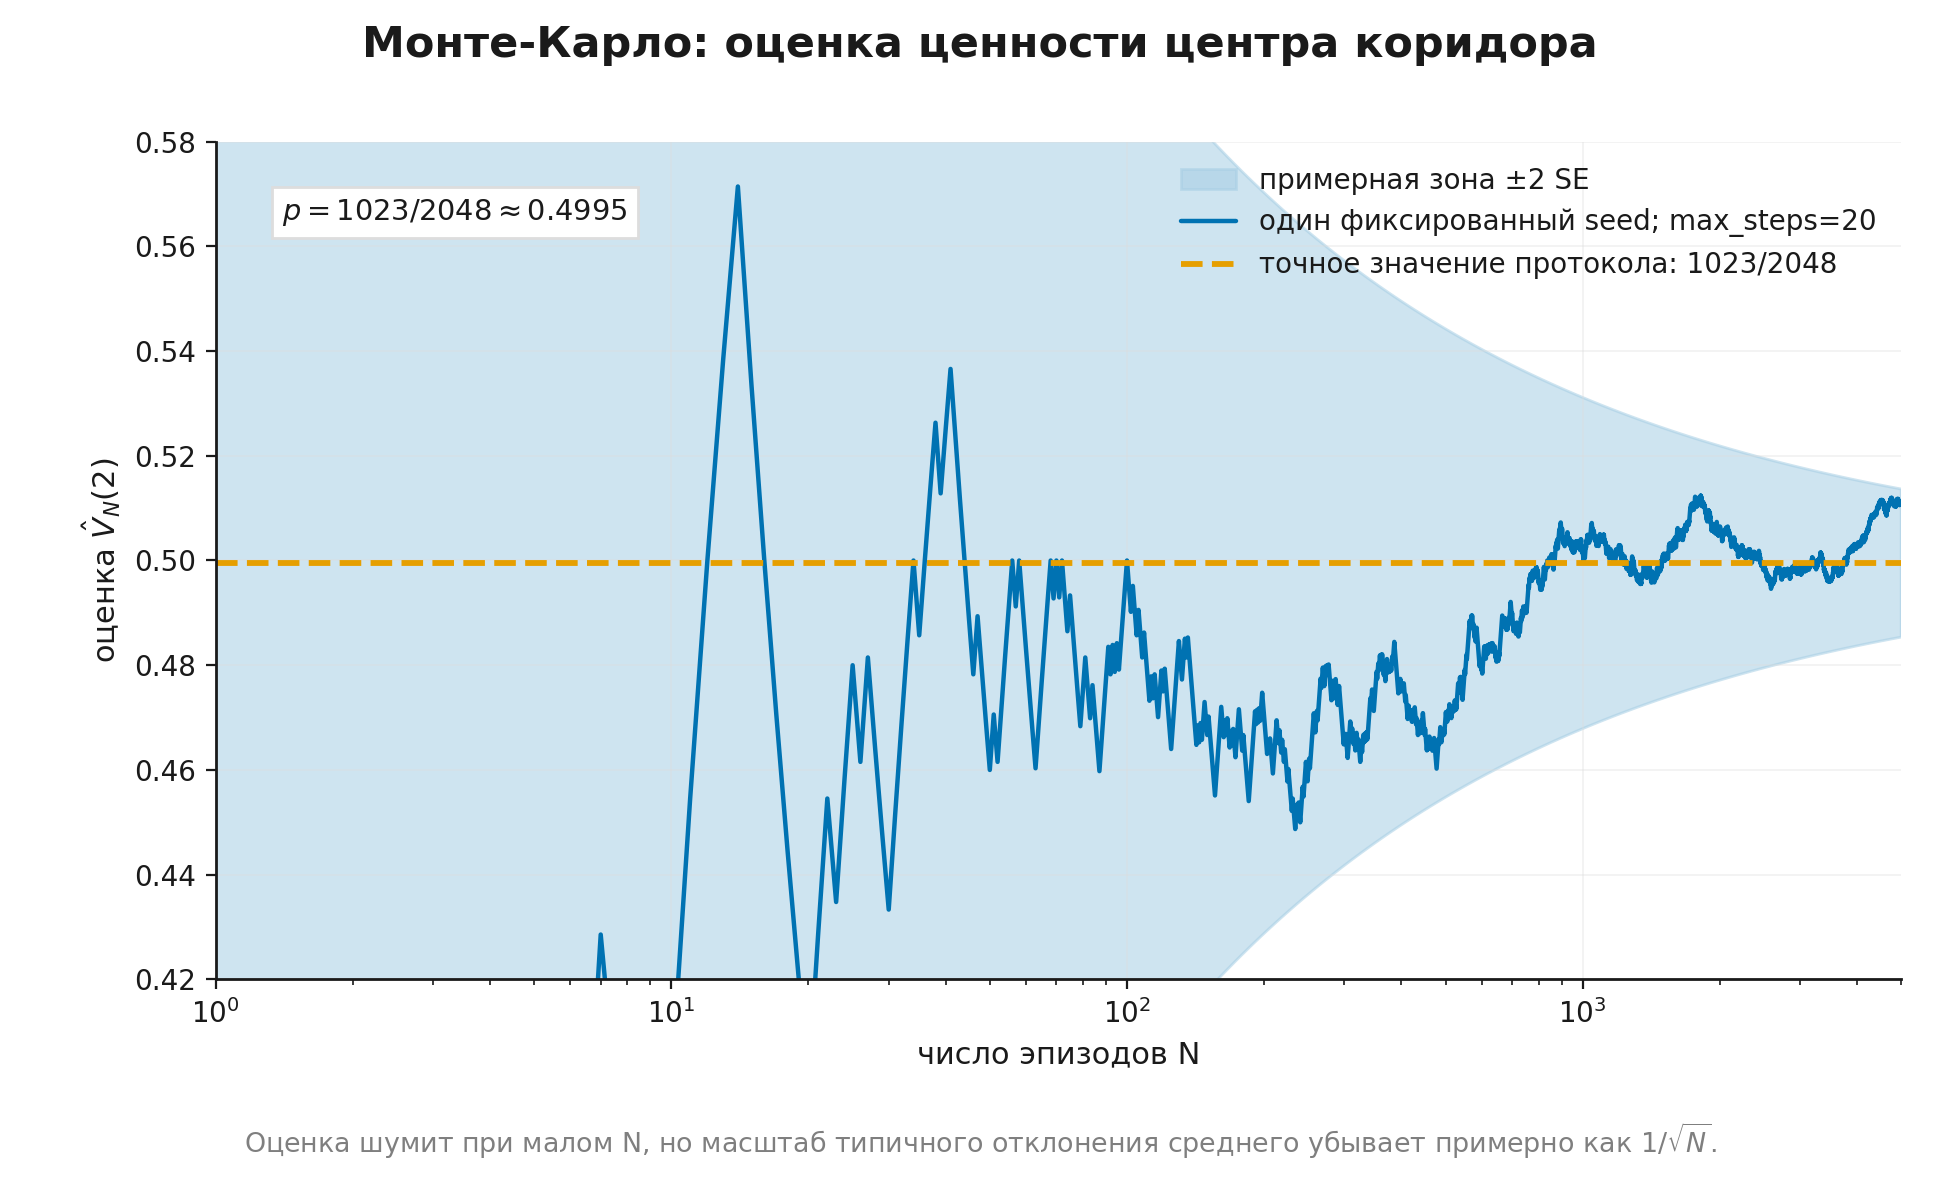
На графике не нужно искать «красивую» монотонную сходимость: отдельная конечная оценка может быть выше или ниже точного значения. Смысл в другом: при росте числа независимых эпизодов шум в среднем масштабе уменьшается примерно как , а горизонт и правило остановки должны совпадать с тем, что реализовано в коде.
Та же логика вернётся в RLVR: несколько роллаутов на один запрос дают случайную оценку качества, а размер группы влияет одновременно на дисперсию и стоимость.
Шаг 1.4.5 — Итоги и мини-словарь
После Модуля 1 у нас есть минимальная, но уже точная карта.
- Агент действует в среде, получает награды и порождает траектории.
- Политика — распределение над действиями; в токеновой абстракции LLM точно задаёт .
- Награда относится к одному переходу, а — к накопленному будущему результату.
- При онлайн-сборе политика меняет распределение следующих данных.
- Полный ответ можно моделировать как контекстный бандит, генерацию токенов — как MDP, а агента с инструментами — как POMDP или semi-MDP.
- SFT, DPO, PPO-RLHF, GRPO/RLVR и Best-of-N различаются данными, обратной связью, обновляемыми компонентами и местом оптимизации.
- Формула с температурой относится к чистому softmax; реальная схема декодирования может включать и другие преобразования.
- Более удобная награда или больший бюджет роллаутов не доказывают корректность самой цели.
Мини-словарь сокращений:
| Сокращение | Полное английское название | Роль в курсе |
|---|---|---|
| RL | reinforcement learning | обучение политики по обратной связи и ожидаемой накопленной награде |
| LLM | large language model | модель, которая может параметризовать политику |
| MDP | Markov decision process | полностью наблюдаемая последовательная модель |
| POMDP | partially observable Markov decision process | модель со скрытым состоянием и наблюдениями |
| semi-MDP | semi-Markov decision process | модель, в которой действия имеют различную длительность |
| SFT | supervised fine-tuning | имитация поведения по демонстрациям |
| RLHF | reinforcement learning from human feedback | дообучение политики по человеческим предпочтениям |
| DPO | direct preference optimization | прямая парная оптимизация по фиксированным предпочтениям |
| PPO | proximal policy optimization | оптимизация политики по данным текущей или недавней политики |
| GRPO | group relative policy optimization | PPO-подобный метод с групповой базовой оценкой без обучаемого критика |
| RLVR | reinforcement learning with verifiable rewards | режим RL с автоматически проверяемой наградой |
| KL | Kullback–Leibler divergence | мера отклонения политики от базовой |
| API | application programming interface | интерфейс программирования модели или инструмента |
Итоговая проверка: ответьте на концептуальные вопросы и выполните четыре задачи уровня A: накопленная награда, устойчивый softmax, энтропия и оценка Монте-Карло. На платформе после самостоятельной попытки доступен полный разбор каждого задания. Практика не обязательна для формального прохождения, но именно она помогает превратить определения в рабочий навык.
Дальше — Модуль 2: MDP, уравнения Беллмана, функции и , оценивание и табличные методы управления. Там мы формализуем последовательную часть карты, введённую здесь словами.
Источники и статус актуальности
Ниже приведён короткий маршрут чтения именно к утверждениям этого модуля. Полный двуязычный реестр с классом каждого утверждения, датой проверки и границами применимости находится в Module_1_Sources.md.
- Richard S. Sutton, Andrew G. Barto. Reinforcement Learning: An Introduction, 2nd ed. — основной источник для MDP, политики, накопленной награды, функций ценности и оценивания методом Монте-Карло. Это фундаментальный учебник по RL, а не описание конкретного конвейера дообучения LLM.
- John Schulman et al. Proximal Policy Optimization Algorithms — первичная работа о PPO: сбор роллаутов, несколько эпох обновления по одному пакету и клиппированная суррогатная цель. Формулировку «по данным текущей или недавней политики» в лекции следует читать с учётом повторного использования пакета и возможного отставания политики.
- Long Ouyang et al. Training language models to follow instructions with human feedback — авторское описание практического конвейера InstructGPT: SFT, модель награды по ранжированиям и PPO-RLHF. Это важный исторический пример, но не универсальная обязательная последовательность этапов.
- Rafael Rafailov et al. Direct Preference Optimization: Your Language Model is Secretly a Reward Model — источник для DPO, парной цели и связи с KL-регуляризованной постановкой предпочтений. В курсе DPO намеренно не переименовывается в классический офлайн-RL.
- Zhihong Shao et al. DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models — работа, вводящая GRPO как PPO-подобный метод с групповой относительной оценкой и без отдельного обучаемого критика. Отсутствие критика не означает отсутствия базовой оценки.
- DeepSeek-AI. DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning — авторский отчёт о крупномасштабном RL/GRPO для задач с рассуждением и о различии между R1-Zero и многостадийным R1. Результаты и интерпретации отчёта не следует принимать за полную независимую репликацию.
- Zichen Liu et al. Understanding R1-Zero-Like Training: A Critical Perspective — полезное уточнение к семейству GRPO: анализ последствий некоторых нормировок и предложение Dr. GRPO. Выводы относятся к конкретному оценивателю и целевой функции, а не дают универсальной гарантии «несмещённого RL».
Современные примеры в лекции образуют снимок на указанную дату, а не рейтинг моделей и не утверждение о единственной правильной архитектуре post-training. Для них особенно важно читать колонку «Boundary / limitation» в полном реестре источников.