Модуль 11. RL для LLM-агентов: инструменты, среда и длинные траектории
Версия материала: 2026.23
Фактический снимок: 2026-08-06
Язык: RU
Основная практика: уровень A — браузер и центральный процессор (CPU); уровень B — бесплатный Colab T4 или платный доступ к модели через провайдера
Структура: 5 уроков, 25 шагов
Ориентировочное время: 10–12 часов без факультативного запуска модели
В предыдущих модулях один ответ часто можно было рассматривать как завершённую траекторию: модель получила запрос, сгенерировала текст и один раз получила награду. У агента граница ответа перестаёт быть границей задачи. Модель вызывает инструмент, видит результат, изменяет план, снова действует и только через несколько ходов достигает или не достигает цели.
Обучение с подкреплением для LLM-агентов (agentic reinforcement learning, Agentic RL) изучает именно этот режим: политика многократно взаимодействует с внешней средой, а итог зависит не только от качества текста, но и от последовательности действий, наблюдений, побочных эффектов и правил остановки.
Практическая задача модуля:
Спроектировать обучаемого агента так, чтобы состояние, действия, маска функции потерь, награда и журнал роллаута описывали одну и ту же реальную систему.
После прохождения модуля вы сможете:
- отличать одноразовую генерацию от интерактивного эпизода;
- формулировать агентную задачу как MDP, POMDP или полумарковскую модель;
- различать скрытое состояние среды, наблюдение, историю и внешнюю память;
- отделять токены политики от сообщений пользователя и результатов инструментов;
- строить корректную маску функции потерь для многоходовой траектории;
- сохранять логарифмы вероятностей и версию политики для каждого хода;
- различать траекторную, ходовую и токеновую редукцию функции потерь;
- выводить телескопическое тождество для TD-остатков;
- объяснять, что даёт траекторная награда и чего она не сообщает о конкретном действии;
- проектировать потенциальное формирование награды без изменения оптимальной политики при выполнении условий теоремы;
- распознавать циклы, фермерство награды и ошибки проверяющей системы;
- вычислять вероятность информативной группы при бинарной награде;
- выбирать полосу сложности и размер группы вместо попытки исправить вырожденные данные скоростью обучения;
- различать траекторные, последовательностные, ветвящиеся, повторно используемые и офлайн-методы обучения агентов;
- составлять контракт воспроизводимой и безопасной среды;
- запускать синтетического агента с инструментами и обучать его на CPU.
Лекция остаётся самодостаточной: закрытый банк не требуется для чтения открытых материалов.
Практический маршрут. После лекции идут оцениваемые задания, решения, открывающиеся после попытки, и исполняемая практика. Само объяснение остаётся самодостаточным.
Урок 11.1. От ответа к взаимодействию со средой
Урок 11.1. От ответа к взаимодействию со средой
- Что меняется, когда модель начинает действовать
- Состояние, наблюдение, история и память — четыре разных объекта
- Токен, вызов инструмента и макродействие
- Успех, естественное завершение, усечение и техническая ошибка
- Минимальная формализация агентного эпизода
далее — 2 проверочных шага
Шаг 11.1.1 — Что меняется, когда модель начинает действовать
Пусть обычная LLM получает запрос и порождает ответ . В одноразовой постановке удобно считать весь ответ одним действием:
У агента после действия возникает новое наблюдение, которое зависит от состояния мира:
Здесь — состояние среды, — наблюдение, — доступная политике история или иное информационное состояние, а — действие агента. Действием может быть структурированный вызов функции, команда терминала, щелчок по интерфейсу или финальный ответ пользователю.
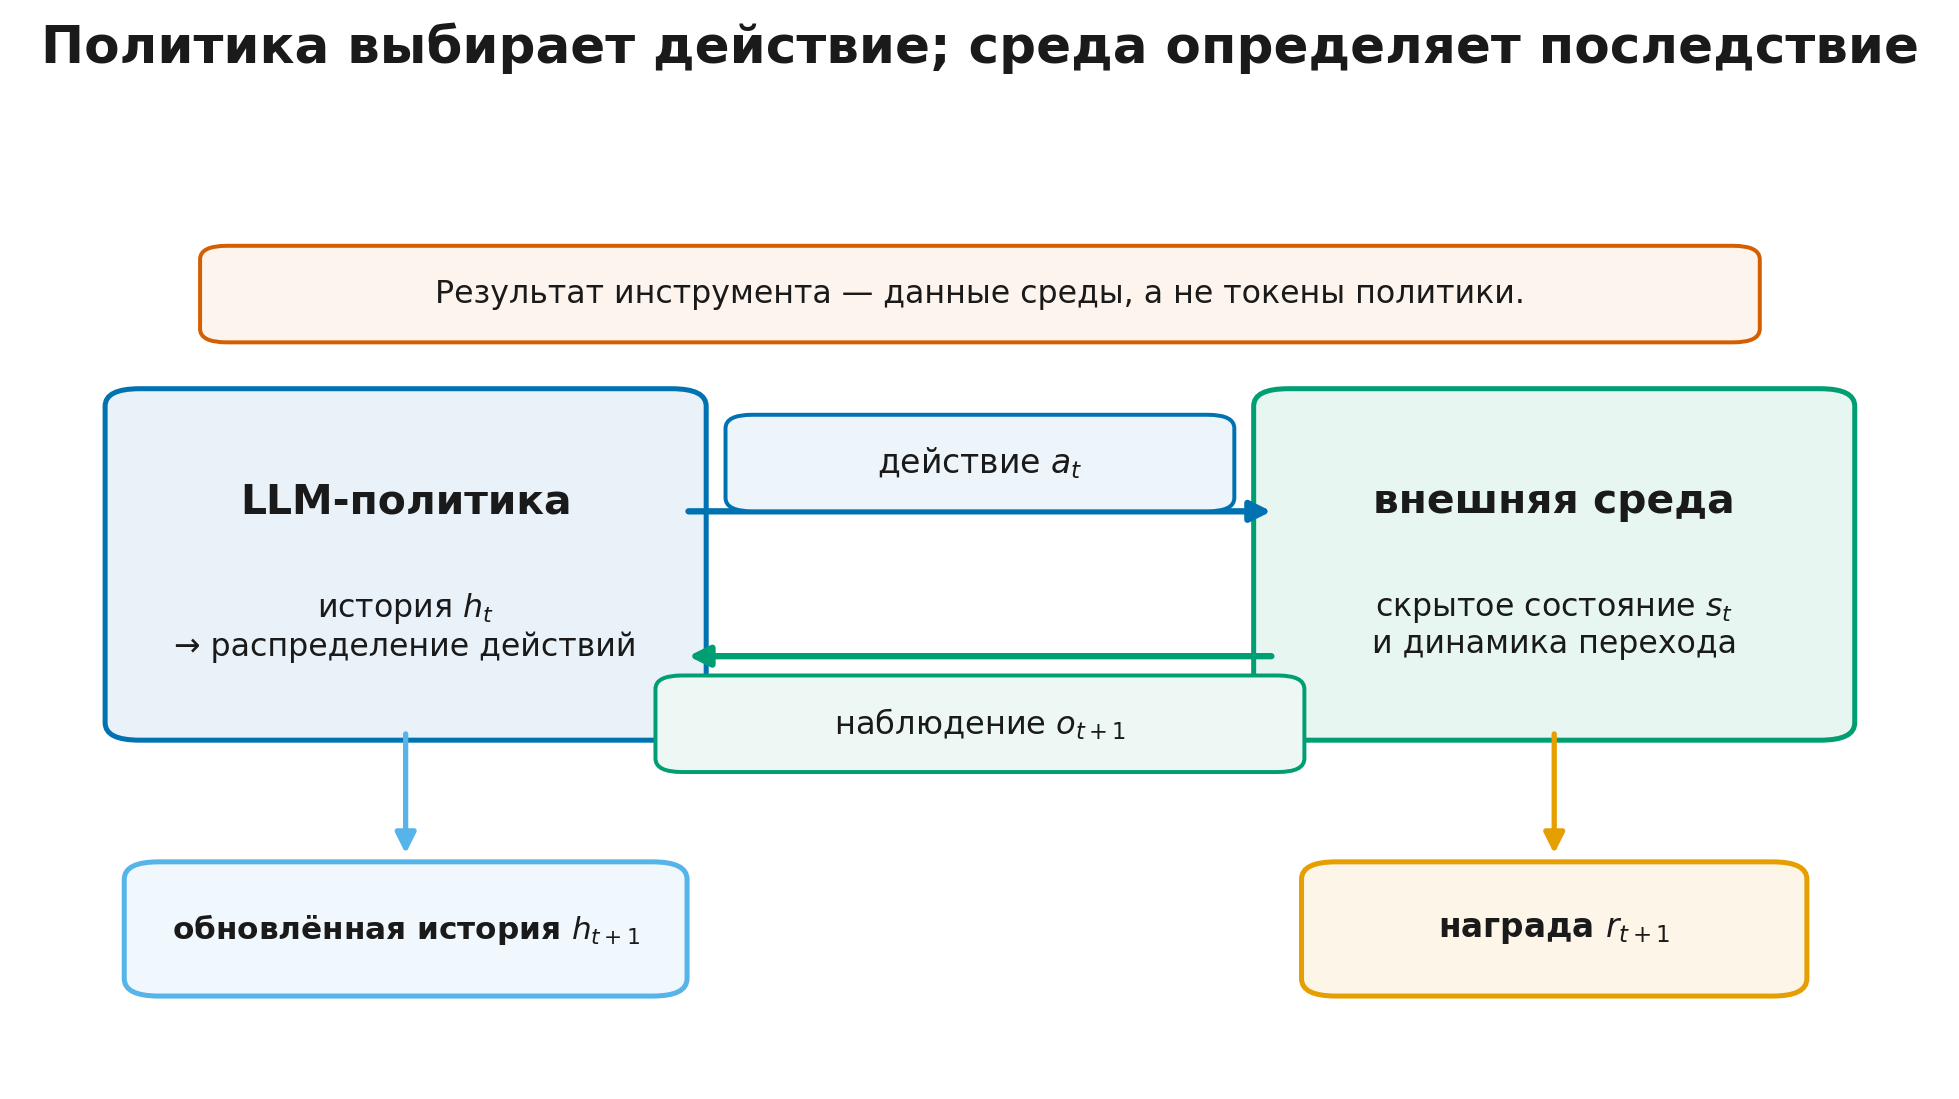
Смысл перехода прост: политика выбирает действие, но не выбирает результат инструмента. Команда pytest принадлежит агенту; текст отчёта о тестах принадлежит среде. Запрос к поисковой системе принадлежит агенту; найденные документы принадлежат среде. Это различие определяет и модель принятия решений, и маску функции потерь, и то, какие логарифмы вероятностей вообще существуют.
ReAct исторически популяризовал чередование рассуждения и действия в одном цикле. В этом курсе ReAct полезен как интерфейсная схема, но не является определением RL для агентов: агент может использовать другой формат планирования, скрытое состояние, внешнюю память или детерминированный контроллер.
Шаг 11.1.2 — Состояние, наблюдение, история и память — четыре разных объекта
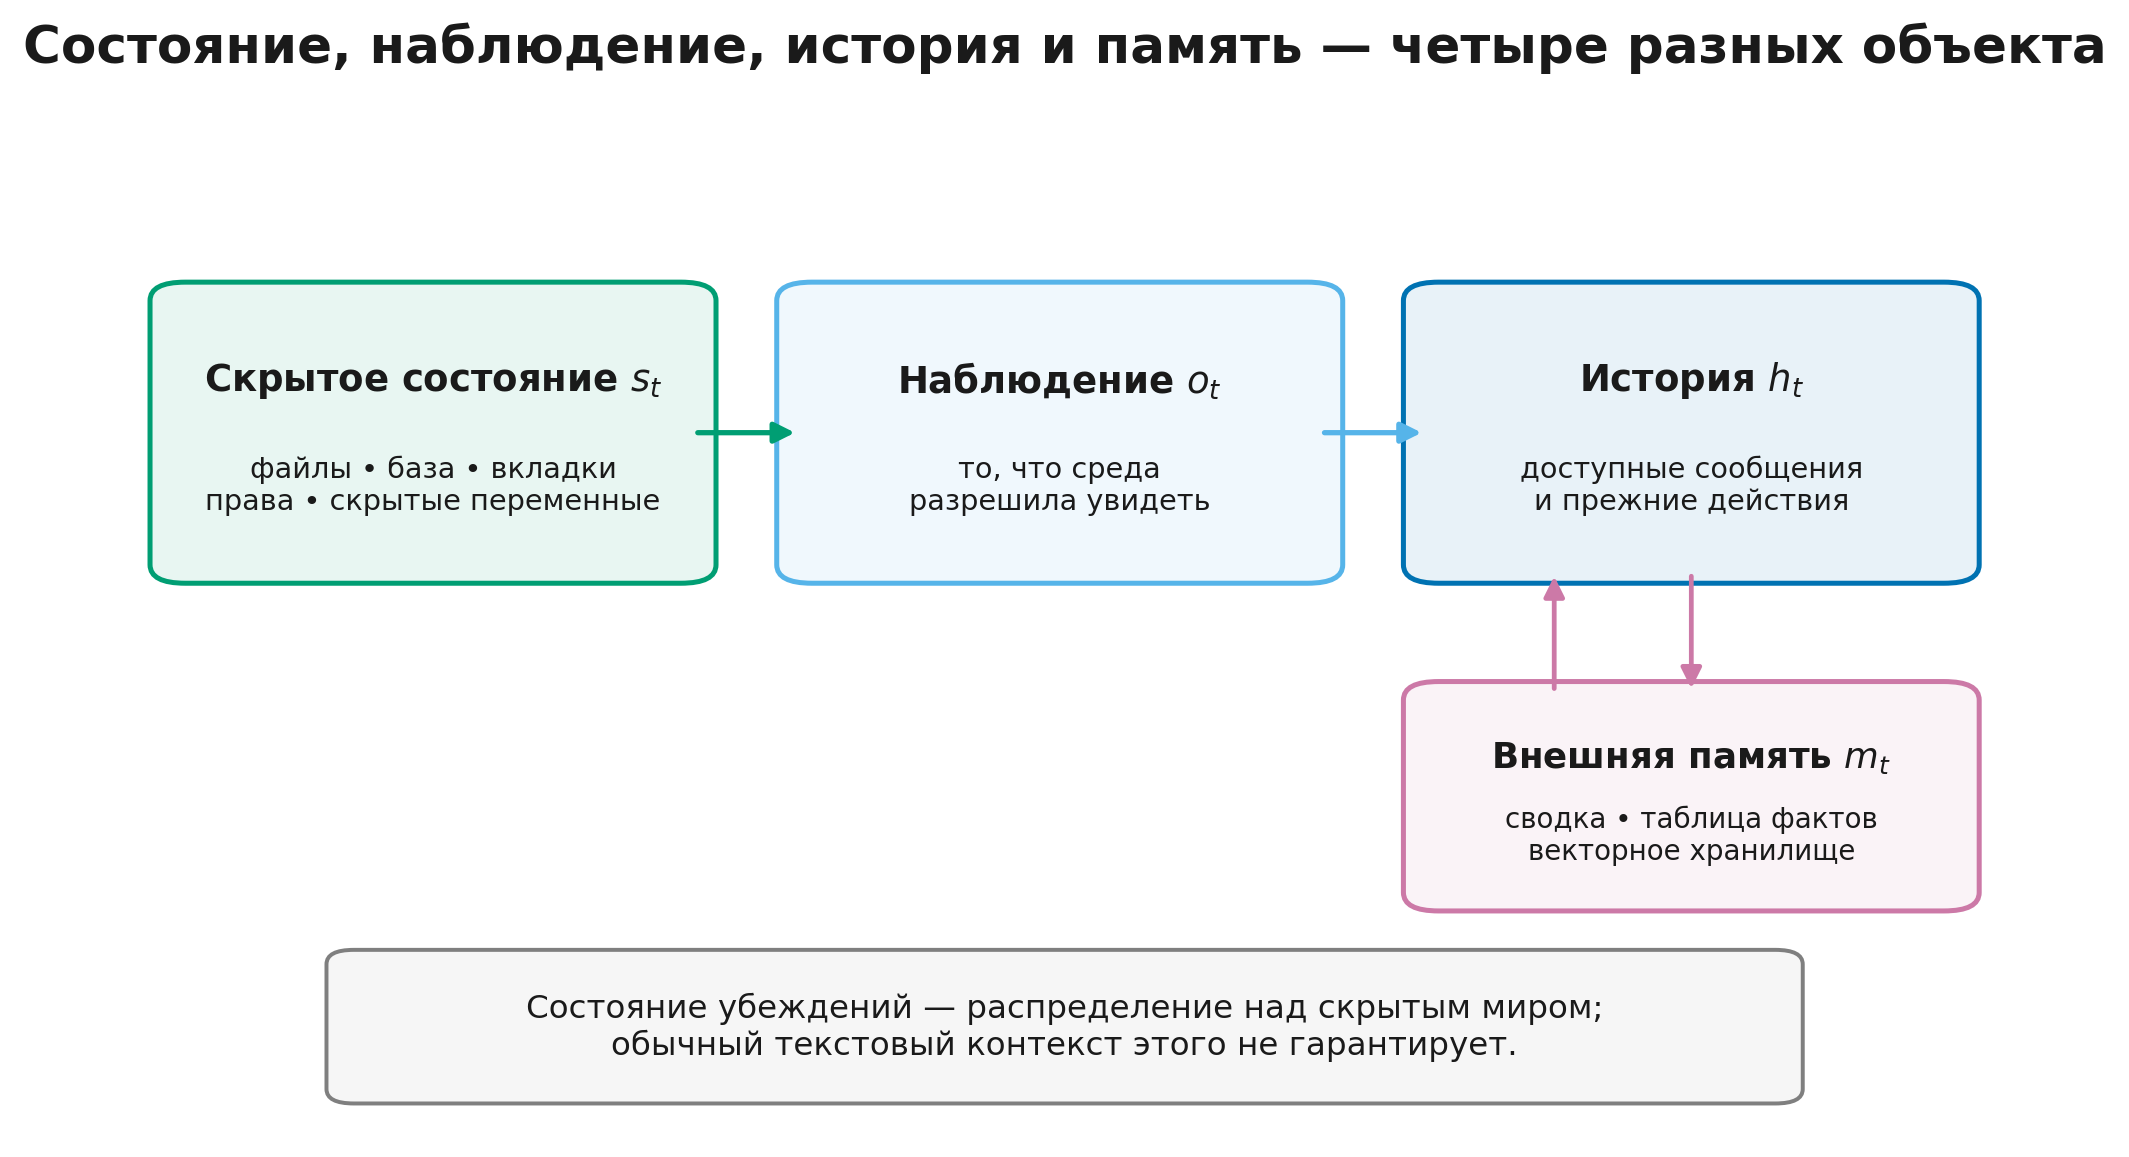
В реальной системе агент обычно не видит полное состояние . Браузер показывает только текущую страницу, терминал — вывод последней команды, программный интерфейс (application programming interface, API) — разрешённые поля ответа. Такая задача естественно описывается частично наблюдаемым марковским процессом принятия решений (partially observable Markov decision process, POMDP).
Важно не смешивать четыре уровня.
- Состояние среды . Например, содержимое файловой системы, записи базы данных, открытые вкладки, права доступа и скрытые переменные симулятора.
- Наблюдение . То, что среда вернула после действия: текст, изображение, код ошибки, фрагмент DOM или результат тестов.
- История . Последовательность доступных сообщений и действий, которую политика получает на текущем ходу.
- Внешняя память . Отдельно поддерживаемая сводка, таблица фактов, векторное хранилище или журнал, который агент может читать и изменять.
История не обязана быть точным состоянием убеждений (belief state) в байесовском смысле. Она лишь содержит информацию, которой политика фактически располагает на текущем ходу. Чтобы стать состоянием убеждений, объект должен представлять распределение над скрытыми состояниями и обновляться согласованно с моделью наблюдений. Обычный текстовый контекст этого не гарантирует. При фиксированных модели среды и начальном распределении полная история действий, наблюдений и наград сама может служить растущим марковским информационным состоянием. Состояние убеждений сжимает эту историю для предсказания, не раскрывая обязательно истинное состояние мира. Окно сообщений или сводка, утратившие часть существенной истории, такой гарантии не имеют.
Отсюда два инженерных следствия.
- Усечение или суммаризация контекста меняет информационное состояние политики и может удалить факт, необходимый для будущего решения.
- Добавление внешней памяти меняет пространство состояний агента: операция записи в память становится частью политики или отдельного контроллера, а ошибка извлечения — частью динамики системы.
Расширение: архитектуры ReAct, Plan-and-Execute и CodeAct, вызов функций (
function calling), протокол контекста модели (Model Context Protocol, MCP) и производственный цикл агента подробно разобраны в курсе Modern LLMs, Модуле 18 «Агенты и работа с инструментами» (modern_llms.module_16_agents). Здесь они используются только как интерфейсы внутри RL-постановки.
Шаг 11.1.3 — Токен, вызов инструмента и макродействие
На уровне трансформера действие по-прежнему является следующим токеном. Но среда обычно отвечает не на каждый токен, а на завершённый структурированный вызов в формате обмена данными (JavaScript Object Notation, JSON):
{"name": "read_file", "arguments": {"path": "src/main.py"}}
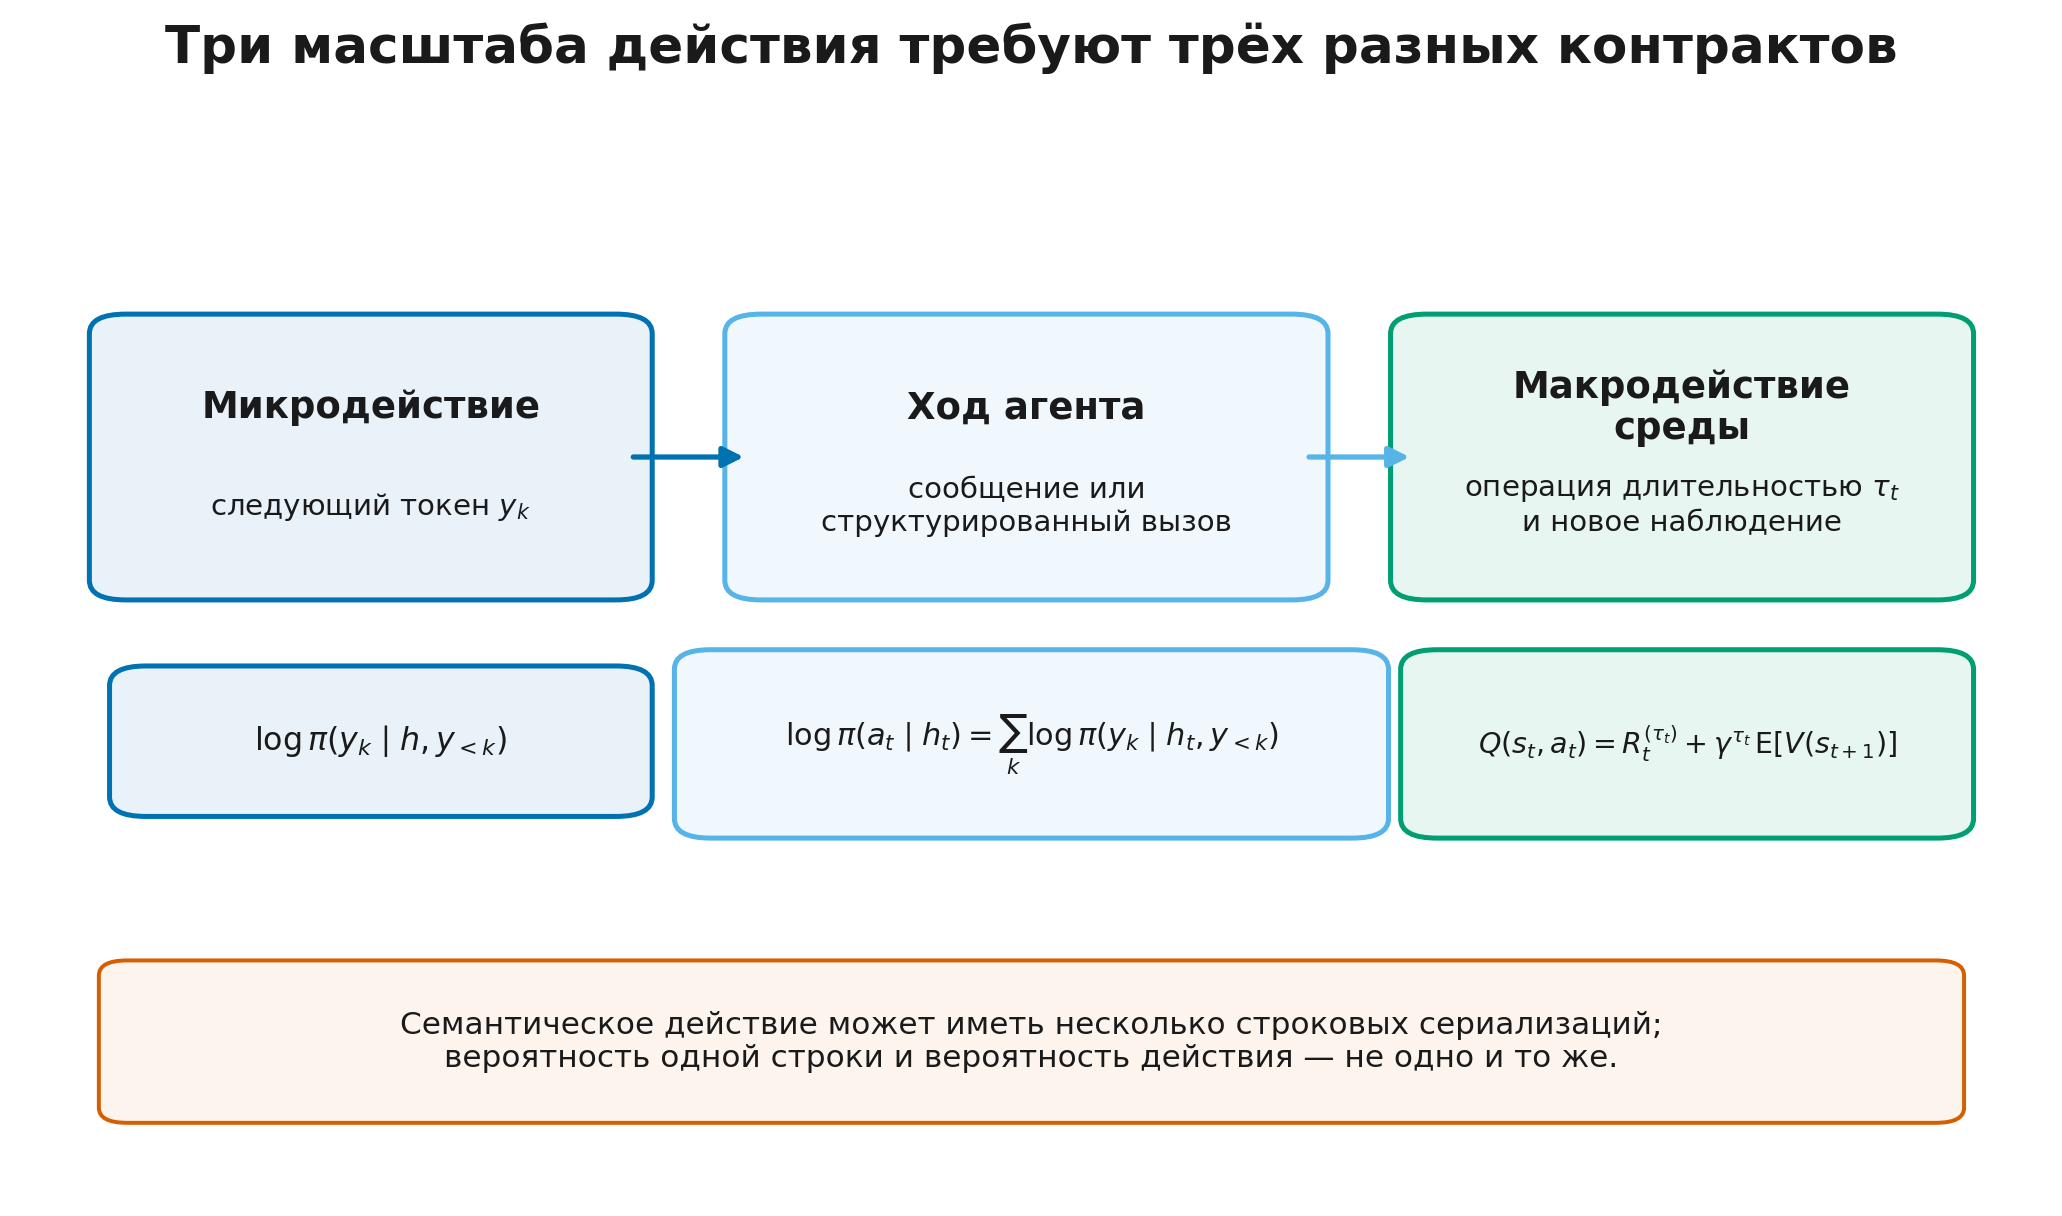
Поэтому полезно различать три масштаба.
- Микродействие: один токен .
- Ход агента: одно сообщение ассистента, возможно содержащее рассуждение, вызов инструмента или финальный ответ.
- Макродействие: завершённая операция среды, которая может занимать переменное время и иметь собственный результат.
Если длительность макродействия равна базовым временным единицам, естественная модель становится полумарковским процессом принятия решений (semi-Markov decision process, semi-MDP). Сначала нужно договориться, где именно платится награда. Если внутри макродействия возникают примитивные награды , их согласованная накопленная величина равна
Тогда продолжение дисконтируется на фактически прошедшее время:
Для LLM-агента это не только формальность. Быстрый вызов калькулятора, минутный запуск тестов и ожидание ответа пользователя имеют разную стоимость. Если цель включает задержку или цену API, продолжительность действия должна войти в награду, ограничение или явный отчёт о стоимости.
Есть ещё одна тонкость. Несколько строк могут соответствовать одному семантическому действию. Например, два JSON с разным количеством пробелов после разбора вызывают одну функцию. Вероятность семантического действия тогда равна сумме вероятностей всех строк, которые парсер отображает в это действие. На практике функции потерь почти всегда работают с фактически сгенерированной строкой, поэтому правила сериализации и парсинга входят в определение политики поведения.
Шаг 11.1.4 — Успех, естественное завершение, усечение и техническая ошибка
Многоходовая среда должна различать по крайней мере четыре причины остановки.
| Причина | Пример | Что означает для обучения |
|---|---|---|
| Успех | тесты прошли, целевое состояние достигнуто | терминальный исход с положительной наградой |
| Задачный провал | агент нарушил правило или достиг необратимого неверного состояния | терминальный исход с заданной наградой |
| Техническое усечение | исчерпан внешний лимит времени или длины, не являющийся правилом задачи | продолжение неизвестно; может требоваться бутстрэппинг или исключение |
| Сбой среды | контейнер не запустился, API недоступен, проверяющая система упала | это не обязательно ошибка политики; нужен отдельный статус |
В этом курсе, Модуле 2 «Состояние, ценность и уравнения Беллмана» (rl_llm.module_02_values_bellman), мы уже разделяли terminated и truncated. Для агента различие становится критичным: дорогой эпизод может оборваться из-за лимита инфраструктуры, хотя политика ещё могла завершить задачу.
Нельзя дать один универсальный совет «все усечённые траектории исключать» или «всем ставить нулевую награду».
- Если лимит является частью постановки, например «решить не более чем за 15 вызовов», превышение лимита — настоящий терминальный провал.
- Если лимит введён только сборщиком роллаутов, нулевая награда смешивает сложность задачи с плохим поведением. Для критика может потребоваться бутстрэппинг; для чисто траекторного метода — отдельная политика обработки или исключение из обновления.
- Если среда сломалась, запись должна иметь технический статус и не маскироваться под задачный провал.
Эта бухгалтерия входит в контракт среды, а не оставляется на усмотрение последующего анализа.
Шаг 11.1.5 — Минимальная формализация агентного эпизода
Один эпизод агента удобно записать так:
Политика видит не обязательно , а информационное состояние . Цель остаётся знакомой:
Но распределение траекторий теперь включает внешнюю динамику и наблюдения:
Формула показывает, что агент не контролирует всё распределение. Градиент по проходит через вероятности действий политики; переходы и наблюдения определяют, какие будущие состояния будут достигнуты.
Для полного воспроизводимого описания одной фразы «использовали RL для агента» недостаточно. Нужно определить:
- что считается действием;
- какой объект видит политика;
- какие сообщения создаёт среда;
- как завершается эпизод;
- где возникает награда;
- какие действия необратимы;
- какая часть траектории входит в функцию потерь.
Следующий урок посвящён последнему пункту.
Урок 11.2. Траектория, маска и функция потерь
Урок 11.2. Траектория, маска и функция потерь
- Кто породил каждый токен
- Маска обучаемых токенов и разбавление сигнала
- Логарифмы вероятностей нужно сохранять на каждом ходе
- Траекторная, ходовая и токеновая редукция
- Контракт роллаута многоходового агента
далее — 6 проверочных шагов
Шаг 11.2.1 — Кто породил каждый токен
Транскрипт агента может выглядеть как единая последовательность:
system → user → assistant(tool call) → tool → assistant → tool → assistant(final)
Но с точки зрения политики эта лента неоднородна.
- Сегменты
assistantбыли сгенерированы политикой поведения. tool,userиsystemбыли вставлены средой или шаблоном.- Структурированный JSON вызова инструмента является действием политики, если его действительно породила модель.
- Служебные токены, добавленные шаблоном после генерации, не следует автоматически считать действиями.
Главный критерий не роль сообщения как строка, а происхождение токена:
В функцию потерь политики входит токен, для которого известна вероятность его выбора политикой поведения в том состоянии, где он был выбран.
Если JSON создаёт детерминированный контроллер из скрытой команды модели, политика в RL-смысле включает только скрытую команду. Если контроллер исправляет или переписывает действие, это преобразование становится частью среды или составной политики и должно быть записано отдельно.
Если система использует закрытые или недоступные внутренние токены рассуждения, их нельзя задним числом включить в RL-обновление без записанных идентификаторов и логарифмов вероятностей.
Шаг 11.2.2 — Маска обучаемых токенов и разбавление сигнала
Пусть показывает, является ли токен действием политики. Для простого траекторного преимущества функция потерь REINFORCE-подобного вида записывается как
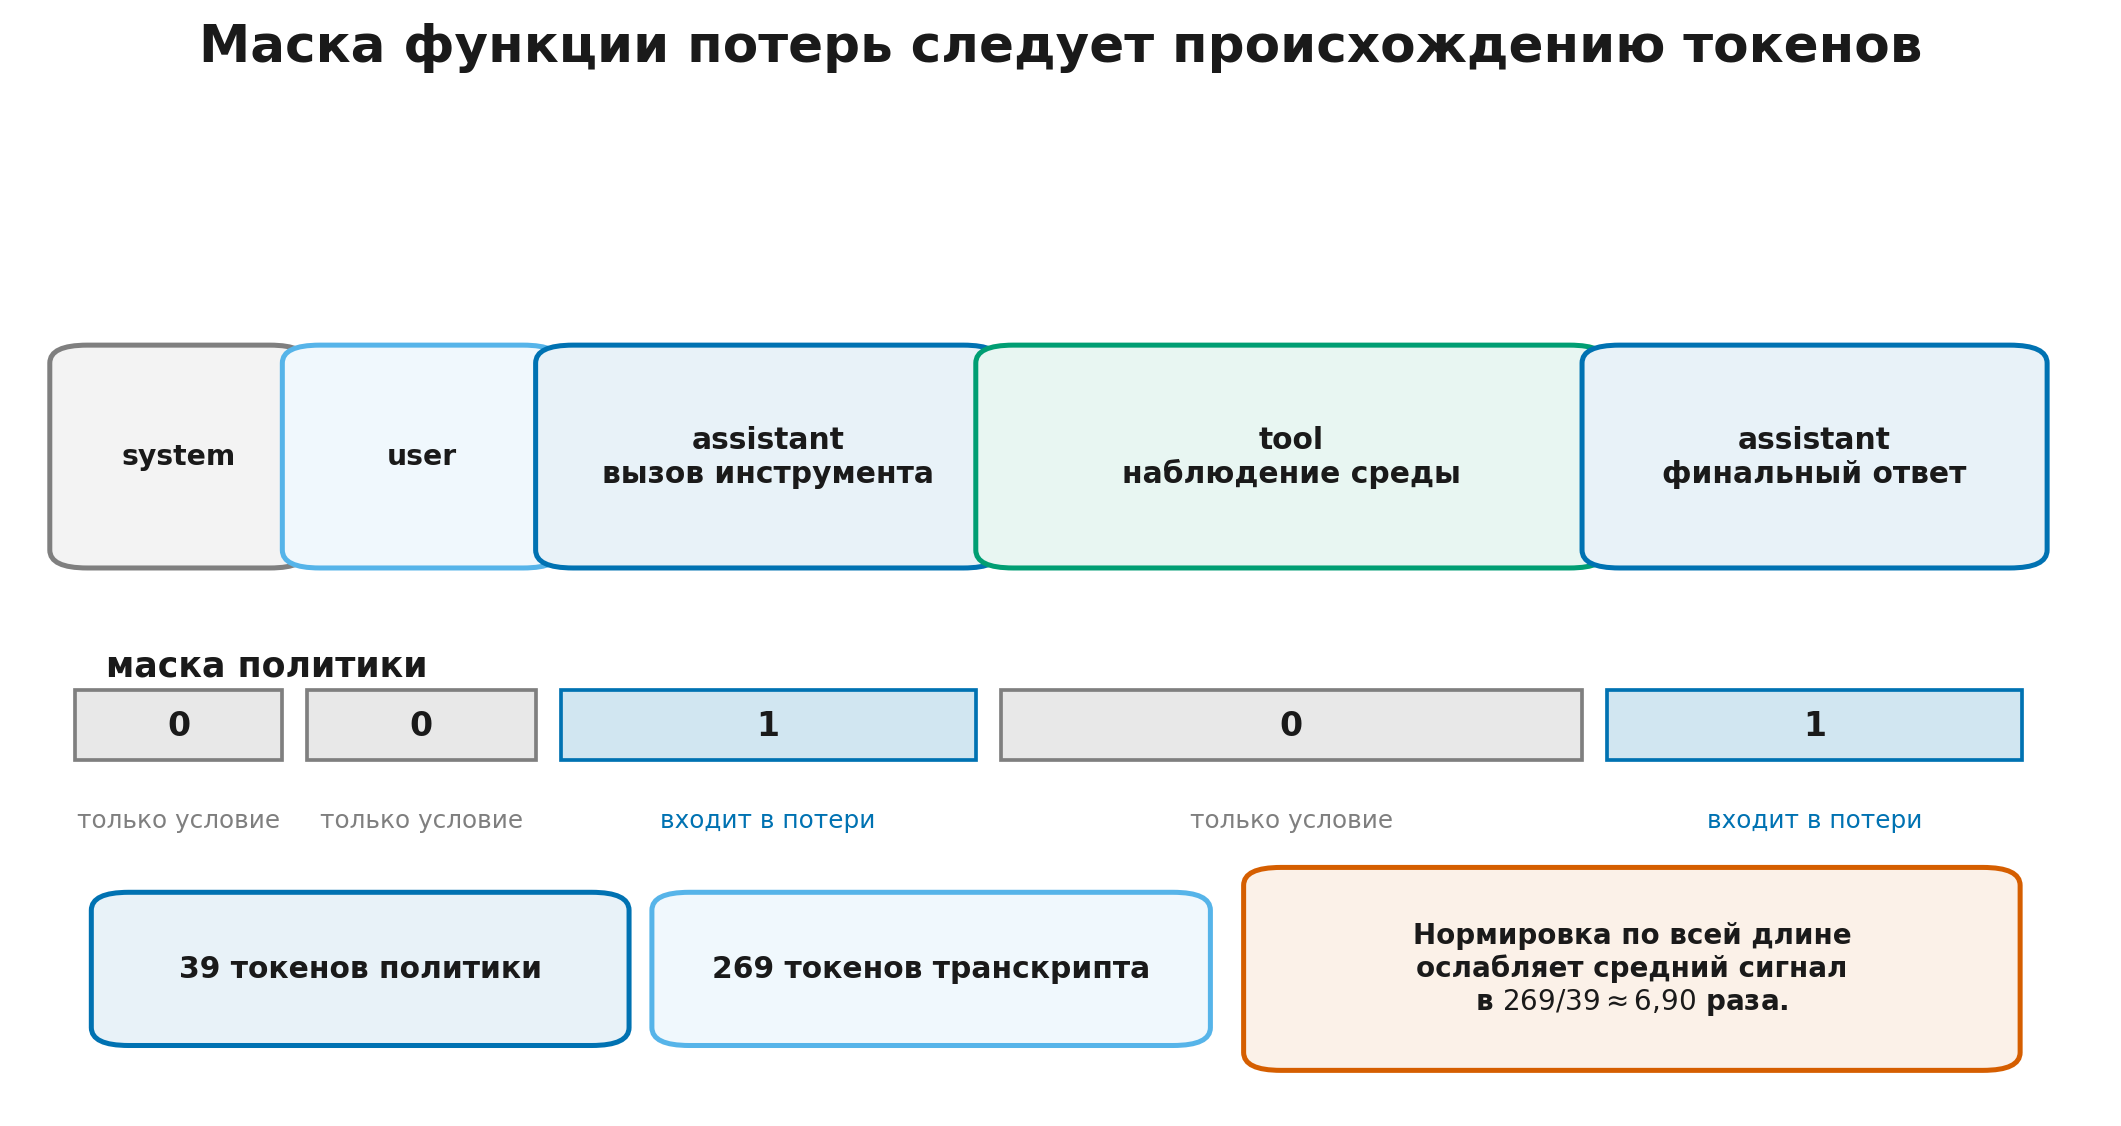
Маска решает две разные задачи.
- Не создаёт градиент на наблюдениях, которых политика не выбирала.
- Определяет знаменатель нормировки.
Пусть политика породила 40 токенов, а среда добавила 290. Если делить сумму на полную длину 330, вклад каждого токена политики уменьшается в
раза по сравнению с нормировкой по токенам политики. Это не просто постоянная: многословные наблюдения получают меньший вес обновления, хотя длину ответа инструмента политика часто не контролирует.
Исключение наблюдений из функции потерь не означает, что их нельзя использовать для обучения модели мира. Такое обучение возможно, но это отдельная цель с отдельной интерпретацией. Смешивать её с градиентом политики через случайно немаскированную ленту нельзя.
Шаг 11.2.3 — Логарифмы вероятностей нужно сохранять на каждом ходе
В одноразовой генерации движок возвращает токены и их логарифмы вероятностей за один вызов. Роллаут агента состоит из серии вызовов, между которыми контекст меняется из-за наблюдений среды.
Для каждого токена политики нужно знать:
- идентификатор токена;
- позицию и номер хода;
- логарифм вероятности под политикой поведения;
- версию политики поведения;
- параметры декодирования;
- точный контекст или достаточный способ его воспроизвести.
Логарифм вероятности одного хода равен сумме токеновых логарифмов:
Если обучение использует новую политику , последовательностное отношение вероятностей хода равно
Здесь легко ошибиться дважды.
- Пересчитать старые логарифмы вероятностей другой версией токенизатора, шаблона или политики.
- Использовать базовый softmax вместо фактической политики поведения после температуры, top-p, масок и других преобразований.
В этом курсе, Модуле 6 «LLM как политика: токены, логарифмы вероятностей и KL» (rl_llm.module_06_llm_policy), этот контракт уже сформулирован для одного ответа. В агентной системе тот же контракт должен выполняться на каждом ходе.
Шаг 11.2.4 — Траекторная, ходовая и токеновая редукция
Даже при одинаковых токеновых членах функции потерь итоговый градиент зависит от порядка усреднения.
Токеновая редукция:
Траекторная редукция:
Ходовая редукция:
Три цели отвечают на разные вопросы.
- Токеновая редукция сильнее взвешивает длинные ответы.
- Траекторная даёт одинаковый общий вес каждому эпизоду.
- Ходовая даёт одинаковый вес каждому ходу, но длинные эпизоды всё ещё содержат больше ходов.
Нельзя назвать одну редукцию безусловно правильной. Нужно назвать единицу статистического примера и проверить, не создаёт ли выбранный знаменатель нежелательный стимул к длине, краткости или частым вызовам инструментов.
Шаг 11.2.5 — Контракт роллаута многоходового агента
Минимальная запись роллаута должна позволять ответить на пять вопросов:
- что сделала политика;
- что вернула среда;
- какой версией политики было выбрано действие;
- почему эпизод остановился;
- можно ли воспроизвести исходное состояние и проверку.
Практический контракт включает:
task_id
trajectory_id
environment_id
environment_version
initial_state_id / reset_seed
policy_version per turn
token_ids
policy_mask
behavior_logprobs
turn_ids
action_text and parsed_action
observations
reward_components
terminated / truncated / infra_error
stop_reason
wall_clock_time / tool_latency
verifier_version
Текстового транскрипта недостаточно. Два одинаково выглядящих сообщения могут иметь разную токенизацию; два одинаковых вызова могут быть выполнены в разных состояниях базы; одинаковая награда может быть получена разными версиями проверяющей системы.
Полезная проверка перед обучением — заново собрать по журналу:
- число обучаемых токенов;
- логарифм вероятности каждого хода;
- причину остановки;
- итоговую награду;
- контрольную сумму снимка среды.
Если эти величины нельзя восстановить, роллаут пригоден для демонстрации, но не обязательно для воспроизводимого RL.
Урок 11.3. Распределение заслуги на длинном горизонте
Урок 11.3. Распределение заслуги на длинном горизонте
- Что даёт одна итоговая награда
- Накопленные награды и TD-остатки по ходам
- Процессная обратная связь и ретроспективный критик
- Потенциальное формирование награды
- Проверять состояние мира, а не убедительность текста
далее — 3 проверочных шага
Шаг 11.3.1 — Что даёт одна итоговая награда
Пусть эпизод получает только итоговую награду . Простейший оцениватель градиента имеет вид
При стандартных условиях это не обязательно смещённый оцениватель. Одна и та же накопленная награда действительно может умножать все действия траектории. Проблема в другом.
- Высокая дисперсия. Случайный ранний выбор, удачный ответ инструмента и поздняя ошибка объединяются в одно число.
- Грубое распределение заслуги. Все действия успешной траектории поощряются одинаковым знаком, включая лишние и потенциально вредные.
- Длинный горизонт. Число возможных причин исхода растёт, а число эпизодов обычно ограничено стоимостью среды.
Опорный уровень уменьшает дисперсию, но сам по себе не сообщает, какой ход изменил вероятность успеха. Групповое относительное преимущество сравнивает траектории одного запроса, но остаётся траекторным сигналом, если один коэффициент раздаётся всем ходам.
Значит, итоговая награда — корректная отправная точка, а не полная теория распределения заслуги.
Шаг 11.3.2 — Накопленные награды и TD-остатки по ходам
Если среда или критик дают информацию на границах ходов, можно использовать объекты из Модуля 2 «Состояние, ценность и уравнения Беллмана» (rl_llm.module_02_values_bellman) и Модуля 4 «Градиенты политики: от REINFORCE к PPO» (rl_llm.module_04_policy_gradients).
Накопленная награда от хода :
Одношаговый остаток обучения по временным различиям (temporal-difference residual, TD-остаток):
При отсутствии преждевременного обнуления ценности выполняется телескопическое тождество:
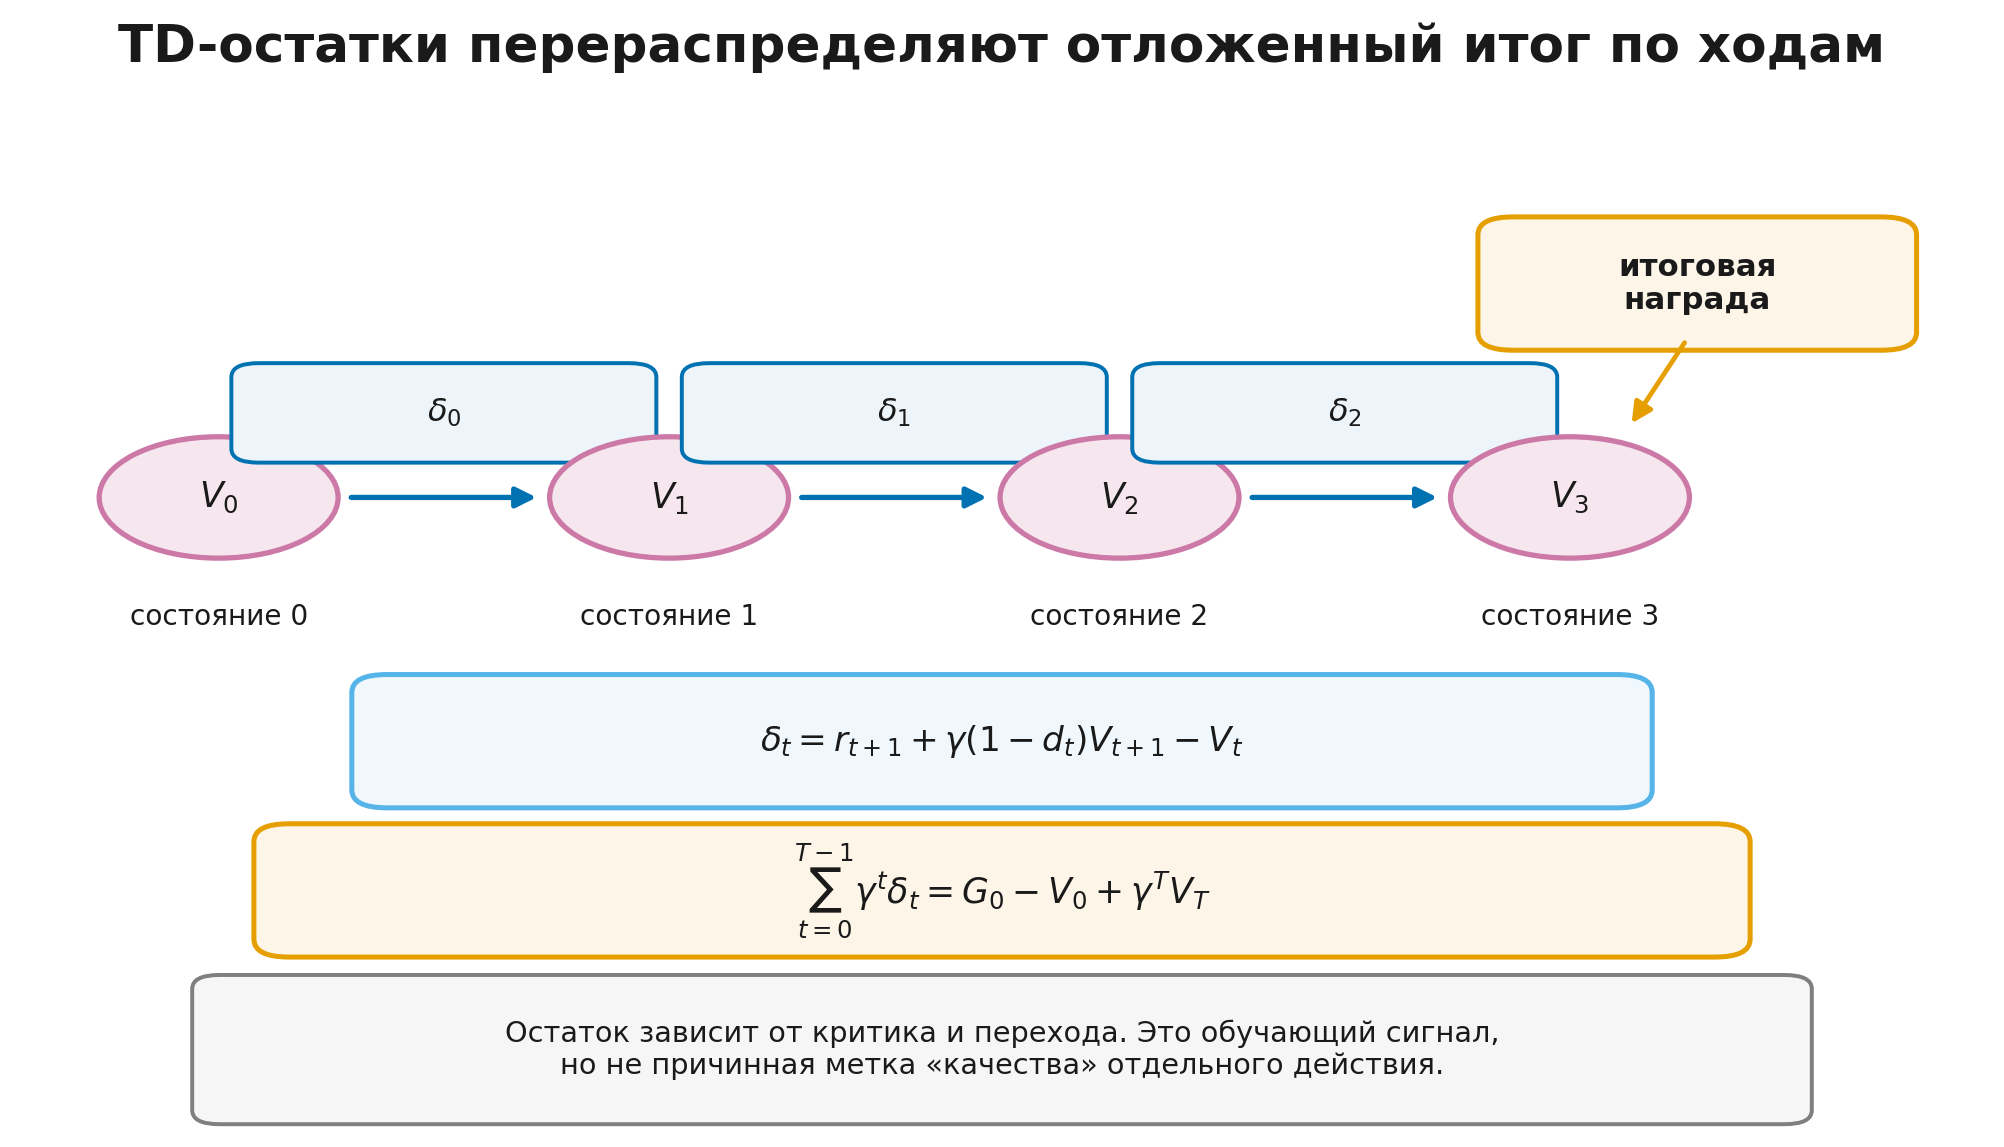
Вывод короткий: подставьте и заметите, что каждый промежуточный член сокращается со следующим .
Это тождество полезно как проверка кода, но не превращает в причинный диагноз действия. Малый остаток может возникнуть из-за:
- ошибки критика;
- шумного наблюдения;
- неудачи инструмента;
- скрытого состояния;
- действия, полезность которого проявится позже.
TD-сигнал говорит о несогласованности награды и последовательных оценок ценности, а не автоматически о виновности конкретного хода.
Шаг 11.3.3 — Процессная обратная связь и ретроспективный критик
Есть три распространённых способа получить более плотный сигнал.
- Проверяемые промежуточные события. Например, файл создан, тестовый модуль найден, корректный ключ подобран. Такие события должны проверяться по состоянию мира.
- Модель награды процесса (
process reward model, PRM). Она оценивает промежуточный префикс, но её значение зависит от определения метки и обучающего распределения. - Ретроспективный критик (
hindsight critic). После завершения эпизода он анализирует траекторию и назначает оценку ходам или переходам.
Плотность не равна истинности. Ретроспективная модель может убедительно объяснить исход, но ошибиться в причинной связи. PRM может перенять стилевые признаки. Награду за проверяемое событие иногда можно многократно получать в цикле, не приближаясь к цели.
Для каждого промежуточного сигнала полезно спросить:
- какой объект он оценивает;
- кто создаёт метку;
- можно ли проверить её независимо;
- зависит ли оценка от текущей политики продолжения;
- не получает ли агент награду повторно за одно состояние;
- меняет ли сигнал исходную оптимальную политику.
Последний вопрос приводит к потенциальному формированию награды.
Шаг 11.3.4 — Потенциальное формирование награды
Наивная награда « за каждый полезно выглядящий шаг» часто создаёт цикл: агент повторяет действие, которое платит чаще, вместо завершения задачи.
Безопаснее начать с потенциального формирования награды (potential-based reward shaping). Для функции потенциала добавляется
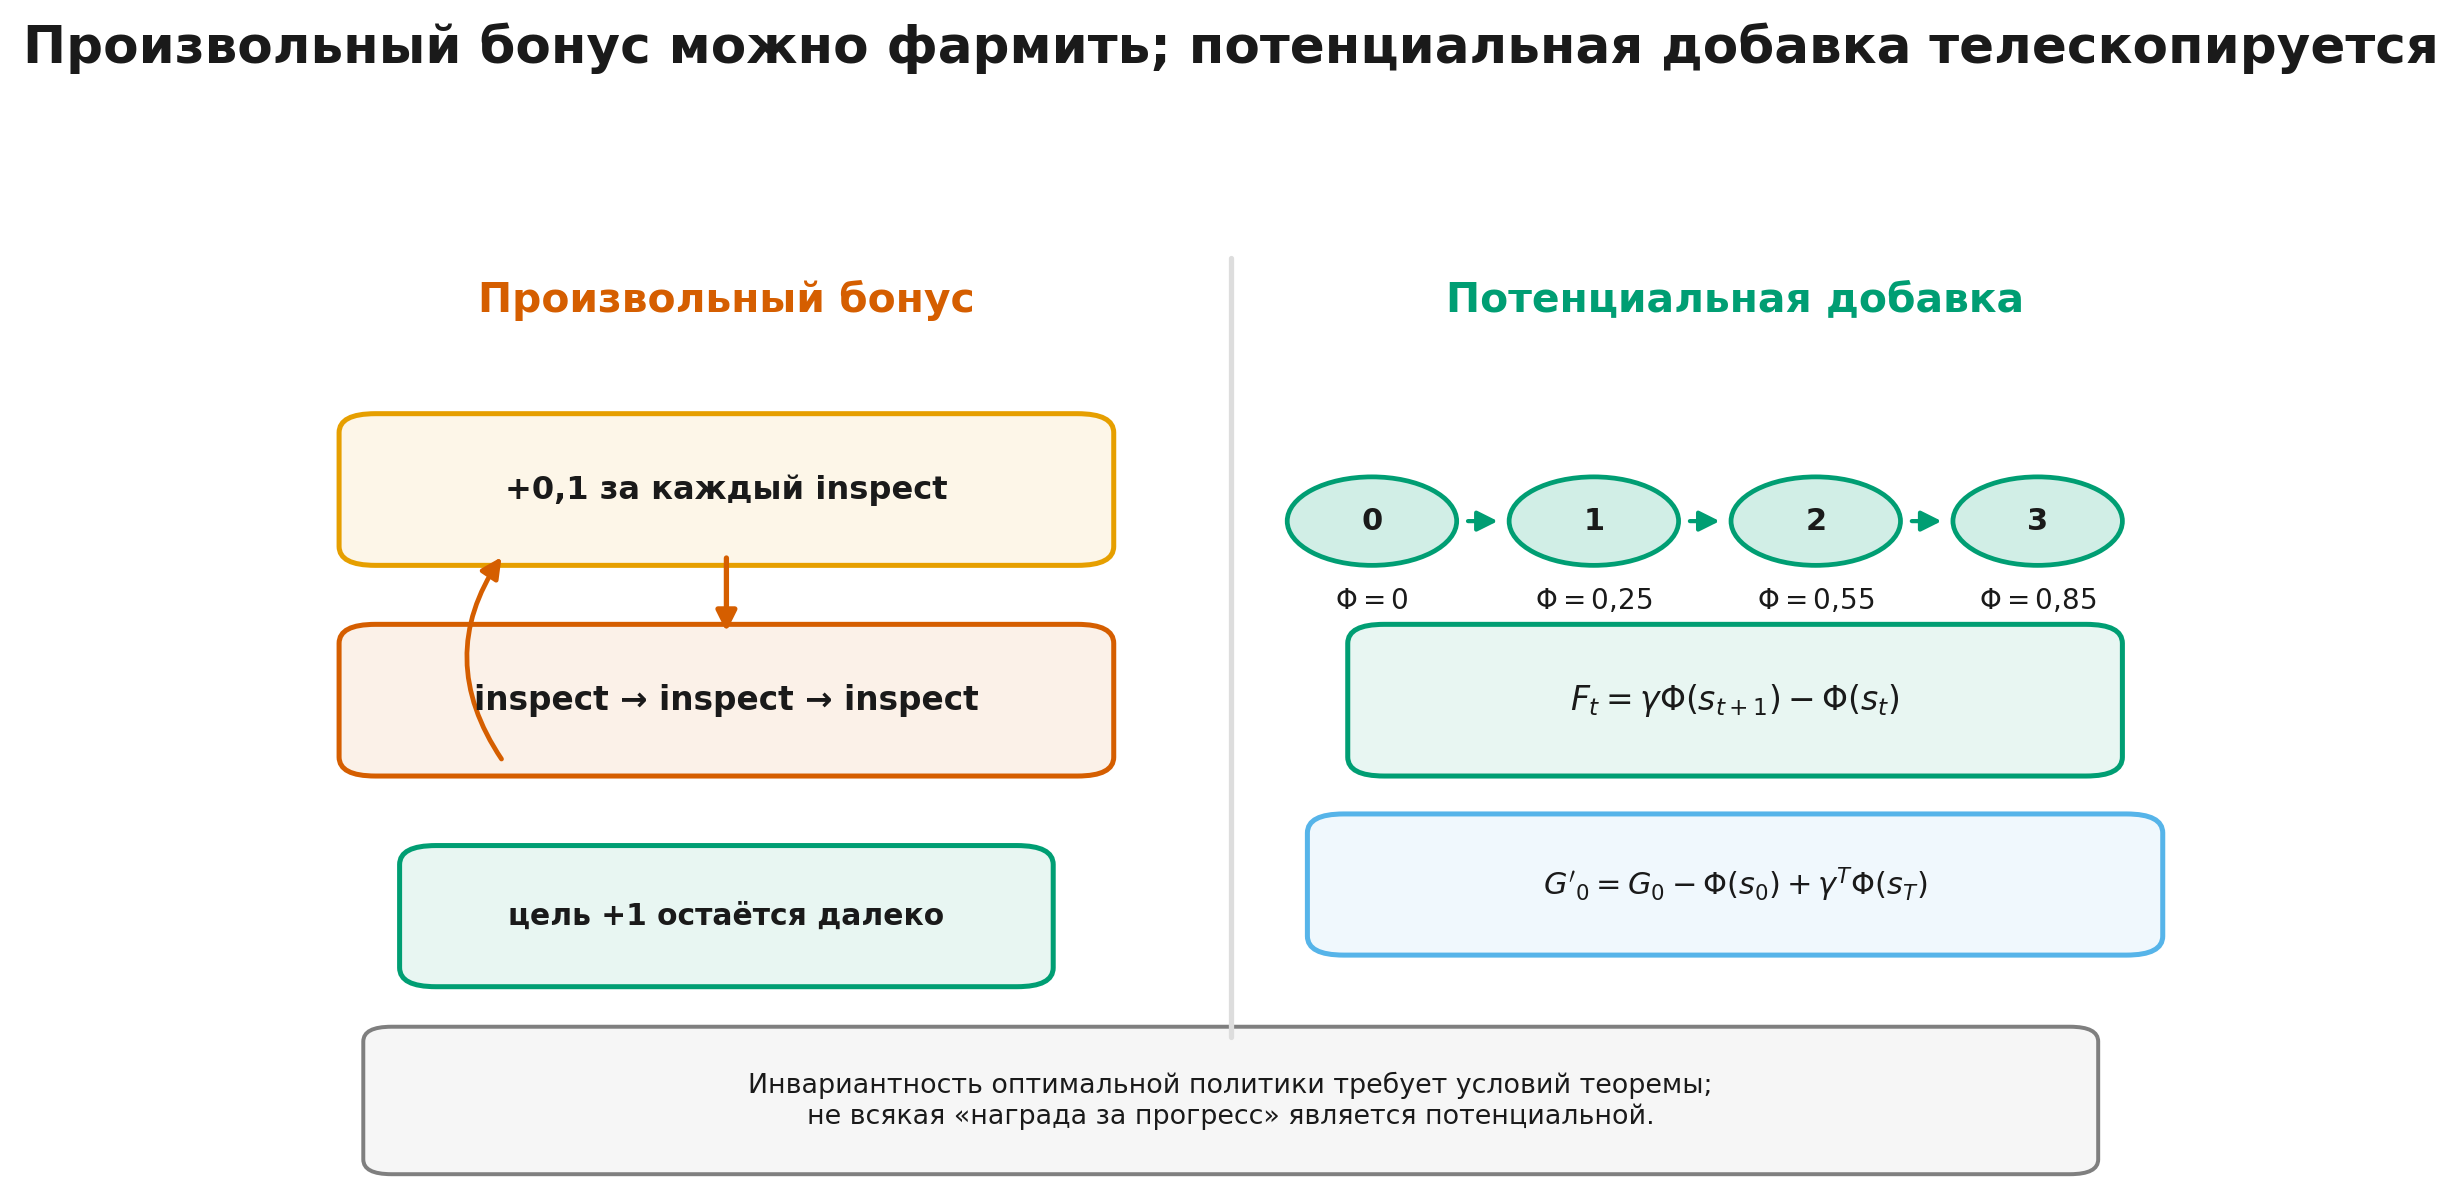
Дисконтированная сумма добавок телескопирует:
В классической постановке это сохраняет множество оптимальных политик. Но рядом с результатом нужны условия.
- Формирующая добавка имеет именно потенциальный вид с тем же .
- Состояние, от которого зависит , входит в марковскую постановку.
- Граничный член обработан согласованно: например, терминальные потенциалы заданы правильно или рассматривается соответствующая продолжающаяся задача.
- Функция награды и правило остановки не меняются скрытым образом.
- При частичной наблюдаемости потенциал по наблюдению может не соответствовать потенциалу истинного состояния и требует отдельного анализа.
Потенциальное формирование награды сохраняет оптимум при условиях теоремы, но не гарантирует ускорения обучения, хорошей аппроксимации функции ценности или устойчивости нейросетевой оптимизации.
Шаг 11.3.5 — Проверять состояние мира, а не убедительность текста
Для агента финальная награда должна по возможности зависеть от результата во внешней среде.
- Для программирования: изменённый репозиторий и тесты.
- Для браузера: состояние базы, корзины или опубликованной записи.
- Для терминала: содержимое файлов, код возврата и инварианты системы.
- Для диалога с инструментами: выполненное действие и соблюдение политики, а не только вежливый финальный ответ.
Фраза «готово» не доказывает выполнение задачи. И наоборот, неидеально сформулированный финальный текст может сопровождать правильное состояние мира.
Практический проверяющий контур должен возвращать не только одно число, но и диагностику:
success
world_state_checks
format_checks
safety_checks
invalid_actions
resource_usage
infra_status
Полезный частичный кредит строится из монотонных или однократно оплачиваемых изменений состояния. Например, первый успешный вход в систему можно вознаградить один раз; каждый повторный вызов login — нет. Даже здесь нужно проверять, не изменяет ли частичный кредит приоритеты задачи.
Главный принцип урока:
Награда должна описывать желаемое изменение мира, а текст агента — быть лишь одним из способов его вызвать.
Урок 11.4. Исследование и оптимизация агентной политики
Урок 11.4. Исследование и оптимизация агентной политики
- Когда группа траекторий ничего не сообщает
- Полоса сложности и динамический отбор задач
- Токеновое и последовательностное отношение вероятностей
- Ветвление после инструмента и ARPO
- Карта современных методов RL для агентов
далее — 3 проверочных шага
Шаг 11.4.1 — Когда группа траекторий ничего не сообщает
Пусть для одного запроса генерируется независимых траекторий, а награда бинарна. Если вероятность успеха одной траектории равна , группа содержит относительный сигнал только тогда, когда в ней есть и успех, и провал.
Вероятность вырожденной группы:
Вероятность информативной:
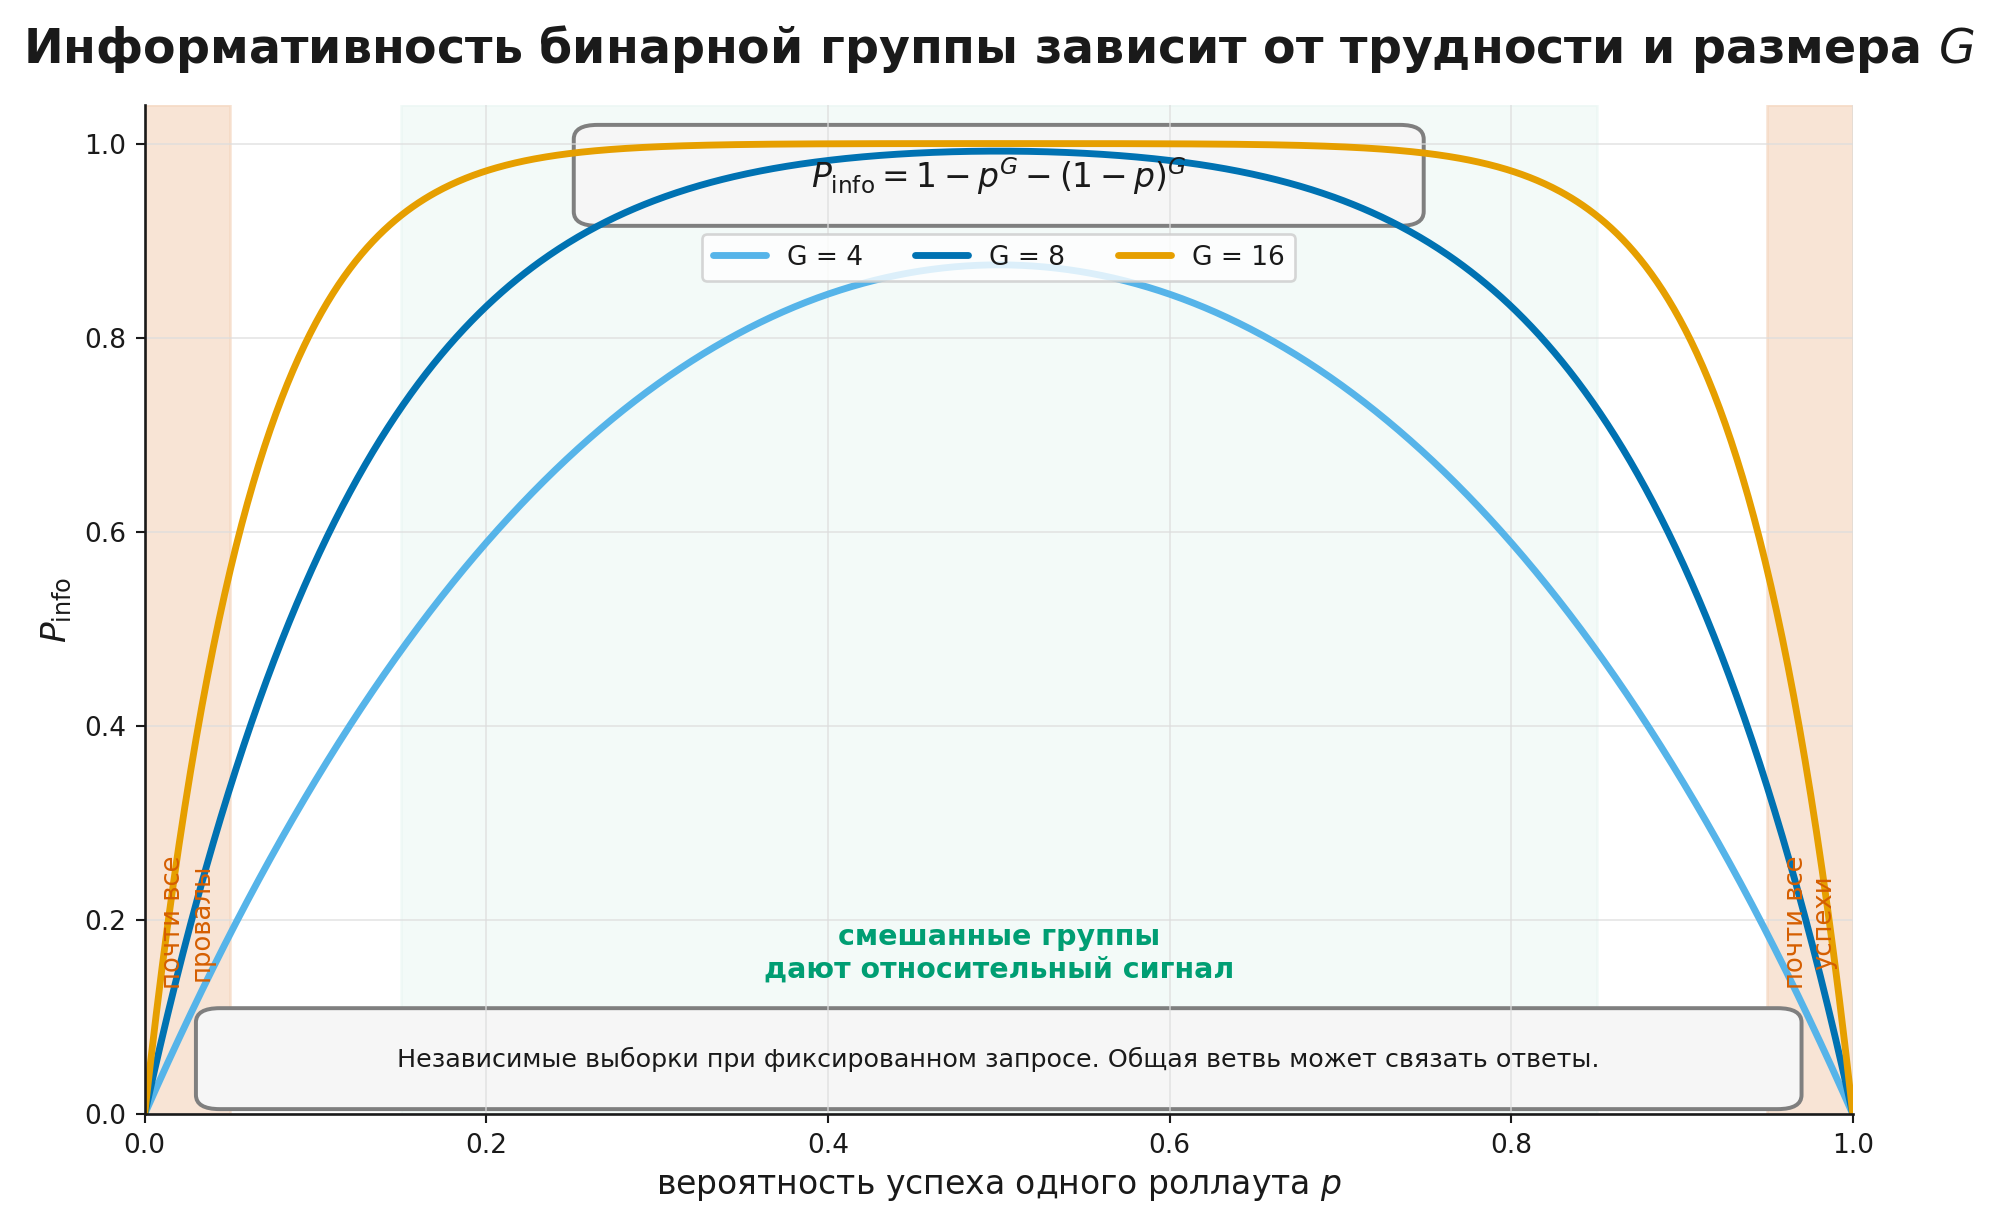
При и :
То есть в среднем нужна примерно
группы, чтобы увидеть одну с внутренним сравнением.
Увеличение скорости обучения здесь не помогает: нулевой относительный сигнал, умноженный на большую скорость, остаётся нулевым. Более прямые рычаги:
- увеличить размер группы;
- выбрать задачи промежуточной сложности;
- дать лучший начальный SFT;
- изменить декодирование и увеличить разнообразие;
- использовать частичный проверяемый сигнал;
- применять повторное использование или офлайн-данные с явной поправкой на смену распределения;
- динамически фильтровать задачи без вариации награды.
Шаг 11.4.2 — Полоса сложности и динамический отбор задач
Задачи с почти всегда дают все провалы; задачи с — все успехи. Наиболее информативны запросы, для которых текущая политика находится между этими крайностями.
Это создаёт полосу сложности. Она не является фиксированным набором задач: после улучшения политики вчерашняя трудная задача становится лёгкой.
Простой динамический протокол:
- оценить успех политики на каждом семействе задач;
- поддерживать минимальное число наблюдений и интервалы неопределённости;
- чаще выбирать задачи с ненулевой вероятностью и успеха, и провала;
- сохранять долю лёгких задач для контроля забывания;
- сохранять долю трудных задач для обнаружения расширения границы;
- не удалять задачу навсегда по одной неудачной группе.
Важно считать вырожденность условно по запросу. Средняя доля успеха 0.5 по всему набору может скрывать смесь задач с и ; почти каждая их группа всё равно будет вырожденной.
Динамический отбор задач меняет распределение обучения. Поэтому отчёт должен содержать как минимум:
- исходное распределение задач;
- распределение выбранных роллаутов;
- вероятность или правило отбора;
- метрики на неизменяемом оценочном наборе.
Иначе улучшение на обучающей полосе легко принять за общий прогресс.
Шаг 11.4.3 — Токеновое и последовательностное отношение вероятностей
Для одного хода можно построить токеновые отношения
или одно последовательностное отношение
Для всей траектории произведение продолжается по всем ходам. На длинном горизонте оно быстро становится численно и статистически нестабильным: небольшие расхождения перемножаются, а редкие большие веса доминируют.
Поэтому практические методы делают разные компромиссы:
- клиппируют локальные отношения;
- агрегируют на уровне токена, хода или последовательности;
- ограничивают возраст роллаута;
- повторно используют только отобранные траектории;
- добавляют поведенческий якорь;
- переходят к офлайн-предпочтениям вместо прямого выборочного перевзвешивания (
importance sampling).
Эти методы оптимизируют не один и тот же точный оцениватель. При сравнении нужно записать:
- где вычисляется отношение;
- какой знаменатель использован;
- как нормируются длины;
- сколько обновлений получает один роллаут;
- насколько стара политика поведения;
- какое правило отбрасывает экстремальные веса.
Модуль 12 «Инфраструктура RL для LLM: память, роллауты и асинхронность» (rl_llm.module_12_infrastructure) подробно разберёт запаздывание политики (policy lag) и асинхронный конвейер. Здесь достаточно увидеть, почему длинная траектория агента усиливает проблему данных, собранных другой версией политики.
Шаг 11.4.4 — Ветвление после инструмента и ARPO
Полная повторная генерация траектории тратит бюджет на повторение одинаковых ранних ходов. Альтернатива — ветвиться в точке, где наблюдение инструмента сделало выбор неопределённым.
Пусть общий префикс привёл к состоянию . Из него генерируются несколько продолжений:
Такой дизайн может дать более локальное сравнение, но вводит новые вопросы:
- кто выбирает точку ветвления;
- можно ли воспроизвести состояние среды в этой точке;
- одинаковы ли скрытые состояния у ветвей;
- как учитывать стоимость общего префикса;
- какой сигнал приписывать действиям до ветвления;
- не смещает ли отбор ветвей обучающее распределение.
Agentic Reinforced Policy Optimization (ARPO) использует адаптивное ветвление, ориентированное на неопределённость после взаимодействия с инструментом, и отдельную оценку распределения преимущества по шагам. Это конкретный алгоритм из работы 2025 года, а не общее название любого RL для агентов.
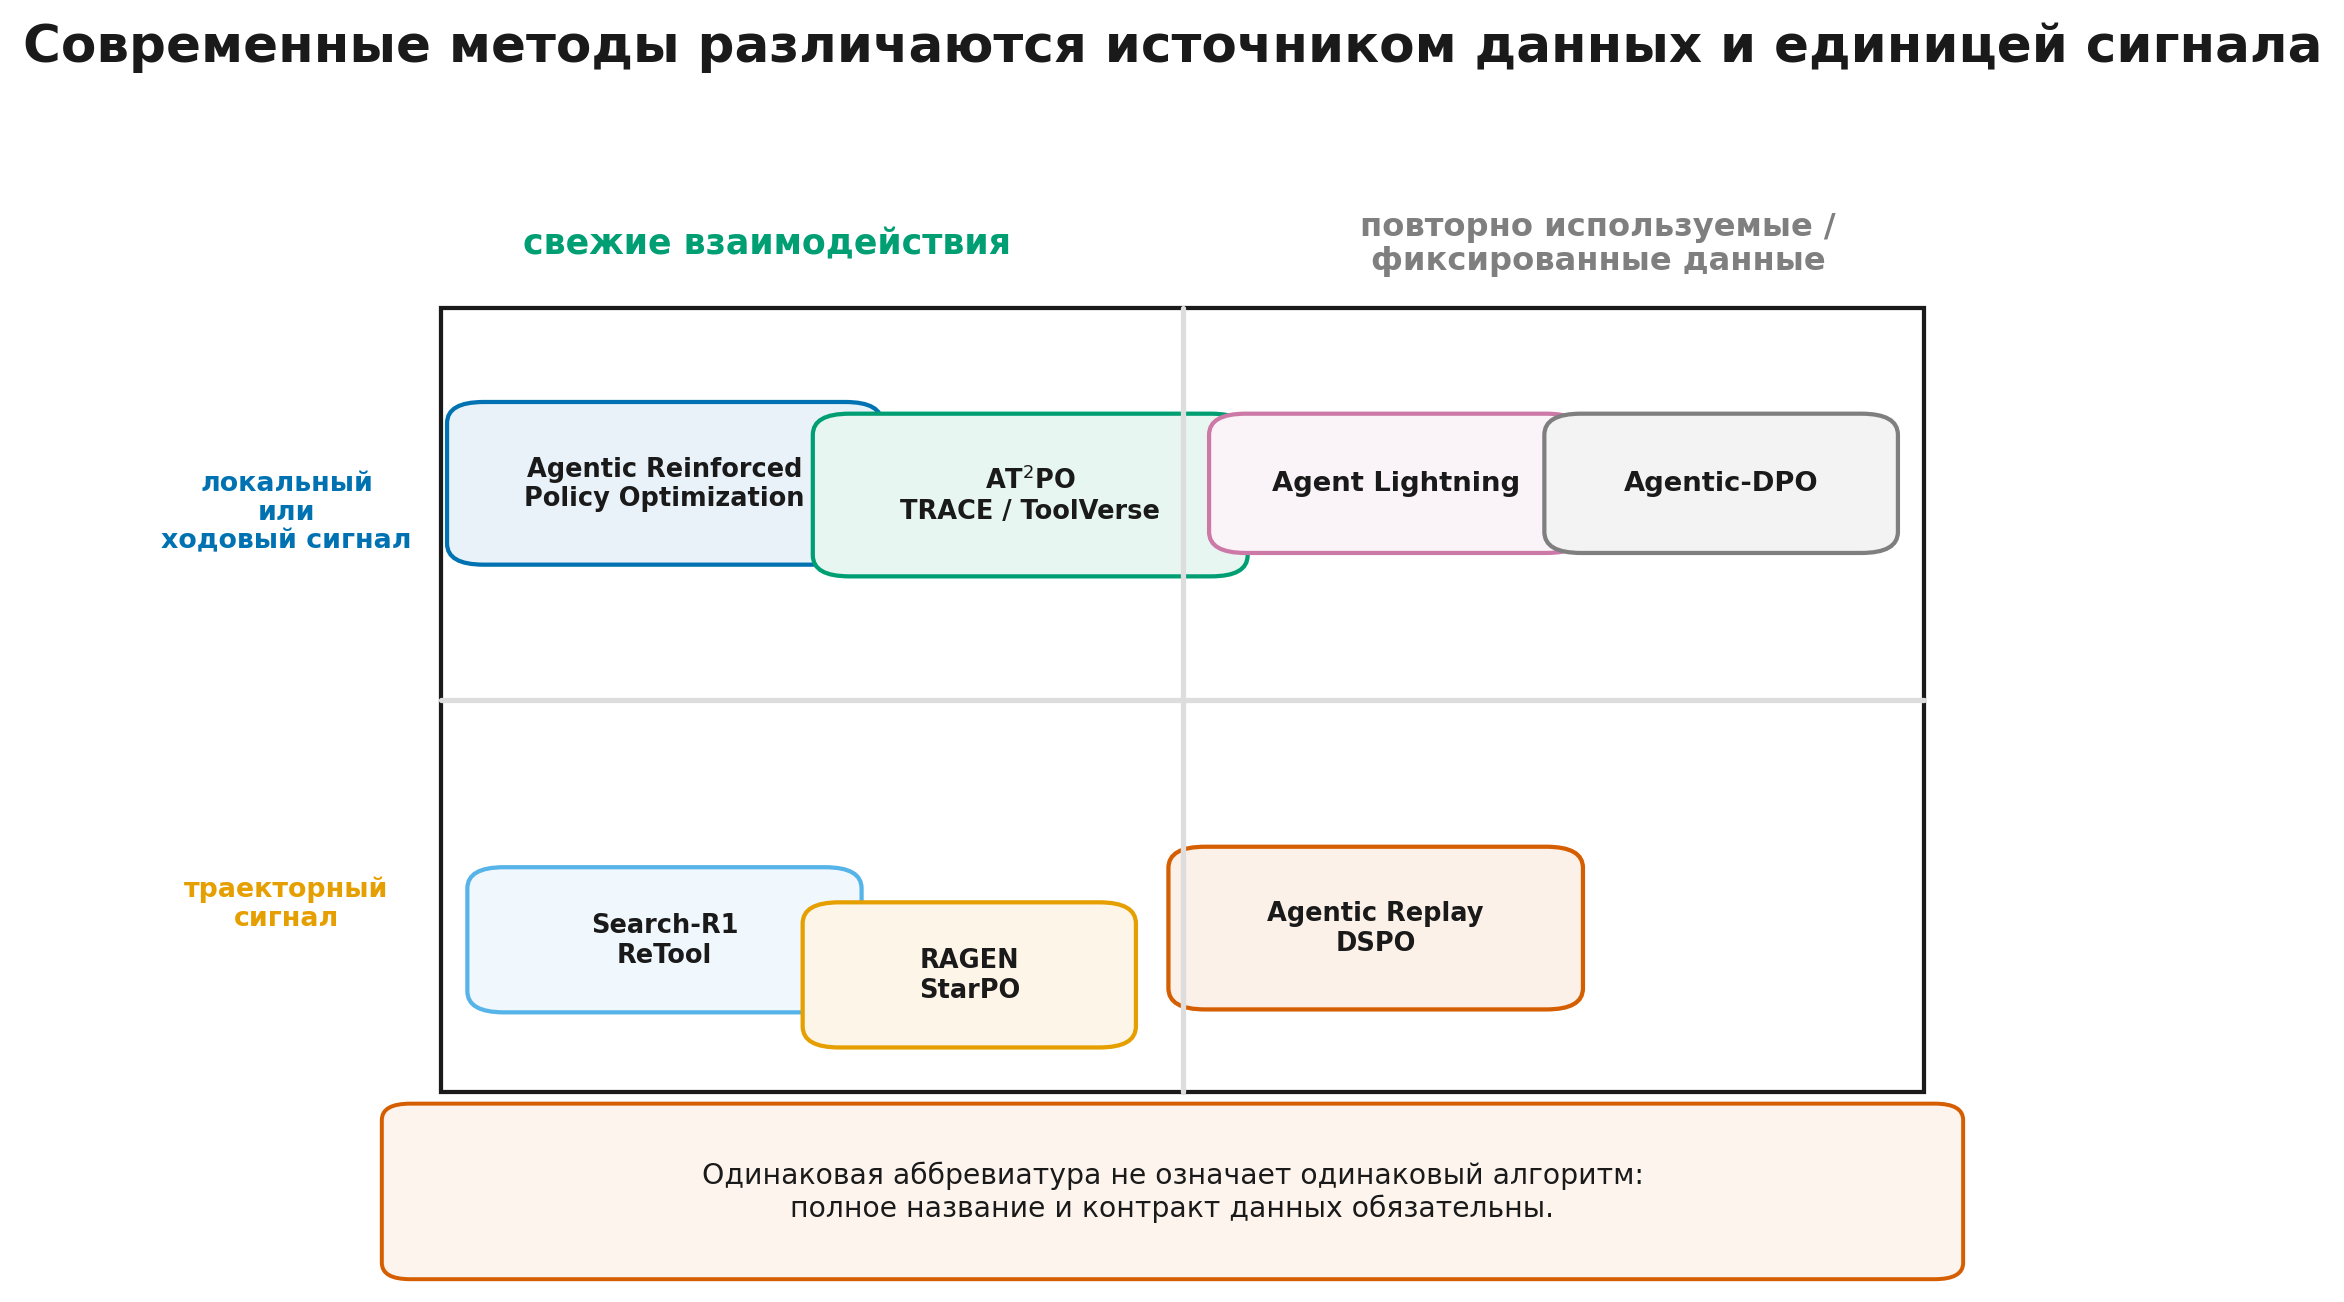
Есть и другое Agentic Replay Policy Optimization, также сокращаемое ARPO: оно добавляет повторное использование успешных траекторий при обучении GUI-агентов. Совпадение сокращений — реальный источник путаницы. В таблицах и первом упоминании нужно писать полное название.
Шаг 11.4.5 — Карта современных методов RL для агентов
Современные методы удобнее различать не по громкости названия, а по трём вопросам: откуда берутся состояния, на каком масштабе строится обучающий сигнал и насколько данные совпадают с текущей политикой.
| Метод или линия | Данные | Единица сигнала | Что добавляется | Главная граница |
|---|---|---|---|---|
| Search-R1 / ReTool | свежие многоходовые роллауты | итог задачи | реальные вызовы поиска или интерпретатора, маска наблюдений среды | узкая проверяемая среда и высокая стоимость роллаутов |
| RAGEN / StarPO | свежие траектории среды | траектория и состояние | стабилизация длинного интерактивного цикла | чувствительность к устройству среды и фильтрации |
| Agentic Reinforced Policy Optimization | свежие ветвящиеся траектории | ход после инструмента и итог | адаптивное ветвление по неопределённости и оценка вклада шагов | состояние среды нужно корректно восстановить в точке ветвления |
AT²PO | дерево многоходовых продолжений | ход | раскрытие дерева и пошаговое распределение заслуги по ходам | дополнительный поиск меняет распределение собранных данных |
TRACE (Turn-level Reward Assignment via Credit Estimation — назначение награды по ходам через оценку заслуги) | свежие длинные траектории | ход или граница инструмента | более плотная оценка вклада отдельных действий | качество сигнала зависит от выбранного оценивателя состояния |
| Agentic Replay Policy Optimization / DSPO | свежие и отобранные либо повторно используемые траектории | траектория или последовательность | повторное использование данных или динамический фильтр | смещение из-за данных другой политики и изменение распределения задач |
| Agent Lightning | трассы произвольного агента | иерархические переходы | отделение исполнения агента от тренера и модуль иерархического распределения заслуги | корректность трассировки и декомпозиции |
| Agentic-DPO | экспертные состояния и одношаговые отрицательные действия | предпочтение действия в состоянии | офлайн-оптимизация без новых полных роллаутов во время шага градиента | покрытие экспертных траекторий и качество отрицательных действий |
Эта карта отражает источники, доступные на 6 августа 2026 года, и не является рейтингом. Даже одинаковое слово «ход» в двух работах может означать разные границы: сообщение ассистента, вызов инструмента, переход среды или узел дерева. Сравнение допустимо только после выравнивания среды, модели, бюджета, проверяющей системы и единицы редукции.
Практический выбор начинается с вопроса: можем ли мы безопасно и достаточно дёшево получать новые состояния мира? Если да, онлайн-RL использует ошибки текущей политики и способен посещать новые состояния. Если нет, повторное использование данных и офлайн-предпочтения дешевле, но сильнее зависят от покрытия. Отдельно нужно решить, где нужен точный итоговый сигнал, где допустим критик, а где ветвление действительно воспроизводит одно и то же состояние среды.
Урок 11.5. Среда, безопасность и воспроизводимая практика
Урок 11.5. Среда, безопасность и воспроизводимая практика
- Среда для обучения строже среды для демонстрации
- Песочница, права и необратимые действия
- Среды и оценочные наборы: что именно они проверяют
- Практика: агент в среде «ключ и дверь»
- Итоговый протокол агентного эксперимента
далее — 7 проверочных шагов
Шаг 11.5.1 — Среда для обучения строже среды для демонстрации
Демонстрационный агент может один раз открыть сайт или запустить скрипт. Обучающая среда должна выдержать тысячи повторов и каждый раз отвечать на вопрос: «какая задача была поставлена и в каком состоянии она началась?»
Минимальные свойства:
- Сброс (
reset). Возвращает среду в известное начальное состояние. - Версионирование. Фиксируются образ контейнера, данные, правила, инструменты и проверяющая система.
- Изоляция. Один роллаут не меняет начальное состояние другого.
- Детерминированные семена там, где это возможно. Случайность среды записывается, а не исчезает.
- Проверка состояния мира. Итог оценивается программно или по прозрачному протоколу.
- Наблюдаемость инфраструктуры. Латентность, ошибки, повторы и тайм-ауты сохраняются.
- Ограничение ресурсов. CPU, память, сеть, дисковое пространство и число вызовов имеют явные лимиты.
Набор тестов сам по себе ещё не является обучающей средой. Для обучения нужны интерфейсы reset, step, безопасное выполнение и достаточная скорость. И наоборот, среда для обучения сама по себе ещё не является честным оценочным стендом: политика могла видеть её состояния, правила или проверяющую систему.
По официальной документации TRL, доступной 6 августа 2026 года, GRPOTrainer поддерживает environment_factory: отдельный экземпляр среды создаётся для каждого сгенерированного продолжения, а среда может владеть состоянием, инструментами и наградой. Документация также описывает интеграции OpenEnv, Harbor и выбор среды на уровне примера. Это текущий контракт конкретной библиотеки, а не математическое требование Agentic RL; версии и сигнатуры нужно повторно фиксировать перед запуском.
Шаг 11.5.2 — Песочница, права и необратимые действия
Обучение усиливает любое действие многократным повторением. Поэтому агенту нельзя давать производственные права только потому, что один демонстрационный запуск выглядел безопасно.
Базовая модель разрешений:
- по умолчанию нет доступа к сети и внешним секретам;
- файловая система временная или снабжена снимками;
- разрешены только перечисленные инструменты и аргументы;
- опасные операции требуют отдельного подтверждения или запрещены;
- каждый вызов имеет тайм-аут и предел вывода;
- вложенные процессы и потребление ресурсов ограничены;
- побочные эффекты записываются в неизменяемый журнал;
- проверяющая система выполняется отдельно от агента.
Особенно опасны действия, которые нельзя отменить простым reset: отправка сообщения, покупка, удаление удалённого ресурса, публикация, изменение учётной записи. Для обучения их заменяют симулятором, теневым режимом или двухфазным протоколом «подготовить → проверить → подтвердить».
Наблюдения также могут быть враждебными. Веб-страница или файл способны содержать инструкции, которые пытаются переопределить задачу агента. Поэтому граница доверия должна быть частью состояния: политика получает содержимое как данные среды, а не как системную инструкцию.
Безопасность здесь не приложение к RL. Она определяет допустимое пространство действий и тем самым саму задачу оптимизации.
Шаг 11.5.3 — Среды и оценочные наборы: что именно они проверяют
Разные семейства сред измеряют разные способности.
- WebArena — работа с воспроизводимыми веб-приложениями и проверка функционального результата.
- OSWorld — мультимодальное управление реальными настольными приложениями и межпрограммные рабочие процессы.
- -bench — взаимодействие агента, симулированного пользователя и API при соблюдении доменных правил; итог сравнивается с целевым состоянием базы.
- SWE-bench и родственные среды — изменение репозитория с выполнением тестов и проверкой патча.
- Поисковые и вычислительные среды — последовательные вызовы поиска, Python или калькулятора с итоговой проверкой ответа.
Итоговый показатель на оценочном наборе смешивает как минимум:
- качество базовой модели;
- формат наблюдений;
- контроллер и память;
- параметры декодирования;
- бюджет действий;
- стабильность среды;
- проверяющую систему;
- стратегию повторных попыток.
Поэтому «улучшили агента на оценочном наборе» ещё не означает, что именно RL улучшил политику. Нужны абляции относительно SFT, изменения инструкции, Best-of-N, повторного запуска и изменения инфраструктуры.
Для честной оценки полезно отделять:
- обучающие среды;
- отложенные задачи в известных средах;
- новые начальные состояния;
- новые инструменты и схемы;
- новые семейства сред.
Чем дальше оценка от обучающего контура, тем сильнее она проверяет перенос, но тем труднее объяснить источник ошибки.
Шаг 11.5.4 — Практика: агент в среде «ключ и дверь»
Скрытое состояние среды содержит цвет целевой двери, факт осмотра комнаты, переносимый ключ, открытую дверь и остаток задачного бюджета. Наблюдение с цветом показывается только после inspect; затем рекуррентная политика должна удержать подсказку во внутреннем состоянии. Доступны макродействия:
inspect
pickup_red
pickup_blue
open_red
open_blue
finish
Контроллер маскирует синтаксически невозможные фазы — например, не предлагает open_* до подбора ключа, — но не сообщает скрытый цвет. Такая маска уменьшает бессмысленное пространство действий, однако не решает задачу за агента: выбор красного или синего действия остаётся за политикой.
Практика показывает полный контур:
reset,step, задачное завершение и внешнее усечение сборщиком;- транскрипт действий, наблюдений, версий политики и старых логарифмов вероятностей;
- разреженную итоговую награду и потенциальное формирование;
- рекуррентную архитектуру «актор–критик» на PyTorch;
- on-policy сбор роллаутов и обновление по накопленным наградам;
- отдельную жадную оценку на красных и синих задачах;
- проверку того, что потенциальная добавка изменяет плотность сигнала, но телескопируется в граничный член.
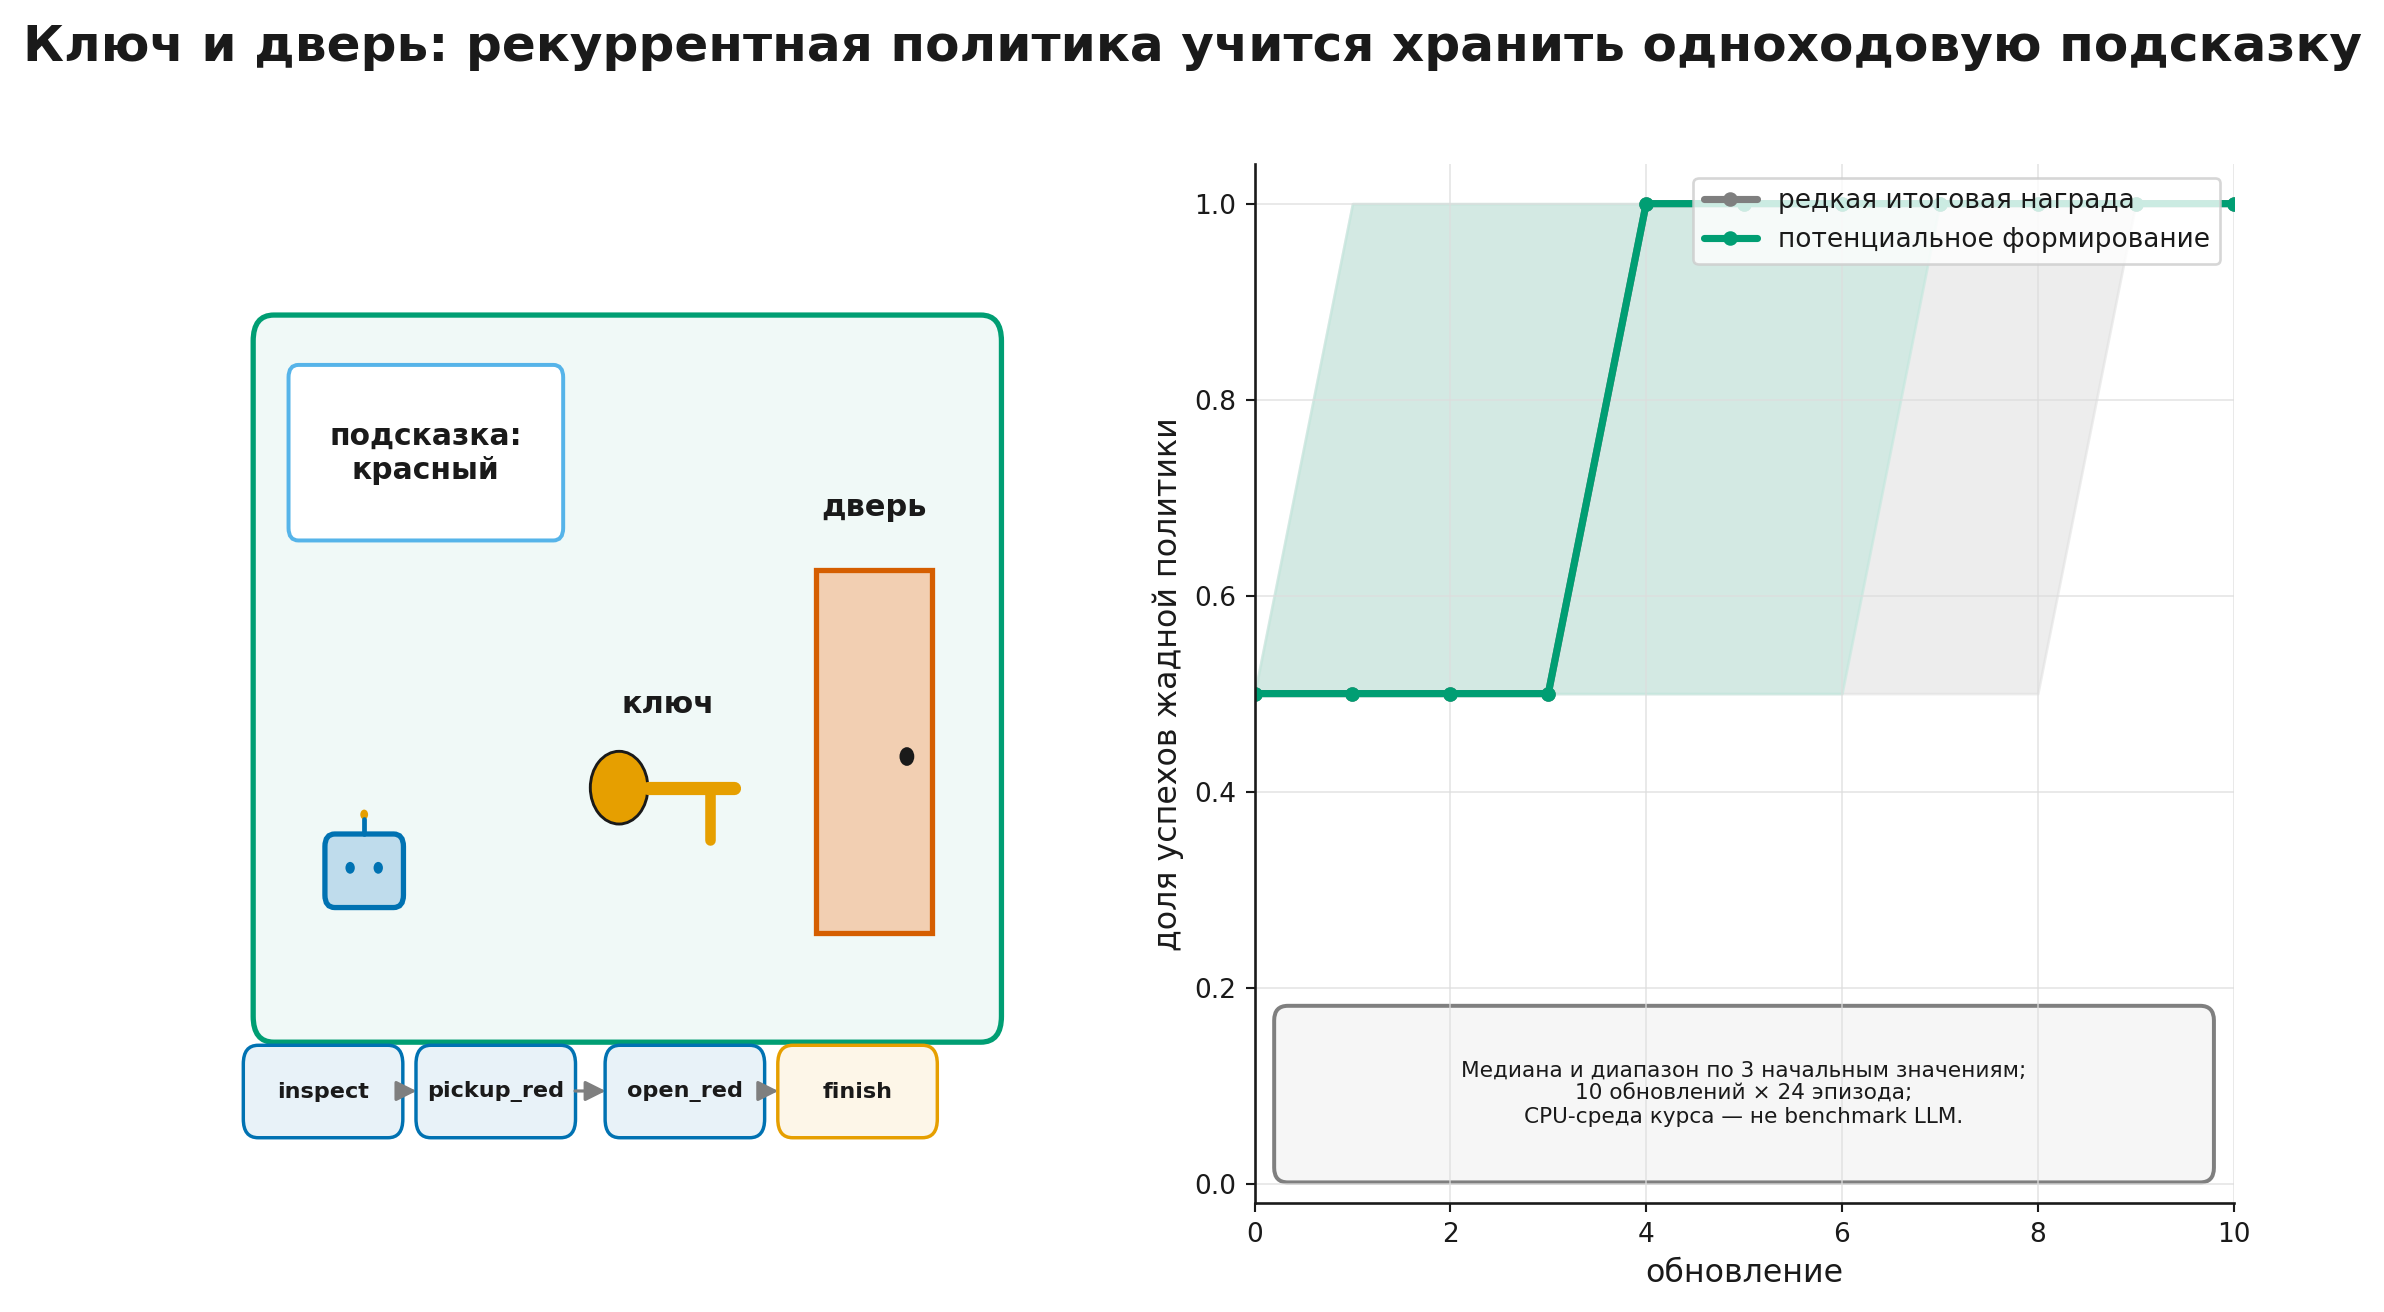
Быстрый профиль выполняется на CPU. Числа на графике являются результатом фиксированной синтетической среды курса и не переносятся на реальные LLM. Полный профиль увеличивает число независимых запусков. Факультативная ветвь с Qwen3-0.6B и GRPOTrainer(environment_factory=...) дана как инженерный шаблон, по умолчанию отключена и не использована для заявлений о качестве.
Смысл практики не в том, чтобы объявить маленького агента «реалистичной LLM», а в том, чтобы сохранить реалистичный контракт: частичную наблюдаемость, многоходовые действия, состояние среды, происхождение токенов, причины остановки, версию политики и воспроизводимую проверку исхода.
Шаг 11.5.5 — Итоговый протокол агентного эксперимента
Перед запуском многоходового RL зафиксируйте шесть слоёв.
1. Задача и среда
- пространство начальных состояний;
- наблюдения и скрытые переменные;
- доступные действия;
reset, версии и семена;- критерии успеха и провала.
2. Политика поведения
- модель, токенизатор и шаблон;
- инструменты и сериализация;
- декодирование;
- версия весов на каждом ходе;
- контроллер и память.
3. Журнал роллаута
- токены, маска и логарифмы вероятностей;
- действия и наблюдения;
- версии среды;
- причины остановки;
- время, стоимость и ошибки.
4. Награда и распределение заслуги
- итоговая проверка состояния;
- частичный кредит;
- потенциальное формирование;
- критик или PRM;
- обработка усечения и сбоя среды.
5. Обновление
- единица группировки;
- редукция по токенам, ходам или траекториям;
- отношение вероятностей и клиппирование;
- повторное использование данных;
- максимальный возраст политики поведения.
6. Оценивание
- успех и надёжность по повторным попыткам;
- число ходов и вызовов;
- стоимость и задержка;
- технические ошибки;
- перенос на отложенные состояния и среды;
- аудит безопасности и неожиданных побочных эффектов.
Главная идея модуля теперь видна целиком:
RL для агентов начинается не с выбора нового оптимизатора. Он начинается с точного определения того, где заканчивается политика, где начинается среда и какие данные связывают действие с изменением мира.
В Модуле 12 «Инфраструктура RL для LLM: память, роллауты и асинхронность» (rl_llm.module_12_infrastructure) этот контракт будет перенесён в распределённый конвейер: генерация и обучение разойдутся по разным процессам, появятся отстающие траектории, версии весов, очереди, контроль свежести и системная стоимость.
Источники и статус актуальности
Полный реестр утверждений, типов оснований и ограничений находится в Module_11_Sources.md. Для последовательного чтения достаточно следующего маршрута.
- Kaelbling, Littman, Cassandra — Planning and Acting in Partially Observable Stochastic Domains — классическая основа различия между скрытым состоянием, наблюдением и состоянием убеждений; статья не делает текстовую историю LLM точным belief state автоматически.
- Ng, Harada, Russell — Policy Invariance Under Reward Transformations — теорема о потенциальном формировании награды и её условиях; произвольные промежуточные бонусы этой гарантии не получают.
- ReAct, Search-R1 и ReTool — переход от интерфейсного цикла «рассуждение–действие–наблюдение» к многоходовому обучению с поиском или исполнителем; результаты относятся к конкретным средам и бюджетам.
- Agentic Reinforced Policy Optimization, ATPO, TRACE и ToolVerse — разные способы ветвления и распределения сигнала по ходам. Их названия скрывают несовпадающие определения «хода» и разные источники оценок.
- Agent Lightning и Agentic-DPO — соответственно отделение исполнения агента от тренера и офлайн-преобразование экспертных состояний в предпочтения действий; ни один подход не устраняет требования к корректной трассировке или покрытию.
- TRL GRPOTrainer, OpenEnv и Harbor — датированный инженерный контракт для stateful environment training. Перед запуском нужно зафиксировать фактически установленную версию.
- WebArena, OSWorld, -bench и SWE-bench — разные классы сред. Итоговая метрика смешивает модель, контроллер, бюджет, инфраструктуру и проверяющую систему.
Все датированные утверждения в этой редакции отражают источники, проверенные 6 августа 2026 года. Результаты ноутбука помечены как собственные синтетические эксперименты курса, а не как внешний benchmark.